
Dans le champ foisonnant des sciences du comportement et de la cognition, la communication visuelle des résultats empiriques constitue un enjeu épistémologique de premier plan. Présenter des données quantitatives sans expliciter leur incertitude sous-jacente revient à occulter la nature fondamentalement stochastique des processus psychologiques. Les représentations graphiques dépouillées de repères de dispersion conduisent inévitablement la communauté scientifique, les décideurs et les étudiants à des interprétations biaisées, alimentant une confiance trompeuse dans des estimations ponctuelles isolées. L’intégration méthodique de barres d’erreur permet précisément de rétablir la vérité des données en ancrant visuellement la moyenne dans sa marge d’erreur probabiliste ou sa variabilité intrinsèque.
Bien que les logiciels statistiques spécialisés tels que R, SPSS ou Jamovi constituent l’équipement traditionnel des laboratoires, l’avènement du tableur infonuagique Google Sheets a profondément démocratisé la gestion préliminaire, l’analyse descriptive et le partage collaboratif des données de recherche. Son interface accessible offre une plateforme agile pour l’enseignement méthodologique, le prototypage expérimental rapide et la diffusion transparente des observations de terrain. Toutefois, la maîtrise des paramètres graphiques avancés de cet outil — singulièrement la configuration exacte des barres d’erreur — exige une compréhension technique et conceptuelle rigoureuse qui dépasse largement le simple clic d’activation d’une option prédéfinie.
Ce guide exhaustif se propose d’explorer en profondeur la méthodologie et l’implémentation pratique des barres d’erreur au sein de Google Sheets dans le cadre de la recherche quantitative en psychologie et en sciences sociales. En articulant théorie statistique (écart-type, erreur type, intervalles de confiance), exigences typographiques de l’American Psychological Association (APA) et procédures logicielles détaillées pas à pas, cet article fournit aux chercheurs, analystes et étudiants les clés nécessaires pour transformer des jeux de données bruts en visualisations probantes, rigoureuses et conformes aux plus hauts standards académiques.
1. Introduction à la visualisation de l’incertitude dans la recherche psychologique
1.1 Importance épistémologique de la représentation de la variance en psychologie
La recherche psychologique contemporaine repose sur l’observation de systèmes vivants caractérisés par une complexité et une hétérogénéité intrinsèques considérables. Contrairement aux constantes universelles des sciences physiques, les comportements humains, les temps de réaction, les scores d’anxiété ou les capacités mnésiques fluctuent continuellement sous l’influence conjointe de prédispositions biologiques, de trajectoires développementales individuelles et de contingences contextuelles imprévisibles. Réduire un échantillon d’individus à une simple valeur centrale, telle qu’une moyenne arithmétique ou une médiane, constitue un écueil méthodologique réductionniste majeur. La variance n’est pas un artefact négligeable ou un simple déchet expérimental qu’il conviendrait de lisser ; elle représente la matière même de la psychologie différentielle et cognitive. L’omettre d’une visualisation graphique prive le lecteur des informations indispensables pour appréhender l’ampleur réelle des divergences interindividuelles et la stabilité globale du phénomène psychique sous investigation.
Dans le contexte actuel de la crise de la réplicabilité — qui a profondément ébranlé la psychologie sociale et cognitive au cours de la dernière décennie —, la transparence graphique s’est imposée comme une exigence déontologique impérative. Les méta-analyses et les réplications directes ont démontré à maintes reprises que la surévaluation de la force des effets découle fréquemment d’une interprétation abusive de différences moyennes statistiquement fragiles. Lorsque les graphiques scientifiques n’illustrent que des colonnes d’amplitude sans expliciter la variabilité de l’échantillonnage, les chercheurs et les évaluateurs pairs sont victimes d’une forme d’illusion optique inférentielle : les contrastes paraissent nets, francs et indiscutables, alors même que les distributions sous-jacentes présentent un chevauchement quasi intégral. La matérialisation systématique de l’incertitude graphique agit comme un puissant garde-fou cognitif contre les conclusions hâtives et la publication de faux positifs.
En réponse à ces dérives, les comités éditoriaux des revues académiques internationales de référence ont drastiquement révisé leurs normes de publication. L’abandon progressif des graphiques en barres pleines — parfois qualifiés péjorativement de dynamite plots — au profit de représentations visualisant simultanément la tendance centrale et l’erreur associée traduit une volonté collective de transparence empirique. L’observateur doit pouvoir juger d’un coup d’œil si une variation de performance de dix millisecondes dans une tâche d’attention soutenue émerge d’un groupe homogène ou si elle n’est que la résultante fortuite de quelques individus extrêmes masquant une inertie globale du groupe. Cette transition vers une présentation exhaustive de la structure des données constitue le socle sur lequel repose la confiance renouvelée dans les sciences expérimentales.
Il est enfin fondamental d’opérer une scission théorique limpide entre la dispersion descriptive, qui cartographie la variabilité brute observée au sein de l’échantillon prélevé, et la précision de l’estimation inférentielle, qui modélise le degré de confiance accordé à la généralisation d’un résultat vers la population parente. Confondre ces deux niveaux d’analyse sur une figure scientifique induit des contresens majeurs : une dispersion descriptive substantielle peut tout à fait coexister avec une estimation inférentielle d’une extrême précision dès lors que la cohorte d’étude est exceptionnellement large. La restitution visuelle de ces dimensions exige donc une vigilance sémiotique absolue dans le choix des segments d’erreur employés.
1.2 Rôle de Google Sheets dans le flux de travail des chercheurs et étudiants
L’écosystème de la recherche scientifique et de l’enseignement universitaire s’est profondément transformé avec l’avènement des technologies infonuagiques en temps réel. Historiquement cantonnée à des progiciels installés localement sur des stations de travail dédiées, l’analyse quantitative s’effectue désormais couramment via des plateformes d’informatique distribuée. À cet égard, Google Sheets s’est imposé comme un vecteur de travail indispensable, particulièrement au sein des laboratoires collaboratifs multisites et des promotions universitaires. Son modèle d’accès universel, affranchi des barrières tarifaires des licences propriétaires et des contraintes d’incompatibilité de systèmes d’exploitation, permet à des équipes distantes de renseigner simultanément des protocoles expérimentaux, d’épurer des matrices de données et de confronter leurs lectures empiriques dans un cadre collaboratif fluide.
Au-delà de cette dimension coopérative, le tableur de Google offre un environnement particulièrement performant pour le prototypage rapide d’analyses exploratoires. Lors de la phase de recueil des données sur le terrain ou lors de la mise au point d’un paradigme comportemental novateur, le chercheur a besoin de jauger instantanément l’allure générale des distributions sans devoir configurer des scripts d’importation complexes sous R ou structurer des dictionnaires de variables sous SPSS. La réactivité des liaisons dynamiques entre les cellules de calcul et les modules graphiques permet un retour visuel immédiat : toute modification, imputation ou correction d’une saisie erronée se répercute instantanément sur le graphique support et ses indicateurs d’incertitude. Cette souplesse interactive favorise une familiarisation kinesthésique avec les données, éminemment bénéfique pour la formation des apprentis chercheurs aux concepts de distribution et d’erreur.
Il convient néanmoins de reconnaître avec lucidité les limites architecturales de Google Sheets face aux impératifs rigides de la publication académique indexée. Conçu initialement pour des usages de gestion bureautique et de reporting commercial, le logiciel intègre des comportements automatisés qui ne respectent pas spontanément l’orthodoxie statistique — à l’instar de son paramétrage par défaut appliquant un pourcentage arbitraire de dix pour cent aux barres d’erreur. De surcroît, la flexibilité de personnalisation des éléments graphiques (formes des marqueurs, typographie normalisée, positionnement asymétrique des moustaches d’erreur) demeure restreinte en comparaison des moteurs graphiques programmés comme ggplot2. Pour autant, ces obstacles techniques ne constituent aucunement une fatalité : en déployant des stratégies méthodologiques ingénieuses et en détournant certaines fonctionnalités natives, il demeure parfaitement possible de générer sous Google Sheets des visualisations d’une rigueur irréprochable, répondant sans réserve aux exigences formelles des comités de lecture les plus stricts.
2. Fondements méthodologiques : Différencier écart-type, erreur type et intervalle de confiance
2.1 L’écart-type : Mesure descriptive de la variabilité interindividuelle
L’écart-type, universellement désigné par l’abréviation ET dans la littérature francophone ou SD (pour Standard Deviation) selon les normes internationales, constitue la mesure d’élection de la dispersion d’une distribution de données continues autour de sa moyenne arithmétique. Sur le plan formel, il correspond à la racine carrée de la variance, elle-même définie comme la moyenne des carrés des écarts à la moyenne. En rétablissant l’unité de mesure originale de la variable — qu’il s’agisse de millisecondes, de points obtenus à une échelle de dépression de Beck ou de battements cardiaques par minute —, l’écart-type confère une intelligibilité directe et concrète à la dispersion des données. Si un échantillon d’individus soumis à un test d’efficience mnésique présente une moyenne de 50 points avec un écart-type de 5 points, nous appréhendons immédiatement que la majorité des scores s’agrègent dans une fourchette étroite, alors qu’un écart-type de 20 points dénoterait une dispersion massive des compétences au sein du collectif évalué.
Dans l’évaluation des traits psychologiques et des aptitudes cognitives, une lecture avisée de l’écart-type s’avère capitale pour apprécier l’hétérogénéité des comportements au sein du paradigme considéré. Sous l’hypothèse d’une distribution gaussienne normale, la règle empirique stipule qu’approximativement 68,2 % des observations se situent à plus ou moins un écart-type de la moyenne, tandis que 95,4 % s’inscrivent dans un intervalle de deux écarts-types. Représenter un écart-type sur un graphique au moyen de barres d’erreur fournit donc une synthèse éminemment descriptive : il ne renseigne en rien sur la validité de l’estimation statistique de la moyenne populationnelle, mais illustre avec fidélité l’étendue réelle du comportement individuel typique observé au sein du groupe d’expérimentation.
Une distinction épistémologique cruciale doit être opérée entre la variabilité intrinsèque du phénomène mesuré et le bruit expérimental dû aux imprécisions instrumentales. L’écart-type englobe inévitablement ces deux composantes. Dans une tâche psychologique complexe, une forte valeur de l’écart-type peut refléter des stratégies cognitives divergentes adoptées spontanément par les participants (variabilité substantielle d’intérêt), mais elle peut tout aussi bien résulter d’une consigne ambiguë générant des interprétations désordonnées ou d’une instabilité des conditions environnementales de passation (bruit parasitaire). Le chercheur doit par conséquent s’abstenir d’interpréter automatiquement l’écart-type comme une simple imprécision méthodologique qu’il conviendrait de minimiser artificiellement : il est souvent la signature directe de la variabilité psychologique authentique.
2.2 L’erreur type de la moyenne : Évaluation de la précision de l’échantillonnage
Contrairement à l’écart-type qui résume l’étendue des données individuelles effectivement observées, l’erreur type de la moyenne (fréquemment notée ETM ou SEM pour Standard Error of the Mean) s’inscrit au cœur de la démarche inférentielle. Elle quantifie non pas la dispersion des sujets au sein de l’échantillon, mais la dispersion théorique des moyennes d’une infinité d’échantillons hypothétiques de même taille prélevés aléatoirement au sein de la même population d’origine. L’erreur type formalise donc la précision de l’estimation : elle mesure l’amplitude des fluctuations d’échantillonnage auxquelles le chercheur doit s’attendre en répliquant son protocole. Son ancrage conceptuel procède directement du théorème central limite, lequel garantit que, pour des tailles d’échantillon suffisantes, la distribution d’échantillonnage de la moyenne tend vers une distribution normale, indépendamment de la forme de la distribution de la variable parente.
L’expression mathématique de l’erreur type met en lumière sa relation mécanique fondamentale avec la taille de l’échantillon : elle s’obtient en divisant l’écart-type empirique par la racine carrée de l’effectif total ($N$). Il en découle une conséquence pratique incontournable pour la recherche expérimentale : l’erreur type décroît de façon non linéaire à mesure que le nombre de participants s’accroît. Pour diviser par deux la valeur de l’erreur type — et donc doubler la précision de l’estimation —, il est mathématiquement nécessaire de quadrupler la taille de l’échantillon expérimental. Cette réalité statistique conditionne l’arbitrage permanent entre les ressources allouées au recrutement de participants et le degré d’exactitude requis pour valider les hypothèses opérationnelles.
Dans la littérature psychologique, l’erreur type demeure la mesure de référence la plus fréquemment greffée aux diagrammes factoriels comparant des conditions expérimentales distinctes (par exemple, condition contrôle versus condition avec induction de stress). En réduisant l’amplitude visuelle de la barre d’erreur en regard de l’écart-type brut, l’erreur type permet aux lecteurs avertis d’apprécier la stabilité relative des moyennes groupales. Cependant, son usage expose à des méprises majeures lorsqu’elle est confondue avec un intervalle de confiance ou lorsqu’elle est mobilisée de manière imprudente pour statuer visuellement sur la significativité statistique d’une différence observée.
2.3 Les intervalles de confiance : Fondement de l’inférence statistique moderne
L’intervalle de confiance (généralement calculé à un seuil nominal de 95 % et abrégé IC 95 % ou 95% CI) constitue le vecteur privilégié de l’estimation par intervalle préconisé par la statistique fréquentiste contemporaine. Rigoureusement défini, un intervalle de confiance à 95 % ne signifie pas qu’il y a 95 % de probabilité que la véritable moyenne populationnelle se trouve circonscrite entre ses bornes spécifiques — cette dernière étant un paramètre fixe et non une variable aléatoire dans l’orthodoxie néo-fisherienne ou neyman-pearsonienne. La définition exacte stipule que si l’on répétait l’expérience un nombre infini de fois dans des conditions parfaitement identiques, 95 % des intervalles ainsi construits recouvriraient la véritable moyenne de la population. Dans la pratique empirique, l’intervalle de confiance est unanimement interprété comme une délimitation des valeurs de paramètres plausibles et compatibles avec les données collectées.
L’évaluation visuelle de la significativité statistique par l’observation des intervalles de confiance à 95 % représentés sur un graphique est d’une utilité diagnostique exceptionnelle, pourvu que l’on applique des règles mathématiques rigoureuses. Dans le cadre de deux échantillons indépendants de variances comparables, une absence totale de chevauchement entre les barres d’intervalles de confiance à 95 % correspond toujours à une différence statistiquement significative à un seuil $p$ substantiellement inférieur à 0,05 (en réalité souvent proche de $p < 0,01$). Inversement, un chevauchement modéré — n’excédant pas approximativement la moitié d’un bras de l’intervalle — demeure parfaitement compatible avec une significativité statistique au seuil classique de $\alpha = 0,05$. Cette propriété géométrique offre une lecture immédiate et nuancée de la portée des données, surpassant la simple dichotomie binaire issue du test de nullité d’hypothèse ($p < 0,05$).
L’alignement avec les directives éditoriales de l’American Psychological Association (Manuel APA, 7e édition) plaide sans ambiguïté pour l’hégémonie des intervalles de confiance dans la confection des graphiques scientifiques. L’APA exhorte expressément les chercheurs à fournir des estimations d’effet accompagnées de leurs intervalles de confiance plutôt que de s’en remettre exclusivement aux seuils de probabilité brute ($p$-values). Visualiser un intervalle de confiance à 95 % dans Google Sheets permet non seulement de satisfaire aux critères de soumission des revues de rang A, mais transmet une information synthétique d’une richesse incomparable : la localisation de la moyenne, la marge d’erreur symétrique de son estimation et l’éventail complet des valeurs théoriques cohérentes avec la réalité empirique du laboratoire.
3. Préparation et structuration rigoureuse des données dans Google Sheets
3.1 Organisation tabulaire adaptée aux fonctions graphiques
La réussite de la construction graphique sous Google Sheets dépend de manière critique de l’architecture matricielle initiale de la feuille de calcul. Contrairement aux logiciels d’analyse statistique spécialisés qui privilégient systématiquement le format dit « long » — où chaque ligne correspond à une observation unitaire et chaque colonne à une variable d’identification —, le moteur de rendu visuel de Google Sheets opère de manière optimale à partir d’un format « large » ou d’une table d’agrégation préalablement structurée. Il est indispensable de séparer physiquement, au sein de votre classeur, l’onglet réservé à l’enregistrement brut des données d’expérimentation de l’onglet dévolu aux calculs synthétiques et à la génération des visualisations.
Pour un plan d’expérience typique comparant plusieurs conditions indépendantes, l’architecture tabulaire doit comporter une colonne dédiée à l’identification textuelle explicite des modalités de la variable indépendante (par exemple : « Condition Témoin », « Stress Léger », « Stress Sévère ») et une colonne contiguë stipulant la moyenne agrégée de la variable dépendante d’intérêt. Tout mélange au sein de la même plage de données entre des chaînes textuelles descriptives et des données numériques pures doit être banni, sous peine de corrompre l’interprétation automatique du type de données opérée par l’algorithme d’importation graphique du tableur.
Avant d’engager la moindre démarche de restitution visuelle, une procédure de nettoyage méthodique des données s’impose selon les critères de troncature établis a priori dans le plan d’analyse préenregistré. Les temps de réaction aberrants (inférieurs à 150 millisecondes, trahissant une anticipation motrice, ou excédant trois écarts-types au-dessus de la moyenne individuelle) doivent être filtrés ou imputés conformément aux pratiques standardisées de la psychologie cognitive. Une attention scrupuleuse doit également être accordée au formatage des cellules : les séparateurs décimaux (virgule selon les conventions francophones ou point selon les standards anglo-saxons) doivent être strictement unifiés au sein des paramètres du fichier Google Sheets (menu Fichier > Paramètres > Paramètres régionaux), afin d’éviter que des cellules numériques ne soient traitées par inadvertance comme du texte brut aligné à gauche.
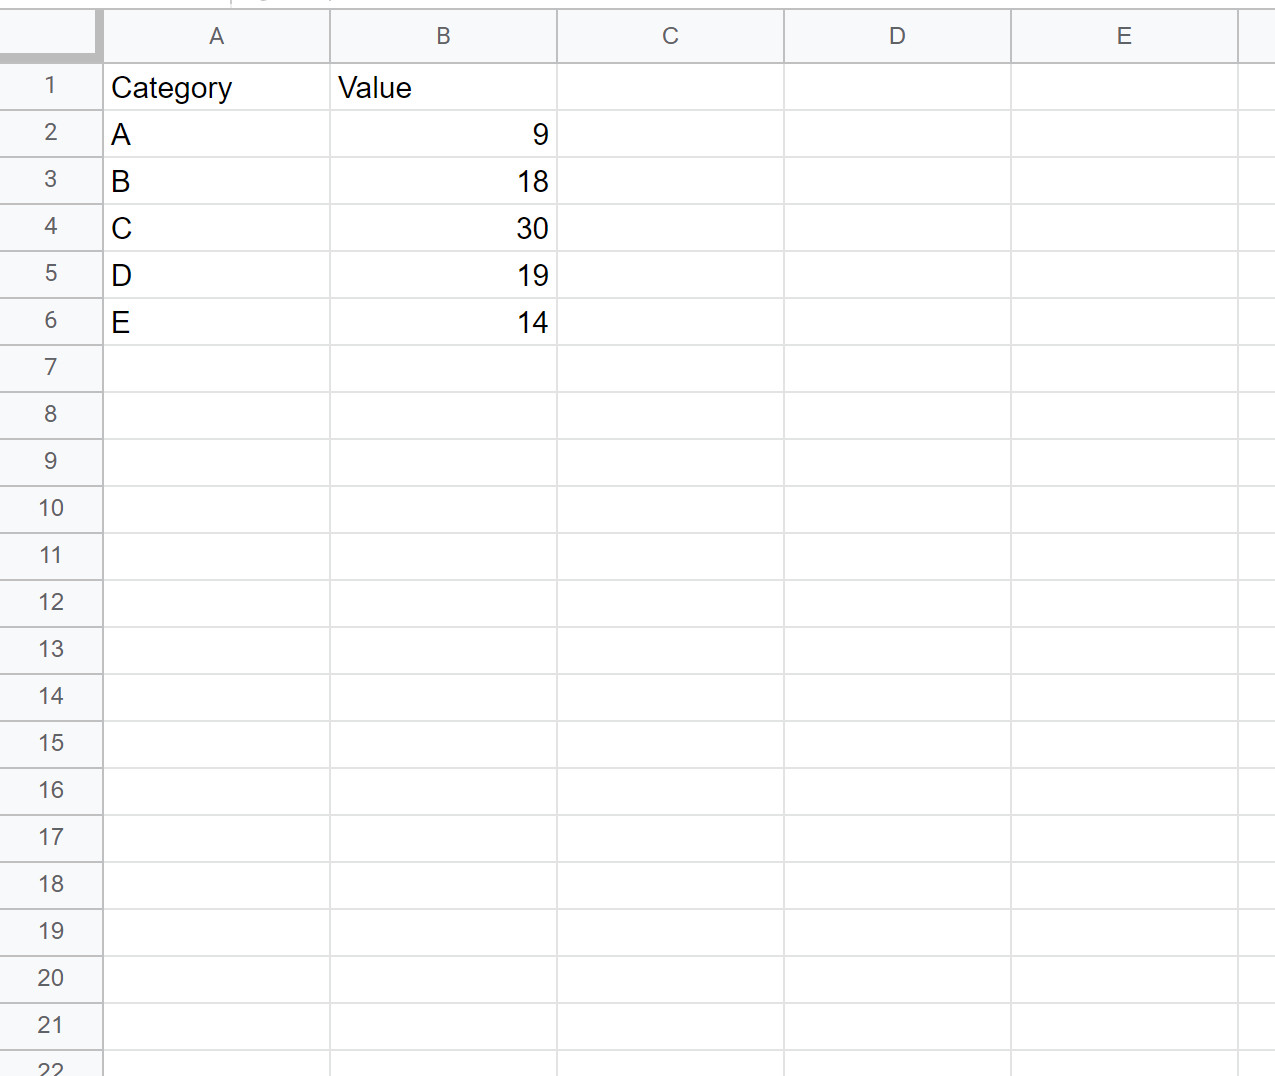
3.2 Calcul automatisé des statistiques descriptives préalables
L’implémentation de barres d’erreur précises requiert le déploiement préalable de formules mathématiques robustes sur la feuille de calcul. L’époque des calculs manuels à la calculatrice reportés sur le tableur est définitivement révolue : l’automatisation intégrale garantit l’actualisation dynamique du graphique en cas d’ajustement du corpus empirique. Pour obtenir la moyenne arithmétique d’une cohorte sur une variable continue, la syntaxe standardisée consiste à insérer l’expression =MOYENNE(plage). Immédiatement en dessous de cette valeur, l’estimation sans biais de l’écart-type de l’échantillon doit être exécutée via la fonction =ECARTYPE.STANDARD(plage) — en veillant impérativement à proscrire la fonction ECARTYPE.P, cette dernière appliquant une division par $N$ au lieu de $N – 1$, ce qui sous-estimerait artificiellement la variance au sein d’un échantillon psychologique restreint.
La quantification de la taille de l’échantillon s’avère indispensable pour pondérer rigoureusement les métriques inférentielles subséquentes. Elle s’effectue dynamiquement au moyen de la formule =NB(plage), laquelle comptabilise exclusivement les cellules renfermant des valeurs numériques valides, écartant d’emblée les cases vides et les données manquantes dues à des abandons en cours d’expérimentation. Dès lors, le calcul de l’erreur type de la moyenne s’obtient par l’imbrication programmatique de l’écart-type et de la racine carrée de l’effectif :
=ECARTYPE.STANDARD(plage) / RACINE(NB(plage))
Cette expression formalise avec exactitude le dénominateur $\sqrt{N}$ imposé par les théorèmes fondamentaux de la statistique d’échantillonnage.
Pour matérialiser un intervalle de confiance à 95 %, il est nécessaire d’associer l’erreur type calculée précédemment à la valeur critique de la distribution $t$ de Student correspondant aux degrés de liberté ($df = N – 1$) de la série de mesures. Bien que certains manuels élémentaires préconisent une multiplication arbitraire par la constante 1,96 — valeur issue de la distribution normale centrée réduite $\mathcal{N}(0, 1)$ —, cette approximation s’avère fautive dès lors que l’effectif du groupe s’avère inférieur à cent participants, ce qui constitue la norme dans la vaste majorité des protocoles de neurosciences et de psychologie expérimentale. L’estimation exacte de la marge d’erreur de l’intervalle de confiance s’obtient donc sous Google Sheets par la commande :
=LOI.STUDENT.INVERSE.N(0,05; NB(plage)-1) * (ECARTYPE.STANDARD(plage) / RACINE(NB(plage)))
La valeur numérique qui en résulte constituera le rayon exact de la barre d’erreur à apposer visuellement au-dessus et en dessous de la moyenne estimée.
4. Génération du graphique support : Colonnes et nuages de points
4.1 Sélection du format graphique approprié selon le plan d’expérience
Le choix typologique du conteneur visuel dans Google Sheets n’est pas une considération purement esthétique ; il engage directement la grammaire graphique et la validité épistémique de l’interprétation des données. Dans le cadre d’un plan expérimental inter-sujets simple — comparant par exemple un groupe contrôle non traité à deux groupes recevant des posologies distinctes d’un entraînement attentionnel informatisé —, le diagramme en colonnes (verticales) demeure l’option conventionnelle la plus lisible. Il matérialise l’indépendance ontologique des modalités de la variable catégorielle tout en offrant une base géométrique claire sur laquelle greffer les segments d’incertitude.
En revanche, dès lors que le protocole implique des mesures répétées intra-sujets ou une dimension temporelle continue (telle qu’une courbe d’apprentissage moteur s’étalant sur plusieurs blocs d’essais successifs ou une cinétique de récupération émotionnelle post-traumatique), l’usage des diagrammes en colonnes doit être formellement rejeté. L’emploi d’un graphique linéaire ou d’un nuage de points reliés par des segments s’impose alors impérativement. Ce format suggère sans ambiguïté au système perceptif du lecteur la continuité sous-jacente des observations issues des mêmes unités expérimentales, évitant de fragmenter visuellement un processus évolutif unique.
Pour initialiser le processus de rendu sous Google Sheets, la sélection matricielle des cellules doit être exécutée avec une rigueur absolue. L’opérateur doit sélectionner la plage contiguë intégrant les en-têtes textuels désignant les modalités ainsi que les moyennes numériques correspondantes préalablement consolidées dans le tableau récapitulatif. Il est impératif de ne pas inclure directement à ce stade les colonnes dévolues aux écarts-types ou aux erreurs types : ces données d’incertitude ne doivent pas être traitées par le moteur graphique comme des séries d’observations indépendantes, sous peine de voir émerger des colonnes superflues dénuées de sens physique au sein du graphique.
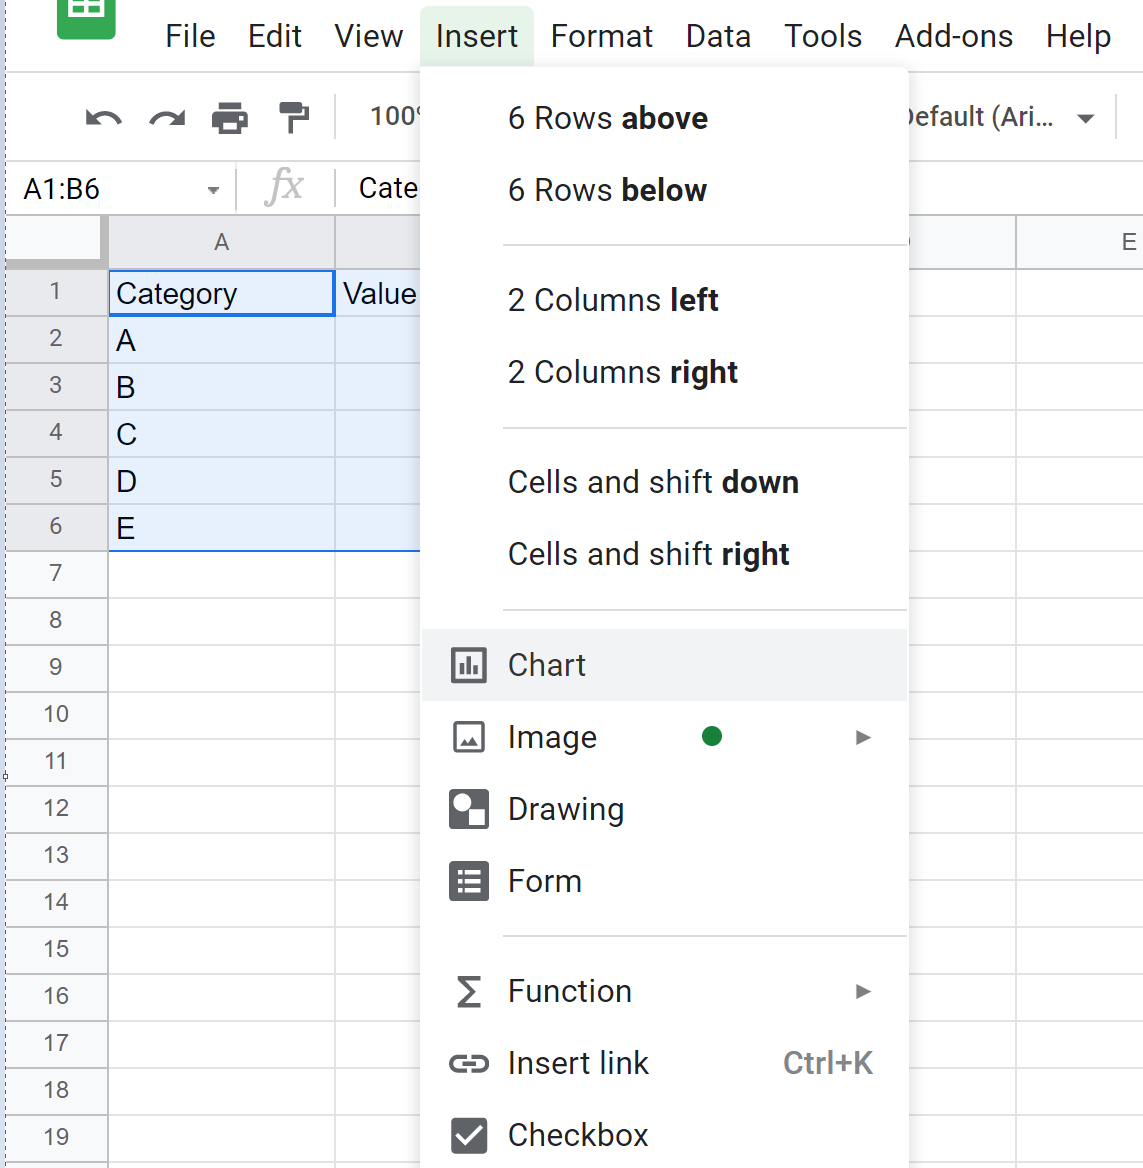
4.2 Initialisation du composant graphique via l’éditeur Google Sheets
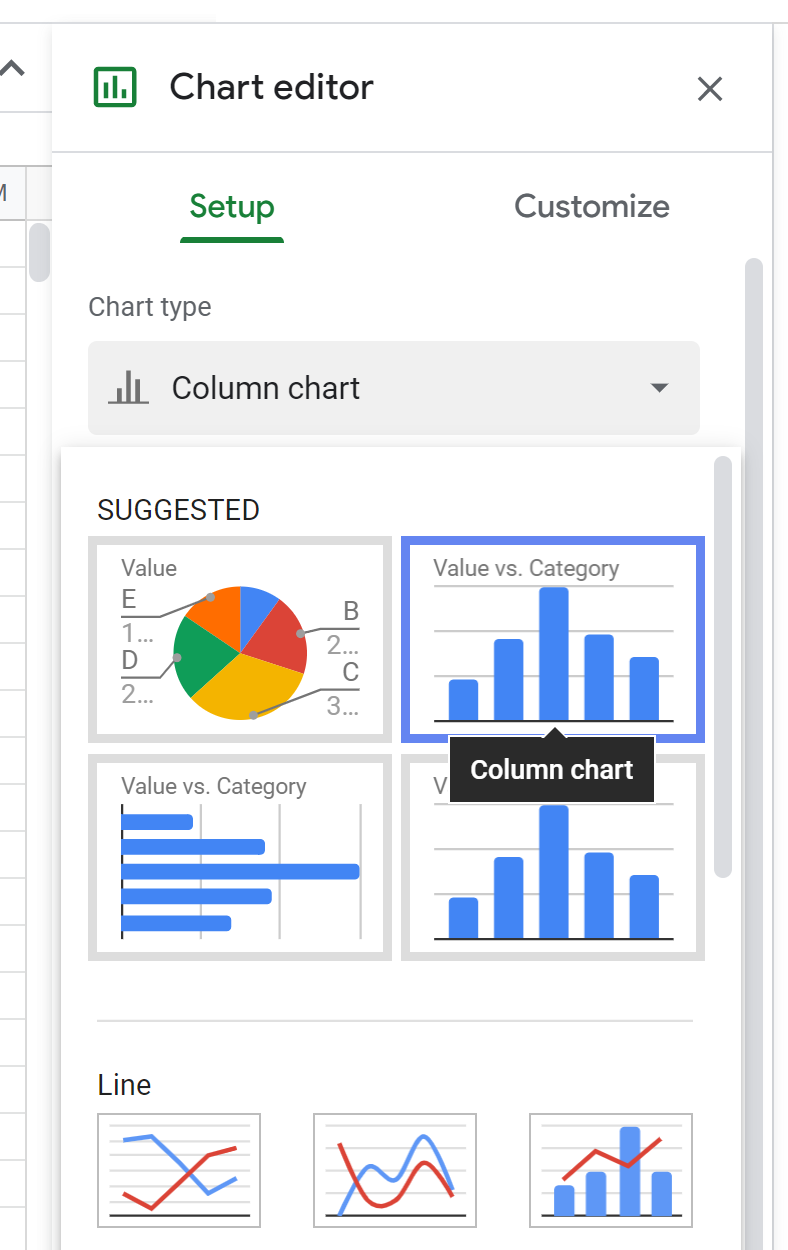
Une fois la sélection matricielle rigoureusement effectuée, l’insertion de l’objet graphique s’opère via la barre d’outils supérieure en déployant le menu Insertion puis en cliquant sur Graphique. Google Sheets active instantanément un algorithme d’inférence visuelle qui génère un canevas graphique au cœur de la feuille active, tout en faisant surgir sur la partie latérale droite de l’écran le panneau interactif intitulé « Éditeur de graphiques ». Cet éditeur se divise en deux volets opérationnels cardinaux : l’onglet « Configurer », dévolu à la structure relationnelle des données, et l’onglet « Personnaliser », consacré aux propriétés morphologiques et typographiques de la visualisation.
Il est fréquent que l’algorithme d’aide à la décision graphique de Google Sheets applique initialement un type de rendu inadéquat (tel qu’un graphique en secteurs ou un diagramme empilé). L’utilisateur doit immédiatement rectifier ce comportement dans l’onglet « Configurer » en déroulant le menu « Type de graphique » pour sélectionner « Graphique à colonnes » ou « Graphique linéaire ». Il convient de vérifier sans délai la bonne attribution des axes : le champ « Axe horizontal (X) » doit faire référence à la série de cellules contenant les libellés nominaux de la variable indépendante, tandis que le champ « Série » doit pointer avec exactitude vers la plage numérique des moyennes calculées.
Une attention méticuleuse doit être prêtée aux deux cases à cocher localisées au bas du volet « Configurer » : « Associer la ligne X aux en-têtes » et « Utiliser la colonne X en tant qu’identifiants ». L’activation adéquate de ces paramètres conditionne la génération automatisée d’une légende conforme et garantit que Google Sheets ne tentera pas d’interpréter le titre textuel de votre colonne d’évaluation psychologique comme un point de donnée numérique manquant, ce qui décalerait l’ensemble du système de coordonnées cartésiennes de la figure.
5. Procédure pas à pas : Insertion basique des barres d’erreur natives
5.1 Navigation dans l’onglet de personnalisation des séries
L’adjonction matérielle de barres d’erreur aux éléments géométriques du graphique s’effectue exclusivement au travers de l’interface de mise en forme avancée du logiciel. Pour y accéder, l’utilisateur doit faire basculer l’éditeur de graphiques sur son second volet intitulé « Personnaliser ». Ce panneau déploie une arborescence thématique hiérarchisée gérant l’ensemble des paramètres visuels de la figure (style général, titres des axes, quadrillage, légende). L’opérateur doit identifier et cliquer sur l’intitulé de la section « Séries » pour déployer l’intégralité de ses options sous-jacentes.
Dans l’hypothèse où le graphique comporte plusieurs séries d’observations superposées (par exemple, les scores d’hommes et de femmes évalués sous deux conditions expérimentales distinctes), la partie supérieure de la section « Séries » offre un menu déroulant sélectif. Ce commutateur permet d’appliquer les réglages de manière globale à « Toutes les séries » ou de cibler spécifiquement une variable d’intérêt singulière. Pour assurer une cohérence méthodologique sans faille, il est impératif d’ajuster individuellement chaque série dès lors que les variances empiriques diffèrent entre les sous-groupes de l’étude.
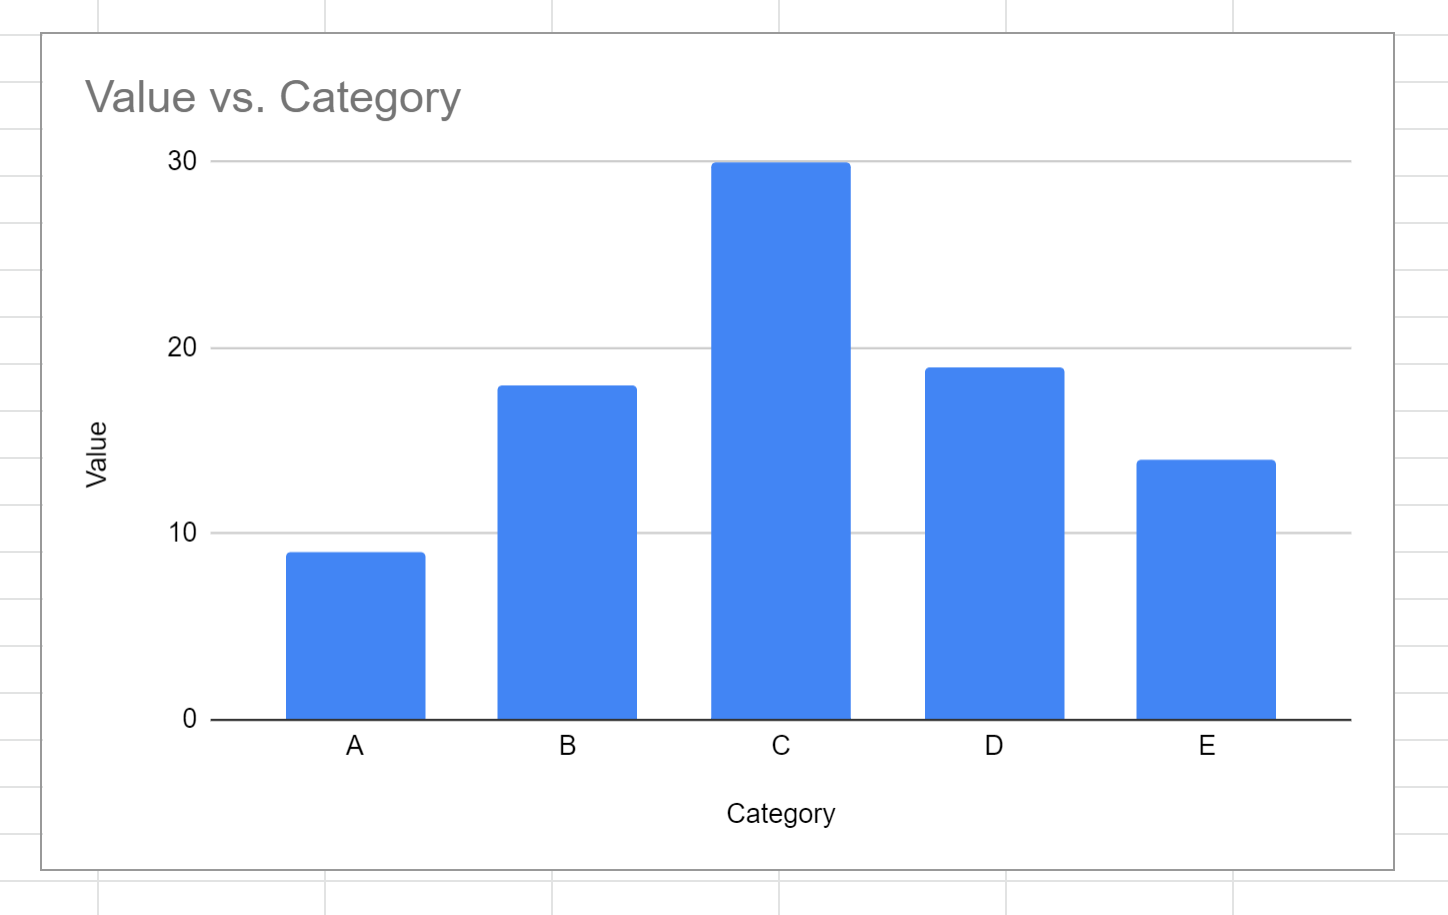
En faisant défiler les propriétés de la section « Séries » vers le bas, trois cases à cocher structurelles se présentent à l’observateur : « Étiquettes de données », « Ligne de tendance » et enfin « Barres d’erreur ». Le simple fait de cocher la case dédiée aux « Barres d’erreur » déclenche l’affichage immédiat sur le graphique support de segments bilatéraux verticaux ancrés sur le sommet de chaque colonne ou sur chaque point de coordonnées cartésiennes. Cet instant marque l’insertion du composant d’incertitude dans l’espace visuel.
5.2 Application des paramètres standards par défaut
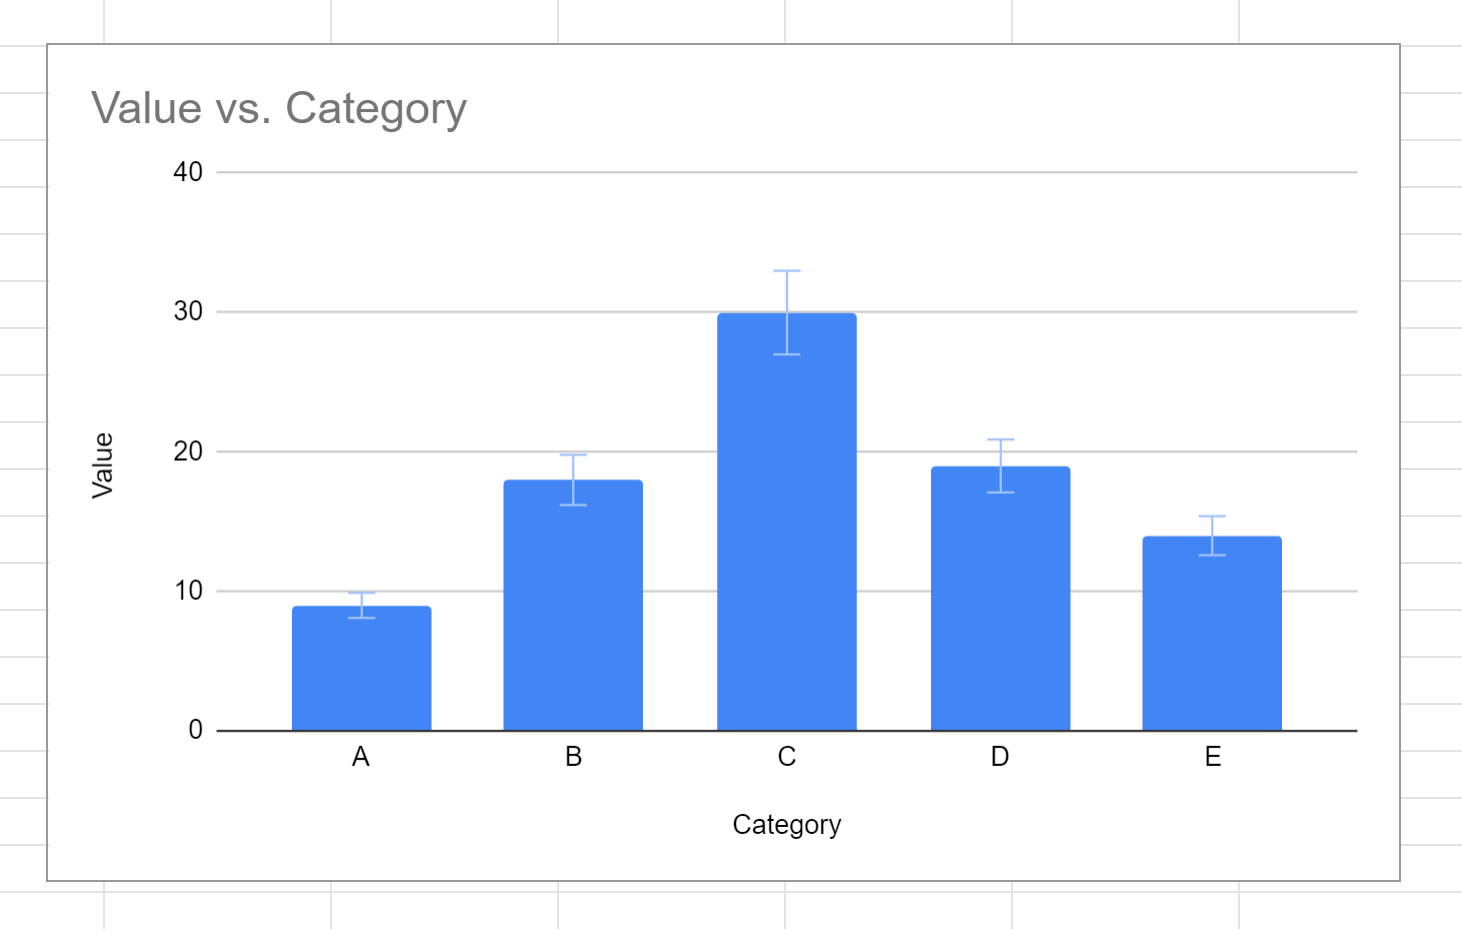
Dès l’activation de l’option « Barres d’erreur », Google Sheets applique automatiquement un ensemble de paramètres algorithmiques prédéfinis sans solliciter l’aval préalable de l’analyste. Le logiciel configure par défaut un type d’erreur basé sur le « Pourcentage » et injecte uniformément la valeur numérique de « 10 % ». Cela signifie que chaque barre d’erreur générée s’étire vers le haut et vers le bas d’une distance correspondant exactement à un dixième de la hauteur absolue de la colonne correspondante. Ce comportement mécanique constitue un danger méthodologique majeur pour quiconque ignorerait son fonctionnement sous-jacent.
Sur le plan géométrique, l’affichage déployé par le tableur est strictement bilatéral et symétrique. Le logiciel projette un segment rectiligne vertical traversant la valeur centrale estimée, terminé à chaque extrémité par un empattement horizontal perpendiculaire (souvent désigné sous le vocable technique de moustache ou whisker). Ces empattements visent à faciliter la lecture micrométrique des coordonnées extrêmes sur l’axe des ordonnées. La couleur de ce segment hérite par défaut de la teinte de la série de données associée, bien qu’elle puisse être assombrie pour des impératifs d’accessibilité visuelle.
Il est impératif de souligner avec gravité l’inadéquation radicale de ces réglages d’usine dans le champ de la recherche scientifique. Un pourcentage arbitraire de dix pour cent ne correspond à aucune réalité probabiliste, inférentielle ou descriptive au sein d’une expérience de psychologie. Maintenir un tel paramétrage par défaut dans un rapport d’étude, un mémoire universitaire ou une publication soumise à des pairs constitue une faute méthodologique rédhibitoire, trahissant une méconnaissance technique flagrante de l’outil informatique et des lois élémentaires de la mesure empirique.
6. Configuration des barres d’erreur basées sur le pourcentage
6.1 Modalités de paramétrage de l’option Pourcentage
Bien que son application brute à des fins inférentielles doive être fermement proscrite, l’option « Pourcentage » intégrée à Google Sheets demeure un mécanisme fonctionnel qu’il convient de savoir paramétrer avec précision pour des contextes d’analyse spécifiques. Une fois la case « Barres d’erreur » activée dans le menu « Séries », un menu déroulant contextuel immédiatement adjacent intitulé « Type » devient accessible. L’utilisateur peut y sélectionner l’option « Pourcentage » parmi les alternatives proposées (qui comprennent également « Valeur constante » et « Écart-type »).
Dès la sélection de ce mode, un champ textuel d’entrée numérique libellé « Valeur » s’illumine sous le sélecteur de type. C’est dans cet espace que l’opérateur renseigne la valeur proportionnelle désirée, exprimée sous forme d’entier ou de nombre décimal (par exemple, 5 pour 5 % ou 2,5 pour 2,5 %). Dès la validation de la saisie par l’appui sur la touche d’entrée du clavier, le moteur graphique de Google Sheets recalcule dynamiquement la longueur des barres d’erreur associées à chaque point de la série.
L’une des caractéristiques logicielles notables de cette modalité réside dans sa réactivité algorithmique face aux fluctuations des cellules sources. Si la valeur de la moyenne affichée dans la table est modifiée — consécutivement à l’intégration de nouveaux participants au protocole expérimental ou à l’élimination de données polluées —, l’étendue visuelle de la barre d’erreur relative au pourcentage est recalculée instantanément. La marge d’erreur visuelle s’ajuste ainsi de manière parfaitement proportionnelle à la nouvelle magnitude de la valeur centrale observée.
6.2 Applications psychologiques et réserves méthodologiques
L’emploi d’une barre d’erreur fixée en pourcentage de la moyenne ne peut se justifier que dans un éventail extrêmement circonscrit de paradigmes psychologiques. On peut envisager sa pertinence dans certaines tâches d’estimation sensorielle relative relevant de la psychophysique classique. Selon la célèbre loi de Weber-Fechner, le seuil différentiel de perception ($\Delta I$) est proportionnel à l’intensité du stimulus physique initial ($I$), maintenant un ratio constant ($\Delta I / I = k$) sur une large fraction du continuum perceptif. Dans ce cas très particulier, si un protocole vise à illustrer un modèle théorique prédisant une variabilité relative strictement invariante le long d’une échelle d’intensité lumineuse ou acoustique, l’usage de barres d’erreur en pourcentage peut acquérir une valeur heuristique et illustrative indéniable.
Néanmoins, en dehors de ces niches théoriques très restrictives, l’usage du pourcentage induit des distorsions méthodologiques inacceptables. Le danger principal réside dans la corrélation artificielle et mécanique introduite entre l’amplitude apparente de l’incertitude et la grandeur absolue du score moyen. Considérons une expérience comparant les performances mnésiques de sujets jeunes (moyenne de 80 mots rappelés) et de patients atteints de démence débutante (moyenne de 20 mots rappelés). Si une barre d’erreur de 10 % est appliquée de manière uniforme, le groupe de sujets sains exhibera une fenêtre d’erreur apparente de 8 mots de part et d’autre, tandis que le groupe clinique semblera bénéficier d’une marge d’incertitude étroite de 2 mots seulement.
Cette divergence visuelle ne procède en rien d’une différence de dispersion empirique ou de précision métrologique entre les deux groupes ; elle constitue un pur artefact géométrique généré par l’inégalité des moyennes de base. En psychologie différentielle et cognitive, où la variance a fréquemment tendance à s’accroître précisément chez les populations présentant des déficits fonctionnels, l’application d’un pourcentage fixe inverse la réalité empirique et délivre un message visuel totalement erroné. Il convient donc d’édicter une recommandation formelle : sauf justification théorique absolue découlant d’une loi de proportionnalité explicite, l’option « Pourcentage » ne doit jamais être mobilisée pour représenter l’incertitude statistique dans un rapport de recherche.
7. Paramétrage des barres d’erreur à valeur constante
7.1 Mise en œuvre technique d’une marge d’erreur uniforme
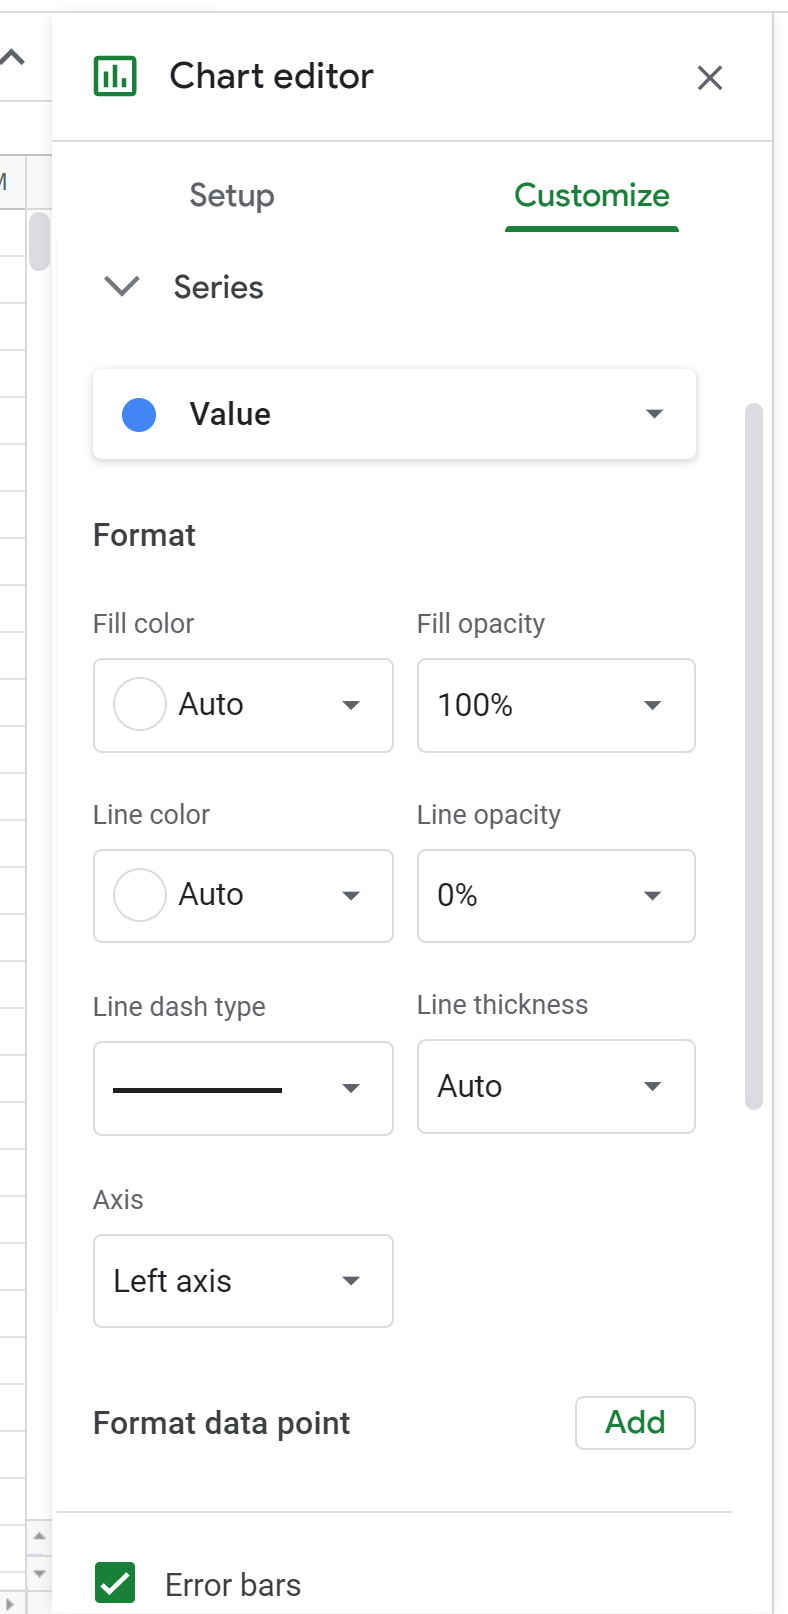
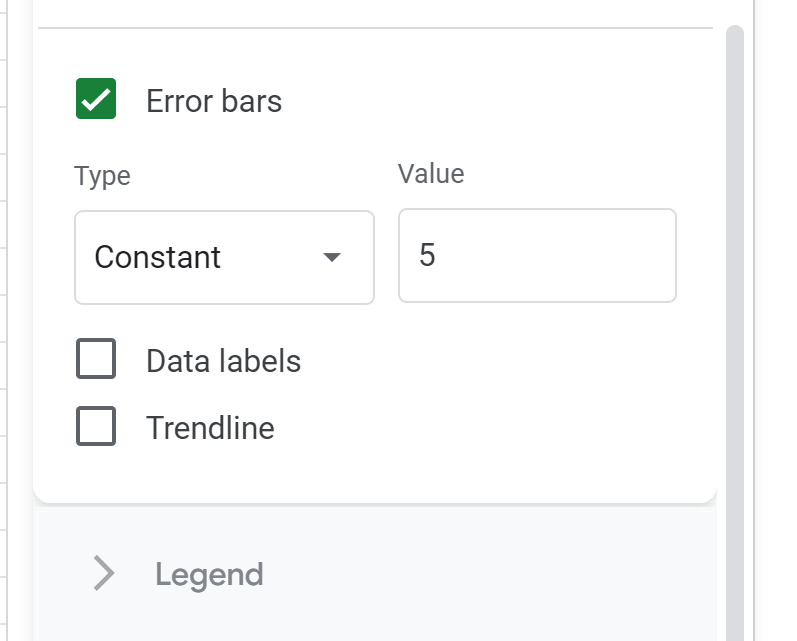
Le second mode opérationnel offert nativement par l’éditeur de graphiques de Google Sheets est la modalité « Constante ». Pour l’activer, l’utilisateur doit déployer l’onglet « Personnaliser », ouvrir la section « Séries », cocher l’option « Barres d’erreur », puis commuter le sélecteur « Type » sur l’entrée « Constante ». L’interface dévoile alors un champ de saisie directe intitulé « Valeur », au sein duquel le chercheur renseigne une grandeur numérique absolue — exprimée dans l’unité de mesure exacte de la variable dépendante projetée sur l’axe vertical des ordonnées.
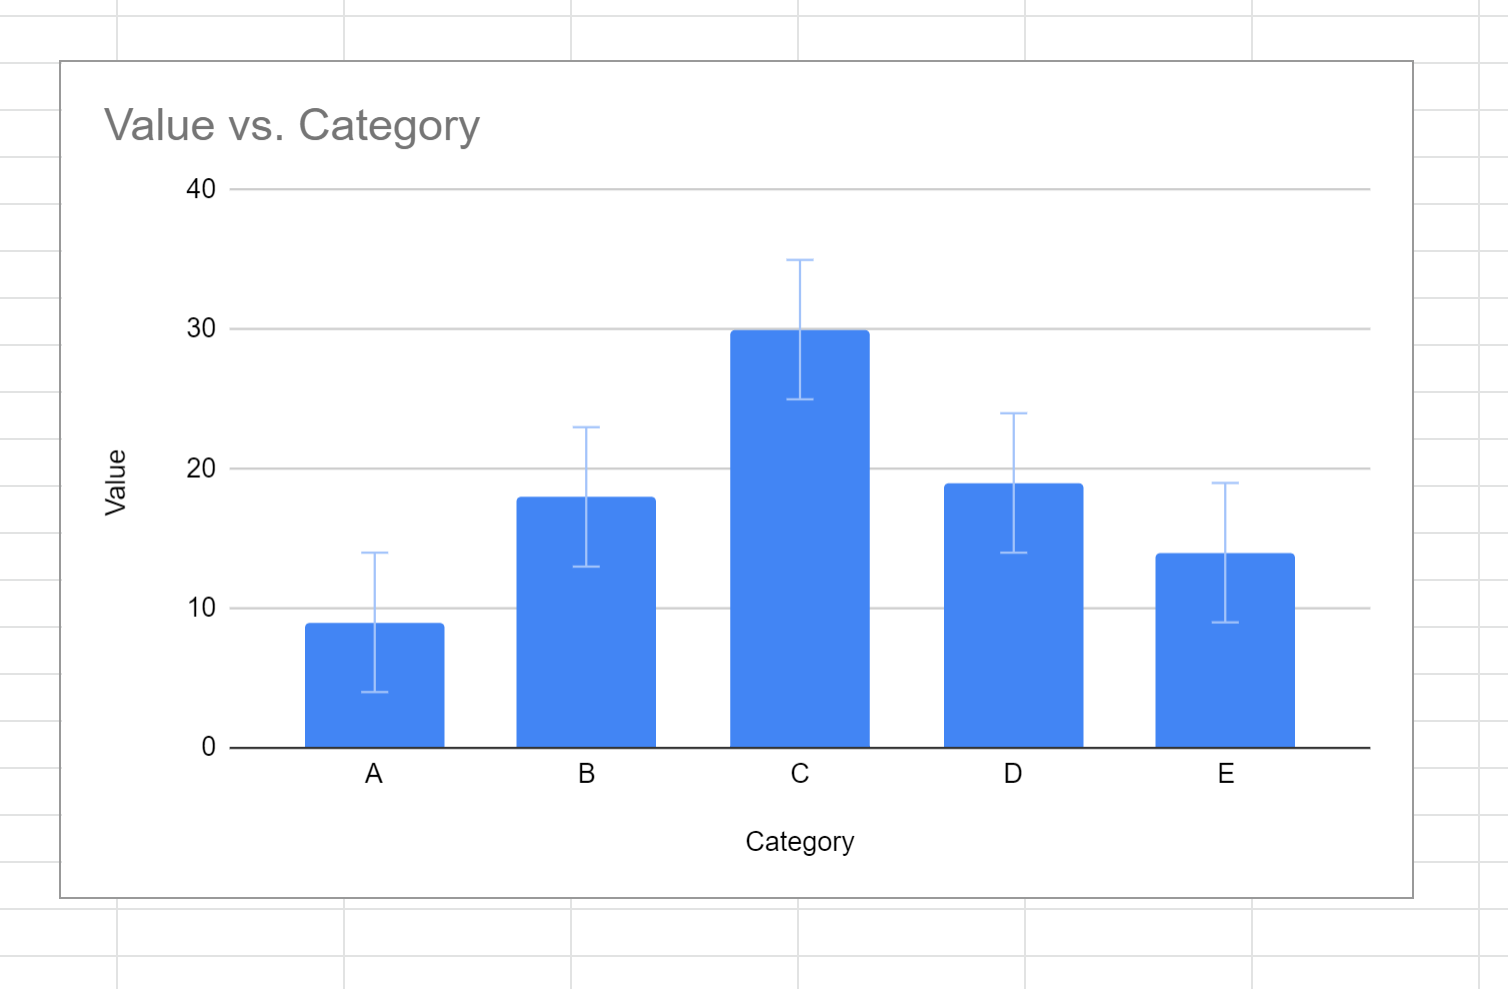
Contrairement au mécanisme proportionnel examiné précédemment, le mode constant injecte une déviation rigoureusement identique en valeur absolue sur l’intégralité des points ou colonnes appartenant à la série paramétrée. Si la valeur numérique 15 est renseignée dans une étude chronométrique dont l’axe vertical est gradué en millisecondes, chaque moyenne expérimentale se verra coiffée d’une barre d’erreur s’étendant exactement de 15 millisecondes vers le haut et de 15 millisecondes vers le bas, que la moyenne du groupe soit de 250 ou de 800 millisecondes.
La mise en place d’une valeur constante impose une surveillance accrue de la gestion visuelle de l’axe vertical. Dans l’onglet « Personnaliser », sous la rubrique « Axe vertical », il s’avère souvent capital de fixer explicitement les valeurs « Min » et « Max ». En effet, si l’une des moyennes expérimentales est proche de zéro et que la constante d’erreur excède cette magnitude, le segment descendant de la barre d’erreur risque de plonger en deçà de l’axe horizontal d’origine. Une telle configuration peut créer une troncature inesthétique ou suggérer de façon absurde des temps de réaction négatifs, obligeant le chercheur à calibrer méticuleusement l’intervalle visible des ordonnées.
7.2 Cas d’usage : Erreur instrumentale et seuils de discrimination
Le recours à des barres d’erreur de valeur constante trouve sa justification expérimentale légitime dans la représentation de l’imprécision métrologique instrumentale. Lors de l’enregistrement de biomarqueurs ou de données physiologiques complexes (par exemple la conductance cutanée, l’électromyographie faciale ou le suivi oculaire via eye-tracker), les dispositifs matériels d’acquisition introduisent un bruit de fond technique ou une incertitude de calibrage d’une magnitude connue et fixe. Si un capteur oculaire présente une précision spatiale certifiée par le constructeur à plus ou moins 0,5 degré d’angle visuel, l’apposition d’une barre d’erreur constante de 0,5 unité sur le graphique assure la matérialisation irréprochable de cette limite matérielle universelle, totalement indépendante des fluctuations biologiques propres aux sujets évalués.
Un autre cas d’application méthodologique fécond réside dans l’illustration des seuils différentiels absolus au sein des protocoles de détection de signaux ou de psychophysique sensorielle classique. Lorsque le modèle théorique sous-jacent postule qu’une marge de tolérance perceptive fixe s’applique uniformément à une batterie de stimuli expérimentaux indépendamment de leur nature qualitative, l’ancrage d’une constante géométrique permet de confronter d’un regard l’écart des observations réelles à cette norme théorique d’invariance.
Néanmoins, la transposition de ce mode aux comparaisons de moyennes inter-sujets ordinaires se heurte à un écueil statistique rédhibitoire : l’hypothèse sous-jacente d’homoscédasticité parfaite. Dans la réalité empirique des sciences du comportement, l’égalité stricte des variances entre plusieurs groupes expérimentaux demeure une fiction statistique. L’administration d’un traitement pharmacologique, l’induction d’une charge cognitive intense ou le vieillissement cérébral s’accompagnent quasi systématiquement d’un phénomène marqué d’hétéroscédasticité, c’est-à-dire d’un éclatement différentiel des variances entre les sous-échantillons. Plaquée de manière artificielle sur un tel jeu de données, une barre d’erreur constante dissimule l’hétérogénéité des réactions individuelles au protocole, ce qui contrevient aux règles élémentaires de l’honnêteté scientifique.
8. Utilisation de l’écart-type natif dans Google Sheets
8.1 Fonctionnement du calcul automatisé de l’écart-type
L’éditeur graphique de Google Sheets intègre un troisième mode de génération d’incertitude particulièrement prisé : l’option native « Écart-type ». Pour y accéder au sein du volet « Séries », il suffit de basculer le menu déroulant « Type » sur l’entrée « Écart-type ». À première vue, cette option semble incarner la panacée ergonomique absolue pour le psychologue soucieux de représenter la dispersion de ses participants sans avoir à coder d’opérations matricielles complexes.
Toutefois, la compréhension du mécanisme par lequel l’algorithme sous-jacent dérive cette métrique exige une vigilance analytique de chaque instant. Lorsque Google Sheets applique son mode « Écart-type » à un graphique généré à partir de données brutes étendues, son moteur statistique interne analyse l’ensemble des observations associées à chaque modalité et en extrait mathématiquement la déviation standard. L’interface offre alors un champ de réglage numérique subsidiaire qui ne correspond plus à une valeur absolue d’erreur, mais à un multiplicateur d’écart-type. Renseigner la valeur « 1 » projette un segment équivalant à un écart-type ($\pm 1 SD$), tandis que renseigner « 2 » déploie une étendue de deux écarts-types ($\pm 2 SD$), couvrant théoriquement plus de 95 % d’une population gaussienne.
Cette automatisation logicielle séduisante cache toutefois un piège technique massif dans lequel s’égarent d’innombrables étudiants et chercheurs. Si le graphique support a été conçu — conformément aux recommandations usuelles de clarté tabulaire exposées au chapitre 3 — à partir d’une table résumée présentant uniquement la moyenne consolidée de chaque condition expérimentale, l’option native d’écart-type perd tout son sens. Dans une telle configuration, Google Sheets calcule l’écart-type… des moyennes affichées dans la colonne, et non des scores individuels des sujets qui ont permis d’aboutir à ces moyennes ! L’utilisateur se retrouve ainsi avec une barre d’erreur homogène absurde, calculée sur un échantillon dérisoire de quelques points d’agrégation.
8.2 Avantages et contraintes pour l’analyse descriptive
Lorsque le graphique est branché avec discernement sur des données natives non agrégées, l’option « Écart-type » procure un bénéfice descriptif indéniable. Elle permet d’un simple clic d’embrasser visuellement le périmètre de normalité théorique des réponses de l’échantillon d’étude. En psychométrie et lors de l’étalonnage d’outils d’évaluation cognitive, cette fonction permet de localiser instantanément si un patient ou une cohorte clinique se situe en deçà du seuil critique des deux écarts-types sous la moyenne normative du groupe de contrôle, matérialisant ainsi graphiquement le franchissement d’un palier pathologique.
Cependant, les contraintes méthodologiques inhérentes à cette fonctionnalité native s’avèrent rédhibitoires pour la recherche avancée. D’une part, elle s’avère totalement incapable d’afficher des variances inégales lorsque le graphique est construit sur une table de synthèse : le logiciel attribue le même multiplicateur d’écart-type à toutes les colonnes de la série graphique active, masquant irrémédiablement l’hétéroscédasticité propre aux conditions empiriques. D’autre part, elle interdit nativement toute dissymétrie des barres d’erreur, postulant de facto une symétrie parfaite des données autour de la tendance centrale — une hypothèse régulièrement battue en brèche par les distributions de scores psychologiques fortement asymétriques (telles que les échelles d’évaluation du stress post-traumatique ou les distributions log-normales des temps de réaction chronométriques).
Enfin, la confusion terminologique entretenue par l’intitulé « Écart-type » conduit fréquemment les néophytes à une erreur conceptuelle préjudiciable : considérer que cette option génère l’erreur type de la moyenne. L’écart-type natif ne prend aucunement en compte la taille de l’échantillon ($N$) au dénominateur pour évaluer la précision de la moyenne ; il renseigne exclusivement sur la dispersion brute des observations. Prétendre statuer sur la significativité statistique d’une différence inter-groupes en se fondant sur l’observation des barres d’écart-type natif relève de l’aberration méthodologique la plus totale.
9. Technique avancée : Barres d’erreur personnalisées pour l’erreur type et l’intervalle de confiance
9.1 Contourner les limitations natives via des séries de données superposées
Face aux limites fonctionnelles des options natives de Google Sheets — incapacité d’affecter des valeurs d’erreur distinctes et hétérogènes par condition sur une série unique, absence de calcul automatique direct de l’erreur type pondérée ou des intervalles de confiance à 95 % —, le chercheur doit recourir à une ingénierie de contournement matricielle. Cette stratégie experte consiste à structurer les données tabulaires de façon à ce que chaque condition expérimentale soit reconnue par le moteur graphique comme une série autonome indépendante, autorisant ainsi un paramétrage sur-mesure de sa barre d’erreur respective.
La mise en œuvre impose d’abandonner l’alignement vertical classique des conditions au sein d’une seule colonne de moyennes. Il convient de construire une matrice diagonale décalée. Dans ce schéma structurel, la première colonne conserve les étiquettes descriptives textuelles sur chaque ligne (par exemple : Ligne 2 = « Témoin », Ligne 3 = « Thérapie Cognitive », Ligne 4 = « Pleine Conscience »). En revanche, au lieu d’inscrire toutes les moyennes dans une même colonne B, nous affectons une colonne dédiée à chaque condition expérimentale : la cellule B2 accueille la moyenne du groupe Témoin (les cellules B3 et B4 restant rigoureusement vides), la cellule C3 accueille la moyenne du groupe Thérapie Cognitive (C2 et C4 restant vides), et la cellule D4 accueille la moyenne du groupe Pleine Conscience (D2 et D3 restant vides).
En sélectionnant l’intégralité de ce bloc matriciel et en générant un graphique à colonnes standards, Google Sheets identifie trois séries distinctes (Série B, Série C, Série D) au lieu d’une série unifiée. L’utilisateur retrouve alors la pleine maîtrise opérationnelle de ses visualisations : dans l’onglet « Personnaliser > Séries », il lui suffit de sélectionner successivement chaque série individuelle dans le menu déroulant, d’activer les « Barres d’erreur », de basculer le mode sur « Constante » et de renseigner manuellement dans le champ « Valeur » la valeur exacte de l’erreur type ou du demi-intervalle de confiance spécifiquement calculé pour cette condition dans sa table descriptive. Ce procédé garantit l’affichage de barres d’erreur de magnitudes rigoureusement différentes pour chaque condition, rétablissant avec exactitude l’hétérogénéité empirique des variances.
9.2 Mise en œuvre d’un intervalle de confiance à 95 % personnalisé
Pour conférer à la visualisation une rigueur d’estimation inférentielle indiscutable, la démarche experte consiste à coupler cette architecture matricielle au calcul dynamique de l’intervalle de confiance fondé sur la loi $t$ de Student. Comme explicité dans le troisième chapitre, la marge d’erreur d’un intervalle de confiance à 95 % dépend intimement des degrés de liberté propres à chaque groupe expérimental. Dans des recherches impliquant des échantillons inégaux — suite à des données manquantes non aléatoires ou des contraintes logistiques de recrutement —, chaque modalité expérimentale présente un seuil $t$ critique distinct, rendant toute généralisation uniforme totalement invalide.
La procédure opérationnelle se décompose en trois étapes algorithmiques au sein du tableur :
- Calcul de l’erreur type de chaque groupe dans une ligne dédiée :
=ECARTYPE.STANDARD(plage_groupe) / RACINE(NB(plage_groupe)). - Détermination de la valeur critique bilatérale $t$ au seuil de signification de 5 % :
=LOI.STUDENT.INVERSE.N(0,05; NB(plage_groupe)-1). - Calcul du produit multiplicatif de ces deux termes pour obtenir le demi-intervalle de confiance absolu ($CI_{95}$) :
=cellule_t_critique * cellule_erreur_type.
Une fois ces valeurs numériques d’intervalle de confiance dérivées avec exactitude pour chaque modalité de l’expérience, le chercheur navigue dans le panneau de personnalisation graphique de Google Sheets. En sélectionnant tour à tour chaque série décalée de son graphique, il injecte la valeur résultante du $CI_{95}$ dans le champ « Constante » de la barre d’erreur associée. Le résultat visuel final offre une fidélité d’une élégance absolue : chaque moyenne est flanquée d’une barre d’incertitude dont l’amplitude reflète mathématiquement à la fois la variabilité interne du sous-échantillon et l’exactitude d’estimation conditionnée par sa taille propre, accomplissant ainsi l’idéal de rigueur exigé par l’inférence moderne.
10. Conformité visuelle avec les normes de publication académique (Style APA)
10.1 Épuration esthétique du graphique selon les canons scientifiques
La transformation d’un graphique brut généré sous Google Sheets en une figure prête pour la publication dans une revue de psychologie indexée exige un travail méticuleux d’épuration esthétique. La charte graphique par défaut des tableurs grand public regorge d’artifices visuels — teintes criardes, effets d’ombres portées, arrière-plans teintés et quadrillages denses — qualifiés par Edward Tufte de chartjunk (bruit visuel parasite). Ces fioritures perturbent l’encodage perceptif des données et contreviennent formellement aux canons de sobriété édictés par le style APA (7e édition).
La première phase d’assainissement consiste à éliminer impitoyablement les grilles de lecture : sous l’onglet « Personnaliser > Quadrillage et graduations », l’opérateur doit désactiver l’affichage des lignes de quadrillage principales et secondaires pour l’axe vertical comme pour l’axe horizontal. L’arrière-plan de la zone de traçage et du graphique global doit être configuré en blanc pur (hexadécimal #FFFFFF), en s’assurant que la bordure extérieure de l’objet graphique est neutralisée (« Aucun »). Concernant la palette chromatique, l’APA préconise l’usage de nuances de gris hautement contrastées, de hachures géométriques distinctes ou d’une palette accessible aux lecteurs atteints de déficiences de la vision des couleurs (telles que les palettes Viridis ou ColorBrewer), en bannissant rigoureusement les effets tridimensionnels ou les dégradés spéculaires.
La standardisation typographique constitue le second pilier de la mise en conformité académique. L’intégralité des textes du graphique — désignation des axes, étiquettes de graduation, mentions de séries — doit adopter une police d’écriture sans empattement hautement lisible, universelle et neutre, à l’instar d’Arial, Calibri ou Helvetica, en maintenant une cohérence de corps de police (généralement entre 10 et 12 points pour les libellés d’axes, et 9 points pour les graduations numériques). Les axes d’abscisses et d’ordonnées doivent être tracés au moyen de lignes franches de couleur noire ou gris anthracite (#000000 ou #333333) d’une épaisseur constante d’un ou deux points, terminées par des graduations orientées vers l’extérieur du tracé cartésien.
10.2 Rédaction de la légende et des notes de bas de figure
L’adjonction de barres d’erreur sur une figure scientifique impose une responsabilité déontologique stricte : l’explicitation exhaustive et univoque de leur nature statistique. Une barre d’erreur dénuée de légende constitue une énigme méthodologique inacceptable qui invalide l’usage scientifique du graphique. Le lecteur ne dispose d’aucun moyen intrinsèque pour deviner si le segment déployé représente un écart-type, une erreur type, un intervalle de confiance à 90 %, 95 % ou 99 %, ou une étendue interquartile descriptive. Selon les directives expresses du Manuel de publication de l’APA (Section 7.22 à 7.36), la définition de l’indicateur d’erreur doit figurer explicitement dans la note textuelle disposée immédiatement sous la figure.
La formulation de la note de figure répond à une syntaxe codifiée extrêmement précise. Elle débute invariablement par le terme Note. composé en italique et suivi d’un point. Le texte qui succède doit énoncer clairement la signification de la tendance centrale, la nature mathématique exacte de la barre d’erreur, ainsi que la taille des échantillons associés à chaque condition. Si les groupes expérimentaux possèdent des effectifs homogènes, une mention globale de type $N = 45$ suffit ; si les effectifs diffèrent, les effectifs spécifiques doivent être détaillés ($n_1 = 22$, $n_2 = 23$).
Voici un modèle rédactionnel canonique, conforme aux exigences éditoriales internationales, à transposer fidèlement sous une figure intégrant des barres d’erreur construites dans Google Sheets :
Figure 1. Temps de réaction moyen lors de la tâche de Stroop émotionnelle en fonction de la valence affective des stimuli. Les barres d’erreur représentent les intervalles de confiance à 95 % calculés à partir de la distribution $t$ de Student ($N = 30$ par condition). Les moyennes dont les barres d’erreur ne se chevauchent pas diffèrent significativement au seuil bilatéral $\alpha = 0,05$.
Si l’auteur a opté pour la représentation de l’erreur type ou de l’écart-type, la note doit substituer rigoureusement les acronymes appropriés : « Les barres d’erreur représentent $\pm 1$ erreur type de la moyenne (ETM) » ou « Les barres d’erreur représentent $\pm 1$ écart-type empirique (ET) ». Cet impératif de précision dissipe toute ambiguïté interprétative et garantit la réplicabilité analytique du rapport empirique.
11. Écueils d’interprétation et biais cognitifs fréquents
11.1 L’illusion de non-significativité face au chevauchement visuel
L’interprétation visuelle des barres d’erreur fait l’objet de biais cognitifs documentés au sein de la communauté des chercheurs en sciences humaines. L’écueil le plus dommageable et le plus répandu consiste en l’illusion d’absence de significativité face au chevauchement de deux barres d’erreur. D’innombrables expérimentateurs appliquent de manière fallacieuse une heuristique intuitive simpliste : si les barres d’erreur de deux conditions expérimentales se superposent dans l’espace vertical du graphique, ils en déduisent immédiatement l’absence de différence statistiquement significative, omettant d’accomplir les tests inférentiels requis. Cette déduction visuelle spontanée s’avère mathématiquement erronée dans la vaste majorité des cas de figure concrets.
Le comportement inférentiel d’une divergence dépend fondamentalement de la nature statistique de la barre projetée. Lorsque les graphiques affichent des barres d’erreur type de la moyenne ($\pm 1 ETM$), l’absence de chevauchement visuel vertical constitue un critère excessivement conservateur. Deux moyennes distantes dont les barres d’erreur type se chevauchent marginalement peuvent tout à fait produire un test de Student hautement significatif au seuil conventionnel de $p < 0,05$. Inversement, lorsque l’on observe des intervalles de confiance à 95 % pour deux échantillons indépendants, une intersection visuelle modérée — tant qu’elle ne dépasse pas approximativement 25 à 50 % de la longueur d’un demi-intervalle — demeure parfaitement compatible avec une significativité statistique avérée au seuil nominal usuel.
L’illusion devient véritablement catastrophique dans le cadre des plans expérimentaux à mesures répétées (protocoles intra-sujets). Dans ce paradigme où chaque individu est son propre témoin, la variabilité interindividuelle globale est mathématiquement neutralisée par l’analyse statistique (comme dans une ANOVA à mesures répétées ou un test $t$ pour échantillons appariés), laquelle n’évalue que la variance des différences individuelles intra-sujets. Or, les barres d’erreur standard projetées sur un graphique Google Sheets classique reflètent la variance interindividuelle totale. Il en résulte un découplage complet entre l’apparence visuelle et la réalité mathématique : deux conditions intra-sujets peuvent présenter des barres d’erreur largement superposées tout en révélant un effet expérimental d’une significativité statistique éclatante ($p < 0,001$). Juger de la significativité intra-sujet sur un graphique standard constitue ainsi une pure aberration méthodologique.
11.2 Les biais induits par les représentations graphiques tronquées
L’altération de l’échelle géométrique constitue un autre puissant facteur de déformation de la perception visuelle de l’incertitude. La pratique controversée de la troncature de l’axe vertical — consistant à démarrer l’origine de l’axe des ordonnées non pas à zéro, mais à une valeur arbitraire immédiatement inférieure à la moyenne la plus basse — a pour conséquence d’amplifier de manière disproportionnée les contrastes observés. Si cette démarche s’avère parfois légitime en psychophysiologie pour observer des micro-variations de signaux continus, son application à des diagrammes en colonnes fausse radicalement la perception de la magnitude de l’effet par rapport à son incertitude empirique.
Lorsque l’origine zéro est supprimée sur un graphique à colonnes, le rapport visuel entre la hauteur géométrique de la barre pleine et l’amplitude de la barre d’erreur est artificiellement détruit. Une différence de moyenne triviale et dénuée de toute pertinence clinique ou psychologique réelle se retrouve magnifiée, apparaissant comme une montagne colossale dominant une vallée, tandis que la barre d’erreur semble proportionnellement imposante ou, au contraire, marginale selon la fenêtre d’étirement sélectionnée. Cette distorsion visuelle exploite les failles du système perceptif humain, lequel évalue intuitivement les ratios de surface et de hauteur plutôt que de déchiffrer avec minutie les graduations numériques marginales de l’axe.
Un mécanisme inverse opère lors du recours non explicité à des échelles logarithmiques ou semi-logarithmiques. Si les transformations logarithmiques sont indispensables pour linéariser des données hautement asymétriques — à l’instar des distributions des temps de réponse comportementaux —, la projection de barres d’erreur symétriques au sein d’un repère logarithmique constitue une faute grave. Dans un espace log, une incertitude constante vers le haut et vers le bas correspond à des marges de variabilité exponentiellement dissemblables dans l’échelle physique originelle. Le chercheur se doit de respecter une déontologie rigoureuse : préserver l’origine naturelle des échelles physiques d’évaluation psychologique, ou signaler explicitement par des artifices graphiques univoques toute discontinuité ou transformation d’échelle mise en œuvre.
12. Transition méthodologique : Quand passer de Google Sheets aux environnements dédiés
12.1 Évaluation comparative des capacités analytiques
S’il est indéniable que Google Sheets fournit une passerelle pédagogique remarquable et un dispositif de prototypage collaboratif de premier ordre, le chercheur engagé dans une démarche de publication scientifique de haut niveau doit savoir identifier avec lucidité les frontières techniques de l’outil. Face aux exigences croissantes de reproductibilité computationnelle et à la complexité des plans factoriels contemporains, les tableurs généralistes révèlent des limitations structurelles intrinsèques qu’il devient fastidieux de contourner.
Le tableau comparatif suivant synthétise les fonctionnalités analytiques et graphiques de Google Sheets en regard des principaux environnements informatiques spécialisés utilisés en recherche psychologique et comportementale :
- Google Sheets : Excellente collaboration native en temps réel et accessibilité universelle immédiate ; néanmoins, l’attribution de barres d’erreur hétérogènes exige des montages matriciels complexes, l’automatisation des corrections pour mesures répétées est absente, et l’exportation vectorielle haute résolution (norme SVG ou EPS à 300/600 DPI) demeure très restreinte.
- R (avec le package ggplot2) : Reproductibilité scientifique absolue via des scripts d’analyse auditables ; prise en charge native exhaustive de toutes les grammaires visuelles d’incertitude (barres asymétriques, violons, distributions de demi-points) ; adaptation parfaite aux protocoles factoriels complexes, au prix d’une courbe d’apprentissage technique exigeante.
- Python (avec Seaborn et Matplotlib) : Intégration transparente aux pipelines de sciences des données et d’apprentissage automatique ; flexibilité absolue de personnalisation géométrique ; automatisation native des intervalles de confiance par rééchantillonnage de type bootstrap non paramétrique.
- Jamovi / JASP : Logiciels statistiques libres d’accès combinant la rigueur des packages R sous-jacents et le confort d’une interface graphique interactive ; génération automatisée en un clic de figures respectant rigoureusement les normes APA de 7e édition, idéales pour la transition des étudiants vers la recherche clinique formalisée.
L’une des défaillances les plus manifestes de Google Sheets réside dans son incapacité native à implémenter les barres d’erreur corrigées pour les mesures répétées intra-sujets selon la célèbre méthodologie formalisée par Cousineau (2005) et perfectionnée par Morey (2008). Dans un protocole intra-sujet, l’application de la méthode de Cousineau-Morey implique de normaliser au préalable les scores des participants pour éliminer la variance interindividuelle globale avant de dériver l’erreur type ou l’intervalle de confiance, puis d’appliquer un coefficient multiplicatif de correction lié au nombre de conditions répétées. Alors qu’un script R ou une simple case à cocher sous Jamovi exécute cette opération mathématique de pointe de manière transparente, sa matérialisation dans Google Sheets impose un déploiement de formules d’une complexité extrême, augmentant drastiquement le risque d’erreurs humaines de calcul au sein des cellules.
12.2 Synthèse pratique pour la pratique quotidienne du chercheur
Au terme de cette analyse approfondie, il convient d’adopter une posture méthodologique pragmatique et équilibrée. Google Sheets ne doit être ni diabolisé comme un instrument indigne de la science, ni érigé en panacée universelle capable de supplanter les consoles de programmation statistique spécialisées. Le tableau de bord décisionnel du chercheur doit s’articuler autour de critères clairs indexés sur les différentes phases du cycle de vie de la recherche empirique.
Le recours à Google Sheets s’avère particulièrement pertinent et fécond dans les configurations suivantes :
- Lors des phases exploratoires préliminaires de collecte de données, où la priorité méthodologique réside dans le contrôle de la qualité de la saisie et le dépistage collaboratif immédiat des anomalies empiriques au sein de l’équipe de laboratoire.
- Dans le contexte de l’enseignement académique de premier cycle universitaire, pour initier visuellement et de manière interactive les étudiants à la dissociation conceptuelle capitale entre dispersion brute (écart-type) et marge d’échantillonnage (erreur type).
- Pour la communication interne rapide au sein d’un consortium de recherche multidisciplinaire ou la rédaction de rapports d’avancement d’étape ne nécessitant pas les standards d’encodage vectoriel des maisons d’édition scientifique internationales.
À l’inverse, la transition vers des environnements dédiés comme R ou Jamovi s’impose catégoriquement dès lors que l’étude aborde des modélisations statistiques avancées (modèles mixtes linéaires, régressions logistiques multiniveaux), des plans à mesures répétées requérant des corrections de sphéricité et d’interdépendance des barres d’erreur, ou lorsque la soumission du manuscrit est destinée à une revue savante exigeant la transmission intégrale des scripts de reproduction computationnelle des figures.
En définitive, la rigueur scientifique ne réside pas dans l’outil logiciel mobilisé, mais dans la lucidité méthodologique de l’opérateur qui le manipule. Savoir contraindre Google Sheets à afficher des barres d’erreur fidèles, fondées sur une dérivation statistique exacte de l’écart-type ou de l’intervalle de confiance, permet de réconcilier l’agilité collaborative d’un tableur infonuagique avec les impératifs cardinaux d’honnêteté et de transparence intellectuelle qui fondent l’entreprise scientifique moderne.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903
- Cousineau, D. (2005). Confidence intervals in within-subject designs: A simple solution to Loftus and Masson’s method. Tutorials in Quantitative Methods for Psychology, 1(1), 42–45. https://doi.org/10.20982/tqmp.01.1.p042
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. The Journal of Cell Biology, 177(1), 7–11. https://doi.org/10.1083/jcb.200702088
- Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61–64. https://doi.org/10.20982/tqmp.04.2.p061
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0