
Dans le vaste champ de l’analyse statistique multivariée et de la psychométrie appliquée, l’évaluation rigoureuse des associations entre variables qualitatives constitue un défi méthodologique fondamental. Lorsque les chercheurs sont confrontés à des données catégorielles, les métriques usuelles de corrélation linéaire telles que le coefficient produit-moment de Bravais-Pearson ne peuvent être mobilisées sans une adaptation conceptuelle et algébrique préalable. C’est précisément pour répondre à cette exigence analytique qu’a été formalisé le coefficient Phi (noté Φ ou rφ), un indicateur non paramétrique spécifiquement conçu pour quantifier l’intensité et la direction de la relation existant entre deux variables dichotomiques pures.
Le coefficient Phi occupe une place singulière dans l’histoire des statistiques inférentielles, se situant à l’intersection exacte de l’analyse d’indépendance du test du Chi-deux et de la théorie classique des scores en psychologie. Qu’il s’agisse de mesurer la concordance entre deux diagnostics psychiatriques, d’analyser l’interdépendance de réponses binaires à des items d’évaluation cognitive, ou d’estimer la force d’un effet expérimental au sein d’un plan factoriel à deux modalités, ce coefficient offre une mesure standardisée d’une grande élégance mathématique. Sa simplicité de calcul apparente dissimule néanmoins des propriétés théoriques profondes, notamment une équivalence formelle stricte avec le coefficient de corrélation linéaire de Pearson appliqué à des variables de Bernoulli.
Cet article propose une exploration exhaustive et didactique du coefficient Phi, articulant ses fondements théoriques, sa dérivation algébrique, ses applications pratiques et ses contraintes structurelles. À travers une analyse détaillée de la structure des tables de contingence 2×2, la résolution pas-à-pas d’un exemple empirique issu de la sociologie électorale, et une étude comparative critique face aux métriques concurrentes telles que le V de Cramer, la corrélation tétrachorique ou le Kappa de Cohen, ce guide constitue une référence approfondie pour les étudiants, chercheurs et praticiens en sciences comportementales et biomédicales.
1. Introduction et fondements conceptuels du coefficient Phi
1.1 Origine historique et développement par Karl Pearson
L’émergence du coefficient Phi s’inscrit au cœur de l’âge d’or de la biométrie et de la statistique moderne, au tournant du XXe siècle. Confronté aux limites de la corrélation linéaire standard face aux caractères qualitatifs discrets, le mathématicien et biostatisticien britannique Karl Pearson chercha à développer des indices capables de quantifier le degré d’association entre des attributs nominaux sans présupposer une distribution continue sous-jacente. Pearson publia au début des années 1900 une série de mémoires fondateurs dans la revue Biometrika, établissant les bases théoriques de ce qui deviendrait l’analyse des tables de contingence. Le coefficient Phi fut initialement conceptualisé comme une mesure de divergence par rapport à l’indépendance statistique, directement reliée à la statistique du test du Chi-deux qu’il venait lui-même de formaliser en 1900.
Le développement de cette métrique ne s’est pas fait sans de vifs débats épistémologiques, dont le plus célèbre opposa Karl Pearson à son contemporain George Udny Yule. Alors que Yule défendait des coefficients d’association fondés sur les produits croisés purs et insensibles aux marges (comme le Q de Yule), Pearson insistait sur la nécessité d’ancrer la mesure d’association dans le cadre probabiliste général de la distribution de fréquence observée par rapport aux fréquences théoriques attendues. Pour Pearson, l’objectif était de construire une métrique normalisée, oscillant idéalement entre -1 et +1, capable de traduire directement la force du lien statistique au sein d’une population finie ou infinie.
Dans l’histoire de la psychométrie naissante, le coefficient Phi devint rapidement un outil indispensable pour les pionniers de l’évaluation mentale, tels que Charles Spearman et Louis Leon Thurstone. L’évaluation de l’intelligence et des aptitudes spécifiques reposant très fréquemment sur des items scored de manière binaire (réussite ou échec, correct ou incorrect), les psychomètres avaient un besoin impérieux d’un indice de corrélation maniable pour estimer l’inter-corrélation des items et fonder les premières analyses factorielles. Le coefficient Phi a ainsi constitué l’un des premiers ponts quantitatifs entre la théorie des probabilités et l’évaluation standardisée des conduites humaines.
1.2 Nature des variables étudiées : La dichotomie stricte
L’application rigoureuse et épistémologiquement valide du coefficient Phi exige une compréhension approfondie de la nature ontologique des données analysées. Cet indice s’applique exclusivement à des couples de variables dichotomiques, c’est-à-dire des variables qualitatives nominales ne comportant que deux modalités mutuellement exclusives et conjointement exhaustives. Cependant, la littérature méthodologique opère une distinction cruciale entre les dichotomies dites « vraies » ou naturelles et les dichotomies dites « artificielles ».
Une dichotomie vraie ou naturelle caractérise un phénomène dont l’état intrinsèque est binaire de manière objective et discrète. En recherche médicale et psychiatrique, l’état de survie (vivant versus décédé), la présence ou l’absence formellement établie d’une mutation génétique spécifique, ou le portage clinique d’un allèle particulier représentent des dichotomies naturelles. Dans ces contextes, la variable ne masque aucun continuum sous-jacent mesurable ; l’attribut est qualitativement présent ou absent. C’est pour ce type précis de variables que le coefficient Phi exprime pleinement sa validité de construit, car il ne postule à aucun moment l’existence d’une variable latente distribuée selon une courbe de Gauss.
À l’inverse, les dichotomies artificielles résultent d’un découpage opérationnel arbitraire appliqué à une variable fondamentalement continue. Par exemple, la catégorisation d’un score de dépression obtenu à l’inventaire de Beck en deux classes « déprimé » et « non-déprimé » via un seuil clinique (cut-off point), ou la scission de l’âge chronologique en « jeunes » et « âgés », introduit une dichotomie artificielle. Si le calcul du coefficient Phi demeure techniquement possible sur de telles données, il induit une perte sévère d’information statistique et une sous-estimation systématique de la force réelle de la liaison par rapport au coefficient de corrélation tétrachorique. Les conditions préalables d’application de Phi requièrent donc idéalement des mesures nominales qualitatives authentiques, préservant ainsi la nature intrinsèquement discrète du phénomène sous investigation.
1.3 Rôle et pertinence en recherche psychologique contemporaine
Bien que les modèles statistiques contemporains privilégient souvent les régressions logistiques multivariées et la modélisation par équations structurelles, le coefficient Phi conserve une pertinence de premier plan dans la recherche expérimentale et observationnelle en psychologie. Son champ d’application privilégié réside tout d’abord dans l’évaluation psychométrique de la fidélité test-retest lors de passations d’épreuves à choix binaire forcé. Lorsqu’un protocole expérimental requiert des sujets qu’ils répondent par « Oui » ou par « Non », ou qu’ils choisissent entre deux alternatives incompatibles, le coefficient Phi fournit une estimation directe et standardisée de la stabilité temporelle des réponses individuelles à travers le temps.
Dans le domaine de l’évaluation clinique et diagnostique, le coefficient Phi est couramment employé pour déterminer l’accord inter-juges ou l’accord inter-diagnostics lorsque deux cliniciens indépendants évaluent la présence ou l’absence d’un trouble répertorié dans les classifications nosographiques telles que le Manuel diagnostique et statistique des troubles mentaux (DSM-5). Bien que le coefficient Kappa de Cohen soit parfois préféré pour corriger l’accord fortuit, Phi demeure la métrique d’association pure indispensable pour quantifier le degré de co-occurrence systématique entre deux étiquettes nosologiques distinctes au sein d’une cohorte clinique.
Enfin, en psychologie sociale et en psychologie cognitive, Phi est largement exploité comme métrique de taille d’effet standardisée. Dans le cadre de plans expérimentaux factoriels manipulant une condition binaire (par exemple : exposition à un stimulus d’amorçage vs condition témoin) et mesurant une réponse comportementale discrète (par exemple : acceptation vs refus d’une requête), le test d’hypothèse globale du Chi-deux indique si un écart existe, mais seul le coefficient Phi permet d’exprimer la magnitude intrinsèque de cet effet indépendamment de la taille de l’échantillon, autorisant ainsi l’inclusion directe de l’étude dans des méta-analyses quantitatives.
2. Structure mathématique du tableau de contingence 2×2
2.1 Organisation spatiale et notation standard des fréquences observées
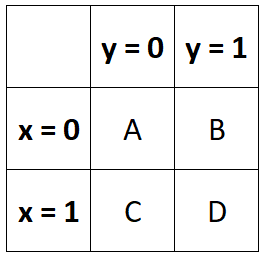
L’architecture fondamentale sous-jacente au calcul du coefficient Phi repose sur la configuration spatiale d’une table de contingence de dimensions 2×2. Cette matrice croise les deux niveaux de la variable indépendante théorique (désignons-la par X) avec les deux niveaux de la variable dépendante ou concurrente (désignons-la par Y). Par convention universelle dans la littérature statistique francophone et internationale, les lignes représentent généralement les modalités de la première variable (présence vs absence, ou modalité 1 vs modalité 2), tandis que les colonnes matérialisent les modalités de la seconde variable.
La matrice canonique à quatre quadrants est partitionnée selon les cellules conventionnelles A, B, C et D, qui hébergent les fréquences conjointes empiriques observées au sein de l’échantillon :
- Cellule A (quadrant supérieur gauche) : Fréquence des observations présentant simultanément la modalité 1 pour X et la modalité 1 pour Y (concordance positive, présence conjointe des deux attributs).
- Cellule B (quadrant supérieur droit) : Fréquence des observations présentant la modalité 1 pour X mais la modalité 2 pour Y (discordance, présence de l’attribut X et absence de l’attribut Y).
- Cellule C (quadrant inférieur gauche) : Fréquence des observations présentant la modalité 2 pour X mais la modalité 1 pour Y (discordance, absence de l’attribut X et présence de l’attribut Y).
- Cellule D (quadrant inférieur droit) : Fréquence des observations présentant simultanément la modalité 2 pour X et la modalité 2 pour Y (concordance négative, absence conjointe des deux attributs).
Cette disposition spatiale s’harmonise parfaitement avec une convention de codage binaire numérique dans laquelle l’état de présence ou le succès est affecté du chiffre 1, et l’état d’absence ou l’échec du chiffre 0. Dès lors, la cellule A réunit les paires (1, 1), la cellule B les paires (1, 0), la cellule C les paires (0, 1), et la cellule D les paires (0, 0). La structuration rigoureuse de ce tableau constitue l’étape préparatoire incontournable de toute modélisation catégorielle.
2.2 Calcul et importance des totaux marginaux
Autour de ce noyau central constitué des quatre cellules conjointes gravitent les totaux marginaux, obtenus par sommation unidimensionnelle le long des axes horizontaux et verticaux. Les marges de lignes représentent les distributions univariées de la variable X, tandis que les marges de colonnes traduisent les distributions univariées de la variable Y. La rigueur analytique impose une formalisation précise de ces totaux :
- Total de la première ligne : (A + B), représentant le nombre global d’occurrences de la modalité 1 de X.
- Total de la seconde ligne : (C + D), représentant le nombre global d’occurrences de la modalité 2 de X.
- Total de la première colonne : (A + C), matérialisant l’effectif total de la modalité 1 de Y.
- Total de la seconde colonne : (B + D), matérialisant l’effectif total de la modalité 2 de Y.
La somme combinée des deux marges horizontales ou des deux marges verticales équivaut invariablement à la taille totale de l’échantillon, universellement désignée par la lettre N, telle que :
N = A + B + C + D = (A + B) + (C + D) = (A + C) + (B + D)
L’importance des totaux marginaux ne saurait être sous-estimée. En statistique bivariée, les proportions marginales constituent une contrainte structurelle majeure sur la covariance observable. Comme nous le démontrerons ultérieurement, la distribution relative des totaux marginaux (c’est-à-dire le fait qu’une modalité soit très rare ou hautement fréquente) impose un plafond mathématique strict à la valeur maximale que le coefficient Phi peut atteindre, introduisant un biais potentiel d’atténuation lorsque les distributions marginales des deux variables divergent substantiellement.
2.3 Probabilités conditionnelles sous l’hypothèse d’indépendance
Le fondement logique de toute mesure d’association repose sur la comparaison entre la réalité observée dans les cellules empiriques et ce que le modèle probabiliste prédirait sous l’hypothèse nulle (notée H0) d’indépendance stochastique stricte. Deux événements aléatoires X et Y sont dits indépendants au sens de Kolmogorov si et seulement si la probabilité conjointe de leur intersection est égale au produit de leurs probabilités marginales respectives : P(X ∩ Y) = P(X) × P(Y).
Transposée à notre tableau de contingence 2×2, cette règle probabiliste permet de calculer l’effectif théorique attendu (fréquemment désigné par la lettre E pour Expected frequency) pour chacun des quatre quadrants en l’absence de tout lien statistique entre les variables :
- Effectif attendu pour la cellule A : EA = [(A + B) × (A + C)] / N
- Effectif attendu pour la cellule B : EB = [(A + B) × (B + D)] / N
- Effectif attendu pour la cellule C : EC = [(C + D) × (A + C)] / N
- Effectif attendu pour la cellule D : ED = [(C + D) × (B + D)] / N
L’ampleur de l’association statistique dans l’échantillon dépend directement du vecteur d’écart résiduel entre les fréquences observées (O) et les fréquences théoriques attendues (E), formalisé par la quantité (O – E). Si le comportement des individus vis-à-vis de la variable Y est totalement indépendant de leur statut sur la variable X, les fréquences observées oscilleront étroitement autour des valeurs attendues sous le seul effet des fluctuations d’échantillonnage, conduisant à un coefficient Phi proche de zéro.
3. Formulation algébrique et décomposition du coefficient Phi
3.1 La formule classique du déterminant normalisé
L’expression algébrique canonique du coefficient Phi se structure sous la forme d’un ratio confrontant la divergence croisée des cellules internes au produit géométrique des quatre totaux marginaux. La formule explicite universelle s’énonce comme suit :
Φ = (A×D – B×C) / √[ (A + B) × (C + D) × (A + C) × (B + D) ]
Pour appréhender l’élégance de cette formule, il convient d’en décomposer séparément le numérateur et le dénominateur. Le numérateur, (A×D – B×C), correspond rigoureusement au déterminant de la matrice carrée d’ordre 2 formée par les fréquences observées du tableau de contingence. En algèbre linéaire, le déterminant mesure l’aire orientée du parallélogramme sous-tendu par les vecteurs lignes ou colonnes. Si les variables sont positivement associées, les individus s’accumulent préférentiellement sur la diagonale principale (cellules A et D), maximisant le produit A×D au détriment du produit croisé B×C. Inversement, une association négative se traduit par une prépondérance des cellules de discordance, rendant le produit B×C supérieur à A×D, ce qui confère naturellement au numérateur une valeur négative.
Le dénominateur, quant à lui, assure une fonction de standardisation et de normalisation métrique. En extrayant la racine carrée du produit continué des quatre sommes marginales √[(A+B)(C+D)(A+C)(B+D)], le dénominateur quantifie la variabilité maximale théorique permise par les contraintes marginales de l’échantillon. Cette division ramène la grandeur du déterminant à une échelle standardisée, théoriquement bornée entre -1 et +1 sous certaines conditions de symétrie, garantissant que l’indice demeure invariant face à des multiplications d’échelle globales de l’échantillon.
3.2 Dérivation alternative à partir de la statistique du Chi-deux
Une propriété mathématique majeure du coefficient Phi réside dans son interconnexion directe avec la statistique de Pearson du test d’indépendance du Chi-deux (notée χ²). Cette relation offre une méthode de dérivation alternative d’une redoutable efficacité calculatoire. Dans une table de contingence 2×2 à un degré de liberté, la valeur du Chi-deux standard s’exprime par la somme des carrés des écarts normalisés entre valeurs observées et théoriques : χ² = Σ [(O – E)² / E].
Après développement algébrique complet et factorisation, il apparaît que la statistique du Chi-deux calculée sans correction de continuité peut être réécrite sous la forme compacte suivante :
χ² = [ N × (A×D – B×C)² ] / [ (A + B) × (C + D) × (A + C) × (B + D) ]
En observant attentivement cette équation, on constate immédiatement que la fraction composant la partie droite n’est autre que le carré du coefficient Phi. Il en découle l’égalité fondamentale reliant les deux métriques :
χ² = N × Φ² ⇒ |Φ| = √( χ² / N )
Cette dérivation alternative présente un avantage computationnel considérable pour le chercheur : dès lors qu’un logiciel statistique a calculé le test du Chi-deux global pour un tableau 2×2 sur un vaste jeu de données, il suffit de diviser cette valeur par la taille totale N puis d’extraire la racine carrée pour obtenir l’amplitude absolue du coefficient Phi. Toutefois, une limite intrinsèque de cette approche par la racine carrée réside dans la perte automatique du signe directionnel de la relation : le signe (+ ou -) doit alors être réassigné manuellement par l’analyste en examinant si les effectifs observés sur la diagonale principale sont supérieurs ou inférieurs aux prédictions de l’indépendance.
3.3 Hypothèses sous-jacentes et postulats mathématiques
Bien que le coefficient Phi soit une statistique non paramétrique affranchie de l’obligation d’une distribution normale multivariée des erreurs, sa validité inférentielle et descriptive n’en demeure pas moins assujettie au respect strict d’un ensemble de postulats mathématiques :
- Indépendance stricte des observations : Chaque unité statistique (sujet, observation, événement) ne doit apparaître qu’une seule et unique fois dans l’ensemble de la table de contingence. Les protocoles de mesures répétées ou de données appariées violent cette condition et requièrent d’autres outils (tels que le test de McNemar).
- Exhaustivité et exclusion mutuelle catégorielle : Les deux modalités de chaque variable doivent être formulées de telle sorte que chaque participant appartienne sans ambiguïté à une catégorie, et à une seule. Les catégories chevauchantes sont formellement proscrites.
- Sensibilité critique aux faibles effectifs théoriques : Si le calcul purement descriptif de la valeur numérique de Phi reste toujours réalisable, toute inférence statistique (estimation de la p-valeur associée via le Chi-deux) devient hautement instable si les effectifs théoriques attendus tombent en deçà de 5 dans l’une quelconque des quatre cellules (critère classique de Cochran).
4. Exemple pratique pas-à-pas : Étude du genre et de la préférence politique
4.1 Présentation du scénario expérimental et des données brutes
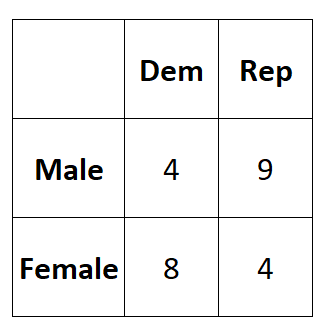
Afin d’ancrer ces développements abstraits dans une dynamique pédagogique concrète, analysons une investigation sociologique empirique portant sur la relation potentielle entre l’identité de genre et l’orientation électorale lors d’un scrutin municipal polarisé. Un politologue souhaite tester l’hypothèse selon laquelle les préférences partisanes se distribuent de manière différenciée selon le genre des électeurs. Un échantillon aléatoire probabiliste strict de N = 25 électeurs a été interrogé dans un bureau de vote représentatif.
Les variables opérationnalisées sont définies comme suit :
- Variable X (Genre) : Modalité 1 = Genre Féminin ; Modalité 2 = Genre Masculin.
- Variable Y (Préférence partisane) : Modalité 1 = Candidat Écologiste / Progressiste ; Modalité 2 = Candidat Conservateur.
Le dépouillement minutieux des questionnaires individuels a généré la matrice d’observations brutes suivante :
- Cellule A (Féminin × Écologiste) : A = 4
- Cellule B (Féminin × Conservateur) : B = 9
- Cellule C (Masculin × Écologiste) : C = 8
- Cellule D (Masculin × Conservateur) : D = 4
Procédons sans tarder au calcul rigoureux des sommes marginales :
- Marge de la ligne 1 (Total Féminin) : A + B = 4 + 9 = 13
- Marge de la ligne 2 (Total Masculin) : C + D = 8 + 4 = 12
- Marge de la colonne 1 (Total Écologiste) : A + C = 4 + 8 = 12
- Marge de la colonne 2 (Total Conservateur) : B + D = 9 + 4 = 13
- Effectif total de l’échantillon : N = 13 + 12 = 25 (la cohérence de sommation croisée est vérifiée car 12 + 13 = 25).
4.2 Application rigoureuse de la formule de calcul manuel
Disposant de l’intégralité des termes requis, nous pouvons désormais exécuter le calcul algébrique manuel de manière séquentielle, en veillant à conserver la plus haute précision décimale intermédiaire afin d’éviter tout écueil d’arrondi.
Étape 1 : Calcul méthodique du numérateur (Déterminant de la matrice)
Le numérateur correspond à la différence des produits croisés diagonaux :
Numérateur = (A × D) – (B × C)
Numérateur = (4 × 4) – (9 × 8)
Numérateur = 16 – 72
Numérateur = -56
Le fait que le numérateur prenne une valeur substantiellement négative indique d’emblée une tendance directionnelle inverse : les individus féminins (codés 1 en ligne) ont moins voté pour le candidat écologiste (codé 1 en colonne) qu’attendu sous la stricte concordance diagonale, reportant massivement leur choix sur le candidat conservateur dans cet échantillon particulier.
Étape 2 : Calcul méthodique du dénominateur (Produit continué des marges)
Multiplions entre elles les quatre sommes marginales :
Produit des marges = (A + B) × (C + D) × (A + C) × (B + D)
Produit des marges = 13 × 12 × 12 × 13
Produit des marges = (13 × 13) × (12 × 12)
Produit des marges = 169 × 144
Produit des marges = 24 336
Extrayons maintenant la racine carrée arithmétique de ce produit :
Dénominateur = √(24 336)
Dénominateur = 156 (remarquons que la racine tombe sur un nombre entier parfait, car √[13² × 12²] = 13 × 12 = 156).
Étape 3 : Résolution du quotient final
Il nous suffit désormais de diviser le numérateur par le dénominateur :
Φ = -56 / 156
En procédant à la division décimale :
Φ ≈ -0,358974359…
Arrondi conventionnellement à quatre décimales, nous obtenons : Φ = -0,3590 (ou -0,36 selon les standards de publication usuels). La cohérence dimensionnelle est totale : la valeur se situe sans contestation au sein de l’intervalle théorique admissible [-1 ; +1].
4.3 Vérification automatisée par calculatrice statistique
Dans un contexte d’ingénierie des données ou de validation de protocoles de recherche, la vérification par des outils algorithmiques ou des calculatrices statistiques spécialisées constitue un impératif de reproductibilité. En injectant directement la table de contingence matricielle dans un moteur d’inférence statistique (ou une calculatrice dédiée à la corrélation Phi), le résultat obtenu pour le test du Chi-deux sans correction de continuité est rigoureusement :
χ² = [ 25 × (-56)² ] / 24 336 = [ 25 × 3 136 ] / 24 336 = 78 400 / 24 336 ≈ 3,22156
En dérivant le coefficient Phi par la formule alternative : |Φ| = √(3,22156 / 25) = √(0,12886) ≈ 0,35897. L’exactitude du calcul manuel est ainsi confirmée au dix-millième près. L’erreur la plus fréquente commise lors de ces saisies réside dans l’inversion involontaire des cellules B et C, ce qui altérerait l’assignation du sens de l’association si le tableau n’était pas parfaitement symétrique en ses marges, ou dans la confusion classique entre les effectifs bruts et les pourcentages de profils de lignes.
5. Interprétation quantitative et qualitative des valeurs de Phi
5.1 Le continuum d’association théorique de -1 à +1
L’espace métrique du coefficient Phi s’étend théoriquement sur un continuum borné entre -1,00 et +1,00, à l’instar du coefficient de corrélation produit-moment de Pearson. La compréhension précise des ancrages cardinaux de cette échelle conditionne la qualité de l’interprétation substantielle des données empiriques :
- Φ = +1,00 (Association positive parfaite) : Cet état survient lorsque la totalité des observations se distribue exclusivement sur la diagonale principale descendante (cellules B et C strictement égales à zéro). Il existe alors une concordance univoque et absolue : chaque fois que la variable X présente la modalité 1, la variable Y présente inéluctablement la modalité 1, et il en va de même pour la modalité 2. La prévisibilité d’une variable à partir de l’autre est absolue.
- Φ = 0,00 (Indépendance statistique complète) : Cette valeur indique une absence totale de relation linéaire entre les deux variables. La proportion d’individus présentant la modalité 1 de Y est rigoureusement identique, que l’on se place chez les individus de la modalité 1 de X ou de la modalité 2 de X. La connaissance du statut d’une entité sur la variable X n’apporte strictement aucun gain d’information prédictive sur son statut pour la variable Y.
- Φ = -1,00 (Association négative parfaite) : Ce scénario symétrique se manifeste lorsque les cellules de concordance A et D sont strictement nulles. Tous les individus sont regroupés au sein des cellules discordantes B et C. Il règne une exclusion mutuelle parfaite : l’appartenance à la modalité 1 pour X garantit de manière déterministe l’appartenance à la modalité 2 pour Y.
Il importe de souligner avec force que le signe affecté au coefficient Phi (+ ou -) ne possède aucune signification morale, téléologique ou biologique intrinsèque. Le signe mathématique n’est que le reflet direct du système arbitraire d’attribution numérique des codes binaires (0 et 1) aux étiquettes verbales des modalités. Si un chercheur inverse l’assignation des codes 0 et 1 pour la seule variable Y dans notre exemple politique précédent (en assignant 1 au candidat Conservateur et 2 à l’Écologiste), la valeur absolue du coefficient demeurera strictement identique (|Φ| = 0,36), mais le signe se transformera instantanément en +0,36.
5.2 Grilles de lecture empiriques et critères de taille d’effet
Au-delà du signe directionnel, la communauté scientifique s’appuie sur des conventions partagées pour qualifier la magnitude concrète de l’association observée. Le cadre de référence le plus largement adopté en sciences comportementales et biomédicales demeure celui formalisé par le psychologue et méthodologue Jacob Cohen (1988) dans son ouvrage de référence sur l’analyse de puissance :
- Effet de faible amplitude (Petite taille d’effet) : |Φ| ≈ 0,10. L’association existe statistiquement, mais elle demeure difficilement perceptible à l’œil nu sans un échantillon de taille importante.
- Effet d’amplitude moyenne (Taille d’effet modérée) : |Φ| ≈ 0,30. La tendance relationnelle devient visible au niveau descriptif et commence à posséder des implications pratiques notables.
- Effet de forte amplitude (Grande taille d’effet) : |Φ| ≥ 0,50. L’interdépendance entre les deux attributs est substantielle, indiquant un fort pouvoir discriminant ou un recouvrement conceptuel marqué.
À la lumière de cette typologie universelle, la valeur obtenue dans notre exemple empirique (Φ = -0,3590) se classe sans ambiguïté dans la catégorie des effets de taille modérée à substantielle. Toutefois, la rigueur méthodologique invite à rejeter toute interprétation dogmatique de ces seuils conventionnels. Comme le soulignait Cohen lui-même, la portée substantielle d’une taille d’effet ne peut s’apprécier qu’à l’aune du champ théorique considéré : un coefficient Phi de 0,15 liant la prise d’une molécule préventive à la réduction de la mortalité par infarctus possède une valeur sociétale et médicale considérable, tandis qu’un coefficient de 0,30 entre deux items d’un même test d’intelligence refléterait une cohérence interne décevante.
Une perspective analytique complémentaire consiste à élever le coefficient Phi au carré, obtenant ainsi le coefficient de détermination :
Φ² = (-0,35897)² ≈ 0,1289 (soit 12,89 %)
Cette grandeur nous informe que près de 12,9 % de la variance de la préférence politique dans notre échantillon est directement expliquée ou partagée avec l’identité de genre des électeurs interrogés, le reste relevant de facteurs résiduels non mesurés.
5.3 Traduction substantive des résultats dans le contexte d’étude
L’exercice statistique ne saurait s’achever sur la simple énonciation d’un indice chiffré ; il appartient au chercheur de traduire ces grandeurs en propositions intelligibles au regard des concepts de la discipline d’accueil. Dans notre exemple empirique portant sur 25 électeurs :
L’observation d’un coefficient Φ = -0,36 indique une polarisation comportementale notable au sein de cet échantillon. Compte tenu du système de codage (1 = Féminin / Écologiste ; 2 = Masculin / Conservateur), la composante négative traduit le fait que les électrices interrogées se sont préférentiellement détournées du candidat écologiste au profit du candidat conservateur (environ 69 % des femmes ont voté pour le candidat conservateur dans cet échantillon, contre seulement 33 % des hommes). L’effet est tangible et structurellement significatif sur le plan descriptif.
Cependant, deux précautions déontologiques et méthodologiques capitales doivent être énoncées :
- Proscription de l’inférence causale hâtive : L’existence d’une corrélation Phi substantielle entre le genre et le choix électoral ne démontre en aucune manière que le fait d’être une femme « cause » le vote conservateur. Des variables médiatrices ou confondantes non contrôlées (âge, catégorie socio-professionnelle, quartier de résidence) pourraient expliquer intégralement cette tendance bivariée.
- Distinction impérative entre taille d’effet et certitude statistique : Une taille d’effet modérée (|Φ| = 0,36) sur un échantillon restreint de 25 personnes n’implique nullement que ce résultat soit reproductible ou statistiquement robuste face à l’aléa d’échantillonnage, comme va le démontrer immédiatement le passage à l’inférence formelle.
6. Lien théorique et inférentiel entre le coefficient Phi et le test du Chi-deux
6.1 Test d’hypothèse nulle et inférence statistique
Dans la démarche hypothético-déductive propre à la méthode scientifique, le calcul de la taille d’effet doit être complété par une procédure de décision statistique permettant de trancher entre la plausibilité d’une véritable loi de population et le simple jeu du hasard de l’échantillonnage. L’appareillage de l’inférence statistique classique de Neyman-Pearson s’articule autour de la confrontation de deux hypothèses rivales :
- L’hypothèse nulle (H0) : Au sein de la population parente globale de laquelle l’échantillon a été extrait, les variables X et Y sont stochastiquement indépendantes. Cela revient à formaliser mathématiquement que la valeur du paramètre populationnel Φpop est rigoureusement égale à 0 (soit Φpop = 0).
- L’hypothèse alternative (H1) : Au sein de la population parente, il existe une association non fortuite entre X et Y, ce qui s’exprime par Φpop ≠ 0 (test bilatéral).
Pour statuer sur la réjection de l’hypothèse nulle au seuil de signification de premier ordre conventionnel (α = 0,05), le coefficient empirique Phi est transformé en statistique inférentielle de test à l’aide de la propriété d’équivalence asymptotique :
χ²calculé = N × Φ²
Sous H0, cette grandeur suit asymptotiquement la loi de distribution théorique du Chi-deux avec un nombre de degrés de liberté (noté dl ou df) conditionné par les dimensions de la matrice :
dl = (Nombre de lignes – 1) × (Nombre de colonnes – 1) = (2 – 1) × (2 – 1) = 1
Dans les tables de distribution du Chi-deux à 1 degré de liberté, la valeur critique seuil correspondant à un risque α = 0,05 est universellement fixée à 3,841. Si la statistique calculée dépasse ce seuil critique, H0 est rejetée au profit de l’existence d’une liaison statistiquement significative.
6.2 Calcul de la p-valeur pour l’exemple empirique
Reprenons les paramètres de notre scénario sociologique : N = 25 et Φ = -0,35897.
Injectons ces éléments dans la formule de conversion :
χ²calculé = 25 × (-0,35897)² = 25 × 0,12886 ≈ 3,22
Comparons à présent cette valeur empirique au seuil critique normatif :
On constate que : χ²calculé (3,22) < χ²critique (3,841).
Le calcul exact de l’intégrale de la loi du Chi-deux à 1 degré de liberté au-delà de 3,22 fournit une probabilité critique associée de :
p = 0,0727 (soit environ 7,27 %)
La règle de décision statistique est sans équivoque : dans la mesure où la p-valeur observée est strictement supérieure au seuil prédéfini de 5 % (p > 0,05), il est impossible de rejeter l’hypothèse nulle au seuil de confiance de 95 %. Malgré une taille d’effet substantielle (|Φ| = 0,36), nous sommes contraints de conclure que les données observées ne fournissent pas une preuve statistiquement convaincante de l’existence d’un lien entre le genre et la préférence électorale dans la population globale.
Cette discordance apparente entre la taille de l’effet et sa significativité met en relief le concept fondamental de puissance statistique (1 – β). Avec un micro-échantillon de 25 individus seulement, l’erreur standard de l’estimateur est particulièrement volumineuse, et le test manquait cruellement de puissance pour distinguer un effet réel du bruit d’échantillonnage aléatoire. Cet exemple didactique démontre pourquoi un analyste ne doit jamais confondre l’amplitude d’un effet avec son statut inférentiel.
6.3 Correction de continuité de Yates et ajustements pour petits échantillons
La statistique théorique de Pearson repose sur l’hypothèse que les effectifs observés se comportent de manière continue, or un tableau de contingence est par définition composé de variables discrètes à valeurs entières. Pour corriger ce biais d’approximation qui a tendance à sous-estimer la p-valeur (et donc à gonfler artificiellement le taux de faux positifs ou erreur de type I) sur les échantillons modestes, le statisticien Frank Yates a introduit la correction de continuité de Yates.
La formule modifiée incorpore un terme d’ajustement soustractif de 0,5 à la valeur absolue de l’écart :
χ²Yates = [ N × ( |A×D – B×C| – 0,5×N )² ] / [ (A + B)(C + D)(A + C)(B + D) ]
Appliquons cet ajustement à notre numérateur d’exemple :
| -56 | – (0,5 × 25) = 56 – 12,5 = 43,5
(43,5)² = 1 892,25
Numérateur corrigé = 25 × 1 892,25 = 47 306,25
χ²Yates = 47 306,25 / 24 336 ≈ 1,9439
La p-valeur bondit immédiatement à p ≈ 0,1632. La correction de Yates se révèle très conservatrice, réduisant considérablement la valeur du Chi-deux et par voie de conséquence la significativité statistique. Bien que certains méthodologues contemporains critiquent la correction de Yates pour son excès de conservatisme, elle demeure largement implantée dans les logiciels commerciaux.
Toutefois, lorsque les effectifs d’échantillons sont ténus (comme dans notre cas avec N = 25 et des cellules contenant des effectifs de 4), l’alternative inférentielle reine demeure le test exact de Fisher. Fondé sur la distribution hypergéométrique conditionnelle sous marges fixes, le test de Fisher calcule la probabilité combinatoire exacte d’obtenir la configuration observée ou une configuration plus extrême sans recourir à aucune approximation asymptotique.
7. Équivalence mathématique entre le coefficient Phi et le r de Pearson
7.1 Démonstration formelle pour deux variables de Bernoulli
L’un des théorèmes les plus remarquables et les plus élégants de la théorie statistique appliquée stipule que le coefficient Phi n’est pas une simple approximation heuristique, mais qu’il est rigoureusement et mathématiquement identique au coefficient de corrélation produit-moment de Bravais-Pearson calculé sur deux variables indicatrices aléatoires (lois de Bernoulli) codées 0 et 1. Cette convergence formelle mérite une démonstration explicite pas-à-pas.
Soient deux variables aléatoires discrètes X et Y, ne prenant que les valeurs scalaires 0 ou 1 pour chaque observation. Reprenons la structure matricielle standardisée où :
- P(X = 1, Y = 1) = A / N
- P(X = 1, Y = 0) = B / N
- P(X = 0, Y = 1) = C / N
- P(X = 0, Y = 0) = D / N
Rappelons la définition universelle du coefficient de corrélation de Bravais-Pearson r :
r = Cov(X, Y) / [ σX × σY ]
Déterminons dans un premier temps les espérances mathématiques individuelles et la covariance :
Puisque X prend la valeur 1 avec la probabilité pX = (A + B)/N et la valeur 0 avec la probabilité (C + D)/N, l’espérance mathématique de X est simplement sa moyenne binaire :
E[X] = pX = (A + B) / N
De la même manière, pour Y :
E[Y] = pY = (A + C) / N
Le produit des variables X × Y ne peut valoir 1 que si et seulement si X = 1 ET Y = 1 simultanément (c’est-à-dire dans la cellule A). Dans tous les autres cas (cellules B, C, D), le produit est nul. Il s’ensuit que :
E[X × Y] = P(X = 1, Y = 1) = A / N
Exprimons la covariance :
Cov(X, Y) = E[X × Y] – ( E[X] × E[Y] )
Cov(X, Y) = (A / N) – [ ( (A + B) / N ) × ( (A + C) / N ) ]
Mettons au même dénominateur N² :
Cov(X, Y) = [ N×A – (A + B)(A + C) ] / N²
Développons le produit : (A + B)(A + C) = A² + A×C + A×B + B×C
Substituons N par la somme de ses parties (A + B + C + D) dans le terme N×A :
N×A = A² + A×B + A×C + A×D
En soustrayant le terme développé :
Cov(X, Y) = [ (A² + A×B + A×C + A×D) – (A² + A×C + A×B + B×C) ] / N²
Les termes A², A×B et A×C se simplifient mutuellement, nous laissant l’expression pure :
Cov(X, Y) = ( A×D – B×C ) / N²
Intéressons-nous à présent aux écarts-types au dénominateur. Pour une variable de Bernoulli de probabilité marginale p, la variance théorique est égale à p(1 – p) :
Var(X) = pX(1 – pX) = [ (A + B) / N ] × [ 1 – (A + B) / N ] = [ (A + B) / N ] × [ (C + D) / N ] = [ (A + B)(C + D) ] / N²
Var(Y) = pY(1 – pY) = [ (A + C) / N ] × [ 1 – (A + C) / N ] = [ (A + C) / N ] × [ (B + D) / N ] = [ (A + C)(B + D) ] / N²
Le produit des écarts-types σX × σY équivaut à la racine carrée du produit des variances :
σX × σY = √[ Var(X) × Var(Y) ] = √[ ( (A + B)(C + D) / N² ) × ( (A + C)(B + D) / N² ) ]
En extrayant le dénominateur N² hors du radical :
σX × σY = √[ (A + B)(C + D)(A + C)(B + D) ] / N²
Formons le ratio final du coefficient de Pearson r :
r = Cov(X, Y) / ( σX × σY ) = [ (A×D – B×C) / N² ] / [ √[ (A + B)(C + D)(A + C)(B + D) ] / N² ]
Le terme N² présent aux dénominateurs des deux fractions s’annule immédiatement :
r = ( A×D – B×C ) / √[ (A + B)(C + D)(A + C)(B + D) ] ≡ Φ
La preuve mathématique est ainsi scellée de manière irréfutable : le coefficient Phi n’est rien d’autre que l’exact coefficient de corrélation produit-moment de Bravais-Pearson appliqué à des variables dichotomiques encodées numériquement sous forme de valeurs 0 et 1.
7.2 Conséquences pour les modèles linéaires et la modélisation statistique
Cette identité mathématique fondamentale entraîne des répercussions pratiques et théoriques majeures au sein de la modélisation statistique computationnelle. La première implication directe réside dans la capacité à incorporer sans la moindre altération mathématique des coefficients Phi au sein d’une matrice de corrélation de Pearson globale. Dans les architectures logicielles de traitement de données quantitatives, il n’est nullement nécessaire de mobiliser une routine spécifique pour les paires d’items binaires : l’application de l’algorithme standard du produit-moment produit intrinsèquement la métrique Phi exacte.
La deuxième conséquence capitale concerne la régression linéaire bivariée par les moindres carrés ordinaires (MCO). Si l’on régresse une variable indicatrice Y (codée 0/1) sur une variable indicatrice X (codée 0/1), la pente de la droite de régression β1 est directement proportionnelle au coefficient Phi pondéré par le ratio des variances marginales :
β1 = Φ × ( σY / σX ) = [ (A×D – B×C) ] / [ (A + B)(C + D) ]
En géométrie vectorielle hilbertienne, le coefficient Phi partage rigoureusement les mêmes propriétés trigonométriques que le r de Pearson : il s’interprète comme le cosinus de l’angle θ séparant les deux vecteurs d’observations binaires centrés au sein de l’espace euclidien à N dimensions : Φ = cos(θ). Cette correspondance spatiale élégante unifie l’analyse des tableaux discrets et la géométrie des modèles linéaires continus.
7.3 Différences conceptuelles fondamentales malgré l’identité mathématique
Face à une telle superposition algébrique, l’analyste pourrait être tenté d’effacer toute frontière conceptuelle entre Phi et Pearson. Une telle assimilation relèverait pourtant d’une profonde naïveté épistémologique. Les fondements ontologiques des grandeurs mesurées demeurent radicalement irréductibles l’un à l’autre.
Le coefficient de Pearson classique a été historiquement développé pour modéliser des variables mesurées sur des échelles d’intervalles ou de rapports, possédant des propriétés métriques continues où la notion d’unité constante fait sens (par exemple, la taille, le temps de réaction, le revenu monétaire). Dans ce cadre, Pearson postule classiquement que le couple de variables suit une distribution normale bivariée (loi de Gauss à deux dimensions), caractérisée par une forme de cloche elliptique et l’absence de troncature artificielle.
À l’opposé, les variables traitées par le coefficient Phi reposent sur des échelles qualitatives nominales dépourvues de toute continuité métrique intrinsèque. Il n’existe aucun continuum physique graduel entre être vivant ou être décédé, ni entre voter pour le parti vert ou le parti conservateur : ce sont des catégories discrètes pures. Prétendre que les postulats de normalité bivariée sont satisfaits sur des vecteurs composés uniquement de 0 et de 1 constituerait une aberration statistique manifeste. L’identité des équations ne doit donc jamais masquer l’hétérogénéité radicale des représentations conceptuelles du réel sous-jacentes à la mesure.
8. Applications concrètes du coefficient Phi en psychologie et sciences sociales
8.1 Psychométrie : Analyse d’items et cohérence interne
Dans la construction d’instruments de mesure standardisés (tests d’aptitude, batteries neuropsychologiques, questionnaires de personnalité), l’analyse d’items constitue une phase critique conditionnant la validité finale de l’échelle. Lorsque les items adoptent un format dichotomique (vrai/faux, accord/désaccord, réussite/échec), le coefficient Phi s’impose comme l’outil classique pour quantifier l’interdépendance des items.
Au sein de la Théorie Classique des Tests (TCT), la matrice de corrélation inter-items est intégralement constituée de coefficients Phi. Ces indices permettent d’estimer l’homogénéité conceptuelle de l’outil et interviennent directement dans la formulation de l’alpha de Cronbach ou du coefficient de fidélité de Kuder-Richardson 20 (KR-20), qui n’est qu’une dérivation mathématique spécifique de l’alpha lorsque les items sont binaires. Un coefficient Phi trop faible entre deux items censés saturer le même trait latent (par exemple, Φ < 0,15) signalera à l’analyste qu’un des items introduit du bruit de mesure non spécifique et doit être exclu de l’instrument.
De plus, Phi sert fréquemment à calculer l’indice de discrimination d’un item par rapport à un critère externe binarisé. Par exemple, lors de la calibration d’un test d’aptitude spatiale destiné à sélectionner des pilotes d’aviation, chaque item est croisé avec l’issue de la formation initiale (réussite du cursus vs élimination). L’intensité de la corrélation Phi entre la réussite à l’item et le succès final au cursus détermine le pouvoir prédictif spécifique de l’épreuve.
8.2 Psychopathologie clinique et épidémiologie psychiatrique
L’exploration des comorbidités constitue l’un des champs d’application les plus prolifiques du coefficient Phi en recherche clinique. La nosographie psychiatrique dominante structure les troubles sous la forme d’entités discrètes binaires : un patient répond ou ne répond pas aux critères d’un épisode dépressif majeur, d’un trouble panique ou d’une dépendance alcoolique. L’évaluation de la force de la co-occurrence syndromique au sein d’une cohorte de patients nécessite une métrique standardisée.
Considérons une étude épidémiologique portant sur l’association entre le Trouble de Stress Post-Traumatique (TSPT) et l’Abus de Substances. Le croisement des diagnostics forme une table 2×2. Le calcul de Phi permet d’exprimer synthétiquement l’intensité de cette comorbidité en une valeur standardisée directement comparable à d’autres associations nosologiques au sein de la littérature internationale. De même, les épidémiologistes utilisent le coefficient Phi pour mesurer le lien statistique existant entre un facteur d’exposition environnemental binaire (par exemple : antécédent d’exposition à une catastrophe naturelle) et le déclenchement ultérieur d’une pathologie définie.
Dans la recherche sur l’évaluation thérapeutique, Phi permet de quantifier l’efficacité clinique comparative de deux protocoles de soins (par exemple : Thérapie Cognitive et Comportementale vs Traitement Habituel) face à une issue dichotomique standardisée (rémission clinique complète vs maintien de l’état morbide), constituant une métrique de taille d’effet essentielle lors des synthèses méta-analytiques d’essais contrôlés randomisés.
8.3 Psychologie cognitive et neuropsychologie expérimentale
Les protocoles expérimentaux contemporains en neurosciences cognitives et en psychologie de la perception génèrent massivement des données comportementales dichotomiques à travers des paradigmes de décision rapide en temps contraint. Dans la Théorie de la Détection du Signal (TDS), la performance d’un observateur confronté à un bruit de fond visuel ou auditif est traditionnellement résumée dans une table 2×2 croisant la présence réelle du stimulus avec la réponse de l’observateur, distinguant ainsi les Détections correctes (Hits), les Fausses Alarmes, les Omissions (Misses) et les Rejets corrects.
Au-delà des métriques classiques de sensibilité comme le d’ (d-prime), le coefficient Phi peut être mobilisé pour quantifier le niveau global d’association entre la présence objective du signal physique et la réponse perceptuelle de l’opérateur, notamment dans des conditions d’automatisation des tâches de surveillance industrielle ou militaire. Dans les paradigmes d’amorçage cognitif (priming), les chercheurs recourent à Phi pour mesurer comment une amorce sémantique inconsciente augmente sélectivement la probabilité de catégoriser correctement un stimulus cible ultérieur, fournissant un indice sans équivoque de la plasticité du traitement de l’information non conscient.
9. Contraintes structurelles et paradoxe des distributions marginales
9.1 La restriction d’amplitude imposée par les marges asymétriques
Malgré sa robustesse apparente, le coefficient Phi est affecté par une faille mathématique majeure qui a suscité d’abondants débats dans la littérature méthodologique : le phénomène de restriction d’amplitude induit par l’asymétrie des distributions marginales. Alors que l’on enseigne couramment que les coefficients de corrélation oscillent librement entre les bornes parfaites de -1 et +1, cette amplitude maximale n’est accessible pour Phi que sous une condition exceptionnellement stricte : les distributions marginales des deux variables doivent être parfaitement symétriques et identiques.
Démontrons ce paradoxe par un cas concret d’école. Supposons une recherche portant sur un item très difficile au sein d’un examen, réussi par seulement 10 % des candidats (pX = 0,10 ; donc 90 % d’échecs). Imaginons que l’on croise cet item avec une seconde variable où le taux d’occurrence est de 50 % (pY = 0,50). Il est arithmétiquement impossible que la corrélation Phi atteigne la valeur de +1,00 ! Même dans le cas où 100 % des candidats ayant réussi le premier item réussissent également le second, la cellule discordante B sera mécaniquement contrainte d’accueillir des observations en raison de la disparité des totaux de colonnes et de lignes.
La valeur maximale théorique atteignable par le coefficient, universellement désignée par Φmax, est rigoureusement conditionnée par les probabilités marginales. Lorsque les deux variables présentent une association positive, la borne supérieure s’exprime formellement par :
Φmax = √[ ( pX × (1 – pY) ) / ( pY × (1 – pX) ) ] (en posant par convention que pX ≤ pY)
Dans notre cas théorique où pX = 0,10 et pY = 0,50 :
Φmax = √[ (0,10 × 0,50) / (0,50 × 0,90) ] = √[ 0,05 / 0,45 ] = √(0,1111) ≈ 0,3333
Il en résulte une conséquence stupéfiante pour le chercheur non averti : dans cette configuration distributionnelle, une association empirique absolue et parfaite entre les deux phénomènes se traduira par un coefficient Phi empirique plafonné à 0,33 ! L’analyste appliquant mécaniquement les grilles de Cohen qualifierait cet effet de simple « effet modéré », alors qu’il se trouve en réalité face à la relation la plus puissante permise par les contraintes marginales de son échantillon. Ce phénomène induit une sous-estimation dramatique de la force du lien et interdit toute comparaison brute de coefficients Phi calculés sur des échantillons présentant des profils marginaux divergents.
9.2 Le coefficient Phi normalisé (Phi / Phi max)
Face à cette distorsion pénalisante, le psychomètre Edward E. Cureton a proposé dès 1959 une procédure d’ajustement standardisée : le calcul du coefficient Phi normalisé ou ratio de Cureton, souvent formalisé par le symbole Φ / Φmax. Cette métrique consiste simplement à diviser le coefficient Phi empiriquement calculé par la valeur maximale théorique que celui-ci pouvait atteindre compte tenu des marges observées de la table de contingence :
Φnormalisé = Φobservé / Φmax
Si nous reprenons l’exemple théorique d’un tableau dont les marges imposent un plafond à Φmax = 0,3333, et supposons que le calcul brut de Phi ait donné une valeur de 0,30 :
Φnormalisé = 0,30 / 0,3333 = 0,90.
Grâce à cette normalisation, l’analyste rétablit l’échelle d’interprétation originelle : le coefficient indique que la relation concrète observée mobilise 90 % de l’intensité d’association maximale mathématiquement réalisable dans ces conditions d’échantillonnage.
Toutefois, cette correction de normalisation ne fait pas l’unanimité parmi les statisticiens théoriciens. Les critiques soulignent que le ratio Φ / Φmax présente des propriétés d’échantillonnage instables et une variance asymptotique mal définie, ce qui rend le calcul d’intervalles de confiance conventionnels particulièrement ardu. De plus, dans les zones de marges extrêmement asymétriques, de micro-fluctuations d’échantillonnage peuvent entraîner des inflations artificielles spectaculaires du ratio normalisé, augmentant de facto le risque d’erreur de type I.
9.3 Recommandations pratiques pour traiter l’asymétrie distributionnelle
Afin de naviguer avec discernement au sein de ces contraintes structurales, le méthodologue moderne doit observer un ensemble de recommandations séquentielles lors du traitement de données dichotomiques :
- Inspection systématique préalable des fréquences marginales : Tout rapport d’analyse statistique impliquant le coefficient Phi doit impérativement déclarer les proportions marginales observées pour chaque modalité. Si l’une des proportions descend en dessous de 0,15 ou dépasse 0,85, l’alerte méthodologique sur la restriction d’amplitude doit être formellement consignée.
- Calcul systématique de la borne maximale Φmax : Lorsque l’asymétrie marginale est prononcée, il est recommandé de rapporter conjointement la valeur de Phi observée et celle de Φmax, permettant ainsi au lecteur de situer l’amplitude empirique par rapport à son plafond effectif.
- Arbitrage en faveur d’indices insensibles aux marges : Si l’objectif principal de la recherche est d’établir l’intensité absolue de la relation sans qu’elle soit pondérée par la rareté différentielle des attributs, le chercheur doit renoncer au coefficient Phi et opter délibérément pour des métriques structurellement insensibles aux totaux marginaux, telles que l’Odds Ratio (Rapport de cotes) ou la corrélation tétrachorique.
10. Comparaison critique entre Phi et les indices statistiques alternatifs
10.1 Phi versus le V de Cramer
Dans la boîte à outils du chercheur quantitativiste, le V de Cramer (nommé en hommage au mathématicien Harald Cramér) est fréquemment présenté comme l’alternative universelle pour mesurer l’association entre variables nominales quelconques. La formule générale du V de Cramer s’écrit :
V = √[ χ² / ( N × min(r – 1, c – 1) ) ]
où r représente le nombre de lignes de la table de contingence, et c le nombre de colonnes.
Il est fondamental de comprendre le lien intime unissant ces deux métriques : dans le cas exclusif et précis d’une table de contingence 2×2, le V de Cramer est strictement et absolument identique au coefficient Phi en valeur absolue. En effet, dans un tableau 2×2 :
r = 2 donc (r – 1) = 1 ; c = 2 donc (c – 1) = 1.
Le terme minimal min(2 – 1, 2 – 1) vaut donc rigoureusement 1.
L’équation du V de Cramer se simplifie instantanément en :
V = √[ χ² / (N × 1) ] = √( χ² / N ) ≡ |Φ|
Le coefficient Phi n’est donc pas une métrique concurrente du V de Cramer, mais constitue sa spécialisation canonique pour les tables 2×2. L’unique différence réside dans le fait que le V de Cramer est par définition une grandeur strictement positive (|V| ≥ 0) dépourvue de signe directionnel, tandis que le coefficient Phi conserve la possibilité d’exprimer une directionnalité négative (-1 à +1) grâce à l’orientation ordonnée de ses modalités croisées. Dès lors qu’une matrice dépasse les dimensions 2×2 (par exemple une table 3×2 ou 4×3), le coefficient Phi cesse d’être applicable et le V de Cramer devient l’indicateur d’élection incontournable.
10.2 Phi versus le coefficient de corrélation tétrachorique
L’opposition entre le coefficient Phi et le coefficient de corrélation tétrachorique (noté rtet) incarne l’un des débats conceptuels les plus stimulants de la psychométrie. Comme nous l’avons abordé au premier chapitre, le choix entre ces deux métriques dépend entièrement de l’ontologie supposée des variables mesurées.
Le coefficient de corrélation tétrachorique postule formellement que les deux catégories observables discrètes ne sont que les manifestations artificiellement coupées de deux variables latentes continues sous-jacentes distribuées conjointement selon une loi normale bivariée. Par exemple, la réussite ou l’échec à un item de mathématiques difficile est vue comme la projection discrète d’une compétence cognitive continue chez le sujet, franchissant ou non un certain seuil d’exigence.
L’avantage éclatant du coefficient tétrachorique sur le coefficient Phi réside dans son insensibilité remarquable au phénomène de restriction d’amplitude marginale. Même si un item présente un taux de réussite de 5 % et l’autre de 95 %, le coefficient tétrachorique est capable de converger vers +1,00 si la continuité sous-jacente est parfaitement alignée. Cependant, cet avantage a un coût méthodologique : le calcul tétrachorique repose sur des approximations d’intégration numérique lourdes et complexes, possède une variance d’échantillonnage beaucoup plus élevée que Phi, et s’avère particulièrement vulnérable à la violation du postulat de normalité bivariée latente.
L’arbre de décision clinique et psychométrique est donc limpide :
- Choisir le coefficient Phi lorsque les variables sont des dichotomies naturelles pures (statut vital, sexe biologique, occurrence d’un événement externe discret).
- Choisir le coefficient tétrachorique lorsque l’on analyse des réponses comportementales dichotomisées artificiellement à des fins opérationnelles mais issues de traits psychologiques intrinsèquement continus (aptitudes cognitives, attitudes, dimensions de personnalité).
10.3 Phi versus l’Odds Ratio (Rapport de cotes) et le Risque Relatif
Dans les sciences biomédicales, la pharmacovigilance et l’épidémiologie contemporaine, le coefficient Phi est fréquemment supplanté par l’Odds Ratio (OR, ou Rapport de cotes), dont la formulation repose exclusivement sur le produit croisé des cellules du tableau de contingence :
OR = ( A × D ) / ( B × C )
L’Odds Ratio mesure le rapport entre la cote (odd) d’un événement au sein d’un premier groupe exposé et sa cote au sein d’un groupe non exposé. Les propriétés mathématiques de l’Odds Ratio lui confèrent deux supériorités majeures sur le coefficient Phi dans les contextes épidémiologiques :
- Insensibilité absolue aux distributions marginales : L’Odds Ratio demeure rigoureusement invariant même si l’on multiplie arbitrairement l’une des lignes ou des colonnes par un facteur d’échelle constant. Il ne souffre d’aucun phénomène de plafonnement structurel équivalent au Φmax.
- Interprétation clinique directe et intuitive : Un OR de 3,5 se traduit immédiatement par une proposition clinique claire : les individus exposés au facteur de risque ont une cote 3,5 fois plus élevée de développer la pathologie cible par rapport aux individus sains. À l’inverse, l’expression d’un coefficient Phi de 0,22 demeure beaucoup plus abstraite pour les praticiens de santé.
Cependant, le coefficient Phi conserve une utilité irremplaçable lorsqu’il s’agit d’intégrer des données d’association bivariée au sein de modèles corrélationnels linéaires globaux ou de quantifier la part de variance expliquée (Φ²), une opération mathématiquement interdite avec l’Odds Ratio. Dans les rapports cliniques de haut niveau méthodologique, il est désormais fréquent de consigner conjointement l’Odds Ratio (avec son intervalle de confiance à 95 %) pour sa translucidité clinique et le coefficient Phi pour son inscription métrique standardisée.
10.4 Phi versus le Kappa de Cohen
Une confusion récurrente dans la pratique de la recherche consiste à mobiliser indistinctement le coefficient Phi ou le coefficient Kappa de Cohen (κ) pour évaluer l’accord entre deux examinateurs cliniques portant des diagnostics binaires indépendants sur une série de patients. Il s’agit pourtant de deux grandeurs épistémologiquement divergentes :
- Le coefficient Phi est une mesure d’association statistique pure : Il quantifie le parallélisme de variation conjointe entre deux axes, sans exiger formellement que les évaluateurs utilisent les mêmes étiquettes nominatives sur la même échelle absolue.
- Le Kappa de Cohen est une mesure d’accord absolu inter-juges corrigée du hasard : Il pénalise explicitement tout désaccord marginal systématique entre les juges. La formulation du Kappa repose sur la proportion d’accord observé (Po) confrontée à la proportion d’accord attendue par le hasard (Pe) : κ = (Po – Pe) / (1 – Pe).
Dans un contexte d’accord inter-juges clinique, l’emploi de Phi peut conduire à un optimisme erroné. Si deux psychiatres présentent un biais de jugement sévère (par exemple, le premier diagnostique systématiquement 80 % des patients comme dépressifs, tandis que le second n’en diagnostique que 20 %), le coefficient Phi mesurera simplement si leurs divergences respectives se corrèlent, alors que le Kappa s’effondrera lourdement pour sanctionner ce désaccord opérationnel majeur. Le Kappa de Cohen s’impose donc impérativement dans les études de fiabilité inter-examinateurs, tandis que Phi doit être réservé à l’évaluation du lien fonctionnel unissant deux phénomènes distincts.
11. Implémentation computationnelle : Calcul de Phi avec R, Python et SPSS
11.1 Procédure d’analyse dans l’environnement statistique R
L’environnement statistique open-source R constitue la plateforme analytique privilégiée des biostatisticiens et des psychomètres. Le calcul du coefficient Phi peut y être exécuté selon plusieurs approches algorithmiques complémentaires, sans jamais nécessiter de codage complexe.
Pour construire la matrice de données de notre exemple électoral sous R, l’analyste utilise la fonction native matrix() en spécifiant les effectifs observés concaténés : c(4, 8, 9, 4) organisés sur 2 lignes et 2 colonnes avec l’argument byrow = FALSE. Une fois la matrice instanciée sous le nom conventionnel tab, l’approche la plus directe et la plus élégante consiste à mobiliser la bibliothèque spécialisée psych (développée par William Revelle pour la recherche comportementale) via l’appel de la fonction dédiée phi(tab). Cette commande renvoie instantanément la valeur exacte du coefficient avec son signe directionnel préservé (-0.36).
Alternativement, le chercheur peut dériver Phi directement à partir du test du Chi-deux standard de base sans dépendance externe. En exécutant l’instruction test <- chisq.test(tab, correct = FALSE), l’objet résultant contient la statistique statistic. Il suffit d’appliquer la formule vectorielle : sqrt(test$statistic / sum(tab)) pour extraire la magnitude absolue de Phi. Pour visualiser élégamment ces données croisées, l’écosystème graphique R propose la bibliothèque vcd (Visualizing Categorical Data) avec la commande mosaic(tab), qui produit un graphique en mosaïque illustrant graphiquement l’ampleur des résidus de Pearson au sein de chaque cellule par des aplats de couleurs proportionnels aux écarts observés.
11.2 Exécution avec le langage Python pour la science des données
Dans le domaine de la science des données industrielles, du traitement automatique de données d’enquêtes massives et de l’apprentissage automatique, le langage Python offre des modules d’une robustesse exceptionnelle via les écosystèmes Pandas, NumPy et SciPy.
La première étape méthodologique consiste généralement à tabuler les colonnes de données individuelles d’un DataFrame à l’aide de la méthode performante pandas.crosstab(). Une fois le tableau de contingence 2×2 généré sous forme de matrice matricielle bidimensionnelle, l’extraction de l’association s’effectue traditionnellement par le sous-module scipy.stats.chi2_contingency. La fonction éponyme chi2_contingency(matrice, correction=False) renvoie un tuple contenant la statistique du Chi-deux globale, la p-valeur exacte asymptotique, les degrés de liberté (dl = 1) ainsi que la matrice des effectifs théoriques attendus (E).
La dérivation computationnelle du coefficient Phi s’obtient alors en appliquant la formule numpy standard : phi = np.sqrt(chi2 / n). Pour préserver le signe de l’association au sein d’un pipeline d’ingénierie statistique automatisé, les data scientists utilisent l’extension statsmodels.stats.contingency_tables.Table2x2, dont les attributs fournissent directement les métriques d’association normalisées, l’Odds Ratio avec ses intervalles de confiance logarithmiques, ainsi que les coefficients d’interaction binaire. Ces scripts peuvent être aisément encapsulés au sein de boucles itératives pour scanner simultanément des milliers de croisements d’items binaires dans de vastes bases de données psychométriques.
11.3 Protocole de traitement dans le logiciel IBM SPSS Statistics
Le progiciel IBM SPSS Statistics demeure une référence incontournable au sein des départements académiques de psychologie, des sciences infirmières et des instituts de sondage d’opinion. L’obtention du coefficient Phi sous SPSS s’opère au travers d’une interface graphique intuitive articulée autour du menu des analyses descriptives bivariées.
Le protocole opératoire canonique sous SPSS se déroule selon la séquence d’instructions suivante :
- Accéder au menu principal supérieur : Analyse > Statistiques descriptives > Tableaux croisés… (Crosstabs).
- Insérer la première variable catégorielle dans le champ « Lignes » et la seconde variable dans le champ « Colonnes ».
- Cliquer sur le bouton « Statistiques… » situé sur le volet droit de la boîte de dialogue.
- Au sein de la fenêtre contextuelle des statistiques d’association nominale, cocher obligatoirement les cases « Chi-deux » et « Phi et V de Cramer ».
- Valider les sélections en cliquant sur « Poursuivre » puis sur « OK » (ou exécuter la commande via le bouton « Coller » dans un fichier de syntaxe SPSS).
L’interprétation de la fenêtre de résultats (Viewer) SPSS requiert une vigilance critique. SPSS génère un tableau intitulé « Mesures symétriques » (Symmetric Measures) affichant deux lignes identiques pour le Phi et le V de Cramer. Il convient de vérifier scrupuleusement la colonne « Signification approximative » (Approx. Sig.), qui donne la p-valeur bilatérale associée. Concernant le signe algébrique (+ ou -), SPSS affiche généralement une valeur absolue positive dans ce tableau récapitulatif ; il est donc impératif que le chercheur examine attentivement la table de croisement des pourcentages pour assigner le sens substantiel réel de la corrélation selon l’ordre chronologique de codage numérique de ses modalités.
12. Directives de rédaction académique et intégration selon les normes APA
12.1 Formatage typographique et notation des résultats en style APA 7
L’American Psychological Association (normes APA, 7e édition) impose des règles typographiques et structurelles rigoureuses pour l’insertion des résultats statistiques dans les manuscrits soumis à publication internationale dans les revues à comité de lecture. Le respect scrupuleux de ces standards garantit la transparence, la clarté et l’uniformité de la communication scientifique.
La notation du coefficient Phi doit obéir à des impératifs précis :
- Le symbole de la statistique doit être le caractère grec Φ mis en forme italique (ou la notation alternative latine rφ).
- Règle typographique d’absence du zéro initial : Dans la mesure où le coefficient de corrélation Phi possède une amplitude théoriquement bornée qui ne peut jamais excéder la valeur absolue de 1,00, les normes APA prescrivent formellement d’omettre le zéro précédant la virgule ou le point décimal (par exemple, écrire Φ = -.36 et non Φ = -0.36). La même règle s’applique impérativement à la p-valeur (écrire p = .073 et non p = 0.073).
- Les valeurs statistiques doivent être systématiquement arrondies à deux ou trois décimales de précision.
L’énoncé standardisé d’un test d’indépendance croisant le résultat du Chi-deux et la taille d’effet Phi au sein du corps du texte doit respecter la séquence syntaxique suivante :
χ²(degrés de liberté, N = taille d’échantillon) = valeur calculée, p = valeur exacte, Φ = valeur de taille d’effet.
Appliqué à notre exemple pratique de sociologie électorale, le paragraphe canonique conforme aux normes APA 7 se rédige textuellement comme suit :
« Une analyse de contingence par tableau croisé a été conduite pour évaluer la relation entre l’identité de genre des participants et leur vote lors du scrutin municipal. L’association n’a pas atteint le seuil conventionnel de significativité statistique, χ²(1, N = 25) = 3.22, p = .073, bien que la magnitude de la taille d’effet observée reflète une association modérée à substantielle entre ces deux variables, Φ = -.36. La puissance statistique limitée liée à la taille de l’échantillon incite à interpréter cette tendance directionnelle avec prudence. »
12.2 Présentation visuelle : Conception de tableaux académiques de contingence
Lorsque les données catégorielles constituent l’objet d’investigation central d’un article de recherche, il est hautement recommandé d’en matérialiser la synthèse sous la forme d’un tableau académique formel respectant les critères d’élégance et de sobriété dictés par le style APA. Un tableau conforme aux normes se caractérise par l’absence totale de bordures verticales et l’usage minimaliste de trois lignes horizontales directrices majeures : une sous le titre, une sous les en-têtes de colonnes, et une fermant le tableau au-dessus des notes.
Le tableau doit présenter sans ambiguïté :
- Les libellés textuels explicites des variables et de leurs modalités respectives.
- Pour chaque cellule conjointe, l’insertion concomitante de l’effectif brut n et du pourcentage pertinent (généralement le pourcentage de profil de ligne ou de colonne, précisé entre parenthèses).
- Les totaux marginaux de lignes et de colonnes clairement individualisés.
- Une note de bas de tableau (introduite par le mot Note. en italique) explicitant le test statistique appliqué, le niveau de signification et le codage conventionnel employé pour établir le signe du coefficient Phi.
12.3 Recommandations déontologiques et transparence méthodologique
L’intégrité de la démarche scientifique et les exigences croissantes du mouvement pour la Science Ouverte (Open Science) imposent aux chercheurs de rompre avec les pratiques anciennes de reporting sélectif. Il est désormais déontologiquement inacceptable de ne mentionner que le statut de significativité (la fameuse dichotomie p < .05) en occultant l’ampleur concrète de la taille d’effet mesurée par Phi.
Les recommandations méthodologiques internationales contemporaines (notamment portées par le groupe de travail JARS de l’APA : Journal Article Reporting Standards) exigent que les manuscrits rendent compte des données de manière transparente en observant les critères suivants :
- Rapportage exhaustif de la taille d’effet : Le coefficient Phi doit être systématiquement rapporté, que le résultat du test du Chi-deux soit statistiquement significatif ou non. L’absence de significativité n’annule pas la réalité empirique de l’effet dans l’échantillon observé.
- Discussion explicite de la puissance statistique et des limites : Lorsque la significativité n’est pas atteinte en présence d’une taille d’effet substantielle, l’auteur a le devoir déontologique de discuter formellement le manque de puissance de son étude lié aux effectifs, évitant ainsi de conclure faussement à une « absence d’effet » dans la population (écueil de l’acceptation indue de l’hypothèse nulle).
- Mise à disposition des données et de la syntaxe de calcul : Dans un esprit de reproductibilité absolue de la recherche, les auteurs sont instamment invités à déposer sur des plateformes institutionnelles ouvertes (telles que le Centre for Open Science ou OSF) les scripts d’analyse informatique (R, syntaxe SPSS, notebooks Python) ainsi que les matrices de contingence brutes ayant servi au calcul du coefficient Phi.
Références
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
- Cureton, E. E. (1959). Note on Φ/Φmax. Psychometrika, 24(1), 89–91. https://doi.org/10.1007/BF02289799
- Fisher, R. A. (1922). On the interpretation of χ² from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
- Fleiss, J. L., Levin, B., & Paik, M. C. (2003). Statistical methods for rates and proportions (3rd ed.). John Wiley & Sons.
- McHugh, M. L. (2012). Interrater reliability: The kappa statistic. Biochemia Medica, 22(3), 276–282. https://doi.org/10.11613/BM.2012.031
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Pearson, K. (1904). Mathematical contributions to the theory of evolution. XIII. On the theory of contingency and its relation to association and normal correlation. Drapers’ Company Research Memoirs, Biometric Series I. Dulau and Co.
- Yates, F. (1934). Contingency tables involving small numbers and the χ² test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604
- Yule, G. U. (1912). On the methods of measuring association between two attributes. Journal of the Royal Statistical Society, 75(6), 579–652. https://doi.org/10.2307/2340126