
La mesure quantitative en psychologie, en psychiatrie et dans l’ensemble des sciences biomédicales repose sur un postulat épistémologique fondamental : la fidélité des instruments d’évaluation conditionne la validité de toute inférence scientifique ou décision diagnostique. Lorsqu’un clinicien évalue la sévérité d’un épisode dépressif majeur à l’aide d’une échelle standardisée, ou lorsqu’un chercheur quantifie des patterns comportementaux à partir d’enregistrements vidéo, une question centrale émerge inévitablement : dans quelle mesure le score obtenu reflète-t-il le statut réel de l’individu plutôt que la subjectivité de l’évaluateur ou le bruit inhérent au protocole de mesure ? C’est précisément pour formaliser et quantifier cette part de variance véritable que la théorie psychométrique contemporaine mobilise le coefficient de corrélation intraclasse (CCI).
Développé initialement à partir des travaux de génétique et d’agronomie de Sir Ronald Fisher, puis adapté aux exigences des sciences du comportement par des méthodologistes émérites tels que Patrick Shrout, Joseph Fleiss, Kenneth McGraw et S. P. Wong, le CCI s’est imposé comme la référence analytique absolue pour jauger la reproductibilité et la concordance des mesures continues. Contrairement aux coefficients de corrélation traditionnels qui se bornent à sonder le covariement linéaire entre deux distributions, le coefficient de corrélation intraclasse s’ancre dans le cadre de l’analyse de la variance (ANOVA) et des modèles linéaires mixtes. Cette approche permet d’isoler, de décomposer et de comparer rigoureusement les différentes composantes de la variance : la variabilité propre aux sujets évalués, celle imputable aux juges ou évaluateurs, et celle relevant de l’erreur aléatoire non systématique.
Cependant, l’application du CCI ne saurait se réduire à l’exécution machinale d’un algorithme statistique au sein d’un logiciel d’analyse. La versatilité mathématique de cet indice se traduit par une pluralité de modèles (à une voie, à deux voies aléatoires, à deux voies mixtes), de types de relation (accord absolu versus simple cohérence) et d’unités d’observation (mesure unique versus moyenne de plusieurs cotateurs). Une méconnaissance de ces distinctions fondamentales conduit fréquemment les chercheurs à des erreurs d’interprétation notables, gonflant artificiellement les indices de fidélité ou masquant des biais méthodologiques substantiels. Ce guide exhaustif a pour vocation d’exposer de manière approfondie les fondements théoriques, les dérivations mathématiques, les critères de décision et les implications cliniques du coefficient de corrélation intraclasse, tout en fournissant un exemple empirique intégralement calculé à la main et guidé sous les logiciels de référence.
1. Introduction et fondements conceptuels du coefficient de corrélation intraclasse
1.1 Définition formelle et objet de mesure
Le coefficient de corrélation intraclasse tire son ancrage conceptuel des axiomes cardinaux de la théorie classique des tests (TCT), initiée par Charles Spearman et consolidée ultérieurement par Lord et Novick. Selon ce paradigme, tout score observé ($X$) à une épreuve quantitative ou une échelle d’évaluation clinique est la résultante linéaire de deux composantes additives inobservables : le score vrai du sujet ($T$, pour True score) et une erreur de mesure stochastique ($E$, pour Error), formalisée par l’équation fondamentale $X = T + E$. Dès lors que plusieurs évaluateurs indépendants attribuent des notes à un échantillon d’individus, la variance totale observée au sein de la matrice de données se scinde conceptuellement en variance véritable entre les sujets ($\sigma^2_s$) et en variance d’erreur de mesure ($\sigma^2_e$).
Dans ce cadre rigoureux, le CCI se définit formellement comme le ratio de la variance attribuable à l’objet de la mesure (la variabilité réelle sous-jacente entre les patients ou participants) sur la variance phénotypique totale observée. L’objet premier du coefficient est d’évaluer avec précision la reproductibilité et le degré de concordance d’évaluations continues répétées, qu’elles soient issues de multiples observateurs (fidélité inter-juges) ou d’occasions de mesure distinctes (stabilité test-retest). La grandeur calculée reflète la proportion de variance qui n’est pas contaminée par le bruit méthodologique.
Il est impératif de marquer dès l’abord la distinction fondamentale entre une simple corrélation bivariée et l’évaluation d’un accord absolu. Alors qu’une association bivariée classique scrute uniquement la propension de deux séries de données à varier conjointement selon une droite de régression de pente quelconque, la concordance évaluée par le CCI requiert une identité stricte des valeurs attribuées. Deux cliniciens cotant une symptomatologie peuvent présenter une synchronisation relative parfaite tout en différant de dix points de manière constante sur une échelle psychométrique ; une telle divergence altère lourdement l’accord absolu sans pour autant dégrader la corrélation linéaire ordinaire.
1.2 Importance du CCI dans la recherche psychologique et clinique
L’omniprésence du CCI dans la littérature psychiatrique, neuropsychologique et épidémiologique contemporaine découle de la nécessité de standardiser les instruments d’évaluation diagnostique. Les échelles cliniques — qu’il s’agisse de mesurer la dépression via l’échelle de Hamilton (HDRS), l’anxiété au moyen de la STAI, ou les déficits exécutifs à travers des batteries cognitives standardisées — ne possèdent aucune utilité clinique si leur cotation dépend des idiosyncrasies de l’examinateur. L’établissement préalable d’un niveau élevé de corrélation intraclasse constitue ainsi le prérequis méthodologique non négociable autorisant l’usage clinique et la comparabilité des données entre centres hospitaliers.
Dans le domaine des observations comportementales directes — par exemple, l’encodage des interactions dyadiques mère-enfant ou la quantification des stéréotypies dans le trouble du spectre de l’autisme —, la fidélité inter-juges est constamment menacée par la fatigue des observateurs, l’ambiguïté des grilles d’encodage et les dérives interprétatives. Le CCI fournit ici un indicateur synthétique permettant de valider les phases d’entraînement des évaluateurs, garantissant que le système de cotation est suffisamment robuste pour être appliqué en aveugle lors d’essais cliniques randomisés.
Parallèlement, la mesure de la stabilité temporelle ou fidélité test-retest mobilise intensivement le CCI pour attester qu’un instrument psychologique ne fluctue pas sous l’effet du hasard lorsque l’état clinique du patient demeure invariant à intervalle temporel maîtrisé. Enfin, la maîtrise de l’erreur de mesure via le CCI conditionne directement la puissance statistique des recherches cliniques. Une erreur de mesure excessive dilue les tailles d’effet réelles (phénomène d’atténuation statistique) et impose un accroissement exponentiel de la taille d’échantillon pour mettre en évidence l’efficacité d’une molécule ou d’une psychothérapie, risquant d’aboutir à des conclusions faussement négatives (erreur de type II).
1.3 L’échelle de valeur et ses propriétés fondamentales
D’un point de vue métrologique, le coefficient de corrélation intraclasse est une quantité adimensionnelle bornée théoriquement dans l’intervalle fermé $[0, 1]$, bien que certaines estimations empiriques d’ANOVA puissent occasionnellement générer des valeurs marginalement négatives en présence d’anomalies d’échantillonnage. En règle générale, la valeur 0 dénote l’échec absolu du système de mesure : la totalité de la variabilité observée provient de l’erreur aléatoire ou des biais systématiques des évaluateurs, signifiant que les vraies différences entre patients sont totalement indétectables au milieu du bruit instrumental.
À l’opposé, un coefficient atteignant la valeur unitaire de 1,0 caractérise un instrument d’une fidélité idéale. Dans cette configuration chimérique, la variance d’erreur résiduelle s’annule complètement ($\sigma^2_e = 0$) : chaque sujet se voit assigner des scores rigoureusement identiques par l’ensemble des juges, ou lors de chaque session de passation. Dès lors, le score observé se confond rigoureusement avec le score vrai postulated par la TCT. Entre ces deux bornes extrêmes, le score numérique du CCI s’interprète directement comme un ratio de composantes de variance.
Par exemple, l’obtention d’un CCI évalué à 0,82 indique précisément que 82 % de la variance totale des scores observés au sein de la cohorte est directement imputable aux différences interindividuelles réelles concernant le trait latent évalué, tandis que les 18 % résiduels découlent des artefacts de mesure, des divergences d’ancrage entre évaluateurs ou du bruit stochastique. L’apparition de valeurs négatives dans les sorties de logiciels d’analyse de variance signale généralement une violation majeure des postulats du modèle, un phénomène de variance inter-sujets inférieure à la variance résiduelle au sein d’échantillons excessivement homogènes, ou un désaccord systématique polarisé entre cotateurs.
2. Distinction comparative : CCI versus autres indices de fidélité
2.1 Comparaison critique entre le CCI et le r de Pearson
L’une des dérives méthodologiques les plus pernicieuses observées dans les sciences biomédicales consiste à utiliser indûment le coefficient de corrélation de Pearson ($r$) en guise d’indice de fidélité inter-juges. Le coefficient de Pearson mesure exclusivement la force et la direction d’une relation linéaire bivariée entre deux séries de nombres. De par sa construction mathématique, centrée et réduite sur les moyennes et écarts-types respectifs de chaque série, la formule du $r$ de Pearson standardise les données de telle sorte qu’elle neutralise complètement les différences de moyennes et d’échelles entre les juges.
Considérons à titre d’illustration clinique deux psychiatres évaluant une cohorte de patients sur une échelle de dépression de 0 à 50. Si le second psychiatre attribue à chaque patient exactement le score du premier psychiatre augmenté systématiquement d’une constante de 10 points (reflétant une sévérité d’évaluation accrue ou une erreur de calibrage), le coefficient de corrélation de Pearson sera rigoureusement égal à 1,00. Cette association linéaire parfaite dissimule pourtant un désaccord clinique patent : pour un seuil diagnostique fixé à 20, les deux praticiens parviendront à des conclusions thérapeutiques radicalement discordantes pour un sous-groupe substantiel d’individus.
Le CCI, lorsqu’il est configuré sous l’angle de l’accord absolu, pénalise sévèrement un tel décalage additif constant en intégrant la différence des moyennes des juges au dénominateur de sa formulation statistique, faisant chuter la valeur de la fidélité. De surcroît, le coefficient de Pearson est intrinsèquement bivarié, interdisant le traitement simultané de panels réunissant trois évaluateurs ou davantage sans multiplier les calculs redondants par paires, un obstacle méthodologique que le cadre unifié de l’ANOVA sous-jacent au CCI contourne avec élégance.
2.2 Distinction entre le CCI et le Kappa de Cohen ou Fleiss
La ligne de démarcation fondamentale séparant le coefficient de corrélation intraclasse des coefficients de la famille du Kappa de Cohen ou du Kappa de Fleiss réside dans la nature ontologique des variables collectées. Les statistiques Kappa ont été expressément élaborées pour manipuler des données catégorielles nominales ou qualitatives pures (ex. : présence versus absence d’un trouble psychiatrique, classification sémiologique selon les catégories du DSM). Le Kappa quantifie l’accord observé au-delà de celui qui surviendrait par la seule force du hasard, en confrontant les distributions marginales croisées.
En pratique clinique, l’erreur consisterait à convertir artificiellement une variable continue issue d’une échelle d’évaluation validée en catégories dichotomiques ou ordinales (telles que dépression « légère », « modérée », « sévère ») afin de pouvoir calculer un Kappa de Cohen. Une telle dichotomisation appauvrit drastiquement l’information métrique, détruit la variance continue sous-jacente et réduit de façon artificielle la puissance statistique de l’étude. Pour pallier cette perte d’information ordinale, certains auteurs recourent au Kappa quadratique pondéré (weighted Kappa).
Il a toutefois été formellement démontré sur le plan mathématique, notamment par Fleiss et Cohen (1973), que le Kappa quadratiquement pondéré est mathématiquement équivalent au coefficient de corrélation intraclasse sous certaines hypothèses de distribution lorsque les poids appliqués aux désaccords suivent une loi quadratique inverse. Dès l’instant où l’on traite de scores continus, d’échelles de Likert denses ou de mesures dimensionnelles, le recours au CCI s’impose naturellement, évitant l’arbitraire des choix de pondération propres aux matrices catégorielles.
2.3 Complémentarité avec le coefficient Alpha de Cronbach
L’alpha de Cronbach ($\alpha$) est omniprésent dans la psychométrie moderne pour attester de la consistance interne d’un questionnaire constitué d’une collection d’items censés mesurer un même trait latent. Ce que beaucoup de praticiens ignorent, c’est que l’alpha de Cronbach n’est rien d’autre qu’un cas particulier mathématique du coefficient de corrélation intraclasse. Plus précisément, l’alpha de Cronbach est rigoureusement identique au CCI de cohérence basé sur la moyenne de $k$ mesures au sein d’un modèle à deux voies (noté conventionnellement ICC(C,k) ou ICC(3,k)).
Toutefois, la finalité conceptuelle des deux coefficients diffère profondément au sein de la démarche empirique. Tandis que l’alpha de Cronbach explore la redondance et la covariance mutuelle des items d’une échelle administrée à une population — sous l’hypothèse restrictive de tau-équivalence où chaque item présente la même charge factorielle vis-à-vis du score vrai —, le CCI s’emploie principalement à caractériser l’interchangeabilité de cotateurs humains ou de dispositifs techniques procédant à des évaluations globales.
Le choix méthodologique est ainsi guidé par l’objet de recherche : pour démontrer la cohésion interne d’un test psychométrique psychologique lors de sa phase de construction, le cadre de Cronbach (ou mieux, le coefficient oméga de McDonald) est sollicité. Dès lors qu’il s’agit d’attester de la fidélité inter-évaluateurs ou de la reproductibilité test-retest d’une note finale issue dudit test, le modèle complet du CCI — autorisant la dissociation de l’erreur absolue et relative — devient incontournable.
3. Les trois modèles statistiques du CCI selon Shrout et Fleiss
3.1 Modèle à effets aléatoires à une voie (One-Way Random)
Dans leur publication séminale de 1979, Shrout et Fleiss ont formalisé une typologie tripartite devenue le standard absolu de la discipline. Le premier modèle, désigné sous le nom de modèle à effets aléatoires à une voie (One-Way Random Effects Model), repose sur une hypothèse structurelle bien particulière : chaque sujet $i$ de l’échantillon est évalué par un sous-ensemble distinct de $k$ juges, ces derniers étant tirés au sort de manière totalement aléatoire au sein d’une population infinie d’évaluateurs potentiels. Dans ce schéma expérimental, les évaluateurs qui notent le sujet A ne sont pas les mêmes que ceux qui évaluent le sujet B.
Sur le plan mathématique, le modèle linéaire sous-jacent s’écrit de la façon suivante :
$$X_{ij} = \mu + s_i + \epsilon_{ij}$$
où $\mu$ représente la moyenne générale de la population, $s_i$ est l’effet aléatoire propre au sujet $i$ (distribué normalement selon $\mathcal{N}(0, \sigma^2_s)$), et $\epsilon_{ij}$ constitue une composante d’erreur résiduelle globale englobant indifféremment l’effet individuel de l’évaluateur $j$, l’interaction sujet-évaluateur et le bruit aléatoire ($\epsilon_{ij} \sim \mathcal{N}(0, \sigma^2_\epsilon)$).
Ce modèle souffre d’une faiblesse méthodologique majeure : il est absolument incapable d’isoler la variance attribuable aux évaluateurs de la variance d’erreur résiduelle pure. Tout biais systématique de notation entre les juges est irrémédiablement confondu avec l’aléa statistique. C’est pourquoi son usage s’avère restreint en recherche clinique rigoureuse, demeurant confiné aux situations logistiques complexes où un plan factoriel croisé complet est impraticable (par exemple, dans les études épidémiologiques de grande envergure où les patients sont examinés par des médecins généralistes locaux tous différents).
3.2 Modèle à effets aléatoires à deux voies (Two-Way Random)
Le modèle à effets aléatoires à deux voies (Two-Way Random Effects Model) constitue la clé de voûte des études méthodologiques d’évaluation de la fidélité. Sa structure repose sur deux conditions fondamentales : d’une part, un ensemble identique de $k$ évaluateurs évalue l’ensemble des $n$ sujets de l’étude (plan d’échantillonnage totalement croisé) ; d’autre part, ces $k$ évaluateurs sont eux-mêmes considérés comme un échantillon représentatif tiré au sort au sein d’une population plus vaste d’évaluateurs experts qualifiés.
Le modèle statistique linéaire s’exprime ainsi formellement :
$$X_{ij} = \mu + s_i + r_j + (sr)_{ij} + e_{ij}$$
Dans cette équation, $\mu$ est la constante globale, $s_i \sim \mathcal{N}(0, \sigma^2_s)$ représente la variance réelle inter-sujets, $r_j \sim \mathcal{N}(0, \sigma^2_r)$ symbolise la variance systématique entre les évaluateurs (leur tendance globale à la sévérité ou à la mansuétude), $(sr)_{ij}$ incarne l’interaction spécifique entre un sujet et un évaluateur, et $e_{ij} \sim \mathcal{N}(0, \sigma^2_e)$ matérialise l’erreur pure aléatoire. En l’absence de réplications pour chaque cellule $(i, j)$, l’interaction et l’erreur pure sont combinées en un terme résiduel unique.
L’immense valeur scientifique du modèle à deux voies aléatoires réside dans sa capacité de généralisation. Dès lors que les juges sont traités comme un facteur aléatoire, les conclusions relatives à la fidélité de l’outil psychométrique ne restent pas cantonnées aux trois ou quatre cliniciens ayant participé à l’expérimentation ; elles sont statistiquement généralisables à l’ensemble de la population des professionnels susceptibles d’administrer l’échelle dans des conditions similaires. C’est pourquoi ce modèle représente le choix incontournable pour la validation d’instruments dans les essais multicentriques internationaux.
3.3 Modèle à effets mixtes à deux voies (Two-Way Mixed)
Le troisième modèle de la nomenclature, dit modèle à effets mixtes à deux voies (Two-Way Mixed Effects Model), adopte un dispositif d’observation superficiellement semblable mais fondé sur une prémisse épistémologique opposée. Dans cette configuration, le même panel de $k$ évaluateurs note l’intégralité des $n$ sujets, mais ces évaluateurs constituent les seules modalités d’intérêt. Ils ne sont aucunement tirés d’un réservoir d’évaluateurs virtuels et n’ont pas vocation à représenter une population élargie.
Dans ce modèle mixte, les sujets demeurent un facteur aléatoire ($s_i \sim \mathcal{N}(0, \sigma^2_s)$), mais les juges sont modélisés comme un facteur fixe assujetti à la contrainte $\sum r_j = 0$. En conséquence, la variance observée entre les juges ne représente pas un paramètre d’échantillonnage aléatoire mais une constante fixe inhérente à ce panel spécifique de cotateurs. Ce modèle trouve sa pleine justification lorsque les chercheurs s’intéressent à l’accord d’un comité d’experts permanent, d’un groupe d’arbitres nommément désignés ou de juges institutionnels fixes.
La distinction mathématique avec le modèle aléatoire à deux voies s’avère subtile mais cruciale lors de l’estimation des composantes d’erreur. Si les formules calculatoires de cohérence sont souvent identiques sur le plan arithmétique entre le modèle mixte et le modèle aléatoire, le domaine d’inférence statistique diverge drastiquement. Avec un modèle à effets mixtes, les résultats de fidélité ne peuvent en aucun cas être extrapolés au-delà du groupe restreint des expérimentateurs ayant collecté les données, interdisant toute conclusion quant à la fidélité universelle de l’instrument sur le terrain clinique général.
4. Types de relation de mesure : Accord absolu versus Cohérence
4.1 Définition et implications du critère d’accord absolu (Absolute Agreement)
Le critère d’accord absolu (Absolute Agreement) impose la contrainte métrologique la plus intransigeante qui soit : les évaluations attribuées par différents juges ne sont considérées comme fidèles que si les scores numériques coïncident point par point. Si le juge A attribue une note de 18 sur une échelle d’évaluation du risque suicidaire, le juge B doit impérativement noter 18 pour que l’accord soit jugé parfait. Tout écart d’étalonnage, d’ancrage ou de sévérité globale entre les professionnels est comptabilisé sans concession comme une variance d’erreur.
Dans les formulations algébriques du CCI, le choix de l’accord absolu se traduit mathématiquement par l’incorporation explicite de la variance entre évaluateurs ($\sigma^2_r$) au dénominateur du ratio. Le dénominateur agrège ainsi la variance vraie, la variance des évaluateurs et la variance résiduelle d’erreur :
$$CCI_{\text{Accord Absolu}} = \frac{\sigma^2_s}{\sigma^2_s + \sigma^2_r + \sigma^2_e}$$
Si un évaluateur s’avère structurellement plus sévère qu’un autre, $\sigma^2_r$ devient substantiel, gonflant le dénominateur et réduisant drastiquement la valeur finale du coefficient.
Ce niveau d’exigence est indispensable dès lors que les scores individuels servent de fondement à des prises de décisions cliniques unilatérales, à l’application de seuils diagnostiques stricts (par exemple, prescrire une intervention pharmacologique si le score excède 24) ou au suivi épidémiologique de cohortes longitudinales. Ignorer la composante d’accord absolu dans un tel contexte induirait un risque élevé de biais diagnostique au préjudice des patients.
4.2 Définition et implications du critère de cohérence (Consistency)
À l’inverse, le critère de cohérence (Consistency) adopte une posture d’évaluation beaucoup plus libérale et permissive. La cohérence s’intéresse uniquement au maintien du rang relatif des sujets au sein de l’échantillon. Si l’ordre hiérarchique des participants est parfaitement conservé d’un évaluateur à l’autre, le critère de cohérence sera pleinement validé, nonobstant la présence d’un décalage systématique massif dans la valeur absolue des cotations.
Sous ce critère, la variance systématique imputable aux évaluateurs ($\sigma^2_r$) est purement et simplement soustraite ou omise du terme d’erreur figurant au dénominateur du ratio :
$$CCI_{\text{Cohérence}} = \frac{\sigma^2_s}{\sigma^2_s + \sigma^2_e}$$
Dès lors, si le clinicien A cote les trois patients d’une série à 10, 20 et 30, et que le clinicien B leur attribue respectivement les notes de 15, 25 et 35, le coefficient de cohérence sera strictement égal à 1,00. La divergence de 5 points, purement systématique, est totalement ignorée par la métrique.
Le choix de la cohérence s’avère recevable et pertinent dans les études fondamentalement corrélationnelles, où les scores finaux sont destinés à être normalisés (via des scores Z ou des centiles) ou corrélés à d’autres variables psychologiques dimensionnelles. En revanche, transposer un indice de fidélité reposant sur la seule cohérence dans un protocole clinique de décision thérapeutique binaire constitue une faute méthodologique critique, susceptible de masquer une hétérogénéité d’évaluation inacceptable dans le diagnostic au lit du malade.
4.3 Critères de décision pour sélectionner le type d’accord adapté
Le choix entre accord absolu et cohérence doit impérativement être arrêté en amont de la phase de recueil des données, au regard des objectifs scientifiques et pratiques de l’investigation. L’arbre décisionnel s’articule autour d’une interrogation centrale : les scores attribués par différents observateurs ou à différentes époques ont-ils vocation à être interchangeables au sens strict du terme ? Si la réponse est affirmative — ce qui est le cas pour toute application clinique individuelle, sélection académique par concours ou essai thérapeutique médicamenteux —, l’accord absolu représente l’unique option recevable.
En contrepoint, si la recherche ambitionne d’examiner comment une dimension psychologique s’associe à des marqueurs neurobiologiques ou génétiques, l’ordre hiérarchique des individus prime sur l’étalonnage absolu des échelles, rendant le calcul de la cohérence conceptuellement admissible. Il importe également de considérer l’effort d’étalonnage préalablement consenti : dans le cas où les observateurs ont suivi un entraînement intensif de standardisation pour harmoniser leurs repères de cotation, l’accord absolu valide de manière probante l’efficacité de ce calibrage expérimental.
Opter opportunément pour un coefficient de cohérence au motif fallacieux que sa valeur numérique est systématiquement supérieure ou égale à celle de l’accord absolu relève d’une pratique d’inflation artificielle de la fidélité. Les comités de lecture des revues scientifiques de premier rang exigent désormais que ce choix soit rigoureusement documenté et pénalisent l’usage du modèle de cohérence lorsque la pratique clinique visée requiert une comparabilité absolue des scores bruts.
5. Unité de mesure : Évaluateur unique versus Moyenne d’évaluateurs
5.1 Formule pour mesure unique : Single Rater / Measurement (k = 1)
La question de l’unité d’observation constitue le troisième axe déterminant la forme du CCI. L’analyse pour évaluateur unique (conventionnellement étiquetée Single Rater ou Single Measurement) quantifie la fidélité et la reproductibilité escomptées du score émis par un seul et unique juge pris isolément sur le terrain clinique ou de recherche. Le modèle s’interroge : si un patient quelconque entre dans un cabinet de consultation et fait l’objet d’un examen par un clinicien unique, dans quelle mesure ce score individuel est-il reproductible par un confrère quelconque ?
Cette perspective incarne fidèlement la réalité quotidienne de la pratique médicale et psychologique, où des contraintes budgétaires, temporelles et logistiques évidentes interdisent le doublement ou le triplement systématique des praticiens lors des consultations régulières. La métrique de l’évaluateur unique reflète la fidélité sans fard d’une mesure brute non agrégée, ce qui la rend particulièrement vulnérable aux idiosyncrasies de cotation, à l’inattention momentanée et au manque d’expérience du clinicien.
Sur le plan calculatoire, la formule issue du tableau d’ANOVA (détaillée ultérieurement) rapporte directement la variance inter-sujets au total de la variance unitaire comprenant l’erreur individuelle. En conséquence, les scores de CCI(1) ou de CCI « Single » s’avèrent structurellement inférieurs à leurs homologues basés sur des moyennes, confrontant le chercheur à la réalité non filtrée de l’erreur d’observation.
5.2 Formule pour mesures moyennes : Average Raters / Measurements (k > 1)
À l’autre extrémité de la conceptualisation se trouve la formule pour mesures moyennes (désignée sous le label Average Raters ou Average Measurements). Ce coefficient ne prétend pas caractériser la fidélité d’une cotation unitaire, mais la fidélité du score composite obtenu en calculant la moyenne arithmétique des notes attribuées par un panel prédéfini et immuable de $k$ évaluateurs. Le postulat fondamental repose sur la mécanique d’agrégation statistique : les erreurs aléatoires idiosyncrasiques des différents évaluateurs tendent à s’annuler mutuellement lorsque leurs avis sont moyennés, stabilisant considérablement le score agrégé.
Ce phénomène d’élévation mécanique de la fidélité répond précisément à la célèbre formule de prophétie de Spearman-Brown. Mathématiquement, à mesure que le nombre d’évaluateurs $k$ croît, le dénominateur d’erreur résiduelle se trouve divisé par ce facteur $k$, catapultant la valeur du CCI moyen (noté conventionnellement ICC(k) ou ICC « Average ») à des niveaux fréquemment très supérieurs à 0,90.
Le recours à la fidélité moyenne est parfaitement légitime et impératif dans les dispositifs institutionnels et de recherche où le score final retenu découle obligatoirement d’une collégialité : jurys d’admission universitaire, commissions médicales d’évaluation de l’invalidité, ou panels de double cotation d’IRM cérébrales dans les protocoles d’essais cliniques de phase III. Néanmoins, transférer indûment la valeur flatteuse d’un CCI moyen pour cautionner la pratique ultérieure d’un médecin exerçant seul dans son officine relève du non-sens méthodologique.
5.3 Arbitrage méthodologique et calcul du nombre optimal d’évaluateurs
L’existence de cette dualité unitaire-moyenne permet aux investigateurs de mener de véritables calculs d’optimisation expérimentale lors des phases de conception des protocoles de recherche. Dans de nombreux domaines cliniques, la fidélité unitaire ($CCI_1$) d’une épreuve comportementale complexe s’avère modeste (par exemple, voisine de 0,60), ce qui se révèle insuffisant pour une classification diagnostique d’une grande rigueur.
Au moyen de la relation dérivée de Spearman-Brown appliquée aux composantes de variance du CCI, le méthodologiste peut déterminer le nombre exact $k$ d’évaluateurs indépendants requis pour hisser la fidélité du score moyen ($CCI_k$) au-dessus d’un seuil critique prédéterminé (par exemple 0,85 ou 0,90) :
$$k_{\text{optimal}} = \frac{CCI_{\text{cible}} \cdot (1 – CCI_{\text{unique}})}{CCI_{\text{unique}} \cdot (1 – CCI_{\text{cible}})}$$
Ce calcul d’ingénierie statistique confronte immédiatement les chercheurs à un arbitrage coût-bénéfice. Le rendement marginal du recrutement d’évaluateurs supplémentaires est décroissant : le saut de fidélité gagné en passant d’un juge à deux juges est massif, l’apport d’un troisième reste appréciable, mais la sollicitation d’un quatrième ou d’un cinquième cotateur n’apporte souvent qu’une amélioration asymptotique négligeable au prix d’un alourdissement logistique et financier considérable.
6. Fondements mathématiques et décomposition des variances via l’ANOVA
6.1 Le tableau d’analyse de la variance (ANOVA) à deux facteurs
Le calcul effectif de l’ensemble des déclinaisons du coefficient de corrélation intraclasse passe par la construction et l’estimation des carrés moyens issus d’un tableau d’analyse de variance (ANOVA) à deux facteurs sans répétition, croisant $n$ sujets (lignes) et $k$ évaluateurs (colonnes). La variabilité globale des scores $X_{ij}$ autour de la grande moyenne empirique $\bar{X}_{bulletbullet}$ est fractionnée en trois sommes de carrés orthogonales.
La décomposition algébrique fondamentale des sommes de carrés (SS) se formule de la manière suivante :
- Somme des Carrés Totale ($SS_{\text{total}}$) :
$$SS_{\text{total}} = \sum_{i=1}^n \sum_{j=1}^k (X_{ij} – \bar{X}_{bulletbullet})^2 \quad \text{a\vec} \quad ddl = nk – 1$$ - Somme des Carrés entre Sujets ($SS_{\text{sujets}}$) :
$$SS_{\text{sujets}} = k \sum_{i=1}^n (\bar{X}_{ibullet} – \bar{X}_{bulletbullet})^2 \quad \text{a\vec} \quad ddl = n – 1$$ - Somme des Carrés entre Évaluateurs / Juges ($SS_{\text{juges}}$) :
$$SS_{\text{juges}} = n \sum_{j=1}^k (\bar{X}_{bullet j} – \bar{X}_{bulletbullet})^2 \quad \text{a\vec} \quad ddl = k – 1$$ - Somme des Carrés Résiduelle / Erreur ($SS_{\text{erreur}}$) :
$$SS_{\text{erreur}} = SS_{\text{total}} – SS_{\text{sujets}} – SS_{\text{juges}} \quad \text{a\vec} \quad ddl = (n – 1)(k – 1)$$
En divisant chaque somme de carrés par ses degrés de liberté ($ddl$) respectifs, on obtient les Carrés Moyens (Mean Squares ou MS) : le Carré Moyen inter-Sujets ($BMS = \frac{SS_{\text{sujets}}}{n-1}$), le Carré Moyen inter-Juges ($JMS = \frac{SS_{\text{juges}}}{k-1}$) et le Carré Moyen de l’Erreur résiduelle ($EMS = \frac{SS_{\text{erreur}}}{(n-1)(k-1)}$). Ces carrés moyens constituent les estimateurs non biaisés des combinaisons linéaires des variances théoriques du modèle.
6.2 Formulations explicites des dix formes standards du CCI
L’harmonisation terminologique issue des travaux de McGraw et Wong (1996), unifiant la classification princeps de Shrout et Fleiss (1979), structure l’estimation du CCI selon une nomenclature matricielle standardisée. Selon le plan expérimental retenu, les formules mathématiques exploitent directement les carrés moyens de l’ANOVA :
1. Modèle à une voie aléatoire (One-Way Random) :
Dans ce modèle, le carré moyen intra-sujets ($WMS$) agrège l’ensemble de la variance interne. Les formulations s’écrivent :
$$ICC(1,1) = \frac{BMS – WMS}{BMS + (k – 1)WMS}$$
$$ICC(1,k) = \frac{BMS – WMS}{BMS}$$
2. Modèle à deux voies aléatoires – Accord Absolu (Two-Way Random, Absolute Agreement) :
Ici, la variance systématique des juges ($JMS$) figure formellement au dénominateur pour sanctionner tout écart absolu entre les évaluateurs :
$$ICC(A,1) \text{ ou } ICC(2,1) = \frac{BMS – EMS}{BMS + (k – 1)EMS + \frac{k}{n}(JMS – EMS)}$$
$$ICC(A,k) \text{ ou } ICC(2,k) = \frac{BMS – EMS}{BMS + \frac{JMS – EMS}{n}}$$
3. Modèle à deux voies – Cohérence (Two-Way Mixed/Random, Consistency) :
Le terme $JMS$ disparaît totalement de la formule, l’erreur étant restreinte à l’interaction résiduelle $EMS$ :
$$ICC(C,1) \text{ ou } ICC(3,1) = \frac{BMS – EMS}{BMS + (k – 1)EMS}$$
$$ICC(C,k) \text{ ou } ICC(3,k) = \frac{BMS – EMS}{BMS}$$
Cette dernière expression $ICC(3,k)$ correspond point par point à la formulation algébrique standard de l’alpha de Cronbach.
6.3 Calcul de l’erreur type de mesure et intervalles de confiance
L’estimation ponctuelle d’un coefficient de corrélation intraclasse ne suffit pas à asseoir une conclusion scientifique ; la quantification de son incertitude d’échantillonnage s’avère indispensable. Celle-ci repose d’abord sur la dérivation de l’Erreur Type de Mesure (Standard Error of Measurement ou SEM), qui quantifie la dispersion des scores observés autour du score vrai d’un patient, exprimée directement dans l’unité de l’échelle d’évaluation originelle :
$$SEM = SD_{\text{total}} \cdot \sqrt{1 – CCI}$$
où $SD_{\text{total}}$ est l’écart-type combiné de l’ensemble des mesures. Dans le modèle à deux voies en accord absolu, une formulation plus exacte de la variance d’erreur de mesure directe est $SEM = \sqrt{EMS + \frac{JMS – EMS}{n}}$ ou, de manière approchée et classique, $SEM = \sqrt{EMS}$.
À partir du SEM, les cliniciens peuvent calculer le Changement Minimal Détectable (Minimal Detectable Change ou MDC), seuil en deçà duquel une variation de score chez un patient entre deux consultations peut être raisonnablement attribuée au simple bruit de mesure plutôt qu’à une modification clinique réelle :
$$MDC_{95%} = SEM \cdot 1{,}96 \cdot \sqrt{2} \approx 2{,}77 \cdot SEM$$
Parallèlement, la dérivation des intervalles de confiance à 95 % ($IC_{95%}$) du CCI mobilise les quantiles de la distribution $F$ de Fisher-Snedecor, associant les degrés de liberté du numérateur ($n-1$) et du dénominateur issus des espérances mathématiques des carrés moyens. Un intervalle de confiance large constitue une mise en garde immédiate contre un manque criant de puissance statistique ou un sous-échantillonnage des sujets évalués.
7. Directives d’interprétation et seuils critiques des valeurs du CCI
7.1 Seuils méthodologiques standards selon Koo et Li (2016)
Bien que toute segmentation d’un continuum statistique comporte une part inévitable d’arbitraire, la communauté internationale s’accorde aujourd’hui sur les directives méthodologiques contemporaines édictées par Koo et Li (2016). Ces autrices ont formalisé une grille d’évaluation actualisée, venue supplanter les repères plus anciens et excessivement indulgents de Landis et Koch (1977) ou de Fleiss (1986) :
- Valeur inférieure à 0,50 : Fidélité médiocre (Poor reliability). La variance d’erreur domine le signal de mesure. L’instrument est incapable de discriminer convenablement les sujets ; son utilisation en pratique clinique ou en recherche est à proscrire impérativement.
- Valeur comprise entre 0,50 et 0,75 : Fidélité modérée (Moderate reliability). L’instrument présente un niveau de reproductibilité acceptable pour des études exploratoires ou des analyses de cohortes globales, mais s’avère insuffisant pour poser des diagnostics individuels précis sans mesures répétées.
- Valeur comprise entre 0,75 et 0,90 : Bonne fidélité (Good reliability). Ce niveau est le standard attendu dans les protocoles d’expérimentation clinique et la recherche académique de haut niveau. Les cotateurs manifestent une convergence satisfaisante autorisant l’utilisation de l’outil pour tester des hypothèses de recherche complexes.
- Valeur supérieure à 0,90 : Excellente fidélité (Excellent reliability). Le bruit de mesure est minimal. Ce standard d’excellence est strictement requis lorsque des décisions cliniques individuelles critiques dépendent directement du score (ex. : décision d’hospitalisation sans consentement, éligibilité à une neurochirurgie, tests neuropsychologiques médicolégaux).
7.2 Interprétation prudente basée sur l’intervalle de confiance
Une recommandation cruciale, trop souvent négligée dans les articles empiriques, stipule que l’interprétation de la qualité métrologique d’un test ne doit jamais s’effectuer sur la base exclusive de l’estimation ponctuelle du CCI, mais doit reposer formellement sur la borne inférieure de son intervalle de confiance à 95 %. Une telle rigueur méthodologique évite de cautionner des outils dont la fiabilité apparente résulterait d’un artefact d’échantillonnage.
À titre d’illustration, si une étude portant sur un panel restreint de 12 patients rapporte une estimation ponctuelle séduisante de $CCI = 0{,}84$, mais que l’intervalle de confiance associé s’étale de $0{,}48$ à $0{,}95$, le chercheur ne peut en aucun cas déclarer que la fidélité de l’outil est « bonne ». Étant donné que la borne inférieure ($0{,}48$) plonge dans la zone d’une fidélité « médiocre », l’instrument est susceptible d’échouer dans près de la moitié des situations de cotation. La seule conclusion légitime est de juger l’estimation incertaine et d’exiger une réplication sur un échantillon plus vaste.
L’étroitesse de l’intervalle de confiance est sous la dépendance directe du nombre de sujets inclus dans l’étude, ainsi que du nombre d’évaluateurs mobilisés. L’accroissement de la cohorte de patients permet de resserrer drastiquement les marges d’erreur et de garantir que la borne inférieure dépasse le seuil critique de recevabilité scientifique fixé a priori.
7.3 Impact de l’hétérogénéité de l’échantillon sur la valeur du CCI
Le coefficient de corrélation intraclasse, de par sa nature de ratio de variances ($\frac{\sigma^2_s}{\sigma^2_{\text{total}}}$), recèle un comportement mathématique paradoxal qu’il est capital de comprendre : sa valeur dépend étroitement de la variance inter-sujets présente dans l’échantillon étudié. Si une étude recrute une population extrêmement hétérogène (combinant par exemple des témoins sains, des patients dépressifs légers et des patients catatoniques hospitalisés), la variance inter-sujets $\sigma^2_s$ sera gigantesque. Mécaniquement, le ratio de variance augmentera, produisant un CCI artificiellement spectaculaire, alors même que l’erreur de mesure intrinsèque de l’appareil reste élevée.
Inversement, si l’on tente d’évaluer la fidélité d’une échelle au sein d’un échantillon très homogène — par exemple, un groupe restreint de patients souffrant tous d’un trouble dépressif résistant de sévérité quasi-identique —, le phénomène de restriction de variance va comprimer dramatiquement la variance inter-sujets $\sigma^2_s$. Dans ce contexte, même si les évaluateurs attribuent des scores très proches (faible erreur de mesure absolue), le CCI s’effondrera mathématiquement pour afficher des valeurs modestes voire médiocres.
C’est pourquoi il est impératif d’interpréter le CCI conjointement avec l’Erreur Type de Mesure ($SEM$) et l’écart-type global de la population. Le $SEM$ possède l’immense avantage d’être indépendant de la variance de l’échantillon et d’offrir une estimation absolue de la marge d’erreur dans l’unité de l’instrument. Un échantillonnage clinique rigoureux doit impérativement reproduire la diversité réelle de la population cible à laquelle le test est destiné pour conférer au CCI toute sa validité écologique.
8. Exemple pratique détaillé : Évaluation psychométrique de symptômes dépressifs
8.1 Contexte de l’étude et présentation des données brutes
Afin d’ancrer de manière irréfutable ces développements théoriques dans la réalité pratique, examinons un protocole expérimental complet mené au sein d’un service de psychiatrie universitaire. Dix patients ($n = 10$) souffrant de troubles de l’humeur ont été sélectionnés de manière consécutive. Chacun de ces dix patients a fait l’objet d’un entretien clinique approfondi semi-structuré, filmé en haute définition sous protocole standardisé.
Trois psychologues cliniciens indépendants ($k = 3$), désignés conventionnellement par Juge 1, Juge 2 et Juge 3, ont visionné l’ensemble des dix entretiens vidéo dans un ordre randomisé et en aveugle complet les uns des autres. Chaque psychologue a coté l’échelle de dépression de Hamilton à 17 items (Hamilton Depression Rating Scale, HDRS), dont le score total théorique oscille de 0 à 52. Les scores bruts obtenus sont consignés dans la matrice rectangulaire ci-dessous :
| Patient | Juge 1 | Juge 2 | Juge 3 | Total Patient ($T_i$) | Moyenne Patient ($\bar{X}_{ibullet}$) |
|---|---|---|---|---|---|
| Patient 1 | 14 | 16 | 15 | 45 | 15,00 |
| Patient 2 | 22 | 24 | 23 | 69 | 23,00 |
| Patient 3 | 8 | 10 | 9 | 27 | 9,00 |
| Patient 4 | 30 | 32 | 31 | 93 | 31,00 |
| Patient 5 | 17 | 19 | 18 | 54 | 18,00 |
| Patient 6 | 25 | 28 | 27 | 80 | 26,67 |
| Patient 7 | 12 | 13 | 11 | 36 | 12,00 |
| Patient 8 | 29 | 31 | 30 | 90 | 30,00 |
| Patient 9 | 19 | 21 | 20 | 60 | 20,00 |
| Patient 10 | 16 | 18 | 17 | 51 | 17,00 |
| Total Juge ($C_j$) | 192 | 212 | 201 | Grand Total = 605 | – |
| Moyenne Juge ($\bar{X}_{bullet j}$) | 19,20 | 21,20 | 20,10 | – | Moyenne Globale = 20,167 |
L’objectif scientifique est d’évaluer la reproductibilité clinique de cette cotation. Considérant que les trois psychologues représentent un échantillon de cliniciens issus du milieu hospitalier et que l’échelle HDRS sert à déterminer des seuils diagnostiques absolus pour orienter les prescriptions d’antidépresseurs, le choix méthodologique se porte sans équivoque sur le modèle à effets aléatoires à deux voies avec critère d’accord absolu pour mesure unique, noté ICC(A,1) ou ICC(2,1).
8.2 Calcul pas à pas via le tableau d’ANOVA
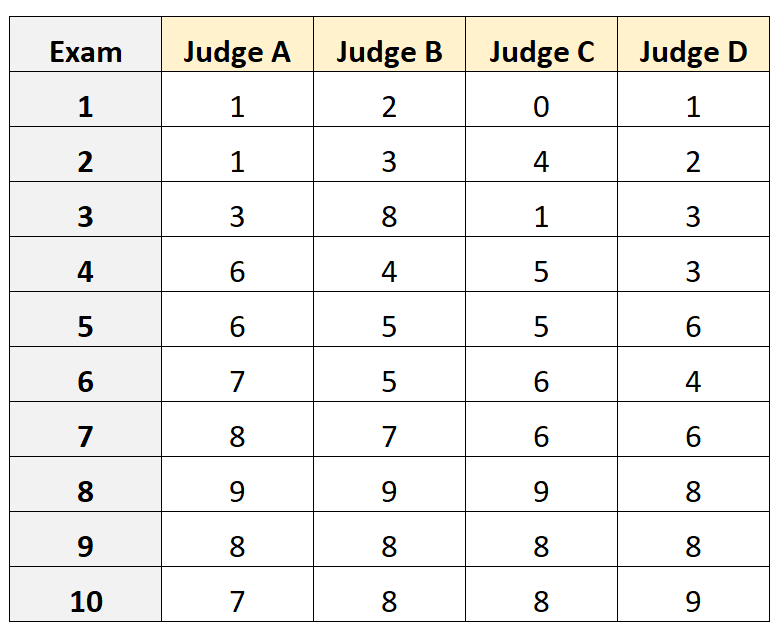
Procédons à l’ensemble des dérivations arithmétiques intermédiaires nécessaires à l’élaboration du tableau d’analyse de variance à deux facteurs :
Étape 1 : Terme de correction global ($C$) :
Avec $N = n \times k = 10 \times 3 = 30$ observations au total et une somme globale $\sum X_{ij} = 605$ :
$$C = \frac{(\sum X_{ij})^2}{N} = \frac{605^2}{30} = \frac{366025}{30} = 12200{,}833$$
Étape 2 : Somme Totale des Carrés ($SS_{\text{total}}$) :
Sommons les carrés de l’ensemble des 30 valeurs individuelles :
$$\sum X_{ij}^2 = 14^2 + 16^2 + 15^2 + 22^2 + 24^2 + 23^2 + dots + 16^2 + 18^2 + 17^2 = 13745$$
$$SS_{\text{total}} = 13745 – C = 13745 – 12200{,}833 = 1544{,}167$$
Étape 3 : Somme des Carrés entre Sujets / Patients ($SS_{\text{sujets}}$) :
À partir des sommes de chaque ligne $T_i$ :
$$\sum T_i^2 = 45^2 + 69^2 + 27^2 + 93^2 + 54^2 + 80^2 + 36^2 + 90^2 + 60^2 + 51^2$$
$$\sum T_i^2 = 2025 + 4761 + 729 + 8649 + 2916 + 6400 + 1296 + 8100 + 3600 + 2601 = 41077$$
$$SS_{\text{sujets}} = \frac{\sum T_i^2}{k} – C = \frac{41077}{3} – 12200{,}833 = 13692{,}333 – 12200{,}833 = 1491{,}500$$
Étape 4 : Somme des Carrés entre Évaluateurs / Juges ($SS_{\text{juges}}$) :
À partir des totaux de chaque colonne $C_j$ :
$$\sum C_j^2 = 192^2 + 212^2 + 201^2 = 36864 + 44944 + 40401 = 122209$$
$$SS_{\text{juges}} = \frac{\sum C_j^2}{n} – C = \frac{122209}{10} – 12200{,}833 = 12220{,}900 – 12200{,}833 = 20{,}067$$
Étape 5 : Somme des Carrés de l’Erreur résiduelle ($SS_{\text{erreur}}$) :
Par soustraction orthogonale directe :
$$SS_{\text{erreur}} = SS_{\text{total}} – SS_{\text{sujets}} – SS_{\text{juges}} = 1544{,}167 – 1491{,}500 – 20{,}067 = 32{,}600$$
Étape 6 : Synthèse du tableau d’ANOVA et calcul des Carrés Moyens :
- Degrés de liberté inter-sujets : $ddl = n – 1 = 10 – 1 = 9$
- Degrés de liberté inter-juges : $ddl = k – 1 = 3 – 1 = 2$
- Degrés de liberté de l’erreur : $ddl = (n – 1)(k – 1) = 9 \times 2 = 18$
- Carré Moyen inter-Sujets ($BMS$) : $BMS = \frac{1491{,}500}{9} = 165{,}722$
- Carré Moyen inter-Juges ($JMS$) : $JMS = \frac{20{,}067}{2} = 10{,}033$
- Carré Moyen de l’Erreur ($EMS$) : $EMS = \frac{32{,}600}{18} = 1{,}811$
8.3 Résultats numériques et interprétation clinique
Nous pouvons désormais injecter ces valeurs numériques rigoureusement établies dans la formule formelle du modèle à deux voies aléatoires en accord absolu pour mesure unique, noté $ICC(A,1)$ :
$$ICC(A,1) = \frac{BMS – EMS}{BMS + (k – 1)EMS + \frac{k}{n}(JMS – EMS)}$$
Remplaçons les symboles par leurs valeurs empiriques :
$$\text{Numérateur} = 165{,}722 – 1{,}811 = 163{,}911$$
$$\text{Dénominateur} = 165{,}722 + (3 – 1) \cdot 1{,}811 + \frac{3}{10} \cdot (10{,}033 – 1{,}811)$$
$$\text{Dénominateur} = 165{,}722 + 3{,}622 + 0{,}3 \cdot (8{,}222) = 165{,}722 + 3{,}622 + 2{,}467 = 171{,}811$$
$$ICC(A,1) = \frac{163{,}911}{171{,}811} \approx 0{,}954$$
Calculons également, à titre de confrontation pédagogique, la valeur de l’accord absolu basé sur la moyenne des trois évaluateurs, noté $ICC(A,k)$ ou $ICC(A,3)$ :
$$ICC(A,3) = \frac{BMS – EMS}{BMS + \frac{JMS – EMS}{n}} = \frac{163{,}911}{165{,}722 + \frac{8{,}222}{10}} = \frac{163{,}911}{165{,}722 + 0{,}822} = \frac{163{,}911}{166{,}544} \approx 0{,}984$$
Analysons enfin l’impact clinique à l’aide de l’erreur type de mesure résiduelle :
$$SEM \approx \sqrt{EMS} = \sqrt{1{,}811} \approx 1{,}35 \text{ points}$$
Le Changement Minimal Détectable à 95 % ($MDC_{95%}$) qui en découle est évalué à :
$$MDC_{95%} = 1{,}35 \times 2{,}77 \approx 3{,}74 \text{ points}$$
Conclusion clinique : Le coefficient obtenu ($ICC(A,1) = 0{,}954$) dépasse largement le seuil d’excellence de 0,90 établi par Koo et Li (2016). Cette valeur atteste que l’échelle HDRS administrée dans ces conditions standardisées présente une fidélité inter-juges exceptionnelle : plus de 95 % de la variance des scores reflète les différences réelles de gravité dépressive entre les patients, tandis que l’impact de la divergence entre cliniciens demeure minime. De surcroît, le $MDC$ nous indique avec une certitude statistique de 95 % qu’une fluctuation inférieure à 4 points chez un patient suivi au fil du temps relève d’une imprécision de cotation inhérente au test, alors qu’une baisse égale ou supérieure à 4 points signe une véritable amélioration symptomatique induite par le traitement.
9. Mise en œuvre pas à pas sur les logiciels statistiques standards
9.1 Calcul du CCI sous SPSS
Le progiciel IBM SPSS Statistics propose un module complet et ergonomique pour calculer les différentes déclinaisons du coefficient de corrélation intraclasse. Les données doivent être impérativement structurées sous le format « large » (wide format), où chaque ligne du tableur correspond à un sujet unique et chaque colonne représente un évaluateur (par exemple trois colonnes intitulées Juge1, Juge2, Juge3).
La procédure pas à pas s’articule comme suit :
- Accédez au menu supérieur et sélectionnez : Analyse > Échelle > Analyse de fiabilité…
- Dans la boîte de dialogue principale, faites basculer les variables d’évaluateurs (
Juge1,Juge2,Juge3) dans la zone de sélection intitulée Éléments. Conservez le modèle « Alpha » présélectionné par défaut pour l’analyse principale. - Cliquez sur l’onglet Statistiques… situé sur la droite de l’écran.
- Au sein de la sous-section inférieure intitulée Coefficient de corrélation intraclasse, cochez la case d’activation.
- Deux menus déroulants deviennent alors accessibles :
- Modèle : Choisissez À deux facteurs aléatoires (correspondant au modèle Two-Way Random de Shrout & Fleiss) ou À deux facteurs mixtes selon votre plan théorique.
- Type : Sélectionnez impérativement Accord absolu (pour intégrer la sévérité des juges) ou Cohérence (si seuls les classements relatifs importent).
- Validez en cliquant sur Poursuivre, puis sur OK pour exécuter la syntaxe.
La fenêtre de résultats affiche un tableau synthétique intitulé « Intraclass Correlation Coefficient ». SPSS y détaille deux lignes distinctes : la ligne « Mesures individuelles » (qui correspond à $ICC(2,1)$ avec sa valeur ponctuelle de 0,954, son intervalle de confiance à 95 % et son test $F$) et la ligne « Mesures moyennes » ($ICC(2,3)$ affichant 0,984). Pour un rapport scientifique évaluant un praticien unique, seule la ligne « Mesures individuelles » doit être retenue.
9.2 Implémentation sous le logiciel R
L’environnement statistique libre R offre une flexibilité incomparable pour le traitement psychométrique au travers de son écosystème de packages spécialisés, au premier rang desquels figure la bibliothèque renommée psych développée par William Revelle. Les données doivent être importées sous la forme d’un data frame ou d’une matrice rectangulaire structurée de manière analogue au format SPSS (colonnes = juges, lignes = sujets).
L’exécution de la routine statistique s’opère au moyen des lignes d’instructions suivantes :
Pour installer et charger la bibliothèque : install.packages("psych") puis library(psych). Définissez ensuite votre matrice de données (par exemple nommée donnees_hdrs) contenant les colonnes d’évaluation. L’appel de la fonction générique est immédiat : resultat <- ICC(donnees_hdrs). L’affichage complet s’obtient simplement par l’instruction print(resultat).
La console R génère un tableau synoptique extrêmement instructif détaillant simultanément les six formes fondamentales canonisées par Shrout et Fleiss : ICC1 (modèle à une voie unitaire), ICC2 (modèle à deux voies aléatoires unitaire, accord absolu), ICC3 (modèle à deux voies mixtes unitaire, cohérence), complétées par leurs versions moyennes respectives ICC1k, ICC2k et ICC3k. L’utilisateur peut ainsi extraire programmatiquement les bornes inférieures et supérieures de l’intervalle de confiance via resultat$results$lower.bound et resultat$results$upper.bound, facilitant l’automatisation des rapports reproductibles sous RMarkdown ou Quarto.
9.3 Implémentation sous Python
Dans l’écosystème open source Python, traditionnellement tourné vers l’apprentissage automatique, les calculs psychométriques et biomédicaux sont remarquablement pris en charge par le module statistique pingouin, conçu spécifiquement pour reproduire les standards méthodologiques académiques avec une syntaxe fluide et concise.
Contrairement à SPSS ou à la fonction ICC de R, pingouin requiert que les données soient fournies au format dit « long » (tidy long format), où chaque ligne individuelle représente une cotation unique identifiée par trois descripteurs : l’identifiant du sujet, l’identifiant de l’évaluateur, et le score numérique attribué. La conversion d’un DataFrame Pandas classique au format long s’exécute aisément via la méthode pandas.melt().
L’algorithme s’exécute ensuite en deux instructions élémentaires : après importation du module par import pingouin as pg, on invoque la fonction dédiée : tableau_icc = pg.intraclass_corr(data=df_long, targets='Patient', raters='Juge', ratings='Score'). La variable tableau_icc stocke un tableau récapitulatif listant rigoureusement les six modèles de Shrout et Fleiss, complétés des degrés de liberté, des valeurs de statistique $F$, des p-values associées et des intervalles de confiance à 95 %, offrant une intégration fluide au sein de pipelines de science des données médicales.
10. Hypothèses statistiques, limites et pièges méthodologiques
10.1 Vérification des postulats statistiques fondamentaux
Comme toute procédure paramétrique découlant de la théorie générale de l’analyse de la variance, le coefficient de corrélation intraclasse n’est valide que si un certain nombre d’hypothèses distributionnelles sous-jacentes sont raisonnablement respectées par les données empiriques. La première de ces conditions concerne l’hypothèse de normalité : la distribution du trait latent sous-jacent au sein de la population de sujets doit suivre une loi approximativement gaussienne, tout comme les résidus d’erreur du modèle d’ANOVA ($\epsilon_{ij} \sim \mathcal{N}(0, \sigma^2)$).
La seconde exigence repose sur l’homogénéité des variances ou homoscédasticité : la variance des scores attribués par chaque évaluateur doit être statistiquement homogène, ce qui implique qu’un observateur ne doit pas présenter une dispersion erratique tandis qu’un autre manifesterait une variance extrêmement resserrée. Enfin, les résidus doivent être stochastiquement indépendants les uns des autres, ce qui prohibe formellement toute influence mutuelle ou concertation entre les cotateurs lors de la passation des épreuves.
L’évaluation méthodologique de ces postulats requiert le déploiement de tests formels (test de normalité de Shapiro-Wilk appliqué aux résidus de l’ANOVA, test d’homoscédasticité de Levene pour confronter les variances des juges) ainsi que l’examen graphique de diagrammes quantile-quantile (Q-Q plots). Lorsque les violations de normalité s’avèrent manifestes ou que les données présentent une asymétrie marquée, le statisticien doit envisager des transformations mathématiques préalables (ex. : transformation logarithmique) ou se tourner vers des estimateurs robustes et des procédures non-paramétriques de rééchantillonnage par bootstrap.
10.2 Gestion des données manquantes et plans expérimentaux incomplets
L’un des talons d’Achille de la méthode d’estimation du CCI basée sur l’ANOVA standard (sommes de carrés de type III) réside dans son intransigeance face aux matrices de données incomplètes : l’absence d’une seule valeur pour un sujet donné conduit irrémédiablement à l’exclusion pure et simple de l’intégralité des mesures de ce participant (suppression par liste ou listwise deletion), ce qui induit une perte substantielle de puissance statistique et expose l’étude à des biais de sélection.
Dans les contextes cliniques réels où certains patients manquent des séances d’évaluation ou lorsque des évaluateurs ne peuvent coter l’ensemble de la cohorte, il est désormais vivement préconisé d’abandonner l’ANOVA classique au profit des modèles linéaires mixtes (Linear Mixed-Effects Models, LMM) paramétrés via l’estimation du Maximum de Vraisemblance Restreint (REML). Les modèles mixtes accommodent avec élégance les structures de données déséquilibrées et les données manquantes sous l’hypothèse d’une absence aléatoire (Missing at Random, MAR).
Sous cette approche contemporaine, les composantes de variance $\sigma^2_s$, $\sigma^2_r$ et $\sigma^2_e$ sont estimées directement à partir des équations mixtes itératives sans exiger de plan factoriel complet équilibré. Le CCI est ensuite reconstitué en combinant les paramètres de variance obtenus. Cette flexibilité algorithmique autorise l’inclusion de covariables explicatives continues ou catégorielles pour contrôler d’éventuels facteurs de confusion confondants.
10.3 Erreurs courantes commises par les chercheurs
La littérature médicale regorge de confusions conceptuelles récurrentes lors de l’application du CCI, que les relecteurs méthodologistes se doivent d’épingler systématiquement. L’erreur la plus dévastatrice réside dans la sélection opportuniste d’un modèle de Cohérence alors que la finalité avouée du dispositif est d’établir un seuil diagnostique ou une classification clinique absolue. Ce dévoiement occulte les écarts de calibrage entre professionnels et surestime de manière pernicieuse la fidélité réelle de l’instrument.
Une seconde aberration fréquente consiste à publier en exergue la valeur flatteuse du CCI basé sur la moyenne des juges ($ICC_k$), tout en omettant de mentionner que la pratique clinique courante ne mobilisera qu’un praticien unique ($ICC_1$). Cette dissimulation biaise lourdement les conclusions, faisant croire à tort qu’une note unique délivrée en cabinet possède la stabilité statistique d’un comité collégial d’experts.
S’ajoute à cela l’omission quasi-systématique de la mention des intervalles de confiance à 95 %, masquant l’imprécision inhérente aux cohortes sous-dimensionnées, ainsi que la confusion récurrente entre la forme $ICC(2,1)$ (modèle aléatoire généralisable) et la forme $ICC(3,1)$ (modèle fixe restreint). Un rapport statistique rigoureux doit proscrire l’usage du terme générique et indéfini « le CCI » et spécifier explicitement la notation formelle adopted (ex. : $ICC(A,1)$ selon McGraw et Wong, ou $ICC(2,1)$ selon Shrout et Fleiss).
11. Applications concrètes en neuropsychologie et évaluation clinique
11.1 Validation de la fidélité test-retest d’outils neuropsychologiques
Dans le champ de la neuropsychologie clinique, l’évaluation de la stabilité temporelle ou fidélité test-retest des batteries évaluant les fonctions exécutives, l’attention soutenue ou la mémoire épisodique mobilise intensément le coefficient de corrélation intraclasse. Le protocole implique l’administration d’une même tâche cognitive standardisée à une cohorte d’individus à deux moments temporels distants ($T_1$ et $T_2$). Dans ce paradigme, le temps constitue un facteur d’observation fixe ou aléatoire à deux modalités répétées.
La principale difficulté méthodologique réside dans le contrôle de l’effet d’apprentissage (practice effect). Lors de la seconde passation, la familiarité des participants avec le matériel expérimental engendre fréquemment une progression globale des performances (élévation systématique de la moyenne à $T_2$). Si l’investigateur emploie indûment un modèle d’accord absolu sans discernement, cette translation des scores sera comptabilisée comme une erreur instrumentale, dégradant le coefficient. Le recours à un modèle à deux voies mixtes en cohérence — ou l’utilisation de versions parallèles du test rigoureusement calibrées — permet de dissocier l’effet moyen d’apprentissage de la fidélité temporelle relative des classements.
De surcroît, le calibrage minutieux de l’intervalle temporel s’avère stratégique : un délai excessivement court (ex. : 24 heures) amplifie démesurément la remémoration des réponses par le sujet, tandis qu’un intervalle démesurément étendu (ex. : 6 mois) introduit le risque d’une fluctuation biologique réelle du statut cognitif du patient (neurodéveloppement chez l’enfant ou processus neurodégénératif chez le sujet âgé), confondant l’instabilité du trait avec le manque de fidélité de l’outil.
11.2 Codage d’interactions dyadiques et comportementales
L’observation clinique directe des interactions comportementales — telles que la syntonie affective parent-nourrisson lors du paradigme du visage impassible (Still-Face) ou les comportements d’agressivité verbale au sein de thérapies de couple — repose sur le décryptage minutieux d’enregistrements vidéo séquencés par des codeurs humains formés à des grilles d’observation denses.
Dans ces dispositifs complexes, la dérive de cotation constitue une menace permanente. Au fil des semaines d’annotation, les codeurs subissent l’influence de la fatigue, d’une assimilation progressive de biais personnels et d’une perte d’étalonnage mutuel. La mise en œuvre d’un protocole de double codage partiel continu — où 20 % à 30 % des séquences vidéo font l’objet d’une double cotation aveugle par deux évaluateurs distincts — permet de monitorer en temps réel le CCI au fil du déroulement de l’étude.
Si la valeur du $CCI(A,1)$ fléchit sous la barre critique de 0,75 en cours d’expérimentation, une session de recalibrage collégial immédiat est déclenchée pour réharmoniser l’interprétation des critères opérationnels de la grille. Cette surveillance continue de la corrélation intraclasse garantit l’intégrité métrologique du recueil de données et immunise l’étude contre les artefacts longitudinaux d’observation.
11.3 Standardisation d’épreuves qualitatives ou projectives
L’usage des épreuves projectives (telles que le test de Rorschach selon le Système Intégré d’Exner) ou des entretiens cliniques semi-structurés qualitatifs fait historiquement l’objet de vifs débats quant à son statut de scientificité. La critique la plus virulente pointe l’arbitraire interprétatif et la subjectivité projectionnelle du clinicien examinateur lors du codage des verbalisations du patient.
Pour conférer à ces outils une respectabilité scientifique irréprochable auprès des comités d’accréditation et des organismes médico-légaux, les psychométriciens contemporains soumettent systématiquement les variables quantitatives issues du Rorschach (indices de perception formelle, localisation des déterminants, réponses kinesthésiques) à des épreuves strictes de fidélité inter-évaluateurs quantifiées par le CCI. L’établissement de coefficients d’accord absolu excédant 0,80 ou 0,85 fournit la preuve empirique indiscutable que les scores ne résultent pas de l’imagination de l’évaluateur mais traduisent fidèlement la structure psychologique du patient.
Sur le plan éthique et déontologique, un clinicien ne saurait utiliser un score dérivé d’un bilan psychologique qualitatif pour orienter une décision de garde d’enfant ou une expertise judiciaire pénale sans être en mesure de citer les indices de fidélité intraclasse attestant de l’interchangeabilité de ses conclusions avec celles de ses pairs.
12. Synthèse méthodologique et recommandations pour la rédaction scientifique
12.1 Grille de décision pour la sélection de la forme exacte du CCI
Afin d’offrir une vision synoptique aux praticiens et aux chercheurs engagés dans la conception de protocoles scientifiques, la matrice logique ci-dessous récapitule les critères d’arbitrage guidant la sélection incontestable du modèle de CCI approprié :
| Question Méthodologique Fondamentale | Configuration Expérimentale | Type de Modèle | Forme Shrout-Fleiss (1979) | Forme McGraw-Wong (1996) |
|---|---|---|---|---|
| Chaque sujet est-il évalué par des juges différents tirés au sort ? | Juges non croisés, sujets uniques | One-Way Random | ICC(1,1) / ICC(1,k) | One-Way Random |
| Les juges sont-ils identiques pour tous les sujets et généralisables ? | Plan croisé complet, juges aléatoires | Two-Way Random | ICC(2,1) / ICC(2,k) | Two-Way Random (Accord Absolu) |
| Les juges sont-ils les seuls d’intérêt, et seuls leurs rangs relatifs importent ? | Plan croisé complet, juges fixes | Two-Way Mixed | ICC(3,1) / ICC(3,k) | Two-Way Mixed (Cohérence) |
| La prise de décision future reposera-t-elle sur un clinicien isolé ? | Pratique clinique courante individuelle | Unité : Single Rater | Indice suffixé « ,1 » | Single Measurement |
| La prise de décision reposera-t-elle sur la moyenne d’un panel ? | Comités collégiaux, jurys experts | Unité : Average Rater | Indice suffixé « ,k » | Average Measurement |
En renseignant cette checklist en amont de toute soumission d’article, le chercheur s’assure d’une parfaite cohérence interne entre ses hypothèses théoriques, son design expérimental et ses outils de calcul statistique.
12.2 Modèle de rapport textuel standardisé des résultats
Les normes éditoriales de l’American Psychological Association (APA 7e édition) et les recommandations internationales pour la publication d’études de fidélité (lignes directrices GRRAS : Guidelines for Reporting Reliability and Agreement Studies) imposent un formalisme strict lors de la rédaction des résultats d’une analyse de corrélation intraclasse. Tout compte rendu doit mentionner de façon explicite le modèle choisi, le type d’accord, l’unité de mesure, la statistique $F$ d’ANOVA, les degrés de liberté, la valeur de $p$, et surtout l’intervalle de confiance à 95 %.
Voici un modèle canonique de paragraphe de résultats, prêt à être adapté pour une publication académique :
« La fidélité inter-évaluateurs de l’échelle HDRS-17 a été estimée à partir d’un modèle de corrélation intraclasse à deux voies à effets aléatoires avec accord absolu pour mesure unique (ICC[A,1]). L’indice de fidélité obtenu est de 0,954, avec un intervalle de confiance à 95 % s’étendant de 0,876 à 0,987 (F[9, 18] = 91,51, p < 0,001). Conformément aux directives de Koo et Li (2016), ce résultat traduit une excellente fidélité de l’instrument entre les cliniciens, la borne inférieure de l’intervalle confirmant une concordance satisfaisante. L’erreur type de mesure (SEM) a été établie à 1,35 point, déterminant un seuil de changement minimal détectable (MDC95%) de 3,74 points sur l’échelle clinique. »
12.3 Perspectives futures et développements contemporains
Bien que formalisé initialement au siècle dernier, le champ du coefficient de corrélation intraclasse demeure en constante effervescence théorique et algorithmique. L’essor contemporain de l’inférence bayésienne appliquée aux sciences du comportement renouvelle en profondeur l’estimation de la fidélité. Au lieu de se cantonner à des estimations ponctuelles de carrés moyens d’ANOVA tributaires d’hypothèses de normalité souvent rigides, les approches bayésiennes via des chaînes de Markov Monte-Carlo (MCMC) permettent de dériver des distributions a posteriori complètes pour le CCI.
Ces méthodes bayésiennes intègrent avec fluidité des lois a priori informatives issues de méta-analyses antérieures et génèrent des Intervalles de Crédibilité à 95 % d’une interprétation clinique beaucoup plus intuitive que les intervalles de confiance fréquentistes classiques. Parallèlement, le développement de modèles multiniveaux hiérarchiques permet désormais d’imbriquer l’estimation de l’accord inter-juges au sein de structures écologiques complexes (ex. : patients nichés au sein de thérapeutes, eux-mêmes nichés au sein de multiples cliniques ou centres hospitaliers distincts).
Enfin, l’émergence des technologies d’intelligence artificielle et de traitement automatisé du signal (reconnaissance faciale des émotions, analyse acoustique de la prosodie vocale dépressive) impose de confronter désormais la concordance non plus uniquement entre humains, mais entre évaluateurs humains et algorithmes de cotation automatique. Dans ce paysage technologique en mutation rapide, le coefficient de corrélation intraclasse demeure plus que jamais la boussole métrologique indispensable garantissant la rigueur, l’éthique et la reproductibilité de la mesure de l’esprit humain.
Références
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37-46. https://doi.org/10.1177/001316446002000104
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297-334. https://doi.org/10.1007/BF02310555
- Fisher, R. A. (1925). Statistical Methods for Research Workers. Oliver and Boyd.
- Fleiss, J. L. (1986). The Design and Analysis of Clinical Experiments. John Wiley & Sons.
- Fleiss, J. L., & Cohen, J. (1973). The equivalence of weighted kappa and the intraclass correlation coefficient as measures of reliability. Educational and Psychological Measurement, 33(3), 613-619. https://doi.org/10.1177/001316447303300309
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155-163. https://doi.org/10.1016/j.jcm.2016.02.012
- Kottner, J., Audigé, L., Brorson, S., Donner, A., Gajewski, B. J., Hróbjartsson, A., Roberts, C., Shoukri, M., & Streiner, D. L. (2011). Guidelines for Reporting Reliability and Agreement Studies (GRRAS) were proposed. Journal of Clinical Epidemiology, 64(1), 96-106. https://doi.org/10.1016/j.jclinepi.2010.03.002
- Landis, J. R., & Koch, G. G. (1977). The measurement of observer agreement for categorical data. Biometrics, 33(1), 159-174. https://doi.org/10.2307/2529310
- Lord, F. M., & Novick, M. R. (1968). Statistical Theories of Mental Test Scores. Addison-Wesley.
- McGraw, K. O., & Wong, S. P. (1996). Forming inferences about some intraclass correlation coefficients. Psychological Methods, 1(1), 30-46. https://doi.org/10.1037/1082-989X.1.1.30
- Revelle, W. (2023). psych: Procedures for Psychological, Psychometric, and Personality Research. R package version 2.3.6. Northwestern University.
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420-428. https://doi.org/10.1037/0033-2909.86.2.420
- Streiner, D. L., Norman, G. R., & Cairney, J. (2015). Health Measurement Scales: A Practical Guide to Their Development and Use (5th ed.). Oxford University Press.
- Vallat, R. (2018). Pingouin: Statistics in Python. Journal of Open Source Software, 3(31), 1026. https://doi.org/10.21105/joss.01026
- Weir, J. P. (2005). Quantifying test-retest reliability using the intraclass correlation coefficient and the SEM. The Journal of Strength & Conditioning Research, 19(1), 231-240. https://doi.org/10.1519/15184.1