
L’analyse des données contemporaine, confrontée à l’explosion de la dimensionnalité et à la complexité croissante des architectures d’échantillonnage, exige des méthodologies d’investigation capables d’extraire du sens sans imposer de carcan théorique restrictif. Dans les sciences comportementales, la psychométrie, la sociologie quantitative et la bio-informatique, les chercheurs se heurtent fréquemment à des corpus empiriques au sein desquels aucune variable d’étiquetage n’est préalablement définie. Face à ces espaces multivariés, la taxonomie computationnelle s’érige en discipline cardinale pour structurer l’hétérogénéité sous-jacente des observations et révéler des groupements naturels jusqu’alors occultés par la masse informationnelle brute.
Au cœur de cet arsenal exploratoire, la classification ascendante hiérarchique (CAH) occupe une position épistémologique et pratique prépondérante. Contrairement aux approches de partitionnement direct, la démarche hiérarchique ne force pas les observations dans un nombre de catégories arbitrairement figé dès l’amorce de l’analyse. Elle déploie au contraire une perspective morphologique continue, organisant les entités étudiées selon une arborescence graduée qui capture les proximités proximales et les divergences globales. Cette structure généalogique offre une finesse d’analyse inégalée pour appréhender les organisations multi-échelles, des micropopulations homogènes aux macro-typologies générales.
L’environnement statistique R s’impose historiquement comme l’écosystème de prédilection pour conduire ces investigations typologiques de haute précision. Doté d’une implémentation matricielle native optimisée et enrichi par une communauté prolifique d’algorithmiciennes et de statisticiens, R propose une suite complète d’outils dédiés à l’ingénierie des distances, à l’agrégation hiérarchique, à la modélisation sémiologique des arbres et à la validation inférentielle des topologies obtenues. Cet article propose une déconstruction exhaustive, théorique et opérationnelle, de la classification hiérarchique sous R, guidant le chercheur depuis les axiomes fondamentaux de la dissimilarité jusqu’à la validation robuste et l’interprétation substantielle des profils comportementaux.
1. Fondements conceptuels de la classification non supervisée et pertinence académique
1.1 Définition et principes de l’apprentissage non supervisé
L’apprentissage non supervisé se distingue fondamentalement du paradigme supervisé par l’absence délibérée d’une variable cible, d’un label externe ou d’un critère de vérité terrain préalablement assigné aux unités statistiques. Dans le cadre supervisé, l’objectif algorithmique consiste à optimiser une fonction de perte paramétrique ou non paramétrique reliant un vecteur de covariables à une réponse empirique connue, qu’il s’agisse d’une régression continue ou d’une discrimination catégorielle. En revanche, la classification non supervisée évolue au sein d’un espace multidimensionnel où seules les relations endogènes entre observations guident le processus de découverte statistique. Il s’agit d’une démarche purement inductive dans laquelle l’algorithme doit synthétiser la topologie intrinsèque du nuage de points sans guidage téléologique.
Cette approche vise la découverte de structures latentes au sein d’ensembles de données multidimensionnels. L’hypothèse directrice postule que les entités observées ne se distribuent pas de manière aléatoire ou uniforme dans l’espace des variables, mais qu’elles se condensent autour de sous-variétés géométriques ou de bassins de densité spécifiques. Ces concentrations reflètent des régularités sous-jacentes, des mécanismes générateurs communs ou des contraintes écologiques et psychologiques partagées. L’enjeu méthodologique consiste dès lors à projeter la lumière sur ces configurations dissimulées par l’enchevêtrement des covariations, sans introduire de biais de confirmation lié aux attentes du modélisateur.
D’un point de vue épistémologique, la distinction entre analyse prédictive et analyse exploratoire de données, telle que théorisée initialement par John Tukey, prend ici tout son sens. Tandis que la modélisation prédictive se focalise sur l’extrapolation et la performance d’assignation sur de nouveaux échantillons, l’analyse exploratoire vise l’intelligibilité des phénomènes et la génération d’hypothèses novatrices. La classification non supervisée ne prétend pas décréter une vérité ontologique absolue, mais fournir une cartographie heuristique simplifiée de la réalité empirique. Elle permet au chercheur d’appréhender la complexité d’un corpus de données, d’identifier des régularités morphologiques et d’élaborer des cadres typologiques rigoureux susceptibles d’être soumis ultérieurement à des tests confirmatoires.
1.2 Divergences méthodologiques entre classification k-means et classification hiérarchique
La distinction opérationnelle entre le partitionnement non hiérarchique, exemplifié par l’algorithme des k-means (ou k-moyennes), et la classification hiérarchique réside dans la géométrie computationnelle sous-jacente et les contraintes structurelles imposées à l’espace des solutions. Dans le partitionnement k-means, l’analyste est contraint de postuler a priori une valeur exacte pour le nombre de classes, désigné par le paramètre $k$. Cette exigence représente une limite substantielle en phase exploratoire, car la véritable granularité taxinomique du phénomène étudié est généralement ignorée. Une sous-estimation de $k$ comprime l’hétérogénéité empirique et masque des sous-groupes cruciaux, tandis qu’une sur-estimation fracture artificiellement des catégories continues et cohérentes.
Au-delà de cette contrainte initiale, l’algorithme des k-means repose sur un processus d’optimisation itératif hautement sensible aux initialisations aléatoires des centroïdes. Cette instabilité structurelle enferme fréquemment la solution numérique dans des minima locaux de la fonction de variance intra-classe, nécessitant de multiples réplications aléatoires pour stabiliser une solution optimale. De surcroît, le partitionnement par centroïdes impose implicitement une hypothèse d’hyper-sphéricité et d’homogénéité de volume sur les clusters générés, rendant l’algorithme particulièrement vulnérable face à des structures de données asymétriques, allongées ou imbriquées de manière non convexe.
À l’inverse, l’approche hiérarchique s’affranchit totalement de la fixation préalable d’un nombre $k$ d’agrégats. Elle déploie une trajectoire d’assemblage continue et déterministe, matérialisée sous la forme d’un arbre généalogique appelé dendrogramme. Chaque palier d’agrégation ou de scission reflète une intensité mathématique de proximité, permettant au praticien d’examiner simultanément de multiples niveaux de granularité sans devoir recalculer intégralement les partitions. Cette absence de contrainte initiale, couplée à un déterminisme absolu des calculs dès lors que la matrice de dissimilarité est fixée, confère à la classification hiérarchique une transparence conceptuelle et une flexibilité analytique supérieures pour la caractérisation fine des données comportementales.
1.3 Applications psychologiques et comportementales des méthodes de clustering
Dans les disciplines psychologiques et comportementales, la variabilité interindividuelle constitue à la fois un défi analytique majeur et le cœur même de l’investigation empirique. La classification hiérarchique y trouve une application privilégiée pour l’identification de profils de personnalité et de typologies comportementales. Plutôt que de postuler l’existence de types de personnalités rigides et mutuellement exclusifs sur une base purement intuitive, les chercheurs utilisent les méthodes de clustering pour agréger des individus sur la base de patterns multidimensionnels complexes. Par exemple, au sein du modèle des Big Five, la classification permet de vérifier l’émergence empirique de constellations de traits spécifiques, comme les profils résilients, surcontrôlés ou sous-contrôlés, validant ou infirmant les théories morphologiques de la personnalité humaine.
L’exploitation de la classification hiérarchique s’étend avec une efficacité remarquable à la segmentation des réponses apportées à des échelles psychométriques et des inventaires cliniques standardisés. Les questionnaires d’évaluation de la symptomatologie dépressive, des manifestations anxieuses ou du syndrome d’épuisement professionnel (burnout) génèrent des matrices de covariance denses où les individus manifestent des profils de détresse hétéroclites. Le clustering permet d’isoler des sous-populations cliniques présentant des configurations symptomatiques distinctes, telles que des formes de dépression à prédominance somatique versus cognitive, autorisant ainsi une catégorisation diagnostique plus fine que celle proposée par les scores globaux univariés.
Enfin, la recherche translationnelle et les sciences de l’éducation mobilisent l’approche arborescente pour explorer l’hétérogénéité des trajectoires thérapeutiques, développementales ou d’apprentissage. En intégrant des mesures longitudinales répétées au sein du calcul de dissimilarité, la classification hiérarchique permet de cartographier la divergence des évolutions individuelles au fil du temps. Les cliniciens peuvent dès lors repérer des trajectoires d’échec précoce, des profils de rémission spontanée ou des patterns de résistance aux psychothérapies conventionnelles, fournissant ainsi une base empirique pour l’adaptation personnalisée des protocoles d’intervention.
2. Taxonomie algorithmique : approches ascendantes et descendantes
2.1 Classification ascendante hiérarchique (CAH) : algorithme agglomératif
La classification ascendante hiérarchique, désignée sous l’appellation générique d’algorithme agglomératif, suit une trajectoire computationnelle partant de la base de l’arborescence pour s’élever progressivement vers son sommet. Au stade initial de la procédure, noté étape zéro, l’algorithme considère que chaque observation individuelle constitue un cluster unitaire à part entière, désigné dans la littérature sous le terme de singleton. Pour un ensemble de données comprenant $n$ entités d’observation, la configuration de départ comporte donc rigoureusement $n$ clusters disjoints, chacun caractérisé par une inertie interne nulle et une distance réflexive égale à zéro.
Le processus se déroule ensuite de manière itérative selon un schéma d’agrégation glouton (greedy algorithm). À chaque étape de la boucle computationnelle, l’algorithme scanne l’ensemble de la matrice de dissimilarité pour identifier les deux groupes présentant la plus faible distance globale, selon le critère de liaison préalablement sélectionné. Ces deux entités sont immédiatement fusionnées au sein d’un nouveau cluster composite, réduisant le nombre total de groupes de $k$ à $k – 1$. La matrice de distance est alors actualisée pour intégrer cette nouvelle entité et recalculer ses proximités avec l’ensemble des clusters restants. Ce cycle de détection et de coalescence se répète exactement $n – 1$ fois, jusqu’à ce que la totalité des observations soit agglomérée au sein d’un macro-cluster universel unique renfermant la population globale.
Cette élégance conceptuelle s’accompagne d’un coût computationnel substantiel qui gouverne la praticabilité de l’approche. Sur le plan de la complexité temporelle, l’implémentation naïve de l’algorithme agglomératif présente une complexité asymptotique de l’ordre de $O(n^3)$, bien que des formulations algorithmiques optimisées, à l’instar de l’algorithme de Murtagh et Legendre, parviennent à abaisser cette charge à une complexité quadratique en $O(n^2)$. Sur le plan spatial, la nécessité de stocker en mémoire vive la matrice triangulaire inférieure des distances impose une allocation mémoire en $O(n^2)$. Pour des cohortes dépassant plusieurs dizaines de milliers d’individus, ces exigences matérielles entraînent une saturation rapide de la RAM, érigeant la taille d’échantillon en contrainte technique déterminante.
2.2 Classification descendante hiérarchique : algorithme divisif
À l’opposé diamétral de la logique agglomérative, la classification descendante hiérarchique, incarnée historiquement par l’algorithme DIANA (Divisive Analysis) développé par Leonard Kaufman et Peter Rousseeuw, amorce son parcours taxinomique au sommet de la hiérarchie. Dans cette configuration initiale, l’intégralité des $n$ observations est condensée dans un macro-cluster universel unique. L’objectif algorithmique consiste dès lors à fractionner récursivement cet ensemble hétérogène en sous-groupes successifs, de manière à maximiser la variance ou la distance inter-classes à chaque scission spatiale.
À chaque itération de la procédure divisive, l’algorithme identifie le cluster présentant le diamètre le plus élevé, c’est-à-dire l’hétérogénéité interne maximale. Au sein de ce groupe, l’observation démontrant la plus grande dissimilarité moyenne par rapport à l’ensemble de ses pairs est extraite pour initier un groupe dissident (splinter group). Les autres entités de l’agrégat sont ensuite réattribuées séquentiellement à ce nouveau noyau dissident si leur proximité moyenne avec celui-ci surpasse leur proximité avec le groupe d’origine. Cette mécanique de bifurcation binaire se poursuit jusqu’à l’isolement complet de chaque individu sous forme de singleton terminal.
En dépit de son élégance mathématique et de son aptitude théorique à capturer avec une grande acuité les macro-structures globales des données dès les premiers découpages, l’approche divisive demeure marginale dans la recherche appliquée en raison de son coût de calcul exponentiel. Le nombre de partitions binaires possibles pour scinder un ensemble de $n$ éléments en deux sous-ensembles non vides est donné par la combinatoire $2^{n-1} – 1$. L’exploration exhaustive de cet espace décisionnel devenant instantanément prohibitive dès lors que $n$ excède quelques dizaines d’unités, les implémentations pratiques doivent recourir à des heuristiques d’optimisation locale strictes. Cette limitation structurelle explique la prépondérance quasi hégémonique de la classification ascendante dans les progiciels statistiques contemporains.
2.3 Représentation conceptuelle du dendrogramme
Le dendrogramme, du grec dendron signifiant arbre et gramma désignant le tracé, constitue la transcription graphique bidimensionnelle intégrale du processus de classification hiérarchique. Sa topologie arborescente met en scène l’histoire séquentielle des regroupements ou des divisions. Les feuilles terminales de l’arbre correspondent aux unités statistiques individuelles ou aux variables analysées. À mesure que l’on progresse le long de la structure, des branches horizontales et verticales s’entrecroisent pour matérialiser les points de jonction où deux entités distinctes s’unissent pour former un groupe morphologique unifié.
L’axe des ordonnées (ou des abscisses selon l’orientation adoptée) possède une sémantique fondamentale : il quantifie la distance ultramétrique à laquelle s’opère chaque événement de fusion. Contrairement à une simple distance géométrique, la distance ultramétrique satisfait une inégalité triangulaire renforcée, formulée par la relation $d(x, z) le max[d(x, y), d(y, z)]$. Cette hauteur d’interconnexion indique l’ampleur de la dissimilarité séparant les sous-ensembles au moment précis de leur agrégation. Plus un nœud d’articulation se situe à une altitude élevée dans le dendrogramme, plus la divergence morphologique entre les groupes fusionnés est prononcée, signalant une hétérogénéité substantielle.
Une propriété mathématique cardinale de cette représentation réside dans la monotonie des hauteurs de fusion successives. Dans des conditions standard de liaison, l’altitude des nœuds croît de manière strictement monotone au fil des itérations agglomératives, garantissant l’absence d’inversions visuelles perturbatrices (crossovers). Le dendrogramme réussit la prouesse graphique de compresser une structure relationnelle définie au sein d’un hyper-espace multidimensionnel complexe pour la projeter fidèlement dans un plan interprétable, préservant la hiérarchisation globale des voisinages sans dénaturer les proximités relatives originelles.
3. Formalisation mathématique des métriques de distance et matrices de dissimilarité
3.1 Distances géométriques pour données continues
Le point de départ analytique de toute classification hiérarchique réside dans la conversion d’une matrice d’observations de dimensions $n \times p$, comportant $n$ individus décrits par $p$ covariables quantitatives, en une matrice de dissimilarité carrée et symétrique de dimensions $n \times n$. Dans le domaine des variables strictement continues, les distances géométriques issues de l’espace métrique réel représentent le socle classique de calcul. La métrique la plus universellement employée est la distance euclidienne canonique. Pour deux vecteurs d’observations individuelles notés $\mathbf{x}_i = (x_{i1}, x_{i2}, dots, x_{ip})$ et $\mathbf{x}_j = (x_{j1}, x_{j2}, dots, x_{jp})$, la distance euclidienne se formalise ainsi :
$$d_{\text{Euclidienne}}(\mathbf{x}_i, \mathbf{x}_j) = \sqrt{\sum_{k=1}^{p} (x_{ik} – x_{jk})^2}$$
Cette formulation mesure la longueur du segment rectiligne reliant deux points dans un espace euclidien $p$-dimensionnel. Dans de nombreux algorithmes d’optimisation, la distance euclidienne au carré est préférée afin d’alléger les calculs en s’affranchissant de l’opérateur de racine carrée et de conférer une pénalité quadratique croissante aux écarts dimensionnels marqués. Toutefois, la métrique euclidienne manifeste une sensibilité aiguë aux valeurs aberrantes (outliers), car la sommation des différences élevées au carré amplifie de façon disproportionnée l’impact des variations extrêmes situées sur une seule dimension.
Pour atténuer cette vulnérabilité structurelle, la distance de Manhattan, également connue sous le terme de norme $L_1$ ou distance en blocs de ville (city-block distance), propose une formulation géométrique plus robuste. Elle correspond à la somme des valeurs absolues des écarts unidimensionnels :
$$d_{\text{Man\hat\tan}}(\mathbf{x}_i, \mathbf{x}_j) = \sum_{k=1}^{p} |x_{ik} – x_{jk}|$$
En renonçant à l’élévation quadratique, la norme $L_1$ assure une invariance de pondération face aux écarts marginaux, ce qui en fait un instrument de choix lorsque les distributions empiriques présentent des queues épaisses. Ces deux mesures constituent des cas particuliers d’une formalisation paramétrique plus globale : la distance de Minkowski d’ordre $m$, définie par :
$$d_{\text{Minkowski}}(\mathbf{x}_i, \mathbf{x}_j) = \left( \sum_{k=1}^{p} |x_{ik} – x_{jk}|^m \right)^{\frac{1}{m}}$$
Cette généralisation permet à l’analyste de moduler la sévérité accordée aux déviations dimensionnelles en manipulant le paramètre continu $m$, où $m=1$ restitue la distance de Manhattan, $m=2$ équivaut à la distance euclidienne, et la limite quand $m to \infty$ converge vers la distance de Chebyshev, dominée par le différentiel unidimensionnel maximal absolu.
3.2 Distances corrélationnelles et angulaires pour variables psychométriques
Dans de nombreuses investigations psychologiques et psychométriques, la proximité d’intérêt entre deux sujets ne réside pas dans l’égalité arithmétique absolue de leurs réponses, mais dans l’homologie structurale de leurs profils comportementaux. Deux individus évaluant une série d’items sur une échelle ordinale peuvent manifester un décalage d’ancrage systématique lié à des styles de réponse contrastés (l’un acquiesçant globalement de façon généreuse tandis que l’autre modère ses pointages), tout en partageant une hiérarchisation rigoureusement identique de leurs préférences. Dans un tel contexte, les distances géométriques classiques s’avèrent inadaptées, car elles interprètent ce décalage d’échelle additif comme une dissemblance substantielle.
La distance basée sur le coefficient de corrélation linéaire de Pearson pallie cette difficulté en mesurant l’affinité morphologique des patterns de réponse. Elle s’obtient généralement en retranchant le coefficient de corrélation linéaire bivarié de la valeur unitaire, sous la forme $d_{\text{Pearson}}(\mathbf{x}_i, \mathbf{x}_j) = 1 – r_{ij}$, ou par sa transformation métrique normalisée $d_{\text{Pearson_metrique}}(\mathbf{x}_i, \mathbf{x}_j) = \sqrt{2(1 – r_{ij})}$. Cette mesure s’annule lorsque deux profils sont strictement proportionnels et covariants, neutralisant ainsi les variations d’ordonnée à l’origine et les amplitudes globales de réponse pour se concentrer exclusivement sur la dynamique des variations relatives à travers les items.
Lorsque les données empiriques découlent d’échelles de Likert ordinales ou violent les présomptions de normalité bivariée, la distance basée sur le coefficient de corrélation de rangs de Spearman constitue l’alternative non paramétrique idéale. Elle s’évalue en convertissant préalablement les valeurs dimensionnelles de chaque individu en rangs internes avant d’appliquer la formulation corrélationnelle. D’autre part, la distance cosinus évalue l’angle vectoriel séparant deux observations au sein de l’espace multidimensionnel :
$$\cos(\theta) = \frac{\mathbf{x}_i \cdot \mathbf{x}_j}{|\mathbf{x}_i|_2 |\mathbf{x}_j|_2}$$
La distance cosinus, définie par $1 – \cos(\theta)$, fait abstraction totale de la norme ou de la magnitude vectorielle pour focaliser la quantification de similarité sur l’orientation directionnelle pure. Cette métrique trouve un écho fondamental dans les analyses textuelles, l’exploration de corpus sémantiques psychologiques et le traitement de données comportementales de haute dimension où la sparsité matricielle est élevée.
3.3 Dissimilarités mixtes et distance de Gower
Les protocoles de recherche en sciences humaines et sociales collectent rarement des jeux de données d’une pureté métrique unilatérale. Les bases de données agrègent couramment des covariables quantitatives continues (âge, indices physiologiques), des variables catégorielles nominales polytomiques (appartenance culturelle, statut marital), des variables dichotomiques binaires symétriques ou asymétriques (présence ou absence de traits nosographiques) et des mesures d’ordre ordinal (degrés de sévérité clinique). L’application directe d’une métrique euclidienne sur de tels ensembles hybrides constitue une aberration méthodologique détruisant la validité de l’analyse.
Pour surmonter cette contrainte complexe, John C. Gower a formulé en 1971 un coefficient de dissimilarité générale permettant de combiner simultanément ces diverses échelles au sein d’une métrique unifiée. Le coefficient de dissimilarité de Gower entre l’observation $i$ et l’observation $j$, noté $S_{ij}$, est défini par la moyenne pondérée des dissimilarités partielles calculées sur l’ensemble des $p$ dimensions variables :
$$S_{ij} = \frac{\sum_{k=1}^{p} w_{ijk} s_{ijk}}{\sum_{k=1}^{p} w_{ijk}}$$
Dans cette formalisation mathématique d’une rare élégance, le terme $s_{ijk}$ représente la contribution de dissimilarité de la $k$-ième variable. Pour une variable quantitative ou ordinale, $s_{ijk} = |x_{ik} – x_{jk}| / R_k$, où $R_k$ désigne l’étendue (l’amplitude maximale observée) de la variable $k$ au sein de la cohorte échantillonnale globale. Pour une variable catégorielle nominale, $s_{ijk}$ adopte une logique bivalente : la valeur est fixée à $0$ si les deux sujets partagent la même modalité et à $1$ en cas de discordance catégorielle. Le paramètre de pondération $w_{ijk}$ prend généralement la valeur $1$, mais il bascule automatiquement à $0$ si l’une des observations présente une valeur manquante pour la variable considérée, ou dans le cas d’une variable binaire asymétrique où l’absence mutuelle d’un trait rare ne doit pas être interprétée comme un indice de proximité structurelle.
L’implémentation opérationnelle de cette métrique sous l’environnement R est encapsulée de manière optimale dans la fonction daisy du package cluster. Cette fonction identifie automatiquement le type statistique de chaque colonne au sein d’un dataframe ou autorise l’utilisateur à spécifier explicitement la nature métrique de chaque covariable via l’argument type. Elle génère en sortie un objet de classe dissimilarity, prêt à être injecté de façon transparente dans les algorithmes de classification hiérarchique.
4. Mécanismes de liaison (Linkage Methods) et dynamique d’agrégation
4.1 Liaison simple (Single Linkage) et liaison complète (Complete Linkage)
Lors de chaque itération agglomérative d’une classification hiérarchique, l’algorithme doit évaluer la distance non plus entre deux points isolés, mais entre deux grappes composites renfermant potentiellement de multiples observations. Le mécanisme régissant cette évaluation est formalisé par la méthode de liaison (linkage method). La méthode de la liaison simple, ou règle du plus proche voisin, stipule que la dissimilarité séparant deux clusters $A$ et $B$ équivaut à la distance minimale absolue existant entre n’importe quel élément de $A$ et n’importe quel élément de $B$ :
$$D_{\text{single}}(A, B) = \min { d(x, y) : x in A, , y in B }$$
Cette modalité de calcul confère à l’algorithme la capacité théorique de détecter des clusters présentant des géométries non linéaires complexes, telles que des structures concentriques ou sinueuses. Cependant, la liaison simple souffre d’un écueil structurel notoire désigné sous l’appellation d’effet de chaîne (chaining effect). Il suffit qu’une séquence continue de points épars fasse office de pont spatial entre deux concentrations de densité denses pour que la liaison simple les fusionne prématurément, générant des dendrogrammes étirés, asymétriques et pratiquement inexploitables pour l’interprétation substantielle.
À l’autre extrémité du spectre se situe la méthode de la liaison complète, ou règle du voisin le plus éloigné. Ici, la dissimilarité inter-clusters est définie par la distance maximale observable entre une entité issue du cluster $A$ et une entité issue du cluster $B$ :
$$D_{\text{complete}}(A, B) = \max { d(x, y) : x in A, , y in B }$$
Cette approche impose une contrainte de compacité spatiale particulièrement stricte. Deux groupes ne peuvent être fusionnés que si le diamètre de l’agrégat résultant n’excède pas un certain seuil de proximité. La liaison complète neutralise radicalement l’effet de chaîne et tend à produire des grappes compactes, bien sphériques et de dimensions géométriques équivalentes. Toutefois, sa sensibilité aux valeurs aberrantes est extrême : une seule observation atypique située en périphérie d’un groupe peut enfler considérablement la distance globale et empêcher une fusion légitime.
4.2 Liaison moyenne (Average Linkage / UPGMA) et liaison médiane
Pour concilier la permissivité de la liaison simple et le conservatisme de la liaison complète, les méthodologistes recourent fréquemment à la liaison moyenne, connue historiquement sous l’acronyme UPGMA (Unweighted Pair Group Method with Arithmetic Mean). Cette approche évalue la dissimilarité entre deux clusters $A$ et $B$ comme la moyenne arithmétique de l’ensemble des distances reliant toutes les paires possibles d’observations inter-groupes :
$$D_{\text{average}}(A, B) = \frac{1}{|A| \cdot |B|} \sum_{x in A} \sum_{y in B} d(x, y)$$
En intégrant la globalité des interactions par paires, la liaison moyenne amortit l’impact déstabilisateur des observations singulières et produit des arbres équilibrés qui reflètent fidèlement la densité relative des nuages de points. Cette méthode est réputée pour sa robustesse empirique et son excellente préservation des distances métriques originelles au sein de la matrice cophénétique.
Il convient de distinguer l’UPGMA de sa variante pondérée, le WPGMA (Weighted Pair Group Method with Arithmetic Mean), également désigné sous le terme de méthode de McQuitty. Dans la formule UPGMA, chaque observation individuelle contribue de manière équiprobable au calcul final, ce qui confère un poids supérieur aux clusters comportant un effectif élevé. Dans le WPGMA, lors de la fusion d’un cluster $A$ avec un groupe résultant de l’union préalable de $B$ et $C$, la distance est calculée simplement par la demi-somme des distances $D(A, B)$ et $D(A, C)$, indépendamment du nombre d’individus hébergés dans chaque entité. Cette pondération uniforme des sous-branches est particulièrement utile lorsque l’échantillonnage présente des déséquilibres artificiels de représentativité.
Enfin, la liaison médiane et la méthode du centroïde (UPGMC) projettent les clusters au travers de leurs points focaux géométriques. La méthode du centroïde mesure la distance séparant les centres de gravité respectifs des deux groupes. Bien qu’intuitive, cette formulation recèle un risque mathématique majeur : elle peut enfreindre la monotonie de la hauteur de fusion, provoquant des inversions de branches sur le dendrogramme (un cluster parent étant agrégé à une altitude inférieure à celle de ses propres sous-composants), ce qui complique sévèrement sa lecture sémiologique.
4.3 Méthode de Ward : minimisation de l’inertie intra-classe
Introduite par Joe H. Ward Jr. en 1963, la méthode de minimisation de la variance constitue sans conteste l’algorithme d’agrégation le plus plébiscité dans les sciences sociales et comportementales. Contrairement aux approches géométriques fondées sur des extrêmes ou des moyennes locales, Ward ancre sa logique décisionnelle dans la théorie de l’analyse de la variance (ANOVA) et le théorème de décomposition de l’inertie de Huygens. Selon ce principe, l’inertie totale $I_{\text{tot}}$ d’un nuage d’observations se décompose rigoureusement en la somme de l’inertie intra-classe ($I_{\text{intra}}$ ou Within-cluster Sum of Squares, WSS) et de l’inertie inter-classes ($I_{\text{inter}}$ ou Between-cluster Sum of Squares, BSS) :
$$I_{\text{tot}} = I_{\text{intra}} + I_{\text{inter}}$$
À chaque étape d’agrégation ascendante, la fusion de deux groupes entraîne nécessairement une dégradation de l’homogénéité interne globale, se traduisant par un accroissement direct de l’inertie intra-classe. Le critère de Ward stipule que l’algorithme doit fusionner, à chaque itération, la paire de clusters dont la réunion minimise l’augmentation de cette inertie intra-classe, ce qui équivaut rigoureusement à maximiser la variance inter-classes résultante. Le surcroît de variance induit par la fusion des groupes $A$ et $B$, possédant respectivement des effectifs $n_A$ et $n_B$ et des centres de gravité $\mathbf{g}_A$ et $\mathbf{g}_B$, s’exprime selon la formule métrique :
$$\Delta I(A, B) = \frac{n_A n_B}{n_A + n_B} |\mathbf{g}_A – \mathbf{g}_B|^2$$
Cette formalisation confère à la méthode de Ward une propension naturelle à générer des classes remarquablement compactes, denses, homogènes et de dimensions comparables. Dans l’écosystème R, une subtilité algorithmique cardinale doit être maîtrisée lors de l’appel de la fonction hclust : la distinction entre les arguments method = « ward.D » et method = « ward.D2 ». L’algorithme mathématique original formulé par Ward exige que les distances injectées soient des distances euclidiennes élevées au carré. Lorsque l’analyste utilise ward.D2, le logiciel prend en entrée une matrice de distances euclidiennes standards $d$ et applique automatiquement l’élévation au carré au cours de la formule de récurrence de Lance-Williams. À l’inverse, l’option historique ward.D applique la formule directement sur les distances non carrées, générant un écart par rapport à la véritable minimisation de l’inertie de Ward. Dans la quasi-totalité des contextes de recherche contemporains, l’usage exclusif de ward.D2 est donc formellement prescrit.
5. Configuration de l’environnement de travail et sélection du jeu de données en R
5.1 Sélection et chargement des bibliothèques R spécialisées
Pour exécuter un pipeline complet de classification hiérarchique alliant rigueur algorithmique, puissance graphique et profondeur diagnostique, le chargement préalable d’une suite modulaire de packages spécialisés est impératif. Bien que le moteur de base de R contienne des fonctions fonctionnelles comme hclust et dist, l’ingénierie moderne s’appuie sur des extensions conçues pour enrichir l’analytique et standardiser les flux de données. Le package fondamental cluster fournit l’infrastructure computationnelle avancée pour le calcul de dissimilarités mixtes via daisy et les méthodes d’agrégation alternatives comme agnes. Parallèlement, le package factoextra propose une couche d’abstraction moderne dédiée à la visualisation élégante des modèles factoriels et des partitions de clustering.
La bibliothèque dendextend représente l’outil le plus abouti pour la chirurgie et la manipulation fine des objets dendrogrammiques sous R. Elle permet d’accéder à chaque nœud, branche et étiquette de l’arbre pour en modifier les propriétés sémiologiques de manière programmatique. En complément, la collection de packages réunie sous la bannière du tidyverse, incluant dplyr, tidyr et ggplot2, garantit une manipulation fluide des structures tabulaires, simplifiant l’intégration ultérieure des scores de clustering au sein du dataframe analytique original.
Enfin, la question de la reproductibilité scientifique impose une gestion scrupuleuse des dépendances et de l’aléa logiciel. Bien que la classification ascendante hiérarchique soit déterministe dans son calcul une fois la matrice de distance établie, de multiples phases adjacentes de l’analyse – telles que le rééchantillonnage statistique (bootstrap), les algorithmes d’imputation stochastique ou l’initialisation de projections factorielles – dépendent directement du générateur de nombres pseudo-aléatoires de R. L’initialisation systématique de la graine computationnelle via l’instruction set.seed() doit figurer au début absolu de tout script de recherche, scellant l’invariance exacte des sorties numériques et graphiques à travers les réplications.
5.2 Présentation et inspection descriptive du jeu de données
Pour ancrer cette démonstration dans un réalisme empirique tangible, nous sélectionnons un jeu de données multidimensionnel issu de la psychométrie appliquée et des sciences comportementales. Considérons un échantillon de $n = 300$ individus ayant complété un inventaire d’évaluation de la symptomatologie de l’épuisement professionnel et de la santé psychologique au travail. Ce protocole évalue six dimensions quantitatives fondamentales : l’épuisement émotionnel (EE), la dépersonnalisation ou cynisme professionnel (DP), la perte d’accomplissement personnel (AP), le niveau d’anxiété situationnelle (ANX), les manifestations somatiques du stress (SOM) et l’engagement cognitif au travail (ENG). L’enjeu est d’identifier si la population se structure spontanément en typologies cliniquement intelligibles, sans orienter les catégories par des coupures arbitraires.
L’amorce de la procédure sous R requiert une auscultation minutieuse de la morphologie du jeu de données à l’aide des primitives d’inspection globale. L’application de la fonction str() renseigne sur l’architecture interne de l’objet, confirmant la nature matricielle ou tabulaire des données et l’adéquation des typages de colonnes (valeurs numériques continues). La fonction glimpse(), issue de l’écosystème dplyr, offre une visualisation condensée des premiers vecteurs individuels, permettant de vérifier l’alignement des variables.
Simultanément, l’exécution de la commande summary() génère les statistiques descriptives paramétriques et non paramétriques élémentaires : minimums, premiers quartiles, médianes, moyennes arithmétiques, troisièmes quartiles et valeurs maximales pour chaque échelle d’évaluation. Cette première lecture permet de repérer d’éventuelles anomalies de saisie, telles que des scores excédant les bornes théoriques de l’inventaire psychométrique, et d’observer les disparités d’amplitude globale séparant les différentes dimensions d’investigation.
5.3 Exploration visuelle préliminaire des corrélations
Avant d’engager le calcul de la dissimilarité interindividuelle, il est méthodologiquement indispensable de sonder la structure d’intercorrélation des variables psychométriques. En effet, dans le calcul de la plupart des métriques géométriques comme la distance euclidienne, l’existence d’une forte colinéarité entre deux ou plusieurs variables introduit une redondance informationnelle majeure. Deux échelles hautement corrélées (par exemple, $r > 0.85$ entre l’épuisement émotionnel et l’anxiété) capturent un construit psychologique sous-jacent quasi identique. En intégrant ces deux colonnes sans ajustement, le chercheur accorde implicitement un poids mathématique double à cette dimension symptomatique, biaisant la topologie finale du dendrogramme au détriment des variables indépendantes.
Pour cartographier ces dépendances multivariées sous R, la matrice de corrélation de Pearson ou de Spearman est générée à l’aide de la fonction cor(), puis projetée visuellement via le package corrplot. La commande corrplot(cor(data), method = « circle », type = « upper ») déploie une sémiologie graphique où la couleur et la dimension des cercles quantifient l’amplitude et la direction des liens de covariance. Une telle matrice permet d’identifier d’un coup d’œil les blocs dimensionnels synergiques et d’anticiper la structure factorielle qui guidera la formation des clusters.
En présence d’une matrice de dispersion bivariée, tracée à l’aide de la fonction pairs() ou de bibliothèques avancées telles que GGally::ggpairs(), l’analyste peut également contrôler la linéarité des relations, l’hétéroscédasticité des résidus et l’existence potentielle de sous-populations multimodales déjà visibles sur des projections bidimensionnelles. Cette inspection confirme si certaines variables dominantes risquent d’écraser la mesure d’éloignement global.
6. Prétraitement rigoureux : normalisation, centrage et traitement des données manquantes
6.1 Impact critique de l’échelle de mesure sur les métriques de distance
L’écueil méthodologique le plus dévastateur dans l’application de la classification hiérarchique réside dans l’asymétrie non contrôlée des variances et des échelles d’expression des variables. Considérons une analyse comportementale combinant une variable psychophysiologique, telle que la conductance cutanée ou le rythme cardiaque mesuré sur une amplitude s’étendant de $60$ à $180$ battements par minute, et une échelle psychométrique standardisée bornée entre $1$ et $5$. Si la distance euclidienne est calculée directement sur ces données brutes, l’écart maximal potentiel sur la dimension cardiaque est de $120$ unités, tandis qu’il n’est que de $4$ unités sur l’échelle psychométrique.
Dans cette configuration, les différences arithmétiques observées sur le rythme cardiaque vont totalement écraser les écarts observés sur l’échelle psychométrique lors de l’élévation des différences au carré. La distance globale deviendra un reflet quasi exclusif de la variable physiologique, réduisant l’échelle psychométrique à un bruit statistique marginal. L’algorithme de clustering n’opérera dès lors pas une synthèse multidimensionnelle équilibrée, mais une simple segmentation univariée déguisée sous une forme multivariée.
Ce phénomène d’écrasement métrique impose une règle méthodologique intangible : toute classification hiérarchique reposant sur des distances géométriques doit impérativement être précédée d’une étape de standardisation rigoureuse. Cette transformation mathématique a pour objectif d’homogénéiser l’influence relative de chaque variable dans l’espace multidimensionnel, garantissant que chaque trait psychologique dispose d’un pouvoir discriminant équitable lors de la construction des topologies dendrogrammiques.
6.2 Techniques de centrage et réduction des variables sous R
L’environnement R propose une panoplie de techniques de transformation pour uniformiser les distributions empiriques. L’approche standard la plus employée dans la littérature scientifique est la standardisation par le score $z$ (z-score scaling), exécutée nativement par la fonction scale(). Cette procédure soustrait la moyenne arithmétique de chaque variable et divise la différence par l’écart-type empirique correspondant :
$$z_{ik} = \frac{x_{ik} – \bar{x}_k}{s_k}$$
Après application de la commande data_scaled <- scale(data), chaque covariable se caractérise par une moyenne rigoureusement égale à zéro et une variance (ainsi qu’un écart-type) unitaire. La distance euclidienne calculée sur cette matrice standardisée reflète dès lors les déviations des individus par rapport au barycentre de l’échantillon, exprimées en unités d’écart-type, rétablissant une équité métrique totale entre variables.
Cependant, la standardisation par le score $z$ s’appuie sur la moyenne et l’écart-type, deux indicateurs paramétriques notoirement vulnérables à la présence de valeurs extrêmes. Si un échantillon contient des valeurs aberrantes massives, l’écart-type sera gonflé artificiellement, comprimant la variance du reste de la cohorte. Pour immuniser le prétraitement contre cette distorsion, l’analyste peut recourir à la standardisation robuste basée sur la médiane et l’écart absolu médian (MAD, Median Absolute Deviation) :
$$x_{ik}^{\text{robuste}} = \frac{x_{ik} – \text{Med}_k}{\text{MAD}_k}$$
Sous R, cette transformation s’implémente aisément via des fonctions personnalisées ou par le package robustbase. Une autre stratégie alternative, la normalisation min-max, contraint l’ensemble des observations dans un intervalle fermé $[0, 1]$ par la formule $(x_{ik} – \min_k) / (\max_k – \min_k)$. Cette dernière est particulièrement indiquée lorsque la distribution des données est bornée par construction et que l’on désire préserver rigoureusement l’homothétie originelle des supports numériques sans assumer une distribution gaussienne sous-jacente.
6.3 Gestion des valeurs manquantes et des valeurs aberrantes
Les fonctions algorithmiques de classification hiérarchique sous R, telles que dist() et hclust(), ne tolèrent structurellement aucune cellule manquante (NA). Dès lors qu’une seule composante d’un vecteur d’observation fait défaut, le calcul de la distance euclidienne entre ce sujet et l’ensemble de ses pairs devient indéterminé. L’analyste se trouve confronté à l’arbitrage critique entre la suppression des cas non complets (listwise deletion) et l’imputation statistique.
L’élimination pure et simple des sujets présentant des valeurs manquantes, bien que triviale via na.omit(), introduit des biais d’échantillonnage sévères si le mécanisme générateur des données manquantes n’est pas strictement indépendant du phénomène étudié (mécanismes MAR, Missing at Random, ou MNAR, Missing Not at Random). De plus, elle ampute la puissance statistique de l’étude. Il est dès lors largement préférable de mobiliser des protocoles d’imputation multivariée sophistiqués. Dans les cadres multidimensionnels, l’imputation par les $k$ plus proches voisins (k-NN) ou l’imputation factorielle par le package spécialisé missMDA (via la fonction imputePCA() de Josse et Husson) permettent d’estimer les valeurs absentes en exploitant la structure de corrélation globale des variables, sans déformer la matrice de variance-covariance empirique.
Parallèlement, la détection des valeurs aberrantes multivariées (multivariate outliers) constitue une étape non négociable. Un individu peut présenter des valeurs univariées acceptables sur chaque item pris isolément, mais afficher une combinaison hautement improbable au regard de la structure générale de la population. L’identification de ces profils s’opère par le calcul de la distance de Mahalanobis pour chaque observation :
$$D_M(\mathbf{x}_i) = \sqrt{(\mathbf{x}_i – boldsymbol{\mu})^T boldsymbol{\Sigma}^{-1} (\mathbf{x}_i – boldsymbol{\mu})}$$
où $boldsymbol{\mu}$ désigne le vecteur des moyennes et $boldsymbol{\Sigma}$ la matrice de covariance de l’échantillon. Les observations dont la distance de Mahalanobis excède la valeur critique issue de la distribution du Chi-carré au seuil nominal (souvent $\alpha = 0.001$) doivent être soumises à un examen approfondi. Si ces entités résultent d’erreurs de saisie ou d’échantillonnage, leur retrait s’impose; s’il s’agit de singularités réelles, leur influence sur le dendrogramme doit être surveillée pour éviter qu’elles ne forment des branches isolées artificielles qui dégraderaient l’interprétation des clusters principaux.
7. Implémentation pas à pas de la classification ascendante hiérarchique avec hclust
7.1 Calcul de la matrice de distance empirique
Une fois les variables nettoyées et correctement standardisées au sein d’un dataframe ou d’une matrice numérique, la première phase opérationnelle du pipeline de classification consiste à calculer la matrice de dissimilarité pairwise. Dans R, l’outil canonique dédié à cette tâche est la fonction dist(). Cette primitive logicielle, hautement optimisée en langage C sous-jacent, prend en argument le jeu de données transformé et calcule les écarts entre toutes les paires d’observations.
L’argument method spécifie la géométrie métrique retenue pour le traitement. Les options disponibles incluent « euclidean », « maximum », « manhattan », « canberra », « binary » ou « minkowski ». Pour notre étude psychométrique standardisée, l’instruction s’exécute selon la syntaxe suivante :
d_matrix <- dist(data_scaled, method = "euclidean")
Le résultat produit par cet appel n’est pas un tableau rectangulaire conventionnel, mais un objet spécifique de classe dist. Afin d’économiser l’espace en mémoire vive, R ne stocke pas les $n^2$ entrées de la matrice complète, mais uniquement la partie triangulaire inférieure stricte, excluant la diagonale principale dont les valeurs sont identiquement nulles par axiome d’auto-similarité. Pour examiner visuellement les premiers coefficients d’éloignement, l’analyste peut convertir temporairement cet objet en matrice classique via la commande as.matrix(d_matrix)[1:5, 1:5].
Il importe de souligner les contraintes d’échelle liées à ce calcul. La dimension de l’objet dist croît selon la combinatoire $n(n – 1) / 2$. Si pour $n = 300$ individus, la matrice ne requiert que $44,850$ valeurs à stocker (une charge dérisoire pour les systèmes informatiques actuels), un échantillon de $n = 50,000$ sujets exige l’allocation d’environ $1.25 \times 10^9$ éléments en double précision, représentant près de $10$ gigaoctets de mémoire vive rien que pour la structure de distance. Cette réalité computationnelle rappelle l’importance de dimensionner judicieusement ses protocoles expérimentaux sous R.
7.2 Exécution de l’algorithme agglomératif hclust
La matrice de distance empirique étant instanciée, le déploiement de l’agglomération hiérarchique s’opère par l’appel de la fonction hclust(). Cette fonction prend en entrée prioritaire l’objet de distance préalablement calculé et applique de façon récursive le critère de fusion désigné par le paramètre method. Dans le respect des recommandations relatives à la minimisation de l’inertie intra-classe, nous formulons l’instruction :
hc_ward <- hclust(d_matrix, method = "ward.D2")
L’objet retourné, de classe hclust, encapsule la trajectoire taxinomique intégrale sous une architecture structurelle extrêmement compacte. Pour comprendre l’anatomie de cette sortie algorithmique, il convient d’en décomposer les trois composantes vectorielles et matricielles fondamentales accessibles via l’opérateur dollar :
- Le composant
hc_ward$merge: Il s’agit d’une matrice d’entiers de dimensions $(n – 1) \times 2$. Chaque ligne $k$ décrit l’opération de fusion exécutée à l’étape $k$ de l’algorithme. Un indice négatif $-i$ indique que l’entité agrégée est l’observation singleton $i$ issue du jeu de données original. Un entier positif $+j$ signale que l’élément agrégé est le cluster composite déjà constitué à l’étape $j$ de la boucle agglomérative. Cette organisation retrace l’arbre généalogique exact de l’ensemble du corpus. - Le composant
hc_ward$height: Ce vecteur numérique de longueur $n – 1$ consigne la distance ultramétrique exacte à laquelle s’est opérée chaque fusion successive. Dans le cas de l’option ward.D2, ces hauteurs correspondent rigoureusement à l’accroissement de la décomposition d’inertie induit par chaque union. L’inspection de ce vecteur permet d’observer les sauts qualitatifs de dissemblance au fil des étapes. - Le composant
hc_ward$order: Ce vecteur contient la permutation optimale des $n$ identifiants individuels, calculée pour disposer les feuilles le long de l’axe horizontal du tracé sans croisement de branches, assurant ainsi une lisibilité topologique fluide lors du rendu graphique.
7.3 Implémentation alternative via la fonction agnes du package cluster
Bien que hclust() demeure la commande historique de référence, la fonction agnes() (Agglomerative Nesting), intégrée dans le package cluster, propose une approche fonctionnelle plus riche et polyvalente. Une singularité remarquable d’agnes() est sa capacité à absorber indifféremment une matrice de distance précalculée ou directement une matrice brute d’observations, prenant alors en charge l’évaluation de la dissimilarité de manière transparente, y compris par le coefficient mixte de Gower si spécifié.
L’intérêt statistique majeur d’agnes() réside dans le calcul automatique du coefficient d’agglomération (Agglomerative Coefficient, AC). Cet indicateur scalaire, borné strictement entre $0$ et $1$, quantifie la robustesse globale de la structure de classification mise au jour par l’arbre. Pour chaque observation $i$, l’algorithme évalue le rapport entre sa distance de première fusion et sa hauteur de rattachement finale au macro-cluster global. Plus les observations sont agrégées précocement à des niveaux bas par rapport à l’altitude terminale de l’arbre, plus le coefficient d’agglomération converge vers $1$, attestant d’une structure de données hautement polarisée en groupes naturels distincts. Inversement, une valeur d’AC proche de $0$ signale un nuage de points isotrope ou uniforme dépourvu d’organisations typologiques manifestes.
Cette propriété métrique permet de conduire une comparaison objective et quantitative de l’efficacité d’agrégation entre plusieurs méthodes de liaison sur un même jeu de données. En itérant une boucle computationnelle sous R évaluant le coefficient AC à travers les méthodes « ward », « complete », « average » et « single », le chercheur dispose d’une métrique formelle pour sélectionner le mécanisme d’assemblage le plus représentatif de la géométrie de son échantillon :
methods <- c("average", "single", "complete", "ward")
sapply(methods, function(m) agnes(data_scaled, method = m)$ac)
Dans la grande majorité des topologies empiriques psychométriques, la méthode de Ward dégage le coefficient d’agglomération le plus élevé, confirmant sa capacité supérieure à structurer des partitions contrastées.
8. Visualisation, personnalisation et analyse sémiologique du dendrogramme
8.1 Génération de visualisations dendrogrammiques de base et avancées
La transcription visuelle de l’objet hclust constitue la première confrontation directe de l’analyste avec l’architecture classificatoire mise au jour. Dans le moteur de base de R, la simple application de la méthode générique plot(hc_ward) engendre un dendrogramme fonctionnel. Bien que cette primitive suffise pour un diagnostic exploratoire sommaire, sa sémiologie graphique demeure austère : les étiquettes se chevauchent fréquemment sur de grands échantillons, l’absence de couleur obscurcit la séparation des sous-arbres, et les possibilités de mise en page sont contraintes.
Pour dépasser ces limites esthétiques et analytiques, le package factoextra propose la fonction fviz_dend(), qui s’appuie sur le moteur graphique de ggplot2. Cette fonction transforme l’arbre hiérarchique en une visualisation haute définition, totalement personnalisable. Elle permet d’assigner des palettes colorimétriques distinctes aux clusters identifiés, d’ajuster l’épaisseur des segments, de moduler la typographie des labels et de projeter des rectangles englobants autour des partitions choisies pour focaliser le regard sur la structure de groupe.
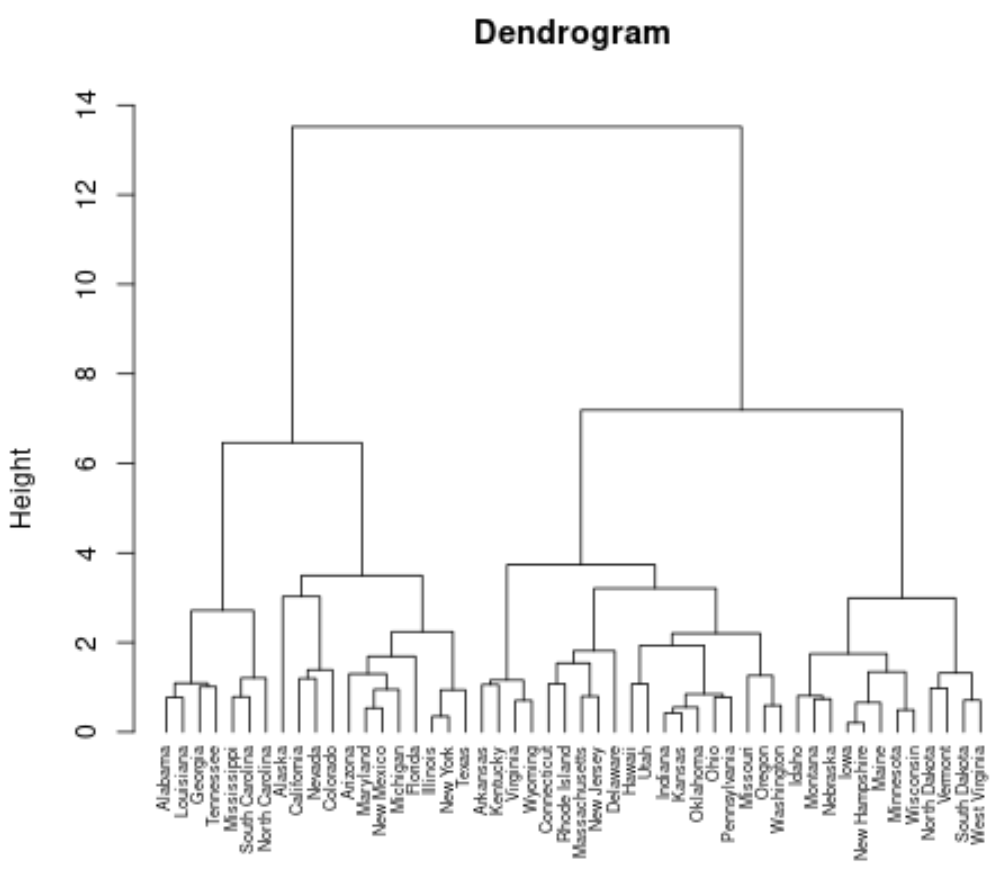
L’ajustement géométrique de l’orientation spatiale de l’arbre participe également à l’intelligibilité de la figure. En paramétrant horiz = TRUE au sein de fviz_dend(), l’arbre bascule d’une disposition verticale classique à une disposition horizontale. Cette réorientation est particulièrement profitable lorsque les identifiants d’individus ou les intitulés de variables sont textuellement longs, permettant une lecture de gauche à droite sans rotation incommodante de la tête ou des labels. L’esthétique des visualisations dendrogrammiques contemporaines permet ainsi d’allier rigueur mathématique et efficience de transmission scientifique lors de la phase de publication.
8.2 Manipulation avancée avec la bibliothèque dendextend
Lorsque la structure de données exige une granularité de personnalisation chirurgicale, le package dendextend, développé par Tal Galili, s’affirme comme le standard algorithmique de pointe. dendextend opère une mutation de l’objet natif hclust pour le convertir en un objet de classe dendrogram, ouvrant la voie à une syntaxe fonctionnelle fluide utilisant l’opérateur de composition (pipe).
Grâce à la commande polyvalente set(), l’analyste accède à un contrôle complet sur chaque composant microscopique de l’arbre :
dend <- as.dendrogram(hc_ward) %>%
set("branches_k_color", k = 3, value = c("#E41A1C", "#377EB8", "#4DAF4A")) %>%
set("branches_lwd", 1.2) %>%
set("labels_cex", 0.6) %>%
set("labels_colors", k = 3)
Cette flexibilité autorise une coloration différenciée des branches selon le découpage en $k$ classes, une graduation de l’épaisseur des traits pour souligner des chemins critiques dans la généalogie des fusions, et une gestion ciblée des nœuds d’articulation. Pour les cohortes volumineuses regroupant plusieurs centaines d’individus, l’affichage linéaire traditionnel devient saturé et difficilement lisible. dendextend résout élégamment cette contrainte de compacité en autorisant le tracé de dendrogrammes circulaires ou phylogénétiques via la fonction circlize. Les branches se déploient alors de façon radiale à partir d’un centre commun vers une circonférence extérieure, maximisant l’utilisation de la surface graphique bidimensionnelle et restituant la structure relationnelle avec une densité esthétique et informative optimale.
8.3 Comparaison graphique de deux dendrogrammes (Tanglegram)
Dans la recherche typologique, l’analyste se trouve régulièrement confronté à la nécessité de confronter deux solutions de classification concurrentes appliquées sur la même cohorte. Cette confrontation peut viser à mesurer la convergence morphologique obtenue par deux métriques de distance divergentes (par exemple, la distance euclidienne face à la distance de Manhattan), à sonder la sensibilité de l’échantillon face à deux méthodes de liaison distinctes (Ward versus liaison moyenne), ou à comparer les structures issues de deux vagues temporelles successives dans un protocole longitudinal.
La bibliothèque dendextend formalise cette démarche comparative par la génération d’un tanglegramme (tanglegram). Cette représentation visuelle dispose les deux dendrogrammes analysés en miroir face à face, reliant chaque observation commune située à gauche à son homologue situé à droite par des lignes de connexion transversales :
dend1 <- as.dendrogram(hclust(d_matrix, method = "ward.D2"))
dend2 <- as.dendrogram(hclust(d_matrix, method = "complete"))
tanglegram(dend1, dend2, sort = TRUE, common_subtrees_color_lines = TRUE)
L’évaluation sémiologique repose sur l’inspection de ces segments d’interconnexion. Lorsque les deux arbres partagent une topologie rigoureusement congruente, les lignes de liaison s’alignent de manière strictement horizontale et parallèle. À l’inverse, des divergences structurales induisent un enchevêtrement chaotique des lignes transversales. Ce degré d’enchevêtrement est formalisé mathématiquement par le coefficient d’enchevêtrement (entanglement), une valeur scalaire oscillant entre $0$ (absence totale de croisement, congruence topologique absolue) et $1$ (enchevêtrement maximal, incompatibilité des arbres).
Sur le plan métrique quantitatif, cette concordance graphique est corroborée par le calcul du coefficient de corrélation cophénétique via la fonction cophenetic(). La matrice cophénétique consigne les distances de fusion lues directement sur la hauteur de l’arbre pour chaque paire d’observations. En appliquant la commande cor(d_matrix, cophenetic(hc_ward)), le chercheur évalue le coefficient de fidélité avec lequel l’arborescence dendrogrammique simplifiée restitue les véritables dissimilarités géométriques multidimensionnelles de l’espace de départ, une corrélation supérieure à $0.75$ témoignant généralement d’une excellente représentativité de la projection arborescente.
9. Élagage de l’arbre et critères objectifs de détermination du nombre optimal de clusters
9.1 Élagage pratique du dendrogramme avec cutree
Le dendrogramme dans sa totalité offre un panorama continu allant de l’individualité absolue ($n$ singletons) à l’universalité collective (un macro-groupe unique). Pour transformer cette trajectoire relationnelle en une typologie opérationnelle exploitable par les praticiens, il est nécessaire de trancher transversalement l’arbre à un niveau déterminé. Cette opération de partitionnement binaire, appelée élagage ou coupure de l’arbre, est exécutée sous R par la fonction cutree().
Deux modalités d’élagage mutuellement exclusives s’offrent à l’analyste lors de l’appel de la fonction :
- La coupure par spécification du nombre de classes (argument
k) : Le chercheur ordonne à l’algorithme de sectionner l’arbre de manière à isoler exactement $k$ sous-arbres disjoints. La commande clusters_k3 <- cutree(hc_ward, k = 3) balaye les fusions du sommet vers la base et matérialise une partition contenant rigoureusement trois groupes d’observations. - La coupure par seuil de hauteur ultramétrique (argument
h) : L’analyste fixe une altitude de dissemblance critique sur l’axe des hauteurs. La commande clusters_h <- cutree(hc_ward, h = 15) tire une ligne sécante horizontale à la coordonnée $h = 15$. Tous les sous-arbres s’articulant en deçà de ce plafond forment des clusters indépendants. Cette seconde option est particulièrement utile lorsqu’une distance théorique maximale d’hétérogénéité acceptable est définie a priori dans le protocole expérimental.
Le vecteur d’entiers retourné par cutree(), dont la longueur coïncide exactement avec la taille de l’échantillon $n$, assigne à chaque sujet l’identifiant numérique de son groupe d’appartenance ($1, 2, dots, k$). L’étape finale de cette phase consiste à fusionner de manière étanche ce vecteur de labels avec le dataframe initial, formalisée typiquement par la commande data_final <- data %>% mutate(Cluster = as.factor(clusters_k3)). Cette assignation permet d’ancrer les regroupements abstraits dans le profil descriptif d’origine pour engager les analyses d’impact et de caractérisation statistique.
9.2 Méthodes heuristiques et statistiques pour identifier k optimal
La détermination de la hauteur de coupe optimale, ou le choix de la valeur canonique du nombre $k$ de classes, représente le pivot critique conditionnant la validité des inférences subséquentes. Laisser cette décision au seul arbitrage subjectif de l’observateur face au dendrogramme expose la recherche au risque d’arbitraire et de confirmation d’attentes théoriques préalables. Pour rationaliser ce processus, une série de critères heuristiques et de métriques formelles doit être mobilisée.
La première approche, d’inspiration heuristique, repose sur l’analyse de l’éboulis des hauteurs d’agrégation (Elbow Method ou méthode du coude). En observant la courbe retraçant la hauteur de fusion en fonction du nombre d’étapes (ou la décroissance de l’inertie intra-classe selon les $k$ successifs), le chercheur identifie une rupture de pente abrupte. Un grand saut vertical entre deux paliers d’agrégation consécutifs indique que l’algorithme tente d’unir deux macro-groupes profondément hétérogènes. La coupure optimale se positionne précisément juste avant cette dégradation majeure de l’homogénéité interne.
Une seconde approche statistique, particulièrement robuste, s’appuie sur l’optimisation du coefficient moyen de silhouette (Rousseeuw, 1987). Pour chaque observation individuelle $i$, la largeur de silhouette $s(i)$ évalue la compacité de son groupe d’assignation en regard de son éloignement par rapport au cluster limitrophe le plus proche :
$$s(i) = \frac{b(i) – a(i)}{\max(a(i), b(i))}$$
où $a(i)$ mesure la distance moyenne de l’entité $i$ à l’ensemble des autres éléments de son propre cluster, et $b(i)$ représente la distance moyenne minimale séparant $i$ des éléments d’un autre cluster rival. La valeur de $s(i)$ oscille entre $-1$ et $+1$. Un score approchant $+1$ indique que le sujet est remarquablement positionné au sein d’un groupe dense et bien ségrégué; un score nul signale que l’individu est localisé sur la frontière de décision spatiale; un score négatif atteste d’une assignation erronée. La fonction fviz_nbclust(data_scaled, hcut, method = « silhouette ») itère ce calcul pour des valeurs croissantes de $k$ et trace la moyenne globale de la cohorte, désignant le sommet de la courbe comme le nombre $k$ maximisant la qualité géométrique de la partition.
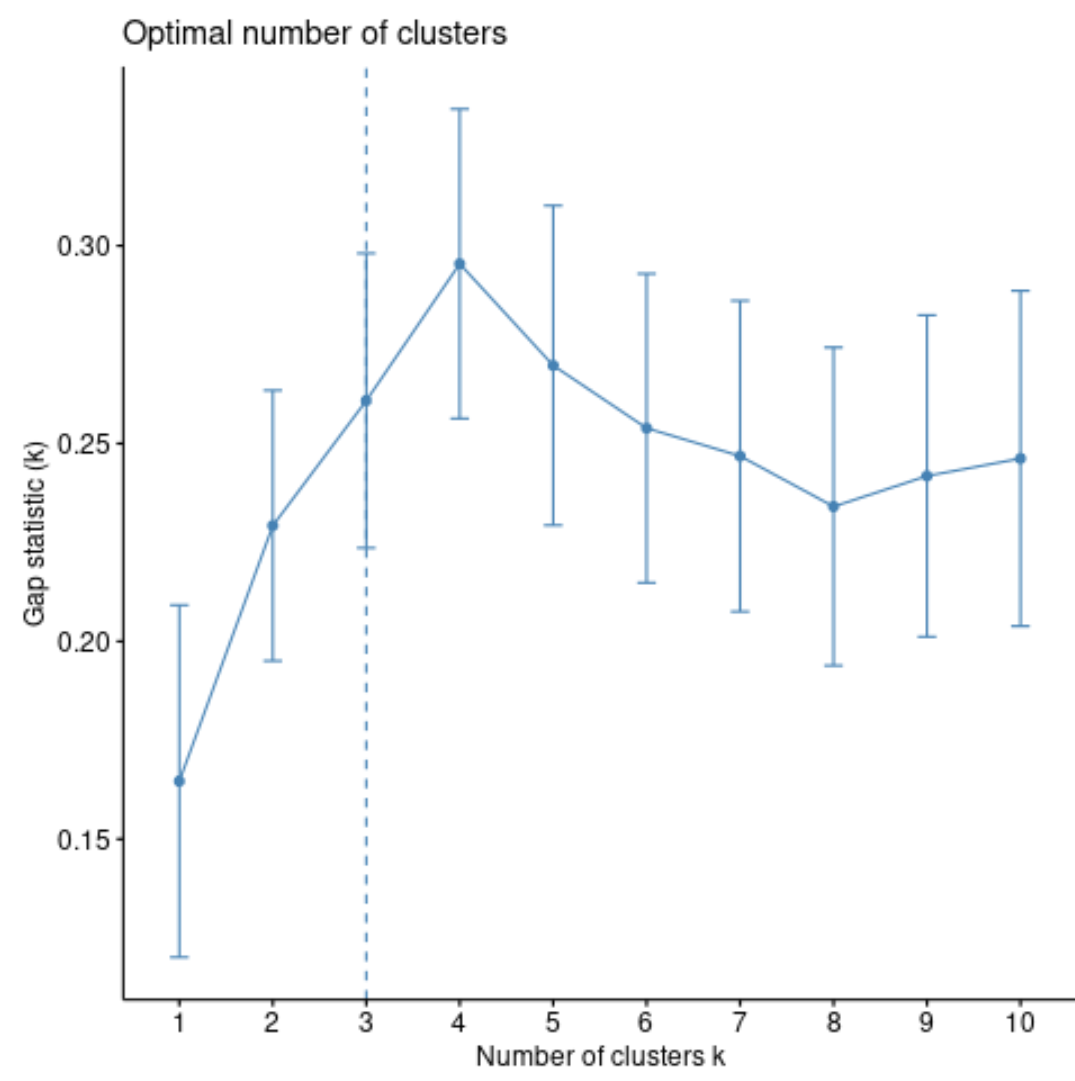
Enfin, la statistique de l’écart (Gap Statistic), introduite par Tibshirani, Walther et Hastie, confronte la décroissance de l’inertie intra-classe empirique à celle issue d’une distribution de référence nulle simulée par tirages uniformes de Monte-Carlo au sein d’un hyper-rectangle englobant :
$$\text{Gap}(k) = E_n^*{\log(W_k)} – \log(W_k)$$
Accessible sous R par la commande clusGap(), la statistique identifie la valeur minimale de $k$ pour laquelle le gain de structuration obtenu dépasse significativement l’espérance mathématique générée par le hasard uniforme, garantissant ainsi que les regroupements isolés ne sont pas le sous-produit d’une illusion paréidolique sur du bruit pur.
9.3 Évaluation exhaustive par consensus multi-indices
Dans de nombreuses configurations empiriques complexes, les critères d’évaluation univariés comme la silhouette, le coude ou la statistique du gap formulent des recommandations discordantes. L’un suggère une coupure parcimonieuse à deux macro-classes, tandis qu’un autre privilégie une granularité fine à cinq micro-profils. Cette instabilité diagnostique plonge le chercheur dans une incertitude méthodologique inconfortable quant au partitionnement le plus rigoureux.
Pour dépasser ces contradictions locales, le package spécialisé NbClust, mis au point par Malika Charrad et ses collaborateurs, implémente une procédure d’arbitrage par consensus computationnel exhaustif. La fonction maîtresse NbClust() évalue simultanément jusqu’à 30 indices de validation interne historiques issus de la littérature statistique internationale, parmi lesquels l’indice de Calinski-Harabasz, l’indice de Davies-Bouldin, l’indice de Dunn, le critère de Frey et van Groenewoud, la statistique de Hartigan, l’indice de McClain-Rao, ainsi que les critères d’information pseudo-$F$ et pseudo-$T^2$ :
res_nbclust <- NbClust(data = data_scaled, distance = "euclidean", min.nc = 2, max.nc = 8, method = "ward.D2", index = "all")
Le package soumet l’échantillon à l’intégralité de ces métriques pour chaque niveau d’élagage potentiel entre min.nc et max.nc, puis consigne le vote individuel de chaque indicateur mathématique. En appliquant la règle de la majorité (majority rule), NbClust synthétise les résultats dans un histogramme récapitulatif identifiant le nombre exact de classes désigné par le plus large consensus méthodologique.
Cette validation collégiale fournit une légitimité empirique indiscutable à la décision de coupure finale. Elle permet d’équilibrer judicieusement le compromis classique entre la parcimonie théorique (préférer un nombre réduit de groupes pour en faciliter la communication clinique ou organisationnelle) et la granularité descriptive (conserver suffisamment de nuances pour ne pas dissoudre des sous-profils symptomatiques critiques).
10. Caractérisation multidimensionnelle et interprétation substantielle des profils obtenus
10.1 Profilage statistique et calcul des indicateurs de tendance centrale par classe
Une partition algorithmique n’acquiert une valeur scientifique que lorsque ses groupes constituants sont traduits en propositions théoriques tangibles. Une fois les labels de clusters assignés aux observations via cutree(), l’analyste engage le profilage descriptif en calculant les indicateurs statistiques conditionnels pour chaque variable d’intérêt. Sous l’écosystème dplyr, ce calcul s’exécute avec fluidité par le pipeline :
profils_stats <- data_final %>%
group_by(Cluster) %>%
summarise(across(where(is.numeric), list(mean = mean, sd = sd, median = median)))
Ce tableau d’agrégation dresse l’anatomie paramétrique de chaque groupe. Pour déterminer quelles dimensions définissent de manière statistiquement significative la spécificité de chaque cluster, le recours aux valeurs-tests (v-test), encapsulées dans la fonction catdes() du package FactoMineR, est particulièrement fécond. Le v-test compare la moyenne d’une variable continue au sein d’un cluster spécifique $\bar{x}_k$ à la moyenne générale de l’ensemble de l’échantillon $\bar{X}$. Sous l’hypothèse nulle d’homogénéité globale, la statistique suit asymptotiquement une loi normale centrée réduite :
$$v = \frac{\bar{x}_k – \bar{X}}{\sqrt{\frac{s^2}{n_k} \left( \frac{N – n_k}{N – 1} \right)}}$$
Une valeur-test supérieure en valeur absolue à $1.96$ ou $2.58$ signale que la variable considérée est respectivement sur-représentée ou sous-représentée au sein du profil à un seuil d’erreur de $\alpha = 0.05$ ou $\alpha = 0.01$. Ce diagnostic ordonne automatiquement les variables par puissance de caractérisation, guidant l’analyste vers les traits cardinaux qui différencient substantiellement chaque entité sociologique ou clinique.
Lorsque la base d’analyse héberge également des covariables catégorielles d’arrière-plan (sexe, catégorie socioprofessionnelle, comorbidités déclarées), la caractérisation s’enrichit de tableaux croisés de contingence croisant ces variables avec le label de clustering. L’exécution de tests d’indépendance du Chi-carré de Pearson via chisq.test() et l’extraction des résidus standardisés ajustés révèlent si certaines catégories démographiques manifestent une attraction ou une répulsion élective envers certains profils comportementaux.
10.2 Projection visuelle des clusters dans l’espace multidimensionnel réduit
L’inspection tabulaire des moyennes conditionnelles, bien qu’indispensable, échoue à transmettre intuitivement la manière dont les clusters coexistent et se séparent dans l’espace multidimensionnel. La conjonction synergique de la classification hiérarchique et de l’Analyse en Composantes Principales (ACP) offre une solution géométrique remarquable pour résoudre cette contrainte visuelle. Cette approche hybride est conceptualisée sous l’intitulé de Classification Hiérarchique sur Composantes Principales (HCPC), promue par l’école d’analyse des données française.
La démarche consiste à réaliser une ACP sur les variables standardisées préalablement à la visualisation, puis à projeter les assignations de clusters directement sur le premier plan factoriel constitué par les axes principaux $1$ et $2$. À l’aide de la fonction fviz_cluster() de factoextra, le modélisateur génère un graphique de dispersion enrichi :
fviz_cluster(list(data = data_scaled, cluster = clusters_k3), ellipse.type = "convex", palette = "jco", ggtheme = theme_minimal())
Sur ce tracé factoriel, chaque point représente un individu, coloré selon son appartenance typologique. Les groupes sont ceints par des ellipses de confiance paramétriques (par exemple des ellipses de concentration à $95%$) ou par leurs enveloppes convexes respectives. L’examen des axes factoriels fournit une clé de lecture substantielle immédiate : en confrontant les corrélations des variables initiales avec les facteurs latents (le cercle des corrélations), l’analyste décrypte la nature des forces sous-jacentes qui provoquent l’éloignement des clusters sur le plan cartésien.
Cette visualisation permet en outre d’évaluer la séparabilité effective des classes : des ellipses totalement disjointes attestent de typologies nettes, étanches et exemptes de recouvrement, tandis que des ellipses se chevauchant partiellement illustrent des zones de transition morphologique où s’agrègent des profils comportementaux intermédiaires ou atypiques.
10.3 Traduction théorique des profils dans le domaine d’application
La dernière étape du cycle analytique réside dans la conversion des constats statistiques en constructs théoriques identifiés, nommés et contextualisés. Dans le cadre de notre exemple portant sur l’inventaire de santé au travail, supposons que l’élagage consensuel à $k = 3$ révèle les caractéristiques de profilage suivantes :
- Le Groupe 1 (45 % de la cohorte) : Démontre des scores d’épuisement émotionnel (EE) et d’anxiété (ANX) significativement inférieurs à la moyenne ($v\text{-test} +6$). Ce profil est baptisé en termes substantiels : « Profil Résilient et Engagé ».
- Le Groupe 2 (35 % de la cohorte) : Manifeste un épuisement émotionnel modéré, mais se distingue par des valeurs exceptionnellement élevées sur l’échelle de cynisme professionnel et de dépersonnalisation (DP, $v\text{-test} > +7$), avec un engagement effondré. Ce cluster incarne la typologie : « Profil de Désengagement Défensif ».
- Le Groupe 3 (20 % de la cohorte) : Cumule des valeurs critiques explosives sur l’épuisement émotionnel, les symptômes somatiques du stress (SOM) et l’anxiété ($v\text{-test} > +8$), accompagnées d’un effondrement total de l’accomplissement personnel. Cette classe représente indubitablement : « Profil de Détresse Sévère et Burnout Avéré ».
Cette dénomination conceptuelle ancre l’analyse de données dans la littérature clinique et comportementale établie. Le chercheur peut dès lors confronter cette tripartition aux modèles théoriques existants (par exemple, le modèle Exigences-Ressources au travail de Demerouti et Bakker), évaluant si les regroupements empiriques corroborent les mécanismes étiologiques postulés.
De surcroît, ces typologies déploient des implications directes pour l’élaboration d’interventions ciblées. Au lieu d’administrer des protocoles préventifs uniformes à l’ensemble d’une organisation, les services de santé au travail peuvent moduler leurs réponses : les individus du profil de désengagement bénéficieront d’un réaménagement managérial et d’une redéfinition du sens des tâches, tandis que les membres du profil de détresse sévère feront l’objet d’une prise en charge médico-psychologique individualisée d’urgence. La classification hiérarchique transcende ainsi le statut d’exercice statistique pour s’ériger en instrument décisionnel à haute valeur ajoutée opérationnelle.
11. Validation statistique de la stabilité et réplicabilité des clusters
11.1 Évaluation de la stabilité par rééchantillonnage bootstrap
Une vulnérabilité structurelle inhérente à la classification ascendante hiérarchique tient à son déterminisme glouton : dès lors qu’une fusion est scellée à une altitude basse, elle est irréversible et contraint définitivement l’ensemble des ramifications supérieures. Si un sous-groupe se forme en raison d’une fluctuation d’échantillonnage locale ou d’un artefact marginal dans les données, cette distorsion est propagée jusqu’au sommet du dendrogramme. Il est dès lors capital d’évaluer la stabilité inférentielle de chaque nœud arborescent par des protocoles de rééchantillonnage stochastique (bootstrapping).
La bibliothèque pvclust, développée par Ryota Suzuki et Hidetoshi Shimodaira, s’impose comme la référence méthodologique absolue sous R pour mener cette validation. Par l’appel de la fonction pvclust(), le logiciel génère un nombre massif d’échantillons bootstrap (typiquement $B = 1000$ réplications) par tirage avec remise au sein du jeu d’observations multidimensionnel, recalculant à chaque étape l’arborescence complète :
fit_pv <- pvclust(t(data_scaled), method.hclust = "ward.D2", method.dist = "euclidean", nboot = 1000)
L’algorithme de pvclust calcule pour chaque nœud du dendrogramme deux indicateurs de significativité statistique aux propriétés fondamentales :
- La valeur p au bootstrap standard (BP, Bootstrap Probability) : Elle correspond à la fréquence relative simple avec laquelle le sous-cluster spécifique réapparaît à l’identique au fil des $B$ réplications bootstrap. Bien qu’intuitive, cette mesure présente un biais systématique négatif, sous-estimant la véritable significativité du cluster lorsque la taille d’échantillon ou la variabilité des données est modérée.
- La valeur p approximativement non biaisée (AU, Approximately Unbiased p-value) : Calculée au moyen d’un rééchantillonnage bootstrap multi-échelle faisant varier de manière contrôlée la taille des pseudo-échantillons tirés, la valeur p AU corrige le biais inhérent au bootstrap classique par une méthode d’approximation géométrique asymptotique.
Lors de la visualisation via plot(fit_pv), les valeurs p sont imprimées au-dessus de chaque articulation arborescente. L’analyste se focalise sur les nœuds arborant une valeur p AU supérieure ou égale à $0.95$ (correspondant au seuil conventionnel $\alpha = 0.05$). Les sous-arbres satisfaisant cette contrainte, pouvant être encadrés automatiquement par l’instruction pvrect(fit_pv, alpha = 0.95), sont considérés comme des configurations empiriquement robustes et hautement reproductibles, tandis que les embranchements à faible valeur AU doivent être interprétés avec une extrême circonspection car susceptibles de résulter du seul bruit d’échantillonnage.
11.2 Indices de cohérence interne et compacité des partitions
Au-delà de la stabilité stochastique globale des nœuds, la validation d’une partition typologique requiert l’évaluation de sa qualité morphologique interne. Une partition est statistiquement solide si elle conjugue une compacité maximale au sein de chaque groupe (faible dispersion interne) et une séparation maximale entre les groupes (isolement spatial net).
L’inspection détaillée des largeurs de silhouette individuelles, obtenue par l’extraction des données via cluster::silhouette(clusters_k3, d_matrix) et visualisée par factoextra::fviz_silhouette(), met en lumière la cohérence individuelle des sujets. Le tracé range les individus par cluster et affiche horizontalement leurs coefficients $s(i)$. Cette visualisation identifie immédiatement les unités statistiques marginales arborant des barres négatives : ces individus correspondent à des profils aberrants ou mal classés, positionnés plus près d’un cluster voisin que du centre de leur propre groupe. Un cluster exhibant une proportion notable de coefficients négatifs doit être considéré comme fragile ou artificiel.
D’autres métriques mathématiques formalisent ce ratio compacité/séparation :
- L’indice de Dunn : Défini par le rapport entre la distance inter-clusters minimale (la séparation la plus étroite entre deux groupes) et le diamètre intra-cluster maximal (la plus grande dispersion interne observée au sein d’un cluster). Un indice de Dunn élevé signale une partition exemplaire, car même les deux classes les plus proches demeurent plus éloignées l’une de l’autre que l’extension maximale de n’importe quel groupe.
- L’indice de Davies-Bouldin : Il évalue pour chaque paire de classes le ratio de leur dispersion interne cumulée sur la distance séparant leurs centroïdes, retenant pour chaque groupe la pire configuration d’adjacence avant d’en calculer la moyenne générale. Un indice de Davies-Bouldin faible indique que les classes sont globalement bien séparées par rapport à leur taille respective.
Ces indicateurs, disponibles dans les packages clValid ou clusterCrit, permettent de soumettre la partition à des tests de sensibilité en injectant des perturbations aléatoires mineures (bruit gaussien léger) dans la matrice de données originales afin de surveiller la résilience des coefficients de qualité morphologique.
11.3 Reproductibilité sur sous-échantillons indépendants
Le test ultime de la validité d’une typologie réside dans sa capacité de généralisation en dehors de l’échantillon exact qui a servi à son estimation algorithmique. Si des profils comportementaux représentent des entités écologiques réelles et non de simples idiosyncrasies d’un jeu de données particulier, ils doivent émerger avec une structure congruente lorsque l’analyse est répliquée sur une population indépendante issue de la même population cible.
Pour operationaliser ce contrôle sous R, un protocole de validation croisée par partitionnement aléatoire de l’échantillon (split-sample validation) est instauré. L’échantillon initial de $N$ observations est scindé aléatoirement en deux sous-ensembles équivalents : un échantillon de dérivation (ou d’apprentissage, $N_1 = N/2$) et un échantillon de validation (ou de réplication, $N_2 = N/2$). Le pipeline complet de classification hiérarchique (standardisation, calcul de distance, hclust avec Ward, élagage à $k$ classes) est exécuté de manière totalement autonome sur l’échantillon de dérivation $N_1$.
Pour évaluer la réplicabilité sur l’échantillon de validation $N_2$, deux stratégies sont couramment combinées :
- On exécute une classification hiérarchique indépendante sur $N_2$ pour obtenir une partition empirique directe.
- Parallèlement, on projette les individus de $N_2$ au sein des clusters dérivés de $N_1$ en assignant chaque nouveau sujet au centre de gravité le plus proche issu du premier modèle (classification par plus proche centroïde).
Le degré de concordance entre la partition empirique directe de $N_2$ et l’assignation issue du modèle de $N_1$ est ensuite rigoureusement quantifié à l’aide de l’Indice de Rand Ajusté (ARI, Adjusted Rand Index), accessible via le package mclust ou fossil :
ari_score <- adjustedRandIndex(partition_directe, partition_projetee)
L’indice de Rand ajusté mesure la proportion de paires d’individus classées de manière concordante (soit groupées ensemble, soit séparées dans les deux partitions), corrigée de l’effet du hasard. Un score ARI supérieur à $0.70$ atteste d’une excellente reproductibilité structurelle, conférant une assise scientifique irréfutable à la typologie et validant sa pertinence pour une extrapolation élargie aux populations cibles.
12. Extensions méthodologiques : grands jeux de données et approches hybrides
12.1 Classification hiérarchique sur grandes bases de données : l’algorithme CLARA
L’expansion vertigineuse des volumes de données dans les registres médico-administratifs, les banques de données génomiques ou les plateformes numériques comportementales place les algorithmes hiérarchiques conventionnels face au « mur de la mémoire ». Dès lors qu’une base atteint $N = 100,000$ observations, le calcul et le stockage de la matrice de dissimilarité pairwise exigent près de $5 \times 10^9$ coefficients à mémoriser en double précision, une charge qui excède instantanément les capacités des stations de travail standards et provoque l’échec computationnel de la fonction dist().
Pour briser ce goulot d’étranglement tout en préservant l’intégrité de la philosophie de regroupement, Leonard Kaufman et Peter Rousseeuw ont conçu l’algorithme CLARA (Clustering Large Applications). Implémenté nativement dans le package cluster via la fonction clara(), cet algorithme contourne le problème de complexité spatiale en s’appuyant sur un schéma d’échantillonnage probabiliste itératif :
clara_res <- clara(big_data_scaled, k = 4, metric = "euclidean", samples = 50, pamLike = TRUE)
Plutôt que d’évaluer la matrice globale sur l’intégralité du corpus, CLARA extrait de manière répétée de petits sous-échantillons aléatoires représentatifs (typiquement de taille $n_{\text{sub}} = 40 + 2k$). Sur chaque sous-échantillon, l’algorithme déploie un partitionnement robuste autour des médoïdes (PAM, Partitioning Around Medoids), une approche moins sensible aux outliers que les centroïdes classiques. Les médoïdes optimaux extraits de ces itérations sont ensuite utilisés pour assigner l’ensemble de la méga-cohorte globale selon la règle de la distance minimale.
Le compromis réside dans une légère perte de finesse topologique au niveau des micro-branches locales en échange d’une réduction drastique de la complexité temporelle et spatiale, ramenée à une échelle linéaire $O(k \cdot n_{\text{sub}}^2 + k(N – k))$, autorisant la segmentation fluide de cohortes comprenant plusieurs centaines de milliers d’unités statistiques.
12.2 Approches hybrides : combinaison k-means et classification hiérarchique
Pour concilier la rapidité computationnelle du partitionnement non hiérarchique et la profondeur d’interprétation visuelle de l’arborescence dendrogrammique, les méthodologistes recourent fréquemment à des architectures de classification hybrides. L’une des stratégies les plus fécondes consiste à utiliser les k-means ou le partitionnement par médoïdes comme une phase de prétraitement et de compression géométrique préliminaire.
Dans ce protocole en deux temps, l’analyste applique d’abord un partitionnement k-means paramétré avec un nombre élevé de classes (par exemple $k = 100$ pour un jeu de données de $N = 20,000$ individus). Cette première étape agrège rapidement les individus au sein de micro-clusters denses et compacts, réduisant la taille du problème de $20,000$ observations élémentaires à $100$ centroïdes virtuels sans dénaturer la distribution sous-jacente du nuage de points.
Dans un second temps, la classification ascendante hiérarchique avec la méthode de Ward est appliquée non plus sur les données brutes individuelles, mais exclusivement sur la matrice des $100$ centroïdes pondérés par les effectifs respectifs de leurs classes d’origine. Cette démarche est encapsulée de manière totalement automatisée au sein de la fonction HCPC() (Hierarchical Clustering on Principal Components) du package FactoMineR via l’argument kk :
res_hcpc <- HCPC(res_pca, kk = 100, method = "ward")
Cette synergie computationnelle élimine le bruit statistique microscopique, contourne les limitations de mémoire vive, et génère un dendrogramme parfaitement traçable et manipulable par le chercheur. Elle démontre comment l’ingénierie algorithmique contemporaine sous R parvient à transcender les clivages méthodologiques traditionnels pour offrir des solutions scalables et robustes.
12.3 Bonnes pratiques, pièges récurrents et directives pour le chercheur
La conduite d’une classification hiérarchique sous R, si elle est d’une grande accessibilité logicielle, n’est pas exempte d’écueils méthodologiques majeurs que tout chercheur rigoureux doit s’efforcer de neutraliser. Le premier piège réside dans la réification abusive des regroupements : un algorithme de classification produit structurellement des clusters, y compris lorsqu’il est alimenté par des matrices de nombres purement aléatoires issus d’un bruit blanc uniforme. Le devoir déontologique de l’analyste consiste à prouver que la partition finale capture une hétérogénéité substantielle réelle en s’appuyant impérativement sur des critères de validation stochastiques (tels que pvclust, la Gap Statistic ou l’indice de Rand ajusté) avant de promulguer l’existence de typologies empiriques.
Le second écueil méthodologique concerne l’omission de la standardisation des variables ou l’utilisation inappropriée d’une métrique de distance en contradiction avec la nature d’échelle des données. L’application mécanique de la distance euclidienne sur des échelles qualitatives nominales sans recours à la métrique de Gower, ou sur des variables continues non réduites présentant des variances asymétriques, invalide intégralement les conclusions scientifiques des travaux.
De même, la traçabilité et la reproductibilité computationnelle exigent la consignation minutieuse des environnements d’exécution. Les variations incrémentales entre versions de packages (comme les évolutions historiques de la méthode ward.D vers ward.D2 dans R) peuvent induire des divergences de regroupement sur des cas limites. L’analyste doit documenter explicitement la version de R exploitée, les versions des bibliothèques mobilisées (via la commande sessionInfo()), fixer scrupuleusement la graine aléatoire (set.seed) et mettre à disposition des scripts d’analyse modulaires et autonomes.
Pour encadrer la valorisation scientifique des résultats typologiques, la grille d’évaluation suivante formalise les exigences minimales d’une publication académique de haut niveau :
- Justification formelle du prétraitement : Démonstration explicite de l’impact des échelles de mesure, stratégie d’imputation documentée pour les données manquantes et justification du choix de standardisation (z-score versus robuste).
- Explicitation du choix métrique : Argumentation théorique reliant la distance choisie (euclidienne, Manhattan, Pearson, Gower) à la morphologie attendue des construits étudiés.
- Détail transparent du mécanisme de liaison : Mention explicite de l’algorithme d’agrégation retenu (notamment ward.D2) et contrôle des coefficients d’agglomération (AC).
- Détermination rationnelle du nombre $k$ : Présentation documentée d’au moins deux métriques de consensus objectif (silhouette, gap, indice de Davies-Bouldin, ou consensus NbClust) pour justifier le seuil d’élagage.
- Preuves de stabilité et de validité : Rapport systématique des valeurs de significativité par rééchantillonnage bootstrap (valeurs p AU de pvclust) et validation de la réplicabilité sur sous-échantillon (ARI).
- Caractérisation multidimensionnelle complète : Fourniture des tableaux de moyennes, des écarts-types, des valeurs-tests et projections visuelles sur plans factoriels permettant au lecteur d’évaluer la séparabilité substantielle des groupes.
En respectant rigoureusement ces préceptes opératoires, le chercheur s’assure que la classification ascendante hiérarchique sous R ne se réduit pas à une heuristique descriptive subjective, mais déploie sa véritable puissance : celle d’un instrument d’investigation scientifique rigoureux, capable d’isoler des typologies comportementales authentiques et de renouveler l’édifice théorique des disciplines explorées.
Références
- Charrad, M., Ghazzali, N., Boiteau, V., & Niknafs, A. (2014). NbClust: An R package for determining the relevant number of clusters in a data set. Journal of Statistical Software, 61(6), 1–36. https://doi.org/10.18637/jss.v061.i06
- Everitt, B. S., Landau, S., Leese, M., & Stahl, D. (2011). Cluster analysis (5th ed.). John Wiley & Sons. https://doi.org/10.1002/9780470977811
- Galili, T. (2015). dendextend: an R package for visualizing, adjusting and comparing trees of hierarchical clustering. Bioinformatics, 31(22), 3718–3720. https://doi.org/10.1093/bioinformatics/btv428
- Gower, J. C. (1971). A general coefficient of similarity and some of its properties. Biometrics, 27(4), 857–871. https://doi.org/10.2307/2528823
- Husson, F., Lê, S., & Pagès, J. (2017). Exploratory multivariate analysis by example using R (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/b21874
- Kassambara, A. (2017). Practical guide to cluster analysis in R: Unsupervised machine learning (Vol. 1). STHDA.
- Kaufman, L., & Rousseeuw, P. J. (1990). Finding groups in data: An introduction to cluster analysis. John Wiley & Sons. https://doi.org/10.1002/9780470316801
- Lance, G. N., & Williams, W. T. (1967). A general theory of classificatory sorting strategies: 1. Hierarchical systems. The Computer Journal, 9(4), 373–380. https://doi.org/10.1093/comjnl/9.4.373
- Murtagh, F., & Legendre, P. (2014). Ward’s hierarchical agglomerative clustering method: Which algorithms implement Ward’s criterion? Journal of Classification, 31(3), 274–295. https://doi.org/10.1007/s00357-014-9161-z
- Rousseeuw, P. J. (1987). Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, 53–65. https://doi.org/10.1016/0377-0427(87)90125-7
- Suzuki, R., & Shimodaira, H. (2006). Pvclust: An R package for assessing the uncertainty in hierarchical clustering. Bioinformatics, 22(12), 1540–1542. https://doi.org/10.1093/bioinformatics/btl117
- Tibshirani, R., Walther, G., & Hastie, T. (2001). Estimating the number of clusters in a data set via the gap statistic. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 63(2), 411–423. https://doi.org/10.1111/1467-9868.00293
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Ward, J. H., Jr. (1963). Hierarchical grouping to optimize an objective function. Journal of the American Statistical Association, 58(301), 236–244. https://doi.org/10.1080/01621459.1963.10500845