
Dans l’arsenal méthodologique contemporain des sciences du comportement, la modélisation statistique occupe une place prépondérante, servant de passerelle indispensable entre la conceptualisation théorique abstraite et la réalité empirique observée. Parmi la diversité foisonnante des outils quantitatifs développés au cours du siècle dernier, la régression linéaire multiple s’est imposée comme l’un des piliers les plus universellement sollicités par les chercheurs en psychologie, en neurosciences cognitives et en sciences sociales. Cet algorithme d’inférence et de prédiction séduit par son élégance conceptuelle : condenser la complexité d’une multitude de facteurs dispositionnels, cognitifs, environnementaux ou psychopathologiques au sein d’une équation paramétrique lisible, permettant d’isoler l’influence spécifique de chaque variable explicative sur un comportement ou un état psychologique donné.
Cependant, cette apparente simplicité opératoire dissimule une armature mathématique rigoureuse dont la viabilité dépend entièrement du respect scrupuleux d’un ensemble de conditions structurales sous-jacentes. Trop souvent réduite dans les logiciels statistiques modernes à un simple clic générant une table d’indices p et de coefficients bêta, la régression linéaire multiple repose sur les principes fondamentaux formulés par les pionniers de la statistique mathématique, notamment à travers le théorème de Gauss-Markov. Ce cadre formalise mathématiquement les conditions sous lesquelles la méthode des moindres carrés ordinaires produit des estimateurs non biaisés et d’une efficacité optimale. Lorsque ces postulats fondamentaux sont ignorés, l’architecture inférentielle s’effondre silencieusement : les erreurs types se distordent, les tests d’hypothèses perdent leur validité probabiliste, et la réplicabilité des découvertes empiriques se trouve irrémédiablement compromise.
Le présent traité méthodologique a pour vocation d’explorer de manière exhaustive, approfondie et didactique les cinq postulats cardinaux de la régression linéaire multiple dans le contexte spécifique de la recherche comportementale et psychologique. En examinant successivement la linéarité fonctionnelle, l’absence de multicolinéarité excessive, l’indépendance stochastique des résidus, l’homoscédasticité des variances d’erreur et la normalité de leur distribution, nous fournirons aux chercheurs, analystes et cliniciens les outils conceptuels, graphiques et inférentiels nécessaires pour diagnostiquer rigoureusement chaque violation et y apporter les remédiations analytiques contemporaines les plus robustes. Loin d’être de simples contraintes administratives de publication, la maîtrise et l’investigation de ces postulats constituent le rempart ultime contre les dérives méthodologiques qui alimentent la crise contemporaine de la reproductibilité scientifique.
1. Introduction méthodologique à la régression linéaire multiple en psychologie
1.1 Fondements mathématiques et utilité en recherche comportementale
La recherche comportementale se heurte continuellement à la nature multifactorielle des phénomènes psychologiques. Qu’il s’agisse d’expliquer les variations de la symptomatologie dépressive, le rendement académique, l’engagement professionnel ou l’efficacité d’un processus mnésique, aucun facteur unique ne saurait rendre compte de la totalité de la variance observée. La régression linéaire multiple répond à cette complexité ontologique en modélisant formellement la relation fonctionnelle unissant une variable dépendante continue, couramment dénommée critère ou variable d’issue, à un vecteur de covariables psychologiques, démographiques ou expérimentales. En transcendant le cadre restrictif des corrélations bivariées simples, elle offre la possibilité d’analyser l’effet partiel d’un prédicteur donné tout en maintenant statistiquement constants l’ensemble des autres facteurs inclus dans le modèle, permettant ainsi d’approcher une forme de contrôle expérimental sur des données observationnelles.
D’un point de vue épistémologique, il demeure impératif de distinguer avec clarté la prédiction empirique pure de l’inférence causale. Si un modèle de régression peut maximiser l’ajustement aux données pour optimiser la prédiction pragmatique d’un comportement futur, l’attribution d’un statut causal aux coefficients de régression exige des postulats théoriques et des designs de recherche qui dépassent largement les simples propriétés de l’échantillon. En psychométrie, la tentation de réifier une association statistique en lien de causalité directe est fréquente ; or, l’équation de régression ne fait que quantifier une dépendance conditionnelle statistique. La formulation mathématique de la régression linéaire multiple s’articule élégamment au travers de l’algèbre matricielle. Pour un échantillon de n observations et p prédicteurs, le système d’équations s’exprime sous la forme compacte :
Y = Xβ + ε
Dans cette formulation, Y représente un vecteur colonne de dimension n × 1 contenant les scores individuels sur le critère psychologique, X est la matrice du plan d’expérience ou de régression de dimension n × (p + 1) dont la première colonne est uniformément constituée de uns pour modéliser la constante (intercept), β est le vecteur colonne (p + 1) × 1 des paramètres théoriques de population à estimer, et ε est le vecteur n × 1 des perturbations aléatoires non observées. L’estimation de ce vecteur de paramètres par la méthode des moindres carrés ordinaires (MCO) consiste à minimiser la somme du carré des résidus, aboutissant à la solution analytique fondamentale :
β̂ = (XTX)-1XTY
Cette dérivation matricielle met en lumière une vulnérabilité inhérente aux modèles empiriques : la grande sensibilité des coefficients bêta standardisés face aux variations d’échantillonnage, particulièrement lorsque la taille de l’échantillon est restreinte ou que les prédicteurs partagent une covariance substantielle. Dans les études comportementales, les coefficients standardisés sont couramment mobilisés pour comparer l’importance relative de différents construits psychologiques, tels que l’impact comparé de l’estime de soi et du soutien social sur le bien-être subjectif. Cependant, si la matrice XTX présente des singularités ou des instabilités numériques, de minimes fluctuations dans les données brutes peuvent induire des basculements radicaux dans les magnitudes et les signes de ces coefficients, compromettant dramatiquement l’interprétabilité psychologique des résultats.
1.2 Rôle crucial de la vérification des postulats dans l’intégrité scientifique
L’intégrité de l’inférence statistique dépend de la concordance entre les propriétés formelles des données recueillies et les hypothèses postulées par la mécanique mathématique des MCO. La vérification systématique de ces postulats ne constitue pas une simple formalité bureaucratique exigée par les comités de lecture des revues savantes, mais la condition sine qua non de la préservation de la puissance statistique des tests d’hypothèses basés sur la distribution t de Student et la distribution F de Fisher-Snedecor. Lorsque les postulats fondamentaux sont respectés, les tests d’hypothèse nulle quant à la significativité des covariables opèrent avec une précision probabiliste nominale, garantissant que le risque d’erreur consenti correspond rigoureusement au seuil alpha prédéterminé.
À l’inverse, l’omission du diagnostic méthodologique expose le chercheur à une distorsion asymétrique des taux d’erreur de type I (rejeter à tort l’hypothèse nulle en concluant à l’existence d’un effet psychologique inexistant) et d’erreur de type II (échouer à détecter un effet théoriquement et cliniquement authentique en raison d’une dégradation de la puissance statistique). Dans le domaine de l’évaluation des construits psychologiques, de telles aberrations analytiques conduisent à la prolifération de théories spécieuses ou, à l’opposé, à l’abandon prématuré de pistes thérapeutiques prometteuses. Le socle théorique soutenant l’optimalité des moindres carrés ordinaires est formalisé par le théorème de Gauss-Markov. Ce théorème démontre mathématiquement que, sous réserve du respect des postulats d’espérance nulle de l’erreur, d’homoscédasticité, d’absence d’autocorrélation et d’exogénéité stricte, l’estimateur des MCO est le meilleur estimateur linéaire non biaisé (BLUE : Best Linear Unbiased Estimator), ce qui signifie qu’il possède la variance d’échantillonnage minimale parmi tous les estimateurs linéaires sans biais.
Le non-respect de ces prémisses déchoit immédiatement l’estimateur de sa propriété de variance minimale ou induit un biais direct d’estimation. Cette réalité méthodologique s’inscrit au cœur même de la crise contemporaine de la réplicabilité qui secoue les sciences comportementales depuis plus d’une décennie. De nombreuses méta-analyses et initiatives de réplication systématique ont révélé qu’une proportion alarmante d’effets publiés dans des revues prestigieuses s’avèrent impossibles à reproduire empiriquement. Si des pratiques de recherche douteuses telles que le p-hacking ou l’harmonisation sélective des hypothèses après obtention des résultats (HARKing) ont été largement incriminées, la négligence chronique des diagnostics de régression et l’ajustement aveugle de modèles MCO sur des données violant manifestement les postulats sous-jacents constituent un facteur causal direct et structurel de cette volatilité des publications scientifiques.
1.3 Conséquences globales d’une inférence basée sur un modèle mal spécifié
L’estimation d’un modèle de régression caractérisé par une mauvaise spécification engendre des répercussions désastreuses sur l’ensemble de la chaîne inférentielle. Le premier symptôme manifeste d’une telle anomalie réside dans la distorsion structurelle de la matrice de covariance asymptotique des paramètres estimés, conduisant à des erreurs types erronées. Dès lors que les erreurs types sont sous-estimées, les statistiques de test t sont artificiellement gonflées, réduisant indûment les p-valeurs et créant une illusion statistique de précision et de significativité hautement trompeuse. Les intervalles de confiance associés aux coefficients bêta perdent alors leur propriété fondamentale de couverture nominale : un intervalle calculé au niveau théorique de 95 % peut, en pratique, n’encapsuler la véritable valeur du paramètre de population que dans 70 % voire 50 % des réplications virtuelles de l’étude.
Cette dérive computationnelle altère profondément la validité des tailles d’effet rapportées dans la littérature académique. En psychologie empirique, où la quantification de la magnitude d’un effet guide tant l’avancement théorique que la méta-analyse, les biais systématiques affectant les métriques d’association (qu’il s’agisse des coefficients standardisés ou du coefficient de détermination global R2) polluent cumulativement le corpus scientifique. Une surestimation artificielle du R2 attribuable à une mauvaise spécification ou au non-respect de l’indépendance donne l’illusion qu’un ensemble restreint de dimensions cognitives explique l’essentiel d’une pathologie, orientant ainsi indûment les efforts ultérieurs des équipes de recherche mondiales vers des voies d’investigation sans issue.
Au-delà de la sphère académique pure, les répercussions d’une inférence biaisée sont particulièrement critiques dans le domaine appliqué de la psychologie clinique, de la neuropsychologie et de la psychologie du travail. Le déploiement d’interventions préventives, de protocoles de remédiation cognitive ou de programmes organisationnels repose sur l’identification rigoureuse des facteurs de risque et de résilience modélisés en régression. Si les conclusions quantitatives reposent sur des coefficients faussés par des violations structurelles, la validité écologique des interventions s’en trouve ruinée. Les praticiens risquent d’investir des ressources substantielles dans la manipulation de cibles thérapeutiques qui ne constituent en réalité que des artéfacts statistiques d’un modèle mal paramétré. Pour prévenir ces risques systémiques, l’implémentation d’un flux de travail diagnostique systématique et transparent avant toute diffusion ou publication des résultats s’impose comme un impératif déontologique inhérent à la pratique scientifique contemporaine.
2. Postulat 1 : La linéarité de la relation entre variables
2.1 Définition conceptuelle et théorique en contexte psychologique
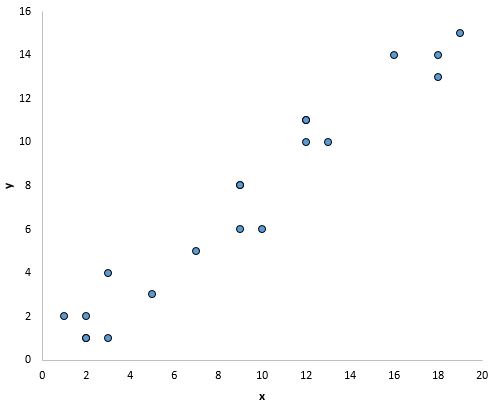
Le postulat de linéarité constitue le point de départ ontologique de la régression linéaire multiple. Conceptuellement, il postule que la valeur attendue (espérance mathématique conditionnelle) de la variable dépendante est une fonction strictement linéaire des différentes variables indépendantes intégrées dans le modèle. Autrement formulé, l’effet marginal exercé par une variation unitaire d’un prédicteur sur le critère est supposé invariant sur toute l’étendue de l’échelle de mesure de ce prédicteur, lorsque les autres variables sont maintenues constantes. Cette hypothèse impose une relation rectiligne entre chaque variable explicative et la variable d’issue. Dans le paysage de la mesure psychologique, cette supposition est particulièrement audacieuse au regard de la nature complexe, dynamique et souvent adaptative des processus cognitifs, affectifs et somatiques.
Il importe toutefois d’opérer une distinction formelle indispensable entre la linéarité par rapport aux variables et la linéarité par rapport aux paramètres. Le modèle de régression linéaire standard exige formellement la linéarité de ses paramètres β, et non pas nécessairement une relation linéaire d’ordre un entre les variables brutes. Une équation incorporant le carré d’une variable explicative ou une transformation logarithmique demeure strictement un modèle linéaire au sens mathématique du terme, car les paramètres y sont engagés de manière additive et multiplicative simple, sans être élevés à des puissances inconnues ni logés à l’intérieur d’opérateurs non linéaires. Cette distinction offre une marge de manœuvre analytique considérable pour intégrer des dynamiques non linéaires au sein du cadre général des MCO.
Les manifestations psychologiques authentiquement curvilignes sont légion dans la littérature comportementale. L’archétype historique le plus célèbre réside incontestablement dans l’effet Yerkes-Dodson, qui formalise la relation en U inversé unissant l’éveil physiologique ou le niveau de stress à la performance cognitive : un niveau d’activation modéré maximise l’efficacité attentionnelle, tandis qu’une sous-activation entraîne l’apathie et qu’une hyper-activation induit une désorganisation cognitive sévère. De même, la relation entre l’âge chronologique et les capacités de mémoire de travail à travers le cycle de vie présente une trajectoire curvilinéaire typique, caractérisée par une maturation progressive durant l’enfance suivie d’un déclin graduel à l’âge avancé. Tenter de modéliser de telles dynamiques par une simple droite de régression linéaire de premier degré constitue une simplification théorique abusive. De surcroît, les échelles psychométriques souffrent fréquemment d’effets de plancher ou de plafond résultant d’une restriction d’amplitude artificielle dans les instruments d’évaluation (par exemple, des échelles de dépistage clinique administrées à des populations saines), ce qui engendre mécaniquement des courbures asymptotiques aux extrémités de la distribution qui violent ouvertement la linéarité présumée.
2.2 Conséquences mathématiques et conceptuelles de la non-linéarité
L’estimation aveugle d’une droite linéaire sur un ensemble de données sous-tendu par une fonction curviligne engendre des distorsions analytiques sévères qui compromettent l’intégrité globale du modèle. Sur le plan mathématique, l’algorithme des moindres carrés ordinaires cherchera coûte que coûte à faire passer une ligne droite optimale au milieu de la dispersion des observations. Ce processus a pour effet direct d’atténuer artificiellement la magnitude de la relation globale, sous-estimant drastiquement la part de variance réellement explicable par le phénomène étudié. Un prédicteur qui partagerait une relation quadratique parfaite (en forme de parabole symétrique) avec un critère psychologique afficherait une corrélation linéaire de Pearson strictement égale à zéro, conduisant le chercheur à la conclusion absurde de l’absence totale d’association entre ces deux construits.
Cette méconnaissance de la courbure structurelle a pour conséquence corollaire de reléguer toute la dynamique systématique non modélisée dans le terme d’erreur résiduelle ε. La variance qui aurait dû être mathématiquement expliquée par une fonction quadratique ou cubique se retrouve absorbée au sein de la somme des carrés des erreurs résiduelles. Ce gonflement artificiel de l’erreur résiduelle a deux conséquences majeures : d’une part, il provoque une réduction drastique de la statistique F globale du modèle ainsi que des statistiques t individuelles de chaque coefficient, entraînant une chute drastique de la puissance statistique ; d’autre part, il induit une surestimation de l’erreur type d’estimation, fragilisant la précision de toute projection ou inférence future.
Sur le plan conceptuel et épistémologique, l’incapacité à détecter et à modéliser adéquatement une relation non linéaire génère une incohérence théorique profonde. Les processus d’adaptation humaine, d’épuisement professionnel (burnout) ou de régulation émotionnelle obéissent rarement à des lois proportionnelles pures ; ils comportent des seuils d’activation, des points de bascule et des phénomènes de saturation. Imposer un carcan linéaire uniforme sur de tels mécanismes aboutit à une dénaturation de l’architecture cognitive modélisée. De plus, la pente de l’estimateur β̂ ainsi obtenue souffre d’un biais systématique qui varie en fonction de la région de la variable indépendante où l’échantillonnage s’avère le plus dense, ruinant irrémédiablement la généralisabilité des résultats à des contextes où les distributions marginales des prédicteurs différeraient.
3. Diagnostic et remédiation du postulat de linéarité
3.1 Outils graphiques et statistiques d’évaluation de la linéarité
L’inspection minutieuse de la forme fonctionnelle unissant les variables constitue la première étape incontournable du diagnostic de régression. Le réflexe analytique initial consiste en la construction de diagrammes de dispersion bivariés systématiques croisant chaque prédicteur individuel avec la variable dépendante. Pour dépasser les limites perceptives inhérentes à la dispersion brute des points, l’adjonction d’une courbe d’ajustement non paramétrique basée sur la méthode de lissage local Loess (Locally Estimated Scatterplot Smoothing) s’avère hautement révélatrice. L’algorithme Loess ajuste des régressions polynomiales pondérées au sein de voisinages locaux glissants, permettant à la courbe de se courber organiquement pour épouser les inflexions naturelles des données psychométriques sans imposer d’hypothèse paramétrique rigide a priori. Tout écart substantiel entre cette courbe empirique lissée et la droite théorique de régression linéaire met immédiatement en évidence un défaut de linéarité univariée.
Toutefois, en régression multiple, la relation bivariée brute peut masquer ou altérer la véritable relation conditionnelle en raison de la présence d’autres covariables au sein du modèle. Pour contourner cette limitation, les méthodologistes préconisent le recours aux graphiques de résidus partiels, également désignés sous le terme de diagrammes de régression partielle ou component-plus-residual plots. Ces représentations projettent les résidus du modèle global additionnés de la contribution linéaire propre du prédicteur cible contre les valeurs de ce même prédicteur. En nettoyant graphiquement la relation de l’influence confondante exercée par l’ensemble des autres covariables incluses, ces diagrammes isolent rigoureusement la géométrie véritable de l’effet partiel, permettant d’identifier sans ambiguïté la présence de motifs quadratiques, logarithmiques ou sigmoïdes.
Au-delà de l’évaluation visuelle, la confirmation empirique de la linéarité requiert l’administration de tests statistiques formels de spécification fonctionnelle. Le plus universellement éprouvé est le test RESET de Ramsey (Regression Equation Specification Error Test). Ce test inférentiel procède en ré-estimant le modèle de régression initial après y avoir inséré des termes d’ordre supérieur basés sur les puissances des valeurs prédites (généralement Ŷ2, Ŷ3 et Ŷ4). Si l’introduction conjointe de ces termes non linéaires génère une augmentation statistiquement significative de la variance expliquée (évaluée au moyen d’un test de Fisher omnibus), le modèle initial est formellement déclaré mal spécifié, attestant de la présence de non-linéarités sous-jacentes ou de variables d’interaction omises. Dans les inventaires de personnalité ou les échelles de psychopathologie, cette approche détecte avec acuité les points d’inflexion non modélisés dans les scores d’items cumulés.
3.2 Stratégies d’ajustement et de modélisation non linéaire
Lorsqu’un diagnostic atteste formellement de la faillite du postulat de linéarité, l’analyste de données dispose d’un riche éventail d’approches méthodologiques pour réajuster le modèle sans nécessairement renoncer à la structure analytique des moindres carrés. La solution la plus directe et la plus élégante sur le plan conceptuel réside dans l’introduction de termes polynomiaux d’ordre supérieur. Si le diagramme de régression partielle met en exergue une concavité symétrique évocatrice de l’effet Yerkes-Dodson, le chercheur insérera dans l’équation le terme au carré du prédicteur concerné (Xj2). L’équation modélise alors une parabole où le coefficient linéaire capture la pente au point d’origine et le coefficient quadratique modélise la courbure et l’accélération du phénomène psychologique. Il demeure primordial, dans une telle démarche, de centrer préalablement la variable prédictive sur sa moyenne avant d’en calculer les puissances, afin de juguler l’émergence d’une multicolinéarité structurelle indésirable entre le terme simple et son terme quadratique.
Une alternative tout aussi puissante réside dans l’application de transformations mathématiques univariées non linéaires aux prédicteurs ou au critère. Lorsque la dynamique psychologique manifeste une décélération progressive ou des rendements décroissants (par exemple, l’impact marginal d’un accroissement de revenu sur le niveau de bonheur subjectif), l’application d’une fonction logarithmique naturelle (log(X)) permet de linéariser la relation. À l’inverse, si le phénomène subit une accélération exponentielle (comme l’escalade émotionnelle lors de crises de panique répétées), une transformation exponentielle ou une puissance inverse peut redresser la courbure dans l’espace de régression, autorisant l’usage serein de la machinerie des MCO tout en préservant une interprétabilité paramétrique rigoureuse.
Pour les configurations comportementales complexes où les relations fonctionnelles dévient de toute forme polynomiale ou géométrique élémentaire, les modèles additifs généralisés (GAM) offrent une transition paradigmatique idéale. Développés par Hastie et Tibshirani, les GAM remplacent la somme rigide des termes linéaires standard βjXj par une somme de fonctions de lissage non paramétriques fj(Xj) estimées par des splines de lissage pénalisées. Cette approche permet aux données de déterminer librement la morphologie fonctionnelle de la relation tout en conservant la structure additive qui facilite l’interprétation isolée de chaque effet prédictif. Enfin, si des motifs à seuils abrupts sont identifiés, le recours à la régression spline monotone ou à la régression segmentée (piecewise regression) autorise la modélisation de pentes différenciées de part et d’autre d’un seuil critique empiriquement estimé, offrant un reflet fidèle des transitions de phase cognitives ou comportementales.
4. Postulat 2 : L’absence de multicolinéarité entre prédicteurs
4.1 Origine et nature de la redondance informationnelle
Le second postulat fondamental de la régression linéaire multiple stipule que les prédicteurs intégrés dans la matrice de régression doivent être linéairement indépendants ou, à tout le moins, ne pas manifester d’interdépendance linéaire quasi-parfaite. La multicolinéarité désigne précisément une situation statistique dans laquelle deux ou plusieurs variables explicatives présentent une corrélation substantielle entre elles, introduisant une redondance informationnelle majeure au sein du système explicatif. En psychologie et en sciences comportementales, la multicolinéarité constitue l’un des défis méthodologiques les plus omniprésents, en raison même de l’architecture théorique des construits étudiés, qui partagent fréquemment des soubassements conceptuels et neurocognitifs communs.
Ce phénomène découle directement de la propension des batteries de tests psychométriques à mesurer des facettes intriquées d’une même métadimension. Par exemple, au sein du modèle des Big Five, si l’on tente de modéliser l’intensité du burnout professionnel en incluant simultanément comme prédicteurs les scores de Névrosisme global, de Sous-échelle d’Anxiété-Trait, d’Affectivité Négative et d’Épuisement Émotionnel précoce, on introduit inévitablement des variables qui partagent une part massive de leur variance réelle. Cette redondance est encore exacerbée par le problème de l’erreur de mesure partagée, inhérente aux inventaires d’auto-évaluation soumis au même format de réponse de type Likert ou aux mêmes biais de désirabilité sociale.
D’un point de vue mathématique, il est indispensable de différencier la multicolinéarité parfaite de la multicolinéarité quasi-parfaite. La multicolinéarité parfaite survient lorsqu’une variable explicative est une combinaison linéaire exacte et déterministe d’une ou plusieurs autres variables (par exemple, si un chercheur intègre par inadvertance les sous-scores de trois domaines cognitifs ainsi que leur score total cumulé dans la même équation). Dans ce cas extrême, la matrice d’information XTX devient strictement singulière ; son déterminant s’annule, rendant son inversion matricielle (XTX)-1 mathématiquement impossible. L’algorithme des MCO s’interrompt purement et simplement.
En pratique empirique, c’est la multicolinéarité quasi-parfaite qui se manifeste : la matrice demeure inversible, mais elle s’avère numériquement mal conditionnée et instable. Les colonnes de la matrice X sont si fortement alignées dans l’espace vectoriel que la variance des coefficients de régression explose littéralement. Le corollaire immédiat est un gonflement dramatique de l’erreur type associée à chaque coefficient bêta, ce qui dilue l’estimation ponctuelle dans un bruit d’échantillonnage excessif.
4.2 Répercussions sur l’interprétation des effets partiels
L’inflation des erreurs types causée par la multicolinéarité a des répercussions directes sur l’interprétabilité psychologique des modèles statistiques. Le symptôme le plus spectaculaire réside dans l’extrême instabilité numérique des coefficients bêta estimés : la modification minime d’une seule observation au sein de la base de données, l’ajout ou le retrait d’un sujet atypique, ou une simple réplication sur un échantillon indépendant issu de la même population peut provoquer des variations massives de l’amplitude des pentes de régression, voire des inversions complètes de signes. Le modèle devient hypersensible aux idiosyncrasies de l’échantillon d’étalonnage, perdant toute prétention à la robustesse scientifique.
Sur le plan analytique, la régression linéaire multiple vise à isoler l’effet propre de chaque prédicteur, défini comme l’impact de ce dernier conditionnellement à la présence de toutes les autres covariables. Or, lorsque deux variables partagent 80 % ou 90 % de leur variance, il ne subsiste qu’une fraction dérisoire de variance unique (spécifique) pour chaque prédicteur. L’algorithme se trouve dans l’incapacité statistique d’attribuer avec certitude les parts d’explication respectives à l’un ou l’autre des construits. Il en résulte un phénomène troublant fréquemment rencontré par les psychologues : le paradoxe du modèle hautement significatif dans son ensemble mais stérile dans ses composantes individuelles. Le test F global d’adéquation affiche une valeur p hautement significative (indiquant que l’ensemble des prédicteurs prédit excellemment le critère), assorti d’un R2 substantiel, mais aucun des tests t individuels n’atteint le seuil de significativité nominal (α = 0,05).
De surcroît, la multicolinéarité sévère induit fréquemment des inversions de signes contre-intuitives, un phénomène étroitement lié aux effets de suppression statistique décrits par Horst et Cohen. Un prédicteur qui manifeste une corrélation bivariée positive robuste et théoriquement congruente avec la variable dépendante peut subitement afficher un coefficient bêta partiel négatif au sein du modèle multiple. Bien que des mécanismes réels de suppression suppressive puissent exister dans l’architecture cognitive, ces inversions de signes résultent le plus souvent d’un artéfact computationnel induit par l’inversion d’une matrice presque singulière. Les chercheurs non avertis échafaudent alors des hypothèses théoriques complexes pour expliquer un prétendu effet protecteur ou délétère qui n’est en réalité qu’un pur fantôme algorithmique.
5. Détection et traitement de la multicolinéarité
5.1 Indices diagnostiques quantitatifs
L’évaluation rigoureuse de la colinéarité au sein d’un ensemble de covariables exige une méthodologie à étapes successives, combinant des indicateurs bivariés simples et des métriques d’interdépendance multivariée. La première inspection analytique repose sur l’examen minutieux de la matrice de corrélations de Pearson inter-items ou inter-échelles. L’observation de coefficients bivariés r excédant la valeur seuil de 0,80 ou 0,85 constitue un signal d’alerte sans équivoque quant à la présence d’une redondance d’information majeure. Néanmoins, se cantonner à ce seul diagnostic bivarié serait méthodologiquement myope : une multicolinéarité dévastatrice peut parfaitement émerger de la combinaison linéaire conjointe de trois ou quatre prédicteurs qui, pris isolément par paires, ne manifestent que des corrélations modérées de l’ordre de 0,40 à 0,50.
Pour quantifier l’impact réel de l’ensemble du réseau de covariation sur la précision de chaque paramètre, l’indice de référence incontournable est le facteur d’inflation de la variance (VIF), intrinsèquement lié à la tolérance. Pour un prédicteur Xj donné, la tolérance est définie mathématiquement par :
Tolérancej = 1 – Rj2
où Rj2 représente le coefficient de détermination obtenu en régressant artificiellement le prédicteur Xj sur l’ensemble de tous les autres prédicteurs du modèle. La tolérance quantifie précisément la proportion de variance de ce prédicteur qui n’est pas partagée avec ses pairs. Le facteur d’inflation de la variance correspond simplement à l’inverse de la tolérance :
VIFj = 1 / (1 – Rj2)
Le VIF exprime directement le facteur multiplicatif par lequel la variance d’échantillonnage de l’estimateur β̂j se trouve augmentée en raison de la colinéarité, comparativement à ce qu’elle aurait été si les prédicteurs avaient été rigoureusement orthogonaux. Si les seuils empiriques traditionnels de tolérance < 0,10 ou VIF > 10 sont universellement cités dans les manuels élémentaires, la recherche psychométrique contemporaine adopte des critères sensiblement plus prudents : un VIF supérieur à 5, voire à 2,5 dans les contextes d’échantillons de taille modeste, signale d’ores et déjà une contamination préjudiciable de l’estimation statistique.
L’arsenal diagnostique le plus sophistiqué repose sur l’analyse spectrale proposée par Belsley, Kuh et Welsch. Cette approche examine les valeurs propres (λ) de la matrice des variables indépendantes standardisées. Elle calcule l’indice de conditionnement (Condition Index, CI), défini comme la racine carrée du rapport entre la valeur propre maximale et chaque valeur propre individuelle :
κ = √(λmax / λk)
Un indice de conditionnement excédant 30 (associé à des proportions de décomposition de la variance supérieures à 0,50 pour deux prédicteurs ou plus sur la même dimension propre) identifie avec une précision chirurgicale l’existence d’une dépendance linéaire quasi-parfaite, désignant nommément les construits statistiques impliqués dans cette redondance mutuelle.
5.2 Procédures correctives empiriques et théoriques
Face à un diagnostic avéré de multicolinéarité, le chercheur ne doit pas succomber au découragement méthodologique, mais mobiliser l’une des solutions d’ajustement adaptées à la question de recherche sous-jacente. La stratégie la plus intuitive et théoriquement élégante consiste en l’élimination sélective ou la fusion conceptuelle des prédicteurs redondants. Si deux échelles psychométriques d’anxiété présentent un VIF prohibitif, leur fusion en un score composite unique (par sommation standardisée ou moyenne arithmétique) permet de capturer la dimension sous-jacente avec une fidélité de mesure supérieure, en vertu des postulats de la théorie classique des tests qui établit que l’agrégation d’indicateurs convergents accroît la consistance interne.
Une seconde approche mathématique consiste à opérer une réduction dimensionnelle préalable par une analyse en composantes principales (ACP) ou une analyse factorielle exploratoire. En extrayant les facteurs orthogonaux (non corrélés) qui condensent le bloc d’indicateurs redondants, le chercheur peut substituer à ces derniers les scores factoriels factorisés au sein de l’équation de régression linéaire finale. La colinéarité est ainsi ramenée à un niveau strictement nul (VIF = 1), bien que cette procédure s’accompagne d’une légère perte de nuance sémantique quant à l’interprétation des étiquettes de prédicteurs originaux.
Lorsque la structure théorique impose formellement de conserver l’ensemble des prédicteurs individuels initiaux, les méthodes de régression pénalisée issues de l’apprentissage statistique moderne s’imposent comme la référence méthodologique. La régression Ridge (Hoerl & Kennard, 1970) introduit une pénalité quadratique de type L2 sur la magnitude des coefficients dans la fonction de coût des MCO :
Minimiser Σ (Y – Xβ)2 + λ Σ βj2
En injectant une quantité infinitésimale de biais contrôlé via le paramètre de régularisation λ, la régression Ridge stabilise numériquement la matrice de covariance inversible, réduisant drastiquement la variance des coefficients estimés. La régression Lasso (Least Absolute Shrinkage and Selection Operator), articulée autour d’une pénalité de type L1 sur la somme des valeurs absolues, force les coefficients des prédicteurs les plus redondants à s’annuler exactement, opérant une sélection automatisée et parcimonieuse des variables. L’Elastic Net combine quant à lui harmonieusement les pénalités L1 et L2, stabilisant la sélection de groupes de variables psychologiques fortement corrélées.
Enfin, au sommet de la hiérarchie méthodologique, la modélisation par équations structurelles (SEM) avec variables latentes permet d’adresser frontalement la nature même de la corrélation entre prédicteurs en isolant explicitement l’erreur de mesure au sein de modèles de mesure confirmatoires, affranchissant les trajectoires structurelles de la contamination induite par la colinéarité des scores observés.
6. Postulat 3 : L’indépendance des observations et des erreurs
6.1 Fondements de l’échantillonnage et de l’orthogonalité des résidus
Le troisième postulat fondamental sur lequel repose l’optimalité de l’estimation par les MCO concerne l’indépendance stochastique des observations et l’absence d’autocorrélation entre les erreurs résiduelles. En termes statistiques formels, la covariance conditionnelle entre les résidus d’erreur associés à deux observations quelconques i et j doit être rigoureusement nulle pour tout i ≠ j :
Cov(εi, εj | X) = 0
Ce postulat sous-tend que la déviation résiduelle d’une unité d’observation par rapport à sa valeur attendue modélisée ne fournit aucune information prédictive quant à la direction ou à l’amplitude de l’écart résiduel manifesté par une autre unité de l’échantillon. Cette hypothèse découle intrinsèquement de la méthode d’échantillonnage aléatoire simple dans une population cible idéale.
Cependant, la réalité empirique du recueil de données en psychologie viole fréquemment cette prémisse théorique idéalisée. Deux configurations de recherche majeures induisent systématiquement des dépendances résiduelles structurelles : les mesures répétées longitudinales et l’échantillonnage en grappes (ou hiérarchique). Dans les protocoles longitudinaux, les évaluations écologiques momentanées (EMA) sur smartphone ou les études de suivi développemental, plusieurs observations temporelles sont collectées de manière répétée auprès des mêmes individus au fil du temps. Les caractéristiques biopsychologiques stables, les traits de personnalité et les dynamiques affectives d’un sujet créent une corrélation intra-individuelle massive des résidus : si le score de dépression d’un participant à l’instant t est supérieur à la prédiction du modèle général, son résidu à l’instant t+1 aura une probabilité écrasante d’être également positif.
D’autre part, la vie humaine s’organise naturellement au sein de structures sociales emboîtées. Les élèves sont regroupés dans des classes, elles-mêmes intégrées au sein d’établissements scolaires ; les employés opèrent au sein d’équipes de travail soumises à un même leadership organisationnel ; les patients sont pris en charge par des thérapeutes spécifiques au sein de centres de soins. Ces structures génèrent un effet de grappe ou de contexte inévitable : les individus partageant le même micro-environnement manifestent une homogénéité comportementale accrue par rapport aux individus extérieurs à la grappe, violant directement l’indépendance des erreurs.
La présence d’une telle dépendance sérielle ou spatiale non modélisée a pour impact immédiat une sous-estimation systématique et dramatique de l’erreur type des coefficients. L’algorithme des MCO, incapable de discerner la répétition de l’information, traite chaque ligne de la base de données comme une unité indépendante d’évidence empirique, gonflant artificiellement les degrés de liberté réels du modèle.
6.2 Risques inférentiels liés à la non-indépendance en psychologie
L’inflation des degrés de liberté résultant du déni de l’interdépendance des observations a des conséquences délétères sur les tests d’hypothèses statistiques. Le risque inférentiel majeur réside dans une augmentation exponentielle et incontrôlée du taux d’erreur de première espèce (α). Alors que le chercheur croit opérer au seuil de signification conventionnel de 5 %, le taux réel de faux positifs peut grimper à 20 %, 40 %, voire excéder 60 % en présence d’une autocorrélation résiduelle modérée à forte ou d’un coefficient de corrélation intraclasse (ICC) non négligeable au sein de grappes éducatives ou thérapeutiques.
Cette distorsion computationnelle conduit à l’acceptation erronée d’hypothèses de recherche spécieuses qui échoueront irrémédiablement lors de tentatives de réplication indépendantes. Des interventions pédagogiques ou thérapeutiques sont ainsi fréquemment déclarées efficaces alors que l’effet statistiquement significatif relevé n’était qu’un artéfact induit par la non-indépendance des observations d’un échantillon clusterisé. Le cadre de régression MCO standard confond tragiquement la variance intra-individuelle (variabilité des états dynamiques chez une même personne au fil du temps) et la variance inter-individuelle (différences stables entre les traits des individus d’une population). Cette confusion conceptuelle produit des inférences écologiques fallacieuses, où des corrélations établies entre individus sont attribuées indûment à des processus psychologiques opérant au sein des individus.
Dès lors que la structure d’indépendance des perturbations aléatoires est compromise, la matrice de covariance théorique des erreurs ne se réduit plus à une matrice scalaire σ2I, mais se transforme en une matrice complexe non diagonale Σ. Dans cette configuration, les théorèmes de Student et de Fisher perdent leur validité mathématique : les statistiques de test ne suivent plus les distributions canoniques t et F, et les valeurs de probabilité p qui en découlent sont dénuées de toute rigueur probabiliste, rendant caduque l’ensemble des inférences tirées du modèle.
7. Diagnostic et modélisation de la dépendance résiduelle
7.1 Tests formels et graphiques d’autocorrélation
Pour statuer sur la validité du postulat d’indépendance, l’analyste doit inspecter l’organisation structurelle de ses données et mobiliser des tests inférentiels ciblés sur les séries résiduelles ordonnées temporellement ou spatialement. L’instrument historique le plus classiquement cité est le test de Durbin-Watson. Ce test évalue formellement la présence d’une autocorrélation résiduelle de premier ordre au sein d’une séquence de données ordonnées, au moyen de la statistique d définie par la formule :
d = Σt=2n (et – et-1)2 / Σt=1n et2
La valeur de la statistique d oscille théoriquement dans un intervalle borné entre 0 et 4. Lorsque les résidus sont parfaitement indépendants de manière sérielle, la valeur empirique gravite étroitement autour de 2. Une valeur tendant vers 0 témoigne d’une autocorrélation positive majeure (les résidus successifs se succèdent en conservant la même polarité positive ou négative), tandis qu’une valeur se rapprochant de 4 indique une autocorrélation négative marquée. Bien que ce test demeure largement implanté dans les logiciels généralistes, son utilité se cantonne rigoureusement aux dépendances autorégressives de décalage d’ordre un (AR(1)) et exige une séquence temporelle continue sans valeurs manquantes.
Pour surmonter ces contraintes restrictives, le test de Breusch-Godfrey (ou test multiplicateur de Lagrange pour l’autocorrélation) constitue une alternative nettement supérieure. Ce test inférentiel évalue l’autocorrélation résiduelle jusqu’à un ordre arbitraire p spécifié par l’utilisateur (AR(p)), en régressant les résidus du modèle initial sur les prédicteurs originaux ainsi que sur les p décalages temporels successifs de ces mêmes résidus. Il s’avère particulièrement pertinent pour modéliser des rythmes circadiens ou des cycles hebdomadaires au sein de protocoles psychologiques longitudinaux.
Sur le plan qualitatif, l’inspection des graphiques d’autocorrélation résiduelle — nommément le correlogramme de la fonction d’autocorrélation (ACF) et de la fonction d’autocorrélation partielle (PACF) — permet de repérer instantanément la géométrie de la dépendance temporelle. Dans les protocoles écologiques momentanés, l’analyste s’assurera impérativement que l’ordre temporel des horodatages numériques a été scrupuleusement respecté avant le calcul de ces fonctions, afin d’éviter tout diagnostic faussé.
7.2 Solutions méthodologiques avancées pour données dépendantes
Lorsque la structure du design expérimental trahit une violation irréductible de l’indépendance des observations, le chercheur doit renoncer aux MCO classiques au profit d’architectures analytiques contemporaines capables d’intégrer explicitement la structure de covariance des données. La solution méthodologique royale réside incontestablement dans l’adoption des modèles linéaires mixtes (également désignés sous les vocables de modèles hiérarchiques linéaires, HLM, ou modèles multiniveaux). En distinguant les effets fixes (reflétant les relations structurelles globales au niveau de la population) des effets aléatoires (capturant la variabilité propre à chaque sujet ou à chaque grappe via l’estimation de variances d’intercepts et de pentes aléatoires), ces modèles séparent rigoureusement la variance intra-groupe de la variance inter-groupe :
Yij = β0j + β1j Xij + εij
β0j = γ00 + u0j
β1j = γ10 + u1j
Cette spécification permet de modéliser avec exactitude le coefficient de corrélation intraclasse, rétablissant la validité nominale des erreurs types et la puissance adéquate des tests d’hypothèses sur des données imbriquées.
Pour les devis longitudinaux comportant des mesures répétées où la variabilité inter-individuelle pure n’est pas la cible théorique première mais doit être neutralisée au profit de l’effet moyen populationnel, le cadre des équations d’estimation généralisées (GEE), introduit par Liang et Zeger, constitue une approche robuste majeure. Les GEE modélisent directement l’espérance marginale tout en stipulant une structure de covariance de travail a priori (autorégressive AR(1), échangeable ou non structurée), combinée à un estimateur sandwich empirique garantissant la convergence des erreurs types même en cas de mauvaise spécification partielle de la matrice de travail.
Si la dépendance sérielle est détectée dans un échantillon temporel sans structure hiérarchique complexe, l’application de la correction de covariance de type Newey-West (HAC : Heteroscedasticity and Autocorrelation Consistent) permet d’ajuster les erreurs types standards pour neutraliser l’impact simultané de l’autocorrélation et de l’hétéroscédasticité sans altérer les estimations ponctuelles des coefficients. Enfin, dans les configurations organisationnelles simples où le niveau d’intervention se situe au niveau du groupe, une agrégation raisonnée des scores individuels au niveau méso-organisationnel (en vérifiant préalablement la justification empirique de l’agrégation via les indices rwg et ICC) permet de ramener l’unité d’analyse à son niveau d’indépendance véritable.
8. Postulat 4 : L’homoscédasticité des résidus
8.1 Compréhension de la constance de la variance d’erreur
Le quatrième postulat sous-jacent au modèle des moindres carrés ordinaires est celui de l’homoscédasticité, un terme d’origine grecque signifiant littéralement « même dispersion ». Ce postulat exige formellement que la variance conditionnelle des termes d’erreur résiduelle demeure strictement constante sur l’ensemble de l’espace défini par les prédicteurs ou les valeurs prédites de la variable dépendante. Mathématiquement, pour chaque vecteur d’observations Xi, l’espérance de l’erreur au carré doit être invariante :
Var(εi | Xi) = σ2 ∀ i ∈ {1, …, n}
Lorsque cette condition d’homogénéité de la dispersion est violée, les résidus sont dits hétéroscédastiques. La dispersion d’erreur varie alors en fonction des valeurs prises par un ou plusieurs prédicteurs.
En psychologie différentielle, clinique et cognitive, l’hétéroscédasticité est une configuration empirique fréquente plutôt qu’une exception marginale. Les comportements humains manifestent intrinsèquement une variabilité conditionnelle asymétrique. Un exemple paradigmatique réside dans l’étude des habiletés cognitives : lors de tâches d’attention soutenue ou de résolution de problèmes logiques, les sujets affichant de hauts scores de capacité cognitive globale manifestent une performance stable et homogène (traduite par une variance résiduelle restreinte), tandis que les sujets à faible capacité présentent des variations erratiques massives d’un essai à l’autre en fonction de la fatigue ou du désengagement attentionnel, générant une dispersion résiduelle considérablement accrue à l’extrémité inférieure de l’échelle.
De même, dans l’investigation des psychopathologies sévères (telles que les échelles de dissociation, d’idées suicidaires ou de stress post-traumatique), les individus issus de populations saines présentent une dispersion presque nulle confinée au plancher de l’échelle, alors que les patients en phase aiguë d’un trouble psychiatrique exhibent des fluctuations cliniques d’une variabilité considérable, produisant une hétéroscédasticité structurelle flagrante. Il est fondamental de distinguer l’homoscédasticité globale de l’hétéroscédasticité conditionnelle, cette dernière résultant souvent de l’omission d’une variable modératrice clé qui module précisément l’intensité de la réponse chez certains sous-groupes de la population étudiée. Le maintien de l’homoscédasticité conditionnelle est l’un des critères assurant l’efficacité asymptotique des coefficients MCO selon le théorème de Gauss-Markov.
8.2 Impacts statistiques de l’hétéroscédasticité
L’existence d’une hétéroscédasticité résiduelle a des impacts statistiques profonds qui, bien que différents de ceux induits par la violation de la linéarité, compromettent sévèrement l’inférence statistique. Il est important de souligner que la présence d’hétéroscédasticité n’induit pas de biais direct dans l’estimation ponctuelle des coefficients de régression β̂ ; les pentes estimées par les MCO demeurent mathématiquement non biaisées et convergentes si les autres postulats de linéarité et d’exogénéité sont respectés. En revanche, l’estimateur des MCO perd immédiatement sa propriété d’efficacité maximale : il cesse d’être le meilleur estimateur linéaire non biaisé (BLUE).
La conséquence néfaste majeure se situe au niveau du calcul de la matrice de variance-covariance des coefficients. La formule standard de l’erreur type σ2(XTX)-1 présume une variance résiduelle unique et scalaire. Dès lors que cette variance varie localement, les erreurs types calculées par les progiciels conventionnels s’avèrent mathématiquement incorrectes et biaisées. Dans la majorité des cas cliniques et comportementaux où la variance s’accroît conjointement avec les valeurs du critère, les erreurs types sont sous-estimées, induisant une compression artificielle des p-valeurs et une multiplication incontrôlée des erreurs d’inférence de type I.
De surcroît, l’hétéroscédasticité déforme gravement les intervalles de prédiction individuels. Contrairement aux intervalles de confiance (qui quantifient l’incertitude entourant l’estimation de la moyenne conditionnelle), les intervalles de prédiction délimitent la zone de certitude probabiliste où devrait se loger le score d’un nouvel individu particulier. Sous l’hypothèse d’homoscédasticité, ces bandes de prédiction sont uniformément parallèles à la droite de régression. En présence d’hétéroscédasticité non corrigée, le modèle attribue un intervalle d’une largeur invariable à l’ensemble du spectre de mesure. Dès lors, la précision pronostique est erronée : l’intervalle est trop large pour les sujets chez qui la variance d’erreur est en réalité faible, et dramatiquement trop étroit et sous-dimensionné pour les sujets situés dans les zones de haute variabilité.
En contexte neuropsychologique ou psychiatrique, cette anomalie expose les praticiens à des erreurs diagnostiques graves, en établissant des seuils de détection de déclin pathologique calculés avec une précision trompeuse pour les scores extrêmes.
9. Identification et traitement de l’hétéroscédasticité
9.1 Démarches diagnostiques visuelles et inférentielles
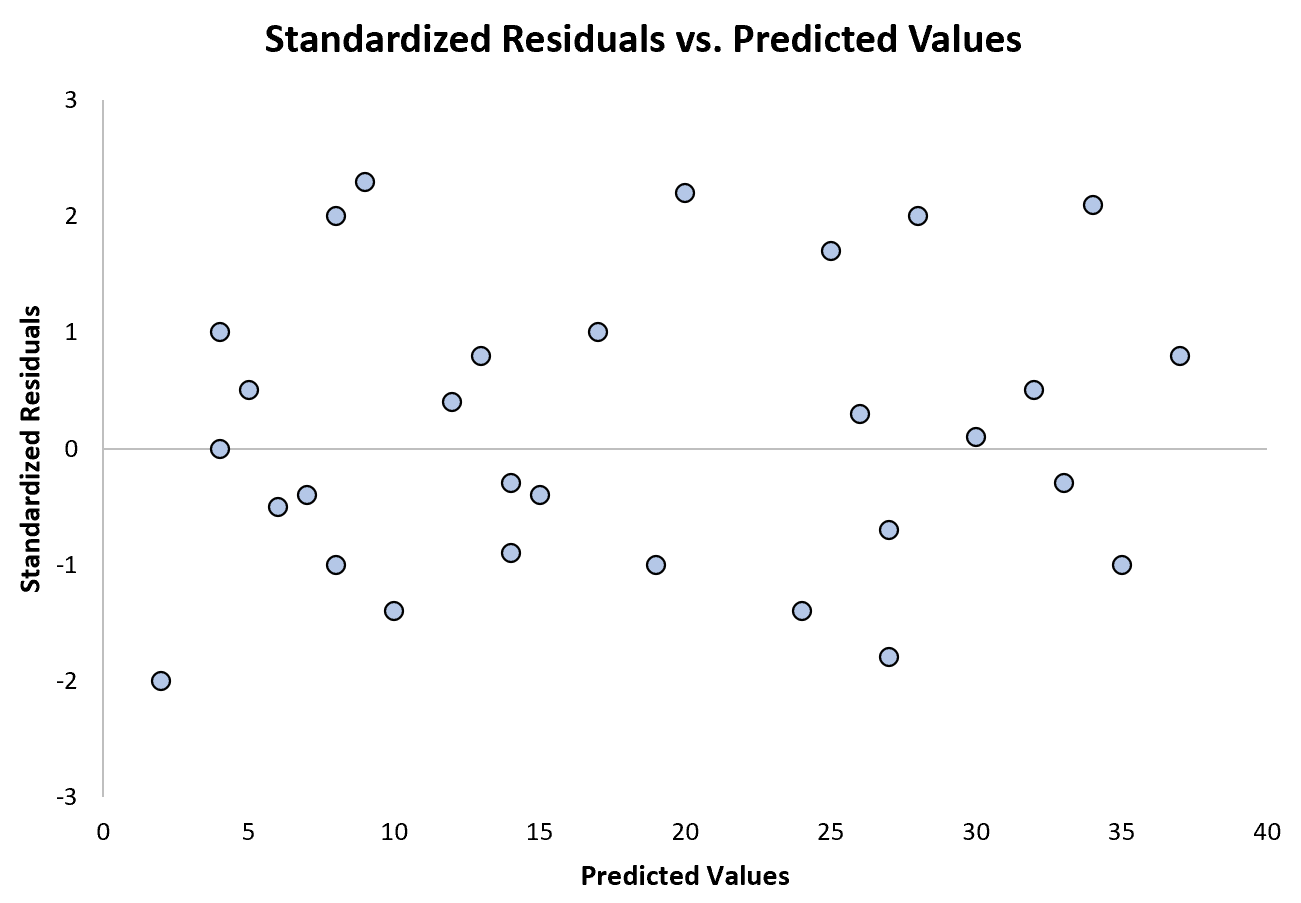
Le diagnostic méthodique de l’hétéroscédasticité commence impérativement par une évaluation graphique minutieuse de la distribution des perturbations aléatoires. L’outil diagnostique cardinal est le graphique des résidus standardisés ou studentisés en fonction des valeurs prédites (fitted values, Ŷ). Si le postulat d’homoscédasticité est pleinement satisfait, le nuage de points résultant doit adopter la forme d’une bande horizontale parfaitement rectangulaire, homogène et aléatoirement dispersée de part et d’autre de la ligne horizontale zéro, sans aucun agencement systématique discernable.
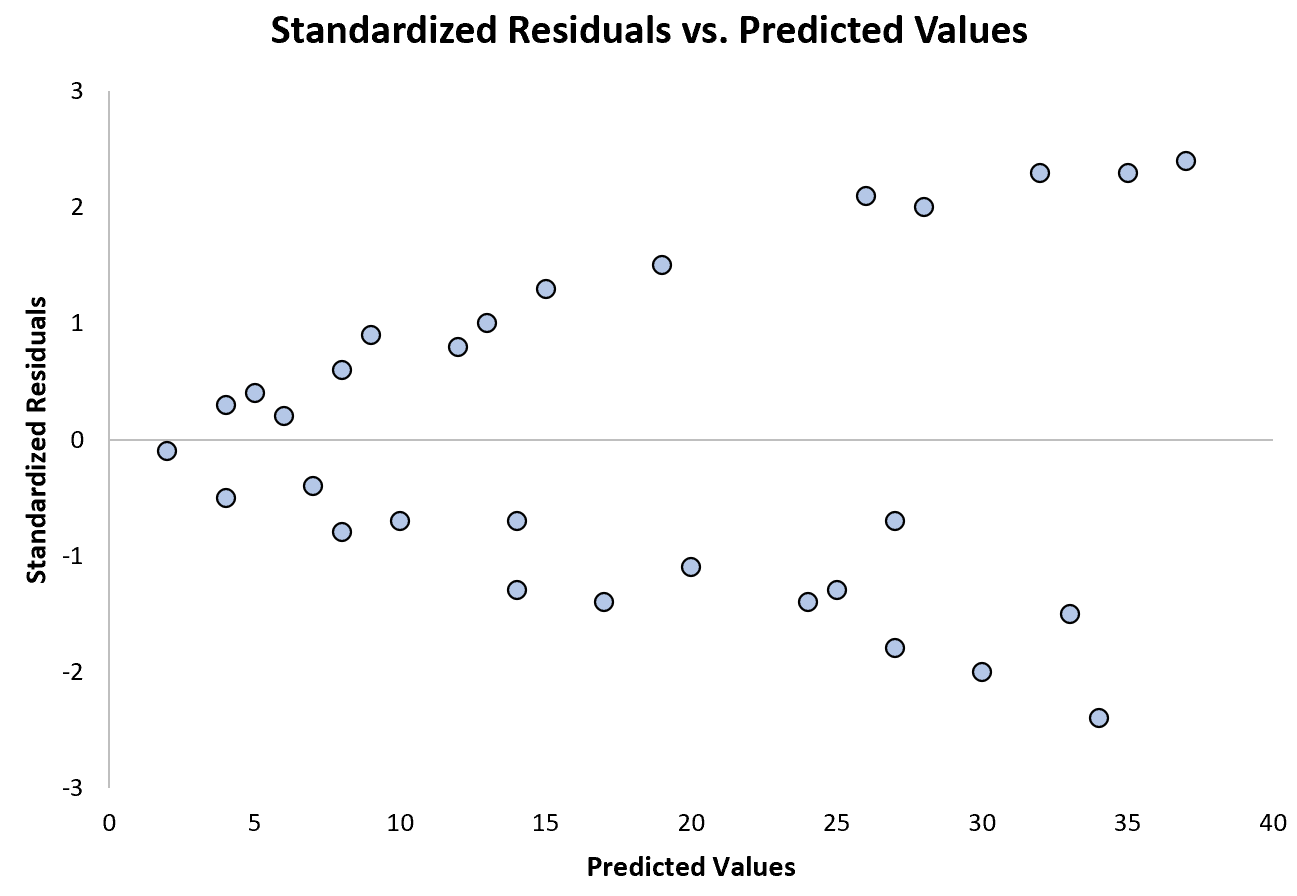
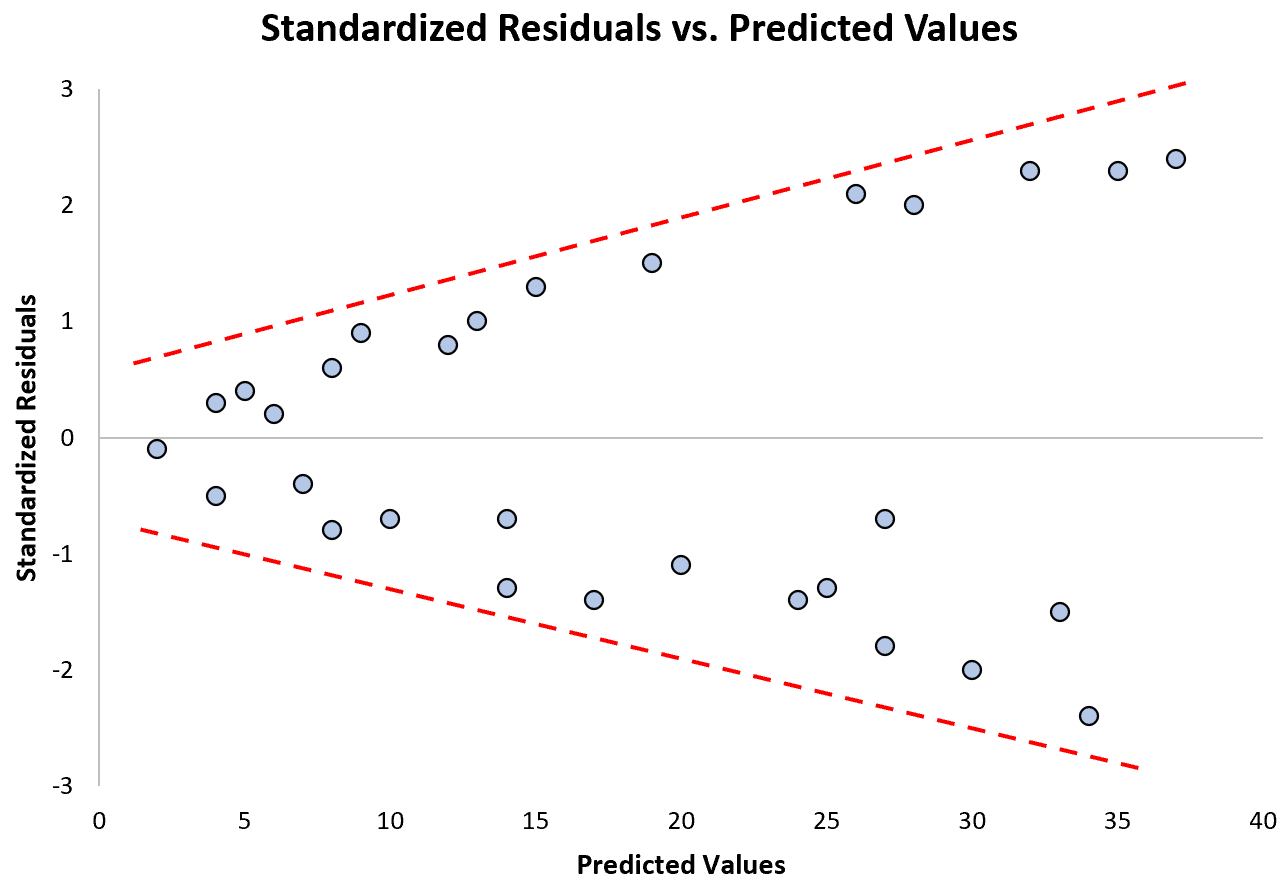
La présence d’une violation s’identifie visuellement par l’émergence de motifs géométriques caractéristiques. Le patron le plus universellement observé en recherche psychométrique est le motif en entonnoir (funnel shape) ou en mégaphone : la dispersion verticale des résidus est extrêmement concentrée pour les faibles valeurs ajustées, puis s’évase progressivement pour former un éventail très étalé au fur et à mesure que les scores prédits s’élèvent. D’autres configurations, telles que le motif en fuseau (variance faible aux extrémités et forte au centre) ou en double entonnoir, trahissent des singularités structurelles dans la variabilité conditionnelle du phénomène évalué.
Pour dépasser la subjectivité inhérente à l’analyse visuelle des graphiques résiduels, le statisticien dispose de batteries de tests inférentiels rigoureux. Le test de Breusch-Pagan figure parmi les plus universellement déployés. Il s’appuie sur la régression auxiliaire des résidus carrés (standardisés par la variance de l’erreur) sur l’ensemble des prédicteurs initiaux suspectés de moduler la variabilité. Sous l’hypothèse nulle d’homoscédasticité, la statistique multiplicateur de Lagrange suit asymptotiquement une distribution du χ2 dont les degrés de liberté correspondent au nombre de régresseurs testés. La version corrigée de ce test, proposée par Koenker (souvent désignée sous le nom de test de Breusch-Pagan-Koenker ou test de score studentisé), assouplit l’exigence préalable de normalité stricte des résidus, conférant une robustesse substantielle au diagnostic sur des échantillons psychologiques non gaussiens.
Enfin, le test général de White offre un diagnostic qui ne présuppose aucune forme spécifique d’hétéroscédasticité. Ce test régresse les résidus carrés sur tous les prédicteurs d’origine, leurs carrés respectifs ainsi que l’ensemble de leurs produits croisés (interactions bivariées). En évaluant la variance résiduelle contre toute courbure non linéaire de second ordre, le test de White fournit un verdict global exhaustif sur l’homogénéité de la variance à travers l’espace multidimensionnel du modèle.
9.2 Procédures de stabilisation de la variance
Dès lors que l’hétéroscédasticité est détectée au sein du modèle, plusieurs options d’ajustement méthodologique s’offrent au chercheur pour restaurer la validité des inférences. La voie la plus moderne, la plus flexible et la moins invasive consiste à recourir aux estimateurs de covariance robustes à l’hétéroscédasticité, historiquement initiés par Halbert White. Ces estimateurs, communément désignés sous l’appellation d’estimateurs sandwich ou estimateurs HC (Heteroscedasticity-Consistent), conservent intacts les coefficients ponctuels des MCO mais substituent à la formule classique de calcul de la variance la structure matricielle :
Var(β̂) = (XTX)-1 (XT Ω̂ X) (XTX)-1
où Ω̂ est une matrice diagonale incorporant les carrés des résidus individuels. Les perfectionnements successifs apportés par MacKinnon et White ont donné naissance à des variantes hautement performantes adaptées aux petits échantillons d’études cliniques : les estimateurs HC3 (qui applique une pondération inverse proportionnelle aux leviers d’observation (1 – hii)2) et HC4 (introduit par Cribari-Neto pour juguler l’impact délétère d’observations à fort effet de levier). L’implémentation des erreurs types HC3/HC4 permet d’obtenir des statistiques t et des intervalles de confiance parfaitement calibrés sans altérer les métriques d’origine des données.
Une seconde approche analytique historique réside dans l’application de transformations stabilisatrices de variance directement sur la variable dépendante. La méthode de transformation paramétrique de Box-Cox cherche par maximisation de vraisemblance la puissance optimale λ permettant de transformer simultanément Y vers l’homoscédasticité et la normalité résiduelle :
Y(λ) = (Yλ – 1) / λ (si λ ≠ 0) ; log(Y) (si λ = 0)
La transformation logarithmique classique (log(Y)) ou racine carrée (√Y) permet souvent d’absorber l’accroissement proportionnel de la variance d’erreur dans les distributions positives asymétriques.
Si la forme fonctionnelle de l’hétéroscédasticité est modélisable avec certitude (par exemple, si l’on démontre que la variance résiduelle est directement proportionnelle au carré d’un prédicteur démographique ou organisationnel), la régression par les moindres carrés pondérés (WLS) offre un cadre d’estimation optimal. Le WLS pondère chaque observation de manière inversement proportionnelle à sa variance d’erreur attendue (wi = 1 / σi2), accordant un poids statistique supérieur aux sujets chez qui la mesure est précise et minorant l’influence des observations hautement volatiles, ce qui rétablit l’optimalité BLUE.
Enfin, le recours à la régression quantile développée par Koenker et Bassett s’avère particulièrement fécond en recherche différentielle. En estimant non pas uniquement la moyenne conditionnelle mais l’ensemble des centiles de la distribution (médiane, 10e centile, 90e centile), la régression quantile permet de cartographier avec finesse comment les effets des prédicteurs diffèrent selon les zones de réactivité comportementale, transformant l’hétéroscédasticité en un objet d’investigation théorique plutôt qu’en une simple nuisance statistique.
10. Postulat 5 : La normalité de la distribution des résidus
10.1 Clarification théorique et déconstruction des mythes
Le cinquième postulat fondamental de la régression linéaire multiple par les MCO postule que le terme d’erreur aléatoire conditionnelle ε suit une distribution normale de moyenne nulle et de variance σ2 dans la population :
ε | X ~ N(0, σ2I)
Ce postulat est probablement l’un des plus fréquemment mal compris et mal interprété dans la communauté de la recherche en psychologie. Le premier mythe méthodologique majeur consiste à exiger que la variable dépendante brute Y ou que les prédicteurs X suivent une distribution gaussienne univariée. Il s’agit d’une confusion conceptuelle profonde : la méthode de régression n’impose aucune contrainte de normalité sur les variables indépendantes marginales — qui peuvent être ordinales, discrètes, dichotomiques (comme le genre ou un groupe expérimental) ou fortement asymétriques — ni même sur la variable dépendante brute. L’exigence formelle s’applique exclusivement à la distribution des résidus d’erreur conditionnels, c’est-à-dire aux écarts non expliqués subsistant une fois le modèle ajusté.
La seconde clarification épistémologique indispensable concerne la portée opérationnelle du Théorème Central Limite (TCL). Nombre de manuels statistiques soulignent que dès lors que la taille de l’échantillon devient substantielle (typiquement N ≥ 100 ou 200 sujets en psychologie), les propriétés asymptotiques du TCL garantissent que la distribution d’échantillonnage des coefficients β̂ converge vers une loi normale, quelle que soit la forme de la distribution sous-jacente des erreurs résiduelles individuelles. Par conséquent, pour des échantillons de grande envergure, le non-respect de la normalité des résidus n’invalide généralement pas les conclusions tirées des tests d’hypothèses univariés t et globaux F, car la convergence asymptotique compense la non-gaussianité de la population.
Toutefois, ce confort asymptotique devient inopérant dans de multiples contextes de la recherche en psychologie. Dans les études cliniques de neuro-imagerie, les expérimentations en neuropsychologie portant sur des populations de patients atteints de lésions cérébrales rares, ou lors de protocoles thérapeutiques intensifs, les échantillons disponibles n’excèdent souvent pas 20 à 40 participants. Dans ce cadre d’échantillons réduits, le TCL ne peut opérer. La validité exacte des tests statistiques t et F est alors conditionnée par la forme de la distribution d’erreur. De surcroît, même au sein d’échantillons massifs, la normalité résiduelle conditionnelle demeure une exigence stricte pour la calibration des intervalles de prédiction individuels : prédire avec justesse l’évolution psychopathologique future d’un patient particulier à 95 % exige rigoureusement que la queue de distribution des perturbations aléatoires réponde à la forme géométrique de la loi normale.
10.2 Conséquences de l’asymétrie et de l’aplatissement résiduels
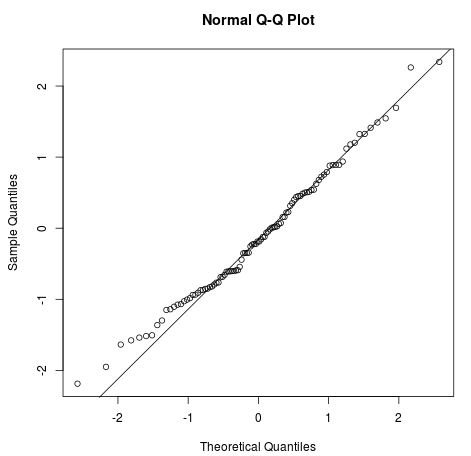
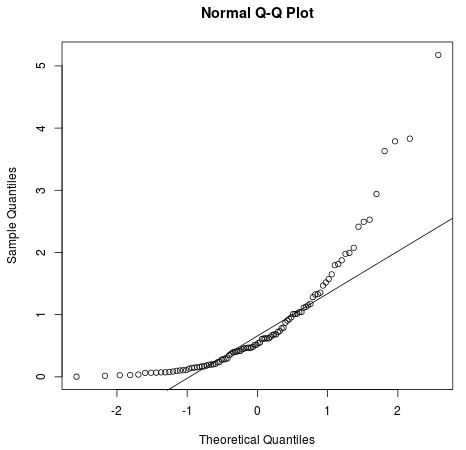
Lorsque le postulat de normalité résiduelle est substantiellement violé au sein d’échantillons de taille modeste ou restreinte, l’appareil inférentiel subit des déformations tangibles. La défaillance de la normalité prend principalement deux formes géométriques au sein des résidus : l’asymétrie (skewness) et l’aplatissement ou présence de queues lourdes (kurtosis). L’asymétrie résiduelle se produit lorsque le modèle tend à sous-estimer ou surestimer systématiquement les scores d’une sous-population marginale, produisant une traîne asymétrique de résidus positifs ou négatifs. Cette asymétrie induit une altération de la validité exacte des seuils de décision probabiliste p, décalant les zones critiques de rejet de l’hypothèse nulle.
De manière corollaire, les limites inférieures et supérieures des intervalles de confiance calculés autour des coefficients de régression perdent leur symétrie probabiliste. Alors que la théorie mathématique présume que le paramètre réel a une probabilité égale de 2,5 % d’excéder la borne supérieure ou de se situer sous la borne inférieure, une distribution résiduelle asymétrique conduit à des intervalles tronqués d’un côté et indûment étendus de l’autre, compromettant l’évaluation du doute scientifique.
Les conséquences méthodologiques sont encore plus sévères en présence de kurtosis résiduel excessif, c’est-à-dire lorsque les erreurs manifestent une distribution leptokurtique caractérisée par un pic central acéré et des queues épaisses (heavy tails). La présence de queues lourdes trahit la survenue d’écarts extrêmes bien plus fréquents que ce que prédit la fonction de densité gaussienne. Dans cette configuration, les moindres carrés ordinaires s’avèrent hypersensibles : en vertu de la minimisation de l’erreur au carré (Σ ei2), l’algorithme accorde une influence disproportionnée aux observations situées dans les queues de distribution. Une poignée d’individus atypiques peut dès lors faire basculer l’orientation des pentes β, dégradant la robustesse du modèle.
Dans les études exploratoires sous-dimensionnées fréquemment conduites en sciences cognitives, cette sensibilité accrue majore dramatiquement le risque de fausses découvertes statistiques, en confondant l’effet de quelques données extrêmes non normales avec une véritable loi psychologique populationnelle.
11. Évaluation de la normalité et solutions analytiques robustes
11.1 Analyses qualitatives et tests formels d’adéquation
L’évaluation rigoureuse du postulat de normalité des résidus mobilise une synergie d’inspections qualitatives fines et de validations inférentielles formalisées. L’outil diagnostique de référence le plus probant est le diagramme quantile-quantile normal (Q-Q plot). Ce graphique projette les résidus studentisés observés contre les quantiles théoriques qu’ils devraient adopter s’ils étaient rigoureusement issus d’une distribution normale standard. Lorsque le postulat est scrupuleusement honoré, les points de données s’alignent étroitement le long d’une droite de référence diagonale à 45 degrés traversant le plan. Toute déviation morphologique fournit une indication directe sur la pathologie des résidus : une courbure concave ou convexe systématique signale une asymétrie marquée, tandis qu’une morphologie en « S » inversé ou en sigmoïde étirée démontre indubitablement la présence de queues lourdes ou légères.
En complément du diagramme Q-Q, la construction de l’histogramme des résidus standardisés avec superposition de la courbe normale théorique de même moyenne et variance permet d’apprécier visuellement l’allure générale de la densité empirique. Cette visualisation doit systématiquement être étayée par le calcul quantitatif précis des coefficients standardisés d’asymétrie de Fisher (skewness) et d’aplatissement (kurtosis). Dans le cadre d’un échantillon convenable, des valeurs d’asymétrie oscillant au-delà de l’intervalle [-1 ; +1], ou un kurtosis excédant l’intervalle [-2 ; +2], constituent des indications formelles de déviation critique vis-à-vis du postulat gaussien.
Sur le versant des tests formels d’adéquation, le test de Shapiro-Wilk s’impose comme le test inférentiel le plus puissant et le plus sensible pour détecter la non-normalité résiduelle, surpassant largement le test historique de Kolmogorov-Smirnov (même assorti de la correction de Lilliefors). Le test de Shapiro-Wilk évalue le rapport entre l’estimateur de la variance dérivé de l’ordre linéaire des quantiles et l’estimateur classique de la variance d’échantillonnage. Une p-valeur inférieure au seuil alpha nominal conduit au rejet formel de l’hypothèse de normalité.
Toutefois, l’analyste expérimenté doit manier les tests formels de normalité avec une lucidité méthodologique critique : sur les très grands échantillons fréquemment analysés en psychologie différentielle (plusieurs milliers de sujets), la puissance statistique devient si titanesque que des déviations infinitésimales et triviales sans aucune répercussion inférentielle pratique font rejeter l’hypothèse nulle de normalité (p < 0,001), incitant à tort le chercheur à abandonner des modèles MCO pourtant asymptotiquement viables. À l’inverse, dans les petits échantillons où la normalité est une condition vitale, le test manque structurellement de puissance pour identifier des violations modérées. Dès lors, le diagnostic final doit impérativement découler d’un arbitrage éclairé combinant métriques quantitatives et lecture experte du Q-Q plot.
11.2 Alternatives analytiques modernes et rééchantillonnage
Lorsque les résidus manifestent une non-normalité irréductible et que l’échantillon est de taille trop restreinte pour s’en remettre sereinement au Théorème Central Limite, les méthodes contemporaines de rééchantillonnage offrent une issue méthodologique robuste. L’approche de référence incontournable est l’amorçage non paramétrique (bootstrapping). Cette méthodologie probabiliste s’affranchit entièrement des hypothèses distributionnelles paramétriques sous-jacentes. En générant des milliers de ré-échantillons virtuels (généralement B = 2000 ou 5000) tirés avec remise à partir de la matrice de données originale, l’algorithme reconstruit empiriquement la distribution d’échantillonnage de chaque coefficient bêta.
Le calcul d’intervalles de confiance BCa (Bias-Corrected and Accelerated) permet d’obtenir des bornes inférentielles de haute précision ajustées simultanément pour l’asymétrie empirique et le biais d’échantillonnage, restituant une intégrité probabiliste optimale aux conclusions de recherche sans nécessiter de transformation de variables.
Une alternative de modélisation paramétrique majeure consiste à abandonner les MCO au profit des modèles linéaires généralisés (GLM) introduits par Nelder et Wedderburn. Au lieu de contraindre les perturbations à la distribution gaussienne, le cadre GLM autorise la variable dépendante à appartenir à toute la famille exponentielle :
- Les distributions de Poisson ou Binomiale Négative permettent de modéliser les scores de comptage hautement asymétriques (nombre de passages à l’acte agressifs, nombre de rechutes addictives, fréquence de crises d’angoisse).
- La distribution Gamma ou Log-normale excelle dans la modélisation des temps de réaction continus, caractérisés par une longue traîne asymétrique positive.
Parallèlement, les méthodes de régression robuste, à l’instar des estimateurs M-estimateurs de Huber ou des estimateurs biséquarrés de Tukey, appliquent des fonctions de perte pondérées qui décroissent progressivement l’influence des résidus extrêmes situés dans les queues lourdes de la distribution, immunisant l’analyse contre la distorsion par les valeurs atypiques non gaussiennes.
Enfin, l’application formelle de transformations mathématiques univariées sur la variable dépendante (telles que la transformation logarithmique ou la fonction Box-Cox susmentionnée) demeure une démarche envisageable pour normaliser conjointement les données, pourvu que le chercheur tienne compte de la ré-expression sémantique subséquente des métriques d’association sur l’échelle transformée.
12. Synthèse procédurale et guide de bonnes pratiques psychométriques
12.1 Matrice décisionnelle séquentielle pour l’analyste de données
Afin de prémunir la recherche comportementale contre les pièges de l’ajustement empirique aveugle, l’analyste de données doit adopter un flux de travail rigoureux et standardisé, structuré selon une séquence logique prédéfinie. Le processus diagnostique ne s’exécute pas de manière anarchique après la lecture des coefficients, mais s’insère à des étapes charnières de la construction du modèle.
La première phase — la vérification pré-estimation — se focalise sur l’architecture de la matrice des variables indépendantes X. Elle englobe le calcul systématique des corrélations bivariées inter-items, le diagnostic des facteurs d’inflation de la variance (VIF) et l’examen du conditionnement matriciel afin de neutraliser toute multicolinéarité avant même de s’intéresser aux résidus. C’est également à ce stade que la structure méthodologique de l’échantillonnage est confrontée au postulat d’indépendance (identification d’effets de grappes ou de séries longitudinales requérant d’emblée une transition vers des modèles mixtes).
La seconde phase — l’analyse post-estimation — se consacre à l’autopsie critique des résidus empiriques du modèle initialement ajusté. Cette étape examine conjointement les quatre autres postulats à travers une chronologie standardisée :
- Évaluation de la linéarité par l’inspection des graphiques de résidus partiels et l’exécution du test RESET de Ramsey.
- Vérification de l’homoscédasticité via le diagramme des résidus studentisés contre valeurs prédites, conforté par les tests de Breusch-Pagan-Koenker ou de White.
- Examen de la normalité par le truchement du Q-Q plot normal, des coefficients de skewness/kurtosis et du test de Shapiro-Wilk.
- Détection conjointe des observations influentes et des points leviers.
Cette dernière évaluation est cruciale : une violation apparente d’homoscédasticité ou de normalité ne résulte parfois que de la distorsion causée par un ou deux cas extrêmes aberrants. Le recours concomitant à la distance de Cook (avec le seuil critique conventionnel D > 4/n ou D > 1) et aux statistiques DFBETAS (évaluant l’impact du retrait d’une observation spécifique sur chaque coefficient de régression individuel) permet d’isoler avec rigueur les données idiosyncrasiques qui faussent l’estimation globale du modèle.
Face aux violations identifiées, l’analyste se réfère à une matrice décisionnelle hiérarchisée :
- Si la taille d’échantillon est massive (N > 500), les violations modérées de normalité résiduelle sont tolérées en vertu du TCL, mais l’hétéroscédasticité impose systématiquement l’activation des erreurs types robustes HC3/HC4.
- Si l’hétéroscédasticité est couplée à une non-linéarité, la transformation de variables (Box-Cox) ou la modélisation polynomiale/spline s’impose prioritairement.
- En présence de structures hiérarchiques dépendantes, la migration vers les modèles multiniveaux constitue un impératif méthodologique incontournable.
12.2 Recommandations pour la rédaction académique transparente
La crédibilité de la science psychologique repose sur une transparence absolue lors de la dissémination des protocoles d’analyse. Les standards de publication modernes édictés par l’American Psychological Association (normes APA Journal Article Reporting Standards, ou JARS-Quant) proscrivent formellement la pratique désuète consistant à publier un tableau de régression linéaire sans apporter la preuve circonstanciée de la vérification de ses postulats sous-jacents. Dans la section « Analyses statistiques » et « Résultats », les auteurs doivent divulguer de manière transparente et explicite l’intégralité du protocole diagnostique implémenté.
Cette déclaration méthodologique exige de préciser nommément :
- Les valeurs maximales de VIF observées ainsi que les tolérances minimales associées, certifiant l’absence de redondance multicolinéaire.
- La conformité de la structure fonctionnelle (en mentionnant formellement les résultats du test RESET de Ramsey ou l’inspection des résidus partiels).
- Le statut d’homoscédasticité des variances résiduelles (en stipulant les résultats du test de Breusch-Pagan) et, le cas échéant, le type exact de correction d’erreur type robuste mobilisé (par exemple, « En raison d’une légère hétéroscédasticité résiduelle confirmée par le test de Breusch-Pagan, χ2(4) = 14,2, p = 0,007, l’ensemble des erreurs types et des tests d’inférence t a été estimé à l’aide de l’estimateur sandwich HC4 de Cribari-Neto »).
- L’évaluation de la normalité résiduelle (Q-Q plot) et le recours éventuel à l’amorçage (bootstrapping) non paramétrique BCa (en précisant le nombre exact d’itérations rééchantillonnées, e.g., 5000 répétitions).
Dans la perspective de la science ouverte (Open Science), l’adhésion aux meilleures pratiques contemporaines implique le partage public et reproductible du code d’analyse au sein d’entrepôts de données certifiés (comme l’Open Science Framework, OSF, ou GitHub). Que les calculs aient été orchestrés via des scripts R (mobilisant des packages spécialisés tels que car, sandwich, lmtest et performance), des modules Python (avec statsmodels et scikit-learn) ou des logiciels à interface graphique transparente comme JASP ou jamovi, la mise à disposition intégrale du code autorise une vérification inter-pairs sans ambiguïté.
Enfin, la section Discussion du manuscrit académique doit intégrer une analyse critique et lucide des limites inhérentes aux ajustements statistiques opérés : les transformations de variables ont-elles altéré la métrique d’interprétation originale ? Le recours aux coefficients robustes ne masque-t-il pas une sous-population clinique qualitativement distincte qu’il conviendrait d’explorer à l’aide d’autres paradigmes ? C’est à ce prix — alliant rigueur formelle, méticulosité computationnelle et humilité épistémologique — que la modélisation statistique restituera toute sa noblesse et sa fiabilité à la compréhension scientifique de l’esprit et du comportement humain.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287-1294. https://doi.org/10.2307/1911963
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cribari-Neto, F. (2004). Asymptotic inference under heteroskedasticity of unknown form. Computational Statistics & Data Analysis, 45(2), 215-233. https://doi.org/10.1016/S0167-9473(02)00366-3
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409-428. https://doi.org/10.2307/2332388
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). Sage Publications.
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized additive models. Chapman & Hall/CRC.
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55-67. https://doi.org/10.1080/00401706.1970.10488634
- Koenker, R. (1981). A note on studentizing a test for heteroscedasticity. Journal of Econometrics, 17(1), 107-112. https://doi.org/10.1016/0304-4076(81)90062-2
- Koenker, R., & Bassett, G. (1978). Regression quantiles. Econometrica, 46(1), 33-50. https://doi.org/10.2307/1913643
- Liang, K.-Y., & Zeger, S. L. (1986). Longitudinal data analysis using generalized linear models. Biometrika, 73(1), 13-22. https://doi.org/10.1093/biomet/73.1.13
- MacKinnon, J. G., & White, H. (1985). Some heteroskedasticity-consistent covariance matrix estimators with improved finite sample properties. Journal of Econometrics, 29(3), 305-325. https://doi.org/10.1016/0304-4076(85)90018-7
- Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703-708. https://doi.org/10.2307/1913610
- Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350-371. https://doi.org/10.1111/j.2517-6161.1969.tb00796.x
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817-838. https://doi.org/10.2307/1912934