
Dans le champ de l’économétrie appliquée, de la biométrie et de la psychométrie contemporaine, la modélisation statistique linéaire demeure la pierre angulaire de l’analyse des relations de dépendance entre variables. Qu’il s’agisse d’évaluer l’impact d’un stress physiologique sur des performances cognitives ou d’isoler des facteurs prédictifs au sein d’une cohorte clinique, l’estimation des paramètres structuraux repose sur un critère fondamental d’adéquation empirique. Au cœur de cette architecture mathématique se trouve la somme des carrés des résidus, communément désignée sous l’acronyme SCR en français ou Residual Sum of Squares (RSS) dans la littérature internationale. Cette métrique quantifie l’inadéquation globale d’un modèle en agrégeant l’énergie quadratique des déviations inexpliquées entre les observations factuelles et les prédictions théoriques du modèle.
Le tableur Microsoft Excel s’est imposé comme une interface computationnelle omniprésente au sein des laboratoires universitaires, des départements de recherche clinique et des organisations d’analyse décisionnelle. Si des environnements dédiés comme R, Python, SAS ou SPSS monopolisent les publications spécialisées de pointe, Excel demeure l’outil d’audit préliminaire, d’exploration et de transmission pédagogique par excellence. Néanmoins, l’obtention rigoureuse de la somme des carrés des résidus dans un tableur ne saurait se réduire à une simple manipulation mécanique de cellules. Elle exige une maîtrise approfondie des principes mathématiques sous-jacents, une vigilance constante quant à la topologie matricielle des plages de calcul, ainsi qu’une compréhension claire des algorithmes internes exploités par le moteur de calcul de Microsoft.
Ce guide exhaustif a pour vocation d’analyser en profondeur les fondements théoriques, les modalités techniques de calcul et les implications pratiques de la somme des carrés des résidus sous Excel. Nous examinerons successivement l’ancrage conceptuel de la SCR dans la méthode des moindres carrés ordinaires, les protocoles de préparation matricielle des données psychométriques, les trois approches opératoires majeures sous Excel — de la décomposition arithmétique pas à pas jusqu’à la vectorisation dynamique via la fonction matricielle DROITEREG et l’Utilitaire d’analyse —, avant d’aborder les extensions multivariées, les diagnostics d’ajustement résiduel et les impératifs de reproductibilité scientifique.
1. Fondements théoriques de la somme des carrés des résidus en modélisation statistique
1.1 Définition mathématique et conceptuelle du résidu statistique
Dans le cadre d’un modèle de régression linéaire simple ou multiple, le résidu statistique empirique, formellement désigné par la notation $e_i$, représente l’écart arithmétique précis constaté pour une observation individuelle $i$ entre sa valeur empirique observée $y_i$ sur la variable réponse et sa valeur estimée ou prédite $\hat{y}_i$ générée par l’hyperplan de régression. Cette relation s’établit selon l’équation canonique :
$$e_i = y_i – \hat{y}_i$$
D’un point de vue psychométrique et expérimental, ce résidu incarne la part d’erreur de mesure non captée par les variables explicatives sélectionnées, la variabilité idiosyncratique du sujet, ainsi que l’effet agrégé de multiples influences stochastiques non modélisées. Il est impératif d’opérer une distinction épistémologique stricte entre les perturbations théoriques inobservables, traditionnellement notées $\varepsilon_i$, associées au processus générateur de données sous-jacent dans la population mère, et les résidus empiriques $e_i$, qui constituent de simples estimations d’échantillon conditionnées par les paramètres spécifiques calculés via les données disponibles.
Selon les préceptes cardinaux établis par Carl Friedrich Gauss et Adrien-Marie Legendre dans le cadre de la méthode des moindres carrés ordinaires (MCO), les estimateurs empiriques sont dérivés de manière à forcer deux propriétés fondamentales de l’échantillon : d’une part, la somme algébrique des résidus est rigoureusement nulle ($\sum_{i=1}^{N} e_i = 0$), garantissant l’absence de biais systématique global, et d’autre part, le vecteur des résidus est rigoureusement orthogonal au sous-espace vectoriel sous-tendu par les régresseurs, ce qui implique que la covariance d’échantillon entre les variables prédictives et les résidus est exactement égale à zéro.
1.2 Rôle de la somme des carrés des résidus dans l’évaluation de l’ajustement
La somme des carrés des résidus (SCR), formalisée mathématiquement par l’expression :
$$SCR = \sum_{i=1}^{N} e_i^2 = \sum_{i=1}^{N} (y_i – \hat{y}_i)^2$$
représente la métrique fondamentale quantifiant la variabilité résiduelle totale non expliquée par l’équation de régression. Le choix d’une fonction de perte quadratique — par opposition à une norme absolue de type déviation moyenne absolue — repose sur des justifications d’une grande rigueur algébrique et probabiliste. Historiquement, l’élévation au carré confère à la fonction d’erreur des propriétés différentielles optimales, autorisant un calcul analytique direct des paramètres par simple annulation des dérivées partielles (les équations normales).
Cependant, cette structure quadratique induit une sensibilité exacerbée aux écarts de grande amplitude. Une observation individuelle s’écartant substantiellement de la trajectoire moyenne exercera un poids disproportionné sur la magnitude finale de la SCR, puisque sa déviation est multipliée par elle-même. Dans une perspective d’optimisation, la minimisation de la SCR constitue le critère sélectif exclusif qui détermine l’emplacement et l’orientation géométrique de la droite ou de l’hyperplan au sein de l’espace euclidien multidimensionnel. Lors de la confrontation de plusieurs modèles concurrents appliqués à un échantillon rigoureusement identique, le modèle minimisant la SCR sera jugé mécaniquement supérieur en termes d’adéquation descriptive directe aux données de l’échantillon.
1.3 Décomposition de la variance totale au sein du modèle linéaire
La compréhension pleine et entière de la portée statistique de la SCR nécessite son insertion au sein de l’équation fondamentale de décomposition de la variance. La dispersion globale observée de la variable réponse par rapport à sa propre moyenne arithmétique $\bar{y}$ est mesurée par la Somme des Carrés Totale (SCT, ou Total Sum of Squares, SST) :
$$SCT = \sum_{i=1}^{N} (y_i – \bar{y})^2$$
En vertu du théorème de Pythagore appliqué aux espaces hilbertiens dans lesquels s’opèrent les projections orthogonales des MCO, cette quantité scalaire se scinde de manière exacte et sans terme croisé en deux composantes mutuellement exclusives :
$$SCT = SCM + SCR$$
où la Somme des Carrés du Modèle (SCM, ou Explained Sum of Squares, SSE/SSM) traduit la variation captée par la droite de régression :
$$SCM = \sum_{i=1}^{N} (\hat{y}_i – \bar{y})^2$$
Cette relation structurelle permet de dériver directement le coefficient de détermination univarié ou multivarié, noté $R^2$, défini comme la proportion de la variance totale imputable à la structure explicative du modèle :
$$R^2 = \frac{SCM}{SCT} = 1 – \frac{SCR}{SCT}$$
Dans les sciences du comportement, où les phénomènes psychologiques intègrent intrinsèquement une forte composante stochastique, ce ratio offre aux chercheurs un baromètre d’évaluation de la robustesse prédictive de leurs constructions théoriques, isolant l’incertitude résiduelle incontournable de l’effet modélisé.
2. Structuration et prétraitement des données psychologiques sous Excel
2.1 Organisation matricielle des variables indépendantes et dépendantes
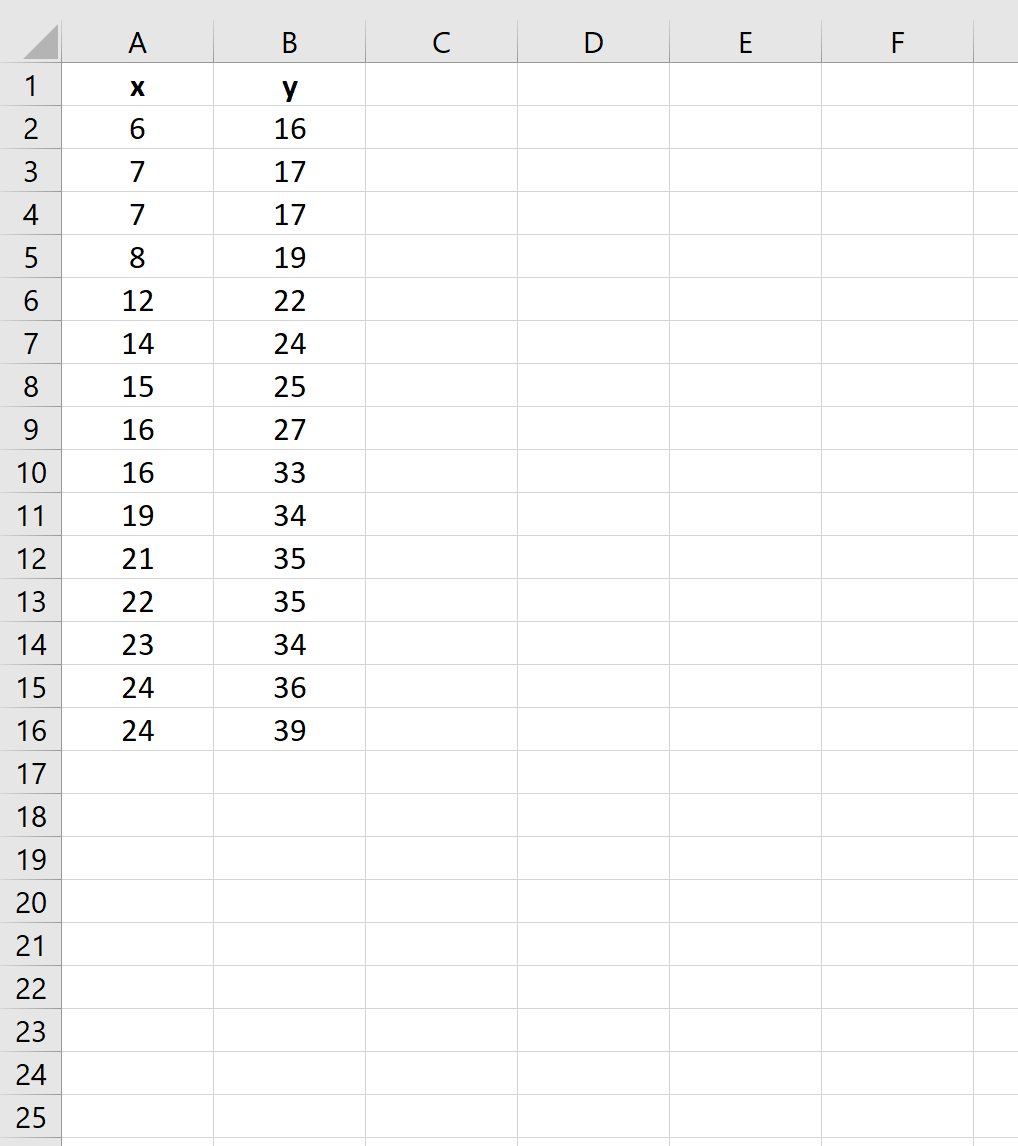
L’implémentation opérationnelle de calculs statistiques avancés au sein d’un tableur requiert une rigueur absolue dans l’agencement topologique des jeux de données. La disposition canonique adoptée en psychométrie quantitative impose une structure matricielle bidimensionnelle standardisée où les lignes horizontales figurent les unités d’observation distinctes (les sujets ou participants à l’étude) et les colonnes verticales accueillent les variables d’intérêt. Pour optimiser les calculs matriciels ultérieurs sous Excel, la variable dépendante ou critère ($Y$) doit être positionnée dans une colonne clairement identifiée, tandis que la ou les variables indépendantes ($X$) doivent être organisées en colonnes immédiatement adjacentes et contiguës, ce qui évite les discontinuités de plage lors des appels de fonctions spécialisées.
Chaque variable continue issue d’inventaires psychométriques ou de mesures chronométriques doit faire l’objet d’un contrôle de typologie au niveau des cellules Excel. Il convient de s’assurer que le format de cellule est explicitement configuré sur « Nombre » avec un séparateur décimal strictement conforme aux paramètres régionaux du système d’exploitation (généralement la virgule dans l’environnement francophone). L’intégrité référentielle du tableau gagne à être renforcée par le nommage formel des plages de cellules via le Gestionnaire de noms d’Excel. En attribuant par exemple le libellé Score_Stress à la plage B2:B51 et Score_Anxiete à la plage C2:C51, l’analyste sécurise la formulation syntaxique de ses algorithmes et prévient les erreurs de glissement de références lors de recopies incrémentales complexes.
2.2 Identification et traitement des observations aberrantes
En raison de l’élévation au carré inhérente au calcul de la SCR, la présence d’une unique observation atypique au sein d’un échantillon psychologique peut exercer une distorsion majeure sur l’estimation globale du modèle. Avant toute procédure d’ajustement, une phase de criblage univarié et bivarié s’impose. Sous Excel, l’analyste peut générer une colonne d’évaluation des scores standardisés (scores $Z$) en utilisant la fonction CENTREE.REDUITE, ou en appliquant la transformation élémentaire :
$$Z_i = \frac{X_i – \bar{X}}{s}$$
où la moyenne $\bar{X}$ est obtenue par =MOYENNE() et l’écart-type d’échantillon $s$ par =ECARTYPE.STANDARD(). Un score absolu excédant la valeur critique de 3, ou même 2,5 dans de petits échantillons, signale une observation potentiellement discordante.
Face à de telles anomalies, deux stratégies méthodologiques prévalent : l’exclusion argumentée du participant ou la winsorisation. La winsorisation consiste à ramener la valeur déviante au percentile acceptable le plus proche (par exemple le 95e percentile), limitant son influence délétère sans amoindrir la taille de l’échantillon. Dans tous les cas de figure, l’impact de la rétention ou de l’éviction de ces données extrêmes sur la magnitude de la SCR finale doit être rigoureusement consigné dans un journal d’audit analytique, afin d’assurer l’intégrité déontologique de la recherche empirique.
2.3 Contrôle préliminaire des postulats de linéarité
Le calcul et l’interprétation de la somme des carrés des résidus reposent sur le postulat implicite que la relation unissant les régresseurs au critère est fondamentalement de nature linéaire. Poser l’hypothèse de linéarité sans validation visuelle préalable expose le praticien à d’importantes erreurs d’inférence. Excel dispose d’outils graphiques permettant de contrôler ce postulat en insérant un diagramme de dispersion bivarié (« Nuage de points ») croisant la variable explicative en abscisse et la variable dépendante en ordonnée.
Une fois le nuage tracé, l’adjonction instantanée d’une courbe de tendance linéaire via les options graphiques permet d’évaluer visuellement la trajectoire des points expérimentaux. L’apparition d’une inflexion curviligne, d’une trajectoire parabolique ou d’effets de seuil prononcés signale une inadéquation structurelle du modèle linéaire simple. Si une non-linéarité sévère est détectée, la minimisation de la SCR par une droite fournira une mesure artificiellement gonflée de l’erreur résiduelle, celle-ci intégrant un biais de spécification morphologique qui aurait pu être résolu par l’introduction d’un terme polynomial ou d’une transformation logarithmique préalable.
3. Méthode pas à pas : Calcul arithmétique manuel de la SCR dans Excel
3.1 Estimation des paramètres de la régression via PENTE et ORDONNEE.ORIGINE
La méthode pédagogique et analytique par excellence consiste à décomposer le flux computationnel cellule par cellule. Cette approche manuelle garantit une traçabilité intégrale de chaque transformation arithmétique. La première étape opérationnelle exige l’estimation ponctuelle des deux coefficients de la droite de régression univariée : la pente structurale ($\beta_1$) et l’ordonnée à l’origine ou constante ($\beta_0$).
Pour calculer la pente $\beta_1$, Excel intègre la fonction native PENTE. La formulation syntaxique requiert une attention soutenue quant à l’ordonnancement des vecteurs d’entrée. Il convient d’écrire impérativement :
=PENTE(plage_Y; plage_X)
L’inversion accidentelle de ces deux arguments constitue l’une des erreurs les plus récurrentes dans l’usage statistique d’Excel, inversant de facto la direction de causalité modélisée. Dans une cellule mitoyenne, l’ordonnée à l’origine $\beta_0$ est dérivée au moyen de la fonction ORDONNEE.ORIGINE selon la même syntaxe rigoureuse :
=ORDONNEE.ORIGINE(plage_Y; plage_X)
Il importe de conserver ces valeurs calculées dans leurs cellules de destination sans jamais appliquer d’arrondis intermédiaires manuels, afin de préserver l’entière précision de l’arithmétique en virgule flottante 64 bits implémentée par le moteur de calcul du tableur.
3.2 Génération de la colonne des valeurs prédites ŷ
Une fois les paramètres d’ajustement stabilisés, il devient possible de calculer l’estimation théorique pour chacun des individus de la cohorte. Supposons que les observations de la variable dépendante $Y$ soient logées dans la plage B2:B51, que la variable prédictive $X$ réside en A2:A51, et que les coefficients $\beta_1$ et $\beta_0$ aient été respectivement calculés dans les cellules E1 et E2.
Dans une colonne dédiée, par exemple la colonne C débutant à la cellule C2, l’analyste spécifie l’équation d’estimation linéaire en associant la valeur observée du régresseur aux coefficients fixés :
=$E$1*A2 + $E$2
L’utilisation systématique du symbole dollar ($) pour verrouiller les coordonnées absolues des cellules hébergeant les paramètres est indispensable. Lors de la propagation incrémentale de la formule vers le bas (par double-clic sur la poignée de recopie jusqu’à la cellule C51), l’adressage relatif ajustera la variable $X$ d’observation en observation (de A2 à A51) tout en maintenant constants les coefficients d’estimation. À des fins de validation de cohérence interne, l’analyste vérifiera que la moyenne arithmétique de la colonne des prédictions (=MOYENNE(C2:C51)) est strictement identique, à la tolérance de calcul près, à la moyenne empirique de la variable observée d’origine (=MOYENNE(B2:B51)).
3.3 Calcul des résidus individuels et de leurs carrés
Le calcul des écarts résiduels individuels s’opère dans une nouvelle colonne adjacente, par exemple la colonne D. En cellule D2, la formalisation de l’erreur empirique s’obtient par la simple soustraction arithmétique de la valeur modélisée à la valeur réellement mesurée :
=B2 - C2
Cette formule est ensuite répliquée sur toute la hauteur de la cohorte jusqu’en D51. L’analyste attentif pourra insérer un test de contrôle immédiat en calculant la somme simple de cette colonne par =SOMME(D2:D51). Conformément aux propriétés mathématiques démontrées dans la section 1.1, cette sommation doit converger vers zéro. En pratique, en raison de l’imprécision inhérente à la représentation binaire des nombres réels décimaux selon la norme IEEE 754, Excel affichera une valeur infinitésimale de l’ordre de $10^{-14}$ ou $10^{-15}$, attestant de la rectitude de l’estimation.
L’étape immédiatement consécutive réside dans l’élévation au carré de ces déviations individuelles. Dans la colonne E, à partir de la ligne 2, la formule implémente l’opérateur d’élévation à la puissance (^2) :
=D2^2
Cette transformation produit une série scalaire strictement positive, neutralisant les compensations de signes et pénalisant les écarts d’amplitude majeure conformément à la métrique de Gauss-Legendre.
3.4 Agrégation finale au moyen de la fonction SOMME
La sommation terminale matérialisant la métrique recherchée intervient alors par l’application de la fonction de réduction SOMME sur l’intégralité de la colonne des carrés résiduels. Au bas de la plage, ou au sein d’une cellule de synthèse réservée dans un tableau de bord analytique, la commande suivante est exécutée :
=SOMME(E2:E51)
Le résultat renvoyé constitue la valeur définitive et sans biais de la somme des carrés des résidus (SCR) pour le jeu de données analysé. Par définition structurelle, ce nombre réel doit être strictement supérieur ou égal à zéro. Une valeur théorique égale à zéro caractériserait un alignement absolu de la totalité des points expérimentaux sur la droite de régression, configuration hautement improbable dans les disciplines empiriques.
L’intérêt didactique majeur de cette méthode modulaire réside dans la transparence de l’auditabilité : si une valeur empirique est modifiée en cellule B5 pour simuler un scénario prospectif, l’ensemble des colonnes dépendantes répercute l’effet en cascade de manière transparente, permettant d’observer en temps réel la sensibilité de la SCR aux altérations locales de données.
4. Méthode matricielle avancée : Extraction directe de la SCR via DROITEREG
4.1 Syntaxe exhaustive et paramétrage des arguments de DROITEREG
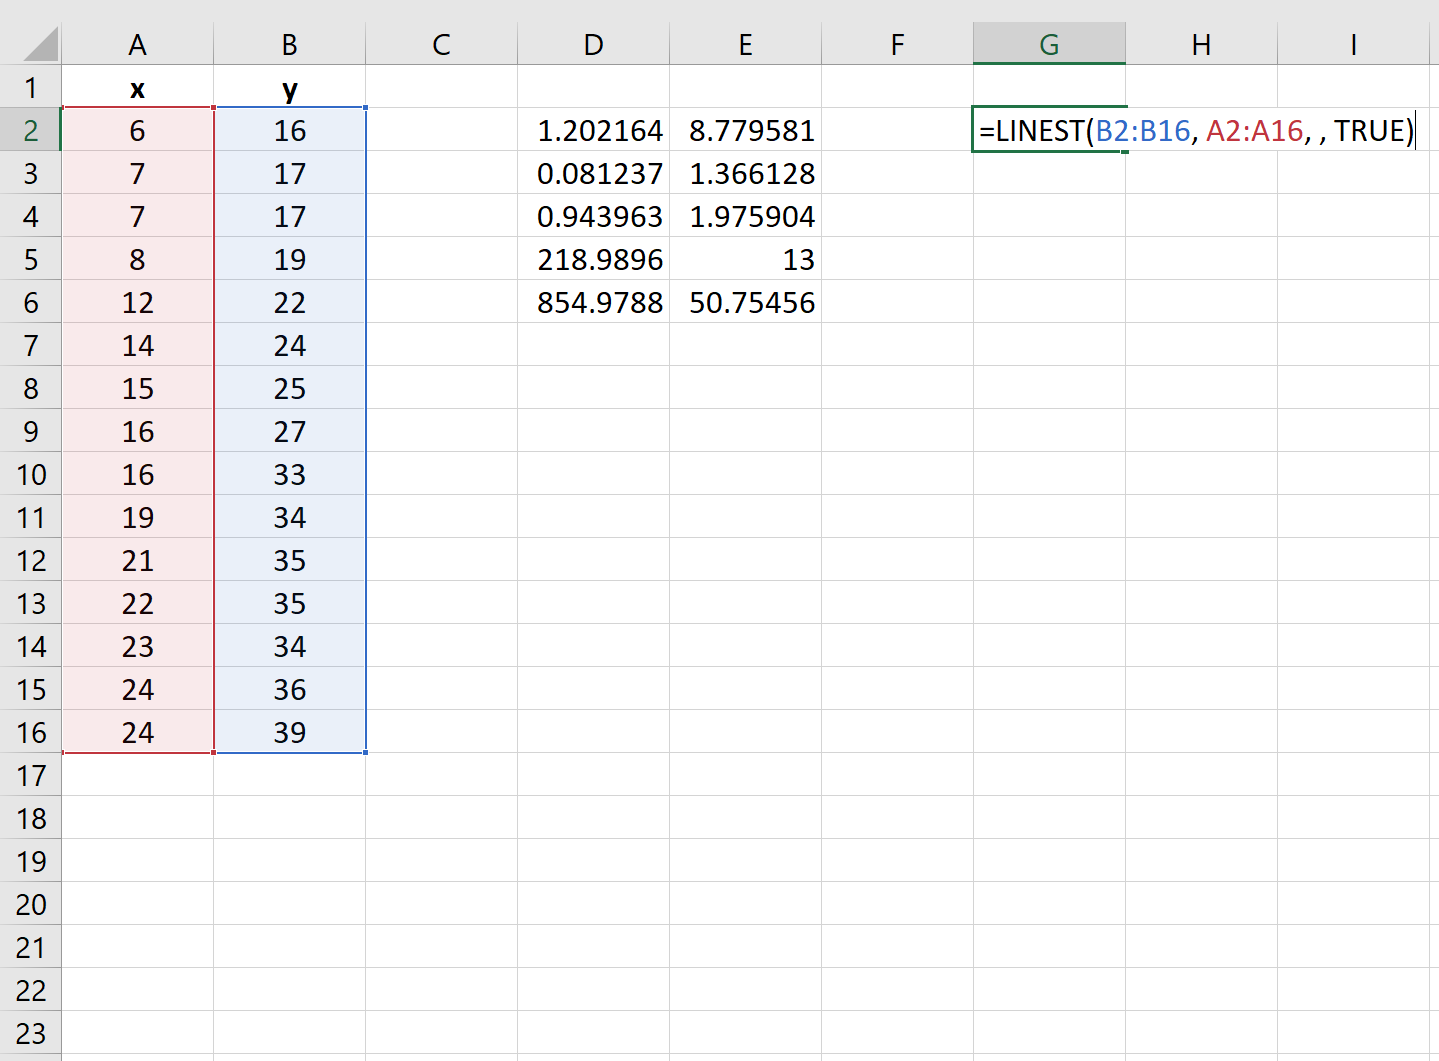
Pour les analyses nécessitant rapidité d’exécution, compacité du classeur et suppression des colonnes intermédiaires volumineuses, Microsoft Excel propose une fonction matricielle native de haut niveau : la fonction DROITEREG (désignée sous l’appellation LINEST dans les versions anglophones). Cette fonction exécute directement l’estimation des MCO selon une formalisation vectorielle interne. Sa syntaxe standardisée s’articule autour de quatre arguments :
=DROITEREG(y_connus; [x_connus]; [constante]; [statistiques])
Le premier argument, y_connus, héberge la plage de cellules continues contenant la variable dépendante. Le second, x_connus, correspond à la plage de la ou des variables explicatives. Le troisième argument est une valeur logique booléenne : si cet argument est omis ou fixé à VRAI, l’ordonnée à l’origine $\beta_0$ est normalement estimée par l’algorithme ; s’il est fixé à FAUX, la constante est contrainte à être rigoureusement égale à zéro, une pratique comportant d’importants risques statistiques qui seront abordés en section 10.3.
Le quatrième argument, statistiques, revêt une importance capitale pour l’extraction de la SCR. Par défaut, s’il est ignoré ou positionné sur FAUX, DROITEREG renvoie uniquement le vecteur des coefficients directeurs. Pour forcer l’extraction du bloc statistique complet incluant l’analyse de variance du modèle, il est formellement obligatoire d’affecter à cet argument la valeur booléenne VRAI.
4.2 Validation matricielle et déploiement du tableau de sortie
L’exploitation de DROITEREG avec le commutateur statistique activé produit une matrice de sortie structurée de 5 lignes de hauteur sur un nombre de colonnes dépendant de la dimensionnalité du modèle (précisément $k+1$ colonnes, où $k$ correspond au nombre de prédicteurs). Selon la version de la suite bureautique mobilisée, le protocole d’insertion diffère de façon substantielle :
- Sur les versions historiques d’Excel (versions 2019 et antérieures) : Le moteur de calcul ne gérant pas nativement la dynamique des tableaux expansifs, l’utilisateur doit préalablement sélectionner avec le curseur de souris un bloc rectangulaire vide d’exactement 5 lignes sur 2 colonnes (en régression univariée), saisir la formule dans la barre d’édition, puis exécuter la validation matricielle historique par la combinaison combinée de touches
Ctrl + Maj + Entrée. La formule apparaît alors encapsulée entre des accolades{...}. - Sur Microsoft 365 et Excel 2021/2024 : L’intégration du nouveau moteur de calcul à tableaux dynamiques simplifie la procédure. Il suffit de taper la formule dans une seule cellule et d’appuyer sur la touche
Entréestandard. Le tableau s’étend et se propage automatiquement (« effet d’épanchement » ou spill) sur la plage adjacente requise.
Une vigilance particulière s’impose pour s’assurer qu’aucune cellule préexistante ne vienne obstruer l’espace d’expansion matricielle requis, sous peine de déclencher l’erreur de blocage d’épanchement #PROPAGATION! (ou #SPILL!).
4.3 Repérage topographique précis de la SCR dans la matrice statistique
La matrice statistique renvoyée par la fonction DROITEREG respecte une topographie invariable et standardisée qu’il convient de savoir décrypter avec précision :
- Ligne 1 : Affiche les coefficients de régression estimés ($\beta_k, dots, \beta_1, \beta_0$) agencés de droite à gauche.
- Ligne 2 : Fournit les erreurs-types asymptotiques associées à chaque coefficient respectif.
- Ligne 3 : Présente le coefficient de détermination univarié $R^2$ en colonne 1, et l’erreur-type globale de l’estimation de la régression ($s_e$) en colonne 2.
- Ligne 4 : Renvoie la statistique globale de Fisher ($F$) en colonne 1, et le nombre de degrés de liberté résiduels ($ddl = N – k – 1$) en colonne 2.
- Ligne 5 : Contient la décomposition de l’analyse de variance (ANOVA) du modèle. La colonne 1 héberge la Somme des Carrés de la Régression (SCM), tandis que la colonne 2 héberge précisément la Somme des Carrés des Résidus (SCR).
Pour extraire de manière totalement dynamique la valeur scalaire de la SCR sans avoir à déployer l’intégralité du tableau de 10 cellules dans son classeur, il est possible d’encapsuler la fonction matricielle au sein de la fonction d’adressage INDEX. La formule compacte s’écrit alors sans ambiguïté :
=INDEX(DROITEREG(plage_Y; plage_X; VRAI; VRAI); 5; 2)
Cette expression renvoie directement la valeur numérique de la SCR dans une cellule unique, préservant la compacité du classeur tout en bénéficiant de l’optimisation algorithmique des matrices d’Excel.
5. Méthode automatisée : Utilisation de l’Utilitaire d’analyse statistique
5.1 Activation et configuration du complément Analysis ToolPak
Pour les praticiens de la psychométrie et de la biométrie souhaitant obtenir un bilan statistique d’une exhaustivité comparable aux rapports de logiciels spécialisés, Microsoft Excel intègre nativement un module d’extension nommé Utilitaire d’analyse (ou Analysis ToolPak). Bien qu’installé par défaut avec le logiciel, ce complément n’est généralement pas activé lors de l’installation initiale.
La procédure d’initialisation se déroule selon le protocole suivant :
- Accéder au menu Fichier situé dans le ruban supérieur, puis sélectionner l’onglet Options en bas du volet de navigation.
- Dans la boîte de dialogue contextuelle, cliquer sur la catégorie Compléments.
- Dans le menu déroulant inférieur intitulé Gérer, s’assurer que l’option Compléments Excel est bien active, puis cliquer sur le bouton Atteindre…
- Une nouvelle fenêtre contextuelle énumère les modules disponibles : cocher formellement la case Utilitaire d’analyse (il est inutile de cocher le module VBA sauf en cas d’automatisation par scripts macro), puis valider en cliquant sur OK.
À l’issue de cette opération, un nouveau groupe fonctionnel nommé Analyse apparaît à l’extrémité droite de l’onglet Données du ruban principal d’Excel, arborant le bouton de commande Utilitaire d’analyse. En milieu universitaire ou au sein d’infrastructures hospitalières dotées de profils informatiques aux droits restreints, cette opération ne réclame aucun droit d’administrateur système et peut être déployée librement au niveau du profil utilisateur.
5.2 Exécution de la procédure de régression linéaire
Une fois le module initialisé, la mise en œuvre de la régression s’effectue via une interface graphique interactive :
- Cliquer sur Utilitaire d’analyse dans l’onglet Données, faire défiler la liste alphabétique des outils statistiques, sélectionner l’item Régression, puis cliquer sur OK.
- Dans le champ de saisie Plage d’entrée Y, sélectionner la plage contenant la variable dépendante (par exemple
$B$1:$B$51). - Dans le champ Plage d’entrée X, désigner la plage hébergeant la ou les variables explicatives (par exemple
$A$1:$A$51). - Si la première ligne des plages sélectionnées inclut les en-têtes textuels identifiant les variables, cocher impérativement l’option Intitulés. Cette précaution garantit un étiquetage explicite des coefficients au sein des tables de résultats.
- Dans la section Options de sortie, déterminer l’emplacement de destination du rapport d’analyse en cochant au choix Plage de sortie (en spécifiant une cellule libre sur la feuille courante) ou Nouvelle feuille de calcul.
- Pour enrichir l’audit des données, cocher les options complémentaires Résidus et Graphique des résidus.
- Valider la configuration globale en cliquant sur le bouton OK pour déclencher la compilation instantanée des calculs.
5.3 Lecture et extraction de la SCR dans le tableau ANOVA généré
L’utilitaire d’analyse génère un rapport synthétique structuré en trois blocs distincts : les Statistiques de la régression, le tableau de l’Analyse de variance (ANOVA), et la table d’estimation paramétrique des coefficients détaillant les tests de Student ($t$) et les valeurs p associées. L’extraction de la somme des carrés des résidus s’opère au sein du deuxième bloc, précisément dans le tableau d’analyse de variance.
Ce tableau matriciel présente une organisation orthogonale invariable :
- En lignes, la décomposition des sources de variabilité : Régression (la part expliquée), Résidus (l’erreur inexpliquée), et Total (la variabilité brute globale).
- En colonnes, les métriques dévolues : Degrés de liberté (notés ddl ou df), la Somme des carrés (colonne désignée sous l’en-tête SC ou SS), la Moyenne des carrés (notée MS), ainsi que la valeur du F de Fisher et sa significativité critique associée.
Pour relever sans ambiguïté la valeur de la SCR, il suffit de repérer l’intersection exacte entre la ligne intitulée Résidus et la colonne libellée SC (ou SS). La valeur numérique inscrite à cet emplacement correspond point par point, à la décimale près, au résultat produit par l’agrégation arithmétique manuelle du paragraphe 3.4 et à la cellule issue de DROITEREG du paragraphe 4.3. Si l’analyste souhaite utiliser cette valeur dans d’autres calculs sur sa feuille principale, il peut pointer directement vers cette cellule par référence dynamique.
6. Extension au cadre de la régression linéaire multiple dans Excel
6.1 Configuration matricielle multi-prédicteurs pour la SCR
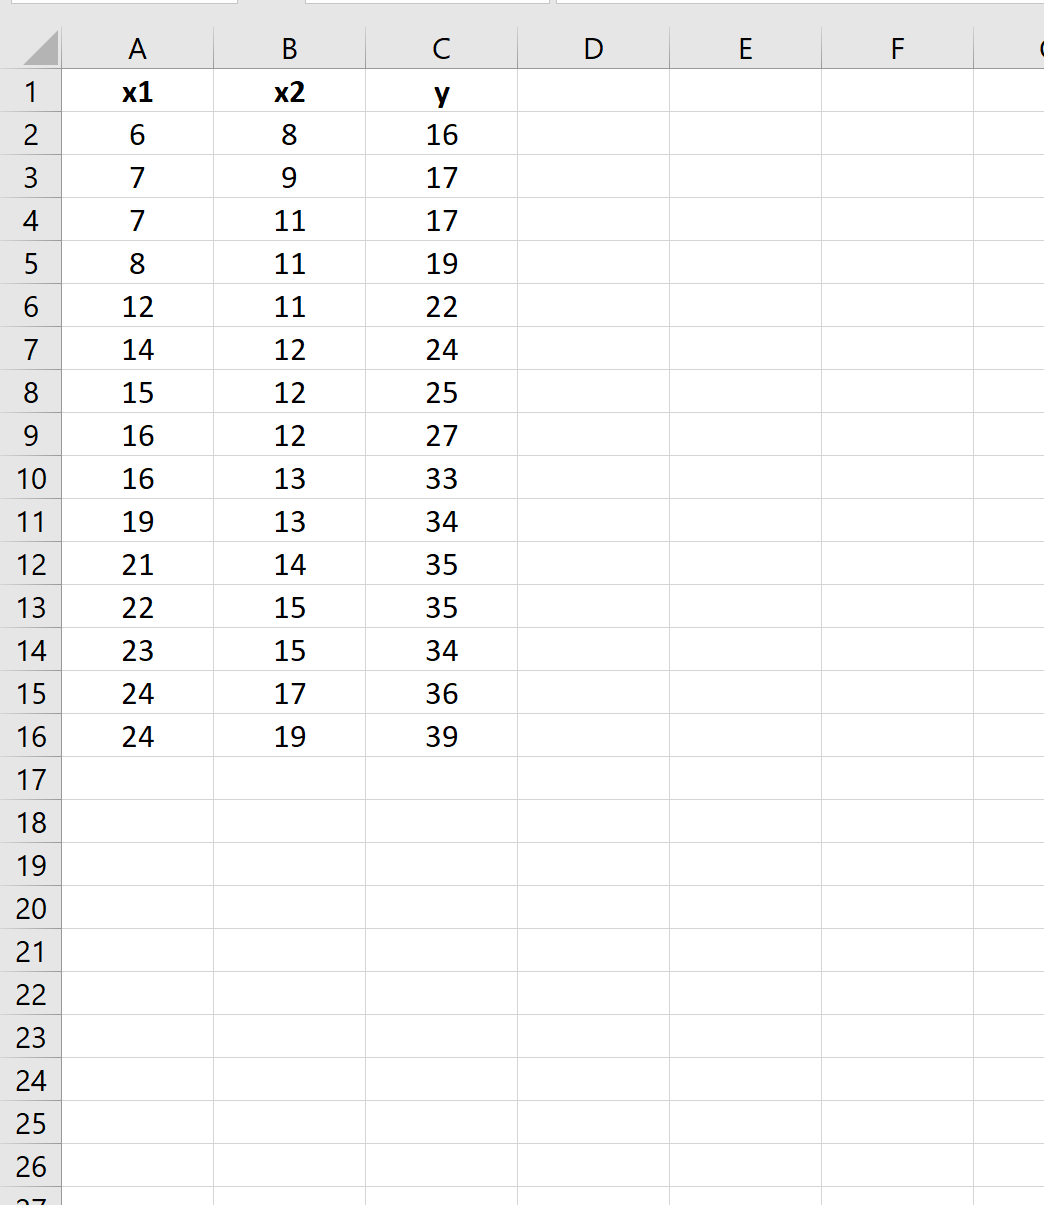
La modélisation psychologique exige rarement l’analyse d’un déterminisme univarié simple. L’explication de processus complexes fait plus fréquemment intervenir une constellation de régresseurs concomitants. L’extension du calcul de la somme des carrés des résidus au cas multivarié requiert une discipline stricte dans l’organisation spatiale du classeur Excel. Lorsque l’analyste incorpore plusieurs variables prédictives, celles-ci doivent impérativement être configurées dans des colonnes adjacentes non disjointes (par exemple les colonnes A, B et C hébergeant respectivement le niveau de stress perçu, l’âge chronologique et l’indice de privation de sommeil).
La fonction DROITEREG s’adapte sans rupture formelle à cette extension multivariée :
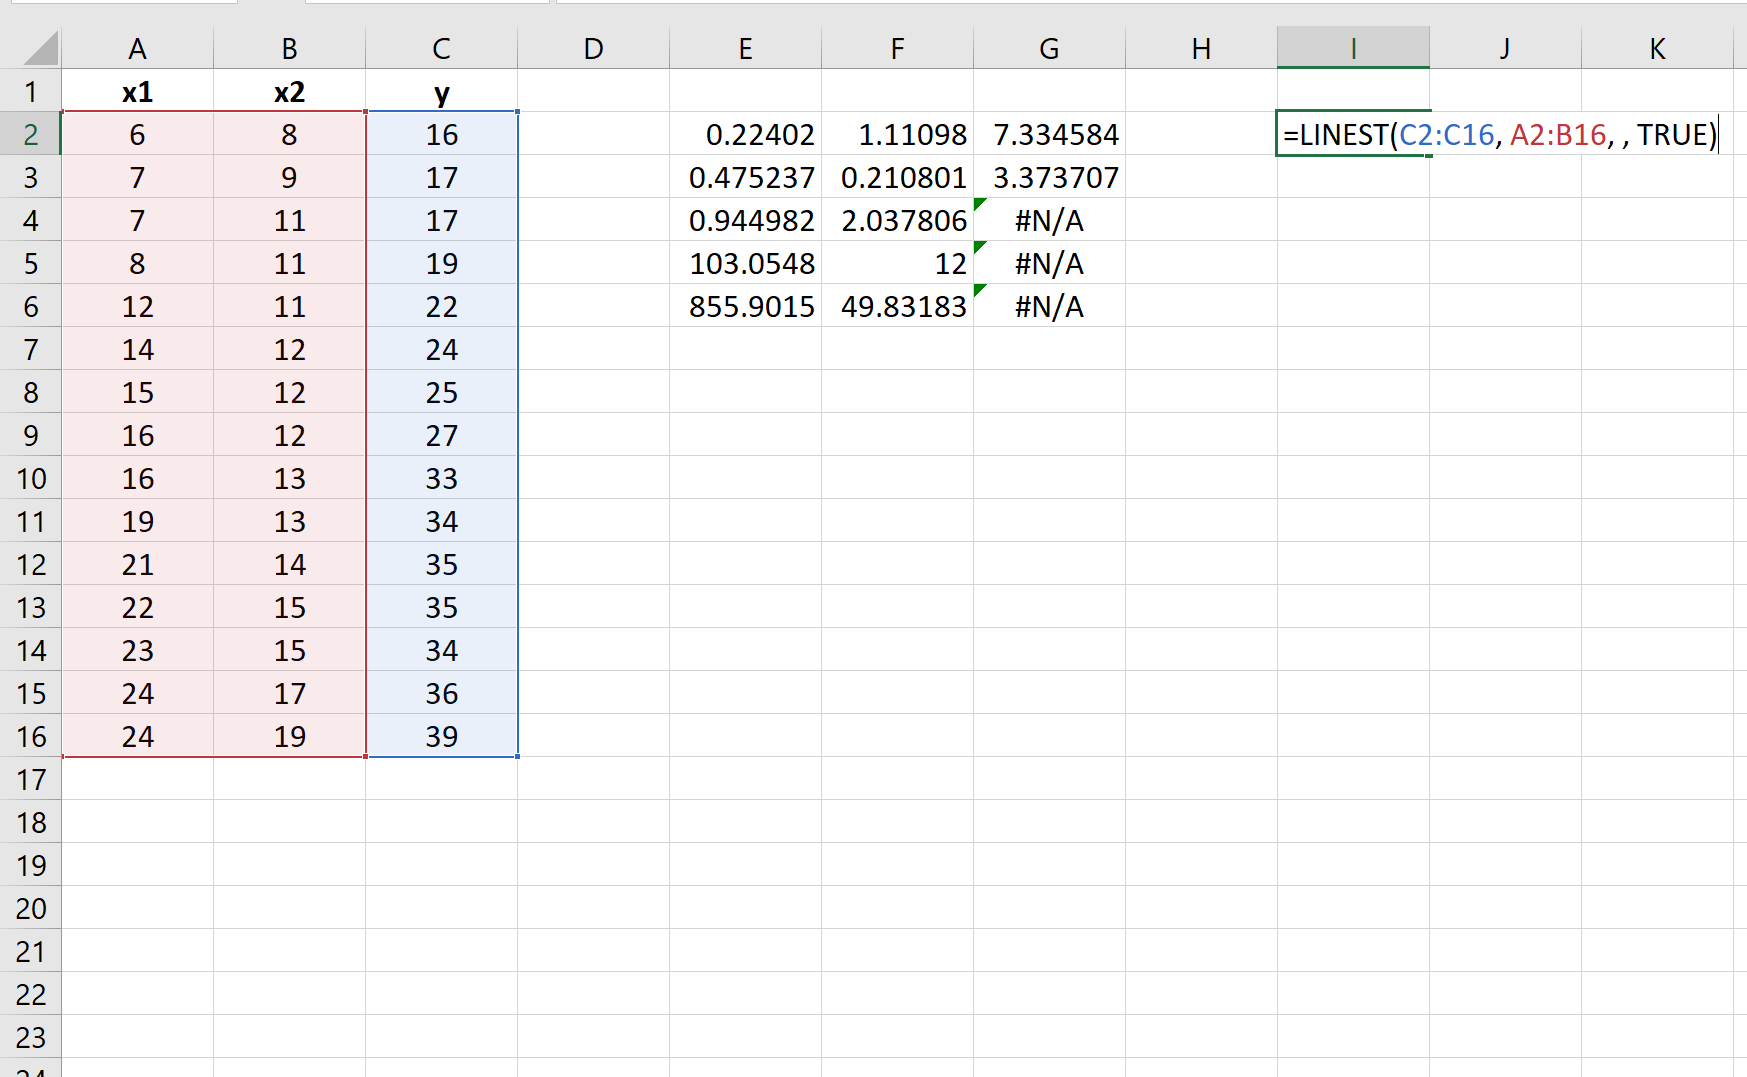
=DROITEREG(plage_Y; plage_X1_a_Xk; VRAI; VRAI)
où plage_X1_a_Xk désigne l’ensemble du bloc matriciel des prédicteurs (par exemple A2:C51). Dans la matrice statistique résultante, la largeur globale du tableau s’étend horizontalement pour accommoder l’ensemble des régresseurs. Cependant, une propriété remarquable doit être soulignée : la topologie de la zone ANOVA de DROITEREG demeure parfaitement invariante. Quelle que soit la quantité de variables explicatives incorporées dans l’équation, la Somme des Carrés des Résidus se retrouve toujours localisée de manière systématique en ligne 5, colonne 2 du tableau généré. Par conséquent, la formule d’extraction directe :
=INDEX(DROITEREG(plage_Y; plage_X1_a_Xk; VRAI; VRAI); 5; 2)
conserve une universalité algorithmique absolue, qu’il y ait un ou cinquante régresseurs dans le modèle.
6.2 Calcul vectoriel direct de la SCR multivariée par SOMMEPROD
L’utilisation de colonnes auxiliaires pour calculer manuellement les prédictions individuelles $\hat{y}_i$ dans un modèle multivarié peut s’avérer fastidieuse lorsque les dimensions augmentent. Pour contourner cette lourdeur, Excel offre une alternative vectorielle puissante grâce à la fonction SOMMEPROD (équivalent fonctionnel du produit scalaire multivarié). Cette fonction permet de dériver les prédictions individuelles et d’en sommer directement les déviations quadratiques sans créer la moindre colonne intermédiaire.
Si les coefficients directeurs de régression estimés pour les variables $X_1, X_2, X_3$ ont été isolés horizontalement dans la plage F1:H1 et que l’ordonnée à l’origine est stockée en cellule I1, la valeur prédite pour la première ligne d’observation (ligne 2) s’exprime vectoriellement sous la forme :
=SOMMEPROD(A2:C2; $F$1:$H$1) + $I$1
Pour agréger l’intégralité de la SCR sur l’ensemble de l’échantillon d’une traite, les utilisateurs avancés d’Excel peuvent encapsuler cette projection matricielle au sein d’une formule matricielle vectorisée combinant le produit matriciel PRODUITMAT :
=SOMME((plage_Y - (PRODUITMAT(plage_X; TRANSPOSE(vecteur_pentes)) + constante))^2)
Cette approche tire parti des capacités d’algèbre linéaire natives d’Excel pour calculer l’énergie résiduelle avec une grande vitesse d’exécution, ce qui s’avère particulièrement utile lors du traitement de volumineuses bases de données expérimentales.
6.3 Comparaison de modèles hiérarchiques emboîtés par la variation de la SCR
En recherche quantitative, l’analyse par régression hiérarchique constitue une pratique méthodologique standard visant à déterminer si l’adjonction séquentielle d’un ensemble de nouvelles variables prédictives apporte un gain d’explication statistiquement tangible au-delà d’un modèle de base plus parcimonieux. Ce protocole repose sur l’évaluation de la réduction incrémentale de la somme des carrés des résidus.
Considérons un modèle restreint ($M_1$) intégrant $k_1$ variables prédictives, caractérisé par une somme résiduelle $SCR_1$, et un modèle complet ou augmenté ($M_2$) intégrant $k_2$ variables ($k_2 > k_1$), présentant une somme résiduelle $SCR_2$. Dès lors que le modèle restreint est formellement emboîté dans le modèle complet, l’inégalité $SCR_2 le SCR_1$ est mathématiquement garantie : l’ajout de variables diminue mécaniquement l’erreur résiduelle d’échantillon. Pour valider si cette diminution de la SCR n’est pas le fruit d’un surapprentissage opportuniste mais traduit une amélioration statistiquement significative, on calcule sous Excel le test $F$ d’accroissement résiduel :
$$F = \frac{(SCR_1 – SCR_2) / (k_2 – k_1)}{SCR_2 / (N – k_2 – 1)}$$
La mise en œuvre de cette relation arithmétique entre cellules comparant les SCR des deux modèles permet ensuite d’extraire la probabilité critique exacte via la fonction de distribution de Fisher :
=LOI.F.DROITE(F_calcule; k2 - k1; N - k2 - 1)
Si la valeur p ainsi déduite passe sous le seuil alpha conventionnel de 0,05, l’expérimentateur conclut que l’abaissement de la SCR compense statistiquement la perte de parcimonie induite par l’ajout des nouveaux paramètres.
7. Formules Excel condensées pour un calcul instantané sans colonnes auxiliaires
7.1 Formulation compacte combinant SOMMEPROD, PENTE et ORDONNEE.ORIGINE
Certains classeurs de production ou tableaux de bord synthétiques imposent des contraintes d’ergonomie strictes, interdisant le recours aux tables ANOVA volumineuses ou aux colonnes de calcul décomposées. Il est tout à fait possible de condenser l’intégralité du calcul arithmétique de la SCR au sein d’une unique formule scalaire autonome en combinant harmonieusement SOMMEPROD avec les fonctions scalaires PENTE et ORDONNEE.ORIGINE.
Considérant que la variable dépendante réside dans la plage B2:B51 et le régresseur unique en A2:A51, la formule s’articule comme suit :
=SOMMEPROD((B2:B51 - (PENTE(B2:B51; A2:A51)*A2:A51 + ORDONNEE.ORIGINE(B2:B51; A2:A51)))^2)
Le fonctionnement interne de cette formule mérite d’être explicité :
- L’expression
(PENTE(...)*A2:A51 + ORDONNEE.ORIGINE(...))génère un vecteur virtuel contenant les 50 valeurs prédites $\hat{y}_i$. - La soustraction vectorielle avec
B2:B51produit le vecteur virtuel des 50 résidus individuels $e_i$. - L’opérateur
^2élève chaque composante de ce vecteur à la puissance deux. - La fonction
SOMMEPRODforce l’évaluation matricielle de ces opérations vectorielles sous-jacentes et réalise l’agrégation scalaire terminale sans nécessiter de validation matricielle spéciale par les trois touches, y compris sur les versions d’Excel antérieures à 2021.
Cette approche allie compacité et sécurité computationnelle, préservant l’intégrité visuelle de la feuille de calcul.
7.2 Utilisation de fonctions modernes : LET et LAMBDA pour modulariser la SCR
L’introduction récente dans Microsoft 365 des fonctions de programmation fonctionnelle avancée, notamment LET et LAMBDA, transforme la construction des calculs statistiques sous Excel en éliminant les recalculs redondants et en améliorant la lisibilité des formules.
Dans la formule combinée précédente, les fonctions PENTE et ORDONNEE.ORIGINE devaient recalculer les coefficients sur l’ensemble de la plage pour chaque composante vectorielle. Grâce à la fonction LET, l’analyste peut instancier des variables locales et découper le flux logique de calcul :
=LET(y; B2:B51; x; A2:A51; b1; PENTE(y; x); b0; ORDONNEE.ORIGINE(y; x); y_estime; b1*x + b0; SOMME((y - y_estime)^2))
Dans cette structure déclarative, les vecteurs y et x ainsi que les scalaires b1 et b0 ne sont évalués qu’une seule fois par le moteur d’Excel, ce qui réduit considérablement les temps de calcul sur les bases de données volumineuses. Pour aller plus loin dans la standardisation, il est possible d’encapsuler cette logique dans le Gestionnaire de noms d’Excel via une fonction LAMBDA nommée CALCUL_SCR :
=LAMBDA(plage_y; plage_x; LET(b1; PENTE(plage_y; plage_x); b0; ORDONNEE.ORIGINE(plage_y; plage_x); SOMME((plage_y - (b1*plage_x + b0))^2)))
Dès lors, n’importe quel chercheur ou collaborateur au sein du classeur peut obtenir instantanément la somme résiduelle en appelant simplement sa propre fonction personnalisée :
=CALCUL_SCR(B2:B51; A2:A51)
Cette approche permet de démocratiser des calculs statistiques rigoureux tout en évitant les erreurs de syntaxe répétitives.
7.3 Dérivation indirecte de la SCR à partir de SCT et du coefficient R²
Une alternative élégante pour dériver la somme des carrés des résidus repose sur l’exploitation des équations fondamentales de décomposition de la variance décrites dans la section 1.3. Puisque le coefficient de détermination est formellement défini par $R^2 = 1 – (SCR / SCT)$, un simple réarrangement algébrique permet d’isoler la SCR :
$$SCR = SCT \times (1 – R^2)$$
Excel dispose précisément de deux fonctions natives spécialisées permettant d’évaluer directement ces deux composantes :
- La Somme des Carrés Totale ($SCT$), qui représente la somme des déviations quadratiques par rapport à la moyenne univariée, s’obtient instantanément via la fonction
SOMME.CARRES.ECARTSappliquée sur le vecteur de la variable dépendante :=SOMME.CARRES.ECARTS(plage_Y). - Le coefficient de détermination de la régression ($R^2$) est calculé par la fonction
COEFFICIENT.DETERMINATION:=COEFFICIENT.DETERMINATION(plage_Y; plage_X).
La synthèse déductive s’exprime ainsi au sein d’une cellule unique :
=SOMME.CARRES.ECARTS(plage_Y) * (1 - COEFFICIENT.DETERMINATION(plage_Y; plage_X))
Il convient néanmoins de formuler une mise en garde méthodologique concernant cette démarche indirecte. Bien que mathématiquement exacte sur le plan théorique, cette formulation peut présenter de légères variations d’arrondi sur des jeux de données mal conditionnés en raison de l’imprécision inhérente à la soustraction d’un nombre proche de 1 en virgule flottante. L’extraction directe via DROITEREG ou la sommation arithmétique directe demeurent les méthodes à privilégier pour garantir une précision numérique maximale.
8. Interprétation de la magnitude de la SCR en recherche psychologique
8.1 Sensibilité à l’échelle de mesure et nécessité de normalisation
Une incompréhension fréquente chez les praticiens novices consiste à interpréter la magnitude brute scalaire de la somme des carrés des résidus comme un indice intrinsèque et absolu de performance du modèle. Il est fondamental de souligner que la SCR est une métrique dimensionnelle non bornée : sa valeur dépend strictement de la métrique et de l’unité de mesure initiales attribuées à la variable dépendante $Y$.
À titre d’illustration, si une variable psychophysiologique exprimée en secondes présente une SCR de 15, la simple conversion de cette même mesure en millisecondes multipliera mécaniquement les écarts individuels par un facteur 1 000, et par conséquent la SCR finale sera multipliée par un facteur d’un million ($1,000^2$), atteignant la valeur brute de 15 000 000, sans que le pouvoir explicatif réel du modèle n’ait été modifié en quoi que ce soit. Dès lors, il est strictement impossible de statuer sur la qualité d’ajustement empirique d’un modèle en s’appuyant uniquement sur la valeur brute absolue de sa SCR.
La comparaison de la SCR entre modèles n’a de validité épistémologique rigoureuse que si les modèles mis en concurrence partagent exactement le même échantillon d’observations et une variable dépendante configurée dans une échelle de mesure rigoureusement identique. Si l’objectif analytique exige de comparer des ajustements entre des construits mesurés sur des échelles hétérogènes (par exemple comparer l’ajustement d’un modèle prédisant des temps de réaction par rapport à un modèle prédisant les scores à un questionnaire d’attitude de type Likert), une standardisation intégrale préalable des variables en scores $Z$ (via la fonction CENTREE.REDUITE) s’avère indispensable pour neutraliser les effets d’échelle métrique.
8.2 Calcul de la variance résiduelle et de l’erreur type d’estimation
Bien que la SCR capture l’énergie d’erreur brute globale, elle cumule les résidus sur l’ensemble des unités statistiques observées, ce qui rend sa valeur directement proportionnelle à la taille d’échantillon $N$. Pour obtenir une estimation non biaisée de la dispersion résiduelle propre au processus générateur, il convient d’ajuster la SCR en fonction de ses degrés de liberté résiduels ($ddl$).
Cette division donne naissance à la variance résiduelle de l’échantillon, notée $s_e^2$ ou Carré Moyen Résiduel (CMR, ou Mean Square Residual, MSR) :
$$s_e^2 = \frac{SCR}{N – k – 1}$$
où $k$ représente le nombre total de prédicteurs. En extrayant la racine carrée de cette variance, l’analyste dérive l’erreur type de l’estimation ($s_e$), qui présente l’avantage considérable de s’exprimer directement dans l’unité de mesure d’origine de la variable dépendante $Y$.
Sous Excel, si la SCR a été calculée dans la cellule F5, l’erreur-type de l’estimation pour un modèle univarié ($k=1$) s’obtient par la formule :
=RACINE(F5 / (NB(plage_Y) - 2))
Cette statistique possède une utilité clinique et diagnostique remarquable : dans la mesure où les postulats d’homoscédasticité et de normalité sont respectés, environ 68 % des observations empiriques réelles fluctueront dans une bande de dispersion comprise entre $\hat{y}_i \pm s_e$, et environ 95 % se situeront dans un intervalle de $\hat{y}_i \pm 1,96 , s_e$, fournissant ainsi un cadre quantifié pour établir des intervalles de prédiction psychométriques individuels.
8.3 Critères d’information pénalisés fondés sur la SCR
Dans les contextes d’analyse avancée où l’on cherche à arbitrer entre la qualité de l’ajustement aux données et la complexité structurelle du modèle, les chercheurs utilisent des critères d’information pénalisés. L’objectif est d’éviter le surapprentissage en pénalisant les modèles incorporant un trop grand nombre de paramètres prédictifs.
Deux métriques fondées directement sur la valeur de la somme des carrés des résidus sont couramment mobilisées dans les protocoles de sélection de modèles :
- Le Critère d’Information d’Akaike (AIC), dont l’expression asymptotique sous hypothèse de résidus gaussiens s’écrit :
$$AIC = N \times \ln\left(\frac{SCR}{N}\right) + 2(k + 1)$$ - Le Critère d’Information Bayésien (BIC, ou critère de Schwarz), qui introduit une pénalité plus sévère proportionnelle au logarithme népérien de la taille d’échantillon :
$$BIC = N \times \ln\left(\frac{SCR}{N}\right) + (k + 1)\ln(N)$$
Ces critères sont facilement calculables sous Excel. En désignant par F5 la cellule hébergeant la SCR, par A2:A51 la variable dépendante ($N=50$), et pour un modèle à régresseur unique ($k=1$, soit $k+1 = 2$ paramètres estimés en comptant la constante), la formule d’implémentation de l’AIC s’écrit simplement :
=NB(A2:A51)*LN(F5/NB(A2:A51)) + 2*2
Lors de la confrontation de modèles théoriques alternatifs appliqués au même jeu de données, le chercheur privilégiera le modèle affichant la valeur de critère (AIC ou BIC) la plus basse, atteignant ainsi le meilleur équilibre méthodologique entre minimisation de la variance résiduelle et parcimonie théorique.
9. Diagnostics graphiques des résidus pour valider la pertinence de la SCR
9.1 Graphique des résidus bruts en fonction des valeurs prédites
L’obtention d’une somme des carrés des résidus, aussi faible soit-elle, ne garantit en rien la validité méthodologique du modèle si les postulats fondamentaux du modèle linéaire sont violés. Le contrôle de l’hypothèse d’homoscédasticité — qui stipule que la variance des résidus doit rester constante quel que soit le niveau des prédictions — s’appuie sur la construction sous Excel d’un graphique diagnostique croisant les résidus en ordonnée et les valeurs prédites en abscisse.
Le protocole sous Excel s’articule comme suit :
- Sélectionner simultanément la colonne des valeurs prédites $\hat{y}$ (colonne C de notre démarche manuelle) et la colonne des résidus bruts $e$ (colonne D).
- Accéder à l’onglet Insertion et générer un graphique de type Nuage de points (sans ligne de raccordement).
- Insérer une ligne de référence horizontale au niveau de l’ordonnée zéro en traçant une courbe de tendance linéaire sur une série artificielle nulle ou en utilisant les outils de dessin vectoriel.
L’interprétation diagnostique de la distribution des points est immédiate :
- Si le nuage présente une dispersion homogène et aléatoire formant une bande rectangulaire le long de l’axe horizontal, le postulat d’homoscédasticité est validé.
- Si le nuage adopte une structure morphologique en « entonnoir » ou en « mégaphone » (la dispersion des résidus s’élargissant à mesure que les valeurs prédites augmentent), le modèle présente un problème d’hétéroscédasticité.
La présence d’une hétéroscédasticité invalide l’optimalité statistique des estimateurs des MCO : bien que les coefficients restent non biaisés, ils ne sont plus à variance minimale, et la SCR résultante reflète une erreur d’ajustement asymétrique. Dans un tel contexte, l’analyste sous Excel doit envisager l’application d’une transformation logarithmique stabilisatrice sur la variable dépendante (par exemple =LN(B2)) avant de réitérer le calcul de sa régression.
9.2 Évaluation de la normalité de la distribution des résidus
Bien que l’estimation mathématique ponctuelle de la SCR par les MCO n’exige pas en soi la normalité stricte des résidus pour être opérée, cette hypothèse gaussienne s’avère indispensable dès lors que l’analyste souhaite réaliser des inférences statistiques fiables (tests de Student, dérivation d’intervalles de confiance ou calculs de significativité dans le tableau ANOVA). Une distribution asymétrique ou à queues lourdes fausse les tests de significativité dérivés de la décomposition de la SCR.
Pour auditer cette conformité distributionnelle sous Excel, plusieurs approches complémentaires s’offrent à l’analyste :
- Générer un histogramme de distribution des résidus bruts (colonne D) via le bouton Histogramme de l’onglet Insertion, en veillant à ajuster la largeur des classes pour inspecter l’allure générale de la cloche de Gauss.
- Calculer les coefficients de forme formels : le coefficient d’asymétrie via la fonction native
=COEFFICIENT.ASYMETRIE(D2:D51)(qui doit idéalement osciller entre -0,5 et +0,5) et le coefficient d’aplatissement ou kurtosis via la fonction=KURTOSIS(D2:D51)(dont la valeur doit se rapprocher de 0 pour refléter une distribution mésokurtique). - Construire un diagramme quantile-quantile (Q-Q plot) approché en classant les résidus par ordre croissant, en calculant leurs rangs percentiles empiriques théoriques au moyen de la fonction
=LOI.NORMALE.STANDARD.INVERSE((RANG(D2; $D$2:$D$51) - 0,5)/NB($D$2:$D$51)), puis en projetant ces quantiles théoriques face aux résidus standardisés réels dans un nuage de points. Tout écart systématique par rapport à la bissectrice signale une déviation de normalité qu’il convient de rapporter dans l’étude.
9.3 Détection visuelle des points de levier et résidus extrêmes
Les résidus individuels ne possèdent pas tous la même influence mécanique sur la fixation de la droite de régression et, par corollaire, sur l’amplification de la somme des carrés des résidus. Une observation combinant une déviation résiduelle marquée et une position excentrée sur l’espace des régresseurs (fort effet de levier) peut à elle seule orienter la pente et fausser l’ensemble de la SCR.
Pour mettre en place un système de détection sous Excel, la méthode standard consiste à calculer la colonne des résidus standardisés ($e_i^*$), obtenue en divisant chaque résidu brut par l’erreur-type globale de régression $s_e$ :
=D2 / $E$3
(en supposant l’erreur type $s_e$ positionnée en cellule E3). L’analyste peut ensuite instaurer une règle de mise en forme conditionnelle sur cette colonne de résidus standardisés :
- Sélectionner la plage des résidus standardisés.
- Cliquer sur Mise en forme conditionnelle > Règles de mise en surbrillance des cellules > Supérieur à… et fixer le critère à
2(avec remplissage rouge clair). - Répéter l’opération en ajoutant une règle Inférieur à… fixée à
-2.
Les observations associées à des résidus standardisés excédant $|2|$ ou $|2,5|$ ressortent immédiatement en surbrillance. Cette alerte visuelle invite le chercheur à recalculer provisoirement la SCR en neutralisant ces unités statistiques au moyen d’un filtre dynamique, afin de quantifier l’impact de ces valeurs extrêmes sur la stabilité de son modèle prédictif.
10. Dépannage des anomalies et erreurs d’implémentation sous Excel
10.1 Résolution des codes d’erreur fréquents (#VALEUR!, #NOMBRE!, #REF!)
La mise en œuvre des fonctions de régression et le traitement vectoriel sous Excel confrontent régulièrement les praticiens à une typologie spécifique de codes d’erreur. Savoir diagnostiquer rapidement l’origine de ces blocages permet de préserver la fiabilité des calculs :
- L’erreur
#VALEUR!: C’est l’anomalie la plus récurrente lors de l’usage deDROITEREG,PENTEouSOMMEPROD. Elle se manifeste dans deux cas principaux :- Une asymétrie dimensionnelle entre les vecteurs d’entrée. Si la plage $Y$ couvre 50 lignes (par exemple
B2:B51) tandis que la plage $X$ en couvre accidentellement 49 ou 51 (par exempleA2:A50), Excel est dans l’incapacité d’effectuer les opérations terme à terme et renvoie immédiatement l’erreur. - La présence de caractères non numériques ou d’espaces invisibles au sein des séries de données quantitatives (ce qui arrive fréquemment lors d’imports bruts de fichiers CSV avec séparateurs d’espace). L’utilisation de la fonction
=ESTNUM()permet d’isoler rapidement la cellule incriminée.
- Une asymétrie dimensionnelle entre les vecteurs d’entrée. Si la plage $Y$ couvre 50 lignes (par exemple
- L’erreur
#REF!: Se déclenche de manière critique lorsqu’une colonne hébergeant des calculs intermédiaires nécessaires à la dérivation de la SCR (comme la colonne des prédictions $\hat{y}$) a été supprimée ou déplacée, rompant irrémédiablement les liaisons de dépendance référentielle. - L’erreur
#PROPAGATION!(ou#SPILL!sous Excel 365) : Se manifeste lorsque la matrice statistique déployée dynamiquement parDROITEREGrencontre un obstacle physique (une cellule non vide, du texte, ou même une simple formule d’espace blanc) sur les 5 lignes ou les colonnes requises immédiatement en dessous ou à droite de la formule d’appel. Le simple nettoyage de la plage d’expansion permet de résoudre instantanément le problème.
10.2 Gestion rigoureuse des données manquantes (valeurs non renseignées)
Dans les enquêtes par questionnaires ou les expérimentations cliniques, l’occurrence de données manquantes (sujets n’ayant pas renseigné un item ou données perdues lors de passations) constitue une réalité empirique récurrente. L’impact de ces cellules vides sur les fonctions d’Excel diffère fondamentalement selon la méthode opératoire retenue, ce qui peut conduire à des incohérences d’estimation majeures au sein d’une même équipe de recherche :
- Les fonctions de régression directes comme
PENTE,ORDONNEE.ORIGINEouDROITEREGgèrent nativement les cellules vides en appliquant une exclusion par paire (pairwise deletion). Si une observation comporte une valeur manquante sur $X$ ou sur $Y$, la paire correspondante est ignorée du calcul. - En revanche, si l’analyste déploie la méthode manuelle cellule par cellule (Section 3), une cellule vide dans la colonne $X$ peut être implicitement interprétée comme un zéro numérique par l’expression arithmétique de la droite de régression (
=$E$1*A2 + $E$2), générant alors une prédiction $\hat{y}$ erronée pour un participant absent, ce qui fausse ensuite la colonne des résidus et gonfle artificiellement la SCR finale.
Pour prévenir ce biais méthodologique, il est vivement recommandé de purger préalablement l’espace matriciel des lignes incomplètes au moyen de la nouvelle fonction dynamique FILTRE. La syntaxe suivante permet d’isoler automatiquement les seuls enregistrements complets sur les deux dimensions avant d’engager le moindre calcul résiduel :
=FILTRE(A2:B51; (A2:A51"") * (B2:B51""))
Cette approche garantit un échantillon d’analyse rigoureusement intègre et évite les distorsions d’échantillonnage masquées.
10.3 Risques mathématiques de forcer la constante à zéro
La syntaxe de la fonction DROITEREG autorise l’utilisateur à contraindre l’ordonnée à l’origine à zéro en assignant la valeur FAUX à son troisième argument :
=DROITEREG(plage_Y; plage_X; FAUX; VRAI)
Si cette option peut sembler séduisante dans de rares contextes physiques où la nullité structurelle du point d’origine est un impératif ontologique absolu, elle comporte des risques méthodologiques majeurs dès lors qu’elle est appliquée à des sciences humaines ou comportementales. La suppression de la constante rompt instantanément l’orthogonalité de projection des MCO :
- La somme des résidus cesse formellement d’être nulle ($\sum e_i \neq 0$), introduisant un biais systématique dans les estimations.
- La relation d’orthogonalité fondamentale entre les prédictions et les résidus disparaît, entraînant la rupture de l’égalité canonique de décomposition de la variance : $SCT \neq SCM + SCR$.
- Dans un tel cadre contraint, la somme des carrés des résidus peut paradoxalement devenir supérieure à la somme des carrés totale d’origine, conduisant à des aberrations analytiques où le coefficient $R^2$ renvoyé par Excel devient mathématiquement négatif.
Par conséquent, en modélisation psychométrique et comportementale, il est impératif de conserver systématiquement le troisième argument de DROITEREG sur VRAI, garantissant la validité statistique des estimateurs de dispersion résiduelle.
11. Études de cas concrètes : Calcul et interprétation de la SCR en psychométrie
11.1 Cas 1 : Régression simple – Stress perçu et intensité des symptômes anxieux
Afin de concrétiser l’application de ces démarches méthodologiques, considérons une étude clinique menée auprès d’une cohorte de $N = 50$ participants universitaires. Les chercheurs mesurent le niveau de stress perçu à l’aide de l’échelle validée PSS-10 (constituant le régresseur continu $X$, positionné dans la plage A2:A51) et évaluent simultanément l’intensité des symptômes anxieux au moyen de l’inventaire GAD-7 (formant la variable dépendante $Y$, répertoriée dans la plage B2:B51).
Pour illustrer la convergence parfaite des méthodes développées dans cet article, les trois calculs sont exécutés en parallèle sur la feuille de calcul :
- Approche arithmétique manuelle : L’estimation de la pente via
=PENTE(B2:B51; A2:A51)renvoie la valeur $b_1 = 0,7824$. L’ordonnée à l’origine issue de=ORDONNEE.ORIGINE(B2:B51; A2:A51)s’établit à $b_0 = 2,1415$. La dérivation des colonnes de prédictions $\hat{y}_i$, d’écarts $e_i$ et de carrés $e_i^2$ permet d’obtenir par=SOMME(E2:E51)une Somme des Carrés des Résidus finale de :
$$SCR = 342,876$$ - Approche matricielle directe : L’implémentation de la fonction vectorielle encapsulée :
=INDEX(DROITEREG(B2:B51; A2:A51; VRAI; VRAI); 5; 2)renvoie instantanément la valeur scalaire rigoureusement identique de $342,876$. - Approche compacte instantanée : L’évaluation de la formule autonome :
=SOMMEPROD((B2:B51 - (PENTE(B2:B51; A2:A51)*A2:A51 + ORDONNEE.ORIGINE(B2:B51; A2:A51)))^2)confirme de nouveau l’obtention de $342,876$.
Sur le plan de l’interprétation substantielle, la somme des carrés totale ($SCT$) calculée via =SOMME.CARRES.ECARTS(B2:B51) renvoyant la valeur de $895,420$, le ratio de variance inexpliquée s’établit à $SCR / SCT = 342,876 / 895,420 = 0,3829$. Nous en déduisons que 38,29 % de la variabilité des symptômes anxieux échappe à l’action prédictive du stress perçu, ce qui correspond à un coefficient d’explication de $R^2 = 1 – 0,3829 = 0,6171$ (soit 61,71 % de variance expliquée par le modèle univarié).
11.2 Cas 2 : Régression multiple – Prédiction de la performance cognitive
Étudions à présent une configuration multivariée dans laquelle une équipe de recherche en neuropsychologie cherche à modéliser la performance d’un groupe d’adultes à un test standardisé de mémoire de travail ($Y$, logé dans la plage D2:D51) à partir de trois prédicteurs continus : l’âge chronologique ($X_1$, plage A2:A51), l’indice de qualité du sommeil mesuré par actimétrie ($X_2$, plage B2:B51), et le niveau d’anxiété-trait ($X_3$, plage C2:C51).
L’utilisation de l’Utilitaire d’analyse de régression avec sélection de la plage dépendante D1:D51 et de la plage explicative multivariée A1:C51 génère le tableau d’analyse de variance suivant :
- Ligne 1 (Régression) : Degrés de liberté $ddl_M = 3$ ; Somme des carrés $SCM = 1,245,632$ ; Carré moyen $MS_M = 415,211$.
- Ligne 2 (Résidus) : Degrés de liberté $ddl_R = 50 – 3 – 1 = 46$ ; Somme des carrés $SCR = 521,418$ ; Carré moyen $CMR = 521,418 / 46 = 11,335$.
- Ligne 3 (Total) : Degrés de liberté $ddl_T = 49$ ; Somme des carrés $SCT = 1,767,050$.
À partir de cette extraction de la SCR, le calcul du test $F$ de significativité globale du modèle s’obtient directement par le ratio des carrés moyens :
$$F = \frac{MS_M}{CMR} = \frac{415,211}{11,335} = 36,63$$
La dérivation sous Excel de la probabilité associée par =LOI.F.DROITE(36,63; 3; 46) renvoie une valeur p hautement significative ($p < 0,001$). L'erreur-type de l'estimation associée est déduite par =RACINE(11,335) = 3,367 points d’échelle, fournissant au clinicien la précision métrique concrète des estimations individuelles issues de la combinaison de ces trois déterminants biologiques et comportementaux.
11.3 Synthèse comparative des trois démarches méthodologiques dans Excel
Le tableau ci-dessous synthétise les caractéristiques comparées des trois voies opératoires envisageables sous Excel pour calculer la somme des carrés des résidus, éclairant le praticien sur le choix le plus approprié selon le contexte applicatif :
- Méthode arithmétique pas à pas (Colonnes de calcul) :
- Vitesse de déploiement : Faible (exige la mise en place de 3 colonnes de calcul intermédiaires).
- Flexibilité / Dynamisme : Moyenne (l’ajout d’une observation ou d’un prédicteur requiert de réajuster manuellement la structure des formules).
- Traçabilité et auditabilité : Maximale (permet d’inspecter visuellement chaque résidu individuel $e_i$).
- Risque d’erreur opératoire : Modéré (lié principalement aux oublis de verrouillage absolu des coordonnées par le symbole
$). - Usage recommandé : Phase d’apprentissage méthodologique, validation pédagogique, détection visuelle d’observations aberrantes isolées.
- Méthode matricielle directe (DROITEREG / INDEX) :
- Vitesse de déploiement : Immédiate (une seule cellule de formule suffit pour obtenir la SCR).
- Flexibilité / Dynamisme : Maximale (s’actualise instantanément lors de l’extension des séries de données sans occuper d’espace sur la feuille).
- Traçabilité et auditabilité : Synthétique (la structure interne des résidus n’est pas directement visualisée).
- Risque d’erreur opératoire : Faible (sous réserve de respecter l’indexation matricielle fixe : ligne 5, colonne 2).
- Usage recommandé : Tableaux de bord décisionnels, automatisations répétitives, intégration dans des modèles statistiques chaînés.
- Utilitaire d’analyse statistique (Analysis ToolPak) :
- Vitesse de déploiement : Rapide (génération semi-automatisée via des boîtes de dialogue interactives).
- Flexibilité / Dynamisme : Rigide et statique (le rapport produit ne se recalcule pas automatiquement en cas de modification des données sources ; il doit être régénéré à chaque mise à jour).
- Traçabilité et auditabilité : Excellente (génération simultanée d’un tableau ANOVA complet conforme aux standards de publication académique).
- Risque d’erreur opératoire : Quasi nul (l’interface guide l’utilisateur pas à pas).
- Usage recommandé : Rapports d’analyse finaux, documentation académique standardisée, validation inférentielle globale d’un modèle établi.
12. Bonnes pratiques, reproductibilité et auditabilité des calculs dans Excel
12.1 Protocoles de structuration pour la reproductibilité scientifique
Face à la crise de la reproductibilité qui traverse les sciences empiriques, l’usage d’Excel dans la chaîne de traitement statistique exige une discipline méthodologique rigoureuse. Trop d’analyses publiées ou de rapports d’expertise souffrent d’un manque d’auditabilité dû à une imbrication désordonnée entre données brutes, transformations intermédiaires et résultats synthétiques.
Pour garantir la reproductibilité des calculs de dispersion résiduelle, il convient d’adopter les principes directeurs suivants :
- Établir un partitionnement spatial strict du classeur en réservant une feuille de calcul dédiée exclusivement aux données sources originales (nommée par exemple
DATA_BRUTES), verrouillée en écriture pour prévenir toute altération involontaire. Les calculs et analyses doivent être déportés sur une seconde feuille distincte (nomméeANALYSES_SCR). - Bannir formellement les adresses de cellules alphanumériques brutes au profit de plages nommées sémantiques. Une formule rédigée sous la forme
=INDEX(DROITEREG(Score_Anxiete; Score_Stress; VRAI; VRAI); 5; 2)présente une clarté conceptuelle bien supérieure à la référence opaque=INDEX(DROITEREG(B2:B51; A2:A51; VRAI; VRAI); 5; 2). - Documenter systématiquement dans une section de métadonnées la version exacte du système d’exploitation et du tableur utilisés, ainsi que la date de compilation et les options d’environnement actives, garantissant ainsi la traçabilité des algorithmes mis en œuvre.
12.2 Audit et traçabilité des dépendances de calcul
Le tableur Excel dispose d’outils d’audit intégrés permettant de vérifier les chaînes de liaison computationnelles avant d’entériner les résultats d’un modèle :
- Dans l’onglet Formules, l’utilisation des boutons Repérer les antécédents et Repérer les dépendants matérialise graphiquement, par des flèches directionnelles, le flux de dépendance reliant les données sources initiales à la cellule terminale de la SCR. Cette précaution permet d’identifier d’éventuelles références orphelines ou des décalages involontaires d’intervalles lors de recopies manuelles.
- Vérifier formellement l’absence totale de références circulaires masquées en inspectant l’outil d’avertissement situé dans Formules > Vérification des erreurs > Références circulaires.
- Implémenter une cellule d’assertion logique validant la fermeture stricte du bilan de variance pythagoricien. L’analyste peut insérer une formule de contrôle booléen telle que :
=SI(ABS(SOMME.CARRES.ECARTS(plage_Y) - (INDEX(DROITEREG(plage_Y; plage_X; VRAI; VRAI); 5; 1) + INDEX(DROITEREG(plage_Y; plage_X; VRAI; VRAI); 5; 2))) < 0,00001; "MODÈLE VALIDE"; "ERREUR STRUCTURELLE")
Cette assertion contrôle de manière automatisée que la Somme des Carrés Totale est rigoureusement égale à la somme de la SCM et de la SCR, alertant immédiatement l’utilisateur en cas d’anomalie de décomposition.
12.3 Validation croisée des résultats Excel avec des environnements statistiques dédiés
Dans le cadre d’un protocole de publication au sein de revues scientifiques à comité de lecture, il est recommandé de procéder à une validation croisée des calculs réalisés sous Excel en les confrontant aux résultats issus d’environnements d’analyse statistique spécialisés, tels que le logiciel R ou la bibliothèque statsmodels de Python.
À cette fin, le jeu de données issu d’Excel est exporté sous un format plat standardisé (CSV délimité par des virgules). Sous la console de commande R, la séquence de script minimale s’écrit de manière très concise :
donnees <- read.csv("donnees_psychometrie.csv")
modele <- lm(Score_Anxiete ~ Score_Stress, data = donnees)
scr_R <- sum(residuals(modele)^2)
cat("SCR extraite sous R :", scr_R, "n")
Dans la grande majorité des cas pratiques, les valeurs scalaires obtenues sous R et sous Excel coïncident de façon exacte jusqu’à la huitième décimale. Tout écart résiduel mineur relevé au-delà de la dixième décimale relève de variations infinitésimales de gestion de l’arithmétique matricielle IEEE 754 entre les bibliothèques C/Fortran sous-jacentes (LAPACK/BLAS exploitées par R) et le moteur de calcul propriétaire de Microsoft. La mise en évidence de cette concordance numérique établit une chaîne de confiance méthodologique inattaquable pour l’ensemble des parties prenantes de la recherche.
Références
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied Multiple Regression/Correlation Analysis for the Behavioral Sciences (3rd ed.). Lawrence Erlbaum Associates.
- Draper, N. R., & Smith, H. (1998). Applied Regression Analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
- Fox, J. (2016). Applied Regression Analysis and Generalized Linear Models (3rd ed.). SAGE Publications.
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser.
- Legendre, A.-M. (1805). Nouvelles méthodes pour la détermination des orbites des comètes. F. Didot.
- Microsoft Support. (2024). Fonction DROITEREG. Microsoft Corporation. https://support.microsoft.com/fr-fr/office/droitereg-fonction-8434e199-ee23-4483-8b1b-92a363d6fe0e
- Microsoft Support. (2024). Utiliser l’Utilitaire d’analyse pour effectuer des analyses de données complexes. Microsoft Corporation. https://support.microsoft.com/fr-fr/office/charger-l-utilitaire-d-analyse-6a63e598-cd6d-42e3-9317-6d40a1a6da31
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
- Tabachnick, B. G., & Fidell, L. S. (2019). Using Multivariate Statistics (7th ed.). Pearson.
- Wilkinson, L. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594
- Wooldridge, J. M. (2020). Introductory Econometrics: A Modern Approach (7th ed.). Cengage Learning.