
Dans le domaine des sciences comportementales, de la psychologie différentielle et de la psychométrie, la modélisation statistique par régression linéaire multiple constitue une pierre angulaire pour sonder les relations complexes unissant plusieurs variables prédictives à un phénomène d’intérêt. Qu’il s’agisse de mesurer l’impact de dimensions de la personnalité sur la performance académique, de quantifier l’influence de multiples stresseurs organisationnels sur l’épuisement professionnel ou de délimiter les facteurs cognitifs sous-tendant la mémoire de travail, les chercheurs manipulent presque invariablement des variables fortement intriquées. Cette interdépendance naturelle entre les construits psychologiques pose un défi méthodologique fondamental, connu sous le nom de multicollinéarité.
Lorsque deux ou plusieurs variables explicatives partagent une fraction substantielle de leur variance, la capacité des moindres carrés ordinaires (MCO) à isoler l’effet propre de chaque prédicteur se trouve compromise. Les estimateurs des coefficients de régression perdent leur précision, leurs erreurs-types se dilatent de manière disproportionnée et la puissance statistique des tests d’hypothèse s’effondre. Face à ce péril invisible, l’inspection visuelle naïve des coefficients ou la simple analyse des matrices de corrélation bivariée se révèlent dramatiquement insuffisantes. Une quantification rigoureuse de ce phénomène requiert un instrument diagnostique multivarié dédié : le facteur d’inflation de la variance, universellement désigné sous l’acronyme VIF (pour Variance Inflation Factor).
Le langage de programmation et environnement statistique R s’est imposé comme la référence incontournable pour la recherche psychologique moderne, offrant des bibliothèques spécialisées capables de déceler, quantifier et remédier aux distorsions induites par la multicollinéarité. Ce guide méthodologique exhaustif a pour vocation d’exposer l’intégralité du traitement du VIF dans R. De ses fondements mathématiques et algébriques à son calcul algorithmique pas à pas, en passant par l’interprétation des sorties logicielles, les adaptations aux variables qualitatives polytomiques et les stratégies de remédiation conformes aux standards académiques internationaux de l’American Psychological Association (APA), ce manuel fournit aux chercheurs une feuille de route rigoureuse et directement reproductible.
1. Introduction à la multicollinéarité dans la modélisation en psychologie
1.1 Définition et nature de la multicollinéarité dans les sciences comportementales
La multicollinéarité désigne une situation statistique dans laquelle une interdépendance linéaire exacte ou quasi-exacte se manifeste entre au moins deux variables explicatives intégrées dans un modèle de régression linéaire multiple. Sur le plan théorique, il convient d’opérer une distinction fondamentale entre la corrélation bivariée simple et la multicollinéarité multivariée. Deux prédicteurs peuvent présenter une corrélation bivariée modérée, par exemple un coefficient de Pearson de 0,45, tout en générant une collinéarité sévère lorsqu’ils sont combinés à un ensemble d’autres régresseurs qui, pris collectivement, reproduisent la quasi-totalité de la variance d’un troisième construit. Ce phénomène invisible au niveau des paires de variables constitue l’essence même de la collinéarité multivariée.
Dans les sciences comportementales, la multicollinéarité n’est que rarement un artefact technique ; elle découle directement de la nature intrinsèque des objets d’étude psychologiques. Les instruments psychométriques reposent sur la mesure de construits latents non observables directement, tels que l’anxiété-trait, l’estime de soi, l’intelligence fluide ou les facettes de la personnalité issues du modèle des Big Five. Dans les inventaires d’auto-évaluation, les sous-échelles conçues pour capturer des facettes théoriquement distinctes d’un même macro-construit partagent inévitablement une variance commune substantielle. Par exemple, au sein d’une échelle évaluant l’affectivité négative, les scores de dépression, d’anxiété et d’hostilité présentent une redondance conceptuelle et statistique élevée, rendant leur intégration conjointe dans une équation de régression particulièrement périlleuse.
Il est par ailleurs impératif de différencier la multicollinéarité structurelle de la multicollinéarité inhérente aux données empiriques. La multicollinéarité des données émerge naturellement du plan d’échantillonnage ou de la corrélation écologique propre à la population étudiée, sans que l’expérimentateur n’ait manipulé mathématiquement les variables. À l’inverse, la multicollinéarité structurelle est générée par le statisticien lui-même lors de la spécification du modèle, typiquement par l’introduction de termes d’interaction multiplicatifs (le produit de deux régresseurs) ou de termes polynomiaux (l’élévation au carré ou au cube d’un prédicteur continu pour modéliser une relation curvilinéaire). Bien que leurs origines conceptuelles diffèrent, ces deux formes exercent la même contrainte déstabilisatrice sur les propriétés asymptotiques des estimateurs des moindres carrés ordinaires.
Sur le plan mathématique, le théorème de Gauss-Markov stipule que, sous les hypothèses de linéarité, d’exogénéité stricte, d’homoscédasticité et d’absence d’autocorrélation, l’estimateur des moindres carrés ordinaires est le meilleur estimateur linéaire non biaisé (BLUE, pour Best Linear Unbiased Estimator). Toutefois, cette propriété suppose qu’aucune relation de collinéarité parfaite n’existe au sein de la matrice de données. Lorsque la collinéarité devient quasi-parfaite, la matrice de variance-covariance des coefficients estimés devient quasi-singulière, provoquant une instabilité numérique critique qui sape la validité des inférences statistiques.
1.2 Impacts de la collinéarité sur les modèles de régression linéaire
L’effet le plus délétère de la multicollinéarité réside dans le gonflement artificiel et démesuré des erreurs-types associées aux coefficients de régression partiels. Dans une régression multiple, le coefficient non standardisé associé à un prédicteur représente la variation attendue de la variable dépendante pour chaque unité d’augmentation de ce prédicteur, toutes les autres variables du modèle étant maintenues strictement constantes. Or, si un régresseur est fortement prédictible à partir des autres, l’opération mathématique consistant à « maintenir constants » les prédicteurs concurrents devient empiriquement intenable : l’échantillon ne contient pas suffisamment de variance indépendante pour dissocier l’effet propre de chaque élément.
Ce manque d’information orthogonale se traduit mécaniquement par une variance d’échantillonnage gigantesque. Les erreurs-types des paramètres estimés explosent, ce qui élargit considérablement les intervalles de confiance associés. Par voie de conséquence directe, la statistique du test de Student, définie comme le ratio du coefficient estimé sur son erreur-type, diminue drastiquement. Des variables psychologiques possédant une influence théorique et empirique majeure sur le phénomène étudié peuvent ainsi voir leur valeur p dépasser largement le seuil conventionnel de significativité de 0,05, conduisant le chercheur à commettre une erreur de type II : conclure à l’absence d’effet d’une variable qui possède pourtant un rôle substantiel dans la population parente.
Un autre symptôme alarmant de la collinéarité avancée est la volatilité extrême et l’inversion imprévisible des signes des coefficients de régression. Il n’est pas rare d’observer un prédicteur dont la corrélation bivariée avec le critère est fortement positive afficher un coefficient de régression négatif et statistiquement non significatif au sein du modèle global. Ce comportement erratique, parfois qualifié d’effet de suppression statistique pathologique ou d’artefact de bascule, désoriente l’interprétation théorique. De surcroît, le modèle devient hypersensible aux moindres fluctuations de l’échantillon : l’ajout, le retrait ou la modification de quelques observations isolées suffit à modifier radicalement la magnitude et l’orientation des paramètres estimés.
Enfin, la multicollinéarité vicie gravement les tentatives d’attribution de l’importance relative des prédicteurs. En psychologie appliquée, les cliniciens et les psychologues du travail cherchent fréquemment à hiérarchiser les déterminants d’un comportement à l’aide des coefficients standardisés bêta ou de décompositions de variance. Sous l’effet d’une collinéarité non maîtrisée, la variance commune partagée par les prédicteurs redondants est arbitrairement assignée à l’une ou l’autre des variables en fonction de micro-fluctuations d’échantillonnage. Il devient dès lors méthodologiquement invalide d’affirmer qu’un construit particulier prévaut sur un autre dans l’explication du critère.
1.3 Pourquoi le facteur d’inflation de la variance est indispensable
Face aux périls documentés de la collinéarité, de nombreux chercheurs commettent l’erreur méthodologique de s’en remettre exclusivement à l’examen de la matrice des corrélations de Pearson pour valider la qualité de leurs données. Cette pratique est foncièrement déficiente. Une matrice bivariée n’évalue que les associations prises deux à deux. Elle demeure structurellement aveugle aux dépendances linéaires d’ordre supérieur. Par exemple, trois variables prédictives peuvent afficher entre elles des corrélations bivariées modestes, n’excédant pas 0,35, tout en permettant à deux d’entre elles d’expliquer conjointement 95 % de la variance de la troisième à travers une combinaison linéaire multivariée. Se fier uniquement aux seuils bivariés classiques, comme le seuil arbitraire de r supérieur à 0,70 ou 0,80, induit un faux sentiment de sécurité et masque des collinéarités destructrices.
Le facteur d’inflation de la variance s’impose précisément comme l’outil diagnostique incontournable car il quantifie l’interdépendance multivariée globale d’un prédicteur à l’égard de la totalité des autres variables explicatives présentes dans l’équation. Le VIF synthétise en un indicateur scalaire unique le degré exact selon lequel la variance de l’estimateur d’un coefficient de régression est gonflée par rapport à une situation idéale où les régresseurs seraient rigoureusement orthogonaux les uns aux autres. Il opère une intégration holistique de la structure de dépendance interne du modèle matriciel.
Dans le paradigme contemporain de la reproductibilité scientifique et de la psychométrie rigoureuse, le VIF remplit un rôle central dans le contrôle de la validité interne des inférences. Les revues de premier plan à comité de lecture exigent désormais la transparence quant aux métriques diagnostiques de régression. Rapporter les valeurs de VIF garantit à la communauté scientifique que les conclusions théoriques tirées sur les poids relatifs des construits ne reposent pas sur des artefacts statistiques issus d’une matrice mal conditionnée. Il constitue le prérequis analytique absolu avant toute validation d’hypothèses causales ou corrélationnelles complexes.
2. Fondements mathématiques du facteur d’inflation de la variance
2.1 Formulation algébrique et lien avec la tolérance
Pour appréhender la mécanique computationnelle du facteur d’inflation de la variance, il est nécessaire de formaliser l’expression algébrique de la variance de l’estimateur d’un coefficient de régression dans le cadre des moindres carrés ordinaires. Considérons un modèle linéaire multiple comportant $p$ prédicteurs continus :
$$Y = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + dots + \beta_j X_j + dots + \beta_p X_p + \varepsilon$$
La variance d’échantillonnage de l’estimateur $\hat{\beta}_j$ du coefficient associé au $j$-ième prédicteur $X_j$ s’exprime rigoureusement sous la forme suivante :
$$operatorname{Var}(\hat{\beta}_j) = \frac{\sigma^2}{(n – 1) \cdot s_j^2} \times \frac{1}{1 – R_j^2}$$
Dans cette équation canonique, $\sigma^2$ représente la variance des résidus du modèle global (la variance de l’erreur $varepsilon$), $n$ désigne la taille de l’échantillon d’observations, et $s_j^2$ symbolise la variance empirique de la variable explicative $X_j$. Le terme le plus remarquable est $R_j^2$, qui représente le coefficient de détermination auxiliaire obtenu en régressant la variable $X_j$ sur l’intégralité des $p – 1$ autres prédicteurs du modèle. Cette équation de régression auxiliaire prend la structure formelle :
$$X_j = \alpha_0 + \sum_{k \neq j} \alpha_k X_k + u_j$$
Le facteur d’inflation de la variance associé au régresseur $X_j$, noté $\text{VIF}_j$, est formellement défini comme le multiplicateur présent dans l’équation de variance :
$$\text{VIF}_j = \frac{1}{1 – R_j^2}$$
L’observation directe de cette formulation met en exergue des propriétés mathématiques élégantes :
- Lorsque $X_j$ est totalement orthogonal aux autres prédicteurs, le coefficient de détermination auxiliaire $R_j^2$ est nul. Le dénominateur se simplifie en 1, et $\text{VIF}_j = 1$. La variance de l’estimateur atteint son minimum théorique absolu.
- À mesure que la dépendance linéaire s’accroît, $R_j^2$ se rapproche de l’unité. Le dénominateur $1 – R_j^2$ tend vers zéro, provoquant une croissance asymptotique du VIF vers l’infini. Si $R_j^2 = 0{,}90$, le VIF s’élève à 10 ; si $R_j^2 = 0{,}95$, il atteint 20 ; pour un $R_j^2 = 0{,}99$, le VIF culmine à 100.
De cette équation découle immédiatement la notion statistique de tolérance, désignée par $T_j$. La tolérance représente la fraction de variance du prédicteur $X_j$ qui n’est pas partagée avec les autres prédicteurs du modèle :
$$T_j = 1 – R_j^2 = \frac{1}{\text{VIF}_j}$$
L’erreur-type de l’estimateur, étant égale à la racine carrée de sa variance, subit directement l’effet multiplicatif de la racine carrée du VIF :
$$operatorname{SE}(\hat{\beta}_j) propto \sqrt{\text{VIF}_j}$$
Cette relation linéaire directe démontre avec clarté la portée du phénomène : un VIF de 4 double l’erreur-type de l’estimateur ($\sqrt{4} = 2$), un VIF de 9 la triple ($\sqrt{9} = 3$), et un VIF de 16 la quadruple ($\sqrt{16} = 4$). L’intervalle de confiance du coefficient $\beta_j$, calculé comme $\hat{\beta}_j \pm t_{\text{crit}} \times operatorname{SE}(\hat{\beta}_j)$, se trouve élargi dans les mêmes proportions géométriques, réduisant drastiquement la précision de l’estimation psychométrique.
2.2 Le facteur d’inflation de la variance généralisé (GVIF)
La formulation algébrique classique du VIF présentée ci-dessus repose sur le postulat que chaque terme du modèle correspond à un régresseur continu unique possédant un seul degré de liberté. Or, dans la modélisation psychologique contemporaine, les prédicteurs intègrent fréquemment des variables qualitatives nominales ou ordinales à modalités multiples (par exemple : le type de trouble clinique selon le DSM, le niveau d’éducation ou le statut professionnel). Ces variables catégorielles polytomiques sont nécessairement encodées dans le modèle sous la forme d’un ensemble de plusieurs variables indicatrices muettes (dummy variables).
L’application directe du VIF conventionnel sur les variables indicatrices individuelles génère des distorsions méthodologiques majeures. D’une part, les valeurs de VIF obtenues varient arbitrairement selon le choix de la modalité de référence (le groupe de base contrasté). D’autre part, les variables indicatrices issues d’une même variable catégorielle polytomique sont intrinsèquement corrélées entre elles par construction mathématique, conduisant à des faux positifs de collinéarité artificielle. Pour surmonter cette impasse théorique, les statisticiens John Fox et Georges Monette ont introduit en 1992 le facteur d’inflation de la variance généralisé (GVIF).
Sur le plan matriciel, considérons le partitionnement des prédicteurs en blocs de variables, où le sous-vecteur $X_j$ contient l’ensemble des indicatrices représentant une variable catégorielle dotée de $df_j$ degrés de liberté. Soit $R$ la matrice de corrélation complète des régresseurs du modèle, et soient $R_{jj}$ et $R_{-j,-j}$ les sous-matrices associées respectivement au sous-ensemble $X_j$ et au reste des variables explicatives. Fox et Monette définissent le GVIF à travers le ratio des déterminants matriciels :
$$\text{GVIF}_j = \frac{det(R_{jj}) \cdot det(R_{-j,-j})}{det(R)}$$
Le déterminant d’une matrice de corrélation quantifie le volume d’un hyper-ellipsoïde dans l’espace multidimensionnel. Si le bloc de variables $X_j$ est orthogonal aux autres prédicteurs, le déterminant global $det(R)$ se décompose exactement en le produit de $det(R_{jj})$ et $det(R_{-j,-j})$, conférant au GVIF la valeur unitaire de 1. Plus le chevauchement d’espace est marqué, plus le déterminant du dénominateur s’effondre, amplifiant la valeur du GVIF.
Cependant, la grandeur brute du GVIF croît mécaniquement avec le nombre de degrés de liberté $df_j$ propres à la variable catégorielle considérée. Pour restaurer une comparabilité dimensionnelle directe avec le VIF unidimensionnel classique, Fox et Monette ont établi une métrique ajustée universellement adoptée, consistant à élever le GVIF à la puissance $1 / (2 \cdot df_j)$ :
$$\text{GVIF}_j^{\frac{1}{2 \cdot df_j}}$$
Cette transformation exponentielle inverse normalise l’indicateur à une échelle unidimensionnelle comparable à un facteur d’inflation d’erreur-type. Pour évaluer cette grandeur vis-à-vis des seuils critiques conventionnels de régression (tels que le seuil de 5 ou de 10), le chercheur doit élever cette valeur normalisée au carré. Ainsi, la condition mathématique de non-collinéarité critique s’énonce formellement :
$$\left(\text{GVIF}_j^{\frac{1}{2 \cdot df_j}}\right)^2 < \text{Seuil Critique}$$
Cette avancée méthodologique permet d’évaluer de façon unifiée et rigoureuse des modèles composites mêlant échelles continues et variables qualitatives polytomiques au sein du langage R.
3. Préparation de l’environnement R et des données psychométriques
3.1 Installation et chargement des bibliothèques nécessaires
L’écosystème R dispose d’une riche panoplie de packages permettant de calculer et de diagnostiquer la multicollinéarité selon diverses perspectives algorithmiques. Pour garantir un flux de travail robuste, professionnel et conforme aux standards actuels de la science ouverte, plusieurs bibliothèques complémentaires doivent être mobilisées. Le socle historique et le plus réputé pour le calcul du VIF et du GVIF réside dans le package car (Companion to Applied Regression), maintenu par John Fox et Sanford Weisberg. Ce package offre l’implémentation de référence de la fonction vif().
En parallèle, l’écosystème moderne easystats, et plus particulièrement le package performance développé par Daniel Lüdecke et ses collaborateurs, offre des fonctions de diagnostic d’une élégance remarquable, capables de générer des interprétations qualitatives automatisées et d’exporter directement les métriques pour la publication scientifique. Deux autres packages méritent une attention particulière : le package olsrr, spécifiquement orienté vers l’apprentissage et le diagnostic pas à pas des modèles MCO, et le package rms (Regression Modeling Strategies) de Frank Harrell, réputé pour la rigueur de ses analyses semi-paramétriques.
Enfin, la manipulation des données psychométriques, la transformation des variables et les visualisations requièrent l’intégration de la suite tidyverse, comprenant notamment dplyr, tidyr, readr et ggplot2. Il est essentiel de veiller à la compatibilité des versions installées en exécutant une session R propre et reproductible. L’installation des packages s’opère via les commandes standards sur le réseau CRAN :
Pour installer et charger ces outils essentiels dans l’environnement R, on exécutera les commandes suivantes en début de script :
Dans la console R, la commande install.packages(c("car", "performance", "see", "olsrr", "rms", "tidyverse", "haven")) permet de récupérer l’ensemble de ces dépendances. Le chargement s’effectue ensuite classiquement au moyen de la fonction library() pour chaque bibliothèque requise. Il est hautement recommandé de consigner les informations de session via l’appel à la fonction sessionInfo() afin de documenter les versions précises des algorithmes utilisés lors de l’analyse, assurant ainsi une auditabilité totale de la recherche empirique.
3.2 Importation et nettoyage du jeu de données
Les données psychométriques collectées sur le terrain, qu’elles proviennent de plateformes en ligne telles que Qualtrics ou d’extractions de logiciels cliniques propriétaires, transitent très souvent sous les formats SPSS (fichiers .sav) ou texte délimité (fichiers .csv). Le package haven fournit l’outil idéal pour importer les fichiers SPSS tout en préservant l’intégrité des étiquettes de valeurs et des métadonnées grâce à sa fonction read_sav(). Pour les formats tabulaires textuels, la fonction read_csv() du package readr assure une lecture rapide et rigoureusement typée.
Dès l’importation effectuée, le chercheur doit procéder à un audit méthodique de la structure des données. Les variables catégorielles doivent impérativement être converties en facteurs R à l’aide de la fonction as.factor() ou factor(), en prenant soin de définir explicitement la modalité de référence via l’argument levels ou la fonction relevel(). Omettre cette conversion risque de fausser l’intégralité du calcul ultérieur, la fonction de modélisation pouvant interpréter des codes numériques discrets (par exemple 1, 2, 3 désignant des pathologies différentes) comme une variable continue sur une échelle d’intervalle, dénaturant ainsi l’ajustement MCO et les calculs matriciels du VIF.
Le traitement des données manquantes constitue une autre étape charnière. La présence de valeurs manquantes (notées NA dans R) entraîne par défaut une suppression univariée ou par liste (listwise deletion) lors de l’exécution de la régression linéaire via lm(). Si les données manquantes ne sont pas réparties de manière totalement aléatoire (MCAR, Missing Completely at Random), cette suppression mécanique peut induire des biais d’échantillonnage sévères et altérer artificiellement les variances empiriques des prédicteurs. Selon l’ampleur du phénomène, le chercheur privilégiera une imputation multiple par équations chaînées (via le package mice) ou vérifiera scrupuleusement que l’échantillon complet analysé conserve une représentativité suffisante.
Enfin, l’examen univarié des distributions psychométriques s’avère indispensable. Le calcul d’indices d’asymétrie (skewness) et d’aplatissement (kurtosis), complété par des diagrammes en boîte (boxplots), permet d’identifier les valeurs extrêmes ou aberrantes. Dans les échelles psychologiques, un score aberramment élevé ou bas peut agir comme un point de levier (high leverage point), déformant localement la matrice de corrélation des prédicteurs et gonflant ou masquant fallacieusement la collinéarité du modèle.
4. Ajustement du modèle de régression linéaire de référence
4.1 Spécification de l’équation de régression avec la fonction lm()
L’estimation du modèle de régression constitue la matrice opérationnelle sur laquelle se grefferont l’ensemble des diagnostics de multicollinéarité. Dans R, l’ajustement d’un modèle linéaire par les moindres carrés ordinaires s’opère via la fonction fondamentale lm() (pour Linear Model). La spécification d’un modèle théorique en psychologie découle d’un cadre conceptuel rigoureux ; les variables prédictives ne doivent jamais être agrégées de façon purement exploratoire, mais sélectionnées en vertu d’hypothèses étayées par la littérature scientifique.
La syntaxe canonique repose sur l’écriture symbolique par formule, où la variable dépendante (le critère continu) est positionnée à gauche du tilde ~, et les régresseurs explicatifs sont disposés à droite, reliés par des opérateurs d’addition :
modele_psycho <- lm(Epuisement ~ Charge_Travail + Conflit_Role + Ambiguite_Role + Soutien_Social + Statut_Clinique, data = donnees_recherche)
Cette commande instancie en mémoire un objet complexe de classe lm. Cet objet encapsule une collection structurée de composants mathématiques : le vecteur des coefficients estimés $\hat{\beta}$, le vecteur des résidus observés, les valeurs prédites $\hat{Y}$, les matrices de projection ainsi que les degrés de liberté résiduels. L’analyse immédiate de la sortie textuelle via la commande summary(modele_psycho) fournit une vue synoptique préliminaire. Le chercheur y inspectera le coefficient de détermination global $R^2$, sa variante ajustée pénalisant la complexité du modèle ($R^2_{\text{adj}}$), ainsi que la statistique du test de Fisher globale (test $F$) et sa valeur $p$ associée, attestant que le modèle explique une fraction significative de la variance du critère.
Avant même d’examiner le VIF, il est prudent d’évaluer la cohérence interne des coefficients estimés. Un signe d’alerte classique de collinéarité réside dans l’obtention d’un $R^2$ global très élevé, conjugué à un test $F$ hautement significatif ($p 0{,}05$). Cette discordance manifeste que les prédicteurs prédisent efficacement le critère collectivement, mais que la collinéarité empêche le modèle d’isoler la contribution singulière de chacun.
4.2 Diagnostic visuel initial des résidus et des relations bivariées
L’évaluation méticuleuse des données exige d’analyser le comportement des résidus et la distribution croisée des prédicteurs avant de focaliser son attention sur les indices numériques scalaires. Une inspection graphique de la matrice de nuages de points (scatterplot matrix) fournit une première cartographie visuelle de la redondance des prédicteurs. À l’aide de fonctions graphiques telles que pairs() dans le système graphique de base de R ou ggpairs() issue de la bibliothèque GGally, le chercheur peut scruter les corrélations bivariées et identifier des configurations d’alignement linéaire presque parfait entre deux construits psychologiques.
Cette visualisation préliminaire permet également de détecter d’éventuelles relations non linéaires sous-jacentes. Si deux prédicteurs présentent une relation curvilinéaire marquée (par exemple, en U inversé), la corrélation linéaire de Pearson peut sous-estimer substantiellement leur interdépendance fonctionnelle réelle, dissimulant une collinéarité non linéaire susceptible de perturber l’estimation.
Parallèlement, le diagnostic des résidus au moyen des graphiques classiques générés par plot(modele_psycho) permet de vérifier les hypothèses d’homoscédasticité (constance de la variance des erreurs) et de normalité des résidus. Bien que la multicollinéarité n’invalide pas directement la normalité des résidus, la présence d’une hétéroscédasticité résiduelle marquée peut fausser le calcul de la variance d’erreur $\sigma^2$, ce qui interagit négativement avec l’instabilité induite par la collinéarité. La détection de ces anomalies permet d’orienter le diagnostic et de s’assurer que le modèle est assaini de tout problème de spécification élémentaire.
5. Calcul du VIF avec le package standard car
5.1 Utilisation de la fonction vif() sur un modèle linéaire
La méthode la plus éprouvée, la plus citée dans les revues internationales et la plus rigoureusement vérifiée pour calculer le facteur d’inflation de la variance dans R repose sur la fonction vif() du package car. Pour déployer cet algorithme, il suffit d’appliquer directement la fonction à l’objet de régression linéaire préalablement estimé :
vif_resultats <- car::vif(modele_psycho)
L’architecture interne de la fonction vif() inspecte dynamiquement la nature des prédicteurs inclus dans la formule du modèle. Deux scénarios computationnels distincts se présentent alors :
- Cas 1 : Modèle composé exclusivement de variables continues (ou de variables dichotomiques possédant 1 seul degré de liberté). Dans cette configuration, la fonction renvoie un vecteur nommé de valeurs scalaires correspondant aux VIF univariés classiques calculés selon la formule $1 / (1 – R_j^2)$. Chaque élément du vecteur porte le nom du prédicteur associé.
- Cas 2 : Modèle incluant au moins une variable catégorielle polytomique à plus de deux modalités (ou des termes d’interaction multivariés). Dans ce cadre, la fonction
vif()bascule automatiquement sur l’algorithme de Fox et Monette (1992) et génère une matrice à trois colonnes détaillant le facteur d’inflation de la variance généralisé :GVIF,Df(degrés de liberté de la variable), et la valeur normaliséeGVIF^(1/(2*Df)).
Une des forces majeures de la fonction vif() du package car est sa capacité à intercepter et diagnostiquer les singularités matricielles. Si une variable présente une collinéarité linéaire parfaite avec d’autres (par exemple, si un score total a été inclus par mégarde dans le modèle aux côtés de l’intégralité de ses sous-scores constitutifs), l’algorithme de factorisation QR sous-jacent à lm() produira un coefficient non défini avec la mention NA (ce que l’on qualifie de prédicteur aliasé). Dans cette situation, la fonction vif() génère immédiatement un message d’erreur explicite signalant la présence de singularités, contraignant l’analyste à identifier et éliminer la variable redondante à l’aide de la commande alias(modele_psycho).
5.2 Interprétation des sorties scalaires et tabulaires
La lecture et la décomposition de la sortie produite par la commande vif() conditionnent la prise de décision statistique. Lorsqu’une matrice de GVIF est générée, le chercheur est confronté à un tableau structuré dont la compréhension analytique est cruciale. Examinons la nature mathématique des colonnes renvoyées :
La première colonne, intitulée GVIF, reporte la valeur brute du ratio des déterminants matriciels. Cette valeur est proportionnelle à la complexité de la variable catégorielle ; un facteur clinique comptant six niveaux possédera cinq degrés de liberté ($df = 5$) et affichera nécessairement un GVIF brut dont l’amplitude nominale peut être trompeusement élevée sans que cela ne reflète une collinéarité excessive par degré de liberté.
La deuxième colonne, Df, rappelle précisément le nombre de degrés de liberté consommés par le paramètre dans la matrice du plan d’expérience ($p – 1$ contrastes pour une variable à $p$ catégories).
La troisième colonne, notée GVIF^(1/(2*Df)), représente la métrique décisionnelle clé. Elle exprime la racine carrée de l’inflation de la variance par dimension unitaire. Il s’agit de l’équivalent direct de la valeur $\sqrt{\text{VIF}}$ pour une variable continue unidimensionnelle. Pour interpréter cette valeur vis-à-vis des seuils historiques et consensuels de la littérature psychologique, le statisticien doit élever cette valeur normalisée au carré. À titre d’exemple :
- Si la colonne
GVIF^(1/(2*Df))affiche une valeur de $1{,}414$, l’élévation au carré donne $(1{,}414)^2 \approx 2{,}0$, ce qui correspond à un VIF virtuel équivalent de 2, indiquant une collinéarité parfaitement bénigne. - Si cette valeur atteint $2{,}236$, son élévation au carré équivaut à $(2{,}236)^2 \approx 5{,}0$, matérialisant l’atteinte du seuil de vigilance modérée.
- Si cette valeur franchit le cap de $3{,}162$, son carré $(3{,}162)^2 \approx 10{,}0$ signale une multicollinéarité critique et pathologique menaçant la stabilité du modèle.
L’extraction programmatique de ces indices dans un script R s’opère aisément par manipulation d’indexation vectorielle ou matricielle, facilitant l’automatisation de seuils d’alerte dans les chaînes de traitement psychométriques à grande échelle.
6. Calculs alternatifs du VIF via d’autres écosystèmes R
6.1 Le package performance pour une intégration moderne
Au cours des dernières années, le projet easystats a profondément modernisé le paysage de l’analyse statistique sous R en proposant une suite unifiée de packages orientés vers l’ergonomie, la clarté et la publication. Au sein de cet écosystème, le package performance met à disposition des psychologues la remarquable fonction check_collinearity(). Cette fonction apporte une plus-value substantielle par rapport aux outils traditionnels en démocratisant des diagnostics qualitatifs étayés et standardisés.
Son exécution s’applique directement sur l’objet modélisé :
diagnostic_colin <- performance::check_collinearity(modele_psycho)
print(diagnostic_colin)
La sortie produite par check_collinearity() se distingue par sa lisibilité immédiate. L’algorithme ne se borne pas à aligner des chiffres bruts ; il organise les prédicteurs sous une typologie hiérarchisée et attribue à chaque variable un statut d’évaluation diagnostique explicite :
- Faible collinéarité (Low correlation) : VIF généralement inférieur à 5, indiquant que le gonflement des erreurs-types est négligeable et que les estimations sont fiables.
- Collinéarité modérée (Moderate correlation) : VIF compris entre 5 et 10, appelant à la prudence lors de l’interprétation des poids de régression individuels.
- Forte collinéarité (High correlation) : VIF supérieur à 10, signalant une instabilité critique nécessitant impérativement une intervention méthodologique.
De surcroît, le package gère avec une transparence exemplaire la cohabitation de variables continues et catégorielles. Les objets retournés par check_collinearity() intègrent directement des attributs compatibles avec les fonctions d’exportation telles que insight::export_table(), facilitant la génération instantanée de tableaux au format Markdown, LaTeX ou HTML pour insertion directe dans les manuscrits scientifiques.
6.2 Approches complémentaires avec olsrr et rms
En dehors des packages car et performance, d’autres bibliothèques spécialisées offrent des perspectives complémentaires enrichissant la palette diagnostique du chercheur. Le package olsrr, développé par Aravind Hebbali, se focalise spécifiquement sur les modèles de régression linéaire par les moindres carrés ordinaires. Sa fonction ols_vif_tol() propose une sortie bivalente particulièrement didactique :
olsrr::ols_vif_tol(modele_psycho)
Cette commande génère un tableau synthétique contenant côte à côte les deux facettes indissociables de l’équation : la Tolérance statistique ($T_j = 1 – R_j^2$) et le Facteur d’Inflation de la Variance ($\text{VIF}_j = 1 / T_j$). Cette double présentation s’avère précieuse dans le milieu académique, car certains comités éditoriaux privilégient encore la tolérance comme métrique principale de non-redondance, exigeant que celle-ci demeure supérieure à 0,20 ou 0,10.
D’autre part, pour les chercheurs adoptant les méthodologies d’analyse de données de régression avancées promues par Frank Harrell, le package rms fournit une fonction alternative rms::vif(). Ce package s’utilise en étroite synergie avec la fonction d’ajustement ols() propre à rms. L’avantage distinctif de l’approche de Harrell réside dans sa prise en charge native des non-linéarités complexes, telles que les splines cubiques restreintes. Lorsque des splines sont déployées pour modéliser des effets psychométriques complexes, la fonction rms::vif() regroupe intelligemment l’ensemble des termes polynomiaux ou nodaux associés à une même variable sous un test de collinéarité matriciel unifié, prévenant ainsi les bévues d’interprétation inhérentes aux décompositions isolées.
7. Calcul algorithmique pas à pas du VIF sans package spécialisé
7.1 Programmation manuelle via des régressions auxiliaires
Comprendre la mécanique computationnelle du VIF exige de transcender les « boîtes noires » logicielles. L’écriture d’un algorithme pas à pas sous R, sans solliciter de bibliothèques tierces, permet de vérifier expérimentalement la théorie des régressions auxiliaires et d’affûter sa maîtrise statistique.
Soit un jeu de données psychométriques constitué d’une matrice de prédicteurs continus. La procédure algorithmique itérative se déploie selon la séquence suivante :
- Isoler l’ensemble des $p$ variables explicatives au sein d’un tableau dédié (exclure le critère $Y$).
- Initialiser un vecteur numérique destiné à accueillir les valeurs de VIF calculées.
- Pour chaque variable $j$ allant de 1 à $p$ :
- Définir temporairement la variable $X_j$ comme la variable dépendante auxiliaire.
- Spécifier les $p – 1$ variables restantes comme prédicteurs explicatifs du sous-modèle.
- Ajuster le modèle linéaire auxiliaire par la fonction
lm(). - Extraire le coefficient de détermination auxiliaire $R_j^2$ via la décomposition
summary()$r.squared. - Appliquer la transformation arithmétique formelle : $\text{VIF}_j = 1 / (1 – R_j^2)$.
- Assigner le résultat dans le vecteur de destination.
La transcription de cette logique en code R base s’exécute à l’aide d’une boucle classique ou de structures vectorielles fonctionnelles du type sapply() :
Imaginons un tableau nommé X_data contenant les variables prédictives Stress, Charge, et Anxiete. La boucle itère à travers les colonnes : pour chaque indice, une régression est ajustée où la colonne courante est expliquée par toutes les autres via la formule as.formula(paste(nom_cible, "~ .")). On extrait ensuite summary(reg_aux)$r.squared, et la valeur finale $1 / (1 – R^2)$ est injectée dans le vecteur résultant. La concordance mathématique absolue entre les sorties générées par ce code manuel et les résultats renvoyés par la fonction car::vif() confirme empiriquement la perfection de la théorie algébrique sous-jacente.
7.2 Approche algébrique matricielle directe
Bien que la boucle de régressions auxiliaires illustre parfaitement le concept pédagogique, elle s’avère inefficace sur le plan computationnel lorsque la dimension matricielle grandit. Les mathématiques matricielles sous-jacentes permettent d’extraire la totalité des facteurs d’inflation de la variance en une seule opération d’algèbre linéaire hautement optimisée, tirant parti de la matrice de corrélation empirique des prédicteurs.
Considérons la matrice $X$ des prédicteurs standardisés (centrés et réduits, de sorte que chaque colonne possède une moyenne nulle et une variance unitaire). La matrice carrée de corrélation de Pearson de dimension $p \times p$, désignée par $R_{XX}$, s’obtient directement par le produit matriciel :
$$R_{XX} = \frac{1}{n – 1} X^T X = operatorname{cor}(X)$$
Un théorème fondamental de l’analyse multivariée démontre que la matrice inverse de la matrice de corrélation, notée $R_{XX}^{-1}$, contient directement les facteurs d’inflation de la variance sur sa diagonale principale. Plus précisément, le $j$-ième élément diagonal de la matrice inverse correspond exactement au VIF associé au régresseur $X_j$ :
$$\text{VIF}_j = \left( R_{XX}^{-1} \right)_{jj}$$
Dans l’environnement de calcul R, l’inversion d’une matrice s’effectue au moyen de la fonction fondamentale solve(), et l’extraction de la diagonale principale est opérée par diag(). La procédure matricielle s’exprime donc en une ligne élégante :
vif_matriciel <- diag(solve(cor(X_data)))
Cette formulation matricielle directe possède une puissance de calcul vertigineuse : là où une série de régressions auxiliaires itératives sollicite de multiples routines d’optimisation numérique consécutives, l’inversion directe par décomposition LU ou de Cholesky calcule instantanément les VIF de dizaines de construits psychométriques en quelques fractions de milliseconde. De plus, les éléments situés hors de la diagonale principale de la matrice inverse $R_{XX}^{-1}$ renferment les coefficients de corrélation partielle négatifs normalisés, fournissant un atlas exhaustif de la structure de dépendance interne des variables.
8. Seuils d’interprétation et critères décisionnels en psychométrie
8.1 Les règles empiriques conventionnelles : 1, 5 et 10
Dans la pratique de la modélisation statistique, l’évaluation de la gravité d’un VIF repose traditionnellement sur des repères heuristiques établis par les pionniers de l’économétrie et de l’analyse des données. Ces seuils de coupure (cut-off points) ne relèvent pas de lois probabilistes rigides mais de règles empiriques de bon sens méthodologique qui guident la prise de décision :
- VIF = 1,0 : Orthogonalité parfaite. Les régresseurs sont totalement indépendants les uns des autres. Aucune variance n’est partagée. L’erreur-type de l’estimateur se situe à son minimum théorique. Cette situation n’apparaît quasiment jamais dans les protocoles d’observation psychologiques non randomisés.
- 1,0 < VIF < 5,0 : Collinéarité faible à modérée. Cette zone caractérise la quasi-totalité des études empiriques bien conçues dans les sciences comportementales. Bien qu’une interdépendance partielle existe entre les construits, le gonflement de la variance demeure circonscrit (une valeur de VIF égale à 4 n’augmente l’erreur-type que d’un facteur de 2). L’intégrité des tests d’hypothèse bilatéraux n’est pas fondamentalement menacée, et les estimateurs conservent une stabilité acceptable.
- 5,0 ≤ VIF < 10,0 : Seuil de préoccupation et d’alerte. Le coefficient de détermination auxiliaire se situe entre $0{,}80$ et $0{,}90$. À partir de ce seuil, préconisé par des méthodologues rigoureux tels que Hair et al., la collinéarité commence à masquer des effets statistiquement tangibles. Les coefficients deviennent sensibles aux variations d’échantillonnage et les intervalles de confiance s’élargissent de manière préoccupante. Le chercheur doit impérativement documenter ce niveau et engager une réflexion sur l’indépendance de ses construits.
- VIF ≥ 10,0 : Multicollinéarité sévère et critique. C’est la limite supérieure consensuelle adoptée dans la majorité des manuels classiques de régression (par exemple, Kline, Cohen ou Chatterjee). Un VIF de 10 équivaut à un coefficient de détermination auxiliaire $R_j^2$ de 90 % ($1 / (1 – 0{,}90) = 10$). Cela signifie que neuf dixièmes de la variance du prédicteur sont totalement redondants avec les autres variables du modèle. L’erreur-type est multipliée par plus de 3,16, provoquant une instabilité numérique intolérable et invalidant toute interprétation substantielle des paramètres de régression.
8.2 Spécificités du contexte des sciences psychologiques
Bien que la règle du VIF inférieur à 10 soit universellement citée, son application aveugle aux sciences psychologiques sans contextualisation substantielle constitue une dérive méthodologique majeure. La psychologie présente des singularités métrologiques qui imposent d’ajuster le regard porté sur ces indices.
D’une part, dans le cadre de recherches confirmatoires visant à tester des théories élaborées, des auteurs influents recommandent d’abaisser le seuil d’intervention à un VIF de 3, voire 2,5. Dans l’évaluation de modèles de médiation ou d’effets modérateurs subtils, un gonflement de la variance, même modeste, réduit considérablement la puissance statistique nécessaire pour capturer des tailles d’effet ténues (qui sont la norme en psychologie, avec des $R^2$ additionnels oscillant souvent entre 2 % et 5 %). Tolérer un VIF avoisinant 8 ou 9 condamne presque systématiquement le chercheur à ignorer des processus psychologiques médiateurs sous-jacents pourtant réels.
D’autre part, la fiabilité métrologique des instruments psychométriques module drastiquement la portée du VIF. Les construits en psychologie sont mesurés avec une marge d’erreur d’échantillonnage de mesure inhérente, quantifiée par des indices tels que l’alpha de Cronbach ou l’oméga de McDonald. L’atténuation due à l’erreur de mesure peut masquer une collinéarité réelle : deux construits qui partageraient 95 % de leur variance au niveau de leurs variables latentes pures peuvent n’afficher qu’un VIF modéré de 3 au niveau de leurs scores observés en raison du bruit métrologique présent dans les indicateurs. Ainsi, une collinéarité en apparence bénigne dans les scores composites observés peut masquer une quasi-identité conceptuelle au niveau latent.
Enfin, la taille globale de l’échantillon $n$ doit impérativement être intégrée dans l’équation d’arbitrage. Comme l’a souligné l’économètre Peter Kennedy, l’erreur-type dépend conjointement du VIF et de la taille d’échantillon via le facteur inverse $\sqrt{n – 1}$. Dans une mégadonnée psychologique (par exemple les bases de données UK Biobank regroupant des dizaines de milliers de participants), un VIF de 6 n’empêchera pas les erreurs-types de demeurer infinitésimales et les tests de conserver une puissance statistique colossale. À l’inverse, dans un protocole clinique restreint portant sur 45 patients cérébrolésés, un VIF de 3,5 suffira à détruire la puissance de détection et à rendre les inférences totalement caduques.
9. Gestion de la collinéarité induite : interactions et polynômes
9.1 La multicollinéarité structurelle issue des termes multiplicatifs
L’étude des processus comportementaux exige fréquemment d’évaluer si l’effet d’une variable indépendante $X$ sur le comportement $Y$ dépend du niveau d’une seconde variable modératrice $Z$. Dans le cadre de la modélisation linéaire standard, cette hypothèse de modération s’opérationnalise par l’introduction d’un terme d’interaction multiplicatif, correspondant au produit arithmétique direct des deux variables : $X \times Z$. De même, pour explorer des phénomènes d’adaptation ou de fatigue où la performance décline au-delà d’un optimum (relation curvilinéaire en cloche), les chercheurs adjoignent un terme polynomial quadratique : $X^2$.
Lorsque ces termes dérivés sont calculés directement à partir des scores bruts, un phénomène mathématique inévitable survient : le produit $X \times Z$ ou le carré $X^2$ affiche une corrélation linéaire bivariée gigantesque avec ses composantes additives simples de départ. Si une variable $X$ possède une moyenne empirique positive non nulle, les valeurs de $X$ et de $X^2$ varient obligatoirement de concert. Lors de l’estimation du modèle complet par lm(), les valeurs du VIF associées aux termes simples ainsi qu’au terme multiplicatif s’envolent, dépassant fréquemment les valeurs de 30, 50, voire 100.
Cette explosion spectaculaire du VIF engendre une panique méthodologique injustifiée chez de nombreux étudiants et chercheurs non avertis. Il s’agit en réalité d’une multicollinéarité strictement structurelle ou artificielle. Contrairement à la collinéarité des données, cette dépendance n’est que la conséquence mathématique d’une échelle arbitraire de mesure dont l’origine (le zéro) n’est pas centrée. Elle n’altère en rien la validité du test d’hypothèse globale de l’interaction, n’impacte ni la valeur du $R^2$ total du modèle, ni l’erreur-type du terme multiplicatif de plus haut degré, ni la capacité prédictive globale du modèle.
9.2 Le centrage des variables comme solution technique
Bien que la multicollinéarité structurelle n’affecte pas l’omnibus du modèle, elle détruit l’interprétabilité intuitive des coefficients d’ordre inférieur (les effets constitutifs simples) et peut générer des erreurs d’arrondi numérique dans les algorithmes d’inversion matricielle. La solution méthodologique universelle pour dissiper cette collinéarité structurelle réside dans le centrage sur la moyenne empirique (mean centering).
Le centrage consiste à soustraire à chaque score individuel la moyenne arithmétique de la variable au sein de l’échantillon :
$$X_c = X – \bar{X} \quad \text{et} \quad Z_c = Z – \bar{Z}$$
Le terme multiplicatif d’interaction est ensuite construit en effectuant le produit des variables préalablement centrées : $X_c \times Z_c$. De même, le terme quadratique devient $X_c^2$. En éliminant la composante de moyenne positive constante, le centrage orthogonalise (ou réduit substantiellement la dépendance linéaire entre) le terme d’interaction et ses composantes simples d’origine.
Dans l’environnement R, le centrage s’opère instantanément à l’aide de la fonction native scale(), en configurant l’argument de réduction d’échelle sur scale = FALSE pour ne conserver que la soustraction de la moyenne :
donnees$Stress_c <- as.numeric(scale(donnees$Stress, center = TRUE, scale = FALSE))
donnees$Soutien_c <- as.numeric(scale(donnees$Soutien, center = TRUE, scale = FALSE))
modele_modere <- lm(Burnout ~ Stress_c * Soutien_c, data = donnees)
Lorsque le chercheur réexécute la fonction car::vif(modele_modere) sur ce modèle réajusté, les valeurs du VIF s’effondrent spectaculairement pour réintégrer la zone de totale sécurité (généralement entre 1 et 2). De surcroît, le centrage confère aux coefficients de premier ordre une signification substantielle limpide selon les normes établies par Aiken et West : le coefficient associé à $X_c$ représente l’effet conditionnel de $X$ sur $Y$ précisément au niveau moyen de la variable modératrice $Z$ ($\bar{Z} = 0$), rendant l’interprétation clinique et comportementale remarquablement élégante.
10. Stratégies méthodologiques pour remédier à un VIF excessif
10.1 Suppression ou fusion raisonnée des prédicteurs
Lorsque le diagnostic confirme l’existence d’une multicollinéarité des données critique (VIF supérieur à 10 pour des prédicteurs non structuraux), le modèle viole le principe de parcimonie scientifique et le chercheur a le devoir d’assainir sa spécification. La démarche la plus élémentaire, mais néanmoins la plus périlleuse, consiste à supprimer purement et simplement la variable présentant le VIF le plus extravagant.
Toutefois, la suppression d’une variable explicative ne doit jamais résulter d’un simple arbitrage informatique automatisé. Écarter arbitrairement un construit théoriquement cardinal expose le modèle au biais de la variable omise (omitted variable bias), transférant mécaniquement l’effet du prédicteur exclu sur les termes restants et faussant radicalement leurs coefficients. Si deux construits sont théoriquement distincts mais empiriquement trop collinéaires dans l’échantillon, le chercheur doit sélectionner celui dont la validité psychométrique interne et la qualité métrologique sont les plus documentées dans la littérature.
Une alternative infiniment supérieure sur le plan épistémologique consiste à opérer une fusion raisonnée des prédicteurs collinéaires. En psychométrie, la collinéarité aiguë entre plusieurs sous-échelles traduit très souvent l’existence d’un macro-construit de niveau hiérarchique supérieur. Si trois sous-échelles mesurant l’épuisement émotionnel, la dépersonnalisation et la perte d’accomplissement personnel génèrent des VIF mutuels supérieurs à 8, agréger ces indicateurs au sein d’un score composite global d’épuisement professionnel (par sommation standardisée ou moyenne pondérée) résout simultanément le problème de collinéarité et accroît la fiabilité de la mesure.
Enfin, pour dépasser définitivement les limites du modèle de régression univarié ordinaire, le recours à la modélisation par équations structurelles (SEM, Structural Equation Modeling), via le package R lavaan, constitue le standard d’excellence. La modélisation en variables latentes sépare explicitement la variance commune (le construit latent partagé) de la variance unique et de l’erreur de mesure, contournant les écueils algorithmiques des moindres carrés ordinaires.
10.2 Méthodes de régression régularisée et réduction de dimension
Lorsque la structure de recherche ou le mandat théorique impose de maintenir l’intégralité des prédicteurs collinéaires dans le modèle sans en exclure aucun, les méthodes d’estimation pénalisées constituent la réponse computationnelle moderne par excellence. Développée originellement par Hoerl et Kennard, la régression Ridge est conçue spécifiquement pour juguler les matrices de variance-covariance mal conditionnées.
Sur le plan mathématique, l’algorithme des moindres carrés ordinaires cherche à minimiser la somme des résidus au carré : $\sum (Y_i – \hat{Y}_i)^2$. La régression Ridge introduit une pénalité L2 proportionnelle au carré de la magnitude des coefficients :
$$\min_{\beta} \left{ \sum_{i=1}^n \left( Y_i – \beta_0 – \sum_{j=1}^p \beta_j X_{ij} \right)^2 + \lambda \sum_{j=1}^p \beta_j^2 \right}$$
En injectant une petite constante positive $lambda$ sur la diagonale principale de la matrice du plan d’expérience avant son inversion ($(X^T X + \lambda I)^{-1}$), la régression Ridge force les déterminants matriciels à s’éloigner de zéro. Cette manœuvre stabilise spectaculairement les variances d’échantillonnage et contracte les coefficients vers zéro. Bien qu’elle introduise un léger biais mathématique dans l’estimation, elle fait s’effondrer l’erreur quadratique moyenne globale (compromis biais-variance), neutralisant totalement les symptômes délétères de la collinéarité. Dans R, ces modélisations pénalisées (Ridge, Lasso L1, et Elastic Net) s’exécutent avec une formidable efficacité via le package glmnet.
Une autre stratégie de modélisation mathématique repose sur la réduction de dimension par régression sur composantes principales (PCR, Principal Component Regression), accessible par le package pls. La PCR extrait préalablement les axes factoriels principaux de la matrice des prédicteurs, générant un ensemble de composantes orthogonales non corrélées ($r = 0$, donc VIF strictement égal à 1), sur lesquelles le critère psychologique est ensuite régressé sans la moindre trace de collinéarité résiduelle.
10.3 Augmentation de la taille de l’échantillon d’observation
Une solution structurelle souvent négligée pour neutraliser l’impact néfaste d’un VIF substantiel consiste à augmenter l’effort de collecte de données empiriques afin d’accroître la taille $n$ de l’échantillon d’observation. L’analyse minutieuse de la formule de l’erreur-type démontre que la précision d’un estimateur découle d’un équilibre de forces entre la collinéarité multivariée et l’effectif total :
$$operatorname{SE}(\hat{\beta}_j) = \frac{\sigma}{s_j \sqrt{n – 1}} \times \sqrt{\text{VIF}_j}$$
Il apparaît avec évidence que si le terme multiplicateur $\sqrt{\text{VIF}_j}$ gonfle l’erreur-type au numérateur, l’accroissement continu du dénominateur via le terme $\sqrt{n – 1}$ compense directement cette dégradation. Un quadruplement de la taille de l’échantillon ($4n$) divise le dénominateur par un facteur de 2 ($\sqrt{4} = 2$), annulant exactement l’effet négatif d’un VIF s’élevant à 4 ($\sqrt{4} = 2$).
Dans la phase de planification d’un protocole empirique en psychologie, le chercheur prudent réalise des calculs de puissance statistique a priori (par exemple à l’aide du logiciel G*Power ou du package R pwr). S’il anticipe, sur la base d’études pilotes ou de la littérature existante, que ses échelles psychométriques partageront une intercorrélation marquée, il est méthodologiquement judicieux d’introduire un facteur de correction de taille d’échantillon proportionnel au VIF attendu. Ajuster l’échantillonnage en amont garantit le maintien d’une puissance adéquate (usuellement $1 – \beta = 0{,}80$ ou $0{,}90$) même en présence d’une collinéarité résiduelle irréductible.
11. Visualisation graphique et communication des résultats
11.1 Visualisation du VIF avec ggplot2
La communication scientifique moderne privilégie la clarté visuelle plutôt que de fastidieux alignements de listes numériques. La construction d’un diagramme en barres horizontales ordonné au moyen de la bibliothèque graphique ggplot2 constitue le moyen le plus élégant, informatif et percutant de rendre compte du diagnostic de collinéarité dans un article ou un rapport de recherche.
Pour construire une représentation conforme aux standards esthétiques et typographiques de l’APA, le vecteur ou la matrice des VIF doit être extrait, converti en une structure tabulaire data.frame, puis ordonné de manière croissante afin de faciliter la lecture comparative. Des repères visuels horizontaux ou verticaux viennent ensuite matérialiser les seuils décisionnels universels de 5 (vigilance) et de 10 (seuil critique).
Sur le plan programmatique, le code commence par extraire les valeurs scalaires via car::vif(modele_psycho), convertit le résultat à l’aide de tibble::enframe(), et ordonne les modalités grâce à la fonction reorder(name, value). Les composantes graphiques de ggplot2 prennent le relais pour projeter les barres avec geom_col(), inverser les axes par coord_flip(), et intégrer des droites de référence en pointillés rouges via geom_hline() aux seuils fatidiques de 5 et 10. L’application d’un thème épuré tel que theme_classic() ou theme_minimal() confère au graphique la sobriété et la rigueur indispensables aux publications scientifiques de rang A.
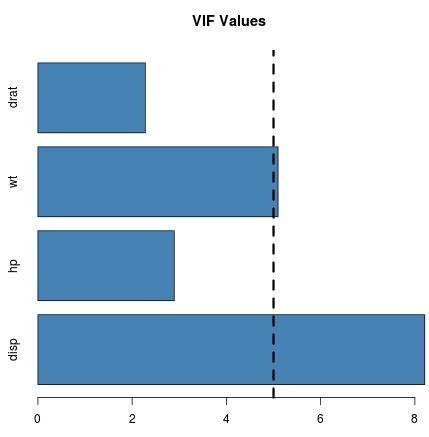
Cette visualisation graphique offre un diagnostic d’une lisibilité immédiate : tout prédicteur dont la barre demeure cantonnée sous le premier seuil de 5 est instantanément validé par le lecteur comme exempt de distorsion collinéaire ; les variables empiétant dans la zone intermédiaire entre 5 et 10 font l’objet d’un examen attentif, tandis que celles dépassant la ligne fatidique de 10 sont visuellement isolées comme pathologiques.
11.2 Visualisations intégrées avec see et olsrr
Pour les chercheurs souhaitant s’affranchir de l’écriture détaillée de scripts graphiques ggplot2 personnalisés, les écosystèmes modernes proposent des fonctions de visualisation clé en main d’une sophistication remarquable. Le package see, composante visuelle de la suite easystats, intègre une surcharge universelle de la méthode générique plot() spécialement calibrée pour les objets diagnostiques de collinéarité.
L’exécution de la séquence suivante génère instantanément un graphique diagnostique de qualité professionnelle :
diag_colin <- performance::check_collinearity(modele_psycho)
plot(diag_colin)
Le visuel produit par le package see segmente automatiquement le diagramme en zones colorées codifiées par gradient chromatique (généralement vert pour la zone de sécurité, jaune-orangé pour l’alerte modérée, et rouge cramoisi pour la collinéarité sévère). Chaque barre de régresseur se teinte de la couleur correspondant à son niveau de risque, et le graphique gère de façon transparente les variables catégorielles en reportant la métrique transformée normalisée par degré de liberté.
Dans un registre similaire, le package olsrr offre la fonction ols_plot_resid_regress() et des routines de traçage de collinéarité directe. Pour assurer une intégration optimale dans les manuscrits soumis aux maisons d’édition académiques, ces figures peuvent être exportées dans des formats vectoriels haute résolution (tels que PDF ou TIFF à 600 DPI) au moyen de la fonction ggsave(), garantissant une netteté typographique irréprochable exempte de toute pixellisation.
12. Étude de cas complète et rédaction des normes APA
12.1 Analyse pas à pas d’un scénario de recherche en psychologie
Pour ancrer l’ensemble de ces préceptes méthodologiques dans la pratique concrète de la recherche, déployons une étude de cas intégrale, intégralement reproductible. Imaginons une étude clinique menée auprès de $N = 350$ professionnels de santé en milieu hospitalier, visant à prédire le niveau d’épuisement professionnel (Burnout mesuré sur une échelle continue de 0 à 100) à partir de plusieurs stresseurs organisationnels et psychologiques :
Charge_Travail: Score d’intensité perçue de la charge de travail cognitive.Pression_Temporelle: Score d’urgence et de contrainte de temps (étroitement corrélé à la charge).Conflit_Role: Mesure des exigences de service incompatibles.Soutien_Collegues: Mesure du soutien social instrumental perçu.Soutien_Superviseur: Mesure du soutien émotionnel émanant de la hiérarchie.
Le script d’analyse débute par l’ajustement du modèle de régression linéaire de référence :
modele_hopital <- lm(Burnout ~ Charge_Travail + Pression_Temporelle + Conflit_Role + Soutien_Collegues + Soutien_Superviseur, data = donnees_soignants)
summary(modele_hopital)
L’inspection des résultats montre un coefficient d’ajustement élevé ($R^2 = 0{,}62$, $F(5, 344) = 112{,}3$, $p < 0{,}001$). Néanmoins, un examen scrupuleux des prédicteurs révèle que la variable Pression_Temporelle affiche un coefficient non significatif ($p = 0{,}34$), tandis que la variable Charge_Travail présente un effet plus faible qu’anticipé par les méta-analyses antérieures. Pour diagnostiquer la cause profonde de cette anomalie, l’analyste exécute le calcul du VIF via le package car :
vif_hopital <- car::vif(modele_hopital)
print(vif_hopital)
La sortie numérique révèle la matrice suivante :
Charge_Travail: VIF = 11,45 (Tolérance = 0,087)Pression_Temporelle: VIF = 10,82 (Tolérance = 0,092)Conflit_Role: VIF = 1,42 (Tolérance = 0,704)Soutien_Collegues: VIF = 2,85 (Tolérance = 0,351)Soutien_Superviseur: VIF = 2,64 (Tolérance = 0,378)
Le diagnostic est sans appel : les variables Charge_Travail et Pression_Temporelle franchissent toutes deux le seuil critique d’alarme de 10. La matrice de corrélation bivariée indique entre elles un coefficient de Pearson de $r = 0{,}94$. Cette redondance conceptuelle et empirique massive gonfle artificiellement leurs erreurs-types respectives d’un facteur supérieur à 3,3 ($\sqrt{11{,}45} \approx 3{,}38$), masquant le rôle individuel de la pression temporelle.
Conformément aux préconisations méthodologiques du chapitre 10, l’analyste procède à une remédiation par fusion raisonnée. Les deux échelles collinéaires sont combinées par moyenne standardisée en un score composite unique dénommé Surcharge_Globale. Le modèle révisé est alors réajusté :
donnees_soignants$Surcharge_Globale <- (scale(donnees_soignants$Charge_Travail) + scale(donnees_soignants$Pression_Temporelle)) / 2
modele_assaini <- lm(Burnout ~ Surcharge_Globale + Conflit_Role + Soutien_Collegues + Soutien_Superviseur, data = donnees_soignants)
car::vif(modele_assaini)
Dans ce modèle assaini, l’intégralité des valeurs de VIF réintègre une zone d’excellence (tous les VIF demeurent désormais strictement inférieurs à 2,1). Le nouveau construit Surcharge_Globale affiche un coefficient standardisé positif massif ($\beta = 0{,}58$, $p < 0{,}001$), restituant fidèlement la dynamique psychologique sous-jacente sans la moindre distorsion computationnelle.
12.2 Rédaction du compte rendu méthodologique selon le style APA
La communication scientifique des résultats au sein d’un manuscrit soumis aux revues de l’American Psychological Association requiert une rigueur formelle absolue. Le diagnostic de multicollinéarité doit être consigné à la fois de façon narrative dans le corps de texte des résultats et de manière synthétique au sein des tableaux récapitulatifs de régression.
Voici un modèle exemplaire de paragraphe de restitution méthodologique pour la section Résultats :
« Avant de tester les hypothèses focales, nous avons soumis les prédicteurs à un audit de multicollinéarité. L’évaluation préliminaire du modèle initial a mis en évidence des niveaux sévères de collinéarité entre la charge de travail et la pression temporelle, les facteurs d’inflation de la variance s’élevant respectivement à 11,45 et 10,82, dépassant largement le seuil d’exclusion consensuel de 10 (Fox & Weisberg, 2019 ; Hair et al., 2019). Conformément aux recommandations de la littérature psychométrique, ces deux construits redondants ont été agrégés en un indice composite unique de surcharge globale. L’estimation du modèle de régression linéaire multiple assaini a démontré une absence totale de collinéarité problématique résiduelle, l’ensemble des VIF s’échelonnant désormais de 1,21 à 2,05 (toutes les valeurs de tolérance étant supérieures à 0,48). Ce modèle explique 61,8 % de la variance de l’épuisement professionnel, $F(4, 345) = 139{,}62$, $p < 0{,}001$, $R^2_{\text{ajusté}} = 0{,}614$. »
Au niveau de la présentation tabulaire, les normes APA 7th edition préconisent d’inclure les métriques diagnostiques dans le tableau récapitulatif des paramètres de régression. Le tableau comportera les colonnes classiques : prédicteurs, coefficients non standardisés ($B$), erreurs-types ($\text{SE}$), coefficients standardisés ($\beta$), statistique de Student ($t$), valeur de significativité ($p$), ainsi que deux colonnes supplémentaires dédiées à la Tolérance et au VIF (ou GVIF normalisé le cas échéant). L’insertion systématique de ces indicateurs garantit la reproductibilité des analyses, rassure les évaluateurs sur la solidité des inférences et hisse la communication des données psychologiques au plus haut niveau de transparence scientifique.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203774441
- Dormann, C. F., Elith, J., Bacher, S., Buchmann, C., Carl, G., Carré, G., Marquéz, J. R. G., Gruber, B., Lafourcade, B., Leitão, P. J., Münkemüller, T., McClean, C., Osborne, P. E., Reineking, B., Schröder, B., Skidmore, A. K., Zurell, D., & Lautenbach, S. (2013). Collinearity: A review of methods to deal with it and a simulation study evaluating their performance. Ecography, 36(1), 27–46. https://doi.org/10.1111/j.1600-0587.2012.07348.x
- Fox, J., & Monette, G. (1992). Generalized collinearity diagnostics. Journal of the American Statistical Association, 87(417), 178–183. https://doi.org/10.1080/01621459.1992.10475190
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications.
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning.
- Harrell, F. E. (2015). Regression modeling strategies: With applications to linear models, logistic and ordinal regression, and survival analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-19425-7
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- O’Brien, R. M. (2007). A caution regarding rules of thumb for variance inflation factors. Quality & Quantity, 41(5), 673–690. https://doi.org/10.1007/s11135-006-9018-6