
Dans le champ de la recherche contemporaine en psychologie, en neurosciences cognitives et en sciences du comportement, l’accès direct aux caractéristiques exhaustives d’une population cible relève d’une impossibilité matérielle et méthodologique. Qu’il s’agisse d’évaluer la charge dépressive moyenne au sein d’une nation, le temps de réaction moteur face à un stimulus anxiogène ou l’efficacité relative d’un protocole de remédiation cognitive, les chercheurs doivent inévitablement travailler sur des échantillons finis. C’est précisément au cœur de cette contrainte empirique que s’enracine l’inférence statistique, dont le premier pilier opérationnel est constitué par l’estimation ponctuelle. Cette démarche consiste à assigner, à partir d’un ensemble restreint de données d’observation, une valeur numérique unique destinée à représenter au mieux la valeur théorique inconnue d’un paramètre populationnel.
Le tableur Microsoft Excel, omniprésent dans les laboratoires académiques, les structures hospitalières et les cabinets de conseil organisationnel, constitue fréquemment le premier environnement logiciel au sein duquel ces données brutes sont collectées, apurées et analysées. Si des progiciels spécialisés tels que R, SPSS ou SAS sont traditionnellement mobilisés pour les modélisations multivariées avancées, Excel demeure un outil d’une puissance sous-estimée pour l’exécution rigoureuse des calculs d’estimations ponctuelles. Toutefois, la fausse simplicité de son interface dissimule de nombreux pièges conceptuels et algorithmiques : confusion entre métriques d’échantillon et de population, gestion hasardeuse des données manquantes, ou encore altération de la précision décimale par des fonctions d’arrondi prématurées.
Ce guide propose une immersion didactique et méthodologique exhaustive dans le calcul des estimations ponctuelles sous Microsoft Excel. En articulant formalisation mathématique, impératifs psychométriques et applications pratiques pas à pas, cet article s’adresse aux chercheurs, cliniciens, statisticiens et étudiants soucieux de consolider la validité interne et externe de leurs analyses de données. À travers l’exploration de jeux de données écologiques issus de la psychologie clinique et de la santé au travail, nous examinerons comment transformer une série d’enregistrements expérimentaux bruts en estimateurs ponctuels optimaux, scientifiquement irréprochables et prêts pour une publication conforme aux normes de l’American Psychological Association (APA).
1. Fondements théoriques de l’estimation ponctuelle en psychologie et sciences du comportement
1.1 Définition formelle du paramètre de population versus statistique d’échantillon
L’édifice de la statistique inférentielle repose sur une démarcation épistémologique fondamentale entre le monde théorique des populations et l’univers empirique des échantillons. En psychologie quantitative, une population désigne l’ensemble exhaustif des entités d’intérêt clinique ou expérimental — par exemple, l’ensemble des adultes francophones présentant un trouble d’anxiété généralisée selon les critères diagnostiques du Manuel diagnostique et statistique des troubles mentaux (DSM-5). Les propriétés numériques invariantes mais inaccessibles de cette population sont désignées sous le terme de paramètres. À l’opposé, un échantillon constitue un sous-ensemble fini d’individus extraits de cette population parente, et les métriques calculées directement sur ces données observées constituent des statistiques.
Sur le plan des conventions mathématiques internationales, cette dualité se traduit par l’emploi de symboles distincts issus des alphabets grec et latin. La moyenne d’une variable au sein d’une population globale est universellement notée $\mu$ (mu), tandis que la proportion théorique d’un attribut catégoriel y est désignée par le symbole $\pi$ (pi) ou parfois $P$. Inversement, la moyenne calculée sur un échantillon empirique est représentée par le symbole $\bar{x}$ (x-barre), et la proportion observée est notée $p$. Cette distinction n’est pas une simple coquetterie typographique : elle matérialise l’écart conceptuel entre une valeur fixe, absolue mais fondamentalement inconnue ($\mu$ ou $\pi$), et une variable aléatoire fluctuante ($x̄$ ou $p$) dont la valeur exacte dépend intrinsèquement de l’échantillon particulier sélectionné lors de l’investigation empirique.
Pour que cette projection du particulier vers le général soit méthodologiquement soutenable dans les protocoles de psychologie cognitive ou clinique, l’échantillonnage doit obligatoirement respecter des principes probabilistes stricts, garantissant que chaque membre de la population mère possède une probabilité d’inclusion connue et non nulle. Dès lors que l’échantillonnage s’avère biaisé — par exemple lors du recrutement de cohortes exclusivement composées d’étudiants de premier cycle universitaire en psychologie, population emblématique du paradigme dit « WEIRD » (Western, Educated, Industrialized, Rich, Democratic) analysé par Henrich, Heine et Norenzayan —, la capacité de la statistique d’échantillon à servir de point d’ancrage inférentiel pour caractériser le paramètre de population se trouve gravement compromise.
1.2 Propriétés statistiques fondamentales d’un estimateur ponctuel optimal
Un estimateur ponctuel est une règle algorithmique ou une fonction mathématique appliquée aux valeurs observées d’un échantillon dans le but de produire un nombre unique servant d’approximation du paramètre cible. Cependant, toutes les fonctions mathématiques envisageables ne se valent pas. En théorie statistique classique, un estimateur d’excellence doit valider quatre critères majeurs : l’absence de biais, l’efficacité, la consistance et la robustesse.
Le critère d’absence de biais (ou d’exactitude) stipule que la valeur attendue, ou espérance mathématique $E(\hat{\theta})$, de l’estimateur $\hat{\theta}$ doit être rigoureusement égale à la valeur réelle du paramètre inconnu $\theta$, soit $E(\hat{\theta}) = \theta$. En termes intuitifs, si l’on répétait une expérimentation psychologique un nombre infini de fois en extrayant à chaque reprise un échantillon aléatoire de même taille au sein de la population, la moyenne arithmétique de l’ensemble des estimations ponctuelles obtenues convergerait précisément vers la valeur véritable du paramètre. Si un estimateur présente un écart systématique, il est dit biaisé, ce qui conduit à une sous-estimation ou à une surestimation récurrente du phénomène psychologique sous examen.
L’efficacité statistique s’intéresse quant à elle à la dispersion de l’estimateur autour du paramètre. Entre deux estimateurs sans biais, le plus efficace est celui qui présente la variance d’échantillonnage minimale pour une taille d’échantillon donnée. Un estimateur efficace minimise les fluctuations erratiques d’un échantillon à un autre. La consistance (ou convergence asymptotique), garantie par le théorème de la loi des grands nombres, assure que lorsque la taille $n$ de l’échantillon tend vers l’infini, l’estimation ponctuelle converge en probabilité vers la valeur exacte du paramètre. Enfin, la robustesse mesure l’aptitude de l’estimateur à maintenir ses propriétés d’exactitude et d’efficacité même lorsque les postulats distributionnels sous-jacents — telle que l’hypothèse de normalité gaussienne des scores psychométriques — sont modérément violés.
1.3 Rôle de l’estimation ponctuelle dans l’inférence psychologique
L’estimation ponctuelle constitue le pivot névralgique à partir duquel se déploie l’ensemble de la recherche expérimentale et appliquée en psychologie. Dans le domaine de la psychométrie appliquée et de l’évaluation standardisée, l’étalonnage des échelles d’intelligence (telles que le WAIS ou le WISC de Wechsler) ou des inventaires de personnalité repose entièrement sur la détermination de paramètres normatifs. La moyenne et l’écart-type d’échantillon obtenus lors des campagnes de normalisation nationale deviennent les points de référence officiels permettant de transformer le score brut d’un patient en note standardisée (notes $Z$, quotients intellectuels avec moyenne de 100 et écart-type de 15, ou rangs centiles).
Dans la recherche interventionnelle — qu’il s’agisse de mesurer le bénéfice d’une psychothérapie cognitive et comportementale (TCC) ou l’effet d’une molécule psychoactive —, l’estimation ponctuelle permet de quantifier avec netteté la taille de l’effet moyen (par exemple le $d$ de Cohen). Elle fournit une valeur opérationnelle unique indispensable aux méta-analyses, aux décideurs de santé publique et aux praticiens de terrain pour juger de la pertinence clinique d’une approche thérapeutique.
Néanmoins, la pratique scientifique moderne impose de ne jamais considérer l’estimation ponctuelle comme une vérité absolue immuable. Les théoriciens contemporains de la modélisation des traits latents rappellent continuellement que l’estimation ponctuelle n’est que la condensation synthétique d’une distribution probabiliste sous-jacente. Elle représente l’hypothèse la plus vraisemblable ou l’espérance conditionnelle des données recueillies, devant impérativement servir de tremplin à la modélisation de l’incertitude via les erreurs types et les intervalles de confiance.
2. Typologie des estimateurs ponctuels et correspondances statistiques
2.1 La moyenne d’échantillon comme estimateur sans biais de la moyenne de population
La moyenne arithmétique d’échantillon, universellement désignée par $\bar{x}$, est sans conteste l’estimateur ponctuel le plus fréquemment calculé lors de l’analyse de variables continues en psychologie. Sa formulation mathématique pour un échantillon de taille $n$ s’énonce :
$$\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i$$
La primauté de la moyenne d’échantillon s’explique par sa propriété mathématique d’estimateur sans biais de variance minimale (MVUE, Minimum Variance Unbiased Estimator) sous condition de normalité de la distribution parente. En vertu du principe de linéarité de l’espérance, l’espérance de la somme de variables aléatoires indépendantes et identiquement distribuées équivaut à la somme de leurs espérances :
$$E(\bar{x}) = E\left(\frac{1}{n}\sum_{i=1}^{n} x_i\right) = \frac{1}{n}\sum_{i=1}^{n} E(x_i) = \frac{1}{n} \cdot (n \cdot \mu) = \mu$$
Toutefois, en psychométrie et en psychopathologie quantitative, la moyenne souffre d’un talon d’Achille majeur : son point de rupture nul. Une valeur extrême ou aberrante (consécutive à une erreur de transcription, à un biais de complaisance ou à une manifestation psychopathologique aiguë) suffit à déporter substantiellement la moyenne arithmétique hors du centre de gravité effectif de la cohorte. Face à des distributions asymétriques — fréquentes dans les mesures de temps de réaction ou les échelles de dépression —, les méthodologistes préconisent la comparaison avec des estimateurs plus robustes, tels que la médiane empirique (qui sépare l’échantillon en deux sous-groupes d’effectifs égaux) ou la moyenne tronquée (qui écarte un pourcentage prédéfini des observations situées aux deux extrêmes).
2.2 La proportion d’échantillon pour l’évaluation de variables catégorielles
Lorsqu’une variable comportementale ou clinique revêt une nature binaire (présence ou absence d’un comportement autolesionnel, réussite ou échec à un item de mémoire de travail, adhésion ou refus d’un protocole pharmacologique), chaque observation individuelle $x_i$ peut être assimilée à une variable aléatoire suivant une loi de Bernoulli de paramètre $\pi$. La variable prend conventionnellement la valeur 1 en cas de succès (présence de l’attribut d’intérêt) et la valeur 0 en cas d’échec (absence de l’attribut).
L’estimateur ponctuel de la proportion populationnelle $\pi$ est la fréquence relative observée, notée $p$, qui s’exprime par le ratio entre le nombre de cas positifs observés ($k$) et l’effectif global de l’échantillon ($n$) :
$$p = \frac{k}{n} = \frac{\sum_{i=1}^{n} x_i}{n}$$
L’espérance de cet estimateur équivaut précisément à $E(p) = \pi$, ce qui confirme qu’il s’agit d’un estimateur sans biais. Sa variance d’échantillonnage est donnée par $\sigma_p^2 = \frac{\pi(1-\pi)}{n}$. Lorsque la taille de l’échantillon est substantielle et que le produit $n \cdot p$ ainsi que le produit $n \cdot (1-p)$ sont tous deux supérieurs ou égaux à 5 (idéalement supérieurs ou égaux à 10 pour une approximation optimale), la distribution d’échantillonnage de la proportion converge harmonieusement vers une distribution normale selon le théorème central limite, autorisant ainsi des extrapolations épidémiologiques rigoureuses de la prévalence des troubles psychologiques.
2.3 La variance et l’écart-type corrigés dans la modélisation comportementale
La quantification de la variabilité interindividuelle constitue une préoccupation tout aussi déterminante que celle de la tendance centrale. Si l’on applique naïvement la formule de la variance populationnelle à un échantillon de données en divisant la somme des carrés des écarts à la moyenne par $n$, on obtient la variance empirique brute :
$$S_{\text{naïf}}^2 = \frac{1}{n}\sum_{i=1}^{n} (x_i – \bar{x})^2$$
Or, les mathématiciens ont démontré de longue date que cet estimateur direct est mathématiquement biaisé. Puisque les écarts individuels sont calculés par rapport à la moyenne empirique $\bar{x}$ (qui est elle-même le point qui minimise par définition la somme des carrés des écarts de l’échantillon) et non par rapport à la véritable moyenne inconnue $\mu$, la dispersion calculée est systématiquement compressée. L’espérance mathématique de la variance naïve équivaut en réalité à :
$$E(S_{\text{naïf}}^2) = \frac{n-1}{n}\sigma^2$$
Cette sous-estimation systématique de la variabilité réelle de la population est corrigée grâce à la célèbre correction de Bessel, qui consiste à substituer le dénominateur $n$ par les degrés de liberté $n-1$. L’estimateur sans biais de la variance de la population, noté $s^2$, devient :
$$s^2 = \frac{1}{n-1}\sum_{i=1}^{n} (x_i – \bar{x})^2$$
Bien que la racine carrée de cette variance corrigée, $s = \sqrt{s^2}$, conserve un biais minime (la racine carrée étant une fonction concave en vertu de l’inégalité de Jensen), $s$ représente l’estimateur ponctuel standard et universellement adopté de l’écart-type populationnel $\sigma$. En psychométrie clinique, $s$ renseigne précisément sur le niveau d’hétérogénéité des manifestations symptomatiques au sein de la cohorte analysée.
3. Préparation et structuration des données expérimentales sous Excel
3.1 Organisation tabulaire des variables quantitatives et qualitatives
Avant d’engager la moindre saisie de commande algorithmique dans Excel, la structure architecturale du classeur doit se conformer aux standards stricts du concept de « données ordonnées » (tidy data) formalisé par Hadley Wickham. Dans le paradigme psychologique, cette discipline implique qu’une ligne unique corresponde invariablement à une unité expérimentale unique (un participant, un patient ou un animal de laboratoire) et qu’une colonne contienne les observations relatives à une unique variable opérationnelle.
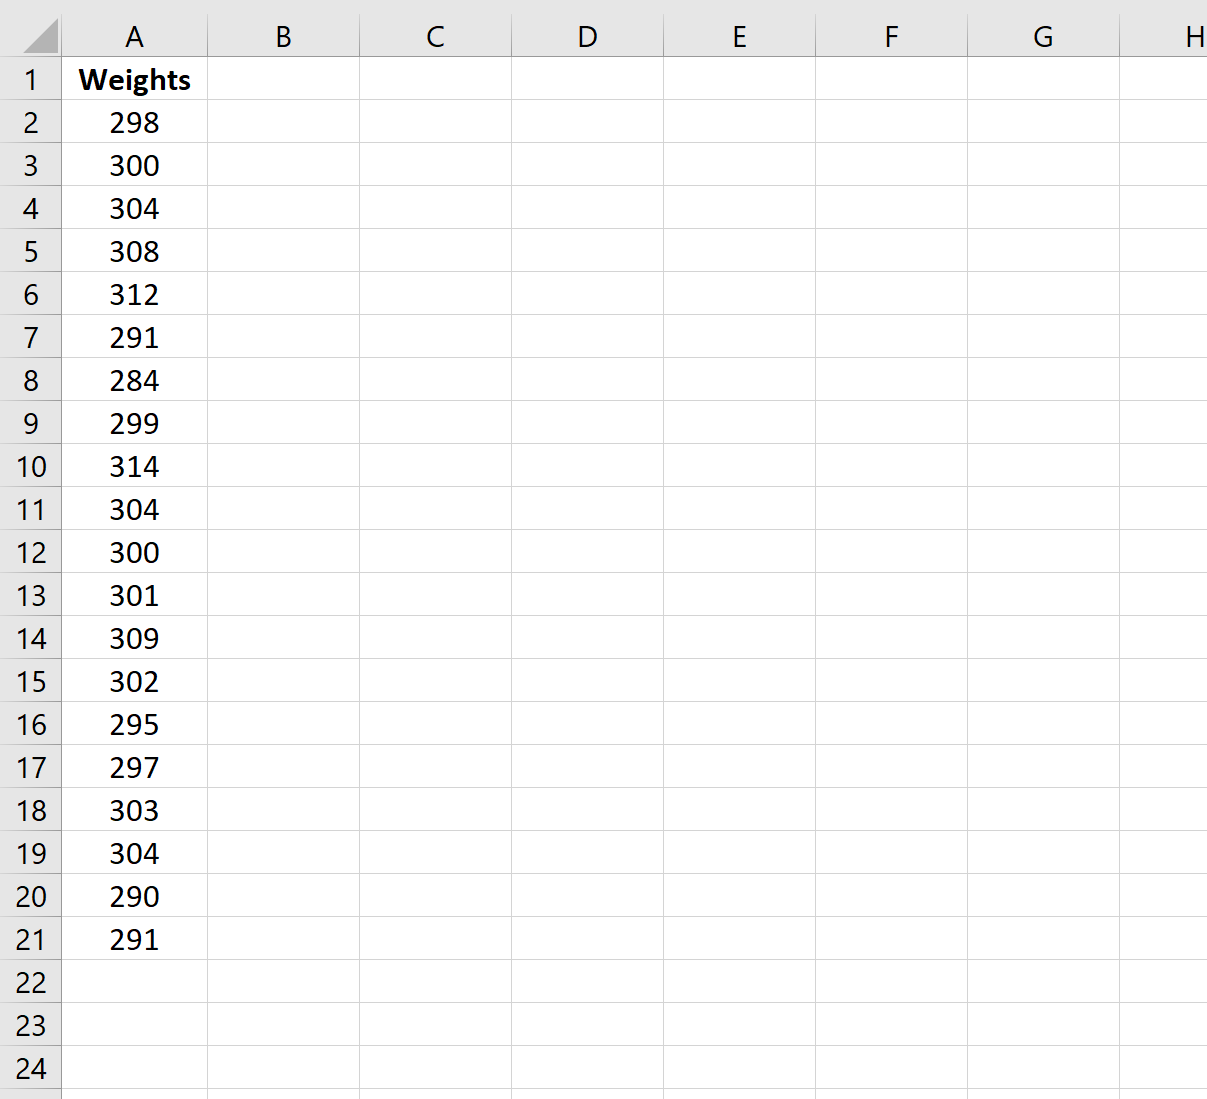
La première ligne du tableur (ligne d’en-tête) doit accueillir des dénominations de variables concises, intelligibles, dénuées d’espaces, de caractères accentués ou de symboles spéciaux susceptibles de provoquer des dysfonctionnements lors de scripts ultérieurs (par exemple : ID_Sujet, Score_Anxiete_HAMA, Statut_Burnout). Pour les variables qualitatives de nature dichotomique, la règle d’or consiste à bannir les codages textuels (« Oui »/« Non », « Présent »/« Absent ») au profit d’un codage numérique booléen rigoureux : la valeur 1 pour la survenue de l’événement clinique ou du symptôme investigué, et la valeur 0 pour son absence constatée.
Il est par ailleurs impératif d’utiliser les fonctionnalités avancées de gestion des données d’Excel en convertissant immédiatement la plage brute en Tableau structuré (raccourci Ctrl + L ou Ctrl + T sous Windows, Cmd + T sous macOS). Cette conversion permet d’attribuer un nom dynamique à la matrice (par exemple Tableau_Clinique), transformant les références matricielles statiques opaques (comme $B$2:$B$31) en références structurées intuitives (Tableau_Clinique[Score_Anxiete]), ce qui immunise les calculs contre les erreurs d’extension lors de l’ajout ultérieur de nouveaux participants.
3.2 Nettoyage préliminaire et détection des valeurs aberrantes
La rigueur d’une estimation ponctuelle dépend intrinsèquement de la pureté du matériau empirique traité. Les erreurs de saisie manuelle (un score de 220 sur une échelle bornée entre 0 et 50) ont le pouvoir de fausser irrémédiablement la moyenne d’échantillon. Pour prévenir ces altérations, l’implémentation de règles de Validation des données (situées dans l’onglet Données > Outils de données) est vivement recommandée dès la phase de conception du masque de saisie. En restreignant la saisie à des nombres entiers strictement compris entre les bornes théoriques du test psychométrique employé, le chercheur bloque toute pollution à la source.
Une vigilance aiguë doit également entourer le traitement des données manquantes (missing data). Dans l’écosystème d’Excel, une cellule entièrement vide et une cellule hébergeant le chiffre zéro (0) génèrent des comportements algorithmiques diamétralement opposés. La fonction de calcul de la moyenne ignore par défaut les cellules complètement vierges, mais intègre scrupuleusement les cellules contenant la valeur numérique zéro dans le dénominateur $n$. Si un expérimentateur saisit un « 0 » pour symboliser l’absence d’évaluation chez un patient défaillant, l’estimation ponctuelle de la moyenne sera mécaniquement tirée vers le bas de manière erronée.
La détection exploratoire des valeurs extrêmes peut s’opérer par l’intermédiaire du formatage conditionnel mettant en surbrillance les observations s’écartant de plus de 2,5 ou 3 écarts-types de la tendance globale, ou par l’inspection visuelle des quartiles. Toute exclusion d’une observation jugée aberrante doit faire l’objet d’une justification clinique ou méthodologique traçable et documentée dans le protocole de recherche, afin d’interdire les pratiques de manipulation des données (p-hacking).
3.3 Formatage et vérification de l’intégrité des types de données
L’un des dysfonctionnements les plus pernicieux lors de l’utilisation d’Excel pour l’analyse statistique réside dans la coexistence silencieuse de données au format texte et de données au format numérique. Ce problème survient de manière quasi systématique lors de l’importation de fichiers .csv issus de plateformes d’enquêtes psychologiques en ligne (Qualtrics, SurveyMonkey, Google Forms, Gorilla Experiment Builder). Une colonne de scores chiffrés importée au format texte sera visuellement alignée à gauche par défaut et sera superbement ignorée par des fonctions comme MOYENNE ou VAR.S, conduisant à des estimations fondées sur des sous-échantillons incomplets sans qu’aucun message d’erreur ne soit émis.
Pour certifier l’intégrité numérique d’une série de données, le chercheur peut insérer temporairement une colonne de contrôle hébergeant la fonction logique :
=ESTNUM(B2)
Si la formule renvoie FAUX, la valeur sous-jacente est textuelle. Sa conversion impérative s’opère soit via la fonction =CNUM(B2), soit en recourant à la fonctionnalité Texte en colonnes de l’onglet Données, en validant le format numérique standard. Un autre écueil classique réside dans le paramétrage des conventions régionales du système d’exploitation. Dans l’espace francophone, le séparateur décimal officiel est la virgule (,), alors que les données internationales emploient le point (.). L’inadéquation entre le paramètre d’Excel et le séparateur présent dans les données brutes transforme instantanément les réels en chaînes de caractères inertes.
4. Calcul de l’estimation ponctuelle de la moyenne dans Excel (Exemple 1 : Scores d’anxiété)
4.1 Contexte psychologique et jeu de données expérimentales
Pour illustrer de manière tangible l’exécution du calcul d’une estimation ponctuelle de moyenne sous Microsoft Excel, considérons un protocole de recherche clinique en psychiatrie hospitalière. Une équipe évalue un échantillon probabiliste de $n = 30$ patients adultes récemment diagnostiqués avec un épisode dépressif majeur, dans le but d’estimer le niveau d’anxiété comorbide moyen de cette population clinique avant toute mise en place d’une chimiothérapie ou psychothérapie. L’instrument psychométrique retenu est l’Échelle d’anxiété de Hamilton (HAM-A, Hamilton Anxiety Rating Scale), dont le score total varie continûment entre 0 et 56 points, les scores supérieurs à 25 traduisant une anxiété sévère.
Les 30 observations empiriques recueillies et répertoriées dans la plage B2:B31 d’une feuille de calcul intitulée Evaluation_Anxiete sont les suivantes :
24, 28, 19, 32, 27, 22, 35, 18, 29, 31, 26, 20, 33, 25, 28, 21, 30, 24, 27, 34, 16, 29, 23, 31, 26, 37, 22, 28, 25, 30.
Notre objectif méthodologique consiste à déterminer, à partir de cette unique série d’observations empiriques, l’estimation ponctuelle sans biais de l’espérance mathématique de l’anxiété $\mu$ au sein de la population parente de ces patients.
4.2 Application de la fonction MOYENNE pas à pas
Microsoft Excel dispose de la fonction native MOYENNE (ou AVERAGE dans la déclinaison anglophone du logiciel), qui exécute automatiquement la sommation de l’ensemble des arguments numériques fournis avant de diviser cette somme par le dénombrement effectif des valeurs numériques valides. Pour obtenir l’estimation ponctuelle $\bar{x}$, le protocole opératoire est le suivant :
- Positionner le curseur dans une cellule de restitution dégagée, par exemple la cellule
E2. - Saisir la formule utilisant la plage de données fixes :
=MOYENNE(B2:B31)
Ou, si le jeu de données a été judicieusement formalisé en tableau structuré nomméCohorteCliniquecomportant la colonneScore_HAMA:=MOYENNE(CohorteClinique[Score_HAMA]) - Valider la saisie en pressant la touche Entrée.
Le calcul interne exécuté par l’algorithme d’Excel somme les 30 scores (soit une somme globale égale à 790) et la divise par l’effectif total 30. Le résultat numérique affiché est égal à :
26,33333333...
Sur le plan de l’interprétation clinique et psychométrique, cette valeur constitue notre estimation ponctuelle du niveau moyen d’anxiété de la population cible ($\hat{\mu} = 26,33$). Elle situe la tendance centrale de cette patientèle dans la strate diagnostique de l’anxiété modérée à sévère (seuil usuel fixé à 25 sur la HAM-A). Cependant, la restitution brute de l’ensemble des décimales produites par le processeur arithmétique constitue une aberration scientifique ; le résultat doit être formellement arrondi à deux décimales ($26,33$) conformément aux directives internationales de reporting psychométrique.
4.3 Alternatives robustes face aux distributions asymétriques
L’observation isolée de l’estimation ponctuelle de la moyenne arithmétique peut s’avérer trompeuse si la distribution empirique présente une asymétrie marquée (skewness) ou des scores atypiques résultant de spécificités neurobiologiques ou cliniques particulières. Pour s’assurer de la pertinence de l’estimation, le statisticien doit évaluer conjointement d’autres estimateurs ponctuels de tendance centrale.
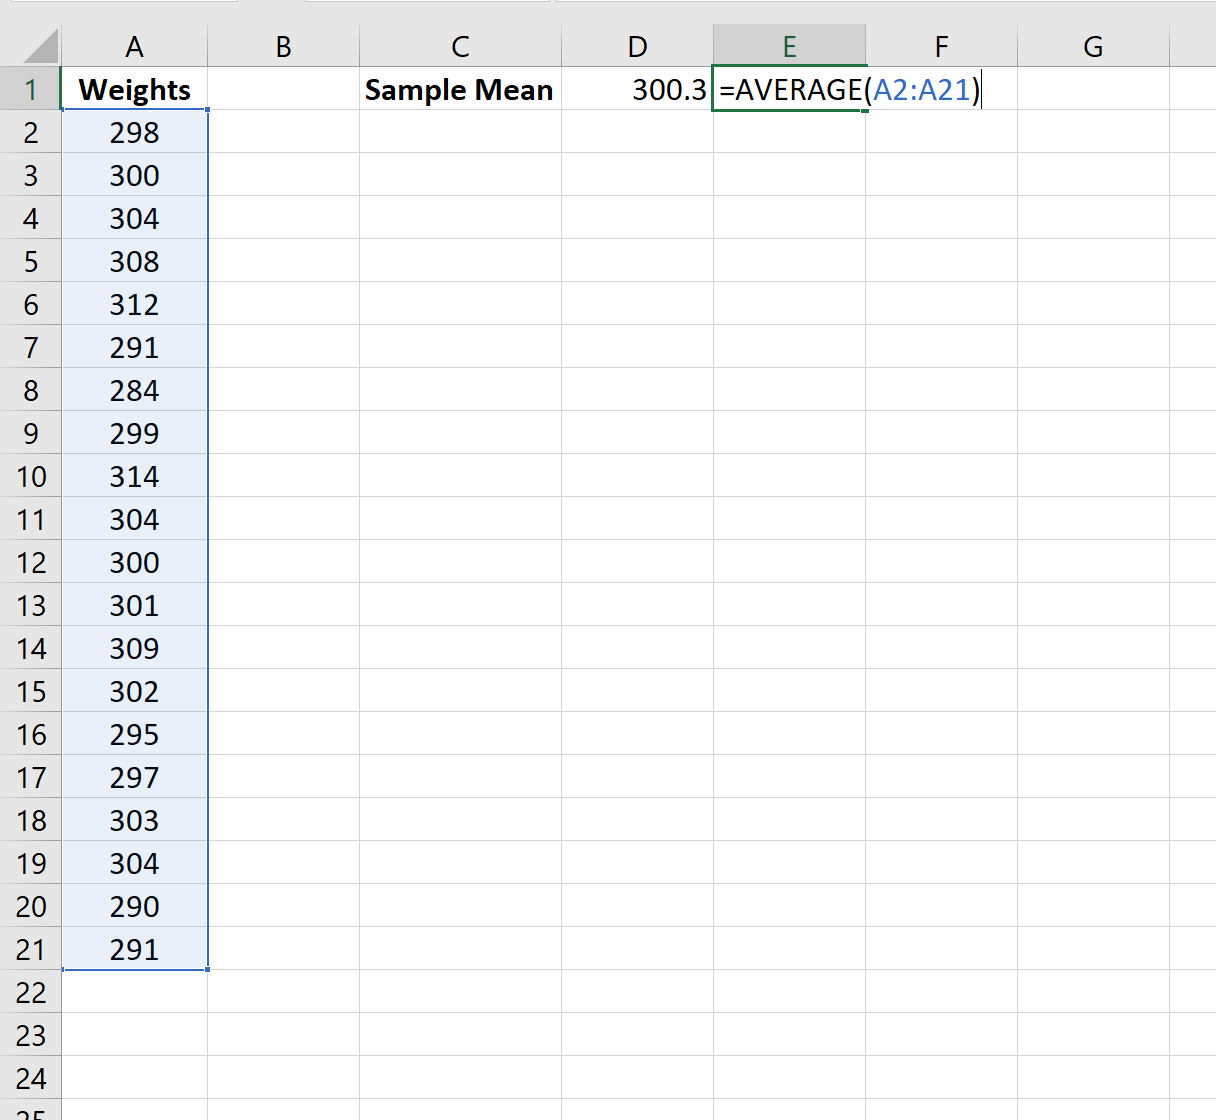
La première alternative robuste est la médiane d’échantillon, obtenue sous Excel via la fonction dédiée :
=MEDIANE(B2:B31)
Dans notre cohorte de 30 patients, la médiane renvoie la valeur 26,50. La quasi-concordance entre l’estimation de la moyenne ($26,33$) et celle de la médiane ($26,50$) témoigne d’une distribution symétrique satisfaisante, renforçant la légitimité de la moyenne arithmétique en tant qu’estimateur non biaisé et efficace dans cette configuration précise.
La seconde alternative, particulièrement plébiscitée en psychométrie moderne, est la moyenne tronquée (ou modifiée). La fonction Excel MOYENNE.REDUITE (ou TRIMMEAN) permet d’évincer une fraction proportionnelle des valeurs situées aux extrêmes de la distribution. Sa syntaxe s’établit comme suit :
=MOYENNE.REDUITE(B2:B31; 0,10)
L’argument 0,10 ordonne l’exclusion globale de 10 % des données les plus extrêmes (soit 5 % pour les valeurs les plus basses et 5 % pour les valeurs les plus hautes de la série ordonnée). Si l’échantillon comportait des scores marginaux perturbateurs (par exemple un patient ayant répondu au hasard en sélectionnant systématiquement le score maximal), la moyenne tronquée neutraliserait ce biais pour fournir un estimateur ponctuel épuré de la tendance centrale sous-jacente.
5. Calcul de l’estimation ponctuelle d’une proportion dans Excel (Exemple 2 : Prévalence de symptômes)
5.1 Opérationnalisation d’une variable binaire en psychopathologie
La recherche épidémiologique et comportementale manipule fréquemment des variables nominales dichotomiques. Considérons une investigation en santé publique universitaire visant à estimer le taux de prévalence ponctuelle d’un épisode dépressif caractérisé (EDC) au sein d’une population de $15,000$ étudiants inscrits dans une université européenne. L’équipe médicale administre un questionnaire de dépistage standardisé (le PHQ-9, Patient Health Questionnaire) à un échantillon probabiliste de $n = 150$ étudiants sélectionnés au hasard.
Pour operationaliser cette variable en vue d’un traitement statistique automatisé dans Excel, le résultat diagnostique est binarisé dans la colonne C (cellules C2:C151), intitulée Depistage_EDC :
- Le code
1désigne un participant dont le score au PHQ-9 est supérieur ou égal au seuil validé de 10 points (indiquant la présence probable d’une dépression clinique modérée à sévère). - Le code
0correspond à un participant dont le score est inférieur à 10 (absence de symptomatologie dépressive cliniquement significative).
Le paramètre populationnel que nous cherchons à estimer est la prévalence réelle $\pi$ de ce trouble au sein de l’ensemble de la population estudiantine de cette institution.
5.2 Mise en œuvre via les fonctions NB.SI et NB
La démarche pédagogique classique pour extraire l’estimation ponctuelle de la proportion $p$ consiste à expliciter de façon transparente la formule mathématique du ratio $p = \frac{k}{n}$, en calculant isolément le numérateur et le dénominateur au moyen des fonctions de comptage d’Excel.
Le comptage du nombre de cas positifs ($k$) s’exécute par la fonction conditionnelle NB.SI :
=NB.SI(C2:C151; 1)
Cette commande parcourt la plage cible et dénombre l’occurrence exacte du critère d’intérêt (la présence du chiffre 1). Supposons que cette formule renvoie la valeur 36. Il y a donc 36 étudiants dépistés positifs au sein de l’échantillon.
Le dénombrement de la taille globale de l’échantillon analysé ($n$) s’obtient au moyen de la fonction NB, qui comptabilise l’intégralité des cellules contenant des valeurs numériques au sein de la série :
=NB(C2:C151)
Cette fonction retourne ici la valeur 150.
L’estimation ponctuelle finale de la prévalence est alors extraite par la formule combinée :
=NB.SI(C2:C151; 1) / NB(C2:C151)
Le quotient obtenu dans la cellule de destination est précisément de 0,24. En appliquant à la cellule le formatage Pourcentage avec une décimale (disponible dans le ruban Accueil), la valeur devient 24,0 %. L’estimation ponctuelle de la prévalence de la dépression dans cette population étudiante est donc de 24 %.
5.3 Méthode alternative simplifiée avec la fonction MOYENNE
Bien que la combinaison de NB.SI et NB offre une excellente clarté conceptuelle, il existe une méthode de calcul immensément plus rapide, élégante et rigoureusement identique sur le plan mathématique : l’application directe de la fonction MOYENNE à la colonne binaire codée en 0 et 1.
La démonstration de cette propriété est immédiate. Soit une série de $n$ variables indicatrices $x_i in {0, 1}$. La somme des observations $\sum_{i=1}^{n} x_i$ équivaut strictement à la sommation des 1, c’est-à-dire au nombre absolu de cas positifs $k$. Dès lors :
$$\text{Moyenne}(x) = \frac{\sum_{i=1}^{n} x_i}{n} = \frac{k}{n} = p$$
Dans la pratique sur feuille de calcul, il suffit donc de renseigner l’unique formule suivante :
=MOYENNE(C2:C151)
Cette fonction effectue la sommation des 36 valeurs « 1 » et des 114 valeurs « 0 », puis divise immédiatement le total par 150, renvoyant instantanément 0,24. Cette méthode synthétique limite grandement le risque d’erreur de frappe au sein des formules complexes et s’intègre harmonieusement dans les tableaux de bord statistiques dynamiques.
6. Estimation ponctuelle des paramètres de dispersion sous Excel
6.1 Calcul de la variance d’échantillon sans biais
La fourniture d’une estimation ponctuelle de tendance centrale est scientifiquement incomplète si elle ne s’accompagne pas d’une estimation ponctuelle de la dispersion des scores. Dans Microsoft Excel, le calcul de la variance requiert une vigilance absolue en raison de l’existence historique de deux fonctions concurrentes : VAR.P et VAR.S.
La fonction VAR.P (correspondant à la variance d’une population exhaustive) calcule la dispersion en divisant la somme des carrés des écarts par l’effectif total $n$. Si un chercheur applique VAR.P aux scores de notre premier exemple d’anxiété ($n = 30$, plage B2:B31), Excel exécute :
$$\text{VAR.P} = \frac{1}{30}\sum_{i=1}^{30} (x_i – 26,33)^2 \approx 24,96$$
Cette utilisation est méthodologiquement incorrecte car nous ne disposons que d’un sous-ensemble d’individus et non de la totalité des patients de la population. Ce calcul souffre du biais de sous-estimation explicité dans la section 2.3. L’analyste doit impérativement recourir à la fonction VAR.S (où « S » renvoie au terme anglophone Sample, c’est-à-dire échantillon, anciennement codée VAR dans les versions historiques d’Excel) :
=VAR.S(B2:B31)
Cette commande intègre dans son algorithme la correction de Bessel et divise la somme des carrés par $n – 1$, soit 29 :
$$s^2 = \frac{1}{29}\sum_{i=1}^{30} (x_i – 26,33)^2 \approx 25,82$$
L’estimation ponctuelle sans biais de la variance de l’anxiété dans la population d’intérêt est donc de 25,82 points au carré. L’écart entre 24,96 et 25,82 illustre parfaitement la distorsion induite par l’omission de la correction de Bessel sur les échantillons de taille clinique restreinte.
6.2 Calcul de l’écart-type d’échantillon
Bien que la variance soit mathématiquement indispensable pour la mise en œuvre de tests d’hypothèses ultérieurs (tels que l’analyse de variance ou ANOVA), elle présente le désavantage clinique de s’exprimer dans le carré de l’unité de mesure initiale (des « points d’anxiété au carré »), ce qui prive le clinicien de toute intuition concrète de la magnitude des variations.
L’estimateur ponctuel de l’écart-type de la population est calculé dans Excel à l’aide de la fonction ECARTYPE.STANDARD (ou STDEV.S en version anglophone, anciennement ECARTYPE) :
=ECARTYPE.STANDARD(B2:B31)
L’algorithme extrait la racine carrée de la variance corrigée précédemment calculée :
$$s = \sqrt{25,816} \approx 5,08$$
Cette valeur de $5,08$ points rétablit la quantification de la variabilité interindividuelle à l’échelle d’origine du test HAM-A. En la comparant aux normes psychométriques publiées dans la littérature psychiatrique internationale (où l’écart-type normatif oscille généralement autour de 5 à 6 points chez les patients dépressifs hospitalisés), le chercheur valide la consistance de son échantillon, attestant que la variabilité symptomatique observée dans sa cohorte est parfaitement représentative de l’hétérogénéité classiquement décrite en clinique institutionnelle.
6.3 Automatisation des statistiques descriptives complètes
Pour les analyses exploratoires préliminaires, l’exécution manuelle successive de l’ensemble des formules statistiques peut s’avérer chronophage. Excel intègre un complément logiciel natif extrêmement puissant : l’Utilitaire d’analyse (Analysis ToolPak). Pour l’activer s’il n’apparaît pas encore dans l’onglet Données, il suffit de se rendre dans Fichier > Options > Compléments, de sélectionner Compléments Excel, puis de cocher la case relative à l’Utilitaire d’analyse.
Une fois activé, son exploitation s’articule comme suit :
- Cliquer sur l’icône Utilitaire d’analyse située à l’extrême droite de l’onglet Données.
- Sélectionner l’option Statistiques descriptives dans la liste déroulante et valider avec OK.
- Définir la plage d’entrée (par exemple
$B$1:$B$31en prenant soin de cocher la case Intitulé en première ligne). - Cocher l’option Rapport statistique (Summary statistics).
- Sélectionner une cellule de destination pour la sortie tabulaire (par exemple
$G$2) et cliquer sur OK.
Le module génère instantanément un tableau exhaustif recensant la moyenne arithmétique ($26,33$), l’erreur type ($0,93$), la médiane ($26,50$), le mode ($28$), la variance d’échantillon corrigée ($25,82$), l’écart-type d’échantillon ($5,08$), l’aplatissement (kurtosis), le coefficient d’asymétrie (skewness) et l’étendue. Ce rapport automatisé permet d’exécuter un contrôle de cohérence croisé immédiat entre les formules saisies unitairement et le moteur statistique compilé du logiciel.
7. Au-delà du point fixe : Quantification de l’erreur type dans Excel
7.1 Théorie de la variabilité d’échantillonnage et erreur type de la moyenne
Bien que l’estimation ponctuelle fournisse la « meilleure estimation unique » accessible d’un paramètre, elle souffre d’une faiblesse inhérente : elle ne renseigne en rien sur sa propre précision. Si dix équipes de recherche distinctes menaient l’étude sur l’anxiété auprès de dix échantillons distincts de 30 patients issus du même hôpital, elles obtiendraient immanquablement dix estimations ponctuelles de moyennes légèrement différentes ($25,8$ ; $26,9$ ; $26,1$ ; etc.). Cette variabilité purement imputable au hasard de l’échantillonnage est formalisée par la distribution d’échantillonnage de la moyenne.
L’écart-type de cette distribution d’échantillonnage théorique est appelé erreur type de la moyenne (abrégée en SEM, pour Standard Error of the Mean). Elle mesure l’ampleur moyenne des fluctuations entre l’estimateur ponctuel $\bar{x}$ et le paramètre réel $\mu$. Sa formule mathématique est :
$$\sigma_{\bar{x}} = \frac{\sigma}{\sqrt{n}}$$
Puisque la valeur exacte de l’écart-type de la population $\sigma$ demeure inconnue, nous la remplaçons par son estimateur ponctuel sans biais $s$, ce qui permet de calculer l’erreur type estimée :
$$SE_{\bar{x}} = \frac{s}{\sqrt{n}}$$
Cette relation démontre avec force que la précision de l’estimation ponctuelle s’accroît non pas proportionnellement à la taille de l’échantillon $n$, mais à la racine carrée de $n$. Ainsi, pour doubler la précision d’une estimation ponctuelle (c’est-à-dire réduire de moitié l’erreur type), il s’avère indispensable de quadrupler la taille de la cohorte évaluée.
7.2 Formulation algorithmique de l’erreur type de la moyenne sous Excel
Étrangement, Microsoft Excel ne comporte aucune fonction native unitaire dédiée à l’erreur type de la moyenne (il n’existe pas d’instruction du type =ERREUR.TYPE()). Dès lors, le chercheur doit construire une formule combinant la fonction de dispersion corrigée et la fonction d’extraction de racine carrée de l’effectif.
Pour nos scores d’anxiété logés dans la plage B2:B31, la syntaxe dynamique optimale s’écrit :
=ECARTYPE.STANDARD(B2:B31) / RACINE(NB(B2:B31))
Analysons la chronologie de calcul exécutée par Excel :
ECARTYPE.STANDARD(B2:B31)évalue l’écart-type d’échantillon $s$, soit $5,08097…$NB(B2:B31)calcule le dénombrement effectif $n$, soit 30.RACINE(30)résout la racine carrée de l’effectif, soit environ $5,47722…$- La division finale produit : $\frac{5,08097}{5,47722} \approx 0,92765$ points.
En arrondissant selon les normes scientifiques, nous obtenons une erreur type estimée de 0,93 point. Ce chiffre s’interprète rigoureusement ainsi : si l’on procédait à des tirages répétés d’échantillons de 30 patients au sein de cette population, la moyenne d’échantillon fluctuerait autour de la moyenne réelle avec un écart-type moyen d’environ 0,93 point sur l’échelle HAM-A.
7.3 Calcul de l’erreur type d’une proportion sous Excel
De manière totalement analogue, l’estimation ponctuelle d’une proportion $p$ est soumise à la variance d’échantillonnage binomiale. L’erreur type théorique d’une proportion d’échantillon s’exprime par la formule :
$$SE_p = \sqrt{\frac{p(1-p)}{n}}$$
Cette métrique possède une propriété géométrique déterminante : le produit $p(1-p)$ atteint son maximum mathématique absolu lorsque $p = 0,50$. L’erreur type est donc maximale lorsque la proportion estimée avoisine 50 % (situation d’indécision maximale), alors qu’elle décroît considérablement à mesure que la prévalence observée tend vers des valeurs extrêmes proches de 0 ou de 1.
Reprenons notre exemple épidémiologique d’étudiants dépistés pour la dépression, où la proportion estimée $p = 0,24$ repose sur un échantillon $n = 150$. Si la proportion $p$ réside dans la cellule E2 et que la taille d’échantillon $n$ est contenue dans la cellule E3, la formule Excel se transcrit directement par :
=RACINE((E2 * (1 - E2)) / E3)
Si l’on préfère une formule intégrale autonome ne dépendant d’aucune cellule intermédiaire et opérant directement sur la plage binaire brute C2:C151 :
=RACINE((MOYENNE(C2:C151) * (1 - MOYENNE(C2:C151))) / NB(C2:C151))
L’exécution numérique de ce calcul aboutit à :
$$SE_p = \sqrt{\frac{0,24 \cdot 0,76}{150}} = \sqrt{\frac{0,1824}{150}} = \sqrt{0,001216} \approx 0,03487$$
Exprimée sous forme de pourcentage, l’erreur type de notre estimation de prévalence est d’environ 3,49 %. Ce paramètre de variabilité sert de socle pour l’ensemble des modélisations de l’incertitude associées aux variables nominales.
8. Construction des intervalles de confiance autour de l’estimation ponctuelle
8.1 Complémentarité fondamentale entre estimation ponctuelle et estimation par intervalle
L’estimation ponctuelle fournit un ancrage précieux mais présente une faiblesse statistique structurelle : la probabilité formelle que la moyenne d’échantillon empirique $\bar{x}$ coïncide à la décimale exacte près avec le paramètre de population $\mu$ d’une variable continue est mathématiquement égale à zéro ($P(\bar{x} = \mu) = 0$). Pour appréhender l’inévitable imprécision de l’estimateur, l’estimation ponctuelle doit obligatoirement s’accompagner d’une estimation par intervalle de confiance.
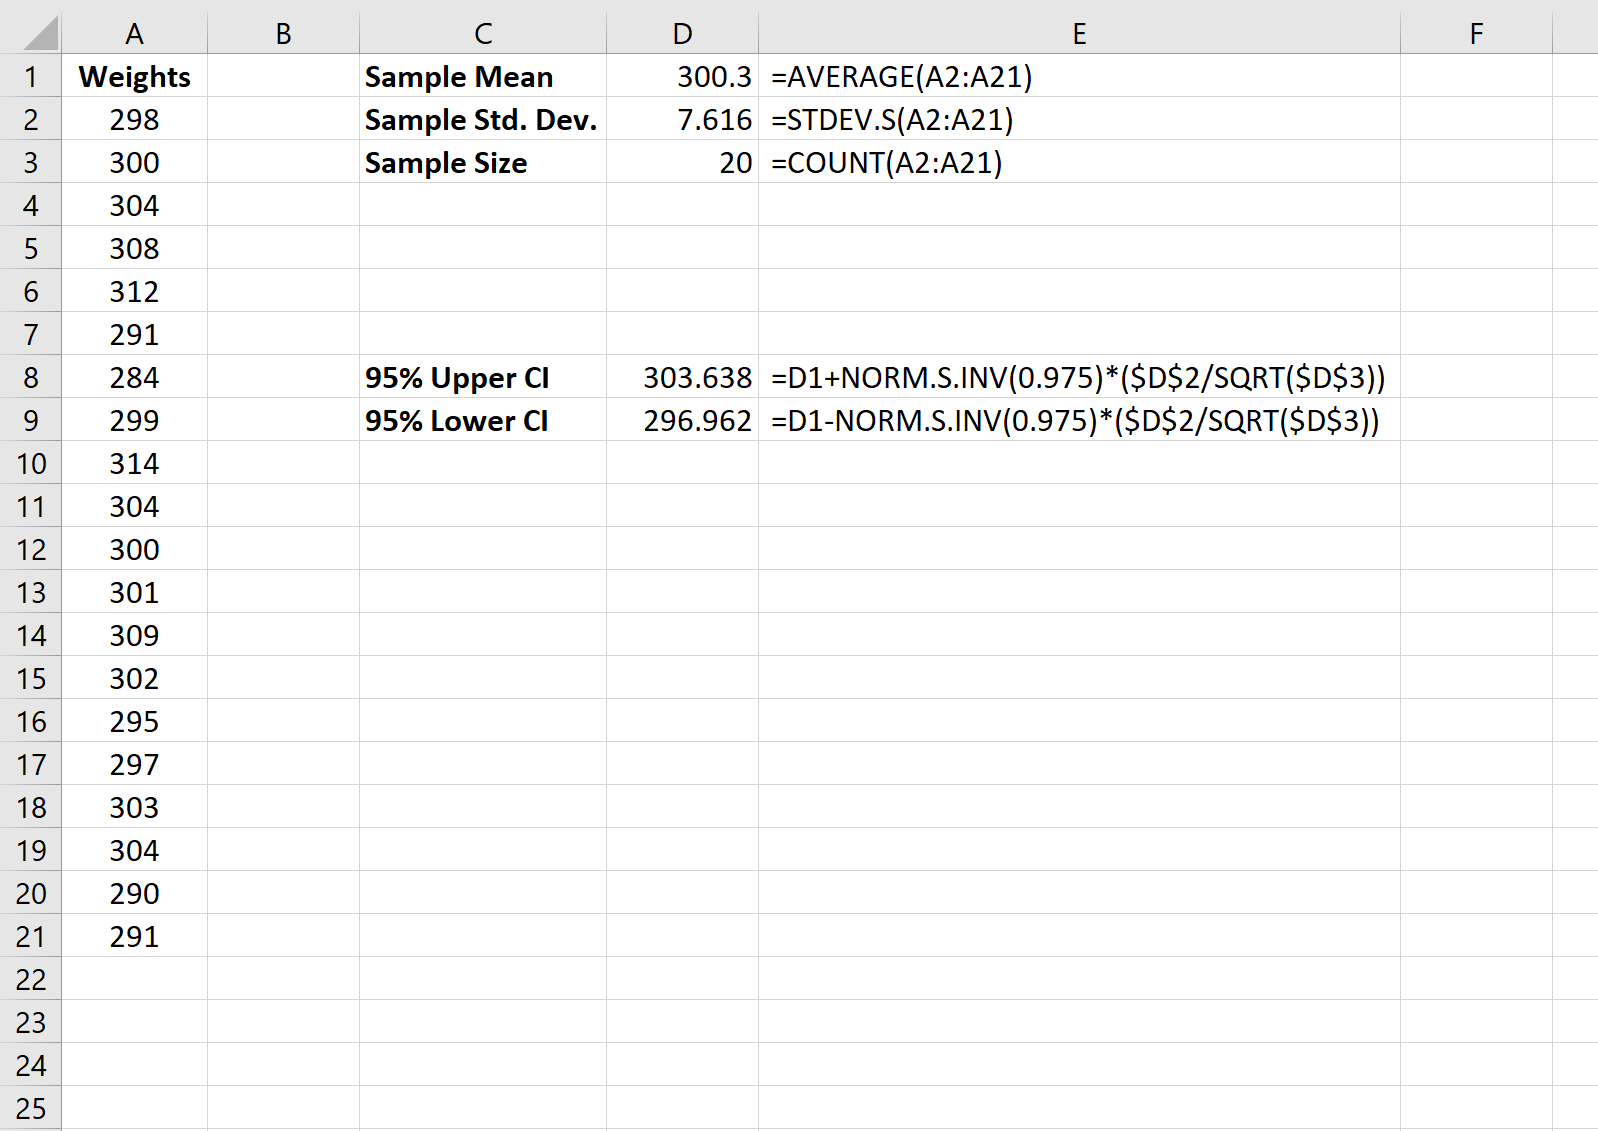
Un intervalle de confiance délimite, autour de l’estimation ponctuelle, une plage de valeurs plausibles construite à un niveau de certitude statistique désigné par le symbole $1 – \alpha$ (le plus souvent fixé à 95 %, ce qui correspond à un seuil de risque d’erreur $\alpha = 0,05$, ou à 99 % avec $\alpha = 0,01$). La signification théorique rigoureuse d’un intervalle de confiance à 95 % est souvent mal comprise : elle ne signifie pas qu’il y a 95 % de chances que le paramètre vrai se trouve dans cet intervalle particulier. Elle signifie que si nous reproduisions l’étude une infinité de fois dans les mêmes conditions expérimentales, 95 % des intervalles ainsi construits recouvriraient la valeur immuable du paramètre populationnel inconnu.
La largeur de cet intervalle est régie par le produit de l’erreur type ($SE$) et d’une valeur critique issue d’une loi de probabilité théorique. Le choix de la distribution théorique appropriée obéit à des critères stricts :
- Lorsque l’écart-type de la population $\sigma$ est inconnu (ce qui est invariablement le cas en sciences humaines) et que la taille d’échantillon est petite ($n < 30$), le recours à la distribution $t$ de Student avec $n – 1$ degrés de liberté est impératif afin de compenser l’incertitude supplémentaire apportée par l’estimation conjointe de l’écart-type $s$.
- Lorsque la taille de l’échantillon est importante ($n ge 30$ voire $n > 100$), le théorème central limite garantit que la distribution $t$ converge asymptotiquement vers la loi normale standard $Z$.
8.2 Utilisation de INTERVALLE.CONFIANCE.STUDENT pour les petits échantillons
Dans nos données d’anxiété ($n = 30$, plage B2:B31), nous nous situons exactement à la frontière méthodologique, où l’emploi de la loi de Student demeure le choix le plus rigoureux et conservateur. Microsoft Excel intègre depuis sa version 2010 la fonction statistique perfectionnée INTERVALLE.CONFIANCE.STUDENT (ou CONFIDENCE.T).
La syntaxe de cette fonction requiert trois arguments ordonnés :
=INTERVALLE.CONFIANCE.STUDENT(alpha; ecart_type; taille)
Pour déterminer la demi-largeur de l’intervalle (fréquemment appelée marge d’erreur, $ME$) au seuil de confiance bilatéral de 95 % ($\alpha = 0,05$), la formule s’écrit :
=INTERVALLE.CONFIANCE.STUDENT(0,05; ECARTYPE.STANDARD(B2:B31); NB(B2:B31))
Sur notre jeu de données, Excel calcule la valeur critique bilatérale $t_{0,05; 29} \approx 2,0452$ et la multiplie par l’erreur type calculée précédemment ($0,92765$), ce qui produit une marge d’erreur égale à :
1,8973 (soit approximativement 1,90 point).
Pour finaliser l’estimation par intervalle, nous devons retrancher et ajouter cette marge d’erreur à notre estimation ponctuelle centrale :
- Borne inférieure (CI_Bas) :
=MOYENNE(B2:B31) - INTERVALLE.CONFIANCE.STUDENT(0,05; ECARTYPE.STANDARD(B2:B31); NB(B2:B31))
Ce qui donne : $26,333 – 1,897 = \mathbf{24,44}$. - Borne supérieure (CI_Haut) :
=MOYENNE(B2:B31) + INTERVALLE.CONFIANCE.STUDENT(0,05; ECARTYPE.STANDARD(B2:B31); NB(B2:B31))
Ce qui donne : $26,333 + 1,897 = \mathbf{28,23}$.
L’estimation conjointe se synthétise ainsi : notre meilleure estimation ponctuelle du score moyen d’anxiété est de $26,33$ points, et nous avons 95 % de confiance que le paramètre moyen réel de la population se trouve compris entre $24,44$ et $28,23$ points sur l’échelle HAM-A.
8.3 Utilisation de INTERVALLE.CONFIANCE.NORMALE pour les grandes cohortes
Lorsque la taille de l’échantillon devient substantielle (par exemple $n = 500$ participants dans une étude transversale sur le sommeil), la distribution d’échantillonnage de la moyenne ne nécessite plus de pénalisation pour petits degrés de liberté. Dans ces conditions, la fonction appropriée est INTERVALLE.CONFIANCE.NORMALE (ou CONFIDENCE.NORM), qui exploite la valeur critique $Z_{alpha/2}$ issue de la loi normale centrée réduite (égale à environ $1,96$ pour un seuil de confiance de 95 %).
Sa formulation opérationnelle sous Excel est strictement parallèle :
=INTERVALLE.CONFIANCE.NORMALE(alpha; ecart_type; taille)
Si l’on appliquait à titre comparatif cette fonction gaussienne à nos 30 scores d’anxiété :
=INTERVALLE.CONFIANCE.NORMALE(0,05; ECARTYPE.STANDARD(B2:B31); NB(B2:B31))
Le résultat généré serait de 1,818 point. La marge d’erreur calculée sous la loi normale ($1,82$) est artificiellement plus étroite que celle calculée sous la loi de Student ($1,90$). Cette sous-évaluation de la marge d’erreur pour les petits effectifs illustre pourquoi l’usage inconsidéré de la loi normale sur de petits groupes constitue un piège méthodologique qui gonfle le taux d’erreur de première espèce (rejet erroné de l’hypothèse nulle).
9. Étude de cas clinique 1 : Évaluation de l’efficacité d’une psychothérapie
9.1 Protocole de mesure et recueil des données pré-post traitement
Pour illustrer la portée décisionnelle de l’estimation ponctuelle dans l’exercice clinique evidence-based, développons une étude longitudinale contrôlée évaluant l’efficacité d’une psychothérapie cognitivo-comportementale (TCC) axée sur la dépression. L’étude suit un protocole à mesures répétées pré-post intervention auprès d’une cohorte de 20 patients souffrant d’un épisode dépressif majeur récurrent.
Les patients ont complété l’Inventaire de dépression de Beck de deuxième édition (BDI-II) à deux reprises temporelles : à l’admission dans le protocole (semaine 0, score pré-traitement) et à l’issue de 12 séances hebdomadaires de thérapie structurée (semaine 12, score post-traitement). Le score au BDI-II s’échelonne de 0 à 63 points.
Les données sont ordonnées dans un tableau Excel comportant quatre colonnes :
- Colonne
A: Identifiant du patient (Sujet_01àSujet_20). - Colonne
B:BDI_Pre(plageB2:B21). - Colonne
C:BDI_Post(plageC2:C21). - Colonne
D: Variable dérivée de changement thérapeutique, calculée par la différence de score pour chaque participant :=B2 - C2dans la celluleD2, étendue jusqu’àD21.
En formulant la soustraction sous la forme « Score Pré moins Score Post », une valeur différentielle positive dénote une amélioration symptomatique (diminution du score de dépression au cours de la prise en charge).
9.2 Calcul de l’estimation ponctuelle du gain thérapeutique moyen
La question scientifique centrale porte sur la réduction clinique moyenne que l’on peut espérer obtenir dans la population cible grâce à cette intervention thérapeutique spécifique. L’estimateur ponctuel d’intérêt est donc la moyenne des différences individuelles ($\bar{D}$).
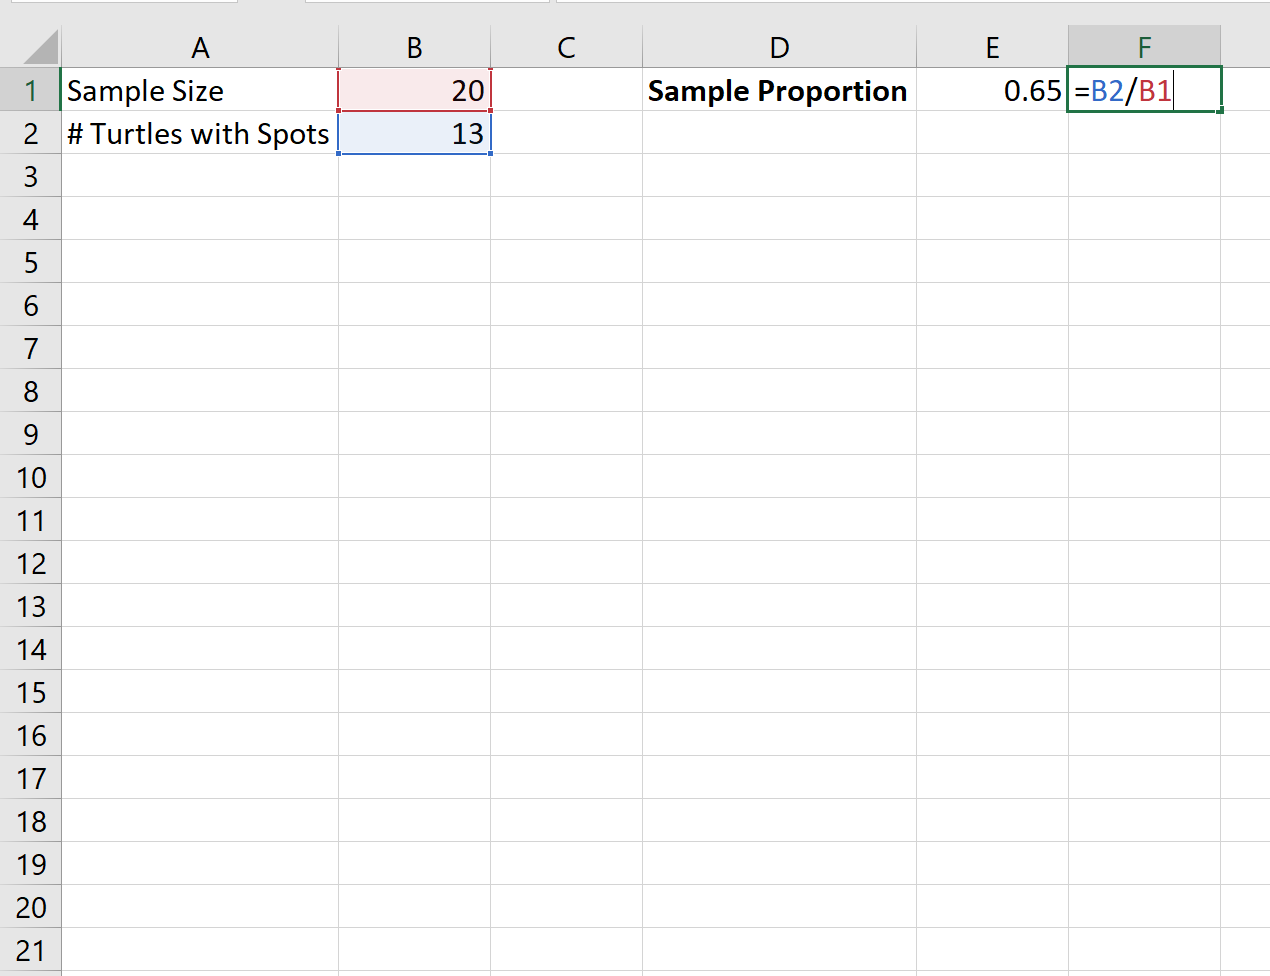
Dans la cellule G2, nous inscrivons la formule d’estimation ponctuelle :
=MOYENNE(D2:D21)
Supposons que la somme des réductions de scores observées chez les 20 participants s’élève à 214 points. Le résultat produit par la fonction équivaut à :
10,70
L’estimation ponctuelle du gain thérapeutique moyen est donc d’une baisse de 10,70 points sur l’inventaire BDI-II. Pour quantifier la variance des réponses individuelles au traitement, nous insérons dans la cellule G3 la commande de l’écart-type d’échantillon :
=ECARTYPE.STANDARD(D2:D21)
Supposons que cette commande retourne la valeur de 4,32 points. Ce résultat met en évidence une hétérogénéité significative des réponses thérapeutiques : bien que le gain moyen se situe autour de 10 points, certains participants ont expérimenté des rémissions spectaculaires (réductions supérieures à 18 points) tandis que d’autres ont manifesté des progrès modestes (réductions de 2 ou 3 points seulement).
En psychologie clinique empirique, cette estimation ponctuelle doit être confrontée à la notion de différence minimale cliniquement importante (DMCI). La littérature psychiatrique s’accorde généralement à fixer le seuil d’amélioration cliniquement perceptible au BDI-II à une baisse d’au moins 5 points. Notre estimation ponctuelle de $10,70$ points dépasse très largement ce seuil de pertinence clinique.
9.3 Validation inférentielle et interprétation psychologique des résultats
Afin de valider que cette réduction moyenne de 10,70 points n’est pas le simple produit d’une fluctuation aléatoire d’échantillonnage ou d’un effet placebo non spécifique, nous devons cadrer cette estimation ponctuelle par son intervalle de confiance à 95 % fondé sur la distribution de Student ($df = 20 – 1 = 19$).
Nous calculons la marge d’erreur dans la cellule G4 :
=INTERVALLE.CONFIANCE.STUDENT(0,05; G3; NB(D2:D21))
Avec $s = 4,32$ et $n = 20$, la fonction retourne une marge d’erreur de 2,02 points. Nous en déduisons les bornes de notre intervalle de confiance :
- Borne inférieure : $10,70 – 2,02 = \mathbf{8,68}$ points de réduction.
- Borne supérieure : $10,70 + 2,02 = \mathbf{12,72}$ points de réduction.
L’analyse inférentielle confirme la puissance de l’effet thérapeutique : même dans le scénario d’échantillonnage le plus défavorable permis par la borne inférieure ($8,68$ points), la réduction symptomatique demeure largement supérieure au seuil clinique de 5 points, et n’englobe en aucun cas la valeur zéro (qui correspondrait à une absence totale de changement thérapeutique). Cette modélisation atteste de la supériorité statistique et de la pertinence clinique de l’intervention TCC évaluée.
10. Étude de cas clinique 2 : Enquête épidémiologique sur le burn-out chez les soignants
10.1 Constitution de la cohorte et catégorisation diagnostique
Considérons à présent une étude épidémiologique en psychologie organisationnelle et santé au travail. L’objectif est d’estimer la prévalence ponctuelle de l’épuisement professionnel sévère (burn-out) parmi les personnels soignants (infirmiers et aides-soignants) exerçant dans les pôles de réanimation et d’urgence d’un centre hospitalier universitaire régional.
Un échantillon probabiliste stratifié de $n = 250$ soignants a complété le Maslach Burnout Inventory (MBI). L’instrument évalue trois dimensions fondamentales : l’épuisement émotionnel, la dépersonnalisation (ou cynisme) et l’accomplissement personnel. Selon les critères cliniques consensuels, un soignant est catégorisé en « burn-out sévère » dès lors qu’il présente un score d’épuisement émotionnel supérieur à 30 couplé à un score de dépersonnalisation supérieur à 12.
Dans la feuille de calcul Excel, chaque professionnel occupe une ligne (de la ligne 2 à la ligne 251). La colonne E héberge le statut diagnostique booléen :
1: Diagnostic de burn-out sévère confirmé.0: Niveaux d’épuisement faibles à modérés (inférieurs aux seuils critiques).
Après application d’un filtre de contrôle pour vérifier l’absence d’omissions, nous certifions la présence de 250 observations complètes dans la plage E2:E251.
10.2 Estimation ponctuelle de la prévalence hospitalière
Pour extraire l’estimation ponctuelle de la prévalence du syndrome au sein de ce pôle hospitalier, nous mobilisons la fonction matricielle simple dans la cellule H2 :
=MOYENNE(E2:E251)
Supposons que la sommation des soignants franchissant le seuil diagnostique révèle 70 cas positifs sur les 250 soignants évalués. La formule renvoie la fraction décimale :
0,28
Soit une estimation ponctuelle de la prévalence globale équivalant à 28,0 %. À des fins de validation transparente, le statisticien vérifie ce résultat en décomposant les opérations dans les cellules adjacentes :
- Cellule
H3(Nombre de cas) :=NB.SI(E2:E251; 1)$\rightarrow$ renvoie70. - Cellule
H4(Effectif total) :=NB(E2:E251)$\rightarrow$ renvoie250. - Cellule
H5(Ratio) :=H3 / H4$\rightarrow$ renvoie0,28.
Cette estimation ponctuelle de 28 % indique qu’approximativement plus d’un soignant sur quatre se trouve dans une situation de détresse psychologique majeure au sein de cette unité. Cependant, avant d’engager des alertes institutionnelles, il convient d’analyser les biais d’échantillonnage potentiels : un taux de participation différencié (les soignants les plus épuisés ayant pu soit rejeter le questionnaire par manque d’énergie, soit au contraire s’en emparer massivement comme canal de contestation) peut impacter la représentativité de l’estimateur ponctuel.
10.3 Encadrement probabiliste de la proportion estimée
Compte tenu de la taille substantielle de l’échantillon ($n = 250$), le théorème central limite s’applique sans réserve pour la modélisation de la proportion ($n \cdot p = 250 \cdot 0,28 = 70 ge 10$, et $n \cdot (1-p) = 250 \cdot 0,72 = 180 ge 10$). La distribution d’échantillonnage de la proportion suit une loi normale. Étant donné l’enjeu médico-légal et institutionnel de l’enquête, la direction de l’hôpital réclame un niveau de confiance particulièrement élevé, fixé à 99 % ($\alpha = 0,01$).
Calculons l’erreur type de la proportion dans la cellule H6 :
=RACINE((H2 * (1 - H2)) / H4)
L’opération numérique donne :
$$SE_p = \sqrt{\frac{0,28 \cdot 0,72}{250}} = \sqrt{\frac{0,2016}{250}} = \sqrt{0,0008064} \approx 0,028398 \text{ (soit } 2,84 % \text{)}$$
Pour un niveau de confiance bilatéral de 99 %, la valeur critique $Z_{0,005}$ est déterminée dans Excel via la fonction de loi normale standard inverse :
=LOI.NORMALE.STANDARD.INVERSE(1 - 0,01/2)
Cette commande renvoie $Z \approx 2,5758$. La marge d’erreur pour cette proportion au seuil de 99 % s’obtient alors en multipliant la valeur critique par l’erreur type :
=LOI.NORMALE.STANDARD.INVERSE(0,995) * H6
Ce calcul fournit une marge d’erreur de 0,0731 (soit $7,31%$).
L’intervalle de confiance à 99 % de la prévalence s’établit en déduisant et en ajoutant cette marge à notre estimation ponctuelle :
- Borne inférieure : $28,00% – 7,31% = \mathbf{20,69%}$
- Borne supérieure : $28,00% + 7,31% = \mathbf{35,31%}$
En synthèse, l’équipe d’audit peut conclure avec un niveau de confiance de 99 % que la proportion réelle de soignants frappés par un burn-out sévère au sein de l’établissement se situe entre $20,7%$ et $35,3%$. Même la limite basse de cet intervalle ($20,7%$) traduit une situation de crise organisationnelle imposant le déploiement immédiat de dispositifs de soutien psychologique et d’aménagement de la charge de travail.
11. Erreurs courantes, pièges méthodologiques et bonnes pratiques sous Excel
11.1 Confusion entre fonctions de population et d’échantillon
Le piège statistique le plus prévalent sous Microsoft Excel réside dans l’utilisation indifférenciée des variantes de population et d’échantillon des fonctions de second ordre, principalement l’écart-type et la variance. Ce problème est aggravé par le fait qu’il n’existe aucune divergence syntaxique pour la moyenne (une fonction fictive telle que MOYENNE.P n’existant pas, car la moyenne empirique arithmétique d’un échantillon partage la même formulation de base que celle d’une population).
En revanche, comme explicité au chapitre 6, sélectionner accidentellement VAR.P ou ECARTYPE.P sur des données expérimentales conduit à omettre la correction de Bessel $n-1$. Cette erreur engendre une sous-estimation systématique de la variabilité d’autant plus sévère que l’échantillon est restreint :
- Sur un échantillon de taille $n = 5$,
ECARTYPE.Psous-estime l’écart-type réel d’environ 10,6 %. - Sur un échantillon de taille $n = 10$, la sous-estimation est encore de 5,1 %.
- Sur un échantillon de taille $n = 30$, la sous-estimation persiste à hauteur de 1,7 %.
Pour prévenir ces dérives dans les modèles institutionnels partagés, les méthodologistes doivent auditer les cellules à l’aide de la fonctionnalité Formules > Afficher les formules (raccourci Ctrl + ") et verrouiller les cellules de calcul via la protection des feuilles (onglet Révision > Protéger la feuille) afin d’interdire aux utilisateurs de modifier ou de substituer par inadvertance les fonctions VAR.S et ECARTYPE.STANDARD.
11.2 Impact délétère des cellules vides et des encodages textuels
L’altération silencieuse des calculs d’estimations ponctuelles consécutive à une mauvaise interprétation de la valeur nulle par rapport à l’absence de saisie constitue un fléau récurrent dans Excel. Il convient de retenir les règles immuables appliquées par le moteur de calcul :
- Si une cellule est totalement vide, la fonction
MOYENNEla passe sous silence au numérateur comme au dénominateur. L’effectif $n$ retenu pour le calcul de l’estimateur s’ajuste à la baisse, ce qui préserve l’exactitude de la moyenne des cas documentés. - Si une cellule héberge le chiffre zéro (0), elle est comptabilisée comme une mesure clinique valide. Le zéro intègre la sommation au numérateur (sans accroître la somme) et incrémente de 1 le diviseur $n$, ce qui tire mécaniquement l’estimation ponctuelle vers le bas.
- Si une valeur numérique est encodée sous forme de chaîne de caractères (par exemple
" 24"avec une espace parasite ou une apostrophe de préfixe'24), les fonctionsMOYENNE,VAR.SetECARTYPE.STANDARDl’excluent silencieusement de l’opération, sans alerter l’analyste par un message de code d’erreur (tel que#VALEUR!).
Pour contrer ces périls, il est vivement conseillé d’intégrer des tests d’intégrité avant toute analyse inférentielle. L’emploi conjoint de NB.VIDE(plage) pour vérifier le volume exact de données absentes et de SOMMEPROD(ESTTEXTE(plage)*1) pour détecter toute importation accidentelle de chaînes textuelles au sein des colonnes de scores permet de sécuriser la validité computationnelle de l’ensemble du classeur.
11.3 Arrondis prématurés et perte de précision décimale
Une tentation fréquente chez les utilisateurs débutants consiste à introduire la fonction d’arrondi mathématique ARRONDI(valeur; décimales) directement au sein des étapes de calcul intermédiaires d’une chaîne algorithmique — par exemple en arrondissant l’estimation ponctuelle de la moyenne avant de l’injecter dans le calcul de la somme des carrés des écarts ou de l’erreur type.
Cette pratique constitue une infraction méthodologique sévère : les erreurs d’arrondi se propagent et s’amplifient de manière exponentielle au fur et à mesure des dérivations statistiques ultérieures (un phénomène connu en analyse numérique sous le nom de perte de signification ou instabilité numérique). L’architecture logicielle d’Excel applique la norme internationale IEEE 754 relative à l’arithmétique flottante en double précision, conservant en mémoire vive jusqu’à 15 chiffres significatifs réels.
La règle d’or consiste à préserver l’intégralité de la précision sous-jacente tout au long de la chaîne analytique et à ne restreindre le nombre de décimales que de manière purement visuelle, en utilisant les outils de formatage d’affichage des cellules (icônes Ajouter/Réduire une décimale du ruban Accueil). La fonction d’arrondi explicite ARRONDI ne doit être mobilisée qu’à l’ultime étape de communication finale du score dans le rapport synthétique rédigé.
12. Synthèse, automatisation et intégration dans les rapports de recherche APA
12.1 Conception d’une matrice d’analyse réutilisable sous Excel
Pour pérenniser et standardiser les flux de travail dans un laboratoire de psychologie ou un cabinet clinique, la construction d’un gabarit (ou template) d’analyse réutilisable s’impose comme une solution d’excellence organisationnelle. Ce modèle doit dissocier physiquement l’espace de saisie brute des variables de la matrice de restitution statistique automatisée.
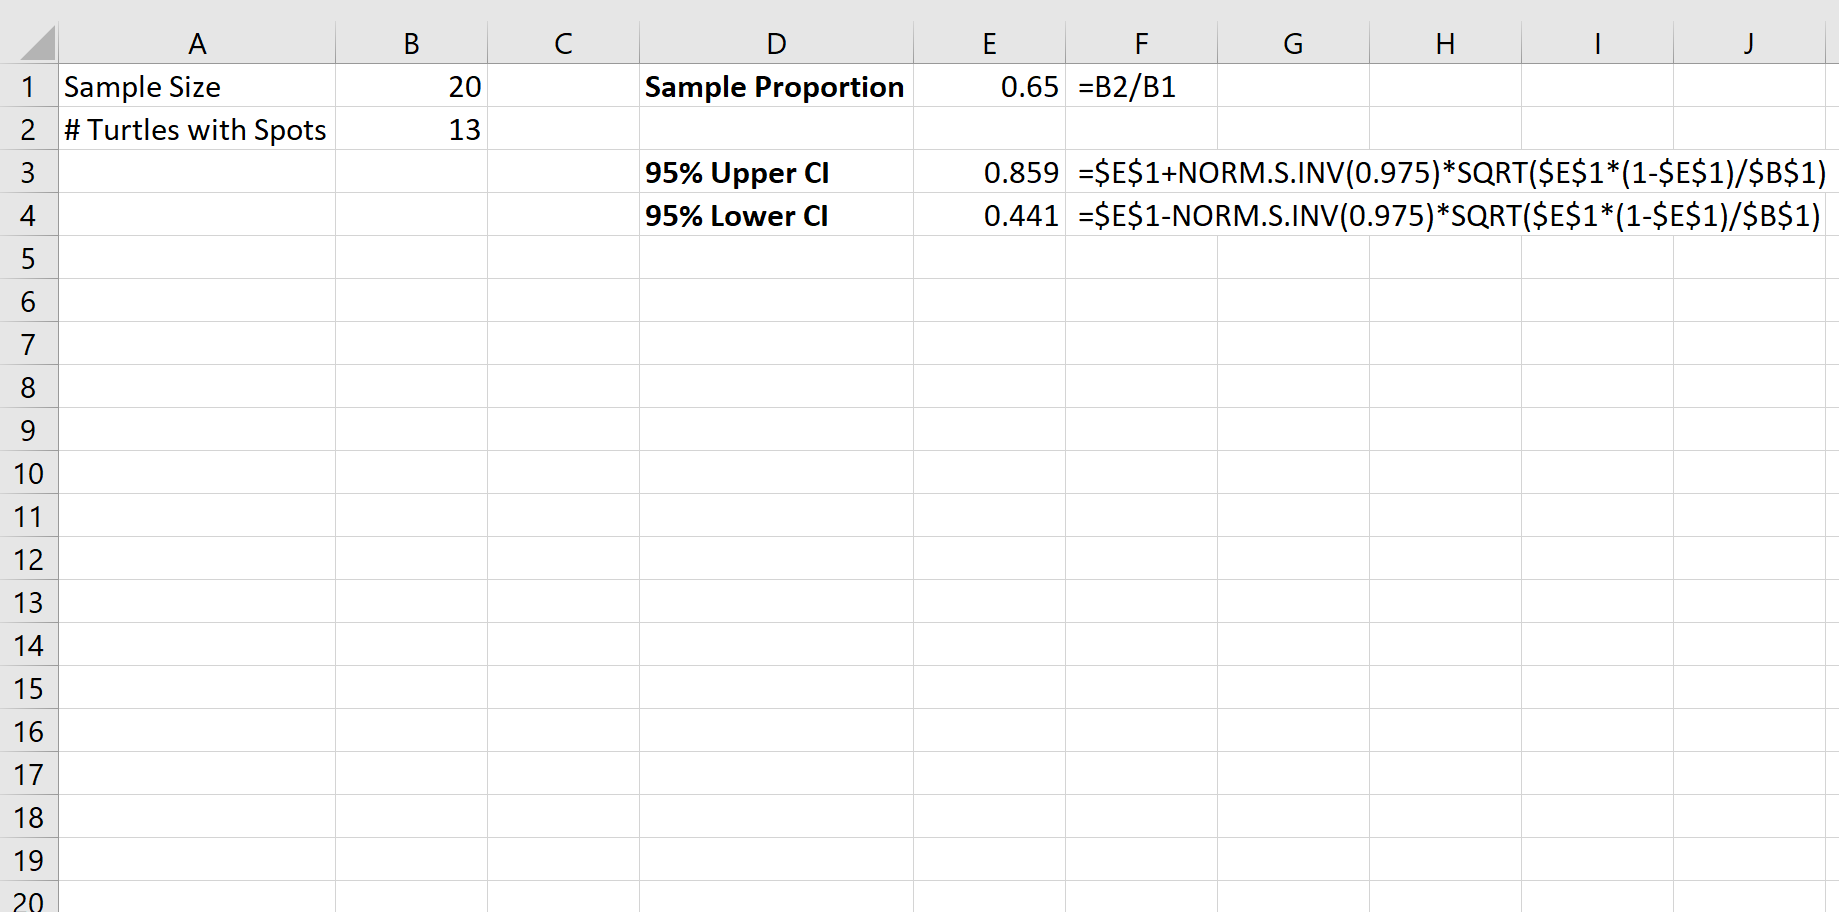
La feuille de calcul peut ainsi être articulée en deux sections distinctes :
- Zone A (Entrée dynamique des données) : Un Tableau structuré Excel officiel (baptisé par exemple
Saisie_Donnees). L’intérêt fondamental de cette structure réside dans son extension automatique : dès qu’un nouvel enregistrement de participant est complété sur la première ligne libre inférieure, le tableau absorbe la ligne et met à jour instantanément la plage couverte sans qu’aucune reconfiguration humaine des formules ne soit requise. - Zone B (Tableau de bord statistique) : Un bloc de restitution figé, protégée en écriture, regroupant les équations fondamentales articulées autour des références structurées :
- Taille de l’échantillon ($n$) :
=NB(Saisie_Donnees[Score]) - Estimation ponctuelle de la moyenne ($\bar{x}$) :
=MOYENNE(Saisie_Donnees[Score]) - Estimation ponctuelle de l’écart-type ($s$) :
=ECARTYPE.STANDARD(Saisie_Donnees[Score]) - Erreur type ($SE$) :
=ECARTYPE.STANDARD(Saisie_Donnees[Score])/RACINE(NB(Saisie_Donnees[Score])) - Marge d’erreur à 95 % ($ME$) :
=INTERVALLE.CONFIANCE.STUDENT(0,05; ECARTYPE.STANDARD(Saisie_Donnees[Score]); NB(Saisie_Donnees[Score])) - Bornes de l’IC à 95 % : Bornes inférieure et supérieure calculées par déduction et addition dynamique.
- Taille de l’échantillon ($n$) :
Ce gabarit standardisé immunise l’organisation contre les erreurs d’écrasement de formules et garantit la réplicabilité intégrale des estimations au fil des campagnes d’investigation successives.
12.2 Visualisation graphique rigoureuse avec barres d’erreur
La communication scientifique moderne exige une restitution graphique claire des estimations ponctuelles et de leur incertitude d’échantillonnage. Dans Excel, l’adjonction de barres d’erreur sur les graphiques à barres ou les nuages de points constitue une étape méthodologique fondamentale, trop souvent dévoyée par une configuration incorrecte des options graphiques.
Pour construire une visualisation irréprochable sur le plan académique :
- Générer un graphique à barres standard à partir de la valeur de l’estimation ponctuelle de la moyenne (ou des moyennes comparées entre deux groupes, par exemple « Groupe Témoin » versus « Groupe Expérimental »).
- Sélectionner la série graphique, cliquer sur le symbole « + » vert d’ajout d’éléments graphiques (ou onglet Création de graphique > Ajouter un élément de graphique), et cocher l’option Barres d’erreur.
- Écueil absolu à éviter : Ne jamais sélectionner les configurations d’erreurs par défaut proposées par Excel (telles que les barres d’erreur à « Pourcentage standard » de 5 % ou « Valeur fixe », qui n’ont aucune consistance inférentielle dans un article scientifique).
- Sélectionner Autres options de barres d’erreur… pour ouvrir le volet de configuration latéral.
- Dans la section Marge d’erreur, cocher la case d’option Personnalisée, puis cliquer sur le bouton Spécifier une valeur.
- Dans la boîte de dialogue contextuelle, pointer le sélecteur de la Valeur d’erreur positive vers la cellule contenant votre calcul rigoureux de l’Erreur Type (SE) ou de la Marge d’erreur de l’Intervalle de Confiance, et faire de même pour la Valeur d’erreur négative.
Cette rigueur de paramétrage assure que l’indicateur graphique d’incertitude correspond à la réalité statistique sous-jacente des données.
12.3 Normes de présentation des résultats selon le style de l’APA (7e édition)
La restitution écrite des estimations ponctuelles au sein d’une thèse, d’un mémoire professionnel ou d’un article soumis à une revue internationale à comité de lecture doit se plier aux prescriptions formelles de l’American Psychological Association (APA 7th Edition). L’APA impose un ensemble de conventions typographiques strictes :
- Les symboles statistiques latins doivent être obligatoirement transcrits en italique : la moyenne d’échantillon est notée M, l’écart-type est abrégé en SD (pour Standard Deviation), l’erreur type en SE, et la proportion empirique en p.
- Les symboles statistiques grecs (tels que $\mu$, $\sigma$, ou $\pi$) ne s’écrivent jamais en italique.
- Les métriques d’estimations ponctuelles s’énoncent systématiquement accompagnées de leur indice de dispersion et de leur encadrement par intervalle de confiance.
- Le formatage numérique standard requiert d’arrondir les moyennes, écarts-types et intervalles de confiance à deux décimales, avec une espace insécable positionnée de part et d’autre des opérateurs d’égalité ou d’inégalité ($M = 26,33$ ; $p < ,001$).
Voici des modèles rédactionnels types prêts à l’emploi permettant d’insérer les résultats calculés sous Excel au sein de vos manuscrits scientifiques :
Modèle pour l’estimation d’une moyenne continue (Exemple 1) :
« Le niveau moyen d’anxiété évalué auprès des patients à l’admission via l’échelle de Hamilton s’élève à M = 26,33 (SD = 5,08, SE = 0,93), avec un intervalle de confiance à 95 % compris entre [24,44 ; 28,23]. Cette estimation ponctuelle confirme une intensité symptomatique cliniquement significative au sein de la cohorte d’admission. »
Modèle pour l’estimation d’un gain d’intervention thérapeutique pré-post (Étude de cas 1) :
« L’intervention psychothérapeutique TCC sur 12 semaines a produit une réduction moyenne substantielle des scores dépressifs mesurés au BDI-II, avec une estimation ponctuelle du gain thérapeutique de M = 10,70 points (SD = 4,32, 95 % IC [8,68 ; 12,72]). L’intervalle de confiance n’englobant pas le seuil de significativité minimale de 5 points, l’effet thérapeutique peut être qualifié d’efficace et robuste. »
Modèle pour l’estimation d’une proportion catégorielle (Étude de cas 2) :
« L’enquête épidémiologique conduite auprès des professionnels de santé en milieu hospitalier critique met en évidence une estimation ponctuelle de la prévalence du burn-out sévère de 28,0 % (70 soignants sur N = 250), SE = 2,84 %, 99 % IC [20,69 % ; 35,31 %]. Ces données démontrent une vulnérabilité psychologique majeure au sein des équipes soignantes. »
En adoptant cette méthodologie intégrée — depuis l’organisation tabulaire des données sous Excel jusqu’à la formulation académique normalisée —, les praticiens et chercheurs en sciences du comportement garantissent la rigueur, l’intégrité et la reproductibilité absolue de leurs démarches empiriques.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2012). Understanding The New Statistics: Effect Sizes, Confidence Intervals, and Meta-Analysis. Routledge.
- Field, A. (2018). Discovering Statistics Using IBM SPSS Statistics (5th ed.). SAGE Publications.
- Hamilton, M. (1959). The assessment of anxiety states by rating. British Journal of Medical Psychology, 32(1), 50–55. https://doi.org/10.1111/j.2044-8341.1959.tb00467.x
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/S0140525X0999152X
- Howell, D. C. (2013). Statistical Methods for Psychology (8th ed.). Cengage Learning.
- Kroenke, K., Spitzer, R. L., & Williams, J. B. (2001). The PHQ-9: Validity of a brief depression severity measure. Journal of General Internal Medicine, 16(9), 606–613. https://doi.org/10.1046/j.1525-1497.2001.016009606.x
- Maslach, C., Jackson, S. E., & Leiter, M. P. (1996). Maslach Burnout Inventory Manual (3rd ed.). Consulting Psychologists Press.
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10