
Dans le paysage foisonnant des analyses quantitatives appliquées aux sciences du comportement, à la neuropsychologie et aux sciences sociales, la mesure de l’association entre deux entités empiriques constitue l’un des piliers méthodologiques fondamentaux. Les praticiens, chercheurs et analystes de données se heurtent quotidiennement à des configurations d’échantillonnage où les variables mesurées ne partagent pas le même statut métrique. Alors que le coefficient de corrélation linéaire de Pearson règne sans partage lorsque deux variables continues obéissent à des échelles d’intervalles ou de rapports, une situation expérimentale omniprésente impose une modélisation hybride : l’évaluation du lien statistique unissant une variable qualitative strictement binaire à une variable quantitative continue.
C’est précisément au cœur de cette configuration bivariée que s’inscrit la corrélation point-bisériale, désignée dans la littérature psychométrique par le symbole rpb. Qu’il s’agisse de mesurer la discrimination d’un item de test cognitif opposant la réussite à l’échec face au score global, d’étudier l’impact d’une mutation génétique dichotomique sur un indice d’efficience attentionnelle, ou encore de quantifier la relation entre la présence d’un diagnostic clinique et le niveau d’une cytokine sérique, ce coefficient fournit un indice standardisé d’une clarté exemplaire. Il condense au sein d’une valeur métrique unique comprise entre -1 et +1 la force et l’orientation de la covariation observée.
Bien que des environnements logiciels spécialisés tels que R, SPSS ou SAS offrent des modules dédiés à l’extraction de ce paramètre, le tableur Microsoft Excel demeure l’écosystème numérique le plus universellement déployé au sein des laboratoires universitaires, des cliniques et des départements d’évaluation psychologique. Ce guide exhaustif a pour vocation de déconstruire pas à pas les fondements théoriques, la logique algébrique, les conditions de validité inférentielle et l’exécution computationnelle de la corrélation point-bisériale dans Excel, en exploitant tant ses fonctions matricielles natives que le calcul analytique décomposé, tout en garantissant une restitution académique rigoureuse conforme aux exigences de l’American Psychological Association (APA).
1. Fondements théoriques de la corrélation point-bisériale en psychologie
1.1 Définition et origines mathématiques du coefficient
L’édification de la corrélation point-bisériale plonge ses racines historiques dans l’essor de la psychométrie classique au tournant du XXe siècle, sous l’impulsion conjointe de Karl Pearson et de Charles Spearman. Confrontés à l’évaluation des aptitudes intellectuelles naissantes et à la standardisation des premiers examens standardisés, les pionniers de la statistique moderne durent élaborer des outils mathématiques capables de formaliser l’interdépendance entre des performances discrètes (succès versus échec à une épreuve donnée) et des construits psychologiques sous-jacents postulés continus, tels que le facteur général d’intelligence. Le coefficient de corrélation point-bisériale, formellement modélisé comme une adaptation du coefficient produit-moment, matérialise l’intensité du lien fonctionnel reliant une variable nominale binaire X (ne comportant que deux modalités exclusives) et une variable métrique continue Y mesurée au moins sur une échelle d’intervalles.
Sur le plan de l’épistémologie quantitative, il convient de souligner avec insistance que la corrélation point-bisériale quantifie une simple association bivariée symétrique et ne saurait en aucun cas être interprétée comme la preuve irréfutable d’une chaîne de causalité déterministe. Une covariation substantielle entre l’appartenance à un groupe et le score mesuré peut émerger sous l’effet de confondeurs latents, d’une rétroaction causale inverse ou d’artefacts d’échantillonnage. En tant qu’indice standardisé, le coefficient rpb possède des propriétés métriques rigoureuses : il est invariant face aux transformations linéaires positives des scores continus et demeure systématiquement circonscrit dans l’intervalle fermé [-1, ; +1]. La valeur 0 signale une stricte indépendance linéaire des distributions conditionnelles, tandis que les valeurs extrêmes -1 et +1 reflètent une partition mathématique parfaite et sans chevauchement des scores continus de part et d’autre de la frontière catégorielle.
Dans la perspective de la théorie classique des tests, l’intérêt primordial de cet indice réside dans sa capacité à synthétiser l’information sans nécessiter de transformations non linéaires complexes. En associant un statut catégoriel à une grandeur quantitative, la formulation point-bisériale permet d’obtenir un estimateur convergent de la taille de l’effet standardisée, fournissant ainsi une base solide pour toute inférence ultérieure sur les populations parentes.
1.2 Distinction épistémologique entre variables dichotomiques naturelles et artificielles
L’analyse des distributions catégorielles en psychologie expérimentale impose une distinction conceptuelle fondamentale entre deux architectures de variables binaires : les dichotomies vraies (ou naturelles) et les dichotomies artificielles (ou forcées). Une dichotomie naturelle renvoie à une variable dont l’état intrinsèque est ontologiquement discret et ne procède d’aucune simplification arbitraire opérée par l’expérimentateur. L’exemple paradigmatique réside dans le statut vital d’un sujet en recherche biomédicale (survivant versus décédé), l’attribution aléatoire à une condition dans un protocole en double aveugle (groupe recevant un placebo versus groupe recevant le principe actif), ou encore le porteur d’une allèle spécifique face à un non-porteur en génétique comportementale. Dans ces configurations, la frontière séparant les deux états est nette, immuable et exempte de continuum latent.
À l’opposé, les dichotomies artificielles découlent d’une décision méthodologique consistant à tronquer un continuum continu sous-jacent au moyen d’un seuil de césure opérationnel. La classification des individus en catégories « anxieux » versus « non anxieux » sur la base d’une note de coupure établie arbitrairement à un score seuil, ou encore la partition d’un temps de réaction en catégories « rapide » et « lent » par médiane divisée (median split), illustrent cette seconde classe de variables. D’un point de vue statistique, le choix de traiter une dichotomie comme naturelle ou artificielle oriente drastiquement la sélection de l’outil d’analyse. Lorsque la variable binaire est authentiquement discrète, la corrélation point-bisériale rpb représente l’estimateur mathématiquement légitime et non biaisé.
En revanche, lorsqu’une dichotomie découle de l’écrasement d’une variable normalement distribuée, l’emploi du rpb tend à sous-estimer systématiquement la magnitude de la relation sous-jacente en raison d’une perte sèche d’information variance. Dans ce dernier scénario spécifique, la théorie statistique préconise théoriquement le recours au coefficient de corrélation bisériale standard rb, lequel réajuste mathématiquement l’estimation en intégrant la fonction de densité de la loi normale au point de césure. Maîtriser cette divergence épistémologique est primordial avant de lancer une quelconque procédure dans Excel, sous peine d’altérer la validité de construit de l’étude.
1.3 Champs d’application privilégiés en sciences du comportement
Le champ d’application le plus prééminent de la corrélation point-bisériale réside incontestablement dans la psychométrie et l’ingénierie des instruments de mesure psychologiques, spécifiquement au sein du protocole d’analyse de la qualité des items (item analysis). Dans ce contexte, chaque item d’un test standardisé à correction objective (par exemple un inventaire d’aptitudes cognitives où la réponse est notée 1 pour exact et 0 pour erroné) est corrélé au score global total cumulé par les répondants sur l’ensemble de l’épreuve. Ce coefficient de corrélation item-total corrigé constitue l’indice de discrimination cardinal de l’item : il documente avec précision la capacité d’un énoncé spécifique à différencier les sujets affichant un haut niveau de compétence latent de ceux qui manifestent un niveau modeste.
Au-delà de la psychométrie scolaire ou cognitive, la neuropsychologie et la psychiatrie computationnelle sollicitent intensément la corrélation point-bisériale lors de la validation convergente de critères diagnostiques nosographiques. Lorsqu’un clinicien évalue l’impact de la présence formelle d’un trouble psychiatrique (comme l’état de stress post-traumatique, codé de manière binaire : absence = 0, présence = 1) sur une série de biomarqueurs neurophysiologiques continus (volume hippocampique mesuré par IRM morphométrique, taux de cortisol salivaire matinal ou score d’extinction de la peur conditionnée), le coefficient rpb capture directement l’intensité du dysfonctionnement physiologique en fonction du statut nosologique.
Enfin, la psychologie sociale, organisationnelle et différentielle emploie cette mesure dans le cadre des analyses comparatives intergroupes. Qu’il s’agisse d’évaluer l’écart d’adhésion à une politique d’entreprise entre cadres et employés non cadres, d’analyser le différentiel d’empathie cognitive selon le sexe assigné à la naissance au sein d’une cohorte neurotypique, ou de modéliser l’efficacité d’un protocole d’intervention comportementale (cohorte exposée versus cohorte témoin) sur la régulation de l’affect négatif, le coefficient rpb agit comme un descripteur standardisé pivot de la taille de l’effet bivarié.
2. Comparaison structurelle entre le coefficient point-bisériale et le r de Pearson
2.1 L’équivalence mathématique fondamentale avec Pearson
Une incompréhension récurrente dans l’enseignement de la statistique appliquée consiste à conceptualiser la corrélation point-bisériale comme une entité algorithmique fondamentalement disjointe de la corrélation de Bravais-Pearson. Il est formellement démontré sur le plan algébrique que la corrélation point-bisériale constitue en réalité un cas particulier strict, une simplification mathématique directe, du coefficient produit-moment de Pearson, survenant lorsque l’un des deux vecteurs de données est astreint à ne prendre que deux états scalaires discrets conventionnels (en l’occurrence les entiers 0 et 1). Les propriétés de la covariance et de la standardisation par le produit des écarts-types s’appliquent sans aucune dérogation théorique.
Lorsque la formule standard du r de Pearson est déployée sur une matrice comprenant une colonne continue et une colonne binaire numérique, l’expression générale se contracte élégamment pour faire disparaître les sommes de carrés complexes de la variable binaire au profit d’une expression pondérée par les proportions d’individus appartenant à chaque catégorie et par l’écart-type global de la variable métrique. L’équivalence des résultats numériques obtenus par l’une ou l’autre formulation n’est ni approximative ni asymptotique : elle est rigoureusement exacte à la décimale près, quelle que soit la taille finie de l’échantillon analysé.
Cette identité structurelle implique d’immenses avantages pratiques pour le chercheur. Elle signifie qu’il n’est nullement nécessaire de disposer d’un moteur de calcul spécialisé ou d’une bibliothèque logicielle ésotérique pour extraire ce paramètre psychométrique. Tout environnement informatique implémentant l’algorithme conventionnel de Pearson calcule de facto une corrélation point-bisériale parfaite dès lors que la variable qualitative est conditionnée sous une forme numérique appropriée.
2.2 Rôle et impact du codage binaire numérique
L’assimilation opérationnelle d’une variable catégorielle nominale par un algorithme mathématique exige au préalable l’attribution de valeurs numériques fixes à chacune de ses modalités. Dans la tradition statistique universelle, le codage binaire conventionnel retient les entiers 0 et 1 (couramment désigné sous le terme de codage dummy ou variable muette). Ce choix n’est pas anodin sur le plan arithmétique : attribuer 0 et 1 permet à la moyenne de la variable dichotomique X de coïncider très exactement avec la proportion p de sujets possédant l’attribut codé 1, simplifiant ainsi radicalement les calculs d’espérance mathématique et de variance d’échantillonnage.
Toutefois, il est impératif de cerner l’impact de la polarité du codage sur la directionnalité de l’indice. Si l’on attribue la valeur 0 au groupe témoin et la valeur 1 au groupe expérimental, un coefficient rpb positif traduira une supériorité de la moyenne de la variable continue au sein du groupe expérimental. Si, à l’inverse, l’analyste décide d’inverser les étiquettes numériques en assignant la valeur 1 au groupe témoin et la valeur 0 au groupe expérimental, la valeur absolue de la corrélation demeurera rigoureusement inchangée, mais son signe algébrique basculera instantanément de positif à négatif.
L’amplitude absolue du coefficient d’association est donc strictement invariante face à la permutation des codes numériques binaires. Cette invariance confère une flexibilité opérationnelle précieuse, mais elle impose en contrepartie une obligation méthodologique inaliénable : documenter systématiquement et sans ambiguïté la convention de codage adoptée dans les carnets de laboratoire et les rapports d’analyse, afin d’interdire toute méprise quant à la direction clinique ou comportementale de l’effet identifié.
2.3 Justification de l’utilisation directe des fonctions de corrélation dans Excel
À la lumière de l’équivalence algébrique formelle démontrée précédemment, l’emploi direct des fonctions statistiques standards intégrées nativement dans Microsoft Excel se trouve pleinement légitimé sur le plan méthodologique. L’étudiant, l’ingénieur de recherche ou le praticien en psychométrie n’a pas besoin de programmer des macros Visual Basic for Applications (VBA) complexes ni d’aligner manuellement des dizaines d’étapes de calcul matriciel pour parvenir à une estimation sans faille de la corrélation point-bisériale.
L’utilisation directe de l’algorithme standard interne de corrélation d’Excel offre un gain d’efficience temporelle substantiel lors du traitement de volumineuses cohortes de données empiriques. Les fonctions natives du tableur ont été optimisées au fil des décennies pour gérer avec une grande précision numérique les opérations d’accumulation de sommes de produits croisés, limitant ainsi de manière drastique la propagation des erreurs d’arrondi qui affectent inévitablement les calculs manuels menés étape par étape sur des fractions intermédiaires.
De surcroît, le recours aux commandes génériques d’Excel réduit considérablement la probabilité d’erreurs typographiques ou d’inversions de dénominateurs lors de la saisie des équations mathématiques détaillées. Le recours à l’architecture native de calcul d’Excel démocratise l’accès à une analyse statistique avancée tout en garantissant un niveau de reproductibilité computationnelle total, condition sine qua non d’une démarche scientifique intègre.
3. Hypothèses sous-jacentes et conditions d’application statistique
3.1 Exigence de normalité au sein des sous-populations
Bien que la corrélation point-bisériale puisse être techniquement calculée à titre de statistique purement descriptive sur n’importe quel ensemble de couples de données numériques, son utilisation dans un cadre inférentiel — c’est-à-dire pour tester si le lien observé dans l’échantillon s’étend significativement à la population parente — repose sur des postulats distributionnels précis. Le premier de ces prérequis exige que la variable continue Y suive une distribution normale (ou gaussienne) au sein de chacune des deux sous-populations délimitées par la variable binaire X. Cela signifie que la distribution de Y conditionnellement à X = 0 et la distribution de Y conditionnellement à X = 1 doivent chacune afficher une morphologie symétrique en cloche.
Pour évaluer la conformité des données empiriques à cette exigence dans un tableur comme Excel, l’analyste peut recourir à l’examen minutieux des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) calculés séparément pour chaque sous-groupe au moyen des fonctions =COEFFICIENT.ASYMETRIE() et =KURTOSIS(). Des valeurs comprises entre -1 et +1 pour ces deux métriques signalent généralement un profil distributionnel suffisamment proche de la normalité théorique pour autoriser l’inférence paramétrique standard. Lorsque la rigueur académique l’exige, la mise en œuvre complémentaire d’un test d’adéquation plus formel, tel que le test de Shapiro-Wilk ou le test de Kolmogorov-Smirnov avec correction de Lilliefors, s’avère hautement recommandable.
Néanmoins, en vertu du théorème central limite, le modèle inférentiel associé à la corrélation point-bisériale manifeste une robuste résilience face aux déviations modérées de la normalité dès lors que les effectifs globaux atteignent des tailles confortables (couramment N supérieur à 50 ou 100 observations). En présence d’échantillons restreints (N inférieur à 30) caractérisés par des distributions lourdement asymétriques ou plurimodales, la validité des valeurs p associées se dégrade, exposant l’investigateur au risque d’une inflation incontrôlée de l’erreur de type I ou d’une perte dommageable de puissance statistique.
3.2 Homogénéité des variances (homoscédasticité)
Le second pilier conditionnant la validité inférentielle de la corrélation point-bisériale réside dans le postulat d’homoscédasticité, ou d’homogénéité des variances conditionnelles. En vertu de ce principe statistique, la dispersion intrinsèque de la variable quantitative Y autour de sa moyenne de groupe doit être substantiellement équivalente au sein des deux modalités de la variable dichotomique X. En termes formels, la variance de la sous-population 0 doit égaler la variance de la sous-population 1 (σ02 = σ12 = σ2).
Dans l’environnement Excel, la vérification préliminaire de cette condition s’effectue aisément en extrayant la variance d’échantillon pour chaque sous-cohorte via la commande =VAR.S() appliquée séparément aux scores des deux sous-groupes, puis en calculant leur ratio. Si le rapport entre la variance la plus élevée et la variance la plus faible n’excède pas un facteur d’environ 1,5 à 2 dans le cadre d’échantillons de tailles similaires, l’hypothèse d’homoscédasticité est généralement jugée empiriquement tenable. Pour une démonstration formelle, l’application d’un test F de Fisher d’égalité de deux variances peut être exécutée via la fonction native =TEST.F() disponible dans Excel.
La violation sévère de l’homogénéité des variances — situation qualifiée d’hétéroscédasticité — engendre des conséquences préjudiciables sur l’estimation statistique. Lorsque le groupe possédant la plus faible taille d’échantillon affiche simultanément la variance la plus exacerbée, l’erreur-type théorique du coefficient est systématiquement sous-estimée, ce qui débouche sur des tests de significativité artificiellement optimistes et un taux de faux positifs inacceptable. À l’inverse, si le groupe de grand effectif présente la variance la plus large, le test statistique devient excessivement conservateur, masquant de véritables relations empiriques.
3.3 Indépendance des observations et équilibre de l’échantillonnage
Le troisième postulat fondamental réside dans la stricte indépendance statistique de toutes les observations composant la matrice de données. Chaque ligne du jeu de données doit correspondre à une entité d’échantillonnage distincte, sélectionnée de manière probabiliste ou quasi-aléatoire au sein de la population cible. Ce postulat interdit formellement l’utilisation de la corrélation point-bisériale standard dans le cadre de designs longitudinaux à mesures répétées, d’échantillonnages par grappes non contrôlés, ou de configurations où les réponses d’un individu seraient conditionnées par celles d’un autre participant (dynamiques de dyades ou de fratries non modélisées).
Parallèlement à l’indépendance d’échantillonnage, la proportion relative d’individus composant chaque modalité binaire (notées respectivement p pour la catégorie 1 et q = 1 – p pour la catégorie 0) exerce une contrainte mécanique majeure sur le comportement métrique de l’indice. Alors qu’une variable continue croisée avec une autre variable continue peut théoriquement atteindre les bornes extrêmes absolues de -1,00 et +1,00, la corrélation point-bisériale ne peut culminer à ces maxima absolus que si et seulement si l’échantillon est parfaitement équilibré, c’est-à-dire lorsque la proportion d’individus est rigoureusement symétrique (p = q = 0,50).
Dès lors que la distribution catégorielle devient asymétrique (par exemple dans le cas d’une maladie rare où seulement 5 % de la cohorte est diagnostiquée positive, conférant p = 0,05 et q = 0,95), la valeur maximale théorique atteignable pour rpb subit un plafonnement mathématique sévère, tombant souvent en dessous de 0,40 ou 0,30, même en présence d’une séparation quasi-parfaite des scores sous-jacents. Ce phénomène d’atténuation structurelle impose une immense prudence d’interprétation : un coefficient d’apparence modeste obtenu sur des groupes hautement déséquilibrés peut masquer une taille d’effet clinique d’une ampleur considérable.
4. Organisation et assainissement des données expérimentales dans Excel
4.1 Structuration tubulaire matricielle des variables
L’application rigoureuse et fluide d’analyses quantitatives au sein d’Excel repose en premier lieu sur la structuration irréprochable de la feuille de calcul en une matrice de données conforme aux principes canoniques des bases de données relationnelles (« données bien rangées » ou tidy data). Dans cette configuration standardisée, chaque ligne horizontale doit impérativement représenter une unité expérimentale unique et exclusive (un sujet, un patient ou un répondant), tandis que chaque colonne verticale doit incarner une variable opérationnelle spécifique clairement délimitée.
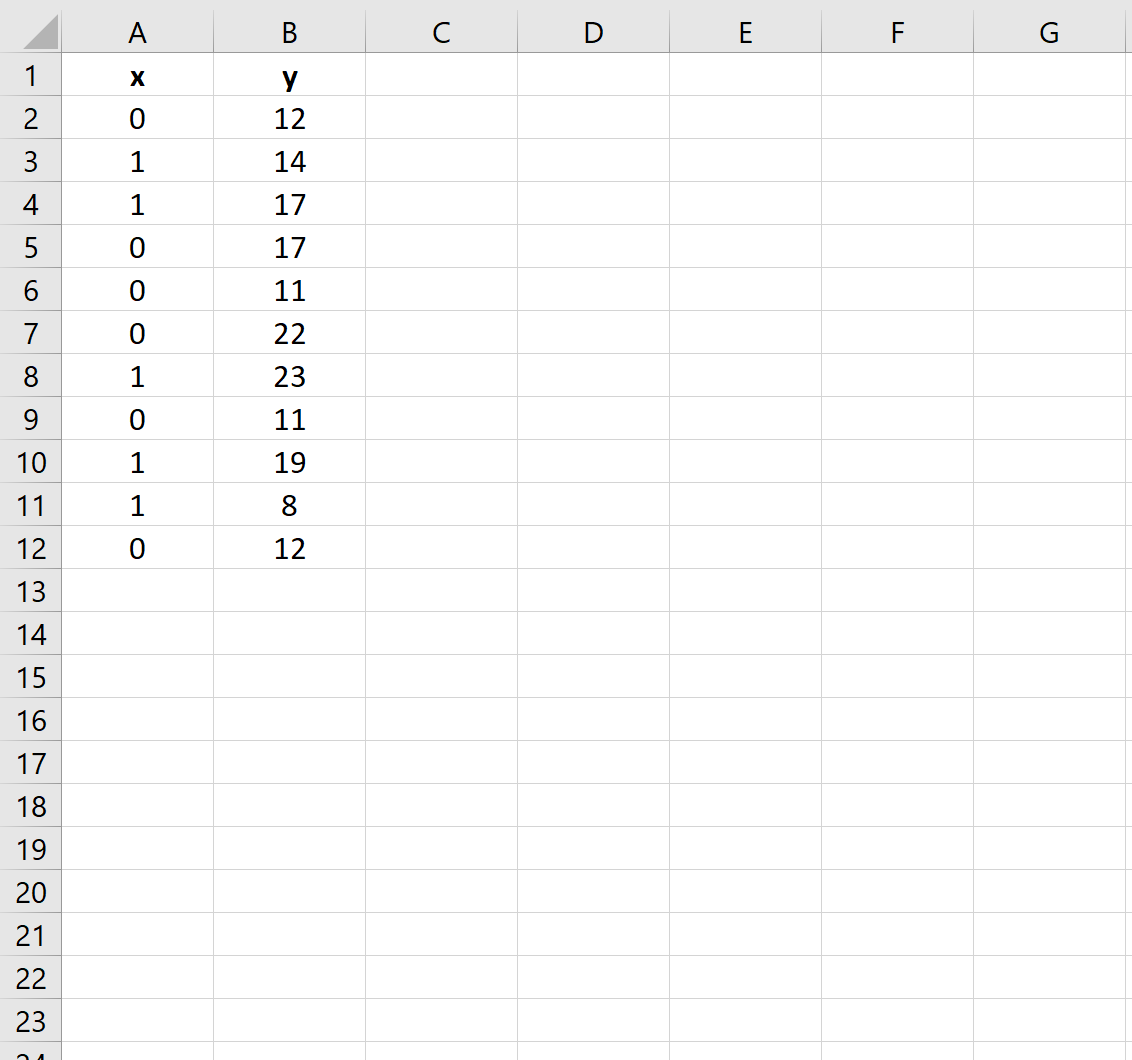
Pour mener à bien une corrélation point-bisériale, la disposition minimale recommandée s’articule autour de trois colonnes contiguës. La première colonne (Colonne A) doit être réservée à un identifiant unique et non nominatif du participant (par exemple ID_Sujet, indexé de SUBJ_001 à SUBJ_N), garantissant ainsi la traçabilité intégrale de l’audit des données et préservant l’anonymat prescrit par les comités d’éthique. La deuxième colonne (Colonne B) accueille la variable indépendante binaire (par exemple Groupe_Traitement ou Statut_Diagnostic). Enfin, la troisième colonne (Colonne C) héberge la variable dépendante quantitative continue (par exemple Score_Memoire_Chiffres ou Temps_Reaction_ms).
La première ligne de la feuille de calcul doit être exclusivement consacrée aux en-têtes de colonnes, rédigés sous forme d’étiquettes alphanumériques explicites mais compactes, proscrivant les espaces superflus, les caractères accentués complexes ou les symboles mathématiques susceptibles d’induire des erreurs d’adressage dans les formules. Il est hautement recommandé d’activer le figeage de cette ligne d’en-tête (via l’onglet Affichage > Figer les volets > Figer la ligne supérieure) afin de préserver la lisibilité de la matrice lors du défilement des cohortes volumineuses.
4.2 Recodage numérique des variables qualitatives textuelles
Il est extrêmement fréquent que les matrices de données brutes issues de plateformes d’enquêtes en ligne (telles que Qualtrics, LimeSurvey ou Google Forms) ou d’extractions de dossiers médicaux informatisés intègrent la variable catégorielle sous une forme textuelle ou verbale non interprétable directement par les algorithmes de corrélation linéaire. Des désignations telles que « Témoin » et « Traité », « Échec » et « Réussite », ou « Présent » et « Absent » doivent impérativement être converties en valeurs numériques discrètes standardisées 0 et 1.
Pour accomplir cette transformation de façon automatisée et sans risque d’altération manuelle, l’analyste insère une nouvelle colonne de traitement et mobilise la fonction logique SI() d’Excel. Supposons que les mentions verbales « Placebo » et « Molécule » soient consignées dans la plage B2:B101. Dans la cellule C2, la commande suivante sera inscrite :
=SI(B2="Molécule"; 1; SI(B2="Placebo"; 0; ""))
Cette formulation conditionnelle imbriquée attribue avec une rigueur absolue la valeur 1 à toute occurrence de la modalité active, la valeur 0 au groupe témoin, et renvoie une cellule vide (chaîne nulle) en présence de toute saisie non reconnue, prévenant ainsi les contaminations numériques accidentelles. Une fois saisie en C2, cette formule est incrémentée le long de toute la colonne par double-clic sur la poignée de recopie située à l’angle inférieur droit de la cellule sélectionnée.
Alternativement, pour les bases de données figées ne nécessitant pas d’actualisation dynamique, l’outil natif de recherche et remplacement d’Excel (accessible via le raccourci clavier Ctrl + H) permet de substituer instantanément les chaînes textuelles par leurs équivalents entiers. Cependant, cette méthode destructive doit être précédée d’une copie de sauvegarde intégrale du classeur brut, afin de préserver l’accès immédiat aux données sources initiales en cas d’audit méthodologique.
4.3 Traitement des valeurs manquantes et aberrantes
L’assainissement scrupuleux des données en amont de toute exécution statistique conditionne la véracité des résultats obtenus. En matière de valeurs manquantes (cellules vides ou codes non réponses), la règle absolue régissant la corrélation bivariée sous Excel est celle de l’exclusion complète par paire (listwise deletion). Les deux séries de données analysées doivent présenter un alignement vectoriel parfaitement synchronisé : si un sujet renseigne son statut binaire mais présente une valeur manquante sur la mesure continue (ou inversement), cette ligne doit être purement et simplement neutralisée de l’intervalle de corrélation.
La présence de valeurs aberrantes (outliers) sur la variable continue constitue une menace redoutable pour la stabilité du rpb. En raison de sa structure linéaire héritée de Pearson, le coefficient repose sur l’élévation au carré des écarts à la moyenne ; une unique observation déviante située à 4 ou 5 écarts-types de la moyenne conditionnelle de son groupe peut distordre artificiellement l’indice, le gonflant ou l’annihilant de manière totalement fallacieuse. Pour détecter ces anomalies sous Excel, il est préconisé de calculer les scores centrés-réduits (z-scores) de la variable continue au moyen de la formule :
=CENTREE.REDUITE(C2; MOYENNE($C$2:$C$101); ECARTYPE.STANDARD($C$2:$C$101))
Toute observation générant un z-score dont la valeur absolue excède le seuil conventionnel de 3,00 (voire 3,29 dans les grands échantillons) doit faire l’objet d’un examen qualitatif minutieux. L’expérimentateur doit déterminer s’il s’agit d’une erreur de saisie manifeste (par exemple un temps de réaction négatif ou un score dépassant le plafond théorique du test), auquel cas la donnée est corrigée ou expurgée, ou d’une variabilité biologique extrême mais authentique. Toutes les exclusions d’observations doivent être documentées de manière exhaustive dans le cahier de recherche, en explicitant le critère numérique strict ayant présidé à la décision.
5. Procédure d’exécution directe avec la fonction CORREL d’Excel
5.1 Syntaxe générale et paramétrage de l’argument
Microsoft Excel intègre au sein de sa bibliothèque mathématique standard une fonction spécifiquement dédiée au calcul instantané du coefficient de corrélation produit-moment de Bravais-Pearson, partagée sous la syntaxe générique CORREL (ou indifféremment PEARSON, les deux dénominations sollicitant le même sous-programme algorithmique). Cette fonction requiert la déclaration de deux arguments obligatoires, désignés sous le terme de matrices (ou plages vectorielles de cellules) :
=CORREL(matrice1; matrice2)
Dans la déclinaison francophone du tableur, l’opérateur de séparation des arguments est traditionnellement le point-virgule (;), tandis que les éditions anglophones recourent à la virgule standard (,). Le paramètre matrice1 désigne la plage continue de cellules contenant les valeurs de la première variable (par exemple la variable catégorielle préalablement codée en 0 et 1), tandis que le paramètre matrice2 cible l’intervalle délimitant les scores de la seconde variable continue.
L’une des propriétés formelles les plus appréciables de cette fonction réside dans sa stricte commutativité mathématique. L’ordre d’introduction des arguments ne possède rigoureusement aucune incidence sur le résultat produit par le tableur : la commande =CORREL(Plage_X; Plage_Y) renverra une valeur strictement identique à la syntaxe =CORREL(Plage_Y; Plage_X). La seule exigence structurelle inaltérable imposée par l’algorithme est l’égalité dimensionnelle exacte des deux matrices déclarées : le nombre de cellules individuelles composant matrice1 doit correspondre exactement au nombre de cellules assignées à matrice2.
5.2 Application pas à pas sur un jeu de données psychométriques
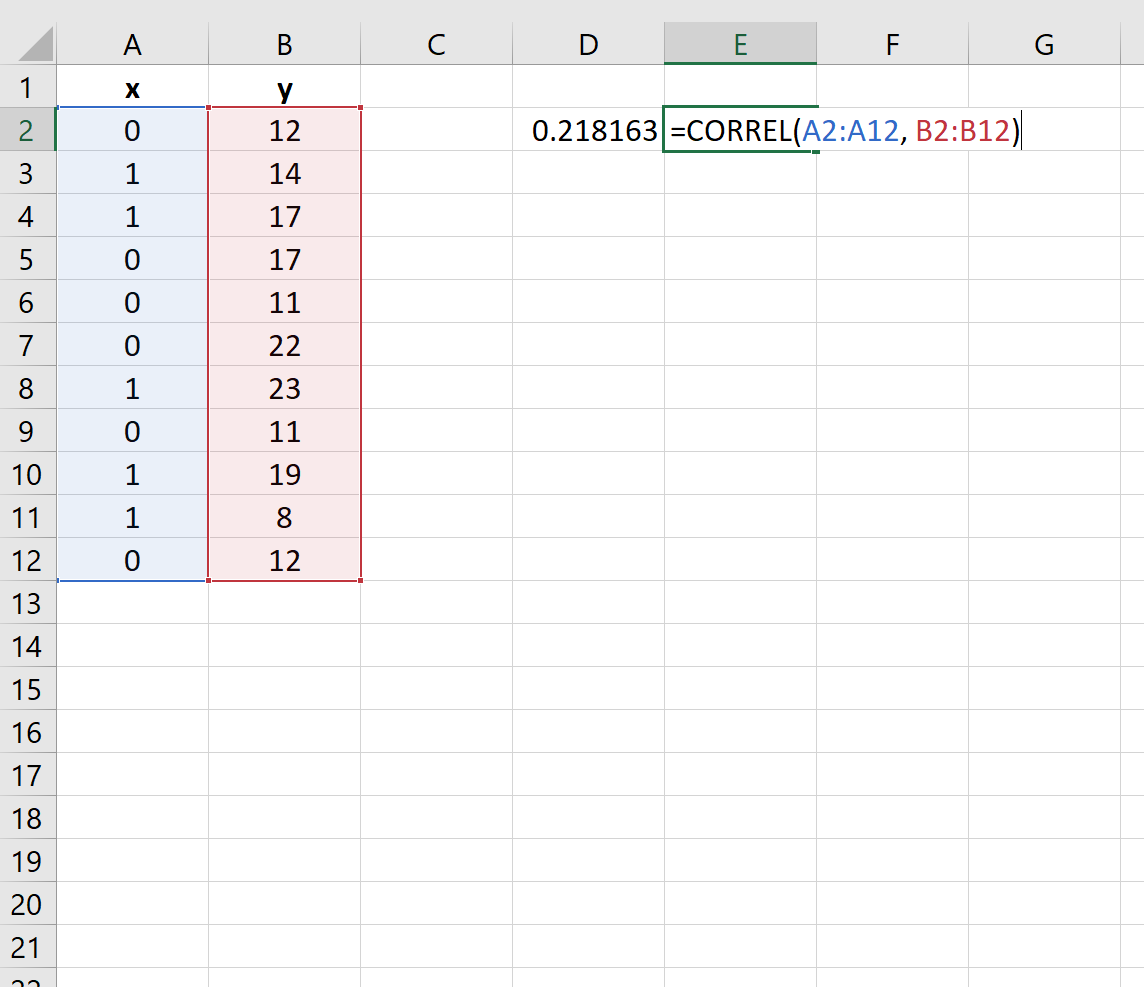
Afin de concrétiser la manipulation dans un contexte représentatif des sciences du comportement, considérons une étude psychométrique portant sur 50 participants (N = 50). L’investigateur cherche à mesurer le lien entre la réussite à une tâche d’attention soutenue informatisée (variable binaire codée 1 pour Succès et 0 pour Échec, implantée dans la plage de cellules B2:B51) et le score obtenu à un sous-test d’efficience mnésique continue (plage de cellules C2:C51).
La démarche séquentielle d’exécution s’articule comme suit au sein du tableur :
- Étape 1 : Naviguer vers une cellule vierge située en dehors de la matrice principale des données brutes, par exemple la cellule
E2, destinée à accueillir la statistique finale. - Étape 2 : Saisir le signe d’égalité conventionnel déclenchant l’évaluation de formule :
=. - Étape 3 : Inscrire le nom de la fonction en capitales ou minuscules :
CORREL(. - Étape 4 : Sélectionner à la souris la plage délimitant la variable dichotomique, de la cellule
B2à la celluleB51, ou inscrire manuellement la référence matricielle absolue$B$2:$B$51. - Étape 5 : Insérer le séparateur syntaxique point-virgule (
;). - Étape 6 : Pointer ensuite la plage contenant les scores continus de mémoire, s’étendant de la cellule
C2à la celluleC51(soit$C$2:$C$51). - Étape 7 : Fermer la parenthèse de l’expression mathématique pour obtenir l’équation complète :
=CORREL($B$2:$B$51; $C$2:$C$51). - Étape 8 : Appuyer sur la touche Entrée du clavier pour déclencher l’évaluation algorithmique.
Le tableur restitue instantanément la valeur numérique brute du coefficient de corrélation point-bisériale, par exemple 0,462819.... L’analyste prendra soin de formater l’affichage de cette cellule numérique via le menu contextuel de formatage pour ne conserver que trois décimales significatives, conformément aux conventions typographiques internationales de reporting scientifique.
5.3 Dépannage des codes d’erreur fréquents dans Excel
Lors de l’implémentation de la fonction CORREL, l’utilisateur peut être confronté à l’apparition inopinée de codes d’erreur standards d’Excel. Le diagnostic rapide et la résolution méthodique de ces dysfonctionnements participent de la compétence opérationnelle de tout analyste de données expérimentales.
L’erreur la plus emblématique est le message #DIV/0!. Dans le contexte de la commande CORREL, cette anomalie ne provient généralement pas d’une tentative explicite de division par un zéro isolé, mais signale l’absence totale de variance au sein de l’une des deux matrices d’entrée. Si, par inadvertance, la variable binaire ne comporte qu’une seule et unique modalité pour l’ensemble des lignes (par exemple si la totalité des participants a été codée 1, suite à une erreur de filtrage ou de sélection de plage), la somme des carrés des écarts à la moyenne s’annule rigoureusement (σ = 0). Le dénominateur de l’équation de Pearson tombant à zéro, l’algorithme renvoie mécaniquement l’indétermination #DIV/0!. La correction impose de vérifier la variance de chaque vecteur via =VAR.S().
Le second incident technique courant est la matérialisation du code #VALEUR!. Cette erreur survient dès lors que l’une des cellules comprises dans les plages vectorielles déclarées contient une chaîne textuelle non convertible, un caractère d’espacement parasite ou un caractère masqué hérité d’un import de fichier externe. Si la variable binaire contient accidentellement le texte « 1 » sous format texte au lieu de la valeur numérique 1, le calcul matriciel est bloqué. La sélection de la colonne suivie de l’application de la commande Convertir (onglet Données) permet d’assainir instantanément les types de données sous-jacents.
Enfin, si les deux plages vectorielles déclarées ne possèdent pas rigoureusement la même taille métrique (par exemple si la matrice 1 s’étend de B2:B51 tandis que la matrice 2 s’étend de C2:C50), Excel n’émettra pas toujours une erreur bloquante explicite mais peut tronquer arbitrairement l’analyse ou refuser d’évaluer la fonction. Une vigilance constante quant à la stricte concordance dimensionnelle des vecteurs analysés s’avère indispensable.
6. Calcul analytique détaillé selon la formule mathématique dédiée
6.1 Décomposition algébrique de l’équation point-bisériale
Bien que l’extraction via la fonction CORREL s’avère opérationnellement parfaite, la décomposition pas à pas de l’équation algébrique dédiée enrichit considérablement la compréhension conceptuelle des mécanismes psychométriques qui gouvernent l’indice. Dans la littérature académique spécialisée, la corrélation point-bisériale est formellement définie par l’équation canonique suivante :
rpb = [(M1 – M0) / Stot] × √(p × q)
Où chaque composante mathématique remplit une fonction structurelle déterminée :
- M1 : Moyenne arithmétique de la variable continue Y calculée exclusivement pour les individus appartenant à la modalité codée 1.
- M0 : Moyenne arithmétique de la variable continue Y calculée exclusivement pour les individus appartenant à la modalité codée 0.
- Stot : Écart-type standard non biaisé de l’ensemble des scores de la variable continue Y, amalgamant l’intégralité de l’échantillon sans distinction de groupe.
- p : Proportion d’individus assignés à la modalité codée 1 au sein de l’échantillon total (soit N1 / N).
- q : Proportion d’individus assignés à la modalité codée 0 au sein de l’échantillon total (soit N0 / N, ou 1 – p).
L’observation attentive de cette architecture factorielle révèle une perspective heuristique fondamentale : le premier terme [(M1 – M0) / Stot] n’est rien d’autre que l’expression d’une différence moyenne standardisée, remarquablement analogue au d de Cohen exploité pour quantifier les tailles d’effet dans les comparaisons de moyennes. Le second terme, √(p × q), agit comme un facteur de correction et de pondération directement tributaire du ratio d’équilibre de l’échantillon. Cette formule décomposée met en lumière le fait que la corrélation point-bisériale mesure simultanément la magnitude du contraste intergroupe et la parité structurelle de la distribution catégorielle.
6.2 Calcul des moyennes conditionnelles avec MOYENNE.SI
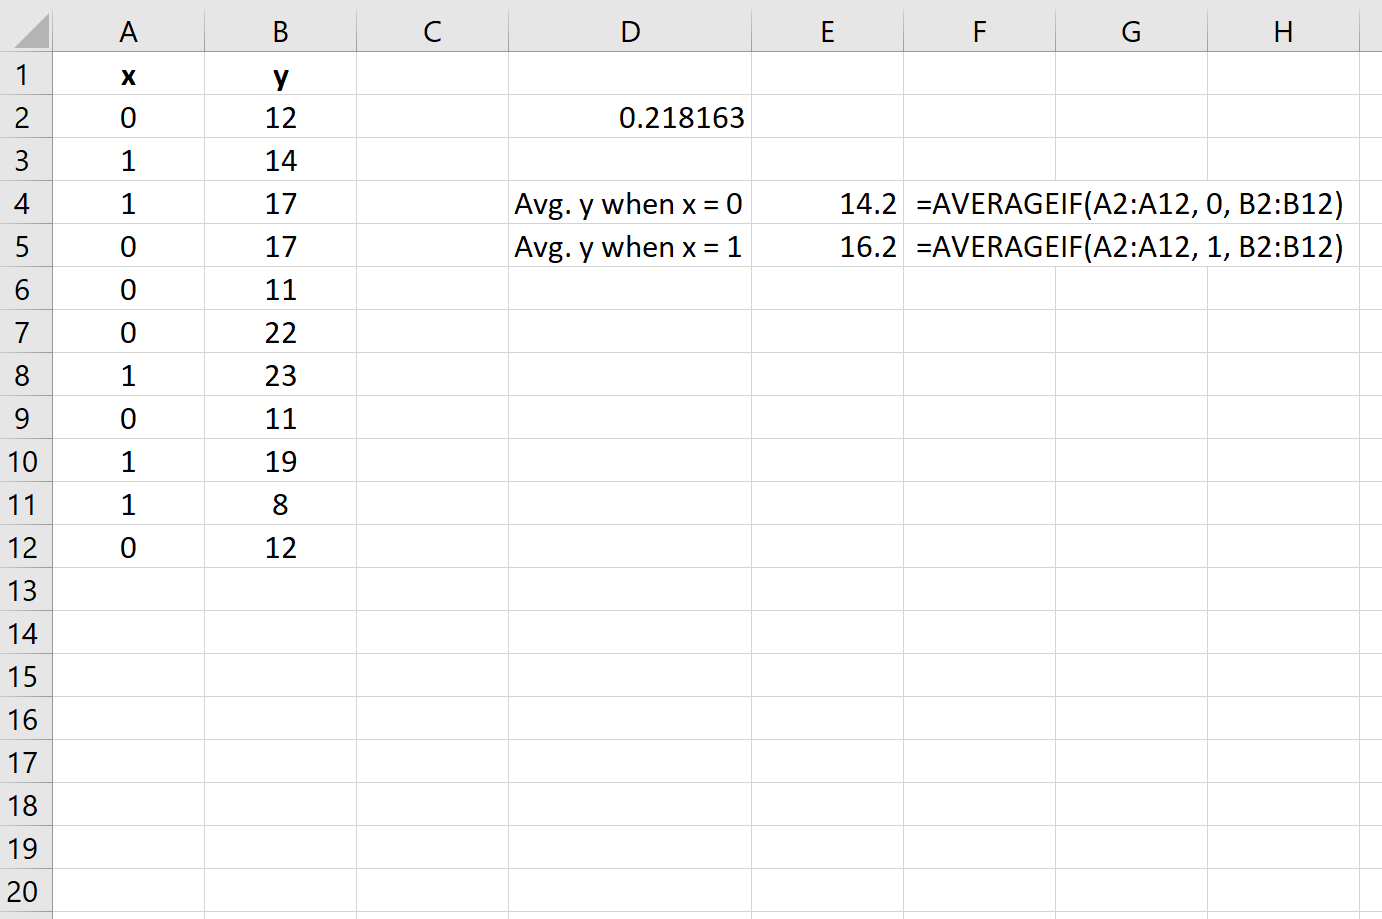
L’implémentation de la formule dédiée dans Excel requiert l’extraction préalable des moyennes conditionnelles associées à chacune des deux catégories. À cette fin, le tableur met à disposition la fonction statistique conditionnelle MOYENNE.SI(), dont la structure évite tout recours à des filtres manuels ou à des tris préalables susceptibles de désorganiser l’intégrité de la matrice.
Pour calculer la moyenne des scores continus affichés par le sous-groupe codé 0, l’analyste se positionne sur une cellule dédiée (par exemple E5) et saisit la syntaxe suivante :
=MOYENNE.SI($B$2:$B$51; 0; $C$2:$C$51)
Dans cette formulation, le premier argument $B$2:$B$51 définit la plage de référence contenant les étiquettes de groupes binaires, le deuxième argument 0 établit le critère logique d’inclusion sélective, et le troisième argument $C$2:$C$51 précise la plage sur laquelle s’opère l’accumulation arithmétique de la moyenne. Excel isole de façon totalement transparente les seules cellules de scores associées au label 0 et en extrait l’espérance arithmétique M0.
Symétriquement, l’extraction de la moyenne conditionnelle M1 pour le groupe codé 1 s’opère dans une cellule contiguë (par exemple E6) au moyen de la formule homologue :
=MOYENNE.SI($B$2:$B$51; 1; $C$2:$C$51)
Une fois ces deux scalaires calculés, la différence brute intergroupes (M1 – M0) est simplement déterminée au sein d’une troisième cellule (E7) par la soustraction élémentaire : =E6 - E5. Cette valeur numérique brute consigne le différentiel absolu observé sur l’échelle de mesure originale.
6.3 Calcul des paramètres de dispersion et des proportions de groupe
L’étape suivante consiste à quantifier la variabilité globale de la variable continue et à déterminer le profil démographique de l’échantillon. L’estimation de l’écart-type d’échantillon non biaisé Stot s’effectue en exploitant la fonction standard corrigée des degrés de liberté (N – 1) via la commande :
=ECARTYPE.STANDARD($C$2:$C$51)
Cette valeur, positionnée par exemple en E8, servira de normalisateur au numérateur de la différence moyenne standardisée.
Parallèlement, la caractérisation des proportions de groupes exige de dénombrer les effectifs catégoriels respectifs. Pour extraire l’effectif N1 du groupe codé 1, on emploie la fonction de comptage conditionnel :
=NB.SI($B$2:$B$51; 1)
De même, l’effectif total N de l’échantillon est déterminé au moyen de la fonction générique :
=NB($C$2:$C$51)
Dès lors, la proportion p s’obtient instantanément en cellule E9 par la division de l’effectif du groupe 1 par l’effectif total (=NB.SI($B$2:$B$51; 1) / NB($C$2:$C$51)). La proportion résiduelle q, relative au groupe codé 0, est immédiatement dérivée en cellule E10 par le complément unitaire : =1 - E9.
Enfin, le facteur multiplicatif de pondération √(p × q) est synthétisé en combinant la fonction mathématique d’extraction de racine carrée RACINE() et le produit des deux proportions calculées :
=RACINE(E9 * E10)
6.4 Synthèse et validation croisée des résultats
Toutes les composantes scalaires de l’équation dédiée étant désormais isolées dans des cellules dédiées du classeur, l’assemblage final du coefficient analytique s’effectue au sein d’une cellule récapitulative (par exemple E12) par l’expression combinée :
=(E7 / E8) * E11
Ce calcul consolide le ratio de contraste standardisé multiplié par la racine du produit des proportions d’échantillonnage.
La validation croisée constitue une étape d’assurance qualité statistique déterminante. Dans une cellule immédiatement adjacente (par exemple E13), l’analyste rappelle la commande directe étudiée dans la section précédente :
=CORREL($B$2:$B$51; $C$2:$C$51)
L’expérimentateur compare ensuite scrupuleusement la valeur retournée en E12 à celle affichée en E13. Les deux sorties numériques doivent converger de manière rigoureusement identique, sans la moindre divergence métrique au-delà des infimes résidus de précision computationnelle à la quinzième décimale. Cette concordance parfaite apporte la démonstration empirique sans équivoque que la commande native CORREL exécute fidèlement l’intégration conceptuelle de la corrélation point-bisériale, et atteste de l’absence totale d’erreur de saisie dans l’implémentation des formules manuelles décomposées.
7. Interprétation quantitative et clinique du coefficient obtenu
7.1 Signification de la polarité (positive ou négative)
L’interprétation de la directionnalité du coefficient de corrélation point-bisériale ne peut s’effectuer qu’au travers d’une lecture croisée rigoureuse avec le système de codage initialement attribué à la variable dichotomique. Contrairement à une corrélation de Pearson standard unissant deux grandeurs continues — où le signe traduit intuitivement une augmentation ou une diminution conjointe sur un repère cartésien standard —, le signe du rpb traduit une hiérarchie ordinale entre les deux moyennes conditionnelles.
L’émergence d’un coefficient affublé d’une polarité positive (rpb > 0) indique formellement que les participants caractérisés par le code numérique le plus élevé (soit la valeur conventionnelle 1) présentent une moyenne arithmétique sur la variable continue supérieure à celle des participants affectés au code numérique inférieur (la valeur 0). Sur le plan clinique ou comportemental, cela signifie que la possession de l’attribut catégoriel matérialisé par 1 est associée à une intensification de la grandeur mesurée continue.
À l’inverse, l’obtention d’un coefficient négatif (rpb < 0) matérialise une relation inverse : la moyenne du groupe codé 1 est statistiquement inférieure à la moyenne du groupe codé 0. Dans ce scénario, l'appartenance à la catégorie 1 est synonyme d'une régression ou d'une dépression des scores continus. Il apparaît donc de manière patente que le signe d'un rpb n’est pas un attribut biologique immuable, mais un artefact purement tributaire du schéma de balisage numérique sélectionné par le statisticien lors de l’agencement de sa base Excel.
7.2 Grille de lecture de l’amplitude selon les normes de Cohen
Pour appréhender l’amplitude de l’association statistique mise en évidence, la communauté scientifique internationale recourt couramment aux repères heuristiques canoniques formalisés par Jacob Cohen (1988) pour les coefficients de corrélation de la famille r. Selon ces seuils conventionnels unanimement adoptés :
- Effet modeste ou faible : Un coefficient oscillant aux alentours de |r| = 0,10 (expliquant environ 1 % de la variance globale).
- Effet moyen ou modéré : Un coefficient avoisinant |r| = 0,30 (expliquant environ 9 % de la variance globale).
- Effet fort ou marqué : Un coefficient atteignant ou dépassant |r| = 0,50 (expliquant 25 % ou plus de la variance globale).
Cependant, l’application aveugle et décontextualisée de ces critères de lecture à la corrélation point-bisériale soulève d’importantes réserves méthodologiques. Comme explicité précédemment, le plafonnement mathématique intrinsèque du rpb causé par le déséquilibre potentiel des effectifs de sous-groupes (p ≠ q) conduit fréquemment à une sous-estimation systématique de la puissance réelle du phénomène étudié. Un rpb de 0,25 obtenu dans une cohorte où le groupe clinique ne représente que 10 % de l’échantillon peut en réalité refléter une séparation quasi-complète des distributions conditionnelles, correspondant à une taille d’effet substantielle si elle était mesurée sous l’angle du d de Cohen.
Il est par conséquent vivement recommandé d’ajuster l’interprétation de la force du coefficient aux standards spécifiques du domaine expérimental concerné. En recherche épidémiologique ou en génétique comportementale, où les influences polyfactorielles sont innombrables, des coefficients compris entre 0,10 et 0,20 sont considérés comme hautement significatifs et porteurs de retombées cliniques majeures. En revanche, dans le contexte de la standardisation d’un test psychométrique d’intelligence, un item dont la corrélation point-bisériale avec le score global total est inférieure à 0,30 sera fréquemment jugé trop peu discriminant pour être conservé dans la mouture définitive de l’instrument.
7.3 Calcul et interprétation du coefficient de détermination
Pour transcender les limites de l’échelle d’évaluation ordinale du coefficient de corrélation et communiquer des résultats d’une intelligibilité clinique irréprochable, les statisticiens recourent au calcul du coefficient de détermination, universellement désigné sous la notation r2 (ou R2). Sur le plan opératoire, cette statistique s’obtient tout simplement en élevant le coefficient de corrélation point-bisériale au carré.
Dans la feuille de calcul Excel, si le coefficient rpb est localisé dans la cellule E2, l’extraction de son coefficient de détermination s’opère instantanément dans une cellule adjacente au moyen de la syntaxe élémentaire suivante :
=E2^2
Sur le plan sémantique et conceptuel, le r2 exprime la proportion (ou le pourcentage, si la cellule est formattée en mode pourcentage) de la variance totale de la variable quantitative continue qui se trouve directement expliquée, prédite ou comptabilisée par l’appartenance à la catégorie dichotomique. Si l’on relève une corrélation point-bisériale rpb = 0,40 entre le statut clinique (sain vs malade) et un indice d’attention sélective, le coefficient de détermination s’élève à 0,16. L’analyste peut formuler avec une rigueur irréprochable que 16 % de la variabilité interindividuelle observée sur les scores d’attention sélective est attribuable à l’état nosologique des sujets.
Cette mesure de taille d’effet standardisée en termes de fraction de variance partagée présente un intérêt clinique considérable pour la communication des résultats de recherche. Elle neutralise l’arbitraire de l’unité de mesure initiale de la variable continue et offre un support de comparaison universel permettant de confronter l’impact d’interventions thérapeutiques distinctes ou d’approches diagnostiques concurrentes au sein d’une méta-analyse.
8. Test d’hypothèse et évaluation de la significativité statistique dans Excel
8.1 Formulation des hypothèses nulle et alternative
La confirmation empirique d’un coefficient d’échantillonnage non nul ne saurait suffire à proclamer l’existence d’une relation authentique au sein de la population parente. Le hasard d’échantillonnage peut générer une covariation artificielle au sein d’une cohorte restreinte d’observations. L’inférence statistique impose donc la formulation préalable d’un cadre de test d’hypothèse rigoureux régissant la prise de décision scientifique.
L’hypothèse nulle, désignée par H0, postule l’absence totale de corrélation point-bisériale linéaire entre la variable dichotomique et la variable continue au sein de la population de référence. Elle s’écrit formellement :
H0 : ρpb = 0
À l’opposé, l’hypothèse alternative bilatérale (two-tailed), désignée par H1, stipule que le paramètre populationnel dévie significativement de zéro, sans présager a priori de la supériorité d’un groupe spécifique :
H1 : ρpb ≠ 0
Dans des configurations expérimentales spécifiques étayées par une abondante littérature préalable, le chercheur peut formuler une hypothèse alternative unilatérale (one-tailed), postulant exclusivement soit une corrélation positive (ρpb > 0), soit une corrélation négative (ρpb < 0). Dans la pratique psychologique contemporaine, le test bilatéral demeure toutefois le standard normatif universellement exigé par les comités éditoriaux des revues scientifiques, prévenant toute manipulation opportuniste du risque d'erreur de première espèce (alpha). Ce seuil de tolérance nominal α est conventionnellement fixé à 0,05 (5 %) ou à 0,01 (1 %) selon le niveau d’exigence requis.
8.2 Calcul de la statistique t de Student associée
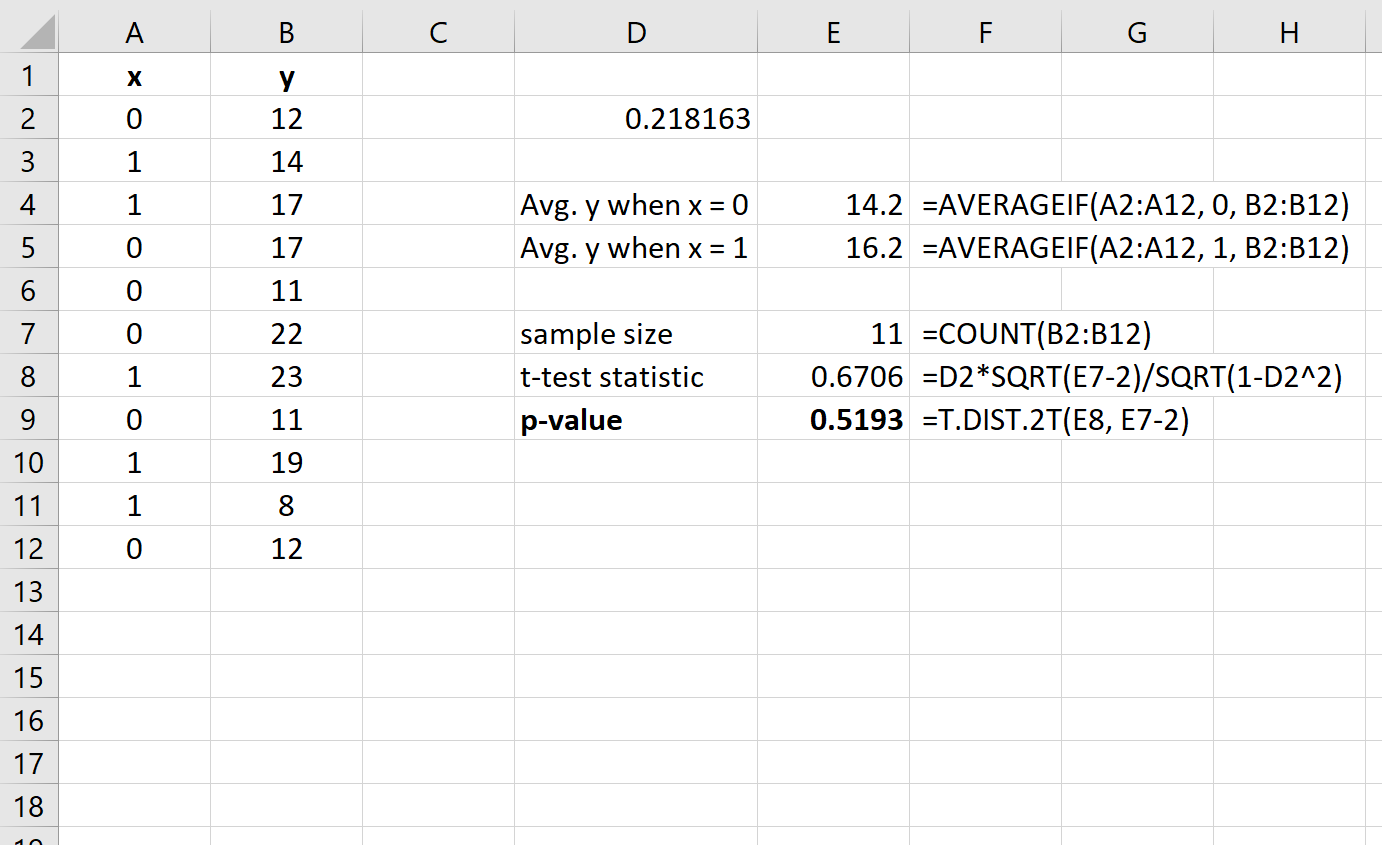
Pour déterminer si la valeur empirique de rpb dévie suffisamment de zéro pour justifier le rejet de l’hypothèse nulle, il est nécessaire de transformer ce coefficient en une statistique inférentielle suivant une distribution de probabilité théorique connue sous H0. Sous les hypothèses de normalité et d’homoscédasticité, la transformation standard convertit le coefficient de corrélation d’échantillon en une statistique t de Student. L’équation de conversion s’énonce comme suit :
t = rpb × √[(N – 2) / (1 – rpb2)]
Cette variable aléatoire t obéit rigoureusement à une loi de Student paramétrée par N – 2 degrés de liberté (ddl), où N incarne l’effectif total d’observations appariées composant l’échantillon.
Pour orchestrer cette conversion au sein d’Excel, supposons que la valeur du coefficient rpb soit hébergée en cellule E2 et que la taille totale de l’échantillon N (50 participants) soit consignée en cellule E3. L’implémentation algorithmique de la statistique t s’effectue dans une cellule cible (par exemple E15) par la saisie de l’instruction suivante :
=E2 * RACINE((E3 - 2) / (1 - E2^2))
La statistique t ainsi générée capture la magnitude de l’écart standardisé séparant l’estimation empirique de la valeur nulle théorique. Plus l’échantillon N est étendu et plus la corrélation rpb est affirmée, plus la grandeur absolue de cette statistique t s’accroît, compressant de facto la probabilité que le lien observé soit le fruit de fluctuations fortuites d’échantillonnage.
8.3 Calcul exact de la p-valeur bilatérale
L’étape décisionnelle ultime repose sur l’extraction de la valeur p (p-value), représentant la probabilité exacte d’observer une statistique t au moins aussi extrême que celle obtenue empiriquement, sous l’hypothèse stricte de véracité de l’hypothèse nulle H0. Excel intègre des fonctions de distribution d’une extrême précision numérique pour évaluer cette probabilité cumulée.
Pour obtenir la p-valeur bilatérale associée à la statistique t calculée en E15, avec des degrés de liberté localisés en E16 (formule =E3-2), l’analyste fait appel à la fonction standardisée LOI.STUDENT.BILATERALE() :
=LOI.STUDENT.BILATERALE(ABS(E15); E16)
Il est crucial de noter l’adjonction systématique de la fonction de valeur absolue ABS() imbriquée autour de l’argument de la statistique t. En effet, la fonction bilatérale d’Excel exige structurellement un paramètre positif non nul pour calculer l’aire sous les deux queues de la distribution de Student symétrique. Si la statistique t empirique est négative (en présence d’une corrélation négative), l’omission de la commande ABS() déclenchera l’apparition d’un code d’erreur #NOMBRE!.
La prise de décision s’opère ensuite par comparaison directe du résultat renvoyé avec le seuil critique α :
- Si la p-valeur est strictement inférieure à 0,05 (p < 0,05), l'hypothèse nulle est rejetée. Le chercheur conclut formellement à l'existence d'une corrélation point-bisériale statistiquement significative dans la population cible.
- Si la p-valeur excède le seuil de 0,05 (p ≥ 0,05), le chercheur échoue à rejeter l’hypothèse nulle. Les données expérimentales ne fournissent pas d’évidence statistique suffisante pour affirmer que l’association observée n’est pas réductible aux seuls aléas d’échantillonnage.
Pour parachever l’estimation inférentielle, il est recommandé de calculer l’intervalle de confiance à 95 % du coefficient au moyen de la classique transformation z de Fisher, disponible sous Excel via la commande =FISHER(E2) et sa réciproque =FISHER.INVERSE(), encadrant ainsi le coefficient d’une marge d’incertitude métrique rigoureuse.
9. Visualisation graphique académique des résultats sur tableur
9.1 Création d’un nuage de points catégorisé
L’exploration visuelle constitue un prolongement indispensable de la quantification numérique. Elle permet de valider empiriquement l’adéquation du modèle linéaire, de déceler d’éventuelles valeurs aberrantes résiduelles et de donner corps à la distribution comparée des groupes. Toutefois, la confection d’un graphique de dispersion bivarié associant une variable catégorielle discrète et une variable continue sous Excel présente un piège sémiologique redoutable : le chevauchement massif des points d’observation (overplotting).
Lorsque tous les participants du groupe 0 sont alignés sur l’abscisse 0,0 et que tous ceux du groupe 1 sont superposés sur l’abscisse 1,0, les marqueurs de données s’entassent verticalement, masquant la densité réelle de la distribution des observations. Pour pallier cette distorsion visuelle, la pratique méthodologique avancée consiste à introduire une micro-dispersion artificielle purement graphique sur l’axe horizontal, technique reconnue en data science sous l’appellation de « jittering ».
Pour exécuter un jittering propre dans Excel, l’analyste crée une colonne auxiliaire dédiée à la visualisation, adjacente à la variable binaire originelle. Si le code de groupe 0 ou 1 se situe en cellule B2, on inscrit en D2 la formule dynamique suivante :
=B2 + ALEA.ENTRE.BORNES(-15; 15) / 100
Cette expression ajoute une composante stochastique minime comprise entre -0,15 et +0,15 à la coordonnée nominale, diffusant harmonieusement les points autour des ancrages 0 et 1. Il suffit ensuite de sélectionner cette colonne parasitée D comme plage des abscisses (X) et la colonne continue C comme plage des ordonnées (Y), puis d’insérer un graphique de type Nuage de points (Scatter plot) standard. Les points se déploient alors sous la forme de deux colonnes de points nuancées, rendant immédiatement perceptibles la dispersion interne, le degré de chevauchement et les asymétries de distribution au sein de chaque modalité.
9.2 Représentation par diagramme à barres d’erreur des moyennes
Bien que le nuage de points enrichi offre une vue granulaire des observations individuelles, le format graphique le plus universellement plébiscité dans les revues académiques de psychologie pour illustrer une corrélation point-bisériale demeure le diagramme en bâtons ou à colonnes comparatives des moyennes conditionnelles, agrémenté de barres d’erreur métriques.
La genèse de cette figure sous Excel impose au préalable la construction d’un mini-tableau récapitulatif synthétique sur la feuille de calcul, comportant :
- Une colonne libellée détaillant les deux modalités qualitatives de l’étude (ex : « Groupe Contrôle » et « Groupe Expérimental »).
- Une colonne affichant les moyennes conditionnelles extraites via
MOYENNE.SI()(M0 et M1). - Une colonne consignant les erreurs-types de la moyenne correspondantes (SEM), obtenues en divisant l’écart-type conditionnel
ECARTYPE.STANDARD()par la racine carrée de l’effectif catégorielRACINE(NB.SI()).
L’expérimentateur sélectionne les étiquettes et les moyennes, puis clique sur Insertion > Graphique en colonnes groupées 2D. Une fois le squelette de base érigé, il convient d’y greffer les barres d’erreur scientifiques. L’utilisateur sélectionne les séries de colonnes, active les Éléments de graphique (croix verte latérale), coche Barres d’erreur, puis navigue vers Autres options de barres d’erreur. Dans le panneau de configuration latérale, il coche Personnalisé, clique sur Spécifier une valeur, et sélectionne la plage de cellules hébergeant les erreurs-types calculées pour les champs positif et négatif.
Une vigilance impérative doit être portée sur l’axe vertical des ordonnées (axe Y). Par défaut, Excel tronque fréquemment la base des axes pour maximiser artificiellement les contrastes. Pour éviter toute accusation de manipulation fallacieuse de la taille d’effet, l’axe vertical doit impérativement être configuré pour débuter au zéro théorique de l’instrument de mesure, ou refléter l’intégralité du spectre valide de l’échelle d’évaluation continue employée.
9.3 Conformité stylistique aux normes des publications scientifiques (APA)
L’insertion directe d’un graphique généré par défaut sous Excel au sein d’un manuscrit scientifique ou d’un mémoire de recherche viole la quasi-totalité des directives graphiques établies par l’American Psychological Association (normes APA 7e édition). Les graphiques par défaut du tableur se caractérisent par une pollution visuelle marquée (« chartjunk ») qu’il convient de purger méticuleusement.
Pour mettre une figure Excel en conformité avec les critères de publication académique, l’analyste applique la série d’ajustements structurels suivants :
- Suppression des lignes de quadrillage : Sélectionner l’ensemble du quadrillage horizontal d’arrière-plan et presser la touche Supprimer. Les publications scientifiques privilégient un fond d’un blanc virginal, exempt de toute interférence optique.
- Gestion de la palette chromatique : Proscrire les teintes vives, fluorescentes ou les dégradés par défaut d’Office. Convertir le remplissage des colonnes ou des marqueurs de points en aplats monochromes sobres : gris neutre, noir pur ou nuances contrastées de gris clair et foncé.
- Épuration des bordures et axes : Formater l’axe horizontal et l’axe vertical pour afficher une ligne continue fine de couleur noire (épaisseur 0,75 à 1 pt), munie de graduations extérieures orientées vers l’extérieur. Éliminer la boîte d’encadrement globale entourant le graphique.
- Typographie normalisée : Harmoniser toutes les polices textuelles de la figure en sélectionnant une police universelle sans empattement conforme à l’APA (comme Arial, Calibri ou Helvetica), calibrée en corps 9 à 11 pt pour les axes et légendes.
- Légendes et titres intégrés : Supprimer le titre automatique situé au sommet du graphique d’Excel. Selon les normes APA, le libellé d’une figure ne figure jamais à l’intérieur du conteneur visuel, mais est consigné dans le corps du manuscrit textuel sous la forme standardisée d’une mention supérieure « Figure X » en gras, suivie de son titre en italique, et assortie d’une note explicative descriptive en bas de figure.
10. Études de cas concrètes appliquées à la psychologie
10.1 Psychométrie : Analyse de la discrimination d’un item de test cognitif
Considérons une situation d’étalonnage psychométrique dans laquelle un enseignant-chercheur évalue la validité de construit d’un nouvel item arithmétique (Item n°12) destiné à intégrer une batterie d’évaluation du raisonnement logique chez l’adolescent. Un échantillon d’essai de 120 collégiens a passé l’épreuve. L’Item 12 est évalué de manière dichotomique : 1 point en cas de réponse correcte, 0 point en cas d’omission ou d’erreur de raisonnement. Le critère quantitatif continu est le score total cumulé à l’ensemble du test (hors Item 12 pour prévenir le problème de circularité de contamination auto-corrélative), standardisé sur une échelle de 0 à 50 points.
L’agencement des données dans Excel place les scores dichotomiques de l’Item 12 dans la plage B2:B121 et les scores totaux corrigés dans la plage C2:C121. L’application de la formule =CORREL(B2:B121; C2:C121) renvoie un coefficient point-bisériale empirique rpb = 0,44. Le calcul de la statistique de Student via =E2*RACINE((120-2)/(1-E2^2)) génère une valeur t(118) = 5,31, associée à une p-valeur bilatérale extraite par =LOI.STUDENT.BILATERALE(5,31; 118) strictement inférieure à 0,001 (p = 4,7 × 10⁻⁷).
Sur le plan de l’expertise psychométrique, ce résultat documente un excellent pouvoir de discrimination de l’item. La valeur de 0,44 dépasse largement le seuil standard de rétention fixé à 0,30 par la théorie classique des tests. Ce coefficient atteste que les apprenants réussissant cet item obtiennent des performances moyennes au test global significativement supérieures à celles de leurs pairs en échec (différence moyenne de 8,2 points pour un écart-type global de 9,4 points). L’Item 12 est déclaré valide et retenu dans l’assemblage définitif du test d’aptitude cognitive.
10.2 Psychopathologie : Association entre antécédents traumatiques et score d’anxiété
Dans le cadre d’un protocole de recherche clinique en psychopathologie de l’adulte, une équipe hospitalo-universitaire étudie l’impact de l’exposition documentée à un événement de vie potentiellement traumatique au cours de l’enfance sur la sévérité des manifestations d’anxiété évaluées à l’âge adulte. L’échantillon clinique comprend 80 patients consultants au sein d’un centre médico-psychologique. La variable indépendante est binaire : antécédents de trauma infantile validés par hétéro-évaluation (codé 1, N1 = 32) versus absence d’antécédent traumatique caractérisé (codé 0, N0 = 48). La variable continue dépendante est le score brut total extrait à l’inventaire d’anxiété de Spielberger (STAI-Trait), oscillant de 20 à 80 points.
Les données compilées dans la feuille Excel (plages B2:B81 pour le statut trauma et C2:C81 pour l’inventaire STAI) aboutissent à l’évaluation d’un coefficient point-bisériale direct =CORREL(B2:B81; C2:C81) affichant rpb = 0,38. Le coefficient de détermination associé =0,38^2 indique que 14,44 % de la variance des scores d’anxiété-trait au sein de cette file active est directement associée à la survenue d’un trauma précoce. La statistique inférentielle confirme la significativité de cette relation avec t(78) = 3,63 et une p-valeur bilatérale de 0,0005.
L’analyse qualitative des moyennes conditionnelles révèle que les patients ayant vécu un traumatisme affichent un score moyen d’anxiété de 54,6 points (ET = 8,1), contre 46,2 points (ET = 7,9) pour les patients exempts d’antécédents majeurs. Ces résultats corroborent solidement les modèles théoriques postulant une altération pérenne des circuits neurobiologiques de régulation du stress consécutive aux expériences adverses infantiles. Ils soulignent auprès des équipes soignantes l’impérieuse nécessité d’un dépistage précoce des facteurs d’adversité infantile lors de l’admission en psychiatrie adulte afin de guider des choix psychothérapeutiques ciblés (comme les approches de désensibilisation et retraitement par mouvements oculaires ou les thérapies axées sur le trauma).
10.3 Psychologie du travail : Statut de télétravail et niveau d’engagement professionnel
Une enquête transversale menée au sein d’une multinationale du secteur tertiaire vise à explorer les corrélats organisationnels du télétravail chez 200 collaborateurs (N = 200). La direction des ressources humaines cherche à déterminer si le déploiement massif du télétravail à domicile altère l’engagement des salariés envers l’entreprise. La variable binaire opérationnalise le mode d’organisation du travail : télétravail exclusif ou prédominant (≥ 3 jours par semaine à domicile, codé 1, N1 = 110) versus travail présentiel exclusif ou ultra-majoritaire (sur site, codé 0, N0 = 90). La variable continue est l’indice d’engagement professionnel quantifié via l’échelle validée d’Utrecht (UWES-9), dont les scores s’étendent de 0 à 6 points.
L’extraction de la corrélation sous Excel via la fonction CORREL renvoie un indice point-bisériale très ténu : rpb = -0,07. La conversion inférentielle menée dans le tableur produit une statistique de Student t(198) = -0,986, débouchant sur une p-valeur bilatérale équivalente à 0,325. Étant donné que cette probabilité excède largement le seuil décisionnel canonique de 0,05, l’hypothèse nulle d’indépendance statistique entre les deux construits ne peut être rejetée.
Dans les conclusions du rapport adressé à la gouvernance d’entreprise, les psychologues du travail explicitent que le statut de télétravail n’exerce aucune influence directe discernable sur la vivacité de l’engagement psychologique des employés, le coefficient de détermination révélant que moins de 0,5 % de la variance de l’engagement est liée au mode de travail physique. La discussion méthodologique met en relief la nécessité d’étudier de tierces variables modératrices ou médiatrices complexes non capturées par ce modèle bivarié simple, telles que le style de management de proximité, la charge perçue de conciliation vie personnelle-vie professionnelle ou la qualité du matériel ergonomique déployé au domicile.
11. Limites méthodologiques et alternatives statistiques
11.1 Sensibilité à l’asymétrie de distribution des catégories
La limite structurelle la plus rédhibitoire de la corrélation point-bisériale réside incontestablement dans sa sensibilité extrême au déséquilibre des proportions d’échantillonnage entre les deux modalités de la variable binaire. Comme évoqué lors de l’étude des postulats sous-jacents, l’amplitude théorique maximale de l’indice subit une contrainte mathématique mécanique dès lors que les effectifs N0 et N1 divergent de la stricte parité 50/50 (p = q = 0,50).
Sur le plan mathématique formel, la borne supérieure absolue atteignable par le coefficient point-bisériale est directement bornée par la formule :
rpb(max) = y / √[(p × (1 – p))]
Où y matérialise l’ordonnée de la fonction de densité de la loi normale standard centrée-réduite au quantile correspondant au point de découpage proportionnel p. Si l’on imagine un échantillon caractérisé par une asymétrie marquée où p = 0,90 et q = 0,10, la valeur maximale absolue théorique que le coefficient rpb peut mathématiquement atteindre ne dépasse pas environ 0,58, même dans la configuration où la variable continue opérerait une ségrégation parfaite sans la moindre superposition d’intervalles entre les deux catégories d’observations.
Cette distorsion induit un risque permanent de sous-estimation clinique de l’effet. L’analyste non averti observant un rpb de 0,28 au sein d’une cohorte asymétrique pourrait hâtivement conclure à un lien modeste, alors même que cet indice approche le plafond asymptotique absolu autorisé par la métrique de son échantillon. Dès lors que le ratio entre les effectifs des deux groupes franchit le seuil critique de 80/20 (ou a fortiori 90/10), l’interprétation brute du rpb devient excessivement périlleuse et requiert des réajustements analytiques spécifiques.
11.2 Comparaison critique avec la corrélation bisériale
Pour s’affranchir de la pénalisation computationnelle imposée par le plafonnement de la corrélation point-bisériale lorsque la dichotomie résulte de l’artéfact d’un seuillage arbitraire appliqué sur un continuum latent sous-jacent, Karl Pearson a élaboré le coefficient de corrélation bisériale proprement dit, conventionnellement symbolisé par rb.
La corrélation bisériale formule le postulat théorique explicite que la variable catégorielle binaire observée X dissimule en réalité une variable sous-jacente normalement distribuée X*, dont la manifestation observable a été rabotée par l’érection d’une frontière de coupure stricte. La relation mathématique unissant la corrélation bisériale au coefficient point-bisériale s’exprime par le facteur multiplicateur de correction suivant :
rb = rpb × [√(p × q) / y]
Où y représente l’ordonnée de la courbe normale unitaire au point de scission z correspondant aux proportions p et q. Dans la mesure où la quantité √(p × q) est toujours inférieure ou égale à l’ordonnée y de la distribution normale, le terme de correction [√(p × q) / y] est structurellement supérieur à 1,00. En conséquence directe, le coefficient de corrélation bisériale rb est invariablement d’une magnitude plus élevée que le coefficient point-bisériale rpb calculé sur la même matrice de données.
Bien que séduisante sur le plan conceptuel pour restaurer l’estimation théorique non pénalisée de la taille d’effet, la corrélation bisériale présente des vulnérabilités métriques notoires : elle est hautement instable face aux violations de normalité de la variable latente et peut, sous certaines configurations empiriques caractérisées par des déviations leptokurtiques, dépasser la valeur absolue de 1,00, violant ainsi les principes fondamentaux de la standardisation des indices de corrélation. Le tableau synthétique ci-dessous récapitule les critères d’arbitrage méthodologique gouvernant le choix entre ces deux approches métriques :
| Critère d’évaluation | Corrélation Point-Bisériale (rpb) | Corrélation Bisériale (rb) |
|---|---|---|
| Nature ontologique de la variable binaire | Dichotomie vraie, naturelle et discrète (ex: statut de survie, mutation génétique, groupe expérimental). | Dichotomie artificielle issue d’un découpage sur un continuum latent (ex: succès/échec scolaire, diagnostic seuillé). |
| Bornes métriques formelles | Strictement confiné à l’intervalle fermé [-1,00 ; +1,00]. | Peut excéder mathématiquement ±1,00 en cas d’anomalies distributionnelles. |
| Sensibilité au déséquilibre p / q | Forte atténuation mécanique de la valeur maximale atteignable. | Correction robuste de l’atténuation via l’ajustement sur la hauteur d’ordonnée normale. |
| Calcul direct sous Excel | Immédiat via la fonction standard =CORREL(). |
Requiert une modélisation paramétrique complexe mobilisant LOI.NORMALE.STANDARD(). |
11.3 Complémentarité avec le test t de Student et la régression logistique
L’analyse bivariée d’un jeu de données confrontant une variable binaire et une variable continue ne s’enferme pas exclusivement dans le calcul du coefficient de corrélation. Il existe une passerelle mathématique biunivoque absolue reliant la corrélation point-bisériale au test t de Student pour échantillons indépendants sous hypothèse de variances égales. Le test de l’hypothèse nulle H0 : ρpb = 0 via la statistique t conduit à une valeur t et à une p-valeur formellement identiques à celles produites par le test de comparaison de deux moyennes indépendantes (H0 : μ1 – μ0 = 0).
La distinction entre ces deux procédures ne relève donc pas d’une différence de mécanique mathématique, mais d’une pure divergence d’angle de lecture épistémologique :
- Le test t de Student focalise l’attention du praticien sur le différentiel moyen brut exprimé dans l’unité de mesure clinique ou expérimentale d’origine (perspective de contraste moyen).
- La corrélation point-bisériale transcende l’unité de mesure arbitraire pour renvoyer un indice de taille d’effet universellement standardisé reflétant la qualité de la prédiction linéaire (perspective d’association).
Toutefois, dès lors que la question expérimentale s’élargit pour examiner le rôle concomitant de multiples prédicteurs — par exemple si le chercheur souhaite évaluer le lien entre la présence d’une pathologie (binaire) et un marqueur cognitif (continu) tout en neutralisant statistiquement les effets de l’âge, du niveau d’études ou du sexe biologique —, la corrélation bivariée simple atteint ses limites structurelles intrinsèques. Dans cette configuration multivariée, la régression logistique binaire s’impose comme le prolongement méthodologique incontournable. Elle permet d’estimer l’effet net propre de la variable continue sur la probabilité d’occurrence de la modalité dichotomique au moyen d’odds ratios (rapports de cotes ajustés), tout en intégrant un ensemble illimité de covariables de contrôle continues et catégorielles.
12. Normes de rapportage académique et bonnes pratiques de reproductibilité
12.1 Rédaction des résultats selon les standards du style APA 7
La communication publique des résultats issus d’une analyse de corrélation point-bisériale au sein d’un article scientifique, d’une thèse de doctorat ou d’un rapport psychologique doit se conformer rigoureusement aux normes typographiques et structurelles formalisées dans le manuel officiel de publication de l’APA (Publication Manual of the American Psychological Association, 7e édition).
La restitution narrative complète d’une corrélation point-bisériale doit obligatoirement encapsuler les paramètres métriques clés suivants : la désignation formelle de l’indice statistique (noté rpb ou simplement r si la nature dichotomique a été explicitée dans la section méthodologique), le nombre précis de degrés de liberté consigné entre parenthèses, la valeur empirique exacte du coefficient arrondie à deux décimales, la significativité statistique exacte (valeur p exprimée avec trois décimales sans zéro initial), et si possible l’intervalle de confiance à 95 %.
Voici un canevas canonique de formulation narrative hautement recommandable en contexte francophone académique :
« Une corrélation point-bisériale a été calculée afin d’évaluer la force de l’association unissant le statut d’exposition au traumatisme (0 = absence, 1 = présence) et le niveau d’anxiété-trait mesuré par l’inventaire STAI chez les 80 participants de l’échantillon. Les analyses révèlent une corrélation positive statistiquement significative et de magnitude modérée à forte, rpb(78) = 0,38, IC95% [0,17 ; 0,55], p < 0,001. La proportion de variance expliquée par l'appartenance de groupe s'élève à 14,4 % (r² = 0,144). Les participants exposés au traumatisme présentent des scores moyens d'anxiété substantiellement plus élevés (M = 54,60 ; ET = 8,10) que les participants exempts de traumatisme documenté (M = 46,20 ; ET = 7,90). »
Sur le plan des conventions typographiques strictes imposées par l’APA :
- Toutes les lettres latines incarnant des symboles statistiques scalaires doivent être composées en italique (ex : r, t, p, M, ET, N).
- Les indices textuels inférieurs (subscripts) ne sont pas mis en italique s’ils renvoient à un mot ou un acronyme descriptif, mais la notation de base rpb tolère l’italique intégral selon les éditeurs.
- Le symbole de la valeur p s’écrit en minuscule italique p. En typographie anglo-saxonne, on omet traditionnellement le zéro avant la virgule pour les grandeurs probabilistes ne pouvant excéder l’unité (ex: p = .003) ; dans un manuscrit entièrement composé en langue française, l’usage de la virgule et la mention du zéro initial sont conservés (ex: p = 0,003), conformément aux normes de l’Imprimerie Nationale.
12.2 Conception de tableaux récapitulatifs aux normes académiques
Dans le cadre de vastes protocoles empiriques évaluant de multiples variables continues face à un prédicteur dichotomique (par exemple lors de l’exploration d’un profil neurocognitif complet confrontant un groupe clinique et un groupe témoin), la présentation textuelle brute devient vite illisible. L’ordonnancement des sorties métriques au sein d’un tableau synthétique normé APA s’avère indispensable.
Les canons esthétiques et structurels de l’APA proscrivent formellement l’utilisation de tout quadrillage vertical au sein des tableaux scientifiques. La grille tabulaire ne doit comporter que trois traits horizontaux continus majeurs : une ligne supérieure délimitant le sommet de l’en-tête, une ligne inférieure fermant l’en-tête, et une ligne de base clôturant le pied du tableau avant les notes de bas de page. Le modèle tabulaire ci-dessous illustre l’agencement parfait d’une matrice comparative bivariée prête pour soumission éditoriale :
| Variable neuropsychologique | Groupe Contrôle (n = 50) M (ET) |
Groupe Clinique (n = 50) M (ET) |
rpb | IC à 95% | p |
|---|---|---|---|---|---|
| Mémoire de travail (Empan) | 6,42 (1,15) | 5,18 (1,22) | -0,46 | [-0,61 ; -0,29] | < 0,001 |
| Vitesse de traitement (s) | 28,34 (4,12) | 34,80 (5,67) | 0,53 | [0,37 ; 0,66] | < 0,001 |
| Flexibilité mentale (Erreurs) | 12,10 (3,45) | 13,05 (3,80) | 0,13 | [-0,07 ; 0,32] | 0,198 |
| Fluidité verbale phonologique | 22,40 (5,10) | 18,90 (4,85) | -0,33 | [-0,50 ; -0,14] | 0,001 |
Note. N = 100. Le codage du groupe attribue la modalité 0 au Groupe Contrôle et la modalité 1 au Groupe Clinique. M et ET représentent respectivement la moyenne arithmétique et l’écart-type d’échantillon. rpb matérialise le coefficient de corrélation point-bisériale. IC désigne l’intervalle de confiance calculé par transformation z de Fisher.
12.3 Documentation et gouvernance des fichiers Excel de recherche
La crise contemporaine de la reproductibilité scientifique a incité les institutions académiques, les bailleurs de fonds de la recherche et les comités éditoriaux à exiger une traçabilité numérique absolue des chaînes de traitement de données brutes. L’utilisation d’Excel en recherche quantitative ne peut être cautionnée que si le classeur fait l’objet d’une gouvernance méthodologique rigoureuse prévenant les corruptions de données indétectables.
Pour ériger un fichier Excel aux standards de la science ouverte (Open Science) et garantir la reproductibilité intégrale des coefficients de corrélation calculés, l’investigateur applique scrupuleusement les principes opérationnels suivants :
- Création d’un onglet Dictionnaire de Données (Codebook) : Le premier onglet de tout classeur d’analyse doit impérativement répertorier l’intégralité des variables de l’étude. Pour chaque en-tête de colonne, ce catalogue documente : le libellé étendu de la variable, son échelle de mesure exacte (nominale binaire, ordinale, continue à intervalles), l’instrument de mesure d’origine, et la description explicite et inaltérable des codes conventionnels adoptés (ex : « 0 = Sujet témoin recevant une solution saline ; 1 = Sujet traité recevant 10 mg de principe actif »).
- Cloisonnement strict des données brutes et des calculs : Les matrices de données originelles issues du recueil empirique doivent être figées sur un onglet source dénommé
RAW_DATA, configuré en lecture seule protégée par mot de passe. Toutes les opérations d’assainissement, de recodage matriciel et d’extraction statistique par fonctionsCORRELouMOYENNE.SIdoivent être opérées sur un onglet distinct, préservant la traçabilité intégrale de la chaîne d’audit computationnelle. - Verrouillage structurel des cellules formulaires : Afin d’éliminer le spectre redoutable des écrasements typographiques accidentels de formules lors de manipulations manuelles de filtrage, il convient de verrouiller formellement les cellules hébergeant les architectures analytiques (via le menu Format de cellule > Protection > Verrouillée, complété par l’activation de Protéger la feuille).
- Archivage pérenne sous formats interopérables ouverts : Si le classeur dynamique
.xlsxdemeure l’outil d’exécution fonctionnel au quotidien, l’archivage scientifique définitif imposé par les dépôts institutionnels (tels que l’Open Science Framework – OSF ou Zenodo) exige l’exportation concomitante d’une copie conforme de la matrice des données au format texte brut délimité universel.csv(Comma-Separated Values). Ce format universel garantit la pérennité séculaire de l’accès aux données, indépendamment des évolutions commerciales et des obsolescences logicielles de l’écosystème propriétaire de tableur.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
- Levallois, P. (2018). Statistiques appliquées aux sciences du comportement (3e éd.). Chenelière Éducation.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Pearson, K. (1909). On a new method of determining correlation between a measured character A, and a character B, of which only the percentage of cases wherein B exceeds (or falls short of) a given intensity is recorded for each grade of A. Biometrika, 7(1/2), 96–105. https://doi.org/10.2307/2345366
- Rosenthal, R. (1994). Parametric measures of effect size. In H. Cooper & L. V. Hedges (Eds.), The handbook of research synthesis (pp. 231–244). Russell Sage Foundation.
- Tate, R. F. (1954). Correlation between a discrete and a continuous variable. Point-biserial correlation. The Annals of Mathematical Statistics, 25(3), 603–607. https://doi.org/10.1214/aoms/1177728730
- Tate, R. F. (1955). The theory of correlation between two continuous variables when one is dichotomized. Biometrika, 42(1/2), 205–216. https://doi.org/10.2307/2333433
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.