
La boîte à moustaches, universellement désignée sous le vocable anglo-saxon de boxplot ou plus formellement sous l’appellation de diagramme de Tukey, constitue l’une des innovations sémiologiques et statistiques les plus remarquables de la seconde moitié du vingtième siècle. Conçue à une époque où le calcul informatisé émergeait à peine, elle a profondément redéfini les modalités par lesquelles les chercheurs appréhendent visuellement la dispersion, la tendance centrale et la morphologie sous-jacente des ensembles de données quantitatives. Alors que la statistique classique, sous l’impulsion des travaux fondateurs de Ronald Fisher, Karl Pearson et Jerzy Neyman, accordait une primauté quasi exclusive aux estimateurs paramétriques tels que la moyenne arithmétique et la variance empirique, la boîte à moustaches a incarné un changement de paradigme vers une exploration non paramétrique, robuste et immédiatement intelligible des distributions.
Dans les sciences du comportement, en psychologie expérimentale, en neuropsychologie clinique ainsi que dans l’ensemble des disciplines biomédicales et sociales, la boîte à moustaches s’est imposée comme un instrument méthodologique de premier ordre. Ces domaines se heurtent structurellement à des corpus de données caractérisés par une variabilité intrinsèque substantielle, des asymétries prononcées, des phénomènes d’écrasement aux bornes et l’irruption fréquente d’observations extrêmes issues de singularités individuelles ou d’artefacts de mesure. En substituant aux résumés gaussiens traditionnels une armature fondée sur l’ordre et le rang des observations, ce graphique préserve la fidélité de l’information brute tout en synthétisant avec une économie visuelle remarquable la topographie globale de l’échantillon.
Le présent traité propose une déconstruction exhaustive, théorique, mathématique et appliquée de la boîte à moustaches. En articulant son ancrage historique avec ses propriétés algorithmiques les plus rigoureuses, ses applications concrètes en recherche comportementale, ses variantes modernes et les exigences formelles de la publication scientifique contemporaine, cet article offre aux chercheurs, cliniciens et analystes de données un cadre conceptuel complet pour exploiter toute la puissance analytique de cet outil graphique fondamental.
1. Fondements conceptuels et émergence historique de la boîte à moustaches
1.1 Origine théorique et travaux pionniers de John Tukey
L’acte de naissance officiel de la boîte à moustaches remonte aux travaux séminaux du mathématicien et statisticien américain John Wilder Tukey. Dès la fin des années 1960, au sein des laboratoires Bell et de l’Université de Princeton, Tukey développe une critique vigoureuse de l’orientation excessivement confirmatoire que prenait la statistique académique de son époque. Cette réflexion culminera en 1977 avec la parution de son ouvrage magistral, Exploratory Data Analysis (EDA). Tukey y introduit formellement le tracé sous le nom initial de schematic plot ou box-and-whisker plot. L’objectif premier de cette entreprise n’était pas de remplacer l’inférence formelle, mais d’instaurer une étape préalable indispensable : celle d’une écoute ouverte, visuelle et sans a priori dogmatique de ce que les données ont à révéler avant toute tentative de modélisation probabiliste rigide.
Cette démarche constituait une véritable rupture épistémologique face à l’école statistique classique. Durant des décennies, l’évaluation d’un jeu de données quantitatives imposait d’emblée la supposition d’une distribution normale sous-jacente, réduisant l’analyse à l’estimation de deux paramètres fondamentaux : la moyenne arithmétique et l’écart-type. Tukey perçut avec acuité le danger inhérent à ce réductionnisme mathématique. Dans le monde empirique, et singulièrement dans les sciences humaines et du vivant, les distributions gaussiennes parfaites relèvent davantage de l’idéalité théorique que de la réalité empirique. En élaborant un dispositif graphique fondé sur des statistiques d’ordre, insensibles aux déformations induites par les valeurs exceptionnelles, Tukey ouvrit la voie à ce que l’on qualifiera plus tard de statistique robuste.
Du point de vue structurel, la boîte à moustaches a connu une évolution remarquable depuis son tracé manuscrit originel, conçu pour être esquissé rapidement à l’aide d’un simple crayon et d’une règle sur du papier millimétré, jusqu’aux visualisations vectorielles haute définition générées par les environnements computationnels contemporains. Le prototype initial, parfois qualifié de range-bar ou de boîte élémentaire, reliait simplement les extrêmes autour de la médiane et des quartiles sans distinction formelle des anomalies. Très rapidement, Tukey perfectionna l’algorithme en introduisant des barrières arithmétiques précises destinées à isoler graphiquement les observations aberrantes. Cette transition d’un schéma descriptif sommaire vers une architecture computationnelle standardisée a fait de la boîte à moustaches la pierre angulaire de la transition historique de la statistique descriptive traditionnelle vers la sémiologie graphique moderne.
1.2 Rôle épistémologique en psychologie expérimentale et différentielle
L’adoption de la boîte à moustaches au sein de la psychologie scientifique et des neurosciences comportementales a profondément transformé les pratiques d’investigation empirique. Dans les protocoles de psychologie expérimentale, où des sujets sont soumis à des conditions contrôlées, l’analyse immédiate des représentations graphiques permet de sonder simultanément l’hétérogénéité intra-groupe et les disparités inter-groupes. Alors que la comparaison classique de moyennes tend à diluer la variabilité individuelle sous une unique valeur agrégée, la boîte à moustaches expose sans concession l’étendue réelle des comportements observés au sein de chaque strate expérimentale, permettant à l’expérimentateur de constater instantanément si un effet moyen significatif n’est pas en réalité le produit déformé d’une poignée d’individus atypiques.
De surcroît, la boîte à moustaches joue un rôle prophylactique majeur contre « l’illusion de normalité » qui contamine fréquemment la recherche en sciences comportementales. Dans de nombreuses études cliniques ou cognitives, les échantillons analysés présentent des effectifs restreints, typiquement compris entre quinze et quarante participants par groupe. Dans ces conditions, présumer a priori de la normalité de la distribution relève du sophisme méthodologique. La visualisation directe de la position de la médiane au sein du rectangle interquartile et la comparaison de l’envergure des moustaches permettent de briser cette illusion, confrontant immédiatement le chercheur à l’asymétrie empirique ou à la présence de modes secondaires.
Cette fidélité à la réalité brute de la distribution agit comme un puissant contrepoids aux biais de confirmation cognitifs du chercheur. Face à des résultats préliminaires ambigus, la tentation peut être grande de recourir à des transformations mathématiques inadéquates ou à des exclusions arbitraires d’observations pour forcer la significativité statistique sous le paradigme des tests de signification de l’hypothèse nulle (NHST). La boîte à moustaches préserve l’intégrité de la structure distributionnelle. Elle ne concurrence pas l’inférence formelle par les tests paramétriques ou non paramétriques ; elle en constitue l’assise critique, guidant l’analyste dans le choix motivé de tests conformes aux postulats métrologiques réels des données.
1.3 Définition formelle et taxonomie des composantes graphiques
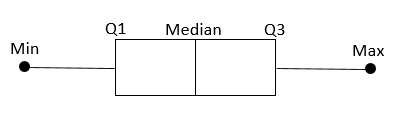
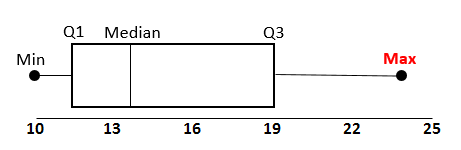
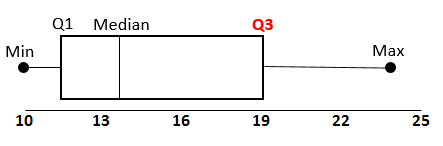
D’un point de vue morphologique, la boîte à moustaches standardisée est un artefact graphique unidimensionnel structuré autour d’un ensemble rigoureusement défini de composantes géométriques. L’élément central est constitué d’un rectangle, communément appelé « la boîte », dont l’extension spatiale le long de l’axe de mesure est délimitée par les premier et troisième quartiles empiriques de la distribution, respectivement notés Q1 et Q3. La longueur de ce polygone matérialise donc l’intervalle interquartile, qui encapsule de facto les 50 % centraux des données observées. À l’intérieur de ce cadre rectangulaire, un segment transversal franc vient marquer avec précision l’emplacement de la médiane, ou cinquantième centile.
De part et d’autre de cette boîte centrale émergent des extensions linéaires orthogonales appelées « moustaches » (ou whiskers dans la terminologie originale). Selon la convention la plus largement répandue, formalisée par Tukey, ces segments rectilignes ne s’étirent pas nécessairement jusqu’aux valeurs absolues minimales et maximales de la série statistique. Ils se projettent vers l’extérieur jusqu’à atteindre l’observation empirique la plus extrême qui demeure contenue à l’intérieur d’un intervalle de sécurité défini par des « barrières intérieures ». Toute valeur située en deçà de la moustache inférieure ou au-delà de la moustache supérieure est formellement catégorisée comme une valeur périphérique ou aberrante, rompant avec la ligne continue du graphique.
Ces observations atypiques font l’objet d’une différentiation graphique systématique au moyen de glyphes individualisés : de petits cercles évidés, des croix ou des astérisques positionnés avec une rigoureuse exactitude le long de l’axe métrique. L’ensemble de cette composition repose sur une échelle numérique continue, continue-discrète ou de rang, projetée verticalement ou horizontalement. L’une des propriétés formelles majeures de cet agencement réside dans son invariance d’échelle : quelle que soit l’amplitude globale de la variable physique ou psychologique mesurée, la boîte à moustaches applique une métrique spatiale strictement proportionnelle, permettant d’appréhender d’un seul coup d’œil l’ensemble des propriétés de dispersion et de centralité du phénomène étudié.
2. L’armature mathématique : le résumé à cinq nombres
2.1 La médiane comme mesure de tendance centrale non paramétrique
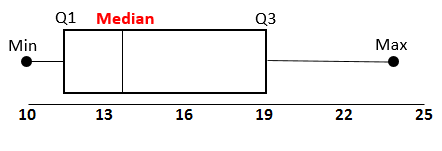
L’édifice mathématique de la boîte à moustaches s’enracine dans le concept formalisé par Tukey sous la dénomination de « résumé à cinq nombres » (five-number summary). Au cœur névralgique de ce système se trouve la médiane, mesure d’ordre par excellence de la tendance centrale non paramétrique. Soit un ensemble de $N$ observations numériques issues d’une variable quantitative, ordonnées de manière non décroissante tel que $x_{(1)} le x_{(2)} le dots le x_{(N)}$. La médiane empirique, désignée usuellement par $M$ ou $Q_2$, partitionne l’échantillon en deux sous-ensembles d’effectifs rigoureusement équivalents, laissant exactement 50 % des observations à sa gauche et 50 % à sa droite sur l’axe des réels.
Sa formulation computationnelle dépend de la parité de l’effectif total de l’échantillon :
- Si $N$ est impair, la médiane correspond précisément à l’observation centrale située au rang indiciaire $\frac{N + 1}{2}$, soit $M = x_{\left(\frac{N+1}{2}\right)}$.
- Si $N$ est pair, il n’existe pas d’observation matérielle isolée au centre exact de la série ; la médiane est alors définie par convention comme la moyenne arithmétique des deux valeurs centrales d’indices $\frac{N}{2}$ et $\frac{N}{2} + 1$, ce qui donne $M = \frac{x_{\left(\frac{N}{2}\right)} + x_{\left(\frac{N}{2}+1\right)}}{2}$.
Cette construction confère à la médiane une résistance absolue aux perturbations induites par les scores extrêmes. Contrairement à la moyenne arithmétique qui présente un point de rupture (breakdown point) nul — une seule valeur infiniment aberrante suffisant à corrompre totalement la moyenne —, la médiane possède un point de rupture asymptotique de 50 %. Dans les applications psychométriques et neuropsychologiques, cette propriété s’avère providentielle. Considérons l’exemple paradigmatique des temps de réaction cognitive mesurés en millisecondes : ces distributions manifestent presque invariablement une asymétrie positive prononcée, étirée par des temps d’inattention transitoires. L’emploi de la médiane neutralise l’impact délétère de ces latences massives, fournissant un étalonnage fidèle de la vitesse d’exécution réelle du sujet sans requérir d’élagage arbitraire de l’échantillon.
2.2 Détermination des quartiles inférieur (Q1) et supérieur (Q3)
Si le statut de la médiane ne souffre d’aucune contestation algorithmique, l’estimation rigoureuse des premier et troisième quartiles, respectivement notés $Q_1$ et $Q_3$, révèle une complexité mathématique insoupçonnée. Sur le plan théorique, $Q_1$ et $Q_3$ correspondent aux vingt-cinquième et soixante-quinzième centiles empiriques, délimitant les tranches quartilaires de la population étudiée. Cependant, la transposition computationnelle de ce fractionnement sur des séries d’observations discrètes soulève d’importantes divergences algorithmiques. Dans une étude devenue célèbre, les statisticiens Rob Hyndman et Yanan Fan (1996) ont identifié et formalisé pas moins de neuf méthodes distinctes employées par les principaux logiciels de calcul scientifique mondiaux.
Dans la méthode originelle de Tukey, désignée sous le terme de « charnières » (hinges), la médiane est incluse dans le calcul des demi-séries si $N$ est impair. D’autres approches, à l’instar de l’algorithme standard implémenté dans le logiciel SAS ou l’interpolation linéaire continue adoptée dans l’environnement R (notamment le Type 7, souvent configuré par défaut), procèdent par pondération continue des indices de rangs fractionnaires. Selon la formule générale d’Hyndman et Fan, le rang $p_k$ associé au centile $k$ est défini par :
$$p_k = a + (N + 1 – 2a) \times k$$
où la constante $a$ varie selon le modèle choisi (par exemple, $a = 0$ pour les méthodes empiriques symétriques, $a = 1/2$ pour les estimateurs sans biais sous loi normale). La valeur du quartile est ensuite obtenue par interpolation linéaire entre les observations encadrant ce rang fractionnaire.
Les implications méthodologiques de ces divergences algorithmiques ne sont nullement anecdotiques lorsqu’il s’agit de traiter des séries de données psychométriques discrètes, telles que des scores globaux issus d’échelles d’auto-évaluation de type Likert ou des décomptes d’erreurs en tâches neuropsychologiques. Selon que le logiciel utilise la méthode des charnières de Tukey ou une interpolation continue, la valeur calculée de $Q_1$ ou de $Q_3$ peut glisser d’une unité entière dans les échantillons de taille modeste. Ce phénomène de granularité souligne l’impérieuse nécessité pour le chercheur de comprendre la mécanique computationnelle sous-jacente de son environnement logiciel afin de ne pas attribuer une signification clinique fallacieuse à de micro-variations quantilaires purement calculatoires.
2.3 Extrêmes observés et délimitation du spectre empirique
Les deux dernières composantes du résumé à cinq nombres sont constituées par les valeurs extrêmes effectives de la série analysée : le minimum absolu, noté $x_{(1)}$, et le maximum absolu, noté $x_{(N)}$. Ces deux valeurs circonscrivent avec une totale transparence l’amplitude d’échantillonnage globale, formalisée par la différence soustractive $W = x_{(N)} – x_{(1)}$. Dans la boîte à moustaches originelle proposée par Tukey, les extrémités des traits linéaires rejoignaient invariablement ces deux bornes absolues, offrant une vue synthétique mais indifférenciée de la dispersion maximale.
Toutefois, la statistique exploratoire moderne a introduit une démarcation conceptuelle fondamentale entre limites brutes d’échantillonnage et valeurs atypiques. Dans les visualisations contemporaines, le minimum et le maximum bruts ne commandent plus systématiquement la terminaison des moustaches. Si une observation $x_{(N)}$ dépasse le seuil critique défini par les barrières d’exclusion, elle est dissociée de la ligne continue pour être représentée sous la forme d’un point isolé. Dès lors, les extrémités physiques des moustaches viennent s’ancrer sur ce que l’on qualifie d’observations adjacentes : respectivement, la valeur la plus basse qui demeure supérieure ou égale à la barrière inférieure, et la valeur la plus élevée qui demeure inférieure ou égale à la barrière supérieure.
Cette sophistication métrologique transforme radicalement la perception visuelle de la variabilité psychologique. En confrontant directement l’étendue couverte par les moustaches à l’amplitude totale incluant les valeurs disjointes, l’analyste perçoit instantanément la part de dispersion imputable au tronc central cohérent des données et celle découlant de déviations marginales. Cette distinction empêche une lecture biaisée de la variabilité expérimentale, prévenant le risque d’attribuer artificiellement à l’ensemble d’une cohorte clinique une variabilité phénotypique démesurée causée par un unique enregistrement psychophysiologique corrompu.
3. Dissection de la dispersion : l’intervalle interquartile et ses extensions
3.1 Calcul et propriétés métrologiques de l’intervalle interquartile
L’intervalle interquartile (usuellement abrégé IQR pour Interquartile Range) constitue la métrique centrale de dispersion associée à la boîte à moustaches. Analytiquement, il s’obtient par la simple soustraction arithmétique de la valeur du premier quartile de celle du troisième quartile :
$$\text{IQR} = Q_3 – Q_1$$
Sur le plan géométrique, l’écart interquartile définit directement la hauteur (ou la largeur, dans une disposition horizontale) du polygone rectangulaire central. Par définition probabiliste et empirique, cet intervalle embrasse très exactement les cinquante pour cent médians de la distribution analysée. Il neutralise ainsi délibérément le quart le plus faible et le quart le plus élevé des observations recueillies.
D’un point de vue métrologique, l’intervalle interquartile jouit d’une propriété de robustesse fondamentale : un point de rupture égal à 25 %. Cela signifie qu’il est capable de tolérer jusqu’à un quart de données hautement corrompues, aberrantes ou infinies à chaque extrémité du spectre sans voir sa propre valeur numérique dériver vers l’infini. À cet avantage s’ajoute une propriété d’invariance face à toute transformation monotone strictement croissante appliquée aux variables observées. Alors que l’écart-type requiert une échelle d’intervalle stricte et subit des distorsions imprévisibles dès lors que les données subissent des transformations non linéaires (telles que des fonctions logarithmiques ou exponentielles fréquemment sollicitées en modélisation psychophysique), l’ordonnancement des rangs régissant l’IQR garantit une préservation rigoureuse de la hiérarchie distributionnelle sous-jacente.
3.2 Modélisation des seuils intérieurs et extérieurs
Afin d’isoler objectivement les déviations statistiques remarquables sans dépendre d’une modélisation paramétrique a priori, John Tukey a forgé un système empirique ingénieux de délimitations spatiales, désignées dans la littérature sous les termes de « clôtures » ou « barrières » (fences). Les barrières intérieures sont formellement modélisées par les expressions suivantes :
- Barrière intérieure inférieure : $\text{BII} = Q_1 – 1{,}5 \times \text{IQR}$
- Barrière intérieure supérieure : $\text{BIS} = Q_3 + 1{,}5 \times \text{IQR}$
Parallèlement à ces limites de premier niveau, Tukey a établi des barrières extérieures, destinées à classifier les anomalies d’une gravité supérieure :
- Barrière extérieure inférieure : $\text{BEI} = Q_1 – 3{,}0 \times \text{IQR}$
- Barrière extérieure supérieure : $\text{BES} = Q_3 + 3{,}0 \times \text{IQR}$
Le choix conventionnel du coefficient multiplicateur de 1,5 ne relève pas d’une intuition purement arbitraire, mais d’une profonde justification probabiliste adossée au modèle gaussien théorique. Dans le cadre d’une loi normale parfaite $\mathcal{N}(\mu, \sigma^2)$, l’écart interquartile équivaut analytiquement à environ $1{,}349 \times \sigma$. Par suite, l’adjonction de $1{,}5 \times \text{IQR}$ de part et d’autre des quartiles positionne approximativement les barrières intérieures à une distance de $\mu \pm 2{,}7 \times \sigma$ par rapport au centre de gravité. Sous cette hypothèse normale, la probabilité théorique qu’une observation s’aventure spontanément au-delà des barrières intérieures est d’environ 0,007 (soit moins de 0,7 % de l’échantillon global, soit environ 1 observation sur 140). Ce multiplicateur de 1,5 a donc été méticuleusement calibré pour minimiser le taux de fausses alertes sur des distributions modérément symétriques tout en garantissant une sensibilité diagnostique aiguë face aux dérives distributionnelles réelles.
3.3 Typologie algorithmique des valeurs atypiques
L’application rigoureuse de ce système de barrières innerve une classification dichotomique des données exogènes au sein des environnements d’analyse statistique :
- Les valeurs atypiques modérées (mild outliers) : Elles regroupent l’ensemble des points d’observation qui se logent au-delà des barrières intérieures tout en demeurant à l’intérieur de l’enceinte dessinée par les barrières extérieures. Mathématiquement, une valeur $x_i$ est une anomalie modérée si elle satisfait à l’une des deux conditions suivantes :
$$\text{BII} > x_i ge \text{BEI} \quad \text{ou} \quad \text{BIS} < x_i le \text{BES}$$
Dans les représentations canoniques, ces observations sont matérialisées par des marqueurs discrets, le plus fréquemment des cercles vides ou des points circulaires pleins de taille réduite. - Les valeurs aberrantes extrêmes (extreme outliers) : Elles qualifient toute observation numérique franchissant les limites ultimes fixées par les barrières extérieures :
$$x_i \text{BES}$$
Dans une distribution normale théorique, l’émergence d’une telle observation représente une probabilité quasi infinitésimale (approximativement un cas sur plusieurs centaines de milliers). Dans les publications académiques et les interfaces logicielles professionnelles, ces points sont visuellement singularisés par des glyphes distinctifs, usuellement une étoile ou un astérisque ($star$).
Dans la pratique psychologique clinique et neuropsychologique, cette graduation algorithmique revêt des conséquences diagnostiques immédiates. La détection d’une valeur atypique modérée peut fréquemment traduire l’expression d’une variabilité comportementale rare mais écologique — par exemple, un profil de surdouance intellectuelle sur une sous-échelle de traitement visuo-spatial, ou un épisode de dissociation cognitive passager au cours d’un paradigme de vigilance. À l’inverse, l’apparition d’une valeur extrême doit obligatoirement déclencher un protocole de vérification d’intégrité métrologique : défaillance matérielle d’une cellule de réponse chronométrique, erreur de transcription lors de la saisie cléricale des dossiers patients, ou désengagement complet du participant transgressant les consignes expérimentales.
4. Diagnostic de la distribution : asymétrie, aplatissement et forme
4.1 Identification visuelle de l’asymétrie distributionnelle
L’un des avantages heuristiques majeurs de la boîte à moustaches réside dans son aptitude à servir de stéthoscope visuel pour diagnostiquer l’asymétrie statistique (skewness) d’une série continue sans recourir aux calculs des moments d’ordre supérieur. Cette évaluation repose sur la lecture conjointe de deux indices géométriques internes : le centrage de la médiane à l’intérieur du polygone interquartile et le rapport de proportionnalité des moustaches externes.
Dans une distribution parfaitement symétrique, la barre transversale médiane coupe la boîte en deux compartiments rectangulaires d’égales proportions ($(M – Q_1) \approx (Q_3 – M)$), et les moustaches supérieure et inférieure manifestent des longueurs rigoureusement identiques. À l’inverse, lorsque l’on analyse des latences de traitement de l’information en chronométrie cognitive ou des mesures d’évitement comportemental chez des sujets phobiques, on observe une asymétrie positive (vers la droite). Sur la boîte à moustaches, ce phénomène se traduit par un tableau clinique univoque :
- La médiane s’affaisse vers le bas de la boîte, comprimée à proximité immédiate de $Q_1$ ;
- Le compartiment supérieur compris entre la médiane et $Q_3$ s’étire considérablement ;
- La moustache supérieure présente une envergure nettement plus importante que la moustache inférieure ;
- Une traîne de valeurs atypiques se déploie exclusivement au-delà de la clôture supérieure.
Inversement, l’asymétrie négative (vers la gauche) se rencontre couramment dans les protocoles d’évaluation des compétences acquises ou lors de l’administration d’épreuves d’intelligence standardisées chez des cohortes hautement sélectionnées, générant des « effets de plafond » (ceiling effects). Dans cette configuration, les scores s’agglutinent contre la borne maximale de l’épreuve. La boîte à moustaches projette alors la médiane contre le bord supérieur $Q_3$, tandis que le compartiment inférieur $(M – Q_1)$ et la moustache inférieure s’allongent vers les zones de performance résiduelle, signalant immédiatement au psychomètre l’inadéquation de la sensibilité métrologique de son instrument dans les zones supérieures de l’aptitude.
4.2 Inférences relatives à l’aplatissement et à la densité
Au-delà de l’asymétrie, la géométrie de la boîte à moustaches autorise des inférences fondamentales quant au degré d’aplatissement et à la concentration de la densité de probabilité, caractéristiques formalisées en statistique par le kurtosis. Lorsque les observations manifestent une concentration leptokurtique aiguë — c’est-à-dire une accumulation hyper-dense d’individus autour d’une modalité centrale avec des queues de distribution épaisses —, le rectangle central se contracte drastiquement le long de l’axe métrique. L’intervalle interquartile se rétrécit, enserré par des moustaches proportionnellement très longues, tandis que de multiples points atypiques s’isolent au-delà des clôtures de Tukey.
À l’opposé, une configuration platykurtique, représentative de cohortes uniformément dispersées sur l’espace d’évaluation psychologique, engendre un étalement maximal de la boîte interquartile, qui vient occuper une fraction prépondérante de la portée totale des données, les moustaches se trouvant alors singulièrement réduites, voire résiduelles, en l’absence totale de points atypiques périphériques.
Néanmoins, la prudence épistémologique impose de reconnaître les limites inhérentes à la boîte à moustaches face aux distributions complexes, tout particulièrement les structures strictement bimodales ou multimodales. Une boîte à moustaches est incapable de faire la distinction graphique entre une distribution unimodale parfaitement étalée de type uniforme et une distribution comportant deux modes denses symétriquement séparés par un creux de probabilité béant au niveau de la médiane. Dans les deux cas, la boîte peut arborer une physionomie rigoureusement identique. Pour contourner cette cécité structurelle lors des phases de criblage exploratoire, les chercheurs associent couramment la boîte à moustaches à des estimateurs de densité par noyau (Kernel Density Estimation), stratégie intégrée à l’origine du développement des diagrammes en violon.
4.3 Évaluation comparative face au modèle normal théorique
Avant d’engager des modélisations mathématiques lourdes relevant du modèle linéaire général — telles que l’analyse de variance univariée ou multivariée (ANOVA/MANOVA) ou les régressions linéaires multiples —, l’évaluation de la conformité des résidus avec la loi normale est un impératif méthodologique incontournable. Si des procédures analytiques formelles existent (comme les tests de Shapiro-Wilk ou de Kolmogorov-Smirnov), la boîte à moustaches constitue un outil de filtrage visuel préliminaire d’une remarquable efficacité pour juger de l’adéquation au modèle théorique de Gauss-Laplace.
Une conformité visuelle satisfaisante avec la loi normale impose le respect simultané de quatre critères morphologiques stricts :
- Un centrage quasi parfait du segment de la médiane au milieu exact de la boîte interquartile ($M \approx \frac{Q_1 + Q_3}{2}$) ;
- Une égalité substantielle des longueurs respectives des moustaches supérieure et inférieure ;
- Une proportion de points étiquetés comme valeurs atypiques infinitésimale (ne devant pas excéder 0,7 % dans les échantillons de taille substantielle) ;
- Un positionnement symétrique de ces éventuelles anomalies de part et d’autre des bornes extrêmes.
L’invalidation manifeste de l’un de ces critères morphologiques fournit à l’analyste un signal d’alerte précoce d’une violation critique des postulats d’homoscédasticité ou de normalité des résidus. Ce diagnostic visuel épargne au chercheur l’application aveugle de tests d’adéquation paramétriques qui, sur de très grands échantillons, tendent à rejeter systématiquement la normalité pour des écarts infinitésimaux et cliniquement dénués de toute pertinence, ou qui, sur de très petits groupes expérimentaux, manquent cruellement de puissance statistique pour détecter des asymétries pourtant dévastatrices.
5. Protocole de construction manuelle et calculatoire
5.1 Ordonnancement et partitionnement d’une série psychologique
La confection rigoureuse d’une boîte à moustaches repose sur un protocole algorithmique déterministe que chaque chercheur doit maîtriser pour saisir la réalité calculatoire sous-jacente aux sorties logicielles. La première phase de cette méthodologie exige l’ordonnancement séquentiel ascendant de la série brute des observations quantitatives recueillies. Soit un échantillon de mesures continues ou quasi-continues représentant, par exemple, les scores d’anxiété-trait obtenus par une cohorte clinique lors d’un protocole d’admission hospitalière. La série désordonnée d’origine ${x_1, x_2, dots, x_N}$ est transformée en une statistique d’ordre formelle :
$$x_{(1)} le x_{(2)} le x_{(3)} le dots le x_{(N)}$$
Cette étape de tri requiert une attention méticuleuse quant au traitement des scores ex aequo (égalités de rang). Contrairement à ce qui prévaut lors du calcul de certains coefficients de corrélation de rangs non paramétriques (comme le rho de Spearman) où les égalités contraignent à l’attribution de rangs moyens fractionnaires, la statistique d’ordre destinée à la boîte à moustaches maintient l’intégrité sérielle des observations dupliquées. Chaque observation conserve son propre indice dans la chaîne ordonnée, préservant la masse empirique totale $N$ indispensable au partitionnement quantilaire ultérieur.
5.2 Algorithme séquentiel de calcul du résumé numérique
Une fois la série rigoureusement triée, la résolution mathématique des grandeurs directrices s’effectue selon la démarche séquentielle standardisée formalisée par John Tukey :
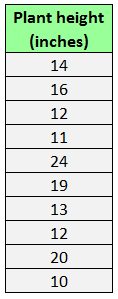
- Extraction de la médiane : La médiane $M$ est identifiée. Si $N$ est impair, elle prend la valeur de l’élément d’indice central $k = (N+1)/2$. Si $N$ est pair, elle est calculée par la demi-somme des éléments aux rangs $N/2$ et $(N/2) + 1$.
- Scission en sous-groupes quartilaires : La série ordonnée est partitionnée en deux demi-séries : la moitié inférieure (contenant les observations allant de $x_{(1)}$ jusqu’au centre) et la moitié supérieure (contenant les observations s’étendant du centre jusqu’à $x_{(N)}$). Dans l’algorithme originel des charnières de Tukey, si $N$ est impair, l’élément médian $M$ est inclus simultanément comme borne maximale de la demi-série inférieure et comme borne minimale de la demi-série supérieure.
- Détermination des quartiles $Q_1$ et $Q_3$ : Le premier quartile $Q_1$ est simplement calculé comme étant la médiane empirique de la demi-série inférieure. Symétriquement, le troisième quartile $Q_3$ est calculé comme la médiane empirique de la demi-série supérieure.
- Calcul de la dynamique interquartile et des seuils : L’écart interquartile est dérivé :
$$\text{IQR} = Q_3 – Q_1$$
Les barrières théoriques sont immédiatement posées :
$$\text{BII} = Q_1 – (1{,}5 \times \text{IQR}) \quad \text{et} \quad \text{BIS} = Q_3 + (1{,}5 \times \text{IQR})$$
5.3 Traçage géométrique et conventionnel de l’épure
La transcription géométrique de ces grandeurs calculées sur un plan en deux dimensions obéit à un cahier des charges sémiologique immuable :
En premier lieu, un axe de coordonnées cartésiennes — vertical pour les conventions usuelles de présentation des variables dépendantes, ou horizontal — est gradué de façon strictement linéaire et continue, en se fondant sur les unités psychométriques de l’instrument de mesure.
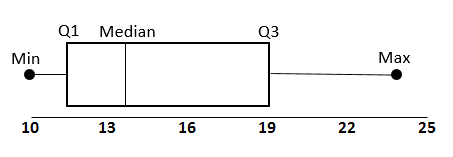
En second lieu, le corps principal de la boîte est dessiné : il s’agit d’un rectangle dont les arêtes perpendiculaires à l’axe métrique s’alignent rigoureusement sur les valeurs calculées pour $Q_1$ et $Q_3$. La largeur transversale de la boîte est arbitraire dans la version classique, mais doit impérativement demeurer constante entre toutes les conditions comparées. À l’intérieur de ce cadre, un segment de ligne plein, souvent plus épais que le contour de la boîte, est tracé au niveau exact de la coordonnée de la médiane $M$.
En troisième lieu, les extensions filiformes (moustaches) sont projetées depuis le centre des parois de la boîte :
- La moustache inférieure prend naissance en $Q_1$ et descend le long de l’axe jusqu’à la valeur de l’observation empirique la plus petite qui soit encore strictement supérieure ou égale à la barrière $\text{BII}$. Elle ne se termine jamais dans le vide théorique d’une barrière, mais s’ancre sur une donnée réelle.
- Symétriquement, la moustache supérieure prend naissance en $Q_3$ et progresse le long de l’axe jusqu’à la valeur de l’observation empirique la plus haute qui demeure strictement inférieure ou égale à la barrière $\text{BIS}$.
- Des segments perpendiculaires horizontaux d’arrêt sont fréquemment tracés à l’extrémité de ces lignes pour en marquer la clôture empirique.
Enfin, les valeurs résiduelles de l’échantillon situées au-delà des terminaisons des moustaches sont reportées individuellement à leur coordonnée exacte sous forme de glyphes individualisés (points ou croix pour les observations comprises entre la barrière intérieure et la barrière extérieure ; étoiles pour les valeurs transcendant la barrière extérieure).
6. Applications spécifiques en recherche comportementale et psychométrie
6.1 Analyse différentielle des scores aux échelles psychométriques
Le champ de la psychométrie contemporaine tire un bénéfice heuristique substantiel de l’usage des boîtes à moustaches, tout particulièrement lors du déploiement de batteries standardisées évaluant les dimensions de la personnalité (telles que le modèle en cinq facteurs, ou Big Five) ou des construits psychopathologiques transversaux (dépression, anxiété généralisée, alexithymie). Lors de l’administration pré- et post-interventionnelle de protocoles psychothérapeutiques, la disposition juxtaposée des boîtes à moustaches associées aux deux temps de mesure transcende l’information délivrée par un simple test t de Student pour échantillons appariés.
Cette visualisation expose sans ambiguïté si l’abaissement escompté de la détresse symptomatique s’accompagne d’une réduction salutaire de la dispersion interindividuelle (resserrement de la boîte interquartile et des moustaches) ou si, au contraire, l’intervention thérapeutique induit une polarisation phénotypique, caractérisée par un sous-groupe de répondeurs massifs et une traîne persistante d’individus réfractaires se détachant sous forme de valeurs atypiques supérieures. Dans le contexte de l’étalonnage des tests auprès de cohortes de normalisation stratifiées selon les tranches d’âge, les boîtes à moustaches alignées horizontalement permettent de contrôler d’un seul regard si la dispersion relative des aptitudes mesurées demeure métrologiquement stable à travers le cours de la vie ou si l’hétérogénéité des performances cognitives s’accroît inexorablement sous l’effet du vieillissement cérébral différentiel.
6.2 Étude chronométrique des temps de réaction cognitive
L’analyse des temps de réaction (TR) lors de tâches d’attention soutenue, d’amorçage sémantique ou d’inhibition exécutive (telle que la tâche de Stroop) confronte structurellement les neuroscientifiques à des distributions hautement asymétriques, typiquement ajustées par des modèles mathématiques de type distribution ex-gaussienne ou loi de Wald. Dans ce cadre empirique, l’utilisation aveugle de la moyenne et de l’écart-type est méthodologiquement pernicieuse : un unique ralentissement de plusieurs secondes induit par un micro-sommeil attentionnel ou un clignement oculaire déforme artificiellement la moyenne arithmétique d’un participant sur un bloc d’essais.
La boîte à moustaches restitue avec une élégance visuelle incomparable la réalité de la cinétique mentale :
- La moustache inférieure, invariablement courte et compacte, matérialise le mur physiologique infranchissable de la vitesse de conduction axonale et du temps d’intégration synaptique sensoriel (typiquement autour de 150 à 200 millisecondes) ;
- Le corps de la boîte interquartile délimite la bande passante opératoire centrale et la vitesse de croisière cognitive de l’individu ;
- L’étirement de la moustache supérieure expose la labilité attentionnelle transitoire ;
- L’isolement des réponses ultra-tardives au rang d’anomalies de Tukey offre la possibilité de documenter rigoureusement la fréquence d’échappement attentionnel sans contraindre le chercheur à retrancher arbitrairement des points du corpus d’analyse au moyen de seuils de coupure fixes et injustifiés.
6.3 Suivi longitudinal des trajectoires thérapeutiques
Dans la recherche clinique interventionnelle et les essais contrôlés randomisés (ECR) en psychiatrie et en psychologie de la santé, le monitoring longitudinal des trajectoires de rétablissement impose le recours à des représentations visuelles capables d’absorber la complexité temporelle de mesures répétées. La restitution graphique de l’évolution symptomatique d’une cohorte à des échéances régulières (par exemple : inclusion, semaine 2, semaine 4, semaine 8 et suivi à 6 mois) au moyen d’une série chronologique de boîtes à moustaches juxtaposées sur l’axe temporel horizontal constitue un standard d’une clarté inégalée.
Cette approche séquentielle permet d’apprécier visuellement si la cinétique de guérison procède d’un glissement global de la distribution des scores de détresse psychologique vers les valeurs d’asymptote saine, ou si la structure distributionnelle se disloque au fil des semaines. Elle permet de repérer précocement les profils d’individus non-répondeurs ou de rechuteurs qui s’extirpent de la boîte centrale pour former des îlots d’anomalies cliniques supérieures persistantes. Dans les comités de surveillance des données et de tolérance des essais cliniques (DSMB), ces visualisations non paramétriques apportent une transparence immédiate, éliminant tout artefact mathématique susceptible de masquer l’inefficacité partielle d’une molécule ou d’une psychothérapie innovante chez un sous-segment vulnérable de la patientèle.
7. Comparaisons factorielles et plans expérimentaux multigroupes
7.1 Visualisation des contrastes dans les devis inter-sujets
Lorsque le protocole de recherche s’articule autour de plans expérimentaux inter-sujets comportant de multiples conditions indépendantes (par exemple, la comparaison de performances mnésiques sous trois dosages pharmacologiques distincts confrontés à une condition placebo), la boîte à moustaches parallèle s’impose comme un puissant dispositif d’investigation exploratoire et comparative. La juxtaposition rigoureuse de boîtes sur un même système d’axes cartésiens permet d’évaluer d’emblée la pertinence de l’hypothèse de recherche avant même l’exécution des tests inférentiels.
L’analyste examine avec une acuité particulière le degré de chevauchement vertical entre les boîtes interquartiles. Si le rectangle central d’une condition expérimentale se détache entièrement sans recouvrement au-dessus de celui du groupe témoin, la probabilité d’un effet thérapeutique massif (associé à une taille d’effet substantielle, mesurable par un $d$ de Cohen ou un $\eta_p^2$ élevé) devient manifeste. Inversement, un chevauchement prononcé des médianes et des boîtes signale d’emblée que les variations observées entre les moyennes relèvent vraisemblablement du bruit stochastique d’échantillonnage plutôt que d’un déterminisme expérimental solide.
De plus, cette disposition multigroupes constitue l’outil diagnostique le plus intuitif pour juger du respect de l’hypothèse d’homos張édasticité (homogénéité des variances intra-groupes), postulat mathématique cardinal de l’analyse de variance (ANOVA). Si l’une des boîtes associées à une modalité présente une hauteur interquartile trois ou quatre fois supérieure à celle des boîtes adjacentes, le chercheur se trouve confronté à une hétéroscédasticité critique. Ce constat impose d’abandonner le modèle classique de Fisher au profit de formulations corrigées robustes, telles que l’ANOVA de Welch, ou d’engager des modélisations linéaires généralisées adaptées.
7.2 Exploration des effets d’interaction dans les plans factoriels
Dans les devis factoriels complexes croisant au moins deux variables indépendantes (par exemple, un plan factoriel $2 \times 2$ évaluant l’Impact de la Valence Émotionnelle [Positive vs Négative] et du Statut Clinique [Sujet Dépressif vs Sujet Témoin] sur le rappel mnésique), les boîtes à moustaches matricielles déploient une puissance sémiotique supérieure aux graphiques linéaires de moyennes traditionnels. En organisant le canevas graphique en sous-panneaux juxtaposés ou en utilisant des codes colorimétriques distinctifs pour dédoubler les boîtes à chaque niveau du premier facteur, le chercheur rend immédiatement lisibles les dynamiques de croisement.
Cette approche permet de traquer les non-linéarités et les effets d’interaction antagonistes ou modérateurs :
- Elle illustre avec clarté si l’impact d’une condition d’induction de stress n’opère une dispersion des scores que chez les sujets génétiquement vulnérables, tout en laissant les boîtes des sujets résilients parfaitement compactes et insensibles à la manipulation expérimentale ;
- Elle évite de confondre un effet d’interaction issu d’une véritable inversion développementale avec un artefact attribuable à une poignée de profils paradoxaux situés dans une unique cellule du plan expérimental ;
- Elle offre une restitution conjointe de la magnitude des effets principaux et des interactions de variance, éclairant les processus psychologiques sous-jacents avec une granularité qu’aucun tableau de valeurs $F$ de Snedecor ne peut égaler.
7.3 Représentation graphique des mesures répétées intra-sujets
L’analyse visuelle des plans d’expérience à mesures répétées (devis intra-sujets) impose d’aborder la boîte à moustaches avec une vigilance conceptuelle aiguë. Par construction graphique standard, la boîte à moustaches traite chaque ensemble de points comme une collection d’observations indépendantes. Or, dans un protocole où les mêmes participants traversent successivement plusieurs conditions expérimentales, il existe une covariance intra-sujet étroite (dépendance sérielle des observations). Présenter de simples boîtes à moustaches isolées pour chaque condition masque entièrement l’information relative à la concordance ou au maintien de l’ordre hiérarchique des participants à travers le temps.
Pour remédier à cette lacune méthodologique sans renoncer à la robustesse non paramétrique de l’outil, la science contemporaine des données préconise l’emploi de boîtes à moustaches combinées ou enrichies par des tracés appariés (paired boxplots). Dans ce dispositif sophistiqué, les boîtes traditionnelles délimitant les quartiles marginaux de chaque session sont superposées à une constellation de segments filiformes reliant individuellement le score de chaque sujet entre la condition A et la condition B. Ce couplage permet d’apprécier simultanément :
- L’évolution macroscopique de la distribution globale (translation de la boîte, dilatation ou contraction de l’IQR) ;
- La consistance microscopique de la dynamique comportementale (parallélisme des trajectoires individuelles attestant de la robustesse de l’effet intra-individuel, ou entrecroisement chaotique de lignes révélant une instabilité temporelle profonde).
8. Variantes contemporaines et extensions avancées
8.1 Boîtes crantées et inférence sur la divergence des médianes
Face à la demande croissante d’outils combinant synthèse exploratoire et capacité de décision inférentielle rapide sans nécessiter le calcul laborieux de tests statistiques en aval, McGill, Tukey et Larsen ont proposé en 1978 une extension géométrique de premier ordre : la boîte à moustaches crantée (notched boxplot). Le principe consiste à pratiquer un rétrécissement ou un étranglement symétrique en biseau de part et d’autre des parois latérales de la boîte, centré directement sur la coordonnée médiane.
L’étendue de ce cran le long de l’axe métrique ne relève d’aucun artifice graphique décoratif ; elle matérialise un intervalle de confiance asymptotique non paramétrique autour de la médiane, calculé selon la formulation probabiliste suivante :
$$\text{Cran} = M \pm 1{,}57 \times \frac{\text{IQR}}{\sqrt{N}}$$
où $M$ représente la médiane empirique, $\text{IQR}$ l’intervalle interquartile de l’échantillon et $N$ l’effectif total de la modalité analysée. La constante arithmétique 1,57 découle de l’hypothèse asymptotique gaussienne permettant de garantir un niveau de confiance conjoint d’approximativement 95 % lors de la comparaison visuelle de deux échantillons indépendants.
La règle d’or régissant l’interprétation inférentielle de ces crans est d’une grande simplicité opératoire : si les crans creusés sur les flancs de deux boîtes juxtaposées ne manifestent aucun chevauchement vertical le long de l’axe métrique, le chercheur peut formellement rejeter l’hypothèse d’égalité des deux médianes de population avec un niveau de confiance équivalent à un seuil d’erreur alpha de 5 % ($p < 0{,}05$). Cette fonctionnalité fait de la boîte crantée un dispositif de diagnostic comparatif d'une redoutable efficacité lors de criblages préliminaires de données cliniques ou d'enquêtes épidémiologiques massives.
8.2 Boîtes à largeur variable proportionnelle à l’effectif
Dans de nombreux protocoles de recherche en neurosciences cognitives ou en psychopathologie du développement, les comparaisons inter-groupes souffrent d’une asymétrie d’échantillonnage inévitable. Considérons la confrontation d’une cohorte de patients atteints d’un syndrome neuropsychologique rare (par exemple, le syndrome de Williams ou la démence sémantique précoce), n’intégrant qu’un contingent restreint de $N = 12$ individus, face à une cohorte témoin normotypique regroupant $N = 120$ participants sains appariés. Présenter deux boîtes à moustaches standard d’égales dimensions physiques induit un biais perceptif trompeur chez le lecteur, en conférant inconsciemment le même poids statistique et la même robustesse épistémique à ces deux estimations.
Pour neutraliser ce piège de la cognition visuelle, la variante dite à largeur variable (variable-width boxplot) module la dimension transversale physique du rectangle en fonction directe de la taille de l’effectif contributif. Selon la convention algorithmique prédominante, la largeur horizontale de la boîte est rendue strictement proportionnelle à la racine carrée de l’effectif du groupe considéré :
$$\text{Largeur} propto \sqrt{N}$$
Sous ce régime d’affichage, la boîte du groupe témoin apparaîtra visuellement plus de trois fois plus massive et volumineuse que celle du sous-groupe clinique restreint. Cette mise en page intuitive alerte instantanément le lecteur quant aux degrés respectifs de puissance statistique et d’erreur-type inhérents à chaque groupe, empêchant toute surinterprétation des singularités d’une boîte étroite dont l’instabilité d’échantillonnage saute immédiatement aux yeux.
8.3 Hybridation avec les diagrammes de dispersion et de violon
L’avènement des environnements computationnels avancés de visualisation scientifique au tournant du vingt-et-unième siècle a favorisé l’hybridation féconde de la boîte à moustaches avec d’autres représentations de la densité distributionnelle. La première de ces hybridations majeures s’est matérialisée par l’intégration d’un nuage de points individualisés transparents et aléatoirement bruités latéralement (jittered strip-chart) superposé au tracé de la boîte. Cette technique permet de dépasser la rigidité synthétique du résumé à cinq nombres en exposant chaque donnée matérielle sous la forme d’un quantum d’information identifiable.
Parallèlement, la statistique computationnelle a vu émerger le diagramme en violon (violin plot), conçu par Hintze et Nelson en 1998, qui fusionne l’armature de la boîte à moustaches avec une courbe bilatérale d’estimation de la densité de probabilité par la méthode du noyau. Ces démarches convergentes ont culminé dans le développement contemporain du diagramme en goutte de pluie (raincloud plot), particulièrement plébiscité en neurosciences comportementales et en psychologie expérimentale.
Comme l’illustre la conception novatrice de ce format hybride, le chercheur dispose simultanément :
- D’un demi-violon latéral offrant le tracé continu de la densité de probabilité lissée (révélant les creux, les bosses et la multimodalité) ;
- D’une boîte à moustaches centrale ultra-compacte ancrant les repères non paramétriques cardinaux (médiane, IQR, valeurs extrêmes) ;
- D’une nappe de points réels étalée sous la forme de gouttelettes projetées à la base du tracé, révélant la granularité métrique absolue.
Cette triade visuelle réalise l’idéal méthodologique d’une transparence analytique totale, combinant le niveau macroscopique de l’agrégation ordinale et le niveau microscopique des observations individuelles brutes.
9. Avantages métrologiques et limites comparatives face aux autres graphiques
9.1 Supériorité analytique sur les diagrammes en barres classiques
Durant plusieurs décennies, les publications académiques en psychologie, en biologie et en médecine ont été massivement dominées par l’usage des diagrammes en barres affublés d’une antenne supérieure représentant l’écart-type ou l’erreur standard, communément qualifiés avec dérision dans le monde statistique de « graphiques de dynamite » (dynamite plots). Dès le milieu des années 2010, une vaste fronde méthodologique internationale s’est levée pour réclamer le bannissement éditorial pur et simple de ces visualisations trompeuses, pointant la supériorité métrologique écrasante de la boîte à moustaches.
Le diagramme en barres induit un biais d’asymétrie cognitive massif : le regard humain accorde inconsciemment une masse physique et une importance statistique au corps de la barre colorée qui comble l’espace depuis l’axe zéro jusqu’au sommet moyen, alors que la véritable information distributionnelle réside uniquement dans la variance autour de ce point terminal. De surcroît, la barre dissimule de façon opaque la dispersion interne, le degré d’asymétrie, l’aplatissement et la présence de valeurs aberrantes. Deux distributions radicalement hétérogènes — l’une strictement normale et compacte, l’autre bimodale et polluée par des valeurs extrêmes aberrantes — peuvent produire un diagramme en barres parfaitement identique. La boîte à moustaches déchire ce voile d’opacité en substituant à une moyenne décontextualisée la projection spatiale objective de l’ensemble des quartiles et des frontières d’exclusion de l’échantillon.
9.2 Complémentarité fonctionnelle avec les histogrammes
L’histogramme de fréquences constitue le rival sémiotique classique de la boîte à moustaches pour l’investigation empirique d’une variable continue. Une comparaison épistémologique rigoureuse démontre que ces deux outils ne s’excluent pas, mais exercent une complémentarité fonctionnelle indispensable au statisticien :
- Capacité de comparaison simultanée : Si l’histogramme excelle dans l’autopsie univariée d’une unique cohorte isolée, il devient visuellement illisible et surchargé dès lors qu’il s’agit de juxtaposer plus de trois ou quatre conditions expérimentales sur un même système d’axes. La boîte à moustaches, grâce à son horizontalité synthétique et sa compacité unidimensionnelle, permet l’alignement et la comparaison fluide de dix, vingt ou cinquante groupes expérimentaux consécutifs sans perte de clarté visuelle.
- Indépendance des paramètres de partitionnement : La physionomie d’un histogramme dépend de manière dramatique de la largeur arbitraire choisie pour les intervalles de classe (bin width) et du point d’ancrage d’origine. Un même corpus de données peut paraître unimodal ou asymétrique selon le découpage retenu. La boîte à moustaches, dérivée de la statistique d’ordre, est totalement exempte de cet arbitraire de discrétisation.
- Détection de la multimodalité : En contrepartie, l’histogramme demeure supérieur pour démasquer instantanément des distributions multimodales ou des discontinuités de spectre (lacunes de données à certaines coordonnées métriques) que le résumé quantilaire de la boîte à moustaches compacte indifféremment dans son polygone interquartile. La prescription méthodologique idéale réside donc dans un usage séquentiel : l’histogramme lors du défrichage univarié initial de la variable, la boîte à moustaches pour orchestrer la comparaison factorielle multigroupes.
9.3 Limites inhérentes et conditions d’inapplicabilité
Malgré sa robustesse méthodologique, la boîte à moustaches n’échappe pas à un ensemble de contraintes formelles et de conditions limites sous lesquelles son usage devient inapproprié, voire activement trompeur pour l’analyste :
La première de ces impasses concerne les effectifs critiques d’échantillons très restreints, classiquement dès que $N < 10$. Dans un groupe composé de cinq à huit individus, tenter d'extraire des quartiles, des demi-séries et des clôtures extérieures relève d'une illusion computationnelle totale. Les statistiques de rang y deviennent hypersensibles aux moindres fluctuations d'un seul participant, et le tracé de barrières basées sur $1{,}5 \times \text{IQR}$ conduit soit à étiqueter à tort des observations normales comme aberrantes, soit à compresser la variabilité dans un rectangle dépourvu de toute fiabilité populationnelle. Dans ce contexte de très petit échantillon, la restitution exclusive du nuage exhaustif des points bruts individuels constitue le seul standard sémiotique valide.
La seconde limitation majeure émerge lors de l’application de boîtes à moustaches sur des échelles discrètes à très faible granularité, telles que des échelles d’attitudes de Likert à 3, 4 ou 5 points ordinaux. Dans ces configurations de mesure tronquée, les valeurs de $Q_1$, de la médiane et de $Q_3$ s’empilent fréquemment sur un ou deux entiers seulement. La boîte se ratatine alors en une unique ligne horizontale ou un carré difforme, et les moustaches disparaissent complètement, anéantissant tout bénéfice visuel. Enfin, comme souligné précédemment, les distributions parfaitement uniformes (plates) génèrent des boîtes à moustaches d’apparence symétrique normale, masquant entièrement l’absence pathologique de mode central dans la cohorte analysée.
10. Mise en œuvre numérique dans les environnements statistiques dédiés
10.1 Programmation rigoureuse sous le logiciel R
L’environnement open-source de calcul statistique R constitue la matrice contemporaine la plus sophistiquée pour la génération et l’automatisation de boîtes à moustaches haute résolution. Dès son installation de base, le moteur graphique permet l’instanciation immédiate d’un tracé via la fonction primitive fondamentale boxplot(), qui autorise la syntaxe par formule reliant la variable dépendante aux facteurs catégoriels de classification :
boxplot(Score_Anxiete ~ Condition_Therapeutique, data = CohorteClinique, notch = TRUE, range = 1.5)
Dans cet appel canonique, le paramètre booléen notch = TRUE ordonne la confection des biseaux d’inférence de la médiane selon la formule de McGill, tandis que l’argument range = 1.5 commande l’application scrupuleuse des clôtures classiques de Tukey pour le calcul de l’ancrage des moustaches.
Néanmoins, l’élaboration de figures destinées à l’édition scientifique internationale requiert le déploiement du package spécialisé ggplot2, fondé sur les principes sémiologiques de la grammaire des graphiques (The Grammar of Graphics de Leland Wilkinson). Grâce à la fonction geom_boxplot() combinée aux mécanismes de facettage (facet_wrap() ou facet_grid()), le chercheur contrôle chaque strate structurelle de la boîte à moustaches. Cette chaîne de traitement graphique permet de superviser avec une précision chirurgicale la pondération millimétrique des bordures de boîte, l’injection de palettes chromatiques adaptées aux troubles de la vision des couleurs (telles que la palette viridis), l’extraction programmatique des coordonnées exactes des valeurs atypiques détectées, ainsi que l’application de thèmes graphiques épurés éradiquant les artefacts de fond.
10.2 Déploiement analytique dans l’écosystème Python
Au sein de l’écosystème informatique Python, prédominant dans les infrastructures de neuro-imagerie computationnelle, d’apprentissage automatique et d’exploitation de données psychophysiologiques massives (signaux EEG, eye-tracking), la construction des boîtes à moustaches s’appuie sur la synergie entre les bibliothèques scientifiques fondamentales Matplotlib et Seaborn. La méthode matplotlib.pyplot.boxplot() offre un accès granulaire à l’ensemble des composantes vectorielles internes du tracé graphique, renvoyant un dictionnaire Python structuré contenant les références matricielles vers les éléments dessinés (les boîtes, les médianes, les moustaches, les chapeaux de clôture et les glyphes des anomalies marginales).
La surcouche déclarative Seaborn simplifie grandement l’articulation de ces tracés avec les structures tabulaires de données massives (DataFrames Pandas) au moyen de sa fonction haut niveau seaborn.boxplot(). Cette bibliothèque automatise avec une fluidité exceptionnelle la déclinaison des boîtes selon des variables de croisement hiérarchique grâce à l’argument hue :
sns.boxplot(x="Groupe_Clinique", y="Temps_Reaction", hue="Niveau_Stress", data=df_exp, showmeans=False, whis=1.5)
Cette commande orchestre instantanément la stratification factorielle complète, isolant les sous-échantillons croisés et gérant rigoureusement l’espacement latéral proportionnel des boîtes. L’intégration de packages statistiques connexes, tels que statannotations, permet en outre d’automatiser l’adjonction vectorielle de crochets de significativité statistique (marquant les valeurs d’inégalités $p$ issues de tests non paramétriques de Wilcoxon ou de Mann-Whitney) directement positionnés au-dessus des clôtures des boîtes, aboutissant à une chaîne d’exportation vers des formats vectoriels haute définition (PDF ou SVG) immédiatement conformes aux exigences éditoriales des plus grandes revues internationales.
10.3 Exploitation ergonomique sous SPSS et JASP en psychologie
Pour les praticiens hospitaliers et les chercheurs en sciences comportementales privilégiant les environnements logiciels pourvus d’interfaces utilisateur graphiques (GUI), les suites logicielles SPSS (IBM) et JASP représentent des standards majeurs. Au sein de SPSS, la génération de boîtes à moustaches s’effectue via le sous-module d’exploration des données (Descriptives / Explore) ou via le générateur de graphiques interactif. SPSS applique rigoureusement la taxonomie de Tukey en différentiant systématiquement les anomalies modérées — repérées par des ronds accompagnés du numéro de ligne du participant dans la matrice — des anomalies extrêmes, étiquetées par un astérisque explicite. Cette identification nominale immédiate permet au chercheur de repérer instantanément le dossier clinique d’un patient problématique dans sa base de données.
L’émergence récente du logiciel libre JASP, développé sous la houlette de l’Université d’Amsterdam, a profondément modernisé cette pratique en proposant une approche dynamique, reproductible et résolument ancrée dans les standards de la science ouverte. Intégrant nativement les paradigmes bayésiens et fréquentistes, JASP permet la génération en temps réel de boîtes à moustaches hautement personnalisables au sein de ses modules d’analyse descriptive et factorielle. En cochant simplement les options dédiées, l’utilisateur enrichit instantanément le diagramme de Tukey de violons de densité symétriques, de nuages de points bruités proportionnels ou d’intervalles de crédibilité bayésiens. JASP garantit en outre l’exportation directe des tracés aux formats vectoriels conformes aux directives stylistiques de l’American Psychological Association, éliminant tout recours laborieux à des logiciels de retouche graphique tiers.
11. Écueils méthodologiques et erreurs d’interprétation chez le chercheur
11.1 Confusion persistante entre métriques paramétriques et robustes
En dépit de sa simplicité géométrique apparente, la boîte à moustaches fait l’objet d’une incompréhension méthodologique persistante chez un grand nombre de chercheurs novices ou non familiers de la statistique d’ordre. L’une des erreurs d’interprétation les plus répandues dans la littérature scientifique consiste à opérer une confusion cognitive inconsciente entre les métriques non paramétriques affichées et les estimateurs paramétriques gaussiens classiques. De nombreux auteurs rédigent ainsi des sections de résultats en désignant le segment central de la boîte sous le vocable de « moyenne arithmétique » ou en interprétant l’extension de la boîte interquartile comme s’il s’agissait d’un étalement d’un ou deux écarts-types autour du centre.
Cette substitution conceptuelle induit des biais d’inférence majeurs. Assimiler l’intervalle interquartile à un écart-type empirique standardisé constitue une hérésie mathématique : l’IQR isole strictement 50 % des observations d’une cohorte, alors qu’un intervalle de deux écarts-types centrés sur la moyenne encapsule asymptotiquement 68,2 % des données sous loi normale, et un écart-type complet projeté de part et d’autre embrasse plus de 95 % des observations. Déduire des conclusions sur la symétrie ou la variabilité absolue d’un échantillon en projetant mentalement les règles empiriques du modèle de Gauss sur une boîte à moustaches issue d’une population exponentielle ou log-normale conduit inévitablement à des contresens scientifiques graves lors de la communication des résultats.
11.2 Gestion problématique des valeurs aberrantes détectées
Le second écueil méthodologique, d’une portée éthique et déontologique majeure en recherche scientifique, réside dans la gestion des points d’observation qui se retrouvent rejetés au-delà des moustaches du graphique. Il existe chez de nombreux expérimentateurs une propension délétère à instrumentaliser l’algorithme des clôtures de Tukey comme une sentence d’exclusion mécanique : tout individu étiqueté comme valeur atypique par le logiciel statistique se voit purement et simplement biffé du fichier de données brutes avant la conduite des analyses de variance ou des modélisations causales.
Cette pratique de suppression aveugle constitue une grave transgression de l’éthique de la recherche empirique. La boîte à moustaches est un instrument d’exploration diagnostique, non un algorithme de censure des données. La présence d’une valeur au-delà d’une moustache constitue une invite impérieuse à une enquête clinique et technique approfondie :
- S’agit-il d’une erreur d’encodage matériel (par exemple, la saisie accidentelle d’un âge de 220 ans au lieu de 22) ? Dans ce cas exclusif, la correction ou l’élagage se justifie pleinement.
- S’agit-il au contraire de l’expression empirique valide d’une divergence phénotypique remarquable au sein de la population humaine (comme une performance surhumaine sur une tâche d’empan de mémoire de travail chez un individu présentant un syndrome d’Asperger) ? L’amputation de cette donnée corrompt irrémédiablement la fidélité écologique de l’échantillonnage scientifique.
Dans ces circonstances ambiguës, la déontologie scientifique impose la réalisation d’une « double analyse de sensibilité », consistant à exécuter et publier rigoureusement les modèles statistiques selon les deux modalités (avec et sans les observations périphériques), documentant avec transparence si le rejet de ces cas modifie substantiellement ou non la conclusion substantielle de la recherche.
11.3 Interprétation fallacieuse de la longueur des moustaches
Un piège d’interprétation visuelle fréquent concerne la lecture géométrique de la terminaison des moustaches. De nombreux analystes commettent la méprise de considérer l’extrémité physique de la moustache comme matérialisant en tout temps la barrière théorique intérieure de Tukey (soit la coordonnée rigide $Q_3 + 1{,}5 \times \text{IQR}$). Guidés par cette fausse croyance, ils estiment à tort que l’absence de valeurs atypiques supérieures indique nécessairement que les observations s’étirent exactement jusqu’à ce seuil arithmétique.
Il est impératif de rappeler que la moustache ne flotte jamais dans un vide mathématique abstrait : elle stoppe impérativement sa trajectoire à la valeur réelle de l’observation la plus haute (ou la plus basse) qui ne transcende pas la barrière. Par conséquent, dans un échantillon de données discontinues ou présentant une granularité étalée, une moustache supérieure d’apparence trapue peut simplement refléter l’absence fortuite de participants dans la frange comprise entre la dernière observation valide et la barrière théorique. L’observateur doit donc se garder d’inférer une troncature artificielle ou une homogénéité suspecte de la distribution sur la foi de la seule brièveté géométrique d’une moustache, sans avoir préalablement vérifié la dispersion réelle des points sous-jacents sur l’axe continu de mesure.
12. Normes de publication académique (APA) et transmission scientifique
12.1 Conformité stylistique aux directives de l’APA 7e édition
La transcription des boîtes à moustaches dans le cadre de soumissions d’articles aux revues scientifiques de premier rang éditées par l’American Psychological Association (APA) ou d’autres consortiums biomédicaux prestigieux impose une soumission stricte aux standards typographiques et visuels édictés par le manuel officiel de style (APA 7e édition). Ces directives visent à garantir une lisibilité optimale, une sobriété formelle et l’éradication de tout bruit décoratif superflu (ce que le théoricien de la sémiologie graphique Edward Tufte qualifiait de chartjunk).
En vertu de ces critères institutionnels, les représentations graphiques doivent se conformer à un cahier des charges rigoureux :
- Proscription formelle de tout effet d’ombrage tridimensionnel (3D) ou d’effets de profondeur factices susceptibles de distordre la perception spatiale des quartiles ;
- Suppression systématique des lignes de quadrillage d’arrière-plan (gridlines) superflues et des encadrements extérieurs fermés, le canevas devant reposer sur un fond blanc pur doté de deux axes cartésiens noirs nettement délimités ;
- Choix de palettes chromatiques sobres, déclinées en niveaux de gris contrastés ou en teintes contrastées universellement discernables pour les relecteurs daltoniens ;
- Typographie des étiquettes d’axes standardisée, usuellement sans empattement (telle qu’Arial, Helvetica ou Calibri) en adoptant un corps de police compris entre 8 et 14 points pour assurer une parfaite lisibilité après redimensionnement éditorial ;
- Mention scrupuleuse, sur l’axe de la variable dépendante, de la dénomination complète du construit psychométrique investigué, systématiquement accompagnée de son unité de mesure physique ou métrique précisée entre parenthèses.
12.2 Rédaction scientifique des légendes et notes méthodologiques
L’un des préceptes directeurs de l’APA 7e édition impose que chaque figure scientifique soit accompagnée d’une légende et d’une note de bas de figure autonomes, rédigées avec une précision telle qu’un lecteur averti puisse interpréter l’intégralité du graphique sans devoir se référer obligatoirement au corps du texte principal de l’article. La mention laconique « Boîte à moustaches des scores » est méthodologiquement inadmissible dans un périodique à comité de lecture.
La note méthodologique attachée à la boîte à moustaches (introduite par l’italique Note.) doit obligatoirement expliciter la sémantique de chaque composante du tracé :
- Elle doit formellement statuer sur la nature exacte représentée par la barre transversale intérieure (la médiane empirique) et les bornes de la boîte (le premier quartile $Q_1$ et le troisième quartile $Q_3$) ;
- Elle doit formellement consigner la convention d’ancrage adoptée pour les moustaches (par exemple : « Les moustaches délimitent les valeurs minimales et maximales comprises à l’intérieur d’un intervalle de $1{,}5 \times \text{IQR}$ ») ;
- Elle doit expliciter la signification probabiliste des glyphes d’anomalies (par exemple : « Les points ouverts matérialisent les valeurs atypiques modérées situées au-delà de $1{,}5 \times \text{IQR}$, et les astérisques désignent les valeurs extrêmes transcendant $3{,}0 \times \text{IQR}$ ») ;
- Elle doit impérativement préciser la taille de l’effectif associé à chaque modalité ($n = dots$) sous peine de masquer l’asymétrie de puissance statistique régissant les diverses conditions expérimentales comparées.
12.3 Exigences contemporaines de science ouverte et reproductibilité
La crise de réplicabilité qui a traversé la psychologie expérimentale et les neurosciences cognitives tout au long de la dernière décennie a profondément transformé les exigences éditoriales relatives à la communication des données visuelles. Dans la perspective des protocoles de science ouverte (Open Science Framework), la boîte à moustaches statique figée sur une page d’article imprimée au format PDF ne suffit plus à combler les exigences contemporaines d’intégrité empirique. Les comités de rédaction des revues de pointe exigent désormais la traçabilité complète de la chaîne de calcul ayant présidé à l’édification de chaque boîte.
Ce nouveau contrat de scientificité repose sur le dépôt systématique, dans des archives publiques pérennes et certifiées (telles qu’OSF, Zenodo ou Dataverse) :
- Des matrices tabulaires intégrales de données brutes sous-jacentes, anonymisées et structurées sous des formats ouverts pérennes (fichiers CSV ou TSV) ;
- Des scripts de programmation complets et exécutables (fichiers de code R, notebooks Python ou syntaxes SPSS/JASP) encapsulant l’ensemble des opérations de tri d’ordre, de calcul quantilaire et de modélisation visuelle mises en œuvre par les auteurs ;
- De la documentation rigoureuse des versions logicielles des bibliothèques mobilisées, conjurant ainsi les risques de glissements discrets de résultats imputables aux variations algorithmiques d’estimation quantilaire identifiées par Hyndman et Fan.
Par cette transparence méthodologique totale, la boîte à moustaches se réaffirme comme ce que John Tukey avait prophétisé dès l’origine : non point un ornement graphique illustratif, mais un puissant protocole de démocratisation, d’auditabilité et de robustesse de la découverte empirique.
Références
- Benjamini, Y. (1988). Opening the box of a boxplot. The American Statistician, 42(4), 257–262. https://doi.org/10.1080/00031305.1988.10475580
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Hintze, J. L., & Nelson, R. D. (1998). Violin plots: A box plot-density trace synergism. The American Statistician, 52(2), 181–184. https://doi.org/10.1080/00031305.1998.10480559
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473541
- McGill, R., Tukey, J. W., & Larsen, W. A. (1978). Variations of box plots. The American Statistician, 32(1), 12–16. https://doi.org/10.1080/00031305.1978.10479236
- Rousselet, G. A., Foxe, J. J., & Bolam, J. P. (2016). A few simple steps to improve the description of group results in neuroscience. European Journal of Neuroscience, 44(9), 2647–2651. https://doi.org/10.1111/ejn.13400
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2e éd.). Springer. https://doi.org/10.1007/0-387-28695-0