
Dans le domaine de l’analyse quantitative appliquée aux sciences comportementales, à la neuroergonomie et à la psychométrie expérimentale, la modélisation statistique rigoureuse des observations discrètes constitue le socle indispensable de l’inférence scientifique. Qu’il s’agisse d’évaluer le taux d’exactitude d’un patient cérébrolésé lors d’une tâche de dénomination lexicale, de quantifier la performance de détection d’un signal auditif faible au sein d’un environnement bruité, ou d’analyser les comportements d’évitement conditionné chez l’animal de laboratoire, les chercheurs sont constamment confrontés à des données catégorielles binaires. Dans ce paradigme fondamental, la loi binomiale s’impose comme le cadre probabiliste de référence pour agréger et interpréter ces suites d’événements dichotomiques.
Toutefois, la manipulation pratique de ce modèle stochastique soulève fréquemment des difficultés d’ordre méthodologique et conceptuel, même chez des praticiens et chercheurs chevronnés. La distinction entre la fonction de masse de probabilité (désignée par l’acronyme universel BinomPDF pour Binomial Probability Density Function ou plus exactement Probability Mass Function) et la fonction de répartition cumulative (désignée sous le terme BinomCDF pour Binomial Cumulative Distribution Function) représente l’une des pierres d’achoppement les plus récurrentes lors de l’analyse de données. Confondre une probabilité ponctuelle avec une probabilité cumulée n’est pas une simple imprécision calculatoire : cette méprise altère directement la structure logique des tests d’hypothèses, fausse le contrôle du risque d’erreur de première espèce (l’erreur alpha), et peut conduire à des conclusions diagnostiques ou expérimentales entièrement erronées.
Le présent article propose une exploration exhaustive, mathématique et empirique de la dichotomie fondamentale entre BinomPDF et BinomCDF. À travers le prisme de la psychologie quantitative, des neurosciences computationnelles et de l’évaluation clinique standardisée, nous détaillerons les postulats probabilistes sous-jacents, décortiquerons les architectures algorithmiques de chaque fonction, fournirons des procédures pas à pas pour les environnements de calcul courants (TI-84, R, Python) et analyserons des cas d’application concrets. Cette monographie vise à doter les étudiants, cliniciens et chercheurs d’une grille de lecture définitive pour naviguer avec aisance entre probabilité ponctuelle et agrégation cumulative, garantissant ainsi une parfaite conformité avec les standards méthodologiques les plus exigeants de la communauté scientifique.
1. Fondements théoriques de la distribution binomiale en sciences du comportement
1.1 Origine et postulats de l’épreuve de Bernoulli
L’édifice de la statistique binomiale repose sur un modèle élémentaire théorisé par le mathématicien suisse Jacques Bernoulli au tournant du XVIIIe siècle : le schéma de Bernoulli. Dans le contexte des sciences du comportement, une épreuve de Bernoulli se définit comme une expérience stochastique idéalisée ne tolérant que deux issues mutuellement exclusives et conjointement exhaustives. Par convention formelle, l’un des événements est arbitrairement qualifié de « succès » (codé numériquement par la valeur 1) tandis que l’événement alternatif est désigné comme un « échec » (codé 0). En psychologie cognitive expérimentale, ce modèle s’applique idéalement aux protocoles à choix forcé à deux alternatives (2-AFC pour Two-Alternative Forced Choice), où la réponse d’un participant ne peut être que strictement correcte ou incorrecte.
Pour étendre ce modèle unitaire à une succession de répétitions et aboutir à une distribution binomiale formelle, trois conditions sine qua non doivent être scrupuleusement respectées par le protocole expérimental. La première exigence stipule que l’expérience globale doit être constituée d’un nombre déterminé, fixe et fini d’essais, noté $n$. La deuxième condition, souvent la plus délicate à garantir sur le plan empirique en sciences humaines, exige une indépendance statistique absolue entre l’ensemble des observations successives. Selon ce postulat, la probabilité d’occurrence d’un succès lors de l’essai d’indice $i$ ne doit en aucun cas être influencée par l’issue des essais précédents, excluant de facto tout phénomène d’ancrage perceptif non contrôlé ou de mémorisation de séquence sans réinitialisation de la tâche.
La troisième condition fondamentale réside dans la stricte constance de la probabilité de succès, désignée conventionnellement par la lettre $p$, tout au long des $n$ épreuves. Le paramètre complémentaire, représentant la probabilité d’échec, est universellement noté $q = 1 – p$. Dans un laboratoire de psychologie expérimentale, cette invariance temporelle implique que l’état neuropsychologique interne du sujet ne subisse aucune dérive substantielle : le niveau de vigilance, l’attention soutenue, la motivation intrinsèque et la sensibilité sensorielle doivent demeurer parfaitement stationnaires. Si le participant développe une fatigue cognitive au fil des blocs expérimentaux, ou si à l’inverse il bénéficie d’un effet d’apprentissage procédural modifiant sa précision, le postulat de stationnarité est formellement violé, rendant caduque l’application orthodoxe du modèle binomial standard.
1.2 Modélisation des variables aléatoires discrètes en psychométrie
Dans le domaine de la psychométrie et de la modélisation mathématique du comportement, la transition de l’épreuve unitaire de Bernoulli vers le comptage global s’opère par la définition d’une variable aléatoire discrète, usuellement notée $X$. Cette variable associe à chaque issue de l’espace échantillonnal le nombre total de succès observés au terme des $n$ répétitions expérimentales. Formellement, si l’on représente chaque essai élémentaire par une variable indicatrice $Y_i \sim \mathcal{B}(p)$ pour $i in {1, 2, dots, n}$, la variable d’intérêt s’exprime sous la forme linéaire de leur somme :
$$X = \sum_{i=1}^n Y_i$$
L’espace fondamental des événements d’une telle variable, noté $\Omega$, correspond à l’ensemble discret et borné des entiers naturels compris entre zéro et $n$ : $\Omega = {0, 1, 2, dots, n}$. Contrairement aux distributions continues qui modélisent des temps de réaction ou des dimensions latentes sur une infinité non dénombrable de valeurs réelles, la distribution binomiale concentre sa masse probabiliste exclusivement sur ces $n+1$ points discrets. En psychométrie classique, cette structure discrète correspond typiquement au score brut obtenu par un sujet soumis à une batterie d’évaluation cognitive comprenant un nombre délimité d’items indépendants.
Les propriétés structurelles de cette variable aléatoire se caractérisent par son espérance mathématique $E(X)$ et sa variance théorique $V(X)$. L’espérance, qui reflète le score moyen théorique obtenu par une population infinie de sujets soumis à ce protocole, est définie par le produit direct de la taille de l’échantillon d’épreuves et de la probabilité intrinsèque de réussite :
$$E(X) = n \cdot p$$
La variance théorique, mesurant la dispersion intrinsèque des scores autour du centre de gravité probabiliste sous l’effet du seul hasard d’échantillonnage, est donnée par l’équation :
$$V(X) = n \cdot p \cdot (1 – p)$$
L’écart-type correspondant, noté $\sigma$, s’exprime naturellement par la racine carrée de cette variance : $\sigma = \sqrt{n \cdot p \cdot (1 – p)}$. Ces moments d’ordre un et deux constituent les paramètres de normalisation cruciaux pour situer la performance brute d’un individu par rapport aux attentes purement stochastiques du modèle de base.
1.3 Importance de la modélisation probabiliste dans la recherche quantitative
L’incorporation de la théorie probabiliste au sein de la recherche quantitative en sciences humaines répond à une impérieuse nécessité épistémologique : départager ce qui relève de l’activité cognitive organisée de ce qui procède de la simple fluctuation stochastique. Dans toute tâche expérimentale évaluant des capacités perceptives, motrices ou mnésiques, un participant peut produire des réponses correctes par le simple jeu du hasard. Par exemple, lors d’un test de discrimination auditive binaire où deux tonalités de fréquences très proches sont présentées, un sujet entièrement anosognosique ou privé de sensation auditive obtiendra en moyenne 50 % de réussite en devinant au hasard ($p = 0{,}5$).
Dès lors, la modélisation probabiliste fournit le critère objectif permettant d’établir un seuil de significativité statistique rigoureux. Le chercheur ne se contente pas d’observer qu’un participant a obtenu 14 réussites sur 20 essais ; il doit déterminer avec une certitude mathématique quantifiable si cette performance s’écarte suffisamment du centre de la distribution théorique du hasard pour rejeter l’hypothèse nulle ($H_0$). Cette démarche fonde la méthode inférentielle de confirmation d’hypothèse en psychologie quantitative.
Il est par ailleurs fondamental d’opérer une distinction ontologique stricte entre la distribution empirique des données — celle qui est collectée sur un échantillon d’individus dans des conditions réelles et imparfaites de laboratoire — et la distribution probabiliste théorique sous-jacente. La première est contingente, bruitée, soumise aux erreurs d’échantillonnage et aux artefacts de mesure ; la seconde est un objet mathématique idéal, défini a priori par ses paramètres de population. La validation d’une théorie psychologique consiste précisément à tester l’adéquation formelle (par exemple via des tests de goodness-of-fit) entre ces configurations empiriques et les prédictions analytiques générées par le modèle binomial théorique.
2. Définition conceptuelle et formulation mathématique de BinomPDF
2.1 Nature de la fonction de masse de probabilité (PDF)
Dans l’arsenal terminologique de l’analyse stochastique, l’acronyme BinomPDF renvoie à la Binomial Probability Density Function, une dénomination issue de l’anglais technique qui, bien que consacrée par l’usage dans les interfaces logicielles et calculatrices, constitue un léger abus de langage pour les puristes de l’analyse mathématique. En toute rigueur, une variable aléatoire discrète ne possède pas de densité au sens de l’intégrale de Lebesgue, mais une fonction de masse de probabilité (Probability Mass Function ou PMF). Cette fonction assigne une masse de probabilité non nulle et ponctuelle à chaque valeur discrète prise par la variable aléatoire.
Le calcul opéré par BinomPDF répond à une interrogation expérimentale fondamentalement ponctuelle : « Quelle est la probabilité d’observer de manière exacte, stricte et exclusive, un nombre $k$ de succès au cours de $n$ essais indépendants, sachant que la probabilité de succès à chaque essai est invariantement égale à $p$ ? ». Sur le plan notationnel, cette opération s’exprime rigoureusement par l’égalité probabiliste suivante :
$$P(X = k) = \text{BinomPDF}(n, p, k)$$
Dans un protocole d’évaluation neuropsychologique, recourir à BinomPDF revient à isoler un état singulier du système. Par exemple, si l’on cherche à déterminer la vraisemblance qu’un patient commette exactement et rigoureusement deux erreurs lors d’un protocole d’attention sélective à dix essais, la fonction de masse fournit la quantification probabiliste exacte de cet événement discret singulier, indépendamment de toute considération sur les scores adjacents (trois erreurs, une erreur ou zéro erreur).
2.2 Décomposition de la formule binomiale ponctuelle
L’expression analytique de la fonction de masse binomiale condense plusieurs principes combinatoires et probabilistes élémentaires qu’il convient de disséquer pour en appréhender la dynamique interne. L’équation maîtresse régissant le calcul de BinomPDF s’énonce comme suit :
$$P(X = k) = \binom{n}{k} p^k (1 – p)^{n – k}$$
Le premier terme de cette décomposition, $\binom{n}{k}$, représente le coefficient binomial, souvent lu verbalement « combinaison de $k$ parmi $n$ ». Sur le plan computationnel, il se calcule via la formule des factorielles :
$$\binom{n}{k} = \frac{n!}{k!(n – k)!}$$
D’un point de vue conceptuel, ce coefficient dénombre l’ensemble des arrangements distincts ou chemins combinatoires possibles permettant d’aboutir à un total de $k$ succès distribués arbitrairement au long des $n$ positions de la séquence temporelle. Par exemple, pour obtenir deux succès sur trois essais ($n=3, k=2$), trois configurations temporelles uniques sont envisageables : (Succès, Succès, Échec), (Succès, Échec, Succès), ou (Échec, Succès, Succès). Le coefficient binomial vaut donc précisément $\binom{3}{2} = 3$.
Le second terme structurel, $p^k$, quantifie la probabilité conjointe de survenue des $k$ succès individuels requis par le calcul. En vertu du postulat d’indépendance statistique entre les épreuves, cette probabilité s’obtient par la multiplication itérative de la probabilité marginale de succès $p$, élevée à la puissance $k$.
Enfin, le troisième terme, $(1 – p)^{n – k}$ (ou $q^{n-k}$), formalise la probabilité conjointe d’occurrence des $n – k$ échecs nécessaires pour compléter la série d’épreuves. De manière analogue, ce facteur résulte de la multiplication de la probabilité unitaire d’échec par elle-même sur l’ensemble des essais non couronnés de succès. La formule globale de BinomPDF réalise ainsi le produit logique entre le nombre de trajectoires expérimentales équivalentes et la probabilité intrinsèque de n’importe laquelle de ces trajectoires particulières.
2.3 Conditions d’application clinique et expérimentale de BinomPDF
L’exploitation de BinomPDF en milieu clinique ou dans les protocoles de laboratoire n’est méthodologiquement légitime que lorsque la question scientifique porte expressément sur une valeur numérique absolue et exclusive. Un cas d’école concerne l’analyse de modèles théoriques prédictifs issus de la psychologie de l’apprentissage ou des sciences comportementales. Lorsqu’un modèle computationnel formalise l’acquisition d’un automatisme moteur et prédit qu’à un stade intermédiaire précis d’entraînement, un sujet doit manifester un taux d’erreur exactement calibré, le chercheur confronte directement cette prédiction ponctuelle aux données via BinomPDF.
De même, dans les protocoles de détection de profils atypiques au sein de questionnaires psychométriques (comme la détection de biais de réponse mécanique ou de randomisation volontaire de la part d’un répondant), BinomPDF permet de tester la vraisemblance d’un score d’acquiescement spécifique par rapport à une distribution attendue. La fonction permet d’interroger la plausibilité d’une réponse exacte à un niveau d’occurrence fixé par une norme empirique préalable.
Néanmoins, les conditions d’application de BinomPDF rencontrent des limites méthodologiques majeures dès lors que le clinicien ou l’expérimentateur formule une hypothèse directionnelle. Dans la quasi-totalité des tests d’hypothèses diagnostiques, l’intérêt ne réside pas dans le fait qu’un patient obtienne rigoureusement un score donné, mais qu’il performe « au moins à ce niveau » ou « au plus à ce niveau ». Tenter de statuer sur le déficit cognitif d’un individu en se référant uniquement à la probabilité ponctuelle BinomPDF d’avoir réussi 3 items sur 15 constitue une faute analytique lourde : cette valeur isole une barre unique de la distribution sans tenir compte du fait que des scores encore plus effondrés (2, 1 ou 0 réussite) renforcent l’évidence clinique du déficit. C’est précisément pour répondre à cette exigence d’accumulation ordonnée que s’impose le recours à la fonction de répartition.
3. Définition conceptuelle et formulation mathématique de BinomCDF
3.1 Nature de la fonction de répartition cumulative (CDF)
L’acronyme BinomCDF désigne la Binomial Cumulative Distribution Function, traduite en français sous l’appellation standard de fonction de répartition cumulative de la loi binomiale. En statistique inférentielle, cette fonction mathématique fondamentale décrit la probabilité qu’une variable aléatoire discrète $X$ prenne une valeur inférieure ou égale à un niveau de seuil critique spécifié, noté conventionnellement $k$.
Alors que la fonction ponctuelle BinomPDF interroge l’exactitude stricte de l’occurrence, BinomCDF répond à une question de dépassement ou de borne : « Quelle est la probabilité d’observer au maximum $k$ succès lors de la réalisation de $n$ essais de Bernoulli indépendants ? ». L’expression analytique canonique qui gouverne cette relation s’écrit formellement sous la forme de l’inégalité large :
$$P(X le k) = \text{BinomCDF}(n, p, k)$$
Cette approche cumulative reflète fidèlement la réalité de la prise de décision diagnostique et de l’inférence scientifique, où les performances humaines s’évaluent sur un continuum ordinal plutôt que sur des valeurs nominales isolées. Dans l’espace de probabilité, BinomCDF n’isole pas un point géométrique isolé sur l’axe des abscisses, mais embrasse une région intégrée de la distribution s’étendant depuis l’origine absolue du domaine de définition jusqu’à la valeur d’évaluation limite.
3.2 Algorithme d’agrégation et sommation des probabilités
Sur le plan mathématique et algorithmique, la fonction de répartition cumulative d’une distribution discrète ne requiert aucun concept de calcul intégral continu ; elle s’obtient par la sommation séquentielle directe des probabilités ponctuelles individuelles générées par la fonction de masse de Bernoulli. La structure computationnelle de BinomCDF s’énonce rigoureusement comme suit :
$$P(X le k) = \sum_{i=0}^k P(X = i) = \sum_{i=0}^k \binom{n}{i} p^i (1 – p)^{n – i}$$
Cette sommation discrète impose des contraintes fondamentales sur les propriétés analytiques de la fonction de répartition. Premièrement, pour tout $k ge n$, la sommation couvre l’intégralité du support de la variable aléatoire ; par conséquent, la fonction atteint asymptotiquement la certitude absolue :
$$\text{BinomCDF}(n, p, n) = \sum_{i=0}^n \binom{n}{i} p^i (1 – p)^{n – i} = (p + (1 – p))^n = 1^n = 1$$
Deuxièmement, la fonction de répartition binomiale vérifie une propriété stricte de monotonie non décroissante. Pour deux valeurs discrètes $k_1$ et $k_2$ de l’espace d’épreuve telles que $0 le k_1 < k_2 le n$, l'accumulation additive de termes nécessairement positifs ou nuls implique rigoureusement que :
$$\text{BinomCDF}(n, p, k_1) le \text{BinomCDF}(n, p, k_2)$$
La courbe représentative de cette fonction présente par conséquent une allure en escalier discontinue (ou étagée), chaque marche verticale marquant l’adjonction abrupte de la masse probabiliste $P(X = k)$ au niveau de chaque entier $k$, tandis que la fonction demeure rigoureusement horizontale entre deux entiers successifs.
3.3 Pertinence méthodologique des mesures cumulées en psychologie
L’utilisation de mesures cumulées constitue la norme méthodologique prévalente en psychométrie expérimentale, en neuropsychologie clinique et en évaluation des apprentissages scolaires. Cette prépondérance s’explique par la nature intrinsèque des hypothèses scientifiques soumises à l’épreuve des faits. Dans un contexte diagnostique, la préoccupation centrale du neuropsychologue n’est jamais de déterminer la probabilité qu’un individu obtienne rigoureusement un score dégradé arbitraire (par exemple, exactement 4 bonnes réponses), mais d’évaluer la rareté relative d’une performance située « à ce niveau ou à un niveau inférieur ».
Ce calcul cumulatif fonde la dérivation des rangs percentiles théoriques dans les populations de référence. Lorsqu’un praticien administre une batterie d’efficience mnésique standardisée, localiser le résultat d’un patient au 5e percentile de la distribution binomiale attendue sous l’hypothèse de normalité implique directement le calcul de $P(X le k_{\text{patient}})$. Si cette valeur cumulative descend sous le seuil d’alerte clinique (usuellement $\alpha = 0{,}05$ ou $\alpha = 0{,}01$), l’examinateur dispose d’une preuve probabiliste robuste attestant que la faiblesse du score observé ne saurait être décemment imputée aux simples aléas du tirage stochastique.
De surcroît, dans les démarches d’inférence statistique confirmatoire unilatérale, la fonction BinomCDF constitue l’outil direct d’estimation de la $p$-value empirique. Rejeter l’hypothèse nulle au profit de l’hypothèse selon laquelle un entraînement cognitif détériore ou améliore un système réclame l’intégration de toute la masse de probabilité contenue dans la queue de distribution d’intérêt. Ignorer cette sommation mènerait à une surévaluation systématique de la singularité d’un résultat et déstabiliserait l’ensemble de la mécanique du test de Neyman-Pearson.
4. Distinction fondamentale : ponctualité contre cumul statistique
4.1 Comparaison directe des équations mathématiques
Pour clarifier sans ambiguïté la divergence structurelle séparant la démarche ponctuelle de la démarche cumulative, il convient d’opposer formellement leurs opérateurs analytiques fondamentaux. L’opérateur sous-tendant BinomPDF est un opérateur d’égalité stricte, isolant un singleton dans l’espace des événements :
$$\text{BinomPDF}(n, p, k) iff P(X = k)$$
À l’inverse, l’opérateur régissant BinomCDF est un opérateur ensembliste d’inégalité large, intégrant une union d’événements disjoints :
$$\text{BinomCDF}(n, p, k) iff P(X le k) = P\left(\big\cup_{i=0}^k {X = i}\right)$$
Sur le plan géométrique, au sein d’une représentation par diagramme en bâtons d’une distribution discrète, la valeur fournie par $\text{BinomPDF}(n, p, k)$ correspond très exactement à la hauteur propre du bâton érigé à l’abscisse $k$. Elle quantifie une densité de probabilité concentrée sur une coordonnée unique. En contrepartie, la valeur calculée par $\text{BinomCDF}(n, p, k)$ représente la somme des hauteurs de tous les bâtons situés depuis l’abscisse $0$ inclusivement jusqu’au bâton situé à l’abscisse $k$ inclusivement (ou l’aire cumulée des rectangles associés sous un histogramme discret dont les bases sont unitaires).
L’impact de la variation de la borne $k$ sur ces deux entités mathématiques met en lumière une divergence dynamique flagrante. Lorsque $k$ progresse le long de l’axe des entiers, la valeur de $\text{BinomPDF}(n, p, k)$ commence par croître jusqu’à atteindre un sommet au niveau du mode de la distribution (proche de la moyenne théorique $np$), puis amorce une décroissance inéluctable vers zéro au fur et à mesure que $k$ s’éloigne dans la queue supérieure de distribution. En revanche, $\text{BinomCDF}(n, p, k)$ ne connaît aucune phase de récession : c’est une fonction invariablement croissante (au sens large) qui accumule chaque tranche de probabilité pour tendre de manière monotone et irréversible vers 1.
4.2 Différences d’interprétation théorique des résultats
L’absence de distinction claire entre ponctualité et cumul introduit des confusions théoriques pernicieuses dans l’évaluation psychométrique et neuropsychologique. L’une des erreurs conceptuelles les plus fréquentes consiste à confondre la condition « être exactement à la moyenne » avec la condition « appartenir à la moitié inférieure de la cohorte ». Dans une tâche expérimentale standardisée comportant $n = 100$ essais dichotomiques calibrés pour présenter une difficulté médiane ($p = 0{,}50$), l’espérance théorique de succès s’élève exactement à $\mu = 100 \times 0{,}50 = 50$.
Si un praticien évalue la probabilité qu’un sujet obtienne rigoureusement le score moyen théorique, le recours à BinomPDF livre un résultat qui surprend souvent l’intuition profane :
$$P(X = 50) = \text{BinomPDF}(100, 0{,}50, 50) \approx 0{,}0796$$
La probabilité d’être exactement à la moyenne n’est donc que d’environ 7,96 %. En revanche, si l’on s’intéresse à la probabilité qu’un individu obtienne un score se situant dans l’ensemble de la distribution inférieur ou égal à cette moyenne centrale, l’évaluation via BinomCDF révèle une réalité probabiliste totalement différente :
$$P(X le 50) = \text{BinomCDF}(100, 0{,}50, 50) \approx 0{,}5398$$
Il existe donc près de 54 % de chances qu’un sujet n’excède pas ce score médian en raison de l’asymétrie discrète locale et de l’inclusion de la valeur médiane. Confondre ces deux approches entraîne des distorsions massives du risque d’erreur de première espèce lors des tests d’hypothèses unilatérales. En sélectionnant par inadvertance la fonction ponctuelle BinomPDF en lieu et place de la fonction cumulative BinomCDF pour tester le déficit potentiel d’un participant se situant dans une zone frontière, l’expérimentateur isole une probabilité infinitésimale (la hauteur d’un bâton excentré) et conclut fallacieusement à la rareté statistique extraordinaire du comportement observé, ignorant que cette valeur ponctuelle basse est partagée par l’ensemble des points d’une distribution hautement dispersée.
4.3 Représentation graphique comparative
L’analyse visuelle des tracés graphiques permet d’ancrer définitivement la distinction mathématique entre les deux fonctions. La représentation classique de la fonction de masse de probabilité (BinomPDF) prend la forme d’un diagramme en bâtons verticaux non connectés. Chaque abscisse entière $k in {0, 1, dots, n}$ supporte une ordonnée isolée dont l’amplitude traduit $P(X = k)$. Cette courbe discrète adopte une silhouette en cloche caractéristique, symétrique lorsque $p = 0{,}50$, ou dissymétrique (oblique à droite ou à gauche) lorsque le paramètre $p$ s’écarte substantiellement de la neutralité médiane.
À l’opposé, la fonction de répartition cumulative (BinomCDF) se matérialise graphiquement par une fonction continue par morceaux, connue sous le terme mathématique de fonction en escalier (ou courbe sigmoïdale discontinue). L’élévation de chaque palier vertical correspond rigoureusement à la hauteur du bâton de probabilité ponctuelle à cet instant précis. Pour tout point d’abscisse compris dans l’intervalle semi-ouvert $[k, k+1[$, la valeur de la fonction demeure strictement constante sur le plateau horizontal avant de subir un saut quantique d’amplitude $P(X = k+1)$ lors du franchissement de l’entier suivant.
Cette distinction topologique éclaire la façon d’appréhender les queues de distribution (distribution tails). Alors que dans le diagramme ponctuel de BinomPDF, les queues de distribution sont constituées d’une série de bâtons quasi imperceptibles écrasés sur l’axe des abscisses, dans le graphique de BinomCDF, les queues se visualisent sous la forme d’une lente convergence asymptotique : la queue gauche débute au ras de zéro pour s’élever progressivement, tandis que la queue droite s’aplatit dans une approche infiniment tangente de la valeur plafond de 1,0. C’est l’épaisseur cumulée de ces paliers finaux qui dicte la significativité statistique d’une épreuve comportementale.
5. Implémentation technique et calculs sur la TI-84 et logiciels statistiques
5.1 Procédure d’accès et syntaxe sur TI-84
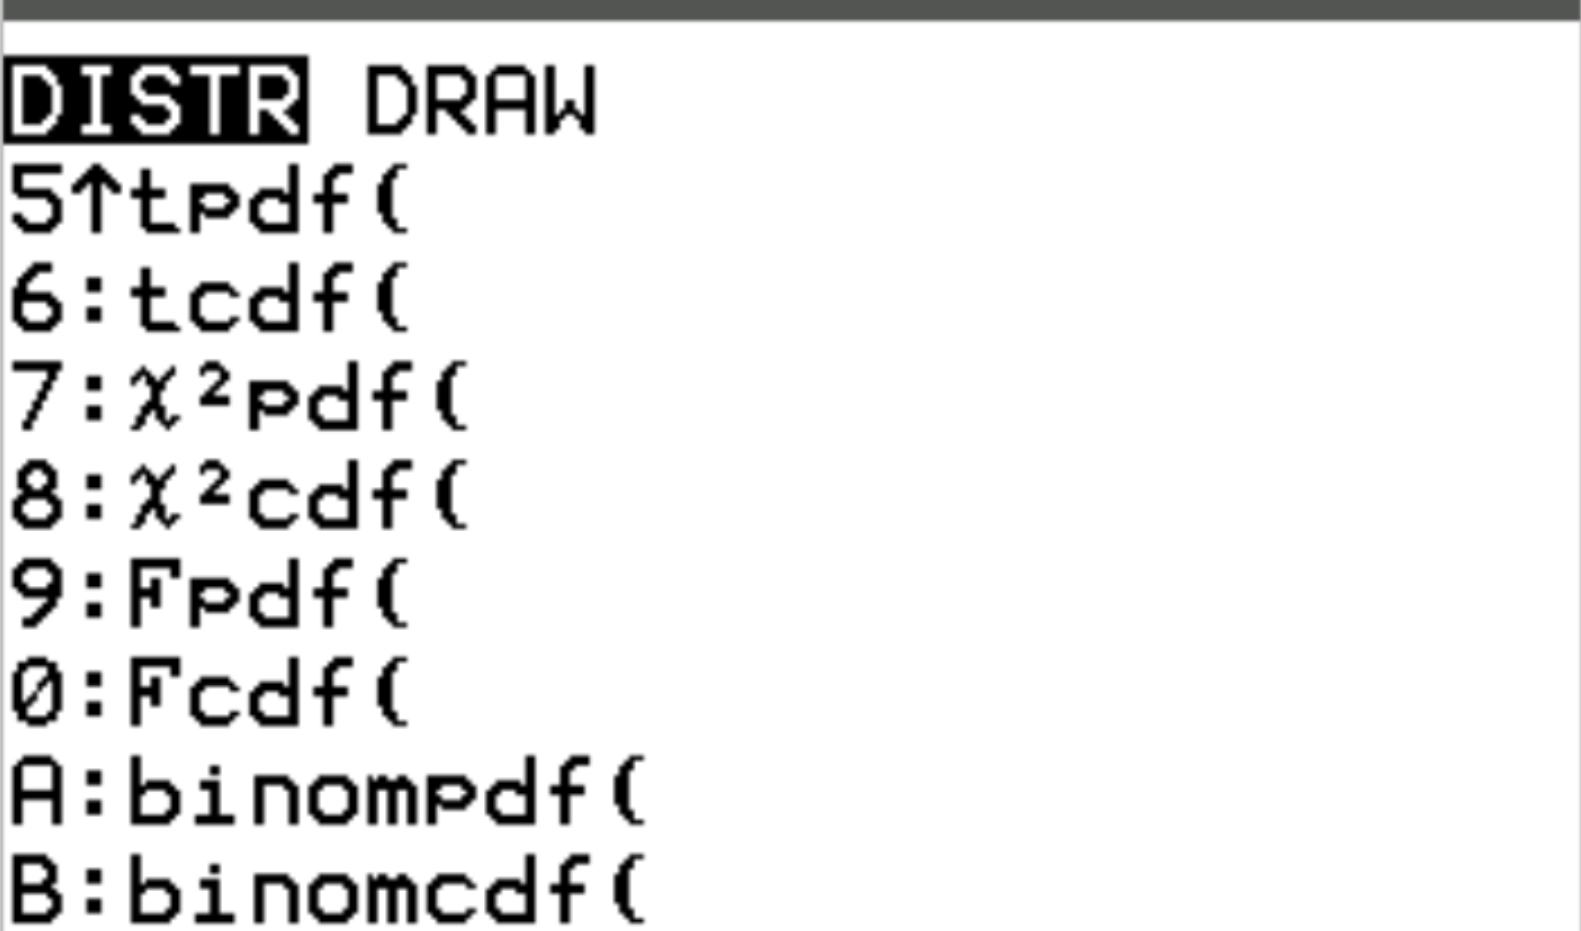
Au sein des cursus universitaires en psychologie quantitative et dans la pratique clinique de terrain, la calculatrice graphique de la famille Texas Instruments (notamment les modèles TI-84 Plus et TI-84 Plus CE) demeure l’un des outils de calcul portable les plus largement mobilisés. L’environnement logiciel de ces machines regroupe l’ensemble des lois statistiques sous le menu dédié DISTR (Distributions), auquel l’opérateur accède par la combinaison séquentielle des touches 2nd puis VARS.
Au sein de ce répertoire mathématique, la fonction de masse ponctuelle est répertoriée sous l’item binompdf( (généralement accessible via l’option A du menu défilant), tandis que la fonction cumulative de sommation est localisée sous la commande binomcdf( (correspondant usuellement à l’option B). La syntaxe canonique programmée dans le noyau du microprocesseur exige impérativement la saisie rigoureuse de trois arguments séparés par des virgules arithmétiques standards, respectant un ordre immuable :
binompdf(n, p, k)
binomcdf(n, p, k)
Dans cette formulation syntaxique, $n$ (souvent étiqueté trials ou numtrials dans les versions récentes du système d’exploitation à interface assistée) représente le nombre total d’essais indépendants programmés ; $p$ figure la probabilité élémentaire de succès pour chaque essai individuel ; et $k$ (étiqueté x value) désigne le seuil discret de succès soumis à l’évaluation. Il convient de souligner une divergence opérationnelle majeure entre les générations de calculatrices : sur les modèles classiques monochromes (TI-84 Plus standard), la fonction requiert une saisie textuelle linéaire en ligne de commande pure, tandis que sur les modèles récents (TI-84 Plus CE dotés d’écrans couleur haute définition), un assistant graphique interactif (Stat Wizards) s’affiche, guidant l’utilisateur pas à pas pour renseigner les trois paramètres avant d’injecter la commande formelle dans l’écran de calcul principal.
5.2 Traduction syntaxique sous environnement R et Python
Dans la recherche académique contemporaine et l’analyse de données massives (Big Data comportementales), le traitement statistique s’est largement déporté vers des écosystèmes informatiques hautement reproductibles tels que les langages de programmation R et Python. La maîtrise de la traduction conceptuelle entre les fonctions de la TI-84 et ces langages de scripts s’avère indispensable pour tout chercheur en psychologie computationnelle.
Dans l’environnement statistique R, référence historique de la biométrie et des sciences sociales, la nomenclature des lois de probabilité suit un préfixe systématique combiné au radical du modèle. La lettre d (pour density) est associée à la fonction de masse ponctuelle, formalisant l’équivalence stricte :
binompdf(n, p, k) $long\leftrightarrow$ dbinom(x = k, size = n, prob = p)
Symétriquement, la lettre p (pour probability ou fonction de répartition) commande la sommation cumulative, établissant la passerelle directe avec BinomCDF :
binomcdf(n, p, k) $long\leftrightarrow$ pbinom(q = k, size = n, prob = p)
Il est fondamental de noter l’inversion de l’ordre d’entrée des arguments dans R comparativement à la logique des calculatrices : la valeur seuil du score ($x$ ou $q$) est exigée en première position d’argument, immédiatement suivie par la taille d’épreuve $n$ (spécifiée par l’argument size) et la probabilité élémentaire $p$ (argument prob). R offre en outre un paramètre booléen hautement utile, lower.tail. Configuré par défaut sur TRUE, il calcule $P(X le k)$ ; basculé sur lower.tail = FALSE, il évalue de façon vectorisée et stable la queue supérieure stricte $P(X > k)$.
Sous Python, les calculs probabilistes sont centralisés au sein de la sous-bibliothèque statistique spécialisée scipy.stats, laquelle s’appuie sur la classe unifiée binom. La correspondance syntaxique rigoureuse s’organise alors par l’invocation de méthodes d’instances spécifiques :
binompdf(n, p, k) $long\leftrightarrow$ scipy.stats.binom.pmf(k, n, p)
binomcdf(n, p, k) $long\leftrightarrow$ scipy.stats.binom.cdf(k, n, p)
L’utilisation de ces librairies sous R et Python permet d’automatiser des séries de milliers de calculs simultanés sur des matrices complexes de réponses de participants, tout en éliminant les risques de manipulations manuelles inhérents aux claviers des calculatrices physiques.
5.3 Gestion des messages d’erreur et vérification des paramètres
L’exécution de ces algorithmes stochastiques sur microprocesseur expose occasionnellement l’utilisateur à des messages d’erreur système ou à des artefacts d’arrondi numérique qu’il convient de diagnostiquer avec méthode. La première famille d’anomalies computationnelles concerne la violation formelle du domaine de définition mathématique des paramètres d’entrée. Si un expérimentateur saisit par inadvertance une probabilité $p$ strictement négative ($p 1$), les calculatrices de type TI-84 interrompent immédiatement le traitement pour renvoyer le code bloquant ERR:DOMAIN.
De même, les arguments d’échantillon $n$ et de score $k$ doivent impérativement satisfaire à des contraintes de positivité et de discrétisation entière. Introduire une valeur non entière pour $k$ (par exemple $k = 4{,}5$) sur une calculatrice ancienne déclenche une troncature implicite silencieuse ou une erreur de syntaxe ; sur les processeurs modernes, cela peut engendrer des approximations hasardeuses fondées sur des prolongements continus par la fonction Gamma d’Euler. Par ailleurs, si l’argument $k$ excède la taille physique d’épreuve ($k > n$), la logique mathématique stipule que la probabilité ponctuelle est nulle ($P(X = k) = 0$) et que la probabilité cumulative est maximale ($P(X le k) = 1$) ; certains systèmes archaïques peuvent néanmoins générer une anomalie de bornes.
Une seconde catégorie critique de dysfonctionnement technique relève du dépassement de capacité numérique (overflow arithmétique). Le calcul analytique direct de $\binom{n}{k}$ sollicite l’évaluation de factorielles $n!$. Or, les microprocesseurs standards codent les entiers et nombres à virgule flottante sur une capacité mémoire délimitée. Sur une TI-84, la valeur maximale traitable sans interruption d’exécution s’élève à $9{,}999999999 \times 10^{99}$. Dès lors que la taille d’épreuve $n$ franchit le seuil critique de 70, la quantité $70! \approx 1{,}1978 \times 10^{100}$ excède ce registre machine, risquant de déclencher un message ERR:OVERFLOW si l’algorithme sous-jacent ne procède pas par transformation logarithmique préalable (somme des log-factorielles via la fonction log-gamma).
6. Exemples pratiques d’application avec BinomPDF
6.1 Cas clinique : Test de mémoire de travail visuo-spatiale
Afin de concrétiser l’exploitation diagnostique de la fonction de masse de probabilité BinomPDF, analysons un cas d’évaluation clinique standardisé en neuropsychologie humaine. Un praticien reçoit en consultation un patient adulte victime d’un traumatisme crânien fermé afin d’objectiver l’intégrité de ses capacités de mémoire de travail visuo-spatiale. Le bilan mobilise une variante informatisée du paradigme expérimental des blocs de Corsi. Le dispositif soumet le patient à un bloc homogène comprenant rigoureusement dix essais indépendants ($n = 10$).
Pour chaque essai unitaire, le protocole mobilise une séquence complexe de stimuli dont la difficulté a été étalonnée : sur la base des données normatives de sujets contrôles appariés en âge et niveau d’éducation, la probabilité intrinsèque de reproduction intégrale sans faute d’une séquence donnée est estimée à $p = 0{,}40$. Lors de la passation clinique de ce test, le patient réussit avec succès très exactement 7 séquences sur les 10 présentées. Le clinicien s’interroge sur la représentativité statistique ponctuelle de ce score spécifique.
L’interrogation mathématique porte de manière exclusive sur l’événement $P(X = 7)$. L’opération se traduit par la commande TI-84 suivante :
binompdf(10, 0.40, 7)
Le calcul analytique sous-jacent applique rigoureusement la décomposition polynomiale de Bernoulli :
$$P(X = 7) = \binom{10}{7} \times (0{,}40)^7 \times (1 – 0{,}40)^{10 – 7}$$
$$P(X = 7) = \frac{10!}{7! \cdot 3!} \times (0{,}40)^7 \times (0{,}60)^3$$
$$P(X = 7) = 120 \times 0{,}0016384 \times 0{,}216 \approx 0{,}042467$$
Le résultat obtenu, arrondi au centième de pourcentage, s’élève à approximativement $4{,}25,%$. L’interprétation clinique ponctuelle de ce chiffre indique que si un sujet possédant une mémoire de travail strictement standard exécute cette batterie d’évaluation, la probabilité brute qu’il obtienne exactement et spécifiquement le score de 7 sur 10 est de l’ordre de 4,25 %. Ce chiffre isole la singularité de cet échelon précis de performance au sein du paysage stochastique du test.
6.2 Cas expérimental : Conditionnement opérant chez le rongeur
Dans le domaine des neurosciences comportementales et de la psychopharmacologie préclinique, le recours à la fonction BinomPDF permet de valider des modèles d’extinction ou d’acquisition au sein de dispositifs automatisés. Considérons une étude s’intéressant à l’apprentissage d’une réponse de conditionnement opérant chez le rat de souche Wistar placé à l’intérieur d’une chambre de conditionnement opérant (boîte de Skinner standardisée). Le protocole expérimental comporte l’enregistrement de $n = 20$ opportunités d’activation d’un levier rétractable motorisé.
Sous la ligne de base d’exploration motrice spontanée (mesurée avant tout conditionnement et en l’absence absolue de renforçateur primaire nutritif), la probabilité basale qu’un rongeur explore et presse le levier durant l’intervalle de présentation de dix secondes est évaluée empiriquement à $p = 0{,}15$. Un chercheur souhaite vérifier si l’animal manifeste une réactivité correspondant très précisément au seuil théorique de transition opérante préliminaire, défini par le modèle computationnel comme l’émission d’exactement 5 réponses motrices ($k = 5$).
Le chercheur formule la requête sur sa calculatrice de laboratoire via l’instruction :
binompdf(20, 0.15, 5)
L’évaluation numérique déploie le développement combinatoire :
$$P(X = 5) = \binom{20}{5} \times (0{,}15)^5 \times (0{,}85)^{15}$$
$$P(X = 5) = 15504 \times 0{,}0000759375 \times 0{,}087354 \approx 0{,}10284$$
La probabilité stochastique qu’un animal sous niveau de veille normal produise précisément cinq activations spontanées est donc d’environ $10{,}28,%$. Ce résultat fournit aux neurobiologistes la masse d’ancrage nécessaire pour vérifier si le modèle d’exploration aléatoire décrit convenablement l’état intermédiaire de l’animal avant que l’administration d’un antagoniste dopaminergique ne vienne altérer cette dynamique comportementale.
6.3 Cas psychométrique : Questionnaire de choix forcé à choix multiples
En psychométrie et en docimologie universitaire, la détection des comportements de réponse aléatoire constitue un enjeu méthodologique prééminent. Considérons un questionnaire d’aptitude cognitive standardisé composé de $n = 15$ questions à choix forcé. Pour chacune de ces questions, quatre options de réponse exclusives sont soumises à l’étudiant, dont une seule représente la solution valide ($p = \frac{1}{4} = 0{,}25$).
Imaginons qu’un correcteur suspecte un candidat d’avoir complété l’intégralité de l’examen en cochant les cases de façon purement stochastique sans même lire les énoncés. Lors du dépouillement automatisé des copies, le logiciel relève que l’étudiant a validé rigoureusement 12 items corrects sur les 15 proposés ($k = 12$). Le responsable de l’évaluation souhaite quantifier la probabilité ponctuelle qu’une telle prouesse exacte puisse résulter du strict hasard d’échantillonnage.
La fonction ponctuelle s’implémente immédiatement selon les paramètres formels :
binompdf(15, 0.25, 12)
Le calcul détaillé de l’expression mathématique s’exécute ainsi :
$$P(X = 12) = \binom{15}{12} \times (0{,}25)^{12} \times (0{,}75)^3$$
$$P(X = 12) = 455 \times (5{,}96046 \times 10^{-8}) \times 0{,}421875 \approx 1{,}144 \times 10^{-5}$$
Cette évaluation met en lumière une probabilité d’occurrence ponctuelle infime, de l’ordre de $0{,}0000114$, soit environ une chance sur 87 400. Ce calcul démontre avec une rigueur absolue la totale invraisemblance de l’hypothèse d’une réussite accidentelle pour ce score d’exactitude spécifique, attestant soit d’une réelle compétence cognitive, soit d’une violation flagrante de l’intégrité de l’examen (telle qu’une fuite préalable du corrigé officiel).
7. Exemples pratiques d’application avec BinomCDF
7.1 Évaluation du dépistage neuropsychologique : Seuil de déficit cognitif
L’utilité diagnostique prépondérante de la fonction cumulative BinomCDF se révèle pleinement lors de la détection clinique des troubles cognitifs majeurs. Considérons un protocole de dépistage précoce de l’anomie lexicale au moyen d’une tâche de dénomination rapide d’images d’objets usuels. L’épreuve comporte un ensemble restreint de $n = 12$ planches iconographiques étalonnées. Dans une population clinique de référence ne présentant aucune altération neurologique avérée, le taux moyen de succès pour cette tâche d’accès lexical fluide s’établit à $p = 0{,}75$.
Un patient âgé consulte à la suite d’accidents ischémiques transitoires répétés. Soumis à ce protocole de 12 essais, ce patient échoue massivement et ne parvient à dénommer correctement que 3 items au total. Pour le neuropsychologue, la démarche diagnostique ne consiste pas à évaluer la probabilité qu’un sujet sain obtienne rigoureusement 3 réussites, mais d’estimer le risque d’observer une performance aussi dégradée, c’est-à-dire au maximum 3 réussites (englobant les éventualités encore plus sévères de 2, 1 ou 0 succès).
La formalisation du test implique donc l’inégalité $P(X le 3)$, programmée sur calculatrice par la commande :
binomcdf(12, 0.75, 3)
Le traitement algorithmique effectue la sommation des quatre termes discrets successifs :
$$P(X le 3) = \sum_{i=0}^3 \binom{12}{i} (0{,}75)^i (0{,}25)^{12 – i}$$
$$P(X le 3) = P(X=0) + P(X=1) + P(X=2) + P(X=3)$$
$$P(X le 3) \approx 0{,}00000006 + 0{,}00000215 + 0{,}00003541 + 0{,}00035407 \approx 0{,}0003917$$
La probabilité cumulée obtenue est d’environ $0{,}039,%$, soit une valeur largement inférieure au seuil critique de significativité $\alpha = 0{,}01$. Le clinicien peut dès lors conclure formellement au rejet de l’hypothèse d’une performance normale : le score observé objective l’existence d’un déficit cognitif sévère du système lexico-sémantique, la sommation cumulative apportant la garantie mathématique que la pathologie suspectée ne relève pas d’une simple variation d’humeur ou d’attention ponctuelle.
7.2 Contrôle qualité d’une batterie d’évaluations psychologiques
Dans les grands centres d’évaluation psychologique ou lors de campagnes nationales de recrutement psychométrique, la standardisation et l’absence de biais de cotation par les examinateurs représentent une exigence absolue de fiabilité. Pour s’assurer de l’homogénéité des pratiques, un comité de révision méthodologique effectue des contrôles réguliers de conformité par échantillonnage aléatoire.
Supposons qu’un lot standardisé de $n = 50$ protocoles de tests de personnalité complexes soit tiré au sort pour un audit qualitatif indépendant. D’après les standards établis par le manuel de contrôle, un taux d’erreur de cotation marginale de $p = 0{,}08$ (soit 8 % de feuilles d’examen comportant une cotation litigieuse) est jugé tolérable sans que la validité de l’ensemble de la batterie d’évaluation ne soit formellement compromise. La règle d’arbitrage méthodologique stipule qu’une session d’évaluation globale est validée et certifiée conforme si l’auditeur découvre au maximum 2 protocoles comportant des irrégularités parmi les 50 analysés ($k = 2$).
La quantification de la probabilité que le centre d’évaluation respecte ces critères stricts de certification sous les hypothèses nominales s’effectue par BinomCDF :
binomcdf(50, 0.08, 2)
La sommation des tranches discrètes d’erreurs potentielles s’exprime ainsi :
$$P(X le 2) = \sum_{i=0}^2 \binom{50}{i} (0{,}08)^i (0{,}92)^{50 – i}$$
$$P(X le 2) = P(X=0) + P(X=1) + P(X=2)$$
$$P(X=0) = \binom{50}{0} (0{,}08)^0 (0{,}92)^{50} \approx 0{,}01546$$
$$P(X=1) = \binom{50}{1} (0{,}08)^1 (0{,}92)^{49} \approx 0{,}06720$$
$$P(X=2) = \binom{50}{2} (0{,}08)^2 (0{,}92)^{48} \approx 0{,}14316$$
$$P(X le 2) \approx 0{,}01546 + 0{,}06720 + 0{,}14316 \approx 0{,}22582$$
Le résultat de cette analyse cumulative révèle qu’il n’existe approximativement que $22{,}58,%$ de chances de constater au plus deux protocoles erronés au sein du lot audité. Cette faible valeur indique aux auditeurs que le seuil de tolérance retenu ($k le 2$) est particulièrement drastique face au taux marginal de base toléré de 8 %, fournissant un cadre rationnel pour décider de recalibrer les critères de validation ou de former les cotateurs afin de réduire la variabilité inter-juges.
7.3 Tâche de détection du signal en psychologie de la perception
Au sein du paradigme expérimental classique de la théorie de la détection du signal (TDS), la distinction entre la sensibilité perceptive réelle d’un observateur ($d’$) et son biais de décision interne ($\beta$ ou critère $c$) s’avère centrale. Imaginons une expérience de psychoacoustique fondamentale portant sur la perception subliminale de micro-ruptures spectrales au sein d’un flux continu de bruit blanc. Un participant volontaire est soumis à une séquence de $n = 30$ essais critiques. Lors de ces essais particuliers, aucun signal sonore n’est en réalité émis par l’appareillage numérique : il s’agit d’essais « bruit seul » (Catch Trials).
Tout signalement positif de la présence d’une rupture sonore lors de ces essais constitue donc par définition une fausse alarme. D’après un modèle normatif de réponse conservatrice, le taux de fausses alarmes tolérable chez un participant non biaisé est supposé être de $p = 0{,}20$. Le protocole expérimental cherche à établir si le sujet a manifesté une propension particulièrement stricte ou réticente à déclarer la détection du stimulus, caractérisée par l’observation d’au plus 8 fausses alarmes au cours de la session ($k = 8$).
Le calcul de l’accumulation inférieure s’exécute immédiatement par l’appel à BinomCDF :
binomcdf(30, 0.20, 8)
L’algorithme numérique procède à l’agrégation ordonnée des probabilités discrètes de l’origine jusqu’à la borne d’évaluation :
$$P(X le 8) = \sum_{i=0}^8 \binom{30}{i} (0{,}20)^i (0{,}80)^{30 – i} \approx 0{,}87134$$
Cette analyse statistique démontre qu’il existe une probabilité d’environ $87{,}13,%$ d’enregistrer 8 fausses alarmes ou moins chez un observateur moyen opérant sous ce niveau de contrainte sensorielle. Cette donnée cumulative permet au psychologue expérimentaliste de conclure que la performance observée s’inscrit pleinement dans la variabilité physiologique normale et n’indique pas un biais conservateur exceptionnel, ce qui autorise l’intégration sans réserve des données de ce participant au sein de la cohorte d’analyse générale.
8. Calcul de probabilités complexes et manipulation des inégalités
8.1 Stratégie pour les probabilités strictement inférieures : P(X < k)
L’une des difficultés les plus pernicieuses dans l’exploitation pratique des fonctions de distribution cumulative sur calculatrices ou bibliothèques statistiques réside dans le traitement rigoureux du sens mathématique des inégalités. Par conception algorithmique immuable, la quasi-totalité des architectures électroniques (TI-84 en tête) et des modules de calcul scientifique implémentent la fonction BinomCDF sous la forme exclusive de l’inégalité large : $\text{BinomCDF}(n, p, k) = P(X le k)$.
Toutefois, une problématique empirique en sciences du comportement s’énonce fréquemment sous la forme d’une inégalité stricte : « Quelle est la probabilité qu’un sujet obtienne strictement moins de $k$ réussites ? », soit formellement $P(X < k)$. Face à cette formulation verbale, appliquer directement la fonction cumulative à la valeur numérique $k$ ($\text{BinomCDF}(n, p, k)$) constitue une grossière erreur d'inclusion. En effet, dans le domaine des variables aléatoires discrètes à support entier, l’égalité structurelle suivante prévaut impérativement :
$$P(X < k) iff P(X le k – 1)$$
Dans un continuum discret, le plus grand entier strictement inférieur à $k$ est rigoureusement l’entier $k – 1$. Il n’existe aucune masse de probabilité intermédiaire entre les abscisses $k-1$ et $k$. Par conséquent, la règle de translation universelle sur TI-84 s’établit de la manière suivante :
$$P(X < k) = \text{binomcdf}(n, p, k – 1)$$
Illustrons cette mécanique analytique : si un chercheur analyse une cohorte de 20 épreuves ($n = 20, p = 0{,}5$) et désire quantifier la probabilité qu’un participant réalise strictement moins de 6 succès ($P(X < 6)$), il doit exclure la tranche ponctuelle de l'abscisse 6 de son accumulation. Il programme alors impérativement :
binomcdf(20, 0.5, 5)
Saisir l’argument 6 aurait pour conséquence mathématique directe d’agréger indûment la masse $P(X = 6)$, gonflant artificiellement la probabilité résultante de près de 3,7 % et compromettant irrémédiablement la précision de l’inférence.
8.2 Stratégie du complément pour les probabilités supérieures : P(X > k) et P(X >= k)
L’évaluation des queues de distribution droites (supérieures) soulève une asymétrie computationnelle majeure : les calculatrices standards ne disposent pas d’une commande primitive dédiée aux probabilités supérieures pour la loi binomiale. Dès lors, le chercheur doit obligatoirement invoquer le principe mathématique fondamental des événements complémentaires pour contourner cette limitation technique.
En vertu des axiomes fondateurs de Kolmogorov, la somme des probabilités de l’ensemble de l’univers probabiliste est univoquement égale à l’unité :
$$\sum_{i=0}^n P(X = i) = 1$$
Considérons en premier lieu le cas d’une hypothèse unilatérale exigeant d’atteindre ou de dépasser un certain seuil de performance : « Obtenir au moins $k$ succès », formalisé par l’inégalité large $P(X ge k)$. L’événement rigoureusement complémentaire à cette condition d’excellence cognitive correspond au fait d’obtenir un score strictement inférieur à $k$, c’est-à-dire au maximum $k – 1$ succès. Dès lors, l’équation de résolution analytique se formalise de la façon suivante :
$$P(X ge k) = 1 – P(X < k) = 1 – P(X le k – 1)$$
Sur l’interface de programmation d’une TI-84, la saisie canonique pour évaluer « au moins $k$ succès » s’opère donc selon la séquence rigoureuse :
1 - binomcdf(n, p, k - 1)
Considérons en second lieu le cas d’une inégalité strictement supérieure : « Obtenir strictement plus de $k$ succès », noté mathématiquement $P(X > k)$. Ici, l’événement opposé embrasse l’ensemble des scores situés depuis l’origine jusqu’à $k$ inclusivement, soit $P(X le k)$. La dérivation algébrique de l’événement complémentaire s’écrit alors :
$$P(X > k) = 1 – P(X le k)$$
La transcription syntaxique correspondante sur calculatrice s’exécute directement par l’instruction :
1 - binomcdf(n, p, k)
La maîtrise absolue de ces règles de décalage d’un point entier conditionne la validité des conclusions lors de l’évaluation de surperformances cognitives exceptionnelles ou lors de la détection de biais de chance statistique.
8.3 Résolution des probabilités d’intervalle fermé : P(a <= X <= b)
L’investigation psychométrique ne se cantonne pas aux seules extrémités polaires de la distribution ; elle réclame fréquemment la délimitation de zones intermédiaires représentant la « normalité statistique » ou un corridor d’efficience adaptative. La question formelle s’énonce alors : « Quelle est la probabilité que le score d’un participant s’insère à l’intérieur d’un intervalle fermé comprenant entre $a$ et $b$ succès inclusivement ? », formalisé analytiquement par :
$$P(a le X le b) \quad \text{a\vec} \quad 0 le a le b le n$$
Pour résoudre cette équation sans devoir sommer fastidieusement chaque terme individuel par BinomPDF, la théorie des probabilités cumulatives applique le théorème de décomposition des intervalles. Ce principe démontre que la masse probabiliste confinée entre les bornes $a$ et $b$ s’obtient par la soustraction géométrique de deux fonctions de répartition cumulatives : la probabilité cumulée jusqu’au plafond supérieur $b$, amputée de la masse probabiliste cumulée strictement inférieure au plancher $a$. L’expression formelle s’écrit rigoureusement :
$$P(a le X le b) = P(X le b) – P(X < a) = P(X le b) – P(X le a – 1)$$
La transcription opératoire immédiate pour l’utilisateur d’une calculatrice graphique de type TI-84 correspond à la formule d’assemblage :
binomcdf(n, p, b) - binomcdf(n, p, a - 1)
Prenons un exemple d’application en neuropsychologie cognitive : un praticien administre une batterie d’attention soutenue comportant $n = 25$ épreuves de temps de réaction à discrimination visuelle ($p = 0{,}60$). Le clinicien cherche à déterminer la probabilité théorique qu’un patient se positionne dans une zone de réactivité intermédiaire modérée, caractérisée par l’observation d’un score situé rigoureusement entre 10 et 16 réussites incluses ($a = 10, b = 16$).
L’implémentation de la différence cumulative s’articule par l’instruction :
binomcdf(25, 0.60, 16) - binomcdf(25, 0.60, 9)
L’extraction computationnelle des deux termes cumulatifs révèle :
$$\text{binomcdf}(25, 0{,}60, 16) = P(X le 16) \approx 0{,}72648$$
$$\text{binomcdf}(25, 0{,}60, 9) = P(X le 9) \approx 0{,}01317$$
$$P(10 le X le 16) = 0{,}72648 – 0{,}01317 = 0{,}71331$$
Il existe par conséquent une probabilité théorique d’environ $71{,}33,%$ qu’un sujet standard réalise un score compris dans cet intervalle de performance. Tout sujet dont le résultat s’échapperait de cet intervalle par le haut ou par le bas pourrait alors être légitimement suspecté de déviation comportementale par rapport à cette norme de variabilité attendue.
9. Erreurs fréquentes d’interprétation et pièges méthodologiques
9.1 Confusion récurrente entre probabilité ponctuelle et cumulative
Parmi les sources d’invalidation méthodologique recensées dans les mémoires de recherche et les publications scientifiques en psychologie expérimentale, la confusion entre BinomPDF et BinomCDF occupe une position prédominante. Cette dérive procède souvent d’une lecture superficielle de la formulation des hypothèses de recherche. Lorsqu’un chercheur pose l’hypothèse de travail selon laquelle un patient « présente un trouble perceptif car il n’a obtenu que 4 succès sur 20 essais », l’esprit non averti tend à traduire immédiatement cette phrase par l’évaluation ponctuelle de la performance observée : $P(X = 4)$.
L’impact de ce sophisme statistique sur le contrôle de l’erreur de type I s’avère particulièrement dévastateur. En substituant BinomPDF à BinomCDF, le praticien commet une sous-estimation systématique et massive de la probabilité d’erreur réelle. Considérons l’exemple d’une tâche à choix forcé ($n = 20, p = 0{,}5$). Si un sujet obtient $k = 4$ réussites, l’évaluation ponctuelle via BinomPDF indique :
$$P(X = 4) = \text{binompdf}(20, 0{,}5, 4) \approx 0{,}00462 \quad (0{,}46,%)$$
Fasciné par cette valeur largement inférieure au seuil alpha canonique de 5 % ($0{,}00462 < 0{,}05$), l'analyste inexpérimenté proclame prématurément le caractère hautement significatif du déficit. Or, le test formel d'hypothèse unilatérale exige l'intégration de la zone cumulative de rejet :
$$P(X le 4) = \text{binomcdf}(20, 0{,}5, 4) \approx 0{,}00591 \quad (0{,}59,%)$$
Dans ce cas particulier, l’hypothèse reste rejetée car la valeur de $k$ est extrêmement éloignée du centre. Cependant, considérons un score frontière tel que $k = 6$. La probabilité ponctuelle vaut $\text{binompdf}(20, 0{,}5, 6) \approx 0{,}03695$ (ce qui semble faussement significatif sous le seuil de $5,%$ !), tandis que la probabilité cumulative réelle atteint $\text{binomcdf}(20, 0{,}5, 6) \approx 0{,}05766$ (qui excède le seuil de $5,%$ et impose de conserver l’hypothèse nulle d’absence de déficit). Utiliser la PDF sur des cas frontières produit des faux positifs à répétition, conduisant à des faux diagnostics cliniques dont les répercussions humaines et thérapeutiques peuvent s’avérer dommageables.
9.2 Erreur d’inclusion de la borne supérieure dans le calcul cumulatif
Le second écueil méthodologique universellement constaté lors de la manipulation des distributions binomiales est l’omission du décalage d’un entier lors de l’application de la règle de dérivation par le complément. Cette erreur, fréquemment qualifiée dans le jargon informatique d’erreur de clôture (ou off-by-one error), trouve son origine dans l’incapacité de l’expérimentateur à transcrire une formulation en langage naturel vers un opérateur mathématique rigoureux.
Le piège s’illustre particulièrement lors du traitement de l’expression : « Réussir au moins 8 items sur 10 ». Entendant le chiffre 8, de nombreux praticiens saisissent mécaniquement sur leur calculatrice :
1 - binomcdf(10, p, 8) quad text{[FORMULATION ERRONÉE]}
Cette saisie soustrait l’ensemble des probabilités de l’intervalle $[0, 8]$ de la masse totale d’un univers probabiliste. Par conséquent, la tranche correspondant à la valeur 8 est arbitrairement expulsée du calcul ! Ce faisant, l’opérateur n’évalue nullement $P(X ge 8)$, mais bien $P(X ge 9)$, soit l’occurrence de 9 ou 10 succès uniquement. Pour quantifier fidèlement « au moins 8 succès », le 8 doit faire partie du résultat conservé ; il convenait donc de ne retrancher que les entiers situés jusqu’à 7 :
1 - binomcdf(10, p, 7) quad text{[FORMULATION RIGOREUSE]}
Pour immuniser les chercheurs contre ce risque d’erreur, des algorithmes de contrôle systématique des bornes doivent être instaurés au sein des protocoles d’analyse. Un moyen mnémotechnique universel consiste à décomposer mentalement la série d’entiers discrets sous forme d’une ligne d’états : ${0, 1, dots, k-1} mid {k, dots, n}$. L’opérateur visualise ainsi physiquement le point de césure exact où doit opérer le découpage de la fonction cumulative de sommation.
9.3 Violations des postulats fondamentaux du modèle binomial
Au-delà des méprises purement calculatoires portant sur les fonctions PDF et CDF, l’invalidation méthodologique la plus insidieuse résulte de la méconnaissance des postulats de validité du modèle binomial lui-même. Dans une proportion non négligeable de publications en psychologie expérimentale, les auteurs appliquent des modèles binomiaux à des jeux de données qui violent de manière flagrante les critères de Bernoulli.
La première violation structurelle est induite par la présence d’une dépendance temporelle ou sérielle au fil des mesures répétées administrées à un même sujet. Dans les épreuves comportementales complexes, les participants développent des stratégies cognitives séquentielles : un échec à l’essai $i$ peut provoquer un sursaut attentionnel augmentant la probabilité de succès à l’essai $i+1$, ou inversement, induire une réaction de découragement et de désengagement passif minorant la performance subséquente. Dans ces conditions, les essais ne sont plus indépendants : il existe une autocorrélation sérielle des résidus.
La seconde violation majeure réside dans la non-stationnarité du paramètre d’efficacité $p$. L’intervention de phénomènes d’épuisement cognitif au fil d’une longue passation expérimentale (faisant décroître $p(t)$ au fil du temps) ou à l’opposé l’apparition de mécanismes de consolidation mnésique procédurale (faisant croître $p(t)$) détruit l’homogénéité du modèle. Face à de telles données empiriques, persister à utiliser les fonctions BinomPDF ou BinomCDF génère des distributions biaisées par une surdispersion (overdispersion) ou une sous-dispersion substantielle. Le recours à des modèles alternatifs plus souples, tels que la distribution bêta-binomiale ou les modèles linéaires généralisés mixtes (GLMM) incorporant un effet aléatoire sujet, devient alors impératif pour préserver l’intégrité de la déduction statistique.
10. Applications avancées en psychométrie et standardisation d’outils
10.1 Calibrage de tests cognitifs par la théorie des réponses aux items
Dans l’ingénierie contemporaine de la mesure psychologique, l’évaluation des aptitudes intellectuelles s’est affranchie de la simple théorie classique des tests pour s’ancrer dans les modèles probabilistes de la théorie des réponses aux items (TRI ou Item Response Theory). Au sein de ces paradigmes psychométriques avancés, la modélisation binomiale conserve un rôle central pour l’ajustement mathématique des courbes caractéristiques des items (CCI).
Dans le modèle logistique à trois paramètres (modèle 3PL de Birnbaum), la probabilité conditionnelle $P_i(\theta)$ qu’un sujet d’aptitude latente donnée $\theta$ réponde correctement à l’item $i$ est formalisée par l’équation non linéaire :
$$P_i(\theta) = c_i + \frac{1 – c_i}{1 + e^{-a_i (\theta – b_i)}}$$
Dans cette formalisation structurelle, le paramètre $c_i$ représente le plancher asymptotique de pseudo-devinement (pseudo-guessing), lequel correspond à la probabilité qu’un sujet présentant un déficit cognitif sévère ou une absence d’aptitude ($\theta to -\infty$) réussisse l’item par hasard. L’étalonnage empirique de ce paramètre $c_i$ mobilise directement les fonctions de masse binomiale sur des sous-groupes de contrôle afin de vérifier si les patrons de réponse s’écartent des fréquences binomiales de hasard pur. La fonction de masse permet d’isoler la variabilité attribuable au devinement stochastique de celle résultant d’une compréhension partielle de l’énoncé.
Par ailleurs, l’évaluation de la fonction d’information globale d’un test psychométrique, notée $I(\theta)$, s’appuie sur la sommation des variances binomiales locales de chaque item. Aux extrêmes de la distribution latente (les zones de très haute compétence ou de déficit profond), la modélisation binomiale cumulative BinomCDF est employée pour modéliser le comportement des scores planchers et plafonds, garantissant que l’outil de diagnostic préserve une erreur standard de mesure (SEM) minimale sur l’ensemble du continuum clinique évalué.
10.2 Détermination de la taille d’échantillon et puissance statistique
L’une des étapes les plus délicates de la conception d’un protocole expérimental en psychologie quantitative réside dans la détermination a priori de la taille minimale de l’échantillon d’épreuves $n$ requis pour garantir une puissance statistique admissible ($1 – \beta ge 0{,}80$). Un nombre insuffisant d’essais expose le chercheur au risque d’impuissance diagnostique : il s’avère incapable de rejeter l’hypothèse nulle même lorsque l’effet comportemental recherché existe réellement.
La puissance d’un test binomial unilatéral évaluant si une compétence cognitive dépasse le hasard standard ($H_0 : p = p_0$ contre $H_1 : p = p_1$ avec $p_1 > p_0$) s’exprime mathématiquement comme une fonction cumulative dépendante du seuil critique de rejet $k_{\text{critique}}$ déterminé sous $H_0$. Pour un risque alpha fixé ($\alpha = 0{,}05$), la puissance statistique formelle correspond à la probabilité de franchir ce seuil sous l’hypothèse alternative $H_1$ :
$$\text{Puissance} = 1 – \text{BinomCDF}(n, p_1, k_{\text{critique}} – 1)$$
Si la taille $n$ de la batterie d’essais est trop modeste (par exemple $n = 8$ lors d’une tâche à deux choix, $p_0 = 0{,}50$), même la réussite intégrale de l’ensemble des essais ($k = 8$) ne produit qu’une $p$-value ponctuelle et cumulative de :
$$P(X = 8) = (0{,}5)^8 = \frac{1}{256} \approx 0{,}0039$$
Cependant, si le participant réussit 7 essais sur 8, l’évaluation cumulative révèle que $P(X ge 7) = 8 \times (0{,}5)^8 + (0{,}5)^8 = \frac{9}{256} \approx 0{,}035$. Mais si le participant commet seulement deux erreurs ($k = 6$), la probabilité cumulée bondit à :
$$P(X ge 6) = \frac{1 + 8 + 28}{256} = \frac{37}{256} \approx 0{,}1445$$
Dans ce cadre expérimental sous-dimensionné, un score de 6 sur 8 ne permet pas d’écarter l’hypothèse du hasard au seuil de $5,%$, ce qui illustre le manque aigu de sensibilité statistique de l’expérience. L’optimisation algorithmique fondée sur l’inversion de BinomCDF permet de calculer avec exactitude la taille $n$ minimale requise pour discriminer statistiquement une altération subtile de performance vis-à-vis d’une norme établie.
10.3 Contrôle des taux de faux positifs dans les batteries multidimensionnelles
L’évaluation contemporaine en neuropsychologie clinique implique rarement l’administration d’une épreuve unique isolée ; elle repose de façon universelle sur l’administration de batteries multidimensionnelles exhaustives (comprenant entre 20 et 60 indices quantitatifs distincts évaluant la mémoire épisodique, les fonctions exécutives, le langage et la motricité fine). Cette multiplicité des épreuves soulève le redoutable problème statistique du cumul du risque de fausses anomalies diagnostiques au sein de la population générale.
Si un clinicien fixe le seuil diagnostique d’anomalie unitaire sur chaque sous-test au 5e percentile inférieur ($\alpha = 0{,}05$), et sous l’hypothèse théorique de travail d’une indépendance orthogonale stricte entre $m$ indices administrés, le nombre de scores anormaux observés chez un individu sain suit rigoureusement une distribution binomiale :
$$X_{\text{anomalies}} \sim \mathcal{B}(m, 0{,}05)$$
L’utilisation de la fonction de répartition BinomCDF permet de modéliser avec précision le taux de base de la pathologie apparente chez des sujets parfaitement indemnes de toute atteinte neurologique. Par exemple, au sein d’une batterie neuropsychologique globale comprenant $m = 30$ épreuves indépendantes, la probabilité qu’un individu sain sélectionné au hasard manifeste au moins un score déficitaire (fausse alarme globale) se formalise par l’événement complémentaire :
$$P(X ge 1) = 1 – \text{BinomCDF}(30, 0{,}05, 0) = 1 – (1 – 0{,}05)^{30} = 1 – (0{,}95)^{30} \approx 0{,}7854$$
Il existe donc une probabilité théorique stupéfiante de près de $78{,}5,%$ qu’un sujet tout à fait normal présente au moins une note étiquetée comme « pathologique » au cours de son bilan. Poursuivant cette analyse via BinomCDF, la probabilité d’observer au moins trois scores anormaux par pur hasard s’élève encore à :
$$P(X ge 3) = 1 – \text{BinomCDF}(30, 0{,}05, 2) \approx 0{,}1878 \quad (18{,}78,%)$$
L’intégration de ces calculs cumulatifs binomialisés protège le corps médical contre le risque d’un surdiagnostic épidémique en neuropsychologie, en démontrant objectivement que la présence de plusieurs notes faibles isolées constitue un phénomène stochastique attendu dans toute batterie d’évaluation large, contraignant les praticiens à élever leurs exigences de seuils multidimensionnels.
11. Approximation continue et alternatives asymptotiques à la loi binomiale
11.1 Transition de la loi binomiale vers la loi normale de Laplace-Gauss
Lorsque la taille d’échantillon $n$ croît substantiellement, le calcul discret direct des coefficients combinatoires par BinomPDF et BinomCDF se heurte à des contraintes computationnelles sévères. Historiquement, cette barrière numérique a motivé l’élaboration du théorème central limite et de sa variante discrète fondamentale : le théorème de Moivre-Laplace. Ce théorème démontre que sous des conditions d’échantillonnage suffisantes, la loi binomiale converge asymptotiquement en distribution vers une distribution continue de Laplace-Gauss :
$$X \sim \mathcal{B}(n, p) x\rightarrow{\mathcal{D}} \mathcal{N}\left(\mu = np, , \sigma^2 = np(1 – p)\right)$$
La validité empirique de cette approximation continue repose sur des critères d’adéquation universellement reconnus en biométrie. Les règles de bonne pratique imposent que les trois conditions de seuil suivantes soient simultanément vérifiées :
$$n ge 30, \quad n \cdot p ge 5 \quad \text{et} \quad n \cdot (1 – p) ge 5$$
(Certains auteurs prescrivent un seuil plus conservateur de $np ge 10$ lorsque la probabilité $p$ s’éloigne notablement de $0{,}50$). Lors de cette transition d’une distribution discrète vers un continuum probabiliste, la fonction cumulative discrète $P(X le k)$ est approximée par l’intégrale de Gauss de la fonction de densité normale.
Cette démarche impose l’introduction obligatoire de la correction de continuité (ou correction de Yates/Fisher). Étant donné qu’une loi continue n’assigne aucune masse à un point précis ($P(X = k) = 0$ au sens de l’intégrale continue), chaque entier discret $k$ de la distribution binomiale doit être conceptualisé comme un intervalle réel unitaire centré s’étendant sur $[k – 0{,}5 ,;, k + 0{,}5]$. Dès lors, la correspondance approximative s’établit avec rigueur par la transformation centrée-réduite :
$$\text{BinomCDF}(n, p, k) = P(X le k) \approx \Phi\left(\frac{k + 0{,}5 – np}{\sqrt{np(1 – p)}}\right)$$
où $Phi(z)$ représente la fonction de répartition de la loi normale centrée réduite $\mathcal{N}(0, 1)$. L’omission délibérée de ce terme correcteur de $+0{,}5$ génère un biais systématique d’estimation qui dégrade la fiabilité des inférences, particulièrement lorsque la taille $n$ demeure d’amplitude modérée.
11.2 Convergence vers la distribution de Poisson pour événements rares
Dans un ensemble spécifique de configurations expérimentales, l’approximation normale s’avère totalement inapplicable, en dépit d’une taille d’épreuve $n$ particulièrement élevée. Cette situation survient lorsque la probabilité de survenue d’un succès individuel est extrêmement faible ($p to 0$), de sorte que la condition $np ge 5$ n’est pas satisfaite. Dans cette zone de modélisation stochastique, la distribution binomiale converge non pas vers une gaussienne, mais vers la loi de Poisson, traditionnellement baptisée « loi des événements rares ».
Formellement, si $n to \infty$ et $p to 0$ tandis que le produit asymptotique $\lambda = n \cdot p$ demeure strictement constant et fini (avec comme heuristique empirique $n ge 50$ et $p le 0{,}05$), la fonction de masse de probabilité binomiale se transforme analytiquement en la fonction de masse de Poisson :
$$\text{BinomPDF}(n, p, k) = \binom{n}{k} p^k (1 – p)^{n – k} x\rightarrow{\mathcal{L}} \frac{\lambda^k e^{-\lambda}}{k!}$$
De façon équivalente, la sommation cumulative BinomCDF s’aligne fidèlement sur la fonction cumulative de Poisson (désignée sur les calculatrices graphiques par la fonction poissoncdf(lambda, k)) :
$$\text{BinomCDF}(n, p, k) x\rightarrow{\mathcal{L}} \sum_{i=0}^k \frac{\lambda^i e^{-\lambda}}{i!}$$
Cette alternative computationnelle s’avère particulièrement pertinente en épidémiologie psychiatrique et en psychologie clinique lors de l’enregistrement d’actes comportementaux critiques exceptionnels au sein d’une large cohorte. Par exemple, dans le suivi longitudinal d’un millier de patients institutionnalisés ($n = 1000$) surveillés pour le risque de passage à l’acte auto-agressif sévère (dont la probabilité marginale journalière est établie à $p = 0{,}002$, conférant une intensité moyenne de $\lambda = 1000 \times 0{,}002 = 2$), la modélisation poissonnienne simplifie drastiquement le calcul des probabilités cumulées tout en garantissant une stabilité numérique optimale que ne permettrait pas l’évaluation directe de coefficients factoriels géants $\binom{1000}{k}$.
11.3 Limites de calculabilité des processeurs et calculatrices modernes
Les avancées technologiques de la microélectronique ont profondément étendu le champ des calculs stochastiques réalisables sur support nomade. Néanmoins, l’architecture interne des processeurs de calculatrices grand public (telles que la gamme TI-84 reposant historiquement sur une déclinaison perfectionnée du microprocesseur 8 bits Zilog Z80 cadencé à quelques dizaines de mégahertz) impose des limitations matérielles strictes dont l’utilisateur averti doit avoir conscience.
La première contrainte tient à la précision arithmétique de la représentation en virgule flottante. Les calculatrices encodent les nombres réels avec une précision nominale de 14 chiffres significatifs, n’en affichant que 10 à l’écran. Lors de l’évaluation cumulative d’événements hautement improbables situés dans l’extrême queue droite d’une distribution binomiale (par exemple $P(X le k)$ lorsque la valeur est égale à $0{,}999999999999999$), les routines d’arrondi numérique du registre interne peuvent forcer brutalement la valeur à $1{,}0$. Ce phénomène d’absorption numérique prive l’analyste de la possibilité d’évaluer avec exactitude le risque résiduel complémentaire $P(X > k) = 1 – P(X le k)$, provoquant un résultat erroné de 0 absolu.
La seconde limitation concerne les temps d’exécution requis pour la sommation itérative de BinomCDF sur des échantillons massifs. Si un chercheur commande l’instruction binomcdf(50000, 0.4, 21000) sur une TI-84 standard monochrome, la machine n’applique pas une intégrale continue abstraite mais exécute une boucle séquentielle de sommation discrète de 21 001 termes combinatoires individuels. Ce traitement peut mobiliser le microcontrôleur durant de longues secondes, déchargeant les batteries et bloquant temporairement l’interface. Dans de telles conditions, le recours aux approximations asymptotiques présentées supra (loi normale ou distribution de Poisson) ou l’exportation des analyses vers des plateformes de calcul vectoriel haute performance sous environnement R ou Python s’avère non seulement une marque d’élégance méthodologique, mais une absolue nécessité pratique.
12. Synthèse méthodologique et guide décisionnel pour les chercheurs
12.1 Tableau synoptique des équivalences verbales et mathématiques
Pour prévenir les confusions terminologiques lors de la conception d’un devis expérimental ou de la rédaction d’un rapport de diagnostic neuropsychologique, le tableau comparatif ci-dessous synthétise l’ensemble des correspondances sémantiques formelles liant les expressions du langage naturel, les opérateurs ensemblistes stochastiques et les commandes algorithmiques d’exécution sur calculatrice graphique :
| Formulation verbale en français | Opérateur mathématique formel | Fonction statistique mobilisée | Syntaxe canonique sur TI-84 |
|---|---|---|---|
| Exactement $k$ succès | $P(X = k)$ | Fonction de masse (PDF) | binompdf(n, p, k) |
| Au maximum $k$ succès / Au plus $k$ succès | $P(X le k)$ | Fonction de répartition (CDF) | binomcdf(n, p, k) |
| Strictement moins de $k$ succès / Moins de $k$ | $P(X < k) iff P(X le k – 1)$ | Fonction de répartition décalée | binomcdf(n, p, k - 1) |
| Au moins $k$ succès / Pas moins de $k$ succès | $P(X ge k) iff 1 – P(X le k – 1)$ | Complémentaire de répartition | 1 - binomcdf(n, p, k - 1) |
| Strictement plus de $k$ succès / Plus de $k$ | $P(X > k) iff 1 – P(X le k)$ | Complémentaire de répartition | 1 - binomcdf(n, p, k) |
| Entre $a$ et $b$ succès (inclusivement) | $P(a le X le b) iff P(X le b) – P(X le a – 1)$ | Différence de répartitions | binomcdf(n, p, b) - binomcdf(n, p, a - 1) |
12.2 Arbre décisionnel pour le choix entre BinomPDF et BinomCDF
Afin de structurer le raisonnement statistique sous-tendant le choix de l’opérateur probabiliste adéquat, le chercheur ou le clinicien peut suivre un algorithme décisionnel séquentiel en trois étapes heuristiques fondamentales :
Étape 1 : Diagnostic de la nature de la question de recherche. L’expérimentateur doit interroger l’essence de son hypothèse théorique. S’agit-il d’évaluer la vraisemblance d’un état ponctuel, exclusif et isolé au sein du système expérimental ? Si la réponse est strictement affirmative (« Nous cherchons uniquement la probabilité d’obtenir la note exacte $k$ »), l’orientation logique pointe de manière irrévocable vers la fonction de masse de probabilité : BinomPDF(n, p, k). Si la réponse est négative, le traitement relève du continuum cumulatif et bascule vers l’étape subséquente.
Étape 2 : Délimitation de la directionnalité de la borne étudiée. Le chercheur examine l’orientation de l’inégalité régissant la zone de rejet de son hypothèse nulle :
- Si la recherche vise une région cumulative inférieure (performance dégradée, borne basse, « au plus », « au maximum »), l’opérateur est un opérateur direct d’accumulation inférieure. Il convient de vérifier si la borne est stricte (convertir $P(X < k)$ en $k-1$) ou large ($P(X le k)$ conservant $k$), et d'exécuter
BinomCDF. - Si la recherche investigue une région cumulative supérieure (performance remarquable, sur-réussite au test, « au moins », « plus de »), l’analyste constate l’impossibilité d’une évaluation native directe et bascule vers l’étape de complémentation algébrique.
Étape 3 : Application de la dérivation par le complément. Pour les queues supérieures de distribution, l’expérimentateur applique la loi de négation : isoler la masse supérieure réclame la soustraction de l’ensemble de la masse inférieure non désirée par rapport à l’univers unitaire. Il convient d’identifier avec minutie le dernier entier appartenant à la zone rejetée afin de renseigner l’argument de sommation :
- Pour « au moins $k$ succès » ($P(X ge k)$), la zone rejetée s’arrête à $k-1$ : la commande formelle est
1 - binomcdf(n, p, k - 1). - Pour « strictement plus de $k$ succès » ($P(X > k)$), la zone rejetée s’étend jusqu’à $k$ inclusivement : la commande formelle est
1 - binomcdf(n, p, k).
12.3 Bonnes pratiques de reporting statistique selon les normes APA
L’exigence de transparence méthodologique et de reproductibilité empirique imposée par l’American Psychological Association (APA, 7e édition) régit rigoureusement la manière de rapporter les analyses binomiales au sein des manuscrits académiques et rapports d’évaluation clinique standardisés. Tout rapport de résultat probabiliste fondé sur le modèle binomial doit impérativement expliciter la valeur précise de l’ensemble des paramètres structurels du modèle.
La formulation standardisée impose de spécifier dans le corps du texte la taille totale de l’échantillon d’épreuves unitaire ($n$), la probabilité théorique postulée sous l’hypothèse nulle ($p$), ainsi que le nombre précis de succès observés sur le terrain empirique ($k$ ou $x$). Il est en outre requis d’énoncer clairement la directionnalité du test (test unilatéral à gauche, unilatéral à droite, ou bilatéral). La valeur de probabilité empirique résultante (la $p$-value) doit être transcrite avec une précision rigoureuse, en mentionnant s’il s’agit d’une probabilité ponctuelle obtenue par PDF ou d’une probabilité cumulée dérivée de la CDF.
Voici des exemples concrets de formulations académiques conformes aux canons de publication internationaux :
Exemple de rapport unilatéral cumulatif (BinomCDF, test de déficit) :
« Les capacités d’identification visuelle du patient ont été évaluées au moyen d’un protocole à choix forcé composé de 20 épreuves indépendantes ($n = 20$), pour lesquelles la probabilité de réussite aléatoire sous l’hypothèse nulle d’un comportement stochastique est de $p = 0{,}50$. Le patient a produit un total de 5 identifications correctes. Une analyse probabiliste cumulative basée sur la loi binomiale indique que la probabilité d’observer au maximum 5 réussites par le simple jeu du hasard est statistiquement significative au seuil conventionnel, BinomCDF$(20; 0{,}50; 5) : P(X le 5) = 0{,}0207$, autorisant le rejet de l’hypothèse nulle et attestant d’une altération perceptive significative. »
Exemple de rapport ponctuel (BinomPDF, test d’adéquation de modèle) :
« Conformément aux prédictions de notre modèle d’apprentissage moteur intermédiaire, nous avons testé l’occurrence d’exactement 8 erreurs au cours des 25 essais d’entraînement chez les rongeurs naïfs ($n = 25, p = 0{,}30$). La probabilité ponctuelle théorique d’observer précisément ce profil comportemental s’élève à BinomPDF$(25; 0{,}30; 8) : P(X = 8) = 0{,}1651$. Cette observation empirique s’aligne fidèlement sur la distribution de masse attendue sous l’hypothèse du modèle structurel. »
Le respect scrupuleux de ces protocoles de transmission garantit une communication exempte d’ambiguïté entre chercheurs, valide l’intégrité déontologique des bilans neuropsychologiques et consacre l’apport irremplaçable de la statistique quantitative à l’édification des sciences du comportement humain.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bernoulli, J. (1713). Ars conjectandi, opus posthumum. Impensis Thurnisiorum, Fratrum.
Birnbaum, A. (1968). Some latent trait models and their use in inferring an examinee’s ability. In F. M. Lord & M. R. Novick (Eds.), Statistical theories of mental test scores (pp. 395–479). Addison-Wesley.
Green, D. M., & Swets, J. A. (1966). Signal detection theory and psychophysics. John Wiley & Sons.
Hogg, R. V., McKean, J., & Craig, A. T. (2018). Introduction to mathematical statistics (8th ed.). Pearson.
Macmillan, N. A., & Creelman, C. D. (2004). Detection theory: A user’s guide (2nd ed.). Lawrence Erlbaum Associates.
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Strauss, E., Sherman, E. M., & Spreen, O. (2006). A compendium of neuropsychological tests: Administration, norms, and commentary (3rd ed.). Oxford University Press.
Texas Instruments. (2020). TI-84 Plus CE reference guide. Texas Instruments Incorporated. https://education.ti.com/
Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., Carey, C. J., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2