
Dans l’édifice de l’inférence causale et de l’analyse statistique contemporaine, peu d’obstacles méthodologiques s’avèrent aussi redoutables et ubiquitaires que le biais de variable omise (souvent désigné sous l’acronyme OVB pour Omitted Variable Bias). Qu’il s’agisse d’évaluer l’efficacité d’une psychothérapie innovante, d’estimer les retombées d’un aménagement ergonomique sur la productivité au travail ou de quantifier l’impact du temps d’écran sur le développement cognitif des enfants, l’analyste se heurte systématiquement à l’impossibilité pratique et théorique d’observer et d’inclure la totalité des facteurs explicatifs pertinents au sein d’une équation structurelle. L’exclusion d’une variable cruciale ne se réduit pas à une simple perte de précision descriptive ; elle distord de manière substantielle les coefficients estimés, transformant des corrélations fortuites en pseudo-causalités et masquant des leviers d’action thérapeutique ou sociétale authentiques.
Ce phénomène d’illusion statistique trouve ses fondements dans l’intrication des réseaux causaux du monde réel. En l’absence d’une randomisation expérimentale absolue — condition idéale rarement atteignable dans les sciences sociales et du comportement en raison d’impératifs déontologiques et logistiques évidents —, les variables explicatives sélectionnées absorbent mécaniquement la variance des facteurs latents non mesurés avec lesquels elles partagent une covariance non nulle. Dès lors, le modèle attribue indûment à un prédicteur sous examen les effets qui procèdent en réalité de l’élément laissé dans l’ombre. Cette distorsion mine la validité interne des recherches, érode la reproductibilité empirique des paradigmes scientifiques et conduit trop souvent à des prises de décision cliniques ou à des politiques publiques erronées.
Le présent article propose une exploration rigoureuse, mathématique et conceptuelle du biais de variable omise. À travers une analyse formelle de ses conditions d’émergence, de sa dynamique matricielle et de ses manifestations empiriques variées — depuis les études cliniques en psychopathologie jusqu’aux neurosciences cognitives et à la psychologie organisationnelle —, ce document détaille les outils de diagnostic contemporains ainsi que les stratégies économétriques permettant d’en atténuer les répercussions destructrices sur l’inférence causale.
1. Introduction fondamentale au biais de variable omise
1.1 Définition conceptuelle et théorique
Le biais de variable omise constitue l’une des manifestations les plus élémentaires et pourtant pernicieuses du problème général de l’endogénéité en modélisation statistique. Historiquement conceptualisé dans le champ de l’économétrie linéaire et formalisé dans la théorie générale des modèles de régression, ce biais survient lorsqu’un analyste cherche à quantifier l’effet causal d’une variable indépendante désignée sur un critère dépendant, tout en omettant, délibérément ou par ignorance, un ou plusieurs régresseurs qui participent activement au processus générateur de données sous-jacent. En substance, le chercheur estime un modèle restreint qui postule une relation directe, alors que la réalité phénoménologique implique un réseau plurifactoriel plus vaste.
Sur le plan de l’estimation, l’impact immédiat de cette exclusion sur la méthode des moindres carrés ordinaires (MCO) est dévastateur. L’hypothèse fondamentale d’exogénéité stricte des régresseurs — qui stipule que le terme d’erreur stochastique présente une espérance conditionnelle nulle sachant les variables explicatives incluses — se trouve irrémédiablement violée. La variance de la variable omise, au lieu de demeurer un bruit de fond non biaisé, se retrouve amalgamée au résidu du modèle tout en demeurant corrélée au prédicteur retenu. Cette violation brise le théorème de Gauss-Markov : les estimateurs MCO perdent leur propriété d’être les meilleurs estimateurs linéaires sans biais (BLUE, Best Linear Unbiased Estimator).
Il importe de distinguer avec la plus grande rigueur ce biais structurel de la simple erreur de mesure aléatoire. Une erreur de mesure classique sur la variable dépendante augmente l’imprécision des estimations sans en altérer la justesse fondamentale, tandis qu’une erreur de mesure sur la variable explicative induit généralement une atténuation mécanique vers zéro (le biais d’atténuation). À l’inverse, le biais de variable omise est directionnel, systématique et asymptotiquement persistant : il ne disparaît jamais avec l’accroissement de la taille de l’échantillon empirique. Augmenter le nombre d’observations d’un échantillon sous-spécifié ne fait que conférer un degré de certitude statistique fallacieux à un coefficient fondamentalement erroné.
1.2 Pertinence du concept dans les sciences psychologiques
Si la formalisation de l’OVB découle des sciences économiques, son acuité épistémologique est particulièrement vive dans le domaine des sciences psychologiques, de la psychopathologie et de la neuropsychologie. Les sciences du comportement se distinguent par l’omniprésence de construits latents non observables directement : des abstractions théoriques telles que le névrosisme, l’intelligence générale, l’estime de soi, le climat de sécurité psychologique ou le sentiment d’efficacité personnelle ne peuvent être appréhendées qu’au travers d’indicateurs psychométriques imparfaits. La modélisation du comportement humain implique une multitude de déterminants biologiques, génétiques, cognitifs, environnementaux et socioculturels qui interagissent en permanence de façon non linéaire.
Dans cet écosystème complexe, la prévalence des devis de recherche observationnels et corrélationnels rend la psychologie particulièrement vulnérable à l’omission de facteurs explicatifs majeurs. Contrairement aux sciences de laboratoire qui s’appuient sur des isolats expérimentaux stricts, les psychologues étudient fréquemment des individus en contexte écologique, où les trajectoires de vie, les vulnérabilités développementales et les contextes institutionnels s’enchevêtrent. L’impossibilité d’isoler physiquement les sujets de leur histoire développementale fait en sorte que chaque modèle statistique appliqué à des données observationnelles court le risque de négliger une constellation de covariables critiques.
Les conséquences sur la validité de l’inférence causale en psychologie sont profondes. Lorsque des publications scientifiques affirment qu’une thérapie cognitivo-comportementale spécifique réduit l’anxiété sociale, ou que la consultation assidue des réseaux sociaux génère une baisse de l’affect positif chez l’adolescent, l’absence de prise en compte de covariables latentes fondamentales remet en cause le statut de ces affirmations. Cette vulnérabilité structurelle constitue l’un des moteurs sous-jacents majeurs de la crise contemporaine de la reproductibilité en psychologie, où des effets largement médiatisés s’évanouissent dès lors que des protocoles plus sévères contrôlent adéquatement pour les caractéristiques individuelles stables et l’environnement familial préexistant.
1.3 Terminologie associée et confusions fréquentes
La littérature méthodologique souffre fréquemment d’un manque de rigueur terminologique, favorisant des confusions délétères entre variable modératrice, variable médiatrice et variable confondante. Une variable confondante (ou facteur de confusion) est une variable externe qui affecte simultanément la cause présumée et l’effet étudié, créant une association parasite ou distordant la véritable magnitude de l’effet causal. C’est précisément l’omission d’une telle variable de confusion qui génère le biais de variable omise. À l’opposé, une variable médiatrice se situe le long du chemin causal direct : elle explique le mécanisme sous-jacent par lequel la variable indépendante transmet son effet à la variable dépendante. Contrôler ou inclure à tort une variable médiatrice équivaut à neutraliser le mécanisme étudié (sur-ajustement), ce qui constitue une erreur d’inférence diamétralement opposée à l’omission d’un facteur de confusion.
La variable modératrice, quant à elle, spécifie les conditions sous lesquelles la force ou la direction de la relation entre la variable explicative et le critère fluctue ; elle traduit une interaction statistique et non un biais d’attribution univarié. Par ailleurs, il convient de ne pas confondre le biais de spécification issu d’une omission avec le biais de sélection de l’échantillon. Le biais de sélection découle du mécanisme par lequel les entités entrent dans l’échantillon d’analyse (conditionnement sur une variable commune ou conditionnement sur le critère d’intérêt, souvent rattaché au biais de Berkson ou à la troncation), tandis que le biais de variable omise altère l’estimation même lorsque la population est échantillonnée de manière probabiliste et représentative.
Enfin, dans le vocabulaire des modèles d’équations structurelles (SEM), le biais de variable omise s’intègre au sein du concept plus englobant d’endogénéité. L’endogénéité peut découler de la causalité inverse (simultanéité), de l’erreur de mesure sur les régresseurs ou de l’omission de variables. Comprendre l’OVB requiert de le concevoir comme une instanciation mathématique précise où le vecteur d’erreurs d’une équation structurelle capture l’action d’une force extérieure corrélée avec la matrice de design du modèle estimé.
2. Les conditions statistiques nécessaires à l’apparition du biais
2.1 La condition de corrélation avec la variable explicative incluse
Pour qu’une variable non incluse dans un modèle économétrique ou psychométrique engendre un biais de variable omise au sens mathématique strict, deux conditions cumulatives et non négociables doivent être simultanément satisfaites. La première condition impose que la variable omise doive impérativement présenter une covariance empirique non nulle avec la variable explicative focalisée, conditionnellement à l’ensemble des autres régresseurs déjà présents dans le modèle. En d’autres termes, il doit exister une dépendance statistique — linéaire ou non linéaire — entre le prédicteur examiné par le chercheur et l’élément demeuré hors du cadre d’observation.
Si cette condition n’est pas remplie, c’est-à-dire si la variable omise se révèle parfaitement orthogonale au régresseur inclus dans la population étudiée, l’omission ne génère strictement aucun biais sur l’estimateur ponctuel du coefficient associé à ce prédicteur. L’orthogonalité garantit que le prédicteur inclus ne peut, sur le plan algébrique, « absorber » la variance de l’entité absente. La projection linéaire du résidu structurel sur l’espace engendré par la variable indépendante demeure identiquement nulle.
Cependant, l’absence de biais ponctuel ne signifie pas l’absence d’impact sur la modélisation globale. Lorsque la variable omise est orthogonale au régresseur inclus mais dotée d’une force explicative propre sur le critère dépendant, sa variance non modélisée bascule intégralement dans le terme d’erreur résiduel de la régression. Il en résulte une inflation mécanique de la variance résiduelle du modèle, ce qui dégrade la précision de l’estimateur en augmentant ses erreurs-types et en réduisant la puissance statistique des tests d’inférence, sans pour autant fausser la moyenne asymptotique de l’estimation du paramètre.
2.2 La condition de relation causale avec la variable dépendante
La seconde condition absolue stipule que la variable omise doit exercer un effet propre non nul sur la variable dépendante, cet effet devant être conceptuellement compris au sein du véritable processus générateur de données. Si une variable présente une corrélation, même extrêmement robuste, avec le prédicteur d’intérêt mais qu’elle ne possède aucun lien structural causal, direct ou indirect, avec la variable dépendante observée, son omission du modèle de régression n’induit aucun préjudice quant à l’exactitude de l’estimateur MCO.
Formaliser cette condition implique de reconnaître la distinction primordiale entre un contrôle statistique méthodologiquement nécessaire et l’introduction superflue de bruit observationnel. Dans l’espace des données de population, la dérivée partielle de l’espérance de la variable dépendante par rapport à la variable omise — en maintenant le régresseur principal constant — doit être rigoureusement différente de zéro. Cette exigence positionne la variable omise comme un facteur déterminant autonome au sein de la mécanique de causalité qui produit les variations du phénomène psychologique ou comportemental étudié.
Dans les cas où une variable absente ne satisfait pas cette seconde condition (par exemple, un attribut démographique corrélé à l’exposition thérapeutique mais totalement étranger au mécanisme neurobiologique ou cognitif de guérison du trouble), l’omission de cette covariable n’affecte ni la justesse, ni la consistance de l’estimateur de l’effet thérapeutique. Le coefficient estimé demeure non biaisé pour le paramètre d’intérêt de la population.
2.3 L’interaction simultanée des deux conditions
Il est fondamental de souligner avec la plus grande vigueur théorique que le biais de variable omise ne saurait survenir si l’une ou l’autre de ces deux conditions fait défaut. C’est exclusivement leur conjonction simultanée qui crée la brèche méthodologique fatale. L’omission d’une variable qui prédit la dépendance mais qui n’a aucun lien avec la cause présumée ne fausse pas l’effet moyen ; de même, l’omission d’une variable corrélée au prédicteur mais dépourvue de toute répercussion sur le critère dépendant ne biaise en rien la relation modélisée.
Le tableau théorique des interactions met en lumière la nature asymétrique des risques d’estimation :
- Condition 1 satisfaite et Condition 2 satisfaite : Présence indiscutable d’un biais de variable omise. L’estimateur est biaisé, inconsistent, et les conclusions causales sont mathématiquement corrompues.
- Condition 1 satisfaite et Condition 2 non satisfaite : Aucun biais sur le paramètre du prédicteur focalisé. Les estimations demeurent convergentes vers la vraie valeur causale.
- Condition 1 non satisfaite et Condition 2 satisfaite : Absence de biais sur l’estimateur ponctuel. L’estimateur est non biaisé et convergent, mais son efficacité statistique est sous-optimale en raison d’une variance résiduelle élargie.
- Condition 1 non satisfaite et Condition 2 non satisfaite : Neutralité totale du phénomène. La variable ignorée est méthodologiquement non pertinente pour le modèle sous examen.
Cette interaction démontre qu’une variable ne devient une « variable de confusion » dangereuse que lorsqu’elle constitue un pont stochastique à double sens, liant le système explicatif retenu au récepteur comportemental mesuré.
3. Formalisation mathématique et démonstration économétrique
3.1 Le modèle théorique réel vs le modèle estimé
Afin de saisir les rouages mathématiques profonds du biais de variable omise, il convient de formaliser la rupture structurelle entre le modèle théorique régissant la population et le modèle opérationnel spécifié par le chercheur. Considérons que le véritable processus générateur de données au sein de la population cible s’exprime selon le modèle linéaire général suivant, désigné comme le « modèle complet » ou « vrai » :
Y = β0 + β1X1 + β2X2 + u
Dans cette formulation canonique, Y représente le critère scalaire dépendant, X1 incarne la variable explicative principale d’intérêt clinique ou théorique, et X2 désigne la variable dont l’omission est envisagée. Le terme u représente l’erreur structurelle non corrélée, respectant l’hypothèse classique d’exogénéité stricte : E(u | X1, X2) = 0. Les paramètres β1 et β2 traduisent respectivement l’impact causal structurel marginal de X1 et X2 sur Y.
Supposons désormais que l’analyste, soit par ignorance théorique, soit par contrainte empirique de collecte, omette la variable X2 et estime par la méthode des moindres carrés ordinaires le modèle sous-spécifié ou « modèle restreint » :
Y = α0 + α1X1 + ε
Dans ce modèle restreint, le nouveau terme d’erreur stochastique résiduelle composite, ε, n’est rien d’autre que l’amalgame de l’aléa véritable u et de l’effet structurel de la variable exclue, soit l’identité mathématique élémentaire :
ε = β2X2 + u
Le point de rupture de l’estimation MCO apparaît de façon immédiate : si X1 et X2 ne sont pas strictement indépendants sur le plan stochastique, alors le régresseur inclus X1 est inévitablement corrélé au nouveau résidu ε, ce qui viole irrémédiablement l’orthogonalité fondamentale requise par les conditions d’application des MCO.
3.2 Calcul de l’espérance de l’estimateur par les moindres carrés
Pour calculer rigoureusement l’espérance conditionnelle de l’estimateur obtenu via le modèle restreint, noté b1 (ou α̂1), partons de la formule standard de l’estimateur des moindres carrés univarié :
b1 = Σ((X1i – X̄1)(Yi – Ȳ)) / Σ((X1i – X̄1)2) = Cov(X1, Y) / Var(X1)
En substituant le véritable processus générateur de données Y = β0 + β1X1 + β2X2 + u au sein de la covariance empirique, et en exploitant la bilinéarité de l’opérateur de covariance, nous obtenons le développement analytique suivant :
Cov(X1, Y) = Cov(X1, β0 + β1X1 + β2X2 + u)
Cov(X1, Y) = β1Var(X1) + β2Cov(X1, X2) + Cov(X1, u)
Sous l’hypothèse structurelle où l’aléa pur u est exogène (donc Cov(X1, u) = 0), la division par la variance de X1 livre l’expression formelle de l’estimateur restreint :
b1 = β1 + β2 · [ Cov(X1, X2) / Var(X1) ]
En prenant l’espérance mathématique conditionnelle de cet estimateur par rapport à la matrice des observations de X1, nous obtenons l’équation canonique fondamentale du biais de variable omise :
E(b1 | X1) = β1 + β2 · γ1
Le terme scalaire γ1 = Cov(X1, X2) / Var(X1) n’est autre que la pente de la régression linéaire auxiliaire de la variable omise X2 sur la variable incluse X1. L’expression démontre sans équivoque que le terme de distorsion, ou biais absolu, est strictement égal au produit de deux composantes distinctes : l’effet propre de la variable omise sur le critère (β2) multiplié par la relation linéaire projetée de la variable incluse sur la variable omise (γ1).
3.3 Impact sur l’inférence statistique et les tests d’hypothèses
L’expression analytique dérivée précédemment démontre formellement le caractère pernicieux du biais sur les propriétés d’échantillonnage de l’estimateur. Le biais ne tend pas vers zéro lorsque la taille de l’échantillon n croît vers l’infini :
plim (b1) = β1 + β2 · γ1 ≠ β1
L’estimateur est donc asymptotiquement inconsistant. Mais les ravages méthodologiques s’étendent bien au-delà de la distorsion du coefficient ponctuel. La variance résiduelle du modèle restreint est mécaniquement faussée, car elle inclut à tort le terme quadratique associé à l’effet de X2. La formule standard de calcul de l’erreur-type de l’estimateur repose sur l’hypothèse de résidus homoscédastiques et non corrélés au régresseur. Cette prémisse étant violée, le dénominateur des ratios statistiques de test perd toute validité formelle.
En conséquence immédiate, la statistique t de Student conventionnelle :
t = (b1 – βnul) / σ̂(b1)
ne suit plus une loi de Student sous l’hypothèse nulle. Cela provoque une déformation majeure des seuils de décision critique : les taux d’erreur de type I (rejeter à tort une hypothèse nulle pourtant vraie, et donc décréter l’existence d’un effet psychologique inexistant) augmentent de manière vertigineuse, atteignant fréquemment des valeurs de 20 % à 50 % au lieu du seuil nominal de 5 %. Symétriquement, lorsqu’un biais de signe opposé atténue artificiellement le coefficient réel vers zéro, le taux d’erreur de type II explose, condamnant des interventions psychothérapeutiques pourtant cliniquement bénéfiques à être rejetées lors des phases d’évaluation préliminaires.
4. Directionnalité et magnitude du biais : la matrice des signes
4.1 Biais positif et surestimation des effets
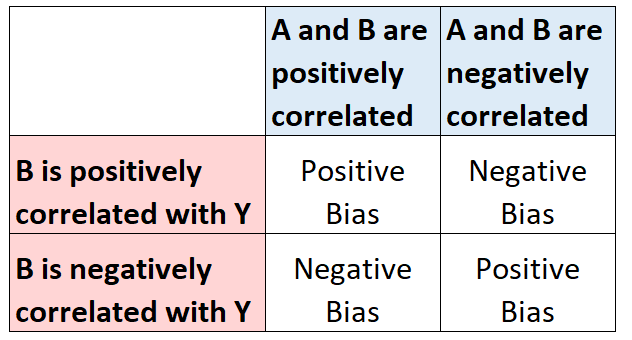
La directionnalité du biais d’omission est régie de façon déterministe par l’algèbre des signes issue du terme correctif β2 · γ1. Un biais positif survient lorsque le produit du coefficient d’impact β2 et de la relation stochastique γ1 est strictement supérieur à zéro. Cette dynamique s’incarne empiriquement à travers deux configurations typiques : soit les deux paramètres sont simultanément positifs (β2 > 0 et γ1 > 0), soit ils sont simultanément négatifs (β2 < 0 et γ1 < 0).
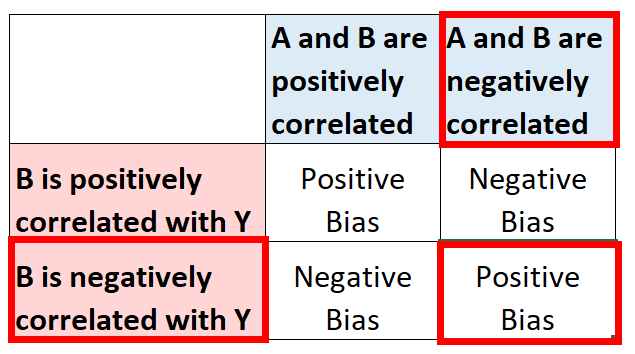
Lorsque cette condition opère, l’espérance mathématique de l’estimateur b1 excède la vraie valeur causale β1 (soit E(b1) > β1). L’analyste se trouve alors dans une situation où l’impact de l’intervention psychologique, de la caractéristique cognitive ou du dispositif comportemental étudié est massivement surestimé. Dans les cas les plus critiques de cette pathologie statistique, un régresseur X1 dont l’effet thérapeutique ou causal réel est rigoureusement nul (β1 = 0) apparaîtra comme statistiquement ultra-significatif et positif aux yeux de l’expérimentateur peu méfiant.
Ce mécanisme est le pourvoyeur principal d’illusions d’efficacité dans les études non randomisées : si les individus qui s’auto-sélectionnent au sein d’une activité enrichissante (p. ex., une pratique méditative novatrice) possèdent simultanément un capital psychologique initial plus favorable (γ1 > 0) et que ce capital favorise par nature la réduction ultérieure des symptômes anxieux (β2 > 0), la méthode des MCO attribuera faussement l’ensemble de la guérison spontanée au protocole méditatif lui-même.
4.2 Biais négatif et sous-estimation des effets
À l’opposé structural de cette première dynamique se déploie le biais négatif, régi par un produit de correction strictement négatif : β2 · γ1 < 0. Cet état méthodologique émerge dès lors que les deux composantes présentent des signes divergents. On observe ce profil lorsque l’effet de la variable omise sur le critère est positif tandis que sa corrélation avec le régresseur inclus est négative (β2 > 0 et γ1 < 0), ou inversement, lorsque l’effet sur le critère est négatif alors que l’association avec le prédicteur est positive (β2 < 0 et γ1 > 0).
Dans cette configuration, l’estimateur naïf sous-évalue systématiquement l’ampleur du véritable paramètre causal : E(b1) < β1. L’effet réel d’un traitement ou d’une caractéristique psychologique se retrouve artificiellement écrasé, étouffé par l’influence antagoniste de la variable absente. Cela se traduit par une atténuation sévère de l’importance clinique ou théorique du lien étudié, conduisant les chercheurs à conclure prématurément à l’inefficacité d’un paradigme pourtant fonctionnel.
Le cas le plus déroutant de cette distorsion négative réside dans l’inversion pure et simple du signe du coefficient estimé. Un traitement psychologique qui exerce un effet protecteur authentique (β1 < 0 sur un indice de dépression) peut ainsi, en présence d’un facteur de confusion omettant une variable de détresse environnementale majeure concentrée chez les bénéficiaires de l’intervention, afficher un coefficient estimé hautement significatif mais de signe positif (b1 > 0). Le traitement est alors perçu, à tort, comme toxique ou iatrogène par les cliniciens.
4.3 Paradoxe de Simpson comme manifestation limite
Le célèbre paradoxe de Simpson représente la forme la plus dramatique et intuitivement troublante du biais de variable omise lorsque la variable latente ignorée est de nature catégorielle. Ce paradoxe mathématique caractérise une situation où une association statistique observée de manière globale au niveau d’une population agrégée s’inverse complètement et systématiquement dès lors que l’on segmente les données conditionnellement aux sous-groupes définis par la variable omise.
Dans le formalisme de l’OVB, le paradoxe de Simpson n’est en rien une curiosité miraculeuse ou une anomalie inexplicable : il s’agit précisément de la matérialisation géométrique d’un biais d’omission d’une magnitude absolue supérieure à la taille de l’effet structurel direct, avec un produit β2 · γ1 de signe contraire et de magnitude supérieure à β1. Lorsque la distribution marginale de la variable de confusion crée une pondération déséquilibrée entre les strates, la projection bidimensionnelle de l’effet agrégé prend la pente inverse des trajectoires internes à chaque strate.
Dans l’évaluation psychométrique ou médicale, l’omission d’une variable binaire telle que la sévérité clinique sous-jacente des patients peut faire apparaître une psychothérapie brève comme associée à des taux de rechute supérieurs au niveau global. Pourtant, au sein du groupe des patients légers comme au sein du groupe des patients sévères analysés isolément, la psychothérapie diminue de manière indiscutable la probabilité de rechute. Le paradoxe de Simpson illustre avec une clarté sans concession le péril mortel que fait peser l’omission de variables sur les déductions tirées des données d’observation.
5. Causes fondamentales de l’omission de variables dans la recherche
5.1 Inaccessibilité et non-mesurabilité des construits
L’omission d’une variable explicative essentielle au sein d’un protocole empirique ne résulte que très rarement d’une négligence méthodologique coupable de l’analyste. Dans la vaste majorité des cas documentés en sciences sociales et psychologiques, cette omission s’impose aux chercheurs en raison de barrières épistémologiques et pratiques infranchissables liées à la nature même des phénomènes mentaux. De nombreux construits psychologiques critiques — au premier rang desquels figurent la vulnérabilité génétique sous-jacente, le potentiel intellectuel inné, la résilience pré-morbide ou le style d’attachement primaire inconscient — relèvent de dimensions profondément enfouies, pour lesquelles il n’existe aucun instrument de mesure direct, universel et exempt d’erreur.
À cette barrière ontologique s’ajoute l’obstacle pragmatique de la charge temporelle et financière imposée aux participants et aux structures de recherche. Administrer des batteries complètes d’évaluations neuropsychologiques standardisées, des bilans génomiques pangénomiques (GWAS) ou des passations d’imagerie par résonance magnétique fonctionnelle (IRMf) auprès d’échantillons de taille représentative requiert des ressources matérielles souvent inaccessibles aux laboratoires universitaires. Face à l’épuisement attentionnel des répondants et aux impératifs d’attrition, les devis d’investigation sont contraints d’élaguer les instruments de recueil, laissant hors champ des pans entiers de la variance individuelle.
Enfin, le cadre éthique et déontologique de la recherche institutionnelle proscrit formellement la collecte de données privées hautement sensibles lorsque celle-ci n’est pas strictement justifiée ou susceptible de générer des détresses psychologiques disproportionnées chez les sujets. L’omission des antécédents d’abus physiques ou sexuels subis durant la petite enfance dans des protocoles évaluant les fonctions exécutives en constitue un exemple paradigmatique : la non-mesure de ces traumatismes découle d’impératifs de protection des participants, mais obère irrémédiablement l’étanchéité statistique des modèles explicatifs ultérieurs.
5.2 Insuffisance de cadre théorique préalable
Une cause majeure mais fréquemment sous-estimée de la sous-spécification des modèles réside dans l’immaturité théorique relative de certains sous-champs de la psychologie contemporaine. En présence de paradigmes émergents ou de domaines caractérisés par une parcellisation des modèles concurrents, l’investigateur ne dispose pas toujours de la carte conceptuelle requise pour identifier a priori l’ensemble des facteurs de risque et des modificateurs d’effet. La modélisation causale rigoureuse requiert la formulation explicite de graphes orientés acycliques (DAG, Directed Acyclic Graphs), un formalisme emprunté à la physique mathématique et à l’intelligence artificielle causale que la majorité des cursus de formation en psychologie continue d’ignorer.
Cette carence formaliste ouvre un boulevard au biais de confirmation psychologique propre aux chercheurs eux-mêmes. Fasciné par l’hypothèse innovante qu’il a formulée autour d’un mécanisme spécifique — par exemple, l’influence d’un nouveau profil d’engagement numérique sur l’estime de soi —, le chercheur tend à structurer sa collecte de données de manière téléologique. Les variables théoriquement rivales, traditionnelles ou concurrentes (le capital culturel parental, la cohésion de la fratrie, l’isolement géographique) sont alors reléguées au second plan ou jugées a priori négligeables.
Il en résulte des spécifications tronquées où l’architecture du modèle reflète l’état partiel des croyances subjectives du chercheur plutôt que la totalité du réseau générateur du phénomène. En l’absence d’une cartographie systématique des chemins causaux reliant les déterminants historiques de l’individu aux variables cibles, le modèle statistique devient le véhicule passif de préjugés théoriques non testés.
5.3 Contraintes de conception expérimentale et longitudinale
Les limitations inhérentes aux devis de recherche empiriques constituent le troisième vecteur structurel de l’omission de variables. Même au sein d’études longitudinales prospectivement planifiées, la déperdition différentielle de sujets au fil du temps (le phénomène d’attrition) induit des biais d’omission d’une extrême complexité. Les individus présentant les scores d’impulsivité les plus élevés, les niveaux de précarité matérielle les plus sévères ou les tableaux psychopathologiques les plus instables sont structurellement ceux qui abandonnent prématurément le suivi des cohortes de recherche. Cette disparition sélective transforme une variable observable à l’inclusion en un facteur de confusion latent non mesuré lors des vagues de recueil subséquentes.
Par ailleurs, l’exploitation croissante par les chercheurs en sciences humaines de données secondaires — qu’il s’agisse de registres hospitaliers administratifs, de bases de données assurantielles ou d’archives médico-légales — exacerbe cette contrainte de conception. Ces méga-bases observationnelles n’ont pas été conçues pour répondre à des interrogations psychologiques précises : elles regorgent de codes diagnostiques généraux et de données factuelles d’utilisation des soins, mais demeurent totalement muettes sur l’état d’esprit des individus, la dynamique intrafamiliale subjective ou la détresse existentielle ressentie.
Enfin, la non-stationnarité temporelle des processus comportementaux représente un écueil colossal. Une covariable mesurée lors de la première vague de recueil peut évoluer selon une trajectoire temporelle stochastique propre au cours du temps. Si le modèle longitudinal postule à tort que cette variable demeure statique (comme un niveau de revenu parental ou un état anxieux mesuré uniquement au départ), la fraction dynamique non actualisée de cette caractéristique bascule instantanément dans le statut d’une variable omise à haute corrélation temporelle.
6. Exemples en psychologie clinique et psychopathologie
6.1 Évaluation de l’efficacité d’une psychothérapie pour la dépression
Considérons l’un des paradigmes les plus classiques de la recherche en santé mentale : l’évaluation de l’efficacité d’un protocole de thérapie brève pour le traitement de l’épisode dépressif majeur. Un chercheur postule un modèle de régression linéaire standard liant la qualité de l’alliance thérapeutique perçue lors des premières séances (variable X1) à la réduction globale des scores symptomatiques sur l’inventaire de dépression de Beck (BDI) au terme de la prise en charge (variable Y). L’analyse empirique révèle une corrélation hautement significative : plus l’alliance thérapeutique est évaluée favorablement, plus la symptomatologie dépressive décroît.
L’omission méthodologique majeure réside ici dans la non-prise en compte de la sévérité psychopathologique initiale du patient ou de son niveau de défense narcissique/personnalité borderline sous-jacente (variable omise X2). Les patients souffrant des formes dépressives les plus légères ou dotés de styles d’attachement plus sécurisants ont une propension intrinsèque beaucoup plus forte à établir un lien d’alliance thérapeutique chaleureux et fluide avec leur psychothérapeute (γ1 > 0). Parallèlement, ces mêmes patients disposent de chances considérablement plus élevées de guérison spontanée ou de rémission rapide au cours de la période d’évaluation, indépendamment de toute technicité thérapeutique déployée (β2 > 0, en formulant Y comme gain de santé).
En vertu de l’équation E(b1) = β1 + β2 · γ1, le coefficient reliant l’alliance thérapeutique à la rémission absorbe massivement le pronostic favorable propre aux tableaux cliniques initiaux moins sévères. L’impact propre et spécifique de l’alliance thérapeutique — bien qu’existant certainement — se retrouve substantiellement surévalué. Cette distorsion conforte les partisans de l’école des facteurs communs dans une certitude méthodologiquement illusoire et dissimule la réalité clinique brute : la difficulté relationnelle éprouvée avec un patient très sévère est le symptôme de sa pathologie, et non pas nécessairement la cause unique de l’échec de la prise en charge.
6.2 Consommation de substances et comorbidités anxieuses
Un autre cas paradigmatique d’attribution causale erronée causée par l’OVB concerne l’étiologie des troubles anxieux et paniques consécutifs à la consommation régulière de cannabis chez les adolescents. De multiples enquêtes épidémiologiques transversales et longitudinales sommaires ont documenté une élévation substantielle de la fréquence des crises d’angoisse aiguës et du diagnostic de trouble panique (variable Y) chez les sujets déclarant un usage chronique de cannabinoïdes (variable X1), concluant hâtivement à une neurotoxicité anxiogène directe de la molécule.
Une modélisation étiologique rigoureuse met toutefois en lumière deux variables omises colossales : la vulnérabilité génétique partagée (notamment les polymorphismes affectant le transporteur de la sérotonine ou les récepteurs endocannabinoïdes CB1) et l’exposition précoce à des traumatismes psychiques intrafamiliaux graves durant la période pré-verbale (variables regroupées sous X2). L’exposition à un milieu infantile violent ou désorganisé induit de manière démontrée une hyperréactivité structurelle de l’axe hypothalamo-hypophyso-surrénalien, prédisposant massivement à l’émergence des troubles anxieux (β2 > 0).
Simultanément, les adolescents soumis à cette charge traumatique sévère recourent massivement à l’automédication par le cannabis dans une tentative désespérée de réguler une dysphorie intolérable et des reviviscences post-traumatiques (γ1 > 0). En omettant ces déterminants biographiques fondamentaux du modèle de régression, l’épidémiologiste commet une erreur de causalité directe : la corrélation brute cannabis-anxiété est artificiellement gonflée par l’action conjointe de la détresse affective préexistante. Cette méprise détourne les praticiens de la prise en charge du noyau traumatique sous-jacent, focalisant l’effort d’intervention exclusivement sur la conduite addictive symptomatique.
6.3 Interventions pharmacologiques versus soutien psychosocial
Le débat relatif à l’efficacité comparée des protocoles purement pharmacologiques (administration d’inhibiteurs sélectifs de la recapture de la sérotonine – ISRS) et des programmes d’accompagnement psychosocial en situation de détresse psychique illustre parfaitement les dérives de l’omission d’une variable contextuelle ubiquitaire : le soutien social perçu et la structure relationnelle informelle du patient (variable omise X2).
Dans de nombreuses études d’efficacité observationnelles (souvent issues de bases de données d’assurances de santé), les patients inscrits dans des parcours d’accompagnement psychosocial intensif (variable X1) présentent des taux de rétablissement fonctionnel (variable Y) nettement supérieurs à ceux recevant une simple médication de première ligne prescrite par un médecin généraliste. Cependant, les individus qui s’orientent vers ces thérapies complexes et qui s’y maintiennent possèdent en moyenne un capital social beaucoup plus structuré — amis proches, conjoints investis, stabilité de l’hébergement — que les personnes marginalisées ou isolées qui ne bénéficient que de visites médicales espacées de dix minutes (γ1 > 0).
Le soutien social effectif constituant l’un des prédicteurs les plus puissants du rétablissement psychologique global (β2 > 0), son omission du modèle comparatif d’efficacité confère aux dispositifs psychosociaux un avantage comparatif largement fictif. À l’inverse, l’efficacité pharmacologique intrinsèque de la molécule se retrouve sous-évaluée dans l’échantillon tout-venant parce que le groupe pharmacologique concentre les patients les plus désaffiliés socialement. Les méta-analyses qui synthétisent ces études non contrôlées disséminent ainsi des recommandations de pratique clinique qui reposent en partie sur des artefacts statistiques générés par la non-mesure du lien social.
7. Exemples en psychologie cognitive et neuropsychologie
7.1 Entraînement cérébral et fonctions exécutives
Le marché des logiciels d’entraînement cérébral et de remédiation cognitive sur support numérique s’est largement nourri d’une vaste illusion méthodologique tributaire du biais de variable omise. Au début des années 2010, de multiples publications ont affirmé qu’une pratique soutenue de jeux vidéo d’agilité mentale informatisés (variable X1) améliorait de manière substantielle la performance générale de la mémoire de travail et l’intelligence fluide des individus (variable Y), suggérant l’existence d’un puissant effet de « transfert lointain » (far transfer).
L’écueil expérimental sous-jacent à ces déductions hâtives résidait dans l’omission conjointe de deux covariables majeures au sein des devis observationnels et quasi-expérimentaux à groupes non équivalents : le niveau d’intelligence fluide initial des participants et leur degré d’alphabétisation numérique/statut socio-économique (variables X2). Les individus qui adhèrent spontanément à ces programmes cognitifs payants et s’y investissent pendant des mois présentent, dès le point de départ, des capacités d’abstraction cognitive et une motivation d’accomplissement intrinsèque largement supérieures à la moyenne (γ1 > 0).
Ces aptitudes cognitives préexistantes constituent évidemment le déterminant central de la performance mesurée aux tests de contrôle terminaux (β2 > 0). Dès lors que des méthodologistes rigoureux ont réintroduit ces covariables fondamentales au sein de modèles de régression multivariée, ou ont mis en place des protocoles d’essais contrôlés randomisés utilisant des groupes contrôles actifs (jouant à des jeux vidéo conventionnels), le coefficient estimé b1 s’est immédiatement effondré vers zéro. L’effet de transfert miraculeux n’était rien d’autre que l’image résiduelle d’une intelligence générale préexistante non contrôlée.
7.2 Temps d’écran et capacités attentionnelles chez l’enfant
L’une des controverses les plus intenses de la psychologie contemporaine de l’éducation concerne l’impact présumé du temps d’écran (télévision, tablettes, ordiphones) sur la survenue du trouble du déficit de l’attention avec ou sans hyperactivité (TDAH) chez l’enfant d’âge préscolaire. D’innombrables rapports corrélationnels ont alerté l’opinion publique sur l’existence d’une association linéaire nette : plus l’enfant cumule d’heures quotidiennes d’exposition aux stimuli numériques (variable X1), plus son score d’inattention et d’agitation motrice (variable Y) est élevé.
La quasi-totalité des modèles alarmistes initiaux souffrait pourtant d’une omission criante : la non-mesure du climat familial éducatif, incluant la disponibilité affective parentale, le niveau de stress parental chronique, le nombre de livres présents au domicile, ainsi que la qualité de la régulation du sommeil de l’enfant (variables X2). Les foyers au sein desquels les parents subissent une précarité matérielle extrême ou un épuisement psychologique sévère sont contraints, par manque de ressources et de relais de garde, d’utiliser les écrans comme outil de contention passive, ce qui se traduit par une exposition numérique accrue de leur progéniture (γ1 > 0).
Or, ce stress environnemental chronique et le manque d’étayage langagier précoce constituent des facteurs de risque étiologiques indépendants massifs de troubles de l’autorégulation émotionnelle et de l’attention chez l’enfant en bas âge (β2 > 0). L’omission de cette dimension parentale et neurobiologique reporte son poids sur la variable temps d’écran. Le régresseur numérique devient le bouc émissaire statistique d’une vulnérabilité contextuelle plus vaste, faisant croire aux cliniciens et aux décideurs politiques que l’éradication du support technique résoudrait magiquement les désordres attentionnels des enfants.
7.3 Vieillissement cognitif et maintien de l’autonomie
Dans la recherche gérontologique et neuropsychologique consacrée au déclin cognitif lié à l’âge, l’évaluation du rôle protecteur de l’activité physique constitue un domaine d’investigation privilégié. Les études d’observation épidémiologiques mettent systématiquement en évidence un gradient remarquable : les personnes âgées qui s’adonnent à une activité motrice hebdomadaire soutenue (variable X1) démontrent une préservation accrue de leurs fonctions mnésiques et des scores significativement moins dégradés au test du Mini-Mental State Examination (MMSE) après dix ans de suivi (variable Y).
Une analyse causale critique impose toutefois d’interroger la présence de deux variables omises omniprésentes : la réserve cognitive précoce (mesurée par le niveau d’instruction initial et la complexité des activités professionnelles exercées durant la vie adulte) et l’état de pathologie cardiovasculaire sous-jacente infraclinique (variables X2). Les aînés qui maintiennent une pratique sportive régulière sont précisément ceux qui ne présentent pas de micro-infarctus cérébraux silencieux, de vasculopathie diffuse ou d’arthrose invalidante débutante (γ1 > 0, en formulant la santé cardiovasculaire de façon positive).
Simultanément, l’intégrité de la microvascularisation cérébrale est le facteur de protection biologique primordial contre l’apparition des lésions de type démentiel et la dégradation des capacités d’orientation temporo-spatiale (β2 > 0). En omettant les marqueurs biomédicaux précis de l’état microvasculaire et la réserve cognitive accumulée, l’épidémiologie attribue au seul mouvement mécanique de l’exercice physique un effet protecteur neurobiologique qui découle en fait de l’absence préalable de maladie vasculaire subclinique. Si le sport est assurément bénéfique pour la santé générale, l’ampleur exacte de son pouvoir régénérateur sur les neurones est largement surdimensionnée par l’OVB.
8. Exemples en psychologie du travail et des organisations
8.1 Pratiques de télétravail et productivité individuelle
L’expansion fulgurante des modalités de travail hybride et de télétravail consécutive aux crises sanitaires mondiales a suscité une profusion d’études en psychologie organisationnelle. De nombreux travaux empiriques d’entreprises ont tenté de modéliser la performance professionnelle individuelle auto-évaluée ou hiérarchique (variable Y) en fonction du nombre hebdomadaire de jours travaillés à domicile (variable X1). Les régressions basiques ont fréquemment révélé une pente positive robuste, incitant les gestionnaires à conclure que l’éloignement physique du bureau boostait intrinsèquement le rendement des salariés.
L’omission majeure au sein de ces modèles organisationnels réside dans le trait de personnalité fondamental qu’est la Conscienciosité (issu du modèle des Big Five) ainsi que la qualité de l’espace ergonomique personnel au domicile (variables regroupées sous X2). Les travailleurs qui sollicitent et obtiennent un volume important de télétravail sont majoritairement des individus dotés de hauts niveaux d’auto-discipline, d’autonomie dans la gestion des priorités et disposant d’un logement spacieux comportant un bureau dédié et silencieux (γ1 > 0).
Or, la conscienciosité est historiquement reconnue en psychométrie du travail comme le prédicteur non cognitif le plus puissant et stable de la performance en entreprise (β2 > 0). En omettant ce trait de personnalité structurant de l’équation, le modèle de régression impute indûment à l’aménagement logistique (le télétravail) une efficacité productive qui découle directement des caractéristiques psychologiques individuelles des employés autorisés à télétravailler. Cette erreur de causalité conduit les directions des ressources humaines à imposer des politiques de travail à distance généralisées à des profils collaborateurs possédant une faible autorégulation ou vivant dans des espaces restreints et chaotiques, avec pour résultat un effondrement imprévu de leurs performances.
8.2 Style de leadership transformationnel et bien-être des subordonnés
La littérature consacrée au management d’équipe et au leadership a massivement glorifié le concept de « leadership transformationnel » — caractérisé par la motivation inspirante, la considération individualisée et la stimulation intellectuelle. Une pléthore d’enquêtes corrélationnelles transversales documente une association inverse frappante entre la perception de ce style de gestion chez le supérieur immédiat (variable X1) et le niveau d’épuisement professionnel (burnout mesuré par le MBI) rapporté par les collaborateurs (variable Y).
Cependant, ces protocoles omettent fréquemment les déterminants objectifs et matériels du contexte organisationnel, au premier rang desquels figurent la charge de travail quantitative réelle (volume d’heures, cadences, interruptions constantes de tâches) et la sécurité de l’emploi structurelle de l’entreprise (variables X2). Dans les organisations en bonne santé financière, opérant sur des marchés protégés et pourvues d’effectifs suffisants, les managers bénéficient de marges de manœuvre considérables qui leur permettent d’adopter des postures d’écoute bienveillante et de valorisation humaine (γ1 > 0).
Simultanément, c’est précisément l’allégement de cette charge de travail concrète et l’absence de menace de licenciement économique qui protègent la santé mentale et le système nerveux des salariés contre l’effondrement psychique de l’épuisement (β2 < 0 sur le score d’épuisement). L’omission de la charge de travail objective génère un biais négatif (β2 · γ1 < 0), ce qui surévalue dramatiquement la magnitude protectrice du comportement relationnel du leader. Le modèle donne l’illusion managériale qu’un changement de posture stylistique chez les cadres suffirait à éradiquer le burnout, tout en laissant intacte une charge de travail inhumaine.
8.3 Incitations financières et motivation intrinsèque
L’étude de l’impact des politiques de rémunération à la performance sur l’engagement psychologique des salariés représente un terrain de confrontation théorique historique entre l’économie néoclassique et la théorie de l’autodétermination de Deci et Ryan. De nombreuses entreprises collectent des données internes montrant que l’octroi de primes financières variables significatives (variable X1) est positivement corrélé à l’engagement organisationnel affectif ou à la rétention à long terme (variable Y).
Cette analyse souffre d’un biais d’omission sévère dès lors qu’elle ignore le sentiment d’autonomie décisionnelle concédé aux collaborateurs et la reconnaissance symbolique non monétaire qu’ils reçoivent au quotidien (variables X2). Dans la pratique des organisations, les postes assortis de primes d’intéressement très élevées sont quasi exclusivement des fonctions d’encadrement supérieur ou d’expertise complexe, lesquelles s’accompagnent structurellement d’une grande latitude managériale, d’un contrôle de son propre emploi du temps et d’un statut honorifique élevé au sein du corps social de l’entreprise (γ1 > 0).
Pourtant, selon la psychologie motivationnelle, c’est précisément le sentiment d’autonomie et de compétence qui constitue le carburant psychologique essentiel de l’engagement authentique (β2 > 0). L’omission de cette latitude décisionnelle biaise positivement l’estimateur de l’effet de l’argent sur l’engagement. L’organisation se convainc alors que la prime monétaire brute est le levier causale exclusif de la motivation, échouant à réaliser que si l’on applique des primes monétaires à des tâches répétitives, hyper-contrôlées et aliénantes, l’effet d’éviction de la motivation intrinsèque (crowding-out effect) détruit la fidélité des salariés.
9. Exemples en psychologie du développement et de l’éducation
9.1 Styles parentaux et réussite académique
L’un des biais d’omission les plus dévastateurs et socialement stigmatisants au sein de la psychologie de l’éducation se matérialise dans les modèles évaluant l’influence des styles parentaux d’éducation sur les performances scolaires des enfants. Depuis les travaux séminaux de Diana Baumrind, une abondante littérature observationnelle démontre que les pratiques de parentalité « démocratique » ou « bienveillante » — caractérisées par le dialogue, l’explication des règles et l’absence de châtiments punitifs (variable X1) — sont hautement prédictives de l’obtention de moyennes scolaires élevées et de la poursuite d’études supérieures longues (variable Y).
Le problème méthodologique fondamental réside dans l’omission totale du capital intellectuel héritable (génétique comportementale) et du capital culturel et socio-économique familial objectif (variables X2). D’une part, les parents dotés d’un niveau d’instruction supérieur et de fonctions exécutives très développées ont une capacité beaucoup plus importante à adopter des styles de communication calmes, verbalement élaborés et dénués de débordements impulsifs de violence (γ1 > 0). D’autre part, ces mêmes parents transmettent à leurs enfants une double dotation : un patrimoine génétique favorisant la vitesse de traitement de l’information, et un environnement domiciliaire riche en sollicitations cognitives, livres et soutien scolaire privé, facteurs qui gouvernent de façon massive la performance académique standardisée (β2 > 0).
L’omission de la transmission génétique et culturelle dans ces modèles conventionnels conduit à attribuer l’entièreté de la réussite scolaire à la qualité morale ou pédagogique des pratiques parentales au sein du foyer. Ce biais débouche sur une culpabilisation théorique profondément injuste des familles issues des classes populaires, en postulant que l’échec scolaire précoce de leurs enfants découlerait exclusivement d’un déficit d’aptitudes éducatives parentales, alors qu’il est en grande partie conditionné par des inégalités structurelles de capital économique et culturel transmises en amont.
9.2 Programmes préscolaires précoces et développement socio-émotionnel
L’évaluation des politiques publiques d’éducation compensatoire précoce (à l’instar des programmes de type Head Start aux États-Unis ou des dispositifs de dédoublement des classes préscolaires en France) fournit une autre illustration éclatante du biais de variable omise dans les devis non totalement randomisés. Lorsque l’on compare le développement socio-émotionnel et langagier (variable Y) d’enfants inscrits dans ces cohortes enrichies (variable X1) à celui d’enfants scolarisés dans les filières traditionnelles, les résultats peuvent varier du spectaculaire à l’insignifiant selon les spécifications économétriques retenues.
L’omission fréquente réside dans la non-mesure du degré d’implication parentale spontanée et de la qualité de la nutrition et des soins pédiatriques de la petite enfance (variables X2). Au sein des zones d’éducation prioritaires, les parents qui effectuent les démarches administratives complexes requises pour inscrire leur enfant dans des programmes pilotes sont précisément les plus mobilisés pour le bien-être de leur progéniture, faisant preuve d’un haut niveau d’investissement éducatif informel (γ1 > 0).
Cette implication parentale active constitue un moteur fondamental de la maturation affective et cognitive de l’enfant (β2 > 0). Si l’évaluateur ne contrôle pas scrupuleusement ce facteur d’auto-sélection en amont, l’effet bénéfique du programme préscolaire sera massivement surévalué. Le risque opérationnel est majeur : croire que la simple duplication de la structure physique ou du calendrier scolaire du programme produira automatiquement les mêmes gains chez des enfants issus de foyers en situation de détresse extrême où l’implication parentale est entravée par la précarité.
9.3 Harcèlement scolaire et développement de troubles anxio-dépressifs
Dans la recherche sur les dynamiques de victimation en milieu scolaire, un postulat clinique fréquent établit que l’expérience subie de brimades, d’intimidations ou de harcèlement par les pairs durant la scolarité élémentaire (variable X1) constitue la cause directrice exclusive de l’émergence des troubles internalisés sévères (épisodes dépressifs majeurs, phobie sociale) observés à l’adolescence (variable Y).
Si la gravité intrinsèque et l’effet destructeur du harcèlement scolaire ne font aucun doute sur le plan empirique général, la modélisation statistique univariée souffre de l’omission d’une variable confondante essentielle : la vulnérabilité tempéramentale innée (inhibition comportementale précoce, phobie sociale d’apparition infantile) et le climat d’attachement intrafamilial insécure-évitant préalable (variables X2). Des données développementales convergentes démontrent que les enfants présentant une fragilité émotionnelle innée ou un déficit de compétences sociales sont, de façon tragique, ciblés préférentiellement par les agresseurs au sein de la cour de récréation (γ1 > 0).
Or, cette même vulnérabilité émotionnelle primaire et l’absence de base sécurisante parentale conduisent statistiquement au développement ultérieur de troubles anxio-dépressifs, même en l’absence de tout épisode de victimation extérieure (β2 > 0). L’omission de cet ancrage développemental préexistant empêche de modéliser avec précision l’effet net propre au harcèlement lui-même, et interdit surtout de comprendre pourquoi certains enfants harcelés résilient remarquablement tandis que d’autres s’effondrent. En masquant les facteurs de fragilité primaires, l’analyste se prive de leviers d’intervention précoces axés sur le renforcement des habiletés sociales et de la sécurité d’attachement chez l’enfant en amont de son entrée dans le groupe de pairs.
10. Implications méthodologiques et épistémologiques du problème
10.1 La crise de reproductibilité sous l’angle du biais d’omission
La psychologie et les sciences comportementales traversent depuis plus d’une décennie une crise de reproductibilité sans précédent, marquée par l’échec cuisant de tentatives systématiques de réplication de résultats expérimentaux et observationnels fondateurs. Si les pratiques de mauvaise conduite scientifique délibérée ou les manipulations d’échantillonnage ont été pointées du doigt, le rôle silencieux mais hégémonique du biais de variable omise dans cette crise commence à peine à être pleinement apprécié dans son ampleur structurelle.
La vulnérabilité première découle de l’extrême sensibilité des conclusions scientifiques aux variations mineures des devis de modélisation entre laboratoires indépendants. Dans la recherche non expérimentale, un laboratoire A observera un effet statistiquement significatif d’une variable comportementale X1 sur Y parce qu’il n’a pas inclus la covariable X2 au sein de son protocole. Lorsqu’un laboratoire B tente de répliquer ce paradigme mais intègre, au nom de considérations théoriques plus complètes, cette fameuse covariable X2, l’effet initialement rapporté par le laboratoire A s’annihile instantanément. L’inconsistance des résultats ne procède pas d’une fraude, mais d’une divergence de contrôle des facteurs de confusion.
Ce phénomène alimente directement le « p-hacking » involontaire et le biais de publication. L’analyste confronté à une régression multivariée dont les résultats ne franchissent pas le seuil canonique de significativité (p < 0,05) est fréquemment tenté — sous l’influence pernicieuse des critères éditoriaux des revues — de retirer du modèle les variables explicatives secondaires qui semblaient peu pertinentes. En retirant une variable confondante dont l’inclusion nettoyait le coefficient de son biais, le chercheur fait artificiellement bondir le coefficient d’intérêt et abaisse son p-value. Cette pratique revient à fabriquer délibérément un biais de variable omise pour forcer une publication, polluant ainsi la littérature académique d’affirmations causales insolubles lors des méta-analyses ultérieures.
10.2 La distinction fondamentale entre prédiction et inférence causale
La confusion entre modélisation prédictive et inférence causale constitue le cœur de l’écueil épistémologique induit par l’omission de variables. Il est théoriquement essentiel d’affirmer qu’un modèle de régression souffrant d’un biais de variable omise sévère sur le plan causal peut parfaitement conserver — et même parfois maximiser — une performance prédictive statistique spectaculaire au sein d’un jeu de données observationnel. Si l’objectif unique de l’analyste consiste à prédire la valeur future de Y à partir des données disponibles de X1, le fait que X1 capture illégitimement l’influence de la variable omise X2 est dénué de conséquence fâcheuse : le régresseur agit comme un proxy informationnel efficace.
C’est la raison pour laquelle les algorithmes contemporains de Machine Learning supervisé (tels que les forêts aléatoires, les réseaux neuronaux profonds ou le gradient boosting) excellent dans les tâches de pronostic ou de détection sans se soucier du statut des variables omises. En revanche, dès lors que l’on bascule dans l’inférence causale — c’est-à-dire que l’on se pose la question interventionniste fondamentale : « Si j’interviens activement sur la valeur de X1 pour la modifier chez cet individu, quelle sera la variation effective observée sur son critère Y ? » —, le modèle prédictif s’effondre lamentablement.
Manipuler une variable corrélée qui ne fait qu’absorber l’action d’une variable omise latente est une démarche clinique ou politique totalement stérile. Prescrire une baisse forcée du temps d’écran dans l’espoir de guérir le TDAH sans agir sur la détresse environnementale du foyer familial, ou forcer des cadres à adopter un vocabulaire bienveillant sans réduire la surcharge de travail des équipes, relève directement de cette confusion méthodologique fatale entre corrélation prédictive et causalité structurelle.
10.3 Éthique de la recherche et validité interne des protocoles
L’omission de variables dépasse le simple statut d’anomalie algébrique pour s’ériger en problème déontologique et éthique majeur dans la pratique scientifique moderne. Les chercheurs en sciences humaines et médicales assument une responsabilité épistémique impérative vis-à-vis de la société, des patients et des politiques publiques qui financent et consomment leurs travaux. Publier des conclusions affirmant l’efficacité indiscutable d’une démarche thérapeutique ou stigmatisant une catégorie sociologique sur la base de modèles non robustes et sous-spécifiés constitue un manquement direct aux exigences de la rigueur scientifique.
Cette responsabilité exige la plus grande transparence méthodologique dans la formulation des limites inhérentes aux devis de recherche non randomisés. Tout investigateur exploitant des données corrélationnelles se doit de postuler formellement la vulnérabilité de son protocole à la présence de variables de confusion inobservées. Affirmer de façon dogmatique une relation causale directe à partir d’un simple modèle de régression multivariée sans avoir mis en œuvre de batteries de tests de sensibilité ou sans expliciter la plausibilité d’inobservables rivaux relève d’une négligence académique grave.
L’acceptabilité clinique et sociale des recommandations formulées par la communauté scientifique dépend entièrement de cette probité. Lorsque des décennies de conseils pédiatriques ou d’injonctions managériales s’avèrent avoir été bâtis sur des artefacts statistiques générés par des variables oubliées, le lien de confiance entre la société civile et les institutions savantes s’érode durablement. L’exigence de validité interne ne saurait être subordonnée à la quête d’impact médiatique ou de financements institutionnels.
11. Outils de détection et analyses de sensibilité
11.1 Diagnostics statistiques et tests de spécification
Face à la menace permanente de l’OVB, l’économétrie et la statistique moderne ont développé des outils diagnostics permettant d’interroger la validité de spécification des modèles de régression. Le plus célèbre d’entre eux est incontestablement le test de spécification de l’erreur de régression de Ramsey (test RESET). Formulé par l’économiste James Ramsey en 1969, ce test repose sur une intuition algébrique élégante : si le modèle estimé initialement est correctement spécifié et n’omet aucune variable causale pertinente liée aux régresseurs, alors aucune combinaison non linéaire des valeurs prédites (Ŷ2, Ŷ3, etc.) ne devrait posséder un quelconque pouvoir explicatif incrémental sur la variable dépendante Y.
La mise en œuvre pratique du test RESET s’articule selon une procédure séquentielle rigoureuse :
- Estimation du modèle restreint initial par les MCO et extraction du vecteur des valeurs ajustées Ŷ.
- Estimation d’un modèle auxiliaire augmenté incluant des puissances entières successives des valeurs ajustées : Y = β0 + β1X1 + δ1Ŷ2 + δ2Ŷ3 + … + e.
- Test de l’hypothèse nulle conjointe d’absence de mauvaise spécification à l’aide d’un test de Fisher (F-test) : H0 : δ1 = δ2 = … = 0.
Si la statistique de Fisher dépasse le seuil critique (conduisant au rejet sans équivoque de l’hypothèse nulle), cela apporte la preuve formelle que l’espérance conditionnelle des résidus n’est pas nulle et que le modèle souffre d’un défaut structurel majeur, dont les causes dominantes sont soit une forme fonctionnelle erronée (non-linéarité méconnue), soit l’omission pure et simple de variables explicatives fondamentales. Parallèlement, l’examen scrupuleux de l’homoscédasticité des résidus via les tests de White ou de Breusch-Pagan apporte des indices convergents : une hétéroscédasticité persistante non explicable par la nature de la variable dépendante traduit très souvent l’effet caché d’une variable omise modifiant la variance structurelle du phénomène le long des strates de l’échantillon.
Cependant, il importe de souligner avec lucidité les limites intrinsèques inhérentes à ces tests statistiques traditionnels. Un test de spécification ne peut révéler l’omission d’une variable que si celle-ci induit une violation visible de la linéarité globale ou de l’homogénéité résiduelle. Si la variable omise s’insère dans un processus strictement linéaire sans générer de résidus atypiques évidents, les tests de Ramsey et de White afficheront une conformité parfaite, laissant l’analyste dans l’illusion totale de la validité d’un coefficient pourtant profondément biaisé.
11.2 Analyses de sensibilité causale et bornes de robustesse
Pour dépasser l’impasse des tests de spécification aveugles aux inobservables linéaires, la méthodologie contemporaine a conçu des approches d’évaluation de robustesse basées sur des analyses de sensibilité contrefactuelle. L’une des contributions majeures de ces dernières années est la méthode des bornes d’Oster (formulée par l’économiste Emily Oster en 2019). Cette méthode postule une heuristique puissante : la stabilité du coefficient du régresseur d’intérêt lors de l’incorporation progressive de covariables observables dans le modèle, combinée à l’augmentation du coefficient de détermination (R2), permet de déduire le degré de sélection sur les variables inobservables nécessaire pour réduire l’effet causal estimé à zéro.
Oster formalise un paramètre d’invariance, noté δ, qui quantifie la force relative des inobservables par rapport aux observables. Si une étude démontre qu’il faudrait que les variables omises latentes soient deux ou trois fois plus corrélées au traitement que l’ensemble des covariables de contrôle connues réunies pour faire disparaître l’effet thérapeutique (δ > 1), les conclusions de l’investigateur sont considérées comme hautement robustes face au risque d’OVB.
Dans le même esprit de rigueur méthodologique, l’épidémiologiste Tyler VanderWeele et le statisticien Peng Ding ont introduit la valeur E (E-value). Définie dans le cadre des risques relatifs et transposable aux régressions linéaires standardisées, la valeur E spécifie la magnitude minimale d’association qu’une variable de confusion non mesurée devrait simultanément partager avec le traitement (l’exposition) et avec le critère de santé (le résultat) pour expliquer intégralement l’association observée, conditionnellement à tous les facteurs déjà inclus. Par exemple, si une étude évaluant une technique psychologique obtient une E-value de 3,5, cela signifie qu’aucune variable omise ne pourra inverser ou annuler la conclusion causale à moins qu’elle ne soit associée au traitement et au résultat avec un risque relatif supérieur à 3,5, par-delà les contrôles existants. Ces outils de bornage probabiliste constituent le rempart moderne le plus efficace contre les spéculations infondées sur la fragilité des inférences empiriques.
11.3 Utilisation des graphes orientés acycliques (DAG)
L’avènement des graphes orientés acycliques (DAG), théorisés de façon magistrale par le lauréat du prix Turing Judea Pearl, a littéralement révolutionné l’approche formelle du biais de variable omise et de la sélection des variables de contrôle. Un DAG causal est une structure mathématique constituée de nœuds (représentant les variables mesurées et non mesurées) reliés par des flèches unidirectionnelles (représentant les relations causales directes admises par la théorie du domaine), sans aucun chemin revenant en boucle sur lui-même.
Grâce à ce formalisme, l’identification du biais de variable omise se déduit de façon non paramétrique à travers le célèbre critère de la porte dérobée (backdoor criterion). Un chemin de porte dérobée entre la variable explicative X et le critère Y est défini comme tout chemin non causal débutant par une flèche pointant vers X (ex. X ← Z → Y). La théorie des DAG démontre formellement qu’un effet causal d’intérêt est identifiable et exempt de tout biais de variable omise si et seulement si l’analyste conditionne statistiquement (par ajustement, stratification ou régression) sur un ensemble de variables suffisant permettant de bloquer tous les chemins de porte dérobée ouverts reliant X à Y.
L’immense apport des DAG consiste également à immuniser le chercheur contre les erreurs symétriques catastrophiques : le sur-ajustement et le biais de collision (collider bias). En effet, conditionner ou introduire dans une équation de régression une variable qui constitue un nœud de collision (une variable C vers laquelle convergent deux flèches de causalité : X → C ← U) a pour conséquence mathématique immédiate d’ouvrir artificiellement un chemin de dépendance stochastique parasite qui était préalablement bloqué au repos. De nombreux chercheurs croyant « contrôler » vertueusement pour un maximum de variables introduisent des collisionneurs au sein de leurs équations, fabriquant de toutes pièces un biais de variable omise qui n’existait pas dans le système naturel originel.
12. Stratégies méthodologiques et économétriques de remédiation
12.1 Devis expérimentaux purs et randomisation contrôlée
Au sommet de la hiérarchie méthodologique de neutralisation du biais de variable omise trône de manière incontestée l’essai contrôlé randomisé (ECR). La puissance épistémologique souveraine de la randomisation réside dans sa capacité à opérer une orthogonalisation physique pure et déterministe entre l’assignation au groupe d’intervention et l’ensemble infini des caractéristiques individuelles des participants. En tirant au sort l’attribution de la condition expérimentale (X1 = 1 pour le groupe traité, X1 = 0 pour le groupe témoin), le chercheur brise définitivement tout lien stochastique potentiel entre le statut d’exposition et les covariables latentes X2.
Sur le plan mathématique, la randomisation stricte force l’espérance conditionnelle de covariance à s’annihiler de manière absolue : Cov(X1, X2) = 0, ce qui entraîne ipso facto la nullité du coefficient auxiliaire γ1 = 0. En conséquence directe de l’équation E(b1) = β1 + β2 · γ1, le terme correctif s’évanouit intégralement :
E(b1) = β1 + β2 · (0) = β1
L’estimateur des moindres carrés univarié redevient strictement non biaisé pour le paramètre causal vrai dans la population. Il n’est alors plus nécessaire d’identifier, de quantifier ou de contrôler la constellation complexe des facteurs confondants inobservables (génétique, histoire traumatique, traits de personnalité latents) : la loi des grands nombres garantit que ces caractéristiques se distribuent de façon statistiquement équivalente au sein de tous les bras de l’essai expérimental.
Néanmoins, il est impératif de souligner les bornes éthiques et pratiques incontournables qui limitent l’application de la randomisation en psychologie. On ne peut éthiquement assigner aléatoirement des enfants à grandir au sein d’environnements parentaux dysfonctionnels, forcer des individus sains à fumer des cannabinoïdes pour évaluer la neurotoxicité à dix ans, ou licencier aléatoirement des salariés pour tester les réactions au burnout. Dès lors que l’objet de recherche touche à des facteurs de vulnérabilité vitale ou à des dynamiques développementales irréversibles, le chercheur se voit irrémédiablement contraint d’abandonner l’étalon-or expérimental pour naviguer au sein de devis d’observation naturelle où le risque de biais d’omission redevient menaçant.
12.2 Méthodes quasi-expérimentales et variables instrumentales
Lorsque la randomisation expérimentale directe est moralement impossible ou logistiquement hors de portée, les sciences économétriques et le courant de la révolution de la crédibilité empirique (Joshua Angrist, Guido Imbens) préconisent le recours à des approches quasi-expérimentales avancées, au premier rang desquelles figure la méthode des variables instrumentales (IV) estimée par la régression des doubles moindres carrés (2SLS, Two-Stage Least Squares).
Le principe d’une variable instrumentale Z consiste à identifier un phénomène exogène — souvent généré par une loterie naturelle, un changement réglementaire administratif soudain ou une discontinuité géographique arbitraire — qui présente deux propriétés canoniques strictes :
- Pertinence de l’instrument : La variable Z doit être fortement prédictive de la variation du traitement endogène X1 (Cov(Z, X1) ≠ 0).
- Restriction d’exclusion : La variable Z ne doit exercer aucun effet direct propre sur le critère Y, ni partager aucune corrélation avec le terme d’erreur structurel incluant les variables omises X2 (Cov(Z, u) = 0). Son impact sur Y ne peut s’effectuer qu’exclusivement à travers son rôle d’impulsion sur X1.
En projetant d’abord le régresseur endogène X1 sur l’instrument exogène Z lors de la première étape pour isoler sa fraction de variance « propre », puis en exploitant uniquement cette fraction purifiée au sein de l’équation explicative de Y lors de la seconde étape, l’estimateur IV purge intégralement le coefficient du biais de variable omise.
Cependant, cette élégance théorique s’accompagne d’exigences extrêmes. Trouver un instrument véritablement valide en sciences comportementales relève souvent de la gageure théorique. De plus, la présence d’un instrument faible (un instrument dont la corrélation avec X1 est ténue) conduit à une explosion de l’erreur-type de l’estimateur et peut paradoxalement amplifier dramatiquement le biais par rapport aux MCO naïfs au moindre relâchement marginal de la restriction d’exclusion.
12.3 Données de panel, appariement et modélisation avancée
Dans l’arsenal des approches computationnelles permettant de juguler l’OVB au sein de données observationnelles complexes, l’exploitation de données longitudinales de panel au moyen de modèles à effets fixes (Fixed Effects – FE) représente l’un des outils les plus puissants. L’estimateur à effets fixes exploite la variance intra-individuelle répétée au fil des vagues temporelles en effectuant une transformation de centrage par rapport à la moyenne individuelle (within transformation). Ce procédé algébrique neutralise et élimine mécaniquement de l’équation mathématique l’ensemble exhaustif des caractéristiques individuelles invariantes dans le temps — qu’il s’agisse de la dotation génétique, de l’origine sociologique structurelle ou des traits de tempérament fondamentaux — même si ces variables demeurent totalement inobservées et non mesurées par le chercheur.
En complément des effets fixes, l’appariement par score de propension (Propensity Score Matching – PSM) permet d’équilibrer l’échantillon d’analyse sur l’espace multidimensionnel des covariables observables. En modélisant la probabilité conditionnelle d’un individu de recevoir le traitement ou d’adopter le comportement X1 sachant l’ensemble de ses caractéristiques observables via une régression logistique préalable, le PSM permet d’apparier chaque individu exposé à un jumeau statistique non exposé doté d’une propension quasi-identique. Bien que le PSM réduise considérablement le biais lié aux observables, il est capital de garder à l’esprit qu’il reste structurellement vulnérable aux variables omises non observées non corrélées au score d’appariement.
Enfin, la modélisation par équations structurelles (SEM) intégrant des variables latentes formalise de manière explicite les matrices de covariance entre construits théoriques en isolant l’erreur de mesure au sein de modèles de mesure confirmatoires distincts du modèle structurel de régression. Cette double stratification algorithmique permet de corriger le biais d’atténuation et de capturer une fraction importante de la variance de confusion latente qui perturberait sans cela les estimateurs d’une régression ordinaire.
12.4 Bonnes pratiques contemporaines de la science ouverte
Pour immuniser durablement la discipline contre les dégâts épistémologiques du biais d’omission et les dérivations du p-hacking, l’écosystème international de la recherche scientifique opère une transition décisive vers les protocoles de la science ouverte. La mesure la plus structurante réside dans le pré-enregistrement obligatoire des plans d’analyses statistiques (Registered Reports) sur des plateformes indépendantes telles que l’Open Science Framework (OSF) avant le lancement effectif de la collecte des données empiriques.
En formalisant à l’avance l’architecture précise des modèles de régression qui seront déployés, la liste définitive des covariables de contrôle admises, les tests de sensibilité prescrits et les critères d’exclusion d’échantillonnage, le chercheur s’interdit d’omettre a posteriori des variables pour forcer artificiellement l’émergence d’un seuil p significatif. Les comités de lecture des revues évaluent alors la rigueur méthodologique et la pertinence théorique de l’étude indépendamment de la significativité statistique brute des coefficients finaux obtenus.
Parallèlement, la pratique des analyses de spécification multicourbes (multiverse analysis) s’impose progressivement comme une norme d’excellence empirique. Au lieu de ne présenter qu’une seule et unique régression multivariée arbitrairement choisie par les auteurs, l’analyste programme un script computationnel exécutant systématiquement l’ensemble de la combinatoire de toutes les spécifications de modèles plausibles (incluant toutes les permutations possibles de variables de contrôle, de transformations fonctionnelles et d’imputations de données). La publication affiche ensuite la courbe de distribution des milliers d’estimateurs générés, permettant aux pairs d’évaluer en un coup d’œil si l’effet d’intérêt est robuste à la quasi-totalité des spécifications envisageables ou s’il s’effondre lamentablement dès que certaines covariables critiques sont réintroduites dans le modèle.
Le partage intégral et transparent des bases de données brutes anonymisées ainsi que des scripts de syntaxe (R, Python, Stata) parachève ce tournant méthodologique. Il permet à la communauté savante de réanalyser instantanément les données publiées, de tester l’impact d’autres variables de confusion candidates ignorées par l’équipe initiale, et de préserver ainsi l’intégrité de l’édifice scientifique mondial contre les égarements méthodologiques du biais de variable omise.
Références
- Angrist, J. D., & Pischke, J.-S. (2009). Mostly Harmless Econometrics: An Empiricist’s Companion. Princeton University Press. https://press.princeton.edu/books/paperback/9780691120355/mostly-harmless-econometrics
- Cinelli, C., & Hazlett, C. (2020). Making sense of sensitivity: Extending omitted variable bias to the modern researcher. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 82(1), 39–67. https://doi.org/10.1111/rssb.12348
- Imbens, G. W., & Rubin, D. B. (2015). Causal Inference in Statistics, Social, and Biomedical Sciences. Cambridge University Press. https://doi.org/10.1017/CBO9781139025751
- Oster, E. (2019). Unobservable selection and coefficient stability: Theory and evidence. Journal of Business & Economic Statistics, 37(2), 187–204. https://doi.org/10.1080/07350015.2016.1227711
- Pearl, J. (2009). Causality: Models, Reasoning, and Inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350–371. https://doi.org/10.1111/j.2517-6161.1969.tb00796.x
- Rohrer, J. M. (2018). Thinking clearly about correlation and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629
- Steegen, S., Tuerlinckx, F., Gelman, A., & Vanpaemel, W. (2016). Increasing transparency through a multiverse analysis. Perspectives on Psychological Science, 11(5), 702–712. https://doi.org/10.1177/1745691616658637
- VanderWeele, T. J., & Ding, P. (2017). Sensitivity analysis in observational research: Introducing the E-value. Annals of Internal Medicine, 167(4), 268–274. https://doi.org/10.7326/M16-2607
- Wooldridge, J. M. (2010). Econometric Analysis of Cross Section and Panel Data (2nd ed.). MIT Press. https://mitpress.mit.edu/9780262232586/econometric-analysis-of-cross-section-and-panel-data/