
La recherche quantitative contemporaine repose sur un postulat fondamental mais perpétuellement menacé : la capacité d’extrapoler, avec un degré d’incertitude quantifiable, les caractéristiques observées au sein d’un échantillon à l’ensemble d’une population cible. Ce processus d’inférence statistique, théorisé depuis les travaux pionniers de Jerzy Neyman sur les intervalles de confiance et le sondage stratifié, présuppose que les unités sélectionnées par un plan de sondage probabiliste fournissent effectivement l’information empirique sollicitée. Or, dans la pratique empirique des sciences humaines, de la psychométrie, de la sociologie et de l’épidémiologie, cette chaîne inférentielle se heurte à une réalité comportementale incontournable : tous les individus sélectionnés n’acceptent pas de participer, ne peuvent pas être joints, ou interrompent leur participation en cours de protocole.
Cette déperdition d’unités d’observation engendre le phénomène méthodologique redouté du biais de non-réponse. Loin d’être une simple réduction mécanique de la puissance statistique attribuable à la diminution de la taille d’échantillon, le biais de non-réponse constitue une erreur systématique. Il émerge lorsque la propension d’un individu à répondre à une sollicitation de recherche est statistiquement corrélée aux variables mêmes que le chercheur cherche à mesurer ou à leurs déterminants profonds. Dès lors, l’échantillon final effectivement observé cesse d’être une réduction homothétique de la population d’origine pour devenir un sous-ensemble auto-sélectionné, porteur de distorsions structurelles imperceptibles lors d’une simple analyse univariée naïve.
Dans un contexte contemporain marqué par l’érosion continue des taux de participation aux enquêtes probabilistes et l’omniprésence des sondages en ligne auto-administrés, la maîtrise conceptuelle, diagnostique et corrective de ce biais s’impose comme une compétence vitale pour quiconque produit ou interprète des données empiriques. Le présent traité propose une exploration exhaustive du biais de non-réponse, articulant ses fondements théoriques, sa modélisation mathématique rigoureuse, ses manifestations concrètes dans divers champs disciplinaires, et l’arsenal méthodologique permettant d’en atténuer les effets délétères sur la validité scientifique des conclusions.
1. Introduction fondamentale au concept de biais de non-réponse
1.1 Définition opératoire et distinction terminologique
Le biais de non-réponse se définit formellement comme l’écart systématique existant entre l’estimation d’un paramètre statistique calculée à partir des données recueillies auprès des répondants effectifs et la valeur réelle de ce même paramètre dans la population cible d’intérêt, cet écart étant attribuable aux différences systématiques entre les individus qui participent à l’enquête et ceux qui s’y refusent ou demeurent injoignables. Il importe de dissocier catégoriquement ce concept de la notion de simple taux de non-réponse brut. En effet, un taux élevé de non-réponse n’engendre pas automatiquement un biais d’estimation sévère, de même qu’un taux de participation exceptionnellement haut ne prémunit pas de façon absolue contre des distorsions préjudiciables : le biais n’émerge que s’il existe une covariance non nulle entre le mécanisme régissant la participation et la variable dépendante investiguée.
D’un point de vue terminologique et méthodologique, la littérature spécialisée formalisée par l’American Association for Public Opinion Research (AAPOR) distingue rigoureusement la non-réponse totale (ou non-réponse à l’unité) de la non-réponse partielle (ou non-réponse à l’item). La première renvoie à la situation où une unité d’échantillonnage sélectionnée ne fournit absolument aucune donnée exploitable, que ce soit par refus explicite, incapacité physique ou cognitive, barrière linguistique ou impossibilité technique de contact. La seconde survient lorsqu’un répondant accepte de participer au protocole global mais omet, délibérément ou non, de répondre à certaines questions spécifiques au sein du questionnaire, par exemple sur des variables sensibles telles que le revenu financier, l’orientation sexuelle ou la consommation de psychotropes.
Sur le plan épistémologique, l’existence du biais de non-réponse remet en cause l’idéal positiviste d’une observation neutre du réel en sciences humaines. Il introduit une circularité complexe : l’instrument de mesure sélectionne involontairement son propre objet d’étude. Si l’acte de répondre dépend de dispositions psychologiques ou sociales qui font précisément l’objet de l’évaluation, la représentativité statistique s’effondre, transformant une tentative d’inférence générale en une simple description d’un groupe comportemental particulier : celui des « répondeurs coopératifs ».
1.2 Le rôle de l’échantillonnage probabiliste dans la recherche quantitative
L’édifice de la statistique inférentielle repose presque intégralement sur le paradigme de l’échantillonnage probabiliste, conceptualisé pour neutraliser les biais de sélection subjectifs de l’expérimentateur. Dans un schéma d’échantillonnage probabiliste idéal, chaque unité de la population cible dispose d’une probabilité d’inclusion non nulle et parfaitement calculable a priori. Cette condition d’équiprobabilité (ou de probabilité connue dans les plans stratifiés et à plusieurs degrés) garantit mathématiquement que les estimateurs non biaisés de type Horvitz-Thompson convergent asymptotiquement vers les vrais paramètres de la population, autorisant le calcul d’erreurs-types rigoureuses et d’intervalles de confiance valides.
Le comportement de non-réponse introduit une brisure fondamentale dans ce contrat mathématique. Dès lors qu’un individu refuse de coopérer, la probabilité d’inclusion théorique définie par le plan d’échantillonnage est immédiatement polluée par une probabilité empirique de réponse inconnue. Le processus de collecte ne relève plus d’un tirage aléatoire contrôlé par le chercheur, mais d’un processus de sélection bivarié où la nature même des individus dicte leur entrée dans la base finale de données. Par conséquent, les formules traditionnelles de calcul de la variance et des marges d’erreur deviennent invalides ou trompeusement optimistes, sous-estimant dramatiquement l’incertitude réelle pesant sur les estimations.
Cette dégradation transforme de facto un échantillon probabiliste rigoureusement conçu en une structure fonctionnelle hybride, souvent plus proche méthodologiquement d’un échantillon de convenance que d’un modèle d’inférence statistique pur. Même si les bases de sondage initiales proviennent de registres d’état civil complets, un taux d’attrition élevé réintroduit les écueils inhérents aux cohortes volontaires non maîtrisées, ruinant la légitimité des tests d’hypothèses nulles si aucun redressement adéquat n’est opéré.
1.3 Aperçu historique de l’émergence du concept en psychométrie
L’histoire de la méthodologie quantitative a été jalonnée de crises salutaires révélant l’ampleur du problème de non-réponse. L’un des jalons les plus emblématiques demeure le fiasco retentissant du sondage d’opinion mené par le magazine américain Literary Digest lors de l’élection présidentielle de 1936. En envoyant dix millions de cartes postales de consultation et en recevant plus de deux millions de retours, la publication prédisait la défaite écrasante de Franklin D. Roosevelt face à Alf Landon. Le triomphe réel de Roosevelt mit en lumière non seulement le biais de couverture inhérent aux listes d’abonnés téléphoniques et de propriétaires d’automobiles, mais surtout un biais colossal de non-réponse : les électeurs mécontents et hostiles au New Deal s’étaient mobilisés massivement pour renvoyer leur bulletin par rapport aux électeurs satisfaits, démontrant empiriquement qu’un volume titanesque de données ne compense jamais un mécanisme de sélection non aléatoire.
Au cours des décennies 1940 et 1950, avec les travaux pionniers de Morris Hansen, William Hurwitz et plus tard Donald Rubin, les méthodologistes et psychométriciens ont commencé à formaliser l’impact de l’abstention des participants. En psychométrie, la standardisation des tests d’intelligence et des inventaires de personnalité nécessitait l’étalonnage de scores standardisés sur des échantillons normatifs. Les chercheurs ont rapidement constaté que les personnes acceptant de se soumettre à de longues batteries de tests présentaient des configurations de traits distinctes de la moyenne générale, manifestant notamment une plus grande conformité sociale et des capacités cognitives supérieures.
Cette prise de conscience a progressivement hissé le biais de non-réponse au rang de menace systémique pour la validité méthodologique. Ce qui était initialement perçu comme un simple aléa logistique ou une question de déperdition d’effectifs a été requalifié en une variable psychologique et sociologique en soi. L’acte de refus est devenu un objet d’investigation scientifique fondamental au sein du paradigme de l’Erreur Totale d’Enquête (Total Survey Error), redéfinissant la rigueur de la collecte de données.
2. Fondements théoriques et modélisation statistique de la non-réponse
2.1 Taxonomie de Rubin : mécanismes MCAR, MAR et MNAR
L’analyse moderne des données incomplètes et du biais de non-réponse repose sur la typologie matricielle formulée par le statisticien Donald Rubin en 1976. Cette modélisation segmente les mécanismes générateurs de données manquantes en trois catégories distinctes, fondées sur les relations de dépendance conditionnelle entre les variables observées, les variables non observées et la probabilité d’absence de la donnée. Comprendre cette taxonomie s’avère indispensable pour sélectionner les méthodes d’inférence appropriées et jauger la sévérité du risque de biais.
Le premier mécanisme est celui des données manquantes complètement au hasard, désigné par l’acronyme MCAR (Missing Completely At Random). Dans ce scénario idéal, la probabilité qu’une donnée soit manquante est strictement indépendante de la valeur de la variable considérée, ainsi que de toutes les autres variables incluses dans le protocole de recherche. Mathématiquement, si nous désignons par (Y) la variable d’intérêt et par (R) l’indicateur de réponse ((R=1) si répondant, (R=0) si non-répondant), la condition s’écrit (P(R | Y, X) = P(R)). Lorsque les données sont MCAR, l’échantillon des répondants demeure une copie réduite non biaisée de la population ; seule la puissance statistique est diminuée, sans altération de l’espérance mathématique des estimateurs.
Le second mécanisme correspond aux données manquantes au hasard, ou MAR (Missing At Random). Ici, la probabilité de non-réponse est corrélée à certaines caractéristiques observées chez les individus (notées (X)), mais, conditionnellement à ces variables auxiliaires disponibles, elle devient indépendante de la valeur de la variable d’intérêt manquante ((Y)). L’expression formelle est (P(R | Y, X) = P(R | X)). À titre d’exemple, si les hommes âgés refusent plus fréquemment de participer à un dépistage clinique que les jeunes femmes, mais qu’au sein de la sous-population des hommes âgés, la décision de participer ne dépend aucunement de leur statut sérologique réel, le mécanisme relève du MAR. Ce cas de figure autorise des rectifications statistiques valides via la pondération ou l’imputation conditionnelle.
Le troisième mécanisme, constituant l’épicentre structurel du biais de non-réponse, est celui des données manquantes non au hasard, abrégé en MNAR (Missing Not At Random) ou non-ignorable. Dans cette configuration critique, la probabilité de non-réponse dépend directement et intrinsèquement de la valeur de la variable inobservée elle-même, même après conditionnement par l’ensemble des covariables mesurables : (P(R | Y, X) neq P(R | X)). C’est le cas emblématique de l’étude sur l’évasion fiscale où les fraudeurs les plus massifs refusent catégoriquement de déclarer leur patrimoine, ou du patient lourdement déprimé incapable de compléter un inventaire psychopathologique en raison même de son état catatonique ou de son aboulie. Sous l’hypothèse MNAR, tout redressement standard par les variables démographiques échoue à restaurer la neutralité de l’estimateur.
2.2 Le modèle de propension à répondre (Response Propensity)
Pour théoriser le passage d’une population échantillonnée à un ensemble final de répondants, la statistique d’enquête utilise le concept de propension à répondre (ou response propensity). Ce paradigme postule que chaque unité (i) de la population finie dispose d’une disposition latente continue à participer à l’investigation si elle y est invitée. Cette propension individuelle, notée (rho_i), prend une valeur comprise dans l’intervalle ([0, 1]) et s’interprète comme la probabilité théorique de réponse sous un protocole de sollicitation donné.
Cette propension n’est pas une simple constante universelle attachée à l’individu ; elle est la résultante d’une interaction complexe entre les caractéristiques intrinsèques du sujet (traits de personnalité, capital culturel, acuité cognitive, engagement civique) et les paramètres contextuels de l’enquête (mode d’administration, sponsor de l’étude, incitations financières, climat sociopolitique du moment). Les scores de propension peuvent être modélisés, en phase rétrospective, par des fonctions de régression logistique ou des modèles probit où la variable dépendante binaire (réponse vs refus) est régressée sur une batterie de covariables auxiliaires connues pour l’ensemble des individus de l’échantillon initial (qu’ils aient répondu ou non), telles que les informations issues des cadres de sondage administratifs :
[ text{logit}(rho_i) = lnleft(frac{rho_i}{1 – rho_i}right) = beta_0 + sum_{k=1}^K beta_k X_{ki} ]
L’utilité analytique de cette formalisation réside dans sa capacité à quantifier le risque de distorsion distributionnelle. Si l’on démontre que les scores de propension à répondre (hat{rho}_i) présentent une forte corrélation linéaire ou non-linéaire avec les variables substantielles étudiées au sein du sous-groupe des répondants, il devient hautement probable que les estimations globales souffrent d’un biais systématique prononcé. En outre, l’inverse de cette propension estimée ((w_i = 1 / hat{rho}_i)) sert couramment de fondement mathématique aux techniques de rééquilibrage par pondération inverse, que nous explorerons ultérieurement.
2.3 Relation mathématique entre taux de non-réponse et amplitude du biais
L’intuition commune commet fréquemment l’erreur d’assimiler l’ampleur du taux de non-réponse à l’ampleur mécanique du biais qui en résulte. Or, la théorie statistique classique de l’échantillonnage, notamment vulgarisée par Robert Groves et ses collaborateurs, démontre que le biais d’un estimateur moyen est une fonction multiplicative conjointe de la proportion de non-répondants et de la divergence structurelle entre les deux sous-populations. Soit une population de taille (N) partitionnée entre (N_R) répondants et (N_M) non-répondants, telle que le taux global de non-réponse soit (m = N_M / N). Si nous nous intéressons à la moyenne (bar{Y}) d’une variable continue, le biais de la moyenne observée parmi les seuls répondants s’exprime selon l’équation fondamentale :
[ text{Biais}(bar{y}_R) = bar{y}_R – bar{Y} = m (bar{y}_R – bar{y}_M) ]
Cette relation fondamentale met en lumière un axiome méthodologique capital : même en présence d’un taux d’abandon massif (par exemple, (m = 0,80)), le biais sera rigoureusement nul si la moyenne des individus omis s’avère parfaitement identique à celle des répondants effectifs ((bar{y}_R = bar{y}_M)). Réciproquement, un faible taux de non-réponse (par exemple, (m = 0,05)) peut induire une distorsion substantielle et altérer la prise de décision clinique ou politique si le sous-groupe réfractaire se caractérise par des valeurs extrêmes sur la variable d’intérêt (cas où (|bar{y}_R – bar{y}_M|) est extraordinairement élevé).
Dans un cadre stochastique où la réponse dépend de propensions individuelles continues (rho_i), cette relation s’exprime de façon plus élégante par la covariance entre la propension à répondre et la variable d’intérêt, normalisée par la propension moyenne dans la population :
[ text{Biais}(bar{y}_R) = frac{text{Cov}(rho, Y)}{bar{rho}} ]
Il découle formellement de ce théorème que le biais de non-réponse est maximal lorsque la corrélation empirique entre la propension de coopération et le phénomène psychologique, médical ou comportemental à quantifier atteint un sommet. C’est précisément cette corrélation structurelle cachée qui détruit la validité des inférences, bien plus que la seule abstention numérique considérée isolément.
3. Les causes structurelles liées à la conception de l’enquête
3.1 Longueur excessive et surcharge cognitive
Parmi les déterminants méthodologiques imputables à l’investigateur, le dimensionnement excessif de l’instrument de mesure figure au premier rang des générateurs d’abandon et de non-coopération. Lorsqu’un protocole d’enquête requiert une mobilisation cognitive dépassant les capacités attentionnelles du sujet, le phénomène d’épuisement du répondant (respondent fatigue) s’enclenche de manière prévisible. Selon les modèles de traitement de l’information développés en psychologie cognitive par Roger Tourangeau, le processus complet de réponse à un item mobilise quatre phases séquentielles : la compréhension de la question, la récupération mnésique des informations pertinentes, l’intégration évaluative et le formatage de la réponse selon l’échelle proposée. Répéter cette boucle des dizaines ou des centaines de fois impose un fardeau cognitif intenable.
Ce fardeau se traduit d’abord par un déclin progressif de la qualité des données — les répondants basculant vers des stratégies de satisfaction superficielle (satisficing), cochant machinalement des réponses par défaut, accordant systématiquement leur assentiment (acquiescement) ou choisissant l’option médiane. Dans un second temps, il se mue en rupture brutale : le participant abandonne purement et simplement la complétion du protocole. Cet arrêt prématuré transforme une unité potentiellement informative en un cas de non-réponse partielle ou totale, selon les critères d’acceptabilité fixés pour la validation du dossier de données.
La recherche méthodologique contemporaine a établi des seuils critiques : au-delà d’une durée d’administration de quinze à vingt minutes pour les formats numériques dématérialisés, les taux d’abandon augmentent de manière quasi exponentielle. Les individus les plus vulnérables à cette attrition temporelle sont invariablement les participants souffrant de troubles de l’attention, les personnes âgées, les ménages surchargés de responsabilités familiales et professionnelles, ainsi que les sujets à faible capital scolaire. Le choix d’une batterie d’échelles trop dense produit ainsi une sélection involontaire au profit exclusif des sujets dotés de temps libre et d’une endurance cognitive supérieure à la moyenne.
3.2 Clarté de la formulation et complexité linguistique
L’inadéquation linguistique des questionnaires constitue un filtre sélectif redoutable, souvent sous-estimé par les concepteurs de protocoles issus des milieux universitaires. L’usage d’un registre de langue trop soutenu, l’incorporation de tournures syntaxiques passives complexes, de doubles négations ou d’un jargon scientifique hermétique excluent silencieusement mais mécaniquement les franges de la population dont la maîtrise de la littératie est précaire. Face à un libellé indéchiffrable, l’individu fait l’expérience d’un sentiment d’incompétence académique et préfère classiquement clore l’évaluation plutôt que de renvoyer l’image d’un échec personnel.
Un autre écueil méthodologique fréquent réside dans la formulation de questions dites « à double détente » (double-barreled questions), qui agrègent subrepticieusement deux propositions distinctes au sein d’un même item. Confronté à une interrogation telle que « Pensez-vous que notre politique de soins en santé mentale est accessible et efficace ? », le participant qui perçoit les soins comme hautement accessibles mais totalement inopérants se trouve confronté à une aporie logique. L’impossibilité de trancher de façon univoque engendre l’hésitation, la frustration et, in fine, l’abstention pure et simple face à la question, augmentant le volume de données manquantes non aléatoires sur des thématiques clés.
Au-delà de la syntaxe, l’ergonomie visuelle et la lisibilité typographique exercent une influence directe sur les taux d’abandon. Des polices de caractères trop petites, des contrastes chromatiques insuffisants, l’absence d’optimisation d’affichage sur terminaux mobiles (téléphones multifonctions) ou la surcharge visuelle des matrices de réponses créent une fatigue oculaire qui décourage la persévérance des participants. L’accessibilité universelle de la présentation n’est pas un luxe esthétique, mais un impératif méthodologique de premier ordre pour préserver l’inclusivité de l’échantillon recueilli.
3.3 Absence de politiques d’incitation adaptées
La décision de participer à une étude de recherche scientifique s’analyse avec pertinence à la lumière de la théorie de l’échange social, formalisée dans le contexte des enquêtes par Don Dillman. Selon ce cadre théorique, un individu consent à consacrer son temps et ses ressources cognitives à une évaluation si, et seulement si, il anticipe que les récompenses symboliques ou matérielles obtenues excéderont les coûts subjectifs inhérents à sa participation, tout en évoluant dans un climat de confiance relationnelle et institutionnelle. L’omission de stratégies incitatives réfléchies déséquilibre immédiatement cette équation coût-bénéfice au détriment de l’acceptation.
Une distinction méthodologique fondamentale oppose les incitations préalables inconditionnelles (fournies avant même que la décision de répondre ne soit prise) aux rétributions conditionnelles (versées ultérieurement, après validation de la complétion du questionnaire). Les méta-analyses consacrées à la collecte de données prouvent de manière concordante que les compensations inconditionnelles, même d’un montant monétaire modeste, déclenchent une puissante norme anthropologique de réciprocité psychologique : le don initial incite l’enquêté à honorer la sollicitation par obligation morale, multipliant les taux d’engagement bien plus efficacement qu’une promesse d’indemnisation conditionnelle différée, souvent assimilée à un échange marchand prosaïque ou à un mécanisme commercial suspect.
Cependant, l’introduction imprudente d’incitations peut produire des effets pervers majeurs si le format de rétribution sélectionne indirectement certains profils démographiques. Offrir des compensations strictement monétaires peut motiver de façon préférentielle les cohortes aux revenus très bas ou des répondants professionnels peu soucieux de la sincérité de leurs déclarations, tout en laissant indifférents les foyers aisés. De la même façon, proposer des bons d’achat pour des plateformes d’achat en ligne exclut psychologiquement les personnes âgées éloignées du commerce électronique. L’incitation doit donc être minutieusement calibrée pour s’adresser à l’ensemble du spectre socioculturel visé, sous peine de transformer une mesure corrective en un nouveau moteur de distorsion.
4. Les déterminants psychologiques et comportementaux du refus de participer
4.1 Désirabilité sociale et évitement des thématiques sensibles
L’exploration scientifique de comportements déviants, illégaux, moralement réprouvés ou relevant de l’intimité psychologique profonde déclenche des mécanismes de résistance comportementale massifs. Lorsqu’un individu est invité à répondre à des questions portant sur la consommation de stupéfiants illicites, la délinquance fiscale, les conduites sexuelles non conventionnelles, le racisme intériorisé ou l’idéation suicidaire, il perçoit un risque évident pour la préservation de son identité et de son statut moral. Le biais de désirabilité sociale ne s’exprime donc pas uniquement par la falsification consciente des réponses (surdéclaration des vertus et sous-déclaration des vices) ; il s’exprime prioritairement et radicalement par le refus pur et simple d’engager le dialogue avec l’enquêteur.
Les mécanismes de défense psychologique s’activent pour neutraliser l’anxiété d’évaluation. L’individu interprète le questionnaire comme une situation d’intrusion inquisitoire dans sa sphère privée. Chez les sujets présentant des vulnérabilités psychiques manifestes, des sentiments de honte toxique ou une culpabilité intense, cette sollicitation est vécue comme une agression potentielle, entraînant un repli protecteur immédiat. Ce mécanisme induit un biais de sélection par évitement sélectif où le segment de population incarnant précisément la forme la plus prononcée du comportement cible se retire délibérément de l’espace d’observation.
En clinique psychiatrique, ce phénomène s’observe avec acuité lors de l’investigation d’antécédents traumatiques ou de conduites paranoïdes. Plus le traumatisme est enkysté et non résolu, plus la confrontation à des items introspectifs ravive une réactivité émotionnelle intolérable que le participant tente d’étouffer par l’évitement actif de l’étude. Dès lors, les prévalences observées au sein des panels volontaires sous-estiment structurellement l’ampleur et la toxicité des pathologies lourdes, confinant les données recueillies aux cas d’intensité modérée ou stabilisée.
4.2 Implication thématique et biais de saillance personnelle
Le niveau d’affinité, de curiosité ou de préoccupation personnelle d’un individu à l’égard de l’objet de recherche constitue un des prédicteurs les plus puissants de son entrée volontaire dans l’échantillon. Ce mécanisme génère ce que la sociologie empirique désigne comme le biais de saillance personnelle (topic interest bias). Lorsqu’une sollicitation aborde une problématique identifiée dès l’objet d’invitation (par exemple : le bien-être animal, les pratiques sportives intensives, le sentiment d’insécurité urbaine ou l’éducation parentale), les citoyens pour lesquels ce sujet résonne émotionnellement ou idéologiquement s’auto-sélectionnent spontanément avec un enthousiasme démesuré.
À l’inverse, les fractions de la population pour lesquelles la thématique est perçue comme anecdotique, ennuyeuse, dépourvue d’enjeu ou étrangère à leurs préoccupations immédiates ignorent massivement l’invitation. Les individus modérés, tièdes, neutres ou indécis sont systématiquement invisibilisés. Ce différentiel de mobilisation crée une distorsion majeure : il transforme ce qui devrait être une distribution continue en cloche (courbe de Gauss) en une distribution faussement polarisée ou unilatéralement surchargée en intensité.
Un exemple frappant se rencontre dans les consultations menées sur la mise en place de nouvelles régulations de transport urbain : les cyclistes convaincus et les automobilistes furieux s’emparent avidement de la parole publique, tandis que la vaste majorité silencieuse des usagers occasionnels et indifférents s’abstient d’y consacrer la moindre minute. L’analyse des données d’un tel échantillon conclura à une exacerbation irréconciliable des antagonismes au sein de la cité, alors même qu’elle ne fait que photographier l’écume des minorités militantes passionnées.
4.3 Méfiance institutionnelle et protection de la vie privée
Le consentement à l’acte de recherche repose sur un pacte épistémique tacite : le répondant présume que l’organisme collecteur est intègre, que son travail poursuit une fin d’intérêt général ou de rigueur scientifique et que les données nominatives ne seront jamais utilisées à des fins coercitives, commerciales ou policières. Or, dans les sociétés post-industrielles contemporaines, la défiance envers les grandes institutions — universités, agences gouvernementales, instituts statistiques d’État, médias et grands groupes économiques — a atteint des sommets documentés par les baromètres d’opinion.
Les individus manifestant un fort cynisme institutionnel, des croyances conspirationnistes ou une méfiance diffuse envers les autorités perçoivent les enquêtes comme des dispositifs de surveillance panoptique ou des manœuvres de manipulation sociopolitique. Les sollicitations émanant d’organismes publics sont assimilées par certaines sous-populations marginalisées ou désabusées à des instruments de contrôle bureaucratique visant à restreindre leurs prestations sociales ou à surveiller leurs activités privées. Ce climat mental dicte une fin de non-recevoir sans appel à tout protocole scientifique.
De surcroît, les angoisses légitimes entourant la protection de la vie privée à l’ère numérique, nourries par les fuites massives de données et le profilage publicitaire invasif, renforcent la réticence à partager des informations personnelles. Les garanties formelles d’anonymisation et la conformité au Règlement Général sur la Protection des Données (RGPD), bien qu’indispensables, peinent parfois à apaiser les craintes des segments les plus soupçonneux, privant de facto l’épidémiologie sociale et la psychologie politique d’un accès aux cohortes antisystème.
5. L’inaccessibilité et les barrières technologiques dans l’échantillonnage
5.1 Fracture numérique et biais générationnels
La dématérialisation croissante des instruments de collecte, portée par l’attrait économique et la vélocité logistique des protocoles en ligne, s’est heurtée de plein fouet à la réalité sociologique de l’illectronisme et des disparités d’équipement. La fracture numérique ne se résume pas à l’absence matérielle d’accès à Internet ; elle englobe les disparités profondes en matière de compétences informationnelles, de fluidité navigationnelle et d’aisance face aux environnements logiciels interactifs. Ce clivage trace une frontière nette à travers le corps social, isolant des pans entiers de la population en dehors des bases d’enquêtes numériques.
L’effet générationnel constitue la manifestation la plus aiguë de cette distorsion. Les personnes âgées de plus de 75 ans, souvent exclues de l’usage autonome des interfaces pour tablettes ou téléphones intelligents, affichent des taux de non-réponse phénoménaux dès lors que l’administration d’un questionnaire exige un parcours entièrement digitalisé. Même lorsque ces individus disposent d’un raccordement au réseau, la difficulté de déchiffrer les instructions techniques ou la peur de commettre une erreur informatique fatale conduisent à l’abandon précoce.
Corrélativement, la précarité socio-économique génère une barrière matérielle tangible : de nombreux ménages défavorisés ne possèdent pas d’ordinateur personnel fixe et ne se connectent que par le biais de téléphones cellulaires d’entrée de gamme dotés de forfaits de données restreints. Tenter de leur faire remplir un questionnaire complexe non optimisé pour les petits écrans se solde par un échec quasi garanti. Il s’ensuit que les enquêtes exclusivement administrées sur le Web tendent mécaniquement à surreprésenter les populations jeunes, diplômées, urbaines et économiquement stables, faussant tout diagnostic prétendant à l’universalité.
5.2 Variations selon le mode d’administration
L’architecture du mode d’administration — qu’il s’agisse du face-à-face traditionnel au domicile, des appels téléphoniques assistés par ordinateur (CATI), du questionnaire postal auto-administré ou des enquêtes sur Internet (CAWI) — structure de manière décisive le profil de la non-réponse. Chaque canal déploie son propre filtre sociodémographique et psychologique, créant des typologies de non-répondants hautement divergentes selon les modalités opérationnelles retenues par l’équipe de recherche.
Le mode téléphonique, qui a constitué l’âge d’or des sondages probabilistes dans la seconde moitié du vingtième siècle, fait face à une obsolescence rapide due aux métamorphoses des habitudes communicationnelles. L’abandon massif des lignes fixes au profit exclusif de la téléphonie mobile, combiné à la généralisation d’algorithmes anti-spam intelligents et au refus réflexe des citoyens de décrocher face à un numéro d’appel masqué ou non identifié, a fait chuter les taux de coopération téléphonique à des niveaux critiques (fréquemment inférieurs à 5 % dans de nombreuses études occidentales récentes). Les quelques individus qui décrochent et acceptent de répondre forment un échantillon hyperspécifique, caractérisé par un âge moyen élevé et une sédentarité marquée.
Le tableau ci-dessous illustre comment les différents modes d’administration engendrent des dynamiques de sélection distinctes au sein des sous-populations :
- Face-à-face à domicile : Taux de réponse bruts historiquement les plus élevés, mais coût unitaire prohibitif ; biais de refus concentré dans les zones résidentielles ultra-sécurisées (immeubles fermés, résidences fermées) et les quartiers fortement marginalisés, ainsi que chez les actifs aux horaires de travail étendus.
- Courrier postal : Bonne acceptabilité auprès des générations âgées et des zones rurales, mais délais de collecte très longs ; fort taux d’abandon chez les jeunes adultes à forte mobilité résidentielle et chez les individus en situation de faible littératie.
- Enquêtes en ligne (Web) : Très faible coût marginal et rapidité d’exécution, mais auto-sélection massive ; sous-représentation critique des seniors, des bas revenus et des populations précaires ; taux d’attrition élevé au cours du questionnaire.
Pour contourner ces impasses unilatérales, la méthodologie contemporaine préconise de plus en plus les dispositifs mixtes séquentiels (par exemple, contact initial par courrier avec lien numérique, suivi d’une relance postale papier, puis d’une visite à domicile en phase ultime pour les réfractaires). Si ces approches hybrides réduisent significativement le biais de non-réponse global, elles introduisent une nouvelle complexité analytique : le biais de mode, dans lequel l’instrument de mesure lui-même modifie les réponses fournies selon que l’on s’adresse à un humain ou à un écran.
5.3 Populations marginalisées et invisibilité statistique
Au-delà des simples considérations techniques, le biais de non-réponse culmine tragiquement dans la non-couverture et le refus cumulé des populations les plus précaires de l’espace social. Les personnes sans domicile fixe, les travailleurs sans statut légal, les demandeurs d’asile hébergés en structures d’urgence, les nomades, ainsi que les patients placés en institutions psychiatriques de longue durée ou en centres de détention échappent presque structurellement aux bases de sondage conventionnelles. Même lorsqu’ils y figurent théoriquement, l’inaccessibilité de leur lieu de vie ou la méfiance légitime envers toute démarche d’identification administrative les rend virtuellement invisibles dans les enquêtes d’envergure.
Ce phénomène d’éviction crée une invisibilité statistique aux conséquences sanitaires et sociales dévastatrices. Les indicateurs de santé publique, les calculs du taux de pauvreté ou les diagnostics épidémiologiques dressés à partir des grandes enquêtes de ménages ont tendance à édulcorer la réalité de la misère matérielle et des détresses psychopathologiques extrêmes, puisque les franges les plus démunies de la collectivité n’ont tout simplement pas pu ou pas voulu participer au relevé.
Lorsqu’un chercheur tente de combler cette lacune par des protocoles spécialisés de terrain, il fait face à des taux de refus dictés par la lassitude d’être l’objet d’études sans retombées perceptibles dans l’existence quotidienne (sur-sollicitation extractive). L’absence de ces groupes dans les diagnostics de santé communautaire compromet la légitimité éthique des rapports scientifiques et conforte les politiques d’austérité en masquant l’ampleur des besoins réels.
6. Exemples concrets de biais de non-réponse en recherche psychologique et sociale
6.1 Enquêtes sur la dépression et la santé mentale
La recherche clinique et épidémiologique sur les troubles de l’humeur offre sans doute l’illustration la plus spectaculaire et dramatique du mécanisme de données manquantes non au hasard (MNAR). Dans ce domaine, la pathologie investiguée agit intrinsèquement comme un puissant inhibiteur du comportement de réponse. La dépression majeure se manifeste sémiologiquement par une constellation symptomatique associant anergie profonde, ralentissement psychomoteur, sentiment d’inutilité existentielle, anhédonie globale et aboulie. Exiger d’un individu submergé par un tel état d’ouvrir une enveloppe, d’allumer un ordinateur, de lire un questionnaire d’auto-évaluation et d’analyser ses états émotionnels internes revient à lui demander un effort disproportionné face à ses ressources psychiques.
Il en résulte un paradoxe clinique pervers : les patients traversant les épisodes dépressifs les plus sévères et invalidants sont les premiers à ignorer les sollicitations de suivi ou à abandonner les protocoles de recherche en cours de route. Les données finalement colligées ne documentent que les sujets souffrant de dépressions légères, de dysthymie modérée ou d’épisodes en voie de rémission, dont les capacités volitives et exécutives demeurent suffisamment préservées pour honorer la passation.
Ce biais produit une sous-estimation systématique et pernicieuse de la sévérité réelle des scores de dépression dans les populations étudiées. Plus grave encore, dans les essais cliniques randomisés évaluant l’efficacité de nouvelles molécules antidépressives ou de protocoles psychothérapeutiques, les abandons sélectifs parmi les participants non répondeurs au traitement peuvent faire conclure fallacieusement au triomphe d’une thérapie : les patients en échec thérapeutique complet sombrent dans l’abstention et disparaissent des analyses naïves, laissant artificiellement surreprésentés les seuls individus ayant tiré bénéfice du traitement.
6.2 Études de personnalité et biais d’auto-sélection
L’administration des modèles de personnalité contemporains, au premier rang desquels figure le modèle à cinq facteurs (Big Five évaluant l’Ouverture, la Conscienciosité, l’Extraversion, l’Agréabilité et le Névrosisme), est minée de l’intérieur par le biais d’auto-sélection des répondants. Remplir un inventaire de personnalité exige un temps de pause, une docilité à la consigne, un respect des normes académiques et un désir minimum d’obliger l’expérimentateur, autant de dispositions psychologiques qui ne sont pas réparties de façon homogène au sein de la population générale.
Les données empiriques démontrent systématiquement une surreprésentation nette des personnes affichant des scores élevés en agréabilité (disposition à aider, altruisme, esprit de conciliation) et en conscienciosité (sens du devoir, organisation, respect des engagements pris) au sein des panels de recherche psychologique. Ces individus se sentent moralement tenus de remplir le questionnaire qui leur a été adressé et le font avec minutie. À l’inverse, les sujets présentant des traits marqués d’hostilité, d’antagonisme social, de désinhibition impulsive ou d’opposition passive jettent l’instrument à la corbeille sans le moindre remords.
De même, les personnes caractérisées par un névrosisme exacerbé — notamment celles aux prises avec une anxiété sociale aiguë ou une vulnérabilité aux jugements extérieurs — évitent fréquemment ces démarches par crainte de l’exposition émotionnelle de leurs failles subjectives. Cette sélection comportementale non aléatoire a pour effet corollaire pervers de fausser l’étalonnage psychométrique des échelles : les moyennes normatives de la population générale sont artificiellement décalées vers un profil pro-social, rendant tout diagnostic ultérieur appliqué à un individu réfractaire excessivement sévère par rapport à une « norme » qui n’était en vérité que la moyenne des personnalités les plus conciliantes du pays.
6.3 Mesures de la satisfaction au travail et climat organisationnel
Dans la sphère de la psychologie du travail et des organisations, les audits de climat social et les baromètres de satisfaction interne constituent un terrain d’élection du biais de non-réponse, générant une distorsion distributionnelle très caractéristique sous la forme d’une bimodalité artificielle. Lorsqu’une direction des ressources humaines lance un questionnaire anonyme sur l’engagement au travail et la qualité des relations managériales, le taux d’abstention atteint souvent des seuils considérables.
L’analyse des profils de participation révèle une dynamique de mobilisation asymétrique :
- D’une part, les salariés enthousiastes, pleinement intégrés, loyaux et bénéficiant d’une reconnaissance professionnelle élevée se saisissent volontiers de l’enquête pour faire part de leur gratitude et conforter la légitimité de leur position (saillance positive).
- D’autre part, les collaborateurs en rupture idéologique, animés d’une rancœur tenace ou d’une colère inextinguible contre le management, y voient un exutoire cathartique pour déverser leurs critiques au vitriol (saillance négative).
Au milieu de ces deux postures antithétiques, le vaste corps des salariés oscillant entre satisfaction tiède, détachement modéré ou lucidité pragmatique renonce massivement à répondre, estimant que la démarche relève de la poudre aux yeux managériale sans impact réel sur leur quotidien. Plus dommageable encore, les salariés en situation de détresse psychologique aiguë ou soumis à des pressions hiérarchiques toxiques s’imposent un silence stratégique par peur absolue que les promesses d’anonymat soient rompues et que leurs déclarations fassent l’objet de représailles professionnelles déguisées. L’analyse des résultats conduit ainsi la direction à des interprétations désastreuses, concluant à tort à une fracture binaire de l’entreprise tout en ignorant la vulnérabilité réelle de ses employés les plus muselés.
7. Exemples empiriques en santé publique et épidémiologie
7.1 Études sur les conduites addictives et les consommations de substances
L’épidémiologie des addictions offre une démonstration paroxystique de la divergence comportementale séparant les participants des non-participants. Les données de santé publique sur la prévalence de l’alcoolisme chronique, de la consommation de cocaïne, d’opiacés, de méthamphétamines ou de tabac reposent très largement sur des enquêtes nationales déclaratives en population générale. Or, les individus engagés dans une trajectoire d’addiction sévère cumulent tous les facteurs prédictifs de l’inaccessibilité et du refus : précarisation matérielle, rupture des liens institutionnels, crainte constante des sanctions pénales liées aux substances illicites, et honte liée au sentiment de perte de contrôle.
L’effet le plus pervers réside dans le mécanisme du biais de l’enquêté sain (healthy volunteer bias). Les personnes qui acceptent d’ouvrir leur porte à un enquêteur de santé publique ou de consacrer 45 minutes à un bilan épidémiologique téléphonique sont, en moyenne, des individus plus soucieux de leur bien-être corporel, plus attentifs aux recommandations de prévention, adhérant plus volontiers aux régimes alimentaires équilibrés et consommant des toxiques avec modération. Les buveurs compulsifs ou les polyconsommateurs réguliers, pris dans des cycles d’intoxication et de sevrage partiel, refusent massivement de s’infliger le miroir accusateur d’un inventaire de consommation.
Ce phénomène induit des paradoxes épidémiologiques notoires. Si l’on applique naïvement les taux de prévalence d’alcoolo-dépendance issus d’une enquête en population générale aux données de vente d’alcool délivrées par les services fiscaux, un gouffre béant apparaît : une part vertigineuse du volume d’éthanol consommé dans un pays n’est tout simplement déclarée par aucun des répondants de l’échantillon. L’interprétation scientifique naïve de ces enquêtes fausse dramatiquement le calibrage des politiques publiques de réduction des risques, conduisant les autorités à sous-dimensionner l’offre de centres d’addictologie dans les territoires les plus exposés.
7.2 Attrition de cohorte dans les recherches longitudinales
Dans les devis de recherche prospective et les études de cohorte longitudinales — qui constituent le sommet de la preuve épidémiologique pour établir des relations de causalité temporelle — le biais de non-réponse prend la forme évolutive de l’attrition sélective. L’attrition désigne l’érosion continue et progressive de l’échantillon de départ au fur et à mesure que se succèdent les vagues de recueil de données espacées de plusieurs mois ou années.
Si la perte de vue de participants s’opérait de manière purement aléatoire (par exemple en raison de déménagements imprévus sans lien avec l’état de santé, relevant du mécanisme MCAR), la seule conséquence serait une réduction de la précision statistique des intervalles de confiance. Mais dans la réalité empirique, l’abandon du suivi est quasi exclusivement informatif et différentiel : les participants qui cessent de répondre aux vagues de suivi sont préférentiellement ceux dont l’état physique s’est détérioré, qui ont développé des complications morbides graves, qui ont sombré dans l’isolement social ou qui sont décédés entre deux contacts sans que l’équipe de recherche en soit informée.
Cette dynamique d’érosion sélective transforme insidieusement la cohorte au fil du temps en un concentré de survivants privilégiés dotés d’une résilience biologique et économique hors normes. Si un chercheur évalue l’impact à long terme d’une pathologie chronique en analysant uniquement les patients restés fidèles au protocole après dix années de suivi, il observera une incidence des complications artificiellement basse et un niveau d’autonomie fonctionnelle miraculeusement préservé. L’absence de modélisation mathématique du processus d’attrition débouche ainsi sur des conclusions thérapeutiques d’un optimisme trompeur, masquant l’hécatombe sanitaire survenue parmi les non-répondants perdus de vue.
7.3 Recherches sur l’observance thérapeutique et la conformité médicale
La recherche sur l’observance thérapeutique — définie comme la rigueur avec laquelle un patient suit les prescriptions médicamenteuses et les conseils hygiéno-diététiques délivrés par le corps médical — est structurellement frappée d’incohérence méthodologique dès lors qu’elle utilise des questionnaires auto-administrés sans triangulation objective. La décision d’un malade de remplir scrupuleusement un carnet de bord médical ou de répondre aux relances régulières d’un protocole de pharmacovigilance est l’expression directe de la même disposition psychologique que celle qui le conduit à avaler ses comprimés aux heures prescrites : le respect de la norme médicale et la docilité au protocole.
Par une analogie comportementale limpide, les patients qui délaissent leurs traitements en raison d’effets secondaires indésirables, de lassitude psychologique, de croyances profanes alternatives ou d’un déni de la maladie sont précisément ceux qui envoient promener les formulaires de suivi envoyés par les équipes soignantes. Le non-répondant à l’enquête sur l’observance est presque par définition un non-observant thérapeutique.
Par voie de conséquence, les études publiées dans la littérature biomédicale affichent des taux d’adhésion aux traitements chroniques (antihypertenseurs, antirétroviraux, statines, neuroleptiques) souvent spectaculairement supérieurs à la réalité constatée lors de tests biologiques directs de dosage sérique ou d’analyses de traçabilité des délivrances en pharmacie. Ce biais conduit à surestimer massivement l’efficacité perçue des molécules en pratique courante, tout en masquant l’urgence de développer des conditionnements thérapeutiques plus tolérables ou des stratégies d’accompagnement plus empathiques.
8. Conséquences méthodologiques sur la représentativité et la validité
8.1 Déformation structurelle de l’échantillon final
La conséquence première et la plus évidente du biais de non-réponse réside dans la défiguration morphologique des échantillons de données finales. Alors que le plan d’échantillonnage théorique garantit initialement une représentation homothétique fidèle de la pyramide des âges, de la stratification socio-professionnelle, des niveaux de scolarisation et de la ventilation géographique, le filtre comportemental de la coopération humaine altère de façon irréversible les distributions marginales et conjointes de ces variables fondamentales.
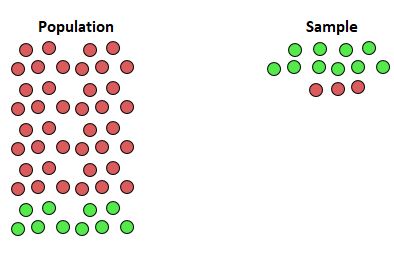
De manière presque universelle à travers les démocraties occidentales, le profil type de l’échantillon final de répondants aux enquêtes publiques se caractérise par une surreprésentation robuste et constante des femmes, des personnes d’âge mûr ou retraitées, des individus titulaires de diplômes de l’enseignement supérieur, et des ménages disposant d’un ancrage territorial stable (propriétaires de leur logement). À l’autre extrémité de la pyramide sociologique, les jeunes adultes de 18 à 25 ans, les célibataires mobiles, les hommes de classes populaires et les populations issues de l’immigration récente présentent des déficits de représentation atteignant régulièrement des facteurs de un à trois.
Cette déformation ne se traduit pas uniquement par des écarts sur les pourcentages démographiques élémentaires : elle induit une perte d’hétérogénéité au sein des données. En élaguant les extrémités marginales de l’espace social — c’est-à-dire les ultra-riches hermétiques et les grands précaires inaccessibles — la non-réponse contracte artificiellement la variance globale des phénomènes mesurés. Les estimateurs de dispersion tels que l’écart-type se trouvent sous-évalués, donnant l’illusion trompeuse d’un consensus ou d’une uniformité sociétale qui ne reflète que l’homogénéité culturelle du segment des participants coopératifs.
8.2 Compromission de la validité interne et externe
L’altération de la structure de l’échantillon porte un coup direct aux deux piliers de l’architecture épistémologique scientifique formulés par Donald Campbell : la validité externe et la validité interne. L’atteinte à la validité externe est la plus intuitive : dès lors que l’échantillon observé n’est plus représentatif de la population de référence, aucune généralisation inductive n’est formellement autorisée. Les conclusions tirées d’une étude menée auprès d’une cohorte spontanément réunie ne s’appliquent légitimement qu’à l’univers restreint des individus partageant les dispositions psychologiques de ces répondeurs, ruinant l’ambition d’universalité de la recherche.
Plus subtile et redoutable est la menace pesant sur la validité interne, c’est-à-dire la rectitude des relations causales inférées entre les variables au sein de l’échantillon. Un postulat erroné très répandu chez les expérimentateurs consiste à croire que les analyses multivariées, les régressions logistiques et les modèles d’équations structurelles sont immunisés contre le biais de sélection : tant que l’on contrôle par les covariables sociodémographiques, le lien causal entre le traitement et le résultat demeurerait pur. Rien n’est plus faux sur le plan mathématique.
La non-réponse agit comme un filtre de sélection sur variable dépendante ou sur un nœud commun (collider bias ou biais de collision dans le formalisme des graphes causaux acycliques de Judea Pearl). Lorsque l’entrée dans l’échantillon dépend conjointement de la cause présumée et de l’effet étudié, conditionner involontairement l’analyse sur le sous-ensemble des seuls répondants revient à introduire une corrélation fallacieuse artificielle entre ces deux variables. L’expérimentateur peut ainsi observer une corrélation statistiquement significative spectaculaire entre deux phénomènes purement indépendants dans la réalité, ou inversement, masquer une relation causale authentique sous l’effet de ce prisme déformant.
8.3 Risques décisionnels pour les politiques publiques et la clinique
L’impact du biais de non-réponse dépasse largement le cadre des querelles méthodologiques d’amphithéâtre universitaire : il emporte des conséquences matérielles, financières et humaines considérables dès lors que les données faussées sont transmises aux décideurs politiques, aux autorités sanitaires ou aux directeurs de la prévoyance sociale. Lorsqu’un gouvernement provincial ou national alloue ses enveloppes budgétaires sur la base d’une cartographie des besoins erronée, l’inefficacité de l’action publique devient inévitable.
Si une enquête sur la santé des adolescents conclut fallacieusement à une chute des comportements suicidaires ou de la cyberdépendance parce que les jeunes les plus atteints ont délaissé l’instrument d’évaluation, les ministères de tutelle peuvent arbitrer en faveur d’un désengagement financier des centres d’écoute et de prise en charge psychologique précoce. Les ressources financières, toujours limitées, sont alors déroutées vers des programmes ciblant les besoins des classes moyennes visibles, au détriment tragique des urgences sanitaires vécues par les populations muettes.
Sur le versant médical et clinique, s’appuyer sur des essais aux cohortes sélectives conduit à délivrer des autorisations de mise sur le marché pour des molécules dont l’efficacité réelle en population générale s’avère infiniment moindre que celle vantée dans les publications, ou dont la tolérance est grevée d’effets indésirables sévères qui n’avaient pas été rapportés par les non-répondants de l’étude princeps. La responsabilité éthique et sociétale du statisticien et du chercheur est ici directement engagée : diffuser des résultats non corrigés de la non-réponse revient à propager des vérités scientifiques mutilées, menaçant la santé publique et le bien commun.
9. Méthodes diagnostiques : Détecter et mesurer le biais de non-réponse
9.1 Comparaison avec les paramètres de population connus
La démarche diagnostique initiale pour traquer le biais de non-réponse consiste à procéder à un benchmarking comparatif entre la composition de l’échantillon recueilli et les distributions réelles de la population d’origine, lorsque ces dernières sont documentées de façon quasi exhaustive par des registres administratifs fiables, des recensements généraux de la population ou des bases de données de l’état civil. Cette confrontation s’effectue usuellement sur des variables sociodémographiques pivotales telles que le sexe, la tranche d’âge, le niveau d’instruction validé, la région de résidence et la catégorie socio-professionnelle.
D’un point de vue inférentiel, le chercheur soumet ces divergences à des tests d’ajustement du khi-deux de Pearson ou à des tests d’adéquation de Kolmogorov-Smirnov. Si la valeur du test indique un rejet hautement significatif de l’hypothèse nulle d’homogénéité distributionnelle, l’existence d’une sélection différentielle à l’entrée est irréfutablement démontrée. La découverte d’un écart majeur sur une variable structurelle (par exemple, un échantillon ne comportant que 8 % d’ouvriers alors que le recensement en dénombre 22 %) constitue un signal d’alarme sans équivoque.
Toutefois, cette méthodologie souffre d’une limite conceptuelle fondamentale : le postulat de transposition. Valider que l’échantillon est parfaitement équilibré sur les variables sociodémographiques connues ne garantit en aucune manière l’absence de biais sur les variables psychologiques, cliniques ou comportementales d’intérêt principal. Un échantillon peut présenter une parité de genre et une pyramide des âges immaculées tout en abritant un biais de non-réponse massif si, au sein de chaque strate d’âge et de sexe, seuls les individus dotés d’une vision optimiste de l’existence ont consenti à participer. Le diagnostic externe par registre administratif est une condition nécessaire, mais absolument jamais suffisante.
9.2 Analyse du continuum de résistance : répondants tardifs versus précoces
Face à l’impossibilité d’accéder directement aux caractéristiques des réfractaires définitifs, les méthodologistes exploitent une heuristique analytique particulièrement élégante : la théorie du continuum de résistance, initialement théorisée par Leslie Kish et opérationnalisée dans de multiples protocoles d’enquête contemporains. Cette théorie postule que la population ne se divise pas de façon manichéenne entre répondants et non-répondants, mais s’ordonne le long d’un axe continu d’efforts requis pour obtenir la coopération du sujet.
À une extrémité de ce continuum se situent les répondants spontanés ou précoces, qui participent dès la première sollicitation sans aucune hésitation. À l’autre extrémité figurent les non-répondants ultimes, impossibles à joindre ou refusant catégoriquement toute participation après de multiples démarches. Entre ces deux bornes se trouvent les répondants tardifs ou difficiles, qui ne finissent par capituler et consentir à répondre qu’au terme d’une stratégie intensive de relances multicanales, d’appels répétés, de visites de courtoisie ou d’augmentation des compensations financières. L’hypothèse de travail centrale stipule que ces répondants arrachés de haute lutte partagent des propriétés psychologiques et comportementales beaucoup plus proches de celles des non-répondants définitifs que de celles des répondants spontanés.
L’expérimentateur fragmente dès lors sa base de données selon le nombre d’itérations ou le temps nécessaire à l’obtention du questionnaire (par exemple : réponse après 1 relance, après 2 à 4 relances, après 5 relances ou plus). En examinant les scores moyens des variables cibles d’un sous-groupe à l’autre, on cherche à identifier une tendance linéaire ou monotone. Si l’on observe, par exemple, que le score moyen d’anxiété ou le niveau d’endettement financier croît de façon continue à mesure que la résistance des sujets augmente avant de céder, il est statistiquement légitime d’extrapoler cette pente pour projeter les scores vraisemblables des non-répondants finaux, attestant ainsi de la présence indiscutable d’un biais de non-réponse sur ces dimensions.
9.3 Enquêtes de suivi auprès d’un sous-échantillon de non-répondants
L’approche diagnostique la plus rigoureuse et la plus irréfutable sur le plan méthodologique — bien qu’elle représente un défi logistique et budgétaire considérable — demeure l’enquête de suivi intensive sur sous-échantillon de réfractaires (nonresponse follow-up study). Le protocole consiste à isoler, par tirage aléatoire probabiliste, une fraction représentative de l’ensemble des individus ayant formellement rejeté la sollicitation initiale ou n’ayant pas donné signe de vie au terme du calendrier d’enquête standard (par exemple, 15 % à 20 % des unités manquantes).
Ce sous-échantillon fait ensuite l’objet d’un assaut méthodologique exceptionnel, rompant radicalement avec le mode opératoire initial afin de désamorcer les causes du refus premier. Si l’enquête était initialement auto-administrée en ligne, les enquêteurs dépêchent des professionnels chevronnés du face-à-face directement aux adresses des réfractaires. Le questionnaire original est drastiquement élagué pour être réduit à une version ultra-courte ne conservant que les cinq ou six questions pivots du projet, le temps de passation étant ramené à moins de trois minutes pour lever l’objection du manque de temps. Simultanément, des incitations financières immédiates et inconditionnelles de montants substantiels sont remises en main propre dès le franchissement du seuil.
Ce déploiement de force permet d’obtenir la réponse d’une proportion substantielle de ce sous-groupe d’irréductibles. En comparant formellement les distributions obtenues sur ce noyau de « non-répondants convertis » avec celles des répondants initiaux de la première phase, l’équipe de recherche peut calculer des intervalles de tolérance rigoureux et chiffrer précisément l’écart moyen (bar{y}_R – bar{y}_M). Dès cet instant, l’inconnue maîtresse de l’équation du biais est levée, autorisant des recalibrages statistiques d’une fiabilité scientifique absolue sur l’ensemble du corpus de données.
10. Stratégies préventives lors de la phase de conception et de collecte
10.1 Optimisation ergonomique et allègement cognitif
La lutte contre le biais de non-réponse commence bien avant l’envoi de la moindre convocation : elle se joue dès l’ingénierie même de l’instrument de mesure. Une collecte performante repose sur le respect inconditionnel de l’ergonomie cognitive. Tout projet quantitatif moderne doit obligatoirement inclure une phase de pré-test qualitatif approfondi auprès de petits panels de participants issus des strates démographiques les plus fragiles de la population ciblée. Le recours à la méthodologie des « entretiens cognitifs » (cognitive interviewing), au cours desquels les volontaires verbalisent à haute voix leurs pensées et leurs doutes pendant qu’ils complètent le document, permet de débusquer les ambiguïtés lexicales, les questions anxiogènes et les blocages interprétatifs avant le déploiement généralisé.
L’élagage radical du volume d’items constitue le second levier préventif. Les chercheurs doivent résister à la tentation encyclopédique consistant à accumuler des échelles exploratoires secondaires superflues par simple opportunisme méthodologique. Chaque minute supplémentaire au-delà du dixième rang de passation élève le taux d’abandon chez les répondants les moins motivés. Les formats d’évaluation doivent privilégier des présentations visuelles épurées, des polices typographiques sans empattement garantissant une lisibilité optimale sur les interfaces de téléphones intelligents, et des échelles de réponse dont le calibrage est constant pour éviter la désorientation de l’esprit (par exemple, conserver la même orientation d’ancrage positif/négatif sur l’ensemble de l’épreuve).
Enfin, l’incorporation des questionnaires informatisés adaptatifs (Computerized Adaptive Testing – CAT), adossés aux modèles mathématiques de la Théorie de la Réponse à l’Item (TRI), représente une avancée majeure de la psychométrie moderne. Grâce à des algorithmes de sélection itérative dynamique, le système sélectionne après chaque réponse l’item suivant dont le niveau de difficulté ou de gravité informe au maximum la position du sujet sur le trait latent mesuré. Cette technologie permet d’atteindre une précision psychométrique équivalente à une échelle conventionnelle de soixante items en n’en soumettant qu’une douzaine, divisant par quatre le fardeau cognitif et neutralisant radicalement les abandons de fatigue.
10.2 Protocoles de communication et personnalisation des sollicitations
La première prise de contact structure de manière quasi définitive l’attitude psychologique de l’enquêté. La lettre ou le message d’invitation initial ne doit pas être rédigé comme une communication administrative aride ou une circulaire impersonnelle, mais comme un document de plaidoyer éthique et social engageant. Pour mobiliser la bienveillance de l’interlocuteur, ce document doit clarifier sans détour :
- L’utilité sociétale concrète de l’étude (en quoi les données permettront d’améliorer le service public, de soigner une maladie ou de résoudre un problème communautaire).
- La légitimité morale et scientifique indiscutable de l’institution commanditaire (universités, centres hospitaliers, instituts de recherche publique).
- La raison formelle pour laquelle cet individu précis a été tiré au sort, en lui expliquant avec pédagogie qu’il est irremplaçable et que sa défection ne peut être comblée par son voisin sans fausser la vérité mathématique du résultat.
La personnalisation des messages joue un rôle psychologique décisif pour contrer le sentiment de dilution de responsabilité (effet spectateur). S’adresser nommément à la personne par son patronyme plutôt que par un générique flou (« Cher participant ») élève significativement la propension d’ouverture du courrier ou du courriel. Cette personnalisation doit néanmoins respecter un équilibre délicat : elle ne doit jamais paraître intrusive ou susciter la sensation d’un profilage policier qui réveillerait l’angoisse paranoïde.
Le cadencement chronologique des relances constitue un art méthodologique rigoureux. Les recherches conduites selon la Tailored Design Method de Dillman préconisent une séquence stratégique en quatre ou cinq vagues multicanales savamment espacées : un pré-avis officiel annonçant la démarche, l’envoi de l’instrument principal quelques jours plus tard, une carte postale ou un SMS de remerciement et de rappel à J+7, une relance ferme avec réexpédition complète du matériel à J+21, et enfin une dernière sollicitation solennelle à J+35 avertissant de la clôture prochaine du registre. Varier les canaux au fil des relances (par exemple, relancer par SMS ou appel téléphonique un individu sollicité initialement par courrier électronique) permet de briser les barrières spécifiques à chaque média et d’atteindre des segments jusqu’alors inaccessibles.
10.3 Garanties éthiques et techniques de sécurisation psychologique
Pour désamorcer la méfiance des répondants confrontés à des thématiques ultrasensibles, la mise en scène irréprochable de la confidentialité et de la protection des libertés fondamentales s’avère incontournable. Les formulaires de consentement libre et éclairé doivent exposer de façon limpide, sans jargon juridique dissuasif, les mécanismes de dissociation des identités, le cryptage des bases de données et la séparation stricte et étanche entre les coordonnées de contact et le fichier des réponses substantielles.
Lorsque la thématique touche à des comportements hautement illégaux, délictueux ou passibles de sanctions pénales, le chercheur peut déployer des artifices méthodologiques sophistiqués tels que les techniques de réponse randomisée (Randomized Response Technique – RRT), inaugurées par Stanley Warner. Le principe mathématique consiste à introduire délibérément un bruit aléatoire contrôlé dans le processus de réponse : avant de répondre à une question binaire sensible (« Avez-vous déjà détourné des fonds publics ? »), le répondant lance un dé ou une pièce de monnaie à l’abri du regard de l’enquêteur. Selon le résultat du tirage aléatoire, le participant est tenu soit de dire la vérité absolue, soit de répondre « Oui » de façon automatique, soit de répondre « Non ».
Puisque l’enquêteur ignore le résultat du tirage du dé, il lui est rigoureusement impossible de savoir si un « Oui » émis par un répondant individuel correspond à un aveu de culpabilité authentique ou à l’application mécanique de la consigne du dé aléatoire. La sécurité psychologique de l’enquêté est alors totale, ce qui pulvérise ses résistances à coopérer. Parallèlement, le statisticien connaissant la loi de probabilité du générateur aléatoire retire mathématiquement le bruit artificiel lors du calcul agrégé, obtenant ainsi une estimation parfaitement non biaisée de la proportion réelle de fraudeurs dans l’échantillon global.
11. Techniques d’ajustement statistique post-collecte
11.1 Pondération par calage sur marges et stratification a posteriori
Lorsque la collecte est close et que l’existence d’une distorsion de l’échantillon final est constatée, le premier réflexe méthodologique consiste à appliquer des techniques de redressement statistique par pondération (weighting adjustments). Le principe sous-jacent repose sur l’attribution d’un coefficient multiplicateur (ou poids statistique (w_i)) individualisé à chaque unité répondante, de manière à accroître artificiellement l’influence des sous-groupes sous-représentés et à comprimer celle des segments surreprésentés dans le calcul des moyennes et des pourcentages globaux.
La méthode la plus canonique et robuste d’ajustement est le calage sur marges (connu sous le terme de raking ratio estimation ou algorithme de Deming-Stephan). Cet algorithme itératif intervient lorsque l’on connaît la distribution marginale univariée de plusieurs variables auxiliaires dans la population cible (par exemple, les totaux de population pour le sexe, les tranches d’âge, les catégories socio-professionnelles et les régions), mais que le tableau croisé multidimensionnel complet de toutes ces variables combinées n’est pas disponible dans les registres publics. L’algorithme ajuste les poids de façon cyclique, variable par variable, en multipliant les coefficients par les ratios d’écart aux marges de référence, jusqu’à ce que les distributions marginales de l’échantillon convergent simultanément et exactement vers toutes les cibles démographiques connues à une marge d’erreur infinitésimale près.
Cependant, l’ingénierie du redressement statistique trouve sa limite théorique absolue dans la nature du mécanisme sous-jacent de non-réponse. La pondération post-enquête postule formellement que le processus relève d’un mécanisme de données manquantes au hasard (MAR) conditionnellement aux variables de calage intégrées. En clair, le calage sur marges fait l’hypothèse héroïque qu’un ouvrier non diplômé ayant consenti à répondre à l’enquête pense, agit et ressent exactement les mêmes choses que les ouvriers non diplômés qui ont jeté le questionnaire à la poubelle. Si cette hypothèse de substituabilité intra-strate est violée (mécanisme MNAR) — c’est-à-dire si le comportement de refus procède d’une variable spécifique inobservée non corrélée aux variables du calage —, le redressement sur marges ne corrige absolument aucun biais substantiel. Pire encore, il peut amplifier la variance des estimateurs et donner une fausse impression d’exactitude scientifique à des données profondément perverties.
11.2 Méthodes d’imputation multiple pour données MNAR
Pour traiter la non-réponse partielle (items manquants au sein d’unités par ailleurs coopératives) et affronter le spectre des mécanismes non ignorables (MNAR), les approches fondées sur l’imputation multiple (MI), formulées par Donald Rubin, constituent le standard de référence en biomédecine et en psychométrie computationnelle. Les méthodes naïves d’imputation univariée (imputation par la moyenne, par la régression déterministe ou par le transport de la dernière observation [LOCF]) sont unanimement condamnées par la communauté statistique car elles traitent les valeurs complétées comme des certitudes absolues, comprimant artificiellement les erreurs-types et gonflant démesurément le risque d’erreur de type I (faux positifs).
L’imputation multiple résout cette aporie en remplaçant chaque case vide par un vecteur de (m) valeurs plausibles générées stochastiquement à partir d’une distribution prédictive postérieure ((m) oscillant généralement entre 10 et 50 itérations). Cette procédure produit (m) bases de données distinctes et complétées. L’analyste applique ensuite ses modèles statistiques cibles (régressions, ANOVA, équations structurelles) sur chacune des (m) bases séparément, puis agrège les coefficients et les matrices de variance-covariance selon les célèbres règles de combinaison de Rubin. Ces formules fusionnent la variance intra-imputation (l’erreur d’échantillonnage habituelle) et la variance inter-imputation (qui quantifie formellement l’incertitude spécifique attribuable au fait que la donnée était manquante), restituant ainsi une marge d’erreur statistiquement irréprochable.
Dans le cas particulièrement redoutable où les données sont suspectées d’être MNAR, le modélisateur doit recourir à des architectures statistiques non conventionnelles capables de briser la symétrie de l’imputation :
- Les modèles de mélange de motifs (Pattern-Mixture Models) : Ces modèles stratifient formellement la population selon le profil de manquance et attribuent des distributions conditionnelles différentes aux données manquantes par rapport aux données observées. Le chercheur spécifie délibérément des paramètres de décalage (delta adjustments) traduisant l’hypothèse clinique selon laquelle les absents ont des scores moyens plus pénalisés de (delta) unités par rapport aux présents.
- L’analyse de sensibilité systématique : Puisque l’ampleur exacte du décrochage MNAR est par nature mathématiquement non identifiable à partir des seules données observées, l’équipe scientifique fait varier le paramètre (delta) à travers une grille de valeurs cliniquement plausibles (du scénario le plus optimiste au pire désastre sanitaire). L’objectif est d’évaluer à partir de quel seuil de divergence structurelle des non-répondants les conclusions majeures de l’étude (par exemple, la supériorité d’une molécule ou la significativité d’un coefficient de risque) s’effondrent. Si les conclusions résistent aux scénarios les plus sombres, la robustesse inférentielle est consolidée.
11.3 Le modèle de sélection en deux étapes de Heckman
Développé par le prix Nobel d’économie James Heckman en 1979 pour résoudre les problèmes d’échantillons tronqués dans l’économie du travail (notamment l’offre de salaire des femmes sur le marché de l’emploi), le modèle de sélection en deux étapes de Heckman s’est imposé comme une méthodologie phare pour modéliser et purger mathématiquement le biais de sélection issu de la non-réponse non ignorable (MNAR) dans les sciences comportementales.
Le paradigme d’Heckman décompose le problème sous la forme de deux équations corrélées : une équation latente de résultat (la variable psychologique substantielle (Y_i) qui n’est observée que si le sujet répond) et une équation latente de sélection (la propension à participer à l’enquête (Z_i^*)). Le système se formalise de la façon suivante :
[ Y_i = beta X_i + epsilon_{1i} quad text{(Équation substantielle)} ]
[ Z_i^* = gamma W_i + epsilon_{2i} quad text{avec } R_i = 1 text{ si } Z_i^* > 0 text{ et } R_i = 0 text{ sinon (Équation de sélection)} ]
L’insight génial d’Heckman est de postuler que les termes d’erreur résiduels des deux équations suivent une loi normale bivariée avec une corrélation non nulle : (text{Corr}(epsilon_1, epsilon_2) = rho). Si (rho neq 0), cela prouve empiriquement qu’il existe des variables inobservées communes qui influencent à la fois la décision de répondre et le niveau du score substantiel (preuve formelle du mécanisme MNAR). Dès lors, estimer l’équation substantielle par une simple régression des moindres carrés ordinaires (MCO) sur les seuls répondants engendre une omission de variable causale et un biais direct sur les estimateurs (hat{beta}).
La résolution opérationnelle en deux étapes s’articule comme suit :
- Étape 1 : Un modèle probit est estimé sur l’intégralité de l’échantillon initial (répondants et non-répondants) pour prédire l’indicateur binaire de réponse (R_i) à partir du vecteur de covariables (W_i). À l’issue de cette régression, on calcule pour chaque unité participante une quantité statistique fondamentale appelée le ratio inverse de Mills (souvent désigné par (lambda_i)), qui quantifie le risque instantané ou le résidu de sélection conditionnel :
[ lambda_i = frac{phi(gamma W_i)}{Phi(gamma W_i)} ]
où (phi) est la fonction de densité et (Phi) la fonction de répartition de la loi normale centrée réduite.
- Étape 2 : L’équation substantielle initiale est alors régressée par les moindres carrés en y injectant, en tant que régresseur explicatif supplémentaire, ce ratio inverse de Mills estimé :
[ Y_i = beta X_i + theta hat{lambda}_i + u_i ]
L’incorporation de (hat{lambda}_i) a pour effet d’absorber intégralement la distorsion imputable au mécanisme de sélection. Le test d’hypothèse de Student sur le coefficient (hat{theta}) offre un test diagnostique direct du biais de sélection : si (hat{theta}) est significativement différent de zéro, l’existence du biais de non-réponse est validée, et les estimateurs (hat{beta}) corrigés redeviennent rigoureusement convergents et non biaisés.
Néanmoins, la mise en œuvre empirique du modèle de Heckman requiert une vigilance méthodologique extrême quant aux restrictions d’exclusion. Pour que le modèle soit statistiquement stable et ne souffre pas d’une multicolinéarité catastrophique entre (hat{lambda}) et les variables (X), il est impératif que le vecteur de sélection (W) contienne au moins une variable (dite variable instrumentale de contact) qui prédise très fortement la décision de répondre sans exercer la moindre influence directe sur la variable substantielle de résultat (Y). En psychologie sociale ou en santé publique, identifier un tel instrument d’exclusion (comme l’identité ou le charisme de l’enquêteur, ou la météo le jour de l’appel) relève d’un redoutable défi théorique.
12. Perspectives contemporaines et nouveaux défis méthodologiques
12.1 L’impact du Big Data et de la collecte passive de données
L’essor vertigineux des flux de données massives (Big Data) et la multiplication des capteurs connectés (téléphones intelligents, montres biométriques, traces numériques de navigation, transactions bancaires dématérialisées) ont suscité chez certains observateurs l’illusion techno-scientifique de la fin prochaine des enquêtes traditionnelles et, par voie de conséquence, de l’extinction définitive du biais de non-réponse. La thèse naïve proclamait que l’enregistrement passif continu et automatisé des comportements humains, englobant des millions d’individus sans sollicitation explicite de leur volonté, abolirait le problème du refus de participer.
Cette vision est radicalement invalidée par l’épistémologie de la mesure numérique. Loin de supprimer le biais de sélection, la collecte passive ne fait qu’en transposer les mécanismes sous des formes plus opaques et complexes à déconstruire. Tout enregistrement par capteur repose sur un prérequis infrastructurel d’inclusion : posséder un terminal haut de gamme compatible, maintenir ses applications actives, accepter les conditions générales d’utilisation invasives, évoluer dans des zones géographiques couvertes par les réseaux de télécommunication à haut débit, et ne pas faire usage de navigateurs sécurisés masquant l’adresse IP ou bloquant les mouchards.
Ceux qui génèrent le flot continu de traces massives forment un sous-groupe hyper-connecté et spécifique de l’humanité. Le refus explicite autrefois manifesté face à l’enquêteur s’est métamorphosé en stratégies de résistance numérique (data refusal, paramétrage anti-traçage, adblockers, déconnexion volontaire, usage de faux profils). Dès lors, les analyses conduites à partir de gigantesques corpus de mégadonnées (tels que les flux de publications sur les réseaux sociaux pour ausculter le moral de la nation) souffrent d’un biais d’inclusion phénoménal que leur taille titanesque (plusieurs téraoctets de données) ne fait qu’enkyster avec une puissance statistique trompeuse, transformant l’inférence en une gigantesque extrapolation fallacieuse.
12.2 L’intelligence artificielle au service de la personnalisation de la collecte
En réponse à l’érosion persistante des taux de participation, l’ingénierie des enquêtes quantitatives intègre désormais des architectures d’intelligence artificielle et d’apprentissage automatique (machine learning) pour concevoir des systèmes de collecte hyper-adaptatifs (responsive and adaptive survey designs). Ces protocoles computationnels visent à optimiser dynamiquement l’allocation des efforts de terrain et la nature des interactions en temps réel.
En phase de déploiement, des modèles d’arbres de décision ou de forêts aléatoires (random forests) calculent et réactualisent en permanence, au vu des métadonnées contextuelles (paradata : heure des tentatives, historique des interactions, caractéristiques du quartier d’habitation), le score prédictif instantané de propension à répondre de chaque unité encore récalcitrante. Le système oriente automatiquement les ressources humaines et financières les plus coûteuses (dépêcher un enquêteur d’élite, proposer un incitatif financier plus élevé) vers les individus dont la non-réponse menace le plus gravement l’équilibre structurel de l’échantillon, cessant d’insister auprès des profils déjà abondamment collectés.
À une échelle plus intime, l’IA générative commence à être testée pour formater dynamiquement l’expérience utilisateur des questionnaires en ligne en ajustant la formulation textuelle des invitations selon le profil linguistique détecté du destinataire. Cette hyper-personnalisation comportementale soulève néanmoins d’épineuses interrogations éthiques et déontologiques. L’application d’incitations comportementales (nudging algorithmique) conçues pour briser la réticence d’individus vulnérables peut franchir la frontière ténue séparant la facilitation du contact de la manipulation psychologique insidieuse, menaçant le principe fondamental du consentement éclairé.
12.3 Exigences de transparence et standards de reporting scientifique
Face à la dégradation structurelle des taux de réponse à l’échelle planétaire et à la tentation de certains laboratoires de dissimuler l’ampleur de leurs pertes d’effectifs pour faciliter la publication de leurs articles, la communauté scientifique internationale a instauré des normes de reporting méthodologique d’une intransigeance croissante. Les standards formalisés par l’AAPOR pour les enquêtes sociales, ou par les déclarations internationales CONSORT (pour les essais randomisés) et STROBE (pour les études observationnelles en épidémiologie) exigent désormais des bilans de flux quantitatifs exhaustifs.
Tout manuscrit scientifique soumis à évaluation par les pairs doit obligatoirement intégrer un diagramme de flux détaillant chaque phase du recrutement : nombre d’unités initialement échantillonnées, nombre d’adresses invalides ou hors champ, refus catégoriques, rendez-vous non honorés, barrières de langue, abandons partiels et effectif final validé. L’application rigoureuse des formules standardisées de calcul des taux de réponse (déclinées par l’AAPOR sous les indices formels RR1 à RR6) met un terme à l’opacité des calculs informels visant à embellir les bilans de collecte.
De surcroît, les revues académiques de premier rang exigent désormais systématiquement qu’une analyse documentée du biais potentiel de non-réponse accompagne la section méthodologique de toute publication empirique. Les comités de rédaction requièrent que les auteurs démontrent empiriquement la robustesse de leurs conclusions face à des analyses de sensibilité pour données manquantes non au hasard (MNAR) et qu’ils explicitent sans complaisance les limites de représentativité de leur échantillon. Cette transparence radicale ne constitue pas un aveu de faiblesse méthodologique, mais la condition sine qua non pour préserver l’autorité épistémologique et la confiance du public envers la démarche scientifique à une époque saturée d’approximations informationnelles.
Références
American Association for Public Opinion Research. (2016). Standard definitions: Final dispositions of case codes and outcome rates for surveys (9th ed.). AAPOR.
Campbell, D. T., & Stanley, J. C. (1963). Experimental and quasi-experimental designs for research. Rand McNally.
Couper, M. P. (2000). Web surveys: A review of issues and approaches. Public Opinion Quarterly, 64(4), 464–494. https://doi.org/10.1086/318641
Dillman, D. A., Smyth, J. D., & Christian, L. M. (2014). Internet, phone, mail, and mixed-mode surveys: The tailored design method (4th ed.). John Wiley & Sons.
Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
Groves, R. M., & Couper, M. P. (1998). Nonresponse in household interview surveys. John Wiley & Sons.
Groves, R. M., & Peytcheva, E. (2008). The impact of nonresponse rates on nonresponse bias: A meta-analysis. Public Opinion Quarterly, 72(2), 167–189. https://doi.org/10.1093/poq/nfn011
Hansen, M. H., & Hurwitz, W. N. (1946). The problem of non-response in sample surveys. Journal of the American Statistical Association, 41(236), 517–529. https://doi.org/10.1080/01621459.1946.10501894
Heckman, J. J. (1979). Sample selection bias as a specification error. Econometrica, 47(1), 153–161. https://doi.org/10.2307/1912352
Kish, L. (1965). Survey sampling. John Wiley & Sons.
Little, R. J., & Rubin, D. B. (2019). Statistical analysis with missing data (3rd ed.). John Wiley & Sons.
Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558–625. https://doi.org/10.2307/2342192
Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press.
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. John Wiley & Sons.
Tourangeau, R., Rips, L. J., & Rasinski, K. (2000). The psychology of survey response. Cambridge University Press.
von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., & Vandenbroucke, J. P. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. The Lancet, 370(9596), 1453–1457. https://doi.org/10.1016/S0140-6736(07)61602-X
Warner, S. L. (1965). Randomized response: A survey technique for eliminating evasive answer bias. Journal of the American Statistical Association, 60(309), 63–69. https://doi.org/10.1080/01621459.1965.10480775