
Dans le champ de l’inférence statistique et de l’analyse quantitative des données, la comparaison de deux moyennes constitue l’une des démarches les plus fondamentales et les plus fréquemment entreprises par les chercheurs, qu’il s’agisse de valider l’efficacité d’un protocole clinique, d’évaluer l’impact d’une innovation pédagogique ou de mesurer des divergences cognitives au sein de populations distinctes. Depuis les travaux fondateurs de William Sealy Gosset, publiant sous le pseudonyme de Student en 1908, le test t classique s’est imposé comme la référence analytique prépondérante. Néanmoins, l’édifice mathématique originel de ce test repose sur des hypothèses sous-jacentes particulièrement rigides, au premier rang desquelles figure l’homoscédasticité, c’est-à-dire l’égalité stricte des variances au sein des populations d’origine. Lorsque cette prémisse fondamentale est mise en défaut, la validité des conclusions inférentielles s’effondre, exposant le praticien à une distorsion potentiellement sévère du taux d’erreur de première espèce.
Face à cette impasse méthodologique, désignée dans les annales statistiques sous l’appellation canonique du problème de Behrens-Fisher, la communauté scientifique a dû concevoir des procédures d’ajustement robustes capables de préserver l’intégrité de la décision statistique sans imposer une structure de variance arbitraire ou invérifiable. C’est dans ce cadre théorique exigeant que s’inscrit l’apport séminal de Franklin Erdmann Satterthwaite en 1946. En proposant une solution analytique élégante fondée sur la méthode d’égalisation des moments, Satterthwaite a permis de redéfinir la notion même de degrés de liberté, en transformant cette valeur jadis restreinte aux nombres entiers en une grandeur continue effective, directement calibrée sur les caractéristiques empiriques des échantillons observés.
L’approximation de Satterthwaite ne représente pas un simple artifice technique marginal réservé aux spécialistes de l’économétrie théorique ; elle constitue au contraire le pilier computationnel indispensable qui sous-tend aujourd’hui les logiciels modernes de traitement de données statistiques. De l’exécution quotidienne du test t de Welch à l’estimation complexe des effets fixes dans les modèles linéaires mixtes et hiérarchiques, cette formule mathématique offre une réponse pragmatique et élégante à l’un des défis les plus ubiquitaires de la science expérimentale contemporaine : comment inférer avec précision des vérités populationnelles lorsque l’hétérogénéité des données vient contredire les postulats des manuels classiques.
1. Introduction aux tests d’hypothèses et au problème de Behrens-Fisher
1.1 Le cadre d’inférence des tests de comparaison de deux moyennes
L’histoire de la statistique moderne est intrinsèquement liée à la nécessité de prendre des décisions objectives à partir d’échantillons restreints extraits de populations infinies ou inaccessibles. Dans les disciplines quantitatives, et plus particulièrement en psychométrie, en sciences du comportement et en épidémiologie, le protocole standard consiste souvent à juxtaposer deux cohortes indépendantes afin d’évaluer si la différence observée entre leurs moyennes d’échantillon traduit une divergence véritable à l’échelle populationnelle ou si elle peut être raisonnablement attribuée aux simples fluctuations de l’échantillonnage aléatoire. La comparaison de deux groupes, qu’il s’agisse d’un groupe expérimental opposé à un groupe témoin recevant un placebo, ou de deux sous-groupes cliniques distincts, s’appuie sur la formulation formelle d’une hypothèse nulle posant l’absence de divergence substantielle entre les paramètres centraux des populations étudiées.
Le test t de Student a été originellement conçu pour répondre à cette interrogation fondamentale. Ses fondements mathématiques exigent toutefois le respect scrupuleux de conditions probabilistes précises. Le postulat fondamental réside dans la distribution normale des variables continues au sein des deux populations mères. Parallèlement, le modèle stipule l’indépendance mutuelle absolue des observations au sein de chaque échantillon et entre les groupes. Enfin, la condition sine qua non de ce développement théorique repose sur l’hypothèse d’homogénéité des variances, souvent désignée sous le vocable d’homoscédasticité. Sous cette hypothèse, les variances des deux populations sont présumées strictement identiques, ce qui autorise les statisticiens à combiner ou agglomérer les variances d’échantillon en un estimateur composite unique, souvent désigné sous l’expression de variance combinée ou pooled variance.
Dans la pratique expérimentale, cette condition d’homogénéité des variances est fréquemment violée. La sensibilité du taux d’erreur de première espèce (le risque alpha nominal, habituellement fixé à 5 %) face à la non-conformité de cette exigence s’avère particulièrement alarmante. Lorsque les variances réelles divergent notablement et que les effectifs des groupes sont inégaux, la statistique de Student ne suit plus du tout une loi de Student théorique sous l’hypothèse nulle. Cette non-adéquation probabiliste produit soit une inflation spectaculaire des faux positifs, incitant le chercheur à déclarer une découverte scientifique là où il n’existe que du bruit aléatoire, soit une perte dramatique de puissance statistique rendant le test excessivement conservateur. L’intégrité de la démarche inférentielle s’en trouve dès lors profondément compromise.
1.2 La nature mathématique du problème de Behrens-Fisher
Le problème mathématique émergeant de la tentative de comparer deux moyennes issues de populations normales aux variances a priori inconnues et potentiellement inégales porte le nom de problème de Behrens-Fisher. Exposé initialement par Walter-Ulrich Behrens en 1929 puis reformulé par Ronald Aylmer Fisher en 1935 à l’aide de sa théorie de l’inférence fiduciaire, ce dilemme a cristallisé d’intenses débats épistémologiques et méthodologiques qui ont marqué l’histoire des probabilités durant tout le milieu du vingtième siècle.
D’un point de vue purement analytique, le nœud du problème réside dans l’absence de ce que les statisticiens appellent une statistique de test exacte et sans paramètre de nuisance. Lorsque l’on soustrait la moyenne du premier groupe de celle du second, la variance de cette différence est égale à la somme des variances des moyennes individuelles, soit le rapport de la première variance sur sa taille d’échantillon additionné au rapport de la seconde variance sur sa propre taille. Dans la mesure où les véritables variances populationnelles demeurent des quantités théoriques inaccessibles, elles doivent obligatoirement être estimées par les variances calculées sur les échantillons. Dès lors, le dénominateur de la statistique de test ne se distribue plus selon la racine carrée d’une loi du khi-deux divisée par ses degrés de liberté, condition mathématique absolue pour générer la distribution t canonique de Student.
L’impossibilité d’obtenir une distribution d’échantillonnage exacte sous l’approche fréquentiste classique découle du fait que la distribution réelle de la statistique pivotale dépend du rapport inconnu des deux variances populationnelles. Ce ratio constitue un paramètre de nuisance typique : une variable non désirée qui conditionne le comportement probabiliste du test sans que l’on puisse l’isoler directement. Face à cette énigme réfractaire aux solutions exactes simples, la communauté des sciences quantitatives n’a eu d’autre choix que d’explorer la voie des solutions approchées, cherchant à concevoir des statistiques d’échantillonnage dont le comportement converge de manière quasi parfaite vers les lois théoriques connues, garantissant ainsi un contrôle empirique infaillible du taux d’erreur de type I.
1.3 Rôle de Franklin E. Satterthwaite dans l’histoire de la statistique
Au milieu des années 1940, alors que les débats entre Ronald Fisher, Jerzy Neyman et Egon Pearson faisaient rage concernant la nature philosophique des tests d’hypothèses, un statisticien appliqué nommé Franklin Erdmann Satterthwaite consacra ses recherches à la résolution concrète de problèmes de modélisation dans le domaine de la recherche agronomique et industrielle. En 1946, Satterthwaite publia un article fondamental dans la prestigieuse revue Biometrics Bulletin, intitulé « An Approximate Distribution of Estimates of Variance Components ».
La motivation première de Satterthwaite ne concernait pas initialement le test t bilatéral à deux groupes, mais portait sur l’analyse de variance à effets aléatoires et la décomposition des composantes de la variance au sein de plans d’expérience complexes. Dans ces structures méthodologiques sophistiquées, les estimateurs des différentes sources d’erreur et de variabilité ne s’expriment pas comme de simples variances d’échantillon uniques, mais prennent la forme de combinaisons linéaires d’estimations de variances, c’est-à-dire de sommes ou de différences de plusieurs carrés moyens indépendants, chacun étant initialement distribué selon un multiple d’une loi du khi-deux.
L’intuition remarquable de Satterthwaite consista à poser qu’une combinaison linéaire de variances d’échantillons indépendantes pouvait être remarquablement bien approximée par une unique distribution du khi-deux synthétique, sous réserve de déterminer des degrés de liberté ajustés spécifiques. Cette généralisation théorique s’est avérée extraordinairement féconde. Très rapidement, les mathématiciens ont réalisé que la variance d’échantillonnage de la différence entre deux moyennes sous condition d’hétérogénéité des variances n’est rien d’autre qu’une combinaison linéaire de deux variances indépendantes. L’extension de la méthode de Satterthwaite au cadre de la comparaison de deux moyennes indépendantes a ainsi fourni la clé algébrique requise pour adapter le test t aux contextes d’hétéroscédasticité, scellant durablement le nom de son auteur dans l’arsenal des méthodes quantitatives contemporaines.
2. Fondements théoriques de l’approximation de Satterthwaite
2.1 Le concept de degrés de liberté effectifs
Dans la perspective pédagogique usuelle de l’enseignement de la statistique, les degrés de liberté sont presque invariablement présentés sous la forme d’un nombre entier strict, corrélé de manière univoque au nombre total d’observations collectées diminué du nombre de contraintes linéaires ou de paramètres déjà estimés à partir de ces mêmes données. Ainsi, pour un échantillon unique de taille n, la variance est divisée par n – 1, ce qui formalise le fait qu’une fois la moyenne arithmétique fixée, seules n – 1 observations demeurent libres de varier arbitrairement. Dans le cadre d’un test t de Student standard à deux groupes, la somme des degrés de liberté s’établit traditionnellement à n₁ + n₂ – 2.
L’introduction de l’approximation de Satterthwaite révolutionne cette conception intuitive en introduisant la notion de degrés de liberté continus ou effectifs. Satterthwaite a démontré que lorsque deux sources de variabilité non concordantes s’agrègent, le système ne se comporte pas comme une structure déterministe régie par une somme discrète de dimensions géométriques, mais plutôt comme une distribution dont l’incertitude globale correspond à un niveau intermédiaire d’information d’échantillonnage. Les degrés de liberté effectifs ne correspondent plus nécessairement à un entier naturel ; ils deviennent une valeur continue, pouvant être égale par exemple à 19,42 ou 34,78. Cette continuité reflète mathématiquement l’incertitude marginale accrue qui émerge de l’estimation conjointe de deux paramètres d’échelle disparates.
Cet ajustement des degrés de liberté a un impact mécanique direct et décisif sur la distribution d’échantillonnage théorique utilisée pour évaluer la statistique pivotale. En réduisant les degrés de liberté effectifs en deçà de la somme combinée nominale, la procédure élargit les queues de la distribution t. Cet élargissement des queues de probabilité a pour conséquence directe d’éloigner les valeurs critiques nécessaires pour rejeter l’hypothèse nulle à un niveau de confiance donné. En d’autres termes, les degrés de liberté effectifs intègrent dans la géométrie même de la distribution de référence le fait que l’erreur-type estimée est intrinsèquement plus instable et sujette à fluctuation que sous l’hypothèse simplificatrice d’une variance commune partagée.
2.2 L’approximation d’une somme de khi-deux pondérés
Pour appréhender la mécanique théorique conçue par Satterthwaite, il est indispensable d’examiner le comportement stochastique des estimateurs de variance. Si l’on extrait un échantillon aléatoire d’effectif n issu d’une population normale de variance σ², la théorie probabiliste fondamentale stipule que la variance échantillonnale sans biais s², multipliée par ses degrés de liberté df = n – 1 et divisée par la variance populationnelle σ², suit rigoureusement une distribution du khi-deux à df degrés de liberté. Néanmoins, lorsque le praticien s’intéresse à la variance de la différence entre deux moyennes, la grandeur qu’il doit manipuler s’écrit formellement :
V = (s₁² / n₁) + (s₂² / n₂)
Cette expression représente sans ambiguïté une combinaison linéaire de deux variables aléatoires indépendantes qui suivent chacune, à un facteur d’échelle près, une distribution du khi-deux. Or, la somme pondérée de deux distributions du khi-deux ne suit pas, d’un point de vue analytique strict, une nouvelle loi du khi-deux. Franklin Satterthwaite a résolu cette complexité en appliquant un principe bien connu en calcul stochastique : la méthode d’égalisation des moments statistiques. Cette démarche consiste à postuler que la variable combinée V peut être approximée par une variable aléatoire idéale suivant une loi du type (a · χ²_ν) / ν, où la constante scalaire a et le paramètre de degrés de liberté effectifs ν sont calculés de manière à ce que les deux premiers moments de la distribution approximante (l’espérance et la variance mathématiques) correspondent exactement aux deux premiers moments de la combinaison linéaire véritable.
Sachant que l’espérance d’une variance d’échantillon s² est égale à la variance populationnelle σ² et que sa propre variance théorique vaut 2σ⁴ / df, Satterthwaite a calculé l’espérance et la variance globales de la somme pondérée. En égalisant la variance de la distribution de substitution à la variance de la combinaison linéaire originale, et en isolant algébriquement le paramètre d’incertitude ν, il est parvenu à une solution analytique remarquable reliant directement les degrés de liberté effectifs aux variances observées et aux effectifs de chaque échantillon. Le résultat ainsi dégagé possède une propriété essentielle : il s’adapte continuellement au degré d’asymétrie structurelle entre les variances observées.
2.3 Intégration au sein du test t de Welch
Parallèlement aux découvertes de Satterthwaite, le statisticien britannique Bernard Lewis Welch s’est penché de manière quasi synchrone sur les défaillances du test t classique en contexte d’hétéroscédasticité. Dans une série d’articles précurseurs parus en 1938 et 1947, Welch a conçu une variante de la statistique t de Student qui abandonne définitivement l’usage de la variance combinée au profit d’une erreur-type séparée, calculée par la racine carrée de la somme des variances d’échantillon pondérées par leurs effectifs respectifs. Cependant, une statistique n’a de valeur opérationnelle que si l’on connaît la loi de probabilité qui régit son comportement sous l’hypothèse nulle.
C’est précisément ici que s’opère la synthèse entre les réflexions de Welch et l’approximation de Satterthwaite. En appliquant la formule de calcul des degrés de liberté effectifs de Satterthwaite directement au dénominateur de la statistique de Welch, les statisticiens ont formalisé ce qui est désigné de manière universelle sous l’appellation de test t de Welch-Satterthwaite, ou plus couramment de test t de Welch. Dans ce dispositif méthodologique, la statistique calculée est comparée non pas aux tables immuables de Student basées sur n₁ + n₂ – 2, mais à une distribution de Student dont les degrés de liberté sont recalculés dynamiquement pour chaque échantillon spécifique à l’aide de l’approximation de Satterthwaite.
Des décennies d’investigations par simulations numériques intensives de Monte-Carlo ont confirmé empiriquement la robustesse exceptionnelle de cette combinaison. Quels que soient les écarts réels entre les variances des populations et les disparités entre les effectifs échantillonnés, l’ajustement de la valeur p induit par la formule de Satterthwaite garantit que le taux réel de rejet de l’hypothèse nulle sous la condition de vérité demeure ancré de façon quasi inaltérable autour de la valeur seuil nominale, neutralisant ainsi avec succès l’écueil ancestral posé par Behrens et Fisher.
3. La formule mathématique des degrés de liberté de Satterthwaite
3.1 Décomposition algébrique de l’équation
L’expression mathématique de l’approximation de Satterthwaite pour les degrés de liberté d’un test de comparaison de deux moyennes indépendantes s’impose comme une construction analytique équilibrée. Soient deux échantillons indépendants de tailles respectives n₁ et n₂, présentant des variances d’échantillon sans biais notées s₁² et s₂². Les degrés de liberté nominaux initiaux associés à chacun de ces deux échantillons sont définis par df₁ = n₁ – 1 et df₂ = n₂ – 1. L’estimation des degrés de liberté effectifs continus, conventionnellement symbolisée par la lettre grecque ν (nu) ou par l’abréviation df, s’énonce selon la formule suivante :
df = [ (s₁² / n₁) + (s₂² / n₂) ]² / [ ( (s₁² / n₁)² / (n₁ – 1) ) + ( (s₂² / n₂)² / (n₂ – 1) ) ]
Pour appréhender la portée de cette équation, il convient de décomposer minutieusement ses deux composantes architecturales. Le numérateur de la formule représente le carré parfait de la variance d’échantillonnage totale de la différence entre les deux moyennes. Ce terme quantifie l’amplitude brute globale de l’erreur quadratique standard attendue dans l’estimation de la distance entre les deux paramètres de position. En d’autres termes, il constitue la mesure d’échelle globale de la variabilité conjointe du modèle expérimental.
Le dénominateur de l’équation, quant à lui, se présente sous la forme d’une somme de deux termes fractionnaires pondérés. Chacun de ces termes correspond au carré de la variance d’échantillonnage de la moyenne d’un groupe individuel, divisé par le nombre de degrés de liberté initialement alloué à cet échantillon spécifique. Cette structure au dénominateur joue le rôle d’un facteur de pénalisation de l’instabilité statistique : plus l’une des composantes de variance repose sur un petit échantillon (faisant ainsi diminuer son diviseur n – 1), plus cette fraction spécifique prend de l’ampleur mathématique, gonflant le dénominateur total et provoquant, par voie de conséquence, un écrasement substantiel des degrés de liberté effectifs globaux.
3.2 Limites analytiques et bornes de la formule
Une étude rigoureuse du comportement aux limites de l’équation de Satterthwaite met en lumière des propriétés analytiques majeures qui régissent son intervalle de définition. On peut prouver formellement que la valeur calculée pour df est strictement bornée, tant supérieurement qu’inférieurement, par les dimensions d’échantillonnage initiales des deux groupes :
min(n₁ – 1, n₂ – 1) ≤ df ≤ n₁ + n₂ – 2
La preuve de la borne inférieure s’établit en considérant une situation de disparité extrême. Supposons par exemple que la variance de l’échantillon 1 devienne démesurément supérieure à celle du groupe 2, au point que le rapport s₁² / n₁ écrase totalement le terme s₂² / n₂. Dans cette hypothèse limite, les termes relatifs au second échantillon tendent vers zéro dans la formule de Satterthwaite. Le numérateur se réduit alors asymptotiquement à (s₁² / n₁)², tandis que le dénominateur se simplifie en (s₁² / n₁)² / (n₁ – 1). En effectuant la division, le ratio se simplifie parfaitement pour donner exactement n₁ – 1. Cela démontre avec une parfaite clarté mathématique que les degrés de liberté effectifs ne peuvent jamais descendre en dessous du nombre de degrés de liberté de l’échantillon présentant la variabilité relative dominante.
À l’opposé du spectre, la borne supérieure maximale correspond à la situation d’homogénéité absolue au sein de groupes rigoureusement équilibrés. Lorsque les effectifs sont identiques (n₁ = n₂ = n) et que les variances calculées sont parfaitement équivalentes (s₁² = s₂² = s²), la formule de Satterthwaite se réduit algébriquement après factorisation directe à 2 · (n – 1), ce qui équivaut scrupuleusement à n₁ + n₂ – 2, c’est-à-dire précisément le total entier des degrés de liberté exploité par le test t classique de Student. Enfin, dans le cas asymptotique où la taille du premier groupe tendrait vers l’infini tandis que celle du second demeurerait finie, les degrés de liberté de Satterthwaite convergeraient naturellement vers n₂ – 1, illustrant la capacité du modèle à transférer l’intégralité du fardeau de l’incertitude inférentielle sur le sous-système le plus restreint en données.
3.3 Sensibilité mathématique aux déséquilibres
L’analyse différentielle de l’équation de Satterthwaite révèle une élasticité particulièrement marquée lorsque l’on combine simultanément une asymétrie de taille d’échantillon et une divergence de variance. Il existe à cet égard deux configurations fondamentales aux conséquences radicalement opposées sur le plan de la déperdition des degrés de liberté effectifs.
La première configuration, souvent qualifiée de condition défavorable ou d’association négative, survient lorsque l’échantillon dont l’effectif est le plus faible présente la variance la plus élevée. Dans cette éventualité, le terme s² / n afférent au petit groupe devient écrasant par rapport à celui du grand groupe, en raison de la présence conjointe d’un numérateur fort et d’un dénominateur faible. L’application de la formule de Satterthwaite entraîne alors une chute brutale des degrés de liberté effectifs, qui viennent s’aligner quasi exclusivement sur l’effectif restreint du petit groupe. Par cette diminution abrupte, le formalisme de Satterthwaite contraint l’expérimentateur à adopter une posture hautement prudente, reflétant la précarité méthodologique de l’information issue du groupe le plus instable.
La seconde configuration, dite d’association positive, se caractérise à l’inverse par une situation où le grand groupe possède la plus forte variabilité, tandis que le groupe à faible effectif affiche une dispersion très resserrée. Dans un tel cas de figure, l’élasticité de l’équation amortit substantiellement la chute des degrés de liberté, permettant à df de conserver une valeur intermédiaire généreuse, proche de l’effectif du groupe le plus abondant. L’interaction conjointe des ratios de variance et des ratios d’échantillonnage dicte ainsi, sans intervention arbitraire extérieure, la trajectoire continue du paramètre de forme de la distribution de référence.
4. Le test t de Welch versus le test t de Student standard
4.1 Comparaison méthodologique des deux approches
Pour mesurer pleinement la rupture paradigmatique induite par l’association de la formule de Satterthwaite avec la statistique de Welch, il est indispensable de confronter directement son architecture algorithmique à celle du test t de Student originel. Dans le formalisme classique de Student, l’hypothèse d’homoscédasticité autorise le calcul de la variance combinée selon l’équation standard :
s_p² = [ (n₁ – 1)s₁² + (n₂ – 1)s₂² ] / (n₁ + n₂ – 2)
Cette variance agrégée est ensuite insérée sous le radical au dénominateur du test pour former l’erreur-type de la différence des moyennes, exprimée par SE = √[ s_p² · (1/n₁ + 1/n₂) ]. Ce mécanisme de mutualisation repose sur le postulat théorique selon lequel s₁² et s₂² ne représentent que deux reflets empiriques distincts d’un seul et unique paramètre sous-jacent σ². Si cette prémisse est rigoureusement vérifiée, la variance combinée constitue en effet le meilleur estimateur linéaire sans biais de la dispersion populationnelle commune, maximisant ainsi l’efficience statistique de la procédure.
En revanche, dès lors que les variances de population divergent réellement, la variance combinée s’avère lourdement biaisée par rapport à l’erreur-type théorique véritable de la différence des moyennes. Le calcul de la moyenne pondérée favorise mathématiquement le groupe possédant la taille d’échantillon la plus massive. Si ce groupe dominant présente incidemment la plus petite variance, la variance combinée sous-estimera dramatiquement l’instabilité globale du système, produisant une erreur-type artificiellement minuscule. À l’inverse, l’approche de Welch conjuguée aux degrés de liberté de Satterthwaite refuse par principe de fusionner les variances observées. En conservant la somme découplée (s₁²/n₁) + (s₂²/n₂) sous la racine carrée, elle préserve fidèlement la dynamique probabiliste propre à chaque sous-population, sans assujettir arbitrairement l’une à l’autre.
4.2 Contrôle de l’erreur de type I en cas de violation d’homogénéité
La conséquence la plus délétère de l’utilisation inopportune du test t de Student traditionnel réside dans l’altération imprévisible du taux d’erreur de première espèce, c’est-à-dire la probabilité de rejeter indûment l’hypothèse nulle lorsque celle-ci est fondamentalement vraie. Les nombreuses études de modélisation stochastique menées depuis les années 1970 ont mis en évidence la fragilité structurelle de l’inférence classique face à l’hétéroscédasticité couplée à des effectifs inégaux.
Dans la configuration critique où le groupe au plus faible effectif possède la variance la plus élevée, le test t de Student devient excessivement libéral. Le dénominateur basé sur la variance combinée est artificiellement comprimé, ce qui propulse la statistique t calculée vers des valeurs anormalement élevées. Par conséquent, pour un risque alpha nominal théorique fixé conventionnellement à 5 % (0,05), le taux réel de faux positifs peut facilement s’envoler pour atteindre 10 %, 20 % voire plus de 30 % dans des contextes d’hétérogénéité modérée à sévère. Le chercheur se retrouve ainsi à publier des conclusions triomphantes totalement infondées, victime d’une illusion probabiliste générée par la non-conformité de ses données aux postulats du modèle.
Inversement, lorsque le groupe au plus grand effectif affiche la plus grande variance, le test de Student devient excessivement conservateur. L’erreur-type combinée est artificiellement gonflée, étouffant la statistique t et faisant chuter le taux d’erreur de première espèce effectif bien en deçà du seuil nominal (parfois sous la barre des 1 %). Si cette configuration évite les faux positifs, elle détruit littéralement la puissance statistique du test, empêchant la détection d’effets expérimentaux bien réels. À l’opposé de ces dérives, l’approximation de Satterthwaite garantit une stabilité exemplaire : grâce à l’ajustement dynamique des degrés de liberté, le taux effectif d’erreur alpha demeure confiné de manière constante autour de la valeur nominale de 5 %, indépendamment du ratio des variances et des déséquilibres d’effectifs.
4.3 Puissance statistique relative des deux tests
L’argument historique qui a longtemps freiné l’adoption universelle du test de Welch-Satterthwaite reposait sur la crainte d’un coût méthodologique en termes de puissance statistique. De nombreux manuels pédagogiques du siècle dernier laissaient entendre que sous des conditions d’homogénéité des variances parfaites, renoncer au test de Student standard au profit du test de Welch équivaudrait à sacrifier inutilement des degrés de liberté et, par conséquent, à amenuiser la capacité de détection de l’expérimentateur.
Les investigations analytiques modernes ont définitivement dissipé cette réticence. Il a été abondamment démontré que lorsque les postulats classiques d’homoscédasticité et de normalité sont scrupuleusement satisfaits, la perte de puissance statistique encourue par l’application du test de Welch avec approximation de Satterthwaite est rigoureusement infinitésimale. Même au sein d’échantillons d’une extrême exiguïté (par exemple des groupes de 10 observations), la différence de puissance entre le test de Student exact et l’approximation de Satterthwaite se quantifie généralement à la deuxième ou troisième décimale de pourcentage, représentant un désavantage absolument imperceptible dans le cadre de la pratique scientifique réelle.
En revanche, dès que l’homoscédasticité s’avère imparfaite, le test de Welch-Satterthwaite offre fréquemment une puissance statistique nettement supérieure à celle du test de Student standard, particulièrement dans les scénarios où la variance la plus forte se trouve dans l’échantillon le plus grand. Compte tenu du fait qu’il est rigoureusement impossible dans la réalité expérimentale d’attester d’une égalité parfaite absolue des variances de deux populations non observées, la littérature statistique contemporaine, sous l’impulsion de méthodologistes influents comme Rand R. Wilcox ou Andrew J. Tomarken, préconise sans réserve d’abandonner définitivement le test t de Student au profit de l’usage systématique par défaut du test de Welch régulé par l’approximation de Satterthwaite.
5. L’hétérogénéité des variances dans la recherche en psychologie
5.1 Origines fréquentes des variances inégales en psychologie
Dans les sciences psychologiques et les neurosciences cognitives, l’émergence d’une hétérogénéité substantielle des variances entre les groupes expérimentaux ou naturels ne constitue pas une anomalie expérimentale accidentelle ; elle représente au contraire une caractéristique endémique et scientifiquement informative des systèmes psychiques étudiés. La recherche clinique et psychothérapeutique offre une illustration saisissante de cette réalité structurelle à travers le concept d’effets de traitement hétérogènes.
Lorsqu’un groupe d’individus diagnostiqués pour un trouble anxieux ou dépressif majeur est soumis à un protocole d’intervention psychologique novateur tandis qu’un groupe témoin est assigné à une liste d’attente, l’intervention thérapeutique n’exerce presque jamais un effet uniforme et linéaire sur chaque sujet. Certains participants réagissent de manière spectaculaire, affichant une rémission clinique quasi totale de leurs symptômes, tandis que d’autres manifestent des améliorations modestes, et qu’une fraction marginale peut voir sa détresse stagner ou s’aggraver. Ce phénomène de variabilité de la réponse thérapeutique a pour conséquence mécanique inévitable d’accroître massivement la variance post-traitement au sein du groupe expérimental, tandis que la variance du groupe témoin demeure stable. Postuler l’homogénéité des variances dans un tel paradigme reviendrait à nier la complexité fondamentale des différences interindividuelles face à la prise en charge clinique.
Par ailleurs, les instruments d’évaluation psychométrique eux-mêmes génèrent fréquemment des distorsions de variance d’origine purement méthodologique. Les effets plancher et plafond constituent à cet égard une source majeure d’hétéroscédasticité artificielle. Si une échelle psychologique de dépression est administrée simultanément à une cohorte d’étudiants sains issus de la population générale et à une cohorte hospitalisée en unité psychiatrique, les scores des sujets sains vont inévitablement s’agglutiner massivement contre la borne inférieure du questionnaire (l’absence totale de symptômes). Cette compression forcée de l’amplitude de réponse engendre une variance résiduelle extrêmement étriquée chez les témoins, tandis que le groupe clinique, dont les scores s’étalent sur l’ensemble du continuum pathologique, présente une variance démesurément supérieure.
5.2 Défis liés aux plans expérimentaux quasi-expérimentaux
L’investigation empirique en psychologie est bien souvent tributaire de contraintes éthiques et logistiques incontournables qui interdisent le recours à l’assignation aléatoire intégrale propre aux devis expérimentaux purs. Les chercheurs sont alors contraints de s’appuyer sur des plans de recherche quasi-expérimentaux, juxtaposant des groupes naturels prédéterminés tels que des individus atteints de traumatismes crâniens confrontés à des sujets neurotypiques, des représentants de minorités socioculturelles, ou différentes tranches d’âge au cours du développement ontogénétique.
Dans ce cadre pragmatique, il s’avère généralement impossible de calibrer ou d’équilibrer arbitrairement les effectifs d’échantillonnage n₁ et n₂ sur le terrain. La prévalence clinique naturelle des pathologies lourdes limite drastiquement le vivier de recrutement pour le groupe clinique expérimental, alors même que le recrutement de sujets témoins sains peut être conduit avec une relative abondance. L’analyste se retrouve dès lors de manière quasi systématique confronté à une conjonction redoutable : des effectifs sévèrement asymétriques associés à des variances intrinsèquement dissemblables.
Si le praticien applique dans ce contexte un test d’homoscédasticité préliminaire, tel que le test de Levene classique, pour décider s’il a le droit d’utiliser le test t traditionnel de Student, il s’expose à une vulnérabilité méthodologique majeure. Sur de petits échantillons cliniques, les tests de conformité de variance souffrent d’une insuffisance dramatique de puissance statistique, échouant systématiquement à déceler des hétérogénéités pourtant dévastatrices pour l’erreur de type I. Le chercheur en déduit erronément que l’hypothèse nulle d’égalité des variances est vérifiée, applique le test de Student classique, et publie des résultats substantiellement faussés.
5.3 Critique de la pratique du pré-test d’égalité des variances
L’une des déviances procédurales les plus solidement ancrées dans la formation académique consiste à préconiser une stratégie en deux étapes successives pour la comparaison de deux moyennes : le chercheur exécute en premier lieu un test de normalité et un pré-test d’homogénéité des variances (généralement le test de Levene ou le test de Bartlett), puis choisit le test de Student classique si la valeur p du pré-test dépasse 0,05, ou se résout à mobiliser le test de Welch-Satterthwaite si ce même pré-test s’avère statistiquement significatif.
La littérature méthodologique contemporaine a formulé une critique d’une sévérité sans appel à l’encontre de cette routine séquentielle, formalisée notamment par Mark O. Schucany et H. K. Ng. Le problème fondamental réside dans le conditionnement statistique : la distribution de la statistique finale du test d’hypothèse dépend intrinsèquement du résultat du test préliminaire de variance. En soumettant la décision méthodologique à un premier filtre probabiliste incertain, l’expérimentateur modifie la structure globale de l’espace d’échantillonnage, aboutissant paradoxalement à une statistique finale conditionnelle dont l’erreur globale de type I ne correspond plus à aucun paramètre maîtrisé.
Ce conditionnement séquentiel produit ce que les biostatisticiens nomment une stratégie d’inférence instable, susceptible d’amplifier les distorsions analytiques au lieu de les atténuer. Dans la mesure où l’approximation de Satterthwaite intégrée au test de Welch n’engendre aucune perte de puissance notable lorsque les variances s’avèrent être parfaitement égales, mais immunise totalement l’analyste dès lors qu’elles divergent, la seule démarche rationnelle, scientifiquement défendable et universellement recommandée consiste à écarter purement et simplement le pré-test de variance. Il convient d’adopter d’emblée, par défaut et sans condition préalable, l’approximation de Welch-Satterthwaite pour toute comparaison univariée de deux moyennes indépendantes.
6. Exemple pratique détaillé : Calcul manuel pas à pas
6.1 Présentation des données de l’échantillon
Afin de matérialiser de façon limpide et concrète la dynamique calculatoire de l’approximation de Satterthwaite, nous présentons ici une étude de cas inspirée de la recherche en neuropsychologie cognitive. Imaginons qu’un laboratoire cherche à mesurer l’efficacité d’un entraînement attentionnel informatisé chez des patients présentant un déclin cognitif léger. L’investigateur compare les scores obtenus à une batterie d’évaluation des fonctions exécutives standardisée entre un premier groupe expérimental de participants ayant suivi l’entraînement et un second groupe témoin n’ayant bénéficié que d’un suivi passif standard. Les scores ont été relevés et se présentent sous la forme de données quantitatives continues.
Le groupe expérimental (Groupe 1) rassemble un effectif d’échantillon réduit de n₁ = 11 patients. Les observations individuelles brutes collectées pour ce groupe s’énoncent précisément comme suit : 14, 16, 17, 18, 19, 19, 20, 21, 22, 22, et 24 points. La somme arithmétique de ces 11 scores vaut rigoureusement :
∑ x₁_i = 14 + 16 + 17 + 18 + 19 + 19 + 20 + 21 + 22 + 22 + 24 = 212
En effectuant la division élémentaire par la taille de l’échantillon, nous obtenons la moyenne arithmétique d’échantillon du premier groupe, soit x̄₁ = 212 / 11 ≈ 19,2727 points (arrondie conventionnellement à 19,27).
Le groupe témoin (Groupe 2) intègre quant à lui un effectif légèrement plus étendu de n₂ = 13 participants. Les scores individuels bruts enregistrés pour ce second groupe s’établissent comme suit : 17, 19, 20, 21, 22, 23, 23, 24, 25, 26, 27, 28, et 29 points. La sommation de l’ensemble de ces 13 valeurs aboutit à la quantité numérique :
∑ x₂_i = 17 + 19 + 20 + 21 + 22 + 23 + 23 + 24 + 25 + 26 + 27 + 28 + 29 = 304
La moyenne arithmétique d’échantillon pour le groupe témoin se calcule dès lors par le ratio x̄₂ = 304 / 13 ≈ 23,3846 points (arrondie à 23,38). L’inspection initiale de ces paramètres centraux révèle une différence brute de moyennes de x̄₁ – x̄₂ = 19,2727 – 23,3846 = -4,1119 points. La divergence des tailles de groupes (11 contre 13) et la disparité des dispersions observables requièrent une évaluation rigoureuse de la variance sans agrégation arbitraire.
6.2 Calcul des variances échantillonnales et des erreurs types
L’étape préliminaire incontournable pour mobiliser l’équation de Satterthwaite consiste à quantifier la dispersion interne de chaque échantillon en calculant leur variance sans biais respective. Pour ce faire, nous établissons en premier lieu la somme des carrés des écarts à la moyenne pour le Groupe 1. Les écarts individuels par rapport à la moyenne x̄₁ = 19,2727 sont élevés au carré :
- (14 – 19,2727)² = (-5,2727)² ≈ 27,8014
- (16 – 19,2727)² = (-3,2727)² ≈ 10,7106
- (17 – 19,2727)² = (-2,2727)² ≈ 5,1652
- (18 – 19,2727)² = (-1,2727)² ≈ 1,6198
- (19 – 19,2727)² = (-0,2727)² ≈ 0,0744
- (19 – 19,2727)² = (-0,2727)² ≈ 0,0744
- (20 – 19,2727)² = (0,7273)² ≈ 0,5290
- (21 – 19,2727)² = (1,7273)² ≈ 2,9836
- (22 – 19,2727)² = (2,7273)² ≈ 7,4382
- (22 – 19,2727)² = (2,7273)² ≈ 7,4382
- (24 – 19,2727)² = (4,7273)² ≈ 22,3474
La somme totale des carrés des écarts pour le Groupe 1 est égale à SS₁ ≈ 86,1822. Les degrés de liberté associés à cet échantillon spécifique valent df₁ = n₁ – 1 = 11 – 1 = 10. Nous obtenons la variance d’échantillon sans biais du Groupe 1 :
s₁² = SS₁ / (n₁ – 1) = 86,1822 / 10 = 8,6182
Procédons de façon parfaitement analogue pour le Groupe 2, dont la moyenne s’établit à x̄₂ = 23,3846. En sommant les carrés des déviations individuelles de ses 13 membres :
- (17 – 23,3846)² = (-6,3846)² ≈ 40,7631
- (19 – 23,3846)² = (-4,3846)² ≈ 19,2247
- (20 – 23,3846)² = (-3,3846)² ≈ 11,4555
- (21 – 23,3846)² = (-2,3846)² ≈ 5,6863
- (22 – 23,3846)² = (-1,3846)² ≈ 1,9171
- (23 – 23,3846)² = (-0,3846)² ≈ 0,1479
- (23 – 23,3846)² = (-0,3846)² ≈ 0,1479
- (24 – 23,3846)² = (0,6154)² ≈ 0,3787
- (25 – 23,3846)² = (1,6154)² ≈ 2,6095
- (26 – 23,3846)² = (2,6154)² ≈ 6,8403
- (27 – 23,3846)² = (3,6154)² ≈ 13,0711
- (28 – 23,3846)² = (4,6154)² ≈ 21,3019
- (29 – 23,3846)² = (5,6154)² ≈ 31,5327
La somme des carrés des écarts pour le second groupe s’élève à SS₂ ≈ 155,0767. Les degrés de liberté nominaux correspondants sont df₂ = n₂ – 1 = 13 – 1 = 12. La variance d’échantillon sans biais du Groupe 2 est donc de :
s₂² = SS₂ / (n₂ – 1) = 155,0767 / 12 = 12,9231
Nous pouvons désormais calculer les termes élémentaires de variance d’échantillonnage de chaque moyenne, c’est-à-dire le carré de l’erreur-type de chaque groupe :
V₁ = s₁² / n₁ = 8,6182 / 11 ≈ 0,7835
V₂ = s₂² / n₂ = 12,9231 / 13 ≈ 0,9941
L’erreur-type globale de la différence entre les moyennes selon la formulation de Welch correspond à la racine carrée de la somme de ces deux grandeurs élémentaires :
SE_(diff) = √(V₁ + V₂) = √(0,7835 + 0,9941) = √(1,7776) ≈ 1,3333
6.3 Application de la formule de Satterthwaite
Avec l’ensemble de ces grandeurs intermédiaires rigoureusement établies, nous sommes en mesure d’exécuter pas à pas la formule de Satterthwaite afin d’extraire les degrés de liberté effectifs applicables à cette comparaison statistique.
Commençons par évaluer le numérateur de l’équation, qui correspond au carré de la variance totale de la différence des moyennes :
Numérateur = [ (s₁² / n₁) + (s₂² / n₂) ]² = [ 0,7835 + 0,9941 ]² = [ 1,7776 ]² ≈ 3,1599
Passons maintenant au calcul scrupuleux du dénominateur, qui est formé par la somme des variances d’échantillonnage élevées au carré et divisées individuellement par leurs degrés de liberté nominaux :
Pour le Groupe 1 :
Terme₁ = (s₁² / n₁)² / (n₁ – 1) = (0,7835)² / 10 = 0,6139 / 10 = 0,06139
Pour le Groupe 2 :
Terme₂ = (s₂² / n₂)² / (n₂ – 1) = (0,9941)² / 12 = 0,9882 / 12 = 0,08235
En procédant à l’addition de ces deux termes intermédiaires, le dénominateur total s’établit précisément à :
Dénominateur = Terme₁ + Terme₂ = 0,06139 + 0,08235 = 0,14374
Il ne reste plus qu’à opérer la division finale du numérateur par le dénominateur pour faire émerger la valeur exacte des degrés de liberté effectifs de Satterthwaite :
df = 3,1599 / 0,14374 ≈ 21,9834
Comme nous pouvons le constater, le calcul aboutit à une valeur non entière continue de 21,98 degrés de liberté. Dans un test t de Student standard à deux échantillons, le nombre de degrés de liberté nominal aurait été fixé forfaitairement à n₁ + n₂ – 2 = 11 + 13 – 2 = 22. Bien que dans cet exemple précis les dispersions soient modérément hétérogènes et les effectifs relativement proches, conduisant à une valeur de Satterthwaite très proche de 22, cette grandeur décimale traduit rigoureusement l’incertitude induite par les variances inégales (8,62 contre 12,92).
7. Interprétation statistique et inférentielle de l’exemple
7.1 Détermination de la valeur critique et de la p-valeur
Dès lors que la statistique t de Welch a été calculée et que les degrés de liberté continus de Satterthwaite ont été résolus, la démarche inférentielle exige de statuer sur le rejet ou le maintien de l’hypothèse nulle. Reprenons la statistique empirique issue de nos calculs :
t = (x̄₁ – x̄₂) / SE_(diff) = (19,2727 – 23,3846) / 1,3333 = -4,1119 / 1,3333 ≈ -3,084
L’étape analytique suivante requiert la détermination de la valeur critique seuil ou le calcul direct de la probabilité d’obtenir une statistique au moins aussi extrême par le seul jeu du hasard, notée valeur p. Historiquement, les chercheurs utilisaient des tables de distribution t de Student imprimées, lesquelles ne contenaient naturellement que des colonnes associées à des degrés de liberté entiers.
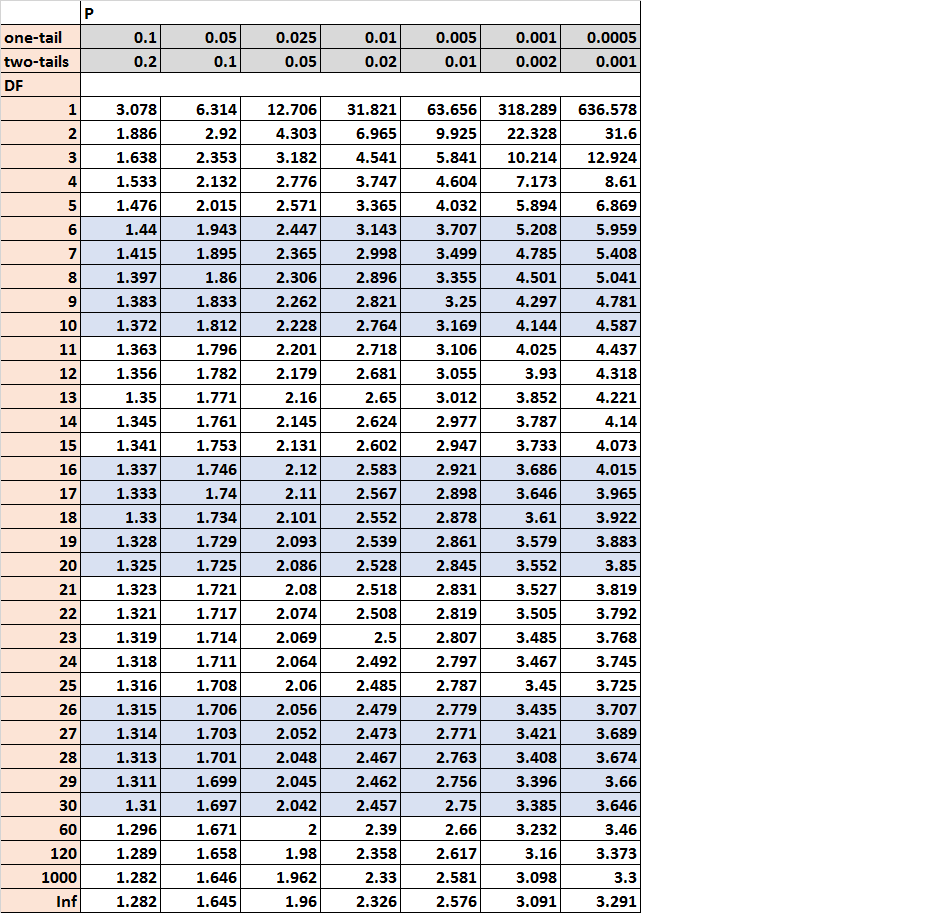
Lorsque l’on est confronté à des degrés de liberté décimaux comme df = 21,98, la méthode manuelle traditionnelle consistait à réaliser une interpolation linéaire entre les lignes 21 et 22 de la table statistique, ou bien à adopter une approche conservative en arrondissant par défaut à l’entier inférieur le plus proche (soit 21). Pour un seuil de signification bilatéral conventionnel de α = 0,05, la valeur critique tabulée pour 21 degrés de liberté est d’environ t_crit = ±2,0796, et pour 22 degrés de liberté, elle s’établit à t_crit = ±2,0739. L’interpolation précise à 21,98 confère une valeur critique seuil de t_crit ≈ ±2,0740.
Les logiciels informatiques modernes s’affranchissent de toute approximation tabulaire en évaluant numériquement la fonction de répartition cumulative de la loi de Student régularisée à l’aide de la fonction bêta incomplète. Pour notre statistique observée t = -3,084 associée aux degrés de liberté de Satterthwaite df = 21,98, le calcul de probabilité bilatérale exacte fournit une valeur de :
p = 0,0054
Cette valeur de probabilité étant très nettement inférieure au seuil conventionnel de 0,05 (et même sous le seuil plus exigeant de 0,01), la décision méthodologique s’impose avec une force irréfutable : l’hypothèse nulle d’égalité des moyennes d’attention exécutive entre les deux populations doit être formellement rejetée au seuil alpha de 5 %.
7.2 Construction de l’intervalle de confiance ajusté
L’inférence moderne ne saurait se limiter au simple énoncé d’une valeur p binaire ; elle se doit d’apporter une estimation par intervalle de l’ampleur véritable du paramètre populationnel étudié. L’intervalle de confiance à 95 % pour la différence entre deux moyennes, ajusté par la procédure de Welch-Satterthwaite, se structure selon la formulation générale :
IC₉₅% = (x̄₁ – x̄₂) ± [ t_(crit ; 0,05 ; df) · SE_(diff) ]
En incorporant dans cette équation la valeur critique bilatérale ajustée aux degrés de liberté de Satterthwaite (t_crit ≈ 2,0740), la différence observée entre les moyennes (-4,1119) et l’erreur-type composite de Welch (SE_(diff) ≈ 1,3333), nous obtenons la marge d’erreur suivante :
Marge d’erreur = 2,0740 · 1,3333 ≈ 2,7653
L’intervalle de confiance s’établit par conséquent par l’addition et la soustraction de cette marge d’erreur à la différence des moyennes d’échantillon :
Borne inférieure = -4,1119 – 2,7653 = -6,8772
Borne supérieure = -4,1119 + 2,7653 = -1,3466
Soit un intervalle de confiance à 95 % formellement circonscrit entre [-6,88 ; -1,35] points. Sur le plan de l’interprétation concrète, cela signifie que nous pouvons affirmer avec un degré de confiance de 95 % que la véritable supériorité moyenne du score du groupe témoin sur le groupe expérimental dans la population générale se situe entre 1,35 et 6,88 points sur l’échelle d’évaluation neuropsychologique. Le fait que cet intervalle n’englobe aucunement la valeur zéro corrobore mathématiquement le rejet indiscutable de l’hypothèse nulle d’invariance cognitive.
7.3 Discussion des conclusions substantielles
Au-delà du verdict statistique brut, la quantification de l’ampleur substantielle du phénomène mesuré impose d’évaluer la taille d’effet standardisée. Dans le cadre d’un test t classique respectant l’homoscédasticité, le d de Cohen conventionnel s’obtient en divisant la différence des moyennes par la racine carrée de la variance combinée. Néanmoins, en situation d’hétéroscédasticité confirmée, l’utilisation de la variance combinée induit un biais de calcul direct dans la standardisation de la taille d’effet.
Dans ce contexte, les méthodologistes recommandent d’employer une variante corrigée, fréquemment dénommée d de Cohen ajusté ou delta de Glass. Lorsque l’on utilise la moyenne quadratique des deux écarts-types d’échantillon pour standardiser l’écart (écart-type moyen combiné non pondéré s_moy = √[(s₁² + s₂²)/2] = √[(8,6182 + 12,9231)/2] = √[10,7706] ≈ 3,2819), la taille d’effet standardisée s’élève à :
d = |19,2727 – 23,3846| / 3,2819 = 4,1119 / 3,2819 ≈ 1,25
Une valeur de d = 1,25 dénote une taille d’effet massive selon les conventions établies par Jacob Cohen dans les sciences comportementales (où une valeur de 0,80 est déjà qualifiée de forte). Sur le plan théorique de la recherche appliquée, ce résultat statistique indique que les patients non entraînés du groupe témoin affichent un score d’attention exécutive supérieur de plus d’un écart-type entier par rapport aux participants ayant suivi l’entraînement informatisé testé. Les concepteurs du protocole expérimental se trouvent ainsi confrontés à une preuve empirique solide montrant non seulement que leur programme d’entraînement n’a pas produit les bénéfices cognitifs postulés, mais qu’il a potentiellement interféré négativement avec d’autres apprentissages quotidiens, un enseignement clinique capital qui n’aurait pu être étayé avec une telle sérénité sans la rigueur computationnelle apportée par l’approximation de Satterthwaite.
8. Mise en œuvre dans les logiciels de statistique et d’analyse de données
8.1 Exécution et syntaxe sous R et environnement tidyverse
Dans l’écosystème open-source R, environnement de programmation prééminent pour la recherche quantitative et la biométrie, l’approximation de Satterthwaite bénéficie d’une reconnaissance institutionnelle singulière : elle est configurée comme le traitement par défaut de la fonction standard de comparaison de moyennes. Contrairement à d’anciens logiciels commerciaux qui continuaient par routine à forcer le test de Student homoscédastique, les architectes du projet R (la R Core Team) ont fait le choix épistémologique délibéré d’appliquer le test de Welch avec degrés de liberté de Satterthwaite dès l’appel primitif de la fonction standard.
Pour exécuter cette procédure sur deux vecteurs de données numériques nommés groupe1 et groupe2, la commande syntaxique s’énonce sous sa forme la plus pure par :
t.test(groupe1, groupe2)
Par défaut, l’argument formel var.equal est paramétré sur la valeur logique FALSE. Lorsque R évalue cette fonction, il ne suppose en aucun cas l’égalité des variances. Il procède au calcul découplé des erreurs-types, applique l’équation de Satterthwaite pour dériver les degrés de liberté décimaux, et génère en sortie un objet de classe htest explicitant sans équivoque dans son titre l’exécution d’un « Welch Two Sample t-test ». L’analyste y observe directement la valeur de t, l’indication précise des degrés de liberté effectifs non entiers (df = 21.983), la p-valeur exacte, l’intervalle de confiance asymptotique à 95 % et les moyennes d’échantillons calculées.
Au-delà de l’analyse bivariée simple, l’approximation de Satterthwaite est intensément sollicitée dans l’environnement R pour les modélisations linéaires hiérarchiques complexes. Au sein du package largement plébiscité lmerTest, développé par Alexandra Kuznetsova, Per Bruun Brockhoff et Rune Haubo Bojesen Christensen, l’extension du modèle linéaire mixte ajusté via lme4 mobilise par défaut l’approximation de Satterthwaite pour estimer les degrés de liberté continus associés à chaque coefficient d’effet fixe. Les sorties des tableaux d’analyse de variance affichent des colonnes dédiées aux degrés de liberté effectifs continus calculés par Satterthwaite, autorisant une déduction probabiliste exacte de la significativité des facteurs explicatifs.
8.2 Procédure sous IBM SPSS Statistics
Au sein du logiciel propriétaire IBM SPSS Statistics, largement implanté dans les laboratoires de psychologie et de sciences sociales, l’implémentation de la méthode de Satterthwaite obéit à une organisation d’affichage tabulaire spécifique mais systématique. L’utilisateur accède à la procédure en naviguant à travers le menu général : Analyser > Comparer les moyennes > Test T pour échantillons indépendants.
Une fois les variables de test et la variable de regroupement spécifiées, SPSS ne contraint pas l’expérimentateur à choisir a priori entre l’une ou l’autre des approches. Dans la fenêtre de restitution des résultats, le tableau principal intitulé « Test des échantillons indépendants » présente deux lignes d’inférence distinctes superposées :
- La première ligne porte la mention explicite : « Hypothèse de variances égales » (correspondant au test de Student classique fondé sur la variance combinée et un nombre entier strict de degrés de liberté).
- La seconde ligne porte la mention fondamentale : « Hypothèse de variances inégales » (correspondant formellement au test de Welch instrumenté par l’approximation de Satterthwaite).
Dans cette seconde rangée, l’utilisateur observe sous la colonne intitulée ddl (ou df dans la version anglophone) un chiffre comportant invariablement deux ou trois décimales après la virgule. Ce chiffre décimal correspond scrupuleusement, au centième près, à la résolution analytique de l’équation de Satterthwaite développée dans nos sections précédentes. Bien que SPSS fournisse également sur la gauche du tableau le résultat préliminaire du test de Levene sur l’égalité des variances, les directives méthodologiques contemporaines imposent aux chercheurs de délaisser la première ligne pour se focaliser exclusivement sur la ligne « Hypothèse de variances inégales », garantissant la publication de résultats irréprochables face aux violations de postulats.
8.3 Calculs avec Python, Jamovi et JASP
L’expansion fulgurante du langage de programmation Python dans l’analyse de données scientifiques s’est accompagnée de la mise à disposition d’outils rigoureux pour l’évaluation inférentielle. Au sein de la bibliothèque de référence scipy.stats, le calcul d’une comparaison de moyennes s’effectue via la fonction ttest_ind(). Il est impératif de noter que, contrairement à R, l’argument equal_var y est positionné par défaut sur la valeur True, reconduisant de façon discutable le test t de Student historique. Pour enjoindre Python à appliquer le test de Welch et l’approximation de Satterthwaite, l’analyste doit impérativement déclarer explicitement le paramètre :
scipy.stats.ttest_ind(groupe1, groupe2, equal_var=False)
Pour les praticiens désireux d’obtenir une restitution détaillée incluant explicitement les degrés de liberté décimaux de Satterthwaite ainsi que les tailles d’effet ajustées, le recours à des bibliothèques plus orientées vers la psychométrie comme Pingouin ou statsmodels s’avère particulièrement recommandé. Sous Pingouin, l’appel de pingouin.ttest(groupe1, groupe2, correction=True) retourne directement un tableau complet sous la forme d’un DataFrame contenant la valeur de t, les degrés de liberté décimaux exacts et la taille d’effet sous forme de g de Hedges non biaisé.
Enfin, pour les étudiants et chercheurs privilégiant les environnements logiciels graphiques libres sans codage textuel, des plateformes modernes telles que Jamovi ou JASP offrent une ergonomie optimale. Conçues sur une infrastructure interne exploitant le moteur d’exécution de R, ces interfaces permettent, par une simple coche intitulée « Welch » dans le menu des tests t pour échantillons indépendants, de désactiver la statistique classique et de faire apparaître instantanément des tables d’analyses aux normes de publication scientifique affichant les degrés de liberté continus de Satterthwaite.
9. L’approximation de Satterthwaite dans les modèles mixtes et hiérarchiques
9.1 Généralisation aux modèles linéaires à effets mixtes (LMM)
Si l’approximation de Satterthwaite est universellement reconnue pour son rôle salvateur dans le cadre élémentaire de la comparaison de deux groupes indépendants, sa contribution la plus impressionnante dans la statistique appliquée contemporaine concerne la modélisation linéaire à effets mixtes (LMM) et les modèles hiérarchiques emboîtés. Dans ces structures d’analyse avancées, couramment utilisées pour traiter des mesures répétées ou des cohortes d’individus regroupés au sein de clusters naturels (comme des patients traités par différents thérapeutes ou des élèves répartis dans différentes classes), la notion classique de degrés de liberté devient mathématiquement indéterminée.
Dans un modèle mixte, la variabilité globale se scinde en effets fixes (les paramètres d’intérêt moyen partagés par l’ensemble de la population) et en effets aléatoires (les déviations propres à chaque individu ou à chaque grappe). Dès lors, la matrice de variance-covariance des résidus n’est plus une simple matrice diagonale scalaire homoscédastique, mais adopte une structure hautement complexe intégrant des corrélations intra-classe et des variances résiduelles différentielles. Lors de l’évaluation de la significativité statistique d’un coefficient fixe ou d’une interaction par un test de Wald ou un test F multivarié, le dénominateur de la statistique ne correspond à aucune somme de carrés élémentaire univoque.
Face à ce vide théorique, l’approximation de Satterthwaite a été brillamment généralisée pour projeter la matrice de variance-covariance estimée des paramètres fixes sur un espace de substitution unidimensionnel équivalent. En calculant les dérivées partielles de la fonction de variance par rapport aux paramètres de covariance estimés (le gradient et la matrice hessienne), l’algorithme de Satterthwaite multivarié parvient à attribuer à chaque terme du modèle un degré de liberté effectif continu spécifique. Cette avancée méthodologique permet d’effectuer des tests F fiables et de calculer des valeurs p hautement précises, même au sein de devis hautement déséquilibrés comportant des fractions significatives de données manquantes.
9.2 Satterthwaite versus approximation de Kenward-Roger
Dans la littérature spécialisée consacrée aux modèles mixtes, l’approximation de Satterthwaite se trouve fréquemment mise en concurrence ou juxtaposée avec une autre procédure analytique renommée : l’approximation de Kenward-Roger, formulée par Michael G. Kenward et James H. Roger en 1997. L’arbitrage entre ces deux approches de pointe constitue un sujet d’investigation récurrent pour les méthodologistes quantitatifs.
L’approche de Kenward-Roger peut être appréhendée comme une extension perfectionnée de la méthode de Satterthwaite. En plus d’ajuster les degrés de liberté de la statistique de test sur la base de principes d’égalisation des moments similaires à ceux de Satterthwaite, l’algorithme de Kenward-Roger introduit une correction explicite du biais d’échantillon fini directement au sein de la matrice de variance-covariance estimée des effets fixes. Dans les modèles estimés par la méthode du maximum de vraisemblance restreint (REML), la substitution des véritables covariances par leurs estimations ponctuelles engendre une sous-estimation systématique de l’incertitude dans les petits échantillons. Kenward-Roger recalibre cette dispersion en intégrant des termes correctifs de second ordre, avant de dériver des degrés de liberté ajustés.
Sur le plan pratique, de nombreuses investigations comparatives de Monte-Carlo démontrent que les deux approximations génèrent des résultats extrêmement concordants dès lors que la taille globale de l’échantillon atteint un niveau modéré (par exemple au-delà de 40 à 50 observations groupées). Toutefois, lorsque l’on est confronté à des designs expérimentaux d’une exiguïté critique (moins de 15 sujets ou grappes) associés à des matrices de corrélations particulièrement complexes (comme des structures autorégressives ou autorégressives hétérogènes), la méthode de Kenward-Roger présente une supériorité marginale dans le contrôle strict de l’erreur de type I, tandis que l’approximation de Satterthwaite offre une stabilité de convergence algorithmique supérieure et un coût computationnel nettement moindre.
9.3 Applications directes dans les devis psychologiques longitudinaux
L’impact des degrés de liberté effectifs de Satterthwaite est particulièrement manifeste dans la recherche clinique longitudinale en psychologie. Considérons une étude d’intervention évaluant la réduction de la charge dépressive chez des patients suivis de manière répétée à l’inclusion, à 4 semaines, à 12 semaines et lors d’un suivi à 6 mois. Dans ce type de recueil écologique, le phénomène d’attrition expérimentale (l’abandon en cours de protocole par certains participants) engendre inévitablement des données incomplètes et des matrices hautement déséquilibrées.
L’usage historiquement répandu de l’analyse de variance à mesures répétées (ANOVA-RM) contraignait les chercheurs à exclure purement et simplement tout sujet présentant la moindre donnée manquante (suppression par liste ou listwise deletion), laminant ainsi la taille effective de l’échantillon, tout en exigeant le respect d’une hypothèse de sphéricité très rarement observée sur le terrain. Le basculement vers les modèles linéaires mixtes affranchit l’investigateur de cette obligation d’exhaustivité et de sphéricité, en exploitant l’intégralité des points de mesure renseignés par chaque participant.
Cependant, dans ces conditions de recueil asymétrique, le nombre d’observations disponibles fluctue à chaque instant temporel : le niveau de certitude probabiliste associé à l’évaluation du traitement à 6 mois (où de nombreux sujets ont pu décrocher) n’est absolument pas équivalent à celui du temps initial. Grâce à l’incorporation de l’approximation de Satterthwaite au sein des modèles mixtes, les degrés de liberté calculés pour l’effet du temps s’adaptent dynamiquement, reflétant la contraction de l’information empirique disponible sans jamais forcer l’analyste à des imputations hasardeuses ou à des amputations de données dévastatrices pour l’intégrité de la recherche.
10. Méthodes alternatives et comparaisons empiriques
10.1 L’alternative de Welch-Aspin et développements asymptotiques
Bien que l’approximation de Satterthwaite constitue la solution dominante et conventionnelle au problème de Behrens-Fisher dans les logiciels actuels, l’histoire des mathématiques appliquées a vu éclore d’autres tentatives analytiques remarquables. Parmi celles-ci, l’approche développée par Alice A. Aspin en 1948, prolongeant les travaux mathématiques initiaux de Bernard Lewis Welch, mérite une attention théorique particulière.
Contrairement à la démarche de Satterthwaite, qui repose sur une égalisation pragmatique des deux premiers moments de distribution globale pour trouver une loi équivalente unique, la méthode dite de Welch-Aspin mobilise des développements en séries de Taylor et des expansions asymptotiques formelles de la fonction de distribution de probabilité cumulée. L’objectif d’Aspin consistait à exprimer la probabilité de dépassement d’une valeur critique sous forme d’une série infinie dépendant des puissances inverses des degrés de liberté de chaque groupe individuel (1/df₁, 1/df₂, 1/df₁², etc.).
D’un point de vue purement théorique, la solution de Welch-Aspin fournit une précision mathématique d’un ordre supérieur à l’approximation de Satterthwaite dans certaines conditions extrêmes, car elle intègre formellement les termes d’ordre 3 et d’ordre 4 du développement en série stochastique. Toutefois, cette formulation analytique s’avère d’une lourdeur algorithmique prodigieuse, exigeant l’évaluation fastidieuse de polynômes différentiels complexes. En pratique, l’approximation élégante et directe de Satterthwaite confère une exactitude numérique presque rigoureusement indifférenciable de celle de Welch-Aspin pour la quasi-totalité des tailles d’échantillons exploitées en science expérimentale, ce qui explique son adoption universelle par les concepteurs d’algorithmes au détriment des séries d’Aspin.
10.2 Approches de rééchantillonnage (Bootstrap et permutations)
L’essor vertigineux de la puissance de calcul informatique au cours des dernières décennies a favorisé l’émergence d’une approche computationnelle radicalement affranchie des distributions théoriques paramétriques : les méthodes de rééchantillonnage, au premier rang desquelles figure le bootstrap conçu par Bradley Efron.
Face à des données caractérisées par une hétérogénéité prononcée des variances et des effectifs asymétriques, les chercheurs ont parfois recours au bootstrap sauvage (wild bootstrap) ou à des tests de permutations adaptés aux contextes hétéroscédastiques. Le principe consiste à rééchantillonner des milliers de fois les données empiriques avec remise, en appliquant des facteurs de pondération aléatoires qui reproduisent les variances différentielles locales, afin de générer empiriquement la distribution de la statistique sans faire appel à la loi de Student théorique.
Si ces méthodes intensives en calcul apportent une flexibilité remarquable et s’avèrent d’une aide précieuse lorsque les données manifestent simultanément une forte asymétrie non normale et des variances inégales, les simulations systématiques menées par des biostatisticiens démontrent que l’approximation de Satterthwaite demeure d’une précision équivalente dans la quasi-totalité des scénarios usuels dès que la taille totale de l’échantillon dépasse une vingtaine d’unités. L’intérêt du bootstrap réside principalement dans les situations où la violation de l’hypothèse de normalité est si grotesque (distributions plurimodales, bimodalités sévères, valeurs aberrantes majeures) que même l’adaptation de la loi de Student par Satterthwaite ne permet plus de modéliser adéquatement les queues de distribution.
10.3 Tests non paramétriques (Mann-Whitney / Wilcoxon)
L’un des réflexes conditionnés les plus préjudiciables encore trop souvent observés dans la pratique de la recherche consiste à recommander le recours systématique au test non paramétrique de Mann-Whitney (identifié également sous l’appellation de test de la somme des rangs de Wilcoxon) dès lors que les données violent l’hypothèse d’homogénéité des variances ou de normalité.
Cette prescription repose sur un mythe méthodologique profond qu’il convient de déconstruire avec la plus grande fermeté : le test de Mann-Whitney n’est pas un test de comparaison de moyennes. Il s’agit fondamentalement d’un test d’infériorité stochastique, qui évalue si la probabilité qu’une observation issue de la première population dépasse une observation issue de la seconde est égale à 0,5. Pour que le test de Mann-Whitney puisse être légitimement interprété comme une comparaison de médianes ou de positions centrales, il exige impérativement une hypothèse sous-jacente très stricte : l’égalité parfaite des formes de distribution, ce qui inclut formellement… l’égalité des variances !
Lorsque deux populations possèdent des variances hétérogènes, leurs fonctions de répartition empiriques ne se déduisent plus l’une de l’autre par une simple translation spatiale. Les études méthodologiques ont prouvé que dans cette situation d’hétéroscédasticité, le test non paramétrique de Mann-Whitney subit exactement les mêmes distorsions massives de son taux d’erreur de première espèce que le test t de Student classique. Par conséquent, substituer un test de Mann-Whitney à un test t de Student en présence de variances inégales ne résout en aucun cas le problème de Behrens-Fisher, mais introduit une confusion interprétative supplémentaire. Dans ce scénario, le test t de Welch régulé par l’approximation de Satterthwaite s’avère immensément supérieur et robuste, conservant sa parfaite validité inférentielle même sous des conditions d’asymétrie modérée.
11. Normes de rapportage académique et directives APA 7
11.1 Règles stylistiques et typographiques de l’APA pour les degrés de liberté décimaux
La transcription des analyses quantitatives au sein des publications savantes est rigoureusement encadrée par les conventions internationales, parmi lesquelles le manuel de style de l’American Psychological Association (APA 7e édition) fait figure de standard absolu dans les sciences du comportement, l’éducation et la santé mentale. L’incorporation de l’approximation de Satterthwaite implique des exigences typographiques précises qui rompent avec les routines traditionnelles associées aux tests classiques.
Le format canonique de rapportage d’un test t exige la présentation séquentielle de la lettre t en italique, immédiatement suivie de la valeur des degrés de liberté insérée entre parenthèses sans espace, d’un signe d’égalité, de la valeur numérique calculée de la statistique arrondie à deux décimales, et enfin de la valeur exacte du niveau de probabilité (la p-valeur) arrondie à trois décimales (précédée d’un espace de part et d’autre du signe opératoire) :
t(df) = valeur, p = valeur
La règle d’or stylistique de l’APA pour le test de Welch-Satterthwaite impose l’obligation formelle de conserver impérativement les décimales pour les degrés de liberté. Il est formellement prohibé d’arrondir les degrés de liberté effectifs de Satterthwaite à l’entier naturel le plus proche. Le rapportage d’une écriture telle que t(21,98) = -3,08, p = ,005 signale immédiatement et sans ambiguïté au lecteur averti et aux réviseurs méthodologistes que le chercheur a appliqué la correction de Satterthwaite pour variances hétérogènes, assurant une transparence analytique totale sur la démarche inférentielle poursuivie.
11.2 Transparence méthodologique et science ouverte
Dans le contexte actuel de la crise de la reproductibilité scientifique et de la promotion active des pratiques de science ouverte, l’omission des justifications analytiques entourant le choix des tests d’hypothèses n’est plus tolérée au sein des comités éditoriaux des revues de premier rang. Il ne suffit plus de consigner passivement une ligne de résultat chiffré dans la section Résultats ; le protocole inférentiel doit être méthodologiquement anticipé et documenté avec rigueur dès la section Méthode.
Le chercheur se doit d’indiquer explicitement dans le paragraphe consacré à l’analyse des données qu’en raison des risques documentés d’inflation du taux d’erreur de première espèce liés aux violations d’homoscédasticité, toutes les comparaisons univariées de moyennes ont été conduites via le test de Welch avec approximation des degrés de liberté de Satterthwaite, indépendamment des diagnostics de variances. Cette transparence permet d’écarter tout soupçon de « p-hacking » ou de sélection a posteriori avantageuse : une pratique déviante consistant à exécuter simultanément le test de Student et le test de Welch pour ne retenir opportunément dans l’article final que celui dont la p-valeur franchit par hasard le seuil de significativité de 0,05.
De surcroît, les directives de science ouverte encouragent vivement le dépôt des scripts de calcul (code R, syntaxe SPSS ou script Python) sur des entrepôts de données publiques pérennes comme l’Open Science Framework (OSF). La mise à disposition de lignes de code attestant de la désactivation explicite de l’argument d’égalité de variance (var.equal = FALSE) offre aux pairs évaluateurs la garantie irréfutable de la probité méthodologique et de la rigueur computationnelle ayant présidé à l’analyse empirique.
11.3 Exemples concrets de rédaction pour articles de recherche
Afin de guider concrètement les chercheurs dans la transcription formelle de leurs résultats statistiques au sein de manuscrits destinés à des revues à comité de lecture, nous proposons ci-après des modèles rédactionnels types adaptés aux normes APA 7, déclinés selon les configurations inférentielles courantes.
Modèle pour un résultat statistiquement significatif (reprenant les calculs de notre exemple pratique) :
« Afin d’évaluer l’impact du programme d’entraînement attentionnel, une comparaison des scores d’attention exécutive a été réalisée entre le groupe expérimental et le groupe témoin. Compte tenu des effectifs inégaux et pour se prémunir contre toute hétérogénéité des variances, un test t de Welch avec approximation des degrés de liberté de Satterthwaite a été mobilisé par défaut. L’analyse révèle une supériorité statistiquement significative des scores du groupe témoin (M = 23,38 ; SD = 3,59) par rapport au groupe expérimental (M = 19,27 ; SD = 2,94), t(21,98) = -3,08, p = ,005, d ajusté = 1,25, IC à 95 % [-6,88 ; -1,35]. Ces résultats traduisent une différence d’une ampleur substantielle en faveur du groupe n’ayant pas reçu l’intervention testée. »
Modèle pour un résultat statistiquement non significatif avec rapportage de l’intervalle d’équivalence :
« La comparaison des niveaux de réactivité émotionnelle mesurés entre les participants du groupe contrôle (M = 45,12 ; SD = 8,45 ; n = 18) et ceux du groupe d’intervention brève (M = 43,80 ; SD = 14,20 ; n = 12) a été menée au moyen d’un test t de Welch appliquant la correction de Satterthwaite. L’analyse ne met en évidence aucune différence statistiquement significative entre les deux cohortes, t(16,42) = 0,29, p = ,773, d ajusté = 0,11, IC à 95 % [-8,15 ; 10,79]. La présence de variances substantielles et hétérogènes combinée à l’exiguïté de l’échantillon se traduit par un nombre effectif de degrés de liberté contracté (df = 16,42), illustrant l’incertitude entourant l’estimation du paramètre et incitant à interpréter cette absence de significativité avec circonspection. »
Dans les tableaux synthétiques récapitulatifs au format APA, il est recommandé d’insérer une note de bas de tableau indiquant explicitement : « Note. Les degrés de liberté pour les tests t sont calculés via l’approximation de Satterthwaite pour tenir compte de l’inégalité potentielle des variances et sont par conséquent rapportés avec leurs valeurs décimales effectives. »
12. Synthèse et bonnes pratiques pour les chercheurs
12.1 Synthèse des points clés de l’approximation
L’exploration approfondie de l’approximation de Franklin E. Satterthwaite permet d’en dégager les fondements conceptuels majeurs qui ont transformé la pratique de l’inférence statistique contemporaine. Au cœur de cette innovation réside la prise en compte explicite du problème de Behrens-Fisher : l’impossibilité d’obtenir une distribution t de Student standard exacte lorsque deux populations indépendantes présentent des variances inégales. En traitant l’erreur-type de la différence des moyennes comme une combinaison linéaire de deux variables aléatoires d’échantillonnage de type khi-deux indépendantes, Satterthwaite a fourni une passerelle mathématique permettant d’adapter la distribution de référence par la méthode d’égalisation des moments.
La rupture méthodologique majeure opérée par ce développement consiste à affranchir les degrés de liberté de leur carcan géométrique entier initial pour leur conférer une nature continue et dynamique. Les degrés de liberté effectifs df calculés ne dépendent plus simplement de la somme figée des tailles d’échantillons (n₁ + n₂ – 2), mais évoluent de manière continue en réponse directe à l’interaction entre les effectifs et les variances observées. Cette calibration continue élargit de manière optimale les queues de probabilité de la statistique de test, neutralisant instantanément l’inflation catastrophique du taux de faux positifs qui gangrène les études recourant aveuglément au test de Student standard en contexte hétéroscédastique.
Loin de constituer une simple curiosité historique restreinte à l’analyse bivariée des années 1940, la formule de Satterthwaite demeure aujourd’hui l’un des piliers computationnels les plus sophistiqués des sciences quantitatives. Son extension aux modèles linéaires mixtes et hiérarchiques permet de résoudre l’estimation de significativité des paramètres fixes au sein de structures hautement corrélées, asymétriques et incomplètes, témoignant de l’universalité et de la pérennité de cette avancée théorique.
12.2 Arbre décisionnel pour l’analyse de deux groupes
À la lumière de l’état actuel de la science méthodologique et des consensus forgés au cours des deux dernières décennies, la démarche analytique présidant à la comparaison de deux groupes indépendants peut être synthétisée sous la forme d’un arbre décisionnel d’une grande rigueur opérationnelle :
- Étape 1 : Diagnostic de la nature de la variable et de la structure de distribution
- Si la variable dépendante est strictement continue et présente une distribution symétrique sans anomalies outrancières (même sous une légère asymétrie tolérée par le théorème central limite), s’orienter vers la démarche paramétrique univariée.
- Si la variable présente une distribution hautement discrète, ordinale pure, ou une bimodalité extrême associée à de très petits échantillons (n < 8), s’orienter vers des méthodes de permutation exacte ou de rééchantillonnage bootstrap non paramétrique.
- Étape 2 : Éradication formelle du pré-test d’égalité des variances
- Ne pas procéder à un test préliminaire de Levene, de Bartlett ou de Fisher pour statuer sur l’homoscédasticité des données, en raison du biais de conditionnement et de la faible puissance de ces tests préliminaires.
- Étape 3 : Application par défaut de l’approximation de Welch-Satterthwaite
- Appliquer systématiquement, par principe méthodologique universel, le test t de Welch intégrant les degrés de liberté de Satterthwaite.
- Si les variances sont parfaitement homogènes, le test de Welch-Satterthwaite convergera automatiquement vers le test de Student sans déperdition discernable de puissance. Si les variances sont hétérogènes, il préservera rigoureusement l’intégrité du taux d’erreur nominal alpha à 5 %.
- Étape 4 : Rapportage intégral aux normes contemporaines
- Publier la statistique observée en conservant impérativement les degrés de liberté continus décimaux de Satterthwaite, accompagnée de la valeur exacte de p, de l’intervalle de confiance ajusté et d’une mesure de taille d’effet standardisée non biaisée.
12.3 Perspectives d’évolution dans les sciences psychologiques
L’assimilation généralisée de l’approximation de Satterthwaite au sein des pratiques de recherche quotidiennes a d’ores et déjà permis d’élever substantiellement la fiabilité des conclusions publiées dans les revues internationales. En immunisant les analystes contre les faux positifs artificiellement générés par des variances inégales, cette rigueur algorithmique a constitué l’un des premiers remparts structurels contre la fragilité réplicative qui a secoué les sciences du comportement au cours des années 2010.
Dans la perspective du développement des méthodologies quantitatives, les principes algorithmiques formalisés par Satterthwaite continuent de nourrir les innovations computationnelles les plus contemporaines. On assiste aujourd’hui à une hybridation féconde entre les approximations par égalisation de moments et les cadres de modélisation bayésienne empirique. Dans ces architectures avancées, les estimations de degrés de liberté effectifs dérivés de Satterthwaite servent fréquemment à calibrer les distributions a priori faiblement informatives (priors) des paramètres d’échelle au sein de chaînes de Markov Monte-Carlo (MCMC), accélérant considérablement la convergence algorithmique dans les modèles hiérarchiques à haute dimensionnalité.
En définitive, la formule de Satterthwaite démontre qu’une découverte théorique fondamentale ne s’estompe jamais sous l’effet du temps technologique, mais gagne au contraire en légitimité à mesure que les capacités computationnelles permettent d’en exploiter toute la puissance analytique. Pour tout chercheur, psychomètre ou analyste de données soucieux de la solidité de ses preuves empiriques, la maîtrise de cette approximation ne représente pas un simple raffinement accessoire, mais un impératif méthodologique qui sépare l’illusion statistique de la découverte scientifique véritable.
Références
- Aspin, A. A. (1948). An examination and further development of a formula arising in the problem of comparing two mean values. Biometrika, 35(1/2), 88–96. https://doi.org/10.2307/2332630
- Behrens, W.-U. (1929). Ein Beitrag zur Fehlerberechnung bei wenigen Beobachtungen. Landwirtschaftliche Jahrbücher, 68, 807–837.
- Fisher, R. A. (1935). The fiducial argument in statistical inference. Annals of Eugenics, 6(4), 391–398. https://doi.org/10.1111/j.1469-1809.1935.tb02120.x
- Kenward, M. G., & Roger, J. H. (1997). Small sample inference for fixed effects from restricted maximum likelihood. Biometrics, 53(3), 983–997. https://doi.org/10.2307/2533558
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Schucany, W. R., & Ng, H. K. T. (2006). Preliminary goodness-of-fit tests for normality do not validate the one-sample Student t-test. Communications in Statistics – Theory and Methods, 35(11), 2075–2085. https://doi.org/10.1080/03610920600762464
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Tomarken, A. J., & Serlin, R. C. (1986). Comparison of ANOVA alternatives under variance heterogeneity and specific noncentrality structures. Psychological Bulletin, 99(1), 90–99. https://doi.org/10.1037/0033-2909.99.1.90
- Welch, B. L. (1938). The significance of the difference between two means when the population variances are unequal. Biometrika, 29(3/4), 350–362. https://doi.org/10.2307/2332010
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.2307/2332510
- Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3rd ed.). Academic Press.