
L’analyse de la variance (ANOVA) constitue l’un des piliers méthodologiques les plus robustes et les plus répandus au sein de la recherche contemporaine en psychologie, en neurosciences cognitives et, plus largement, dans l’ensemble des sciences comportementales. Conçue pour disséquer la variabilité observée au sein de données empiriques et en attribuer les fractions respectives à des sources d’influence identifiables ou à l’aléa de l’échantillonnage, cette méthode inférentielle permet aux chercheurs de dépasser les comparaisons binaires rudimentaires. Dès lors qu’un protocole d’expérimentation mobilise plus de deux conditions d’observation ou cherche à capturer la complexité des dynamiques humaines, la question du choix structural du modèle devient cruciale. Une décision inadéquate entre une approche à facteur unique et une architecture factorielle peut compromettre la puissance du test statistique, obscurcir des mécanismes psychologiques sous-jacents ou introduire des erreurs de spécification majeures.
Le dilemme fondamental opposant l’analyse de variance à un facteur (dite univariée ou one-way ANOVA) et l’analyse de variance à deux facteurs (dite factorielle ou two-way ANOVA) ne relève pas d’une simple divergence technique ou arithmétique. Il engage la conceptualisation même de la problématique scientifique, la gestion parcimonieuse de la variance résiduelle et la capacité du chercheur à modéliser des interactions complexes. Là où l’ANOVA à un facteur isole l’action d’une variable indépendante unique pour en mesurer le retentissement direct sur une variable dépendante continue, l’ANOVA à deux facteurs tisse une matrice explicative plus dense. Cette dernière permet de scruter simultanément deux déterminants qualitatifs, tout en révélant si l’influence de l’un se trouve modulée, amplifiée ou neutralisée par la présence conjointe de l’autre.
Ce guide exhaustif a pour vocation d’offrir une exploration théorique, mathématique et méthodologique approfondie de ces deux dispositifs statistiques incontournables. En cheminant des fondements épistémologiques du modèle linéaire général jusqu’aux finesses de l’interprétation des effets d’interaction et à la gestion des violations de postulats, cet article fournit aux chercheurs, statisticiens et étudiants avancés en psychologie les grilles de lecture indispensables pour orienter rigoureusement leur choix analytique. À travers des études de cas empiriques détaillées et des recommandations fondées sur les standards les plus exigeants de la psychométrie contemporaine, nous éclairerons les conditions précises sous lesquelles chaque modèle déploie sa pleine pertinence scientifique.
1. Fondements théoriques et épistémologiques de l’analyse de variance en psychologie
1.1 Origine et utilité du modèle linéaire général
L’analyse de variance puise ses racines historiques directes dans les travaux pionniers de l’agronome et statisticien britannique Sir Ronald Aylmer Fisher au début des années 1920. Confronté à la variabilité inhérente aux rendements agricoles de la station expérimentale de Rothamsted, Fisher a formalisé un cadre mathématique révolutionnaire destiné à isoler la part de variation attribuable à des traitements spécifiques (tels que la composition des engrais ou les variétés de semences) de la fluctuation aléatoire propre aux conditions pédologiques et climatiques. Très rapidement, ce cadre conceptuel a dépassé le champ de l’agronomie pour investir les sciences du comportement. Des méthodologistes visionnaires, à l’instar de Quinn McNemar, ont compris que l’esprit humain, loin de constituer un système déterministe simple, présentait une variabilité individuelle et situationnelle tout à fait analogue aux parcelles expérimentales de Fisher.
Au sein de la psychométrie et de la psychologie quantitative contemporaines, l’ANOVA ne se conçoit plus comme un ensemble de recettes calculatoires isolées, mais s’intègre harmonieusement dans la théorie unificatrice du modèle linéaire général (GLM). Le GLM postule que toute valeur observée d’une variable dépendante continue peut être exprimée comme la somme d’une combinaison linéaire de prédicteurs (qu’ils soient catégoriels ou continus), pondérés par des paramètres spécifiques, et d’une composante d’erreur stochastique résiduelle. Dans cette optique mathématique unifiée, la distinction traditionnelle entre le test de Student, la régression linéaire multiple et l’analyse de variance s’estompe : le test de t pour échantillons indépendants n’est rien d’autre qu’une ANOVA restreinte à deux modalités, tandis que l’ANOVA générale représente un cas particulier de régression linéaire où l’ensemble des variables prédictives a été préalablement codé sous forme de variables catégorielles indicatrices (ou variables muettes dites dummy variables).
L’utilité méthodologique primordiale de l’ANOVA réside dans sa capacité mathématique à juguler l’inflation exponentielle de l’erreur de type I, communément désignée par le risque alpha. Lorsqu’un chercheur souhaite évaluer les disparités existant entre k groupes expérimentaux (par exemple, quatre protocoles thérapeutiques distincts), le recours naïf à une série de tests de t de Student indépendants s’avère proscrit. Pour quatre groupes, le nombre de comparaisons bilatérales directes s’élève à k(k – 1) / 2, soit six tests distincts. En fixant le seuil de signification nominal à $\alpha = 0{,}05$ par test, la probabilité cumulée de rejeter à tort au moins une hypothèse nulle vraie sur l’ensemble de la famille de tests (taux d’erreur par famille, ou family-wise error rate) n’est plus de 5 %, mais atteint $1 – (1 – 0{,}05)^6 \approx 0{,}265$, soit un risque alarmant de 26,5 %. L’analyse de variance résout élégamment ce péril épistémologique en effectuant un test omnibus unique. Elle interroge simultanément la matrice de dispersion globale sous l’hypothèse nulle d’invariance des moyennes, maintenant ainsi rigoureusement le risque d’erreur de première espèce au seuil prédéterminé de 5 % pour l’ensemble du dispositif expérimental.
1.2 Décomposition de la variance totale : intra-groupe et inter-groupes
L’édifice conceptuel de l’analyse de variance repose sur le théorème fondamental de partitionnement de la somme des carrés des écarts à la moyenne. D’un point de vue arithmétique, la variabilité globale mesurée au sein d’une cohorte de sujets peut être entièrement scindée en deux composantes orthogonales et additives. Soit un ensemble de données où chaque individu i appartenant à un groupe j présente un score $Y_{ij}$. La somme totale des carrés des écarts ($SC_{Totale}$ ou Total Sum of Squares), calculée par rapport à la moyenne générale ($\bar{Y}_{..}$), se décompose formellement selon l’identité remarquable suivante :
$$SC_{Totale} = SC_{Inter} + SC_{Intra}$$
Où $SC_{Inter}$ (somme des carrés inter-groupes, ou Between-groups Sum of Squares) quantifie la dispersion des moyennes conditionnelles de chaque groupe ($\bar{Y}_{.j}$) autour de la moyenne globale de l’échantillon, pondérée par le nombre de sujets par condition. Sur le plan épistémologique, cette composante constitue l’indicateur direct de l’effet expérimental : si la manipulation méthodologique opérée par le chercheur induit une différenciation réelle des états psychologiques ou comportementaux, les moyennes des groupes divergeront substantiellement les unes des autres, gonflant proportionnellement la magnitude de $SC_{Inter}$.
À l’inverse, la composante $SC_{Intra}$ (somme des carrés intra-groupe, souvent dénommée somme des carrés résiduelle ou Within-groups / Error Sum of Squares) mesure la somme des déviations quadratiques des scores individuels $Y_{ij}$ par rapport à la moyenne spécifique de leur propre groupe d’appartenance ($\bar{Y}_{.j}$). Puisque l’ensemble des participants assignés à une même cellule expérimentale sont soumis à un protocole rigoureusement identique, toute variation constatée en leur sein ne saurait découler du facteur manipulé. Cette variance résiduelle reflète par conséquent l’agrégation de l’hétérogénéité interindividuelle préexistante (traits de personnalité, aptitudes cognitives basales, prédispositions génétiques), des erreurs de mesure psychométriques inhérentes aux instruments standardisés et des fluctuations environnementales non contrôlées.
Pour convertir ces sommes de carrés en estimateurs non biaisés de la variance (désignés sous le vocable de carrés moyens, $CM$ ou Mean Squares), chaque somme est divisée par ses degrés de liberté ($ddl$) respectifs. Le rapport de ces deux variances permet d’établir la statistique de test, le ratio F de Fisher-Snedecor :
$$F = \frac{CM_{Inter}}{CM_{Intra}} = \frac{SC_{Inter} / (k – 1)}{SC_{Intra} / (N – k)}$$
Ce ratio $F$ formalise un quotient signal/bruit d’une remarquable limpidité conceptuelle. Le numérateur incarne le signal théorique (la variance provoquée par le traitement expérimental, augmentée de la variance d’échantillonnage), tandis que le dénominateur représente le bruit de fond (l’aléa résiduel pur). Si l’hypothèse nulle est rigoureusement exacte, le numérateur et le dénominateur estiment la même quantité sous-jacente de variance d’erreur, conférant au ratio $F$ une espérance mathématique proche de l’unité. En revanche, dès lors qu’un effet réel opère au sein des populations parentes, le carré moyen inter-groupes surpasse significativement le carré moyen résiduel, projetant la statistique observée vers la queue de distribution théorique de Snedecor et justifiant le rejet de l’invariance postulée.
1.3 Rôle pivot dans les protocoles expérimentaux en sciences humaines
L’analyse de variance s’est érigée en standard d’excellence méthodologique pour la validation quantitative des paradigmes expérimentaux en psychologie cognitive, sociale, clinique et différentielle. Sa structure computationnelle impose aux chercheurs une rigueur opérationnelle sans équivalent dans la formalisation préalable de leurs hypothèses de recherche. Dans les protocoles de psychologie cognitive, par exemple, où l’on cherche à isoler les sous-composantes d’une architecture mentale (mémoire de travail, attention sélective, fonctions exécutives), l’ANOVA offre le substrat mathématique indispensable pour vérifier si la manipulation temporelle ou perceptive imposée aux sujets altère systématiquement les chronométries mentales ou les taux d’erreurs au-delà de la simple stochasticité des comportements.
Dans ce contexte expérimental, la distinction conceptuelle entre variables indépendantes manipulées (dites provoquées) et variables indépendantes invoquées (ou assignées) revêt une importance épistémique cruciale. Une variable manipulée émane d’une intervention délibérée du chercheur, telle que l’administration d’une molécule pharmacologique, l’induction d’un stress aigu ou la présentation d’amorces sémantiques distinctes, suivie d’une randomisation intégrale des sujets. En revanche, les variables invoquées renvoient à des caractéristiques intrinsèques non manipulables que les participants possèdent avant leur entrée dans le laboratoire, à l’instar du genre biologique, du quotient intellectuel, d’un diagnostic nosographique (présence d’un trouble anxieux généralisé vs. sujets témoins) ou de l’appartenance générationnelle. L’ANOVA possède la flexibilité structurelle requise pour intégrer indifféremment ou simultanément ces deux ordres de variables, tout en alertant le statisticien sur la portée causale de ses inférences.
En effet, la solidité inférentielle offerte par l’analyse de variance constitue le garant premier de la validité interne d’une recherche. En formalisant mathématiquement la part d’erreur attribuable à l’échantillonnage, elle prémunit l’expérimentateur contre les pièges de l’illusion de corrélation et des conclusions prématurées. Simultanément, lorsqu’elle est articulée à des plans d’échantillonnage probabilistes ou stratifiés, l’ANOVA soutient la validité externe des résultats expérimentaux en autorisant la généralisation statistique des constats locaux à l’ensemble de la population cible. Elle forme ainsi le pivot méthodologique qui permet de transformer une observation comportementale ponctuelle en une découverte scientifique reproductible et falsifiable selon les critères poppériens.
2. L’ANOVA à un facteur : architecture, principes et fonctionnement
2.1 Définition structurelle et formalisation mathématique
L’analyse de variance univariée à un facteur inter-sujets (souvent désignée sous le vocable d’ANOVA à plan simple ou one-way independent ANOVA) intervient lorsqu’un protocole d’investigation ne mobilise qu’une seule et unique variable indépendante catégorielle, comportant au minimum trois modalités distinctes ($k ge 3$). Bien qu’elle soit théoriquement applicable à une variable à deux niveaux ($k = 2$), son recours est alors strictement équivalent au test de t de Student pour échantillons indépendants ($F = t^2$). L’architecture à un facteur déploie donc son utilité opérationnelle spécifique dès lors que le chercheur cherche à comparer simultanément plusieurs univers de traitement au moyen d’une seule règle de classification mutuellement exclusive.
Sur le plan de la modélisation mathématique, le cadre linéaire additif sous-jacent s’exprime au moyen de l’équation suivante pour chaque observation individuelle :
$$Y_{ij} = \mu + \alpha_j + \varepsilon_{ij}$$
Dans cette formalisation, $Y_{ij}$ représente le score observé sur la variable dépendante continue pour le i-ème participant ($i = 1, 2, dots, n_j$) affecté au j-ème niveau du facteur expérimental ($j = 1, 2, dots, k$). Le paramètre $\mu$ correspond à la moyenne générale théorique de la population parente indépendamment des traitements (la constante du modèle). Le terme $\alpha_j = \mu_j – \mu$ symbolise l’effet différentiel propre à la j-ème modalité du facteur, sous la contrainte d’identifiabilité standard imposant que la somme pondérée des effets soit nulle ($\sum_{j=1}^k \alpha_j = 0$ pour un plan équilibré). Enfin, $\varepsilon_{ij}$ figure le terme d’erreur résiduelle non observée, supposé distribué de manière indépendante et identique selon une loi normale centrée d’espérance nulle et de variance constante $\sigma^2$, soit $\varepsilon_{ij} \sim \mathcal{N}(0, \sigma^2)$.
À partir de cette écriture formelle se dégagent les hypothèses statistiques soumises au test empirique. L’hypothèse nulle ($H_0$), postulée a priori, affirme l’absence absolue d’effet du facteur considéré, traduisant une stricte équivalence des espérances mathématiques des populations associées à chaque modalité :
$$H_0 : \mu_1 = \mu_2 = dots = \mu_k \quad Long\leftrightarrow \quad \alpha_1 = \alpha_2 = dots = \alpha_k = 0$$
L’hypothèse alternative ($H_1$) revêt quant à elle une nature composite non directionnelle. Elle n’exige nullement que l’ensemble des moyennes soient toutes dissemblables les unes des autres, mais affirme simplement la rupture d’égalité sur au moins l’une des paires sous-jacentes :
$$H_1 : \exists , (j, j’) \quad \text{tel que} \quad \mu_j ne \mu_{j’} \quad Long\leftrightarrow \quad \exists , j \quad \text{tel que} \quad \alpha_j ne 0$$
Le système admet $k – 1$ degrés de liberté associés à la source de variation factorielle inter-groupes, et $N – k$ degrés de liberté dévolus à l’estimation de l’erreur intra-groupe (où $N = \sum_{j=1}^k n_j$ représente la taille totale de l’échantillon analysé). Le total cumulé des degrés de liberté s’élève logiquement à $N – 1$.
2.2 La procédure d’inférence statistique univariée
La conduite de l’inférence statistique au sein de l’ANOVA univariée s’articule autour de la construction rigoureuse du tableau de décomposition de la variance. Ce tableau synthétise les composantes calculatoires élémentaires et structure le raisonnement inférentiel en mettant en regard les sommes de carrés, les degrés de liberté, les carrés moyens correspondants et le ratio de test empirique résultant :
Pour amorcer l’estimation, le statisticien calcule la moyenne générale $\bar{Y}_{..}$ ainsi que les moyennes conditionnelles $\bar{Y}_{.j}$. À partir de ces indicateurs sont calculées la somme des carrés inter-groupes :
$$SC_{Inter} = \sum_{j=1}^k n_j (\bar{Y}_{.j} – \bar{Y}_{..})^2$$
et la somme des carrés résiduelle intra-groupe :
$$SC_{Intra} = \sum_{j=1}^k \sum_{i=1}^{n_j} (Y_{ij} – \bar{Y}_{.j})^2$$
Une fois les carrés moyens obtenus par division de chaque somme par son degré de liberté correspondant ($CM_{Inter} = SC_{Inter} / [k – 1]$ et $CM_{Intra} = SC_{Intra} / [N – k]$), le ratio $F_{obs} = CM_{Inter} / CM_{Intra}$ est confronté à la distribution théorique de Fisher tabulée à $k – 1$ et $N – k$ degrés de liberté pour un seuil d’erreur alpha conventionnel (habituellement fixé à $0{,}05$ ou $0{,}01$). Si la statistique empirique calculée excède la valeur critique théorique $F_{critique}$, ou si la valeur p (probabilité asymptotique d’observer une valeur au moins aussi extrême sous l’hypothèse nulle vraie) est strictement inférieure au seuil $\alpha$, le chercheur prononce le rejet formel de l’hypothèse nulle d’homogénéité globale des moyennes.
Néanmoins, la simple décision de rejet ne renseigne aucunement sur l’ampleur substantielle du phénomène mesuré, cette dernière demeurant tributaire de la taille d’échantillon. C’est pourquoi la pratique psychométrique moderne impose l’adjonction systématique d’indices de taille d’effet. Le premier d’entre eux, le coefficient êta-carré ($\eta^2$), exprime la proportion brute de variance de la variable dépendante expliquée par l’appartenance aux différents groupes :
$$\eta^2 = \frac{SC_{Inter}}{SC_{Totale}}$$
Toutefois, l’indice $\eta^2$ souffre d’un biais systématique à la hausse en tant qu’estimateur descriptif d’échantillon, surestimant la véritable variance expliquée dans la population, tout particulièrement lorsque les effectifs de sous-groupes sont restreints. Pour corriger cette distorsion, l’oméga-carré ($\omega^2$), théorisé par William L. Hays, offre un estimateur considérablement plus rigoureux et non biaisé :
$$\omega^2 = \frac{SC_{Inter} – (k – 1)CM_{Intra}}{SC_{Totale} + CM_{Intra}}$$
Cet ajustement retranche la part de variance attendue sous le simple effet du hasard au numérateur et pénalise le dénominateur, fournissant aux psychologues une appréciation hautement fiabilisée de la force d’association théorique étudiée.
2.3 Champs d’application privilégiés en recherche psychologique
L’ANOVA à un facteur s’illustre particulièrement au sein des paradigmes expérimentaux visant à isoler l’efficience comparative de stratégies thérapeutiques ou de protocoles d’intervention univoques. Dans le champ de la psychologie clinique et de la psychiatrie factuelle, elle intervient de manière paradigmatique lors de l’évaluation simultanée de plusieurs modalités psychothérapeutiques. Imaginons une étude clinique randomisée conçue pour amoindrir les manifestations pathologiques du trouble d’anxiété sociale. Le chercheur assigne aléatoirement une cohorte homogène de patients à trois conditions mutuellement exclusives : une thérapie cognitive et comportementale (TCC) de type beckien, une thérapie d’acceptation et d’engagement (ACT) ancrée dans les approches de troisième vague, et un groupe témoin placé sur liste d’attente avec suivi non dirigé. Au terme des douze semaines de prise en charge, les scores obtenus sur l’échelle d’anxiété de Liebowitz sont comparés via une ANOVA univariée. Le facteur « Modalité d’intervention » comportant trois niveaux, le test permet de statuer de manière globale et sécurisée sur l’existence d’une supériorité d’au moins un protocole sur les autres, avant d’engager des comparaisons par paires ciblées.
En neurosciences comportementales et en neuropsychopharmacologie, l’ANOVA univariée est également le vecteur privilégié de l’analyse des relations dose-réponse. Lorsqu’une équipe examine les répercussions d’une substance psychoactive (par exemple, un agoniste dopaminergique ou un extrait nootropique) sur les temps de réaction motrice lors d’une tâche d’attention soutenue, le protocole mobilise fréquemment plusieurs paliers posologiques : un véhicule placebo (0 mg), une dose faible, une dose médiane et une dose élevée. Le facteur « Posologie » structure l’analyse en quatre niveaux distincts. L’ANOVA permet alors d’objectiver mathématiquement si l’accroissement quantitatif de la concentration moléculaire engendre une modulation statistiquement tangible des performances chronométriques, pavant la voie à la détection de profils de réponse non linéaires ou en U inversé.
Enfin, dans le secteur de la psychologie différentielle et du développement tout au long de la vie (life-span development), l’ANOVA à un facteur sert couramment à mesurer l’impact de découpages chronologiques ou catégoriels non manipulés. L’étude de l’efficience de l’inhibition cognitive mesurée par le paradigme de Stroop à travers trois tranches d’âge distinctes — les jeunes adultes (18-25 ans), les adultes d’âge mûr (40-55 ans) et les personnes âgées autonomes (65-80 ans) — illustre parfaitement cette configuration. Ici, la variable catégorielle « Groupe d’âge » à trois niveaux agit comme facteur unique de classification transversale, permettant de tester empiriquement l’hypothèse du déclin progressif des fonctions de contrôle exécutif lié au vieillissement physiologique normal.
3. L’ANOVA à deux facteurs : complexité factorielle et structure matricielle
3.1 Structure factorielle croisée et formalisation mathématique
Dès lors que la conceptualisation scientifique intègre la concomitance de deux déterminants distincts, le recours à un plan d’analyse de variance à deux facteurs (désigné en anglais sous l’appellation two-way factorial ANOVA) devient impératif. Ce modèle statistique traite simultanément deux variables indépendantes qualitatives, souvent notées arbitrairement Facteur A et Facteur B, comportant respectivement J et K modalités. Dans un plan factoriel complet croisé de type $J \times K$, chaque niveau du facteur A est combiné de façon exhaustive avec chaque modalité du facteur B, engendrant un maillage matriciel composé de $J \times K$ cellules expérimentales distinctes au sein desquelles les observations sont collectées.
La puissance conceptuelle de l’ANOVA factorielle découle de son équation structurelle additive étendue, capable d’isoler les influences propres à chaque variable tout en quantifiant leur co-action dynamique :
$$Y_{ijk} = \mu + \alpha_j + \beta_k + (\alpha\beta)_{jk} + \varepsilon_{ijk}$$
Dans cette formalisation mathématique :
- $Y_{ijk}$ désigne la mesure empirique recueillie auprès du i-ème individu ($i = 1, dots, n_{jk}$) positionné dans la cellule issue de l’intersection du j-ème niveau de A ($j = 1, dots, J$) et du k-ème niveau de B ($k = 1, dots, K$).
- $\mu$ symbolise la moyenne générale non pondérée de l’ensemble de la population parente.
- $\alpha_j$ représente l’effet principal théorique imputable à la j-ème modalité du facteur A, mesuré par l’écart marginal de cette modalité à la moyenne générale ($\mu_{j.} – \mu$).
- $\beta_k$ figure l’effet principal théorique imputable à la k-ème modalité du facteur B, mesuré par l’écart marginal équivalent ($\mu_{.k} – \mu$).
- $(\alpha\beta)_{jk}$ constitue le terme cardinal d’interaction statistique entre le facteur A et le facteur B pour la cellule spécifique $(j, k)$. Il reflète la fraction de la réponse moyenne qui ne peut pas être prédite par la simple sommation arithmétique de l’effet moyen de A et de l’effet moyen de B.
- $\varepsilon_{ijk}$ représente l’erreur stochastique individuelle résiduelle de mesure, distribuée normalement selon $\mathcal{N}(0, \sigma^2)$.
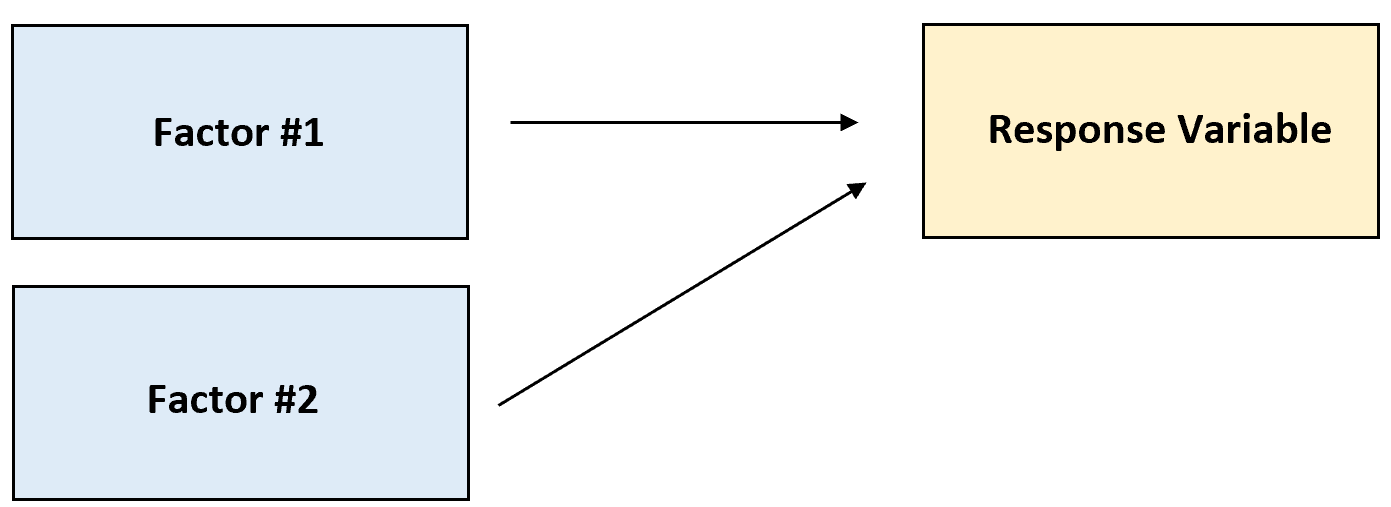
Le théorème de partitionnement de la variance s’étend ici de manière particulièrement élégante. La somme des carrés totale se subdivise désormais en quatre composantes parfaitement orthogonales dans le cas de plans équilibrés :
$$SC_{Totale} = SC_A + SC_B + SC_{AB} + SC_{Intra}$$
Chacune de ces sources de variation dispose de ses degrés de liberté propres, dictés par la combinatoire matricielle du plan :
- Pour le facteur A : $ddl_A = J – 1$
- Pour le facteur B : $ddl_B = K – 1$
- Pour le terme d’interaction croisée A $\times$ B : $ddl_{AB} = (J – 1)(K – 1)$
- Pour l’erreur résiduelle intra-groupe : $ddl_{Intra} = N – JK$ (où $N = \sum \sum n_{jk}$)
- Pour la variation totale de l’échantillon : $ddl_{Totale} = N – 1$
Cette décomposition méticuleuse offre une résolution analytique d’une grande finesse, inaccessible aux modèles univariés séquentiels.
3.2 Les effets principaux : isolement et évaluation marginale
Au sein d’un dispositif factoriel, la notion d’effet principal (main effect) formalise l’impact global et direct exercé par une variable indépendante spécifique sur la variable dépendante, considéré à travers l’ensemble des modalités du second facteur, comme si ce dernier avait été neutralisé ou agrégé. L’évaluation de l’effet principal d’un facteur consiste ainsi à examiner la variance constatée entre ses moyennes marginales. La moyenne marginale de la j-ème modalité du facteur A correspond à la moyenne arithmétique de l’ensemble des observations rattachées à ce palier j, calculée en fusionnant sans distinction l’ensemble des niveaux associés du facteur B.
Sur le plan de l’inférence hypothético-déductive, l’ANOVA à deux facteurs procède à deux tests indépendants d’effets principaux au moyen de deux ratios de Fisher distincts partageant le même dénominateur résiduel :
Pour le facteur A, le test interroge l’hypothèse nulle $H_{0(A)} : \alpha_1 = dots = \alpha_J = 0$ via la statistique :
$$F_A = \frac{CM_A}{CM_{Intra}} = \frac{SC_A / (J – 1)}{SC_{Intra} / (N – JK)}$$
Pour le facteur B, l’hypothèse nulle d’invariance marginale $H_{0(B)} : \beta_1 = dots = \beta_K = 0$ est soumise à la statistique analogue :
$$F_B = \frac{CM_B}{CM_{Intra}} = \frac{SC_B / (K – 1)}{SC_{Intra} / (N – JK)}$$
Cette approche permet ainsi de déterminer si l’action du premier facteur est globalement significative, indépendamment du second, et réciproquement. Toutefois, une limite épistémologique majeure doit être fermement soulignée : l’interprétation concrète d’un effet principal marginal perd une part substantielle de sa validité heuristique et clinique dès lors que le terme d’interaction s’avère statistiquement significatif. Si la relation entre le facteur A et la mesure comportementale varie du tout au tout selon la modalité active du facteur B, proclamer qu’il existe un effet global moyen de A relève d’une simplification trompeuse, susceptible de masquer des inversions locales d’une portée théorique capitale.
3.3 Avantages méthodologiques par rapport aux analyses séparées
Face à une problématique impliquant deux déterminants de recherche, certains praticiens peu avertis commettent l’erreur d’exécuter deux analyses de variance à un facteur totalement disjointes, en examinant d’une part l’effet de A sur l’échantillon groupé, puis d’autre part l’effet de B. Cette stratégie séquentielle dégradée présente une triple infériorité méthodologique, statistique et conceptuelle qu’il convient de proscrire rigoureusement.
Le gain méthodologique premier réside dans l’accroissement substantiel de la puissance statistique généré par le modèle factoriel. Lorsqu’on conduit une ANOVA à un facteur sur le prédicteur A en omettant B, l’intégralité de la variabilité systématique induite par l’action de B et par l’interaction A $\times$ B se trouve mécaniquement reléguée dans la somme des carrés résiduelle intra-groupe ($SC_{Intra}$). Le dénominateur du ratio F s’en trouve artificiellement gonflé, réduisant drastiquement la valeur empirique de la statistique de test et augmentant le risque d’erreur de type II (non-rejet d’une hypothèse nulle fausse). En intégrant explicitement B au sein de la matrice factorielle, le chercheur extrait la variance explicable propre à ce second facteur hors du terme d’erreur résiduel. Le carré moyen d’erreur ($CM_{Intra}$) s’en trouve considérablement purifié et diminué, ce qui affine la sensibilité du test à identifier des effets réels de faible à moyenne intensité pour le facteur principal A.
Le second avantage est d’ordre logistique et économique : le principe d’économie d’échantillonnage formalisé par Fisher. En déployant un plan factoriel, le chercheur répond rigoureusement à deux questions scientifiques distinctes au sein d’une seule et même cohorte expérimentale. La puissance requise pour tester l’effet principal marginal de A bénéficie de l’ensemble de l’effectif N, de même que celle allouée au facteur B. Enfin, et surtout, les analyses univariées séparées sont structurellement incapables de révéler l’existence d’une interaction. Elles postulent implicitement une additivité stricte et aveugle des influences environnementales ou biologiques, condamnant l’expérimentateur à ignorer des phénomènes psychologiques cardinaux où une variable en potentialise, atténue ou inverse une autre.
4. Le concept fondamental d’interaction statistique
4.1 Compréhension conceptuelle de l’effet d’interaction
Le concept d’interaction statistique constitue sans conteste l’apport le plus riche et le plus fascinant de la modélisation factorielle à la recherche scientifique. Fondamentalement, une interaction se matérialise lorsque l’effet d’une variable indépendante sur la variable dépendante ne conserve pas une valeur constante, mais dépend formellement de la modalité spécifique adoptée par une seconde variable indépendante. Autrement dit, l’impact du facteur A change de magnitude, voire de polarité, en fonction du niveau d’affectation sur le facteur B. Dès lors, le comportement du système sous observation ne se résume plus à la simple addition des forces en présence : il devient conditionnel, configurant une dynamique statistique fondamentalement multiplicative.
Dans la pratique de la recherche psychologique et psychiatrique, l’interaction statistique incarne la traduction empirique directe des phénomènes de modération clinique et des paradigmes de vulnérabilité différentielle (modèles diathèse-stress). Illustrons ce propos par la réponse thérapeutique à deux antidépresseurs aux profils pharmacologiques divergents (Facteur A : Molécule sérotoninergique vs. Molécule noradrénergique) croisée avec le profil symptomatique dominant des patients (Facteur B : Présentation avec ralentissement psychomoteur vs. Présentation avec agitation anxieuse majeure). Si l’efficacité de la molécule sérotoninergique surpasse largement celle de la noradrénergique chez les patients anxieux, alors que la relation s’inverse rigoureusement chez les patients présentant un ralentissement moteur, nous nous trouvons en présence d’une interaction pure. Raisonner sur les effets moyens globaux des molécules s’avérerait non seulement dénué de sens statistique, mais cliniquement dangereux.
De cet état de fait découle une règle méthodologique immuable en psychométrie : la primauté analytique de l’interaction sur les effets principaux. Face à un tableau factoriel, le chercheur doit impérativement examiner la significativité statistique de la ligne d’interaction ($F_{AB}$) avant de porter son regard sur les effets principaux $F_A$ et $F_B$. Si le terme d’interaction est significatif, les effets principaux doivent être immédiatement suspendus, relativisés ou interprétés avec une extrême circonspection, la réalité des données imposant une décomposition détaillée sous la forme d’analyses conditionnelles fines.
4.2 Typologie des interactions : ordinale, disordinale et croisée
L’analyse géométrique des représentations graphiques permet de catégoriser les interactions selon une typologie morphologique tripartite, dictant la légitimité interprétative des effets principaux résiduels.
L’interaction ordinale se caractérise par des lignes de profils qui ne sont pas parallèles mais convergent ou divergent sans jamais s’intercepter sur l’intervalle des modalités observées. Dans cette configuration, la direction des différences demeure strictement inchangée : une modalité donnée du facteur A reste systématiquement supérieure à l’autre modalité à travers l’ensemble des niveaux du facteur B, mais l’ampleur de cet écart varie de façon marquée. Par exemple, une technique de remédiation cognitive améliore les capacités de rétention mnésique tant chez les sujets jeunes que chez les sujets âgés, mais le bénéfice quantitatif s’avère deux fois plus ample chez les individus âgés. L’effet principal de la technique conserve alors une interprétabilité directionnelle globale solide (la remédiation est bénéfique pour tous), bien que sa magnitude soit modulée par l’âge.
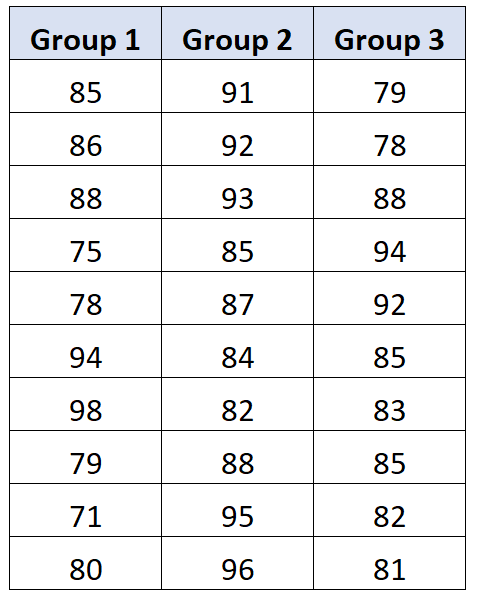
L’interaction disordinale (ou interaction croisée, crossover interaction) représente la configuration la plus spectaculaire et la plus perturbatrice pour les effets principaux. Graphiquement, les segments de droites reliant les moyennes conditionnelles s’interceptent franchement au sein du repère cartésien. La direction de l’effet d’un facteur s’inverse littéralement selon les niveaux du second facteur. L’exemple clinique développé précédemment illustre typiquement une interaction disordinale symétrique : le traitement 1 est supérieur sous la condition B1, mais devient inférieur sous la condition B2. Dans de telles circonstances, les moyennes marginales globales peuvent s’équilibrer parfaitement, conduisant à des ratios $F$ d’effets principaux totalement non significatifs ($F \approx 0$). Conclure à l’inutilité des traitements sur la base de ces moyennes marginales aveugles constituerait un contresens tragique, masquant l’existence de deux effets simples majeurs mais opposés.
La détection de ces typologies requiert impérativement le déploiement d’outils de visualisation graphique rigoureux. Il est formellement recommandé de tracer des diagrammes de profils d’interaction (interaction plots) sous la forme de tracés en lignes ou de nuages conditionnels, accompagnés des barres d’erreur matérialisant les erreurs types de la moyenne (SEM) ou, idéalement, les intervalles de confiance à 95 % ajustés aux comparaisons intra-cellules.
4.3 Analyse des effets simples consécutive à une interaction significative
Dès lors que le ratio de Fisher valide l’existence d’une interaction statistiquement significative ($p < \alpha$), le protocole inférentiel standard s'interrompt pour céder la place à l'analyse méthodique des effets simples (simple effects analysis). L’objectif est de décomposer la structure factorielle multidimensionnelle en une série de sous-analyses univariées locales, en isolant l’impact du facteur primaire à chaque niveau fixe pris individuellement par le facteur modérateur.
La procédure s’articule en deux étapes séquentielles :
- Le partitionnement conditionnel des sommes de carrés : Le chercheur examine l’effet simple du facteur A au niveau $b_1$ du facteur B (noté $A \text{ at } b_1$), puis au niveau $b_2$ ($A \text{ at } b_2$). Sur le plan calculatoire, la somme des carrés de l’interaction et la somme des carrés de l’effet principal de A se trouvent reconfigurées en une somme des carrés d’effets simples :
$$SC_{A} + SC_{AB} = SC_{A \text{ at } b_1} + SC_{A \text{ at } b_2} + dots + SC_{A \text{ at } b_K}$$
Chaque effet simple est ensuite testé au moyen d’un ratio F spécifique, dont le numérateur est le carré moyen de l’effet simple local et le dénominateur demeure impérativement le carré moyen résiduel global ($CM_{Intra}$) issu de l’ANOVA factorielle complète, afin de maximiser les degrés de liberté de l’erreur et la fidélité de l’estimation du bruit. - Le contrôle de l’inflation de l’erreur globale : L’exécution d’une série de tests d’effets simples réintroduit le risque d’inflation du taux d’erreur par famille de tests (risque alpha cumulé). Il est donc indispensable d’appliquer une procédure d’ajustement aux valeurs critiques conditionnelles, telle que la correction séquentielle de Holm-Bonferroni ou la méthode de Benjamini-Hochberg pour le contrôle du taux de fausses découvertes (FDR), garantissant une protection inférentielle sans compromettre excessivement la puissance statistique locale.
5. Les postulats statistiques préalables indispensables
5.1 Indépendance des observations et plan d’échantillonnage
L’édifice mathématique de l’analyse de variance repose sur un triptyque de postulats fondamentaux régissant la distribution des résidus stochastiques. Parmi eux, le postulat d’indépendance mutuelle des observations constitue l’exigence la plus inflexible et la plus sensible aux distorsions inférentielles. Formellement, il requiert que la valeur résiduelle $\varepsilon_{ijk}$ associée à une unité d’observation donnée ne présente aucune covariance ou corrélation sérielle avec la valeur résiduelle de tout autre participant de l’échantillon ($\text{Cov}(\varepsilon_i, \varepsilon_{i’}) = 0 \quad \forall , i ne i’$).
Ce postulat est avant tout garanti par l’architecture méthodologique du protocole expérimental et la qualité de la procédure d’échantillonnage, plutôt que par des corrections algorithmiques a posteriori. Il suppose l’assignation aléatoire intégrale (randomisation vraie) des sujets au sein des différentes conditions expérimentales et l’absence totale d’interactions communicatives ou d’influences environnementales partagées entre participants durant l’administration des épreuves. Dans les protocoles en psychologie sociale ou cognitive, par exemple, tester des participants réunis au sein d’une même pièce physique peut engendrer une violation sournoise de l’indépendance par transmission involontaire d’indices comportementaux ou par émulation contextuelle.
Les conséquences d’une entorse à l’indépendance des erreurs sont dévastatrices pour la validité de l’inférence statistique. Même une corrélation intra-classe résiduelle positive minime entre observations (par exemple $\rho = 0{,}05$ ou $0{,}10$), fréquente lorsque les sujets sont nichés au sein d’unités collectives telles que des classes scolaires ou des services hospitaliers sans modélisation multiniveau appropriée, provoque un effondrement de la variance d’échantillonnage réelle. Le ratio F de Fisher s’en trouve massivement gonflé de manière artificielle, entraînant une inflation exponentielle de l’erreur de type I : le taux de faux positifs réel peut atteindre 30 % à 50 % alors même que le chercheur croit opérer au seuil nominal de 5 %. Il importe par ailleurs de distinguer formellement le plan à mesures indépendantes (inter-sujets), objet central du présent article, des plans à mesures répétées ou mixtes (intra-sujets), où la dépendance longitudinale sérielle des observations recueillies sur un même individu fait l’objet d’un traitement mathématique adapté via les critères de sphéricité de Mauchly.
5.2 Normalité de la distribution des résidus
Le second postulat postule que la variable dépendante — et plus rigoureusement, les résidus d’estimation non observés $\varepsilon_{ijk}$ au sein de chaque cellule expérimentale — est distribuée selon une loi normale parente d’espérance nulle et de variance d’erreur déterminée. Il est fondamental de dissiper une confusion théorique récurrente : l’ANOVA n’exige nullement que la variable dépendante globale, agrégée sur l’ensemble de la cohorte hétérogène, présente une distribution normale (celle-ci étant souvent bimodale ou plurimodale du fait même de la séparation des moyennes induite par les traitements). L’exigence de gaussianité s’applique strictement aux fluctuations d’erreur au sein de chaque sous-groupe expérimental, ou de manière équivalente, à l’ensemble du vecteur des résidus standardisés centrés du modèle complet.
L’évaluation diagnostique de ce postulat mobilise une double approche descriptive et inférentielle :
- Analyses métriques d’asymétrie et d’aplatissement : L’examen des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) renseigne sur la morphologie distributionnelle. En psychométrie empirique, des indices standardisés d’asymétrie oscillant entre $-1$ et $+1$, et de kurtosis entre $-2$ et $+2$, sont généralement jugés acceptables pour maintenir la fiabilité du test classique.
- Tests statistiques formels d’adéquation : Les épreuves inférentielles de normalité, telles que le test de Shapiro-Wilk (recommandé pour les échantillons d’effectif $N 300$), leur hyper-sensibilité conduit au rejet formel de la normalité pour des déviations infimes et totalement anodines pour l’estimation, alors que sur de très petits effectifs ($N < 20$), leur faible puissance statistique échoue à détecter des distorsions sévères.
- Inspections graphiques qualitatives : L’examen attentif des histogrammes de résidus chapeautés par la courbe gaussienne théorique et, plus particulièrement, des diagrammes quantile-quantile normaux (Normal Q-Q plots), fournit l’outil diagnostique le plus fiable. Tout écart majeur des points par rapport à la bissectrice rectiligne idéale trahit la présence de déviations structurelles ou de valeurs aberrantes (outliers) nécessitant un traitement idoine.
Fort heureusement, l’analyse de variance démontre une robustesse relative remarquable face aux entorses modérées de la normalité, en vertu des propriétés asymptotiques formalisées par le théorème central limite. Dès lors que les effectifs de cellules atteignent un seuil raisonnable ($n_{jk} ge 20 \text{ à } 30$) et que les tailles de groupes demeurent équilibrées, l’erreur sur le taux nominal de première espèce reste marginale, préservant la validité opérationnelle de la décision statistique.
5.3 Homogénéité des variances ou homoscédasticité
Le troisième postulat fondamental, désigné sous le terme d’homoscédasticité (ou homogénéité des variances), exige que la variance de l’erreur stochastique résiduelle soit strictement identique au sein de toutes les populations dont sont extraits les sous-groupes expérimentaux. Sur le plan formel :
$$\sigma_1^2 = \sigma_2^2 = dots = \sigma_K^2 = \sigma^2$$
Cette condition est vitale car le dénominateur de la statistique F repose sur le regroupement (pooling) de l’ensemble des dispersions locales au sein d’une métrique unique, le carré moyen intra-groupe ($CM_{Intra}$). Si les populations parentes affichent des dispersions intrinsèques radicalement discordantes, cette mise en commun perd son assise mathématique, compromettant la représentativité de l’estimation de l’erreur globale.
L’exploration empirique de l’homoscédasticité fait appel à plusieurs procédures inférentielles de référence :
- Le test de Levene : Reposant sur l’analyse de variance des écarts absolus des scores par rapport à la moyenne du groupe, ou idéalement par rapport à la médiane (variante de Brown-Forsythe, nettement plus robuste face aux distributions asymétriques), le test de Levene examine l’hypothèse nulle d’égalité des variances. Une valeur p associée inférieure à 0,05 signale une hétéroscédasticité statistiquement significative.
- Le test de Bartlett : Plus sensible mais excessivement dépendant de la stricte normalité des données, ce test est à réserver aux contextes où la gaussianité a été rigoureusement attestée en amont.
L’impact déstabilisant de l’hétéroscédasticité sur le ratio F de l’ANOVA dépend intimement de l’équilibre des effectifs entre les cellules du plan expérimental. Lorsque le plan est strictement équilibré ($n_1 = n_2 = dots = n_K$), l’ANOVA classique s’avère particulièrement robuste : même en présence de ratios de variances de l’ordre de 1 pour 4 entre le groupe le moins dispersé et le plus dispersé, l’erreur de type I effective fluctue à peine autour du seuil nominal (souvent entre 0,05 et 0,06). En revanche, la combinaison funeste d’une hétérogénéité des variances et de tailles de cellules inégales désorganise totalement le test :
- Si les groupes aux effectifs les plus réduits présentent les variances les plus volumineuses, le dénominateur de l’ANOVA sous-estime l’erreur réelle : le ratio F devient hyper-libéral, projetant l’erreur de type I à des taux inacceptables (dépassant fréquemment 15 % à 20 %).
- À l’opposé, si les groupes volumineux concentrent les variances les plus fortes, le dénominateur surestime l’erreur : le test devient excessivement conservateur, anéantissant la puissance statistique et gonflant l’erreur de type II.
En présence d’une hétéroscédasticité caractérisée, le recours aux corrections mathématiques robustes s’impose. Pour l’ANOVA à un facteur, le test de Welch (fondé sur une pondération inverse par les variances individuelles et un ajustement des degrés de liberté selon l’approximation de Satterthwaite) et le test de Brown-Forsythe offrent des solutions d’une fiabilité remarquable, restituant un contrôle nominal impeccable du taux d’erreur alpha sans sacrifier indûment la puissance de détection.
6. Critères décisionnels : quand choisir l’ANOVA à un facteur ?
6.1 Configuration du protocole de recherche univarié
L’arbitrage méthodologique conduisant au choix d’une ANOVA à un facteur plutôt qu’à un modèle factoriel s’articule avant tout autour de la formulation intrinsèque de la question de recherche et de l’architecture du protocole expérimental déployé. L’analyse univariée s’impose d’emblée comme le choix naturel et optimal lorsque la problématique scientifique cible de façon univoque l’influence d’une unique variable indépendante de catégorisation sur une dimension comportementale donnée. Cette configuration se rencontre fréquemment dans les phases exploratoires ou inaugurales d’un programme d’investigation, lorsque le chercheur cherche à établir la preuve de concept fondamentale d’une action thérapeutique ou cognitive sans que des interactions complexes n’aient encore été théoriquement conceptualisées ou suspectées.
Elle constitue également l’outil de référence pour l’analyse de séquences graduées d’un même protocole d’action ou de dosage. Par exemple, lorsqu’un protocole évalue les modifications de l’attention sélective à travers quatre environnements sonores distincts (silence absolu, bruit blanc continu, musique instrumentale douce, bruits de conversation urbaine), le dispositif est régi par une taxonomie situationnelle unidimensionnelle : l’ambiance sonore globale. Introduire artificiellement une partition factorielle dans un tel dispositif relèverait d’une erreur d’ingénierie statistique susceptible de complexifier indûment l’interprétation sans gain heuristique réel.
6.2 Taille de l’échantillon et contraintes de puissance statistique
La disponibilité effective de la cohorte d’étude et les impératifs mathématiques de la puissance statistique représentent un second critère décisionnel déterminant. Dans de nombreux contextes appliqués en psychologie clinique, en neuropsychologie des lésions cérébrales focales ou au sein de populations pédiatriques hautement spécifiques, le recrutement des participants constitue un goulet d’étranglement majeur. Si une recherche ne parvient à mobiliser qu’une cohorte totale restreinte de 30 à 45 individus rigoureusement diagnostiqués, le déploiement d’une ANOVA à un facteur répartissant ces patients en trois groupes de 10 à 15 sujets préserve une densité cellulaire minimale acceptable pour assurer l’inférence.
Vouloir coûte que coûte appliquer un plan factoriel croisé $2 \times 2$ ou $3 \times 2$ sur un effectif aussi contraint fragmenterait dramatiquement le tableau expérimental en 4 ou 6 cellules distinctes, réduisant le nombre de sujets à des niveaux critiques (5 à 7 individus par cellule). Une telle dilution cellulaire engendre un effondrement dramatique de la puissance a priori. D’après les calculs psychométriques formalisés via des outils spécialisés tels que G*Power, la détection d’une interaction d’amplitude moyenne ($\text{taille d’effet } f = 0{,}25$, équivalent à $\eta^2_p \approx 0{,}06$) au seuil de puissance usuel de $(1 – \beta) = 0{,}80$ avec $\alpha = 0{,}05$ réclame un échantillon global d’au moins 128 à 158 participants dans un plan $2 \times 2$. Si la cohorte accessible est structurellement bridée par des contraintes logistiques infranchissables, le choix raisonné de l’ANOVA univariée garantit la viabilité analytique du test, évitant d’exposer l’expérimentateur au risque d’une étude sous-puissante incapable d’isoler des effets réels majeurs.
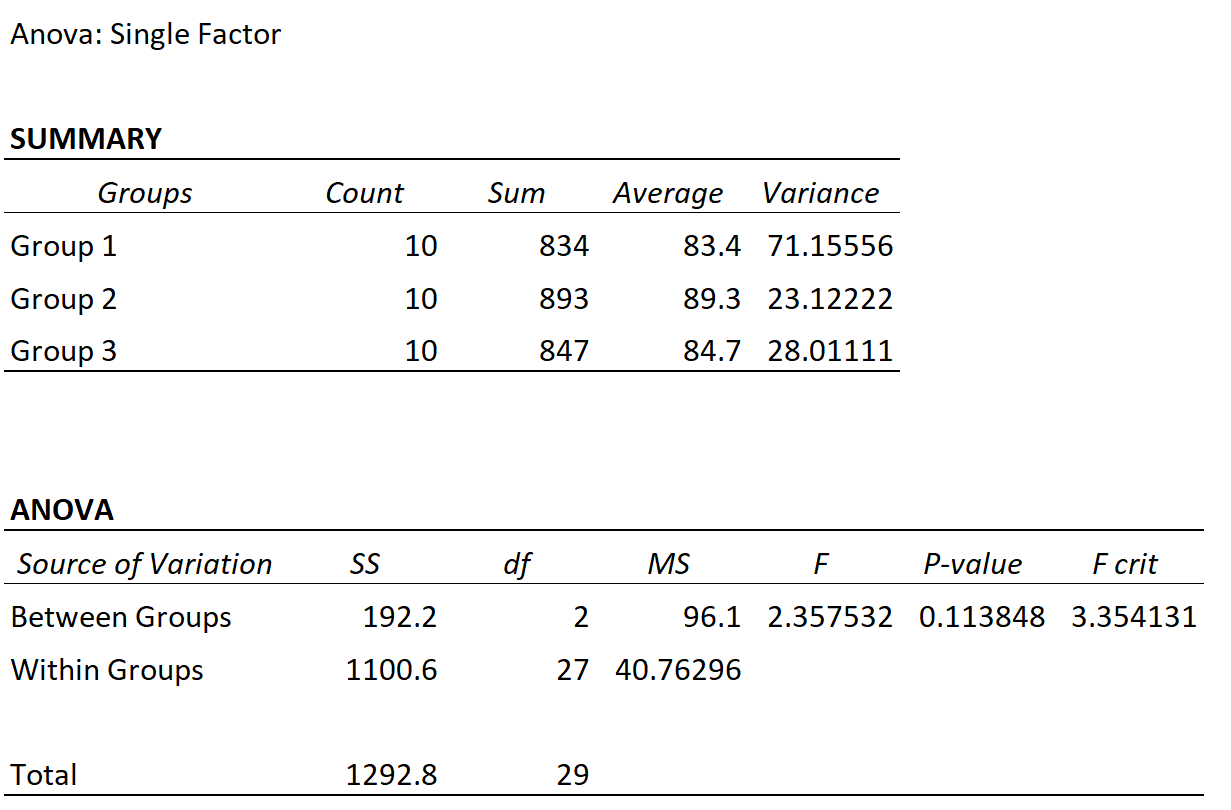
6.3 Simplicité d’interprétation et parcimonie scientifique
Le principe épistémologique du rasoir d’Ockham (lex parsimoniae), qui enjoint de privilégier les explications théoriques les plus sobres n’introduisant aucune entité superflue, trouve une résonance directe dans le champ de la statistique décisionnelle. Dès lors qu’une hypothèse scientifique peut être rigoureusement falsifiée ou corroborée par un modèle structural à un seul facteur, l’ajout compulsif de variables classificatoires accessoires sans ancrage théorique préalable dégrade la clarté conceptuelle des conclusions.
Cette considération revêt une importance stratégique majeure dans la recherche translationnelle et la psychologie appliquée, où les résultats statistiques doivent être restitués à des partenaires cliniciens, des praticiens hospitaliers, des éducateurs ou des décideurs médico-économiques. Une ANOVA à un facteur délivre un message opérationnel direct : elle démontre sans ambiguïté si le traitement testé engendre un bénéfice supérieur par rapport aux alternatives standard ou au placebo, et quantifie sans détour l’écart absolu attendu. Cette limpidité de lecture facilite l’implémentation concrète des recommandations thérapeutiques sur le terrain professionnel, là où les subtilités d’un modèle d’interaction complexe peuvent introduire des hésitations d’action et compliquer l’adoption des données probantes en pratique courante.
7. Critères décisionnels : quand opter pour l’ANOVA à deux facteurs ?
7.1 Test explicite d’hypothèses de modération
L’arbitrage bascule résolument en faveur de l’ANOVA à deux facteurs lorsque l’appareil théorique sous-jacent postule formellement une hypothèse de modération, c’est-à-dire l’existence d’une relation conditionnelle. En psychologie moderne, les théories monocausales pures sont de plus en plus battues en brèche par la reconnaissance de la complexité dynamique des conduites humaines. Dès lors qu’un chercheur formule une proposition scientifique du type « L’intervention cognitive A optimisera l’attention soutenue, mais cette efficacité sera contingentée par le niveau d’anxiété-trait basal des participants », le plan univarié devient structurellement obsolète et déficient.
L’intégration délibérée d’une variable modératrice — qu’elle soit de nature biologique (génotype, statut hormonal), sociodémographique (sexe biologique, niveau socio-éducatif) ou environnementale (contexte d’administration sécurisant vs. stressant) — exige l’armature matricielle de l’ANOVA factorielle croisée. Ce dispositif permet de sonder avec une précision chirurgicale les frontières et les seuils d’efficacité des protocoles. Il permet d’identifier précisément pour quel sous-groupe spécifique un traitement s’avère particulièrement pertinent, pour quel autre il s’avère neutre, et dans quelles circonstances il peut éventuellement induire des réactions iatrogènes paradoxales, matérialisant ainsi la vision contemporaine de la médecine personnalisée et des thérapies psychologiques sur mesure.
7.2 Contrôle expérimental et intégration de variables de bloc
Même en l’absence d’une hypothèse centrale articulée autour de la modération conceptuelle, l’ANOVA factorielle constitue une arme méthodologique de premier ordre pour optimiser le contrôle expérimental et épurer le bruit résiduel à travers l’intégration de variables de bloc (blocking factors). Dans tout protocole en sciences comportementales, il subsiste des variables parasites potentiellement influentes qui, sans constituer le foyer d’intérêt primaire de la recherche, introduisent une variance parasite substantielle au sein des mesures (par exemple, le moment de la passation de l’épreuve expérimentale : matin vs. fin d’après-midi ; ou l’expérience antérieure avec un type de dispositif numérique : novices vs. experts).
Si ces variables parasites sont purement et simplement ignorées au sein d’une ANOVA à un facteur, leur variance se déverse aveuglément dans la somme des carrés résiduelle intra-groupe ($SC_{Intra}$), réduisant dramatiquement le ratio $F$ du facteur expérimental principal. En érigeant cette source de nuisance en second facteur de contrôle méthodologique au sein d’un plan factoriel complet, le chercheur extrait délibérément cette variance d’arrière-plan du terme d’erreur. Le dénominateur s’en trouve allégé et le test sur le traitement principal gagne immédiatement en acuité et en puissance statistique.
Il importe de distinguer formellement cette approche factorielle de l’analyse de covariance (ANCOVA). Alors que l’ANOVA à deux facteurs requiert que la variable de contrôle soit découpée en modalités catégorielles qualitatives distinctes intégrées dans la matrice orthogonale du plan, l’ANCOVA modélise directement une covariable continue au moyen d’un ajustement linéaire de régression partagée. Dès lors que la variable parasite d’intérêt se prête structurellement à une classification en classes homogènes bien tranchées, l’ANOVA factorielle offre l’avantage capital de tester d’emblée si cette variable de bloc interagit de façon imprévue avec le traitement principal, une hypothèse fondamentale d’homogénéité des pentes de régression que l’ANCOVA tient trop souvent pour acquise sans vérification empirique rigoureuse.
7.3 Évaluation écologique des comportements complexes
L’argument épistémologique ultime plaidant pour l’ANOVA factorielle repose sur l’impératif de validité écologique des modèles psychométriques. L’environnement réel dans lequel s’articulent les comportements, les affects et les décisions des individus ne fonctionne jamais selon des stimuli isolés en vase clos, mais s’apparente à une écologie saturée de déterminants en résonance continue. Isoler une variable indépendante dans le cadre rigide d’une analyse univariée en neutralisant artificiellement l’ensemble du contexte environnant peut aboutir à des conclusions expérimentales irréalistes, incapables de se transférer vers les situations concrètes du quotidien.
L’ANOVA à deux facteurs capture cette écologie complexe en matérialisant la non-linéarité des influences humaines. Elle illustre comment la motivation intrinsèque interagit avec les récompenses matérielles extrinsèques pour moduler la créativité, comment l’éclairage ambiant module la charge mentale en fonction de la difficulté intrinsèque d’une tâche, ou encore comment les compétences de régulation émotionnelle modèrent les répercussions du stress organisationnel sur l’épuisement professionnel (burnout). En enrichissant les conclusions théoriques au-delà des modélisations causales unidimensionnelles simplistes, l’architecture factorielle dote les sciences humaines d’une assise empirique à la hauteur de la complexité de son objet d’étude.
8. Étude de cas pratique : protocole d’ANOVA à un facteur en psychologie clinique
8.1 Mise en situation et formulation des hypothèses
Afin de concrétiser la chaîne computationnelle et inférentielle de l’analyse univariée, déployons une investigation empirique contrôlée menée au sein d’un service de psychiatrie hospitalo-universitaire. Une équipe de recherche clinique examine l’efficacité comparative de protocoles thérapeutiques brefs sur la réduction des symptômes dépressifs auprès d’une cohorte de patients répondant aux critères diagnostiques du trouble dépressif caractérisé d’intensité modérée (selon le DSM-5). Un échantillon total de 45 patients volontaires ($N = 45$) est recruté et affecté, par randomisation informatique intégrale sous enveloppes scellées, à l’un des trois bras expérimentaux suivants, configurant un plan équilibré comprenant 15 sujets par condition ($n_1 = n_2 = n_3 = 15$) :
- Groupe 1 : Protocole de Thérapie Cognitive et Comportementale classique (TCC) axée sur la restructuration cognitive et l’activation comportementale (12 séances hebdomadaires).
- Groupe 2 : Protocole de Thérapie Cognitive basée sur la Pleine Conscience (MBCT, Mindfulness-Based Cognitive Therapy) intégrant la méditation guidée et le désengagement attentionnel (programme intensif de 8 semaines).
- Groupe 3 : Groupe témoin placé sur liste d’attente (LA) bénéficiant du suivi médical et psychiatrique habituel non structuré.
La variable dépendante continue ($Y$) est constituée par le score total résiduel mesuré sur l’Inventaire de Dépression de Beck de seconde édition (BDI-II), administré à l’issue des huit semaines de prise en charge par des évaluateurs indépendants maintenus en aveugle strict de l’assignation des patients. Les hypothèses statistiques s’établissent formellement comme suit :
- $H_0 : \mu_{TCC} = \mu_{MBCT} = \mu_{LA}$ (Les trois populations parentes présentent des scores résiduels de dépression strictement identiques au terme de l’intervention).
- $H_1 : \exists , (j, j’) \text{ tel que } \mu_j ne \mu_{j’}$ (Au moins deux approches thérapeutiques se démarquent significativement quant au niveau de sévérité dépressive résiduelle).
Le seuil d’erreur alpha consenti pour ce test omnibus est classiquement fixé à $\alpha = 0{,}05$.
8.2 Calcul pas à pas et lecture des résultats
Les passations standardisées fournissent les statistiques descriptives suivantes au sein de chaque groupe :
- Groupe TCC : $n_1 = 15$, moyenne empirique $\bar{Y}_1 = 14{,}20$, variance empirique $s_1^2 = 18{,}40$.
- Groupe MBCT : $n_2 = 15$, moyenne empirique $\bar{Y}_2 = 16{,}80$, variance empirique $s_2^2 = 21{,}10$.
- Groupe Liste d’attente : $n_3 = 15$, moyenne empirique $\bar{Y}_3 = 24{,}60$, variance empirique $s_3^2 = 24{,}50$.
La moyenne générale s’établit à $\bar{Y}_{..} = (14{,}20 + 16{,}80 + 24{,}60) / 3 = 18{,}533$.
Procédons au partitionnement rigoureux de la variance :
- Somme des carrés inter-groupes ($SC_{Inter}$) :
$$SC_{Inter} = 15 \times (14{,}20 – 18{,}533)^2 + 15 \times (16{,}80 – 18{,}533)^2 + 15 \times (24{,}60 – 18{,}533)^2$$
$$SC_{Inter} = 15 \times (-4{,}333)^2 + 15 \times (-1{,}733)^2 + 15 \times (6{,}067)^2$$
$$SC_{Inter} = 15 \times 18{,}775 + 15 \times 3{,}003 + 15 \times 36{,}809 = 281{,}625 + 45{,}045 + 552{,}135 = 878{,}805$$ - Somme des carrés intra-groupe ($SC_{Intra}$) :
Sachant que la somme des carrés interne d’un groupe s’obtient par $(n_j – 1) \times s_j^2$ :
$$SC_{Intra} = (15 – 1) \times 18{,}40 + (15 – 1) \times 21{,}10 + (15 – 1) \times 24{,}50$$
$$SC_{Intra} = 14 \times (18{,}40 + 21{,}10 + 24{,}50) = 14 \times 64{,}00 = 896{,}000$$ - Somme des carrés totale ($SC_{Totale}$) :
$$SC_{Totale} = SC_{Inter} + SC_{Intra} = 878{,}805 + 896{,}000 = 1774{,}805$$
Déterminons ensuite les degrés de liberté et les carrés moyens afférents :
- $ddl_{Inter} = k – 1 = 3 – 1 = 2$
- $ddl_{Intra} = N – k = 45 – 3 = 42$
- $CM_{Inter} = SC_{Inter} / ddl_{Inter} = 878{,}805 / 2 = 439{,}403$
- $CM_{Intra} = SC_{Intra} / ddl_{Intra} = 896{,}000 / 42 = 21{,}333$
Calculons le ratio empirique de Fisher-Snedecor :
$$F_{obs} = \frac{CM_{Inter}}{CM_{Intra}} = \frac{439{,}403}{21{,}333} = 20{,}60$$
En consultant la table théorique de la distribution $F$ pour 2 et 42 degrés de liberté au seuil de risque $\alpha = 0{,}05$, la valeur critique se fixe à $F_{critique}(2, 42) \approx 3{,}22$. La statistique empirique ($F_{obs} = 20{,}60$) surpasse massivement cette borne critique, se soldant par une valeur asymptotique $p < 0{,}0001$. Le statisticien rejette sans équivoque l'hypothèse nulle $H_0$ et conclut à l'existence d'une différence hautement significative entre les trois conditions cliniques.
8.3 Quantification de la magnitude de l’effet
Conformément aux exigences de la psychométrie contemporaine, la significativité statistique doit être complétée par la métrique de l’ampleur d’effet. Calculons l’êta-carré descriptif :
$$\eta^2 = \frac{SC_{Inter}}{SC_{Totale}} = \frac{878{,}805}{1774{,}805} = 0{,}495$$
Ce résultat indique que 49,5 % de la variance totale des scores de dépression mesurés au BDI-II est directement imputable au facteur thérapeutique. Calculons à présent l’oméga-carré corrigé ($\omega^2$), garant d’une estimation non biaisée au sein de la population parente :
$$\omega^2 = \frac{SC_{Inter} – (k – 1)CM_{Intra}}{SC_{Totale} + CM_{Intra}} = \frac{878{,}805 – (2 \times 21{,}333)}{1774{,}805 + 21{,}333} = \frac{878{,}805 – 42{,}666}{1796{,}138} = \frac{836{,}139}{1796{,}138} \approx 0{,}466$$
Selon les repères conventionnels établis par Jacob Cohen pour le champ des sciences comportementales (où un $\omega^2$ de 0,01 dénote un effet faible, 0,06 un effet moyen, et 0,14 un effet puissant), une valeur de $\omega^2 = 0{,}466$ reflète une taille d’effet exceptionnellement puissante. Dans le contexte de la psychologie clinique, cette magnitude traduit une pertinence empirique de tout premier plan : l’engagement dans une psychothérapie structurée (TCC ou MBCT) ne relève pas d’une simple divergence mathématique subtile, mais transforme radicalement le pronostic clinique des patients par rapport à l’évolution spontanée observée sur liste d’attente.
9. Étude de cas pratique : protocole d’ANOVA à deux facteurs en psychologie cognitive
9.1 Protocole expérimental factoriel complet
Explorons désormais la dynamique factorielle au sein d’une expérience de laboratoire en psychologie cognitive et ergonomie comportementale. Des chercheurs s’intéressent aux mécanismes de consolidation mnésique lors de l’apprentissage de lexiques techniques complexes. Ils formulent l’hypothèse selon laquelle l’efficacité relative des techniques pédagogiques est contingentée par l’état d’épuisement cognitif des apprenants, suggérant une interaction majeure entre le mode d’encodage et la charge adaptative basale.
Le protocole retient un plan factoriel croisé inter-sujets de type $3 \times 2$ :
- Facteur A : Technique de mémorisation (3 modalités) :
- $a_1$ : Répétition passive simple (relecture itérative des fiches terminologiques).
- $a_2$ : Élaboration sémantique profonde (création de phrases contextuelles et de liens conceptuels).
- $a_3$ : Récupération espacée active (auto-évaluation intermittente via flashcards numériques).
- Facteur B : État de fatigue cognitive (2 modalités) :
- $b_1$ : Condition reposée (passation matinale après une nuit de sommeil complète et normalisée).
- $b_2$ : Condition épuisée (passation consécutive à une tâche continue d’inhibition exécutive de deux heures générant un épuisement des ressources d’attention dirigée).
Un effectif de 120 étudiants universitaires ($N = 120$) est mobilisé, puis réparti de façon parfaitement équilibrée à raison de 20 participants par cellule expérimentale ($n_{jk} = 20$ pour l’ensemble des 6 cellules du plan). La variable dépendante continue est le score de rappel libre différé (nombre de termes correctement restitués sur une liste cible de 50 items, évalué 24 heures après la phase d’apprentissage).
9.2 Analyse matricielle des résultats et tableau factoriel
Le traitement des données fournit les scores moyens suivants au sein de la matrice $3 \times 2$ :
- Sous la condition reposée ($b_1$) :
- Répétition passive ($a_1b_1$) : $\bar{Y}_{11} = 22{,}50$ ($s = 3{,}10$)
- Élaboration sémantique ($a_2b_1$) : $\bar{Y}_{21} = 38{,}20$ ($s = 3{,}40$)
- Récupération espacée ($a_3b_1$) : $\bar{Y}_{31} = 41{,}10$ ($s = 3{,}20$)
- Moyenne marginale condition reposée : $\bar{Y}_{.1} = 33{,}933$
- Sous la condition de fatigue cognitive ($b_2$) :
- Répétition passive ($a_1b_2$) : $\bar{Y}_{12} = 19{,}80$ ($s = 3{,}00$)
- Élaboration sémantique ($a_2b_2$) : $\bar{Y}_{22} = 24{,}10$ ($s = 3{,}30$)
- Récupération espacée ($a_3b_2$) : $\bar{Y}_{32} = 36{,}40$ ($s = 3{,}50$)
- Moyenne marginale condition épuisée : $\bar{Y}_{.2} = 26{,}767$
- Moyennes marginales des techniques (Facteur A) :
- Répétition passive ($\bar{Y}_{1.}$) = $21{,}15$
- Élaboration sémantique ($\bar{Y}_{2.}$) = $31{,}15$
- Récupération espacée ($\bar{Y}_{3.}$) = $38{,}75$
- Moyenne globale de l’échantillon : $\bar{Y}_{..} = 30{,}350$
Les sommations des carrés des écarts fournissent les résultats analytiques suivants :
- $SC_A (\text{Technique}) = 6223{,}35$ avec $ddl_A = J – 1 = 3 – 1 = 2$
- $SC_B (\text{Fatigue}) = 1540{,}83$ avec $ddl_B = K – 1 = 2 – 1 = 1$
- $SC_{AB} (\text{Interaction}) = 1046{,}85$ avec $ddl_{AB} = (3 – 1)(2 – 1) = 2$
- $SC_{Intra} (\text{Erreur}) = 1226{,}40$ avec $ddl_{Intra} = N – JK = 120 – 6 = 114$
- $SC_{Totale} = 10037{,}43$ avec $ddl_{Totale} = 119$
Procédons au calcul des carrés moyens et des statistiques F associées :
- $CM_A = 6223{,}35 / 2 = 3111{,}675 implies F_A = 3111{,}675 / 10{,}758 = 289{,}24$ ($p < 0{,}001$)
- $CM_B = 1540{,}83 / 1 = 1540{,}830 implies F_B = 1540{,}830 / 10{,}758 = 143{,}23$ ($p < 0{,}001$)
- $CM_{AB} = 1046{,}85 / 2 = 523{,}425 implies F_{AB} = 523{,}425 / 10{,}758 = 48{,}65$ ($p < 0{,}001$)
- $CM_{Intra} = 1226{,}40 / 114 = 10{,}758$
Le ratio de Fisher associé au terme d’interaction croisée ($F_{AB} = 48{,}65$) s’avère hautement significatif au-delà du seuil critique $F_{critique}(2, 114) \approx 3{,}08$ ($p < 0{,}0001$). L'êta-carré partiel dévolu à l'interaction atteint une ampleur remarquable :
$$\eta_p^2 = \frac{SC_{AB}}{SC_{AB} + SC_{Intra}} = \frac{1046{,}85}{1046{,}85 + 1226{,}40} = \frac{1046{,}85}{2273{,}25} \approx 0{,}460$$
Ce résultat démontre qu’environ 46 % de la variance résiduelle disponible est contrôlée par l’effet modérateur de la fatigue sur l’efficacité relative des techniques pédagogiques. Conformément aux règles méthodologiques impératives, la présence de cette interaction massive interdit toute interprétation isolée et directe des effets principaux bruts de la technique ou de la fatigue.
9.3 Décomposition par contrastes et interprétation cognitive
Face à cette puissante interaction factorielle, le chercheur engage l’analyse des effets simples de la technique d’apprentissage séparément pour chaque état d’éveil cognitif :
- Chez les participants reposés ($b_1$) : L’analyse de l’effet simple révèle que l’élaboration sémantique ($\bar{Y} = 38{,}20$) rivalise étroitement avec la récupération espacée ($\bar{Y} = 41{,}10$), toutes deux surclassant drastiquement la répétition passive ($\bar{Y} = 22{,}50$). Le contraste a posteriori confirme que l’écart entre élaboration et récupération espacée, bien que statistiquement décelable, demeure de faible amplitude clinique ($d = 0{,}88$).
- Chez les participants en état d’épuisement cognitif ($b_2$) : Le profil bascule spectaculairement. La performance d’élaboration sémantique s’effondre littéralement, chutant de 38,20 à 24,10 points (une régression de près de 37 %), se rapprochant dangereusement du niveau plancher de la répétition passive ($24{,}10$ vs. $19{,}80$). À l’inverse, la technique de récupération espacée démontre une remarquable résilience face à la fatigue, se maintenant à un niveau d’excellence élevé avec un score moyen de 36,40 items restitués. L’effet simple de la technique sous condition d’épuisement affiche une statistique $F_{A \text{ at } b_2} = 142{,}50$ ($p < 0{,}001$), et le contraste spécifique opposant la récupération espacée à l'élaboration sémantique atteint une magnitude gigantesque ($d = 3{,}62$).
Sur le plan de la théorie cognitive, cette décomposition factorielle apporte un éclairage substantiel sur l’allocation des ressources attentionnelles, conceptualisée notamment au sein du modèle capacity-ressources de Daniel Kahneman. L’élaboration sémantique profonde exige une mobilisation massive, continue et délibérée des fonctions de contrôle exécutif et de la mémoire de travail au sein du cortex préfrontal dorsolatéral. Lorsque le système cognitif subit un épuisement préalable par déplétion de ses réserves de contrôle attentionnel, l’apprenant ne dispose plus des ressources endogènes nécessaires pour générer des élaborations associatives complexes, conduisant à l’effondrement de la consolidation mnésique. En revanche, le protocole de récupération espacée, articulé autour d’amorces d’interrogation externes concrètes (stimulus-réponse via cartes de rappel), décharge la mémoire de travail en s’appuyant sur des processus de récupération indicée plus automatisés. Cette démonstration empirique n’aurait jamais pu être formalisée au moyen d’analyses univariées séparées, soulignant la supériorité heuristique incontestable de l’ANOVA à deux facteurs.
10. Analyses post-hoc et méthodes de contrastes planifiés
10.1 Contrôle de l’inflation de l’erreur globale de type I
L’obtention d’un ratio F omnibus significatif au sein d’une analyse de variance (qu’elle soit à un ou deux facteurs) scelle l’existence d’une divergence systématique entre les conditions d’observation, mais conserve une nature non spécifique. Le test omnibus indique qu’au moins une paire de moyennes diffère significativement, sans préciser la localisation exacte des ruptures. C’est à ce stade qu’interviennent les comparaisons multiples, dont la gestion statistique impose une rigueur méthodologique absolue sous peine de compromettre la validité des conclusions par explosion du risque d’erreur de type I.
Comme formalisé précédemment, la multiplication non contrôlée des tests bilatéraux engendre une élévation rapide de l’erreur globale par famille ($\alpha_{FW} = 1 – [1 – \alpha]^c$, où c représente le nombre de comparaisons exécutées). Pour un facteur comportant 5 modalités, l’exploration exhaustive de toutes les paires possibles requiert $c = 5(4)/2 = 10$ comparaisons distinctes, portant le risque cumulé de fausse découverte à plus de 40 % au seuil nominal usuel. Pour endiguer ce péril, le chercheur doit opérer une distinction épistémologique fondamentale entre deux démarches d’investigation :
- Les contrastes a priori (ou planifiés) : Formulés en amont de la collecte des données sur la base de déductions théoriques strictes, ces contrastes ne testent qu’un sous-ensemble délimité d’hypothèses orthogonales (non redondantes). Dans ce cadre restreint, le statisticien peut mobiliser des pénalités douces, voire s’en dispenser si le nombre d’hypothèses orthogonales indépendantes n’excède pas les degrés de liberté factoriels ($k – 1$).
- Les tests post-hoc a posteriori : Conduits à l’issue de l’analyse dans une perspective exploratoire ou confirmatoire exhaustive (exploration de l’ensemble des paires de cellules), ces tests exigent l’application de pénalités correctrices rigoureuses destinées à maintenir le taux d’erreur par famille rigoureusement à 5 %, quelle que soit l’intensité du chalutage statistique opéré au sein de la matrice.
10.2 Panorama des tests post-hoc usuels
Le corpus de la psychométrie quantitative met à la disposition du chercheur un éventail de procédures d’ajustement post-hoc spécialisées, dont le choix opérationnel doit être dicté par la nature des contrastes visés et le respect des postulats d’homoscédasticité et d’équilibre des effectifs.
Le test de la plus petite différence significative honnête de Tukey (Tukey’s HSD) s’impose comme le standard méthodologique absolu pour la comparaison par paires exhaustives de toutes les cellules au sein d’un modèle factoriel ou univarié équilibré respectant le postulat d’homogénéité des variances. Fondé sur la distribution de l’étendue studentisée (studentized range statistic $q$), le test de Tukey ajuste dynamiquement la distance critique minimale requise pour déclarer deux moyennes distinctes en fonction du nombre total de groupes en compétition, garantissant un équilibre parfait entre puissance statistique et protection conservatrice contre les faux positifs.
La classique correction de Bonferroni opère une démarche arithmétique simple et universelle consistant à diviser le seuil alpha nominal par le nombre de comparaisons conduites ($alpha’ = \alpha / c$). Bien qu’extrêmement robuste et flexible, Bonferroni pèche par un conservatisme excessif dès lors que le nombre de contrastes augmente, pénalisant lourdement la puissance du test. Pour pallier ce déficit, la procédure séquentielle de Holm-Bonferroni (dite approche step-down) classe les valeurs p empiriques par ordre croissant et leur applique un seuil correcteur dégressif ($\alpha / [c – rank + 1]$). Elle surclasse mathématiquement la correction classique de Bonferroni en offrant un gain de puissance substantiel tout en conférant une protection absolue au taux d’erreur de première espèce.
Le test de Scheffé offre quant à lui la protection la plus stricte et la plus universelle qui soit. Il permet d’explorer non seulement l’ensemble des comparaisons binaires, mais également n’importe quel contraste complexe non planifié (par exemple, confronter la moyenne combinée des groupes 1 et 2 à la moyenne combinée des groupes 3 et 4). En contrepartie de cette liberté totale de fouille de données, le test de Scheffé affiche la puissance statistique la plus faible de tout l’arsenal post-hoc, exigeant des amplitudes d’effet volumineuses pour franchir le seuil d’exclusion.
Enfin, lorsque le diagnostic d’homoscédasticité a révélé une violation patente de l’égalité des variances intra-groupes (confirmée par un test de Levene significatif) conjuguée à des tailles d’échantillons hétérogènes, l’ensemble des procédures susmentionnées s’avèrent inopérantes et risquées. Le chercheur doit impérativement se tourner vers la procédure de Games-Howell. Dérivée des principes de correction de Welch, la méthode de Games-Howell n’assume ni l’égalité des variances ni l’équilibre des effectifs : elle recourt à une estimation locale des erreurs types combinées et ajuste spécifiquement les degrés de liberté selon la formule de Welch-Satterthwaite pour chaque comparaison binaire, offrant un rempart inférentiel d’une fiabilité exemplaire.
10.3 Stratégie analytique post-interaction
L’articulation des tests de comparaisons multiples au décours d’une ANOVA à deux facteurs régie par une interaction significative exige une démarche méthodologique hautement formalisée. L’application brute et indifférenciée du test de Tukey sur l’ensemble des cellules de la matrice factorielle globale (par exemple, comparer sans discernement la cellule $a_1b_1$ à la cellule $a_3b_2$) constitue un non-sens analytique fréquent : de tels contrastes obliques mêlent simultanément des variations imputables aux deux facteurs distincts, générant des constats dépourvus de portée heuristique claire.
La séquence analytique préconisée par les méthodologistes s’ordonne rigoureusement comme suit :
- Délimitation des sous-familles d’effets simples : Le statisticien décompose l’interaction en sous-familles conceptuellement cohérentes, correspondant à la fixation successive des modalités du facteur modérateur (examiner l’impact du facteur A au niveau $b_1$, puis au niveau $b_2$).
- Ajustement par sous-famille : Les corrections d’erreur par famille (Tukey HSD ou Holm-Bonferroni) sont alors appliquées strictement au sein de chaque tranche conditionnelle d’effets simples. La valeur critique est calculée à partir des effectifs locaux tout en conservant, pour les modèles homoscédastiques, le carré moyen d’erreur global ($CM_{Intra}$) du modèle factoriel complet comme estimateur de la variance de fond.
- Synthèse narrative et reporting unifié : La transcription textuelle finale doit fusionner les indices de contraste conditionnels, les tailles d’effet associées (par exemple, le d de Cohen standardisé dérivé de l’erreur poolée) et les intervalles de confiance à 95 % des différences moyennes, dressant un portrait multidimensionnel des singularités comportementales mises au jour par le plan factoriel.
11. Erreurs méthodologiques courantes et pièges d’interprétation
11.1 Confusions conceptuelles et erreurs de spécification
Dans la littérature empirique en sciences humaines, les erreurs de spécification statistique demeurent encore trop fréquentes, altérant la reproductibilité des résultats scientifiques. L’une des bévues les plus dommageables consiste en l’exécution séparée de multiples ANOVA univariées successives au lieu d’élaborer un plan factoriel unifié. Confronté à un protocole croisant une modalité thérapeutique et le sexe des participants, l’expérimentateur novice scinde fréquemment sa cohorte pour conduire une ANOVA sur le sous-échantillon masculin, puis une seconde ANOVA sur le sous-échantillon féminin. Constatant une significativité chez les premiers ($p < 0{,}01$) et une absence de significativité chez les secondes ($p = 0{,}12$), il conclut imprudemment que le traitement agit différemment selon le sexe. Cette inférence constitue le sophisme statistique bien connu formalisé par Gelman et Stern (2006) : la différence entre un résultat significatif et un résultat non significatif n’est pas nécessairement significative. Seule l’observation d’un ratio F d’interaction $A \times B$ formellement significatif au sein d’une ANOVA à deux facteurs intégrée autorise légitimement à statuer sur l’existence d’une réponse différentielle selon le sexe.
Un second piège conceptuel majeur réside dans la confusion récurrente entre variables inter-sujets (mesures indépendantes, où chaque participant appartient à une et une seule cellule) et variables intra-sujets (mesures répétées ou appariées, où chaque sujet est mesuré à travers l’ensemble des conditions expérimentales ou des temps de suivi). L’application d’une ANOVA factorielle inter-sujets classique sur des données collectées de manière répétée au cours du temps (par exemple, T1 pré-test, T2 post-test, T3 suivi à 6 mois) viole de manière flagrante le postulat fondamental d’indépendance stochastique des erreurs. Les variances associées aux effets intra-individuels s’en trouvent complètement biaisées, invalidant le test statistique. Dans un tel contexte, le chercheur doit impérativement recourir à l’ANOVA à mesures répétées, au plan mixte (split-plot ANOVA) ou aux modèles linéaires à effets mixtes.
11.2 Plans non équilibrés et attribution de la variance
L’apparition de déséquilibres au niveau des effectifs cellulaires ($n_{jk}$ inégaux) représente une complication courante au sein des protocoles expérimentaux réels, souvent consécutive à l’attrition d’échantillon, à la non-réponse de certains participants ou à des défaillances techniques lors de la passation des épreuves. Au sein d’une ANOVA à un facteur, ce déséquilibre n’altère en rien l’orthogonalité fondamentale des calculs arithmétiques, affectant uniquement la sensibilité du test en présence d’hétéroscédasticité. En revanche, au sein d’une ANOVA à deux facteurs, le déséquilibre des effectifs détruit irrémédiablement l’orthogonalité du plan.
Dès lors que les effectifs cellulaires ne sont plus proportionnels, les facteurs A, B et le terme d’interaction $A \times B$ ne constituent plus des sources de variation mathématiquement indépendantes : ils deviennent corrélés, engendrant une fraction de variance partagée ou chevauchante entre prédicteurs. La question fondamentale de l’attribution de cette variance partagée a donné lieu à la formalisation de trois méthodes distinctes de calcul des sommes des carrés :
- Les sommes des carrés de Type I (approche séquentielle) : La variance est allouée hiérarchiquement selon l’ordre strict d’entrée des facteurs spécifié par l’utilisateur au sein du logiciel statistique. Le premier facteur incorporé capture toute la variance qu’il peut expliquer, y compris la part partagée avec les facteurs ultérieurs. Cette méthode est extrêmement sensible à l’ordre arbitraire de déclaration des variables et doit être rigoureusement évitée dans les plans factoriels équilibrés ou non équilibrés, sauf visée théorique purement hiérarchique explicite.
- Les sommes des carrés de Type II (approche hiérarchique non ordonnée) : L’effet de chaque facteur principal est ajusté par rapport à l’autre facteur principal, en supposant l’absence totale d’interaction ($SC_A$ est ajusté pour B, et $SC_B$ est ajusté pour A, mais sans contrôle pour $AB$). Cette approche optimise la puissance d’analyse des effets principaux, mais s’avère profondément biaisée et non interprétable dès lors qu’une interaction réelle est présente dans les données.
- Les sommes des carrés de Type III (approche marginale simultanée) : Chaque source de variation est ajustée orthogonalement par rapport à l’intégralité des autres composantes du modèle linéaire général ($SC_A$ est contrôlé simultanément pour B et pour $AB$ ; de même pour $SC_B$ et $SC_{AB}$). Les tests portent ainsi rigoureusement sur les moyennes marginales non pondérées (estimated marginal means ou least-squares means), qui reconstituent les espérances théoriques comme si le plan d’expérience avait été rigoureusement équilibré.
En conformité absolue avec les standards contemporains de la recherche en psychologie et les recommandations des logiciels spécialisés (tels que SPSS, R avec le package car, ou Jamovi), la méthode de Type III constitue la recommandation méthodologique impérative pour le traitement inférentiel des plans factoriels déséquilibrés.
11.3 Surinterprétation de la seule valeur p
L’ultime écueil méthodologique, d’ordre épistémologique, réside dans l’assujettissement dogmatique à la seule valeur p (le « culte du $p < 0{,}05$ » dénoncé par l'American Statistical Association). Une valeur p infinitésimale n’offre en aucune circonstance une mesure de la véracité de l’hypothèse substantive sous-jacente, ni de la pertinence clinique ou comportementale du phénomène constaté. Sur un échantillon volumineux ($N = 1000$), une différence résiduelle microscopique de 0,5 point sur une échelle de mesure en comptant 100 franchira aisément le seuil d’exclusion statistique ($p < 0{,}001$), tout en incarnant un artefact psychométrique totalement dépourvu de retentissement clinique ou adaptatif concret pour les individus.
Pour prévenir cette dérive réductionniste, le chercheur doit obligatoirement arrimer l’interprétation des résultats statistiques à deux composantes complémentaires indissociables :
- La quantification formelle des tailles d’effet standardisées : La présentation conjointe des indices d’association ($\eta^2$, $\eta_p^2$, $\omega^2$) ou d’écart réduit ($d$ de Cohen) est impérative pour situer le résultat sur une échelle d’importance psychologique objective.
- La publication systématique des intervalles de confiance à 95 % : Tant pour les moyennes marginales que pour les amplitudes des contrastes différentiels, les intervalles de confiance traduisent avec limpidité la marge de précision et l’incertitude intrinsèque inhérente à l’échantillonnage empirique, replaçant l’inférence statistique dans une perspective scientifique mature et mesurée.
12. Arbre décisionnel comparatif et alternatives statistiques
12.1 Algorithme de décision pour le chercheur
Afin de synthétiser le cheminement analytique permettant au chercheur d’orienter sans ambiguïté son choix méthodologique, le protocole séquentiel d’arbitrage statistique s’articule selon l’algorithme rigoureux suivant :
Étape 1 : Cartographie des variables indépendantes
- Le dispositif expérimental ne mobilise-t-il qu’une seule et unique variable indépendante catégorielle ($k ge 3$) ?
- Si Oui : Orientation directe vers l’ANOVA à un facteur (considérer l’Étape 3 pour les postulats distributionnels).
- Si Non : Deux variables indépendantes qualitatives distinctes sont-elles manipulées ou invoquées simultanément ($J \times K$) ? $implies$ Poursuivre vers l’Étape 2.
Étape 2 : Qualification du design factoriel et des mesures
- Les deux facteurs catégoriels impliquent-ils des participants distincts et mutuellement exclusifs au sein de chaque cellule (plan inter-sujets pur) ?
- Si Oui : L’ANOVA à deux facteurs inter-sujets constitue le modèle structurel de référence.
- Si Non : Si l’un des facteurs repose sur des mesures répétées dans le temps ou des épreuves intra-individuelles appariées, basculer impérativement vers une ANOVA mixte (split-plot ANOVA) ou un modèle linéaire à effets mixtes.
Étape 3 : Audit de conformité des postulats métriques
- Les données violent-elles sévèrement la normalité résiduelle au sein de petits effectifs cellulaires ($n_{jk} < 15$) ? $implies$ Envisager les alternatives non-paramétriques (Étape 4).
- Le postulat d’homogénéité des variances (homoscédasticité) est-il violé sur un plan à effectifs cellulaires déséquilibrés ?
- Pour le plan à un facteur : Adopter immédiatement la correction robuste de Welch.
- Pour le plan à deux facteurs : Recourir aux sommes des carrés de Type III, conjointement à des procédures post-hoc robustes de type Games-Howell ou basculer vers des approches par rééchantillonnage.
12.2 Alternatives robustes et non-paramétriques
Lorsque les distributions empiriques se heurtent à des violations insurmontables des postulats paramétriques classiques — notamment en présence de variables de mesure ordinales (échelles de Likert à faible granularité), d’asymétries structurelles irréductibles ou de valeurs aberrantes légitimes refusant toute normalisation par transformation mathématique — le chercheur doit mobiliser des alternatives statistiques appropriées.
Face à l’ANOVA à un facteur, le substitut non-paramétrique par excellence est le test de Kruskal-Wallis. Ce test substitue aux valeurs continues brutes leur rang ordinal cumulé sur l’ensemble de l’échantillon groupé, évaluant l’hypothèse nulle selon laquelle les distributions des rangs médians des différents sous-groupes sont issues d’une même population mère, éliminant ainsi toute dépendance envers la loi normale parente.
En revanche, la transposition non-paramétrique de l’ANOVA factorielle à deux facteurs s’avère nettement plus complexe sur le plan mathématique. Le test de rangs de Friedman ne s’adresse qu’aux plans à blocs complets randomisés ou à mesures répétées à un facteur, et ne résout pas la modélisation croisée inter-sujets. L’analogue non-paramétrique le plus rigoureux est la méthode d’alignement et de transformation par les rangs (Aligned Rank Transform ou ART, formalisée par Wobbrock et al., 2011). Cette technique algorithmique novatrice retire préalablement l’ensemble des effets marginaux estimés pour isoler la variance propre à une composante cible spécifique avant d’assigner les rangs, permettant de calculer légitimement des ratios de test non-paramétriques précis tant pour les effets principaux que pour l’effet d’interaction croisée.
Enfin, deux approches computationnelles de pointe s’érigent aujourd’hui en standards privilégiés de la psychométrie avancée :
- Les méthodes de rééchantillonnage par bootstrap : En générant des milliers d’itérations d’échantillonnage aléatoire avec remise à partir de la cohorte observée, le bootstrap dérive empiriquement la distribution d’échantillonnage réelle des statistiques sans formuler aucune assise distributionnelle a priori, fournissant des intervalles de confiance d’une fiabilité remarquable pour les contrastes et les interactions.
- Les modèles linéaires mixtes (LMM) : Indispensables dès lors que les données présentent une structure hiérarchique, un nidage institutionnel ou un taux volumineux de données manquantes non aléatoires, les modèles mixtes surpassent définitivement l’ANOVA classique en intégrant avec souplesse l’aléa spécifique des participants sous forme d’ordonnées à l’origine ou de pentes aléatoires.
12.3 Normes de restitution des résultats selon les standards de l’APA
L’exactitude méthodologique d’un protocole d’analyse de variance se parachève dans la rigueur de sa communication scientifique. Les directives de la 7-ème édition du manuel de publication de l’American Psychological Association (APA) stipulent des règles formelles d’écriture destinées à garantir la transparence intégrale des inférences quantitatives.
La formulation conventionnelle des résultats inférentiels exige la déclaration synoptique continue de la statistique de test, des degrés de liberté associés au facteur et à l’erreur résiduelle, de la valeur empirique exacte du ratio F, de la valeur p précise au centième ou millième supérieur (l’écriture $p = 0{,}000$ étant formellement proscrite au profit de $p < 0{,}001$), et de l'indice de taille d'effet standardisé idoine :
Exemple de rédaction pour une ANOVA à un facteur :
« L’analyse de variance univariée à un facteur a révélé un effet statistiquement hautement significatif de la modalité thérapeutique sur les scores résiduels de dépression au terme du traitement, $F(2, 42) = 20{,}60$, $p < 0{,}001$, $\omega^2 = 0{,}47$. Les comparaisons post-hoc conduites au moyen du test de Tukey HSD démontrent que le protocole TCC engendre des scores de dépression résiduels significativement plus faibles ($M = 14{,}20$, $ET = 4{,}29$) que la condition liste d'attente ($M = 24{,}60$, $ET = 4{,}95$, $p < 0{,}001$, $d = 2{,}24$). De même, le programme MBCT ($M = 16{,}80$, $ET = 4{,}59$) surclasse la liste d'attente de manière significative ($p < 0{,}001$, $d = 1{,}63$). En revanche, la supériorité de la TCC par rapport à la MBCT ne franchit pas le seuil de signification statistique conventionnel sur cet échantillon ($p = 0{,}248$, $d = 0{,}58$). »
Exemple de rédaction pour une ANOVA à deux facteurs avec interaction :
« L’analyse de variance factorielle $3 \times 2$ révèle des effets principaux statistiquement significatifs pour la technique de mémorisation, $F(2, 114) = 289{,}24$, $p < 0{,}001$, $\eta_p^2 = 0{,}84$, ainsi que pour l'état d'éveil cognitif, $F(1, 114) = 143{,}23$, $p < 0{,}001$, $\eta_p^2 = 0{,}56$. Toutefois, ces effets marginaux sont conditionnés par une interaction croisée hautement significative entre la technique d'apprentissage et la fatigue cognitive, $F(2, 114) = 48{,}65$, $p < 0{,}001$, $\eta_p^2 = 0{,}46$. L'analyse consécutive des effets simples indique que sous condition d'épuisement cognitif, la technique de récupération espacée préserve un score d'encodage significativement supérieur ($M = 36{,}40$, $ET = 3{,}50$) à celui permis par l'élaboration sémantique ($M = 24{,}10$, $ET = 3{,}30$, $t(114) = 11{,}38$, $p < 0{,}001$, $d = 3{,}62$), alors que ces deux approches affichaient des performances étroitement comparables en condition de repos ($M = 41{,}10$ vs. $M = 38{,}20$, $p = 0{,}018$, $d = 0{,}88$). »
La structuration tabulaire des sorties factorielles doit par ailleurs rassembler de façon explicite les colonnes canoniques : Source de variation, Somme des carrés ($SC$), Degrés de liberté ($ddl$), Carrés moyens ($CM$), Statistique $F$, Valeur $p$ et Taille d’effet partagée ($\eta_p^2$), permettant à la communauté scientifique de vérifier de manière transparente la cohérence mathématique de l’analyse et d’intégrer sans difficulté ces données au sein de futures synthèses méta-analytiques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Gelman, A., & Stern, H. (2006). The difference between « significant » and « not significant » is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006X152607
- Hays, W. L. (1994). Statistics (5th ed.). Harcourt Brace College Publishers.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Kahneman, D. (1973). Attention and effort. Prentice-Hall.
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Wobbrock, J. O., Findlater, L., Gergle, D., & Higgins, J. J. (2011). Aligning rank transform techniques for non-parametric factorial ANOVA in human-computer interaction. In Proceedings of the SIGCHI Conference on Human Factors in Computing Systems (pp. 535–546). ACM. https://doi.org/10.1145/1978942.1979017