
L’analyse de variance à un facteur, communément désignée sous l’acronyme anglo-saxon One-Way ANOVA, constitue l’un des piliers méthodologiques fondamentaux de l’expérimentation en sciences humaines, sociales et comportementales. Conçue initialement par le statisticien Ronald Aylmer Fisher dans le cadre de ses travaux agronomiques au début du vingtième siècle, cette méthode s’est rapidement imposée comme la référence analytique incontournable pour comparer simultanément les moyennes de trois populations indépendantes ou davantage. Dans les disciplines quantitatives modernes, la capacité à partitionner la variabilité observée en composantes systématiques et aléatoires permet aux chercheurs d’éprouver des hypothèses théoriques complexes tout en maintenant un contrôle rigoureux des risques inférentiels.
Le logiciel SAS (Statistical Analysis System) s’est établi au fil des décennies comme une référence internationale incontestée dans les domaines biomédicaux, pharmaceutiques et psychométriques pour le traitement des données hautement structurées. Doté d’une rigueur computationnelle absolue, le progiciel SAS offre plusieurs procédures dédiées à l’analyse de variance, notamment les procédures génériques et spécialisées que sont la procédure ANOVA et la procédure GLM (General Linear Model). Bien que l’exécution brute de ces algorithmes puisse sembler aisée de prime abord, l’implémentation robuste d’une analyse univariée exige une compréhension intime des hypothèses de distribution sous-jacentes, des commandes d’importation, des stratégies de détection des violations méthodologiques et de l’interprétation des sorties matricielles complexes.
Ce guide exhaustif a pour vocation de détailler, avec le plus haut niveau d’exigence académique et pratique, l’ensemble du cycle analytique associé à l’exécution d’une ANOVA à un facteur dans l’environnement SAS. De la formalisation algébrique de la décomposition des sommes de carrés jusqu’à la rédaction normalisée des résultats selon les critères stricts de l’American Psychological Association (APA), chaque étape est disséquée afin de fournir aux méthodologistes, doctorants et biostatisticiens les outils conceptuels et programmatiques nécessaires à une exploitation inférentielle irréprochable de leurs données de recherche.
1. Fondements théoriques de l’ANOVA à un facteur en sciences psychologiques
1.1 Principe général et modélisation de la variance
L’analyse de variance à un facteur repose sur la formulation d’un modèle linéaire général univarié dans lequel la variable dépendante quantitative continue est exprimée en fonction d’un niveau d’effet imputable à un facteur catégoriel unique, combiné à une erreur résiduelle aléatoire. Sur le plan mathématique, l’observation individuelle associée au participant j assigné à la condition expérimentale i s’écrit formellement sous la forme : Y(ij) = mu + alpha(i) + epsilon(ij), où mu représente la moyenne générale théorique de la population parente, alpha(i) symbolise l’effet différentiel associé à la modalité spécifique du facteur d’intérêt, et epsilon(ij) caractérise la déviation stochastique individuelle inhérente à l’échantillonnage. Dans ce cadre épistémologique, l’objectif consiste à tester la nullité conjointe de tous les effets différentiels alpha(i), ce qui équivaut à postuler que les k sous-populations présentent des moyennes parfaitement superposables.
Le mécanisme central de l’ANOVA réside dans la partition de la somme des carrés totale (Total Sum of Squares, notée SST) en deux composantes mutuellement exclusives et géométriquement orthogonales : la somme des carrés inter-groupes (Between Sum of Squares, notée SSB) et la somme des carrés intra-groupe (Within Sum of Squares, notée SSW). La variabilité totale quantifie l’éloignement global de chaque score empirique individuel par rapport à la moyenne générale de l’ensemble de l’échantillon d’étude. La somme des carrés inter-groupes traduit les fluctuations entre les moyennes conditionnelles de chaque modalité et le barycentre global, capturant ainsi la part de variance explicable par le traitement ou la condition expérimentale administrée. À l’opposé, la somme des carrés intra-groupe reflète la dispersion des scores individuels autour de la moyenne de leur propre groupe, représentant ainsi le bruit statistique non contrôlé, également qualifié d’erreur résiduelle ou de variance non expliquée.
La statistique inférentielle décisive issue de cette décomposition est le ratio F de Fisher-Snedecor. Il s’obtient en divisant le carré moyen inter-groupes (Mean Square Between, MSB), calculé en rapportant SSB à ses degrés de liberté (k – 1), par le carré moyen intra-groupe (Mean Square Within, MSW), calculé en rapportant SSW à ses degrés de liberté résiduels (N – k). Sous l’hypothèse nulle d’absence totale d’effet de traitement, le carré moyen inter-groupes constitue un estimateur non biaisé de la même variance résiduelle que le carré moyen intra-groupe. Par conséquent, le ratio F adopte une distribution théorique d’échantillonnage de Fisher tabulée selon k – 1 et N – k degrés de liberté. Si la valeur empirique du ratio F dépasse le seuil critique défini au préalable par le chercheur, l’hypothèse nulle est formellement rejetée, confirmant l’existence d’une différence systématique entre au moins deux des moyennes sous revue.
1.2 Utilité de l’ANOVA face aux comparaisons multiples par tests t de Student
Face à un protocole expérimental impliquant la comparaison simultanée de trois groupes ou davantage, le réflexe naïf d’un analyste débutant consisterait à appliquer une série itérative de tests t de Student pour deux échantillons indépendants sur chaque paire possible de modalités. Cette approche intuitive souffre toutefois d’une tare statistique rédhibitoire : le phénomène d’inflation du risque global d’erreur de première espèce, universellement désigné sous le vocable de taux d’erreur par famille d’hypothèses (Family-Wise Error Rate). L’erreur de type I, conventionnellement fixée au seuil nominal alpha de 0,05, désigne la probabilité d’affirmer à tort l’existence d’un effet statistiquement significatif alors que l’hypothèse nulle est pourtant parfaitement vérifiée dans la population.
Le calcul combinatoire révèle avec clarté la magnitude exponentielle de cette dérive inférentielle. Pour un plan expérimental comportant k groupes distincts, le nombre total de comparaisons binaires non redondantes s’élève à k(k – 1) divisé par deux. En postulant l’indépendance statistique stricte de ces épreuves, la probabilité cumulée de commettre au moins une erreur de première espèce sur l’ensemble de la batterie d’évaluations se calcule selon la formule analytique : alpha global = 1 – (1 – alpha nominal)^k, où k représente ici le nombre total de comparaisons effectuées. Ainsi, dans un dispositif méthodologique comprenant quatre conditions d’intervention, six tests t individuels seraient théoriquement nécessaires. Le taux effectif d’erreur alpha cumulé n’est alors plus de 0,05, mais bondit à 1 – (1 – 0,05)^6, soit environ 0,265. Le chercheur s’expose dès lors à une probabilité supérieure à 26 % de déclarer faussement une découverte scientifique fortuite.
L’analyse de variance à un facteur préserve l’intégrité de la démarche scientifique en agissant comme un test omnibus préliminaire. Le terme omnibus dérive du latin et signifie littéralement pour tous ; il signale que l’épreuve statistique évalue globalement la configuration des moyennes sans accorder de privilège directionnel ou bilatéral à une dyade particulière. L’ANOVA fournit ainsi un verrou probabiliste unique maintenant le taux d’erreur de type I exactement au seuil prédéterminé de 0,05 sur l’ensemble du système de données. Ce n’est que dans la mesure où ce filtre omnibus s’avère statistiquement significatif que la communauté méthodologique autorise le déploiement de procédures d’ajustement a posteriori pour explorer quelles paires précises divergent de manière probante.
1.3 Applications empiriques en psychologie cognitive et comportementale
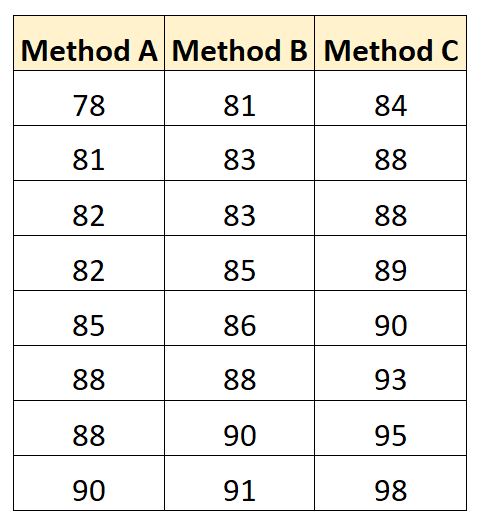
Les sciences psychologiques modernes recourent massivement à l’analyse de variance à un facteur pour opérationnaliser des paradigmes expérimentaux transversaux. En psychologie de l’éducation et en neurosciences de l’apprentissage, les protocoles visent fréquemment à comparer l’efficacité pédagogique relative de différentes méthodologies d’enseignement. Imaginons un chercheur désireux d’étudier l’impact de trois modalités d’encodage mnésique sur la rétention lexicale à long terme : un premier groupe mémorise des stimuli textuels via une méthode traditionnelle de répétition par cœur, un deuxième groupe utilise une technique d’imagerie mentale visuelle interactive, tandis qu’un troisième groupe recourt à une méthode d’encodage multisensoriel tactile-visuel. Le score obtenu à un examen standardisé de rappel après quarante-huit heures constitue la variable dépendante continue, tandis que la technique pédagogique matérialise le facteur indépendant à trois niveaux.
Dans le domaine de la psychologie clinique et des thérapies comportementales, l’ANOVA à un facteur permet d’évaluer la réponse différentielle à divers protocoles de prise en charge psychologique du trouble de l’anxiété généralisée. Les investigateurs peuvent constituer quatre bras parallèles indépendants : un groupe contrôle placé sur liste d’attente sans traitement actif, un groupe bénéficiant d’une thérapie cognitivo-comportementale classique, un groupe soumis à un entraînement cognitif de réduction du biais attentionnel assisté par ordinateur, et un groupe engagé dans un protocole de réduction du stress basée sur la pleine conscience. La quantification de l’anxiété sur une échelle psychométrique validée, administrée à l’issue des protocoles d’intervention, permet de discriminer de manière causale l’effet spécifique imputable aux approches thérapeutiques étudiées.
Enfin, la psychologie cognitive ergonomique recourt continuellement à ces modélisations pour sonder la dégradation des capacités d’attention sélective face à des perturbations environnementales physiques. Un protocole classique peut consister à exposer des opérateurs à des environnements sonores contrastés lors d’une tâche de vigilance radar continue : silence de référence, bruit blanc continu, et musique verbale polyphonique. Les temps de réaction moyens mesurés en millisecondes permettent d’objectiver mathématiquement si les ressources attentionnelles exécutives sont modulées par la nature intrinsèque des stresseurs acoustiques, en comparant la variance induite entre les scénarios ambiants à la variance idiosyncrasique des participants.
2. Hypothèses statistiques et conditions d’application préalables
2.1 Indépendance des observations et échantillonnage aléatoire
L’indépendance statistique des observations représente l’hypothèse méthodologique la plus critique de l’analyse de variance, tout en étant la plus réfractaire aux rectifications calculatoires a posteriori. Cette condition stipule que la valeur prise par la variable dépendante pour une observation j au sein d’une modalité expérimentale i n’exerce aucune influence directe ou indirecte sur le score d’une quelconque autre observation du jeu de données, et n’est soumise à aucune covariance systématique non modélisée. Cette indépendance dépend intrinsèquement du protocole d’échantillonnage et de la rigueur de l’assignation aléatoire des unités statistiques aux diverses conditions de traitement.
Lorsque cette hypothèse d’indépendance est violée, les conséquences sur l’inférence statistique sont dévastatrices. En présence d’une corrélation résiduelle positive entre participants — un phénomène omniprésent lors du recueil de données au sein d’unités sociales préexistantes telles que des classes scolaires, des fratries ou des groupes thérapeutiques —, l’estimation de l’erreur résiduelle intra-groupe (MSW) est substantiellement biaisée vers le bas. Les observations regroupées ayant tendance à se ressembler davantage que des individus sélectionnés au hasard absolu dans la population, le dénominateur du test F devient artificiellement compressé. Cela gonfle de manière disproportionnée la statistique F observée, conduisant à des p-valeurs facticement minuscules et propulsant le taux réel d’erreur de type I bien au-delà de 20 ou 30 % pour un seuil nominal affiché de 5 %.
Les investigateurs doivent impérativement prévenir ces écueils dès la phase d’opérationnalisation empirique en évitant les passations collectives non contrôlées ou les interférences directes entre sujets. Si des participants interagissent verbalement durant une tâche cognitive ou si plusieurs mesures proviennent d’un même sujet au fil du temps, le modèle univarié standard à un facteur pour échantillons indépendants s’avère totalement inopérant. Il convient alors de recourir à des modèles linéaires mixtes hiérarchiques intégrant des intercepts aléatoires via la procédure MIXED de SAS pour modéliser adéquatement la matrice de variance-covariance intraclasse.
2.2 Normalité de la variable dépendante et robustesse statistique
L’ANOVA classique assume formellement que la variable dépendante quantitative continue, ou de façon plus rigoureuse les résidus aléatoires epsilon(ij), suivent une distribution gaussienne symétrique au sein de chacune des k sous-populations définies par le facteur catégoriel. Cette exigence théorique découle directement de la construction mathématique de la distribution F de Fisher, qui est modélisée à partir du rapport de deux variables aléatoires indépendantes suivant chacune une distribution de Chi-deux divisée par leurs degrés de liberté respectifs. Or, une variable de Chi-deux n’est obtenue que par la sommation de carrés d’observations normalement distribuées et centrées réduites.
En pratique expérimentale, les données psychologiques pures présentent fréquemment des écarts perceptibles vis-à-vis de la cloche gaussienne idéale, prenant la forme d’asymétries positives marquées pour les latences temporelles ou de phénomènes d’aplatissement (kurtosis platykurtique ou leptokurtique) pour des scores d’évaluation clinique. L’analyse de variance démontre toutefois une robustesse remarquable face aux déviations modérées de la normalité, à condition que les échantillons sous chaque condition soient équilibrés et d’effectifs suffisants. En vertu des principes asymptotiques gouvernés par le théorème central limite, la distribution des moyennes d’échantillonnage tend inéluctablement vers la normalité à mesure que les effectifs croissent, neutralisant une vaste part du biais inférentiel potentiel.
Une règle prudentielle généralement admise dans la littérature de biostatistique postule que dès lors que les effectifs conditionnels atteignent ou dépassent vingt à trente participants par groupe (n >= 25 ou 30), et en l’absence de valeurs aberrantes extrêmes tirant artificiellement les barycentres, la validité des seuils de décision associés au test F demeure intacte. En revanche, face à des micro-échantillons (n < 10 par groupe) présentant des asymétries sévères, les estimations probabilistes exactes sont faussées, justifiant alors soit des transformations non linéaires de la variable (par exemple logarithmiques ou inverses), soit le basculement vers des alternatives non paramétriques.
2.3 Homogénéité des variances (homoscédasticité)
L’hypothèse d’homoscédasticité, ou d’homogénéité des variances, exige que la variance théorique de la variable réponse soit rigoureusement identique au sein de chaque strate définie par les k niveaux du facteur indépendant. Formellement, l’équation sigma^2(1) = sigma^2(2) = … = sigma^2(k) = sigma^2 doit être satisfaite. Le modèle de l’ANOVA poolant l’ensemble des déviations quadratiques individuelles pour constituer un dénominateur commun d’erreur (le carré moyen intra-groupe MSW), cette opération algébrique de mise en commun perd son sens théorique fondamental si les sous-populations exhibent des dispersions intrinsèquement divergentes.
L’impact de l’hétéroscédasticité sur la robustesse du test F dépend de façon déterminante de la configuration des effectifs d’échantillonnage des groupes. Dans le cas d’un plan strictement équilibré, caractérisé par des tailles d’échantillons parfaitement identiques dans chaque condition (n(1) = n(2) = … = n(k)), le test F conserve une robustesse remarquable même face à des disparités de variance substantielles, tant que le rapport entre la variance la plus élevée et la variance la plus faible ne dépasse pas un facteur de trois ou quatre. L’inflation du taux d’erreur alpha demeure alors négligeable pour la prise de décision pratique.
En revanche, la conjonction pernicieuse d’une hétéroscédasticité et d’un plan expérimental déséquilibré (tailles de groupes asymétriques) engendre des distorsions statistiques majeures. Deux scénarios distincts se présentent :
Dans le premier cas, qualifié de relation positive, les groupes détenant les effectifs les plus massifs affichent également les variances les plus larges ; l’estimateur poolé de l’erreur résiduelle se trouve alors démesurément surévalué, rendant le test excessivement conservateur avec une perte tragique de puissance statistique (taux de fausses alertes tombant bien en deçà de 5 % au détriment de la détection des effets réels).
Dans le second cas, dit de relation négative, les groupes aux effectifs les plus restreints possèdent les variances les plus étendues ; le dénominateur MSW est alors dramatiquement sous-estimé, rendant le test excessivement libéral. Le taux d’erreur de première espèce peut alors culminer jusqu’à 15 ou 20 %, produisant une profusion de faux positifs scientifiques. Dès lors, le diagnostic rigoureux de l’homoscédasticité avant toute ANOVA sur données asymétriques s’avère absolument indispensable.
3. Structuration et importation des données dans l’environnement SAS
3.1 Création du jeu de données expérimental via l’étape DATA
L’environnement SAS architecture l’ensemble de ses manipulations de données autour de deux briques syntaxiques cardinales : l’étape DATA et l’étape PROC. Pour implémenter une analyse de variance, la première opération consiste à élaborer ou compiler une table de données SAS rectangulaire respectant strictement le format dit univarié long, dans lequel chaque ligne individuelle correspond rigoureusement à une unité d’observation unique (un participant) et chaque colonne représente une variable nominale ou continue formalisée. L’étape DATA permet de saisir directement des matrices d’observations dans l’éditeur de programme à des fins de modélisation rapide ou de vérification didactique.
L’instruction INPUT occupe une position charnière au sein du bloc DATA. Elle permet d’instancier les identifiants de colonnes et de stipuler leur typage système intrinsèque. Pour désigner la variable indépendante catégorielle représentant les méthodes pédagogiques ou conditions d’exposition expérimentale, il convient d’accoler immédiatement le modificateur alphanumérique dollar ($) derrière le nom de la variable dans l’instruction INPUT. L’absence de ce symbole conduit inévitablement SAS à interpréter la modalité comme une variable quantitative numérique continue, ce qui déclencherait des erreurs de conversion d’entrées lors de la lecture d’étiquettes textuelles alphabétiques. La variable dépendante continue, quant à elle, ne porte aucun caractère suffixe et se trouve déclarée comme champ numérique standard.
La commande DATALINES (ou son équivalent sémantique CARDS) signale au compilateur SAS que les lignes subséquentes du script ne constituent pas des instructions exécutables, mais le flux brut des valeurs d’enregistrement. Les entrées doivent être séparées par des espaces simples respectant l’ordre syntaxique de l’instruction INPUT, chaque ligne se terminant par un retour chariot. La clôture de l’étape est impérativement matérialisée par l’instruction RUN, qui commande l’exécution immédiate du bloc d’instructions compilé et génère le fichier binaire SAS7BDAT dans la bibliothèque temporaire de travail WORK. Le strict respect d’une typographie sans ambiguïté pour les modalités textuelles (par exemple eviter les espaces insécables ou accents discordants) garantit une segmentation factorielle parfaite lors des étapes inférentielles subséquentes.
3.2 Importation de formats externes (CSV, Excel) via PROC IMPORT
Dans la conduite effective de recherches universitaires d’envergure, les données brutes proviennent quasi systématiquement de collecteurs externes numériques, de plateformes de tests en ligne ou de tableurs électroniques sous formats CSV ou Microsoft Excel (.xlsx). L’importation de ces gisements d’informations vers l’espace de travail SAS s’opère de façon canonique à l’aide de la procédure utilitaire PROC IMPORT. Cette procédure dédiée automatise la lecture, l’attribution des métadonnées et la génération instantanée de la table SAS exploitable par les modules de modélisation mathématique.
La formulation syntaxique de base implique de stipuler l’emplacement physique du fichier source via l’argument DATAFILE, de désigner la table de destination via OUT=, et de préciser le moteur d’interprétation via l’argument DBMS. Pour un fichier séparé par des virgules, l’option DBMS=CSV est spécifiée, tandis qu’un fichier de tableur récent requiert DBMS=XLSX. Deux options de contrôle s’avèrent indispensables pour préserver l’intégrité de la structure : l’option GETNAMES=YES commande à SAS de mobiliser la toute première rangée du tableau source pour générer les libellés de colonnes, et l’argument REPLACE autorise l’écrasement dynamique de la table dans l’espace WORK en cas d’exécutions successives du script d’analyse.
Un écueil classique d’importation réside dans la détermination erronée des formats de colonnes, notamment lorsqu’une variable numérique contient sporadiquement des caractères textuels de codage de données manquantes (tels que NA ou non disponible). Par défaut, SAS évalue les types de variables en inspectant uniquement les vingt premières rangées du document externe. Si une modalité texte n’apparaît qu’au-delà de cette frontière, ou si la dispersion des longueurs est mal calibrée, la variable quantitative peut être tragiquement tronquée ou convertie en chaîne alphanumérique. Pour circonscrire catégoriquement cette instabilité, il est impératif d’intégrer l’option GUESSINGROWS=MAX (ou un volume d’observations arbitrairement vaste, tel que GUESSINGROWS=5000), contraignant l’algorithme à scanner l’intégralité du document avant de statuer sur le typage définitif de la table SAS.
3.3 Contrôle qualité et validation de la structure de table
L’étape préliminaire incontournable avant tout déploiement de calculs probabilistes réside dans la réalisation d’un audit de conformité structurelle de la table SAS importée. Cet examen systématique permet d’éviter l’inclusion accidentelle d’anomalies de typage qui invalideraient le modèle linéaire. Deux procédures descriptives élémentaires se partagent cette tâche diagnostique initiale : la procédure PROC CONTENTS et la procédure PROC PRINT.
La procédure PROC CONTENTS fournit une autopsie méticuleuse des métadonnées logiques du fichier SAS. Son exécution permet de certifier que la variable dépendante continue figure sans équivoque avec le statut numérique (Type: Num), et que sa longueur mémoire est adaptée pour accueillir des valeurs à virgule flottante sans perte de précision. Simultanément, l’analyste s’assure que la variable de groupement factoriel est correctement indexée en format alphanumérique (Type: Char) ou qu’elle est assortie d’un format de libellé personnalisé si elle a été encodée numériquement (1, 2, 3). Cette vérification prévient l’erreur catastrophique consistant à insérer une variable continue dans la liste des régresseurs continus au lieu de la traiter comme un facteur à effets fixes qualitatif.
Conjointement, l’invocation de la procédure PROC PRINT complétée par l’option d’observation restreinte OBS=10 permet d’imprimer dans la fenêtre de résultats un échantillon représentatif des premières lignes de la base. Cet examen visuel direct sert à valider le parfait alignement des vecteurs de scores, la bonne conversion des délimiteurs décimaux (points versus virgules européennes) et la détection d’éventuels décalages de cellules. De plus, la détection des valeurs manquantes s’avère capitale : dans SAS, une case vide numérique est désignée par un point isolé (. ) et sera automatiquement exclue par l’algorithme d’ANOVA selon le principe de l’analyse par suppression par observation (listwise deletion). Déterminer le volume exact de ces exclusions techniques est un préalable indispensable pour documenter fidèlement les effectifs réels engagés dans l’épreuve statistique.
4. Diagnostic exploratoire et vérification empirique des postulats dans SAS
4.1 Statistiques descriptives par groupe avec PROC MEANS
Toute exploration inférentielle rigoureuse doit impérativement s’enraciner dans une analyse descriptive exhaustive des caractéristiques distributionnelles des sous-échantillons. Dans SAS, la procédure PROC MEANS est le moteur d’agrégation privilégié pour extraire instantanément la moyenne empirique, l’écart-type d’échantillonnage, la variance, la médiane, l’écart interquartile, ainsi que l’erreur-type de la moyenne pour chacun des niveaux du facteur catégoriel. Cette ventilation différentielle est déclenchée de façon optimale par l’insertion de l’instruction CLASS, suivie de l’intitulé de la variable nominale désignant les groupes expérimentaux.
L’instruction VAR désigne expressément la variable réponse métrique soumise à l’évaluation. En agrémentant l’en-tête de la procédure des spécificateurs statistiques ciblés tels que N, MEAN, STD, MEDIAN, QRANGE et CLM, le chercheur dispose d’une matrice condensée résumant l’architecture de ses données. La lecture comparative des moyennes conditionnelles permet d’esquisser une intuition clinique ou théorique préliminaire quant à la supériorité relative d’un traitement sur un autre. Plus fondamentalement encore, l’analyse comparative des écarts-types offre une première estimation visuelle du respect du postulat d’homoscédasticité : une divergence disproportionnée (par exemple un écart-type triplant d’une modalité à l’autre) alerte immédiatement l’analyste sur une probable violation des variances stables.
De surcroît, le calcul systématique des intervalles de confiance à 95 % autour de la moyenne conditionnelle (dérivés de l’option CLM) matérialise l’étendue plausible du paramètre dans la population parente. Le chevauchement massif ou, au contraire, la disjonction visuelle nette entre les bornes inférieures et supérieures d’intervalles de confiance de deux modalités renseigne l’investigateur sur l’issue hautement prévisible du test d’hypothèse global de Fisher. Cet examen chiffré évite ainsi les déconvenues d’interprétation lors de l’obtention des volumineuses matrices de calcul inférentielles de l’ANOVA.
4.2 Évaluation de la normalité avec PROC UNIVARIATE
L’évaluation rigoureuse du postulat de normalité des distributions univariées requiert une instrumentation statistique plus sophistiquée que les simples indicateurs de tendance centrale. C’est ici qu’intervient la procédure PROC UNIVARIATE, outil diagnostique suprême au sein de la gamme SAS pour l’examen des propriétés de forme d’une distribution. Pour sonder la normalité conditionnelle au sein de chaque bras expérimental, la procédure est exécutée en association avec l’instruction CLASS, tandis que l’adjonction de l’option NORMAL au sein de l’instruction d’ouverture commande le calcul automatique d’une batterie complète d’épreuves de conformité gaussienne formelles.
Le système SAS délivre simultanément les résultats du test de Shapiro-Wilk (statistique W), de Kolmogorov-Smirnov (avec correction d’asymétrie de Lilliefors), de Cramér-von Mises et d’Anderson-Darling. Pour des tailles d’échantillons courantes en sciences humaines (N < 2000), le test de Shapiro-Wilk demeure le standard absolu d’arbitrage en raison de sa puissance statistique supérieure face à une vaste diversité de distorsions distributionnelles. Une p-valeur associée à la statistique W supérieure au seuil usuel de 0,05 conduit à maintenir l’hypothèse nulle de distribution normale des observations au sein de la modalité investiguée, corroborant la licéité de l’ANOVA.
Néanmoins, les épreuves de signification formelles souffrant d’une sensibilité exacerbée face aux grands effectifs (où des écarts minimes et sans conséquence réelle sur le test F deviennent significatifs) et d’un déficit d’efficacité criant au sein des micro-cohortes, il est indispensable de corroborer ces sorties avec des indicateurs graphiques et numériques structurels. L’instruction PROBPLOT complétée de l’option / NORMAL(MU=EST SIGMA=EST) génère des graphiques quantile-quantile (Q-Q plots) d’une précision exemplaire. L’observation d’un alignement harmonieux des points empiriques le long de la bissectrice théorique confirme l’adéquation gaussienne. De surcroît, les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) édités dans la sortie doivent idéalement être circonscrits dans la fenêtre numérique de -1,0 à +1,0 pour garantir une neutralité inférentielle totale.
4.3 Tests formels d’homoscédasticité dans SAS
Bien que l’examen comparatif des écarts-types issus de la procédure MEANS fournisse un éclairage préliminaire, la validation méthodologique formelle du postulat d’égalité des variances réclame l’exécution de tests d’hypothèses dédiés. L’architecture SAS n’oblige pas à recourir à des calculs matriciels externes pour cette tâche : les procédures ANOVA et GLM intègrent des fonctionnalités natives capables de sonder l’homogénéité des variances au moyen de l’option HOVTEST (Homogeneity of Variance Test) adossée à l’instruction MEANS.
Par défaut, l’instruction syntaxique HOVTEST sans argument complémentaire ordonne l’exécution du test classique de Levene. Cette procédure repose conceptuellement sur la réalisation d’une analyse de variance appliquée non pas directement aux scores bruts, mais aux valeurs absolues des écarts séparant chaque observation individuelle de la moyenne empirique de son groupe respectif. Si l’écart moyen à la moyenne varie d’un groupe à l’autre, cela démontre que la dispersion sous-jacente est asymétrique. Une p-valeur du test de Levene inférieure à 0,05 force le rejet de l’hypothèse nulle d’homogénéité des variances, signalant que le postulat d’homoscédasticité est violé.
Le test de Levene standard basé sur la moyenne mathématique présente toutefois le défaut notoire d’être lui-même vulnérable à l’absence de normalité des scores, risquant de rejeter faussement l’homoscédasticité uniquement parce que la distribution est étirée. Pour surmonter cet écueil, SAS propose la variante particulièrement puissante et robuste de Brown-Forsythe, accessible via la directive syntaxique HOVTEST=BF. Cette alternative ingénieuse remplace la moyenne empirique par la médiane conditionnelle lors du calcul des déviations absolues individuelles. Dès lors que l’analyste anticipe des asymétries modérées dans ses données, le recours au test de Brown-Forsythe s’impose comme la solution privilégiée pour attester de la viabilité des variances sans interférence avec les anomalies de forme de distribution.
5. Exécution de l’analyse avec la procédure PROC ANOVA
5.1 Syntaxe fondamentale et structure déclarative
La procédure PROC ANOVA constitue historiquement le premier module programmé au sein du noyau SAS pour accomplir l’analyse de variance des modèles équilibrés. Sa syntaxe repose sur une économie de moyens et une clarté déclarative remarquables. L’instruction liminaire PROC ANOVA DATA=nom_de_table instancie l’environnement de calcul en ciblant le fichier d’intérêt archivé dans les bibliothèques du système. Immédiatement sous l’amorce de la procédure, deux instructions structurelles s’avèrent impératives pour configurer l’espace vectoriel : l’instruction CLASS et l’instruction MODEL.
L’instruction CLASS joue un rôle primordial dans la grammaire computationnelle de SAS. Elle désigne expressément au compilateur quelles sont les variables indépendantes qui doivent être traitées comme des facteurs de classification discrets qualitatifs, indépendamment de leur codage alphanumérique ou numérique en mémoire. L’omission de cette commande capitale empêcherait le système d’instancier la matrice d’indicatrices (dummy coding) nécessaire à la partition factorielle, conduisant à une interruption de la compilation avec émission d’un code d’erreur bloquant dans le journal (SAS Log).
Faisant suite à la déclaration des facteurs, l’instruction MODEL formalise la relation fonctionnelle univariée sous la syntaxe mathématique universelle de type variable_dépendante = variable_indépendante (par exemple Score = Methode). Cette écriture stipule sans ambiguïté que la variabilité de la variable métrique située à gauche du signe égal doit être décomposée et expliquée par les modalités discrètes du facteur positionné à droite. L’ensemble de la séquence est scellé par l’instruction RUN, laquelle déclenche l’exécution des algorithmes de factorisation et génère le tableau matriciel officiel de l’ANOVA dans la fenêtre de sortie ODS.
5.2 Champ d’application et restriction aux designs équilibrés
Il est impérieux de souligner avec la plus grande fermeté scientifique la frontière d’applicabilité de la procédure PROC ANOVA. Ce module computationnel a été exclusivement conçu, optimisé et conservé pour le traitement des plans dits équilibrés (balanced designs), c’est-à-dire les protocoles expérimentaux où le nombre de sujets assignés à chaque modalité factorielle est rigoureusement identique (n(1) = n(2) = … = n(k)). Dans cette configuration d’orthogonalité mathématique parfaite, les estimateurs des sommes de carrés ne présentent aucun chevauchement structurel, ce qui autorise des calculs directs basés sur les totaux de bordures sans recourir à des inversions de matrices généralisées complexes.
Lorsque le plan expérimental devient déséquilibré — ce qui survient quasi systématiquement en recherche de terrain par suite d’abandons de participants, de données corrompues ou de contraintes d’échantillonnage inhérentes aux cohortes cliniques —, la propriété d’orthogonalité s’effondre. Dans ce contexte, l’application de la procédure PROC ANOVA devient méthodologiquement invalide. Si un utilisateur tente d’exécuter PROC ANOVA sur des données déséquilibrées, SAS procède certes aux calculs, mais insère un avertissement formel dans le journal d’exécution stipulant expressément que la table est asymétrique et que les sommes de carrés calculées peuvent s’avérer erronées ou hautement trompeuses.
Les sommes de carrés générées par la procédure ANOVA dans un plan déséquilibré ne correspondent pas aux sommes des carrés partielles rigoureusement ajustées pour les autres composantes. Il en résulte un risque majeur de sous-estimation ou de surestimation de la statistique F, altérant irrémédiablement le processus décisionnel inférentiel. Par conséquent, l’usage moderne de PROC ANOVA doit être restreint aux protocoles de laboratoire strictement équilibrés ou aux fins d’enseignement introductif, la modélisation générale d’études réelles devant impérativement être confiée à la procédure PROC GLM.
5.3 Optimisation des sorties avec le système ODS Graphics
L’exploitation contemporaine de SAS dépasse la simple restitution de listings chiffrés arides grâce à la puissance du système ODS (Output Delivery System) Graphics. Cette infrastructure graphique intégrée modernise l’interprétation des résultats statistiques en produisant de manière synchronisée des figures d’une résolution vectorielle irréprochable, directement exploitables pour la dissémination et la publication dans des revues académiques internationales.
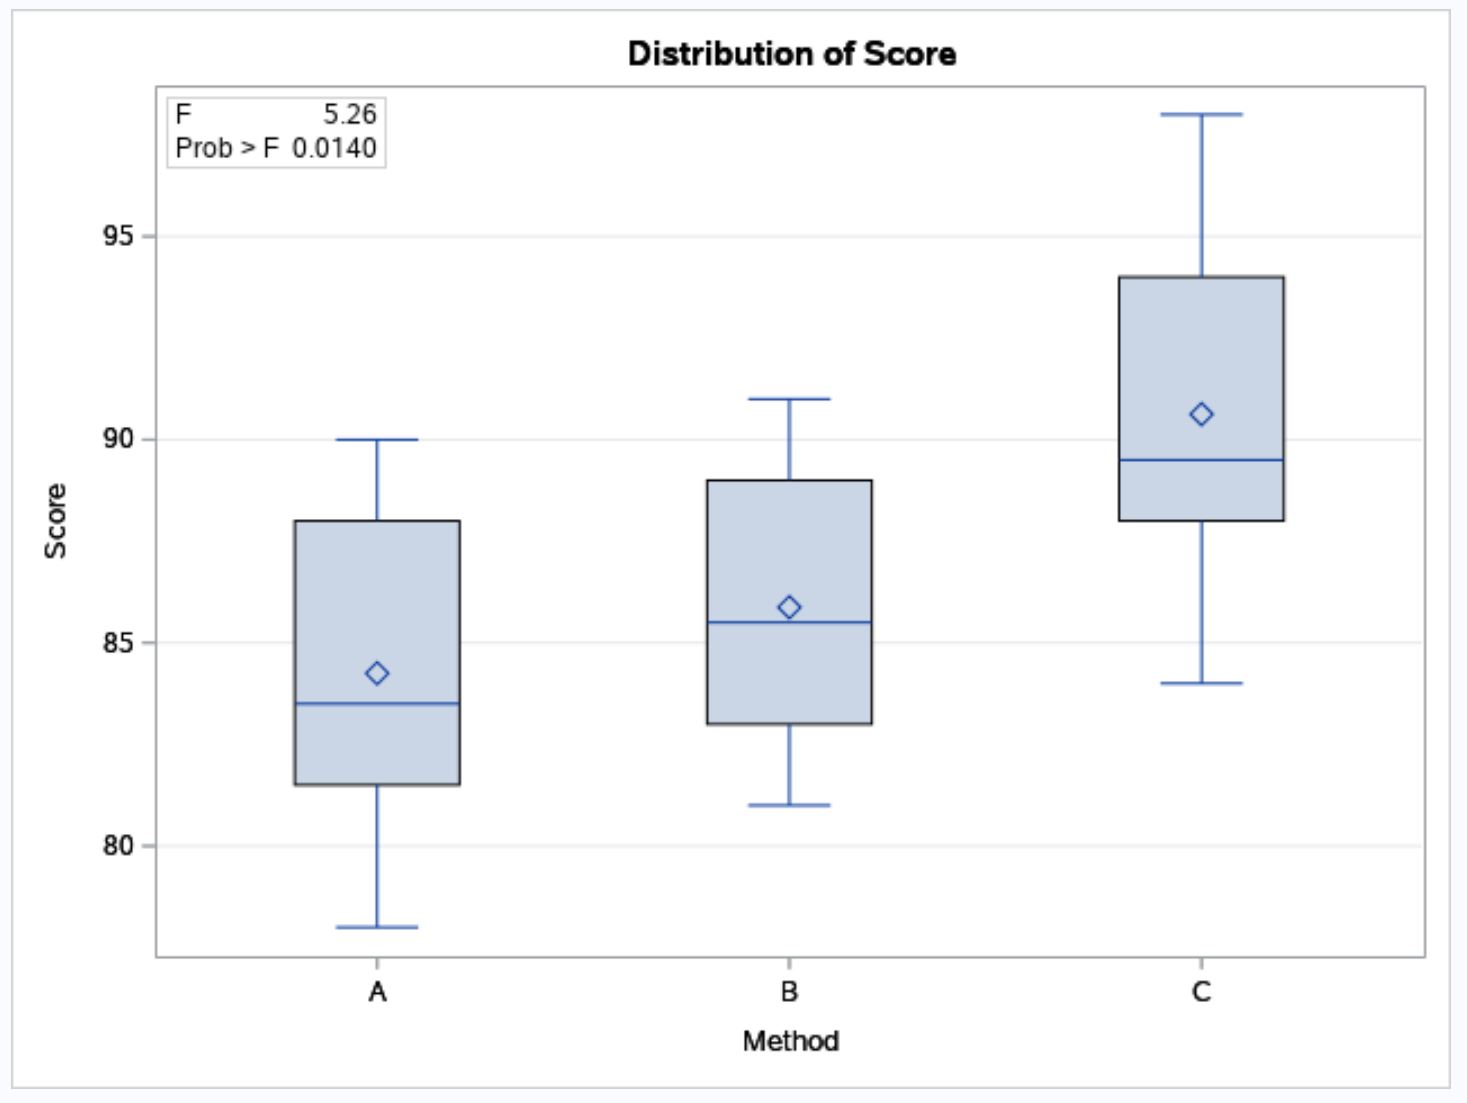
Pour activer l’ensemble du pipeline visuel automatisé, le chercheur doit obligatoirement émettre l’instruction globale ODS GRAPHICS ON avant d’exécuter la procédure analytique. Dès cet instant, la procédure PROC ANOVA ne se borne plus à produire des tableaux matriciels de variance : elle orchestre la confection automatique d’un ensemble de figures diagnostiques hautement informatives. Parmi celles-ci figure en premier lieu le diagramme en boîtes à moustaches conditionnel (Box Plot), qui représente la médiane, l’écart interquartile, les valeurs adjacentes et la moyenne arithmétique (symbolisée par un losange ou un marqueur distinctif) pour chaque condition expérimentale étudiée.
Parallèlement, le moteur ODS génère des panneaux d’analyse de résidus (Residual Plots) illustrant les écarts standardisés en fonction des valeurs prédites, ainsi que des graphiques de répartition quantile-quantile des résidus du modèle linéaire. Pour les chercheurs préparant des manuscrits scientifiques, ces représentations peuvent être exportées sous des formats vectoriels haute fidélité (tels que PDF, SVG ou TIFF à 300 DPI) au moyen de l’instruction ODS LISTING GPATH=’chemin_d_accès’ combinée à des options de style formel telles que STYLE=JOURNAL, garantissant un rendu graphique épuré en noir et blanc conforme aux standards éditoriaux de l’APA.
6. Décodage et interprétation approfondie de la sortie SAS
6.1 Analyse du tableau de variance global (ANOVA Table)
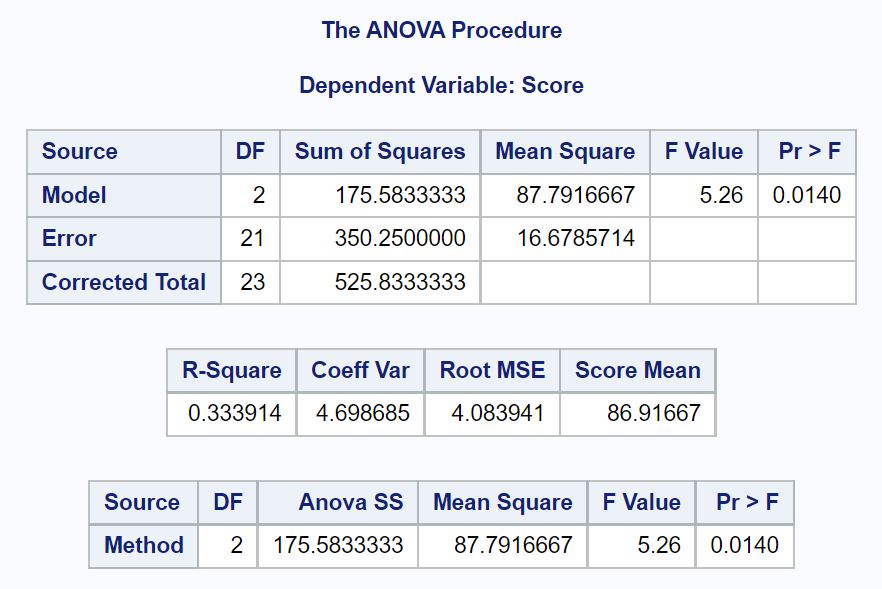
La sortie standard éditée par SAS lors de l’exécution d’une analyse de variance s’articule autour d’une matrice structurée universellement appelée ANOVA Table. La première section synthétise la performance du modèle global en confrontant la variabilité expliquée par le modèle complet à l’erreur aléatoire résiduelle. La colonne Degree of Freedom (DF) répertorie les degrés de liberté attachés à chaque source d’instabilité : pour le modèle, cette quantité est immuablement égale au nombre de groupes factoriels moins un (DF = k – 1), tandis que pour l’erreur résiduelle, elle correspond au nombre total d’observations moins le nombre de groupes (DF = N – k). La somme de ces deux valeurs reconstitue le degré de liberté total de l’expérience (DF = N – 1).
La colonne Sum of Squares (sommes des carrés) expose la décomposition numérique de l’énergie de variance. On y retrouve la somme des carrés du modèle (SSB), caractérisant la variabilité expliquée par l’assignation expérimentale, et la somme des carrés de l’erreur (SSW), chiffrant le bruit résiduel intra-groupe non modélisé. La colonne consécutive, intitulée Mean Square (carrés moyens), transcrit le calcul fondamental consistant à diviser chaque somme de carrés par son degré de liberté respectif. Le carré moyen du modèle (MSB = SSB / (k – 1)) quantifie l’intensité moyenne du signal d’effet par dimension factorielle, tandis que le carré moyen de l’erreur (MSW = SSW / (N – k)) quantifie la variance résiduelle de référence du système d’échantillonnage.
L’aboutissement ultime de ce tableau se matérialise dans les deux dernières colonnes : la valeur de F (F Value) et la probabilité critique associée (Pr > F). La statistique F est calculée par la division directe MSB / MSW. La p-valeur indique la probabilité asymptotique d’observer un ratio F empirique au moins aussi extrême que celui mesuré dans l’échantillon, sous la postulation stricte que l’hypothèse nulle d’égalité absolue des moyennes de population soit vraie. Si cette valeur de probabilité passe sous la barre conventionnelle de l’alpha à 0,05 (ou plus rigoureusement < 0,001 selon les cas), le chercheur rejette avec confiance l’égalité universelle des moyennes conditionnelles.
6.2 Indicateurs d’ajustement : R-carré et coefficient de variation
Immédiatement sous le tableau fondamental de décomposition de variance, SAS édite une série d’indices de qualité d’ajustement globaux indispensables pour étayer l’évaluation clinique du modèle. Le premier de ces métriques est le coefficient de détermination usuel, libellé R-Square (R^2). Cet indice sans unité, rigoureusement contraint entre zéro et un, traduit la proportion exacte de variance totale du score dépendant qui se trouve mathématiquement expliquée ou capturée par le facteur catégoriel. Un R-carré de 0,342 stipule, par exemple, que 34,2 % de la variabilité observée dans les performances des sujets est strictement attribuable à la méthode pédagogique administrée, les 65,8 % résiduels relevant de variations individuelles non contrôlées.
Le deuxième indice délivré est l’écart-type résiduel de l’erreur, identifié sous la formule Root MSE (Root Mean Square Error). Il correspond algébriquement à la racine carrée arithmétique de la variance d’erreur résiduelle (racine carrée de MSW). Ce paramètre fondamental quantifie la déviation type résiduelle moyenne des scores individuels par rapport au barycentre de leur propre groupe d’appartenance, exprimée dans l’unité de mesure directe de la variable dépendante d’origine. C’est un indicateur pragmatique absolu de la fidélité de prédiction du modèle linéaire.
Enfin, SAS calcule l’indice Coeff Var (Coefficient de Variation), obtenu en divisant Root MSE par la moyenne générale absolue de l’ensemble de l’échantillon, le tout multiplié par cent. Cet indice de dispersion relative permet d’apprécier la précision interne des mesures indépendamment de leur échelle métrique brute. En sciences comportementales, un coefficient de variation contenu en deçà de 10 à 15 % signale une métrologie particulièrement constante et stable, tandis qu’une valeur excédant 30 ou 40 % dénote une dispersion résiduelle substantielle relative à l’intensité moyenne du phénomène examiné.
6.3 Prise de décision statistique concernant l’hypothèse nulle
L’arbitrage formel conclu à la lecture de la sortie SAS est tributaire de la confrontation des hypothèses statistiques formelles préalablement posées. L’hypothèse nulle opérationnelle, canoniquement notée H0, postule qu’il n’existe aucune divergence entre les moyennes des k populations sous revue, soit formellement : mu(1) = mu(2) = … = mu(k). L’hypothèse alternative générale, notée H1, stipule l’existence d’au moins une paire de moyennes différant de façon statistiquement décelable, ce qui s’énonce mathématiquement par l’existence d’au moins un couple d’indices (i, j) tel que mu(i) n’est pas égal à mu(j).
Si la mention Pr > F délivrée par la procédure s’établit à un niveau inférieur ou égal à l’alpha nominal (classiquement alpha = 0,05), la sentence inférentielle est sans appel : l’hypothèse nulle H0 est rejetée au profit de l’hypothèse alternative H1. Le chercheur conclut alors avec un niveau de confiance fixé à 95 % que la modalité expérimentale exerce un effet macroscopique systématique sur la variable métrique étudiée. Inversement, si la probabilité excède le seuil de 0,05, l’investigateur échoue à rejeter H0 et doit conclure que les variations observées entre les moyennes d’échantillons relèvent plausiblement des seules fluctuations de l’échantillonnage aléatoire.
Il est impérieux de garder à l’esprit la limite gnoséologique inhérente au test F global de Fisher. En tant qu’épreuve purement omnibus, un rejet hautement significatif de l’hypothèse nulle n’offre absolument aucun éclairage sur la localisation interne ou la directionalité des écarts. Ce résultat atteste seulement que la constellation des k moyennes ne forme pas un bloc homogène. L’analyste se trouve incapable, à ce stade du décodage, de certifier si chaque groupe surpasse individuellement tous les autres, ou si un seul traitement déviant et atypique a suffi à propulser le ratio F hors de sa zone de conformité stochastique, nécessitant impérieusement le basculement vers des investigations post-hoc.
7. Analyses post-hoc et ajustement pour comparaisons multiples
7.1 Procédure HSD de Tukey via l’instruction MEANS
Dès lors que le filtre omnibus de l’analyse de variance a confirmé le rejet de l’hypothèse nulle d’égalité globale des moyennes, la communauté méthodologique autorise le déploiement des tests de comparaisons par paires non planifiées, universellement appelés tests post-hoc. Parmi la panoplie des techniques d’ajustement, le test Honestly Significant Difference (HSD) développé par John Tukey fait figure de référence de choix lors de l’évaluation de toutes les paires possibles de moyennes. Dans la programmation SAS, l’activation de cette procédure s’effectue avec élégance au moyen de l’adjonction de l’option / TUKEY au sein de l’instruction MEANS de la procédure ANOVA ou GLM.
Pour enrichir substantiellement l’interprétation des contrastes, il est recommandé de juxtaposer l’option CLDIFF (Confidence Limits for Differences). Cette instruction commande à SAS de calculer et d’éditer les intervalles de confiance simultanés à 95 % pour l’intégralité des différences moyennes possibles entre groupes. Le principe mathématique fondamental de la méthode HSD repose sur l’utilisation de la distribution de l’amplitude studentisée (Studentized Range Distribution, q) plutôt que sur la classique loi de Student univariée. Ce recours compense mathématiquement l’inflation combinatoire du taux d’erreur, maintenant le risque familial global strictement au seuil nominal alpha fixé à 0,05 sur toute la matrice des contrastes.
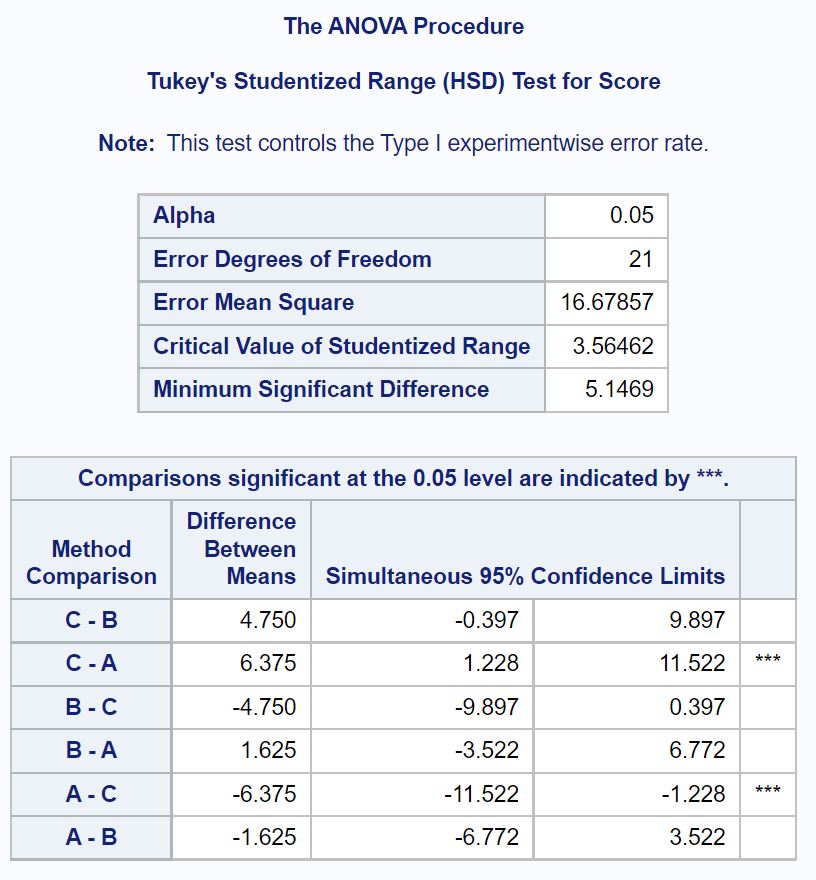
Dans la sortie SAS générée par l’instruction MEANS variable / TUKEY CLDIFF, l’analyste scrute les lignes de comparaison binaires. Pour chaque dyade (par exemple Méthode A versus Méthode B), SAS fournit la différence brute observée entre les moyennes empiriques (Mean Difference), ainsi que la borne inférieure et la borne supérieure de l’intervalle de confiance simultané ajusté. Si cet intervalle de confiance n’englobe pas la valeur zéro (les deux bornes étant de même signe, soit strictement positives, soit strictement négatives), le contraste est déclaré statistiquement significatif au niveau d’erreur globale sélectionné. Cette présentation par intervalles fournit une estimation inestimable de la précision des écarts moyens réels dans la population.
7.2 Alternatives post-hoc : Bonferroni, Scheffé et Dunnett
Bien que le test de Tukey constitue la procédure polyvalente d’élection pour explorer l’ensemble des paires de modalités, d’autres stratégies d’ajustement post-hoc s’avèrent préférables selon l’architecture épistémologique du protocole. SAS offre la possibilité de mobiliser ces alternatives en insérant simplement les options correspondantes au sein de l’instruction MEANS : / BONFERRONI, / SCHEFFE ou / DUNNETT.
L’ajustement de Bonferroni repose sur le principe de l’inégalité de Boole, divisant arbitrairement le seuil nominal alpha par le nombre k de comparaisons effectivement programmées (alpha_ajusté = alpha / m). Cette approche est particulièrement puissante et recommandée dès lors que l’expérimentateur ne s’intéresse qu’à un sous-ensemble restreint et a priori de comparaisons ciblées (contrastes planifiés). En revanche, appliquée sans discernement à l’exhaustivité des combinaisons possibles d’un grand nombre de groupes, la méthode de Bonferroni devient excessivement conservative, réprimant indûment la puissance statistique et risquant d’induire de multiples erreurs de deuxième espèce (non-détection d’effets pourtant tangibles).
Le test de Scheffé, invoqué via l’option SCHEFFE, représente la procédure de protection la plus rigoureuse et conservative existant en analyse de variance. Sa flexibilité mathématique permet de tester non seulement des contrastes dyadiques simples (moyenne contre moyenne), mais également n’importe quel contraste complexe multidimensionnel (par exemple la moyenne combinée de deux approches innovantes face à un groupe témoin) tout en maintenant le taux d’erreur de première espèce global en deçà de 0,05. Enfin, la méthode de Dunnett (option DUNNETT(‘Contrôle’)) est expressément optimisée pour les protocoles cliniques ou industriels où chaque traitement actif doit être comparé exclusivement à un groupe de référence contrôle unique, sans que les traitements actifs ne soient comparés entre eux, ce qui maximise substantiellement la puissance statistique relative par rapport au test omnibus de Tukey.
7.3 Lecture des matrices de différences et identification des sous-ensembles homogènes
La lecture efficace des sorties post-hoc de SAS requiert une familiarisation avec les deux formats d’affichage matriciel que le progiciel génère selon les options déclarées : la matrice de marquage par astérisques et le tableau d’identification des sous-ensembles homogènes (Homogeneous Subsets ou Tukey Grouping).
Lorsque l’option CLDIFF est invoquée, SAS affiche pour chaque contraste dyadique une rangée d’indicateurs où figure une colonne spécifique signalée par trois astérisques (***). Cette signalétique typographique saillante attire instantanément le regard du chercheur sur les paires de moyennes dont l’intervalle de confiance simultané exclut zéro, indiquant une divergence probante au seuil alpha sélectionné. L’analyste peut ainsi dresser rapidement l’inventaire des contrastes qui ont contribué au rejet du modèle omnibus global de variance.
Le second mode de restitution, produit par défaut par l’option TUKEY (sans CLDIFF) ou enrichi par l’option LINES, structure les conclusions d’une manière encore plus visuelle et didactique à travers des colonnes de regroupement alphabétiques étiquetées A, B, C. Deux ou trois conditions expérimentales partageant une même lettre d’assignation catégorielle (par exemple Méthode A et Méthode B appartenant toutes deux au groupe A) forment un sous-ensemble homogène dont les moyennes ne présentent aucune divergence statistiquement significative entre elles. Si une condition arbore exclusivement la lettre de classification B tandis que ses comparses arborent la lettre A, cela atteste d’un décrochage univoque et substantiel de ce groupe vis-à-vis des autres. Cette classification limpide permet de hiérarchiser immédiatement l’efficacité des protocoles au sein du rapport de recherche.
8. Traitement des plans déséquilibrés et complexes avec PROC GLM
8.1 Transition méthodologique de PROC ANOVA vers PROC GLM
Lorsque le plan expérimental déroge au postulat d’orthogonalité stricte en raison d’effectifs inégaux par modalité (n(i) distinct de n(j)), la transition méthodologique de la procédure PROC ANOVA vers la procédure PROC GLM (General Linear Model) s’impose comme un impératif technique absolu. PROC GLM a été expressément conçue dès les versions fondatrices de SAS pour résoudre le modèle linéaire général par inversion de matrices de projections des moindres carrés (généralisation de Moore-Penrose), traitant avec une rigueur mathématique égale les plans équilibrés, les plans asymétriques et les devis factoriels complexes combinant covariables continues et facteurs discrets.
Sur le plan computationnel, lorsque les effectifs d’échantillonnage sont parfaitement équilibrés, les résultats mathématiques produits par PROC GLM sont rigoureusement identiques à la décimale près à ceux générés par PROC ANOVA. L’équivalence théorique est alors totale. Cependant, la supériorité algorithmique de GLM se manifeste pleinement dès qu’un déséquilibre émerge. Là où PROC ANOVA applique des décompositions arithmétiques naïves basées sur les effectifs marginaux bruts qui faussent les calculs de variabilité, PROC GLM mobilise l’algèbre matricielle pour réévaluer chaque effet après ajustement mutuel des autres composantes du modèle.
La syntaxe opératoire de PROC GLM conserve l’architecture familière et intuitive de la procédure ANOVA, requérant invariablement la déclaration DATA=, l’instruction CLASS pour indexer les variables catégorielles qualitatives et l’instruction MODEL pour formuler l’équation régressive. L’avantage fondamental réside dans la flexibilité incomparable de GLM pour intégrer des instructions spécialisées telles que LSMEANS et pour partitionner adéquatement les sommes de carrés, éliminant ainsi les approximations méthodologiques inhérentes au module ANOVA historique.
8.2 Distinction cruciale entre Sommes des Carrés de Type I et de Type III
L’une des singularités les plus fondamentales de la procédure PROC GLM réside dans sa production systématique et disjointe de plusieurs catégories de sommes de carrés, principalement désignées sous les vocables de Sommes des Carrés de Type I et de Sommes des Carrés de Type III. La compréhension des divergences mathématiques qui sous-tendent ces matrices est cruciale pour prévenir toute dérive analytique dans le dépouillement des résultats.
Les sommes des carrés de Type I (Type I Sum of Squares) sont rigoureusement séquentielles ou hiérarchiques. Dans cette décomposition, chaque terme introduit dans l’instruction MODEL se voit attribuer la part de variance qu’il est en mesure d’expliquer après avoir contrôlé uniquement les facteurs déclarés avant lui dans la chaîne syntaxique du script SAS, sans tenir compte des prédicteurs spécifiés ultérieurement. Par conséquent, la valeur de Type I SS dépend intrinsèquement de l’ordre d’écriture des termes dans le programme. Si cet agencement séquentiel conserve une pertinence lors de l’exécution de régressions polynomiales hiérarchiques ordonnées par la théorie, il s’avère totalement inapproprié et dangereux pour l’interprétation d’une ANOVA à plusieurs facteurs ou de plans factoriels déséquilibrés.
Les sommes des carrés de Type III (Type III Sum of Squares), universellement désignées comme sommes des carrés partielles ou ajustées, constituent le standard méthodologique absolu exigé par la communauté scientifique internationale en psychologie et en biostatistique. Dans cette formulation matricielle, chaque terme du modèle est évalué en mesurant la variabilité propre qu’il explique au-delà de l’ensemble de tous les autres effets inscrits dans le modèle, comme s’il avait été inséré en toute dernière position. Cette modélisation garantit une indépendance totale vis-à-vis de l’ordre d’écriture des variables dans le code. Les sommes des carrés de Type III testent la signification de la variance unique marginale et compensent intégralement la distorsion imputable aux effectifs inégaux au sein des sous-groupes.
8.3 Moyennes des moindres carrés (LS-Means) et tests personnalisés
Dans un plan expérimental présentant des effectifs asymétriques par modalité, les moyennes arithmétiques brutes des groupes ne reflètent plus fidèlement l’effet théorique net des traitements en raison du déséquilibre structurel de pondération des observations. Pour pallier cette anomalie numérique, PROC GLM déploie une instruction capitale : la directive LSMEANS (Least-Squares Means), couramment appelée moyennes des moindres carrés ou moyennes marginales ajustées.
Les moyennes marginales ajustées calculées par l’instruction LSMEANS estiment les valeurs attendues des moyennes conditionnelles qui auraient été observées si l’échantillonnage avait été parfaitement équilibré à travers toutes les cellules du plan factoriel. Alors que la simple commande MEANS calcule les moyennes empiriques arithmétiques directes des sous-échantillons — lesquelles s’avèrent potentiellement biaisées par la disparité des volumes de recueil —, l’instruction LSMEANS applique une estimation linéaire non biaisée dérivée des paramètres régressifs du modèle matriciel global.
De surcroît, l’instruction LSMEANS permet d’intégrer immédiatement des procédures de correction pour comparaisons multiples adaptées aux plans non orthogonaux au moyen de la clause syntaxique / ADJUST=TUKEY (ou ADJUST=BON). Pour évaluer spécifiquement des contrastes hypothétiques directionnels personnalisés (par exemple tester si la moyenne combinée de deux traitements actifs est strictement supérieure à un groupe de contrôle), PROC GLM autorise l’usage des instructions CONTRAST et ESTIMATE. Ces commandes permettent au méthodologiste de définir des vecteurs de coefficients linéaires pondérés satisfaisant la contrainte que leur somme arithmétique soit nulle, lui offrant un contrôle total sur l’épistémologie inférentielle de son expérimentation.
9. Quantification de la taille d’effet et calcul de puissance a posteriori
9.1 Calcul de l’Éta-carré (Eta-squared) et de l’Éta-carré partiel
Dans la recherche contemporaine, la seule publication d’une statistique de test significative assortie d’une p-valeur infinitésimale (par exemple p < 0,001) est universellement jugée insuffisante pour étayer des conclusions scientifiques rigoureuses. La p-valeur renseignant exclusivement sur la plausibilité de l’hypothèse nulle au regard de la taille d’échantillon mobilisée, elle ne fournit aucune indication sur l’ampleur pragmatique ou clinique du phénomène observé. La mesure de la taille d’effet s’avère donc impérative, l’indicateur le plus répandu au sein du modèle univarié étant l’Éta-carré (noté eta^2).
L’Éta-carré se définit conceptuellement comme le rapport direct entre la somme des carrés associée au facteur expérimental (SSB) et la somme des carrés totale (SST), formalisé par la relation arithmétique élémentaire : eta^2 = SSB / SST. Dans le cadre exclusif de l’ANOVA à un facteur pour échantillons indépendants, l’Éta-carré standard et l’Éta-carré partiel (partial eta-squared) sont rigoureusement équivalents, le dénominateur de variabilité n’étant partitionné qu’entre un effet unique et l’erreur aléatoire. Cet indice quantifie le pourcentage précis de la variance totale de la variable réponse qui est directement imputable au facteur expérimental.
Pour apprécier l’envergure pratique des résultats documentés, la communauté académique s’appuie communément sur les seuils heuristiques formulés par le statisticien Jacob Cohen dans ses travaux fondateurs :
- Une valeur d’Éta-carré approchant 0,01 correspond à un effet modeste ou faible, signalant que le phénomène n’explique qu’un pour cent de l’instabilité des réponses.
- Un indice voisin de 0,06 atteste d’un effet moyen, perceptible et cliniquement tangible dans la majorité des protocoles comportementaux.
- Une valeur culminant à 0,14 ou au-delà matérialise un effet large et massif, confirmant que le facteur constitue un déterminant prépondérant des variations individuelles.
Il convient néanmoins de garder à l’esprit que l’Éta-carré est un estimateur descriptif basé sur les données d’échantillon qui a tendance à surestimer systématiquement la proportion réelle de variance expliquée au niveau de la population parente, en particulier au sein de dispositifs méthodologiques n’engageant que de faibles effectifs d’observation.
9.2 Estimation sans biais avec l’Oméga-carré (Omega-squared)
Face à la surestimation structurelle inhérente à l’Éta-carré, les biostatisticiens et psychomètres rigoureux privilégient l’usage de l’Oméga-carré (noté omega^2) pour chiffrer la taille d’effet globale. L’Oméga-carré a été spécifiquement développé pour corriger le biais optimiste de l’échantillonnage en déduisant de la somme des carrés de l’effet la part de variance qu’il est prévisible d’obtenir par simple fluctuation aléatoire stochastique, calibrée sur le carré moyen de l’erreur résiduelle.
La formulation algébrique canonique de l’Oméga-carré dans le modèle à un facteur s’énonce selon le ratio suivant : omega^2 = (SSB – (k – 1) * MSW) / (SST + MSW). En soustrayant le produit des degrés de liberté du facteur par le carré moyen de l’erreur au numérateur, et en incrémentant le dénominateur total de cette même variance résiduelle de référence, l’Oméga-carré procure un estimateur asymptotiquement non biaisé de la part de variance véritablement gouvernée par le facteur au sein de la population cible. Les valeurs de l’Oméga-carré sont inévitablement inférieures à celles de l’Éta-carré calculé sur le même jeu de données, ce différentiel étant d’autant plus substantiel que l’effectif total N est réduit.
Bien que SAS n’édite pas systématiquement l’Oméga-carré dans son affichage standard de base, son extraction s’automatise de façon élégante grâce au système ODS OUTPUT. L’analyste exporte le tableau matriciel de décomposition de variance de PROC GLM vers une table de travail temporaire au moyen de la clause ODS OUTPUT ModelANOVA=nom_de_table, puis exécute une brève étape DATA pour appliquer la formule algébrique ci-dessus aux scalaires SSB, SST, MSW et degrés de liberté archivés. L’intégration de cette valeur sans biais dans les publications confère une intégrité méthodologique incontestable aux conclusions exposées.
9.3 Analyse de la puissance statistique rétrospective avec PROC POWER
La puissance statistique, désignée mathématiquement par la quantité 1 – bêta, représente la probabilité qu’un protocole expérimental donné parvienne à rejeter formellement l’hypothèse nulle lorsque celle-ci est effectivement fausse dans la population parente. L’évaluation de cette propriété est essentielle pour juger de la sensibilité d’une étude : un protocole sous-puissant risque d’échouer à mettre en évidence des différences substantielles bien réelles, conduisant à des erreurs de deuxième espèce (bêta) préjudiciables à l’avancement théorique.
Le module PROC POWER de SAS constitue l’environnement analytique le plus perfectionné pour modéliser la puissance prospective ou rétrospective d’un dispositif. Pour auditer une analyse de variance univariée à un facteur, la syntaxe sollicite la sous-procédure ONESUFACH (One-Way ANOVA). L’utilisateur paramètre le profil d’évaluation en formulant l’instruction GROUPMEANS, où sont inscrites les k moyennes empiriques observées ou postulées, complétée par l’instruction STDDEV renseignant l’écart-type résiduel commun estimé (Root MSE), et par l’instruction NTOTAL (ou GROUPNS pour spécifier les effectifs individuels de chaque groupe).
L’exécution de PROC POWER avec la directive POWER=. ordonne à SAS de calculer instantanément la puissance statistique effective du protocole empirique déployé. L’obtention d’une puissance atteignant ou dépassant le standard académique conventionnel de 0,80 atteste que le dispositif méthodologique bénéficiait de plus de 80 % de chances d’identifier un effet d’une telle amplitude au seuil d’erreur alpha de 0,05. Si la puissance mesurée plafonne à un niveau insatisfaisant (par exemple 0,45), cette métrique commande au chercheur d’observer une réserve prudente dans ses conclusions quant aux effets non significatifs et lui permet de calibrer les effectifs d’échantillonnage requis pour de futures réplications expérimentales.
10. Représentations graphiques avancées avec PROC SGPLOT
10.1 Diagrammes en boîtes à moustaches (Boxplots) comparatifs
La communication scientifique moderne exige une restitution visuelle claire de l’architecture des distributions. Au sein du système SAS, la procédure PROC SGPLOT s’impose comme l’outil d’ingénierie graphique de référence pour concevoir des visualisations personnalisées hautement informatives. Pour traduire la dispersion conditionnelle des scores au fil des modalités d’une ANOVA, la commande maîtresse est l’instruction VBOX (Vertical Boxplot).
L’instruction VBOX requiert au minimum la spécification de la variable dépendante continue sur l’axe des ordonnées (argument de variable principal) et de la variable indépendante catégorielle sur l’axe des abscisses au moyen de l’option CATEGORY=. PROC SGPLOT génère alors une boîte englobant l’intervalle interquartile compris entre le premier quartile (Q1, vingt-cinquième centile) et le troisième quartile (Q3, soixante-quinzième centile). La barre horizontale continue sectionnant l’intérieur de la boîte signale l’emplacement rigoureux de la médiane empirique du sous-groupe, tandis que les moustaches verticales s’étirent pour matérialiser les valeurs extrêmes non aberrantes selon la métrique standard de 1,5 fois l’espace interquartile au-delà des charnières.
L’intérêt de la procédure VBOX réside également dans sa faculté d’afficher simultanément les moyennes empiriques directes au moyen d’un marqueur graphique paramétrable via l’option MEANATTRS=(SYMBOL=Diamond COLOR=Navy). Cette superposition conjointe de la médiane et de la moyenne permet de poser un diagnostic visuel instantané sur la symétrie de la distribution : une moyenne s’éloignant nettement de la barre médiane signale une asymétrie conditionnelle. De surcroît, les observations atypiques franchissant les moustaches apparaissent sous forme de points individualisés, facilitant l’identification des données aberrantes susceptibles d’influencer le calcul du modèle linéaire.
10.2 Graphiques de moyennes accompagnés des barres d’erreur
Bien que les boîtes à moustaches soient remarquables pour apprécier les caractéristiques de forme d’une distribution, les conventions éditoriales académiques en psychologie cognitive et expérimentale privilégient fréquemment la présentation de graphiques de profils de moyennes assortis d’intervalles de dispersion stochastiques. Deux approches graphiques coexistent au sein de PROC SGPLOT pour élaborer ces figures : l’instruction VBARPARM combinée à des calculs de bordure préalables, ou l’utilisation de l’instruction DOT ou SERIES adossée à des barres d’erreur explicites.
L’analyste dispose de la possibilité de paramétrer avec une rigueur absolue la signification statistique incarnée par les segments des barres d’erreur (Error Bars). Il est capital de ne jamais entretenir d’ambiguïté dans la légende du graphique quant à l’estimateur déployé :
- Les barres représentant un écart-type complet (+/- 1 SD) illustrent la dispersion brute et l’étendue de la variance interindividuelle au sein de la condition.
- Les barres illustrant une erreur-type (+/- 1 SEM) quantifient la fidélité d’échantillonnage de la moyenne empirique observée.
- Les barres visualisant l’intervalle de confiance à 95 % (+/- 1,96 SEM) fournissent la zone de plausibilité populationnelle du paramètre et facilitent une évaluation visuelle immédiate des contrastes.
La stylisation éditoriale sous PROC SGPLOT s’ajuste au moyen d’instructions annexes intuitives. L’adjonction des commandes XAXIS et YAXIS autorise la spécification fine des bornes d’échelles, l’incrémentation des graduations métriques et l’élimination des grilles d’arrière-plan superflues pour privilégier un habillage épuré en niveaux de gris (option NOCHECK, GRID OFF, LABELATTRS=(FAMILY=’Arial’ SIZE=10pt)). Ces réglages confèrent aux figures un rendu professionnel répondant aux préconisations typographiques des périodiques scientifiques.
10.3 Diagnostic visuel des résidus du modèle
La validité interne des conclusions inférentielles repose sur la conformité des résidus de modélisation aux hypothèses théoriques posées par Gauss-Markov. Si l’évaluation des scores bruts conditionnels offre des indications précieuses, l’examen direct des déviations résiduelles epsilon(ij) = Y(ij) – Y_predit(ij) constitue le test de validation définitif. Dans SAS, l’extraction de ces composantes résiduelles s’opère en adjoignant une instruction OUTPUT au corps de la procédure PROC GLM.
L’instruction OUTPUT OUT=table_diagnostique PREDICTED=Valeurs_Predites RESIDUAL=Residus_Bruts STUDENT=Residus_Studentises commande à SAS de générer une table temporaire enrichie dans laquelle chaque observation individuelle est assortie de sa prédiction mathématique (qui correspond pour l’ANOVA à la moyenne de son groupe de rattachement) et de son résidu résiduel standardisé. Cette extraction offre le matériau numérique pour déclencher une batterie de représentations diagnostiques approfondies sous PROC SGPLOT.
Le premier graphique diagnostique indispensable consiste à tracer le nuage de points croisant les résidus studentisés en ordonnée et les valeurs prédites en abscisse au moyen de l’instruction SCATTER X=Valeurs_Predites Y=Residus_Studentises. L’adjonction d’une ligne de référence horizontale au niveau zéro via l’instruction REFLINE 0 / AXIS=Y permet de vérifier l’homoscédasticité : la dispersion verticale des points autour de cette ligne d’équilibre doit demeurer équivalente d’un palier prédictif à l’autre. Un étalement des résidus adoptant la forme d’un cône ou d’un entonnoir signale sans équivoque une hétéroscédasticité problématique. Enfin, le tracé d’un histogramme des résidus superposé à une courbe de densité normale théorique (via l’instruction HISTOGRAM Residus_Bruts couplée à DENSITY Residus_Bruts / TYPE=NORMAL) permet de sceller visuellement l’adhésion finale au postulat de normalité résiduelle.
11. Restitution académique des résultats selon les normes de l’APA (7e édition)
11.1 Directives de rédaction pour le test global omnibus
La rédaction des conclusions statistiques au sein des revues scientifiques régies par l’American Psychological Association (APA, 7e édition) est soumise à des normes de formalisation et de typographie rigoureuses. L’objectif est d’assurer une transparence totale et une reproductibilité optimale des énoncés méthodologiques. Pour rendre compte du test F global d’une analyse de variance à un facteur, le modèle rédactionnel prescrit une structure canonique intégrant les degrés de liberté, la valeur empirique du test, le seuil exact de signification probabiliste et la mesure de taille d’effet correspondante.
Sur le plan typographique formel, toutes les lettres alphabétiques symbolisant des paramètres statistiques ou des métriques inférentielles doivent impérativement être formatées en italique : le F majuscule de Fisher (F), le p minuscule de la p-valeur (p), les abréviations de moyennes (M) et d’écarts-types (SD), ainsi que la lettre grecque symbolisant l’indice de taille d’effet (Éta-carré partiel ou Oméga-carré, écrit en toutes lettres ou inséré via le symbole eta^2 ou omega^2). Les degrés de liberté associés au modèle et à l’erreur doivent être insérés immédiatement entre parenthèses, séparés par une virgule, sans espace après la virgule, accolés au symbole de test, sous la forme : F(df_modele, df_erreur).
Les règles d’arrondi numérique stipulent que les valeurs de statistiques d’épreuve (F) et les indices de taille d’effet doivent être documentés avec deux décimales de précision (par exemple F(2, 42) = 8,45, eta^2 = 0,29). La restitution de la p-valeur obéit à une règle spécifique : celle-ci doit être rapportée avec trois décimales (par exemple p = 0,003). De surcroît, une probabilité ne pouvant excéder l’unité, le zéro liminaire avant la virgule décimale doit être omis selon les conventions anglo-saxonnes ou conservé selon les chartes francophones mais toujours sans jamais rapporter de valeur nulle absolue. Si la sortie SAS indique Pr > F < .0001, il est formellement prohibé d’écrire p = 0,000 ; il convient d’énoncer strictement p < 0,001.
11.2 Présentation textuelle et tabulaire des comparaisons par paires
La communication scientifique des analyses post-hoc ne saurait se borner à affirmer qu’une modalité surpasse une autre. Le protocole rédactionnel exige d’accompagner chaque comparaison par paires des statistiques descriptives conditionnelles complètes, incluant la moyenne arithmétique (M) et l’écart-type (SD) de chacun des groupes sous examen, ainsi que l’intervalle de confiance à 95 % (noté IC 95 %) entourant la différence observée entre les moyennes.
La narration textuelle doit spécifier la nature précise de la correction pour comparaisons multiples déployée dans SAS pour contenir le taux d’erreur de première espèce. Une formulation usuelle s’articule ainsi : Des comparaisons par paires ajustées au moyen de la méthode HSD de Tukey ont révélé que les participants soumis à la méthode d’imagerie visuelle interactive (M = 78,42, SD = 6,15) ont obtenu des performances significativement supérieures à celles des participants assignés à la méthode de répétition machinale (M = 65,18, SD = 7,32), différence moyenne = 13,24, IC 95 % [8,12, 18,36], p < 0,001. Inversement, l’absence d’écart statistique entre deux modalités doit être documentée avec la même précision descriptive en soulignant le franchissement de la zone de non-signification.
Dans l’éventualité où le dispositif factoriel intègre un nombre volumineux de conditions rendant la description textuelle redondante, la confection d’un tableau synthétique respectant strictement les standards de mise en page de l’APA constitue la modalité de communication privilégiée. Un tableau APA se caractérise par une sobriété géométrique intégrale, excluant tout quadrillage vertical et ne conservant que trois lignes horizontales principales de délimitation (au-dessus et en dessous de l’en-tête, et au bas du tableau). Les lettres de classification issues de la commande TUKEY / LINES sont juxtaposées en exposant à côté des moyennes pour expliciter les regroupements homogènes sans surcharger visuellement la matrice.
11.3 Exemple de paragraphe de résultats contextualisé à l’étude
Afin d’ancrer ces directives dans la réalité de la pratique éditoriale, voici un exemple de paragraphe de résultats publiable, formalisé pour rendre compte d’une recherche évaluant l’impact de trois méthodes d’apprentissage lexical sur un score continu de rétention mnésique (variable notée Score, n = 15 participants par condition, N = 45) analysée sous SAS avec PROC GLM :
Une analyse de variance à un facteur pour échantillons indépendants a été conduite afin de déterminer si les scores de rétention lexicale à 48 heures variaient en fonction de la méthode d’apprentissage administrée (Répétition traditionnelle, Imagerie visuelle interactive, Approche multisensorielle). L’évaluation préliminaire des postulats de modélisation a confirmé la normalité des résidus de distribution au moyen du test de Shapiro-Wilk (W = 0,978, p = 0,542) ainsi que l’homogénéité des variances conditionnelles au moyen du test de Levene basé sur la moyenne, F(2, 42) = 1,18, p = 0,317. Les analyses ont été compilées sous le logiciel SAS 9.4 à l’aide de la procédure GLM.
Les résultats de l’ANOVA omnibus révèlent un effet principal hautement significatif de la méthode d’apprentissage sur les scores de mémorisation, F(2, 42) = 14,82, p < 0,001, omega^2 = 0,38. Conformément aux critères de Cohen, cette valeur d’Oméga-carré traduit une taille d’effet très importante, signalant que 38 % de la variance des performances mnésiques est expliquée par le protocole expérimental. Les analyses post-hoc déployées selon la procédure de Tukey (HSD) indiquent que l’approche multisensorielle engendre des performances significativement supérieures (M = 82,13, SD = 6,84) comparativement à la méthode d’imagerie visuelle (M = 74,67, SD = 5,92, p = 0,008, IC 95 % [1,85, 13,07]) et à la répétition traditionnelle (M = 66,20, SD = 7,41, p < 0,001, IC 95 % [10,32, 21,54]). Enfin, la méthode par imagerie visuelle s’est révélée significativement plus efficiente que la méthode par répétition traditionnelle (p = 0,002, IC 95 % [2,86, 14,08]). En somme, ces données soutiennent solidement l’hypothèse d’une hiérarchie cognitive préférentielle pour l’encodage multimodal des informations verbales.
12. Dépannage syntaxique et solutions aux violations méthodologiques courantes
12.1 Diagnostics des erreurs et alertes classiques dans le log SAS
L’apprentissage de la programmation SAS implique nécessairement de développer des compétences d’investigation pour décoder les messages d’avertissement (WARNING) et de refus d’exécution (ERROR) imprimés dans le journal d’exécution (SAS Log). La rigueur syntaxique du compilateur SAS ne tolère aucune approximation de structure.
L’incident de compilation le plus fréquent chez l’analyste débutant réside dans l’omission pure et simple de l’instruction CLASS en amont de l’instruction MODEL au sein de PROC ANOVA ou PROC GLM. Face à ce manquement, SAS émet une ERROR bloquante signalant que la variable indépendante est continue et refuse de décomposer la variance en degrés de liberté discrets, car il tente alors d’ajuster une régression linéaire simple continue univariée sans classification. Une autre anomalie récurrente concerne l’absence de l’instruction RUN à la terminaison du bloc déclaratif : la session SAS entre alors en état de veille passive indéfinie (PROC ANOVA RUNNING), le système attendant des spécifications complémentaires qui ne surviennent jamais, laissant la fenêtre de résultats désespérément vierge.
Un autre désagrément diagnostique classique concerne la conversion silencieuse ou l’invalidation d’entrées consécutive à une inadéquation de format. Si une variable numérique comprend par mégarde un délimiteur décimal sous forme de virgule textuelle au lieu du point décimal international dans un fichier source non typé, SAS ne génère pas nécessairement une erreur fatale mais produit un WARNING indiquant que des valeurs non valides ont été converties en données manquantes (. ). Les observations affectées sont alors exclues de l’analyse, réduisant à l’insu de l’expérimentateur le degré de liberté résiduel (DF Error). L’inspection minutieuse de la première ligne de texte éditée par PROC GLM, spécifiant le nombre d’observations engagées dans le calcul (Number of Observations Read vs Used), s’avère vitale pour vérifier qu’aucun sujet n’a été accidentellement évincé de l’échantillonnage.
12.2 Alternatives non paramétriques en cas d’échec des postulats : PROC NPAR1WAY
Lorsque le diagnostic exploratoire met en lumière des violations sévères des conditions de distribution — typiquement en présence d’une asymétrie majeure conjuguée à un échantillon extrêmement restreint (n < 10 par cellule) rendant inapplicable le théorème central limite —, le statisticien doit impérativement renoncer au modèle paramétrique classique fondé sur la distribution de Fisher pour ne pas propager d’inférences fallacieuses. La voie de dérivation canonique consiste alors à mobiliser l’analogue non paramétrique de l’ANOVA à un facteur : le test de Kruskal-Wallis par rangs.
L’implémentation du test de Kruskal-Wallis dans l’écosystème SAS est déléguée à une procédure utilitaire hautement performante : PROC NPAR1WAY (Non-Parametric One-Way). La syntaxe canonique requiert l’adjonction de l’option WILCOXON au sein de l’instruction d’ouverture de la procédure, formulée sous la séquence : PROC NPAR1WAY DATA=nom_de_table WILCOXON;. À l’instar des procédures linéaires, l’agencement s’appuie ensuite sur l’instruction CLASS pour identifier la variable de classification factorielle et sur l’instruction VAR pour cibler la variable dépendante continue.
Le principe computationnel du test de Kruskal-Wallis repose sur l’abandon des scores métriques bruts au profit de leur conversion ordinale en rangs hiérarchiques conjoints s’étalant de 1 jusqu’à N sur l’ensemble global de la base. SAS calcule la somme et la moyenne des rangs assignés à chaque modalité factorielle. L’algorithme dérive ensuite la statistique H de Kruskal-Wallis, qui suit asymptotiquement une loi de distribution de Chi-deux à k – 1 degrés de liberté. Si la p-valeur de l’épreuve du Chi-deux s’établit en deçà du seuil critique alpha de 0,05, l’investigateur peut affirmer l’existence d’une stochastic dominance signifiant que les distributions des sous-populations diffèrent quant à leur position médiane, contournant ainsi élégamment l’impératif de normalité sans délaisser le contrôle probabiliste.
12.3 Gestion de l’hétérogénéité des variances : ANOVA de Welch dans SAS
Dans les configurations empiriques fréquentes où l’hypothèse de normalité résiduelle est pleinement respectée, mais où le test de Levene ou de Brown-Forsythe condamne sans équivoque le postulat d’homogénéité des variances (hétéroscédasticité avérée sigma^2(i) distinct de sigma^2(j)) au sein d’un plan expérimental présentant des effectifs déséquilibrés, le basculement vers un test non paramétrique n’est ni théoriquement optimal ni techniquement requis. La réponse méthodologique d’élection réside dans l’application d’une correction de variance hétérogène : l’ANOVA de Welch.
L’ANOVA de Welch résout l’asymétrie des dispersions en renonçant au principe du poolage commun de l’erreur résiduelle intra-groupe (MSW). Au lieu de fondre les variances conditionnelles dans une estimation unique globale, l’algorithme de Welch pondère chaque moyenne de groupe par l’inverse de sa variance d’échantillonnage spécifique divisée par sa taille d’observation (w(i) = n(i) / s^2(i)). Cette approche supprime l’influence indue des sous-groupes instables. Pour intégrer cette modification computationnelle dans SAS, l’analyste utilise l’instruction MEANS en lui adjoignant l’option / WELCH au sein de la procédure PROC GLM ou PROC ANOVA.
Dans le tableau récapitulatif généré par l’option WELCH, SAS délivre la statistique de Welch révisée ainsi qu’un recalcul mathématique des degrés de liberté de l’erreur résiduelle. En raison de l’ajustement adaptatif de Satterthwaite gouvernant cette correction, le degré de liberté de l’erreur ne correspond plus à un entier fixe (N – k), mais prend la forme d’un nombre réel décimal ajusté (par exemple DF = 18,34). L’évaluation de la p-valeur associée à cette statistique de Welch permet de statuer sur la signification de l’effet avec une rigueur absolue, immunisant l’analyse contre les risques de faux positifs inhérents aux variances inégales tout en maintenant une puissance statistique substantiellement supérieure aux transformations de variables empiriques approximatives.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4th ed.). Pearson Prentice Hall.
Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434-447. https://doi.org/10.1037/1082-989X.8.4.434
SAS Institute Inc. (2021). SAS/STAT 15.2 user’s guide: The ANOVA procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
SAS Institute Inc. (2021). SAS/STAT 15.2 user’s guide: The GLM procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.