
L’analyse statistique des protocoles expérimentaux et observationnels constitue l’un des piliers fondamentaux de la démarche scientifique moderne, en particulier au sein des sciences humaines, cognitives, biomédicales et comportementales. Dès lors qu’un chercheur souhaite éprouver l’effet d’une variable indépendante catégorielle sur une variable dépendante continue, l’analyse de variance, universellement désignée sous l’acronyme d’ANOVA (pour Analysis of Variance), s’impose naturellement comme la méthode paramétrique d’élection. Toutefois, la structure même du recueil des données expérimentales impose fréquemment une contrainte méthodologique singulière : l’évaluation répétée des mêmes unités expérimentales — le plus souvent des participants humains ou des modèles animaux — à travers différentes conditions temporelles, contextuelles ou expérimentales. Dans cette configuration d’appariement structurel, l’ANOVA unidirectionnelle classique à groupes indépendants s’avère totalement inopérante, car elle méconnaît fondamentalement la corrélation inhérente qui unit les observations émanant d’un même individu.
Pour répondre à cette exigence analytique et exploiter pleinement la richesse des protocoles intra-sujets (dits within-subjects designs), les statisticiens ont développé le formalisme de l’ANOVA à mesures répétées. Ce modèle linéaire sophistiqué ne se contente pas d’étendre la logique de comparaison des moyennes à plus de deux conditions appariées ; il propose une refonte conceptuelle et mathématique intégrale de la décomposition de la variance. En isolant méthodiquement la variabilité propre aux caractéristiques stables des individus, cette technique permet d’extirper du terme d’erreur aléatoire une fraction substantielle de bruit de fond statistique, augmentant ainsi de manière spectaculaire la sensibilité et la puissance statistique des tests d’hypothèses sans exiger des cohortes pléthoriques.
Le présent article propose une exploration exhaustive, rigoureuse et didactique de l’ANOVA à mesures répétées. De ses assises épistémologiques et théoriques jusqu’à son implémentation assistée par ordinateur (R, SPSS, JASP), en passant par le traitement minutieux de ses postulats — singulièrement le défi incontournable de la sphéricité —, les formulations matricielles de son partitionnement de variance et la résolution intégrale, pas à pas, d’un cas clinique issu de la psychologie, ce guide offre aux chercheurs, cliniciens, statisticiens et étudiants une ressource académique définitive pour comprendre, exécuter et rapporter ce test selon les normes scientifiques les plus exigeantes de l’American Psychological Association (APA).
1. Introduction et fondements conceptuels de l’ANOVA à mesures répétées
1.1 Définition et nature du plan intra-sujet
L’ANOVA à mesures répétées, désignée dans la littérature anglo-saxonne sous les termes de Repeated Measures ANOVA ou within-subjects ANOVA, représente une extension du test t de Student pour échantillons appariés à des situations comportant au moins trois niveaux d’un facteur expérimental intra-individuel, ou impliquant la combinaison de plusieurs facteurs mesurés sur les mêmes entités. En méthodologie quantitative, un plan intra-sujet se caractérise par le fait que chaque participant ou unité d’observation traverse l’ensemble des conditions définies par le protocole expérimental. Contrairement aux plans inter-sujets (between-subjects), où chaque groupe est constitué d’individus distincts et mutuellement exclusifs, le plan intra-sujet confère à chaque individu le statut de son propre témoin ou contrôle méthodologique.
Cette approche longitudinale ou multi-conditions permet de capturer des dynamiques évolutives complexes ou des contrastes perceptifs, émotionnels et comportementaux fins. L’avantage fondamental de cette configuration réside dans la neutralisation presque absolue de la variance interindividuelle résiduelle. Dans la nature humaine, les individus diffèrent drastiquement quant à leurs capacités cognitives de base, leurs traits de personnalité, leurs prédispositions génétiques ou leur histoire développementale. Dans un plan à groupes indépendants, ces variations constituent une source massive de variabilité non contrôlée qui s’accumule directement dans le terme d’erreur. À l’inverse, l’évaluation répétée d’un même échantillon permet d’ancrer les comparaisons sur une base baseline constante, séparant de facto ce qui relève de la singularité individuelle de ce qui découle de la manipulation expérimentale.
D’un point de vue épistémologique, ce paradigme opère une distinction lumineuse entre la variabilité systématique — induite de manière reproductible par la manipulation de la variable indépendante — et le bruit aléatoire (erreur de mesure, fluctuations attentionnelles momentanées, oscillations physiologiques). En formalisant cette dichotomie au cœur de son architecture de calcul, l’ANOVA à mesures répétées optimise le rapport signal/bruit, offrant une clarté inférentielle inégalée pour valider ou falsifier des hypothèses causales au sein des disciplines empiriques.
1.2 Pertinence et usages prédominants en sciences psychologiques
Au sein des sciences psychologiques, de la neuropsychologie et des neurosciences cognitives, les plans à mesures répétées ne constituent pas une simple commodité statistique, mais une nécessité intrinsèque liée aux objets d’étude investigués. L’un des usages les plus emblématiques concerne sans nul doute l’évaluation de l’efficacité d’interventions thérapeutiques au fil du temps. Qu’il s’agisse de mesurer la trajectoire de rémission d’un trouble dépressif majeur, la désensibilisation face à des stimuli phobogènes ou la restauration cognitive post-accident vasculaire cérébral, les chercheurs évaluent systématiquement les patients à des jalons chronologiques précis : phase de pré-test (avant traitement), per-test (au milieu de la prise en charge), post-test immédiat et suivis longitudinaux (follow-up à moyen et long terme). L’ANOVA à mesures répétées permet d’objectiver mathématiquement si l’inflexion temporelle observée traduit un bénéfice clinique statistiquement significatif.
Dans le domaine des neurosciences cognitives et de la psychophysique, ce modèle est omniprésent pour disséquer les mécanismes de traitement de l’information sous de multiples conditions attentionnelles, sensorielles ou temporelles. Les paradigmes expérimentaux confrontent typiquement le même participant à des centaines d’essais subdivisés en blocs de stimuli visuels congruents, incongruents ou neutres, ou à différentes fréquences de présentation subliminale et supraliminale. Soumettre des participants distincts à chacune de ces micro-variations serait méthodologiquement absurde et introduirait une hétérogénéité ingérable.
Enfin, l’ANOVA à mesures répétées offre une optimisation décisive de la représentativité des échantillons cliniques à effectif réduit. Dans l’étude de populations rares — telles que des patients porteurs de lésions cérébrales focales spécifiques, de syndromes génétiques orphelins ou d’élites sportives exceptionnelles —, recruter de vastes cohortes est matériellement impossible. Le plan intra-sujet maximise la puissance statistique exploitable à partir d’un échantillon restreint, rendant scientifiquement viables des investigations de pointe sur des populations particulièrement difficiles à mobiliser.
1.3 Typologie des protocoles à mesures répétées
L’application de l’ANOVA à mesures répétées s’articule autour de trois grandes configurations structurales, chacune répondant à une logique de questionnement scientifique propre :
- Le protocole temporel longitudinal : Dans cette structure, la variable dépendante est mesurée de manière itérative au cours du temps à intervalles définis (jours, semaines, mois ou années). La variable indépendante intra-sujet est explicitement la temporalité ou l’âge des participants. L’objectif premier consiste à modéliser la trajectoire développementale, l’apprentissage continu ou l’érosion progressive d’un construit psychologique ou biologique.
- Le protocole d’exposition séquentielle à des conditions expérimentales : Les participants sont exposés à une suite de conditions qualitatives ou quantitatives contrastées au sein d’une même session ou de sessions consécutives sans que le temps ne constitue en lui-même le facteur causal principal. Par exemple, un sujet peut être confronté successivement à un environnement sonore silencieux, à un bruit blanc continu et à un fond musical distracteur, afin d’évaluer l’impact de l’écologie auditive sur sa vitesse de traitement cognitif.
- Les plans mixtes (split-plot ANOVA) : Ces designs hybrides sophistiqués associent au moins un facteur intra-sujet (comme le temps ou le type de tâche) et au moins un facteur inter-sujets (tel que le groupe clinique versus groupe contrôle sain, ou le genre biologique). Ces modèles permettent non seulement d’évaluer les effets principaux de chaque variable, mais surtout de tester l’interaction croisée : l’évolution temporelle de la symptomatologie est-elle significativement différente selon que le patient reçoit une molécule active ou un placebo ?
2. Situations d’application empirique en psychologie et neurosciences
2.1 Suivi temporel de l’évolution clinique
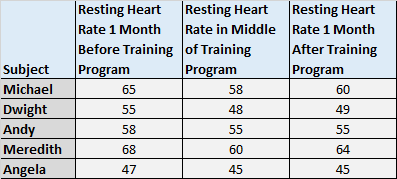
Le suivi rigoureux de l’évolution clinique constitue l’un des terrains d’application les plus fertiles de l’ANOVA à mesures répétées. Considérons une étude d’intervention psychiatrique visant à réduire les scores de symptomatologie anxieuse chez des individus souffrant de Trouble Anxiété Généralisée (TAG). Les chercheurs administrent l’échelle d’anxiété de Hamilton (Hamilton Anxiety Rating Scale, HAM-A) ou l’inventaire d’anxiété de Beck (BAI) à quatre jalons temporels rigoureusement calibrés : avant l’amorce de la prise en charge (Baseline, T0), à la sixième semaine d’intervention (T1), au terme du protocole de thérapie cognitivo-comportementale à douze semaines (T2), et enfin lors d’une session de contrôle post-thérapeutique à six mois (T3).
Grâce à la modélisation intra-sujet, il devient possible d’évaluer non seulement si le traitement induit une réduction statistiquement robuste de la détresse psychologique entre le pré-test et le post-test, mais également de tester la rémanence ou le maintien à long terme des gains thérapeutiques acquis. L’analyse statistique permet de vérifier formellement l’absence d’effet rebond ou de rechute symptomatique à T3. De plus, lorsqu’elle est intégrée dans un plan mixte incorporant un bras contrôle placé sur liste d’attente, l’analyse permet de dissocier mathématiquement l’effet de rémission spontanée ou l’effet placebo de la dynamique thérapeutique active spécifiquement imputable aux techniques de restructuration cognitive et d’exposition.
2.2 Paradigmes expérimentaux à conditions multiples
Dans le domaine de la psychologie cognitive expérimentale, les temps de réaction mesurés en millisecondes et la précision des réponses forment la matière première de la modélisation des architectures mentales. Le paradigme classique de Stroop fournit une illustration canonique de protocole intra-sujet : chaque sujet est exposé successivement à des mots de couleur imprimés dans une encre congruente (le mot « ROUGE » écrit en rouge), incongruente (le mot « BLEU » écrit en vert) ou neutre (le mot « TABLE » écrit en noir). L’ANOVA à mesures répétées à un facteur (Condition : 3 niveaux) permet de vérifier avec une précision chronométrique maximale si l’inhibition cognitive requise dans la condition incongruente génère un coût temporel statistiquement quantifiable par rapport aux conditions de base.
De façon analogue, en psychophysiologie et en neurosciences affectives, les réponses électrodermales (conductance cutanée) ou les variations du diamètre pupillaire sont enregistrées en continu tandis que les participants visionnent des blocs d’images standardisées issues de l’IAPS (International Affective Picture System). Les conditions manipulent typiquement la valence émotionnelle (scènes positives, négatives ou neutres) et le niveau d’éveil physiologique (arousal fort vs faible). La comparaison intra-sujet de l’amplitude moyenne des réponses sympathiques permet d’isoler les signatures neurovégétatives précises associées aux processus émotionnels, tout en contrôlant la variabilité considérable de la réactivité cutanée basale propre à la physiologie individuelle de chaque sujet.
Enfin, dans les études sur la mémoire de travail, l’évaluation de la rétention mnésique sous différents régimes de charge cognitive (par exemple, mémoriser des listes composées de 3, 6 ou 9 items tout en réalisant une tâche concurrente de suppression articulatoire) repose intégralement sur ces plans appariés, démontrant avec acuité comment les capacités de rappel s’érodent à mesure que les ressources exécutives sont saturées.
2.3 Bénéfices méthodologiques par rapport aux plans inter-sujets
L’arbitrage entre un plan inter-sujets et un plan à mesures répétées repose sur des considérations statistiques et logistiques décisives. Le premier avantage indéniable réside dans la réduction drastique du nombre de participants requis pour atteindre une puissance statistique nominale (généralement établie à 1 – β = 0,80 ou 0,90). Pour une taille d’effet moyenne observée (η²p ≈ 0,06), un plan inter-sujets comparant quatre conditions expérimentales nécessiterait couramment un recrutement de plus d’une centaine de participants distincts. En revanche, un protocole à mesures répétées, en raison de la forte corrélation positive inter-conditions qui lie les mesures, peut fréquemment atteindre le même niveau de puissance avec un effectif de 20 à 30 individus seulement.
Le deuxième bénéfice méthodologique majeur concerne l’atténuation structurelle des biais de confusion. Dans un plan inter-sujets, malgré les vertus de la randomisation, il subsiste toujours un risque non nul qu’un groupe expérimental présente fortuitement une moyenne d’âge légèrement plus élevée, un niveau d’anxiété-trait sous-jacent supérieur, ou des compétences verbales plus affirmées que le groupe contrôle. Ces facteurs confondants non mesurés polluent l’estimation de l’effet causal. Dans un plan intra-sujet, ces caractéristiques individuelles demeurent rigoureusement identiques et constantes à travers toutes les modalités de test. Par conséquent, la sensibilité expérimentale pour détecter de très faibles tailles d’effet en ressort considérablement décuplée, faisant de ce protocole l’outil de prédilection de la recherche expérimentale de haute précision.
3. Comparaison structurelle : ANOVA unidirectionnelle vs ANOVA à mesures répétées
3.1 Partitionnement divergent de la variance totale
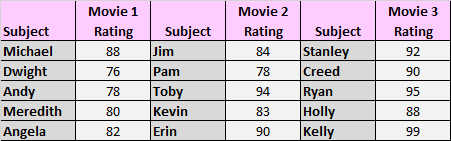
Pour appréhender la mécanique intrinsèque de l’ANOVA à mesures répétées, il convient de confronter son architecture de calcul à celle de l’ANOVA unidirectionnelle classique à groupes indépendants. Dans cette dernière, la variabilité totale observée au sein des données, quantifiée par la Somme des Carrés Totale (notée SST), est divisée de manière binaire en deux composantes exclusives : la Somme des Carrés Inter-groupes (SSBetween), qui capture les variations existant entre les moyennes des différents groupes expérimentaux, et la Somme des Carrés Intra-groupes (SSWithin), couramment appelée Somme des Carrés de l’Erreur (SSE).
Dans ce modèle classique, l’erreur résiduelle agrège indistinctement l’ensemble des divergences existant entre les scores individuels et la moyenne de leur groupe respectif. Cette variance résiduelle englobe donc à la fois l’erreur de mesure contingente et la gigantesque variabilité interindividuelle biologique, cognitive et comportementale propre à chaque être humain. La formule canonique de décomposition s’exprime ainsi :
SSTotale = SSTraitement + SSErreur
À l’opposé, l’ANOVA à mesures répétées opère une double décomposition analytique d’une remarquable élégance mathématique. La Somme des Carrés Totale est d’abord scindée en une composante Inter-sujets (SSSujets) et une composante Intra-sujets (SSIntra-sujets). La composante inter-sujets mesure la mesure dans laquelle les scores globaux moyens d’un individu s’écartent de la moyenne générale de l’échantillon, captant ainsi la variance idiosyncrasique des participants. Ensuite, la composante intra-sujets est elle-même subdivisée en deux sous-ensembles : la variabilité attribuable au traitement ou aux conditions expérimentales (SSTraitement) et la variabilité résiduelle inexpliquée (SSErreur).
Le saut qualitatif est conceptuellement fondamental : la variance propre aux participants (SSSujets) est purement et simplement soustraitée du terme d’erreur résiduel. Ce que le modèle inter-sujets considérait aveuglément comme de l’erreur aléatoire est ici identifié, isolé et neutralisé de l’équation différentielle.
3.2 Impact direct sur la puissance statistique
L’éviction de la variance interindividuelle du terme d’erreur résiduelle exerce des répercussions directes et massives sur l’ensemble de la chaîne inférentielle. Rappelons que le test d’hypothèse de l’ANOVA repose sur la statistique F de Fisher-Snedecor, définie comme le rapport entre le Carré Moyen du Traitement (MSTraitement) et le Carré Moyen de l’Erreur (MSErreur) :
F = MSTraitement / MSErreur
Puisque le Carré Moyen de l’Erreur correspond au quotient de la Somme des Carrés de l’Erreur par ses degrés de liberté respectifs (MSErreur = SSErreur / dfErreur), la réduction substantielle de SSErreur contracte drastiquement le dénominateur de la fraction. Par conséquent, pour un effet de traitement d’amplitude donnée au numérateur, la statistique F empirique calculée sera considérablement plus élevée dans un plan à mesures répétées que dans un plan à groupes indépendants portant sur des données équivalentes.
Cette majoration mécanique du ratio F augmente de façon spectaculaire la probabilité de rejeter l’hypothèse nulle (H₀) lorsque celle-ci est réellement fausse dans la population générale, maximisant ainsi la puissance statistique du protocole. Il existe cependant une contrepartie mathématique inévitable à ce gain d’efficacité : la partition de la variance consomme des degrés de liberté. En isolant la composante inter-sujets, le modèle retire (N – 1) degrés de liberté qui appartenaient traditionnellement au terme d’erreur résiduel. Toutefois, dans l’immense majorité des applications empiriques où les mesures répétées présentent une corrélation intra-classe positive substantielle (r > 0,30), le bénéfice découlant de la miniaturisation de SSErreur surpasse de très loin la légère perte de degrés de liberté au dénominateur.
3.3 Synthèse comparative des deux paradigmes
Afin de synthétiser les divergences structurelles majeures existant entre ces deux approches incontournables de l’analyse linéaire, le tableau suivant explicite l’organisation des sources de variation, les degrés de liberté associés et les spécificités mécaniques de chaque paradigme analytique :
| Caractéristique méthodologique | ANOVA simple à groupes indépendants | ANOVA à mesures répétées |
|---|---|---|
| Structure de l’échantillonnage | Échantillons indépendants : chaque individu n’appartient qu’à un seul groupe. | Échantillons appariés : chaque participant est évalué sous toutes les conditions. |
| Décomposition de la variance (SS) | SSTotale = SSBetween + SSWithin | SSTotale = SSSujets + SSTraitement + SSErreur |
| Dénominateur du ratio F | Carré moyen intra-groupe (inclut la variabilité interindividuelle). | Carré moyen de l’interaction Sujet × Traitement (variance individuelle retirée). |
| Degrés de liberté de l’erreur | Ntotal – k (plus élevés) | (N – 1)(k – 1) (réduits par l’extraction des sujets) |
| Postulat de variance spécifique | Homoscédasticité (égalité des variances inter-groupes). | Sphéricité (égalité des variances des différences appariées). |
| Risque en cas d’erreur de modèle | Inapplicable aux données appariées (perte massive de puissance). | Violation de sphéricité si non corrigée (inflation de l’erreur de Type I). |
L’application erronée d’une ANOVA à groupes indépendants sur des données appariées constitue une faute méthodologique sévère. En omettant de soustraire la variance interindividuelle, le chercheur gonfle artificiellement le dénominateur d’erreur, commettant un risque majeur d’erreur de type II (β), c’est-à-dire l’incapacité dramatique à détecter un effet expérimental pourtant bien réel dans la réalité empirique.
4. Les postulats théoriques et conditions préalables d’application
4.1 Niveau de mesure et distribution normale des variables
L’inférence statistique issue de l’ANOVA à mesures répétées repose sur un socle d’hypothèses mathématiques rigoureuses qu’il incombe au chercheur de contrôler impérativement avant toute interprétation définitive. La première condition préalable concerne l’échelle de mesure : la variable dépendante doit impérativement posséder une nature quantitative continue, mesurée sur une échelle d’intervalles constants ou une échelle de rapports. Les variables ordinales (telles que les échelles de Likert à faible nombre de points) ou nominales ne répondent pas aux propriétés requises par les opérations d’algèbre linéaire sous-jacentes au modèle linéaire général.
La seconde exigence formelle postule la normalité de la distribution des données. Plus précisément, dans le cadre du modèle général univarié à mesures répétées, il est exigé que les distributions de la variable dépendante à chaque niveau du facteur intra-sujet — ou, de manière plus formelle encore, la distribution des résidus d’estimation du modèle statistique — suivent une loi normale univariée et multivariée. Pour évaluer cette conformité au sein de chaque modalité, les praticiens mobilisent un faisceau convergent d’indices diagnostiques :
- Des tests statistiques d’adéquation, au premier rang desquels figure le test de Shapiro-Wilk, reconnu comme le test le plus puissant et sensible pour éprouver la normalité sur des échantillons de petite à moyenne taille (typiquement N < 50). Un test de Shapiro-Wilk non significatif (p > 0,05) confirme l’absence de déviation critique par rapport à la courbe de Gauss.
- L’inspection visuelle minutieuse des diagrammes quantile-quantile (Q-Q plots normaux), au sein desquels les valeurs observées doivent s’agréger de manière rectiligne le long de la bissectrice théorique idéale.
- L’analyse des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Selon les standards méthodologiques académiques, des coefficients standardisés oscillant dans un intervalle compris entre -1,0 et +1,0 (ou -1,96 et +1,96 pour les ratios z correspondants) témoignent d’une préservation satisfaisante de l’hypothèse de normalité.
4.2 Indépendance des observations et structure des données
Le postulat d’indépendance des observations revêt une dualité structurelle fascinante dans le cadre de l’ANOVA à mesures répétées. D’une part, le modèle repose explicitement sur l’hypothèse d’une dépendance statistique assumée et rigoureusement modélisée entre les mesures multiples recueillies auprès d’un même individu. Le fait qu’un participant rapide à la condition A demeure tendanciellement rapide à la condition B est précisément l’information que l’analyse cherche à capter et à formaliser.
D’autre part, le modèle exige une indépendance mutuelle stricte entre les différents participants ou grappes d’échantillonnage. Le comportement ou le score obtenu par le sujet i ne doit en aucun cas être influencé, conditionné ou contaminé par les réponses formulées par le sujet j. Cette condition implique une passation expérimentale rigoureusement standardisée (en cabines isolées ou sessions individuelles) et l’exclusion formelle de données nichées non modélisées (par exemple des élèves au sein d’une même classe ou des membres d’une même cellule familiale), sous peine de violer gravement l’hypothèse de résidus non autocorrélés.
Dans ce contexte structural, la gestion rigoureuse des valeurs aberrantes (outliers) est capitale. Une valeur univariée extrême — identifiable par un z-score excédant ±3,29 ou via l’analyse des boîtes à moustaches de Tukey (points situés au-delà de 1,5 fois l’écart interquartile) — peut exercer un levier disproportionné sur le calcul des moyennes conditionnelles et déformer la somme des carrés. Au niveau multivarié, l’identification de profils atypiques anormaux de réponses répétées requiert le calcul des distances de Mahalanobis (D²). Toute observation dont la valeur de D² excède la valeur critique de la distribution du χ² aux degrés de liberté correspondants doit être inspectée avec suspicion clinique et statistique.
4.3 Robustesse du test face aux déviations modérées
Comme la majorité des tests paramétriques dérivés du modèle linéaire général, la statistique F de l’ANOVA à mesures répétées témoigne d’une robustesse mathématique remarquable face aux entorses modérées au postulat de normalité univariée. En vertu du théorème central limite, lorsque la taille de l’échantillon devient suffisamment large (généralement dès lors que N ≥ 30 à 40 individus), la distribution d’échantillonnage des moyennes converge inexorablement vers une forme normale asymptotique, quand bien même la distribution parente sous-jacente manifesterait une asymétrie non négligeable.
Toutefois, cette tolérance légendaire de la statistique F face à la non-normalité s’effondre dramatiquement lorsque l’on aborde la question de l’hétérogénéité des structures de covariance. Si les déviations de distribution ne modifient que marginalement le taux réel d’erreur de type I (faux positifs) sous des effectifs raisonnables, la présence concomitante d’une non-normalité sévère et d’une violation du postulat d’équicorrélation compromet gravement la validité des conclusions. C’est précisément cette sensibilité extrême aux patrons de covariation internes qui place le postulat de sphéricité au cœur absolu de la validité de l’ANOVA à mesures répétées.
5. Le postulat de sphéricité : Fondements mathématiques et détection
5.1 Conceptualisation de la sphéricité vs homogénéité des variances
Dans l’ANOVA unidirectionnelle pour groupes indépendants, le postulat d’homogénéité des variances (ou homoscédasticité) stipule simplement que les variances de la variable dépendante au sein de chaque groupe expérimental doivent être statistiquement égales dans la population parente :
σ²₁ = σ²₂ = … = σ²ₖ
Dans un plan à mesures répétées, cette exigence homoscédastique simple s’avère totalement insuffisante et incomplète. Les observations n’étant pas indépendantes, il est indispensable de considérer la matrice complète de variance-covariance de dimension k × k (où k représente le nombre de conditions répétées). Le postulat idoine requis par la modélisation univariée est la sphéricité. La condition de sphéricité postule formellement que les variances de toutes les différences possibles calculées entre paires de conditions répétées doivent être égales au sein de la population. Mathématiquement, pour trois conditions (A, B, C), la condition s’écrit :
Var(YA – YB) = Var(YA – YC) = Var(YB – YC)
Rappelons que la variance de la différence entre deux variables aléatoires dépend à la fois de leurs variances respectives et de leur covariance mutuelle : Var(X – Y) = Var(X) + Var(Y) – 2 × Cov(X, Y). Par conséquent, pour que la sphéricité soit respectée, il suffit que la matrice de covariance satisfasse à la condition de circularité énoncée par Huynh et Feldt, ou plus spécifiquement à la condition de symétrie composée (compound symmetry). La symétrie composée représente un cas particulier restreint mais suffisant de sphéricité : elle exige que toutes les variances conditionnelles diagonales soient équivalentes (σ²₁ = σ²₂ = … = σ²ₖ = σ²) et que toutes les covariances hors-diagonale soient rigoureusement identiques (σ₁₂ = σ₁₃ = σ₂₃ = σcov). Dès lors qu’un protocole comporte au moins trois conditions (k ≥ 3), l’examen de cette propriété devient une obligation méthodologique incontournable. Lorsque k = 2, le postulat est mathématiquement irréprochable par définition puisqu’il n’existe qu’une unique différence par paire.
5.2 Le test de sphéricité de Mauchly
L’instrument diagnostique le plus universellement déployé au sein des logiciels statistiques pour évaluer la recevabilité empirique de cette condition est le test de sphéricité de Mauchly (introduit par le statisticien John W. Mauchly en 1940). Ce test formalise la confrontation des hypothèses suivantes :
- Hypothèse Nulle (H₀) : La matrice de covariance des variables transformées orthogonales est proportionnelle à une matrice identité, attestant que la sphéricité est formellement respectée au sein de la population.
- Hypothèse Alternative (H₁) : Les variances des différences par paires présentent des disparités structurales significatives, violant le postulat de sphéricité.
Le calcul de la statistique de Mauchly (notée W) repose sur le rapport entre la moyenne géométrique et la moyenne arithmétique des valeurs propres (λ) de la matrice de covariance orthogonale normalisée de rang (k – 1), ce qui s’exprime par le déterminant matriciel :
W = ∏ λᵢ / [ (1 / (k – 1)) × ∑ λᵢ ](k – 1)
La statistique W varie théoriquement dans un intervalle fermé borné entre 0 et 1. Une valeur de W = 1 traduit une adéquation parfaite et absolue à la sphéricité. À l’inverse, plus la statistique W s’approche de zéro, plus la violation du postulat est drastique. Une approximation asymptotique par la loi du χ² permet de déduire la valeur critique p. Si le test de Mauchly affiche une valeur statistiquement significative (p < 0,05), les chercheurs doivent formellement rejeter l’hypothèse nulle de sphéricité.
Néanmoins, les méthodologistes mettent en garde contre deux travers majeurs inhérents au test de Mauchly. D’une part, à l’instar de nombreux tests d’adéquation, il souffre d’un manque notoire de puissance sur les cohortes cliniques de taille modeste (typiquement N < 20), échouant fréquemment à détecter des violations dommageables. D’autre part, sur de vastes bases de données d’enquêtes ou de neuro-imagerie (N > 200), il devient hypersensible, signalant comme statistiquement significatives d’infimes variations mathématiques sans aucune portée clinique ni distorsion réelle pour l’inférence. Pour ces raisons fondamentales, de nombreux statisticiens recommandent de ne pas se fier aveuglément à la significativité du test de Mauchly, mais de surveiller systématiquement les indices de correction epsilon (ε).
5.3 Conséquences statistiques de la violation de la sphéricité
L’ignorance ou la tolérance d’une violation non traitée de la condition de sphéricité engendre des distorsions statistiques d’une gravité exceptionnelle. Sur le plan formel, la distribution mathématique exacte de la statistique de test ne suit plus la distribution théorique du F de Fisher-Snedecor aux degrés de liberté initiaux du modèle.
Le phénomène direct qui en résulte est une inflation massive et insidieuse du taux d’erreur de type I (α). Alors que le seuil de significativité nominal est fixé de manière conventionnelle à 5 % (α = 0,05), le taux réel de faux positifs sous violation sévère de sphéricité peut atteindre des niveaux inacceptables oscillant entre 10 %, 15 % voire plus de 20 % ! En d’autres termes, le chercheur qui exploite un test non corrigé risque d’affirmer avec une assurance injustifiée l’existence d’une découverte scientifique ou d’un effet thérapeutique majeur, alors que ce résultat apparent ne traduit qu’un artéfact lié à l’inadéquation de la matrice de covariance. La variance résiduelle se retrouve sous-estimée, conférant aux valeurs empiriques de F des probabilités critiques p artificiellement écrasées vers zéro. Face à ce péril épistémologique, la mise en œuvre de procédures de redressement des degrés de liberté s’impose comme une nécessité absolue.
6. Procédures de correction en cas de non-sphéricité
6.1 La correction d’epsilon de Greenhouse-Geisser
Face à la violation caractérisée du postulat de sphéricité, la stratégie conventionnelle la plus élégante et la plus éprouvée ne consiste pas à abandonner le modèle univarié, mais à réajuster la sévérité du seuil critique du test F. Pour ce faire, les statisticiens introduisent un multiplicateur de correction désigné par la lettre grecque epsilon (ε), dont l’estimation pionnière fut théorisée par Greenhouse et Geisser en 1959.
L’indice ε quantifie le degré précis d’écart d’une matrice empirique par rapport à la sphéricité parfaite. Sa valeur est théoriquement bornée entre une limite inférieure absolue de 1 / (k – 1) — représentant le cas pathologique de non-sphéricité maximale — et une borne supérieure unitaire de 1,00, correspondant à la stricte vérification de l’hypothèse nulle. La formule de calcul de l’estimateur de Greenhouse-Geisser (ε̂GG) s’exprime à travers les traces et les éléments de la matrice de covariance de la manière suivante :
ε̂GG = [ tr(S)² ] / [ (k – 1) × tr(S²) ]
Une fois la valeur ε̂GG estimée à partir des données de l’échantillon, la procédure de correction consiste à réduire proportionnellement les degrés de liberté associés au facteur de traitement et à l’erreur résiduelle lors de la consultation de la table de Fisher. Les nouveaux degrés de liberté ajustés (notés df*) deviennent :
df*Traitement = ε̂GG × (k – 1) et df*Erreur = ε̂GG × (N – 1)(k – 1)
Cette contraction des degrés de liberté déplace le seuil critique de rejet vers la droite de la distribution, rendant l’obtention d’un résultat significatif plus exigeante et neutralisant parfaitement l’inflation du risque d’erreur de type I. La littérature statistique spécialisée note toutefois que l’estimateur de Greenhouse-Geisser possède un caractère intrinsèquement conservateur. Il tend à sous-estimer légèrement la valeur réelle de l’epsilon de la population lorsque celle-ci se rapproche de 1. Par consensus méthodologique, la correction de Greenhouse-Geisser est expressément recommandée dès lors que l’indice calculé se révèle sévèrement dégradé, concrètement lorsque ε̂GG < 0,75.
6.2 La correction de Huynh-Feldt
Conscients de la propension excessive de la méthode de Greenhouse-Geisser à comprimer les degrés de liberté et donc à pénaliser la puissance statistique lorsque l’entorse à la sphéricité demeure modérée, les chercheurs Huynh et Feldt (1976) ont élaboré un estimateur alternatif moins punitif. L’epsilon de Huynh-Feldt (noté ε̂HF) applique un coefficient de redressement qui prend en considération non seulement le nombre de conditions k, mais également la taille de la cohorte N :
ε̂HF = [ N(k – 1)ε̂GG – 2 ] / [ (k – 1) × ( (N – 1) – (k – 1)ε̂GG ) ]
Par construction mathématique, l’indice ε̂HF est systématiquement supérieur ou égal à ε̂GG pour un jeu de données identique. De ce fait, les degrés de liberté résiduels sont moins dramatiquement tronqués, ce qui préserve une puissance statistique optimale. Il est généralement prescrit d’adopter formellement la correction de Huynh-Feldt lorsque le calcul initial de l’epsilon de Greenhouse-Geisser dépasse le seuil charnière de 0,75 (ε̂GG ≥ 0,75).
Une particularité calculatoire de l’algorithme de Huynh-Feldt mérite d’être soulignée : dans certaines configurations empiriques où les données frôlent une parfaite symétrie circulaire, la formule algébrique peut produire un résultat supérieur à l’unité (ε̂HF > 1,00). Face à cette aberration théorique, les logiciels statistiques modernes (tels que SPSS ou R) appliquent une troncature automatique immédiate, ramenant formellement la valeur à ε = 1,000, ce qui équivaut à conserver l’intégralité des degrés de liberté originaux sans pénalisation.
6.3 L’alternative multivariée (MANOVA à mesures répétées)
Lorsque la sphéricité est lourdement compromise et que le chercheur rechigne à subir les ajustements conservateurs des méthodes d’epsilon, une voie royale mathématique s’ouvre : l’approche multivariée. En formulant le problème à travers le prisme de l’analyse multivariée de variance (MANOVA), les k mesures répétées acquises sur chaque sujet ne sont plus appréhendées comme les modalités séquentielles d’un seul facteur univarié, mais comme un vecteur multidimensionnel de k variables dépendantes corrélées.
Le modèle procède en construisant k – 1 contrastes d’écarts ou combinaisons linéaires indépendantes entre les conditions (par exemple, Δ₁ = Condition 2 – Condition 1, et Δ₂ = Condition 3 – Condition 2). L’hypothèse nulle stipule que le vecteur centroïde de ces différences est rigoureusement égal au vecteur nul dans la population parente. Le bénéfice suprême de cette approche réside dans son immunité mathématique totale face au postulat de sphéricité : la MANOVA intègre et modélise explicitement l’ensemble des intercorrélations empiriques sans exiger la moindre égalité des variances des différences ! L’évaluation de l’effet s’opère via des statistiques multivariées reconnues :
- Le Lambda de Wilks (Λ) : Représente le rapport du déterminant de la matrice des sommes de carrés et produits croisés d’erreur sur le déterminant de la matrice totale. Plus Λ est proche de zéro, plus l’effet du traitement est puissant.
- La Trace de Pillai (V) : Somme des valeurs propres associées à la variance expliquée. Réputée pour son exceptionnelle robustesse face aux déviations de distribution multivariée.
- La Trace de Hotelling-Lawley et la plus grande racine de Roy : D’autres indices canoniques exploités selon des contextes distributionnels spécifiques.
Le tableau comparatif suivant synthétise les critères de décision pour arbitrer entre les voies univariée et multivariée :
| Critère de sélection | ANOVA univariée corrigée (GG / HF) | MANOVA à mesures répétées |
|---|---|---|
| Sensibilité à la sphéricité | Requiert obligatoirement une correction d’epsilon si violée. | Totalement insensible (la sphéricité n’est pas un postulat). |
| Taille d’échantillon requise | Fonctionne de manière fiable sur de très petits échantillons (N < 15). | Exige impérativement N > (k – 1), idéalement N ≥ k + 10. |
| Puissance sous sphéricité respectée | Puissance maximale et optimale. | Légèrement moins puissante (consommation accrue de degrés de liberté). |
| Puissance sous violation sévère | Modérée en raison de la compression forte des degrés de liberté. | Souvent supérieure dès lors que la taille d’échantillon est confortable. |
7. Décomposition mathématique et formulation de la variance
7.1 Somme des carrés totale et décomposition primaire
L’élégance de l’analyse de variance réside dans sa capacité à découper la variabilité totale d’un ensemble de données en composantes additives parfaitement orthogonales. Considérons un protocole expérimental comprenant N participants évalués chacun à travers k conditions expérimentales répétées. Notons Yij le score obtenu par le sujet i (avec i = 1, 2, …, N) sous la condition j (avec j = 1, 2, …, k). Le nombre total d’observations recueillies dans l’expérience est désigné par Ntotal = N × k.
Définissons préalablement les moyennes arithmétiques clés régissant ces structures :
- La grande moyenne globale (Grand Mean), notée Ȳ.. :
Ȳ.. = (1 / (N × k)) × ∑i=1N ∑j=1k Yij - La moyenne individuelle du participant i sur l’ensemble de ses conditions, notée Ȳi. :
Ȳi. = (1 / k) × ∑j=1k Yij - La moyenne conditionnelle observée pour la modalité expérimentale j, notée Ȳ.j :
Ȳ.j = (1 / N) × ∑i=1N Yij
La Somme des Carrés Totale (SSTotale) quantifie l’ensemble des déviations quadratiques de chaque point de données individuel par rapport à la grande moyenne de l’expérience :
SSTotale = ∑i=1N ∑j=1k (Yij – Ȳ..)²
La première phase de scission analytique sépare cette variabilité globale en une composante interindividuelle et une composante intra-individuelle :
SSTotale = SSInter-sujets + SSIntra-sujets
La Somme des Carrés Inter-sujets (SSSujets ou SSBetween-subjects) reflète la divergence entre la moyenne générale propre à chaque participant et la grande moyenne. Chaque écart est pondéré par le nombre de mesures k prises sur l’individu :
SSSujets = k × ∑i=1N (Ȳi. – Ȳ..)²
Quant à la Somme des Carrés Intra-sujets (SSIntra-sujets ou SSWithin-subjects), elle agrège les déviations des scores individuels par rapport à la moyenne personnelle du participant :
SSIntra-sujets = ∑i=1N ∑j=1k (Yij – Ȳi.)²
7.2 Isolation de la variance du traitement et de l’erreur
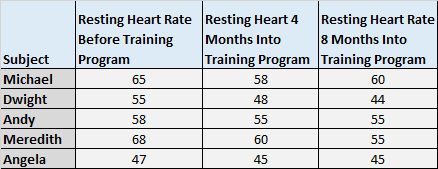
L’étape critique et fondamentale de l’ANOVA à mesures répétées consiste à décomposer la variabilité intra-sujets en ses deux constituants constitutifs : l’effet imputable à la variable indépendante manipulée et le reliquat d’erreur non expliquée :
SSIntra-sujets = SSTraitement + SSErreur
La Somme des Carrés du Traitement (également désignée par SSConditions ou SSTemps) capture les variations induites par les différentes modalités de la manipulation expérimentale. Elle est calculée en mesurant l’écart de chaque moyenne conditionnelle par rapport à la grande moyenne globale, pondéré par le nombre de participants N :
SSTraitement = N × ∑j=1k (Ȳ.j – Ȳ..)²
La Somme des Carrés de l’Erreur (notée SSErreur ou SSRésiduelle) incarne l’inconsistance différentielle de la réponse des participants face au traitement. Sur le plan théorique formel, cette erreur correspond à l’interaction Sujet × Traitement. Elle quantifie dans quelle mesure l’effet spécifique du traitement varie d’un participant à l’autre. Mathématiquement, l’équation résiduelle directe s’établit comme suit :
SSErreur = ∑i=1N ∑j=1k (Yij – Ȳi. – Ȳ.j + Ȳ..)²
En pratique calculatoire, il est immensément plus aisé d’isoler SSErreur par simple soustraction arithmétique en exploitant les clôtures établies précédemment :
SSErreur = SSTotale – SSSujets – SSTraitement
7.3 Structure matricielle des équations
L’expression sommatoire indicée peut avantageusement être transcrite sous forme matricielle et géométrique dans l’espace euclidien à RN×k dimensions. Soit Y le vecteur colonne unicolonne de dimension (N × k) × 1 regroupant l’exhaustivité des observations expérimentales ordonnées par sujet et condition.
La décomposition de la variance s’opère par projection orthogonale sur des sous-espaces vectoriels linéaires disjoints. Définissons la matrice de centrage global CN×k, la matrice de projection orthogonale sur les moyennes des sujets PS, et la matrice de projection sur les moyennes des conditions de traitement PT. Le produit des matrices de projection respecte rigoureusement la condition d’idempotence et d’orthogonalité bilatérale :
PS × PT = (1 / (N × k)) × JN×k
où J représente la matrice dont tous les coefficients sont égaux à un. La clôture algébrique parfaite assure que la distance euclidienne carrée totale s’additionne rigoureusement sans perte d’information :
|| Y – Ȳ..1 ||² = || (PS – PGrandMean)Y ||² + || (PT – PGrandMean)Y ||² + || (I – PS – PT + PGrandMean)Y ||²
Cette formulation matricielle confirme de manière irréfutable le théorème de Cochran : chaque forme quadratique suit de manière indépendante une loi du χ² pondérée par son rang tensoriel, ce qui fonde la stricte validité probabiliste du futur test F de l’ANOVA.
8. Calcul des degrés de liberté, carrés moyens et statistique F
8.1 Attribution analytique des degrés de liberté
À l’instar de la décomposition de la somme des carrés, les degrés de liberté (degrees of freedom, notés df) obéissent à une règle stricte d’additivité algébrique. Chaque degré de liberté représente le nombre d’entités indépendantes pouvant varier librement dans l’estimation statistique après l’imposition des contraintes mathématiques (les moyennes d’échantillon).
L’attribution s’établit selon la partition canonique suivante :
- Degrés de liberté totaux : Puisqu’il y a N × k observations au total et qu’une contrainte unique (la grande moyenne) est fixée, nous obtenons :
dfTotal = N × k – 1 - Degrés de liberté inter-sujets : Portant sur les moyennes des N participants :
dfSujets = N – 1 - Degrés de liberté intra-sujets : Obtenus par différence entre le total et la partie inter-sujets :
dfIntra-sujets = dfTotal – dfSujets = (N × k – 1) – (N – 1) = N(k – 1) - Degrés de liberté du traitement : Mesurent la liberté de variation entre les k conditions expérimentales :
dfTraitement = k – 1 - Degrés de liberté de l’erreur résiduelle : Représentent les degrés de liberté résiduels au sein du bloc intra-sujets, équivalant au produit croisé des degrés de liberté des participants et du traitement :
dfErreur = dfIntra-sujets – dfTraitement = N(k – 1) – (k – 1) = (N – 1)(k – 1)
La vérification arithmétique de fermeture de la chaîne des degrés de liberté est immédiate et vérifiable pour tout plan factoriel :
dfTotal = dfSujets + dfTraitement + dfErreur ⇒ (N × k – 1) = (N – 1) + (k – 1) + (N – 1)(k – 1)
8.2 Détermination des carrés moyens (Mean Squares)
Les sommes des carrés représentent des grandeurs cumulatives qui augmentent proportionnellement au nombre d’observations recueillies. Elles ne peuvent donc pas être comparées directement pour inférer des variances. Afin d’obtenir des estimateurs sans biais de la variance de la population sous l’hypothèse nulle, il est indispensable de standardiser chaque somme des carrés par son volume respectif d’information indépendante : ses degrés de liberté. Cette étape formalise la construction des Carrés Moyens (Mean Squares, notés MS) :
Le Carré Moyen du Traitement (MSTraitement) reflète la variance engendrée conjointement par la manipulation expérimentale réelle et le bruit aléatoire d’échantillonnage :
MSTraitement = SSTraitement / dfTraitement = SSTraitement / (k – 1)
Le Carré Moyen de l’Erreur (MSErreur) constitue l’estimateur de référence non biaisé de la variance résiduelle aléatoire pure, dégagé de toute influence interindividuelle systématique :
MSErreur = SSErreur / dfErreur = SSErreur / [ (N – 1)(k – 1) ]
Il importe de noter que bien que le Carré Moyen des Sujets (MSSujets = SSSujets / (N – 1)) puisse être techniquement calculé, il ne fait généralement l’objet d’aucun test d’hypothèse dans un plan purement intra-sujet, son extraction n’ayant pour finalité que l’assainissement mécanique de MSErreur.
8.3 Calcul et distribution de la statistique de test F
Le test de l’hypothèse nulle d’égalité des moyennes conditionnelles — stipulant qu’au sein de la population générale, les différentes conditions de la variable intra-sujet n’exercent aucun effet différentiel (μ₁ = μ₂ = … = μₖ) — s’effectue par la statistique du ratio de variance F :
F = MSTraitement / MSErreur
Sous l’hypothèse nulle (H₀), et sous réserve du strict respect des postulats de normalité et de sphéricité (ou d’application adéquate des corrections afférentes), ce ratio d’estimateurs de variance indépendants suit exactement la distribution de Fisher-Snedecor paramétrée par les degrés de liberté du numérateur et du dénominateur :
F ~ F( dfTraitement, dfErreur ) = F( k – 1, (N – 1)(k – 1) )
La règle de décision statistique découle de cette distribution théorique. Pour un risque de première espèce consenti α (habituellement calibré à 0,05), le statisticien identifie dans les tables probabilistes la valeur critique Fcritique associée aux degrés de liberté du modèle :
- Si Fobservé > Fcritique (ou de manière équivalente si la valeur p empirique associée est strictement inférieure au seuil α, soit p < 0,05), l’hypothèse nulle H₀ est formellement rejetée. Le chercheur conclut à l’existence d’un effet statistiquement significatif de la condition expérimentale.
- Si Fobservé ≤ Fcritique (p ≥ 0,05), le chercheur échoue à rejeter H₀, affirmant que les variations observées entre les conditions ne peuvent être distinguées des fluctuations aléatoires d’échantillonnage.
9. Exemple empirique résolu pas à pas : Cas pratique en psychologie
9.1 Présentation du protocole expérimental et matrice de données
Pour illustrer sans équivoque la réalité computationnelle de l’ANOVA à mesures répétées, examinons un cas pratique concret en psychologie clinique. Une équipe hospitalière évalue l’efficacité d’un nouveau protocole de psychothérapie brève de gestion du stress sur un échantillon clinique de N = 6 patients souffrant de détresse psychologique. Le niveau d’anxiété est évalué via un inventaire psychométrique validé (score continu variant de 0 à 50 points, où un score élevé dénote une anxiété sévère). Chaque patient est mesuré à trois jalons temporels successifs (k = 3) :
- Temps 1 (T1) : Pré-test (évaluation initiale lors de l’admission).
- Temps 2 (T2) : Mi-parcours (après quatre semaines de prise en charge).
- Temps 3 (T3) : Post-test (au terme des huit semaines de thérapie).
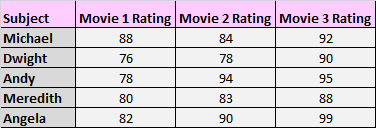
La matrice des données brutes, enrichie des sommes et moyennes marginales calculées pour chaque sujet et chaque condition, se présente ainsi :
| Patient (i) | T1 (Pré-test) | T2 (Mi-parcours) | T3 (Post-test) | Somme Sujet (Ti) | Moyenne Sujet (Ȳi.) |
|---|---|---|---|---|---|
| S1 | 32 | 28 | 20 | 80 | 26,667 |
| S2 | 36 | 31 | 23 | 90 | 30,000 |
| S3 | 28 | 24 | 17 | 69 | 23,000 |
| S4 | 40 | 35 | 25 | 100 | 33,333 |
| S5 | 30 | 26 | 18 | 74 | 24,667 |
| S6 | 34 | 29 | 19 | 82 | 27,333 |
| Somme Cond. (T.j) | 200 | 173 | 122 | Total G = 495 | – |
| Moyenne (Ȳ.j) | 33,333 | 28,833 | 20,333 | – | Ȳ.. = 27,500 |
Les paramètres globaux de l’échantillon s’établissent comme suit : effectif N = 6, nombre de conditions k = 3, nombre total d’observations Ntotal = 6 × 3 = 18. La grande moyenne arithmétique s’élève à :
Ȳ.. = 495 / 18 = 27,500 points
9.2 Application calculatoire des formules théoriques
Procédons désormais à la quantification méticuleuse de chaque source de variation en appliquant les formules mathématiques définies à la section 7.
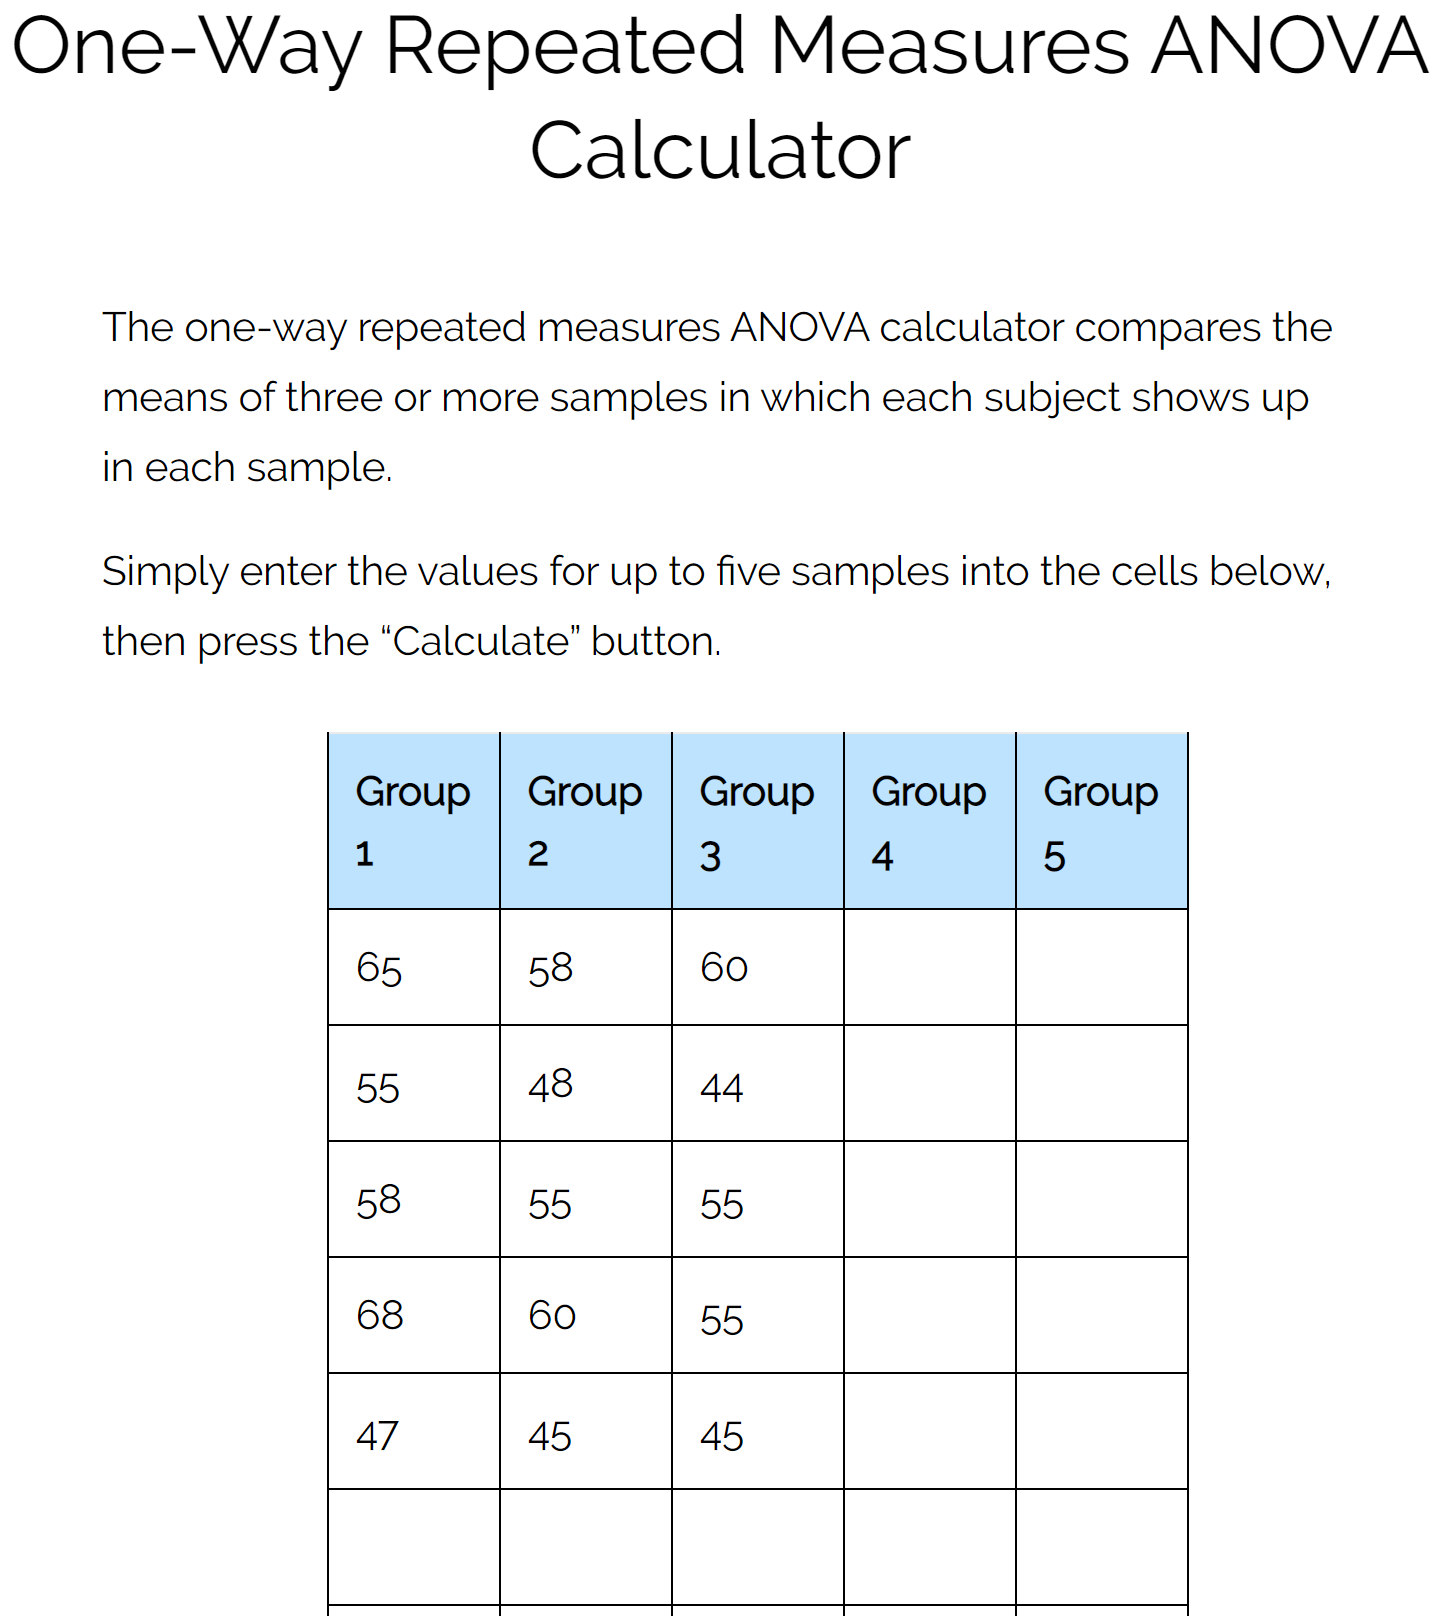
1. Calcul de la Somme des Carrés Totale (SSTotale) :
La somme des carrés de l’ensemble des 18 observations individuelles brutes s’élève à :
∑ Yij² = 32² + 28² + 20² + 36² + 31² + 23² + 28² + 24² + 17² + 40² + 35² + 25² + 30² + 26² + 18² + 34² + 29² + 19²
∑ Yij² = 1024 + 784 + 400 + 1296 + 961 + 529 + 784 + 576 + 289 + 1600 + 1225 + 625 + 900 + 676 + 324 + 1156 + 841 + 361 = 14351
Le facteur de correction du terme global (terme C) vaut :
C = (Total G)² / (N × k) = (495)² / 18 = 245025 / 18 = 13612,5
Ainsi, la déviation totale s’obtient directement :
SSTotale = ∑ Yij² – C = 14351 – 13612,5 = 738,500
2. Calcul de la Somme des Carrés Inter-Sujets (SSSujets) :
Calculons la somme des carrés des totaux individuels de chaque participant divisée par k = 3 :
∑ (Ti)² / k = [ 80² + 90² + 69² + 100² + 74² + 82² ] / 3 = [ 6400 + 8100 + 4761 + 10000 + 5476 + 6724 ] / 3 = 41461 / 3 = 13820,333
En retranchant le facteur de correction C :
SSSujets = 13820,333 – 13612,500 = 207,833
3. Calcul de la Somme des Carrés du Traitement Temporel (SSTraitement) :
Calculons la somme des carrés des totaux de chaque condition temporelle divisée par N = 6 :
∑ (T.j)² / N = [ 200² + 173² + 122² ] / 6 = [ 40000 + 29929 + 14884 ] / 6 = 84813 / 6 = 14135,500
En soustrayant le terme C :
SSTraitement = 14135,500 – 13612,500 = 523,000
4. Déduction de la Somme des Carrés de l’Erreur Résiduelle (SSErreur) :
Par soustraction algébrique rigoureuse des composantes de variance orthogonales :
SSErreur = SSTotale – SSSujets – SSTraitement = 738,500 – 207,833 – 523,000 = 7,667
9.3 Construction et interprétation de la table ANOVA
Les sommes de carrés étant établies, calculons les degrés de liberté correspondants :
- dfSujets = N – 1 = 6 – 1 = 5
- dfTraitement = k – 1 = 3 – 1 = 2
- dfErreur = (N – 1)(k – 1) = 5 × 2 = 10
- dfTotal = N × k – 1 = 18 – 1 = 17
Nous pouvons désormais déterminer les Carrés Moyens (MS) et le ratio F empirique :
- MSTraitement = SSTraitement / dfTraitement = 523,000 / 2 = 261,500
- MSErreur = SSErreur / dfErreur = 7,667 / 10 = 0,767
- Fobservé = MSTraitement / MSErreur = 261,500 / 0,767 = 340,94
L’ensemble de ces métriques est agencé au sein de la table récapitulative standard de l’ANOVA :
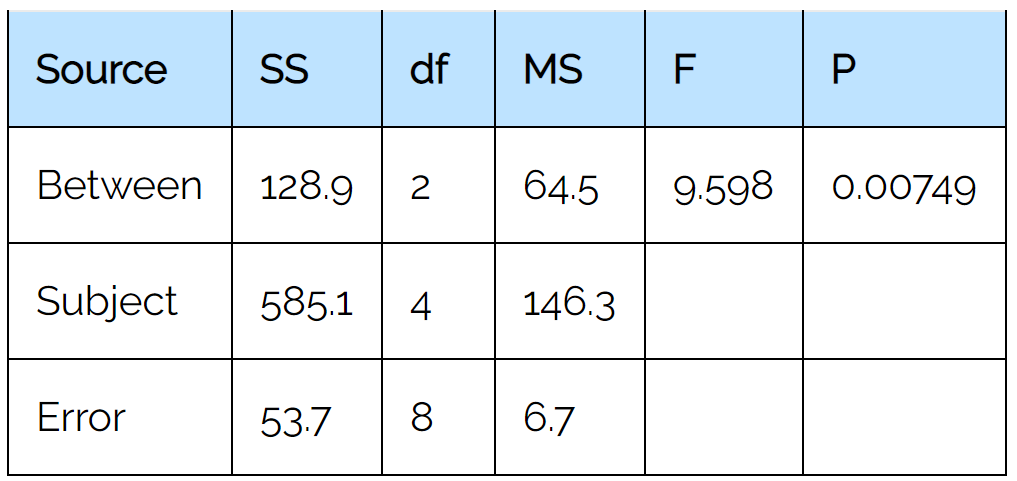
| Source de Variation | Somme des Carrés (SS) | Degrés de Liberté (df) | Carré Moyen (MS) | F de Fisher | Valeur p |
|---|---|---|---|---|---|
| Inter-sujets (Sujets) | 207,833 | 5 | 41,567 | – | – |
| Traitement (Temps) | 523,000 | 2 | 261,500 | 340,94 | < 0,001 |
| Erreur (Résiduelle) | 7,667 | 10 | 0,767 | – | – |
| Total | 738,500 | 17 | – | – | – |
Décision statistique : En consultant la distribution théorique du F pour α = 0,05 avec df₁ = 2 et df₂ = 10, la valeur critique théorique s’élève à Fcritique(2, 10) = 4,10. Notre statistique observée (Fobs = 340,94) pulvérise ce seuil critique de rejet (p = 3,42 × 10⁻¹⁰, soit p < 0,001). Nous rejetons sans ambiguïté l’hypothèse nulle H₀. Il existe un effet statistiquement hautement significatif du temps sur le niveau d’anxiété des patients. L’intervention thérapeutique induit une altération massive et systématique des scores cliniques.
10. Analyses a posteriori (Post-Hoc) et estimation de la taille d’effet
10.1 Quantification de l’ampleur de l’effet
L’obtention d’une valeur p statistiquement significative informe uniquement le chercheur sur la probabilité que la différence observée résulte du hasard sous l’hypothèse nulle ; elle ne renseigne aucunement sur l’ampleur substantielle ou l’importance clinique de l’effet constaté. Il est donc impératif d’adjoindre systématiquement une mesure de la taille d’effet (effect size).
Dans les plans à mesures répétées, l’indice d’élection universellement rapporté est l’êta-carré partiel (noté η²p). Contrairement à l’êta-carré classique (qui rapporterait SSTraitement à la variance totale absolue, sous-estimant artificiellement l’effet en conservant le bruit des sujets), l’êta-carré partiel évalue la part de variabilité expliquée par le traitement après avoir formellement extrait la variance inter-sujets :
η²p = SSTraitement / [ SSTraitement + SSErreur ]
En reprenant les données de notre cas pratique de la section 9 :
η²p = 523,000 / [ 523,000 + 7,667 ] = 523,000 / 530,667 = 0,985
Cela signifie que 98,5 % de la variance intra-sujet résiduelle des scores d’anxiété est directement gouvernée par l’évolution temporelle de la thérapie ! Selon les critères de référence énoncés par Jacob Cohen (1988), les seuils conventionnels d’interprétation pour η²p s’établissent comme suit :
- Effet faible : η²p ≈ 0,01 (environ 1 % de variance expliquée).
- Effet moyen : η²p ≈ 0,06 (environ 6 % de variance expliquée).
- Effet fort : η²p ≥ 0,14 (14 % et au-delà de variance expliquée).
Bien que massivement utilisé, l’êta-carré partiel présente une légère tendance à la surestimation positive au sein des petits échantillons. Pour pallier ce biais, certains statisticiens préconisent l’estimation de l’oméga-carré partiel (ω²p), dont la formulation intègre les carrés moyens de l’erreur :
ω²p = [ dfTraitement × (MSTraitement – MSErreur) ] / [ dfTraitement × MSTraitement + (N – dfTraitement) × MSErreur + SSSujets ]
10.2 Procédures de comparaisons multiples par paires
L’ANOVA à mesures répétées constitue un test global (dit omnibus) : son résultat hautement significatif indique qu’au moins deux moyennes conditionnelles diffèrent de manière non fortuite, mais il est par nature incapable de spécifier quelles paires temporelles précises portent cette différence. Les scores de T1 à T2 sont-ils significativement différents ? La décrue se maintient-elle de T2 à T3 ?
Pour répondre à cette question, le chercheur doit exécuter des tests post-hoc de comparaisons multiples. Toutefois, multiplier les comparaisons par paires expose à une redoutable menace mathématique : l’inflation de l’erreur de Type I (dite Family-Wise Error Rate, notée αFW). Si l’on réalise c tests indépendants au seuil unitaire α = 0,05, la probabilité globale de commettre au moins un faux positif s’élève selon la loi binomiale à :
αFW = 1 – (1 – α)c
Pour 3 comparaisons (T1 vs T2, T2 vs T3, T1 vs T3), le risque global s’élève déjà à 14,3 %. Pour neutraliser ce biais, plusieurs procédures d’ajustement sont appliquées :
- La correction de Bonferroni : La méthode la plus stricte, consistant à diviser le seuil α par le nombre total de comparaisons planifiées :
αajusté = α / c = 0,05 / 3 = 0,0167.
Chaque test t apparié n’est déclaré significatif que si sa valeur p empirique est strictement inférieure à 0,0167. - La méthode séquentielle de Holm-Bonferroni : Une alternative plus puissante (dite step-down) qui ordonne les valeurs p par ordre croissant et ajuste successivement les seuils critiques de façon dégressive (α / c, α / (c – 1), etc.), évitant la sur-pénalisation aveugle de Bonferroni.
- Le test HSD de Tukey (Honestly Significant Difference) : Adapté aux protocoles intra-sujets en exploitant la distribution de l’étendue studentisée (Studentized Range Distribution, q), offrant un compromis idéal entre puissance et contrôle strict du taux d’erreur globale.
10.3 Analyse de contrastes a priori et tendances polynomiales
Lorsque le chercheur dispose d’hypothèses théoriques précises en amont du recueil des données, les comparaisons post-hoc exploratoires cèdent avantageusement la place aux contrastes a priori planifiés. Dans le cadre spécifique des protocoles longitudinaux où l’axe intra-sujet représente une progression temporelle ordonnée, l’analyse de tendances polynomiales orthogonales s’avère particulièrement éclairante.
Cette approche décompose mathématiquement la somme des carrés du traitement (SSTraitement) en composantes géométriques distinctes :
- La tendance linéaire : Évalue si l’évolution globale de la variable dépendante suit une trajectoire rectiligne monotone (décroissance ou croissance régulière et constante à vitesse fixe).
- La tendance quadratique : Teste la présence d’une inflexion en forme de parabole (courbe en U ou en U inversé), indiquant par exemple une amélioration clinique fulgurante au cours des premières semaines suivie d’un palier ou d’une stabilisation asymptotique.
- La tendance cubique : Identifie des dynamiques d’oscillation en forme de « S » (accélération, ralentissement puis reprise d’évolution).
Dans notre cas d’étude clinique sur l’anxiété, l’analyse des contrastes révèle une composante linéaire hautement significative (traduisant l’érosion globale de l’anxiété), couplée à une décomposition quadratique qui permet d’attester si l’essentiel du gain psychologique est engrangé dès la première moitié de la prise en charge thérapeutique.
11. Mise en œuvre assistée par logiciels d’analyse statistique
11.1 Exécution sous l’environnement statistique R
L’environnement open-source de calcul statistique R représente le standard de référence mondial pour la recherche scientifique computationnelle. Pour exécuter une ANOVA à mesures répétées, la manipulation initiale capitale consiste à structurer convenablement la matrice de données. Les logiciels attendent généralement que les données soient configurées en format long (long format), où chaque ligne unique représente une observation temporelle individuelle, plutôt qu’en format large (wide format).
La conversion s’opère couramment via le package tidyr en mobilisant la commande pivot_longer(). Une fois le jeu de données configuré avec les colonnes Patient, Temps et Anxiete, l’analyse paramétrique canonique peut être sollicitée via la fonction de base aov() en intégrant la modélisation explicite de la strate d’erreur intra-sujet :
modele <- aov(Anxiete ~ Temps + Error(Patient/Temps), data = donnees_longues)
summary(modele)
Dans cette syntaxe, le terme Error(Patient/Temps) spécifie formellement que le facteur Temps est niché au sein des unités aléatoires Patient, forçant le modèle à partitionner convenablement la variance interindividuelle.
Pour une approche plus ergonomique incluant le contrôle automatisé de la sphéricité, la communauté biomédicale plébiscite le package rstatix et sa fonction phare anova_test() :
library(rstatix)
res_anova <- anova_test(data = donnees_longues, dv = Anxiete, wid = Patient, within = Temps)
get_anova_table(res_anova, correction = « auto »)
L’argument correction = "auto" évalue instantanément le test de Mauchly et applique en temps réel l’ajustement de Greenhouse-Geisser ou de Huynh-Feldt si la sphéricité est rejetée, garantissant un flux de travail rigoureux et reproductible.
11.2 Mise en œuvre dans le logiciel IBM SPSS Statistics
Le logiciel commercial IBM SPSS Statistics demeure une référence historique très implantée dans les laboratoires de psychologie clinique et de psychiatrie. Contrairement à R, SPSS exige que les données soient impérativement préparées en format large, où chaque participant occupe une seule et unique ligne horizontale, et où les niveaux du facteur intra-sujet sont disposés dans des colonnes adjacentes dédiées (ex. colonnes T1, T2, T3).
La navigation procédurale s’exécute à travers l’arborescence des menus suivants :
- Sélectionner : Analyser > Modèle linéaire général > Mesures répétées…
- Une boîte de dialogue liminaire invite à formaliser le nom du facteur intra-sujet (par exemple Temps) et à renseigner son nombre exact de modalités (dans notre exemple : 3). Cliquer ensuite sur Ajouter, puis sur Définir.
- Dans la fenêtre principale, basculer les variables de la liste source (
T1,T2,T3) au sein du cadre récepteur intitulé Variables intra-sujets. - Ouvrir le sous-menu Options, cocher impérativement les cases Statistiques descriptives et Estimations de la taille d’effet (pour générer l’êta-carré partiel). Dans la section d’ajustement des comparaisons multiples, sélectionner le facteur temporel, activer l’affichage des moyennes marginales estimées et cocher Bonferroni. Valider en cliquant sur Poursuivre puis OK.
La lecture de la sortie de calculs SPSS requiert une vigilance méthodologique ciblée. Le chercheur inspecte d’abord le tableau intitulé Test de sphéricité de Mauchly pour relever la statistique W et la valeur critique Sig. Si Sig. < 0,05, il doit impérativement délaisser la première ligne (« Sphéricité supposée ») du grand tableau subséquent intitulé Tests des effets intra-sujets pour lire directement les lignes corrigées étiquetées « Greenhouse-Geisser » ou « Huynh-Feldt », garantissant la rectitude formelle des conclusions rapportées.
11.3 Analyse open-source avec JASP et Jamovi
Au cours de la dernière décennie, les logiciels libres et ouverts JASP (développé par l’Université d’Amsterdam) et Jamovi ont profondément transformé la pratique de l’analyse de données en alliant la puissance algorithmique de R à une interface graphique intuitive et dynamique.
Dans JASP, la mise en place d’une ANOVA à mesures répétées s’opère avec une fluidité remarquable :
- Depuis l’onglet ANOVA, choisir l’option Repeated Measures ANOVA.
- Dans la section supérieure d’assignation, nommer le facteur intra-sujet (ex. Temps) et déclarer les niveaux (ex. T1, T2, T3). Assigner ensuite par glisser-déposer les colonnes correspondantes du fichier de données.
- Déployer le volet Assumption Checks et activer l’option Sphericity tests ainsi que les options de correction afférentes (Greenhouse-Geisser et Huynh-Feldt).
- Activer dans l’onglet Additional Options le calcul automatisé de la taille d’effet (η²p et ω²p) ainsi que les tracés graphiques descriptifs avec leurs barres d’erreur dans l’onglet Descriptive Plots.
Le point fort incontestable de JASP et Jamovi réside dans la restitution instantanée et en temps réel de tableaux dynamiques directement typographiés selon les préconisations formelles de publication de l’APA, dispensant le chercheur des fastidieuses étapes de reformatage manuel de données.
12. Biais méthodologiques, précautions et rédaction scientifique
12.1 Gestion des menaces à la validité interne
Si le plan à mesures répétées résout avec brio la variabilité interindividuelle, il introduit des menaces spécifiques et redoutables pesant sur la validité interne de la recherche. Dès lors qu’un même participant est soumis de manière séquentielle à plusieurs conditions expérimentales, l’ordre d’administration de ces conditions peut contaminer les résultats observés.
La première menace concerne l’effet d’ordre et de rang (order effects), regroupant deux mécanismes psychologiques antagonistes :
- L’effet d’apprentissage ou d’entraînement (practice effect) : Le sujet devient progressivement plus habile, plus rapide et plus détendu au fur et à mesure des sessions de passation, augmentant artificiellement ses performances lors des dernières conditions du protocole indépendamment de leur valeur expérimentale intrinsèque.
- L’effet de fatigue, d’ennui ou d’usure attentionnelle : Lors de sessions psychophysiques éreintantes ou d’évaluations mnésiques prolongées, la baisse de vigilance et la lassitude cognitive peuvent dégrader sévèrement les performances lors des conditions finales.
La seconde menace majeure réside dans l’effet de report (carryover effect), survenant lorsqu’une condition expérimentale continue d’exercer ses effets physiologiques ou cognitifs rémanents sur la condition subséquente. C’est typiquement le cas des essais pharmacologiques (nécessitant l’instauration stricte de périodes de sevrage ou washout periods) ou des inductions d’états de stress émotionnel intense, dont l’impact végétatif ne s’estompe que très lentement.
Pour neutraliser méthodologiquement ces distorsions, la règle d’or est le contrebalancement. Dans un contrebalancement complet, toutes les permutations ordonnées possibles des conditions sont générées et équitablement réparties entre les participants (par exemple, pour 3 conditions A, B et C, les 6 ordres ABC, ACB, BAC, BCA, CAB et CBA sont administrés à des sous-groupes égaux). Lorsque le nombre de conditions rend cette combinatoire impraticable (ex. k = 5 générant 120 ordres), les chercheurs emploient un protocole en carré latin équilibré, où chaque condition apparaît une fois et une seule à chaque position ordinale et précède et suit immédiatement chaque autre condition un nombre strictement égal de fois.
12.2 Gestion des données manquantes dans les suivis longitudinaux
L’un des talons d’Achille les plus critiques de l’ANOVA univariée à mesures répétées réside dans son intransigeance absolue face aux données manquantes (missing data). Dans les études longitudinales s’étalant sur plusieurs mois ou années, l’attrition des cohortes est un phénomène inévitable : des patients déménagent, interrompent leur participation, développent des effets secondaires ou oublient un rendez-vous d’évaluation.
Or, les algorithmes de l’ANOVA générale recourent par défaut à la suppression par liste complète (listwise deletion). Si un participant manque une seule évaluation parmi les cinq jalons du protocole, l’intégralité de ses données — y compris les quatre évaluations rigoureusement recueillies — est impitoyablement éjectée du modèle de variance ! Cette hécatombe de données entraîne une réduction drastique et inacceptable de la puissance statistique de l’étude, tout en introduisant un biais de sélection gravissime si l’attrition n’est pas complètement aléatoire (mécanisme MCAR, Missing Completely At Random).
Face à cette impasse structurelle, la statistique contemporaine préconise de délaisser l’ANOVA traditionnelle au profit des Modèles Linéaires Mixtes (Linear Mixed-Effects Models, LMM ou modèles hiérarchiques linéaires). Les modèles mixtes modélisent les mesures répétées comme des unités nichées au sein des individus via des coefficients aléatoires (random intercepts et random slopes). Leurs atouts sont révolutionnaires :
- Ils conservent l’intégralité des participants dans l’analyse, exploitant chaque observation disponible sans supprimer l’individu porteur d’une valeur manquante (sous hypothèse de données manquantes ignorables MAR, Missing At Random).
- Ils tolèrent sans la moindre difficulté des espacements temporels inégaux d’un patient à l’autre (par exemple, un sujet réévalué après 28 jours et un autre après 35 jours).
- Ils autorisent la modélisation directe et explicite de structures de covariance hautement sophistiquées (autorégressives d’ordre 1 [AR(1)], Toeplitz ou non structurées), transcendant définitivement les contraintes rigides de la sphéricité univariée.
12.3 Rédaction et communication des résultats selon les normes de l’APA
La transmission des résultats scientifiques dans les revues à comité de lecture internationales obéit à des normes typographiques et formelles extrêmement strictes codifiées par l’American Psychological Association (normes APA, 7ᵉ édition). Le compte rendu d’une ANOVA à mesures répétées doit impérativement expliciter le modèle testé, les statistiques descriptives, la vérification du postulat de sphéricité, la statistique de test F, les degrés de liberté (corrigés si nécessaire), la valeur p exacte et l’indice de taille d’effet.
Pour notre exemple pratique clinique développé à la section 9, la formulation textuelle standardisée s’énonce comme suit :
« Une analyse de variance (ANOVA) à mesures répétées à un facteur a été conduite afin d’évaluer l’impact d’une thérapie cognitivo-comportementale sur le niveau d’anxiété mesuré à trois jalons temporels (Pré-test, Mi-parcours, Post-test). Le postulat de sphéricité a été vérifié et respecté selon le test de Mauchly, W = 0,891, χ²(2) = 0,87, p = 0,647 (ε = 0,90). L’analyse révèle un effet principal du temps hautement significatif, F(2, 10) = 340,94, p < 0,001, η²p = 0,985. Les comparaisons multiples par paires corrigées selon la procédure de Bonferroni indiquent une réduction statistiquement significative des scores moyens d’anxiété entre le Pré-test (M = 33,33, ET = 4,27) et le Mi-parcours (M = 28,83, ET = 3,92 ; p < 0,001), ainsi qu’entre le Mi-parcours et le Post-test final (M = 20,33, ET = 2,94 ; p < 0,001). »
Si la sphéricité avait été rejetée (par exemple p = 0,02 avec un εGG = 0,68), la formulation aurait intégré les degrés de liberté décimaux ajustés :
« Le postulat de sphéricité ayant été violé (test de Mauchly W = 0,42, p = 0,018), les degrés de liberté ont été ajustés via la correction de Greenhouse-Geisser (ε = 0,68). L’effet principal du temps demeure hautement significatif, F(1,36, 6,80) = 340,94, p < 0,001, η²p = 0,985. »
Enfin, sur le plan de la communication graphique, les figures illustrant les trajectoires conditionnelles doivent éviter de tracer des barres d’erreur basées sur l’écart-type ou l’intervalle de confiance interindividuel classique. En effet, ces intervalles bruts incorporent la variance entre sujets, masquer la finesse de la manipulation intra-sujet. Il est formellement prescrit de tracer des intervalles de confiance intra-sujets (calculés selon les méthodes standardisées de Loftus et Masson, 1994, ou de Cousineau-Morey), qui éliminent graphiquement la variance interindividuelle et offrent une cohérence visuelle parfaite avec le verdict du test F.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.utstat.toronto.edu/~brunner/oldclass/378f16/readings/CohenPower.pdf
- Cousineau, D. (2005). Confidence intervals in within-subject designs: A simple alternative to Loftus and Masson’s approach. Tutorials in Quantitative Methods for Psychology, 1(1), 42-45. https://doi.org/10.20982/tqmp.01.1.p042
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications. https://uk.sagepub.com/en-gb/eur/discovering-statistics-using-ibm-spss-statistics/book257666
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95-112. https://doi.org/10.1007/BF02289823
- Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69-82. https://doi.org/10.2307/1164736
- Loftus, G. R., & Masson, M. E. (1994). Using confidence intervals in within-subject designs. Psychonomic Bulletin & Review, 1(4), 476-490. https://doi.org/10.3758/BF03210951
- Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204-209. https://doi.org/10.1214/aoms/1177731909
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61-64. https://doi.org/10.20982/tqmp.04.2.p061
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson. https://www.pearson.com/en-us/subject-catalog/p/using-multivariate-statistics/P200000003445