
Dans le champ contemporain des sciences du comportement, de la psychométrie et de la recherche clinique, les protocoles expérimentaux génèrent des volumes de données caractérisés par une dimensionalité croissante. L’administration d’inventaires de personnalité comportant plusieurs dizaines d’items, l’évaluation de batteries neuropsychologiques exhaustives ou encore l’enregistrement simultané de marqueurs comportementaux et physiologiques confrontent inévitablement les chercheurs au phénomène de multicolinéarité et à la dispersion de l’information. Face à cette prolifération de variables interdépendantes, l’analyse multivariée requiert des techniques d’agrégation d’information capables de préserver la richesse du signal tout en réduisant le bruit et la redondance.
L’analyse en composantes principales (ACP), initialement conceptualisée par Karl Pearson en 1901 puis développée de manière indépendante pour les variables aléatoires par Harold Hotelling en 1933, s’impose comme la méthodologie fondamentale d’apprentissage non supervisé pour répondre à ce défi. En projetant un ensemble de variables quantitatives initialement corrélées sur un nouvel espace vectoriel composé d’axes orthogonaux et non corrélés, l’ACP offre un cadre d’une rigueur mathématique remarquable. Elle permet d’appréhender la variance globale d’un système complexe sous la forme d’un nombre restreint de composantes synthétiques hiérarchisées selon leur inertie.
Ce guide propose une exploration approfondie et rigoureuse de l’ACP appliquée aux données psychologiques sous l’environnement statistique R. En articulant les fondements algébriques et géométriques avec une mise en pratique détaillée sur un jeu de données psychométriques, cet article décortique chaque étape du flux de traitement : de l’évaluation préalable de l’échantillonnage et de la factorisabilité jusqu’à l’interprétation substantielle des saturations, la visualisation factorielle avancée et l’intégration des scores dans des modèles prédictifs ultérieurs.
1. Introduction théorique à l’analyse en composantes principales en psychologie
1.1 Le défi de la haute dimensionnalité dans les mesures psychométriques
L’investigation empirique des processus cognitifs, des structures de la personnalité et des psychopathologies repose quasi systématiquement sur le recueil de multiples indicateurs manifestes. Qu’il s’agisse d’échelles de Likert au sein d’un questionnaire d’auto-évaluation, de temps de réaction mesurés à travers diverses conditions expérimentales ou de scores d’efficience à des subtests d’intelligence, la réalité psychologique est appréhendée par un ensemble étendu de variables observées. Cette haute dimensionnalité engendre une problématique majeure : la redondance informationnelle. En vertu des intercorrélations inhérentes aux processus psychologiques, plusieurs dizaines d’items mesurent fréquemment des facettes étroitement imbriquées d’un même phénomène général, ce qui alourdit considérablement l’espace d’analyse sans apporter nécessairement de variance spécifique pertinente.
L’analyse bivariée classique montre rapidement ses limites face à la combinatoire des relations croisées. Lorsque le nombre de variables observables s’élève à plusieurs dizaines, la matrice des corrélations contient plusieurs centaines de coefficients distincts, rendant l’interprétation globale humaine impossible sans une méthode de synthèse structurée. L’évaluation isolée de chaque paire de variables fait courir le risque d’une inflation du taux d’erreur de type I lors des tests d’hypothèses multiples et masque les relations structurelles globales qui gouvernent la matrice de données. Les modèles statistiques avancés, tels que la régression multiple ou la classification supervisée, souffrent alors de collinearité extrême, ce qui déstabilise l’estimation des coefficients de régression et gonfle artificiellement leurs erreurs-types.
Pour dépasser ces entraves méthodologiques, la recherche en sciences comportementales nécessite une réduction d’échelle rigoureuse. Cette contraction de l’espace dimensionnel permet aux psychométriciens de dégager des axes d’interprétation synthétiques tout en minimisant la perte d’information empirique. L’objectif cardinal consiste à résumer un ensemble initial de prédicteurs corrélés en un sous-ensemble parcimonieux d’indicateurs orthogonaux, tout en garantissant que la variance totale observée dans l’échantillon initial soit préservée au niveau le plus élevé possible au sein du modèle compacté.
1.2 Définition et objectifs fondamentaux de l’ACP
L’analyse en composantes principales appartient à la classe des méthodes d’apprentissage statistique non supervisé. Contrairement aux approches supervisées qui cherchent à prédire une variable réponse ou une classe diagnostique externe à partir d’un ensemble de variables explicatives, l’ACP traite l’ensemble des descripteurs sur un plan strictement égalitaire. Elle n’impose aucune distinction fonctionnelle entre variables dépendantes et indépendantes, se focalisant exclusivement sur la modélisation de la structure d’interdépendance globale des variables quantitatives observées.
D’un point de vue opératoire, l’ACP opère une transformation linéaire géométrique des données d’origine. Les variables de départ, mesurées dans un repère multidimensionnel non orthogonal en raison de leurs intercorrélations, sont transformées en un nouveau jeu de variables composites appelées composantes principales. Ces dernières possèdent deux propriétés géométriques fondamentales : elles sont rigoureusement orthogonales entre elles, ce qui garantit une corrélation linéaire nulle entre chaque paire de composantes, et elles sont hiérarchisées de manière séquentielle. La première composante principale capture la fraction maximale de la variance totale du jeu de données, la seconde capture la variance maximale résiduelle non absorbée par la première sous contrainte d’orthogonalité, et ainsi de suite jusqu’à la dernière dimension.
Cette approche matérialise le principe de parcimonie scientifique (ou rasoir d’Ockham) en psychométrie. En condensant l’information issue de multiples items au sein de quelques axes directeurs, le chercheur passe du niveau des variables manifestes — intrinsèquement bruyantes et dépendantes du format d’interrogation — à des dimensions synthétiques globales. Ces composantes capturent les tendances lourdes du comportement ou de la cognition des participants, facilitant ainsi la dérivation d’indices récapitulatifs exploitables pour la description clinique ou la modélisation ultérieure.
1.3 Contexte d’application dans la recherche en sciences comportementales
Dans la pratique contemporaine des sciences comportementales, l’ACP trouve une vaste palette d’applications empiriques. L’un des usages les plus fréquents réside dans la phase préliminaire d’élaboration et de raffinement des instruments d’évaluation psychologique. Face à une version expérimentale d’un inventaire de personnalité ou d’une échelle clinique comprenant une centaine d’items, l’ACP permet d’identifier rapidement la topographie générale de la variance, de repérer les items redondants ou ceux qui échouent à saturer sur les premières composantes majeures, orientant ainsi l’élagage rationnel de l’instrument.
Au-delà de la psychométrie classique des questionnaires, l’ACP est largement mobilisée dans les approches neurocomportementales et neuropsychologiques intégratives. Lorsqu’une étude combine des mesures comportementales (latences, taux d’erreurs, indices d’inhibition), des biomarqueurs neurophysiologiques (amplitudes de potentiels évoqués, connectivité fonctionnelle en imagerie par résonance magnétique) et des scores neuropsychologiques composites, l’espace des données devient rapidement intenable pour une modélisation directe. L’ACP permet alors de condenser ces profils multidimensionnels hétérogènes en indices synthétiques d’efficience neurocognitive ou de vulnérabilité clinique.
Enfin, la méthode intervient comme outil de diagnostic et de purification statistique au sein de protocoles expérimentaux complexes. Elle autorise la détection de corrélations parasites induites par des variations méthodologiques communes, telles que le biais d’acquiescement ou la fatigue expérimentale, et permet de séparer ces artéfacts méthodologiques des patterns de variance psychologique réels. En simplifiant la matrice des données sans altérer la topologie des écarts interindividuels, elle conditionne le succès des analyses inférentielles subséquentes.
2. Fondements mathématiques et géométriques de la réduction de dimension
2.1 Formulation algébrique des combinaisons linéaires
Sur le plan algébrique formel, considérons un échantillon de $n$ participants évalués sur $p$ variables quantitatives continues notées $X_1, X_2, dots, X_p$. Chaque composante principale, notée $Z_m$ (où $m in {1, 2, dots, p}$), est définie mathématiquement comme une combinaison linéaire normalisée de l’ensemble des variables observées initiales :
$$Z_m = a_{1m}X_1 + a_{2m}X_2 + dots + a_{\pm}X_p = \sum_{j=1}^{p} a_{jm} X_j$$
Dans cette formulation, les coefficients réels $a_{jm}$ représentent les poids factoriels ou pondérations (souvent désignés sous le terme technique de loadings). Afin d’éviter que la variance de la composante $Z_m$ ne croisse indéfiniment par simple dilatation arbitraire des coefficients, une contrainte géométrique de normalisation vectorielle unitaire est impérativement imposée. La somme des carrés des pondérations pour une composante donnée doit être rigoureusement égale à un :
$$\sum_{j=1}^{p} a_{jm}^2 = \mathbf{a}_m^T \mathbf{a}_m = 1$$
L’exigence d’orthogonalité mutuelle entre les différentes composantes implique que pour toute paire d’indices $m$ et $k$ avec $m \neq k$, les vecteurs de pondérations doivent être strictement orthogonaux, satisfaisant la relation $\mathbf{a}_m^T \mathbf{a}_k = 0$. Cette contrainte matricielle garantit que la covariance empirique entre les composantes $Z_m$ et $Z_k$ est nulle dans l’échantillon. En notation matricielle compacte, si $\mathbf{X}$ désigne la matrice centrée de dimensions $n \times p$ et $\mathbf{A}$ la matrice unitaire de passage de dimensions $p \times p$ dont les colonnes correspondent aux vecteurs $\mathbf{a}_m$, la matrice des coordonnées projetées des individus $\mathbf{Z}$ s’exprime par le produit matriciel direct :
$$\mathbf{Z} = \mathbf{X} \mathbf{A}$$
2.2 Décomposition en valeurs propres et vecteurs propres
La résolution analytique de l’optimisation sous contrainte évoquée précédemment repose sur le théorème spectral appliqué aux matrices symétriques définies positives. Lorsque les variables $X$ sont préalablement centrées et réduites à une variance unitaire, la matrice d’association de départ est la matrice des corrélations de Pearson, notée $\mathbf{R}$, de dimensions $p \times p$. Trouver les pondérations qui maximisent la variance de la combinaison linéaire équivaut à résoudre l’équation fondamentale aux valeurs propres :
$$\mathbf{R} \mathbf{a}_m = \lambda_m \mathbf{a}_m$$
Dans cette relation centrale, $\lambda_m$ représente la valeur propre (eigenvalue) associée au vecteur propre unitaire $\mathbf{a}_m$ (eigenvector). La valeur propre quantifie directement l’inertie ou la variance capturée par la composante principale correspondante $Z_m$. La somme des $p$ valeurs propres est exactement égale à la trace de la matrice initiale. Lorsque l’analyse est conduite sur la matrice de corrélation, la trace vaut $p$ (chaque variable unitaire possédant une variance égale à 1) :
$$\sum_{m=1}^{p} \lambda_m = \text{Tr}(\mathbf{R}) = p$$
Sur le plan algorithmique contemporain, les environnements de calcul haute performance tels que R n’implémentent généralement pas l’inversion explicite de la matrice de corrélation pour extraire ses valeurs spectrales, car cette opération peut être source d’instabilité numérique lorsque $p$ est élevé ou en présence de quasi-colinéarité. Ils privilégient la décomposition en valeurs singulières (Singular Value Decomposition ou SVD) appliquée directement sur la matrice de données centrée-réduite $\mathbf{X}^*$. La SVD factorise la matrice selon la formule $\mathbf{X}^* = \mathbf{U} \mathbf{D} \mathbf{V}^T$, où $\mathbf{U}$ est une matrice unitaire $n \times p$, $\mathbf{D}$ est une matrice diagonale contenant les valeurs singulières $d_m$, et $\mathbf{V}$ est la matrice orthogonale $p \times p$ correspondant directement aux vecteurs propres de la matrice de covariance. Les valeurs propres s’obtiennent alors immédiatement par la relation analytique :
$$\lambda_m = \frac{d_m^2}{n – 1}$$
2.3 Représentation géométrique par projection orthogonale
L’intuition géométrique sous-jacente à l’ACP constitue l’une de ses caractéristiques les plus séduisantes pour l’analyse des données comportementales. Considérons un nuage de points composé de $n$ individus évoluant dans un espace euclidien réel à $p$ dimensions, où chaque axe cartésien correspond à une variable observée. Le barycentre de ce nuage de points est positionné à l’origine grâce au centrage des données. L’inertie totale du nuage représente la dispersion globale des observations autour de ce centre de gravité.
L’ACP réalise une rotation rigide orthogonale de l’ensemble de ce système d’axes cartésiens. Le premier axe principal est déterminé de manière à coïncider avec la direction d’étirement maximal du nuage de points, c’est-à-dire l’axe sur lequel la projection orthogonale des individus maximise la variance empirique. Le second axe est orienté perpendiculairement au premier de façon à maximiser l’inertie résiduelle projetée, et le processus se poursuit séquentiellement pour l’ensemble des dimensions orthogonales disponibles.
Cette maximisation de la variance projetée possède une stricte contrepartie géométrique : elle équivaut mathématiquement à minimiser la somme des carrés des distances euclidiennes de projection entre les points d’origine dans l’espace $\mathbb{R}^p$ et leurs projetés orthogonaux sur le sous-espace réduit de dimension inférieure $k < p$. Par conséquent, la configuration spatiale relative des participants (leurs proximités euclidiennes, synonymes de profils psychologiques similaires) est préservée de manière optimale au sein du sous-espace factoriel de rang réduit retenu par le chercheur.
3. Distinction essentielle entre ACP et analyse factorielle exploratoire
3.1 Différences conceptuelles fondamentales
Une confusion épistémologique et méthodologique tenace persiste au sein de la littérature psychologique et des sciences sociales quant à la distinction séparant l’analyse en composantes principales (ACP) de l’analyse factorielle exploratoire (AFE, ou modèle des facteurs communs). Bien que ces deux familles d’analyse partagent des similarités opérationnelles indéniables — telles que la manipulation de matrices de corrélation et l’utilisation de graphiques de décroissance des valeurs propres —, leurs architectures mathématiques fondamentales et leurs ambitions théoriques divergent radicalement.
Le modèle de l’ACP repose sur la partition et l’explication de la variance totale contenue dans les variables observées. L’ACP ne formule aucune hypothèse a priori quant à la nature physique ou latente de la source de variance. Les composantes principales constituent des aggrégats purement descriptifs, calculés comme des combinaisons mathématiques descendantes directes des indicateurs manifestes. La variance d’un item est intégralement injectée dans le calcul sans aucune distinction entre variance systématique et variance d’erreur de mesure.
À l’inverse, l’AFE postule l’existence d’un modèle réflexif ascendant sous-jacent. Selon ce modèle théorique, des variables inobservables appelées traits latents ou construits théoriques (par exemple, le facteur général d’intelligence $g$ ou le névrosisme) causent directement les covariations observées au niveau des variables manifestes. L’AFE décompose la variance de chaque variable en deux parts imperméables : la communauté ($h^2$), qui représente la variance partagée avec les autres items via les facteurs communs latents, et l’unicité ($u^2$), qui englobe à la fois la variance spécifique propre à l’item et la variance résiduelle d’erreur de mesure. L’AFE ne s’intéresse qu’à la modélisation de la variance commune, ignorant délibérément l’unicité lors de l’estimation factorielle.
| Dimension de comparaison | Analyse en composantes principales (ACP) | Analyse factorielle exploratoire (AFE) |
|---|---|---|
| Modèle mathématique | Combinaison linéaire directe des items observés (sommation descriptive) | Modèle à variables latentes causant les variations des items observés |
| Variance traitée | Variance totale (commune + spécifique + erreur = 1.0 sur la diagonale) | Variance commune uniquement (communautés estimées sur la diagonale) |
| Présence de l’erreur | L’erreur de mesure est incorporée dans les composantes principales | L’erreur de mesure est explicitement isolée au sein de l’unicité |
| Indétermination des scores | Aucune : calcul direct et déterministe des scores par algèbre matricielle | Indétermination factorielle : les scores ne peuvent être qu’approximés |
| Objectif scientifique | Réduction parcimonieuse des données, prédiction, compression d’indices | Découverte de construits psychologiques latents non observables |
3.2 Critères méthodologiques de choix pour le chercheur
Le choix entre l’ACP et l’AFE ne relève pas d’une préférence statistique arbitraire, mais doit impérativement s’aligner sur les finalités théoriques de l’investigation empirique. Lorsque le psychologue a pour finalité prioritaire d’élaborer des indices composites, de réduire la dimensionnalité d’un grand nombre de scores comportementaux pour alimenter une analyse ultérieure de régression, ou de concevoir un système de classification compact, l’ACP représente l’outil de référence absolu. Elle garantit une solution déterministe, stable et calculée sans les instabilités numériques d’estimation itérative inhérentes aux méthodes du maximum de vraisemblance utilisées en factorisation des facteurs communs.
En revanche, lorsque la visée scientifique de l’étude touche à la validation de construit psychologique — c’est-à-dire lorsqu’il s’agit de tester l’existence empirique de dimensions psychologiques non observables réputées générer les réponses des participants —, l’AFE s’avère conceptuellement indispensable. Dans cette situation, l’ACP tend à surestimer de façon systématique la quantité de variance expliquée par les premiers axes et gonfle artificiellement les saturations factorielles en intégrant le terme d’erreur dans l’agrégat mathématique, ce qui peut conduire le chercheur à des conclusions prématurées sur l’homogénéité d’un construit.
L’impact de la taille d’échantillon sur la reproductibilité structurelle varie également entre ces deux approches. L’ACP fait preuve d’une robustesse computationnelle accrue face aux échantillons de taille modeste, ne souffrant pas des problèmes fréquents de convergence ou des cas de Heywood (communautés excédant l’unité) qui entravent régulièrement l’estimation de l’AFE. Cependant, dès lors que les communautés des variables sont faibles (inférieures à 0,40) et que le nombre d’indicateurs par dimension est restreint, l’écart de structure entre les deux méthodes se creuse drastiquement, imposant une prudence rigoureuse lors de l’interprétation substantielle des composantes.
4. Préparation de l’environnement R et sélection des packages statistiques
4.1 Configuration des bibliothèques fondamentales
L’écosystème open-source R propose une gamme d’outils statistiques dédiée à l’analyse multivariée. Pour exécuter une chaîne de traitement complète, standardisée et conforme aux exigences méthodologiques actuelles, l’installation conjointe de plusieurs paquets complémentaires s’avère nécessaire. Alors que le moteur de base de R intègre nativement des procédures d’analyse dimensionnelle, la communauté scientifique a développé des extensions spécialisées facilitant l’évaluation psychométrique, l’extraction multidimensionnelle et le rendu graphique de niveau publication.
Le premier ensemble fonctionnel repose sur les extensions consacrées aux sciences comportementales et à la manipulation des données : le métapaquet tidyverse (englobant notamment dplyr pour le filtrage et la restructuration, ainsi que ggplot2 pour les visualisations graphiques avancées) combiné au paquet spécialisé psych, maintenu par William Revelle. Ce dernier fournit des fonctions d’analyse descriptive multivariée, des tests de diagnostic d’échantillonnage et des outils d’analyse parallèle indispensables au psychométricien.
Le second ensemble méthodologique est structuré autour de l’école française d’analyse des données avec le paquet FactoMineR, développé par François Husson et ses collaborateurs à l’Institut Agro d’Angers. Ce moteur de calcul est dédié à la conduite d’analyses factorielles complètes, permettant la gestion conjointe des variables actives et des éléments supplémentaires illustratifs (individus et variables catégorielles ou quantitatives). Enfin, l’extension factoextra, développée par Alboukadel Kassambara, fournit l’interface de visualisation bâtie sur le système graphique de ggplot2 permettant d’extraire, de mettre en forme et de tracer avec précision les représentations spatiales issues des objets créés par FactoMineR ou prcomp.
Pour installer et charger l’ensemble de ces bibliothèques dans votre session R active, le protocole standard s’exécute comme suit :
install.packages(c("tidyverse", "psych", "FactoMineR", "factoextra", "corrplot"))
library(tidyverse)
library(psych)
library(FactoMineR)
library(factoextra)
library(corrplot)
4.2 Comparaison technique entre prcomp et princomp
Dans la distribution native du paquetage stats de R, deux fonctions fondamentales coexistent pour l’analyse en composantes principales : prcomp() et princomp(). Bien qu’elles visent théoriquement le même objectif mathématique, leurs algorithmes sous-jacents diffèrent substantiellement, ce qui entraîne des conséquences directes sur la précision numérique et la stabilité des calculs.
La fonction historique princomp() utilise la méthode classique de diagonalisation par décomposition en valeurs propres (fonction interne eigen()) appliquée explicitement sur la matrice de covariance ou de corrélation de l’échantillon. Cette procédure calcule la matrice des covariances en étape intermédiaire en divisant les sommes de carrés par l’effectif $n$ (estimateur du maximum de vraisemblance biaisé de la variance, plutôt que le diviseur $n – 1$). Cette approche présente une vulnérabilité numérique accrue face aux phénomènes d’arrondi machine lorsque certaines variables présentent des variances divergentes ou lorsque la colinéarité entre items est très forte, conduisant parfois à des matrices quasi-singulières que l’algorithme ne parvient pas à inverser correctement.
À l’opposé, la fonction prcomp() applique la décomposition en valeurs singulières (SVD) directement sur la matrice des données centrée (et éventuellement mise à l’échelle), sans jamais calculer formellement la matrice de covariance intermédiaire. L’algorithme SVD présente des propriétés de stabilité numérique largement supérieures, particulièrement dans les contextes où le nombre d’observations $n$ est inférieur au nombre de variables $p$, ou lors de l’investigation de grands jeux de données psychométriques comportant de légères instabilités de variance. Sur le plan de la théorie statistique appliquée contemporaine, l’utilisation de prcomp() est universellement privilégiée par rapport à princomp() au sein de la communauté des utilisateurs de R.
5. Collecte, structuration et exploration du jeu de données psychologiques
5.1 Définition de l’exemple empirique fil rouge
Pour illustrer de manière concrète l’ensemble des étapes computationnelles et des décisions méthodologiques, nous mobiliserons un jeu de données psychométriques inspiré des travaux de référence sur la taxonomie des traits de personnalité selon le modèle à cinq facteurs (le Big Five). Ce corpus d’apprentissage est constitué d’un échantillon normatif de $n = 500$ jeunes adultes ayant complété un inventaire de personnalité abrégé comprenant 10 indicateurs continus quantitatifs. Les variables mesurées sur une échelle de type Likert en 7 points (allant de 1 = « Pas du tout d’accord » à 7 = « Tout à fait d’accord ») explorent les facettes suivantes :
- V1_Extraversion_Sociable : Tendance à engager facilement des conversations et rechercher la compagnie d’autrui.
- V2_Extraversion_Dynamique : Niveau d’énergie perçu, loquacité et enthousiasme comportemental.
- V3_Neuroticisme_Anxieux : Fréquence des manifestations d’appréhension et d’anticipation négative.
- V4_Neuroticisme_Vulnerable : Sensibilité émotionnelle au stress et sentiment de débordement.
- V5_Conscienciosite_Organise : Tendance à structurer méthodiquement son environnement et ses tâches.
- V6_Conscienciosite_Rigoureux : Souci du détail, exactitude et persévérance dans le travail.
- V7_Agreabilite_Empathique : Disposition à l’écoute bienveillante et à la compassion envers autrui.
- V8_Agreabilite_Cooperation : Recherche de conciliation sociale et évitement des conflits interpersonnels.
- V9_Ouverture_Curieux : Intérêt pour les idées abstraites, la philosophie et la culture intellectuelle.
- V10_Ouverture_Creatif : Goût prononcé pour les arts, l’imagination et l’expression originale.
Le tableau des données comprend également deux variables illustratives supplémentaires qui ne participeront pas à la construction active des composantes de l’ACP, mais serviront à enrichir l’interprétation ultérieure des profils : le Sexe des répondants (variable binaire catégorielle) et le score d’Efficience_Cognitive (variable quantitative globale issue d’une tâche de raisonnement fluide). L’importation de ce fichier dans R se réalise par les commandes standards d’importation, adaptées aux formats textuels délimités ou aux sorties propriétaires d’outils d’enquête en ligne :
data_psy <- read.csv("donnees_personnalite_bigfive.csv", header = TRUE, stringsAsFactors = FALSE)
items_actifs <- data_psy[, paste0("V", 1:10)]
5.2 Exploration descriptive et structure de corrélation
Avant d’engager toute procédure de factorisation ou de réduction d’échelle, l’examen scrupuleux de la distribution statistique de chaque item constitue un préalable méthodologique obligatoire. En psychométrie, la non-normalité sévère d’une variable peut affecter la linéarité des associations bivariées et fausser le calcul du coefficient de corrélation produit-moment de Pearson. La fonction describe() du paquetage psych génère un bilan synthétique comprenant la moyenne arithmétique, l’écart-type, la médiane, ainsi que les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) pour chaque descripteur :
describe(items_actifs)
Des indices d’asymétrie excédant la valeur absolue de 2 ou des coefficients d’aplatissement dépassant 7 signalent des distorsions distributionnelles aiguës exigeant soit des transformations non linéaires préventives, soit l’usage de matrices de corrélations polychoriques si les échelles ne comportent qu’un nombre très restreint de modalités ordinales. Dans notre jeu de données normatif, l’ensemble des items manifeste une distribution symétrique unimodale satisfaisante compatible avec les hypothèses de l’ACP.
L’étape exploratoire subséquente consiste à évaluer la structure matricielle d’association à travers le calcul complet de la matrice des corrélations de Pearson :
matrice_corr <- cor(items_actifs, use = "pairwise.complete.obs")
corrplot(matrice_corr, method = "color", type = "upper", order = "hclust", addCoef.col = "black", tl.col = "black", tl.srt = 45)
La commande graphique corrplot ordonnance la matrice selon une classification hiérarchique ascendante (order = "hclust"). Cette ségrégation visuelle permet au psychologue d’observer la formation de blocs homogènes sur la diagonale principale. On repère instantanément des corrélations bivariées très vigoureuses ($r > 0,60$) unissant les paires d’items conceptuellement proches (par exemple $V_1$ avec $V_2$, ou $V_3$ avec $V_4$), tandis que les corrélations inter-blocs demeurent modérées ou faibles. L’émergence manifeste de ces agrégats de covariance annonce la présence d’une structure factorielle sous-jacente bien conditionnée pour la condensation géométrique.
6. Vérification des postulats statistiques et prétraitement des données
6.1 Gestion des données manquantes et valeurs aberrantes
L’intégrité numérique d’une analyse en composantes principales dépend étroitement de la qualité du prétraitement des données. La présence d’observations multivariées aberrantes (outliers) constitue une source majeure de dégradation de la solution factorielle : en raison de la nature géométrique de l’ACP, qui cherche à maximiser les sommes de distances quadratiques au carré, un unique individu atypique situé aux marges extrêmes de l’espace multidimensionnel peut exercer un effet de levier considérable sur l’orientation spatiale des axes principaux, créant une pseudo-composante artificielle qui ne reflète aucunement le comportement global de l’échantillon.
La détection statistique rigoureuse de ces profils multivariés repose sur le calcul de la distance de Mahalanobis ($D^2$) pour chaque participant. Cette distance pondère l’écart quadratique séparant le vecteur de scores individuels du centre de gravité multivarié par l’inverse de la matrice de covariance de l’échantillon, intégrant ainsi la corrélation existant entre les items :
d2_mahalanobis <- mahalanobis(items_actifs, center = colMeans(items_actifs), cov = cov(items_actifs))
seuil_critique <- qchisq(p = 0.999, df = ncol(items_actifs))
individus_aberrants seuil_critique)
Les observations dont la statistique excède la valeur critique issue de la distribution du Chi-deux avec $p$ degrés de liberté au seuil conservateur $\alpha = 0,001$ doivent faire l’objet d’un examen minutieux afin d’identifier d’éventuelles erreurs de saisie ou des patrons de réponses inattentives (par exemple des réponses stéréotypées invariantes), justifiant leur exclusion préalable du corpus actif.
Concernant les données manquantes, le traitement par suppression par liste entière (listwise deletion) induit une réduction drastique de la puissance statistique et peut biaiser l’échantillon si les omissions ne sont pas strictement aléatoires (MCAR). Il est fortement recommandé d’appliquer une imputation par algorithme EM (Expectation-Maximization) ou par imputation multiple à travers des bibliothèques telles que mice avant de procéder à l’extraction factorielle, garantissant une estimation non biaisée des covariances.
6.2 Tests de factorisabilité de la matrice
Toute matrice de données ne se prête pas de manière légitime à une réduction d’échelle. Si les variables mesurées sont parfaitement orthogonales dans la population, la matrice des corrélations empiriques se réduit conceptuellement à une matrice identité $\mathbf{I}_p$ affectée uniquement de fluctuations aléatoires d’échantillonnage. Dans une telle configuration, l’extraction de composantes n’apporte aucune synthèse réelle de l’information. Deux indicateurs statistiques standardisés permettent de valider formellement l’adéquation de la matrice avant tout calcul de réduction :
Le premier test est le test de sphéricité de Bartlett. Il pose l’hypothèse nulle statistique selon laquelle la matrice de corrélation de la population est équivalente à une matrice identité (déterminant $|\mathbf{R}| = 1$). La statistique de test repose sur le déterminant de la matrice empirique et suit asymptotiquement une loi du $\chi^2$ :
cortest.bartlett(matrice_corr, n = nrow(items_actifs))
Un test statistiquement significatif ($p < 0,001$) conduit au rejet péremptoire de l'hypothèse de sphéricité, certifiant que les items partagent une quantité substantielle de covariance autorisant l'agrégation factorielle. Néanmoins, ce test étant extrêmement sensible à l'augmentation de la taille d'échantillon $n$, il doit impérativement être complété par une mesure de la force des corrélations partielles.
Le second critère, le plus déterminant en psychométrie, est l’indice d’adéquation d’échantillonnage de Kaiser-Meyer-Olkin (KMO). Cet indice évalue le ratio entre la somme des carrés des coefficients de corrélation simple et la somme des carrés de ces mêmes corrélations augmentée de la somme des carrés des corrélations partielles (coefficients anti-images). Il s’obtient via la fonction dédiée :
KMO(r = matrice_corr)
L’indice global KMO oscille théoriquement entre 0 et 1. Selon les critères établis par Kaiser en 1974, la factorisabilité est jugée inacceptable en deçà de 0,50, médiocre entre 0,60 et 0,69, satisfaisante entre 0,70 et 0,79, méritoire entre 0,80 et 0,89, et excellente au-delà de 0,90. La fonction fournit également la valeur KMO individuelle propre à chaque variable (Measure of Sampling Adequacy, MSA). Tout item dont le MSA individuel chute en dessous du seuil critique de 0,50 doit être impérativement éliminé de la matrice d’analyse afin de ne pas déstabiliser la structure globale de projection.
6.3 Standardisation et centrage-réduction des variables
Dans la formulation mathématique de l’ACP, le traitement d’échelle des variables brutes conditionne entièrement la structure factorielle résultante. On distingue deux approches fondamentales : l’ACP conduite sur la matrice de covariance non standardisée et l’ACP conduite sur la matrice de corrélation standardisée (variables centrées-réduites à une moyenne nulle et un écart-type unitaire).
Lorsque l’ACP est calculée directement sur la matrice de covariance brute, les variables qui possèdent les variances empiriques les plus étendues dominent mathématiquement la détermination des premiers axes factoriels. Si un chercheur associe dans une même batterie un temps de réaction continu mesuré en millisecondes (dont la variance peut s’élever à plusieurs milliers d’unités) et une échelle clinique bornée entre 1 et 7 (dont la variance excède rarement 2 unités), la première composante principale sera presque entièrement absorbée par le temps de réaction, masquant la contribution informative des autres descripteurs. La réduction d’échelle refléterait alors un simple artéfact d’unité métrique plutôt qu’une réalité psychologique sous-jacente.
Pour neutraliser ces disparités d’unités de mesure et assurer une pondération initiale rigoureusement équitable de l’ensemble des prédicteurs psychologiques, l’opération de centrage-réduction (standardisation Z-score) est impérative :
$$X_{ij}^* = \frac{X_{ij} – \bar{X}_j}{s_j}$$
Le centrage fixe l’origine du repère euclidien directement au centre de gravité multidimensionnel du nuage d’individus, tandis que la division par l’écart-type empirique $s_j$ confère à chaque variable une variance scalaire standardisée égale à 1,0. Dans l’environnement R, cette précaution se configure de manière transparente en transmettant l’argument scale. = TRUE au sein de prcomp() ou scale.unit = TRUE dans FactoMineR::PCA(). L’analyse est alors rigoureusement équivalente à une décomposition spectrale de la matrice des corrélations de Pearson.
7. Exécution pas à pas de l’ACP sous R : code et syntaxe
7.1 Implémentation standard avec prcomp()
La mise en œuvre de l’analyse en composantes principales à l’aide des fonctionnalités natives du cœur statistique de R s’effectue via l’invocation de prcomp(). Cette fonction réclame en entrée la matrice de données ou le tableau de variables numériques actives, assorti du paramétrage explicite du centrage et de la mise à l’échelle :
acp_prcomp <- prcomp(items_actifs, center = TRUE, scale. = TRUE)
L’exécution de cette ligne de code crée instantanément un objet composite de classe prcomp. L’inspection des éléments structuraux internes de cet objet permet de saisir la façon dont R encapsule l’ensemble des grandeurs algébriques produites par la décomposition en valeurs singulières :
acp_prcomp$sdev :Un vecteur contenant les écarts-types des composantes principales extraites, qui correspondent exactement aux racines carrées des valeurs propres ($\sqrt{\lambda_m}$). Le carré de ces valeurs fournit directement la variance capturée par chaque axe.acp_prcomp$rotation :La matrice de passage orthogonale dont les colonnes hébergent les vecteurs propres unitaire ($\mathbf{a}_m$). Ces coefficients représentent les saturations factorielles (ou eigenvectors) qui définissent l’orientation géométrique des nouvelles dimensions.acp_prcomp$center :Le vecteur des moyennes empiriques d’origine de chaque variable ayant servi au centrage barycentrique.acp_prcomp$scale :Le vecteur des écarts-types d’origine ayant servi à la réduction unitaire des descripteurs.acp_prcomp$x :La matrice des coordonnées transformées des participants au sein du nouvel espace orthogonal réduit. Chaque ligne correspond au vecteur des scores factoriels d’un participant sur les différentes composantes.
L’interrogation de l’objet au moyen de la méthode générique summary(acp_prcomp) génère en sortie console un tableau standardisé synthétisant les résultats de l’extraction :
summary(acp_prcomp)
Ce tableau présente, pour chacune des composantes séquentielles (PC1 à PC10 dans notre exemple), l’écart-type associé, la proportion de variance totale expliquée individuellement par l’axe (qui vaut $\lambda_m / p$), ainsi que la proportion cumulative de variance absorbée à mesure que l’on agrège les composantes successives.
7.2 Implémentation approfondie avec FactoMineR::PCA()
Pour le chercheur en sciences sociales, l’extension FactoMineR propose une approche nettement plus intégrée, spécifiquement conçue pour l’analyse multidimensionnelle exploratoire. Sa fonction pivot PCA() prend en charge nativement la séparation entre variables actives (qui déterminent l’espace factoriel) et éléments supplémentaires illustratifs (qui sont projetés a posteriori sans influencer le calcul des axes). En reprenant l’intégralité du jeu de données incluant les descripteurs contextuels, l’appel s’articule comme suit :
acp_factominer <- PCA(data_psy, quanti.sup = 12, quali.sup = 11, scale.unit = TRUE, ncp = 5, graph = FALSE)
L’argument quanti.sup = 12 spécifie que la douzième colonne (le score d’Efficience_Cognitive) est une variable quantitative supplémentaire illustrative. L’argument quali.sup = 11 désigne la onzième colonne (la variable catégorielle Sexe) comme un facteur illustratif. L’argument ncp = 5 ordonne à l’algorithme de ne conserver en mémoire active que les cinq premières dimensions factorielles pour les calculs détaillés de projection, tandis que graph = FALSE désactive la génération immédiate des tracés graphiques standards par défaut.
L’objet structuré issu de PCA() se distingue par une organisation hiérarchique modulaire facilitant l’accès direct aux diagnostics quantitatifs spécialisés :
acp_factominer$eig :Matrice résumant les valeurs propres absolues, le pourcentage de variance expliquée et le pourcentage cumulatif.acp_factominer$var :Liste contenant l’ensemble des métriques associées aux variables actives, subdivisée en coordonnées ($coord), corrélations ($cor), qualités de projection cosinus carré ($cos2) et pourcentages de contribution relative à l’inertie des axes ($contrib).acp_factominer$ind :Liste structurée de façon symétrique pour les observations individuelles, contenant les coordonnées factorielles, les contributions et les indices de cos2 de chaque participant.acp_factominer$quanti.supetacp_factominer$quali.sup :Blocs d’analyse hébergeant les projections, corrélations et tests de valeur-test associés aux éléments contextuels illustratifs.
8. Critères méthodologiques de sélection du nombre optimal de composantes
8.1 Règle de Kaiser-Guttman et pourcentage de variance
L’une des décisions méthodologiques les plus critiques dans la conduite de l’ACP réside dans la détermination de la dimensionalité intrinsèque du modèle : combien de composantes principales faut-il raisonnablement conserver pour décrire l’échantillon sans réintroduire de bruit non interprétable ? Une sous-extraction factorielle compresse excessivement les données et mélange des dimensions conceptuelles distinctes, tandis qu’une sur-extraction fragmente les traits réels et retient des fluctuations d’échantillonnage aléatoires dénuées de signification théorique.
Le critère historique le plus universellement répandu est la règle de Kaiser-Guttman (souvent désignée sous le nom de critère de Kaiser). Ce critère heuristique stipule que seules les composantes associées à une valeur propre strictement supérieure à 1,0 ($\lambda_m > 1,0$) doivent être retenues lorsque l’ACP est effectuée sur une matrice de corrélations standardisées. La justification sous-jacente est intuitive : chaque variable observée apportant initialement une quantité de variance standardisée égale à 1,0, une composante synthétique n’est considérée comme scientifiquement pertinente que si elle parvient à expliquer une variance globale supérieure à celle apportée par un unique item isolé.
Cependant, la littérature méthodologique contemporaine a largement documenté les faiblesses inhérentes à ce critère. Des études de simulation de type Monte-Carlo ont démontré de longue date que la règle de Kaiser tend de manière systématique à sur-estimer le nombre réel de dimensions lorsque le nombre d’items $p$ est modéré à élevé ($p > 30$), ou à sous-estimer ce nombre lorsque l’échantillon est de faible effectif avec de fortes saturations. Il est donc proscrit en recherche académique rigoureuse de se fier exclusivement à cette règle automatique.
En parallèle, les chercheurs examinent la proportion cumulative de variance expliquée. Dans les sciences comportementales, où l’erreur de mesure est substantielle en raison de la nature indirecte des instruments d’évaluation, le consensus méthodologique considère qu’une solution factorielle globale satisfaisante doit atteindre un plancher cumulatif situé entre 60 % et 80 % de la variance totale initiale, bien que ce seuil doive toujours être modulé en fonction de la complexité intrinsèque du domaine psychologique investigué.
8.2 Test du coude de Cattell (Scree Plot)
Pour pallier la rigidité mécanique de la règle de Kaiser, Raymond Cattell a proposé en 1966 une approche diagnostique graphique fondée sur le principe de l’éboulis géologique : le test du coude (scree test). Ce procédé repose sur la représentation graphique ordonnée des valeurs propres en fonction de leur rang séquentiel d’extraction, les points étant reliés par une trajectoire segmentée.
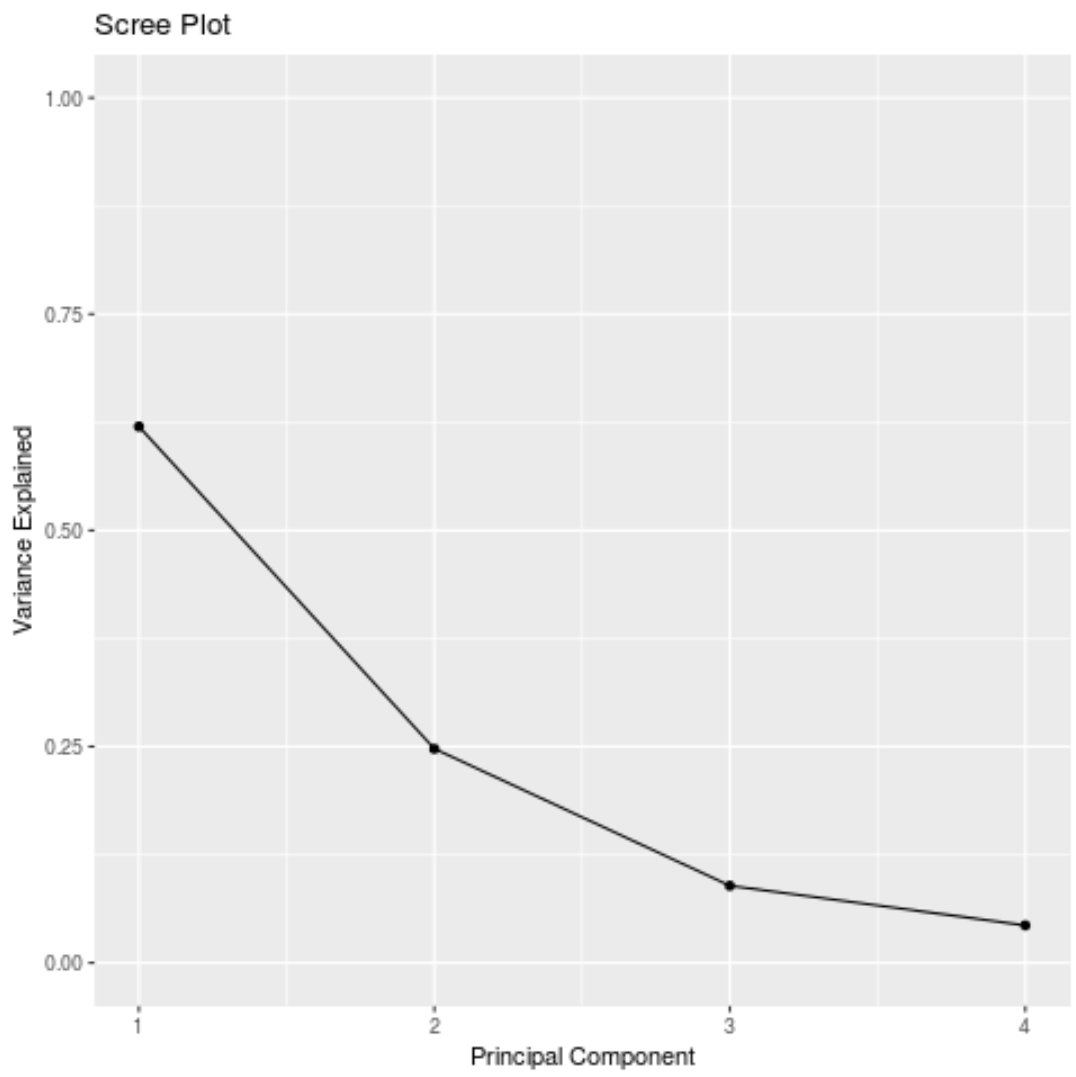
L’interprétation théorique du scree plot repose sur la détection d’une rupture de pente visuelle majeure (le « coude »). La partie initiale abrupte du graphique représente les composantes dominantes structurant le signal psychologique fondamental, tandis que la zone asymptotique droite, où la décroissance des valeurs propres devient linéaire et quasi-horizontale, figure le résidu ou l’éboulis d’erreur aléatoire. Le critère de décision impose d’arrêter l’extraction immédiatement avant le point d’inflexion marquant le début de cette sédimentation uniforme.
La bibliothèque factoextra permet de générer ce diagnostic graphique avec un niveau de clarté optimal grâce à la fonction fviz_eig() :
fviz_eig(acp_factominer, addlabels = TRUE, ylim = c(0, 50), barfill = "#2c3e50", barcolor = "#2c3e50", linecolor = "#e74c3c") + theme_minimal() + labs(title = "Éboulis des valeurs propres (Scree Plot)", x = "Dimensions principales", y = "Pourcentage de variance expliquée")
Bien que le test du coude apporte une flexibilité d’évaluation supérieure au critère de Kaiser, sa lecture conserve une composante subjective indéniable. Lorsque l’éboulis présente plusieurs points d’inflexion successifs ou une pente douce sans décroissance franche, l’accord inter-juges peut se détériorer sensiblement, nécessitant le recours à des critères décisionnels computationnellement indépendants de l’appréciation humaine.
8.3 Analyse parallèle de Horn
Considérée par l’ensemble des statisticiens méthodologistes contemporains comme la procédure empirique la plus fiable pour la détermination du nombre de dimensions, l’analyse parallèle de Horn (1965) neutralise l’impact délétère de l’erreur d’échantillonnage par une approche computationnelle de type simulation.
Le principe théorique repose sur un constat mathématique : même au sein d’une population où les variables sont strictement décorrélées (absence totale de structure factorielle réelle), une analyse en composantes principales menée sur un échantillon aléatoire fini de taille $n$ et de dimension $p$ extraira toujours des valeurs propres supérieures à 1,0 pour les premiers axes en vertu des fluctuations du hasard. L’analyse parallèle simule un grand nombre de matrices de données aléatoires indépendantes possédant exactement les mêmes caractéristiques structurelles que le jeu de données empirique (même effectif $n$, même nombre d’items $p$, et distributions univariées identiques). Les valeurs propres issues de ces simulations aléatoires répétées (généralement 500 ou 1 000 itérations) sont extraites, et leurs valeurs moyennes ou leur 95e centile sont calculés pour chaque rang dimensionnel.
La règle décisionnelle de Horn stipule qu’une composante observée n’est méthodologiquement légitime que si sa valeur propre empirique dépasse strictement la valeur propre correspondante issue de la distribution simulée aléatoire (idéalement au 95e centile pour une sécurité conservatrice). L’implémentation sous R s’exécute de façon intégrée à l’aide de la fonction fa.parallel() du paquetage psych :
analyse_parallele <- fa.parallel(items_actifs, fa = "pc", n.iter = 500, show.legend = TRUE, main = "Analyse parallèle de Horn (ACP vs Matrices Aléatoires)")
Sur le graphique généré en sortie, la courbe des valeurs propres empiriques réelles est directement confrontée à la courbe en pointillés représentant le seuil des données aléatoires. Le nombre d’axes à retenir correspond rigoureusement au nombre de composantes dont la valeur empirique se situe au-dessus de la ligne aléatoire critique. Dans le cadre de notre exemple appliqué au Big Five, cette méthode tranche sans ambiguïté en validant la conservation précise de 5 composantes principales distinctes.
9. Extraction et interprétation substantielle des composantes
9.1 Analyse des saturations factorielles (Loadings)
Une fois le nombre optimal de composantes arrêté, la tâche analytique centrale consiste à décoder la signification substantielle et la portée psychologique des nouvelles dimensions extraites. Cette interprétation s’opère par l’examen minutieux des saturations factorielles (loadings). Dans le cadre d’une ACP standardisée, la saturation $r_{jm}$ représente la corrélation bivariée directe unissant la variable observée $X_j$ et la composante principale $Z_m$. Mathématiquement, elle se déduit du vecteur propre unitaire pondéré par la racine carrée de la valeur propre de l’axe :
$$r_{jm} = \text{Cor}(X_j, Z_m) = a_{jm} \sqrt{\lambda_m}$$
La valeur de ces saturations fluctue à l’intérieur de l’intervalle canonique $[-1,0 ; +1,0]$. Une saturation proche de zéro indique que la variable manifeste n’entretient aucune affinité géométrique ou linéaire avec l’axe considéré, tandis qu’une valeur avoisinant les pôles signale une dépendance étroite. En pratique psychométrique, un item est traditionnellement considéré comme un descripteur cardinal d’une composante lorsque sa saturation dépasse le seuil absolu de $|r| ge 0,50$ ou $0,60$, traduisant le fait que plus d’un quart à un tiers de sa variance propre est mobilisé par ladite composante.
Pour extraire et formater la matrice complète des saturations avec R, on peut interroger l’objet de FactoMineR :
saturations <- acp_factominer$var$coord[, 1:5]
round(saturations, 3)
Dans certaines configurations complexes où de multiples variables manifestent des saturations croisées intermédiaires sur plusieurs dimensions simultanées (ce qui obscurcit la structure simple de Thurstone), les praticiens ont parfois recours à des techniques de rotation géométrique orthogonale (telle que la procédure Varimax de Kaiser) ou oblique (Promax, Oblimin). Il convient néanmoins de souligner avec fermeté une vérité mathématique : l’application d’une rotation modifie la répartition de l’inertie entre les axes et brise l’orthogonalité stricte séquentielle de l’ACP d’origine (dans le cas des rotations obliques). Si la visée prioritaire est la recherche d’une structure factorielle causale simple, l’usage de l’analyse factorielle exploratoire couplée à une rotation oblique est formellement plus orthodoxe sur le plan théorique que la rotation artificielle de composantes principales.
9.2 Qualité de représentation (Cos2) et contribution des variables
L’évaluation rigoureuse de la projection des items au sein du nouvel espace géométrique restreint impose d’examiner deux indices quantitatifs complémentaires fournis par le formalisme de l’analyse des données : la qualité de représentation spatiale ($\cos^2$) et la contribution relative à l’inertie dimensionnelle ($contrib$).
Le cosinus carré ($\cos^2$) mesure la proportion de la variance d’une variable spécifique qui est effectivement captée et restituée par un axe factoriel particulier (ou par un plan dimensionnel conjoint). Géométriquement, il correspond au carré du cosinus de l’angle vectoriel formé entre le vecteur d’origine de la variable et sa projection orthogonale sur l’axe. Dans une ACP sur variables standardisées, le $\cos^2$ pour la variable $j$ sur l’axe $m$ équivaut simplement au carré de la corrélation :
$$\cos^2_{jm} = r_{jm}^2 = (a_{jm} \sqrt{\lambda_m})^2$$
La somme des $\cos^2$ d’un item sur l’ensemble des dimensions retenues dans le modèle réduit mesure la qualité globale de sa reconstitution dans le sous-espace. Un item dont le $\sum \cos^2$ sur les axes conservés est particulièrement faible (par exemple inférieur à 0,40) doit être appréhendé avec une prudence critique extrême : ses relations apparentes sur les graphiques factoriels relèvent d’une illusion géométrique d’écrasement de perspective, l’item évoluant en réalité dans des dimensions résiduelles orthogonales non retenues par le chercheur.
La contribution ($contrib$), quant à elle, mesure la part de responsabilité relative qu’exerce une variable donnée dans la construction géométrique de la variance d’un axe principal défini. Elle s’exprime sous forme de pourcentage et se calcule comme le ratio entre la variance captée par cette variable sur l’axe et l’inertie globale totale de cet axe ($\lambda_m$) :
$$\text{Contrib}_{jm} = \frac{r_{jm}^2}{\lambda_m} \times 100$$
Puisque chaque axe représente une inertie totale égale à sa valeur propre, la somme des contributions de l’ensemble des $p$ variables pour un axe donné est rigoureusement égale à 100 %. En situation d’équi-répartition théorique parfaite, chaque variable contribuerait à hauteur d’un seuil moyen de $100 / p$ % (soit 10 % dans notre modèle à 10 items). Tout descripteur dont la contribution excède ce seuil théorique de référence est considéré comme un pôle structurant moteur de la composante.
L’affichage analytique et graphique de ces deux métriques s’opère aisément sous R via factoextra :
fviz_cos2(acp_factominer, choice = "var", axes = 1:2, fill = "#3498db")
fviz_contrib(acp_factominer, choice = "var", axes = 1, fill = "#e67e22")
10. Visualisation graphique avancée des résultats psychométriques
10.1 Cercle des corrélations des variables
Le cercle des corrélations constitue la représentation iconique de l’analyse en composantes principales appliquée à des variables standardisées. Projetées à l’intérieur d’un repère cartésien borné par un cercle trigonométrique unitaire de rayon 1,0, les variables sont matérialisées sous la forme de flèches vectorielles émergeant du centre d’origine $(0, 0)$.
La lecture analytique de ce graphe répond à des propriétés trigonométriques précises :
- Longueur du vecteur : La longueur d’une flèche vectorielle reflète la qualité de sa représentation dans le plan factoriel bidimensionnel affiché. Plus l’extrémité de la flèche s’approche de la circonférence du cercle unitaire, plus son $\cos^2$ cumulé est élevé, garantissant que la variable s’inscrit fidèlement dans le plan factoriel considéré. À l’inverse, une flèche très courte signale une variable mal représentée, dont la dynamique principale se situe sur d’autres axes non affichés.
- Angle entre deux vecteurs : Le cosinus de l’angle formé par deux flèches vectorielles approche la corrélation linéaire de Pearson existant entre ces deux items. Un angle aigu très étroit ($< 30^circ$) indique une forte corrélation positive ($r to +1$). Un angle droit ($90^circ$) signale une absence de corrélation linéaire empirique ($r to 0$, orthogonalité). Enfin, un angle plat ($180^circ$, vecteurs diamétralement opposés) traduit une relation linéaire négative inverse robuste ($r to -1$).
La fonction fviz_pca_var() permet une personnalisation esthétique approfondie en modulant la pigmentation chromatique des vecteurs selon leur qualité de représentation spatiale ($\cos^2$) ou leur intensité contributive :
fviz_pca_var(acp_factominer, col.var = "cos2", gradient.cols = c("#00AFBB", "#E7B800", "#FC4E07"), repel = TRUE) + theme_minimal() + labs(title = "Cercle des corrélations - Items psychométriques", color = "Qualité (Cos2)")
L’argument repel = TRUE est crucial dans les études psychologiques comportant un grand nombre de mesures : il mobilise un algorithme de positionnement dynamique évitant le chevauchement typographique des étiquettes de texte, garantissant une lisibilité optimale indispensable pour l’insertion documentaire dans des revues académiques.
10.2 Projection du nuage des individus et cartes factorielles
De manière complémentaire au cercle des variables, l’ACP génère la cartographie factorielle des participants. Chaque sujet de l’échantillon est positionné dans le nouvel espace bidimensionnel selon ses scores factoriels factorisés sur les axes retenus. Cette projection offre une synthèse visuelle instantanée de l’hétérogénéité morphologique de l’échantillon, permettant d’identifier immédiatement la dispersion typologique, les grappes naturelles d’individus et les trajectoires comportementales divergentes.
Le tracé des coordonnées des individus s’obtient par la commande standard :
fviz_pca_ind(acp_factominer, geom.ind = "point", pointsize = 2, col.ind = "#2c3e50", alpha.ind = 0.6) + theme_minimal() + labs(title = "Carte factorielle des participants (Plan 1-2)", x = "Composante 1", y = "Composante 2")
La véritable puissance analytique de la cartographie individuelle émerge lors de l’intégration des variables supplémentaires contextuelles. L’affichage de sous-groupes cliniques ou sociodémographiques permet d’évaluer la validité convergente de la solution factorielle. Par exemple, la stratification du nuage des individus selon la variable illustrative catégorielle Sexe, assortie du calcul d’ellipses de concentration de confiance statistique bivariée à 95 %, s’opère par la configuration suivante :
fviz_pca_ind(acp_factominer, geom.ind = "point", habillage = 11, addEllipses = TRUE, ellipse.level = 0.95, palette = c("#e74c3c", "#3498db"), repel = TRUE) + theme_minimal() + labs(title = "Stratification des scores psychologiques selon le Sexe")
Cette visualisation permet de diagnostiquer instantanément si un groupe de participants occupe une région polarisée de l’espace factoriel, indiquant une divergence systématique sur les composantes de personnalité sous-jacentes.
10.3 Construction et lecture rigoureuse du biplot
Le biplot factoriel représente le dispositif visuel intégrateur ultime de l’analyse en composantes principales, fondé sur les travaux initiaux de Ruben Gabriel en 1971. Cette représentation superpose simultanément sur une unique grille cartésienne le nuage des coordonnées individuelles des participants et les vecteurs directeurs des variables observées.
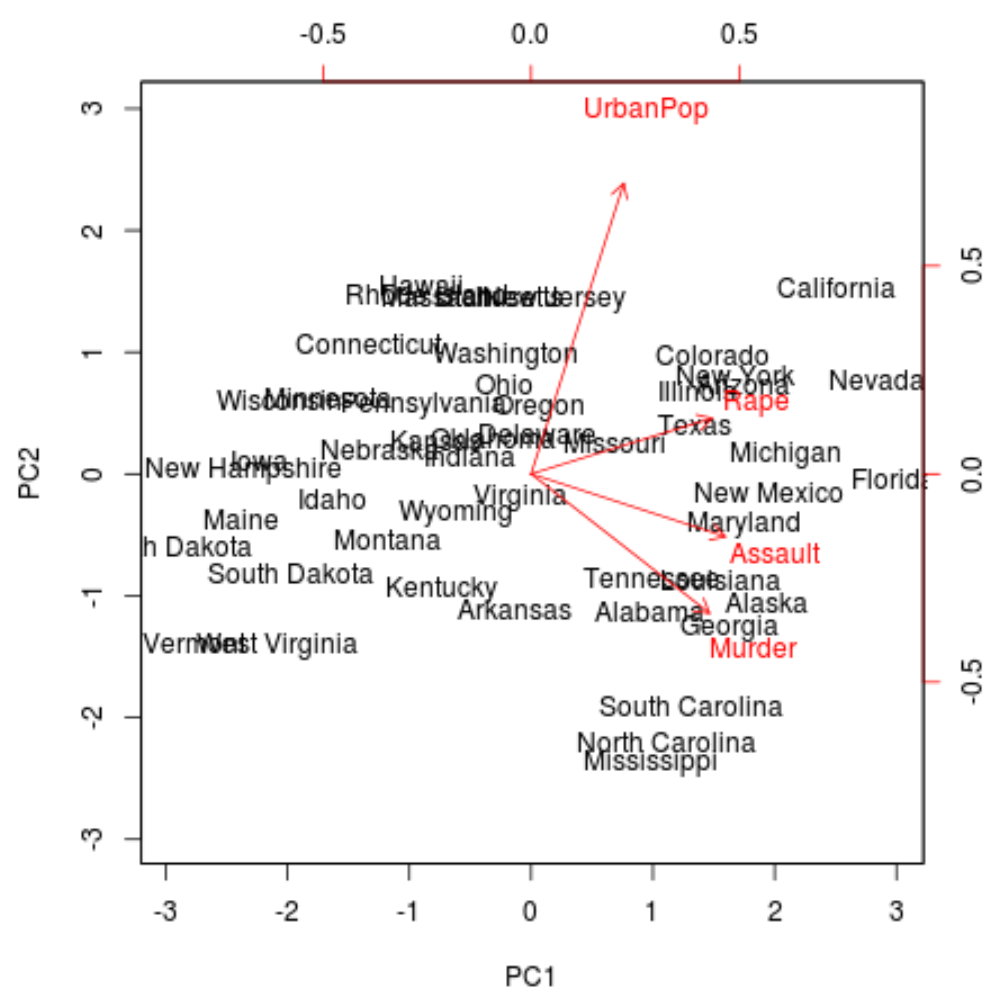
La lecture méthodologique d’un biplot exige une rigueur théorique absolue afin d’éviter des confusions d’interprétation fréquentes. Il est fondamental de rappeler que les points (individus) et les flèches (variables) n’évoluent pas dans des espaces scalaires directement superposables : ils sont tracés dans des métriques interdépendantes. La position spatiale d’un individu par rapport à un vecteur variable indique son profil relatif : projeter orthogonalement le point d’un participant sur la ligne directrice prolongée d’une flèche vectorielle permet d’estimer directement si ce participant obtient un score standardisé supérieur, égal ou inférieur à la moyenne générale de l’échantillon sur cette variable spécifique.
La génération d’un biplot publiable, conforme aux standards de restitution graphique de l’American Psychological Association (APA), se réalise avec fviz_pca_biplot() :
fviz_pca_biplot(acp_factominer, axes = c(1, 2), col.ind = "grey70", col.var = "#c0392b", label = "var", repel = TRUE, alpha.ind = 0.5) + theme_classic() + labs(title = "Biplot ACP : Variables de personnalité et participants", x = "Dimension 1 : Réactivité Émotionnelle", y = "Dimension 2 : Engagement Social")
Afin de préserver la lisibilité de la figure face à des échantillons volumineux, l’argument label = "var" désactive l’affichage individuel des identifiants des participants, ne conservant que les labels textuels associés aux vecteurs des items, tandis que la transparence optique (alpha.ind = 0.5) prévient la saturation visuelle induite par les superpositions de points centraux.
11. Exploitation des scores factoriels dans les analyses prédictives
11.1 Extraction et stockage des scores individuels
L’une des plus-values cardinales de l’analyse en composantes principales réside dans sa capacité à transformer un tableau lourd de variables colinéaires en un ensemble compact d’indices métriques utilisables dans des protocoles inférentiels ultérieurs. Contrairement à l’analyse factorielle exploratoire, où les scores factoriels des sujets souffrent d’une indétermination mathématique inhérente (les scores ne pouvant être qu’estimés de façon probabiliste par régression ou méthode de Bartlett), les scores de composantes de l’ACP sont rigoureusement déterministes et exacts.
Chaque score individuel correspond simplement au calcul arithmétique de la combinaison linéaire des valeurs centrées-réduites du participant multipliées par les pondérations unitaires ($a_{jm}$). L’extraction de ces coordonnées et leur réintégration au sein de la base de données de recherche s’effectuent sans aucune ambiguïté :
scores_individus <- as.data.frame(acp_prcomp$x[, 1:5])
colnames(scores_individus) <- paste0("Score_Composante_", 1:5)
donnees_completes <- cbind(data_psy, scores_individus)
Par construction mathématique, ces nouveaux scores composites possèdent une moyenne empirique rigoureusement nulle ($\mu = 0$). Leurs variances sont directement égales aux valeurs propres de leurs axes respectifs ($\text{Var}(\text{PC}_m) = \lambda_m$) lorsque l’extraction provient de prcomp(). Si le protocole expérimental requiert des scores composites strictement réduits à une variance unitaire unifiée pour des modélisations standardisées, il suffit d’opérer la division scalaire systématique par l’écart-type de chaque composante ($\sqrt{\lambda_m}$) :
scores_standardises <- scale(scores_individus)
Ces indices composites synthétisent l’information comportementale des participants avec une perte minimale de fidélité empirique et peuvent être immédiatement sauvegardés pour des études de cohortes longitudinales ou intégrés dans des modèles d’équations structurelles.
11.2 Résolution des problèmes de multicollinéarité en régression
Dans la recherche empirique, la présence d’une multicolinéarité sévère entre prédicteurs comportementaux fragilise dramatiquement les analyses de régression linéaire multiple ou logistique. Lorsque des items étroitement corrélés sont introduits simultanément pour prédire un critère clinique ou cognitif externe, la matrice $(\mathbf{X}^T \mathbf{X})$ approche de la singularité. Cette déstabilisation numérique gonfle de manière disproportionnée les facteurs d’inflation de la variance (VIF), élargit artificiellement les intervalles de confiance des coefficients $\beta$ et induit des inversions de signes contre-intuitives, rendant toute interprétation étiologique erronée.
La régression sur composantes principales (Principal Component Regression ou PCR) résout définitivement cette contrainte mathématique. En substituant aux prédicteurs initiaux hautement corrélés les composantes principales extraites, le statisticien garantit par construction que la covariance mutuelle entre chaque terme régresseur est strictement nulle :
$$\text{Cov}(\text{Score}_m, \text{Score}_k) = 0 \quad (\forall m \neq k)$$
En conséquence absolue, les facteurs d’inflation de la variance de l’ensemble des prédicteurs régressés tombent tous rigoureusement à leur plancher théorique parfait :
$$\text{VIF}_m = \frac{1}{1 – R_m^2} = \frac{1}{1 – 0} = 1,00$$
L’implémentation pratique de ce modèle de régression sous R pour prédire une variable clinique continue (par exemple, un indice d’adaptation psychosociale noté Score_Adaptation) s’écrit de manière très fluide :
modele_pcr <- lm(Score_Adaptation ~ Score_Composante_1 + Score_Composante_2 + Score_Composante_3, data = donnees_completes)
summary(modele_pcr)
Chaque coefficient de régression estimé $\beta_m$ reflète désormais l’effet unique et totalement indépendant de la dimension synthétique associée, isolé de toute interférence colinéaire parasite. Cette isolation orthogonale garantit une additivité parfaite de la variance expliquée : le coefficient de détermination global ($R^2$) du modèle équivaut exactement à la somme arithmétique directe des coefficients de corrélation semi-partielle au carré unissant chaque composante individuelle au critère d’intérêt.
12. Bonnes pratiques de publication académique et écueils méthodologiques
12.1 Normes de rapport statistique selon l’APA
La communication scientifique des résultats d’une analyse en composantes principales dans les revues arbitrées par les pairs exige la conformité la plus scrupuleuse aux standards de reporting établis par le manuel de style de l’American Psychological Association (7e édition). Trop souvent, des manuscrits soumis omettent des informations métriques primordiales, compromettant l’évaluation critique par les relecteurs et empêchant toute méta-analyse ultérieure.
Le corps textuel de la section Méthode ou Résultats doit obligatoirement expliciter de façon chronologique :
- La justification théorique du choix de l’ACP au détriment de l’AFE en lien avec les objectifs poursuivis (réduction descriptive versus modélisation causale latente).
- L’exhaustivité des procédures de nettoyage préalable (détection d’outliers multivariés via Mahalanobis, nature et traitement des données manquantes).
- Les résultats chiffrés des diagnostics formels de factorisabilité : la valeur globale de l’indice KMO (ainsi que la fourchette des indices individuels MSA) et la statistique complète du test de sphéricité de Bartlett ($\chi^2$, degrés de liberté, niveau d’exactitude $p$).
- L’exposé des critères de rétention dimensionnelle appliqués, en privilégiant l’analyse parallèle de Horn et en confrontant ses conclusions à celles du scree plot de Cattell et de la règle de Kaiser.
- La mention systématique des versions logicielles mobilisées et des paquetages R spécifiques (avec citations explicites des auteurs pour FactoMineR, factoextra et psych) pour garantir la reproductibilité computationnelle du script de recherche.
Sur le plan iconographique et tabulaire, un tableau synthétique normé s’impose impérativement. Ce tableau doit documenter, pour l’ensemble des items observés, les saturations factorielles complètes sur chaque dimension retenue, les communautés ou cosinus carrés cumulés, ainsi que la valeur propre ($lambda$) et le pourcentage de variance expliquée (individuel et cumulatif) au bas de chaque colonne factorielle. Les saturations dominantes caractérisant sémantiquement l’axe sont traditionnellement mises en valeur en caractères gras pour faciliter la lecture transversale de la topographie factorielle.
12.2 Erreurs fréquentes à proscrire dans l’analyse de données psychologiques
L’évaluation rigoureuse de la littérature psychologique met en lumière plusieurs écueils méthodologiques récurrents qu’il convient de proscrire formellement :
L’omission de la standardisation face à des échelles hétérogènes : Omettre de renseigner scale. = TRUE au sein de prcomp() lorsque les indicateurs présentent des étendues métriques ou des variances divergentes constitue une erreur élémentaire destructrice. Une telle omission subordonne l’orientation factorielle aux seules unités scalaires arbitraires, privant la solution de toute validité de construit psychologique.
La confusion sémantique entre composantes et facteurs latents : Il est formellement erroné d’écrire dans un article que l’ACP a permis de révéler des « facteurs psychologiques latents causant les réponses ». L’ACP est une sommation descendante descriptive de variables manifestes. Désigner une composante comme une entité causale latente constitue un glissement conceptuel invalide. Si l’objectif théorique est d’isoler un construit latent pur débarrassé de l’erreur de mesure, seule l’analyse factorielle exploratoire ou confirmatoire est légitime.
L’interprétation d’axes situés sous le bruit d’échantillonnage : Tenter d’attribuer une signification psychologique sophistiquée à une composante expliquant une fraction marginale de variance (par exemple moins de 5 % d’inertie) et rejetée par l’analyse parallèle constitue une forme grave de sur-interprétation du bruit statistique aléatoire. Les régularités observées sur ces dimensions terminales ne sont jamais réplicables d’un échantillon à un autre.
La généralisation hâtive de la structure factorielle : Une structure de composantes principales n’est rigoureusement valable que pour la population et les conditions de recueil spécifiques dont l’échantillon d’étalonnage est issu. Décréter qu’une structure factorielle dérivée chez des étudiants occidentaux est universelle sans procéder à des analyses d’invariance de mesure trans-groupes (équivalence configurationnelle, métrique et scalaire) au sein d’échantillons de validation croisée indépendants constitue une violation majeure des principes de la psychométrie contemporaine.
Références
- Cattell, R. B. (1966). The scree test for the number of factors. Multivariate Behavioral Research, 1(2), 245–276. https://doi.org/10.1207/s15327906mbr0102_10
- Gabriel, K. R. (1971). The biplot graphic display of matrices with application to principal component analysis. Biometrika, 58(3), 453–467. https://doi.org/10.1093/biomet/58.3.453
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Hotelling, H. (1933). Analysis of a complex of statistical variables into principal components. Journal of Educational Psychology, 24(6), 417–441. https://doi.org/10.1037/h0071325
- Husson, F., Lê, S., & Pagès, J. (2017). Exploratory Multivariate Analysis by Example Using R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/b21874
- Kaiser, H. F. (1974). An index of factorial simplicity. Psychometrika, 39(1), 31–36. https://doi.org/10.1007/BF02291575
- Kassambara, A. (2017). Practical Guide to Principal Component Methods in R. STHDA. http://www.sthda.com/english/articles/31-principal-component-methods-in-r-practical-guide/
- McCrae, R. R., & Costa, P. T. (1987). Validation of the five-factor model of personality across instruments and observers. Journal of Personality and Social Psychology, 52(1), 81–90. https://doi.org/10.1037/0022-3514.52.1.81
- Pearson, K. (1901). On lines and planes of closest fit to systems of points in space. Philosophical Magazine, 2(11), 559–572. https://doi.org/10.1080/14786440109462720
- Revelle, W. (2023). psych: Procedures for Personality and Psychological Research. Northwestern University, Evanston, Illinois. https://CRAN.R-project.org/package=psych
- Widaman, K. F. (1993). Common factor analysis versus principal component analysis: Differential bias in representing model parameters? Multivariate Behavioral Research, 28(3), 263–311. https://doi.org/10.1207/s15327906mbr2803_1