
Dans le vaste champ de la méthodologie de recherche en sciences humaines et comportementales, peu de questions méthodologiques élémentaires suscitent autant de débats récurrents, d’hésitations pédagogiques et de confusions conceptuelles que la classification métrique de l’âge chronologique. Présent dans la quasi-totalité des protocoles expérimentaux, des enquêtes épidémiologiques et des devis corrélationnels en psychologie du développement ou en neuropsychologie, l’âge apparaît à première vue comme une donnée empirique d’une simplicité désarmante. Pourtant, dès lors qu’il s’agit de formaliser sa nature mathématique dans le cadre de la théorie de la mesure, les avis des étudiants, des chercheurs et même de certains manuels d’introduction à la statistique appliquée se polarisent fréquemment entre deux catégories fondamentales : l’échelle d’intervalle et l’échelle de rapport (souvent désignée sous le terme anglophone d’échelle de ratio).
Cette hésitation n’est pas une simple querelle byzantine de sémantique statistique. La qualification d’une variable au sein d’un niveau d’échelle précis détermine directement l’éventail des opérations arithmétiques autorisées, la validité des indices de tendance centrale et de dispersion calculés, ainsi que la légitimité théorique des inférences statistiques paramétriques qui en découlent. Traiter abusivement une variable d’intervalle comme une variable de rapport conduit à des contresens épistémologiques majeurs, tandis que reléguer une authentique variable de rapport au rang d’une simple échelle d’intervalle prive l’analyste d’outils statistiques puissants, tels que le calcul des ratios, l’emploi de la moyenne géométrique ou encore l’évaluation du coefficient de variation standardisé.
L’objectif de cet article de référence est de trancher définitivement cette controverse métrologique en fournissant une démonstration théorique, mathématique et empirique exhaustive. En mobilisant le cadre classique de la taxonomie des échelles de mesure proposé par Stanley Smith Stevens, nous analyserons en profondeur les caractéristiques intrinsèques de l’âge chronologique, examinerons ses divergences structurelles avec les échelles d’intervalle emblématiques (comme la température Celsius ou les quotients intellectuels), explorerons les conséquences de ses manipulations méthodologiques courantes (centrage, standardisation, discrétisation en cohortes) et détaillerons les bonnes pratiques d’analyse statistique requises dans la recherche contemporaine de haut niveau.
1. 1. Introduction théorique : La taxonomie des échelles de mesure de Stevens en psychologie
1.1 Origine et portée de la classification de Stanley Smith Stevens (1946)
Pour appréhender avec exactitude la nature métrique de l’âge, il est indispensable de replacer le débat dans sa matrice historique et épistémologique originelle : la publication de l’article fondateur de Stanley Smith Stevens dans la revue Science en 1946, intitulé « On the Theory of Scales of Measurement ». Dans les décennies 1930 et 1940, la psychologie scientifique naissante, et plus particulièrement la psychophysique, faisait face à une crise de légitimité majeure orchestrée par les physiciens et les membres de la British Association for the Advancement of Science (notamment le comité Ferguson). Ces derniers contestaient formellement le statut de science quantitative à la psychologie, arguant que les sensations humaines (telles que l’intensité perçue d’un son ou d’une luminosité) ne pouvaient être additionnées au sens physique classique, à l’image des masses ou des longueurs régies par les postulats d’additivité de Hölder et de Campbell.
Face à cet écueil épistémologique qui menaçait de reléguer les mesures psychologiques au statut de simples approximations qualitatives, Stevens proposa une redéfinition révolutionnaire de la mesure. Pour le psychologue de Harvard, mesurer ne consiste pas uniquement à concaténer des étalons matériels fondamentaux, mais à « assigner des nombres à des objets ou à des événements selon des règles déterminées » (« assignment of numerals to objects or events according to rules »). Cette extension conceptuelle a permis de formaliser l’idée qu’il n’existe pas une forme unique de mesure, mais une gradation de structures métriques distinctes, chacune définie par un ensemble d’invariances sous un groupe particulier de transformations mathématiques. La portée de ce cadre théorique a dépassé très largement la psychophysique pour devenir le socle normatif universel de la méthodologie quantitative en psychologie, en sociologie, en biométrie et en sciences de l’éducation.
La puissance du modèle de Stevens réside dans sa structure hiérarchique cumulative. À chaque palier d’échelle correspondent des propriétés formelles spécifiques que sont l’identité (discrimination qualitative), l’ordre (ordonnancement directionnel), la distance (égalité métrique des intervalles) et l’origine (présence d’un point zéro non arbitraire). Dès lors qu’un niveau supérieur est atteint, il hérite intégralement des prérogatives formelles des niveaux inférieurs tout en y adjoignant une contrainte mathématique supplémentaire qui restreint le groupe des transformations admissibles. Cette formalisation conditionne de manière directe la validité des énoncés empiriques : une conclusion statistique n’est scientifiquement recevable que si elle demeure invariante face aux transformations admises par l’échelle sur laquelle repose la variable analysée.
1.2 Vue d’ensemble des quatre niveaux de mesure canoniques
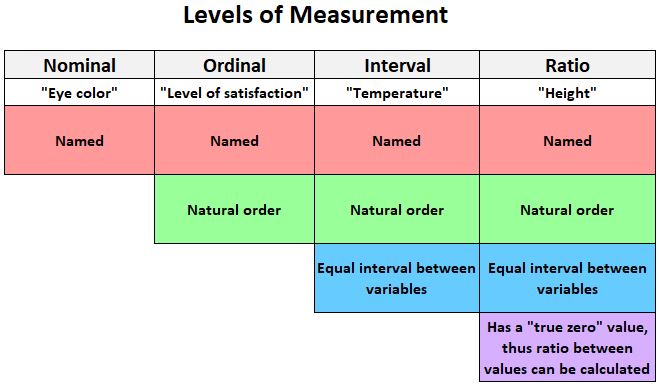
La hiérarchie classique de Stevens se décline en quatre niveaux canoniques ordonnés selon leur degré de sophistication métrique : nominal, ordinal, d’intervalle et de rapport. Au niveau le plus élémentaire, l’échelle nominale repose exclusivement sur la propriété d’identité. Les nombres ou symboles n’y sont assignés qu’à titre d’étiquettes typologiques destinées à classifier des entités au sein de sous-ensembles mutuellement exclusifs et exhaustivement collectifs. Les seules relations formelles permises sont l’équivalence ($A = B$) et la non-équivalence ($A \neq B$). Aucune relation de grandeur, de transitivité directionnelle ou de métrique sous-jacente n’est définie. Toute transformation biunivoque (permutation univoque) préserve la structure de l’information. En psychologie, les variables telles que le diagnostic nosologique selon le DSM, le groupe d’appartenance ethnique ou le statut expérimental (condition témoin versus condition traitée) relèvent rigoureusement de ce registre.
L’échelle ordinale introduit pour sa part la propriété d’ordre directionnel. Les valeurs attribuées permettent d’établir une hiérarchie stricte ou sériation entre les observations selon la relation « plus grand que », « plus petit que » ou « égal à » ($A > B > C$). Cependant, l’échelle ordinale ne possède aucune métrique métrologique constante : la distance séparant le premier du deuxième individu ne garantit en rien une magnitude égale à celle séparant le deuxième du troisième. Les données ordinales sont invariantes sous toute transformation monotone strictement croissante $y = f(x)$. Les échelles de Likert typiques des questionnaires d’attitudes, les rangs scolaires ou encore les stades de développement cognitif de Jean Piaget illustrent parfaitement ce niveau : on peut affirmer qu’un enfant au stade des opérations formelles a franchi une étape ultérieure par rapport à un enfant au stade préopératoire, sans que la distance cognitive entre les deux stades puisse être mesurée en unités égales fixes.
L’échelle d’intervalle franchit un cap qualitatif déterminant en introduisant la métrique d’égalité des intervalles. Dans une telle échelle, non seulement l’ordre des entités est connu, mais la distance numérique qui sépare deux unités consécutives possède une signification quantitative rigoureusement identique sur l’ensemble du continuum (l’écart entre 10 et 20 est équivalent à l’écart entre 80 et 90). Toutefois, l’échelle d’intervalle se caractérise par l’absence d’un point d’origine absolu : son point zéro est conventionnel, fixé arbitrairement par le concepteur de l’outil de mesure. L’échelle est invariante sous les transformations affines positives de forme $y = ax + b$ (avec $a > 0$). Les scores standardisés aux tests d’intelligence ou la température mesurée en degrés Celsius en constituent les archétypes les plus documentés.
Enfin, l’échelle de rapport (ou échelle de ratio) représente l’aboutissement métrologique de la taxonomie. Elle conserve la totalité des attributs des échelles précédentes (identité, sériation ordinale, constance des intervalles) tout en y adjoignant une caractéristique cruciale : un zéro absolu, naturel et non arbitraire, correspondant à l’absence totale et fondamentale de la dimension physique ou temporelle mesurée. En raison de cette origine absolue, l’échelle de rapport n’est invariante que sous le groupe très restreint des transformations par similitude géométrique de type $y = ax$ (avec $a > 0$). Cela signifie que seule l’unité de mesure peut être modifiée arbitrairement, le zéro demeurant intangible. Ce niveau est le seul qui autorise mathématiquement l’énoncé de ratios ou de proportions directes (affirmer qu’une valeur est le « double » ou le « tiers » d’une autre), propriété fondamentale qui s’applique à la masse, à la longueur, au temps de réaction, et, comme nous le démontrerons formellement, à l’âge chronologique.
1.3 La pertinence singulière de la mesure de l’âge en sciences psychologiques
Au sein des sciences psychologiques, l’âge chronologique n’est pas une simple variable descriptive reléguée aux tableaux récapitulatifs des caractéristiques sociodémographiques d’une cohorte d’étude. Il constitue l’axe organisateur primordial de la psychologie du développement sur l’ensemble de l’arc de la vie (life-span development), de l’embryogenèse cognitive du nourrisson jusqu’aux trajectoires de déclin neurocognitif associées à la sénescence et aux démences neurodégénératives. Qu’il serve de variable indépendante principale dans les études quasi-expérimentales, de covariable d’ajustement dans les modèles linéaires généraux ou d’index temporel structurant dans les analyses de courbes de croissance latentes, l’âge est ubiquitaire.
Néanmoins, une ambiguïté persistante traverse la littérature spécialisée et les cursus universitaires quant à la classification exacte de l’âge. Nombre d’étudiants, et parfois de chercheurs chevronnés, hésitent lorsqu’il s’agit d’assigner l’âge à l’échelle d’intervalle ou à l’échelle de rapport. Ce dilemme découle principalement d’une confusion entre la nature temporelle sous-jacente de la variable et les modes pragmatiques de son recueil empirique dans les protocoles de recherche. Lorsque l’âge est collecté sous forme d’années révolues entières, ou qu’il est découpé a posteriori en catégories fermées pour les besoins d’une analyse de variance (ANOVA factorielle), l’illusion d’une échelle discontinue ou purement ordinale peut émerger dans l’esprit de l’analyste.
Cette hésitation théorique emporte des conséquences considérables sur la validité interne et externe des conclusions scientifiques. La décision de considérer l’âge comme une variable d’intervalle ou de rapport influence le choix entre des statistiques paramétriques de haute puissance et des alternatives non paramétriques plus conservatrices. Elle conditionne la légitimité de transformations mathématiques non linéaires indispensables, comme la modélisation logarithmique du temps de réaction en fonction de l’âge ou le recours au coefficient de variation pour comparer la variabilité interindividuelle entre différentes tranches de vie. Clarifier la nature métrologique de l’âge s’impose donc comme un impératif méthodologique de premier ordre pour garantir la rigueur de l’inférence en psychologie scientifique.
2. 2. Définitions approfondies : Les échelles d’intervalle versus les échelles de rapport
2.1 Caractéristiques structurales de l’échelle d’intervalle
L’architecture formelle d’une échelle d’intervalle repose sur le postulat fondamental de l’équidistance unitaire. Cela signifie qu’une unité de mesure déterminée conserve une valeur quantitative identique quel que soit le niveau où l’on se situe sur le continuum considéré. Mathématiquement, pour quatre points ordonnés $x_1 < x_2 < x_3 < x_4$, si l'égalité $x_2 – x_1 = x_4 – x_3$ est vérifiée, alors la différence psychologique ou physique sous-jacente séparant les deux premières observations est rigoureusement équivalente à la différence séparant les deux dernières. Cette propriété confère une interprétabilité directe aux différences brutes, permettant le calcul d'opérations d'addition et de soustraction entre les scores.
Cependant, l’élément distinctif et limitant de l’échelle d’intervalle réside dans l’absence d’une ancre d’origine absolue : son zéro est par essence relatif, fixé par pure commodité méthodologique ou convention culturelle. Par conséquent, la position de la valeur numérique « 0 » ne coïncide aucunement avec le néant ou l’extinction complète du phénomène sous-jacent. L’invariance de cette échelle sous les transformations affines de forme :
$$y = ax + b \quad \text{a\vec } a > 0 \text{ et } b in \mathbb{R}$$
démontre formellement cette contingence. Le paramètre multiplicatif $a$ modifie l’amplitude de l’unité de mesure (facteur d’échelle), tandis que le paramètre additif $b$ décale l’origine de manière totalement arbitraire. Cette liberté d’adjonction de la constante $b$ interdit toute interprétation en termes de proportionnalité directe. Si une échelle admet un décalage d’origine arbitraire, le rapport entre deux mesures :
$$\frac{y_1}{y_2} = \frac{ax_1 + b}{ax_2 + b}$$
n’est pas constant et dépend entièrement de la valeur choisie pour $b$. Ainsi, affirmer au sein d’une échelle d’intervalle qu’une entité possède « deux fois plus » de l’attribut mesuré qu’une autre constitue une erreur mathématique caractérisée, car ce ratio s’effondre instantanément dès lors que l’on applique une transformation affine légitime en modifiant l’origine de l’échelle.
2.2 Caractéristiques structurales de l’échelle de rapport (ou de ratio)
L’échelle de rapport représente le sommet de l’édifice taxinomique de Stevens en intégrant l’ensemble des contraintes formelles des échelles subordonnées, tout en supprimant l’arbitraire du point d’origine. Dans une échelle de rapport, le point zéro n’est ni négociable ni contextuel : il s’agit d’un zéro absolu, naturel et universel. Il représente l’état d’absence totale et indépassable de l’entité physique, spatiale, matérielle ou temporelle évaluée. L’existence de ce zéro absolu verrouille définitivement le positionnement de l’origine de l’échelle sur le continuum métrique.
En vertu de cette contrainte fondamentale, le groupe de transformations mathématiques admissibles sur une échelle de rapport se restreint drastiquement aux transformations linéaires directes, dites transformations par similitude :
$$y = ax \quad \text{a\vec } a > 0$$
Dans ce cadre formel strict, la constante additive $b$ des transformations affines est impérativement nulle ($b = 0$). Toute translation d’origine est formellement proscrite sous peine de briser la structure intrinsèque de l’échelle. La seule liberté accordée au chercheur réside dans le choix du facteur multiplicatif $a$, qui correspond au choix de l’unité conventionnelle employée pour quantifier la grandeur (passer des centimètres aux mètres, des secondes aux heures, ou des grammes aux kilogrammes).
Cette invariance par similitude confère à l’échelle de rapport sa propriété emblématique : l’isomorphisme parfait des rapports numériques avec les grandeurs mesurées. Quel que soit le facteur d’échelle $a$ retenu pour la quantification, le ratio calculé entre deux entités mesurées demeure parfaitement invariant :
$$\frac{y_1}{y_2} = \frac{ax_1}{ax_2} = \frac{x_1}{x_2}$$
Les propriétés mathématiques de multiplication et de division prennent dès lors leur pleine signification physique et psychométrique. Il devient rigoureusement licite de déclarer qu’un événement temporel ayant nécessité 400 millisecondes a duré deux fois plus longtemps qu’un événement s’étant déployé sur 200 millisecondes, ou qu’un objet d’une masse de 10 kilogrammes est cinq fois plus lourd qu’un objet de 2 kilogrammes. Ces affirmations conservent leur véracité empirique absolue quel que soit l’étalon métrique sélectionné par l’observateur.
2.3 Le test empirique du zéro absolu : critère de démarcation décisif
Pour trancher méthodologiquement l’appartenance d’une variable à l’échelle d’intervalle ou à l’échelle de rapport, la communauté des psychométriciens et des méthodologues applique un protocole d’évaluation conceptuel rigoureux : le test empirique du zéro absolu (ou test d’annulation dimensionnelle). Ce test vise à sonder la signification physique et ontologique du chiffre zéro lorsqu’il est attribué à une observation donnée.
Le critère de démarcation se formule à travers l’interrogation suivante : la valeur zéro représente-t-elle l’extinction totale, substantielle et complète de la grandeur physique mesurée, ou n’est-elle qu’un repère pratique convenu entre scientifiques pour marquer un seuil de référence transitoire ? Dans une échelle de rapport, l’assignation de la valeur zéro signifie sans la moindre ambiguïté qu’il n’y a « rien » à mesurer. Une longueur de zéro mètre signifie le néant spatial de l’objet ; une masse de zéro gramme désigne l’absence absolue de matière pondérale ; une intensité lumineuse de zéro lux correspond à l’obscurité totale et indépassable.
À l’inverse, si l’on applique ce test d’annulation à des variables comme la température en degrés Celsius ou le quotient intellectuel, l’échelle échoue immédiatement à démontrer l’absoluité de son origine. Zéro degré Celsius ne représente pas l’absence absolue d’énergie cinétique ou de chaleur dans un corps (le zéro absolu thermodynamique se situant à $-273{,}15$ °C sur l’échelle Kelvin). De même, un score théorique de zéro à une échelle composite de Wechsler ne signifierait aucunement une disparition pure et simple de l’activité cognitive, mais traduirait simplement l’inaptitude du protocole de test à mesurer des compétences sous le seuil d’étalonnage inférieur de l’instrument. L’application scrupuleuse de ce test d’annulation constitue la clé de voûte pour déterminer le véritable statut métrologique de l’âge chronologique.
3. 3. La démonstration formelle : Pourquoi l’âge est rigoureusement une variable de rapport
3.1 L’âge chronologique comme durée temporelle écoulée
Pour statuer formellement sur la classification de l’âge dans la taxonomie de Stevens, il convient d’expliciter sa définition opérationnelle fondamentale au sein de la physique et des sciences biomédicales. L’âge chronologique d’un organisme vivant n’est rien d’autre qu’une mesure de temps continu écoulé depuis un événement discret initial identifié de manière non ambiguë : l’émergence biologique de cet organisme dans le monde physique (la naissance dans les conventions médicales et juridiques standards). De ce point de vue métrologique strict, l’âge partage rigoureusement toutes les dimensions du temps newtonien classique : il s’agit d’une grandeur scalaire unidimensionnelle s’écoulant de façon continue, linéaire et monotone.
En tant que segment temporel délimité par une borne d’origine et un point d’observation présent, l’âge chronologique est dimensionnellement homogène à toute autre durée physique mesurée en chronométrie expérimentale (à l’instar du temps de réaction ou de la latence d’une réponse saccadique). Le système international d’unités (SI) définit la seconde ($s$) comme unité de base du temps physique. L’âge chronologique, qu’il soit comptabilisé en secondes, en heures, en jours ou en années solaires (correspondant chacune au temps de révolution de la Terre autour du Soleil), repose sur une métrique universelle dont les unités sont continues, infinitésimalement divisibles et rigoureusement additives.
La concaténation temporelle répond parfaitement aux axiomes mathématiques d’additivité de Hölder : deux périodes d’existence consécutives d’une année chacune correspondent, d’un point de vue chronométrique strict, à une période cumulée exactement équivalente à une durée continue de deux années. Il n’existe aucune fluctuation intrinsèque de la métrique temporelle sous-jacente de l’âge chronologique au fil de son écoulement : l’année vécue par un individu entre son 80e et son 81e anniversaire comporte rigoureusement le même nombre de secondes, de minutes et de révolutions planétaires que celle écoulée entre son premier et son deuxième anniversaire.
3.2 L’identification du véritable point zéro pour la variable âge
L’étape décisive de notre démonstration réside dans la validation empirique et théorique du point zéro. La variable « âge chronologique » possède-t-elle un zéro absolu naturel ou repose-t-elle sur un zéro arbitraire conventionnel ? L’analyse biologique et physique ne laisse aucun doute : l’instant précis où un être vivant naît correspond à une durée temporelle d’existence post-natale strictement nulle. À l’instant infinitésimal $t_0$ marquant la délivrance, le nouveau-né a cumulé une durée de vie extra-utérine égale à exactement zéro seconde, zéro jour et zéro année.
Ce point zéro n’est pas le résultat d’un consensus sociologique arbitraire ou d’une décision méthodologique négociable, à l’instar de la fixation du point de congélation de l’eau pour les degrés Celsius. Il matérialise l’absence totale et indubitable de la grandeur temporelle mesurée : avant l’instant de la naissance, la durée d’existence chronologique autonome est inexistante. De plus, il n’existe pas d’âge chronologique strictement négatif dans le continuum temporel du vivant ; l’espace métrique de l’âge est un sous-ensemble borné inférieurement par zéro, défini formellement sur l’ensemble des réels positifs ou nuls :
$$\text{Âge} in [0, +\infty[$$
Même si l’on souhaitait déplacer l’événement initial de l’âge chronologique de la naissance vers la conception biologique (fécondation du zygote) pour définir un âge gestationnel strict, la nature formelle de l’échelle demeurerait absolument inchangée. L’instant de la fécondation marquerait tout autant un instant $t_0$ absolu d’initiation du développement biologique, où la durée cumulée d’existence embryonnaire est égale à zéro. Dans un cadre comme dans l’autre, le zéro n’est pas un étalon relatif conventionnel, mais un zéro ontologique absolu.
3.3 La légitimité des proportions et ratios multiplicatifs
La conséquence mathématique directe de l’existence de ce zéro naturel et de la constance des intervalles temporels est l’admissibilité totale des opérations multiplicatives de division et de formulation de ratios. L’énoncé suivant constitue une proposition empiriquement et mathématiquement valide : « Un individu âgé de 40 ans a vécu exactement deux fois plus longtemps qu’un individu âgé de 20 ans, ou quatre fois plus longtemps qu’un enfant âgé de 10 ans. »
Cette proportionnalité directe vérifie impeccablement la règle fondamentale d’invariance par similitude de Stevens ($y = ax$). Pour le démontrer de manière irréfutable, procédons à un changement arbitraire d’unité de mesure sur cette comparaison d’âges. Considérons l’individu $A$ âgé de 40 années solaires et l’individu $B$ âgé de 20 années solaires. Calculons le ratio de leurs âges dans cette unité :
$$\text{Ratio}_{\text{années}} = \frac{\text{Âge}(A)}{\text{Âge}(B)} = \frac{40}{20} = 2{,}00$$
Convertissons désormais ces mêmes âges chronologiques dans une autre unité temporelle, par exemple en mois de calendrier civil (multiplication par le scalaire $a = 12$) ou en jours moyens (multiplication par le scalaire $a = 365{,}25$) :
$$\text{Ratio}_{\text{mois}} = \frac{40 \times 12}{20 \times 12} = \frac{480}{240} = 2{,}00$$
$$\text{Ratio}_{\text{jours}} = \frac{40 \times 365{,}25}{20 \times 365{,}25} = \frac{14,610}{7,305} = 2{,}00$$
Le ratio $(t_A / t_B)$ demeure strictement invariant et constant quelle que soit l’unité choisie pour quantifier le temps écoulé. Cette démonstration formelle établit sans équivoque possible que l’âge chronologique satisfait rigoureusement à l’ensemble des axiomes, propriétés et invariances mathématiques caractérisant les variables de rapport (échelles de ratio). Prétendre qu’il s’agit d’une simple échelle d’intervalle constitue une régression théorique infondée.
4. 4. Comparaison éclairante : L’âge face à des variables d’intervalle emblématiques
4.1 Le cas classique de la température en degrés Celsius et Fahrenheit
Pour mieux saisir la singularité métrologique de l’âge en tant qu’échelle de rapport, il est particulièrement formateur de le confronter au cas d’école universellement cité pour illustrer l’échelle d’intervalle : la température mesurée en degrés Celsius (°C) ou en degrés Fahrenheit (°F). L’histoire de la thermométrie illustre parfaitement la genèse d’un zéro conventionnel. Lorsque le physicien suédois Anders Celsius établit son échelle au XVIIIe siècle, il décida arbitrairement d’assigner la valeur numérique « 0 » au point de congélation de l’eau distillée sous pression atmosphérique standard, et la valeur « 100 » à son point d’ébullition.
En conséquence directe de ce choix arbitraire, la valeur 0 °C n’indique en aucun cas une absence totale de chaleur ou d’énergie cinétique microscopique au sein des molécules de matière. Cette relativité de l’origine rend mathématiquement illégitime toute affirmation proportionnelle directe au sein de ces échelles. Il est formellement erroné d’affirmer qu’une journée où le thermomètre affiche 20 °C est « deux fois plus chaude » qu’une journée où il n’affiche que 10 °C. Si l’on traduit ces deux températures dans l’échelle Fahrenheit par l’application de la transformation affine positive :
$$T(^circ\text{F}) = 1{,}8 \times T(^circ\text{C}) + 32$$
la température de 10 °C devient 50 °F, tandis que la température de 20 °C devient 68 °F. Or, le rapport entre ces deux mesures en degrés Fahrenheit donne :
$$\frac{68}{50} = 1{,}36 \neq 2{,}00$$
Le ratio s’est totalement effondré lors du changement d’unité en raison de la présence de la constante additive ($+32$). Ce n’est qu’en migrant vers l’échelle thermodynamique absolue de Kelvin (K), où le zéro absolu correspond à la cessation théorique totale de toute agitation thermique ($0\text{ K} = -273{,}15\text{ }^circ\text{C}$), que la température acquiert le statut métrologique d’échelle de rapport. Contrairement à la température en degrés Celsius qui exige une correction constante pour redevenir une échelle de rapport, l’âge chronologique ne nécessite aucune conversion : son zéro est d’emblée l’équivalent naturel du zéro Kelvin de la thermodynamique.
4.2 Les scores aux tests psychométriques standardisés (QI et échelles de Wechsler)
Dans le champ spécifique de la psychologie différentielle et de la psychométrie contemporaine, les scores aux tests standardisés d’aptitudes cognitives, tels que les Quotients Intellectuels (QI) issus de la Wechsler Adult Intelligence Scale (WAIS) ou du WISC, sont classiquement considérés comme relevant du niveau de l’échelle d’intervalle (bien que certains théoriciens stricts les qualifient d’échelles ordinales quasi-quantitatives). La distribution de ces scores est calibrée de manière purement conventionnelle pour épouser les paramètres d’une loi normale théorique de moyenne fixée à 100 et d’écart-type égal à 15.
Dans un tel dispositif d’évaluation standardisée, l’assignation d’un véritable score « 0 » absolu est totalement dépourvue de signification empirique. Aucun clinicien ou psychomètre ne peut prétendre mesurer une absence totale d’intelligence chez un individu. Quand bien même un sujet n’obtiendrait aucun point à l’ensemble des subtests présentés, cette observation signifierait uniquement l’échec de la batterie de tests à discriminer ses aptitudes, et non pas que son activité psychique, cognitive ou synaptique est nulle. Par voie de conséquence, un protocole de test de QI ne permet en aucune manière d’affirmer qu’un individu présentant un score de 140 possède une intelligence « deux fois supérieure » à celle d’un individu crédité d’un score de 70.
Le contraste avec l’âge chronologique est ici saisissant. Tandis que le score psychométrique de QI dépend intégralement d’une construction statistique relative et normalisée au sein d’une cohorte de référence (la note dépend du groupe d’étalonnage), l’âge chronologique d’un participant ne dépend d’aucune distribution statistique extrinsèque. Il s’agit d’une quantité mesurable directement dans le monde réel par rapport à son point d’origine d’existence, exempte de tout artéfact de centrage ou de normalisation conventionnelle préalable.
4.3 Le calendrier grégorien versus l’âge chronologique
Une source particulièrement courante de confusion conceptuelle réside dans l’incapacité fréquente à distinguer l’année calendaire historique (la date de l’événement) de la durée d’existence effective (l’âge). L’année calendaire au sein du calendrier grégorien (par exemple, l’année 2024 après J.-C.) constitue incontestablement une échelle d’intervalle. Son repère d’origine — l’année 1, traditionnellement ancrée sur la naissance présumée du Christ — est une convention historico-culturelle et religieuse totalement arbitraire.
L’histoire de l’humanité, l’évolution cosmique et le temps géologique se sont déployés durant des milliards d’années antérieurement à cette ancre conventionnelle (justifiant l’usage d’années négatives : avant Jésus-Christ). Dès lors, déclarer que l’année 2000 après J.-C. représente « deux fois plus de temps » que l’année 1000 après J.-C. est un non-sens physique absolu. Le rapport s’avère entièrement contingent : dans le calendrier hébraïque ou le calendrier républicain français, ces mêmes moments historiques correspondent à des valeurs numériques dont le ratio est radicalement dissemblable.
En revanche, l’âge chronologique s’obtient par l’opération mathématique de soustraction vectorielle entre la date du jour d’observation ($t_{\text{mesure}}$) et la date de survenue de la naissance ($t_{\text{naissance}}$) :
$$\text{Âge} = t_{\text{mesure}} – t_{\text{naissance}}$$
En soustrayant deux points d’une échelle d’intervalle partageant la même unité de temps, le terme d’origine arbitraire ($b$) s’annule purement et simplement :
$$\text{Âge} = (at_{\text{mesure}} + b) – (at_{\text{naissance}} + b) = a(t_{\text{mesure}} – t_{\text{naissance}})$$
Cette soustraction différentielle engendre une nouvelle variable quantitative métrique dont l’origine est réancrée à zéro. Ainsi, alors que la date de naissance et la date de passation du test sont des coordonnées situées sur une échelle d’intervalle calendaire, l’écart chronologique résultant — c’est-à-dire l’âge chronologique — est projeté avec une rigueur absolue sur une échelle de rapport.
5. 5. Propriétés mathématiques et opérations statistiques autorisées sur la variable âge
5.1 Statistiques descriptives applicables à l’échelle de rapport
L’appartenance avérée de l’âge chronologique à l’échelle de rapport confère aux chercheurs le privilège d’exploiter la totalité des outils de la statistique descriptive, sans la moindre restriction formelle. Au niveau de la tendance centrale, si les échelles ordinales se limitent à la médiane et les échelles d’intervalle à la moyenne arithmétique ordinaire, les échelles de rapport autorisent en toute rigueur l’usage de moyennes d’ordre supérieur : la moyenne géométrique ($G$) et la moyenne harmonique ($H$).
La moyenne géométrique, définie pour un échantillon de taille $n$ par l’expression :
$$G = \left( \prod_{i=1}^n x_i \right)^{\frac{1}{n}} = \exp\left( \frac{1}{n} \sum_{i=1}^n \ln(x_i) \right)$$
est particulièrement précieuse en psychologie du développement lorsque les variations de l’âge suivent des progressions exponentielles ou des distributions fortement asymétriques à droite (ce qui est systématique dans les études néonatales ou de petite enfance où quelques mois d’écart traduisent des bonds de maturation disproportionnés). Son calcul exige impérativement que toutes les valeurs observées soient strictement positives ($x_i > 0$), une condition formellement garantie par l’espace métrique d’une variable de rapport non nulle.
En matière de dispersion statistique, outre l’étendue, l’écart interquartile, la variance et l’écart-type classique ($s$), l’âge permet le recours au coefficient de variation (CV), défini comme le ratio de l’écart-type sur la moyenne arithmétique :
$$\text{CV} = \frac{s}{\bar{x}}$$
Le coefficient de variation est une mesure adimensionnelle de variabilité relative. Il est rigoureusement prohibé sur une échelle d’intervalle, car la modification arbitraire de l’origine ($b \neq 0$) altère la valeur de la moyenne au dénominateur sans modifier l’écart-type au numérateur, rendant le CV totalement instable et dépourvu de validité. Sur l’âge chronologique, le calcul du CV est d’une stabilité mathématique irréprochable et autorise des comparaisons standardisées de dispersion temporelle entre des populations pédiatriques et gériatriques.
5.2 Transformations mathématiques admissibles sur l’âge
Le statut d’échelle de rapport autorise l’application d’un spectre étendu de transformations mathématiques non linéaires, indispensables pour répondre aux violations d’homoscédasticité ou de normalité des résidus dans les modèles linéaires appliqués aux sciences du comportement. Parmi ces transformations, la conversion logarithmique de l’âge ($\ln(\text{âge})$ ou $\log_{10}(\text{âge})$) est monnaie courante dans la littérature empirique. Elle permet d’opérationnaliser l’hypothèse classique de rendements cognitifs décroissants au cours du développement : les gains structuraux majeurs observés dans les premières années de vie se tassent progressivement à mesure que l’âge chronologique croît.
De même, les transformations de l’âge en puissances ou en racines carrées ($\sqrt{\text{âge}}$ ou $\text{âge}^2$) sont pleinement admissibles et couramment mobilisées dans les analyses de régression polynomiale afin de modéliser des courbes de performance cognitive en forme de cloche inversée (U inversé) sur l’ensemble de la trajectoire de vie. L’invariance métrique garantit que ces opérations ne dénaturent pas la structure topologique de la variable sous-jacente.
Toutefois, une vigilance théorique rigoureuse s’impose concernant les restrictions d’usage. Si la multiplication ou la division par un scalaire positif quelconque ($k > 0$) maintient intacte l’échelle de rapport, toute opération additive non justifiée consistant à ajouter une constante arbitraire $c$ à l’âge ($y = \text{âge} + c$) rétrograde instantanément la variable au niveau d’une échelle d’intervalle. L’analyste perd alors définitivement la légitimité d’interpréter les rapports multiplicatifs initiaux sur la variable transformée.
5.3 Analyses inférentielles paramétriques de haute puissance
Sur le plan de l’inférence statistique, la classification de l’âge comme variable de rapport continue autorise l’ensemble des méthodes paramétriques fondées sur le modèle linéaire général (GLM) et ses extensions multivariées. L’intégration de l’âge chronologique sous sa forme brute continue maximise la puissance statistique des tests d’hypothèse en éliminant les pertes massives de variance inhérentes aux catégorisations arbitraires.
Dans l’analyse de covariance (ANCOVA), l’âge peut être introduit comme covariable quantitative continue pour ajuster statistiquement les moyennes de groupes expérimentaux indépendants sur les performances mnésiques ou attentionnelles. Cette démarche permet de purger la variance d’erreur de la composante liée au vieillissement et de tester avec une sensibilité maximale l’effet principal d’un traitement clinique ou d’un programme de remédiation cognitive.
Dans le domaine de la modélisation statistique avancée, l’âge en tant que variable de rapport sert d’épine dorsale aux modèles d’équations structurelles (SEM) et aux modèles de courbes de croissance latentes (Latent Growth Curve Modeling, LGM). Dans ces devis de modélisation longitudinale, l’affectation de coefficients de pente chronologiques fixes correspondant précisément à l’âge exact des sujets à chaque temps de recueil repose impérativement sur la constance des intervalles et la présence d’une métrique temporelle absolue. L’estimation des trajectoires individuelles de déclin cognitif ou de plasticité cérébrale n’atteint une convergence et une interprétabilité satisfaisantes que grâce à cette métrologie unifiée.
6. 6. L’âge dans les devis de recherche en psychologie : Variable continue versus discrétisée
6.1 La nature continue fondamentale de l’âge
D’un point de vue conceptuel et mathématique, l’âge est une variable quantitative continue. Le temps physique s’écoule selon une infinité continue et non dénombrable de micro-instants, de sorte qu’entre deux points temporels quelconques d’existence d’un individu, il est toujours théoriquement possible d’intercaler un instant intermédiaire. Dans la réalité empirique du laboratoire ou de la clinique, cependant, une dichotomie s’opère inévitablement entre la continuité sous-jacente du phénomène biologique et le mode discret de son enregistrement par l’observateur.
Dans l’écrasante majorité des protocoles de recherche en sciences sociales et comportementales, l’âge est recueilli sous la forme d’un nombre entier d’années révolues au dernier anniversaire (par exemple : 24 ans). Cette convention sociale d’expression temporelle constitue, d’un point de vue statistique strict, une opération d’arrondissement systématique à l’entier inférieur (fonction mathématique partie entière ou floor function, notée $lfloor x rfloor$) :
$$\text{Âge}_{\text{discret}} = \lfloor \text{Âge}_{\text{conti\nu}} \rfloor$$
Cette troncature introduit une erreur de mesure non nulle, uniformément distribuée sur l’intervalle $[0, 1[$ an, induisant un biais moyen d’environ six mois d’évaluation par défaut par rapport à la durée d’existence réelle de l’individu. Bien que les valeurs empiriques ainsi manipulées prennent l’apparence de nombres discrets au sein du fichier de données, la variable sous-jacente demeure conceptuellement continue. Ce format d’enregistrement tronqué n’altère en rien son statut fondamental d’échelle de rapport, tout comme la troncature au millimètre supérieur ne transforme pas une mesure de longueur en échelle purement qualitative.
6.2 La pratique discutable de la dichotomisation et catégorisation de l’âge
Malgré la richesse métrologique de l’âge, une pratique méthodologique regrettable et historiquement ancrée dans la recherche psychologique consiste à découper artificiellement cette variable continue en sous-groupes discrets, par exemple au moyen d’un split médian (« sujets jeunes » versus « sujets âgés ») ou d’une stratification en classes d’âges préétablies (ex. : 20-35 ans, 36-50 ans, 51-65 ans, 66 ans et plus). Cette catégorisation est généralement justifiée par la volonté contestable de soumettre les données à des analyses de variance (ANOVA factorielles bivariées) jugées plus faciles d’interprétation ergonomique que des modèles de régression multiple continue.
Cette pratique de dichotomisation a été unanimement condamnée par les plus éminents méthodologues en psychologie quantitative, à l’instar de MacCallum et ses collaborateurs (2002). La discrétisation forcée d’une variable continue entraîne une dégradation dramatique de l’information statistique. Elle induit une réduction drastique de la puissance statistique des tests inférentiels, pouvant équivaloir à la perte sèche d’un tiers à la moitié de l’échantillon expérimental. Parallèlement, elle accroît considérablement le risque de commettre des erreurs d’inférence de type I (faux positifs) en générant des artéfacts d’effets d’interaction illusoires liés aux regroupements non aléatoires aux frontières arbitraires des catégories.
Sur le plan métrologique fondamental, la catégorisation opère une régression dévastatrice : elle prend une variable riche dotée d’une échelle de rapport de haute précision pour la rabaisser autoritairement au niveau d’une simple échelle ordinale appauvrie. Deux individus âgés respectivement de 34 ans et 36 ans, qui ne sont séparés que par deux courtes années d’écart chronologique, se trouvent scindés artificiellement dans deux catégories étanches (« jeunes » versus « adultes d’âge mûr »), alors qu’un individu de 36 ans est assimilé de force à un individu de 50 ans au sein de la même classe, dissimulant l’hétérogénéité développementale intra-groupe sous une homogénéité postulée totalement fallacieuse.
6.3 Bonnes pratiques contemporaines pour le traitement continu de l’âge
Pour dépasser ces dérives méthodologiques sans renoncer à la capacité d’appréhender la complexité des dynamiques développementales, la recherche contemporaine en psychologie cognitive et neurosciences computationnelles privilégie désormais des méthodes d’analyse non linéaires préservant intégralement l’âge sous sa métrique continue brute. Face à l’hypothèse récurrente selon laquelle les effets de l’âge ne sont pas strictement linéaires au fil de l’existence, le recours aux modèles additifs généralisés (Generalized Additive Models, GAM) s’impose aujourd’hui comme le standard d’excellence méthodologique.
Les modèles GAM utilisent des fonctions lissantes ou splines de régression pénalisées pour modéliser avec souplesse la relation fonctionnelle continue unissant l’âge chronologique aux indicateurs d’efficacité cognitive ou de volume cortical :
$$Y_i = \beta_0 + f(\text{Âge}_i) + \varepsilon_i$$
Dans cette formulation, $f(\text{Âge}_i)$ représente une fonction non paramétrique continue estimée directement à partir des données observées. Cette approche permet de détecter empiriquement les véritables points d’inflexion développementaux ou d’accélération sénescente, sans recourir à aucune découpe arbitraire préalable de la distribution de l’âge. La collecte initiale des données doit donc impérativement recueillir la date de naissance exacte et la date d’expérimentation, afin de préserver dans la matrice de données l’échelle de rapport continue à sa résolution temporelle maximale.
7. 7. L’âge chronologique versus l’âge développemental, cognitif et subjectif
7.1 L’âge mental et développemental en psychométrie clinique
La primauté de l’échelle de rapport démontrée pour l’âge chronologique ne doit pas être extrapolée sans précaution épistémologique à d’autres construits temporels forgés par la psychologie clinique, au premier rang desquels figure le concept historique d’âge mental. Élaboré initialement par Alfred Binet et Théodore Simon au début du XXe siècle pour concevoir l’ancêtre des épreuves psychométriques modernes d’orientation scolaire, l’âge mental désignait le niveau moyen de développement cognitif atteint par un enfant, étalonné sur les performances normatives des groupes d’âges chronologiques successifs.
D’un point de vue strictement métrologique, l’âge mental ne constitue en aucun cas une échelle de rapport, et ne répond même que de façon très discutable aux postulats de l’échelle d’intervalle. En effet, l’équidistance des unités y est totalement rompue : l’écart intellectuel séparant un âge mental de 4 ans et un âge mental de 5 ans chez un jeune enfant représente une expansion structurale massive du langage, de la motricité fine et de la socialisation, alors que le décalage séparant un âge mental de 14 ans et un âge mental de 15 ans traduit des raffinements cognitifs beaucoup plus subtils et spécifiques aux capacités d’abstraction métacognitive.
En l’absence de constance dans la métrique unitaire sous-jacente, l’âge mental s’apparente conceptuellement à une échelle ordinale standardisée. C’est précisément l’impasse mathématique inhérente au calcul du ratio initial de William Stern :
$$\text{QI}_{\text{classique}} = \left(\frac{\text{Âge Mental}}{\text{Âge Chronologique}}\right) \times 100$$
qui a conduit David Wechsler à abandonner définitivement cette formulation défaillante (où une variable ordinale imparfaite était divisée par une variable de rapport exacte) au profit d’un quotient d’écart standardisé par rapport au groupe de pairs de même âge chronologique, réancrant ainsi la mesure dans une métrique d’intervalle statistique conventionnelle rigoureuse.
7.2 L’âge biologique, cérébral et épigénétique
L’essor vertigineux des neurosciences translationnelles et de la biologie du vieillissement a vu émerger de nouveaux indicateurs visant à quantifier l’état de sénescence physiologique d’un individu indépendamment de son temps d’existence calendaire. Parmi ceux-ci, l’estimation de l’âge cérébral par imagerie par résonance magnétique (IRM structurelle couplée à des algorithmes de machine learning) et l’estimation de l’âge épigénétique à partir des horloges de méthylation de l’ADN développées par Steve Horvath occupent une place de choix.
Bien que ces algorithmes soient entraînés pour prédire une valeur cible exprimée dans l’unité physique des années d’âge chronologique (ce qui leur confère en apparence la métrique d’une échelle de rapport), leur exploitation analytique en neuro-imagerie et en psychopathologie se focalise généralement sur la différence relative, baptisée le score d’écart d’âge cérébral (Brain Age Gap Estimate, BrainAGE) :
$$\Delta_{\text{BrainAGE}} = \text{Âge Cérébral Prédit} – \text{Âge Chronologique Réel}$$
L’analyse métrique de cet indicateur $\Delta_{\text{BrainAGE}}$ illustre avec clarté la bascule entre échelles. Dès lors que l’on soustrait l’âge chronologique effectif de l’âge prédit, le score différentiel résultant se distribue autour d’une moyenne de zéro (indiquant un cerveau structurellement conforme à son âge calendaire), prenant des valeurs positives chez les patients souffrant de maladies neurodégénératives précoces (accélération du vieillissement) ou négatives chez les individus résilients. Ce score d’écart $\Delta$ ne répond plus aux critères d’une échelle de rapport, car le zéro ne signifie aucunement une « absence d’âge cérébral », mais simplement une synchronisation parfaite entre biologie et calendrier. Cette métrique dérivée opère rigoureusement comme une échelle d’intervalle.
7.3 L’âge subjectif et psychologique perçu
Enfin, la psychologie sociale et la gérontologie comportementale accordent une importance croissante à l’âge subjectif ou ressenti. Opérationnalisé classiquement par des questionnaires standardisés demandant aux participants d’indiquer « l’âge qu’ils ont l’impression d’avoir au fond d’eux-mêmes » dans différentes sphères de leur fonctionnement (âge physique, âge mental, âge social), ce construit psychologique s’affranchit des contraintes temporelles objectives.
Bien que la réponse soit recueillie en années numériques continues, le statut métrologique de l’âge subjectif s’avère profondément ambigu et asymétrique. Il subit l’influence massive d’effets d’ancrage cognitif, de pressions normatives d’identification sociale, et d’un biais systématique de rajeunissement perçu chez la quasi-totalité des individus adultes à partir du cap de la quarantaine. Rien ne permet de garantir sur le plan psychométrique qu’un écart de 5 ans entre l’âge subjectif et l’âge réel chez un sujet de 25 ans possède la même signification fonctionnelle qu’un décalage équivalent de 5 ans chez un aîné de 75 ans.
En l’absence de vérification empirique de l’égalité absolue des intervalles psychologiques sous-jacents, l’âge subjectif doit être appréhendé avec une grande prudence méthodologique. Alors que l’âge chronologique demeure inconditionnellement une échelle de rapport d’une rigidité physique absolue, l’âge subjectif relève au mieux d’une échelle d’intervalle approximative et bruitée, voire d’une simple métrique pseudo-ordinale dépendante de la psychométrie de son instrument de mesure.
8. 8. Exemples concrets et études de cas en méthodologie psychologique
8.1 Étude de cas 1 : Modélisation du temps de réaction en fonction de l’âge
Pour illustrer la portée fondamentale du statut d’échelle de rapport de l’âge chronologique dans les analyses de données expérimentales, examinons la modélisation de la vitesse de traitement de l’information cognitive au cours du vieillissement adulte normal. Dans le cadre théorique monumental développé par Timothy Salthouse (1996) autour de la Processing Speed Theory, le ralentissement neurocognitif global est conçu comme un processus multiplicatif proportionnel plutôt que comme une addition constante de latence temporelle.
Dans un protocole expérimental typique mesurant le temps de réaction (TR) dans des tâches de discrimination perceptive chez des sujets âgés de 20 à 80 ans, les chercheurs ont pu observer que les adultes âgés de 70 ans présentent en moyenne un temps de réaction 1,5 fois plus long que des jeunes adultes âgés de 20 ans. Cette formalisation s’exprime mathématiquement sous la forme d’un modèle de ralentissement généralisé de Brinley :
$$\text{TR}_{\text{âgés}} = \alpha \times \text{TR}_{\text{jeunes}}$$
L’interprétation théorique de ces ratios de ralentissement au sein des modèles cognitifs n’est valide que parce que l’âge est lu sur une échelle de rapport continue. Si l’âge ne possédait qu’une échelle d’intervalle à zéro conventionnel déplaçable, comparer les coefficients d’accélération ou de ralentissement entre différentes décennies perdrait tout fondement logique. L’existence d’une origine absolue partagée par les deux métriques (le zéro seconde pour le temps de réaction et le zéro année pour l’âge de l’observateur) permet de dériver des équations différentielles décrivant le taux d’altération de la vitesse neuronale par unité relative de durée d’existence vécue.
8.2 Étude de cas 2 : Trajectoires d’acquisition du vocabulaire chez le jeune enfant
Un second cas d’école emblématique concerne la modélisation des premières étapes de l’acquisition du langage chez le nourrisson et le jeune enfant. Dans les protocoles fondés sur les inventaires de développement communicatif de MacArthur-Bates (CDI), les chercheurs étudient l’accroissement du lexique productif entre l’âge de 8 mois et l’âge de 30 mois. Dans ces devis de recherche précoce, l’âge est quasi-systématiquement mesuré à la résolution du jour ou du mois précis écoulé depuis la naissance.
Considérons la progression lexicale entre 12 mois et 24 mois comparée à celle s’étalant entre 60 mois (5 ans) et 72 mois (6 ans). Dans les deux cas, la durée brute absolue écoulée est identique : exactement 12 mois calendaires d’intervalle. Pourtant, sur le plan de la dynamique développementale, le passage de 12 à 24 mois correspond à un doublement de l’âge chronologique total de l’enfant ($\text{Ratio} = 24 / 12 = 2{,}00$), s’accompagnant d’une explosion syntaxique et lexicale spectaculaire (passage de l’holophrase aux combinaisons de mots). En revanche, le passage de 60 à 72 mois ne représente qu’une augmentation marginale de 20 % de l’âge total accumulé par l’enfant ($\text{Ratio} = 72 / 60 = 1{,}20$).
Cette distinction développementale majeure démontre la supériorité explicative de la métrique de rapport sur la simple métrique d’intervalle. L’impact fonctionnel d’un intervalle temporel donné sur la maturation neurobiologique dépend de manière critique de son ratio par rapport à l’histoire d’existence globale de l’organisme. Traiter l’âge comme une simple échelle d’intervalle rendrait mathématiquement imperceptible cette dimension de proportionnalité relative qui gouverne les fenêtres critiques du développement synaptique précoce.
8.3 Étude de cas 3 : Le piège de l’âge de début de consommation de substances
En psychopathologie développementale et en épidémiologie des conduites addictives, une vaste littérature s’intéresse à l’âge d’initiation à la consommation de substances psychoactives (alcool, tabac, cannabis) comme facteur étiologique majeur prédictif de la sévérité des troubles de l’usage ultérieurs à l’âge adulte. L’objectif analytique consiste à modéliser la probabilité de survenue de la dépendance en fonction de l’âge auquel l’individu a expérimenté pour la toute première fois le produit toxique.
L’analyse méthodologique de cette variable révèle des écueils redoutables si les propriétés d’échelle sont mal maîtrisées. Dans les modèles de survie ou modèles à risques proportionnels de Cox, le « temps jusqu’à l’événement » (l’âge d’initiation) est formellement traité comme une variable de durée issue d’une échelle de rapport, dont le point zéro correspond impérativement à la naissance de l’individu. Ignorer ce zéro d’exposition absolue et borner artificiellement l’analyse statistique aux seuls individus ayant consommé le produit (en excluant les sujets abstinents sous forme d’une censure à droite non modélisée) introduit un biais de sélection dramatique qui déforme l’estimation des fonctions de risque de base.
La validité des coefficients de régression exponentiels (rapports de risque instantané ou Hazard Ratios, HR) calculés dans ces modèles de Cox repose directement sur l’invariance par similitude temporelle de l’échelle de rapport de l’âge. Confondre ce continuum absolu avec un repère chronologique d’intervalle conventionnel conduirait à violer l’hypothèse de proportionnalité des risques sous-jacente au modèle, invalidant de fait les recommandations préventives de santé publique fondées sur ces calculs.
9. 9. Les confusions fréquentes et pièges conceptuels chez les chercheurs
9.1 Le sophisme du zéro inaccessible chez l’adulte
L’un des sophismes méthodologiques les plus tenaces et fréquemment rencontrés chez les étudiants en psychologie et les chercheurs en sciences humaines s’énonce ainsi : « Mon échantillon de recherche ne recrute que des adultes âgés de 18 à 65 ans ; aucun de mes participants n’a 0 an. Par conséquent, pour mon étude empirique, l’âge ne peut pas être considéré comme une échelle de rapport, puisqu’il ne contient pas de zéro dans sa plage de données. »
Ce raisonnement constitue une erreur conceptuelle profonde quant à la définition même d’une échelle de mesure dans le paradigme de Stevens. L’appartenance d’une variable à un niveau d’échelle est une propriété mathématique et ontologique intrinsèque de l’espace métrique théorique auquel appartient la grandeur observée, et non pas une caractéristique dépendante des valeurs accidentellement échantillonnées dans un protocole particulier. Pour qu’une échelle soit de rapport, il n’est aucunement exigé que la valeur zéro soit présente dans le fichier de données statistiques collecté ; il est seulement exigé que le zéro absolu existe conceptuellement sur le continuum physique sous-jacent et serve d’ancre d’origine absolue à la métrique.
Pour démasquer l’inanité de ce sophisme, il suffit d’établir une analogie élémentaire avec des variables physiques universellement reconnues comme des échelles de rapport pures : la masse corporelle ou la taille des êtres humains. Si un chercheur conduit une expérimentation biomédicale sur une cohorte d’athlètes dont les poids oscillent strictement entre 70 et 95 kilogrammes, l’absence d’individus pesant 0 kilogramme dans l’échantillon ne retire absolument rien au fait que la masse corporelle demeure une échelle de rapport dotée d’un zéro absolu. Il en va rigoureusement de même pour l’âge chronologique : le fait qu’une cohorte ne contienne pas de nouveau-nés ne rétrograde aucunement l’âge au rang d’échelle d’intervalle.
9.2 La confusion entre l’origine de l’échelle et l’origine de la mesure
Un deuxième piège épistémologique classique provient de la confusion pernicieuse entre l’origine absolue de l’échelle de la grandeur mesurée ($t = 0$, naissance de l’individu) et l’origine temporelle arbitraire fixée pour les besoins d’un protocole expérimental spécifique ($t_0$, instant d’inclusion dans une étude clinique ou début d’une session de tâche informatisée). Lorsqu’un expérimentateur suit des cohortes longitudinales pendant 10 ans, le temps écoulé depuis le début de l’expérimentation possède son propre zéro conventionnel expérimental.
Cette distinction devient critique lors des étapes de modélisation statistique avancée impliquant des opérations de centrage de l’âge (procédure courante consistant à soustraire l’âge moyen de l’échantillon à l’âge de chaque sujet : $\text{Âge}_{\text{centré}} = \text{Âge} – \bar{x}$). À l’issue de cette manipulation, la nouvelle valeur « 0 » attribuée à un participant ne correspond plus à son existence naissante, mais au fait d’avoir un âge rigoureusement équivalent à la moyenne de l’échantillon. Dès cet instant précis, la variable transformée est formellement devenue une échelle d’intervalle dotée d’un zéro relatif.
La confusion réside dans l’oubli fréquent de cette transformation de structure métrique lors de l’interprétation des résultats. Si un chercheur oublie de restituer l’échelle brute originale par décentrage lors de la formulation de ses conclusions, il s’expose à commettre des erreurs grossières en tentant d’interpréter des ratios ou des proportions directes sur la variable centrée, ratios qui ont été vidés de toute validité par la translation affine initiale.
9.3 L’incompréhension des unités temporelles non conventionnelles
Une dernière source d’interrogation méthodologique concerne l’impact du changement d’unité sur la nature formelle de l’échelle temporelle. Certains auteurs se demandent si l’évaluation de l’âge en semaines de développement fœtal, en trimestres gestationnels ou en ères de développement biologique modifie la qualification de l’échelle.
La théorie formelle de la mesure démontre que toute multiplication par une constante positive d’échelle ($y = ax$ avec $a > 0$) laisse strictement invariant le groupe de transformations de l’échelle de rapport. Qu’un âge soit quantifié en millisecondes, en jours juliens, en années solaires ou en siècles, le passage d’une unité à l’autre ne fait qu’ajuster la magnitude numérique sans altérer l’origine absolue du vecteur temps. L’isomorphisme mathématique avec la structure physique de la durée est parfaitement conservé.
De surcroît, le débat obstétrical entre l’âge gestationnel (calculé depuis le premier jour des dernières règles) et l’âge fœtal réel (déterminé par échographie précoce à partir de la fécondation) ne remet pas en cause l’essence de l’échelle de rapport. Il ne s’agit dans ce cas que d’un débat empirique sur l’identification précise de l’événement biologique marquant le véritable point zéro du système vivant, et non d’une remise en question de l’existence d’une origine absolue en soi.
10. 10. Conséquences psychométriques de la modification d’échelle : Centrage, standardisation et catégorisation
10.1 Le centrage de l’âge dans les modèles de régression multiple
Dans l’analyse de régression linéaire multiple et les modèles linéaires mixtes (HLM), le centrage de l’âge sur la moyenne du groupe (Group-Mean Centering) ou sur la moyenne générale de l’échantillon (Grand-Mean Centering) est une pratique statistique hautement recommandée, voire indispensable. Cette procédure mathématique simple consiste à appliquer la transformation :
$$\text{Âge}_{ci} = \text{Âge}_i – \bar{X}_{\text{âge}}$$
L’objectif méthodologique principal de ce centrage est d’atténuer la multicolinéarité sévère qui émerge inévitablement dans les modèles de régression polynomiale comportant des termes quadratiques ($\text{Âge}^2$) ou des termes d’interaction inter-variables ($\text{Âge} \times \text{Condition}$). Par ailleurs, le centrage confère une interprétabilité clinique directe à l’ordonnée à l’origine (la constante $\beta_0$) du modèle : celle-ci n’exprime plus la valeur théorique absurde du score cognitif d’un nouveau-né d’âge zéro dans une étude sur le vieillissement adulte, mais correspond très concrètement au score moyen prédit pour un individu présentant l’âge moyen exact de la cohorte d’étude.
Néanmoins, il est fondamental de comprendre la conséquence métrologique exacte de cette manipulation : le centrage rétrograde techniquement l’âge d’une échelle de rapport vers une échelle d’intervalle pure. En appliquant une translation d’amplitude négative ($b = -\bar{X}_{\text{âge}}$), l’analyste détruit l’ancrage sur le zéro absolu. La valeur $0$ de la variable centrée est désormais relative à la distribution de l’échantillon spécifique. En conséquence directe, le calcul du coefficient de variation ou la formulation d’énoncés de proportionnalité multiplicative deviennent strictement proscrits sur les valeurs d’$\text{Âge}_{c}$. L’analyste doit impérativement décentrer la variable pour réinvestir la métrique de rapport lors de la restitution des résultats finaux.
10.2 La standardisation en scores Z (cote z)
Une transformation statistique plus poussée fréquemment appliquée à l’âge dans les devis de psychologie différentielle et de génétique comportementale est la standardisation complète en cotes centrées réduites (scores $Z$). Cette opération est définie mathématiquement par l’équation :
$$Z_{\text{âge}, i} = \frac{\text{Âge}_i – \bar{X}_{\text{âge}}}{S_{\text{âge}}}$$
où $\bar{X}_{\text{âge}}$ représente la moyenne arithmétique de l’échantillon et $S_{\text{âge}}$ son écart-type d’échantillonnage. La distribution résultante possède désormais une moyenne fixée à 0 et une variance unitaire rigoureusement égale à 1. Cette conversion facilite la comparaison directe du coefficient de régression de l’âge avec d’autres prédicteurs psychométriques standardisés (coefficients bêta standardisés $\beta$).
Sur le plan des échelles de mesure, la standardisation achève de dépouiller la variable âge de toute son essence de rapport en engendrant formellement des valeurs négatives pour l’ensemble des individus situés en dessous de la moyenne d’âge du groupe. Or, comme nous l’avons formellement établi, un âge strictement négatif est un non-sens physique dans l’échelle de rapport originelle. La standardisation convertit l’âge en une échelle d’intervalle pure normalisée : les distances métriques relatives en unités d’écarts-types sont rigoureusement préservées, mais tout lien avec l’origine absolue d’existence est temporairement suspendu pour les besoins de l’analyse multivariée.
10.3 Le passage à des tranches d’âge et l’inversion vers l’ordinal
La modification d’échelle la plus dommageable pour l’intégrité de la variable âge chronologique reste son découpage arbitraire en classes qualitatives étanches pour les besoins de tableaux descriptifs ou d’analyses non paramétriques. Considérons le découpage classique suivant fréquemment observé dans la littérature : $[18-25\text{ ans}]$, $[26-35\text{ ans}]$, $[36-50\text{ ans}]$, $[51-65\text{ ans}]$, et $[66\text{ ans et plus}]$.
Cette transformation détruit instantanément les propriétés structurales de l’échelle de rapport ainsi que celles de l’échelle d’intervalle :
- Perte du zéro absolu : La modalité d’origine disparaît au profit d’un ensemble de catégories fermées dont le début d’ancrage est fixé arbitrairement à 18 ans.
- Rupture de l’égalité des intervalles : Les amplitudes numériques des classes d’âges créées sont flagrantes d’inégalité (la première classe couvre une largeur de 7 ans, la deuxième de 9 ans, la troisième de 14 ans, tandis que la dernière catégorie $[66\text{ ans et plus}]$ est une borne supérieure béante et indéfinie). L’unité de distance unitaire s’effondre totalement.
- Rétrogradation vers une échelle ordinale appauvrie : Tout ce qu’il reste de l’information mathématique originelle est une relation de monotonicité ordinale faible : un sujet classé dans le groupe 3 est incontestablement plus âgé qu’un sujet classé dans le groupe 2.
Le calcul subséquent d’une moyenne statistique sur ces codes de catégories (par exemple affecter le code 1 à la première tranche, 2 à la deuxième, etc., puis calculer la moyenne des codes de groupe) constitue une hérésie méthodologique sans nom. La richesse d’une variable de rapport continue ne doit jamais être délibérément sacrifiée à moins qu’une justification clinique absolue ne l’impose formellement dans des cadres diagnostiques réglementés.
11. 11. L’âge dans les plans d’expérience complexes : Cohorte, longitudinal et transversal
11.1 Le paradoxe âge-période-cohorte en psychologie du vieillissement
L’utilisation de l’âge comme variable de rapport analytique atteint son paroxysme de complexité méthodologique au sein des plans d’expérience dédiés à l’étude de la sénescence cognitive. Dans ce champ de recherche, les méthodologues sont confrontés à une impasse conceptuelle majeure formulée sous le nom de paradoxe ou problème d’identification Âge-Période-Cohorte (APC). Ce problème découle de la relation de colinéarité linéaire parfaite qui lie inexorablement ces trois dimensions temporelles fondamentales :
$$\text{Période de mesure} = \text{Année de cohorte (naissance)} + \text{Âge chronologique}$$
Dans un devis transversal classique (où des groupes d’âges chronologiques différents sont évalués simultanément à un instant unique de mesure), l’âge se trouve intrinsèquement confondu de manière inextricable avec l’effet de cohorte (l’ensemble des déterminants historiques, éducatifs, nutritionnels et socioculturels partagés par une même génération d’individus, à l’instar de l’effet Flynn sur les scores de QI). L’âge chronologique mesuré sur son échelle de rapport physique n’agit ici que comme un substitut (proxy) indirect d’une cascade complexe de mécanismes neurobiologiques sous-jacents entremêlés à des artéfacts d’histoire générationnelle.
La modélisation de ce paradoxe ne peut être abordée avec rigueur statistique qu’en s’appuyant sur la nature d’échelle de rapport de l’âge chronologique. Seule la constance rigoureuse des intervalles temporels permet d’ajuster mathématiquement les matrices de covariance au sein d’algorithmes de décomposition statistique avancée (comme les modèles APC à effets intrinsèques contraints) destinés à démêler la part de variance attribuable au vieillissement chronologique propre de celle relevant des changements d’époque ou de culture.
11.2 L’analyse longitudinale et les modèles multiniveaux
Face aux limites des comparaisons transversales, le devis longitudinal — où une même cohorte d’individus est suivie de manière prospective à travers des vagues d’évaluations successives réparties sur plusieurs années ou décennies — constitue la méthodologie reine pour quantifier le véritable déclin ou la plasticité développementale intra-individuelle. L’analyse contemporaine de ces données complexes mobilise les modèles de régression multiniveaux (Multilevel Modeling ou modèles mixtes linéaires pour mesures répétées).
Dans ce cadre analytique de pointe, la modélisation formelle du temps au niveau 1 (le niveau intra-individuel des mesures répétées) soulève une question d’échelle capitale : faut-il utiliser comme index temporel l’âge chronologique exact du participant à chaque vague de mesure, ou le temps écoulé depuis le début de l’inclusion dans l’étude clinique (durée du suivi) ? La flexibilité de l’échelle de rapport de l’âge chronologique confère ici un avantage décisif. En intégrant l’âge chronologique brut comme métrique continue variable selon les sujets :
$$Y_{ti} = \beta_{0i} + \beta_{1i}(\text{Âge}_{ti} – \text{Âge}_{0}) + \varepsilon_{ti}$$
le modèle multiniveau s’accommode avec une élégance mathématique totale des calendriers d’évaluations décalés ou irréguliers (unbalanced spaced measurements). Chaque sujet n’étant pas systématiquement revu à des intervalles d’anniversaires parfaitement synchronisés, la projection de ses données sur le continuum unifié de l’échelle de rapport de l’âge permet d’estimer les pentes individuelles d’évolution cognitive avec une justesse qu’aucune échelle d’intervalle conventionnelle discrète ne saurait atteindre.
11.3 Les plans transversaux séquentiels
Pour dépasser l’antagonisme structurel entre approches transversales et longitudinales, le psychologue K. Warner Schaie a conçu à la fin des années 1960 un protocole d’investigation révolutionnaire : le devis séquentiel de cohorte (qui a donné naissance à la prestigieuse Seattle Longitudinal Study). Ce protocole expérimental hautement sophistiqué consiste à répliquer longitudinalement des cohortes transversales successives à intervalles réguliers d’années (par exemple tous les 7 ans) en intégrant à chaque vague d’évaluation une nouvelle cohorte de participants d’âges comparables.
L’architecture de ces devis transversaux séquentiels repose intégralement sur l’équidistance stricte et la proportionnalité métrique de l’échelle de l’âge chronologique. Les cellules factorielles de la matrice d’observation exigent une correspondance mathématique parfaite entre l’intervalle séparant les vagues de mesure (7 années calendaires) et l’intervalle séparant les groupes d’âge chronologique inclus (ex. : 21 ans, 28 ans, 35 ans, 42 ans, etc., formant des incréments constants de 7 années solaires d’existence). La validité des algorithmes d’estimation de la convergence et la séparation effective des composantes de cohorte et de vieillissement dépendent de la préservation absolue de cette métrique de rapport temporelle exacte.
12. 12. Synthèse pratique, arbre décisionnel et recommandations pour les chercheurs
12.1 Arbre décisionnel pour classifier les variables temporelles en psychologie
Afin de prémunir les chercheurs, doctorants et analystes de données contre toute incertitude méthodologique lors de la rédaction de leurs protocoles ou le traitement de leurs bases de données quantitatives, nous avons formalisé un protocole systématique d’aide à la décision métrologique. Cet algorithme séquentiel permet de qualifier n’importe quelle variable temporelle dans le cadre canonique de Stanley Smith Stevens :
- Étape 1 : Le test d’équivalence et de classification catégorielle. La variable ne sert-elle qu’à répartir les observations dans des classes distinctes sans hiérarchie directionnelle intrinsèque (ex. : génération X versus génération Y traitée sans ordre chronologique direct) ?
- Si Oui : Échelle Nominale. Seules les fréquences et modes sont autorisés.
- Si Non : Passer impérativement à l’Étape 2.
- Étape 2 : Le test de transitivité et de sériation directionnelle. Les modalités de la variable peuvent-elles être ordonnées selon une logique formelle « plus grand que » ou « plus petit que », mais sans que l’on puisse garantir mathématiquement que la distance métrique séparant l’élément 1 de l’élément 2 soit strictement égale à celle séparant l’élément 2 de l’élément 3 (ex. : stade de développement de Piaget, âge mental brut en clinique) ?
- Si Oui : Échelle Ordinale. Utiliser les médianes, quantiles et tests de rangs non paramétriques.
- Si Non : Passer impérativement à l’Étape 3.
- Étape 3 : Le test d’équidistance des intervalles unitaires. La distance numérique d’une unité de mesure est-elle constante, stable et identique sur l’intégralité du continuum mesuré (ex. : une année d’écart possède-t-elle la même valeur temporelle partout) ?
- Si Non : Retour à l’Échelle Ordinale.
- Si Oui : L’échelle est au minimum d’intervalle. Passer à l’Étape 4 pour trancher la nature ultime de la mesure.
- Étape 4 : Le test décisif de l’origine absolue et du zéro naturel. La valeur zéro de la variable désigne-t-elle l’absence absolue, totale et ontologique de la propriété mesurée (extinction complète de la durée écoulée), ou n’est-elle qu’un point de référence conventionnel et transitoire arbitrairement fixé par les conventions humaines ?
- Si le zéro est relatif/arbitraire (ex. : année calendaire grégorienne, température en °C, âge centré sur la moyenne) : Échelle d’Intervalle confirmée. Invariance affine positive ($y = ax + b$). Ratios interdits.
- Si le zéro est absolu/naturel (ex. : âge chronologique brut depuis la naissance, temps de réaction, durée cumulée d’existence) : Échelle de Rapport (Ratio) pleinement confirmée. Invariance par similitude stricte ($y = ax$). Ratios, moyennes géométriques et coefficients de variation légitimes.
12.2 Recommandations méthodologiques pour le recueil de l’âge
Au regard des démonstrations mathématiques et empiriques déployées tout au long de cette étude, plusieurs impératifs méthodologiques doivent désormais guider la pratique des chercheurs en psychologie, en épidémiologie et en sciences sociales lors de la phase de conception des instruments de collecte de données :
- Privilégier systématiquement le recueil de la date de naissance exacte : Dans les formulaires de collecte (qu’ils soient administrés en ligne ou sur support papier), les chercheurs doivent s’astreindre à recueillir la date de naissance précise du participant (jour, mois, année) ainsi que la date exacte de passation de l’épreuve expérimentale. Ce procédé permet de calculer rétrospectivement par algorithme automatisé l’âge exact sous forme d’une variable quantitative continue à très haute résolution temporelle décimale, préservant l’échelle de rapport dans sa plénitude informationnelle.
- Bannir formellement les cases à cocher par tranches d’âge lors de la collecte primaire : Recueillir directement l’âge des sujets sous la forme de cases d’intervalles préétablis (ex. : cocher $[18-29\text{ ans}]$, $[30-45\text{ ans}]$, etc.) constitue une erreur de méthode impardonnable. Cette pratique détruit irrémédiablement l’échelle de rapport dès l’amont de l’étude. Il sera mathématiquement impossible de reconstituer la distribution continue d’origine une fois les données collectées sous ce format dégradé.
- Conserver la variable brute intouchée dans les référentiels de données : Avant toute manipulation statistique de centrage, de standardisation ou de discrétisation imposée par une modélisation mathématique spécifique, le fichier de données maîtres (master raw dataset) doit impérativement archiver l’âge chronologique sous sa forme brute native d’échelle de rapport continue.
12.3 Lignes directrices pour la rédaction des sections Méthode et Résultats selon les normes APA
La publication d’articles scientifiques respectant les standards internationaux d’excellence académique, notamment ceux édictés par l’American Psychological Association (normes APA, 7e édition), requiert une transparence et une précision rédactionnelle exemplaire dans la restitution de la variable âge au sein des sections Méthode (sous-section Participants) et Résultats.
Dans la section Participants, les auteurs doivent systématiquement reporter les indicateurs de tendance centrale et de dispersion appropriés aux variables de rapport continues : la moyenne arithmétique ($M$) et l’écart-type ($SD$), rigoureusement complétés par l’étendue réelle observée sous la forme du minimum et du maximum effectifs de l’échantillon. L’écriture canonique doit adopter la forme suivante :
« L’échantillon expérimental était composé de 148 participants adultes ($M_{\text{âge}} = 24{,}62\text{ ans}$, $SD = 3{,}18$, étendue : $19{,}12 – 34{,}85\text{ ans}$). »
Dans la section Résultats, lorsque l’âge est introduit dans des modèles de régression multiple ou des analyses de covariance (ANCOVA), les chercheurs doivent expliciter sans ambiguïté la nature métrique retenue pour le traitement de la variable : spécifier s’il s’agit de l’âge chronologique brut continu (échelle de rapport), de l’âge centré sur la moyenne générale de l’échantillon pour stabiliser la variance (échelle d’intervalle), ou d’un terme polynomial quadratique destiné à capter une non-linéarité développementale. Si des analyses par cohortes sont menées, les auteurs doivent impérativement justifier les fondements théoriques ou biomédicaux du découpage retenu et reconnaître explicitement dans la discussion des limites de l’étude la perte de puissance statistique inhérente à la discrétisation ordinale de l’échelle temporelle.
En observant ces directives rigoureuses, la communauté scientifique garantit la reproductibilité de ses inférences, l’exactitude de ses formulations théoriques et le respect scrupuleux des lois mathématiques qui régissent la fascinante discipline de la mesure du comportement humain.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Binet, A., & Simon, T. (1905). Méthodes nouvelles pour le diagnostic du niveau intellectuel des anormaux. L’Année Psychologique, 11(1), 191–244. https://doi.org/10.3406/psy.1904.3675
- Campbell, N. R. (1920). Physics: The elements. Cambridge University Press.
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Horvath, S. (2013). DNA methylation age of human tissues and cell types. Genome Biology, 14(10), Article R115. https://doi.org/10.1186/gb-2013-14-10-r115
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19
- Salthouse, T. A. (1996). The processing-speed theory of adult age differences in cognition. Psychological Review, 103(3), 403–428. https://doi.org/10.1037/0033-295X.103.3.403
- Schaie, K. W. (1965). A general model for the study of developmental problems. Psychological Bulletin, 64(2), 92–107. https://doi.org/10.1037/h0022711
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.