
L’édification de la connaissance scientifique repose fondamentalement sur la capacité du chercheur à traduire la complexité phénoménologique du réel en unités d’information intelligibles, comparables et analysables. Dans les sciences contemporaines, qu’il s’agisse de la psychologie cognitive, de la sociologie quantitative, de l’épidémiologie ou des neurosciences computationnelles, cette opération de réduction et de modélisation s’incarne dans le concept cardinal de variable. Tout protocole d’investigation empirique débute par une interrogation sur la nature des manifestations observées : s’agit-il de caractériser un état, une modalité d’être ou une appartenance catégorielle, ou s’agit-il d’évaluer une intensité, une fréquence d’occurrence ou une grandeur physique ? Cette dichotomie fondamentale entre le qualitatif et le quantitatif constitue la pierre angulaire de toute l’architecture méthodologique.
Pourtant, loin de se réduire à une simple commodité lexicale ou à une classification pédagogique préliminaire, la distinction entre variables qualitatives et variables quantitatives engage des postulats épistémologiques profonds et conditionne l’ensemble de la chaîne de traitement des données. Du choix des instruments d’évaluation à la sélection des modèles statistiques inférentiels, en passant par la légitimité des opérations arithmétiques autorisées, la méconnaissance des propriétés intrinsèques d’une variable expose l’analyste à des sophismes méthodologiques dévastateurs. L’histoire des sciences humaines et sociales regorge d’artefacts expérimentaux et de conclusions fallacieuses nés de l’attribution abusive de propriétés métriques à des données purement catégorielles, ou, inversement, de l’appauvrissement dramatique d’informations numériques continues par des discrétisations injustifiées.
Le présent traité propose une exploration systématique, exhaustive et rigoureuse de cette frontière méthodologique déterminante. En s’appuyant sur l’épistémologie de la mesure, la psychométrie classique, la métrologie cognitive et les canons de la statistique moderne, cette analyse vise à doter les étudiants, cliniciens et chercheurs d’un cadre conceptuel inébranlable. Il conviendra d’examiner la genèse conceptuelle des variables, d’en disséquer les propriétés logiques et mathématiques, de détailler les taxonomies canoniques issues des travaux de Stanley Smith Stevens, puis d’exposer les implications concrètes de ces distinctions sur la collecte, la description statistique, la modélisation probabiliste et la représentation visuelle des données empiriques.
1. Introduction conceptuelle aux variables dans la recherche scientifique
1.1 Définition fondamentale d’une variable en sciences du comportement
Au sens le plus pur de l’épistémologie des sciences du comportement, une variable désigne une propriété, un attribut ou une entité phénoménologique susceptible de prendre différentes valeurs ou d’adopter des modalités distinctes selon les unités d’observation considérées ou au cours du temps chez un même individu. Elle s’oppose formellement à la constante, dont la valeur demeure invariante au sein du référentiel expérimental défini. Dans le cadre de l’investigation empirique, la variable ne se confond pas avec le phénomène brut ; elle constitue une abstraction formalisée résultant d’une décision méthodologique explicite.
Le passage d’une entité théorique abstraite — telle que l’anxiété, la mémoire de travail, l’intelligence fluide ou le statut socio-économique — à une variable scientifique mesurable exige une opération critique désignée sous le terme d’opérationnalisation. Opérationnaliser un construit théorique consiste à spécifier sans ambiguïté les opérations matérielles, les comportements observables ou les indicateurs physiologiques par lesquels ce construit sera identifié, quantifié ou catégorisé dans le monde sensible. Par exemple, le construit abstrait d’« agressivité » peut être opérationnalisé soit sous la forme qualitative d’une typologie comportementale (agression verbale, agression physique directe, évitement passif-agressif), soit sous la forme quantitative du nombre d’impacts enregistrés sur un dispositif mécanique ou du dosage plasmatique de testostérone.
La nécessité de classifier rigoureusement ces variables en amont de toute démarche empirique répond à un impératif de validité scientifique. Faute d’une identification préalable sans faille de la nature de la variable — qu’elle soit indépendante, dépendante, modératrice, médiatrice ou confondante —, le chercheur s’expose à une incapacité fondamentale à structurer son plan de recherche (devis expérimental, quasi-expérimental ou corrélationnel). L’opérationnalisation détermine ainsi le périmètre des inférences admissibles et constitue le point d’ancrage exclusif sur lequel repose la réplicabilité du protocole.
1.2 L’importance cruciale de la distinction qualitatif-quantitatif
La césure entre variables qualitatives et quantitatives transcende les aspects purement formels du codage des données : elle gouverne directement l’édifice de la validité interne et de la validité externe d’une recherche. La validité interne, qui renvoie à la certitude que les variations observées sur la variable dépendante sont causées de manière univoque par la manipulation de la variable indépendante, dépend d’une mesure exempte de biais de classification ou d’artefacts d’échelle. La validité externe, quant à elle, concerne la transférabilité et la généralisabilité des résultats à la population cible ; elle exige que les propriétés métriques attribuées aux observations reflètent fidèlement la structure réelle du phénomène étudié dans la nature.
D’un point de vue analytique, la nature qualitative ou quantitative d’une variable exerce une contrainte axiomatique sur l’arsenal statistique éligible. Les mathématiques appliquées aux sciences sociales ne tolèrent aucune confusion d’échelle : l’application aveugle d’algorithmes matriciels, de calculs différentiels ou de tests d’hypothèses suppose que les structures de données sous-jacentes respectent des postulats stricts d’homoscédasticité, de normalité ou d’additivité. Appliquer une analyse de variance ou un calcul de régression des moindres carrés ordinaires à des données catégorielles dépourvues de distance métrique constitue une violation frontale des postulats mathématiques, aboutissant inéluctablement à des taux prohibitifs d’erreurs de type I (faux positifs) ou de type II (faux négatifs).
Enfin, dans le champ de la psychométrie et de l’évaluation clinique, l’évitement des erreurs d’interprétation exige une vigilance constante. Attribuer une valeur arithmétique arbitraire à un tableau clinique (par exemple, coder 1 pour la dépression majeure, 2 pour le trouble bipolaire, 3 pour la schizophrénie) ne confère en aucun cas à ces entités nosologiques une quelconque métrique sous-jacente. Tenter d’en calculer la « moyenne » constitue une hérésie épistémologique qui obscurcit la réalité clinique plutôt qu’elle ne l’éclaire.
1.3 La taxonomie de Stanley Smith Stevens comme cadre épistémologique
Pour dissiper l’anarchie conceptuelle régnant sur la mesure dans les sciences de l’esprit au début du XXe siècle, le psychologue et biophysicien américain Stanley Smith Stevens publia en 1946 dans la revue Science un article fondateur intitulé « On the Theory of Scales of Measurement ». Dans ce mémoire révolutionnaire, Stevens dépassa l’approche classique de la physique — qui restreignait la mesure à l’évaluation de grandeurs additives — pour proposer une définition unifiée : « La mesure est l’assignation de nombres à des objets ou à des événements selon des règles déterminées ».
Stevens conceptualisa une taxonomie quadripartite hiérarchisée, articulée autour de quatre niveaux de mesure fondamentaux, caractérisés chacun par un groupe d’invariance mathématique et des opérations arithmétiques spécifiques autorisées :
- L’échelle nominale : niveau d’abstraction le plus fondamental, fondé exclusivement sur des relations d’équivalence (identité ou différence). Les nombres n’y fonctionnent que comme de simples étiquettes symboliques.
- L’échelle ordinale : niveau introduisant une relation d’ordre strict ou de préordre complet (supériorité ou infériorité), permettant d’ordonner les observations sans pour autant quantifier l’écart arithmétique qui les sépare.
- L’échelle d’intervalle : premier niveau authentiquement métrique, où la distance séparant deux unités consécutives demeure constante le long du continuum, mais dont le point zéro est conventionnel ou arbitraire.
- L’échelle de rapport (ou de ratio) : sommet de la hiérarchie de mesure, combinant l’égalité des intervalles avec l’existence d’un zéro absolu, non arbitraire, correspondant à l’absence totale de la grandeur étudiée.
Cette classification incarne la transition épistémologique entre la description purement catégorielle (les échelles nominales et ordinales, associées aux variables qualitatives) et la quantification métrique stricte (les échelles d’intervalle et de rapport, réservées aux variables quantitatives). Comprendre cette hiérarchie est indispensable pour appréhender les conditions formelles autorisant les transformations mathématiques licites sur les jeux de données empiriques.
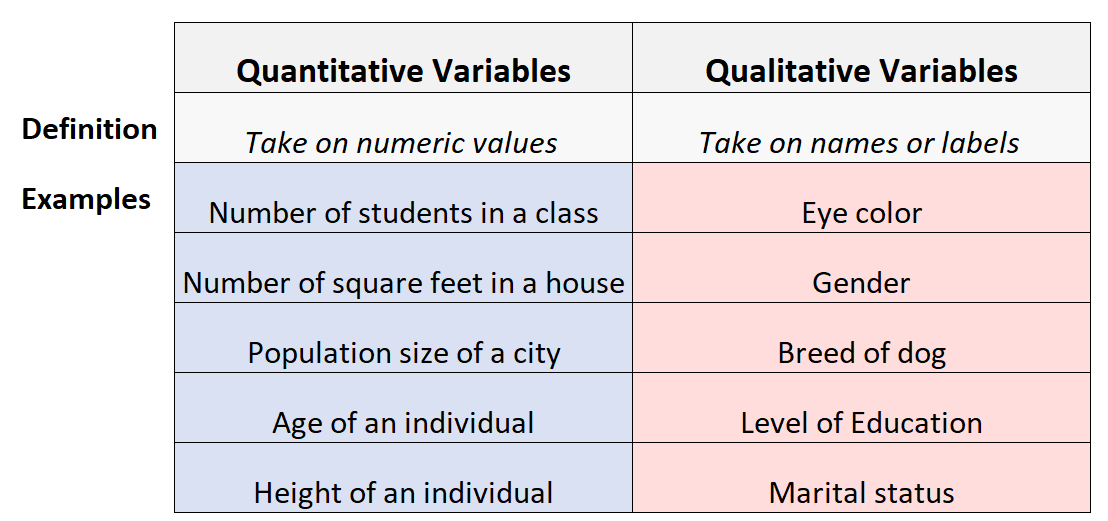
2. Définition et caractéristiques fondamentales des variables qualitatives
2.1 Qu’est-ce qu’une variable qualitative ou catégorielle ?
Une variable est dite qualitative — ou, par équivalence terminologique dans la littérature statistique anglo-saxonne, catégorielle — lorsque les différentes manifestations ou états qu’elle peut prendre ne s’expriment pas sous la forme de grandeurs numériques intrinsèques, mais sous la forme d’états de fait, de modalités ou d’attributs distinctifs. La nature de ces données est par essence non métrique. Elles visent à répondre aux interrogations fondamentales de classification : « À quelle catégorie cette observation appartient-elle ? », « Quelle est la nature de cet état clinique ? » ou « Quel type de comportement a été manifesté ? ».
Dans ce paradigme, les modalités d’une variable qualitative consistent en des étiquettes sémantiques, des descripteurs verbaux ou des noms génériques. Les entités observées sont assignées à des classes d’appartenance fermées. Même lorsqu’un chercheur utilise un logiciel statistique et encode numériquement ces modalités pour en faciliter le stockage binaire dans une matrice (par exemple en attribuant la valeur 1 aux individus célibataires, 2 aux individus mariés et 3 aux individus divorcés), ce chiffre est entièrement dénué de toute signification arithmétique directe. Il ne représente ni une quantité, ni un comptage, ni un degré.
En conséquence immédiate, les opérations arithmétiques fondamentales telles que l’addition, la soustraction, la multiplication ou la division de ces codes de modalité sont rigoureusement dépourvues de sens logique. Réaliser la moyenne arithmétique de statuts d’occupation ou calculer la variance de codes postaux génère un non-sens mathématique complet. Les variables qualitatives documentent une différence de nature ou de typologie, jamais une différence de magnitude spatiale ou métrologique.
2.2 Propriétés logiques des variables qualitatives
L’élaboration scientifique d’une variable qualitative requiert le respect scrupuleux de trois principes fondamentaux issus de la logique formelle et de la théorie des ensembles : l’exhaustivité, l’exclusivité mutuelle et l’équivalence intra-classe.
Le principe d’exhaustivité stipule que le système de catégorisation adopté doit offrir un nombre suffisant de modalités pour que l’intégralité des observations possibles de l’échantillon puisse être assignée sans équivoque à l’une d’entre elles. Aucun individu, aucun comportement, aucun stimulus ne doit se trouver dépourvu de réceptacle classificatoire. Dans la pratique de la modélisation statistique, cette contrainte est fréquemment résolue par l’adjonction contrôlée d’une catégorie résiduelle hermétique du type « Autre » ou « Non spécifié ailleurs », bien que celle-ci doive demeurer marginale pour ne pas masquer un déficit d’opérationnalisation.
Le principe d’exclusivité mutuelle impose qu’une unité d’observation donnée ne puisse appartenir simultanément qu’à une seule et unique modalité de la variable à un instant t. Si les sous-ensembles constituant les catégories présentent une quelconque intersection non vide, le système s’effondre logiquement, rendant impossibles les calculs élémentaires de probabilités conjointes ou disjointes. En notation formelle ensembliste, si $A_i$ et $A_j$ représentent deux modalités distinctes d’une même variable qualitative, alors leur intersection doit nécessairement être vide :
$$A_i \cap A_j = \emptyset \quad \forall i \neq j$$
Enfin, le principe d’équivalence formelle au sein d’une modalité postule que tous les individus ou événements réunis sous une étiquette identique doivent être strictement indiscernables sous l’angle du critère considéré. Si deux sujets sont classifiés sous la modalité « Attachement sécure », ils sont postulés comme équivalents vis-à-vis de cette propriété nosologique, quand bien même leurs trajectoires de vie diffèrent sur d’autres aspects.
2.3 Exemples classiques en psychologie et sciences sociales
Les sciences humaines et sociales mobilisent massivement les variables qualitatives pour conceptualiser la diversité du fonctionnement individuel et collectif. L’un des exemples les plus emblématiques réside dans la nosographie psychiatrique moderne, structurée notamment par le Manuel diagnostique et statistique des troubles mentaux (DSM-5). Au sein de cet ouvrage canonique, la classification d’un patient selon la typologie des troubles anxieux — Trouble Anxieux Généralisé, Trouble Panique, Agoraphobie, Phobie Spécifique — représente une variable qualitative nominale polytomique. Chaque modalité est un label qualitatif défini par un faisceau de critères cliniques explicites, sans relation arithmétique les unes avec les autres.
Dans la recherche sociologique et démographique, les variables qualitatives structurent les strates fondamentales de description des populations d’étude :
- Le statut matrimonial (célibataire, marié, pacsé, divorcé, veuf).
- La filiation ou l’affiliation culturelle déclarée.
- Le secteur d’activité professionnelle selon les nomenclatures de l’INSEE.
- Le genre biologique assigné à la naissance ou l’identité de genre autodéterminée.
Un autre cas paradigmatique en psychologie du développement est la célèbre typologie de l’attachement infantile établie par Mary Ainsworth à travers la procédure standardisée de la « Situation Étrange ». Les nourrissons sont catégorisés de manière qualitative en patrons comportementaux distincts : attachement sécure (type B), attachement insécure-évitant (type A) et attachement insécure-résistant/ambivalent (type C), auxquels s’est adjoint ultérieurement le patron désorganisé (type D). Ces catégories décrivent des organisations systémiques qualitatives de réponses émotionnelles et relationnelles face au stress de la séparation, et non des scores additifs sur un continuum numérique indifférencié.
3. Typologie des variables qualitatives : nominales versus ordinales
3.1 Les variables qualitatives nominales : la simple classification
Les variables qualitatives nominales incarnent le degré zéro de la quantification dans la théorie de Stevens. Elles reposent sur une règle d’assignation dont l’unique exigence est la préservation de l’identité des catégories. Dans une variable nominale, il n’existe absolument aucune notion d’ordonnancement, de hiérarchie intrinsèque ou de gradation naturelle entre les modalités. Aucune modalité ne peut être considérée en soi comme « supérieure », « meilleure » ou « plus intense » qu’une autre. L’ordre de présentation des catégories dans un tableau ou un logiciel relève de la pure convention alphabétique ou aléatoire.
Un sous-ensemble fondamental de ces variables est constitué par les variables dichotomiques (ou binaires), qui ne comportent que deux modalités possibles mutuellement exclusives. Les exemples abondent dans le paradigme expérimental : succès versus échec à une tâche d’inhibition cognitive, présence versus absence d’un réflexe photomoteur, statut vivant versus décédé lors d’un suivi de cohorte en oncologie, ou réponse binaire vrai versus faux dans un test de fluidité sémantique. La variable dichotomique bénéficie d’un statut computationnel singulier : elle peut être intégrée telle quelle dans des modèles linéaires sous la forme d’une indicatrice probabiliste (variable dite muette ou dummy), sans fausser les calculs mathématiques.
À l’inverse, lorsque la variable qualitative nominale présente trois modalités ou davantage, elle est qualifiée de multinomiale ou polytomique. C’est le cas par exemple du groupe sanguin dans le système ABO (A, B, AB, O), de l’orientation théorique dominante d’un clinicien (psychanalytique, cognitivo-comportementale, systémique, humaniste) ou du choix électoral lors d’un scrutin présidentiel. La manipulation analytique de ces variables exige des techniques spécifiques fondées sur des tables de contingence ou des codages matriciels multiples.
3.2 Les variables qualitatives ordinales : l’apparition du rang
Les variables qualitatives ordinales introduisent un saut qualitatif majeur au sein de la catégorisation : elles ajoutent la notion d’ordre sous-jacent ou de gradation naturelle entre les modalités répertoriées. Si deux observations appartiennent à des catégories différentes, le chercheur peut non seulement affirmer qu’elles sont distinctes, mais également que l’une possède un rang plus élevé que l’autre relativement au critère évalué. Les relations logiques formellement autorisées ne se limitent plus à l’égalité ou l’inégalité ($=$ ou $\neq$), mais intègrent les opérateurs d’inégalité stricte ou large ($A$ présente une intensité acoustique de 80 décibels et un stimulus $B$ de 40 décibels, ces nombres réfèrent à des variations d'énergie physique directement comparables via les lois de la log-linéarité acoustique.
De surcroît, la variable quantitative s'articule généralement autour d'une unité de mesure standardisée et invariante (secondes, milligrammes, battements par minute, micromols par litre), qui garantit la comparabilité temporelle et géographique des acquisitions de données. Même en psychologie, où l'unité de mesure est souvent plus abstraite (comme dans les scores standardisés d'échelles normées), l'objectif est d'atteindre une métrique commune permettant de situer l'individu a\vec une précision chirurgicale sur un continuum conti\nu de performance ou d'aptitude cognitive.
<h3>4.2 Propriétés mathématiques des grandeurs quantitatives</h3>
L'assise formelle des variables quantitatives repose sur un ensemble d'axiomes algébriques rigoureux, décrits initialement par Hölder dans la théorie générale des grandeurs mesurables. La première propriété essentielle est la <strong>comparabilité directe</strong> des grandeurs relatives : pour deux valeurs distinctes $x$ et $y$ d'une variable quantitative, il est non seulement trivial de statuer sur $x > y$ ou $x < y$, mais il devient possible de chiffrer précisément l'amplitude de l'écart arithmétique absolu défini par le vecteur $(x – y)$.
La seconde propriété déterminante est l'<strong>additivité</strong> (ou concaténation empirique). Deux grandeurs quantitatives de même dimension peuvent être agrégées pour composer une grandeur nouvelle égale à leur somme arithmétique. Cette additivité garantit que l'accumulation de variations infinitésimales le long de l'échelle engendre un déplacement proportionnel de la grandeur totale. Elle autorise de facto les opérations soustractives qui fondent la notion fondamentale de variance statistique.
Enfin, la structure interne des données quantitatives r\end possible le calcul des moments mathématiques de la distribution d'une variable aléatoire $X$. Là où les variables qualitatives se cantonnent aux dénombrements d'effectifs, la variable quantitative permet d'extraire :
<ul>
<li>Le premier moment ordinaire : l'espérance mathématique ou moyenne arithmétique $\mu$, qui synthétise le barycentre de la distribution.</li>
<li>Le deuxième moment centré : la variance $\sigma^2$, qui quantifie l'inertie quadratique et la dispersion moyenne des observations autour du centre.</li>
<li>Le troisième moment centré normalisé : le coefficient d'asymétrie (<em>skewness</em>), évaluant la déviation de la distribution par rapport à la symétrie gaussienne.</li>
<li>Le quatrième moment centré normalisé : le coefficient d'aplatissement (<em>kurtosis</em>), quantifiant l'épaisseur relative des queues de distribution et la propension à générer des valeurs extrêmes (effet leptokurtique ou platikurtique).</li>
</ul>
<h3>4.3 Exemples emblématiques en recherche expérimentale et clinique</h3>
L'histoire de la psychologie scientifique et des neurosciences cognitives s'est construite sur l'effort incessant de transformer l'observation clinique en variables quantitatives d'une précision millimétrique. L'un des exemples les plus emblématiques et les plus anciennement documentés — depuis les travaux pionniers de Franciscus Donders en chronométrie mentale — réside dans la mesure du <strong>temps de réaction</strong>. Exprimée en millisecondes ($ms$), cette variable temporelle continue quantifie le délai s'écoulant entre l'apparition soudaine d'un stimulus perceptif et la production motrice d'une réponse comportementale (appui sur un bouton pressoir). Elle offre une fenêtre objective et infinitésimale sur la dynamique de la cascade des computations neuronales et de l'effort attentionnel alloué.
Dans l'évaluation des fonctions mnésiques, l'expérimentateur utilise traditionnellement des variables quantitatives issues du dénombrement, telles que le nombre d'essais d'apprentissage nécessaires à un participant pour mémoriser sans faille une liste de 15 mots (procédure de Rey), ou le nombre d'éléments rappelés immédiatement lors d'une tâche d'empan mnésique verbal ou spatial (cubes de Corsi). Dans ce cadre, la grandeur observée quantifie directement la capacité de stockage et la résistance à l'interférence cognitive du système d'encodage.
Dans le domaine psychométrique, le <strong>score brut</strong> obte\nu à un test standardisé d'évaluation intellectuelle — comme les matrices progressives de Raven ou les subtests de la <em>Wechsler Adult Intelligence Scale</em> (<a href="https://www.pearsonassessments.com" target="_blank" rel="noopener noreferrer">WAIS-IV</a>) — constitue une variable quantitative issue de la sommation d'items résolus. Transformé ultérieurement en score étalonné standardisé (Quotient Intellectuel a\vec $\mu = 100$ et $\sigma = 15$), cet indice numérique permet d'ordonner et d'évaluer la magnitude du fonctionnement cognitif général d'un sujet par comparaison rigoureuse à sa cohorte développementale de référence.
<h2>5. Typologie des variables quantitatives : discrètes versus continues</h2>
<h3>5.1 Les variables quantitatives discrètes : la logique du dénombrement</h3>
Au sein du vaste ensemble des grandeurs numériques, la théorie statistique opère une scission fondamentale entre grandeurs discrètes et continues. Une <strong>variable quantitative discrète</strong> est une variable dont l'ensemble des valeurs admissibles est fini ou dénombrable (au sens mathématique de la bijection a\vec l'ensemble des entiers naturels $\mathbb{N}$). Elle ne peut assumer que des valeurs numériques isolées, séparées les unes des autres par des intervalles infranchissables au sein desquels aucune valeur intermédiaire ne possède de réalité empirique.
La logique génératrice d'une variable discrète procède presque systématiquement du <strong>dénombrement</strong> ou du co\mptage d'occurrences d'un phénomène donné au sein d'une unité spatio-temporelle bien délimitée. On ne « mesure » pas une variable discrète à l'aide d'un instrument gradué infini ; on « compte » des unités indivisibles. De facto, ces variables s'expriment la plupart du temps sous forme d'entiers naturels ($0, 1, 2, 3, dots, k$).
En clinique psychiatrique et en psychologie de la santé, les exemples de variables discrètes structurent l'anamnèse quantitative :
<ul>
<li>Le nombre de crises de panique vécues par un patient au cours des sept derniers jours.</li>
<li>Le nombre d'hospitalisations antérieures dans un service de soins de crise.</li>
<li>La taille de la fratrie d'un individu ou le nombre d'enfants à charge.</li>
<li>Le nombre d'erreurs commises lors de la passation informatisée du test de Stroop ou du Wiscon\sin Card Sorting Test.</li>
</ul>
Il est biologiquement et logiquement aberrant de concevoir qu'un sujet ait vécu $2,74$ crises de panique ou appartienne à une fratrie de $3,14$ enfants. Ces quantités procèdent de sauts ontologiques indivisibles, régis d'un p\oint de vue probabiliste par des lois discrètes telles que la loi de Poisson, la loi binomiale ou la loi hypergéométrique.
<figure class="wpt-preserved-image"><img src="https://fr.arabpsychology.com/wp-content/uploads/2026/09/qual3.png" alt="Qualitative vs. quantitative variables" /><figcaption>Qualitative vs. quantitative variables</figcaption></figure>
<h3>5.2 Les variables quantitatives continues : le continuum métrique</h3>
À l'opposé rigoureux de la discrétisation, une <strong>variable quantitative continue</strong> est une entité dont le domaine de définition couvre l'ensemble des nombres réels $\mathbb{R}$ ou un intervalle conti\nu sous-jacent de cet ensemble. En théorie formelle, une telle variable est susceptible d'adopter une infinité indénombrable de valeurs entre deux points quelconques de son échelle, aussi infiniment rapprochés soient-ils. Il n'existe aucun saut ontologique ni interruption dans le continuum géométrique de la grandeur mesurée.
Dans la pratique scientifique, la granularité de la valeur numérique réellement obtenue ne dép\end aucunement de la nature ontologique de la grandeur — qui est postulée comme parfaitement continue —, mais exclusivement du pouvoir de résolution et de la sensibilité instrumentale de l'appareil de mesure mobilisé. Que l'on mesure une durée de latence cognitive en secondes, en millisecondes ou en microsecondes, la grandeur sous-jacente s'écoule de façon continue ; seul l'arrondi matériel de l'instrument en fige l'affichage à une décimale finie.
Les sciences bio-comportementales et les neurosciences regorgent de variables quantitatives continues mesurées à l'aide de senseurs physiques de haute fidélité :
<ul>
<li>Le taux de cortisol salivaire ou plasmatique (exprimé en $nmol/L$), indicateur biologique majeur de la réponse au stress de l'axe hypothalamo-hypophyso-surrénalien.</li>
<li>La conductance cutanée électrodermale (exprimée en microsiemens, $\mu S$), mesurant l'activation autonome sympathique en réponse à des stimuli aversifs.</li>
<li>L'amplitude et la latence pic-à-pic d'une onde électroencéphalographique dans les potentiels évoqués cognitifs, comme la négativité de mésappariement (MMN) ou la composante P300.</li>
<li>La température corporelle centrale, la pression artérielle systolique et diastolique, ou la masse corporelle globale d'un sujet expérimental.</li>
</ul>
<h3>5.3 Frontière opérationnelle et discrétisation des données continues</h3>
Bien que la distinction conceptuelle entre grandeurs discrètes et continues soit \limpide au plan théorique, la réalité du laboratoire et du traitement des données informatisé impose une <strong>frontière opérationnelle</strong> plus nuancée. En effet, tout convertisseur analogique-numérique — qu'il s'agisse d'un système d'acquisition électrophysiologique ou d'une horloge numérique de processeur — effectue un échantillonnage temporel et une quantification discrète d'un signal originellement continu. Toute variable continue enregistrée dans un jeu de données scientifique est donc techniquement représentée par un nombre fini de bits et tronquée sous forme d'une valeur décimale discrétisée.
Toutefois, le problème méthodologique le plus saillant ne réside pas dans cette limitation technique universelle, mais dans les pratiques délibérées de <strong>discrétisation artificielle</strong> (communément désignée sous l'anglicisme <em>binning</em>) opérées par certains chercheurs. Cette pratique consiste à agréger une variable continue brute en un nombre arbitrairement restre\int de catégories ordinales (par exemple, regrouper les âges chronologiques des participants en tranches : 18-29 ans, 30-49 ans, 50 ans et plus) ou, pire encore, à procéder à une <strong>dichotomisation médiane</strong> (séparer un échantillon en deux sous-groupes « scores élevés » versus « scores faibles » de dépression sur la base de la médiane arithmétique de l'échantillon).
La littérature méthodologique contemporaine (notamment les travaux canoniques de MacCallum, Zhang, Preacher et Rucker) a unanimement condamné ces pratiques de discrétisation arbitraire. La dichotomisation d'une variable quantitative continue engendre une perte dramatique d'information statistique (réduisant drastiquement la variance expliquée), ampute sévèrement la puissance statistique des tests d'hypothèses subséquents, masque la détection d'éventuelles non-linéarités relationnelles et majore dramatiquement le risque de produire des associations fallacieuses. Sauf impératif clinique normatif absolu préétabli et validé (tel qu'un seuil de toxicité biologique formel), les variables quantitatives doivent impérativement être collectées, modélisées et analysées dans leur métrique continue originelle.
<h2>6. Échelles d'intervalle et de rapport : l'ancrage quantitatif de Stevens</h2>
<h3>6.1 L'échelle d'intervalle : distances égales et zéro arbitraire</h3>
L'<strong>échelle d'intervalle</strong> constitue le premier palier authentiquement quantitatif et métrique de la taxonomie de Stanley Smith Stevens. Elle se définit par une propriété géométrique déterminante : la constance absolue des intervalles séparant deux unités consécutives sur l'ensemble de l'étendue de l'échelle. Cela signifie qu'un déplacement d'un p\oint — c'est-à-dire l'écart arithmétique séparant une valeur $x$ de la valeur $(x + 1)$ — possède rigoureusement la même signification physique, cognitive ou magnitude relationnelle, que ce déplacement se produise au début, au centre ou à l'extrémité supérieure de l'échelle.
Néanmoins, la signature épistémique exclusive de l'échelle d'intervalle réside dans le <strong>caractère conventionnel ou arbitraire de son p\oint zéro</strong>. Dans une telle métrique, la valeur zéro ne désigne en aucun cas l'absence totale ou l'anéantissement de la grandeur sous-jacente mesurée. Le zéro est simplement un p\oint d'ancrage conventionnel, fixé pour des motifs de commodité pratique ou historique par la communauté scientifique.
L'illustration canonique est fournie par l'échelle de température Celsius : $0^circ\text{C}$ ne signifie nullement l'absence intégrale de chaleur (qui se situe au zéro absolu thermodynamique, soit $-273,15^circ\text{C}$), mais correspond arbitrairement au p\oint de solidification de l'eau pure sous une pression atmosphérique normale standard. Il est donc mathématiquement valide d'affirmer que l'élévation de température entre $10^circ\text{C}$ et $20^circ\text{C}$ ($+10^circ\text{C}$) est rigoureusement équivalente à celle survenue entre $30^circ\text{C}$ et $40^circ\text{C}$ ($+10^circ\text{C}$). En revanche, il est formellement faux d'affirmer qu'un fluide à $40^circ\text{C}$ est « deux fois plus chaud » qu'un fluide à $20^circ\text{C}$. En psychologie cognitive, les scores standardisés de Quotient Intellectuel (QI) relèvent de cette logique d'intervalle : un individu affichant un QI de 140 n'est pas « deux fois plus intelligent » qu'un individu présentant un QI de 70, car le score de zéro au QI n'est qu'un artefact mathématique d'extrapolation théorique ne correspondant à aucune absence absolue de processus cognitif.
<h3>6.2 L'échelle de rapport (ou de ratio) : l'existence du zéro absolu</h3>
Au sommet incontesté de la hiérarchie de la mesure trône l'<strong>échelle de rapport</strong> (ou échelle de ratio). Elle réunit et sublime l'ensemble des propriétés des trois échelles précédentes : l'ordonnancement hiérarchique strict des modalités, la constance universelle de la métrique des intervalles inter-unités, auxquelles elle adj\oint une caractéristique fondamentale : <strong>l'existence d'un zéro absolu naturel</strong>, invariant et non arbitraire.
La présence de ce p\oint zéro originel signifie la négation ou l'absence totale et irréductible de la dimension ou de la propriété phénoménologique sous investigation. Par voie de conséquence, sur une échelle de rapport, non seulement les distances (différences arithmétiques) sont pleinement interprétables, mais les <strong>ratios ou rapports de grandeurs</strong> acquièrent une validité mathématique universelle. Il devient pleinement licite de procéder à des multiplications ou à des divisions entre les valeurs observées sans altérer la signification physique des données.
Les grandeurs mesurées en laboratoire physique ou comportemental relèvent majoritairement de cette échelle :
<ul>
<li>La durée temporelle (par exemple, une latence de réponse motrice de $400,ms$ est très exactement deux fois plus longue qu'une latence de $200,ms$ ; $0,ms$ représente l'ins\tantanéité absolue).</li>
<li>La masse corporelle ou la force d'écrasement dynamométrique (un dynamomètre affichant zéro newton témoigne de l'absence complète de contraction musculaire mesurable).</li>
<li>La distance spatiale parcourue par un rongeur dans un labyrinthe de Morris ou une arène d'évaluation de l'anxiété (<em>open-field</em>).</li>
<li>La concentration sérique d'une molécule pharmacologique ou d'une hormone régulatrice.</li>
</ul>
<h3>6.3 Synthèse des transformations mathématiques autorisées</h3>
L'apport épistémologique impérissable de Stevens réside dans la formalisation des groupes mathématiques de transformation sous lesquels les relations empiriques mesurées demeurent parfaitement invariantes. La règle directrice stipule qu'une analyse statistique n'est valide que si elle demeure invariante sous les transformations mathématiques autorisées pour le niveau de mesure considéré.
Pour une <strong>échelle ordinale</strong>, toute <strong>transformation monotone strictement croissante</strong> $f(x)$ est admissible : »>$$).
Néanmoins, la caractéristique déterminante — et la limite épistémique absolue — de la variable ordinale réside dans l’indétermination de la distance métrique entre les rangs successifs. L’écart arithmétique séparant le rang 1 du rang 2 n’est en rien garanti équivalent à l’écart séparant le rang 2 du rang 3. Le passage d’une modalité à une autre reflète une transition qualitativement ordonnée sans calibrage métrologique fixe. L’ordonnancement informe sur la direction du changement ou la séquence des intensités, mais il est rigoureusement muet sur l’amplitude absolue ou relative de cette différence.
En psychométrie et en clinique médicale, les exemples de variables ordinales sont omniprésents. On peut citer l’évaluation standardisée de la sévérité d’un symptôme clinique (par exemple : absent, léger, modéré, sévère), les stades de développement piagétiens chez l’enfant (sensori-moteur, préopératoire, opérations concrètes, opérations formelles), le niveau d’instruction d’un participant (primaire, secondaire inférieur, secondaire supérieur, supérieur court, supérieur long), ou encore le classement final des candidats à un concours d’internat en psychiatrie. Le premier du concours est incontestablement mieux classé que le deuxième, et le deuxième mieux que le troisième ; pourtant, il est matériellement impossible de déduire des rangs d’arrivée l’ampleur des écarts de compétences ou de notes brutes qui les séparent.
3.3 Le débat méthodologique autour des échelles de Likert
L’utilisation massive des échelles de réponse à points fermés — popularisées en 1932 par le sociologue et psychologue américain Rensis Likert — constitue l’épicentre d’un débat méthodologique et statistique séculaire au sein des sciences comportementales. Un item de type Likert présente une affirmation à laquelle le sujet répond en choisissant parmi une série de modalités verbales ordonnées (par exemple : « Pas du tout d’accord », « Plutôt pas d’accord », « Neutre », « Plutôt d’accord », « Tout à fait d’accord »). De par sa construction structurelle, un tel item constitue indiscutablement une variable qualitative ordinale : rien ne permet d’attester que la distance psychologique ressentie entre « Pas du tout d’accord » et « Plutôt pas d’accord » soit rigoureusement congruente à celle séparant « Neutre » et « Plutôt d’accord ».
Toutefois, une pratique quasi universelle dans la modélisation statistique — issue de la tradition de la théorie classique des tests — consiste à attribuer des entiers consécutifs à ces modalités (de 1 à 5) et à sommer les scores de plusieurs items censés mesurer un même construit latent pour dériver un score global sommatif. Dès lors, les analystes traitent fréquemment cette variable résultante comme une mesure quantitative de niveau quasi-intervalle, s’autorisant le calcul de moyennes arithmétiques, de coefficients de corrélation de Pearson et de modélisations structurelles linéaires.
Les risques épistémiques et statistiques inhérents à cette assimilation abusive sont massifs. Comme l’ont démontré de nombreux théoriciens de la mesure (notamment dans les paradigmes de la modélisation de Rasch et de la théorie de réponse aux items), présumer arbitrairement l’équidistance des intervalles sur une échelle ordinale peut fausser l’estimation de l’erreur standard, engendrer des distorsions d’inférence sévères et occulter des effets non linéaires cruciaux. Les tenants d’une orthodoxie méthodologique rappellent a\vec force que le traitement d’une échelle ordinale brute par des tests paramétriques viole les prémisses de validité formelle, préconisant l’usage exclusif de la statistique non paramétrique ou de modèles de régression ordinale à seuils latents (modèles probit ou logit cumulatifs).
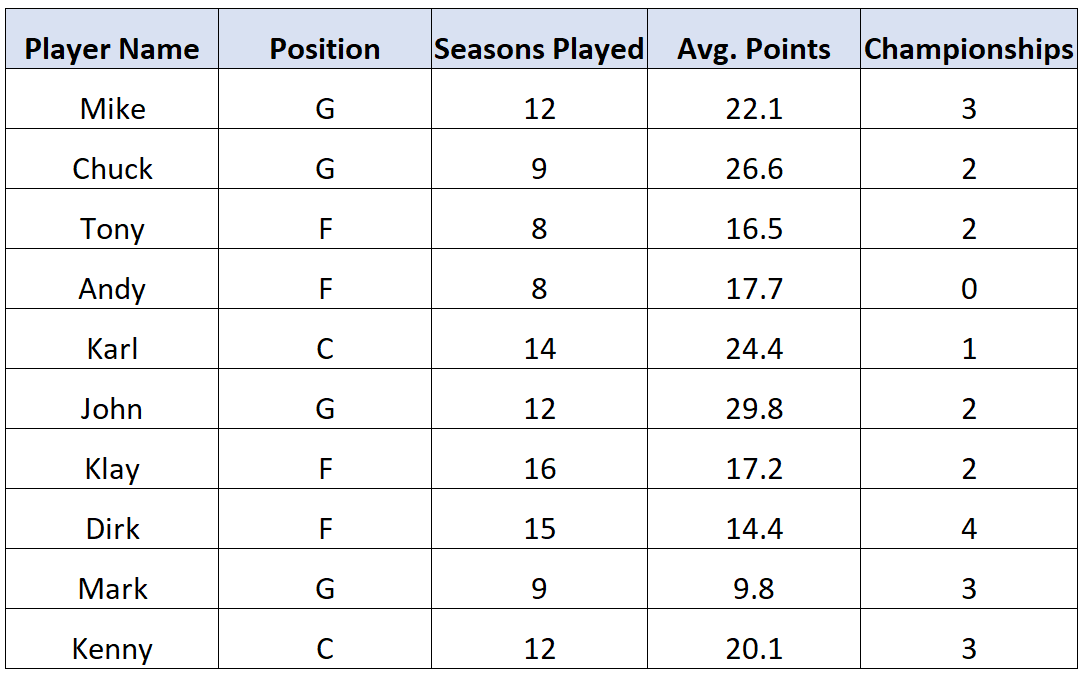
4. Définition et fondements des variables quantitatives
4.1 Qu’est-ce qu’une variable quantitative ou numérique ?
Une variable est formellement définie comme quantitative — ou numérique — lorsqu’elle mesure une grandeur réelle dont les modalités représentent des quantités arithmétiques véritables dotées d’une signification spatiale, temporelle, matérielle ou psychométrique universelle. Contrairement aux modalités catégorielles qui opèrent par différenciation ontologique ou position relative, les valeurs d’une variable quantitative répondent à la question dimensionnelle : « Combien ? », « Quelle quantité ? » ou « Quelle intensité métrique ? ». Elles désignent une ampleur (magnitude) précisément définie.
La propriété intrinsèque qui émancipe la variable quantitative de la subjectivité de l’observateur réside dans son adéquation formelle aux opérations arithmétiques universelles. Parce que les nombres attribués ne sont plus des étiquettes arbitraires mais l’expression directe de la magnitude mesurée, ils autorisent légitimement le calcul d’additions, de soustractions, de moyennes géométriques et de dérivations fonctionnelles. Si un stimulus auditif $A$ présente une intensité acoustique de 80 décibels et un stimulus $B$ de 40 décibels, ces nombres réfèrent à des variations d’énergie physique directement comparables via les lois de la log-linéarité acoustique.
De surcroît, la variable quantitative s’articule généralement autour d’une unité de mesure standardisée et invariante (secondes, milligrammes, battements par minute, micromols par litre), qui garantit la comparabilité temporelle et géographique des acquisitions de données. Même en psychologie, où l’unité de mesure est souvent plus abstraite (comme dans les scores standardisés d’échelles normées), l’objectif est d’atteindre une métrique commune permettant de situer l’individu a\vec une précision chirurgicale sur un continuum conti\nu de performance ou d’aptitude cognitive.
4.2 Propriétés mathématiques des grandeurs quantitatives
L’assise formelle des variables quantitatives repose sur un ensemble d’axiomes algébriques rigoureux, décrits initialement par Hölder dans la théorie générale des grandeurs mesurables. La première propriété essentielle est la comparabilité directe des grandeurs relatives : pour deux valeurs distinctes $x$ et $y$ d’une variable quantitative, il est non seulement trivial de statuer sur $x > y$ ou $x < y$, mais il devient possible de chiffrer précisément l'amplitude de l'écart arithmétique absolu défini par le vecteur $(x – y)$.
La seconde propriété déterminante est l’additivité (ou concaténation empirique). Deux grandeurs quantitatives de même dimension peuvent être agrégées pour composer une grandeur nouvelle égale à leur somme arithmétique. Cette additivité garantit que l’accumulation de variations infinitésimales le long de l’échelle engendre un déplacement proportionnel de la grandeur totale. Elle autorise de facto les opérations soustractives qui fondent la notion fondamentale de variance statistique.
Enfin, la structure interne des données quantitatives r\end possible le calcul des moments mathématiques de la distribution d’une variable aléatoire $X$. Là où les variables qualitatives se cantonnent aux dénombrements d’effectifs, la variable quantitative permet d’extraire :
- Le premier moment ordinaire : l’espérance mathématique ou moyenne arithmétique $\mu$, qui synthétise le barycentre de la distribution.
- Le deuxième moment centré : la variance $\sigma^2$, qui quantifie l’inertie quadratique et la dispersion moyenne des observations autour du centre.
- Le troisième moment centré normalisé : le coefficient d’asymétrie (skewness), évaluant la déviation de la distribution par rapport à la symétrie gaussienne.
- Le quatrième moment centré normalisé : le coefficient d’aplatissement (kurtosis), quantifiant l’épaisseur relative des queues de distribution et la propension à générer des valeurs extrêmes (effet leptokurtique ou platikurtique).
4.3 Exemples emblématiques en recherche expérimentale et clinique
L’histoire de la psychologie scientifique et des neurosciences cognitives s’est construite sur l’effort incessant de transformer l’observation clinique en variables quantitatives d’une précision millimétrique. L’un des exemples les plus emblématiques et les plus anciennement documentés — depuis les travaux pionniers de Franciscus Donders en chronométrie mentale — réside dans la mesure du temps de réaction. Exprimée en millisecondes ($ms$), cette variable temporelle continue quantifie le délai s’écoulant entre l’apparition soudaine d’un stimulus perceptif et la production motrice d’une réponse comportementale (appui sur un bouton pressoir). Elle offre une fenêtre objective et infinitésimale sur la dynamique de la cascade des computations neuronales et de l’effort attentionnel alloué.
Dans l’évaluation des fonctions mnésiques, l’expérimentateur utilise traditionnellement des variables quantitatives issues du dénombrement, telles que le nombre d’essais d’apprentissage nécessaires à un participant pour mémoriser sans faille une liste de 15 mots (procédure de Rey), ou le nombre d’éléments rappelés immédiatement lors d’une tâche d’empan mnésique verbal ou spatial (cubes de Corsi). Dans ce cadre, la grandeur observée quantifie directement la capacité de stockage et la résistance à l’interférence cognitive du système d’encodage.
Dans le domaine psychométrique, le score brut obte\nu à un test standardisé d’évaluation intellectuelle — comme les matrices progressives de Raven ou les subtests de la Wechsler Adult Intelligence Scale (WAIS-IV) — constitue une variable quantitative issue de la sommation d’items résolus. Transformé ultérieurement en score étalonné standardisé (Quotient Intellectuel a\vec $\mu = 100$ et $\sigma = 15$), cet indice numérique permet d’ordonner et d’évaluer la magnitude du fonctionnement cognitif général d’un sujet par comparaison rigoureuse à sa cohorte développementale de référence.
5. Typologie des variables quantitatives : discrètes versus continues
5.1 Les variables quantitatives discrètes : la logique du dénombrement
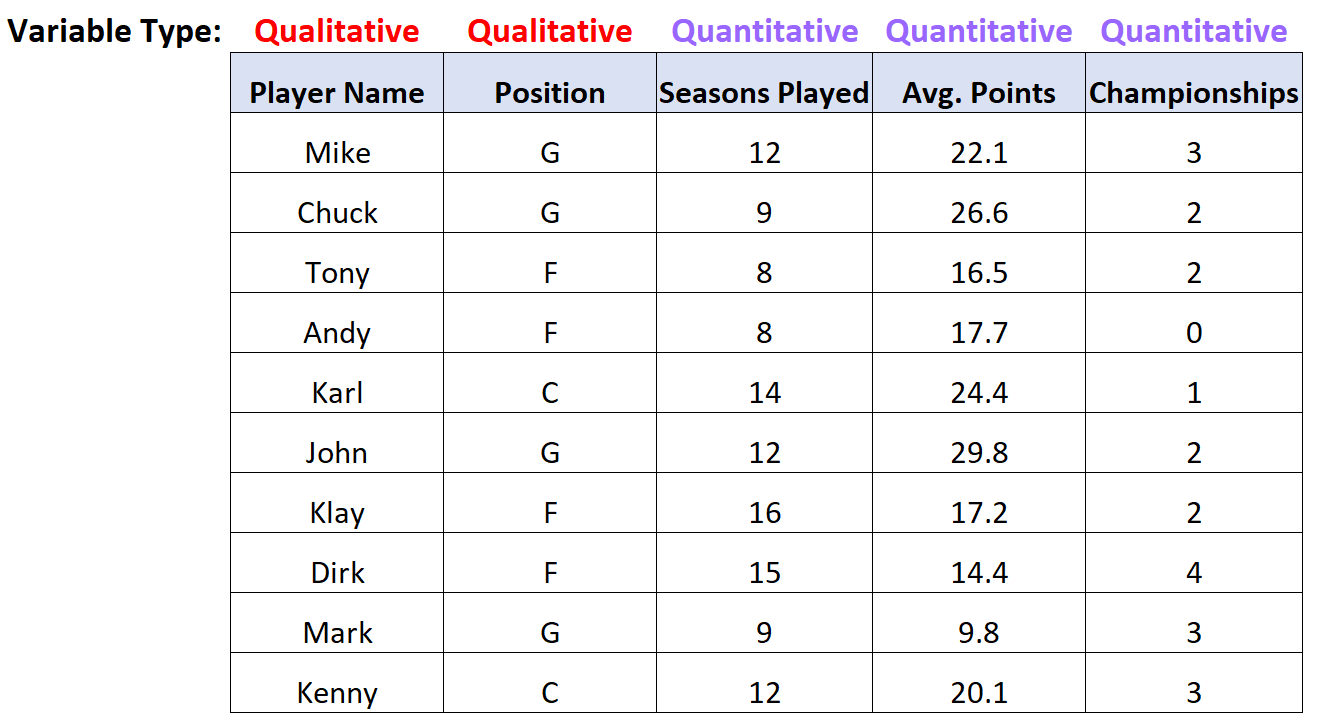
Au sein du vaste ensemble des grandeurs numériques, la théorie statistique opère une scission fondamentale entre grandeurs discrètes et continues. Une variable quantitative discrète est une variable dont l’ensemble des valeurs admissibles est fini ou dénombrable (au sens mathématique de la bijection a\vec l’ensemble des entiers naturels $\mathbb{N}$). Elle ne peut assumer que des valeurs numériques isolées, séparées les unes des autres par des intervalles infranchissables au sein desquels aucune valeur intermédiaire ne possède de réalité empirique.
La logique génératrice d’une variable discrète procède presque systématiquement du dénombrement ou du co\mptage d’occurrences d’un phénomène donné au sein d’une unité spatio-temporelle bien délimitée. On ne « mesure » pas une variable discrète à l’aide d’un instrument gradué infini ; on « compte » des unités indivisibles. De facto, ces variables s’expriment la plupart du temps sous forme d’entiers naturels ($0, 1, 2, 3, dots, k$).
En clinique psychiatrique et en psychologie de la santé, les exemples de variables discrètes structurent l’anamnèse quantitative :
- Le nombre de crises de panique vécues par un patient au cours des sept derniers jours.
- Le nombre d’hospitalisations antérieures dans un service de soins de crise.
- La taille de la fratrie d’un individu ou le nombre d’enfants à charge.
- Le nombre d’erreurs commises lors de la passation informatisée du test de Stroop ou du Wiscon\sin Card Sorting Test.
Il est biologiquement et logiquement aberrant de concevoir qu’un sujet ait vécu $2,74$ crises de panique ou appartienne à une fratrie de $3,14$ enfants. Ces quantités procèdent de sauts ontologiques indivisibles, régis d’un p\oint de vue probabiliste par des lois discrètes telles que la loi de Poisson, la loi binomiale ou la loi hypergéométrique.
5.2 Les variables quantitatives continues : le continuum métrique
À l’opposé rigoureux de la discrétisation, une variable quantitative continue est une entité dont le domaine de définition couvre l’ensemble des nombres réels $\mathbb{R}$ ou un intervalle conti\nu sous-jacent de cet ensemble. En théorie formelle, une telle variable est susceptible d’adopter une infinité indénombrable de valeurs entre deux points quelconques de son échelle, aussi infiniment rapprochés soient-ils. Il n’existe aucun saut ontologique ni interruption dans le continuum géométrique de la grandeur mesurée.
Dans la pratique scientifique, la granularité de la valeur numérique réellement obtenue ne dép\end aucunement de la nature ontologique de la grandeur — qui est postulée comme parfaitement continue —, mais exclusivement du pouvoir de résolution et de la sensibilité instrumentale de l’appareil de mesure mobilisé. Que l’on mesure une durée de latence cognitive en secondes, en millisecondes ou en microsecondes, la grandeur sous-jacente s’écoule de façon continue ; seul l’arrondi matériel de l’instrument en fige l’affichage à une décimale finie.
Les sciences bio-comportementales et les neurosciences regorgent de variables quantitatives continues mesurées à l’aide de senseurs physiques de haute fidélité :
- Le taux de cortisol salivaire ou plasmatique (exprimé en $nmol/L$), indicateur biologique majeur de la réponse au stress de l’axe hypothalamo-hypophyso-surrénalien.
- La conductance cutanée électrodermale (exprimée en microsiemens, $\mu S$), mesurant l’activation autonome sympathique en réponse à des stimuli aversifs.
- L’amplitude et la latence pic-à-pic d’une onde électroencéphalographique dans les potentiels évoqués cognitifs, comme la négativité de mésappariement (MMN) ou la composante P300.
- La température corporelle centrale, la pression artérielle systolique et diastolique, ou la masse corporelle globale d’un sujet expérimental.
5.3 Frontière opérationnelle et discrétisation des données continues
Bien que la distinction conceptuelle entre grandeurs discrètes et continues soit \limpide au plan théorique, la réalité du laboratoire et du traitement des données informatisé impose une frontière opérationnelle plus nuancée. En effet, tout convertisseur analogique-numérique — qu’il s’agisse d’un système d’acquisition électrophysiologique ou d’une horloge numérique de processeur — effectue un échantillonnage temporel et une quantification discrète d’un signal originellement continu. Toute variable continue enregistrée dans un jeu de données scientifique est donc techniquement représentée par un nombre fini de bits et tronquée sous forme d’une valeur décimale discrétisée.
Toutefois, le problème méthodologique le plus saillant ne réside pas dans cette limitation technique universelle, mais dans les pratiques délibérées de discrétisation artificielle (communément désignée sous l’anglicisme binning) opérées par certains chercheurs. Cette pratique consiste à agréger une variable continue brute en un nombre arbitrairement restre\int de catégories ordinales (par exemple, regrouper les âges chronologiques des participants en tranches : 18-29 ans, 30-49 ans, 50 ans et plus) ou, pire encore, à procéder à une dichotomisation médiane (séparer un échantillon en deux sous-groupes « scores élevés » versus « scores faibles » de dépression sur la base de la médiane arithmétique de l’échantillon).
La littérature méthodologique contemporaine (notamment les travaux canoniques de MacCallum, Zhang, Preacher et Rucker) a unanimement condamné ces pratiques de discrétisation arbitraire. La dichotomisation d’une variable quantitative continue engendre une perte dramatique d’information statistique (réduisant drastiquement la variance expliquée), ampute sévèrement la puissance statistique des tests d’hypothèses subséquents, masque la détection d’éventuelles non-linéarités relationnelles et majore dramatiquement le risque de produire des associations fallacieuses. Sauf impératif clinique normatif absolu préétabli et validé (tel qu’un seuil de toxicité biologique formel), les variables quantitatives doivent impérativement être collectées, modélisées et analysées dans leur métrique continue originelle.
6. Échelles d’intervalle et de rapport : l’ancrage quantitatif de Stevens
6.1 L’échelle d’intervalle : distances égales et zéro arbitraire
L’échelle d’intervalle constitue le premier palier authentiquement quantitatif et métrique de la taxonomie de Stanley Smith Stevens. Elle se définit par une propriété géométrique déterminante : la constance absolue des intervalles séparant deux unités consécutives sur l’ensemble de l’étendue de l’échelle. Cela signifie qu’un déplacement d’un p\oint — c’est-à-dire l’écart arithmétique séparant une valeur $x$ de la valeur $(x + 1)$ — possède rigoureusement la même signification physique, cognitive ou magnitude relationnelle, que ce déplacement se produise au début, au centre ou à l’extrémité supérieure de l’échelle.
Néanmoins, la signature épistémique exclusive de l’échelle d’intervalle réside dans le caractère conventionnel ou arbitraire de son p\oint zéro. Dans une telle métrique, la valeur zéro ne désigne en aucun cas l’absence totale ou l’anéantissement de la grandeur sous-jacente mesurée. Le zéro est simplement un p\oint d’ancrage conventionnel, fixé pour des motifs de commodité pratique ou historique par la communauté scientifique.
L’illustration canonique est fournie par l’échelle de température Celsius : $0^circ\text{C}$ ne signifie nullement l’absence intégrale de chaleur (qui se situe au zéro absolu thermodynamique, soit $-273,15^circ\text{C}$), mais correspond arbitrairement au p\oint de solidification de l’eau pure sous une pression atmosphérique normale standard. Il est donc mathématiquement valide d’affirmer que l’élévation de température entre $10^circ\text{C}$ et $20^circ\text{C}$ ($+10^circ\text{C}$) est rigoureusement équivalente à celle survenue entre $30^circ\text{C}$ et $40^circ\text{C}$ ($+10^circ\text{C}$). En revanche, il est formellement faux d’affirmer qu’un fluide à $40^circ\text{C}$ est « deux fois plus chaud » qu’un fluide à $20^circ\text{C}$. En psychologie cognitive, les scores standardisés de Quotient Intellectuel (QI) relèvent de cette logique d’intervalle : un individu affichant un QI de 140 n’est pas « deux fois plus intelligent » qu’un individu présentant un QI de 70, car le score de zéro au QI n’est qu’un artefact mathématique d’extrapolation théorique ne correspondant à aucune absence absolue de processus cognitif.
6.2 L’échelle de rapport (ou de ratio) : l’existence du zéro absolu
Au sommet incontesté de la hiérarchie de la mesure trône l’échelle de rapport (ou échelle de ratio). Elle réunit et sublime l’ensemble des propriétés des trois échelles précédentes : l’ordonnancement hiérarchique strict des modalités, la constance universelle de la métrique des intervalles inter-unités, auxquelles elle adj\oint une caractéristique fondamentale : l’existence d’un zéro absolu naturel, invariant et non arbitraire.
La présence de ce p\oint zéro originel signifie la négation ou l’absence totale et irréductible de la dimension ou de la propriété phénoménologique sous investigation. Par voie de conséquence, sur une échelle de rapport, non seulement les distances (différences arithmétiques) sont pleinement interprétables, mais les ratios ou rapports de grandeurs acquièrent une validité mathématique universelle. Il devient pleinement licite de procéder à des multiplications ou à des divisions entre les valeurs observées sans altérer la signification physique des données.
Les grandeurs mesurées en laboratoire physique ou comportemental relèvent majoritairement de cette échelle :
- La durée temporelle (par exemple, une latence de réponse motrice de $400,ms$ est très exactement deux fois plus longue qu’une latence de $200,ms$ ; $0,ms$ représente l’ins\tantanéité absolue).
- La masse corporelle ou la force d’écrasement dynamométrique (un dynamomètre affichant zéro newton témoigne de l’absence complète de contraction musculaire mesurable).
- La distance spatiale parcourue par un rongeur dans un labyrinthe de Morris ou une arène d’évaluation de l’anxiété (open-field).
- La concentration sérique d’une molécule pharmacologique ou d’une hormone régulatrice.
6.3 Synthèse des transformations mathématiques autorisées
L’apport épistémologique impérissable de Stevens réside dans la formalisation des groupes mathématiques de transformation sous lesquels les relations empiriques mesurées demeurent parfaitement invariantes. La règle directrice stipule qu’une analyse statistique n’est valide que si elle demeure invariante sous les transformations mathématiques autorisées pour le niveau de mesure considéré.
Pour une échelle ordinale, toute transformation monotone strictement croissante $f(x)$ est admissible :$$x_1 > x_2 iff f(x_1) > f(x_2)$$On peut appliquer une transformation logarithmique, exponentielle ou quadratique à une suite ordinale : tant que l’ordre des rangs demeure indemne, l’information sous-jacente est intégralement préservée. C’est pourquoi seule la statistique non paramétrique fondée sur les rangs (Wilcoxon, Mann-Whitney, Kruskal-Wallis) est formellement appropriée à ce niveau.
Pour une échelle d’intervalle, la classe d’invariance est restreinte aux transformations affines positives de la forme linéaire :$$f(x) = ax + b quad (a > 0, b in mathbb{R})$b$ illustre le glissement arbitraire de l'origine (le zéro), tandis que le paramètre $a$ module l'étirement ou la contraction de l'unité de mesure. La célèbre conversion entre les degrés Fahrenheit et les degrés Celsius — $F = \frac{9}{5}C + 32$ — matérialise précisément cette invariance affine. Les ratios de différences arithmétiques sont préservés : »>$$Le paramètre $b$ illustre le glissement arbitraire de l’origine (le zéro), tandis que le paramètre $a$ module l’étirement ou la contraction de l’unité de mesure. La célèbre conversion entre les degrés Fahrenheit et les degrés Celsius — $F = \frac{9}{5}C + 32$ — matérialise précisément cette invariance affine. Les ratios de différences arithmétiques sont préservés :$$frac{(x_1 – x_2)}{(x_3 – x_4)} = frac{(f(x_1) – f(x_2))}{(f(x_3) – f(x_4))}$b = 0$), la seule transformation autorisée est l'<strong>homothétie positive</strong> (transformation linéaire stricte ou multiplication par une constante positive d'échelle) : »>$$Pour une échelle de rapport, l’origine zéro étant immuable et ancrée dans le réel physique ($b = 0$), la seule transformation autorisée est l’homothétie positive (transformation linéaire stricte ou multiplication par une constante positive d’échelle) :$$f(x) = ax quad (a > 0)$$Elle correspond aux simples conversions d’unités de mesure métriques (passer des mètres aux centimètres, des grammes aux kilogrammes ou des secondes aux minutes). Dans ce cadre strict, les ratios entre deux grandeurs directes demeurent éternellement invariants :$$frac{x_1}{x_2} = frac{f(x_1)}{f(x_2)} = frac{ax_1}{ax_2}$\mathbb{R}$).</td>
</tr>
<tr>
<td><strong>Échelles de Stevens associées</strong></td>
<td>Échelle nominale et Échelle ordinale.</td>
<td>Échelle d'intervalle et Échelle de rapport (ratio).</td>
</tr>
<tr>
<td><strong>Opérations arithmétiques autorisées</strong></td>
<td>Aucune sur les données brutes (les calculs de moyennes et variances de codes nominaux sont sans objet).</td>
<td>Addition, soustraction, multiplication, division, calcul différentiel, dérivation fonctionnelle.</td>
</tr>
<tr>
<td><strong>Mesures de tendance centrale canoniques</strong></td>
<td>Mode (nominal et ordinal), Médiane (ordinal exclusivement).</td>
<td>Moyenne arithmétique, Médiane, Moyenne géométrique ou harmonique.</td>
</tr>
<tr>
<td><strong>Indices de dispersion adaptés</strong></td>
<td>Entropie de Shannon, indice de diversité qualitative, étendue interquartile (ordinal).</td>
<td>Écart-type, variance, étendue, écart interquartile, coefficient de variation.</td>
</tr>
<tr>
<td><strong>Tests d'hypothèses inférentiels classiques</strong></td>
<td>Chi-deux d'indépendance de Pearson, test exact de Fisher, modèles log-linéaires, régression logistique.</td>
<td>Test $t$ de Student, ANOVA univariée/multivariée, régression linéaire multiple, modèles mixtes.</td>
</tr>
<tr>
<td><strong>Formats graphiques représentatifs</strong></td>
<td>Diagrammes en barres sectorielles disjointes, diagrammes circulaires, mosaïques de contingence.</td>
<td>Histogrammes continus, diagrammes de densité, boîtes à moustaches, nuages de points.</td>
</tr>
<tr>
<td><strong>Sensibilité statistique et échantillonnage</strong></td>
<td>Nécessite souvent de vastes échantillons pour peupler de façon équilibrée toutes les cellules de croisement.</td>
<td>Sensibilité statistique supérieure à taille d'échantillon égale en raison de la richesse métrique continue.</td>
</tr>
</tbody>
</table>
<figure class="wpt-preserved-image"><img src="https://fr.arabpsychology.com/wp-content/uploads/2026/09/qual3.png" alt="Qualitative vs. quantitative variables" /><figcaption>Qualitative vs. quantitative variables</figcaption></figure>
<h3>7.2 L'arbre de décision méthodologique pour identifier le type d'une variable</h3>
Face à une variable inconnue dans une base de données brute ou un protocole d'expérimentation, le chercheur doit appliquer un algorithme décisionnel séquentiel en trois étapes distinctes pour classifier sans équivoque la nature du phénomène :
<strong>Étape 1 : Discrimination ontologique (Étiquette versus Grandeur numérique).</strong>
L'observateur doit se poser la question suivante : <em>« Les valeurs attribuées représentent-elles intrinsèquement des descripteurs verbaux, des états, des étiquettes arbitraires ou des appartenances de groupe, ou constituent-elles l'expression directe d'une grandeur mesurable ou dénombrable ? »</em>
Si la variable ne fait que regrouper ou dénommer des individus selon une caractéristique d'état, elle est catégorisée comme <strong>qualitative</strong>. Si les valeurs expriment un décompte ou une mesure physique indépendante de l'arbitraire du codage, la variable est classifiée comme <strong>quantitative</strong>.
<strong>Étape 2 : Vérification de la métrique arithmétique.</strong>
Si la variable se présente sous une apparence numérique (des chiffres), l'analyste doit impérativement questionner l'espacement arithmétique : <em>« La différence soustractive $(x_2 – x_1)$ a-t-elle un sens empirique identique et constant sur toute l'échelle ? Le calcul d'une moyenne arithmétique a-t-il une signification substantielle concrète ? »</em>
Si la réponse est négative — par exemple, pour des codes postaux, des numéros d'immatriculation d'écoles ou les chiffres 1, 2, 3 d'un item d'accord —, la variable est irrémédiablement ramenée vers le statut de variable qualitative (nominale si aucun ordre n'existe, ordinale si les chiffres traduisent une gradation hiérarchique). Si la réponse est affirmative, la variable est validée comme quantitative.
<strong>Étape 3 : Spécification terminale de niveau de mesure.</strong>
Pour la branche qualitative : déterminer s'il existe une relation d'ordre naturelle et univoque entre les modalités. Si non $\rightarrow$ <strong>Variable qualitative nominale</strong> ; si oui $\rightarrow$ <strong>Variable qualitative ordinale</strong>.
Pour la branche quantitative : examiner l'ensemble des valeurs théoriquement possibles. Si les valeurs procèdent d'un processus de dénombrement par entiers indivisibles sans possibilité de valeurs intermédiaires réelles $\rightarrow$ <strong>Variable quantitative discrète</strong> ; si les valeurs s'inscrivent sur un continuum indénombrable et sont théoriquement divisibles à l'infini $\rightarrow$ <strong>Variable quantitative continue</strong>. Enfin, vérifier l'existence d'un zéro absolu pour statuer sur la classification finale en échelle d'intervalle versus échelle de rapport.
<h3>7.3 Le piège fréquent des codes numériques attribués aux variables qualitatives</h3>
L'un des artefacts méthodologiques les plus destructeurs en analyse de données — fréquemment observé chez les analystes débutants ou lors de manipulations automatisées de grands jeux de données (<em>\Big Data</em>) — procède de la confusion délétère entre le <strong>contenant informatique</strong> et le <strong>conte\nu métrologique</strong> d'une variable. Dans la majorité des progiciels de statistique contemporains (tels que <a href="https://www.r-project.org" target="_blank" rel="noopener noreferrer">R</a>, SPSS, SAS ou les bibliothèques Python comme Pandas), les chaînes de caractères qualitatives sont couramment converties ou étiquetées à l'aide de codes numériques conventionnels afin d'optimiser l'allocation de mémoire vive et d'accélérer les processus d'indexation matricielle.
Par exemple, une variable de genre peut être arbitrairement codée dans le tableur brut :
<ul>
<li>$0$ pour « Homme »</li>
<li>$1$ pour « Femme »</li>
<li>$2$ pour « Non-binaire »</li>
</ul>
L'erreur classique consiste à solliciter aveuglément des fonctions de résumé statistique sur ce vecteur numérique et à déduire par exemple que la « moyenne » de la variable genre au sein de l'échantillon est de $0,87$. Cette valeur n'a absolument aucun ancrage phénoménologique ni logique. Elle ne décrit aucune entité métrique réelle ; elle n'est que la moyenne mathématique d'étiquettes typographiques. Le fait qu'une variable soit représentée dans une cellule de base de données par un symbole numérique ne transforme en aucun cas cette variable en grandeur quantitative.
Il est impératif pour tout chercheur d'établir une distinction étanche et hermétique entre le <em>codage informatique</em> (qui n'est qu'un artifice d'ingénierie des données) et la <em>nature métrique fondamentale</em> de la variable sous-jacente. L'analyse descriptive et inférentielle doit toujours être subordonnée aux propriétés mathématiques de l'objet mesuré, et jamais dictée par le format technique de son stockage binaire.
<h2>8. Méthodes de collecte et protocoles d'investigation psychologique</h2>
<h3>8.1 Instruments dédiés à la capture de variables qualitatives</h3>
L'investigation rigoureuse de variables qualitatives s'appuie sur une panoplie d'instruments et de dispositifs standardisés conçus pour appréhender la complexité des états cliniques, des dynamiques sociales ou des configurations comportementales sans les dénaturer par une quantification artificielle prématurée. L'instrument matriciel de cette approche en psychopathologie demeure l'<strong>entretien clinique standardisé ou semi-directif</strong>, à l'image du <em>Structured Clinical Interview for DSM Disorders</em> (<a href="https://www.appi.org" target="_blank" rel="noopener noreferrer">SCID</a>). Ces entretiens guident le praticien à travers des arborescences diagnostiques décisionnelles strictes pour assigner le patient à des catégories nosologiques qualitatives formelles.
Dans le domaine de l'analyse discursive et de la recherche psychosociale, les données qualitatives issues de transcriptions verbales intégrales sont traitées via des protocoles d'<strong>analyse thématique informatisée</strong> ou des analyses de conte\nu systématiques. Les productions langagières des participants sont segmentées en unités sémantiques codées de manière exhaustive et mutuellement exclusive. L'observateur extrait des typologies de représentations sociales ou des répertoires interprétatifs qui constituent des variables qualitatives nominales complexes.
Dans l'étude directe du comportement animal ou du jeune enfant, l'observation structurée s'appuie obligatoirement sur l'élaboration minutieuse d'un <strong>éthogramme</strong>. L'éthogramme dresse le répertoire exhaustif des patrons d'action comportementaux élémentaires caractéristiques d'une espèce (postures de soumission, comportements d'agression rituelle, toilettage, jeux locomoteurs). L'expérimentateur observe le flux d'action et consigne la survenue de ces patterns sous la forme de variables qualitatives catégorielles, dont la fiabilité inter-juges est ultérieurement certifiée par des coefficients statistiques d'accord formel (notamment le Kappa de Cohen).
<h3>8.2 Outils de recueil pour variables quantitatives</h3>
L'acquisition de variables quantitatives en sciences expérimentales et en psychobiologie s'inscrit au cœur de la révolution technologique de la mesure continue, instrumentée par des capteurs de haute précision capables de numériser les processus physiologiques a\vec une fidélité temporelle et spatiale optimale. En neurosciences cognitives, les protocoles s'adossent massivement aux <strong>enregistrements électrophysiologiques et biométriques</strong> :
<ul>
<li>Les casques d'<a href="https://www.nature.com" target="_blank" rel="noopener noreferrer">électroencéphalographie</a> (EEG) multicanaux, capturant les fluctuations du voltage synaptique cortical à l'échelle de la microseconde.</li>
<li>Les dispositifs d'imagerie par résonance magnétique fonctionnelle (IRMf), mesurant le signal quantitatif dépendant du niveau d'oxygénation sanguine (signal BOLD, <em>Blood-Oxygen-Level Dependent</em>) à travers des voxels millimétriques dans l'e\space tridimensionnel cérébral.</li>
<li>Les systèmes de poursuite oculaire (<em>eye-tracking</em>), quantifiant des coordonnées spatio-temporelles continues : durée absolue des fixations fovéales, vitesse angulaire des saccades et variations infinitésimales du diamètre pupillaire en tant qu'indice de charge cognitive (pupillométrie).</li>
</ul>
Dans les paradigmes de psychologie cognitive expérimentale, les tâches comportementales sont exécutées sur des ordinateurs dotés de cartes d'acquisition synchronisées afin de minimiser le bruit instrumental. Les logiciels de passation (tels qu'E-Prime, PsychoPy ou OpenSesame) chronomètrent à la milliseconde près les temps d'inspection visuelle et les temps de réaction motrice sous différentes conditions de charge mnésique ou perceptive.
Enfin, en psychométrie formelle, les variables quantitatives proviennent de <strong>batteries d'évaluation standardisées</strong> intégrant des scores sommatifs continus. Des inventaires de personnalité tels que le NEO-PI-R — évaluant les cinq grands facteurs de la personnalité selon le modèle du <em>\Big Five</em> — ou les échelles de dépression standardisées (comme l'inventaire de dépression de Beck, BDI-II) capturent une succession de réponses ordinales pondérées qui sont ensuite compilées selon des algorithmes psychométriques pour générer une magnitude quantitative globale du construit latent.
<h3>8.3 Approches mixtes et convergence méthodologique</h3>
Loin d'incarner une opposition binaire et stérile, la recherche empirique moderne privilégie de plus en plus les <strong>devis de recherche mixtes</strong> (ou convergents), qui intègrent délibérément et harmonieusement l'acquisition de variables qualitatives et de variables quantitatives au sein du même schéma d'investigation. L'objectif épistémique de cette articulation est la <em>triangulation méthodologique</em> : corroborer la validité d'une découverte scientifique en croisant la finesse phénoménologique descriptive des catégories subjectives a\vec la robustesse arithmétique des grandeurs objectives quantifiées.
Dans de tels dispositifs de recherche, les variables qualitatives et quantitatives occupent des fonctions hautement complémentaires. Très fréquemment, la variable qualitative opère comme une <strong>variable indépendante de classification</strong> ou comme un facteur de modération contextuel, tandis que les variables quantitatives constituent les <strong>variables dépendantes</strong> mesurant l'effet direct du traitement ou du contexte. Par exemple, un devis expérimental étudiera la manière dont l'intensité de la réponse autonome cutanée (variable quantitative continue, mesurée en $\mu S$) fluctue sous l'effet du type d'attachement de l'adulte (variable qualitative nominale à trois ou quatre niveaux : sécure, évitant, préoccupé, craintif) lors d'un protocole d'induction de stress psychosocial (le <em>Trier Social Stress Test</em>).
De surcroît, les variables qualitatives peuvent être utilisées pour identifier des sous-groupes cliniques ou comportementaux étanches (analyse en classes latentes ou typologies catégorielles), au sein desquels des trajectoires quantitatives continues différentes sont ensuite modélisées mathématiquement à l'aide d'équations structurelles de croissance ou de modèles de régression multiniveaux. La synergie entre la catégorisation d'état et la métrologie de magnitude constitue l'un des moteurs méthodologiques les plus fertiles de la science computationnelle contemporaine.
<figure class="wpt-preserved-image"><img src="https://fr.arabpsychology.com/wp-content/uploads/2026/09/qual4.png" alt="" /></figure>
<h2>9. Statistiques descriptives adaptées à chaque nature de variable</h2>
<h3>9.1 Description formelle des variables qualitatives</h3>
L'exploration analytique préliminaire d'une variable qualitative récuse formellement l'utilisation des calculs de moyenne et d'écart-type, car ces paramètres reposent sur des sommations arithmétiques impossibles sur des modalités d'états. La description formelle de ces données s'effectue exclusivement à travers le <strong>dénombrement des effectifs bruts</strong> — couramment désignés sous le vocable de <em>fréquences absolues</em> ($n_i$) — qui quantifient le nombre total d'observations appartenant individuellement à la $i$-ième modalité d'un ensemble de $k$ catégories répertoriées.
Afin de neutraliser l'impact de la taille totale de l'échantillon ($N$) et de permettre la comparabilité directe entre des cohortes d'effectifs dissemblables, l'analyste transforme les fréquences absolues en <strong>proportions relatives</strong> ($f_i$) ou en pourcentages, selon l'égalité fondamentale : »>$$
7. Différences structurelles et critères de distinction directe
7.1 Tableau comparatif approfondi des dimensions qualitatives et quantitatives
Pour appréhender d’un seul regard synthétique les divergences conceptuelles, structurelles et computationnelles qui séparent les variables qualitatives des variables quantitatives, le tableau suivant détaille leurs propriétés croisées selon les dimensions méthodologiques fondamentales.
| Dimension d’analyse | Variables Qualitatives (Catégorielles) | Variables Quantitatives (Numériques) |
|---|---|---|
| Question épistémologique centrale | « Quel type ? », « Quelle modalité ? », « Quel état de fait ? » | « Combien ? », « Quelle magnitude ? », « Quelle amplitude ? » |
| Nature fondamentale de l’information | Attribut descriptif, catégorie ontologique, appartenance à un groupe ou positionnement d’ordre hiérarchique. | Grandeur métrique, dénombrement unitaire ou intensité continue sur un continuum réel. |
| Sous-types formels | Nominale (sans ordre intrinsèque) et Ordinale (a\vec gradation hiérarchique sans métrique constante). | Discrète (issue d’un dénombrement fini/entier) et Continue (infiniment divisible dans $\mathbb{R}$). |
| Échelles de Stevens associées | Échelle nominale et Échelle ordinale. | Échelle d’intervalle et Échelle de rapport (ratio). |
| Opérations arithmétiques autorisées | Aucune sur les données brutes (les calculs de moyennes et variances de codes nominaux sont sans objet). | Addition, soustraction, multiplication, division, calcul différentiel, dérivation fonctionnelle. |
| Mesures de tendance centrale canoniques | Mode (nominal et ordinal), Médiane (ordinal exclusivement). | Moyenne arithmétique, Médiane, Moyenne géométrique ou harmonique. |
| Indices de dispersion adaptés | Entropie de Shannon, indice de diversité qualitative, étendue interquartile (ordinal). | Écart-type, variance, étendue, écart interquartile, coefficient de variation. |
| Tests d’hypothèses inférentiels classiques | Chi-deux d’indépendance de Pearson, test exact de Fisher, modèles log-linéaires, régression logistique. | Test $t$ de Student, ANOVA univariée/multivariée, régression linéaire multiple, modèles mixtes. |
| Formats graphiques représentatifs | Diagrammes en barres sectorielles disjointes, diagrammes circulaires, mosaïques de contingence. | Histogrammes continus, diagrammes de densité, boîtes à moustaches, nuages de points. |
| Sensibilité statistique et échantillonnage | Nécessite souvent de vastes échantillons pour peupler de façon équilibrée toutes les cellules de croisement. | Sensibilité statistique supérieure à taille d’échantillon égale en raison de la richesse métrique continue. |
7.2 L’arbre de décision méthodologique pour identifier le type d’une variable
Face à une variable inconnue dans une base de données brute ou un protocole d’expérimentation, le chercheur doit appliquer un algorithme décisionnel séquentiel en trois étapes distinctes pour classifier sans équivoque la nature du phénomène :
Étape 1 : Discrimination ontologique (Étiquette versus Grandeur numérique).
L’observateur doit se poser la question suivante : « Les valeurs attribuées représentent-elles intrinsèquement des descripteurs verbaux, des états, des étiquettes arbitraires ou des appartenances de groupe, ou constituent-elles l’expression directe d’une grandeur mesurable ou dénombrable ? »
Si la variable ne fait que regrouper ou dénommer des individus selon une caractéristique d’état, elle est catégorisée comme qualitative. Si les valeurs expriment un décompte ou une mesure physique indépendante de l’arbitraire du codage, la variable est classifiée comme quantitative.
Étape 2 : Vérification de la métrique arithmétique.
Si la variable se présente sous une apparence numérique (des chiffres), l’analyste doit impérativement questionner l’espacement arithmétique : « La différence soustractive $(x_2 – x_1)$ a-t-elle un sens empirique identique et constant sur toute l’échelle ? Le calcul d’une moyenne arithmétique a-t-il une signification substantielle concrète ? »
Si la réponse est négative — par exemple, pour des codes postaux, des numéros d’immatriculation d’écoles ou les chiffres 1, 2, 3 d’un item d’accord —, la variable est irrémédiablement ramenée vers le statut de variable qualitative (nominale si aucun ordre n’existe, ordinale si les chiffres traduisent une gradation hiérarchique). Si la réponse est affirmative, la variable est validée comme quantitative.
Étape 3 : Spécification terminale de niveau de mesure.
Pour la branche qualitative : déterminer s’il existe une relation d’ordre naturelle et univoque entre les modalités. Si non $\rightarrow$ Variable qualitative nominale ; si oui $\rightarrow$ Variable qualitative ordinale.
Pour la branche quantitative : examiner l’ensemble des valeurs théoriquement possibles. Si les valeurs procèdent d’un processus de dénombrement par entiers indivisibles sans possibilité de valeurs intermédiaires réelles $\rightarrow$ Variable quantitative discrète ; si les valeurs s’inscrivent sur un continuum indénombrable et sont théoriquement divisibles à l’infini $\rightarrow$ Variable quantitative continue. Enfin, vérifier l’existence d’un zéro absolu pour statuer sur la classification finale en échelle d’intervalle versus échelle de rapport.
7.3 Le piège fréquent des codes numériques attribués aux variables qualitatives
L’un des artefacts méthodologiques les plus destructeurs en analyse de données — fréquemment observé chez les analystes débutants ou lors de manipulations automatisées de grands jeux de données (\Big Data) — procède de la confusion délétère entre le contenant informatique et le conte\nu métrologique d’une variable. Dans la majorité des progiciels de statistique contemporains (tels que R, SPSS, SAS ou les bibliothèques Python comme Pandas), les chaînes de caractères qualitatives sont couramment converties ou étiquetées à l’aide de codes numériques conventionnels afin d’optimiser l’allocation de mémoire vive et d’accélérer les processus d’indexation matricielle.
Par exemple, une variable de genre peut être arbitrairement codée dans le tableur brut :
- $0$ pour « Homme »
- $1$ pour « Femme »
- $2$ pour « Non-binaire »
L’erreur classique consiste à solliciter aveuglément des fonctions de résumé statistique sur ce vecteur numérique et à déduire par exemple que la « moyenne » de la variable genre au sein de l’échantillon est de $0,87$. Cette valeur n’a absolument aucun ancrage phénoménologique ni logique. Elle ne décrit aucune entité métrique réelle ; elle n’est que la moyenne mathématique d’étiquettes typographiques. Le fait qu’une variable soit représentée dans une cellule de base de données par un symbole numérique ne transforme en aucun cas cette variable en grandeur quantitative.
Il est impératif pour tout chercheur d’établir une distinction étanche et hermétique entre le codage informatique (qui n’est qu’un artifice d’ingénierie des données) et la nature métrique fondamentale de la variable sous-jacente. L’analyse descriptive et inférentielle doit toujours être subordonnée aux propriétés mathématiques de l’objet mesuré, et jamais dictée par le format technique de son stockage binaire.
8. Méthodes de collecte et protocoles d’investigation psychologique
8.1 Instruments dédiés à la capture de variables qualitatives
L’investigation rigoureuse de variables qualitatives s’appuie sur une panoplie d’instruments et de dispositifs standardisés conçus pour appréhender la complexité des états cliniques, des dynamiques sociales ou des configurations comportementales sans les dénaturer par une quantification artificielle prématurée. L’instrument matriciel de cette approche en psychopathologie demeure l’entretien clinique standardisé ou semi-directif, à l’image du Structured Clinical Interview for DSM Disorders (SCID). Ces entretiens guident le praticien à travers des arborescences diagnostiques décisionnelles strictes pour assigner le patient à des catégories nosologiques qualitatives formelles.
Dans le domaine de l’analyse discursive et de la recherche psychosociale, les données qualitatives issues de transcriptions verbales intégrales sont traitées via des protocoles d’analyse thématique informatisée ou des analyses de conte\nu systématiques. Les productions langagières des participants sont segmentées en unités sémantiques codées de manière exhaustive et mutuellement exclusive. L’observateur extrait des typologies de représentations sociales ou des répertoires interprétatifs qui constituent des variables qualitatives nominales complexes.
Dans l’étude directe du comportement animal ou du jeune enfant, l’observation structurée s’appuie obligatoirement sur l’élaboration minutieuse d’un éthogramme. L’éthogramme dresse le répertoire exhaustif des patrons d’action comportementaux élémentaires caractéristiques d’une espèce (postures de soumission, comportements d’agression rituelle, toilettage, jeux locomoteurs). L’expérimentateur observe le flux d’action et consigne la survenue de ces patterns sous la forme de variables qualitatives catégorielles, dont la fiabilité inter-juges est ultérieurement certifiée par des coefficients statistiques d’accord formel (notamment le Kappa de Cohen).
8.2 Outils de recueil pour variables quantitatives
L’acquisition de variables quantitatives en sciences expérimentales et en psychobiologie s’inscrit au cœur de la révolution technologique de la mesure continue, instrumentée par des capteurs de haute précision capables de numériser les processus physiologiques a\vec une fidélité temporelle et spatiale optimale. En neurosciences cognitives, les protocoles s’adossent massivement aux enregistrements électrophysiologiques et biométriques :
- Les casques d’électroencéphalographie (EEG) multicanaux, capturant les fluctuations du voltage synaptique cortical à l’échelle de la microseconde.
- Les dispositifs d’imagerie par résonance magnétique fonctionnelle (IRMf), mesurant le signal quantitatif dépendant du niveau d’oxygénation sanguine (signal BOLD, Blood-Oxygen-Level Dependent) à travers des voxels millimétriques dans l’e\space tridimensionnel cérébral.
- Les systèmes de poursuite oculaire (eye-tracking), quantifiant des coordonnées spatio-temporelles continues : durée absolue des fixations fovéales, vitesse angulaire des saccades et variations infinitésimales du diamètre pupillaire en tant qu’indice de charge cognitive (pupillométrie).
Dans les paradigmes de psychologie cognitive expérimentale, les tâches comportementales sont exécutées sur des ordinateurs dotés de cartes d’acquisition synchronisées afin de minimiser le bruit instrumental. Les logiciels de passation (tels qu’E-Prime, PsychoPy ou OpenSesame) chronomètrent à la milliseconde près les temps d’inspection visuelle et les temps de réaction motrice sous différentes conditions de charge mnésique ou perceptive.
Enfin, en psychométrie formelle, les variables quantitatives proviennent de batteries d’évaluation standardisées intégrant des scores sommatifs continus. Des inventaires de personnalité tels que le NEO-PI-R — évaluant les cinq grands facteurs de la personnalité selon le modèle du \Big Five — ou les échelles de dépression standardisées (comme l’inventaire de dépression de Beck, BDI-II) capturent une succession de réponses ordinales pondérées qui sont ensuite compilées selon des algorithmes psychométriques pour générer une magnitude quantitative globale du construit latent.
8.3 Approches mixtes et convergence méthodologique
Loin d’incarner une opposition binaire et stérile, la recherche empirique moderne privilégie de plus en plus les devis de recherche mixtes (ou convergents), qui intègrent délibérément et harmonieusement l’acquisition de variables qualitatives et de variables quantitatives au sein du même schéma d’investigation. L’objectif épistémique de cette articulation est la triangulation méthodologique : corroborer la validité d’une découverte scientifique en croisant la finesse phénoménologique descriptive des catégories subjectives a\vec la robustesse arithmétique des grandeurs objectives quantifiées.
Dans de tels dispositifs de recherche, les variables qualitatives et quantitatives occupent des fonctions hautement complémentaires. Très fréquemment, la variable qualitative opère comme une variable indépendante de classification ou comme un facteur de modération contextuel, tandis que les variables quantitatives constituent les variables dépendantes mesurant l’effet direct du traitement ou du contexte. Par exemple, un devis expérimental étudiera la manière dont l’intensité de la réponse autonome cutanée (variable quantitative continue, mesurée en $\mu S$) fluctue sous l’effet du type d’attachement de l’adulte (variable qualitative nominale à trois ou quatre niveaux : sécure, évitant, préoccupé, craintif) lors d’un protocole d’induction de stress psychosocial (le Trier Social Stress Test).
De surcroît, les variables qualitatives peuvent être utilisées pour identifier des sous-groupes cliniques ou comportementaux étanches (analyse en classes latentes ou typologies catégorielles), au sein desquels des trajectoires quantitatives continues différentes sont ensuite modélisées mathématiquement à l’aide d’équations structurelles de croissance ou de modèles de régression multiniveaux. La synergie entre la catégorisation d’état et la métrologie de magnitude constitue l’un des moteurs méthodologiques les plus fertiles de la science computationnelle contemporaine.
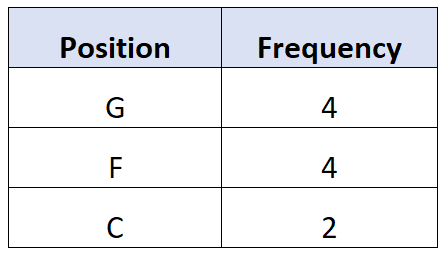
9. Statistiques descriptives adaptées à chaque nature de variable
9.1 Description formelle des variables qualitatives
L’exploration analytique préliminaire d’une variable qualitative récuse formellement l’utilisation des calculs de moyenne et d’écart-type, car ces paramètres reposent sur des sommations arithmétiques impossibles sur des modalités d’états. La description formelle de ces données s’effectue exclusivement à travers le dénombrement des effectifs bruts — couramment désignés sous le vocable de fréquences absolues ($n_i$) — qui quantifient le nombre total d’observations appartenant individuellement à la $i$-ième modalité d’un ensemble de $k$ catégories répertoriées.
Afin de neutraliser l’impact de la taille totale de l’échantillon ($N$) et de permettre la comparabilité directe entre des cohortes d’effectifs dissemblables, l’analyste transforme les fréquences absolues en proportions relatives ($f_i$) ou en pourcentages, selon l’égalité fondamentale :$$f_i = frac{n_i}{N} = frac{n_i}{sum_{j=1}^{k} n_j}$$En matière de tendance centrale, la seule mesure formellement applicable à une variable nominale est le mode (ou modalité modale). Le mode représente tout simplement la catégorie qui agrège le plus grand effectif au sein de l’échantillon observé. Si une distribution présente deux modalités distinctes occupant simultanément les fréquences maximales, elle est qualifiée de distribution bimodale.
Dans le cas spécifique des variables qualitatives ordinales, l’existence d’une gradation naturelle entre les modalités autorise l’utilisation d’outils descriptifs enrichis. Il devient licite de calculer les fréquences cumulées (absolues ou relatives), qui renseignent sur la proportion d’individus dont le statut est inférieur ou égal à un rang déterminé sur l’échelle ordinale :$$F_i = sum_{j=1}^{i} f_j$50^{\text{e}}$ centile de la distribution ordonnée des rangs. L'intervalle interquartile peut également y être mobilisé pour caractériser l'étendue des rangs intermédiaires.
<h3>9.2 Description des variables quantitatives : tendance centrale</h3>
La statistique descriptive appliquée aux variables quantitatives dispose d'une latitude analytique totale pour synthétiser les caractéristiques spatiales d'une distribution de points numériques. L'évaluation de la <strong>tendance centrale</strong> d'un ensemble de mesures quantitatives ${x_1, x_2, dots, x_N}$ s'articule autour de trois paramètres cardinaux — la moyenne arithmétique, la médiane et le mode — dont l'arbitrage dép\end strictement de la forme fonctionnelle de la distribution des données.
La <strong>moyenne arithmétique</strong> ($\bar{x}$) incarne le centre de gravité mathématique exact de la série de données numériques. Elle est définie formellement par l'équation : »>$$De plus, pour les données ordinales, la médiane émerge comme une mesure de tendance centrale parfaitement légitime : elle désigne la modalité du participant situé exactement au $50^{\text{e}}$ centile de la distribution ordonnée des rangs. L’intervalle interquartile peut également y être mobilisé pour caractériser l’étendue des rangs intermédiaires.
9.2 Description des variables quantitatives : tendance centrale
La statistique descriptive appliquée aux variables quantitatives dispose d’une latitude analytique totale pour synthétiser les caractéristiques spatiales d’une distribution de points numériques. L’évaluation de la tendance centrale d’un ensemble de mesures quantitatives ${x_1, x_2, dots, x_N}$ s’articule autour de trois paramètres cardinaux — la moyenne arithmétique, la médiane et le mode — dont l’arbitrage dép\end strictement de la forme fonctionnelle de la distribution des données.
La moyenne arithmétique ($\bar{x}$) incarne le centre de gravité mathématique exact de la série de données numériques. Elle est définie formellement par l’équation :$$bar{x} = frac{1}{N} sum_{i=1}^{N} x_i$E = x_{\max} – x_{\min}$), mais elle ne repose que sur deux valeurs extrêmes, ce qui la r\end éminemment fragile. Les paramètres fondamentaux de référence sont la <strong>variance empirique</strong> ($s^2$) — moyenne quadratique des écarts à la moyenne arithmétique — et son corollaire direct exprimé dans l'unité originale de la mesure, l'<strong>écart-type</strong> ($s$) : »>$$Bien que la moyenne constitue l’estimateur de référence au sein des modèles théoriques gaussiens — car elle intègre l’ensemble de l’information numérique de chaque observation —, elle présente une vulnérabilité critique : une extrême sensibilité aux valeurs aberrantes ou extrêmes (les outliers). Une seule mesure aberrante (par exemple un temps de réaction erratique de 12 secondes généré par un défaut technique lors d’une tâche chronométrique) peut déplacer drastiquement la moyenne et délivrer une vision déformée de la distribution de l’échantillon.
Face à ce biais de non-linéarité ou en présence d’une distribution fortement asymétrique (telle que la distribution des salaires ou des latences cognitives), la médiane constitue l’indicateur de tendance centrale privilégié en raison de sa robustesse non paramétrique exemplaire. La médiane est insensible à l’amplitude numérique des queues de distribution : tant que le rang relatif central demeure inchangé, les valeurs numériques extrêmes peuvent croître indéfiniment sans modifier la médiane. Dans les distributions unimodales parfaitement symétriques (courbe normale de Gauss-Laplace), la moyenne, la médiane et le mode coïncident de manière idéale au même p\oint d’équilibre spatial.
9.3 Description des variables quantitatives : dispersion et forme
Une description quantitative restreinte aux seules mesures de tendance centrale est scientifiquement insuffisante. Deux échantillons cliniques peuvent présenter une moyenne rigoureusement identique de 100 points à un test cognitif tout en reflétant des dynamiques de variabilité radicalement opposées : le premier peut agréger des individus extrêmement homogènes oscillant entre 95 et 105, tandis que le second réunit des profils hétérogènes dispersés entre 40 et 160. L’estimation des paramètres de dispersion s’impose comme un impératif absolu.
L’indice le plus basique est l’étendue ($E = x_{\max} – x_{\min}$), mais elle ne repose que sur deux valeurs extrêmes, ce qui la r\end éminemment fragile. Les paramètres fondamentaux de référence sont la variance empirique ($s^2$) — moyenne quadratique des écarts à la moyenne arithmétique — et son corollaire direct exprimé dans l’unité originale de la mesure, l’écart-type ($s$) :$$s^2 = frac{1}{N – 1} sum_{i=1}^{N} (x_i – bar{x})^2 quad implies quad s = sqrt{s^2}$IQR = Q_3 – Q_1$), mesurant la largeur du spectre spatial englobant les 50 % centraux des données observées.
Au-delà du centre et de la dispersion, l'analyste quantitative documente la <strong>forme structurelle de la distribution</strong> par l'évaluation rigoureuse du coefficient d'asymétrie de Fisher-Pearson ($g_1$, <em>skewness</em>) et du coefficient d'aplatissement ($g_2$, <em>kurtosis</em>). Enfin, la comparaison de variables quantitatives présentant des unités physiques dissemblables (par exemple corréler une tension artérielle en $mmHg$ a\vec un temps de réaction en $ms$) requiert l'opération mathématique de <strong>standardisation</strong>, transformant les scores bruts en <strong>scores Z centrés-réduits</strong> affichant une moyenne universelle nulle ($\mu = 0$) et un écart-type unitaire ($\sigma = 1$) : »>$$Pour les distributions fortement asymétriques où la médiane est adoptée, la métrique de dispersion adéquate est l’écart interquartile ($IQR = Q_3 – Q_1$), mesurant la largeur du spectre spatial englobant les 50 % centraux des données observées.
Au-delà du centre et de la dispersion, l’analyste quantitative documente la forme structurelle de la distribution par l’évaluation rigoureuse du coefficient d’asymétrie de Fisher-Pearson ($g_1$, skewness) et du coefficient d’aplatissement ($g_2$, kurtosis). Enfin, la comparaison de variables quantitatives présentant des unités physiques dissemblables (par exemple corréler une tension artérielle en $mmHg$ a\vec un temps de réaction en $ms$) requiert l’opération mathématique de standardisation, transformant les scores bruts en scores Z centrés-réduits affichant une moyenne universelle nulle ($\mu = 0$) et un écart-type unitaire ($\sigma = 1$) :$$Z_i = frac{x_i – bar{x}}{s}$\chi^2$).
La statistique du $\chi^2$ évalue la somme standardisée des écarts quadratiques constatés entre les fréquences empiriquement observées ($O_{ij}$) dans les cellules d'un tableau croisé à $r$ lignes et $c$ colonnes, et les fréquences théoriques ou espérées ($E_{ij}$) sous l'hypothèse nulle ($H_0$) de parfaite indépendance des deux variables : »>$$
10. Inférence statistique et tests d’hypothèses comparés
10.1 Analyse statistique appliquée aux variables qualitatives
L’univers de l’inférence statistique dédié aux variables qualitatives opère principalement sous le paradigme de l’analyse des fréquences, des tableaux de contingence et de la statistique non paramétrique. Lorsque l’expérimentateur cherche à vérifier s’il existe une dépendance stochastique ou une association significative entre deux variables qualitatives catégorielles — par exemple entre le sexe biologique et le statut diagnostique clinique —, le test d’hypothèse canonique incontournable est le test d’indépendance du Chi-deux de Pearson ($\chi^2$).
La statistique du $\chi^2$ évalue la somme standardisée des écarts quadratiques constatés entre les fréquences empiriquement observées ($O_{ij}$) dans les cellules d’un tableau croisé à $r$ lignes et $c$ colonnes, et les fréquences théoriques ou espérées ($E_{ij}$) sous l’hypothèse nulle ($H_0$) de parfaite indépendance des deux variables :$$chi^2 = sum_{i=1}^{r} sum_{j=1}^{c} frac{(O_{ij} – E_{ij})^2}{E_{ij}}$2 \times 2$ a\vec des cellules sous-peuplées, le chercheur doit obligatoirement mobiliser le <strong>test exact de Fisher</strong>, fondé sur la loi de distribution hypergéométrique exacte de la combinatoire des marges fixes.
Pour mesurer la force ou l'ampleur de cette relation catégorielle (l'équivalent de la taille d'effet), l'analyste utilise le <strong>coefficient Phi</strong> ($phi$) pour les matrices $2 \times 2$, ou le <strong>$V$ de Cramer</strong> pour les tables de contingence de dimensions supérieures. Enfin, lorsqu'il s'agit de prédire l'appartenance d'un sujet à une catégorie qualitative binaire (guérison versus récidive) ou multinomiale en fonction d'un ensemble de régresseurs, la modélisation s'effectue via la <strong>régression logistique binaire ou multinomiale</strong>, modélisant le logarithme du rapport de cotes (<em>log-odds</em>) : »>$$Ce test repose toutefois sur des conditions formelles de validité (notamment les critères de Cochran : les effectifs théoriques ne doivent pas être inférieurs à 5 dans plus de 20 % des cellules). Lorsque la taille globale de l’échantillon est restreinte ou que le tableau croisé est de format $2 \times 2$ a\vec des cellules sous-peuplées, le chercheur doit obligatoirement mobiliser le test exact de Fisher, fondé sur la loi de distribution hypergéométrique exacte de la combinatoire des marges fixes.
Pour mesurer la force ou l’ampleur de cette relation catégorielle (l’équivalent de la taille d’effet), l’analyste utilise le coefficient Phi ($phi$) pour les matrices $2 \times 2$, ou le $V$ de Cramer pour les tables de contingence de dimensions supérieures. Enfin, lorsqu’il s’agit de prédire l’appartenance d’un sujet à une catégorie qualitative binaire (guérison versus récidive) ou multinomiale en fonction d’un ensemble de régresseurs, la modélisation s’effectue via la régression logistique binaire ou multinomiale, modélisant le logarithme du rapport de cotes (log-odds) :$$lnleft(frac{p}{1 – p}right) = beta_0 + beta_1 X_1 + dots + beta_k X_k$1 – \beta$).
Pour comparer les moyennes arithmétiques d'une variable quantitative continue entre deux groupes expérimentaux, le modèle classique est le <strong>test $t$ de Student</strong> pour échantillons indépendants ou le test $t$ pour mesures répétées (échantillons appariés). Dès lors que le plan expérimental implique la comparaison simultanée de trois groupes ou davantage, l'usage séquentiel de tests $t$ multiples est formellement prohibé sous peine d'inflation exponentielle du risque d'erreur de type I ; l'analyste utilise alors l'<strong>Analyse de Variance univariée (ANOVA)</strong> ou multivariée (MANOVA), qui décompose la somme totale des carrés des écarts en variance inter-groupes (due au traitement expérimental) et variance intra-groupes (bruit d'échantillonnage résiduel) via le test du ratio de variance $F$ de Fisher-Snedecor.
Pour examiner l'interdépendance linéaire unissant deux variables quantitatives continues, l'instrument fondamental est le <strong>coefficient de corrélation linéaire de Bravais-Pearson</strong> ($r$). Il quantifie le degré de covariation linéaire standardisée entre deux grandeurs : »>$$
10.2 Analyse statistique dédiée aux variables quantitatives
Lorsque la recherche mobilise des variables quantitatives continues répondant aux postulats de normalité distributionnelle et d’homoscédasticité (égalité des variances), l’investigateur accède au registre le plus puissant et le plus efficient de la biométrie : la statistique paramétrique. Ces modèles exploitent toute la richesse informationnelle de la métrique numérique continue pour maximiser la puissance des tests d’hypothèses ($1 – \beta$).
Pour comparer les moyennes arithmétiques d’une variable quantitative continue entre deux groupes expérimentaux, le modèle classique est le test $t$ de Student pour échantillons indépendants ou le test $t$ pour mesures répétées (échantillons appariés). Dès lors que le plan expérimental implique la comparaison simultanée de trois groupes ou davantage, l’usage séquentiel de tests $t$ multiples est formellement prohibé sous peine d’inflation exponentielle du risque d’erreur de type I ; l’analyste utilise alors l’Analyse de Variance univariée (ANOVA) ou multivariée (MANOVA), qui décompose la somme totale des carrés des écarts en variance inter-groupes (due au traitement expérimental) et variance intra-groupes (bruit d’échantillonnage résiduel) via le test du ratio de variance $F$ de Fisher-Snedecor.
Pour examiner l’interdépendance linéaire unissant deux variables quantitatives continues, l’instrument fondamental est le coefficient de corrélation linéaire de Bravais-Pearson ($r$). Il quantifie le degré de covariation linéaire standardisée entre deux grandeurs :$$r = frac{sum_{i=1}^{N} (x_i – bar{x})(y_i – bar{y})}{sqrt{sum_{i=1}^{N} (x_i – bar{x})^2} sqrt{sum_{i=1}^{N} (y_i – bar{y})^2}}$$
Ce coefficient ouvre la voie à la régression linéaire simple et multiple fondée sur la méthode des moindres carrés ordinaires (MCO). Ces modèles permettent de prédire la magnitude précise d’une variable quantitative continue à partir d’une combinaison linéaire pondérée d’autres prédicteurs quantitatifs, tout en contrôlant l’erreur résiduelle standard d’estimation.
10.3 Le pont entre qualitatif et quantitatif : les analyses hybrides
Dans la pratique scientifique contemporaine, les devis expérimentaux les plus élaborés s’articulent rarement autour de variables exclusivement qualitatives ou exclusivement quantitatives ; ils établissent au contraire des passerelles computationnelles hybrides permettant de faire dialoguer des prédicteurs qualitatifs avec des réponses quantitatives, ou l’inverse.
Le cas d’hybridation le plus fréquent s’incarne dans le modèle de régression linéaire générale où une variable dépendante quantitative continue est prédite par un mélange de variables quantitatives continues (covariables) et de variables qualitatives nominales (facteurs expérimentaux). Pour intégrer une variable qualitative — par exemple l’appartenance à l’un des trois groupes : Contrôle, Psychothérapie brève, Médication — dans une matrice de régression arithmétique, la technique standard consiste à procéder à un codage disjonctif par variables indicatrices (communément appelé dummy coding). Une variable catégorielle à $k$ modalités est transformée mathématiquement en $(k – 1)$ variables binaires indicatrices valant 0 ou 1, une catégorie étant arbitrairement réservée comme modalité de référence d’ancrage.
Un autre pont méthodologique capital est la corrélation de rang de Spearman ($rho$) ou le Tau de Kendall ($tau$), qui permet d’évaluer l’association monotone unissant deux variables qualitatives ordinales, ou d’associer une variable ordinale avec une variable quantitative continue dont les postulats gaussiens sont violés. Ces tests procèdent en convertissant au préalable l’ensemble des valeurs numériques continues en rangs hiérarchiques avant d’en calculer la covariance, préservant ainsi la validité inférentielle en présence de non-linéarités modérées.
11. Visualisation et représentation graphique des données
11.1 Graphiques conventionnels pour variables qualitatives
La transcription visuelle d’un ensemble de données n’est pas un exercice d’ornementation graphique : elle relève de la sémiologie graphique formelle, théorisée initialement par Jacques Bertin. Pour les variables qualitatives catégorielles, le principe fondamental intangible est que le dispositif graphique doit refléter visuellement la discontinuité ontologique existant entre les modalités. Il n’existe aucun continuum physique sous-jacent entre les catégories : chaque barre ou secteur doit donc être graphiquement isolé.
Le graphique canonique de référence pour les variables qualitatives est le diagramme en barres (ou bar chart). Dans ce format, chaque modalité est représentée par un rectangle distinct dont la hauteur (ou la longueur en disposition horizontale) est strictement proportionnelle à l’effectif brut ou à la fréquence relative de la catégorie. Un impératif technique strict est l’existence d’un espace vide franc séparant les barres successives : l’absence de contact physique entre les rectangles matérialise pour le cerveau du lecteur l’absence de continuité métrique entre les classes.
Le diagramme circulaire (ou diagramme en secteurs / camembert) est également mobilisé pour représenter les composantes de parts relatives d’un tout (somme égale à 100 %). Toutefois, la littérature en perception visuelle déconseille fréquemment son usage au profit des diagrammes en barres : l’œil humain présente en effet des biais d’évaluation perceptifs notables lorsqu’il s’agit de comparer des angles de secteurs circulaires par rapport à la comparaison d’alignements de longueurs rectilignes. Pour les tableaux de contingence croisant deux variables qualitatives, le format de prédilection est le diagramme en barres empilées normalisées ou le mosaic plot (graphique en mosaïque), qui module simultanément la largeur et la hauteur des pavés selon les marges marginales et conditionnelles.
11.2 Représentations adaptées aux variables quantitatives
La représentation des variables quantitatives continues répond à des contraintes sémiologiques radicalement inverses de celles des variables catégorielles. Puisque la grandeur sous-jacente est postulée comme continue et infiniment divisible le long d’un axe réel $\mathbb{R}$, le dispositif graphique doit exprimer cette continuité géométrique sans rupture arbitraire.
Le dispositif emblématique pour visualiser la distribution empirique d’une variable quantitative continue est l’histogramme. Bien que superficiellement semblable au diagramme en barres, l’histogramme en diffère fondamentalement : les rectangles verticaux sont contigus et parfaitement accolés sans aucun espacement vide intermédiaire. La surface totale de chaque rectangle — et non simplement sa hauteur — est strictement proportionnelle à la fréquence de la tranche de valeurs (ou classe métrique) considérée le long de l’abscisse. L’histogramme est fréquemment surmonté d’une courbe de densité continue estimée par la méthode du noyau (Kernel Density Estimation, KDE), fournissant une approximation lissée de la distribution de probabilité sous-jacente.
Pour analyser la dispersion spatiale, l’asymétrie et détecter visuellement d’éventuelles valeurs aberrantes, le graphique de prédilection demeure la boîte à moustaches de Tukey (ou boxplot). Elle synthétise en une seule figure univoque :
- La médiane (ligne centrale scindant la boîte).
- Le premier et le troisième quartile ($Q_1$ et $Q_3$), bornant la boîte qui contient les 50 % centraux des données.
- Les « moustaches » s’étendant classiquement jusqu’à 1,5 fois l’écart interquartile ($1,5 \times IQR$).
- Les points individuels situés au-delà des moustaches, matérialisant immédiatement les valeurs aberrantes (outliers).
Enfin, pour explorer graphiquement la relation bivariée unissant deux variables quantitatives continues, le standard absolu est le nuage de points (ou scatterplot), où chaque sujet expérimental est projeté comme une coordonnée spatiale cartésienne $(X_i, Y_i)$ dans un plan bi-dimensionnel, complété éventuellement par une droite de régression linéaire MCO ou une courbe d’ajustement non linéaire locale (LOESS).
11.3 Erreurs sémiologiques courantes dans la publication scientifique
L’examen critique de la littérature scientifique révèle une prévalence alarmante d’erreurs sémiologiques et graphiques graves, qui compromettent la restitution fidèle des résultats expérimentaux et génèrent des confusions conceptuelles majeures chez les pairs évaluateurs. La première faute méthodologique ubiquitaire réside dans la confusion graphique entre l’histogramme et le diagramme en barres. Utiliser un histogramme à barres collées pour figurer des modalités nominales déconnectées suggère fallacieusement l’existence d’une continuité spatiale inexistante. Inversement, insérer des espacements artificiels entre les tranches d’une grandeur quantitative continue détruit visuellement la perception de la densité distributionnelle.
Une seconde erreur sémiologique impardonnable consiste à relier par des segments linéaires continus les moyennes de modalités qualitatives non ordonnées. Tracer une ligne polygonale brisée reliant les scores moyens d’un groupe « Schizophrénie », d’un groupe « Dépression » et d’un groupe « Trouble Bipolaire » constitue un non-sens absolu. Une ligne continue suggère graphiquement un gradient fonctionnel, une trajectoire cinétique ou une fonction mathématique interpolante le long d’une abscisse continue ; or, les pathologies susmentionnées ne constituent en rien des points jalonnant un axe géométrique.
Enfin, la manipulation sémiotique — délibérée ou accidentelle — la plus pernicieuse concerne la troncature de l’axe des ordonnées. Sur un diagramme en barres représentant des fréquences ou des proportions, l’axe vertical doit impérativement débuter à la valeur zéro ($y = 0$). Tronquer l’axe en le faisant débuter à une valeur arbitraire élevée (par exemple fixer l’origine à 80 % pour montrer une variation entre 82 % et 85 %) amplifie visuellement de manière disproportionnée un écart marginal et crée un artefact cognitif trompeur d’effet majeur. Pour les variables quantitatives continues sur boîte à moustaches ou nuage de points, la troncature peut être admissible pour visualiser la variabilité locale, à condition que le saut d’axe soit explicitement signalé par une convention typographique normée.
12. Études de cas appliquées et erreurs classiques de catégorisation
12.1 Cas pratique n°1 : Évaluation de l’efficacité d’une psychothérapie
Pour ancrer ces concepts abstraits dans la réalité de l’investigation empirique, considérons un essai clinique contrôlé randomisé évaluant l’efficacité d’une nouvelle Thérapie Cognitivo-Comportementale (TCC) informatisée pour la dépression majeure. Cent vingt patients répondant aux critères stricts du DSM-5 sont assignés aléatoirement à deux conditions : un groupe expérimental recevant la TCC pendant 12 semaines, et un groupe témoin placé sur liste d’attente active avec soutien psychologique standard.
Dans ce protocole, la variable indépendante est une variable qualitative nominale dichotomique : le groupe d’appartenance thérapeutique (Modalité 0 : Liste d’attente / Modalité 1 : TCC). Les chercheurs enregistrent également une variable sociodémographique : le statut socio-professionnel (variable qualitative nominale polytomique : Cadre, Employé, Ouvrier, Sans emploi) et le niveau de motivation initiale mesuré sur une échelle ordinale à 4 rangs (Faible, Modéré, Élevé, Très élevé).
La variable dépendante principale retenue est le score global de dépression mesuré avant et après l’intervention à l’aide de l’inventaire de dépression de Beck (BDI-II). Ce score sommatif continu est traité comme une variable quantitative de niveau intervalle. En outre, les investigateurs mesurent une variable quantitative continue de niveau ratio : le taux sérique matinal de cortisol plasmatique exprimé en $nmol/L$.
Le plan d’analyse statistique adapté à ce devis hybride consiste à ne pas discrétiser artificiellement les scores de dépression en « guéris » versus « non guéris ». L’analyse de choix est une Analyse de Covariance mixte (ANCOVA) ou un modèle linéaire mixte à mesures répétées. Ce modèle permet de tester l’interaction statistique entre la variable qualitative indépendante (Groupe) et la variable quantitative intra-sujet (Temps chronologique), tout en ajustant pour les covariables quantitatives de base, optimisant ainsi la puissance d’inférence causale du protocole.
12.2 Cas pratique n°2 : Neurosciences cognitives et temps de réaction
Considérons une seconde étude menée en laboratoire de neurosciences cognitives, explorant les mécanismes de l’inhibition attentionnelle à travers une tâche de compatibilité spatiale de type Simon informatisée. Des participants observent des flèches orientées vers la gauche ou vers la droite, apparaissant soit dans l’hémichamp visuel gauche, soit dans l’hémichamp visuel droit d’un écran haute résolution. Les sujets doivent appuyer le plus rapidement possible sur une touche gauche ou droite correspondant à la direction de la flèche, en ignorant sa position spatiale sur l’écran.
La structure taxonomique des variables de cette expérience s’établit avec une rigueur absolue :
- Variable qualitative nominale n°1 (intra-sujet) : La congruence spatiale du stimulus, présentant deux modalités mutuellement exclusives : Congruent (la flèche pointe vers le côté où elle apparaît) versus Incongruent (la flèche pointe vers le côté opposé).
- Variable qualitative nominale n°2 : Le type de stimulus auditif distracteur diffusé simultanément (trois modalités polytomiques : Bruit blanc, Sonorité harmonique, Silence).
- Variable qualitative ordinale : Le bloc d’essais au cours de l’expérience (Bloc 1, Bloc 2, Bloc 3, Bloc 4), traduisant l’avancée séquentielle temporelle et la potentielle émergence d’un effet de fatigue cognitive.
- Variable quantitative continue n°1 (variable dépendante) : Le temps de réaction motrice ($TR$) des essais corrects, enregistré en millisecondes ($ms$) avec une horloge matérielle au millième de seconde (échelle de rapport).
- Variable quantitative continue n°2 (électrophysiologique) : La latence exacte en millisecondes et l’amplitude crête en microvolts ($\mu V$) de l’onde P300 extraite par moyennage des potentiels évoqués sur les électrodes pariétales.
- Variable quantitative discrète : Le nombre absolu d’erreurs commises par le participant au cours de chaque condition expérimentale (comptage par entiers naturels).
Le traitement des erreurs de catégorisation impose ici une vigilance rigoureuse. L’analyste ne doit jamais agréger dans le même calcul les essais corrects et les essais d’erreurs : la précision de réponse constitue une variable qualitative binaire qui filtre en amont l’analyse des temps de réaction continus. L’analyse inférentielle adéquate pour modéliser ces données combine une ANOVA factorielle à mesures répétées sur les latences continues et une modélisation par régression logistique à effets mixtes (GLMM) sur la précision catégorielle binaire de chaque essai.
12.3 Synthèse des pièges conceptuels majeurs et recommandations
Pour immuniser les chercheurs et praticiens contre les dérives méthodologiques récurrentes qui polluent la littérature biomédicale et comportementale, il convient de dresser une synthèse formelle des pièges épistémiques majeurs et de formuler des recommandations prescriptives rigoureuses :
1. Le piège de la dichotomisation médiane d’une variable quantitative.
Couper arbitrairement une variable continue en deux groupes à l’aide de la médiane (par exemple, classifier les participants en « anxieux » versus « non anxieux » sur la base du score médian au questionnaire STAI) est une erreur méthodologique fatale. Cette pratique dégrade la puissance statistique, élimine l’information relative aux écarts individuels et transforme artificiellement deux individus séparés d’un millième de point de part et d’autre de la médiane en deux entités qualitativement antagonistes. Recommandation : Conserver impérativement les variables quantitatives sous leur forme continue originelle et mobiliser la régression linéaire multiple ou les modèles non linéaires.
2. Le piège de l’arithmétisation aveugle des variables qualitatives ordinales.
Traiter les rangs d’une échelle ordinale ou un item de Likert isolé comme une grandeur d’intervalle pure en en publiant la moyenne arithmétique et l’écart-type constitue une imposture formelle dès lors que l’équidistance des intervalles n’est pas psychométriquement établie. Recommandation : Restreindre la description des variables ordinales au mode, à la médiane et aux rangs percentiles, et utiliser exclusivement la statistique non paramétrique ou les modèles logit cumulatifs à seuils proportionnels.
3. Le piège du fétichisme du codage numérique informatique.
Considérer qu’un vecteur de données est quantitatif simplement parce qu’il contient des chiffres dans un fichier informatique (.csv ou .sav) est une source récurrente d’analyses aberrantes. Recommandation : Documenter systématiquement un livre de codes (codebook) exhaustif spécifiant en amont la définition conceptuelle, l’échelle de Stevens sous-jacente et la nature qualitative ou quantitative de chaque colonne matricielle avant tout démarrage analytique.
En respectant scrupuleusement ces démarches épistémologiques et en maintenant une vigilance inébranlable quant à la frontière étanche séparant la catégorisation d’état de la métrologie de magnitude, le chercheur s’assure d’une modélisation statistique exempte d’artefacts, garantissant ainsi l’intégrité, la robustesse et la pérennité scientifique de ses contributions à l’édifice universel du savoir.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- American Psychiatric Association. (2013). Diagnostic and statistical manual of mental disorders (5th ed.). American Psychiatric Publishing. https://doi.org/10.1176/appi.books.9780890425596
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars.
- Cochran, W. G. (1954). Some methods for strengthening the common $\chi^2$ tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Hölder, O. (1901). Die Axiome der Quantität und die Lehre vom Mass. Berichte über die Verhandlungen der Königlich Sächsischen Gesellschaft der Wissenschaften zu Leipzig, Mathematisch-Physische Classe, 53, 1–64.
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 5–55.
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19
- Michell, J. (1999). Measurement in psychology: A critical history of a methodological obsession. Cambridge University Press. https://doi.org/10.1017/CBO9780511490040
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Rasch, G. (1960). Probabilistic models for some intelligence and attainment tests. Danmarks Paedagogiske Institut.
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.