
Dans le vaste champ de la recherche scientifique et de l’analyse quantitative, la rigueur méthodologique repose sur une architecture conceptuelle précise dont l’élément fondamental, souvent tenu pour acquis, demeure le « cas ». Toute investigation statistique, qu’elle examine les mécanismes cognitifs sous-jacents aux troubles de l’attention, l’impact macroéconomique de politiques fiscales ou l’évolution phénotypique de populations végétales face au dérèglement climatique, commence par l’identification sans équivoque de cette unité de mesure. Le cas représente le support empirique tangible sans lequel aucune collecte de données, aucune modélisation et aucune inférence inductive ne seraient concevables. Il incarne l’ancrage réel à partir duquel s’érige l’abstraction mathématique des distributions de probabilité.
Pourtant, la notion de cas transcende la simple qualification d’individu biologique ou de sujet humain. Bien que le langage vernaculaire associe spontanément le cas statistique à la personne répondant à un questionnaire ou participant à un essai clinique, sa nature ontologique et méthodologique est infiniment plus polymorphe. Un cas peut tout aussi bien désigner une dyade conjugale, une salle de classe, une transaction financière, un battement cardiaque au sein d’un enregistrement électrocardiographique, ou encore une région géographique entière. Cette flexibilité définitoire impose aux chercheurs et analystes une vigilance théorique absolue : une méprise sur la délimitation, la granularité ou l’indépendance des cas vicie irrémédiablement l’ensemble des déductions ultérieures, faussant la variance, invalidant les degrés de liberté et précipitant l’analyse dans le gouffre des erreurs écologiques ou atomistes.
Ce guide exhaustif a pour vocation d’analyser en profondeur l’anatomie, la fonction et les implications du concept de cas en statistique. En parcourant ses fondements théoriques, sa matérialisation dans les structures matricielles de données, ses multiples déclinaisons à travers les disciplines des sciences humaines et de la nature, ainsi que les défis computationnels et éthiques qu’il soulève, nous fournirons un cadre d’analyse complet. Qu’il s’agisse d’appréhender les modèles multiniveaux hiérarchiques, de traiter les valeurs aberrantes influentes ou de gérer les déperditions longitudinales d’observations, la maîtrise de l’unité fondamentale d’observation constitue la condition sine qua non de toute démarche scientifique intègre et robuste.
1. Introduction fondamentale : Qu’est-ce qu’un cas en statistique ?
1.1 Définition formelle de l’entité élémentaire
D’un point de vue axiomatique, un cas (couramment désigné sous les vocables d’unité d’observation, d’enregistrement, d’entrée élémentaire ou d’instance) représente la plus petite entité empirique discrète au sein d’une recherche scientifique sur laquelle s’effectue la mesure ou l’observation d’au moins une caractéristique. En statistique inférentielle et descriptive, le cas constitue le socle indivisible de l’échantillon. Il s’agit du porteur phénoménologique d’informations qui, une fois agrégé à ses pairs, permet d’approcher la structure stochastique d’une population cible. En d’autres termes, le cas matérialise l’intersection entre le monde réel observable et l’appareil conceptuel de la théorie quantitative.
Il est fondamental de maintenir une distinction épistémologique stricte entre l’objet théorique abstrait défini dans les hypothèses de recherche et son opérationnalisation sous la forme d’un cas statistique. Par exemple, si l’objet de recherche théorique porte sur « la cohésion d’équipe », le cas opérationnalisé ne sera pas nécessairement le travailleur individuel, mais l’équipe de travail en tant qu’entité collective unitaire. Cette transition de l’abstraction conceptuelle vers l’entrée unitaire standardisée requiert une définition opérationnelle explicite : le chercheur doit définir des frontières non ambiguës permettant de déterminer sans équivoque si une entité donnée appartient ou non à la classe des cas admissibles pour l’analyse envisagée.
L’identification précise de la nature du cas conditionne directement la validité interne d’un protocole d’expérimentation. Si les limites d’un cas sont floues ou si plusieurs entités sont amalgamées par inadvertance en une seule entrée sans normalisation adéquate, les postulats d’homogénéité des unités d’observation sont violés. Cette défaillance conceptuelle engendre une variance résiduelle artificielle qui obscurcit les effets réels ou, inversement, engendre des corrélations fallacieuses. La délimitation univoque de l’entité élémentaire assure ainsi que chaque incrément du compteur de données reflète une instanciation authentique et standardisée du phénomène examiné.
1.2 Le rôle du cas dans l’architecture des données
Dans l’architecture systémique des bases de données de recherche, le cas exerce une fonction cruciale de point d’ancrage invariant. Alors que les phénomènes étudiés peuvent fluctuer, présenter des niveaux multiples de complexité ou varier dans le temps, le cas demeure le repère référentiel auquel l’ensemble des attributs empiriques — les variables — viennent s’agréger. Dans une structure relationnelle ou tabulaire, chaque cas agit comme un nœud central qui maintient la cohérence relationnelle entre des descripteurs démographiques, des mesures psychométriques, des biomarqueurs et des indices comportementaux, empêchant la désarticulation des données recueillies au cours de l’investigation.
Cette individualisation des mesures au sein d’une série statistique multivariée permet aux analystes d’isoler des profils spécifiques et d’explorer la structure de corrélation interne propre aux unités étudiées. C’est la conjonction des propriétés mesurées sur un même cas qui autorise le calcul de covariances : on n’observe pas des variables flottant dans un vide théorique, mais des covariations de caractéristiques portées simultanément par des unités empiriques concrètes. Le cas sert ainsi de véhicule d’intégration qui rend intelligible l’interaction complexe des variables au niveau individuel avant toute tentative d’extrapolation à l’échelle agrégée.
Par voie de conséquence, le statut et le dénombrement rigoureux des cas déterminent de manière impérative la métrique cardinale de toute recherche : la taille de l’échantillon, universellement symbolisée par la lettre N (ou n pour un sous-échantillon). L’attribution de la valeur N n’est jamais un acte trivial de comptage arithmétique ; elle dépend intrinsèquement de ce qui a été théoriquement et méthodologiquement défini comme constituant un cas indépendant. Une confusion quant au statut de l’unité élémentaire — comme considérer des mesures répétées sur le même patient comme des cas distincts — entraîne une surévaluation drastique de la taille de l’échantillon, faussant lourdement la puissance statistique et les seuils de signification des tests d’hypothèse.
1.3 La transition historique : De l’observation anecdotique au cas statistique
L’émergence de la notion moderne de cas statistique s’inscrit au cœur d’une profonde révolution épistémologique survenue entre le XVIIIe et le XIXe siècle. Historiquement, la médecine et l’étude des comportements humains reposaient sur la tradition narrative de l’observation anecdotique : le « cas » clinique désignait une histoire singulière, qualitative, irréductible et détaillée d’un malade spécifique. Les praticiens accumulaient des récits cliniques personnalisés, valorisant l’unicité du patient et la rareté du symptôme, sans chercher à extraire une métrique comparable ou une loi probabiliste régissant des populations étendues.
Cette perspective a connu une mutation radicale sous l’impulsion de pionniers tels qu’Adolphe Quetelet, astronome et mathématicien belge, considéré comme l’un des fondateurs de la « physique sociale ». En appliquant le calcul des probabilités à l’étude des caractéristiques humaines, Quetelet a théorisé le concept de l’« homme moyen » (l’homme moyen), dépouillant l’observation individuelle de ses particularismes anecdotiques pour la transformer en un point de donnée calibré. Le cas est ainsi devenu une unité interchangeable au sein d’une distribution normale, permettant de faire émerger des régularités statistiques sous-jacentes à partir du bruit des variations individuelles. Plus tard, les travaux de Francis Galton et de Karl Pearson sur la biostatistique ont formalisé l’intégration du cas dans des matrices d’observations standardisées.
Cette formalisation mathématique a permis l’avènement des grandes études de cohortes en épidémiologie et en sciences sociales tout au long du XXe siècle. L’unité d’analyse s’est vue soumise à des protocoles de standardisation rigides, où chaque individu ou entité devait être évalué au moyen d’instruments strictement identiques afin de garantir la comparabilité intra-échantillon. Le cas n’est plus envisagé comme une singularité narrative incommensurable, mais comme un vecteur multidimensionnel de mesures numériques, ouvrant la voie au développement de la statistique multivariée moderne, de l’analyse factorielle et des modèles d’équations structurelles.
2. La distinction conceptuelle entre cas et variables
2.1 L’ontologie du cas versus la métrique de la variable
L’un des écueils fondamentaux rencontrés par les étudiants et les praticiens débutants réside dans la confusion entre les concepts ontologiques de « cas » et de « variable ». Ces deux composantes forment pourtant une polarité indissociable mais rigoureusement asymétrique de l’analyse quantitative. Le cas possède une nature ontologique substantive : il est le substrat, le conteneur, l’entité physique ou conceptuelle existant indépendamment de la métrique employée pour l’analyser. À l’opposé, la variable constitue une abstraction opérationnelle, une dimension de mesure, une propriété mutable ou un attribut qualitatif ou quantitatif susceptible de revêtir différentes valeurs selon les cas auxquels elle s’applique.
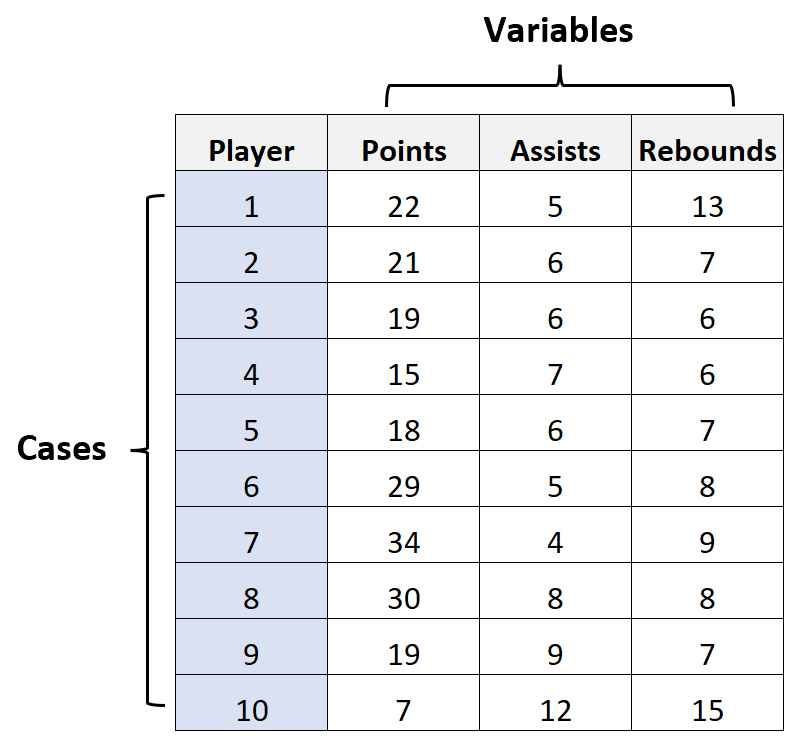
La complémentarité fonctionnelle entre ces deux concepts s’exprime dans la métaphore classique du réceptacle et de son contenu : le cas est le porteur d’attributs, tandis que la variable est l’attribut lui-même mesuré sous une échelle déterminée (nominale, ordinale, d’intervalle ou de rapport). Un patient hospitalisé constitue un cas immuable dans son individualité ; en revanche, sa tension artérielle, son niveau d’anxiété évalué sur une échelle psychométrique et son groupe sanguin représentent des variables distinctes attachées à ce même réceptacle. Confondre l’entité porteuse avec l’attribut mesuré engendre des erreurs logiques funestes dans l’élaboration des protocoles de recherche.
Les risques d’erreur d’interprétation culminent lorsque des chercheurs réifient des variables au détriment des cas qui les soutiennent. Par exemple, affirmer qu’une corrélation positive existe entre « la dépression » et « la rumination mentale » est une formulation raccourcie qui omet la réalité statistique : ce sont les cas individuels qui manifestent simultanément des scores élevés sur la variable dépression et sur la variable rumination. Oublier que la variable n’existe que par l’intermédiaire des cas observés conduit fréquemment à des extrapolations abstraites déconnectées de la distribution empirique réelle, masquant la présence éventuelle de sous-groupes dissimulés ou d’anomalies de répartition au sein de l’échantillon.
2.2 La structure bidimensionnelle de la matrice de données rectangulaire
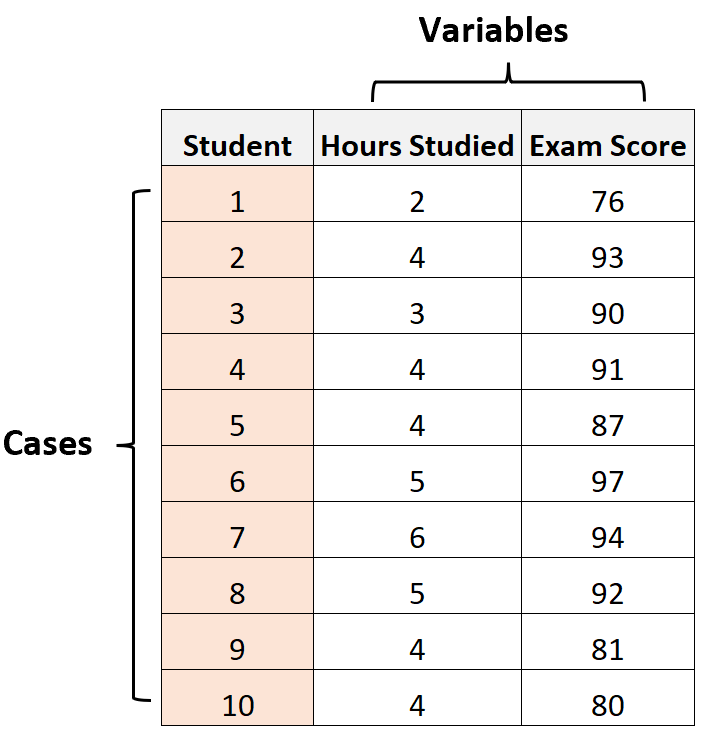
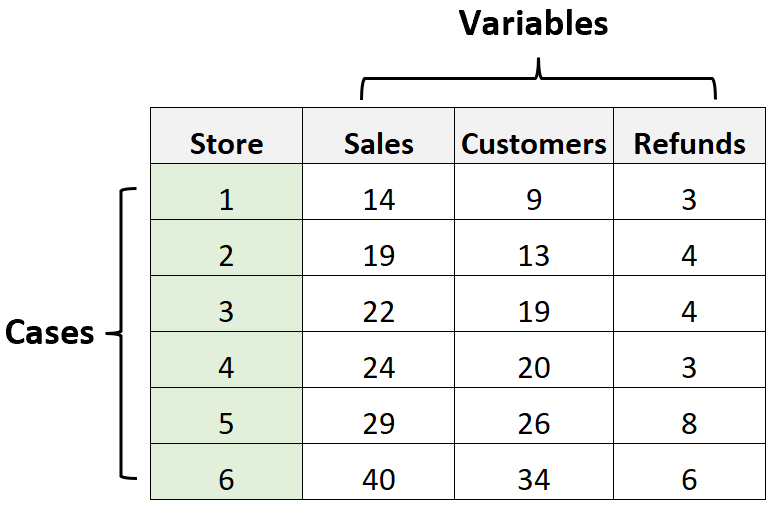
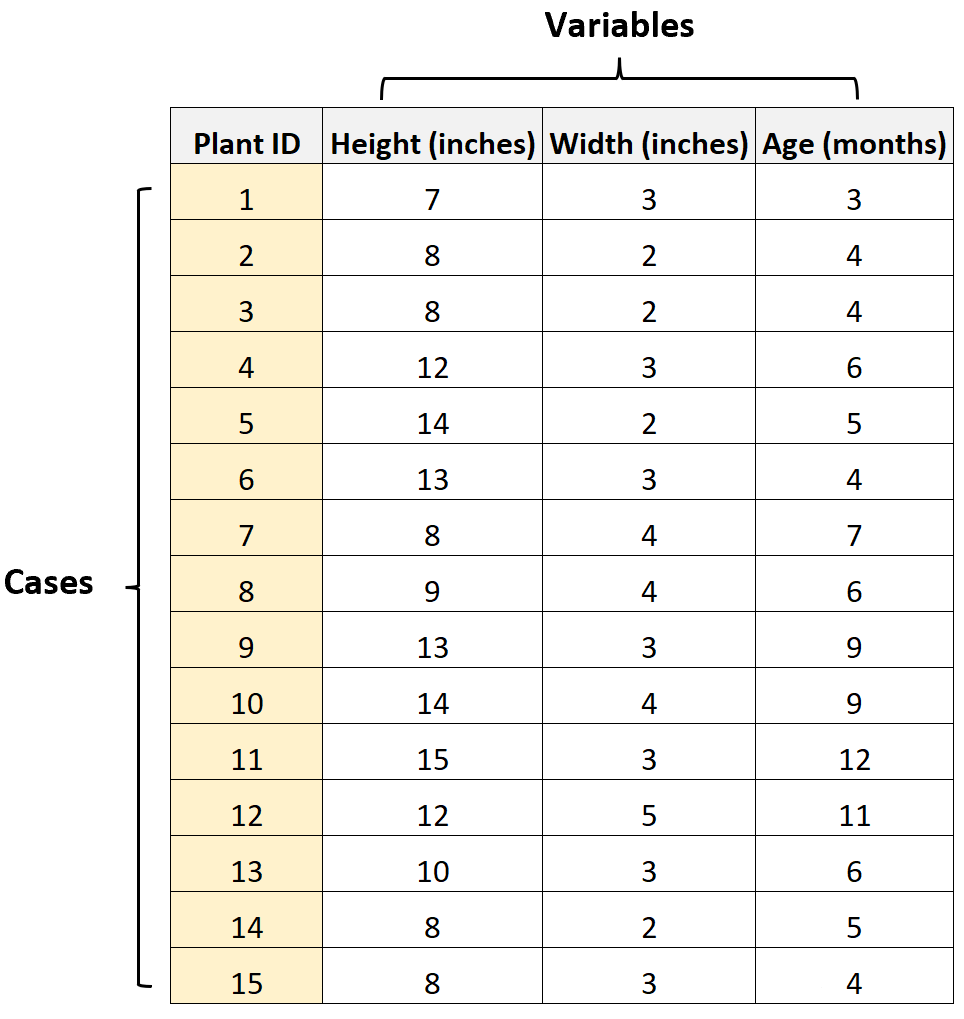
En science des données et en statistique computationnelle, la relation fondamentale entre cas et variables se traduit universellement par la construction d’une matrice de données rectangulaire, souvent qualifiée de tableau plat ou de table tabulaire standard. Par convention mathématique quasi absolue, codifiée notamment dans les standards de la science des données décrits par Hadley Wickham dans le paradigme des données bien rangées (tidy data), chaque ligne de la matrice correspond rigoureusement à un cas unique, tandis que chaque colonne correspond à une variable spécifique décrivant ces cas.
Sur le plan algébrique, une telle matrice se définit formellement par ses dimensions ( n times p ), où ( n ) représente la cardinalité de l’ensemble des cas observés (la taille de l’échantillon) et ( p ) symbolise le nombre de variables ou de descripteurs recueillis pour chacun de ces cas. L’élément scalaire situé à l’intersection de la ( i )-ème ligne et de la ( j )-ème colonne, usuellement noté ( x_{ij} ), correspond ainsi précisément à la réalisation numérique ou catégorielle de la variable ( j ) mesurée spécifiquement sur le cas ( i ). Cette structure implique que tous les éléments figurant sur une même ligne partagent la même unité empirique de référence, assurant la cohésion interne de l’observation.
Le respect scrupuleux de cette convention matricielle n’est pas un simple choix esthétique d’organisation bureautique ; il s’agit d’une exigence algorithmique pour l’application des progiciels statistiques contemporains tels que R, Python, SPSS, Stata ou SAS. Dès lors qu’une ligne de la matrice combine des fragments d’observations provenant de multiples cas, ou qu’une variable est fragmentée arbitrairement sur plusieurs lignes sans structure d’emboîtement définie, les calculs de covariances, les projections factorielles et les inversions matricielles requises par les modèles de régression deviennent mathématiquement insolubles ou fondamentalement biaisés.
2.3 Relations univoques et dépendances multivariées
L’un des avantages conceptuels majeurs de la configuration matricielle réside dans la capacité d’un cas singulier à générer un profil multivarié complexe, formalisé sous la forme d’un vecteur ligne :
$$\mathbf{x}_i = [x_{i1}, x_{i2}, dots, x_{ip}]$$
Ce vecteur résume l’ensemble de l’état informationnel associé au cas ( i ) au sein du système expérimental étudié. Loin de se cantonner à une suite de chiffres disjoints, le profil multivarié intègre l’ensemble des interactions, symétries et déséquilibres entre les différentes dimensions de mesure pour ce participant ou cette entité spécifique.
Dans un cadre géométrique euclidien à ( p ) dimensions (où chaque dimension est configurée par l’une des variables du protocole), chaque cas est projeté sous la forme d’un point géométrique précis dans cet hyperespace. La proximité spatiale entre deux points reflète ainsi directement la similarité globale de leurs profils de variables, ouvrant la voie aux techniques de classification non supervisée (comme le clustering k-means ou la classification ascendante hiérarchique) qui s’appuient sur le calcul de distances inter-cas, telles que la distance euclidienne ou la distance de Manhattan. Le cas n’est donc plus perçu de façon unidimensionnelle mais comme une coordonnée complexe dans un continuum multivarié.
Enfin, l’examen de l’ensemble des vecteurs de cas permet d’appréhender les dépendances multivariées par le calcul des matrices de variance-covariance et de corrélation. La covariance entre deux variables ne traduit rien d’autre que la propension des cas à dévier de manière synchrone de leurs moyennes respectives : si les cas qui présentent des valeurs élevées sur la variable ( X ) présentent également des valeurs supérieures à la moyenne sur la variable ( Y ), la covariance sera positive. Le cas constitue ainsi le médium exclusif à travers lequel les variables manifestent leurs liens fonctionnels ou stochastiques, matérialisant le principe fondamental selon lequel l’analyse des variables n’est que l’analyse formalisée des variations collectives observées sur les cas.
3. Terminologie équivalente : Cas, unités expérimentales, unités d’échantillonnage et sujets
3.1 Unités expérimentales et unités d’échantillonnage
Dans la littérature méthodologique, plusieurs termes sont fréquemment employés de façon interchangeable avec celui de « cas », bien qu’ils désignent des réalités techniques subtilement différenciées selon la phase de l’investigation scientifique concernée. La notion d’unité expérimentale trouve son origine dans les travaux fondateurs de Sir Ronald Fisher en agronomie et en statistiques appliquées. Elle se définit rigoureusement comme la plus petite entité physique ou matérielle à laquelle un traitement expérimental peut être assigné de manière aléatoire et indépendante. Par exemple, si un engrais particulier est pulvérisé sur une parcelle de terrain dans son ensemble, l’unité expérimentale est la parcelle entière, et non chaque plante individuelle croissant sur cette parcelle, car les plantes ne peuvent être assignées indépendamment aux différents traitements.
À l’inverse, l’unité d’échantillonnage relève du vocabulaire de l’échantillonnage probabiliste et de la théorie des sondages. Elle désigne l’élément constitutif de la base de sondage qui est sélectionné lors d’une étape du processus de tirage au sort. Dans les protocoles d’échantillonnage simples à un degré, l’unité d’échantillonnage coïncide parfaitement avec l’unité finale d’observation (par exemple, tirer au sort un citoyen dans le registre national de la population pour lui administrer un questionnaire électoral). Dans cette configuration épurée, unité d’échantillonnage, unité expérimentale et cas statistique se superposent exactement.
Cependant, de nombreuses situations de recherche mettent en évidence une dissociation nette entre l’unité d’échantillonnage et le cas d’analyse final. Dans le cadre d’un échantillonnage en grappes ou à plusieurs degrés, l’unité d’échantillonnage de premier degré peut être un hôpital ou un établissement scolaire, l’unité de second degré un service clinique ou une classe, et l’unité finale d’observation — le cas proprement dit — le patient ou l’élève. Considérer la structure d’échantillonnage comme identique à l’unité de cas sans intégrer les mécanismes de dépendance spatiale ou institutionnelle constitue une grave infraction méthodologique, susceptible d’annihiler la validité des tests statistiques employés.
3.2 Le concept de sujet et de participant en recherche psychologique
Au sein des sciences comportementales et cognitives, une inflexion terminologique majeure a marqué les dernières décennies : le glissement du terme de « sujet » vers celui de « participant ». Historiquement, sous le règne du behaviorisme et de la psychophysique classique, le terme de sujet était la désignation universelle de l’individu soumis aux stimulations expérimentales. Ce vocabulaire, emprunté aux sciences médicales et physiologiques, traduisait une vision mécaniste où l’individu était « assujetti » au protocole conçu par l’expérimentateur, son statut se limitant à celui d’un réacteur biologique passif produisant des sorties comportementales mesurables.
Sous la pression conjuguée des comités d’éthique de la recherche (notamment guidés par les directives de l’American Psychological Association) et du courant de la psychologie humaniste, le terme de participant a progressivement été imposé. Ce choix lexical souligne l’agentivité, le consentement éclairé et le rôle collaboratif de l’être humain engagé dans le processus d’investigation scientifique. En matière de rédaction académique, l’emploi de « cas » ou de « sujet » pour désigner directement une personne est aujourd’hui proscrit dans les sections narratives, bien que le vocable de « cas » demeure parfaitement légitime et indispensable dès lors qu’il s’agit de décrire la formalisation computationnelle et mathématique des données (par exemple : « le filtrage a conduit à l’exclusion de douze cas »).
Sur le plan épistémologique, la transformation d’un participant humain en un cas statistique soulève la question de la réification de l’expérience subjective. Un cas statistique ne capture jamais l’intégralité holistique d’une conscience humaine ; il n’en extrait qu’une projection discrétisée et calibrée sous forme de scores standardisés, de temps de réaction exprimés en millisecondes ou d’occurrences verbales catégorisées. Le chercheur en psychologie doit maintenir une vigilance constante face à cette réduction opérationnelle : si elle s’avère indispensable pour le traitement mathématique des cohortes, elle ne doit en aucun cas conduire à l’illusion que le cas statistique épuise la richesse du participant empirique réel.
3.3 Unités d’observation versus unités d’analyse
La littérature statistique impose une clarification fondamentale entre l’unité d’observation (le niveau auquel la collecte empirique de données est concrètement effectuée) et l’unité d’analyse (le niveau auquel les inférences statistiques, les modélisations et les tests d’hypothèse sont formellement calculés). Si ces deux dimensions sont fréquemment synchrones, leur dissociation délibérée ou accidentelle constitue un enjeu analytique majeur susceptible d’engendrer des erreurs interprétatives considérables.
L’inadéquation entre l’unité d’observation et l’unité d’analyse conduit directement à deux pathologies méthodologiques symétriques bien documentées :
- L’erreur écologique (ou sophisme écologique) : Elle survient lorsqu’un chercheur déduit des conclusions relatives à des individus (cas individuels) exclusivement à partir de données recueillies et analysées au niveau agrégé (groupes, villes, pays). L’exemple classique documenté par William S. Robinson en 1950 a démontré qu’une corrélation positive élevée entre le taux d’alphabétisation et la proportion d’immigrants au niveau des États américains masquait en réalité une corrélation individuelle négative : les immigrants étaient individuellement moins alphabétisés, mais ils avaient tendance à s’installer dans des États où la population globale était davantage éduquée.
- L’erreur atomiste (ou individualiste) : Symétrique de la précédente, cette erreur consiste à extrapoler des dynamiques collectives ou des caractéristiques structurelles macroscopiques à partir de mesures réalisées uniquement au niveau des cas individuels, sans tenir compte des effets d’interaction systémique, des régulations institutionnelles ou de l’impact du contexte social englobant.
Pour prévenir ces écueils, le chercheur doit expliciter avec une rigueur absolue la manière dont il procède lors du passage d’un niveau d’observation à un autre. Lorsqu’on agrège des données (en calculant, par exemple, la moyenne des scores de satisfaction au travail de dix employés pour définir le score unique d’un département), le département devient formellement le nouveau cas d’analyse, et la variance intra-départementale est irrévocablement éliminée de l’estimation. Toute inférence subséquente doit alors être formulée au niveau de l’unité collective et non des acteurs individuels qui la composent.
4. La représentation matricielle des cas dans l’analyse de données
4.1 L’encodage formel et les identifiants uniques (ID)
La translation opérationnelle du cas empirique vers l’espace virtuel de l’ordinateur exige un système de repérage infaillible reposant sur l’attribution d’un identifiant unique (couramment désigné sous le sigle ID, pour Identifier). Cet identifiant consiste en une chaîne numérique ou alphanumérique univoque attribuée à chaque cas dès la phase initiale de collecte ou de numérisation. L’ID agit comme une clé primaire au sens de la théorie des bases de données relationnelles : il garantit qu’aucune ambiguïté n’est possible entre deux cas partageant par coïncidence des attributs démographiques ou des mesures similaires.
L’attribution de ces codes aveugles répond simultanément à des impératifs éthiques stricts et à des nécessités d’intégrité de la recherche. En vertu des réglementations internationales sur la protection des données personnelles (telles que le Règlement Général sur la Protection des Données – RGPD en Europe), les données identifiantes directes (noms, prénoms, numéros de sécurité sociale, adresses postales) doivent être promptement dissociées des données expérimentales. Le fichier de correspondance liant l’ID numérique à l’identité civile du participant doit être chiffré et stocké sur un serveur sécurisé distinct, rendant le jeu de données d’analyse strictement pseudonymisé.
Au-delà de la conformité juridique, l’identifiant invariant constitue la condition préalable indispensable à la traçabilité des cas tout au long du cycle de vie des données. Lors des étapes d’épuration (data cleaning), d’imputation des valeurs manquantes, de fusion avec des sources de données auxiliaires ou de détection des données aberrantes, l’ID permet de documenter de manière transparente et reproductible chaque manipulation subie par un cas spécifique. Une base de données dépourvue d’un système d’ID robuste est vouée à des erreurs de duplication, d’alignement ou de permutation silencieuse de lignes, altérant de manière irréversible la fidélité de l’échantillon.
4.2 Organisation en format large (Wide) versus format long (Long)
L’organisation interne des cas au sein de la matrice rectangulaire subit des transformations structurelles selon la configuration des protocoles d’investigation, en particulier lors de l’application de devis à mesures répétées ou d’études longitudinales. Deux paradigmes d’agencement matriciel prévalent en analyse de données : le format large (wide format) et le format long (long format).
Dans le format large, la règle fondamentale « un cas = une ligne » est strictement préservée. Si un protocole implique d’évaluer le niveau d’anxiété d’un échantillon de participants à trois moments distincts (pré-test, post-test, et suivi à six mois), la matrice comportera une seule ligne par participant, et les mesures répétées seront déployées horizontalement sur trois colonnes distinctes (par exemple : anxiete_t1, anxiete_t2, anxiete_t3). Ce format est particulièrement intuitif pour l’opérateur humain et demeure le format exigé par les procédures d’analyse de variance à mesures répétées (ANOVA à mesures répétées) traditionnelles dans des logiciels comme SPSS.
En revanche, dans le format long, la structure matricielle redéfinit l’unité de ligne. Chaque ligne ne représente plus l’individu global dans son intégralité temporelle, mais l’interaction spécifique entre l’individu et un moment d’observation précis : c’est l’unité « cas-temps » (ou occasion de mesure). Dès lors, pour un participant mesuré à trois reprises, la matrice comportera désormais trois lignes distinctes. Une colonne contiendra l’identifiant invariant du participant (répété trois fois), une seconde colonne identifiera l’instant temporel (t1, t2, t3), et une unique colonne contiendra la valeur de la variable dépendante mesurée à cet instant :
- Structure en format large : Ligne 1 = [ID_101, Anxiete_T1, Anxiete_T2, Anxiete_T3]
- Structure en format long :
- Ligne 1 = [ID_101, Temps_1, Score_Anxiete]
- Ligne 2 = [ID_101, Temps_2, Score_Anxiete]
- Ligne 3 = [ID_101, Temps_3, Score_Anxiete]
Le choix entre ces formats n’est pas neutre. Si le format large s’avère limité face aux données manquantes survenues lors des suivis successifs (provoquant l’exclusion totale du cas dans les algorithmes classiques), le format long est structurellement requis par les approches contemporaines plus robustes, telles que les modèles linéaires mixtes (MLM) et les équations d’estimation généralisées (GEE). Dans ces architectures avancées, le format long permet de traiter avec souplesse les cohortes asynchrones et d’intégrer des cas dont le calendrier de recueil comporte des intervalles inégaux ou des observations partielles.
4.3 Les vecteurs de cas dans les opérations d’algèbre linéaire
L’appréhension de l’analyse multivariée contemporaine requiert de dépasser la conception purement tabulaire de la feuille de calcul pour adopter le formalisme de l’algèbre linéaire, où chaque cas est modélisé sous la forme d’un vecteur géométrique appartenant à un espace vectoriel réel de dimension ( p ) (noté ( mathbb{R}^p )). Considérer un cas statistique comme un vecteur de coordonnées ( mathbf{x}_i in mathbb{R}^p ) permet d’appliquer la géométrie vectorielle à la comparaison analytique de multiples observations simultanées.
Au sein de cet espace à ( p ) dimensions, la proximité spatiale de deux cas ( mathbf{x}_i ) et ( mathbf{x}_k ) peut être formalisée mathématiquement. La mesure la plus élémentaire est la distance euclidienne canonique :
$$d(\mathbf{x}_i, \mathbf{x}_k) = \sqrt{\sum_{j=1}^{p} (x_{ij} – x_{kj})^2}$$
Cependant, en statistique appliquée, les variables présentent souvent des échelles de dispersion divergentes et des corrélations mutuelles substantielles. Dans ce contexte, l’algèbre linéaire recourt préférentiellement à la distance de Mahalanobis, qui standardise les écarts en intégrant l’inverse de la matrice de covariance empirique ( mathbf{Sigma} ) :
$$D_M(\mathbf{x}_i, \mathbf{x}_k) = \sqrt{(\mathbf{x}_i – \mathbf{x}_k)^T \mathbf{\Sigma}^{-1} (\mathbf{x}_i – \mathbf{x}_k)}$$
Cette formulation permet de mesurer l’éloignement d’un cas par rapport à un autre — ou par rapport au centroïde global de l’échantillon — en tenant compte des corrélations sous-jacentes, éliminant ainsi les biais de redondance dimensionnelle.
En outre, l’ensemble de la matrice de dispersion empirique se déduit directement du produit matriciel des vecteurs de cas centrés sur leurs moyennes. Si l’on désigne par ( mathbf{X}_c ) la matrice ( n times p ) dont chaque colonne a été préalablement soustraite de sa moyenne empirique, la matrice de variance-covariance des variables d’échantillonnage ( mathbf{S} ) se calcule élégamment selon l’expression :
$$\mathbf{S} = \frac{1}{n-1} \mathbf{X}_c^T \mathbf{X}_c$$
Cette relation démontre de manière irréfutable que les propriétés de dispersion et de covariance des variables sont l’émanation directe du produit interne des vecteurs de cas transcrits dans la géométrie matricielle.
5. Exemples concrets de cas dans la recherche en psychologie
5.1 Psychométrie et évaluation cognitive individuelle
Le champ de la psychométrie contemporaine fournit l’illustration canonique où l’individu biologique coïncide parfaitement avec le cas statistique unitaire. Lors de l’administration d’échelles d’intelligence standardisées (telles que l’échelle de Wechsler pour adultes ou WAIS-IV) ou d’inventaires de personnalité et d’affects (comme le questionnaire de personnalité à cinq facteurs NEO-PI-3 ou l’inventaire de dépression de Beck BDI-II), chaque patient ou participant constitue une ligne distincte dans la base de données de validation ou de diagnostic.
Dans ce cadre analytique, le cas unitaire se voit attribuer un vecteur de scores composites dérivé de la sommation d’items spécifiques : l’indice de compréhension verbale, l’indice de raisonnement perceptif, la mémoire de travail et la vitesse de traitement. L’analyse statistique vise alors deux finalités distinctes. D’une part, au niveau normatif de la population, l’accumulation de milliers de cas étalonne les distributions, établit la fidélité des échelles via le calcul du coefficient alpha de Cronbach ou de l’oméga de McDonald, et valide l’architecture dimensionnelle par analyse factorielle confirmatoire (AFC).
D’autre part, au niveau clinique appliqué, l’analyse d’un cas unique prend tout son sens lors de la comparaison du profil du patient aux normes de référence. Par le calcul de scores standardisés (scores Z ou notes standardisées T), le clinicien détermine à combien d’écarts-types de la moyenne populationnelle se situe le cas évalué pour chaque dimension cognitive. L’investigation des dissociations cognitives (par exemple, déterminer si la supériorité des performances verbales par rapport aux aptitudes visuo-spatiales est statistiquement significative chez un sujet donné) repose sur des modèles mathématiques de comparaison intra-cas formalisés notamment par John R. Crawford et Paul H. Garthwaite.
5.2 Psychologie sociale : Groupes, dyades et interactions comme cas
L’un des apports majeurs de la psychologie sociale à la méthodologie quantitative réside dans la démonstration que le cas statistique n’est pas intrinsèquement lié à l’organisme biologique singulier, mais peut incarner un système relationnel d’ordre supérieur. Lorsqu’une recherche porte sur l’interaction conjugale, la négociation bilatérale ou le conflit interpersonnel, l’unité fondamentale d’analyse pertinente est souvent la dyade (le couple, le tandem négociateur-acheteur, ou la paire soignant-soigné).
Dans cette configuration, l’attribution du statut de cas à la dyade (et non aux deux membres pris isolément) répond à un impératif méthodologique incontournable : neutraliser ou modéliser l’interdépendance statistique. Les réponses données par les deux membres d’une même dyade sont inévitablement corrélées, violant l’hypothèse d’indépendance des observations (postulat fondamental de l’estimation par les moindres carrés ordinaires). Les variables attachées au cas dyadique sont alors des métriques partagées ou interactives : l’indice de concordance décisionnelle, l’écart de satisfaction subjective au sein du couple, ou le temps global mis à converger vers un accord mutuel.
L’approche contemporaine privilégiée pour traiter ces configurations est le modèle d’interdépendance acteur-partenaire (Actor-Partner Interdependence Model, ou APIM), conceptualisé par David A. Kenny. Dans ce paradigme, les données peuvent être organisées avec la dyade comme cas d’analyse supérieur, au sein duquel s’imbriquent les mesures distinctes de l’acteur et du partenaire. Le chercheur évalue simultanément l’effet acteur (l’impact des propres caractéristiques d’un individu sur son propre résultat) et l’effet partenaire (l’impact des caractéristiques de l’autre membre de la dyade sur ce résultat), démontrant la complexité et la richesse de la définition du cas au niveau interactif.
5.3 Psychologie organisationnelle : Équipes et départements comme cas
En psychologie organisationnelle et du travail, l’attention méthodologique se déplace fréquemment des travailleurs individuels vers des entités collectives plus vastes : équipes opérationnelles, unités de production, agences bancaires ou départements d’entreprise. Lorsque l’objectif scientifique est d’évaluer l’impact du « climat de sécurité », de la « culture d’innovation » ou du « leadership transformationnel partagé » sur des indicateurs de performance, le cas statistique devient formellement l’entité organisationnelle collective, ce qui implique que ( N ) équivaut au nombre d’équipes ou de services audités.
Ce basculement requiert des procédures rigoureuses d’agrégation des mesures individuelles. Le chercheur administre des questionnaires d’évaluation aux salariés (unités d’observation), mais calcule ensuite la moyenne de ces réponses par équipe pour forger l’attribut unique attribué au cas organisationnel. Cette opération ne peut se faire de manière arbitraire ; elle doit être validée empiriquement par la démonstration d’un accord intra-groupe suffisant, quantifié par des indices d’accord inter-juges tels que le ( r_{wg} ) de James, Demaree et Wolf, ou les coefficients de corrélation intraclasse ICC(1) et ICC(2).
Une fois l’agrégation méthodologiquement légitimée, les variables analysées reflètent fidèlement les propriétés systémiques de chaque cas organisationnel : le taux de roulement du personnel (turnover annuel), le taux de fréquence des accidents du travail, la marge opérationnelle collective ou la productivité globale. Considérer l’équipe comme un cas unique permet d’élucider des lois macro-organisationnelles sans risquer de surpondérer artificiellement les résultats par l’inflation factice d’une taille d’échantillon basée sur des centaines de réponses individuelles redondantes.
6. Exemples interdisciplinaires de cas en dehors du champ psychologique
6.1 Sciences de l’éducation : Étudiants, salles de classe et établissements
Le champ des sciences de l’éducation se caractérise par une imbrication structurelle où la définition du cas est hautement contextuelle. Dans une recherche portant sur les déterminants de la réussite aux examens, l’analyste peut opter pour différents niveaux de focalisation :
- L’élève individuel : Le cas est l’apprenant. Les variables mesurées sont son statut socio-économique, son temps d’étude hebdomadaire, son score d’anxiété scolaire et sa note à l’évaluation nationale standardisée.
- La classe scolaire : Le cas est le groupe-classe unitaire (( N = text{nombre de classes} )). Les variables associées englobent le nombre moyen d’élèves par classe (taille de la cohorte), l’ancienneté pédagogique de l’enseignant titulaire, et la performance académique moyenne agrégée de la division.
- L’établissement ou le district : Le cas est l’école, le collège ou le lycée dans son ensemble. Les attributs mesurés correspondent alors au budget alloué par élève, au statut public ou privé sous contrat, à la situation géographique (zone rurale versus réseau d’éducation prioritaire) et au taux global de diplomation.
Le choix de l’unité de cas conditionne la nature même des politiques publiques déductibles de la recherche. Une étude évaluant l’efficacité d’un nouveau manuel pédagogique attribuera l’intervention à la classe ou à l’école entière ; traiter les élèves comme des cas statistiquement indépendants alors qu’ils ont tous suivi le même enseignant dans la même pièce conduirait à sous-estimer massivement les erreurs-types des estimations, créant de faux effets statistiquement significatifs (faux positifs).
6.2 Sciences économiques et gestion : Points de vente et transactions
En économétrie appliquée, en gestion d’entreprise et en marketing quantitatif, le cas prend des formes adaptées aux flux d’activité économique et aux transactions marchandes. Deux configurations illustrent cette variabilité d’échelle : l’analyse des réseaux de distribution et l’analyse comportementale des paiements.
Dans l’analyse des réseaux de distribution, le cas statistique correspond souvent au point de vente physique ou au magasin franchisé. Au sein d’un grand groupe de vente au détail comportant 800 succursales, chaque magasin constitue une ligne de la base de données. Les variables associées incluent la surface de vente en mètres carrés, le flux piétonnier hebdomadaire capté, la zone de chalandise démographique, le montant des dépenses publicitaires locales et le chiffre d’affaires trimestriel généré. L’objectif analytique consiste à modéliser la rentabilité marginale par unité commerciale au moyen de modèles de régression linéaire multiple ou d’analyses d’enveloppement de données (DEA).
À un niveau de granularité micro-analytique extrême, le cas statistique devient la transaction financière unitaire. Dans les architectures de détection des fraudes bancaires ou de modélisation algorithmique du risque de crédit, chaque opération par carte bancaire ou virement constitue un cas unique (( N ) pouvant atteindre des centaines de millions d’entrées). Les attributs attachés à ce cas ponctuel comprennent l’horodatage précis à la seconde, le montant de la transaction, le protocole d’authentification utilisé, l’adresse IP d’émission, l’écart géographique par rapport à la localisation habituelle du porteur, et une variable cible dichotomique indiquant si la transaction s’est avérée frauduleuse ou légitime.
6.3 Biologie et écologie : Spécimens vivants et écosystèmes
La recherche biologique et environnementale illustre avec une clarté remarquable la diversité morphologique du cas statistique, oscillant de l’organisme microscopique aux biomes territoriaux. En botanique expérimentale ou en morphométrie animale, le cas est classiquement le spécimen vivant individuel (une souris de laboratoire, un plant de maïs, un poisson d’élevage). Les mesures documentées caractérisent la croissance somatique, l’expression de profils d’ARN messagers spécifiques, la surface foliaire ou l’indice de masse corporelle.
Néanmoins, dès lors que l’on aborde l’écologie des communautés et la biogéographie, le cas devient une entité spatiale délimitée : la parcelle expérimentale ou le quadrat. Pour évaluer la biodiversité végétale le long d’un gradient d’altitude, l’écologue délimite sur le terrain cinquante parcelles de 10 mètres sur 10 mètres le long d’un versant montagneux. Chaque parcelle constitue formellement un cas statistique. Les variables mesurées ne sont pas des individus uniques, mais des indices écosystémiques synthétiques : l’indice de diversité de Shannon-Wiener, la richesse spécifique (nombre total d’espèces différentes répertoriées dans le quadrat), la biomasse végétale sèche cumulée, l’inclinaison de la pente et le pH du sol.
De même, en hydrobiologie et en toxicologie environnementale, le cas statistique est fréquemment un prélèvement ponctuel ou un échantillon d’eau standardisé recueilli à une coordonnée GPS donnée et à une profondeur définie. Les attributs du cas seront la concentration en microgrammes par litre de résidus de métaux lourds, le niveau d’oxygène dissous, la turbidité et la turbidité bactériologique. L’indépendance de ces cas géospatiaux constitue d’ailleurs un défi analytique majeur imposant le recours à la géostatistique et aux modèles de régression autorégressive spatiale.
7. Niveaux d’analyse et cas hiérarchiques : Les modèles multiniveaux
7.1 La hiérarchisation des cas (Unités de niveau 1 et de niveau 2)
Dans la réalité empirique, les entités du monde ne se déploient que rarement sous la forme d’éléments totalement isolés et indépendants ; elles sont le plus souvent insérées dans des structures d’emboîtement naturel ou institutionnel. Les modèles hiérarchiques linéaires (ou modèles multiniveaux) ont été spécifiquement conçus pour reconnaître et modéliser cette architecture où des cas de granularité inférieure sont imbriqués au sein de cas d’ordre supérieur :
- Cas de niveau 1 (Unités micro) : Ce sont les entités élémentaires situées au bas de la pyramide. En recherche médicale ou clinique, il s’agira des patients individuels ; en éducation, des élèves ; en entreprise, des collaborateurs.
- Cas de niveau 2 (Unités macro ou grappes) : Ce sont les contextes structurels collectifs qui englobent les cas de niveau 1. Il s’agira des hôpitaux ou des cliniciens assurant le suivi des patients, des salles de classe abritant les élèves, ou des filiales regroupant les employés.
- Cas de niveau 3 et plus : La hiérarchie peut s’étendre à trois niveaux (les élèves imbriqués dans les classes, elles-mêmes imbriquées dans des établissements scolaires) ou quatre niveaux (incluant les régions ou départements administratifs).
La spécification statistique des modèles multiniveaux requiert l’écriture simultanée d’équations de régression pour chaque niveau d’analyse. Au niveau 1, on modélise la variable dépendante mesurée sur chaque individu en fonction de prédicteurs individuels, tout en autorisant l’ordonnée à l’origine (intercept) et les pentes de régression (slopes) à varier librement d’un groupe de niveau 2 à l’autre. Au niveau 2, ces paramètres variables deviennent eux-mêmes les variables dépendantes expliquées par des prédicteurs propres au contexte structurel :
$$\text{Niveau 1 : } Y_{ij} = \beta_{0j} + \beta_{1j} X_{ij} + e_{ij}$$
$$\text{Niveau 2 : } \beta_{0j} = \gamma_{00} + \gamma_{01} W_j + u_{0j}$$
$$\text{Niveau 2 : } \beta_{1j} = \gamma_{10} + \gamma_{11} W_j + u_{1j}$$
Ignorer cette imbrication en appliquant une régression ordinaire par les moindres carrés en fusionnant l’ensemble des cas dans un modèle plat (flat model) gonfle artificiellement les degrés de liberté résiduels. Ce biais majeur conduit à une sous-estimation systématique des erreurs types des estimateurs de coefficients, provoquant un taux alarmant d’erreurs de type I (rejet intempestif de l’hypothèse nulle en faveur d’un effet inexistant).
7.2 Le coefficient de corrélation intraclasse (ICC)
Pour arbitrer objectivement sur la nécessité de mobiliser une modélisation multiniveau plutôt qu’une analyse par régression classique ignorant les groupements, le statisticien évalue le coefficient de corrélation intraclasse (généralement désigné par l’acronyme anglophone ICC ou par la lettre grecque ( rho )). L’ICC évalue l’ampleur de la dépendance statistique mutuelle partagée par des cas de niveau 1 inclus au sein d’une même unité de niveau 2.
Mathématiquement, l’estimation de l’ICC procède d’un partitionnement rigoureux de la variance totale observée de la variable d’intérêt en deux composantes indépendantes, à partir d’un modèle non conditionnel à effets aléatoires (modèle vide sans aucun prédicteur) :
$$\rho = \frac{\tau_{00}}{\tau_{00} + \sigma^2}$$
Dans cette formulation fondamentale, ( tau_{00} ) (tau zéro-zéro) symbolise la variance inter-groupes (la variabilité mesurée entre les différents cas de niveau 2), tandis que ( sigma^2 ) (sigma carré) représente la variance intra-groupe (la dispersion résiduelle entre les cas de niveau 1 au sein de chaque groupe). L’ICC prend donc ses valeurs dans l’intervalle canonique compris entre 0 et 1.
L’interprétation analytique de la valeur obtenue guide directement la stratégie computationnelle :
- Si ( rho = 0 ) (ou tend vers 0, usuellement ( < 0{,}05 )), la variance entre les grappes est négligeable : l'appartenance à un groupe donné n'exerce aucune influence mesurable sur le comportement des cas de niveau 1, autorisant le recours aux techniques classiques de régression ordinaire.
- Si ( rho ) excède 0,05 ou 0,10 (valeurs extrêmement courantes en sciences comportementales et biomédicales, où 10 % à 25 % de la variance d’un score de bien-être ou de performance clinique dépend de la clinique ou du thérapeute), l’hypothèse d’indépendance des observations est formellement violée. Le recours aux modèles linéaires mixtes devient une exigence méthodologique non négociable sous peine d’émettre des inférences fallacieuses.
7.3 Études longitudinales et le temps comme niveau d’observation
Une application conceptuellement fascinante de la théorie des modèles hiérarchiques concerne les protocoles d’investigation longitudinaux ou d’échantillonnage de l’expérience quotidienne (Experience Sampling Method – ESM / Ecological Momentary Assessment – EMA). Dans ce paradigme analytique moderne, la hiérarchisation spatiale ou institutionnelle est transposée dans la dimension chronologique : le temps est modélisé comme un niveau d’observation emboîté.
Dans cette structure, les cas de niveau 1 sont constitués par les moments de mesure successifs ou les occasions d’observation temporelle répétées (par exemple, les cinq notifications quotidiennes envoyées sur le smartphone d’un patient pendant quatorze jours, générant 70 points de mesure par sujet). Le cas de niveau 2 est quant à lui la personne, l’individu singulier au sein duquel s’imbriquent ces observations séquentielles :
- Niveau 1 (Cas chronologiques) : Fluctuations intra-individuelles (l’état de stress à l’instant ( t ), la glycémie post-prandiale, l’activité physique mesurée par accélérométrie durant l’heure écoulée).
- Niveau 2 (Cas individuels) : Différences inter-individuelles stables dans le temps (le niveau d’anxiété-trait de base, l’âge, le bagage génétique, la pathologie chronique).
Cette conceptualisation révolutionne l’analyse longitudinale en apportant une réponse définitive aux contraintes historiques des méthodes d’analyse de variance à mesures répétées. Dans les modèles multiniveaux longitudinaux (modèles de courbes de croissance latente ou Growth Curve Models), les cas dont le suivi temporel est incomplet ne sont plus systématiquement rejetés. De surcroît, le modèle s’adapte sans encombre à des intervalles de collecte irréguliers (où le délai séparant deux visites varie d’un patient à l’autre), permettant d’estimer avec précision les trajectoires moyennes de développement de la cohorte tout en captant la variabilité idiosyncrasique des courbes d’évolution propres à chaque cas unitaire.
8. Cas atypiques, influents et extrêmes : Détection et impact statistique
8.1 Typologie des valeurs aberrantes (Outliers univariés et multivariés)
L’exploration préalable d’un jeu de données met invariablement en lumière la présence de cas dont les valeurs s’écartent spectaculairement du comportement de la masse des observations. L’analyste doit classifier avec une rigueur clinique la typologie de ces cas singuliers en distinguant les outliers univariés des outliers multivariés.
Un cas aberrant univarié se manifeste par une coordonnée extrême sur une seule variable prise isolément. Sa détection s’effectue usuellement par la standardisation des scores en cotes Z (où une cote supérieure en valeur absolue à ( |Z| > 3{,}0 ) ou ( 3{,}29 ) indique un cas situé à plus de trois écarts-types de la moyenne empirique, théoriquement hautement improbable sous une distribution normale) ou par l’intervalle interquartile de Tukey représenté sur un diagramme en boîte (boxplot), où un cas est qualifié d’extrême s’il se positionne à plus de 1,5 ou 3 fois l’écart interquartile (IQR) au-delà des quartiles ( Q_1 ) ou ( Q_3 ).
À l’inverse, l’outlier multivarié constitue une anomalie bien plus insidieuse : les valeurs prises par le cas sur chacune des variables évaluées séparément peuvent paraître parfaitement banales et s’inscrire dans les normes univariées, mais leur combinaison multivariée simultanée s’avère hautement aberrante. Considérons une base de données biomédicale contenant l’âge et le statut de grossesse : observer un individu âgé de 9 ans est fréquent dans l’échantillon, et observer une femme enceinte l’est tout autant ; en revanche, observer un cas combinant simultanément un âge de 9 ans et un état de grossesse caractérise un outlier multivarié manifeste. La détection de ces configurations atypiques repose sur le calcul de la distance de Mahalanobis pour chaque cas et sa comparaison formelle à une distribution de Chi-deux (( chi^2 )) paramétrée par un nombre de degrés de liberté équivalant au nombre de variables analysées.
Face à ces cas, il est impératif de distinguer trois étiologies distinctes :
- Erreurs de transcription ou d’instrumentation : Des erreurs matérielles de frappe (par exemple, saisir un âge de « 250 » au lieu de 25 ans) ou des dysfonctionnements de capteurs, dont la correction ou l’exclusion est univoque.
- Hétérogénéité de la population sous-jacente : Le cas atypique n’appartient pas véritablement à la population cible échantillonnée (par exemple, l’inclusion accidentelle d’un patient schizophrène sous traitement neuroleptique lourd dans un échantillon de contrôle évaluant les temps de réaction normaux).
- Variabilité biologique ou comportementale authentique : Le cas constitue une expression légitime, quoique rare, de la variabilité naturelle du phénomène étudié, fournissant une information scientifique inestimable qui ne saurait être occultée.
8.2 L’effet de levier et l’influence des cas sur les paramètres de régression
Tous les cas atypiques n’exercent pas un impact destructeur identique sur les estimations économétriques ou statistiques. En analyse de régression linéaire, la modélisation fait une distinction fondamentale entre le concept d’effet de levier (leverage) et celui d’influence.
L’effet de levier quantifie l’éloignement des valeurs d’un cas par rapport au centre de gravité de l’espace multidimensionnel constitué exclusivement par les variables prédictrices indépendantes (( X )). Il est algébriquement mesuré par les éléments diagonaux ( h_{ii} ) de la matrice chapeau (Hat matrix, ( mathbf{H} = mathbf{X}(mathbf{X}^Tmathbf{X})^{-1}mathbf{X}^T )). Une valeur de levier ( h_{ii} ) élevée (typiquement supérieure à ( 2p/n ) ou ( 3p/n )) confère au cas un potentiel géométrique considérable d’attraction sur la surface de régression : comme sur une balançoire à bascule, un cas situé à l’extrémité distale du domaine d’observation peut basculer la pente à lui seul.
Cependant, un cas peut posséder un fort effet de levier sans pour autant fausser la régression, pourvu qu’il se situe exactement dans le prolongement de la trajectoire définie par les autres points (résidu proche de zéro). C’est la conjonction d’un effet de levier substantiel et d’un résidu élevé qui produit l’influence, c’est-à-dire une altération substantielle de la valeur numérique des coefficients de régression (( beta )) lorsque le cas en question est soustrait de la base de calcul. L’indice d’influence le plus canonique est la distance de Cook (( D_i )), qui évalue le décalage global induit sur le vecteur des valeurs prédites :
$$D_i = \frac{\sum_{j=1}^{n} (\hat{y}_j – \hat{y}_{j(i)})^2}{p \cdot MSE}$$
Dans cette équation, ( hat{y}_{j(i)} ) symbolise la prédiction calculée pour la ( j )-ème observation lorsque le modèle a été ajusté en omettant délibérément le cas ( i ), et ( MSE ) désigne l’erreur quadratique moyenne du modèle. Un cas présentant une distance de Cook supérieure à 1,0 (ou, de manière plus conservatrice, supérieure à ( 4/n )) est considéré comme hautement influent et requiert un examen minutieux.
Pour affiner le diagnostic, les analystes inspectent des métriques complémentaires hautement granulaires :
- Les DFBETAS : Mesurent précisément de combien d’erreurs-types le coefficient de régression d’une variable prédictrice spécifique varie lors du retrait du cas ( i ).
- Les DFFITS : Évaluent le décalage de la prédiction du cas ( i ) exprimé en unités d’écart-type.
- La covariance ratio (COVRATIO) : Évalue si la précision globale de l’estimation de la matrice de covariance est améliorée ou dégradée par l’inclusion du cas en question.
8.3 Prise de décision méthodologique : Conserver, ajuster ou supprimer un cas
Face à un cas statistiquement influent ou atypique, le chercheur fait face à un dilemme déontologique et méthodologique critique. La suppression mécanique et discrétionnaire des cas déviants constitue l’une des pratiques de recherche les plus douteuses (Questionable Research Practices, ou QRP) répertoriées dans la crise de la reproductibilité scientifique. Éliminer opportunément des cas au motif qu’ils affaiblissent la significativité statistique d’une hypothèse ou altèrent la linéarité attendue introduit un biais de confirmation dévastateur qui invalide la valeur épistémique des résultats publiés.
Trois démarches structurées et transparentes doivent être privilégiées :
- L’analyse de sensibilité comparative : La stratégie la plus intègre consiste à exécuter et publier les analyses en double exemplaire : une première estimation intégrant l’intégralité des cas, et une seconde excluant le ou les cas influents identifiés. Si les conclusions théoriques demeurent inchangées, l’influence des cas est qualifiée de cosmétique ; si les résultats divergent radicalement, cette instabilité doit être discutée ouvertement comme une limite majeure de la robustesse des données.
- Les techniques d’estimation robustes : Plutôt que d’amputer l’échantillon, le statisticien peut recourir à des algorithmes réfractaires à l’influence des valeurs extrêmes. Les M-estimateurs développés par Peter J. Huber, la régression de Theil-Sen ou la régression quantile (qui modélise la médiane plutôt que la moyenne conditionnelle) pondèrent automatiquement les cas en fonction de l’ampleur de leurs résidus, minimisant l’impact des outliers sans les radier de l’échantillon.
- L’ajustement sans rejet (Winsorisation et transformations) : La winsorisation consiste à remplacer la valeur d’un cas extrême par la valeur seuil la plus proche située à une borne percentile prédéterminée (par exemple, le 95e ou 99e percentile), préservant ainsi le rang de l’observation sans autoriser sa magnitude démesurée à biaiser les covariances. De même, les transformations non linéaires monotones (logarithmique, racine carrée, ou transformation de Box-Cox) permettent de compresser les distributions asymétriques à queue lourde, réintégrant organiquement les cas extrêmes au sein de la courbure normale.
9. Échantillonnage, représentativité et pondération des cas
9.1 Sélection probabiliste versus non probabiliste des cas
La validité des inférences statistiques déduites d’un ensemble de cas repose en amont sur le protocole méthodologique ayant présidé à leur sélection au sein de la population parente. La distinction cardinale de la théorie de l’échantillonnage sépare les protocoles probabilistes des protocoles non probabilistes.
Dans un échantillonnage probabiliste, chaque entité constitutive de la population possède une probabilité non nulle et calculable à l’avance d’être extraite pour former un cas d’étude dans l’échantillon final. L’échantillonnage aléatoire simple (où chaque cas jouit d’une équiprobabilité rigoureuse de tirage), l’échantillonnage stratifié proportionnel (où les cas sont prélevés au sein de strates homogènes pour garantir la reproduction exacte des fractions démographiques de la population) et l’échantillonnage en grappes incarnent ce standard d’excellence. Seuls ces protocoles autorisent l’application mathématique formelle de la théorie de l’erreur d’échantillonnage et l’estimation rigoureuse d’intervalles de confiance non biaisés.
À l’opposé, les sciences comportementales et biomédicales contemporaines opèrent massivement, par contrainte matérielle ou budgétaire, avec des échantillons de convenance (échantillonnage non probabiliste). Dans cette configuration, les cas sont inclus en vertu de leur accessibilité géographique, institutionnelle ou financière (étudiants de première année d’université rémunérés par des crédits de cours, volontaires recrutés via les réseaux sociaux, patients consultant spontanément dans un centre hospitalier spécifique). Les répercussions méthodologiques sont substantielles : la probabilité d’inclusion étant inconnue, les biais d’autosélection altèrent la composition de l’échantillon. Un exemple emblématique réside dans l’effet WEIRD (Western, Educated, Industrialized, Rich, Democratic) documenté par Henrich, Heine et Norenzayan : l’écrasante majorité des cas étudiés en psychologie mondiale provient d’une fraction démographique marginale et non représentative de l’humanité, limitant drastiquement la validité externe des lois déduites.
9.2 Pondération statistique des cas sous-représentés ou surreprésentés
Lorsqu’un échantillon de cas présente des distorsions structurelles avérées par rapport aux caractéristiques démographiques connues de la population de référence (par exemple, une surreprésentation des femmes diplômées et un déficit critique d’hommes jeunes peu qualifiés), l’analyste fait appel aux techniques de pondération statistique (survey weights).
La pondération consiste à affecter à chaque cas ( i ) un coefficient multiplicateur ou un poids ( w_i ) dans les calculs de statistiques descriptives et de modélisation. Un cas appartenant à une sous-population sous-échantillonnée se voit attribuer un poids supérieur à l’unité (( w_i > 1 )), augmentant artificiellement son influence sur les moyennes et les tables de contingence pour « parler au nom » de ses pairs manquants. Inversement, un cas issu d’un groupe surreprésenté reçoit un poids fractionnaire (( 0 < w_i < 1 )).
Les techniques contemporaines les plus sophistiquées mobilisent le calage sur marges (algorithme Raking Ratio ou méthode de Deville et Särndal). Cette procédure itérative ajuste simultanément les pondérations des cas de manière à ce que les distributions marginales multivariées de l’échantillon s’alignent parfaitement sur les totaux de population issus des recensements nationaux (croisant par exemple l’âge, le sexe, la profession et le diplôme). Toutefois, si la pondération rétablit la justesse des estimateurs ponctuels de tendance centrale, elle entraîne un coût analytique : la variance d’échantillonnage s’en trouve accrue. Ce phénomène, formalisé par l’effet de plan (design effect de Kish), élargit les erreurs types et réduit la puissance statistique effective du pool de cas analysé.
9.3 La puissance statistique en fonction du volume total de cas (N)
Le volume cumulé de cas inclus dans le protocole constitue le moteur direct de la puissance statistique (( 1 – beta )), c’est-à-dire la capacité probabiliste d’un test à détecter un effet d’une amplitude donnée dans la population lorsqu’un tel effet existe bel et bien. L’estimation a priori du volume de cas indispensable pour conduire une recherche informative n’est pas une conjecture empirique mais une démarche d’optimisation mathématique rigoureusement formalisée.
Sous le modèle formalisé par Jacob Cohen, la puissance dépend d’une relation fonctionnelle impliquant quatre grandeurs fondamentales : le seuil d’erreur de première espèce (( alpha ), usuellement fixé à 0,05), la puissance désirée (( 1 – beta ), classiquement fixée à 0,80 ou 0,90), la taille d’effet minimale théoriquement pertinente (par exemple, le ( d ) de Cohen pour les différences de moyennes, ou le ( r ) de Pearson pour les associations linéaires) et le nombre total de cas ( N ). Des progiciels spécialisés d’analyse de puissance, tels que G*Power, permettent de déterminer avec une précision chirurgicale le contingent minimal de cas à recruter pour ne pas conduire une recherche sous-puissante (underpowered study), vouée à l’inconclusivité statistique.
Toutefois, une dérive symétrique guette le chercheur contemporain à l’ère du Big Data : les risques inhérents au suréchantillonnage massif. Dès lors que ( N ) s’élève à des dizaines ou des centaines de milliers de cas, l’erreur type s’effondre mathématiquement vers zéro, rendant tout test de Student ou d’ANOVA statistiquement ultra-significatif (( p < 0{,}00001 )), même pour des micro-fluctuations dénuées de toute pertinence clinique, pratique ou biologique. Dans ces conditions de sur-puissance, l'analyste doit impérativement subordonner l'interprétation des valeurs-p à l'examen méticuleux des tailles d'effet standardisées et de leurs intervalles de confiance.
10. Gestion et programmation des cas dans les environnements statistiques
10.1 Manipulation des cas sous SPSS et logiciels à interface graphique
L’utilisation de logiciels à interface graphique utilisateur (GUI) tels qu’IBM SPSS Statistics, JASP ou Jamovi structure visuellement l’interaction de l’analyste avec le cas statistique. Dans l’environnement classique de SPSS, la distinction ontologique s’incarne matériellement par le double affichage de la fenêtre principale : l’onglet « Vue de données » (Data View) affiche la matrice empirique où chaque ligne numérotée représente physiquement un cas, tandis que l’onglet « Vue de variables » (Variable View) détaille les métadonnées et attributs de chaque colonne.
La gestion opérationnelle des cas dans ces environnements graphiques requiert la maîtrise d’outils de segmentation spécifiques. La commande centrale Sélectionner des observations (Select Cases) permet d’isoler temporairement ou définitivement des sous-ensembles de cas répondant à des critères logiques booléens précis (par exemple, isoler uniquement les cas où sexe = 2 AND age >= 65). Cette procédure génère une variable de filtre binaire (filter_$) marquant les cas exclus d’une barre oblique sur leur numéro de ligne, garantissant que les calculs subséquents s’exécutent sans altérer l’intégrité de la base intégrale.
De surcroît, ces logiciels proposent des modules d’inspection automatique de la qualité des cas, à l’instar de la fonction Identifier les observations dupliquées (Identify Duplicate Cases). Ce module compare des clés primaires ou des vecteurs complets pour repérer les doublons de saisie ou les répondeurs frauduleux récurrents. De même, les procédures de scission de fichier (Scinder le fichier / Split File) permettent d’itérer automatiquement les analyses statistiques sur différentes sous-cohortes de cas sans avoir à fractionner physiquement le jeu de données d’origine.
10.2 Manipulation programmatique des cas avec R (Tidyverse)
Dans l’écosystème de programmation statistique open source R, la manipulation des cas a connu une standardisation élégante avec l’essor du Tidyverse et tout particulièrement de la bibliothèque dplyr. Au sein de cette grammaire d’analyse de données, le cas correspond rigoureusement à une ligne d’une structure rectangulaire moderne nommée tibble (ou data frame optimisé).
L’isolation et le filtrage des cas s’opèrent par l’intermédiaire du verbe idiomatique filter(), qui prend pour arguments des prédicats logiques vectorisés :
L’instruction suivante permet par exemple d’isoler les cas répondant à des seuils cliniques précis :
donnees_filtrees <- donnees %>% filter(score_depression > 15, !is.na(temps_reaction))
Le verbe complémentaire slice() permet d’extraire des cas selon leur index positionnel absolu ou relatif (par exemple, extraire les dix premiers cas avec slice_head(n = 10) ou sélectionner des cas de manière aléatoire pour un sous-échantillonnage de rééchantillonnage avec slice_sample()).
Le regroupement des cas et les calculs statistiques agrégés s’articulent autour du couple fonctionnel group_by() et summarise(). L’analyste peut ainsi faire basculer dynamiquement le niveau d’analyse des cas : en regroupant les observations individuelles par leur identifiant d’établissement scolaire, le chercheur condense les données pour forger une nouvelle table où chaque ligne représente désormais l’école en tant que nouveau cas d’analyse agrégé.
Enfin, la métamorphose dimensionnelle indispensable entre le format large et le format long est assurée par le package tidyr via les fonctions siamoises pivot_longer() et pivot_wider(). La première fonction démultiplie les lignes de la matrice pour convertir des variables de mesures répétées en nouveaux cas-moments longitudinaux, préparant les données pour la modélisation sous lme4 ou brms.
10.3 Gestion des cas en Python pour la modélisation statistique (Pandas)
Dans le monde du calcul scientifique et du machine learning sous Python, la bibliothèque centrale régissant l’organisation des cas est Pandas, articulée autour de sa structure de données emblématique : le DataFrame. Contrairement aux approches purement matricielles matricielles de NumPy, Pandas intègre explicitement un Index vectoriel dédié spécifiquement à la désignation, au repérage et à l’alignement des cas (lignes).
L’adressage des cas s’effectue au moyen de deux indexeurs majeurs :
.iloc[]: Indexation positionnelle basée sur les entiers purs (permettant d’extraire des tranches de cas selon leur position physique ordonnée dans la mémoire, de 0 à ( n-1 ))..loc[]: Indexation explicite par étiquettes, exploitant directement les identifiants uniques (ID) configurés en index de la table.
L’interrogation conditionnelle repose sur des mécanismes d’indexation booléenne sophistiqués. La création d’un masque logique — par exemple :
masque = (df['age'] >= 18) & (df['diagnostic'] == 'Remission')
permet de projeter instantanément une sous-population de cas dans un nouvel objet par vectorisation optimisée sous-jacente en C :
df_inclus = df.loc[masque]
Une puissance déterminante de Pandas réside dans son mécanisme d’alignement automatique des cas lors des opérations vectorielles et des fusions relationnelles (merge() ou join()). Si deux jeux de données distincts contiennent des variables différentes recueillies sur les mêmes participants mais organisées dans un ordre de saisie discordant, la correspondance exacte des identifiants d’index garantit que les calculs de covariation s’exécutent strictement sur les mêmes cas, immunisant le chercheur contre les corruptions de données par désalignement de lignes.
11. Cas manquants et attrition : Problématiques d’incomplétude
11.1 Taxonomie des données manquantes selon Rubin
Dans les enquêtes de terrain comme dans les essais expérimentaux, il est exceptionnel que chaque cas dispose d’un vecteur de mesures totalement exhaustif. Pour conceptualiser rigoureusement l’incomplétude des cas, l’épidémiologiste et statisticien Donald B. Rubin a forgé une taxonomie théorique devenue le cadre de référence mondial pour le traitement des données lacunaires.
Cette taxonomie segmente les mécanismes d’absence en trois catégories stochastiques :
- Manquant complètement au hasard (MCAR – Missing Completely At Random) : La probabilité qu’une valeur soit absente est strictement indépendante de toute variable observée ou inobservée au sein de l’étude. L’absence d’une mesure pour un cas découle d’un événement purement fortuit (par exemple, un tube à essai accidentellement brisé par un technicien de laboratoire ou une page de questionnaire détachée par le vent). Les cas complets demeurent un échantillon aléatoire non biaisé de la cohorte d’origine.
- Manquant au hasard (MAR – Missing At Random) : La probabilité d’incomplétude d’une variable dépend systématiquement d’autres variables observées et disponibles dans la matrice de données, mais non de la valeur manquante elle-même. Par exemple, si les hommes âgés omettent plus fréquemment de répondre à une question portant sur la dépression que les femmes jeunes, l’incomplétude est dite MAR pourvu que le sexe et l’âge aient été intégralement collectés par ailleurs.
- Manquant non au hasard (MNAR – Missing Not At Random) : Le mécanisme le plus pernicieux. La probabilité d’absence est directement dépendante de la valeur sous-jacente non observée. Typiquement, un patient souffrant d’une rechute dépressive aiguë d’une gravité exceptionnelle est précisément incapable de sortir de son lit pour se rendre à la visite de suivi clinique de l’étude. La valeur manquante est intimement corrélée à son propre niveau d’absence, introduisant un biais systématique impossible à corriger sans modélisation explicite du mécanisme d’absence.
11.2 L’attrition expérimentale et la perte différentielle de cas
Dans les essais cliniques randomisés (ECR) et les protocoles longitudinaux, l’incomplétude ne se résume pas à l’omission ponctuelle d’un item ; elle prend la forme massive de l’attrition expérimentale (ou perte au suivi), c’est-à-dire l’abandon définitif d’un sous-ensemble de cas au fil des étapes séquentielles du protocole. Ce phénomène menace mortellement l’un des piliers cardinaux de la méthode expérimentale : l’équivalence initiale inter-groupes conférée par l’assignation aléatoire.
Le péril méthodologique majeur réside dans l’attrition différentielle, situation où les taux ou les profils d’abandon diffèrent structurellement entre le groupe expérimental et le groupe de contrôle. Si un nouveau traitement pharmacologique engendre des effets indésirables gastro-intestinaux sévères, les cas les plus fragiles ou les moins répondeurs du groupe expérimental renonceront prématurément au protocole, tandis que les cas du groupe placebo poursuivront l’étude jusqu’à son terme. L’échantillon final de cas disponibles dans le groupe expérimental se trouvera ainsi artificiellement purgé de ses participants les plus mal portants, induisant une surestimation fallacieuse de l’efficacité thérapeutique du principe actif.
Pour parer à ce désastre méthodologique, les standards épidémiologiques internationaux (notamment codifiés dans les lignes directrices CONSORT) imposent le recours systématique à l’analyse en intention de traiter (ITT, Intention-to-Treat). Ce paradigme exige que tous les cas randomisés initialement soient rigoureusement maintenus dans l’analyse statistique au sein du groupe auquel ils avaient été affectés au départ, indépendamment de leur observance du traitement ou de leur abandon anticipé. L’analyse ITT préserve la randomisation initiale et fournit une estimation écologique réaliste de l’efficacité pragmatique de l’intervention.
11.3 Approches méthodologiques de traitement des cas incomplets
Historiquement, le traitement par défaut réservé aux cas incomplets dans les logiciels informatiques était la suppression par cas complet (listwise deletion ou casewise deletion). Cette méthode expéditive consiste à éliminer purement et simplement toute ligne de la matrice présentant la moindre valeur manquante sur l’une des variables mobilisées dans le modèle. Bien que séduisante par sa simplicité, cette pratique est aujourd’hui universellement décriée : d’une part, elle ampute drastiquement la taille de l’échantillon (( N )), pulvérisant la puissance statistique des tests ; d’autre part, dès lors que les données ne répondent pas à l’hypothèse ultra-restrictive MCAR, la suppression de cas complets injecte des biais substantiels dans l’estimation des coefficients.
Pour dépasser ces limites, l’état de l’art contemporain repose sur deux méthodologies robustes :
- L’estimation par maximum de vraisemblance à pleine information (FIML – Full Information Maximum Likelihood) : Fréquemment mobilisée dans les modèles d’équations structurelles et les modèles multiniveaux, la FIML ne cherche pas à combler artificiellement les cases vides. Elle calcule la fonction de vraisemblance globale en exploitant l’ensemble de l’information mathématique contenue dans les composantes observées de chaque cas, permettant ainsi à chaque participant de contribuer au modèle à hauteur exacte des données qu’il a fournies.
- L’imputation multiple (MI – Multiple Imputation) : Conceptualisée par Rubin, l’imputation multiple génère un ensemble de ( M ) bases de données complètes distinctes (généralement ( M = 5 ) à 100). Les valeurs manquantes de chaque cas y sont remplacées par des tirages stochastiques issus de distributions prédictives multivariées intégrant l’incertitude de la prédiction. Les analyses statistiques sont exécutées de manière identique sur chacune des ( M ) bases de données, puis les résultats sont combinés au moyen des règles de Rubin (Rubin’s rules), garantissant une estimation non biaisée des erreurs-types.
12. Synthèse épistémologique : Du cas singulier à l’inférence populationnelle
12.1 L’approche nomothétique versus l’approche idiographique
L’intégration du cas dans la démarche scientifique ravive une tension philosophique pérenne, initialement théorisée par le philosophe néokantien Wilhelm Windelband et introduite en psychologie par Gordon Allport : la polarité irréductible entre l’approche nomothétique et l’approche idiographique.
L’approche nomothétique privilégie l’universel, la loi générale et l’invariance abstraite. Elle envisage le cas comme un simple échantillon interchangeable, dont la singularité idiosyncrasique n’est qu’un bruit de fond ou une variance d’erreur qu’il convient de lisser par l’agrégation de cohortes massives. À l’extrême opposé, l’approche idiographique valorise la spécificité unitaire, concevant l’organisation psychodynamique, historique et comportementale de l’individu unique comme un tout cohérent impossible à appréhender par des moyennes statistiques de groupe. La critique classique formulée par les cliniciens rappelle souvent avec ironie qu’« aucun individu ne possède exactement 2,4 enfants », soulignant la déconnexion possible entre les grandeurs nomothétiques agrégées et la réalité phénoménologique d’un cas particulier.
Une réconciliation méthodologique moderne s’est opérée au travers des protocoles expérimentaux à cas unique (Single-Case Experimental Designs – SCED). Dans ces protocoles (plans d’inversion ABAB, plans à niveaux de base multiples), le cas singulier devient son propre groupe de contrôle. Par des mesures répétées intensives du comportement à travers des phases alternées de traitement et d’absence d’intervention, le chercheur applique des modélisations de séries temporelles (modèles autorégressifs intégrés de moyenne mobile ou ARIMA) sur un ( N = 1 ). La rigueur de l’inférence statistique et le contrôle expérimental sont ainsi préservés sans renoncer à la granularité idiographique de l’individu.
12.2 Le théorème central limite et le comportement collectif des cas
Le saut conceptuel permettant de métamorphoser un ensemble de cas empiriques disparates en une inférence probabiliste solide relative à une population infinie repose sur l’un des piliers mathématiques les plus admirables de la théorie des probabilités : le théorème central limite (TCL).
Le théorème central limite énonce que la distribution d’échantillonnage de la moyenne arithmétique calculée sur un ensemble de ( n ) cas indépendants et identiquement distribués (hypothèse IID) converge asymptotiquement vers une loi normale (distribution gaussienne), quelle que soit la forme de la distribution de la variable au sein de la population parente, pourvu que sa variance soit finie. Ce phénomène remarquable signifie que, même si les cas individuels présentent une distribution empirique asymétrique, bimodale ou uniforme, la moyenne de ces cas exhibera une régularité mathématique prévisible dès lors que la taille de l’échantillon devient suffisamment large (conventionnellement ( n ge 30 )).
C’est précisément cette régularité collective qui autorise le calcul de l’erreur type de la moyenne (( SE )) :
$$SE = \frac{\sigma}{\sqrt{n}}$$
Cette relation fondamentale met en évidence le rôle de la taille de l’agrégat de cas : l’erreur d’estimation diminue de manière proportionnelle à la racine carrée de la cardinalité des cas. C’est l’accumulation de cas indépendants qui resserre l’étau de l’incertitude autour du paramètre populationnel inconnu, autorisant le statisticien à quantifier formellement le niveau de confiance qu’il peut accorder à ses prédictions.
12.3 Conclusion : Le cas statistique comme passerelle entre réel et modèle
Au terme de cette exploration transversale, le cas statistique s’impose avec force comme la fondation indivisible de toute inférence scientifique. Qu’il prenne les contours concrets d’un être humain consignant ses émotions sur une échelle clinique, d’une colonie bactérienne sur une boîte de Petri, d’un magasin dans un réseau d’approvisionnement ou d’une transaction numérique dans une chaîne de blocs, le cas représente le point de contact irremplaçable entre l’infinie complexité du monde phénoménal et la rigueur formalisée des modèles mathématiques.
Cette transition ne doit toutefois jamais s’opérer dans l’amnésie méthodologique. Le processus d’abstraction qui réduit un cas vivant ou un système dynamique à un simple vecteur de chiffres matriciels comporte un risque permanent de réification. Les statistiques ne décrivent pas les entités réelles dans leur totalité existentielle ; elles n’évaluent que les variables qui ont été retenues pour les caractériser. Il appartient au chercheur conscient de ses responsabilités éthiques et scientifiques de maintenir une vigilance épistémologique constante, veillant à ce que les conventions matricielles, les pondérations d’échantillonnage et les suppressions d’outliers ne trahissent jamais la réalité empirique fondamentale que les cas étaient censés éclairer.
En définitive, la qualité d’une architecture statistique ne se mesure pas uniquement à la complexité des algorithmes de régression ou à l’élégance des fonctions de perte appliquées, mais avant tout à la lucidité avec laquelle l’analyste a su définir, recueillir, respecter et interpréter chaque cas. C’est dans le dialogue intègre entre la singularité du cas empirique et l’universalité de la loi statistique que réside la véritable puissance explicative de la recherche quantitative.
Références
Allport, G. W. (1937). Personality: A psychological interpretation. Henry Holt and Company.
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.sciencedirect.com/book/9780121790608/statistical-power-analysis-for-the-behavioral-sciences
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.2307/1268249
Crawford, J. R., & Garthwaite, P. H. (2002). Investigation of the single case in neuropsychology: Confidence limits on the abnormality of test scores and test score differences. Neuropsychologia, 40(8), 1196–1208. https://doi.org/10.1016/S0028-3932(01)00224-X
Deville, J.-C., & Särndal, C.-E. (1992). Calibration estimators in survey sampling. Journal of the American Statistical Association, 87(418), 376–382. https://doi.org/10.2307/2290268
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/S0140525X0999152X
Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
Kenny, D. A., Kashy, D. A., & Cook, W. L. (2006). Dyadic data analysis. Guilford Press. https://davidakenny.net/apim.htm
Quetelet, A. (1835). Sur l’homme et le développement de ses facultés, ou Essai de physique sociale. Bachelier.
Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). SAGE Publications.
Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351–357. https://doi.org/10.2307/2087176
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. John Wiley & Sons. https://doi.org/10.1002/9780470316696
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
Windelband, W. (1894). Geschichte und Naturwissenschaft. Heitz.