
L’investigation scientifique des processus psychologiques et comportementaux se heurte inévitablement à la complexité intrinsèque de la nature humaine et à l’extrême variabilité des contextes environnementaux. Pendant des décennies, le paradigme positiviste classique a encouragé la recherche de lois universelles et d’effets de causalité directs et invariants, postulant qu’une cause spécifique produit un effet donné de manière homogène à travers l’ensemble des individus. Toutefois, cette modélisation bivariée simplificatrice s’avère fréquemment insuffisante, voire trompeuse, lorsqu’elle est confrontée à la réalité du terrain clinique, de la dynamique organisationnelle ou du développement cognitif et affectif. Face à des résultats empiriques souvent discordants ou caractérisés par une reproductibilité imparfaite, la recherche contemporaine en sciences sociales s’est progressivement orientée vers des architectures méthodologiques plus sophistiquées, capables d’appréhender la conditionalité des lois psychologiques.
C’est au cœur de cette mutation épistémologique que s’impose le concept de variable modératrice. En rupture avec les schémas mécanistes linéaires de type cause-conséquence, l’analyse de modération interroge explicitement les frontières de validité, la magnitude et la directionalité des phénomènes observés. Elle permet au chercheur et au praticien de dépasser la simple question de savoir si une variable indépendante influence une variable dépendante, pour poser des questions éminemment plus fécondes : pour qui cette influence est-elle opérante, et dans quelles circonstances s’exprime-t-elle avec le plus d’acuité ? L’identification des variables modératrices constitue ainsi une étape fondamentale pour contextualiser les découvertes scientifiques, prévenir les généralisations abusives et élaborer des interventions ciblées et personnalisées, fondées sur une compréhension rigoureuse des sous-populations et des environnements d’élection.
Le présent article propose une analyse approfondie, conceptuelle et quantitative de la variable modératrice dans le champ de la psychologie et des sciences quantitatives du comportement. À travers un parcours alliant fondements théoriques, modélisations mathématiques, démonstrations empiriques et guides procéduraux, nous explorerons les mécanismes par lesquels la modération affine notre lecture des réalités humaines. De la distinction classique avec la médiation jusqu’aux raffinements statistiques contemporains permis par la technique de Johnson-Neyman ou la modélisation multiniveau, ce panorama complet vise à fournir aux chercheurs, aux doctorants et aux cliniciens les outils méthodologiques nécessaires pour concevoir, tester et interpréter des modèles conditionnels avec une rigueur statistique optimale.
1. Introduction aux variables modératrices dans la recherche psychologique
1.1 Définition conceptuelle et rôle méthodologique
Sur le plan conceptuel, une variable modératrice se définit comme une variable qualitative (catégorielle) ou quantitative (continue) qui affecte la direction, la nature ou la force de la relation statistique unissant une variable indépendante (le prédicteur) à une variable dépendante (le critère). Selon la formalisation princeps établie par Baron et Kenny (1986), l’introduction d’un modérateur postule que l’impact d’une variable $X$ sur une variable $Y$ n’est pas uniforme mais varie de façon prévisible en fonction des valeurs prises par une troisième variable, traditionnellement désignée par la lettre $W$ ou $Z$. Autrement dit, la relation primaire n’est plus envisagée comme une propriété intrinsèque et immuable du système psychologique étudié, mais comme une fonction mathématique dépendante du contexte individuel, biologique ou environnemental.
Ce statut confère à la modération un rôle méthodologique décisif pour affiner la validité externe et la validité écologique des modèles théoriques. En reconnaissant explicitement que les réponses psychologiques sont contingentes, les chercheurs évitent l’écueil des conclusions universelles erronées. Par exemple, affirmer qu’un stress psychosocial majeur induit nécessairement un épisode dépressif caractérisé constitue une simplification abusive ; affirmer que cette association dépend étroitement du niveau de soutien social perçu ou d’un polymorphisme génétique régulateur de la sérotonine relève d’une modélisation conditionnelle scientifiquement robuste. Le modérateur agit ainsi comme un paramètre de cadrage qui délimite l’espace d’application d’une théorie psychologique donnée.
Enfin, la prise en compte systématique de la modération incarne le passage indispensable d’une causalité linéaire simple à une compréhension systémique et intégrative des conduites humaines. Dans les systèmes vivants, les relations de cause à effet s’inscrivent dans des réseaux interactifs d’une haute densité. L’effet d’une intervention thérapeutique, l’impact d’une méthode pédagogique ou les répercussions d’un changement organisationnel sont sans cesse modulés par les caractéristiques préexistantes des individus et de leur milieu. La variable modératrice traduit formellement cette interdépendance au sein des analyses statistiques, offrant une grille de lecture conforme à la complexité ontologique des phénomènes mentaux.
1.2 La transition des modèles bivariés aux modèles conditionnels
L’histoire de la psychométrie et de l’analyse des données comportementales montre une dépendance prolongée envers les modèles de régression bivariés et les corrélations simples de Pearson. Ces méthodes fondamentales reposent sur l’hypothèse sous-jacente que la pente de régression liant le prédicteur au critère demeure constante à travers l’ensemble des observations composant l’échantillon. Or, cette hypothèse d’homogénéité relationnelle s’effondre régulièrement lorsqu’elle est mise à l’épreuve des faits. Lorsqu’un chercheur observe une corrélation globale proche de zéro entre deux variables réputées théoriquement associées, cette absence d’effet global masque fréquemment deux sous-effets d’intensités comparables mais de directions opposées au sein de différents sous-groupes de la population étudiée.
L’émergence formelle de l’effet d’interaction statistique a fourni la réponse mathématique à cette contradiction empirique. En intégrant la notion de conditionalité, les modèles de régression multiple ont cessé de contraindre les trajectoires relationnelles à une pente unique. L’interaction capture précisément la mesure dans laquelle la dérivée première de la variable dépendante par rapport à la variable indépendante varie en fonction d’une autre coordonnée dimensionnelle du système. Cela permet d’extraire des signaux théoriques pertinents là où l’analyse bivariée standard ne générait qu’un résidu inexpliqué élevé et un décourageant constat d’insignifiance statistique.
Par conséquent, l’intégration des conditions d’émergence des phénomènes psychiques transforme la démarche scientifique. Loin d’être de simples anomalies ou du bruit de mesure parasitant un modèle déterministe, les variations individuelles et contextuelles deviennent le cœur même de l’investigation. La question scientifique ne consiste plus à évaluer si une relation existe dans l’absolu, mais à formaliser précisément l’éventail des conditions paramétriques requises pour que cette relation apparaisse, s’annule, s’inverse ou atteigne son intensité maximale.
1.3 Les questions fondamentales : Pour qui et quand ?
L’intégration d’une variable modératrice dans une matrice de recherche répond fondamentalement à des interrogations de contingence, qu’il convient de distinguer rigoureusement des interrogations de processus causal. Les questions de contingence se résument classiquement par les interrogations jumelles : pour qui et quand un phénomène spécifique se produit-il ? L’interrogation « pour qui ? » renvoie à l’hétérogénéité des sujets observés. Elle explore les caractéristiques différentielles, qu’elles soient démographiques, génétiques, cognitives ou structurales de la personnalité, qui rendent certains individus particulièrement réceptifs, vulnérables ou imperméables à l’influence de la variable indépendante.
À travers ce prisme modérateur, la recherche clinique et épidémiologique a fait des progrès majeurs dans l’identification des sous-populations à risque et des trajectoires de résilience. Par exemple, face au traumatisme infantile ($X$), l’apparition de troubles anxieux à l’âge adulte ($Y$) ne touche pas indifféremment tous les individus ; l’organisation du style d’attachement ou la présence de ressources cognitives spécifiques ($W$) agissent comme des variables modératrices modulant la trajectoire psychopathologique. Identifier les modérateurs revient ainsi à cartographier les facteurs de vulnérabilité intrinsèques et les remparts protecteurs qui expliquent la divergence des trajectoires humaines confrontées à des stresseurs identiques.
D’autre part, l’interrogation « quand ? » porte sur les frontières contextuelles, temporelles et écologiques qui délimitent l’efficacité d’un phénomène ou d’une intervention. Une technique de prise en charge psychothérapeutique peut s’avérer exceptionnellement efficiente dans un climat de faible stress environnemental, mais perdre toute pertinence clinique lors d’une crise psychosociale aiguë. La variable modératrice formalise ces bornes environnementales. Elle prévient les échecs de réplication en explicitant que les protocoles expérimentaux ou interventionnels ne sont pas transférables sans tenir compte de la température contextuelle dans laquelle ils ont été originellement testés et validés.
2. Distinction fondamentale entre variable modératrice et variable médiatrice
2.1 La modération : modification de la relation
L’une des confusions les plus persistantes dans la littérature scientifique en psychologie et en sciences de l’éducation réside dans l’assimilation erronée des concepts de modération et de médiation. Pourtant, ces deux architectures statistiques répondent à des logiques épistémologiques et mathématiques radicalement différentes. La modération s’intéresse exclusivement à la modification de la force ou de la polarité d’une relation existante. Sur le plan statistique formel, elle se matérialise par l’estimation d’un terme d’interaction multiplicatif, correspondant au produit arithmétique de la variable indépendante et de la variable candidate à la modération ($X \times W$). Le modérateur ne cherche en aucun cas à expliquer la chaîne causale intermédiaire, mais spécifie les variations de son gradient.
Une caractéristique méthodologique fréquente du modérateur est sa relative antériorité ou sa stabilité temporelle vis-à-vis du prédicteur. Très souvent, les modérateurs sont représentés par des traits stables non influençables par la manipulation expérimentale ou par l’occurrence de la variable indépendante, tels que le sexe biologique, les polymorphismes génétiques, l’âge chronologique ou les dimensions stables de la personnalité issues du modèle en cinq facteurs (Big Five). Le modérateur préexiste généralement à l’occurrence de $X$ et demeure inchangé par l’action de celle-ci.
De surcroît, une propriété fondamentale de la modération réside dans l’absence totale d’obligation théorique ou statistique d’une corrélation préalable entre la variable indépendante ($X$) et la variable modératrice ($W$). Dans un devis expérimental idéal, $X$ et $W$ sont même rigoureusement indépendantes ou orthogonales, ce qui garantit une puissance maximale pour détecter leur interaction sans risque de confusion factorielle. Le modérateur n’est pas le produit de $X$, il en est simplement le régulateur conditionnel externe.
2.2 La médiation : explication du mécanisme causal
À l’opposé de la modération, la médiation s’attache à expliciter le mécanisme sous-jacent, le processus intermédiaire ou le vecteur causal par lequel une variable indépendante transmet son influence à la variable dépendante. La médiation répond aux questions épistémologiques fondamentales « comment ? » et « pourquoi ? ». Dans une chaîne de médiation simple, la variable indépendante $X$ exerce une influence directe sur la variable médiatrice $M$, qui à son tour influence la variable dépendante $Y$. Le médiateur est donc un effet généré par $X$ et une cause productrice de $Y$.
Cette configuration implique une exigence absolue de séquence temporelle stricte : la variable prédictive $X$ doit précéder chronologiquement la survenue du médiateur $M$, qui doit lui-même impérativement précéder l’observation du critère $Y$. Contrairement au modérateur qui est souvent une disposition stable, le médiateur est intrinsèquement dynamique et malléable ; il constitue la courroie de transmission interne du système. Par exemple, si l’on étudie l’impact d’une restructuration d’entreprise ($X$) sur les symptômes somatiques des employés ($Y$), le sentiment de perte de contrôle ($M$) constitue un médiateur plausible : la restructuration engendre la perte de contrôle, qui à son tour détériore la santé physique des agents.
Sur le plan analytique, la démonstration d’un effet médiateur requiert l’estimation de l’effet indirect, classiquement quantifié par le produit des coefficients des chemins causaux ($a \times b$), où $a$ représente la régression de $M$ sur $X$, et $b$ la régression de $Y$ sur $M$ contrôlée pour $X$. Il est ici mathématiquement impératif que $X$ et $M$ soient corrélées, puisque l’existence même de la médiation repose sur la capacité de $X$ à faire varier $M$. La médiation démonte l’engrenage interne de l’horlogerie causale, là où la modération se contente de mesurer la vitesse à laquelle les aiguilles tournent selon la température ambiante.
2.3 Modèles hybrides : médiation modérée et modération médiée
Bien que la distinction conceptuelle entre modération et médiation soit nette, la réalité clinique et empirique exige souvent l’articulation simultanée de ces deux principes au sein de modèles conditionnels de processus unifiés, théorisés et popularisés par des méthodologistes contemporains tels qu’Andrew F. Hayes (2018). Ces architectures hybrides dépassent les cloisonnements méthodologiques initiaux de Baron et Kenny pour modéliser des dynamiques psychologiques d’une extrême précision.
La médiation modérée (ou modèle de processus conditionnel) se produit lorsque l’effet indirect transmis par le médiateur dépend quantitativement du niveau d’une variable modératrice. Cela signifie que le mécanisme explicatif fonctionne vigoureusement chez certains individus ou dans certains contextes, mais s’avère inopérant ou inversé chez d’autres. Par exemple, dans l’étude de l’impact d’une psychothérapie d’inspiration analytique ($X$) sur la réduction de l’anxiété sociale ($Y$) via l’accroissement des capacités d’introspection ($M$), ce processus intermédiaire d’introspection peut être fortement modéré par l’ouverture à l’expérience des patients ($W$). Pour les patients hauts en ouverture, le chemin indirect est robuste ; pour les patients très faibles en ouverture, la thérapie ne transite pas par ce mécanisme interne.
Inversement, la modération médiée désigne une configuration dans laquelle un effet d’interaction initialement observé entre deux variables ($X \times W$) est lui-même transmis à la variable dépendante par le biais d’un mécanisme intermédiaire ($M$). En psychopathologie et en psychologie du travail, ces modèles intégrés permettent d’atteindre une finesse descriptive sans précédent : ils révèlent non seulement par quels mécanismes psychiques profonds les causes produisent leurs effets, mais établissent avec une rigueur mathématique les conditions précises de contingentement limitant l’activation de ces chaînes causales.
3. Typologie et propriétés des variables modératrices
3.1 Variables modératrices qualitatives ou catégorielles
Dans la recherche empirique, les variables modératrices se présentent sous des formes métriques contrastées, imposant des démarches analytiques spécifiques. Les modérateurs qualitatifs ou catégoriels regroupent l’ensemble des variables nominales, qu’elles soient naturellement dichotomiques ou polytomiques. Une variable dichotomique divise l’échantillon en deux sous-groupes mutuellement exclusifs, tels que le genre assigné à la naissance (homme vs femme), le statut clinique (patient schizophrène vs témoin sain), ou l’assignation expérimentale à une condition d’amorçage cognitif (condition témoin vs condition d’activation émotionnelle). Dans ce cas, la modération examine si la pente reliant $X$ à $Y$ est formellement différente d’un groupe à l’autre.
Lorsque la variable modératrice catégorielle comprend plus de deux modalités (variables polytomiques, comme le niveau de qualification socio-professionnelle découpé en trois strates ou des groupes d’appartenance ethnoculturelle), l’analyste ne peut se contenter d’une simple variable numérique unique sans risquer de créer une relation d’ordre fallacieuse. Il devient impératif de recourir à des systèmes de codage algébrique formels, au premier rang desquels figure le codage d’indicatrice (dummy coding) ou le codage d’effet (effect coding). Pour une variable modératrice comprenant $k$ catégories, il est méthodologiquement nécessaire de créer $k – 1$ variables indicatrices indépendantes.
Chacune de ces variables indicatrices doit alors être multipliée par la variable indépendante $X$ pour former $k – 1$ termes d’interaction distincts au sein de l’équation de régression. Le rejet de l’hypothèse nulle d’absence de modération n’est alors pas fondé sur la significativité isolée d’un seul terme d’interaction, mais sur un test omnibus (généralement un test d’augmentation de variance $F$) évaluant si l’ensemble des termes d’interaction associés à la variable polytomique contribue de façon statistiquement significative à l’accroissement du coefficient de détermination global ($R^2$) du modèle explicatif.
3.2 Variables modératrices quantitatives ou continues
Contrairement aux facteurs catégoriels, les modérateurs quantitatifs se déploient le long d’un continuum numérique continu ou quasi-continu, correspondant à des échelles d’intervalles ou de rapports. Ces variables englobent la majorité des construits psychométriques classiques mesurés par des échelles standardisées, tels que les scores composites d’anxiété-trait, le quotient intellectuel, l’âge chronologique, le revenu annuel ou les indices de satisfaction au travail. Lorsqu’un modérateur est continu, la modification imposée à la relation entre $X$ et $Y$ n’est plus une rupture discrète entre sous-échantillons étanches, mais une transformation infinitésimale et graduelle de la pente de régression.
L’évaluation statistique d’un modérateur continu préserve l’intégralité de la variance et de la sensibilité métrique des instruments de mesure. La pente de la variable dépendante par rapport à la variable indépendante devient elle-même une fonction linéaire continue du modérateur. Pour chaque accroissement d’une unité sur l’échelle de mesure du modérateur, l’effet de $X$ sur $Y$ est modifié d’une quantité fixe équivalente au coefficient de régression affecté au terme d’interaction multiplicatif.
Un impératif méthodologique fondamental associé aux modérateurs continus est le maintien strict de leur continuité statistique lors du traitement analytique. Les pratiques anciennes consistant à découper arbitrairement une variable continue en groupes artificiels (comme la division par la médiane) constituent une hérésie psychométrique universellement condamnée par les méthodologistes contemporains. Maintenir la continuité garantit l’intégrité de la structure mathématique des données et évite l’altération artificielle des seuils d’erreur de première et de seconde espèce.
3.3 Facteurs d’état versus facteurs de trait
Une distinction conceptuelle déterminante dans la typologie des modérateurs en psychologie réside dans la partition temporelle et structurelle entre facteurs d’état et facteurs de trait. Les modérateurs d’état correspondent à des conditions transitoires, fluctuantes et hautement contextuelles caractérisant le sujet ou son environnement immédiat à un instant $t$. Il peut s’agir d’un niveau aigu de fatigue cognitive induit par une tâche prolongée, d’un niveau d’activation physiologique transitoire, d’un affect momentané ou de conditions écologiques ponctuelles comme la présence d’un bruit ambiant perturbateur durant une évaluation neuropsychologique.
À l’inverse, les modérateurs de trait représentent des propriétés structurelles, longitudinalement stables et endogènes de l’individu. Ces variables dispositionnelles englobent les traits fondamentaux de la personnalité (tels que le névrosisme ou la conscience), les structures cognitives stables, les styles d’attachement développés durant l’enfance ou encore des prédispositions tempéramentales neurobiologiques. Ces modérateurs caractérisent la manière habituelle et chronique dont une personne interagit avec son environnement et filtre les stimulations externes.
Cette distinction opère un impact majeur sur la reproductibilité des protocoles de recherche en laboratoire. Lorsqu’une relation expérimentale entre un stimulus et une réponse comportementale est modérée par un facteur d’état mal contrôlé par les expérimentateurs (par exemple, la privation de sommeil des participants lors de sessions matinales comparées à des sessions vespérales), les tentatives de réplication indépendantes aboutiront fréquemment à des échecs patents. Identifier si un modérateur relève du registre de l’état ou du trait conditionne directement la standardisation des protocoles cliniques et la sélection raisonnée des critères d’inclusion dans les essais contrôlés randomisés.
4. Exemples cliniques et empiriques approfondis
4.1 Exemple 1 : Exercice physique, rythme cardiaque et genre
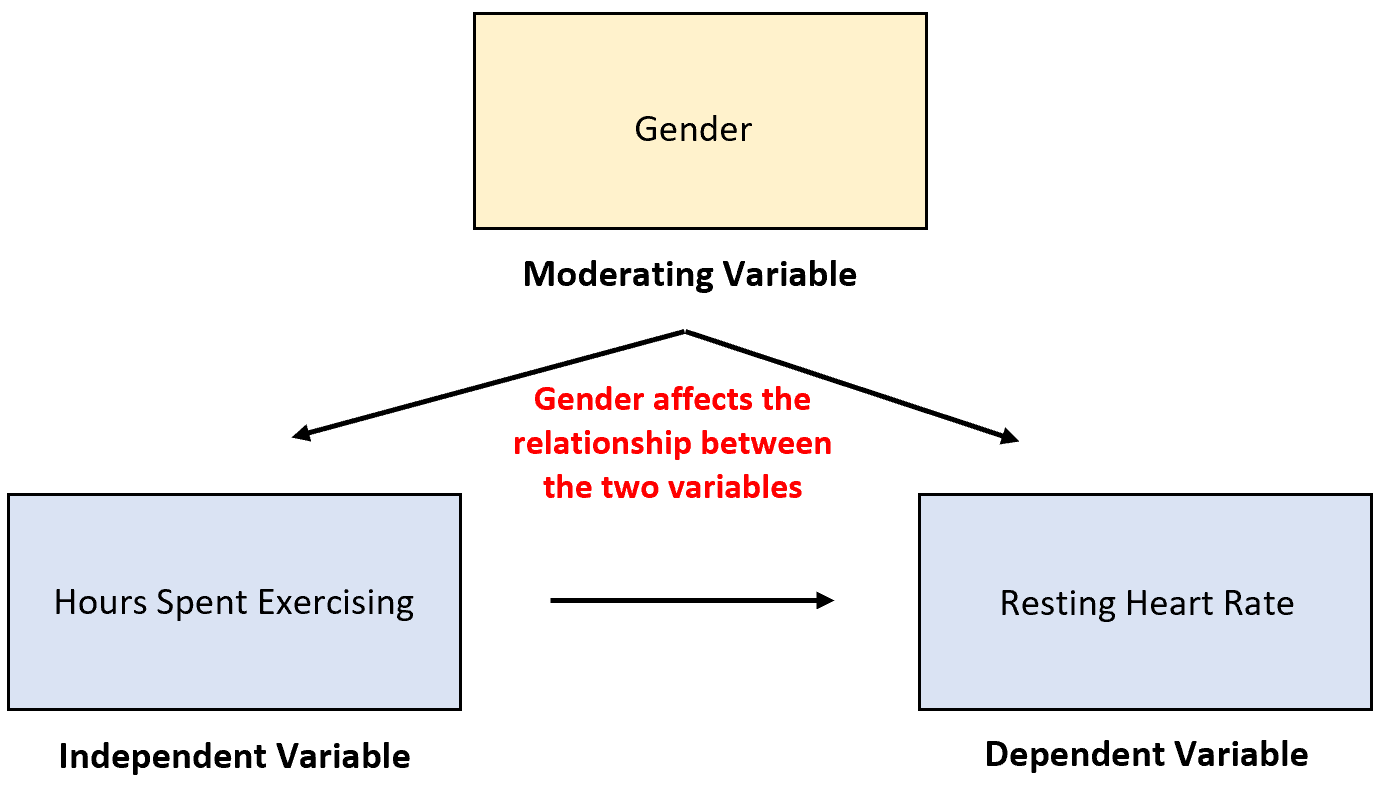
Afin de matérialiser de façon concrète l’action d’une variable modératrice catégorielle dichotomique, examinons une modélisation physiologique classique reliant le volume hebdomadaire d’entraînement physique d’endurance ($X$, mesuré en heures par semaine) à l’évolution de la fréquence cardiaque au repos ($Y$, mesurée en battements par minute). L’hypothèse physiologique générale soutient que l’activité cardiovasculaire régulière induit des adaptations du système nerveux autonome et une hypertrophie ventriculaire excentrique saine, se traduisant par une bradycardie de repos bénéfique pour l’espérance de vie.
Cependant, l’amplitude de ce remodelage cardiaque est soumise à des régulations endocriniennes et génétiques différenciées selon le sexe biologique des sujets. Dans cette configuration empirique, le genre ($W$, codé conventionnellement 0 pour les hommes et 1 pour les femmes) intervient comme une variable modératrice qualitative. L’effet de chaque heure supplémentaire d’entraînement aérobie sur l’abaissement des pulsations cardiaques n’est pas rigoureusement identique chez les athlètes masculins et féminins, en raison notamment des différences moyennes de masse myocardique initiale, de volume sanguin circulant et de concentrations plasmatiques en testostérone et en œstrogènes.
L’analyse statistique de ce modèle révélera typiquement une interaction significative entre le volume d’entraînement et le genre. Chez les hommes (groupe de référence, $W = 0$), la pente de régression simple reliant l’exercice au rythme cardiaque affichera une valeur fortement négative, par exemple $b = -2{,}5$, indiquant une diminution moyenne de 2,5 battements par minute pour chaque heure d’entraînement hebdomadaire additionnelle. Chez les femmes ($W = 1$), si le coefficient d’interaction associé est positif, disons $b_{\int} = +0{,}9$, la pente spécifique aux sujets féminins sera calculée comme étant de $(-2{,}5 + 0{,}9) = -1{,}6$ battement par minute par heure d’effort. Le genre a ainsi modéré la magnitude du bénéfice d’adaptation cardiaque, sans en altérer la directionalité fondamentale globale.
4.2 Exemple 2 : Alliance thérapeutique, psychothérapie et sévérité initiale
En psychopathologie clinique et en évaluation des psychothérapies, l’efficacité d’une prise en charge cognitivo-comportementale (TCC) sur l’atténuation de la symptomatologie dépressive majeure fournit une illustration majeure de modération impliquant un construit relationnel continu. Soit la qualité de l’alliance thérapeutique perçue par le patient après la troisième séance ($X$, mesurée par le questionnaire WAI) et la réduction des scores d’inventaire de dépression de Beck à l’issue d’un protocole de seize semaines ($Y$). L’alliance thérapeutique est généralement corrélée à une amélioration clinique, mais cette relation est substantiellement modérée par la sévérité initiale du tableau dépressif mesurée à l’inclusion dans le protocole ($W$, échelle continue du HAM-D).
L’hypothèse clinique postule que pour des patients présentant une dépression légère à modérée, l’alliance thérapeutique, bien que confortable, n’est pas le déterminant exclusif du pronostic ; ces patients bénéficient largement de la restructuration cognitive et des exercices comportementaux programmés de façon autonome. En revanche, pour des patients présentant une dépression sévère, caractérisés par un ralentissement psychomoteur majeur, une anhédonie profonde et des distorsions relationnelles intenses, l’établissement d’une alliance thérapeutique sécure et robuste devient le prérequis indispensable, le catalyseur amplificateur sans lequel aucune technique active de TCC ne peut être tolérée ou mobilisée par le sujet souffrant.
L’analyse statistique mettra en exergue un effet d’amplification (ou synergie modératrice). La pente reliant l’alliance thérapeutique à la rémission clinique sera modeste ou modérée chez les patients dont les scores de sévérité initiale se situent à un écart-type en dessous de la moyenne de l’échantillon. En revanche, cette pente deviendra extrêmement accentuée et hautement prédictive chez les patients dont le niveau de sévérité initiale excède d’un écart-type la moyenne clinique. La sévérité psychopathologique initiale agit ici comme un modérateur quantitatif continu qui détermine la centralité fonctionnelle de la relation d’aide dans le destin du traitement curatif.
4.3 Exemple 3 : Stress professionnel, épuisement et soutien social
Le champ de la psychologie de la santé au travail et des organisations offre l’un des exemples de modération les plus solidement documentés à travers le modèle classique « Exigences-Contrôle-Soutien » développé par le sociologue et psychologue du travail Robert Karasek (1979). Considérons l’impact néfaste d’une surcharge de travail quantitative chronique et prolongée ($X$) sur le développement de l’épuisement professionnel ou syndrome de burn-out ($Y$, quantifié par les sous-échelles d’épuisement émotionnel du Maslach Burnout Inventory). Il est largement établi qu’une sollicitation mentale excédant systématiquement les ressources adaptatives du salarié conduit à une altération marquée de son homéostasie psychophysiologique.
Toutefois, la relation unissant les exigences du travail à l’épuisement émotionnel n’est pas rigide : elle est fortement modérée par le niveau de soutien social perçu de la part des collègues et du management hiérarchique ($W$, variable continue mesurée par l’échelle de Karasek). Dans cette configuration, le soutien social opère comme un amortisseur psychosocial ou effet tampon (buffer effect). Lorsque les interactions professionnelles sont empreintes de reconnaissance, d’entraide technique et de réassurance émotionnelle, les conséquences physiologiques et psychiques de la surcharge opérationnelle sont considérablement amorties.
Mathématiquement, le terme d’interaction affichera un coefficient négatif statistiquement significatif. Lorsque le soutien social perçu est particulièrement faible (par exemple, à -1 écart-type), la courbe de régression montre que chaque unité d’augmentation de la surcharge de travail produit une hausse drastique de l’épuisement émotionnel. En revanche, lorsque le soutien social est élevé (+1 écart-type), la pente s’infléchit significativement vers l’horizontalité : les exigences élevées génèrent alors beaucoup moins de détresse psychologique. Le soutien social a neutralisé l’impact délétère de la charge de travail, matérialisant parfaitement la fonction de bouclier protecteur conférée par la modération statistique.
5. Formalisation mathématique et analyse de régression
5.1 L’équation de régression linéaire multiple avec terme d’interaction
Pour dépasser l’abstraction conceptuelle et saisir la mécanique de la modération, il est nécessaire de formaliser rigoureusement son équation mathématique au sein du modèle linéaire général. Dans une régression linéaire multiple standard impliquant un prédicteur unique et une variable dépendante, l’équation s’écrit classiquement sous la forme :
$$Y = \beta_0 + \beta_1 X + \varepsilon$$
Lorsqu’on postule l’existence d’une variable modératrice $W$, le modèle linéaire intègre non seulement les deux variables isolées, mais également leur produit croisé ou terme d’interaction multiplicatif. L’équation de régression complète de la modération s’écrit formellement ainsi :
$$Y = \beta_0 + \beta_1 X + \beta_2 W + \beta_3 (X \times W) + \varepsilon$$
Où :
- $Y$ représente la variable dépendante (le critère prédit) ;
- $\beta_0$ représente la constante de régression (l’ordonnée à l’origine, correspondant à la valeur estimée de $Y$ lorsque l’ensemble des régresseurs du modèle est égal à zéro) ;
- $\beta_1$ représente le coefficient de l’effet simple (ou conditionnel) de la variable indépendante $X$ ;
- $\beta_2$ représente le coefficient de l’effet simple (ou conditionnel) de la variable modératrice $W$ ;
- $\beta_3$ représente le coefficient de régression spécifique associé au terme d’interaction multiplicatif $(X \times W)$ ;
- $varepsilon$ symbolise le terme résiduel d’erreur stochastique, supposé indépendant, identiquement et normalement distribué avec une moyenne de zéro et une variance constante $\sigma^2$.
L’architecture mathématique de cette équation révèle la nature de la modération à travers le calcul de la dérivée partielle de $Y$ par rapport à $X$. Si l’on dérive l’équation ci-dessus par rapport au prédicteur $X$, on obtient la formule fondamentale suivante :
$$\frac{\partial Y}{\partial X} = \beta_1 + \beta_3 W$$
Cette expression démontre avec une limpidité mathématique absolue que l’effet de $X$ sur $Y$ n’est plus une quantité statique représentée par un coefficient fixe unique, mais une fonction linéaire dépendante de la variable modératrice $W$. Le paramètre $\beta_3$ capture l’ampleur exacte avec laquelle la pente de régression de $X$ s’altère pour chaque incrément d’une unité de $W$. Si $\beta_3$ n’est pas statistiquement différent de zéro selon le test d’hypothèse associé, la modération est nulle, et la dérivée redevient constante, retombant sur le modèle additif classique sans interaction.
5.2 Le centrage des variables prédictrices
Dans l’application pratique de la régression linéaire avec terme d’interaction, une problématique mathématique et interprétative surgit immédiatement lorsque les variables indépendantes $X$ et $W$ sont des variables continues dont l’échelle métrique d’origine ne possède pas de zéro absolu naturel ou signifiant (ce qui est le cas de la quasi-totalité des échelles psychologiques, comme une échelle de Likert de 1 à 7 ou un score de QI). Si l’on injecte directement les scores bruts dans l’équation, le terme produit $(X \times W)$ présentera inévitablement une corrélation mathématique substantielle avec ses propres composantes constitutives isolées $X$ et $W$.
Cette corrélation induite mécaniquement est désignée sous le terme de multicolinéarité non essentielle. Bien qu’elle n’altère en rien l’estimation de l’effet d’interaction global $\beta_3$, ni la prédiction globale de $Y$ ou le coefficient $R^2$, elle provoque une inflation délétère de l’erreur-type des coefficients simples $\beta_1$ et $\beta_2$, rendant leurs tests d’inférence $t$ hautement instables et sujets à caution. De surcroît, sans transformation préalable, le coefficient $\beta_1$ représente la pente de $X$ sur $Y$ lorsque $W$ vaut exactement zéro. Si la valeur zéro n’a aucun sens théorique ou n’existe tout simplement pas dans la distribution observée (par exemple, un score de dépression mesuré par une échelle où le minimum absolu est 10), le coefficient $\beta_1$ devient une extrapolation mathématique absurde et dépourvue de toute utilité clinique.
La solution méthodologique canonique, théorisée de longue date par Aiken et West (1991), consiste à procéder au centrage sur la moyenne (mean centering) des variables continues $X$ et $W$ avant de procéder au calcul de leur produit arithmétique. Cette transformation algébrique simple consiste à soustraire la moyenne arithmétique de l’échantillon à chaque score individuel :
$$X_{centré} = X_i – \bar{X}$$
$$W_{centré} = W_i – \bar{W}$$
L’équation de régression est alors reformulée en utilisant les composantes centrées et leur produit :
$$Y = \beta_0 + \beta_1 (X – \bar{X}) + \beta_2 (W – \bar{W}) + \beta_3 [(X – \bar{X}) \times (W – \bar{W})] + \varepsilon$$
Cette manipulation dissout la multicolinéarité non essentielle et transforme radicalement l’intelligibilité des paramètres. Désormais, lorsque $W_{centré} = 0$, cela signifie rigoureusement que le sujet se situe à la moyenne exacte de l’échantillon sur la variable modératrice. Dès lors, $\beta_1$ s’interprète intuitivement comme l’effet simple du prédicteur pour un individu moyen sur le modérateur. De même, $\beta_0$ correspond à la valeur moyenne attendue de $Y$ lorsque toutes les variables indépendantes se situent à leur moyenne respective. Le centrage restitue ainsi une signification psychologique aux coefficients d’ordre inférieur sans en altérer la robustesse.
5.3 Significativité statistique et taille d’effet incrémentale
L’évaluation rigoureuse d’un effet de modération ne repose pas uniquement sur l’examen du seuil de significativité $p$ associé au test de Student ($t$) du coefficient $\beta_3$. Une méthodologie rigoureuse exige une démarche de régression hiérarchique par étapes afin de quantifier l’accroissement spécifique de variance expliqué par l’introduction du terme multiplicatif par rapport à un modèle strictement additif.
Dans la première étape de cette démarche, la variable dépendante est régressée uniquement sur les effets principaux directs de $X$ et de $W$ :
$$\text{Modèle 1 : } Y = \beta_0 + \beta_1 X + \beta_2 W + \varepsilon$$
Ce premier modèle fournit un coefficient de détermination initial, désigné par $R_1^2$. Dans un second temps, le terme d’interaction $(X \times W)$ est incorporé dans l’équation afin d’engendrer le modèle conditionnel complet :
$$\text{Modèle 2 : } Y = \beta_0 + \beta_1 X + \beta_2 W + \beta_3 (X \times W) + \varepsilon$$
Ce modèle enrichi produit un second coefficient de détermination, $R_2^2$. L’apport singulier de la modération est alors quantifié par le changement de variance expliquée, soit :
$$\Delta R^2 = R_2^2 – R_1^2$$
La validité statistique de cet incrément est formellement soumise à un test de Fisher-Snedecor ($\Delta F$), dont l’équation s’énonce :
$$\Delta F = \frac{\Delta R^2 / k_2}{(1 – R_2^2) / [N – (k_1 + k_2) – 1]}$$
Où $k_1$ est le nombre de prédicteurs initiaux, $k_2$ est le nombre de termes d’interaction ajoutés (généralement 1 dans une modération simple), et $N$ représente la taille globale de l’échantillon. Un test $\Delta F$ significatif au seuil conventionnel ($\alpha = 0{,}05$) confirme que la modération apporte une contribution explicative irréductible aux seuls effets directs.
En ce qui concerne la taille d’effet statistique, standardisée par l’indice $f^2$ de Cohen, il est crucial d’adopter des critères d’interprétation lucides et contextualisés propres aux sciences comportementales. La formule du $f^2$ pour l’effet d’interaction s’exprime comme :
$$f^2 = \frac{\Delta R^2}{1 – R_2^2}$$
Alors que des valeurs de $f^2$ de 0,02, 0,15 et 0,35 sont classiquement désignées comme des tailles d’effet petites, moyennes et grandes dans l’analyse de régression linéaire standard, la littérature spécialisée souligne qu’en matière d’interaction entre variables continues, un $\Delta R^2$ oscillant entre 0,01 et 0,03 (c’est-à-dire expliquant seulement 1 % à 3 % de variance additionnelle) constitue en réalité un effet modérateur moyen, parfaitement typique et théoriquement hautement substantiel dans les réalités de terrain caractérisées par un bruit de mesure élevé.
6. Représentation graphique et interprétation visuelle
6.1 Tracé des pentes simples (Simple Slopes Analysis)
L’obtention d’un coefficient d’interaction $\beta_3$ statistiquement significatif au sein d’une équation de régression multiple indique que la pente varie, mais ne permet pas de se représenter directement la dynamique du phénomène étudié. L’exploration fine d’un effet modérateur exige une décomposition géométrique post-hoc désignée sous le nom d’analyse des pentes simples (simple slopes analysis). Cette méthode consiste à recalculer l’effet spécifique du prédicteur $X$ sur le critère $Y$ à des valeurs conditionnelles discrètes choisies de la variable modératrice $W$.
La convention méthodologique prédominante consiste à évaluer et à tracer les droites de régression conditionnelles à trois niveaux représentatifs fondamentaux de la distribution du modérateur :
- Au niveau de la moyenne de $W$ ($\bar{W}$), illustrant la tendance centrale de la population ;
- À un écart-type en dessous de la moyenne ($\bar{W} – 1,\text{ET}$), modélisant les individus présentant un faible niveau sur la dimension modératrice ;
- À un écart-type au-dessus de la moyenne ($\bar{W} + 1,\text{ET}$), modélisant les individus caractérisés par un niveau élevé sur le modérateur.
Sur le plan géométrique, la représentation s’effectue dans un repère cartésien bidimensionnel où l’axe des abscisses ($X$) porte la variable indépendante continue et l’axe des ordonnées ($Y$) indique la variable dépendante. Les trois droites de régression conditionnelles y sont superposées. L’analyste observe alors visuellement la divergence, la convergence ou l’intersection de ces segments de droite. Chacune de ces trois pentes simples fait l’objet d’un test de Student spécifique destiné à déterminer si la pente conditionnelle diffère statistiquement de zéro à ce niveau précis de la variable modératrice, autorisant une conclusion clinique ciblée pour chaque profil de sujet.
6.2 Modération d’amplification (synergie) versus d’atténuation (tampon)
L’observation morphologique des faisceaux de droites conditionnelles permet de classifier la dynamique sous-jacente en deux grandes familles phénoménologiques : les modérations d’amplification et les modérations d’atténuation. La modération d’amplification, souvent qualifiée de dynamique synergique, se produit lorsque des niveaux croissants de la variable modératrice renforcent et accentuent la magnitude de la relation initiale positive ou négative. Sur le plan géométrique, l’écartement angulaire entre les droites s’évase nettement, et la pente conditionnelle devient de plus en plus raide au fur et à mesure que l’on progresse vers les valeurs supérieures de $W$.
Un exemple caractéristique d’amplification se rencontre fréquemment en psychologie de la motivation scolaire : si l’effet de l’auto-efficacité académique ($X$) sur la performance aux examens ($Y$) est examiné sous le prisme de l’intérêt intrinsèque pour la matière ($W$), la pente est modérément positive chez les élèves peu intéressés, mais devient exponentiellement abrupte chez les élèves passionnés. Le modérateur agit ici comme un catalyseur puissant qui déverrouille le plein potentiel de la variable indépendante.
À l’opposé, la modération d’atténuation (ou effet tampon / neutralisant) se manifeste visuellement par un écrasement progressif de la pente de régression, celle-ci tendant vers une ligne rigoureusement horizontale à mesure que le modérateur augmente ou diminue. C’est la configuration typique observée dans les recherches sur la résilience psychosociale. Lorsqu’on étudie l’impact de l’exposition à des événements de vie stressants sur la détresse somatique sous la modération de la régulation émotionnelle par réévaluation cognitive, la pente fortement ascendante observée chez les régulateurs déficients s’infléchit et s’aplatit totalement chez les régulateurs efficients. Le modérateur absorbe le choc systémique et dissout l’impact perturbateur du prédicteur.
6.3 L’interaction antagoniste ou inversée (Cross-over interaction)
Parmi les manifestations visuelles de la modération, la configuration la plus spectaculaire et cliniquement la plus critique est sans conteste l’interaction antagoniste, couramment désignée en biométrie sous les vocables de cross-over interaction ou d’interaction disjonctive. Dans cette situation géométrique spécifique, les droites conditionnelles ne se contentent pas de diverger ou de converger : elles se croisent frontalement à l’intérieur de la zone empirique des données observables, entraînant un renversement complet de la directionalité du lien unissant $X$ à $Y$ selon les strates du modérateur.
Cette configuration implique que la relation positive observée chez un sous-groupe d’individus devient une relation négative et délétère chez un autre groupe. Imaginons une recherche évaluant l’efficacité d’une rétroaction critique explicite formulée par un superviseur ($X$) sur le niveau de motivation intrinsèque d’employés créatifs ($Y$), sous la modération de l’estime de soi professionnelle ($W$). Pour des salariés possédant une haute estime de soi, la rétroaction critique est perçue comme un défi stimulant, entraînant une pente positive marquée entre critique et engagement créatif. Pour des salariés fragilisés par une faible estime de soi, la même rétroaction critique est assimilée à une agression identitaire disqualifiante, provoquant un désengagement massif illustré par une pente fortement négative.
Sur le plan éthique et clinique, la découverte d’une cross-over interaction revêt une importance cardinale. Elle alerte immédiatement les praticiens sur le fait qu’une intervention psychologique standardisée peut générer des bénéfices substantiels pour un segment de la population tout en s’avérant iatrogène et destructrice pour un autre. L’omission du modérateur dans une telle circonstance conduirait à une moyenne globale trompeuse suggérant une absence totale d’effet de l’intervention (les deux pentes de sens contraires s’annulant mutuellement dans l’analyse globale), occultant tragiquement à la fois l’opportunité thérapeutique pour les uns et le risque d’aggravation pour les autres.
7. Méthodes de décomposition avancées : Au-delà de la méthode pick-a-point
7.1 Limites inhérentes à la méthode traditionnelle des quantiles
Bien que l’analyse des pentes simples aux valeurs caractéristiques $\pm 1,\text{ET}$ (méthode dite conventionnelle du pick-a-point) ait dominé la littérature empirique pendant plus de trois décennies, elle fait l’objet de critiques méthodologiques sévères dans la psychométrie moderne. La première critique d’ordre épistémologique concerne l’arbitraire complet qui préside au choix des valeurs conditionnelles de décomposition. Pourquoi fixer arbitrairement l’observation clinique à un écart-type plutôt qu’à 1,5 écart-type ou aux quartiles de la distribution ?
La seconde limite majeure découle de la perte substantielle d’information inhérente à la sélection de points d’ancrage discrets le long d’une dimension continue. En se focalisant exclusivement sur des coupes transversales figées, la méthode pick-a-point masque totalement ce qui se produit entre ces seuils artificiels. De surcroît, si la variable modératrice présente une distribution qui s’écarte modérément de la courbe normale de Gauss (par exemple en cas d’asymétrie marquée ou d’aplatissement kurtotique), fixer un point conditionnel à $+1,\text{ET}$ ou $-1,\text{ET}$ peut projeter l’évaluation mathématique sur des zones de distribution totalement dépourvues d’observations réelles, créant des artefacts interprétatifs déconnectés de la réalité du jeu de données.
Enfin, la méthode des pentes simples traditionnelles présente un risque élevé d’erreurs de conclusion à proximité des frontières de significativité. Un chercheur peut observer qu’une pente simple est statistiquement significative à $+1,\text{ET}$ ($p = 0{,}04$) mais ne l’est plus à la moyenne ($p = 0{,}06$). Cette dichotomie binaire induite par le franchissement arbitraire du seuil de 5 % ne dit rien sur le point précis du continuum où le phénomène bascule réellement de la zone d’indifférence statistique vers la zone d’impact robuste.
7.2 Technique de Johnson-Neyman
Pour s’émanciper définitivement des faiblesses inhérentes à la méthode pick-a-point, les méthodologistes recommandent désormais l’emploi systématique de la technique développée initialement par Johnson et Neyman (1936) et remise au premier plan de l’analyse computationnelle moderne par Hayes et Matthes. La technique de Johnson-Neyman inverse fondamentalement la démarche : au lieu de fixer arbitrairement des valeurs du modérateur pour calculer la significativité de la pente de $X$, elle résout analytiquement l’équation pour déterminer les valeurs exactes du modérateur $W$ pour lesquelles le ratio $t$ de la pente conditionnelle franchit précisément la valeur critique de significativité au seuil $\alpha$ souhaité.
Mathématiquement, le test consiste à exprimer la statistique de Student du test de la pente simple en fonction de la variable modératrice $W$ :
$$t(W) = \frac{b_1 + b_3 W}{\text{ET}_{b_1 + b_3 W}}$$
En fixant cette fonction égale aux valeurs critiques bilatérales $t_{\text{crit}}$ (par exemple $\pm 1{,}96$ pour un degré de liberté tendant vers l’infini à $\alpha = 0{,}05$), l’équation quadratique résultante permet d’isoler une ou deux racines réelles. Ces racines constituent les bornes critiques définissant les zones exactes de significativité (regions of significance) le long du continuum complet de la variable modératrice.
Cette approche fournit une information d’une valeur scientifique inestimable : elle permet d’affirmer, sans aucun arbitraire de découpage, que l’effet de $X$ sur $Y$ est statistiquement significatif pour toute valeur de $W$ supérieure à un seuil quantitatif précisément calculé (par exemple pour tout score de soutien social supérieur à 42,35 sur l’échelle), et non significatif en deçà. La technique produit une enveloppe d’intervalles de confiance continus à 95 % tracée sur toute l’étendue des valeurs observées du modérateur, offrant une transparence totale sur le comportement dynamique du modèle mathématique.
7.3 Intégration pratique dans les publications scientifiques
L’intégration de la technique de Johnson-Neyman dans les manuscrits scientifiques soumis aux revues internationales à comité de lecture est devenue un gage d’excellence méthodologique, répondant aux exigences accrues de robustesse et de reproductibilité des résultats. La restitution formelle de cette technique combine un paragraphe textuel standardisé selon les normes éditoriales de l’American Psychological Association (APA) et un graphique de Johnson-Neyman d’une lecture immédiate.
Dans le corps du texte, le chercheur détaille la valeur numérique exacte du seuil de transition critique identifié, le pourcentage précis d’observations de l’échantillon empirique situées de part et d’autre de cette frontière, ainsi que la valeur minimale et maximale de l’effet simple observé sur les segments concernés. L’intérêt majeur pour l’évaluation clinique réside dans la détermination de seuils opérationnels concrets. En médecine comportementale ou en psychologie scolaire, le repérage de cette frontière mathématique permet de définir avec exactitude à partir de quel score sur une échelle diagnostique continue une prise en charge commence réellement à déployer des bénéfices statistiquement fiables pour le patient.
Le graphique associé représente sur l’axe horizontal l’éventail complet des valeurs observées de la variable modératrice, et sur l’axe vertical la magnitude de l’effet simple conditionnel de $X$ sur $Y$. Deux courbes en pointillés enveloppent la droite d’estimation centrale pour matérialiser les bornes supérieure et inférieure de l’intervalle de confiance à 95 %. Une ligne horizontale marquant le zéro parfait sert de référence : dès que l’intervalle de confiance ne contient plus le zéro, l’effet est immédiatement lisible comme statistiquement significatif, une ligne verticale pointillée signalant la coordonnée exacte du point de bascule de Johnson-Neyman.
8. Outils logiciels pour tester la modération
8.1 La macro PROCESS d’Andrew Hayes
Dans l’écosystème contemporain des logiciels d’analyse statistique, la macro computationnelle PROCESS développée par Andrew F. Hayes s’est imposée comme la référence mondiale incontournable pour l’estimation des modèles de modération, de médiation et de processus conditionnels complexes. Entièrement gratuite et régulièrement mise à jour, la macro s’intègre sous forme de syntaxe ou d’interface graphique conviviale au sein des progiciels majeurs que sont IBM SPSS Statistics, SAS, ainsi que dans l’environnement de programmation statistique R.
Pour modéliser une variable modératrice simple, PROCESS met à disposition son architecture canonique désignée sous l’appellation de « Modèle 1 ». L’un des mérites majeurs de cet outil réside dans l’automatisation intégrale de procédures analytiques fastidieuses : le logiciel effectue le centrage automatique des variables prédictrices continues pour éliminer les colinéarités artificielles, calcule le produit croisé d’interaction sans requérir la création manuelle de colonnes de données supplémentaires, et génère instantanément l’analyse des pentes simples aux centiles conventionnels ainsi que la décomposition fine selon la technique de Johnson-Neyman.
Par ailleurs, PROCESS a largement contribué à la démocratisation des méthodes de rééchantillonnage non paramétriques (bootstrap). Bien que le terme d’interaction dans une régression linéaire standard soit testé par une statistique paramétrique $t$ classique, l’utilisation conjointe des routines de rééchantillonnage bootstrap (généralement configurées à 5 000 ou 10 000 tirages avec remise) au sein de la macro Hayes garantit des inférences statistiques d’une résilience remarquable contre les déviations modérées par rapport au postulat de normalité des résidus, fournissant des intervalles de confiance corrigés des biais d’une très haute fidélité méthodologique.
8.2 Modélisation par équations structurelles (SEM)
Bien que la régression multiple standard implémentée dans PROCESS demeure l’approche la plus accessible, elle souffre d’une contrainte structurelle inhérente : elle postule implicitement que toutes les variables observées sont mesurées sans la moindre erreur instrumentale (fiabilité parfaite de 1,00). Pour surmonter cette limite intrinsèque dans le cadre de construits psychométriques complexes, la modélisation par équations structurelles (Structural Equation Modeling – SEM) constitue le paradigme d’excellence, opérationnalisé à travers des environnements logiciels spécialisés tels que Mplus, AMOS ou le package incontournable lavaan sous R.
La modélisation par équations structurelles offre la possibilité fondamentale de décomposer la variance des variables en variance vraie (associée au construit latent sous-jacent) et en variance d’erreur de mesure non corrélée, grâce à l’ajustement préalable d’un modèle de mesure factoriel confirmatoire. Dès lors, tester l’interaction entre deux variables latentes permet d’estimer un effet modérateur totalement purgé du bruit de mesure instrumental. Cette purification méthodologique résout l’un des fléaux récurrents de la modération en régression classique, à savoir l’atténuation dramatique des termes d’interaction provoquée par l’imperfection psychométrique des échelles composites.
Sur le plan technique, l’analyse de modération en SEM s’organise selon deux stratégies modélisatrices distinctes :
- L’analyse par groupes multiples (multigroup SEM), réservée aux modérateurs catégoriels, qui teste formellement l’invariance métrique des paramètres structurels à travers les groupes d’intérêt en contraignant les pentes d’un modèle d’équations structurelles à l’égalité ;
- L’analyse par intégration de produits d’indicateurs latents continus, s’appuyant sur des algorithmes d’intégration numérique avancés tels que l’estimateur LMS (Latent Moderated Structural Equations) disponible nativement dans Mplus, qui capture les interactions non linéaires directement au niveau de la structure latente.
8.3 Packages R spécialisés pour la visualisation et l’analyse
L’essor fulgurant de l’écosystème open-source fondé sur le langage de programmation R a enrichi la panoplie des analystes de données quantitatives en psychologie grâce à une constellation de packages spécialisés conçus pour décupler les capacités de diagnostic et de communication graphique des modèles conditionnels. Parmi cette panoplie, le package interactions s’est hissé au rang de standard académique pour le post-traitement des régressions modérées linéaires et généralisées.
Grâce à ses fonctions phares interact_plot() et johnson_neyman(), ce package permet de paramétrer des graphiques vectoriels de publication d’une grande élégance esthétique, entièrement compatibles avec la grammaire graphique de ggplot2. Il génère automatiquement le tracé continu des zones de Johnson-Neyman en surlignant en couleur les sections de significativité statistique, tout en intégrant des tracés de densité marginale pour avertir immédiatement le chercheur en cas de rareté d’observations empiriques sur les extrémités des distributions conditionnelles.
Parallèlement, le package rockchalk (pour Regression, Observations, Conditions, and Heteroscedasticity) offre des routines avancées dédiées au diagnostic géométrique des surfaces de réponse et à la gestion assistée de la colinéarité non essentielle. Conjointement avec des outils de mise en forme automatisée tels que sjPlot ou gtsummary, ces packages permettent aux scientifiques de compiler en quelques lignes de code des tableaux d’interaction hiérarchique prêts pour l’impression, conformes aux exigences typographiques et statistiques les plus strictes de l’American Psychological Association.
9. Puissance statistique et exigences d’échantillonnage
9.1 Le problème critique de la sous-puissance des effets d’interaction
S’il existe un piège méthodologique redoutable et universellement documenté qui guette les chercheurs s’engageant dans l’étude des variables modératrices, c’est incontestablement celui de la sous-puissance statistique chronique affectant la détection des effets d’interaction. De nombreuses thèses doctorales et projets de recherche concluent à tort à l’absence de modération, alors même que le phénomène existe au sein de la population parente, en raison d’une défaillance dans le dimensionnement de leur protocole empirique (erreur de type II excessive).
La vulnérabilité accrue du terme d’interaction face à l’imprécision statistique provient de la propagation mathématique de l’erreur de mesure. Lorsqu’on calcule le produit croisé arithmétique de deux variables continues ($X \times W$), l’erreur de mesure aléatoire inhérente à $X$ se multiplie avec l’erreur de mesure affectant $W$. Par conséquent, la fidélité psychométrique du terme multiplicatif résultant est invariablement inférieure à la fidélité de chacune de ses variables composantes considérées isolément. Si la fiabilité de $X$ est de 0,70 et celle de $W$ de 0,70 (des valeurs très ordinaires en psychologie empirique), la fiabilité théorique de leur produit croisé peut s’effondrer aux alentours de 0,49.
Cette dégradation de la fidélité métrique induit une atténuation drastique de la taille d’effet observable du coefficient d’interaction $\beta_3$. Le signal statistique recherché se retrouve enseveli sous une couche de bruit aléatoire considérablement épaissie. Par conséquent, un protocole expérimental conçu avec un échantillonnage classique jugé tout à fait adéquat pour repérer un effet direct moyen de régression s’avérera dramatiquement sous-calibré et incapable de rejeter l’hypothèse nulle dès lors qu’il s’agit d’extraire la variance subtile portée par le terme d’interaction.
9.2 Calcul de la taille d’échantillon nécessaire
Pour se prémunir contre les écueils de l’erreur de type II et asseoir la robustesse des conclusions scientifiques, la détermination de la puissance statistique a priori constitue un impératif déontologique et méthodologique absolu. L’outil international de référence pour cette démarche prospective est le logiciel G*Power, conjointement aux calculateurs spécialisés dans les régressions multiples hiérarchiques linéaires.
Dans le cadre d’un test d’interaction hiérarchique, le calcul de la taille d’échantillon requise ne doit jamais être configuré sur la base de la variance globale totale expliquée par l’ensemble des régresseurs du modèle ($R^2$), mais spécifiquement sur la base de l’augmentation incrémentale de variance escomptée attribuable au seul terme d’interaction ($\Delta R^2$). Comme nous l’avons souligné, les tailles d’effet réelles des modérations continues en psychologie oscillent typiquement entre un $\Delta R^2$ de 0,01 ($f^2 = 0{,}0101$, très petite taille d’effet) et 0,03 ($f^2 = 0{,}0309$, petite à modérée).
Si l’on calibre une analyse de puissance a priori sous G*Power (test de famille $F$ : Linear multiple regression: Fixed model, $R^2$ increase) en visant les standards psychométriques académiques d’une puissance statistique conventionnelle de $1 – \beta = 0{,}80$ avec un seuil de significativité $\alpha = 0{,}05$ pour tester l’ajout d’un unique terme multiplicatif, les exigences d’échantillonnage explosent :
- Pour détecter une modération de taille $f^2 = 0{,}02$ ($\approx 2,%$ de variance incrémentale), il est indispensable de recruter un échantillon minimal valide de $N = 395$ participants ;
- Pour détecter une modération plus discrète mais théoriquement signifiante de $f^2 = 0{,}01$ ($1,%$ de variance additionnelle), la taille d’échantillon requise grimpe à $N = 785$ participants.
Ces données chiffrées mettent en lumière une réalité méthodologique fondamentale : pour tester une modération avec un niveau de confiance statistique équivalent à celui d’un effet principal direct classique, la taille d’échantillon nécessaire doit couramment être multipliée par deux, voire par quatre. Ce saut d’échelle quantitatif conditionne directement la faisabilité logistique et la pérennité financière des projets doctoraux et des subventions de recherche.
9.3 Stratégies d’optimisation de la puissance de détection
Face aux contraintes logistiques et financières qui limitent fréquemment la collecte de cohortes dépassant plusieurs centaines de sujets, les chercheurs doivent déployer des stratégies méthodologiques compensatoires d’optimisation préventive pour maximiser artificiellement la puissance statistique de leurs analyses de modération. La première stratégie fondamentale réside dans l’élévation systématique de la fidélité psychométrique des outils d’évaluation employés. L’utilisation d’échelles composites rigoureusement validées, affichant des indices de consistance interne élevés (coefficients oméga de McDonald ou alpha de Cronbach excédant 0,85 ou 0,90), compresse l’erreur de mesure aléatoire et limite mécaniquement l’atténuation délétère du terme produit multiplicatif.
La seconde stratégie s’applique spécifiquement aux devis de recherche expérimentaux conduits en laboratoire : l’ingénierie factorielle orthogonale. Lorsque les variables indépendantes sont expérimentalement manipulées plutôt que simplement observées, le chercheur a la latitude de créer un design factoriel parfaitement équilibré (par exemple un plan $2 \times 2$ avec des tailles de cellules strictement égales). Cette configuration confère une indépendance statistique parfaite aux prédicteurs (corrélation $r = 0$), éliminant toute multicolinéarité parasite et maximisant géométriquement la puissance de capture de l’interaction à taille d’échantillon constante.
Enfin, dans le cadre d’études corrélationnelles ou observationnelles où la manipulation expérimentale est impossible, une approche d’échantillonnage raisonné consiste à opérer un sur-échantillonnage ciblé des valeurs extrêmes sur la variable modératrice continue. En surreprésentant volontairement dans la cohorte les individus se positionnant aux franges supérieures et inférieures de la distribution du modérateur ($W$), le chercheur accroît substantiellement la dispersion de variance utile du terme croisé. Bien que cette méthode impose des précautions ultérieures de pondération statistique pour préserver la validité écologique globale, elle constitue un levier puissant pour détecter l’existence d’une interaction conditionnelle sous des contraintes d’effectifs restreints.
10. Modération dans les devis longitudinaux et écologiques
10.1 Modélisation multiniveau et modération inter-niveaux (Cross-level)
Dans la recherche contemporaine en psychologie cognitive, sociale et organisationnelle, les données récoltées présentent très fréquemment une structure hiérarchique ou emboîtée (nested data). C’est le cas par exemple d’élèves nichés au sein de classes scolaires distinctes, de patients suivis au sein de multiples cabinets de consultation thérapeutique, ou de collaborateurs regroupés au sein d’équipes opérationnelles. L’analyse de régression par les moindres carrés ordinaires s’avère ici inappropriée, car elle viole le postulat fondamental d’indépendance des résidus statistiques.
La modélisation linéaire multiniveau (ou modèles mixtes hiérarchiques) apporte la solution structurelle à cette complexité environnementale en introduisant le concept de modération inter-niveaux (cross-level moderation). Dans ce cadre, la relation unissant un prédicteur de niveau 1 ($X_{ij}$, spécifique à l’individu $i$ au sein du groupe $j$) à un critère individuel ($Y_{ij}$) est elle-même modérée par une variable contextuelle ou écologique caractérisant le groupe dans sa globalité ($W_j$, variable de niveau 2). L’équation structurelle de niveau 1 permet à la pente de régression de devenir un paramètre aléatoire (random slope) :
$$Y_{ij} = \beta_{0j} + \beta_{1j} X_{ij} + \varepsilon_{ij}$$
À l’étage supérieur (niveau 2), cette pente de régression $\beta_{1j}$ devient à son tour la variable dépendante d’une sous-équation prédite par la variable contextuelle de groupe :
$$\beta_{1j} = \gamma_{10} + \gamma_{11} W_j + u_{1j}$$
Dans cette architecture élégante, le paramètre structurel fixe $\gamma_{11}$ quantifie formellement la modération inter-niveaux. Il évalue dans quelle mesure le climat de travail d’un département hospitalier ($W_j$) atténue ou amplifie l’impact individuel de l’exposition à la souffrance des patients ($X_{ij}$) sur l’épuisement psychologique du soignant ($Y_{ij}$). Cette approche permet de modéliser avec une précision mathématique la façon dont les macro-structures environnementales régulent les micro-processus psychologiques individuels.
10.2 Modération temporelle et dynamique intra-individuelle
L’avènement technologique des smartphones et des dispositifs biométriques connectés a propulsé l’utilisation massive des protocoles d’évaluation écologique momentanée (Ecological Momentary Assessment – EMA) ou d’échantillonnage de l’expérience vécue (Experience Sampling Methods – ESM). Dans ces protocoles intensifs, les participants sont sollicités plusieurs fois par jour durant des semaines pour consigner en temps réel leurs états émotionnels, leurs stresseurs et leurs comportements, générant des séries temporelles multivariées hautement granulaires.
L’analyse de ces séries temporelles intègre la modération dans une perspective dynamique intra-individuelle (within-person moderation). La question posée n’est plus de savoir si les individus les plus stressés en moyenne sont les plus déprimés, mais si, pour un même individu donné, la réactivité émotionnelle instantanée face à un conflit relationnel survenu à un moment précis ($t$) est modérée par la qualité de son sommeil mesurée objectivement la nuit précédente ($t-1$) ou par ses fluctuations d’humeur matinale. Les variations temporelles deviennent le cadre d’analyse de la conditionnalité psychophysiologique.
En parallèle, l’analyse des devis longitudinaux par panels croisés a bénéficié d’avancées théoriques décisives à travers les modèles autorégressifs à panneaux croisés avec effets aléatoires modérés (RI-CLPM modérés). Ces méthodologies de pointe permettent de distinguer rigoureusement la variance stable inter-individuelle (between-person) des processus dynamiques transitoires intra-individuels (within-person), évitant des artefacts séculaires de confusion statistique et révélant comment des traits ou des événements de vie modèrent les trajectoires développementales d’autorégulation au fil des années.
10.3 Stabilité temporelle du modérateur et inférence causale
La dimension temporelle introduit une condition épistémologique essentielle pour garantir la robustesse de l’inférence causale dans les devis non purement expérimentaux : la chronologie d’occurrence de la variable modératrice. Pour qu’une variable puisse prétendre au statut indiscutable de modérateur causal d’une relation reliant un événement déclencheur $X$ à une conséquence comportementale $Y$, il est méthodologiquement impératif que le modérateur soit mesuré chronologiquement avant l’émergence du phénomène $X$, ou qu’il s’agisse d’un trait structurel dont l’invariance temporelle est scientifiquement incontestée.
Cette antériorité temporelle offre une protection absolue contre le biais de causalité inverse et les boucles de rétroaction rétroactives. Si le modérateur potentiel $W$ est évalué simultanément à la variable indépendante $X$ ou après l’apparition du critère $Y$ au sein d’une enquête transversale unique, l’analyste court le risque permanent d’une distorsion de réalité : la variable $W$ postulée comme modératrice pourrait en réalité n’être qu’un produit secondaire dérivé de $Y$, ou un médiateur non reconnu de la relation globale. Par exemple, si l’on postule que la détresse affective perçue modère l’impact d’une perte d’emploi sur la somatisation, mais que cette détresse est mesurée six mois après le licenciement, elle peut résulter de la dégradation de l’état physique du sujet plutôt que de constituer une prédisposition modératrice initiale.
Il est donc crucial de distinguer rigoureusement les modérateurs invariants (tels que le patrimoine génétique, le rang dans la fratrie ou la constitution neuro-développementale) des modérateurs dynamiques et modifiables (tels que les stratégies de coping, l’estime de soi ou le réseau relationnel). Pour ces derniers, seule une architecture méthodologique prospective à mesures répétées échelonnées dans le temps permet d’établir une inférence causale valide et de confirmer que les modificateurs de trajectoire étaient bel et bien en place avant que la chaîne causale ne s’amorce.
11. Erreurs fréquentes et pièges d’interprétation
11.1 Confusion entre modérateur, variable de contrôle et confounder
Une anomalie méthodologique fréquente dans la littérature en psychologie réside dans l’incapacité récurrente de certains auteurs à conceptualiser rigoureusement le statut théorique de leurs variables tierces, conduisant à une confusion délétère entre variable modératrice, variable de contrôle statistique (covariable) et facteur de confusion (confounder). Cette confusion n’est pas simplement sémantique ; elle altère directement la structure des équations mathématiques estimées et la validité des conclusions scientifiques qui en découlent.
Une variable de contrôle statistique classique est introduite de manière additive dans un modèle de régression pour neutraliser un bruit parasite ou éliminer une source de variance exogène suspectée d’obscurcir l’estimation non biaisée de l’effet direct de $X$ sur $Y$. En contrôlant pour l’âge ou le sexe, le chercheur soustrait la variance partagée pour isoler la composante résiduelle propre au prédicteur. En revanche, postuler une variable modératrice relève d’une logique inverse : le chercheur ne cherche pas à ajuster pour annuler une hétérogénéité gênante, mais tente précisément de modéliser cette hétérogénéité comme un objet théorique noble doté d’une valeur explicative majeure.
Le danger méthodologique culminant réside dans l’erreur consistant à traiter par inadvertance un authentique modérateur structurel comme une simple covariable de contrôle linéaire passive. En injectant le modérateur uniquement comme terme additif simple sans formuler le terme produit d’interaction ($X \times W$), l’analyste contraint l’effet à demeurer artificiellement homogène et invariant à travers l’échantillon. Cette erreur peut masquer complètement l’existence d’une relation réelle mais contrastée. L’utilisation contemporaine des Graphes Acycliques Orientés (Directed Acyclic Graphs – DAG) permet de clarifier ces statuts théoriques en distinguant les biais de confusion des interactions causales avant la formulation des modèles statistiques.
11.2 L’erreur de la dichotomisation des variables continues
Parmi l’ensemble des pratiques méthodologiques néfastes documentées en statistique comportementale, la transformation délibérée d’une variable modératrice quantitativement continue en une variable catégorielle artificielle — classiquement par la méthode de découpage par la médiane (median split) — demeure l’erreur la plus répandue et la plus destructrice. Malgré les mises en garde répétées des plus grands méthodologistes computationnels, notamment à travers l’article séminal de MacCallum, Zhang, Preacher et Rucker (2002), cette pratique continue d’apparaître ponctuellement dans certaines publications empiriques.
La dichotomisation d’une variable continue engendre des conséquences statistiques désastreuses :
- Une perte colossale de variance et d’information métrique : transformer une échelle continue riche de dizaines d’échelons en une variable binaire grossière élimine instantanément entre un tiers et la moitié de l’information statistique contenue dans les données ;
- Une réduction drastique de la puissance statistique du test de détection, abaissant la probabilité de rejeter l’hypothèse nulle d’absence d’interaction d’une façon équivalente à l’amputation de 30 % à 50 % de l’effectif réel de l’échantillon ;
- L’assimilation fallacieuse de profils subjectifs hautement contrastés : deux sujets situés respectivement juste au-dessus et juste en dessous de la médiane (par exemple avec des scores de 50 et 51) sont classés dans deux groupes catégoriels opposés (« bas » vs « haut »), tandis que deux sujets situés aux antipodes de la distribution (avec des scores de 51 et 99) sont artificiellement agrégés et déclarés équivalents au sein du groupe des « hauts » ;
- Le risque d’engendrer des effets d’interaction fallacieux (spurious interactions) : si les prédicteurs continus initiaux sont modérément corrélés entre eux, la dichotomisation brise la linéarité sous-jacente et génère mathématiquement des artefacts de significativité statistique pour l’interaction qui ne correspondent à aucune réalité empirique dans la population parente.
Face à ce réquisitoire méthodologique sans appel, il est désormais unanimement admis qu’aucune dichotomisation d’une variable continue ne peut être tolérée dans l’analyse de modération moderne. L’ensemble des techniques contemporaines présentées précédemment, au premier rang desquelles la technique de Johnson-Neyman, opèrent nativement sur des échelles continues et rendent totalement caduque cette régression analytique archaïque.
11.3 Interprétation erronée des effets principaux non conditionnels
Une dernière source récurrente de confusion épistémologique chez les chercheurs débutants réside dans la lecture et l’interprétation erronées des coefficients d’ordre inférieur (communément appelés à tort « effets principaux ») au sein d’une équation de régression multiple dès lors que le terme d’interaction $b_3 (X \times W)$ s’avère statistiquement significatif. Dans un modèle additif standard sans interaction, les coefficients de régression représentent effectivement les effets constants et universels de chaque prédicteur en contrôlant pour les autres. Mais dans un modèle conditionnel incluant un produit croisé, cette règle d’interprétation devient caduque.
Dans l’équation $Y = b_0 + b_1 X + b_2 W + b_3 (X \times W)$, le coefficient $b_1$ ne mesure pas l’effet global, principal ou moyen de $X$ sur $Y$. Il quantifie rigoureusement et exclusivement l’effet conditionnel de $X$ lorsque la variable modératrice $W$ est égale à zéro. Si la variable $W$ n’a pas été préalablement centrée sur sa moyenne arithmétique, la valeur zéro peut se situer en dehors du spectre empirique des observations, rendant l’interprétation de $b_1$ totalement déconnectée de la tendance globale du phénomène.
Il est donc d’une nécessité absolue de s’interdire de formuler des conclusions théoriques sur les effets directs isolés en présence d’un terme d’interaction d’ordre supérieur significatif sans contextualiser immédiatement leur conditionalité. Un chercheur ne peut affirmer simplement : « Le stress professionnel altère significativement la santé mentale des soignants ($b_1 = -0{,}35, p < 0{,}01$) ». Il doit impérativement préciser : « Le stress professionnel altère significativement la santé mentale des soignants spécifiquement pour les individus présentant un score nul (ou moyen si la variable est centrée) sur la variable de soutien social, cet effet étant par ailleurs significativement modéré par cette dernière variable ($b_3 = 0{,}15, p = 0{,}02$) ». L’interaction absorbe et redéfinit la sémantique même des coefficients simples qui la composent.
12. Protocole méthodologique pas à pas pour tester une variable modératrice
12.1 Phase 1 : Justification théorique a priori et pré-enregistrement
La conduite d’une analyse de modération rigoureuse ne doit jamais être le fruit d’une exploration opportuniste de données menée au hasard des croisements statistiques disponibles (pratique délétère connue sous le nom de HARKing : Hypothesizing After the Results are Known). La première phase méthodologique fondamentale réside dans l’ancrage théorique rigoureux et la formulation a priori d’hypothèses directionnelles précises. Le chercheur doit pouvoir articuler, sur la base des modèles conceptuels de sa discipline et de la littérature empirique préexistante, pourquoi une variable donnée devrait altérer la force ou la direction de la relation étudiée.
Cette réflexion préliminaire aboutit à la formalisation opérationnelle sans ambiguïté des trois construits indispensables :
- La variable indépendante focale ($X$), dont on cherche à tester la portée prédictive ;
- La variable dépendante d’intérêt ($Y$), représentant le critère ou la conséquence comportementale modélisée ;
- La variable candidate à la modération ($W$), identifiée comme facteur de contingence individuel ou contextuel ;
- Le sens directionnel précis de l’effet d’interaction anticipé (effet d’amplification synergique ou au contraire effet tampon amortisseur).
Dans le contexte actuel de la crise de réplication qui traverse les sciences psychologiques et biomédicales, la démarche de rigueur par excellence consiste à déposer un pré-enregistrement formel du protocole de recherche sur des plateformes ouvertes dédiées, telles que l’Open Science Framework (OSF). Ce document public fige avant tout recueil de données la taille d’échantillon ciblée (étayée par un calcul de puissance statistique a priori), la stratégie de nettoyage des observations et le plan analytique exact qui sera exécuté. Ce verrouillage méthodologique garantit l’intégrité de la distinction entre analyses purement confirmatoires et démarches exploratoires post-hoc.
12.2 Phase 2 : Vérification rigoureuse des postulats et préparation des données
Une fois les données collectées dans le respect strict des critères d’échantillonnage préalablement définis, la seconde phase méthodologique consiste en un contrôle rigoureux des postulats fondamentaux du modèle linéaire général. Une équation de régression conditionnelle est soumise aux mêmes exigences strictes qu’une régression multiple classique : normalité de la distribution des résidus d’estimation (évaluée visuellement par les tracés quantiles-quantiles Q-Q plots et formellement par le test de Shapiro-Wilk), homoscédasticité de la variance d’erreur (vérifiée par l’inspection des graphiques des résidus standardisés en fonction des valeurs prédites et par le test de Breusch-Pagan), et linéarité structurelle des relations.
Une attention méticuleuse doit être portée au diagnostic des valeurs aberrantes univariées et multivariées hautement influentes. Dans le cadre d’un modèle d’interaction, quelques points de données extrêmes positionnés de manière atypique à la fois sur la variable indépendante et sur le modérateur peuvent exercer un effet de levier (leverage) disproportionné sur l’estimation de la pente angulaire du terme croisé. L’examen des distances de Cook et des valeurs de DFFITS permet d’isoler ces observations atypiques pour s’assurer qu’un effet modérateur ne constitue pas l’artefact artificiel généré par deux ou trois sujets extrêmes au sein d’une cohorte.
La préparation finale de la matrice de données requiert alors deux étapes de transformation métrique incontournables :
- Si la variable modératrice est continue, application systématique du centrage sur la moyenne arithmétique globale pour le prédicteur ($X_{centré}$) et pour le modérateur ($W_{centré}$), selon la procédure exposée à la section 5.2 ;
- Si la variable modératrice est nominale à plus de deux modalités, création formelle des variables indicatrices (dummy variables) selon le schéma de codage d’effet ou d’indicatrice approprié ;
- Génération mathématique de la variable de produit croisé formalisant l’interaction : $(X_{centré} \times W_{centré})$ pour les prédicteurs continus, ou produit de $X$ avec chacune des variables indicatrices créées pour les modérateurs catégoriels.
12.3 Phase 3 : Estimation, décomposition et rapport selon les normes APA
La troisième et ultime phase opérationnelle consiste en l’estimation hiérarchique du modèle, la décomposition post-hoc de l’interaction et la rédaction académique standardisée des conclusions conformément aux normes de l’American Psychological Association (APA 7th edition). L’estimation s’effectue en deux étapes consécutives : le chercheur évalue d’abord le modèle direct additif (Étape 1 : $Y sim X + W$), puis le modèle conditionnel complet incluant le produit croisé (Étape 2 : $Y \sim X + W + X \times W$), en isolant méticuleusement la statistique de l’augmentation de variance expliquée ($\Delta R^2$) et son test $\Delta F$ associé.
Si et seulement si le terme d’interaction est statistiquement significatif au seuil retenu, l’analyste procède obligatoirement à la décomposition post-hoc du modèle. Il mobilise la commande appropriée sous R ou sous la macro PROCESS pour générer :
- L’analyse des pentes simples aux valeurs discrètes conventionnelles (moyenne, $-1,\text{ET}$, $+1,\text{ET}$), en consignant pour chacune la pente non standardisée $b$, son erreur-type standardisée $\text{ET}$, le ratio de Student $t$, la probabilité critique associée $p$, et l’intervalle de confiance à 95 % ;
- La technique de Johnson-Neyman identifiant les bornes d’inflexion critiques exactes du modérateur délimitant la zone de significativité continue ;
- Le graphique d’interaction standardisé de haute définition, incluant le tracé clair des droites conditionnelles et la visualisation explicite des intervalles de confiance.
La transcription narrative finale au sein de la section « Résultats » de l’article scientifique doit répondre à une formulation rigoureuse, exemplaire et sans équivoque, dont le modèle syntaxique académique se structure comme suit :
« Une régression linéaire multiple hiérarchique a été conduite pour tester l’hypothèse selon laquelle le soutien social ($W$) modère la relation unissant la surcharge de travail ($X$) à l’épuisement émotionnel ($Y$). L’ensemble des variables continues ont été centrées sur leur moyenne respective avant l’analyse. L’introduction des effets principaux simples à l’Étape 1 a expliqué une proportion significative de variance du critère, $R^2 = 0{,}24, F(2, 247) = 39{,}12, p < 0{,}001$. L’introduction du terme d’interaction multiplicative surcharge de travail $\times$ soutien social à l’Étape 2 a induit une augmentation statistiquement significative de la variance expliquée, $\Delta R^2 = 0{,}031, \Delta F(1, 246) = 10{,}34, p = 0{,}001, f^2 = 0{,}04$. Le coefficient de régression spécifique associé au terme d’interaction s’est avéré significatif et négatif, $b = -0{,}18, \text{ET} = 0{,}056, t(246) = -3{,}21, p = 0{,}001, \text{IC à 95 % } [-0{,}290 ; -0{,}070]$. L’analyse des pentes simples post-hoc révèle que pour les salariés percevant un faible niveau de soutien social ($-1,\text{ET}$), la surcharge de travail est fortement associée à une hausse de l’épuisement émotionnel, $b = 0{,}52, \text{ET} = 0{,}08, t = 6{,}50, p < 0{,}001, \text{IC à 95 % } [0{,}36 ; 0{,}68]$. Pour les salariés disposant d’un niveau moyen de soutien social, cette association demeure significative mais modérée, $b = 0{,}34, \text{ET} = 0{,}06, t = 5{,}67, p < 0{,}001$. Enfin, pour les salariés caractérisés par un niveau élevé de soutien social ($+1,\text{ET}$), la pente s’infléchit substantiellement, $b = 0{,}16, \text{ET} = 0{,}07, t = 2{,}28, p = 0{,}023, \text{IC à 95 % } [0{,}02 ; 0{,}30]$. La technique de Johnson-Neyman a permis d’établir que l’effet délétère de la surcharge de travail cesse totalement d’être statistiquement significatif dès lors que le score centré de soutien social excède $+1{,}42$ écart-type (représentant 8,5 % de l’échantillon). Ces résultats confirment empiriquement l’hypothèse de l’effet protecteur amortisseur conféré par le soutien social face à la charge organisationnelle. »
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE Publications.
- Baron, R. M., & Kenny, D. A. (1986). The moderator-mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
- Hayes, A. F. (2018). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (2nd ed.). The Guilford Press.
- Hayes, A. F., & Matthes, J. (2009). Computational procedures for probing interactions in OLS and logistic regression: SPSS and SAS implementations. Behavior Research Methods, 41(3), 924–936. https://doi.org/10.3758/BRM.41.3.924
- Johnson, P. O., & Neyman, J. (1936). Tests of certain linear hypotheses and their application to some educational problems. Statistical Research Memoirs, 1, 57–93. https://doi.org/10.1007/BF02288367
- Karasek, R. A. (1979). Job demands, job decision latitude, and mental strain: Implications for job redesign. Administrative Science Quarterly, 24(2), 285–308. https://doi.org/10.2307/2392498
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19
- Marsh, H. W., Wen, Z., & Hau, K.-T. (2004). Structural equation models of latent interactions: Evaluation of alternative estimation strategies and indicator construction. Psychological Methods, 9(3), 275–300. https://doi.org/10.1037/1082-989X.9.3.275
- Preacher, K. J., Rucker, D. D., & Hayes, A. F. (2007). Addressing moderated mediation hypotheses: Theory, methods, and prescriptions. Multivariate Behavioral Research, 42(1), 185–227. https://doi.org/10.1080/00273170701341316
- Rindskopf, D. (1984). Using pseudovariables to model conditional effects in regression. Psychological Bulletin, 96(3), 597–603. https://doi.org/10.1037/0033-2909.96.3.597
- Rosnow, R. L., & Rosenthal, R. (1989). Definition and interpretation of interaction effects. Psychological Bulletin, 105(1), 143–146. https://doi.org/10.1037/0033-2909.105.1.143