
Dans le domaine de la recherche empirique, des sciences comportementales et de l’épidémiologie clinique, l’établissement rigoureux de relations de cause à effet constitue l’un des idéaux épistémologiques les plus complexes à atteindre. Bien souvent, les chercheurs observent des associations statistiques robustes entre deux phénomènes sans pour autant être en mesure d’affirmer avec certitude que l’un est le produit direct de l’autre. Cette difficulté conceptuelle réside dans la présence de multiples strates de déterminants sous-jacents qui influencent simultanément la genèse, l’intensité et l’expression des variables étudiées. La modélisation de ces dynamiques exige des instruments d’analyse théorique capables de démêler les simples covariations fortuites des véritables chaînes étiologiques.
Parmi les concepts méthodologiques essentiels à la compréhension des dynamiques causales figure la notion de variable antécédente. Trop souvent confondue avec d’autres entités analytiques telles que les variables médiatrices, modératrices ou confondantes, la variable antécédente occupe pourtant une place singulière au sein de la chronologie explicative des phénomènes humains. Elle s’inscrit au commencement de la chaîne d’influence, posant les conditions préalables indispensables à l’apparition ou à la modification de la variable indépendante présumée, tout en exerçant une onde de choc statistique et conceptuelle sur la variable dépendante d’intérêt. Sans une conceptualisation rigoureuse de cette variable souche, toute tentative d’explication scientifique s’expose à de sévères biais d’attribution.
Le présent article propose une analyse approfondie et systématique de la variable antécédente dans la démarche scientifique contemporaine. En explorant ses fondements épistémologiques, ses spécificités mathématiques et statistiques, ainsi que ses distinctions fondamentales avec les autres formes de variables, cette étude a pour objectif de fournir aux chercheurs, cliniciens et analystes un cadre herméneutique robuste. À travers des exemples appliqués empruntés à l’économie comportementale, à la psychologie de la santé, au développement humain et à la psychopathologie, nous mettrons en lumière la manière dont la prise en compte scrupuleuse des antécédents permet d’éviter l’écueil des corrélations illusoires et renforce substantiellement la validité des modèles scientifiques.
1. Introduction conceptuelle : Définition et fondements de la variable antécédente
La construction d’un modèle d’inférence causale repose sur la capacité du chercheur à décomposer la complexité du réel en unités conceptuelles distinctes et mesurables. Pour saisir la nature d’une variable antécédente, il convient d’abord d’examiner ses fondements étymologiques, son inscription méthodologique et sa fonction ordonnatrice au sein du design de recherche.
1.1 Étymologie et définition épistémologique
D’un point de vue purement étymologique, le terme « antécédent » puise son origine dans le verbe latin antecedere, formé du préfixe ante (signifiant « avant ») et de cedere (signifiant « marcher » ou « aller »). L’antécédent désigne donc littéralement ce qui marche devant, ce qui précède dans l’espace et, par extension conceptuelle, ce qui s’installe chronologiquement en amont d’un événement déterminé. Dans le champ de la logique philosophique classique et de l’épistémologie des sciences formelles, l’antécédent constitue la première partie d’une proposition conditionnelle (la prémisse de type « Si P »), dont dépend la validité logique du conséquent (« alors Q »).
Transposée au domaine de la méthodologie de la recherche quantitative et expérimentale, la variable antécédente se définit de manière formelle comme une variable qui précède à la fois la variable indépendante présumée et la variable dépendante dans la séquence temporelle et causale d’un modèle d’investigation. Contrairement aux variables qui émergent de manière contingente au cours d’un processus expérimental, l’antécédent représente un facteur préexistant, doté d’une antériorité nomologique avérée. Il façonne l’environnement de base dans lequel les entités d’intérêt évoluent et interagissent.
La fonction principale d’une variable antécédente est d’ordre explicatif et clarificateur. En méthodologie scientifique, une corrélation bivariée observée entre deux construits ne révèle en rien la directionnalité ni l’authenticité de la relation empirique. L’introduction d’une variable antécédente permet de soulever le voile sur les mécanismes sous-jacents qui régissent les covariations statistiques. Elle permet au chercheur de répondre à des interrogations structurelles majeures : la variable indépendante est-elle véritablement le moteur initial du phénomène observé, ou n’est-elle elle-même que la résultante phénoménologique d’un statut, d’une prédisposition ou d’un événement antérieur qui orchestre silencieusement la relation apparente ? C’est dans cette perspective de clarification causale que réside la valeur heuristique fondamentale de l’antécédent.
1.2 Le triptyque variable antécédente, indépendante et dépendante
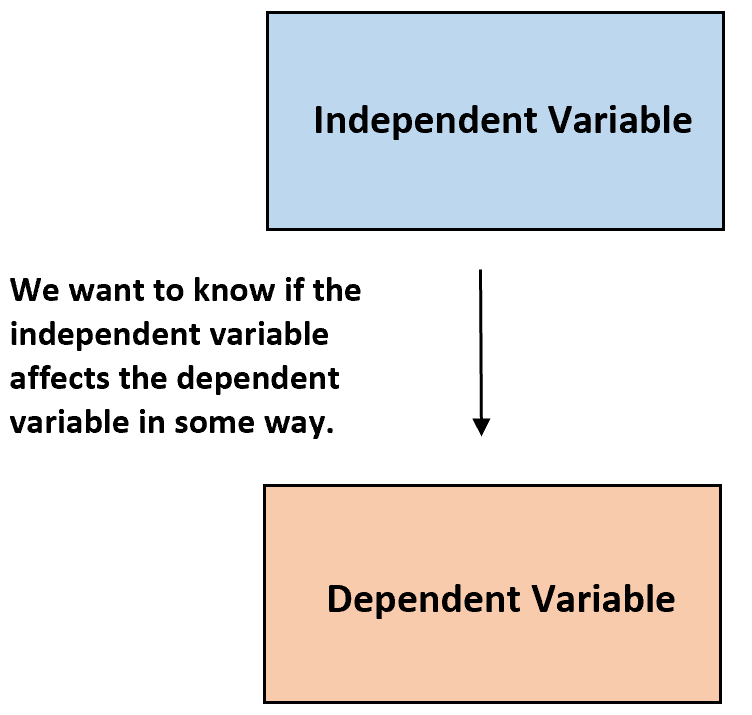
L’architecture standard de l’expérimentation et de l’observation empirique s’articule traditionnellement autour d’un diptyque élémentaire : la variable indépendante ($X$), supposée agir comme la cause opérante ou le facteur manipulé, et la variable dépendante ($Y$), représentant l’effet, l’aboutissement ou la réponse comportementale mesurée par l’investigateur. Cependant, cette structure bivariée pèche souvent par réductionnisme en ignorant les couches de complexité systémique dans lesquelles s’insère le comportement humain ou biologique. L’intégration de la variable antécédente, communément notée $X_0$ ou $A$, donne naissance à un triptyque séquentiel qui affine considérablement la modélisation de la chaîne causale théorique.
Dans cette modélisation élargie formalisée par la trajectoire $X_0 to X_1 to Y$, la variable antécédente ($X_0$) déploie une influence double, à la fois directe et indirecte. D’une part, elle détermine ou module le niveau, l’occurrence ou l’intensité de la variable indépendante ($X_1$). En d’autres termes, les sujets d’une étude n’arrivent pas vierges de toute influence face à la variable indépendante : leurs scores sur $X_1$ sont en partie ou en totalité tributaires de leur exposition préalable à $X_0$. D’autre part, la variable antécédente propage une partie de sa variance vers la variable dépendante ($Y$), soit à travers le vecteur intermédiaire de la variable indépendante, soit par l’intermédiaire de voies causales parallèles qui contournent cette dernière.
Cette propagation de la variance modifie profondément l’interprétation théorique du modèle. Si le chercheur omet d’inclure $X_0$ dans son schéma analytique, la variance partagée entre $X_0$ et $Y$ risque d’être imputée à tort, dans sa totalité, à la relation unilatérale entre $X_1$ et $Y$. Le positionnement séquentiel de l’antécédent impose une structure hiérarchique : $X_0$ agit comme un prédécesseur structurel, $X_1$ comme un relais proximal ou une variable focale, et $Y$ comme le critère ultime. Cette décomposition permet de cartographier la trajectoire causale avec une fidélité accrue, respectant la réalité multi-déterminée des systèmes psychologiques et sociologiques complexes.
1.3 Importance de la conceptualisation dans la démarche scientifique
L’intégration rigoureuse de la variable antécédente dès les phases initiales de la conception d’une recherche constitue un rempart épistémologique contre les dérives interprétatives. L’un des pièges les plus récurrents de l’analyse de données réside dans l’acceptation sans réserve de corrélations de surface. Deux variables peuvent fluctuer de concert de manière statistiquement significative simplement parce qu’elles réagissent toutes deux à l’impulsion d’une même variable antécédente non mesurée. Sans un effort théorique préalable visant à conceptualiser ces facteurs souterrains, le chercheur s’expose au risque de proclamer l’existence d’une relation causale là où il n’y a en vérité qu’une covariation épiphénoménale.
Au sein des modèles psychométriques modernes, la prise en compte des antécédents renforce la validité de construit et la cohérence théorique globale des instruments d’évaluation. Lorsqu’un psychologue cherche à mesurer un trait latent ou un état affectif, ce construit ne s’exprime jamais dans un vide contextuel ou temporel. Identifier les variables antécédentes permet de délimiter avec précision les frontières du concept investigué et de s’assurer que les indicateurs empiriques recueillis reflètent bien le mécanisme ciblé plutôt que l’empreinte résiduelle d’une condition préalable. Cette démarche confère au modèle théorique une plus grande robustesse face aux épreuves de falsifiabilité poppériennes.
Enfin, l’exercice d’anticipation des variables antécédentes s’avère indispensable lors de la revue systématique de la littérature. C’est à ce stade préliminaire que le scientifique doit recenser l’ensemble des facteurs de risque, des prédispositions génétiques, des statuts socio-économiques ou des événements historiques susceptibles d’agir comme des variables antécédentes dans son domaine d’investigation. Cette cartographie préventive permet de concevoir des protocoles de collecte de données adaptés, intégrant les instruments de mesure appropriés pour capturer ces antécédents, prévenant ainsi l’émergence ultérieure de biais de confusion systémiques impossibles à corriger a posteriori.
2. Chronologie causale et antériorité temporelle en recherche psychologique
L’établissement de la causalité en psychologie et en sciences sociales ne peut faire l’économie d’une réflexion approfondie sur la dimension temporelle des phénomènes. Toute inférence prétendant à un statut causal repose sur un axiome indépassable : la cause doit impérativement précéder l’effet dans le temps.
2.1 Le principe d’antériorité temporelle dans la causalité
L’antériorité temporelle constitue l’un des piliers cardinaux de la philosophie de la causalité, depuis les analyses séminales de David Hume jusqu’aux développements contemporains de l’économétrie des séries temporelles formalisés par le postulat de Clive Granger. Selon le principe de causalité au sens de Granger, une variable $X$ ne peut être qualifiée de cause d’une variable $Y$ que si la connaissance des états passés de $X$ permet d’améliorer significativement la prédiction des états futurs de $Y$, au-delà de ce que permet la seule connaissance des états passés de $Y$. Ce postulat implique une directionalité irréversible : le flux temporel dicte l’asymétrie causale.
Il est physiquement et logiquement impossible pour un effet de rétroagir chronologiquement sur sa cause antécédente. Bien que des systèmes dynamiques complexes puissent présenter des boucles de rétroaction cybernétiques (où l’effet $Y$ à l’instant $t_1$ influence à son tour la variable $X$ à l’instant $t_2$), chaque segment individuel de causalité respecte scrupuleusement l’antériorité temporelle locale. En méthodologie de la recherche, il est crucial de ne pas confondre cet ordre temporel réel des processus ontologiques avec l’ordre logique ou opérationnel dans lequel le chercheur recueille ses mesures. Un questionnaire administré à un temps $T$ peut très bien interroger un événement survenu dix ans auparavant : l’antécédent conserve alors son antériorité temporelle réelle, bien que son enregistrement psychométrique soit synchrone avec d’autres mesures.
Cette distinction exige une vigilance méthodologique constante. L’asymétrie temporelle impose que la variable antécédente soit ancrée dans une temporalité qui préexiste à l’émergence des variations de la variable indépendante. Si cette préséance temporelle ne peut être établie sur des bases factuelles, historiques ou méthodologiques irréfutables, le statut de variable antécédente devient purement spéculatif, fragilisant l’ensemble de l’édifice explicatif du chercheur et exposant ses conclusions à des critiques épistémologiques majeures.
2.2 Défis d’identification dans les devis transversaux
En dépit des impératifs chronologiques de la causalité, une part considérable de la recherche empirique en sciences humaines repose sur des devis transversaux (cross-sectional designs), au sein desquels l’ensemble des variables d’intérêt est mesuré à un point unique dans le temps. Ce choix méthodologique, souvent dicté par des contraintes logistiques, budgétaires ou d’opportunité, engendre des vulnérabilités intrinsèques lorsqu’il s’agit d’isoler et d’identifier avec certitude une variable antécédente. Dans un devis transversal, la simultanéité de la mesure aplatit la dimension temporelle, transformant une dynamique diachronique en une simple photographie synchronique.
Dans cette configuration statique, le risque d’erreur de spécification causale est maximal. Sans repères temporels objectifs pour déterminer si $X_0$ a effectivement précédé $X_1$, le chercheur est contraint de postuler l’antécédence sur la seule base de postulats théoriques ou du bon sens, des fondements qui peuvent s’avérer trompeurs. Par exemple, si l’on mesure simultanément l’estime de soi, le niveau d’anxiété et la performance académique, déterminer avec certitude laquelle de ces variables agit comme antécédent structurel relève de la conjecture si les données ont été collectées le même jour via un unique faisceau de questionnaires.
Pour pallier ce déficit structurel des devis transversaux, les chercheurs recourent fréquemment à la collecte de données rétrospectives, demandant aux participants d’évoquer des états, des comportements ou des événements passés. Toutefois, cette approche introduit des biais cognitifs majeurs, au premier rang desquels figure le biais de rappel sélectif (recall bias). L’humeur actuelle du sujet, ses théories implicites sur le changement personnel, ou des distorsions mnésiques reconstructives peuvent altérer profondément la fidélité des données relatives à l’antécédent supposé. Le rappel d’un événement antérieur peut ainsi être involontairement contaminé par l’état psychologique présent du participant, détruisant l’indépendance de mesure requise pour valider l’antériorité causale.
2.3 Avantages des devis longitudinaux pour valider l’antécédence
Face aux apories des études transversales, les devis de recherche longitudinaux s’imposent comme le standard méthodologique par excellence pour identifier, tester et valider l’existence de variables antécédentes. En articulant la collecte des données autour de plusieurs vagues successives espacées dans le temps ($T_1, T_2, T_3, dots, T_n$), le chercheur s’assure d’un isomorphisme parfait entre l’ordre temporel des mesures et la séquence chronologique postulée par sa théorie causale.
Dans un protocole longitudinal prospectif rigoureux, la variable antécédente potentielle ($X_0$) est mesurée lors de la première vague ($T_1$), bien avant que la variable indépendante ($X_1$) ne se déploie pleinement ou ne soit mesurée à la vague suivante ($T_2$), tandis que la variable dépendante ($Y$) fait l’objet d’une évaluation lors d’une vague ultérieure ($T_3$). Cette approche permet le déploiement de techniques analytiques sophistiquées, telles que les modèles de panel à décalage croisé (cross-lagged panel models) ou les modèles de courbes de croissance latente (latent growth curve modeling). Ces méthodes permettent d’isoler l’influence prospective de l’antécédent tout en contrôlant les niveaux de base (baseline) des variables subséquentes.
L’apport inestimable des devis longitudinaux réside dans leur capacité à éliminer formellement les hypothèses alternatives fondées sur la causalité inversée. En démontrant qu’une variation mesurée au temps $T_1$ prédit de façon robuste un changement intra-individuel de la variable dépendante au temps $T_3$, tout en neutralisant l’état du système au temps $T_1$, le chercheur apporte une preuve empirique de premier ordre en faveur de la directionalité causale. La documentation objective de la préexistence temporelle de l’antécédent confère ainsi au modèle une validité interne incomparable, inaccessible aux designs purement transversaux.
3. Distinction fondamentale : Variable antécédente versus variable médiatrice
La modélisation causale avancée requiert une taxonomie rigoureuse des rôles endossés par les différentes entités statistiques. Une confusion fréquente dans la littérature spécialisée concerne l’assimilation erronée de la variable antécédente à la variable médiatrice, alors même que ces deux concepts obéissent à des logiques structurales et fonctionnelles diamétralement opposées.
3.1 Positionnement structural dans le modèle causal
La distinction fondamentale entre une variable antécédente et une variable médiatrice s’illustre avant tout par leur localisation topologique respective au sein du graphe causal d’un protocole d’investigation. La variable antécédente se situe invariablement à la racine de la chaîne d’investigation, en amont de la variable indépendante focale : son positionnement structurel s’écrit formellement sous la forme $X_0 to X to Y$. Dans ce schéma, l’antécédent $X_0$ agit comme le déclencheur primaire ou le cadre initial qui préside à l’émergence ou à la distribution de la variable indépendante $X$.
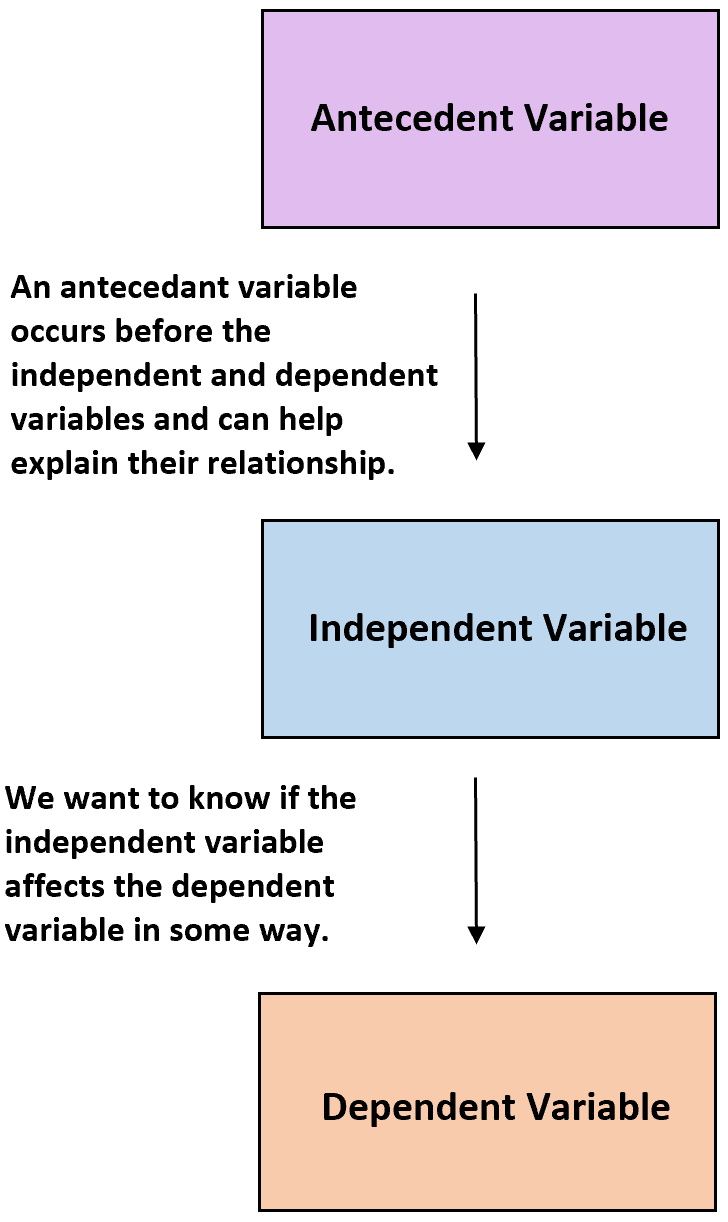
À l’inverse, la variable médiatrice ($M$) s’insère strictement à l’intérieur de l’intervalle causal qui sépare la variable indépendante de la variable dépendante, selon le schéma classique $X to M to Y$. Le médiateur ne précède pas la variable indépendante ; il en est le produit chronologique et fonctionnel direct. Dans le modèle de médiation, la variable indépendante $X$ transmet son énergie causale à $M$, qui à son tour transmet cette impulsion à la variable dépendante $Y$. Il existe donc une différence ontologique radicale : l’antécédent crée la variable indépendante, tandis que le médiateur est généré par elle.
Cette différence structurelle dicte la transmissibilité du mécanisme causal. Dans le cadre d’un antécédent, l’effet sur $Y$ peut être entièrement indirect (en passant exclusivement par $X$) ou s’accompagner d’effets directs résiduels ($X_0 to Y$). Dans le cadre d’une médiation pure, la suppression ou la neutralisation expérimentale de $X$ annule l’activation de $M$. En revanche, la manipulation de $X$ dans un modèle avec antécédent ne modifie en aucun cas l’existence ou les valeurs prises par $X_0$, puisque la causalité ne remonte jamais le temps. La clarté de cette distinction topologique est indispensable à la formulation correcte d’équations structurelles non dégénérées.
3.2 Interprétation théorique du mécanisme d’action
Au-delà de leur configuration géométrique dans un schéma conceptuel, l’antécédent et le médiateur répondent à des interrogations théoriques distinctes concernant la nature profonde des phénomènes psychologiques ou comportementaux. La variable médiatrice se consacre à l’élucidation de l’intériorité du phénomène : elle cherche à expliciter comment ou pourquoi une relation causale spécifique s’opère entre deux variables déjà corrélées. Elle incarne le mécanisme psychologique, biologique ou cognitif sous-jacent qui traduit une stimulation externe en une réponse comportementale.
Par exemple, si l’on étudie l’impact d’un entraînement cognitif ($X$) sur la mémoire de travail ($Y$), une augmentation de la densité synaptique dans le cortex préfrontal dorsolatéral peut agir comme un médiateur ($M$). Ce médiateur dévoile la « boîte noire » du phénomène et explique la machinerie interne liant l’intervention au résultat. En revanche, la variable antécédente se pose une question de genèse et de conditionnement préliminaire : qu’est-ce qui a rendu possible l’existence de cette condition initiale, ou qui prédispose les individus à se trouver dans cet état particulier ?
Dans le même exemple, le statut nutritionnel de l’enfant durant la petite enfance ou le niveau de plasticité neuronale d’origine génétique constitue une variable antécédente ($X_0$). Elle clarifie les conditions préexistantes qui déterminent à la fois la probabilité d’adhésion à l’entraînement cognitif ($X$) et le niveau absolu de départ des performances mnésiques ($Y$). Cette divergence d’interprétation porte des conséquences majeures pour les applications cliniques ou éducatives : intervenir sur un médiateur vise à bloquer ou optimiser la transmission d’une cause existante, tandis qu’intervenir sur un antécédent relève de la prévention primaire, consistant à modifier les déterminants de base en amont de tout processus pathologique ou développemental.
3.3 Critères statistiques de différenciation formelle
Pour départager de manière empirique et non ambiguë un modèle d’antécédence d’un modèle de médiation, les chercheurs s’appuient sur des démarches statistiques codifiées, dont la plus célèbre est issue des travaux pionniers de Baron et Kenny (1986), aujourd’hui perfectionnée par les approches contemporaines de modélisation par équations structurelles (SEM) et d’inférence causale moderne formalisée par Andrew Hayes.
Dans l’approche de Baron et Kenny pour tester une médiation simple ($X to M to Y$), quatre conditions statistiques successives doivent être impérativement satisfaites :
- La variable indépendante $X$ doit prédire significativement la variable dépendante $Y$ dans un modèle de régression simple ($Y = cX + e_1$).
- La variable indépendante $X$ doit prédire significativement le médiateur présumé $M$ ($M = aX + e_2$).
- Le médiateur $M$ doit prédire significativement la variable dépendante $Y$ lorsque la variable indépendante est contrôlée simultanément ($Y = c’X + bM + e_3$).
- Le coefficient direct $c’$ entre $X$ et $Y$ doit être significativement inférieur au coefficient total $c$ (médiation partielle), voire devenir nul (médiation totale).
À l’opposé, si l’on postule que la variable analysée est un antécédent ($X_0$) et non un médiateur, la structure de covariance attendue est profondément modifiée. Dans ce scénario, c’est $X_0$ qui doit prédire $X$ de façon asymétrique dans un modèle de régression univarié, et non l’inverse. Si le chercheur tente d’ajuster un modèle de médiation en traitant un antécédent réel comme s’il s’agissait d’un médiateur (spécifiant à tort $X to X_0 to Y$), les indices d’ajustement global de la modélisation par équations structurelles (tels que le RMSEA, le CFI et le TLI) se dégraderont drastiquement par rapport au modèle véridique respectant la hiérarchie chronologique ($X_0 to X to Y$).
Les tests de comparaison de modèles non emboîtés, basés sur le critère d’information d’Akaike (AIC) ou le critère d’information bayésien (BIC), permettent de confirmer formellement la supériorité statistique du positionnement antécédent par rapport au positionnement médiateur. Une mauvaise attribution structurelle engendre des matrices de résidus hautement corrélées, signalant une violation manifeste des contraintes d’indépendance conditionnelle imposées par les données.
4. Distinction critique : Variable antécédente, variable modératrice et variable confondante
La panoplie méthodologique du chercheur comprend d’autres catégories de variables qu’il est impératif de ne pas amalgamer avec l’antécédent. Les variables modératrices et les variables confondantes constituent deux cas de figure dont les implications statistiques et épistémologiques exigent une démarcation scrupuleuse.
4.1 Différenciation avec la variable modératrice
La variable modératrice incarne une fonction analytique totalement dissemblable de celle d’un antécédent temporel. En statistiques appliquées, la modération renvoie à un modificateur d’effet : c’est une variable qualitative ou quantitative qui affecte la direction ou la force de la relation entre la variable indépendante et la variable dépendante. Mathématiquement, la modération est formalisée par l’introduction d’un terme d’interaction multiplicatif ($X \times Z$) dans l’équation de régression générale ($Y = \beta_0 + \beta_1 X + \beta_2 Z + \beta_3 (X \times Z) + \epsilon$).
La question de recherche à laquelle répond un modérateur n’a rien de commun avec celle que soulève une variable antécédente. Le modérateur répond aux interrogations du type : Pour qui cette relation s’applique-t-elle ? ou Dans quelles conditions contextuelles l’effet est-il maximisé ou inhibé ? Par exemple, le genre biologique ou le sentiment d’efficacité personnelle peut agir comme un modérateur modulant l’impact d’un traitement thérapeutique sur la réduction de l’anxiété : le traitement peut s’avérer extrêmement probant chez les sujets dotés d’un haut sentiment d’efficacité, et totalement inefficace chez ceux dont le score est bas.
En revanche, la variable antécédente ne modifie pas nécessairement la nature de la pente liant $X$ à $Y$ ; elle agit en amont en alimentant la variabilité de $X$ elle-même. Alors que le modérateur interagit avec la variable indépendante sans être nécessairement corrélé avec elle (l’indépendance entre $X$ et le modérateur $Z$ est même idéale dans les plans expérimentaux pour éviter les problèmes de multicolinéarité), l’antécédent est intrinsèquement lié à $X$ par une relation de détermination préalable. Confondre ces deux statuts conduit fréquemment à spécifier des termes d’interaction dépourvus de sens théorique au détriment de l’explication séquentielle des faits.
4.2 La variable confondante comme cas particulier d’antécédent
Dans le vocabulaire épidémiologique et économétrique, la variable confondante (ou facteur de confusion) représente l’une des menaces les plus pernicieuses pesant sur la validité interne d’une étude. Une variable confondante est une variable qui est à la fois associée causalement à la variable d’exposition (la variable indépendante) et à l’issue de santé ou au comportement analysé (la variable dépendante), sans pour autant se situer sur la trajectoire causale directe reliant l’exposition à l’issue.
Il existe une perméabilité conceptuelle évidente entre ces notions : toute variable confondante authentique est, par essence, une variable antécédente commune aux variables indépendante et dépendante. Elle prend la forme classique d’une cause commune (structure en fourche ou bifurcation causale : $Y \leftarrow X_0 \rightarrow X$). Lorsque cette configuration se présente, la variable antécédente génère ce que la statistique descriptive nomme une corrélation fallacieuse ou fallacieuse (spurious correlation). Les variables $X$ et $Y$ semblent interagir intimement, alors que leur apparente communion statistique n’est que le reflet projeté de leur dépendance partagée à l’égard de l’antécédent $X_0$.
Cependant, il convient de souligner que toutes les variables antécédentes ne sont pas systématiquement des variables confondantes délétères. Une variable antécédente peut agir exclusivement sur la variable indépendante ($X_0 \rightarrow X \rightarrow Y$) sans exercer d’influence directe résiduelle sur la variable dépendante $Y$. Dans cette configuration précise (semblable à une variable instrumentale en économétrie), l’antécédent n’introduit aucun biais de confusion dans l’estimation de l’effet direct de $X$ sur $Y$, mais permet d’expliquer pourquoi les individus présentent des niveaux hétérogènes d’exposition à $X$.
4.3 Conséquences méthodologiques d’une mauvaise classification
La classification erronée d’une variable dans un protocole d’analyse statistique emporte des conséquences préjudiciables qui peuvent invalider intégralement les conclusions d’un programme de recherche. Le premier écueil réside dans le phénomène de sur-ajustement statistique (overcontrolling). Si un chercheur prend par mégarde une variable médiatrice authentique pour une variable antécédente confondante et décide de contrôler statistiquement cette variable par une régression multiple ou une analyse de covariance, il neutralisera artificiellement le mécanisme causal même qu’il cherchait à mettre au jour, masquant ainsi des effets réels et aboutissant à des erreurs de type II (faux négatifs).
Le danger inverse, tout aussi dévastateur, réside dans le biais du collisionneur (collider stratification bias). Si une variable est en réalité un effet commun de la variable indépendante et de la dépendante ($X \rightarrow C \leftarrow Y$) et que le chercheur la traite par erreur comme un antécédent ou une variable confondante en la conditionnant dans ses modèles de régression, il induira de toutes pièces une association statistique artificielle et non causale entre $X$ et $Y$. Ce piège analytique, formalisé par les développements de l’inférence causale moderne, montre à quel point l’attribution d’un statut causal erroné peut corrompre les résultats empiriques.
Enfin, une mauvaise classification entraîne inévitablement une distorsion de l’interprétation théorique. Attribuer les propriétés d’un modérateur à ce qui constitue en fait un antécédent prive la communauté scientifique d’une compréhension fine de la temporalité du phénomène étudié. Les modèles prédictifs élaborés sur de telles bases s’avèrent incapables de guider des interventions pratiques efficaces dans le monde réel, car ils ciblent des points d’impact méthodologiquement inadaptés.
5. Premier exemple canonique décortiqué : L’âge et le revenu annuel
Afin d’ancrer ces développements théoriques dans une réalité tangible, examinons en détail un exemple canonique issu de l’économie du travail et de la sociologie quantitative : l’analyse de la relation apparente entre l’âge chronologique des individus et leur niveau de revenu annuel.
5.1 Présentation du cas empirique de base
Considérons une enquête socio-économique représentative menée à l’échelle d’une population active nationale, dans laquelle les analystes s’intéressent aux déterminants financiers du bien-être matériel. L’hypothèse linéaire primaire formulée de prime abord postule que l’âge chronologique d’un salarié ($X$) prédit positivement son niveau de revenu annuel ($Y$). L’intuition théorique sous-jacente s’appuie classiquement sur les modèles de capital humain : au fur et à mesure qu’un individu avance en âge, il accumule de l’expérience professionnelle, consolide son réseau de relations, gravit les échelons hiérarchiques et bénéficie de revalorisations salariales régulières fondées sur l’ancienneté.
Dans les premières phases de l’exploration descriptive des données, un modèle de régression linéaire simple bivarié semble corroborer avec force cette assertion théorique. L’équation de régression estimée s’écrit de la manière suivante :
$$\text{Reve\nu} = \beta_0 + \beta_1 (\text{Âge}) + \epsilon$$
Les résultats affichent un coefficient de régression $\beta_1$ positif et hautement significatif ($p < 0{,}001$), associé à un coefficient de détermination ($R^2$) substantiel, attestant qu'une part non négligeable de la variabilité des revenus est corrélée aux variations de l'âge des participants. Les décideurs institutionnels ou les analystes hâtifs pourraient être tentés de conclure que le temps biologique est un moteur universel et direct de l'enrichissement professionnel. Pourtant, ce modèle bivarié simple présente une insuffisance explicative manifeste : il traite les individus de différents âges comme s'ils étaient rigoureusement interchangeables sous tous les autres aspects de leur existence sociale.
5.2 Introduction du niveau d’éducation comme variable antécédente
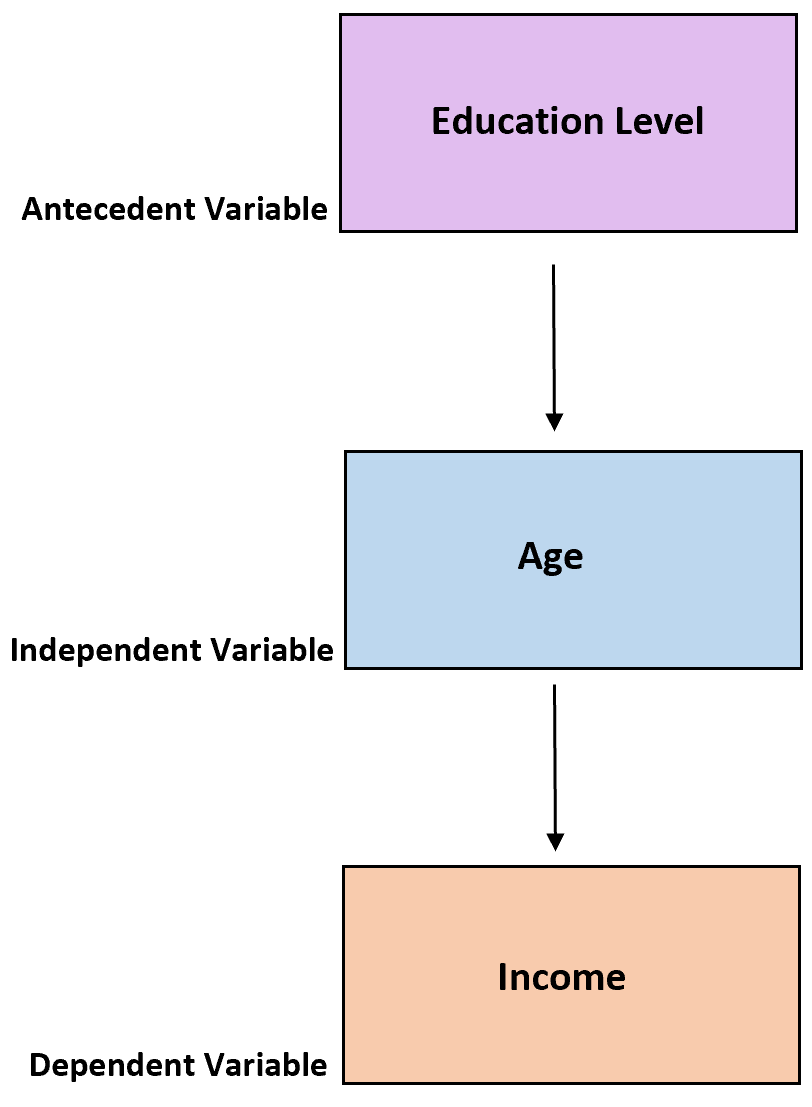
Pour dépasser le caractère réducteur de cette association univariée, il devient indispensable d’introduire dans la matrice causale une variable structurelle majeure qui se situe chronologiquement et logiquement en amont : le niveau d’études initial ou le diplôme le plus élevé obtenu par l’individu au sortir de sa formation initiale ($X_0$). Cette variable d’éducation précoce présente toutes les caractéristiques définitoires d’une variable antécédente par rapport au couple Âge-Revenu.
D’une part, le niveau d’éducation initial conditionne directement la temporalité de l’insertion sur le marché de l’emploi, et donc l’âge auquel l’individu est observé à différentes étapes de sa carrière. Les individus poursuivant des études universitaires prolongées (doctorats, grandes écoles) s’insèrent dans la population active rémunérée à un âge chronologique nettement plus avancé que les personnes sortant du système scolaire sans qualification dès la fin de l’obligation légale d’instruction. En outre, au sein d’une population hétérogène, les réformes successives des systèmes d’enseignement supérieur induisent des effets de cohorte massifs : les cohortes générationnelles plus jeunes bénéficient d’un accès structurellement plus large aux diplômes supérieurs que les cohortes plus anciennes.
D’autre part, le niveau d’éducation initiale imprime une trajectoire décisive sur le potentiel de gains économiques tout au long de la vie d’un salarié. Il ouvre l’accès à des postes d’encadrement supérieur, à des secteurs d’activité à haute valeur ajoutée technologique ou financière, et procure des amortisseurs majeurs contre la précarité salariale. Dès lors, le gradient observé entre l’âge et la rémunération ne s’explique-t-il pas, au moins partiellement, par le fait que les individus plus âgés ayant atteint les sommets salariaux correspondent à une élite sélectionnée dotée d’une formation scolaire qui continue de structurer les hiérarchies de rémunération ? Le parcours éducatif se révèle être une variable antécédente qui conditionne l’âge d’entrée et le profil de carrière.
5.3 Décomposition mathématique et interprétation analytique
Pour vérifier rigoureusement cette reconfiguration causale, le statisticien met en œuvre une régression linéaire multiple incorporant le niveau d’éducation ($X_0$) aux côtés de l’âge ($X_1$) pour prédire le revenu ($Y$) :
$$\text{Reve\nu} = \beta_0 + \beta_1 (\text{Âge}) + \beta_2 (\text{Éducation}) + \epsilon$$
L’estimation des moindres carrés ordinaires révèle un phénomène statistique classique mais hautement révélateur : le coefficient de régression partielle associé à l’âge ($\beta_1$) subit une forte atténuation comparativement à sa valeur estimée dans le modèle simple univarié. Une proportion importante de la variance de la rémunération que l’on attribuait aveuglément à la maturation temporelle ou à l’âge se trouve désormais absorbée par le terme $\beta_2$ mesurant l’effet propre de l’éducation initiale. Dans certains sous-échantillons d’emplois hautement spécialisés, l’effet propre de l’âge devient même négligeable après contrôle rigoureux du bagage éducatif initial.
L’analyse de cette décomposition mathématique démontre que la variable éducation se comporte typiquement comme une variable antécédente génératrice de l’illusion causale partielle du modèle bivarié. L’éducation antérieure prédétermine le segment de marché sur lequel le travailleur opérera à chaque tranche d’âge de sa vie. En négligeant cette antécédence temporelle et institutionnelle, les chercheurs auraient commis une grave erreur d’omission de variable fondamentale, menant à surestimer le retour économique marginal de la seule ancienneté chronologique.
6. Deuxième exemple approfondi en psychologie : Méditation et niveau de bonheur
Le champ de la psychologie contemporaine de la santé et du bien-être offre un second terrain d’application particulièrement instructif pour illustrer le rôle des variables antécédentes dans la déconstruction des postulats simplistes.
6.1 Formulation de l’hypothèse de psychologie positive
Au cours des deux dernières décennies, la littérature en psychologie positive s’est largement focalisée sur les bénéfices potentiels des interventions basées sur la pleine conscience (mindfulness) et les pratiques méditatives traditionnelles ou adaptées. L’hypothèse de travail formulée de manière récurrente pose que la régularité et l’intensité de la pratique méditative ($X$) augmentent de manière causale directe le niveau de bien-être subjectif et de bonheur global autodéclaré ($Y$) des individus.
Dans une étude observationnelle typique, un échantillon d’adultes remplit une batterie d’instruments standardisés évaluant la fréquence hebdomadaire de leur engagement méditatif (en minutes cumulées) ainsi que des échelles psychométriques validées, telles que la Satisfaction with Life Scale (SWLS) d’Ed Diener ou l’échelle de bien-être subjectif de l’Organisation Mondiale de la Santé (WHO-5). L’analyse corrélationnelle simple révèle presque invariablement un coefficient de corrélation de Pearson positif, statistiquement robuste ($r \approx 0{,}35$ à $0{,}45$, $p < 0{,}001$), reliant l'engagement méditatif à une perception élevée de bonheur personnel. Les partisans zélés de ces pratiques pourraient immédiatement en déduire un mandat direct d'intervention publique : pour rendre les citoyens heureux, il suffirait de prescrire la méditation quotidienne à l'ensemble du corps social.
6.2 L’émergence du stress professionnel comme antécédent critique
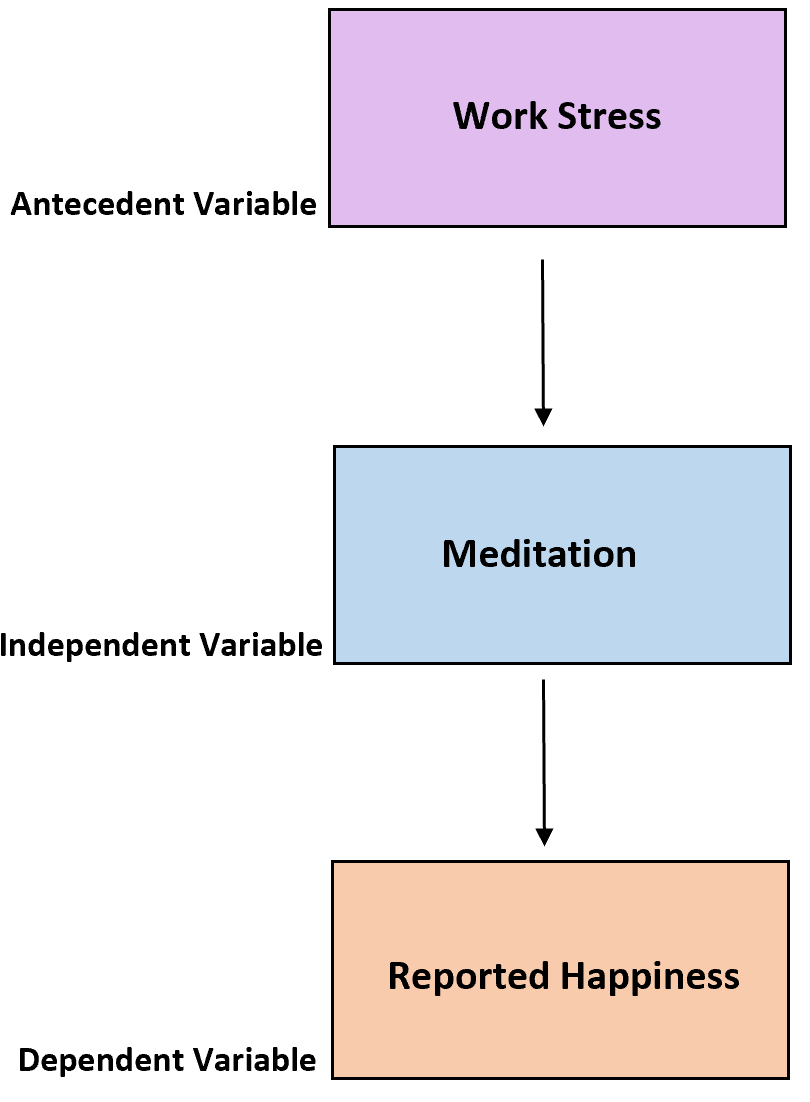
Cependant, une analyse méthodologique rigoureuse exige d’interroger les conditions de possibilité mêmes de la pratique méditative au sein de la vie quotidienne des sujets interrogés. Pourquoi certains individus trouvent-ils le temps psychologique, la disponibilité cognitive et la sérénité logistique nécessaires pour s’asseoir en silence quarante-cinq minutes chaque jour, tandis que d’autres s’en révèlent totalement incapables ? C’est ici qu’intervient une variable antécédente fondamentale : le niveau d’exposition au stress professionnel chronique et les conditions matérielles d’existence ($X_0$).
Le stress professionnel toxique, généré par des horaires dérégulés, une charge de travail écrasante, la précarité de l’emploi et l’absence d’autonomie décisionnelle, agit en amont comme un filtre puissant. Un individu soumis à un environnement de travail hautement stressant et précaire dispose d’une réserve de ressources cognitives et attentionnelles (ego depletion) considérablement amenuisée. Ce stress antérieur inhibe structurellement l’adoption et le maintien régulier d’une discipline contemplative comme la méditation. Simultanément, ce même stress chronique érode de manière directe et destructrice les circuits neurobiologiques de la récompense et du bien-être, abaissant dramatiquement les scores sur les échelles de bonheur ($Y$).
Le capital temps et la sécurité organisationnelle préexistante constituent ainsi le véritable substrat causal. Les individus qui méditent assidûment sont majoritairement des sujets qui bénéficient au préalable d’un cadre de vie suffisamment préservé du stress chronique aigu pour pouvoir intégrer une routine introspective. Le niveau de stress environnemental de base apparaît donc comme une variable antécédente majeure qui détermine à la fois l’opportunité de méditer et l’état psychologique de base des participants.
6.3 Implications thérapeutiques et interprétatives
Lorsque les épidémiologistes et psychologues modélisent conjointement ces variables par des approches multivariées adaptées, en contrôlant les niveaux de base de stress environnemental et de charge mentale préexistante, l’amplitude de la corrélation directe entre la méditation et le bonheur autodéclaré connaît un affaissement notable. Bien que la méditation conserve fréquemment un effet thérapeutique bénéfique réel chez des individus stabilisés, une part prépondérante de la variance partagée initialement observée était en réalité attribuable à ce biais d’auto-sélection en amont.
Ces constats portent des implications cliniques et politiques d’une gravité exceptionnelle. Proposer la méditation comme une panacée universelle en ignorant la variable antécédente que constitue la toxicité du cadre de travail relève d’une erreur d’attribution causale aux relents moralisateurs : cela revient à imputer à une défaillance individuelle de pratique un mal-être en réalité déterminé par des conditions structurelles en amont. Pour concevoir des essais cliniques randomisés fiables évaluant les interventions de pleine conscience, il devient impératif de stratifier les échantillons en fonction de cet antécédent de charge mentale de départ, sous peine d’évaluer non pas l’efficacité de la méditation en soi, mais le profil privilégié de ceux qui ont le luxe de pouvoir la pratiquer.
7. Exemples cliniques et développementaux dans la recherche comportementale
Au-delà des domaines organisationnels ou socio-économiques, l’identification de variables antécédentes s’avère vitale au cœur des sous-disciplines fondamentales de la psychologie contemporaine, telles que le développement humain, la psychiatrie biologique et les neurosciences cognitives.
7.1 Psychologie du développement : Attachement parental et sociabilité adulte
Dans le sillage des théories de John Bowlby et de Mary Ainsworth, la psychologie du développement étudie avec prédilection l’influence des schèmes relationnels établis dans la petite enfance sur l’ajustement socio-émotionnel tout au long de la vie. Imaginons une étude examinant chez des adultes de 30 ans le lien entre la satisfaction conjugale ($X$) et la qualité de leur réseau de soutien social amical ($Y$). Les résultats indiquent sans surprise que les conjoints épanouis dans leur couple bénéficient également d’amitiés plus stables et épanouissantes.
Toutefois, ce modèle horizontal omet une variable antécédente fondamentale : la sécurité de l’attachement infantile précoce ($X_0$), mesurée par exemple au cours des deux premières années de vie via le protocole de la Situation Étrange. L’attachement sécure agit comme un antécédent développemental qui structure les modèles internes opérants (MIO) de l’individu. Un enfant ayant bénéficié d’un étayage parental sensible développe des capacités de régulation émotionnelle supérieures et une confiance de base qui vont simultanément déterminer son aptitude à choisir un partenaire romantique bienveillant ($X$) et sa facilité à nouer et entretenir des liens sociaux harmonieux hors du couple ($Y$).
Démêler l’impact de cet antécédent développemental face aux événements de vie adulte contemporains est essentiel. Sans la mesure rétrospective ou prospective de la qualité de l’attachement précoce, un thérapeute pourrait supposer à tort que les dysfonctionnements du réseau d’amitié résultent exclusivement de frictions conjugales actuelles, ignorant le fait que les deux sphères expriment de concert la réactualisation d’une insécurité d’attachement préexistante.
7.2 Psychopathologie : Traumatismes de l’enfance et troubles anxieux
En psychiatrie clinique et en psychopathologie quantitative, l’étude des déterminants de l’anxiété et de la dépression a longtemps été obscurcie par l’omission de variables antécédentes biographiques critiques. Soit une recherche tentant d’évaluer si la survenue d’un divorce conflictuel à l’âge adulte ($X$) cause le déclenchement d’un trouble anxieux généralisé ($Y$). L’association empirique directe est indiscutablement élevée : les individus divorcés affichent des taux de prévalence anxieuse largement supérieurs à ceux des individus mariés.
Cependant, l’introduction de l’exposition aux traumatismes infantiles complexes ou aux expériences négatives vécues durant l’enfance (Adverse Childhood Experiences, ou ACEs : maltraitance physique, abus émotionnels, négligence grave) agit comme une variable antécédente massive ($X_0$). Les neurosciences du stress démontrent que les traumatismes infantiles précoces induisent une altération permanente de la réactivité de l’axe hypothalamo-hypophyso-surrénalien (HPA) et une sensibilisation amygdalienne durable. Cette vulnérabilité neurobiologique et psychologique précoce accroît considérablement la probabilité d’instabilité relationnelle et de ruptures conjugales conflictuelles à l’âge adulte ($X$), tout en abaissant le seuil de déclenchement des pathologies anxieuses ($Y$).
Le contrôle systématique de cette variable antécédente lors de l’anamnèse clinique permet aux praticiens de distinguer les réactions d’adaptation passagères induites par une séparation d’une psychopathologie structurelle ancrée dans un traumatisme développemental lointain. En recherche épidémiologique, négliger les ACEs conduit à biaiser drastiquement l’effet attribuable aux facteurs précipitants de l’âge adulte.
7.3 Psychologie cognitive : Sommeil antérieur et performances mnésiques
Le domaine de la psychologie cognitive expérimentale n’échappe pas à cette exigence, même au sein d’environnements de laboratoire strictement standardisés. Considérons une expérience visant à comparer l’efficacité de deux méthodes pédagogiques d’encodage mnésique ($X$ : méthode par répétition espacée versus méthode par élaboration sémantique) sur le score de rappel différé ($Y$) lors d’un test standardisé de mémoire épisodique.
Bien que la manipulation expérimentale semble nette, la qualité et la durée du sommeil lent profond de la nuit précédant l’expérience agissent comme une variable antécédente physiologique immédiate ($X_0$). Un déficit de sommeil antérieur impacte directement la capacité d’attention soutenue et la bande passante de la mémoire de travail nécessaires pour s’engager activement dans la condition d’apprentissage proposée ($X$), tout en diminuant la viabilité des mécanismes de potentialisation à long terme dans l’hippocampe indispensables à la restitution finale lors du test ($Y$).
Si cette variable antécédente n’est pas mesurée ou neutralisée en amont par des protocoles actigraphiques ou des questionnaires de veille-sommeil rigoureux, la variabilité résiduelle aléatoire augmentera exponentiellement, au risque d’engloutir la significativité statistique de la différence entre les deux méthodes pédagogiques testées. Ce cas démontre que l’antécédence ne se compte pas uniquement en décennies biographiques, mais s’applique avec la même vigueur heuristique à des échelles de temps circonscrites aux vingt-quatre heures précédant une expérimentation.
8. L’impact de la variable antécédente sur la validité interne et externe
L’oubli ou l’ignorance délibérée des variables antécédentes constitue une menace systémique pour la robustesse de l’édifice scientifique. Ce déficit d’identification compromet la confiance que l’on peut accorder aux relations observées, tout en invalidant la transposition pratique des résultats hors du laboratoire.
8.1 Menaces pesant sur la validité interne
La validité interne désigne le degré d’exactitude avec lequel un chercheur peut affirmer qu’une relation observée entre deux variables reflète une relation causale directe et sans équivoque, exempte de perturbations méthodologiques. L’omission d’une variable antécédente structurante pulvérise les prétentions de validité interne d’une étude en favorisant l’émergence d’artefacts statistiques pernicieux.
Le premier d’entre eux est la corrélation fallacieuse (spurious correlation). Lorsqu’une variable antécédente commune pilote simultanément les variations de la variable indépendante et de la dépendante, le chercheur observe une covariation quantitativement impressionnante qui ne repose sur aucun mécanisme substantiel direct entre $X$ et $Y$. Il attribue par conséquent à la variable indépendante un pouvoir explicatif ou transformateur dont elle est totalement dénuée. Cette illusion causale est à la source du célèbre paradoxe de Simpson, dans lequel l’omission d’une variable d’antécédence sous-jacente peut non seulement amplifier ou masquer un effet, mais aller jusqu’à en inverser mathématiquement le signe de la pente de régression.
Le biais d’omission de variables génère également un gonflement artificiel des coefficients d’association standardisés. Les modèles statistiques qui ignorent l’antécédent violent l’un des postulats fondamentaux de l’économétrie et de la modélisation linéaire : l’exogénéité stricte des régresseurs. Le terme d’erreur du modèle de régression devient mécaniquement corrélé avec la variable indépendante, ce qui biaise de manière irrémédiable l’estimation des coefficients des moindres carrés. L’analyste se trouve alors prisonnier d’un modèle non identifiable au sens causal, proclamant la découverte de vérités scientifiques qui ne sont que des illusions d’optique numérique.
8.2 Conséquences sur la validité externe et la généralisabilité
La validité externe concerne l’aptitude d’une conclusion scientifique à être généralisée au-delà de l’échantillon d’investigation d’origine, à d’autres populations, contextes temporels ou environnements géographiques. Une étude qui omet de documenter ses variables antécédentes s’expose à une faillite spectaculaire de sa validité externe dès lors qu’elle fait l’objet de tentatives de reproduction.
Si une association entre une thérapie psychologique brève ($X$) et une réduction des symptômes anxieux ($Y$) a été observée au sein d’une cohorte d’étudiants d’université occidentale, instruits et socialement favorisés, ces participants partagent une série d’antécédents structurels favorables (sécurité matérielle, haut niveau de littératie cognitive, stabilité résidentielle). Si le protocole est ensuite reproduit au sein d’une clinique communautaire desservant des populations marquées par des antécédents chroniques de précarité sévère et de traumatismes cumulés, l’efficacité thérapeutique mesurée précédemment peut s’effondrer intégralement.
L’échec de la réplication ne découle pas d’une incompétence des praticiens réplicateurs, mais d’une méconnaissance des conditions de base nécessaires à l’expression de l’effet. En taisant les variables antécédentes qui constituaient le terreau silencieux de l’effet initial, les chercheurs originaux ont privé la communauté scientifique des paramètres de calibration requis pour circonscrire le domaine d’applicabilité réelle de leur découverte. L’universalité supposée des lois psychologiques s’effondre face à l’hétérogénéité des antécédents historiques et sociodémographiques des sujets humains.
8.3 Éthique de la recherche et interprétation des politiques publiques
Les défaillances méthodologiques induites par l’ignorance des variables antécédentes dépassent de loin les querelles théoriques académiques : elles engendrent des dommages sociétaux, éthiques et financiers d’une ampleur considérable lorsqu’elles orientent des programmes de santé publique ou des politiques d’éducation gouvernementales.
Lorsqu’un modèle statistique erroné identifie à tort une variable intermédiaire ou superficielle comme le levier causal d’une problématique sociale, des millions d’euros d’investissements publics sont alloués à des interventions ciblées qui s’avèrent condamnées à l’échec. Si l’on déploie par exemple des programmes massifs destinés à inculquer aux élèves en difficulté scolaire le sens de « l’ambition professionnelle » au prétexte que l’ambition est corrélée aux bons résultats académiques, en occultant le fait que le statut socio-économique et l’accès à des ressources linguistiques précoces constituent la véritable variable antécédente conjointe de ces deux construits, l’intervention publique échouera inévitablement à réduire les inégalités réelles d’apprentissage.
La responsabilité éthique des chercheurs en sciences humaines et du comportement est engagée de façon majeure. Publier des conclusions d’inférence causale fondées sur des devis naïfs ignorant les antécédents structurels contribue à disséminer des dogmes méthodologiquement non fondés. Ces raccourcis alimentent une rhétorique stigmatisante qui renvoie les individus à leur propre responsabilité dans leurs échecs ou leurs pathologies, masquant les véritables déterminants étiologiques et politiques situés en amont dans la trajectoire de vie.
9. Représentation graphique et modélisation causale (Graphes Acycliques Dirigés)
Pour prévenir ces écueils et formaliser rigoureusement le statut des variables au sein de modèles complexes, la méthodologie contemporaine s’appuie massivement sur le cadre mathématique des Graphes Acycliques Dirigés (DAGs, pour Directed Acyclic Graphs), conceptualisé par le lauréat du prix Turing Judea Pearl.
9.1 Introduction aux DAGs selon l’approche de Judea Pearl
Un Graphe Acyclique Dirigé est une formalisation mathématique visuelle et non paramétrique composée de nœuds (représentant les variables) interconnectés par des arêtes unilatéralement orientées, traditionnellement figurées par des flèches (représentant les relations causales directes potentielles). Le qualificatif « acyclique » consigne l’interdiction logique formelle de générer des boucles causales fermées où une variable pourrait être la cause rétrospective d’elle-même au même instant ($X to Y to X$), respectant ainsi le sens irréversible du temps physique.
Dans ce formalisme axiomatique, la variable antécédente trouve une transcription graphique immédiate et non ambiguë. Lorsqu’une variable $X_0$ exerce le statut d’antécédent commun générant une corrélation fallacieuse entre une variable de traitement ($X$) et un critère ($Y$), cette configuration est modélisée par une bifurcation où le nœud $X_0$ projette deux flèches divergentes simultanées :
$$X \leftarrow X_0 \rightarrow Y$$
Cette représentation visuelle permet aux analystes d’identifier d’un simple coup d’œil les flux directionnels de transmission de l’information causale et statistique. Elle clarifie la provenance de l’association entre les nœuds et fournit un substrat logique rigoureux pour discriminer les causes directes, les médiateurs consécutifs et les antécédents distaux, évitant ainsi le flou sémantique inhérent aux descriptions textuelles informelles.
9.2 Blocage des chemins de porte dérobée induits par l’antécédent
L’apport fondamental des DAGs de Pearl réside dans la formulation du concept de « chemin de porte dérobée » (backdoor path) et dans la théorie mathématique de la $d$-séparation (dépendance directionnelle). Un chemin de porte dérobée est défini comme tout trajet non causal reliant la variable de traitement $X$ à la variable de résultat $Y$, trajet dont la première arête pointe vers le traitement ($X \leftarrow dots \rightarrow Y$). Ce chemin dérobé est précisément le vecteur par lequel la variable antécédente injecte une corrélation trompeuse parasite dans le système.
Pour isoler mathématiquement le véritable effet causal de $X$ sur $Y$, le chercheur doit impérativement bloquer tous les chemins de porte dérobée existants. Le critère de la porte dérobée énonce formellement qu’un ensemble de variables $Z$ permet de neutraliser le biais si aucune variable de $Z$ n’est un descendant causal direct de $X$, et si $Z$ bloque tous les chemins ouverts entre $X$ et $Y$ débutant par une flèche orientée vers $X$. Dans notre cas d’école, conditionner (c’est-à-dire contrôler statistiquement par ajustement) sur la variable antécédente $X_0$ « bloque » ce chemin parasite en rendant $X$ et $Y$ $d$-séparés au travers de ce canal spécifique.
Le formalisme des DAGs permet également d’énoncer les interdits méthodologiques fondamentaux : conditionner sur un collisionneur (un nœud recevant deux flèches convergentes, $to C \leftarrow$) ouvre un chemin initialement inactif et crée de la corrélation artificielle. Les règles rigoureuses de la $d$-séparation érigées par Pearl permettent ainsi aux chercheurs d’identifier mathématiquement l’ensemble minimal suffisant de variables antécédentes à mesurer et à inclure dans leurs régressions pour identifier l’effet causal authentique avec un maximum d’économie statistique.
9.3 Formalisation dans les modèles d’équations structurelles (SEM)
L’étape subséquente de la modélisation formelle consiste à traduire le schéma conceptuel du DAG dans un système paramétrique d’équations structurelles simultanées (SEM, Structural Equation Modeling). Cette démarche autorise la prise en compte conjointe des variables antécédentes sous forme de construits latents non observés directement, débarrassés de l’erreur de mesure grâce à la triangulation d’indicateurs empiriques multiples.
Dans un modèle d’équations structurelles complet, le modèle de mesure spécifie la relation entre les variables latentes ($X_0, X, Y$) et leurs items observables respectifs, tandis que le modèle structural formalise le réseau de régression linéaire sous-jacent :
$$X = \gamma_1 X_0 + \zeta_1$$
$$Y = \beta_1 X + \gamma_2 X_0 + \zeta_2$$
L’estimation de ces équations simultanées à l’aide d’algorithmes du maximum de vraisemblance (ML) permet de décomposer rigoureusement la variance totale en effets directs (le coefficient structurel reliant $X$ à $Y$), effets indirects (la transmission passant par la séquence $X_0 to X to Y$), et effets résiduels non expliqués ($\zeta_1, \zeta_2$).
L’évaluation de la qualité globale d’ajustement du modèle théorique aux données empiriques est sanctionnée par des indices de performance standardisés : le Comparative Fit Index (CFI), le Tucker-Lewis Index (TLI) et le Root Mean Square Error of Approximation (RMSEA). L’omission indue d’une variable antécédente structurante induit une discordance violente entre la matrice de covariance observée et la matrice de covariance implicite recalculée par le modèle, provoquant un rejet statistique du modèle théorique par un test du khi-deux hautement significatif et des indices d’ajustement dégradés.
10. Méthodes statistiques pour identifier et mesurer les variables antécédentes
La panoplie méthodologique contemporaine fournit un ensemble d’outils statistiques puissants destinés à évaluer empiriquement l’influence des variables antécédentes et à ajuster leur impact lors de l’estimation des effets d’intérêt.
10.1 Analyses de régression hiérarchique et multiple
La régression multiple hiérarchique séquentielle demeure l’une des techniques les plus intuitives et couramment employées pour mettre en évidence le statut et l’effet amortisseur d’une variable antécédente. Contrairement à une régression simultanée ordinaire (méthode « Entrée standard »), la régression hiérarchique impose une entrée progressive et ordonnée des régresseurs dans le modèle, respectant l’antériorité chronologique théorisée.
Le protocole analytique se déploie usuellement en deux ou plusieurs blocs successifs :
- Étape 1 (Bloc des variables antécédentes) : Le chercheur introduit exclusivement la variable antécédente $X_0$ pour prédire la variable dépendante $Y$. Cette première régression permet de consigner la variance brute partagée entre l’antécédent et le critère final ($R_1^2$).
- Étape 2 (Bloc expérimental / focal) : Le chercheur injecte dans l’équation la variable indépendante focale $X_1$ aux côtés de l’antécédent $X_0$.
L’attention du méthodologiste se porte alors sur deux métriques analytiques déterminantes. D’une part, la variation du coefficient de détermination ($\Delta R^2$) et le test de significativité du changement de $F$ associé permettent d’établir si la variable indépendante apporte une contribution explicative unique au-delà de ce que prédisait déjà la variable antécédente seule. D’autre part, la comparaison entre le coefficient de régression standardisé univarié ($\beta_{\text{brut}}$) de la variable indépendante et son coefficient ajusté multivarié ($\beta_{\text{partiel}}$) met en exergue le niveau d’absorption de variance opéré par l’antécédent. Une atténuation prononcée du coefficient de la variable indépendante confirme empiriquement le rôle de vecteur d’antécédence joué par le premier bloc.
10.2 Analyse de covariance (ANCOVA)
Dans les dispositifs de recherche quasi-expérimentaux ou expérimentaux dans lesquels la variable indépendante est catégorielle (par exemple, assignation à un groupe d’intervention psychologique versus un groupe témoin sur liste d’attente), l’Analyse de Covariance (ANCOVA) s’impose comme une méthode de référence pour intégrer la variable antécédente sous la forme d’une covariable quantitative continue.
L’objectif majeur de l’ANCOVA est double. Premièrement, elle permet d’ajuster statistiquement les moyennes post-test de la variable dépendante des différents groupes pour neutraliser les éventuelles disparités préexistantes sur la variable antécédente (par exemple, un niveau d’anxiété de base ou un bagage cognitif inégal avant le démarrage de l’intervention). Deuxièmement, en retirant de la variance d’erreur intra-groupe la part prévisible attribuable à l’antécédent, l’ANCOVA réduit le dénominateur du ratio $F$ de Snedecor, augmentant substantiellement la puissance statistique du test de l’effet principal de l’intervention.
Néanmoins, la légitimité de l’application de l’ANCOVA est subordonnée au respect rigoureux d’un ensemble de postulats mathématiques, dont le plus crucial est l’hypothèse d’homogénéité des pentes de régression. Le chercheur doit obligatoirement tester l’absence d’interaction statistique significative entre le facteur de groupe (la variable indépendante) et la covariable antécédente ($X \times X_0$). Si cette hypothèse est violée, cela signifie que l’effet de l’intervention varie lui-même en fonction de l’antécédent, forçant le chercheur à abandonner l’ANCOVA standard pour se tourner vers des techniques plus complexes d’analyse de modération conditionnelle, telles que la procédure de Johnson-Neyman.
10.3 Score de propension et appariement statistique
Dans les études observationnelles d’envergure où la randomisation est rendue impossible pour des impératifs d’ordre déontologique ou pratique, les différences d’antécédents entre le groupe exposé et le groupe non exposé induisent des déséquilibres massifs qui menacent toute conclusion causale. L’approche du score de propension (Propensity Score Analysis), formalisée par Paul Rosenbaum et Donald Rubin, offre une réponse méthodologique remarquable à cette difficulté.
Le score de propension représente la probabilité conditionnelle ($e_i$) qu’un individu $i$ soit assigné ou exposé à la variable indépendante $X = 1$ (par exemple, prendre un traitement antidépresseur spécifique), compte tenu d’un vecteur exhaustif de covariables antécédentes observées ($X_0$ : antécédents médicaux, statut économique, antécédents familiaux, comorbidités) :
$$e_i = P(X_i = 1 mid X_{0i})$$
Cette probabilité est généralement estimée à l’aide d’une régression logistique multivariée ou d’algorithmes d’apprentissage automatique supervisé (arbres de régression amplifiés).
Une fois le score de propension calculé pour chaque sujet, diverses techniques d’ajustement peuvent être déployées :
- L’appariement sur le score de propension (Matching) : Les individus exposés sont appariés individuellement à des individus non exposés disposant d’une valeur de score de propension rigoureusement équivalente, créant ainsi des cohortes jumelles synthétiques équilibrées sur tous les antécédents mesurés.
- La stratification : L’échantillon est segmenté en quintiles de propension, au sein desquels les comparaisons sont exemptes de la majorité du biais d’antécédence.
- La pondération par l’inverse de la probabilité de traitement (IPTW) : Chaque individu est pondéré par l’inverse de sa propension à recevoir le traitement qu’il a effectivement reçu, ce qui crée une pseudo-population théorique où la distribution des antécédents est parfaitement orthogonale à l’exposition.
Ces approches permettent de mimer statistiquement les propriétés d’un essai randomisé contrôlé, purifiant l’estimation de l’effet causal résiduel du poids des disparités antécédentes.
11. Stratégies de contrôle expérimental et quasi-expérimental
Si les correctifs statistiques a posteriori s’avèrent précieux, les méthodologistes s’accordent à considérer que la prévention active en amont, par le biais d’un devis de recherche scrupuleusement architecturé, demeure la stratégie la plus performante pour maîtriser les variables antécédentes.
11.1 La randomisation comme barrière ultime contre les antécédents
Théorisée par Sir Ronald Fisher dans les années 1920, la randomisation — ou assignation aléatoire des unités d’observation aux différentes conditions expérimentales — constitue le dispositif épistémologique le plus abouti jamais conçu pour neutraliser l’impact parasite des variables antécédentes.
Le mécanisme de la randomisation opère par la loi des grands nombres. Lorsqu’un échantillon d’effectif suffisant est réparti de manière purement probabiliste entre une condition expérimentale et une condition témoin, les caractéristiques individuelles préexistantes des participants — qu’il s’agisse de traits de personnalité, de facteurs génétiques, de quotients intellectuels ou de statuts socio-économiques — se distribuent de façon statistiquement équivalente au sein des différents groupes. La randomisation a pour effet de briser mathématiquement toute flèche causale potentielle qui reliait une variable antécédente $X_0$ à la variable indépendante expérimentale $X$. Dans le langage des DAGs, la randomisation efface physiquement la porte dérobée :
$$X_0 to X \quad \text{devient} \quad X_0 \quad \text{et} \quad X$$
L’intérêt suprême de la randomisation réside dans le fait qu’elle neutralise non seulement les variables antécédentes connues et scrupuleusement mesurées par les investigateurs, mais également — et de façon invisible — la totalité des variables antécédentes inconnues, non théorisées ou technologiquement immesurables. C’est cette propriété d’équilibrage universel qui confère à l’essai randomisé contrôlé (ERC) son statut incontesté de référence absolue au sommet de la hiérarchie des preuves scientifiques.
Toutefois, la randomisation trouve des limites éthiques et pratiques incontournables en psychologie et en médecine. On ne peut éthiquement assigner aléatoirement des enfants à grandir dans un milieu carencé, ni contraindre des sujets à fumer ou à subir des agressions pour tester leurs effets causaux. Dans ces multiples configurations où l’expérimentation pure est exclue, les chercheurs sont contraints de revenir à des plans observationnels ou quasi-expérimentaux, réactivant l’impératif absolu de mesurer et de contrôler manuellement les antécédents.
11.2 Stratification et homogénéisation de l’échantillon
Lorsque la randomisation intégrale ne peut être mobilisée ou que la taille de l’échantillon demeure trop modeste pour garantir un équilibrage probabiliste parfait de tous les facteurs critiques, les chercheurs peuvent recourir à des méthodes de contrôle physique direct des variables antécédentes, telles que la stratification et l’homogénéisation expérimentale.
La stratification (ou constitution de blocs expérimentaux aléatoires) consiste à subdiviser préalablement l’échantillon total en sous-groupes mutuellement exclusifs et homogènes en regard d’une variable antécédente critique identifiée (par exemple, constituer un sous-groupe d’individus à faible résilience de base et un autre à forte résilience). L’assignation aléatoire à la condition de traitement ou au groupe témoin est ensuite orchestrée de façon équilibrée et indépendante à l’intérieur de chacune des strates. Ce protocole garantit formellement que l’antécédent sera réparti dans des proportions rigoureusement identiques au sein de toutes les conditions de l’étude, interdisant toute contamination de la relation principale.
L’autre alternative de conception est la restriction sélective ou homogénéisation de l’échantillon. Le chercheur érige des critères d’inclusion et d’exclusion stricts visant à maintenir la variable antécédente constante pour l’ensemble des participants. Par exemple, si l’on craint que l’âge ou le bilinguisme précoce agisse comme une variable antécédente perturbatrice dans une tâche d’acquisition lexicale, le chercheur peut restreindre son recrutement exclusivement à des sujets monolingues natifs âgés de 20 à 22 ans.
Cette stratégie élimine radicalement la variance de l’antécédent au sein des données, protégeant de facto la validité interne du protocole. Cependant, elle se solde par un arbitrage méthodologique douloureux : en maximisant la pureté interne de l’expérience, le chercheur mutile sévèrement sa validité externe. Les conclusions obtenues au sein d’une cohorte ultra-homogène deviennent impossibles à extrapoler à des populations présentant des profils d’antécédents diversifiés.
11.3 Contrôle par plan de recherche à mesures répétées
Une stratégie de design expérimental particulièrement élégante pour éradiquer l’influence distorse des variables antécédentes interindividuelles consiste à déployer un plan de recherche à mesures répétées, également qualifié de plan intra-sujets (within-subject design).
Dans cette architecture empirique, chaque participant est confronté successivement à l’ensemble des conditions expérimentales de l’étude (y compris la condition témoin). Le participant agit ainsi comme son propre contrôle statistique. Les propriétés individuelles stables, qu’il s’agisse de variables antécédentes génétiques durables, de traits de personnalité profonds, d’antécédents d’éducation parentale ou d’expériences biographiques révolues, demeurent parfaitement invariantes entre les différentes conditions auxquelles le sujet est soumis.
En soustrayant mathématiquement la variance interindividuelle globale de la variance d’erreur résiduelle lors de l’ANOVA pour mesures répétées, le chercheur purifie le test de l’effet intra-individuel de l’impact des antécédents stables. Cette approche déploie une sensibilité et une puissance statistique remarquables avec des effectifs d’échantillons nettement plus réduits que ceux requis par les plans inter-sujets indépendants.
Néanmoins, les plans intra-sujets introduisent des défis méthodologiques propres qui se substituent aux problématiques d’antécédence stable : les effets d’ordre, de report (carryover effects) et de fatigue ou d’apprentissage. Si la soumission à la condition $A$ modifie de façon irréversible l’état psychologique ou cognitif du sujet avant qu’il n’aborde la condition $B$, la condition $A$ devient elle-même une nouvelle variable antécédente non désirée altérant la réponse à $B$. Le contrebalancement rigoureux de l’ordre de passation des conditions (selon des plans en Carré Latin) s’avère alors obligatoire pour neutraliser cette nouvelle menace temporelle.
12. Synthèse méthodologique, défis contemporains et bonnes pratiques de publication
L’intégration mature des variables antécédentes dans l’écosystème de la recherche contemporaine reflète le degré de rigueur scientifique globale d’une discipline. À l’heure où les sciences humaines font face à une profonde crise de réplicabilité, la formalisation systématique de la chronologie causale s’impose comme un impératif de rigueur incontournable.
12.1 Check-list méthodologique pour les chercheurs et étudiants
Afin de prémunir les investigateurs contre l’omission préjudiciable de variables antécédentes, il est recommandé d’appliquer une liste de contrôle systématique dès les phases de réflexion conceptuelle d’un projet de recherche. Ce protocole herméneutique repose sur une série d’interrogations séquentielles fondamentales :
- L’antériorité chronologique globale : Existe-t-il des facteurs structurels, biologiques, historiques ou psychosociaux qui se sont déployés chronologiquement avant l’émergence des variations de ma variable indépendante focale ?
- L’influence bidirectionnelle sur le système : Ces facteurs préexistants sont-ils susceptibles de prédire simultanément le niveau d’exposition ou de score de la variable indépendante et le niveau de la variable dépendante ? Si oui, le potentiel de corrélation fallacieuse est maximal.
- La discrimination fonctionnelle : Ai-je confondu un antécédent avec un médiateur ? Le facteur candidat est-il généré par la variable indépendante (médiateur), ou conditionne-t-il la présence de celle-ci (antécédent) ?
- La suffisance du blocage causal : Selon les axiomes des Graphes Acycliques Dirigés (DAGs), l’ensemble des variables de contrôle retenues bloque-t-il l’intégralité des chemins de porte dérobée sans conditionner sur des collisionneurs ?
- La justification théorique : L’insertion de chaque covariable dans mes modèles statistiques de régression est-elle étayée par un rationnel théorique robuste, documenté dans la littérature préalable, ou procède-t-elle d’une exploration opportuniste non étayée (fishing expedition) ?
L’intégration transparente d’un paragraphe spécifiquement dédié à la discussion des variables omises potentielles dans la section « Limites » des articles empiriques doit devenir un standard déontologique universel. Le chercheur doit expliciter avec humilité intellectuelle quelles sont les variables antécédentes qu’il n’a pu mesurer faute de moyens logistiques ou d’instruments validés, et comment leur omission potentielle est susceptible de biaiser ou de tempérer la portée de ses conclusions causales.
12.2 Standards de transparence et science ouverte
Le mouvement mondial pour la science ouverte (Open Science) offre des leviers institutionnels puissants pour assainir l’usage des variables de contrôle et le traitement des variables antécédentes dans la littérature scientifique publiée. Historiquement, l’omission ou l’inclusion ad hoc de covariables antécédentes a constitué l’un des vecteurs les plus insidieux du p-hacking (manipulation des analyses statistiques pour forcer la significativité sous le seuil arbitraire de $p < 0{,}05$).
En l'absence de protocole explicite fixé a priori, un analyste peu scrupuleux peut tester de multiples permutations de modèles de régression : incluant une covariable antécédente spécifique, puis la retirant, puis en intégrant une autre, jusqu'à obtenir opportunément un coefficient statistiquement significatif pour la variable indépendante d'intérêt. Pour éradiquer ces pratiques dégradantes, les revues académiques de premier rang exigent désormais le pré-enregistrement (preregistration) des protocoles sur des plateformes dédiées telles que l’Open Science Framework (OSF) ou AsPredicted.
Dans un rapport pré-enregistré, le chercheur doit obligatoirement spécifier par avance la totalité de ses variables antécédentes, la chaîne causale théorisée sous forme de graphe, ainsi que la formule exacte de l’équation de régression qui sera déployée une fois les données acquises. Tout écart analytique survenu lors du traitement final doit être explicitement désigné comme une analyse exploratoire non confirmatoire. De surcroît, la mise à disposition publique des données anonymisées et des scripts de code statistique (sous R, Python ou syntaxe Mplus) permet aux pairs de vérifier la sensibilité des résultats à l’inclusion ou à l’exclusion des différents antécédents, garantissant une reproductibilité computationnelle intégrale.
12.3 Conclusion épistémologique : Vers une psychologie causale rigoureuse
La compréhension scrupuleuse, l’identification formelle et le traitement statistique adapté des variables antécédentes ne constituent pas de simples raffinements techniques dévolus aux méthodologistes pointilleux. Ils incarnent le fondement même de la prétention des sciences comportementales, sociales et cliniques à produire un savoir empirique véridique et cumulatif.
La crise de la réplication qui a ébranlé la psychologie expérimentale au cours de la dernière décennie a douloureusement rappelé à la communauté des chercheurs que l’observation d’une corrélation statistique, même reproduite sur un échantillon significatif, ne vaut pas causalité. L’illusion que la sophistication des algorithmes computationnels d’apprentissage ou la taille massive des banques de données (Big Data) pourraient se substituer à une théorie causale solide s’est heurtée à la réalité ontologique du monde : les mégadonnées sans modélisation de l’antécédence ne font que mesurer des biais avec une précision infime.
Pour dépasser le simple constat descriptif de covariations éphémères et prétendre à l’explication mécaniste véritable des dynamiques de l’esprit et de la société, le chercheur moderne doit embrasser une posture épistémologique rigoureuse. Cette posture exige de penser le temps, de respecter l’histoire développementale et structurelle des sujets observés, et de cartographier avec lucidité les forces antérieures qui façonnent les phénomènes de surface. C’est à ce prix méthodologique, exigeant mais fécond, que la recherche empirique consolidera sa validité scientifique, son intégrité éthique et sa capacité à guider avec clairvoyance les transformations positives du monde humain.
Références
Baron, R. M., & Kenny, D. A. (1986). The moderator-mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
Campbell, D. T., & Stanley, J. C. (1963). Experimental and quasi-experimental designs for research. Rand McNally.
Granger, C. W. (1969). Investigating causal relations by econometric models and cross-spectral methods. Econometrica, 37(3), 424–438. https://doi.org/10.2307/1912791
Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). The Guilford Press.
Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
Pearl, J., Glymour, M., & Jewell, N. P. (2016). Causal inference in statistics: A primer. John Wiley & Sons.
Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41
Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
VanderWeele, T. J. (2015). Explanation in causal inference: Methods for mediation and interaction. Oxford University Press. https://doi.org/10.1093/med/9780199325870.001.0001