
Dans le champ contemporain de l’analyse des données quantitatives et des sciences du comportement, l’inférence statistique ne peut plus être dissociée de la modélisation visuelle. Trop souvent, la tentation réductionniste conduit les chercheurs à résumer des dynamiques empiriques complexes à une poignée d’indicateurs synthétiques tels que la moyenne, l’écart-type ou le coefficient de corrélation linéaire. Pourtant, ces métriques numériques, bien qu’essentielles, occultent fréquemment des structures distributionnelles hétérogènes, des bifurcations de trajectoires, ou encore l’influence pernicieuse d’observations atypiques. L’émergence de la modélisation statistique computationnelle au sein de l’environnement de programmation R a profondément transformé ces pratiques en offrant des instruments capables d’articuler simultanément la puissance du calcul mathématique et la rigueur de l’exploration graphique bidimensionnelle.
Au cœur de cet écosystème méthodologique, le package ggplot2, conçu par le statisticien Hadley Wickham, s’est imposé comme le standard académique incontesté pour la visualisation des données. Reposant sur les postulats théoriques de la grammaire des graphiques introduits par Leland Wilkinson, cette bibliothèque logicielle propose un cadre conceptuel puissant fondé sur la décomposition analytique des représentations visuelles en couches fonctionnelles indépendantes mais coordonnées. L’intégration d’un modèle d’ajustement linéaire par la méthode des moindres carrés ordinaires au sein d’un nuage de points n’y constitue pas un simple artifice cosmétique, mais un acte épistémologique par lequel le statisticien formalise graphiquement une hypothèse de dépendance fonctionnelle entre deux grandeurs mesurées.
Ce guide exhaustif a pour vocation d’analyser en profondeur les principes théoriques, les mécanismes algorithmiques et les protocoles d’implémentation pratique régissant le tracé de droites de régression linéaire sous ggplot2. Destiné aux chercheurs, doctorants, biostatisticiens et analystes des sciences expérimentales soucieux d’atteindre une rigueur méthodologique sans compromis, ce document examine pas à pas l’ensemble de la chaîne de traitement : de la formalisation des hypothèses mathématiques aux diagnostics d’homoscédasticité, de la personnalisation esthétique selon les normes typographiques internationales à l’extension du modèle aux structures stratifiées et multidimensionnelles.
1. 1. Fondements méthodologiques de la régression linéaire et rôle de la visualisation en sciences comportementales
1.1 1.1 Importance épistémologique de la visualisation des relations bivariées
L’histoire de la statistique appliquée est jalonnée de mises en garde contre l’acceptation aveugle d’indicateurs numériques isolés. Le célèbre quartet d’Anscombe, formulé en 1973 par le statisticien Francis Anscombe, demeure la démonstration la plus éclatante de cette vulnérabilité méthodologique : quatre jeux de données distincts, présentant des moyennes, des variances, une droite de régression et un coefficient de corrélation rigoureusement identiques au centième près, révèlent à l’examen graphique des réalités sous-jacentes totalement divergentes. L’un d’eux décrit une courbe quadratique parfaite, un autre manifeste une rupture causée par un unique point d’inflexion à fort levier, tandis que le dernier présente une distribution verticale artificielle parasitée par une valeur extrême. Dans le champ des sciences cognitives, de la psychophysique et des neurosciences comportementales, ignorer la structure géométrique d’une relation bivariée revient à accepter des conclusions scientifiques biaisées sur la seule foi d’un indice agrégé.
Le coefficient de corrélation de Pearson, largement mobilisé dans la littérature pour quantifier l’association entre deux variables continues, présente en effet des limites intrinsèques majeures. Il postule une relation strictement linéaire et s’avère hautement vulnérable aux non-linéarités sous-jacentes ainsi qu’à l’hétérogénéité des sous-populations observées. Dans l’analyse d’échelles psychométriques ou de temps de réaction cognitive, il n’est pas rare de constater une saturation des performances (effets de plafond ou de plancher) qui produit une atténuation artificielle de la corrélation globale. Seule une inspection graphique granulaire permet de mettre en lumière la présence d’une asymptote ou d’un seuil critique à partir duquel la dynamique prédictive change de nature.
Visualiser une relation bivariée avant toute formalisation modélisatrice constitue ainsi un impératif épistémologique. La projection visuelle offre un accès direct à la dispersion réelle des observations empiriques, à la densité locale des données le long du continuum et aux éventuelles ruptures de continuité. L’ajustement linéaire subséquent ne s’envisage plus alors comme une simple boîte noire automatisée, mais comme l’incarnation visuelle d’une hypothèse paramétrique précise, dont la validité empirique peut être continuellement confrontée à l’agencement réel des points sur le plan cartésien.
1.2 1.2 Modélisation par les moindres carrés ordinaires (MCO)
La formalisation mathématique de la régression linéaire simple repose sur le principe fondamental de minimisation de l’écart spatial entre les données observées et le vecteur théorique d’espérance conditionnelle. Étant donné un ensemble de couples de données empiriques comprenant une variable explicative indépendante x et une variable réponse dépendante y, le modèle linéaire cherche à identifier une droite définie par une ordonnée à l’origine et un coefficient de pente. L’approche par les moindres carrés ordinaires consiste à minimiser la somme des carrés des résidus verticaux, c’est-à-dire la somme des différences quadratiques entre chaque valeur observée et sa valeur correspondante prédite sur la droite. L’élévation au carré de ces déviations assure la pénalisation disproportionnée des écarts majeurs tout en éliminant les compensations arithmétiques entre résidus positifs et résidus négatifs.
Il est crucial de maintenir une distinction théorique nette entre la droite d’ajustement empirique ainsi calculée et la véritable relation causale sous-jacente. L’ajustement par les moindres carrés ne fait qu’établir le meilleur résumé linéaire descriptif d’une covariation au sein de l’échantillon collecté. Attribuer un sens directionnel ou causal à la droite estimée implique un ensemble de justifications méthodologiques et théoriques indépendantes du calcul mathématique. En l’absence d’une manipulation expérimentale contrôlée avec assignation aléatoire des sujets, la droite de régression doit être appréhendée comme une simple projection d’espérance statistique conditionnelle, et non comme la preuve déterministe qu’une modification délibérée de la variable explicative engendrera mécaniquement le glissement attendu sur la variable de réponse.
De surcroît, la validité inférentielle de l’ajustement linéaire repose sur les hypothèses classiques du théorème de Gauss-Markov. Ce cadre paramétrique exige la linéarité intrinsèque de la relation, l’exogénéité stricte des régresseurs, l’indépendance mutuelle des termes d’erreur, leur homoscédasticité (homogénéité de la variance des résidus le long de l’axe prédictif) ainsi que leur normalité distributionnelle pour le calcul valide des intervalles de confiance et des tests d’hypothèses. Lorsque ces postulats sont enfreints, la droite des moindres carrés perd son statut d’estimateur linéaire sans biais et de variance minimale, soulignant l’importance critique de coupler l’estimation numérique à des diagnostics graphiques exhaustifs.
1.3 1.3 La grammaire des graphiques appliquée à l’inférence statistique
L’implémentation computationnelle de la modélisation visuelle au sein du logiciel R a été révolutionnée par l’introduction de la grammaire des graphiques théorisée par Leland Wilkinson et opérationnalisée dans ggplot2. Ce paradigme architectural repose sur l’idée novatrice qu’un graphique statistique ne doit pas être appréhendé comme une entité statique monolithique, mais comme la composition systématique de strates géométriques, esthétiques et calculatoires rigoureusement interconnectées. Au lieu de proposer des commandes graphiques fermées et préconfigurées, ggplot2 fournit une syntaxe déclarative modulaire où chaque composant joue un rôle fonctionnel spécifique.
Le principe structurant fondamental réside dans le découplage conceptuel entre la source des données empiriques, les correspondances esthétiques et les géométries visuelles de rendu. La structure matricielle brute contenant les variables est liée aux axes par une fonction d’association cartographique (l’esthétique aes), tandis que les modalités concrètes d’affichage (points, lignes, polygones, barres) sont déléguées à des fonctions géométriques dédiées (telles que geom_point ou geom_smooth). Les transformations statistiques ne sont pas exécutées en amont dans des structures disparates, mais encapsulées directement dans la chaîne de traitement graphique, permettant par exemple de dériver une droite d’ajustement sans avoir à générer manuellement un tableau secondaire de prédictions vectorielles.
Cette modularité présente un avantage inestimable pour la communication scientifique universitaire. Elle confère à la construction graphique une traçabilité complète et une reproductibilité absolue, conformes aux exigences contemporaines de la science ouverte. Un tracé élaboré sous ggplot2 devient un script logique formel où les hypothèses inférentielles, la stratification par cohortes et la stylisation éditoriale sont explicitement documentées dans le flux de code, facilitant l’évaluation par les pairs, les réanalyses systématiques et l’actualisation dynamique des visualisations dès lors que les bases de données empiriques sont amendées.
2. 2. Préparation de l’environnement R et structure des données empiriques
2.1 2.1 Chargement des bibliothèques logicielles requises
L’édification d’un flux de travail reproductible sous R débute obligatoirement par l’initialisation contrôlée de l’environnement d’exécution et la déclaration transparente des packages analytiques requis. L’écosystème moderne de manipulation de données s’organise préférentiellement autour du méta-package tidyverse, qui intègre nativement ggplot2 ainsi qu’un ensemble de bibliothèques complémentaires optimisées pour la transformation et la modélisation statistique. Pour garantir l’intégrité computationnelle de l’analyse, l’utilisateur doit s’assurer que les versions des modules déployés sont stables et compatibles avec les standards contemporains de la recherche internationale.
Au-delà du package ggplot2 lui-même, il est fortement recommandé d’adjoindre des extensions méthodologiques spécialisées telles que broom pour la conversion standardisée des objets statistiques en tableaux de données rectangulaires ordonnés, ainsi que ggpubr pour l’automatisation avancée de l’intégration des métriques de tests formels. Dans le cadre d’un rapport universitaire ou d’un manuscrit soumis à publication, la réinitialisation préalable de la session de travail et le paramétrage explicite des options globales de la console permettent d’éviter toute interférence résiduelle provenant d’objets mémorisés lors d’analyses antérieures.
La gestion stricte de la reproductibilité implique également la fixation délibérée d’une graine aléatoire (via la fonction set.seed) dès lors que des procédures d’échantillonnage, des simulations de Monte-Carlo ou des rééchantillonnages non paramétriques (bootstrap) sont mobilisés dans la construction des intervalles de confiance associés à la régression. Cette discipline programmatique assure qu’un autre chercheur exécutant rigoureusement le même script obtiendra une configuration graphique et des estimations numériques parfaitement identiques au pixel près.
2.2 2.2 Définition et encapsulation du jeu de données expérimental
Pour fonder les démonstrations empiriques de cet ouvrage, nous construisons un jeu de données contrôlé encapsulé dans une structure tabulaire rectangulaire standard (l’objet data.frame ou son équivalent modernisé tibble). La rigueur méthodologique impose de s’assurer que les vecteurs sous-jacents adoptent les formats de typage appropriés : les variables quantitatives continues doivent être strictement enregistrées sous la classe numérique flottante (double ou numeric), tandis que les éventuelles variables de classification factorielle doivent être expressément converties en facteurs catégoriels ordonnés ou nominaux.
L’inspection préalable de la matrice des données constitue une étape non négociable avant toute tentative de modélisation visuelle. Il est indispensable de vérifier la complétude des séries observées et d’identifier la présence éventuelle de valeurs manquantes (notées NA dans l’interpréteur R). Par défaut, le moteur de rendu de ggplot2 avertit l’utilisateur et élimine de manière transparente les lignes présentant des valeurs indéterminées sur l’un des deux axes. Toutefois, dans le cadre d’un rapport de laboratoire rigoureux, cette exclusion doit être documentée, mesurée et traitée consciemment en amont afin d’éviter tout biais d’attrition invisible dans la modélisation ultérieure.
L’application systématique des fonctions d’analyse univariée élémentaires (telles que le calcul des étendues, des moyennes tronquées, des médianes et des écarts interquartiles) permet de valider la plausibilité biologique et expérimentale des distributions collectées. Ce diagnostic primaire certifie que les variables ne comportent aucune erreur d’encodage aberrante (par exemple une mesure négative sur une échelle d’amplitude strictement positive) susceptible de distordre lourdement l’estimation de la droite des moindres carrés lors de sa projection géométrique.
2.3 2.3 Contextualisation psychologique des variables d’étude
Afin de maximiser la pertinence pédagogique et la clarté conceptuelle des développements présentés, notre modèle bivarié s’ancre dans un paradigme classique de psychologie expérimentale et des sciences cognitives de l’apprentissage. La variable explicative continue x correspondra au temps total d’exposition active à un stimulus d’apprentissage complexe, quantifié précisément en minutes au sein d’un environnement de laboratoire hautement standardisé. Cette variable indépendante manipule l’intensité de l’encodage mnésique et reflète la charge temporelle allouée à la tâche par chaque sujet de la cohorte.
La variable dépendante y mesurera quant à elle l’indice d’intégration cognitive obtenu par les participants lors d’une évaluation psychométrique standardisée, calibrée sur un continuum théorique de 0 à 100 points. Ce score composite pondère la rapidité de récupération de l’information et la précision conceptuelle démontrée lors de la phase de rappel différé. Cette configuration métrique reproduit avec fidélité les structures de données fréquemment rencontrées dans les protocoles de recherche en neuro-ergonomie, en sciences de l’éducation et en psychopharmacologie cognitive.
La validité écologique d’une telle modélisation réside dans la recherche d’une fonction de transfert permettant de quantifier le rendement marginal de chaque unité de temps supplémentaire accordée à l’apprentissage. La formalisation linéaire pose ainsi l’hypothèse d’une progression continue et proportionnelle du score d’intégration cognitive en fonction de la durée d’exposition, offrant un cadre expérimental idéal pour éprouver la robustesse de l’ajustement visuel par les moindres carrés sous ggplot2.
3. 3. Construction du nuage de points fondamental avec geom_point()
3.1 3.1 Définition de l’objet graphique de base et des esthétiques
La mise en œuvre de la grammaire des graphiques débute par l’initialisation de l’objet racine via la fonction fondamentale ggplot(). Cet appel inaugural requiert obligatoirement deux arguments cardinaux : l’assignation du tableau de données source et la définition des correspondances esthétiques par l’intermédiaire de la commande interne aes(). L’argument esthétique ne détermine pas la couleur ou l’épaisseur des éléments physiques finaux, mais établit le mapping mathématique formel reliant les dimensions conceptuelles de la structure de données aux axes orthogonaux du repère cartésien bidimensionnel.
L’exécution de la seule instruction associant les variables aux coordonnées cartésiennes horizontales (x) et verticales (y) ne produit aucun tracé visible sur le périphérique de sortie. Elle génère un canevas vierge, structurellement configuré, où le moteur graphique a calculé l’emprise minimale et maximale des échelles numériques sans pour autant projeter de matière géométrique. Ce comportement illustre le principe de séparation stricte entre les dimensions mathématiques et les représentations physiques : le repère spatial existe, les bornes d’inférence sont posées, mais la matérialisation sensorielle des observations requiert l’adjonction délibérée de couches d’affichage subséquentes.
Dans la pratique académique, il est d’usage d’assigner cet objet initial à un identifiant dans l’espace de travail R. Cette stratégie permet de préserver la structure canonique de base et d’y concaténer ensuite, par l’opérateur arithmétique d’addition, diverses explorations géométriques alternatives sans avoir à recalculer l’affectation cartésienne d’origine, garantissant ainsi une efficacité computationnelle et une clarté logicielle remarquables.
3.2 3.2 Implantation de la couche géométrique des observations
La concrétisation visuelle du jeu de données s’opère par la superposition de la couche géométrique geom_point() sur le canevas initialement paramétré. Chaque ligne du tableau de données empiriques est alors traduite en un marqueur discret positionné à l’intersection exacte de ses coordonnées sur les axes d’abscisse et d’ordonnée. L’addition de cette géométrie transforme le repère abstrait en un nuage de points (ou scatterplot), pierre angulaire de toute démarche exploratoire bivariée.
Dès l’apparition du nuage de points, le chercheur doit prêter une attention rigoureuse à la lisibilité de la densité distributionnelle. Lorsque le volume d’échantillonnage devient conséquent ou que les instruments de mesure présentent une résolution grossière, le phénomène d’occultation réciproque (souvent désigné sous le terme de overplotting ou sur-traçage) peut masquer l’accumulation locale de dizaines de points au même emplacement géométrique. La manipulation de l’argument de transparence alpha au sein de la fonction géométrique permet de conférer à chaque marqueur une perméabilité photonique, révélant par gradation de teinte les zones de saturation distributionnelle les plus denses.
L’observation qualitative immédiate du tracé ainsi constitué fournit les premières indications indispensables sur la morphologie de la relation : une orientation ascendante globale témoigne d’une covariation positive entre le temps d’exposition et la performance cognitive, tandis que la largeur du faisceau de dispersion des points autour de la trajectoire médiane donne une approximation intuitive de l’intensité de la corrélation et du niveau de bruit stochastique résiduel inhérent au protocole expérimental.
3.3 3.3 Diagnostic visuel des cas atypiques et valeurs extrêmes
L’examen minutieux du nuage de points constitue le premier rempart méthodologique contre les biais induits par les observations atypiques et les valeurs extrêmes influentes. Dans le cadre de l’estimation par les moindres carrés, la présence d’un point isolé situé à une distance substantielle du barycentre de la distribution peut altérer radicalement la trajectoire de la droite d’ajustement. Un point présentant une valeur de variable explicative très inhabituelle possède un bras de levier mathématique considérable, capable d’attirer artificiellement vers lui la ligne de régression au détriment de l’adéquation globale avec le reste de l’échantillon.
Il importe de distinguer rigoureusement sur le plan théorique une valeur aberrante issue d’un artefact technique ou d’une erreur d’enregistrement d’une observation authentiquement extrême reflétant la variance légitime du comportement humain. Dans les protocoles cognitifs, un sujet manifestant un temps d’apprentissage extraordinairement long associé à une performance quasi nulle peut traduire un décrochage motivationnel complet ou un dysfonctionnement de l’interface informatique. L’élimination mécanique d’un point atypique sans justification empirique explicite viole les principes déontologiques de la recherche ; néanmoins, son identification géométrique précoce au sein du nuage de points est indispensable pour guider les décisions de modélisation ultérieures.
Cette première inspection visuelle guide également le chercheur dans le choix entre un ajustement purement linéaire et l’éventuelle nécessité de recourir à des méthodes de régression robuste. Si le nuage de points révèle que la majorité des sujets suit une tendance bien définie mais que quelques observations périphériques menacent de déstabiliser le calcul des moindres carrés ordinaires, cette constatation motivera une analyse comparative formelle entre la droite conventionnelle et un modèle d’estimation résistant aux valeurs aberrantes.
4. 4. Ajustement et intégration de la droite de régression via geom_smooth()
4.1 4.1 Spécification de la méthode linéaire dans geom_smooth()
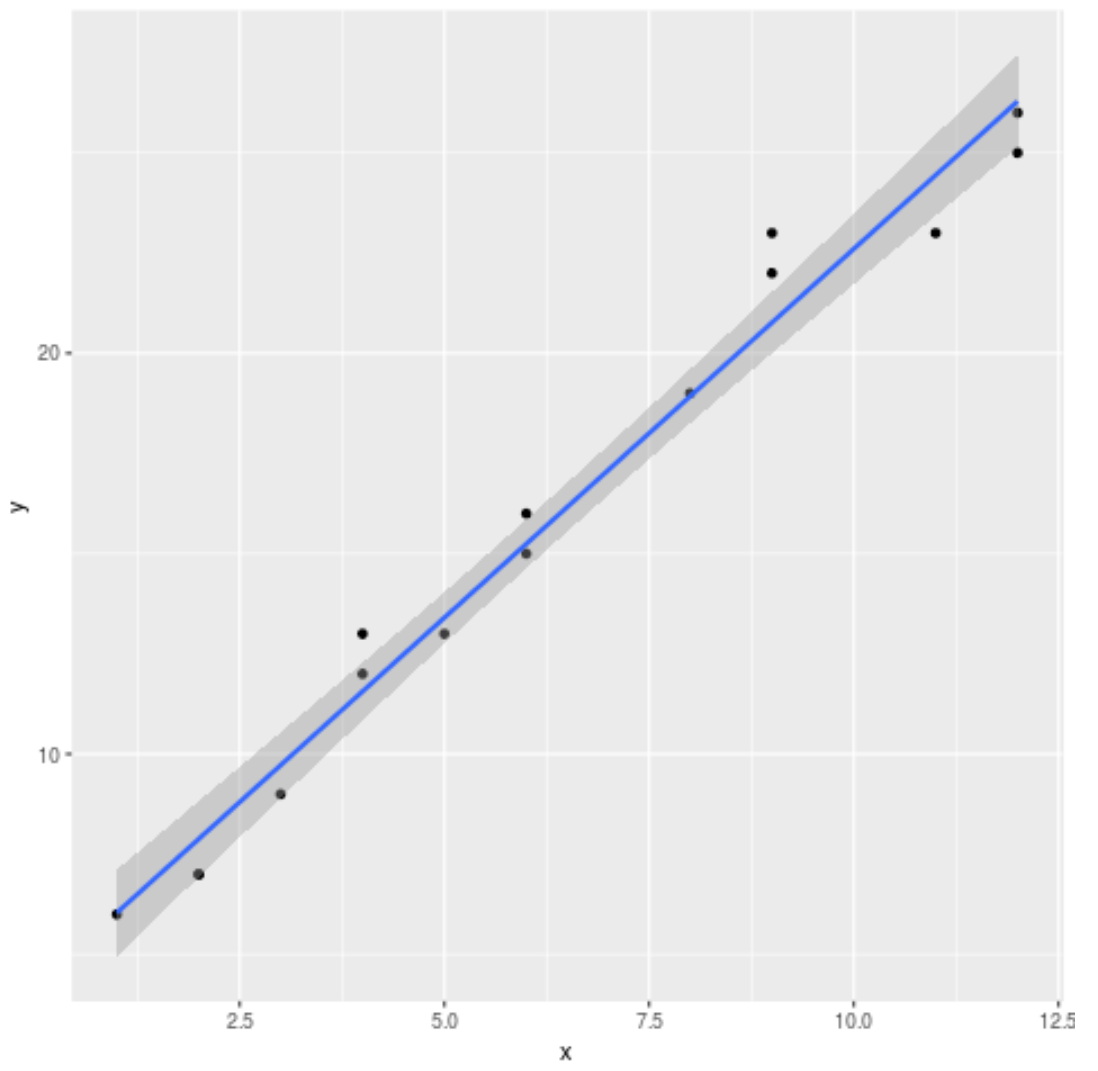
L’introduction d’une ligne de tendance continue superposée au nuage de points est régie dans ggplot2 par la fonction polyvalente geom_smooth(). Lorsqu’elle est appelée sans paramétrage explicite de son moteur algorithmique, cette fonction recourt par défaut à une régression locale non paramétrique pondérée, communément appelée LOESS (ou à des modèles additifs généralisés GAM pour les jeux de données comprenant plus de mille observations). Bien que très pertinente pour capturer des sinuosités locales complexes, l’estimation LOESS ne répond pas aux objectifs d’une modélisation paramétrique formelle fondée sur l’hypothèse d’une relation strictement proportionnelle.
Pour contraindre le moteur graphique à tracer la droite théorique correspondant au modèle linéaire univarié des moindres carrés, il est impératif de déclarer sans ambiguïté l’argument méthodologique en renseignant la chaîne de caractères method = « lm » au sein de la fonction. Cette déclaration ordonne à ggplot2 d’invoquer en arrière-plan la routine statistique standard lm() de R pour dériver la solution analytique exacte minimisant la somme des résidus quadratiques verticaux sur l’ensemble de l’échantillon visualisé.
Ce mécanisme illustre la puissance conceptuelle de la couche stat_smooth, intégrée sous-jacente à geom_smooth. Au lieu de contraindre l’utilisateur à exécuter manuellement une régression, à extraire les coordonnées vectorielles de la droite et à les réinjecter laborieusement dans un objet géométrique linéaire distinct, la grammaire des graphiques prend en charge de façon transparente la totalité de l’estimation statistique et du rendu cartésien correspondant, assurant une parfaite fidélité entre l’algorithme mathématique et la projection spatiale résultante.
4.2 4.2 Paramétrage de la formule mathématique interne
Bien que la commande method = « lm » impose un ajustement linéaire, la forme fonctionnelle précise de la relation doit idéalement être explicitée au moyen de l’argument syntaxique formula. Par défaut, le moteur assume la formule symbolique élémentaire y ~ x, stipulant que la coordonnée verticale y est modélisée comme une fonction linéaire de premier degré de la coordonnée horizontale x. Il est hautement recommandé dans les publications scientifiques de déclarer formellement formula = y ~ x pour rendre le code pleinement univoque et prévenir d’éventuelles modifications de comportement induites par les versions futures de l’écosystème logiciel.
Cette formulation symbolique ouvre des possibilités remarquables d’extension paramétrique sans pour autant abandonner le cadre des moindres carrés. Si le phénomène cognitif sous-jacent suggère des rendements marginaux décroissants ou une dynamique de saturation sans rupture brutale, l’expérimentateur peut spécifier une transformation polynomiale d’ordre supérieur au sein même du moteur d’affichage, par exemple en formulant formula = y ~ poly(x, 2) pour modéliser une composante parabolique, ou en intégrant des composantes logarithmiques. La régression demeure formellement linéaire au sens de ses coefficients statistiques tout en épousant graphiquement une courbure mathématique continue adaptée aux fondements théoriques de l’expérience.
Il convient de souligner la stricte équivalence algorithmique entre les calculs opérés par la fonction graphique geom_smooth() et ceux dérivés de la fonction console native lm() de R. L’estimation des coefficients de pente et d’ordonnée à l’origine repose sur les mêmes matrices de projection orthogonale, garantissant qu’aucune divergence numérique ne viendra séparer les résultats d’un tableau d’analyse de la variance de la représentation graphique visualisée sur la figure finale.
4.3 4.3 Superposition hiérarchique des couches graphiques
Dans l’architecture de ggplot2, l’ordre séquentiel d’addition des couches géométriques via l’opérateur additif conditionne de façon absolue la profondeur de champ du rendu final. Les éléments déclarés en premier sont physiquement projetés au niveau du plan inférieur du canevas, tandis que les fonctions géométriques déclarées subséquemment viennent recouvrir les tracés préexistants selon le principe classique du calque de composition graphique.
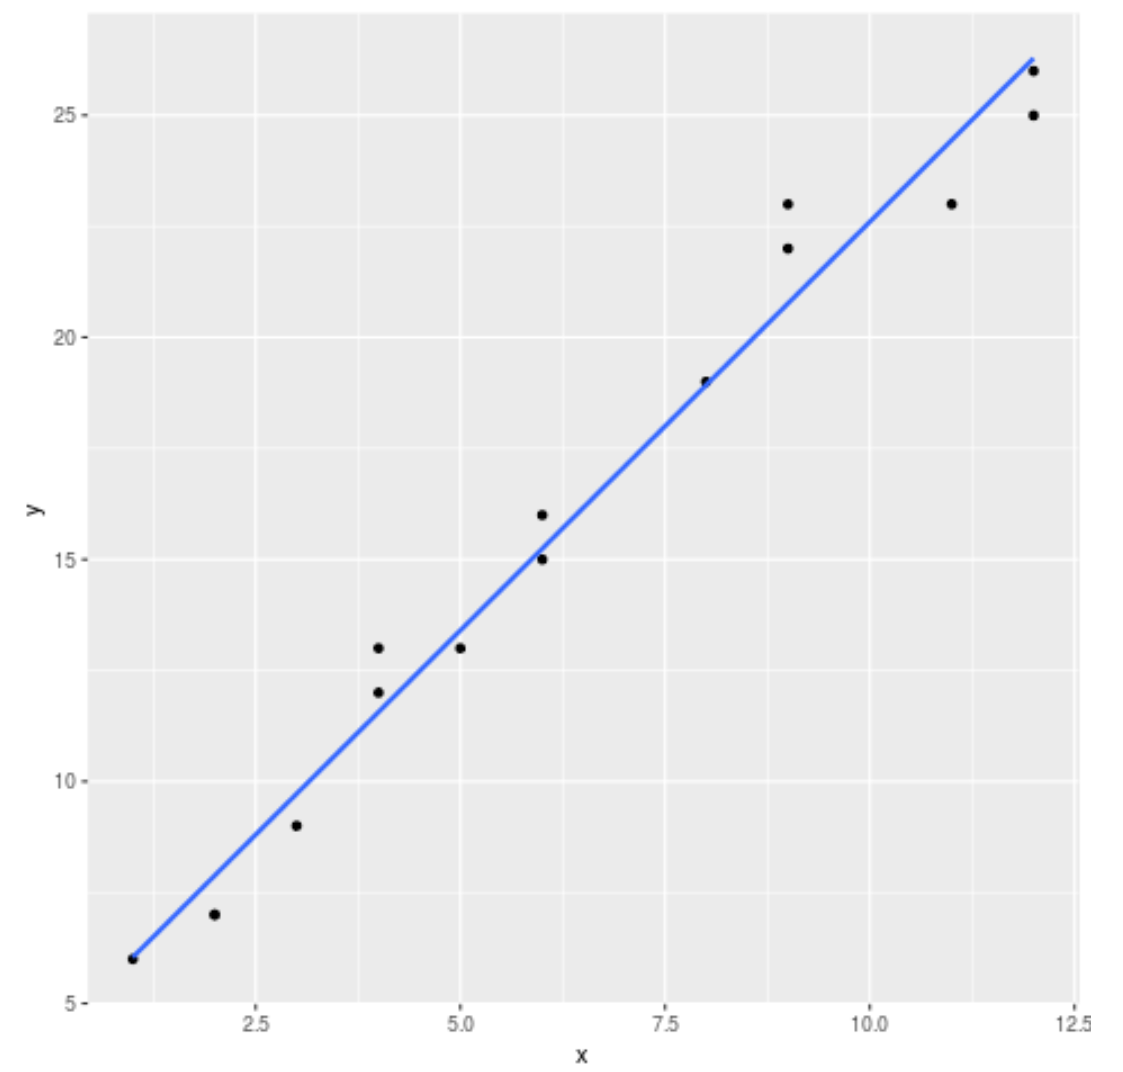
La pratique la plus courante et la plus lisible consiste à appeler en premier lieu geom_point() puis à surimposer en second lieu geom_smooth(method = « lm »). Cette hiérarchisation assure que la droite de régression et son enveloppe d’incertitude ne soient pas tronquées ou masquées par la densité locale des observations ponctuelles. Dans certaines configurations éditoriales où le nuage de points comporte des centaines de marqueurs compacts, l’adjonction de la droite au-dessus des données garantit son intelligibilité vectorielle et met immédiatement en valeur la tendance centrale du modèle sans être parasitée par la texture du bruit sous-jacent.
Cependant, si la droite est opaque et présente une épaisseur substantielle, elle peut occlure précisément les observations empiriques qui s’alignent le long de sa trajectoire médiane. Le recours à des stratégies de transparence graduée (en ajustant le paramètre alpha de la couche de lissage) résout élégamment ce dilemme : les points d’observation demeurent nettement perceptibles sous la ligne d’ajustement, offrant au lecteur une appréciation visuelle continue de l’adhérence du modèle mathématique à l’ensemble du faisceau expérimental.
5. 5. Articulation statistique entre la modélisation lm() et sa projection visuelle
5.1 5.1 Estimation formelle du modèle de régression univarié
Pour exploiter pleinement la richesse d’une figure statistique, la visualisation sous ggplot2 doit impérativement s’articuler avec l’estimation numérique formelle du modèle linéaire au sein de l’interpréteur R. Cette étape s’exécute par la commande fondamentale assignant le modèle univarié à un objet dédié, traditionnellement formalisée par la syntaxe modele <- lm(y ~ x, data = donnees). Cette démarche permet d’isoler l’ensemble des matrices de covariance, des résidus d’échantillonnage et des métriques de significativité dans un conteneur analytique autonome.
L’interrogation détaillée de cet objet statistique au moyen de la fonction générique summary(modele) génère le tableau récapitulatif canonique de l’ajustement. Ce document analytique présente l’estimation ponctuelle des coefficients, leurs erreurs standards associées, les valeurs du test t de Student et les seuils de probabilité critique (p-values). Il fournit également la statistique globale de Fisher, qui permet de rejeter ou de maintenir l’hypothèse nulle d’absence totale d’association linéaire entre la durée d’exposition au stimulus et le niveau d’intégration cognitive obtenu par les apprenants.
L’obtention de ces sorties textuelles brutes ne saurait toutefois remplacer l’inspection graphique, de la même manière que la figure ne peut se substituer à la rigueur des tests numériques. L’excellence méthodologique en recherche quantitative exige une osmose totale entre l’analyse tabulaire et la restitution visuelle : chaque paramètre calculé dans le compte rendu d’inférence doit trouver son pendant géométrique direct et compréhensible sur le tracé publié.
5.2 5.2 Décomposition et interprétation des coefficients d’ajustement
L’équation de la droite d’ajustement s’articule autour de deux grandeurs fondamentales dont l’interprétation théorique éclaire le comportement des variables expérimentales. La première est l’ordonnée à l’origine (communément appelée intercept ou constante du modèle). Sur le plan mathématique, elle correspond à l’espérance conditionnelle de la variable dépendante lorsque la variable explicative s’établit à une valeur strictement nulle. Dans notre paradigme cognitif, elle quantifie le niveau d’intégration basale ou les acquis préalables manifestés par un individu qui n’aurait bénéficié d’aucun temps d’exposition formel au stimulus d’apprentissage.
La seconde grandeur capitale est le coefficient directeur, ou pente de la droite (slope). Ce paramètre exprime le taux de variation marginal de la réponse consécutif à une augmentation d’une unité sur l’axe de la variable indépendante. Concrètement, une pente positive quantifie le gain moyen prédit sur le score de performance psychométrique pour chaque minute supplémentaire d’apprentissage effectif. La significativité statistique de ce coefficient, établie par un test de Student vérifiant l’écart à zéro, constitue le test d’hypothèse pivot attestant de l’impact réel de l’entraînement expérimental.
L’analyse scrupuleuse des erreurs standards associées à ces coefficients conditionne également la fiabilité des projections déduites du tracé. Une pente associée à une erreur standard très faible se traduira géométriquement par une droite stable et rigide, dont l’inclinaison demeurerait quasiment inchangée si l’on répétait l’expérience sur d’autres cohortes indépendantes issues de la même population parente.
5.3 5.3 Correspondance directe entre métriques numériques et composantes du graphique
Il existe un isomorphisme parfait entre les paramètres algébriques issus du modèle des moindres carrés et la structure topologique du graphique produit par ggplot2. L’ordonnée à l’origine se lit géométriquement à l’intersection exacte de la droite d’ajustement avec l’axe vertical des ordonnées, pour autant que l’axe des abscisses intègre explicitement l’origine zéro. Dans le cas fréquent où l’échelle horizontale est tronquée pour encadrer uniquement l’étendue empirique des données (par exemple de 20 à 60 minutes), l’ordonnée visible à la frontière gauche du tracé ne correspond plus à l’intercept théorique, piège cognitif fréquent que le chercheur doit savoir désamorcer lors de la lecture critique de ses figures.
La pente de régression détermine quant à elle l’angle d’inclinaison vectoriel de la droite modélisée au sein du repère cartésien standardisé. Il convient néanmoins d’avertir l’analyste que la perception visuelle subjective de cette déclivité dépend entièrement des ratios d’échelle géométrique assignés aux axes. Une modification arbitraire du format d’affichage (l’élargissement ou la compression verticale de la fenêtre graphique) peut accentuer ou aplanir visuellement une pente sans que ses propriétés numériques sous-jacentes n’aient varié d’un iota, rendant indispensable la conservation d’une mise à l’échelle proportionnée et cohérente d’un panneau à l’autre.
Enfin, le coefficient de détermination R² trouve sa traduction visuelle immédiate dans la compacité du nuage de points le long de la ligne d’ajustement. Plus la variance résiduelle non expliquée par le modèle linéaire tend vers zéro, plus les marqueurs empiriques viennent s’agréger étroitement autour de la trajectoire modélisée, jusqu’à se confondre idéalement avec elle lorsque R² approche la valeur unitaire. À l’inverse, un coefficient de détermination médiocre se traduit géométriquement par une dispersion amorphe et large, avertissant immédiatement le lecteur que la droite tracée ne constitue qu’une synthèse imparfaite d’un processus soumis à une grande hétérogénéité individuelle ou à des facteurs non mesurés.
6. 6. Maîtrise et interprétation des intervalles de confiance
6.1 6.1 Définition statistique de la zone d’incertitude paramétrique
L’une des caractéristiques les plus rigoureuses de la fonction geom_smooth() dans ggplot2 réside dans l’affichage par défaut d’une bande ombrée entourant la droite de régression. Cette enveloppe géométrique matérialise l’intervalle de confiance statistique associé à la prédiction de l’espérance conditionnelle de la variable de réponse. Loin de représenter une simple marge de sécurité visuelle arbitraire, cette zone délimite précisément la région cartésienne au sein de laquelle la « vraie » droite de régression populationnelle a une probabilité définie (traditionnellement 95 %) de se situer sous réserve de répétitions infinies du protocole d’échantillonnage.
Il est impératif d’établir une démarcation conceptuelle nette entre l’intervalle de confiance de la droite d’ajustement (représenté par ggplot2) et un intervalle de prédiction individuel. L’intervalle de confiance modélise l’incertitude relative à l’estimation de la moyenne conditionnelle de la population pour une valeur d’abscisse donnée ; sa largeur tend asymptotiquement vers zéro à mesure que la taille de l’échantillon N croît vers l’infini. À l’inverse, un intervalle de prédiction intègre en sus la variance stochastique individuelle inhérente à chaque observation ; il demeure par conséquent beaucoup plus large, même face à des cohortes de très grande taille, car il englobe le bruit non réductible du comportement humain.
La morphologie incurvée de cette enveloppe d’incertitude présente un intérêt pédagogique considérable. Elle adopte la forme caractéristique d’un diabolo ou d’un sablier, étant au plus étroit au niveau du barycentre de l’échantillon (c’est-à-dire à la moyenne conjointe des variables x et y), puis s’évasant de manière hyperbolique à mesure que l’on s’éloigne vers les extrémités du domaine observé. Ce profil géométrique rappelle visuellement au chercheur que la précision de l’inférence linéaire se dégrade inéluctablement dès que l’on s’écarte du cœur des données collectées.
6.2 6.2 Personnalisation et désactivation de l’intervalle de confiance
Bien que hautement informative dans un contexte académique, l’affichage de l’enveloppe de confiance peut être neutralisé ou modifié selon les impératifs de clarté de la publication. Pour supprimer intégralement l’ombrage statistique et ne conserver que le tracé linéaire nu, il suffit d’assigner l’argument logique booléen se = FALSE au sein de la fonction geom_smooth(method = « lm »). Cette option s’avère particulièrement judicieuse lorsque le graphique superpose une multitude de droites de régression correspondant à différents groupes expérimentaux, évitant ainsi la saturation cognitive et la collision illisible de plusieurs bandes d’incertitude entrelacées.
Lorsque la préservation de la zone d’incertitude est requise par les normes méthodologiques de la discipline, l’expérimentateur a la faculté d’en moduler le seuil probabiliste au moyen de l’argument level. Si la valeur par défaut est conventionnellement fixée à level = 0.95 (correspondant à l’alpha standard de 5 %), il est parfaitement envisageable de durcir la contrainte d’inférence en paramétrant un intervalle à 99 % via level = 0.99, ce qui aura pour conséquence graphique directe d’élargir visiblement l’emprise de l’enveloppe ombrée pour refléter l’exigence accrue de certitude paramétrique.
Le choix éditorial de conserver ou d’exclure cette bande d’incertitude doit reposer sur des critères épistémologiques rigoureux : dans les études pilotes ou les recherches impliquant de faibles échantillons où l’imprécision d’échantillonnage est substantielle, dissimuler l’intervalle de confiance relève de la tromperie visuelle en donnant l’illusion d’une trajectoire parfaitement assurée là où règne une incertitude paramétrique considérable.
6.3 6.3 Personnalisation esthétique de l’enveloppe d’incertitude
L’ajustement des propriétés visuelles de l’enveloppe d’incertitude s’avère indispensable pour harmoniser la figure avec la charte graphique de la revue ciblée ou pour garantir une lisibilité optimale sur des supports physiques imprimés en noir et blanc. L’argument fill déclaré au sein de geom_smooth() permet de modifier la couleur de remplissage de la zone ombrée, autorisant l’utilisation de teintes douces, neutres ou assorties à la couleur directrice du modèle afin d’éviter les contrastes excessifs qui détourneraient l’attention du lecteur.
Le contrôle de l’opacité au moyen de la valeur alpha joue un rôle ergonomique crucial. Par défaut, ggplot2 applique une transparence modérée, mais celle-ci peut être affinée (par exemple en assignant une valeur comprise entre 0.10 et 0.20) pour s’assurer que les marqueurs ponctuels situés en arrière-plan demeurent parfaitement discernables sous la bande d’incertitude. Une enveloppe trop opaque dégrade la lecture des observations empiriques, tandis qu’une enveloppe trop diaphane s’efface lors des impressions papier à faible résolution contrastée.
La personnalisation peut également consister à dissocier visuellement la couleur de la droite centrale de celle de son intervalle associé. En combinant un trait sombre hautement contrasté pour la droite moyenne et une ombre pastel très claire pour l’enveloppe paramétrique, l’analyste établit une hiérarchie visuelle intuitive qui guide le regard de la prédiction centrale vers l’étendue de sa variance probable.
7. 7. Personnalisation esthétique avancée de la droite d’ajustement
7.1 7.1 Contrôle des propriétés géométriques du tracé linéaire
Pour conférer à la visualisation une qualité éditoriale digne des plus prestigieuses revues scientifiques internationales, le chercheur dispose d’une maîtrise intégrale des attributs géométriques régissant le tracé de la droite d’ajustement. L’argument chromatique color (ou son équivalent syntaxique colour) constitue le premier levier de différenciation. Plutôt que de conserver la teinte bleue par défaut de ggplot2, il est souvent préférable d’adopter des codes hexadécimaux professionnels ou des teintes sobres et affirmées (telles que le bleu nuit, le bordeaux ou le gris ardoise) permettant de détacher nettement la ligne directrice sur le fond du graphique.
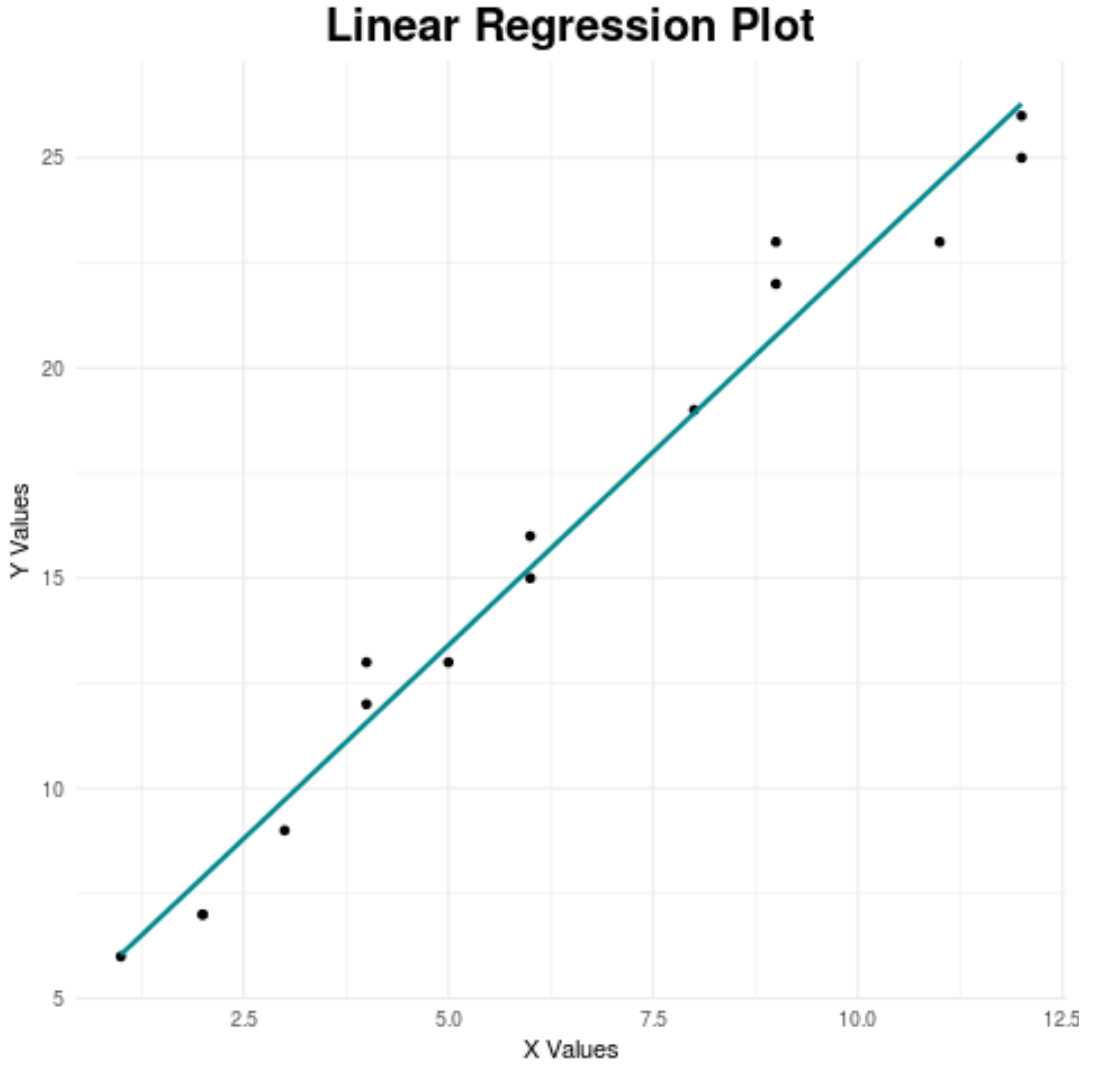
L’épaisseur du trait se module précisément via le paramètre linewidth (qui a succédé au paramètre déprécié size dans les versions récentes de ggplot2 pour les géométries linéaires). Un tracé trop fin risque de disparaître lors de la réduction de la figure au format d’une colonne de texte typographique, tandis qu’un trait excessivement épais introduit une impression d’empâtement qui nuit à la précision de lecture cartésienne. Une épaisseur calibrée entre 1 et 1.5 millimètre offre généralement le compromis parfait entre autorité visuelle et finesse géométrique.
Le typage de la ligne s’opère au moyen de l’argument linetype, acceptant des valeurs textuelles standardisées telles que « solid » (ligne continue), « dashed » (tirets réguliers) ou « dotted » (pointillés). Ce paramètre se révèle indispensable lorsqu’il s’agit de différencier graphiquement plusieurs modèles statistiques concurrents projetés sur un même panneau (par exemple pour distinguer la droite théorique principale d’un modèle contraint ou d’une droite de référence idéale), tout en garantissant une intelligibilité parfaite même si le document final est reproduit en niveaux de gris purs.
7.2 7.2 Stylisation simultanée des points d’observation
L’esthétique de la droite de régression ne peut être dissociée de celle du nuage de points qui la soutient. Pour parfaire le ratio encre-données (concept séminal théorisé par Edward Tufte stipulant que chaque goutte d’encre utilisée sur une figure doit transmettre une information scientifique utile), les marqueurs d’observation doivent faire l’objet d’un calibrage typographique soigné. L’argument shape permet de modifier la forme géométrique des points, autorisant l’emploi de disques pleins classiques (forme 19), de cercles évidés à simple contour (forme 1) ou de glyphes hybrides à remplissage et contour distincts (formes 21 à 25).
L’utilisation de la forme 21 s’avère particulièrement féconde dans les publications haut de gamme. Elle offre l’avantage exceptionnel de permettre la déclaration conjointe d’une couleur de bordure sombre via l’argument color (ou stroke pour en contrôler la finesse) et d’une couleur d’intérieur personnalisée via l’argument fill, combinée à une transparence sélective. Ce traitement esthétique empêche les points de fusionner en masses indistinctes en cas de forte proximité spatiale tout en conservant une grande netteté des contours individuels.
La dimension des glyphes, régie par le paramètre size, doit être proportionnée au volume global de l’échantillon étudié. Pour un échantillon clinique restreint de quelques dizaines de participants, des marqueurs d’une taille de 2.5 à 3 points assurent une présence visuelle robuste. À l’opposé, face à de grandes cohortes épidémiologiques regroupant plusieurs milliers d’enregistrements, la taille doit être abaissée vers 0.5 à 1 point pour préserver la granularité fine de la texture distributionnelle.
7.3 7.3 Application d’une palette chromatique adaptée à l’accessibilité
La conception contemporaine de figures scientifiques impose une conformité stricte aux exigences d’accessibilité universelle et d’inclusion perceptive. Une proportion significative de la population masculine mondiale présente des déficits de la vision des couleurs (particulièrement le daltonisme de type deutéranopie et protanopie). Il est par conséquent formellement proscrit dans la pratique éditoriale moderne d’utiliser des associations chromatiques antagonistes rouge-vert pour signaler des contrastes méthodologiques ou des comparaisons de modèles.
L’intégration de palettes perceptuellement uniformes développées scientifiquement, telles que les célèbres gammes Viridis, Plasma ou Cividis (disponibles nativement dans ggplot2 via la famille de fonctions scale_color_viridis_d ou _c), résout définitivement cet écueil. Ces gradients de couleurs ont été mathématiquement construits pour que les contrastes de luminosité perçus demeurent strictement linéaires et constants, y compris pour les personnes daltoniennes ou lors de l’impression intégrale de l’article sur une imprimante monochrome standard.
Ce respect des impératifs d’accessibilité s’aligne directement sur les recommandations stylistiques de la septième édition du manuel de publication de l’American Psychological Association (APA). En privilégiant la sobriété, les contrastes à forte amplitude lumineuse et l’indépendance de l’information par rapport à la seule composante chromatique (en couplant systématiquement couleur et type de ligne), le chercheur s’assure que son message inférentiel sera décodé avec une fidélité absolue par l’ensemble de la communauté scientifique internationale.
8. 8. Enrichissement informatif : intégration des équations et métriques statistiques
8.1 8.1 Insertion manuelle d’annotations avec annotate()
Pour qu’un graphique statistique atteigne son plein potentiel de communication, il doit autant que possible être autosuffisant, permettant au lecteur d’appréhender la teneur du modèle mathématique sans être contraint d’effectuer d’incessants allers-retours entre le corps du texte académique et la figure. L’une des méthodes les plus directes pour adjoindre ces informations consiste à utiliser la fonction annotate() de ggplot2. Cette fonction permet de positionner manuellement un élément typographique textuel en spécifiant ses coordonnées spatiales absolues x et y au sein du repère cartésien.
Cette approche manuelle offre un contrôle chirurgical sur l’agencement esthétique. L’analyste peut ainsi rédiger textuellement l’équation de régression sous la forme y = 0.85x + 12.30, tout en adjoignant sur une ligne secondaire la valeur exacte du coefficient de détermination ajusté (R² = 0.68) et la taille d’effet correspondante. Pour garantir une intégration harmonieuse, la chaîne de caractères doit être placée dans une zone visuellement dégagée du repère, généralement dans l’un des quadrants supérieurs ou inférieurs épargnés par le nuage de points et la droite d’ajustement.
L’argumentation esthétique de la fonction annotate inclut la maîtrise de la taille de police (paramètre size), de l’alignement horizontal et vertical (paramètres hjust et vjust) ainsi que du style de fonte. L’utilisation du paramètre parse = TRUE permet en outre d’interpréter les expressions au format mathématique formel de R, autorisant l’affichage élégant de symboles grecs, d’indices ou de puissances conformément aux canons typographiques les plus rigoureux.
8.2 8.2 Automatisation des annotations statistiques avec des extensions dédiées
Bien que l’annotation manuelle confère une liberté esthétique totale, elle présente un défaut majeur de maintenabilité : toute mise à jour du jeu de données expérimental ou tout rééchantillonnage modifie les coefficients du modèle et impose une réécriture fastidieuse et propice aux erreurs de transcription humaine. Pour pallier cette faiblesse et s’inscrire dans une logique computationnelle pleinement reproductible, la communauté R a développé des extensions hautement spécialisées, au premier rang desquelles figure le package ggpubr.
L’utilisation de fonctions dédiées telles que stat_regline_equation() et stat_cor() permet d’automatiser l’extraction et l’affichage des métriques sans aucune intervention manuelle. La première fonction calcule dynamiquement les coefficients d’ajustement et projette l’équation mathématique directement sur le graphique, tandis que la seconde dérive instantanément le coefficient de corrélation de Pearson (ou de Spearman selon les spécifications paramétriques) accompagné de son niveau d’étoiles de significativité ou de sa valeur exacte de p.
Cette automatisation garantit une synchronisation perpétuelle et parfaite entre la couche sous-jacente des données empiriques et le rendu typographique affiché sur la figure. Si une observation erronée est ultérieurement purgée de la base de données, la régénération du graphique réactualisera instantanément l’inclinaison de la droite, son ordonnée à l’origine, ainsi que l’ensemble des formules et coefficients imprimés au sein du canevas, éliminant tout risque de discordance interne dans le manuscrit final.
8.3 8.3 Affichage des segments résiduels entre points et droite
Sur le plan didactique comme sur celui de l’évaluation critique du modèle, visualiser concrètement ce que représentent les résidus apporte une plus-value inestimable. Dans la théorie des moindres carrés ordinaires, le résidu d’une observation correspond au segment vertical séparant le point empirique de sa projection orthogonale théorique sur la droite de régression. Rendre ces distances visibles transforme un concept mathématique abstrait en une réalité spatiale immédiatement tangible.
La mise en œuvre de cette technique sous ggplot2 requiert d’extraire au préalable les valeurs ajustées (fitted values) issues de l’objet de régression lm() et de les réintégrer dans le tableau de données d’origine. Il devient alors possible d’invoquer la fonction géométrique geom_segment() en liant chaque point d’abscisse x et d’ordonnée y à sa projection théorique d’abscisse x et d’ordonnée ajustée y_pred. Le paramétrage d’un trait fin, discontinu et légèrement translucide pour ces segments verticaux permet d’illustrer spectaculairement les écarts individuels sans saturer la composition graphique.
Cette décomposition graphique de l’erreur d’ajustement s’avère particulièrement percutante lors des communications orales, des cours méthodologiques universitaires ou des phases d’exploration préliminaire. Elle permet de matérialiser instantanément aux yeux des évaluateurs l’origine physique de la variance résiduelle et d’identifier au premier regard les observations dont la déviation verticale pèse lourdement sur la fonction de coût quadratique minimisée par l’algorithme.
9. 9. Modélisation linéaire groupée et analyse des interactions visuelles
9.1 9.1 Ajustement de droites de régression par sous-groupes expérimentaux
En sciences comportementales et médicales, les dynamiques empiriques sont rarement homogènes sur l’ensemble d’une population hétérogène. L’analyste est constamment confronté à l’existence de facteurs de stratification discrets — tels que la distinction entre un groupe clinique et un groupe témoin, ou différentes conditions d’intervention expérimentale. L’un des atouts les plus spectaculaires de ggplot2 réside dans son aptitude à dériver automatiquement des modélisations linéaires distinctes pour chaque modalité d’une variable catégorielle sans nécessiter la moindre boucle itérative dans le script.
Pour orchestrer cette stratification au sein du tracé, il suffit d’associer la variable catégorielle d’intérêt à une caractéristique esthétique globale au sein de la fonction aes(), par exemple en spécifiant aes(color = groupe) ou aes(linetype = groupe). Dès lors que cette correspondance est déclarée, la couche geom_smooth(method = « lm ») hérite de cette structure factorielle et calcule de façon autonome autant de droites des moindres carrés distinctes qu’il existe de modalités dans le groupe d’assignation, chacune adoptant sa propre teinte chromatique et sa propre trajectoire d’inclinaison.
Cette approche permet d’identifier visuellement en une fraction de seconde la présence d’un effet modérateur ou d’une interaction statistique entre la variable continue et le facteur de groupe. Si les droites d’ajustement des deux sous-groupes s’avèrent rigoureusement parallèles, l’effet de la variable indépendante s’exerce de manière uniforme indépendamment de la condition. Si, à l’inverse, les droites manifestent un croisement ou des inclinaisons fortement divergentes (une pente fortement ascendante pour le groupe entraîné et une pente plane ou décroissante pour le groupe témoin), l’interaction entre le temps d’exposition et la condition d’appartenance devient une évidence visuelle indiscutable.
9.2 9.2 Séparation graphique par facettage analytique
Lorsque l’analyse implique plus de deux ou trois catégories d’observation, la superposition de l’ensemble des nuages de points et des droites de régression sur un unique repère cartésien peut engendrer un enchevêtrement illisible préjudiciable à l’évaluation scientifique. Le concept de facettage (souvent désigné sous l’expression de petits multiples conceptualisée par Edward Tufte) apporte une réponse méthodologique remarquable à cette contrainte en décomposant l’affichage en une matrice de sous-graphiques cohérents.
L’implémentation de cette décomposition s’effectue avec une fluidité exceptionnelle sous ggplot2 au moyen des fonctions facet_wrap() ou facet_grid(). En renseignant la variable catégorielle de partitionnement, le moteur scinde le canevas global en autant de panneaux distincts que de modalités factorielles, chaque sous-graphique restituant fidèlement le nuage de points et la droite d’ajustement propres à son sous-échantillon tout en partageant des échelles cartésiennes communes et harmonisées.
Le maintien d’échelles fixes et rigoureusement identiques d’un panneau à l’autre constitue une exigence déontologique impérative dans la majorité des scénarios comparatifs. L’autorisation d’échelles libres (via l’argument scales = « free ») peut ponctuellement s’avérer nécessaire si les étendues de valeurs divergent de plusieurs ordres de grandeur, mais elle introduit un risque majeur d’illusion d’optique en empêchant la comparaison directe et immédiate des pentes et des dispersions relatives entre les différentes cohortes expérimentales.
9.3 9.3 Distanciation entre ajustement global et ajustement intragroupe
L’un des pièges statistiques les plus dévastateurs de l’analyse bivariée stratifiée est le célèbre paradoxe de Simpson. Ce phénomène contre-intuitif survient lorsqu’une tendance observée au niveau global de l’échantillon agrégé s’avère totalement inversée ou annulée lorsque l’on analyse séparément les sous-groupes constitutifs. Une variable de confusion non prise en compte peut ainsi engendrer une corrélation globale fallacieuse, masquant la véritable nature des mécanismes agissant à l’échelle locale de chaque strate.
Pour prévenir cette dérive analytique, ggplot2 autorise la superposition conjointe et simultanée de la droite de régression globale et des droites spécifiques à chaque sous-groupe sur un même espace de visualisation. Ce raffinement technique repose sur la gestion subtile de la portée des esthétiques globales versus locales. En définissant l’association groupée exclusivement au sein de la géométrie des points (geom_point(aes(color = groupe))) tout en maintenant un appel neutre et non stratifié au niveau d’une couche geom_smooth(method = « lm », color = « black », linewidth = 1.2), la droite d’ensemble viendra surplomber avec autorité les sous-tendances catégorielles.
Cette articulation simultanée entre macro-structure et micro-structures offre au lecteur une compréhension globale incomparable. Elle permet de mettre immédiatement en lumière d’éventuels décalages d’ordonnée d’un groupe à l’autre tout en démontrant visuellement la convergence ou la discordance des pentes partielles avec la tendance moyenne de la population globale étudiée.
10. 10. Diagnostic graphique des postulats de la régression linéaire
10.1 10.1 Visualisation conjointe de la linéarité et des écarts d’ajustement
L’application d’un modèle des moindres carrés ordinaires repose sur l’hypothèse primordiale que la fonction d’espérance conditionnelle reliant les variables est fondamentalement linéaire. Pour vérifier empiriquement ce postulat avant de valider définitivement la projection d’une droite rigide, une démarche méthodologique particulièrement élégante consiste à superposer sur un même graphique la droite paramétrique lm et une courbe d’ajustement non paramétrique flexible de type LOESS.
Dans ggplot2, cette confrontation s’exécute avec une extrême simplicité en convoquant successivement deux couches geom_smooth() : la première spécifiant method = « lm » (matérialisée par exemple par une ligne continue contrastée) et la seconde déclarant method = « loess » (stylisée par un trait discontinu de teinte différenciée). Si la courbe LOESS ondoie très étroitement autour de la droite de régression sans manifester de déviations systématiques, le postulat de linéarité est empiriquement conforté.
Si, au contraire, l’ajustement non paramétrique révèle une inflexion systématique marquée (adoptant une forme en U suggérant une dynamique quadratique, ou une courbure asymptotique évoquant une saturation logarithmique), l’analyste a sous les yeux la preuve matérielle irréfutable que la droite linéaire viole la réalité de la structure relationnelle. Ce constat visuel interdit la conclusion hâtive et impose de reformuler l’équation d’ajustement pour y inclure des transformations de variables adaptées.
10.2 10.2 Construction d’un graphique résidus-valeurs ajustées sous ggplot2
Le diagnostic de l’homoscédasticité (homogénéité de la variance des termes d’erreur) et de la structure des résidus constitue le second pilier de la validation méthodologique d’une régression. La procédure la plus féconde repose sur la construction d’un diagramme confrontant les valeurs prédites par le modèle sur l’axe des abscisses aux résidus correspondants sur l’axe des ordonnées. Ce tracé diagnostique crucial s’élabore avec une remarquable concision en exploitant la fonction augment() du package broom, qui enrichit instantanément le jeu de données d’origine des vecteurs de prédictions et d’erreurs standardisées.
Le graphique ainsi généré doit impérativement comporter une ligne de référence horizontale stationnaire d’ordonnée zéro, implantée au moyen de geom_hline(yintercept = 0, linetype = « dashed », color = « grey50 »). L’agencement idéal des points résiduels autour de cette frontière doit ressembler à une constellation rectangulaire totalement aléatoire et homogène, dépourvue de toute organisation directionnelle ou morphologique décelable.
La présence visuelle d’un motif en entonnoir (où la dispersion verticale des résidus s’élargit ou se resserre progressivement le long de l’axe des valeurs ajustées) constitue la signature caractéristique d’une rupture d’homoscédasticité (hétéroscédasticité). De même, un agencement courbé des résidus dénonce une modélisation incomplète de la forme fonctionnelle. Dans de telles circonstances, les tests de significativité conventionnels dérivant du modèle linéaire classique sont invalidés, nécessitant le recours à des estimateurs de variance robustes ou à des transformations de Box-Cox sur la variable réponse.
10.3 10.3 Évaluation graphique de la normalité distributionnelle des erreurs
Le calcul rigoureux des intervalles de confiance et la validité des statistiques inférentielles de Student ou de Fisher reposent sur le postulat fondamental que la distribution des résidus d’échantillonnage suit une loi normale centrée en zéro. Bien que des tests numériques formels d’adéquation existent (tels que le test de Shapiro-Wilk ou de Kolmogorov-Smirnov), ils s’avèrent excessivement sensibles aux grands échantillons et manquent de puissance face aux petites séries. L’évaluation visuelle par un diagramme quantile-quantile (ou Q-Q plot) demeure l’étalon-or international pour juger de la normalité empirique.
L’écosystème ggplot2 intègre nativement des géométries dédiées à cette exigence analytique via les fonctions geom_qq() et geom_qq_line(). En associant la colonne des résidus standardisés à l’esthétique d’échantillonnage (aes(sample = .std.resid)), le moteur cartographie les quantiles théoriques attendus d’une loi normale unitaire face aux quantiles empiriquement observés au sein des données expérimentales.
L’adéquation des résidus au postulat de normalité se manifeste graphiquement par l’alignement rigoureux des points le long de la bissectrice droite projetée par geom_qq_line(). Des décrochages prononcés et systématiques au niveau des extrémités supérieures ou inférieures (les queues de distribution) révèlent la présence de kurtosis anormale (distribution leptokurtique ou platikurtique) ou d’une asymétrie marquée (skewness). Ces déviations alertent immédiatement le statisticien sur la fragilité des p-valeurs inférées et l’incitent à recourir à des méthodes d’inférence non paramétriques par rééchantillonnage de type bootstrap.
11. 11. Cas complexes : extrapolation, contraintes d’échelle et transformations de variables
11.1 11.1 Contrôle de l’étendue du tracé et risques liés à l’extrapolation
Par défaut, la fonction geom_smooth() borne strictement la longueur de la droite de régression aux valeurs minimales et maximales empiriquement observées sur l’axe de la variable explicative x. Cette bride algorithmique par défaut constitue une sécurité méthodologique bienvenue : elle empêche le chercheur de projeter visuellement une tendance au-delà des territoires réellement documentés par l’expérience, limitant ainsi le risque d’extrapolation abusive.
Il existe néanmoins des cas d’usage théoriques où l’analyste souhaite délibérément prolonger la trajectoire du modèle pour explorer son comportement prédictif à court terme ou matérialiser son intersection physique avec l’ordonnée d’origine. Cette extension s’active en spécifiant l’argument fullrange = TRUE au sein de geom_smooth(). La droite se déploie alors de manière rectiligne sur l’intégralité du domaine cartésien défini par les limites de l’axe, soulignant avec netteté les extrapolations attendues.
Il est fondamental de distinguer la manipulation de l’étendue graphique via le système de coordonnées cartésiennes de celle opérée par le filtrage des échelles. L’utilisation de coord_cartesian(xlim = c(min, max)) opère un zoom spatial pur sans altérer le calcul des modèles sous-jacents, préservant l’intégrité de la droite originelle. À l’opposé, contraindre les bornes par scale_x_continuous(limits = c(min, max)) a pour conséquence d’exclure physiquement du jeu de données toutes les observations situées hors de la zone spécifiée avant d’exécuter la régression, ce qui recalculera artificiellement une pente entièrement nouvelle et méthodologiquement viciée.
11.2 11.2 Ajustement de régressions avec variables transformées
Dans de nombreuses disciplines expérimentales, la dynamique reliant les variables ne relève pas d’une cinétique arithmétique additive, mais d’une loi de puissance ou d’une cinétique exponentielle de croissance ou de décroissance. Dans ce contexte, tenter d’ajuster une droite directement sur les unités brutes produirait un ajustement médiocre et théoriquement injustifiable. La linéarisation de telles relations requiert le passage à des échelles logarithmiques ou semi-logarithmiques.
L’environnement ggplot2 gère ces modélisations complexes avec une flexibilité conceptuelle remarquable grâce aux fonctions d’échelle telles que scale_x_log10() et scale_y_log10(). Lorsque ces transformations sont appliquées aux axes, la couche geom_smooth(method = « lm ») ajuste la droite des moindres carrés directement sur les grandeurs transformées logarithmiquement. La droite projetée sur le graphique apparaît alors rigoureusement rectiligne dans l’espace déformé des puissances de dix, permettant de tester visuellement des hypothèses de proportionnalité relative ou d’élasticité constante.
L’analyste doit toutefois exercer une vigilance sémantique scrupuleuse lors de la rédaction de ses légendes et de l’interprétation des résultats. La pente dérivée sur un repère logarithmique ne quantifie plus un accroissement unitaire absolu de la réponse, mais un taux de variation proportionnel en pourcentage (une multiplication scalaire). La clarté didactique impose d’expliciter sans ambiguïté la nature de la transformation d’échelle afin d’éviter que le lecteur non averti n’interprète la trajectoire linéaire affichée comme une relation arithmétique classique.
11.3 11.3 Régression robuste et alternatives face aux valeurs influentes
Lorsque le diagnostic exploratoire du nuage de points révèle la présence inaltérable de valeurs atypiques ou de distributions à queues lourdes menaçant la stabilité de la méthode des moindres carrés ordinaires, le chercheur ne doit pas succomber à la tentation arbitraire de supprimer ces données sans justification substantielle. La démarche méthodologique rigoureuse consiste plutôt à substituer à la régression classique une modélisation linéaire robuste, capable de résister à la contamination d’observations périphériques.
Cette alternative s’intègre au sein du flux graphique de ggplot2 en exploitant la puissance du package MASS et de son estimateur rlm (robust linear model). En spécifiant simplement method = MASS::rlm au sein de geom_smooth(), le moteur graphique délaisse la minimisation quadratique standard pour appliquer des algorithmes de moindres carrés repondérés itérativement (tels que la fonction de coût de Huber). Les observations présentant de forts résidus voient leur poids marginal progressivement atténué dans l’estimation finale de la trajectoire.
Sur le plan de la restitution scientifique, superposer sur une même figure la droite conventionnelle des moindres carrés ordinaires (en trait discontinu) et la droite issue de l’estimation robuste (en ligne continue contrastée) constitue un modèle de transparence académique. Cette double projection démontre visuellement aux relecteurs l’exacte sensibilité des conclusions du modèle face aux données influentes, apportant une preuve tangible de la robustesse de l’effet rapporté.
12. 12. Standardisation éditoriale aux normes APA et finalisation pour publication
12.1 12.1 Configuration des thèmes typographiques aux standards universitaires
La configuration esthétique native de ggplot2, caractérisée par son arrière-plan grisâtre quadrillé de blanc, a été conçue pour optimiser le discernement perceptif lors de l’exploration de données sur écran d’ordinateur. Elle est en revanche totalement inadaptée aux exigences de sobriété, de neutralité et de lisibilité propres aux publications scientifiques universitaires internationales, qui réclament des arrière-plans immaculés et une élimination rigoureuse de tout élément décoratif superflu.
L’application d’un thème standardisé épuré constitue la première étape d’une mise en conformité éditoriale. La fonction theme_classic() offre une structure de départ exemplaire : elle supprime instantanément le fond grisâtre, élimine le maillage du quadrillage parasite et réimplante des axes cartésiens noirs rigoureux dotés de graduations externes nettes. L’alternative theme_bw() peut être retenue lorsqu’un encadrement complet de la zone graphique est exigé par la charte de la revue.
Pour parfaire l’alignement sur les prescriptions stylistiques de l’APA (7e édition), l’analyste déploiera la fonction personnalisée theme(). Cette interface de contrôle typographique avancée permet de fixer la famille de police de caractères institutionnelle (généralement Helvetica, Arial ou Times New Roman), d’harmoniser la taille relative des légendes et des graduations numériques, et d’ajuster méticuleusement l’espacement entre les étiquettes textuelles et les axes cartésiens afin de prévenir tout chevauchement ou tassement visuel disgracieux.
12.2 12.2 Libellés formels, titres, unités et légendes scientifiques
Une figure scientifique ne peut prétendre à l’excellence sans un appareil de légendage complet, précis et rigoureux. La fonction générique labs() constitue l’outil central pour enrichir l’environnement cartésien de ses métadonnées indispensables. Les libellés d’abscisse et d’ordonnée ne doivent jamais se contenter des identifiants abrégés issus des colonnes du tableau de données brutes, mais formuler explicitement le nom du construit psychologique mesuré, impérativement accompagné de son unité de mesure physique ou psychométrique entre parenthèses.
Le traitement des titres obéit à des règles académiques strictes qui divergent de la communication médiatique ou d’entreprise. Les normes APA préconisent d’éviter l’adjonction d’un titre massif directement au sein de la matrice visuelle du canevas ; le graphique doit s’insérer sobrement sous la mention normalisée Figure X, suivie d’une note de figure concise et descriptive située en bas du bloc d’affichage. La fonction labs(caption = « … ») permet le cas échéant d’adosser directement cette notice méthodologique au document exporté.
L’organisation typographique des légendes factorielles doit faire l’objet d’un soin similaire. Leur positionnement dans l’espace graphique se module par l’argument legend.position au sein de la fonction theme(). En ancrant judicieusement la boîte de légende à l’intérieur d’un espace vide du canevas ou en bas horizontalement, l’analyste maximise l’espace utile dévolu à la visualisation des données tout en garantissant un décodage immédiat de chaque composante stylistique mobilisée sur le graphique.
12.3 12.3 Exportation vectorielle et conservation de la résolution graphique
L’aboutissement du protocole graphique réside dans la phase d’exportation numérique du fichier source vers les formats de reproduction destinés à la composition de l’article imprimé ou numérique. L’utilisation des captures d’écran manuelles ou des mécanismes de copie matricielle basse définition proposés par défaut par certains environnements logiciels constitue une erreur critique qui dégrade irréversiblement la finesse des tracés et produit une pixellisation floue lors de la mise en page finale.
La commande académique de référence pour pérenniser le rendu sous ggplot2 est la fonction ggsave(). Cette routine logicielle permet de spécifier avec une rigueur absolue les dimensions spatiales réelles du document final au moyen des arguments width, height et de l’unité de mesure physique units = « cm » ou « in », calibrées exactement sur la largeur de colonne de la revue destinataire (souvent 8.5 cm pour une colonne simple ou 17 cm pour une double colonne panoramique).
L’arbitrage entre formats matriciels et vectoriels conditionne l’intégrité visuelle de l’œuvre scientifique. Si une image matricielle au format TIFF ou PNG est requise, une résolution minimale de 300 à 600 points par pouce (dpi = 600) doit être formellement déclarée pour garantir la netteté chirurgicale du texte et des points. Néanmoins, la recommandation méthodologique souveraine consiste à privilégier sans réserve les formats vectoriels purs tels que le PDF ou le SVG. Ces conteneurs d’instructions géométriques conservent l’indépendance de résolution à l’infini, assurant que les droites des moindres carrés, les points d’observation et les annotations mathématiques conserveront une pureté géométrique absolue, sans aucune dégradation, de la version préliminaire d’évaluation jusqu’à l’impression finale de la monographie de recherche.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Kassambara, A. (2023). ggpubr: ‘ggplot2’ based publication ready plots (R package version 0.6.0). CRAN. https://CRAN.R-project.org/package=ggpubr
- Robinson, D., Hayes, A., & Couch, S. (2023). broom: Convert statistical analysis objects into tidy tibbles (R package version 1.0.5). CRAN. https://CRAN.R-project.org/package=broom
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0