
Dans l’arsenal des outils pédagogiques et scientifiques contemporains, la calculatrice graphique de la gamme Texas Instruments, et plus particulièrement la TI-84 Plus sous ses diverses déclinaisons, occupe une place prépondérante au sein de l’enseignement secondaire supérieur et des premières années universitaires. Utilisée quotidiennement par des millions d’étudiants, d’ingénieurs et de chercheurs à travers le monde, cette plateforme de calcul symbolise le pont opératoire entre l’abstraction des théories mathématiques et leur application computationnelle directe. L’étude des probabilités discrètes, pierre angulaire de l’analyse stochastique, confronte régulièrement les praticiens à la nécessité de caractériser le comportement moyen à long terme d’un phénomène soumis au hasard. Au cœur de cette démarche réside la notion fondamentale d’espérance mathématique, métrique centrale qui synthétise la tendance d’une variable aléatoire en pondérant chaque issue envisageable par sa vraisemblance intrinsèque.
Toutefois, si la définition analytique de l’espérance mathématique relève d’une formulation linéaire d’une grande élégance, sa résolution concrète sur des jeux de données volumineux ou des lois empiriques complexes exige une maîtrise instrumentale sans faille. L’erreur méthodologique la plus fréquente consiste à confondre la simple moyenne arithmétique d’une série statistique brute avec l’espérance théorique d’un modèle probabiliste. Cette confusion engendre des contresens conceptuels majeurs, notamment lorsque les pondérations ne sont pas adéquatement appliquées dans les registres matriciels de la calculatrice. L’exploitation rigoureuse des fonctionnalités statistiques de la TI-84 Plus permet non seulement d’automatiser ces calculs avec une vitesse d’exécution remarquable, mais offre également un cadre idéal pour valider les propriétés formelles d’une distribution de probabilité et minimiser les risques d’erreurs arithmétiques.
Le présent traité méthodologique et théorique a pour vocation de guider le lecteur à travers une exploration exhaustive des techniques permettant de déterminer l’espérance mathématique d’une variable aléatoire discrète à l’aide de la TI-84 Plus. En articulant les fondements axiomatiques du calcul des probabilités avec des protocoles opératoires détaillés pas à pas, ce document expose les démarches séquentielles, de la saisie primitive des listes jusqu’à l’implémentation d’algorithmes personnalisés en TI-Basic. Que l’on opte pour l’approche décomposée par produit de Hadamard vectoriel ou pour l’utilisation experte du module 1-Var Stats, chaque protocole est ici disséqué, analysé et mis en perspective à la lumière de cas d’usage académiques, de diagnostics d’anomalies logicielles et d’applications issues de la théorie de la décision.
1. Fondements théoriques de l’espérance mathématique et des distributions de probabilité
1.1 Définition formelle d’une variable aléatoire discrète
Dans le cadre axiomatique formalisé par le mathématicien russe Andreï Kolmogorov en 1933, un espace probabilisé est rigoureusement défini par un triplet fondamental constitué d’un univers des possibles, d’une tribu ou algèbre d’événements sur cet univers, et d’une mesure de probabilité assignant à chaque événement une valeur comprise dans l’intervalle unitaire fermé. Une variable aléatoire discrète, traditionnellement notée par une lettre majuscule telle que X, constitue une application mesurable qui associe à chaque élément de cet espace fondamental un nombre réel appartenant à un ensemble de valeurs dénombrable, fini ou infini. Contrairement aux variables aléatoires continues, dont l’ensemble d’arrivée est constitué d’intervalles denses de la droite réelle nécessitant l’emploi de fonctions de densité de probabilité et le recours à l’intégration au sens de Riemann ou de Lebesgue, la variable discrète se singularise par la nature isolée de ses réalisations potentielles.
La caractérisation complète d’une telle variable repose sur la définition de sa fonction de masse de probabilité, souvent désignée sous le terme de loi de probabilité discrète. Cette fonction fait correspondre à chaque modalité spécifique x la probabilité exacte que la variable aléatoire prenne cette valeur précise. L’ensemble fondamental sous-jacent, bien qu’abstrait et souvent rattaché à des expériences physiques, biologiques ou économiques aléatoires, voit ainsi sa structure probabiliste entièrement projetée sur la droite réelle. La fonction de masse concentre toute l’information stochastique du système : elle permet de quantifier avec une rigueur absolue la vraisemblance de chaque état possible et constitue l’assise mathématique indispensable sur laquelle reposent l’ensemble des moments statistiques, à commencer par le moment d’ordre un, plus communément qualifié d’espérance mathématique.
Il est fondamental de noter que l’affectation des valeurs réelles aux événements élémentaires ne découle pas toujours d’une mesure physique directe ; elle peut procéder d’une convention de codage arbitraire, comme dans le cas des variables indicatrices de Bernoulli, ou d’une quantification financière ou psychométrique. Quelle que soit la nature de l’évaluation numérique, la structure discrète impose que l’ensemble des réalisations puisse être indexé par un ensemble d’indices dénombrable. Cette spécificité topologique confère au calcul des probabilités discrètes une structure purement algébrique, autorisant des opérations de sommation directe sans qu’il soit nécessaire de mobiliser la machinerie du calcul infinitésimal pour la détermination des valeurs centrales.
1.2 Formulation mathématique de l’espérance mathématique
L’espérance mathématique d’une variable aléatoire discrète X, universellement symbolisée par la notation E(X) ou par la lettre grecque mu, représente la valeur théorique moyenne attendue d’un phénomène stochastique lorsque l’expérience associée est réitérée un nombre indéfini de fois dans des conditions strictement identiques et indépendantes. Sur le plan analytique, pour une variable aléatoire prenant un nombre fini de valeurs distinctes x_1, x_2, …, x_n avec des probabilités respectives P(X = x_i), l’espérance s’exprime comme la somme pondérée de toutes les valeurs possibles par leurs probabilités associées. La formule canonique prend la forme suivante : mu = Somme(x_i * P(X = x_i)) pour i variant de 1 à n. Dans l’éventualité d’un ensemble de valeurs infini dénombrable, cette écriture se généralise sous la forme d’une série numérique, sous réserve impérative de la convergence absolue de ladite série pour garantir l’indépendance de la somme par rapport à l’ordre d’indexation des termes.
D’un point de vue géométrique et mécanique, l’espérance mathématique s’interprète rigoureusement comme le barycentre ou le centre de gravité d’une distribution de masses ponctuelles distribuées le long d’un axe unidimensionnel. Si l’on imagine une tige d’épaisseur négligeable sur laquelle chaque point de coordonnée x_i supporte une masse pesante équivalente à sa probabilité P(x_i), le point d’équilibre parfait du système correspond très précisément à l’abscisse mu. Cette analogie mécanique met en lumière la sensibilité de l’espérance aux valeurs extrêmes : une valeur x_i très éloignée de l’origine, même dotée d’une faible probabilité, exercera un moment de force considérable sur la position d’équilibre globale. Cette propriété montre à quel point l’espérance reflète la structure globale de la distribution plutôt qu’une simple tendance locale.
Il importe de souligner la démarcation conceptuelle radicale entre la moyenne empirique observée au sein d’un échantillon fini et l’espérance mathématique théorique issue du modèle probabiliste a priori. Alors que la moyenne arithmétique constitue une grandeur statistique descriptive, fluctuante et sujette à la variabilité d’échantillonnage inhérente à toute observation concrète, l’espérance mathématique est une constante déterministe invariable, intrinsèque à la loi de probabilité sous-jacente. En vertu de la loi forte des grands nombres, la moyenne empirique d’une suite de variables aléatoires indépendantes et identiquement distribuées converge presque sûrement vers cette espérance théorique à mesure que la taille de l’échantillon tend vers l’infini. L’espérance ne décrit donc pas nécessairement le résultat d’un tirage isolé — elle peut d’ailleurs prendre une valeur inaccessible pour la variable elle-même, comme une espérance de 3,5 pour le lancer d’un dé à six faces —, mais elle constitue l’ancre asymptotique de l’ensemble du processus stochastique.
1.3 Conditions de validité d’une distribution de probabilité
Pour qu’un tableau de correspondances ou une fonction numérique puisse prétendre au statut légitime de distribution de probabilité d’une variable aléatoire discrète, deux axiomes fondamentaux et indissociables doivent être simultanément et rigoureusement satisfaits. Le premier de ces critères relève de la contrainte absolue de positivité ou de non-négativité. Pour chaque valeur envisageable x_i appartenant au support de la variable aléatoire, la probabilité assignée doit impérativement être comprise à l’intérieur de l’intervalle fermé [0, 1]. Une probabilité strictement négative est une aberration ontologique dépourvue de sens dans le calcul standard des probabilités, tandis qu’une valeur excédant l’unité violerait le principe fondamental selon lequel la mesure de l’univers tout entier est bornée à 1. Dans la pratique informatique sur calculatrice, toute introduction accidentelle d’une valeur extérieure à cette plage compromet irrémédiablement la cohérence des calculs statistiques ultérieurs.
Le second critère fondamental réside dans la condition de fermeture, couramment désignée sous le vocable de condition de normalisation unitaire. La somme totale de toutes les probabilités associées à l’ensemble exhaustif des réalisations disjointes doit être strictement égale à l’unité : Somme(P(X = x_i)) = 1. Cette égalité traduit l’axiome selon lequel la réalisation d’au moins l’un des événements élémentaires mutuellement exclusifs composant l’espace fondamental est un événement certain. Si la somme des probabilités est inférieure à un, la distribution est dite sous-normalisée, ce qui trahit l’omission d’une ou plusieurs issues potentielles du système. Inversement, une somme supérieure à un indique une redondance ou un chevauchement illicite entre événements supposés disjoints. Dans l’un ou l’autre de ces scénarios déviants, l’application aveugle de la formule de l’espérance aboutirait à une distorsion quantitative du barycentre théorique.
Dans le contexte opérationnel du calcul sur machine, un défi récurrent réside dans l’impact des erreurs d’arrondi sur la cohérence statistique globale. Lorsque les probabilités théoriques dérivent de fractions rationnelles irréductibles — telles qu’un tiers ou un septième — dont le développement décimal est infini, la saisie de représentations décimales tronquées génère inévitablement un écart résiduel par rapport à l’unité. Une somme empirique affichant 0,9999 ou 1,0001 peut sembler négligeable au premier abord ; néanmoins, elle induit un biais systématique dans le calcul des moments d’ordre supérieur et peut déclencher des comportements inattendus au sein des algorithmes internes de la calculatrice. La préservation de la cohérence mathématique exige donc soit la saisie des fractions exactes au sein de l’éditeur de la machine, soit la mise en œuvre d’une étape d’ajustement proportionnel préalablement à toute analyse approfondie.
2. Configuration initiale et préparation de la calculatrice TI-84 Plus
2.1 Initialisation et réinitialisation de l’environnement statistique
L’exactitude des calculs statistiques menés sur une calculatrice graphique de la famille TI-84 dépend en premier lieu de la pureté de son environnement mémoire. Au fil des sessions de travail, l’accumulation de variables temporaires, de fonctions résiduelles stockées dans l’éditeur graphique, ou de listes de données issues d’exercices précédents est susceptible d’interférer avec les opérations en cours. Pour prévenir tout conflit d’allocation de registres, il est vivement conseillé d’accéder au gestionnaire de mémoire de l’appareil. La séquence de touches [2nd] suivie de [MEM] (accessible via la touche du chiffre [+]) ouvre le menu d’administration du système. À partir de cette interface, le choix de l’option de réinitialisation partielle ou totale permet d’assainir la mémoire vive sans nécessairement effacer les programmes archivés ou les applications logicielles intégrées.
Dans la majorité des contextes d’évaluation ou de travaux dirigés, la purge intégrale des listes de données constitue une étape préparatoire indispensable et suffisante. Plutôt que de supprimer manuellement les valeurs cellule par cellule, l’utilisateur gagne à mobiliser l’instruction native ClrList. En accédant au catalogue des fonctions ou en pressant directement [STAT] puis en sélectionnant la commande [4:ClrList] sur l’écran principal, il suffit de renseigner les identifiants des listes ciblées, séparés par une virgule, par exemple ClrList L1, L2, L3. La validation par la touche [ENTER] exécute l’effacement immédiat des registres correspondants, garantissant ainsi que les vecteurs de calcul démarreront sur des structures dimensionnelles vierges, libres de toute scorie numérique.
Une anomalie fréquente rencontrée par les utilisateurs de la TI-84 réside dans la disparition inopinée d’une ou plusieurs colonnes standard au sein de l’éditeur de listes, accident survenant généralement après une fausse manipulation impliquant la touche de suppression de colonne. Lorsque la liste L1 ou L2 n’apparaît plus à l’écran, l’environnement statistique est temporairement désorganisé. La résolution de ce désagrément s’opère instantanément grâce à la commande de restauration de l’éditeur : il convient de presser la touche [STAT], de choisir l’option [5:SetUpEditor], puis d’appuyer sur [ENTER]. Cette procédure rétablit l’ordonnancement par défaut des six listes système fondamentales de L1 à L6, réalignant l’interface sur sa configuration d’usine optimale pour l’accueil de nouvelles données de distribution.
2.2 Réglages de précision et modes d’affichage des décimales
La précision de l’affichage sur l’écran d’une TI-84 Plus est régie par les paramètres définis dans le panneau de configuration fondamental, accessible via la touche [MODE] située au sommet du clavier. Par défaut, la machine doit être configurée sur le réglage Float (flottant) sur la deuxième ligne du menu. Ce mode permet à la calculatrice de restituer le nombre maximal de décimales significatives adaptées à la largeur de l’écran matriciel, évitant ainsi un tronquage artificiel prématuré des probabilités de faible amplitude. Si un mode fixe, tel que Fix 2 ou Fix 3, avait été préalablement sélectionné pour des besoins comptables ou physiques, les probabilités fines — comme 0,0004 — risqueraient d’apparaître sous la forme trompeuse d’un zéro absolu, faussant dramatiquement la perception de la distribution par l’analyste.
Dans le traitement de distributions comportant des probabilités infimes, caractéristiques des événements rares modélisés par exemple par des variantes discrétisées de processus de Poisson, la maîtrise de la notation scientifique s’avère incontournable. Sur la TI-84, la première ligne du menu [MODE] permet de basculer entre le mode standard Normal, le mode scientifique Sci et le mode ingénieur Eng. En conservant le réglage Normal, la calculatrice convertit automatiquement en notation scientifique standard les nombres strictement inférieurs à 0,001 en faisant usage du symbole typographique E, lequel remplace la base dix et son exposant. La distinction rigoureuse entre le symbole d’exposant E et la constante népérienne ou la touche alphabétique est essentielle pour prévenir toute confusion lors de la lecture des résultats d’espérance.
La conservation intégrale des décimales internes joue un rôle déterminant dans la neutralisation du biais d’arrondi cumulatif. Bien que l’afficheur n’explicite qu’un nombre restreint de chiffres à l’écran, le processeur de la TI-84 conserve en réalité les calculs internes codés sur quatorze chiffres significatifs selon la norme arithmétique propriétaire de Texas Instruments. Il est impératif que l’opérateur s’abstienne de réintroduire manuellement des résultats intermédiaires préalablement tronqués à la craie ou sur le papier, sous peine de propager une erreur d’arrondi qui se répercutera directement sur l’espérance calculée. L’utilisation continue des registres mémoire internes et des références dynamiques aux listes constitue la garantie suprême d’une rigueur scientifique irréprochable.
2.3 Présentation de l’éditeur de listes de la TI-84
L’accès à la matrice d’édition des données statistiques s’effectue par une pression sur la touche dédiée [STAT], suivie de la sélection du premier onglet contextuel EDIT et de l’activation de l’option [1:Edit…] par la touche [ENTER]. L’interface qui se déploie alors prend la forme d’un tableau à double entrée structuré en colonnes verticales standardisées, chacune identifiée par son en-tête réservé : L1, L2, L3, jusqu’à L6. Cette architecture bidimensionnelle permet une visualisation spatiale directe des correspondances univoques entre les réalisations de la variable aléatoire et les probabilités qui leur sont respectivement assignées par la fonction de masse.
La navigation au sein de cette grille s’opère au moyen du pavé multidirectionnel situé dans le quadrant supérieur droit du clavier. Le curseur actif se matérialise par une cellule en surbrillance inverse. Au bas de l’écran, une barre d’état dynamique renseigne en temps réel l’adresse précise de l’élément sélectionné ainsi que son contenu numérique exhaustif, lequel s’affiche avec la totalité de ses décimales internes lorsque le curseur stationne sur une cellule donnée. Cette zone d’affichage inférieure constitue un repère visuel indispensable pour inspecter la précision réelle d’une valeur sans se fier uniquement à la représentation condensée imposée par la largeur restreinte des colonnes de l’éditeur.
Pour optimiser la saisie et corriger les erreurs de frappe avec célérité, la TI-84 intègre plusieurs touches de raccourci opératoires hautement fonctionnelles. La touche [DEL] (pour Delete) supprime instantanément la cellule sélectionnée, provoquant la translation vers le haut de l’ensemble des éléments sous-jacents de la colonne. Inversement, la combinaison de touches [2nd] suivie de [INS] (située sur la touche [DEL]) permet d’intercaler une nouvelle cellule vide au-dessus de l’élément actif, facilitant l’intégration d’une modalité omise sans contraindre l’utilisateur à réécrire l’intégralité de la colonne. La maîtrise de ces mécanismes d’édition élémentaires prévient l’apparition d’asymétries de longueur entre les colonnes, source majeure d’interruption logicielle lors de la phase de calcul.
3. Méthode arithmétique pas à pas : Saisie des données dans les listes L1 et L2
3.1 Saisie rigoureuse des valeurs de la variable aléatoire dans L1
La première phase opérationnelle dans la recherche de l’espérance mathématique consiste à consigner l’ensemble des modalités du support de la variable aléatoire au sein de la première liste système, conventionnellement assignée à la colonne L1. En positionnant le curseur sur la première cellule libre identifiée par L1(1), l’opérateur introduit successivement chaque valeur discrète x_i, en validant chaque saisie individuelle par une pression ferme sur la touche [ENTER]. L’appui sur cette touche a pour effet mécanique d’enregistrer la valeur dans le registre tampon et de faire descendre automatiquement le curseur vers la ligne immédiatement inférieure, garantissant ainsi une cadence de frappe fluide et continue.
Une attention typographique et syntaxique toute particulière doit être accordée au traitement des valeurs négatives. Dans de nombreuses applications probabilistes, notamment dans les contextes financiers où la variable aléatoire modélise des pertes nettes ou des rendements d’actifs déficitaires, les réalisations du système prennent des valeurs inférieures à zéro. Sur les calculatrices Texas Instruments, il est impératif d’utiliser la touche de négation unaire notée [(-)], située sur la rangée inférieure à côté de la touche d’entrée, et de ne jamais la confondre avec l’opérateur binaire de soustraction [-] localisé parmi les opérations fondamentales de droite. L’emploi erroné du symbole de soustraction pour désigner un nombre négatif déclenche irrémédiablement une erreur d’exécution de syntaxe et bloque le processus de saisie.
Bien que l’ordre mathématique de sommation soit commutatif dans le cadre d’un support fini, il est fortement recommandé d’introduire les valeurs de la variable de manière strictement monotone croissante. Cette discipline d’ordonnancement facilite la relecture critique, accélère la vérification visuelle de l’exhaustivité des modalités et prévient l’omission d’une valeur charnière ou le dédoublement involontaire d’une modalité identique. Une fois la dernière valeur saisie, l’analyste doit impérativement s’assurer que la taille du support correspond fidèlement à la dimension théorique attendue en vérifiant l’indice numérique indiqué dans la barre d’état inférieure de la calculatrice.
3.2 Saisie des probabilités associées dans L2
Après avoir complété la saisie des valeurs de la variable dans la liste L1, l’utilisateur actionne la flèche directionnelle droite pour déplacer le curseur d’édition dans la colonne adjacente L2, positionnant la sélection sur la cellule initiale L2(1). Cette deuxième liste a pour vocation exclusive de recevoir les pondérations probabilistes P(X = x_i) correspondant biunivoquement à chacune des modalités enregistrées en vis-à-vis dans la colonne L1. L’alignement strict ligne par ligne entre la valeur d’une réalisation et son poids stochastique constitue la condition sine qua non de la validité de l’opération vectorielle à venir.
La saisie des probabilités s’effectue généralement sous forme décimale au moyen de la touche du point typographique [.]. Néanmoins, lorsque les probabilités d’origine sont exprimées sous forme de fractions rationnelles exactes — par exemple lors du tirage de cartes dans un jeu de 52 cartes ou du lancement de plusieurs dés équilibrés —, il est infiniment plus avantageux de saisir directement la fraction dans la cellule, telle que 4/52 ou 1/6. La TI-84 convertit instantanément cette expression fractionnaire en son équivalent décimal interne à haute précision dès que la touche [ENTER] est sollicitée, éliminant ainsi les approximations prématurées et les erreurs humaines de retranscription.
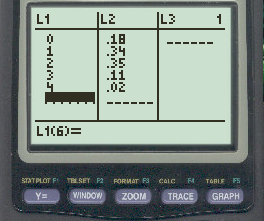
Préalablement à toute étape ultérieure de sommation, un contrôle dimensionnel rigoureux s’impose de façon catégorique. L’analyste doit observer la ligne terminale de son tableau : la dernière cellule remplie de L1 doit être rigoureusement alignée horizontalement avec la dernière cellule remplie de L2. Si l’une des deux colonnes compte un élément de plus ou de moins que sa voisine, le système d’exploitation de la calculatrice se trouvera dans l’incapacité d’effectuer le produit vectoriel terme à terme, ce qui provoquera inéluctablement une interruption d’exécution lors du lancement de la commande arithmétique. La symétrie matricielle des deux vecteurs de données doit être absolue.
3.3 Validation de la somme des probabilités dans L2
Avant d’engager le calcul de l’espérance proprement dit, une démarche scientifique exigeante impose de vérifier expérimentalement la conformité de la distribution saisie avec l’axiome de fermeture. Il est en effet crucial d’exclure toute faute de frappe dans la liste L2, une probabilité mal retranscrite ayant pour conséquence directe de déplacer artificiellement le barycentre de la loi. Pour opérer cette vérification sans altérer l’éditeur de listes, l’utilisateur quitte temporairement cet écran en composant la séquence [2nd] puis [QUIT] (accessible via la touche [MODE]), revenant ainsi à l’écran d’accueil interactif de la machine.
Sur l’écran principal, l’agrégation de la liste des probabilités s’exécute en sollicitant la commande vectorielle sum. Cette instruction est accessible en pressant [2nd] puis [LIST] (situé sur la touche [STAT]), en naviguant à l’aide de la flèche droite vers le sous-menu supérieur MATH, puis en sélectionnant la cinquième commande [5:sum(]. Une fois l’instruction affichée sur la ligne de commande, il convient de spécifier l’argument vectoriel en insérant le nom de la liste des probabilités via le raccourci [2nd] puis [L2] (touche du chiffre [2]), avant de refermer la parenthèse et de presser [ENTER] pour exécuter la requête sum(L2).
Le résultat généré par la calculatrice doit afficher de manière irrévocable la valeur entière 1. Si l’écran affiche un total divergent, par exemple 0,95 ou 1,04, cela signale sans ambiguïté une anomalie dans le jeu de données : une modalité probabiliste a pu être omise, une virgule a pu être décalée, ou une mauvaise valeur a été insérée dans l’une des cellules de L2. L’opérateur doit alors obligatoirement réintégrer l’éditeur de listes via [STAT] [1:Edit], auditer méticuleusement chaque ligne de la distribution, et rectifier les anomalies jusqu’à ce que la condition unitaire sum(L2) = 1 soit scrupuleusement honorée, garantissant l’intégrité de la structure mathématique sous-jacente.
4. Calcul de l’espérance par transformation vectorielle : L1 multiplié par L2 dans L3
4.1 Programmation de l’en-tête de colonne L3
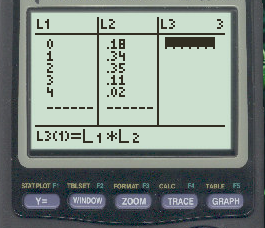
L’une des méthodes les plus transparentes et pédagogiquement éclairantes pour déterminer l’espérance mathématique consiste à utiliser la capacité de la TI-84 à exécuter des opérations vectorielles terme à terme entre les colonnes de son éditeur. Cette approche repose sur la génération dynamique d’une troisième liste, L3, dont chaque élément représentera le produit individuel x_i * P(X = x_i). Pour programmer cette transformation, l’utilisateur retourne dans l’éditeur de données via [STAT] [1:Edit] et déplace le curseur vers le haut jusqu’à surligner en inverse vidéo l’en-tête alphabétique L3 situé au sommet de la troisième colonne.
Lorsque le curseur est positionné directement sur le libellé de l’en-tête et non sur la première cellule, la ligne d’édition située au bas de l’écran bascule en mode de formule générale, signalée par l’égalité L3 =. À cet emplacement précis, l’opérateur compose la formule mathématique en invoquant les identifiants structurels des listes. Il tape successivement [2nd] puis [L1] (touche [1]), appuie sur la touche de multiplication arithmétique [*], puis tape [2nd] suivi de [L2] (touche [2]). La syntaxe visible au bas de l’afficheur prend alors la forme exacte L3 = L1 * L2.
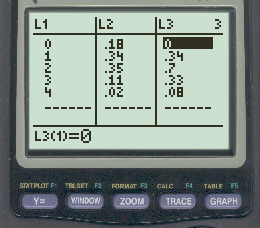
En validant cette instruction par la touche [ENTER], la calculatrice effectue instantanément le calcul matriciel et peuple l’ensemble de la colonne L3 avec les résultats issus du produit terme à terme de chaque cellule de la variable par sa probabilité associée. Cette méthode présente l’avantage inestimable de conserver le lien fonctionnel entre les colonnes : si l’utilisateur modifie ultérieurement une valeur dans L1 ou une probabilité dans L2, le contenu de la colonne L3 est automatiquement recalculé et actualisé en temps réel, évitant toute obsolescence des données intermédiaires.
4.2 Compréhension du produit de Hadamard des listes
L’opération exécutée par la TI-84 lors de la saisie de l’instruction L1 * L2 correspond précisément à ce que l’analyse matricielle désigne sous le nom de produit de Hadamard ou produit composante par composante de deux vecteurs de même dimension. Contrairement au produit scalaire classique qui produit un scalaire unique en sommant les multiplications, le produit de Hadamard génère un nouveau vecteur de dimension identique, au sein duquel chaque élément L3(i) découle de la relation algébrique L3(i) = L1(i) * L2(i). Cette décomposition offre une visibilité directe sur la mécanique interne du calcul probabiliste.
L’observation attentive des valeurs peuplant la colonne L3 permet à l’analyste de mesurer la contribution relative de chaque issue probabiliste à l’espérance mathématique globale. Il devient immédiatement perceptible qu’une issue dotée d’une valeur numérique x_i très élevée mais d’une probabilité d’occurrence marginale peut apporter une contribution arithmétique globale équivalente, voire inférieure, à celle d’une modalité modeste mais hautement récurrente. Cette étape d’auscultation des produits intermédiaires éclaire la dynamique de la distribution en révélant les segments du support qui pèsent le plus lourdement sur la résultante finale.
Par ailleurs, l’examen visuel de la colonne L3 constitue un sas de détection des anomalies numériques et des aberrations opératoires. Si une cellule de la colonne L3 affiche une valeur de signe inattendu, une magnitude disproportionnée ou un format d’erreur, l’opérateur peut immédiatement tracer l’origine de la défaillance en inspectant les entrées correspondantes dans L1 et L2. Cette granularité analytique s’avère particulièrement précieuse dans le cadre de l’apprentissage universitaire, car elle démystifie le processus de pondération en empêchant qu’il soit perçu comme une opération magique dissimulée au cœur du système d’exploitation de la machine.
4.3 Sommation des produits pour obtenir l’espérance finale
Une fois le vecteur des pondérations individuelles matérialisé dans la liste L3, l’achèvement de la procédure nécessite d’exécuter la sommation de l’ensemble de ces composantes pour concrétiser la formule canonique de l’espérance : mu = Somme(L3(i)). L’opérateur quitte l’éditeur de tableaux pour regagner l’écran d’accueil principal en sollicitant la combinaison d’échappement [2nd] puis [QUIT].
Sur l’écran d’accueil, l’utilisateur fait de nouveau appel à l’opérateur d’agrégation vectorielle en composant la séquence [2nd] puis [LIST], en se déplaçant vers l’onglet MATH, et en choisissant la commande [5:sum(]. À l’intérieur de la parenthèse ouverte, il indique cette fois le registre de la liste résultante en tapant [2nd] puis [L3] (touche du chiffre [3]), avant de fermer la parenthèse. L’écran affiche alors la syntaxe épurée sum(L3).
Une ultime pression sur la touche [ENTER] déclenche l’évaluation séquentielle de la somme de tous les éléments de la troisième liste. La valeur scalaire qui s’imprime instantanément sur la ligne de réponse représente sans la moindre ambiguïté l’espérance mathématique exacte de la variable aléatoire modélisée. L’étudiant ou le chercheur peut dès lors consigner cette valeur, rigoureusement documentée par les étapes intermédiaires de son élaboration vectorielle, dans son rapport d’analyse ou sa copie d’examen.
5. Méthode optimisée : Utilisation de la fonction 1-Var Stats avec liste de pondération
5.1 Accès et configuration de la commande 1-Var Stats
Bien que la méthode vectorielle décomposée décrite précédemment offre une clarté pédagogique indéniable, Texas Instruments a intégré au sein du système d’exploitation de la TI-84 un module statistique automatisé d’une remarquable puissance : la fonction 1-Var Stats (statistiques à une variable). Ce sous-programme interne est spécialement conçu pour traiter simultanément les valeurs d’une variable et leurs fréquences ou probabilités de pondération associées, réduisant le temps d’exécution à une simple formalité procédurale. L’accès à cet outil s’effectue en pressant la touche [STAT], puis en déplaçant le curseur vers l’onglet central [CALC] à l’aide de la flèche droite.
Au sein du menu CALC, la toute première option, répertoriée sous l’intitulé [1:1-Var Stats], est sélectionnée par défaut ; il suffit de presser [ENTER] pour l’activer. Sur les modèles récents dotés des systèmes d’exploitation modernes (tels que la TI-84 Plus Silver Edition ou la TI-84 Plus CE), un formulaire guidé d’aide à la saisie, couramment désigné sous le terme d’écran de prompt ou d’assistant statistique, s’affiche alors à l’écran. Cette interface conviviale comporte trois champs paramétriques essentiels : List, FreqList, et la commande d’exécution Calculate.
La configuration de ces paramètres requiert une rigueur absolue. Dans le premier champ intitulé List, l’utilisateur doit impérativement renseigner l’emplacement de la variable aléatoire, soit [2nd] [L1]. Ensuite, en descendant d’une ligne au moyen de la flèche basse, le curseur se positionne sur le champ hautement stratégique nommé FreqList (liste de fréquences ou de pondérations). C’est à cet endroit précis qu’il convient d’assigner la liste des probabilités en introduisant la commande [2nd] [L2]. Laisser ce champ vierge constituerait une faute méthodologique majeure, car la calculatrice traiterait alors chaque valeur de L1 comme une donnée brute équiprobable de fréquence unitaire, annihilant tout le travail de modélisation probabiliste.
5.2 Syntaxe de commande pour les modèles sans menu guidé
Sur les calculatrices TI-84 d’anciennes générations ou lorsque l’option d’assistance interactive a été délibérément désactivée dans les configurations système (mode Stat Wizards: OFF dans le menu [MODE]), la sélection de l’instruction [1:1-Var Stats] ne déploie pas d’écran guidé. À la place, l’instruction textuelle brute 1-Var Stats est directement collée sur l’écran d’accueil interactif, le curseur clignotant attendant que l’opérateur formule la commande selon la syntaxe algorithmique standard de Texas Instruments.
Dans ce contexte non guidé, la convention syntaxique universelle exige que l’utilisateur déclare successivement la liste de la variable aléatoire, suivie d’un séparateur d’arguments obligatoire, puis de la liste contenant les probabilités d’occurrence. Le séparateur requis est exclusivement la virgule textuelle standard, obtenue via la touche spécifique [,] située juste au-dessus de la touche du chiffre [7]. La commande complète formulée par l’opérateur doit donc présenter l’aspect formel suivant : 1-Var Stats L1, L2.
L’omission de la virgule ou l’inversion involontaire des arguments (telle que la syntaxe incorrecte 1-Var Stats L2, L1) conduit à des erreurs d’interprétation désastreuses. Dans le cas d’une inversion, la machine tenterait d’interpréter les probabilités décimales comme des modalités discrètes et les entiers de la variable comme des coefficients de fréquence, générant des résultats dénués de toute signification mathématique. Une fois la ligne d’instruction scrupuleusement vérifiée sur l’afficheur, l’appui sur la touche [ENTER] déclenche l’exécution instantanée des calculs de moments statistiques.
5.3 Lecture et identification des paramètres statistiques générés
Dès la validation de la commande 1-Var Stats, la TI-84 projette sur l’écran un panneau de synthèse dense regroupant une multitude d’indicateurs statistiques univariés. Le premier paramètre affiché à la première ligne, désigné par le symbole x-barre (une lettre x surmontée d’une barre horizontale), indique la moyenne calculée de la distribution. Bien que ce symbole renvoie traditionnellement dans la littérature statistique à la moyenne empirique d’une série d’observations d’échantillon, la calculatrice l’emploie ici par commodité d’affichage typographique pour matérialiser la moyenne théorique pondérée de la loi. En conséquence, la valeur affichée en regard de x-barre équivaut rigoureusement à l’espérance mathématique E(X) = mu recherchée.
La validation de la structure probabiliste s’opère quant à elle par l’inspection de la ligne identifiée par la lettre n, située généralement vers le milieu de la liste déroulante des résultats. Le paramètre n quantifie la somme cumulative des pondérations introduites dans le champ FreqList. Dans le cadre strict d’une distribution de probabilités normalisée, la valeur de n doit impérativement afficher n = 1. Si la ligne n présente une valeur différente de l’unité, cela indique sans équivoque que la liste L2 n’a pas été calibrée sur une échelle de probabilités unitaires mais sur des effectifs bruts ou des pourcentages non réduits, ce qui requiert une interprétation contextualisée immédiate.
Il importe d’effectuer une différenciation théorique scrupuleuse entre les deux métriques de dispersion fournies consécutivement par l’écran de résultats : l’écart-type d’échantillon noté Sx et l’écart-type de population symbolisé par la lettre grecque minuscule sigma-x. Dans le cas où les pondérations représentent des probabilités dont la somme est égale à 1, l’indicateur Sx perd tout fondement opératoire (la division par n – 1 impliquant un dénominateur nul ou sans pertinence physique), et l’afficheur renvoie soit une valeur d’erreur, soit une valeur aberrante. Seule la métrique sigma-x correspond fidèlement à l’écart-type théorique de la variable aléatoire, grandeur dont le carré restitue la variance exacte de la distribution de probabilité.
6. Analyse comparative et validation croisée des deux approches
6.1 Avantages et limites de l’approche matricielle manuelle (L1 * L2)
L’approche matricielle vectorielle reposant sur la programmation explicite de la colonne L3 = L1 * L2 suivie de la sommation sum(L3) brille par son immense valeur didactique. Elle force l’opérateur à matérialiser mentalement et visuellement chaque composante du produit de l’espérance, renforçant l’ancrage conceptuel de la définition théorique. En observant directement la table de valeurs ainsi générée, l’analyste demeure en prise directe avec la structure arithmétique de ses données et peut évaluer d’un simple coup d’œil l’impact relatif de chaque issue sur la tendance globale du système probabiliste étudié.
Un avantage corollaire réside dans la grande flexibilité de manipulation offerte par cette méthode décomposée. Si une distribution particulière exige l’exclusion conditionnelle d’une modalité, l’application d’une fonction de gain non linéaire sous la forme d’une transformation g(X) (par exemple dans le cadre du théorème de transfert où l’on cherche à calculer l’espérance de X^2 ou d’une fonction d’utilité logarithmique), l’approche matricielle permet de programmer avec une aisance déconcertante des colonnes dérivées telles que L4 = (L1^2) * L2. Cette modularité s’avère infiniment supérieure à celle des boîtes noires logicielles préprogrammées.
En contrepartie, cette démarche décomposée comporte des limites opérationnelles patentes, au premier rang desquelles figure un risque accru d’erreur humaine de manipulation. La saisie manuelle de formules dans les en-têtes de colonnes expose l’utilisateur à des écrasements intempestifs de registres de listes, à des corruptions accidentelles de cellules individuelles, ou à des maladresses de syntaxe lors des étapes de navigation successives entre l’éditeur et l’écran principal. De surcroît, cette méthode n’offre pas d’accès direct et immédiat aux indicateurs statistiques de dispersion, obligeant l’utilisateur à bâtir de nouvelles colonnes de calcul pour accéder à la variance et à l’écart-type.
6.2 Efficacité et rapidité de la commande 1-Var Stats
À l’opposé de la démarche décomposée, la mobilisation de la commande native 1-Var Stats assortie de son argument de pondération FreqList représente le summum de l’efficacité computationnelle sur la plateforme TI-84. En une fraction de seconde et par le biais d’un nombre minimal de frappes de touches, cette procédure synthétise l’intégralité du profil statistique de la variable aléatoire. Dans des situations de forte tension temporelle, telles que les épreuves minutées des concours d’entrée aux grandes écoles ou les examens universitaires standardisés, ce gain de temps opérationnel constitue un atout stratégique déterminant pour le candidat.
Au-delà de la simple obtention de l’espérance mathématique mu = x-barre, cette commande précalcule et délivre simultanément une batterie exhaustive de paramètres descriptifs d’un intérêt majeur. L’accès instantané à l’écart-type théorique sigma-x dispense l’opérateur d’un fastidieux calcul manuel de la variance par la formule de König-Huygens. Par ailleurs, la restitution concomitante de la somme brute des pondérations n offre une opportunité de vérification interne instantanée : si n s’écarte de 1, l’analyste sait dans la seconde même qu’une erreur s’est glissée dans sa saisie, sans avoir eu besoin d’exécuter une fonction sommatoire séparée.
Le principal écueil de cette méthode réside paradoxalement dans son automatisation poussée, qui favorise une utilisation machinale dénuée de recul critique. Un utilisateur mal averti risque d’ignorer la fonction du paramètre FreqList, de confondre les rôles de Sx et sigma-x, ou de valider aveuglément des résultats tronqués issus d’une mauvaise désignation des registres de listes. L’efficacité de la fonction 1-Var Stats ne dispense donc en rien d’une compréhension théorique préalable des concepts sous-jacents ; elle en exige au contraire une maîtrise d’autant plus affûtée pour interpréter convenablement l’avalanche d’indicateurs projetés simultanément sur l’écran.
6.3 Protocole de vérification croisée en contexte académique
Face aux enjeux des évaluations académiques de haut niveau, le recours systématique à un protocole de double validation croisée constitue la démarche d’excellence par excellence. Un étudiant ou un chercheur consciencieux ne saurait se satisfaire d’une unique trajectoire de calcul pour valider des conclusions probabilistes déterminantes. La mise en œuvre successive des deux méthodologies — calcul matriciel par L1 * L2 d’une part, et vérification via 1-Var Stats L1, L2 d’autre part — assure une imperméabilité quasi totale face aux aléas de la manipulation machine.
Ce protocole de vérification croisée s’articule autour d’une routine opérationnelle en trois points :
- Exécuter en premier lieu la saisie soignée dans L1 et L2 au sein de l’éditeur de listes, puis programmer la colonne L3 = L1 * L2 afin d’obtenir la vision analytique détaillée et d’agréger par sum(L3).
- Solliciter immédiatement la commande 1-Var Stats L1, L2 sur l’écran d’accueil afin de comparer la valeur de x-barre avec le résultat précédemment affiché par sum(L3), en exigeant une stricte identité jusqu’à la dernière décimale affichable.
- Contrôler que l’indicateur n renvoyé par 1-Var Stats équivaut très exactement à 1,0000000000, confirmant ainsi que le jeu de probabilités satisfait irréfutablement à la condition de fermeture unitaire.
Dans l’éventualité rarissime où une divergence microscopique apparaîtrait entre les deux méthodes au niveau de la douzième ou treizième décimale, celle-ci s’expliquerait par des cheminements algorithmiques internes légèrement distincts au sein du processeur, induisant des dynamiques d’arrondi infinitésimales différentes lors de l’application de la norme en virgule flottante. Dans ce cas, la valeur obtenue par la commande sommatoire directe sum(L3) doit être privilégiée pour sa transparence arithmétique linéaire. Ce protocole d’audit garantit une fiabilité documentaire absolue avant toute retranscription définitive sur feuille d’examen.
7. Cas pratique détaillé : Modélisation d’une distribution de scores sportifs
7.1 Présentation des données empiriques et de la table de probabilité
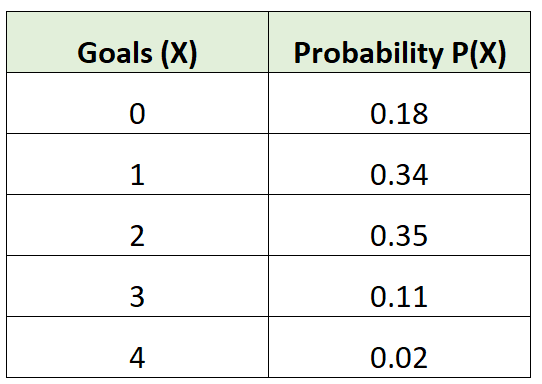
Afin d’illustrer la matérialisation empirique de ces protocoles au sein d’un cas d’étude réaliste, examinons la modélisation statistique du nombre de buts inscrits par une formation professionnelle de football au cours d’un championnat d’élite sur une saison complète. Soit la variable aléatoire discrète X caractérisant le « nombre de buts marqués au cours d’une rencontre officielle par l’équipe étudiée ». L’analyse rétrospective d’un large échantillon de matches a permis d’établir une loi de probabilité empirique robuste, bornant le support des réalisations observables de 0 à 4 buts inscrits par confrontation.
La fonction de masse de probabilité établie par l’équipe d’analystes de la performance se formalise au travers de la distribution tabulaire suivante :
- Pour x = 0 but : probabilité associée P(X = 0) = 0,18
- Pour x = 1 but : probabilité associée P(X = 1) = 0,34
- Pour x = 2 buts : probabilité associée P(X = 2) = 0,35
- Pour x = 3 buts : probabilité associée P(X = 3) = 0,11
- Pour x = 4 buts : probabilité associée P(X = 4) = 0,02
Préalablement à toute intégration informatique, la vérification de la cohérence axiomatique du modèle impose de valider la somme des pondérations : 0,18 + 0,34 + 0,35 + 0,11 + 0,02 = 1,00. La condition de fermeture unitaire étant scrupuleusement satisfaite, et chacune des composantes appartenant rigoureusement à l’intervalle [0, 1], le tableau constitue une distribution de probabilité théoriquement recevable et prête à faire l’objet d’un traitement univarié sur la TI-84.
7.2 Exécution intégrale du calcul sur la TI-84
L’opérateur débute la procédure en purgeant la mémoire statistique de travail. Depuis l’écran d’accueil, il tape la commande ClrList L1, L2, L3 et valide par [ENTER]. Il presse ensuite [STAT] puis [1:Edit…] pour pénétrer dans l’éditeur de tableaux. Dans la colonne L1, il saisit séquentiellement les entiers composant le support de la variable aléatoire : [0] [ENTER], [1] [ENTER], [2] [ENTER], [3] [ENTER], et enfin [4] [ENTER]. La colonne L1 comporte ainsi très exactement cinq éléments étagés du rang 1 au rang 5.
À l’aide du pavé directionnel, le curseur bascule vers la colonne L2 pour y consigner les probabilités associées. L’utilisateur introduit pas à pas : [.] [1] [8] [ENTER], [.] [3] [4] [ENTER], [.] [3] [5] [ENTER], [.] [1] [1] [ENTER], et [.] [0] [2] [ENTER]. Un rapide contrôle visuel confirme que la cellule L1(5) et la cellule L2(5) sont rigoureusement face à face, attestant de la symétrie dimensionnelle du modèle.
L’utilisateur presse alors [STAT], se déplace sur [CALC], et valide [1:1-Var Stats]. Dans l’assistant de configuration, il assigne List: L1 et FreqList: L2, puis sélectionne Calculate. En l’espace d’un battement de cil, la TI-84 calcule la réponse. La première ligne affiche ostensiblement : x-barre = 1.45. Concomitamment, la vérification de la ligne de taille confirme n = 1. L’espérance mathématique de la distribution de buts marqués s’élève donc avec une exactitude mathématique parfaite à très exactement 1,45 but par rencontre.
7.3 Interprétation contextuelle de la valeur obtenue
L’obtention de la valeur numérique E(X) = 1,45 appelle une interprétation conceptuelle et opérationnelle d’une grande rigueur. Sur le plan physique immédiat, il est d’une évidence triviale qu’une formation sportive ne saurait marquer 1,45 but au terme d’une confrontation donnée, le football n’admettant que des réalisations entières positives. L’espérance ne constitue aucunement une prédiction d’un événement discret futur particulier, mais bien la moyenne asymptotique vers laquelle convergera inéluctablement le total cumulé de buts divisé par le nombre de matches joués, à mesure que l’équipe disputera un volume représentatif de rencontres sous ce régime d’efficacité stochastique.
Il est fondamental de dissocier formellement cette espérance de la valeur modale de la distribution. En observant attentivement la fonction de masse, la probabilité maximale culmine à P(X = 2) = 0,35, désignant le score de 2 buts comme le mode de la série probabiliste. De même, la médiane se positionne également sur la valeur 2. Pourtant, l’espérance mathématique s’établit à 1,45, soit une valeur sensiblement inférieure au mode et à la médiane. Cette asymétrie à gauche (ou étalement vers les scores faibles) s’explique par l’influence pondératrice non négligeable des matches à zéro but (18 % des cas) et à un but (34 % des cas), qui tirent le barycentre de la distribution en deçà du sommet de sa densité discrète.
Sur le plan stratégique et décisionnel, une espérance de 1,45 but par match procure à l’encadrement technique et aux statisticiens sportifs une métrique de calibrage prédictif d’une utilité majeure. Elle permet d’établir des modélisations de rentabilité, d’ajuster les cotes sur les marchés de paris sportifs via des distributions de Poisson ajustées sur cette intensité d’espérance lambda = 1,45, et de mesurer à long terme si une modification tactique engendre un gain statistiquement significatif au-delà des simples fluctuations aléatoires saisonnières.
8. Calcul de la variance et de l’écart-type d’une distribution sur TI-84
8.1 Fondements mathématiques de la variance pour variable discrète
Si l’espérance mathématique synthétise de manière admirable le centre de gravité d’une distribution de probabilité, elle s’avère intrinsèquement aveugle quant à la dispersion des valeurs autour de ce pivot central. Deux variables aléatoires peuvent présenter des espérances mathématiques rigoureusement identiques tout en découlant de dynamiques stochastiques radicalement hétérogènes — l’une concentrée étroitement autour de sa moyenne, l’autre dispersée de manière erratique vers des extrêmes opposés. Pour quantifier cette variabilité intrinsèque, le calcul probabiliste mobilise le moment centré d’ordre deux, universellement qualifié de variance mathématique et noté V(X) ou sigma^2.
Sur le plan axiomatique, la variance est définie comme l’espérance mathématique du carré des écarts des valeurs de la variable par rapport à leur espérance théorique. Sa formulation originelle s’écrit : V(X) = E[(X – mu)^2] = Somme((x_i – mu)^2 * P(X = x_i)) pour i balayant l’ensemble du support. Cette sommation d’écarts quadratiques garantit que toutes les déviations, qu’elles soient positives ou négatives, contribuent positivement à l’accroissement de la métrique de dispersion, les écarts majeurs étant amplifiés de façon exponentielle par l’élévation au carré.
Pour des facilités de manipulation analytique et computationnelle, le théorème de König-Huygens reformule cette expression sous une forme équivalente hautement efficiente : V(X) = E(X^2) – [E(X)]^2, signifiant que la variance équivaut à l’espérance des carrés diminuée du carré de l’espérance. La racine carrée positive de la variance engendre quant à elle l’écart-type théorique, désigné par la lettre grecque sigma. Présentant l’immense avantage d’être exprimé dans la même unité physique de mesure que la variable aléatoire sous-jacente — contrairement à la variance qui s’exprime en unités quadratiques —, l’écart-type constitue la mesure de référence universelle du risque, de la volatilité et de l’incertitude dans les modèles stochastiques contemporains.
8.2 Extraction directe des paramètres de dispersion via 1-Var Stats
L’utilisation de la fonction 1-Var Stats L1, L2 sur la TI-84 présente l’avantage exceptionnel de calculer et d’afficher simultanément les composantes de dispersion lors de l’évaluation de l’espérance, épargnant ainsi à l’utilisateur un travail arithmétique manuel particulièrement laborieux et sujet aux bévues de calcul. Dès l’exécution de la commande statistique univariée, l’écran des résultats délivre une lecture exhaustive de la dispersion.
L’analyste doit impérativement porter son attention sur le symbole sigma-x. Sur une calculatrice Texas Instruments, ce symbole est expressément réservé à l’écart-type de population, c’est-à-dire l’écart-type théorique pondéré calculé selon la formule exacte où la somme des carrés est divisée par n (qui vaut 1 dans notre modélisation probabiliste). À l’inverse, l’indicateur Sx qui le précède matérialise l’écart-type d’échantillon, calculé avec un dénominateur correctif de type n – 1 propre à l’inférence statistique inductive. Dans le contexte de l’étude d’une loi de probabilité théorique unitaire où n = 1, le calcul de Sx tente une division par 1 – 1 = 0, se traduisant soit par un symbole d’indétermination, soit par une exclusion pure et simple de l’affichage. L’unique grandeur scientifique de référence à extraire pour l’écart-type est donc sans équivoque sigma-x.
Pour déduire la variance mathématique V(X) à partir des données fournies par 1-Var Stats, l’utilisateur quitte l’écran de synthèse par [2nd] [QUIT] et regagne l’écran principal. Au lieu de retaper manuellement les décimales de sigma-x au risque de provoquer une troncature, la TI-84 offre un mécanisme de rappel dynamique hautement sécurisé. En appuyant sur la touche [VARS], en sélectionnant le menu [5:Statistics…], puis en activant la commande [4:sigma-x], la calculatrice colle le registre exact de l’écart-type directement sur la ligne de commande. Il suffit alors de presser la touche de mise au carré [x^2] suivie de [ENTER] pour afficher la variance théorique exacte de la distribution, calculée à l’abri de toute déperdition de précision.
8.3 Méthode alternative par colonnes personnalisées dans l’éditeur
À l’instar de la démarche vectorielle employée pour le calcul décomposé de l’espérance, il est tout à fait possible et hautement formateur de calculer la variance mathématique directement au sein de l’éditeur de tableaux en mobilisant de nouvelles colonnes pour mettre en scène la formule de définition Somme((x_i – mu)^2 * P(x_i)). Supposons que les valeurs x_i soient archivées dans L1, les probabilités dans L2, et que la valeur scalaire de l’espérance mu préalablement déterminée vaille 1,45 (comme dans notre étude de cas sportive).
L’opérateur accède à l’éditeur via [STAT] [1:Edit…] et déplace son curseur vers l’en-tête de la colonne L4. En mode d’édition de formule d’en-tête, il introduit l’expression des écarts quadratiques par rapport à la moyenne : L4 = (L1 – 1.45)^2 et valide par [ENTER]. La colonne L4 se remplit instantanément des valeurs représentant le carré de la déviation de chaque issue par rapport à l’espérance théorique du système.
Le curseur est ensuite translaté vers l’en-tête supérieur de la colonne L5. Dans cet emplacement, l’utilisateur applique la pondération probabiliste aux écarts quadratiques en composant la formule matricielle L5 = L4 * L2 et valide par [ENTER]. Chaque cellule de la liste L5 contient désormais la contribution élémentaire de chaque modalité à la variance globale du modèle. De retour sur l’écran d’accueil interactif, l’exécution de l’instruction sum(L5) renvoie sans détour la variance mathématique exacte V(X). L’extraction de sa racine carrée par l’opérateur [2nd] [V] confirme l’adéquation parfaite avec la valeur sigma-x fournie par l’algorithme interne de 1-Var Stats, achevant ainsi une boucle de validation scientifique d’une rigueur absolue.
9. Diagnostic des erreurs fréquentes et résolution des anomalies système
9.1 Résolution de l’erreur ERR:DIM MISMATCH
Parmi les messages d’interruption logicielle générés par le système d’exploitation de la TI-84, le signal d’alerte ERR:DIM MISMATCH (erreur d’incompatibilité de dimension) constitue incontestablement l’incident le plus fréquemment rencontré par les étudiants lors de l’évaluation de l’espérance mathématique. Ce message de blocage survient quasi systématiquement lorsque la calculatrice tente d’exécuter une opération matricielle ou un traitement statistique univarié exigeant deux listes d’arguments — typiquement L1 * L2 ou 1-Var Stats L1, L2 — alors que les deux listes impliquées possèdent un nombre inégal d’éléments enregistrés.
Lorsque cette fenêtre d’erreur surgit, la réaction immédiate consiste à ne pas presser aveuglément la touche [1:Quit], mais à sélectionner l’option [2:Goto] si celle-ci est proposée par le menu contextuel, ou à regagner manuellement l’éditeur de listes via [STAT] [1:Edit…]. L’analyste doit descendre tout au bas de ses deux colonnes L1 et L2 pour repérer la ligne de terminaison. Dans la quasi-totalité des cas répertoriés, une liste contient par exemple six entrées tandis que la liste adjacente n’en comporte que cinq, situation survenant fréquemment lorsqu’une probabilité a été accidentellement omise ou qu’une touche d’effacement a supprimé une cellule isolée sans supprimer la ligne correspondante.
La résolution de cette anomalie requiert un réalignement dimensionnel rigoureux. Si un élément est manquant dans l’une des colonnes, l’opérateur peut utiliser la combinaison d’insertion [2nd] [INS] pour ouvrir un espace vide et réintroduire la donnée manquante sans corrompre le reste de la séquence. Si au contraire un zéro parasite ou une valeur surnuméraire stationne au fond d’une colonne à la suite d’un exercice antérieur, il convient de positionner le curseur sur cet intrus et de l’annihiler proprement à l’aide de la touche de suppression individuelle [DEL]. Dès lors que l’égalité dimensionnelle dim(L1) = dim(L2) est matériellement restaurée, la commande statistique s’exécutera sans la moindre entrave logicielle.
9.2 Résolution de l’erreur ERR:DATA TYPE et ERR:STAT
Une autre pathologie d’exécution récurrente se manifeste sous la bannière de l’alerte ERR:DATA TYPE (erreur de type de données). Cette interruption matérielle intervient lorsque l’interpréteur de la TI-84 rencontre un objet dont la nature typologique est incompatible avec les contraintes scalaires de l’arithmétique numérique. L’origine la plus banale de cette anomalie réside dans l’introduction involontaire d’une chaîne de caractères alphabétiques, d’un espace vide non formaté, ou d’une référence textuelle au sein de l’une des cellules des listes statistiques L1 ou L2, phénomène qui se produit couramment lorsqu’une pression maladroite sur la touche alphabétique [ALPHA] a précédé la frappe d’un chiffre.
Un problème particulièrement pernicieux au sein de la communauté francophone concerne la confusion récurrente entre les séparateurs décimaux. Sur la TI-84, le séparateur décimal valide est exclusivement le point typographique [.] localisé sur le pavé numérique inférieur. L’usage accidentel de la virgule syntaxique [,] — réservée par le système à la séparation des arguments au sein des fonctions — au beau milieu d’une cellule de liste déclenche une corruption immédiate de la structure de données. L’utilisateur doit auditer attentivement le contenu de ses colonnes et s’assurer que chaque nombre est bien doté d’un point décimal standard et non d’une virgule syntaxique.
Quant à l’erreur répertoriée sous le libellé ERR:STAT, elle signale généralement un conflit d’allocation statistique plus structurel. Ce dysfonctionnement émerge principalement lorsqu’un tracé graphique statistique (accessible via [2nd] [STAT PLOT]) est resté actif en tâche de fond avec des assignations de listes erronées ou corrompues, pendant que l’utilisateur tente de lancer un calcul univarié sur l’écran d’accueil. La désactivation globale de l’ensemble des tracés graphiques via le menu STAT PLOT (option [4:PlotsOff] validée sur l’écran principal) résout instantanément cette interférence en libérant les registres internes nécessaires au processeur de calcul statistique.
9.3 Anomalies conceptuelles : Probabilités non normalisées
Toutes les défaillances computationnelles ne se traduisent pas nécessairement par un message d’erreur explicite renvoyé par la machine. Les anomalies les plus redoutables sont incontestablement d’ordre conceptuel : la calculatrice exécute fidèlement les opérations demandées, délivre une valeur numérique apparemment recevable, mais le résultat est fondamentalement faussé en raison d’une incohérence dans le modèle soumis. Le cas le plus critique est celui d’une distribution où la somme de la liste de pondération L2 s’écarte substantiellement de l’unité.
Si un utilisateur applique machinalement la formule vectorielle sum(L1 * L2) alors que la somme de L2 équivaut à 1,20 ou 0,80, la valeur obtenue ne représentera en aucun cas l’espérance mathématique de la variable. En effet, la formule canonique de l’espérance présuppose de façon axiomatique que la masse totale de probabilité équivaut exactement à 1. Dans le cas contraire, le calcul vectoriel direct ne calcule plus un barycentre normalisé, mais une somme de moments non mise à l’échelle. En revanche, si l’on applique la fonction 1-Var Stats L1, L2 à un tel tableau, la calculatrice divise automatiquement la somme des produits par la somme cumulée des fréquences n pour afficher x-barre, ce qui compense artificiellement l’absence de normalisation, mais masque à l’analyste l’invalidité probabiliste de sa distribution de départ.
Pour régulariser une distribution de fréquences observées ou de probabilités non normalisées et la convertir en une loi de probabilité rigoureuse, la TI-84 offre une procédure de normalisation algorithmique immédiate. Il suffit de programmer dans l’éditeur de listes la transformation vectorielle de la colonne de pondération au moyen de la formule suivante : L2 = L2 / sum(L2). Par cette instruction unitaire, chaque coefficient individuel de L2 est divisé par la somme totale de la colonne, projetant ainsi instantanément l’intégralité du vecteur sur une échelle unitaire strictement conforme à l’axiome de fermeture. L’évaluation de l’espérance mathématique peut dès lors être engagée avec une sécurité méthodologique absolue.
10. Applications pratiques : Théorie de la décision et modèles comportementaux
10.1 Modélisation de loteries et calcul de l’espérance de gain
L’un des terrains d’application les plus fertiles et les plus intuitifs de l’espérance mathématique réside dans l’ingénierie financière des jeux de hasard et la modélisation mathématique des loteries institutionnelles. Dans ce cadre opérationnel, la variable aléatoire X modélise le gain net financier direct d’un joueur participant à un jeu de tirage sous conditions d’incertitude. Le gain net se formalise rigoureusement comme le gain brut potentiel diminué du coût d’acquisition inhérent au ticket de participation ou à la mise d’engagement. Par conséquent, la distribution statistique comporte quasi universellement une modalité négative significative correspondant à la perte sèche de la mise pour les participants non primés.
Prenons l’exemple académique d’un jeu de tirage équitable où un participant engage une mise forfaitaire de 10 euros. La structure des prix alloue un gain brut de 500 euros avec une probabilité de 0,01, un gain brut de 50 euros avec une probabilité de 0,08, et l’absence de gain brut (0 euro) dans l’ensemble des cas restants, soit une probabilité complémentaire de 1 – 0,01 – 0,08 = 0,91. La formalisation rigoureuse de la variable de gain net X se traduit par les couples suivants :
- Pour les perdants : x_1 = 0 – 10 = -10 euros, avec P(X = -10) = 0,91
- Pour le rang secondaire : x_2 = 50 – 10 = +40 euros, avec P(X = 40) = 0,08
- Pour le gros lot : x_3 = 500 – 10 = +490 euros, avec P(X = 490) = 0,01
En consignant ces valeurs dans la TI-84 — en prenant bien soin d’introduire le montant négatif via la touche [(-)] 10 dans L1 et les probabilités dans L2 —, l’exécution de 1-Var Stats L1, L2 délivre une espérance mathématique x-barre = -1.00 euro. Cette grandeur fondamentale permet de trancher avec certitude quant à l’équité du jeu : l’espérance étant strictement négative, la loterie est dite inéquitable ou en défaveur absolue du joueur. Sur un nombre considérable de participations réitérées, le joueur perdra en moyenne mathématique un euro par ticket validé. L’analyse de l’espérance met ainsi en lumière le mécanisme mathématique qui assure aux opérateurs de loteries des marges bénéficiaires déterministes à l’abri de toute incertitude de long terme.
10.2 Évaluation du risque en psychologie de la décision
Si l’espérance mathématique objective constitue la norme cardinale de la décision rationnelle en environnement classique, l’analyse comportementale et l’économie expérimentale ont mis en lumière les limites patentes de cette métrique pour décrire les choix humains effectifs en situation d’incertitude. Le paradoxe de Saint-Pétersbourg, historiquement formalisé par Daniel Bernoulli au XVIIIe siècle, a magistralement démontré que l’esprit humain ne cherche pas à maximiser l’espérance monétaire brute mais l’espérance d’une fonction d’utilité subjective non linéaire, souvent caractérisée par une concavité marquée traduisant une aversion intrinsèque au risque.
Ces travaux ont culminé à la fin du XXe siècle avec l’avènement de la théorie des perspectives développée par Daniel Kahneman et Amos Tversky. Cette théorie postule que les décideurs réels évaluent les issues sous forme de gains ou de pertes par rapport à un point de référence neutre, manifestent une aversion aux pertes bien supérieure à l’attrait d’un gain équivalent, et distordent les probabilités objectives au moyen d’une fonction de pondération subjective qui surestime systématiquement les événements de très faible probabilité et sous-estime les probabilités moyennes et élevées.
La TI-84 Plus constitue un laboratoire d’expérimentation d’une puissance remarquable pour quantifier ces modèles comportementaux avancés. En programmant dans une colonne dédiée L3 une fonction d’utilité ou de valeur de type v(x) — par exemple L3 = L1^(0.88) pour les gains positifs et L3 = -2.25 * ((-L1)^(0.88)) pour les pertes selon les calibrations standards de Tversky et Kahneman —, puis en pondérant ces utilités par les probabilités réelles ou distordues stockées dans L2, l’étudiant peut calculer sur sa calculatrice l’utilité espérée globale d’un arbre décisionnel complexe. Cette démarche établit un pont opératoire concret entre l’abstraction des théories psychologiques contemporaines et la rigueur du calcul stochastique univarié.
10.3 Discrétisation de variables psychométriques pour l’analyse prédictive
Dans les sciences comportementales, la sociologie quantitative et la psychométrie contemporaine, la mesure des attitudes, des traits de personnalité latents ou des états affectifs recourt très fréquemment à des échelles de mesure ordinale de type Likert en 5 ou 7 points d’ancrage sémantique (allant par exemple de « Pas du tout d’accord » codé 1 jusqu’à « Entièrement d’accord » codé 5). La transformation de ces distributions de fréquences empiriques en modèles de variables aléatoires discrètes permet de soumettre ces indicateurs qualitatifs aux opérations d’évaluation stochastique.
Considérons l’administration d’un questionnaire standardisé évaluant l’épuisement professionnel auprès d’une cohorte clinique représentative. La distribution des réponses sur un item pivot se traduit par un support discret X = {1, 2, 3, 4, 5} consigné dans la colonne L1 de la TI-84. Les fréquences relatives observées, assimilées aux probabilités d’occurrence de la population étudiée, sont saisies dans L2 : par exemple 0,05 pour le niveau 1 ; 0,15 pour le niveau 2 ; 0,40 pour le niveau 3 ; 0,30 pour le niveau 4 ; et 0,10 pour le niveau 5. L’évaluation de l’espérance mathématique par la procédure 1-Var Stats L1, L2 délivre immédiatement la valeur attendue mu = 3,25.
Dans ce cadre analytique, l’espérance mathématique fonctionne comme l’indicateur central du score d’échelle du trait latent au sein du groupe étudié. Bien que l’échelle Likert soit fondamentalement ordinale au plan strict de la théorie de la mesure de Stevens, son traitement en variable aléatoire discrète permet de calculer des espérances conditionnelles, de comparer quantitativement la charge de détresse psychologique entre différentes sous-populations professionnelles, et de concevoir des matrices d’aide à la décision clinique fondées sur la modélisation probabiliste du comportement humain.
11. Automatisation avancée : Création d’un programme TI-Basic dédié
11.1 Architecture algorithmique du script de calcul d’espérance
Lorsque la détermination des paramètres de distributions de probabilités discrètes s’inscrit dans un flux de travail répétitif, la saisie récurrente de commandes au sein de menus multiples peut devenir source de lassitude et d’erreurs opératoires. Le développement d’un programme autonome rédigé dans le langage natif TI-Basic embarqué au cœur de la TI-84 permet de concevoir une interface interactive épurée, assurant la prise en charge intégrale de la chaîne de calcul, depuis la collecte interactive des données jusqu’à la restitution ergonomique des métriques fondamentales.
L’architecture algorithmique d’un tel script doit répondre à un cahier des charges fonctionnel exigeant, articulé en quatre phases logiques séquentielles :
- Une phase d’initialisation assurant l’effacement de l’écran texte, l’affichage d’une bannière informative et la purge préventive des registres vectoriels dédiés.
- Une boucle interactive d’acquisition de données sollicitant de l’utilisateur le nombre exact de modalités distinctes de la variable aléatoire, suivie de l’introduction pas à pas des couples successifs composés de la modalité x_i et de sa probabilité associée P(x_i).
- Un module critique d’évaluation de cohérence axiomatique, chargé de sommer la liste des probabilités saisies afin d’interrompre l’exécution et de notifier l’opérateur en cas d’écart statistiquement significatif par rapport à la condition de normalisation unitaire Somme(P) = 1.
- Une phase terminale de traitement computationnel et de restitution visuelle formatée, projetant simultanément à l’écran l’espérance mathématique E(X), la variance théorique V(X) ainsi que l’écart-type de population sigma(X).
11.2 Codage pas à pas dans l’éditeur de programmes TI-Basic
Pour implémenter cet algorithme sur la calculatrice, l’opérateur active le gestionnaire de programmes en pressant la touche dédiée [PRGM], navigue vers la droite jusqu’à l’onglet [NEW], et sélectionne l’option [1:Create New]. La machine l’invite alors à nommer son script en utilisant les caractères alphabétiques : nous pouvons par exemple le nommer ESPERANC (la longueur du libellé étant matériellement bornée à huit caractères alphanumériques sous l’environnement Texas Instruments) avant de valider par [ENTER].
Le codage de l’algorithme s’effectue séquentiellement en composant les instructions textuelles accessibles via la touche [PRGM] (qui déploie désormais les menus de structures de contrôle et d’entrées/sorties) :
:ClrHome (accessible via [PRGM] [I/O] [8:ClrHome] pour nettoyer l’afficheur)
:Disp « ESP PROBABILITE » (instruction [PRGM] [I/O] [3:Disp] pour afficher le titre)
:Prompt N (instruction [PRGM] [I/O] [2:Prompt] invitant à définir le nombre de modalités)
:{N}->dim(L1) (dimensionnement vectoriel direct via [2nd] [LIST] [OPS] [3:dim])
:{N}->dim(L2)
:For(I,1,N) (boucle d’itération via [PRGM] [CTL] [4:For])
:ClrHome
:Disp « MODALITE »,I
:Prompt X
:X->L1(I) (stockage de la modalité dans L1)
:Disp « PROBABILITE »,I
:Prompt P
:P->L2(I) (stockage de la probabilité dans L2)
:End (clôture de la boucle via [PRGM] [CTL] [7:End])
:sum(L2)->S (sommation de contrôle de fermeture unitaire)
:If abs(S-1)>0.001 (structure conditionnelle de sécurité via [PRGM] [CTL] [1:If])
:Then
:Disp « ERREUR: SOMME P!=1 »
:Stop (interruption de sécurité via [PRGM] [CTL] [8:Stop])
:End
:sum(L1*L2)->E (calcul vectoriel direct de l’espérance mathématique)
:sum((L1-E)^2*L2)->V (calcul vectoriel direct de la variance théorique)
:V(V)->D (calcul de l’écart-type théorique via la racine carrée)
:ClrHome
:Disp « E(X) = »,E (restitution des résultats finaux formatés)
:Disp « V(X) = »,V
:Disp « SIGMA= »,D
:Stop
L’achèvement de la saisie du code se conclut en quittant l’éditeur par la combinaison [2nd] [QUIT]. Le programme compilé est désormais prêt à l’emploi et définitivement consigné dans la mémoire vive de l’appareil.
11.3 Optimisation du code et restitution des métriques complètes
L’exécution de ce script personnalisé s’opère sur l’écran principal par un simple appui sur [PRGM], suivi de la sélection du programme sous l’onglet [EXEC] et de la validation par [ENTER]. L’interface utilisateur guide pas à pas le praticien dans la saisie de ses paramètres sans exiger de sa part la moindre manipulation de listes dans les menus matriciels conventionnels, éliminant de facto tout risque de glissement dimensionnel ou de mauvaise application de la liste de pondération.
Un raffinement algorithmique supplémentaire réside dans la gestion de la mémoire utilisateur à la terminaison du programme. Dans la version de base détaillée ci-dessus, les listes L1 et L2 sont modifiées de manière transparente, ce qui permet à l’utilisateur de réexaminer ses données a posteriori dans l’éditeur s’il souhaite procéder à un contre-interrogatoire visuel. Si l’on préfère préserver l’intégrité des listes par défaut de la machine, il est tout à fait possible de substituer dans le code source les identifiants L1 et L2 par des listes personnalisées nommées (par exemple LPROB et LVAL), isolant ainsi totalement l’exécution du programme des registres conventionnels de l’élève.
Enfin, la dissémination de cet utilitaire statistique s’avère d’une remarquable simplicité au sein d’une promotion universitaire ou d’un groupe d’étude. Grâce au port mini-USB standard embarqué sur les modèles contemporains de la TI-84 et au câble de liaison inter-calculatrices, l’outil de transmission de données accessible via la séquence [2nd] [LINK] permet de transférer le script compilé d’une machine émettrice vers un appareil récepteur en une fraction de seconde, conférant à l’ensemble du groupe de travail un outil d’audit probabiliste d’une fiabilité absolue.
12. Bonnes pratiques académiques, vérification et rédaction des conclusions
12.1 Normes de présentation des calculs dans les travaux universitaires
Dans le cadre des évaluations universitaires et des examens nationaux sanctionnant les cycles d’études supérieures, la possession d’une réponse numérique correcte ne représente qu’une fraction de l’attente du jury d’évaluation. L’outil informatique, aussi puissant soit-il, ne saurait se substituer à la démonstration formelle du raisonnement épistémologique. Afficher directement sur sa copie une espérance de 1,45 en se bornant à mentionner « calculé sur TI-84 » est unanimement sanctionné par les commissions d’examen comme un manquement flagrant à l’exigence de rigueur scientifique.
La transcription académique irréprochable d’un calcul d’espérance mathématique doit obligatoirement respecter une trame rédactionnelle tripartite codifiée :
- L’explicitation formelle et littérale de la formule générale du moment d’ordre un régissant la distribution discrète : E(X) = Somme(x_i * P(X = x_i)).
- La présentation claire du tableau de la loi de probabilité récapitulant les modalités disjointes et leurs probabilités respectives, accompagnée de la mention expresse confirmant que la condition de normalisation est remplie (Somme P(X = x_i) = 1).
- Le développement arithmétique explicite intégrant les valeurs numériques de l’exercice au moins sur les premiers et derniers termes de la somme, matérialisé par une formulation linéaire : E(X) = (0 * 0,18) + (1 * 0,34) + (2 * 0,35) + (3 * 0,11) + (4 * 0,02).
Ce n’est qu’au terme de ce déploiement démonstratif que l’analyste peut légitimement consigner la valeur numérique finale obtenue sur la TI-84. La calculatrice graphique doit être explicitement désignée dans le corps du devoir comme un instrument de vérification computationnelle et d’assistance au calcul arithmétique, et non comme une boîte noire décisionnelle dispensant l’étudiant de justifier le substrat théorique sur lequel repose son argumentation mathématique.
12.2 Règles d’arrondi et conservation de la précision scientifique
La gestion des chiffres significatifs et des approximations numériques conditionne directement la crédibilité scientifique d’un rapport technique ou d’un mémoire de recherche en modélisation probabiliste. Une règle cardinale trop souvent transgressée consiste à opérer des arrondis précoces sur les valeurs intermédiaires lors du remplissage des tables de données ou de l’application de fonctions de transfert sur le support de la variable aléatoire. L’arrondi prématuré agit comme un poison arithmétique cumulatif dont la dérive se propage de façon exponentielle au travers des sommations et des élévations quadratiques ultérieures.
Dans la mesure du possible, l’analyste doit impérativement privilégier l’usage des valeurs rationnelles exactes sous forme de fractions irréductibles lors de la saisie dans la liste L2 de la TI-84, laissant au processeur de la calculatrice le soin de gérer la conservation interne de la mantisse sur quatorze chiffres significatifs. Ce n’est qu’au moment de la rédaction finale des conclusions que la métrique terminale fait l’objet d’un arrondi conventionnel, dont la granularité doit être scrupuleusement indexée sur la précision des instruments de mesure d’origine du phénomène observé.
En l’absence de directive académique explicite imposant une norme particulière (telle qu’un arrondi à deux ou trois décimales par exemple), il est généralement recommandé de conserver au minimum un chiffre significatif de plus dans l’expression de l’espérance mathématique que le niveau de précision caractérisant les modalités du support initial. De surcroît, toute valeur décimale tronquée doit être accompagnée de l’opérateur d’approximation adéquat et non d’une fausse égalité absolue, traduisant ainsi une conscience aiguë des frontières séparant la perfection de l’objet mathématique abstrait de son approximation computationnelle concrète.
12.3 Synthèse procédurale et aide-mémoire opérationnel
En guise de synthèse opérationnelle immédiatement mobilisable lors de situations d’évaluation ou de calculs d’ingénierie sous contrainte de temps, l’ensemble des protocoles méthodologiques exposés au sein de ce document peut être condensé sous la forme d’un aide-mémoire procédural unifié. Ce guide séquentiel garantit l’accès le plus direct, le plus rapide et le plus sécurisé à l’évaluation de l’espérance d’une loi de probabilité discrète sur la TI-84 Plus :
Séquence opératoire universelle en 5 étapes clés :
- Assainissement : Pressez [2nd] [MEM], sélectionnez ClrAllLists puis [ENTER], ou exécutez la commande d’échappement ClrList L1, L2 sur l’écran d’accueil interactif pour garantir l’indépendance de votre session de calcul.
- Remplissage des vecteurs : Accédez à l’éditeur via [STAT] [1:Edit…]. Encodez scrupuleusement les modalités de la variable x_i dans L1 (en mobilisant impérativement [(-)] pour les négatifs) et les probabilités P(x_i) dans L2 (sous forme décimale ou fractionnaire).
- Audit dimensionnel : Vérifiez horizontalement le parallélisme absolu du tableau : la ligne finale de L1 doit être alignée de façon symétrique avec la ligne finale de L2 pour neutraliser tout risque d’interruption ERR:DIM MISMATCH.
- Exécution univariée : Pressez [STAT], naviguez vers [CALC], activez [1:1-Var Stats]. Dans le menu contextuel guidé, affectez List: L1 et FreqList: L2, puis validez sur Calculate (ou tapez la commande formelle 1-Var Stats L1, L2 sur les modèles sans assistant).
- Extraction et validation : Identifiez la valeur de l’espérance mathématique en lisant la première ligne x-barre. Vérifiez immédiatement la conformité probabiliste sur la ligne de sommation en confirmant que n = 1. Extrayez si nécessaire la valeur de l’écart-type théorique en consignant la grandeur sigma-x.
En intégrant ces réflexes opératoires et en conservant une conscience permanente des passerelles reliant l’algèbre matricielle aux axiomes fondamentaux des probabilités, l’utilisateur de la TI-84 transforme sa calculatrice graphique en un instrument d’analyse stochastique d’une précision infaillible, gage d’excellence académique et de rigueur professionnelle durable.
Références
Bernoulli, D. (1954). Exposition of a new theory on the measurement of risk. Econometrica, 22(1), 23-36. https://doi.org/10.2307/1909829 (Ouvrage original publié en 1738)
Kahneman, D., & Tversky, A. (1979). Prospect theory: An analysis of decision under risk. Econometrica, 47(2), 263-291. https://doi.org/10.2307/1914185
Kolmogorov, A. N. (1956). Foundations of the theory of probability (N. Morrison, Trad.; 2e éd.). Chelsea Publishing Company. (Ouvrage original publié en 1933)
Saporta, G. (2011). Probabilités, analyse des données et statistique (3e éd.). Éditions Technip.
Texas Instruments. (2020). Guide de référence de la calculatrice graphique TI-84 Plus CE. Texas Instruments Incorporated. https://education.ti.com
Wackerly, D. D., Mendenhall, W., & Scheaffer, R. L. (2008). Mathematical statistics with applications (7e éd.). Thomson Brooks/Cole.