
Dans le champ foisonnant des sciences comportementales, de la psychologie cognitive et de la recherche biomédicale, l’inférence statistique constitue la pierre angulaire permettant de transformer de simples observations numériques en conclusions théoriques robustes. Parmi l’arsenal d’outils quantitatifs mis à la disposition des chercheurs, les tests de comparaison de moyennes occupent une place prépondérante. Le test t de Student représente très souvent la première épreuve de vérité méthodologique à laquelle est soumise une hypothèse expérimentale. Pourtant, sous cette appellation générique se cache une bifurcation fondamentale qui engage l’architecture même du protocole de recherche : l’opposition entre le test t pour échantillons indépendants (ou non apparié) et le test t pour échantillons dépendants (ou apparié).
Le choix entre ces deux déclinaisons ne relève nullement d’une simple préférence computationnelle ou d’une commodité analytique secondaire. Il reflète fidèlement la structure du devis expérimental, dictant la manière dont la variabilité interindividuelle est appréhendée, modélisée, puis neutralisée ou conservée au sein du terme d’erreur. Une méprise à cette étape charnière peut conduire à des erreurs de décision statistique désastreuses : soit une perte dramatique de puissance statistique incapable de détecter un effet pourtant bien réel (erreur de type II), soit à l’inverse une sous-estimation artificielle de la variance d’échantillonnage générant des faux positifs trompeurs (erreur de type I).
Cet article propose une exploration exhaustive, didactique et rigoureuse des fondements, des mécanismes mathématiques sous-jacents, des hypothèses de validité et des applications cliniques du test t apparié et du test t non apparié. Destiné aux chercheurs, étudiants et analystes soucieux de consolider leurs bases méthodologiques, ce guide décortique pas à pas chaque composante théorique tout en proposant des études de cas détaillées et des recommandations conformes aux plus hauts standards académiques contemporains.
1. Fondements statistiques et rôle des tests t en psychologie
1.1 Origine et utilité du test t de Student en sciences comportementales
L’histoire de la statistique moderne est jalonnée d’avancées pratiques nées de contraintes industrielles et expérimentales réelles. Le test t de Student doit son existence aux travaux pionniers de William Sealy Gosset au début du XXe siècle. Chimiste et statisticien en chef au sein de la brasserie Guinness à Dublin, Gosset était confronté à un dilemme récurrent : comment évaluer la qualité des matières premières agricoles, telles que le malt ou le houblon, à partir d’échantillons d’une taille extrêmement réduite ? À cette époque, la théorie statistique classique reposait quasi exclusivement sur la loi normale, qui exigeait la connaissance préalable de la variance de la population générale ou, à tout le moins, de très grands échantillons permettant une approximation fiable via le théorème central limite.
Contraint par la politique stricte de confidentialité de son employeur lui interdisant toute publication scientifique sous son patronyme civil, Gosset fit paraître son article séminal de 1908 dans la revue Biometrika sous le pseudonyme désormais immortel de « Student ». Son apport révolutionnaire réside dans la dérivation exacte de la distribution de probabilité d’une moyenne échantillonnale standardisée lorsque l’écart-type de la population demeure inconnu et doit être estimé à partir des données observées. Cette distribution, baptisée distribution t de Student, présente des queues plus épaisses que la distribution normale standard, reflétant directement l’incertitude supplémentaire induite par l’estimation simultanée de la moyenne et de la variance à partir de petits effectifs.
Dans le domaine des sciences comportementales et de la psychologie, cette percée conceptuelle a trouvé un terrain d’application fertile. Les chercheurs en psychologie clinique, en neuropsychologie ou en psychologie sociale travaillent très fréquemment avec des cohortes de taille modeste. Les contraintes éthiques, le coût financier substantiel de la passation de tests standardisés, la rareté de certains profils cliniques (comme les patients cérébrolésés) ou la complexité des enregistrements électrophysiologiques limitent souvent les échantillons à quelques dizaines de participants. L’inférence statistique via le test t permet d’estimer les paramètres réels d’une population cible tout en tenant compte explicitement de la fluctuation d’échantillonnage inhérente à la variabilité psychologique des êtres humains.
1.2 Distinction préliminaire entre plan intra-sujet et plan inter-sujets
La compréhension de la statistique inférentielle appliquée exige une articulation sans faille entre le formalisme mathématique et la méthodologie de la recherche expérimentale. Au cœur de cette articulation se trouve la distinction fondamentale entre le devis à mesures répétées, qualifié de plan intra-sujet (within-subjects design), et le devis à groupes indépendants, qualifié de plan inter-sujets (between-subjects design). Cette taxonomie méthodologique détermine de façon biunivoque le choix de l’algorithme de comparaison de moyennes à mobiliser.
Dans un plan inter-sujets, chaque participant est assigné de façon exclusive à une seule modalité de la variable indépendante. Par exemple, un chercheur évaluant l’efficacité d’une technique d’ancrage mnésique comparera un groupe de participants ayant suivi l’entraînement à un groupe distinct de participants n’ayant reçu aucune instruction particulière. L’avantage conceptuel majeur de ce devis réside dans l’absence totale de contamination croisée entre les conditions : aucun participant ne subit les effets de report, d’apprentissage ou de lassitude générés par une exposition séquentielle à de multiples modalités. En contrepartie, ce plan souffre d’un bruit de fond considérable, car les différences observées entre les groupes englobent non seulement l’effet du traitement expérimental, mais aussi la variabilité interindividuelle préexistante (capacités cognitives de base, traits de personnalité, niveau d’attention).
À l’opposé, le plan intra-sujet soumet chaque individu de l’échantillon à l’ensemble des conditions expérimentales de l’étude, ou recueille des mesures longitudinales répétées au fil du temps. Le paradigme classique pré-test / post-test en psychothérapie constitue l’illustration la plus éclatante de cette approche. Ici, chaque participant devient son propre témoin statistique. Cette configuration méthodologique a des répercussions considérables sur la validité interne du protocole : en mesurant les variations au sein même de chaque individu, le statisticien isole la variance imputable à l’intervention en purgeant le terme d’erreur de la variance stable propre aux individus. C’est précisément cette divergence d’architecture qui impose le recours, soit au test t non apparié pour les plans inter-sujets, soit au test t apparié pour les plans intra-sujets.
1.3 Objectifs scientifiques de la comparaison de deux moyennes
Pourquoi la comparaison de deux moyennes demeure-t-elle l’une des opérations les plus courantes dans la démarche scientifique empirique ? Sur le plan méthodologique, elle répond au besoin de quantifier l’impact d’une variable indépendante catégorielle dichotomique (présence vs absence de traitement, condition A vs condition B, groupe clinique vs groupe sain) sur une variable dépendante quantitative mesurée sur une échelle d’intervalle ou de rapport (temps de réaction en millisecondes, score d’anxiété sur une échelle psychométrique, concentration salivaire de cortisol).
Sur le plan épistémologique, la comparaison de moyennes s’inscrit dans la démarche de décision statistique théorisée par Jerzy Neyman et Egon Pearson, combinée aux principes de significativité initiés par Ronald Fisher. L’objectif premier est d’évaluer la vraisemblance des données empiriques observées sous l’égide d’une hypothèse par défaut, appelée hypothèse nulle (désignée conventionnellement par H0). Cette hypothèse postule l’absence totale de différence ou d’effet dans la population d’origine :
H0 : μ1 – μ2 = 0 (ou μD = 0)
Face à cette posture conservatrice, le chercheur formule une hypothèse alternative (désignée par H1), qui affirme l’existence d’une divergence systématique entre les paramètres des populations étudiées :
H1 : μ1 – μ2 ≠ 0 (ou μD ≠ 0)
Qu’il s’agisse de mesurer le gain thérapeutique induit par une prise en charge cognitive-comportementale ou d’identifier une asymétrie de vitesse de traitement de l’information entre les deux hémisphères cérébraux, le test t fournit le cadre inférentiel standardisé permettant d’évaluer si l’écart empirique observé dépasse ce qui pourrait être raisonnablement attribué aux simples aléas d’échantillonnage.
2. Définition et caractéristiques du test t non apparié (échantillons indépendants)
2.1 Principe fondamental de l’indépendance d’échantillonnage
Le test t non apparié, également désigné sous le vocable de test t pour échantillons indépendants ou test t inter-groupes, repose sur un postulat méthodologique strict : l’indépendance probabiliste absolue entre les deux ensembles d’observations comparés. Cela signifie que la valeur mesurée pour un individu donné appartenant au premier groupe ne fournit aucune information prédictive, n’exerce aucune influence et ne présente aucune covariance avec la valeur mesurée pour un individu quelconque du second groupe.
Sur le plan pratique et expérimental, cette condition d’indépendance est traditionnellement garantie par la procédure de randomisation (assignation aléatoire). Lorsqu’un panel de sujets représentatifs d’une population est recruté, chaque individu est attribué à l’un des deux groupes par le biais d’un mécanisme purement aléatoire (tirage au sort, table de nombres aléatoires ou algorithme de permutation pseudorandomisée). Cette randomisation vise à répartir de manière équitable l’ensemble des variables parasites, observables ou latentes, entre les deux conditions, éliminant ainsi toute corrélation systématique entre les membres des deux cohortes.
D’un point de vue structurel et informatique, les données destinées à un test t non apparié se présentent sous la forme de deux vecteurs distincts d’observations non appariables. Si le chercheur dispose d’une base de données, chaque ligne représente une entité physique ou un participant unique, associé à une variable dépendante continue et à un facteur inter-sujets à deux niveaux spécifiant l’appartenance groupale. Les deux groupes peuvent d’ailleurs présenter des effectifs différents (n1 ≠ n2), cette asymétrie numérique ne remettant nullement en cause la faisabilité computationnelle du test, bien qu’elle affecte sa robustesse face à la violation d’autres postulats.
2.2 Scénarios typiques d’application en recherche clinique et sociale
Le spectre d’application du test t pour échantillons indépendants est particulièrement vaste en sciences humaines et médicales. L’un des archétypes demeure l’essai contrôlé randomisé (ECR) à deux bras. Dans le cadre de l’évaluation clinique d’un nouveau protocole de prise en charge du trouble de stress post-traumatique, par exemple, un groupe de patients reçoit une psychothérapie innovante tandis qu’un second groupe, recruté parallèlement, est orienté vers une liste d’attente ou un traitement de soutien standardisé. À l’issue de l’intervention, la sévérité résiduelle des symptômes est comparée entre ces deux populations indépendantes.
Un deuxième grand champ d’application réside dans l’étude des différences individuelles associées à des variables catégorielles quasi-expérimentales ou invoquées. Dans cette configuration, le chercheur ne manipule pas directement la variable indépendante, car celle-ci reflète des états biologiques, développementaux ou démographiques intrinsèques aux sujets. On comparera ainsi les performances en mémoire épisodique entre un groupe de sujets bilingues simultanés et un groupe de sujets strictement monolingues, ou encore le niveau de dépression mesuré chez des patients atteints d’une pathologie neurodégénérative comparativement à des témoins sains appariés sur la tranche d’âge.
Enfin, la psychologie du travail et des organisations recourt massivement à ce test pour évaluer les disparités d’attitudes ou de santé psychologique au travail selon les contextes organisationnels. Un consultant peut ainsi analyser si le score d’épuisement professionnel (burnout) diffère de façon statistiquement significative entre les salariés opérant dans un environnement en télétravail complet et ceux travaillant exclusivement sur site en présentiel. Dans tous ces cas de figure, les participants du groupe A ne partagent aucun lien de mesure avec les participants du groupe B.
2.3 Mécanisme de calcul de la variance combinée
L’estimation de l’erreur type de la différence entre les deux moyennes constitue le cœur algorithmique du test t non apparié classique (conçu par Student). Puisque les deux groupes proviennent théoriquement d’une même population parente (sous l’hypothèse nulle) ou de deux populations partageant une dispersion similaire, le modèle statistique postule l’égalité des variances des deux groupes, propriété connue sous le nom d’homoscédasticité (σ12 = σ22 = σ2).
Afin d’estimer cette variance commune inconnue σ2 avec le maximum d’efficience et de précision, le test calcule la variance combinée ou pondérée (communément désignée dans la littérature anglo-saxonne sous le terme de pooled variance, notée sp2). Cette grandeur mathématique correspond à la moyenne pondérée des variances observées dans chaque groupe, les poids étant attribués proportionnellement aux degrés de liberté de chaque échantillon :
sp2 = [ (n1 – 1)s12 + (n2 – 1)s22 ] / (n1 + n2 – 2)
Le dénominateur de cette équation révèle la valeur des degrés de liberté globaux du test non apparié classique : dl = n1 + n2 – 2. Deux degrés de liberté sont consommés en amont pour estimer les deux moyennes arithmétiques respectives de chaque cohorte. L’erreur type de la différence entre les deux moyennes (SEdiff) se formalise ensuite ainsi :
SEdiff = √[ sp2 × (1/n1 + 1/n2) ]
Il apparaît clairement à travers cette formulation que si les effectifs n1 et n2 sont fortement déséquilibrés, le calcul de la variance pondérée accordera un poids écrasant au groupe le plus fourni. Si ce déséquilibre s’accompagne d’une rupture d’homogénéité des variances (hétéroscédasticité), la statistique t classique sera gravement biaisée, nécessitant une correction mathématique spécifique que nous aborderons ultérieurement.
3. Définition et caractéristiques du test t apparié (échantillons dépendants)
3.1 Principe de la dépendance et des mesures répétées
Le test t apparié, aussi qualifié de test t pour échantillons dépendants, pour mesures répétées ou pour séries appariées, intervient dans des contextes méthodologiques où les observations du premier ensemble sont intrinsèquement et indissociablement liées aux observations du second ensemble. Ici, la notion de dépendance stochastique n’est pas un artefact indésirable, mais constitue précisément le levier expérimental central du devis d’étude.
La dépendance statistique peut émerger selon plusieurs configurations expérimentales distinctes mais équivalentes sur le plan du traitement des données. La première, omniprésente en psychologie expérimentale et en médecine comportementale, est le design pré-post où la même entité biologique ou cognitive est soumise à deux vagues de mesure successives séparées par un intervalle temporel ou par l’administration d’une tâche critique. Une seconde modalité repose sur l’appariement délibéré (matching) de deux participants distincts sur la base de caractéristiques d’intérêt susceptibles de moduler fortement la variable réponse (par exemple, apparier un patient d’un groupe expérimental avec un participant témoin ayant rigoureusement le même quotient intellectuel, le même âge et le même statut socio-économique). Enfin, la dépendance peut être naturelle ou écologique, comme c’est le cas lors de l’étude de couples mariés (dyades), de paires de jumeaux monozygotes ou dizygotes, ou encore de fratries.
Dans toutes ces circonstances, il existe une corrélation intra-classe positive substantielle entre la valeur observée dans la première condition et celle obtenue dans la seconde pour la même unité expérimentale. Un participant naturellement lent lors d’une tâche de mémoire en phase pré-test le sera également, toutes choses égales par ailleurs, en phase post-test. Cette corrélation mutuelle entre les séries de mesures invalide d’emblée l’usage du test t pour échantillons indépendants, sous peine de violer le postulat fondamental d’indépendance des observations.
3.2 Transformation des données en scores de différence
L’élégance algorithmique du test t apparié réside dans sa capacité à réduire la complexité d’un problème à deux échantillons interdépendants en une analyse univariée à un seul échantillon. Plutôt que de modéliser directement les distributions brutes des variables X1 et X2 avec leurs variabilités individuelles respectives, le statisticien opère une soustraction terme à terme pour chaque unité appariée i :
Di = X1i – X2i
Cette opération arithmétique élémentaire génère un vecteur unidimensionnel unique composé de n scores de différence (où n représente le nombre de paires observées). Dès lors, le problème statistique se reformule de manière radicalement simplifiée : il ne s’agit plus de vérifier si la moyenne de l’échantillon 1 diffère de celle de l’échantillon 2, mais de déterminer si la moyenne empirique de ces scores de différence (notée D̄) s’écarte de façon statistiquement significative de zéro (ou de toute autre valeur théorique μ0 prédéfinie par le chercheur) :
D̄ = (∑ Di) / n
L’écart-type de ces différences, noté sD, est alors calculé classiquement en évaluant la dispersion des scores individuels Di autour de leur moyenne D̄. Cette métrique synthétise la variabilité des changements intra-individuels, abstraction faite du niveau de base absolu auquel chaque participant se situait initialement. Le test t apparié est donc, en substance mathématique rigoureuse, un test t pour échantillon unique appliqué au vecteur différentiel D.
3.3 Détermination des degrés de liberté pour mesures répétées
L’une des particularités les plus manifestes du test t apparié concerne le calcul de ses degrés de liberté. Étant donné que le traitement analytique s’opère sur le vecteur condensé des scores de différence, le nombre d’unités statistiques effectives n’est plus le nombre total d’enregistrements réalisés (qui s’élève à 2n), mais bien le nombre de paires ou d’individus suivis, soit n. Par conséquent, la formule des degrés de liberté pour un devis apparié s’écrit invariablement :
dl = n – 1
À première vue, cette quantification donne l’impression d’un lourd sacrifice méthodologique. Si l’on recrute 30 participants dans un schéma intra-sujet pré-test/post-test, le test t apparié disposera de 30 – 1 = 29 degrés de liberté. Si ce même volume global de 60 mesures avait été réparti entre deux groupes indépendants de 30 sujets, le test t non apparié aurait affiché 30 + 30 – 2 = 58 degrés de liberté. Or, sur une distribution t de Student, un nombre plus faible de degrés de liberté implique des valeurs critiques plus élevées pour atteindre le seuil conventionnel de significativité α = 0,05, ce qui pénalise mécaniquement le test.
Néanmoins, ce recul apparent des degrés de liberté est très largement compensé sur le plan de la variance résiduelle. En soustrayant chaque observation pré-test de son équivalent post-test, toute la variance interindividuelle stable (les différences chroniques de réactivité, de cognition ou de traits physiologiques d’un sujet à un autre) est littéralement soustraite de l’équation. Le dénominateur de la fraction t s’en trouve spectaculairement diminué dès lors que les deux mesures présentent une forte corrélation positive, décuplant ainsi la sensibilité expérimentale du test au détriment de la perte marginale d’une fraction de degrés de liberté.
4. Analyse comparative directe : mécanismes sous-jacents et différences conceptuelles
4.1 Origine de la variance résiduelle et contrôle du bruit de fond
La distinction la plus profonde entre un devis apparié et un devis non apparié réside dans la manipulation et la décomposition de la variance d’échantillonnage. Dans tout protocole scientifique en psychologie, la variabilité totale recueillie par l’instrument de mesure peut être scindée en deux composantes fondamentales : la variance systématique, induite directement par le phénomène étudié ou le traitement appliqué, et la variance non systématique, souvent désignée sous le terme générique d’erreur ou de « bruit de fond ».
Dans un test t pour échantillons indépendants, la variance d’erreur englobe indifféremment toutes les divergences qui distinguent les individus entre eux à l’intérieur de chaque cohorte. Si nous évaluons un programme de renforcement mnésique en comparant un groupe témoin et un groupe expérimental, la variance résiduelle contiendra l’impact du niveau intellectuel général, des prédispositions génétiques, de la fatigue du jour, de l’âge des sujets et de leur degré de motivation intrinsèque. Cette masse de fluctuations individuelles non contrôlées vient grossir l’erreur type de la différence de moyennes, ce qui « noie » le signal expérimental dans un océan de variance interindividuelle.
À l’inverse, le devis apparié procède à une filtration en amont de ce bruit interindividuel. Dans la mesure où le même sujet fournit à la fois la mesure basale et la mesure finale, les caractéristiques stables et durables propres à cet individu demeurent théoriquement invariantes entre les deux moments d’évaluation. Lors du calcul de la différence Di = Xpost, i – Xpré, i, la contribution constante du quotient intellectuel ou du tempérament individuel s’annule algébriquement. Ne subsiste dans la variance d’erreur que la fluctuation intra-individuelle aléatoire propre à l’instabilité transitoire du sujet et à l’imprécision de la mesure. Le rapport signal/bruit s’en trouve considérablement accru.
4.2 Structure matricielle et organisation des ensembles de données
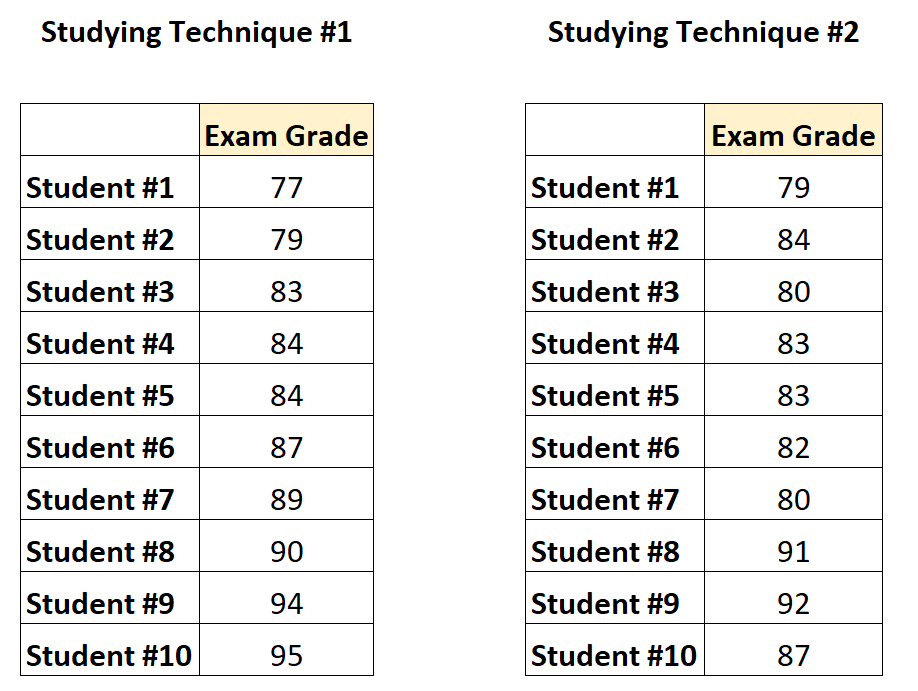
Sur le plan pratique de la gestion des données (data management), le choix de la modélisation conditionne la structuration matricielle des tables d’analyse au sein des progiciels statistiques (tels que R, Python, SPSS ou Jamovi). Deux grands paradigmes coexistent : le format large (wide format) et le format long (long format).
Pour un test t apparié, le format large est généralement la configuration native adoptée par les chercheurs. Chaque ligne représente une unité d’échantillonnage distincte (un participant ou une dyade). Les différentes vagues d’évaluation s’alignent horizontalement sous forme de colonnes dédiées : par exemple, la colonne « Score_Temps1 » et la colonne « Score_Temps2 ». La matrice de données est donc de dimensions n lignes par 2 colonnes métriques. Cette structure met en exergue le parallélisme et la dépendance des mesures.
Pour un test t non apparié, bien qu’il soit possible de structurer les données en deux colonnes isolées dans certains logiciels rudimentaires, le standard analytique moderne impose le format long. Dans ce format, l’ensemble des scores mesurés sur la variable dépendante est empilé dans une seule et unique colonne numérique verticale, tandis qu’une seconde colonne adjacente, appelée variable d’identification ou facteur groupal, indique le niveau d’appartenance de chaque sujet (par exemple : « Témoin » versus « Expérimental »). La table s’étend sur N = n1 + n2 lignes.
Cette distinction organisationnelle a des implications immédiates sur la gestion des valeurs manquantes (missing data). Dans un test non apparié, si un individu omet de remplir son questionnaire, seule sa propre ligne est exclue de l’échantillon global, n’affectant pas le groupe opposé. Dans un test apparié en format large, la défaillance d’un participant au post-test entraîne l’exclusion totale de la paire (exclusion par liste ou listwise deletion), car la différence Di ne peut être calculée si l’un des deux termes de la soustraction est absent. Ce phénomène engendre une perte sèche d’information pouvant affaiblir la représentativité de l’étude.
4.3 Tableau synoptique des divergences fondamentales
Afin de synthétiser les clivages méthodologiques et analytiques qui séparent ces deux approches fondamentales de l’inférence de Student, le tableau suivant propose une vue comparative détaillée de l’ensemble de leurs paramètres cardinaux.
| Critère de comparaison | Test t non apparié (Indépendant) | Test t apparié (Mesures répétées) |
|---|---|---|
| Structure du devis expérimental | Plan inter-sujets (groupes indépendants distincts). | Plan intra-sujet (mesures répétées ou paires appariées). |
| Hypothèse nulle (H0) | μ1 – μ2 = 0 (les moyennes de population sont identiques). | μD = 0 (la moyenne des différences intra-paires est nulle). |
| Origine de la variance d’erreur | Variabilité interindividuelle + erreur de mesure. | Fluctuations intra-individuelles résiduelles uniquement. |
| Formulation des degrés de liberté | dl = n1 + n2 – 2 | dl = n – 1 (où n est le nombre de paires). |
| Rôle de la corrélation intra-classe | Strictement nulle (postulat d’indépendance totale). | Généralement positive et exploitée pour réduire l’erreur type. |
| Risques méthodologiques majeurs | Non-équivalence initiale des groupes ; attrition asymétrique. | Effets d’apprentissage, d’ordre, de fatigue cognitive ; report. |
| Implication pour l’inférence causale | Nécessite une randomisation sans faille pour neutraliser les confondeurs. | Contrôle intrinsèque des variables stables mais vulnérable à la maturation. |
5. Formulations mathématiques et comparaison des formules statistiques
5.1 Formule mathématique du test t pour échantillons indépendants
L’expression analytique du test t de Student classique pour deux échantillons indépendants repose sur le ratio entre l’écart brut des moyennes constatées et l’estimation de l’erreur type de cet écart. Sous l’hypothèse nulle stipulant que la différence attendue est égale à zéro (μ1 – μ2 = 0), la statistique t s’écrit :
t = (X̄1 – X̄2) / [ sp × √(1/n1 + 1/n2) ]
Dans cette formulation, X̄1 et X̄2 représentent les moyennes arithmétiques empiriques respectives des groupes 1 et 2, tandis que sp correspond à la déviation standard combinée (la racine carrée de la variance combinée sp2 détaillée dans la section 2.3).
Cependant, lorsque le postulat d’égalité des variances est enfreint (σ12 ≠ σ22), l’utilisation directe de la variance combinée sp2 fausse lourdement la distribution d’échantillonnage de la statistique. Pour remédier à cette vulnérabilité théorique majeure, l’adaptation de Welch-Satterthwaite s’impose. La formule de la statistique t de Welch abandonne la notion de variance combinée au profit d’une addition directe des erreurs types de chaque cohorte :
tWelch = (X̄1 – X̄2) / √(s12/n1 + s22/n2)
Cette statistique ne suit plus une distribution t avec n1 + n2 – 2 degrés de liberté, mais une loi de Student dont les degrés de liberté sont ajustés à la baisse selon une fonction non linéaire complexe dépendant du rapport des variances et de la taille respective de chaque échantillon :
dlWelch = [ (s12/n1 + s22/n2)2 ] / [ (s12/n1)2/(n1 – 1) + (s22/n2)2/(n2 – 1) ]
Cet ajustement abaisse le nombre effectif de degrés de liberté (qui prend souvent une valeur décimale non entière), rendant le seuil de rejet de H0 plus exigeant, ce qui préserve l’intégrité du taux d’erreur de première espèce (α = 0,05) en situation d’hétéroscédasticité.
5.2 Formule mathématique du test t pour échantillons appariés
Pour le test t apparié, la formule générale s’affranchit des estimateurs multi-groupes pour converger vers la structure compacte du test pour échantillon unique appliqué au différentiel. En notant D̄ la moyenne arithmétique des scores de différence individuels, sD leur écart-type empirique, et n le nombre total de paires observées, l’équation s’énonce :
t = (D̄ – μ0) / (sD / √n)
Le terme μ0 représentant l’écart théorique sous l’hypothèse nulle (quasi systématiquement μ0 = 0), l’expression opérationnelle devient tout simplement :
t = D̄ / (sD / √n)
Le calcul formel de l’écart-type des différences s’effectue selon l’algorithme usuel de la déviation quadratique :
sD = √[ ∑(Di – D̄)2 / (n – 1) ]
Il est extrêmement instructif de relier cette formulation aux paramètres descriptifs initiaux des deux variables corrélées X1 et X2. Sur le plan des lois de probabilité, la variance d’une différence entre deux variables aléatoires dépendantes s’exprime par le théorème de Bienaymé étendu :
Var(X1 – X2) = Var(X1) + Var(X2) – 2 × Cov(X1, X2)
En introduisant le coefficient de corrélation linéaire de Pearson (noté r) liant les deux mesures, la formule de la variance empirique de la différence devient :
sD2 = s12 + s22 – 2 × r × s1 × s2
Cette relation fondamentale explicite mathématiquement la dépendance directe qui lie la variance du score différentiel à l’intensité de la corrélation test-retest existant entre les conditions expérimentales.
5.3 Anatomie de l’erreur type : démonstration du gain de précision
L’anatomie comparative des dénominateurs du test t constitue l’une des démonstrations les plus élégantes de la théorie statistique. Le dénominateur représente dans les deux cas l’erreur type de la différence de moyennes (SEdiff), c’est-à-dire l’écart-type de la distribution d’échantillonnage de l’estimateur.
Considérons un scénario symétrique idéal dans lequel les deux conditions présentent la même taille d’échantillon (n1 = n2 = n) et des variances d’échantillonnage identiques (s12 = s22 = s2). Si nous traitions ces données avec la formule du test t non apparié, l’erreur type au carré s’écrirait :
SEnon-apparié2 = s2/n + s2/n = 2s2/n
Examinons désormais l’erreur type au carré du test t apparié pour les mêmes observations couplées :
SEapparié2 = sD2/n = (s12 + s22 – 2rs1s2) / n = (2s2 – 2rs2) / n = (2s2/n) × (1 – r)
Il en découle la relation algébrique directe et remarquable reliant les deux erreurs types :
SEapparié = SEnon-apparié × √(1 – r)
Cette formule met en lumière le gain phénoménal de précision apporté par le protocole intra-sujet :
- Si la corrélation test-retest est nulle (r = 0), √(1 – 0) = 1 : l’erreur type appariée est strictement équivalente à l’erreur type non appariée. Le test apparié perd alors un léger avantage en raison de ses degrés de liberté réduits (n – 1 au lieu de 2n – 2).
- Si la corrélation est modérée (r = 0,50), √(1 – 0,50) = √0,50 ≈ 0,707 : l’erreur type appariée est diminuée de près de 30 % par rapport à celle du devis indépendant.
- Si la corrélation est très forte (r = 0,80), typique de mesures psychométriques stables ou de biomarqueurs physiologiques, √(1 – 0,80) = √0,20 ≈ 0,447 : l’erreur type est divisée par plus de deux.
Puisque la statistique t s’obtient en divisant la différence des moyennes par cette erreur type, réduire cette dernière par un facteur 2 revient à doubler instantanément la valeur du t calculé pour une taille d’effet identique. Ce mécanisme explique mathématiquement la supériorité systématique du test apparié en matière de précision et de sensibilité détectionnelle.
6. Hypothèses statistiques et conditions d’application
6.1 Hypothèses requises pour le test t non apparié
L’inférence statistique issue du test t pour échantillons indépendants ne conserve sa validité probabiliste que si un ensemble précis de postulats théoriques est satisfait par le jeu de données empiriques. La méconnaissance de ces conditions peut fausser la valeur de p et altérer gravement les conclusions tirées.
La première hypothèse concerne la nature métrique de la variable dépendante : celle-ci doit être mesurée sur une échelle d’intervalle ou de rapport continue. Les variables purement ordinales ou qualitatives ne répondent pas formellement à ce prérequis, bien que des scores composites issus d’échelles de Likert agrégées soient couramment tolérés dans la pratique en sciences sociales.
La seconde hypothèse, la plus critique de toutes, est celle de l’indépendance stricte des observations. Aucune dépendance ne doit exister, qu’elle soit intra-groupe (un sujet influençant un autre sujet au sein de la même salle d’expérimentation) ou inter-groupes. La violation de ce postulat gonfle artificiellement les taux d’erreur de première espèce d’une manière qu’aucun ajustement mathématique standard ne peut corriger a posteriori.
La troisième hypothèse réside dans la normalité de la distribution de la variable au sein de chaque population parente. Dans chaque groupe, la distribution théorique des données doit suivre une courbe en cloche de Gauss. Néanmoins, en vertu du théorème central limite, le test de Student s’avère particulièrement robuste aux écarts modérés à la normalité dès lors que les tailles d’échantillon sont suffisantes (typiquement n ≥ 30 par groupe) et que les distributions ne présentent pas d’asymétrie extrême ni de queues trop épaisses.
Enfin, la quatrième hypothèse est l’homoscédasticité, qui stipule l’égalité des variances des deux populations comparées (σ12 = σ22). Ce postulat est particulièrement sensible lorsque les effectifs des deux cohortes sont inégaux (n1 ≠ n2). En cas de violation conjuguée à un déséquilibre d’effectif, le taux d’erreur de type I réel peut s’éloigner drastiquement du seuil nominal de 5 %.
6.2 Hypothèses requises pour le test t apparié
Bien que le test t apparié partage certains principes avec sa contrepartie indépendante, ses exigences distributionnelles diffèrent de façon subtile mais déterminante, simplifiant grandement sa vérification empirique.
Comme pour tout test paramétrique, la variable d’intérêt doit être continue. L’indépendance demeure également requise, mais elle se déplace au niveau des unités d’appariement : chaque paire d’observations (ou chaque sujet) doit être rigoureusement indépendante des autres paires composant l’échantillon. En revanche, la dépendance interne à chaque paire est non seulement acceptée mais indispensable.
L’hypothèse distributionnelle cardinale du test apparié fait souvent l’objet d’une confusion généralisée dans la communauté scientifique : le test n’exige nullement que la variable brute pré-test soit distribuée normalement, ni que la variable post-test le soit. L’unique postulat de normalité porte exclusivement sur la distribution des scores de différence Di = X1i – X2i. Il est tout à fait possible que les distributions de X1 et de X2 affichent individuellement une asymétrie marquée, mais que leur différence terme à terme se conforme admirablement à la symétrie gaussienne. Il suffit donc d’inspecter la normalité du seul vecteur D.
Par ailleurs, le postulat d’homogénéité des variances entre les deux conditions temporelles ou appariées n’est pas une condition stricte d’application du test t apparié, puisque l’analyse opère sur une seule série condensée de scores. Enfin, le protocole méthodologique doit s’assurer de l’absence d’effets de report asymétriques (carryover effects), c’est-à-dire l’hypothèse qu’un passage dans la condition 1 n’altère pas irréversiblement la manière dont le sujet réagira dans la condition 2.
6.3 Vérification diagnostique des postulats théoriques
La pratique statistique moderne proscrit toute confiance aveugle envers les données brutes sans une inspection diagnostique approfondie des postulats sous-jacents. Cette démarche combine des méthodes visuelles exploratoires et des tests d’hypothèses formels.
Pour évaluer la normalité, le test de Shapiro-Wilk constitue la référence méthodologique la plus puissante pour des échantillons de taille petite à moyenne (N < 50). Complété par le test de Kolmogorov-Smirnov (avec correction de Lilliefors), il évalue si la déviation par rapport à la distribution gaussienne dépasse le seuil du hasard. Cependant, ces tests formels souffrent d’une limite paradoxale : ils manquent de puissance sur de très petits effectifs (incapables de détecter des anomalies réelles) et s’avèrent excessivement sensibles sur de grands échantillons (rejetant la normalité pour des écarts insignifiants sans conséquence pratique). Les méthodologistes recommandent donc de privilégier l’examen qualitatif des diagrammes quantile-quantile (Q-Q plots), complété par les métriques d’asymétrie (skewness) et d’aplatissement (kurtosis), dont les valeurs absolues doivent idéalement osciller entre -1 et +1.
Concernant l’homogénéité des variances requise pour le test non apparié, le test de Levene (basé sur l’écart absolu à la médiane, plus robuste que le test de Bartlett face aux écarts de normalité) est le standard préconisé. Si la p-value du test de Levene est inférieure à 0,05, l’hypothèse d’homoscédasticité est rejetée. Dans cette situation, le chercheur doit renoncer au test t classique de Student et adopter impérativement la correction de Welch-Satterthwaite, désormais implémentée par défaut dans des logiciels comme R.
7. Puissance statistique, taille d’effet et sensibilité expérimentale
7.1 Comparaison de la puissance statistique entre devis apparié et non apparié
La puissance statistique, quantifiée par le complémentaire du risque de deuxième espèce (1 – β), désigne la probabilité d’un test statistique de rejeter l’hypothèse nulle lorsque celle-ci est effectivement fausse dans la population générale. En d’autres termes, c’est la capacité de l’expérimentateur à détecter un effet ou une différence qui existe réellement. À effectif total de mesures égal, le devis apparié affiche presque systématiquement une puissance statistique nettement supérieure à celle du devis indépendant.
Ce différentiel de sensibilité s’explique directement par la relation mise en évidence à la section 5.3. En purgeant le dénominateur de la variabilité interindividuelle, le test apparié contracte la distribution d’échantillonnage de l’estimateur autour de la vraie valeur du paramètre. La probabilité que la valeur t calculée franchisse le seuil critique pour un seuil α donné s’accroît donc substantiellement. Cet avantage s’accentue exponentiellement au fur et à mesure que la corrélation intra-classe (r) s’élève.
Il existe néanmoins un seuil théorique où l’avantage du test apparié s’annule : si la corrélation intra-classe est nulle (r = 0), ou pire, négative (ce qui peut survenir dans des contextes rares de compétition entre membres d’une même dyade), la perte de la moitié des degrés de liberté (n – 1 au lieu de 2n – 2) n’est plus compensée par une réduction de la variance. Dans cette configuration atypique, le test apparié présente une puissance légèrement inférieure à celle du test non apparié. Mais dans l’écrasante majorité des protocoles cognitifs ou cliniques pré-post, les corrélations test-retest oscillent entre 0,50 et 0,85, garantissant un gain de puissance massif au schéma apparié.
7.2 Mesures de taille d’effet adaptées à chaque contexte
La seule mention de la significativité statistique via la valeur de p ne renseigne aucunement sur l’ampleur quantitative ou l’importance clinique d’un effet découvert. C’est pourquoi les directives contemporaines (notamment celles de l’APA) imposent la communication systématique des tailles d’effet standardisées. La famille du d de Cohen domine ce champ méthodologique, mais sa formulation computationnelle diverge selon le devis d’échantillonnage employé.
Pour le test t non apparié, le d de Cohen classique standardise l’écart entre les deux moyennes indépendantes par l’écart-type combiné :
dind = (X̄1 – X̄2) / sp
Pour le test t apparié, la situation conceptuelle est plus subtile et a engendré d’abondantes controverses dans la littérature métrologique. Deux métriques principales coexistent :
- Le dz de Cohen : Il standardise la moyenne des différences par l’écart-type des différences : dz = D̄ / sD. Cette métrique reflète directement la puissance du test statistique (elle est liée à la valeur t par l’équation dz = t / √n). Toutefois, elle ne peut être comparée directement au d d’un devis inter-sujets dans le cadre d’une méta-analyse, car elle est artificiellement gonflée par la corrélation test-retest.
- Le drm (pour repeated measures) : Il standardise la moyenne des différences par l’écart-type moyen des scores d’origine, corrigé du coefficient de corrélation : drm = [ D̄ / √(s12 + s22 – 2rs1s2) ] × √[ 2(1 – r) ]. Cette variante replace l’ampleur de l’effet sur la même échelle métrique qu’un devis inter-sujets classique.
Enfin, lorsque les échantillons sont particulièrement réduits (N < 20), le d de Cohen a tendance à surestimer légèrement la taille d’effet dans la population. Il convient alors d’appliquer le facteur de correction analytique de Larry Hedges pour obtenir le g de Hedges, un estimateur asymptotiquement sans biais.
7.3 Dimensionnement de l’échantillon et analyse a priori de puissance
L’un des devoirs éthiques et logistiques du chercheur consiste à dimensionner rigoureusement son échantillon avant d’engager la collecte des données, évitant ainsi le double écueil de l’étude sous-puissante (incapable d’aboutir à des conclusions fiables) et du gaspillage de ressources expérimentales. Cette planification s’effectue via une analyse de puissance a priori, généralement réalisée à l’aide du logiciel de référence G*Power.
Supposons que nous souhaitions détecter une taille d’effet standard considérée comme moyenne selon les conventions heuristiques de Cohen (d = 0,50), avec un risque de première espèce conventionnel α = 0,05 et une puissance statistique visée robuste de 1 – β = 0,80 pour un test bilatéral :
- Dans le cas d’un test t pour échantillons indépendants (non apparié), le calcul stipule un effectif requis de 64 participants par groupe, soit un total de 128 participants à recruter et tester.
- Dans le cas d’un test t pour échantillons appariés, en faisant l’hypothèse très réaliste d’une corrélation pré-post modérée à forte de r = 0,60, l’effectif requis s’effondre à seulement 27 participants au total (chacun étant testé deux fois).
Cette comparaison chiffrée démontre l’immense économie de recrutement et de coûts opérée par l’approche intra-sujet. Pour des protocoles biomédicaux complexes ou des recherches utilisant l’imagerie par résonance magnétique fonctionnelle (IRMf), où le coût unitaire par session d’enregistrement se chiffre en centaines d’euros, le devis apparié s’impose très souvent comme la seule voie financièrement et logistiquement viable.
8. Études de cas appliquées en psychologie
8.1 Cas pratique 1 : Évaluation de l’anxiété avant et après thérapie cognitive (test apparié)
Afin d’illustrer la mécanique computationnelle du devis apparié, considérons une étude clinique menée auprès d’une cohorte de 30 patients diagnostiqués avec un trouble d’anxiété généralisée. Le protocole évalue l’efficacité d’un programme novateur de thérapie cognitive et comportementale (TCC) étalé sur une durée de 8 semaines. Le niveau de symptomatologie anxieuse est quantifié à l’aide de l’inventaire d’anxiété état-trait de Spielberger (STAI-Y), une échelle psychométrique continue validée allant de 20 à 80 points, où un score plus élevé dénote une détresse accrue.
Chaque patient i remplit le questionnaire à deux reprises : immédiatement avant la première séance (Xpré) et à l’issue des huit semaines de thérapie (Xpost). Les données descriptives révèlent une moyenne pré-thérapeutique Mpré = 61,40 (SD = 7,20) et une moyenne post-thérapeutique Mpost = 48,60 (SD = 8,10). La corrélation linéaire de Pearson entre les scores pré-test et post-test est particulièrement élevée : r = 0,72.
La modélisation commence par le calcul du vecteur des scores de différence individuelle pour chaque sujet : Di = Xpost, i – Xpré, i. La moyenne arithmétique de cette diminution s’élève à D̄ = -12,80 points (indiquant une baisse moyenne de près de 13 points de l’anxiété). En exploitant la formule de variance étendue, l’écart-type des différences s’établit à :
sD = √[ 7,202 + 8,102 – 2(0,72)(7,20)(8,10) ] = √[ 51,84 + 65,61 – 83,98 ] = √33,47 ≈ 5,785
L’erreur type de la moyenne des différences vaut alors SED = 5,785 / √30 ≈ 5,785 / 5,477 ≈ 1,056. La valeur de la statistique t de Student pour séries appariées se calcule ainsi :
t = D̄ / SED = -12,80 / 1,056 = -12,12
Avec dl = 30 – 1 = 29 degrés de liberté, la probabilité critique bilatérale associée est infinitésimale (p < 0,001). La taille d’effet standardisée calculée sur les scores de différence atteint dz = |-12,80| / 5,785 = 2,21, traduisant un effet thérapeutique massif. Sur le plan clinique, une réduction de plus de 12 points au STAI transcende la simple significativité statistique pour signer une rémission clinique hautement signifiante chez une large majorité des patients suivis.
8.2 Cas pratique 2 : Effet d’un amorçage cognitif sur le temps de réaction (test non apparié)
Examinons désormais un protocole de laboratoire issu de la psychologie cognitive expérimentale étudiant l’accès au lexique mental. Un chercheur postule que la présentation subliminale d’une amorce sémantique congruente (par exemple le mot « HÔPITAL » affiché pendant 33 millisecondes) accélère l’identification d’une cible subséquente (le mot « MÉDECIN ») par rapport à une amorce sémantiquement neutre (« BALCON »). Afin d’éviter que les participants ne devinent l’objectif de l’étude ou ne développent des stratégies conscientes, un plan inter-sujets strict est implémenté.
Cinquante volontaires sont assignés par randomisation informatique à deux conditions mutuellement exclusives :
- Groupe Amorçage Congruent : n1 = 25 participants, temps de réaction moyen M1 = 485 ms (SD1 = 42 ms).
- Groupe Amorçage Neutre : n2 = 25 participants, temps de réaction moyen M2 = 520 ms (SD2 = 46 ms).
Avant d’engager le test paramétrique, le chercheur vérifie le postulat d’homoscédasticité via le test de Levene. Celui-ci s’avère non significatif (F(1, 48) = 0,38, p = 0,54), autorisant le recours au test t de Student standard avec variance combinée. Le calcul de la variance combinée s’opère comme suit :
sp2 = [ (24 × 422) + (24 × 462) ] / (25 + 25 – 2) = [ 42336 + 50784 ] / 48 = 93120 / 48 = 1940
L’écart-type combiné vaut donc sp = √1940 ≈ 44,045 ms. L’erreur type de la différence entre les deux moyennes indépendantes est calculée par :
SEdiff = 44,045 × √(1/25 + 1/25) = 44,045 × √0,08 ≈ 44,045 × 0,2828 ≈ 12,46 ms
La statistique t s’obtient alors en rapportant l’écart expérimental à cette erreur type :
t = (485 – 520) / 12,46 = -35 / 12,46 = -2,81
Les degrés de liberté s’élevant à dl = 25 + 25 – 2 = 48, la consultation des tables de la loi de Student fournit une valeur critique pour α = 0,05 de ±2,01. La valeur observée |-2,81| étant supérieure au seuil théorique, nous rejetons l’hypothèse nulle au seuil bilatéral (p = 0,007). L’intervalle de confiance à 95 % de la différence de moyennes s’établit entre [-60,05 ms ; -9,95 ms]. La taille d’effet standardisée correspond à un d de Cohen de d = |-35| / 44,045 = 0,79, ce qui correspond à un effet cognitif de magnitude importante selon les standards internationaux.
8.3 Cas pratique 3 : Erreur d’assignation et comparaison des résultats selon le test choisi
Pour prendre la pleine mesure de la divergence mécanique entre ces deux épreuves, il est particulièrement instructif de simuler une erreur méthodologique classique : appliquer intentionnellement un test non apparié sur des données issues d’un protocole apparié. Reprenons l’ensemble des données de l’étude clinique exposée à la section 8.1 (N = 30 patients évalués avant et après TCC), où le test t apparié correct avait abouti à une statistique éclatante de t(29) = -12,12 avec p < 0,001.
Imaginons un instant qu’un statisticien débutant méconnaisse la structure répétée de ces observations et traite les colonnes « Pré » et « Post » comme s’il s’agissait de deux groupes mutuellement exclusifs de 30 participants distincts chacun. Le calcul de la variance combinée sp2 intégrerait alors l’intégralité de la variabilité interindividuelle :
sp2 = [ (29 × 7,202) + (29 × 8,102) ] / 58 = (51,84 + 65,61) / 2 = 58,725 ⇒ sp ≈ 7,663
L’erreur type de la différence calculée selon le modèle non apparié atteindrait alors :
SEdiff = 7,663 × √(1/30 + 1/30) = 7,663 × √0,0667 ≈ 7,663 × 0,2582 ≈ 1,979
La statistique t qui en résulterait chuterait à :
t = -12,80 / 1,979 = -6,47
Certes, dans cet exemple particulier où l’effet thérapeutique est titanesque, la valeur t de -6,47 demeure statistiquement significative (p < 0,001). Mais observons l’amplitude du préjudice causé par cette modélisation erronée : l’erreur type estimée est passée de 1,056 à 1,979 (soit une inflation artificielle de près de 87 % du terme d’erreur !), tandis que la valeur de la statistique t a été amputée de près de la moitié de sa magnitude (passant de -12,12 à -6,47).
Si l’effet réel de la TCC avait été plus subtil (par exemple une réduction modeste de 3 points d’anxiété), le test t apparié l’aurait détecté avec aisance, tandis que le test non apparié aurait erronément conclu à l’absence d’effet significatif (erreur de type II). Cette démonstration prouve qu’omettre de modéliser la covariance intra-sujet dilue la puissance statistique et peut anéantir des mois d’investigation scientifique rigoureuse.
9. Biais méthodologiques et menaces à la validité
9.1 Biais inhérents aux devis pour mesures répétées (test apparié)
Si le devis intra-sujet analysé par un test t apparié offre une sensibilité statistique inégalée, il n’en demeure pas moins exposé à des menaces redoutables pesant sur sa validité interne. La première et la plus pernicieuse de ces menaces est sans conteste l’effet d’ordre et de report (order and carryover effects).
Dans les tâches cognitives ou motrices, les participants soumis à une seconde évaluation bénéficient fréquemment d’un effet d’apprentissage (practice effect). La simple familiarisation avec l’interface informatique, les consignes expérimentales ou les stimuli présentés lors du pré-test entraîne une amélioration mécanique des performances lors du post-test, même en l’absence totale d’efficacité de l’intervention testée. Inversement, lors de protocoles longs et fastidieux, la seconde passation peut être pénalisée par la fatigue cognitive, la baisse d’attention ou la perte de motivation du sujet, simulant à tort une détérioration de ses facultés.
Pour neutraliser méthodologiquement ces biais inhérents à la répétition, le chercheur doit mettre en œuvre des techniques de contrebalancement. Dans les plans croisés (crossover designs), la moitié de l’échantillon reçoit la condition A suivie de la condition B, tandis que l’autre moitié expérimente la condition B avant la condition A, selon une séquence déterminée par tirage aléatoire ou plan en carré latin. De surcroît, l’espacement temporel suffisant entre les sessions de mesure (période de sevrage ou washout period) est indispensable pour dissiper les effets de rémanence pharmacologique ou cognitive.
9.2 Biais inhérents aux devis à groupes indépendants (test non apparié)
À l’inverse, le test t pour échantillons indépendants est structurellement immunisé contre les effets de contamination séquentielle, chaque sujet n’étant évalué qu’une seule fois dans une condition unique. Toutefois, ce modèle s’expose à d’autres écueils méthodologiques majeurs, au premier rang desquels figure le biais de sélection.
Même lorsque la randomisation est exécutée dans les règles de l’art, le hasard peut engendrer des déséquilibres fortuits entre les groupes sur de petites cohortes. Si, par malchance stochastique, le groupe expérimental rassemble des individus présentant une mémoire de travail initialement plus performante que ceux du groupe témoin, la supériorité constatée en fin d’étude sera fallacieusement attribuée au traitement plutôt qu’à cette asymétrie préexistante non contrôlée.
Une seconde menace critique réside dans l’attrition différentielle ou la mortalité expérimentale dissymétrique. Si l’une des deux conditions expérimentales s’avère particulièrement pénible, anxiogène ou contraignante, les participants les plus fragiles ou les moins motivés abandonneront l’étude avant son terme. Le groupe résiduel se trouvera alors enrichi de manière non aléatoire en individus résilients, introduisant un biais systématique de survie qui faussera la comparaison des moyennes finales.
Enfin, les tests inter-sujets sont considérablement plus sensibles à la présence de valeurs aberrantes extrêmes (outliers). Un seul participant affichant une performance extraordinairement atypique dans un groupe de 20 personnes peut déplacer substantiellement la moyenne de son groupe et gonfler l’écart-type combiné, masquant ainsi l’effet réel de la variable manipulée.
9.3 Régression statistique vers la moyenne
La régression statistique vers la moyenne représente un piège méthodologique et conceptuel fascinant, découvert par Sir Francis Galton à la fin du XIXe siècle. Ce phénomène stochastique se manifeste dès lors que deux mesures imparfaitement corrélées sont recueillies de manière longitudinale, en particulier lorsque les sujets ont été recrutés sur la base de scores initiaux extrêmes.
En psychologie clinique et en éducation, il est d’usage courant de sélectionner pour un programme de remédiation les participants les plus en difficulté (par exemple, les enfants affichant les 5 % de scores les plus bas à un test de lecture, ou les patients présentant les niveaux de dépression les plus aigus). Or, tout score observé est la résultante de la compétence réelle de l’individu et d’une part d’erreur de mesure aléatoire non systématique. Les individus ayant obtenu un score extrêmement bas lors du pré-test ont très probablement cumulé un niveau intrinsèque faible et une part conjoncturelle de malchance aléatoire (mauvaise forme le jour du test, distraction temporaire).
Lors de la seconde passation (post-test), cette composante d’erreur aléatoire aura tendance à se normaliser. Par un pur mécanisme probabiliste de régression vers la moyenne, les scores du post-test afficheront une remontée automatique vers le centre de gravité de la population, sans que l’intervention thérapeutique ou pédagogique n’y soit pour quoi que ce soit. Un test t apparié appliqué à ce groupe unique mesurera une amélioration hautement significative et conduira l’expérimentateur à conclure à tort au triomphe de son protocole. Pour déjouer ce sophisme empirique, l’intégration impérative d’un groupe témoin indépendant équivalent, également sélectionné sur des critères extrêmes mais ne recevant aucune prise en charge, est absolument indispensable.
10. Alternatives non paramétriques et approches de substitution
10.1 Alternative au test t non apparié : Le test U de Mann-Whitney
Lorsque les données empiriques recueillies violent frontalement les postulats sous-tendant le test t de Student classique pour échantillons indépendants — notamment en présence d’une asymétrie distributionnelle prononcée, d’effectifs très faibles (n < 15 par condition) ou de variables d’intérêt strictement ordinales —, le recours aux statistiques paramétriques devient méthodologiquement intenable. L’alternative non paramétrique canonique est le test U de Mann-Whitney (également connu sous le nom de test de la somme des rangs de Wilcoxon).
Le principe fondamental de cette procédure repose sur la transmutation des données brutes en rangs ordinaux. Les observations des deux groupes sont fusionnées en un ensemble unique de taille N = n1 + n2, puis ordonnées de façon croissante du plus petit au plus grand rang (de 1 à N). Le test calcule ensuite la somme des rangs attribués à chacun des deux groupes d’origine. Si l’hypothèse nulle est vraie, la distribution des rangs doit être répartie de manière équilibrée et homogène entre les deux cohortes. À l’inverse, si l’un des traitements surpasse l’autre, les rangs les plus élevés se concentreront systématiquement dans le groupe expérimental.
Sur le plan interprétatif, le test U ne compare pas à proprement parler les moyennes arithmétiques, mais évalue la dominance stochastique : il teste la probabilité P(X > Y) qu’une observation tirée au hasard dans la population 1 soit supérieure à une observation extraite de la population 2. Si les distributions des deux groupes partagent une forme identique (même dispersion et même asymétrie), le test peut alors être interprété rigoureusement comme une comparaison de médianes. Il affiche une efficacité asymptotique relative d’environ 95,5 % par rapport au test t sous l’hypothèse de normalité, tout en surpassant ce dernier dès lors que les données s’écartent sensiblement de la loi gaussienne.
10.2 Alternative au test t apparié : Le test des rangs signés de Wilcoxon
Face à un devis à mesures répétées ou des paires associées pour lequel le vecteur différentiel Di = X1i – X2i enfreint gravement le postulat de normalité, le chercheur doit délaisser le test t apparié au bénéfice du test des rangs signés de Wilcoxon (Wilcoxon signed-rank test).
L’ingéniosité algorithmique de ce test réside dans sa capacité à intégrer simultanément le sens (le signe) et la magnitude relative de chaque changement individuel. La procédure s’articule en étapes successives rigoureuses :
- Calcul des scores de différence Di pour l’ensemble des n paires. Les paires affichant une différence nulle (Di = 0) sont traditionnellement éliminées du calcul (correction de Pratt possible).
- Transformation de ces différences en valeurs absolues |Di|, abstraction faite de leur polarité positive ou négative.
- Attribution d’un rang croissant à ces valeurs absolues, de 1 pour la divergence la plus infime jusqu’à n pour l’écart le plus substantiel. Les cas d’ex æquo se voient attribuer la moyenne des rangs partagés.
- Réassignation à chaque rang du signe arithmétique (+ ou -) hérité de la différence initiale Di.
- Calcul séparé de la somme des rangs positifs (W+) et de la somme des rangs négatifs (W–).
La statistique du test retient la plus petite de ces deux sommes (notée W ou T). Sous l’hypothèse nulle d’un effet nul, la distribution des rangs positifs et négatifs doit s’équilibrer mutuellement. Le test des rangs signés de Wilcoxon préserve une excellente puissance statistique (efficacité asymptotique de 3/π ≈ 95,5 % sous loi normale) tout en résistant totalement aux déformations induites par les valeurs aberrantes sur les distributions de scores bruts.
10.3 Approches modernes : Rééchantillonnage et méthodes robustes
Au-delà de la dichotomie historique opposant les tests de Student paramétriques aux tests de rangs non paramétriques, l’essor de la puissance de calcul computationnelle a démocratisé des méthodologies analytiques novatrices d’une flexibilité remarquable. Deux grands courants dominent les pratiques contemporaines : le rééchantillonnage par bootstrap et la modélisation statistique robuste.
Le bootstrap (ou rééchantillonnage non paramétrique avec remise), théorisé par Bradley Efron, s’affranchit totalement de toute hypothèse distributionnelle a priori. Pour estimer l’intervalle de confiance de la différence de moyennes (qu’elle soit indépendante ou appariée), l’ordinateur tire des milliers de sous-échantillons empiriques (typiquement 5 000 ou 10 000 itérations) au sein de la base de données existante. L’intervalle de confiance bootstrap corrigé des biais et accéléré (BCa) offre une estimation d’une fiabilité remarquable, particulièrement utile face à des distributions asymétriques ou plurimodales où la notion de moyenne conserve une pertinence théorique mais où la loi normale échoue.
Une seconde voie moderne repose sur les méthodes robustes développées par Rand Wilcox, telles que l’analyse des moyennes tronquées (trimmed means, élaguant par exemple 20 % des queues de distribution) couplée au test de Yuen. Cette approche neutralise l’influence corruptrice des extrêmes tout en corrigeant formellement l’hétéroscédasticité sans nécessiter d’hypothèse de normalité stricte.
Enfin, dans les devis pour mesures répétées complexes ou longitudinaux, la modélisation linéaire mixte (Linear Mixed Models, LMM) surclasse progressivement le test t apparié. En modélisant les intercepts et les pentes comme des effets aléatoires propres à chaque sujet, les modèles mixtes intègrent naturellement la dépendance séquentielle, traitent avec élégance les données manquantes sans éliminer l’intégralité de la cohorte, et permettent d’ajouter des covariables d’ajustement continues.
11. Arbre de décision méthodologique : Guide pratique de sélection du test
11.1 Étape 1 : Évaluation de l’architecture du devis expérimental
La première décision de l’analyste ne relève pas de calculs numériques, mais d’une inspection logique de l’architecture méthodologique ayant présidé à la collecte des données. Le chercheur doit se poser une question sans ambiguïté : Existe-t-il une relation logique, temporelle, génétique ou organisationnelle liant les observations de la première série à celles de la seconde série ?
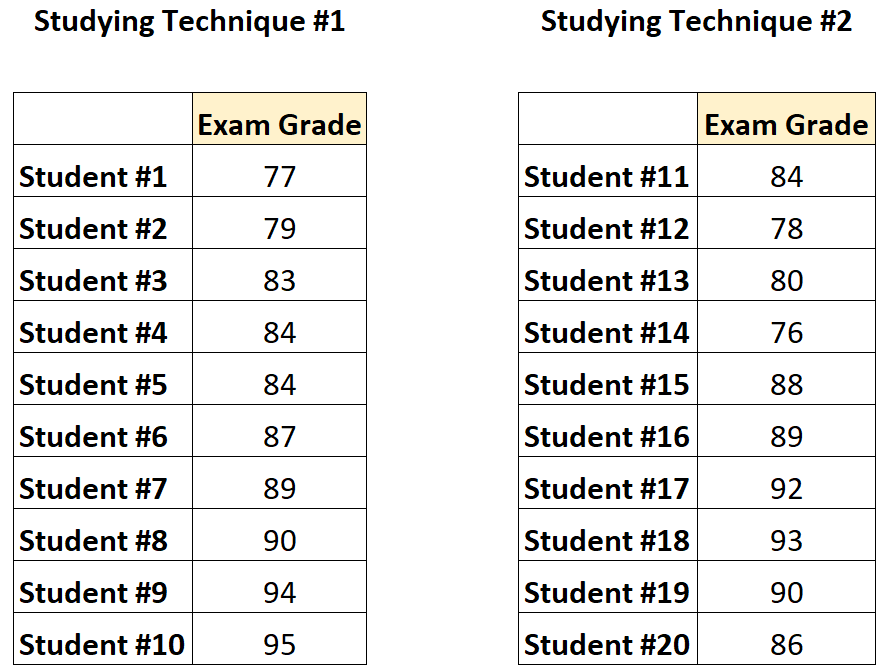
Si la réponse est affirmative, le devis relève de la dépendance statistique. Les situations archétypiques recouvrent :
- Le schéma pré-test / post-test sur la même entité biologique ou humaine.
- L’exposition d’un même individu à deux conditions environnementales contrastées (condition yeux ouverts vs yeux fermés, bruit ambiant vs silence).
- Les paires écologiques : couples conjugaux, fratries, jumeaux monozygotes ou dizygotes.
- L’appariement expérimental sur score de propension ou variables de contrôle (chaque sujet du groupe A est explicitement couplé à un sujet du groupe B présentant le même âge et le même statut clinique).
Dans l’ensemble de ces cas, l’architecture impose d’emprunter la branche de l’appariement. Si, au contraire, les deux cohortes ont été constituées par tirage aléatoire indépendant ou reflètent deux populations naturelles disjointes n’ayant aucun lien de mesure individuel (hommes vs femmes, étudiants en sciences vs étudiants en lettres), l’architecture relève rigoureusement des échantillons indépendants.
11.2 Étape 2 : Contrôle des propriétés métriques et distributionnelles
Une fois la famille de test arrêtée sur le plan structurel, l’analyste procède au tamisage des conditions de validité distributionnelles. La première vérification concerne la nature de la variable dépendante : s’agit-il d’une échelle métrique d’intervalle ou de rapport ?
- Si la variable est purement nominale dichotomique (ex. échec vs réussite) : réorienter l’analyse vers un test du Chi-carré d’indépendance (pour échantillons indépendants) ou un test de McNemar (pour mesures répétées).
- Si la variable est ordinale pure (rangs, échelle d’appréciation à 3 points non sommative) : bifurquer vers le test U de Mann-Whitney (indépendant) ou le test des rangs signés de Wilcoxon (apparié).
Si la métrique est quantitative continue, l’inspection de la normalité s’impose :
- Branche indépendante : Tester la normalité au sein de chaque groupe séparément via les graphiques Q-Q et le test de Shapiro-Wilk. Si la normalité est violée et que n < 30 par groupe, opter pour le test U de Mann-Whitney ou le bootstrap. Si la normalité est satisfaite, procéder immédiatement au contrôle de l’homoscédasticité via le test de Levene.
- Branche appariée : Calculer préalablement la colonne des différences Di = X1i – X2i. Évaluer la normalité de cette unique colonne différentielle. Si la distribution de D dévie drastiquement de la loi de Gauss et que l’effectif n est restreint (n < 25), basculer vers le test des rangs signés de Wilcoxon. Si la normalité est respectée, le test t apparié standard est validé.
11.3 Étape 3 : Prise en compte de la taille de l’échantillon et de la robustesse
La dernière étape du processus décisionnel affine le choix algorithmique en intégrant la volumétrie des données et les corrections de robustesse modernes.
Dans la branche des échantillons indépendants ayant validé l’hypothèse de normalité :
- Si le test de Levene est non significatif (variances homogènes) et que les groupes présentent des effectifs rigoureusement équilibrés (n1 = n2) : le test t de Student classique avec variance combinée est pleinement légitime.
- Si le test de Levene est significatif (hétéroscédasticité confirmée), ou si les variances divergent sur des groupes d’effectifs inégaux : adopter sans réserve le test t de Welch. De nombreux méthodologistes modernes recommandent d’ailleurs d’utiliser le test de Welch par défaut dans toutes les situations, car il converge asymptotiquement vers le test de Student lorsque les variances sont égales tout en protégeant infailliblement le chercheur contre les conséquences de l’hétéroscédasticité.
Concernant le comportement asymptotique à grand échantillon (N > 50 ou 100 par condition) : en vertu du théorème central limite, les déviations mineures ou modérées par rapport à la normalité n’exercent qu’une influence marginale sur l’exactitude des valeurs de p. Dans ce contexte de larges cohortes, les tests paramétriques (Student ou Welch) peuvent être maintenus en toute sécurité, à condition que les données soient exemptes de valeurs aberrantes extrêmes causées par des erreurs de saisie.
12. Normes de rapport académique APA et implémentation logicielle
12.1 Directives de rédaction selon les normes de l’American Psychological Association (APA 7)
La diffusion rigoureuse des résultats statistiques dans les revues internationales indexées exige le respect scrupuleux des normes formalisées dans la 7e édition du manuel de publication de l’American Psychological Association (APA 7). La restitution d’une comparaison de moyennes ne saurait se limiter à la simple mention d’une valeur de p.
Le standard rédactionnel APA impose une syntaxe articulée intégrant conjointement :
- L’identification explicite de la nature du test mobilisé (ex. test t pour échantillons indépendants, test t de Welch, ou test t pour mesures répétées).
- La présentation des statistiques descriptives fondamentales pour chaque condition : la moyenne arithmétique (notée M en italique) et l’écart-type (noté SD en italique), ainsi que l’intervalle de confiance à 95 % de la différence.
- La formulation formelle de la statistique inférentielle sous le gabarit syntaxique : t(degrés de liberté) = valeur arrondie au centième, p = valeur exacte au millième (sauf si p < 0,001), suivi de la taille d’effet standardisée (d de Cohen ou g de Hedges).
- Le respect scrupuleux de la typographie académique : les symboles statistiques alphabétiques (t, p, M, SD, d, F) s’écrivent obligatoirement en italique, tandis que les lettres grecques (μ, σ, α, β) et les chiffres demeurent en caractères romains droits.
Exemple de rédaction conforme APA 7 pour un test non apparié :
Un test t pour échantillons indépendants a été conduit afin d’évaluer l’impact du type d’amorçage sur le temps de réaction des participants. Les résultats indiquent que les participants exposés à une amorce sémantiquement congruente ont répondu de façon significativement plus rapide (M = 485 ms, SD = 42 ms) que les participants exposés à une amorce neutre (M = 520 ms, SD = 46 ms), t(48) = -2,81, p = 0,007, d = 0,79, IC à 95 % [-60,05, -9,95].
Exemple de rédaction conforme APA 7 pour un test apparié :
Un test t pour échantillons appariés a été réalisé pour mesurer l’évolution de la symptomatologie anxieuse avant et après l’intervention thérapeutique. Une diminution statistiquement significative des scores d’anxiété a été mise en évidence entre la phase pré-thérapeutique (M = 61,40, SD = 7,20) et la phase post-thérapeutique (M = 48,60, SD = 8,10), t(29) = -12,12, p < 0,001, dz = 2,21, IC à 95 % [-14,96, -10,64].
12.2 Exécution et extraction des résultats sous R et Python
L’implémentation logicielle de ces tests au sein des environnements d’analyse de données modernes repose sur des fonctions standardisées garantissant la reproductibilité computationnelle.
Dans l’environnement statistique R, la fonction générique t.test() gère nativement l’ensemble de ces modélisations via l’ajustement de ses paramètres booléens :
- Test t non apparié classique (Student) : Nécessite de spécifier l’égalité des variances :
t.test(score ~ groupe, data = mon_dataframe, var.equal = TRUE) - Test t non apparié de Welch (option par défaut sous R) :
t.test(score ~ groupe, data = mon_dataframe, var.equal = FALSE) - Test t apparié : Requiert l’activation de l’argument d’appariement :
t.test(mon_dataframe$post, mon_dataframe$pre, paired = TRUE)
Dans l’écosystème Python, c’est la bibliothèque scientifique SciPy, plus précisément son sous-module scipy.stats, qui propose les fonctions de référence :
- Test t indépendant :
from scipy import stats
stats.ttest_ind(groupe1, groupe2, equal_var=True) # Pour Student
stats.ttest_ind(groupe1, groupe2, equal_var=False) # Pour Welch - Test t apparié :
stats.ttest_rel(mesure_post, mesure_pre)
Dans les deux langages, les objets renvoyés contiennent précisément la valeur numérique de la statistique observée, le décompte des degrés de liberté et la probabilité critique asymptotique associée.
12.3 Exécution et lecture des sorties sous SPSS et JASP
Pour les chercheurs privilégiant les interfaces graphiques, des logiciels tels que SPSS (IBM) ou JASP offrent des modules d’analyse dédiés dont la lecture critique nécessite une solide maîtrise des tableaux de sortie générés.
Sous SPSS, l’analyse d’un devis inter-sujets s’opère via le menu Analyser > Comparer les moyennes > Test T pour échantillons indépendants. La table de sortie présente deux blocs cardinaux :
- Le Test de Levene sur l’égalité des variances : SPSS affiche une valeur F et sa significativité associée. Si Sig. > 0,05, le chercheur doit lire les résultats figurant sur la première rangée du tableau (« Hypothèse de variances égales »). Si Sig. ≤ 0,05, il est impératif de déplacer sa lecture sur la seconde rangée (« Hypothèse de variances inégales »), qui fournit les paramètres corrigés selon l’algorithme de Welch-Satterthwaite.
- Le Test T de Student : Fournit la statistique t, les degrés de liberté (qui deviennent fractionnaires sous la correction de Welch), la valeur p bilatérale (ou unilatérale dans les versions récentes) et l’intervalle de confiance de la différence.
Pour un devis intra-sujet, l’utilisateur sélectionne Analyser > Comparer les moyennes > Test T pour échantillons appariés, puis insère les deux variables temporelles dans la case « Paires de variables ». Le tableau de sortie indique d’abord le coefficient de corrélation de Pearson calculé entre les deux vagues, permettant de valider l’existence de la dépendance linéaire, suivi de la ligne de résultat du test t appliqué à la différence.
Le logiciel open-source JASP (développé par l’Université d’Amsterdam) propose une interface dynamique particulièrement élégante. En cochant simplement les options « Welch », « Student » ou « Wilcoxon », l’utilisateur génère un tableau synthétique unifié. De plus, JASP excelle dans la restitution visuelle en traçant instantanément des graphiques d’estimation présentant les distributions de densité de probabilité, les données individuelles appariées sous forme de nuages de points reliés par des segments (spaghetti plots), et les barres d’erreur basées sur l’écart-type de la différence, évitant ainsi les représentations trompeuses basées sur des diagrammes en barres classiques.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. CRC Press.
Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.2307/1164588
Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491
Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289–337. https://doi.org/10.1098/rsta.1933.0009
Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.2307/2332510
Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.
Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80–83. https://doi.org/10.2307/3001968