
L’inférence statistique appliquée aux variables catégorielles constitue l’un des piliers méthodologiques fondamentaux de la recherche empirique contemporaine, particulièrement au sein des sciences humaines, sociales et comportementales. Face à des données nominales où les mesures quantitatives continues font défaut, le chercheur doit pouvoir déterminer avec précision si la répartition observée d’un phénomène au sein de différentes modalités discrètes relève des simples fluctuations aléatoires de l’échantillonnage ou si elle témoigne d’un ajustement significatif à un modèle théorique préalablement formulé. C’est précisément à cette exigence épistémologique que répond le test d’adéquation du Khi-deux, formalisé pour la première fois à l’aube du vingtième siècle et demeuré incontournable pour tester des hypothèses de distribution probabiliste.
Dans le paysage des technologies de traitement de données, les logiciels tableurs en nuage, et plus particulièrement Google Sheets, ont profondément démocratisé l’accès aux outils d’analyse quantitative tout en modifiant les paradigmes de la reproductibilité scientifique. Longtemps cantonnée à des progiciels statistiques propriétaires et fermés tels que SPSS ou SAS, l’exécution d’un test d’adéquation peut désormais être intégralement programmée, auditée et partagée en temps réel au sein d’une feuille de calcul accessible. Cette accessibilité ne dispense nullement le praticien d’une rigueur mathématique irréprochable : la manipulation des fonctions algorithmiques requiert une compréhension intime des mécanismes de sommation, de dérivation des degrés de liberté et de pondération résiduelle.
Ce guide exhaustif a pour vocation d’articuler les fondements mathématiques et épistémologiques du test d’adéquation du Khi-deux avec son implémentation opérationnelle pas à pas dans Google Sheets. À travers un protocole analytique complet, nous aborderons la modélisation théorique des fréquences attendues, l’ingénierie des formules de Pearson, l’analyse post-hoc des résidus standardisés, le calcul de la taille d’effet et les normes de publication académique les plus strictes. En appréhendant simultanément l’architecture algorithmique du tableur et la théorie de la décision statistique, le chercheur ou l’analyste sera en mesure de concevoir des classeurs automatisés, fiables et méthodologiquement irréprochables.
1. Fondements théoriques et épistémologiques du test d’adéquation du Khi-deux
1.1 Origine statistique et pertinence en sciences du comportement
L’histoire de la statistique moderne a connu une inflexion majeure en 1900 lorsque Karl Pearson a publié son article séminal introduisant le critère du Khi-deux pour évaluer la qualité d’ajustement d’un ensemble d’observations à une loi théorique. Avant cette percée conceptuelle, l’analyse inférentielle était dominée par l’hypothèse sous-jacente de normalité gaussienne, contraignant les chercheurs à modéliser des variables continues et symétriques. Pearson a révolutionné cette approche en concevant une distribution d’échantillonnage limite qui permettait de traiter les variables nominales discrètes, où les données sont regroupées en classes qualitatives distinctes, sans présupposer une distribution sous-jacente des mesures au niveau individuel.
D’un point de vue épistémologique, la distinction entre variables nominales discrètes et métriques continues structure en profondeur la modélisation du vivant et du comportement. Dans les disciplines comportementales, en psychologie cognitive ou en sociologie quantitative, les comportements se manifestent fréquemment sous la forme de choix préférentiels discrets : adhésion à une thérapie, sélection d’une modalité d’apprentissage, orientation vers une décision d’achat ou expression d’un trait caractériel. Le test d’adéquation permet de déterminer si ces patterns décisionnels observés dévient de manière stochastique ou systématique par rapport à une attente probabiliste prédéfinie.
Il est crucial de dissocier conceptuellement le test d’adéquation du Khi-deux (parfois qualifié de test d’homogénéité unidimensionnelle ou de conformité) du test d’indépendance bivarié du Khi-deux. Si les deux procédures partagent la même machinerie algébrique globale, le test d’adéquation évalue si un vecteur unidimensionnel de fréquences observées se conforme à un vecteur de probabilités théoriques a priori. À l’inverse, le test d’indépendance analyse une table de contingence bidimensionnelle afin de juger si deux variables catégorielles distinctes sont associées ou statistiquement autonomes au sein d’une même population.
1.2 Formalisation des hypothèses statistiques nulle et alternative
La mise en œuvre formelle du test d’adéquation repose sur l’énonciation probabiliste rigoureuse de deux hypothèses rivales, mutuellement exclusives et conjointement exhaustives. L’hypothèse nulle, désignée par H0, postule que la distribution empirique observée au sein de l’échantillon d’étude est congruente avec le modèle théorique sous-jacent. Mathématiquement, pour un système comprenant k catégories mutuellement exclusives, H0 postule l’égalité vectorielle entre le vecteur des probabilités observées et le vecteur des probabilités attendues spécifiées : p1 = π1, p2 = π2, …, pk = πk, où chaque πi représente la proportion théorique dictée par le modèle d’isodistribution ou une prédiction théorique issue de la littérature.
L’hypothèse alternative, notée H1, s’exprime dans un cadre strictement non directionnel. Elle stipule qu’il existe au moins une modalité indicée i pour laquelle la probabilité empirique réelle diffère de la proportion postulée par le modèle : ∃ i ∈ {1, …, k} tel que pi ≠ πi. Cette nature non directionnelle confère une sensibilité omnibus au test : la statistique globale signale l’existence d’une divergence au sein du système sans préciser, à ce stade, quelle catégorie spécifique est surreprésentée ou sous-représentée. L’interprétation fine des asymétries catégorielles nécessitera ultérieurement des procédures de décomposition locale et d’analyse des résidus.
Le contrôle de la décision statistique s’opère par la fixation préalable d’un seuil de signification alpha, matérialisant le risque d’erreur de première espèce, c’est-à-dire la probabilité de rejeter H0 alors que celle-ci est vérifiée dans la population parente. Les conventions scientifiques établissent ce seuil à des niveaux de 0,05, 0,01 ou 0,001 selon la criticité des conclusions. Un abaissement du seuil alpha protège drastiquement contre les faux positifs mais accroît mécaniquement le risque d’erreur de type II (bêta), exigeant ainsi une vigilance soutenue lors du dimensionnement de l’étude pour maintenir une puissance statistique adéquate.
1.3 Structure mathématique de la statistique de Pearson
La statistique empirique formulée par Karl Pearson condense l’ensemble des écarts catégoriels en une grandeur scalaire unique. Pour un ensemble de k classes disjointes, la statistique notée X² (ou empiriquement χ²) est calculée selon l’expression analytique suivante :
X² = Σi=1…k [ (Oi – Ei)² / Ei ]
où Oi désigne l’effectif brut observé dans la i-ème classe et Ei représente l’effectif théorique attendu sous l’empire de l’hypothèse nulle. Cette formulation exhibe des propriétés géométriques et stochastiques d’une grande élégance. Le numérateur (Oi – Ei)² constitue une distance euclidienne quadratique. L’élévation à la puissance deux neutralise la polarité des écarts : un déficit ou un surplus de comptage contribuent tous deux positivement à l’accroissement de la statistique globale. Cette non-linéarité quadratique amplifie de surcroît l’impact des déviations massives par rapport aux légères oscillations probabilistes.
Le dénominateur Ei joue un rôle de standardisation et de pondération relative fondamental. En divisant le carré de l’écart par l’effectif attendu sous-jacent, Pearson intègre directement la variance de chaque classe selon la loi de Poisson ou la distribution multinomiale, où la variance asymptotique est proportionnelle à la moyenne attendue. Ainsi, un écart absolu de 10 observations ne possède pas la même signification statistique selon qu’il survient dans une modalité où Ei = 15 ou dans une modalité où Ei = 1000. La sommation de ces écarts standardisés converge asymptotiquement vers une loi continue du Khi-deux à k – 1 degrés de liberté dès lors que les effectifs théoriques sont suffisamment élevés.
2. Conditions d’application et postulats méthodologiques préalables
2.1 Échantillonnage probabiliste et indépendance stricte des observations
La validité interne d’un test d’adéquation repose de façon irréductible sur le respect de plusieurs postulats méthodologiques primordiaux. Le premier d’entre eux exige que les données proviennent d’un échantillonnage probabiliste rigoureux. Chaque unité statistique au sein de la population cible doit disposer d’une probabilité d’inclusion non nulle et connue. L’échantillonnage aléatoire simple demeure le standard par excellence : il immunise l’inférence contre les biais d’autosélection, les effets de convenance et la captation préférentielle de profils atypiques qui fausseraient structurellement la distribution catégorielle observée.
Le postulat de l’indépendance mutuelle des observations constitue une condition sine qua non souvent sous-estimée. Chaque observation consignée dans la table doit correspondre à une unité statistique distincte, ce qui exclut catégoriquement l’utilisation de mesures répétées longitudinales sur les mêmes individus ou l’agrégation d’événements produits en grappes interdépendantes. Si un individu est mesuré plusieurs fois et que ses choix successifs sont traités comme des observations indépendantes, l’autocorrélation intra-sujet gonfle artificiellement la taille de l’échantillon nominal N, provoquant un effondrement artificiel de la variance attendue et une prolifération massive d’erreurs de type I.
En psychologie expérimentale et en recherche comportementale, les protocoles doivent neutraliser activement les effets d’entraînement, de contagion émotionnelle ou d’interactions sociales directes lors du recueil des réponses. Si un participant observe ou subit l’influence des choix effectués par ses pairs au moment de formuler sa décision, l’indépendance stochastique des comptages est violée. Dans le cadre d’études sur panels ou de cohortes suivies dans le temps, l’analyste devra systématiquement s’orienter vers des modèles pour mesures répétées (comme le test de Cochran ou les modèles d’équations estimantes généralisées) plutôt que d’appliquer de manière erronée un test d’adéquation classique sur des séries temporelles dépendantes.
2.2 Règle de Cochran et contraintes sur les effectifs attendus
Bien que les données collectées soient de nature discrète, la statistique X² est comparée à une fonction de densité de probabilité continue : la loi théorique du Khi-deux. Ce passage du discret au continu ne constitue qu’une approximation asymptotique qui n’est valide que si la taille de l’échantillon global et les effectifs attendus dans chaque modalité atteignent une masse critique. Dès 1952 et 1954, le statisticien William Cochran a formalisé les directives méthodologiques gouvernant cette validité asymptotique, fixant un cadre opérationnel aujourd’hui universellement adopté par la communauté scientifique.
La règle de Cochran stipule que pour un test d’adéquation unidimensionnel comportant plus de deux catégories, aucun effectif théorique attendu Ei ne doit être strictement inférieur à 1, et au maximum 20 % des catégories peuvent comporter un effectif attendu inférieur à 5. Si le système ne comporte que deux modalités (k = 2, soit un degré de liberté), la règle est encore plus stricte : l’ensemble des effectifs théoriques doit impérativement être supérieur ou égal à 5. Lorsque ces seuils ne sont pas atteints, la distribution d’échantillonnage empirique de la statistique X² devient discontinue, ses queues de distribution s’épaississent et la p-valeur calculée devient instable, conduisant à des rejets abusifs de l’hypothèse nulle.
Face à la violation caractérisée de cette contrainte, le chercheur dispose de plusieurs options méthodologiques documentées. La première consiste à opérer un regroupement rationnel de modalités adjacentes ou théoriquement apparentées afin de gonfler les effectifs attendus des classes résiduelles, sous réserve que cette opération conserve un sens substantiel pour la discipline. Si la fusion des catégories est conceptuellement impossible ou indésirable, l’analyste doit abandonner l’approximation asymptotique du Khi-deux et recourir à une méthode exacte, telle que le test binomial exact pour deux classes ou le test multinomial exact, dont les distributions de probabilités réelles sont calculées par combinatoire sans aucune distorsion d’approximation.
2.3 Nature et exhaustivité des catégories qualitatives
La structuration du système de classification constitue le socle taxonomique sur lequel repose toute la validité du test. Deux principes fondamentaux doivent régir la définition des modalités : l’exclusion mutuelle et l’exhaustivité collective. Le principe d’exclusion mutuelle impose que chaque observation empirique appartienne à une et une seule catégorie du modèle. Aucun individu ne peut être doublement comptabilisé ni hésiter entre deux modalités en raison d’un chevauchement sémantique des définitions opérationnelles.
L’exhaustivité impose quant à elle que l’ensemble des catégories couvre l’intégralité absolue des états possibles de la variable dans la population cible. Tout sujet participant à l’étude doit pouvoir trouver une classe d’accueil au sein du protocole. Si des comportements ou des réponses sont omis du système catégoriel sans justification théorique explicite, la taille totale de l’échantillon N se trouve artificiellement sous-estimée, ce qui fausse le calcul des proportions attendues pour l’ensemble des classes restantes et corrompt la distribution de probabilité globale.
La gestion des catégories résiduelles (telles que les réponses « Autre », « Ne sait pas » ou les non-réponses partielles) requiert une posture épistémologique tranchée. L’inclusion automatique d’une catégorie « Divers » disparate risque d’agglomérer des processus comportementaux hétérogènes, créant un résidu massif qui dominera l’analyse au détriment des catégories d’intérêt substantiel. À l’inverse, l’exclusion arbitraire des non-réponses peut introduire un biais de sélection si l’abstention est corrélée à un trait psychologique sous-jacent. Enfin, le chercheur doit arbitrer la granularité du codage : une fragmentation excessive en une multitude de sous-catégories réduit les effectifs par cellule et érode la puissance statistique globale, tandis qu’une catégorisation trop grossière occulte des variations comportementales fines.
3. Configuration et paramétrage optimal de Google Sheets pour l’analyse
3.1 Paramètres linguistiques, régionaux et séparateurs décimaux
L’exécution rigoureuse de calculs statistiques au sein de Google Sheets nécessite une configuration technique préalable de l’environnement de calcul, particulièrement en ce qui concerne les paramètres régionaux et la gestion syntaxique des arguments. Selon que le classeur est paramétré en environnement francophone (ex. France, Belgique, Canada) ou anglophone (ex. États-Unis, Royaume-Uni), la syntaxe des formules et le rendu des nombres diffèrent radicalement. En mode français, le séparateur décimal conventionnel est la virgule, ce qui contraint l’interpréteur de Google Sheets à utiliser le point-virgule comme délimiteur d’arguments au sein de toutes les fonctions natives.
Une incompréhension de ces conventions régionales constitue la première cause d’erreurs de syntaxe ou de corruption silencieuse des calculs. Par exemple, si un utilisateur tente de copier une formule formulée à l’anglo-saxonne utilisant des virgules pour séparer les plages de données dans une feuille configurée avec des paramètres régionaux français, Google Sheets renverra une erreur d’analyse critique ou interprétera les nombres de manière totalement erronée. Pour ajuster ces paramètres, il convient d’accéder au menu Fichier > Paramètres et de vérifier la cohérence du pays et du fuseau horaire sélectionnés avec les données traitées.
Il importe également de surveiller les mécanismes de conversion automatique de Google Sheets lors de la saisie d’étiquettes de catégories. Le tableur tente fréquemment d’interpréter des chaînes de caractères courtes ou des libellés alphanumériques (comme « 1-5 », « 2020/2021 » ou « Groupe A ») comme des formats de dates, des heures ou des pourcentages standard. Pour prévenir toute altération, les colonnes réservées aux identifiants textuels de catégories doivent être explicitement converties en format « Texte brut » via le menu Format > Nombre > Texte brut, tandis que les colonnes de comptages doivent être verrouillées sur un affichage numérique entier standard.
3.2 Architecture spatiale et structuration tabulaire du classeur
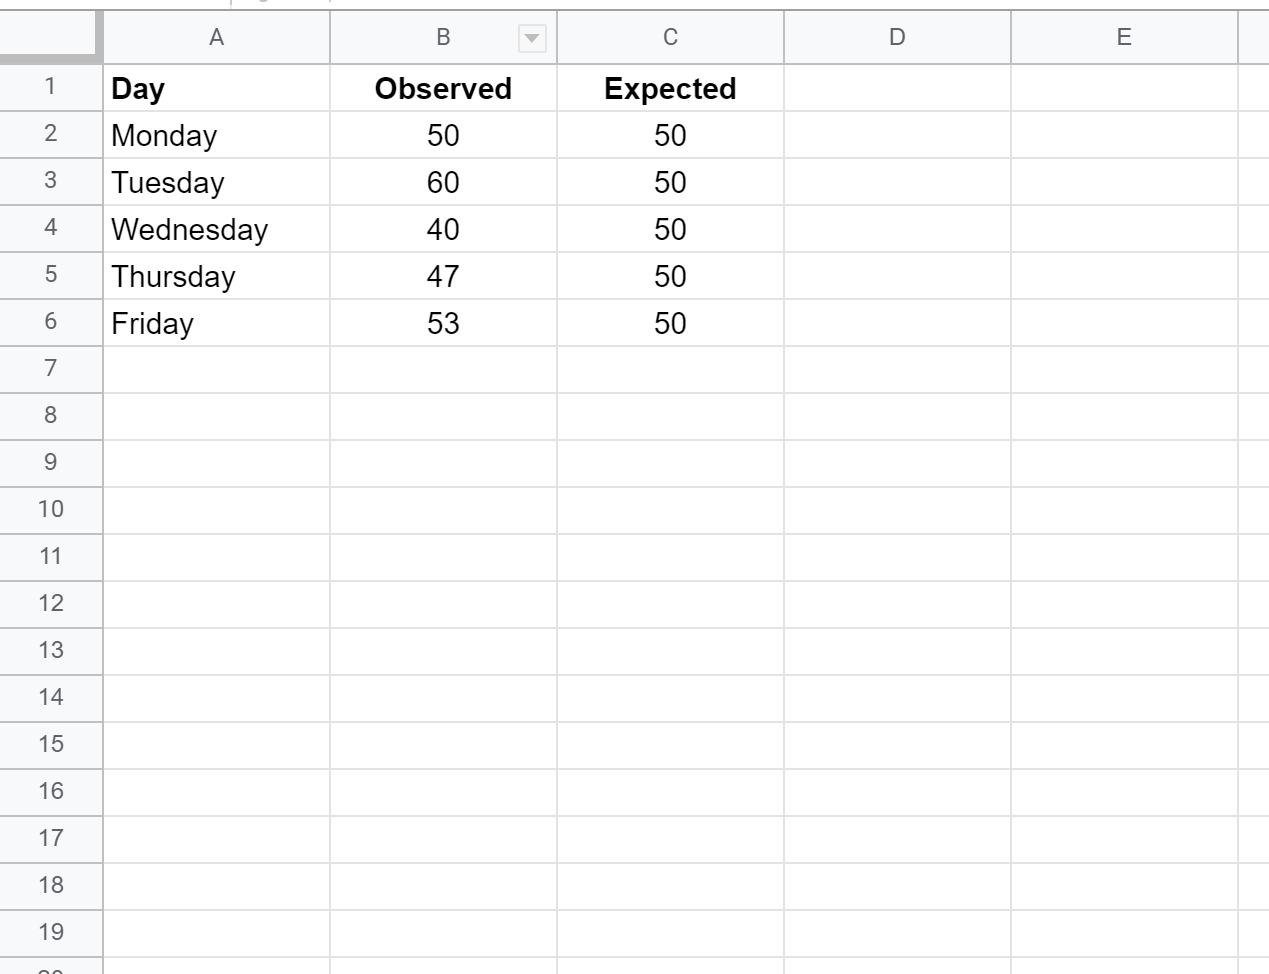
La reproductibilité scientifique impose une discipline d’organisation spatiale rigoureuse au sein de la feuille de calcul. Un classeur analytique dédié au test du Khi-deux ne doit pas se présenter comme une juxtaposition désordonnée de cellules de comptage, mais comme un pipeline de traitement séquentiel standardisé, clairement compartimenté en zones fonctionnelles distinctes : la zone d’ingestion des données observées, la zone de calcul des paramètres théoriques et la zone inférentielle de synthèse décisionnelle.
Une structuration tabulaire optimale adopte une disposition verticale par colonnes où chaque ligne correspond univoquement à une modalité de la variable nominale étudiée. La colonne A reçoit les libellés exhaustifs des modalités catégorielles. La colonne B consigne les effectifs empiriques observés (O). La colonne C accueille les probabilités théoriques a priori (pi), tandis que la colonne D calcule automatiquement les effectifs attendus correspondants (E). Les colonnes subséquentes sont allouées au déroulé algorithmique des calculs résiduels, chaque étape intermédiaire étant isolée pour permettre un audit pas à pas de l’inférence.
Pour clarifier la lecture des formules complexes et sécuriser les références matricielles, le chercheur a tout intérêt à définir des plages nommées via le menu Données > Plages nommées. Assigner des étiquettes sémantiques telles que Effectifs_Observes pour la plage B2:B6 et Effectifs_Attendus pour D2:D6 permet de substituer à l’adressage alphanumérique abstrait une formulation mathématique limpide au sein des fonctions inférentielles. Enfin, la mise en place d’un protocole de protection des cellules (via Données > Protéger les feuilles et les plages) permet de verrouiller l’ensemble des cellules hébergeant des formules, laissant uniquement accessible la zone de saisie brute pour éviter toute altération accidentelle du pipeline statistique.
3.3 Validation des données et contrôles d’intégrité initiaux
Avant d’engager la machinerie du Khi-deux, l’intégrité numérique des données doit être garantie par la mise en place de barrières algorithmiques de validation. Puisque le test d’adéquation porte sur des fréquences de comptage dénombrables, l’introduction de nombres décimaux, de valeurs négatives ou de chaînes de caractères alphabétiques dans la colonne des effectifs observés invaliderait totalement le modèle. Google Sheets permet d’interdire nativement ces anomalies via la fonction de validation des données accessible depuis le menu Données > Validation des données.
Le paramétrage d’une règle stricte imposant que les valeurs saisies soient des nombres entiers supérieurs ou égaux à zéro élimine à la source les erreurs de frappe involontaires. Conjointement, une cellule de contrôle dédiée doit être positionnée en haut ou en bas du tableau pour comparer la somme des effectifs saisis au volume attendu issu du protocole expérimental. La syntaxe =SOMME(B2:B6), confrontée dynamiquement à une variable de contrôle externe via la condition =SI(SOMME(B2:B6)=N_attendu; "Échantillon intègre"; "Anomalie d'effectif"), signale immédiatement tout désalignement numérique.
La mise en forme conditionnelle constitue un outil de diagnostic visuel d’une redoutable efficacité pour identifier les cellules corrompues. L’application d’une règle de coloration mettant en surbrillance rouge toute cellule contenant des caractères invisibles (tels que des espaces parasites consécutifs à un copier-coller défectueux) ou vérifiant la présence de doublons textuels garantit que la classification demeure parfaitement disjointe. L’utilisation combinée des fonctions ESTNUM() et EPURAGE() au sein des étapes préparatoires garantit que chaque cellule injectée dans les calculs ultérieurs possède un statut numérique pur.
4. Saisie et organisation empirique des effectifs observés (O)
4.1 Transcription des données de l’enquête ou de l’expérimentation
La transcription des données issues du terrain expérimental ou de l’administration d’un questionnaire constitue la première matérialisation empirique de l’analyse. Cette phase réclame une rigueur absolue : aucune agrégation hâtive ni manipulation des données ne doit être entreprise directement dans l’interface sans traçabilité complète. Pour illustrer concrètement notre démarche tout au long de ce guide, considérons une recherche menée au sein d’un service de consultation psychologique universitaire visant à évaluer si les demandes d’accompagnement psychologique se répartissent de façon uniforme au long des cinq jours ouvrables de la semaine.
Dans ce scénario clinique, la variable nominale étudiée est le « Jour de la semaine », déclinée en cinq modalités mutuellement exclusives : Lundi, Mardi, Mercredi, Jeudi et Vendredi. L’analyste commence par consigner ces cinq modalités dans la colonne A, de la cellule A2 à la cellule A6. Dans la colonne adjacente, de B2 à B6, sont saisis les comptages empiriques bruts cumulés au cours d’une période d’observation représentative. Admettons que les observations relevées indiquent les effectifs suivants : 45 consultations le Lundi (B2), 32 le Mardi (B3), 28 le Mercredi (B4), 35 le Jeudi (B5) et 60 le Vendredi (B6).
Lors de l’importation de jeux de données volumineux issus de fichiers CSV exportés depuis des plateformes de collecte (telles que Qualtrics ou Google Forms), une attention scrupuleuse doit être portée à la non-altération des fréquences brutes. Il n’est pas rare que des erreurs d’encodage transforment des zéros légitimes en cellules vides. Or, pour Google Sheets, une cellule vide et une cellule contenant le chiffre 0 ne sont pas toujours traitées de façon identique par les fonctions matricielles du Khi-deux. Chaque modalité représentée dans l’échantillon, même si elle n’a fait l’objet d’aucun enregistrement empirique, doit obligatoirement arborer la valeur numérique explicite 0 pour maintenir l’intégrité dimensionnelle de la matrice.
4.2 Calcul de la taille totale de l’échantillon d’étude (N)
La taille globale de la cohorte d’étude, désignée par la variable stochastique N, constitue le multiplicateur scalaire fondamental permettant d’ancrer le modèle probabiliste dans la réalité empirique de l’échantillon. Cette valeur s’obtient par la sommation exhaustive de tous les effectifs observés transcrits dans la colonne B. Dans la cellule B7, située sous la dernière modalité, l’analyste insère la formule canonique :
=SOMME(B2:B6)
Dans notre cas d’étude, cette sommation produit une taille totale N = 45 + 32 + 28 + 35 + 60 = 200 observations. Cette valeur 200 doit immédiatement faire l’objet d’une triple vérification croisée. D’une part, elle doit concorder au nombre d’individus uniques ayant rempli les critères d’inclusion du protocole expérimental sans aucune perte en cours de route. D’autre part, la taille de l’échantillon doit être isolée et explicitement référencée, soit par l’attribution d’un nom de plage défini (ex. Taille_Echantillon), soit par le verrouillage d’une référence absolue $B$7, afin de pouvoir être appelée de façon invariable dans les formules relatives ultérieures.
Dans le cas d’enquêtes sociologiques complexes où des pondérations d’échantillonnage a posteriori sont requises pour redresser la représentativité d’un groupe démographique, les effectifs consignés dans la colonne B ne sont plus des entiers purs mais des fréquences pondérées. Bien que Google Sheets permette techniquement de sommer ces valeurs pondérées, le praticien doit être conscient que le test standard du Khi-deux de Pearson perd sa distribution asymptotique exacte sous des pondérations non entières ou complexes. Il convient dans ce cas particulier d’appliquer des corrections de Rao-Scott ou d’arrondir méthodologiquement les effectifs pondérés selon des critères préalablement théorisés et documentés.
4.3 Représentation graphique préliminaire des observations
L’exploration visuelle préalable des effectifs observés constitue une étape diagnostique indispensable avant toute modélisation formelle. L’insertion d’un diagramme en colonnes (ou diagramme en bâtons) permet d’appréhender instantanément la morphologie de la distribution et d’identifier perceptivement les asymétries catégorielles majeures. Pour concevoir cette visualisation sous Google Sheets, il suffit de surligner la plage des données A2:B6, puis de sélectionner Insertion > Graphique, en optant pour le format de graphique en colonnes standard.
La mise en conformité visuelle avec les normes de communication scientifique de l’American Psychological Association (APA) exige une sobriété exemplaire. Il convient de proscrire tout effet de relief tridimensionnel, d’ombrage ou de remplissage multicolore inutile. L’axe des ordonnées (Y) doit impérativement débuter à l’origine zéro afin de ne pas exagérer optiquement les écarts relatifs entre les catégories. Les barres doivent arborer une teinte unie et neutre (noir, nuances de gris ou bleu acier), et chaque axe doit comporter une étiquette sémantique limpide assortie de ses unités (ex. « Fréquence observée des consultations » pour l’axe Y et « Journée de prise en charge » pour l’axe X).
L’examen de notre diagramme préliminaire révèle d’emblée une dissymétrie marquée au sein des consultations hebdomadaires. Le Lundi (45) et particulièrement le Vendredi (60) exhibent des sommets remarquables, tandis que le Mercredi (28) semble accuser un creux d’activité substantiel. Ce repérage qualitatif nourrit l’intuition du chercheur : la répartition globale ne semble guère se comporter comme une ligne horizontale uniforme. Néanmoins, l’observation perceptive d’une disparité ne permet en aucun cas de conclure à l’existence d’un effet statistiquement robuste ; seule la confrontation mathématique aux fréquences théoriques attendues permettra de trancher.
5. Détermination mathématique des fréquences théoriques ou attendues (E)
5.1 Cas d’une distribution uniforme : modèle d’équiprobabilité
La formulation des fréquences attendues incarne mathématiquement l’hypothèse nulle sous-jacente au test. Dans la configuration la plus fréquente en psychologie cognitive et en écologie comportementale, l’hypothèse nulle postule une absence totale de préférence, de biais ou de contrainte contextuelle : les unités statistiques se répartissent de manière rigoureusement homogène au sein de l’espace des possibles. C’est le modèle de l’équiprobabilité catégorielle, souvent désigné sous le terme d’isodistribution ou d’hypothèse de distribution uniforme.
Sous ce modèle d’équiprobabilité, la probabilité théorique assignée à chaque modalité i est rigoureusement identique et s’obtient en divisant l’unité stochastique par le nombre total de modalités du système : πi = 1 / k. Pour notre scénario clinique articulé autour de k = 5 jours ouvrables, chaque jour possède une probabilité théorique d’occurrence πi = 1 / 5 = 0,20 (soit 20 % des consultations). L’effectif théorique attendu pour chaque catégorie Ei s’obtient alors en multipliant la taille totale de l’échantillon N par cette probabilité uniforme : Ei = N × πi = N / k.
Dans la feuille Google Sheets, la programmation de cette attente uniforme s’effectue dans la colonne D. Dans la cellule D2, l’analyste formule le calcul en verrouillant la référence à la cellule de taille globale à l’aide de l’opérateur dollar :
=$B$7 / 5 ou plus dynamiquement =$B$7 / NB($B$2:$B$6)
L’étirement de cette formule de la cellule D2 à la cellule D6 génère un effectif théorique identique de 40 consultations pour chaque jour de la semaine (puisque 200 / 5 = 40). Une règle arithmétique fondamentale d’intégrité impose que la somme de ces effectifs théoriques soit rigoureusement égale à la taille totale de l’échantillon empirique : Σ Ei = Σ Oi = N. L’insertion de la formule =SOMME(D2:D6) en cellule D7 doit impérativement renvoyer 200, faute de quoi le modèle théorique souffrirait d’une erreur de spécification stochastique.
5.2 Cas d’une distribution théorique asymétrique prédéterminée
Le test d’adéquation ne se cantonne nullement à l’examen de distributions uniformes. Dans une multitude de disciplines, l’hypothèse nulle formalise un modèle théorique complexe préexistant issu de la théorie génétique, de données de recensement démographique ou de modèles psychométriques préalablement validés. Dans ce cadre, les probabilités théoriques πi ne sont pas égales entre elles : elles constituent un vecteur asymétrique a priori qui prédétermine la structure attendue de la population.
Considérons, à titre illustratif, les célèbres lois mendéliennes de l’hérédité pour un croisement dihybride en génétique classique. La théorie biologique prédit une répartition phénotypique strictement asymétrique selon les ratios 9/16, 3/16, 3/16 et 1/16 pour quatre catégories d’hybrides. De la même manière, si un psychologue cherche à vérifier si la répartition des troubles anxieux dans sa clinique reflète la prévalence nationale issue d’une enquête épidémiologique (par exemple 40 % pour le trouble anxieux généralisé, 35 % pour la phobie sociale et 25 % pour le trouble panique), le calcul des fréquences attendues doit intégrer ces coefficients pondérateurs distincts.
Pour programmer ce modèle asymétrique sous Google Sheets, la colonne C est allouée à la saisie manuelle des probabilités théoriques prédéfinies pour chaque ligne. Par exemple, la cellule C2 recevra 0,40, C3 recevra 0,35 et C4 recevra 0,25. Avant toute chose, le chercheur insère en C5 la vérification de normalisation stochastique : =SOMME(C2:C4), dont le résultat doit obligatoirement égaler 1,0000. Ensuite, dans la colonne D des effectifs théoriques, la formule relative pour la ligne 2 s’écrit :
=$B$5 * C2
L’incrémentation verticale de cette formule calcule automatiquement l’effectif attendu proportionnel à chaque catégorie en respectant strictement l’asymétrie postulée par le modèle théorique externe.
5.3 Audit des conditions de validité sur les effectifs attendus
Dès lors que les effectifs théoriques attendus (Ei) sont calculés et stabilisés dans la colonne D, l’analyste doit impérativement conduire l’audit formel des conditions d’application de Cochran avant de poursuivre l’inférence. Il s’agit d’évaluer de manière rigoureuse si l’approximation continue de la loi du Khi-deux est scientifiquement légitime au regard des masses théoriques calculées, évitant ainsi d’invalider les futures décisions statistiques par l’utilisation abusive d’une loi continue sur des effectifs microscopiques.
Pour automatiser ce contrôle dans Google Sheets et prémunir le classeur contre toute erreur d’appréciation humaine, une cellule dédiée peut accueillir une formule booléenne d’évaluation algorithmique. La syntaxe suivante, combinant les fonctions logiques SI(), MIN() et NB.SI(), audite instantanément la conformité aux critères de Cochran :
=SI(MIN(D2:D6)>=5; "Conditions de Cochran vérifiées (100% >= 5)"; SI(ET(MIN(D2:D6)>=1; (NB.SI(D2:D6; "<5")/NB(D2:D6))<=0,2); "Conditions acceptables (<=20% < 5)"; "Alerte : Conditions de Cochran violées !"))
Dans notre cas d’étude clinique portant sur les consultations universitaires, l’effectif théorique uniforme s’établit à 40 observations pour l’ensemble des modalités du système. La valeur minimale MIN(D2:D6) étant égale à 40, le seuil plancher de 5 est très largement dépassé pour 100 % des cellules, ce qui certifie une conformité absolue aux postulats de Cochran. Si tel n’avait pas été le cas, l’analyste aurait dû consigner dans les métadonnées de la feuille la stratégie de remédiation adoptée, qu’il s’agisse de la fusion planifiée de catégories marginales ou de la réorientation de l’étude vers une modélisation multinomiale exacte.
6. Calcul pas à pas des composantes de la statistique du Khi-deux
6.1 Calcul des écarts bruts résiduels (O – E)
L’analyse décomposée de la statistique de Pearson débute par la quantification élémentaire de la divergence entre le réel observé et le modèle attendu. Dans la colonne E du classeur Google Sheets, nous créons la variable des écarts résiduels bruts, traditionnellement notée (O – E). Dans la cellule E2, correspondant à la première modalité (Lundi), la formule arithmétique élémentaire s’écrit :
=B2 - D2
L’étirement de cette formule jusqu’à la cellule E6 permet d’extraire le vecteur complet des déviations empiriques. Pour notre exemple, les résultats s’établissent de la manière suivante : pour le Lundi, 45 – 40 = +5 ; pour le Mardi, 32 – 40 = -8 ; pour le Mercredi, 28 – 40 = -12 ; pour le Jeudi, 35 – 40 = -5 ; et pour le Vendredi, 60 – 40 = +20. L’interprétation du signe algébrique fournit une première indication substantielle : les valeurs positives signalent une surreprésentation empirique des consultations par rapport à l’attente théorique, tandis que les valeurs négatives traduisent un déficit de fréquentation.
Cette étape héberge un mécanisme arithmétique de contrôle fondamental et universel : la somme algébrique des résidus bruts d’un modèle d’adéquation doit obligatoirement être égale à zéro : Σ (Oi – Ei) = 0. En insérant la formule =SOMME(E2:E6) dans la cellule E7, le tableur doit afficher exactement 0 (car +5 – 8 – 12 – 5 + 20 = 0). Si cette somme s’écarte de zéro, même d’une fraction décimale non imputable aux arrondis d’affichage, cela signale de manière irréfutable une erreur dans le calcul ou le report de la taille globale de l’échantillon ou des fréquences théoriques.
6.2 Élévation au carré des écarts : suppression des compensations de signe
La nullité structurelle de la somme des résidus bruts démontre l’impossibilité de quantifier l’erreur globale d’ajustement par une simple sommation linéaire des écarts : les surreprésentations positives viendraient compenser et annuler exactement les sous-représentations négatives, masquant totalement les divergences réelles existantes. Pour surmonter cet écueil d’annulation mutuelle, Pearson a introduit l’élévation des résidus à la puissance carrée, transformant chaque déviation en une grandeur strictement non négative.
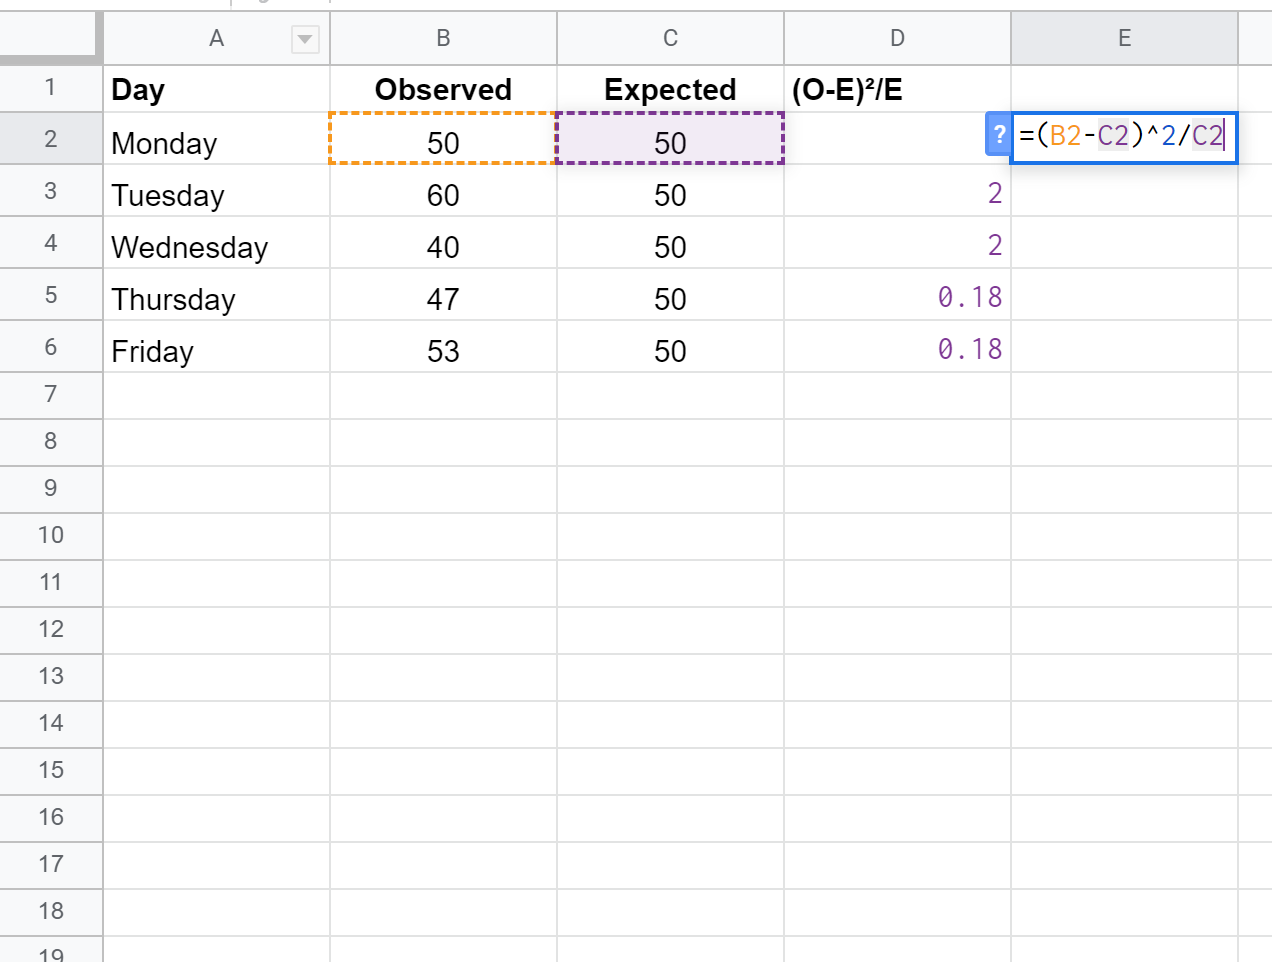
Dans la colonne F du classeur, intitulée « Écarts quadratiques (O – E)² », l’analyste programme l’opération pour la cellule F2 en mobilisant au choix l’opérateur d’exponentiation ou la fonction dédiée :
=(E2)^2 ou =PUISSANCE(E2; 2) ou directement =(B2 - D2)^2
L’application de cette transformation sur nos cinq jours de consultations génère la séquence suivante : pour le Lundi, 5² = 25 ; pour le Mardi, (-8)² = 64 ; pour le Mercredi, (-12)² = 144 ; pour le Jeudi, (-5)² = 25 ; et pour le Vendredi, 20² = 400. Au-delà de la stricte élimination des signes négatifs, l’élévation au carré opère une déformation métrique non linéaire délibérée. Les déviations mineures (comme les 5 unités du Lundi et du Jeudi) sont compressées à une valeur de 25, tandis que la divergence massive du Vendredi (20 unités) est amplifiée de façon exponentielle à 400. Ce mécanisme met mathématiquement en exergue les ruptures majeures de distribution au détriment du bruit de fond stochastique.
6.3 Pondération relative par l’effectif attendu et sommation globale
La dernière phase du calcul élémentaire consiste à pondérer chaque écart quadratique par l’effectif théorique sous-jacent, réalisant ainsi la standardisation de Pearson : (Oi – Ei)² / Ei. Dans la colonne G, intitulée « Contribution au Khi-deux », l’analyste saisit en cellule G2 la formule standard :
=F2 / D2 ou de façon intégrée =((B2 - D2)^2) / D2
Pour nos données cliniques où Ei = 40 pour toutes les catégories, les contributions catégorielles s’évaluent ainsi : pour le Lundi, 25 / 40 = 0,625 ; pour le Mardi, 64 / 40 = 1,600 ; pour le Mercredi, 144 / 40 = 3,600 ; pour le Jeudi, 25 / 40 = 0,625 ; et pour le Vendredi, 400 / 40 = 10,000. L’examen analytique de ces valeurs relatives est particulièrement instructif : il révèle immédiatement que la journée du Vendredi génère à elle seule une contribution de 10 unités standardisées, constituing le moteur prépondérant de l’écart au modèle d’équiprobabilité.
La statistique empirique finale X² de Pearson s’obtient enfin par la sommation vectorielle intégrale de l’ensemble des cellules de cette colonne G. Dans la cellule de synthèse G7, l’analyste entre la formule finale :
=SOMME(G2:G6)
Cette sommation produit la valeur empirique exacte : X² = 0,625 + 1,600 + 3,600 + 0,625 + 10,000 = 16,450. Cette valeur scalaire de 16,45 résume l’intégralité de la divergence multidimensionnelle existant entre la distribution empirique réelle des consultations et le modèle théorique d’uniformité parfaite. Il incombe désormais au chercheur de confronter cette grandeur scalaire à sa distribution d’échantillonnage théorique afin de statuer sur son degré de significativité statistique.
7. Dérivation des degrés de liberté et calcul de la probabilité critique
7.1 Théorie et calcul des degrés de liberté (ddl)
Pour pouvoir associer une probabilité d’occurrence à la statistique empirique calculée, il est impératif de déterminer avec exactitude le paramètre fondamental gouvernant la morphologie de la distribution théorique du Khi-deux : le nombre de degrés de liberté, communément abrégé en ddl (ou df pour degrees of freedom). D’un point de vue géométrique et conceptuel, le degré de liberté représente le nombre de dimensions de variabilité indépendante dont dispose le système statistique étudié.
Dans le cas classique d’un test d’adéquation où l’ensemble des fréquences théoriques attendues est dérivé d’un modèle spécifié a priori sans qu’aucun paramètre de population n’ait été directement estimé à partir des données d’échantillon, le nombre de degrés de liberté est strictement égal au nombre de catégories qualitatives k diminué d’une unité : ddl = k – 1. Cette soustraction d’une dimension découle de la contrainte marginale stochastique globale : la somme des effectifs observés étant obligatoirement égale à la taille fixée de l’échantillon N, dès lors que l’on connaît les fréquences de k – 1 catégories, la fréquence de la dernière catégorie se trouve mathématiquement déterminée et ne possède aucune liberté de variation autonome.
Pour dynamiser ce calcul dans Google Sheets et éviter toute saisie manuelle statique sujette à des désynchronisations futures, l’analyste insère dans une cellule dédiée (par exemple B10) la formule suivante :
=NB(B2:B6) - 1 ou =LIGNES(B2:B6) - 1
Dans notre application sur les jours ouvrés, le modèle comportant 5 modalités (Lundi à Vendredi), la formule renvoie rigoureusement 5 – 1 = 4 degrés de liberté. Il convient de souligner que si le modèle théorique testé avait nécessité l’estimation préalable de paramètres statistiques à partir des données observées (par exemple, ajustement à une loi de Poisson où la moyenne empirique lambda doit être calculée, ou ajustement à une loi normale où la moyenne et la variance sont estimées), chaque paramètre supplémentaire estimé consommerait un degré de liberté additionnel, selon la formule généralisée ddl = k – 1 – m (où m désigne le nombre de paramètres estimés).
7.2 Calcul de la p-valeur via la fonction LOI.KHIDEUX.DROITE
La statistique empirique X² (16,45) et son degré de liberté associé (4) étant formellement établis, l’étape décisive consiste à calculer la probabilité critique asymptotique, couramment appelée p-valeur (p-value). Cette probabilité correspond à l’intégrale unilatérale droite sous la courbe de densité de probabilité de la loi du Khi-deux, s’étendant de la valeur observée X² jusqu’à l’infini positif. Elle quantifie la probabilité d’obtenir, par le seul fait des fluctuations aléatoires d’échantillonnage, une statistique au moins aussi extrême que celle observée, sous l’hypothèse stricte que l’hypothèse nulle d’adéquation H0 est vérifiée.
Sous Google Sheets, cette probabilité est calculée avec une précision algorithmique maximale grâce à la fonction native LOI.KHIDEUX.DROITE (équivalent francophone de la fonction CHISQ.DIST.RT). La syntaxe universelle requiert deux arguments ordonnés : la valeur de la statistique calculée et le nombre de degrés de liberté associés. Dans la cellule de synthèse B11, l’analyste inscrit :
=LOI.KHIDEUX.DROITE(G7; B10)
où G7 héberge la valeur scalaire 16,45 et B10 héberge la valeur 4. L’exécution de cette formule renvoie la valeur décimale 0,002472 (soit environ 0,0025). Cette p-valeur est extrêmement révélatrice : elle indique qu’il n’y a que 0,25 % de chances d’observer une telle divergence par simple tirage stochastique si les consultations étaient réellement uniformément réparties au cours de la semaine. Si la p-valeur s’avérait microscopique (par exemple inférieure à 10⁻⁵), Google Sheets basculerait automatiquement l’affichage en notation scientifique (ex. 2,47E-04). Le chercheur peut alors formater cette cellule via Format > Nombre pour afficher un nombre de décimales approprié.
7.3 Identification de la valeur critique seuil via LOI.KHIDEUX.INVERSE.DROITE
L’approche décisionnelle classique de Neyman-Pearson repose sur la démarcation d’une région critique de rejet déterminée par une valeur seuil tabulée, correspondant au seuil de risque alpha préalablement toléré par l’expérimentateur. Si la statistique X² calculée franchit cette frontière mathématique, l’hypothèse nulle est rejetée. Dans Google Sheets, la dérivation de cette valeur critique seuil s’opère instantanément via la fonction LOI.KHIDEUX.INVERSE.DROITE (équivalent francophone de CHISQ.INV.RT).
La syntaxe impose de renseigner en premier argument le seuil d’erreur de première espèce alpha (généralement 0,05), et en second argument le degré de liberté du modèle. Dans la cellule B12, nous formulons le calcul suivant :
=LOI.KHIDEUX.INVERSE.DROITE(0,05; B10)
Pour 4 degrés de liberté et un niveau de confiance fixé à 95 % (alpha = 0,05), Google Sheets renvoie la valeur critique seuil de 9,4877. La relation géométrique s’éclaire alors parfaitement : la région d’acceptation de H0 s’étend de 0 à 9,488, tandis que toute valeur supérieure à 9,488 pénètre irréversiblement dans la région de rejet critique. Notre statistique observée X² = 16,45 surpassant largement ce seuil théorique, la décision statistique s’impose sans ambiguïté.
Pour conférer à la feuille de calcul une autonomie d’interprétation inférentielle totale, nous pouvons intégrer une règle logique booléenne dans la cellule décisionnelle B13 :
=SI(G7 > B12; "Rejet de H0 (Différence statistiquement significative)"; "Non-rejet de H0 (Adéquation au modèle acceptée)")
Grâce à cette formule dynamique, le classeur adapte automatiquement sa conclusion textuelle en fonction de l’évolution des effectifs empiriques saisis en zone brute, garantissant une reproductibilité opérationnelle immédiate pour de futures études comparatives.
8. Automatisation directe par les fonctions intégrées de Google Sheets
8.1 Mise en œuvre experte de la fonction TEST.KHIDEUX
Bien que la décomposition étape par étape présentée dans les sections antérieures soit indispensable pour comprendre la mécanique interne du test et auditer les composantes locales de l’écart, Google Sheets offre un moteur d’intégration algorithmique capable d’évaluer directement l’adéquation stochastique en une seule formule unifiée : la fonction TEST.KHIDEUX (correspondant à CHISQ.TEST en nomenclature anglophone).
La fonction TEST.KHIDEUX adopte une syntaxe matricielle compacte nécessitant impérativement deux plages de données continues de dimensions géométriques strictement identiques : la plage des effectifs empiriques observés et la plage des effectifs théoriques attendus correspondants. Dans notre classeur, l’analyste implémente cette fonction de manière directe dans la cellule B15 :
=TEST.KHIDEUX(B2:B6; D2:D6)
Une spécificité fondamentale de cette fonction intégrée réside dans son type de retour : TEST.KHIDEUX ne renvoie pas la valeur intermédiaire de la statistique X² de Pearson, mais calcule et affiche directement la p-valeur unilatérale droite exacte. En exécutant cette formule sur nos données, Google Sheets affiche instantanément 0,002472, confirmant de manière rigoureuse et redondante le résultat obtenu par l’articulation séquentielle de nos colonnes intermédiaires et de la fonction LOI.KHIDEUX.DROITE.
L’utilisation experte de TEST.KHIDEUX présente l’avantage majeur d’immuniser les calculs rapides contre les erreurs d’inattention ou de manipulation lors du glissement des formules résiduelles dans de volumineux classeurs. Elle permet également de concevoir des architectures d’analyse extrêmement légères au sein de tableaux de bord exécutifs où la conservation des calculs intermédiaires d’écarts quadratiques n’est pas requise par les utilisateurs finaux.
8.2 Rétro-ingénierie de la statistique X² à partir de la fonction CHISQ
La concision de la fonction TEST.KHIDEUX présente un corollaire limitant : pour les chercheurs devant consigner formellement la statistique X² de Pearson dans leurs rapports académiques sans encombrer leur classeur de colonnes résiduelles, l’absence d’affichage direct de cette grandeur constitue une contrainte ergonomique. Heureusement, les lois de la trigonométrie et de l’analyse stochastique permettent de procéder à une rétro-ingénierie exacte de la statistique de Pearson en inversant la distribution théorique à partir de la p-valeur générée par le test natif.
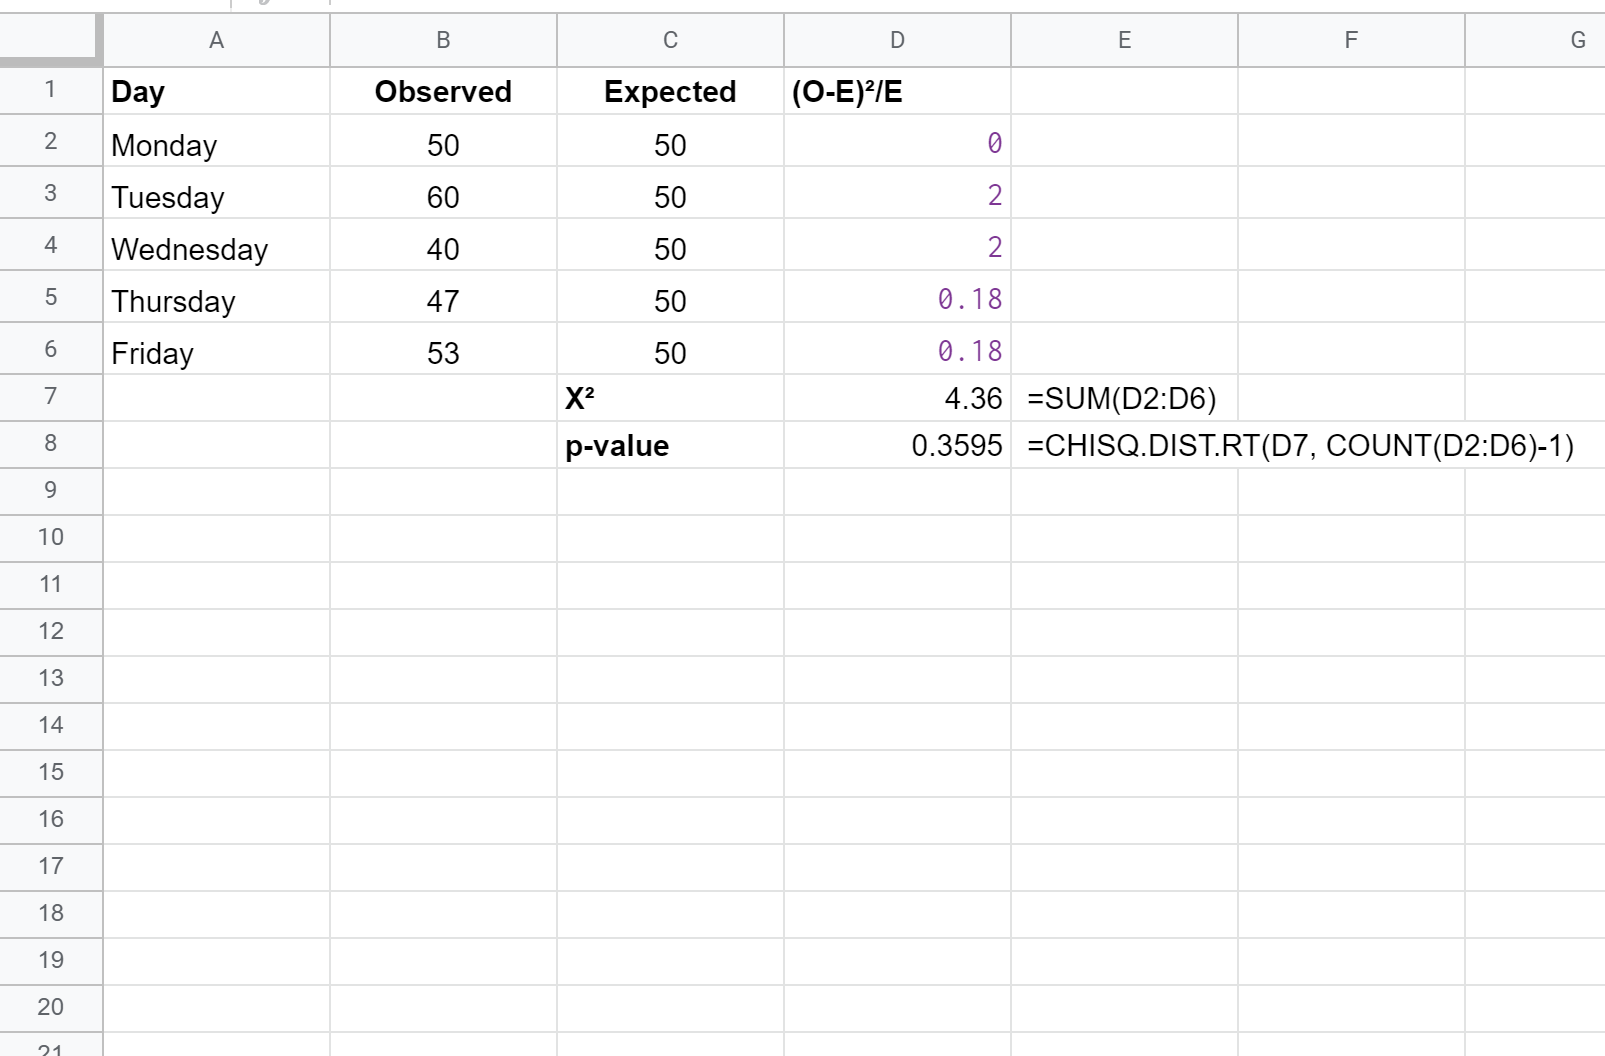
En encapsulant la fonction TEST.KHIDEUX au sein de la fonction quantile LOI.KHIDEUX.INVERSE.DROITE, l’analyste reconstruit de manière élégante et directe la statistique scalaire X² sans solliciter aucune colonne intermédiaire. La syntaxe matricielle avancée s’articule comme suit :
=LOI.KHIDEUX.INVERSE.DROITE(TEST.KHIDEUX(B2:B6; D2:D6); NB(B2:B6) - 1)
Le fonctionnement interne de cette formule imbriquée s’opère en deux temps stochastiques : la fonction interne TEST.KHIDEUX(B2:B6; D2:D6) calcule la probabilité critique exacte (0,002472), puis la fonction enveloppante LOI.KHIDEUX.INVERSE.DROITE recherche la valeur d’abscisse qui isole précisément cette proportion de surface sous la courbe pour 4 degrés de liberté. Le tableur renvoie instantanément la valeur 16,4500, établissant une concordance mathématique absolue avec notre sommation cellulaire pas à pas.
Cette approche synthétique constitue un atout précieux pour le développement de modèles statistiques modulaires sous Google Sheets. Elle permet de structurer des tableaux de bord analytiques compacts où les métriques clés (statistique empirique, ddl et probabilité critique) sont condensées en quelques cellules de formules matricielles autonomes, prêtes à être dupliquées pour analyser simultanément de multiples sous-groupes ou variables démographiques.
8.3 Limites et précautions d’usage des fonctions natives Google Sheets
Malgré leur flexibilité incontestable, les fonctions natives de Google Sheets dédiées au Khi-deux comportent des contraintes algorithmiques et des pièges d’interprétation dont tout analyste rigoureux doit avoir une conscience aiguë. La première contrainte d’intégrité concerne la conformité géométrique absolue des arguments vectoriels : les plages matricielles transmises à TEST.KHIDEUX doivent obligatoirement posséder le même nombre exact de lignes et de colonnes. Une divergence de dimensionnalité génère immédiatement une erreur de type #N/A ou #VALEUR!.
Un comportement inattendu particulièrement insidieux survient lors du traitement des cellules vides ou textuelles au sein des plages cibles. Si une cellule de la plage des effectifs attendus contient par inadvertance une chaîne vide ("") issue d’une formule conditionnelle mal calibrée, ou si un zéro est accidentellement omis, Google Sheets peut exclure silencieusement cette cellule du calcul matriciel. Cette exclusion tronque le nombre de degrés de liberté sous-jacent sans avertir l’analyste par un message d’erreur explicite, faussant radicalement le calcul de la p-valeur finale.
Enfin, il est impératif de noter que la fonction native TEST.KHIDEUX applique aveuglément l’approximation continue asymptotique de Pearson sans jamais vérifier si les critères de Cochran sont remplis sur les effectifs théoriques fournis. De surcroît, elle n’intègre aucune correction de continuité automatique (telle que la correction de Yates) pour les tables à 1 degré de liberté. L’analyste ne doit donc jamais se reposer passivement sur l’obtention d’un résultat numérique automatisé sans avoir préalablement audité la structure sous-jacente de ses fréquences théoriques.
9. Analyses post-hoc et décomposition des résidus standardisés
9.1 Calcul des résidus standardisés de Pearson
L’obtention d’un résultat globalement significatif (X² = 16,45, p = 0,0025) confirme le rejet indiscutable de l’hypothèse nulle d’isodistribution : la fréquentation des consultations psychologiques ne se répartit pas de manière homogène sur la semaine. Cependant, en tant que test omnibus, le Khi-deux est incapable d’indiquer à lui seul quelles journées spécifiques s’écartent substantiellement de la norme théorique. Pour élucider l’architecture locale de cette divergence sans multiplier arbitrairement des sous-tests informels, le chercheur doit procéder à une analyse post-hoc rigoureuse fondée sur le calcul des résidus standardisés de Pearson.
Le résidu standardisé de Pearson, souvent noté Ri, est défini mathématiquement comme le quotient de l’écart brut par la racine carrée de l’effectif attendu sous-jacent :
Ri = (Oi – Ei) / √Ei
Cette transformation est capitale : sous l’hypothèse nulle d’adéquation, chaque résidu standardisé Ri se comporte asymptotiquement comme un score standardisé Z issu d’une loi normale centrée réduite N(0, 1). Dans la colonne H du classeur Google Sheets, nous programmons le calcul de ce résidu pour la première catégorie (Lundi) dans la cellule H2 :
=(B2 - D2) / RACINE(D2)
En propageant cette formule de H2 à H6, nous obtenons les scores Z catégoriels suivants : pour le Lundi, (45 – 40) / √40 = +0,791 ; pour le Mardi, (32 – 40) / √40 = -1,265 ; pour le Mercredi, (28 – 40) / √40 = -1,897 ; pour le Jeudi, (35 – 40) / √40 = -0,791 ; et pour le Vendredi, (60 – 40) / √40 = +3,162. Se référant aux propriétés de la distribution normale standard, les seuils critiques conventionnels de significativité bivariée s’établissent à |Z| > 1,96 pour un seuil alpha de 0,05, et à |Z| > 2,58 pour alpha = 0,01. L’examen des résidus révèle immédiatement que le Vendredi (Z = +3,16) constitue la seule catégorie affichant une surreprésentation hautement significative, tandis que le Mercredi (Z = -1,90) s’approche de la frontière de sous-représentation sans franchir le seuil critique conventionnel à deux queues.
9.2 Résidus standardisés ajustés (résidus d’Haberman)
Bien que les résidus standardisés de Pearson fournissent une excellente première approximation des déviations locales, ils souffrent d’une imperfection théorique : ils ont tendance à sous-estimer la variance réelle de l’échantillonnage car ils ne prennent pas en considération la réduction de liberté induite par la contrainte marginale sur le total N. En 1973, Shelby Haberman a corrigé cette lacune en introduisant les résidus standardisés ajustés (couramment appelés résidus d’Haberman), qui divisent l’écart brut par l’erreur-type exacte de la différence.
Pour un test d’adéquation portant sur un vecteur de probabilités théoriques πi, la formule formelle du résidu ajusté s’exprime selon :
Radj, i = (Oi – Ei) / √(Ei × (1 – πi))
Dans la colonne I de Google Sheets, l’analyste programme l’algorithme d’Haberman en intégrant la proportion théorique de la cellule C2 (ou en formulant le ratio D2/$B$7). Pour la ligne 2, la syntaxe s’écrit :
=(B2 - D2) / RACINE(D2 * (1 - (D2 / $B$7)))
La présence du facteur réducteur (1 – πi) sous le radical diminue le dénominateur, ce qui a pour effet d’accroître la magnitude absolue des scores Z ajustés. Pour nos données, le résidu d’Haberman du Mercredi passe de -1,897 à -12 / √(40 × 0,8) = -12 / √32 = -2,121, tandis que celui du Vendredi s’élève de +3,162 à +20 / √32 = +3,536. L’utilisation des résidus d’Haberman modifie ici sensiblement le diagnostic local : avec un score de -2,12 (dépassant en valeur absolue le seuil de 1,96), la sous-fréquentation du Mercredi devient formellement reconnue comme statistiquement significative, prévenant ainsi une erreur de type II qui aurait masqué un désengagement avéré en milieu de semaine.
9.3 Correction de Bonferroni pour les comparaisons multiples
L’évaluation simultanée de multiples résidus standardisés au sein d’un même jeu de données confronte inévitablement le chercheur à la problématique de l’inflation du risque global d’erreur de type I. Dès lors que l’on procède à k tests d’hypothèses locaux successifs (un test par modalité catégorielle) à un seuil nominal α = 0,05, la probabilité d’observer au moins un faux positif par le simple jeu du hasard s’élève selon la formule du risque cumulé : αglobal = 1 – (1 – α)k. Pour k = 5 catégories, ce risque d’erreur familial s’élève à près de 1 – (0,95)⁵ = 22,62 %, ce qui est scientifiquement inacceptable.
Pour maîtriser cette dérive probabiliste, la méthode la plus conservatrice et universellement reconnue consiste à appliquer la correction de Bonferroni. Cette correction divise le seuil alpha nominal par le nombre total de comparaisons catégorielles conduites : αajusté = α / k. Pour notre étude comprenant 5 jours ouvrés, le seuil de significativité local ajusté s’établit à 0,05 / 5 = 0,010. Dans Google Sheets, le nouveau seuil critique en score Z correspondant à ce niveau de confiance bilatéral plus strict est calculé dynamiquement grâce à la fonction de distribution normale inverse :
=LOI.NORMALE.STANDARD.INVERSE.N(1 - (0,05 / (2 * 5)))
Cette formule renvoie une valeur critique seuil corrigée de |Zcrit| = 2,576 (au lieu du traditionnel 1,96). En confrontant nos résidus d’Haberman à cette borne de Bonferroni, nous constatons que la désaffection du Mercredi (Z = -2,12), bien que substantielle, ne franchit plus ce seuil conservateur de 2,576 et ne peut être affirmée comme statistiquement isolable au niveau de confiance global de 95 %. En revanche, l’affluence massive du Vendredi (Z = +3,54) pulvérise ce critère d’ajustement, confirmant qu’elle constitue l’unique anomalie structurelle robuste régissant le rejet de l’hypothèse nulle.
Pour matérialiser ce diagnostic dans la feuille de calcul, nous appliquons une mise en forme conditionnelle sur la colonne des résidus d’Haberman. En programmant une règle personnalisée basée sur la formule =ABS(I2) >= $K$1 (où K1 héberge la valeur critique corrigée 2,576), Google Sheets colore automatiquement en vert émeraude ou en rouge vif les cellules motrices de l’écart, offrant un tableau de bord post-hoc d’une clarté visuelle irréprochable.
10. Quantification de la taille d’effet et calcul de puissance
10.1 Calcul et interprétation du V de Cramer pour l’adéquation
L’inférence statistique contemporaine exige impérativement d’émanciper l’interprétation des résultats de la seule tyrannie de la p-valeur. Une valeur de p infinitésimale atteste de l’improbabilité de l’hypothèse nulle, mais ne renseigne en rien sur la magnitude clinique, psychologique ou empirique de la divergence observée. La significativité statistique n’étant qu’une fonction conjointe de l’ampleur de l’effet et de la taille de l’échantillon N, une déviation minuscule au sein d’une cohorte colossale peut générer une p-valeur hautement significative sans présenter le moindre intérêt substantiel. Pour quantifier la force de l’adéquation, le calcul d’un indice standardisé de taille d’effet est indispensable.
Pour les modèles catégoriels unidimensionnels comportant k modalités qualitatives, l’indice d’association standardisé le plus communément mobilisé est le V de Cramer. Adapté au contexte du test d’adéquation univarié, le coefficient V se formalise algébriquement par l’expression suivante :
V = √[ X² / (N × (k – 1)) ]
Dans cette formule, le terme (k – 1) correspond au nombre de degrés de liberté du système catégoriel. L’indice V est borné structurellement entre 0 (traduisant une conformité absolue et parfaite entre effectifs observés et théoriques) et 1 (indiquant une concentration maximale et unilatérale de l’ensemble des observations dans une seule modalité alors qu’une répartition uniforme était postulée).
Dans Google Sheets, l’automatisation du calcul du V de Cramer s’opère en cellule B17 en reliant les cellules clés préalablement calculées :
=RACINE(G7 / ($B$7 * B10))
où G7 héberge la statistique X² (16,45), B7 la taille totale N (200) et B10 le degré de liberté k – 1 (4). Le calcul produit : V = √[ 16,45 / (200 × 4) ] = √[ 16,45 / 800 ] = √0,02056 = 0,1434. Selon les grilles d’interprétation conventionnelles établies par Jacob Cohen pour les sciences du comportement, une taille d’effet mesurée par le V de Cramer s’interprète comme faible pour des valeurs avoisinant 0,10, modérée autour de 0,30, et forte au-delà de 0,50. Notre résultat (V = 0,14) quantifie ainsi un effet réel mais de magnitude modeste, tempérant l’enthousiasme que la lecture isolée d’une p-valeur de 0,0025 aurait pu susciter chez l’analyste.
10.2 Indice w de Cohen pour les modèles catégoriels
Bien que le V de Cramer soit largement répandu dans la littérature francophone, le statisticien Jacob Cohen (1988) a formalisé un indice métrique spécifiquement dédié à l’évaluation de la taille d’effet dans les tests d’adéquation et de contingence du Khi-deux : l’indice w de Cohen. Cet indice mesure la distance stochastique euclidienne entre les distributions de probabilités observées et attendues.
La formalisation originale de l’indice w repose sur les proportions empiriques observées (poi = Oi / N) et les proportions théoriques attendues (pei = πi) :
w = √ [ Σi=1…k ( (poi – pei)² / pei ) ]
Par un développement algébrique direct, on démontre que l’indice w est mathématiquement relié à la statistique globale de Pearson et à la taille de l’échantillon par la relation extrêmement compacte suivante :
w = √(X² / N)
Dans la feuille Google Sheets, la mise en œuvre de cette métrique s’exécute avec une remarquable simplicité dans la cellule B18 :
=RACINE(G7 / $B$7)
Pour notre échantillon de consultations, cette formule calcule : w = √(16,45 / 200) = √0,08225 = 0,2868. Selon les balises normatives universelles de Cohen, les seuils d’évaluation pour l’indice w sont précisément définis comme suit : un effet de 0,10 est qualifié de faible (small), un effet de 0,30 correspond à un effet moyen (medium), et une valeur franchissant 0,50 désigne un effet fort (large). Notre valeur w = 0,29 se positionne à l’orée exacte d’un effet d’amplitude moyenne, indiquant que l’écart au modèle d’équiprobabilité possède une consistance pratique indéniable au sein de l’organisation clinique du service hospitalier.
10.3 Notions fondamentales de puissance statistique a posteriori
La puissance statistique d’un test d’adéquation correspond à la probabilité probabiliste 1 – β de rejeter l’hypothèse nulle lorsque celle-ci est effectivement fausse dans la population parente, c’est-à-dire la capacité du protocole à détecter un effet réel d’une amplitude donnée. L’évaluation de la puissance dépend de l’interaction triangulaire unissant le niveau de signification alpha, la taille de l’échantillon N, le nombre de degrés de liberté du modèle et la taille d’effet théorique postulée (w de Cohen).
Bien que Google Sheets ne dispose pas de fonctions directes de calcul de distribution du Khi-deux non centrale (requises pour évaluer la puissance exacte a posteriori sans développement de scripts complexes en Apps Script), l’analyste doit être sensibilisé aux deux écueils métrologiques opposés que sont la sous-puissance et la surpuissance. Dans le cas d’échantillons de taille très modeste (ex. N = 25), un non-rejet de l’hypothèse nulle ne permet en aucun cas de certifier l’adéquation au modèle : l’absence de significativité statistique découle le plus souvent d’un déficit d’observations rendant le test aveugle aux déviations substantielles (erreur de type II).
Inversement, le test d’adéquation du Khi-deux est particulièrement vulnérable à l’effet de surpuissance sur de volumineuses bases de données (ex. N > 10 000). Dans de telles conditions, le dénominateur des erreurs-types s’effondre, rendant le test capable d’identifier comme « hautement significatives » (p < 0,0001) des déviations infimes de l’ordre de quelques fractions de pourcentage par rapport au modèle théorique, sans aucune pertinence écologique réelle. C’est pourquoi la planification d’échantillon rigoureuse requiert d’estimer la taille d’échantillon optimale en amont de l’étude à l’aide de progiciels spécialisés d’analyse de puissance, tels que G*Power, plutôt que de multiplier aveuglément le nombre d’enregistrements empiriques.
11. Protocoles de validation, diagnostics d’erreurs et robustesse du modèle
11.1 Diagnostics des anomalies et pièges statistiques sous Google Sheets
La conduite d’analyses statistiques au sein d’environnements de feuilles de calcul expose le chercheur à des artefacts d’implémentation algorithmique pouvant corrompre silencieusement la justesse des inférences. Le premier diagnostic opérationnel concerne la détection des références circulaires. Lorsqu’un utilisateur tente d’automatiser des vérifications d’intégrité en chaînant les cellules de totaux marginaux (comme le total N en cellule B7) à des formules de contrôle récursives, Google Sheets peut entrer dans des boucles itératives silencieuses si le calcul itératif est activé dans les paramètres du classeur, générant des valeurs asymptotiques totalement décorrélées des données de départ.
Un piège technique récurrent découle de la contamination des libellés catégoriels par des caractères invisibles ou des espaces parasites (caractères de code ASCII 32 ou espaces insécables ASCII 160) souvent injectés lors d’opérations de copier-coller depuis des plateformes web. Si la cellule A2 contient la chaîne "Lundi " (avec un espace terminal invisible) tandis qu’une formule de consolidation ultérieure fait référence à la chaîne pure "Lundi", les fonctions de recherche ou de comptage conditionnel (telles que SOMME.SI ou RECHERCHEV) échoueront silencieusement, traitant les catégories comme distinctes et brisant l’exhaustivité de la table.
L’intégrité des types de données doit faire l’objet d’un contrôle rigoureux : Google Sheets aligne par convention les chaînes de texte à gauche de la cellule et les valeurs numériques pures à droite. Si un effectif observé se retrouve aligné à gauche malgré la saisie d’un chiffre, cela indique que le tableur le stocke sous forme de chaîne textuelle. Cette anomalie invalide les sommations matricielles tout en provoquant des erreurs de type #VALEUR! lors de l’appel de TEST.KHIDEUX. Enfin, le masquage des arrondis via les outils de mise en forme cosmétique d’affichage peut dissimuler des violations des conditions de Cochran, affichant un 5 visuel pour une valeur théorique sous-jacente réelle de 4,9994.
11.2 Stratégies d’ajustement face aux petits effectifs attendus
Lorsque l’audit initial révèle des effectifs attendus chroniquement inférieurs aux seuils minimaux de Cochran, plusieurs voies d’ajustement technique peuvent être mobilisées au sein de Google Sheets pour rétablir la robustesse de l’inférence. La stratégie la plus rationnelle repose sur la fusion empirique et théorique de catégories marginales adjacentes. Si une étude porte sur le choix d’options académiques et que deux filières recueillent des effectifs attendus dérisoires (ex. E1 = 2 et E2 = 3), l’analyste peut procéder à leur agrégation au sein d’une méta-catégorie conceptuellement cohérente (ex. « Autres sciences humaines »), dont l’effectif attendu cumulé franchira le seuil de sécurité de 5.
Dans la situation spécifique d’un modèle d’adéquation ne comportant que deux modalités catégorielles (k = 2, conduisant à 1 degré de liberté), l’approximation continue de Pearson devient excessivement libérale en présence d’échantillons de taille faible à modérée. Il convient alors d’intégrer la correction de continuité de Frank Yates (1934). La correction de Yates consiste à retrancher 0,5 à la valeur absolue de chaque écart brut avant son élévation au carré, réduisant artificiellement la magnitude de la statistique de Pearson pour compenser la discontinuité de la fonction de masse discrète :
X²Yates = Σi=1…2 [ (|Oi – Ei| – 0,5)² / Ei ]
Dans Google Sheets, cette formulation corrigée s’implémente dans la cellule de contribution via la syntaxe suivante :
=(ABS(B2 - D2) - 0,5)^2 / D2
L’effet de la correction de continuité de Yates est d’augmenter la p-valeur finale, introduisant un conservatisme bienvenu qui protège efficacement le chercheur contre les déclarations prématurées de significativité statistique sur des petits échantillons.
11.3 Tests de robustesse par simulation de rééchantillonnage (Bootstrap)
Lorsque la structure des données transgresse substantiellement les postulats asymptotiques classiques et qu’aucune fusion de catégories n’est épistémologiquement acceptable, la robustesse des conclusions peut être établie par des méthodes empiriques de simulation stochastique non paramétrique de type Monte-Carlo ou Bootstrap. Google Sheets dispose d’une infrastructure algorithmique native capable de simuler des milliers de rééchantillonnages virtuels aléatoires sous l’hypothèse nulle sans nécessiter de compilateur externe.
Le principe de la simulation consiste à générer virtuellement un échantillon de taille N = 200 répondant rigoureusement à l’hypothèse nulle d’isodistribution, puis à calculer la statistique X² de Pearson sur cette cohorte artificielle. Pour implémenter ce processus dans une plage de calcul dédiée, nous mobilisons la fonction matricielle pseudo-aléatoire uniforme :
=ALEA.ENTRE.BORNES(1; 5)
En étirant cette formule sur une colonne de 200 lignes, nous simulons une cohorte de 200 choix de jours strictement régis par le hasard de l’équiprobabilité. Une table de comptage secondaire agrège ensuite ces tirages simulés via la fonction NB.SI() pour reconstituer le vecteur des effectifs observés virtuels, dont est immédiatement déduite une statistique X²simule par notre pipeline habituel.
En répétant cette procédure sur un nombre important d’itérations à l’aide d’un tableau de données ou d’une boucle itérative sous Google Apps Script, on obtient une distribution de fréquences empirique de la statistique du Khi-deux affranchie de tout postulat de continuité mathématique. La proportion d’itérations simulées dont la statistique virtuelle surpasse notre valeur empirique observée (16,45) constitue la p-valeur empirique bootstrap. Si cette p-valeur simulée demeure congruente avec la valeur asymptotique calculée par LOI.KHIDEUX.DROITE (0,0025), la robustesse des conclusions scientifiques se trouve formellement et irréfutablement validée.
12. Rédaction académique des résultats aux normes APA et pérennisation du classeur
12.1 Standardisation du rapport textuel selon les normes de l’APA (7e édition)
La communication scientifique des résultats inférentiels au sein d’articles ou de mémoires de recherche est encadrée par des conventions typographiques et rédactionnelles strictes édictées par l’American Psychological Association dans sa septième édition. La restitution des résultats d’un test d’adéquation du Khi-deux ne peut se limiter à une vague mention de significativité ; elle doit obligatoirement expliciter la lettre statistique grecque, les degrés de liberté, la taille globale d’échantillon, la valeur exacte de la statistique de test, le niveau précis de la p-valeur et une métrique standardisée de la taille d’effet.
La syntaxe canonique standardisée se formule de la manière suivante :
χ²(ddl, N = …) = …, p = …, V = … (ou w = …)
Plusieurs règles typographiques impératives doivent être scrupuleusement respectées :
- La lettre grecque χ (Khi), la lettre latine majuscule N, ainsi que les lettres minuscules p, V et w doivent impérativement être composées en caractères italiques.
- Aucun zéro initial ne doit précéder la virgule décimale de la p-valeur (qui s’écrit par exemple p = .002 et non p = 0,002 dans les revues anglophones, ou avec la virgule sans zéro initial selon les directives éditoriales francophones), car une probabilité ne peut mathématiquement jamais excéder l’unité.
- Si la valeur de p est inférieure à un millième, elle ne doit jamais être notée p = .000 (ce qui est une hérésie mathématique), mais formulée sous forme d’inégalité stricte : p < .001.
- Les valeurs de la statistique χ² et de la taille d’effet doivent systématiquement être rapportées avec deux ou trois décimales de précision.
Appliquée à notre recherche sur les consultations universitaires, la rédaction finale s’articulera sous la forme narrative suivante :
« Un test d’adéquation du Khi-deux de Pearson a été conduit afin de déterminer si les consultations psychologiques se répartissaient de manière homogène à travers les cinq jours ouvrés de la semaine au sein de la cohorte clinique (N = 200). L’analyse révèle que la distribution observée dévie de façon statistiquement significative de l’hypothèse d’équiprobabilité théorique, χ²(4, N = 200) = 16,45, p = .002, avec une taille d’effet moyenne mesurée par l’indice w de Cohen (w = .29) et un V de Cramer modéré (V = .14). L’examen post-hoc des résidus standardisés ajustés d’Haberman assorti d’une correction de Bonferroni (αcritique = .010, |Zseuil| = 2,58) indique que cette asymétrie globale est principalement imputable à une surreprésentation hautement significative des demandes de prise en charge le vendredi (O = 60, E = 40, Radj = +3,54). Bien que le mercredi enregistre le plus faible volume de consultations (O = 28, E = 40, Radj = -2,12), cet écart ne franchit pas le seuil conservateur de Bonferroni. Ces observations suggèrent une polarisation comportementale en fin de cycle hebdomadaire justifiant un redéploiement des effectifs thérapeutiques lors de cette journée critique. »
12.2 Conception de tableaux récapitulatifs publiables depuis Google Sheets
La clarté d’un article scientifique repose grandement sur la capacité de ses tableaux à communiquer l’intégralité des paramètres inférentiels de manière autonome et auto-explicative. Les normes APA interdisent formellement l’utilisation de grilles tabulaires fermées, de quadrillages verticaux et de colorations d’arrière-plan fantaisistes : un tableau aux normes académiques ne tolère que trois lignes de bordures horizontales simples (une ligne supérieure délimitant le haut de la table, une ligne inférieure fermant la rangée des en-têtes de colonnes, et une ligne finale soulignant la rangée des totaux de clôture).
Dans Google Sheets, l’analyste conçoit un tableau de publication élégant en masquant le quadrillage par défaut via le menu Affichage > Afficher > Quadrillage, puis en appliquant manuellement les bordures horizontales requises depuis la palette d’outils. La structure colonnaire optimale s’articule comme suit : Colonne 1 : Catégories nominales (Jours) ; Colonne 2 : Fréquences observées (O) ; Colonne 3 : Fréquences théoriques attendues (E) ; Colonne 4 : Pourcentage observé (%) ; Colonne 5 : Résidu brut (O – E) ; Colonne 6 : Résidu standardisé ajusté d’Haberman (Radj).
Toutes les colonnes de données numériques doivent être méticuleusement justifiées à droite afin que les décimales soient parfaitement alignées verticalement, tandis que la première colonne descriptive demeure justifiée à gauche. Sous la bordure inférieure finale fermant le tableau, l’analyste ajoute obligatoirement une section de notes de tableau standardisées. Introduite par le libellé en italique Note., cette section explicite les abréviations utilisées, précise la taille totale de l’échantillon N et signale la significativité locale des résidus au moyen d’astérisques méthodologiques (par exemple : * p < .05, ** p < .01 avec ajustement de Bonferroni). Ce format vectoriel propre peut alors être copié sans perte de formatage vers un logiciel de traitement de texte académique tel que LaTeX, Google Docs ou Microsoft Word.
12.3 Pérennisation, automatisation et partage des gabarits d’analyse
L’un des atouts incomparables de Google Sheets réside dans ses fonctionnalités de travail collaboratif infonuagique et sa capacité à se muer en un gabarit analytique dynamique, pérenne et instantanément réutilisable pour de futurs protocoles expérimentaux ou des cohortes longitudinales successives. Pour transformer notre feuille d’analyse ponctuelle en un moteur statistique permanent, le concepteur doit concevoir une architecture compartimentée séparant hermétiquement les données d’entrée brutes des blocs algorithmiques immuables.
Le protocole de pérennisation implique de protéger l’intégrité logicielle de la feuille en accédant au menu Données > Feuilles et plages protégées. L’administrateur attribue des droits de modification exclusifs aux seules cellules de saisie des données primaires (plage A2:B6), tout en verrouillant formellement l’ensemble des colonnes de calculs résiduels, de degrés de liberté, de p-valeur et de résidus standardisés. De cette manière, les utilisateurs tiers ou les assistants de recherche peuvent saisir de nouveaux jeux de données sans risquer de corrompre par inadvertance les fonctions matricielles sous-jacentes.
Pour documenter le gabarit à l’attention de la communauté scientifique dans une optique de science ouverte (Open Science), chaque en-tête de colonne doit être assorti d’une note contextuelle ou d’un commentaire explicatif documentant la formule mathématique employée et renvoyant à la littérature méthodologique de référence. Enfin, le partage du classeur peut être sécurisé via les autorisations de partage infonuagiques en mode « Lecteur seul », tout en diffusant un lien d’exportation configuré avec le suffixe d’URL /copy. Cette manipulation force tout utilisateur cliquant sur le lien à créer une copie autonome et isolée du gabarit d’analyse sur son propre compte Google Drive, assurant ainsi la dissémination et la reproductibilité pérenne des protocoles quantitatifs.
Références
Cochran, W. G. (1952). The χ² test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
Yates, F. (1934). Contingency tables involving small numbers and the χ² test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604