
Dans le vaste champ de l’analyse quantitative et de la psychométrie contemporaine, la mesure de l’association entre deux variables constitue l’un des piliers fondamentaux de la démarche scientifique. Trop souvent, les praticiens et chercheurs recourent par réflexe aux coefficients de corrélation paramétriques traditionnels, au premier rang desquels figure le coefficient de corrélation produit-moment de Karl Pearson. Néanmoins, l’application aveugle de ces méthodes repose sur des postulats distributionnels particulièrement stricts, tels que la normalité bivariée, la linéarité parfaite des relations et l’homoscédasticité des résidus. Dans la réalité empirique des sciences du comportement, de la psychologie clinique et des neurosciences, les données recueillies s’écartent fréquemment de cet idéal mathématique en adoptant des structures asymétriques, discrètes, ou intrinsèquement ordinales issues d’échelles d’évaluation subjectives.
Face à ces contraintes écologiques majeures, les statistiques non paramétriques offrent des alternatives d’une rigueur et d’une élégance remarquables. Parmi elles, l’approche développée par le statisticien britannique Maurice George Kendall à la fin des années 1930 occupe une place prépondérante. Le coefficient de corrélation de rang, universellement désigné sous le nom de Tau de Kendall (τ), propose une modélisation novatrice de la dépendance statistique en substituant à la distance métrique brute une analyse combinatoire de l’ordonnancement relatif des observations. En se focalisant sur la notion de concordance et de discordance des paires, cette métrique s’affranchit des contraintes métriques conventionnelles pour mesurer avec une précision chirurgicale la monotonicité d’une relation.
Le présent article a pour vocation de dresser un panorama exhaustif, à la fois théorique et appliqué, du Tau de Kendall. À travers une déconstruction minutieuse de ses fondements axiomatiques, de ses variantes algorithmiques adaptées à la présence d’égalités hiérarchiques et d’un exemple clinique calculé pas à pas, ce guide fournit aux chercheurs, statisticiens et cliniciens les clés nécessaires pour maîtriser cet outil fondamental. Nous examinerons également ses propriétés comparatives face au Rho de Spearman et au r de Pearson, ses modalités d’inférence inférentielle, ainsi que son implémentation rigoureuse au sein des environnements d’analyse R, Python et SPSS.
1. 1. Introduction conceptuelle au Tau de Kendall et à l’analyse de rang
1.1 1.1 La notion fondamentale d’association en statistique psychologique
L’exploration des phénomènes psychologiques exige une distinction épistémologique absolue entre le concept de causalité et celui de simple corrélation. En psychologie clinique, en psychopathologie cognitive et en psychiatrie, constater que deux manifestations symptomatiques évoluent de concert ne permet en aucun cas de déduire qu’une variable engendre unilatéralement la seconde. L’association observée peut être sous-tendue par des dynamiques étiologiques croisées, des facteurs de confusion environnementaux ou des mécanismes de rétroaction neurobiologique complexes. La corrélation se borne à quantifier la force, la direction et la consistance mathématique avec laquelle deux séries de mesures covarient à travers un échantillon d’individus donnés.
Historiquement, la quantification de cette interdépendance a longtemps été dominée par les travaux de Francis Galton et de Karl Pearson, ancrés dans une vision continue et gaussienne de la variabilité biologique. Dès 1938, le statisticien britannique Maurice Kendall introduit une perspective radicalement novatrice dans son article fondateur intitulé « A New Measure of Rank Correlation ». Kendall propose d’abandonner l’évaluation des écarts arithmétiques à la moyenne au profit d’un examen minutieux des relations d’ordre relatives entre les sujets. Cette transition conceptuelle donne naissance à la statistique Tau, conceptualisée comme une métrique d’accord ordinal universelle.
La nécessité de recourir à de telles mesures non paramétriques s’avère particulièrement pressante face à la nature atypique des données cliniques. Les scores d’anxiété, les gradients de dépression ou les évaluations d’intensité délirante présentent systématiquement des distributions fortement asymétriques, marquées par des effets de plancher ou de plafond. Traiter de tels indices via des paramètres gaussiens expose le chercheur à des biais d’inférence majeurs et à une inflation incontrôlable des erreurs de type I et II. Le coefficient Tau s’impose alors comme un indice souverain pour préserver l’intégrité de l’analyse ordinale.
1.2 1.2 Typologie des échelles de mesure et données de rangs
La théorisation des niveaux de mesure proposée par Stanley Smith Stevens en 1946 structure la compréhension moderne des variables statistiques en quatre grandes catégories hiérarchisées : nominale, ordinale, d’intervalle et de rapport. Si l’échelle nominale n’autorise que des opérations d’équivalence typologique élémentaire, l’échelle ordinale introduit pour sa part une relation de transitivité asymétrique stricte. Deux observations distinctes peuvent être formellement hiérarchisées selon un gradient croissant ou décroissant, signifiant qu’une modalité est « supérieure », « égale » ou « inférieure » à une autre, sans que l’intervalle quantitatif séparant ces deux échelons successifs ne puisse être tenu pour constant ou homogène.
Dans la pratique clinique et psychométrique, les données proviennent très majoritairement de questionnaires auto-rapportés reposant sur des échelles de Likert, de grilles d’évaluation de symptômes ou de jugements d’experts gradués. Bien qu’il soit fréquent de coder arbitrairement les réponses « Pas du tout d’accord », « Modérément d’accord » et « Entièrement d’accord » par les entiers 1, 2 et 3, rien n’atteste que la distance psychologique séparant le premier palier du second soit rigoureusement équivalente à celle séparant le deuxième du troisième. L’application directe d’opérations d’addition et de calcul de moyennes sur ces scores discrets relève d’une approximation méthodologique contestable.
Face à ces distributions ordinales asymétriques, la transformation des scores continus ou pseudo-continus en rangs hiérarchiques opère une régularisation distributive salvatrice. Cette opération consiste à réassigner à chaque individu un rang reflétant sa position ordonnée au sein du collectif étudié. La manipulation mathématique des rangs neutralise l’impact délétère des distorsions d’échelle non linéaires tout en préservant l’intégralité de l’information structurelle relative aux priorités comparatives.
1.3 1.3 Pourquoi choisir le Tau de Kendall face à d’autres alternatives
Face aux insuffisances patentes des approches paramétriques appliquées aux rangs subjectifs, deux grandes alternatives non paramétriques se partagent l’attention de la communauté scientifique : le coefficient Rho de Spearman (ρ) et le coefficient Tau de Kendall (τ). Bien que le Rho de Spearman soit souvent enseigné en priorité en raison de sa parenté conceptuelle immédiate avec la formule de Pearson appliquée aux rangs, le Tau de Kendall bénéficie de propriétés théoriques incomparablement plus solides et rigoureuses. Tandis que le coefficient de Spearman effectue une pénalisation quadratique artificielle des écarts de rangs, le Tau repose sur une énumération combinatoire directe et intuitive des permutations d’éléments.
Le Tau de Kendall démontre une sensibilité accrue aux micro-variations de l’ordre relatif entre individus, là où d’autres métriques lissent l’information au risque de masquer des incohérences locales. De surcroît, la distribution d’échantillonnage de la statistique Tau sous l’hypothèse nulle d’indépendance converge vers la loi normale standardisée à une vitesse nettement supérieure à celle observée pour le coefficient de Spearman, y compris pour des cohortes de taille modeste. Cette propriété permet de mener des démarches inférentielles particulièrement précises sans nécessiter d’ajustements asymptotiques complexes.
Cette supériorité méthodologique fait du Tau de Kendall l’outil privilégié pour l’analyse des jugements croisés, des évaluations d’aptitudes par panels d’experts et des protocoles cliniques transversaux. Lorsqu’il s’agit de garantir la réplicabilité d’un protocole d’observation médicale ou d’harmoniser les diagnostics différentiels émis par des observateurs indépendants, la robustesse du Tau offre des garanties formelles que les alternatives historiques ne sauraient égaler.
2. 2. Définition mathématique et formulation théorique du coefficient Tau
2.1 2.1 Définition axiomatique du Tau de Kendall standard (Tau-a)
La formalisation axiomatique initiale développée par Maurice Kendall s’articule autour d’une quantification normalisée des accords et des désaccords observés au sein de toutes les paires d’observations possibles d’un échantillon bivarié. Considérons un échantillon de taille n composé de couples d’observations notés (x1, y1), (x2, y2), …, (xn, yn), où x et y représentent deux variables ordinales mesurées sur les mêmes entités expérimentales. L’expression algébrique fondamentale du Tau standard, usuellement désigné par la lettre latine Tau-a (τa), est définie par le rapport suivant :
τa = (C – D) / [n(n – 1) / 2]
Dans cette formulation canonique, le terme C symbolise le nombre total de paires concordantes répertoriées dans l’ensemble de données, tandis que la variable D quantifie le nombre total de paires discordantes. Le dénominateur arithmétique [n(n – 1) / 2] représente rigoureusement le nombre total de paires non ordonnées distinctes qu’il est possible d’extraire d’un ensemble fini de n éléments, selon les lois élémentaires de l’analyse combinatoire.
Cette écriture mathématique n’est pleinement valide qu’à la condition expresse qu’aucune égalité (ou ex æquo) n’apparaisse dans les séries de rangs associées aux variables X et Y. Lorsque cette condition d’injectivité des classements est satisfaite, la somme arithmétique des paires concordantes et discordantes est exactement égale au dénominateur théorique (C + D = n(n – 1) / 2). Par conséquent, la métrique se trouve rigoureusement contrainte dans l’intervalle compact fermé [-1, +1], assurant une interprétation standardisée du degré d’association ordinale.
2.2 2.2 L’espace des paires possibles et combinatoire sous-jacente
Pour appréhender l’essence probabiliste du Tau de Kendall, il est impératif d’explorer la géométrie de l’espace combinatoire dans lequel évoluent les couples d’observations. Soit un ensemble de n sujets distincts. Le nombre total de paires non orientées susceptibles d’être formées est modélisé par le coefficient binomial usuel :
Total des paires = C(n, 2) = n! / [2!(n – 2)!] = n(n – 1) / 2
Chacune de ces paires élémentaires d’indices {i, j}, avec i < j, fait l’objet d’une comparaison exhaustive. L’ensemble de toutes les paires possibles peut ainsi être partitionné de manière exclusive et exhaustive en trois sous-ensembles fondamentaux :
- Le sous-ensemble des paires strictement concordantes (C), pour lesquelles le sens de progression hiérarchique est identique sur les deux dimensions évaluées.
- Le sous-ensemble des paires strictement discordantes (D), pour lesquelles l’ordre relatif des sujets sur la variable X est exactement inversé sur la variable Y.
- Le sous-ensemble des paires liées ou nouées (T), où les deux sujets possèdent un rang identique sur l’une au moins des deux variables observées.
Sur le plan de l’interprétation stochastique, le coefficient Tau peut être réécrit comme la différence entre deux probabilités conditionnelles fondamentales. Si l’on extrait aléatoirement une paire de sujets {i, j} au sein de la population étudiée, le Tau exprime la probabilité que la paire soit concordante diminuée de la probabilité que cette même paire soit discordante : τ = P(Concordance) – P(Discordance). Cette élégance probabiliste confère au Tau une clarté sémantique absolue, dénuée de tout artifice lié aux échelles de mesure sous-jacentes.
2.3 2.3 Intervalle de variation et interprétation des bornes critiques
Le gradient d’intensité du coefficient de Kendall est rigoureusement borné par les valeurs extrêmes -1 et +1, chaque point d’ancrage reflétant une configuration ordinale sans ambiguïté :
L’obtention d’un coefficient τ = +1 traduit un accord ordinal absolu, qualifié de monotonicité strictement croissante. Dans ce scénario parfait, pour l’ensemble des paires du jeu de données, l’individu qui présente le score le plus élevé sur la variable X affiche immanquablement le score le plus élevé sur la variable Y. Aucune inversion de rang ni aucune discordance n’est tolérée (D = 0 et T = 0). D’un point de vue clinique, cela signifie que la hiérarchie de sévérité d’une pathologie établie par un outil A ordonne les patients de façon rigoureusement superposable à un outil B.
À l’opposé, une valeur τ = -1 caractérise une inversion ordinale parfaite, reflétant une relation monotone strictement décroissante. Tout gain hiérarchique sur l’axe X s’accompagne obligatoirement d’une régression ordinale systématique sur l’axe Y (C = 0 et T = 0). Dans les contextes expérimentaux, une telle configuration illustre une opposition fonctionnelle totale entre les deux dimensions mesurées.
Une valeur τ = 0 dénote quant à elle une absence complète d’association monotone, traduisant une indépendance ordinale parfaite. Dans cette situation, le nombre de trajectoires concordantes compense exactement le nombre de trajectoires discordantes (C = D). Il convient néanmoins de souligner, avec toute la rigueur mathématique requise, qu’un Tau nul n’implique pas nécessairement l’absence d’une relation causale complexe, mais seulement l’absence d’une structure directionnelle cohérente. Enfin, les valeurs intermédiaires se distribuent selon des paliers conventionnels : de 0,10 à 0,29 l’association est qualifiée de faible ; de 0,30 à 0,49 elle est modérée ; et au-delà de 0,50, l’accord ordinal est considéré comme fort à exceptionnel dans la littérature psychologique.
3. 3. Mécanique des paires concordantes et discordantes
3.1 3.1 Formalisation mathématique de la concordance
La caractérisation précise du concept de concordance repose sur une définition algébrique universelle appliquée à chaque dyade d’observations. Soient deux sujets distincts notés i et j, caractérisés respectivement par leurs coordonnées bivariées (xi, yi) et (xj, yj). Une paire est définie comme formellement concordante si et seulement si la relation suivante est strictement vérifiée :
(xj – xi)(yj – yi) > 0
Cette condition arithmétique stipule avec une rigueur absolue que la pente reliant les deux points dans le plan cartésien est strictement positive. Deux configurations empiriques distinctes satisfont cette inégalité :
- D’une part, si le sujet j est supérieur au sujet i sur la variable X (xj > xi), il doit obligatoirement se révéler supérieur sur la variable Y (yj > yi). Le produit de ces deux termes strictement positifs est par définition supérieur à zéro.
- D’autre part, si le sujet j est inférieur au sujet i sur la dimension X (xj < xi), il doit simultanément être inférieur sur la dimension Y (yj < yi). Le produit de deux valeurs strictement négatives générant un résultat strictement positif, la condition d’orientation commune demeure scrupuleusement respectée.
Sur le plan algorithmique, l’identification systématique des concordances requiert un tri préalable de la matrice des données selon les rangs croissants de la première variable X. Une fois cette ordonnance initiale établie, l’observateur examine séquentiellement pour chaque observation i l’ensemble des observations subséquentes j (où j > i). Toute valeur yj strictement supérieure à yi valide l’existence d’une unité de concordance supplémentaire incrémentant le total global C.
3.2 3.2 Formalisation mathématique de la discordance
À l’inverse de la concordance, la discordance quantifie les phénomènes de renversement d’ordre relatifs entre les deux dimensions investiguées. Une paire d’observations {i, j} est formellement déclarée discordante si et seulement si l’inégalité différentielle suivante est satisfaite :
(xj – xi)(yj – yi) < 0
Ce critère algébrique exprime l’existence d’une divergence vectorielle antagoniste :
- Soit le sujet j affiche une position supérieure à celle du sujet i sur la variable X (xj > xi) mais présente un score inférieur sur la variable Y (yj < yi).
- Soit le sujet j est inférieur à i sur l’axe X (xj < xi) tout en surpassant ce dernier sur l’axe Y (yj > yi).
Chaque paire discordante identifiée agit mathématiquement comme une force d’atténuation venant neutraliser l’impact positif des paires concordantes au numérateur de la formule. La discordance traduit une défaillance de la cohérence monotone. Sur le plan sémiologique, elle indique que la trajectoire comparative entre deux individus se contredit d’un instrument d’évaluation à l’autre. Graphiquement, sur un nuage de points où les sujets sont disposés selon leurs rangs, les paires discordantes se matérialisent par des segments à pente négative croisant transversalement les trajectoires ascendantes des paires concordantes.
3.3 3.3 Gestion théorique des paires liées (ex æquo)
L’idéal théorique du Tau de Kendall standard postule une distribution continue des scores dans laquelle la probabilité d’observer deux valeurs rigoureusement identiques est mathématiquement nulle. Toutefois, dans la réalité des protocoles psychométriques et médicaux, les données sont collectées à l’aide d’instruments discrets à résolution limitée, rendant l’apparition de scores identiques inévitable. Ces configurations sont qualifiées de paires liées, de rangs noués ou de liens hiérarchiques (ties).
La formalisation mathématique identifie une paire {i, j} comme liée dès lors que l’égalité suivante est vérifiée :
(xj – xi)(yj – yi) = 0
Cette annulation du produit des différences de rangs émerge sous trois formes structurelles distinctes :
- Lien exclusif sur X : Deux sujets obtiennent le même rang sur la variable X mais des rangs distincts sur Y (xi = xj et yi ≠ yj).
- Lien exclusif sur Y : Deux individus affichent une parité parfaite sur la variable Y tout en étant discriminés sur la variable X (xi ≠ xj et yi = yj).
- Lien simultané sur X et Y : Deux observations sont totalement indiscernables sur les deux dimensions considérées (xi = xj et yi = yj).
L’émergence d’ex æquo invalide l’application stricte de la formule du Tau-a. En effet, ces paires ne pouvant être qualifiées ni de concordantes ni de discordantes, l’égalité fondamentale C + D = n(n – 1) / 2 cesse d’être respectée. Si la formule originale est maintenue sans ajustement, le dénominateur demeure invariant tandis que le numérateur (C – D) est mécaniquement tronqué de toutes les paires nouées. Cette défaillance méthodologique entraîne une sous-estimation systématique de l’intensité de l’accord ordinal, nécessitant la mise au point de formulations mathématiques dérivées plus élaborées.
4. 4. Les déclinaisons du coefficient : Tau-a, Tau-b et Tau-c
4.1 4.1 Le Tau-a de Kendall : domaine d’application et restrictions
Le coefficient Tau-a représente la forme originale, non altérée, de la métrique proposée par Kendall en 1938. Sa définition repose exclusivement sur le ratio opposant le différentiel des paires ordonnées au total brut des combinaisons binaires possibles :
τa = (C – D) / [n(n – 1) / 2]
Le domaine de validité mathématique de cette version est particulièrement restreint : elle exige formellement l’absence complète de données dupliquées au sein de chaque variable étudiée. Dès l’instant où des ex æquo se manifestent, le Tau-a devient incapable d’atteindre ses bornes théoriques extrêmes de +1 ou de -1, y compris en présence d’une corrélation d’ordre aussi parfaite que la distribution des données ne le permet. Cette dégradation du dénominateur génère un biais systématique par défaut.
Par conséquent, l’usage contemporain du Tau-a demeure circonscrit à des contextes théoriques précis ou à des protocoles expérimentaux imposant aux participants un classement forcé de stimuli discrets (tâches de tri sans ex æquo autorisé, ordonnancement strict d’items d’attitudes ou compétitions sportives sans égalités possibles). Dès que le protocole de recherche autorise des scores partagés, le Tau-a doit être impérativement délaissé au profit des corrections Tau-b ou Tau-c.
4.2 4.2 Le Tau-b de Kendall : la correction pour les ex æquo dans les tables carrées
Afin de restaurer l’intégrité de l’estimation statistique en présence de scores identiques, Kendall a introduit une variante sophistiquée : le coefficient Tau-b (τb). Cette modélisation ajuste le dénominateur de l’équation en incorporant la moyenne géométrique du nombre effectif de paires discriminables au sein de chaque variable isolée. La formule générale du Tau-b s’exprime de la façon suivante :
τb = (C – D) / √[ (n0 – Tx) (n0 – Ty) ]
Dans cette équation structurelle :
- Le terme n0 représente le volume total initial des paires possibles, soit n0 = n(n – 1) / 2.
- Le terme correctif Tx quantifie le nombre exact de paires liées exclusivement sur la variable X. Pour chaque groupe de rangs partagés i comportant ti observations identiques, le terme correctif s’obtient par la sommation : Tx = ∑ [ti(ti – 1) / 2].
- Le terme correctif Ty quantifie de façon symétrique le nombre de paires nouées sur la variable Y : Ty = ∑ [uj(uj – 1) / 2], où uj désigne l’effectif du j-ième bloc d’égalités sur la dimension Y.
Le Tau-b se distingue par sa propriété de symétrie parfaite (τb(X, Y) = τb(Y, X)) et constitue la norme statistique de référence adoptée par les principaux logiciels d’analyse de données pour l’évaluation des tableaux de contingence carrés (possédant un nombre de lignes rigoureusement identique au nombre de colonnes). En neutralisant le poids des égalités internes, le Tau-b conserve la propriété cardinale de pouvoir atteindre les bornes -1 et +1 lorsque la relation monotone est maximale sous la contrainte des ex æquo présents.
4.3 4.3 Le Tau-c de Kendall (Tau de Stuart-Kendall) pour tables rectangulaires
Bien que le Tau-b résolve avec efficacité le problème des rangs liés au sein des matrices carrées, il se heurte à une limitation structurelle intrinsèque lorsque les données sont synthétisées sous forme de tableaux croisés rectangulaires, c’est-à-dire comptant un nombre asymétrique de lignes et de colonnes (r ≠ c). Dans une table de dimension r × c où r < c, il est mathématiquement impossible pour le Tau-b d’atteindre la borne critique de +1, quand bien même la concentration des fréquences refléterait une monotonicité absolue.
Pour remédier à cette anomalie de calibrage, le statisticien Alan Stuart a proposé en 1953 une normalisation alternative fondée sur la géométrie du tableau de contingence, formulation usuellement dénommée Tau-c de Kendall ou Tau de Stuart-Kendall (τc). Son expression algébrique repose sur la définition suivante :
τc = [2 × m × (C – D)] / [n2 × (m – 1)]
Dans ce modèle :
- Le symbole n désigne l’effectif total de l’échantillon analysé.
- Le paramètre m représente la dimension minimale du tableau croisé, définie formellement par m = min(r, c), où r quantifie le nombre de modalités de la première échelle ordinale et c le nombre de paliers de la seconde variable.
Le Tau-c s’avère indispensable lorsque l’on corrèle des échelles d’évaluation aux calibrages inégaux, à l’exemple d’une échelle de Likert à 3 points confrontée à une grille diagnostique à 5 niveaux de sévérité. En intégrant explicitement la dimensionnalité du tableau, le Tau-c rétablit la pleine amplitude de l’intervalle [-1, +1], empêchant que l’asymétrie catégorielle ne vienne fausser l’interprétation de la force d’association.
5. 5. Exemple pratique détaillé : Calcul manuel pas à pas
5.1 5.1 Présentation du cas d’étude : Accord inter-juges en évaluation clinique
Afin de matérialiser la mécanique opératoire du coefficient Tau de Kendall, examinons une situation concrète issue de la recherche en psychiatrie clinique. Deux cliniciens évaluateurs indépendants, le Docteur A (psychiatre référent) et le Psychologue B (évaluateur externe), examinent une cohorte consécutive de 10 patients admis au sein d’une unité de soins pour troubles anxio-dépressifs.
Chaque professionnel procède à une évaluation globale de la sévérité symptomatique de chaque patient et consigne son jugement sous la forme d’un classement strict, allant du rang 1 (état anxieux le plus modéré) au rang 10 (présentation clinique la plus sévère et invalidante). Afin d’illustrer la méthode du Tau standard sans liens, aucune égalité n’est admise dans ce premier paradigme méthodologique. Le tableau ci-dessous recense l’attribution finale des rangs pour l’ensemble des dix patients examinés :
- Patient 1 (P1) : Évaluateur A = 1 ; Évaluateur B = 3
- Patient 2 (P2) : Évaluateur A = 2 ; Évaluateur B = 1
- Patient 3 (P3) : Évaluateur A = 3 ; Évaluateur B = 4
- Patient 4 (P4) : Évaluateur A = 4 ; Évaluateur B = 2
- Patient 5 (P5) : Évaluateur A = 5 ; Évaluateur B = 6
- Patient 6 (P6) : Évaluateur A = 6 ; Évaluateur B = 5
- Patient 7 (P7) : Évaluateur A = 7 ; Évaluateur B = 8
- Patient 8 (P8) : Évaluateur A = 8 ; Évaluateur B = 7
- Patient 9 (P9) : Évaluateur A = 9 ; Évaluateur B = 10
- Patient 10 (P10) : Évaluateur A = 10 ; Évaluateur B = 9
L’objectif empirique consiste à évaluer le degré de cohérence sémiologique et diagnostique entre les deux praticiens par le calcul manuel rigoureux du Tau de Kendall.
5.2 5.2 Étape 1 et 2 : Réordonnancement et identification systématique des paires
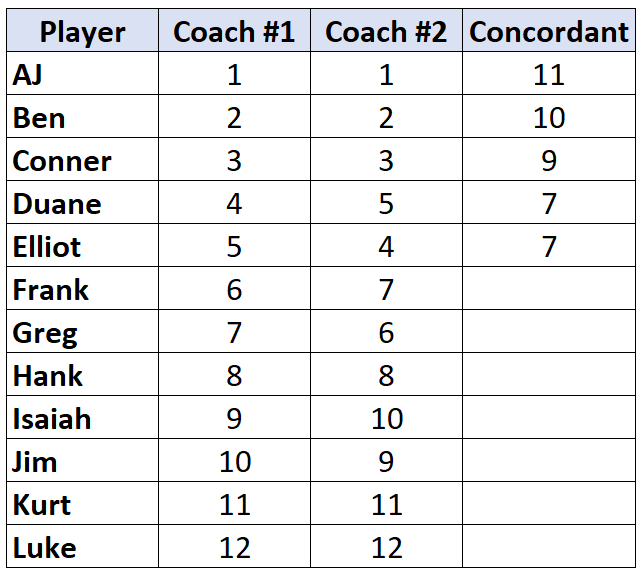
La première démarche méthodologique consiste à réordonner l’ensemble des observations selon les valeurs strictement croissantes des rangs attribués par le premier observateur (Évaluateur A). Dans notre cas d’étude, les patients sont déjà ordonnés selon la séquence naturelle des rangs de A (de 1 à 10). Cet ordonnancement assure que pour toute paire {i, j} avec i < j, nous avons formellement xi < xj. Ainsi, le sens de la comparaison sur la première variable X est systématiquement positif (xj – xi > 0).
Dès lors, la qualification de chaque dyade dépend exclusivement de la trajectoire observée sur la seconde série de rangs (Évaluateur B) :
- Si la valeur du rang assigné par B pour le patient j est strictement supérieure au rang assigné au patient i (yj > yi), la paire est concordante.
- Si la valeur du rang assigné par B pour le patient j est strictement inférieure au rang assigné au patient i (yj < yi), la paire est discordante.
Nous procédons alors au dénombrement exhaustif, observation par observation, en comparant chaque rang de B avec l’ensemble des rangs situés en dessous de lui dans la séquence triée :
- Pour le Patient 1 (rang B = 3) :
- Rangs subséquents strictement supérieurs à 3 : {4, 6, 5, 8, 7, 10, 9} → 7 paires concordantes.
- Rangs subséquents strictement inférieurs à 3 : {1, 2} → 2 paires discordantes.
- Pour le Patient 2 (rang B = 1) :
- Rangs subséquents strictement supérieurs à 1 : {4, 2, 6, 5, 8, 7, 10, 9} → 8 paires concordantes.
- Rangs subséquents strictement inférieurs à 1 : aucun → 0 paire discordante.
- Pour le Patient 3 (rang B = 4) :
- Rangs subséquents strictement supérieurs à 4 : {6, 5, 8, 7, 10, 9} → 6 paires concordantes.
- Rangs subséquents strictement inférieurs à 4 : {2} → 1 paire discordante.
- Pour le Patient 4 (rang B = 2) :
- Rangs subséquents strictement supérieurs à 2 : {6, 5, 8, 7, 10, 9} → 6 paires concordantes.
- Rangs subséquents strictement inférieurs à 2 : aucun → 0 paire discordante.
- Pour le Patient 5 (rang B = 6) :
- Rangs subséquents strictement supérieurs à 6 : {8, 7, 10, 9} → 4 paires concordantes.
- Rangs subséquents strictement inférieurs à 6 : {5} → 1 paire discordante.
- Pour le Patient 6 (rang B = 5) :
- Rangs subséquents strictement supérieurs à 5 : {8, 7, 10, 9} → 4 paires concordantes.
- Rangs subséquents strictement inférieurs à 5 : aucun → 0 paire discordante.
- Pour le Patient 7 (rang B = 8) :
- Rangs subséquents strictement supérieurs à 8 : {10, 9} → 2 paires concordantes.
- Rangs subséquents strictement inférieurs à 8 : {7} → 1 paire discordante.
- Pour le Patient 8 (rang B = 7) :
- Rangs subséquents strictement supérieurs à 7 : {10, 9} → 2 paires concordantes.
- Rangs subséquents strictement inférieurs à 7 : aucun → 0 paire discordante.
- Pour le Patient 9 (rang B = 10) :
- Rangs subséquents strictement supérieurs à 10 : aucun → 0 paire concordante.
- Rangs subséquents strictement inférieurs à 10 : {9} → 1 paire discordante.
- Pour le Patient 10 (rang B = 9) : Aucune observation subséquente (terme ultime de l’échantillon).
5.3 5.3 Étape 3 et 4 : Sommation des concordances et application de la formule
L’étape suivante consiste à opérer la sommation des unités recensées afin d’obtenir les paramètres C et D globaux du protocole :
Total des paires concordantes : C = 7 + 8 + 6 + 6 + 4 + 4 + 2 + 2 + 0 = 39
Total des paires discordantes : D = 2 + 0 + 1 + 0 + 1 + 0 + 1 + 0 + 1 = 6
Pour attester de l’exactitude arithmétique de notre dénombrement, vérifions la somme combinatoire totale des paires examinées : C + D = 39 + 6 = 45. Appliquons la formule du nombre de combinaisons pour n = 10 éléments :
Total théorique = n(n – 1) / 2 = 10(10 – 1) / 2 = 90 / 2 = 45
Le total empirique concorde rigoureusement avec la combinatoire théorique, garantissant l’absence totale d’omission ou de double compte au sein de notre procédure d’énumération. Il ne reste plus qu’à appliquer la formule canonique du Tau de Kendall :
τ = (C – D) / [n(n – 1) / 2] = (39 – 6) / 45 = 33 / 45 ≈ 0,7333
La statistique finale Tau obtenue entre les évaluations diagnostiques des deux praticiens est donc de τ ≈ 0,73.
5.4 5.4 Interprétation psychologique des résultats obtenus
Sur le plan psychométrique et sémiologique, une valeur de Tau de 0,73 témoigne d’une association ordinale particulièrement robuste et cohérente entre les deux cliniciens. Exprimé en termes probabilistes, ce résultat indique que si nous sélectionnons de manière aléatoire deux patients distincts au sein de cette cohorte clinique, il y a 73,3 % de chances en plus que les deux évaluateurs s’accordent sur le patient présentant le tableau clinique le plus sévère, plutôt qu’ils ne soient en désaccord.
Bien que les rangs attribués ne soient pas strictement identiques d’un évaluateur à l’autre (se manifestant par les six paires discordantes identifiées, telles que l’inversion relative observée entre P1 et P2), la convergence hiérarchique globale demeure remarquable. Les légères divergences constatées relèvent typiquement de fluctuations interindividuelles mineures dans l’appréciation des manifestations anxieuses bordières, sans altérer la cohérence d’ensemble du consensus clinique.
Cette concordance atteste d’une excellente fidélité inter-juges, validant l’utilisation conjointe de cette échelle dans le cadre du protocole expérimental sans craindre de biais systématique lié à l’observateur. Néanmoins, il importe de rappeler que cet échantillon illustratif (n = 10) possède une puissance statistique restreinte, nécessitant un test de significativité inférentiel pour exclure formellement l’aléa d’échantillonnage.
6. 6. Gestion approfondie des rangs liés et ajustements algorithmiques
6.1 6.1 Origine et nature des ex æquo dans les mesures comportementales
Dans l’investigation empirique des conduites humaines, la survenue de rangs liés ne constitue pas une anomalie marginale, mais la norme écologique prépondérante. Cette abondance d’ex æquo découle directement de la structure discrète des instruments psychométriques. Lorsqu’un chercheur administre une échelle d’évaluation de la dépression comportant 10 items notés de 0 à 3, le score total maximal est borné à 30 points. Dès lors que la taille de l’échantillon dépasse quelques dizaines de participants, plusieurs individus obtiennent inévitablement des totaux bruts strictement identiques.
L’incapacité inhérente aux outils psychométriques à discriminer finement les manifestations cliniques proches crée une saturation artificielle des scores. Face à ce phénomène, le traitement statistique conventionnel repose sur l’attribution de rangs moyens (procédure dite des mid-ranks). Si deux participants se partagent conjointement les rangs théoriques 4 et 5, le statisticien leur assigne à chacun la valeur médiane (4 + 5) / 2 = 4,5. Si trois sujets se partagent les rangs 7, 8 et 9, chacun se voit attribuer le rang moyen (7 + 8 + 9) / 3 = 8.
Cette condensation des rangs altère profondément la variance distributionnelle de l’échantillon. La dispersion des rangs effectifs se trouve comprimée, rendant caduque l’hypothèse de permutation uniforme qui sous-tend la théorie du Tau-a original et imposant des corrections adaptées.
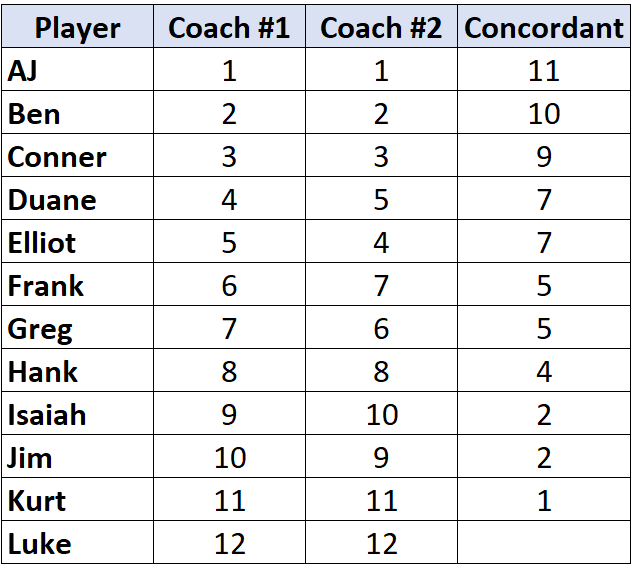
6.2 6.2 Algorithme de calcul du Tau-b avec correction mathématique complète
Pour corriger la distorsion engendrée par la présence de scores partagés, l’algorithme du Tau-b calcule de manière distincte les pénalités associées à chaque groupe de liens sur chacune des deux variables. La formulation complète du dénominateur pondéré s’énonce comme suit :
τb = (C – D) / √[ (n0 – Tx) (n0 – Ty) ]
Le calcul méthodique s’exécute selon les étapes de dérivation suivantes :
- Détermination du nombre total théorique de paires : n0 = n(n – 1) / 2.
- Identification de tous les sous-groupes de rangs liés sur la variable X. Pour chaque groupe i d’effectif ti, on calcule la quantité ti(ti – 1) / 2, puis on somme ces valeurs pour obtenir la pénalité totale : Tx = ∑ [ti(ti – 1) / 2].
- Identification symétrique de tous les sous-groupes d’égalités sur la dimension Y. Pour chaque groupe j comptant uj observations liées, on dérive de même la pénalité globale : Ty = ∑ [uj(uj – 1) / 2].
- Calcul du dénominateur ajusté via le produit des termes (n0 – Tx) et (n0 – Ty), extrait sous radical géométrique.
Cette formulation rétablit la stricte comparabilité de la statistique, garantissant que l’existence de nœuds distributionnels ne vienne artificiellement écraser le coefficient final estimé.
6.3 6.3 Exercice d’application avec égalités multiples
Considérons à présent une cohorte de 6 patients (n = 6) évalués sur une échelle de propension à l’impulsivité (X) et sur une épreuve de prise de risque comportementale (Y). Les scores bruts obtenus révèlent des égalités multiples :
- Patient 1 : X = 12, Y = 105
- Patient 2 : X = 15, Y = 110
- Patient 3 : X = 15, Y = 110
- Patient 4 : X = 18, Y = 115
- Patient 5 : X = 18, Y = 115
- Patient 6 : X = 18, Y = 120
La transformation de ces scores bruts en rangs moyens produit la configuration ordinale suivante :
- Pour la variable X : P1 reçoit le rang 1 ; P2 et P3 se partagent les rangs 2 et 3, soit le rang 2,5 ; P4, P5 et P6 se partagent les rangs 4, 5 et 6, soit le rang moyen (4 + 5 + 6) / 3 = 5.
- Pour la variable Y : P1 reçoit le rang 1 ; P2 et P3 se partagent les rangs 2 et 3, soit le rang 2,5 ; P4 et P5 se partagent les rangs 4 et 5, soit le rang 4,5 ; P6 reçoit le rang 6.
Calculons les termes correctifs des égalités. Le volume total des paires possibles pour n = 6 est n0 = 6(5) / 2 = 15.
Pour la variable X, nous identifions un bloc de 2 observations liées (rang 2,5) et un bloc de 3 observations liées (rang 5) :
Tx = [2(1) / 2] + [3(2) / 2] = 1 + 3 = 4.
Pour la variable Y, nous observons un groupe de 2 observations liées (rang 2,5) et un second groupe de 2 observations liées (rang 4,5) :
Ty = [2(1) / 2] + [2(1) / 2] = 1 + 1 = 2.
Énumérons à présent les paires formées :
- Paire {P1, P2} : X augmente (1 < 2,5), Y augmente (1 < 2,5) → Concordante.
- Paire {P1, P3} : X augmente (1 < 2,5), Y augmente (1 < 2,5) → Concordante.
- Paire {P1, P4} : X augmente (1 < 5), Y augmente (1 < 4,5) → Concordante.
- Paire {P1, P5} : X augmente (1 < 5), Y augmente (1 < 4,5) → Concordante.
- Paire {P1, P6} : X augmente (1 < 5), Y augmente (1 < 6) → Concordante.
- Paire {P2, P3} : X lié (2,5 = 2,5), Y lié (2,5 = 2,5) → Lien simultané.
- Paire {P2, P4} : X augmente (2,5 < 5), Y augmente (2,5 < 4,5) → Concordante.
- Paire {P2, P5} : X augmente (2,5 < 5), Y augmente (2,5 < 4,5) → Concordante.
- Paire {P2, P6} : X augmente (2,5 < 5), Y augmente (2,5 < 6) → Concordante.
- Paire {P3, P4} : X augmente (2,5 < 5), Y augmente (2,5 < 4,5) → Concordante.
- Paire {P3, P5} : X augmente (2,5 < 5), Y augmente (2,5 < 4,5) → Concordante.
- Paire {P3, P6} : X augmente (2,5 < 5), Y augmente (2,5 < 6) → Concordante.
- Paire {P4, P5} : X lié (5 = 5), Y lié (4,5 = 4,5) → Lien simultané.
- Paire {P4, P6} : X lié (5 = 5), Y augmente (4,5 < 6) → Lien sur X.
- Paire {P5, P6} : X lié (5 = 5), Y augmente (4,5 < 6) → Lien sur X.
Nous recensons : C = 11 paires concordantes, D = 0 paire discordante. Les 4 paires restantes correspondent exactement aux liens comptabilisés (Tx et Ty).
Appliquons l’équation du Tau-b :
τb = (11 – 0) / √[ (15 – 4) (15 – 2) ] = 11 / √[ 11 × 13 ] = 11 / √143 ≈ 11 / 11,958 ≈ 0,9199
Si nous avions ignoré la présence des ex æquo en appliquant la formule non ajustée du Tau-a, nous aurions obtenu : τa = 11 / 15 ≈ 0,7333. Cet écart met en évidence l’importance du Tau-b, qui rétablit la réalité de la relation monotone sous-jacente (ici quasi-parfaite) en neutralisant l’effet restrictif des liens.
7. 7. Analyse comparative : Tau de Kendall versus Rho de Spearman
7.1 7.1 Fondements théoriques divergents des deux approches non paramétriques
Bien que le Rho de Spearman et le Tau de Kendall soient tous deux employés pour analyser les associations ordinales non paramétriques, leurs constructions mathématiques reposent sur des principes radicalement différents. Le Rho de Spearman (ρs) est défini conceptuellement comme l’application directe du coefficient de Pearson sur les rangs transformés des variables. Il s’exprime par la formule des différences quadratiques di = R(xi) – R(yi) :
ρs = 1 – [6 × ∑ di2] / [n(n2 – 1)]
Cette formulation implique que le coefficient de Spearman privilégie une interprétation métrique et linéaire indirecte : il quantifie la proportion de variance partagée le long d’une droite de régression ajustée aux rangs. En élevant au carré les écarts différentiels (di2), Spearman pénalise de façon disproportionnée les inversions de rangs extrêmes par rapport aux permutations modérées.
Le Tau de Kendall, quant à lui, s’affranchit de toute référence géométrique à la variance linéaire. Il repose sur une approche combinatoire discrète qui traite chaque observation comme un point de repère ordinal par rapport à l’ensemble des autres sujets. Chaque inversion hiérarchique est pondérée de façon strictement équivalente au sein de la somme (C – D), sans amplification quadratique arbitraire. Le Tau constitue donc une analyse de concordance probabiliste pure, exempte des artefacts inhérents à la linéarité appliquée aux rangs.
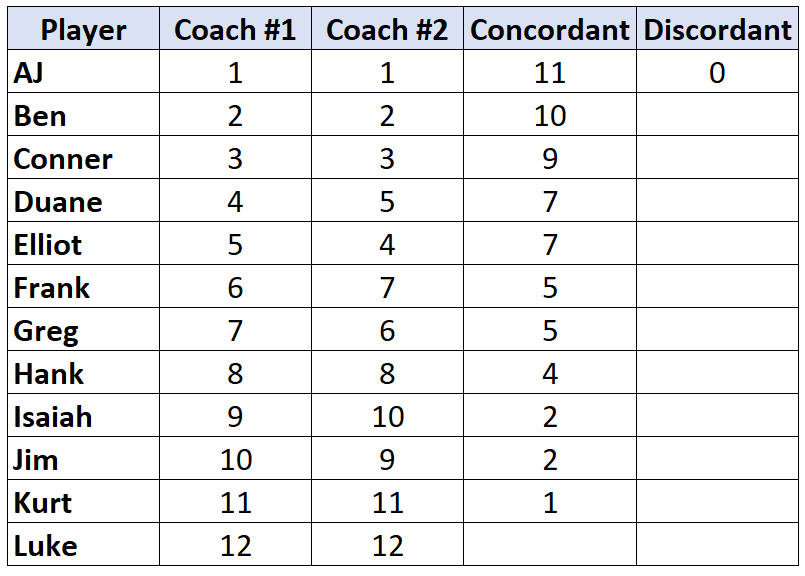
7.2 7.2 Robustesse face aux anomalies et distribution d’échantillonnage
La distinction méthodologique entre ces deux approches devient particulièrement apparente lors de l’examen de leurs propriétés d’échantillonnage et de leur résistance aux valeurs atypiques. Dans les cohortes de petite taille (n < 30), fréquentes en neuropsychologie ou lors de l’étude de pathologies rares, la distribution empirique de la statistique de test de Spearman s’écarte notablement de la normalité théorique. Ses erreurs standards sont sujettes à des fluctuations complexes sous l’effet des configurations locales d’ex æquo.
À l’inverse, la distribution de la statistique de Kendall converge avec une rapidité remarquable vers une loi normale centrée réduite dès que la taille de l’échantillon atteint n ≥ 10. Les bornes d’erreur standard du Tau sont notablement plus stables et prévisibles que celles de son homologue de Spearman. De surcroît, le Tau présente une efficacité relative asymptotique (ARE) remarquable, avoisinant 0,91 par rapport au coefficient paramétrique de Pearson sous des conditions de normalité bivariée idéale.
Sur le plan de la résistance aux données aberrantes (outliers), le Tau de Kendall offre une robustesse supérieure. Une valeur extrême introduisant un déplacement de rang majeur n’impactera le dénombrement des paires de Kendall que de manière bornée (au plus n – 1 paires affectées), alors que la pénalité quadratique de Spearman peut distordre artificiellement le coefficient final.
7.3 7.3 Relations empiriques et conversions entre Tau et Rho
Il est systématiquement constaté dans la littérature empirique que, calculés sur un même jeu de données ordonné, la valeur absolue du Tau de Kendall est inférieure à celle du Rho de Spearman (|τ| < |ρs|). Cette divergence de magnitude ne traduit en aucun cas une moindre sensibilité du Tau, mais découle directement de leurs échelles de normalisation combinatoires respectives.
Lorsque la taille d’échantillon est suffisante et que la distribution sous-jacente respecte une structure de dépendance normale continue, les deux métriques entretiennent une relation asymptotique étroite qui a été modélisée par Karl Pearson et Maurice Kendall sous la relation d’inégalité générale suivante :
-1 ≤ (3 × τ – 2) ≤ ρs ≤ (1 + 2 × τ – τ2) / 2 ≤ 1 (pour des valeurs de τ positives)
De façon plus pragmatique, l’approximation mathématique empirique fréquemment retenue s’exprime par le ratio :
ρs ≈ 1,5 × τ (valide principalement pour les valeurs faibles à modérées, |τ| ≤ 0,50)
Face au choix de la métrique à privilégier pour la publication scientifique, le consensus méthodologique moderne recommande le Tau de Kendall lorsque l’objectif vise une interprétation probabiliste directe de la concordance, la manipulation de petits échantillons, ou l’analyse de données présentant de nombreux ex æquo. Le Rho de Spearman reste utile pour assurer la comparabilité rétrospective avec des publications historiques antérieures à l’informatisation des calculs combinatoires.
8. 8. Comparaison avec le r de Pearson et limites de la modélisation linéaire
8.1 8.1 Rupture des postulats paramétriques classiques en sciences humaines
Le coefficient de corrélation produit-moment développé par Karl Pearson demeure la référence statistique la plus largement enseignée. Sa formule fait intervenir les moments d’ordre 1 et 2 de la distribution :
r = ∑ [(xi – x̄)(yi – ȳ)] / √[ ∑ (xi – x̄)2 ∑ (yi – ȳ)2 ]
L’utilisation légitime de cette formulation repose sur des postulats stricts : continuité parfaite des variables, distribution conjointe normale bivariée, homoscédasticité des résidus et linéarité stricte du lien entre les deux dimensions. Or, dans les investigations en sciences humaines, ces hypothèses théoriques sont régulièrement violées. De nombreux processus psychologiques et neurobiologiques suivent des dynamiques curvilinéaires, sigmoïdes, logarithmiques ou exponentielles (à l’instar de la loi psychophysique de Weber-Fechner ou de la loi de Yerkes-Dodson reliant la performance au stress).
Lorsqu’une relation est strictement monotone mais non linéaire (par exemple, une progression strictement croissante mais logarithmique), le coefficient r de Pearson sous-estime l’intensité de l’association, la droite d’ajustement ne pouvant épouser la trajectoire courbe des points. En revanche, le Tau de Kendall s’affranchit totalement de la géométrie de la courbe : tant que chaque accroissement sur l’axe X s’accompagne d’un accroissement sur l’axe Y, le Tau restera rigoureusement égal à +1.0, reflétant avec fidélité la monotonicité de la relation.
8.2 8.2 Sensibilité aux valeurs extrêmes et points de levier
L’une des limites majeures du coefficient de corrélation de Pearson réside dans son extrême vulnérabilité aux valeurs aberrantes et aux points de levier multivariés. Puisque le calcul du r repose sur l’écart arithmétique à la moyenne élevé au carré, l’introduction d’un unique point situé à plusieurs écarts-types du centroïde suffit à modifier radicalement la valeur de la corrélation, voire à en inverser le signe algébrique.
Cette fragilité impose souvent aux chercheurs des arbitrages déontologiques délicats quant à l’élimination ou la transformation des observations extrêmes au cours du nettoyage des données. À l’inverse, le Tau de Kendall offre une résistance intrinsèque à ces artéfacts de mesure. Quelle que soit la distance métrique séparant une observation aberrante du reste de la cohorte, son influence sur le calcul du Tau est strictement confinée :
- Son rang ne peut dépasser la valeur maximale n.
- Elle ne peut introduire au maximum que (n – 1) discordances dans l’ensemble des paires analysées.
Cette propriété de robustesse garantit la stabilité de la statistique de Kendall face aux perturbations accidentelles qui caractérisent fréquemment les collectes de données cliniques (erreurs d’inattention, réponses extrêmes non censurées ou artéfacts d’enregistrement psychophysiologique).
8.3 8.3 Relation mathématique sous distribution normale bivariée
L’existence d’une relation mathématique reliant le Tau de Kendall au coefficient de corrélation linéaire de Pearson a été formalisée par le théoricien Greiner en 1909, puis généralisée par Maurice Kendall. Lorsque deux variables continues X et Y suivent conjointement une distribution normale bivariée de corrélation théorique paramétrique ρ, il existe une relation trigonométrique directe entre la corrélation linéaire latente et le Tau de concordance :
ρ = sin( π × τ / 2 )
Cette relation permet d’exprimer réciproquement le Tau de Kendall en fonction du paramètre ρ :
τ = (2 / π) × arcsin(ρ)
Cette transformation analytique confère au Tau de Kendall un statut méthodologique privilégié : il peut être exploité comme un estimateur non paramétrique robuste du coefficient de Pearson latent. Si un chercheur suspecte que des données continues normales ont été contaminées par du bruit de mesure non gaussien ou discrétisées par un instrument de mesure imprécis, estimer ρ via la formule de Greiner sin(πτ/2) fournit une estimation de la corrélation sous-jacente moins sensible aux anomalies que le calcul direct du r de Pearson.
9. 9. Inférence statistique, tests d’hypothèses et intervalles de confiance
9.1 9.1 Formulation de l’hypothèse nulle et tests de significativité exacte
L’exploitation inférentielle du Tau de Kendall débute par la définition formelle du cadre de décision statistique. L’hypothèse nulle, notée H0, postule l’indépendance ordinale totale entre les deux variables au sein de la population parente :
H0 : τ = 0
L’hypothèse alternative H1 peut être formulée de façon bilatérale (τ ≠ 0) en l’absence de prédiction sur le sens de la relation, ou de façon unilatérale (τ > 0 ou τ < 0) lorsqu’un cadre théorique préalable justifie une direction précise.
Pour tester cette hypothèse sur des échantillons de petite taille (n ≤ 10), l’inférence ne s’appuie pas sur des approximations continues, mais sur le dénombrement combinatoire exact de la statistique S = C – D. Sous l’hypothèse nulle d’indépendance, l’ensemble des n! permutations possibles des rangs est supposé équiprobable. En énumérant le nombre exact de permutations générant une valeur de S égale ou supérieure à la statistique observée, on obtient la p-valeur exacte par rapport aux tables critiques historiques dressées par Kendall.
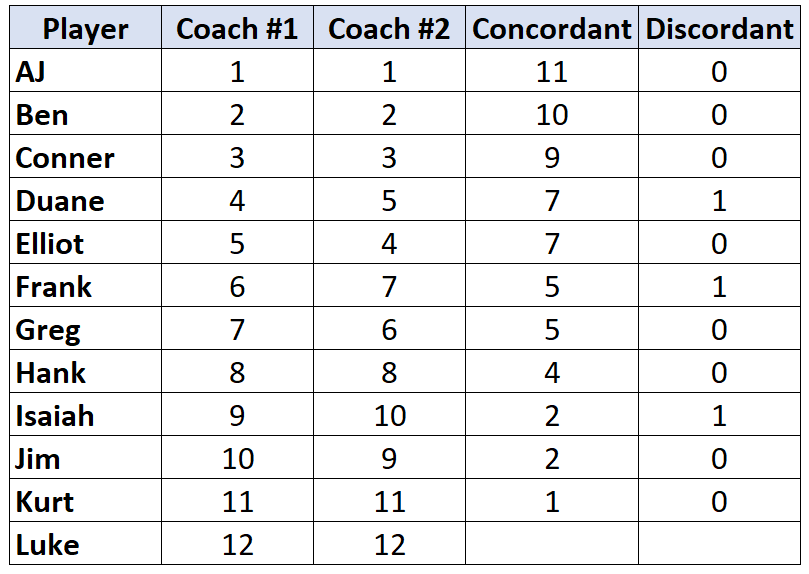
9.2 9.2 Approximation asymptotique par la loi normale pour grands échantillons
Dès lors que la taille de l’échantillon franchit le seuil n > 10, le recours aux tables exactes de permutations devient inutile en raison de la convergence rapide de la statistique S vers une distribution normale gaussienne. Sous l’hypothèse nulle H0 et en l’absence d’ex æquo, l’espérance mathématique de la statistique S est nulle (E(S) = 0), et sa variance théorique exacte s’exprime selon la formule établie par Kendall :
Var(S) = [ n × (n – 1) × (2n + 5) ] / 18
Lorsque les données présentent des rangs liés, la variance de S doit être ajustée à l’aide de termes correctifs prenant en compte les multiplicités d’égalités :
Var(S) = [ n(n – 1)(2n + 5) – ∑ ti(ti – 1)(2ti + 5) – ∑ uj(uj – 1)(2uj + 5) ] / 18 + termes d’ajustement supérieurs
À partir de cette variance théorique, nous pouvons construire une statistique de test standardisée Z en appliquant une correction de continuité empirique :
Z = [ |S| – 1 ] / √Var(S)
Cette variable aléatoire Z converge vers la loi normale standard N(0, 1). Il suffit alors de comparer la valeur calculée aux seuils critiques usuels (±1,96 pour un seuil bilatéral α = 0,05 ; ±2,576 pour α = 0,01) pour conclure à la significativité statistique de l’association observée.
9.3 9.3 Construction des intervalles de confiance pour le Tau de Kendall
Si le test de significativité sous l’hypothèse nulle fournit une valeur p permettant de rejeter H0, les standards méthodologiques contemporains exigent l’estimation de la taille d’effet accompagnée de son intervalle de confiance (usuellement fixé à 95 %). L’estimation de l’erreur standard du Tau en dehors de l’hypothèse nulle (sous l’hypothèse alternative H1 : τ ≠ 0) s’avère toutefois complexe, la distribution d’échantillonnage dépendant de la structure bivariée réelle des rangs.
L’approche asymptotique standard s’appuie sur la formulation de la variance non nulle établie par Gottfried Noether :
SE(τ) ≈ √[ (2 / n) × (1 – τ2) ] (dans sa version simplifiée) ou sur des formulations tensorielles intégrant les concordances partielles.
Face à la complexité de ces formulations analytiques sous présence d’ex æquo, la méthodologie contemporaine privilégie l’utilisation du rééchantillonnage bootstrap non paramétrique (avec un minimum de 2000 à 10 000 itérations). Cette approche algorithmique génère empiriquement la distribution de l’estimateur par tirage avec remise au sein de l’échantillon initial, permettant de dériver des intervalles de confiance corrigés des biais (BCa) particulièrement précis, conformes aux exigences de publication des revues internationales de premier rang.
10. 10. Domaines d’application en psychologie, psychiatrie et neurosciences
10.1 10.1 Évaluation de la fidélité inter-juges et codage clinique
La recherche clinique et l’évaluation diagnostique reposent fréquemment sur le codage d’observations qualitatives par des évaluateurs indépendants. Qu’il s’agisse de mesurer l’intensité de traits autistiques à travers l’ADOS-2, d’évaluer le risque hétéro-agressif à l’aide de l’échelle HCR-20, ou de graduer le risque suicidaire selon la C-SSRS, les professionnels de santé assignent des scores discrets ordonnés. Dans ces contextes, l’emploi du Tau de Kendall s’avère nettement supérieur aux alternatives traditionnelles.
Le Kappa de Cohen, bien que très populaire, est originellement conçu pour des échelles nominales sans ordre sous-jacent. Lorsqu’il est pondéré (Kappa quadratique), il introduit une pénalisation arbitraire des désaccords qui s’apparente aux travers métriques du coefficient de Pearson. Le Tau de Kendall offre une quantification directe du degré de concordance relative entre observateurs, indiquant si la hiérarchie des niveaux de sévérité attribués aux patients est partagée par les cliniciens.
Cette approche est également mobilisée dans les démarches de consensus médical par la méthode Delphi, où des panels d’experts classent par priorité des recommandations thérapeutiques à travers plusieurs tours d’évaluation successifs. L’élévation progressive du coefficient Tau entre les différentes vagues d’évaluation atteste objectivement de la convergence du consensus scientifique.
10.2 10.2 Psychométrie cognitive et chronométrie mentale
En neuropsychologie expérimentale et en sciences cognitives, la chronométrie mentale étudie la latence des processus de traitement de l’information. Dans les paradigmes d’inhibition cognitive (à l’exemple de la tâche de Stroop ou du test de Hayling), les temps de réaction recueillis présentent des distributions fortement asymétriques, caractérisées par de longues queues d’étalement vers les latences élevées et par la présence régulière d’essais aberrants dus à des décrochages attentionnels.
L’évaluation de la relation entre le niveau de complexité subjective d’une tâche exécutive (gradué selon une échelle ordinale) et la latence moyenne de réponse trouve dans le Tau de Kendall un outil d’analyse adapté. En remplaçant les valeurs millisecondées brutes par leur rang d’apparition relatif, le chercheur neutralise l’impact délétère des temps extrêmes tout en captant l’essence fonctionnelle de la réponse psychophysique.
Il en va de même dans les paradigmes de décision économique comportementale explorant l’aversion à la perte ou l’actualisation temporelle des gains. Le classement des choix préférentiels ordonnés fournit des données hiérarchiques que le Tau permet de confronter aux scores de traits de personnalité cognitive (comme la recherche de sensations ou le perfectionnisme) sans requérir d’hypothèse de linéarité paramétrique.
10.3 10.3 Psychologie sociale et enquêtes d’attitudes
L’analyse des représentations collectives, des valeurs morales et des attitudes politiques au sein de cohortes populationnelles étendues repose quasi universellement sur des batteries d’échelles de Likert. L’application du modèle des valeurs humaines de Shalom Schwartz, qui invite les participants à classer par ordre d’importance relative dix valeurs universelles (telles que l’autonomie, la bienveillance, la sécurité ou le pouvoir), génère des structures de données ipsatives strictement ordinales.
Le recours au Tau-b ou au Tau-c de Kendall constitue le standard analytique pour corréler la hiérarchisation de ces valeurs fondamentales avec des indices sociodémographiques stratifiés (niveaux d’éducation ordonnés en cycles primaires, secondaires et supérieurs, déciles de revenus, ou gradients d’âge). De telles enquêtes générant fréquemment des effectifs massifs (n > 1000) mais caractérisés par un nombre restreint de paliers de réponse, la correction pour ex æquo intégrée au Tau-b neutralise le risque de sous-estimation de la force d’association.
Enfin, l’étude des dynamiques conjugales et dyadiques bénéficie de cette métrique pour comparer la congruence des perceptions au sein de couples, qu’il s’agisse d’évaluer la satisfaction relationnelle, le partage perçu des tâches domestiques ou la concordance des styles parentaux.
11. 11. Implémentation computationnelle : R, Python et SPSS
11.1 11.1 Calcul et modélisation sous le langage R
L’environnement statistique open-source R propose une prise en charge native du Tau de Kendall au sein de sa distribution de base, complétée par des bibliothèques spécialisées offrant des fonctionnalités avancées. Le calcul direct du coefficient s’effectue via la fonction générique cor() en spécifiant le paramètre dédié :
L’instruction cor(x, y, method = "kendall") renvoie la valeur numérique du Tau-b de Kendall corrigé pour les ex æquo éventuels. Pour obtenir un rapport d’inférence complet incluant la statistique de test Z et la valeur p bilatérale, le chercheur mobilise la fonction cor.test(x, y, method = "kendall").
Face à des jeux de données de taille restreinte comportant des ex æquo, l’environnement R propose le package Kendall développé par A.I. McLeod, dont la fonction Kendall(x, y) calcule les variances exactes ajustées. Pour construire des intervalles de confiance à 95 % par rééchantillonnage bootstrap non paramétrique, le recours au package boot permet d’exécuter l’algorithme suivant :
La définition d’une fonction d’estimation personnalisée extrayant le coefficient Tau est transmise à l’instruction boot(data, statistic, R = 5000). L’application ultérieure de boot.ci() permet d’obtenir les bornes de confiance BCa (bias-corrected and accelerated), garantissant une rigueur méthodologique optimale pour la communication des résultats empiriques.
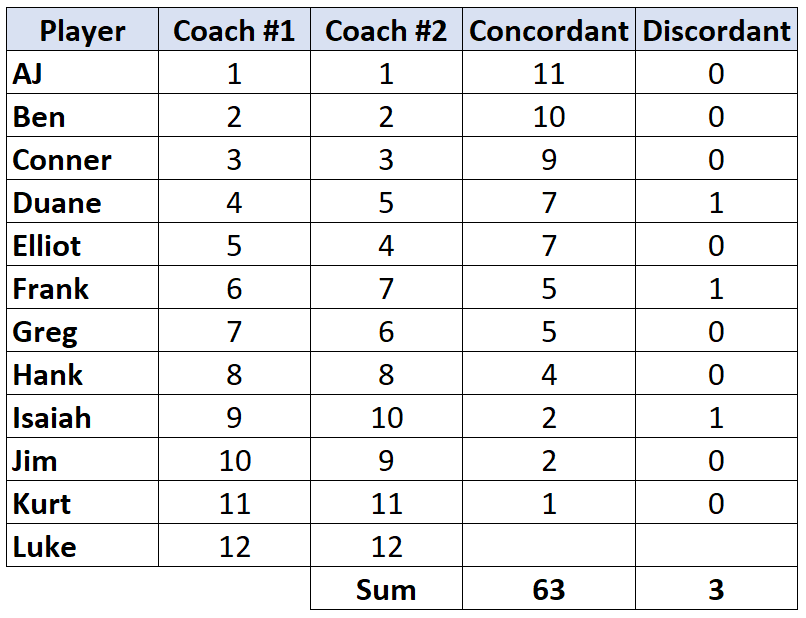
11.2 11.2 Analyse computationnelle avec Python (SciPy et Statsmodels)
Au sein de l’écosystème scientifique Python, l’analyse non paramétrique est principalement orchestrée par les modules scipy.stats et statsmodels. La fonction pivot dédiée au calcul du coefficient est kendalltau(), localisée au sein du sous-module scipy.stats :
L’exécution de la commande from scipy.stats import kendalltau; tau, p_value = kendalltau(x, y, variant='b') calcule le Tau-b ajusté pour les ex æquo et renvoie simultanément la valeur de la statistique et sa significativité p associée. Le paramètre variant permet de basculer alternativement sur la variante variant='c' pour évaluer des tables rectangulaires non symétriques.
Pour l’exploration visuelle conjointe des relations ordinales, les bibliothèques seaborn et matplotlib permettent de construire des diagrammes de dispersion adaptés avec jittering (dispersion artificielle légère des points discrets afin de visualiser les observations superposées), complétés par l’ajustement d’une courbe de tendance monotone non linéaire de type LOESS :
La commande seaborn.regplot(x=x, y=y, lowess=True) met en évidence la forme structurelle de la relation monotone sans imposer la contrainte de linéarité paramétrique du modèle des moindres carrés ordinaires.
11.3 11.3 Procédure d’extraction et lecture des sorties dans SPSS
Le logiciel IBM SPSS Statistics demeure un outil largement diffusé dans les unités de recherche hospitalières et les laboratoires universitaires de psychologie. Pour obtenir le Tau de Kendall sous SPSS, le chercheur dispose de deux cheminements principaux selon la structuration de sa base de données :
Pour des données individuelles brutes en colonnes continues ou ordinales, il convient de naviguer à travers le menu : Analyser > Corrélation > Bivariée… Dans la boîte de dialogue contextuelle, le chercheur sélectionne les variables cibles, décoche l’option par défaut « Pearson », et coche la case « Tau-b de Kendall ». L’activation de cette option génère un tableau croisé symétrique affichant la valeur estimée de τb, l’erreur standard asymptotique, ainsi que la valeur de p pour un test bilatéral.
Pour des données organisées sous la forme de tableaux de contingence croisant deux échelles ordinales catégorielles, la procédure s’effectue via : Analyser > Statistiques descriptives > Tableaux croisés… Sous l’onglet « Statistiques », l’utilisateur active les options « Tau-b de Kendall » et « Tau-c de Kendall ». La lecture des sorties SPSS exige de prêter attention aux libellés : la ligne « Tau-b de Kendall » doit être privilégiée si la matrice est carrée, tandis que la ligne « Tau-c de Kendall » doit être retenue si la matrice est rectangulaire. Une erreur d’interprétation fréquente chez les chercheurs consiste à retenir aveuglément la statistique de Pearson affichée en entête, ignorant la distorsion générée sur ces formats ordinaux.
12. 12. Bonnes pratiques de recherche, pièges d’interprétation et normes APA
12.1 12.1 Écueils fréquents et pièges méthodologiques
L’utilisation de la statistique de concordance de Kendall requiert une vigilance méthodologique continue face à plusieurs biais d’interprétation récurrents dans la littérature scientifique :
Le premier écueil consiste en l’assimilation fallacieuse de la concordance ordinale à une preuve de causalité mécanique. Un coefficient de Kendall τ = 0,80 entre deux échelles comportementales démontre une cohérence remarquable dans l’ordonnancement des sujets, mais n’autorise en aucun cas à affirmer que les variations de la première dimension induisent causalement les fluctuations de la seconde. Les deux métriques peuvent simplement répondre conjointement à des modulations physiologiques sous-jacentes non mesurées.
Le second piège réside dans l’application inappropriée de la formule du Tau-a originale sur des corpus saturés d’ex æquo. Cette bévue, encore fréquente chez les analystes novices, aboutit à une minoration systématique de l’intensité réelle des associations étudiées et peut masquer des consensus cliniques pertinents.
Enfin, une erreur récurrente consiste à déduire une relation linéaire sur la seule observation d’un Tau élevé sans avoir vérifié graphiquement l’allure de la distribution bivariée. Le Tau atteste d’une monotonicité d’ensemble, mais demeure insensible aux inflexions et aux accélérations locales le long de la trajectoire ordinale.
12.2 12.2 Modalités de rédaction des résultats selon les normes APA (7e édition)
La restitution éditoriale des analyses statistiques dans les revues affiliées à l’American Psychological Association (APA, 7e édition) impose un formalisme typographique et rédactionnel précis. Le symbole désignant le Tau de Kendall doit systématiquement être typographié en lettre grecque minuscule et assorti de son indice de variante spécifique (τb ou τc), sans mise en italique (les symboles grecs ne s’italiques pas en normes APA, à l’inverse des lettres latines désignant des statistiques comme r, t, F, ou p).
Le texte doit consigner explicitement la valeur de la statistique de test, la taille de l’échantillon, la valeur exacte de p, ainsi que l’intervalle de confiance à 95 %. Deux modèles de formulation canonique peuvent être retenus :
Exemple de formulation pour un résultat significatif :
« Une corrélation de rang de Kendall a été calculée afin d’évaluer la relation entre l’intensité perçue de la douleur chronique et le degré de catastrophisme psychologique chez 45 patients. Les résultats indiquent une association ordinale positive, forte et statistiquement significative, τb = ,54, 95% IC [,38, ,70], z = 4,82, p < ,001. Conformément aux hypothèses, les patients manifestant les scores de catastrophisme les plus élevés se révèlent être ceux rapportant la symptomatologie douloureuse la plus sévère. »
Exemple de formulation pour un résultat non significatif :
« L’analyse de concordance inter-juges menée sur l’évaluation des troubles du sommeil par deux observateurs indépendants (n = 22) n’a pas révélé d’accord ordinal statistiquement significatif, τb = ,18, 95% IC [-,21, ,57], z = 1,12, p = ,263. Ces résultats suggèrent une disparité sémiologique nécessitant une révision des critères de cotation clinique. »
12.3 12.3 Recommandations pour une analyse psychométrique rigoureuse
Afin de maximiser la transparence, la robustesse et la reproductibilité des analyses de données ordinales au sein de la communauté scientifique, nous recommandons le respect scrupuleux des directives méthodologiques synthétisées dans la liste de contrôle suivante :
- Planification de puissance a priori : Déterminer en amont la taille d’échantillon minimale nécessaire pour détecter la taille d’effet minimale jugée cliniquement pertinente, en appliquant les abaques de Noether ou des simulations de Monte Carlo adaptées au Tau.
- Examen exploratoire préliminaire : Inspecter la structure des fréquences bivariées afin d’identifier la proportion d’ex æquo et de sélectionner rigoureusement la version de Tau adaptée (Tau-b pour les tableaux carrés, Tau-c pour les tables rectangulaires asymétriques).
- Transparence méthodologique : Mentionner explicitement dans la section Méthode la variante de Tau calculée et le progiciel utilisé (avec sa version exacte).
- Systématisation des intervalles de confiance : Ne jamais limiter le rapport à la seule p-valeur ; accompagner chaque coefficient d’un intervalle de confiance à 95 % (analytique ou bootstrappé).
- Science ouverte et réplicabilité : Déposer les matrices de rangs brutes et les scripts d’analyse computationnelle (R, Python ou syntaxe SPSS) au sein d’entrepôts de données ouverts (tels que l’Open Science Framework), favorisant la réplication indépendante des résultats publiés.
Références
- Agresti, A. (2010). Analysis of Ordinal Categorical Data (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9780470594001
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Greiner, R. (1909). Über das Fehlersystem der Kollektivmasslehre. Zeitschrift für Mathematik und Physik, 57, 121-158, 225-260.
- Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1/2), 81-93. https://doi.org/10.2307/2332226
- Kendall, M. G. (1945). The treatment of ties in ranking problems. Biometrika, 33(3), 239-251. https://doi.org/10.2307/2332297
- Kendall, M. G., & Gibbons, J. D. (1990). Rank Correlation Methods (5th ed.). Edward Arnold.
- Noether, G. E. (1981). Why Kendall Tau? Teaching Statistics, 3(2), 41-43. https://doi.org/10.1111/j.1467-9639.1981.tb00422.x
- Siegel, S., & Castellan, N. J. (1988). Nonparametric Statistics for the Behavioral Sciences (2nd ed.). McGraw-Hill.
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
- Stuart, A. (1953). The estimation and comparison of strengths of association in contingency tables. Biometrika, 40(1/2), 105-110. https://doi.org/10.2307/2333101