
Dans le domaine de l’analyse statistique et de la psychométrie appliquée, l’examen des données empiriques souffre fréquemment d’un réductionnisme dommageable : la focalisation exclusive sur les mesures de tendance centrale. Résumer un ensemble complexe d’observations à une moyenne arithmétique ou à une médiane constitue certes un point d’ancrage indispensable pour situer le centre de gravité d’une distribution, mais cette démarche s’avère fondamentalement incomplète, voire trompeuse, si elle n’est pas assortie d’une évaluation rigoureuse de la dispersion. L’hétérogénéité des comportements, des performances cognitives ou des traits de personnalité constitue l’essence même de l’investigation psychologique. Deux cohortes de sujets peuvent présenter une moyenne strictement identique à une épreuve d’évaluation sans pour autant partager la moindre ressemblance clinique : l’une peut révéler une remarquable homogénéité où tous les individus gravitent autour de la norme, tandis que l’autre peut traduire une polarisation extrême dissimulant des profils en grande souffrance et des performances exceptionnelles.
Les mesures de dispersion, souvent qualifiées d’indicateurs de variabilité ou d’étalement, fournissent le contrepoids quantitatif indispensable à la tendance centrale. Elles ont pour vocation d’objectiver l’écartement des observations individuelles par rapport au centre de la distribution, mais également les unes par rapport aux autres. En quantifiant cet écartement, le chercheur ou le praticien accède à la structure profonde des données, ce qui conditionne la fidélité des inférences, la validité des diagnostics et la robustesse des modèles prédictifs élaborés en sciences humaines et sociales. Que l’on s’intéresse à l’amplitude totale des scores, aux distances interquartiles, à la variance ou à l’écart-type, chaque paramètre de dispersion répond à des postulats mathématiques précis et éclaire un pan particulier de la réalité observée.
Ce guide propose une analyse exhaustive et approfondie des concepts, calculs, interprétations et applications cliniques des mesures de dispersion. En parcourant les fondements théoriques de l’étendue, la robustesse statistique de l’écart interquartile, l’élégance algébrique de la variance, la centralité clinique de l’écart-type et les apports des estimateurs modernes, nous fournirons aux chercheurs, cliniciens et étudiants les clés méthodologiques nécessaires pour appréhender la variabilité avec un haut niveau de rigueur scientifique, conformément aux standards les plus exigeants de la psychométrie contemporaine et des normes de publication académique.
1. Introduction aux mesures de dispersion en psychométrie et statistique
1.1 Complémentarité entre tendance centrale et variabilité
La statistique descriptive repose traditionnellement sur deux piliers indissociables : la détermination de la tendance centrale et la quantification de la variabilité. Si les indicateurs tels que la moyenne arithmétique, la médiane ou le mode visent à résumer une distribution de données par une valeur unique jugée représentative, ils occultent délibérément la distribution interne des observations individuelles. Deux distributions peuvent afficher une moyenne rigoureusement égale à 100 tout en décrivant des réalités empiriques radicalement divergentes : dans la première, l’ensemble des scores peut osciller de manière très serrée entre 98 et 102, tandis que dans la seconde, les scores peuvent s’échelonner entre 40 et 160. L’information transmise par la seule moyenne devient alors illusoire, car elle ne renseigne en rien sur la représentativité de cette valeur centrale.
La nécessité de quantifier l’hétérogénéité des scores au sein d’une population clinique ou générale constitue donc un impératif méthodologique. Dans le cadre de l’évaluation psychologique, négliger la variabilité revient à postuler une uniformité comportementale ou cognitive qui n’existe pratiquement jamais. La dispersion mesure la tendance des scores à s’écarter du centre ou à s’éloigner les uns des autres. Plus la dispersion est restreinte, plus la moyenne empirique est informative et stable ; inversement, une dispersion très élevée indique que la moyenne n’est qu’un résumé imparfait masquant une importante diversité interindividuelle.
Sur le plan formel, la dispersion peut être définie comme le degré d’étalement, d’éparpillement ou de variabilité des valeurs d’une variable numérique autour de sa valeur centrale. Cette définition sous-tend que la dispersion ne renseigne pas sur le niveau absolu des performances ou des traits mesurés, mais sur la fidélité avec laquelle un indice central capture l’ensemble de l’échantillon. Un modèle statistique ignorant la dispersion s’expose systématiquement à des erreurs de prédiction majeures, car la validité d’une estimation dépend directement de l’ampleur du résidu de variabilité non expliqué.
1.2 Importance de la dispersion dans l’évaluation psychologique
Dans l’évaluation psychologique et la pratique diagnostique, l’analyse de la dispersion prend une coloration spécifique à travers la distinction fondamentale entre variabilité interindividuelle et variabilité intra-individuelle. La première reflète les écarts existant entre différents sujets au sein d’une même cohorte, ce qui permet d’étalonner les tests cognitifs et d’ajuster les normes populationnelles. La seconde, quant à elle, concerne la fluctuation des performances d’un même individu à travers différentes épreuves ou au cours de passations répétées dans le temps. Par exemple, lors de l’administration d’une échelle d’intelligence comme le WISC ou la WAIS, une dispersion intra-individuelle marquée entre les différents indices factoriels (compréhension verbale, raisonnement perceptif, mémoire de travail, vitesse de traitement) constitue souvent un indicateur clinique plus saillant que le quotient intellectuel global lui-même.
Les conséquences d’un défaut de prise en compte de la dispersion sur le plan diagnostique s’avèrent considérables. Une faible dispersion au sein d’un groupe normatif peut comprimer artificiellement les écarts et masquer l’hétérogénéité réelle des troubles du neurodéveloppement ou des pathologies psychiatriques. À l’opposé, une dispersion excessive des scores normatifs peut conduire à une sous-identification de profils atypiques, comme le haut potentiel intellectuel ou les déficits exécutifs légers, dès lors que le seuil de significativité clinique repose sur un nombre d’écarts-types par rapport à la moyenne. L’étalement des scores conditionne la sensibilité et la spécificité des instruments psychométriques.
Dans l’interprétation clinique quotidienne, le niveau d’homogénéité du groupe de référence ou du profil du patient module substantiellement le diagnostic différentiel. Lorsqu’un sujet présente des scores homogènes et modérément abaissés dans l’ensemble des sphères neuropsychologiques, le clinicien s’oriente plus volontiers vers une étiologie globale ou diffuse, telle qu’une encéphalopathie ou une démence débutante. En revanche, si la dispersion intra-individuelle est exacerbée, révélant la préservation intacte de certaines compétences mnésiques aux côtés d’un effondrement drastique de la flexibilité cognitive, l’hypothèse d’une lésion focale ou d’un syndrome dysexécutif spécifique gagne en plausibilité statistique et clinique.
1.3 Typologie globale des indicateurs de dispersion
L’arsenal statistique dédié à l’évaluation de la dispersion se divise en plusieurs catégories conceptuelles. La distinction majeure s’opère entre les mesures absolues et les mesures relatives de dispersion. Les mesures absolues, telles que l’étendue, l’écart interquartile, la variance et l’écart-type, s’expriment directement dans l’unité de mesure originale de la variable (ou dans le carré de cette unité pour la variance). Elles quantifient la variabilité intrinsèque sans tenir compte de la magnitude globale des scores. À l’inverse, les mesures relatives, dominées par le coefficient de variation, expriment la dispersion comme une proportion ou un pourcentage de la tendance centrale, permettant ainsi de comparer des distributions mesurées dans des unités différentes ou présentant des moyennes d’amplitudes très dissemblables.
Une seconde dichotomie primordiale oppose les indicateurs paramétriques aux indicateurs non paramétriques. Les approches paramétriques, dont les figures de proue sont la variance et l’écart-type, supposent implicitement que les données proviennent d’une distribution théorique connue, typiquement la distribution normale de Gauss. Elles mobilisent l’ensemble des données numériques dans leur algorithme de calcul et se prêtent remarquablement bien aux développements de l’inférence statistique. Les indicateurs non paramétriques, représentés par l’étendue, l’écart interquartile ou l’écart absolu médian, s’appuient sur l’ordre des rangs ou le positionnement relatif des quantiles. Ils s’affranchissent de toute hypothèse distributionnelle rigide et démontrent une robustesse bien supérieure en présence de distributions asymétriques ou tronquées.
Cette distinction théorique renvoie directement à la sensibilité différentielle des indices statistiques aux observations extrêmes et aberrantes. Les mesures quadratiques accordent un poids disproportionné aux écarts les plus importants, ce qui les rend extrêmement vulnérables à une seule donnée atypique résultant d’une erreur de mesure ou d’un profil exceptionnel. Le choix d’une métrique de dispersion ne relève donc jamais du simple hasard : il exige un examen attentif de la forme de la distribution, du niveau d’asymétrie (skewness), de l’aplatissement (kurtosis) et du niveau de mesure de la variable considérée (échelle ordinale, d’intervalle ou de rapport).
2. L’étendue : Fondements théoriques, calculs et limites
2.1 Définition mathématique et protocole de calcul
L’étendue, fréquemment désignée par le terme anglophone range, constitue l’indice de dispersion le plus élémentaire et le plus intuitif de l’analyse quantitative. Sur le plan formel, elle se définit comme la distance arithmétique séparant la valeur maximale observée de la valeur minimale au sein d’un échantillon donné. L’expression analytique s’écrit formellement :
Étendue = Xmax – Xmin
Dans certaines traditions psychométriques anciennes, l’étendue brute est parfois augmentée d’une unité de mesure pour rendre compte de la continuité sous-jacente des variables discrètes (l’étendue totale étant alors définie par Xmax – Xmin + 1). Néanmoins, la définition purement différentielle demeure le standard contemporain en statistique descriptive et inférentielle.
Le protocole systématique de calcul implique d’abord un ordonnancement rigoureux des données brutes en une série statistique croissante ou décroissante. Considérons une passation clinique évaluant le niveau d’anxiété situationnelle auprès d’un groupe de huit patients au moyen d’un questionnaire standardisé dont les scores s’échelonnent de 0 à 50. Les scores obtenus, initialement non triés, sont les suivants : 14, 28, 19, 42, 16, 22, 35, 12.
La première opération consiste à réorganiser la série dans l’ordre croissant :
12, 14, 16, 19, 22, 28, 35, 42
L’identification des bornes extrêmes est désormais immédiate : la valeur minimale observée (Xmin) est égale à 12, et la valeur maximale (Xmax) est de 42. L’application de la formule fournit :
Étendue = 42 – 12 = 30
Cette valeur indique que l’ensemble des profils anxieux de cet échantillon s’étale sur une plage de 30 points d’échelle. L’interprétation intuitive renvoie à l’espace total mobilisé par l’échantillon au sein de l’espace théorique de l’instrument de mesure.
2.2 Avantages opérationnels et simplicité d’usage
En dépit de son caractère rudimentaire, l’étendue présente des vertus opérationnelles non négligeables dans la pratique de terrain et la phase exploratoire de la recherche. Son atout majeur réside dans son immédiateté computationnelle : elle ne requiert aucun calcul algébrique lourd, aucune somme de carrés ni aucun calcul matriciel. Lors d’une évaluation psychologique d’urgence ou d’un dépistage collectif en contexte scolaire ou professionnel, le praticien peut déterminer l’étendue instantanément à la simple lecture d’un tableau récapitulatif des scores ordonnés.
Sur le plan pédagogique et communicationnel, l’étendue offre une clarté conceptuelle inégalée pour expliciter les premiers résultats auprès d’un public non spécialiste, tel que des patients, des parents ou des décideurs en entreprise. Affirmer que les scores de performance des candidats varient entre 15 et 85 points fournit une représentation visuelle directe et concrète du spectre des aptitudes observées, bien plus facilement appréhendable que l’énoncé d’une variance abstraite.
Par ailleurs, l’étendue joue un rôle critique dans le contrôle de la qualité des données (data cleaning). Elle permet de détecter immédiatement d’éventuelles anomalies de saisie informatique ou des valeurs hors limites. Si un inventaire de dépression admet un score maximal théorique de 63 et qu’un praticien constate une valeur maximale de 82, l’étendue résultante signale de manière infaillible une coquille typographique ou un artefact d’encodage avant même d’engager des analyses plus sophistiquées.
2.3 Vulnérabilités statistiques et distorsions méthodologiques
Les limites de l’étendue sont toutefois considérables, au point que la littérature méthodologique la relègue généralement au rang de simple indicateur préliminaire. Sa principale vulnérabilité tient à sa dépendance exclusive envers les deux seules valeurs extrêmes de la distribution. En ignorant la totalité des observations intermédiaires, l’étendue se montre hypersensible aux valeurs aberrantes (outliers). Qu’un seul individu présente un score exceptionnellement bas ou élevé par suite d’une incompréhension des consignes, et l’étendue se trouve démesurément gonflée, dressant un portrait totalement déformé de la cohésion réelle du groupe.
De surcroît, l’étendue entretient une relation de dépendance critique et non souhaitable avec la taille de l’échantillon (N). Sur le plan probabiliste, plus le nombre de sujets inclus dans l’échantillon augmente, plus la probabilité de tirer des individus issus des queues de distribution s’accroît mécaniquement. Par conséquent, l’étendue a une propension structurelle à s’élargir lorsque l’échantillon grandit, ce qui invalide toute comparaison directe d’étendues calculées sur des groupes de tailles hétérogènes.
Enfin, l’étendue est totalement aveugle à la structure distributionnelle interne. Deux échantillons peuvent arborer exactement la même valeur minimale (ex. 10) et la même valeur maximale (ex. 90), générant une étendue identique de 80 points. Pourtant, dans le premier groupe, 98 % des sujets peuvent être massés entre 48 et 52 points, tandis que dans le second, les scores peuvent se répartir de façon bimodale avec la moitié des individus à 10 et l’autre moitié à 90. L’étendue échoue complètement à discriminer ces deux réalités psychologiques opposées, la rendant inapte à alimenter des inférences statistiques robustes.
3. L’écart interquartile : Robustesse et résistance aux valeurs aberrantes
3.1 Fondements des quartiles et partitionnement des distributions
Pour s’affranchir de la sensibilité excessive de l’étendue aux valeurs extrêmes tout en conservant une logique d’intervalle, la statistique non paramétrique s’appuie sur le concept de quantiles, et plus spécifiquement de quartiles. Les quartiles constituent les trois valeurs de coupure qui divisent une distribution de données ordonnées en quatre segments égaux, contenant chacun exactement 25 % des observations de l’échantillon. Le premier quartile (Q1), ou 25e centile, correspond à la valeur sous laquelle se situent 25 % des observations les plus faibles. Le deuxième quartile (Q2), équivalent strict de la médiane ou 50e centile, scinde l’échantillon en deux moitiés équivalentes. Enfin, le troisième quartile (Q3), ou 75e centile, isole les 25 % des scores les plus élevés.
L’écart interquartile, universellement désigné par l’acronyme IQR (pour Interquartile Range), se définit mathématiquement comme la différence arithmétique entre le troisième et le premier quartile :
IQR = Q3 – Q1
Par construction, l’écart interquartile mesure l’étalement des 50 % centraux des données. En tronquant délibérément les 25 % des valeurs les plus basses et les 25 % des valeurs les plus hautes, l’IQR s’avère totalement imperméable aux perturbations engendrées par les scores extrêmes ou aberrants situés aux extrémités du spectre. Il offre ainsi une quantification de la variabilité qui demeure stable et représentative, même lorsque la distribution empirique souffre d’une forte asymétrie ou d’une contamination par des erreurs de mesure périphériques.
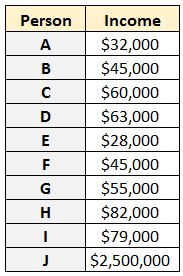
La localisation formelle des rangs des quartiles dépend de la méthode retenue et de la parité de l’échantillon. Dans les conventions de Tukey, souvent appliquées dans les logiciels modernes, la médiane divise d’abord la série en deux sous-groupes (inférieur et supérieur). Si l’échantillon comporte un nombre impair d’observations, la médiane centrale peut être incluse ou exclue des sous-groupes selon l’algorithme choisi. Q1 est ensuite déterminé comme la médiane de la moitié inférieure, et Q3 comme la médiane de la moitié supérieure.
3.2 Exemple détaillé de calcul sur des données comportementales
Afin d’illustrer la mécanique de calcul de l’écart interquartile, examinons une expérience de psychologie cognitive évaluant le temps de réaction (exprimé en millisecondes) lors d’une tâche de discrimination visuelle complexe. Vingt participants adultes (N = 20) ont été testés. Après tri initial, les données brutes ordonnées de manière ascendante se présentent comme suit :
310, 325, 330, 335, 340, 342, 345, 348, 350, 355, 360, 362, 365, 370, 375, 380, 390, 405, 420, 680
Notons d’emblée la présence d’un score extrême de 680 ms, consécutif à une probable distraction transitoire du participant. L’étendue totale de cet échantillon s’élève à 680 – 310 = 370 ms, une valeur largement tirée vers le haut par cette unique mesure atypique.
L’échantillon comportant un nombre pair d’observations (N = 20), la médiane (Q2) se situe à mi-chemin entre la 10e et la 11e observation :
Position Q2 = (20 + 1) / 2 = 10,5
Q2 = (355 + 360) / 2 = 357,5 ms
La partition de la série engendre deux sous-échantillons de 10 observations chacun. La moitié inférieure regroupe les scores : 310, 325, 330, 335, 340, 342, 345, 348, 350, 355. Le premier quartile (Q1) correspond à la médiane de cette première série, située entre la 5e et la 6e valeur :
Q1 = (340 + 342) / 2 = 341 ms
La moitié supérieure regroupe les scores : 360, 362, 365, 370, 375, 380, 390, 405, 420, 680. Le troisième quartile (Q3) correspond à la médiane de cette seconde série, située entre sa 5e et sa 6e valeur (c’est-à-dire les 15e et 16e observations globales) :
Q3 = (375 + 380) / 2 = 377,5 ms
L’écart interquartile s’obtient par la soustraction de Q1 à Q3 :
IQR = 377,5 – 341 = 36,5 ms
La comparaison entre l’étendue brute (370 ms) et l’écart interquartile (36,5 ms) met en exergue l’effet filtrant de l’IQR : tandis que l’étendue reflète l’anomalie d’un temps de réaction isolé, l’écart interquartile révèle que le noyau central des sujets opère dans une fenêtre temporelle extrêmement étroite de 36,5 ms.
3.3 Applications de l’IQR au filtrage des données psychologiques
L’écart interquartile constitue la pierre angulaire de l’analyse exploratoire des données, notamment grâce aux critères formalisés par le statisticien John Tukey pour la détection systématique des valeurs aberrantes. La règle empirique de Tukey s’appuie sur la création de frontières numériques, appelées barrières ou clôtures, établies à partir de Q1 et Q3 au moyen d’un coefficient multiplicateur standard fixé à 1,5 :
- Barrière intérieure inférieure : Q1 – (1,5 × IQR)
- Barrière intérieure supérieure : Q3 + (1,5 × IQR)
Toute observation se situant au-delà de ces clôtures intérieures est qualifiée de valeur aberrante modérée. En reprenant l’exemple précédent, la barrière supérieure s’établit à 377,5 + (1,5 × 36,5) = 432,25 ms. Le score de 680 ms excède largement ce seuil, ce qui confirme objectivement son statut d’outlier. Tukey définit également des barrières extérieures en employant un facteur multiplicateur de 3 (Q3 + 3 × IQR), au-delà desquelles les valeurs sont qualifiées d’aberrantes sévères.
L’application de l’IQR s’avère particulièrement précieuse dans l’analyse des données d’enquêtes psychologiques basées sur des échelles de Likert ordinales ou des distributions hautement asymétriques, telles que les revenus, les durées d’hospitalisation psychiatrique ou les fréquences d’actes compulsifs. Dans ces configurations, l’IQR préserve la fidélité de l’estimation de l’étalement en évitant les dérives induites par la non-normalité.
Toutefois, l’écart interquartile présente des limites intrinsèques dans les démarches de modélisation inférentielle avancée. Fondé sur le rang plutôt que sur des sommes algébriques, il ne se prête pas aux manipulations matricielles complexes indispensables à l’analyse de régression linéaire, à l’analyse factorielle confirmatoire ou aux modélisations par équations structurelles. L’IQR décrit admirablement un échantillon, mais il ne constitue pas un paramètre d’estimation efficace pour les distributions théoriques gouvernant les modèles prédictifs continus.
4. La variance : Modélisation quadratique de l’étalement des données
4.1 Origine conceptuelle des écarts à la moyenne
Bien que les approches fondées sur les rangs présentent une robustesse appréciable, le développement de la statistique inférentielle classique exige un indicateur mathématique qui prenne en compte la valeur exacte de chaque observation par rapport au centre géométrique des données : la moyenne arithmétique. L’intuition fondamentale consiste à quantifier la déviation ou l’écart de chaque score individuel (Xi) vis-à-vis de la moyenne empirique (X̄), soit l’écart (Xi – X̄).
Cependant, une tentative naïve consistant à faire la moyenne arithmétique de ces déviations individuelles se heurte à une impossibilité mathématique absolue. Par définition même de la moyenne arithmétique comme barycentre d’une série de points, la somme algébrique des écarts à la moyenne est structurellement égale à zéro :
∑ (Xi – X̄) = 0
Les écarts positifs des valeurs supérieures à la moyenne compensent et annulent rigoureusement les écarts négatifs des valeurs inférieures. Pour neutraliser les signes négatifs tout en préservant la magnitude des distances, deux voies mathématiques s’ouvrent : l’emploi de la valeur absolue ou l’élévation au carré. Bien que l’écart absolu moyen semble plus intuitif, l’algèbre classique a historiquement privilégié l’élévation au carré sous l’impulsion de Carl Friedrich Gauss et Ronald Fisher. La fonction carré est partout différentiable et dérivable, ce qui autorise l’optimisation par calcul différentiel indispensable à la méthode des moindres carrés ordinaires.
Sur le plan conceptuel, la variance correspond donc à la moyenne du carré des déviations par rapport à la moyenne arithmétique. Cette transformation géométrique produit une conséquence méthodologique majeure : la variance accorde une pondération implicite beaucoup plus lourde aux grands écarts qu’aux petits écarts. Une déviation de 4 unités génère un terme quadratique de 16, tandis qu’une déviation de 8 unités génère un terme de 64, soit un poids quatre fois supérieur pour un écart seulement deux fois plus grand.
4.2 Distinction cruciale entre variance de population et variance d’échantillon
L’estimation de la variance requiert une distinction rigoureuse entre le paramètre descriptif d’une population exhaustive et l’estimateur calculé à partir d’un échantillon fini prélevé au sein de cette population. Lorsque le statisticien a accès à la totalité d’une population de taille N (par exemple, l’ensemble des scores des élèves d’un établissement spécifique), la variance de population, notée σ² (sigma au carré), se calcule selon la formule classique :
σ² = [ ∑ (Xi – μ)² ] / N
où μ représente la moyenne théorique exacte de la population.
En pratique de recherche, le chercheur ne dispose presque jamais de la population intégrale ; il doit inférer les propriétés de la population à partir d’un échantillon aléatoire de taille n. Si l’on applique naïvement la formule précédente en remplaçant μ par la moyenne échantillonnale X̄ et en divisant par n, l’estimateur obtenu est affecté d’un biais systématique : il sous-estime la véritable variance de la population.
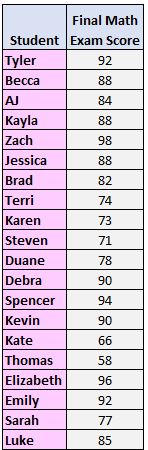
Cette sous-estimation systématique provient du fait que les observations d’un échantillon gravitent mathématiquement plus près de leur propre moyenne arithmétique empirique (X̄) qu’elles ne gravitent autour de la véritable moyenne de la population (μ). La somme des carrés des écarts à la moyenne échantillonnale est minimale par définition. Pour corriger ce biais et obtenir un estimateur non biaisé (asymptotiquement convergent vers le vrai paramètre σ²), le dénominateur n doit être remplacé par les degrés de liberté résiduels, à savoir n – 1. Cette modification essentielle est connue sous le nom de correction de Bessel. La formule de la variance d’échantillon (notée s²) s’écrit formellement :
s² = [ ∑ (Xi – X̄)² ] / (n – 1)
L’impact de la correction de Bessel est d’autant plus prononcé que la taille de l’échantillon est restreinte : sur un effectif de 5 sujets, diviser par 4 au lieu de 5 augmente l’estimation de 25 %. En revanche, lorsque n dépasse plusieurs centaines de sujets, l’écart mathématique entre n et n – 1 devient négligeable, illustrant la convergence asymptotique de l’estimateur.
4.3 Exemple numérique d’application de la formule
Pour ancrer la compréhension de la variance dans la pratique du calcul psychométrique, étudions un échantillon de dix individus (n = 10) ayant complété une échelle d’évaluation de l’extraversion issue d’un inventaire de personnalité (scores théoriques de 0 à 50). Les scores bruts enregistrés sont :
22, 25, 28, 30, 32, 33, 35, 38, 41, 46
La première étape consiste à déterminer la moyenne arithmétique de l’échantillon :
∑ Xi = 22 + 25 + 28 + 30 + 32 + 33 + 35 + 38 + 41 + 46 = 330
X̄ = 330 / 10 = 33,0
La seconde phase implique le calcul systématique des déviations individuelles (Xi – X̄) et de leurs carrés respectifs (Xi – X̄)², récapitulés dans le tableau suivant :
- Sujet 1 : X1 = 22 | Écart = 22 – 33 = -11 | Carré = (-11)² = 121
- Sujet 2 : X2 = 25 | Écart = 25 – 33 = -8 | Carré = (-8)² = 64
- Sujet 3 : X3 = 28 | Écart = 28 – 33 = -5 | Carré = (-5)² = 25
- Sujet 4 : X4 = 30 | Écart = 30 – 33 = -3 | Carré = (-3)² = 9
- Sujet 5 : X5 = 32 | Écart = 32 – 33 = -1 | Carré = (-1)² = 1
- Sujet 6 : X6 = 33 | Écart = 33 – 33 = 0 | Carré = (0)² = 0
- Sujet 7 : X7 = 35 | Écart = 35 – 33 = +2 | Carré = (+2)² = 4
- Sujet 8 : X8 = 38 | Écart = 38 – 33 = +5 | Carré = (+5)² = 25
- Sujet 9 : X9 = 41 | Écart = 41 – 33 = +8 | Carré = (+8)² = 64
- Sujet 10 : X10 = 46 | Écart = 46 – 33 = +13 | Carré = (+13)² = 169
La somme des écarts non élevés au carré donne bien : -11 – 8 – 5 – 3 – 1 + 0 + 2 + 5 + 8 + 13 = 0, vérifiant la propriété barycentrique de la moyenne.
La somme des carrés des écarts (notée fréquemment SS pour Sum of Squares) est égale à :
SS = 121 + 64 + 25 + 9 + 1 + 0 + 4 + 25 + 64 + 169 = 482
Puisqu’il s’agit d’un échantillon dont nous voulons inférer la dispersion populationnelle, nous appliquons la division par n – 1 (degrés de liberté = 10 – 1 = 9) :
s² = 482 / 9 ≈ 53,56 points²
Cette démarche illustre la contrainte dimensionnelle inhérente à la variance : le résultat obtenu s’exprime en « points au carré », une unité abstraite dépourvue de sens clinique direct. Comment un psychologue peut-il interpréter une variabilité d’extraversion exprimée en unités quadratiques ? C’est précisément cette limitation d’intelligibilité pratique qui a conduit à l’adoption universelle de l’écart-type.
5. L’écart-type : L’étalon de référence de la variabilité
5.1 Définition formelle et retour à l’unité originale
L’écart-type (ou déviation standard, d’après l’anglais standard deviation) a été formalisé par Karl Pearson en 1893 afin de pallier l’inconvénient dimensionnel de la variance. Par définition, l’écart-type est la racine carrée positive de la variance. En appliquant cet opérateur à la variance, l’exposant quadratique est annulé, ce qui permet de ramener l’indicateur de dispersion exactement dans l’unité de mesure initiale de la variable étudiée :
s = √s² = √[ ∑ (Xi – X̄)² / (n – 1) ]
Pour la population globale, la déviation standard se note σ et équivaut à la racine carrée de σ². En reprenant l’exemple précédent de l’échelle d’extraversion dont la variance échantillonnale était s² = 53,56, l’écart-type s’établit à :
s = √53,56 ≈ 7,32 points
Désormais, la métrique retrouve toute sa clarté clinique : les scores d’extraversion de notre groupe d’individus dévient en moyenne de 7,32 points autour de la moyenne centrale de 33,0 points. Cette correspondance d’échelle fait de l’écart-type l’étalon par excellence de la variabilité en psychométrie et en biostatistique.
Sur le plan algébrique, l’écart-type jouit de propriétés remarquables lors de transformations affines de la forme Y = aX + b. Si une constante b est additionnée à l’ensemble des scores (décalage horizontal de la distribution), l’écart-type demeure strictement invariant : sY = sX. En revanche, si les scores sont multipliés par un facteur d’échelle a, l’écart-type est multiplié par la valeur absolue de ce facteur : sY = |a| × sX. Cette propriété est au cœur de tous les algorithmes d’étalonnage et de conversion d’échelles de tests cognitifs.
5.2 L’écart-type dans le cadre de la distribution normale
La puissance d’interprétation de l’écart-type se déploie pleinement lorsque la distribution des données se conforme au modèle théorique de la loi normale (ou courbe en cloche de Gauss-Laplace). Dans une distribution gaussienne symétrique et univariée, les paramètres de tendance centrale (moyenne, médiane, mode) sont rigoureusement confondus, et l’écart-type détermine précisément l’inflexion de la courbe ainsi que la répartition probabiliste des scores.
Cette propriété est universellement résumée par la règle empirique 68-95-99,7 :
- Environ 68,27 % des observations se situent dans l’intervalle délimité par la moyenne empirique plus ou moins un écart-type : [X̄ – 1s ; X̄ + 1s].
- Environ 95,45 % des observations sont circonscrites dans l’intervalle défini par la moyenne plus ou moins deux écarts-types : [X̄ – 2s ; X̄ + 2s].
- Environ 99,73 % des observations, c’est-à-dire la quasi-totalité de l’échantillon, sont contenues dans l’intervalle défini par trois écarts-types de part et d’autre de la moyenne : [X̄ – 3s ; X̄ + 3s].
Cette structuration probabiliste offre une assise fondamentale pour la normalisation des instruments psychométriques. L’exemple le plus emblématique réside dans les échelles de Quotient Intellectuel (QI) élaborées par David Wechsler. Par convention mathématique, les scores bruts sont standardisés pour adopter une distribution théorique d’allure normale caractérisée par une moyenne fixée arbitrairement à μ = 100 et un écart-type standardisé fixé à σ = 15.
Dès lors, l’écart-type permet d’assigner immédiatement une rareté probabiliste et une signification clinique à tout résultat obtenu :
- La zone de normalité moyenne s’étend de 85 à 115 (μ ± 1σ), regroupant environ deux tiers de la population générale (68,3 %).
- Un score de 130 se positionne à exactement +2 écarts-types au-dessus de la moyenne. Dans le cadre de la loi normale, la probabilité d’obtenir un score égal ou supérieur à 130 n’est que d’environ 2,27 %, définissant le seuil psychométrique usuel du haut potentiel intellectuel.
- Symétriquement, un score de 70 correspond à -2 écarts-types en dessous de la moyenne. N’intéressant également que 2,27 % des individus, ce seuil sert de repère nosographique pour suspecter une déficience intellectuelle ou un trouble développemental majeur.
5.3 Utilisation de l’écart-type pour la standardisation des scores
L’écart-type ne sert pas uniquement à décrire la largeur d’une distribution ; il constitue l’opérateur arithmétique permettant la transformation des scores bruts en scores standardisés (scores z). Le calcul du score z s’effectue par centrage (soustraction de la moyenne) et réduction (division par l’écart-type) :
z = (X – X̄) / s
Le score z exprime la distance qui sépare un score brut particulier de la moyenne de son groupe de référence, non plus en points d’échelle arbitraires, mais en unités d’écart-type. Un score z de +1,5 indique sans ambiguïté que le participant performe à un écart-type et demi au-dessus de la moyenne de sa cohorte d’âge.
Cette standardisation résout une problématique clinique majeure : l’hétérogénéité des métriques employées dans les batteries neuropsychologiques. Comment comparer les performances d’un patient ayant obtenu 42 points à une épreuve de fluidité verbale (notée sur 60) et 18 points à une épreuve de rétention visuo-spatiale (notée sur 25) ? En convertissant les deux notes brutes en scores z grâce aux moyennes et écarts-types de leurs étalonnages respectifs, le praticien harmonise les mesures sur un dénominateur commun universel.
À partir du score z linéaire, il devient aisé de translater les résultats vers d’autres échelles psychométriques canoniques afin d’éviter la manipulation de valeurs négatives ou décimales :
- L’échelle T (utilisée notamment dans le MMPI) : T = 50 + 10z (moyenne = 50, écart-type = 10).
- L’échelle des notes standardisées (sous-tests de la WAIS/WISC) : Note = 10 + 3z (moyenne = 10, écart-type = 3).
- Les stanines (standard nines) : distribution discrète en neuf classes où la moyenne est fixée à 5 et l’écart-type à 2.
Grâce à cette polyvalence, l’écart-type permet d’établir des profils neurocognitifs multi-échelles rigoureux, autorisant la détection de dissociations cliniques subtiles au sein des fonctions exécutives, mnésiques ou instrumentales d’un même individu.
6. Le coefficient de variation : Mesure relative pour comparaisons inter-groupes
6.1 Fondement théorique du coefficient de variation
Les indicateurs examinés jusqu’à présent (étendue, IQR, variance, écart-type) constituent des mesures absolues de dispersion. Bien qu’essentielles, ces mesures présentent une limite méthodologique intrinsèque : elles sont subordonnées à la dimension physique ou psychométrique de l’outil employé et sont étroitement tributaires de la magnitude des valeurs centrales. Il est dénué de sens de comparer directement l’écart-type d’un temps de réaction mesuré en millisecondes (ex. s = 45 ms) à l’écart-type d’un score d’anxiété mesuré sur une échelle ordinale de 1 à 10 (ex. s = 1,8 point).
Pour dépasser cet écueil, le coefficient de variation (noté CV), formulé originellement par Karl Pearson, définit une mesure relative de dispersion. Il s’exprime comme le rapport de l’écart-type à la moyenne arithmétique, et s’écrit formellement :
CV = s / X̄ (souvent exprimé en pourcentage : CV = [s / X̄] × 100)
En divisant l’écart-type par la moyenne, le coefficient de variation élimine l’effet d’échelle. L’unité de mesure du numérateur s’annulant avec celle du dénominateur, le CV devient un indice totalement adimensionnel. Il quantifie l’ampleur de la dispersion relative par rapport à la masse totale représentée par la moyenne.
L’utilisation du coefficient de variation impose toutefois une condition préalable impérative : la variable analysée doit être mesurée sur une échelle de rapport (ou échelle à zéro absolu), où le zéro correspond à une absence totale de la dimension physique mesurée (comme le temps de réaction, le poids, la conductance cutanée ou la fréquence cardiaque). Sur une échelle d’intervalle pure dépourvue de zéro absolu (telle que la température en degrés Celsius ou un score de QI), la position du zéro est arbitraire ; décaler l’origine de l’échelle modifie arbitrairement la valeur de la moyenne sans altérer l’écart-type, ce qui fausse intégralement la valeur du CV. De surcroît, le CV devient instable et mathématiquement inopérant lorsque la moyenne s’approche de zéro, le quotient tendant alors vers l’infini.
6.2 Cas d’usage comparatif en recherche comportementale
Le coefficient de variation s’avère indispensable dès lors que le chercheur cherche à évaluer la stabilité ou la consistance comportementale entre des conditions expérimentales opérant à des échelles temporelles contrastées. Prenons l’exemple d’une recherche en psychologie du développement comparant la précision motrice d’un groupe d’enfants de 6 ans à celle d’un groupe d’adultes de 25 ans lors d’une tâche de tapotement rythmique (tapping task).
Supposons que les données empiriques recueillies indiquent les paramètres suivants :
- Groupe des enfants : Temps de réponse moyen = 800 ms ; Écart-type = 120 ms
- Groupe des adultes : Temps de réponse moyen = 250 ms ; Écart-type = 50 ms
Une lecture superficielle fondée sur l’écart-type absolu pourrait conduire à affirmer que les adultes sont nettement plus homogènes que les enfants, leur écart-type (50 ms) étant moins de la moitié de celui des enfants (120 ms). Or, les adultes exécutent la tâche beaucoup plus rapidement, ce qui réduit naturellement l’espace absolu de déviation temporelle. Le calcul des coefficients de variation respectifs modifie radicalement cette lecture clinique :
CVenfants = 120 / 800 = 0,15 = 15 %
CVadultes = 50 / 250 = 0,20 = 20 %
Ramenée à la vitesse moyenne d’exécution de chaque population, la variabilité relative des adultes (20 %) s’avère en réalité supérieure à celle des enfants (15 %). Les enfants démontrent une stabilité motrice proportionnellement plus grande que ce que leur écart-type brut laissait supposer. Cet exemple démontre comment le coefficient de variation prémunit le chercheur contre les biais d’interprétation induits par de grands écarts de moyennes entre groupes expérimentaux.
7. L’écart absolu médian et autres indicateurs robustes alternatifs
7.1 L’écart absolu médian (MAD) : Définition et méthode
Lorsque les distributions empiriques s’écartent délibérément de la symétrie gaussienne ou comportent une proportion non négligeable de valeurs contaminantes, ni l’écart-type (trop instable) ni l’IQR (parfois trop restrictif pour certaines inférences) ne constituent l’optimum méthodologique. La statistique robuste moderne préconise alors l’emploi de l’écart absolu médian, universellement désigné par son acronyme anglophone MAD (pour Median Absolute Deviation).
Le MAD se définit conceptuellement comme la médiane des déviations absolues par rapport à la médiane de la distribution. Son protocole analytique se formalise de la façon suivante :
MAD = Médiane( |Xi – Médiane(X)| )
L’immense supériorité méthodologique du MAD repose sur son point de rupture (breakdown point). Le point de rupture quantifie la proportion minimale d’observations aberrantes ou arbitrairement erronées qu’un échantillon peut accueillir avant que l’estimateur de dispersion ne produise une valeur infiniment fausse. L’écart-type possède un point de rupture de 0 % : une seule observation aberrante poussée à l’infini suffit à faire diverger l’écart-type vers l’infini. En revanche, le MAD affiche un point de rupture exceptionnel de 50 %, ce qui signifie que la moitié exacte des données peut être lourdement corrompue sans que l’estimation de la dispersion médiane ne s’effondre.
Pour faire le lien entre le MAD et l’écart-type dans l’estimation paramétrique, les statisticiens appliquent un facteur multiplicatif de cohérence. Pour une distribution parfaitement normale, le MAD théorique équivaut à environ 0,6745 fois l’écart-type σ. Ainsi, pour obtenir un estimateur robuste sans biais de l’écart-type gaussien (souvent noté NMAD ou MAD standardisé), on multiplie le MAD par 1,4826 :
srobuste = 1,4826 × MAD
Prenons un échantillon de sept temps de décision (en secondes) présentant une distribution asymétrique : 2,1 ; 2,3 ; 2,5 ; 2,8 ; 3,2 ; 4,1 ; 14,8 (où 14,8 reflète un blocage moteur atypique). La médiane globale de la série (4e observation) est égale à 2,8 s. Les déviations absolues par rapport à cette médiane sont :
- |2,1 – 2,8| = 0,7
- |2,3 – 2,8| = 0,5
- |2,5 – 2,8| = 0,3
- |2,8 – 2,8| = 0,0
- |3,2 – 2,8| = 0,4
- |4,1 – 2,8| = 1,3
- |14,8 – 2,8| = 12,0
Ordonnons la série de ces déviations absolues : 0,0 ; 0,3 ; 0,4 ; 0,5 ; 0,7 ; 1,3 ; 12,0. La médiane de ces déviations (la 4e valeur) s’élève à 0,5 s. Ainsi, MAD = 0,5 s. L’estimation robuste de l’écart-type est de 1,4826 × 0,5 = 0,7413 s. En comparaison, le calcul de l’écart-type ordinaire sur ces mêmes données produit un résultat faussé de s = 4,45 s en raison de l’observation 14,8. Le MAD isole parfaitement le comportement central sans se laisser influencer par l’anomalie périphérique.
7.2 Variantes tronquées et estimateurs quasi-non-paramétriques
Au-delà du MAD, les approches contemporaines de la robustesse statistique mettent à disposition des chercheurs d’autres estimateurs de dispersion dérivés de la théorie du filtrage. Parmi ces alternatives figurent la variance tronquée (trimmed variance) et l’écart-type winsorisé. Le principe du rognage (trimming) consiste à retirer un pourcentage prédéterminé des observations aux deux extrémités de la distribution (souvent 10 % ou 20 % de part et d’autre) avant de calculer la variance sur le sous-échantillon restant. La winsorisation opère d’une manière légèrement différente : au lieu de supprimer les scores extrêmes, elle les remplace par la valeur de l’observation non rejetée la plus proche, préservant ainsi la taille effective de l’échantillon tout en neutralisant l’impact des queues de distribution épaisses.
Dans les contextes de neurosciences cognitives et de modélisation comportementale de pointe, les estimateurs Sn et Qn, introduits par Peter Rousseeuw et Christophe Croux en 1993, connaissent un essor continu. Ces estimateurs ont été conçus pour surmonter les deux faiblesses inhérentes au MAD : son asymétrie implicite (le MAD suppose que la distribution est symétrique autour de la médiane) et son efficacité statistique relativement médiocre sous condition de normalité stricte (seulement 37 % d’efficacité comparée à l’écart-type gaussien standard).
L’estimateur Sn calcule la médiane de l’ensemble des médianes des différences absolues entre chaque paire d’observations, tandis que l’estimateur Qn s’appuie sur le premier quartile des distances entre toutes les paires possibles de points dans le jeu de données. Ces estimateurs atteignent simultanément un point de rupture élevé de 50 % et une excellente efficacité statistique (dépassant 82 % pour Qn). Ils sont désormais directement intégrés dans les progiciels statistiques modernes (tels que le package robustbase sous R ou les modules robustes de Python) et s’imposent progressivement comme le gold standard dans le traitement des séries chronologiques en électroencéphalographie et en imagerie cérébrale fonctionnelle.
8. Comparaison méthodologique approfondie des mesures de dispersion
8.1 Synthèse comparative des indicateurs d’étalement
L’intégration des différents indicateurs de variabilité exige une compréhension globale de leurs propriétés mathématiques, de leurs exigences métriques et de leurs domaines d’élection. Le tableau analytique suivant dresse une cartographie comparative rigoureuse des cinq principales mesures de dispersion mobilisées en psychométrie et statistique appliquée :
- Étendue : Niveau d’échelle minimal : Ordinal | Point de rupture : 0 % | Sensibilité aux outliers : Maximale | Efficacité sous normalité : Très faible | Usage recommandé : Contrôle rapide de validité des données, description sommaire.
- Écart interquartile (IQR) : Niveau d’échelle minimal : Ordinal | Point de rupture : 25 % | Sensibilité aux outliers : Nulle (insensible) | Efficacité sous normalité : Moyenne | Usage recommandé : Distributions asymétriques, données ordinales, détection formelle des scores aberrants (Tukey).
- Variance (s²) : Niveau d’échelle minimal : Intervalle | Point de rupture : 0 % | Sensibilité aux outliers : Extrême (quadratique) | Efficacité sous normalité : Maximale (100 %) | Usage recommandé : Décompositions mathématiques, ANOVA, régressions, modélisations structurelles.
- Écart-type (s) : Niveau d’échelle minimal : Intervalle | Point de rupture : 0 % | Sensibilité aux outliers : Très élevée | Efficacité sous normalité : Maximale | Usage recommandé : Description clinique de référence, standardisation (scores z), distributions symétriques/normales.
- Écart absolu médian (MAD) : Niveau d’échelle minimal : Intervalle | Point de rupture : 50 % | Sensibilité aux outliers : Nulle (très robuste) | Efficacité sous normalité : Faible (37 %) sauf si ajusté | Usage recommandé : Données hautement contaminées, distributions asymétriques, biomarqueurs bruités.
Ce tableau met en exergue le compromis perpétuel auquel est confronté l’analyste : l’écart-type et la variance possèdent une efficacité statistique optimale sous hypothèse de normalité gaussienne (ils exploitent l’intégralité de l’information contenue dans les scores avec une variance d’échantillonnage minimale), mais ils payent cette puissance au prix d’une vulnérabilité totale aux contaminations. Inversement, les indices robustes comme le MAD et l’IQR sacrifient une part de finesse analytique sur les distributions pures pour garantir une stabilité à toute épreuve face aux perturbations empiriques du monde réel.
8.2 Arbre de décision méthodologique pour le chercheur
Face à un jeu de données empiriques nouvellement collecté, le chercheur ou le psychologue clinicien doit adopter une démarche décisionnelle standardisée pour déterminer l’indicateur de dispersion le plus adéquat. Cette démarche s’articule en quatre étapes systématiques :
Étape 1 : Détermination du niveau de mesure de la variable. Si la variable est de nature ordinale pure (par exemple, un stade de développement de Piaget ou un item isolé d’évaluation clinique gradué sans garantie d’intervalles égaux), les calculs de moyenne et d’écart-type sont proscrits sur le plan fondamental. L’écart interquartile et l’étendue sont alors les seuls indices méthodologiquement valides. Si la variable est mesurée sur une échelle d’intervalle ou de rapport continue, l’analyse peut s’orienter vers les indicateurs quantitatifs.
Étape 2 : Exploration de la morphologie distributionnelle. L’analyste procède à une inspection visuelle conjointe (histogrammes, diagrammes quantile-quantile dits Q-Q plots) et statistique (coefficients d’asymétrie de Pearson, tests de normalité de Shapiro-Wilk ou de D’Agostino-Pearson). Si la distribution présente une symétrie satisfaisante (|asymétrie| < 1) sans queues excessivement lourdes, l’écart-type (s) s’impose comme le paramètre de choix pour accompagner la moyenne arithmétique.
Étape 3 : Traitement de la contamination et des valeurs atypiques. En présence de valeurs aberrantes confirmées, résultant de processus comportementaux distincts ou d’erreurs d’échantillonnage non corrigeables, deux options s’ouvrent. Si les outliers reflètent de réelles variations cliniques qu’il importe de préserver sans déformer le modèle d’ensemble, le couple médiane / écart interquartile (ou médiane / MAD standardisé) doit être substitué au couple moyenne / écart-type. Si la démarche s’inscrit dans un modèle de prédiction paramétrique, l’analyste peut recourir à des variances tronquées ou winsorisées.
Étape 4 : Prise en compte de la finalité et des exigences éditoriales. Lorsque l’objectif est d’effectuer des comparaisons inter-groupes sur des grandeurs de différentes échelles physiques, le coefficient de variation s’avère indispensable sous réserve d’opérer sur une échelle de rapport. Enfin, les directives de publication académique (telles que les préconisations du manuel de publication de l’APA) requièrent l’alignement formel de la tendance centrale et de la dispersion : une moyenne doit impérativement être accompagnée de son écart-type, et une médiane de son écart interquartile.
9. Visualisation graphique de la dispersion des données psychométriques
9.1 La boîte à moustaches (Boxplot) comme représentation canonique
L’exploration visuelle de la variabilité s’incarne de manière privilégiée dans le diagramme en boîte, ou boîte à moustaches (boxplot), conceptualisé par John Tukey en 1977. Ce dispositif graphique synthétise en une seule figure compacte l’ensemble des propriétés de position et de dispersion d’une distribution à travers le résumé à cinq nombres : la valeur minimale non atypique, le premier quartile (Q1), la médiane (Q2), le troisième quartile (Q3) et la valeur maximale non atypique.
L’architecture géométrique du boxplot place au centre une boîte rectangulaire dont la base inférieure matérialise le premier quartile Q1 et la base supérieure le troisième quartile Q3. La hauteur de la boîte représente donc graphiquement la grandeur exacte de l’écart interquartile (IQR). Une ligne transversale rigoureuse coupe l’intérieur du rectangle pour désigner la médiane. L’observation conjointe de la hauteur de la boîte et de la position de la médiane informe instantanément sur la dispersion centrale des scores et sur le degré d’asymétrie locale (une médiane décentrée vers le bas signalant une asymétrie positive).
De part et d’autre de cette boîte centrale émergent des segments verticaux appelés moustaches (whiskers). Dans la configuration standard de Tukey, la moustache inférieure descend jusqu’à la plus petite valeur observée comprise dans la limite de Q1 – 1,5 × IQR, tandis que la moustache supérieure s’étend jusqu’à la plus grande valeur observée n’excédant pas Q3 + 1,5 × IQR. Les données qui s’écartent au-delà de ces frontières sont projetées individuellement sous la forme de points ou d’astérisques isolés, permettant d’identifier immédiatement la nature et la multiplicité des outliers. L’alignement de boxplots parallèles constitue la méthode la plus élégante et performante pour apprécier d’un coup d’œil l’équivalence ou la dissemblance des dispersions entre différents sous-groupes cliniques.
9.2 Graphiques de densité, violons et bandes d’erreur
Bien que le boxplot soit d’une rigueur absolue, il présente une limite notable : il ne renseigne pas sur l’existence d’une multimodalité interne (par exemple, la présence de deux bosses distinctes dans la distribution). Pour surmonter cette restriction, la visualisation contemporaine des données en psychologie utilise couramment les diagrammes en violon (violin plots). Le violin plot combine les vertus de la boîte à moustaches et l’estimation de densité par noyau (kernel density estimation). La largeur de la silhouette du violon varie continûment le long de l’axe vertical en fonction de la concentration locale des scores, révélant avec une précision visuelle inégalée la forme exacte de l’étalement et l’émergence de sous-populations cachées.
Dans la communication scientifique traditionnelle, la représentation de la dispersion recourt fréquemment aux barres d’erreur apposées sur les diagrammes en bâtons ou les graphiques linéaires de moyennes. Cette pratique, bien qu’omniprésente, est source d’innombrables méprises méthodologiques. Il règne une confusion dramatique dans les revues empiriques entre la représentation de la dispersion des données (matérialisée par l’écart-type s) et la représentation de la précision de l’estimation de la moyenne (matérialisée par l’erreur type de la moyenne, notée SEM pour Standard Error of the Mean).
L’écart-type s illustre la variabilité intrinsèque des sujets au sein de l’échantillon, et sa taille ne rétrécit pas artificiellement lorsque l’échantillon augmente. En revanche, l’erreur type (SEM = s / √n) est un indice inférentiel qui mesure la fluctuation d’échantillonnage de la moyenne arithmétique ; plus la taille de l’échantillon n augmente, plus la SEM tend vers zéro. Présenter des barres d’erreur basées sur la SEM pour illustrer la « dispersion » d’un groupe constitue un artifice graphique trompeur qui donne l’illusion visuelle d’une dispersion presque inexistante alors même que la variabilité réelle des sujets demeure substantielle. Les chartes graphiques de la science ouverte exigent désormais que la nature de l’indicateur graphique (s, IQR, SEM ou intervalle de confiance à 95 %) soit explicitement formulée dans la légende de chaque figure.
10. Rôle fondamental de la dispersion dans l’inférence statistique
10.1 Impact direct de la variance sur la puissance statistique
La dispersion ne constitue pas une simple curiosité descriptive ; elle représente le dénominateur de quasiment l’ensemble des équations régissant l’inférence statistique classique. Dans les tests de comparaison d’hypothèses, tels que le test t de Student pour échantillons indépendants ou l’analyse de variance (ANOVA), la statistique de test consiste invariablement à rapporter la variabilité expliquée par le modèle expérimental à la variabilité non expliquée (ou variance résiduelle intra-groupe) :
Statistique de test (t ou F) = Effet du traitement / Variance d’erreur
Cette structure algébrique engendre une conséquence directe : plus la variance intra-groupe est large, plus le dénominateur croît, ce qui comprime la statistique de test et réduit drastiquement la significativité statistique (la p-valeur s’élève). En d’autres termes, une dispersion résiduelle excessive au sein des groupes expérimentaux dilue l’effet des interventions psychologiques ou thérapeutiques, augmentant exponentiellement le risque d’erreur de type II (β), c’est-à-dire l’incapacité à détecter un effet pourtant cliniquement réel.
La maîtrise de la variance constitue donc le levier opérationnel majeur pour maximiser la puissance statistique d’une recherche. Pour compenser une forte dispersion sans modifier le protocole, le chercheur n’a d’autre choix que d’augmenter massivement la taille de son échantillon, ce qui implique des coûts financiers et logistiques considérables. Une stratégie méthodologiquement supérieure consiste à standardiser minutieusement les procédures de passation, à utiliser des instruments psychométriques démontrant une fidélité de consistance interne exemplaire (coefficients alpha de Cronbach ou oméga de McDonald supérieurs à 0,85) et à contrôler les variables parasites au moyen d’analyses de covariance (ANCOVA), afin de purger la variance résiduelle de ses composantes bruitées.
10.2 L’homogénéité des variances comme postulats d’analyse
L’immense majorité des modèles statistiques paramétriques linéaires repose sur un postulat théorique indispensable : l’hypothèse d’homoscédasticité, ou homogénéité des variances. Ce postulat exige que la variance de la variable dépendante demeure rigoureusement équivalente à travers l’ensemble des niveaux du facteur interindividuel étudié :
σ1² = σ2² = … = σk²
Dans la démarche expérimentale, cette égalité des variances doit être préalablement vérifiée au moyen de tests formels. Les plus couramment implémentés sont le test de Bartlett, le test de Levene et le test de Brown-Forsythe. Le test de Bartlett se montre optimal sous réserve d’une normalité parfaite, mais s’avère particulièrement hypersensible aux légers écarts à la loi normale. Le test de Levene, qui évalue l’égalité des variances en appliquant une ANOVA sur les déviations absolues par rapport à la moyenne, offre une robustesse bien plus satisfaisante. Le test de Brown-Forsythe constitue une variante encore supérieure pour les données comportementales bruitées, car il substitue la déviation par rapport à la médiane à la déviation par rapport à la moyenne.
La violation de cette hypothèse d’homogénéité (hétéroscédasticité) a des répercussions désastreuses sur la validité des conclusions scientifiques, tout particulièrement lorsque les tailles d’échantillons des groupes comparés sont inégales. Si le groupe présentant le plus petit effectif possède la variance la plus forte, le test t standard ou l’ANOVA classique devient excessivement libéral : le taux effectif d’erreur de type I (faux positifs) peut s’envoler à 15 % ou 20 % au lieu du seuil nominal de 5 % (α = 0,05). À l’inverse, si le groupe de plus grand effectif affiche la plus grande dispersion, le test devient hyper-conservateur, laminant la puissance statistique. Face à une telle hétérogénéité des variances, l’analyste doit impérativement renoncer aux formules standard pour adopter des corrections robustes, telles que le test t de Welch (qui ajuste les degrés de liberté résiduels) ou l’ANOVA de Welch.
10.3 Dispersion et tailles d’effet standardisées
L’analyse moderne des données psychologiques ne s’arrête plus à la simple décision binaire dictée par les p-valeurs ; elle place l’estimation des tailles d’effet au centre de l’interprétation empirique. L’indicateur le plus célèbre pour quantifier l’écart entre deux groupes est le d de Cohen. Sur le plan mathématique, le d de Cohen se définit comme la différence brute entre les moyennes arithmétiques des deux groupes divisée par l’écart-type combiné ou commun (pooled standard deviation, noté sp) :
d = (X̄1 – X̄2) / sp
où sp = √[ ((n1 – 1)s1² + (n2 – 1)s2²) / (n1 + n2 – 2) ]
Cette formulation mathématique met en lumière le rôle déterminant de la dispersion dans la valorisation de la taille d’effet : la métrique finale du d de Cohen dépend tout autant de la stabilité de la variabilité résiduelle que de l’amplitude du gain brut observé. Deux études évaluant la même thérapie cognitive peuvent constater un différentiel d’amélioration rigoureusement identique de 10 points sur une échelle d’évaluation de l’humeur. Toutefois, si la première étude est affectée par une forte hétérogénéité des participants générant un écart-type combiné de 20 points, le d de Cohen sera de 10 / 20 = 0,50 (effet modéré). Si la seconde étude parvient à contrôler la variance parasite pour atteindre un écart-type combiné de 10 points, le d de Cohen s’élèvera à 10 / 10 = 1,00 (effet extrêmement puissant).
Il importe également de souligner l’impact du phénomène de restriction d’étendue (range restriction) sur les estimations corrélationnelles et les tailles d’effet. Lorsque l’investigateur étudie un échantillon dont la dispersion a été artificiellement tronquée — par exemple en évaluant la relation entre le raisonnement abstrait et la réussite académique uniquement auprès d’étudiants polytechniciens sélectionnés pour leur très haut niveau cognitif —, la variance de la variable prédictive est drastiquement réduite. Cette contraction artificielle de la dispersion engendre une atténuation systématique des coefficients de corrélation de Pearson, faisant apparaître la relation comme faible ou insignifiante alors qu’elle est vigoureuse au sein de la population générale.
11. Études de cas appliquées en psychologie clinique et cognitive
11.1 Cas pratique 1 : Variabilité intra-individuelle dans le TDAH
Pour illustrer la portée diagnostique des mesures de dispersion, examinons une application concrète issue de la neuropsychologie du développement : l’évaluation du Trouble du Déficit de l’Attention avec ou sans Hyperactivité (TDAH). La littérature scientifique a abondamment démontré que le déficit d’inhibition et de régulation attentionnelle typique du TDAH ne se traduit pas nécessairement par un ralentissement systématique des temps de réaction, mais par une instabilité temporelle chronique se manifestant par une dispersion intra-individuelle anormalement élevée au cours des tâches attentionnelles soutenues.
Dans le cadre d’un protocole expérimental mené sur une tâche de performance continue (CPT de type Conners), 100 essais chronométrés consécutifs ont été enregistrés chez deux adolescents âgés de 14 ans : Julien (patient diagnostiqué avec un TDAH de forme combinée) et Thomas (sujet contrôle sans antécédent particulier). Considérons les paramètres statistiques descriptifs extraits des 100 temps de réaction (exprimés en millisecondes) de chaque participant :
- Julien (TDAH) :
- Moyenne arithmétique : 412 ms
- Médiane : 368 ms
- Étendue brute : 840 ms (Min = 290 ms, Max = 1130 ms)
- Écart-type intra-individuel (ISD) : 138 ms
- Écart interquartile (IQR) : 115 ms
- Thomas (Contrôle) :
- Moyenne arithmétique : 398 ms
- Médiane : 395 ms
- Étendue brute : 260 ms (Min = 280 ms, Max = 540 ms)
- Écart-type intra-individuel (ISD) : 42 ms
- Écart interquartile (IQR) : 48 ms
L’analyse des mesures de tendance centrale est frappante de non-significativité : la moyenne de Julien (412 ms) n’est séparée de celle de Thomas (398 ms) que par un écart marginal de 14 millisecondes, totalement insuffisant pour fonder une discrimination clinique objective. Si le clinicien s’était borné à comparer les moyennes, le trouble de Julien serait resté totalement invisible.
En revanche, le recours aux mesures de dispersion fait éclater la spécificité clinique :
- L’écart-type intra-individuel de Julien (138 ms) est plus de trois fois supérieur à celui de Thomas (42 ms).
- L’écart interquartile confirme que les 50 % centraux des performances de Julien s’étalent sur 115 ms contre seulement 48 ms chez le témoin.
- L’étendue spectaculaire de Julien (840 ms) combinée à la divergence entre sa médiane (368 ms) et sa moyenne (412 ms) révèle l’existence de décrochages attentionnels massifs (attentional lapses) générant une queue de distribution extrêmement lourde vers les temps longs.
Ce cas clinique illustre comment l’écart-type intra-individuel s’érige en véritable biomarqueur cognitif. La dispersion cesse ici d’être un paramètre d’erreur gênant pour devenir l’objet même du diagnostic neuropsychologique.
11.2 Cas pratique 2 : Dispersion des scores d’efficacité thérapeutique
Considérons à présent une étude randomisée contrôlée en psychologie clinique évaluant l’efficacité de deux protocoles d’intervention pour la prise en charge des épisodes dépressifs caractérisés chez l’adulte. Quarante patients sont assignés aléatoirement à deux groupes de traitement (n = 20 par bras) : le Groupe A bénéficie d’une Thérapie Cognitive et Comportementale (TCC) protocolisée classique, tandis que le Groupe B reçoit une thérapie novatrice basée sur la pleine conscience et la remédiation émotionnelle. L’efficacité est évaluée par le score d’amélioration nette à l’inventaire de dépression de Beck (BDI-II) calculé entre le pré-test et le post-test (un score positif élevé indiquant une réduction majeure de la sévérité dépressive).
À l’issue des 12 semaines d’intervention, l’analyse descriptive initiale délivre un constat d’équivalence absolue au niveau de la tendance centrale :
- Groupe A (TCC standard) : Moyenne d’amélioration = 14,2 points
- Groupe B (Pleine conscience) : Moyenne d’amélioration = 14,1 points
Sur la foi de ces seules moyennes, les investigateurs pourraient hâtivement conclure que les deux thérapies produisent une efficacité strictement superposable dans la population cible. Pourtant, l’évaluation systématique des indicateurs de variabilité renverse totalement cette lecture simpliste :
- Groupe A (TCC standard) :
- Écart-type : s = 3,1 points
- Écart interquartile : IQR = 4,0 points
- Étendue : Min = 9, Max = 20 (Étendue = 11)
- Groupe B (Pleine conscience) :
- Écart-type : s = 8,9 points
- Écart interquartile : IQR = 12,5 points
- Étendue : Min = -2, Max = 29 (Étendue = 31)
La dispersion des scores au sein du Groupe B est presque le triple de celle observée dans le Groupe A. Que signifie cliniquement cette démesure de variabilité ? Dans le Groupe A, la faible dispersion (s = 3,1) indique que le traitement procure un bénéfice prévisible, stable et modéré pour la quasi-totalité des participants. Dans le Groupe B, la gigantesque dispersion (s = 8,9 ; IQR = 12,5) masque une profonde polarisation de l’effet thérapeutique : certains patients ont vu leur dépression s’aggraver (score négatif de -2), tandis que d’autres ont bénéficié d’une rémission quasi-miraculeuse avec des gains approchant 29 points.
Cette divergence majeure de dispersion interdit moralement et scientifiquement d’affirmer que les deux thérapies sont équivalentes. Elle impose immédiatement aux chercheurs la mise en œuvre d’analyses de modération pour découvrir les variables individuelles (traits de personnalité, niveau d’anxiété comorbide, antécédents traumatiques) qui conditionnent cette dichotomie fonctionnelle entre hyper-répondeurs et non-répondeurs. Sans analyse de dispersion, cette découverte thérapeutique fondamentale aurait été entièrement gommée par la moyenne arithmétique.
12. Recommandations APA pour le rapportage et l’interprétation des données
12.1 Normes formelles de l’American Psychological Association
L’intégrité de la communication scientifique en psychologie et sciences du comportement est encadrée par les directives typographiques et méthodologiques formalisées dans la 7e édition du manuel de publication de l’American Psychological Association (APA). Ces normes prescrivent des règles très strictes concernant le couplage impératif des statistiques de tendance centrale et de variabilité.
La règle cardinale stipule qu’aucune mesure de tendance centrale ne doit être rapportée de façon isolée dans le corps du texte ou dans les tableaux descriptifs. Toute mention d’une moyenne arithmétique doit obligatoirement être associée à son écart-type d’échantillon, et toute mention d’une médiane doit obligatoirement être accompagnée de son écart interquartile ou de l’intervalle interquartile explicite. Les abréviations formelles reconnues par le manuel APA sont :
- M (en italique majuscule) pour désigner la moyenne empirique (Mean).
- SD (en italique majuscule) pour désigner l’écart-type empirique (Standard Deviation).
- Mdn (en italique) pour désigner la médiane (Median).
- IQR (en italique majuscule) pour l’écart interquartile (Interquartile Range).
La formulation standard au sein d’un paragraphe de résultats doit adopter une syntaxe canonique utilisant les parenthèses :
« Les participants du groupe expérimental ont obtenu un score moyen de mémorisation significativement supérieur (M = 24,35, SD = 4,12) à celui des participants du groupe témoin (M = 18,10, SD = 5,68)… »
Pour les distributions asymétriques où la médiane est rapportée, l’APA préconise d’indiquer les bornes réelles des quartiles en sus de l’IQR :
« La latence de réponse médiane était de 450 ms (IQR = 85 ms, Q1 = 410 ms, Q3 = 495 ms)… »
Dans la construction des tableaux statistiques conformes à l’APA (qui prohibent tout quadrillage vertical), les colonnes dédiées à la dispersion doivent figurer immédiatement à droite de la mesure centrale correspondante, chaque colonne comportant un en-tête standardisé (ex. M et SD). Enfin, lors de l’intégration de graphiques à barres ou de diagrammes en lignes, le manuel APA exige de mentionner textuellement dans la légende si les barres d’erreur représentent des écarts-types (±1 SD), des erreurs types de la moyenne (±1 SEM) ou des intervalles de confiance (généralement IC à 95 %).
12.2 Erreurs courantes d’interprétation à proscrire
L’analyse critique des manuscrits soumis aux revues académiques met en lumière la persistance de plusieurs biais et confusions méthodologiques récurrentes relatives à la manipulation de la dispersion :
1. La confusion entre écart-type et erreur type de la moyenne. Il s’agit sans conteste de l’erreur la plus ubiquitaire et la plus préjudiciable. L’écart-type (SD) est un indice descriptif qui mesure la variabilité concrète des individus au sein de l’échantillon. L’erreur type (SEM) est un indice probabiliste qui quantifie la précision théorique de l’estimation de la moyenne. Utiliser la SEM pour décrire la dispersion d’un échantillon constitue une faute méthodologique majeure ayant pour effet cosmétique de masquer l’hétérogénéité réelle des données.
2. Le découplage paramétrique / non paramétrique incohérent. Nombre d’auteurs associent maladroitement une médiane à un écart-type (ex. « Mdn = 15, SD = 4,2 ») ou une moyenne à un écart interquartile. L’écart-type est ancré dans la géométrie des moindres carrés par rapport à la moyenne ; le calculer autour d’une médiane est algébriquement aberrant. L’association stricte doit être respectée : Moyenne avec Écart-type, et Médiane avec IQR ou MAD.
3. L’occultation non documentée des observations aberrantes. Constatant qu’un score atypique fait exploser l’écart-type, certains analystes suppriment l’observation sans aucune justification formelle ni traçabilité méthodologique. Les normes de l’APA et les directives de la science ouverte imposent de documenter chaque exclusion d’outlier, de justifier la procédure retenue (ex. règle de Tukey à 1,5 IQR, distance de Mahalanobis ou seuil z > 3,29) et de rapporter, idéalement, les analyses avant et après exclusion sous la forme d’une analyse de sensibilité.
4. La sur-interprétation de la différence de moyennes en présence de dispersions massives. Déclarer qu’un groupe performe de façon « supérieure » à un autre sur la base d’une différence de moyennes statistiquement significative (ex. p < 0,04) constitue une distorsion si le chevauchement (overlap) des distributions demeure massif en raison de larges écarts-types. Lorsque le d de Cohen est faible (ex. d = 0,20), plus de 85 % des distributions des deux groupes se recouvrent complètement. La différence moyenne n’est alors pas représentative du comportement de la majorité des individus.
12.3 Synthèse et guide de rédaction pour mémoires et publications
Afin de guider les étudiants et chercheurs dans la finalisation de leurs travaux empiriques, nous proposons ci-après un modèle rédactionnel intégrant harmonieusement l’ensemble des exigences méthodologiques relatives aux mesures de dispersion, suivi d’une liste de contrôle synthétique :
Modèle rédactionnel pour la section Résultats :
« L’examen préalable de la morphologie distributionnelle des scores d’anxiété a révélé une asymétrie marquée au sein du groupe clinique (Skewness = 1,42, Kurtosis = 2,85 ; test de Shapiro-Wilk : W = 0,84, p < 0,001), justifiant le recours aux indices de dispersion non paramétriques. Pour ce groupe, la médiane s’établit à 28,00 points (IQR = 14,50, Q1 = 22,00, Q3 = 36,50). À l’inverse, les scores du groupe témoin adhèrent aux postulats de normalité univariée (W = 0,97, p = 0,42) avec une distribution symétrique centrée autour d’une moyenne de 14,20 points (SD = 3,45). Le test de Brown-Forsythe a confirmé l’hétérogénéité des variances entre les deux conditions (F(1, 48) = 16,82, p < 0,001). Par conséquent, la comparaison inter-groupe a été conduite au moyen du test de Welch robuste, attestant d’une élévation significative du niveau d’anxiété chez les patients (t(31,2) = 8,64, p < 0,001, d de Cohen ajusté = 1,76). »
Check-list de vérification avant soumission :
- Chaque moyenne est-elle accompagnée de son écart-type (M, SD) ?
- Chaque médiane est-elle accompagnée de son écart interquartile (Mdn, IQR) ?
- Les barres d’erreur des figures sont-elles explicitement identifiées dans la légende (SD vs SEM vs IC 95 %) ?
- L’hypothèse d’homogénéité des variances a-t-elle été formellement testée avant d’exécuter des tests paramétriques d’inférence ?
- En cas d’hétéroscédasticité, les corrections adéquates (Welch) ont-elles été appliquées et motivées ?
- Les valeurs aberrantes ont-elles été identifiées par une règle statistique robuste (Tukey ou MAD) plutôt que de manière arbitraire ?
- Le coefficient de variation a-t-il été réservé exclusivement à des variables mesurées sur des échelles de rapport ?
L’intégration scrupuleuse de ces démarches garantit que la variabilité des données n’est plus traitée comme une entrave statistique résiduelle, mais comme une source majeure d’intelligibilité scientifique, enrichissant la compréhension clinique et consolidant la reproductibilité des résultats en psychologie moderne.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764-766. https://doi.org/10.1016/j.jesp.2013.03.013
- Pearson, K. (1894). Contributions to the mathematical theory of evolution. Philosophical Transactions of the Royal Society of London. A, 185, 71-110. https://doi.org/10.1098/rsta.1894.0003
- Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273-1283. https://doi.org/10.1080/01621459.1993.10476408
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). Pearson Assessment.
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.