
Dans l’édifice de la science empirique, la transition entre l’observation brute d’un phénomène et la formulation d’une conclusion théorique robuste repose sur une architecture méthodologique rigoureuse : l’inférence statistique. Qu’il s’agisse de valider l’efficacité d’un nouveau protocole thérapeutique, de mesurer l’impact d’une réforme pédagogique ou de détecter des anomalies infinitésimales dans les signaux astrophysiques, les chercheurs sont confrontés à un obstacle épistémologique universel : la variabilité inhérente aux processus d’échantillonnage. En effet, deux échantillons distincts extraits d’une même population ne produiront jamais des métriques strictement identiques, créant une ambiguïté fondamentale quant à la nature des écarts observés. L’écart mesuré reflète-t-il une véritable loi sous-jacente ou n’est-il que l’écume stochastique du hasard ?
Pour dissiper cette incertitude, la théorie des probabilités et l’inférence statistique moderne ont forgé un outil conceptuel d’une puissance remarquable : la statistique de test standardisée. Loin d’être un simple artifice calculatoire, la standardisation d’une statistique constitue une opération de transmutation mathématique. Elle dépouille les données de leurs unités physiques d’origine — qu’il s’agisse de milligrammes, de millisecondes ou de points sur une échelle d’évaluation psychométrique — pour les convertir en une grandeur sans dimension, exprimée en unités de dispersion probabiliste. Cette réduction d’échelle permet de situer n’importe quelle observation empirique sur une échelle universelle d’invraisemblance relative, mesurée à l’aune de ce que le simple hasard aurait pu produire.
Le présent article propose une exploration exhaustive de la statistique de test standardisée, depuis ses fondements théoriques jusqu’à ses applications pratiques les plus avancées. À travers l’analyse détaillée des tests de Student, des scores z, des ratios de variance de Fisher et des tests d’adéquation du Khi-carré, nous expliciterons comment ce rapport fondamental entre signal et bruit régit l’arbre de décision méthodologique. Nous aborderons également les subtilités interprétatives entourant les valeurs critiques, les p-valeurs, la puissance statistique et les impératifs déontologiques du rapportage scientifique dans le paysage contemporain de la recherche internationale.
1. Introduction aux fondements de la statistique de test standardisée
1.1 Distinction fondamentale entre paramètre de population et statistique d’échantillon
L’inférence statistique s’articule autour d’une dichotomie théorique fondamentale : l’opposition conceptuelle entre la population parente et l’échantillon empirique. Le paramètre de population est une valeur numérique fixe, immuable à un instant donné, qui caractérise une propriété intrinsèque de l’ensemble universel d’individus ou d’événements faisant l’objet d’une investigation. Par convention mathématique, les paramètres sont désignés par des lettres grecques, telles que μ pour la moyenne de la population ou σ pour son écart-type. Ces entités possèdent une existence ontologique dans le modèle théorique, mais demeurent, dans l’écrasante majorité des cas réels, parfaitement inconnaissables de manière directe en raison de l’impossibilité matérielle d’ausculter l’exhaustivité d’une population infinie ou démesurée.
À l’opposé du spectre épistémologique se trouve la statistique d’échantillon, calculée sur un sous-ensemble fini et représentatif d’individus extraits de cette population. Contrairement au paramètre, la statistique empirique — désignée par des symboles latins tels que x̄ pour la moyenne ou s pour l’écart-type de l’échantillon — est une variable aléatoire par essence. Sa valeur fluctue d’un échantillon à un autre en raison de l’erreur d’échantillonnage, un phénomène inévitable dès lors que l’on observe une fraction restreinte du réel. Cette stochasticité pose un défi direct à l’inférence causale : comment déduire la nature immuable du paramètre à partir d’un estimateur empirique foncièrement instable ?
C’est précisément pour résoudre cette énigme méthodologique qu’intervient la nécessité de convertir les données brutes issues de l’échantillonnage en mesures universellement comparables. Sans une telle conversion, une déviation empirique reste prisonnière de son échelle locale de mesure, rendant impossible toute quantification rigoureuse du degré d’incertitude associé à l’estimation. La statistique de test standardisée comble cette faille en formalisant mathématiquement l’écart entre la valeur observée et la valeur théorique postulée, rapporté à la fluctuation stochastique attendue de l’estimateur.
1.2 Nécessité de la réduction d’échelle en recherche quantitative
Dans la conduite de protocoles expérimentaux, chaque domaine scientifique génère des métriques assorties d’unités de mesure idiosyncrasiques. En psychologie cognitive, les chercheurs mesurent des latences motrices en millisecondes ; en épidémiologie, des taux de prévalence pour cent mille habitants ; en économie comportementale, des variations monétaires en devises locales. Ces unités brutes, bien qu’indispensables à la description phénoménologique immédiate, deviennent un obstacle épistémologique lorsqu’il s’agit d’isoler le signal méthodologique du bruit expérimental et de porter un jugement probabiliste général sur la validité d’une découverte.
La réduction d’échelle par standardisation offre le moyen d’éliminer définitivement l’arbitraire lié aux instruments de collecte. En neutralisant l’unité métrique originelle, le processus de standardisation dépouille le résultat de son contexte dimensionnel concret pour ne conserver que sa magnitude relative. Dès lors, une variation de 15 millisecondes dans une tâche d’inhibition attentionnelle peut présenter rigoureusement la même signification statistique qu’un différentiel de pression artérielle de 4 millimètres de mercure dans un essai cardiologique, à condition que ces deux variations se situent à la même distance standardisée de leurs moyennes de référence respectives.
Cette invariance d’échelle pose les bases d’un cadre mathématique unifié, indispensable à la méta-analyse et à la synthèse cumulative des connaissances scientifiques. Elle permet aux chercheurs de confronter directement les résultats d’investigations indépendantes conduites avec des méthodologies divergentes ou des instruments d’évaluation hétérogènes. En établissant une grammaire commune pour quantifier la force probante des données, la réduction d’échelle transforme la diversité empirique brute en un système cohérent et universel d’évaluation des hypothèses.
1.3 Rôle de la statistique standardisée dans l’inférence statistique
L’inférence statistique moderne, largement façonnée par les cadres paradigmatiques de Ronald Aylmer Fisher, de Jerzy Neyman et d’Egon Pearson, a pour finalité d’arbitrer entre des modèles théoriques concurrents en évaluant la plausibilité d’une série d’observations. Dans cette optique, la statistique standardisée agit comme un opérateur géométrique et probabiliste : elle convertit une déviation brute, observée dans l’espace physique de l’expérience, en une distance métrique projetée sur une distribution de probabilité théorique sous-jacente.
Cette transformation confère à la statistique standardisée un rôle d’arbitre impartial. En positionnant exactement la mesure empirique sur le continuum de la distribution théorique générée par l’hypothèse de référence, elle quantifie précisément l’atypicité de l’observation empirique. Plus la statistique standardisée s’éloigne du centre de la distribution, plus l’événement observé doit être qualifié d’improbable sous l’hypothèse que seul le hasard des fluctuations d’échantillonnage est à l’œuvre. Le test standardisé permet donc de mesurer la tension logique entre les données du réel et le modèle conceptuel testé.
En dernière analyse, cette quantification de l’écart standardisé constitue le pivot opérationnel de toute la logique décisionnelle en science quantitative. C’est à partir de la valeur numérique prise par cette métrique — qu’elle prenne la forme d’un score z, d’un t de Student ou d’un F d’analyse de variance — que la communauté des chercheurs s’accorde pour rejeter ou maintenir temporairement une hypothèse scientifique, scellant ainsi l’acceptation formelle ou l’abandon progressif d’une théorie dans le corpus du savoir établi.
2. Définition mathématique et conceptuelle de la standardisation
2.1 Le principe sous-jacent de la standardisation mathématique
Sur le plan analytique, la standardisation d’une variable aléatoire consiste à lui appliquer une transformation affine designed pour lui conférer une position et une dispersion canoniques. Soit une statistique empirique θ̂ conçue pour estimer un paramètre de population θ. Si l’on formule une hypothèse théorique quant à la valeur attendue de ce paramètre sous un état de référence donné, désignée par θ0, l’écart brut (θ̂ – θ0) exprime la déviation nette de l’observation par rapport aux attentes du modèle. Toutefois, cet écart brut est ininterprétable isolément sans la prise en compte de l’échelle de variabilité qui gouverne cet estimateur.
Le principe fondamental de la standardisation mathématique consiste donc à rapporter cette divergence brute à une métrique d’échelle représentant la variabilité attendue de l’estimateur. L’opération générale obéit invariablement à la structure canonique suivante : la statistique de test standardisée résulte du quotient entre la divergence observée et l’erreur type de l’estimateur. Géométriquement, cette opération recalibre l’axe des abscisses du repère statistique en opérant une translation de l’origine vers la valeur postulée par le modèle, suivie d’une dilatation ou contraction proportionnelle à l’inverse de la dispersion stochastique.
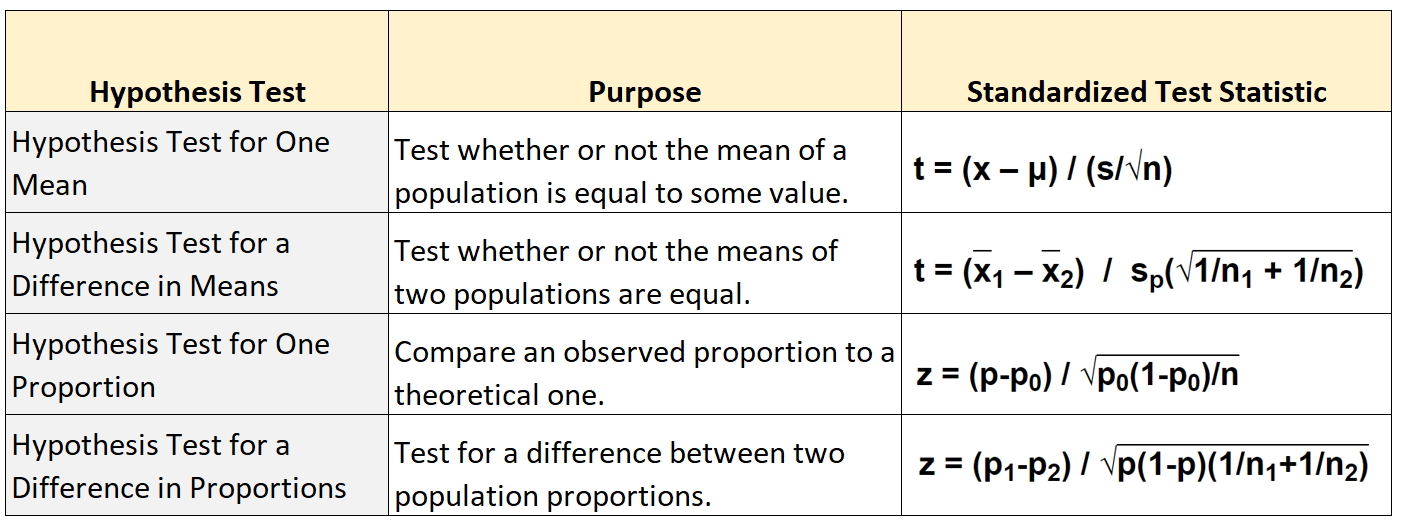
Par ce procédé mathématique élémentaire mais d’une infinie portée, la quantité résultante devient un nombre sans dimension physique. Elle exprime très exactement combien d’unités de déviation stochastique séparent le résultat expérimental du centre de gravité théorique du modèle nul. La standardisation convertit de facto une métrique scalaire quelconque en une mesure universelle de distance statistique, ouvrant la voie à une formalisation probabiliste unifiée indépendante de la nature concrète du système étudié.
2.2 L’erreur type comme dénominateur fondamental
L’élément moteur de la standardisation en contexte inférentiel réside dans le dénominateur de son ratio : l’erreur type. Il existe une confusion fréquente entre l’écart-type empirique d’un échantillon, qui quantifie la dispersion des individus au sein de cet échantillon autour de leur moyenne propre, et l’erreur type d’une statistique, qui quantifie la dispersion théorique de ladite statistique si l’on répétait l’expérience d’échantillonnage une infinité de fois sous des conditions strictement identiques.
L’erreur type modélise mathématiquement l’ampleur prévisible de la fluctuation stochastique de l’échantillonnage. Dans le cas de l’estimation d’une moyenne de population, l’erreur type théorique est formulée par σx̄ = σ / √n, où σ représente la dispersion intrinsèque de la population mère et n l’effectif de l’échantillon. Lorsque σ demeure inconnu du chercheur — ce qui constitue la norme en recherche expérimentale —, on y substitue son estimateur non biaisé s, ce qui donne l’erreur type estimée SE = s / √n. Le dénominateur de la statistique standardisée intègre ainsi explicitement la précision de l’instrument statistique utilisé.
Ce dénominateur présente une sensibilité structurelle majeure à la taille de l’échantillon étudié. En raison de la présence du terme √n au sous-dénominateur de l’erreur type, toute augmentation du nombre d’observations compresse inéluctablement l’amplitude de cette dernière. Par conséquent, pour un écart brut rigoureusement identique entre la moyenne observée et l’hypothèse nulle, une étude reposant sur un effectif massif générera un dénominateur beaucoup plus petit, propulsant mécaniquement la statistique standardisée vers des valeurs extrêmes. Cette dépendance algébrique fondamentale éclaire la double nature de la statistique standardisée : elle est un produit conjoint de la force du signal mesuré et de la puissance métrologique conférée par le volume de l’échantillon.
2.3 Interprétation d’un score de test standardisé
L’interprétation d’un score de test standardisé s’effectue à l’aide d’une métrique relative d’atypicité probabiliste. Une valeur de statistique standardisée égale à zéro ou oscillant dans le voisinage immédiat de zéro indique une adéquation quasi parfaite entre les prédictions théoriques du modèle de référence et les données empiriques recueillies. Dans cette configuration, l’écart observé entre l’estimation et le paramètre théorique est nul ou si infime qu’il ne dépasse en rien la magnitude attendue de la simple fluctuation stochastique inhérente à l’échantillonnage.
La directionnalité de la statistique est codée par son signe algébrique. Une valeur positive indique que la métrique observée dans l’échantillon surpasse la valeur postulée par le modèle théorique, tandis qu’une valeur négative signale une observation inférieure aux attentes de ce même modèle. L’amplitude absolue du score indique la distance à laquelle se situe l’observation par rapport au centre de gravité de l’hypothèse nulle, exprimée en unités de son erreur type. Selon les lois de distribution classiques, un score standardisé oscillant entre -1,96 et +1,96 correspond, dans un cadre de loi normale, à un intervalle contenant approximativement 95 % des observations générées par le pur hasard.
Dès lors qu’une statistique standardisée franchit ces seuils conventionnels pour s’établir à des magnitudes de l’ordre de 3, 4 ou plus, le score signale un degré d’atypicité extrême. Une telle valeur informe le chercheur que si le modèle théorique de référence correspondait fidèlement à la réalité des faits, l’émergence empirique d’un tel écart constituerait un événement extraordinairement rare. Ce haut degré d’invraisemblance contraint l’analyste à questionner la pertinence du modèle postulé initialement.
3. Le cadre méthodologique des tests d’hypothèses statistiques
3.1 Formulation des hypothèses nulle et alternative
La mécanique formelle des tests d’hypothèses statistiques repose sur une structure logique binaire, héritière des travaux de Fisher, Neyman et Pearson, et profondément ancrée dans l’épistémologie de la falsification formalisée par Karl Popper. Au cœur de ce dispositif méthodologique figure l’hypothèse nulle, immuablement notée H0. Elle incarne le postulat conventionnel de base : l’absence d’effet, l’équivalence entre deux traitements, ou l’absence de corrélation entre deux variables au sein de la population parente. L’hypothèse nulle sert d’ancre mathématique rigide ; c’est en supposant explicitement sa vérité stricte que les distributions de probabilités théoriques sont calculées.
En miroir dialectique de H0 se déploie l’hypothèse alternative, notée H1 ou Ha. Elle représente l’affirmation scientifique que le chercheur cherche généralement à étayer empiriquement, à savoir l’existence d’une différence systématique, d’une association directionnelle ou d’un changement d’état. L’hypothèse alternative peut être formulée de façon directionnelle (unilatérale) lorsque des justifications théoriques préexistantes imposent d’envisager l’effet dans un sens unique (par exemple, μ1 > μ2), ou de façon non directionnelle (bilatérale) lorsque le chercheur postule l’existence d’une altération sans préjuger de sa polarité (μ1 ≠ μ2).
Cette architecture reflète une asymétrie logique profonde. Selon la perspective poppérienne, une proposition universelle ne peut jamais être rigoureusement prouvée par l’accumulation d’exemples empiriques, mais elle peut être réfutée par la confrontation avec un contre-exemple solide. En inférence statistique, on ne démontre jamais directement la véracité de l’hypothèse alternative : on se contente d’évaluer si la statistique standardisée générée par les données est suffisamment discordante avec H0 pour forcer l’esprit rationnel à révoquer cette dernière.
3.2 Les étapes systématiques du test d’hypothèse
La mise en œuvre opérationnelle d’un test d’hypothèse statistique exige le respect d’une séquence méthodologique invariante, érigée en rempart contre les biais de confirmation et les dérives interprétatives. La démarche s’articule impérativement en quatre phases distinctes et chronologiquement étanches :
- Énonciation des hypothèses et sélection du seuil critique : Formulation ex ante des hypothèses H0 et H1, accompagnée de la fixation a priori du risque d’erreur consenti, généralement fixé au seuil conventionnel α = 0,05 ou α = 0,01.
- Collecte des données et calcul de la statistique de test standardisée : Administration du protocole empirique et extraction des estimateurs d’échantillon, permettant d’alimenter la formule de la statistique standardisée adaptée au devis de recherche retenu.
- Dérivation de la distribution d’échantillonnage théorique : Identification rigoureuse du comportement probabiliste formel que doit suivre la statistique sous H0 (telle que la loi normale centrée réduite Z, la loi de Student t, ou la loi de Fisher F), compte tenu des contraintes du devis et des degrés de liberté.
- Décision statistique et arbitrage méthodologique : Confrontation formelle entre la statistique standardisée empirique et les seuils critiques théoriques (ou comparaison de la p-valeur associée à α), menant irrévocablement au rejet de H0 en faveur de H1, ou au non-rejet de l’hypothèse nulle.
Chacune de ces étapes participe d’un continuum logique où la subjectivité de l’analyste se trouve encadrée par des contraintes mathématiques rigides. Toute altération de cette séquence temporelle, telle que la modification du seuil de décision après inspection des données brutes, altère la validité de l’inférence probabiliste.
3.3 La distribution théorique d’échantillonnage
Le concept de distribution théorique d’échantillonnage constitue l’échafaudage probabiliste fondamental sans lequel la statistique standardisée ne posséderait aucune portée décisionnelle. Contrairement à la distribution empirique d’un échantillon particulier, la distribution d’échantillonnage représente la fonction de densité de probabilité de l’ensemble infini des statistiques standardisées qui émergeraient si l’on procédait à un rééchantillonnage aléatoire infini au sein d’une même population, dans le respect strict des postulats édictés par l’hypothèse nulle.
Cette distribution offre une cartographie probabiliste exhaustive du comportement de la statistique sous l’empire exclusif des fluctuations du hasard. En d’autres termes, elle prescrit mathématiquement la fréquence théorique à laquelle chaque valeur de la statistique standardisée devrait survenir si aucun effet systématique réel n’était à l’œuvre. Les lois de probabilité canoniques — qu’il s’agisse de la courbe en cloche de Gauss-Laplace ou des lois dérivées de Student et de Fisher — matérialisent ces distributions modèles.
Grâce à cette formalisation distributionnelle, l’espace mathématique des résultats possibles se subdivise nettement en deux régions géométriques : une zone de forte vraisemblance, concentrée autour de l’espérance mathématique sous H0 (qui englobe typiquement 95 % de la masse de probabilité), et des zones d’invraisemblance extrême situées dans les queues de distribution. C’est le positionnement de la statistique standardisée calculée au sein de ces régions qui fonde objectivement la légitimité du rejet probabiliste de l’hypothèse nulle.
4. La statistique de test standardisée pour une moyenne : le test t de Student
4.1 Structure de la formule du test t pour échantillon unique
Lorsque la recherche vise à comparer la moyenne empirique x̄ d’un échantillon unique de taille n à une valeur théorique de population μ0 prédéterminée, et que l’écart-type réel de la population générale demeure inaccessible, la statistique standardisée idoine est le test t développé en 1908 par William Sealy Gosset sous le pseudonyme académique de Student. L’expression analytique de cette statistique se structure selon le rapport suivant :
t = (x̄ – μ0) / (s / √n)
Dans ce modèle d’inférence, le numérateur capture l’écart linéaire pur entre le barycentre empirique de l’échantillon observé et la moyenne théorique sous H0. Il s’agit de la quantification directe du signal empirique décelé. Le dénominateur, quant à lui, formalise l’erreur type estimée de la moyenne. Sa singularité réside dans l’utilisation exclusive de l’écart-type de l’échantillon s, calculé à l’aide de la correction de Bessel (division par n – 1), comme estimateur sans biais de la dispersion de la population générale.
Le ratio t constitue une statistique standardisée au sens plein : il normalise l’écart brut par une métrique de variabilité directement extraite de l’échantillon sous observation. Cette substitution inévitable de s à σ altère cependant la nature de la distribution statistique résultante. Comme s est lui-même une variable aléatoire sujette à une erreur d’échantillonnage substantielle, particulièrement au sein des échantillons de faibles effectifs, le quotient mathématique ne suit plus exactement une loi normale centrée réduite, mais se plie aux exigences structurales plus lâches de la distribution t de Student.
4.2 Le rôle des degrés de liberté
Le concept de degrés de liberté (notés df pour degrees of freedom ou ν) constitue le paramètre fondamental gouvernant la morphologie exacte de la distribution de la statistique standardisée t. D’un point de vue géométrique et mathématique, les degrés de liberté quantifient le nombre de dimensions ou d’observations empiriques qui demeurent totalement indépendantes et libres de varier une fois que les restrictions d’estimations linéaires ont été appliquées. Dans le cadre d’un échantillon unique de taille n, le calcul de l’écart-type empirique s requiert préalablement la détermination de la moyenne d’échantillon x̄, ce qui confisque irrémédiablement un degré de liberté métrologique : il reste donc df = n – 1.
Sur le plan distributionnel, les degrés de liberté modulent l’épaisseur des queues de la fonction de densité de probabilité. Lorsque le nombre de degrés de liberté est restreint, l’estimateur de la variance s2 fluctue de façon erratique d’un échantillon à un autre, ce qui induit une incertitude épistémique accrue quant à la stabilité du dénominateur du test. Pour traduire cette incertitude dans le calcul probabiliste, la distribution théorique de la statistique t de Student s’évase : elle s’aplatit à son sommet et présente des queues de distribution notablement plus épaisses et surélevées que celles d’une loi normale.
Cet épaississement mécanique des extrémités a un impact immédiat sur la décision inférentielle : pour un seuil de signification α donné, la valeur critique que la statistique t standardisée doit franchir pour entraîner le rejet de l’hypothèse nulle est considérablement plus élevée que le seuil standard de 1,96 de la loi normale. Les degrés de liberté agissent ainsi comme une pénalisation statistique explicite imposée aux échantillons de taille modeste, limitant le risque de faux positifs induits par l’instabilité de l’estimation de la variance.
4.3 Convergence de la distribution t vers la distribution normale
L’analyse des propriétés de la statistique standardisée t met en évidence une dynamique asymptotique décrite par la théorie analytique : à mesure que la taille de l’échantillon n croît pour tendre vers l’infini mathématique, la distribution t de Student converge vers la distribution normale centrée réduite Z. Ce phénomène de transition continue illustre la loi forte des grands nombres appliquée à la dispersion : lorsque le volume d’observations devient très important, la variance d’échantillonnage de l’estimateur s2 tend asymptotiquement vers zéro.
En pratique empirique, pour des effectifs excédant une centaine d’observations (df > 100), l’écart-type d’échantillon s devient une approximation extrêmement fidèle du paramètre inconnu σ. L’incertitude pesant sur l’estimation du dénominateur de la statistique standardisée s’atténue, et les queues de la distribution t se contractent jusqu’à se superposer de façon quasi imperceptible avec la courbe normale. Dès lors, les valeurs critiques associées au seuil conventionnel bilatéral α = 0,05 passent d’une valeur de 2,776 pour df = 4 à 2,042 pour df = 30, pour converger enfin vers la constante asymptotique 1,960 lorsque df dépasse plusieurs centaines.
Cette propriété de convergence a des répercussions concrètes sur l’analyse de données. Si, pour les volumineux ensembles de données modernes, la distinction opérationnelle entre la statistique t standardisée et la métrique z devient ténue dans la prise de décision, elle demeure cruciale pour les études à petit effectif. Dans ce contexte, l’utilisation de la distribution t s’avère indispensable pour préserver la validité de l’inférence en évitant une sous-estimation systématique du risque d’erreur de première espèce.
5. La statistique de test standardisée z pour une moyenne connue
5.1 Conditions formelles d’application du test z
La statistique standardisée z — fréquemment dénommée score z de test ou écart normal réduit — constitue l’archétype paradigmatique de la réduction d’échelle en inférence statistique. Son déploiement formel pour l’évaluation de la moyenne d’un échantillon dépend toutefois d’une série de conditions particulièrement exigeantes au plan théorique :
- Connaissance a priori de la variance de la population : Le chercheur doit impérativement connaître de manière exacte la variance σ2 (ou l’écart-type σ) de la population globale dont est extrait l’échantillon, et ce indépendamment des données collectées au cours de l’expérimentation courante.
- Postulat de normalité distributionnelle : La distribution de la variable au sein de la population parente doit suivre une loi normale, ou, à défaut, la taille de l’échantillon étudié doit être suffisamment vaste pour autoriser la mobilisation des théorèmes limites.
- Indépendance stricte des observations : Le tirage des unités d’échantillonnage doit résulter d’un processus aléatoire simple, garantissant que la valeur d’une observation n’exerce aucune influence stochastique sur la valeur d’une autre.
Dans l’écosystème réel des sciences empiriques, et singulièrement au sein de la recherche psychologique, médicale et sociologique, la condition stipulant la connaissance préalable de la variance σ de la population sans que l’on en connaisse la moyenne μ est très rarement remplie. On ne rencontre guère cette configuration théorique que dans le cadre très spécifique de tests standardisés d’aptitude cognitive (tels que les échelles d’intelligence de David Wechsler dotées d’un σ normatif calibré de 15) ou dans les systèmes industriels de contrôle de processus automatisés.
5.2 Formulation mathématique de la statistique z
L’expression mathématique de la statistique de test standardisée z s’établit avec une pureté formelle exemplaire. Elle met directement en rapport l’écart moyen brut avec l’erreur type théorique exacte de la moyenne, comme en témoigne son équation fondamentale :
z = (x̄ – μ0) / (σ / √n)
Dans ce ratio, chaque élément du dénominateur constitue une constante mathématique fixe : la variance σ n’étant pas sujette à estimation empirique dans les données recueillies, le dénominateur de la statistique z demeure immuable d’un échantillon à un autre de taille n. Cette caractéristique structurelle constitue la différence majeure avec la statistique t de Student, où le dénominateur variait de façon aléatoire en fonction de la dispersion interne s propre à chaque extrait empirique.
Par cette formulation, la statistique résultante se conforme d’emblée à la loi normale centrée réduite N(0, 1), caractérisée par une espérance mathématique strictement égale à zéro et une variance fixée à l’unité. Les propriétés mathématiques de cette loi autorisent une dérivation immédiate des probabilités de dépassement au moyen des tables universelles de l’intégrale de Gauss, sans qu’il soit nécessaire de conditionner l’évaluation aux degrés de liberté de l’expérience.
5.3 Théorème central limite et validité du score z
La puissance du test standardisé z dépasse le cadre strict de l’hypothèse de normalité de la population initiale grâce à l’apport d’un pilier de l’analyse stochastique : le théorème central limite (TCL). Formalisé dans ses versions modernes par Laplace, Liapounov et Lindeberg, ce théorème énonce que la somme — et par extension la moyenne arithmétique — d’un nombre élevé de variables aléatoires indépendantes et identiquement distribuées (i.i.d.) d’espérance finie converge en loi vers une distribution normale, quelle que soit la forme fonctionnelle de la distribution sous-jacente au sein de la population d’origine.
Ce résultat confère à la statistique standardisée z une robustesse méthodologique majeure dans les études dotées d’échantillons volumineux. Même si la distribution des scores individuels dans la population générale présente une forte asymétrie positive, une bimodalité prononcée ou un aplatissement marqué, la moyenne d’échantillon x̄ tendra à se comporter selon une loi normale dès lors que l’effectif d’échantillonnage franchit des seuils empiriques communément fixés à n ≥ 30, ou n ≥ 50 dans le cas de distributions modérément dissymétriques.
Il existe néanmoins des limites précises à la validité de cette approximation asymptotique. Face à des distributions pathologiques dotées de queues extrêmement lourdes (génératrices d’une variance théorique infinie) ou en présence d’une asymétrie extrême accompagnée de valeurs aberrantes isolées, la vitesse de convergence prescrite par le théorème central limite peut s’avérer insuffisante pour compenser la non-normalité aux petites et moyennes tailles d’échantillon. Dans ces circonstances, invoquer aveuglément la normalité asymptotique de la statistique z expose le praticien à des distorsions sévères du risque d’erreur alpha réel.
6. Comparaison de deux moyennes : statistiques standardisées indépendantes et appariées
6.1 Statistique t pour deux échantillons indépendants
L’une des configurations expérimentales les plus répandues en science quantitative consiste à évaluer l’écart séparant les moyennes de deux groupes mutuellement exclusifs, à l’image d’un groupe expérimental soumis à une intervention active confronté à un groupe témoin recevant un placebo. La statistique de test standardisée mobilise alors l’estimateur de l’écart des moyennes (x̄1 – x̄2), qu’elle confronte à l’hypothèse nulle d’égalité des espérances μ1 – μ2 = 0. Le ratio s’établit comme suit :
t = ( (x̄1 – x̄2) – (μ1 – μ2)0 ) / SE(x̄1 – x̄2)
La complexité de cette statistique standardisée réside dans l’estimation de l’erreur type de la différence intergroupes au dénominateur. Lorsque les deux groupes peuvent être considérés comme présentant des dispersions identiques dans la population (postulat d’homogénéité des variances ou homoscédasticité), on procède à une estimation groupée de la variance, notée s2p (pooled variance), qui pondère les variances individuelles s12 et s22 par leurs degrés de liberté respectifs (n1 – 1 et n2 – 1). L’erreur type prend alors la forme SE = √[ s2p (1/n1 + 1/n2) ], et la statistique obéit rigoureusement à une distribution de Student possédant df = n1 + n2 – 2 degrés de liberté.
Cependant, lorsque les variances des deux populations sont manifestement hétérogènes (σ12 ≠ σ22) ou que les effectifs des groupes sont asymétriques (n1 ≠ n2), la statistique de Student standard s’effondre et induit une inflation spectaculaire des taux d’erreur de première espèce. Pour remédier à cette vulnérabilité méthodologique, l’adaptation de Welch-Satterthwaite calcule une erreur type non pondérée SE = √(s12/n1 + s22/n2) tout en réduisant analytiquement les degrés de liberté effectifs via une formule d’approximation non entière, garantissant ainsi la validité de la statistique standardisée sous condition d’hétéroscédasticité.
6.2 Statistique t pour mesures répétées ou appariées
Lorsque le devis expérimental implique que les mêmes unités statistiques sont soumises à deux conditions distinctes (mesures avant et après traitement) ou lorsque les participants sont jumelés selon des critères d’appariement précis, les deux ensembles de données ne sont plus stochastiquement indépendants. L’application d’un test standardisé pour groupes indépendants constituerait alors une faute méthodologique majeure en omettant de prendre en compte la corrélation positive unissant les paires de mesures.
Dans cette architecture, la statistique de test standardisée opère une réduction dimensionnelle en transformant les deux vecteurs de scores en une série vectorielle unique de scores de différence intra-individuels : di = xi,1 – xi,2. La moyenne de ces différences, notée d̄, est ensuite standardisée par rapport à l’hypothèse nulle d’une absence d’évolution moyenne (μd = 0). L’expression de la statistique t appariée devient :
t = (d̄ – μd,0) / (sd / √n)
Le calcul de l’erreur type s’appuie ici exclusivement sur la variabilité intra-sujets des différences sd, divisée par la racine carrée du nombre de paires n. Cette formulation élimine mathématiquement du dénominateur toute la variance interindividuelle résiduelle, c’est-à-dire les variations stables tenant aux caractéristiques propres des participants d’un individu à un autre. Par ce mécanisme d’isolation du bruit d’arrière-plan, la statistique standardisée appariée gagne une sensibilité métrologique et une puissance statistique très supérieures à celles d’un devis indépendant équivalent.
6.3 Interprétation contextuelle de la magnitude de t
L’évaluation rigoureuse de la statistique t standardisée, qu’elle émane d’un protocole à mesures indépendantes ou à mesures répétées, s’articule conceptuellement autour de la notion de rapport signal-sur-bruit. Le numérateur incarne le signal expérimental net — la translation moyenne de l’effet induit par la manipulation de la variable indépendante —, tandis que le dénominateur matérialise l’entropie résiduelle du système, c’est-à-dire le bruit de fond méthodologique généré par la variabilité biologique, comportementale ou environnementale incontrôlée.
Dans les devis intra-sujets, la magnitude de la statistique t est directement modulée par le coefficient de corrélation linéaire r reliant les deux séries de mesures. L’erreur type de la différence est en effet reliée algébriquement aux variances individuelles par la formule :
σ2diff = σ12 + σ22 – 2rσ1σ2
Plus la corrélation r s’approche de +1, plus le terme de covariance soustrait ampute la variance de la différence, compressant drastiquement le dénominateur de la statistique standardisée et décuplant la valeur numérique finale de t.
Cette sensibilité structurelle impose d’opérer une distinction conceptuelle entre la magnitude numérique de la statistique de test standardisée et la taille de l’effet substantiel au sein de la population. Une valeur t particulièrement élevée (par exemple t = 8,42) ne témoigne pas nécessairement d’une rupture phénoménologique majeure ou d’un impact clinique spectaculaire ; elle peut résulter tout simplement de l’incorporation d’une taille d’échantillon monumentale au dénominateur via le terme √n. La statistique de test standardisée est une métrique d’évidence contre H0, et non une mesure intrinsèque de l’importance concrète du phénomène examiné.
7. Statistiques de test standardisées pour les proportions
7.1 Test z pour une proportion unique
L’investigation scientifique ne se cantonne pas à l’analyse de variables continues ; elle porte fréquemment sur l’étude de variables catégorielles qualitatives binaires (succès ou échec, présence ou absence de pathologie). Dans ce cadre, la confrontation d’une proportion empirique observée p̂ = x / n au sein d’un échantillon à une proportion théorique de référence p0 postulée par le modèle requiert le calcul d’une statistique standardisée dédiée.
Sous la validité de l’hypothèse nulle, la variable de comptage empirique sous-jacente obéit scrupuleusement aux lois formelles d’une distribution binomiale B(n, p0), dont l’espérance mathématique vaut np0 et la variance np0(1 – p0). Lorsque les effectifs de l’échantillon s’avèrent suffisamment amples, l’erreur type théorique de la proportion sous H0 est modélisée par l’expression σp = √[ p0(1 – p0) / n ]. La statistique standardisée prend par conséquent la forme mathématique suivante :
z = (p̂ – p0) / √[ p0(1 – p0) / n ]
Il importe de souligner avec insistance une particularité analytique propre au test z pour une proportion : le calcul du dénominateur mobilise exclusivement la proportion théorique p0 issue de l’hypothèse nulle, et non la proportion empirique p̂ observée dans les données. Cette particularité découle de la structure de l’inférence : l’erreur type doit être modélisée sous la stricte supposition de vérité de H0.
L’emploi légitime de cette statistique standardisée est conditionné par la vérification de règles de validité relatives aux effectifs minimaux par cellule. Les conventions méthodologiques requièrent généralement que les produits np0 ≥ 10 et n(1 – p0) ≥ 10 soient simultanément satisfaits. Si ces seuils ne sont pas atteints, la distribution binomiale réelle présente une forte asymétrie discrète qui invalide l’usage de la loi normale continue comme distribution théorique de la statistique standardisée.
7.2 Test z pour la comparaison de deux proportions indépendantes
L’analyse comparative de deux pourcentages extraits de populations indépendantes — tels que les taux de rémission observés au sein d’un groupe thérapeutique versus un groupe sous protocole standard — mobilise une logique de standardisation analogue, mais intègre une étape d’estimation groupée. En effet, sous l’hypothèse nulle H0 : p1 = p2 = p, on postule l’existence d’une unique proportion sous-jacente commune gouvernant les deux échantillons.
La statistique standardisée mobilise donc un estimateur combiné non biaisé de cette proportion inconnue, noté p̄, calculé en agrégeant l’ensemble des événements favorables rapporté à l’effectif cumulé des deux groupes : p̄ = (x1 + x2) / (n1 + n2). L’erreur type de l’écart des deux proportions se formalise alors mathématiquement par l’expression :
SE = √[ p̄(1 – p̄) (1/n1 + 1/n2) ]
La statistique de test standardisée résultante prend par suite la structure analytique d’un rapport normalisé :
z = (p̂1 – p̂2) / √[ p̄(1 – p̄) (1/n1 + 1/n2) ]
Cette métrique suit asymptotiquement une loi normale centrée réduite standard. Elle constitue l’instrument privilégié d’évaluation au sein des protocoles contrôlés randomisés avec critères d’évaluation binaires, permettant de quantifier avec rigueur si la divergence observée entre les deux taux d’incidence s’écarte des fluctuations probabilistes admissibles.
7.3 Approximation normale de la loi binomiale
L’usage d’une statistique standardisée z pour analyser des grandeurs proportionnelles repose fondamentalement sur l’approximation normale de la loi binomiale, historiquement établie par le théorème de De Moivre-Laplace. Néanmoins, le passage conceptuel d’une fonction de distribution discrète (où la variable ne prend que des valeurs entières isolées) à une densité de probabilité continue (où la masse probabiliste est distribuée de façon lisse sur l’ensemble des réels) induit une imprécision géométrique intrinsèque.
Pour compenser cette distorsion d’échelle lors de l’intégration, Frank Yates a proposé l’adjonction systématique d’une correction de continuité. Cette correction consiste à réduire la valeur absolue de l’écart au numérateur d’une fraction de demi-unité d’observation discrète (1 / (2n)), contractant artificiellement la statistique standardisée empirique selon la formule :
zcorrigé = ( |p̂ – p0| – 1/(2n) ) / √[ p0(1 – p0) / n ]
Cette correction de Yates produit une statistique standardisée plus conservatrice, limitant les rejets abusifs de l’hypothèse nulle aux effectifs frontières. Cependant, l’avènement contemporain d’une puissance computationnelle illimitée a largement déplacé cette problématique. Lorsque les effectifs sont faibles ou que les distributions catégorielles se révèlent hautement asymétriques, l’ensemble de la communauté biostatistique préconise d’abandonner l’approximation de la statistique z standardisée au profit du calcul direct des probabilités combinatoires exactes via le test exact de Fisher, éliminant ainsi toute approximation distributionnelle.
8. Extensions multivariées : le ratio F et le Khi-carré comme métriques standardisées
8.1 La statistique F d’analyse de variance (ANOVA)
Lorsque le plan expérimental dépasse la dichotomie élémentaire de deux conditions pour comparer simultanément k moyennes de groupes (k ≥ 3), l’application itérative de tests t standardisés indépendants se heurte au problème de l’inflation exponentielle du risque d’erreur globale de type I. Pour surmonter cet écueil, Ronald Fisher a conceptualisé l’analyse de variance (ANOVA), articulée autour d’une nouvelle métrique standardisée : le ratio F de Fisher-Snedecor.
Bien que le ratio F se présente formellement sous la forme d’un quotient de carrés moyens, il procède de la même logique de standardisation que les scores linéaires. Sa formule fondamentale oppose deux estimations indépendantes de la variance du phénomène étudié :
F = MSinter / MSintra = (SSinter / dfinter) / (SSintra / dfintra)
Le numérateur, le carré moyen inter-groupe (MSinter), quantifie la dispersion des moyennes des différents groupes expérimentaux autour de la moyenne générale (le grand barycentre de l’étude), pondérée par la taille des échantillons. Si l’hypothèse nulle d’égalité des k moyennes est rigoureusement exacte, ce terme n’est rien d’autre qu’une estimation de la variance résiduelle du système σ2. En revanche, si des effets de traitement réels induisent des divergences systématiques entre les groupes, le numérateur gonfle en agrégeant cette variance d’effet systématique à la variance d’échantillonnage.
Le dénominateur, le carré moyen intra-groupe (MSintra ou variance résiduelle), capture l’hétérogénéité des sujets individuels mesurée à l’intérieur même de chaque cellule expérimentale autour de la moyenne locale de leur propre groupe. Ce terme ne reflète que le bruit stochastique pur et sert d’étalon de mesure de dispersion. La statistique F s’affirme ainsi comme une déviation relative standardisée : elle rapporte la variabilité intergroupes au niveau du bruit résiduel.
Sous H0, l’espérance mathématique du ratio F oscille autour de la valeur 1. Si la manipulation expérimentale engendre un effet substantiel, le numérateur surpasse largement le dénominateur, propulsant le ratio standardisé F vers des valeurs nettement supérieures à l’unité, localisées dans la queue de rejet de la distribution de Fisher régie par ses deux degrés de liberté spécifiques (df1 = k – 1 et df2 = N – k).
8.2 La statistique du Khi-carré (Chi-deux)
Développée par Karl Pearson en 1900, la statistique du Khi-carré (χ2) constitue une métrique standardisée conçue pour éprouver des hypothèses d’indépendance ou d’adéquation portant sur des distributions de fréquences au sein de tableaux de contingence. Son armature algébrique se structure selon la sommation suivante :
χ2 = ∑ [ (Oi – Ei)2 / Ei ]
où Oi désigne la fréquence empirique formellement observée dans la i-ème cellule du tableau, et Ei la fréquence théorique attendue sous l’hypothèse d’indépendance statistique stricte des variables qualitatives.
Pour appréhender l’essence conceptuelle de cette statistique, il convient d’analyser le terme élémentaire de la sommation :
(Oi – Ei)2 / Ei = [ (Oi – Ei) / √Ei ]2
On constate que le quotient interne (Oi – Ei) / √Ei n’est rien d’autre qu’une statistique standardisée z classique appliquée au comptage d’événements : l’écart brut entre la valeur empirique et son espérance théorique est divisé par l’écart-type de cette variable sous le modèle de Poisson (σ = √Ei). Dès lors, la statistique de Pearson du χ2 se révèle être mathématiquement la somme des carrés de variables normales standardisées indépendantes.
Cette observation structurelle dévoile le lien unissant la loi normale et la distribution du Khi-carré. La géométrie de la distribution du χ2 est paramétrée par ses degrés de liberté, lesquels sont déterminés par les contraintes marginales du tableau de contingence : df = (lignes – 1) × (colonnes – 1). Tout écart systématique entre les données et le modèle d’indépendance accroît la valeur quadratique globale de la statistique, éloignant celle-ci de sa moyenne théorique (qui est rigoureusement égale à df) vers des seuils d’invraisemblance justifiant le rejet de l’hypothèse d’indépendance.
8.3 L’universalité du concept de standardisation
L’exploration approfondie des tests z, de Student t, d’analyse de variance F et d’adéquation du χ2 met en évidence un principe invariant qui transcende la diversité apparente des modèles mathématiques : l’évaluation statistique procède invariablement de la mise en balance d’une quantité représentative du signal empirique face à une métrique normalisatrice du bruit aléatoire.
Cette continuité conceptuelle s’accompagne d’une profonde équivalence mathématique entre ces différentes métriques, qui ne constituent que des manifestations fonctionnelles distinctes d’un même formalisme général unifié. Ainsi, dans le cas canonique d’une comparaison portant sur deux groupes indépendants, le carré exact de la statistique standardisée de Student est strictement égal au ratio F de l’analyse de variance à un facteur : t2(df) = F(1, df). De même, la statistique z standardisée élevée au carré converge sans équivoque vers une statistique du Khi-carré à un degré de liberté : z2 = χ2(1).
Ces ponts algébriques démontrent l’universalité de la standardisation au sein du Modèle Linéaire Général (GLM), qui fédère sous un même cadre théorique les tests t, les analyses de variance factorielles, les corrélations bivariées et les régressions multiples. Quelle que soit l’arborescence analytique mobilisée, le statisticien projette toujours une déviation empirique multidimensionnelle sur une échelle d’étalonnage standardisée, ramenant la décision méthodologique à une évaluation universelle de distance probabiliste.
9. Prise de décision : comparaison avec la valeur critique et calcul de la p-valeur
9.1 Détermination des valeurs critiques et seuils de décision
Le dénouement décisionnel d’un test statistique s’opère par la mise en œuvre de critères de démarcation nets entre le vraisemblable et l’inadmissible. Historiquement, l’école neyman-pearsonienne de l’inférence statistique impose la fixation rigide a priori d’un seuil de signification, universellement désigné par la lettre grecque α. Ce seuil représente la probabilité maximale consentie par le chercheur d’encourir une erreur de type I, à savoir commettre l’imprudence méthodologique de rejeter l’hypothèse nulle alors que celle-ci est objectivement vraie au niveau de la population générale.
La fixation formelle de ce niveau α (habituellement établi selon la tradition fisherienne à 0,05, ou à des bornes plus conservatrices comme 0,01 ou 0,001) détermine de façon univoque les coordonnées spatiales de la zone de rejet sur la fonction de distribution théorique appropriée. Les frontières délimitant cette zone critique constituent les valeurs critiques. Dans le cas canonique d’une loi normale centrée réduite soumise à un devis bilatéral au risque α = 0,05, les valeurs critiques s’établissent de manière immuable à z = -1,96 et z = +1,96, enfermant 95 % de la masse de probabilité dans la zone centrale de non-rejet.
La règle décisionnelle s’énonce dès lors avec une automaticité mathématique rigoureuse : si la valeur absolue de la statistique standardisée empirique excède la valeur critique théorique (|statistique| ≥ valeur critique), le praticien rejette sans détour l’hypothèse nulle H0 au profit de l’hypothèse alternative H1. À l’inverse, si la statistique standardisée calculée échoue à atteindre ces limites normatives, le verdict d’inférence décrète le non-rejet de l’hypothèse nulle, concluant à l’absence de preuves empiriques d’un niveau suffisant pour disqualifier le modèle de référence.
9.2 Calcul et interprétation précise de la p-valeur
L’approche décisionnelle moderne privilégie fréquemment l’usage de la p-valeur (ou valeur p de probabilité) comme indicateur direct du degré de discordance entre les données empiriques et le modèle théorique sous H0. Sur le plan de la théorie analytique, la p-valeur se définit très rigoureusement comme la probabilité cumulée, sous condition stricte de vérité de l’hypothèse nulle, d’obtenir une statistique de test au moins aussi extrême — c’est-à-dire au moins aussi éloignée de l’espérance théorique — que celle effectivement observée dans l’échantillon d’étude.
Il existe une relation mathématique bijective directe reliant la statistique de test standardisée et la p-valeur : pour une distribution théorique et un nombre de degrés de liberté fixés, la p-valeur est calculée directement par l’intégration de la fonction de densité de probabilité au-delà de la coordonnée définie par la statistique standardisée empirique. Plus la statistique standardisée s’éloigne de son espérance théorique, plus la surface d’intégration sous la queue de distribution se restreint, et plus la p-valeur décroît vers zéro.
Cette précision mathématique impose de dissiper des confusions conceptuelles très répandues au sein de la littérature scientifique. La p-valeur ne mesure absolument pas la probabilité de vérité de l’hypothèse nulle P(H0 | D), une grandeur épistémologique inaccessible à l’inférence fréquentiste sans l’injection de distributions de probabilités a priori bayésiennes. De même, son complémentaire (1 – p) ne quantifie en aucun cas la probabilité d’existence d’une hypothèse alternative. La p-valeur exprime exclusivement P(D ≥ d | H0) : une métrique d’atypicité probabiliste conditionnelle calculée sous la stricte assomption de vérité du modèle nul.
9.3 Tests unilatéraux contre tests bilatéraux
L’attribution de la zone de rejet géométrique au sein de la distribution théorique de la statistique standardisée s’opère selon deux découpages topologiques concurrents : les devis unilatéraux (directionnels) et les devis bilatéraux (non directionnels). Ce choix méthodologique exerce un impact direct et massif sur la valeur critique que la statistique standardisée doit impérativement dépasser pour atteindre le seuil de signification statistique.
Dans le cadre d’un test bilatéral, le risque d’erreur α est équitablement partitionné entre les deux queues de la distribution théorique (α / 2 à chaque extrémité). Cette structure symétrique neutralise toute hypothèse a priori sur le sens de l’effet, accordant une sensibilité d’évaluation identique à une augmentation ou à une diminution du paramètre étudié. Pour un test z au seuil conventionnel de 0,05, chaque queue concentre 2,5 % de la probabilité d’erreur, fixant la valeur critique de démarcation à 1,96 en valeur absolue.
À l’opposé, un test unilatéral concentre l’intégralité de la masse critique du risque α (soit 5 %) dans une unique queue de distribution, orientée dans la direction prédite par l’hypothèse scientifique alternative (par exemple, H1 : μ > μ0). Cette concentration topologique rabat immédiatement la valeur critique minimale requise : pour la loi normale, le seuil de rejet s’abaisse de 1,96 à 1,645. La statistique standardisée se trouve alors en position de franchir le seuil décisionnel pour une magnitude d’écart plus modeste, ce qui optimise la sensibilité du test pour une direction donnée.
Toutefois, ce gain de sensibilité comporte une contrepartie méthodologique majeure : si l’effet réel opère dans le sens diamétralement opposé à la conjecture initiale, le chercheur s’interdit formellement de rejeter l’hypothèse nulle, quelle que soit la magnitude phénoménologique de la déviation observée. C’est pourquoi le choix d’un test directionnel unilatéral ne peut s’appuyer sur une démarche opportuniste post hoc destinée à faire franchir artificiellement le seuil de significativité à une statistique chancelante ; il exige une justification théorique, déontologique et méthodologique rigoureuse et irréversible formulée avant toute collecte de données.
10. Puissance statistique et erreurs d’inférence associées
10.1 Les erreurs décisionnelles de type I et de type II
L’inférence statistique fréquentiste, opérant par nature dans un univers d’information empirique incomplète et stochastique, est traversée par deux risques d’erreur antagonistes et structurellement interdépendants : l’erreur de type I (faux positif) et l’erreur de type II (faux négatif). Ces deux formes d’égarement logique peuvent être formalisées par la matrice de contingence décisionnelle suivante :
- Erreur de type I (Risque α) : Décréter le rejet formel de l’hypothèse nulle alors que celle-ci décrit fidèlement l’état réel de la population. Ce résultat survient lorsqu’une statistique d’échantillonnage standardisée atypique émerge du fait du simple hasard des fluctuations d’échantillonnage, induisant le chercheur à halluciner méthodologiquement l’existence d’un effet inexistant.
- Erreur de type II (Risque β) : Échouer à rejeter l’hypothèse nulle alors qu’elle est factuellement erronée et qu’un effet systématique réel opère au sein de la population parente. Ce phénomène advient lorsque la statistique standardisée calculée sur l’échantillon demeure trop modeste en valeur absolue pour franchir la valeur critique de décision.
La gestion de ces risques décisionnels soulève un arbitrage méthodologique fondamental. Toute tentative visant à prémunir le chercheur contre les faux positifs en comprimant drastiquement le seuil α (par exemple en l’abaissant à 0,001) accroît de façon mécanique la probabilité β de commettre une erreur de type II en refusant de valider un effet réel atténué. L’établissement des conventions scientifiques contemporaines — équilibrant un risque α consenti de 5 % face à un risque β toléré de 10 % à 20 % — matérialise une position médiane entre rigueur sceptique et sensibilité de détection expérimentale.
10.2 Différenciation cruciale : statistique de test versus taille d’effet
L’une des dérives conceptuelles les plus dommageables pour l’intégrité de la littérature scientifique contemporaine consiste à confondre la magnitude d’une statistique de test standardisée avec la taille de l’effet substantivement étudié. Si toutes deux constituent des grandeurs dépourvues d’unité de mesure directe, elles répondent à des fonctions méthodologiques et à des dynamiques mathématiques profondément divergentes.
Les métriques de taille d’effet — à l’instar du d de Cohen, du g de Hedges ou du coefficient de corrélation r — sont des descripteurs standardisés purs et adimensionnels de l’ampleur d’un phénomène expérimental au sein de la population. La formule du d de Cohen pour la comparaison de deux groupes, d = (μ1 – μ2) / σ, isole la distance brute entre les barycentres rapportée à la variabilité biologique ou contextuelle standard. Cette quantité est une caractéristique fixe du système étudié et demeure indépendante de la taille de l’échantillon utilisé pour la mesurer.
À l’inverse, la statistique de test standardisée incorpore directement dans son architecture analytique le volume de données collectées. La relation fonctionnelle reliant la statistique de test à la taille de l’effet se formalise schématiquement par l’équation générale :
Statistique de test = Taille de l’effet × Taille de l’échantillon (f(√n))
Dans un test t pour groupes indépendants d’effectifs équivalents n, cette relation prend la forme analytique exacte t = d × √(n / 2). Il découle impérativement de cette formulation qu’une statistique standardisée t exceptionnellement élevée (telle que t = 10,50) peut émerger soit d’un effet spectaculaire (d très grand) sur un échantillon modeste, soit d’un effet infime, totalement négligeable et dénué de toute pertinence pratique réelle (par exemple d = 0,05), mesuré sur un échantillon constitué de centaines de milliers d’observations.
10.3 Modélisation de la puissance statistique
La puissance statistique d’une investigation empirique se définit formellement comme la probabilité d’aboutir au rejet de l’hypothèse nulle lorsque celle-ci est factuellement fausse dans la population générale, soit l’expression probabiliste complémentaire du risque d’erreur de type II : Puissance = 1 – β. Dans l’espace géométrique des fonctions de densité de probabilité, la puissance correspond à la fraction d’aire de la distribution d’échantillonnage théorique modélisée sous l’hypothèse alternative H1 qui se situe au-delà des valeurs critiques fixées par l’hypothèse nulle H0.
Lorsque H1 est vraie, la distribution de la statistique standardisée subit une translation latérale le long de l’axe des abscisses. La statistique standardisée ne suit plus une distribution centrale (comme la distribution t de Student classique centrée sur zéro), mais se transforme en une distribution non-centrale paramétrée par un facteur d’échelle fondamental : le paramètre de non-centralité (δ ou λ). Pour un test t pour échantillon unique, ce paramètre s’établit selon l’expression :
δ = [ (μ1 – μ0) / σ ] × √n = d × √n
Cette modélisation explicite la dépendance de la puissance statistique à l’égard de trois variables interconnectées : la taille de l’effet réel opérant dans la population (d), la sévérité du seuil d’erreur consenti (α), et le volume de l’échantillon (n). Le calcul formel de puissance a priori permet ainsi de déterminer de façon prévisionnelle l’effectif minimal requis pour qu’une statistique standardisée dispose d’une probabilité satisfaisante — conventionnellement établie à 80 % ou 90 % — d’atteindre le seuil critique de significativité, épargnant ainsi aux équipes de recherche la conduite d’études sous-dimensionnées condamnées à l’impuissance statistique.
11. Applications pratiques en recherche psychologique et comportementale
11.1 Expérimentations en psychologie cognitive et neurosciences
Les sciences de l’esprit et de l’encéphale offrent un terrain d’application privilégié aux statistiques standardisées en raison du niveau élevé d’interférence et de bruit propre aux signaux psychophysiologiques. Dans les paradigmes classiques de chronométrie mentale explorant l’attention ou la mémoire de travail (tels que la tâche de Stroop, l’effet Simon ou les protocoles de masquage visuel rétroactif), les variables d’intérêt se traduisent par des temps de réaction chronométrés à la milliseconde près, caractérisés par une asymétrie distributionnelle marquée et une variance interindividuelle considérable.
Dans ce contexte, la conversion des latences de réponse en statistiques de test standardisées s’avère indispensable pour isoler les signatures cognitives subtiles. Les chercheurs calculent des contrastes standardisés sur des séries de mesures appariées, modélisant les soustractions différentielles entre conditions congruentes et incongruentes. L’évaluation de l’effet Stroop ne se résume pas à l’observation d’un différentiel moyen brut de 40 millisecondes ; elle s’établit par l’intermédiaire d’une statistique t standardisée de mesures répétées qui intègre la consistance intra-sujet de ce coût temporel face à son instabilité d’échantillonnage.
En neuroimagerie fonctionnelle par résonance magnétique (IRMf), cette logique de standardisation atteint son paroxysme méthodologique dans l’élaboration des cartes paramétriques statistiques (SPM). Le signal hémodynamique dépendant du niveau d’oxygénation sanguine (BOLD) est analysé à l’échelle de centaines de milliers d’unités volumétriques discrètes dénommées voxels. Pour chaque voxel individuel, une régression linéaire standardisée dérive une statistique t de Student ou un score z traduisant l’activation spécifique induite par la tâche cognitive par rapport à l’état de repos, autorisant ainsi la cartographie topologique objective des réseaux fonctionnels cérébraux.
11.2 Psychométrie et évaluation des tests standardisés
Dans l’univers de la psychométrie appliquée et du diagnostic clinique des habiletés cognitives, la notion de standardisation s’incarne sous deux acceptions épistémologiques qu’il importe de distinguer rigoureusement : les scores z individuels normatifs d’une part, et les statistiques de test standardisées d’autre part.
Le score z individuel normatif, défini par la formule transformationnelle classique zi = (xi – μnorme) / σnorme, est un outil métrologique purement descriptif. Il situe le niveau de performance absolu d’un participant particulier sur une échelle de référence standardisée dérivée d’un étalonnage populationnel représentatif (à l’instar des quotients d’intelligence générale ou des échelles factorielles de personnalité). Ce calcul ne comporte en soi aucune démarche de test d’hypothèse probabiliste d’échantillonnage.
La statistique de test standardisée intervient, quant à elle, lorsque le praticien ou le chercheur cherche à inférer des propriétés structurales relatives aux instruments d’évaluation eux-mêmes ou aux groupes diagnostiques évalués. Elle sert par exemple à éprouver la fidélité de consistance interne des tests par l’intermédiaire de contrastes statistiques, à tester la structure dimensionnelle via des analyses factorielles confirmatoires dont les coefficients de pondération sont standardisés, ou à évaluer formellement si la moyenne obtenue par une cohorte clinique spécifique dévie de manière significative du barème de standardisation théorique à l’aide d’une statistique t d’échantillon unique.
11.3 Recherche clinique et interventions thérapeutiques
L’évaluation rigoureuse de l’efficacité des thérapeutiques médicamenteuses ou psychothérapeutiques (telles que les thérapies cognitives et comportementales pour les troubles de l’humeur) confronte le statisticien à des échelles de mesure ordonnées et des inventaires d’auto-évaluation composites, tels que l’Inventaire de Dépression de Beck (BDI) ou l’Échelle d’Anxiété de Hamilton (HAM-A). Ces instruments métrologiques ne possèdent pas de métrique physique naturelle ; la standardisation statistique constitue dès lors le seul moyen d’objectiver les progrès thérapeutiques enregistrés entre la phase pré-intervention et la phase post-intervention.
Au cours des essais cliniques randomisés en double aveugle, les évolutions symptomatiques individuelles sont converties en une statistique standardisée de contraste pour évaluer la supériorité statistique du protocole actif vis-à-vis d’une condition témoin ou d’un placebo. Toutefois, cette approche inférentielle soulève une distinction épistémologique cruciale au lit du malade : la disjonction entre la signification statistique de la statistique standardisée et sa pertinence clinique effective.
Une intervention thérapeutique administrée à une cohorte de 5 000 patients peut générer une statistique de test t = 4,12 associée à une p-valeur hautement significative (p < 0,0001), tout en ne réduisant les manifestations anxieuses des participants que d’un demi-point sur une échelle d’évaluation graduée de 0 à 60 points. Si cette statistique standardisée rejette l’hypothèse de l’illusion stochastique, elle décrit un effet dont la magnitude empirique est trop ténue pour se traduire par une rémission clinique observable dans la trajectoire du patient. Le calcul de la statistique de test doit par conséquent être complété par l’estimation d’indicateurs de pertinence clinique reconnus, tels que la différence minimale cliniquement importante (MCID) ou le nombre de sujets à traiter (NNT).
12. Hypothèses de validité, erreurs courantes et normes de rapport académique
12.1 Vérification des postulats sous-jacents aux statistiques standardisées
L’utilisation de statistiques de test standardisées paramétriques — t de Student, z, ou F d’ANOVA — n’est épistémologiquement licite que si les propriétés mathématiques des données empiriques recueillies satisfont à une série d’hypothèses distributionnelles restrictives. La violation de ces postulats théoriques altère directement la validité des calculs probabilistes et expose le chercheur à des distorsions imprévisibles de ses taux réels d’erreur :
- Indépendance des observations d’échantillonnage : L’hypothèse que chaque valeur collectée est stochastiquement indépendante de toutes les autres constitue le postulat le plus déterminant de la théorie fréquentiste. Sa violation, qui se manifeste typiquement par la présence d’une autocorrélation temporelle ou d’effets de regroupement en grappes (comme des élèves nichés au sein d’une même classe d’école), gonfle artificiellement le volume effectif de données n. Elle comprime l’erreur type au dénominateur et propulse la statistique standardisée vers des magnitudes fallacieusement élevées.
- Normalité des distributions ou des résidus : L’hypothèse postule que la variable dépendante ou les résidus d’estimation se conforment à une fonction de densité normale de Gauss. Ce postulat doit être vérifié empiriquement par des outils diagnostiques visuels (diagrammes quantile-quantile Q-Q plots) couplés à des tests formels d’adéquation tels que le test de Shapiro-Wilk ou le test de D’Agostino-Pearson.
- Homogénéité des variances (Homoscédasticité) : L’exigence de parité des dispersions résiduelles entre les différents groupes expérimentaux comparés. L’altération de cette égalité doit être dépistée par le test de Levene ou de Bartlett. En cas d’invalidation, l’usage de la statistique standardisée de Student doit être abandonné au profit de corrections robustes, telles que le test t de Welch.
L’exploration attentive de ces postulats constitue un prérequis méthodologique fondamental. Ignorer ces conditions formelles pour appliquer mécaniquement des formules de standardisation sur des données qui les réfutent relève d’une négligence statistique susceptible de disqualifier les conclusions d’une étude.
12.2 Erreurs fréquentes d’interprétation méthodologique
L’histoire récente de la crise de réplicabilité en sciences quantitatives a mis en lumière une série de pathologies méthodologiques et de confusions conceptuelles récurrentes relatives à l’interprétation des statistiques de test standardisées. L’erreur la plus répandue réside dans l’inférence asymétrique consistant à assimiler l’absence de rejet de l’hypothèse nulle à une démonstration scientifique formelle de l’absence d’effet. Une statistique standardisée non significative (telle que t = 1,05, p = 0,30) n’établit jamais que H0 est vraie ; elle informe simplement le praticien que les données recueillies s’avèrent insuffisantes ou trop bruitées pour autoriser son rejet légitime.
Une dérive tout aussi préjudiciable pour la science réside dans les pratiques d’optimisation opportuniste post hoc, collectivement rassemblées sous le vocable de p-hacking ou d’altération des degrés de liberté méthodologiques. Ces conduites répréhensibles consistent à tester une multiplicité de statistiques standardisées concurrentes (en opérant des sélections opportunistes de covariables, des découpages de sous-groupes imprévus ou l’exclusion discrétionnaire d’observations étiquetées comme aberrantes) jusqu’à ce que la statistique standardisée franchisse enfin la frontière critique conventionnelle des p < 0,05.
Enfin, la focalisation exclusive sur la valeur ponctuelle de la statistique standardisée au détriment de l’estimation de l’intervalle de confiance constitue un appauvrissement informationnel préjudiciable. L’intervalle de confiance entourant l’estimateur de base (par exemple la différence des moyennes brutes x̄1 – x̄2) fournit une vue panoramique de l’incertitude métrologique : il délimite l’ensemble continu des valeurs théoriques compatibles avec les données observées, transcendant la sécheresse dichotomique de la statistique standardisée ponctuelle.
12.3 Normes de rapport académique selon le format APA
Afin de garantir la transparence méthodologique, la réplicabilité des procédures analytiques et la clarté herméneutique au sein des revues scientifiques internationales, l’American Psychological Association (APA) a standardisé de manière méticuleuse la syntaxe rédactionnelle requise pour la communication formelle des résultats issus de tests statistiques paramétriques et non paramétriques.
Les normes académiques contemporaines prescrivent la restitution intégrale et systématique de l’ensemble des coordonnées métrologiques gouvernant l’inférence statistique. Cette syntaxe universelle impose d’indiquer sans omission : l’identifiant littéral de la statistique standardisée testée rédigé en italique (par exemple t, z, F, ou χ2), l’énonciation explicite des degrés de liberté inscrits entre parenthèses, la magnitude numérique exacte de la statistique arrondie au centième près, et la p-valeur rigoureuse rapportée au millième près (en s’interdisant les expressions archaïques telles que p < 0,05 au profit de valeurs exactes comme p = 0,034, la formulation p < 0,001 étant réservée aux valeurs infinitésimales).
La convention moderne impose de consigner les résultats selon des formats standardisés précis :
- Pour un test t de Student à deux groupes : t(58) = 2,47, p = 0,016, d = 0,64, IC à 95 % [0,12 ; 1,16].
- Pour une analyse de variance unidirectionnelle (ANOVA) : F(2, 87) = 5,62, p = 0,005, η2p = 0,11.
- Pour un test du Khi-carré d’indépendance de Pearson : χ2(1, N = 150) = 4,23, p = 0,040, φ = 0,17.
Ces directives éditoriales instaurent une obligation méthodologique déterminante : l’adjonction systématique d’un estimateur standardisé de la taille de l’effet (d de Cohen, êta-carré partiel η2p, ou V de Cramér) articulé à ses bornes d’intervalles de confiance respectives. En associant rigoureusement la statistique de test standardisée — métrique de réfutation face au bruit d’échantillonnage — à la taille d’effet standardisée — mesure de la magnitude théorique réelle de l’effet —, le chercheur offre à la communauté scientifique une vision complète, transparente et reproductible de ses résultats.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Cumming, G. (2012). Understanding the new statistics: Effect sizes, confidence intervals, and meta-analysis. Routledge.
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Hays, W. L. (1994). Statistics (5th ed.). Harcourt Brace College Publishers.
Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289–337. https://doi.org/10.1098/rsta.1933.0009
Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
Popper, K. (1959). The logic of scientific discovery. Hutchinson & Co.
Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108