
Dans le paysage contemporain de l’apprentissage statistique et de l’économétrie appliquée, la modélisation des phénomènes complexes se heurte fréquemment à l’écueil fondamental posé par l’arbitrage entre la flexibilité prédictive et la transparence interprétative. Alors que les approches paramétriques conventionnelles imposent des formes fonctionnelles rigides et souvent réductrices sur les données empiriques, les architectures d’apprentissage automatique contemporaines, à l’instar des forêts aléatoires ou des réseaux de neurones profonds, opèrent fréquemment comme des boîtes noires opaques, rendant ardue l’extraction d’inférences causales ou de seuils d’action clairs. C’est précisément au confluent de ces paradigmes divergents que se positionnent les splines de régression adaptative multivariée, universellement désignées sous l’acronyme MARS (Multivariate Adaptive Regression Splines). Introduite par le statisticien Jerome H. Friedman au début des années 1990, cette méthodologie non paramétrique novatrice déploie une approche par morceaux capable de capturer des non-linéarités prononcées et des interactions multidimensionnelles complexes, tout en conservant une structure mathématique explicite directement assimilable à une extension segmentée du modèle linéaire général.
L’originalité épistémologique de MARS réside dans sa capacité à partitionner de façon totalement autonome et guidée par les données l’espace multidimensionnel des variables prédictives, éliminant ainsi le besoin de spécifier a priori les points de rupture ou les transformations polynomiales des covariables. Grâce à l’utilisation systématique de paires de fonctions charnières unilatérales, le modèle délimite des sous-régions au sein desquelles il ajuste des segments linéaires continus, opérant simultanément une sélection rigoureuse de variables et une estimation optimale de la localisation des nœuds d’inflexion. Cette particularité confère à l’algorithme une robustesse remarquable dans l’analyse de données observationnelles à forte variance, particulièrement dans les sciences du comportement, l’épidémiologie clinique, la psychométrie quantitative et l’écologie numérique, où les dynamiques sous-jacentes présentent intrinsèquement des effets de seuil critique, des phénomènes de saturation et des modérations localisées.
Dans l’environnement statistique GNU R, l’implémentation de référence de cette technique est magistralement incarnée par le package earth, conçu par Stephen Milborrow, qui prolonge et enrichit les spécifications initiales de Friedman en y adjoignant des fonctionnalités avancées de diagnostic, de pondération et d’interfaçage avec les métamoteurs d’apprentissage supervisé modernes. Ce traité exhaustif se propose de disséquer minutieusement les fondements mathématiques, l’architecture computationnelle et le protocole d’application pratique de MARS dans R. En combinant rigueur théorique, diagnostics résiduels approfondis et stratégies de validation croisée au sein de l’écosystème caret, ce document constitue un manuel de référence exhaustif destiné aux biostatisticiens, chercheurs en sciences comportementales et praticiens de la science des données désireux d’exploiter la pleine puissance des splines adaptatives pour décrypter la structure cachée de leurs distributions empiriques.
1. Fondements théoriques et épistémologiques des splines de régression adaptative multivariée (MARS)
1.1 Origines statistiques et dépassement du modèle linéaire classique
Le paradigme de la régression linéaire ordinaire repose sur une hypothèse ontologique particulièrement restrictive : la linéarité globale et immuable de l’espérance conditionnelle de la variable dépendante par rapport aux régresseurs. Si cette formulation garantit, sous les conditions canoniques du théorème de Gauss-Markov, l’obtention des meilleurs estimateurs linéaires non biaisés (BLUE), elle démontre une vulnérabilité critique dès lors que la réalité empirique sous-jacente s’écarte de cette rectitude géométrique. Dans les configurations où les covariables exercent des effets marginaux variables selon leur niveau de concentration, l’analyste classique se voit contraint de recourir à des transformations polynomiales d’ordre supérieur ou à des fonctions logarithmiques arbitraires. Toutefois, ces artifices paramétriques souffrent d’une rigidité structurelle sévère : l’introduction d’un terme quadratique ou cubique affecte l’estimation de la pente sur l’intégralité du domaine de définition de la variable, créant des distorsions prédictives majeures aux extrémités de la distribution, un phénomène étroitement apparenté au phénomène d’oscillation de Runge.
Face à ces apories méthodologiques, Jerome H. Friedman a publié en 1991 son article fondateur introduisant MARS au sein des Annals of Statistics, marquant une rupture paradigmatique avec les méthodes d’ajustement global. Friedman a conceptualisé une architecture capable de découvrir de manière endogène les irrégularités locales du paysage des données, affranchissant le chercheur de la corvée de spécification manuelle des non-linéarités. Contrairement aux régressions à noyau ou aux splines de lissage traditionnelles, qui deviennent rapidement inopérantes lorsque le nombre de dimensions s’accroît en raison de la malédiction de la dimensionnalité théorisée par Richard Bellman, MARS concentre son effort algorithmique exclusivement sur les sous-espaces de dimension inférieure contenant de l’information prédictive structurée.
Ce basculement épistémologique matérialise une synthèse remarquable entre deux exigences scientifiques antagonistes : d’une part, la flexibilité opérationnelle propre aux techniques non paramétriques, aptes à épouser des formes topologiques complexes sans hypothèses distributives restrictives ; d’autre part, la clarté explicative inhérente aux modèles linéaires additifs. En générant une équation finale constituée d’une somme pondérée de segments linéaires contigus, MARS conserve la lisibilité analytique directe des coefficients de régression. Chaque paramètre estimé quantifie précisément l’inflexion du taux de variation de la réponse au franchissement d’un seuil critique donné, comblant ainsi le fossé séculaire entre la modélisation statistique inférentielle et l’apprentissage algorithmique prédictif.
1.2 Concepts clés : non-linéarité par morceaux et adaptativité
L’armature théorique de MARS repose sur le principe de la segmentation adaptative de l’espace multidimensionnel des prédicteurs. Plutôt que de contraindre la trajectoire de réponse à une courbure différentiable uniforme sur l’ensemble du domaine d’observation, l’algorithme partitionne dynamiquement ce domaine en hypercubes locaux interconnectés. À l’intérieur de chaque partition, la relation entre l’espérance de la variable cible et les covariables est modélisée par un hyperplan affine simple. Cette approche par morceaux confère au modèle une plasticité remarquable, lui permettant de capturer des accélérations abruptes, des décélérations prononcées, voire des inversions complètes de tendance, tout en maintenant une continuité géométrique absolue aux frontières de chaque intervalle de partitionnement.
Il convient de distinguer sans ambiguïté les splines linéaires par morceaux employées par MARS des splines cubiques lissées conventionnelles prévalant dans les modèles additifs généralisés (GAM). Ces dernières mobilisent des fonctions de base polynomiales de degré trois assorties de contraintes de continuité sur les première et deuxième dérivées, ce qui impose une courbure lisse et continue sur tout le spectre des données. Bien que séduisante d’un point de vue visuel, cette douceur obligatoire engendre deux limitations majeures : elle obscurcit l’identification formelle des seuils discrets où s’opèrent les ruptures de dynamique, et elle exige un coût calculatoire prohibitif dès lors que l’on tente d’estimer des interactions croisées au-delà de deux dimensions. Les splines linéaires par morceaux de MARS, en revanche, n’imposent la continuité que sur la fonction elle-même (continuité de classe C0), tolérant des discontinuités ponctuelles dans la dérivée première au niveau des nœuds (knots), ce qui reflète avec une fidélité accrue les transitions brusques observées dans de nombreux processus empiriques.
Le terme « adaptatif » souligne le caractère entièrement automatisé et probabiliste du positionnement de ces nœuds. Alors que les techniques de régression segmentée traditionnelles requièrent que le modélisateur postule a priori l’emplacement temporel ou spatial des fractures structurelles, MARS teste de façon récursive chaque valeur observée de chaque covariable candidate comme un nœud potentiel. Ce processus itératif réalise simultanément une double tâche computationnelle d’une importance capitale : la sélection automatique des variables prédictives statistiquement pertinentes (en ignorant purement et simplement les variables non informatives) et la localisation optimale des points de brisure fonctionnelle.
1.3 Pertinence de MARS dans l’analyse des données comportementales et psychométriques
L’analyse des distributions comportementales, cognitives et psychométriques expose fréquemment le statisticien à des configurations empiriques qui violent de manière flagrante les hypothèses de linéarité et de normalité multivariée. Dans ces disciplines, les processus psychologiques sous-jacents obéissent rarement à des variations monotones proportionnelles. Au contraire, ils sont caractérisés par des seuils d’activation minimaux, en deçà desquels aucune modification mesurable du comportement n’est détectable, suivis d’une phase de réactivité quasi-linéaire intense, débouchant finalement sur des effets de plafond ou de saturation cognitive où toute augmentation additionnelle du stimulus ne produit aucun incrément de réponse notable.
Considérons, à titre d’illustration méthodologique, la modélisation du syndrome d’épuisement professionnel (burnout) en fonction de la charge de travail hebdomadaire cumulée. Une régression linéaire classique présuppose qu’une heure supplémentaire de labeur génère un préjudice psychologique identique, que le travailleur passe de 20 à 21 heures ou de 60 à 61 heures par semaine. Cette assertion est formellement réfutée par les données cliniques. MARS excelle dans la formalisation de cette phénoménologie : l’algorithme est capable de fixer automatiquement un premier nœud structurel à 42 heures, indiquant l’absence d’impact délétère sous ce seuil, puis une pente ascendante abrupte entre 42 et 58 heures, suivie d’un second nœud au-delà duquel la détresse psychologique se stabilise à un niveau d’épuisement critique maximal. L’équation de base isole ainsi directement les seuils d’intervention organisationnelle pertinents.
En outre, les instruments de mesure psychométriques, tels que les échelles de Likert agrégées ou les scores d’inventaires de personnalité, présentent une variance d’échantillonnage substantielle et sont vulnérables aux erreurs de mesure non systématiques. Les techniques non linéaires hautement flexibles, comme les séparateurs à vaste marge ou les perceptrons multicouches, ont une propension démesurée à surajuster ces fluctuations aléatoires en assimilant le bruit d’échantillonnage à un signal théorique. Par sa politique d’élagage parcimonieux rigoureuse et sa formulation linéaire par morceaux, MARS régularise naturellement la complexité du modèle, offrant un bouclier robuste contre le surapprentissage tout en capturant les non-monotonies authentiques, comme les relations curvilinéaires en U inversé illustrées par la célèbre loi de Yerkes-Dodson reliant le niveau d’éveil physiologique à l’efficacité de la performance cognitive.
2. Architecture mathématique et formalisation des fonctions charnières
2.1 Structure et comportement des fonctions charnières (Hinge Functions)
L’élément atomique de construction de l’architecture MARS est la fonction linéaire par morceaux unilatérale, communément désignée dans la littérature anglo-saxonne sous le vocable de hinge function ou fonction charnière, et mathématiquement équivalente à l’opérateur d’unité linéaire rectifiée (ReLU) massivement employé dans l’ingénierie des réseaux neuronaux profonds. Pour chaque variable prédictive continue x et pour chaque point de rupture potentiel t appartenant au domaine de définition empirique de cette variable, on définit une paire symétrique de fonctions de base réflexives, orientées respectivement vers la droite et vers la gauche :
h(x – t) = [+(x – t)]+ = max(0, x – t)
h(t – x) = [-(x – t)]+ = max(0, t – x)
Ces deux fonctions partagent le même nœud structural situé en x = t. L’examen des propriétés de cette formulation révèle son élégance analytique : pour la fonction orientée vers la droite, toute valeur de l’espace d’entrée strictement inférieure à t est projetée sur une valeur nulle constante, annulant purement et simplement la dérivée locale ; dès lors que x franchit le seuil critique t, la fonction adopte un comportement strictement linéaire de pente unitaire. Inversement, la fonction complémentaire orientée vers la gauche capture l’activité du signal statistique exclusivement dans le domaine où x < t, s’annulant de manière uniforme pour toute valeur supérieure ou égale au nœud.
Du point de vue topologique, cette transformation convertit l’espace original à une dimension en deux demi-plans linéaires raccordés de façon continue au niveau du point d’inflexion. La fonction résultante est continue sur l’intégralité de la droite réelle, garantissant l’absence de sauts ou de ruptures de continuité dans les prédictions du modèle final, même si sa dérivée subit une discontinuité de première espèce au point exact t. En combinant judicieusement de telles paires de fonctions sur différentes variables d’entrée ou à différents niveaux d’un même régresseur, MARS acquiert la capacité d’approximer n’importe quelle surface fonctionnelle multivariée, qu’elle soit continue, convexe, concave ou ondulatoire, avec un niveau de précision arbitrairement élevé selon le nombre de fonctions de base mobilisées.
2.2 Équation générale du modèle MARS
La formalisation globale d’un modèle MARS s’articule comme une expansion linéaire en série de fonctions de base multivariées. L’estimation de l’espérance conditionnelle de la variable de réponse y s’exprime rigoureusement sous la forme analytique suivante :
f(X) = β0 + ∑m=1M βm Bm(X)
Dans cette formulation paramétrique, le scalaire β0 représente le coefficient d’interception globale, reflétant le niveau moyen de base de la réponse lorsque toutes les fonctions de base sont inactives ou nulles. Les coefficients βm correspondent aux poids de régression associés à chaque fonction de base composite Bm(X), tandis que M désigne le nombre total de termes conservés dans le modèle structurel définitif à l’issue de la phase d’optimisation.
Chaque fonction de base Bm(X) peut emprunter l’une des trois formes structurelles suivantes :
- Une valeur unitaire constante, bien que celle-ci soit traditionnellement isolée sous la forme du terme d’interception global
β0. - Une fonction charnière univariée isolée, c’est-à-dire de la forme pure
max(0, xj - t)oumax(0, t - xj), capturant un effet non linéaire univarié direct de la covariable xj. - Un produit croisé multidimensionnel comprenant deux ou plusieurs fonctions charnières portant sur des variables distinctes, formalisé par le produit :
∏k=1Km hm,k(xj(m,k) - tm,k), où Km représente l’ordre d’interaction du terme m.
L’intégration des variables catégoriques s’opère au sein de cette même architecture mathématique unifiée via une adaptation spécifique introduite par Friedman. Pour un facteur qualitatif présentant plusieurs modalités discrètes, l’algorithme génère des fonctions indicatrices d’appartenance à des sous-ensembles de catégories, permettant de fusionner et de segmenter les niveaux de manière totalement adaptative sans recourir nécessairement à une décomposition manuelle intégrale en variables binaires (one-hot encoding), préservant ainsi la parcimonie globale du système d’équations.
2.3 Propriétés computationnelles et stabilité numérique
L’ajustement des coefficients β = (β0, β1, ..., βM)T d’un modèle MARS, une fois l’ensemble des fonctions de base Bm(X) structurellement fixé par l’algorithme adaptatif, s’effectue au moyen de l’estimateur canonique des moindres carrés ordinaires (OLS). En posant la matrice de dessin B de dimension N × (M + 1), où chaque colonne m contient les évaluations empiriques de la fonction de base Bm sur les N observations d’entraînement, le vecteur optimal des coefficients résout le système linéaire normal classique :
(BT B) β = BT y
Sur le plan algorithmique et numérique, la matrice de projection BT B pose des défis de calcul non triviaux. Les fonctions charnières issues d’une même covariable ou de variables fortement corrélées manifestent fréquemment une collinéarité sévère, ce qui induit un mauvais conditionnement spectral de la matrice. Pour parer à toute instabilité d’inversion matricielle ou aux erreurs d’arrondi susceptibles de vicier les prédictions, les implémentations modernes de MARS, notamment au sein du moteur en langage C sous-jacent au package earth, proscrivent l’inversion directe de la matrice d’information. Elles mobilisent systématiquement des décompositions matricielles orthogonales, telles que la décomposition QR modifiée ou l’orthogonalisation de Gram-Schmidt modifiée avec pivotement de colonnes.
Cette orthogonalisation incrémentale confère une stabilité remarquable à l’estimation des estimateurs. De surcroît, le comportement asymptotique de ces estimateurs a été rigoureusement documenté dans la littérature statistique. Sous des conditions de régularité standard relatives au domaine d’échantillonnage et à la distribution sous-jacente des erreurs, les estimateurs des coefficients de MARS convergent vers leurs valeurs optimales au sens de la minimisation de la divergence de Kullback-Leibler, à une vitesse asymptotique qui s’affranchit remarquablement de la dimension globale des prédicteurs, à condition que la véritable dimension sous-jacente de l’espace d’interaction demeure modérée.
3. Algorithme d’ajustement : dynamique des phases avant et arrière
3.1 La phase avant (Forward Pass) : expansion gourmande du modèle
Le calibrage d’un modèle MARS s’articule autour d’une démarche séquentielle en deux temps majeurs, le premier étant constitué par la phase d’expansion avant (forward pass). Cette étape opère selon une heuristique gloutonne ou « gourmande » (greedy algorithm). Le processus s’initialise avec un modèle ne comportant que le terme constant B0(X) = 1, associé à la moyenne empirique de la variable réponse. À chaque itération de la boucle d’expansion, l’algorithme passe en revue de manière exhaustive l’ensemble des fonctions de base déjà admises dans le modèle, ainsi que la totalité des variables prédictives disponibles et l’intégralité de leurs valeurs uniques observées dans l’échantillon d’apprentissage, ces dernières agissant comme des nœuds candidats t.
Pour chaque triplet composé d’une fonction de base parent existante Bp(X), d’une covariable candidate xj (non encore exploitée au sein de Bp afin de prévenir les redondances triviales) et d’un nœud candidat t, l’algorithme construit temporairement une paire réflexive de nouveaux termes :
Bnew,1(X) = Bp(X) × max(0, xj – t)
Bnew,2(X) = Bp(X) × max(0, t – xj)
Ces deux nouvelles fonctions sont momentanément incorporées au modèle. Le système d’équations résultant est intégralement réestimé par les moindres carrés ordinaires, et la diminution conjointe de la somme des carrés des résidus (RSS) est scrupuleusement quantifiée. Le triplet réalisant la réduction maximale de l’erreur résiduelle globale est définitivement sélectionné et intégré au pool des bases actives. Ce cycle itératif se poursuit sans discontinuer jusqu’à ce qu’un critère d’arrêt prédéterminé soit atteint, qu’il s’agisse de la saturation du nombre maximal arbitraire de termes fixé par l’opérateur (paramètre nk dans le package earth) ou d’une diminution marginale de la RSS tombant sous un seuil d’amélioration infinitésimal thresh.
Il est fondamental de noter qu’à l’issue de cette phase avant, le modèle produit se trouve presque systématiquement dans un état de surapprentissage (overfitting) pathologique. En chassant voracement chaque variation locale du nuage de points, l’algorithme absorbe une proportion excessive de fluctuations stochastiques non reproductibles, aboutissant à une variance d’échantillonnage insoutenable et à une complexité structurelle démesurée comptant fréquemment plusieurs dizaines de termes combinés.
3.2 La phase arrière (Backward Pruning) : élagage et parcimonie
Pour remédier à la surparamétrisation délétère générée par la phase d’expansion, MARS met en œuvre une seconde étape correctrice décisive : la phase d’élagage arrière (backward pruning pass). Ce processus opère selon une logique rigoureusement inverse à celle du premier passage. Partant du modèle maximal surajusté obtenu à la fin de la phase avant, l’algorithme procède à l’élimination séquentielle des termes de base dont la contribution explicative marginale s’avère la plus faible, c’est-à-dire ceux dont la suppression provoque le plus infime accroissement de la somme des carrés des résidus.
Contrairement à l’expansion où les fonctions charnières étaient obligatoirement créées et insérées par paires complémentaires, la phase d’élagage jouit d’une liberté totale de démantèlement : elle est parfaitement habilitée à supprimer l’un des bras de la paire tout en conservant son complément si ce dernier démontre une utilité empirique intrinsèque. De plus, les fonctions de base ancêtres peuvent être évincées même si des termes descendants issus de leurs interactions demeurent actifs au sein du modèle, bien que la plupart des implémentations surveillent la hiérarchie pour maintenir une cohérence structurelle minimale si le modélisateur le requiert.
Ce délestage progressif génère une séquence emboîtée de sous-modèles candidats de complexité décroissante, échelonnés depuis le modèle maximal initial jusqu’au modèle intercept-only ne contenant aucun régresseur. Cette stratégie d’élagage est conceptuellement identique à la régularisation mise en œuvre dans les arbres de régression et de classification de type CART (Classification and Regression Trees) développés par Breiman et ses collaborateurs. L’enjeu mathématique de cette phase réside dans la détermination rigoureuse de l’instant exact où l’élagage doit être interrompu, afin de figer le sous-modèle qui concilie de manière optimale le compromis classique entre le biais d’approximation et la variance d’estimation.
3.3 Critère de validation croisée généralisée (GCV)
L’arbitrage ultime guidant la sélection du meilleur sous-modèle au cours de l’élagage arrière ne peut être confié à la simple minimisation de la somme des carrés résiduels empiriques, sous peine de sélectionner inévitablement le modèle le plus complexe et le plus surajusté. L’évaluation de chaque candidat recourt donc à une métrique d’optimisation pénalisée particulièrement raffinée conçue par Grace Wahba : la validation croisée généralisée (Generalized Cross Validation, abrégée en GCV). Le score GCV pour un sous-modèle comprenant un ensemble de bases données se formalise mathématiquement ainsi :
GCV(M) = [ (1 / N) ∑i=1N (yi – fM(xi))2 ] / [ 1 – ( C(M) / N ) ]2
Au numérateur de cette fraction apparaît l’erreur quadratique moyenne standard intra-échantillon. Le dénominateur, quant à lui, opère comme un terme de pénalité de complexité sévère qui gonfle le ratio dès que le nombre effectif de paramètres estimé, noté C(M), croît relativement à la taille de l’échantillon N. La sophistication algorithmique de Friedman réside dans la décomposition formelle de ce terme de complexité effectif :
C(M) = trace(B (BT B)-1 BT) + d × r = (r + 1) + d × r
Dans cette formulation, r quantifie le nombre de fonctions de base indépendantes conservées dans le sous-modèle évalué, tandis que d représente un coefficient de pénalité spécifique alloué à chaque nœud d’inflexion sélectionné. En effet, l’estimation adaptative de l’emplacement d’un nœud ne saurait être considérée comme un calcul computationnellement neutre ; elle s’apparente à l’estimation implicite d’un paramètre continu supplémentaire. Les simulations empiriques étendues menées par Friedman ont démontré qu’une valeur de pénalité de d = 3 (parfois ajustable entre 2 et 4 selon le degré d’interaction) procure une approximation asymptotique remarquablement fidèle de la véritable erreur de prédiction hors-échantillon obtenue par une validation croisée leave-one-out intégrale, tout en épargnant les coûts d’entraînement itératifs prohibitifs de cette dernière.
Le sous-modèle présentant la valeur minimale absolue sur l’ensemble de la trajectoire du profil GCV est finalement élu comme le modèle MARS optimal définitif. Il matérialise le sommet de la parcimonie prédictive, purgeant les fonctions parasites et ne conservant que l’architecture structurelle minimale requise pour capturer l’essence de la régularité des données.
4. Configuration de l’écosystème R et préparation rigoureuse des données
4.1 Installation et chargement des packages spécialisés
L’implémentation opérationnelle des modèles MARS au sein de la plateforme R requiert le déploiement coordonné d’un ensemble de bibliothèques logicielles spécialisées assurant à la fois le moteur de calcul, les routines d’optimisation hyperparamétrique et les interfaces graphiques diagnostiques. Le pilier central de cet édifice est le package earth, développé par Stephen Milborrow. Cette bibliothèque constitue une réécriture moderne, hautement optimisée et substantiellement étendue du code FORTRAN originel écrit par Jerome Friedman dans les années 1990. Elle surpasse historiquement l’ancienne bibliothèque mda en proposant une prise en charge complète des modèles de classification, des matrices creuses, ainsi qu’une panoplie d’outils d’évaluation de la variance d’estimation.
Pour orchestrer les phases comparatives et standardiser le protocole d’apprentissage, le recours au métamoteur caret (Classification and REgression Training) ou à la suite contemporaine tidymodels s’avère hautement stratégique. Ces environnements permettent d’automatiser les schémas de rééchantillonnage croisé et d’explorer de manière programmatique les grilles d’hyperparamètres. Enfin, la manipulation matricielle et la visualisation sémiotique des surfaces de réponse requièrent le chargement conjoint de dplyr pour le remaniement des tenseurs de données, de ggplot2 pour la sémiologie graphique bidimensionnelle, de plotmo pour le tracé immédiat des coupes conditionnelles des modèles statistiques, et de ISLR ou MASS pour l’accès à des jeux de données d’étalonnage psychométriques et biostatistiques mondialement documentés.
L’initialisation de l’environnement s’opère par l’invocation canonique des commandes suivantes en console R :
install.packages(c("earth", "caret", "plotmo", "dplyr", "ggplot2", "ISLR"))
library(earth)
library(caret)
library(plotmo)
library(dplyr)
library(ggplot2)
4.2 Inspection et prétraitement de la structure des données
Bien que MARS démontre une résilience intrinsèque supérieure à celle de la régression linéaire classique face à de multiples pathologies de données (telles que la non-normalité univariée ou la monotonie rompue), l’application rigoureuse de la méthode exige un contrôle drastique de la qualité des prédicteurs avant tout engagement algorithmique. L’étape inaugurale réside dans la vérification de la variance des covariables via l’inspection des prédicteurs à variance quasi-nulle (near-zero variance predictors). Une variable prédictive présentant une distribution dégénérée (par exemple, une modalité concentrant plus de 98 % des observations) est susceptible d’engendrer des instabilités critiques lors de la recherche des nœuds candidats dans la phase d’expansion avant, conduisant à des singularités matricielles numériques.
La gestion des données manquantes (missing values) doit faire l’objet d’un arbitrage méthodologique fondé sur la typologie de l’incomplétude. Contrairement aux arbres de décision non paramétriques purs qui peuvent exploiter des divisions de substitution (surrogate splits), l’algorithme standard d’earth exclut par défaut les lignes comportant des valeurs manquantes (na.action = na.fail ou na.omit). Dans les cadres psychométriques et sociologiques où la non-réponse est courante, l’omission naïve des observations incomplètes expose le chercheur à un biais d’attrition dévastateur. Il est donc impératif de mettre en œuvre une procédure d’imputation multiple par équations chaînées (via le package mice) ou une imputation non paramétrique par plus proches voisins (k-NN) avant d’engager le calibrage de MARS.
Concernant le formatage des types de variables, les covariables qualitatives doivent impérativement être déclarées en tant que factors au sens de la sémantique R. Le package earth possède des algorithmes de factorisation interne capables d’évaluer les regroupements de modalités optimales, prévenant ainsi les erreurs d’encodage arbitraires où des variables catégoriques ordinales seraient traitées de façon fallacieuse comme des gradients continus uniformes.
4.3 Stratégie de partitionnement pour l’évaluation empirique
L’intégrité de l’évaluation prédictive commande d’isoler hermétiquement l’échantillon d’apprentissage dévolu à la construction du modèle de l’échantillon de test destiné à la sanction empirique finale. En présence de modèles adaptatifs à fort pouvoir de segmentation tels que MARS, le risque de fuite d’information (data leakage) est particulièrement prégnant : toute décision de prétraitement ou d’ingénierie des variables fondée sur la globalité du jeu de données biaise favorablement et artificiellement les métriques d’erreur calculées ultérieurement.
Le protocole d’excellence préconise un partitionnement probabiliste stratifié respectant rigoureusement la distribution de probabilité marginale de la variable dépendante continue. Cette stratification s’avère particulièrement cruciale dans les jeux de données comportementales où les valeurs extrêmes de détresse psychologique ou de performance motrice exceptionnelle sont proportionnellement sous-représentées dans les queues de distribution. En mobilisant la fonction createDataPartition du package caret, l’espace d’échantillonnage est partitionné selon un ratio standard (généralement 75 % ou 80 % alloués à la base d’apprentissage, et 20 % ou 25 % sanctuarisés pour le test hors-échantillon).
Cette ségrégation stricte garantit que les erreurs quadratiques moyennes (RMSE) et les coefficients de détermination (R2) rapportés sur l’ensemble de validation constitueront des estimations non biaisées de la généralisabilité du modèle MARS au sein de la population cible sous-jacente.
5. Exploration diagnostique des relations non linéaires préalables dans R
5.1 Visualisation des trajectoires bivariées non linéaires
Préalablement à l’automatisation computationnelle de MARS, le modélisateur statisticien se doit d’acquérir une compréhension phénoménologique de la forme des associations bivariées régissant chaque prédicteur et la réponse ciblée. Cette analyse exploratoire repose principalement sur l’emploi de lisseurs de régression locale par dispersion pondérée (LOESS – Locally Estimated Scatterplot Smoothing) implémentés avec une remarquable flexibilité sémiotique au travers de ggplot2.
L’utilisation systématique de la géométrie geom_smooth(method = "loess", span = 0.75) superposée au nuage de dispersion des points empiriques permet de déceler instantanément l’existence d’hétérogénéités structurales que le modèle linéaire échoue à conceptualiser. L’investigateur doit prêter une attention méticuleuse aux zones de concavité inversée, aux points d’inflexion où la pente s’atténue brusquement (marquant des phénomènes de saturation fonctionnelle), ainsi qu’aux paliers initiaux d’insensibilité. La comparaison optique immédiate entre une droite d’ajustement OLS univariée (method = "lm") et le ruban dynamique du lisseur LOESS documente la nécessité méthodologique formelle d’abandonner le cadre linéaire rigide au profit de la flexibilité segmentée offerte par MARS.
Cette pratique de visualisation prospective permet également au chercheur d’anticiper la vraisemblance empirique des nœuds que le package earth identifiera lors de l’exécution algorithmique ultérieure. Si le lisseur LOESS suggère une rupture d’allure aux alentours du quartile supérieur d’une covariable d’anxiété, la détection computationnelle d’un nœud charnière adjacent confirmera la convergence entre l’intuition graphique descriptive et la régularisation mathématique par minimisation d’erreur.
5.2 Détection préventive de la collinéarité multidimensionnelle
L’existence d’interdépendances linéaires massives entre covariables candidates représente l’une des entraves majeures à la stabilité algorithmique des splines adaptatives. Si la collinéarité sévère n’altère pas substantiellement la capacité purement prédictive globale d’un modèle MARS au sens de la minimisation de l’erreur quadratique moyenne, elle dégrade de façon catastrophique la fidélité de l’interprétation causale et la stabilité structurelle du positionnement des nœuds. Dans une configuration où deux prédicteurs exhibent un coefficient de corrélation linéaire de Pearson excédant des amplitudes critiques (par exemple |r| > 0.85), de minimes fluctuations d’échantillonnage suffisent à basculer arbitrairement la sélection d’un nœud structurel d’une variable à l’autre lors de la phase gloutonne avant.
L’arsenal diagnostique préventif requiert le calcul formel de la matrice de corrélation de Pearson et de Spearman, complété par l’évaluation des facteurs d’inflation de la variance (Variance Inflation Factor, VIF) estimés sur une spécification linéaire additive préliminaire via la bibliothèque car. Tout prédicteur manifestant un score VIF supérieur au seuil canonique de 5 ou 10 signale une redondance informationnelle critique.
En pareille circonstance, le modélisateur averti mettra en œuvre soit une sélection dimensionnelle guidée par la théorie psychométrique (en retenant le construit le plus robuste sur le plan de la validité de contenu), soit une agrégation en score factoriel composite au moyen d’une analyse en composantes principales (ACP) ou d’un modèle d’équations structurelles confirmatoire, purgeant ainsi l’espace des données de sa redondance pathologique avant de soumettre les vecteurs nettoyés à l’optimisation par splines charnières.
5.3 Identification des points atypiques et observations influentes
En vertu de leur sensibilité locale inhérente, les fonctions charnières sont singulièrement vulnérables aux observations influentes situées aux marges extrêmes de l’espace multidimensionnel des prédicteurs. Une valeur aberrante (outlier) ou un point doté d’un bras de levier disproportionné (high leverage point) peut contraindre artificiellement l’algorithme à positionner un nœud structurel à proximité immédiate de cette observation singulière au cours de la phase avant. Ce phénomène produit ce que la littérature nomme un nœud d’isolement : une branche de fonction charnière qui n’est activée que par une ou deux unités statistiques marginales, capturant un artefact stochastique sous couvert d’un prétendu effet d’interaction ou d’un seuil critique non reproductible.
Le diagnostic de ces singularités implique l’évaluation formelle de la distance de Cook et des résidus standardisés calculés sur les approximations d’ouverture. La visualisation des points d’observation au moyen du diagramme de dispersion confrontant les valeurs résiduelles aux leviers (leverage values) met en exergue les unités statistiques dont le potentiel de déformation sur l’ajustement MARS excède les tolérances probabilistes admissibles.
Face à une observation influente certifiée, la doctrine statistique récuse l’élimination arbitraire non documentée. L’analyste doit discriminer entre une erreur matérielle d’encodage (justifiant une correction immédiate ou une délétion légitime) et une variabilité clinique authentique mais extrême. Dans cette seconde occurrence, l’emploi de procédures de winsorisation, ou le recours à l’ajustement robuste au sein d’earth via l’application de fonctions de perte moins sensibles que la somme des carrés purs, garantit que la localisation des nœuds reflète la structure populationnelle globale plutôt que les idiosyncrasies d’individus atypiques isolés.
6. Ajustement d’un modèle MARS univarié et additif avec le package earth
6.1 Syntaxe fondamentale et exécution de base
L’architecture algorithmique de MARS s’exécute avec une remarquable élégance au sein de l’environnement R par l’intermédiaire de la fonction éponyme earth(). Conçue pour mimer l’ergonomie canonique des fonctions d’estimation traditionnelles telles que lm() et glm(), la routine supporte la syntaxe classique par formule mathématique (formula) reliant la variable de réponse vectorielle à la matrice des covariables indicées. Pour modéliser une fonction de régression purement additive, interdisant toute interaction croisée entre variables afin d’isoler exclusivement les trajectoires marginales directes, l’instruction fondamentale s’articule ainsi :
modele_mars_additif <- earth(reponse ~ ., data = donnees_train, degree = 1)
Le paramètre structurel degree = 1 est l’élément régulateur qui restreint l’expansion gloutonne aux seules fonctions de base univariées. L’argument nk (abréviation de number of knots/terms) régit quant à lui le nombre maximal de termes de base susceptibles d’être insérés lors de la phase d’expansion vorace avant. Si l’analyste omet de le spécifier, earth calcule automatiquement un plafond heuristique dérivé de la dimension du jeu de données, défini usuellement comme min(200, max(20, 2 * ncol(x))) + 1. Un autre commutateur fondamental réside dans l’argument thresh, qui définit le seuil d’amélioration minimale de la somme des carrés résiduels (fixé conventionnellement à 0.001) conditionnant la poursuite de l’expansion.
À l’issue de l’exécution, l’objet retourné de classe earth encapsule l’intégralité du processus historique d’ajustement : la chronique détaillée des termes construits lors de la phase avant, la cinétique d’élagage selon le critère GCV durant la phase arrière, les coefficients de régression par moindres carrés finaux, ainsi que les résidus d’approximation nécessaires aux diagnostics subséquents.
6.2 Décomposition et lecture du résumé statistique
L’exploration analytique du modèle s’opère par l’invocation de la méthode d’inspection summary(modele_mars_additif). L’affichage textuel généré en console R fournit une décomposition exhaustive et hiérarchisée de la structure mathématique émergente. La première section du rapport inventorie les coefficients bêta associés à chaque fonction charnière retenue après élagage, ainsi que la valeur du terme constant d’interception globale.
L’interprétation sémiotique d’une ligne d’extrant type, telle que h(burnout - 42.5) * 1.84, se lit de manière limpide : pour toute valeur de l’indicateur de burnout inférieure ou égale au nœud critique de 42,5 unités, le terme s’annule rigoureusement et n’exerce aucune influence sur l’espérance de la réponse ; dès lors que le score franchit ce point de brisure, chaque unité additionnelle de détresse induit un accroissement de 1,84 unité sur la trajectoire de la variable d’intérêt, toutes choses étant égales par ailleurs. Si une fonction complémentaire orientée à gauche coexiste, à l’instar de h(42.5 - burnout) * -0.62, elle quantifie l’allure de la dynamique pré-rupture sur le segment inférieur.
La section terminale du résumé présente les métriques globales de performance interne : le nombre de prédicteurs initiaux effectivement retenus par rapport à la dimension de départ, le nombre total de fonctions de base conservées au terme de l’élagage, le score final de validation croisée généralisée (GCV), ainsi que le coefficient de détermination régularisé (désigné sous le libellé GRSq pour GCV R-squared). Contrairement au classique R2 qui s’accroît mécaniquement avec l’addition de régresseurs redondants, le GRSq intègre la pénalisation pour la recherche adaptative des nœuds ; un score élevé atteste d’une puissance prédictive hautement reproductible hors-échantillon.
6.3 Représentation graphique de la courbe ajustée
L’avantage incomparable des splines de régression adaptative linéaires par morceaux par rapport aux méthodes non paramétriques opaques réside dans leur traductibilité graphique immédiate. L’analyse ne saurait se satisfaire d’une abstraction numérique : l’inspection optique des brisures de pente concrétise empiriquement la théorie postulée par le chercheur. La bibliothèque earth intègre nativement des surcharges graphiques spécialisées, mais l’utilisation conjointe de plotmo() offre un rendu visuel d’une sophistication supérieure.
L’appel de la commande plotmo(modele_mars_additif) génère automatiquement une planche de graphiques isolant l’effet marginal conditionnel de chaque variable indépendante incluse dans l’équation finale, en fixant l’intégralité des autres prédicteurs à leurs valeurs médianes empiriques respectives. La courbe représentative matérialise une trajectoire géométrique brisée, composée de segments linéaires contigus s’articulant précisément au niveau des nœuds mathématiques déterminés par l’algorithme.
Il est hautement recommandé de superposer visuellement les observations de dispersion individuelles à la courbe ajustée et d’y adjoindre les intervalles de confiance à 95 % calculés le long du continuum de prédiction. Cette visualisation met en lumière la variabilité de la précision estimative : aux abords des extrémités de distribution où la densité d’échantillonnage s’amenuise, l’élargissement des bandes de confiance alerte le chercheur sur l’incertitude structurelle entourant la trajectoire, prévenant toute surinterprétation des segments terminaux.
7. Extension aux interactions multivariées d’ordre supérieur
7.1 Paramétrage du degré d’interaction dans earth
L’une des contributions méthodologiques les plus révolutionnaires de MARS réside dans sa capacité à modéliser sans préjugé structural des interactions dimensionnelles d’ordre supérieur sans succomber à l’explosion computationnelle qui paralyse les modèles linéaires généralisés expansés manuellement. Dans le package earth, l’accès à cette capacité multivariée avancée est piloté par l’argument structurel degree. Par défaut calibré sur degree = 1 (modèle purement additif), le fait de reconfigurer cet hyperparamètre à une valeur supérieure modifie radicalement le comportement de la phase d’expansion avant :
modele_mars_interactions <- earth(reponse ~ ., data = donnees_train, degree = 2)
En fixant degree = 2, l’analyste autorise expressément l’algorithme glouton à multiplier une fonction charnière univariée nouvellement créée par une fonction de base univariée préexistante issue d’un autre prédicteur. Il devient ainsi possible de générer des termes composites d’ordre deux combinant deux covariables distinctes. Si des ordres supérieurs d’interaction peuvent être mathématiquement sollicités en paramétrant degree = 3 ou davantage, la communauté méthodologique s’accorde à prescrire une prudence extrême : au-delà du second ordre, le nombre de combinaisons candidates s’accroît selon une cinétique combinatoire exponentielle, dégradant la stabilité computationnelle, amplifiant les risques de surapprentissage sévère et rendant la décomposition cognitive des résultats virtuellement impossible pour l’esprit humain.
Le contrôle de l’explosion dimensionnelle est parallèlement jugulé par le paramètre nk. Dès lors que degree = 2 est stipulé, il convient fréquemment d’augmenter raisonnablement la valeur de nk afin de concéder à l’algorithme un espace d’exploration initial suffisamment vaste pour découvrir les synergies croisées subtiles avant que n’intervienne la phase de purge et d’élagage arrière.
7.2 Interprétation des produits de fonctions charnières
L’intégration d’interactions au sein d’un modèle MARS donne naissance à des termes mathématiques résultant du produit direct de deux fonctions charnières unilatérales simples, adoptant typiquement la syntaxe structurelle suivante :
Bm(X) = max(0, x1 – t1) × max(0, t2 – x2)
D’un point de vue géométrique et conceptuel, ce produit de fonctions de base matérialise un effet modérateur strictement localisé au sein d’un quadrant spécifique de l’espace bidimensionnel des prédicteurs. Contrairement au terme multiplicatif classique d’une régression linéaire standard (x1 × x2) dont l’effet régulateur s’exerce de manière ininterrompue et globale sur toute la surface théorique, le produit charnière de MARS est rigoureusement inactif (prenant une valeur algébrique strictement nulle) sur l’ensemble de l’espace d’entrée, à la seule exception de la région délimitée simultanément par les conditions logiques x1 > t1 ET x2 < t2.
Cette spécificité confère à MARS une puissance analytique sans équivalent pour théoriser les contingences comportementales complexes. En psychologie de la santé ou en psychiatrie épidémiologique, cette formulation permet d’illustrer formellement des hypothèses de vulnérabilité acquise ou de résilience conditionnelle (modèles de diathèse-stress). Par exemple, un niveau de stress aigu mesuré par x1 n’exercera son action pathogène modulée que si et seulement si les ressources de soutien social du sujet (x2) s’effondrent sous un certain seuil de sécurité t2. Dans toute autre circonstance où les capacités adaptatives demeurent préservées, le terme multiplicatif est totalement neutralisé par l’opérateur max(0, ...), traduisant fidèlement la non-linéarité fondamentale des processus d’adaptation humaine.
7.3 Visualisation tridimensionnelle des surfaces de réponse
L’appréhension cognitive d’interactions bivariées non linéaires requiert impérativement l’abandon des représentations planes simples au profit de surfaces de réponse tridimensionnelles (3D response surfaces) et de cartographies par lignes de niveau (contour plots). Le package complémentaire plotmo a été précisément instrumenté pour automatiser cette projection spatiale à partir d’un objet de modèle complexe généré par earth.
L’instruction générique plotmo(modele_mars_interactions, pmethod = "partdep") analyse l’arbre d’équations et génère automatiquement des perspectives orthogonales pour chaque couple de variables engagé dans un terme d’interaction d’ordre deux non nul. L’axe des ordonnées verticales projette l’amplitude de la réponse conditionnelle, tandis que le plan horizontal est articulé par les deux covariables d’interaction. Les zones où le produit de charnières est nul apparaissent sous la forme d’un plateau rigoureusement plan et horizontal. Dès que les coordonnées de l’observation franchissent conjointement le couple de nœuds critiques (t1, t2), la surface s’incline selon une rampe torsadée dont l’angle d’attaque est quantifié par le coefficient estimé βm.
L’adjonction de palettes chromatiques continues (dégradés topologiques) et de diagrammes isoclines permet de documenter les crêtes de synergie ou les vallées d’antagonisme fonctionnel. Cette clarté sémiotique offre au modélisateur un support de communication d’une clarté pédagogique exceptionnelle pour expliciter des arbitrages complexes auprès de décideurs cliniques ou organisationnels hermétiques aux formules algébriques abstraites.
8. Optimisation des hyperparamètres et validation croisée avec caret
8.1 Définition de la grille de recherche hyperparamétrique
Bien que l’algorithme natif d’earth intègre son propre protocole interne d’élagage régulé par le critère de validation croisée généralisée (GCV), l’obtention d’une architecture prédictive d’une résilience absolue commande de confronter le modèle à un schéma d’optimisation externe par validation croisée indépendante. Cette étape a pour finalité d’ajuster finement les deux hyperparamètres déterminants régissant la structure de MARS : le paramètre degree, qui contraint l’ordre maximal d’interaction admissible, et le paramètre nprune, qui borne de manière déterministe le nombre ultime de termes que la phase arrière est autorisée à sanctuariser.
L’infrastructure unifiée offerte par le package caret (Classification and REgression Training) constitue l’environnement privilégié pour conduire ce réglage d’optimisation (hyperparameter tuning). La première étape méthodologique consiste à configurer une matrice de recherche combinatoire méthodique au moyen de la fonction expand.grid(). Une planification rigoureuse définira typiquement une plage d’évaluation explorant les degrés d’interaction un et deux, conjuguée à une séquence arithmétique dense pour nprune s’étirant par exemple de 2 à 30 ou 40 termes potentiels :
grille_hyperparam <- expand.grid(degree = 1:2, nprune = seq(2, 35, by = 2))
Parallèlement, la configuration de l’échantillonnage de réentraînement est confiée à l’opérateur trainControl(). On privilégiera une validation croisée k-fold répétée (par exemple 10 blocs de découpage, réitérés 5 fois avec des graines probabilistes distinctes), matérialisée par l’instruction method = "repeatedcv", number = 10, repeats = 5, garantissant une variance minimale de l’estimateur de l’erreur d’ajustement.
8.2 Exécution de l’entraînement standardisé
Le déclenchement du cycle computationnel d’entraînement est orchestré par l’appel unifié de la fonction train() de caret, en ciblant spécifiquement la méthode algorithmique method = "earth". Ce wrapper transparent transfère les instructions matricielles au moteur sous-jacent de Stephen Milborrow tout en interceptant les flux d’évaluation à chaque pliure de la validation croisée :
set.seed(42)
mars_optimise <- train(

  reponse ~ .,

  data = donnees_train,

  method = "earth",

  trControl = trainControl(method = "repeatedcv", number = 10, repeats = 5),

  tuneGrid = grille_hyperparam,

  metric = "RMSE"

)
Durant cette phase opérationnelle, caret recalibre itérativement le modèle sur 90 % des sous-ensembles d’apprentissage et prédit les 10 % résiduels sanctuarisés, itérant l’opération sur l’intégralité des combinaisons cartésiennes définies dans la grille d’hyperparamètres. Les métriques statistiques d’exactitude prédictive — à savoir la racine carrée de l’erreur quadratique moyenne (RMSE), le coefficient de détermination (R2) et l’erreur absolue moyenne (MAE) — sont scrupuleusement compilées, moyennées et assorties de leurs écarts-types d’échantillonnage respectifs.
Dans l’éventualité de volumétries massives de données ou d’une exploration dense de la grille de réglage, l’investigateur peut préalablement initialiser un backend d’exécution en calcul parallèle multi-cœur via l’enregistrement des packages doParallel ou future, écourtant ainsi drastiquement les délais de convergence temporelle de l’inférence.
8.3 Sélection et validation du modèle optimal
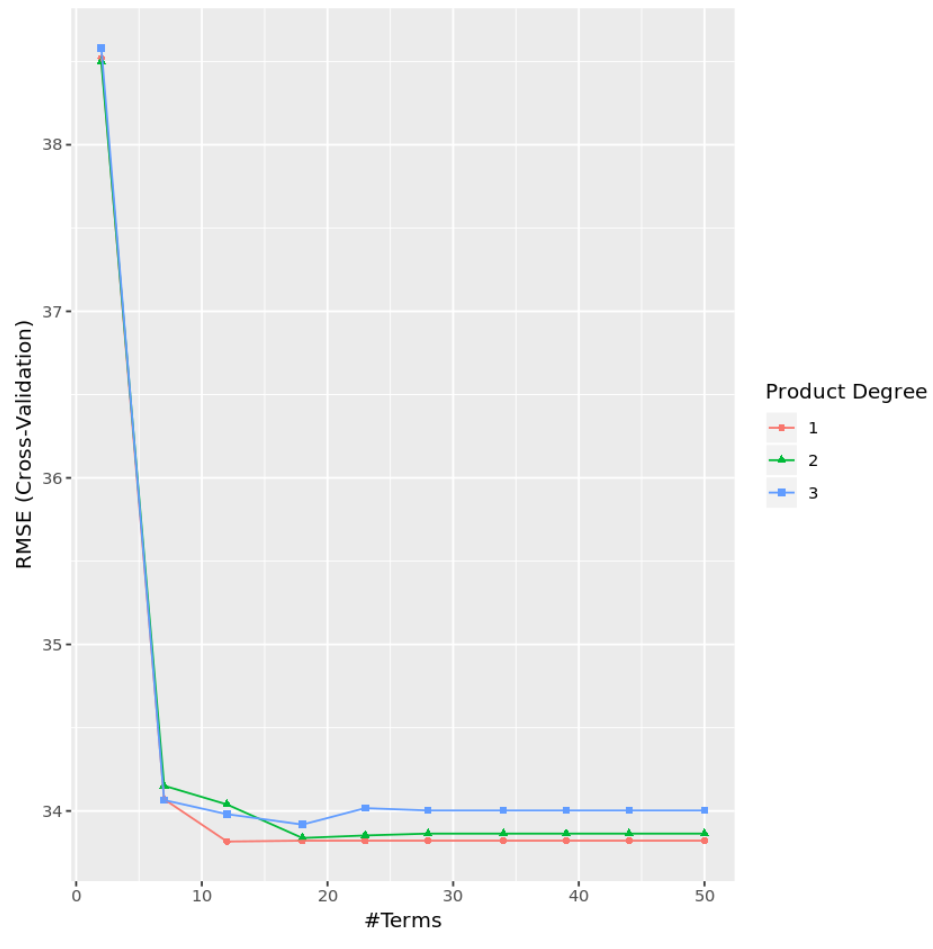
L’arbitrage clôturant la phase d’optimisation hyperparamétrique ne doit pas être guidé aveuglément par la quête effrénée du RMSE minimal absolu. Dans les configurations d’échantillonnage bruitées, le modèle minimisant nominalement l’erreur d’apprentissage au troisième ordre décimal peut afficher une complexité paramétrique disproportionnée, signalant un début de surajustement structurel. L’inspection sémiotique de l’objet optimisé au moyen de la commande ggplot(mars_optimise) expose la trajectoire de l’erreur quadratique en fonction de la taille du modèle découpé selon les différents degrés d’interaction.
On observe de manière quasi-universelle une décroissance rapide et salutaire de l’erreur lorsque nprune s’élève depuis 2 jusqu’à une valeur seuil intermédiaire, formant un coude de stabilisation asymptotique au-delà duquel l’adjonction de termes de base additionnels ne procure aucun gain généralisable mesurable. Conformément aux principes de parcimonie scientifique et aux préconisations de Breiman et Kuhn, il s’avère particulièrement sage de solliciter la règle de l’écart-type unique (One Standard Error Rule), stipulée dans caret par la sélection selectionFunction = "oneSE" au sein de trainControl. Cette heuristique désigne le modèle le plus parcimonieux (le plus dépouillé en termes) dont l’erreur prédictive se situe à moins d’un écart-type de l’erreur minimale absolue observée.
Le sous-modèle ultimement certifié par le protocole est automatiquement réajusté par caret sur l’intégralité du contingent d’entraînement initial. Il est extrait via la commande mars_optimise$finalModel, prêt à subir l’épreuve des diagnostics d’adéquation résiduelle.
9. Diagnostics statistiques et vérification de la validité résiduelle
9.1 Analyse standard des résidus du modèle earth
L’évaluation rigoureuse de la validité inférentielle d’un modèle MARS exige une autopsie méthodique des résidus d’estimation ei = yi - f^(xi). Bien que MARS constitue un estimateur non paramétrique dans la détection des formes fonctionnelles, son ajustement terminal par les moindres carrés ordinaires hérite des postulats fondamentaux de régularité statistique requis pour garantir la validité des intervalles d’estimation. L’outil diagnostique de référence réside dans l’invocation directe de la commande plot.earth(modele_optimal$finalModel), qui génère une planche d’inspection sémiotique normalisée articulée autour de plusieurs représentations graphiques capitales.
Le graphique primordial confronte les résidus standardisés aux valeurs prédites (Residuals vs Fitted). L’absence de structure pathologique se manifeste optiquement par un nuage de points aléatoirement disséminé au sein d’une bande horizontale symétrique centrée sur l’ordonnée zéro, sans manifestation d’évasement en entonnoir. Une dispersion divergente signalerait une violation de l’hypothèse d’homoscédasticité (variance résiduelle constante), suggérant le recours potentiel à une transformation stabilisatrice préalable de la variable réponse (transformation logarithmique ou transformation de Box-Cox) ou à une estimation par moindres carrés pondérés.
Concomitamment, le diagramme quantile-quantile (Normal Q-Q plot) superpose la distribution empirique des résidus aux quantiles théoriques d’une loi normale univariée. Tout décrochage marqué au niveau des queues de distribution alerte sur la présence de résidus à distribution leptokurtique ou asymétrique, ce qui impose une réserve quant à la fiabilité des intervalles de confiance asymptotiques déduits du modèle.
9.2 Diagnostic de dépendance sérielle et non-linéarité résiduelle
Une pathologie insidieuse affectant les modèles de splines adaptatives réside dans l’éventualité d’une non-linéarité rémanente non capturée, consécutive à un élagage arrière excessivement agressif ou à une saturation prématurée de l’espace de recherche des nœuds. L’examen des diagrammes de dispersion confrontant les résidus d’estimation à chacune des covariables d’entrée individuelles (Residuals vs Predictors) s’avère indispensable. La présence de courbures systématiques ou de motifs ondulatoires au sein de ces graphiques diagnostiques constitue la preuve formelle que certaines inflexions structurelles de la variable considérée ont été omises par la phase d’expansion avant, enjoignant le chercheur à relaxer les critères d’arrêt en augmentant nk ou en abaissant thresh.
Dans les contextes expérimentaux comportant une dimension temporelle, spatiale ou hiérarchique emboîtée, la présomption d’indépendance des erreurs est fréquemment enfreinte par des processus d’autocorrélation résiduelle sérielle. Le statisticien déploiera alors les tests d’hypothèse canoniques, notamment le test de Durbin-Watson ou le test de Breusch-Godfrey via le package lmtest appliqué sur la formulation linéaire extraite des bases actives :
lmtest::dwtest(modele_optimal$finalModel)
Si une dépendance sérielle statistiquement significative est formellement détectée, le modèle MARS standard doit être amendé par des structures de covariance des erreurs autorégressives, sous peine de sous-estimer dramatiquement les erreurs-types des coefficients et de fabriquer des seuils décisionnels fallacieux.
9.3 Évaluation de la stabilité des nœuds par rééchantillonnage bootstrap
Une vulnérabilité structurelle inhérente aux algorithmes d’optimisation séquentielle gloutonne réside dans l’instabilité potentielle de la localisation des nœuds d’inflexion face à de minimes perturbations de l’échantillonnage empirique. Si une infime variation stochastique dans le recueil des données induit un déplacement substantiel d’un nœud structurel (par exemple, un seuil diagnostique basculant arbitrairement de 35 à 52 unités selon le sous-échantillon extrait), l’interprétabilité théorique et la portée clinique du modèle s’en trouvent irrémédiablement compromises.
L’évaluation de la robustesse structurelle de l’équation terminale exige la mise en œuvre d’un protocole computationnel de rééchantillonnage non paramétrique par bootstrap (généralement 1 000 réplicats aléatoires avec remise). À chaque itération bootstrap, l’intégralité du processus d’estimation de MARS (phases avant et arrière) est réexécutée de novo sur le pseudo-échantillon généré. On compile subséquemment la distribution empirique de la fréquence d’apparition et des localisations numériques des nœuds pour chaque variable prédictive.
Cette démarche computationnelle permet de calculer des intervalles de confiance empiriques par méthode des percentiles pour l’emplacement des seuils critiques découverts. Un nœud structurellement valide se manifestera sous la forme d’un pic de densité unimodal particulièrement étroit et pointu au sein de l’histogramme des réplicats bootstrap, conférant à la règle décisionnelle une légitimité scientifique inattaquable.
10. Interprétabilité, importance des variables et explicabilité du modèle
10.1 Évaluation de l’importance relative des prédicteurs avec evimp
L’un des défis majeurs posés par les modèles multivariés hautement interactifs réside dans la hiérarchisation intelligible de la contribution explicative relative de chaque variable prédictive candidate. Pour répondre à cette exigence analytique, le package earth intègre une fonction d’analyse factorielle robuste nommée evimp() (abréviation d’estimate variable importance). Cette routine évalue l’impact de chaque prédicteur en appliquant trois métriques fondamentales calculées au terme de la trajectoire d’élagage :
- nsubsets : Cette métrique dénombre la fréquence absolue à laquelle le prédicteur apparaît au sein de la séquence optimale de sous-modèles emboîtés générée par la phase arrière. Une variable omniprésente au travers de la quasi-totalité des sous-ensembles taillés se voit décerner un score de robustesse maximal.
- gcv : Elle quantifie la diminution cumulée du critère de validation croisée généralisée attribuable directement à l’introduction des fonctions charnières incorporant la variable considérée. Ce gain est normalisé sur une échelle percentile relative s’échelonnant de 0 à 100 %.
- rss : Semblable à la métrique GCV, elle mesure la réduction brute de la somme des carrés résiduels intra-échantillon imputable aux termes de base associés au prédicteur, offrant une perspective complémentaire sur la capacité explicative pure.
L’invocation syntaxique plot(evimp(modele_optimal$finalModel)) engendre un diagramme à barres horizontales standardisé ordonnant les covariables selon leur pouvoir explicatif descendant. Cette représentation permet d’opérer une ségrégation salutaire entre les prédicteurs pivots de l’architecture comportementale et les facteurs marginaux dont l’influence explicative résiduelle s’avère négligeable, guidant judicieusement les politiques d’optimisation des instruments de mesure psychométriques en suggérant l’éviction des variables non contributives.
10.2 Graphiques de dépendance partielle et profils d’effets
Bien que l’examen analytique des équations linéaires par morceaux fournisse la description mathématique exacte du système, la restitution intuitive des dynamiques d’action exige la neutralisation des covariables d’ajustement afin d’isoler l’effet marginal pur du facteur focal. Cette translation sémiotique est accomplie au moyen des tracés de dépendance partielle (Partial Dependence Plots, PDP), conceptualisés par Friedman et intégrés dans les bibliothèques plotmo et pdp.
La formulation mathématique du tracé de dépendance partielle pour une variable focale xs s’exprime par le calcul de l’espérance conditionnelle marginalisée sur la distribution empirique des autres variables prédictives complémentaires xc :
f^s(xs) = (1 / N) ∑i=1N f^(xs, xi,c)
En matérialisant cette projection graphique, le chercheur observe de manière univoque l’impact marginal net exercé par la covariable sur l’échelle originelle de la réponse mesurée. Les ruptures de pente visualisées traduisent directement la transition entre différents régimes fonctionnels. Ces tracés mettent en évidence l’existence de zones de latence où l’intervention clinique est dénuée de tout effet observable, consécutives à des seuils de basculement au-delà desquels le gain marginal s’accélère intensément, pour finalement déboucher sur un plateau d’inefficacité relative.
Cette décomposition marginale offre une grille de lecture éminemment opérationnelle, surpassant l’obscurité cognitive des coefficients d’interaction conventionnels dont la magnitude demeure tributaire des niveaux arbitraires assignés aux termes modérateurs.
10.3 Traduction opérationnelle des règles de décision issues de MARS
L’apogée translationnelle de la démarche MARS réside dans sa capacité intrinsèque à convertir une structure statistique non paramétrique en un ensemble intelligible de règles décisionnelles déterministes, exploitables directement par des praticiens non statisticiens au sein d’environnements cliniques, sociologiques ou managériaux. Alors que les prédictions émanant de forêts aléatoires requièrent le déploiement d’un pipeline informatique continu pour évaluer l’agrégation de centaines d’arbres divergents, un modèle MARS calibré peut être intégralement transcrit sous la forme d’un tableau d’évaluation clinique simplifié ou d’un nomogramme de décision.
Chaque nœud t isolé par l’algorithme est susceptible de matérialiser un seuil d’alerte diagnostique standardisé. Considérons la modélisation pronostique de l’adhésion thérapeutique de patients chroniques en fonction de marqueurs psychologiques d’auto-efficacité et de détresse émotionnelle. Si l’équation de régression finale isole un nœud charnière orienté à gauche sur le score d’auto-efficacité à t = 28 points, la règle translationnelle s’énonce avec une limpidité clinique immédiate :
- Tout individu affichant un score d’auto-efficacité inférieur au seuil critique de 28 unités requiert une inclusion prioritaire dans un protocole d’accompagnement éducatif renforcé, chaque point manquant sous ce seuil dégradant proportionnellement son pronostic d’adhésion avec une pente d’action chiffrée par le coefficient β.
- Pour les patients franchissant le seuil des 28 unités, l’impact marginal de la variable s’annule, indiquant que des allocations de ressources éducatives additionnelles s’avéreraient superflues, le comportement d’adhésion ayant atteint son niveau asymptotique optimal.
Cette applicabilité directe comble le fossé séparant la recherche algorithmique avancée de la prise de décision empirique sur le terrain. L’investigateur doit toutefois se garder de toute tentation d’inférence causale abusive : l’identification de ces nœuds adaptatifs documente des régularités observationnelles prédictives hautement probables, mais ne saurait se substituer à une validation par essai contrôlé randomisé pour attester formellement qu’une manipulation expérimentale de ces seuils produira les modifications d’état escomptées.
11. Évaluation comparative : MARS versus modèles alternatifs sous R
11.1 MARS versus Modèle Linéaire Généralisé (GLM) et polynômes
La confrontation empirique de MARS avec les extensions polynomiales des modèles linéaires généralisés (GLM) illustre de manière spectaculaire la supériorité structurelle de l’ajustement par segments continus. Dans la pratique quantitative conventionnelle, la modélisation d’une inflexion non linéaire s’exécute couramment par l’insertion de monômes de degré deux ou trois (y ~ x + I(x^2) + I(x^3)). Si cette formulation permet effectivement d’incurver la trajectoire conditionnelle, elle impose une contrainte de courbure globale hautement préjudiciable : la modification de la position d’un point à l’extrême droite du domaine d’observation contraint la forme de la courbe sur son versant gauche.
De surcroît, les régressions polynomiales sont notoires pour générer des oscillations aberrantes de Runge au voisinage des frontières extrêmes de l’espace d’échantillonnage, fabriquant des prédictions délirantes dès que l’on s’aventure en extrapolation marginale. MARS contourne intégralement cet écueil : les fonctions charnières étant strictement unilatérales, l’estimation des paramètres au-delà d’un nœud spécifique n’exerce aucune contrainte géométrique rétroactive sur la rectitude linéaire des segments antérieurs.
Sur des jeux de données de validation croisée indépendants, la comparaison des métriques d’erreur RMSE sanctionne invariablement la défaite du polynôme global au profit de MARS dès lors que la dynamique sous-jacente recèle des asymétries locales ou des effets de plateau prononcés, MARS préservant une stabilité prédictive remarquable là où le polynôme génère des variances aberrantes.
11.2 MARS versus Modèles Additifs Généralisés (GAM)
Les modèles additifs généralisés (GAM), magistralement instrumentés dans R par l’incontournable package mgcv de Simon Wood, représentent le concurrent le plus direct et le plus intellectuellement raffiné des splines MARS. Les GAM recourent à des splines de lissage pénalisées (telles que les thin plate regression splines) minimisant un compromis formel entre l’ajustement résiduel et une pénalité d’ondulation mesurée par l’intégrale du carré de la dérivée seconde (énergie de flexion).
L’avantage esthétique et probabiliste des GAM réside dans la douceur différentiable absolue de la courbe résultante (continuité de classe C2) : les transitions s’opèrent avec une fluidité organique remarquable, dénuée de tout angle vif, ce qui s’accorde élégamment avec les phénomènes physiques ou biologiques régis par des lois de diffusion fluides. Néanmoins, cet avantage conceptuel se paie au prix de limitations analytiques substantielles :
- Absence de nœuds explicites : Les splines pénalisées dispersent l’inflexion sur l’ensemble continu des données, rendant formellement impossible la dérivation de seuils d’action discrets ou de règles cliniques binaires intelligibles.
- Coût computationnel des interactions multidimensionnelles : L’estimation des surfaces tensorielles croisées complexes (
te()outi()dansmgcv) devient rapidement prohibitive en temps calcul et en mémoire vive lorsque la dimension des variables dépasse trois ou quatre facteurs concomitants, alors que MARS gère avec vélocité des interactions localisées creuses au sein d’espaces prédictifs comptant plusieurs dizaines de régresseurs.
MARS apparaît ainsi comme une alternative pragmatique et parcimonieuse aux GAM, troquant la douceur différentiable infinitésimale de la courbe contre une simplicité computationnelle foudroyante et une traductibilité clinique immédiate des paramètres estimés.
11.3 MARS versus Forêts Aléatoires (Random Forests) et Gradient Boosting
L’essor fulgurant des architectures d’apprentissage ensembliste, incarnées par les forêts aléatoires (via les packages ranger ou randomForest) et les algorithmes d’amplification de gradient (Gradient Boosting via xgboost ou lightgbm), a redéfini les standards de la précision prédictive brute. Ces techniques agrègent des centaines, voire des milliers d’arbres de décision décorrélés pour cartographier des topologies empiriques hautement discontinues sans requérir aucune spécification paramétrique fonctionnelle.
Toutefois, cette supériorité prédictive pure se heurte à l’écueil insurmontable de l’opacité cognitive (effet « boîte noire »). Malgré le déploiement d’artifices post-hoc d’explicabilité comme les valeurs SHAP (SHapley Additive exPlanations), il demeure structurellement impossible d’extraire d’une forêt aléatoire une équation mathématique close et continue synthétisant les relations en jeu. De plus, les arbres de régression prédisent la réponse par des constantes locales discontinues par morceaux, engendrant des surfaces de prédiction en escalier incapables d’extrapoler des tendances linéaires au-delà des valeurs observées lors de l’apprentissage.
MARS, quant à lui, opère une synthèse unique en fournissant une surface de prédiction rigoureusement continue, apte à l’extrapolation linéaire directionnelle, tout en offrant une transparence totale assimilable à celle d’une simple régression par moindres carrés. Sur des jeux de données d’échantillonnage de taille modérée (typiques des protocoles cliniques ou observationnels comptant entre quelques centaines et plusieurs milliers d’observations), MARS rivalise fréquemment en précision brute avec les méthodes d’ensemble, tout en éliminant les coûts computationnels écrasants inhérents à ces dernières.
Par ailleurs, une synergie particulièrement féconde consiste à employer MARS en amont de ces architectures ensemblistes : en exploitant les sous-ensembles de variables et les nœuds critiques découverts par earth pour guider l’ingénierie des caractéristiques (feature engineering), l’analyste maximise conjointement la performance prédictive globale et la compréhension théorique du système modélisé.
12. Bonnes pratiques méthodologiques, limites et extensions avancées
12.1 Règles de bonne conduite méthodologique et pièges fréquents
L’utilisation éclairée des splines de régression adaptative multivariée requiert le respect scrupuleux d’un ensemble de garde-fous méthodologiques destinés à prémunir le chercheur contre les biais de modélisation les plus récurrents. Le premier piège réside dans le surajustement des interactions (interaction overfitting) au sein de cohortes statistiques restreintes. L’analyste novice est fréquemment tenté d’autoriser sans discernement degree = 2 ou degree = 3 sur des échantillons comportant moins de deux cents observations. Dans une telle configuration de rareté d’échantillonnage, MARS exploitera la combinatoire démesurée des fonctions charnières pour épouser fidèlement des coïncidences stochastiques aléatoires, fabriquant des interactions croisées totalement artefactuelles.
Une règle prudentielle canonique stipule que l’exploration d’interactions d’ordre deux ne devrait être envisagée que si l’échantillon d’apprentissage dénombre au minimum 10 à 20 observations pour chaque terme de base potentiel généré lors de la phase avant. À défaut, la restriction délibérée à un modèle purement additif (degree = 1) constitue le choix méthodologique le plus sain et le plus robuste.
Le second écueil concerne les effets de bordure (boundary effects) aux extrémités des distributions empiriques. À l’instar de tout estimateur basé sur des fonctions polynomiales ou linéaires locales, MARS voit sa variance d’estimation s’envoler de façon vertigineuse au-delà des premier et dernier déciles de chaque prédicteur. L’analyste doit formellement proscrire l’extrapolation prédictive au-delà du domaine de validité empirique observé et faire preuve d’un scepticisme méthodique face à tout nœud identifié à l’extrême périphérie d’une variable continue, ce dernier pouvant simplement trahir la présence d’une poignée de points aberrants isolés.
Enfin, la standardisation des protocoles de recherche ouverte (Open Science) commande le partage intégral des scripts R d’exécution, assortis de la fixation obligatoire des graines probabilistes (set.seed()) régissant le partitionnement des données et les allocations bootstrap, afin de garantir la réplicabilité numérique absolue des architectures de nœuds sélectionnées.
12.2 Extension aux variables de réponse binaires et multinomiales
Bien que la formalisation originelle de Friedman ait été conçue pour résoudre des problématiques d’espérance conditionnelle continue (régression), le package earth offre une extension conceptuelle majeure permettant de traiter avec une égale rigueur les problématiques de classification binaire et multinomiale. L’interfaçage s’opère au moyen de l’argument glm, qui réoriente la machinerie d’ajustement vers la famille exponentielle en intégrant une fonction de lien canonique, typiquement la fonction logit :
mars_logistique <- earth(statut_pathologie ~ ., data = donnees_train, degree = 2, glm = list(family = binomial(link = "logit")))
Dans ce cadre méthodologique avancé, la dynamique séquentielle opère de manière hybride : la phase d’expansion avant et l’élagage arrière sélectionnent les meilleures fonctions de base Bm(X) en optimisant le critère classique des moindres carrés, puis le sous-modèle structurel retenu est réajusté en exploitant l’algorithme d’estimation par maximum de vraisemblance à moindres carrés repondérés itérativement (IRLS), convertissant les prédictions scalaires en probabilités conditionnelles d’appartenance à la classe cible :
P(Y = 1 | X) = 1 / [ 1 + exp( – ( β0 + ∑m=1M βm Bm(X) ) ) ]
Cette méthodologie engendre une régression logistique par morceaux d’une efficacité redoutable pour la stratification clinique et l’épidémiologie comportementale. L’évaluation de l’adéquation prédictive ne repose plus sur la RMSE, mais requiert le déploiement d’analyses sémiotiques par courbes ROC (Receiver Operating Characteristic), le calcul des aires sous la courbe (AUC) via le package pROC, et la vérification méticuleuse de l’étalonnage probabiliste au moyen de diagrammes de calibration (calibration plots) garantissant que les risques prédits correspondent fidèlement aux fréquences relatives d’événements observées dans chaque strate de risque diagnostique.
12.3 Perspectives futures et intégration dans la recherche computationnelle
L’horizon méthodologique des splines de régression adaptative multivariée s’inscrit résolument au sein d’approches hybrides conjuguant la modélisation statistique causale et les puissances de calcul de l’intelligence artificielle contemporaine. L’une des trajectoires de recherche les plus prometteuses réside dans l’hybridation entre MARS et la modélisation par équations structurelles (SEM – Structural Equation Modeling). En exploitant earth pour découvrir de manière non supervisée les seuils critiques régissant les variables latentes au sein de modèles de mesure psychométriques, les méthodologistes s’émancipent des postulats de linéarité inter-facteurs rigides qui contraignaient historiquement les modélisations LISREL conventionnelles.
Concomitamment, l’intégration de MARS au sein des flux de travail contemporains de recherche reproductible s’articule élégamment au travers de l’écosystème Quarto et R Markdown. La possibilité de compiler dynamiquement les équations résultantes directement formatées selon la syntaxe typographique LaTeX conforme aux standards éditoriaux les plus exigeants de l’American Psychological Association (APA 7th edition) simplifie considérablement la rédaction des rapports scientifiques et médicaux.
En synthèse, loin de constituer un artefact algorithmique désuet issu des années 1990, les splines de régression adaptative multivariée demeurent, par leur synthèse magistrale entre adaptativité topologique non paramétrique, frugalité computationnelle et lisibilité analytique directe, l’un des fleurons les plus accomplis de l’analyse statistique moderne. Leur appropriation rigoureuse au sein de l’environnement R confère aux chercheurs et biostatisticiens une instrumentation de pointe pour déchiffrer avec lucidité les seuils, ruptures et interactions qui régissent la complexité des systèmes naturels et humains.
Références
- Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984). Classification and Regression Trees. Wadsworth & Brooks/Cole Advanced Books & Software. https://doi.org/10.1201/9781315139470
- Friedman, J. H. (1991). Multivariate Adaptive Regression Splines. The Annals of Statistics, 19(1), 1–67. https://doi.org/10.1214/aos/1176347963
- Friedman, J. H. (1993). Fast MARS. Technical Report No. 110, Department of Statistics, Stanford University.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An Introduction to Statistical Learning: with Applications in R (2nd ed.). Springer. https://doi.org/10.1007/978-1-0716-1418-1
- Kuhn, M., & Johnson, K. (2013). Applied Predictive Modeling. Springer. https://doi.org/10.1007/978-1-4614-6849-3
- Milborrow, S. (2021). earth: Multivariate Adaptive Regression Splines (R package version 5.3.1). Comprehensive R Archive Network (CRAN). https://cran.r-project.org/web/packages/earth/index.html
- Milborrow, S. (2021). plotmo: Plot a Model’s Residuals, Response, and Partial Dependence Plots (R package version 3.6.1). Comprehensive R Archive Network (CRAN). https://cran.r-project.org/web/packages/plotmo/index.html
- Wahba, G. (1990). Spline Models for Observational Data. Society for Industrial and Applied Mathematics (SIAM). https://doi.org/10.1137/1.9781611970128
- Wood, S. N. (2017). Generalized Additive Models: An Introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279