
Dans le champ des sciences comportementales, cognitives et psychométriques, l’investigation empirique se heurte invariablement à la complexité intrinsèque des processus vivants. Pendant des décennies, l’hégémonie du modèle linéaire généralisé a conduit nombre de chercheurs à appréhender les relations entre stimuli et réponses comportementales sous le prisme simplificateur de la proportionnalité directe. Pourtant, la mémoire humaine, la fatigue cognitive, l’acquisition d’aptitudes motrices ou encore la dynamique émotionnelle manifestent presque universellement des propriétés de saturation, de seuils critiques, d’accélérations soudaines ou de bifurcations qualitatives. Forcer de telles dynamiques au sein d’une droite de régression par moindres carrés ordinaires ne constitue pas seulement une approximation discutable : il s’agit d’une altération fondamentale de la réalité phénoménologique susceptible de masquer des mécanismes psychologiques déterminants.
Face à cette exigence méthodologique, le recours à la régression non linéaire s’impose comme une nécessité épistémologique. Si les progiciels statistiques spécialisés tels que le langage R, SPSS ou SAS offrent des bibliothèques algorithmiques sophistiquées, ils constituent souvent une boîte noire conceptuelle qui éloigne l’investigateur de la mécanique fondamentale de l’optimisation numérique. À l’inverse, l’environnement Microsoft Excel offre un cadre transparent, interactif et pédagogique exceptionnel. La manipulation directe des matrices de données, le calcul pas à pas des sommes de résidus quadratiques et l’ajustement paramétrique en temps réel via des solveurs d’optimisation permettent de démystifier l’analyse non linéaire tout en maintenant une rigueur mathématique irréprochable.
Ce guide exhaustif propose une démarche systématique, théorique et opérationnelle destinée aux chercheurs, statisticiens et étudiants avancés souhaitant implémenter des modèles non linéaires au sein d’Excel. De la formalisation conceptuelle des lois psychophysiques aux diagnostics avancés des résidus, en passant par l’exploitation experte de l’algorithme du Gradient Réduit Généralisé (GRG) et le calcul des critères d’information d’Akaike, chaque étape est disséquée avec une précision chirurgicale pour garantir des inférences robustes conformes aux plus hauts standards de publication académique.
1. Fondements théoriques de la régression non linéaire en recherche psychologique
1.1 Distinction entre relations linéaires et non linéaires dans le comportement humain
D’un point de vue formel, une relation entre une variable indépendante X et une variable dépendante Y est qualifiée de linéaire lorsque la dérivée première de la fonction par rapport à ses paramètres est une constante. Dans le cadre de la modélisation statistique standard, cette propriété se traduit par l’hypothèse selon laquelle une variation unitaire du prédicteur engendre une modification proportionnelle et invariable de la variable expliquée, quel que soit le niveau initial de X. Or, le substrat neurobiologique et psychologique des organismes vivants obéit rarement à ce principe d’invariance d’échelle. Le comportement humain est par nature contraint par des capacités computationnelles finies, des structures anatomiques délimitées et des équilibres homéostatiques qui induisent des non-linéarités systématiques.
Les limites intrinsèques du coefficient de corrélation linéaire de Pearson deviennent criantes lorsqu’il est confronté à des dynamiques psychologiques réelles. Un ensemble de données présentant une association déterministe parfaite sous forme parabolique ou sinusoïdale peut afficher un coefficient r proche de zéro, conduisant le chercheur non averti à conclure erronément à l’absence de lien fonctionnel. Cette vulnérabilité découle du fait que la statistique de Pearson quantifie l’alignement strict sur une droite vectorielle et demeure aveugle aux courbures structurelles. Dans les paradigmes expérimentaux mesurant les temps de réaction, l’effort perceptif ou la mémoire de travail, l’apparition d’effets de plancher ou de plafond constitue la signature indiscutable d’une rupture de linéarité.
L’impact de la saturation cognitive et des effets de seuil perceptifs illustre avec force l’inadéquation du postulat linéaire. Lorsqu’un individu est soumis à une tâche d’attention divisée, l’augmentation progressive de la charge mentale ne produit pas une dégradation incrémentale continue de la performance ; celle-ci demeure d’abord stable grâce à la mobilisation de mécanismes compensatoires, avant de s’effondrer brutalement au-delà d’un goulot d’étranglement structurel. Ignorer cette non-linéarité conduit à des biais de spécification majeurs, à une sous-estimation systématique des erreurs types et, in fine, à des inférences théoriques erronées qui compromettent la réplicabilité scientifique.
1.2 Modèles théoriques classiques non linéaires en psychologie
L’histoire de la psychologie scientifique regorge de conceptualisations mathématiques explicitement non linéaires, développées pour capturer l’architecture des fonctions mentales. L’un des archétypes les plus célèbres est sans doute la loi de Yerkes-Dodson, formalisée au début du XXe siècle. Cette loi postule que la relation entre le niveau d’éveil physiologique (ou stress) et l’efficacité de la performance cognitive adopte une trajectoire curviligne en forme de cloche ou de U inversé. Une stimulation trop faible engendre un sous-engagement attentionnel, tandis qu’une activation excessive sature les ressources exécutives. Ce phénomène ne peut être modélisé de manière adéquate que par des fonctions polynomiales du second degré ou des fonctions d’amplitude gaussiennes.
Dans le domaine de l’apprentissage et de la rétention mémorielle, les travaux pionniers d’Hermann Ebbinghaus ont démontré que la perte d’informations au cours du temps ne suit aucunement une droite déclinante constante. La fameuse courbe de l’oubli est rigoureusement caractérisée par une cinétique de décroissance exponentielle, où le taux de perte mnésique est maximal dans les premières minutes suivant l’encodage, avant de se stabiliser asymptotiquement vers un plateau de rétention à long terme. La modélisation de cette dynamique requiert l’ajustement d’une équation exponentielle négative où le paramètre de puissance gouverne la vitesse de dégradation de la trace cérébrale.
Parallèlement, la psychophysique sensorielle s’est construite sur la confrontation directe de formulations non linéaires concurrentes. La loi logarithmique de Weber-Fechner postule que l’intensité de la sensation subjective croît comme le logarithme naturel de l’amplitude physique du stimulus. Cette formulation a été ultérieurement enrichie par la loi de puissance de Stanley Smith Stevens, stipulant que la magnitude perçue est proportionnelle au stimulus élevé à une puissance empirique spécifique à chaque modalité sensorielle. Enfin, les processus d’acquisition d’habiletés complexes et les transitions de stades développementaux (tels que décrits par Jean Piaget ou la psychologie cognitive contemporaine) sont idéalement décrits par des courbes sigmoïdes ou logistiques, rendant compte d’une phase d’accélération initiale suivie d’une décélération asymptotique traduisant l’expertise.
1.3 Pertinence et accessibilité de Microsoft Excel pour la modélisation
L’utilisation de Microsoft Excel en tant que plateforme d’analyse numérique pour la régression non linéaire suscite parfois le scepticisme au sein de cercles académiques habitués aux lignes de commande. Pourtant, l’accessibilité universelle de cet outil au sein des laboratoires universitaires, des départements de recherche clinique et des structures hospitalières en fait un vecteur démocratique fondamental pour l’analyse quantitative. Contrairement aux environnements hermétiques où une ligne de script masque les étapes sous-jacentes du calcul matriciel, le tableur contraint le chercheur à concevoir explicitement la topologie de son modèle, reliant visiblement chaque donnée brute à sa valeur théorique prédite et à son résidu associé.
Sur le plan fonctionnel, si des progiciels comme SPSS ou les packages spécialisés sous R offrent des routines automatisées de convergence (telles que les algorithmes de Gauss-Newton ou de Levenberg-Marquardt), Excel dispose de son propre moteur d’optimisation déterministe extrêmement performant : le complément Solveur, animé par le code d’optimisation non linéaire GRG (Generalized Reduced Gradient). Ce moteur mathématique permet d’ajuster n’importe quelle équation formulée sur mesure, sans être tributaire des modèles préprogrammés restreints des menus déroulants de logiciels tiers.
Le rôle pédagogique de la manipulation cellulaire directe est inestimable. En construisant soi-même les colonnes de prédiction, les calculs d’erreurs locales et les critères globaux de convergence, l’analyste développe une compréhension intime des mécanismes d’optimisation. Néanmoins, cette liberté implique des responsabilités méthodologiques strictes : l’utilisateur d’Excel doit être pleinement conscient des questions de précision numérique, de la gestion des arrondis flottants à double précision et des risques d’échouage dans des minima locaux lors de l’estimation de paramètres fortement corrélés.
2. Préparation et structuration rigoureuse des données expérimentales
2.1 Organisation tabulaire des variables indépendantes et dépendantes
La réussite d’un ajustement non linéaire sous Excel repose sur une discipline rigoureuse dans l’agencement spatial des matrices de données au sein de la feuille de calcul. L’architecture tabulaire doit respecter les conventions de structuration de données ordonnées (dites tidy data). Les prédicteurs ou variables indépendantes (couramment désignés par X, représentant par exemple des millisecondes, des décibels, des doses pharmacologiques ou des cycles d’apprentissage) doivent impérativement être disposés dans des colonnes adjacentes et continues, sans aucune rupture de ligne ni cellules fusionnées qui viendraient entraver la lecture matricielle du logiciel.
Une vigilance particulière doit être accordée à l’appariement temporel ou individuel des observations. Dans les protocoles longitudinaux ou à mesures répétées, chaque rangée horizontale doit correspondre à une unité d’échantillonnage unique et cohérente (un sujet à un temps précis, ou un bloc d’essais standardisé). Il est essentiel de s’assurer de l’homogénéité absolue des formats numériques : les séparateurs décimaux (virgule ou point selon les paramètres régionaux d’Excel) doivent être normalisés pour prévenir l’apparition d’artefacts textuels indétectables à l’œil nu mais invalidant les formules de calcul ultérieures.
Conformément aux normes éditoriales de l’American Psychological Association (APA 7th edition), les en-têtes de colonnes doivent être documentés avec précision. La ligne supérieure (idéalement la ligne 1) doit contenir le nom explicite de la variable, son abréviation conventionnelle en italique et ses unités de mesure exactes entre parenthèses (par exemple : Temps d’exposition (ms) ou Rappel libre (% correct)). Cette standardisation initiale prémunit l’analyste contre toute confusion de référencement relatif ou absolu lors de la rédaction des équations matricielles.
2.2 Traitement préalable des valeurs aberrantes et données manquantes
La régression non linéaire par minimisation des moindres carrés présente une vulnérabilité mathématique notoire face aux observations extrêmes. Puisque la fonction de perte élève les résidus au carré, une seule valeur aberrante non représentative peut exercer un bras de levier disproportionné sur le vecteur de paramètres, déformant l’ensemble de la trajectoire de la courbe ajustée. L’identification visuelle via des graphiques préliminaires doit être systématiquement complétée par des critères statistiques standardisés, tels que l’identification des scores z résiduels excédant l’intervalle [-3, +3] ou l’application de la méthode de l’écart interquartile de Tukey.
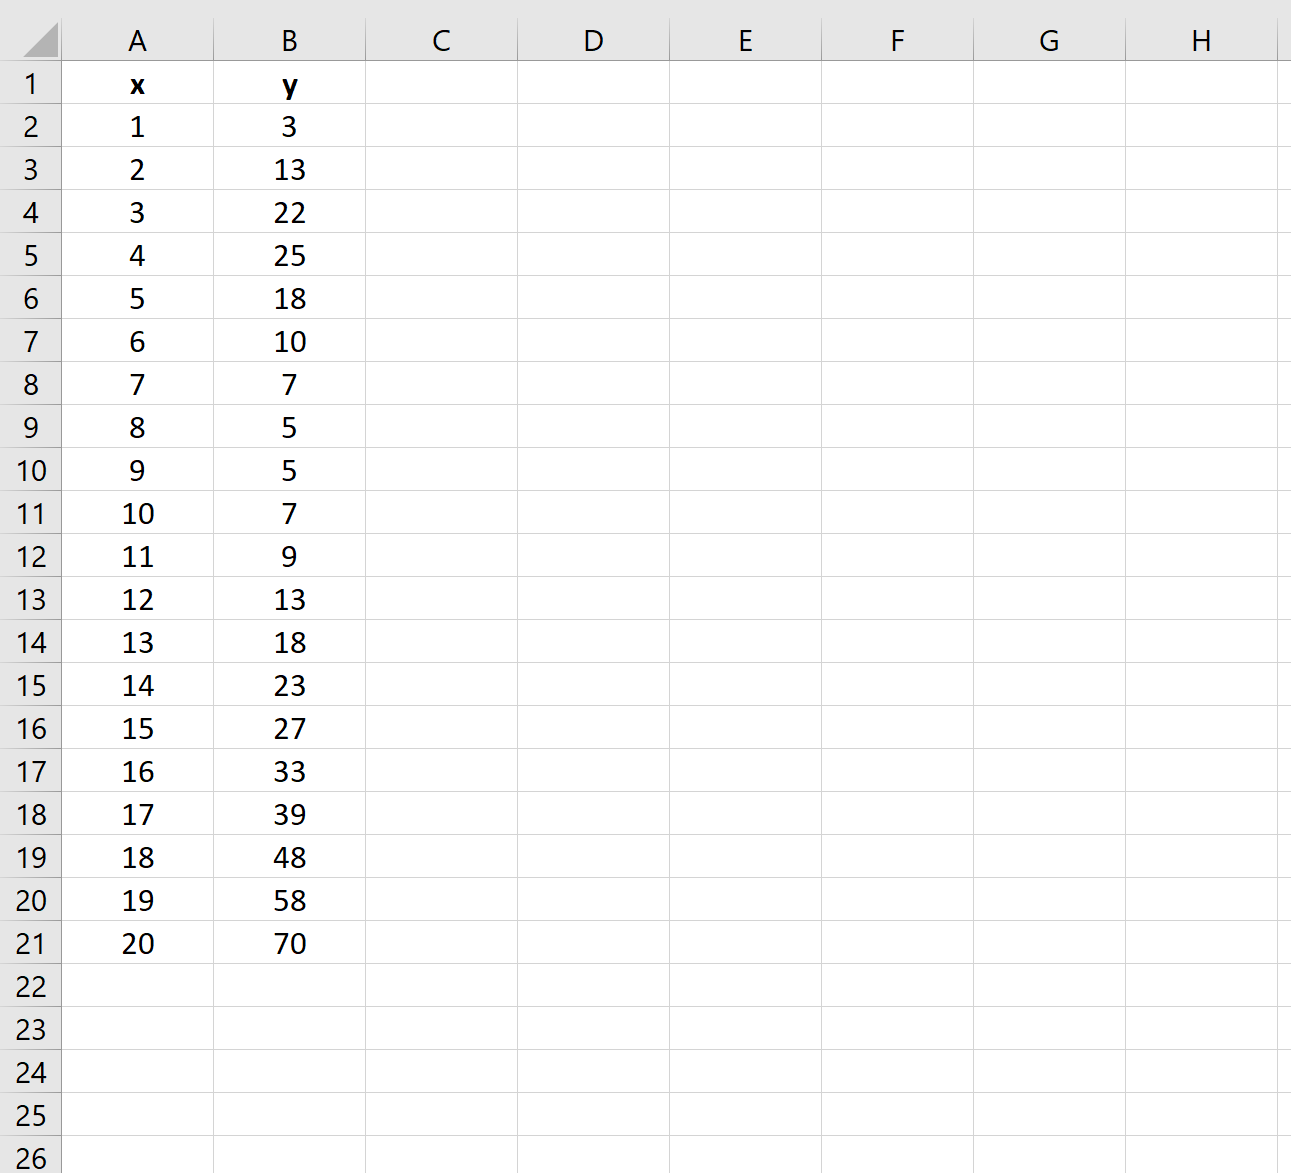
En psychologie cognitive et clinique, l’exclusion d’une donnée ne doit jamais être le fruit de la complaisance statistique mais d’une justification théorique et méthodologique rigoureuse. L’analyste doit discriminer les artefacts techniques (tels qu’une micro-coupure de connexion du capteur biométrique, un temps de réaction inférieur au seuil de conduction axonale physiologique de 100 ms, ou une inattention avérée du participant) des véritables manifestations de la variabilité humaine. Si une observation est écartée, son exclusion doit être consignée de manière transparente dans la section méthodologique du rapport final.
La gestion des cellules vides requiert également une grande prudence. Contrairement à des algorithmes spécialisés capables de procéder à une estimation par maximum de vraisemblance à information complète (FIML), les fonctions arithmétiques d’Excel et le Solveur sont sensibles à la discontinuité des vecteurs. Une cellule vide incluse par inadvertance dans une somme de carrés peut être interprétée comme un zéro absolu, introduisant une distorsion catastrophique dans l’optimisation. Il est donc recommandé d’isoler les séries complètes ou de recourir à des techniques d’imputation multiple préalablement validées avant d’engager la modélisation.
2.3 Normalisation et mise à l’échelle des métriques comportementales
Les algorithmes d’optimisation non linéaire basés sur les gradients éprouvent de sérieuses difficultés numériques lorsque les variables du modèle opèrent sur des échelles de magnitude disproportionnées (par exemple, si X est mesuré en centaines de milliers de millisecondes tandis que Y représente une probabilité comprise entre 0 et 1). Cette disparité engendre une déformation de la surface d’erreur sous forme de ravins étroits, ralentissant considérablement la convergence du Solveur ou provoquant des erreurs de débordement arithmétique. La mise à l’échelle ou la standardisation préalable constitue dès lors une stratégie de stabilisation incontournable.
Le centrage et la réduction des variables (transformation en scores z) ou leur normalisation min-max au sein de l’intervalle standard [0, 1] permet d’équilibrer le paysage de la fonction de coût. Dans le cas de variables fortement asymétriques à droite, caractéristiques des distributions de temps de réponse ou de latences saccadiques, une transformation logarithmique exploratoire préliminaire peut stabiliser la variance hétéroscédastique. Toutefois, l’analyste doit veiller à ne pas confondre la transformation de la variable pour stabiliser le calcul avec la linéarisation forcée du modèle théorique lui-même.
Lorsque l’on manipule des échelles psychométriques ordinales de type Likert (par exemple des évaluations d’intensité subjective en 5 ou 7 points), leur conversion en un continuum probabiliste continu via des transformations de type probit ou logit sous-jacent est souvent requise avant d’ajuster des courbes sigmoïdes. Enfin, la règle d’or de l’intégrité expérimentale impose de conserver le jeu de données brutes original dans un onglet dédié entièrement verrouillé en lecture seule, toutes les opérations de nettoyage et de standardisation étant déportées sur une feuille de travail opérationnelle distincte.
3. Visualisation préliminaire par nuage de points dans Excel
3.1 Génération technique du graphique de dispersion
La première démarche empirique face à un jeu de données bivarié consiste à examiner graphiquement sa morphologie spatiale. Sous Excel, cette opération requiert l’insertion d’un véritable graphique à nuage de points (diagramme de dispersion X-Y). Il convient d’éviter scrupuleusement les graphiques en courbes ou en histogrammes standard proposés par défaut : ces derniers traitent l’axe horizontal comme une suite d’étiquettes catégorielles discrètes et équidistantes, ce qui détruit la proportionnalité métrique réelle de la variable indépendante.
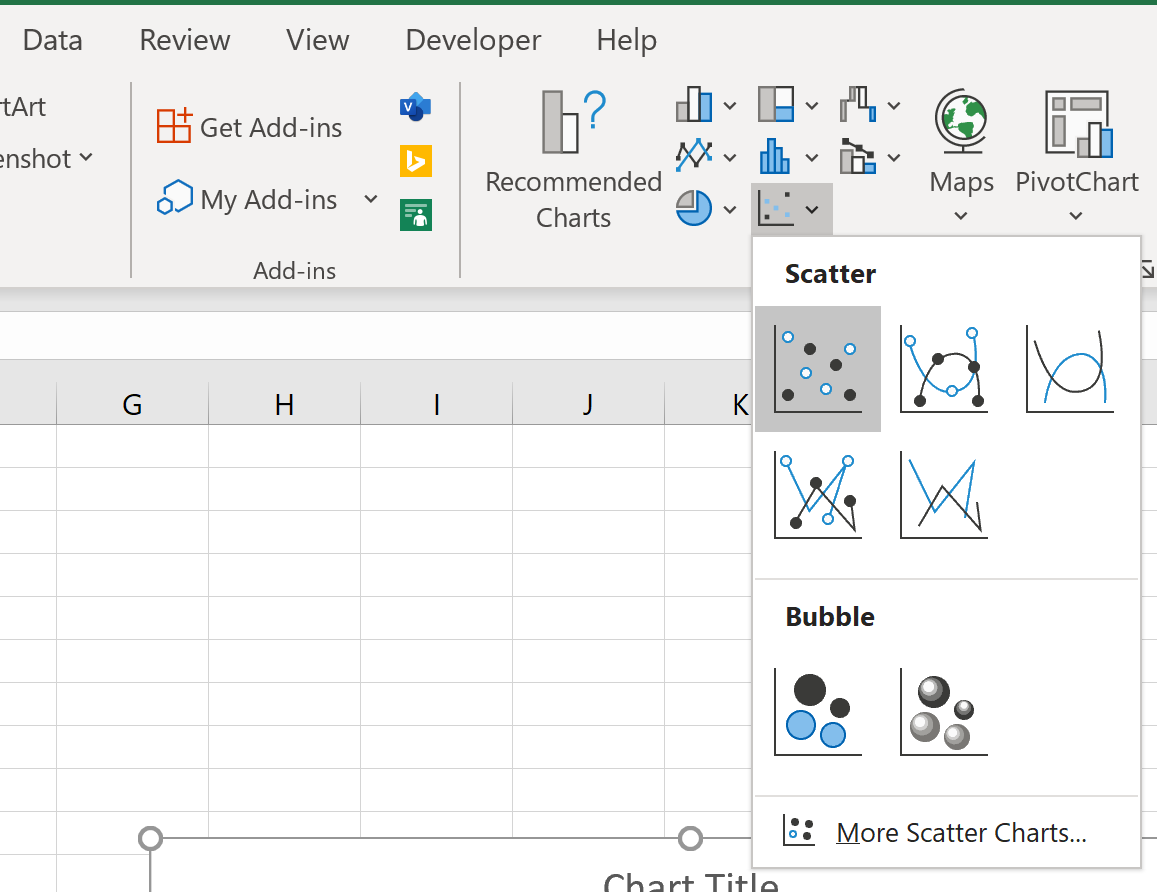
Pour générer correctement le graphique, sélectionnez la plage numérique continue contenant les valeurs de X et Y, en veillant à ne pas intégrer des cellules d’en-tête contenant du texte ambigu qui désorienterait l’assistant de tracé d’Excel. Naviguez ensuite dans le ruban supérieur vers l’onglet Insertion, localisez le groupe Graphiques, puis cliquez sur l’icône Insérer un nuage de points (X, Y). Il est impératif de sélectionner l’option Nuage de points avec marqueurs uniquement, en évitant toute ligne de liaison rectiligne ou lissée qui préjugerait de la relation avant modélisation.
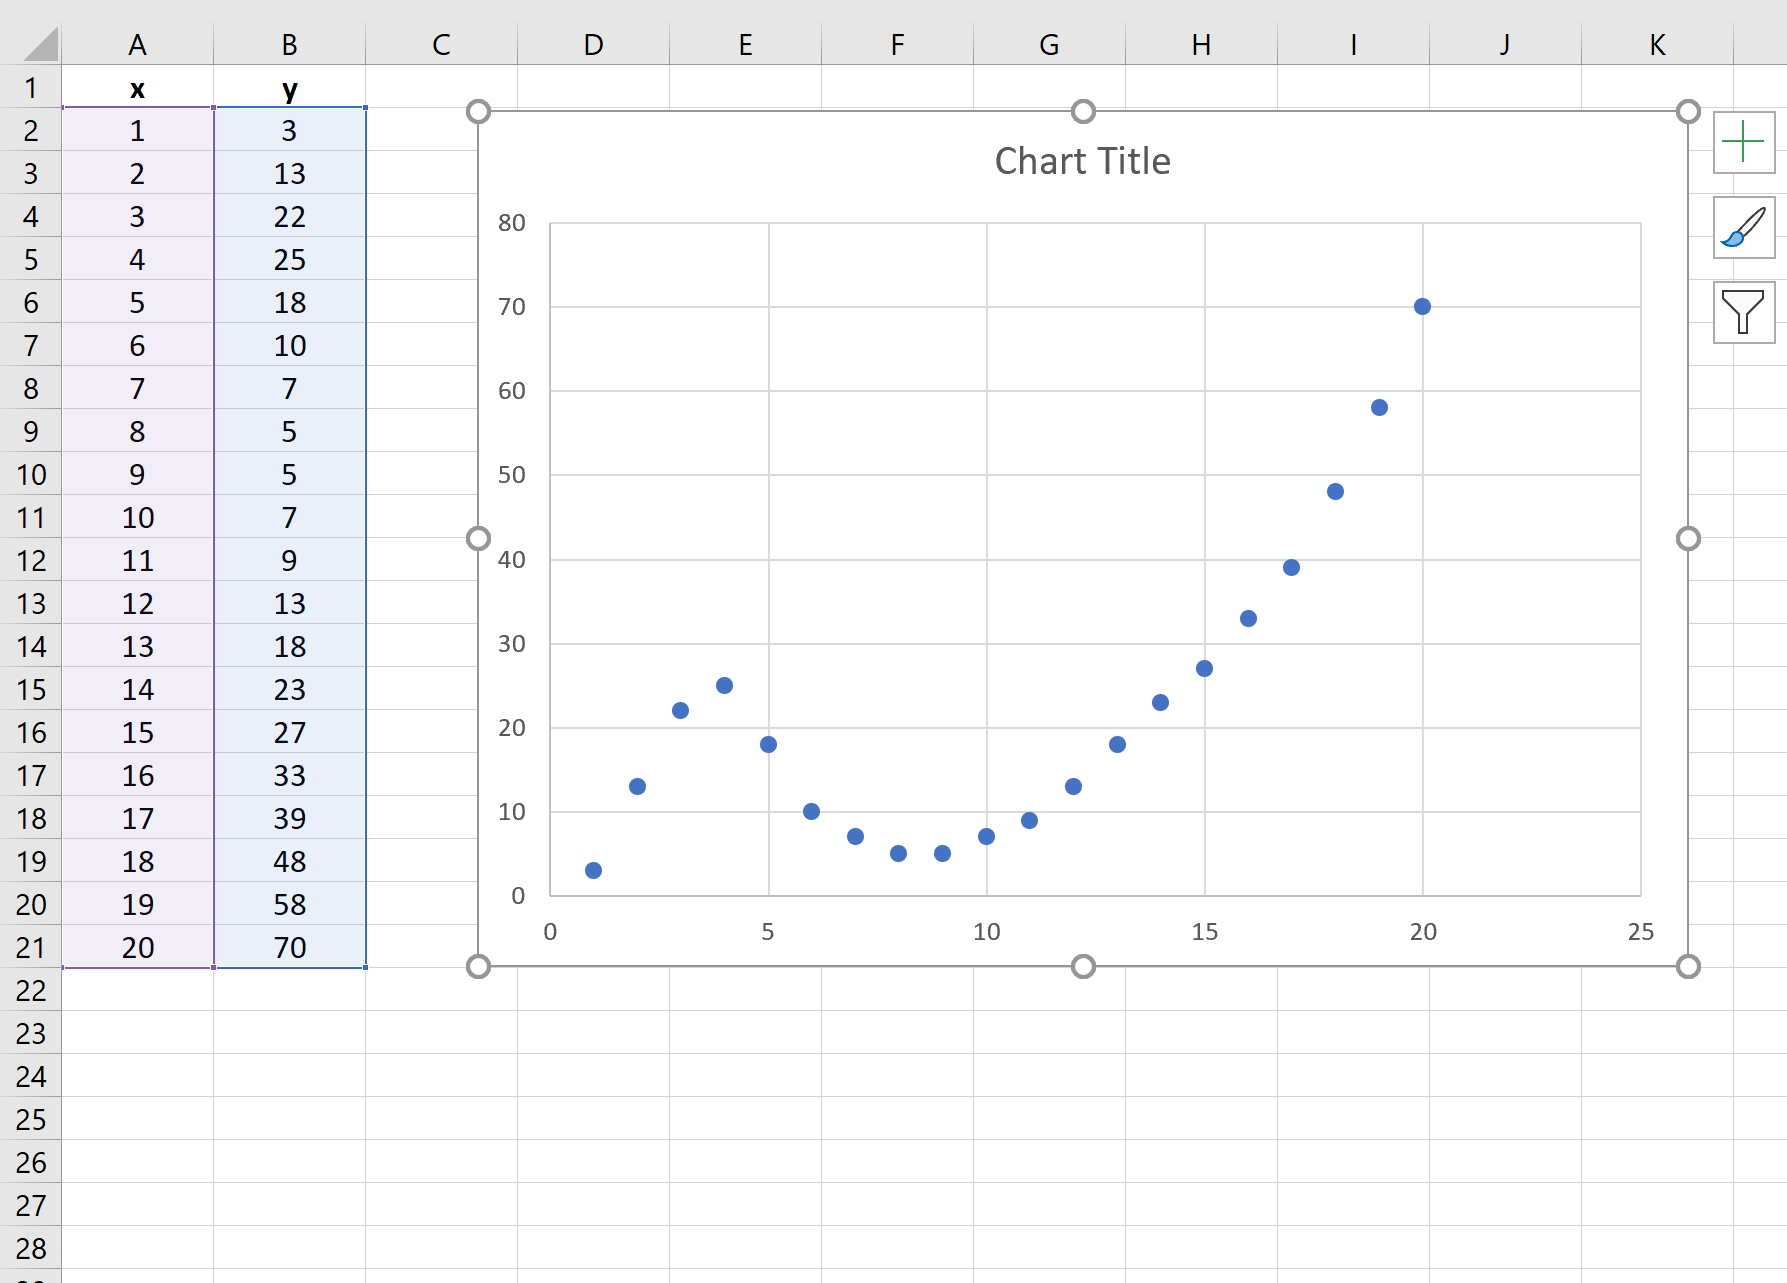
Une fois le graphique inséré, une vérification anatomique immédiate s’impose : la variable indépendante (le stimulus manipulé ou le prédicteur temporel) doit impérativement être assignée à l’abscisse (axe horizontal X), tandis que la variable dépendante (la réponse comportementale ou le score psychométrique) doit figurer en ordonnée (axe vertical Y). Si l’orientation se révèle inversée, il suffit d’accéder au menu Sélectionner des données par un clic droit sur le graphique et de redéfinir manuellement les références de plages des séries X et Y.
3.2 Configuration anatomique et mise à l’échelle des axes
Les paramètres graphiques automatiques d’Excel sont fréquemment sous-optimaux pour l’évaluation scientifique des données comportementales. Par défaut, le logiciel a tendance à étendre les axes bien au-delà de la dynamique réelle des observations, créant des espaces périphériques vides qui compriment le nuage de points et masquent les subtilités d’inflexion de la trajectoire. L’analyste doit donc reprendre la maîtrise manuelle de la géométrie de son tracé.
Double-cliquez sur l’axe des abscisses pour ouvrir le volet latéral Format de l’axe. Dans la section Options d’axe, désactivez les bornes automatiques pour fixer explicitement le Minimum et le Maximum en adéquation avec les limites réelles de votre protocole expérimental. Répétez rigoureusement la même opération pour l’axe des ordonnées. Les graduations principales et secondaires doivent être calibrées en accord avec la granularité de la métrique psychologique mesurée (par exemple des incréments de 10 unités pour des scores sur 100, ou de 0,1 pour des proportions).
L’exploration peut parfois justifier l’activation temporaire de l’échelle logarithmique sur l’un ou l’autre des axes afin d’observer si le nuage se redresse en une trajectoire rectiligne, indice précieux sur la classe de fonction sous-jacente. Enfin, l’intégration systématique des titres d’axes via l’icône Ajouter un élément de graphique (+) est une exigence absolue : chaque axe doit mentionner son libellé complet, son symbole mathématique officiel et son unité d’étalonnage pour garantir une lisibilité autonome du document.
3.3 Diagnostic qualitatif de la courbure et sélection fonctionnelle
L’inspection visuelle attentive du nuage de points constitue une étape sémiologique essentielle. L’œil exercé du chercheur doit y repérer les signatures géométriques caractéristiques des grandes familles d’équations non linéaires. Une distribution qui s’élève pour atteindre un sommet avant de décliner symétriquement oriente d’emblée l’investigation vers un profil parabolique ou polynomial de degré 2, typique des lois de modulation optimale de l’éveil ou de l’efficience attentionnelle.
À l’inverse, si la nuée de points affiche une élévation initiale abrupte suivie d’un amortissement progressif tendant vers un plafond horizontal infranchissable, l’hypothèse d’une cinétique de saturation s’impose. Deux familles d’équations se disputent alors la primauté : les fonctions logarithmiques (qui continuent de croître lentement à l’infini sans asymptote stricte) et les modèles exponentiels négatifs ou de Michaelis-Menten (qui convergent vers une asymptote théorique horizontale finie). Cette distinction visuelle est cruciale, car elle traduit des architectures cognitives radicalement différentes (capacités illimitées mais à rendements décroissants contre capacités strictement bornées par des ressources matérielles).
La détection d’une trajectoire en S étiré (caractérisée par une zone de latence au plancher, une phase intermédiaire quasi-linéaire à forte pente, puis une incurvation vers un plafond) met en évidence une dynamique sigmoïde. Ce profil est typique des épreuves de psychométrie différentielle où le taux de réussite bascule brutalement au passage d’un seuil de compétence latent. L’analyste peut ainsi formuler des hypothèses fonctionnelles étayées, préparant le terrain pour l’ajustement mathématique formel.
4. Ajustement direct par courbe de tendance polynomiale
4.1 Insertion et paramétrage de la courbe de tendance sur le graphique
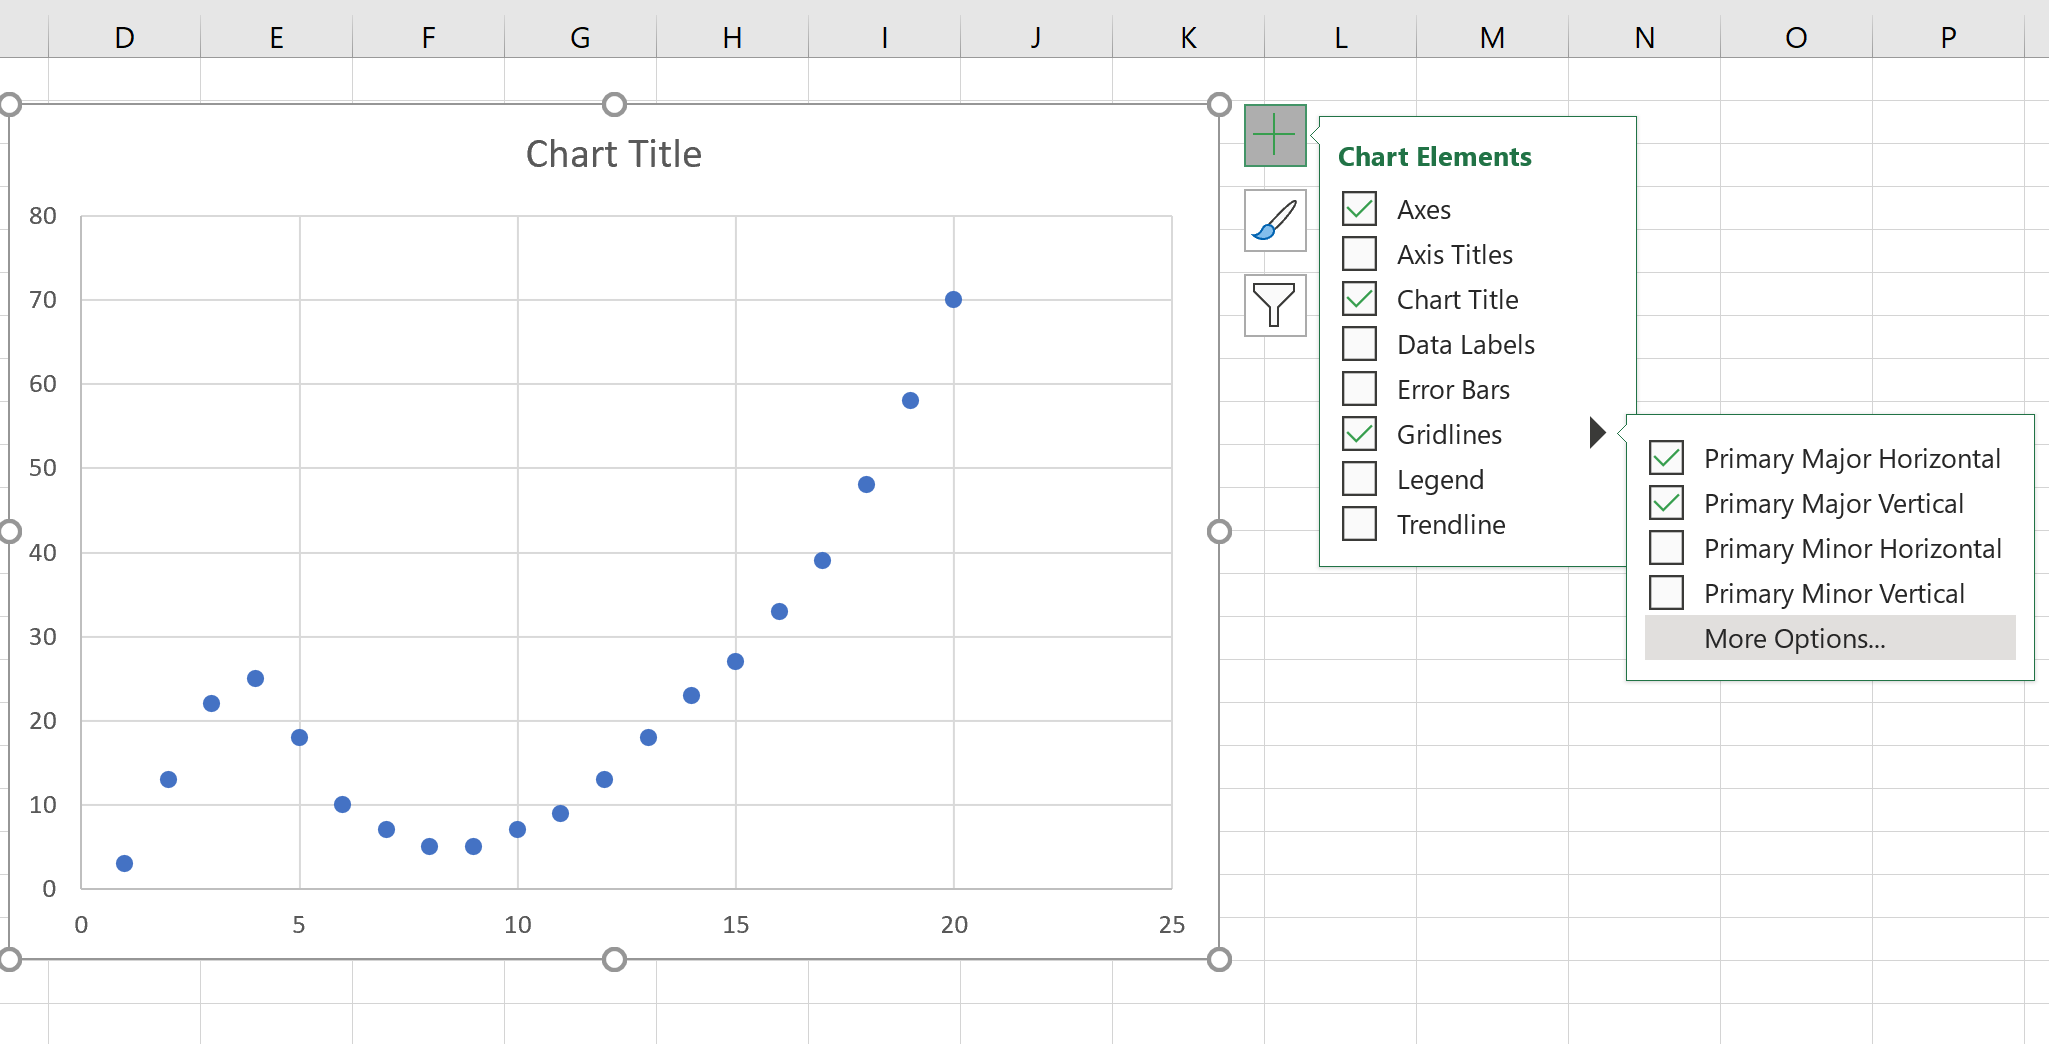
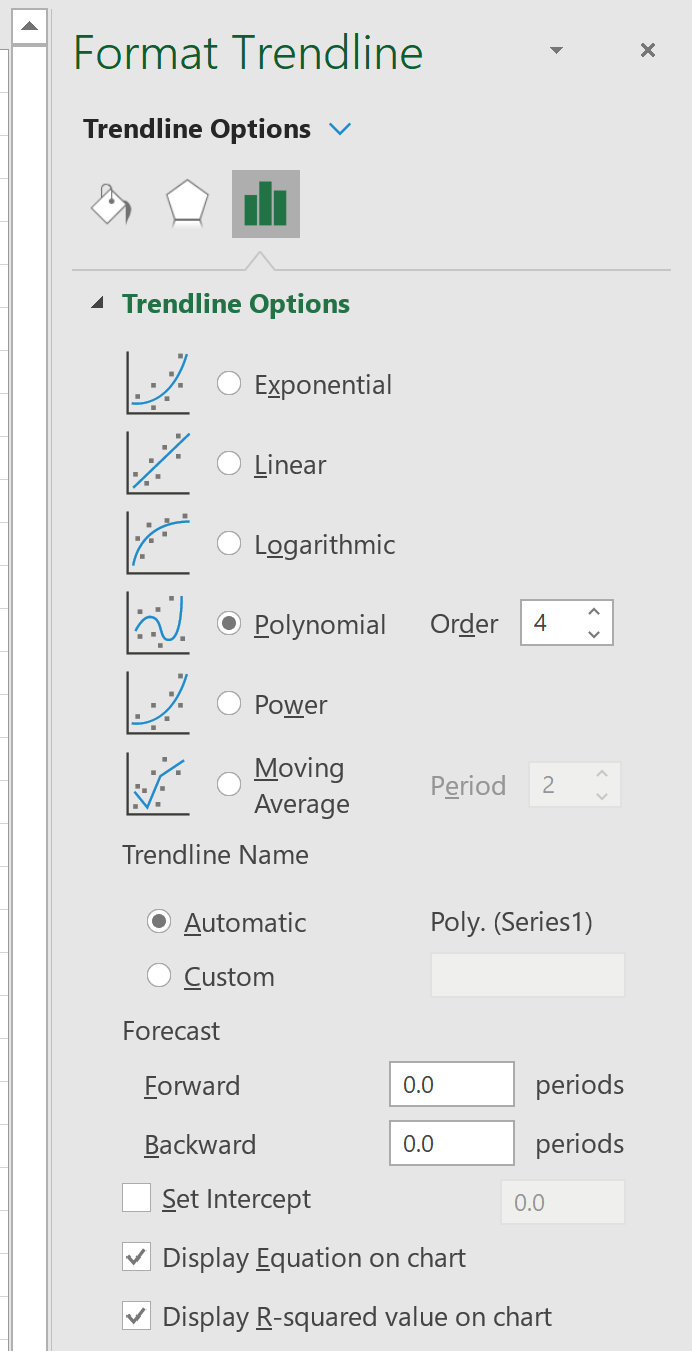
L’environnement graphique d’Excel intègre un moteur interne d’ajustement capable de superposer instantanément des modèles mathématiques paramétriques sur un nuage de points. Pour solliciter cette fonctionnalité, sélectionnez le graphique puis cliquez sur le symbole d’ajout d’élément graphique (+) situé à l’angle supérieur droit de la zone de traçage. Cochez la case Courbe de tendance, puis cliquez sur la flèche adjacente pour accéder à l’option Autres options…, ce qui provoque le déploiement du panneau de configuration dédié dans la marge droite de l’interface.
Au sein de ce volet, Excel affiche un éventail de modèles standard : linéaire, exponentiel, linéaire, logarithmique, polynomial, puissance et moyenne mobile. L’ajustement polynomial s’avère particulièrement utile pour capturer des courbures continues sans exiger l’explicitation préalable d’une asymptote théorique. Pour modéliser une relation non monotone simple, activez le bouton radio Polynomial. Par défaut, Excel initialise le modèle à l’ordre 2, ce qui correspond à l’équation quadratique classique d’une parabole :
Y = a2X2 + a1X + a0
Ce formalisme est particulièrement approprié pour les recherches psychologiques testant des hypothèses de compromis vitesse-précision ou des lois d’optimalité motivationnelle où la performance décline de part et d’autre d’un niveau d’activation médian idéal.
4.2 Exploration et détermination de l’ordre polynomial optimal
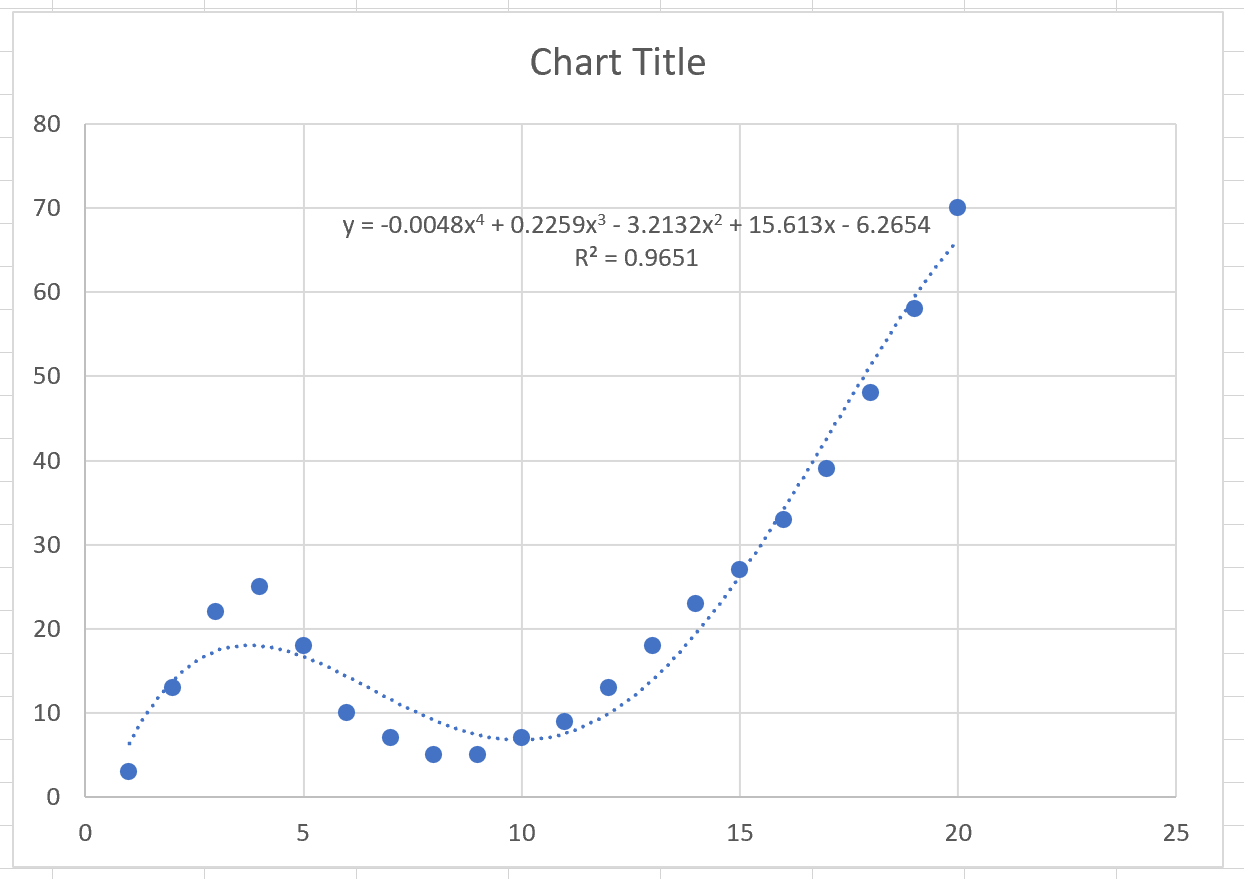
L’interface d’Excel autorise l’analyste à faire varier l’ordre du polynôme de 2 jusqu’à 6 au moyen d’un simple sélecteur numérique. Face à cette souplesse, la tentation méthodologique est grande d’augmenter indûment le degré pour observer l’accroissement continu de l’adhérence apparente de la courbe aux données. Cependant, cette démarche non critique expose le chercheur au péril statistique majeur du surapprentissage (ou overfitting). Un polynôme de degré 5 ou 6 présente de multiples points d’inflexion et se met à serpenter entre les points expérimentaux, modélisant en réalité le bruit de mesure stochastique plutôt que le signal psychologique invariant.
Dans la recherche fondamentale, la sélection d’un ordre polynomial doit demeurer subordonnée au principe de parcimonie scientifique (le rasoir d’Ockham). Un degré 2 (parabole à un seul extremum) ou un degré 3 (courbe cubique présentant une inflexion et deux extrema potentiels) suffisent à épuiser la quasi-totalité des justifications théoriques plausibles en sciences humaines. Les ordres supérieurs génèrent fréquemment des oscillations parasites aux extrémités de la plage d’échantillonnage (le phénomène de Runge), rendant toute extrapolation prédictive totalement caduque et dénuée de signification biologique.
L’exploration doit donc consister à comparer l’incrément de qualité d’ajustement obtenu lors du passage de l’ordre 2 à l’ordre 3. Si l’adjonction d’un terme cubique ne s’accompagne pas d’une élévation substantielle de la variance expliquée ni d’une assise théorique claire (comme l’existence d’une phase de rebond cognitif documentée dans la littérature), le principe méthodologique impose de retenir l’équation du second degré, plus robuste et mathématiquement stable face à la réplication.
4.3 Extraction de l’équation polynomiale et du coefficient de détermination
Une fois la courbe polynomiale positionnée sur le graphique, il convient de rendre ses paramètres quantitatifs directement exploitables pour l’analyse. Dans le bas du panneau Format de la courbe de tendance, cochez obligatoirement les deux options suivantes : Afficher l’équation sur le graphique et Afficher la valeur de R au carré sur le graphique. Excel matérialise immédiatement une étiquette de texte flottante superposée à la zone de traçage, contenant la formulation mathématique complète de la régression et son indicateur de corrélation multiple.
Par défaut, l’affichage standard d’Excel tronque fréquemment les coefficients numériques à deux ou trois chiffres significatifs. Pour des modèles d’ordre 2 ou 3, une telle troncature constitue une source d’erreurs monumentale si l’on tente de recalculer des prédictions : en effet, le terme affecté à X2 ou X3 opère sur des valeurs élevées et la moindre imprécision sur sa quatrième décimale provoque des déviations massives du résultat final. Il est donc indispensable de cliquer directement sur le bloc d’étiquette de l’équation, d’ouvrir le volet Format de l’étiquette de courbe de tendance, d’accéder à la catégorie Nombre et de sélectionner le format Scientifique ou Nombre avec un minimum de 6 décimales fixes.
Le coefficient de détermination R2 ainsi affiché fournit une estimation brute de la proportion de variance comportementale prise en compte par le modèle polynomial. Toutefois, ainsi que nous le théoriserons dans les sections subséquentes, cette statistique graphique doit être interprétée avec circonspection et corroborée par des métriques d’information pénalisant le nombre de paramètres libres engagés dans le modèle.
5. Modélisation logarithmique, exponentielle et de puissance via les outils graphiques
5.1 Application du modèle logarithmique aux processus psychophysiques
L’ajustement d’une courbe de tendance logarithmique via l’outil graphique natif d’Excel constitue l’approche privilégiée pour tester l’adéquation de la célèbre loi de Weber-Fechner dans les études de perception sensorielle. Ce modèle repose sur l’équation générale :
Y = c · ln(X) + b
où Y représente la sensation perçue, X l’intensité physique mesurable du stimulus, c une constante d’échelle reflétant la sensibilité de l’organe sensoriel récepteur, et b une constante de recalage liée au seuil absolu de perceptibilité.
Sur le plan computationnel, l’analyste doit respecter une contrainte mathématique absolue : la fonction logarithmique n’étant pas définie pour les nombres réels négatifs ou nuls, l’axe des X ne doit contenir rigoureusement aucune valeur inférieure ou égale à zéro. Si votre protocole comporte un essai témoin à stimulation nulle (intensité 0), l’algorithme graphique d’Excel échouera immédiatement ou exclura silencieusement ces points, faussant la structure résiduelle. La solution méthodologique consiste à réétalonner la variable par une translation infinitésimale théoriquement justifiable (par exemple X + 0,001) ou à débuter l’analyse au premier seuil différentiel mesurable.
L’interprétation du coefficient multiplicateur c fournit une métrique directe de la compressibilité sensorielle : plus la valeur de c est faible, plus le système cognitif atténue la progression de l’énergie physique entrante pour protéger les réseaux neuronaux contre la saturation. La confrontation du R2 du modèle logarithmique à celui d’un modèle linéaire standard offre une quantification immédiate du gain d’adéquation apporté par la prise en compte de la dynamique compressive du cerveau.
5.2 Implémentation du modèle exponentiel pour l’apprentissage et la rétention
Pour investiguer les cinétiques d’extinction de réflexes conditionnés, la dissipation de la mémoire à court terme ou les courbes d’apprentissage accéléré, l’activation du bouton radio Exponentiel au sein du panneau de tendance graphique constitue la solution immédiate. Le modèle exécuté sous-jacent répond à la structure algébrique :
Y = a · ebX
où a figure la performance initiale ou le niveau d’encodage initial à t = 0, et b représente le taux intrinsèque de croissance (si b > 0) ou de décroissance mnésique (si b < 0).
Une exigence fondamentale de l’algorithme interne d’Excel pour ce tracé graphique est que toutes les observations de la variable dépendante Y doivent être strictement positives (Y > 0). Si des participants ont obtenu un score nul à un test de rétention, Excel refusera tout simplement d’ajuster la courbe exponentielle. Cette contrainte technique découle du fait que le moteur graphique standard d’Excel n’exécute pas une véritable optimisation non linéaire sur les données brutes, mais opère une linéarisation logarithmique déguisée sur la variable Y avant d’appliquer les moindres carrés ordinaires.
À partir de l’équation exponentielle extraite, le chercheur peut dériver directement des invariants temporels majeurs. Par exemple, dans une dynamique de décroissance mnésique d’Ebbinghaus, la « demi-vie » de la trace cognitive (notée t1/2, correspondant au temps requis pour que le souvenir perde la moitié de sa magnitude résiduelle) se calcule mathématiquement par la formule analytique :
t1/2 = ln(0,5) / b
Cette dérivation fournit une métrique standardisée hautement informative permettant la comparaison rigoureuse de la persistance mnésique entre diverses populations cliniques (par exemple des patients amnésiques versus des témoins sains).
5.3 Exploitation de la loi de puissance pour l’estimation de magnitude
L’option Puissance disponible dans les courbes de tendance d’Excel matérialise l’opérationnalisation directe de la loi de Stevens, qui s’énonce selon la formulation :
Y = a · Xk
Dans ce modèle psychophysique d’estimation de magnitude subjective, l’exposant k possède une signification théorique majeure : si k = 1, la transmission de l’information est parfaitement isométrique ; si k < 1, le système manifeste une compression d’échelle (par exemple l’évaluation de la brillance visuelle, où k ≈ 0,33) ; si k > 1, le système opère une amplification protectrice face au danger (par exemple l’estimation de la douleur induite par un choc électrique cutané, où k ≈ 3,5).
Tout comme pour le modèle exponentiel, l’option Puissance impose la stricte positivité conjointe des données sur l’axe des X et sur l’axe des Y, car l’ajustement repose historiquement sur une transformation bilogarithmique implicite. L’analyste peut ainsi confronter directement, sur un même ensemble de données expérimentales de perception, le R2 du modèle logarithmique de Fechner et celui de la loi de puissance de Stevens pour trancher empiriquement quel paradigme conceptuel décrit avec la plus haute fidélité le traitement neurosensoriel étudié.
Il importe toutefois de souligner une limite structurelle de ces outils graphiques préprogrammés : ils sont fondamentalement incapables d’intégrer des paramètres d’asymptote non nulle ou des décalages d’origine libres (tels que Y = a · Xk + y0). Dès lors que le phénomène psychologique implique un niveau de base spontané non nul ou une saturation asymptotique rigide, les courbes de tendance graphiques directes deviennent méthodologiquement obsolètes, contraignant le chercheur à recourir aux méthodes de linéarisation manuelle ou à l’optimisation par le Solveur.
6. Méthode de linéarisation par transformation des variables
6.1 Principes mathématiques de transformation d’équations non linéaires
Avant l’avènement de la puissance computationnelle moderne, la stratégie prédominante pour modéliser des relations curvilignes consistait à leur appliquer des transformations algébriques destinées à redresser l’équation sous une forme linéaire Y* = β0 + β1X*. Cette approche de linéarisation conserve aujourd’hui un intérêt pédagogique et analytique majeur. Considérons par exemple le modèle exponentiel Y = α · eβX. En appliquant l’opérateur du logarithme naturel aux deux membres de l’égalité, l’équation devient :
ln(Y) = ln(α) + βX
En posant Y* = ln(Y) et β0 = ln(α), on retrouve la structure familière d’une régression linéaire simple manipulable par les outils conventionnels.
De façon analogue, la loi de puissance Y = α · Xβ se transforme, par application conjointe du logarithme aux deux variables, en une droite bilogarithmique :
ln(Y) = ln(α) + β · ln(X)
Dans d’autres contextes, tels que les modèles de cinétique cognitive de type Michaelis-Menten décrivant la vitesse de traitement de l’information en fonction de la concentration d’un substrat attentionnel, la transformation en doubles inverses de Lineweaver-Burk (1/Y en fonction de 1/X) permet théoriquement de convertir une fonction hyperbolique saturante en une relation linéaire accessible.
Néanmoins, cette élégance algébrique masque une conséquence théorique critique souvent ignorée des praticiens : la transformation non linéaire de la variable dépendante altère profondément la structure probabiliste des erreurs résiduelles. Si le modèle d’origine postulait des erreurs additives gaussiennes à variance constante (homoscédastiques), la transformation logarithmique postule implicitement que le terme d’erreur original était multiplicatif et log-normal. Cela signifie que la minimisation des moindres carrés sur les variables transformées n’optimise plus la proximité des données dans l’espace métrique original, mais pénalise démesurément les petites valeurs au détriment des grandes.
6.2 Calculs des colonnes transformées dans le tableur
L’exécution pratique de la linéarisation au sein d’Excel requiert la création systématique de nouvelles colonnes de variables calculées. Supposons que les données expérimentales brutes de X et Y soient stockées dans les cellules A2:A101 et B2:B101 d’une feuille de travail opérationnelle. Pour implémenter un modèle exponentiel linéarisé, insérez une nouvelle colonne intitulée ln_Y en cellule C1. Dans la cellule C2, saisissez rigoureusement la formule suivante :
=LN(B2)
Étirez ensuite cette poignée de recopie vers le bas jusqu’à la cellule C101 pour générer instantanément l’ensemble du vecteur transformé.
Une rigueur méticuleuse s’impose dans la gestion des exceptions arithmétiques. Si votre colonne initiale contient des zéros ou des valeurs négatives consécutives à des erreurs d’enregistrement expérimental, Excel renverra immédiatement l’erreur #NOMBRE!. L’analyste doit identifier et documenter ces occurrences en utilisant des formules de contrôle d’intégrité, par exemple :
=SI(B2<=0; « Erreur: valeur non positive »; LN(B2))
Pour une linéarisation bilogarithmique (loi de puissance), créez symétriquement une colonne ln_X en colonne D en utilisant la syntaxe =LN(A2).
Après génération des séries transformées, il est vivement recommandé d’insérer un graphique de dispersion temporaire reliant ln_X et ln_Y. Cette visualisation de contrôle permet de valider empiriquement si l’hypothèse de linéarité sous-jacente est satisfaite dans l’espace transformé : si le tracé demeure incurvé malgré la manipulation mathématique, l’analyste dispose de la preuve irréfutable que la classe fonctionnelle sélectionnée est inadaptée à la réalité du processus cognitif étudié.
6.3 Utilisation de la fonction DROITEREG sur les variables transformées
Une fois les colonnes transformées validées, l’analyste peut exploiter toute la puissance de la fonction matricielle DROITEREG d’Excel pour obtenir un rapport d’estimation économétrique complet. Contrairement aux simples fonctions scalaires PENTE et ORDONNEE.ORIGINE, DROITEREG restitue simultanément les coefficients redressés, leurs erreurs types d’estimation, le coefficient de détermination R2, l’écart-type de la régression et la statistique F de Fisher. Pour une modélisation bilogarithmique où ln_Y est en C2:C101 et ln_X en D2:D101, sélectionnez une plage vide de deux colonnes sur cinq lignes (par exemple F2:G6) et saisissez la syntaxe matricielle suivante :
=DROITEREG(C2:C101; D2:D101; VRAI; VRAI)
Validez la formule par la combinaison de touches Ctrl + Maj + Entrée (sur les versions d’Excel antérieures à Microsoft 365) ou par un simple Entrée sur les versions contemporaines supportant les matrices dynamiques. La matrice de sortie délivre en cellule F2 la pente empirique (qui correspond directement à l’exposant psychophysique β) et en cellule G2 la constante d’ordonnée à l’origine (qui équivaut à ln(α)). Les cellules immédiatement inférieures F3 et G3 fournissent les erreurs types associées à ces deux estimateurs respectifs.
L’étape finale consiste à opérer la rétro-transformation algébrique pour ramener le paramètre d’ordonnée à son unité comportementale originelle. Le coefficient α d’origine s’obtient en appliquant la fonction exponentielle à la cellule contenant l’ordonnée à l’origine :
=EXP(G2)
Attention cependant : en raison de l’inégalité de Jensen, la rétro-transformation directe d’une variable aléatoire log-normale vers l’échelle originale introduit un biais systématique d’estimation à la baisse sur la médiane conditionnelle. Pour corriger ce biais et obtenir une prédiction non biaisée de la moyenne de Y, il convient d’appliquer le facteur de correction de Baskerville en multipliant le résultat par :
EXP((SE_reg^2) / 2)
où SE_reg est l’écart-type résiduel fourni en cellule F4 de la table DROITEREG.
7. Utilisation avancée du Solveur Excel pour la régression non linéaire générale
7.1 Activation et configuration initiale de l’utilitaire Solveur
L’approche la plus générale, la plus élégante et la plus rigoureuse sur le plan méthodologique pour surmonter les distorsions de la linéarisation consiste à ajuster directement le modèle non linéaire aux données brutes au moyen d’un algorithme d’optimisation itérative. Dans l’écosystème Excel, cette puissance de calcul est assurée par le complément Solveur. Cet utilitaire n’étant généralement pas chargé lors de l’installation initiale du tableur, une procédure d’activation technique s’impose avant toute manipulation.
Cliquez sur l’onglet Fichier dans le coin supérieur gauche, puis descendez jusqu’à la commande Options. Dans la boîte de dialogue contextuelle, sélectionnez la catégorie Compléments dans le menu latéral. Dans le menu déroulant inférieur intitulé Gérer, assurez-vous que la mention Compléments Excel soit sélectionnée, puis cliquez sur le bouton Atteindre…. Une petite fenêtre modale apparaît à l’écran : cochez explicitement la case associée au Complément Solveur et validez en cliquant sur OK. L’outil s’intègre alors de façon permanente dans le ruban supérieur sous l’onglet Données, au sein du groupe Analyse.
Contrairement aux fonctions graphiques restreintes, le Solveur traite l’ajustement non linéaire comme un problème d’optimisation mathématique sans contrainte de forme : l’analyste est libre de programmer n’importe quelle équation théorique personnalisée issue de la littérature psychologique, qu’il s’agisse d’un modèle exponentiel à double composante, d’une cinétique d’oubli complexe ou d’une fonction sigmoïde à multiples paramètres d’asymptote.
7.2 Construction de la feuille de calcul dédiée à l’optimisation
La structuration de la feuille de calcul constitue le fondement architectural de la régression non linéaire générale. Elle requiert une séparation spatiale limpide entre les données empiriques observées, les paramètres libres du modèle et les colonnes de calcul dynamique. Réservez une zone dédiée en haut de votre feuille (par exemple la plage E2:E5) pour héberger les paramètres du modèle que le Solveur devra ajuster. Attribuez à chaque cellule un libellé clair dans la colonne adjacente (par exemple D2 pour le paramètre a, D3 pour b, etc.) et renseignez des valeurs initiales arbitraires mais réalistes (valeurs de départ ou priors).
Supposons que nos observations brutes soient positionnées en colonnes A (abscisse X, de A2 à A101) et B (ordonnée Y observée, de B2 à B101). Créez ensuite en colonne C une série intitulée Y_predit. Dans la cellule C2, encodez l’équation fonctionnelle en faisant référence aux variables empiriques et aux cellules de paramètres bloquées impérativement par des références absolues (symboles $). Par exemple, pour un modèle exponentiel de type Y = a · e–bX, la syntaxe exacte en cellule C2 sera :
=$E$2 * EXP(-$E$3 * A2)
Recopiez cette formule vers le bas jusqu’à la cellule C101.
Créez ensuite la colonne D, nommée Residus, dont la cellule D2 calcule la déviation individuelle : =B2-C2. Enfin, configurez la colonne E (ou une colonne E décalée en F si E héberge vos paramètres) sous le titre Residus_Carres, calculant en cellule F2 l’expression :
=D2^2
Cette architecture cellulaire crée une chaîne causale fermée où toute modification des valeurs de paramètres en zone supérieure actualise instantanément les prédictions, les écarts et leurs carrés associés sur l’ensemble de l’échantillon expérimental.
7.3 Définition de la fonction objectif des moindres carrés (SSE)
L’ajustement non linéaire repose sur le critère d’optimalité des moindres carrés (ou Sum of Squared Errors – SSE). Cette quantité scalaire résume la distance globale entre le modèle théorique et la réalité phénoménologique observée. Dans une cellule isolée et clairement mise en évidence (par exemple la cellule H2, baptisée SSE_Objectif), programmez le calcul de la somme totale des résidus au carré. Vous pouvez sommer la colonne des résidus carrés via la syntaxe :
=SOMME(F2:F101)
ou, plus élégamment et sans nécessiter de colonne intermédiaire, faire appel à la fonction native d’Excel calculant directement la somme quadratique des déviations :
=SOMME.CARRES(D2:D101)
Ouvrez ensuite le Solveur en cliquant sur son icône dans l’onglet Données. Dans la boîte de dialogue Paramètres du Solveur, configurez avec une rigueur absolue les éléments suivants :
- Définir l’objectif : pointez directement vers votre cellule cible (dans notre exemple
$H$2). - À : sélectionnez impérativement le bouton radio Min (Minimiser), car la régression consiste à réduire au minimum incompressible l’énergie d’erreur du système.
- Variables de décision : sélectionnez la plage continue ou discontinue des cellules hébergeant les paramètres libres du modèle (par exemple
$E$2:$E$3).
Il est souvent judicieux d’ajouter des contraintes de plausibilité biologique dans la zone Contraintes. Si un paramètre de vitesse temporelle b ou une asymptote supérieure de performance ne peut mathématiquement pas être négatif, cliquez sur Ajouter et spécifiez la condition $E$3 >= 0. Cette précaution guide l’algorithme et prévient les trajectoires d’optimisation aberrantes dans les zones imaginaires ou infinies de la surface de coût.
7.4 Exécution de l’algorithme GRG Non-linéaire et convergence
Le choix du moteur d’optimisation constitue le cœur névralgique de la démarche. Dans le menu déroulant Sélectionner une méthode de résolution, choisissez exclusivement GRG Non-linéaire (Generalized Reduced Gradient). Cette méthode d’optimisation déterministe est expressément conçue pour résoudre des systèmes où les dérivées partielles varient de façon continue par rapport aux paramètres. Cliquez ensuite sur le bouton adjacent Options pour affiner la précision numérique : réglez la Convergence sur un seuil strict (par exemple 0,0000001) et sélectionnez l’option Dérivées : Centrales plutôt que progressives pour accroître substantiellement la précision de l’approximation numérique du gradient.
Cliquez sur le bouton Résoudre. Le moteur GRG calcule le gradient local de la surface d’erreur, détermine la direction de plus grande pente descendante et ajuste pas à pas les paramètres jusqu’à ce que la pente devienne infinitésimale. Lorsque le processus aboutit, une fenêtre d’information s’affiche : vérifiez attentivement que le Solveur énonce expressément le message « Le Solveur a trouvé une solution. Toutes les contraintes et conditions d’optimalité sont satisfaites ». Cochez l’option Conserver la solution du Solveur et validez par OK.
Il est impératif de souligner la vulnérabilité intrinsèque des algorithmes à gradient : la sensibilité critique aux valeurs initiales et le piège des minima locaux. Le Solveur explore le paysage mathématique à partir du point de départ que vous avez renseigné. Si la topologie d’erreur présente de multiples creux (ce qui est fréquent dans les modèles psychométriques complexes), l’algorithme peut s’immobiliser dans un puits secondaire sous-optimal sans jamais atteindre le minimum global absolu. La parade méthodologique consiste à réexécuter l’optimisation en testant plusieurs jeux de valeurs initiales distincts (stratégie du multistart) ou en activant l’option Utiliser des démarrages multiples dans les réglages avancés du Solveur GRG.
8. Modélisation de courbes logistiques et sigmoïdes pour la psychométrie
8.1 Formulation des équations logistiques à 3 et 4 paramètres
L’ajustement de modèles sigmoïdes constitue l’un des sommets méthodologiques de la psychométrie contemporaine et de la Théorie de Réponse aux Items (TRI). Dans l’évaluation des aptitudes intellectuelles, du raisonnement abstrait ou de la discrimination perceptive, la probabilité P d’une réponse correcte en fonction d’un trait latent ou de l’intensité d’un stimulus X obéit quasi systématiquement à une dynamique sigmoïdale asymétrique ou symétrique. L’équation logistique standard à 4 paramètres (4PL), formulation la plus complète en recherche comportementale, s’écrit formellement :
Y = c + (d – c) / (1 + e–a(X – b))
Cette formulation décompose le phénomène psychologique en quatre vecteurs conceptuels distincts :
- d représente l’asymptote supérieure (la performance théorique maximale, plafonnée à 1,0 ou 100 % en l’absence de défaillance attentionnelle).
- c constitue l’asymptote inférieure (le plancher de réponse, reflétant le taux de réussite attribuable à la pseudo-chance ou au devinement aléatoire dans les questionnaires à choix multiples).
- b identifie le point d’inflexion central sur l’axe des X (le seuil de difficulté du stimulus ou de l’item où le participant a une probabilité de réussite exactement médiane entre les deux asymptotes).
- a désigne le facteur de pente ou paramètre de discrimination (qui quantifie la netteté et la rapidité avec laquelle le comportement bascule de l’échec vers la réussite).
Lorsque le paradigme expérimental empêche structurellement le devinement (par exemple dans une tâche de reproduction motrice continue), le paramètre c est fixé à 0, réduisant l’architecture à un modèle logistique à 3 paramètres (3PL).
8.2 Processus d’estimation pas à pas des paramètres asymptotiques
La transcription cellulaire de l’équation logistique à 4 paramètres exige une méticulosité absolue. Allouez les cellules G2, G3, G4 et G5 pour stocker respectivement les paramètres a (discrimination), b (difficulté), c (chance) et d (plafond). Renseignez des valeurs initiales intelligentes déduites de l’analyse visuelle de vos données : si X s’étend de -3 à +3 (métrique classique des traits latents en psychométrie), fixez provisoirement b à 0 (la médiane), a à 1,0, c à la valeur minimale observée (par exemple 0,20 pour un QCM à cinq options), et d à 1,0.
Dans la colonne Y_predit (cellule C2), programmez rigoureusement l’expression mathématique en respectant la hiérarchie des parenthèses :
=$G$4 + ($G$5 – $G$4) / (1 + EXP(-$G$2 * (A2 – $G$3)))
Étirez la cellule jusqu’au terme de votre cohorte d’observations. Dans la feuille de calcul, configurez la cellule d’objectif SSE via la formule =SOMME.CARRES(B2:B101 - C2:C101) validée matriciellement ou via la colonne résiduelle dédiée.
Dans le Solveur, désignez la plage $G$2:$G$5 comme ensemble de cellules variables. L’introduction de contraintes mathématiques et théoriques s’avère ici capitale pour assurer la validité du modèle :
- Contrainte 1 :
$G$4 >= 0(l’asymptote de pseudo-chance ne peut être strictement négative). - Contrainte 2 :
$G$5 <= 1(la probabilité maximale théorique ne saurait excéder l’unité). - Contrainte 3 :
$G$5 >= $G$4(l’asymptote supérieure doit impérativement demeurer supérieure à l’asymptote inférieure). - Contrainte 4 :
$G$2 > 0(la pente doit être positive, postulant qu’une intensité supérieure du trait ne dégrade pas le score).
Exécutez l’optimisation par le moteur GRG Non-linéaire. La convergence affine simultanément les quatre paramètres, stabilisant l’équation de la courbe caractéristique d’item avec une fidélité numérique exceptionnelle.
8.3 Interprétation psychologique des coefficients obtenus
L’extraction des coefficients stabilisés autorise une interprétation clinique et psychométrique d’une grande finesse analytique. Le paramètre de pente a constitue la mesure directe de la qualité discriminative de l’épreuve expérimentale. Un coefficient a très élevé (par exemple supérieur à 2,0) signale que l’item ou le stimulus fonctionne comme un séparateur catégoriel extrêmement tranché : une infime variation de la compétence sous-jacente autour du point de transition fait basculer le comportement d’un état à un autre. À l’inverse, une valeur de a faible (proche de 0,3) indique un test peu sensible, où la probabilité de succès évolue de façon diffuse et imprécise le long du continuum cognitif.
Le point d’inflexion b fournit la métrique standardisée de la difficulté objective de la tâche ou de la sensibilité liminaire du système nerveux. L’abscisse de ce point de demi-saturation correspond au niveau exact d’énergie physique ou d’aptitude psychologique requis pour que la moitié de la transition comportementale soit accomplie. Dans une cohorte clinique, un déplacement systématique du paramètre b vers la droite de l’axe par rapport à un groupe contrôle traduit directement un déficit perceptif ou un retard d’acquisition mesurable en unités d’écart-type.
Enfin, l’examen comparatif des asymptotes c et d renseigne sur les processus attentionnels périphériques. Une élévation inattendue de l’asymptote inférieure c peut révéler l’existence de stratégies de contournement ou de faiblesses méthodologiques dans la conception des distracteurs d’un test. Réciproquement, un abaissement de l’asymptote supérieure d en deçà de 1,0 (par exemple 0,85) quantifie mathématiquement le taux de lapsus attentionnels ou de fatigue neuromusculaire du sujet, des facteurs non liés à l’intelligence spécifique mais polluant la performance globale.
9. Évaluation rigoureuse de la qualité de l’ajustement et des indices de sélection
9.1 Calcul précis et interprétation du R² non linéaire
Dans l’analyse de régression linéaire standard, le coefficient de détermination R2 est universellement interprété comme la proportion de la variance de la variable dépendante capturée par le modèle. Dans le domaine non linéaire, son utilisation soulève d’importants débats épistémologiques et statistiques que tout chercheur rigoureux se doit de maîtriser. Pour dériver le R2 non linéaire dans Excel, il convient d’exécuter son calcul à partir de sa définition matricielle primale :
R2 = 1 – (SSE / SST)
Dans une cellule dédiée, calculez la somme totale des carrés (SST) qui mesure la dispersion empirique totale des données autour de leur moyenne globale :
=SOMME.CARRES.ECARTS(B2:B101)
Ensuite, dans la cellule récapitulative du R2, formulez l’équation : =1 - (H2 / SST) (où H2 correspond à votre cellule d’erreur quadratique SSE optimisée par le Solveur).
Il est impératif d’émettre un avertissement méthodologique majeur : dans un cadre non linéaire, les sommes des carrés ne bénéficient plus de la propriété d’orthogonalité fondamentale propre au modèle linéaire. Par conséquent, l’égalité SST = SSR + SSE n’est plus garantie. Dans certains cas pathologiques où le modèle non linéaire est intrinsèquement inadapté ou contraint de manière inappropriée, la SSE peut surpasser la SST, produisant un R2 négatif. De surcroît, le R2 est mécaniquement gonflé par l’adjonction de paramètres libres supplémentaires, qu’ils possèdent ou non une pertinence réelle.
Pour corriger cette inflation artificielle, l’analyste doit impérativement calculer le R2 ajusté (noté R2adj), lequel intègre une pénalisation relative aux degrés de liberté du modèle :
R2adj = 1 – [(SSE / (n – p)) / (SST / (n – 1))]
où n est la taille effective de l’échantillon (dans notre exemple 100) et p représente le nombre total de paramètres libres estimés par le Solveur. Cette formule s’encode aisément dans Excel et fournit un premier rempart contre le surajustement statistique.
9.2 Indices d’erreur absolue et quadratique moyenne
Au-delà des ratios de variance relatifs qui peuvent induire en erreur, l’évaluation d’un modèle gagne à s’ancrer dans des métriques d’erreur absolue exprimées directement dans l’unité physique ou psychologique de la mesure comportementale. La plus fondamentale est la racine de l’erreur quadratique moyenne (Root Mean Squared Error – RMSE). Elle quantifie l’écart-type de la distribution résiduelle non modélisée et s’exprime par la formule :
RMSE = √(SSE / n)
Dans la feuille Excel, sa programmation est immédiate via la cellule de calcul :
=RACINE(H2 / NB(B2:B101))
Un RMSE faible traduit une concentration étroite des points observés autour de la trajectoire théorique prédite.
Toutefois, la métrique RMSE accorde un poids prépondérant aux écarts ponctuels majeurs en raison de l’élévation au carré des déviations individuelles. Pour obtenir un diagnostic complémentaire moins vulnérable aux artéfacts résiduels isolés, il est pertinent d’implémenter l’erreur absolue moyenne (Mean Absolute Error – MAE). Créez une colonne évaluant la valeur absolue de chaque résidu via la syntaxe =ABS(D2), puis calculez-en la moyenne arithmétique globale via la fonction =MOYENNE(plage_abs).
La comparaison conjointe du RMSE et de la MAE apporte un éclairage substantiel sur la nature de l’erreur expérimentale. Un écart considérable entre ces deux indicateurs (un RMSE nettement supérieur à la MAE) signale sans ambiguïté la présence d’erreurs ponctuelles d’amplitude disproportionnée au sein du protocole. À l’inverse, des grandeurs quasi convergentes témoignent d’une distribution remarquablement uniforme des déviations résiduelles sur l’ensemble de la gamme de mesure.
9.3 Calcul des critères d’information d’Akaike (AIC) et bayésien (BIC)
Lorsqu’un chercheur confronte deux théories psychologiques concurrentes (par exemple une décroissance mnésique de nature exponentielle versus une dynamique modélisée par une loi de puissance), le simple recours au R2 ou au RMSE est insuffisant pour départager formellement les architectures mathématiques si celles-ci possèdent un nombre divergent de paramètres libres. Il est alors nécessaire de recourir aux critères d’information théorique : le critère d’information d’Akaike (AIC) et le critère d’information bayésien (BIC), qui arbitrent rigoureusement le compromis entre la fidélité de l’ajustement et la parcimonie computationnelle.
Dans l’hypothèse canonique d’erreurs indépendantes et identiquement distribuées selon une loi normale, la formulation empirique de l’AIC à partir de la somme des carrés résiduels (SSE) est donnée par la relation :
AIC = n · ln(SSE / n) + 2k
où n est la taille d’échantillon et k le nombre de paramètres estimés dans le modèle (en incluant la variance résiduelle, soit p + 1). Dans un contexte d’échantillons psychologiques finis (où le ratio n/k < 40), l’analyste doit impérativement employer la version corrigée de second ordre (AICc) pour prémunir l’analyse contre un surajustement sévère :
AICc = AIC + [2k(k + 1)] / (n – k – 1)
Cette expression s’encode dans une cellule Excel sans difficulté technique majeure :
=n*LN(SSE/n) + 2*k + (2*k*(k+1))/(n–k-1)
Le critère bayésien BIC, plus sévère face à l’accroissement dimensionnel sur de larges cohortes, intègre pour sa part une pénalisation logarithmique dépendante de n :
BIC = n · ln(SSE / n) + k · ln(n)
L’interprétation de ces métriques est relative : le modèle statistique à retenir comme décrivant le plus fidèlement le mécanisme psychologique sous-jacent est systématiquement celui qui affiche la valeur la plus faible d’AICc ou de BIC. Une différence d’AICc (notée ΔAICc) excédant 2 unités entre deux modèles est considérée comme un élément de preuve significatif en faveur de la spécification la plus parcimonieuse, tandis qu’un écart supérieur à 10 confère une domination statistique écrasante au modèle vainqueur.
10. Diagnostic statistique des résidus et vérification des postulats
10.1 Création et inspection du graphique des résidus
Aucun ajustement non linéaire ne saurait être considéré comme scientifiquement validé par la seule obtention d’un R2 élevé sans une inspection graphique approfondie de ses résidus d’estimation. L’objectif méthodologique de cette vérification est de s’assurer que les déviations entre la théorie et les faits expérimentaux se comportent exclusivement comme un bruit blanc stochastique dénué de toute structure organisationnelle récurrente. Pour conduire ce diagnostic sous Excel, générez un nouveau graphique à nuage de points mettant en relation les valeurs prédites Y_predit (en abscisse X) et les résidus simples Residus (en ordonnée Y).
Une fois le nuage tracé, insérez une ligne horizontale de référence positionnée exactement sur le zéro de l’axe des ordonnées. L’analyste doit alors scruter méticuleusement la morphologie de la dispersion. Une configuration optimale se manifeste sous la forme d’une constellation informe et symétrique de points oscillant de manière aléatoire autour de l’axe zéro, sans modification d’amplitude apparente le long de l’axe de prédiction.
Si la nuée de résidus dessine une structure courbée en forme de parabole, de U ou de W étiré, le diagnostic est sans équivoque : la fonction mathématique sélectionnée échoue à capturer une composante systématique de la dynamique psychologique sous-jacente. Cette distorsion spatiale traduit une erreur de spécification fonctionnelle majeure (par exemple le choix inapproprié d’une droite ou d’un modèle logarithmique simple pour modéliser une cinétique à deux phases de saturation). De même, un élargissement progressif des déviations résiduelles de la gauche vers la droite de l’axe (motif classique d’entonnoir) met en lumière une hétéroscédasticité caractérisée, signalant que la variabilité de la performance comportementale s’accroît à mesure que l’intensité de la réponse s’intensifie.
10.2 Vérification de la normalité de la distribution des erreurs
L’inférence statistique valide (qu’il s’agisse des tests d’hypothèse sur les paramètres ou du calcul des intervalles de confiance) repose sur le postulat fondamental selon lequel les erreurs du modèle suivent une distribution gaussienne homoscédastique d’espérance nulle. Pour évaluer la forme empirique de cette distribution au sein d’Excel, la première approche consiste à créer un histogramme de fréquence des résidus. Vous pouvez utiliser la commande native Histogramme accessible dans l’onglet Insertion, ou recourir à la fonction matricielle FREQUENCE en définissant préalablement des classes d’amplitudes régulières.
Ce diagnostic visuel doit être impérativement soutenu par le calcul formel des moments d’ordre supérieur : le coefficient d’asymétrie (skewness) et le coefficient d’aplatissement (kurtosis). Dans deux cellules adjacentes, calculez ces statistiques en exploitant les fonctions natives d’Excel :
=COEFFICIENT.ASYMETRIE(D2:D101)
=KURTOSIS(D2:D101)
Pour une distribution normale théorique, ces deux indices affichent des valeurs avoisinant strictement le zéro (la fonction KURTOSIS d’Excel restituant l’excès de kurtosis par rapport à la référence gaussienne de 3). Des déviations excédant l’intervalle [-1, +1] signalent des déformations distributionnelles substantielles, invalidant l’hypothèse de normalité.
Pour une rigueur scientifique optimale, l’analyste peut implémenter un diagramme quantile-quantile (Q-Q plot) simplifié. Cette technique consiste à trier les résidus par ordre croissant, à calculer leur rang percentile empirique théorique pi = (i – 0,5) / n, à dériver les quantiles gaussiens théoriques associés via la syntaxe =LOI.NORMALE.STANDARD.INVERSE(p_i), et à tracer les résidus observés en fonction de ces quantiles. Un alignement rectiligne rigoureux valide l’hypothèse d’adéquation gaussienne, tandis que des décrochages aux extrémités (phénomène des queues lourdes) alertent sur la présence récurrente de réactions extrêmes chez certains sujets atypiques.
10.3 Détection de l’autocorrélation des résidus
Dans de nombreuses expériences de psychologie comportementale ou de chronobiologie cognitive, les données sont collectées séquentiellement sous forme de séries temporelles longitudinales (par exemple l’évolution de la vigilance mesurée toutes les dix minutes durant une période de privation de sommeil). Dans ces architectures séquentielles, la violation du postulat d’indépendance mutuelle des observations constitue un écueil analytique fréquent. Lorsque le signe ou la magnitude du résidu au temps t prédit systématiquement le résidu au temps t+1, on observe une autocorrélation sérielle de premier ordre.
Pour mesurer ce phénomène sous Excel, la statistique de Durbin-Watson (d) peut être construite manuellement. Cette statistique évalue le ratio entre la somme des différences résiduelles consécutives au carré et la somme totale des résidus au carré, selon l’expression mathématique :
d = [ ∑i=2..n (ei – ei-1)2 ] / [ ∑i=1..n ei2 ]
Créez en colonne G une formule calculant en cellule G3 la déviation séquentielle : =(D3 - D2)^2, puis étirez jusqu’au terme de la série. Dans une cellule dédiée au diagnostic, évaluez la statistique d par l’expression :
=SOMME(G3:G101) / H2
La statistique de Durbin-Watson oscille structurellement entre 0 et 4. Une valeur proche de 2,0 atteste d’une indépendance sérielle parfaite des déviations résiduelles, corroborant l’intégrité temporelle du protocole expérimental. En revanche, une valeur nettement inférieure à 1,5 indique une autocorrélation sérielle positive prononcée (les déviations positives tendant à s’enchaîner durablement), signe que l’organisme subit des effets d’inertie neuromusculaire ou de mémoire résiduelle non modélisés par l’équation retenue.
11. Estimation de l’incertitude et intervalles de confiance des paramètres
11.1 Approximation de la matrice de variance-covariance
L’un des défis majeurs posés par l’utilisation d’Excel pour la modélisation réside dans le fait que le module Solveur standard, bien qu’extrêmement performant pour identifier l’optimum ponctuel des paramètres, ne délivre pas automatiquement les erreurs types d’estimation ni les intervalles de confiance formels associés aux coefficients calculés. Pour obtenir ces indices d’incertitude indispensables à la publication académique sans recourir à un code tiers, l’analyste peut implémenter une approximation numérique de la matrice de variance-covariance par dérivation numérique.
Dans le formalisme de l’optimisation non linéaire, la matrice de covariance asymptotique des paramètres V est approximée par la relation matricielle :
V = s2 · (JTJ)-1
où s2 est la variance résiduelle non biaisée du modèle (calculée par SSE / (n – p)) et J représente la matrice jacobienne des dérivées partielles numériques de la fonction de prédiction par rapport à chacun des paramètres libres. Pour calculer numériquement chaque élément de la colonne jacobienne associée au paramètre a pour l’observation i, on applique la formule de différence finie centrale dans une colonne de calcul dédiée :
[f(Xi, a + Δa, b) – f(Xi, a – Δa, b)] / (2 · Δa)
où Δa représente un incrément infinitésimal standardisé (par exemple 0,0001 · a).
Une fois les colonnes de la matrice jacobienne générées pour l’ensemble des paramètres du modèle, l’analyste exploite les fonctions d’algèbre matricielle natives d’Excel. Utilisez la fonction PRODUITMAT imbriquée avec TRANSPOSE pour calculer la matrice d’information JTJ, puis sollicitez la fonction INVERSEMAT pour inverser cette matrice. Multipliez ensuite chaque élément diagonal de la matrice inverse obtenue par la variance résiduelle s2 : la racine carrée de ces éléments diagonaux (via la fonction RACINE) restitue avec une haute fidélité mathématique les erreurs types asymptotiques (SE) de chaque paramètre libre.
11.2 Mise en place d’une procédure de rééchantillonnage bootstrap dans Excel
Face à la complexité algorithmique du calcul matriciel des dérivées partielles, le rééchantillonnage bootstrap constitue une alternative non paramétrique élégante, robuste et intuitive pour estimer l’incertitude des paramètres sans formuler d’hypothèses distributionnelles restrictives. Le principe fondamental consiste à générer un grand nombre de pseudo-échantillons expérimentaux de taille n par tirage aléatoire avec remise à partir de la cohorte d’observations initiale, et à réestimer les paramètres sur chacun de ces jeux synthétiques.
Pour opérationnaliser un bootstrap résiduel simple dans Excel, conservez vos valeurs observées X inchangées et créez un vecteur de résidus rééchantillonnés. Dans une nouvelle colonne, utilisez conjointement les fonctions ALEA.ENTRE.BORNES et INDEX pour tirer au hasard, avec probabilité égale, l’un des résidus originaux calculés lors du premier ajustement optimal :
=INDEX($D$2:$D$101; ALEA.ENTRE.BORNES(1; 100))
Générez ensuite une nouvelle variable dépendante pseudo-empirique en additionnant ce résidu simulé à la prédiction d’origine : Y_bootstrap = Y_predit + Residu_aleatoire.
Bien que l’ajustement interactif de centaines d’itérations bootstrap via l’interface graphique du Solveur soit fastidieux, il est aisé d’automatiser cette boucle par une courte macro d’une dizaine de lignes sous l’éditeur Visual Basic for Applications (VBA). La routine exécute séquentiellement la commande SolverSolve UserFinish:=True à chaque tirage aléatoire et archive les coefficients résultants dans un tableau de compilation dédié. L’intervalle de confiance non paramétrique à 95 % pour chaque paramètre se déduit alors simplement en extrayant les percentiles 2,5 % et 97,5 % de la distribution empirique générée, au moyen de la fonction native :
=PERCENTILE.EXCLURE(plage_bootstrap; 0,025)
=PERCENTILE.EXCLURE(plage_bootstrap; 0,975)
11.3 Tracé des bandes de confiance autour de la courbe ajustée
L’aboutissement graphique d’une démarche de modélisation non linéaire réside dans la restitution conjointe de la trajectoire théorique moyenne et de son fuseau d’incertitude statistique le long de l’axe des abscisses. La matérialisation de ces bandes de confiance permet de repérer immédiatement les régions de la dynamique cognitive où le comportement est modélisé avec une haute précision versus les plages exploratoires où l’incertitude prédictive devient considérable (notamment aux extrêmes de la distribution).
Pour construire ces enveloppes sous Excel, déterminez l’erreur type de prédiction conditionnelle (notée SEpred(X)) pour un continuum fin de points le long de la variable X. À partir des erreurs types des coefficients isolées précédemment, programmez deux colonnes supplémentaires bordant la trajectoire de régression : la borne inférieure (Y_lower) et la borne supérieure (Y_upper) calculées pour un niveau de confiance bilatéral de 95 % :
Y_lower = Y_predit – (tcritique · SEpred)
Y_upper = Y_predit + (tcritique · SEpred)
où la valeur de tcritique s’extrait pour n – p degrés de liberté via la fonction =LOI.STUDENT.INVERSE.N(0,05; n-p).
Intégrez ensuite ces deux séries complémentaires au sein de votre graphique à nuage de points principal via le panneau Sélectionner des données. Configurez leur tracé sous la forme de lignes continues discrètes ou de tracés pointillés de teinte atténuée (par exemple un gris neutre semi-transparent) encadrant la courbe théorique principale. L’observateur visualise ainsi immédiatement le phénomène d’évasement en entonnoir caractéristique de l’amplification de l’incertitude aux marges de la plage d’investigation expérimentale, conférant à la restitution visuelle une assise méthodologique irréprochable.
12. Restitution académique des résultats selon les normes APA
12.1 Conception de tableaux récapitulatifs aux normes de publication
La transcription des paramètres issus de la modélisation non linéaire au sein d’un manuscrit scientifique exige le respect méticuleux des conventions typographiques et structurelles prescrites par l’American Psychological Association (APA 7th edition). Les tableaux récapitulatifs doivent éliminer tout quadrillage vertical inutile et restreindre les séparateurs horizontaux à trois lignes fondamentales : la bordure supérieure du tableau, la ligne démarquant les en-têtes de colonnes du corps de données, et la bordure inférieure scellant la fin du bloc.
Les symboles algébriques et statistiques doivent systématiquement figurer en italique standardisé (par exemple a, b, R2adj, RMSE, AICc), tandis que les indices descriptifs demeurent en police romaine normale. Chaque paramètre libre estimé doit être consigné dans une rangée spécifique, documentant conjointement sa valeur ponctuelle optimisée, son erreur type (SE), ainsi que les bornes inférieure et supérieure de son intervalle de confiance à 95 % (noté [IC 95 %]). L’alignement numérique doit être rigoureusement ajusté sur la virgule décimale afin de faciliter la lecture comparative des amplitudes d’effet.
Dans la zone inférieure du tableau, intégrez une note de tableau exhaustive (débutant par l’étiquette en italique Note.). Cette annotation doit préciser la nature de la fonction mathématique ajustée, la taille totale de l’échantillon analysé (N), la méthode d’optimisation numérique déployée sous le tableur (par exemple l’algorithme du gradient réduit généralisé avec critères de convergence à 10-7), et la définition des abréviations métriques mobilisées pour prémunir le lecteur contre toute ambiguïté interprétative.
12.2 Finalisation graphique professionnelle pour les manuscrits
L’insertion directe d’une capture d’écran brute d’un graphique Excel au sein d’un article soumis aux comités de lecture est une pratique méthodologiquement inacceptable. Les standards éditoriaux exigent une qualité graphique irréprochable, une sobriété visuelle totale et une résolution minimale de 300 points par pouce (DPI) pour les sorties tramées, ou une préservation vectorielle native.
Procédez à une épuration rigoureuse des options graphiques par défaut du tableur : supprimez systématiquement le quadrillage d’arrière-plan horizontal et vertical, éliminez les contours de boîte entourant la zone de traçage, et désactivez tout effet décoratif d’ombrage, de dégradé ou de rendu en fausse tridimensionnalité. Harmonisez les polices de caractères du graphique (titres, graduations, étiquettes) avec la typographie globale du manuscrit en privilégiant des fontes neutres telles que Times New Roman ou Arial, calibrées à une taille comprise entre 8 et 12 points pour assurer une parfaite lisibilité après redimensionnement éditorial.
La courbe théorique optimisée doit être tracée sous la forme d’un trait plein d’épaisseur intermédiaire (environ 1,5 pt), contrastant élégamment avec les marqueurs empiriques individuels figurés par des cercles ouverts ou des points pleins semi-transparents. Rédigez enfin une légende de figure autonome et exhaustive, positionnée sous l’illustration, détaillant la signification des symboles, la formule de la trajectoire ajustée et les limites des intervalles de prédiction figurés sur le canevas.
12.3 Rédaction du texte des résultats et justification méthodologique
La restitution narrative des analyses non linéaires au sein de la section Résultats doit conjuguer élégance stylistique, exhaustivité des indices statistiques et clarté conceptuelle. L’auteur doit énoncer expressément la motivation théorique ayant justifié le rejet du cadre linéaire traditionnel, expliciter l’équation formelle retenue pour modéliser le comportement, et décrire avec une totale transparence les étapes de résolution computationnelle exécutées sous Excel.
Une phraséologie académique conforme aux normes actuelles s’articule selon la séquence démonstrative suivante :
« Afin d’examiner l’hypothèse d’une cinétique de saturation cognitive lors de l’apprentissage perceptif, une régression non linéaire basée sur un modèle logistique à 3 paramètres a été ajustée sur les proportions de réponses correctes en fonction du temps d’exposition au stimulus (ms). L’optimisation numérique des moindres carrés a été opérée via l’algorithme du Gradient Réduit Généralisé (GRG) de Microsoft Excel, avec un seuil de convergence paramétré à 10-7. Le modèle logistique démontre une qualité d’ajustement exceptionnelle aux données empiriques (R2adj = .94, RMSE = 0.042, AICc = -312.4), surclassant de manière décisive le modèle linéaire concurrent (R2adj = .71, AICc = -245.1, ΔAICc = 67.3). Le point d’inflexion comportemental, correspondant au seuil de difficulté médiane (b), a été estimé à 245.32 ms, SE = 4.12, IC 95 % [237.15, 253.49]. La pente de discrimination (a) s’établit à 0.035, SE = 0.003, IC 95 % [0.029, 0.041], attestant d’une transition attentionnelle particulièrement abrupte. L’inspection des résidus confirme l’absence d’hétéroscédasticité ou d’autocorrélation sérielle (statistique de Durbin-Watson d = 1.94), validant pleinement la robustesse des inférences formulées. »
Enfin, dans l’esprit des pratiques actuelles de science ouverte et de reproductibilité computationnelle (Center for Open Science), il est fortement recommandé de déposer le classeur Excel original dument documenté, formulé et verrouillé sur un dépôt public pérenne (tel qu’Open Science Framework – OSF). Cette transparence méthodologique permet à la communauté scientifique de vérifier la chaîne de calculs, de tester la sensibilité des algorithmes à d’autres valeurs de départ et d’assurer une pérennité absolue aux conclusions scientifiques publiées.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Baskerville, G. L. (1972). Use of logarithmic regression in the estimation of plant biomass. Canadian Journal of Forest Research, 2(1), 49–53. https://doi.org/10.1139/x72-009
- Burnham, K. P., & Anderson, D. R. (2002). Model selection and multimodel inference: A practical information-theoretic approach (2nd ed.). Springer-Verlag. https://doi.org/10.1007/b97636
- Ebbinghaus, H. (1913). Memory: A contribution to experimental psychology (H. A. Ruger & C. E. Bussenius, Trans.). Teachers College, Columbia University. (Original work published 1885). https://doi.org/10.1037/10011-000
- Fechner, G. T. (1860). Elemente der Psychophysik. Breitkopf und Härtel.
- Lasdon, L. S., Waren, A. D., Jain, A., & Ratner, M. (1978). Design and testing of a generalized reduced gradient code for nonlinear programming. ACM Transactions on Mathematical Software, 4(1), 34–50. https://doi.org/10.1145/355769.355773
- Motulsky, H. J., & Christopoulos, A. (2004). Fitting models to biological data using linear and nonlinear regression: A practical guide to curve fitting. Oxford University Press.
- Myung, I. J. (2000). The importance of complexity in model selection. Journal of Mathematical Psychology, 44(1), 190–204. https://doi.org/10.1006/jmps.1999.1283
- Ratkowsky, D. A. (1990). Handbook of nonlinear regression models. Marcel Dekker.
- Seber, G. A. F., & Wild, C. J. (2003). Nonlinear regression. John Wiley & Sons. https://doi.org/10.1002/0471725315
- Stevens, S. S. (1957). On the psychophysical law. Psychological Review, 64(3), 153–181. https://doi.org/10.1037/h0046162
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503