
La visualisation computationnelle de données constitue le pivot par lequel l’analyse statistique abstraite se transmue en une interprétation scientifique rigoureuse, intelligible et communicable. Dans l’écosystème open source contemporain dédié à la science des données, la bibliothèque logicielle Python Seaborn s’est imposée comme une référence incontournable pour la modélisation graphique des distributions statistiques, l’estimation des densités sous-jacentes et la capture visuelle des corrélations multidimensionnelles. Toutefois, concevoir une représentation graphique sur un canevas interactif éphémère ne résout qu’une fraction du problème analytique. La pérennisation de ces représentations sous la forme de fichiers numériques autonomes, fidèles aux standards éditoriaux et préservant chaque nuance chromatique ou géométrique, représente une étape méthodologique fondamentale que tout chercheur, ingénieur de données et analyste se doit de maîtriser avec minutie.
L’acte de sauvegarder un graphique généré par Seaborn dépasse largement la simple exécution machinale d’une fonction d’écriture sur un disque local. Cette opération engage des mécanismes sophistiqués qui s’articulent autour de la hiérarchie structurelle de Matplotlib, moteur graphique sur lequel repose l’ensemble de l’architecture de Seaborn. Les interactions entre les conteneurs d’axes, les figures englobantes, les moteurs de rastérisation et les convertisseurs vectoriels déterminent directement la qualité, l’échelle et la lisibilité du produit final. Une méconnaissance de ces principes d’ingénierie logicielle conduit invariablement à des artefacts rédhibitoires : typographies tronquées, marges périphériques démesurées, étiquettes de données compressées, ou encore perte irréversible de résolution lors de l’intégration dans des documents scientifiques composés sous LaTeX ou des revues académiques à fort impact.
Cet article propose un examen exhaustif, théorique et appliqué des techniques d’exportation de graphiques Seaborn. En disséquant la dualité entre les fonctions opérant au niveau des axes et celles agissant au niveau de la figure, en explorant la physique numérique des formats matriciels et vectoriels, et en exposant les paramètres cruciaux de résolution spatiale et de confinement géométrique, cette étude fournit un corpus complet de connaissances pratiques. À travers une série d’exemples détaillés et de solutions concrètes aux pathologies d’exportation récurrentes, le praticien découvrira comment automatiser et sublimer la production de ses figures pour répondre aux exigences les plus strictes de la recherche empirique et de l’ingénierie moderne.
1. Introduction à l’exportation des visualisations Seaborn dans l’analyse de données
1.1 Nécessité méthodologique de l’archivage graphique rigoureux
L’archivage des représentations visuelles issues de protocoles expérimentaux ou de pipelines computationnels constitue un impératif méthodologique incontournable au sein de la démarche scientifique moderne. Une visualisation graphique n’est point un ornement esthétique accessoire ; elle matérialise l’état précis d’une distribution de probabilité, met en exergue des non-linéarités empiriques et formalise les conclusions quantitatives déduites à partir d’échantillons massifs. Lorsque ces représentations graphiques sont dégradées par un processus d’exportation approximatif, l’intégrité même des inférences scientifiques se trouve compromise. Les micro-variations dans la dispersion des résidus d’une régression, la superposition subtile de courbes de niveau ou l’orientation exacte des barres d’erreur peuvent être occultées par une compression destructrice ou une mauvaise gestion de l’espace colorimétrique, introduisant ainsi un biais d’interprétation visuelle chez le lecteur ou le réviseur académique.
Dans le contexte des initiatives internationales en faveur de la science ouverte et de la reproductibilité computationnelle, telles que promues par la communauté scientifique mondiale et formalisées dans des référentiels comme les principes FAIR (Facile à trouver, Accessible, Interopérable, Réutilisable), l’exportation graphique doit faire l’objet d’une traçabilité irréprochable. L’image enregistrée ne doit pas simplement capturer l’état statique des données, mais découler d’un pipeline logiciel entièrement déterministe où chaque paramètre d’encodage visuel, de la largeur des traits de tracé à la taille des polices de caractères, est documenté et reproductible à l’identique. Cette discipline garantit que la figure intégrée dans un mémoire de thèse, un brevet ou une communication évaluée par les pairs reflète fidèlement la réalité mathématique des observations sans artifice d’interpolation.
Enfin, la transition depuis l’environnement d’exploration interactive — incarné typiquement par les carnets Jupyter Notebook ou les terminaux IPython — vers les supports formels de diffusion scientifique constitue souvent une source critique de frictions techniques. Durant l’exploration, l’analyste se contente d’un rendu matriciel rapide à l’écran, optimisé pour la vitesse d’affichage dynamique mais inadapté aux supports statiques imprimés. Le passage vers une publication imprimée ou un rapport technique nécessite une mutation méthodologique où l’utilisateur quitte le mode d’affichage dynamique pour configurer un processus d’exportation programmatique déterministe, capable de satisfaire aux contraintes physiques des presses d’imprimerie et aux systèmes de mise en page professionnels.
1.2 Le rôle de Seaborn au sein de l’écosystème scientifique Python
Pour comprendre les subtilités de la sauvegarde d’un graphique Seaborn, il est indispensable de situer cette bibliothèque au sein de la pile logicielle scientifique de Python. Conçue par Michael Waskom, Seaborn n’a pas été développée dans l’optique de remplacer Matplotlib, mais plutôt comme une surcouche de haut niveau visant à simplifier l’orchestration statistique et l’expressivité esthétique de ce dernier. Matplotlib, conçu initialement sur le modèle impératif de MATLAB, offre un contrôle quasi microscopique sur chaque pixel et primitif vectoriel d’un canevas. Cependant, cette granularité extrême impose une verbosité programmatique considérable dès lors qu’il s’agit d’encoder des variables catégorielles multiples, d’estimer des intervalles de confiance par rééchantillonnage bootstrap ou de diviser des visualisations selon des sous-ensembles logiques.
Seaborn résout cette complexité en s’interfaçant directement avec les structures de données tabulaires proposées par la bibliothèque Pandas. Les abstractions de Seaborn acceptent nativement des structures telles que les DataFrames au format long ou large, permettant ainsi d’associer des variables statistiques à des attributs esthétiques complexes — tels que la teinte chromatique (hue), le style de ligne ou la taille des marqueurs — en une seule instruction déclarative. Les fonctions statistiques internes de Seaborn agrègent les données, calculent les tendances centrales et les dispersions d’erreur, puis transmettent ces instructions de bas niveau à Matplotlib, qui se charge de dessiner les éléments géométriques correspondants sur le moteur de rendu graphique spécifié.
Ce couplage intime signifie que toute figure initialisée par Seaborn est ultimement matérialisée sous forme d’une hiérarchie d’objets Matplotlib. Comprendre cette symbiose est capital : lorsque vient le moment de persister le graphique sur le support physique de stockage, c’est presque invariablement l’infrastructure d’entrée-sortie de Matplotlib qui est sollicitée, que ce soit de manière explicite ou via des méthodes déléguées. Seaborn enrichit la sémantique de l’analyse exploratoire, mais s’en remet à la robustesse éprouvée des moteurs d’arrière-plan de Matplotlib pour matérialiser les fichiers finaux dans les formats industriels requis par les scientifiques et les ingénieurs.
2. Architecture sous-jacente : Comprendre l’interaction entre Seaborn et Matplotlib
2.1 Distinction fondamentale entre Axes et Figure
Toute tentative d’exportation maîtrisée sous Seaborn requiert l’assimilation d’une dichotomie conceptuelle fondamentale régissant l’architecture orientée objet de Matplotlib : la séparation rigide entre l’objet conteneur de tracé individuel (matplotlib.axes.Axes) et la toile d’ensemble (matplotlib.figure.Figure). L’objet Figure correspond à la surface totale de dessin, c’est-à-dire l’entité globale qui englobe tous les éléments graphiques, les marges, les zones de texte extérieures et les éventuelles grilles de sous-graphiques. C’est l’analogue de la page blanche ou du canevas physique. L’objet Axes, en revanche, désigne la région spécifique de la figure où les données sont concrètement tracées. Un objet Axes comprend les axes coordonnés (abscisse et ordonnée), les graduations (ticks), les étiquettes de graduation, les lignes de grille et la boîte englobante délimitant l’espace de projection des données.
Une Figure peut encapsuler une multitude d’objets Axes, comme c’est le cas dans une matrice de graphiques ou un agencement de sous-tracés côte à côte, mais un objet Axes ne peut appartenir qu’à une seule Figure parente. Cette relation hiérarchique a une implication directe sur la persistance des fichiers : l’opération d’écriture sur le disque, exécutée par la fonction canonique d’enregistrement, est une responsabilité exclusive qui incombe à l’objet Figure. L’objet Axes n’a pas la capacité intrinsèque d’écrire un fichier de manière autonome, car il n’a pas autorité sur les dimensions globales de la page, la résolution spatiale globale ou les zones de texte qui débordent de ses propres frontières géométriques.
Par conséquent, lorsqu’une fonction Seaborn renvoie une référence vers un objet Axes, le développeur ne peut pas invoquer directement une méthode de sauvegarde sur cette entité sans remonter préalablement la chaîne hiérarchique d’encapsulation. Tenter d’appeler directement une méthode de sauvegarde inexistante sur un objet Axes soulève inévitablement une erreur d’attribut en Python. L’analyste doit impérativement appréhender cette structure arborescente pour naviguer programmatiquement entre l’espace local de manipulation statistique (les axes) et l’espace global de rendu physique (la figure), garantissant ainsi un contrôle sans faille sur les opérations de sérialisation graphique.
2.2 Fonctions au niveau des axes versus fonctions au niveau de la figure
Pour naviguer avec aisance dans la bibliothèque Seaborn, il est indispensable de classer ses fonctions en deux grandes familles architecturales, formalisées par la documentation officielle : les fonctions au niveau des axes (axes-level functions) et les fonctions au niveau de la figure (figure-level functions). Les fonctions au niveau des axes, à l’instar de sns.scatterplot, sns.lineplot, sns.barplot, sns.histplot ou sns.boxplot, sont conçues pour opérer comme des citoyennes disciplinées au sein d’une structure de tracés préexistante. Elles acceptent généralement un argument optionnel désignant explicitement l’axe cible sur lequel elles doivent tracer leurs éléments. Lorsqu’elles sont invoquées, elles exécutent leurs calculs statistiques et renvoient systématiquement une instance de la classe matplotlib.axes.Axes.
À l’opposé, les fonctions au niveau de la figure, telles que sns.relplot, sns.catplot, sns.displot ou sns.lmplot, incarnent des abstractions de niveau supérieur. Ces fonctions ne tracent pas sur un axe préexistant ; elles prennent l’initiative de créer, configurer et orchestrer une nouvelle figure complète, souvent articulée autour d’un gestionnaire de sous-graphiques multi-facettes nommé FacetGrid. Ces fonctions renvoient donc un objet conteneur spécifique à Seaborn (comme FacetGrid, PairGrid ou JointGrid), lequel encapsule une instance de matplotlib.figure.Figure ainsi qu’un tableau multidimensionnel d’objets Axes. Ces fonctions de haut niveau simplifient grandement la décomposition de données selon des variables de conditionnement complexes, disposant automatiquement les sous-graphiques en lignes et colonnes coordonnées.
Le mécanisme d’accès à la méthode d’exportation dépend intimement de la famille à laquelle appartient la fonction utilisée. Dans le cas d’une fonction de niveau figure, l’objet renvoyé possède généralement une délégation interne permettant d’exécuter la sauvegarde directement, ou expose publiquement son attribut de figure sous-jacent. Dans le cas d’une fonction au niveau des axes, le développeur doit employer des passerelles de liaison pour remonter à l’instance de figure parente. Confondre ces deux paradigmes engendre fréquemment des incompréhensions majeures, notamment chez les praticiens qui tentent d’appliquer des directives de redimensionnement de Matplotlib à des structures de haut niveau gérées par Seaborn, aboutissant à des graphiques superflus vides ou à des configurations spatiales discordantes.
3. Méthode fondamentale : Extraction de la figure et syntaxe savefig()
3.1 Extraction programmatique avec get_figure()
Lorsqu’un analyste utilise une fonction opérant au niveau des axes, l’objet résultant de l’appel est, comme explicité précédemment, une instance de matplotlib.axes.Axes. Pour procéder à l’exportation de cette composition vers un support de stockage persistant, la méthode canonique préconisée dans le paradigme orienté objet consiste à solliciter la méthode get_figure() de cet objet d’axes. Cette méthode remonte la hiérarchie interne de Matplotlib et renvoie une référence directe vers l’instance parente matplotlib.figure.Figure à laquelle l’axe appartient. Une fois cette référence acquise, l’accès à la panoplie complète des mécanismes d’exportation est déverrouillé via la méthode universelle savefig().
La syntaxe canonique s’articule ainsi en une succession logique d’instructions. D’abord, l’attribution du résultat du tracé Seaborn à une variable conventionnellement nommée ax permet de conserver le pointeur mémoire vers l’objet d’axes. Ensuite, l’invocation de fig = ax.get_figure() permet d’isoler l’objet de figure. Enfin, l’appel de fig.savefig(‘chemin_du_fichier.extension’) déclenche la sérialisation effective du graphique vers le système de fichiers. Cette approche présente l’avantage inestimable d’une pureté architecturale totale : elle s’affranchit de l’utilisation des fonctions d’état globales de Matplotlib, réduisant drastiquement les risques d’effets de bord indésirables lorsque plusieurs figures sont générées simultanément dans un même environnement d’exécution ou dans un script asynchrone.
Il convient également d’aborder la gestion du cycle de vie des objets graphiques en mémoire vive lors de l’application de cette méthode. L’extraction de la figure via get_figure() n’alloue pas une nouvelle structure de données ; elle retourne simplement un pointeur vers la structure existante en mémoire CPython. Cependant, tant que cette figure n’est pas explicitement fermée ou libérée après son enregistrement via les utilitaires de gestion de fenêtres graphiques, Matplotlib en conserve la référence dans un registre d’état global interne. Dans les applications à haute cadence analytique, l’analyste doit donc faire suivre l’appel à la sauvegarde d’une instruction explicite de fermeture afin de purger les descripteurs de tracés et de préserver les ressources mémoire de l’interpréteur.
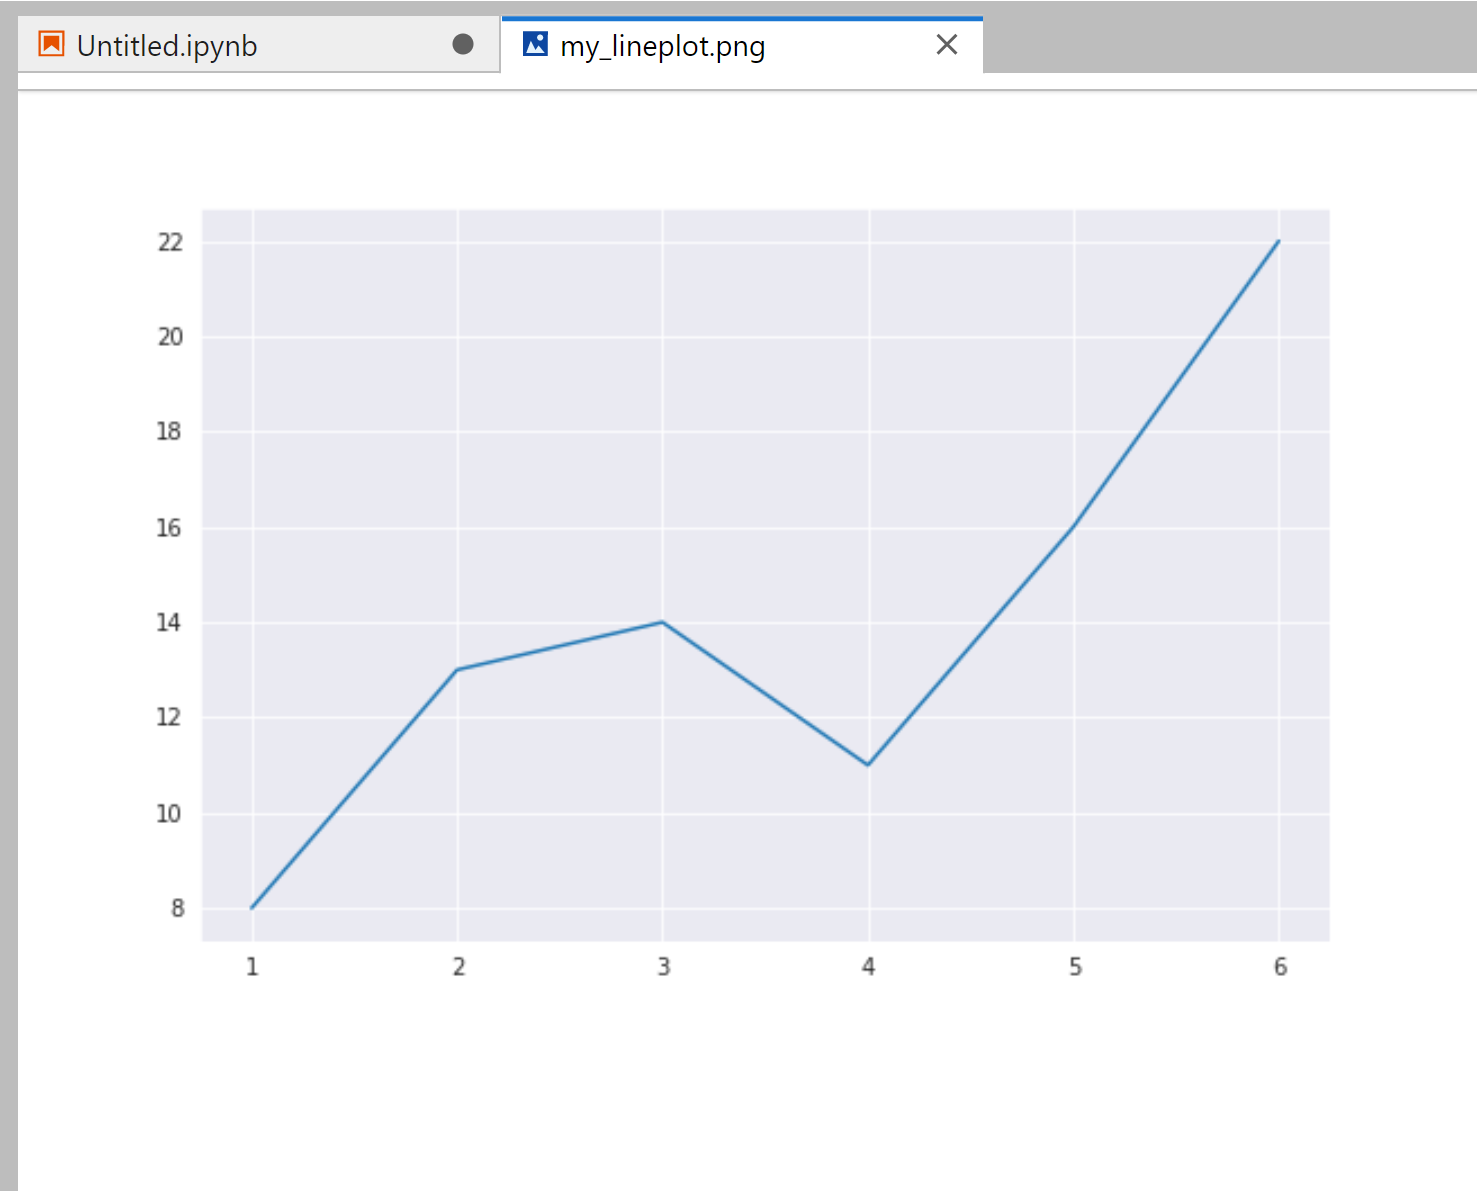
3.2 Exemple pratique élémentaire : Tracé linéaire et exportation
Afin de matérialiser ce concept dans un cadre concret, considérons un scénario analytique dans lequel un chercheur cherche à modéliser et exporter l’évolution temporelle d’un signal biologique synthétique. Le processus débute par la configuration d’un environnement Python intégrant les modules fondamentaux de calcul numérique et d’affichage statistique. L’analyste génère une série de données simulées représentant, par exemple, une dynamique d’oscillation amortie sur une échelle temporelle discrète. Ces données peuvent être aisément structurées dans un DataFrame de Pandas comprenant deux colonnes principales : l’une pour l’indice temporel et l’autre pour la magnitude mesurée du signal.
L’étape suivante consiste à harmoniser l’environnement stylistique en sollicitant les configurations thématiques de Seaborn. L’appel à des fonctions de configuration comme sns.set_theme(style= »whitegrid ») permet d’établir une ligne directrice visuelle sobre, dotée d’une grille blanche facilitant la lecture des métriques quantitatives sans surcharger le canevas d’éléments visuels superflus. Dès lors, le tracé linéaire est matérialisé par l’invocation de sns.lineplot, en associant les colonnes temporelles et spatiales aux axes respectifs. En récupérant l’objet d’axes retourné, l’opérateur peut enrichir le tracé de titres scientifiques explicites et d’étiquettes d’axes assorties de leurs unités de mesure correspondantes.
L’exportation finale intervient par l’extraction de la figure sous-jacente au moyen de get_figure(), suivie immédiatement par l’appel à la méthode savefig en spécifiant le chemin d’accès relatif ou absolu du fichier cible, par exemple sous la désignation « signal_amortis.png ». Dès que l’interpréteur Python achève l’exécution de cette ligne, le moteur de rendu traduit les primitives géométriques en un flux d’octets ordonné, encodé selon la norme matricielle spécifiée, et l’écrit physiquement sur le disque dur local de la machine hôte. Le fichier ainsi constitué est immédiatement disponible pour être annexé à un compte rendu, affiché sur un tableau de bord ou incorporé dans un système d’archivage documentaire automatisé.
4. Typologie des formats d’exportation : Raster versus Vectoriel
4.1 Formats matriciels : PNG et JPEG
Le choix du format de fichier constitue une décision technique cruciale dont dépend la pérennité visuelle des données graphiques exportées. Les formats matriciels, communément appelés images en mode point ou rasters, appréhendent l’espace graphique comme une matrice bidimensionnelle finie de pixels élémentaires, où chaque cellule se voit attribuer une valeur chromatique définie dans un espace de couleurs spécifique (typiquement RVB ou RGBA). Parmi cette famille de formats, le standard PNG (Portable Network Graphics) se distingue comme la référence absolue pour l’enregistrement de visualisations scientifiques d’usage général. Fondé sur un algorithme de compression sans perte nommé Deflate — combinant le codage LZ77 et les arbres de Huffman —, le PNG préserve l’intégralité des transitions nettes, des bordures d’axes, des textes de légende et des points de données individuels sans introduire la moindre dégradation visuelle.
À l’opposé, le format JPEG (Joint Photographic Experts Group) repose sur un algorithme de compression avec perte intrinsèque, fondé sur la transformée en cosinus discrète (DCT) et la quantification adaptative conçue pour refléter la sensibilité psychovisuelle de l’œil humain aux dégradés de scènes naturelles. Si cette méthode se révèle remarquable pour comprimer des photographies du monde réel riches en textures continues, elle s’avère particulièrement toxique pour les graphiques statistiques. L’application du JPEG à des visualisations Seaborn engendre inévitablement des artefacts de compression notoires autour des lignes de tracé contrastées et des caractères typographiques, sous la forme d’un halo de bruit de quantification communément qualifié d’effet de moustique (ringing artifacts). De surcroît, le format JPEG standard ne supporte nativement aucun canal alpha, interdisant ainsi toute possibilité d’arrière-plan transparent.
En pratique, l’utilisation du JPEG doit être rigoureusement proscrite de tout flux de travail académique ou professionnel, sauf dans des cas exceptionnels de contraintes drastiques de bande passante web ou de stockage pour des aperçus temporaires à très basse fidélité. Le PNG demeure le choix prééminent pour les présentations numériques interactives, les affichages sur écrans haute définition et les pages web, garantissant que chaque ligne de régression et chaque point de nuage conservent leur netteté mathématique originelle sans la moindre distorsion induite par des heuristiques de compression avec dégradation.
4.2 Formats vectoriels : PDF, SVG et EPS
Pour les contextes de publication scientifique formelle, de monographies imprimées de haute facture ou de mise en page sous des systèmes de composition comme LaTeX, les formats vectoriels constituent la norme d’excellence absolue. Contrairement aux images matricielles liées à une grille rigide de pixels discrets, les formats vectoriels décrivent la scène graphique sous forme d’une collection d’instructions mathématiques, d’équations géométriques de courbes de Bézier, de polygones délimités et d’opérateurs textuels typographiques. En vertu de cette formulation analytique, une figure vectorielle jouit d’une scalabilité infinie : elle peut être agrandie indéfiniment ou imprimée sur des formats d’affiches monumentaux sans jamais subir la moindre pixellisation ni aliasing géométrique.
Le format PDF (Portable Document Format) s’impose comme le format d’exportation vectoriel le plus robuste et le plus universellement accepté par les comités éditoriaux des grandes revues scientifiques internationales (telles que Nature, Science ou les publications de l’IEEE). Il intègre de façon native les polices vectorielles de caractères, garantissant que les équations mathématiques et les symboles grecs insérés dans les légendes conservent leur pureté calligraphique à n’importe quelle échelle de grossissement. De son côté, le SVG (Scalable Vector Graphics), format standardisé par le World Wide Web Consortium (W3C), se révèle idéal pour les visualisations destinées au web moderne ou nécessitant une post-édition manuelle dans des logiciels d’illustration vectorielle professionnels tels qu’Adobe Illustrator ou Inkscape. Le SVG repose sur une syntaxe XML lisible, facilitant la manipulation programmatique a posteriori des éléments d’arborescence graphique.
Enfin, le format EPS (Encapsulated PostScript) demeure un vestige historique très résilient, encore exigé par certains éditeurs académiques traditionnels opérant sur d’anciennes chaînes de traitement TeX. Bien que largement supplanté par le PDF moderne qui gère plus élégamment la transparence et la compression de sous-ensembles d’instructions, l’EPS reste pleinement pris en charge par l’infrastructure d’exportation de Matplotlib via Seaborn. Lors de la sélection d’un format vectoriel, l’analyste doit néanmoins prêter attention au volume de données : un nuage de points contenant des centaines de milliers d’observations individuelles traduira chaque point en un objet vectoriel distinct, ce qui peut résulter en des fichiers volumineux et ralentir les visualiseurs de documents, un compromis que nous analyserons dans les sections subséquentes.
5. Maîtrise de la résolution spatiale : Le paramètre DPI
5.1 Compréhension théorique de la densité de points par pouce
Le paramètre DPI, acronyme de l’anglais dots per inch (traduisible en français par points par pouce), quantifie la densité spatiale de résolution appliquée lors de la discrétisation d’un canevas continu sur une matrice physique de pixels. Dans le contexte de l’informatique graphique et de l’ingénierie logicielle de Matplotlib, le DPI représente le facteur multiplicateur qui fait le pont entre les dimensions physiques virtuelles d’une figure — traditionnellement exprimées en pouces dans le système impérial hérité de la typographie anglo-saxonne — et les dimensions discrètes de l’image raster finale exprimées en pixels absolus. Mathématiquement, la largeur d’une image en pixels s’obtient par le produit direct de la dimension physique configurée par la valeur du DPI.
Il est impératif d’établir une distinction rigoureuse entre la résolution d’affichage à l’écran et la résolution de reproduction sur support physique ou éditorial. La majorité des écrans d’ordinateurs standards fonctionnent historiquement avec des densités nominales proches de 72 à 96 DPI, bien que les technologies modernes à haute densité (comme les écrans Retina ou 4K) portent ces valeurs bien au-delà de 200 DPI. Toutefois, les spécifications imposées par l’industrie de l’édition scientifique et de l’imprimerie offset reposent sur des critères bien plus exigeants. Un graphique configuré avec un faible DPI paraîtra convenable sur un moniteur standard, mais révélera des flous inacceptables et une pixellisation grossière dès qu’il sera soumis au tramage d’une presse d’impression ou agrandi lors d’un examen minutieux des détails expérimentaux par un pair examinateur.
Néanmoins, l’augmentation indiscriminée du DPI entraîne un coût computationnel et un fardeau de stockage exponentiels. Puisque la surface totale en pixels d’une image matricielle croît proportionnellement au carré de la résolution spatiale, doubler la valeur du DPI quadruple la quantité totale de pixels à calculer, à encoder et à sérialiser sur le disque dur. L’analyste doit donc procéder à un arbitrage réfléchi entre l’exigence de fidélité visuelle chirurgicale et la gestion parcimonieuse de la mémoire vive et de l’empreinte de stockage, particulièrement lorsqu’il s’agit d’automatiser l’exportation de centaines de figures au sein d’un cluster de calcul distribué.
5.2 Mise en œuvre pratique des niveaux de DPI
Dans l’écosystème Seaborn et Matplotlib, la configuration de la densité de résolution spatiale s’opère de manière directe et hautement contrôlée via le paramètre dpi de la méthode de sauvegarde savefig(). Par défaut, si l’argument n’est pas spécifié au moment de l’enregistrement, la figure hérite de la valeur définie dans les paramètres de configuration globaux de Matplotlib (accessibles via le dictionnaire d’exécution matplotlib.rcParams[‘savefig.dpi’]), laquelle est généralement fixée à la valeur de base de 100 DPI. Bien que suffisante pour des aperçus fugaces, cette configuration par défaut demeure insatisfaisante pour les travaux destinés à la publication formelle.
Pour répondre aux exigences des revues scientifiques les plus exigeantes, le standard universel consiste à fixer le paramètre à une valeur minimale de 300 DPI, comme l’illustre la formulation programmatique fig.savefig(‘figure_publication.png’, dpi=300). À cette échelle de densité, une figure dimensionnée à six pouces de large sur quatre pouces de haut générera une matrice de 1800 par 1200 pixels, garantissant une netteté remarquable sur papier glacé ou sous un zoom significatif dans un lecteur de documents PDF. Pour des représentations graphiques particulièrement denses — telles que des cartes thermiques génomiques (heatmaps) comprenant des milliers de segments distincts ou des tracés de trajectoires à haute fréquence temporelle —, il est courant de porter cette valeur à 600 DPI, seuil au-delà duquel l’œil humain devient physiologiquement incapable de discerner la discrétisation des pixels sous des conditions normales de consultation.
Il est fondamental de noter que le paramètre dpi influence exclusivement les formats de sortie matriciels, tels que le PNG, le JPEG ou le TIFF. Dans le cas des formats vectoriels comme le PDF ou le SVG, le DPI n’affecte en rien la géométrie des courbes ou la finesse du texte, puisque ces éléments sont définis par des fonctions continues. Toutefois, si la figure vectorielle intègre des éléments semi-transparents ou des effets de flou qui contraignent le moteur graphique à rastériser localement une sous-région du dessin, la valeur du DPI sera utilisée pour déterminer la densité de pixels de cette sous-zone rastérisée intégrée, préservant ainsi l’homogénéité esthétique globale de la composition scientifique.
6. Optimisation spatiale : Élimination des marges avec bbox_inches
6.1 Le problème de l’espacement superflu par défaut
L’une des frustrations les plus fréquemment rencontrées par les analystes de données lors de la génération de visualisations avec Seaborn réside dans la présence de larges marges blanches périphériques autour du graphique utile. Par défaut, le moteur de rendu de Matplotlib alloue une surface géométrique fixe pour l’ensemble de la figure, calculée d’après les dimensions physiques globales initialisées. À l’intérieur de ce canevas, la boîte de tracé de l’objet Axes est positionnée selon des ratios d’espacement conventionnels prédéterminés. Ces marges par défaut sont prévues de manière conservative afin d’éviter que des étiquettes d’axes conventionnelles n’entrent en collision avec les bords de la fenêtre d’affichage.
Cependant, cette allocation spatiale conservative s’avère particulièrement inadaptée dès lors que la visualisation intègre des composants graphiques périphériques volumineux, tels qu’une légende descriptive riche en catégories, un titre principal multi-lignes, ou des annotations textuelles positionnées à l’extérieur du système de coordonnées cartésiennes. Deux manifestations pathologiques se produisent alors couramment : soit la figure présente d’immenses zones de vide asymétrique qui dégradent l’alignement harmonieux du document final lors de l’intégration dans une mise en page à deux colonnes, soit les éléments les plus extérieurs — tels que les étiquettes des graduations de l’axe des ordonnées ou la boîte de légende — se retrouvent purement et simplement tronqués, car rejetés hors de la zone d’échantillonnage de la figure.
Cette problématique ne relève pas d’un défaut de programmation de Seaborn, mais de la mécanique fondamentale de dimensionnement statique opérée par les canevas Matplotlib de base. Sans directive d’optimisation spécifique, la méthode d’enregistrement sérialise l’intégralité du rectangle physique théorique défini lors de l’initialisation, sans adapter dynamiquement ses frontières aux éléments graphiques réellement instanciés. Pour éliminer cette inélégance spatiale et garantir que le périmètre de l’image finale épouse rigoureusement le contour exact des données tracées et de leurs annotations, il devient nécessaire d’engager un mécanisme algorithmique de calcul de boîte englobante dynamique.
6.2 Application de bbox_inches=’tight’ et contrôle du remplissage
La solution définitive à l’élimination des marges périphériques superflues et à la prévention des troncatures typographiques consiste à mobiliser l’argument bbox_inches=’tight’ au sein de la méthode savefig(). Lorsqu’elle reçoit cette directive, la machinerie d’exportation suspend le processus de découpage conventionnel basé sur les dimensions brutes de la figure. Au lieu de cela, elle active un algorithme de calcul de géométrie computationnelle qui parcourt l’ensemble des artistes visuels (artists) enregistrés sur la scène graphique — incluant les glyphes textuels, les graduations, les légendes, les marqueurs et les titres — et calcule la boîte englobante minimale (bounding box) capable de circonscrire l’intégralité de ces éléments.
Ce calcul dynamique ajuste automatiquement la taille de la toile d’exportation afin qu’aucun pixel utile ne soit tronqué, tout en rabotant l’excédent de blanc périphérique inutile. La syntaxe fig.savefig(‘figure_ajustee.png’, bbox_inches=’tight’) assure une adaptation millimétrique de l’image finale à son contenu réel. Cet ajustement dynamique résout d’emblée l’immense majorité des défauts de composition spatiale, rendant la figure immédiatement prête à une insertion harmonieuse dans des documents LaTeX ou des présentations exécutives sans exiger de recadrage manuel ultérieur dans des logiciels de retouche matricielle.
Pour un contrôle encore plus chirurgical de cette frontière géométrique, Matplotlib met à disposition le paramètre complémentaire pad_inches, qui opère conjointement avec bbox_inches=’tight’. Cet argument numérique, exprimé en fractions de pouce, définit l’épaisseur de la bordure de sécurité résiduelle à insérer tout autour de la boîte englobante calculée. Par défaut fixé à une valeur délicate de 0.1 pouce (environ 2,5 millimètres), il peut être modulé selon les désirs de l’analyste : une valeur de zéro permet d’obtenir un rognage affleurant directement les tracés les plus extrêmes, tandis qu’une valeur légèrement accrue, telle que pad_inches=0.2, permet d’aérer la composition pour des impératifs esthétiques particuliers sans réintroduire l’asymétrie incontrôlée des marges par défaut.
7. Contrôle géométrique : Dimensions et proportions de la figure
7.1 Configuration préalable de la taille via Matplotlib
L’une des compétences fondamentales pour produire des visualisations irréprochables avec Seaborn consiste à abandonner les mécanismes de mise à l’échelle automatique pour embrasser un contrôle déterministe préalable des dimensions physiques de l’espace de travail. Lorsque l’on mobilise des fonctions Seaborn opérant au niveau des axes (comme sns.boxplot ou sns.kdeplot), la démarche la plus rigoureuse et recommandée par les standards du génie logiciel consiste à instancier formellement la figure et l’axe cible via la fonction Matplotlib plt.subplots() avant même d’invoquer la moindre routine statistique de Seaborn.
Cette instanciation préalable repose sur l’exploitation du paramètre figsize, auquel on transmet un tuple de deux valeurs numériques représentant respectivement la largeur et la hauteur du canevas en pouces physiques : fig, ax = plt.subplots(figsize=(8, 5)). Une fois cet espace configuré, la référence à l’objet d’axes est explicitement transmise à la fonction Seaborn via son paramètre ax=ax. Cette démarche sépare vertueusement la configuration spatiale de l’acte de tracé statistique. Elle permet d’adapter la géométrie du dessin aux gabarits très précis imposés par les revues académiques, qui exigent souvent que les figures occupent exactement la largeur d’une colonne de texte (généralement 3,2 à 3,5 pouces) ou la pleine largeur d’une double colonne (environ 6,5 à 7 pouces).
Le contrôle rigoureux de ces dimensions physiques préalables prévient également l’apparition d’un effet pervers bien connu des utilisateurs débutants : la disproportion typographique. Si l’analyste se contente de générer une figure aux dimensions microscopiques par défaut et tente ultérieurement de l’agrandir lors de l’affichage dans son document, la taille des polices de caractères se retrouvera dilatée de manière grotesque. Inversement, si le canevas est dimensionné à des échelles extravagantes (par exemple 25 pouces de large) sans ajuster corrélativement les tailles de police, les étiquettes apparaîtront microscopiques et illisibles dans le document final. Le calibrage méthodique de figsize en adéquation étroite avec la destination finale du document garantit une harmonie visuelle immuable entre les textes du manuscrit et les glyphes de la figure.
7.2 Ajustement des proportions dans les tracés au niveau de la figure
La donne architecturale change radicalement lorsque l’on emploie les fonctions de haut niveau de Seaborn opérant à l’échelle de la figure, à l’image de sns.relplot, sns.displot ou sns.catplot. Étant donné que ces fonctions créent et gèrent de manière autonome leur propre conteneur graphique — la classe FacetGrid —, le paramètre figsize de Matplotlib n’y est pas directement reconnu et son utilisation soulèverait une exception logicielle ou serait purement ignorée. Seaborn propose une approche géométrique différente, articulée autour de deux paramètres fondamentaux : height et aspect.
Le paramètre height détermine la hauteur physique en pouces de chaque sous-graphique individuel (chaque facette) composant la grille globale. Le paramètre aspect, quant à lui, définit le ratio géométrique entre la largeur et la hauteur de chaque facette, de sorte que la formule mathématique liant ces grandeurs s’établit par la relation : largeur = height × aspect. Ainsi, la déclaration d’une fonction avec les arguments height=4 et aspect=1.5 configurera chaque sous-graphique avec une hauteur de 4 pouces et une largeur de 6 pouces (4 multiplié par 1,5), conférant à chaque tracé un profil panoramique adapté aux séries temporelles ou aux comparaisons de catégories nombreuses.
Ce mode de paramétrage confère une souplesse remarquable lors de la conception de figures multi-facettes articulées en colonnes. Si l’analyste décide d’ajouter une facette supplémentaire en partitionnant ses données selon une troisième variable catégorielle (via l’argument col=’variable’), Seaborn étendra automatiquement la largeur globale de la figure de manière proportionnelle pour accueillir la nouvelle colonne d’axes sans comprimer les sous-graphiques préexistants. Une fois la composition finalisée, l’objet de grille résultant peut être exporté directement en sollicitant sa propre méthode savefig(), laquelle répercute fidèlement la géométrie calculée sur le fichier final, préservant l’homogénéité des proportions sans nécessiter d’arithmétique manuelle laborieuse de la part du chercheur.
8. Exportation des structures multi-panneaux : FacetGrid, PairGrid et JointGrid
8.1 Sauvegarde directe depuis l’objet FacetGrid
L’un des atouts les plus éclatants de Seaborn réside dans sa capacité à instancier des visualisations multi-panneaux complexes, permettant d’explorer les relations entre de multiples covariables au moyen d’un partitionnement en facettes orthogonales. L’objet FacetGrid matérialise cette structure en disposant une matrice bidimensionnelle d’axes partageant de manière synchrone leurs échelles de coordonnées. Lorsque l’analyste utilise des constructeurs de haut niveau ou initialise manuellement une instance de FacetGrid, l’objet renvoyé expose des méthodes de commodité qui simplifient considérablement le processus d’exportation vers le disque dur.
La classe FacetGrid encapsule directement une méthode savefig() qui opère comme un mandataire (proxy) transparent vers la méthode sous-jacente de l’objet Figure de Matplotlib. Ainsi, il n’est nullement requis d’extraire préalablement l’instance de figure par des contorsions syntaxiques : l’instruction directe g.savefig(‘matrice_facettes.png’, dpi=300, bbox_inches=’tight’) — où g désigne l’instance de la grille — déclenche l’exécution complète du pipeline d’exportation. Cette méthode propage avec rigueur l’ensemble des arguments clés aux moteurs d’arrière-plan de Matplotlib, garantissant un comportement identique à celui des sauvegardes de figures unitaires.
Toutefois, la sauvegarde de ces structures multi-facettes introduit un défi particulier concernant l’agencement des titres généraux (suptitles) et des légendes partagées. Comme une instance de FacetGrid coordonne de multiples objets Axes autonomes, un titre global configuré via la méthode g.fig.suptitle(‘Titre de Recherche’) risque fréquemment d’entrer en collision géométrique avec les titres individuels des facettes de la rangée supérieure. Pour prévenir ce chevauchement avant l’appel à savefig(), il est souvent indispensable d’ajuster programmatiquement le sommet du canevas en sollicitant g.fig.subplots_adjust(top=0.9), créant ainsi une respiration spatiale adéquate au sein de laquelle le titre global peut s’épanouir sans perturber l’alignement des axes de données.
8.2 Spécificités des visualisations bivariées et multivariées
Au-delà de la grille générique FacetGrid, Seaborn propose des structures spécialisées dans l’analyse conjointe et multivariée que sont PairGrid (généralement instanciée via la fonction de commodité sns.pairplot) et JointGrid (instanciée via sns.jointplot). L’exportation de ces architectures graphiques soulève des considérations techniques spécifiques liées à la disparité des éléments géométriques qu’elles regroupent au sein d’une même entité physique. Un PairGrid, qui projette les distributions croisées de toutes les paires de variables d’un jeu de données sous forme d’une vaste matrice carrée de sous-graphiques, engendre une densité informationnelle et un nombre d’artistes graphiques considérables.
Lors de la sauvegarde d’un PairGrid, particulièrement sur des jeux de données comportant plus d’une dizaine de descripteurs numériques, la figure finale atteint des dimensions massives. L’oubli de l’argument bbox_inches=’tight’ dans cette situation provoque presque systématiquement la troncature des étiquettes des axes diagonaux ou l’amputation de la légende globale située sur le flanc droit de la matrice. En outre, en raison du nombre élevé d’axes générés, l’alignement typographique des étiquettes d’abscisse et d’ordonnée doit être vérifié avec rigueur avant la sérialisation, en veillant à désactiver les graduations superflues dans les panneaux intérieurs pour ne pas saturer l’espace de lecture.
Dans le cas du JointGrid, la complexité réside dans l’intégration harmonieuse d’un graphique central bivarié (nuage de points ou estimation de densité par noyau) flanqué de deux graphiques marginaux univariés (histogrammes ou densités marginales) plaqués contre ses bordures supérieure et droite. L’exportation d’une telle géométrie exige une synchronisation parfaite des rapports de proportion entre la zone centrale et les marges d’affichage. Comme pour FacetGrid, la sauvegarde s’opère soit directement via l’objet résultant de sns.jointplot, soit en accédant explicitement à son attribut interne figure ou fig selon les versions de l’API (g.figure.savefig(‘distribution_conjointe.pdf’)), garantissant la préservation de la géométrie relative complexe des projections marginales.
9. Gestion des composantes esthétiques : Transparence et fonds chromatiques
9.1 Configuration du fond transparent
L’intégration de visualisations statistiques dans des supports de communication modernes — qu’il s’agisse de diapositives de présentation professionnelle reposant sur des arrière-plans sombres, de documents web adaptatifs dotés de thèmes dynamiques clairs et obscurs, ou de posters de congrès — requiert fréquemment l’élimination du fond opaque traditionnel du graphique. Par défaut, Matplotlib et Seaborn génèrent une surface d’arrière-plan blanche opaque qui recouvre l’intégralité du rectangle de la figure et la zone intérieure des axes. Lors de l’incorporation de l’image dans un document non blanc, cette opacité produit un bloc rectangulaire inesthétique qui rompt la continuité visuelle du support hôte.
Pour résoudre cette contrainte, la méthode savefig() propose le paramètre booléen transparent. En fixant rigoureusement transparent=True lors de l’exportation, par exemple via fig.savefig(‘graphique_transparent.png’, transparent=True), l’infrastructure graphique configure le canal alpha de la figure globale (figure patch) ainsi que celui de l’ensemble des conteneurs d’axes (axes patches) à une valeur nulle de zéro. En conséquence, les bordures, les lignes de grille, les points de données, les barres d’erreur et les éléments textuels sont parfaitement conservés avec leur opacité nominale, tandis que tout l’espace interstitiel devient totalement transparent.
Il importe toutefois de souligner une précaution méthodologique majeure lors de l’usage de la transparence : la lisibilité chromatique des données. Un tracé Seaborn dont les polices de caractères et les lignes d’axes sont stylisées en noir profond ou en gris foncé deviendra totalement invisible s’il est ensuite projeté sur une diapositive de conférence dont le fond est anthracite ou noir. L’analyste doit donc anticiper l’environnement chromatique de projection et ajuster en amont la palette des couleurs des artistes graphiques (via sns.set_theme ou des configurations de paramètres locaux) pour assurer un rapport de contraste conforme aux normes d’accessibilité visuelle (comme les standards WCAG) sur le support de destination.
9.2 Personnalisation des couleurs d’arrière-plan à l’export
À l’inverse de la transparence intégrale, de nombreux contextes institutionnels ou éditoriaux exigent une maîtrise rigide et explicite de la couleur d’arrière-plan du graphique exporté, que ce soit pour respecter une charte graphique d’entreprise, pour s’harmoniser avec la teinte crème d’un papier d’édition ancien, ou pour conférer une identité visuelle distincte à un tableau de bord analytique. Bien que Seaborn applique des thèmes esthétiques prédéterminés (tels que darkgrid, whitegrid ou dark), ces configurations d’interface interactive ne se répercutent pas toujours fidèlement lors de l’exportation sur le disque si certains paramètres d’arrière-plan sont écrasés par les valeurs par défaut du moteur d’enregistrement.
Pour verrouiller et personnaliser de manière absolue la coloration périphérique et interne lors de la sérialisation, la méthode savefig() met à disposition deux arguments cruciaux : facecolor et edgecolor. Le paramètre facecolor détermine la teinte de remplissage de la surface totale de la figure, acceptant une diversité de formats de spécification de couleurs, qu’il s’agisse de noms textuels normalisés (par exemple « whitesmoke » ou « lightgray »), de codes hexadécimaux précis (tels que « #FAFAFA »), ou de tuples RVB normalisés. La commande fig.savefig(‘figure_personnalisee.png’, facecolor=’#F0F2F6′, edgecolor=’none’) permet d’imprimer une teinte d’arrière-plan uniforme et contrôlée sur toute l’étendue de l’image.
Une distinction subtile doit être opérée entre la couleur de fond de la figure globale et celle de la zone intérieure de l’axe (le plan de tracé où circulent les lignes de données). Si l’analyste souhaite que la figure globale possède une couleur d’arrière-plan distincte de celle du rectangle des données — une pratique fréquente pour créer un encadrement stylisé —, il convient de définir la couleur de l’axe au niveau de Matplotlib via ax.set_facecolor(‘white’), tout en spécifiant la couleur du canevas global via le paramètre facecolor de savefig(). Cette granularité de paramétrage garantit une harmonie visuelle sans compromettre la lisibilité des distributions statistiques à l’intérieur de la boîte de mesure.
10. Automatisation et intégration dans des flux de traitement par lots
10.1 Génération dynamique de noms de fichiers
Dans les pipelines modernes d’ingénierie de données et d’apprentissage automatique, la génération de visualisations ne s’effectue que rarement de manière unitaire ou artisanale. Le plus souvent, l’analyste doit concevoir des routines automatisées capables de parcourir séquentiellement des dizaines de cohortes de patients, des centaines de catégories de produits ou des milliers d’itérations d’hyperparamètres de modèles statistiques. Dans ce contexte de traitement par lots (batch processing), la sérialisation des graphiques Seaborn exige une stratégie programmatique robuste pour la nomenclature et l’organisation physique des fichiers sur le système de stockage.
L’utilisation conjuguée des chaînes de caractères formatées de Python (f-strings) et de la bibliothèque standard pathlib constitue l’approche professionnelle par excellence pour orchestrer ce partitionnement. En exploitant les f-strings, l’analyste peut concaténer dynamiquement dans le nom de chaque fichier des descripteurs critiques tels que l’identifiant de la variable analysée, le numéro de repli de validation croisée, ou des horodatages précis générés via le module datetime. Cette discipline prévient l’écrasement accidentel de figures antérieures et confère à chaque artefact graphique une sémantique immédiatement déchiffrable par les équipes opérationnelles.
Parallèlement, la classe Path du module pathlib permet de manipuler les chemins d’accès de manière agnostique vis-à-vis du système d’exploitation sous-jacent (résolvant automatiquement les divergences de séparateurs de répertoires entre les environnements Windows et les systèmes POSIX de type Linux ou macOS). Une routine d’automatisation rigoureuse vérifiera systématiquement l’existence du répertoire de destination via la méthode mkdir(parents=True, exist_ok=True) avant d’exécuter la boucle de génération de figures. Chaque tracé Seaborn est ainsi encapsulé au sein d’une itération contrôlée, produisant une arborescence ordonnée de documents graphiques prêts pour l’audit ou la revue analytique distribuée.
10.2 Gestion de la mémoire vive et libération des ressources
L’automatisation du tracé et de l’exportation de visualisations à grande échelle dissimule un piège technique critique inhérent à la gestion de la mémoire sous Matplotlib : la persistance des références dans le registre d’état global de l’interface pyplot. Par conception, afin de permettre la manipulation interactive successive d’un même graphique, Matplotlib maintient en mémoire vive une référence interne persistante vers chaque instance de Figure créée durant la session d’exécution de l’interpréteur Python. Dans un script qui génère des milliers de figures au sein d’une boucle itérative, ce comportement engendre une fuite de mémoire cumulative (memory leak) sévère, conduisant invariablement à la saturation de la RAM et au crash brutal du processus par le système d’exploitation (erreur Out Of Memory).
Pour juguler cette accumulation délétère de structures de données graphiques, l’analyste doit impérativement intégrer des directives explicites de libération des ressources immédiatement après chaque sauvegarde sur le disque. La commande fondamentale est plt.close(fig), qui détruit méthodiquement l’instance de figure spécifiée, désalloue les zones tampons graphiques et notifie le ramasse-miettes (garbage collector) de CPython que les structures de bas niveau sous-jacentes peuvent être récupérées. Pour une sécurité absolue dans des boucles de traitement massif, l’invocation de plt.close(‘all’) permet de purger intégralement le registre de toutes les figures résiduelles en sommeil.
Il convient de distinguer clairement plt.close() de ses fonctions sœurs que sont plt.clf() (qui efface uniquement le contenu de la figure courante sans détruire la figure elle-même) et plt.cla() (qui réinitialise les axes courants sans purger leur conteneur). Dans une architecture de traitement par lots, réutiliser continuellement la même figure via des nettoyages partiels est une source avérée de bugs subtils où des résidus d’échelles ou de styles d’itérations précédentes contaminent les graphiques suivants. La pratique la plus propre sur le plan du génie logiciel consiste à instancier une nouvelle figure à chaque itération, à effectuer le tracé Seaborn, à sérialiser le fichier via savefig(), puis à clore définitivement la figure avec plt.close() avant de passer à l’entité de données subséquente.
11. Résolution des problèmes fréquents lors de la sauvegarde
11.1 Correction des étiquettes rognées et légendes tronquées
L’une des anomalies les plus déroutantes lors de la transition entre l’affichage interactif dans un terminal et la sérialisation physique réside dans le phénomène de troncature des annotations périphériques. Il est très fréquent de constater qu’une figure qui apparaissait impeccablement calibrée à l’écran d’un carnet interactif se retrouve amputée de la moitié de ses étiquettes de graduation verticales, ou voit sa légende latérale sévèrement coupée une fois enregistrée sous forme de fichier image. Ce désagrément découle directement de la divergence entre le moteur de rendu interactif de l’interface graphique (qui s’adapte dynamiquement à la fenêtre) et le moteur de rendu matériel statique employé par savefig().
Pour pallier cette pathologie géométrique, la première arme méthodologique consiste en l’application préventive de la fonction plt.tight_layout() juste avant l’appel à l’exportation. Cette routine calcule un agencement optimisé des sous-graphiques en inspectant l’étendue réelle des textes d’étiquettes et en rétrécissant proportionnellement la zone de tracé des axes pour laisser un espace d’affichage suffisant aux textes extérieurs. Dans les versions récentes de Matplotlib et Seaborn, une alternative encore plus puissante consiste à activer l’agencement contraint dès l’initialisation de la figure via l’argument layout=’constrained’ dans plt.subplots(), qui gère élégamment l’allocation des espaces même en présence de grilles hétérogènes.
Lorsque la troncature concerne spécifiquement une légende volumineuse positionnée à l’extérieur des limites du tracé au moyen de l’attribut bbox_to_anchor, la combinaison de tight_layout() peut parfois s’avérer insuffisante, car cette fonction ignore parfois les artistes graphiques explicitement rejetés hors du domaine normal des axes. Dans cette situation précise, la solution souveraine réside dans l’utilisation de la sauvegarde avec l’argument bbox_inches=’tight’, couplée si nécessaire au paramètre bbox_extra_artists. En passant explicitement la référence de l’objet de légende à bbox_extra_artists=(legende,) au sein de la fonction savefig(), l’analyste ordonne formellement à l’algorithme de boîte englobante d’étendre la frontière physique de découpe jusqu’à enclore intégralement la totalité de la boîte de légende, garantissant un enregistrement complet et sans défaut.
11.2 Fichiers vides ou blancs : Causes et solutions
Un autre problème récurrent qui suscite l’incompréhension de nombreux programmeurs réside dans la génération d’un fichier image parfaitement valide sur le plan du système de fichiers mais entièrement vide ou d’une blancheur immaculée, alors même que le code semble exécuter scrupuleusement les fonctions de dessin. Dans l’écrasante majorité des cas, cette anomalie ne résulte pas d’une corruption de données ou d’une défaillance de Seaborn, mais d’une violation critique de l’ordre logique d’exécution des primitives de contrôle de flux de Matplotlib : l’appel prématuré à la fonction plt.show() avant l’instruction savefig().
Pour saisir l’origine de ce comportement, il faut comprendre le fonctionnement interne de la machine à états de Matplotlib. Lorsque la fonction plt.show() est appelée, le moteur graphique compile la scène, l’affiche dans une fenêtre interactive à l’attention de l’utilisateur, puis, dès que la fenêtre est refermée ou que la cellule du carnet termine son exécution, réinitialise la toile courante en considérant que le cycle de vie de la visualisation est achevé. Si l’instruction plt.savefig() est invoquée après cette étape, le moteur de rendu s’exécute sur une figure qui a déjà été vidée de son contenu graphique, écrivant sur le disque un canevas vierge. La correction est universelle et impérative : l’instruction de sauvegarde doit systématiquement précéder tout appel d’affichage interactif, ou s’y substituer totalement dans les scripts exécutés en arrière-plan sans interface graphique.
Dans les environnements infonuagiques ou conteneurisés tels que Google Colab, les conteneurs Docker ou les serveurs distants sans serveur d’affichage X11, une variante de cette pathologie peut survenir si le backend par défaut tente d’initialiser une liaison vers un serveur graphique inexistant. La bonne pratique de génie logiciel pour prévenir toute défaillance d’enregistrement consiste à déclarer formellement un backend non interactif tout au début du script, avant toute importation de Seaborn, au moyen des directives import matplotlib suivies de matplotlib.use(‘Agg’). Ce réglage verrouille le moteur de rastérisation sur la bibliothèque Anti-Grain Geometry (Agg), dédiée exclusivement à l’écriture directe de fichiers en mémoire et sur disque, garantissant une stabilité sans faille lors de l’exécution de pipelines de visualisation headless.
12. Normes de publication académique et archivage pérenne des données visuelles
12.1 Conformité aux recommandations éditoriales standard
L’intégration d’une visualisation Seaborn dans un manuscrit scientifique destiné à une revue soumise à un comité de lecture rigoureux exige une mise en conformité stricte avec les normes éditoriales académiques, à l’image des directives de l’American Psychological Association (APA 7e édition) ou des manuels de style d’éditeurs tels qu’Elsevier, Springer Nature ou l’IEEE. Ces normes transcendent largement la simple netteté de résolution et imposent des contraintes draconiennes sur l’accessibilité visuelle, la typographie et la structure sémiotique des figures.
Sur le plan de la communication chromatique, les chartes modernes proscrivent formellement l’usage de palettes arc-en-ciel traditionnelles (comme l’historique « jet »), reconnues pour introduire de fausses frontières perceptuelles et être totalement illisibles pour les personnes atteintes de déficiences de la vision des couleurs (dyschromatopsies, telles que la deutéranopie). Seaborn excelle dans ce domaine en intégrant nativement des palettes perceptuellement uniformes et accessibles aux daltoniens, telles que « viridis », « plasma », « cividis » ou la palette spécialisée « colorblind ». L’analyste doit s’assurer, lors de la conception préalable à l’exportation, que l’information quantitative est doublement encodée : par la nuance chromatique, mais également par des variations de forme de marqueurs, de motifs de hachures ou de styles de tirets, permettant une discrimination parfaite même lors d’une impression finale en niveaux de gris monochrome.
Sur le plan typographique, les standards éditoriaux exigent généralement l’emploi de polices sans empattement universelles (telles qu’Arial, Helvetica ou DejaVu Sans) et proscrivent les fontes exotiques non standardisées. De surcroît, lors de l’exportation vers des formats vectoriels comme le PDF ou l’EPS, il est impératif de veiller à ce que les glyphes textuels soient correctement incorporés (embedded) au sein du fichier lui-même sous forme de sous-ensembles de polices vectorielles TrueType ou Type 42, plutôt que convertis grossièrement en tracés géométriques non éditables. Cela permet aux correcteurs éditoriaux d’ajuster si nécessaire la typographie du graphique lors de la composition finale du manuscrit sans altérer l’agencement des données statistiques.
12.2 Protocoles de reproductibilité et bonnes pratiques de documentation
Au-delà de la matérialité du fichier image, l’archivage pérenne des données visuelles s’inscrit au cœur des exigences contemporaines de la science ouverte et de la traçabilité des preuves analytiques. Sauvegarder une figure Seaborn sur un disque local sans consigner concomitamment l’environnement informatique exact qui l’a engendrée constitue une vulnérabilité méthodologique majeure : une mise à jour mineure de Seaborn, de Matplotlib ou de Pandas peut subtilement modifier le calcul d’une densité de noyau, l’agencement d’un intervalle de confiance bootstrap ou le positionnement d’une graduation d’axe lors d’une réexécution future.
Un protocole de reproductibilité exemplaire préconise l’enregistrement conjoint de trois composantes inséparables au sein du référentiel de données : le fichier graphique exporté dans sa résolution maximale (de préférence vectorielle en PDF et matricielle en haute résolution à 300 ou 600 DPI en PNG), le sous-ensemble précis de données brutes ou agrégées ayant alimenté la fonction de tracé (sérialisé par exemple sous format standardisé CSV ou parquet), et enfin le script de code source Python exact ayant généré la figure. Pour une rigueur maximale, ce script doit documenter de manière exhaustive les métadonnées de version des bibliothèques mobilisées, accessibles programmatiquement via les attributs seaborn.__version__ et matplotlib.__version__.
Enfin, l’inscription de ces visualisations dans des archives institutionnelles pérennes (telles que Zenodo, OSF ou les dépôts institutionnels universitaires) confère à ces artefacts graphiques un identifiant d’objet numérique pérenne (DOI). Dans ce cadre, la figure n’est plus un simple fichier volatile isolé sur le disque dur d’un ordinateur personnel, mais devient une entité scientifique auditable, immuable et citable, capable de résister à l’épreuve du temps et de servir de fondation solide pour les investigations futures de la communauté scientifique mondiale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org/
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1922-00a
- Python Software Foundation. (2024). pathlib — Object-oriented filesystem paths. Python 3 Documentation. https://docs.python.org/3/library/pathlib.html
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0
- World Wide Web Consortium. (2018). Scalable Vector Graphics (SVG) 2 specification. W3C. https://www.w3.org/TR/SVG2/