
Dans le paysage contemporain de la science des données et de la recherche computationnelle, la gestion rigoureuse des données constitue le pivot sur lequel repose la validité des inférences statistiques. L’environnement statistique GNU R s’est imposé comme une référence incontournable au sein des laboratoires universitaires, des instituts de sondage et des industries de pointe. Cependant, l’accroissement continu du volume des informations recueillies et la complexité structurelle des objets statistiques modernes imposent des exigences méthodologiques strictes en matière d’archivage intermédiaire. Les analystes et chercheurs sont quotidiennement confrontés au défi de figer des états transitoires d’analyse, d’immortaliser des pipelines de transformation lourds et d’échanger des jeux de données sans dégradation d’information.
Face à ces défis, le recours aux formats textuels conventionnels tels que le CSV ou les structures tabulaires délimitées révèle rapidement ses limites intrinsèques. Bien que bénéficiant d’une interopérabilité apparente, les fichiers plats sacrifient des pans entiers de métadonnées essentielles, contraignant les praticiens à réassigner laborieusement des typologies de variables, des niveaux de facteurs ou des attributs de séries temporelles lors de chaque réimportation. Le format binaire natif RDA (ou RData) émerge précisément pour répondre à cette lacune fondamentale. Conçu au cœur même de l’architecture de R, il encapsule les structures de données dans leur plénitude ontologique, préservant fidèlement chaque nuance de typage, de nommage et d’attribut interne.
Ce traité exhaustif a pour vocation d’analyser en profondeur les mécanismes de sauvegarde et de chargement des fichiers RDA à travers les fonctions fondamentales save() et load(). De la configuration initiale de l’espace de travail aux stratégies avancées d’isolation en environnements hermétiques, ce document expose les fondements théoriques, les justifications computationnelles et les applications empiriques nécessaires à une maîtrise totale de la persistance binaire sous R. En explorant les subtilités algorithmiques de la sérialisation, la gestion des conflits d’espaces de noms et l’optimisation des flux d’entrées-sorties pour les données massives, ce guide offre aux analystes et chercheurs une référence technique complète pour élever la reproductibilité et l’efficience de leurs flux d’analyses.
1. Introduction aux fichiers RDA et à la persistance des données sous R
1.1 Définition et rôle des fichiers RDA en science des données
L’extension de fichier .rda, variante directe du format canonique .RData, désigne un conteneur binaire conçu spécifiquement pour la sérialisation et la persistance d’objets créés au sein du langage statistique R. En informatique théorique, la sérialisation représente le processus de conversion d’une structure de données ou de l’état d’un objet en mémoire vive sous forme d’une séquence d’octets directement transmissible ou inscriptible sur un support de stockage persistant. Dans l’écosystème R, cette sérialisation binaire ne se borne pas à enregistrer des valeurs brutes disposées en lignes et en colonnes. Elle conserve l’architecture logique intégrale, la hiérarchie interne et les attributs sous-jacents des structures mathématiques manipulées, qu’il s’agisse de matrices multidimensionnelles, de modèles linéaires généralisés, de dendrogrammes issus d’une classification hiérarchique ou de listes imbriquées hétérogènes.
Contrairement aux formats textuels standards comme le CSV ou le format délimité par des tabulations, qui imposent une dégradation de l’information par une conversion obligatoire en chaînes de caractères ASCII ou UTF-8, le format RDA sauvegarde la représentation mémoire exacte de l’objet. Cette persistance binaire native confère un avantage substantiel lors des études quantitatives et empiriques requérant des transformations volumineuses. Elle élimine intégralement la latence d’analyse syntaxique lors de la réouverture des fichiers et immunise l’analyste contre les erreurs d’arrondi décimal susceptibles d’altérer la précision d’algorithmes d’optimisation stochastique ou d’économétrie non linéaire.
Dans le cadre de projets d’analyse de données massives, le recours au format RDA s’avère particulièrement pertinent lorsqu’il s’agit de stocker des résultats intermédiaires générés au terme de calculs distribués ou d’itérations bootstrap consommatrices d’énergie processeur. Plutôt que de contraindre une infrastructure de calcul à réitérer des simulations numériques coûteuses, l’analyste archive les représentations binaires des objets statistiques, garantissant une reprise instantanée du pipeline analytique au point exact où il avait été suspendu.
1.2 Enjeux de la reproductibilité computationnelle
La reproductibilité computationnelle s’est imposée au cours de la dernière décennie comme la pierre angulaire de l’intégrité scientifique contemporaine. La capacité d’une équipe de recherche indépendante à répliquer à l’identique les estimations paramétriques, les intervalles de confiance et les tests d’hypothèses d’une publication dépend directement de la traçabilité et de la fidélité des données mobilisées. À cet égard, les fichiers RDA constituent un véhicule privilégié pour garantir qu’aucune distorsion ne s’insinue entre les phases successives d’extraction, de nettoyage, de transformation et de modélisation mathématique.
Lorsqu’un jeu de données complexe est exporté vers un fichier texte, la troncature insidieuse des décimales en virgule flottante double précision peut altérer subtilement les valeurs propres calculées lors d’une décomposition en valeurs singulières ou modifier le seuil de convergence d’un estimateur du maximum de vraisemblance. Le format RDA fige les représentations numériques sous le standard IEEE 754 sans la moindre perte d’information infinitésimale. Cette invariance numérique garantit une rigueur méthodologique absolue, indispensable pour répondre aux critères éditoriaux des comités de lecture les plus exigeants.
Au-delà de la fidélité mathématique, l’adoption systématique du format binaire standardisé facilite le partage de données pré-traitées entre équipes collaboratives dispersées géographiquement. Les chercheurs n’ont plus à transmettre de longs scripts de préparation documentaire pour corriger des séparateurs décimaux erratiques ou des codages de caractères divergents. En harmonisant les supports de stockage au sein de protocoles d’échanges basés sur le format RDA, la communauté scientifique matérialise les principes d’ouverture des données, assurant une transparence sans faille de la chaîne de traitement.
1.3 Pertinence pour les jeux de données en sciences comportementales
Les sciences comportementales, la psychologie différentielle et les neurosciences cognitives manipulent traditionnellement des ensembles de données caractérisés par une grande complexité structurelle. L’administration d’échelles psychométriques de type Likert, la collecte de scores standardisés d’inhibition cognitive ou l’agrégation de temps de réaction longitudinaux génèrent des tables de données où la valeur brute est indissociable de ses propriétés métrologiques. Les fichiers RDA permettent le stockage unifié et structuré d’échelles psychométriques composites, associant intimement les scores observés, les étiquettes sémantiques des items et les matrices de corrélation polychoriques au sein d’une seule et même archive.
De surcroît, les designs expérimentaux sophistiqués, tels que les plans factoriels mixtes à mesures répétées et les modélisations multiniveaux, exigent la conservation scrupuleuse des hiérarchies de regroupement entre sujets, sessions et stimuli. L’aplatissement de ces plans expérimentaux dans des fichiers plats engendre fréquemment la perte des niveaux ordonnés de facteurs expérimentaux, induisant des erreurs méthodologiques majeures lors du réajustement ultérieur des modèles mixtes. Le format binaire neutralise ce péril en préservant nativement l’imbrication des identifiants et l’ordonnancement exact des modalités de contraste.
Enfin, face aux cohortes expérimentales volumineuses intégrant des milliers de participants soumis à des paradigmes d’apprentissage continu, les temps de chargement et d’écriture de fichiers textuels représentent un goulot d’étranglement informatique critique. L’efficience algorithmique offerte par le format RDA, tant sur le plan de la bande passante disque que de la gestion de la mémoire système, autorise un traitement fluide et itératif des cohortes, dynamisant le cycle global de découverte empirique.
2. Fondements techniques : Comprendre le format binaire RDA et RData
2.1 Distinction et équivalence entre les extensions .rda et .RData
Dans la pratique quotidienne du développement sous R, une source récurrente d’interrogation parmi les praticiens réside dans la coexistence des extensions de fichiers .rda et .RData. D’un point de vue purement informatique et selon les spécifications formelles du manuel interne de R édité par le Comprehensive R Archive Network, ces deux dénominations sont rigoureusement interchangeables. Elles renvoient toutes deux au même standard de sérialisation binaire interne implémenté dans le noyau C du moteur R. L’introduction de l’acronyme contracté .rda est apparue historiquement pour répondre aux contraintes de certains systèmes d’exploitation limitant la longueur des extensions de fichiers ou pour des considérations de brièveté syntaxique dans les environnements de scripts automatisés.
L’analyse binaire de l’en-tête d’un fichier sauvegardé avec l’extension .rda révèle une signature strictement identique à celle d’un fichier doté de l’extension .RData. Les octets magiques initiaux, qui renseignent le noyau du système d’exploitation sur la nature du format (typiquement RD2 ou RD3 selon la version du format de sérialisation utilisée), sont rigoureusement superposables. Le mécanisme de désérialisation déclenché par l’interpréteur R ne procède à aucune discrimination fondée sur les caractères composant l’extension du chemin d’accès.
Toutefois, sur le plan des conventions professionnelles de programmation et des directives d’ingénierie logicielle pour le développement de packages, l’usage de l’extension courte .rda est désormais préconisé au sein du sous-répertoire de données documentées (dossier data/). Cette recommandation vise à préserver une homogénéité formelle et une lisibilité maximale dans les répertoires sources, réservant parfois l’extension complète .RData aux instantanés complets de sessions interactives générés à la fermeture de la console.
2.2 Architecture interne et compression native
L’une des prouesses architecturales du format binaire de R réside dans son intégration transparente et modulaire de mécanismes de compression interne sans surcoût opérationnel pour l’utilisateur. Dès lors qu’une opération de sauvegarde est ordonnée, le flux binaire de sérialisation traverse une couche algorithmique de réduction dimensionnelle avant d’être écrit sur le support physique. Par défaut, le moteur utilise l’algorithme gzip (implémenté via la bibliothèque zlib), offrant un compromis éprouvé et équilibré entre le taux de compression volumétrique et la vélocité de calcul nécessaire à la compression et à la décompression.
Pour les contextes analytiques requérant des réductions d’empreinte disque plus drastiques, le moteur offre la possibilité de mobiliser les algorithmes bzip2 ou xz (basé sur l’algorithme LZMA). Cette flexibilité architecturale permet de comprimer des matrices de covariance gigantesques ou des tables de données massives jusqu’à des fractions minimes de leur encombrement originel en mémoire vive. Comparativement à un fichier délimité au format CSV d’un gigaoctet, une sérialisation RDA compressée peut réduire le volume disque à moins de cent mégaoctets, transformant radicalement les exigences de stockage sur les serveurs de calcul haute performance.
Cette contraction matérielle induit un impact direct et mesurable sur les performances d’entrées-sorties. Dans la majorité des architectures modernes, le facteur limitant d’une exécution de script réside dans la bande passante du contrôleur de stockage plutôt que dans la puissance brute des cœurs de calcul du microprocesseur. En réduisant drastiquement le nombre d’octets physiques devant transiter à travers le bus système, la lecture d’une archive binaire RDA compressée s’avère fréquemment bien plus rapide que la lecture d’un fichier textuel décompressé équivalent, même en comptabilisant le temps processeur alloué à la décompression en temps réel.
2.3 Préservation intégrale des métadonnées R
La supériorité technique du conteneur binaire s’exprime avec éclat dans sa fidélité à l’égard du modèle objet hautement polymorphe de R. Les systèmes d’objets orientés, qu’il s’agisse des classes formelles S3 fondées sur des listes annotées, des architectures formelles et typées S4 munies de fentes de contrôle strict, ou encore des environnements encapsulés R6, comportent des hiérarchies de métadonnées invisibles à l’œil nu dans une vue tabulaire, mais indispensables à l’application des méthodes génériques.
Lors de la sérialisation en RDA, chaque pointeur de métadonnée, chaque attribut de classe et chaque liaison d’héritage est rigoureusement conservé dans la trame binaire. Les facteurs, éléments cardinaux de la modélisation statistique dans R, constituent un exemple canonique : là où un fichier plat transforme inévitablement les modalités textuelles en chaînes standard en occultant leur statut ordinal sous-jacent, le fichier RDA maintient sans la moindre altération les entiers d’encodage et le vecteur des niveaux déclarés, qu’ils soient nominaux ou formellement ordonnés.
Cette intégrité absolue s’étend avec une rigueur identique aux indexations temporelles des objets de séries chronologiques, aux identifiants complexes de lignes, aux étiquettes descriptives intégrées par les analystes et aux environnements associés aux formules statistiques. Ainsi, restaurer un modèle linéaire sauvegardé en format RDA restitue immédiatement la formule symbolique, les contrastes paramétriques adoptés lors de l’estimation et l’ensemble des résidus pondérés, garantissant une continuité analytique dépourvue de toute dérive méthodologique.
3. Configuration de l’environnement de travail : getwd() et setwd()
3.1 Identification du répertoire de travail courant avec getwd()
Toute opération de persistance de données sur un support matériel s’inscrit nécessairement dans le cadre spatial du système de fichiers du système d’exploitation hôte. Dans l’écosystème R, la notion de répertoire de travail courant représente le point d’ancrage contextuel à partir duquel tous les chemins d’accès relatifs sont résolus. L’interrogation de cet emplacement fondamental s’effectue au moyen de la fonction native getwd(), acronyme canonique de get working directory. Cette fonction, lorsqu’elle est exécutée sans argument dans la console, interroge l’environnement sous-jacent et renvoie une chaîne de caractères scalaire formalisant le chemin absolu du dossier actif.
L’exécution préliminaire et systématique de cette commande constitue une saine discipline algorithmique. Elle permet au programmeur de vérifier sans équivoque que la session d’exécution courante pointe précisément vers l’espace de stockage alloué au projet d’analyse, écartant le spectre des sauvegardes involontaires au sein du dossier système de l’utilisateur ou du répertoire d’installation de l’exécutable R. La détection précoce d’une discordance de répertoire évite la dispersion anarchique des fichiers de données et prévient l’échec subséquent de scripts de production conçus pour lire des ressources adjacentes.
L’interprétation de la sortie console de getwd() met fréquemment en lumière des configurations inattendues, notamment lors de l’exécution de R au sein d’environnements virtualisés, de conteneurs Docker ou de profils itinérants d’entreprises. Une anomalie récurrente concerne les chemins pointant vers des lecteurs réseaux mappés ou des dossiers temporaires éphémères qui risquent d’être purgés lors de la réinitialisation de la machine hôte. Il incombe donc à l’analyste de contrôler cet ancrage avant d’ordonner la moindre opération d’écriture binaire.
3.2 Modification ciblée du répertoire d’accès via setwd()
Lorsque le diagnostic établi par l’interrogation contextuelle révèle que l’ancrage spatial de la session ne coïncide pas avec l’architecture logique du projet, la modification ciblée du répertoire actif devient impérative. Cette réaffectation dynamique s’opère par l’entremise de la fonction setwd(), pour set working directory, qui prend pour argument principal une chaîne de caractères représentant le chemin vers le nouveau dossier cible. Cette procédure modifie immédiatement l’état interne du processus R pour l’ensemble des instructions subséquentes de lecture et d’écriture sur disque.
L’un des écueils syntaxiques les plus répandus lors de l’utilisation de cette instruction réside dans la divergence des séparateurs de dossiers selon les familles de systèmes d’exploitation. Sous les environnements conformes à la norme POSIX, tels que GNU/Linux et macOS, la barre oblique simple (slash ‘/’) est employée de façon universelle. En revanche, sous l’environnement Microsoft Windows, le système d’exploitation emploie traditionnellement la barre oblique inversée (backslash »). Or, dans la syntaxe formelle de R, la barre oblique inversée possède un statut d’échappement sémantique réservé aux caractères spéciaux. En conséquence, l’écriture directe d’un chemin Windows contenant des barres obliques simples inversées déclenche une erreur syntaxique immédiate.
Pour contourner cet écueil, le standard d’ingénierie logicielle sous R exige l’adoption universelle de la barre oblique standard (‘/’), y compris sur les systèmes Microsoft Windows, que le sous-système de R convertit automatiquement vers les appels systèmes appropriés. Parallèlement, l’analyste doit impérativement intercepter les erreurs d’exécution consécutives à un chemin inexistant ou à des droits d’accès insuffisants, lesquelles interrompent brutalement les scripts par l’émission de messages bloquants interdisant la poursuite des opérations de sérialisation.
3.3 Chemins relatifs contre chemins absolus dans la recherche empirique
L’arbitrage méthodologique entre l’emploi de chemins absolus et de chemins relatifs conditionne la pérennité et la portabilité des flux de travail scientifiques. Un chemin absolu, qui explicite l’intégralité de l’arborescence matérielle depuis la racine du disque de stockage jusqu’au fichier cible, possède une vulnérabilité rédhibitoire. Il assujettit le script à une configuration matérielle, un nom d’utilisateur et un système d’exploitation strictement singuliers. Dès lors que le script est transmis à un relecteur académique ou exécuté sur un serveur de calcul distant, l’arborescence absolue devient caduque, provoquant l’interruption immédiate de l’analyse par absence de cible valide.
À l’inverse, l’usage des chemins relatifs, formulés en référence dynamique au répertoire de base du projet, garantit une portabilité sans faille. Cette pratique d’excellence trouve son accomplissement le plus abouti lorsqu’elle est combinée avec les projets de l’environnement de développement intégré RStudio matérialisés par le fichier de configuration .Rproj. L’ouverture d’un projet de cette nature configure automatiquement et de façon déterministe le répertoire de travail à la racine du projet, rendant l’invocation de l’instruction setwd() entièrement superflue et proscrite dans les scripts partagés.
Pour consolider cette indépendance topologique, la communauté de recherche s’appuie de plus en plus sur des bibliothèques logicielles spécialisées comme le package here. En calculant dynamiquement les chemins absolus par rapport à un indicateur d’ancrage situé à la racine du projet, ces outils neutralisent les ambiguïtés spatiales qui surviennent lorsque des sous-scripts sont nichés au plus profond d’une arborescence complexe, immunisant l’accès aux archives de données contre les variations contextuelles d’exécution.
4. Création d’un jeu de données reproductible pour l’expérimentation
4.1 Fixation de la graine aléatoire avec set.seed()
Dans la démarche expérimentale guidée par le calcul informatique, la création de données synthétiques représente une étape essentielle pour tester des architectures algorithmiques et valider des chaînes de traitement sans dépendre de données de terrain parfois bruitées ou confidentielles. Toutefois, la modélisation de variables probabilistes requiert l’intervention de générateurs de nombres pseudo-aléatoires. Ces algorithmes déterministes reposent sur des séquences mathématiques récursives qui, partant d’une valeur initiale spécifique dénommée graine (seed), déroulent une série prévisible de nombres dont les propriétés distributionnelles imitent fidèlement le hasard pur.
Afin d’assurer une réplicabilité scientifique absolue de nos démonstrations de sauvegarde et de chargement, il est nécessaire de fixer formellement la graine aléatoire à l’aide de l’instruction set.seed(). En transmettant l’argument entier zéro, par l’instruction formelle set.seed(0), nous imposons à l’algorithme sous-jacent (par défaut l’éprouvé Mersenne Twister au sein du noyau de R) de débuter sa progression à un état interne univoque et universellement reproductible.
Cette rigueur de paramétrage garantit que tout praticien, qu’il travaille sur une station de travail sous architecture x86 sous Linux ou sur un environnement ARM sous macOS, générera rigoureusement les mêmes séquences numériques à l’octet près. Cette démarche constitue la condition sine qua non pour valider ultérieurement que le processus de sérialisation et de désérialisation binaire n’introduit aucune altération ou dispersion des données lors des étapes d’écriture sur le disque et de restauration en mémoire centrale.
4.2 Génération de distributions normales multivariées synthétiques
Une fois la stabilité stochastique garantie, la modélisation statistique peut procéder à la simulation d’un ensemble structuré de données quantitatives continues. La fonction rnorm(), dédiée à l’échantillonnage de valeurs distribuées selon la loi normale canonique de Laplace-Gauss, constitue l’outil fondamental pour forger des profils de variables continues standardisées, caractérisées par une espérance théorique nulle et une variance unitaire.
Pour construire un cadre d’expérimentation concret et représentatif des problématiques de recherche en psychométrie ou en modélisation économétrique, nous concevons un tableau de données dénommé df comprenant trois dimensions numériques continues : x, y et z. Chacune de ces colonnes intègre un tirage de dix observations indépendantes issues de cette loi normale standardisée. L’assemblage de ces trois vecteurs est opéré au moyen de la fonction fondamentale data.frame(), qui confère à la matrice résultante la structure tabulaire universelle de R, assignant automatiquement les classes internes adaptées et allouant l’espace mémoire nécessaire.
Ces variables simulées incarnent idéalement, par exemple, des dimensions psychologiques sous-jacentes telles que des scores d’anxiété cognitive, des indices de vitesse de traitement perceptif et des mesures de précision mnésique. Par cette démarche, l’objet matriciel ainsi généré ne constitue pas un simple agrégat abstrait, mais simule fidèlement la configuration structurelle d’une cohorte expérimentale prête pour les opérations de persistance binaire.
4.3 Inspection initiale et validation structurelle de l’objet
La génération programmatique d’un ensemble de données doit obligatoirement être suivie d’une phase de validation empirique avant toute sérialisation. Cette étape d’audit méthodologique vise à certifier la conformité typologique et dimensionnelle de l’objet nouvellement forgé. L’appel à la fonction head() permet d’examiner dans la console les premières lignes du tableau de données, confirmant visuellement la cohérence des ordres de grandeur et l’étiquetage syntaxique régulier des colonnes vectorielles.
Au-delà de l’inspection de surface, le contrôle des dimensions globales et de la hiérarchie interne de l’objet s’opère par l’entremise de fonctions réflexives telles que dim(), str() et class(). La fonction str(), pour structure, se distingue tout particulièrement par sa capacité à condenser en quelques lignes l’inventaire typologique des composantes du tableau, révélant sans ambiguïté le statut de vecteurs numériques en virgule flottante double précision alloués à chaque variable.
Enfin, l’interrogation descriptive synthétique assurée par la fonction summary() fournit un bilan statistique préliminaire complet, calculant instantanément les minima, premier quartile, médiane, moyenne arithmétique, troisième quartile et maxima pour l’ensemble des axes x, y et z. Ces grandeurs numériques forment une empreinte empirique témoin, permettant de certifier sans contestation possible la parfaite conservation de la structure mathématique de l’objet après les étapes de persistance binaire sous forme d’archive RDA.
5. Sauvegarde d’un objet unique avec la fonction save()
5.1 Syntaxe formelle et arguments obligatoires de save()
L’archivage d’un objet présent dans la mémoire vive de l’ordinateur vers un conteneur binaire s’articule autour de la fonction native save(). Cette fonction fondamentale du socle R repose sur une signature formelle souple mais exigeante, acceptant une liste variable d’arguments via le mécanisme des points de suspension syntaxiques (…), couplée à des arguments nommés dont le plus déterminant est le paramètre file.
Sur le plan de l’invocation formelle, la déclaration du premier argument exige le passage direct du nom de l’objet à sauvegarder tel qu’il figure dans l’espace de noms, et ce, sans l’encapsuler au sein de guillemets textuels dans son usage le plus élémentaire. L’interpréteur R procède en effet à une évaluation non standard de cet argument pour extraire simultanément l’identifiant symbolique et le contenu adressé en mémoire vive. L’omission de l’argument file ou une faute de frappe dans sa désignation conduit à des comportements erronés ou à l’écriture non désirée vers des connexions par défaut du système.
L’argument file requiert quant à lui une chaîne de caractères explicite stipulant le chemin d’accès relatif ou absolu du fichier de destination, obligatoirement pourvu de l’extension appropriée, de préférence .rda ou .RData. Par défaut, si le chemin spécifié ne comprend aucun séparateur d’arborescence, l’écriture s’effectue précisément dans le répertoire actif de travail validé préalablement par getwd(), consolidant le lien entre organisation spatiale du système de fichiers et opérations de persistance binaire.
5.2 Exemple pratique : Exportation de l’objet df vers my_data.rda
Pour concrétiser le processus d’écriture, l’instruction méthodologique s’exprime sous la forme épurée : save(df, file = ‘my_data.rda’). Lors de l’envoi de cette ligne de commande à l’interpréteur, un processus algorithmique sophistiqué s’enclenche de manière totalement transparente pour le chercheur. Le noyau R procède à la capture de l’environnement de l’objet, extrait l’arborescence complète de df et amorce la phase d’encodage binaire conforme aux spécifications de la version courante de sérialisation.
Au cours de ce mécanisme, le processeur alloue une mémoire tampon transitoire pour convertir les structures vectorielles en flux d’octets ordonnés, applique l’algorithme de compression sélectionné, puis sollicite le gestionnaire d’entrées-sorties du système d’exploitation afin d’ouvrir un canal d’écriture vers le support physique. L’écriture s’opère de façon monolithique : le fichier my_data.rda est créé ou remplacé sans nécessiter de dialogue interactif complémentaire.
L’absence de tout retour textuel ou avertissement dans la console à l’issue de l’exécution confirme le succès de l’opération dans la tradition des commandes du monde Unix. L’analyste averti ne doit pas interpréter ce silence comme une incertitude, mais comme la validation implicite de l’inscription physique intégrale du tableau de données sur le support persistant, marquant la concrétisation réussie de la phase d’exportation.
5.3 Contrôle de l’existence et de l’intégrité du fichier généré
Dans tout flux de travail automatisé ou au sein d’un pipeline d’analyse critique, il est méthodologiquement imprudent de présumer du succès d’une écriture sans procéder à des vérifications logicielles programmées. L’écosystème R dispose d’une série d’instructions réflexives dédiées à l’interrogation directe du système de fichiers. L’instruction file.exists(‘my_data.rda’) s’impose comme le premier filtre de validation : elle retourne une valeur logique booléenne stricte, confirmant par un résultat positif la présence matérielle du conteneur dans le répertoire courant.
Pour approfondir ce contrôle et s’assurer que le fichier ne se résume pas à une coquille vide issue d’une interruption intempestive du tampon d’écriture, la fonction file.info(‘my_data.rda’) fournit un diagnostic approfondi. Cette fonction extrait une table contenant l’encombrement spatial précis exprimé en octets, la date de dernière modification horodatée à la seconde près, ainsi que les autorisations de lecture, d’écriture et d’exécution accordées au processus courant.
Un examen attentif de ces métadonnées matérielles permet de valider sans équivoque la réalité de la compression binaire. La taille relevée pour un data frame modeste démontre une empreinte minimale sur le disque, tout en certifiant que les descripteurs de fichiers sont adéquatement clôturés par le sous-système de R. L’objet est désormais solidement sanctuarisé sur le disque, immunisé contre tout crash mémoire éventuel de la session de calcul.
6. Sauvegarde multiple : Stocker plusieurs objets dans une archive RDA
6.1 Enregistrement simultané d’objets hétérogènes
La puissance conceptuelle de la fonction save() réside de façon prééminente dans sa faculté à encapsuler simultanément une pluralité d’objets statistiques fondamentalement hétérogènes au sein d’une seule et unique archive physique. Dans la conduite d’un protocole expérimental rigoureux, l’analyse ne se réduit que très rarement à un simple tableau de données isolé. Elle agrège typiquement un jeu de données initial, des listes de paramètres computationnels, des matrices de pondération et des objets complexes modélisant les résultats finaux d’un estimateur statistique.
La syntaxe de sauvegarde multi-objets permet d’énumérer de façon séquentielle l’ensemble des éléments cibles séparés par des virgules avant de spécifier le chemin de destination. L’instruction formelle save(df1, df2, modele, file = ‘experience.rda’) illustre cette capacité d’agrégation holistique. Lors de cette opération, l’archive RDA ne procède pas à une fusion déstructurante des données : elle préserve l’individualité logique, l’arborescence, les métadonnées et l’identifiant propre de chacune de ces entités au sein du même flux binaire compressé.
Cette approche évite l’éparpillement anarchique de dizaines de micro-fichiers sur le disque dur des infrastructures de recherche. Elle confère à l’archive le rôle d’une capsule temporelle expérimentale complète. Le partage d’une étape d’analyse entre deux collaborateurs s’en trouve grandement simplifié : au lieu d’expédier un ensemble désynchronisé de fichiers plats, un unique fichier binaire contient la totalité des composantes nécessaires à la réplication intégrale de la phase d’inférence.
6.2 Utilisation de l’argument list pour la sélection dynamique
Si l’énumération manuelle d’objets répond aux besoins d’analyses simples, elle révèle une rigidité inadaptée face à des architectures de programmation modulaire ou des procédures itératives de simulation. Dans de telles circonstances, les noms des objets devant être persistés ne sont pas nécessairement connus a priori par le développeur, mais sont engendrés dynamiquement par le flux algorithmique au gré de boucles ou de requêtes paramétrées.
Pour faire face à cette contrainte, la fonction save() dispose de l’argument fondamental list. Ce paramètre attend un vecteur de chaînes de caractères contenant les noms symboliques des objets cibles. Ainsi, une instruction telle que save(list = c(‘df1’, ‘df2’, ‘modele’), file = ‘experience.rda’) produit un résultat fonctionnel strictement équivalent à l’énumération directe, mais ouvre des horizons considérables en matière de sélection programmatique.
Cette fonctionnalité s’avère particulièrement puissante lorsqu’elle est couplée à la fonction ls() munie d’expressions régulières (argument pattern). Un ingénieur de données peut concevoir une routine qui extrait automatiquement tous les objets dont l’identifiant débute par le préfixe ‘modele_’ ou se termine par ‘_ajuste’, et transmettre ce vecteur résultant directement à l’argument list. L’automatisation de l’archivage au sein de pipelines industriels devient alors totalement dynamique et exempte de toute intervention manuelle susceptible d’engendrer des oublis méthodologiques.
6.3 Distinguer save() partiel et save.image() pour la session entière
Une confusion doctrinale récurrente chez les utilisateurs intermédiaires du langage R consiste à assimiler la fonction save() à son dérivé global save.image(). Si les deux fonctions forgent des conteneurs binaires régis par les mêmes spécifications techniques sous-jacentes, leur périmètre opérationnel respectif répond à des philosophies radicalement divergentes.
La fonction save.image() est conçue pour opérer une capture intégrale et indifférenciée de la totalité des éléments résidant au sein de l’environnement global (Global Environment). Invoquer cette instruction sans discernement équivaut à archiver indistinctement des données cruciales, des variables temporaires d’itération, des fonctions d’assistance éphémères et d’éventuels tableaux intermédiaires massifs de plusieurs gigaoctets qui encombrent la mémoire vive. Cette pratique de l’instantané indiscriminé conduit invariablement à la création de fichiers volumineux, dégradant les temps de lecture et contaminant l’espace de travail futur par des scories computationnelles inutiles.
D’un point de vue méthodologique et en conformité avec les règles strictes de l’ingénierie des données scientifiques, le recours ciblé à la fonction save() partielle doit toujours être privilégié. La sélection méticuleuse des seules variables indispensables à la poursuite du cycle d’analyse garantit des archives légères, élégantes et documentées, évitant la rétention aveugle d’artefacts volatils contraires aux principes d’économie computationnelle et de clarté logicielle.
7. Gestion de l’espace de travail et suppression d’objets avec rm()
7.1 Suppression ciblée de la mémoire vive avec rm(df)
La rigueur de la validation logicielle exige d’éprouver la fidélité de la restauration des données en réinitialisant artificiellement la mémoire de la session R. Pour attester sans faille de la persistance réelle d’un objet sur le support matériel, il est indispensable de faire disparaître toute trace de sa présence dans la mémoire vive de l’ordinateur avant d’ordonner sa récupération. Cette opération d’élagage mémoriel ciblé s’opère par le truchement de la fonction rm(), abréviation canonique de remove.
L’exécution de l’instruction rm(df) rompt instantanément le lien entre l’identifiant symbolique df et la zone de mémoire centrale allouée à la structure de données. Il convient de souligner la séparation étanche qui prévaut entre l’allocation volatile en mémoire vive (RAM) et la conservation physique sur le disque dur. La commande rm() n’interagit en aucune façon avec le fichier binaire my_data.rda antérieurement généré, lequel demeure rigoureusement intact dans l’arborescence du système de fichiers.
Sur le plan de la gestion des ressources de calcul, cette suppression ciblée constitue une technique fondamentale lors du traitement de jeux de données massifs. Une fois qu’une table intermédiaire lourde a été consolidée et sauvegardée sous format RDA, libérer immédiatement l’empreinte mémoire correspondante permet au ramasse-miettes (garbage collector) de R de recycler la mémoire système pour les étapes algorithmiques suivantes, écartant le risque d’épuisement des capacités matérielles de la station de travail.
7.2 Nettoyage intégral de l’environnement global
Dans la conduite de protocoles de reproductibilité computationnelle, la réinitialisation totale de l’environnement s’avère fréquemment préférable à la suppression fragmentée des variables. Pour vérifier qu’un pipeline d’analyse ne repose sur aucune réminiscence cachée d’une session antérieure, le nettoyage exhaustif du Global Environment constitue une épreuve de résistance méthodologique indispensable.
Cette remise à zéro radicale s’accomplit par l’imbrication syntaxique classique rm(list = ls()). Dans cette formulation, la fonction ls() commence par répertorier l’intégralité des symboles et variables alloués dans l’environnement de travail immédiat, produisant un vecteur de chaînes de caractères englobant toutes les entités actives. Ce vecteur est alors transmis à l’argument list de l’opérateur de destruction rm(), qui exécute une purge intégrale de la mémoire vive utilisateur.
Il importe toutefois de manipuler cette instruction avec une prudence absolue. Son exécution au sein d’un environnement de production où des calculs complexes et non persistés sont en cours engendre des pertes de données irrémédiables. Elle ne doit être mobilisée que dans le cadre délibéré d’une réinitialisation de session visant à tester la robustesse des flux de réimportation binaire à partir de fichiers RDA dûment authentifiés.
7.3 Diagnostic d’absence par ls() et le volet Environnement
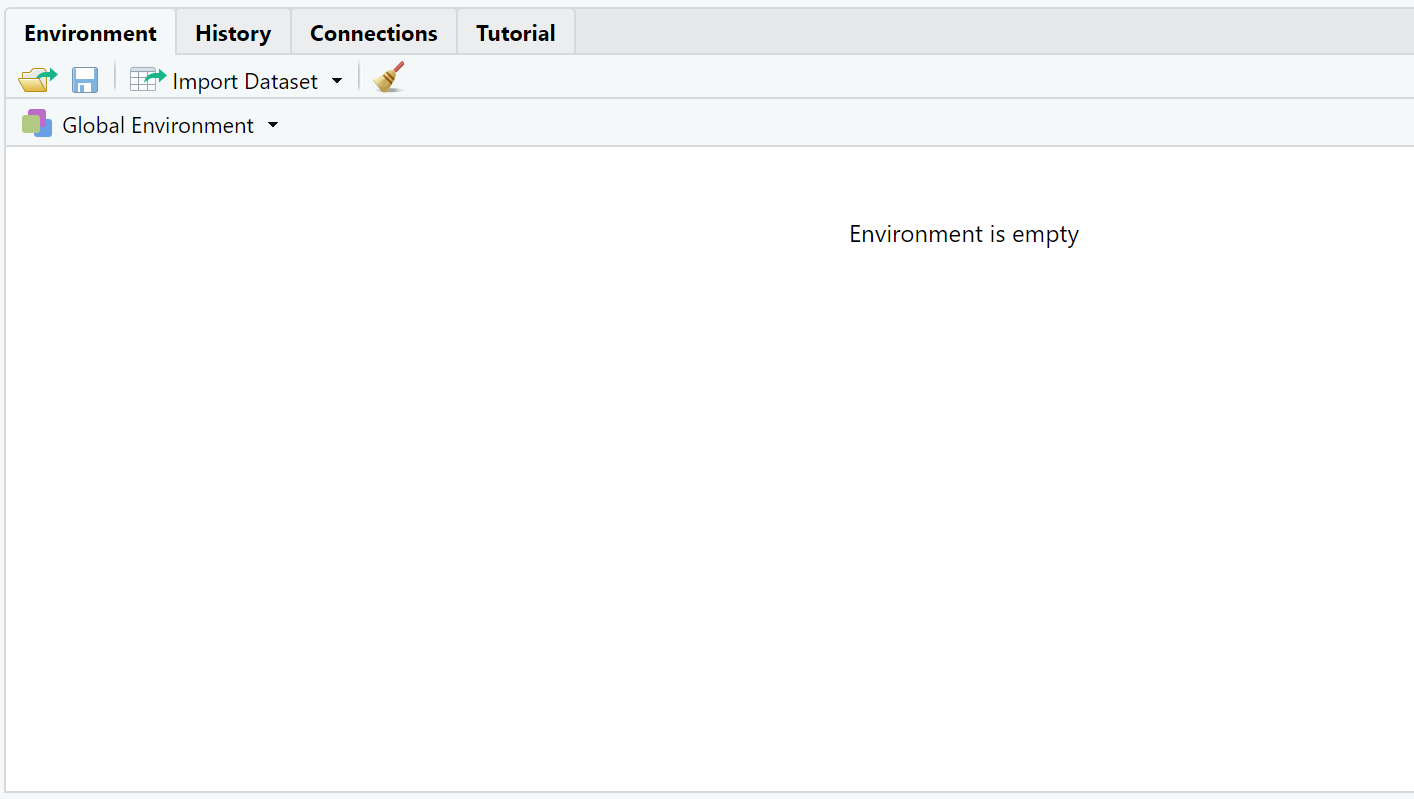
La suppression ayant été exécutée, la confirmation diagnostique de la vacuité de la mémoire constitue l’étape logique suivante. L’interrogation programmatique de l’espace de noms via un nouvel appel direct à la commande ls() sans argument permet d’établir un état des lieux sans équivoque. Dès lors que l’environnement est intégralement purgé, la console répond en retournant le descripteur littéral character(0), attestant de l’absence totale de vecteurs, de matrices ou de structures de données actives dans la session.
Pour les praticiens opérant au sein d’environnements de développement intégrés sophistiqués tels que RStudio, ce diagnostic algorithmique s’accompagne d’un constat visuel direct. Le quadrant supérieur droit, hébergeant l’onglet Environment, affiche instantanément la mention explicite « Environment is empty ». Cette corrélation entre observation visuelle et retour de console confirme l’absence de toute contamination mémorielle résiduelle.
À cet instant précis du cycle d’expérimentation, la station de travail se trouve dans une configuration analogue à celle d’un chercheur indépendant allumant sa machine pour la première fois. Tout calcul ultérieur requérant l’accès au tableau de données df sera condamné à échouer par émission d’une erreur d’objet introuvable, à moins de mobiliser l’opération complémentaire de désérialisation binaire depuis le conteneur physique sur disque.
8. Chargement et restauration des données avec la fonction load()
8.1 Mécanique d’importation et syntaxe fondamentale de load()
La restauration d’un état mémoire préalablement archivé au sein d’un fichier RDA s’opère par l’intermédiaire de la fonction native load(). Contrairement aux fonctions d’importation courantes régissant les formats textuels (telles que read.table ou read.csv) qui nécessitent obligatoirement l’assignation explicite du flux entrant vers une variable d’accueil, la mécanique fondamentale de load() se distingue par un comportement direct de recréation d’objets au sein de l’environnement récepteur.
L’exécution de la commande sous sa forme la plus pure s’articule comme suit : load(file = ‘my_data.rda’). Dès la validation de cette instruction, le sous-système de désérialisation de R entreprend la lecture séquentielle des octets enregistrés dans l’archive. Le moteur identifie l’algorithme de compression requis, décompresse le flux en mémoire tampon, reconstruit méticuleusement les pointeurs d’adresses internes, reconstitue les attributs de classe et rétablit automatiquement l’objet sous son identifiant symbolique d’origine.
Ce mode opératoire présente une singularité majeure qu’il convient de souligner : l’instruction ne renvoie pas l’objet lui-même comme résultat d’évaluation de la fonction, mais effectue ce que la théorie des langages nomme un « effet de bord » (side effect) d’injection directe dans l’environnement. Tenter d’assigner l’évaluation de cette instruction par une syntaxe du type mes_donnees <- load(‘my_data.rda’) ne transfère nullement le tableau de données vers la nouvelle variable, mais stocke simplement une chaîne de caractères contenant le nom des variables injectées, un piège classique pour les non-initiés.
8.2 Restauration effective et validation de la fidélité des valeurs
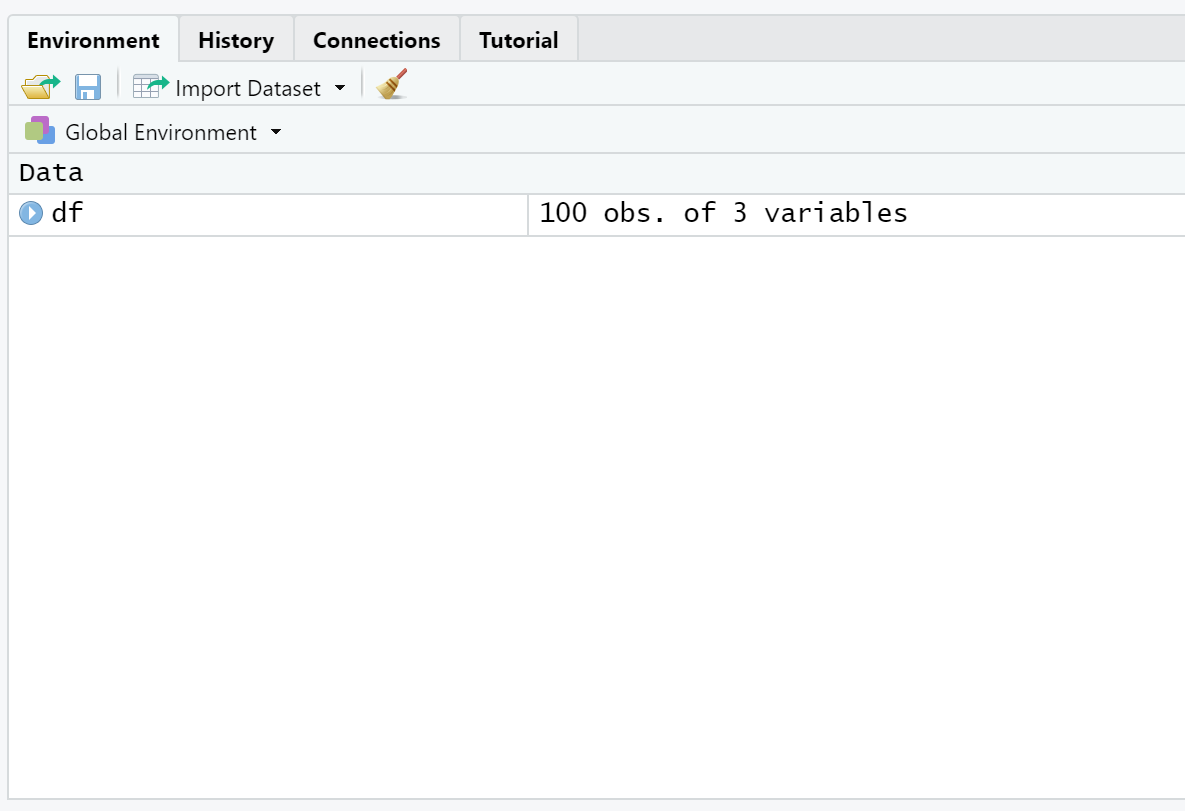
Une fois l’instruction de chargement exécutée, la réinterrogation de l’espace de travail par la commande ls() révèle la réapparition immédiate du symbole df au sein de la mémoire centrale active. L’objet a réintégré l’environnement global avec l’exactitude nominale qu’il possédait au moment précis de son archivage dans le système de fichiers, sans qu’aucune déclaration manuelle n’ait été nécessaire.
Afin d’authentifier la fidélité absolue de la restauration numérique, l’analyste procède à la confrontation méthodique de l’objet restitué avec les paramètres statistiques mesurés avant la phase de suppression. L’exécution de head(df) et de summary(df) permet de constater que les dix observations matricielles simulées sous la graine aléatoire zéro réapparaissent avec une intégrité parfaite. Chaque décimale, chaque signe algébrique et chaque médiane correspond rigoureusement aux grandeurs originales.
Pour transcender l’inspection visuelle et attester formellement de la stricte conformité au bit près, il est d’usage d’employer la fonction de test logique all.equal() ou la vérification binaire stricte identical() face à un objet de référence conservé en cache comparatif. Cette confrontation démontre mathématiquement que la sérialisation RDA n’a introduit aucun artefact de troncature, aucune altération de type vectoriel et aucun décalage d’indexation, attestant de l’invariance computationnelle du procédé.
8.3 Paramètres avancés : Utilisation de verbose pour la traçabilité
Dans le cadre de projets informatiques d’envergure, de traitements par lots (batch processing) sur des clusters de calcul distant, ou lors de l’intégration de scripts au sein de flux d’intégration continue, le chargement silencieux d’objets peut représenter un risque pour la traçabilité des opérations. Lorsqu’une archive contient de multiples variables dont les identifiants ne sont pas connus à l’avance de l’opérateur, l’exécution aveugle de load() obscurcit le suivi des transformations dans les journaux d’exécution.
Pour pallier ce déficit de visibilité opérationnelle, la fonction load() implémente l’argument optionnel verbose, paramétré par défaut sur la valeur logique FALSE. En basculant cet argument vers la valeur active par l’instruction load(file = ‘my_data.rda’, verbose = TRUE), le noyau R consigne sur la sortie standard ou le canal de journalisation le nom de chaque entité restaurée au fur et à mesure de son injection effective dans l’espace d’exécution.
Cette traçabilité accrue constitue un standard d’ingénierie particulièrement précieux lors de l’audit automatisé de scripts de production. Elle permet aux architectes de données de vérifier sans coût algorithmique additionnel que les versions d’objets attendues ont été correctement introduites en mémoire vive, offrant une trace documentaire irréfutable en cas de survenue ultérieure d’incohérences paramétriques lors des phases de modélisation avancée.
9. Gestion des conflits de noms et chargement isolé en environnement dédié
9.1 Le danger critique de l’écrasement silencieux des variables
Bien que le mécanisme d’injection directe caractéristique de la fonction load() confère une remarquable simplicité d’usage lors d’analyses interactives, il recèle un danger conceptuel majeur au sein de projets collaboratifs ou de scripts séquentiels denses : l’écrasement silencieux des variables existantes. Dans la mesure où la désérialisation réassigne unilatéralement les symboles conservés dans l’archive sans solliciter d’approbation préalable du système, toute variable résidant dans la mémoire de travail et partageant fortuitement le même identifiant se trouve instantanément remplacée et anéantie.
Considérons le cas d’un chercheur conduisant une phase lourde de calcul de calibration bayésienne ayant mobilisé plusieurs heures de calcul processeur, dont le résultat intermédiaire est affecté à la variable res. Si ce chercheur exécute l’instruction load(‘donnees_externes.rda’) et que cette archive contient elle-même un tableau auxiliaire anonymisé sous le nom res, la structure de calibration est immédiatement écrasée et définitivement perdue de la mémoire vive, sans qu’aucun message d’alerte, de collision ou de confirmation ne soit émis par l’interpréteur R.
Ce risque de collision toponymique est amplifié de manière exponentielle lors du traitement de données transmises par des tiers ou d’archives patrimoniales insuffisamment documentées. La fragilité inhérente à ce comportement impose l’adoption de patrons de conception programmatique défensifs destinés à neutraliser l’arbitraire de l’écrasement en cloisonnant hermétiquement les flux d’injection binaire.
9.2 Isolation du chargement grâce à l’argument envir et new.env()
La parade architecturale absolue face à la menace d’écrasement destructif repose sur l’exploitation judicieuse de l’argument envir offert par la fonction load(), couplée à l’instanciation programmatique d’environnements dédiés. En langage R, un environnement constitue une structure formelle de liaison associant des symboles textuels à des valeurs mémoires, fonctionnant comme un espace de noms parfaitement clos et distinct du Global Environment traditionnel.
La mise en œuvre de cette technique d’isolation s’opère par l’initialisation préalable d’un conteneur hermétique au moyen de l’instruction e <- new.env(). Une fois cet espace de noms alloué, le chercheur redirige l’injection des données en spécifiant expressément cet environnement récepteur : load(file = ‘my_data.rda’, envir = e). Lors de l’exécution de cet ordre, le flux binaire est désérialisé dans la capsule fermée e, sans qu’aucun symbole extérieur ne soit introduit ni modifié au sein de l’environnement de travail global.
L’accès aux données restaurées s’effectue ensuite avec une sécurité et une granularité totales par l’intermédiaire de la syntaxe d’extraction contextuelle, en sollicitant l’opérateur dollar sous la forme e$df, ou par l’opérateur d’indexation double e[[‘df’]]. Cette approche garantit une étanchéité méthodologique absolue : les variables critiques de la session courante demeurent inviolées, tandis que les données désérialisées sont manipulées comme des attributs encapsulés d’un conteneur dédié.
9.3 Inspection du contenu d’une archive RDA sans chargement destructif
Au-delà de l’isolation physique au sein d’un environnement dédié, une bonne pratique d’ingénierie des données consiste à sonder l’inventaire précis des symboles encapsulés dans une archive RDA inconnue avant même de procéder à l’allocation effective de ses structures dans la mémoire vive. Cette inspection préalable permet de rejeter sans délai des fichiers malveillants, des versions obsolètes ou des archives disproportionnées dont le chargement saturerait la RAM.
Cette prospection non destructive exploite une caractéristique syntaxique subtile de la fonction load() : sa valeur de retour. Lorsqu’elle est invoquée, la fonction load() renvoie de manière invisible un vecteur de chaînes de caractères contenant les identifiants de tous les objets sauvegardés dans l’archive. En combinant cette propriété avec l’argument d’isolation envir = new.env(), l’analyste peut capturer cet inventaire sans polluer son espace courant au moyen de l’expression : noms_objets <- load(file = ‘my_data.rda’, envir = new.env()).
L’examen du vecteur noms_objets permet de déployer une programmation défensive rigoureuse. L’analyste peut conditionner la poursuite de son algorithme à la présence formelle de variables spécifiques via l’opérateur logique d’appartenance %in%, ou déclencher une levée d’exception contrôlée si l’archive s’avère non conforme aux spécifications du protocole d’analyse, instaurant un rempart robuste contre les anomalies de données en production.
10. Comparaison analytique : RDA contre RDS, CSV et formats délimités
10.1 RDA versus RDS : Restauration d’identifiant contre réassignation libre
Au sein de la boîte à outils binaire native de R, le format RDA partage le devant de la scène avec le format RDS, matérialisé par les fonctions canoniques saveRDS() et readRDS(). Bien que reposant sur les mêmes algorithmes de sérialisation interne et de compression binaire sous-jacents, ces deux architectures répondent à des paradigmes philosophiques et structurels fondamentalement opposés qu’il importe de discriminer méthodologiquement.
Le format RDA est par essence un format d’enregistrement contextuel ou d’environnement : il sauvegarde conjointement la valeur de l’objet et l’étiquette nominale (l’identifiant) qui lui est formellement attachée dans l’espace de noms. En corollaire, le rechargement via load() impose le rétablissement automatique de ce nom originel. À l’opposé, le format RDS adopte une approche strictement unitaire et anonyme : saveRDS() sérialise un objet unique dénué de tout ancrage toponymique obligatoire. Lors de son extraction par readRDS(), l’utilisateur a la liberté totale d’assigner l’objet restitué au conteneur variable de son choix via l’opérateur d’affectation classique.
Sur le plan de l’architecture logicielle, le recours au format RDS est universellement préconisé dans le développement de fonctions modulaires, de scripts d’analyse fonctionnelle et de pipelines d’ingénierie où chaque étape transforme un objet entrant anonyme en un objet sortant réassigné. Inversement, le conteneur RDA s’affirme comme le support optimal lorsqu’il s’agit d’archiver des instantanés d’étapes intégrant des ensembles multiples d’objets coordonnés (données, modèles, métadonnées, paramètres), matérialisant un état d’environnement complet à un jalon précis de la recherche empirique.
10.2 RDA versus CSV/TSV : Vitesse, volume et fidélité des types
La confrontation entre le standard binaire RDA et les formats textuels délimités conventionnels tels que le Comma-Separated Values (CSV) ou le Tab-Separated Values (TSV) met en lumière des arbitrages radicaux entre universalité externe et performance computationnelle intrinsèque. Si le format texte délimité bénéficie de l’avantage de pouvoir être lu et édité par n’importe quel éditeur de texte basique ou tableur bureautique, cet atout se paie d’une dégradation drastique sur tous les critères d’efficacité technique.
Le premier écueil des fichiers texte réside dans la lourdeur du traitement syntaxique (parsing). Pour importer un fichier CSV massif, le moteur R doit lire chaque ligne textuelle, décomposer les séparateurs, inférer empiriquement les types de données colonne par colonne et convertir des milliards de chaînes de caractères en représentations numériques à virgule flottante au sein de la mémoire centrale. Cette gymnastique algorithmique engendre des temps d’entrées-sorties considérablement supérieurs à la lecture directe d’un bloc RDA, dont la trame binaire est immédiatement traduisible par le processeur sans inférence intermédiaire.
Le second péril, d’une gravité méthodologique supérieure, concerne l’infidélité du typage. Les formats CSV sont incapables d’immortaliser intrinsèquement la distinction fondamentale entre une chaîne de caractères brute, un facteur non ordonné, un facteur ordonné ou un booléen strict. Lors de chaque réimportation d’un CSV, le script doit réinstancier formellement les niveaux de facteurs et rétablir les formats temporels au prix de dizaines de lignes de code de nettoyage superflues. Le fichier RDA élimine intégralement cette entropie en sanctuarisant la typologie absolue de l’objet, garantissant que la structure réimportée soit le miroir mathématique parfait de la structure exportée.
10.3 Matrice décisionnelle pour le stockage de données empiriques
Pour guider le chercheur et l’ingénieur de données dans le choix rationnel de l’architecture de persistance à déployer, l’établissement d’une matrice décisionnelle opérationnelle s’impose comme une nécessité méthodologique. Le tableau conceptuel suivant formalise les orientations recommandées selon la nature structurelle des données, les impératifs de calcul et la destination finale du livrable scientifique :
- Privilégier le format RDA (.rda) : lorsque le projet implique la sauvegarde coordonnée de multiples objets hétérogènes (par exemple le jeu de données épuré, la formule d’estimation et l’objet de modélisation bayésienne résultant) au sein d’une seule et même archive compacte, ou pour constituer des points de contrôle d’état (checkpoints) au fil de longs pipelines d’analyses expérimentales.
- Privilégier le format RDS (.rds) : lorsque le flux de traitement repose sur une programmation fonctionnelle pure, au sein de laquelle chaque composant scripté prend un objet unitaire en entrée et retourne un objet unique réassignable de manière flexible, sans risquer de collision de noms dans l’espace de travail récepteur.
- Privilégier les formats tabulaires ouverts (CSV / Parquet) : lorsque la finalité première réside dans le partage institutionnel vers des dépôts publics ouverts imposant l’interopérabilité multilingue (vers des analystes exploitant Python, Julia ou SQL), ou pour l’archivage légal à très long terme selon les standards de la science ouverte imposant des formats textuels non propriétaires.
11. Optimisation, compression et intégrité des fichiers RDA pour données massives
11.1 Algorithmes de compression : gzip, bzip2 et xz
L’efficacité de la fonction save() lors de son déploiement sur des jeux de données d’envergure industrielle repose sur la maîtrise fine de ses mécanismes algorithmiques de compression. Par défaut, l’argument compress de la fonction est configuré pour appliquer l’algorithme gzip (ou TRUE). Cette configuration par défaut offre un rendement équilibré, satisfaisant aux exigences de la grande majorité des analyses statistiques courantes en procurant des gains d’espace appréciables pour une pénalité processeur quasiment imperceptible.
Cependant, face à des volumes de données empiriques massifs ou dans des contextes de restriction sévère de l’espace de stockage sur des serveurs distants, l’ingénieur peut commuter vers les algorithmes avancés bzip2 ou xz en spécifiant explicitement compress = ‘xz’ ou compress = ‘bzip2’. L’algorithme xz, articulé autour de la compression par dictionnaire LZMA2, génère des taux de réduction volumétrique remarquables, surpassant systématiquement les performances de gzip sur les données redondantes ou les grandes matrices éparses.
Cette supériorité de compression s’accompagne toutefois d’un coût temporel direct en calcul processeur (charge CPU) lors de la phase d’écriture. L’algorithme xz nécessite des ressources de calcul considérablement plus élevées pour construire ses arbres lexicaux optimisés. L’analyste doit donc procéder à un arbitrage éclairé : consentir à un temps d’écriture initial plus long afin de minimiser l’empreinte disque de façon pérenne et d’accélérer les lectures subséquentes, ou privilégier la rapidité d’archivage transitoire au détriment de l’encombrement physique.
11.2 Stratégies d’écriture rapide face aux volumes de données élevés
Dans certaines architectures de traitement haute performance, telles que les chaînes de calcul distribué ou les boucles d’apprentissage itératif intensif, la contrainte temporelle prévaut sur toute considération d’espace disque. Lorsque des scripts doivent consigner des gigaoctets de données intermédiaires destinées à être relues quelques fractions de seconde plus tard par un autre processus de calcul, le passage par un algorithme de compression lourd devient le goulot d’étranglement majeur bridant les performances globales de l’infrastructure.
Dans ce scénario d’ingénierie spécifique, la stratégie d’optimisation préconisée consiste à désactiver unilatéralement la compression interne en stipulant l’argument compress = FALSE dans l’appel à save(). Le flux binaire sérialisé par le moteur R est alors directement déversé de la mémoire vive vers le support de stockage sans subir la moindre altération algorithmique réductrice.
Sur des stations de travail modernes équipées de disques à semi-conducteurs (SSD) exploitant le protocole NVMe avec des bandes passantes séquentielles de plusieurs gigaoctets par seconde, cette désactivation totale de la compression libère la pleine puissance des contrôleurs physiques. Le temps de sauvegarde s’effondre de manière spectaculaire, transformant des latences de plusieurs minutes en fractions de secondes. De façon alternative, l’analyste peut affiner l’équilibre en ajustant l’argument compression_level sur une échelle de 1 à 9, sélectionnant par exemple un niveau 1 pour bénéficier d’une compression gzip minimale mais ultra-rapide.
11.3 Validation de l’intégrité binaire et prévention des corruptions
La pérennité des données empiriques archivées sous forme binaire exige des garde-fous rigoureux contre le phénomène de corruption silencieuse des fichiers. Une altération matérielle sur un disque magnétique, un incident de transfert réseau à travers un protocole FTP ou une coupure électrique intempestive lors de la clôture des tampons de la fonction save() peut tronquer l’archive RDA. Contrairement à un fichier texte dont une partie tronquée demeure partiellement lisible manuellement, une archive binaire compressée dont l’en-tête ou le dictionnaire de fin de flux est endommagé devient intégralement irrécupérable.
Pour immuniser les protocoles de recherche contre ces défaillances critiques, la génération systématique d’empreintes cryptographiques représente le standard de contrôle de référence. L’utilisation de packages dédiés ou d’outils systèmes via la fonction tools::md5sum(‘my_data.rda’) permet de calculer la somme de contrôle MD5 ou SHA-256 du conteneur immédiatement après sa création physique sur disque. Cette signature hachée condensée est consignée dans un registre de métadonnées accompagnant le projet scientifique.
Lors de la réutilisation ultérieure des données ou après un transfert vers une plateforme de calcul distante, l’analyste recalcule la somme de contrôle de l’archive reçue et la confronte à l’empreinte de référence. La stricte concordance des hachages garantit mathématiquement qu’aucun octet n’a été corrompu, tronqué ou modifié au cours du transit. En cas d’incohérence, le processus interrompt son exécution avant même d’invoquer load(), prévenant ainsi l’apparition d’erreurs d’exécution cryptiques liées à des fins de fichiers inattendues (unexpected end of input).
12. Bonnes pratiques de reproductibilité et pièges courants en recherche
12.1 Standardisation du nommage et organisation des répertoires
L’institutionnalisation de flux de recherche reproductibles impose une stricte cohérence dans l’organisation structurelle des systèmes de fichiers et le choix des conventions de nommage des conteneurs de données. Les méthodologies contemporaines d’ingénierie logicielle préconisent la séparation étanche et inviolable entre les données sources primaires, immuables et protégées en écriture, et les données transformées destinées à l’inférence statistique. Cette gouvernance s’incarne traditionnellement par une arborescence scindant formellement le sous-répertoire data/raw/ (hébergeant les extractions brutes d’enquêtes ou de laboratoires) du sous-répertoire data/processed/ (alloué aux archives binaires RDA consolidées).
Le nommage des archives RDA doit bannir tout flou sémantique ou recours à des termes éphémères tels que « donnees_finales.rda » ou « test2.rda ». Il convient d’adopter des règles de nommage normalisées intégrant le projet, l’étape analytique, la granularité de la cohorte et un horodatage systématique conforme à la norme internationale ISO 8601 (par exemple : « cohorte_memoire_nettoyee_2026-03-30.rda »). Cette discipline toponymique garantit un tri chronologique déterministe et prévient les écrasements accidentels de versions antérieures lors de réitérations de scripts.
De surcroît, chaque fichier de données RDA archivé dans un cadre institutionnel se doit d’être accompagné d’un fichier de métadonnées adjacent (fichier dictionnaire ou documentation d’accompagnement textuel). Ce document annexe répertorie les scripts exacts ayant forgé l’archive binaire, l’environnement logiciel actif au moment de la génération (version de R, architecture matérielle), ainsi que les versions précises des bibliothèques mobilisées, matérialisant une traçabilité totale conforme aux directives FAIR (Findable, Accessible, Interoperable, Reusable).
12.2 Automatisation dans les scripts de pipeline et rapports dynamiques
L’intégration de la sérialisation binaire prend une dimension magistrale dans le cadre de la rédaction de rapports scientifiques automatisés et d’écosystèmes d’édition computationnelle dynamique tels que Quarto et R Markdown. L’un des écueils majeurs de ces environnements réside dans la latence de compilation lorsque le document réexécute l’intégralité des chaînes de calcul et de modélisation lourdes à chaque régénération du document PDF ou HTML final.
La mise en cache conditionnelle articulée autour d’archives RDA offre une solution technique d’une redoutable efficacité. L’analyste encapsule les blocs computationnels intensifs au sein d’une structure conditionnelle qui interroge l’existence préalable d’une archive RDA sur le disque dur via la commande file.exists(). Si l’archive est présente, le bloc algorithmique est court-circuité et les données consolidées sont instantanément injectées en mémoire vive au moyen de la fonction load(), réduisant des temps d’attente de plusieurs heures à quelques centièmes de seconde.
Pour garantir que ce mécanisme de cache ne perpétue pas des données périmées consécutivement à la modification ultérieure des scripts sources, l’ingénierie de pipeline s’appuie sur la gestion des dépendances d’exécution (via des gestionnaires de flux d’analyse tels que le package targets). Ces orchestrateurs surveillent les signatures de hachage des scripts de nettoyage et invalident automatiquement l’archive RDA intermédiaire dès qu’une modification algorithmique sous-jacente est détectée, contraignant le système à réexécuter la sauvegarde binaire pour préserver la stricte fidélité de l’inférence scientifique.
12.3 Erreurs fréquentes et guide de dépannage pas à pas
Même au sein d’environnements de recherche chevronnés, la manipulation des fonctions save() et load() peut se heurter à des blocages techniques récurrents qu’un protocole de dépannage systématique permet de résoudre avec célérité. L’incident le plus fréquemment rencontré s’exprime par le message d’erreur bloquant « cannot open the connection » lors d’un appel à load(). Ce diagnostic signale de façon presque univoque une erreur de trajectoire : soit le fichier cible n’existe pas sous le libellé spécifié, soit le répertoire de travail résolu par getwd() est désaligné par rapport à l’emplacement effectif du document.
La résolution de cette anomalie spatiale impose de vérifier scrupuleusement la casse des caractères (l’environnement R étant strictement sensible à la distinction entre majuscules et minuscules sur tous les systèmes de fichiers conformes à POSIX), de normaliser les barres de séparation vers des barres obliques simples (‘/’), et d’éprouver la validité du chemin par l’instruction logique file.exists(). Un autre piège réside dans le blocage par absence de droits d’accès en écriture lors de l’exécution de save() sur des volumes réseau ou des répertoires protégés par les politiques de sécurité du système hôte, nécessitant la redirection de l’écriture vers un répertoire utilisateur autorisé.
Un cas de figure plus insidieux concerne les anomalies d’incompatibilité de versions majeures de R. Si le format binaire garantit une rétrocompatibilité ascendante impressionnante (une session R contemporaine lit sans difficulté des fichiers créés sous d’anciennes versions), l’inverse n’est pas automatique. Lorsqu’une archive générée avec le format de sérialisation moderne par défaut (version 3, standard depuis R 3.5.0) est transmise à un serveur hébergeant une version patrimoniale obsolète de R, le processus de décompression échoue brutalement. La remédiation consiste à contraindre explicitement la fonction de sauvegarde à adopter un standard antérieur en stipulant l’argument version = 2 au sein de l’appel à save(), restaurant immédiatement l’interopérabilité sans sacrifier l’intégrité de la structure mathématique des données sous-jacentes.
Références
- Chambers, J. M. (2008). Software for data analysis: Programming with R. Springer Science & Business Media. https://doi.org/10.1007/978-0-387-75936-4
- Chambers, J. M. (2016). Extending R. Chapman and Hall/CRC. https://doi.org/10.1201/9781315381305
- Gandrud, C. (2020). Reproducible research with R and RStudio (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429031823
- Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299–314. https://doi.org/10.1080/10618600.1996.10474713
- Peng, R. D. (2011). Reproducible research in computational science. Science, 334(6060), 1226–1227. https://doi.org/10.1126/science.1213847
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- R Core Team. (2023). R internals: A guide to the internal structure of R and coding standards. CRAN. https://cran.r-project.org/doc/manuals/r-release/R-ints.html
- Wickham, H. (2019). Advanced R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781351201315
- Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., … & Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3(1), 1–9. https://doi.org/10.1038/sdata.2016.18