
L’écosystème du langage R s’est imposé au fil des décennies comme l’un des piliers incontournables de l’analyse statistique avancée, de la bio-informatique, de l’économétrie et de la science des données contemporaine. Conçu initialement par Ross Ihaka et Robert Gentleman comme une implémentation libre du langage S, R repose sur des mécanismes d’évaluation dynamique et de liaison lexicale particulièrement sophistiqués. Au cœur de cette architecture réside l’environnement de travail, un espace en constante mutation où cohabitent vecteurs, listes, matrices, modèles statistiques et fonctions personnalisées. Cependant, la flexibilité offerte par ce système interactif constitue un couteau à double tranchant : sans une gestion rigoureuse des objets en mémoire, l’espace de travail peut rapidement devenir un champ de mines computationnel, propice aux collisions de noms, aux fuites de mémoire vive et aux biais expérimentaux majeurs.
La question de la réinitialisation et de l’épuration de l’environnement global ne se résume pas à un simple réflexe de confort ergonomique ou d’esthétique syntaxique. Elle touche aux fondements mêmes de l’intégrité computationnelle et de la crise de la reproductibilité scientifique qui traverse les sciences quantitatives modernes. Un script R exécuté dans un environnement pollué par des assignations antérieures peut produire des résultats silencieusement erronés, masquant des dépendances logiques invisibles qui empêcheront toute réplication ultérieure par des pairs. L’analyste se trouve alors confronté à l’illusion de la cohérence, où le code semble fonctionner localement alors qu’il s’avère vicié dans sa structure interne.
Ce guide exhaustif propose une exploration théorique et pratique des techniques d’assainissement de l’environnement de travail au sein de R et de son interface intégrée RStudio. À travers l’étude minutieuse de trois méthodologies principales — la purge intégrale programmatique, la réinitialisation interactive par interface graphique et l’épuration sélective conditionnelle — cet article détaille les mécanismes d’évaluation sous-jacents, l’impact sur l’architecture mémoire du système et les stratégies d’isolation indispensables à l’établissement de flux d’analyse rigoureux et reproductibles.
1. Fondements théoriques de l’environnement global (.GlobalEnv) dans R
1.1 Architecture des environnements et hiérarchie d’évaluation
Dans l’architecture interne du langage R, un environnement peut être formellement défini comme une collection de symboles (identifiants textuels) associés à des liaisons (bindings) qui pointent vers des objets stockés dans la mémoire vive, enrichie d’un pointeur explicite vers un environnement parent. L’environnement interactif fondamental au sein duquel travaille l’utilisateur est désigné dans la terminologie interne par .GlobalEnv ou globalenv(). Contrairement aux langages fondés sur des portées de bloc purement rigides, R utilise une hiérarchie d’environnements chaînés fonctionnant selon les principes de la portée lexicale (lexical scoping), théorisée notamment dans les travaux de référence sur les arcanes de la programmation R avancée.
Lorsque l’interpréteur tente d’évaluer une expression contenant un symbole donné, il déclenche un processus de résolution de portée le long de ce que l’on nomme la chaîne de recherche (search path), accessible via la commande search(). Cette chaîne commence systématiquement par .GlobalEnv, se poursuit à travers les espaces de noms des packages attachés via l’instruction library(), et se termine invariablement par le package fondamental package:base, chapeauté en dernier recours par l’environnement vide emptyenv(). Si un objet réside dans l’environnement global sous un nom identique à celui d’une fonction importée d’un package officiel, une situation d’ombrage (masking) se produit immédiatement. Cette occultation force l’interpréteur à résoudre le symbole en faveur de l’assignation locale, modifiant potentiellement le comportement d’algorithmes statistiques complexes de manière imperceptible.
Les conséquences d’un environnement global saturé sont multiples et critiques. L’encombrement par des variables éphémères, des sous-ensembles de données intermédiaires et des prototypes de boucles génère un bruit cognitif qui fragilise l’analyse. Lorsqu’un script dépend implicitement d’un objet présent dans .GlobalEnv sans que ce dernier n’ait été initialisé de façon déterministe dans le flux séquentiel du fichier source, le code perd instantanément sa validité scientifique. Dès lors qu’il est exécuté dans une session vierge ou sur un serveur de calcul distant, le processus s’interrompt avec une erreur fatale signalant l’absence de l’objet, ou, pire encore, utilise une variable résiduelle d’une analyse précédente dotée d’une structure compatible mais sémantiquement anachronique.
1.2 Cycle de vie des objets statistiques et allocation mémoire
La gestion du cycle de vie des objets statistiques en R s’inscrit au sein d’un paradigme de gestion dynamique de la mémoire, implémenté principalement en langage C sous la forme de structures SEXPREC (S-expression record). Chaque fois qu’un utilisateur instancie un vecteur, un tableau multidimensionnel ou un cadre de données (data frame), le système d’allocation de R réquisitionne deux types distincts de mémoire vive : les nœuds de cellules (Ncells) pour la structure du pointeur et des métadonnées associées, et les cellules de vecteurs (Vcells) pour le contenu numérique, textuel ou booléen sous-jacent. Cette distinction est visible lors de l’appel aux diagnostics de profilage de la mémoire.
Dans les flux de travail actuels, qui manipulent des téraoctets ou des gigaoctets de données transcriptomiques, financières ou satellitaires, l’accumulation progressive d’objets intermédiaires pose un problème majeur d’épuisement des ressources système. L’évaluation de transformations mathématiques successives engendre fréquemment des duplications temporaires, régies par le mécanisme de copie sur modification (copy-on-modify). Si des structures massives persistent inutilement dans .GlobalEnv, elles maintiennent actives des références fortes qui interdisent au moteur d’exécution de libérer l’espace physique alloué, augmentant la latence générale des opérations d’adressage et exposant la session à des plantages brutaux causés par l’épuisement de la mémoire virtuelle.
Il convient de distinguer avec une extrême rigueur conceptuelle la suppression logique d’une référence et la désallocation physique de la mémoire vive. Lorsqu’un analyste supprime une variable de l’environnement global, il détruit simplement la liaison symbolique entre le nom de la variable et le pointeur mémoire vers la structure SEXPREC. L’objet physique, quant à lui, demeure présent dans les blocs de mémoire de l’interpréteur R jusqu’à ce que le ramasse-miettes (garbage collector) interne ne détecte que le compteur de références vers cette structure est tombé à zéro. Comprendre ce découplage est indispensable pour appréhender les performances réelles des méthodes d’assainissement de l’espace de travail.
2. Reproductibilité scientifique et hygiène de l’espace de travail
2.1 Le piège de la dépendance à l’état antérieur en recherche
La recherche contemporaine assistée par ordinateur fait face à une remise en question profonde de ses résultats expérimentaux, un phénomène documenté sous l’appellation de crise de la reproductibilité. Dans l’écosystème de programmation statistique, le principal vecteur de non-reproductibilité locale réside dans la dépendance à l’état antérieur (state dependency). Lorsqu’un chercheur manipule interactivement des données dans la console R, il altère en continu l’état interne de .GlobalEnv. Des variables sont créées, écrasées, enrichies de colonnes supplémentaires ou transformées par des filtres successifs sans que ces actions ne soient nécessairement transcrites dans l’ordre chronologique exact au sein du script de recherche final.
Ce phénomène engendre ce que les méthodologistes qualifient de variables latentes résiduelles. Par exemple, supposons qu’un modèle de régression multivariée fasse appel à une variable dépendante transformée selon une normalisation logarithmique réalisée manuellement vingt lignes plus tôt. Si le script final omet accidentellement cette ligne de transformation, mais que le chercheur exécute le modèle alors que l’objet transformé est encore présent en mémoire vive, les résultats statistiques finaux afficheront une p-valeur significative et des coefficients erronés. Le code semble autosuffisant, mais il repose en réalité sur un fantôme computationnel. Une fois le document transmis à un comité de relecture académique, le script échouera inévitablement à reproduire les inférences publiées.
L’isolation environnementale stricte est donc un prérequis déontologique et méthodologique. Les protocoles expérimentaux sérieux exigent que chaque pipeline d’analyse soit pensé comme un système clos, dont le résultat final doit pouvoir être généré à l’identique à partir d’un état d’entropie nulle. Cela implique de bannir toute persistance implicite d’objets entre deux itérations d’un modèle et d’instaurer des barrières d’étanchéité systématiques entre les différentes phases d’acquisition, de nettoyage, de modélisation et de rendu visuel des données.
2.2 Bonnes pratiques académiques pour l’intégrité computationnelle
Face à ces périls méthodologiques, les consortiums pour la science ouverte et les spécialistes de l’ingénierie logicielle appliquée aux statistiques ont formalisé des référentiels de bonnes pratiques. Selon ces directives, un script d’analyse statistique ne doit jamais présumer de l’existence préalable d’objets au sein de l’environnement de l’utilisateur. Toute ressource nécessaire au calcul — qu’il s’agisse d’un jeu de données brut, d’un hyperparamètre de régularisation ou d’une constante d’ajustement — doit être explicitement déclarée, lue depuis une source immuable ou instanciée de manière univoque dans le flux séquentiel.
Pour garantir l’intégrité computationnelle d’un projet, il est impératif d’adopter des routines de réinitialisation méthodologique. Cependant, une confusion théorique fréquente subsiste chez de nombreux utilisateurs entre la réinitialisation de l’environnement global et la réinitialisation complète de la session d’exécution de R. Vider .GlobalEnv supprime les symboles définis par l’utilisateur, mais ne réinitialise ni les bibliothèques logicielles déjà attachées au sein du chemin de recherche, ni les options globales du système configurées via la fonction options(), ni les périphériques graphiques restés ouverts dans l’infrastructure sous-jacente.
La communauté académique recommande donc d’intégrer des points de contrôle d’hygiène logicielle réguliers. Avant de valider définitivement un résultat expérimental destiné à la publication scientifique, le praticien doit s’assurer que la chaîne de calculs peut être exécutée de bout en bout au sein d’une instance fraîche de l’interpréteur. Cette rigueur méthodologique permet de prémunir l’équipe de recherche contre les biais de confirmation algorithmique et garantit que les conclusions statistiques reposent sur des preuves computationnelles tangibles, vérifiables et auditables par la communauté internationale.
3. Méthode 1 : Purge intégrale programmatique avec rm(list = ls())
3.1 Décomposition syntaxique de l’instruction canonique
L’instruction rm(list = ls()) représente la formulation la plus célèbre, la plus historique et la plus omniprésente dans la littérature dédiée à la programmation statistique en R. Bien qu’elle soit souvent recopiée de façon mécanique par les débutants, sa compréhension exige une analyse sémantique précise de ses deux composants fondamentaux. La fonction interne ls(), dérivée de la commande Unix éponyme pour « list », a pour fonction primordiale de scanner l’environnement spécifié (par défaut, l’environnement appelant, qui coïncide avec .GlobalEnv en mode interactif) et de retourner un vecteur de chaînes de caractères contenant les noms de tous les symboles d’objets visibles qui y sont stockés.
Ce vecteur textuel est ensuite transmis directement au paramètre formel list de la fonction primitive rm() (abréviation de « remove »). Le rôle de rm() est de détruire les liaisons symboliques associées aux noms qui lui sont fournis. Le comportement d’évaluation standard de rm(...) attend des symboles non évalués passés sous forme d’arguments séparés par des virgules (par exemple rm(a, b, c)). Cependant, pour orchestrer une suppression dynamique et automatisée de la totalité des symboles sans connaître leurs identifiants a priori, l’emploi de l’argument nommé list devient indispensable. Ce dernier indique au moteur d’évaluation de traiter les éléments du vecteur de caractères passé en entrée comme les cibles effectives de la désaffectation.
Il est fondamental de noter que l’évaluation de rm(list = ls()) opère strictement au niveau des tables de symboles de l’environnement désigné. Par défaut, l’argument d’environnement interne de la fonction rm(), désigné par envir, est assigné à as.environment(-1L) ou à l’environnement d’évaluation courant. En exécutant cette instruction dans la console ou à la racine d’un script standard, c’est bien la table de hachage de l’espace de travail global qui est parcourue, identifiant chaque variable pour dissoudre immédiatement sa liaison avec le gestionnaire de mémoire de R.
3.2 Exemple pratique d’application sur un espace hétérogène
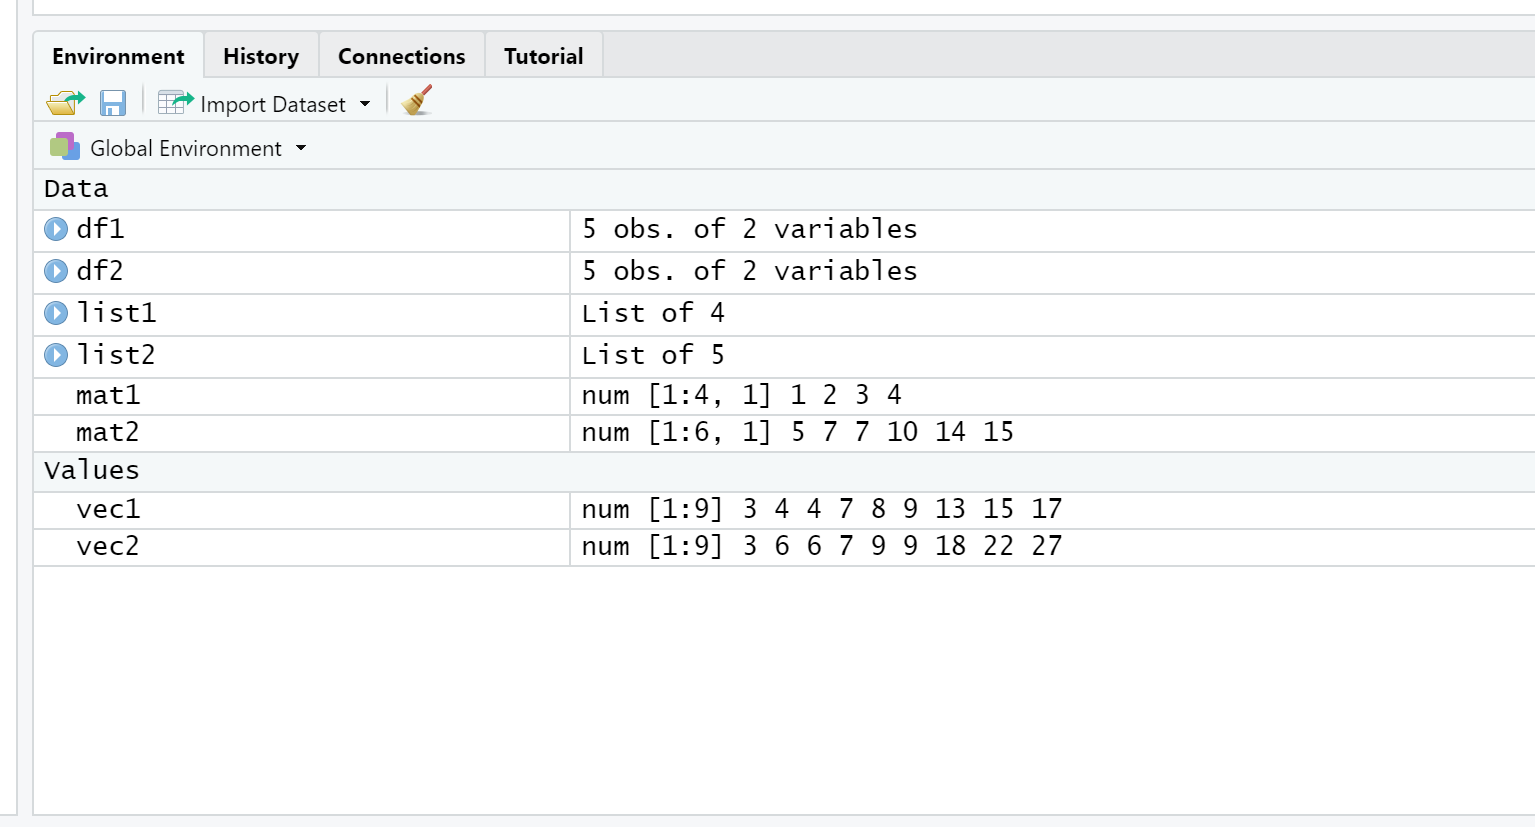
Afin d’illustrer concrètement le fonctionnement de cette mécanique d’éradication, considérons un espace de travail expérimental hétérogène, représentatif d’une session de modélisation statistique. Dans cette configuration, l’analyste crée un jeu de données composite comprenant un vecteur numérique de tirages gaussiens, un tableau de données rectangulaire combinant plusieurs types de variables, et une liste hiérarchique imbriquée contenant les hyperparamètres d’un algorithme d’apprentissage automatique. Les symboles sont créés séquentiellement en mémoire par des assignations usuelles :
Supposons l’instanciation suivante : une variable scalaire seuil <- 0.05, un vecteur de mesures echantillon <- rnorm(1000), un cadre de données donnees_cliniques <- data.frame(id = 1:100, reponse = runif(100)), et enfin une liste d’optimisation parametres_modele <- list(tolerance = 1e-6, max_iter = 500). Si l’on interroge la mémoire à ce stade avec l’instruction ls(), l’interpréteur renvoie un vecteur de quatre chaînes : c("donnees_cliniques", "echantillon", "parametres_modele", "seuil"). L’environnement présente une entropie significative avec des structures de tailles très divergentes.
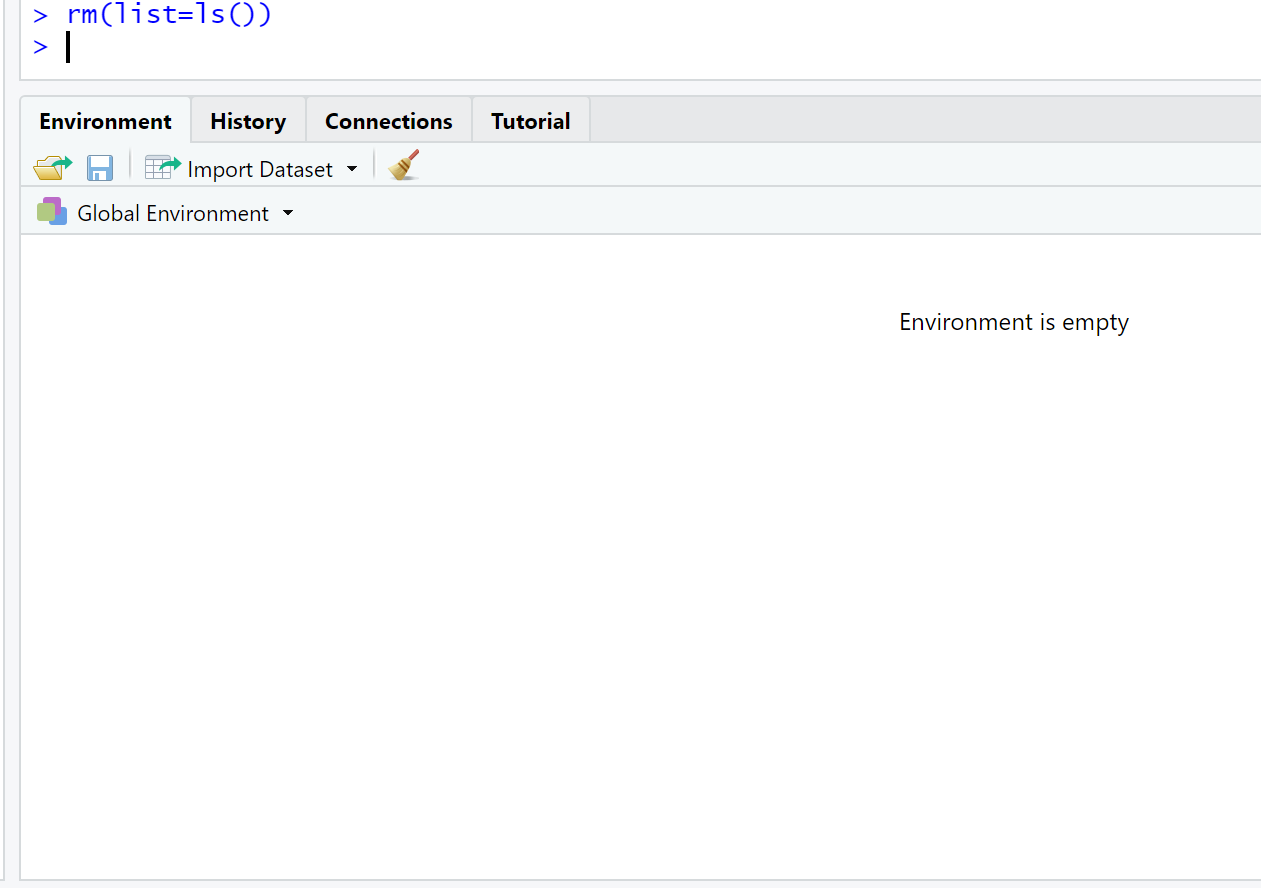
L’exécution immédiate de la commande canonique rm(list = ls()) va consommer ce vecteur textuel. Chaque nom d’objet est successivement résolu, et sa liaison dans .GlobalEnv est supprimée sans préavis ni boîte de confirmation. Pour certifier scientifiquement que la purge a été menée à son terme absolu, le praticien peut interroger le prédicat logique suivant : length(ls()) == 0. Si la console retourne la valeur booléenne TRUE, l’espace des symboles visibles est formellement vacant. Les objets ne sont plus accessibles par leurs identifiants et leur existence dans le flux interactif est entièrement anéantie.
3.3 Traitement spécifique des objets cachés
Une limitation architecturale majeure de l’appel standard ls() réside dans sa politique par défaut de filtrage des identifiants dits cachés ou invisibles. Suivant une convention de nommage empruntée aux systèmes de fichiers de type UNIX, tout symbole dont le nom débute par un point typographique (par exemple .cle_secrete ou .configuration_locale) est considéré comme masqué. Par conséquent, l’invocation basique de ls() ignore scrupuleusement ces variables, ce qui conduit à une omission silencieuse lors de l’application aveugle de rm(list = ls()).
Ce comportement peut devenir problématique dans le cadre d’analyses sensibles. De nombreux packages statistiques avancés, ainsi que certaines procédures d’optimisation numérique ou de connexion à des bases de données relationnelles, stockent temporairement des jetons d’authentification, des tables de cache ou des semences de nombres pseudo-aléatoires au sein de variables cachées précédées d’un point. Si un analyste applique la commande classique en croyant assainir son environnement, ces variables subsistent clandestinement dans .GlobalEnv, continuant d’influencer le comportement des calculs subséquents.
Pour contourner ce biais et accomplir une élimination véritablement exhaustive, il est indispensable de manipuler l’argument logique all.names au sein de la fonction d’énumération. En formulant explicitement l’appel ls(all.names = TRUE), l’interpréteur force la lecture de l’intégralité du registre de hachage de l’environnement, sans aucune exception typographique. La syntaxe canonique de purge absolue et irrévocable s’écrit donc formellement sous la forme : rm(list = ls(all.names = TRUE)). Cette formulation garantit qu’aucune variable clandestine ne survive à l’opération de nettoyage au sein de l’espace utilisateur.
4. Méthode 2 : Réinitialisation interactive via l’icône balai de RStudio
4.1 Localisation et ergonomie de l’outil d’effacement graphique
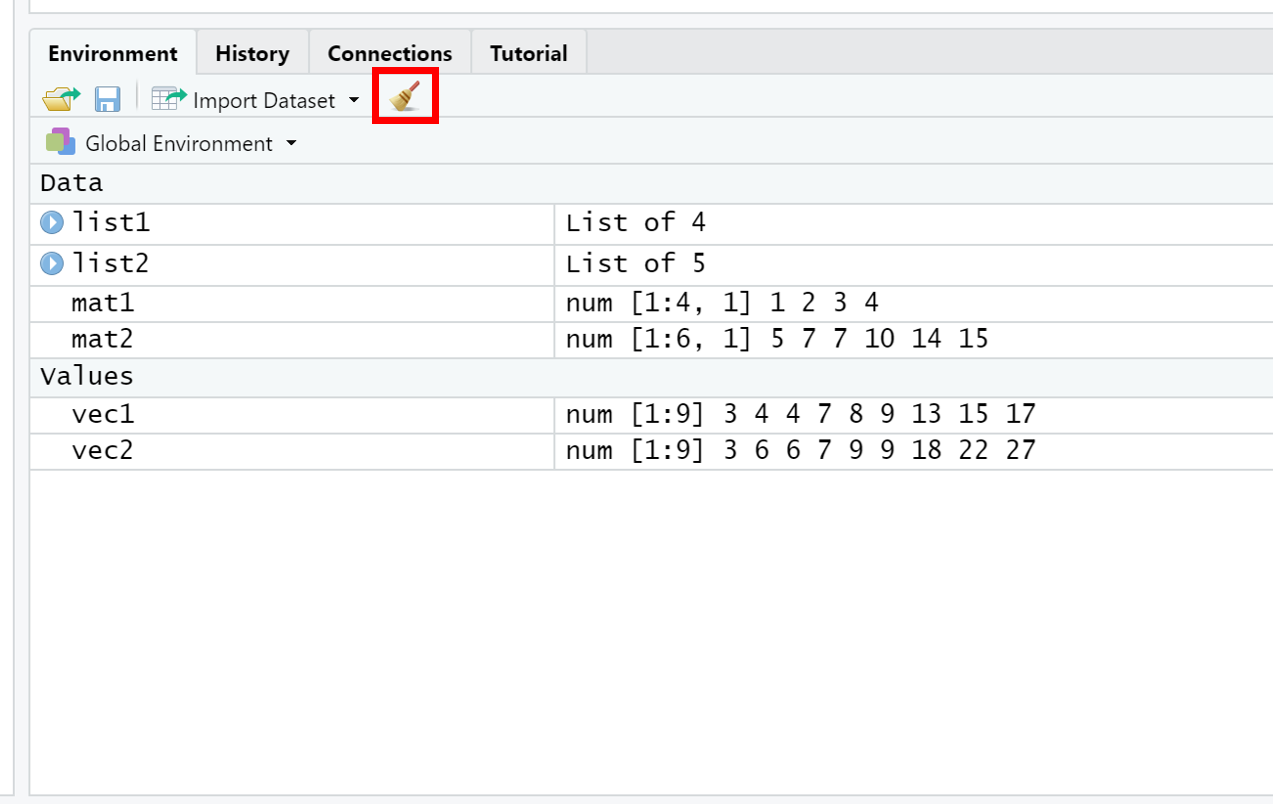
Pour les utilisateurs opérant au sein de l’environnement de développement intégré RStudio, une approche visuelle et interactive a été intégrée nativement pour faciliter l’assainissement de l’espace de travail sans nécessiter la rédaction d’instructions en ligne de commande. Cette fonctionnalité réside dans le panneau d’environnement, positionné par défaut dans le quadrant supérieur droit de l’interface graphique. Dans l’en-tête de cet onglet, à côté du sélecteur d’environnements et de l’historique de commandes, se trouve un bouton orné d’un pictogramme stylisé représentant un balai traditionnel (Clear Environment).
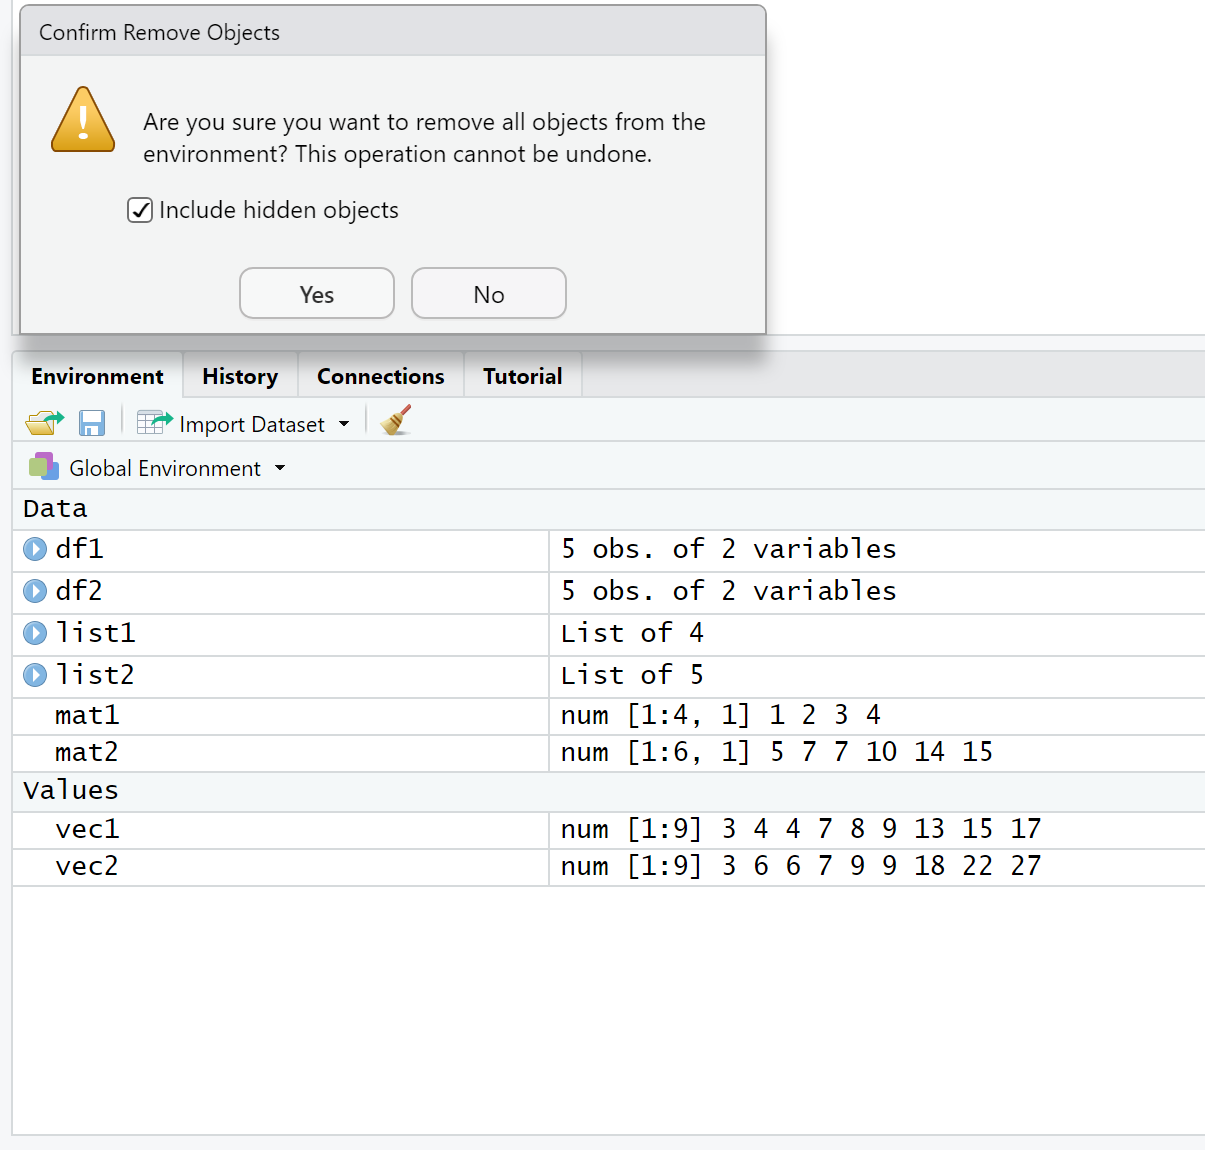
L’ergonomie de cet outil repose sur un principe d’action immédiate sécurisée. Lorsqu’un utilisateur clique sur ce balai, le moteur interne de RStudio intercepte l’événement graphique avant toute modification de la mémoire vive. Une fenêtre modale de dialogue contextuelle apparaît à l’écran, formulant un avertissement explicite : l’utilisateur est invité à confirmer s’il souhaite réellement supprimer tous les objets présents dans l’environnement courant (« Are you sure you want to remove all objects from the environment? »). Ce mécanisme de sécurité prévient efficacement les destructions accidentelles consécutives à une erreur de saisie ou à un clic involontaire lors de sessions d’analyse exploratoire intensives.
D’un point de vue fonctionnel, cette action graphique est conçue pour simplifier la vie des statisticiens qui préfèrent naviguer visuellement dans leurs données. L’onglet ‘Environment’ présente une vue structurée des objets répartis en sections distinctes : les données (Data), les valeurs scalaires ou vectorielles simples (Values), et les définitions fonctionnelles (Functions). Un simple clic sur le balai permet de balayer l’ensemble de ces catégories en une unique opération synchrone, offrant une remise à zéro visuelle instantanée qui réconforte l’opérateur sur l’état de propreté de son plan de travail.
4.2 Gestion des objets invisibles dans l’interface graphique
L’interaction graphique de RStudio ne se cantonne pas à une réplique simpliste du ls() standard ; elle intègre une granularité d’action particulièrement puissante concernant les variables masquées évoquées précédemment. Au sein de la boîte de dialogue de confirmation qui surgit suite au clic sur l’icône de balai, l’environnement de développement propose une case à cocher explicite intitulée « Include hidden objects » (Inclure les objets cachés).
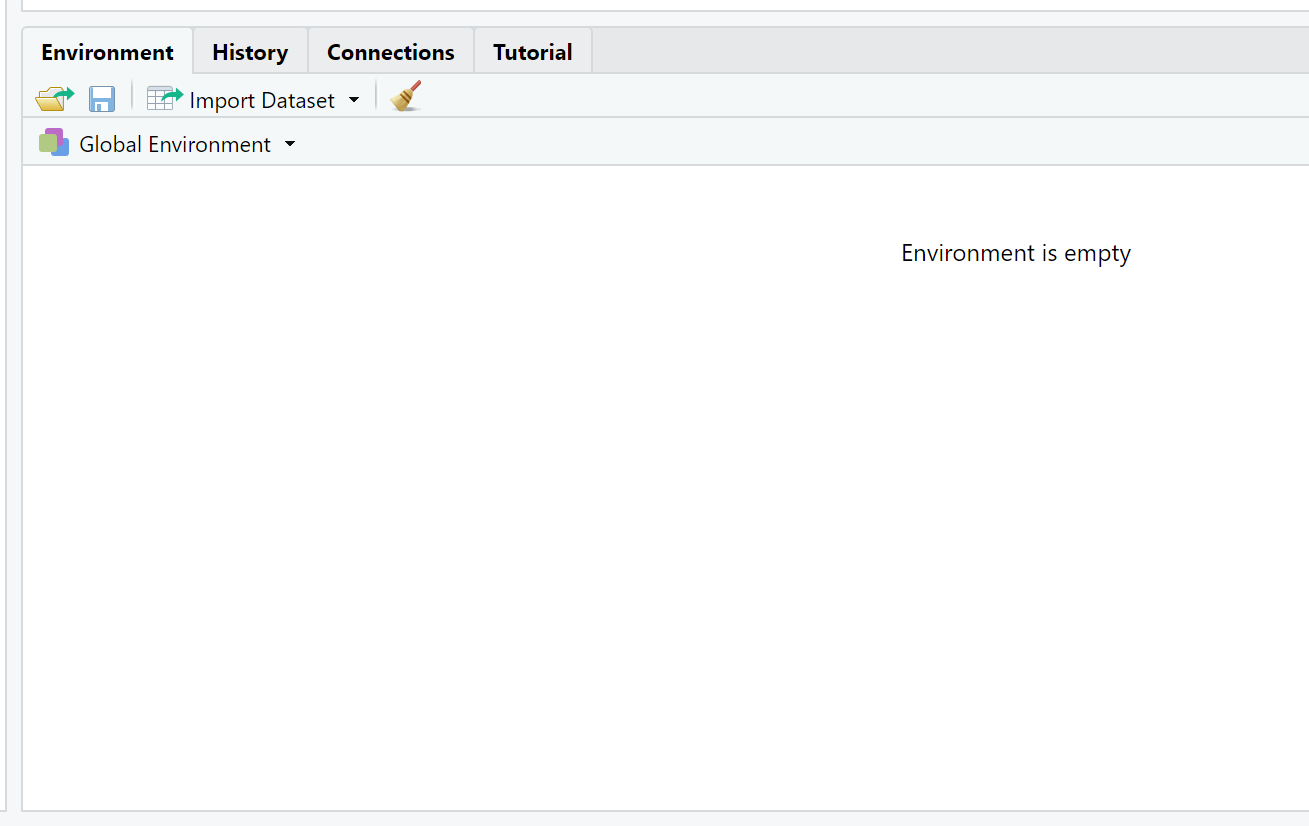
Par défaut, cette option peut être décochée selon les préférences globales de l’utilisateur. Lorsque l’analyste coche délibérément cette option, RStudio modifie la requête de purge sous-jacente pour injecter l’équivalent de all.names = TRUE dans sa procédure interne d’éradication. Les variables de configuration locales, les clés cryptographiques résiduelles et les états internes masqués sont alors balayés au même titre que les variables utilisateur ordinaires. Cette action se traduit par une mise à zéro immédiate de l’arborescence visuelle : l’indicateur d’occupation de l’onglet affiche instantanément la mention « Environment is empty », certifiant visuellement la vacuité de l’espace de travail.
Cette approche graphique est particulièrement didactique dans les contextes de formation ou d’enseignement universitaire. Elle permet à des étudiants néophytes de percevoir immédiatement l’impact d’une suppression d’objets sans la barrière cognitive imposée par la mémorisation de commandes imbriquées aux paramètres complexes. L’interface offre un retour visuel sans ambiguïté : les tables de données disparaissent de la vue du visualiseur de données, les matrices sont désindexées et l’environnement global est restauré dans un état de propreté visuelle totale.
4.3 Limites inhérentes à l’approche par interface graphique
En dépit de son confort évident lors des phases exploratoires, l’approche par interface graphique souffre de limitations intrinsèques rédhibitoires qui la disqualifient totalement pour une utilisation dans des projets scientifiques de production. La première faille concerne l’absence absolue de traçabilité scripturale. Une interaction manuelle via un clic de souris ne laisse aucune empreinte dans le journal des commandes d’un script reproductible ; elle n’existe que dans la temporalité éphémère de l’action physique de l’analyste devant son poste informatique.
Cette carence devient critique dans le contexte de l’intégration continue, du calcul haute performance (HPC) et de la génération automatisée de rapports scientifiques via R Markdown ou Quarto. Dans ces environnements non-interactifs (headless environments), aucune interface utilisateur n’est instanciée : aucun opérateur humain n’est présent pour cliquer sur un bouton visuel. Tout pipeline de traitement de données qui présumerait d’une intervention par interface graphique s’avère incapable d’être exécuté au sein d’un cluster distant, d’un conteneur Docker ou d’un serveur d’automatisation logicielle de type GitHub Actions.
Enfin, cette méthode introduit une dépendance fonctionnelle exclusive envers l’écosystème commercial et open-source de RStudio. Si un collaborateur ou un évaluateur académique tente d’exécuter l’analyse depuis un terminal UNIX pur, via l’interpréteur R standard, ou depuis d’autres environnements intégrés comme Visual Studio Code, GNU Emacs avec le mode ESS (Emacs Speaks Statistics), ou encore JupyterLab, le protocole basé sur l’icône de balai s’avère totalement inopérant. L’hygiène logicielle moderne impose donc de privilégier des méthodes universellement traduisibles sous forme d’instructions exécutables.
5. Méthode 3 : Épuration sélective fondée sur la classe et les attributs
5.1 Principes du filtrage conditionnel des objets en mémoire
Dans de nombreux scénarios de modélisation statistique avancée, la purge intégrale et aveugle de .GlobalEnv s’avère contre-productive, voire néfaste. Imaginons un projet impliquant le chargement d’un référentiel géographique massif de plusieurs gigaoctets dont l’importation et la géolocalisation requièrent un quart d’heure de calcul. L’analyste peut souhaiter éradiquer tous les sous-ensembles de données intermédiaires et les variables d’ajustement sans détruire ce fichier maître ni les fonctions personnalisées qu’il a patiemment écrites au cours de la session. C’est ici qu’intervient l’épuration sélective conditionnelle.
Cette approche repose sur l’interrogation dynamique des métadonnées des objets stockés en mémoire vive. En R, chaque entité possède une typologie interne inspectable via la fonction primitive typeof() et, de manière plus significative dans le paradigme de programmation orientée objet S3, une étiquette de classe formelle révélée par la fonction class(). Cependant, pour inspecter les attributs d’un ensemble d’objets à partir de la liste de leurs noms textuels générée par ls(), il est nécessaire de résoudre dynamiquement ces symboles pour en extraire les véritables instances mémoires. Cette opération s’effectue au moyen de la fonction fondamentale mget() (multiple get).
La commande mget(ls()) prend en argument un vecteur de noms de variables et interroge l’environnement courant pour restituer une liste nommée contenant les objets réels correspondants. Une fois cette liste constituée, il devient possible d’appliquer des prédicats logiques vectorisés en utilisant des fonctions d’ordre supérieur telles que sapply() ou vapply(). L’architecture de programmation fonctionnelle de R permet ainsi de créer des filtres booléens d’une précision chirurgicale, identifiant les objets répondant à des critères structurels spécifiques en vue de leur transmission ciblée à l’instruction rm().
5.2 Élimination ciblée des jeux de données (Data Frames)
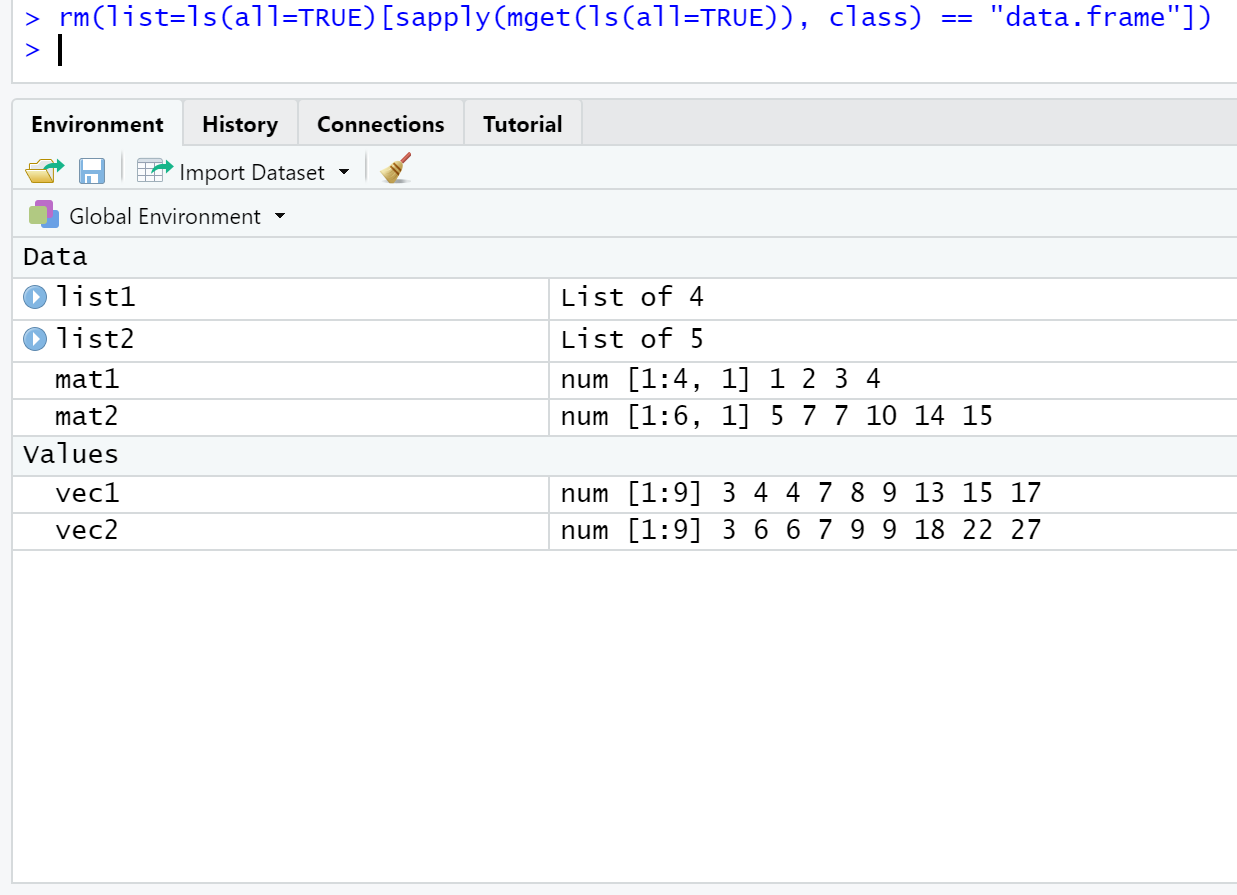
L’application la plus fréquente de cette technique d’épuration sélective concerne la suppression exclusive des tableaux de données (data frames), qui constituent généralement la source principale d’encombrement de la mémoire vive lors des phases de transformation et de jointure statistique. Pour purger spécifiquement ces structures tout en préservant intactes les variables scalaires, les chaînes de configuration et les fonctions mathématiques, on combine l’évaluation de mget() avec le prédicat unaire is.data.frame.
L’expression programmatique maîtresse se formalise selon la structure suivante : rm(list = ls()[sapply(mget(ls()), is.data.frame)]). Décomposons le flux d’exécution interne de cette instruction sophistiquée : premièrement, ls() dresse le catalogue textuel des symboles présents. Deuxièmement, mget(ls()) résout chacun de ces identifiants et retourne la liste des objets correspondants. Troisièmement, sapply(..., is.data.frame) applique le test logique à chaque élément de la liste, retournant un vecteur booléen de même longueur que ls(), où chaque entrée vaut TRUE si l’objet dérive de la classe data.frame et FALSE dans le cas contraire.
Quatrièmement, l’opération d’indexation vectorielle ls()[...] utilise ce masque logique pour n’extraire que les identifiants textuels validant la condition. Enfin, ce sous-vecteur de chaînes est transmis à rm(list = ...) pour destruction. Il convient de souligner la robustesse de cette approche face aux architectures tabulaires modernes : les objets dérivés de packages contemporains majeurs, tels que les structures tibble de l’écosystème Tidyverse ou les tables ultra-rapides de data.table, héritent formellement de la classe data.frame. Par conséquent, cette instruction les identifie et les détruit avec une efficacité égale, garantissant une purge complète des structures tabulaires lourdes.
5.3 Suppression spécifique des structures de type liste
Une démarche parfaitement analogue peut être déployée pour cibler les structures de type liste (list), qui servent abondamment à stocker les résultats de modèles de régression, d’arbres de décision ou d’analyses factorielles complexes. Les listes en R sont des structures récursives hétérogènes : un seul objet de modélisation issu de fonctions comme lm() ou glm() contient une arborescence profonde de vecteurs de résidus, de matrices de covariance et d’arbres d’appels qui peuvent saturer inutilement la mémoire si l’on a extrait les paramètres d’intérêt.
Toutefois, une vigilance théorique s’impose ici concernant la taxonomie des types d’objets en langage S3. En R, un data.frame est techniquement implémenté sous le capot comme une liste dont chaque élément représente une colonne vectorielle de même longueur (ce que confirme l’appel typeof(iris) qui retourne la chaîne "list"). Si un analyste applique naïvement le prédicat générique is.list, l’opération supprimera indifféremment les listes pures et l’ensemble de ses jeux de données tabulaires. Pour isoler les listes génériques pures sans impacter les structures tabulaires, le prédicat doit être affiné avec discernement.
La formulation correcte requiert l’exclusion explicite des classes héritées : on combine alors le test is.list(x) && !is.data.frame(x) au sein d’une fonction anonyme passée à sapply(). L’instruction s’écrit alors : rm(list = ls()[sapply(mget(ls()), function(x) is.list(x) && !is.data.frame(x))]). Cette sélection fine assure l’éradication des conteneurs de résultats statistiques et des hyperparamètres algorithmiques volumineux, tout en garantissant la préservation intégrale des tableaux de données primaires et des variables de paramétrage scalaires requises pour les phases subséquentes du pipeline.
6. Techniques avancées de filtrage programmatique multidimensionnel
6.1 Filtrage basé sur l’expression régulière (Pattern Matching)
Au-delà de la nature typologique des objets, l’organisation sémantique du code repose fréquemment sur des conventions de nommage rigoureuses adoptées par les équipes de recherche. Dans les pipelines de traitement de données séquentielles, il est courant de préfixer ou de suffixer les variables selon leur stade d’avancement au sein du workflow analytique. On retrouve typiquement des désignations comme temp_donnees_brutes, temp_filtre_age, ou encore des résidus de boucles nommés mod_step1, mod_step2, mod_final.
Pour assainir l’environnement de ces artefacts sans toucher au reste de l’espace de travail, la fonction ls() intègre nativement un argument de filtrage textuel nommé pattern, capable d’interpréter des expressions régulières conformes aux standards POSIX ou Perl. Cet argument permet d’opérer une sélection syntaxique directe à la source sans passer par la machinerie d’extraction de mget(). Par exemple, si un analyste souhaite éliminer tous les objets dont l’identifiant commence par le préfixe conventionnel « tmp_ » ou « temp_ », il lui suffit de composer une expression régulière ciblant le début de chaîne.
La commande s’exécute ainsi : rm(list = ls(pattern = "^(tmp|temp)_")). L’opérateur chapeau ^ ancre la recherche au début strict de l’identifiant, tandis que la structure disjonctive capture les deux variantes usuelles suivies d’un tiret bas. De même, pour supprimer l’intégralité des objets se terminant par un suffixe numérique marquant une itération intermédiaire (par exemple des variables finissant par un chiffre), l’expression rm(list = ls(pattern = "[0-9]+$")) permettra une épuration ciblée en une ligne concise. L’exploitation judicieuse du filtrage par motif textuel confère au statisticien une maîtrise remarquable sur l’état de son espace de travail, transformant la discipline de nommage des variables en un puissant outil de gestion des ressources.
6.2 Suppression conditionnelle selon l’empreinte mémoire
Lorsqu’un environnement de calcul scientifique est saturé, la priorité absolue ne réside pas nécessairement dans la suppression de nombreuses petites variables scalaires, mais dans la détection et l’éradication immédiate des monstres de données qui mobilisent l’essentiel de la mémoire vive (RAM). La commande interne object.size() permet de quantifier précisément l’empreinte mémoire occupée par n’importe quelle entité R, en renvoyant une valeur entière quantifiant le volume en octets (bytes).
En couplant l’évaluation de object.size() avec notre mécanisme de résolution vectorisée mget(), il devient possible de concevoir une procédure de purge paramétrée selon un seuil physique critique. Imaginons que nous souhaitions détecter et supprimer instantanément tout objet dont la taille excède 100 mégaoctets (soit 100 * 1024^2 octets), afin de décongestionner d’urgence un serveur de calcul sans interrompre l’environnement applicatif global de l’utilisateur.
Cette logique d’ingénierie s’implémente au moyen d’un filtre d’attribution dynamique : seuil_octets <- 100 * 1024^2, suivi de l’instruction d’éradication : rm(list = ls()[sapply(mget(ls()), object.size) > seuil_octets]). Cette commande inspecte l’empreinte physique exacte de chaque symbole de .GlobalEnv, évalue sa volumétrie réelle par rapport au seuil prédéterminé, et transmet exclusivement les symboles délinquants à rm(). Les matrices de distance volumineuses, les images matricielles brutes ou les gros modèles prédictifs sont éliminés, libérant instantanément l’empreinte mémoire critique tout en préservant le reste des scripts, fonctions auxiliaires et scalaires d’analyse.
7. Comparaison critique et analytique des trois approches
7.1 Critères d’évaluation fonctionnels
Afin d’éclairer le choix du praticien de la donnée face à ces diverses alternatives, il convient d’établir une grille d’évaluation multicritère rigoureuse. Les trois approches étudiées — la purge canonique par rm(list = ls()), l’effacement graphique via l’icône de balai de RStudio, et l’épuration sélective conditionnelle — répondent à des exigences techniques et méthodologiques fondamentalement différentes.
Le premier critère capital est celui de la reproductibilité scripturale et de la portabilité opérationnelle. Sur ce point, la commande programmatique rm(list = ls()) et les techniques de filtrage conditionnel obtiennent un score parfait : intégrées au sein d’un fichier source .R, elles s’exécutent de manière rigoureusement déterministe sur toute machine hébergeant un interpréteur R valide, sans intervention humaine. À l’inverse, l’icône balai de RStudio affiche une portabilité nulle, étant confinée à un environnement de développement particulier et nécessitant une action manuelle interactive impossible à consigner dans un journal d’exécution automatisé.
Le deuxième critère concerne la commodité ergonomique et la vélocité en phase exploratoire. Dans ce registre, le balai de RStudio s’avère particulièrement attractif : un simple geste permet d’effacer les variables sans avoir à taper une seule ligne de code dans la console. Toutefois, ce gain de confort superficiel est contrebalancé par le troisième critère : la granularité et la précision du contrôle exercé sur la mémoire. Tandis que le balai et rm(list = ls()) fonctionnent comme des marteaux-pilons binaires (tout supprimer sans discrimination), le filtrage sélectif offre une souplesse chirurgicale, permettant d’adapter la mémoire aux flux d’analyse de données les plus complexes sans sacrifier les calculs chronophages.
7.2 Matrice décisionnelle selon le contexte de travail
L’arbitrage entre ces méthodologies ne dépend pas d’un dogme absolu, mais du contexte opérationnel dans lequel s’inscrit l’analyste des données. Il est possible de cartographier ces pratiques au sein d’une matrice décisionnelle claire :
- Phase d’enseignement initial et de découverte didactique : L’utilisation de l’icône balai de RStudio est tout à fait recevable. Elle évite aux apprenants d’être confrontés prématurément aux arcanes de la manipulation de chaînes de caractères et de l’évaluation non standard, tout en leur fournissant une représentation visuelle rassurante de la notion d’espace de travail vierge.
- Phase d’expérimentation isolée et de débogage de scripts linéaires : La commande
rm(list = ls(all.names = TRUE))constitue une solution de repli rapide pour nettoyer la mémoire entre deux exécutions manuelles de blocs de code au sein d’une même session, sous réserve expresse de comprendre les limites structurelles de cette approche. - Flux de travail de modélisation statistique avancée et mégadonnées (Big Data) : Le filtrage conditionnel (par classe d’objet ou par empreinte mémoire) s’impose comme la seule stratégie rationnelle. Il permet de jongler intelligemment avec les ressources limitées de la mémoire vive en purgeant sélectivement les objets intermédiaires sans interrompre le cycle de vie des données maîtresses et des fonctions d’inférence.
Pour synthétiser cette analyse comparée, examinons les forces et faiblesses structurelles de chaque modalité d’assainissement :
| Méthode d’assainissement | Portabilité & Automatisation | Granularité de la purge | Niveau de risque méthodologique | Cas d’usage préférentiel |
|---|---|---|---|---|
| rm(list = ls()) | Maximale (scriptable) | Globale (binaire) | Modéré (illusion d’étanchéité) | Scripts exploratoires autonomes |
| Balai RStudio | Nulle (interactif uniquement) | Globale (avec option objets cachés) | Élevé (non consigné dans le code) | Démonstrations & formation initiale |
| Filtrage sélectif | Maximale (scriptable) | Chirurgicale (type, nom, taille) | Faible (contrôle précis) | Pipelines de données massives |
8. Gestion physique de la mémoire vive : Le rôle du Garbage Collector
8.1 Fonctionnement sous-jacent du ramasse-miettes (gc) dans R
Une incompréhension récurrente chez les programmeurs R réside dans la croyance selon laquelle l’exécution de la commande rm() libère instantanément la mémoire vive physique consommée par l’application pour la restituer au système d’exploitation hôte (qu’il s’agisse de Linux, macOS ou Windows). Comme nous l’avons précisé lors de notre étude architecturale, rm() ne fait qu’annihiler la référence nominale au sein de la table des symboles. L’espace physique d’adressage virtuel reste verrouillé par le processus R tant que le ramasse-miettes automatique, ou Garbage Collector (gc), n’a pas opéré son cycle de récupération cyclique.
Le ramasse-miettes de R fonctionne selon un algorithme de marquage et balayage générationnel (generational mark-and-sweep). De manière native, l’interpréteur déclenche automatiquement une passe de ramassage dès lors que les besoins d’allocation de nouveaux objets excèdent les seuils de déclenchement dynamiques alloués aux nœuds de cellules (Ncells) ou aux cellules vectorielles (Vcells). Cependant, l’utilisateur a la possibilité de forcer l’exécution immédiate et synchrone de ce nettoyage physique en invoquant explicitement la fonction sans argument gc().
Lorsqu’on appelle gc() dans la console, la fonction ne se contente pas de libérer les cellules orphelines ; elle imprime à l’écran un rapport de diagnostic particulièrement détaillé. Ce tableau révèle les quantités de Ncells (consacrées aux objets simples, aux pointeurs de listes et aux environnements) et de Vcells (hébergeant les composantes numériques des vecteurs et matrices) actuellement utilisées, ainsi que les plafonds historiques atteints depuis le lancement de la session. L’interprétation de ces métriques permet d’objectiver la diminution effective de la pression exercée sur la mémoire vive après une opération d’épuration majeure.
8.2 Optimisation des ressources lors de calculs scientifiques intensifs
Dans les contextes d’ingénierie des données massives ou de modélisation bayésienne à forte intensité computationnelle, le délai séparant la suppression logique d’une table par rm() et son recyclage effectif par le ramasse-miettes automatique peut être fatal. Si un script volumineux tente d’allouer une nouvelle matrice géante de plusieurs gigaoctets immédiatement après avoir supprimé la précédente, le système d’allocation de R peut renvoyer une erreur irréversible de type cannot allocate vector of size ... simplement parce que le garbage collector n’a pas encore eu l’opportunité temporelle de consolider l’espace d’adressage.
Dans ces situations extrêmes, la bonne pratique d’ingénierie logicielle consiste à chaîner impérativement la commande de purge avec un forçage explicite du ramasse-miettes. On formule ainsi la séquence standardisée suivante : rm(list = ls(all.names = TRUE)); gc(verbose = FALSE). L’argument verbose = FALSE supprime l’affichage textuel du diagnostic pour conserver un journal d’exécution épuré, tout en garantissant que les pages mémoires déréférencées soient immédiatement rendues au pool de ressources exploitables.
Il importe toutefois de mentionner une spécificité liée aux systèmes d’exploitation sous-jacents : sur les plateformes UNIX et assimilées (Linux, macOS), les allocateurs de mémoire système (tels que la bibliothèque standard glibc ou jemalloc) ne restituent pas nécessairement l’intégralité de la mémoire libérée au noyau du système d’exploitation. Ils conservent fréquemment ces blocs dans l’espace d’adressage virtuel du processus R pour optimiser d’éventuelles réallocations futures. Ainsi, le moniteur de tâches du système d’exploitation peut continuer d’afficher une consommation élevée de RAM pour le processus rsession ou R alors même que l’espace interne de R a été entièrement assaini.
9. Limites de rm(list = ls()) et idées reçues en programmation R
9.1 Persistance des packages attachés et options système
Au fil des ans, l’insertion automatique de la ligne rm(list = ls()) au tout début des scripts R est devenue une tradition largement répandue dans les laboratoires de recherche et les cours d’introduction aux statistiques. Nombreux sont ceux qui croient sincèrement que cette commande magique garantit que leur script s’exécute dans des conditions d’isolation parfaites et vierges de toute influence extérieure. Cette croyance relève d’une illusion méthodologique dangereuse.
La commande rm(list = ls()) n’a d’effet que sur les objets résidant strictement dans la table de hachage de .GlobalEnv. Elle est constitutionnellement incapable de modifier la liste des packages attachés au sein du chemin de recherche (search path). Si un utilisateur charge des bibliothèques externes telles que library(dplyr) ou library(MASS) au cours de sa session interactive, ces extensions continuent de résider dans la hiérarchie d’évaluation même après l’exécution de rm(list = ls()). Les fonctions spécialisées de ces packages restent disponibles, et les conflits d’ombrage (tels que le conflit classique entre le select() de dplyr et le select() de MASS) persistent silencieusement.
De surcroît, cette commande ne touche aucunement aux modifications de configurations globales opérées via la fonction options(), telles que le nombre de chiffres significatifs affichés (options(digits = ...)), la gestion des chaînes en facteurs ou les comportements d’affichage des avertissements statistiques (options(warn = ...)). De même, les méthodes de programmation orientée objet S4 enregistrées dynamiquement, les connexions réseau ou de fichiers ouvertes, ainsi que les périphériques graphiques instanciés ne sont pas réinitialisés. L’environnement n’est en rien revenu à son état d’origine, ce qui disqualifie rm(list = ls()) comme garant absolu de la reproductibilité scientifique.
9.2 Risques de corruption d’environnement au sein des fonctions
Un autre écueil technique majeur lié à l’utilisation mal maîtrisée de rm() concerne son comportement au sein des fermetures fonctionnelles (closures). Si un développeur intègre l’instruction rm(list = ls()) à l’intérieur du corps d’une fonction sans spécifier formellement l’environnement cible via le paramètre envir ou pos, la fonction n’effacera pas l’environnement global, mais videra son propre environnement d’évaluation local (l’environnement d’exécution de la fonction).
Inversement, si l’on manipule maladroitement les arguments d’environnement en forçant par exemple pos = 1 ou envir = .GlobalEnv au sein d’une fonction censée être modulaire et autonome, on introduit ce que le génie logiciel qualifie d’effets de bord destructeurs (destructive side effects). L’exécution d’un composant fonctionnel ne devrait sous aucun prétexte altérer arbitrairement l’espace de travail de l’utilisateur hôte sans son consentement explicite, sous peine de rendre les bibliothèques logicielles totalement instables et de provoquer des pertes accidentelles de données critiques.
C’est pourquoi les théoriciens éminents de l’architecture logicielle R, à l’image d’Hadley Wickham et d’autres contributeurs du R Core Team, mènent depuis plusieurs années une campagne active contre l’inclusion de rm(list = ls()) au sommet des scripts de partage. Cet appel perturbe l’espace de travail des collaborateurs qui exécutent le script en détruisant aveuglément leurs propres variables sans résoudre pour autant les problèmes profonds de dépendance d’état mentionnés précédemment.
10. Alternatives structurelles : Vers des sessions de travail étanches
10.1 Redémarrage complet de la session R (Restart R Session)
Puisque la purge de .GlobalEnv s’avère incapable de réinitialiser le chemin de recherche des packages, les options système et les états internes, quelle est la véritable solution préconisée par les standards d’ingénierie pour garantir une virginité computationnelle absolue ? La réponse technique réside dans le redémarrage complet du processus d’exécution de R (Restart R Session).
Dans l’interface RStudio, cette opération s’effectue instantanément au moyen du raccourci clavier standardisé Ctrl + Shift + F10 (ou Cmd + Shift + 0 sous macOS), ou en passant par le menu supérieur : Session > Restart R. Cette action met fin physiquement au processus d’exécution sous-jacent et relance une instance système neuve du binaire R. Tous les packages attachés sont immédiatement déchargés, les bibliothèques C et Fortran compilées chargées dynamiquement (fichiers partagés .dll ou .so) sont purgées, les pointeurs externes sont fermés, et la table des options globales est restaurée selon sa configuration par défaut.
Toutefois, pour que cette manœuvre garantisse une étanchéité scientifique parfaite, il est d’une nécessité vitale de modifier les paramètres de persistance de RStudio. Par défaut, l’interpréteur peut être configuré pour sauvegarder automatiquement l’état de l’espace de travail dans un fichier caché nommé .RData lors de la fermeture de la session, puis de recharger silencieusement ce fichier au démarrage. Si cette option reste active, redémarrer la session ne fera que recharger les fantômes computationnels que l’on cherchait précisément à détruire. Il faut donc impérativement configurer l’option Save workspace to .RData on exit sur « Never » (Jamais) au sein des préférences globales du logiciel.
10.2 Automatisation de l’évaluation isolée via des outils dédiés
Pour les besoins d’automatisation scientifique et de déploiement de pipelines industriels où l’intervention humaine sur un raccourci clavier est proscrite, la communauté R a développé des solutions programmatiques remarquables d’isolation des processus. L’outil de référence dans ce domaine est le package open-source callr, développé spécifiquement pour exécuter du code R au sein d’un sous-processus distinct et totalement éphémère.
Grâce à callr::r(function() { ... }), l’analyste peut lancer une fonction statistique complexe dans une session R d’arrière-plan complètement indépendante de la session courante. Le sous-processus démarre à partir d’un état parfaitement vierge, exécute le calcul, retourne le résultat structuré à la session principale, puis s’éteint immédiatement en libérant l’intégralité des ressources mémoires allouées. Aucune pollution résiduelle ne peut subsister dans l’environnement de l’utilisateur hôte, résolvant définitivement la quadrature du cercle de l’isolation environnementale.
De même, sur le plan de la reproductibilité terminale d’un projet de recherche, l’exécution systématique des scripts via l’utilitaire en ligne de commande Rscript depuis un terminal UNIX (par exemple : Rscript mon_analyse.R --vanilla) garantit un niveau d’intégrité inégalable. L’argument --vanilla désactive explicitement la lecture des fichiers d’historique, le chargement des environnements sauvegardés et l’exécution des profils personnalisés, offrant ainsi une étanchéité computationnelle absolue qui garantit que l’analyse est totalement autonome et reproductible par n’importe quel autre chercheur sur la planète.
11. Automatisation et encapsulation : Création de fonctions personnalisées
11.1 Développement d’un nettoyeur paramétrable sur mesure
Bien que les commandes primitives de R offrent des briques fonctionnelles puissantes, un statisticien rigoureux peut éprouver le besoin de formaliser ses propres procédures de maintenance de l’espace de travail en créant des fonctions utilitaires modulaires et sécurisées. L’objectif est ici de concevoir un nettoyeur d’environnement sophistiqué capable d’accepter une liste blanche explicite d’objets capitaux à préserver (keep list), tout en supprimant l’intégralité du reste de l’espace de travail.
Pour construire une telle fonction d’encapsulation sans risquer les effets de bord d’environnement mentionnés précédemment, il est primordial de manipuler rigoureusement les fonctions setdiff() et le paramètre envir de la fonction rm(). Considérons la mise en œuvre suivante : une fonction utilitaire que nous nommerons nettoyer_environnement(), acceptant un vecteur de caractères garder = c(), un argument logique objets_caches = TRUE, et ciblant explicitement l’environnement global par envir = .GlobalEnv.
À l’intérieur du corps de cette fonction, le mécanisme procède en trois étapes analytiques : d’abord, l’ensemble des symboles existants est énuméré via ls(all.names = objets_caches, envir = envir). Ensuite, la fonction d’ensemble setdiff() calcule la différence ensembliste entre cette liste exhaustive et le vecteur d’exclusions fourni par l’utilisateur (en veillant à ajouter le propre nom de la fonction nettoyeuse pour éviter qu’elle ne s’autodétruise en cours d’exécution). Enfin, l’instruction rm(list = cibles, envir = envir) opère la purge chirurgicale dans le bon espace d’adressage. Cette abstraction méthodologique procure un contrôle fin et sécurisé, idéal pour structurer les différentes étapes d’un long script de modélisation séquentielle.
11.2 Intégration dans le profil de démarrage .Rprofile
Pour les utilisateurs avancés qui souhaitent disposer d’outils de nettoyage personnalisés ou de raccourcis syntaxiques dès l’ouverture de leur logiciel sans avoir à recompiler leurs scripts à chaque session, le langage R met à disposition un fichier de démarrage particulier intitulé .Rprofile. Situé à la racine du répertoire utilisateur ou à la base du répertoire d’un projet R, ce fichier de script est évalué automatiquement par l’interpréteur lors de chaque phase d’initialisation du moteur d’exécution.
Il est tout à fait possible d’y définir des alias de productivité ou d’y charger la fonction utilitaire paramétrée développée précédemment. Cependant, cette pratique soulève un dilemme académique profond en matière de portabilité du code. Si un analyste configure dans son fichier .Rprofile une fonction sur mesure, disons cls(), et qu’il en parseme ensuite ses scripts de recherche partagés, le code deviendra immédiatement invalide et non fonctionnel dès lors qu’il sera testé sur la machine d’un confrère ne possédant pas le même fichier de configuration initial.
Par conséquent, la règle d’or consiste à n’utiliser le fichier .Rprofile que pour des personnalisations ergonomiques strictement passives (comme l’ajustement esthétique de l’invite de commande ou la désactivation de certains bips sonores système), et à ne jamais faire dépendre l’exécution logique d’une analyse statistique d’une fonction déclarée dans ce fichier masqué. Si une routine d’assainissement doit intervenir au cœur d’un protocole d’analyse scientifique, elle doit obligatoirement figurer in extenso au sein d’un module de code explicitement sourcé dans le projet.
12. Synthèse pratique et protocole d’hygiène des données
12.1 Arbre de décision pour le choix de la méthode d’assainissement
Pour guider le praticien de la donnée à travers la multitude des techniques présentées tout au long de cette étude approfondie, il est utile de formaliser un arbre de décision méthodologique clair, structurant le choix de la procédure de nettoyage en fonction de la finalité exacte de l’analyse et de son stade de développement logiciel :
- Cas de figure A : Vous êtes en phase de manipulation exploratoire directe et interactive au sein de l’interface RStudio.
Stratégie recommandée : L’icône de balai (Clear Environment) de l’onglet interactif offre une ergonomie idéale. Veillez simplement à cocher l’option « Include hidden objects » si vous manipulez des connecteurs de bases de données ou des clés cryptographiques locales, afin d’assurer une remise à zéro visuelle et conceptuelle de votre plan de travail. - Cas de figure B : Vous développez un pipeline de traitement séquentiel multi-étapes manipulant des volumes importants de données au sein d’un même script.
Stratégie recommandée : L’épuration sélective conditionnelle (par classe ou par motif textuel) est ici incontournable. Utilisez des filtres vectorisés de typerm(list = ls()[sapply(mget(ls()), is.data.frame)])pour libérer l’espace des tables massives devenues obsolètes tout en conservant vos matrices de pondération, dictionnaires de référence et fonctions auxiliaires, en complétant au besoin par un appel immédiat àgc()pour compacter la mémoire physique. - Cas de figure C : Vous finalisez un document de recherche, préparez la soumission d’un article scientifique ou automatisez un rapport pour un déploiement continu.
Stratégie recommandée : Proscrivez totalementrm(list = ls())en haut de vos fichiers. Adoptez la règle d’or de l’intégrité computationnelle : réinitialisez complètement la session R (Ctrl + Shift + F10) avec l’option de sauvegarde.RDatadésactivée, ou exécutez votre code via un sous-processus isolé au moyen decallrou de la commande terminaleRscript --vanilla. C’est l’unique garantie d’une reproductibilité absolue.
12.2 Check-list méthodologique pour les praticiens de la donnée
En guise de guide opérationnel terminal, tout chercheur, ingénieur ou statisticien devrait valider les points de contrôle suivants avant de considérer son environnement de travail comme conforme aux standards les plus exigeants de la discipline statistique contemporaine :
- 1. Neutralisation du mécanisme de restauration automatique de session : Accédez aux préférences générales de votre environnement (Tools > Global Options dans RStudio) et assurez-vous impérativement que la case « Restore .RData into workspace at startup » est décochée et que l’option « Save workspace to .RData on exit » est configurée sur Never.
- 2. Audit de l’environnement global : Vérifiez périodiquement la vacuité des variables visibles et masquées au moyen de la commande de contrôle
length(ls(all.names = TRUE)) == 0. - 3. Élimination des dépendances d’ordre dans les scripts : Vérifiez qu’aucune variable n’est utilisée dans une régression ou un graphique sans avoir été explicitement calculée ou chargée en amont dans le même document source.
- 4. Découplage de la mémoire physique : Lors de calculs intensifs sur des matrices imposantes, assurez-vous d’avoir orchestré le couplage fonctionnel entre la suppression nominale des références et le compactage de la mémoire via l’instruction
gc(verbose = FALSE). - 5. Épreuve de la machine vierge (The Clean Slate Test) : Fermez intégralement tous vos programmes, ouvrez un terminal système indépendant, et lancez la compilation complète de votre projet depuis une ligne de commande neutre. Si le script génère l’ensemble de ses figures, tableaux statistiques et rapports finaux sans la moindre erreur, votre environnement d’analyse répond formellement aux plus hautes exigences de rigueur et d’intégrité de la science quantitative moderne.
Références
Chambers, J. M. (2008). Software for data analysis: Programming with R. Springer Science & Business Media. https://doi.org/10.1007/978-0-387-75936-4
Gentleman, R. (2008). R programming for bioinformatics. Chapman and Hall/CRC. https://doi.org/10.1201/9781420063684
Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299-314. https://doi.org/10.1080/10618600.1996.10474713
Peng, R. D. (2011). Reproducible research in computational science. Science, 334(6060), 1226-1227. https://doi.org/10.1126/science.1213847
R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Wickham, H. (2019). Advanced R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781351201315
Wickham, H., & Bryan, J. (2023). R Packages: Organize, test, document, and share your code (2nd ed.). O’Reilly Media. https://r-pkgs.org/
Xie, Y., Allaire, J. J., & Grolemund, G. (2018). R markdown: The definitive guide. Chapman and Hall/CRC. https://doi.org/10.1201/9780429782985