
Dans l’écosystème de l’ingénierie des données et de l’analyse biostatistique, la qualité des données textuelles constitue le socle fondamental sur lequel repose l’ensemble des inférences statistiques et des modélisations prédictives. Le logiciel d’analyse statistique SAS (Statistical Analysis System), reconnu mondialement pour sa robustesse dans le traitement de données cliniques, financières et épidémiologiques, impose une rigueur méthodologique absolue dans la manipulation des vecteurs de caractères. Bien souvent, les flux de données brutes issus de saisies manuelles hétérogènes, d’extractions de dossiers médicaux électroniques ou de protocoles d’enquêtes multi-sources présentent des discordances typographiques majeures qui, si elles ne sont pas rectifiées en amont, corrompent irrémédiablement les étapes d’agrégation, de jointure et de classification.
La casse typographique, c’est-à-dire la distinction formelle entre les lettres majuscules (capitales) et minuscules (bas-de-casse), représente l’une des sources les plus fréquentes de biais d’appariement. Dans un environnement binaire où les systèmes comparent les chaînes de caractères selon leurs points de code ASCII ou Unicode sous-jacents, les termes « Traitement », « TRAITEMENT » et « traitement » constituent trois entités strictement distinctes. Cette sensibilité native exige la mise en œuvre de protocoles de normalisation linguistique automatisés et déterministes. Le système SAS répond à cet impératif par l’intermédiaire d’un ensemble de fonctions scalaires natives de haute performance, capables de transformer dynamiquement les chaînes textuelles au sein du vecteur de données de programme (Program Data Vector ou PDV).
Ce traité exhaustif a pour vocation d’analyser en profondeur les mécanismes computationnels, les particularités syntaxiques et les considérations architecturales régissant l’emploi du triptyque fonctionnel fondamental de SAS : UPCASE, LOWCASE et PROPCASE. À travers une exploration méthodique couvrant les fondements algorithmiques, la gestion avancée des délimiteurs, l’incidence des encodages multioctets et les répercussions sur les volumes massifs de données (Big Data), ce guide fournit aux statisticiens, scientifiques de données et développeurs SAS les compétences requises pour concevoir des pipelines de données infaillibles, optimisés et scientifiquement reproductibles.
1. Introduction aux fonctions de manipulation de la casse sous SAS
1.1 Fondements du traitement de chaînes de caractères en environnement SAS
Au sein de l’architecture SAS, le traitement des variables alphanumériques est assujetti à des règles rigides de gestion de la mémoire qui le distinguent nettement des langages de programmation modernes à typage dynamique. Une variable de type caractère dans une table SAS possède une longueur fixe, déclarée explicitement par le développeur ou déduite implicitement lors de la première compilation de l’étape DATA. Cette caractéristique fondamentale implique que chaque chaîne est stockée dans un emplacement contigu d’octets, complété au besoin par des espaces blancs de remplissage (trailing blanks) jusqu’à concurrence de la longueur maximale définie. Lors de l’ingestion de données de recherche, ces particularités structurelles interagissent directement avec les opérations de nettoyage textuel, rendant impérative une compréhension intime de la structure de stockage.
L’intégrité des bases de données de recherche repose sur la conformité lexicale. Dans des secteurs hautement régulés tels que les essais cliniques régis par la Food and Drug Administration (FDA) ou l’Agence Européenne des Médicaments (EMA), les données textuelles non structurées ou semi-structurées, comme les termes d’événements indésirables ou les dénominations communes internationales de médicaments, présentent une variabilité intrinsèque. Si deux enregistrements désignent la même pathologie mais diffèrent uniquement par l’utilisation de majuscules ou de minuscules, l’absence de standardisation produit une fragmentation artificielle des cohortes. Le nettoyage textuel ne relève donc pas d’une simple considération esthétique, mais constitue une condition préalable non négociable à la validité scientifique des analyses.
Il convient également d’établir une différenciation structurelle rigoureuse entre la valeur brute d’une variable (stockée sur le disque et manipulée dans le vecteur de données de programme) et sa représentation formatée (générée temporairement lors de l’exécution de procédures d’affichage comme PROC PRINT ou PROC REPORT). Alors qu’un format d’affichage ne modifie que la projection visuelle des données sans altérer leur réalité binaire sous-jacente, les fonctions de manipulation de la casse transforment directement l’empreinte octale des chaînes de caractères au sein de la table SAS. Cette distinction s’avère critique, car seules les modifications physiques de la valeur brute garantissent que les opérations ultérieures de filtrage, de tri et de fusion s’exécuteront de manière parfaitement déterministe.
1.2 Présentation générale du triptyque fonctionnel : UPCASE, LOWCASE et PROPCASE
Pour assurer la standardisation lexicale dans les étapes DATA et les procédures analytiques, SAS met à disposition des concepteurs trois fonctions natives essentielles : UPCASE, LOWCASE et PROPCASE. Chacune d’entre elles répond à des exigences de transformation morphologique précises, permettant de remodeler instantanément le profil typographique des chaînes de caractères. Ces fonctions opèrent de façon vectorielle au niveau de chaque observation évaluée par le système, garantissant un débit de traitement extrêmement rapide adapté aux jeux de données volumineux.
D’un point de vue comparatif, la fonction UPCASE force la totalité des caractères alphabétiques d’une chaîne à adopter leur équivalent en majuscule, créant ainsi un bloc typographique uniforme particulièrement adapté aux clés de jointure et aux codes normés. À l’opposé, la fonction LOWCASE transmute l’ensemble des lettres en minuscules, une approche largement privilégiée dans la préparation de données textuelles pour le traitement automatique du langage naturel (TALN) ou l’harmonisation d’identifiants réseau tels que les courriels. Enfin, la fonction PROPCASE applique une logique de casse de titre, convertissant la lettre initiale de chaque mot en majuscule tout en forçant toutes les lettres suivantes en minuscules, offrant un compromis idéal pour la mise en forme de données anthroponymiques et toponymiques.
L’impact direct de cette standardisation sur le filtrage de données est immédiat. Par défaut, le moteur de comparaison de SAS applique une stricte sensibilité à la casse (case sensitivity), dictée par les tables d’ordonnancement lexicographique ASCII ou EBCDIC. Ainsi, une condition logique évaluant l’égalité entre une variable contenant la valeur « Placebo » et la constante littérale « PLACEBO » renverra systématiquement un résultat faux. L’intégration judicieuse d’une fonction de transformation de la casse au sein de l’expression conditionnelle annule cette discordance en nivelant les représentations textuelles, sécurisant ainsi l’extraction des sous-populations d’intérêt au sein des cohortes expérimentales.
1.3 Cadre conceptuel : Normalisation des données et validité des analyses
Le cadre conceptuel de la normalisation textuelle s’inscrit au cœur de la gouvernance des données de recherche. La minimisation des erreurs de fusion constitue l’un de ses bénéfices les plus tangibles. Dans les opérations d’appariement de tables relationnelles basées sur des clés composites textuelles, une simple divergence de casse se traduit par un échec de jointure silencieux. Ce phénomène se caractérise par la perte involontaire d’observations critiques ou la génération de valeurs manquantes artificielles lors de l’instruction MERGE ou des requêtes PROC SQL, faussant irrémédiablement le dimensionnement des échantillons statistiques.
Au-delà de la cohérence relationnelle, l’harmonisation des chaînes de caractères conditionne directement la fiabilité des analyses statistiques catégorielles. Des procédures telles que PROC FREQ ou PROC GLIMMIX agrègent les données en fonction de la valeur binaire exacte des modalités. Une variable catégorielle mal normalisée comportant des variantes typographiques distribuera la variance statistique sur des niveaux d’échantillonnage factices, réduisant artificiellement la puissance statistique des tests d’hypothèse et compliquant la convergence des modèles d’estimation. En unifiant les chaînes sous une casse unique et homogène, le statisticien s’assure que chaque catégorie reflète fidèlement la réalité phénoménologique sous-jacente.
Enfin, la reproductibilité scientifique — principe directeur promu par l’Institut National de la Statistique et des Études Économiques (INSEE) et les revues scientifiques à comité de lecture — exige l’incorporation d’un pipeline de nettoyage rigoureux et transparent. L’inclusion systématique d’instructions de standardisation de la casse élimine toute subjectivité liée aux conditions de recueil des données. Elle garantit que des équipes de recherche indépendantes, réexécutant les mêmes programmes SAS sur des données brutes hétérogènes, obtiendront des distributions identiques et des conclusions scientifiques parfaitement superposables.
2. Architecture et syntaxe fondamentale de la fonction UPCASE
2.1 Mécanisme interne et syntaxe de la fonction UPCASE
La fonction UPCASE repose sur une signature syntaxique d’une grande simplicité formelle, définie par l’expression UPCASE(argument), où l’argument représente obligatoirement une expression de type caractère, qu’il s’agisse d’une variable de table, d’une constante littérale délimitée par des guillemets ou du résultat retourné par une autre fonction de chaîne imbriquée. D’un point de vue informatique, cette fonction invoque une routine de bas niveau programmée en langage compilé au cœur du moteur d’exécution de SAS, assurant un traitement unitaire ultra-rapide par octet.
Le comportement interne de la fonction cible prioritairement les caractères alphabétiques standards de la table ISO/IEC 646 (ASCII de base). Lorsqu’un octet se situe dans l’intervalle hexadécimal compris entre 61 et 7A (représentant les lettres minuscules de ‘a’ à ‘z’), l’algorithme applique une opération de soustraction arithmétique de 20 en notation hexadécimale (ou 32 en base décimale). Cette opération binaire décale instantanément l’octet vers la plage comprise entre 41 et 5A, correspondant fidèlement aux caractères alphabétiques majuscules de ‘A’ à ‘Z’.
Il est fondamental de noter que l’algorithme d’UPCASE fait preuve d’une préservation absolue à l’égard de tous les caractères non alphabétiques. Les chiffres (de ‘0’ à ‘9’), les symboles de ponctuation, les caractères de contrôle non imprimables ainsi que les espaces blancs simples ou consécutifs demeurent rigoureusement inchangés après le passage de la fonction. Cette neutralité garantit que les identifiants techniques complexes comportant des segments alphanumériques et des traits d’union conservent leur intégrité syntaxique tout en adoptant une typographie en capitales unifiée.
2.2 Implémentation pratique dans l’étape DATA
Dans le cadre d’un flux de travail SAS conventionnel au sein de l’étape DATA, l’application d’UPCASE peut s’envisager selon deux stratégies d’ingénierie logicielle distinctes : la dérivation vers une nouvelle variable ou la réaffectation in-situ. La création d’une variable cible dérivée constitue la pratique d’excellence en milieu académique et industriel. En formulant une instruction telle que nom_patient_maj = UPCASE(nom_patient);, l’analyste conserve la variable source intacte, préservant ainsi l’historique complet de la donnée brute et facilitant d’éventuels audits de conformité ou de traçabilité médico-légale.
À l’inverse, la réaffectation directe sur la variable existante, exprimée par nom_patient = UPCASE(nom_patient);, altère définitivement la valeur contenue dans le vecteur de données de programme sans modifier la longueur de stockage intrinsèque de la colonne. Dans ce cas de figure, la longueur allouée demeure celle qui avait été fixée lors de la déclaration initiale de la variable source. Si la variable d’origine possédait une allocation de 20 octets, la version convertie en majuscules occupera exactement la même empreinte spatiale de 20 octets, les espaces résiduels de fin de chaîne demeurant préservés.
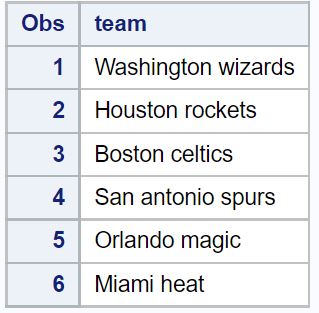
L’observation empirique de cette transformation sur des libellés nominatifs met en lumière son efficacité opérationnelle. Un ensemble d’enregistrements initiaux présentant des saisies telles que « Dupont », « dupont » ou « DuPonT » se voit instantanément standardisé sous l’étiquette unique « DUPONT ». Cette consolidation structurelle simplifie drastiquement les phases d’interrogation analytique ultérieures, tout en immunisant les processus de traitement contre l’arbitraire des conventions de saisie humaine.
2.3 Utilisation d’UPCASE dans les expressions conditionnelles
L’un des usages les plus puissants de la fonction UPCASE réside dans son intégration au sein des expressions logiques conditionnelles, notamment dans les instructions IF-THEN / ELSE et les clauses WHERE. Dans ces contextes, la fonction est souvent employée de façon éphémère en mémoire vive sans qu’il soit nécessaire de créer une colonne permanente supplémentaire sur le stockage physique. Cette approche optimise l’empreinte disque des tables volumineuses tout en offrant une flexibilité absolue lors du requêtage.
En formulant une expression logique telle que WHERE UPCASE(statut_inclusion) = ‘ACTIF’;, le chercheur neutralise la sensibilité à la casse du prédicat de sélection. Que la variable contienne « Actif », « actif » ou « ACTIF », l’observation sera systématiquement retenue pour l’analyse. Cette méthodologie s’avère particulièrement robuste lorsqu’elle est combinée avec l’opérateur d’appartenance logique IN, autorisant des vérifications multi-modalités sécurisées du type IF UPCASE(bras_traitement) IN (‘PLACEBO’, ‘DOSE_FAIBLE’, ‘DOSE_FORTE’) THEN…, ce qui élimine radicalement les erreurs d’omission dues à la typographie.
De surcroît, la combinaison de la fonction UPCASE avec l’opérateur de recherche textuelle LIKE permet de réaliser des filtrages par motifs insensibles à la casse au sein de variables textuelles libres. En codant WHERE UPCASE(commentaire_medical) LIKE ‘%ALLERGIE%’;, l’instruction interceptera toutes les mentions textuelles du terme recherché, indépendamment de leur disposition majuscule ou minuscule au sein de la phrase. Cette stratégie prévient les non-concordances de catégories lors de tris analytiques et fiabilise les études d’innocuité rétrospectives.
3. Architecture et syntaxe fondamentale de la fonction LOWCASE
3.1 Spécifications techniques de la fonction LOWCASE
La fonction LOWCASE constitue le pendant symétrique exact de la fonction UPCASE au sein de la bibliothèque de fonctions SAS. Sa signature formelle s’établit selon la syntaxe standard LOWCASE(argument), l’argument requis étant invariablement une expression à valeur de chaîne de caractères. Tout comme sa contrepartie majuscule, LOWCASE est une fonction déterministe qui opère une transformation directe octet par octet lors du passage de l’enregistrement dans le compilateur et le moteur d’exécution de l’étape DATA.
L’algorithme interne de conversion de LOWCASE cible spécifiquement les octets représentant les caractères alphabétiques majuscules standards de la table ASCII. Chaque octet dont la valeur hexadécimale est comprise dans l’intervalle 41 à 5A (les lettres de ‘A’ à ‘Z’) subit une addition arithmétique de 20 en hexadécimal (soit 32 en décimal), ce qui opère une translation immédiate vers l’intervalle hexadécimal 61 à 7A, correspondant aux caractères alphabétiques minuscules équivalents de ‘a’ à ‘z’.
Face à des séquences textuelles mixtes combinant des symboles graphiques, des chiffres et des marques de ponctuation, la fonction fait preuve d’une robustesse similaire à celle d’UPCASE. Les segments de chaîne qui ne correspondent pas à des lettres majuscules demeurent strictement intouchés. Les caractères déjà en minuscules, les séparateurs d’espaces ainsi que les caractères diacritiques ou spéciaux non gérés par le jeu ASCII de base sont restitués sans modification structurelle, préservant ainsi la longueur géométrique globale de la chaîne d’origine.
3.2 Applications pratiques pour le nettoyage de texte brut
Dans les architectures modernes d’ingestion de données, la fonction LOWCASE s’avère indispensable pour l’uniformisation des identifiants techniques et des métadonnées de communication. La standardisation des adresses de courrier électronique représente l’un des cas d’usage les plus universels. Bien que le protocole Internet standardisé par l’IETF considère la partie locale d’un courriel comme théoriquement sensible à la casse, l’immense majorité des serveurs de messagerie modernes l’interprète de façon insensible. En convertissant systématiquement les adresses électroniques au format minuscule via email_standard = LOWCASE(email_brut);, les analystes éliminent les doublons artificiels et sécurisent les clés de réconciliation CRM ou d’enquêtes en ligne.
Un autre domaine d’application privilégié réside dans la phase de prétraitement des corpus textuels destinés au traitement automatique du langage naturel (TALN) et à la textométrie. Lors de la constitution de matrices termes-documents ou du calcul d’indices de fréquence lexicale (TF-IDF), la casse constitue un bruit statistique indésirable. Deux occurrences d’un substantif, l’une située en milieu de phrase et l’autre en tête de proposition débutant par une majuscule, doivent être vectorisées sous un lemme identique. L’application de LOWCASE constitue la première étape d’assainissement lexical, préalable indispensable aux algorithmes de racinisation (stemming) et de lemmatisation.
Enfin, pour le traitement des codes ouverts issus de questionnaires administrés sur le web ou de formulaires déclaratifs, la fonction LOWCASE permet d’absorber l’extrême hétérogénéité des styles d’écriture des participants. En ramenant l’ensemble des réponses textuelles courtes vers une typographie entièrement en minuscules, l’ingénieur de données neutralise l’impact des touches de verrouillage des majuscules activées accidentellement, facilitant l’automatisation ultérieure de la codification thématique.
3.3 Interactions avec les formats et fonctions de troncature
L’utilisation de la fonction LOWCASE s’inscrit rarement dans une démarche isolée ; elle s’intègre au sein d’une chaîne logique d’instructions de manipulation de chaînes de caractères. Dans cette optique, l’association de LOWCASE avec les fonctions d’élagage d’espaces telles que STRIP et TRIM constitue une synergie technique récurrente. Alors que LOWCASE harmonise la topographie des lettres, l’enveloppement par la fonction STRIP — formulé par chaine_propre = STRIP(LOWCASE(chaine_brute)); — élimine simultanément tous les espaces blancs initiaux (leading blanks) et terminaux (trailing blanks), garantissant une pureté lexicale totale.
Cette imbrication fonctionnelle revêt une importance capitale pour le maintien de la cohérence de la table des symboles dans les procédures SAS. Lorsque des variables sont utilisées pour générer dynamiquement des macro-variables ou pour renseigner des paramètres de formats contrôlés par des tables de transcodage (via PROC FORMAT avec l’option CNTLIN), la présence d’espaces invisibles ou de divergences de casse peut faire échouer la correspondance de format. Une variable épurée par la combinaison de STRIP et LOWCASE assure une réconciliation déterministe avec les tables de conversion du système.
Sur le plan de l’analyse comparative de la mémoire consommée, il importe de souligner que l’application de LOWCASE, même couplée à STRIP, ne réduit pas automatiquement l’espace de stockage alloué à la variable dans la table SAS sur disque, sauf si une instruction explicite LENGTH redéfinit la largeur du champ cible. Bien que les espaces superflus soient supprimés logiquement dans l’évaluation de la chaîne, la variable SAS conserve son allocation d’octets fixe. L’optimisation réelle du volume de stockage nécessite une synchronisation rigoureuse entre les fonctions d’élagage de casse et la dimensionnement physique des colonnes cibles.
4. Architecture et syntaxe avancée de la fonction PROPCASE
4.1 Définition et comportement par défaut de la fonction PROPCASE
La fonction PROPCASE comble une lacune historique des langages de programmation en matière de mise en forme typographique automatisée, en implémentant nativement la conversion vers ce que les linguistes et typographes qualifient de casse de titre ou « Proper Case » (parfois nommée « Title Case »). La syntaxe native minimale de cette fonction s’énonce sous la forme classique PROPCASE(argument), où l’argument représente la chaîne textuelle soumise à la transformation algorithmique.
La règle fondamentale régissant le comportement par défaut de PROPCASE s’articule en deux étapes séquentielles strictement ordonnées. Premièrement, la fonction analyse la chaîne de gauche à droite à la recherche des frontières de mots ; la toute première lettre de la chaîne ainsi que la première lettre alphabétique suivant immédiatement un délimiteur reconnu sont systématiquement transmutées en majuscule. Deuxièmement, de manière tout aussi rigoureuse, l’ensemble des lettres alphabétiques subséquentes composant le corps de chaque mot est systématiquement converti en minuscule.
Cette double action confère à PROPCASE une puissance considérable pour corriger les chaînes saisies intégralement en capitales ou présentant des alternances anarchiques de majuscules et minuscules. Par exemple, une chaîne brute telle que « JEAN-LUC DE LA TOUR » ou « jEaN-lUc dE lA tOuR » sera harmonieusement restructurée sous une forme typographique élégante et normalisée, répondant instantanément aux standards éditoriaux occidentaux les plus exigeants sans nécessiter l’écriture de boucles complexes d’analyse lexicale.
4.2 Délimiteurs par défaut reconnus par PROPCASE
Pour déterminer avec précision où commence un nouveau mot au sein d’une séquence de caractères continue, la fonction PROPCASE intègre une table interne prédéfinie de séparateurs standards. Lorsque la fonction est invoquée dans sa signature unaire (sans second argument), SAS utilise par défaut un ensemble étendu de caractères de ponctuation et de contrôle qui bornent les lemmes textuels. Cette table comprend impérativement l’espace blanc standard, la tabulation horizontale, le saut de ligne, le retour chariot ainsi qu’une panoplie complète de signes typographiques.
Parmi les séparateurs par défaut inclus dans l’architecture de base figurent notamment le point, la virgule, le point-virgule, les deux-points, le point d’exclamation, le point d’interrogation, les parenthèses ouvrantes et fermantes, les crochets, les accolades, les barres obliques et contre-obliques, ainsi que le trait d’union standard. Dès que l’un de ces symboles est intercepté lors du balayage de la chaîne, l’automate à états finis de PROPCASE clôture le mot courant et bascule dans un état d’attente du prochain caractère alphabétique, lequel sera promu au statut de majuscule.
Toutefois, cette richesse de délimitation par défaut peut induire des effets de bord problématiques dans certains contextes professionnels spécialisés, notamment dans le secteur biomédical ou l’industrie technologique. Par exemple, des abréviations conventionnelles comportant des points de suspension ou des identifiants médicaux normés peuvent être déstructurés de façon inappropriée. De même, un acronyme international tel que « UNESCO » ou « CDISC » soumis au comportement par défaut de PROPCASE se trouvera irrémédiablement dégradé sous les formes « Unesco » ou « Cdisc », altérant ainsi la signification terminologique exacte du sigle.
4.3 Cas d’usage privilégiés dans les rapports institutionnels
L’utilisation de la fonction PROPCASE trouve son terrain de prédilection dans la préparation des livrables institutionnels, des rapports réglementaires et des tableaux de bord exécutifs destinés aux autorités de santé ou aux comités de direction. La mise en forme soignée des entités nominatives — incluant les noms propres, les prénoms des investigateurs cliniques, les dénominations d’hôpitaux et les raisons sociales d’entreprises partenaires — exige une présentation typographique irréprochable qui reflète le professionnalisme de l’organisme émetteur.
Dans la chaîne de production graphique de SAS, notamment lors de l’utilisation de SAS ODS Graphics ou des procédures SGPLOT et SGPANEL, la lisibilité des étiquettes d’axes et des légendes constitue un facteur d’ergonomie cognitive déterminant. Des étiquettes rédigées intégralement en lettres capitales saturent visuellement les graphiques et augmentent le temps nécessaire à la lecture des données. L’application de PROPCASE en amont de la génération des rendus visuels permet de produire des légendes harmonieuses, optimisant ainsi l’impact visuel des communications scientifiques.
De plus, au sein des procédures d’édition tabulaire avancées telles que PROC REPORT et PROC TABULATE, l’harmonisation formelle des en-têtes de colonnes et des libellés de rupture (break lines) via PROPCASE confère une homogénéité stylistique immédiate aux rapports multi-pages. Les documents générés au format PDF, RTF ou HTML via le système ODS adoptent ainsi une finition typographique conforme aux critères de publication académique, sans nécessiter d’interventions manuelles fastidieuses de post-traitement bureautique.
5. Gestion des délimiteurs personnalisés dans la fonction PROPCASE
5.1 Extension de la signature avec l’argument délimiteur
Conscients des limites intrinsèques associées à une liste universelle et immuable de délimiteurs, les architectes de SAS ont enrichi la fonction PROPCASE d’une signature étendue comportant un second argument facultatif mais hautement stratégique : PROPCASE(argument, délimiteurs). Ce second paramètre, formulé sous la forme d’une constante littérale textuelle ou d’une variable de caractères, permet au programmeur de spécifier explicitement la liste exhaustive des caractères qui doivent agir en tant que frontières lexicales pour l’opération de transformation.
L’activation de ce second argument modifie fondamentalement le comportement du compilateur SAS. L’incorporation d’une chaîne de délimiteurs personnalisés désactive instantanément et intégralement la liste des séparateurs par défaut. Par conséquent, seuls les symboles figurant dans la chaîne transmise en second paramètre seront désormais habilités à déclencher la promotion en majuscule d’une lettre subséquente. Tous les autres signes de ponctuation, symboles ou opérateurs non mentionnés seront désormais traités comme des caractères ordinaires neutres, empêchant la segmentation artificielle des mots.
La syntaxe de déclaration de ce second argument est d’une remarquable simplicité mais requiert une rigueur typographique absolue. Si le développeur souhaite que seuls l’espace et le trait d’union fassent office de délimiteurs, l’instruction s’écrira précisément nom_propre = PROPCASE(nom_brut, ‘ -‘);. Tout caractère consécutif placé entre les guillemets du second argument est interprété comme un séparateur unitaire indépendant, offrant une granularité de contrôle chirurgicale sur l’analyseur morphologique de la fonction.
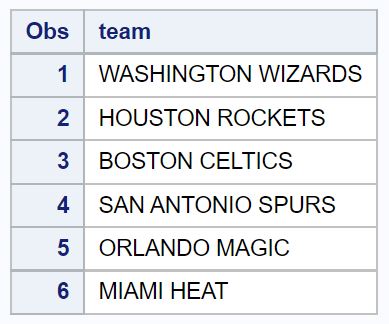
5.2 Résolution des noms composés et particules complexes
La gestion des patronymes et toponymes complexes de la langue française ou des langues romanes met immédiatement en lumière l’impérieuse nécessité de configurer les délimiteurs de PROPCASE. Dans les patronymes composés reliés par un trait d’union, tels que « Jean-Pierre » ou « Marie-Claire », le maintien du trait d’union parmi la liste des délimiteurs autorisés garantit que la seconde composante du prénom recevra bien sa majuscule initiale, générant un résultat parfaitement conforme à l’étiquette linguistique.
En revanche, le traitement des patronymes comportant des apostrophes soulève une problématique d’ingénierie textuelle majeure. Dans des noms d’origine française, irlandaise ou italienne comme « D’Artagnan », « O’Connor » ou « Dell’Aquila », l’inclusion ou l’exclusion de l’apostrophe dans la liste des délimiteurs infléchit radicalement le résultat obtenu. Si l’apostrophe est déclarée comme délimiteur dans le second paramètre de PROPCASE, le caractère suivant est promu en majuscule, produisant l’élégant « O’Connor ». À l’inverse, si l’apostrophe est omise des délimiteurs, la lettre suivant l’apostrophe sera systématiquement rétrogradée en minuscule, générant la graphie indésirable « O’connor ».
Pour les particules nobiliaires ou de liaison telles que « de », « du », « van » ou « von », PROPCASE ne dispose pas nativement d’un dictionnaire grammatical contextuel capable de détecter les mots invariants qui devraient impérativement demeurer en minuscules au sein d’une dénomination en casse de titre. La stratégie logicielle recommandée consiste alors à appliquer PROPCASE dans un premier temps avec les délimiteurs adéquats, puis à enchaîner une procédure de réajustement post-traitement au moyen de la fonction TRANWRD ou d’expressions régulières (PRXCHANGE) afin de restaurer les minuscules institutionnelles sur les particules ciblées (par exemple, en remplaçant systématiquement « De La » par « de la » lorsque ces tokens se situent en position médiane).
5.3 Traitement des identifiants techniques et codes alphanumériques
Dans les environnements d’ingénierie de données industrielles, les colonnes textuelles ne contiennent pas uniquement des noms d’individus, mais hébergent fréquemment des identifiants techniques semi-structurés, tels que des numéros de lots, des codes taxonomiques ou des identifiants d’échantillons de laboratoire associant chiffres, lettres et symboles de démarcation comme la barre de soulignement (underscore).
L’utilisation de la signature étendue de PROPCASE prend ici une dimension analytique cruciale. Par défaut, la barre de soulignement n’est pas systématiquement interprétée comme un délimiteur de mot standard par toutes les versions des moteurs textuels. En déclarant expressément la barre de soulignement comme séparateur via l’instruction code_harmonise = PROPCASE(code_brut, ‘_’);, l’ingénieur impose une structure rigide où chaque segment hiérarchique du code adopte une capitale inaugurale, transformant par exemple « protocole_oncologie_phase3 » en « Protocole_Oncologie_Phase3 ».
L’étude de cas comparative entre une exécution avec et sans second argument illustre de manière spectaculaire ces divergences de comportement. Soit un code d’échantillon médical rédigé sous la forme « LAB-SAMPLE_01-A ». Sous la fonction PROPCASE par défaut, le tiret provoque la mise en majuscule mais la barre de soulignement peut être ignorée selon les versions régionales, aboutissant à une casse hybride inégale. En fixant explicitement les délimiteurs à ‘-_’, le programmeur garantit un traitement symétrique de chaque segment d’information, sécurisant ainsi la taxonomie interne des nomenclatures scientifiques.
6. Analyse comparative : UPCASE vs LOWCASE vs PROPCASE
6.1 Matrice des fonctionnalités et impacts sémantiques
Le choix rationnel de la fonction de transformation textuelle appropriée exige une mise en perspective comparative rigoureuse de leurs spécificités opérationnelles, de leurs signatures syntaxiques et de leurs conséquences directes sur la sémantique de l’information sous-jacente. Le tableau conceptuel ci-dessous synthétise les propriétés fondamentales du triptyque fonctionnel SAS :
- UPCASE : Signature unaire UPCASE(argument). Ne requiert aucun paramètre secondaire. Tous les caractères alphabétiques sont irrévocablement portés au niveau majuscule. Perte totale de la distinction visuelle entre le début d’un lemme et son corps intérieur. Idéal pour les clés relationnelles rigides et les codes normalisés de petite longueur.
- LOWCASE : Signature unaire LOWCASE(argument). Ne tolère aucun paramètre de délimitation. Conversion intégrale vers les minuscules équivalentes. Effacement complet des accents d’insistance et des initiales distinctives. Fonction de choix pour les identifiants internet et la vectorisation de documents textuels en TALN.
- PROPCASE : Signature binaire flexible PROPCASE(argument <, délimiteurs>). Intègre une liste de délimiteurs configurables. Combine majuscule sur la première lettre et minuscules sur les lettres subséquentes de chaque mot. Conserve une lisibilité humaine optimale tout en standardisant les structures nominatives.
Le degré de perte d’information lexicale associé à chaque transformation doit être soigneusement évalué par le statisticien modélisateur. L’application d’UPCASE ou de LOWCASE constitue une réduction entropique maximale : l’information portée par l’alternance originelle des casses est définitivement détruite au profit d’une uniformité binaire. Cette démarche est particulièrement pertinente pour la modélisation statistique paramétrique où l’on cherche à réduire l’espace des modalités qualitatives. À l’opposé, PROPCASE cherche à réinjecter une structure syntaxique conventionnelle, ce qui préserve l’élégance du rendu sémantique mais peut introduire des distorsions si le texte comporte initialement des sigles complexes devant demeurer intégralement en capitales.
6.2 Sensibilité à l’ordonnancement lexicographique et tris
L’un des impacts les plus profonds de la manipulation de la casse réside dans l’ordonnancement lexicographique exécuté par la procédure de tri PROC SORT. Les algorithmes de tri sous-jacents de SAS procèdent à des comparaisons d’octets directes dont le comportement est intimement lié à la table d’encodage du système d’exploitation hôte, généralement la norme ASCII sous Windows et Unix/Linux, ou la norme EBCDIC sous les environnements grands systèmes (Mainframe z/OS).
Dans un environnement à encodage standard ASCII, les points de code des lettres majuscules (valeurs décimales de 65 pour ‘A’ à 90 pour ‘Z’) précèdent strictement les points de code des lettres minuscules (valeurs décimales de 97 pour ‘a’ à 122 pour ‘z’). En conséquence directe, lors de l’exécution d’une instruction PROC SORT sur une table non standardisée, la modalité « Zèbre » sera classée avant la modalité « avocat », introduisant une anomalie majeure dans l’ordre alphabétique perçu par l’utilisateur humain. Si la même table est traitée sous un système EBCDIC, la situation s’inverse radicalement, les minuscules précédant les majuscules dans l’ordre d’évaluation binaire.
Pour éliminer définitivement cette sensibilité au système d’exploitation et garantir un ordonnancement déterministe et reproductible, la recommandation méthodologique absolue consiste à standardiser intégralement les variables de regroupement (clés de tri) au moyen d’UPCASE ou de LOWCASE préalablement à l’appel de PROC SORT ou à l’utilisation d’une instruction BY. Cette pratique garantit que la totalité des entités comparées partagera un espace d’octets homogène, fiabilisant ainsi les procédures de stratification statistique et de calcul de statistiques descriptives par sous-groupes.
6.3 Combinaisons et enchaînements fonctionnels
Dans le développement de programmes de production robustes, les exigences de nettoyage de données imposent fréquemment la nidification et le chaînage séquentiel de plusieurs fonctions de manipulation textuelle au sein d’une seule et même expression algorithmique. SAS autorise une composition fonctionnelle poussée, permettant d’exécuter des transformations morphologiques sophistiquées en une seule ligne de code exécutable.
Un cas de figure canonique implique l’extraction d’un sous-segment de chaîne via la fonction SUBSTR ou SCAN, immédiatement converti en majuscules pour une évaluation logique instantanée. En formulant par exemple IF UPCASE(SUBSTR(code_diagnostic, 1, 3)) = ‘C50’ THEN cancer_sein = 1;, le compilateur procède d’abord au découpage du préfixe de trois caractères, le passe à la fonction UPCASE pour neutraliser toute variation de casse, puis le confronte au code de la Classification Internationale des Maladies (CIM-10), le tout sans allouer d’espace disque résiduel.
De même, la combinaison de PROPCASE avec la fonction de substitution textuelle TRANWRD permet d’adresser avec élégance les cas particuliers évoqués précédemment concernant les particules de liaison. L’imbrication successive nom_final = TRANWRD(PROPCASE(nom_brut), ‘ D’’, ‘ d’’); illustre comment une approche modulaire permet de concilier la standardisation globale en casse de titre et la préservation chirurgicale des subtilités linguistiques. Il convient néanmoins de garder à l’esprit les limites computationnelles de ces opérations imbriquées : sur des volumes massifs comportant plusieurs centaines de millions d’enregistrements, la multiplication de fonctions imbriquées au sein de boucles non optimisées peut solliciter excessivement le processeur (temps CPU), exigeant un équilibrage judicieux entre expressivité syntaxique et efficacité d’exécution.
7. Mise en œuvre pratique sur un jeu de données complet
7.1 Construction du jeu de données expérimental original
Afin d’illustrer de manière tangible l’impact computationnel et visuel des fonctions UPCASE, LOWCASE et PROPCASE, nous concevons un jeu de données expérimental contrôlé simulant une cohorte clinique multicentrique. Ce tableau intègre délibérément les anomalies typographiques les plus fréquemment rencontrées lors des phases d’acquisition de données sur le terrain : majuscules anarchiques issues d’une mauvaise utilisation du clavier, adresses électroniques en capitales hétérogènes et identifiants techniques non alignés.
L’étape DATA dédiée à la génération de cet échantillon s’appuie sur l’instruction DATALINES pour injecter des valeurs brutes emblématiques. Dans ce cadre d’expérimentation, les variables retenues comportent un identifiant de sujet, le patronyme du patient, la dénomination de son centre de rattachement ainsi que son adresse électronique de contact. Les anomalies intégrées permettent d’exposer la réactivité de chaque fonction face à des configurations lexicales réelles et imparfaites.
La visualisation immédiate de cette table originale au moyen de la procédure PROC PRINT DATA=patients_bruts; RUN; met en exergue l’ampleur de la dispersion formelle. Les noms patronymiques oscillent entre des représentations entièrement en minuscules, des structures en majuscules intégrales et des alternances capricieuses (« dUpOnT », « MARTIN-LEFEBVRE », « bernard »). Une telle hétérogénéité visuelle traduit fidèlement l’état dégradé d’un recueil brut et justifie le déploiement immédiat d’une stratégie de normalisation intégrale dans le pipeline SAS.
7.2 Conversion intégrale des variables textuelles
La transformation méthodique des colonnes textuelles s’orchestre au sein d’une nouvelle étape DATA conçue pour appliquer séquentiellement chaque opérateur fonctionnel selon la destination d’usage de la variable considérée. Dans un premier temps, l’identifiant du centre hospitalier d’investigation est soumis à la fonction UPCASE afin de générer une clé de classification catégorielle invariable et rigide, propre à être injectée sans risque dans une clause de stratification statistique.
Dans un deuxième temps, la colonne hébergeant l’adresse électronique fait l’objet d’une transmutation par la fonction LOWCASE, accompagnée d’un diagnostic rigoureux au niveau du journal d’exécution (SAS Log). Le journal permet de certifier qu’aucune conversion de type implicite ou altération involontaire n’a eu lieu durant la translation octale. L’ensemble des composantes des adresses électroniques se retrouve ainsi uniformisé sous une typographie en minuscules homogène, simplifiant toute fusion future avec des systèmes d’envoi de questionnaires de suivi en ligne.
Enfin, la variable patronymique est prise en charge par la fonction PROPCASE, enrichie de son argument de délimitation optionnel pour préserver la structure canonique des prénoms et noms composés reliés par un tiret ou un espace. Le code opérationnel affecte la sortie à une colonne dédiée de longueur suffisante, garantissant que chaque mot composant l’identité civile bénéficie d’une promotion sélective de sa lettre inaugurale tout en maintenant la fluidité de lecture indispensable aux rapports cliniques finaux.
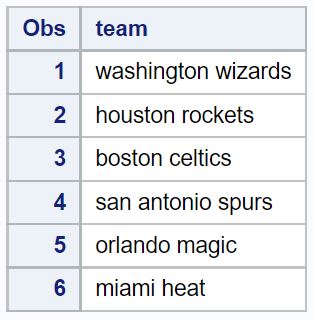
7.3 Vérification systématique et validation des résultats
Une fois l’étape DATA de transformation exécutée, un protocole d’audit et de validation statistique systématique doit être déployé afin d’attester de la conformité du traitement. L’utilisation de la procédure PROC PRINT, configurée avec des options d’étiquettes élaborées (option LABEL), permet d’inspecter visuellement l’alignement des colonnes converties et de vérifier l’absence d’anomalies morphologiques évidentes sur les premiers et derniers centiles de la distribution.
Néanmoins, la validation scientifique ne saurait se limiter à une vérification oculaire informelle. L’audit qualitatif s’appuie obligatoirement sur l’exécution conjointe de la procédure PROC FREQ sur les variables textuelles avant et après normalisation. L’examen comparatif des tables de fréquences révèle instantanément l’effondrement du nombre de modalités distinctes pour une même catégorie conceptuelle. Là où la variable brute présentait cinq ou six variantes typographiques d’un même centre hospitalier (« Paris-Nord », « PARIS-NORD », « paris-nord »), la variable post-UPCASE ne présente plus qu’une modalité unique, consolidant d’un coup l’effectif statistique au sein de la classe d’intérêt.
Parallèlement, une attention méticuleuse doit être accordée à l’inspection du journal SAS pour traquer d’éventuels messages d’avertissement relatifs à des troncatures de chaînes (troncation warnings). La confirmation que le nombre d’octets occupés par les chaînes finales n’a pas dépassé la longueur allouée valide la complétude du traitement et autorise l’intégration sécurisée de la table nettoyée au sein des processus décisionnels et des modules de modélisation avancée.
8. Normalisation des chaînes pour fusions et requêtes SQL
8.1 Standardisation préalable aux fusions de tables (MERGE)
L’appariement de sources de données disparates constitue l’un des piliers de l’analyse décisionnelle et de la pharmaco-épidémiologie. Dans l’étape DATA de SAS, la fusion de deux tables ordonnées s’effectue traditionnellement au moyen de l’instruction MERGE, conditionnée par une clause d’alignement BY désignant la ou les variables clés communes. L’intégrité de cette opération repose intégralement sur l’hypothèse d’une égalité binaire absolue entre les valeurs de la clé BY issues de chaque table mère.
Si la table de pharmacovigilance identifie un sujet sous la modalité « SUBJ_101 » et que la table démographique référence le même individu sous l’étiquette « subj_101 », le compilateur SAS traitera ces deux enregistrements comme deux entités distinctes en raison de la divergence de casse. Il en résultera ce que les statisticiens redoutent le plus : un non-appariement silencieux. Les observations ne seront pas fusionnées sur la même ligne mais insérées séquentiellement avec des cellules vides (valeurs manquantes) pour les variables de la table opposée, corrompant de façon insidieuse le dénominateur des taux d’incidence.
La règle d’or architecturale consiste donc à appliquer de façon préventive la fonction UPCASE (ou LOWCASE) sur la totalité des variables destinées à figurer dans l’instruction BY, et ce au sein de chacune des tables en amont de la procédure PROC SORT et de l’instruction MERGE. Ce diagnostic préventif des variables d’identification élimine les rejets de jointure injustifiés et garantit que chaque patient ou unité statistique sera apparié de façon exhaustive avec ses données cliniques ou comportementales associées.
8.2 Utilisation des fonctions de casse dans PROC SQL
La procédure PROC SQL offre une alternative déclarative d’une remarquable puissance à l’étape DATA pour opérer des jointures et des filtrages complexes. L’un de ses atouts majeurs réside dans sa capacité à intégrer dynamiquement des fonctions de casse au sein même des clauses de jointure (clause ON) et des critères de sélection (clause WHERE), évitant ainsi d’avoir à créer des tables intermédiaires préalablement transformées.
Au sein d’une clause ON, il est parfaitement valide et recommandé d’écrire une instruction de type ON UPCASE(A.code_produit) = UPCASE(B.code_produit). Cette syntaxe permet de réaliser une jointure relationnelle totalement insensible à la casse à la volée. Le moteur SQL interne de SAS évalue la fonction pour chaque ligne comparée, neutralisant les divergences d’encodage sans altérer physiquement la structure physique des tables sources stockées sur le disque de stockage.
Cependant, cette flexibilité syntaxique s’accompagne d’une contrepartie architecturale non négligeable concernant l’exploitation des index de tables. Dans la plupart des systèmes de gestion de bases de données relationnelles, ainsi que dans le moteur natif de SAS, l’application d’une fonction scalaire sur une colonne référencée dans une clause WHERE ou ON empêche l’optimiseur de requêtes d’utiliser un index standard existant sur cette même colonne. Le système est alors contraint d’abandonner la recherche indexée rapide pour basculer vers un balayage séquentiel intégral de la table (full table scan), ce qui peut dégrader considérablement les performances lors du traitement de volumétries massives.
8.3 Création d’index fonctionnels et impact sur les temps de réponse
Face au dilemme opposant souplesse d’interrogation et dégradation des performances lors de requêtes textuelles volumineuses, l’ingénierie des bases de données SAS préconise le recours à des index créés sur des variables spécifiquement préparées. Bien que SAS ne supporte pas nativement les « index fonctionnels » au sens strict d’Oracle (index calculés directement sur une expression comme CREATE INDEX ON table(UPCASE(colonne))), il est aisé d’émuler cette mécanique avec une efficacité redoutable.
La méthodologie consiste à matérialiser physiquement la colonne standardisée au sein de la table SAS lors de sa phase de chargement initial (par exemple via une colonne calculée cle_standard = UPCASE(cle_brute);), puis à créer un index simple ou composite sur cette nouvelle colonne au moyen de l’instruction INDEX CREATE de PROC DATASETS ou PROC SQL. Dès lors, les futures requêtes SQL filtrant ou joignant sur cle_standard bénéficieront d’un accès indexé direct en temps quasi constant, réduisant drastiquement le nombre d’entrées/sorties (I/O) physiques sur le sous-système de disques.
L’arbitrage entre le volume d’espace disque additionnel mobilisé par le stockage de cette colonne redondante et le gain de temps d’exécution des requêtes constitue une décision d’architecture classique. Dans les architectures analytiques en lecture intensive (telles que les entrepôts de données cliniques ou les magasins de données décisionnels), le coût marginal du stockage sur disque est largement surpassé par le bénéfice d’une réduction par un facteur dix ou cent des temps de réponse lors des jointures massives, validant ainsi la pertinence d’une pré-standardisation systématique des clés.
9. Encodages, caractères accentués et internationalisation
9.1 Gestion des caractères accentués avec les fonctions standards
L’une des pierres d’achoppement les plus critiques du traitement de chaînes en environnement francophone concerne l’interaction entre les fonctions de casse traditionnelles et les caractères diacritiques (lettres accentuées telles que ‘é’, ‘è’, ‘à’, ‘ç’, ‘ù’, ‘ô’, etc.). Historiquement, les fonctions natives UPCASE, LOWCASE et PROPCASE ont été développées pour opérer sur le jeu de caractères américain ASCII standard, codé sur 7 bits. Dans ce schéma binaire primitif, les lettres accentuées n’existent pas et relèvent d’extensions de pages de code régionales.
Lorsque SAS s’exécute sous une session configurée avec un encodage mono-octet occidental traditionnel, tel que le standard Windows-1252 (WLATIN1) ou ISO-8859-1 (LATIN1), les fonctions de casse de base parviennent généralement à convertir les caractères accentués courants grâce à des tables de correspondance internes mappées sur le système hôte. Ainsi, sous WLATIN1, l’expression UPCASE(‘état’) produira adéquatement la chaîne « ÉTAT ».
Cependant, la situation devient extrêmement périlleuse dès lors que l’environnement SAS bascule vers un encodage universel multioctet UTF-8, désormais standardisé dans les architectures modernes comme SAS Viya. Sous UTF-8, un caractère accentué n’est plus représenté par un octet unique mais par une séquence de deux octets (par exemple, la lettre ‘é’ est matérialisée par les octets C3 A9 en hexadécimal). Les fonctions standards UPCASE et LOWCASE, opérant par conception sur une base octale stricte sans interpréter la sémantique multioctet, échouent fréquemment à identifier ces séquences comme des lettres alphabétiques. Il en résulte des comportements aberrants où les accents sont soit laissés en minuscules au milieu de majuscules (« éTAT »), soit purement et simplement corrompus, violant l’intégrité textuelle du document.
9.2 Recours aux fonctions KUPCASE, KLOWCASE et KPROPCASE
Pour résoudre définitivement les dysfonctionnements structurels induits par la mondialisation des architectures de données et l’adoption généralisée de l’encodage UTF-8 ou des jeux de caractères asiatiques à double octet (DBCS), SAS propose une famille spécialisée de fonctions textuelles désignées sous le vocable de K-functions (fonctions K). Dans le domaine de la casse, ce sous-système s’incarne à travers les fonctions spécialisées KUPCASE, KLOWCASE et KPROPCASE.
Les fonctions K se caractérisent par un algorithme interne capable de décoder la structure multioctet des points de code Unicode de manière contextuelle. Contrairement aux fonctions historiques qui incrémentent leur pointeur d’un octet à la fois, KUPCASE et ses variantes analysent les octets d’en-tête (lead bytes) pour déterminer la longueur exacte du caractère considéré (1, 2, 3 ou 4 octets) avant d’appliquer la règle de transcription typographique définie par le standard Unicode Consortium. L’implémentation de chaine_propre = KUPCASE(chaine_utf8); garantit ainsi la mise en majuscule parfaite des diacritiques français, allemands ou espagnols sans la moindre corruption binaire.
La supériorité de KPROPCASE est tout aussi manifeste dans les environnements internationalisés. Elle identifie impeccablement le début d’un mot même lorsque celui-ci est introduit par un caractère accentué multioctet (comme « Éléonore »), assurant que l’accentuation majuscule initiale est rigoureusement préservée tout en convertissant les voyelles accentuées subséquentes en leurs équivalents minuscules appropriés. La préservation irréprochable de l’intégrité sémantique des textes francophones repose donc aujourd’hui sur l’adoption systématique de ces fonctions de nouvelle génération au sein des programmes SAS exécutés sous encodage UTF-8.
9.3 Normalisation préalable via les fonctions de translittération
Bien que la conservation des diacritiques soit indispensable pour la restitution esthétique et éditoriale des rapports, de nombreux contextes biostatistiques internationaux exigent une harmonisation phonétique et orthographique encore plus radicale : la désaccentuation complète (stripping diacritics). Dans les études épidémiologiques transversales regroupant des données issues de plusieurs pays européens, la variabilité des conventions de saisie des accents constitue un écueil analytique majeur.
La normalisation préalable par translittération consiste à substituer chaque lettre pourvue d’un signe diacritique par son équivalent alphabétique de base non accentué (par exemple, remplacer ‘é’, ‘è’, ‘ê’, ‘ë’ par un simple ‘e’). Sous SAS, cette opération peut être menée avec une extrême rapidité computationnelle à l’aide de la fonction native TRANSLATE ou de la fonction spécialisée KCVT. En combinant la suppression des accents avec un appel à la fonction UPCASE, le chercheur convertit « Hélène à l’hôpital » en une chaîne dépouillée et invariable : « HELENE A L’HOPITAL ».
Cette méthodologie garantit une portabilité absolue du code et des données entre différentes plateformes d’analyse statistique hétérogènes (SAS Enterprise Guide, SAS Grid, clusters SAS Viya sous Linux et bases de données externes Oracle ou Snowflake). Elle évite les erreurs de décodage d’encodage (phénomène de « mojibake » où les lettres accentuées se transforment en symboles incohérents) et simplifie considérablement les algorithmes d’appariement flou (fuzzy matching) fondés sur des distances d’édition comme l’algorithme de Levenshtein ou le coefficient de Jaro-Winkler.
10. Optimisation des performances sur de grands volumes de données
10.1 Dimensionnement précis de la mémoire et gestion du LENGTH
Dans le paradigme du traitement de données massives (Big Data) sous SAS, où les tables de faits peuvent dénombrer des dizaines de millions d’enregistrements, la gestion rigoureuse de la mémoire et de l’allocation spatiale des variables de caractères cesse d’être une considération secondaire pour devenir un impératif de viabilité technique. Par défaut, lorsqu’une nouvelle variable est initialisée dans une étape DATA sans déclaration explicite préalable, SAS lui attribue une longueur égale à celle du résultat de la première expression évaluée, ou se replie sur une dimension par défaut qui peut s’avérer surdimensionnée.
L’utilisation non maîtrisée des fonctions UPCASE, LOWCASE ou PROPCASE sans déclaration formelle via l’instruction LENGTH peut induire des gaspillages de mémoire considérables. Si une variable temporaire est allouée à 200 octets par précaution alors que les données effectives n’en occupent jamais plus de 20, le moteur SAS réservera néanmoins 200 octets physiques pour chaque ligne de la table. Multiplié par 50 millions d’observations, ce surdimensionnement mécanique génère une surcharge de stockage de plusieurs gigaoctets parfaitement inutile.
Cette dilatation artificielle des tables se répercute directement sur le volume des opérations d’entrées/sorties disque (disk I/O), qui constitue historiquement le principal goulot d’étranglement des serveurs SAS. La bonne pratique de programmation consiste à positionner systématiquement une instruction LENGTH au tout début de l’étape DATA, préalablement à tout appel de fonction de transformation de casse : LENGTH identifiant_clean $20;. Cette discipline garantit un compactage optimal du vecteur de données de programme (PDV), maximisant ainsi le nombre d’enregistrements résidant dans chaque page de mémoire tampon (buffer) lue depuis le sous-système de stockage.
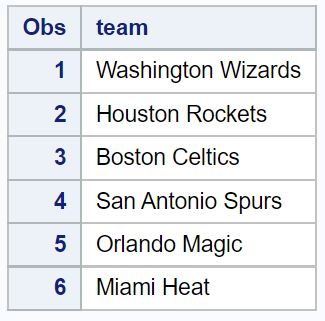
10.2 Modification sur place ou création de variables dérivées
Lors de la conception d’un pipeline d’assainissement textuel à grande échelle, le développeur est confronté à un arbitrage technique fondamental : procéder à une mise à jour sur place (in-situ) de la variable existante ou dériver une nouvelle colonne au sein de la table cible. Cette décision emporte des conséquences divergentes en matière de consommation de mémoire et de gouvernance des données.
La réaffectation directe sur la variable source (ville = UPCASE(ville);) présente l’avantage indéniable d’économiser l’espace disque et la mémoire vive. Le nombre total de colonnes demeure constant, ce qui évite d’alourdir la structure de la table SAS. Toutefois, cette économie se fait au détriment de la traçabilité intégrale de la donnée. En écrasant la valeur originale brute par la valeur normalisée, le chercheur s’interdit tout retour arrière au sein du même jeu de données et complique l’identification d’éventuelles dérives introduites par l’algorithme de conversion.
Pour contourner ce dilemme lors de la manipulation de fichiers gigantiques, l’architecture logicielle SAS offre la possibilité de recourir aux vues de données (DATA step views). En déclarant DATA nom_vue / VIEW=nom_vue; SET table_source; variable_clean = UPCASE(variable_brute); RUN;, aucune table physique n’est écrite sur le disque dur. La transformation est calculée à la volée en mémoire vive uniquement lorsque des procédures aval (comme PROC FREQ ou PROC REG) consomment les données. Cette approche élimine totalement le coût de stockage secondaire tout en offrant une traçabilité logicielle absolue.
10.3 Parallélisation et traitement multithread
Le traitement des chaînes de caractères sur des infrastructures de calcul modernes exige l’exploitation pleine et entière des architectures processeurs multicœurs. Le moteur d’exécution de base de SAS intègre l’option système THREADS, qui autorise la parallélisation de certaines opérations au niveau de l’étape DATA et de procédures analytiques intensives, sous réserve que la licence logicielle et le matériel sous-jacent le permettent.
Dans un contexte multithread, les fonctions scalaires pures telles qu’UPCASE, LOWCASE et PROPCASE bénéficient d’un facteur d’accélération linéaire remarquable. Étant donné que la transformation de casse appliquée à l’observation N est totalement indépendante du résultat obtenu sur l’observation N-1 (absence de dépendance d’état séquentielle), les flux de lignes peuvent être distribués simultanément sur plusieurs cœurs logiques sans risque de collision de mémoire. Chaque cœur traite son bloc d’enregistrements en appliquant l’algorithme de translation d’octets de façon isolée.
Avec l’avènement des architectures infonuagiques SAS Viya et de son moteur en mémoire massivement parallèle CAS (Cloud Analytic Services), cette logique de parallélisation atteint son apogée. Au sein de CAS, les tables sont découpées en blocs physiques répartis sur un cluster de nœuds de calcul. L’exécution d’un traitement de casse sur des centaines de millions d’enregistrements s’exécute de manière hautement distribuée, réduisant le temps de calcul processeur à une fraction minime de ce qu’exigeait autrefois un serveur centralisé traditionnel.
11. Pièges fréquents, erreurs syntaxiques et diagnostic d’anomalies
11.1 Troncature accidentelle de la chaîne de sortie
Parmi les anomalies les plus courantes et les plus insidieuses affectant les programmes de manipulation de chaînes sous SAS figure le phénomène de troncature accidentelle. Cette défaillance se manifeste lorsqu’une chaîne transformée par UPCASE, LOWCASE ou PROPCASE voit sa terminaison amputée, perdant ainsi des caractères cruciaux sans qu’aucune interruption brutale d’exécution ne soit nécessairement déclenchée.
Ce dysfonctionnement trouve son origine dans le mécanisme d’inférence implicite de la longueur des variables au sein de l’étape DATA. Si une nouvelle variable cible est initialisée par une fonction sans que sa longueur n’ait été préalablement fixée par une instruction LENGTH, SAS lui confère la longueur de la chaîne évaluée lors de la toute première itération du programme. Si, par malheur, la première ligne du jeu de données contient une chaîne courte (par exemple un nom de 4 caractères), la variable cible sera irrévocablement dimensionnée à 4 octets. Dès les lignes suivantes, tout nom comportant plus de 4 caractères (comme « LEROUX-DURAND ») sera silencieusement tronqué sous la forme « LERO ».
Pour prévenir cette erreur critique dans les programmes de production scientifique, une règle de gouvernance logicielle absolue doit être instaurée : interdire formellement toute création de variable dérivée sans déclaration de longueur explicite. De plus, l’analyste doit inspecter systématiquement le journal d’exécution de SAS (SAS Log) pour y détecter l’avertissement caractéristique « WARNING: Multiple lengths were specified for the variable… » ou vérifier via la procédure PROC CONTENTS que les longueurs allouées sont en adéquation parfaite avec la distribution attendue des données textuelles.
11.2 Effets inattendus de PROPCASE sur les sigles et termes techniques
Si la fonction PROPCASE brille par sa capacité à formater les dénominations de personnes, son application aveugle sur des champs textuels non homogènes peut engendrer des altérations sémantiques destructrices. Le risque le plus marquant réside dans la dégradation involontaire des acronymes, des sigles institutionnels et des codes alphanumériques normalisés intégrés au sein de phrases descriptives.
Prenons le cas d’une observation clinique consignant le commentaire textuel suivant : « Patient adressé par le SAMU pour prise en charge selon protocole OMS ». Si la fonction PROPCASE est appliquée globalement sur ce champ sans discrimination préalable, la chaîne résultante prendra la forme : « Patient Adressé Par Le Samu Pour Prise En Charge Selon Protocole Oms ». Les entités fondamentales « SAMU » et « OMS » ont perdu leur typographie statutaire en capitales, ce qui non seulement contrevient aux conventions rédactionnelles, mais peut paralyser des algorithmes d’extraction d’information ou de recherche d’entités nommées (NER).
Pour parer à cette dérive, la mise en œuvre de solutions d’ingénierie textuelle avancées s’impose. La stratégie la plus robuste repose sur l’utilisation combinée des expressions régulières Perl via la fonction PRXCHANGE. Après l’application de PROPCASE, un filtre de correction automatique peut confronter le texte à une liste blanche de sigles prédéfinis ou à un dictionnaire lexical de référence afin de réinjecter les majuscules intégrales sur les termes techniques ciblés. Cette architecture modulaire garantit l’élégance de la casse de titre tout en immunisant les sigles critiques contre toute dénaturation.
11.3 Confusion entre fonctions de casse et formats d’affichage
Une confusion théorique fréquente chez les programmeurs SAS juniors réside dans l’assimilation erronée entre l’application d’une fonction scalaire de casse et l’assignation d’un format d’affichage du type $UPCASEw.. Bien que le rendu visuel immédiat dans les fenêtres d’inspection de SAS ou dans les sorties d’impression semble strictement identique, la réalité computationnelle sous-jacente est radicalement divergente.
L’utilisation d’une instruction telle que FORMAT nom_patient $UPCASE20.; ne modifie en aucune manière la valeur binaire des données stockées sur le disque magnétique ou dans la mémoire du vecteur PDV. Le format agit uniquement comme un filtre optique lors du rendu visuel de la table au moyen de procédures SAS. Par conséquent, si ce jeu de données est ensuite interrogé par une clause de filtrage WHERE nom_patient = ‘DUPONT’, la condition échouera si la valeur brute sous le format était demeurée « Dupont ». De même, lors d’une exportation de la table vers un format externe agnostique (comme un fichier délimité CSV ou une base relationnelle PostgreSQL), le format d’affichage est généralement ignoré, exportant la valeur brute non standardisée.
La doctrine de programmation impose donc une règle de démarcation limpide : les formats d’affichage sont réservés aux livrables visuels finaux où la donnée sous-jacente ne subira plus aucun traitement analytique. Dès lors qu’une variable textuelle est appelée à intervenir dans des opérations de fusion, de partitionnement, d’ordonnancement ou d’exportation vers des systèmes tiers, l’altération physique de la chaîne brute via les fonctions exécutables UPCASE, LOWCASE ou PROPCASE constitue l’unique voie garantissant une robustesse déterministe pérenne.
12. Bonnes pratiques académiques et intégration dans les macros SAS
12.1 Standardisation du code au sein du langage macro SAS
Le langage macro de SAS constitue un métalangage de prétraitement puissant chargé de générer dynamiquement du code SAS préalablement à sa compilation finale par le moteur d’exécution. Au sein de cet environnement de macro-programmation, la manipulation de la casse des chaînes de caractères ne s’opère pas au moyen des fonctions classiques de l’étape DATA, mais fait appel à des macro-fonctions spécifiques, au premier rang desquelles figurent %UPCASE et %QUPCASE.
La distinction entre la fonction macro standard %UPCASE et sa variante de masquage %QUPCASE est fondamentale lors de l’ingénierie de programmes complexes. Alors que %UPCASE convertit simplement les lettres en minuscules d’un texte macro en majuscules, %QUPCASE réalise cette même conversion tout en masquant temporairement les caractères spéciaux et les opérateurs logiques (tels que ‘&’, ‘%’, les virgules ou les guillemets) qui pourraient être malencontreusement interprétés par le macro-processeur lors de la phase de résolution textuelle. Cette précaution neutralise le risque de plantage du compilateur macro face à des paramètres textuels imprévisibles.
Il importe de maîtriser la chronologie d’exécution du système SAS : les macro-fonctions de casse s’exécutent au moment de la précompilation textuelle (macro-time), tandis que les fonctions scalaires comme UPCASE s’exécutent lors de l’évaluation itérative des observations (run-time). Pour invoquer une fonction de casse de l’étape DATA au sein de l’environnement macro (par exemple pour appliquer la fonction PROPCASE, qui ne possède pas d’équivalent macro natif direct sous la forme %PROPCASE), le programmeur fait appel à l’interface %SYSFUNC, sous la syntaxe %SYSFUNC(PROPCASE(¯o_variable)). Cette passerelle technique assure une porosité contrôlée et sécurisée entre le macro-langage et la bibliothèque de fonctions scalaires.
12.2 Conception d’une macro-fonction de nettoyage textuel réutilisable
Dans les centres de recherche clinique et les départements biostatistiques d’envergure, l’industrialisation des traitements textuels passe par le développement de macro-fonctions génériques réutilisables, intégrées dans des bibliothèques d’autocall validées selon les normes de l’industrie. La conception d’une macro modulaire dédiée à l’harmonisation de la casse garantit une uniformité totale à travers l’ensemble des études menées par l’organisme.
Une macro-fonction de nettoyage textuel robuste doit accepter plusieurs paramètres stratégiques : le nom de la table d’entrée, le nom de la table de sortie, la liste des variables textuelles à transformer, le type de casse désiré (UP, LOW ou PROP), ainsi qu’un argument optionnel définissant d’éventuels délimiteurs spécifiques pour PROPCASE. Au moyen d’une boucle macro itérant sur le dictionnaire des métadonnées (accessible via le dictionnaire SASHELP.VCOLUMN), la macro inspecte la longueur native de chaque variable ciblée et applique la fonction adéquate sans aucun risque de troncature.
De surcroît, une telle infrastructure logicielle intègre des mécanismes de journalisation automatisée. À chaque exécution, la macro inscrit dans le journal SAS des messages d’information standardisés indiquant le nombre de colonnes modifiées, les paramètres typographiques appliqués ainsi que les éventuelles valeurs manquantes détectées. Cette traçabilité documentaire renforce le contrôle de qualité interne et simplifie les audits techniques lors des revues de code méthodologiques.
12.3 Documentation, traçabilité et reproductibilité scientifique
L’intégration de protocoles de manipulation de la casse dans un écosystème de recherche scientifique s’aligne étroitement avec les directives internationales de la science ouverte (Open Science) et les principes FAIR (Faciles à trouver, Accessibles, Interopérables et Réutilisables). Toute modification apportée à l’état morphologique originel des données textuelles doit être explicitée dans le journal d’analyse de recherche (research logbook) et couverte par des programmes SAS versionnés.
Le respect absolu du principe d’immutabilité des tables sources brutes constitue la clé de voûte de cette démarche d’intégrité. Les jeux de données issus directement des instruments de mesure ou des bases de saisie ne doivent sous aucun prétexte être modifiés de façon destructive par des instructions in-situ. Les scripts d’assainissement doivent impérativement opérer une scission nette entre le répertoire des données brutes (raw data) et le répertoire des données dérivées prêtes à l’analyse (analysis-ready datasets), attestant d’une traçabilité algorithmique intégrale et sans faille.
Pour sceller la validation de l’étape de prétraitement textuel, une check-list d’assurance qualité systématique doit être complétée préalablement au verrouillage de la base de données. Cet audit final vérifie l’absence de troncature de chaîne via le contrôle des métadonnées, confirme l’alignement typographique des clés de jointure à l’aide de PROC COMPARE, et atteste que la distribution des modalités catégorielles ne comporte plus de scissions artificielles dues à la casse. Ce niveau d’exigence méthodologique garantit que les conclusions dérivées des analyses statistiques reflèteront scrupuleusement la vérité des observations empiriques, à l’abri de tout artefact computationnel.
Références
- Cody, R. (2018). Cody’s Data Cleaning Techniques Using SAS (3rd ed.). SAS Institute Inc. https://support.sas.com/en/books.html
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc. https://support.sas.com/en/books.html
- International Organization for Standardization. (1991). Information technology — ISO 7-bit coded character set for information interchange (ISO/IEC Standard No. 646:1991). https://www.iso.org/standard/4777.html
- SAS Institute Inc. (2020). SAS 9.4 Functions and CALL Routines: Reference (5th ed.). SAS Institute Inc. https://go.documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lefunctionsref/titlepage.htm
- SAS Institute Inc. (2021). SAS Viya Operations and Programming Reference. SAS Institute Inc. https://support.sas.com/en/software/viya.html
- The Unicode Consortium. (2023). The Unicode Standard, Version 15.1.0. Unicode Consortium. https://www.unicode.org/versions/Unicode15.1.0/