
Dans le domaine de l’analyse computationnelle et de l’ingénierie des données, la lisibilité et la traçabilité du code source constituent les piliers fondamentaux de la reproductibilité scientifique. Le langage de programmation statistique R, conçu initialement par Ross Ihaka et Robert Gentleman au sein du département de statistique de l’Université d’Auckland, s’est imposé comme une référence incontournable tant dans le monde académique que dans l’industrie décisionnelle. Pourtant, malgré la sophistication théorique de son moteur d’évaluation vectorielle et la richesse inégalée de son écosystème de paquets hébergés sur le Comprehensive R Archive Network (CRAN), les analystes débutants et chevronnés se heurtent fréquemment à une limitation syntaxique surprenante : l’absence apparente d’un mécanisme natif dédié spécifiquement à la création de commentaires sur plusieurs lignes, à l’image des délimiteurs de blocs omniprésents dans d’autres langages algorithmiques.
Cette particularité grammaticale engendre régulièrement des interrogations pratiques et des débats d’ergonomie logicielle. Dans des projets d’envergure impliquant des pipelines statistiques sophistiqués, la nécessité de consigner de volumineux blocs explicatifs — qu’il s’agisse de justifier le choix d’un modèle non linéaire, de détailler un protocole d’imputation de valeurs manquantes ou d’isoler temporairement des sections d’algorithmes complexes pour des phases de débogage — requiert des stratégies méthodologiques rigoureuses. Comprendre comment contourner élégamment cette restriction stylistique sans compromettre l’intégrité de l’environnement d’exécution ni alourdir la charge cognitive de l’analyste représente une compétence indispensable pour quiconque aspire à produire du code professionnel et pérenne.
Ce guide encyclopédique se propose d’explorer de manière exhaustive l’ensemble des méthodes, des paradigmes et des conventions éditoriales permettant d’implémenter des commentaires multilignes dans le langage R. En combinant l’analyse des propriétés du parseur natif, les raccourcis d’automatisation offerts par les environnements de développement intégrés modernes tels que RStudio, ainsi que les alternatives fonctionnelles et les approches de documentation formalisée, cette étude offre un panorama complet des meilleures pratiques de documentation scripturale appliquées aux sciences des données.
1. Introduction à l’annotation de code dans l’analyse de données en R
1.1 Le rôle épistémologique de la documentation du code
L’annotation rigoureuse du code source transcende la simple commodité de programmation pour s’établir comme une véritable exigence épistémologique dans le contexte de l’analyse de données expérimentales et observationnelles. Dans le paradigme de la recherche reproductible, un script d’analyse ne se limite pas à une suite d’instructions exécutables destinées à la machine ; il incarne le récit formel d’une démarche scientifique, décrivant la trajectoire logique menant des données brutes aux inférences finales. La présence de commentaires explicatifs détaillés permet de documenter les postulats théoriques sous-jacents, les critères d’exclusion d’échantillons, les justifications de transformations non linéaires de variables ou encore les motifs du choix de certains hyperparamètres algorithmiques. Sans cette couche sémantique explicite, le code court le risque permanent de devenir opaque, non seulement pour les pairs amenés à auditer les calculs, mais également pour l’auteur lui-même lors de consultations ultérieures.
Par ailleurs, la documentation textuelle au sein des scripts concourt directement à l’atténuation de la charge cognitive ressentie lors des phases de relecture, de révision par les pairs ou de maintenance logicielle. Les pipelines statistiques contemporains manipulent fréquemment des structures de données multidimensionnelles, imbriquent des requêtes de filtrage complexes et mobilisent des algorithmes d’estimation non paramétriques dont la lecture brute n’explicite pas spontanément l’intention analytique. En fournissant des synthèses contextuelles régulières sous la forme de paragraphes explicatifs, l’analyste libère la mémoire de travail de son lecteur, qui peut dès lors se focaliser sur la validation méthodologique plutôt que sur la rétro-ingénierie laborieuse de la logique algorithmique.
Enfin, au sein d’équipes de recherche interdisciplinaires regroupant des statisticiens, des bio-informaticiens, des économètres et des experts sectoriels, les commentaires étendus opèrent comme une passerelle de communication essentielle. Ils garantissent l’intégrité analytique en explicitant les choix de prétraitement qui, autrement, pourraient être mal interprétés ou altérés par inadvertance lors de modifications collaboratives. La traçabilité exhaustive des modifications, consignée directement au cœur des scripts via des blocs de texte descriptifs, confère ainsi aux analyses quantitatives la rigueur nécessaire à leur validation institutionnelle.
1.2 Particularités structurales de l’interpréteur R
Pour appréhender l’absence apparente de constructeurs de commentaires sur plusieurs lignes, il convient d’examiner l’architecture fondamentale du moteur d’exécution de R. Conçu comme un langage interprété issu de l’héritage direct du langage S développé aux Laboratoires Bell par John Chambers, R opère selon un mécanisme d’évaluation séquentielle ligne par ligne piloté par une boucle de lecture, d’évaluation et d’affichage (REPL, pour Read-Eval-Print Loop). Lors de la phase d’analyse lexicale, le parseur lit le flux de caractères source et génère des jetons (tokens) syntaxiques. Dès que le caractère dièse est rencontré, le parseur interrompt immédiatement l’analyse lexicale pour le reste de la ligne en cours et ignore tous les glyphes subséquents jusqu’à ce qu’un caractère de fin de ligne (newline) soit formellement identifié.
Cette grammaire standard, héritée fidèlement de la spécification originelle de S, a délibérément omis d’intégrer des délimiteurs de blocs explicites tels que les séquences slash-astérisque et astérisque-slash canoniques du langage C, de Java ou du C++. Ce choix de conception n’est point une omission fortuite, mais une décision philosophique ancrée dans la tradition des langages de script Unix et des langages fonctionnels dérivés de Scheme. Les concepteurs privilégiaient une syntaxe minimale, évitant les risques d’états d’erreur asymétriques où un délimiteur de fermeture manquant engouffrerait accidentellement des portions entières de code actif sans avertissement immédiat lors d’une saisie interactive dans la console.
Cette structure entraîne toutefois des répercussions concrètes dès lors qu’un praticien doit insérer des métadonnées volumineuses, des abstracts d’articles de recherche ou des dictionnaires de variables complets au sommet d’un script. En l’absence d’une balise ouvrante et fermante universelle permettant d’enclaver plusieurs dizaines de lignes de texte brut sans préfixe individuel, l’analyste doit adapter sa pratique scripturale, soit en recourant aux fonctionnalités de son éditeur de texte, soit en détournant certaines caractéristiques d’évaluation paresseuse du langage.
1.3 Objectifs pédagogiques et méthodologiques du guide
L’ambition de cet ouvrage encyclopédique est de doter les chercheurs, ingénieurs et analystes d’une maîtrise absolue des techniques d’annotation étendue dans l’environnement R. Il s’agit en premier lieu de dissiper la confusion fréquente entourant l’absence de syntaxe multiligne native en cartographiant méthodiquement l’ensemble des solutions disponibles pour générer des blocs de commentaires sans introduire d’anomalies de parsing ni dégrader les performances d’exécution des scripts.
Sur le plan méthodologique, ce guide propose une évaluation critique et comparative des diverses approches existantes. Nous confronterons la méthode canonique reposant sur la répétition du symbole unaire d’annotation — hautement optimisée par les environnements de développement intégrés modernes — avec des artifices syntaxiques internes tels que l’usage de structures conditionnelles non exécutées ou la déclaration de chaînes littérales anonymes. Chaque technique sera disséquée sous l’angle de sa validité technique, de son impact sur l’empreinte mémoire et de sa conformité avec les conventions professionnelles de développement logiciel en R.
Enfin, ce document vise à formaliser des standards de documentation rigoureux, directement transposables dans les flux de travail académiques et industriels. À travers des démonstrations appliquées issues du traitement de données expérimentales, de la modélisation statistique et du développement de paquets R, le lecteur acquerra les réflexes nécessaires pour documenter élégamment ses travaux, garantissant ainsi la pérennité, l’audibilité et l’élégance de sa production computationnelle.
2. La syntaxe fondamentale des commentaires en langage R
2.1 Le symbole dièse (#) comme opérateur unaire d’annotation
Dans la grammaire lexicale formelle du langage R, l’unique opérateur désigné pour l’annotation est le caractère dièse, couramment désigné sous les appellations de croisillon ou hash en typographie anglophone. Sur le plan opérationnel, cet opérateur agit de manière strictement unaire et contextuelle. Lorsque le flux de compilation ou d’interprétation rencontre ce caractère, le moteur de parsing désactive l’évaluation syntaxique pour l’intégralité des octets subséquents sur la ligne courante. Que le dièse apparaisse au tout premier rang d’une ligne ou qu’il soit inséré après une instruction valide (formant alors un commentaire dit en ligne ou inline comment), le résultat demeure invariablement le même : tout le contenu situé à sa droite devient sémantiquement transparent pour l’évaluateur.
Il importe de souligner la distinction absolue que fait le parseur entre le caractère syntaxique d’annotation et le glyphe dièse lorsqu’il se trouve encapsulé à l’intérieur d’une chaîne de caractères délimitée par des guillemets doubles ou simples. Dans une instruction déclarant une variable textuelle contenant un code hexadécimal de couleur ou un mot-clé précédé d’un dièse, le symbole perd instantanément sa fonction d’interrupteur d’interprétation pour être traité comme un élément constitutif du littéral textuel. Pareillement, au sein d’expressions régulières manipulées via les fonctions natives ou les fonctions spécialisées, le symbole dièse conserve une sémantique littérale, sauf activation explicite de modes de commentaires internes spécifiques aux moteurs d’expressions régulières.
Cette stricte séparation garantit une imperméabilité totale entre la structure d’exécution du programme et les métadonnées explicatives. Aucune interférence ne peut survenir entre les commentaires et le graphe de calcul de l’interpréteur, conférant au dièse une robustesse absolue : un commentaire préfixé par ce symbole ne produira jamais d’effets de bord fonctionnels, de modifications de pointeurs d’environnement ou de perturbations du ramasse-miettes (garbage collector).
2.2 L’absence de syntaxe native de bloc multiligne
Contrairement aux langages issus de la tradition algorithmique du C où les séquences ouvrantes et fermantes créent des îlots d’ignorance lexicale sur des pans entiers de code, R ne possède strictement aucun mot-clé ni aucune combinaison de jetons permettant d’initier un bloc de commentaires multilignes délimité de manière native. Dans des langages tels que Python, les docstrings composées de triples guillemets peuvent, bien que constituant techniquement des chaînes littérales, faire office de blocs d’annotation multilignes acceptés par convention. En R, toute tentative d’importer arbitrairement de telles structures en espérant un traitement passif par l’interpréteur conduit inéluctablement à des erreurs d’analyse syntaxique (syntax error) ou à des allocations d’objets inutiles dans l’espace de calcul.
Cette lacune structurelle apparente répond à un impératif de conception d’une rigueur absolue. Dans un langage massivement employé via des consoles interactives où les instructions sont transmises bloc par bloc ou ligne par ligne à l’évaluateur, la présence de commentaires de bloc introduirait un risque majeur de rupture de synchronisation. Si un utilisateur soumettait par mégarde une balise ouvrante sans sa contrepartie fermante dans un terminal interactif, l’interpréteur demeurerait indéfiniment en état d’attente passive (signalé par l’invite de continuation représentée par le signe plus), neutralisant l’exécution subséquente de tous les scripts ultérieurs jusqu’à interruption forcée du processus.
Néanmoins, pour le praticien rédigeant de longues dissertations méthodologiques ou consignant des équations décrivant un modèle bayésien au sein d’un fichier source, cette absence contraint la rédaction. Chaque saut de ligne brise l’immunité lexicale conférée par le dièse de la ligne précédente. En conséquence, pour qu’un paragraphe étendu soit reconnu comme commentaire continu par l’évaluateur, il est impératif que chaque ligne individuelle composant le paragraphe commence par son propre caractère dièse distinct.
2.3 Gestion des espaces et propreté typographique
L’usage du dièse, bien que techniquement suffisant dès lors qu’il est présent, est soumis à des règles d’hygiène stylistique et typographique rigoureuses au sein de la communauté R, formalisées notamment dans le célèbre guide de style rédigé par Hadley Wickham. La première règle élémentaire concerne l’insertion systématique d’une espace insécable ou standard immédiatement après le caractère dièse et avant le début du texte explicatif. Une ligne d’annotation débutant sans cette séparation visuelle compromet la lisibilité immédiate en donnant une impression de surcharge visuelle compacte, particulièrement préjudiciable sur des écrans haute résolution.
Sur le plan de l’alignement architectural, lorsqu’un commentaire s’insère au cœur d’un bloc de code indenté — par exemple à l’intérieur du corps d’une fonction, d’une boucle itérative ou d’une clause conditionnelle —, le caractère dièse doit impérativement respecter le niveau d’indentation du code adjacent. Placer le dièse en colonne zéro alors que le code environnant est indenté de deux ou quatre espaces constitue une rupture stylistique majeure qui déstructure la hiérarchie visuelle du script. Les conventions modernes recommandent de conserver un retrait rigoureusement identique entre le code actif et les commentaires explicatifs associés.
En outre, la propreté typographique impose de limiter la largeur des lignes de commentaires à une longueur maximale comprise entre 80 et 100 caractères. Un commentaire sur plusieurs lignes ne doit en aucun cas consister en une suite de lignes de longueurs disparates générant des effets de drapeaux visuellement disgracieux. Le découpage régulier des phrases, harmonisé sur une marge fixe, confère au script l’apparence ordonnée d’une publication savante, facilitant l’évaluation collaborative sur des plateformes d’hébergement de versions telles que GitHub ou GitLab.
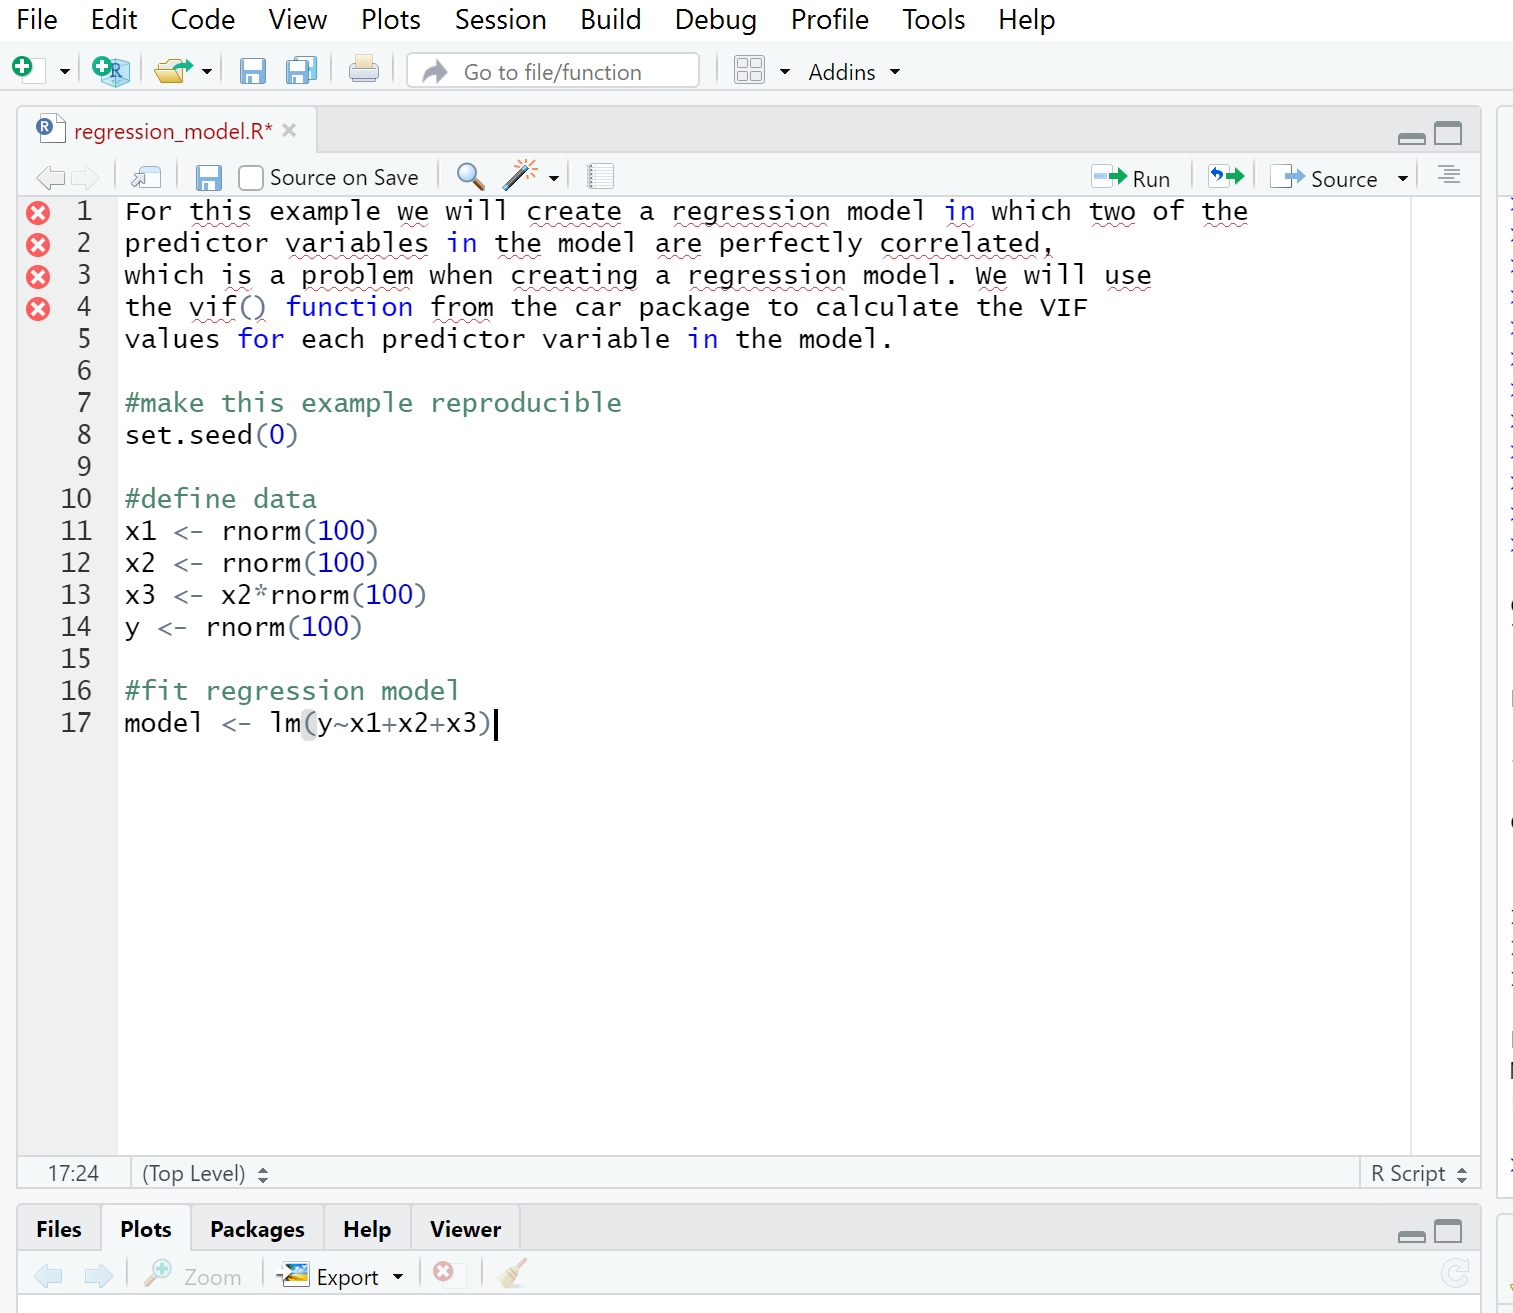
3. Méthode standard dans RStudio : L’utilisation du raccourci clavier
3.1 Fonctionnement du raccourci sous différents systèmes d’exploitation
Pour pallier l’absence de syntaxe native de bloc sans contraindre l’analyste à une fastidieuse frappe manuelle du symbole dièse au début de chaque ligne, l’environnement de développement RStudio (conçu par Posit) a standardisé une fonctionnalité de métaprogrammation éditoriale pilotée par des raccourcis clavier universels. Sous les systèmes d’exploitation Windows et les distributions GNU/Linux, l’utilisateur réalise l’opération en combinant simultanément les touches Contrôle, Majuscule et C (représenté formellement par la séquence Ctrl + Maj + C ou Ctrl + Shift + C). Cette combinaison a été minutieusement sélectionnée pour s’intégrer harmonieusement dans les habitudes ergonomiques des développeurs sans entrer en collision avec les raccourcis système standards de gestion du presse-papiers.
Au sein de l’écosystème macOS d’Apple, la commande est naturellement transposée selon les conventions d’interface de la plateforme : elle mobilise la touche Commande conjointement avec la touche Majuscule et la lettre C (formalisé en Cmd + Shift + C). Le mécanisme sous-jacent est orchestré par le moteur d’édition de texte de RStudio (basé sur Ace ou ses composants propriétaires successifs), qui intercepte l’événement clavier avant même que le moindre flux textuel ne soit transmis au processus R sous-jacent.
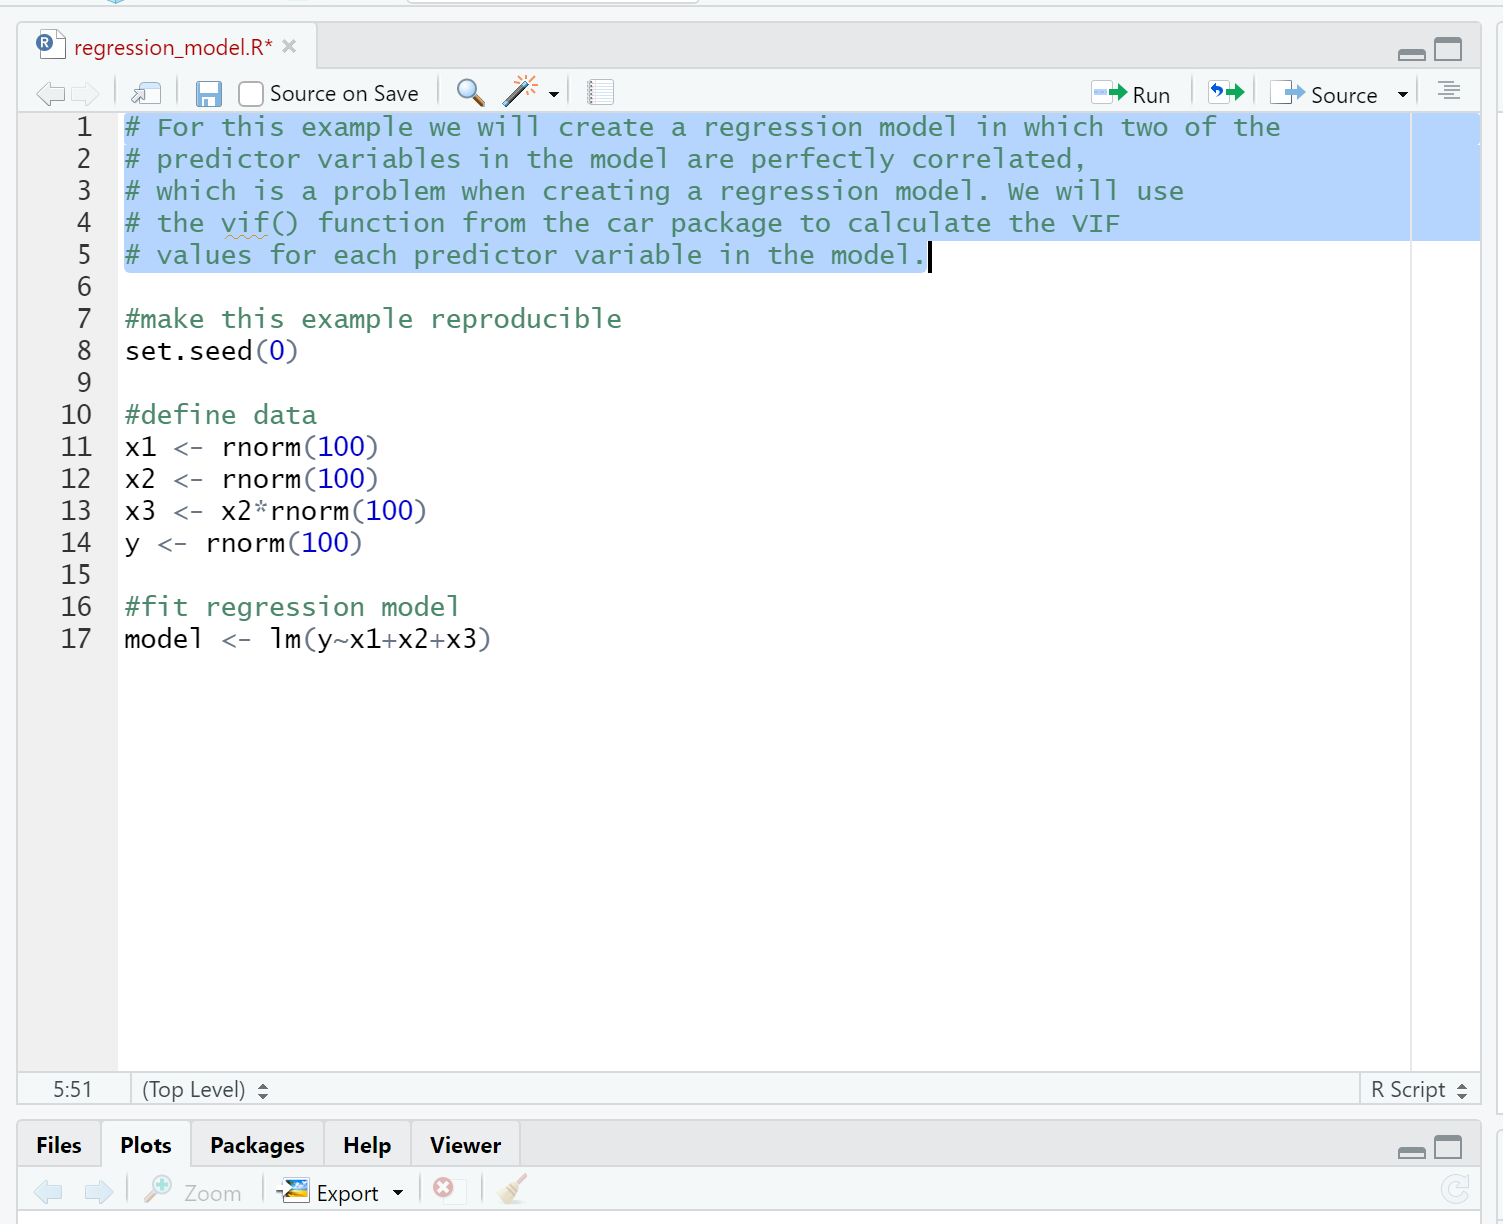
Il est crucial de comprendre que ce raccourci n’opère aucune transformation syntaxique au niveau du compilateur R. Il s’agit exclusivement d’une macro logicielle d’édition textuelle qui analyse la sélection active, identifie les coordonnées matricielles des lignes de code surlignées, et procède à une injection automatisée du symbole dièse immédiatement suivi d’une espace au début de chaque ligne sélectionnée. Cette opération modifie directement le tampon de texte (buffer) en mémoire vive de l’éditeur, garantissant une conformité absolue avec les attentes grammaticales du parseur officiel de R.
3.2 Procédure pas-à-pas pour la mise en commentaire sélective
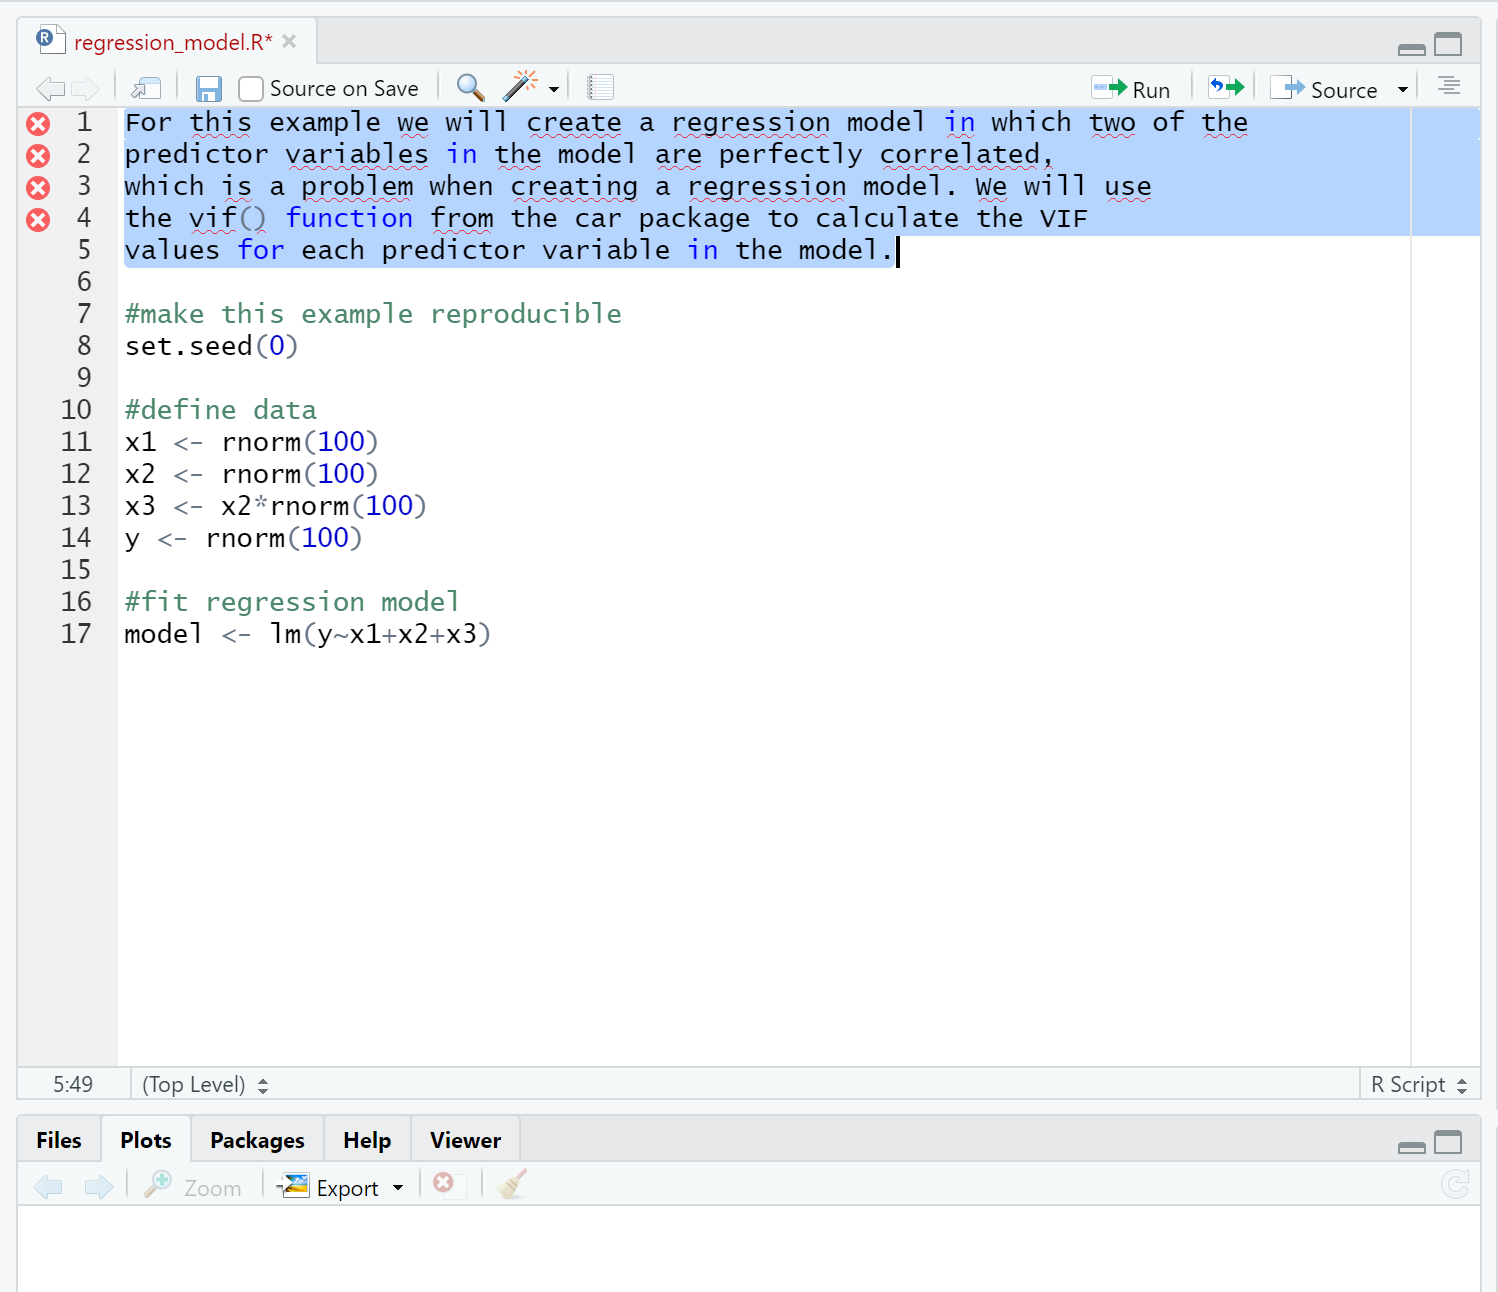
L’exécution de la mise en commentaire multiligne dans RStudio s’articule autour d’une démarche ergonomique d’une grande fluidité. La première étape consiste à délimiter la région de texte cible à l’aide du curseur. L’analyste peut procéder à un surlignage continu en maintenant le bouton gauche de la souris enfoncé ou en utilisant les flèches directionnelles combinées avec la touche Majuscule du clavier. Il convient de souligner que RStudio ne requiert nullement la sélection exhaustive de l’intégralité du premier et du dernier caractère du paragraphe : il suffit qu’au moins un fragment ou un point d’ancrage du curseur traverse une ligne pour que l’éditeur reconnaisse cette dernière comme faisant intégralement partie de la zone d’opération.
Une fois le surlignage établi, l’application de la séquence clavier (Ctrl + Shift + C ou Cmd + Shift + C) déclenche l’altération instantanée du bloc. L’éditeur inspecte chaque ligne de manière autonome. Si les lignes sont indentées, le moteur d’édition fait preuve d’une intelligence contextuelle remarquable : au lieu de placer le dièse à la première colonne physique du document (ce qui détruirait l’architecture visuelle du code), il positionne le symbole au niveau précis de l’indentation active, préservant ainsi l’alignement structural du paragraphe.
Dans les situations où le paragraphe sélectionné contient des lignes entièrement vierges (contenant uniquement un saut de ligne ou des espaces invisibles), RStudio adopte un comportement optimisé selon les versions : soit il insère un dièse unique sans espace subséquente sur la ligne vide afin de maintenir la continuité du bloc visuel de commentaires, soit il préserve la vacuité de la ligne pour aérer le paragraphe. Cette approche prévient l’introduction de résidus de code accidentels et assure une esthétique irréprochable au texte commenté.
3.3 Personnalisation des raccourcis dans l’IDE
Bien que la combinaison Ctrl + Shift + C bénéficie d’une universalité remarquable au sein de la communauté des utilisateurs de R, des impératifs ergonomiques ou des incompatibilités avec certaines configurations régionales de claviers (telles que certaines dispositions spécifiques où la touche C associée à Majuscule déclenche des caractères diacritiques ou des actions tierces) peuvent nécessiter une réaffectation fonctionnelle. RStudio offre un gestionnaire avancé de mappage clavier, accessible via la barre de menus supérieure en suivant le chemin : Tools (Outils) puis Modify Keyboard Shortcuts (Modifier les raccourcis clavier).
À travers cette interface interactive, l’analyste peut rechercher la commande canonique intitulée Comment/Uncomment Lines (Commenter/Décommenter les lignes). Un double-clic sur le champ de saisie associé permet d’enregistrer une nouvelle combinaison personnalisée. Par exemple, les utilisateurs habitués aux conventions de certains autres environnements logiciels comme Visual Studio Code peuvent préférer attribuer la commande à la séquence simple Ctrl + Slash (ou Cmd + /), réduisant ainsi le nombre de touches simultanées nécessaires à l’opération.
L’optimisation de cette ergonomie s’avère particulièrement précieuse lors des sessions intensives d’analyse exploratoire où le va-et-vient entre la documentation explicative et l’isolation rapide de portions de code constitue une activité permanente. La personnalisation permet également de prévenir les micro-traumatismes musculo-squelettiques liés à des extensions complexes des doigts et renforce l’efficience opératoire du chercheur ou de l’ingénieur de données au quotidien.
4. Exemples pratiques d’application du raccourci multiligne dans RStudio
4.1 Exemple 1 : Documentation d’un protocole expérimental
Considérons le cas concret d’une étude clinique randomisée en double aveugle analysée dans R. L’analyste souhaite consigner, directement au début de la phase de modélisation, le rationnel guidant l’inclusion de covariables sociodémographiques et les critères d’ajustement pour des covariables environnementales. Avant toute opération, le texte est initialement rédigé en prose libre, dépourvu du moindre marqueur syntaxique :
Protocole d’ajustement du modèle de régression logistique.
Cohorte A : Patients recrutés entre janvier 2021 et décembre 2022.
Les covariables suivantes sont incluses systématiquement :
– Âge à l’inclusion (exprimé en années continues)
– Indice de masse corporelle (kg/m2)
– Statut tabagique stratifié en trois modalités fonctionnelles.
Le seuil de significativité alpha est rigoureusement fixé à 0.05 avec correction de Bonferroni.
En surlignant l’ensemble de ce paragraphe de sept lignes et en déclenchant la combinaison de touches Ctrl + Shift + C sous un système Windows ou Cmd + Shift + C sous un environnement macOS, RStudio transforme instantanément la prose en un bloc syntaxiquement passif pour le compilateur :
# Protocole d’ajustement du modèle de régression logistique.
# Cohorte A : Patients recrutés entre janvier 2021 et décembre 2022.
# Les covariables suivantes sont incluses systématiquement :
# – Âge à l’inclusion (exprimé en années continues)
# – Indice de masse corporelle (kg/m2)
# – Statut tabagique stratifié en trois modalités fonctionnelles.
# Le seuil de significativité alpha est rigoureusement fixé à 0.05 avec correction de Bonferroni.
Cette conversion instantanée élimine radicalement tout risque d’erreur d’exécution lors du sourçage du fichier complet (via la commande source()). L’indentation des sous-éléments sous forme de tirets demeure intacte, préservant la hiérarchie sémantique du protocole tout en garantissant une transparence totale pour l’interpréteur R.
4.2 Exemple 2 : Désactivation temporaire de blocs d’instructions
Une application quotidienne du mécanisme de mise en commentaire multiligne réside dans l’inhibition temporaire de calculs statistiques chronophages ou d’étapes de nettoyage de données au cours des cycles itératifs de test et de débogage. Imaginons un script manipulant un volumineux tableau de données via les verbes de transformation du paquet dplyr :
donnees_traitees <- donnees_brutes %>%
filter(!is.na(valeur_cible)) %>%
group_by(centre_hospitalier, annee) %>%
mutate(moyenne_centre = mean(mesure_continue, na.rm = TRUE)) %>%
ungroup() %>%
distinct(identifiant_patient, .keep_all = TRUE)
Dans l’hypothèse où l’analyste soupçonne l’étape de regroupement ou le calcul de la moyenne par centre d’induire un goulot d’étranglement computationnel ou une discordance statistique dans la suite de l’algorithme, il peut souhaiter isoler temporairement ces lignes spécifiques. En sélectionnant précisément les deux lignes contenant group_by et mutate, puis en sollicitant le raccourci d’édition, le pipeline devient immédiatement :
donnees_traitees <- donnees_brutes %>%
filter(!is.na(valeur_cible)) %>%
# group_by(centre_hospitalier, annee) %>%
# mutate(moyenne_centre = mean(mesure_continue, na.rm = TRUE)) %>%
ungroup() %>%
distinct(identifiant_patient, .keep_all = TRUE)
L’analyste n’a pas eu besoin de détruire son travail antérieur ni de le couper-coller dans un document annexe. Il peut exécuter le script résiduel (en veillant simplement à raccorder les opérateurs de tuyauterie ou à adapter le flux logique) afin d’évaluer les effets différentiels de cette omission, prévenant efficacement les régressions algorithmiques et fluidifiant la démarche de diagnostic méthodologique.
4.3 Exemple 3 : Encapsulation de métadonnées institutionnelles
La pérennité d’un script scientifique requiert la présence d’un cartouche d’en-tête standardisé, spécifiant l’identité des investigateurs, leurs affiliations institutionnelles, la date de création originelle, la version de R employée lors de la validation initiale ainsi que les conditions d’octroi de licence d’utilisation. Lors de la phase initiale de conception d’un nouveau projet, l’auteur rédige fréquemment ces mentions administratives sous la forme d’un canevas textuel brut :
Titre du projet : Modélisation spatio-temporelle de la prévalence épidémique
Auteur principal : Dr. Alexandre de Montesquieu (Institut National de Recherche)
Co-investigateurs : Équipe DataScience Santé Publique
Date de création : 14 Mars 2024
Dernière révision : Version 2.1.0
Licence : Creative Commons Attribution 4.0 International (CC BY 4.0)
Système requis : R version 4.3.0 ou ultérieure
L’utilisation de la séquence Ctrl + Shift + C transforme ce manifeste institutionnel en un en-tête canonique, immédiatement visualisable et respectueux des normes de codage :
# Titre du projet : Modélisation spatio-temporelle de la prévalence épidémique
# Auteur principal : Dr. Alexandre de Montesquieu (Institut National de Recherche)
# Co-investigateurs : Équipe DataScience Santé Publique
# Date de création : 14 Mars 2024
# Dernière révision : Version 2.1.0
# Licence : Creative Commons Attribution 4.0 International (CC BY 4.0)
# Système requis : R version 4.3.0 ou ultérieure
Cet en-tête ainsi commenté ne pollue en rien l’environnement global de travail (Global Environment). Il ne génère aucune variable indésirable dans la mémoire vive tout en fournissant à quiconque inspecte le code brut l’ensemble des éléments contextuels indispensables pour citer adéquatement l’analyse ou contacter l’équipe de recherche en charge du maintien du pipeline.
5. Décommenter efficacement des blocs de code multilignes dans RStudio
5.1 Le mécanisme de bascule (toggle) de la commande
L’une des plus grandes forces de l’implémentation logicielle des raccourcis dans RStudio réside dans la nature bivalente de l’instruction, qui agit comme un interrupteur logique à bascule (toggle). L’algorithme interne de l’éditeur ne se contente pas d’ajouter aveuglément des caractères d’annotation : il procède au préalable à une inspection sémantique de l’état initial des lignes composant la sélection active. Si l’ensemble des lignes sélectionnées commence déjà par un symbole dièse, l’application de la même combinaison Ctrl + Shift + C (ou Cmd + Shift + C) déclenche la suppression coordonnée de ce caractère d’en-tête.
Cette intelligence opératoire se distingue par sa propreté typographique : l’éditeur ne supprime pas uniquement le croisillon, il évacue également la première espace d’espacement qui le suivait immédiatement, si celle-ci avait été insérée lors de l’opération de mise en commentaire initiale. Le code sous-jacent retrouve rigoureusement son positionnement d’origine, son indentation millimétrée et son statut d’instruction exécutable, sans qu’aucun décalage structurel ou artefact de frappe ne vienne altérer sa conformité syntaxique.
Ce mécanisme symétrique réduit considérablement le temps nécessaire aux phases d’exploration où des blocs entiers d’instructions statistiques sont alternativement activés puis désactivés. En permettant de passer d’un état à l’autre par une unique pulsation clavier, RStudio élimine les manipulations laborieuses consistant à effacer manuellement chaque dièse ligne par ligne, opération proverbiale pour introduire des suppressions accidentelles de parenthèses ou de portions critiques de code.
5.2 Gestion des blocs mixtes contenant du code actif et des commentaires
Une difficulté d’ergonomie fréquente survient lorsqu’un analyste surligne une région hétérogène, comprenant à la fois des instructions informatiques exécutables et des lignes de commentaires préexistants destinés à expliquer ces instructions. Dans une telle configuration mixte, le comportement de l’éditeur doit être minutieusement appréhendé afin d’éviter des confusions méthodologiques.
Face à un bloc mixte, la logique par défaut de RStudio privilégie la sécurité : constatant qu’au moins une ligne du bloc sélectionné n’est pas commentée, l’interpréteur de commandes éditoriales applique le dièse à l’intégralité des lignes surlignées. Les lignes de code deviennent des commentaires (précédées d’un dièse), tandis que les commentaires explicatifs d’origine se voient flanqués d’un deuxième dièse consécutif (formant une séquence ##). Si l’utilisateur réapplique immédiatement la commande, la bascule s’inverse et supprime un niveau d’annotation sur chaque ligne, restaurant le code actif d’une part, et rétablissant les commentaires d’origine à leur statut initial à simple dièse d’autre part.
Toutefois, pour éviter l’inversion involontaire ou la double superposition de commentaires lors de manœuvres partielles, les développeurs aguerris mobilisent la technique des curseurs multiples (multi-cursors). Dans RStudio, en maintenant la touche Alt enfoncée sous Windows/Linux (ou Option sous macOS) tout en faisant glisser la souris verticalement, il est possible de créer une ligne de saisie verticale couvrant plusieurs dizaines de lignes. Cette approche permet de cibler chirurgicalement uniquement les lignes de code à décommenter ou à commenter, sans jamais affecter les annotations narratives intercalées.
5.3 Vérification syntaxique post-décommentage
La réactivation d’un bloc de code multiligne précédemment désactivé ne doit jamais s’effectuer sans une vigilance méthodologique quant à l’intégrité globale du script. Lors de la phase de réintégration, il est fréquent qu’un bloc de code ait été décommenté alors que son environnement syntaxique immédiat a été altéré dans l’intervalle : modifications de noms de variables en amont, suppression de bibliothèques tierces, ou altération de structures de contrôle environnantes.
RStudio intègre un moteur d’analyse statique de code qui fonctionne en arrière-plan et inspecte continuellement l’arbre de syntaxe abstraite du document ouvert. Dès qu’un bloc est décommenté, ce moteur diagnostique immédiatement les potentielles anomalies syntaxiques. La présence d’une parenthèse, d’un crochet ou d’une accolade non appariée au sein du bloc réactivé est instantanément signalée par l’apparition d’un pictogramme d’avertissement rouge ou jaune dans la marge gauche de l’éditeur, complété par un soulignement ondulé sous le segment fautif.
Il constitue une bonne pratique établie d’effectuer immédiatement après le décommentage d’une section substantielle un test de compilation localisé en exécutant le bloc via la combinaison Ctrl + Entrée (Cmd + Return). Cette démarche garantit que le code dégelé ne provoque pas d’arrêt intempestif de l’interpréteur et s’intègre harmonieusement dans l’état computationnel actif de la session R.
6. Approches alternatives natives : Les structures conditionnelles non exécutées
6.1 Le constructeur logique if (FALSE)
Au-delà de l’usage des opérateurs dièses orchestré par les éditeurs de texte, il existe dans la grammaire interne du langage R une technique programmatique permettant de neutraliser l’exécution de blocs substantiels sans insérer le moindre symbole dièse au début de chaque ligne. Cette approche repose sur le constructeur conditionnel fondamental du langage, articulé autour de la structure logique if (FALSE) { ... }.
Le principe computationnel est d’une simplicité mathématique désarmante : l’instruction if évalue une condition booléenne stricte. En assignant la constante logique invariante FALSE comme prédicat de test, l’analyste garantit de manière déterministe que le corps de l’instruction — encapsulé entre l’accolade ouvrante et l’accolade fermante — ne sera jamais exécuté par la machine virtuelle de R. Le flux d’instructions franchit l’évaluation du prédicat, constate sa fausseté absolue, et poursuit son exécution immédiatement après l’accolade fermante.
Cette structure offre ainsi un mécanisme élégant pour mettre en réserve des centaines de lignes d’instructions ou des blocs de prose explicative au sein d’un document R sans avoir recours à des macros de transformation textuelle. La portion de code demeure parfaitement visible et structurée, tout en demeurant complètement inerte au moment de l’exécution séquentielle du script.
6.2 Exemples concrets de contournement via if (FALSE)
L’utilité principale de cette technique se manifeste lors du développement d’algorithmes statistiques complexes comportant des phases d’optimisation numérique ou des routines d’échantillonnage de Monte-Carlo par chaînes de Markov (MCMC) réclamant des heures de calcul. Prenons l’illustration suivante :
if (FALSE) {
# Modèle bayésien à haute intensité computationnelle
modele_lourd <- brm(
formule_complexe,
data = donnees_satellitaires,
iter = 50000,
chains = 8,
cores = 8
)
saveRDS(modele_lourd, file = « resultats_modele_lourd.rds »)
}
Dans cet exemple, l’ensemble des instructions logées au sein de l’accolade est ignoré lors du sourçage global du script. L’analyste peut ainsi laisser coexister dans le même fichier la routine d’ajustement initiale du modèle et les instructions d’exploitation post-estimation situées plus bas dans le script (comme la lecture simple du fichier de résultats préalablement sauvegardé via readRDS()). La mémoire vive de la session R n’est en aucune façon sollicitée par les objets définis dans le bloc conditionnel inactif.
Sur le plan des performances d’exécution, la traversée d’un bloc if (FALSE) impose un coût temporel infinitésimal, mesurable en fractions de microsecondes, correspondant simplement au temps requis par le moteur d’exécution pour constater la valeur booléenne fausse du test et sauter au pointeur de l’accolade fermante dans la table des symboles.
6.3 Mises en garde et limitations impératives de la méthode
En dépit de son apparente flexibilité, le recours à la clause if (FALSE) comporte une contrainte architecturale majeure que tout développeur en R doit impérativement appréhender : le corps de la condition doit être syntaxiquement valide aux yeux du parseur de R. Bien que les instructions ne soient jamais exécutées lors de la phase d’évaluation, le fichier source doit néanmoins être intégralement compilé ou parsé avant toute exécution.
Par conséquent, si un analyste tente d’utiliser un bloc if (FALSE) pour y rédiger un long texte en langage naturel sans respecter les règles de syntaxe de R, l’interpréteur lèvera immédiatement une erreur fatale d’analyse syntaxique :
if (FALSE) {
Attention : ce protocole nécessite d’avoir vérifié l’homogénéité des variances.
L’échantillon numéro 4 présente une aberration statistique évidente.
}
Dans ce scénario, la présence de deux-points, d’apostrophes non appariées ou d’espacements arbitraires sans opérateurs valides fera échouer le parseur de R dès la lecture du fichier, empêchant l’exécution de la moindre ligne du script, y compris celles situées bien en amont de cette structure. La structure if (FALSE) ne peut donc en aucun cas servir de substitut universel pour la rédaction de commentaires textuels libres ; son usage doit être formellement circonscrit à la désactivation temporaire de code R syntaxiquement irréprochable.
7. L’utilisation de chaînes de caractères littérales isolées pour les blocs de texte étendus
7.1 Le concept de chaîne littérale anonyme
Une seconde approche alternative native, souvent méconnue mais parfaitement conforme à la grammaire officielle de R, repose sur la déclaration de chaînes de caractères littérales autonomes et anonymes. En langage R, toute constante littérale textuelle définie entre guillemets doubles ou guillemets simples constitue une expression syntaxiquement recevable. Si cette chaîne de caractères n’est affectée à aucun identifiant d’objet (c’est-à-dire sans l’opérateur d’assignation <- ou =), elle est évaluée comme une valeur scalaire isolée puis immédiatement déréférencée par le ramasse-miettes.
L’interpréteur R accepte nativement que les chaînes de caractères littérales s’étendent sur plusieurs lignes successives sans exiger de délimiteurs de continuité ou de caractères d’échappement pour les sauts de ligne. Il est donc parfaitement possible de concevoir un bloc de documentation multiligne en ouvrant un guillemet double au début d’un paragraphe et en ne le refermant qu’à l’issue de plusieurs pages de texte continu :
«
DOCUMENTATION DES VARIABLES CLINIQUE DU PROJET EPIDEMIO-2024
Cette étude compile les mesures hémodynamiques relevées sur 450 sujets.
Chaque enregistrement comprend :
– Pression artérielle systolique et diastolique (mmHg)
– Fréquence cardiaque moyenne au repos
– Marqueurs sériques d’inflammation (CRP, interleukine-6)
«
# Le code R actif commence ici
library(survival)
Dans cet exemple, l’ensemble du bloc textuel est interprété sans la moindre erreur par le parseur, sans qu’aucun dièse n’ait été apposé sur les lignes intermédiaires. L’expression textuelle forme un tout continu et cohérent.
7.2 Syntaxe moderne : Les chaînes brutes (raw strings)
Historiquement, l’usage de chaînes littérales classiques pour rédiger de longs commentaires présentait un inconvénient notoire : si le texte explicatif contenait des guillemets internes, des apostrophes ou des barres obliques inverses (antislashs, couramment employés dans les formules mathématiques en syntaxe LaTeX ou dans les chemins d’accès de fichiers), le parseur de R exigeait que ces caractères soient scrupuleusement échappés à l’aide d’une barre oblique inverse sous peine de déclencher des erreurs de troncature de chaîne.
Depuis l’avènement majeur de R version 4.0.0, le langage a introduit le concept extrêmement puissant de chaînes de caractères brutes (raw strings). Cette syntaxe novatrice emprunte le préfixe r"(...)" ou R"(...)", dans lequel les délimiteurs peuvent être personnalisés pour éviter toute collision avec le texte interne. Grâce aux chaînes brutes, l’analyste peut intégrer des blocs massifs de documentation intégrant n’importe quel caractère sans jamais avoir recours à l’échappement :
r »—(
Manuel utilisateur du modèle mathématique :
L’équation différentielle s’énonce sous la forme :
frac{dS}{dt} = -beta frac{S I}{N}
Les chemins de données sont formatés selon le standard Windows :
C:UsersAnalysteDocumentsDonnees_Cliniques
Aucun caractère n’a besoin d’être échappé entre ces délimiteurs.
)—«
Cette fonctionnalité confère une robustesse exceptionnelle à la consignation de documentations techniques avancées directement dans le corps des scripts R, abolissant les contraintes de formatage textuel traditionnelles.
7.3 Évaluation des effets de bord sur l’environnement de travail
Bien que séduisante par sa concision et son indépendance vis-à-vis des fonctionnalités des éditeurs tiers, l’utilisation de chaînes de caractères anonymes multilignes soulève des réserves méthodologiques substantielles qui en restreignent l’usage professionnel. Le premier écueil réside dans le mode d’évaluation interactif. Lorsqu’un utilisateur exécute un script ligne par ligne dans la console de RStudio ou d’un terminal R, l’évaluation d’une chaîne littérale anonyme a pour conséquence d’afficher l’intégralité du texte dans la console de sortie, polluant le journal des opérations statistiques.
Le second enjeu concerne la gestion de la mémoire et les performances d’exécution. Contrairement à un véritable commentaire préfixé par un dièse qui est totalement éliminé de l’arbre syntaxique lors de l’analyse lexicale, une chaîne de caractères littérale — fût-elle anonyme — constitue un objet de type character vector qui doit être temporairement alloué dans le tas (heap) de la session R avant d’être marqué pour destruction par le mécanisme de collecte des ordures mémoire. Si cette pénalité demeure insignifiante pour de petits scripts, elle peut dégrader marginalement les performances lors du chargement itératif de milliers de micro-scripts au sein de grappes de calcul haute performance.
Enfin, sur le plan de la communication avec les pairs, un bloc de texte encapsulé entre guillemets est visuellement ambigu. Un lecteur externe peut s’interroger sur l’intention du concepteur : s’agit-il d’un simple commentaire négligé ou d’une variable oubliée qui aurait dû être assignée à un objet de configuration ? C’est pourquoi la majorité des guides de style académiques et industriels déconseillent cette approche au profit des commentaires stricts préfixés par des dièses.
8. Documentation structurée multiligne avec roxygen2 pour les projets de recherche
8.1 Principes du paradigme roxygen2
Lorsque le développement de scripts analytiques s’oriente vers la construction de paquets R formels destinés à être diffusés sur le CRAN ou des dépôts de recherche ouverts (tels que Zenodo ou GitHub), l’annotation de code change de dimension méthodologique. Elle abandonne le statut de note contextuelle informelle pour embrasser un paradigme de documentation intégrée rigoureuse, rendu possible par le paquet standard roxygen2.
Le système roxygen2 s’inspire directement des concepts pionniers de la programmation lettrée théorisés par Donald Knuth et des solutions éprouvées comme Javadoc ou Doxygen. Il résout la question des commentaires multilignes en introduisant une convention d’annotation normalisée : chaque ligne constitutive du bloc de documentation d’une fonction doit débuter par la séquence indissociable formée d’un dièse suivi immédiatement d’une apostrophe droite (#' ). Cette combinaison indique au parseur de roxygen2 que les lignes ainsi marquées ne constituent pas de simples commentaires ignorables, mais forment un bloc de métadonnées destiné à être compilé pour générer automatiquement les pages d’aide officielles du logiciel (les fichiers d’aide au format Rd stockés dans le sous-dossier man d’un paquet).
Cette approche unifiée abolit la dissonance cognitive entre l’écriture du code algorithmique et la rédaction de la documentation externe. Le développeur maintient le code et son descriptif dans un même champ visuel continu, garantissant une synchronisation permanente entre les arguments formels d’une fonction et leurs définitions explicatives.
8.2 Balises fondamentales pour les fonctions statistiques
L’ossature d’un bloc de documentation multiligne roxygen2 s’articule autour de balises sémantiques universelles préfixées par le symbole arobase (@). Ces balises permettent de structurer l’information de façon modulaire et normalisée :
- @title et @description : Les premières lignes non balisées d’un bloc roxygen2 sont conventionnellement attribuées au titre synthétique de la fonction, suivi immédiatement d’un paragraphe étendu détaillant sa logique méthodologique et son champ d’application statistique.
- @param : Cette balise, répétée autant de fois qu’il existe d’arguments formels dans la signature de la fonction, documente la nature des paramètres d’entrée attendus, leurs types de données (matrice, vecteur numérique, tableau de données data.frame) ainsi que leurs contraintes scalaires.
- @return : Décrit minutieusement la structure, la dimensionnalité et la classe de l’objet produit par l’algorithme (par exemple, une liste nommée contenant les coefficients estimés, la matrice de variance-covariance et les résidus standardisés).
- @examples : Délimite un espace d’exemples d’utilisation concrets, entièrement reproductibles et autonomes, qui seront validés dynamiquement lors des tests d’intégration du paquet.
- @references : Permet de citer formellement les publications scientifiques, les monographies de référence ou les articles méthodologiques établissant les théorèmes sur lesquels s’appuie l’implémentation.
- @export : Indique au compilateur d’espace de noms (NAMESPACE) que la fonction documentée doit être rendue publiquement accessible à l’utilisateur final lorsque le paquet est chargé.
8.3 Exemple complet de fonction documentée selon les normes roxygen2
Pour matérialiser l’excellence typographique et structurelle d’un bloc multiligne roxygen2, examinons la formulation d’une fonction calculant un coefficient de corrélation intraclasse dans le cadre d’études de fidélité inter-juges :
#’ Calcul du coefficient de corrélation intraclasse (ICC)
#’
#’ Cette fonction estime le coefficient de corrélation intraclasse pour un modèle
#’ à effets aléatoires à une voie, conformément aux formules dérivées par
#’ Shrout et Fleiss (1979). Elle gère les données déséquilibrées par estimation
#’ du maximum de vraisemblance restreint.
#’
#’ @param donnees Un objet de type data.frame contenant au moins les identifiants
#’ des sujets et les scores quantitatifs attribués par les évaluateurs.
#’ @param variable_score Chaîne de caractères précisant le nom de la colonne
#’ abritant la mesure continue dépendante.
#’ @param variable_sujet Chaîne de caractères précisant le nom de la colonne
#’ identifiant les unités observationnelles individuelles.
#’
#’ @return Une liste de classe ‘resultat_icc’ contenant les composantes suivantes :
#’ item{icc_estime}{Valeur scalaire du coefficient ponctuel estimé.}
#’ item{intervalle_confiance}{Vecteur numérique de longueur deux délimitant
#’ l’intervalle de confiance à 95 pour cent.}
#’ item{variance_inter}{Variance estimée entre les sujets.}
#’ item{variance_residuelle}{Variance d’erreur non expliquée.}
#’
#’ @references Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations:
#’ uses in assessing rater reliability. Psychological Bulletin, 86(2), 420-428.
#’ @export
#’ @examples
#’ df_test <- data.frame(
#’ sujet = rep(1:10, each = 3),
#’ score = rnorm(30, mean = 50, sd = 10)
#’ )
#’ calculer_icc(df_test, « score », « sujet »)
calculer_icc <- function(donnees, variable_score, variable_sujet) {
# Début du corps fonctionnel de l’algorithme statistique
modele <- lm(donnees[[variable_score]] ~ as.factor(donnees[[variable_sujet]]))
anv <- anova(modele)
msb <- anv$ »Mean Sq »[1]
msw <- anv$ »Mean Sq »[2]
k <- length(donnees[[variable_score]]) / length(unique(donnees[[variable_sujet]]))
icc <- (msb – msw) / (msb + (k – 1) * msw)
return(list(icc_estime = icc))
}
Grâce à ce déploiement standardisé, l’invocation de l’instruction devtools::document() analysera ce bloc multiligne pour forger un document d’aide d’une précision chirurgicale, immédiatement consultable via l’opérateur d’interrogation ?calculer_icc au sein de n’importe quelle session de travail.
9. Fonctionnalités de mise en commentaire dans d’autres éditeurs de code
9.1 Configuration et raccourcis dans Visual Studio Code
L’essor fulgurant de Visual Studio Code (VS Code) comme environnement de développement polyvalent a conduit de nombreux data scientists à délaisser partiellement RStudio au profit de la plateforme modulaire de Microsoft. Associé à l’extension officielle R développée par Yuki Ueda et le groupe REditorSupport, VS Code propose une prise en charge native extrêmement puissante de la manipulation de blocs de commentaires multilignes.
Sous VS Code, le raccourci canonique pour commenter ou décommenter un bloc de texte en R est harmonisé avec l’ensemble des autres langages pris en charge par l’éditeur : il s’agit de la combinaison Ctrl + Slash (ou Cmd + / sous macOS). Lorsque l’utilisateur surligne une série de lignes et applique cette commande, VS Code détecte automatiquement le fichier source comme étant rédigé en langage R et insère le préfixe dièse avec une régularité mathématique. De surcroît, VS Code prend en charge la combinaison spécifique de commentaire de bloc (Block Comment) via Maj + Alt + A (ou Shift + Option + A sous macOS). Bien que R ne possède pas de syntaxe native de bloc, l’extension injecte intelligemment des dièses au début de chaque ligne de la sélection, imitant parfaitement l’effet d’un délimiteur de bloc.
Pour accroître l’efficacité de la documentation, les analystes configurant des extraits de code (snippets) dans le fichier de préférences JSON de VS Code peuvent automatiser l’insertion de cartouches de commentaires prédéfinis. Une simple frappe d’un mot-clé déclencheur tel que header suivi de la touche tabulation permet d’injecter instantanément un en-tête institutionnel complet commenté, personnalisable à l’aide de variables dynamiques telles que la date système ou le nom d’utilisateur.
9.2 Édition avancée dans GNU Emacs avec ESS (Emacs Speaks Statistics)
Pour les chercheurs académiques et les développeurs inscrits de longue date dans la tradition des logiciels libres sous Unix, l’éditeur GNU Emacs, épaulé par l’environnement package Emacs Speaks Statistics (ESS), constitue le pinacle de l’ergonomie computationnelle. Conçu dans les années 1990 pour interagir initialement avec S et S-PLUS avant d’intégrer R, ESS intègre une modélisation extrêmement subtile de la typographie des commentaires multilignes.
Dans l’écosystème ESS, la commande universelle d’annotation est matérialisée par la séquence méta-point-virgule (accessible par Alt + ; ou Esc ;). Lorsqu’une région textuelle active est sélectionnée, cette instruction bascule l’état de commentaire du bloc complet. Mais la particularité fondamentale d’ESS réside dans son système de pondération structurelle des commentaires selon le nombre de dièses consécutifs employés :
- Un dièse unique (#) : Réservé par convention aux commentaires de fin de ligne (inline). ESS aligne automatiquement ces annotations sur une colonne prédéfinie (par défaut la colonne 40).
- Deux dièses consécutifs (##) : Dédiés aux commentaires intercalés au sein du code. ESS indente ce bloc pour l’aligner précisément sur le niveau d’indentation logique du code adjacent.
- Trois dièses consécutifs (###) : Réservés aux en-têtes de fonctions ou aux sections majeures. Ces commentaires sont rigoureusement alignés sur la colonne zéro (extrême gauche), quel que soit le niveau d’imbrication du bloc dans le script.
Cette régulation automatisée de l’alignement typographique confère aux scripts édités sous Emacs ESS une élégance esthétique incomparable, plébiscitée dans les laboratoires de statistique mathématique.
9.3 Pratiques sous Vim / Neovim et Nvim-R
L’univers modal des éditeurs Vim et Neovim, notamment enrichi par le greffon spécialisé Nvim-R ou par l’intégration d’arbres syntaxiques via Tree-sitter, offre une rapidité d’exécution foudroyante pour les praticiens maîtrisant la navigation au clavier. En l’absence de tout greffon d’assistance, la création manuelle d’un commentaire multiligne s’effectue avec une économie de gestes exemplaire via le mode visuel bloc :
L’opérateur positionne son curseur au début de la première ligne du paragraphe cible, enclenche le mode visuel bloc par la séquence Ctrl + v, descend son curseur verticalement jusqu’à la dernière ligne souhaitée à l’aide de la touche j, presse la touche I (Majuscule + i) pour activer l’insertion en début de bloc, frappe le symbole # suivi d’une espace, puis presse la touche Échappement (Esc). Instantanément, Neovim réplique la frappe sur l’ensemble des lignes de la zone délimitée.
Pour une intégration encore plus productive, l’adoption de gestionnaires d’annotations modulaires contemporains tels que Comment.nvim permet de commenter et décommenter n’importe quel bloc logique en mode normal via la séquence mnémonique simple gcc (pour la ligne courante) ou gc combiné à un opérateur de mouvement (par exemple gcap pour commenter l’intégralité du paragraphe actif). Cette vélocité opératoire s’avère particulièrement redoutable lors d’interventions sur des serveurs distants en mode terminal pur.
10. Bonnes pratiques rédactionnelles des commentaires multilignes en science
10.1 Distinction entre le ‘pourquoi’ et le ‘comment’
L’efficacité pédagogique et technique d’un bloc de commentaires multilignes repose fondamentalement sur la pertinence conceptuelle de son contenu. L’écueil le plus prégnant chez les analystes juniors consiste à utiliser les commentaires multilignes pour paraphraser mécaniquement ce que le code accomplit déjà explicitement sur le plan syntaxique. Rédiger un paragraphe entier pour expliquer qu’une fonction filter() filtre des lignes ou qu’une instruction select() retient des colonnes constitue une redondance stérile qui encombre visuellement le script sans lui apporter de valeur ajoutée cognitive.
La règle d’or d’une ingénierie logicielle mature exige que le code explicite le ‘comment’ tandis que les commentaires justifient le ‘pourquoi’. Le commentaire multiligne doit être réservé à la consignation des décisions scientifiques qui échappent à l’analyse lexicale du programme :
- Pourquoi telle distribution statistique non gaussienne a-t-elle été choisie pour modéliser le phénomène plutôt qu’un ajustement classique par les moindres carrés ordinaires ?
- Sur quel fondement méthodologique un seuil d’exclusion d’observations atypiques (outliers) fixé à 3 déviations absolues de la médiane (MAD) a-t-il été retenu ?
- Quels sont les arbitrages computationnels justifiant l’utilisation d’une approximation par quasi-vraisemblance plutôt que d’un calcul de vraisemblance exacte trop gourmand en mémoire ?
En orientant systématiquement la rédaction des annotations multilignes vers la rationalisation épistémologique des démarches, l’analyste transforme son script en un document de haute valeur intellectuelle, immédiatement compréhensible et défendable devant un comité d’audit ou un panel de réviseurs académiques.
10.2 Structuration visuelle et délimitation des sections
Dans des scripts quantitatifs volumineux s’étendant fréquemment sur plusieurs milliers de lignes, la structuration visuelle du document revêt une importance capitale pour la navigation ergonomique. RStudio a formalisé une syntaxe d’annotation extrêmement ingénieuse qui permet de transformer de simples commentaires multilignes en véritables chapitres interactifs grâce au pliage de code (code folding) et au panneau de navigation hiérarchique.
Lorsqu’une ligne de commentaire est immédiatement suivie d’une série continue d’au moins quatre caractères identiques choisis parmi le tiret simple (----), le signe égal (====) ou le dièse (####), RStudio identifie cette annotation comme une balise de sectionnement majeur. L’éditeur génère automatiquement une entrée cliquable dans le menu d’arborescence logé en bas à gauche de la fenêtre source et fait apparaître une petite flèche dans la marge numérique permettant de replier visuellement l’intégralité du code et des commentaires contenus dans cette section :
# ==============================================================================
# SECTION 3 : ANALYSE DE SURVIE MULTIVARIÉE PAR MODÈLE DE COX
# ==============================================================================
# Cette section implémente l’estimation des rapports de risques instantanés.
# Les hypothèses de proportionnalité des risques ont été formellement validées
# par l’inspection des résidus de Schoenfeld à l’étape précédente.
# ——————————————————————————
L’utilisation concertée de lignes de séparation composées de 78 ou 80 caractères confère au script un partitionnement visuel impeccable. La hiérarchisation entre titres de niveau 1 (délimités par des signes égaux), titres de niveau 2 (délimités par des tirets) et sous-remarques locales permet d’appréhender l’architecture globale d’un projet de modélisation en un coup d’œil.
10.3 Actualisation et synchronisation avec l’évolution du code
L’un des paradoxes les plus insidieux de la documentation informatique est formulé par la maxime populaire : « Rien n’est plus dangereux qu’un commentaire obsolète ». Dans le flux itératif de la recherche computationnelle, le code source fait l’objet de refactorisations perpétuelles : des fonctions sont optimisées, des jeux de données sont mis à jour, et des algorithmes de test sont substitués à d’autres. Si les blocs de commentaires multilignes ne sont pas rigoureusement actualisés au même rythme que les instructions exécutables qu’ils prétendent documenter, ils deviennent des agents de désinformation massifs.
Un commentaire affirmant qu’une imputation statistique utilise la régression logistique alors que le code sous-jacent a été migré vers un algorithme de forêts aléatoires induira immanquablement en erreur tout relecteur externe, pouvant aboutir à la publication de résultats reposant sur des postulats contradictoires. Pour conjurer cette dérive, les équipes d’analyse quantitative doivent intégrer l’audit systématique des commentaires au sein de leurs protocoles de revue de code par les pairs (peer review).
Sur le plan du suivi de versions avec Git, toute modification substantielle d’une instruction algorithmique doit systématiquement s’accompagner dans le même commit de l’ajustement du bloc d’annotation associé. Cette discipline intellectuelle garantit que l’historique des modifications conserve une cohérence sémantique absolue tout au long du cycle de vie du projet de recherche.
11. Pièges courants et implications techniques des commentaires multilignes
11.1 Consommation mémoire et temps de chargement des scripts
Une croyance répandue parmi les analystes suggère que la présence de volumes massifs de commentaires textuels est rigoureusement neutre sur les performances globales de l’environnement R. Bien que cette affirmation soit fonctionnellement exacte concernant la mémoire vive consommée par les tables d’évaluation des variables de calcul (l’environnement de travail ne stockant pas les commentaires), elle mérite une nuance technique substantielle quant au comportement de la fonction native source() et de l’analyse lexicale.
Lorsque la fonction source(file = "analyse.R") est invoquée pour exécuter un script complet depuis un environnement distant ou local, l’argument formel keep.source joue un rôle déterminant. Par défaut, en mode interactif, cet argument est assigné à TRUE. Cela signifie que l’interpréteur conserve en mémoire une copie textuelle intégrale du code source originel — y compris chaque ligne de commentaire, chaque espace et chaque retour à la ligne — afin de pouvoir restituer des messages d’erreur enrichis indiquant le numéro exact de la ligne fautive en cas d’incident d’exécution.
Dans des architectures de calcul distribué ou sur des nœuds de supercalculateurs haute performance (HPC), le chargement itératif de centaines de scripts contenant des mégaoctets de commentaires textuels descriptifs avec keep.source = TRUE peut induire une surcharge d’allocations de pointeurs textuels non négligeable et allonger de manière mesurable le temps d’analyse lexicale initiale. Dans ces environnements industriels de production, il est recommandé de débrayer expressément ce paramètre en spécifiant keep.source = FALSE pour épurer le graphe d’exécution de toutes ses scories textuelles passives.
11.2 Problèmes d’encodage de caractères dans les commentaires étendus
L’utilisation de la langue française pour la rédaction de volumineux paragraphes de commentaires multilignes expose directement les analystes aux chausse-trappes redoutables de l’encodage des caractères typographiques. La prose française abonde en caractères diacritiques complexes (accents aigus, graves, circonflexes, cédilles et ligatures) qui n’appartiennent pas au jeu de caractères ASCII de base standard à 7 bits.
Si un script est rédigé sous un environnement Windows utilisant historiquement une page de code régionale telle que Windows-1252 (CP-1252) ou ISO-8859-1 (Latin-1) et que ce même fichier est ultérieurement ouvert ou exécuté sur un serveur de calcul sous Linux fonctionnant sous l’encodage universel UTF-8 sans conversion appropriée, le parseur de R rencontrera des séquences d’octets invalides. Dans le meilleur des cas, ces incompatibilités génèrent un phénomène de corruption visuelle désigné sous le terme de mojibake (transformant par exemple le terme « modèle » en « modèle »). Dans le pire des cas, la présence d’octets mal formés dans un commentaire multiligne peut provoquer l’arrêt brutal du parseur avec émission d’une erreur fatale lors de la compilation du fichier source.
Pour prévenir ces dysfonctionnements trans-plateformes, la règle méthodologique absolue impose d’enregistrer impérativement l’ensemble des fichiers sources R sous l’encodage strict UTF-8. Dans RStudio, cette standardisation s’assure en vérifiant l’option dans le menu File puis Save with Encoding… et en veillant à configurer les préférences globales de l’IDE (Tools > Global Options > Code > Saving > Default text encoding) sur UTF-8 permanent.
11.3 Mauvaises interprétations par les outils de linting
Dans un écosystème de programmation professionnel, le respect des standards stylistiques est automatisé par des outils d’analyse statique communément appelés des linters, dont l’implémentation de référence en R est incarnée par le paquet lintr. L’intégration de longs blocs de commentaires multilignes entre fréquemment en collision avec plusieurs règles de vérification stylistique par défaut de ces analyseurs statiques.
Le conflit le plus classique concerne la règle line_length_linter, qui pénalise systématiquement toute ligne de code ou de texte excédant une limite conventionnelle fixée généralement à 80 caractères. Un analyste rédigeant une longue explication textuelle sans procéder à des retours à la ligne manuels réguliers verra son journal d’audit submergé par des dizaines d’avertissements stylistiques. De même, la règle commented_code_linter analyse l’intérieur des commentaires préfixés par des dièses pour tenter d’identifier si l’utilisateur n’aurait pas abandonné par inadvertance du code actif commenté ; or, la présence de descriptions méthodologiques contenant des symboles mathématiques ou des noms de fonctions peut tromper l’heuristique de détection et déclencher de faux positifs intempestifs.
Pour concilier la présence d’une documentation textuelle approfondie et la validation par les outils de linting, il convient de paramétrer rigoureusement le fichier de configuration local .lintr à la racine du projet. L’analyste peut y ajuster la tolérance de longueur de ligne ou exclure ponctuellement certains fichiers de documentation narrative pure de l’analyse statique automatisée.
12. Synthèse méthodologique et recommandations pour une documentation rigoureuse en R
12.1 Arbre décisionnel pour le choix de la méthode d’annotation
Face à la pluralité des mécanismes décrits tout au long de cet ouvrage, l’analyste de données doit disposer d’un cadre décisionnel clair pour sélectionner l’approche d’annotation multiligne la plus adaptée aux finalités spécifiques de son livrable logiciel :
- Contexte exploratoire ou analyse de données ad hoc (scripts uniques, nettoyage ponctuel) : La méthode universelle du dièse systématique gérée par les raccourcis d’automatisation de l’IDE (Ctrl + Shift + C dans RStudio ou Ctrl + / dans VS Code) s’impose sans équivoque. Elle assure une compatibilité absolue avec l’ensemble des systèmes sans introduire de complexité syntaxique ni de surcharge cognitive.
- Développement de paquets logiciels ou bibliothèques réutilisables (CRAN, Bioconductor) : Le recours au paradigme standardisé de roxygen2 (
#') constitue l’unique norme admissible. Il transforme les métadonnées multilignes en documentation officielle validée par les suites de tests formels. - Mise en sommeil temporaire de portions d’algorithmes complexes en phase de mise au point : Le constructeur conditionnel
if (FALSE) { ... }se révèle exceptionnellement pertinent pour désactiver des dizaines de lignes d’instructions sans modifier le texte interne, sous la réserve expresse que le bloc encapsulé demeure syntaxiquement irréprochable pour le compilateur. - Inclusion de volumineux fragments textuels bruts (manuels d’instructions, code LaTeX) : Les chaînes de caractères brutes (
r"---(...)---") constituent une alternative élégante pour préserver l’intégrité de caractères réservés ou de séquences d’échappement, à condition de tolérer leur affichage lors d’une évaluation interactive dans la console.
12.2 Intégration dans le flux de travail de recherche reproductible
L’annotation de code par blocs de commentaires ne représente qu’un jalon au sein d’un paradigme méthodologique beaucoup plus vaste : celui de la recherche scientifique entièrement transparente et computationnellement reproductible. Bien que les commentaires multilignes permettent de documenter un script R avec une rigueur exemplaire, la frontière ultime de la documentation réside dans la transition vers des formats computationnels dynamiques tels que les documents Quarto et R Markdown.
Dans un document Quarto, la dialectique entre commentaire et code actif est sublimée : le texte explicatif n’est plus contraint d’emprunter des artifices syntaxiques ou des dièses d’annotation, il se déploie librement dans un langage de balisage naturel (le Markdown) enrichi d’équations mathématiques formelles en typographie LaTeX, tandis que les instructions informatiques sont encapsulées dans des îlots d’exécution isolés (les code chunks). Les scripts R purs lourdement annotés conservent néanmoins une pertinence fondamentale pour toutes les étapes sous-jacentes de traitement lourd, d’automatisation en tâches de fond (cron jobs) ou de structuration modulaire des fonctions de calcul.
En archivant méthodiquement les scripts sources ainsi documentés au sein de systèmes d’archivage pérennes garantissant l’accès ouvert aux données et aux algorithmes, les chercheurs contribuent activement à l’effort collectif d’intégrité scientifique, assurant que leurs modélisations pourront être comprises, auditées et répliquées par les générations futures de scientifiques à travers le monde.
12.3 Tableau récapitulatif des commandes et syntaxes essentielles
Le tableau synoptique suivant résume l’ensemble des méthodes, syntaxes et environnements éditoriaux étudiés dans ce guide, offrant aux praticiens un aide-mémoire exhaustif pour structurer leurs blocs de commentaires multilignes :
Méthode 1 : Dièse multiple géré par IDE (Méthode Recommandée)
Syntaxe : # Texte de la ligne 1 / # Texte de la ligne 2
Environnements : RStudio, VS Code, Emacs ESS, Neovim.
Raccourci principal : Ctrl + Shift + C (Windows/Linux) ou Cmd + Shift + C (macOS).
Avantages : Conformité grammaticale absolue, absence totale d’effets de bord, intégration native avec le repliement de code.
Inconvénients : Dépendance aux fonctionnalités d’assistance logicielle des éditeurs tiers.
Méthode 2 : Condition logique d’inhibition
Syntaxe : if (FALSE) { instructions... }
Environnements : Universel, directement intégré au moteur d’évaluation de R.
Raccourci principal : Aucun (déclaration algorithmique native).
Avantages : Permet d’isoler instantanément de vastes ensembles d’instructions sans modifier le texte ligne par ligne.
Inconvénients : Exige impérativement une validité syntaxique stricte du contenu sous peine d’interruption fatale du parseur.
Méthode 3 : Chaîne littérale anonyme ou chaîne brute
Syntaxe : "Texte multiligne..." ou r"(Texte brut...)"
Environnements : Universel (chaînes brutes supportées à partir de R version 4.0.0).
Raccourci principal : Aucun (délimiteurs de chaînes standards).
Avantages : Neutralisation totale des contraintes d’échappement avec la syntaxe brute, aucun préfixe requis.
Inconvénients : Risque d’affichage intempestif dans la console interactive, allocation mémoire éphémère superflue.
Méthode 4 : Paradigme de documentation formelle roxygen2
Syntaxe : #' @param ... / #' @return ...
Environnements : Projets de développement de paquets R via devtools.
Raccourci principal : Compilation automatisée via Ctrl + Shift + D (Cmd + Shift + D).
Avantages : Génération automatique des fichiers d’aide officiels (Rd), rigueur formelle standardisée.
Inconvénients : Rigidité structurelle disproportionnée pour de simples scripts d’analyse exploratoire.
Références
Chambers, J. M. (2008). Software for data analysis: programming with R. Springer Science & Business Media. https://doi.org/10.1007/978-0-387-75936-4
Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299-314. https://doi.org/10.1080/10618600.1996.10474713
Knuth, D. E. (1984). Literate programming. The Computer Journal, 27(2), 97-111. https://doi.org/10.1093/comjnl/27.2.97
Peng, R. D. (2011). Reproducible research in computational science. Science, 334(6060), 1226-1227. https://doi.org/10.1126/science.1213847
Posit Software, PBC. (2024). RStudio User Guide: Keyboard Shortcuts. Posit Documentation. https://support.posit.co/hc/en-us/articles/200711853-Keyboard-Shortcuts-in-the-RStudio-IDE
R Core Team. (2024). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Wickham, H. (2019). Advanced R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781351201315
Wickham, H., & Bryan, J. (2023). R Packages: Organize, Test, Document, and Share Your Code (2nd ed.). O’Reilly Media. https://r-pkgs.org/
Wickham, H., Hester, J., & Chang, W. (2022). devtools: Tools to Make Developing R Packages Easier (R package version 2.4.5). Comprehensive R Archive Network. https://CRAN.R-project.org/package=devtools
Wickham, H., Danenberg, P., Csárdi, G., & Eugster, M. (2024). roxygen2: In-Line Documentation for R (R package version 7.3.1). Comprehensive R Archive Network. https://CRAN.R-project.org/package=roxygen2