
Dans le domaine du traitement analytique et de la gouvernance des données volumineuses, l’ingénierie textuelle occupe une place prépondérante au sein des environnements d’entreprise et des laboratoires de recherche. Le système d’analyse statistique SAS (Statistical Analysis System), reconnu pour sa robustesse algorithmique et sa conformité rigoureuse aux standards industriels, déploie une infrastructure logicielle singulière pour l’évaluation et la manipulation des structures de données scalaires et vectorielles. Parmi les opérations fondamentales de manipulation textuelle, la scission de chaînes de caractères selon des délimiteurs spécifiques constitue un pivot méthodologique essentiel, conditionnant l’intégralité du cycle de préparation des données brutes, depuis leur acquisition hétérogène jusqu’à leur incorporation dans des modèles statistiques sophistiqués.
La modélisation prédictive, la fouille de données cliniques et la consolidation des registres administratifs sont fréquemment confrontées à des agrégats textuels denses, tels que des identifiants composites, des journaux de connexions informatiques ou des codifications taxonomiques complexes. Ces éléments requièrent une désagrégation granulaire systématique afin d’isoler chaque unité sémantique au sein de variables distinctes. L’absence d’une architecture native orientée objet dans le moteur d’exécution traditionnel de l’étape DATA de SAS impose une compréhension approfondie de la gestion séquentielle de la mémoire, de la cinématique interne du vecteur de données de programme (*Program Data Vector*, ou PDV), ainsi que des spécificités fonctionnelles des outils de parsing lexical intégrés au logiciel.
Le présent traité propose une analyse exhaustive et rigoureuse des méthodologies de fractionnement textuel par délimiteur sous l’écosystème SAS. En articulant les fondements théoriques de l’allocation mémoire avec les implémentations pratiques de fonctions avancées, ce document examine la fonction cardinale *SCAN*, ses interactions avec les déclarations dimensionnelles *LENGTH*, les mécanismes d’automatisation itérative par tableaux (*ARRAYS*), l’intégration des expressions régulières compilées via la bibliothèque *PRX*, ainsi que les stratégies de factorisation macro-analytique. Cette analyse méthodique vise à équiper les statisticiens, data scientists et biostatisticiens des meilleures pratiques garantissant l’intégrité, la scalabilité et la reproductibilité de leurs protocoles de manipulation textuelle.
1. Introduction théorique et syntaxique du découpage textuel sous SAS
1.1 Fondements de la manipulation de variables alphanumériques
L’architecture interne du système SAS repose historiquement sur une bipartition stricte des types de données : les variables numériques, encodées sur une mantisse et un exposant selon la norme IEEE 754 à virgule flottante en double précision, et les variables alphanumériques, composées de suites d’octets interprétées selon un jeu de caractères défini, tel que US-ASCII, Latin-1 (ISO/IEC 8859-1) ou UTF-8. Dans ce paradigme, une variable de type caractère ne constitue pas une entité dynamique réallouable nativement lors de chaque assignation, mais un espace fixe pré-réservé en mémoire lors de l’initialisation de l’étape de compilation du système. Cette spécificité d’allocation statique implique que toute chaîne textuelle sous SAS est soumise à une contrainte de dimension physique prédéterminée, matérialisée par une suite finie d’octets comblée à droite par des espaces d’espacement (*trailing blanks*).
Les données non normalisées, provenant de systèmes transactionnels, de bases de données relationnelles ou d’extractions semi-structurées, présentent généralement une hétérogénéité structurelle prononcée. Les valeurs textuelles y sont fréquemment agrégées sous la forme de séquences concaténées par des opérateurs typographiques tels que les virgules, les barres verticales, les points-virgules ou les tirets. L’interaction entre ces chaînes non structurées et la mémoire rigide de SAS soulève des enjeux critiques : une chaîne plus courte que la réserve allouée engendre un gaspillage de mémoire vive et d’espace disque, tandis qu’une chaîne excédant cette capacité subit une troncature silencieuse ou génère des alertes majeures dans le journal d’exécution.
Le traitement textuel séquentiel s’articule autour de la lecture continue du flux de caractères de gauche à droite. Le moteur de traitement interprète la chaîne comme une matrice unidimensionnelle d’octets, dont chaque position ordinale est directement accessible via des pointeurs d’adresses relatifs. La compréhension de cette cinématique d’accès s’avère indispensable pour appréhender les transformations algorithmiques complexes, où la délimitation d’un mot dépend de la reconnaissance d’un octet de transition marquant la rupture entre deux entités lexicales consécutives.
1.2 La place du parsing textuel dans les protocoles de recherche empirique
Dans le cadre de la recherche empirique, qu’elle s’exprime au sein d’essais cliniques pharmacologiques régis par les normes du Consortium CDISC (Clinical Data Interchange Standards Consortium) ou d’enquêtes épidémiologiques longitudinales, le fractionnement textuel (*parsing*) constitue une étape indispensable de la chaîne de nettoyage des données. Les identifiants de sujets d’étude, par exemple, sont souvent construits sous une forme composite combinant le numéro de site clinique, l’identifiant du protocole, le groupe de randomisation et l’indice incrémental du patient. Une telle structure agrégée est impropre à l’analyse inférentielle directe ; les variables explicatives doivent être isolées afin de modéliser correctement les effets fixes ou aléatoires dans des régressions hiérarchiques.
De surcroît, la collecte de données informatisées s’accompagne fréquemment de formats d’encodage hybrides où des données scalaires quantitatives sont adossées à des qualificatifs d’incertitude ou des unités de mesure au sein d’un champ unique. Par exemple, une mesure de concentration biologique peut être saisie sous la forme d’une mention combinant une valeur et un seuil de détection. Le chercheur se voit contraint d’isoler l’opérateur relationnel du composant quantitatif afin d’éviter toute perte d’information lors du calcul des statistiques descriptives ou des estimateurs du maximum de vraisemblance.
La rigueur méthodologique impose que ces étapes d’extraction textuelle soient entièrement programmées, documentées et auditables. L’emploi d’approches manuelles ou de traitements interactifs non traçables contrevient aux principes fondamentaux de la reproductibilité scientifique préconisés par les agences de régulation telles que l’Agence Européenne des Médicaments (EMA) ou la Food and Drug Administration (FDA) aux États-Unis. La maîtrise des mécanismes algorithmiques de découpage textuel au sein du langage SAS s’érige ainsi en garant de la validité interne des protocoles d’analyse.
1.3 Définition formelle des délimiteurs et contraintes d’allocation mémoire
D’un point de vue formel et théorique, un délimiteur est défini comme un caractère invariant ou une séquence ordonnée de caractères agissant en tant qu’opérateur de frontière lexicale au sein d’une chaîne de symboles. Le délimiteur n’appartient pas, par nature, à la charge sémantique utile des unités qu’il sépare ; sa fonction unique consiste à partitionner le continu textuel en un ensemble discret de sous-chaînes dénommées jetons lexicaux (*tokens*). Dans le formalisme linguistique et informatique appliqué à SAS, les délimiteurs définissent les conditions d’arrêt et de réinitialisation des pointeurs d’évaluation lors du parcours séquentiel de la chaîne de départ.
La scission d’une chaîne source entraîne des contraintes d’allocation mémoire substantielles au niveau du vecteur de données de programme (PDV). Lorsqu’une variable textuelle est soumise à un découpage lexical pour produire de multiples variables filles, le compilateur SAS doit allouer une quantité fixe d’octets à chacune de ces nouvelles composantes avant même la première itération de lecture des données. Si le programmeur n’explicite pas les longueurs requises, les mécanismes d’inférence implicite du compilateur attribuent généralement une taille standardisée, souvent fixée par défaut à deux cents octets dans le cas de l’appel direct de certaines fonctions scalaires.
Il convient d’établir une distinction opérationnelle stricte entre les délimiteurs implicites reconnus nativement par le système SAS lors de l’exécution de directives générales d’entrée-sortie et les délimiteurs explicites paramétrés scrupuleusement par l’ingénieur de données au sein des fonctions de traitement textuel. Les délimiteurs implicites par défaut de l’interpréteur comprennent fréquemment l’espace typographique et d’autres caractères de contrôle, tandis que les séparateurs explicites peuvent englober n’importe quelle entité du jeu de caractères actif, qu’il s’agisse de signes de ponctuation classiques ou de caractères non imprimables tels que les tabulations horizontales ou les sauts de ligne.
2. Analyse approfondie de la fonction SCAN : Mécanismes et syntaxe
2.1 Structure fondamentale et arguments opératoires de la fonction SCAN
La fonction SCAN représente l’outil canonique et historique implémenté au sein de l’environnement SAS pour segmenter une chaîne de caractères et extraire sélectivement une sous-composante selon son rang ordinal. La syntaxe générique de cette fonction mobilise plusieurs arguments fondamentaux : la chaîne textuelle source soumise à l’analyse, un index numérique entier déterminant la position ordinale du segment à extraire, et une chaîne facultative mais fortement recommandée répertoriant l’ensemble exhaustif des délimiteurs autorisés. À partir de la version 9 du système, un quatrième argument optionnel désignant des modificateurs de comportement a été introduit pour raffiner les modalités d’évaluation lexicale.
L’argument désignant la chaîne source peut se présenter sous la forme d’un littéral textuel délimité par des guillemets simples ou doubles, d’une variable alphanumérique préexistante dans la table d’entrée, ou du résultat d’une expression fonctionnelle imbriquée. Le paramètre d’indexation, quant à lui, est une expression numérique entière indiquant quel segment disjonctif doit être restitué par la fonction. Si l’utilisateur transmet une valeur numérique non entière, le système applique une troncature directe de la partie décimale pour ne conserver que l’entier sous-jacent, conformément aux principes arithmétiques du moteur d’exécution de l’étape DATA.
La déclaration de la liste des délimiteurs s’opère par la transmission d’une séquence de caractères contigus enserrés entre apostrophes. Contrairement à une idée reçue répandue chez les praticiens novices, cette séquence ne constitue pas un motif ou une sous-chaîne multi-caractères indivisible, mais un ensemble discret d’opérateurs unitaires indépendants. Dès lors que l’algorithme rencontre n’importe lequel des symboles déclarés dans cette liste, il le traite instantanément comme un marqueur de rupture de segment, conférant à la fonction SCAN une flexibilité combinatoire remarquable.
2.2 Spécification des délimiteurs uniques et composites
L’utilisation la plus élémentaire de la fonction SCAN réside dans l’application d’un délimiteur unique pour segmenter une expression sérialisée. Un cas d’usage récurrent réside dans le fractionnement de clés primaires techniques où les différents niveaux de granularité fonctionnelle sont reliés par un tiret de soulignement (*underscore*). Dans ce cadre, la fonction scrute le vecteur de caractères et isole chaque mot en bornant son étendue entre le point de départ de la chaîne et le premier tiret de soulignement, ou entre deux tirets consécutifs, garantissant l’extraction d’éléments homogènes.
Cependant, les architectures de données modernes confrontent souvent l’analyste à des structures où plusieurs types de délimiteurs coexistent de manière arbitraire au sein d’une même observation. La fonction SCAN permet de stipuler une pluralité de délimiteurs distincts au sein du même argument littéral. Si l’on déclare une chaîne de séparation regroupant la virgule, le point-virgule et l’espace, l’analyseur lexical considérera indistinctement chacun de ces éléments comme un point d’arrêt légitime, fragmentant la chaîne dès que l’un quelconque de ces caractères est détecté par le pointeur de lecture interne.
Une caractéristique primordiale du comportement algorithmique par défaut de la fonction SCAN classique réside dans sa gestion des délimiteurs consécutifs. Dans sa configuration standard, lorsque deux ou plusieurs délimiteurs se succèdent immédiatement sans comporter de caractère textuel intermédiaire, le moteur d’évaluation les agglomère conceptuellement pour former une seule frontière logique unifiée. Ce comportement, particulièrement utile pour traiter des données formatées avec des alignements par espaces multiples, nécessite néanmoins une vigilance extrême lorsque l’absence de données entre deux délimiteurs consécutifs est censée signaler une valeur manquante.
2.3 Gestion des index positifs et négatifs pour l’extraction
L’une des fonctionnalités les plus puissantes et élégantes de la fonction SCAN réside dans l’orientation directionnelle de son parcours, commandée par le signe arithmétique de son argument d’indexation. Lorsqu’un entier positif est spécifié, la lecture de la chaîne s’effectue dans le sens conventionnel, à savoir de gauche à droite, depuis le premier caractère de la variable jusqu’à son extrémité terminale. L’indice entier positif un cible ainsi systématiquement le segment initial, tandis que l’indice deux extrait le composant suivant, selon une cinématique ascendante strictement croissante.
À l’inverse, l’assignation d’un indice négatif déclenche une inversion structurelle du pointeur d’exploration lexicale, ordonnant au moteur de débuter son analyse à partir du dernier caractère effectif de la chaîne pour progresser de droite à gauche. Ainsi, l’indice négatif un permet de capturer immédiatement le dernier mot d’une chaîne, indépendamment du nombre absolu de sous-composants qui le précèdent dans l’enregistrement. L’indice négatif deux restituera l’avant-dernier segment, et ainsi de suite. Cette approche supprime l’obligation fastidieuse de compter préalablement le nombre total de jetons pour isoler une extension de fichier, un code postal terminal ou un suffixe nominatif.
Lorsque l’indice réclamé, qu’il soit formulé de manière positive ou négative, dépasse la quantité effective de segments repérables au sein de la chaîne textuelle, le comportement du pointeur demeure stable et prévisible : la fonction SCAN n’interrompt pas le flux d’exécution de l’étape DATA et ne déclenche pas d’erreur fatale. Elle renvoie simplement une chaîne de caractères entièrement vide, composée d’espaces d’espacement. Cette tolérance algorithmique facilite grandement l’automatisation des transformations, mais exige en corollaire une vérification méthodique de la non-vacuité des sorties générées.
3. Mise en œuvre pratique : Découpage séquentiel d’une variable textuelle
3.1 Création et structuration de la table de données initiale
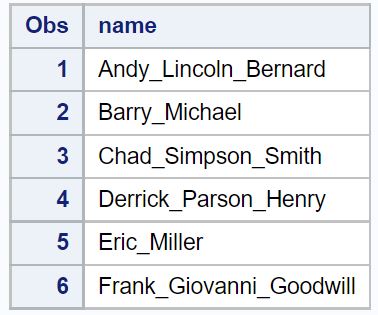
Pour illustrer méthodiquement la mise en œuvre de ces principes syntaxiques, considérons la création d’une étape DATA d’importation manipulant un échantillon représentatif de chaînes textuelles complexes issues d’un système hospitalier d’enregistrement des patients. La création contrôlée d’une table d’expérimentation requiert l’usage de la clause INFORMAT pour calibrer la réception des flux d’octets et de l’instruction DATALINES permettant de soumettre des enregistrements textuels bruts contenant des variations de structure significatives.
Dans ce scénario d’émulation, les chaînes de données brutes intègrent des identifiants complets où le nom du sujet, son identifiant clinique codé et son service d’admission sont sérialisés via des délimiteurs variés, tels que des barres obliques ou des barres verticales. L’utilisation délibérée d’une variable source dotée d’une dimension généreuse assure que le flux d’entrée n’expérimentera aucune troncature prématurée lors de la compilation initiale du vecteur de données de programme.
L’exécution subséquente de la procédure PROC PRINT s’avère indispensable pour certifier la conformité de l’ingestion brute avant toute opération destructive ou transformationnelle. Cette vérification structurelle garantit que les délimiteurs n’ont pas été altérés par des processus de transcodage implicites et permet d’observer empiriquement la variabilité quantitative des sous-composantes présentes dans chaque enregistrement.
3.2 Extraction séquentielle des composants dans de nouvelles colonnes
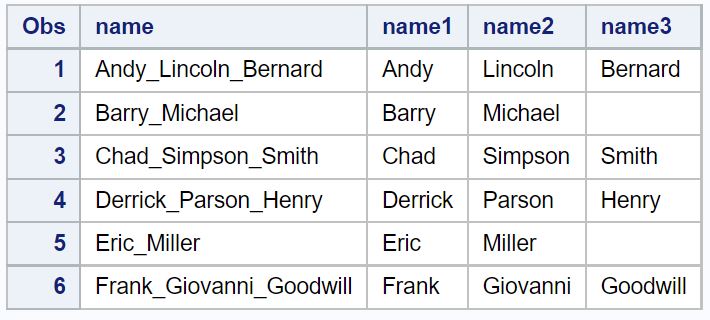
L’opération de partitionnement s’effectue par l’assignation explicite des résultats de la fonction SCAN à des variables dérivées autonomes au sein de l’étape DATA. En invoquant successivement la fonction avec des valeurs d’indices progressives, l’ingénieur de données projette chaque fragment lexical isolé au sein d’une colonne vectorielle dédiée, créant ainsi une matrice tabulaire parfaitement rectangulaire à partir d’une matière textuelle initialement dense et irrégulière.
L’isolation du premier segment s’opère par l’appel de la fonction dotée de l’indice un, capturant le nom patronymique ou le descripteur générique primaire. L’appel séquentiel subséquent avec l’indice deux extrait la référence intermédiaire, tandis que l’argument d’indice trois isole l’attribut d’affectation finale. L’un des atouts déterminants de ce mécanisme réside dans son imperméabilité totale aux variations de longueur intrinsèques de chaque sous-composant : un identifiant comportant trois caractères sera extrait avec la même précision syntaxique qu’une chaîne descriptive en comptant cinquante.
La validation formelle de cette transformation matricielle passe par l’inspection minutieuse des colonnes créées à l’aide des procédures analytiques de base. Il s’agit de s’assurer que les caractères de délimitation ont été intégralement purgés de la sortie et que les limites frontalières n’ont subi aucun glissement systématique consécutif à une mauvaise interprétation des espaces ou des signes typographiques.
3.3 Gestion de la longueur des variables et rôle préventif de l’instruction LENGTH
L’un des écueils les plus pernicieux lors de la programmation de fractionnements textuels sous SAS réside dans le mécanisme d’allocation automatique de longueur appliqué par le compilateur. En l’absence de déclaration dimensionnelle préalable, l’interpréteur de l’étape DATA, constatant qu’une nouvelle variable est initialisée par l’évaluation d’une fonction textuelle telle que SCAN, lui confère d’office une longueur par défaut de deux cents octets. Si cette allocation forfaitaire prévient les risques immédiats de troncature, elle induit une inflation exponentielle de l’empreinte volumétrique des tables de données générées.
Pour juguler cette surconsommation d’espace disque et de mémoire vive, particulièrement désastreuse dans le contexte du traitement de tables massives regroupant des dizaines de millions d’observations, l’emploi impératif de l’instruction LENGTH s’impose en amont immédiat de toute opération d’assignation. En déclarant rigoureusement la taille maximale admissible pour chaque variable fille, le programmeur contraint le vecteur de données de programme à n’allouer que le strict volume d’octets nécessaire à l’hébergement des informations effectives.
Cette discipline préventive élimine par la même occasion les messages d’avertissement susceptibles de polluer le journal d’exécution lors d’opérations comparatives ultérieures entre des variables aux dimensions mal harmonisées. L’optimisation rigoureuse de la dimension des colonnes textuelles contribue substantiellement à l’accélération des temps d’accès aux disques lors des phases d’écriture et de lecture, tout en assurant une gouvernance technique optimale des ressources matérielles allouées aux environnements d’analyse.
4. Gestion des données manquantes et disparités du nombre de délimiteurs
4.1 Comportement de la fonction SCAN face aux segments absents
Dans les jeux de données observationnelles réels, la régularité mathématique du nombre d’éléments séparés par délimiteur constitue l’exception plutôt que la norme. Lorsqu’un enregistrement présente un nombre de subdivisions inférieur à l’indice ordinal requis par l’instruction SCAN, le moteur algorithmique affecte une chaîne constituée exclusivement d’espaces à la variable réceptrice. Cette réponse par défaut s’avère conforme au formalisme de SAS, pour lequel une chaîne vide correspond intrinsèquement à une valeur alphanumérique manquante.
Il est fondamental de distinguer conceptuellement la valeur manquante textuelle, matérialisée par un ensemble d’espaces vierges de tout glyphe, de la valeur manquante numérique représentée par le point canonique au sein du système. Lorsque les sous-chaînes ainsi extraites sont subséquemment utilisées dans des conditions logiques ou des regroupements typologiques, le statisticien doit impérativement tester la présence effective d’octets non vides afin de ne pas fausser les distributions empiriques par l’inclusion non contrôlée d’entités spectrales.
L’impact de ces valeurs manquantes textuelles sur les traitements postérieurs est considérable. Lors de l’agrégation de tables via la procédure PROC FREQ ou lors de la définition de classes au sein d’analyses de survie ou de modèles linéaires généralisés, l’omission d’un traitement préalable des sous-chaînes vides peut induire la création d’une modalité orpheline regroupant l’ensemble des segments non renseignés, altérant ainsi la pertinence statistique et la puissance inférentielle des tests d’hypothèses mis en œuvre.
4.2 Traitement des délimiteurs adjacents ou successifs
L’un des défis d’ingénierie textuelle les plus épineux réside dans l’interprétation sémantique de délimiteurs adjacents. Dans un grand nombre de protocoles de transmission de données délimitées par des tabulations ou des virgules (fichiers au format CSV), la survenue de deux séparateurs consécutifs sans texte intermédiaire signale explicitement qu’un attribut déterminé n’a pas été mesuré ou enregistré pour l’observation courante. Il s’agit d’une cellule vide au sens des représentations tabulaires standardisées.
Or, comme explicité précédemment, la fonction SCAN native dans sa formulation élémentaire traite toute suite continue de délimiteurs identiques ou distincts comme une unique frontière continue. Par conséquent, elle compresse virtuellement le vide intercalaire et saute immédiatement au composant informatif suivant, décalant d’une ou plusieurs positions l’assignation ordinale des segments ultérieurs. Un tel décalage vectoriel introduit une corruption silencieuse des données, où la valeur du quatrième attribut technique se retrouve malencontreusement attribuée à la troisième colonne dérivée.
Pour parer à cette défaillance algorithmique critique, SAS a enrichi les fonctionnalités de son analyseur lexical en introduisant des modificateurs de traitement spécifiques, et propose en alternative fonctionnelle la fonction SCANQ ou des fonctions apparentées à la capture stricte de champs, permettant de stipuler explicitement que chaque délimiteur physique délimite un champ unique, même si celui-ci s’avère totalement dépourvu de matière textuelle.
4.3 Normalisation des observations structurellement incomplètes
L’assainissement de tables de données présentant des disparités structurelles aiguës impose l’application d’un cadre de normalisation méthodique. Face à des segments systématiquement manquants ou tronqués, il devient impératif d’intégrer des routines logiques d’imputation textuelle ou d’assignation d’étiquettes normalisées garantissant l’homogénéité informationnelle de l’échantillon. L’usage combiné de l’instruction IF-THEN-ELSE avec la fonction d’interrogation MISSING ou sa déclinaison alphanumérique CMISS permet d’identifier promptement les anomalies et d’y remédier.
Cette étape d’assainissement systématique empêche la persistance de vecteurs asymétriques dans la matrice d’analyse finale. Une pratique recommandée consiste à substituer aux chaînes vides des codes d’imputation explicites et conventionnels tels que l’acronyme NA (*Not Applicable*) ou ND (*Non Déterminé*), facilitant leur mise à l’écart systématique lors de l’estimation de modèles économétriques ou biostatistiques requérant une complétude absolue des prédicteurs catégoriels.
De plus, l’uniformisation structurelle des enregistrements textuels concourt à sécuriser les échanges de données au sein d’architectures distribuées. Lorsqu’une table SAS épurée est destinée à être exportée vers un environnement de base de données SQL ou vers un entrepôt de données infonuagique (*cloud data warehouse*), la conformité dimensionnelle absolue de chaque champ alphanumérique garantit l’absence d’échecs de chargement liés à des violations de contraintes d’intégrité référentielle ou de typage strict des colonnes.
5. Nettoyage et optimisation de la table finale : Utilisation de DROP et KEEP
5.1 Suppression de la variable source non scindée avec l’instruction DROP
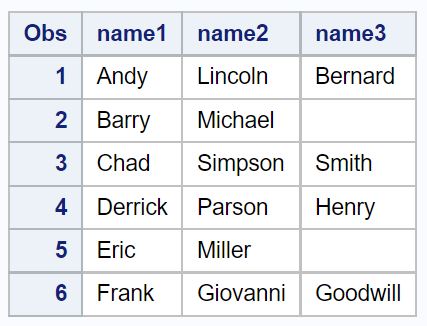
Une fois les opérations de découpage lexical accomplies et les variables dérivées dûment instanciées, la variable textuelle initiale perd fréquemment toute utilité analytique. Le maintien persistant de ces chaînes composites denses au sein des tables de production induit une redondance informationnelle flagrante et alourdit inutilement le stockage sur les systèmes de fichiers haute performance. L’hygiène logicielle et la rigueur de programmation dictent l’élimination systématique des variables mères redondantes.
L’élimination d’une variable au sein du flux de compilation SAS peut s’opérer au moyen de l’instruction globale DROP positionnée directement dans le corps de l’étape DATA. Cette instruction intime au compilateur l’ordre explicite de ne pas transcrire la colonne ciblée dans la table résultante sur disque, tout en la maintenant pleinement accessible en mémoire vive au sein du vecteur de données de programme pendant toute la durée d’évaluation séquentielle des enregistrements. La suppression s’opère donc sans aucune incidence néfaste sur la logique de partitionnement.
Alternativement, le programmeur chevronné privilégiera l’application de l’option de jeu de données DROP= directement adossée à l’instruction de sortie DATA. Cette formulation offre une sélectivité plus granulaire, notamment dans les contextes où l’étape de manipulation donne lieu à l’écriture simultanée de plusieurs tables distinctes requérant des profils de colonnes spécifiques. La réduction subséquente de la charge cognitive lors de la lecture des dictionnaires de variables simplifie grandement l’audit ultérieur des programmes.
5.2 Optimisation sélective de l’espace de stockage avec KEEP
À l’opposé de la stratégie d’exclusion soustractive incarnée par l’instruction DROP, la directive KEEP repose sur une philosophie d’inclusion restrictive et déterministe. Dans les environnements hautement sécurisés ou régis par des contraintes draconiennes de confidentialité des données personnelles (telles que le RGPD en Europe ou la loi HIPAA aux États-Unis), il est infiniment plus sûr de stipuler exhaustivement la liste fermée des variables autorisées à persister au sein de la table finale plutôt que de tenter d’énumérer l’ensemble des éléments transitoires à proscrire.
L’emploi de KEEP confère au code une résilience architecturale remarquable : toute variable temporaire générée de manière fortuite au cours de calculs intermédiaires, d’indices de boucles ou de manipulation de chaînes se trouve automatiquement exclue de la table de sortie, sans nécessiter d’intervention explicite du développeur. Cette étanchéité programmatique réduit à néant le risque de contamination des bases de production par des scories textuelles non vérifiées.
Sur le plan des performances computationnelles, bien que l’impact d’une directive KEEP soit structurellement équivalent à celui d’un DROP bien configuré en termes d’octets écrits sur disque, la clarté syntaxique apportée par une clause d’inclusion exhaustive améliore considérablement la maintenabilité à long terme des scripts analytiques, en particulier lorsque ces derniers sont appelés à être révisés par des pairs ou validés par des organismes d’audit externe.
5.3 Requalification et réorganisation spatiale des tables de données
L’ultime étape du raffinement structurel d’une table consécutive au fractionnement de variables textuelles réside dans la normalisation de la nomenclature des colonnes générées et l’ordonnancement de leur disposition spatiale au sein de l’en-tête de fichier SAS. L’instruction RENAME offre la possibilité de substituer aux appellations techniques temporaires des dénominations sémantiquement transparentes et conformes aux dictionnaires d’attributs de l’institution, facilitant leur assimilation immédiate par les analystes d’affaires.
Parallèlement, la réorganisation de l’ordre géométrique d’apparition des variables dans le vecteur de données de programme s’effectue avec une efficacité inégalée grâce à l’instruction déclarative RETAIN. En stipulant l’agencement ordonné des variables en tête de l’étape DATA, l’ingénieur impose au compilateur de définir l’agencement physique des colonnes au sein du fichier binaire de données, garantissant que les variables fractionnées se positionnent de manière logique et cohérente aux côtés des identifiants cardinaux de la table.
La confirmation de la bonne exécution de ces remaniements architecturaux passe nécessairement par le recours à la procédure PROC CONTENTS. Cette procédure d’audit génère une cartographie descriptive intégrale de la table, répertoriant la typologie rigoureuse, la longueur exacte, les étiquettes associées ainsi que l’ordre physique des variables au sein du système, scellant ainsi la conformité de l’artefact informationnel produit avec les exigences du schéma conceptuel cible.
6. Techniques avancées : Automatisation du découpage avec des tableaux (ARRAYS) et boucles DO
6.1 Déclaration et dimensionnement d’un tableau textuel dynamique
Lorsque la structure textuelle à découper héberge une séquence longue ou indéterminée de segments homogènes — à l’instar d’une chaîne de diagnostics secondaires ou d’un relevé chronologique de relevés météorologiques —, la multiplication mécanique d’instructions d’assignation individuelles devient une pratique inefficiente et génératrice de dette technique. L’ingénierie logicielle sous SAS résout cette problématique d’échelle par l’exploitation des tableaux de variables, désignés sous le terme de SAS ARRAYS.
Un tableau SAS ne constitue pas une structure de données physique en mémoire au sens conventionnel des langages C ou Java, mais une structure de commodité syntaxique qui mappe une collection ordonnée de variables distinctes préexistantes ou créées à la volée dans le vecteur de données de programme. La déclaration d’un tableau alphanumérique requiert la précision explicite du type caractère, de sa dimension cardinale, de la longueur physique assignée à chaque élément individuel, ainsi que du préfixe nominatif des variables qui le composent.
Le calibrage de la borne supérieure du tableau revêt une dimension stratégique. Il convient d’évaluer préalablement la distribution empirique de la variable textuelle pour déterminer avec certitude le nombre maximal théorique de subdivisions observables au sein de l’échantillon. Un dimensionnement insuffisant engendrerait la perte irrémédiable de données périphériques, tandis qu’un surdimensionnement excessif consommerait inutilement des ressources mémoire sans contrepartie fonctionnelle tangible.
6.2 Détermination dynamique du nombre maximal d’éléments par la fonction COUNTW
L’estimation aveugle du nombre de mots délimités au sein d’une chaîne textuelle constitue une approche fragile et potentiellement défaillante. Pour octroyer une flexibilité dynamique au code SAS, l’écosystème met à disposition la fonction hautement optimisée COUNTW. Cette fonction parcourt la chaîne d’entrée et calcule avec une vélocité computationnelle maximale le nombre exact de jetons lexicaux disjonctifs présents dans l’enregistrement, en se basant sur le même catalogue de délimiteurs que celui mobilisé par la fonction SCAN.
L’intégration de la fonction COUNTW au cœur de la logique de programmation permet d’introduire des mécanismes de contrôle adaptatifs au sein de chaque ligne de données. Si un enregistrement est totalement exempt d’informations ou se compose exclusivement d’espaces, COUNTW renvoie la valeur numérique zéro, permettant d’esquiver instantanément les blocs conditionnels de fractionnement et d’économiser ainsi de précieux cycles d’horloge du processeur.
En couplant les résultats de cette fonction avec des techniques de calcul préalables au niveau de l’étape DATA ou au sein de requêtes SQL préliminaires, il devient envisageable de paramétrer automatiquement la dimension des tableaux textuels sans la moindre intervention humaine manuelle, ouvrant la voie à des pipelines de prétraitement pleinement autonomes capables d’absorber des fluctuations structurelles substantielles dans les flux de données entrants.
6.3 Parcours itératif par boucle DO pour extraction automatisée
La symbiose entre la structure de tableau ARRAY, la mesure dynamique de granularité via COUNTW et la structure de contrôle itérative DO matérialise l’état de l’art du découpage textuel au sein de l’étape DATA de SAS. En instanciant une boucle itérative indicée de un jusqu’au plafond mesuré par COUNTW, le programmeur déclenche l’exécution d’un traitement matriciel compact capable de peupler instantanément l’intégralité des variables filles du tableau en une seule directive d’assignation paramétrée.
Au cours de chaque itération de la boucle, l’indice de boucle sert simultanément de sélecteur d’élément au sein du tableau de destination et d’argument d’indexation dynamique pour la fonction SCAN. Il en résulte une compacité algorithmique exemplaire : là où un code impératif naïf nécessiterait cinquante lignes redondantes pour extraire cinquante composantes textuelles, la boucle itérative accomplit cette même tâche au travers de trois instructions unifiées, garantissant une lisibilité irréprochable et réduisant drastiquement le risque d’erreurs de frappe ou d’inattention syntaxique.
Cette approche systématique garantit également que les itérations superflues ne sont jamais exécutées. Si une observation ne renferme que trois sous-chaînes au sein d’une structure de tableau dimensionnée pour en accueillir dix, la boucle termine son exécution dès la troisième itération, laissant les éléments résiduels du tableau sous la forme de chaînes vides. L’uniformisation algorithmique qui en découle permet d’atteindre des débits de traitement extrêmement élevés lors de l’exécution sur des volumes massifs de données d’entreprise.
7. Gestion des délimiteurs variables et multiples au sein d’une même chaîne
7.1 Spécification d’un jeu hétérogène de délimiteurs dans SCAN
L’univers des données issues du monde réel, notamment dans les contextes de collecte de données web, d’ingestion de journaux d’événements réseau ou de numérisation de documents juridiques, se caractérise par une instabilité structurelle notoire. Les chaînes textuelles y contiennent fréquemment une juxtaposition asymétrique de séparateurs différents au sein du même champ, combinant de façon arbitraire des virgules, des barres de fraction, des espaces insécables et des symboles mathématiques pour cloisonner l’information.
La fonction SCAN traite cette hétérogénéité avec une fluidité conceptuelle absolue : l’ensemble des symboles de délimitation identifiés peut être amalgamé au sein de l’argument de chaîne de séparation sans qu’aucun ordre hiérarchique ni caractère d’échappement particulier ne soit requis pour les séparateurs standard. L’interpréteur compile cet argument comme un dictionnaire de caractères de rupture et évalue séquentiellement chaque octet de la chaîne source par rapport à cette table de référence interne.
Il importe toutefois de souligner le danger inhérent aux interférences contextuelles. L’inclusion intempestive d’un signe de ponctuation grammatical courant — tel que l’apostrophe ou le point — dans la liste des délimiteurs peut engendrer le découpage catastrophique d’entités lexicales qui auraient dû demeurer indivisibles, comme les mots élidés ou les nombres décimaux. La définition de l’ensemble des délimiteurs admissibles exige par conséquent une connaissance linguistique et métier approfondie des corpus traités.
7.2 Emploi des modificateurs de la fonction SCAN (SAS 9 et versions ultérieures)
L’introduction des modificateurs de comportement à partir de la version 9 de SAS a constitué une avancée fonctionnelle majeure pour l’ingénierie textuelle, dotant la fonction SCAN d’une versatilité algorithmique jusqu’alors réservée à des langages de script spécialisés comme Perl ou Python. Ces modificateurs, renseignés sous la forme d’un quatrième argument composé d’une chaîne de lettres de contrôle, infléchissent substantiellement le moteur d’isolation des jetons lexicaux.
Le modificateur ‘M’ (*Multiple*) transforme radicalement la cinématique d’évaluation des délimiteurs consécutifs. Alors que la fonction standard fusionne les séparateurs contigus, l’activation du modificateur ‘M’ force l’algorithme à considérer rigoureusement chaque délimiteur individuel. Ainsi, la détection de deux virgules consécutives sans espace intermédiaire conduit à l’extraction formelle d’une chaîne vide représentant la valeur manquante logiquement intercalée entre ces deux bornes, restaurant une parité absolue avec les standards de manipulation de données tabulaires relationnelles.
D’autres modificateurs majeurs enrichissent cette panoplie d’outils, tels que le modificateur ‘R’ (*Reverse*) qui réoriente la recherche lexicale vers un balayage inversé de la chaîne, ou des options spécifiques dédiées à la suppression automatique des caractères de contrôle non imprimables et des espaces de bordure. La maîtrise combinatoire de ces modificateurs dispense le programmeur de longs pré-traitements d’assainissement textuel en condensant au sein d’une seule instruction une logique d’évaluation d’une grande sophistication algorithmique.
7.3 Traitement des chaînes contenant des guillemets et caractères protégés
Un problème paradigmatique particulièrement complexe en matière de découpage textuel survient lorsqu’une sous-chaîne héberge en son sein le caractère même sélectionné comme délimiteur global, le segment textuel étant alors protégé par des délimiteurs typographiques d’encadrement, tels que des guillemets simples ou doubles. Ce cas de figure correspond exactement à la structure canonique des fichiers au format CSV conformes à la norme RFC 4180 de l’IETF, où une adresse postale intégrant une virgule est obligatoirement encadrée de guillemets pour ne pas fausser le décompte des colonnes.
L’application d’une fonction SCAN standard sur une telle chaîne déclencherait une scission illégitime à l’intérieur même de l’adresse protégée, corrompant instantanément la géométrie relationnelle de la table. Pour contourner cet obstacle structurel, SAS met à disposition la fonction spécialisée SCANQ. Cette fonction dispose d’une logique contextuelle native qui neutralise l’effet scindant des délimiteurs dès lors que ceux-ci sont encapsulés au sein de paires de guillemets non équilibrées, préservant ainsi scrupuleusement l’intégrité du fragment textuel encadré.
La mise en œuvre de SCANQ requiert une attention soutenue vis-à-vis de l’échappement des guillemets eux-mêmes au sein des chaînes sources. Si des guillemets doubles sont imbriqués au sein d’un segment lui-même encadré par des apostrophes, le comportement de l’analyseur dépend de la conformité du balisage. Un audit empirique des anomalies de lecture à l’aide d’instructions de traçage s’avère indispensable pour certifier que les frontières complexes de protection ont été respectées de bout en bout par l’interpréteur SAS.
8. Comparaison technique : SCAN vs SUBSTR vs PRXPARSE (Expressions régulières)
8.1 Limites de la fonction SUBSTR face aux largeurs de segments variables
Dans l’arsenal classique des fonctions alphanumériques du système SAS, l’instruction SUBSTR occupe une place historique prépondérante, étant dédiée à l’extraction de sous-chaînes à partir de positions fixes d’adressage absolu d’octets. Bien que redoutablement efficace et économe en ressources de calcul sur des données formatées à colonnes rigides (telles que les vieux fichiers de cartes perforées ou les exports d’unités centrales bancaires au format EBCDIC), SUBSTR dévoile des limites structurelles rédhibitoires dès lors qu’il s’agit de traiter des données à dimensions dynamiques régies par des délimiteurs.
Pour parvenir à segmenter une chaîne par délimiteur à l’aide de SUBSTR, l’analyste se trouve contraint de coupler cette fonction avec des instructions répétées de recherche de motifs telles que INDEX ou FIND, afin de calculer continuellement la position relative de chaque opérateur de séparation. Ce mode opératoire débouche sur une écriture de code d’une complexité arborescente considérable, multipliant les variables d’ajustement arithmétique d’index et augmentant exponentiellement la propension aux erreurs d’adresses décalées d’une unité (*off-by-one errors*).
Dès lors, réserver l’usage de SUBSTR aux seuls environnements où la structure physique des données garantit une invariance spatiale absolue représente une règle cardinale d’ingénierie logicielle. Toute tentative d’adapter artificiellement cette fonction à la navigation au sein de séquences textuelles de longueur arbitraire engendre un code rigide, difficilement maintenable et hautement sensible aux moindres variations dans les flux de données entrants.
8.2 Puissance des expressions régulières avec PRXMATCH et PRXPARSE
Face à des morphologies textuelles hautement désordonnées où les délimiteurs ne sont pas réductibles à de simples caractères invariants mais s’apparentent à des motifs structurels complexes — tels qu’une succession variable d’espaces, de tirets et de chiffres —, les fonctions élémentaires de découpage capitulent au profit des expressions régulières. Depuis l’intégration du moteur compatible Perl au sein de SAS à travers la suite fonctionnelle PRX, le système dispose d’une infrastructure d’analyse syntaxique dotée d’une expressivité formelle totale.
L’utilisation de la bibliothèque commence par l’appel de PRXPARSE, qui compile une chaîne de motif selon la syntaxe des expressions régulières Perl et retourne un identifiant numérique opaque représentant le pointeur de l’automate à états finis sous-jacent. Cet identifiant est ensuite transmis à des routines d’extraction telles que CALL PRXSUBSTR ou CALL PRXPOSN, autorisant la capture de groupes parenthésés hautement sélectifs isolant chaque composante de la chaîne avec une granularité chirurgicale.
Les expressions régulières autorisent l’intégration de conditions contextuelles d’assertion (*lookahead* et *lookbehind*), permettant par exemple de ne déclencher le fractionnement par virgule que si celle-ci n’est pas suivie immédiatement d’un chiffre, préservant ainsi nativement les notations décimales européennes sans requérir de logiques conditionnelles procédurales étendues. Cette sophistication fonctionnelle transforme l’approche du nettoyage textuel complexe en unifiée et concise.
8.3 Critères de performance computationnelle et compromis d’ingénierie
Si la supériorité sémantique et la flexibilité des expressions régulières compilées sont indiscutables, elles s’accompagnent d’un coût computationnel tangible qu’il appartient à l’architecte de données de quantifier rigoureusement. L’initialisation du moteur PRX et l’évaluation non déterministe d’automates textuels sur chaque enregistrement sollicitent des ressources processeur considérablement plus massives que l’exécution de fonctions natives compilées directement en langage machine au niveau du noyau de SAS.
Des analyses comparatives de performances (*benchmarks*) démontrent sans ambiguïté que la fonction SCAN surpasse systématiquement les routines basées sur PRXPARSE d’un facteur de vitesse pouvant osciller entre cinq et vingt, en fonction de la complexité des expressions et du volume de la cohorte analysée. Lorsqu’il s’agit de traiter des tables massives comprenant des dizaines ou des centaines de millions d’enregistrements, cet écart d’efficience se traduit par des différentiels de plusieurs heures de calcul sur des grappes de serveurs industrielles.
Le compromis d’ingénierie réside donc dans un arbitrage éclairé entre la puissance expressive requise et les impératifs de vélocité temporelle. La bonne pratique architecturale dicte de privilégier inconditionnellement la fonction SCAN dès lors que les délimiteurs peuvent être modélisés sous forme de collections discrètes de caractères, et de ne recourir aux moteurs d’expressions régulières PRX que dans les cas d’impasse logique où la dynamique de délimitation exige une interprétation contextuelle non linéaire du motif textuel.
9. Conversion et typage post-découpage : Du format alphanumérique au format numérique
9.1 Problématique du typage implicite généré par la fonction SCAN
Une caractéristique fondamentale du modèle de typage de SAS réside dans le principe de conservation stricte de la nature alphanumérique lors de l’application de fonctions de parsing textuel. La fonction SCAN, conçue exclusivement pour l’analyse lexicale de chaînes, retourne rigoureusement une valeur typée comme chaîne de caractères, même si le segment extrait est matériellement composé d’une succession exclusive de glyphes numériques (par exemple, le nombre deux mille vingt-quatre extrait d’un code chronologique).
Cette imposition formelle a des conséquences majeures : il est rigoureusement impossible de soumettre de telles variables dérivées directement à des procédures statistiques requérant des opérandes scalaires quantitatifs, à l’instar des procédures de modélisation PROC REG ou PROC GLM. Toute tentative d’impliquer une variable caractère issue d’un découpage dans une formule arithmétique contraint le moteur SAS à exécuter une conversion de type implicite au moment de l’exécution.
Bien que SAS assure généralement cette conversion implicite sans provoquer le blocage irréversible du programme, ce comportement constitue une entorse sévère aux bonnes pratiques de programmation. Il surcharge le journal d’exécution d’avertissements explicites signalant que des valeurs de caractères ont été converties en valeurs numériques, ralentit marginalement les cycles de traitement et occulte d’éventuelles erreurs fondamentales d’attribution de format qui auraient dû être détectées dès la phase de compilation.
9.2 Utilisation rigoureuse de la fonction INPUT pour convertir les sous-chaînes
L’approche canonique et académiquement irréprochable pour transmuter un fragment textuel scindé en une véritable variable quantitative continue réside dans le recours explicite et immédiat à la fonction de conversion INPUT. Cette fonction prend en entrée la sous-chaîne isolée par la fonction SCAN et lui applique un format de lecture spécifique (*informat*), garantissant une instanciation numérique immédiate au sein du vecteur de données de programme.
La sélection rigoureuse de l’informat conditionne la fidélité de l’opération. Pour des nombres entiers conventionnels, l’informat standard approprié sera sélectionné. Pour des valeurs financières ou des mesures de laboratoire intégrant des séparateurs de milliers, des virgules décimales ou des notations scientifiques exponentielles, le programmeur mobilisera des informats avancés tels que COMMA. ou E., permettant au système d’interpréter fidèlement la sémantique mathématique sous-jacente sans altération de magnitude.
Sur le plan syntaxique, la combinaison imbriquée se matérialise par une expression condensée unifiée où le résultat de l’extraction SCAN est directement encapsulé en tant qu’argument opératoire de la fonction INPUT. Cette pratique élégante permet de créer directement la variable fille sous son type numérique définitif sans devoir créer de variable alphanumérique intermédiaire, optimisant ainsi l’espace alloué au sein du vecteur de données de programme.
9.3 Détection et gestion des erreurs de conversion numérique
L’un des risques opérationnels les plus critiques lors de la conversion de chaînes textuelles scindées en variables quantitatives découle de la présence possible de caractères non numériques parasites au sein de la sous-chaîne isolée. Si l’utilisateur tente d’appliquer la fonction INPUT standard sur un segment hébergeant des lettres accidentelles ou des symboles d’erreur, le système déclenche des alertes majeures dans le journal, assigne une valeur manquante standard et affiche le contenu de l’enregistrement incriminé, nuisant à la sérénité des chaînes d’intégration automatisées.
Pour circonscrire élégamment cette vulnérabilité, SAS propose des modificateurs d’erreur intégrés à la syntaxe de l’informat au sein de la fonction INPUT. L’adjonction d’un point d’interrogation simple ou d’un point d’interrogation double immédiatement avant la spécification de l’informat intime au processeur l’instruction de neutraliser respectivement les avertissements d’erreur de conversion ou l’affichage verbeux de la ligne d’entrée dans le journal, tout en attribuant silencieusement et proprement une valeur manquante à l’observation défaillante.
Néanmoins, la suppression aveugle des alertes système ne saurait se substituer à une démarche de contrôle qualité proactive. La mise en place de variables indicatrices de contrôle permettant d’isoler en amont les sous-chaînes non conformes à l’aide de fonctions de vérification comme NOTDIGIT ou d’opérateurs de validation logique assure la préservation d’une traçabilité absolue des rejets de conversion au sein des protocoles de recherche clinique et d’ingénierie financière.
10. Applications empiriques : Traitement de données observationnelles complexes
10.1 Décomposition des identifiants composites de sujets d’étude
Dans les vastes répertoires épidémiologiques et les essais cliniques multicentriques internationaux, la normalisation des identifiants patients obéit fréquemment à une nomenclature sérialisée hautement structurée mais synthétisée en une chaîne alphanumérique unique. À titre d’illustration méthodologique, considérons une cohorte médicale où chaque enregistrement est rattaché à une clé composite sérialisant le pays d’investigation, le code du centre hospitalier d’inclusion, l’année d’entrée dans le protocole et le numéro séquentiel incrémental du patient, ces éléments étant séparés par des tirets verticaux.
La dissociation méthodique de cet identifiant composite à l’aide de découpages successifs basés sur la fonction SCAN permet de reconstituer instantanément les variables catégorielles hiérarchiques requises pour les analyses de variance multivariées et les modèles de fragilité en analyse de survie. Chaque niveau d’agrégation géographique et temporel se trouve ainsi individualisé dans une colonne distincte, autorisant les calculs de taux d’incidence stratifiés par pays ou par centre investigateur.
Il est impératif, à l’issue de cette décomposition, de réaliser un contrôle de conformité exhaustif garantissant l’unicité stricte de la nouvelle clé primaire composite générée par la concaténation relationnelle des variables scindées. Ce contrôle d’intégrité relationnelle, exécuté par une procédure PROC SORT assortie de l’option NODUPKEY, protège les modélisations économétriques et biostatistiques ultérieures contre tout biais de double comptage résultant d’erreurs d’assignation amont.
10.2 Extraction des séquences de réponses codifiées issues d’enquêtes
Le traitement des données psychométriques et sociologiques issues de sondages d’opinion ou d’instruments de mesure de qualité de vie confronte fréquemment les analystes à des formats de restitution hautement compactés. Afin de minimiser la charge utile lors de la transmission télématique, les réponses d’un participant à une batterie d’items sur échelle de Likert sont souvent enregistrées sous la forme d’un vecteur textuel unique, où les scores individuels sont séparés par un caractère invariant, tel qu’un point-virgule.
Pour soumettre cette matière brute à des techniques d’analyse factorielle confirmatoire ou à des évaluations de cohérence interne mesurées par le coefficient Alpha de Cronbach, il est indispensable de désérialiser cette chaîne afin de matérialiser chaque item au sein d’une dimension quantitative autonome. La combinaison d’un tableau SAS dimensionné au nombre d’items de l’instrument et d’une boucle itérative mobilisant la fonction INPUT couplée à SCAN réalise cette métamorphose architecturale avec une efficacité informatique sans équivalent.
Cette approche systématique garantit également l’harmonisation immédiate de l’orientation dimensionnelle de la table de données : le passage d’une structure compactée opaque à une structure tabulaire à variables explicatives multiples offre une visibilité directe sur la matrice de corrélation sous-jacente, facilitant l’identification d’éventuels profils de réponses stéréotypées ou d’anomalies de variance chez certains sous-groupes de répondants.
10.3 Séparation des métadonnées temporelles et contextuelles d’expérimentation
Les protocoles contemporains de capture de données en temps réel, déployés par exemple dans les études de cinétique comportementale ou le recueil de télémétrie biomédicale via des capteurs connectés, génèrent des journaux contextuels où sont imbriqués des horodatages précis, des codes d’états physiologiques et des indices de latence matérielle au sein d’un enregistrement textuel continu articulé autour de séparateurs mixtes tels que des deux-points et des arobases.
L’exploitation de ces flux massifs requiert d’isoler en premier lieu la composante chronologique brute afin de la convertir, via les informats appropriés, en un véritable horodatage SAS (*Datetime*) mesurant le nombre de secondes écoulées depuis le premier janvier mille neuf cent soixante. Simultanément, les marqueurs de condition expérimentale et de statut physique doivent être ventilés vers des variables catégorielles distinctes pour servir de covariables au sein de modèles longitudinaux à mesures répétées menés via la procédure PROC MIXED.
L’assurance de l’alignement temporel parfait entre les événements expérimentaux et les réponses physiologiques observées repose sur la précision microseconde de cette extraction. Une erreur d’adressage d’un seul octet lors du découpage des fractions de seconde fausserait irrémédiablement le calcul des vitesses de réaction ou des dérivées d’accélération motrice, soulignant l’importance stratégique d’une validation rigoureuse des algorithmes de fractionnement employés sur ces corpus observationnels critiques.
11. Automatisation macro-analytique : Conception d’une Macro SAS modulaire
11.1 Paramétrage d’une macro pour scinder dynamiquement des colonnes
L’industrialisation des chaînes de traitement statistique au sein d’organisations d’envergure repose sur la factorisation des procédures récurrentes au travers du puissant langage de macro-programmation de SAS. La conception d’une macro-routine paramétrée dédiée au fractionnement dynamique de chaînes textuelles permet d’éradiquer la duplication de code source et d’assurer une gouvernance technique rigoureuse à l’échelle d’une entreprise ou d’une unité de recherche clinique.
Une architecture macro-analytique performante doit recevoir en paramètres formels d’entrée le nom de la table source à manipuler, le nom de la table de destination à produire, l’appellation exacte de la colonne textuelle cible à scinder, le caractère délimiteur assigné et le préfixe sémantique à conférer aux colonnes filles qui seront générées. La macro-routine se charge ensuite de construire de façon programmatique les instructions LENGTH, ARRAY, DO et SCAN au sein d’une étape DATA dynamiquement assemblée lors de l’expansion macro.
La robustesse syntaxique d’une telle routine exige une gestion prudente des caractères spéciaux susceptibles de composer le délimiteur. Si celui-ci s’avère être une virgule ou une esperluette, il pourrait interférer de manière catastrophique avec le compilateur de macro-instructions de SAS lui-même. L’utilisation systématique de fonctions de masquage et de citation macro, telles que %BQUOTE ou %NRQUOTE, protège l’intégrité de la chaîne de délimitation tout au long du processus d’évaluation et de résolution des macro-variables.
11.2 Calcul macro du nombre maximal de séparateurs dans une table
Pour concevoir une macro-commande véritablement autonome et débarrassée de toute contrainte de saisie manuelle de seuils arbitraires, il est nécessaire d’y encapsuler une phase de découverte dynamique de la cardinalité maximale de découpage. Cette phase préparatoire interroge la table source en amont de l’étape de restructuration pour identifier la valeur extrême absolue du nombre de segments observables parmi l’ensemble exhaustif des enregistrements disponibles.
La mise en œuvre de cette mesure s’effectue avec une efficacité informatique exemplaire par l’entremise d’une requête structurée sous PROC SQL couplée à la fonction de dénombrement COUNTW. En formulant une sélection du maximum mathématique de la fonction COUNTW appliquée à la variable cible sur l’ensemble de la table, et en orientant le résultat vectoriel vers une macro-variable globale via la clause d’attribution INTO :, la routine acquiert la connaissance exacte de la dimension critique du traitement.
La valeur numérique ainsi encapsulée dans la macro-variable réceptrice dicte ensuite directement la dimension cardinale du tableau de variables textuelles qui sera matérialisé lors de l’étape DATA ultérieure. Cette intégration garantit un dimensionnement chirurgical absolu : le tableau disposera précisément du nombre de positions requis pour héberger la totalité des segments du cas le plus dense répertorié dans la table, interdisant toute perte d’information tout en bannissant la création de colonnes résiduelles intégralement vides.
11.3 Déploiement et modularité dans les chaînes de traitement automatisées
L’intégration d’un tel composant algorithmique dans un pipeline d’ingénierie logicielle ou d’intégration continue exige le respect de critères stricts de modularité et de résilience technique. Avant toute tentative d’exécution des instructions de transformation textuelle, la macro-routine doit obligatoirement vérifier la véracité des postulats environnementaux par l’intermédiaire de fonctions d’assertion telles que EXIST, certifiant la présence physique effective de la table source sur le système de fichiers configuré.
De surcroît, la macro doit interroger le dictionnaire des variables système (notamment via la table de métadonnées SASHELP.VCOLUMN) pour valider l’existence de la colonne spécifiée et s’assurer de sa nature rigoureusement alphanumérique. En cas d’incohérence, telle que la transmission erronée d’une variable originellement numérique ou l’absence de la table cible, la routine doit interrompre immédiatement son cycle de compilation de manière sécurisée en consignant des messages d’erreur explicites au sein du journal via la directive %PUT, prévenant toute corruption en cascade des étapes analytiques subséquentes.
Enfin, la pérennité institutionnelle de l’artefact macro-analytique impose une documentation interne exhaustive intégrant la cartographie des paramètres acceptés, les dépendances système, les limites de volumétrie testées ainsi qu’un historique versionné des modifications. Cette gouvernance garantit la transférabilité du code au sein des équipes de biostatisticiens et de développeurs de bases de données, consolidant la reproductibilité des analyses à travers le temps et les changements organisationnels.
12. Diagnostic, débogage et bonnes pratiques de programmation sous SAS
12.1 Analyse rigoureuse du journal SAS (SAS Log) et détection des anomalies
Le journal d’exécution de SAS (*SAS Log*) constitue le réceptacle analytique suprême et indissociable de toute démarche rigoureuse de développement sous cet environnement. Une exécution exempte d’erreurs fatales de compilation ne préjuge aucunement de la justesse fonctionnelle des transformations textuelles accomplies. L’analyste se doit d’auditer avec un œil critique chaque section du journal générée postérieurement à l’exécution de procédures de fractionnement de chaînes.
Une vigilance particulière doit être portée à l’émergence d’avertissements relatifs à la troncature textuelle (*truncation warnings*). La survenue d’un tel message signale invariablement qu’une variable réceptrice dérivée a été déclarée avec une longueur physique insuffisante dans l’instruction LENGTH, provoquant la coupure abrupte d’une sous-chaîne et la perte définitive d’octets informationnels précieux. Ce diagnostic requiert une recalibration dimensionnelle immédiate de la variable concernée au sein du code source.
De même, l’audit du nombre effectif d’observations lues et transcrites consigné dans les statistiques de clôture de l’étape DATA fournit une assurance primordiale quant à la conservation volumétrique de la table. Toute discordance entre le volume entrant et le volume sortant trahit une défaillance logique majeure, potentiellement provoquée par un filtrage conditionnel intempestif au sein des blocs itératifs de fractionnement.
12.2 Audit et traçabilité des étapes intermédiaires via PUTLOG
Lorsque la cinématique interne de l’étape DATA présente des comportements aberrants non expliqués par la simple lecture des tables d’agrégation finales, l’insertion chirurgicale de directives de traçage en temps réel devient incontournable. L’instruction PUTLOG représente le mécanisme d’instrumentation logicielle le plus puissant et polyvalent pour disséquer l’état instantané du vecteur de données de programme lors du traitement pas-à-pas de chaque ligne.
Contrairement aux instructions génériques d’affichage console d’autres langages, PUTLOG autorise l’inspection conditionnelle contextuelle. En couplant l’instruction avec des filtres logiques ciblant spécifiquement les enregistrements atypiques — par exemple les cas où le nombre de sous-chaînes dénombrées s’écarte de la médiane attendue —, le développeur peut injecter directement dans le journal la valeur des pointeurs de boucle, les caractères de délimitation identifiés ainsi que les sous-chaînes isolées à chaque itération élémentaire.
L’utilisation de la syntaxe spécialisée _ALL_ au sein d’une clause PUTLOG permet d’obtenir un instantané photographique intégral et non masqué de la mémoire active du vecteur de données de programme à un instant précis du cycle d’exécution. Cette traçabilité micro-analytique lève instantanément le voile sur les écueils de décalages indiciels, les corruptions silencieuses consécutives à des espaces insoupçonnés ou les anomalies d’évaluation des chaînes d’informats.
12.3 Bonnes pratiques pour la reproductibilité et la pérennité algorithmique
L’élévation du code SAS au niveau des exigences de qualité logicielle industrielle implique l’adoption d’un ensemble cohérent de conventions de programmation orientées vers la clarté et la pérennité. La première règle directrice prohibe formellement l’incorporation de valeurs numériques arbitraires directement dans les bornes de fractionnement (*magic numbers*). Toute constante dimensionnelle doit obligatoirement découler d’un calcul dynamique ou être explicitement déclarée et documentée en en-tête de programme sous forme de macro-variable paramétrique.
Parallèlement, la sélection des délimiteurs doit faire l’objet d’un commentaire méthodologique approfondi consigné au sein du script, explicitant les raisons structurelles et sémantiques ayant motivé le choix de chaque symbole. Il convient d’y détailler les hypothèses formulées quant à l’absence de ces caractères au sein de la charge utile des sous-segments, ainsi que les protocoles de mitigation prévus en cas d’apparition imprévue de séparateurs concurrents dans les flux de données futurs.
Enfin, l’interopérabilité des tables produites commande l’application scrupuleuse de standards de nomenclature harmonisés pour toutes les variables filles générées par découpage lexical. L’adoption d’un préfixe sémantique homogène complété par un suffixe ordinal strictement incrémental assure une intégration sans friction dans les catalogues de métadonnées d’entreprise, facilitant l’automatisation ultérieure des étapes de modélisation statistique et consolidant l’intégrité architecturale de l’ensemble du patrimoine informationnel.
Références
- Box, G. E., & Jenkins, G. M. (1976). Time series analysis: Forecasting and control. Holden-Day.
- Clinical Data Interchange Standards Consortium. (2021). Study Data Tabulation Model Implementation Guide (SDTMIG) for Human Clinical Trials (Version 3.3). https://www.cdisc.org/standards/foundational/sdtmig
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute Inc.
- Friedl, J. E. (2006). Mastering regular expressions (3rd ed.). O’Reilly Media.
- Horstman, D. W. (2018). SAS macro programming made easy (3rd ed.). SAS Institute Inc.
- IEEE Standards Association. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://doi.org/10.1109/IEEESTD.2019.8766229
- International Organization for Standardization. (2013). Information technology — Programming languages, their environments and system software interfaces — Information technology — Database languages — SQL (ISO/IEC 9075:2016). ISO.
- Internet Engineering Task Force. (2005). Common Format and MIME Type for Comma-Separated Values (CSV) Files (RFC 4180). https://tools.ietf.org/html/rfc4180
- SAS Institute Inc. (2020). SAS 9.4 Functions and CALL Routines: Reference (5th ed.). SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2021). SAS 9.4 Macro Language: Reference (5th ed.). SAS Institute Inc. https://documentation.sas.com
- Wicklin, R. (2013). Statistical programming with SAS/IML software. SAS Institute Inc.