
Dans l’écosystème de l’ingénierie des données et de l’analyse biostatistique, le traitement des variables alphanumériques constitue un défi perpétuel d’une complexité souvent sous-estimée. Bien que le langage SAS (Statistical Analysis System) ait initialement bâti sa réputation sur ses capacités exceptionnelles de calcul matriciel, de modélisation stochastique et de manipulation de données tabulaires massives, l’explosion des sources textuelles non structurées — telles que les comptes rendus cliniques, les journaux d’événements informatiques, les codifications nosologiques et les données d’enquêtes qualitatives — a imposé le développement d’outils textuels d’une précision chirurgicale. La capacité à interroger, segmenter et auditer des chaînes de caractères sans corrompre l’intégrité des vecteurs sous-jacents représente une compétence fondamentale pour tout statisticien ou architecte de données opérant dans des environnements réglementés.
Au cœur de cette boîte à outils algorithmique réside la fonction FIND de SAS. Introduite pour moderniser, unifier et supplanter des fonctions historiques plus rigides telles qu’INDEX, la fonction FIND s’impose comme un standard d’excellence pour la localisation scalaire de sous-chaînes. Conçue pour offrir une flexibilité paramétrique maximale, elle permet aux développeurs de naviguer au sein de corpus textuels hétérogènes en combinant le contrôle bidirectionnel du balayage, l’insensibilité configurable à la casse typographique et la neutralisation dynamique des espaces superflus. Cette fonction ne se contente pas de répondre à la question binaire de la présence d’un motif ; elle renvoie l’exacte coordonnée ordinale de son occurrence, ouvrant ainsi la voie à des opérations sophistiquées d’extraction, de découpage et de nettoyage automatisé.
Ce guide exhaustif a pour vocation d’analyser en profondeur l’ensemble des mécanismes régissant la fonction FIND dans SAS. En adoptant une perspective à la fois théorique, syntaxique et résolument pragmatique, nous explorerons ses fondations algorithmiques, disséquerons ses paramètres formels, étudierons son comportement face aux anomalies structurelles de données et exposerons des protocoles d’implémentation industrielle. À travers des démonstrations empiriques rigoureuses et des comparaisons architecturales détaillées avec les fonctions connexes du système SAS, cet article fournira aux praticiens les connaissances requises pour concevoir des programmes pérennes, hautement optimisés et conformes aux exigences de la science des données contemporaine.
1. Introduction à la manipulation de chaînes de caractères et à la fonction FIND dans SAS
1.1 Rôle fondamental de l’analyse textuelle dans l’environnement SAS
L’exploitation de mégadonnées au sein des infrastructures décisionnelles contemporaines confronte inévitablement les analystes à une prépondérance croissante de variables textuelles. Qu’il s’agisse de variables catégorielles mal standardisées, de descripteurs nosologiques issus de la classification internationale des maladies, ou de flux continus de métadonnées de télémétrie, la chaîne de caractères demeure le véhicule primaire de l’information brute. Dans l’écosystème SAS, réputé pour sa prééminence dans l’industrie pharmaceutique, le secteur bancaire et les administrations publiques, le traitement rigoureux de ces données textuelles constitue une obligation méthodologique majeure. L’analyse textuelle ne se résume pas à une simple commodité de mise en forme ; elle conditionne la validité des jointures relationnelles, l’exactitude du codage des variables d’exposition et la pertinence des cohortes constituées pour les analyses inférentielles ultérieures.
La manipulation de volumes colossaux de données textuelles requiert des algorithmes capables de sonder des millions d’enregistrements avec un coût d’exécution minimal. La recherche de motifs spécifiques — qu’il s’agisse d’un préfixe d’identification, d’un biomarqueur dans une chaîne d’acides aminés, ou d’un terme diagnostique au sein d’une observation médicale — exige des fonctions analytiques non destructives. Ces outils doivent impérativement inspecter le contenu du vecteur alphanumérique sans en altérer la structure, la longueur déclarée ou les attributs d’encodage sous-jacents. Dans ce contexte, SAS se positionne comme une référence absolue, fournissant un moteur d’exécution déterministe capable de traiter les chaînes de caractères avec une constance mathématique et une neutralité fonctionnelle garantissant la reproductibilité scientifique des traitements appliqués.
1.2 Définition conceptuelle et objectif de la fonction FIND
D’un point de vue conceptuel, la fonction FIND est un opérateur scalaire d’inspection textuelle conçu pour déterminer la position géographique d’une séquence de caractères — communément appelée sous-chaîne ou motif — à l’intérieur d’une séquence textuelle plus vaste, désignée comme chaîne hôte ou chaîne source. Contrairement aux fonctions d’extraction telles que SUBSTR ou aux fonctions de substitution comme TRANWRD ou REGEXPREP, la fonction FIND n’opère aucune mutation sur la mémoire allouée au texte source. Son mandat algorithmique unique consiste à balayer la chaîne cible afin de localiser la première unité lexicale correspondant exactement aux critères définis par l’utilisateur, puis de restituer cette coordonnée sous la forme d’un nombre entier positif.
L’indice retourné par la fonction FIND correspond précisément au numéro d’ordre du premier caractère de la sous-chaîne détectée. Si le motif recherché n’existe pas au sein du segment textuel balayé, ou si les contraintes imposées par les paramètres optionnels ne peuvent être satisfaites, la fonction renvoie invariablement la valeur zéro. Cette dichotomie mathématique entre un indice strictement positif et la valeur zéro confère à la fonction une double utilité : elle sert simultanément d’outil de mesure d’offset pour les découpages dynamiques ultérieurs et de prédicat logique au sein des structures décisionnelles conditionnelles. Cette séparation claire entre détection de position et altération de contenu constitue le fondement d’une programmation défensive et hautement modulable.
1.3 Système d’indexation SAS à base 1
L’une des spécificités techniques primordiales du langage SAS réside dans l’adoption rigoureuse d’un système d’indexation basé sur l’entier 1 (indexation à base 1 ou 1-based indexing). Contrairement à de nombreux langages informatiques issus de la tradition du C, tels que Python, Java ou C++, où le premier élément d’une chaîne ou d’un tableau est référencé par l’indice 0 en vertu de calculs d’adresses mémoires relatives, SAS aborde l’indexation selon une sémantique ordinale directe. Le tout premier caractère situé à l’extrême gauche d’une variable de type caractère occupe donc la position numéro 1. Cette convention conceptuelle simplifie l’interprétation sémantique pour les statisticiens et analystes de données, mais impose une vigilance constante aux développeurs polyglottes habitués aux arithmétiques de pointeurs à décalage nul.
Cette indexation à base 1 a des conséquences directes sur les algorithmes d’analyse séquentielle. Lorsqu’un motif de recherche est identifié immédiatement au début de la variable analysée, la fonction FIND retourne la valeur 1. Par voie de conséquence, le résultat numérique 0 ne saurait en aucun cas désigner le début de la chaîne ; il est universellement et exclusivement réservé par le compilateur SAS pour signaler l’échec de la recherche, c’est-à-dire l’absence stricte de la sous-chaîne au sein de la plage d’inspection. Cette distinction absolue élimine toute ambiguïté lors de l’évaluation logique dans un bloc DATA : un résultat supérieur à zéro s’évalue systématiquement comme un état de vérité booléenne, tandis que le résultat zéro correspond formellement à un état de fausseté.
2. Syntaxe formelle et anatomie des paramètres de la fonction FIND
2.1 Signature exhaustive de l’instruction
La mise en œuvre de la fonction FIND obéit à un formalisme syntaxique rigoureux défini au sein du moteur d’exécution SAS. La signature exhaustive de cette fonction s’articule autour de quatre arguments positionnels distincts, dont deux sont obligatoires et deux sont optionnels. La forme canonique de l’instruction s’exprime de la façon suivante dans le langage du compilateur :
FIND(string, substring <, modifiers> <, startpos>)
Dans cette formulation paramétrique, les chevrons typographiques soulignent la nature facultative des arguments situés en troisième et quatrième position. La présence impérative des deux premiers paramètres constitue le socle minimal permettant l’instanciation de l’algorithme de balayage. L’ajout des paramètres subsidiaires permet d’altérer dynamiquement le comportement du comparateur d’octets sans qu’il soit nécessaire d’encapsuler la variable d’origine dans des fonctions de conversion annexes. Cette architecture modulaire garantit une expressivité maximale tout en préservant une concision appréciable du code source, limitant ainsi la surcharge cognitive lors des phases d’audit et de maintenance applicative.
2.2 Caractérisation de l’argument source (string)
Le premier argument, conventionnellement désigné par le terme générique string, constitue la matière première sur laquelle s’exécute le processus d’inspection. Cet argument accepte une grande diversité d’entités lexicales au sein de l’étape DATA ou des procédures compatibles. Il peut s’agir, en premier lieu, d’une variable de type caractère formellement déclarée et issue d’une table SAS sous-jacente ou instanciée dynamiquement dans le vecteur de données du programme (Program Data Vector – PDV). La longueur de cette variable peut s’étendre de 1 octet jusqu’aux limites maximales allouées par l’architecture du système, soit 32 767 octets pour les environnements SAS traditionnels sous Windows et Unix.
En second lieu, l’argument source peut être matérialisé sous la forme d’une constante littérale, c’est-à-dire une chaîne textuelle brute rigoureusement encadrée par des apostrophes simples ou des guillemets doubles. Enfin, le compilateur SAS autorise l’imbrication d’expressions complexes en lieu et place d’une référence directe à une variable. Cela implique que l’argument string peut résulter de l’évaluation préalable d’une fonction de concaténation telle que CATX, d’une opération de nettoyage préalable, ou encore d’une résolution macro-analytique complexe. Le moteur SAS procède d’abord à l’évaluation intégrale de cette expression matricielle avant de transmettre la séquence d’octets finale au sous-système de balayage de la fonction FIND.
2.3 Spécification de la sous-chaîne cible (substring)
Le second argument, désigné sous le vocable substring, matérialise l’entité textuelle exacte dont le programmeur cherche à déterminer l’occurrence spatiale. Tout comme la chaîne hôte, cette sous-chaîne cible peut être spécifiée par l’intermédiaire d’une variable alphanumérique dédiée ou d’une constante littérale textuelle. La granularité de cette cible s’étend du caractère unique isolé — tel qu’un symbole de délimitation, un signe de ponctuation ou une lettre spécifique — jusqu’à des phrases complexes ou des séquences de caractères alphanumériques multi-octets caractéristiques des encodages contemporains.
Un aspect crucial de la spécification de cet argument réside dans la gestion des longueurs respectives des entités en présence. D’un point de vue algorithmique, si la chaîne cible substring possède une longueur strictement supérieure à celle de la chaîne hôte string soumise à l’analyse, la fonction FIND court-circuite immédiatement le balayage sans générer d’erreur fatale dans le journal d’exécution (LOG). Constatant l’impossibilité mathématique d’une inclusion spatiale, le moteur d’exécution retourne immédiatement la valeur entière 0. De surcroît, le compilateur analyse minutieusement les octets constitutifs de la sous-chaîne en respectant scrupuleusement la séquence d’enchaînement des caractères, ce qui signifie que l’ordre et la continuité spatiale des symboles constituent une contrainte stricte lors de l’opération de mise en correspondance.
3. Gestion de la sensibilité à la casse et exploration des modificateurs
3.1 Comportement par défaut : la sensibilité stricte à la casse
Par défaut, la fonction FIND applique une stratégie d’évaluation binaire rigoureusement asservie à la table d’encodage du système hôte, généralement régie par les standards ASCII ou EBCDIC selon l’architecture matérielle sous-jacente. Cette approche implique une sensibilité stricte à la casse (case sensitivity). En vertu de ce mécanisme natif, chaque glyphe est identifié par sa valeur binaire sous-jacente : par conséquent, la lettre majuscule ‘A’ (code ASCII décimal 65) est traitée comme une entité fondamentalement distincte de la lettre minuscule ‘a’ (code ASCII décimal 97). Ce comportement déterministe est indispensable lors de l’analyse de données techniques structurées où la casse porte une signification sémiotique précise, comme dans le cas des identifiants d’échantillons ou des clés de chiffrement.
Cependant, dans le domaine de la science des données appliquées et de l’intégration de données textuelles non assainies, cette sensibilité stricte constitue une source majeure d’erreurs de faux négatifs. Par exemple, si l’on tente de localiser le mot ‘fox’ au sein d’une variable textuelle contenant la séquence ‘The Quick Fox’, l’implémentation basique de la fonction FIND échouera systématiquement et renverra la valeur 0. L’analyste non averti pourrait alors déduire à tort l’absence du concept recherché, alors que la discordance découle purement d’une divergence typographique introduite lors de la saisie humaine des données.
3.2 Le modificateur ‘i’ : désactivation de la sensibilité à la casse
Afin de pallier les limitations structurelles induites par la sensibilité stricte à la casse sans obliger les développeurs à multiplier les étapes intermédiaires de transformation, les concepteurs du langage SAS ont doté la fonction FIND d’un argument modificateur optionnel. Positionné en troisième position dans la signature de la fonction, le caractère littéral ‘i’ (pour ignore case) intime l’ordre au moteur de recherche textuelle de neutraliser toute distinction entre minuscules et majuscules au cours du processus d’évaluation comparative.
D’un point de vue architectural, l’adjonction de ce modificateur ‘i’ ne modifie pas les données stockées en mémoire physique. SAS procède à une normalisation dynamique à la volée des octets comparés au moment précis de l’exécution du balayage. Ainsi, les graphies ‘FOX’, ‘Fox’, ‘fOx’ ou ‘fox’ sont toutes transitoirement alignées sur une représentation uniforme dans les registres du processeur, permettant une identification spatiale infaillible du motif. Cette approche évite le recours ancestral qui consistait à encapsuler les variables dans les fonctions UPCASE ou LOWCASE, optimisant de ce fait les cycles d’instructions du processeur et épurant drastiquement la syntaxe des scripts analytiques.
3.3 Modificateurs complémentaires et cumulatifs
Au-delà de la gestion de la casse typographique, la fonction FIND intègre d’autres modificateurs destinés à affiner les conditions d’exécution du balayage textuel. Parmi ceux-ci, le modificateur ‘t’ (pour trim) occupe une place prépondérante dans les environnements de production. Dans le système SAS, les variables de type caractère possèdent intrinsèquement une longueur fixe et prédéterminée, ce qui implique que tout espace non utilisé à la fin d’une chaîne est automatiquement comblé par des espaces blancs de remplissage (trailing blanks). Si une sous-chaîne cible provient d’une variable de longueur supérieure au texte réel qu’elle héberge, la recherche standard cherchera à faire correspondre le texte suivi de tous ses espaces terminaux, aboutissant quasi-invariablement à un échec de détection.
L’introduction du modificateur ‘t’ ordonne au compilateur d’élaguer algorithmiquement les espaces de fin de la sous-chaîne cible avant d’initier la procédure de localisation. De surcroît, le moteur SAS autorise la combinaison cumulative de plusieurs modificateurs au sein de la même chaîne d’arguments. Il est ainsi parfaitement licite et recommandé d’agréger les comportements en spécifiant la chaîne littérale ‘it’ ou ‘ti’ comme troisième paramètre de la fonction. Le compilateur analyse cette chaîne de paramètres sans tenir compte de l’ordre d’énumération des lettres de modification et active conjointement l’insensibilité à la casse et la suppression des blancs résiduels, dotant ainsi la fonction FIND d’une robustesse maximale face aux imperfections de structure textuelle.
4. Contrôle de la position de départ avec l’argument startpos
4.1 Recherche directionnelle avant (startpos positif)
Le quatrième paramètre de la fonction FIND, formellement désigné par l’expression startpos, confère au développeur la maîtrise temporelle et spatiale du balayage textuel en désignant le point d’ancrage exact à partir duquel l’inspection doit débuter. Par défaut, en l’absence de ce paramètre, SAS commence systématiquement son analyse à partir du tout premier octet de la chaîne hôte, soit l’indice ordinal 1. Toutefois, la transmission d’une valeur entière positive strictement supérieure à 1 reconfigure instantanément le curseur initial du compilateur.
Lorsqu’un argument startpos strictement positif est fourni, l’algorithme ignore superbement l’ensemble des octets positionnés en amont de cette coordonnée géographique. La recherche s’effectue alors selon une trajectoire directionnelle avant classique, progressant de gauche à droite, depuis l’indice désigné jusqu’à la terminaison de la chaîne. Il importe de souligner avec la plus grande rigueur mathématique que l’indice de position finalement renvoyé par la fonction demeure absolu : le résultat correspond à la coordonnée calculée depuis le début universel de la chaîne hôte, et non à un décalage relatif comptabilisé à partir du point startpos. Cette constance d’indexation prévient les erreurs de calcul d’offset lors de manipulations textuelles imbriquées.
4.2 Recherche rétrograde ou inversée (startpos négatif)
L’une des fonctionnalités les plus puissantes et méconnues de la fonction FIND réside dans sa capacité à opérer un balayage rétrograde ou inversé à travers la chaîne de données. Cette modalité opérationnelle est instanciée dès lors que le développeur affecte une valeur entière négative à l’argument startpos. Dans cette configuration, le signe négatif n’est pas interprété comme une position géométrique relative par rapport à la fin du texte, mais agit comme un commutateur de flux vectoriel : il indique au compilateur qu’il doit changer le sens de lecture et parcourir la chaîne de la droite vers la gauche.
Concrètement, la valeur absolue de ce paramètre négatif — notée mathématiquement |startpos| — détermine la borne spatiale la plus avancée à partir de laquelle s’enclenche la recherche rétrograde. L’algorithme se positionne sur cet indice absolu, puis examine les séquences d’octets antérieures en se déplaçant progressivement vers la gauche, c’est-à-dire vers l’indice 1. Ce mécanisme s’avère providentiel pour identifier la dernière occurrence d’un délimiteur, tel qu’un slash dans une arborescence de répertoires ou un point d’extension dans un nom de fichier complexe. Bien que le parcours s’effectue à rebours, l’indice retourné demeure, là encore, strictement absolu et indexé depuis l’extrémité gauche de la chaîne source.
4.3 Gestion des cas limites liés à la position de départ
L’utilisation de l’argument startpos introduit un espace d’états limites que le programmeur SAS doit impérativement anticiper afin de prévenir les anomalies silencieuses d’exécution. Si la valeur absolue de l’argument startpos excède strictement la longueur matérielle réelle de la chaîne hôte (longueur définie par la fonction LENGTH), le moteur d’exécution interrompt immédiatement l’algorithme sans lever d’exception bloquante. Il consigne un avertissement dans les scénarios extrêmes, mais renvoie principalement la valeur zéro pour indiquer qu’aucune correspondance ne peut logiquement résulter d’une tentative d’inspection en dehors des frontières de l’objet textuel.
En revanche, la transmission d’une valeur numérique égale à 0 pour le paramètre startpos est formellement prohibée par la grammaire de SAS. Étant donné que le système s’articule autour d’une indexation à base 1, la coordonnée 0 est inexistante dans la topologie des chaînes. Une telle tentative déclenche l’affichage d’un message d’erreur explicite dans le journal d’exécution (LOG) et force la variable réceptrice à prendre une valeur numérique manquante (missing value, représentée par un point ‘.’). Enfin, il convient de rappeler une contrainte syntaxique impérative : pour pouvoir spécifier l’argument startpos tout en conservant le comportement par défaut de sensibilité à la casse, le programmeur doit obligatoirement renseigner le troisième paramètre par une chaîne vide matérialisée par deux guillemets successifs sans espace, sous la forme FIND(string, substring, », startpos).
5. Mise en place d’un protocole expérimental : le jeu de données d’exemple
5.1 Construction de la table originale via l’étape DATA
Pour fonder notre étude sur des bases empiriques solides et transparentes, nous devons ériger un environnement de test standardisé au moyen d’une étape DATA déterministe. Cette démarche méthodologique garantit la parfaite reproductibilité des calculs et permet d’observer sans ambiguïté les réactions de l’interpréteur SAS face à diverses typologies de structures textuelles. Nous construisons une table SAS de référence, désignée conventionnellement sous l’identifiant original_data, qui encapsule une collection de données textuelles soigneusement calibrées.
Dans ce protocole, la variable textuelle soumise à nos analyses d’offset sera nommée phrase. Afin d’éviter toute troncature subreptice des chaînes lors de l’allocation initiale par le compilateur, une instruction déclarative LENGTH doit être systématiquement stipulée en amont de toute assignation lexicale. L’utilisation du bloc d’instructions de saisie en ligne DATALINES combiné à un formalisme de lecture par délimiteur permet d’injecter directement nos vecteurs d’expérimentation au sein du flux séquentiel de compilation.
5.2 Structure sémiotique des phrases sélectionnées
Les observations textuelles injectées dans notre protocole expérimental ont été méticuleusement conçues pour couvrir l’exhaustivité des cas de figure qu’un data scientist est susceptible d’affronter dans des bases de données réelles non épurées. Quatre vecteurs de caractères distincts composent cet échantillon d’évaluation :
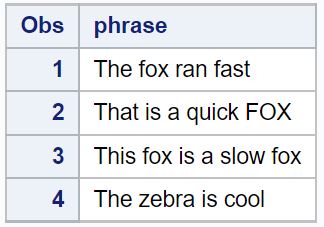
- Observation 1 : « The fox ran fast » — Ce premier enregistrement représente la configuration nominale idéale. La sous-chaîne cible ‘fox’ est inscrite en caractères minuscules conventionnels et s’insère au cœur de la proposition lexicale, entourée d’espaces réguliers de séparation.
- Observation 2 : « That is a quick FOX » — Cette seconde chaîne contient le motif cible transposé dans un registre typographique entièrement en majuscules (‘FOX’). Elle a été formulée pour mettre en lumière la rupture d’évaluation causée par la sensibilité binaire de l’encodage ASCII natif.
- Observation 3 : « This fox is a slow fox » — Ce troisième vecteur textuel se caractérise par la présence délibérée d’une double occurrence de la séquence ‘fox’, rédigée à chaque fois en minuscules. Ce cas d’usage servira de pivot expérimental pour démontrer l’importance du point d’ancrage spatial et la nécessité de balayages itératifs.
- Observation 4 : « The zebra is cool » — Le quatrième enregistrement constitue le contrôle négatif du protocole scientifique. Il est totalement exempt de toute variation du motif ‘fox’, permettant de valider sans équivoque le comportement du compilateur face à une hypothèse nulle d’inclusion.
5.3 Visualisation et validation structurelle avec PROC PRINT
Avant d’engager toute transformation algorithmique via la fonction FIND, il est impératif d’exécuter une procédure de validation structurelle afin de certifier que la table source a été matérialisée sans artefacts de tronquage ou de décalage d’octets. À cette fin, l’invocation de la procédure fondamentale PROC PRINT constitue la démarche canonique recommandée par les standards d’audit du SAS Technical Support.
L’exécution de cette procédure permet de s’assurer de l’intégrité de l’échantillon expérimental. Le tableau ci-dessous synthétise la distribution des vecteurs textuels au sein de la table initiale et servira d’étalon comparatif immuable pour les traitements séquentiels décrits dans les sections subséquentes de notre étude :
| Numéro d’Observation | Valeur de la variable textuelle (phrase) |
|---|---|
| 1 | The fox ran fast |
| 2 | That is a quick FOX |
| 3 | This fox is a slow fox |
| 4 | The zebra is cool |
6. Méthode 1 : Localisation de la première occurrence avec sensibilité stricte
6.1 Écriture du code SAS pour la méthode standard
L’implémentation algorithmique de base de la fonction FIND consiste à requérir la détection du motif cible sans adjoindre de modificateurs typographiques ni spécifier de coordonnée spatiale d’ancrage. Dans ce cadre programmatique standard, nous procédons à la création d’une nouvelle table dérivée, nommée new_data, par instanciation d’une étape DATA qui procède à la lecture séquentielle de notre jeu de données de référence original_data à travers l’instruction de streaming SET.
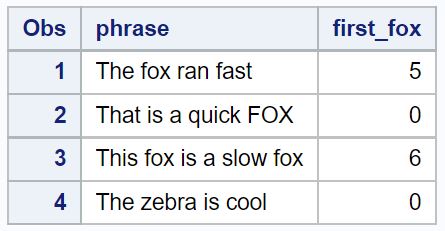
Au sein de cette étape de compilation, nous déclarons une nouvelle variable numérique baptisée first_fox. La valeur scalaire de cette variable est directement générée par l’appel de la fonction sous sa forme minimale : FIND(phrase, ‘fox’). Une fois l’étape finalisée par la directive RUN, nous soumettons la table ainsi consolidée à l’inspection de la procédure PROC PRINT. Cette démarche nous permet d’isoler l’impact pur du comparateur d’octets natif de SAS sur les quatre structures textuelles préalablement configurées.
6.2 Dissection analytique des résultats obtenus
L’évaluation des résultats numériques obtenus à l’issue de cette première méthode expérimentale illustre parfaitement la rigueur déterministe et l’intransigeance du compilateur d’expressions SAS. L’examen détaillé des valeurs inscrites dans la variable first_fox révèle la typologie comportementale suivante :
- Observation 1 : La variable first_fox enregistre avec une exactitude absolue la valeur numérique 5. En analysant la séquence de la chaîne « The fox ran fast », nous observons que le premier caractère ‘T’ occupe l’indice 1, ‘h’ l’indice 2, ‘e’ l’indice 3, l’espace séparateur l’indice 4, et la lettre ‘f’ constitutive du motif débute précisément au cinquième octet. L’algorithme a donc parfaitement rempli son office.
- Observation 2 : La variable réceptrice renvoie la valeur entière 0. Bien que le mot soit sémantiquement présent sous la forme « FOX », la dissemblance de casse empêche la reconnaissance binaire. Le compilateur n’identifie aucune correspondance pour la séquence minuscule ‘fox’.
- Observation 3 : Le moteur SAS affecte la valeur numérique 6 à l’observation « This fox is a slow fox ». Le mot apparaissant en indices 6 et 20, la fonction FIND s’est arrêtée dès la satisfaction de la première correspondance rencontrée lors de sa progression unidirectionnelle vers la droite.
- Observation 4 : Conformément aux lois de la logique formelle, la chaîne témoin « The zebra is cool » hérite de la valeur 0, attestant de l’absence totale du motif.
6.3 Implications programmatiques du résultat nul
La production universelle du résultat 0 pour matérialiser l’insuccès d’une recherche textuelle engendre des répercussions structurelles profondes sur la façon dont les développeurs SAS doivent concevoir leurs arbres de décision logique. Dans la sémantique formelle de SAS, toute valeur numérique non nulle et non manquante est systématiquement évaluée comme une valeur de vérité booléenne vraie (TRUE), tandis que la valeur numérique exacte 0 est interprétée comme équivalente à l’état de fausseté booléenne (FALSE).
Cette propriété algorithmique remarquable autorise des constructions d’une grande élégance mathématique. L’écriture d’une condition telle que « IF FIND(phrase, ‘fox’) THEN DO; » est syntaxiquement valide et hautement efficiente : elle évite l’explicitation redondante d’un opérateur relationnel de comparaison comme « > 0 ». Toutefois, une mise en garde s’impose : le développeur doit toujours garder à l’esprit qu’un résultat nul est un nombre entier rigoureusement différent de la valeur manquante numérique SAS (représentée par un point décimal). Vouloir tester l’absence d’un motif via une clause de filtrage vérifiant si la valeur est manquante conduirait immanquablement à des défaillances logiques critiques au sein des processus décisionnels en production.
7. Méthode 2 : Détection insensible à la casse grâce au modificateur ‘i’
7.1 Écriture du code SAS pour la méthode insensible
Afin de neutraliser les effets délétères de l’hétérogénéité typographique constatée lors de l’application de la méthode standard, nous enrichissons à présent notre implémentation programmatique en exploitant l’argument optionnel de modification. Dans le cadre de cette seconde étape expérimentale, nous dérivons notre jeu de données initial vers une table augmentée en modifiant l’assignation de notre variable d’offset. La nouvelle variable calculée, que nous désignerons conventionnellement sous le libellé first_fox_case_insensitive, fait appel à l’instruction paramétrée FIND(phrase, ‘fox’, ‘i’).
L’introduction de ce troisième paramètre littéral impose au compilateur de restructurer sa routine interne de comparaison de motifs. Il convient de noter que l’argument ‘i’ doit être formellement encapsulé entre des guillemets d’initialisation de constante alphanumérique. L’ordre syntaxique strict des paramètres étant ici préservé, le compilateur comprend que la troisième position est dédiée aux modificateurs algorithmiques et non à une position de départ. La table résultante est ensuite transmise pour compilation à l’interpréteur de commandes et éditée pour observation analytique comparative.
7.2 Interprétation comparative des nouveaux résultats
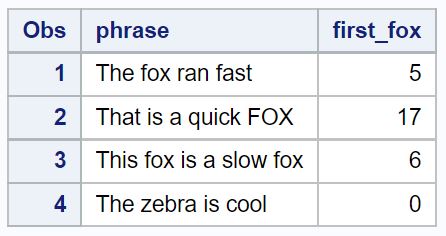
La confrontation directe des métriques issues de la méthode standard avec celles générées par l’adjonction du modificateur ‘i’ démontre empiriquement l’élévation substantielle du taux de rappel de la détection textuelle. L’observation des sorties numériques consolidées permet de dresser le bilan analytique suivant :
| Observation | Texte Source (phrase) | FIND Standard | FIND avec ‘i’ |
|---|---|---|---|
| 1 | The fox ran fast | 5 | 5 |
| 2 | That is a quick FOX | 0 | 17 |
| 3 | This fox is a slow fox | 6 | 6 |
| 4 | The zebra is cool | 0 | 0 |
L’observation numéro 2 constitue le foyer paradigmatique de cette démonstration. Alors que la méthode standard échouait purement et simplement en renvoyant 0, l’activation du modificateur ‘i’ permet d’identifier sans ambiguïté le début du mot « FOX » à la dix-septième position de la chaîne. Les observations 1 et 3 conservent leurs métriques ordinales natives respectives (positions 5 et 6), ce qui atteste que l’insensibilité à la casse n’altère en rien la détection des chaînes déjà conformes. Enfin, l’observation 4 demeure inchangée à 0, prouvant l’absence de faux positifs induits par la flexibilité typographique nouvelle.
7.3 Considérations ergonomiques en science des données
L’exploitation judicieuse du modificateur ‘i’ transcende la simple commodité syntaxique ; elle incarne un principe d’optimisation structurelle hautement valorisé dans le génie logiciel appliqué aux données massives. Historiquement, pour accomplir une détection textuelle indépendante de la casse, les développeurs SAS devaient recourir à une double transformation imbriquée, couramment matérialisée par l’instruction : INDEX(UPCASE(phrase), ‘FOX’). Cette formulation ancestrale, bien que fonctionnelle, présentait des faiblesses architecturales manifestes.
Sur le plan informatique, l’imbrication d’une fonction de conversion d’envergure telle qu’UPCASE contraint le système d’exploitation à allouer un tampon mémoire temporaire pour dupliquer l’intégralité du texte en lettres majuscules avant de pouvoir entamer la phase d’inspection. Lorsque cette opération est répétée sur plusieurs dizaines de millions de lignes au sein d’une grappe de calcul ou d’une infrastructure Hadoop/Spark connectée à SAS, la surcharge de pagination mémoire et de temps processeur devient substantielle. Le modificateur ‘i’ de la fonction FIND opère la vérification octet par octet dans les registres d’évaluation sans jamais allouer d’espace pour dupliquer la chaîne parente, offrant ainsi un gain significatif d’efficience computationnelle tout en épurant radicalement la structure textuelle du programmeur.
8. Traitement des anomalies : valeurs manquantes, espaces et longueurs de chaînes
8.1 Comportement de FIND face aux données manquantes
La résilience d’un système décisionnel s’évalue principalement à sa capacité à gérer harmonieusement les valeurs d’entrée dégénérées ou manquantes sans interruption brutale des chaînes de traitement de production. Dans le paradigme SAS, les données textuelles manquantes sont représentées par un espace vide ou une succession d’espaces blancs occupant toute la longueur allouée à la variable (longueur d’enregistrement fixe). Lorsque la chaîne hôte passée au premier argument de la fonction FIND est manquante, le moteur d’exécution réagit de façon déterministe en retournant invariablement la valeur 0, sans consigner le moindre message d’erreur d’exécution dans le journal de bord.
La situation s’avère toutefois beaucoup plus périlleuse lorsque c’est la sous-chaîne cible (le deuxième paramètre) qui se révèle manquante ou entièrement constituée d’espaces non élagués. Dans cette conjoncture spécifique, l’algorithme tente de localiser un espace blanc au sein de la chaîne hôte. Si celle-ci renferme le moindre espace séparateur, la fonction FIND identifiera cet espace comme la correspondance recherchée et renverra sa position ordinale, générant des comportements algorithmiques inattendus et difficilement décelables lors des revues de code. Il est par conséquent fortement recommandé d’assainir systématiquement la sous-chaîne de recherche à l’aide de tests préalables assurant la non-vacuité du motif avant de solliciter le comparateur d’octets.
8.2 Problématique des espaces de fin (Trailing Blanks) dans SAS
La gestion sous-jacente des chaînes de caractères par le moteur de base de SAS repose historiquement sur l’attribution de blocs de mémoire à longueur statique fixe. Lorsqu’une variable est dimensionnée avec un attribut tel que LENGTH variable_texte $ 50;, tout enregistrement dont la taille réelle est inférieure à 50 octets voit ses octets restants automatiquement assignés à la valeur hexadécimale ’20’x, correspondant au caractère espace dans la table ASCII. Ces espaces de bourrage terminal (trailing blanks) exercent une influence redoutable sur les opérations de localisation textuelle si le développeur omet d’en appréhender le rôle.
Si un analyste utilise une variable auxiliaire pour héberger la cible de sa recherche et que cette variable est dimensionnée plus largement que le terme qu’elle contient, la fonction FIND recherchera le terme ainsi que tous les espaces de fin non tronqués. Par exemple, si la cible contient le mot ‘cat’ suivi de quarante-sept espaces, le motif ‘cat ‘ ne sera jamais localisé dans une phrase continue comme ‘The cat is on the table’. Pour neutraliser ce comportement pervers sans devoir modifier la définition globale du dictionnaire de données, l’incorporation conjointe du modificateur ‘t’ ou le recours à la fonction de compression préliminaire STRIP s’avère absolument indispensable pour garantir la validité des intersections de chaînes.
8.3 Dépassements de limites et caractères non imprimables
Les environnements de production modernes sont fréquemment confrontés à des flux de données pollués par des caractères non imprimables, des ruptures de saut de ligne ou des symboles d’échappement issus de processus d’extraction web ou de transactions de bases relationnelles tierces. La fonction FIND est intrinsèquement équipée pour analyser ces séquences occultes. Il est ainsi parfaitement envisageable d’identifier la coordonnée spatiale d’une tabulation horizontale (représentée par la constante hexadécimale ’09’x) ou d’un retour chariot (constant ‘0A’x ou ‘0D’x) en passant directement la séquence hexadécimale appropriée en second argument de la fonction FIND.
Par ailleurs, l’introduction de valeurs dynamiques pour l’argument startpos génère des risques de dépassement de frontières lorsque ces indices résultent d’un calcul itératif complexe. Si un algorithme calcule une position de départ supérieure à la taille matérielle de la chaîne hôte, la fonction FIND amortit l’anomalie en renvoyant purement et simplement la valeur 0. De même, la gestion des encodages multioctets, tels que l’UTF-8 de plus en plus prévalent dans SAS Viya par rapport au standard historique WLATIN1 sous Windows, exige une attention accrue : sous UTF-8, certains glyphes accentués requièrent deux à quatre octets de stockage, ce qui peut occasionner des décalages d’indices si l’on tente d’interfacer des fonctions basées sur les octets avec des fonctions calibrées sur les caractères logiques.
9. Étude comparative : FIND vis-à-vis des fonctions alternatives de SAS
9.1 FIND contre INDEX : filiation et modernité syntaxique
Pour quiconque explore des programmes SAS patrimoniaux conçus au cours des décennies précédentes, la présence récurrente de la fonction INDEX constitue un constat quasi-systématique. Historiquement, la fonction INDEX constituait la méthode officielle préconisée par l’éditeur pour déterminer l’emplacement d’une séquence de caractères. Sa syntaxe rudimentaire se résume à l’expression élémentaire INDEX(string, substring). Bien que fonctionnellement viable pour des analyses triviales, INDEX souffre de limitations architecturales insurmontables qui ont motivé la création de FIND lors du lancement de la version 9 du système SAS.
La distinction majeure réside dans l’incapacité absolue d’INDEX à accepter des modificateurs d’exécution ou à spécifier un indice de départ arbitraire. Avec INDEX, il est impossible de mener une recherche insensible à la casse sans altérer la mémoire tampon par UPCASE, et il est totalement exclu d’engager un balayage rétrograde ou d’ignorer les n premiers caractères d’une chaîne sans procéder au découpage préalable du texte au moyen de la fonction SUBSTR. La fonction FIND rend donc formellement la fonction INDEX obsolète d’un point de vue de l’ingénierie logicielle contemporaine, apportant une flexibilité et une compacité syntaxique nettement supérieures.
9.2 FIND contre INDEXW : recherche de sous-chaîne vs mot complet
Une confusion particulièrement insidieuse dans la programmation DATA Step concerne l’arbitrage méthodologique entre la fonction FIND et la fonction spécialisée INDEXW. La différence fondamentale entre ces deux outils repose sur la granularité linguistique de l’élément recherché. La fonction FIND est un analyseur de sous-chaînes au sens strict du terme : elle examine le flux d’octets de façon continue et signale la présence du motif dès lors que la séquence de symboles concorde, sans se soucier du contexte morphologique environnant.
À titre d’illustration, si l’on recherche le vocable ‘fox’ au moyen de la fonction FIND au sein d’une variable contenant le nom botanique ‘foxglove’ (la digitale pourpre), la fonction FIND identifiera une correspondance positive et renverra l’indice 1, bien que le concept sémantique de l’animal renard soit totalement absent. En contrepartie, la fonction INDEXW restreint son balayage aux mots complets (words), c’est-à-dire aux séquences de caractères rigoureusement délimitées par des séparateurs canoniques (tels que des espaces, des virgules ou des points). INDEXW ignorera ainsi le terme composite ‘foxglove’ mais détectera le mot isolé ‘fox’. Dès lors, pour toute fouille textuelle asservie à une logique lexicale stricte, INDEXW constitue le choix rationnel, tandis que FIND s’impose pour toute analyse structurelle d’offsets de sous-séquences.
9.3 FIND contre FINDC et VERIFY : sous-chaîne vs liste de caractères
L’arsenal d’inspection textuelle de SAS est complété par deux autres fonctions hautement spécialisées dont le champ d’action ne doit pas être confondu avec celui de FIND : les fonctions FINDC et VERIFY. La fonction FINDC (où le suffixe ‘C’ désigne explicitement le mot Character) ne recherche pas une séquence linéaire ordonnée de caractères, mais inspecte la chaîne hôte afin de localiser la première occurrence de n’importe quel caractère individuel stipulé dans une liste d’arguments cibles. Par exemple, FINDC(texte, ‘aeiou’) identifiera la première voyelle présente dans le texte, quelle qu’elle soit, opération que la fonction FIND est structurellement incapable d’exécuter en une seule instruction.
Quant à la fonction VERIFY, elle adopte une posture diamétralement opposée en agissant comme un opérateur de validation de conformité d’alphabet. VERIFY retourne la coordonnée du tout premier caractère présent au sein de la chaîne hôte qui n’apparaît pas dans la liste des caractères autorisés passés en paramètre. Cette fonction est typiquement mobilisée pour certifier qu’une variable ne contient que des chiffres décimaux ou que des lettres valides. Le tableau comparatif suivant schématise l’arbre décisionnel d’orientation technique régissant le choix de ces différentes fonctions :
| Fonction SAS | Granularité de recherche | Support des Modificateurs | Cas d’usage prioritaire |
|---|---|---|---|
| FIND | Sous-chaîne séquentielle continue | Oui (‘i’, ‘t’) | Localisation d’offset d’une séquence exacte |
| INDEX | Sous-chaîne séquentielle continue | Non | Code patrimonial (legacy) sans options |
| INDEXW | Mot complet délimité | Non | Analyse lexicale et text mining élémentaire |
| FINDC | Caractère unitaire parmi une liste | Oui (‘i’, ‘t’, ‘k’, etc.) | Détection de ponctuation ou voyelles isolées |
| VERIFY | Caractère non conforme à une référence | Non | Contrôle qualité et validation d’alphabet |
10. Intégration avancée de la fonction FIND dans la programmation DATA Step
10.1 Filtrage conditionnel et sous-échantillonnage de tables
L’une des exploitations les plus répandues et efficientes de la fonction FIND s’articule autour de l’élaboration de clauses de sélection conditionnelle dans les flux de traitement de données volumineuses. Dans la grammaire de l’étape DATA, la fonction FIND peut être instanciée directement au sein d’une instruction IF de sous-échantillonnage ou d’une clause de restriction spatiale WHERE. Cette approche permet de filtrer sélectivement des cohortes de patients ou des segments de transactions sans alourdir le dictionnaire de données par la création de colonnes numériques intermédiaires superflues.
Considérons, par exemple, le traitement d’une table d’événements indésirables cliniques comprenant des millions d’enregistrements non standardisés. L’intégration de la clause suivante : IF FIND(description_medicale, ‘infarctus’, ‘i’) > 0 THEN OUTPUT cohorte_cardiologie; permet de capturer avec une efficience maximale toutes les observations pertinentes, indépendamment du fait que le terme apparaisse au début, au milieu ou à la fin du diagnostic, et quelle que soit la casse typographique adoptée par le médecin investigateur. Cette stratégie de filtrage hâtif réduit considérablement l’empreinte mémoire en éliminant les enregistrements non éligibles dès les phases amont du pipeline de données.
10.2 Combinaison matricielle avec la fonction SUBSTR pour l’extraction dynamique
L’utilisation combinée des fonctions FIND et SUBSTR constitue le patron de conception (design pattern) par excellence pour l’analyse syntaxique (parsing) et l’extraction dynamique d’éléments d’information structurés au sein de chaînes hétérogènes. La fonction SUBSTR requiert la fourniture d’une coordonnée numérique de départ et d’une longueur d’extraction. Dans les situations du monde réel, la coordonnée de début d’un paramètre variable ne peut être postulée de façon statique ; elle doit être découverte dynamiquement à l’exécution par la fonction FIND.
Imaginons un journal applicatif où chaque ligne comporte une étiquette d’identification suivie d’une adresse de protocole réseau, sous la forme standardisée « Client_IP=192.168.1.50; Status=OK ». Pour extraire l’adresse de façon totalement dynamique sans recourir à des expressions régulières lourdes, l’analyste procède en deux étapes coordonnées : il utilise d’abord la fonction FIND pour déterminer l’indice de l’étiquette « Client_IP= », ajoute la longueur intrinsèque de cette étiquette pour localiser le premier chiffre de l’adresse, puis exploite un second appel à FIND ciblant le point-virgule terminal pour en déduire la longueur exacte de l’élément à découper via SUBSTR. Ce chaînage algorithmique offre une vitesse de calcul inégalée par les moteurs d’expressions régulières conventionnels.
10.3 Boucles programmées pour identifier toutes les occurrences multiples
Par définition, un appel unitaire à la fonction FIND n’identifie jamais qu’une seule occurrence d’un motif à la fois. Lorsque l’objectif analytique consiste à comptabiliser l’exhaustivité des répétitions d’une sous-chaîne ou à cartographier spatialement chacune de ses apparitions au sein d’un texte littéraire ou génomique étendu, il devient impératif d’intégrer la fonction FIND au sein d’une boucle itérative conditionnelle contrôlée, de type DO WHILE.
L’architecture algorithmique d’une telle routine s’articule autour de la réaffectation dynamique du paramètre startpos à chaque itération du cycle de calcul. L’algorithme initialise sa position de départ à l’indice 1. Dès qu’une occurrence est localisée à un indice p strictement supérieur à 0, cette coordonnée est consignée au sein d’un vecteur de stockage (généralement matérialisé par un ARRAY SAS). Immédiatement après, l’indice de départ de l’itération suivante est reconfiguré à la position p + 1, ou p + LENGTH(motif) si l’on souhaite interdire le chevauchement spatial des motifs détectés. La boucle itère ainsi de façon déterministe jusqu’à ce que la fonction FIND retourne la valeur 0, signifiant l’épuisement complet des correspondances au sein du vecteur analysé.
11. Performance computationnelle et bonnes pratiques en environnement Big Data
11.1 Impact sur le temps CPU et la mémoire vive
À l’ère des mégadonnées et des architectures analytiques d’entreprise telles que SAS Grid ou SAS Viya, l’impact de chaque micro-opération textuelle sur l’infrastructure matérielle sous-jacente doit être rigoureusement quantifié. La recherche d’une sous-chaîne par la fonction FIND repose sur un algorithme de balayage linéaire dont la complexité asymptotique moyenne est proportionnelle au produit de la longueur de la chaîne hôte par celle du motif cible. À l’échelle d’une table contenant plusieurs centaines de millions de lignes d’historique de cartes bancaires, un appel inefficace répété à chaque cycle du vecteur de données (PDV) peut rapidement saturer les cœurs du processeur.
L’introduction du modificateur ‘i’ impose une pénalité computationnelle mesurable, quoique modeste, comparativement au mode natif sensible à la casse. Le compilateur devant exécuter une opération arithmétique de normalisation de registre sur chaque octet évalué, le temps CPU total peut s’accroître d’environ 15 % à 25 % lors de tests massifs sous haute charge. Par conséquent, il demeure hautement recommandé de normaliser préalablement les colonnes de manière permanente dans la base relationnelle source (en appliquant une étape d’ingestion unique) plutôt que de déléguer systématiquement cette charge de désensibilisation à la volée à chaque requête analytique exécutée en aval.
11.2 Optimisation des longueurs de variables avec LENGTH
Une anomalie d’ingénierie extrêmement répandue dans le développement SAS consiste à surdimensionner systématiquement les variables de type caractère par pure précaution déclarative, par exemple en affectant aveuglément un attribut de longueur maximale, tel que LENGTH message $ 32767;. Cette pratique engendre un gaspillage catastrophique des ressources de pagination mémoire et dégrade sévèrement les performances intrinsèques de la fonction FIND.
Lorsqu’une variable de 32 767 octets est soumise à l’inspection de FIND sans utilisation conjointe des modificateurs de rognage appropriés, le sous-système de calcul examine méthodiquement l’intégralité du tampon d’octets alloué, y compris les dizaines de milliers d’espaces de remplissage terminaux qui comblent le vide matériel. Pour garantir un traitement ultra-rapide au sein de la mémoire cache du processeur, le développeur chevronné doit impérativement dimensionner chaque variable alphanumérique au plus juste de son contenu effectif au moyen de l’instruction LENGTH, et exploiter rigoureusement le modificateur ‘t’ ou la fonction TRIM lorsque les sous-chaînes cibles dérivent de colonnes textuelles à géométrie fixe.
11.3 Normalisation du code et lisibilité en milieu de production
Dans un contexte de développement industriel certifié (comme les environnements soumis aux réglementations FDA 21 CFR Part 11 dans l’industrie pharmaceutique), la compacité d’un script ne doit jamais s’obtenir au détriment de sa clarté et de son auditabilité. L’utilisation de la fonction FIND avec des modificateurs cryptiques ou des positions de départ implicites constitue une source récurrente de non-conformités lors des revues de code entre pairs. Il est impératif d’édicter des normes de programmation strictes encadrant l’usage de cette fonction.
Chaque appel à la fonction FIND exploitant des modificateurs combinés ou un balayage rétrograde négatif doit impérativement faire l’objet d’un bloc de commentaires descriptifs explicitant les hypothèses textuelles retenues. De surcroît, afin d’assurer la pérennité et la portabilité des programmes entre les versions SAS 9.4 traditionnelles sous encodage mono-octet et les nouvelles plateformes infonuagiques SAS Viya configurées nativement en UTF-8 multioctet, les analystes doivent privilégier l’utilisation de variables typées explicitement et encapsuler les algorithmes d’extraction complexes au sein de macros SAS paramétrées et rigoureusement documentées.
12. Synthèse méthodologique et guide de résolution des anomalies courantes
12.1 Tableau décisionnel des scénarios d’utilisation de FIND
Afin de fournir aux ingénieurs et analystes de données un cadre de référence opérationnel immédiat, nous avons synthétisé dans la matrice multidimensionnelle ci-dessous l’ensemble des configurations paramétriques optimales de la fonction FIND en regard des cas d’usage industriels les plus fréquemment rencontrés sur le terrain :
| Objectif Analytique | Argument modificateurs | Argument startpos | Formulation syntaxique type |
|---|---|---|---|
| Localisation stricte de première occurrence | Omis (vide) | Omis (défaut 1) | FIND(texte, ‘motif’) |
| Recherche insensible à la casse typographique | ‘i’ | Omis (défaut 1) | FIND(texte, ‘motif’, ‘i’) |
| Recherche avec cible issue d’une variable | ‘it’ ou ‘t’ | Omis (défaut 1) | FIND(texte, var_cible, ‘it’) |
| Recherche séquentielle à partir d’un offset | » ou ‘i’ | Entier positif (>1) | FIND(texte, ‘motif’, ‘i’, 10) |
| Identification de la dernière occurrence | » ou ‘i’ | Entier négatif (<0) | FIND(texte, ‘motif’, », -LENGTH(texte)) |
12.2 Diagnostic et résolution des erreurs fréquentes
L’exploitation de la fonction FIND au sein de flux de scripts denses expose inévitablement les développeurs à des erreurs d’implémentation typiques. L’anomalie la plus pernicieuse consiste en l’interversion accidentelle des deux premiers arguments positionnels, c’est-à-dire spécifier la sous-chaîne cible en première position et la chaîne hôte en seconde position. Cette inversion syntaxique ne génère aucune erreur de compilation si les deux entités sont de type caractère, mais conduit invariablement au retour universel de la valeur 0 dès lors que la sous-chaîne est plus courte que la chaîne hôte, plongeant l’analyste dans une incompréhension totale face à des résultats désespérément vides.
Une seconde défaillance fréquente réside dans la confusion entourant l’ordre des arguments en présence du paramètre startpos. Si l’on souhaite stipuler une position de départ numérique sans utiliser de modificateurs alphabétiques, il est formellement interdit d’omettre purement et simplement le troisième argument en écrivant FIND(texte, ‘motif’, 5). Dans une telle conjoncture, le compilateur SAS interprète le nombre 5 comme un modificateur textuel illégal, consignant immédiatement une erreur syntaxique bloquante dans le journal d’exécution. La syntaxe rigoureuse impose de combler le troisième emplacement par une chaîne vide : FIND(texte, ‘motif’, », 5).
12.3 Checklist de contrôle qualité avant mise en production
Pour garantir une étanchéité opérationnelle absolue avant la mise en production de programmes exploitant intensivement la fonction FIND, chaque script DATA Step doit être confronté à une grille d’audit de qualité logicielle standardisée. Cette revue méthodologique systématique permet de juguler les régressions fonctionnelles et d’assurer une robustesse algorithmique sans faille sur des données réelles :
- Vérification de l’encadrement des modificateurs : S’assurer que tous les modificateurs tels que ‘i’, ‘t’ ou ‘it’ sont rigoureusement entourés de guillemets simples ou doubles et occupent scrupuleusement la troisième position positionnelle de l’instruction.
- Validation du comportement face aux valeurs manquantes : Vérifier par un jeu d’essais unitaire que le programme réagit de façon déterministe et conforme au cahier des charges lorsque la variable textuelle analysée héberge une valeur vide ou constituée exclusivement d’espaces.
- Élagage des cibles dynamiques : Confirmer systématiquement la présence du modificateur ‘t’ ou de la fonction TRIM/STRIP dès lors que le second paramètre de recherche n’est pas une constante textuelle littérale brute mais provient d’une variable SAS préexistante.
- Vérification des bornes d’indexation : S’assurer qu’aucun calcul arithmétique dynamique n’est susceptible de transmettre la valeur numérique 0 à l’argument startpos, ce qui générerait une interruption d’exécution et l’assignation d’une valeur manquante.
- Audit des longueurs de variables : Examiner les instructions LENGTH associées aux variables textuelles réceptrices ou sources afin de proscrire tout surdimensionnement arbitraire susceptible de dégrader les performances de pagination en mémoire vive.
Références
SAS Institute Inc. (2016). SAS(R) 9.4 Functions and CALL Routines: Reference, Fifth Edition. Cary, NC: SAS Institute Inc. Récupéré de https://support.sas.com/documentation/
SAS Institute Inc. (2020). SAS Viya Programming: Data Step Basics. Cary, NC: SAS Institute Inc. Récupéré de https://documentation.sas.com/
Cody, R. (2018). Cody’s Data Cleaning Techniques Using SAS, Third Edition. Cary, NC: SAS Institute Inc.
Horstman, D. W. (2017). Character String Manipulation in the SAS Data Step: Beyond the Basics. Proceedings of the SAS Global Forum 2017 Conference. Cary, NC: SAS Institute Inc.
Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer, Sixth Edition. Cary, NC: SAS Institute Inc.