
Dans le domaine de l’économétrie appliquée, de la biostatistique et de la science des données contemporaine, la sélection d’un échantillon probabiliste rigoureux constitue le pivot méthodologique sur lequel repose l’ensemble de l’édifice inférentiel. Loin d’être une simple opération technique subalterne, l’acte de sous-échantillonner une population cible gouverne la validité interne et externe des conclusions statistiques formulées ultérieurement. Au sein de l’environnement logiciel SAS (Statistical Analysis System), reconnu mondialement pour sa robustesse analytique et sa conformité aux exigences réglementaires strictes de l’administration publique et de l’industrie pharmaceutique, la manipulation d’échantillons fait l’objet d’architectures algorithmiques hautement spécialisées. Ce guide exhaustif explore en profondeur les mécaniques théoriques et opérationnelles présidant à la sélection d’échantillons aléatoires dans l’écosystème SAS, en disséquant minutieusement l’ensemble des paradigmes sous-jacents.
Le traitement des données massives impose fréquemment des arbitrages fondamentaux entre la parcimonie computationnelle et la précision inférentielle. Qu’il s’agisse de calibrer des modèles prédictifs complexes sans saturer la mémoire vive des serveurs de calcul, de sonder des cohortes épidémiologiques étendues à des fins de validation clinique, ou d’auditer des transactions financières volumineuses selon des normes prudentielles éprouvées, l’échantillonnage aléatoire offre une solution formellement démontrée par la théorie des sondages. Les praticiens doivent cependant maîtriser parfaitement les implications de chaque méthode de tirage, sous peine d’introduire des biais d’estimation insidieux susceptibles de compromettre l’objectivité des extrapolations. À travers l’étude de la procédure spécialisée SURVEYSELECT et des alternatives programmatiques en étape DATA, cet article détaille chaque phase du processus d’échantillonnage sous SAS.
Au fil des sections suivantes, les fondements mathématiques de l’équiprobabilité seront articulés avec les impératifs syntaxiques propres au langage SAS. De la configuration élémentaire d’un tirage aléatoire simple sans remise jusqu’aux raffinements méthodologiques de la stratification et du rééchantillonnage avec remise de type bootstrap, chaque concept sera illustré par des cas concrets et des implémentations pas à pas. L’analyse critique des métadonnées probabilistes générées par le système ODS (Output Delivery System), la comparaison systématique des performances algorithmiques sur de volumineuses bases de données, ainsi que la formalisation d’un guide décisionnel exhaustif permettront aux analystes, statisticiens et chercheurs d’acquérir une autonomie conceptuelle et pratique absolue dans l’élaboration de leurs plans de sondage.
1. Fondements méthodologiques de l’échantillonnage aléatoire sous SAS
1.1 Importance de l’aléation dans l’inférence statistique
L’inférence statistique moderne tire sa légitimité de la capacité à généraliser des observations recueillies sur une fraction restreinte d’individus à l’ensemble d’une population parente finie ou infinie. Pour que cette extrapolation mathématique soit rigoureusement valide, le principe fondamental de la représentativité doit être scrupuleusement respecté. Ce principe stipule que la composition de l’échantillon doit refléter fidèlement la structure multidimensionnelle de la population d’origine, tant au niveau des tendances centrales que des dispersions et des covariations entre variables. L’aléation, ou randomisation, constitue l’unique moyen objectif permettant de satisfaire cette exigence sans présupposer de la distribution a priori des variables non observées. En confiant l’attribution des unités d’observation à un processus purement stochastique, le statisticien neutralise l’impact délétère des variables de confusion et garantit que les lois asymptotiques des grands nombres puissent s’appliquer efficacement.
Dans les protocoles quantitatifs, l’élimination des biais de sélection humaine représente une priorité absolue. Lorsqu’un opérateur choisit délibérément les unités d’observation, même en croyant adopter une démarche neutre et objective, il introduit inévitablement des biais cognitifs implicites qui faussent la distribution des données. L’échantillonnage probabiliste élimine cette interférence subjective en soumettant chaque observation à une règle d’inclusion formelle. Les fondements mathématiques régissant ces procédures reposent sur la théorie de la mesure et l’équiprobabilité, garantissant que chaque unité statistique appartenant à la base de sondage possède une probabilité non nulle et strictement calculable d’être intégrée dans le sous-ensemble final. Cette modélisation probabiliste permet de dériver analytiquement les erreurs-types associées aux estimateurs ponctuels et d’établir des intervalles de confiance rigoureux conformes aux théorèmes limites de l’inférence fréquentiste.
1.2 Le module d’échantillonnage SAS : champ d’application et architectures
L’architecture logicielle développée par le SAS Institute intègre une collection de procédures dédiées spécifiquement à la théorie des sondages et à l’analyse des données complexes dans le module SAS/STAT. Contrairement aux approches conventionnelles qui traitent les observations comme des variables indépendantes et identiquement distribuées, les outils d’échantillonnage de SAS reconnaissent explicitement les structures d’enquête sophistiquées comprenant des grappes, des strates et des probabilités d’inclusion inégales. L’architecture de ces outils assure une compatibilité parfaite avec les exigences scientifiques et réglementaires les plus strictes, notamment celles dictées par les agences gouvernementales de statistique, la Food and Drug Administration (FDA) pour les essais cliniques, et le Comité de Bâle pour le contrôle des risques bancaires.
Au sein de cet écosystème, il convient d’opérer une distinction nette entre deux approches de programmation : la sélection algorithmique artisanale élaborée au sein d’une étape DATA séquentielle et l’invocation de procédures analytiques précompilées. Si l’étape DATA offre une liberté algorithmique totale à travers l’écriture manuelle de boucles et de filtres logiques, elle expose le programmeur à des risques accrus d’erreurs méthodologiques et nécessite une gestion complexe de la mémoire tampon. À l’inverse, les procédures spécialisées encapsulent des algorithmes hautement optimisés, conçus par des numériciens chevronnés, et garantissent une stabilité numérique absolue. Cette modularité permet d’intégrer sans friction des processus de sélection probabiliste dans des chaînes de traitement automatisées répondant aux standards académiques et industriels internationaux.
1.3 Présentation générale de la procédure PROC SURVEYSELECT
Au cœur du dispositif d’échantillonnage de SAS se trouve la procédure SURVEYSELECT. Cette procédure constitue le pivot méthodologique incontournable pour quiconque souhaite extraire des sous-ensembles représentatifs à partir de bases de données relationnelles ou de fichiers séquentiels. Sa conception fonctionnelle lui permet d’exécuter aussi bien des tirages élémentaires que des plans de sondage hautement complexes impliquant des allocations optimales de Neyman, des probabilités proportionnelles à la taille de l’unité (designs dits PPS pour Probability Proportional to Size), ou des échantillonnages systématiques avec pas de sondage fractionnaire. La flexibilité de son paramétrage syntaxique en fait l’outil de référence pour les statisticiens méthodologistes.
L’une des forces majeures de la procédure SURVEYSELECT réside dans sa capacité intrinsèque à générer des métadonnées probabilistes complètes lors de l’extraction des données. Alors qu’une extraction manuelle sous d’autres langages omet fréquemment de consigner les paramètres stochastiques du tirage, SURVEYSELECT adjoint automatiquement à chaque observation sélectionnée sa probabilité exacte d’inclusion ainsi que son poids de sondage correspondant. Ces variables additionnelles s’avèrent indispensables pour alimenter en aval les procédures d’analyse d’enquêtes complexes, telles que SURVEYMEANS, SURVEYFREQ, SURVEYREG ou SURVEYLOGISTIC, préservant ainsi la chaîne de traçabilité statistique depuis la base de sondage brute jusqu’à la publication des résultats finaux.
2. Structure syntaxique et grammaire de PROC SURVEYSELECT
2.1 Déclaration des options fondamentales de la procédure
L’invocation de la procédure SURVEYSELECT s’articule autour d’une grammaire déclarative rigoureuse et concise. L’instruction principale débute obligatoirement par le mot-clé de la procédure, immédiatement suivi d’une série d’arguments obligatoires et optionnels qui circonscrivent le comportement global du moteur d’exécution. L’argument DATA= permet de spécifier le jeu de données SAS d’entrée faisant office de base de sondage. Cette table peut résider dans la bibliothèque de travail temporaire WORK ou provenir d’une bibliothèque permanente connectée via un moteur d’accès distant. L’absence de cet argument conduit SAS à utiliser par défaut le dernier jeu de données créé au cours de la session active, une pratique fortement déconseillée dans les environnements de production en raison des risques de mauvaise attribution du flux de données.
Parallèlement, l’argument OUT= désigne la table de destination dans laquelle seront écrites les observations retenues par l’algorithme d’échantillonnage, accompagnées de leurs métadonnées probabilistes. La régulation des flux d’information affichés dans le journal de compilation et dans la fenêtre des résultats s’opère au moyen de commutateurs syntaxiques spécifiques. L’argument NOPRINT peut être inséré pour inhiber totalement la production des tableaux récapitulatifs dans l’interface ODS, ce qui s’avère particulièrement utile lors de l’exécution de simulations itératives de Monte-Carlo comprenant des dizaines de milliers de répétitions. À l’inverse, l’omission de cette option entraîne l’édition d’un rapport synoptique décrivant de manière standardisée l’ensemble des caractéristiques opérationnelles du tirage réalisé.
2.2 Définition de la méthode d’échantillonnage aléatoire simple (METHOD=SRS)
La caractérisation du plan d’échantillonnage s’effectue principalement au moyen de l’option METHOD=. Lorsque le praticien affecte la valeur SRS à cette option, il instruit la procédure d’appliquer l’algorithme de tirage aléatoire simple sans remise (Simple Random Sampling). Sous cette méthode fondamentale, chaque sous-ensemble distinct de n unités issu d’une population globale de taille N possède exactement la même probabilité combinatoire d’être constitué. L’algorithme garantit formellement que l’extraction d’une unité statistique donnée au cours d’un cycle de calcul retire immédiatement cette même unité de la base de tirage résiduelle pour l’ensemble des itérations subséquentes du même échantillon.
Cette spécification se distingue formellement des autres méthodes proposées par la procédure, telles que le tirage avec remise (URS), le tirage systématique (SYS) ou les tirages séquentiels pondérés (PPS). D’un point de vue statistique, le choix de METHOD=SRS entraîne des implications directes sur la variance théorique des estimateurs. En éliminant la possibilité d’observer des redondances au sein de l’échantillon, le tirage sans remise génère une variance d’échantillonnage inférieure à celle observée lors d’un tirage avec remise, grâce à l’application implicite du facteur de correction pour population finie, classiquement modélisé par l’expression (N – n) divisé par (N – 1). Ce gain d’efficacité statistique renforce la précision des intervalles de confiance calculés sur des populations à effectif restreint.
2.3 Le paramètre SEED et l’impératif de reproductibilité scientifique
L’attribution de la graine aléatoire via l’instruction SEED= constitue une exigence déontologique et méthodologique centrale dans la recherche quantitative moderne. Les ordinateurs digitaux étant intrinsèquement déterministes, ils ne peuvent générer de véritables séquences aléatoires physiques ; ils s’appuient sur des générateurs de nombres pseudo-aléatoires (PRNG pour Pseudo-Random Number Generators). Ces algorithmes mathématiques complexes produisent une suite déterministe de nombres distribuant uniformément leurs valeurs sur l’intervalle semi-ouvert zéro-un, en partant d’un état interne initial précisément déterminé par la valeur numérique attribuée au paramètre SEED.
L’assignation explicite d’un entier positif non nul garantit la réplication exacte de l’échantillon lors de réexécutions ultérieures du programme, quelles que soient la machine physique hôte ou la session de travail. Cette reproductibilité stricte est indispensable pour la validation collégiale par les pairs et l’auditabilité des calculs dans les industries réglementées. Si le programmeur omet d’assigner une valeur au paramètre SEED ou s’il spécifie explicitement la valeur zéro, SAS initialise automatiquement le générateur en interrogeant l’horloge interne du processeur hôte au millième de seconde près. Dans cette configuration, chaque exécution produira un échantillon différent, rendant impossible la réitération stricte des résultats scientifiques et compromettant la traçabilité intégrale du protocole expérimental.
3. Configuration et modélisation du jeu de données empirique
3.1 Création du jeu de données de travail avec l’étape DATA
Afin d’ancrer les développements théoriques dans un cadre expérimental tangible et directement reproductible, nous concevons une table représentative intégrant des métriques hétérogènes. La syntaxe repose sur l’exploitation standardisée de l’étape DATA, couplée à l’instruction INPUT permettant de typer rigoureusement les variables collectées. La base de sondage simulée emprunte son contexte aux performances d’athlètes professionnels au sein d’une ligue sportive collective. Ce cadre d’étude offre l’avantage de manipuler simultanément des variables catégorielles nominales, telles que l’appartenance à une franchise ou la désignation textuelle des joueurs, et des variables quantitatives continues ou discrètes reflétant des métriques de productivité physique.
L’instruction DATALINES sert de vecteur d’injection séquentielle pour alimenter la structure matricielle créée en amont. Les observations y sont ordonnées ligne à ligne selon un format libre délimité par des espaces simples. Ce chargement manuel en mémoire vive garantit un contrôle exhaustif des données sous-jacentes, exempt de toute corruption d’encodage ou d’ambiguïté liée à des séparateurs exotiques. L’étape DATA compile le programme en traduisant les déclarations en mémoire tampon (Program Data Vector) avant d’écrire séquentiellement chaque vecteur d’observation sur le disque physique de la bibliothèque de travail.
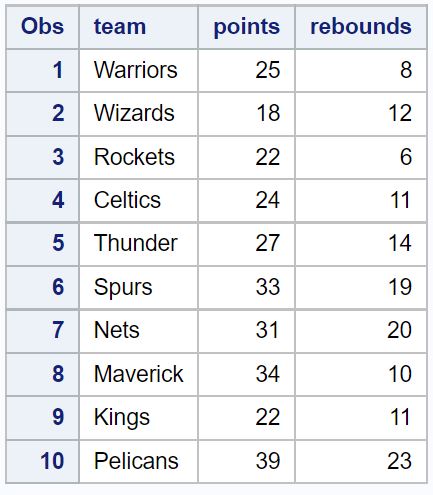
Le bloc d’instructions suivant illustre l’implémentation formelle de cette base d’expérimentation, nommée arbitrairement ATHLETES :
data ATHLETES;
input Equipe $ Joueur $ Points Rebonds;
datalines;
A Adams 14 8
A Baker 19 6
A Clark 9 3
B Davis 8 11
B Evans 16 9
B Frank 21 4
C Ghosh 22 7
C Hills 13 5
C Irwin 18 10
C Jones 12 4
;
run;
3.2 Vérification structurelle via PROC PRINT
Préalablement à toute manipulation stochastique, une inspection rigoureuse de l’intégrité de la table originale s’impose comme une étape incontournable du contrôle qualité. L’utilisation de la procédure PRINT constitue la méthode canonique pour procéder à cette validation d’état. L’examen des sorties permet de certifier que le nombre total d’observations N correspond scrupuleusement aux prévisions méthodologiques, à savoir dix unités statistiques distinctes dans notre cadre empirique. Cette phase de validation élimine le risque d’inclusions fantômes causées par des sauts de ligne non désirés dans le flux de lecture.
Ce diagnostic synoptique vérifie en outre l’adéquation des typologies de données : les chaînes de caractères associées aux colonnes Equipe et Joueur doivent être formatées sans troncature intempestive, tandis que les métriques Points et Rebonds doivent impérativement présenter des statuts de variables numériques positives non grevées par des valeurs manquantes. L’instruction suivante matérialise cette phase de contrôle :
proc print data=ATHLETES noobs;
title « Structure intégrale de la population d’étude »;
run;
L’exécution de cette requête génère une restitution tabulaire limpide dans l’afficheur ODS. La vérification visuelle de ces dix enregistrements confirme la stabilité structurelle du jeu de données et prépare l’application des procédures de sélection probabiliste.
4. Sélection d’un échantillon à effectif fixe via l’option SAMPSIZE
4.1 Implémentation syntaxique de la taille d’échantillon absolue
L’exigence opérationnelle la plus courante rencontrée par les statisticiens d’enquête consiste à extraire un sous-ensemble contenant un nombre prédéterminé et invariable d’unités d’analyse. Au sein de la procédure SURVEYSELECT, cette contrainte volumétrique absolue s’exprime par le biais de l’instruction SAMPSIZE=. En affectant un entier fixe à cet argument, l’utilisateur dicte à l’algorithme d’interrompre le processus de sélection sans remise dès lors que le contingent d’individus tirés atteint la cible quantitative prescrite. Dans notre application démonstrative, nous fixons délibérément la taille d’échantillon à la valeur trois (SAMPSIZE=3) sur une population mère comprenant dix enregistrements.
Cette commande est adossée à l’option METHOD=SRS et assortie d’une graine de randomisation préalablement convenue, par exemple SEED=4567, pour assurer la totale répétabilité de la manipulation. La déclaration syntaxique complète se formule comme suit :
proc surveyselect data=ATHLETES out=ECHANTILLON_FIXE
method=srs
sampsize=3
seed=4567;
run;
À la compilation de cette séquence, le moteur d’exécution de SAS alloue un vecteur d’indices aléatoires fondé sur l’algorithme de Fan, Muller et Rezucha, garantissant un balayage efficace de la table sans saturation de la mémoire vive. Le journal d’exécution (log) enregistre la complétion de la tâche en indiquant le volume exact de la table d’entrée lue et le nombre de lignes écrites dans la table réceptrice, validant le respect de la contrainte volumétrique.
4.2 Analyse du jeu de données d’échantillon extrait
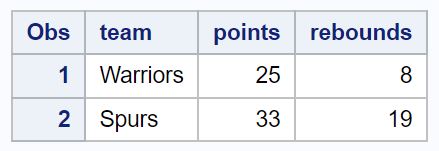
Pour examiner la configuration de la fraction d’individus sélectionnés et interpréter les descripteurs mathématiques nouvellement injectés, nous mobilisons derechef la procédure PRINT appliquée à la table de sortie ECHANTILLON_FIXE. Ce contrôle direct permet de décomposer la structure du résultat obtenu :
proc print data=ECHANTILLON_FIXE noobs;
title « Échantillon aléatoire simple à effectif fixe (n=3) »;
run;
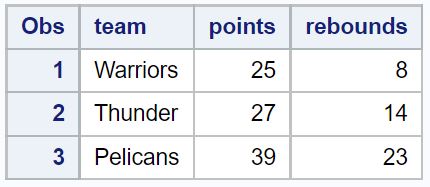
La visualisation de la table générée révèle non seulement les attributs originels des sportifs retenus par le tirage probabiliste, mais également deux colonnes fondamentales générées automatiquement par le moteur de SURVEYSELECT : SelectionProb et SamplingWeight. La variable SelectionProb prend une valeur strictement identique pour l’ensemble des unités sélectionnées, précisément égale à 0.3. Cette valeur correspond au ratio exact entre la taille de l’échantillon ciblé et l’effectif total de la population de départ, soit trois dixièmes. Cette uniformité probabiliste corrobore la nature strictement équiprobable du tirage sans remise.
Corrélativement, la métrique SamplingWeight affiche une valeur constante de 3.3333333333, représentant l’inverse arithmétique rigoureux de la probabilité de sélection élémentaire. Sur le plan de la théorie des sondages, ce poids signifie que chaque individu sélectionné dans l’échantillon représente statistiquement approximativement 3.33 individus au sein de la population globale lors des étapes d’extrapolation ou de calcul de totaux d’intérêt.
4.3 Scénarios méthodologiques d’utilisation de SAMPSIZE
L’arbitrage en faveur d’un échantillon à effectif fixe répond à des contraintes opérationnelles, financières ou analytiques bien définies dans la recherche empirique. En épidémiologie ou en sociologie quantitative, le coût unitaire d’administration d’un questionnaire d’enquête approfondi ou d’un examen médicalisé impose couramment un plafond budgétaire infranchissable. Dans ces circonstances, le dimensionnement de l’échantillon est déterminé de manière exogène par les ressources matérielles disponibles, rendant impératif le recours à l’instruction SAMPSIZE pour garantir l’adéquation absolue entre le protocole statistique et les limites logistiques du projet.
Un autre cas d’usage régulier de l’option SAMPSIZE concerne l’équilibrage artificiel de cohortes au sein de plans expérimentaux quasi-naturels ou dans le cadre de modèles d’apprentissage automatique supervisé confrontés à un déséquilibre de classes d’apprentissage. En extrayant un nombre fixe de cas et de témoins au moyen de tirages distincts, le modélisateur stabilise les estimateurs statistiques et prévient la surpondération des classes majoritaires. Toutefois, le praticien doit se prémunir d’une erreur de logique programmatique majeure : l’affectation d’une valeur de SAMPSIZE strictement supérieure à l’effectif populationnel disponible sous la méthode sans remise. Dans une telle éventualité, le compilateur SAS interrompt brutalement l’exécution de la procédure en consignant une erreur d’incompatibilité logique dans le journal d’exécution.
5. Sélection d’un échantillon proportionnel via l’option SAMPRATE
5.1 Implémentation syntaxique de la fraction de sondage
Lorsque la taille absolue de la base de sondage est variable ou que les objectifs d’analyse reposent sur la conservation systématique d’une fraction relative d’observations, l’emploi de l’option SAMPRATE= s’avère conceptuellement supérieur à celui de SAMPSIZE. Ce paramètre permet d’exprimer la taille de l’échantillon sous la forme d’un ratio ou d’une fraction décimale comprise obligatoirement dans l’intervalle ouvert zéro-un. L’analyste spécifie directement la proportion souhaitée d’individus à extraire de la population cible. Par exemple, pour isoler vingt pour cent de la masse globale de données, la fraction sera modélisée par l’argument SAMPRATE=0.2.
L’intégration de cette fraction relative s’effectue avec la même fluidité syntaxique que celle observée lors de l’usage des effectifs fixes. Associée à une graine reproductible comme SEED=123, la procédure garantit que le moteur stochastique respectera la densité de sélection requise tout au long de la lecture du fichier :
proc surveyselect data=ATHLETES out=ECHANTILLON_TAUX
method=srs
samprate=0.2
seed=123;
run;
Cette formulation est particulièrement adaptée aux pipelines de traitement industriel de données récurrentes, au sein desquels les volumétries de tables sources fluctuent périodiquement sans que la représentativité relative des extractions ne doive être renégociée ou recalculée manuellement.
5.2 Algorithmes d’arrondi et détermination de la taille effective
L’application d’un taux d’échantillonnage théorique à un ensemble discret de N observations soulève inévitablement la question de la gestion des arrondis numériques. Lorsque le produit du taux de sondage par l’effectif populationnel ne débouche pas sur un entier naturel, le système SAS met en œuvre un algorithme déterministe interne d’arbitrage pour arrêter l’effectif n effectif de l’échantillon produit. Par défaut, la procédure SURVEYSELECT arrondit le produit n = N multiplié par SAMPRATE à l’entier le plus proche, avec des conventions de basculement vers le plafond pour les fractions décimales médianes.
Dans le cas d’une population restreinte, comme nos dix athlètes sous un taux de sondage de 0.20, le calcul arithmétique 10 * 0.2 donne exactement l’entier 2. Il n’existe alors aucune ambiguïté de conversion. En revanche, si la population initiale comportait onze individus, un taux de 0.20 induirait une taille mathématique brute de 2.2 individus. Dans cette situation, le compilateur arrête la taille effective de tirage à deux observations. Si l’analyste souhaite imposer une politique d’arrondi personnalisée ou garantir impérativement une borne inférieure minimale d’échantillonnage pour éviter des tirages vides, il est nécessaire de combiner le taux de sondage avec des options d’arrondi explicites ou d’encadrer le processus par un prétraitement en macro-langage.
5.3 Contextes applicatifs privilégiant SAMPRATE sur SAMPSIZE
La supériorité opérationnelle de SAMPRATE s’exprime pleinement dans la gestion de gigantesques entrepôts de données et le prototypage de modèles statistiques. Lorsqu’un jeu de données massives (Big Data) compte plusieurs dizaines de millions d’enregistrements, l’extraction préalable d’un échantillon représentatif de 1% ou de 5% via SAMPRATE permet d’élaborer, de tester et de stabiliser les lignes de code et les algorithmes prédictifs sur une station de travail locale sans saturer les bus de transfert réseau ni immobiliser inutilement la puissance des clusters distribués.
De plus, cette technique constitue le socle standard de la scission des données lors du partitionnement entre échantillons d’entraînement, de validation croisée et de test en modélisation prédictive. L’extraction par fraction garantit que chaque sous-ensemble conserve rigoureusement la densité relative nécessaire à l’apprentissage statistique. De même, dans les enquêtes périodiques longitudinales où le renouvellement fractionnaire de la population est indexé sur l’évolution globale de la démographie d’entreprise, SAMPRATE stabilise la pression d’interrogation sur les cohortes de manière beaucoup plus équitable qu’un quota fixe arbitraire.
6. Analyse approfondie des métadonnées générées par PROC SURVEYSELECT
6.1 La variable SelectionProb : calcul et interprétation
La génération transparente des métadonnées probabilistes par la procédure SURVEYSELECT répond à une nécessité fondamentale de l’inférence scientifique. La variable SelectionProb, intégrée d’office dans toute table de sortie d’échantillonnage, consigne formellement la probabilité d’inclusion élémentaire au premier ordre, notée classiquement pi_i dans la littérature statistique spécialisée. Sous la méthode de sondage aléatoire simple (METHOD=SRS), cette probabilité demeure strictement uniforme pour l’ensemble des éléments de la population et découle de la formule analytique élémentaire pi_i = n / N, où n représente la taille de l’échantillon retenu et N l’effectif exhaustif de la base de sondage.
Cette traçabilité de pi_i revêt une importance fondamentale lors de la phase d’estimation ultérieure. Elle permet notamment la mise en œuvre de l’estimateur de Horvitz-Thompson, qui garantit l’obtention d’une espérance mathématique sans biais pour l’évaluation de totaux de population sur n’importe quel caractère mesurable y, en calculant la somme des valeurs y_i pondérées par l’inverse de leurs probabilités d’inclusion individuelles respectives. Sans la préservation explicite de cette variable dans les structures de données générées par SAS, toute inférence ultérieure sur les variances et les étendues populationnelles risquerait d’être lourdement compromise par une absence d’information sur le plan d’échantillonnage source.
6.2 La variable SamplingWeight : signification statistique
En étroite corrélation avec la probabilité de sélection, la colonne SamplingWeight matérialise le facteur d’expansion ou poids de sondage, conventionnellement désigné par w_i dans les formulations économétriques, défini par l’égalité stricte w_i = 1 / pi_i. Ce coefficient d’extrapolation joue un rôle opérationnel central : il quantifie le nombre d’unités de la population globale qui sont virtuellement représentées par l’individu statistique figurant dans l’échantillon sélectionné. Dans notre exemple initial où la probabilité d’inclusion s’élevait à 0.3, le poids de sondage associé de 3.3333333333 atteste que chaque profil observé en échantillon porte la voix statistique de plus de trois unités mères.
Dans le cadre de modélisations analytiques avancées, telles que les régressions linéaires généralisées ou les modèles à risques proportionnels de Cox, ces poids d’échantillonnage doivent être obligatoirement injectés dans les clauses WEIGHT des procédures d’analyse pour ajuster la fonction de vraisemblance pseudo-maximale. L’omission de cette pondération dans les calculs d’inférence conduirait à sous-estimer drastiquement la variance empirique réelle et produirait des inférences abusives caractérisées par des taux d’erreur de première espèce (rejets à tort de l’hypothèse nulle) excessivement gonflés.
6.3 Tables de synthèse émises par le système ODS de SAS
Parallèlement à l’écriture physique de la table d’échantillon sur le support de stockage, la procédure SURVEYSELECT compile et restitue un jeu de tables descriptives standardisées par l’intermédiaire du système ODS (Output Delivery System). Ces tableaux de synthèse documentent les caractéristiques de l’extraction probabiliste. Le rapport standard émis dans la fenêtre de sortie consigne systématiquement : le nom complet de la table source d’entrée, le nom de la table cible produite, la méthode stochastique sélectionnée (explicitement mentionnée comme Simple Random Sampling), la valeur de la graine aléatoire employée pour l’initialisation du générateur numérique, le nombre d’observations scrutées et la taille finale de l’échantillon extrait.
Ce compte-rendu automatisé constitue une pièce d’audit statistique indispensable. Il fournit une trace documentaire certifiant les paramètres d’échantillonnage sans nécessiter la décompilation manuelle des scripts sous-jacents. L’analyste rigoureux peut aisément capturer ces tables de synthèse ODS sous la forme de fichiers de données autonomes à l’aide de l’instruction ODS OUTPUT, permettant d’intégrer automatiquement ces éléments de gouvernance dans les métadonnées de documentation de projets analytiques ou de registres de contrôle interne.
7. Techniques avancées : échantillonnage avec remise (METHOD=URS)
7.1 Différenciation théorique entre SRS et URS
L’exploration des méthodologies de tirage impose de distinguer fondamentalement l’échantillonnage aléatoire simple sans remise (SRS) de l’échantillonnage aléatoire avec remise, désigné dans la nomenclature SAS sous l’acronyme URS (Unrestricted Random Sampling). Dans le paradigme du tirage avec remise, une observation extraite de la base de sondage n’est pas exclue des tirages suivants : elle est réinjectée immédiatement dans le vivier d’origine. Cette méthode restaure à chaque tirage la composition intégrale de la population d’étude, assurant une stricte indépendance probabiliste mutuelle entre l’ensemble des tirages successifs composant l’échantillon final.
D’un point de vue probabiliste, cette indépendance transforme la loi d’échantillonnage : alors que le tirage sans remise suit une distribution hypergéométrique où la composition de l’urne évolue à chaque tirage, le tirage URS se conforme strictement à une distribution multinomiale stable. Bien que le tirage URS produise une variance théorique plus élevée que le tirage SRS à taille d’échantillon égale en raison de la redondance potentielle d’unités statistiques, il constitue un modèle théorique incontournable pour l’estimation de paramètres sous l’hypothèse de populations mères conceptuellement infinies ou dans le déploiement de techniques de simulation empirique.
7.2 Syntaxe de METHOD=URS dans PROC SURVEYSELECT
L’implémentation opérationnelle de l’échantillonnage avec remise au sein de la procédure SURVEYSELECT requiert la modification de l’instruction de méthode par l’assignation METHOD=URS. Cette bascule algorithmique transforme la structure de la table SAS résultante en autorisant formellement la duplication d’enregistrements identiques. Pour gérer cette multiplicité potentielle sans alourdir artificiellement la volumétrie mémoire du jeu de données généré, SAS intègre par défaut une métadonnée spécifique nommée NumberHits.
Cette variable NumberHits quantifie de façon univoque le nombre de fois exact où une observation spécifique a été sélectionnée par le processus aléatoire. Si un individu est tiré trois fois au cours de l’expérience, il n’apparaîtra par défaut qu’une seule fois dans la table de destination, mais sa variable NumberHits portera la valeur 3. Si l’analyste requiert une démultiplication physique explicite des lignes dupliquées pour alimenter des procédures aveugles à la variable d’occurrence, il suffit de renseigner l’option OUTHITS dans l’en-tête de la commande. L’exemple suivant illustre cette syntaxe :
proc surveyselect data=ATHLETES out=ECHANTILLON_REMISE
method=urs
sampsize=5
outhits
seed=888;
run;
L’activation du commutateur OUTHITS garantit que la table résultante contiendra exactement cinq lignes physiques, quitte à présenter des clones parfaits d’individus ayant bénéficié de plusieurs tirages favorables lors de l’exécution de l’algorithme.
7.3 Applications pratiques au rééchantillonnage de type Bootstrap
L’intérêt contemporain prépondérant pour la méthode URS réside dans son adéquation directe avec les techniques de rééchantillonnage non paramétrique, emblématisées par l’approche Bootstrap d’Efron. Face à des distributions hautement asymétriques, des structures de corrélation complexes ou des estimateurs mathématiquement intraitables par les méthodes asymptotiques usuelles (tels que la médiane, les quantiles extrêmes ou les ratios non linéaires), le Bootstrap permet de dériver empiriquement la distribution d’échantillonnage d’un paramètre en générant un grand nombre de réplicats de même taille que la population initiale, tirés avec remise.
La procédure SURVEYSELECT s’associe idéalement à cette exigence computationnelle grâce à l’instruction REPS=. Ce paramètre permet d’ordonner à SAS de générer simultanément des milliers d’échantillons avec remise distincts en une seule lecture optimisée du fichier source. Le code suivant matérialise la génération industrielle de 1000 réplicats bootstrap de taille N=10 :
proc surveyselect data=ATHLETES out=BOOTSTRAP_SAMPLES
method=urs
sampsize=10
reps=1000
seed=999;
run;
Le jeu de données de destination BOOTSTRAP_SAMPLES contient alors dix mille lignes segmentées par la variable indicatrice Replicate (prenant des valeurs de 1 à 1000). Cette matrice peut ensuite être injectée directement dans des procédures analytiques telles que PROC REG ou PROC GENMOD via une clause d’exécution de groupe BY Replicate, permettant une analyse approfondie des intervalles de confiance bootstrap.
8. Échantillonnage aléatoire stratifié avec l’instruction STRATA
8.1 Nécessité du tri préalable des données avec PROC SORT
L’échantillonnage stratifié consiste à fractionner préalablement la base de sondage globale en sous-ensembles mutuellement exclusifs et collectivement exhaustifs, qualifiés de strates, au sein desquels un échantillonnage probabiliste indépendant (souvent simple sans remise) est ensuite opéré. Cette technique vise à garantir une représentativité optimale de chaque sous-groupe d’intérêt. Sous l’architecture SAS, l’implémentation de la stratification s’appuie sur l’instruction STRATA. Cependant, l’exécution de cette instruction repose sur un prérequis architectural strict : les données d’entrée doivent être impérativement triées selon les variables de stratification avant l’appel de SURVEYSELECT.
Si cette contrainte d’ordonnancement n’est pas honorée, l’interpréteur SAS suspend immédiatement l’exécution de la procédure en générant un message d’erreur bloquant dans le journal, signalant que le jeu de données d’entrée n’est pas ordonné conformément aux strates déclarées. Le recours préalable à la procédure SORT représente donc un passage obligé. Le bloc programmatique suivant illustre cette préparation structurante sur la variable catégorielle Equipe :
proc sort data=ATHLETES out=ATHLETES_TRIES;
by Equipe;
run;
Cette opération réarrange physiquement les pointeurs de lignes sur le disque ou dans la mémoire cache, garantissant que les blocs de strates (Equipe A, B et C) soient continus. L’algorithme de SURVEYSELECT peut ainsi balayer séquentiellement chaque strate sans allouer de structures matricielles complexes en mémoire vive.
8.2 Syntaxe de l’instruction STRATA et allocation des échantillons
Dès lors que la base de sondage respecte l’ordonnancement requis, l’instruction STRATA peut être déployée au sein de SURVEYSELECT pour piloter des stratégies d’allocation variées. La méthode la plus courante réside dans l’attribution d’une taille d’échantillon uniforme pour chaque strate observée, ce qui s’obtient en combinant simplement l’instruction STRATA avec l’argument SAMPSIZE=, comme dans l’exemple ci-dessous :
proc surveyselect data=ATHLETES_TRIES out=ECHANTILLON_STRATIFIE
method=srs
sampsize=1
seed=789;
strata Equipe;
run;
Dans cette configuration, l’algorithme extrait exactement un individu au sein de l’équipe A, un individu au sein de l’équipe B, et un individu au sein de l’équipe C, produisant un échantillon final balancé de trois sportifs.
La flexibilité syntaxique de SURVEYSELECT autorise également des allocations non proportionnelles personnalisées. Si la problématique de recherche exige d’extraire des contingents asymétriques selon les groupes (par exemple, deux joueurs dans l’équipe A, un dans l’équipe B et un dans l’équipe C), l’analyste peut spécifier un vecteur d’effectifs explicite en renseignant la commande sous la forme SAMPSIZE=(2 1 1), les valeurs étant associées séquentiellement aux strates selon leur ordre de tri lexicographique. À l’inverse, si l’on souhaite maintenir la représentativité relative exacte des sous-groupes sans introduire de distorsions structurelles, l’utilisation couplée de l’instruction STRATA avec le paramètre global SAMPRATE= assure une allocation strictement proportionnelle au poids démographique de chaque strate dans la population parente.
8.3 Garantie de représentativité au sein de sous-groupes critiques
Sur le plan méthodologique, l’échantillonnage stratifié procure deux avantages majeurs par rapport à un échantillonnage aléatoire simple brut. En premier lieu, il immunise le chercheur contre le risque d’exclusion fortuite de sous-populations minoritaires. Dans le cadre d’un tirage SRS standardisé sur une population fortement déséquilibrée, il existe une probabilité combinatoire non négligeable qu’une sous-population marginale en volume ne soit absolument pas représentée dans le tirage final. La stratification force la procédure à collecter un contingent prédéfini dans chaque sous-groupe, sécurisant ainsi la comparabilité statistique des segments d’intérêt.
En second lieu, la théorie mathématique des sondages démontre formellement que la stratification induit une réduction substantielle de la variance d’échantillonnage des estimateurs dès lors que les strates sont composées d’unités relativement homogènes par rapport à la variable d’étude (forte variance inter-strates et faible variance intra-strate). En neutralisant la variabilité dispersée entre les strates, la variance de l’estimateur de la moyenne issue d’un plan stratifié s’avère systématiquement inférieure ou égale à celle générée par un tirage aléatoire simple de même taille globale. Ce gain d’efficacité statistique permet d’obtenir des intervalles de confiance plus étroits et d’optimiser l’allocation des ressources d’enquête.
9. Méthodes alternatives d’échantillonnage aléatoire via l’étape DATA
9.1 Génération de nombres pseudo-aléatoires avec la fonction RAND
Bien que la procédure SURVEYSELECT demeure la référence canonique sous SAS, il est fréquent que les ingénieurs de données et biostatisticiens doivent implémenter des processus d’échantillonnage directs au sein même d’une étape séquentielle DATA, notamment lors de traitements massifs en flux continu où le coût d’appel d’une procédure autonome est jugé trop élevé. L’approche élémentaire repose sur l’exploitation des fonctions internes de génération de nombres pseudo-aléatoires, au premier rang desquelles figure la fonction contemporaine RAND. Introduite pour pallier les faiblesses statistiques des générateurs historiques tels que RANUNI, la fonction RAND s’appuie par défaut sur l’algorithme du générateur Mersenne Twister (MT19937), réputé pour sa période astronomique de 2^19937 – 1 et ses excellentes propriétés d’équidistribution multidimensionnelle.
L’extraction d’un taux d’échantillonnage approximatif de vingt pour cent au fil d’une lecture de table s’articule autour de l’évaluation conditionnelle d’un tirage uniforme standardisé sur l’intervalle [0,1]. La syntaxe opérationnelle s’illustre comme suit :
data ECHANTILLON_RAND;
set ATHLETES;
call streaminit(12345);
if rand(‘Uniform’) <= 0.2 then output;
run;
L’instruction CALL STREAMINIT assure l’initialisation déterministe de la graine du générateur de la fonction RAND, garantissant la reproductibilité computationnelle du flux. Chaque observation évaluée dont la valeur pseudo-aléatoire uniforme est inférieure ou égale au seuil de 0.2 est conservée et injectée dans la table de destination. Il convient toutefois de souligner que cette méthode ne garantit pas l’extraction d’une taille d’échantillon rigoureusement fixe ; la taille finale de l’échantillon suit une loi binomiale de paramètres N et p=0.2, fluctuant stochastiquement autour de son espérance mathématique.
9.2 Algorithme d’extraction probabiliste pas à pas
Pour s’affranchir de la fluctuation binomiale inhérente à la fonction uniforme simple et imposer l’extraction d’un effectif rigoureusement exact de n unités parmi N observations sans quitter l’étape DATA, les programmeurs utilisent un algorithme d’ajustement dynamique de la probabilité conditionnelle résiduelle, souvent désigné sous l’appellation d’algorithme de Fan. Cette logique procède par recalcul continu de la probabilité d’inclusion au fur et à mesure du défilement séquentiel des lignes dans la mémoire tampon du Program Data Vector.
Mathématiquement, si nous devons sélectionner encore k unités parmi les m unités de population restant à parcourir, la probabilité d’inclusion attribuée à l’observation immédiatement soumise au test doit valoir exactement k / m. Dès lors qu’une observation est sélectionnée, le compteur d’unités requises k est décrémenté d’une unité, tandis que la réserve d’unités restantes m est automatiquement décrémentée d’une unité à chaque passage de ligne. Le script SAS suivant concrétise cette architecture algorithmique pour extraire très exactement trois sportifs (n=3) parmi les dix constituant la base ATHLETES :
data ECHANTILLON_EXACT_DATA(drop=k m);
retain k 3 m 10;
set ATHLETES;
call streaminit(54321);
if rand(‘Uniform’) <= (k / m) then do;
output;
k = k – 1;
end;
m = m – 1;
if k = 0 then stop;
run;
L’instruction conditionnelle finale commande l’arrêt préventif immédiat de l’étape DATA dès que le contingent k atteint zéro, évitant ainsi d’inutiles cycles d’entrées/sorties sur les observations résiduelles de la table source. Cette optimisation algorithmique procure des gains de performance majeurs lors de l’interrogation de bases de données volumineuses.
9.3 Limites méthodologiques de l’étape DATA face à PROC SURVEYSELECT
En dépit de son élégance algorithmique et de sa rapidité d’exécution brute, l’échantillonnage manuel via l’étape DATA présente des limites méthodologiques sévères qui incitent à lui préférer la procédure SURVEYSELECT dans la majorité des contextes professionnels et académiques. La première restriction réside dans l’incapacité de l’étape DATA à générer et consigner automatiquement les métadonnées probabilistes requises pour l’inférence statistique. Le développeur doit concevoir et coder manuellement le calcul de la probabilité de sélection et du poids de sondage, ce qui accroît drastiquement le risque d’erreurs logiques ou d’implémentation.
La seconde limite concerne l’extrême complexité de programmation requise dès que l’architecture du plan d’échantillonnage s’éloigne du tirage aléatoire simple. L’intégration de contraintes de stratification multidimensionnelle, de grappes hiérarchiques, d’allocations de Neyman ou de sélections avec probabilités proportionnelles à la taille (PPS) exigerait des centaines de lignes de code matriciel en étape DATA, assorties d’une maintenance applicative complexe. PROC SURVEYSELECT synthétise l’ensemble de ces méthodologies avancées en une ligne de paramètre standardisée et testée unitairement par des laboratoires académiques, offrant une sécurité méthodologique sans commune mesure avec les scripts artisanaux.
10. Validation statistique et contrôle d’adéquation de l’échantillon
10.1 Comparaison distributionnelle avec PROC MEANS
L’extraction d’un échantillon probabiliste ne constitue pas l’aboutissement du protocole d’analyse ; elle inaugure une phase impérative de contrôle de qualité et de validation empirique. Le statisticien doit s’assurer que le sous-ensemble extrait présente des caractéristiques distributionnelles compatibles avec les paramètres théoriques de la population source. Pour les variables quantitatives continues ou discrètes, la procédure MEANS offre le levier d’investigation privilégié. Elle permet de confronter les espérances mathématiques, les écarts-types, les médianes et les étendues observés entre la population mère et la fraction tirée.
Dans le cadre de notre étude empirique, nous évaluons la représentativité des métriques de productivité sportive (Points et Rebonds) en comparant les sorties calculées sur la table ATHLETES originale avec celles dérivées de la table d’échantillonnage ECHANTILLON_FIXE :
proc means data=ATHLETES mean std min max nonobs;
var Points Rebonds;
title « Paramètres populationnels de référence »;
run;
proc means data=ECHANTILLON_FIXE mean std min max nonobs;
var Points Rebonds;
title « Statistiques descriptives de l’échantillon extrait »;
run;
L’évaluation des écarts observés entre les moyennes d’échantillon et les paramètres populationnels doit être interprétée au prisme de l’erreur d’échantillonnage théorique. Les fluctuations constatées sont légitimes tant qu’elles s’inscrivent dans l’intervalle d’erreur-type prédéfini par le plan de sondage probabiliste adopté.
10.2 Contrôle d’indépendance et de proportions via PROC FREQ
Pour les attributs catégoriels et variables qualitatives nominales, la validation de représentativité transite par l’analyse des tables de contingence et le calcul des fréquences relatives. La procédure FREQ permet d’opérer ces vérifications structurelles de manière automatisée. En soumettant la variable catégorielle Equipe au crible de cette procédure, l’analyste peut diagnostiquer instantanément d’éventuelles distorsions de profil ou la disparition indésirable de modalités de faible fréquence :
proc freq data=ECHANTILLON_FIXE;
tables Equipe / chisq;
title « Distribution catégorielle au sein de l’échantillon »;
run;
L’option CHISQ sollicite le calcul du test d’adéquation du Khi-deux d’ajustement, permettant de confronter formellement la distribution des fréquences empiriques observées dans l’échantillon à la distribution théorique uniforme attendue sous l’hypothèse nulle d’équiprobabilité de tirage. Si la p-valeur associée demeure supérieure au seuil critique conventionnel (alpha = 0.05), le statisticien conclut à l’absence de biais de sélection manifeste dans l’extraction de l’échantillon.
10.3 Protocoles de détection d’anomalies de tirage
Même lorsque la syntaxe programmatique est rigoureusement exempte de tout défaut, il arrive qu’un tirage pseudo-aléatoire produise un échantillon structurellement déviant ou atypique en raison d’une initialisation malheureuse du générateur de nombres stochastiques (effet dit de graine extrême). Ce phénomène mathématiquement inévitable découle de la nature même de la variabilité d’échantillonnage : sur l’ensemble des échantillons possibles issus d’une loi de probabilité, certains tombent inévitablement dans les queues de distribution et ne reflètent pas les tendances centrales de la population parente.
Pour détecter et documenter ces occurrences dans un cadre de recherche rigoureux, le protocole standard repose sur le calcul de la distance multidimensionnelle de Mahalanobis ou la mise en œuvre de tests non paramétriques d’adéquation de Kolmogorov-Smirnov comparant la fonction de distribution empirique de l’échantillon à celle de la population source. Si un échantillon s’avère non représentatif en raison d’une graine statistique extrême, la démarche scientifique commande de ne pas substituer arbitrairement d’autres graines jusqu’à obtenir le profil intuitivement désiré (pratique prohibée assimilable au p-hacking). La bonne pratique consiste plutôt à revoir le plan d’échantillonnage en adoptant une stratification ciblée sur les variables critiques, garantissant de façon déterministe l’équilibre structurel du sous-ensemble sans compromettre la randomisation interne des tirages.
11. Gestion des grands jeux de données et optimisation des performances
11.1 Optimisation des entrées/sorties disque et utilisation de DROP/KEEP
Le passage à l’échelle sur des bases de données volumineuses renfermant des dizaines de millions d’enregistrements et des centaines de colonnes impose une optimisation drastique de la bande passante d’entrées/sorties (I/O). Lors de l’exécution de la procédure SURVEYSELECT sur de tels volumes, charger l’intégralité des variables de la table source constitue un gaspillage sévère de ressources informatiques. L’utilisation stratégique des options de sélection de colonnes KEEP= ou DROP= directement dans l’instruction de déclaration du jeu de données en entrée (DATA=) permet de filtrer les flux d’octets transférés en ne conservant que les identifiants uniques et les variables de stratification strictement indispensables à la randomisation.
La commande optimisée s’articule selon le modèle syntaxique suivant :
proc surveyselect data=ATHLETES(keep=Joueur Points) out=ECHANTILLON_OPTIMISE
method=srs
sampsize=3
seed=101;
run;
Une alternative encore plus performante consiste à créer une vue logique d’échantillonnage via une instruction SQL VIEW ou une étape DATA VIEW. La création d’une vue évite toute duplication matérielle de la table originale sur le disque de stockage temporaire WORK. SURVEYSELECT n’accède alors aux enregistrements qu’au moment précis de leur lecture séquentielle pour le tirage aléatoire, réduisant drastiquement l’empreinte disque et accélérant notablement le temps d’exécution global.
11.2 Gestion de l’indexation et du partitionnement physique
L’organisation sous-jacente des données exerce une influence directe sur la cinétique d’exécution des algorithmes d’échantillonnage complexe. Lorsque la procédure SURVEYSELECT opère un échantillonnage stratifié via l’instruction STRATA, le tri préalable obligatoire au moyen de PROC SORT peut mobiliser des temps de calcul prohibitifs sur des bases volumineuses. La présence préalable d’un index simple ou composite sur les variables de stratification permet à SAS de contourner cette étape de tri physique chronophage en exploitant directement l’arbre d’index binaire pour lire les strates de manière séquentielle ordonnée.
Dans les environnements analytiques distribués modernes et les architectures de cloud computing haute performance telles que SAS Viya et son moteur CAS (Cloud Analytic Services), l’échantillonnage probabiliste s’adapte à la distribution physique des données sur plusieurs nœuds de calcul en grappe. L’architecture CAS partitionne les tables volumineuses entre différents serveurs de calcul, exécutant l’échantillonnage aléatoire de manière parallèle et asynchrone sur chaque bloc de mémoire distribuée. Pour que la sélection globale respecte scrupuleusement l’équiprobabilité mathématique sans biaiser la représentation des nœuds, le moteur synchronise dynamiquement les allocations partielles en garantissant une randomisation coordonnée à travers l’ensemble du cluster de calcul.
12. Synthèse des bonnes pratiques et erreurs fréquentes dans SAS
12.1 Erreurs classiques de paramétrage syntaxique et logique
La mise en œuvre des procédures d’échantillonnage aléatoire sous SAS est régulièrement entachée d’erreurs récurrentes de paramétrage qui compromettent la validité statistique des résultats. La faute méthodologique la plus répandue consiste en l’omission du paramètre SEED= ou en l’affectation systématique de la valeur zéro. Cette négligence entraîne une réinitialisation automatique du générateur sur l’horloge système du processeur à chaque nouvelle exécution, rendant impossible la reproduction stricte des analyses et privant l’étude de son auditabilité scientifique.
Une seconde erreur fréquente réside dans la confusion logique entre les options SAMPSIZE= et SAMPRATE=. Spécifier par inadvertance un chiffre entier supérieur à 1 au sein de l’instruction SAMPRATE= (par exemple, déclarer SAMPRATE=10 en croyant extraire dix individus) provoque l’interruption immédiate de la compilation avec un message d’erreur bloquant, le taux de sondage étant obligatoirement borné dans l’intervalle [0,1]. Inversement, spécifier une fraction décimale dans SAMPSIZE= produit des comportements inattendus liés aux mécanismes de troncature des entiers. Enfin, les analystes doivent éviter d’écraser la table source en attribuant le même nom de table à la fois dans l’argument DATA= et dans l’argument OUT= de la procédure SURVEYSELECT, ce qui détruirait irréversiblement la base de sondage originale lors de l’exécution.
12.2 Recommandations méthodologiques pour la documentation des analyses
L’intégrité de la recherche quantitative repose sur une discipline rigoureuse de traçabilité et de documentation des protocoles analytiques. Tout rapport d’étude statistique mobilisant un sous-échantillon probabiliste doit consigner formellement les paramètres opérationnels qui ont présidé à sa constitution. Cette documentation standardisée doit expliciter : la version précise du système logiciel SAS utilisé, la dénomination exacte de la procédure et de ses options fonctionnelles (notamment la méthode de sélection déclarée sous METHOD=), l’entier numérique alloué à la graine aléatoire SEED=, ainsi que la date et l’horodatage d’exécution certifiés par le journal système.
Il est vivement recommandé d’adopter une politique systématique d’archivage conjoint des trois composantes fondamentales du traitement : le fichier de script contenant le code source SAS exécuté, le fichier texte intégral du journal de compilation (log) consignant l’absence totale d’avertissements de calcul ou d’erreurs logiques, et la table de sortie résultante enrichie de ses métadonnées probabilistes. Pour les publications académiques ou les soumissions réglementaires officielles, ces éléments méthodologiques garantissent aux évaluateurs et auditeurs externes une reproductibilité parfaite des résultats expérimentaux.
12.3 Guide décisionnel pour le choix des options d’échantillonnage
Pour accompagner le modélisateur dans la sélection des instructions et options les plus adaptées à ses objectifs de recherche, le tableau synoptique suivant résume les choix d’architecture d’échantillonnage au sein de la procédure SURVEYSELECT :
| Objectif méthodologique | Méthode d’échantillonnage | Paramètre de dimensionnement | Instruction complémentaire |
|---|---|---|---|
| Échantillon simple sans remise à effectif déterminé | METHOD=SRS | SAMPSIZE=n | SEED=valeur |
| Échantillon simple sans remise à proportion fixe | METHOD=SRS | SAMPRATE=fraction | SEED=valeur |
| Échantillon avec remise pour bootstrap | METHOD=URS | SAMPSIZE=n ou SAMPRATE=fraction | REPS=nombre / OUTHITS |
| Échantillonnage équilibré au sein de strates distinctes | METHOD=SRS ou URS | SAMPSIZE=n ou SAMPRATE=fraction | STRATA variable(s) + PROC SORT |
| Extraction probabiliste séquentielle en streaming massif | Étape DATA séquentielle | Algorithme de Fan ou RAND(‘Uniform’) | CALL STREAMINIT(valeur) |
L’arbitrage ultime entre l’usage d’une taille absolue ou d’un ratio relatif doit être dicté par la nature des contraintes budgétaires et logistiques du projet : si les ressources d’observation sont strictement contingentées, l’instruction SAMPSIZE= s’impose de facto ; si l’objectif consiste plutôt à préserver l’équilibre démographique des strates au sein d’une population dynamique, l’usage de SAMPRATE= représente le choix méthodologique le plus rigoureux.
Références
Cochran, W. G. (1977). Sampling techniques (3e éd.). John Wiley & Sons.
Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. CRC Press.
Fan, C. T., Muller, M. E., & Rezucha, I. (1962). Development of sampling plans by using sequential (item by item) selection techniques and digital computers. Journal of the American Statistical Association, 57(298), 387-402. https://doi.org/10.1080/01621459.1962.10480667
Horvitz, D. G., & Thompson, D. J. (1952). A generalization of sampling without replacement from a finite universe. Journal of the American Statistical Association, 47(260), 663-685. https://doi.org/10.1080/01621459.1952.10483446
Kish, L. (1965). Survey sampling. John Wiley & Sons.
Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: a 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3-30. https://doi.org/10.1145/272991.272995
SAS Institute Inc. (2023). SAS/STAT 15.3 User’s Guide: The SURVEYSELECT Procedure. SAS Institute Inc. https://documentation.sas.com
Särndal, C.-E., Swensson, B., & Wretman, J. (2003). Model assisted survey sampling. Springer Science & Business Media.