
Dans le champ foisonnant des sciences empiriques contemporaines, qu’il s’agisse de la sociologie quantitative, de l’épidémiologie, du marketing analytique ou de la psychométrie, la robustesse d’une inférence repose fondamentalement sur la qualité de son protocole d’échantillonnage. Face à des populations cibles trop vastes pour être analysées de manière exhaustive, les chercheurs et analystes doivent prélever un sous-ensemble d’observations représentatif, capable de refléter avec une précision mesurable la distribution des variables d’intérêt. L’échantillonnage probabiliste constitue à cet égard la pierre angulaire de la statistique inférentielle, garantissant que chaque unité statistique dispose d’une probabilité d’inclusion non nulle et strictement quantifiable.
Toutefois, la mise en œuvre pratique de ces principes théoriques s’est longtemps heurtée à des contraintes techniques, imposant le recours à des logiciels statistiques spécialisés et onéreux tels que SAS, SPSS ou encore des environnements de programmation comme R et Python. Si ces outils conservent une place prépondérante dans l’analyse de données massives et la modélisation complexe, l’émergence d’outils infonuagiques ubiquitaires à l’instar de Google Sheets a radicalement transformé les flux de travail en recherche appliquée. En combinant accessibilité immédiate, travail collaboratif asynchrone et fonctions matricielles avancées, le tableur de Google s’avère un instrument de randomisation d’une redoutable efficacité, pourvu que ses mécanismes sous-jacents soient parfaitement maîtrisés.
Ce guide exhaustif a pour vocation d’articuler la théorie statistique fondamentale avec l’application technique au sein de Google Sheets. À travers un décryptage minutieux des algorithmes pseudo-aléatoires, une analyse détaillée du comportement volatil de la fonction RAND() et l’exploration de flux de travail dynamiques modernes reposant sur SORTN et RANDARRAY, cet article formalise un protocole opératoire d’une rigueur académique irréprochable. L’objectif est de doter les chercheurs, analystes et auditeurs d’un guide méthodologique complet leur permettant d’extraire des échantillons probabilistes fiables, reproductibles et conformes aux plus hauts standards de la recherche scientifique contemporaine.
1. Fondements méthodologiques de l’échantillonnage aléatoire dans la recherche empirique
1.1 Principes épistémologiques et validité externe
L’inférence statistique repose sur l’hypothèse fondamentale que les paramètres observés au sein d’une fraction restreinte d’une population permettent d’estimer avec une marge d’erreur contrôlée les caractéristiques de la population parente. Dans cette optique, l’échantillonnage aléatoire simple (Simple Random Sampling ou SRS) s’érige en modèle de référence de l’échantillonnage probabiliste. D’un point de vue épistémologique, l’intervention du hasard méthodique n’est pas une abdication du contrôle scientifique, mais l’instrument le plus puissant pour éliminer l’arbitraire et la subjectivité humaine du processus de sélection.
Le premier enjeu méthodologique concerne la préservation de la validité externe, définie comme la possibilité d’extrapoler les conclusions d’une étude au-delà du strict cadre expérimental ou de l’échantillon observé. Un protocole d’échantillonnage non probabiliste, fondé par exemple sur la convenance ou le volontariat, introduit des distorsions systémiques majeures. Ces biais de sélection détruisent irrémédiablement l’équiprobabilité de l’inclusion et invalident le calcul classique des intervalles de confiance ainsi que les tests d’hypothèse formels, ces derniers postulant théoriquement une sélection stochastique.
Il est en outre indispensable d’opérer une distinction théorique nette entre la sélection aléatoire et l’assignation aléatoire (ou randomisation clinique). La sélection aléatoire régit la manière dont les sujets sont extraits d’une base de sondage globale pour constituer l’échantillon d’étude, conditionnant ainsi la représentativité et la généralisabilité des résultats. En revanche, l’assignation aléatoire s’applique au moment de répartir les participants déjà sélectionnés au sein de différents bras d’intervention (groupe témoin versus groupe expérimental), agissant directement sur la validité interne du dispositif expérimental. Google Sheets peut être mobilisé pour l’une ou l’autre de ces finalités, mais les exigences de contrôle et la portée des conclusions divergent drastiquement.
Enfin, la recherche quantitative exigeante ne saurait confondre représentativité empirique et coïncidence numérique. Pour qu’un échantillon soit pleinement probabiliste, l’espace d’échantillonnage doit être exhaustivement cartographié. Cela implique qu’aucun segment de la population ne subisse une probabilité d’exclusion invisible. L’absence d’une base de sondage complète biaise en amont toute démarche aléatoire, quelle que soit la précision algorithmique déployée en aval dans le tableur.
1.2 L’intérêt des outils bureautiques accessibles pour les chercheurs
La démocratisation de l’analyse quantitative passe aujourd’hui par l’adoption de solutions logicielles basées sur le cloud qui réduisent drastiquement la friction technique tout en maintenant un standard de rigueur élevé. Longtemps cantonnés à des tâches administratives élémentaires, les tableurs modernes, et plus particulièrement Google Sheets, ont intégré des moteurs de calcul capables de traiter des matrices de données complexes et de supporter des fonctions d’ordre supérieur. Cette évolution permet d’éviter la rupture technologique habituelle entre la collecte préliminaire des données et leur traitement statistique lourd.
L’un des avantages compétitifs majeurs de Google Sheets réside dans sa nature nativement collaborative. Dans le cadre de projets de recherche multicentriques ou d’enquêtes de terrain coordonnées par des équipes dispersées géographiquement, la possibilité d’interagir en temps réel sur la même base de données évite la prolifération de fichiers locaux désynchronisés, source endémique d’erreurs d’échantillonnage. Le contrôle d’accès granulaire et la traçabilité intégrée offrent un environnement sécurisé pour manipuler les identifiants et orchestrer les tirages sans transférer d’informations sensibles sur des plateformes tierces non auditées.
Pour les cohortes préliminaires, les études pilotes ou l’évaluation de pré-tests de questionnaires, le recours immédiat à des scripts Python ou à des syntaxes R complexes peut s’avérer disproportionné. Google Sheets comble cette brèche méthodologique en offrant une solution rapide, visuelle et vérifiable pour exécuter des sélections probabilistes. La transparence visuelle d’un tableur, où chaque observation est directement observable sous forme de vecteur-ligne et chaque probabilité sous forme de vecteur-colonne, facilite le contrôle qualité immédiat par l’investigateur principal avant l’inclusion formelle des sujets.
2. Préparation et structuration rigoureuse du jeu de données dans Google Sheets
2.1 Nettoyage préliminaire et formatage tabulaire
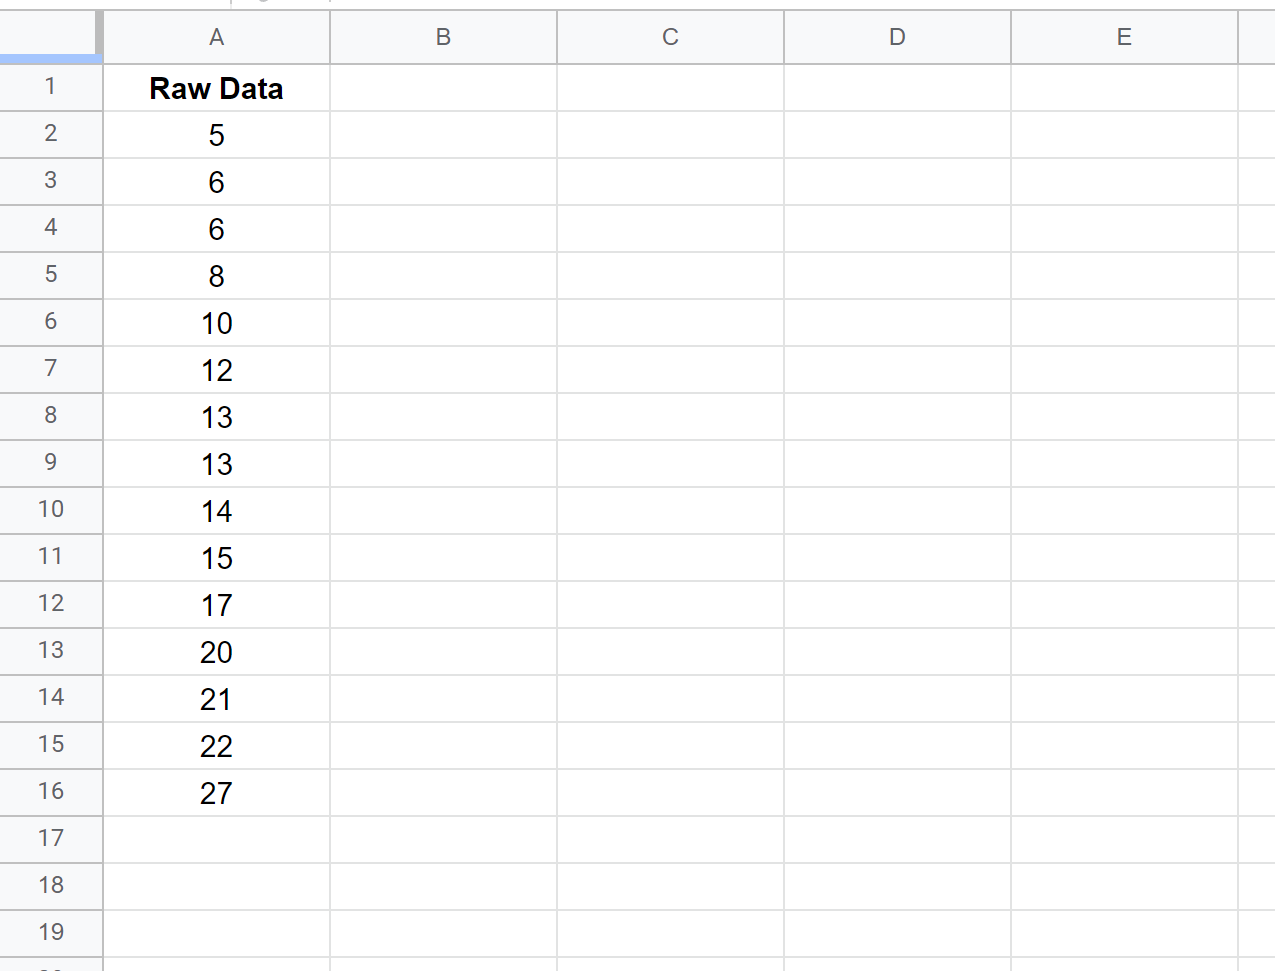
L’application d’un algorithme de sélection aléatoire sur une base de données corrompue ou imparfaitement structurée conduit inéluctablement à un échantillon biaisé, phénomène synthétisé par l’adage informatique « garbage in, garbage out ». Avant toute tentative de génération d’un indice aléatoire, le chercheur doit se livrer à un nettoyage systématique du tableau de données brutes. Cette étape liminaire implique le repérage et le traitement rigoureux des valeurs aberrantes ou extrêmes, la clarification du statut des observations incomplètes (valeurs manquantes ou missing data) et l’éradication des doublons parfaits ou partiels via l’outil natif Données > Nettoyage des données > Supprimer les doublons.
Une bonne pratique fondamentale consiste à attribuer immédiatement à chaque observation un identifiant unique (ID) non informatif. Cet identifiant, généré par exemple via une séquence numérique linéaire (1, 2, 3… N) ou un code alphanumérique opaque, découple l’observation de toute donnée directement nominative ou structurante. Cet ID servira d’ancre relationnelle tout au long des opérations de tri et d’extraction, garantissant qu’aucune ligne ne subisse de dissociation variable-sujet au cours des manipulations ultérieures.
Parallèlement, les intitulés de colonnes (en-têtes) doivent impérativement respecter les conventions internationales de métadonnées scientifiques : concision, absence d’espaces typographiques (remplacés par des tirets bas ou snake_case), absence de caractères spéciaux ou diacritiques susceptibles de perturber les formules d’analyse (par exemple, identifiant_sujet plutôt que N° Sujet d'Étude (2024)). Enfin, l’investigateur doit vérifier la cohérence typologique de chaque colonne : les dates doivent être formellement encodées comme telles, les variables quantitatives continues doivent être exemptes de caractères textuels parasites, et les variables catégorielles doivent être standardisées pour éliminer les incohérences de casse ou les espaces résiduels non visibles.
2.2 Sécurisation et sauvegarde de la population source
La reproductibilité et l’intégrité de la démarche scientifique requièrent une séparation absolue entre le jeu de données d’origine et les structures de manipulation opérationnelle. Dès l’importation de la population source dans Google Sheets, il est impératif de dupliquer l’onglet initial afin de constituer une feuille miroir immuable. Cet onglet, que l’on nommera conventionnellement DONNEES_BRUTES_IMMUTABLES, ne doit faire l’objet d’aucune intervention directe, servant de référence d’audit permanente en cas de contestation méthodologique ou de mauvaise manipulation humaine dans les onglets de travail.
Pour prémunir cette base source contre toute dégradation accidentelle par un collaborateur, le chercheur appliquera un verrouillage strict des plages de cellules via la commande Données > Feuilles et plages protégées. En restreignant les droits de modification au seul investigateur principal ou en verrouillant intégralement la feuille avec un message d’avertissement dissuasif, on sanctuarise le dénominateur de la recherche.
De surcroît, la traçabilité scientifique impose d’activer et de documenter le journal des modifications offert par Google Sheets (Fichier > Historique des versions > Afficher l'historique des versions). Il est hautement recommandé de nommer explicitement les versions clés dans cet historique (par exemple : Version 1.0 – Importation et dédoublonnage terminés – 12/10/2024). Cette traçabilité interne constitue la pièce maîtresse du dossier d’audit (audit trail), attestant auprès des comités d’éthique ou des pairs relecteurs que la population soumise à l’échantillonnage n’a pas subi de tri sélectif post hoc destiné à manipuler artificiellement la composition de l’échantillon extrait.
3. Fonctionnement mathématique et comportement de la fonction RAND()
3.1 Mécanisme de génération pseudo-aléatoire
Les ordinateurs étant des machines intrinsèquement déterministes, ils se révèlent par nature incapables de produire un aléa pur au sens de la physique quantique sans adjonction d’un capteur thermique ou atmosphérique dédié. Les tableurs contemporains contournent cet écueil en déployant des générateurs de nombres pseudo-aléatoires (PRNG). Au cœur du moteur de calcul JavaScript exécuté côté client et côté serveur par Google Sheets opèrent des algorithmes complexes, généralement dérivés de la famille Xorshift ou du Mersenne Twister, conçus pour simuler un hasard statistiquement indistinguable du bruit blanc.
La fonction maîtresse mobilisée à cet effet est la fonction RAND() (ou ALEA() dans la déclinaison linguistique francophone des tableurs traditionnels, bien que Google Sheets reconnaisse universellement la nomenclature anglophone). Sur le plan mathématique, RAND() génère une variable aléatoire continue $X$ suivant une loi uniforme continue sur l’intervalle semi-ouvert $[0, 1[$, notée :
$$X \sim \mathcal{U}(0, 1)$$
Cette distribution théorique implique deux propriétés fondamentales rigoureusement vérifiées par des batteries de tests stochastiques normalisées :
- L’équiprobabilité : Pour tout sous-intervalle $[a, b[$ inclus dans $[0, 1[$, la probabilité que la valeur générée $X$ appartienne à cet intervalle dépend uniquement de sa longueur et s’exprime formellement par $P(a le X < b) = b – a$. Aucun point de la droite réelle comprise entre 0 et 1 n’est privilégié par l’algorithme.
- L’indépendance stochastique : La génération d’une valeur $X_{i}$ à la ligne $i$ ne fournit strictement aucune information prédictive sur la valeur $X_{i+1}$ attribuée à la ligne suivante. Les tirages successifs sont théoriquement mutuellement indépendants et identiquement distribués (i.i.d.).
3.2 Le comportement volatil de la fonction RAND()
L’une des particularités techniques les plus critiques de la fonction RAND() dans les tableurs réside dans sa nature dite volatile. Contrairement aux fonctions déterministes classiques (telles que SOMME, MOYENNE ou CONCATENER), dont le résultat demeure invariant tant que leurs cellules d’entrée ne subissent aucune altération, une fonction volatile est réévaluée à chaque cycle de recalcul global du classeur.
Dans l’écosystème de Google Sheets, la fonction RAND() recalcule automatiquement sa valeur lors de multiples événements déclencheurs :
- La moindre saisie ou modification de données dans n’importe quelle cellule du document, y compris dans un autre onglet.
- L’ouverture, l’actualisation de la page web dans le navigateur ou la reconnexion au serveur distant.
- L’ajout ou la suppression d’une ligne ou d’une colonne au sein du classeur.
- L’expiration de la fréquence d’actualisation configurée dans les paramètres de calcul du fichier (accessible via
Fichier > Paramètres > Calcul, qui permet de planifier des recalculs périodiques à la minute ou à l’heure).
Ce recalcul permanent pose un péril méthodologique majeur pour la recherche quantitative. Si un chercheur associe la fonction RAND() brute à ses lignes d’observations puis procède à un tri sans figer les données, les scores aléatoires seront recalculés immédiatement avant ou pendant l’exécution du tri, bouleversant l’ordre stochastique. Pire encore, toute saisie ultérieure réassignera de nouvelles valeurs aléatoires, rendant impossible la vérification ultérieure de la composition exacte de l’échantillon extrait. La neutralisation de cette volatilité s’impose donc comme un impératif d’intégrité absolue.
4. Étape par étape : Génération des valeurs aléatoires associées aux observations
4.1 Insertion de la colonne de randomisation
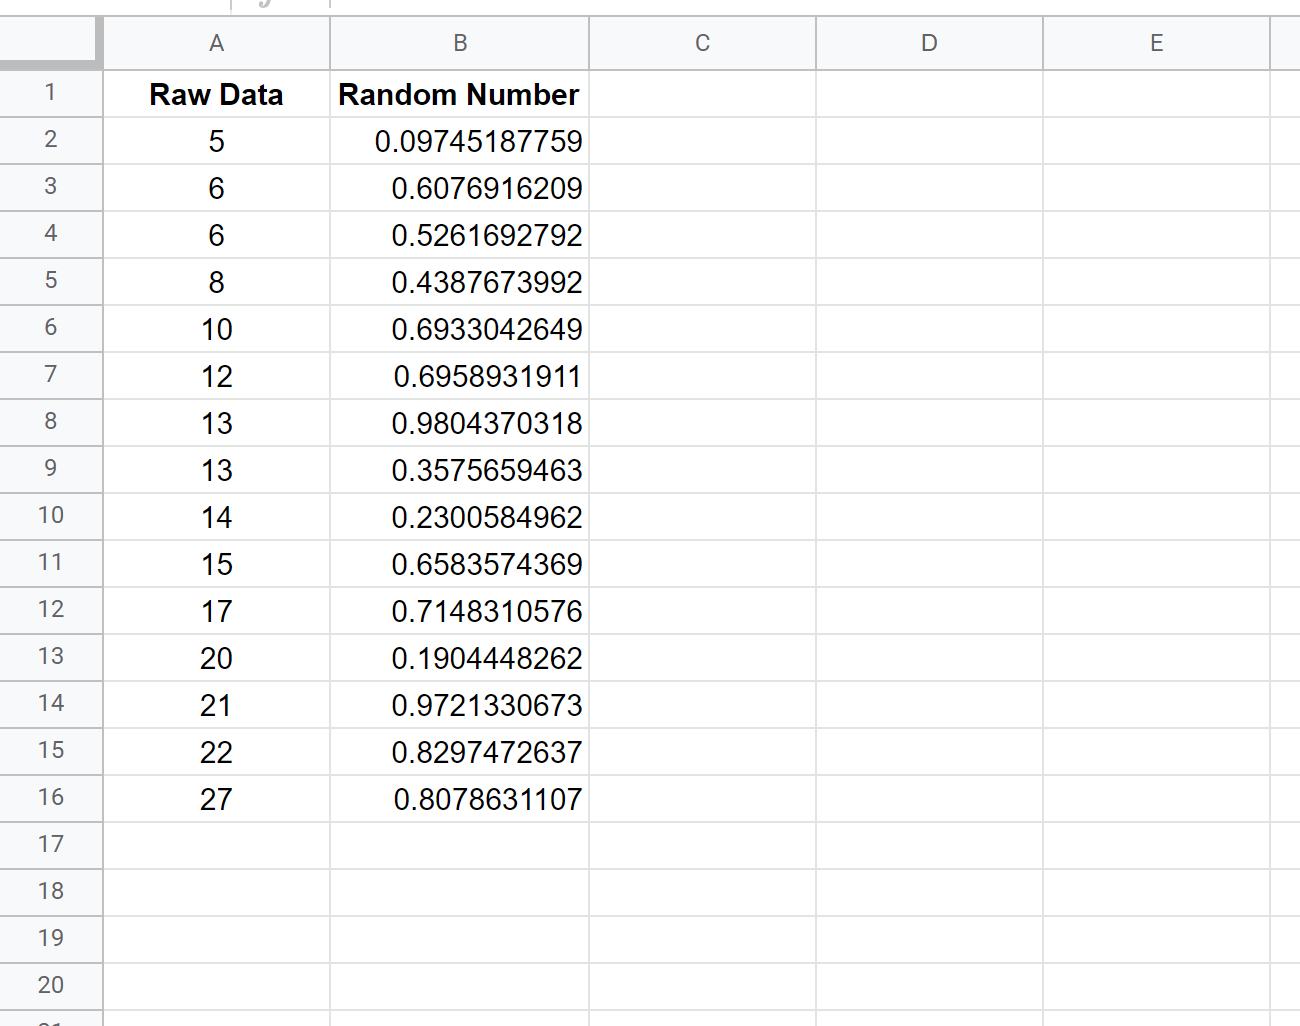
La mise en œuvre pratique de l’échantillonnage aléatoire simple débute par l’adjonction formelle d’une infrastructure de calcul dédiée au sein de la feuille de travail. Positionnez-vous sur la feuille opérationnelle préalablement dupliquée à partir de la source sécurisée. Insérez une nouvelle colonne contiguë au tableau de données, idéalement en première position (colonne A) ou en dernière position à droite de vos données afin de ne pas perturber les indexations existantes.
Attribuez immédiatement à cette colonne un libellé sans équivoque au niveau de la ligne d’en-tête, par exemple Valeur_Aleatoire ou Random_Draw_Index. L’utilisation d’une nomenclature explicite garantit la transparence du protocole lors de la relecture par un tiers. Activez ensuite la première cellule de données de cette colonne (généralement la cellule B2 ou la ligne immédiatement inférieure à la rangée d’en-têtes) et saisissez la syntaxe rigoureuse :
=RAND()
À cet instant, le moteur de calcul instancie un nombre décimal à haute précision (souvent jusqu’à quatorze ou quinze décimales sous notation IEEE 754), par exemple 0,739481920491823. Il convient de s’assurer de la cohérence des paramètres régionaux du document (Fichier > Paramètres > Langue) : selon que votre classeur est configuré selon les standards francophones ou anglo-saxons, le séparateur décimal affiché sera une virgule ou un point. Cette nuance purement visuelle n’altère en rien la précision stochastique sous-jacente du calcul.
4.2 Propagation de la formule sur l’ensemble de la cohorte
Dès lors que la première cellule est opérationnelle, le score aléatoire doit être étendu de façon homogène à l’intégralité des $N$ observations composant la population source. Deux approches techniques se présentent à l’utilisateur, chacune répondant à des volumes d’observations distincts :
La méthode mécanique conventionnelle consiste à double-cliquer sur la poignée de recopie (le petit carré bleu situé dans le coin inférieur droit de la cellule active). Google Sheets analyse alors la colonne adjacente et propage la formule =RAND() verticalement jusqu’à rencontrer la dernière cellule continue non vide. Bien qu’intuitive, cette manipulation manuelle comporte un risque d’interruption prématurée si la colonne de référence comporte des cellules vides involontaires au sein du jeu de données.
Pour les cohortes massives (plusieurs dizaines ou centaines de milliers de lignes), la méthode matricielle s’avère infiniment plus robuste et élégante. Supprimez les cellules inférieures et saisissez, dans la cellule d’en-tête ou la première cellule active, une formule matricielle encapsulée de type :
=ARRAYFORMULA(RANDARRAY(LIGNES(B2:B)))
ou de manière plus classique avec une condition d’existence pour éviter de peupler les lignes vides jusqu’au bas de la feuille :
=ARRAYFORMULA(SI(ESTVIDE(A2:A); ""; RAND()))
Cette approche assure une injection programmatique instantanée du tirage pseudo-aléatoire sur l’exacte étendue dimensionnelle du tableau de données, éliminant tout risque d’oubli manuel de propagation sur les dernières observations de la population.
5. Fixation et stabilisation impérative des nombres aléatoires générés
5.1 La procédure du collage spécial en valeurs seules
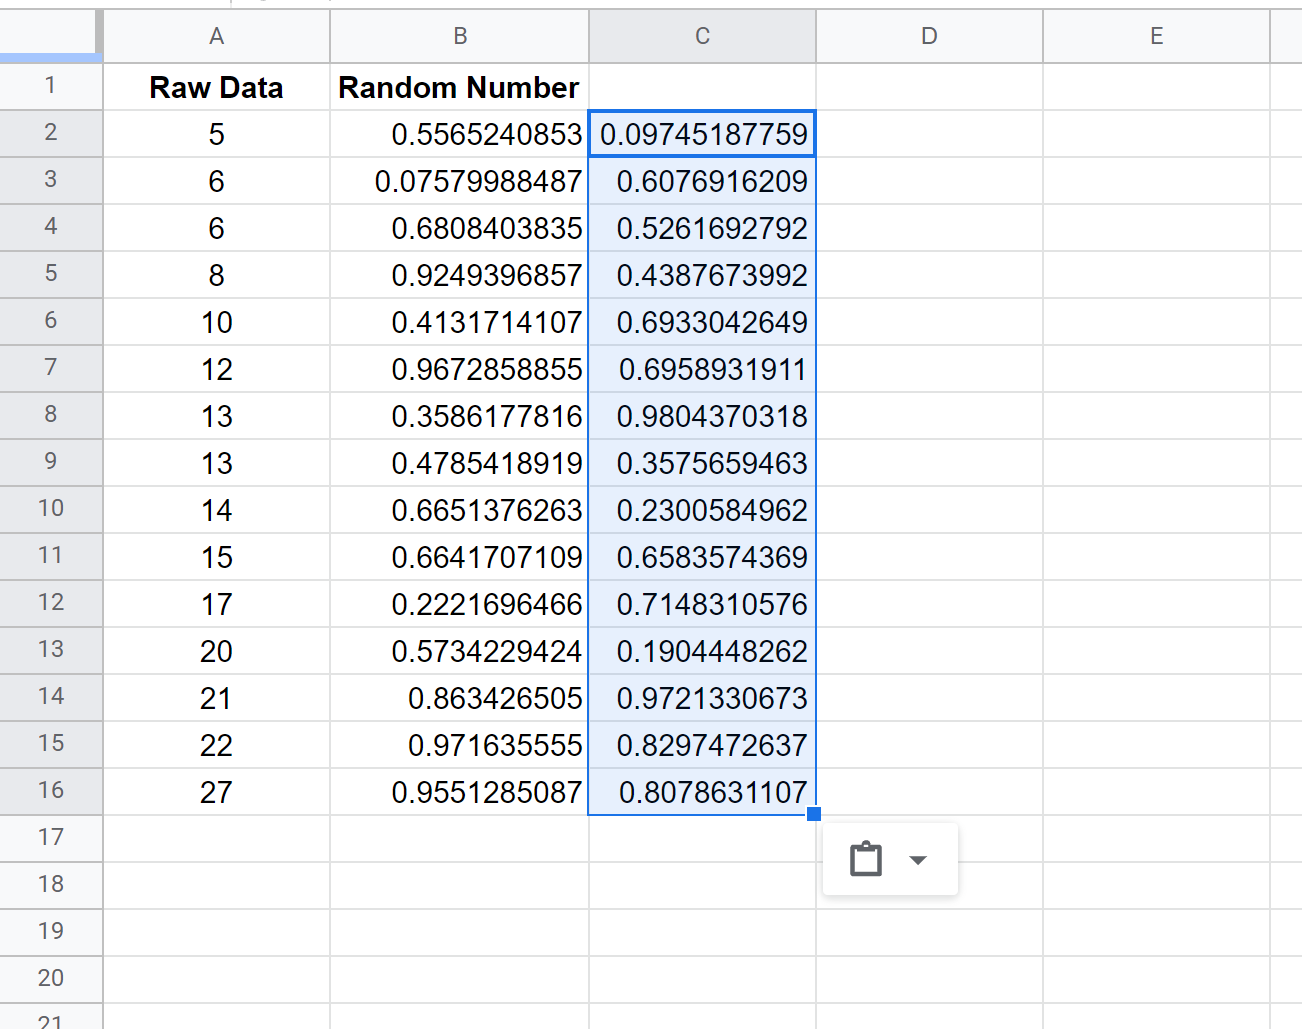
Tel que mis en exergue dans la section 3.2, la persistance de la formule active =RAND() constitue une faille méthodologique critique en raison de sa volatilité intrinsèque. L’étape de fixation, ou conversion en valeurs statiques, représente la barrière d’invariance fondamentale du protocole scientifique. Elle a pour objet de briser le lien algorithmique dynamique reliant la cellule au moteur de recalcul du tableur, transformant la fonction en une valeur flottante constante et immuable.
Le mode opératoire d’une rigueur absolue se décompose ainsi :
- Sélectionnez avec exhaustivité l’ensemble de la plage de cellules hébergeant les valeurs générées par
RAND(), de la ligne 2 à la ligne $N+1$. Pour ce faire, utilisez le raccourci clavierCtrl + Maj + Flèche Bas(sous Windows/Linux) ouCmd + Shift + Flèche Bas(sous macOS) depuis la première cellule afin d’éviter tout oubli de sélection de cellules en queue de distribution. - Copiez immédiatement cette plage dans le presse-papier système par l’instruction standard
Ctrl + CouCmd + C. - Sans modifier l’emprise de la sélection active, appliquez l’instruction de neutralisation : effectuez un clic droit puis sélectionnez
Collage spécial > Valeurs uniquement. Le raccourci clavier universellement consacré pour cette opération salvatrice estCtrl + Maj + V(ouCmd + Shift + Vsous environnement Apple).
Par cette manipulation élémentaire mais vitale, la formule =RAND() est irrémédiablement écrasée par la valeur numérique scalaire qu’elle affichait au moment précis du collage. L’idempotence du jeu de données est désormais garantie : aucune action ultérieure ne pourra modifier le tirage de randomisation attribué à chaque sujet.
5.2 Validation de la stabilisation des valeurs
L’éthique et la rigueur de la démarche expérimentale imposent un contrôle d’assurance qualité avant de poursuivre vers les phases de tri et d’extraction. Le chercheur ne doit jamais présumer de la réussite d’une manipulation bureautique sans en administrer la preuve empirique.
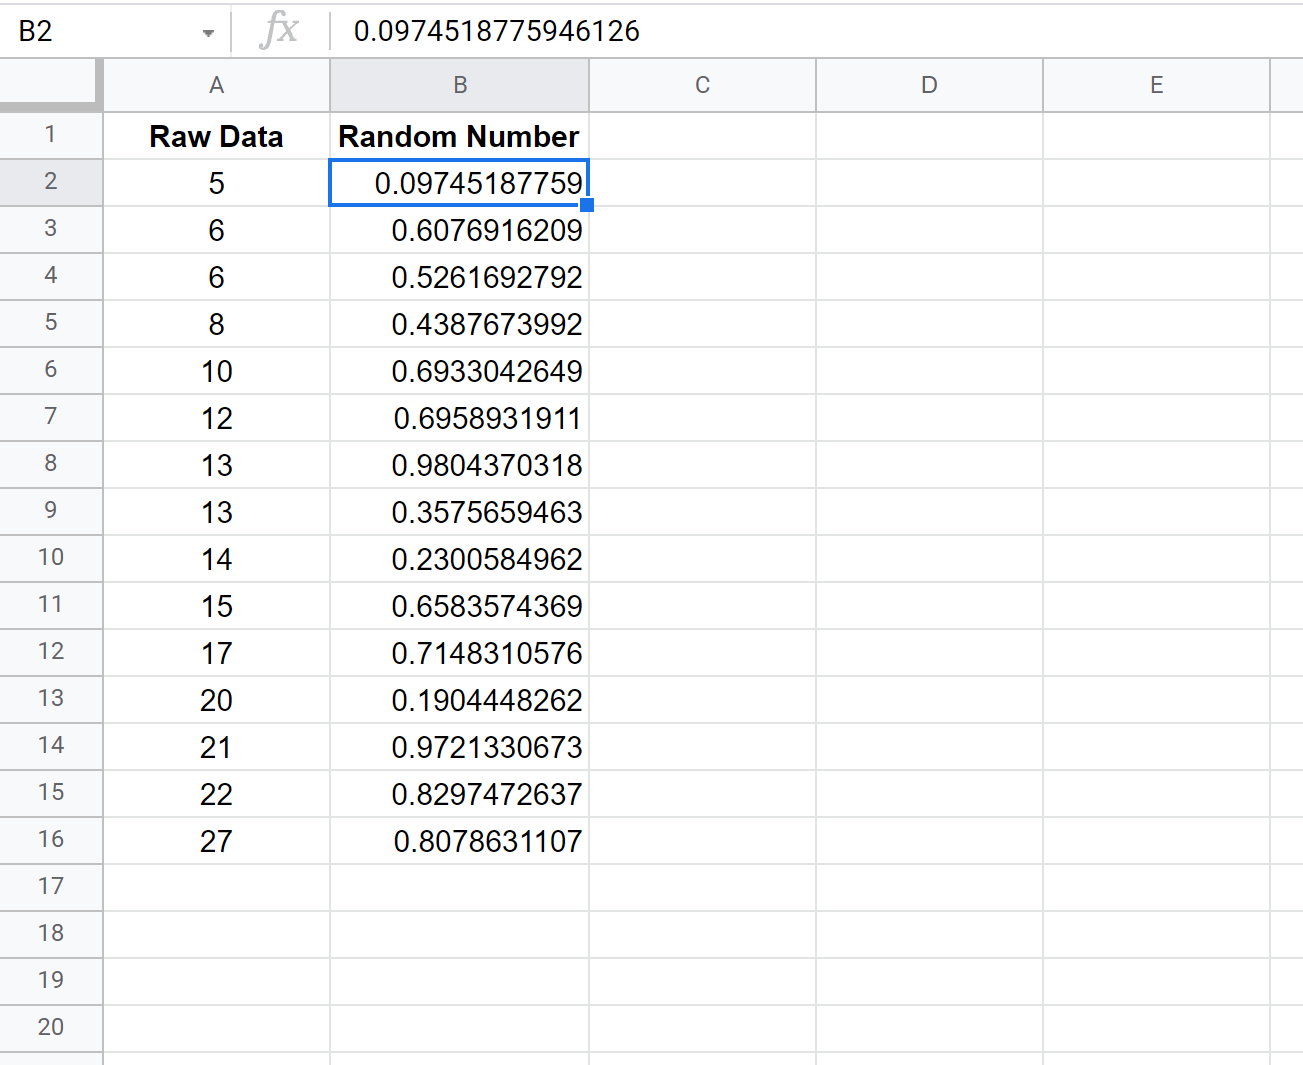
L’inspection commence par l’observation directe de la barre de formule de Google Sheets. Cliquez consécutivement sur plusieurs cellules dispersées de la colonne randomisée (notamment en début, au milieu et en fin de tableau). La barre de formule ne doit plus jamais exhiber la syntaxe =RAND(), mais exclusivement une suite de chiffres décimaux fixes (par exemple 0.482910475829102). Si la moindre référence à RAND() subsiste, le processus de collage spécial a échoué et doit être réitéré sans délai.
Effectuez ensuite un test de perturbation : rendez-vous dans une cellule vierge, à l’extérieur de votre tableau de données, saisissez-y un caractère quelconque et appuyez sur la touche Entrée. Observez attentivement la colonne de randomisation. Si les valeurs demeurent rigoureusement immobiles, la fixation est opérante. Consignez immédiatement dans le cahier de laboratoire électronique ou l’annexe méthodologique l’horodatage précis (date, heure, minute) auquel cette conversion statique a été réalisée. Cet horodatage consolide l’auditabilité de votre recherche.
6. Tri des données et extraction de l’échantillon aléatoire simple
6.1 Paramétrage du tri multi-colonnes
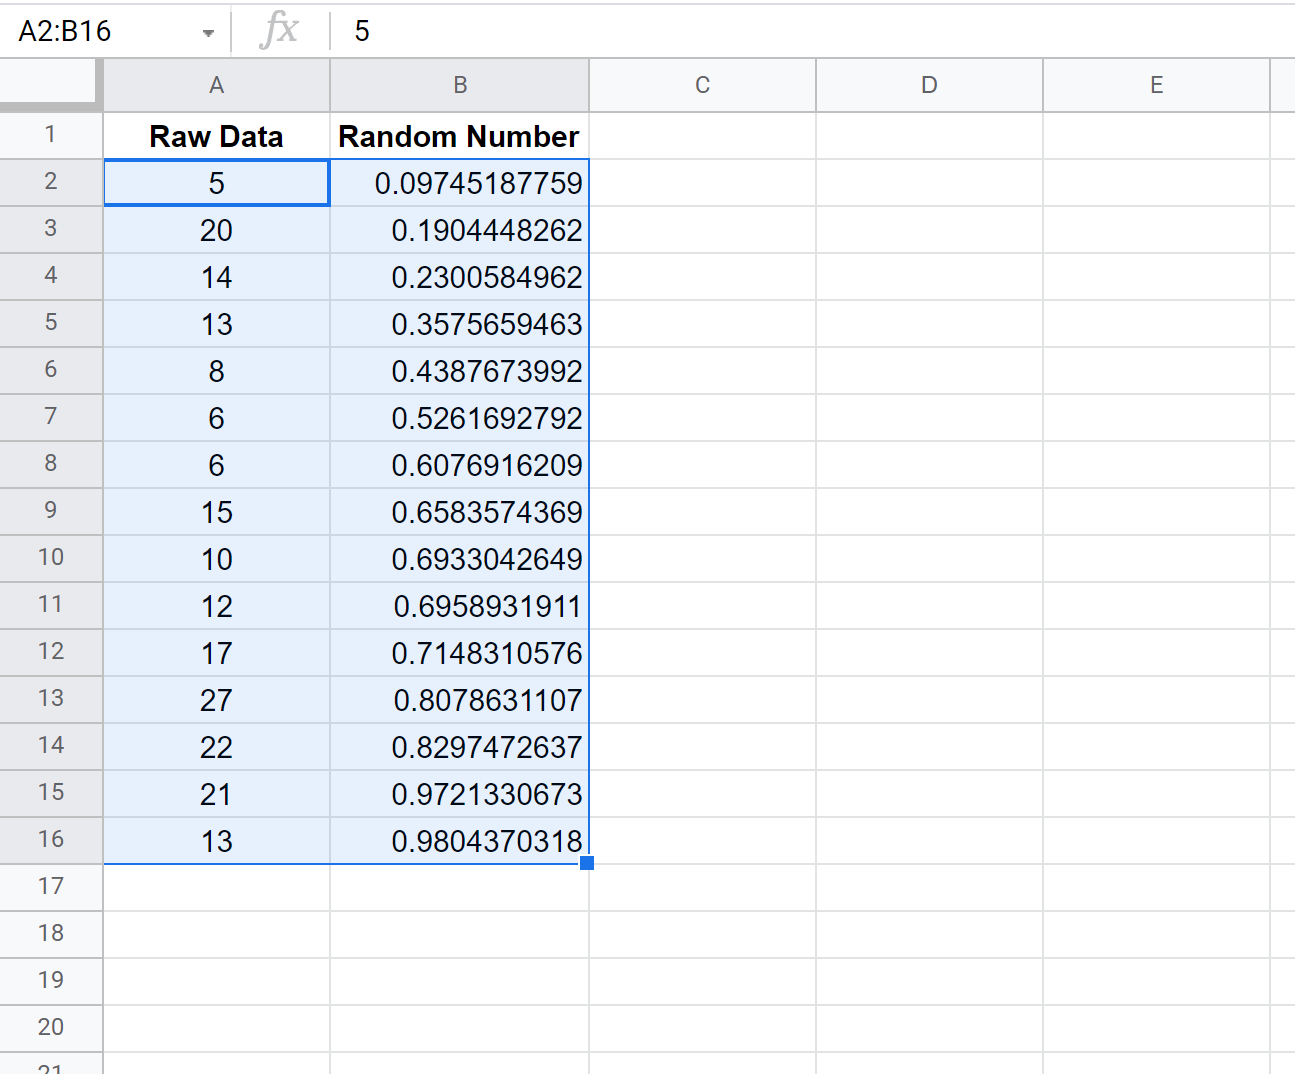
La population source dispose désormais d’un vecteur de valeurs aléatoires uniformes, statiques et indépendantes. Le principe mathématique sous-jacent à la sélection aléatoire simple consiste à trier l’intégralité du tableau selon cette variable stochastique. Dans la mesure où chaque ligne possède une valeur attribuée de manière équiprobable et indépendante, le réordonnancement du tableau selon cet axe produit une permutation aléatoire parfaite (random permutation) de la cohorte.
Toutefois, cette étape requiert une vigilance absolue quant à l’intégrité relationnelle des données. L’erreur humaine classique consiste à trier uniquement la colonne de nombres aléatoires sans y adjoindre les données signalétiques des sujets, désynchronisant les scores de leurs attributs réels. Le protocole d’exécution formel exige les démarches suivantes :
- Sélectionnez l’intégralité du tableau de données, en englobant absolument toutes les colonnes de variables et toutes les lignes d’observations, de l’en-tête initial jusqu’à la dernière cellule inférieure droite. Utilisez la commande
Ctrl + Aaprès vous être positionné au cœur de la matrice pour garantir une capture dimensionnelle complète. - Accédez au menu supérieur :
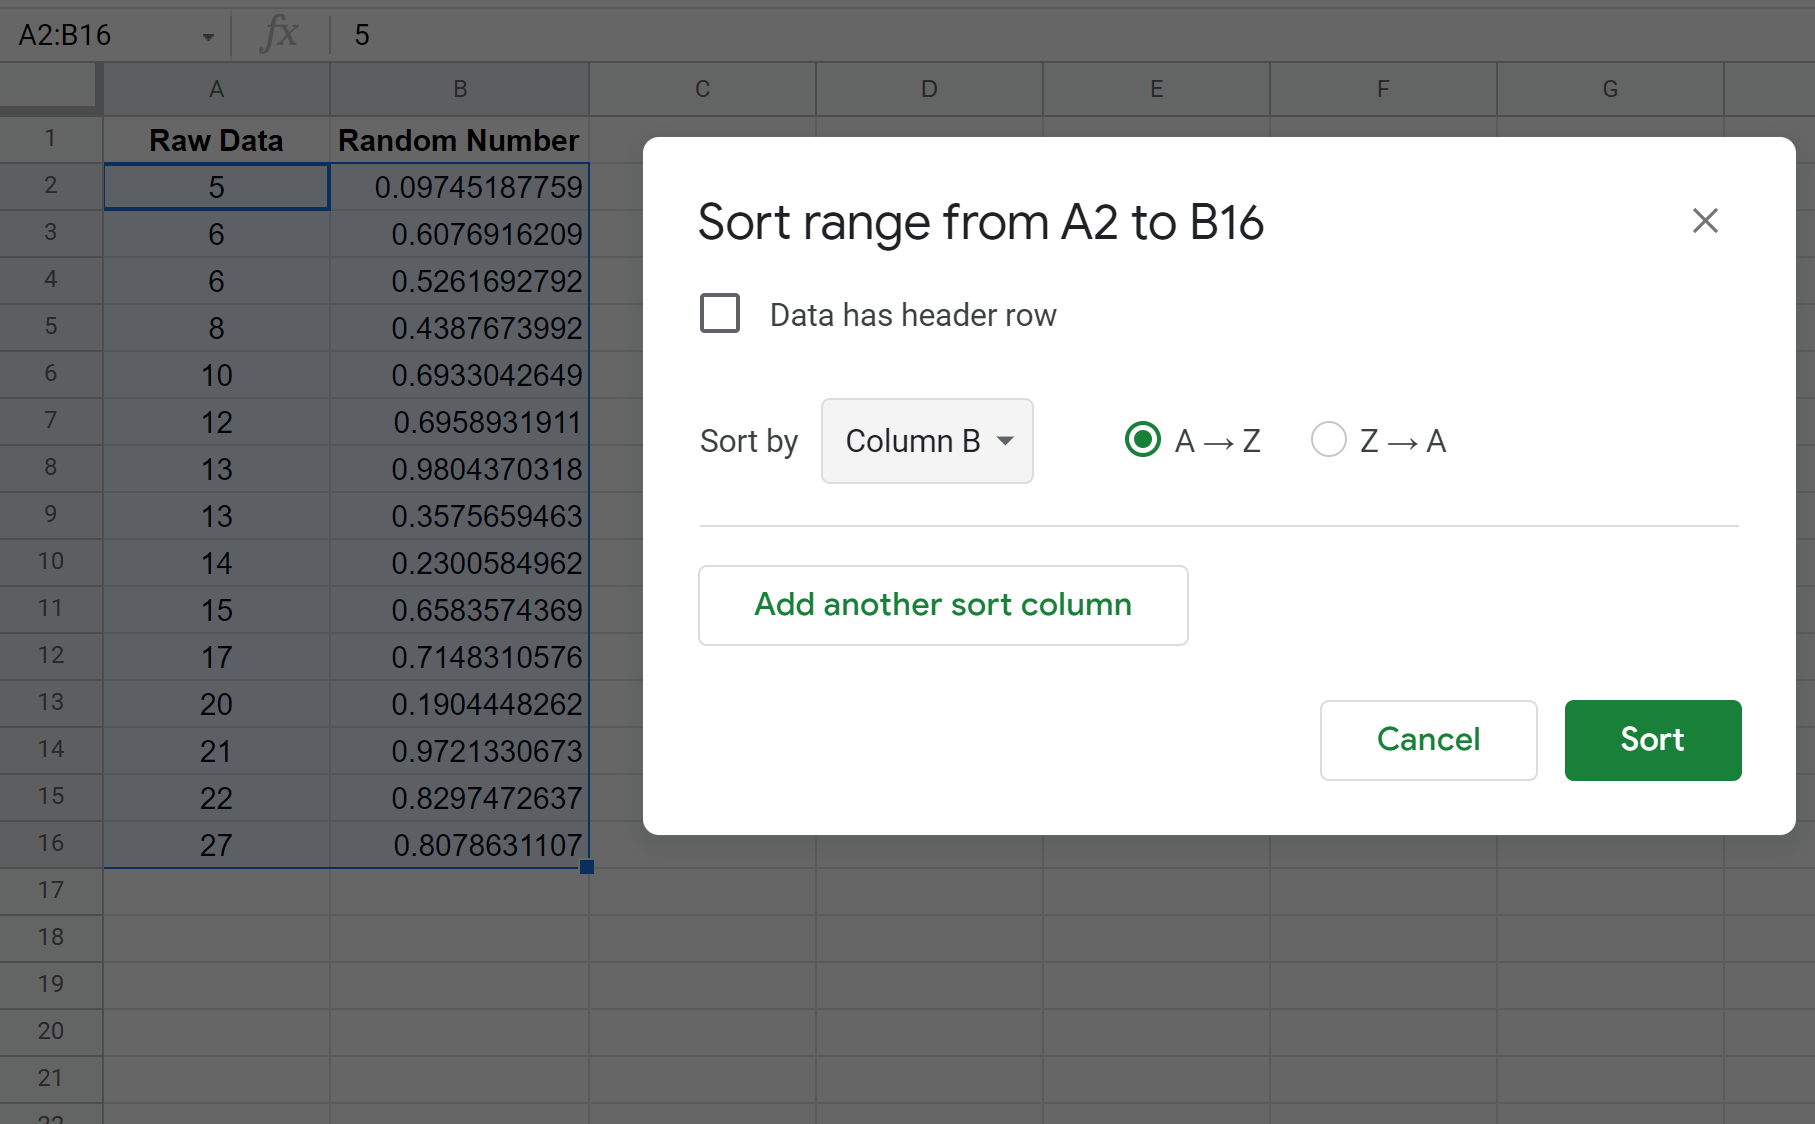
Données > Trier une plage > Options avancées de tri des plages. Évitez absolument les options rapides de tri du clic droit qui pourraient n’affecter que la colonne active. - Dans la fenêtre de dialogue modale qui s’affiche, cochez obligatoirement la case intitulée « Les données ont une ligne d’en-tête ». Cette précaution fondamentale empêche la ligne de libellés d’être aspirée et mélangée dans le corps des observations lors de la réorganisation.
- Dans le menu déroulant « Trier par », désignez précisément votre colonne d’aléa (
Valeur_Aleatoire). Choisissez l’ordre croissant (A à Z) ou décroissant (Z à A) : en vertu des propriétés de la loi uniforme sur $[0, 1]$, les deux orientations sont statistiquement rigoureusement équivalentes. - Validez l’opération en cliquant sur le bouton « Trier ».
6.2 Prélèvement physique du sous-ensemble
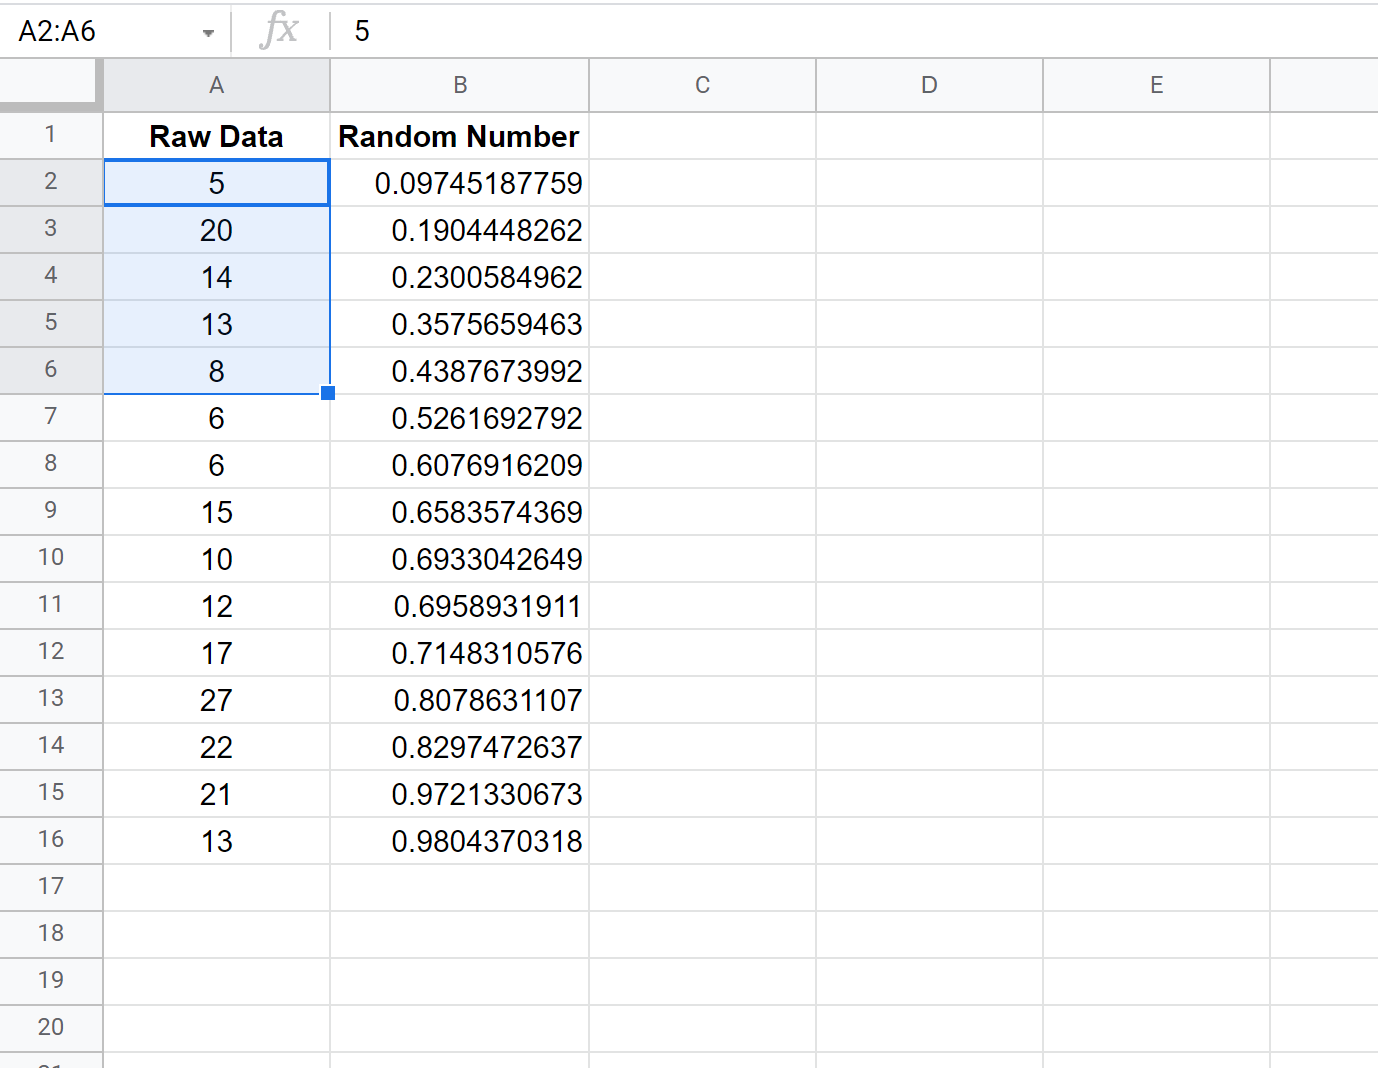
À l’issue du tri multi-colonnes, la base de données entière se retrouve dans un ordre parfaitement aléatoire. Chaque observation possède désormais un rang stochastique formel au sein de la matrice. Le prélèvement d’un échantillon aléatoire de taille $n$ se résume désormais à l’extraction des $n$ premières lignes continues du tableau réorganisé (ou alternativement des $n$ dernières lignes).
Concrètement, si le protocole expérimental requiert un échantillon de $n = 150$ individus issus d’une population de $N = 2,000$ sujets, le chercheur sélectionnera avec précision les lignes d’observations s’étendant de la ligne 2 à la ligne 151 (la ligne 1 étant réservée aux en-têtes de colonnes). Ce prélèvement physique répond scrupuleusement à la définition de l’échantillonnage aléatoire sans remise (sampling without replacement) : un même individu ne peut pas figurer plus d’une fois dans l’échantillon extrait, respectant ainsi l’indépendance des unités expérimentales sous une population finie.
Les lignes ainsi circonscrites doivent être copiées (Ctrl + C) puis collées dans un nouvel onglet formellement identifié, par exemple ECHANTILLON_FINAL_N150. Il est impératif d’exécuter un contrôle d’exhaustivité et de cohérence immédiatement après le transfert : assurez-vous que le nombre de lignes extraites correspond strictement au paramètre $n$ prescrit, que les identifiants uniques sont tous distincts et intacts, et qu’aucune troncature de variable n’a été occasionnée lors de la segmentation mécanique.
7. Méthodes dynamiques avancées sans manipulation manuelle de tri
7.1 Utilisation combinée des fonctions SORTN et RANDARRAY
Bien que le protocole manuel détaillé aux sections 4 à 6 soit pédagogique, largement éprouvé et sécurisant pour les utilisateurs occasionnels, il présente l’inconvénient d’exiger des interventions manuelles successives (copier, coller les valeurs, configurer le tri multi-colonnes, scinder la plage). Dans les contextes de production analytique moderne ou de réplication de modèles, les experts privilégient les formules matricielles dynamiques non destructives. Google Sheets possède une fonction native extraordinairement puissante et trop souvent méconnue : la fonction SORTN.
La fonction SORTN permet de trier une plage de données et de n’en renvoyer que les $n$ premières lignes, réalisant simultanément le tri et la troncature dimensionnelle. En combinant SORTN avec le générateur matriciel RANDARRAY, le chercheur peut extraire un échantillon aléatoire complet en une unique formule scalaire, sans jamais toucher à l’agencement physique du jeu de données source.
Considérons une base de sondage située sur la feuille source dans la plage 'Donnees_Source'!A2:E5000, comprenant 5 000 observations distribuées sur 5 colonnes. Pour extraire dynamiquement un échantillon aléatoire strict de 200 individus au sein d’un nouvel onglet, on insère en cellule A2 de cet onglet la formule canonique suivante :
=SORTN('Donnees_Source'!A2:E5000; 200; 0; RANDARRAY(LIGNES('Donnees_Source'!A2:E5000)); VRAI)
Analysons avec minutie l’architecture de cette formule :
'Donnees_Source'!A2:E5000: La plage matricielle des observations brutes à échantillonner.200: Le paramètre $n$ désignant le nombre précis de lignes que la fonction doit renvoyer dans le résultat final.0: Le mode de gestion des ex æquo (0 signifie qu’aucun doublon de tri n’est toléré, affichant strictement les $n$ premières lignes même en cas de similarité théorique).RANDARRAY(LIGNES('Donnees_Source'!A2:E5000)): Cette fonction génère une colonne virtuelle (non affichée dans la feuille) composée d’exactement autant de nombres aléatoires qu’il y a de lignes dans la plage source, calculée dynamiquement viaLIGNES(...).VRAI: Indique que le tri appliqué sur ce vecteur aléatoire virtuel doit s’effectuer par ordre croissant.
Cette méthodologie élégante présente un avantage scientifique considérable : elle est non destructive. La table de référence demeure totalement vierge de toute modification structurelle, éliminant les risques de mauvaise manipulation des colonnes sources.
7.2 Extraction automatisée avec QUERY et RANDBETWEEN
Une alternative fonctionnelle avancée consiste à marier le langage de manipulation de données semi-structurées de Google Sheets, la fonction QUERY, avec des fonctions génératrices d’indices aléatoires discrets comme RANDBETWEEN. Si QUERY n’intègre pas nativement d’opérateur d’aléa stochastique à l’image du ORDER BY RAND() propre au dialecte SQL traditionnel, on peut contourner cette restriction en injectant un index pseudo-aléatoire dans la matrice passée en premier argument.
En encapsulant un vecteur généré par RANDBETWEEN(1; 1000000) au sein d’une construction littérale de tableau à l’aide d’accolades { ... }, il est possible d’ordonner la requête selon cette variable synthétique. Par exemple :
=QUERY({'Donnees_Source'!A2:E5000 RANDARRAY(LIGNES('Donnees_Source'!A2:E5000))}; "SELECT Col1, Col2, Col3, Col4, Col5 ORDER BY Col6 LIMIT 100")
L’utilisation du langage déclaratif de la fonction QUERY offre l’opportunité unique d’appliquer des critères d’échantillonnage conditionnels simultanément à la randomisation. Le chercheur peut par exemple restreindre le tirage aléatoire aux seuls participants répondant à un critère d’âge spécifique ou à une zone géographique déterminée grâce à une clause WHERE intégrée (ex. : WHERE Col3 >= 18 AND Col4 = 'Actif'). Cette flexibilité opérationnelle évite des étapes fastidieuses de filtrage manuel préliminaire tout en maintenant une rigueur mathématique irréprochable.
Toutefois, une mise en garde s’impose : ces formules matricielles dynamiques demeurent volatiles. Pour préserver l’échantillon extrait dans le temps pour un rapport de recherche, il demeure indispensable de copier la matrice résultante et de la stabiliser via un collage spécial en valeurs seules dans son onglet définitif.
8. Stratégies d’échantillonnage aléatoire stratifié dans Google Sheets
8.1 Segmentation préalable par strates sous-jacentes
Si l’échantillonnage aléatoire simple est le modèle le plus élégant d’un point de vue théorique, il présente une vulnérabilité statistique majeure lorsqu’il s’applique à des populations fortement hétérogènes ou subdivisées en sous-groupes d’effectifs inégaux. Dans ces configurations, le hasard pur peut introduire une erreur d’échantillonnage induisant une sous-représentation critique d’une minorité démographique essentielle à l’analyse. Pour neutraliser ce risque, la méthodologie préconise le recours à l’échantillonnage aléatoire stratifié (Stratified Random Sampling).
L’échantillonnage stratifié consiste à fractionner la population totale $N$ en sous-ensembles mutuellement exclusifs et collectivement exhaustifs, appelés strates, en fonction d’une ou plusieurs variables catégorielles fondamentales (par exemple : tranches d’âge, genre biologique, niveau de diplôme, catégorie socio-professionnelle ou implantation régionale). La première étape opérationnelle dans Google Sheets consiste à identifier clairement la colonne servant de variable de stratification et à mesurer les effectifs relatifs de chaque strate.
Le chercheur doit concevoir une table de contingence de synthèse, mobilisant par exemple la fonction UNIQUE pour lister les différentes strates, adossée à la fonction NB.SI (ou COUNTIF) pour quantifier l’effectif $N_h$ de chaque strate $h$. Cette table permet de déterminer la proportion d’inclusion théorique requise :
$$W_h = \frac{N_h}{N}$$
Dans le cadre d’un échantillonnage stratifié proportionnel, la taille d’échantillon $n_h$ allouée à la strate $h$ est strictement assujettie à son poids dans la population parente : $n_h = n \times W_h$. Si la recherche impose une précision statistique accrue sur des groupes minoritaires, un échantillonnage non proportionnel (ou allocation optimale de Neyman) peut être paramétré pour surreprésenter délibérément certaines strates, sous réserve d’introduire des facteurs de pondération statistique (weights) lors de l’analyse inférentielle ultérieure.
8.2 Application de la randomisation intra-strate
Une fois les quotas d’inclusion calculés pour chaque strate, l’implémentation pratique au sein de Google Sheets peut être orchestrée selon deux approches :
La première stratégie repose sur la méthode manuelle par segmentation : le tableau général est trié en premier niveau par la colonne de la variable de strate, puis en second niveau par la colonne Valeur_Aleatoire stabilisée (via Données > Trier une plage > Ajouter une autre colonne de tri). Les observations se retrouvent ainsi regroupées par strate, et au sein de chaque strate, classées de manière stochastique. Il ne reste plus qu’à prélever manuellement les $n_h$ premières observations pour chaque groupe identifié.
La seconde approche, hautement recommandée pour minimiser les manipulations humaines, exploite les filtres dynamiques via la fonction FILTER combinée à SORTN et RANDARRAY. Pour extraire un quota stochastique de $n_h = 45$ individus appartenant exclusivement à la strate « Groupe_A » (dont le statut figure en colonne C), on appliquera la formule matricielle suivante dans un onglet dédié :
=SORTN(FILTER('Donnees_Source'!A2:E; 'Donnees_Source'!C2:C = "Groupe_A"); 45; 0; RANDARRAY(LIGNES(FILTER('Donnees_Source'!A2:E; 'Donnees_Source'!C2:C = "Groupe_A"))); VRAI)
Cette formule isole automatiquement le sous-ensemble répondant au critère de strate, génère une distribution aléatoire spécifique à cette population filtrée, et n’extrait que l’effectif ciblé de 45 sujets. En répétant cette formule pour l’ensemble des strates (Groupe B, Groupe C, etc.) sur des blocs adjacents ou des feuilles distinctes, le chercheur génère un échantillon stratifié d’une fidélité mathématique exemplaire. La fusion finale des sous-échantillons s’opère par simple empilement vertical au sein d’une matrice consolidée d’analyse.
9. Détermination de la taille de l’échantillon et considérations statistiques
9.1 Calcul de la taille d’échantillon requise (N)
L’extraction d’un échantillon ne saurait s’opérer sur une base intuitive ou arbitraire. Le dimensionnement de la taille d’échantillon $n$ représente un arbitrage méthodologique fondamental entre la puissance statistique des tests programmés, la précision des estimateurs et la faisabilité logistique de l’enquête. L’outil Google Sheets peut être configuré comme un calculateur stochastique autonome pour automatiser ce dimensionnement en amont de la randomisation.
Pour estimer une proportion dans une population considérée comme infinie ou très grande, la formule historique de William G. Cochran (1977) constitue le cadre analytique de référence :
$$n_0 = \frac{Z^2 \cdot p \cdot (1 – p)}{e^2}$$
Dans cette formalisation mathématique :
- $Z$ représente l’abscisse de la loi normale centrée réduite correspondant au niveau de confiance requis (couramment $Z = 1{,}96$ pour un intervalle de confiance à 95 %, ou $Z = 2{,}576$ pour un seuil à 99 %). Dans Google Sheets, cette valeur s’obtient dynamiquement via la fonction
=LOI.NORMALE.STANDARD.INVERSE(1 - (alpha / 2)). - $p$ est la proportion prévalente estimée de la variable d’intérêt. En l’absence d’estimations préexistantes issues de la littérature, on adopte la posture conservatrice maximale de variance maximale en fixant $p = 0{,}50$.
- $e$ formalise la marge d’erreur admissible acceptée par l’investigateur (par exemple $\pm 3,%$ ou $\pm 5,%$, formalisée par $0{,}03$ ou $0{,}05$).
Lorsque la population source finie $N$ est connue avec exactitude (situation standard d’un fichier client, d’un registre électoral ou d’une cohorte hospitalière importée dans un tableur), l’ajustement pour population finie de Cochran doit obligatoirement être implémenté pour éviter le sur-dimensionnement inutile :
$$n = \frac{n_0}{1 + \frac{n_0 – 1}{N}}$$
Le tableau ci-dessous explicite l’implémentation de ces paramètres statistiques au sein d’une feuille de calcul dédiée :
| Paramètre Méthodologique | Notation Mathématique | Syntaxe Google Sheets Recommandée | Valeur d’Exemple |
|---|---|---|---|
| Taille de la population source | $N$ | =NBVAL(Donnees!A2:A) |
5 000 |
| Niveau de confiance ($1 – \alpha$) | $1 – \alpha$ | Saisie manuelle directe | 0,95 (95 %) |
| Score Z critique | $Z$ | =LOI.NORMALE.STANDARD.INVERSE(1 - (0,05/2)) |
1,95996 |
| Marge d’erreur admissible | $e$ | Saisie manuelle directe | 0,03 (±3 %) |
| Proportion postulée | $p$ | Saisie manuelle (conservatrice) | 0,50 |
| Taille d’échantillon corrigée ($n$) | $n$ | =PLAFOND((B3^2*B5*(1-B5)/B4^2)/(1+((B3^2*B5*(1-B5)/B4^2)-1)/B1); 1) |
880 |
9.2 Anticipation de l’attrition et des non-réponses
Tout protocole de recherche empirique se heurte inéluctablement à la friction du monde réel : refus de participation, abandons en cours d’expérimentation, sujets injoignables ou questionnaires rendus inexploitables. Cette attrition dégrade la puissance statistique effective de l’échantillon final si elle n’a pas été modélisée de manière prospective.
Pour compenser cette déperdition inévitable, le chercheur doit appliquer un facteur de sur-échantillonnage systématique dès la phase d’extraction dans Google Sheets. Si le calcul théorique impose un échantillon effectif final de $n = 500$ sujets et que la littérature de référence anticipe un taux d’attrition ou de non-réponse de l’ordre de $R = 25,%$, la taille de l’échantillon initial brut à prélever $n_{ajuste}$ doit être recalculée selon l’équation :
$$n_{ajuste} = \frac{n}{1 – R} = \frac{500}{1 – 0{,}25} \approx 667 \text{ sujets}$$
Une bonne pratique de recherche consiste à constituer, au sein de Google Sheets, une liste de réserve aléatoire ordonnée. Plutôt que de prélever un échantillon démesuré qui surchargerait inutilement les coûts de terrain, le chercheur extrait ses 500 premiers sujets assignés à la cohorte principale d’action, et prélève les 167 sujets suivants dans une liste étiquetée « Réserve_Remplacement ».
En cas de non-réponse avérée d’un sujet de la cohorte principale, celui-ci est substitué par le premier sujet disponible dans la liste de réserve stochastique, dans le strict ordre déterminé par la randomisation initiale. Ce protocole de substitution séquentielle préserve rigoureusement la neutralité probabiliste de l’étude, évitant le remplacement arbitraire par des unités commodes qui détruirait l’équiprobabilité d’inclusion.
10. Biais potentiels, risques méthodologiques et limites logicielles
10.1 Limites de la pseudo-aléation dans les tableurs
Bien que Google Sheets soit un outil exceptionnel pour la quasi-totalité des travaux de recherche universitaire, d’enquêtes d’opinion et d’audits financiers, l’investigateur doit demeurer lucide quant aux limites inhérentes aux logiciels bureautiques face aux exigences de la science des données de très haute précision. La principale limite épistémique tient à la nature du générateur pseudo-aléatoire (PRNG) employé par les navigateurs modernes et les serveurs infonuagiques.
Les générateurs intégrés aux tableurs ne sont pas des générateurs cryptographiquement sécurisés (CSPRNG). Pour des applications sensibles telles que les essais cliniques randomisés pharmaceutiques en double aveugle régis par les normes de la FDA (Food and Drug Administration) ou les protocoles cryptographiques industriels, Google Sheets ne saurait se substituer à des outils certifiés permettant la traçabilité mathématique absolue des graines de randomisation.
La limite fonctionnelle la plus notable de Google Sheets réside dans l’absence de fixation native d’une graine aléatoire (seed) directement accessible par l’utilisateur final. Dans des environnements comme R (via l’instruction set.seed(42)) ou Python (via numpy.random.seed()), l’initialisation du générateur avec un entier spécifique garantit que l’algorithme reproduira à l’identique la suite exacte de nombres pseudo-aléatoires à chaque réévaluation. Dans Google Sheets, la graine est gérée de façon opaque au niveau de l’environnement d’exécution système. Il est donc rigoureusement impossible de recalculer à la demande une séquence aléatoire spécifique si celle-ci n’a pas été physiquement figée par un collage spécial en valeurs seules au moment de sa génération.
10.2 Erreurs humaines récurrentes lors de la manipulation
L’expérience accumulée lors de l’audit de bases de données de recherche démontre que la vaste majorité des corruptions méthodologiques n’impute pas au moteur logiciel, mais découle d’erreurs opératoires humaines lors des phases manuelles de manipulation dans le tableur. Trois écueils majeurs doivent être documentés pour être prévenus :
- La désynchronisation par tri partiel : C’est l’erreur la plus dévastatrice en matière d’intégrité des données. Elle survient lorsque l’opérateur sélectionne visuellement uniquement la colonne des scores aléatoires et clique sur l’outil de tri rapide. Les identifiants aléatoires sont alors permutés entre eux, mais les lignes de données adjacentes demeurent stationnaires, brisant les relations stochastiques préalables ou, pire encore, créant un décalage vertical partiel qui corrompt définitivement les profils des répondants si seules quelques colonnes étaient sélectionnées.
- L’omission de fixation par collage en valeurs : Conserver une colonne
=RAND()dynamique pendant la phase de tri entraîne un comportement paradoxal : le tableur recalcule les valeurs pendant ou immédiatement après le tri, signifiant que l’ordre visuel résultant n’est déjà plus corrélé aux scores présentés à l’écran. L’investigateur extrait alors un échantillon qui ne correspond pas aux valeurs observables. - Le biais de survivance de la base source : La perfection stochastique du tirage dans Google Sheets n’immunise jamais contre les biais de sélection matriciels initiaux. Si la base de sondage d’origine présente un biais de couverture (par exemple, un annuaire sous-représentant structurellement les populations jeunes ou précaires), l’échantillon aléatoire extrait sera le reflet parfaitement fidèle d’une base fondamentalement biaisée.
11. Rigueur scientifique, reproductibilité et éthique des données
11.1 Documentation du processus selon les normes de l’Open Science
Le mouvement contemporain de la science ouverte (Open Science) promeut la transparence absolue des flux de données et la reproductibilité computationnelle intégrale des publications scientifiques. Pour satisfaire à ces exigences déontologiques, un chercheur utilisant Google Sheets ne peut se contenter d’affirmer de manière laconique dans sa section méthodologique : « un échantillon aléatoire de 200 sujets a été extrait ». Il doit fournir la traçabilité complète de sa démarche opératoire.
Le protocole de documentation méthodologique doit scrupuleusement consigner les éléments suivants :
- L’architecture logicielle exacte : version de Google Sheets, système d’exploitation et navigateur web mobilisés lors de la procédure de sélection.
- La date, l’heure universelle coordonnée (UTC) et l’identifiant de version de l’historique Google Sheets correspondant à la fixation définitive des nombres pseudo-aléatoires.
- La syntaxe intégrale des formules déployées (par exemple, enregistrement des formules
ARRAYFORMULA,SORTNouRANDARRAY). - La stratégie retenue pour la gestion des non-réponses et la taille de la liste de réserve aléatoire associée.
Conformément aux normes rédactionnelles de l’American Psychological Association (APA 7th edition) et des comités de lecture internationaux, la section Méthode > Participants doit formellement détailler ces étapes. De surcroît, le jeu de données anonymisé final, incluant obligatoirement la colonne des nombres aléatoires stabilisés d’origine ayant servi au tri, doit être déposé sur un entrepôt de données de recherche certifié (tel que Zenodo, OSF ou Dataverse) pour permettre aux pairs de contrôler la probabilité d’inclusion et la distribution des rangs stochastiques.
11.2 Protection des données et anonymisation
L’exploitation de tableurs hébergés dans le cloud impose une responsabilité accrue quant à la sécurité et à la confidentialité des données personnelles des participants, sous l’égide des réglementations internationales telles que le Règlement Général sur la Protection des Données (RGPD en Union Européenne) ou la loi HIPAA aux États-Unis.
Avant même de procéder à l’importation de la population source dans Google Sheets pour y appliquer une sélection aléatoire, une pseudonymisation ou anonymisation irréversible doit être exécutée :
- Supprimez définitivement les identifiants directs majeurs : noms patronymiques, prénoms, adresses postales précises, numéros de sécurité sociale, coordonnées téléphoniques et adresses de courrier électronique.
- Substituez ces éléments nominatifs par les identifiants uniques alphanumériques opaques préconisés à la section 2.1.
- Stockez la table de correspondance d’anonymisation (reliance key) reliant le code ID à l’identité réelle du sujet dans un fichier externe local chiffré (via VeraCrypt ou équivalent), strictement isolé de l’écosystème Google Drive.
Enfin, configurez de manière draconienne les permissions de partage du classeur Google Sheets (Partager > Accès général). L’accès public via lien (« Tout le monde avec le lien ») doit être formellement banni pour les classeurs de recherche. Limitez strictement les accès nominatifs aux seuls membres autorisés de l’équipe de recherche avec le rôle de lecteur ou de commentateur, en réservant les droits d’édition au gestionnaire de données (Data Steward) exclusivement.
12. Synthèse comparative des flux de travail et arbre de décision
12.1 Comparaison critique des approches manuelles et fonctionnelles
Le choix de la méthode d’échantillonnage au sein de Google Sheets ne relève pas d’une préférence esthétique, mais découle d’un arbitrage rigoureux entre la volumétrie du jeu de données, l’expertise technique des opérateurs et la nécessité de répétition du tirage. Les sections précédentes ont détaillé deux grands paradigmes : l’approche manuelle séquentielle (reposant sur RAND(), le collage de valeurs et le tri de plage) et l’approche matricielle dynamique avancée (reposant sur SORTN et RANDARRAY).
Le tableau comparatif ci-dessous formalise l’analyse critique de ces deux méthodes selon les métriques de performance et de sécurité méthodologique :
| Critère d’Évaluation | Approche Manuelle (RAND + Tri) | Approche Fonctionnelle (SORTN + RANDARRAY) |
|---|---|---|
| Niveau d’expertise requis | Débutant à intermédiaire | Intermédiaire à avancé |
| Intégrité de la base source | Vulnérable aux manipulations de tri directes | Totale (formule non destructive en lecture seule) |
| Risque de désynchronisation des lignes | Élevé en cas de sélection de plage incomplète | Nul (la fonction lie intrinsèquement la matrice) |
| Volatilité du résultat | Neutralisée définitivement par le collage en valeurs | Active par défaut (exige un collage en valeurs post-calcul) |
| Temps d’exécution sur grands volumes | Lent (recopie manuelle, mémoire tampon graphique) | Instantané (calcul matriciel direct par le moteur JS) |
| Filtrage multicritère intégré | Nécessite des filtres manuels préalables | Direct via encapsulation dans FILTER ou QUERY |
| Traçabilité visuelle pour audit | Excellente (chaque sujet affiche son score statique) | Abstraite (l’aléa est encapsulé dans la mémoire vive) |
12.2 Protocole type recommandé pour la recherche
Afin de clore ce guide méthodologique par une synthèse immédiatement actionnable pour la communauté scientifique et professionnelle, nous formalisons ci-dessous l’arbre de décision décisionnel et le protocole standardisé à déployer pour tout projet d’échantillonnage aléatoire dans Google Sheets :
- Phase de Préparation :
- Importer et vérifier la population source complète.
- Nettoyer les doublons et les valeurs aberrantes.
- Sanctualiser l’onglet brut en mode verrouillé protégé.
- Attribuer un identifiant unique (ID) non informatif par observation.
- Phase de Décision Stratégique :
- La population présente-t-elle des sous-groupes structurels hétérogènes cruciaux ?
- Si OUI : S’orienter vers l’échantillonnage stratifié (Section 8) en calculant les effectifs proportionnels $n_h$ par strate.
- Si NON : Adopter l’échantillonnage aléatoire simple (Section 6 ou 7).
- Le flux d’analyse nécessite-t-il une automatisation récurrente sans intervention manuelle ?
- Si OUI : Privilégier la formule dynamique
=SORTN(Donnees; n; 0; RANDARRAY(...); VRAI). - Si NON : Privilégier la méthode pas-à-pas avec fixation manuelle pour une inspection visuelle pas-à-pas.
- Si OUI : Privilégier la formule dynamique
- La population présente-t-elle des sous-groupes structurels hétérogènes cruciaux ?
- Phase de Dimensionnement et d’Extraction :
- Calculer $n$ via la formule de Cochran ajustée pour population finie avec un intervalle de confiance à 95 % ($e le 0{,}05$).
- Appliquer un facteur d’anticipation de non-réponse (+15 % à +30 %) pour constituer la liste de réserve stochastique.
- Exécuter le tirage aléatoire et stabiliser immédiatement le résultat via
Collage spécial > Valeurs uniquement(Ctrl + Maj + V).
- Phase d’Audit et de Diffusion :
- Isoler l’échantillon extrait dans un onglet dédié non modifiable.
- Documenter la manipulation dans le journal de bord avec horodatage UTC précis.
- Exporter le sous-ensemble vers votre pipeline d’analyse quantitative final (R, SPSS, Python, JASP ou Stata).
En observant scrupuleusement ce cheminement opératoire, le praticien s’assure que son travail sur tableur ne relève pas du bricolage informatique, mais s’inscrit au contraire dans les canons les plus exigeants de la méthode expérimentale moderne. Google Sheets démontre ainsi qu’il peut être un véhicule de rigueur scientifique absolue lorsqu’il est sous-tendu par une compréhension intime de ses lois stochastiques et logicielles.
Références
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Sampling+Techniques%2C+3rd+Edition-p-9780471162407
- Google. (s. d.). Fonction RAND – Aide Éditeurs Google Docs. Google Support. Consulté le 12 octobre 2024, à l’adresse https://support.google.com/docs/answer/3093438
- Google. (s. d.). Fonction SORTN – Aide Éditeurs Google Docs. Google Support. Consulté le 12 octobre 2024, à l’adresse https://support.google.com/docs/answer/7354624
- Kish, L. (1965). Survey sampling. John Wiley & Sons. https://doi.org/10.1002/bimj.19680100122
- Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation (TOMACS), 8(1), 3-30. https://doi.org/10.1145/272991.272995
- Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558-625. https://doi.org/10.2307/2342192
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), aac4716. https://doi.org/10.1126/science.aac4716
- VanderPlas, J. (2016). Python data science handbook: Essential tools for working with data. O’Reilly Media. https://jakevdp.github.io/PythonDataScienceHandbook/