
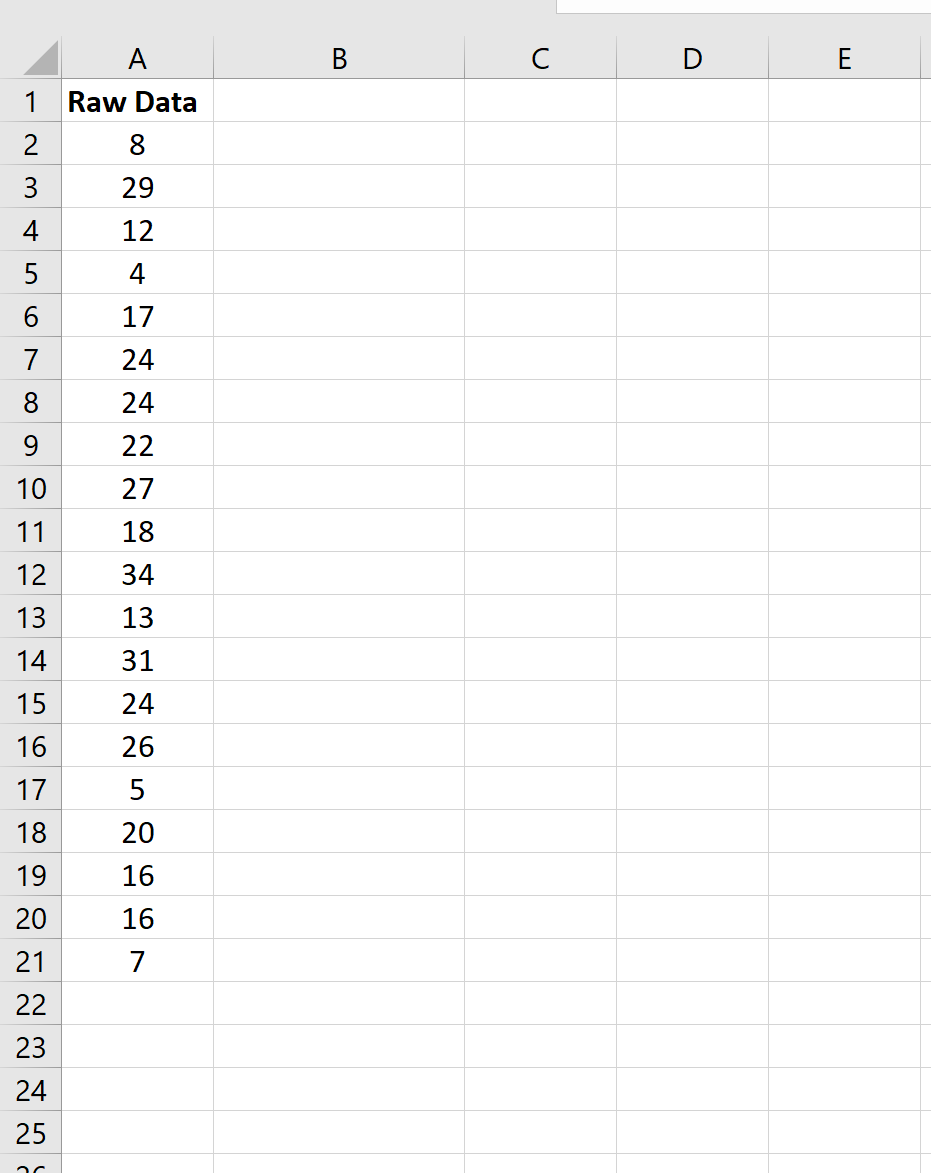
Dans le domaine des sciences quantitatives, de la psychologie cognitive aux neurosciences comportementales et à la sociologie empirique, la validité des conclusions scientifiques repose fondamentalement sur la robustesse de l’échantillonnage. Prélever un sous-ensemble d’observations au sein d’une population parente sans introduire de distorsion systématique représente un défi méthodologique majeur. L’échantillonnage aléatoire simple, en garantissant à chaque unité statistique une probabilité rigoureusement identique et non nulle d’appartenir à la sélection finale, constitue la pierre angulaire de l’inférence statistique. Cette approche probabiliste conditionne directement l’applicabilité du théorème central limite et permet aux chercheurs de généraliser leurs observations locales à des populations globales avec un niveau de confiance mathématiquement quantifiable.
Pourtant, la mise en œuvre pratique de cette randomisation se heurte fréquemment à des contraintes opérationnelles de laboratoire ou de terrain. Si des environnements programmatiques tels que GNU R ou Python (via les bibliothèques NumPy et Pandas) sont couramment employés pour de vastes architectures d’analyse, le tableur Microsoft Excel demeure le logiciel le plus ubiquitaire pour la collecte initiale, le toilettage préliminaire et la structuration des bases de données de recherche. Son accessibilité universelle, son interface bidirectionnelle immédiate et son intégration au sein des structures institutionnelles en font un outil incontournable du flux de travail scientifique quotidien.
Néanmoins, exploiter Microsoft Excel pour exécuter un tirage probabiliste exige une rigueur procédurale intransigeante. L’utilisation naïve de générateurs internes de nombres pseudo-aléatoires expose l’analyste à des écueils critiques : recalculs perpétuels déstabilisant les cohortes, désynchronisation des matrices de variables par des tris partiels, ou encore méconnaissance des limites algorithmiques du tableur. Cet article détaille, de manière exhaustive et pas à pas, le protocole normatif permettant de concevoir, d’exécuter, de valider et de documenter un échantillonnage aléatoire irréprochable sous Excel, garantissant ainsi une reproductibilité conforme aux standards les plus exigeants de la recherche contemporaine.
1. Fondements méthodologiques de l’échantillonnage aléatoire en recherche empirique
1.1 Principes de l’échantillonnage probabiliste et représentativité
L’échantillonnage aléatoire simple (EAS) se définit comme un protocole probabiliste dans lequel chaque unité statistique issue d’une population cible finie de taille N possède une chance exactement équiprobable d’être intégrée dans l’échantillon final de taille n. Dans le contexte méthodologique des sciences comportementales, cette propriété fondamentale assure que la sélection n’est guidée par aucun facteur implicite ou explicite dépendant des caractéristiques psychologiques, démographiques ou contextuelles des sujets observés. L’égalité mathématique de ces probabilités d’inclusion s’exprime par le ratio rigoureux p = n / N. Ce ratio demeure invariant pour toute configuration possible de sous-ensembles de taille n.
L’avantage cardinal de cette procédure réside dans son pouvoir d’atténuation systématique des biais de sélection expérimentale et d’attribution. Dans de nombreux contextes observationnels, les praticiens courent le risque de recruter des participants en fonction de leur disponibilité ou de leur complaisance, générant des biais d’autosélection qui détruisent la comparabilité des groupes. L’imposition d’un processus stochastique neutre neutralise ces distorsions cognitives et comportementales involontaires de l’expérimentateur, répartissant de façon symétrique les variables confusionnelles non mesurées entre les sous-groupes.
La représentativité ainsi conférée à l’échantillon ne signifie pas que ce dernier est une réplique miniature parfaite de la population, mais qu’il offre des estimateurs non biaisés de ses paramètres sous-jacents, comme la moyenne ou la variance. En d’autres termes, l’erreur d’échantillonnage devient purement aléatoire et quantifiée par l’erreur-type. Cela garantit la validité externe des inférences, autorisant l’extrapolation scientifique des conclusions obtenues sur la cohorte d’étude vers la population d’intérêt élargie, conformément aux recommandations des manuels méthodologiques de référence tels que ceux publiés par l’American Psychological Association.
1.2 Distinction entre échantillonnage avec et sans remise
Sur le plan théorique, l’échantillonnage probabiliste se déploie selon deux modalités distinctes : le tirage avec remise (ou échantillonnage bernoullien indépendant) et le tirage sans remise (souvent qualifié d’échantillonnage hypergéométrique). Dans le cadre d’un tirage avec remise, chaque unité sélectionnée est immédiatement réintégrée dans la population avant le tirage suivant. La taille de la population N demeure strictement constante à chaque étape, assurant la constance absolue de la probabilité d’inclusion conditionnelle et l’indépendance statistique absolue des tirages successifs. En conséquence, la variance de la distribution d’échantillonnage s’exprime classiquement sous la forme de la variance de la population divisée par la taille de l’échantillon, sans terme correctif.
À l’inverse, l’échantillonnage sans remise représente le standard méthodologique privilégié pour la quasi-totalité des études empiriques impliquant des participants humains. Lorsqu’un individu est sélectionné pour participer à un protocole clinique, psychométrique ou expérimental, il ne peut matériellement ni éthiquement être interrogé ou exposé à la même tâche plusieurs fois sous peine de contaminer les scores par des effets de mémorisation, d’apprentissage ou d’épuisement. Au cours d’un tirage sans remise, la sélection d’une unité modifie instantanément la composition de la population résiduelle, faisant évoluer la probabilité d’inclusion des éléments restants de 1 / N à 1 / (N – 1), puis 1 / (N – 2), et ainsi de suite.
Cet appauvrissement continu de la base de sondage induit une covariation négative marginale entre les sélections, ce qui a pour corollaire mathématique direct de resserrer la distribution d’échantillonnage de la moyenne. L’impact se traduit par l’application formelle du facteur de correction pour population finie (FCPF), égal à la racine carrée de (N – n) / (N – 1). Dans le cadre de l’exploitation de logiciels bureautiques tels qu’Excel, la distinction opérationnelle entre ces deux paradigmes dicte le choix des formules mathématiques à mobiliser, selon que l’on autorise ou proscrive l’émergence d’occurrences identiques au sein de la sélection.
1.3 Utilité et pertinence de Microsoft Excel dans le protocole de recherche
Bien que des suites spécialisées d’analyse numérique comme SPSS, Stata ou le langage de programmation R soient traditionnellement perçues comme l’étalon-or des calculs inférentiels, Microsoft Excel occupe une position centrale dans les étapes liminaires de la gestion des données. Son ubiquité matérielle garantit que tout collaborateur au sein d’un laboratoire universitaire, d’un institut de sondage ou d’un centre hospitalier peut accéder à la base sans nécessiter l’installation de bibliothèques logicielles tierces ou l’acquisition de compétences poussées en développement informatique. Cette accessibilité universelle fluidifie considérablement les échanges interdisciplinaires.
L’un des atouts déterminants du tableur réside dans la clarté visuelle et la traçabilité qu’il procure au pipeline de traitement de l’information. Contrairement aux scripts procéduraux où la transformation des données demeure parfois implicite dans la mémoire vive de la machine, Excel expose directement la matrice de données ligne par ligne et colonne par colonne. Cette transparence s’avère particulièrement précieuse lors des phases préliminaires de curation, d’inspection visuelle et d’application de filtres d’inclusion ou d’exclusion avant l’acheminement des données vers des architectures computationnelles plus denses.
Enfin, lorsqu’il est employé avec la rigueur scientifique requise, Excel répond pleinement aux exigences de reproductibilité minimale posées par les comités de lecture scientifique. Dès lors que l’analyste documente scrupuleusement la nomenclature des colonnes, le mode de génération pseudo-aléatoire adopté et la méthode d’inhibition des recalculs intempestifs, le processus de constitution de la cohorte d’étude devient entièrement auditable par les pairs, renforçant la transparence globale de la démarche méthodologique.
2. Comprendre les fonctions de génération aléatoire dans Microsoft Excel
2.1 Fonctionnement mathématique de la fonction ALEA (RAND)
Au cœur du moteur de calcul d’Excel pour les opérations d’échantillonnage se trouve la fonction native ALEA(), connue sous l’appellation RAND() dans les environnements anglophones. Cette fonction élémentaire ne requiert aucun argument et génère, à chaque évaluation, un nombre décimal pseudo-aléatoire rigoureusement distribué selon une loi uniforme continue sur l’intervalle ouvert [0, 1[. Cela signifie que toute valeur comprise entre 0 (inclus) et 1 (exclu) possède une densité de probabilité identique de survenir, modélisant ainsi une distribution rectangulaire théorique parfaite où l’espérance mathématique vaut 0,5 et la variance théorique s’établit à 1/12.
Sur le plan algorithmique, les versions contemporaines de Microsoft Excel utilisent une implémentation basée sur le générateur de Wichmann-Hill ou sur le Mersenne Twister selon la révision du noyau de calcul. Ces algorithmes pseudo-aléatoires déterministes reposent sur des séquences récursives complexes régies par des congruences modulaires de très longue période, dépassant typiquement 2^64 opérations sans répétition de cycles. Cette profondeur de cycle garantit que, pour des cohortes de taille humaine ou de dimension moyenne (de quelques centaines à plusieurs centaines de milliers d’enregistrements), l’absence d’autocorrélation entre les nombres consécutifs est mathématiquement suffisante pour prévenir tout biais de périodicité.
Les propriétés de cette distribution uniforme continue s’avèrent idéales pour le tri probabiliste. Comme les valeurs numériques générées adoptent une résolution pouvant atteindre une quinzaine de chiffres significatifs en précision double flottante (norme IEEE 754), chaque ligne de données reçoit une étiquette stochastique quasi-unique. Cette étiquette sert d’indice ordinal indépendant, autorisant une redistribution spatiale intégrale des lignes de la base sans biais d’antériorité.
2.2 La volatilité inhérente aux fonctions de calcul automatique
L’une des caractéristiques les plus déroutantes et méthodologiquement périlleuses de la fonction ALEA() est sa classification en tant que fonction volatile par le moteur de calcul d’Excel. Contrairement aux fonctions déterministes standards (telles que SOMME ou MOYENNE) qui ne sont réévaluées que lorsque les cellules dont elles dépendent subissent une modification, les fonctions volatiles sont recalculées de façon systématique dès qu’un événement survient dans le classeur. L’édition d’une cellule quelconque, la suppression d’une colonne, l’appui sur la touche F9, ou même la simple réouverture du classeur réinitialise l’évaluation d’ALEA().
Cette volatilité dynamique introduit un risque expérimental critique : la modification involontaire et permanente de la composition de l’échantillon. Si un chercheur constitue son échantillon en triant ses données selon une colonne de valeurs ALEA() vivantes, chaque frappe ultérieure sur la feuille modifiera ces valeurs. Tout reclassement ou toute opération subséquente redessinera aléatoirement la sélection, détruisant instantanément l’assignation initiale des participants et rendant toute tentative de réplication locale strictement impossible.
Pour cette raison, la neutralisation de la volatilité constitue une étape pivot du protocole d’échantillonnage. Il est méthodologiquement impératif de disjoindre la phase de génération probabiliste de la phase d’exploitation en figeant de façon irréversible les scores numériques attribués. Ce verrouillage convertit le flux pseudo-aléatoire transitoire en une suite de scalaires immuables, préservant ainsi l’intégrité de la base expérimentale.
2.3 Comparaison entre ALEA(), ALEA.ENTRE.BORNES() et TABLEAU.ALEAT()
Microsoft Excel intègre plusieurs fonctions de génération aléatoire, chacune répondant à des contraintes structurelles distinctes qu’il convient de ne pas confondre lors de la planification d’un tirage expérimental. La fonction ALEA.ENTRE.BORNES(bas; haut) produit exclusivement des nombres entiers discrets distribués uniformément entre deux limites entières spécifiées. Bien qu’elle soit intuitive pour simuler des lancers de dés ou attribuer des identifiants arbitraires de cohortes, elle présente une densité cardinale faible. Lorsque cette fonction est appliquée sur une population importante, elle génère inévitablement de nombreuses ex-aequo (collisions d’entiers), ce qui complique son utilisation directe comme clé de tri sans remise sans l’application d’algorithmes de départage supplémentaires.
À l’inverse, la fonction contemporaine TABLEAU.ALEAT(), introduite avec les moteurs à matrices dynamiques d’Excel pour Microsoft 365, permet de générer un vecteur ou une matrice bidimensionnelle complète de valeurs aléatoires par le biais d’une formule unique inscrite dans une cellule maîtresse. L’analyste peut spécifier la taille du tableau matriciel, les bornes minimales et maximales, ainsi que la nature discrète ou continue des résultats générés. Cette flexibilité confère à TABLEAU.ALEAT() un rôle prépondérant pour les pipelines automatisés modernes, bien qu’elle conserve la volatilité fondamentale propre aux générateurs de Microsoft.
En matière d’échantillonnage aléatoire simple sans remise, la fonction classique ALEA() demeure la méthode de référence la plus sûre et la plus universellement compatible. Sa continuité décimale minimise mathématiquement le risque de doublons d’indexation à des niveaux quasi nuls, garantissant qu’un tri ascendant ou descendant hiérarchisera l’intégralité des observations de la base selon un ordre stochastique strict, sans rupture ni ambiguïté opératoire.
3. Étape 1 : Préparation et structuration rigoureuse du jeu de données
3.1 Organisation tabulaire de la base de sondage
La validité d’un échantillonnage aléatoire repose en premier lieu sur la constitution méthodique de la base de sondage. Cette base représente l’inventaire exhaustif et actualisé de toutes les unités d’échantillonnage composant la population accessible. Dans Microsoft Excel, ce référentiel doit être impérativement structuré selon le modèle de la table relationnelle normalisée : une seule rangée d’en-tête contenant des intitulés de variables sans ambiguïté (ex. ID_Participant, Age, Sexe, Score_Anxiete), suivie immédiatement par les observations individuelles, chaque ligne correspondant à une entité d’étude unique.
L’introduction d’un identifiant unique non nominal pour chaque enregistrement est un prérequis scientifique capital. Cet identifiant (numéro incrémental, code alphanumérique anonymisé) permet d’assurer la traçabilité des données tout en garantissant l’anonymat des participants conformément aux cadres éthiques régissant la recherche clinique et comportementale. Par ailleurs, la feuille de calcul doit être exempte de lignes ou de colonnes totalement vides intercalées au sein du jeu de données. Ces interruptions artificielles fragmentent la continuité des plages de données et conduisent fréquemment les utilitaires de tri automatique à ignorer les blocs sous-jacents, introduisant une troncature silencieuse et désastreuse de la population source.
Il est vivement conseillé de formater cette plage sous forme de véritable Tableau Excel via la commande contextuelle Insérer > Tableau (raccourci Ctrl+L). Cette structure dynamique garantit la cohésion automatique des lignes d’enregistrements, empêchant la dissociation accidentelle entre les attributs descriptifs et les clés d’identification lors des opérations spatiales ultérieures.
3.2 Nettoyage préliminaire et contrôle des valeurs manquantes
Avant d’initialiser tout algorithme d’assignation aléatoire, un audit rigoureux de la qualité des données doit être conduit sur l’ensemble des N enregistrements de la base de sondage. Les jeux de données issus de passations expérimentales, de questionnaires en ligne ou d’extractions de dossiers de santé comportent fréquemment des non-réponses partielles, des erreurs de saisie ou des ruptures de protocole. Si des participants inéligibles ou des profils présentant des valeurs manquantes critiques sur les critères de jugement primaires sont intégrés dans la base de sondage, ils risquent d’être sélectionnés dans l’échantillon final de taille n, obligeant le chercheur à des exclusions post-hoc méthodologiquement discutables.
Le protocole de nettoyage impose donc l’application préalable de filtres contextuels pour repérer les lignes incomplètes. Les observations présentant des incohérences biométriques manifestes (par exemple, un âge négatif ou un score psychométrique hors échelle) doivent être investiguées et purgées de la base avant le tirage au sort. Une fois cette épuration réalisée, le chercheur doit figer la valeur exacte du paramètre N, qui désigne la taille définitive de la population accessible et conforme. Ce nombre servira de dénominateur pour tous les calculs de représentativité et de puissance d’extraction.
Cette étape requiert également la formalisation explicite des critères d’inclusion et d’exclusion dans le protocole de l’étude. Toute exclusion réalisée a posteriori sur l’échantillon randomisé introduit un biais de dérivation qui compromet la nature probabiliste du recrutement. Une sélection n’est véritablement représentative que si elle s’exerce sur un corpus préalablement validé et stabilisé.
3.3 Création d’une sauvegarde de sécurité de la base brute
La manipulation de matrices de données au sein d’un logiciel interactif tel qu’Excel expose l’utilisateur au risque de fausses manœuvres destructrices, notamment l’écrasement involontaire de formules, la permutation accidentelle de plages ou la perte définitive de l’état initial des données. Il constitue une faute de gouvernance méthodologique de mener des opérations de tri ou d’assignation directement sur le fichier d’acquisition source.
Avant de procéder à la génération aléatoire, l’opérateur doit créer un classeur d’archive immuable, nommé selon une nomenclature horodatée normalisée (par exemple, Projet_Cohorte_BaseBrute_AAAA-MM-JJ.xlsx), protégé en écriture et stocké sur un serveur sécurisé disposant de mécanismes de redondance. Au sein du classeur de travail dévolu aux manipulations, il est recommandé de dupliquer la feuille de données brutes pour isoler une feuille spécifiquement intitulée Extraction_Echantillon.
Cette séparation étanche des environnements numériques permet à l’équipe de recherche d’annuler toute dérive procédurale par simple retour à la racine sans perte d’information. Elle documente également la traçabilité intégrale du processus d’extraction, offrant aux auditeurs de données la possibilité de vérifier la concordance parfaite entre la matrice d’origine et la base échantillonnée finale.
4. Étape 2 : Génération des valeurs aléatoires avec la fonction ALEA()
4.1 Insertion de la colonne d’indexation aléatoire
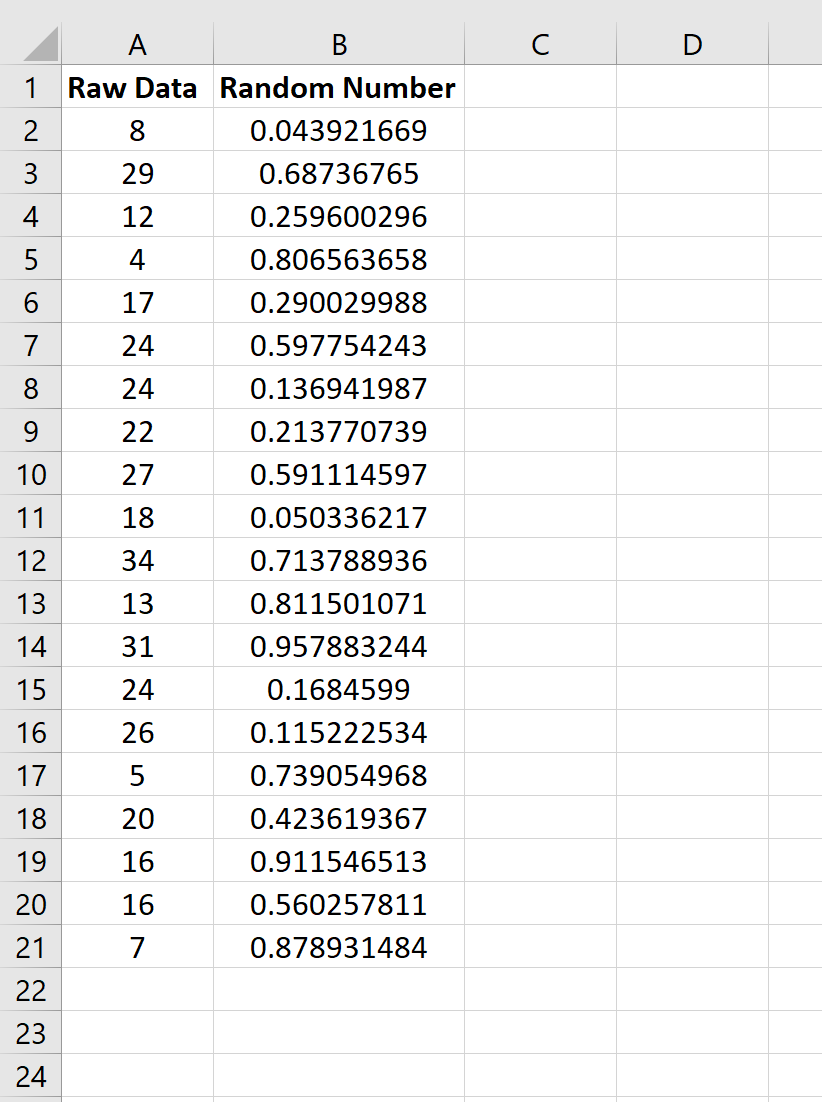
L’opération de randomisation sans remise repose sur l’attribution d’un score continu stochastique à chaque enregistrement de la base. Pour ce faire, l’analyste insère une nouvelle colonne adjacente à la table de données existante. Cette colonne doit recevoir un en-tête explicite et documenté, tel que Valeur_Aleatoire ou Indice_Random_ALEA, afin d’éviter toute confusion ultérieure avec des variables réelles issues des observations de terrain.
Dans la première cellule de cette colonne correspondant au premier sujet d’étude (par exemple, la cellule B2 si la ligne 1 héberge les étiquettes et la colonne A les identifiants de sujets), l’opérateur saisit rigoureusement la commande syntaxique :
=ALEA()
Dès la validation par la touche Entrée, le logiciel évalue la formule et affiche une valeur décimale comprise entre 0 et 1, comportant jusqu’à quinze décimales. Cette valeur représente la concrétisation empirique d’une variable aléatoire continue uniforme U ~ [0, 1[. Elle n’est corrélée avec aucune propriété physique, physiologique ou sociologique de l’observation correspondante, incarnant le principe d’indépendance statistique nécessaire à la neutralité du futur classement.
4.2 Propagation de la formule sur l’intégralité des observations
Pour que la procédure d’échantillonnage soit mathématiquement équitable, la formule de génération doit être étendue à l’ensemble exact des N observations composant la base de sondage épurée, sans la moindre omission ni dépassement. L’opérateur positionne le curseur de la souris sur le coin inférieur droit de la cellule initiale jusqu’à faire apparaître la poignée de recopie (représentée par une croix noire fine), puis exécute un double-clic rapide.
Cette commande native d’Excel propage automatiquement la syntaxe =ALEA() verticalement jusqu’à la dernière ligne consécutive renseignée de la colonne contiguë gauche. L’opérateur doit obligatoirement faire défiler la feuille jusqu’au bas de la table pour attester visuellement que la formule s’arrête strictement à la ligne N + 1 (en tenant compte de la ligne d’en-tête). La présence d’une cellule vide accidentelle dans la colonne de référence latérale interrompt prématurément la recopie automatique, privant les enregistrements situés en aval de toute chance d’éligibilité au tirage au sort.
Si la base a été préalablement convertie en Tableau Structuré Excel, cette propagation est instantanée : la validation de la formule sur la première ligne déclenche la création d’une colonne calculée qui s’étend d’elle-même sur l’ensemble des enregistrements, éliminant ainsi le risque d’erreur humaine d’extension de plage.
4.3 Vérification préliminaire de l’unicité des décimales
Une préoccupation méthodologique fréquente concerne le risque théorique de collision stochastique, c’est-à-dire l’apparition fortuite de deux valeurs aléatoires rigoureusement identiques pour deux participants distincts. Si un tel événement survenait, l’ordre hiérarchique entre ces deux lignes ne serait plus guidé par le hasard pur mais par leur ordre d’apparition résiduel dans la matrice, introduisant un biais marginal d’ordre.
Toutefois, le moteur arithmétique d’Excel opérant selon la norme IEEE 754 à double précision, l’espace d’échantillonnage de la fonction ALEA() s’étend sur 2^53 états distincts, ce qui confère à chaque tirage une finesse d’environ 15 à 17 décimales. La probabilité que deux observations partagent exactement la même valeur au sein d’une cohorte expérimentale classique (même de taille N = 100 000) est infinitésimale (analogue aux probabilités observées dans le paradoxe des anniversaires sur un espace de taille 10^15). Pour vous en assurer formellement, vous pouvez vérifier les propriétés de la précision numérique sur le support technique Microsoft.
L’opérateur peut procéder à une confirmation sommaire en appliquant une règle de mise en forme conditionnelle dédiée aux valeurs en double sur la colonne générée. L’absence de signalement visuel certifie l’unicité fonctionnelle de chaque coefficient attribué, validant l’adéquation de la colonne pour servir d’opérateur d’ordonnancement univoque.
5. Étape 3 : Figeage des valeurs aléatoires via le collage spécial
5.1 Sélection et copie intégrale du vecteur aléatoire
Dès lors que les N valeurs aléatoires ont été générées avec succès, il est indispensable de rompre la dépendance au moteur dynamique de calcul afin d’éviter toute altération ultérieure de la série stochastique. L’opérateur sélectionne la totalité de la colonne contenant les formules =ALEA(). Pour éviter les imprécisions inhérentes au défilement manuel à la souris sur des bases volumineuses, l’usage des commandes au clavier est vivement recommandé.
En se positionnant sur la première cellule de données de la colonne aléatoire (par exemple B2), l’analyste exécute la combinaison de touches Ctrl + Maj + Bas (ou Cmd + Shift + Bas sur macOS). Cette commande étend la sélection instantanément jusqu’à la dernière cellule non vide de la série, garantissant l’inclusion de l’intégralité du vecteur aléatoire sans interruption. L’opérateur exécute ensuite l’ordre de copie par la séquence Ctrl + C (ou Cmd + C).
À cet instant précis, le tableur affiche une bordure animée en pointillés autour du vecteur copié. Il convient de souligner que cette action de copie déclenche souvent une réévaluation visible des fonctions volatiles affichées sur l’écran ; ce comportement transitoire est normal et sera neutralisé par l’opération suivante.
5.2 Application de la commande Collage spécial en valeurs
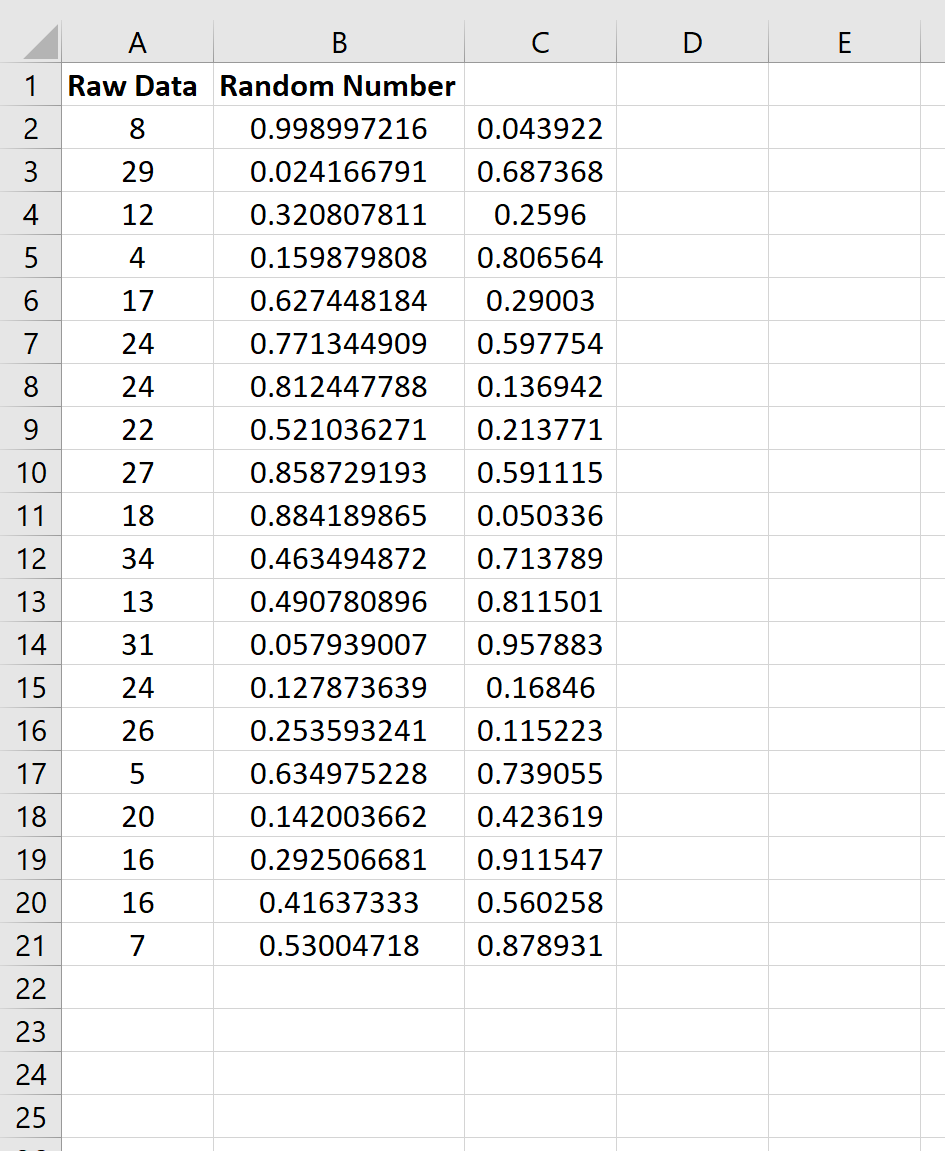
Sans modifier la sélection spatiale des cellules, l’opérateur procède à l’écrasement contrôlé des formules par leurs réalisations numériques statiques. En maintenant le curseur sur la zone sélectionnée, un clic droit permet d’accéder au menu contextuel dans lequel il convient de cliquer sur l’icône Valeurs (V) (représentée graphiquement par un presse-papier estampillé des chiffres 123) sous les options de collage.
Alternativement, l’opérateur peut mobiliser le raccourci global Ctrl + Alt + V pour appeler directement la boîte de dialogue standard Collage spécial, cocher le bouton radio Valeurs, puis valider avec le bouton OK. Cette séquence d’instructions supprime l’instruction algorithmique dynamique sous-jacente =ALEA() pour ne déposer dans chaque cellule qu’un nombre flottant figé et pérenne.
Cette étape matérialise la rupture de volatilité. Elle stabilise la matrice des tirages dans un état déterministe, analogue à la consignation définitive sur papier des résultats d’un tirage au sort par urne physique, rendant la configuration totalement insensible aux modifications contextuelles futures de la feuille de calcul.
5.3 Contrôle d’immutabilité des scores attribués
Avant d’engager les étapes de tri, l’opérateur doit vérifier la parfaite immutabilité de la colonne aléatoire. Pour ce faire, il inspecte attentivement le contenu affiché dans la barre de formule d’Excel en naviguant sur plusieurs cellules individuelles de cette colonne. La barre de formule ne doit plus jamais faire apparaître la syntaxe =ALEA(), mais obligatoirement un nombre décimal constant (par exemple, 0,784159265358979).
Un test expérimental complémentaire consiste à appuyer délibérément sur la touche F9 du clavier, commande système assignée au recalcul forcé de l’ensemble du classeur actif. Si l’opération de collage spécial en valeurs a été menée avec succès, les nombres de la colonne doivent demeurer parfaitement immobiles et insensibles à cette sollicitation. De la même manière, la modification volontaire du contenu d’une cellule quelconque sur une autre feuille ne doit induire aucun scintillement ni réévaluation de la colonne d’indexation.
La validation de ce point d’arrêt méthodologique garantit que l’assignation aléatoire est scellée dans le marbre numérique de l’environnement de calcul. La base de sondage est dès lors prête à subir la réorganisation spatiale dictée par ces nouveaux indices.
6. Étape 4 : Tri des données et extraction finale de l’échantillon
6.1 Configuration du tri multicritère étendu
Le classement des enregistrements selon la valeur de l’indice aléatoire convertit la séquence stochastique continue en un réordonnancement sans remise des observations. Cependant, cette manœuvre présente un danger technique bien identifié : le tri unilatéral. Si l’opérateur commet l’erreur de ne sélectionner que la seule colonne aléatoire avant de cliquer sur un bouton de tri rapide, seules les cellules de cette colonne seront permutées, dissociant les scores aléatoires des identifiants et métadonnées des participants.
Pour prévenir cette catastrophe analytique, l’analyste doit impérativement sélectionner la totalité de la plage de données englobant toutes les colonnes d’attributs (identifiant, sexe, âge, mesures cliniques) ainsi que la colonne d’index aléatoire. La méthode la plus sûre consiste à sélectionner une cellule quelconque au cœur de la matrice et à presser le raccourci Ctrl + A (ou Ctrl + Shift + Espace), en vérifiant méticuleusement que la surbrillance englobe bien l’intégralité du tableau de la cellule supérieure gauche A1 à la cellule inférieure droite la plus distale.
L’opérateur clique ensuite sur l’onglet Données du ruban supérieur, puis active l’outil Trier pour ouvrir la fenêtre de configuration du tri multicritère. Dans cette interface, il convient de cocher scrupuleusement l’option Mes données ont des en-têtes, garantissant que la ligne supérieure de libellés sera exclue de la permutation spatiale.
6.2 Exécution du réordonnancement sans désynchronisation
Au sein de la fenêtre de configuration du tri, l’utilisateur sélectionne la colonne Valeur_Aleatoire dans le menu déroulant Colonne : Trier par. Le paramètre Trier sur doit demeurer réglé sur Valeurs de cellule, et le critère d’Ordre est configuré sur Du plus petit au plus grand (tri ascendant) ou indifféremment Du plus grand au plus petit (tri descendant), les deux orientations étant mathématiquement équivalentes en raison de la parfaite symétrie de la distribution uniforme [0, 1[.
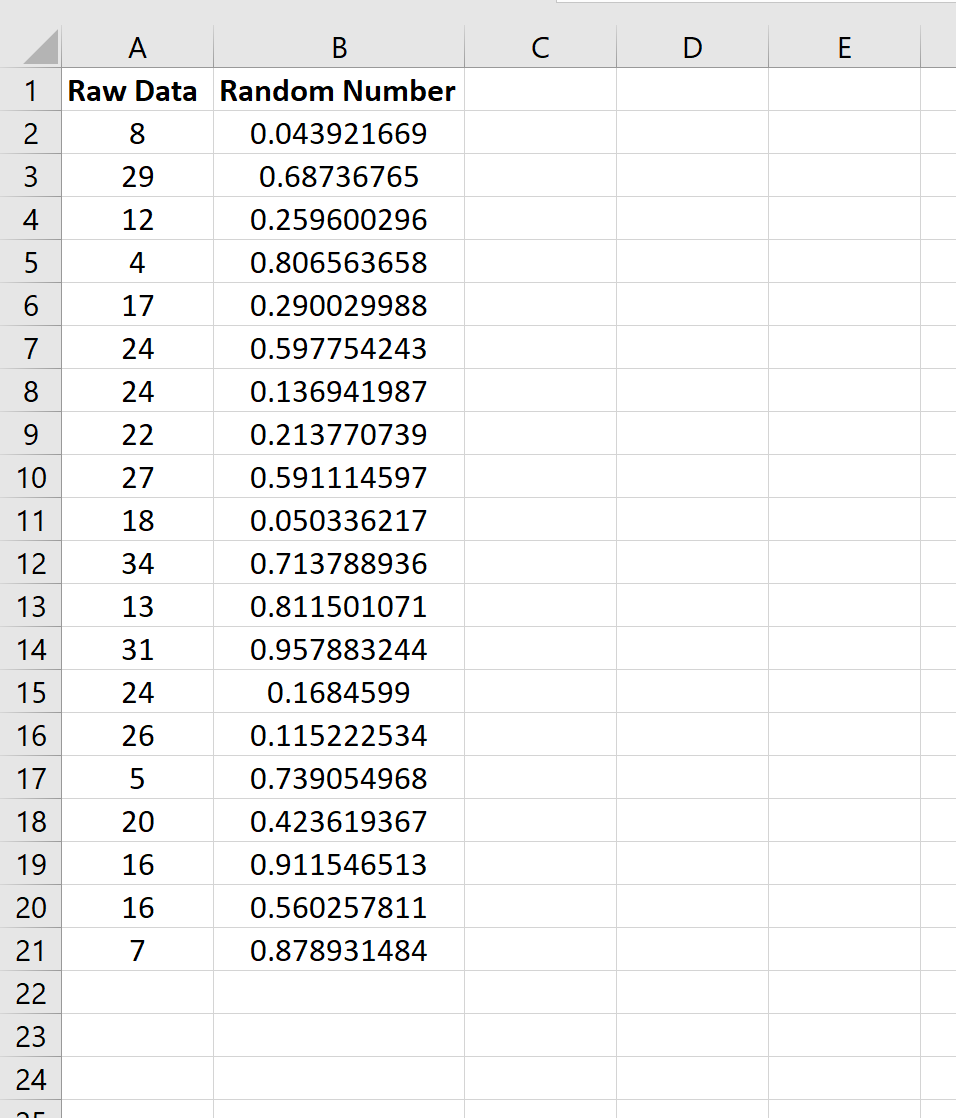
Lors de la validation par le bouton OK, le moteur de tri réorganise spatialement la totalité des lignes du tableau de données de manière synchrone. Chaque ligne se déplace solidairement avec l’ensemble de ses champs attributaires. Les observations dont le tirage aléatoire a attribué les valeurs les plus faibles sont désormais propulsées au sommet de la feuille de calcul, tandis que les valeurs les plus élevées sont reléguées en fin de tableau.
Grâce à ce mécanisme, la position séquentielle d’une observation au sein de la matrice ne dépend plus de son ordre chronologique d’inclusion, de son identifiant numérique initial ou d’une quelconque propriété biologique ou sociale, mais exclusivement de la valeur scalaire aléatoire qui lui a été attachée. L’ordre d’apparition originel a été intégralement détruit au profit d’un désordre stochastique pur et vérifiable.
6.3 Sélection des n premières lignes constituant l’échantillon
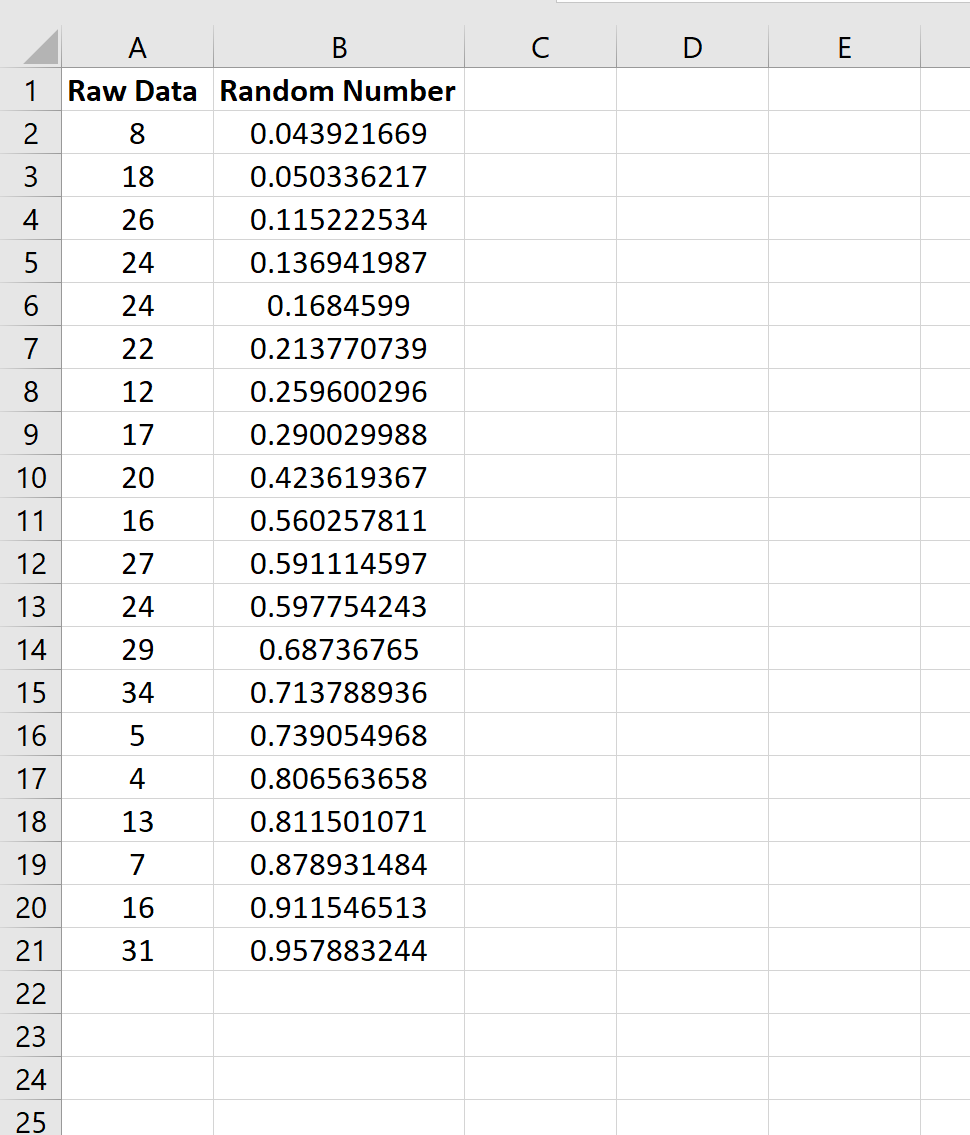
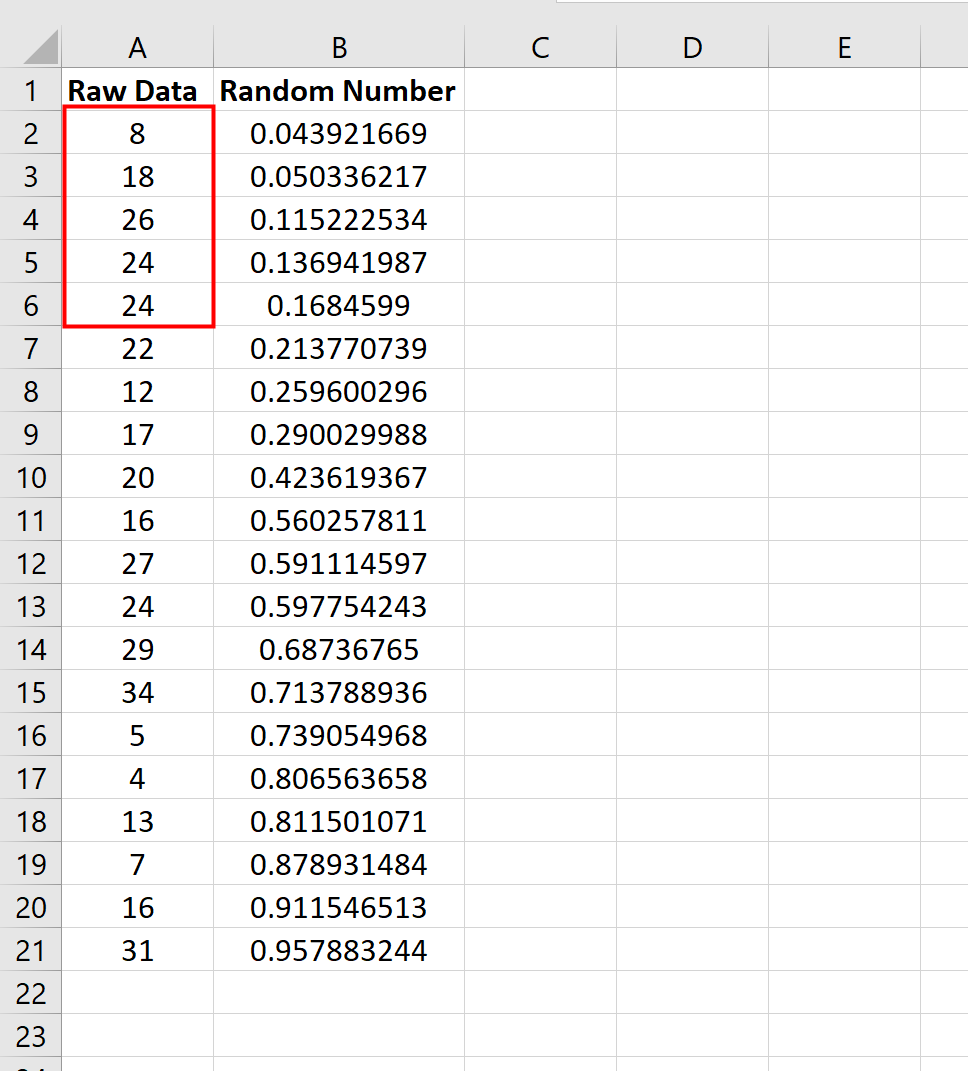
Une fois le tri exécuté, l’échantillonnage aléatoire simple sans remise de taille n s’obtient par la simple extraction des n premières lignes de la base réordonnée. Par exemple, si la population initiale compte N = 2 000 participants éligibles et que le devis expérimental exige un échantillon de n = 150 sujets, il suffit d’isoler les lignes de données 2 à 151 (la ligne 1 étant réservée aux en-têtes de colonnes).
L’opérateur met en surbrillance cette plage de n lignes, exécute une copie (Ctrl + C), et transfère ce bloc vers une feuille de calcul vierge explicitement libellée Echantillon_Final_Extrait. Dans cette feuille cible, il est recommandé d’insérer une colonne additionnelle d’indexation séquentielle de 1 à n attestant formellement de la complétude du volume recruté.
Il est indispensable de consigner avec rigueur dans le classeur la ligne de coupure exacte retenue, la date et l’heure de l’extraction, ainsi que le nom de l’expérimentateur responsable de l’opération. Les données demeurant au-delà de la ligne n + 1 dans la feuille triée constituent la réserve probabiliste de remplacement (ou cohorte de réserve), qui pourra être mobilisée ultérieurement en cas de défection précoce avérée de certains sujets, en suivant strictement l’ordre séquentiel établi par le tirage (voir la méthodologie de gestion des réserves chez l’Institut National de la Statistique et des Études Économiques).
7. Méthode alternative dynamique : Échantillonnage avec les formules matricielles modernes
7.1 Utilisation combinée des fonctions CHOISIRLIGNES et TRIERPAR
Avec l’introduction du moteur de calcul matriciel dynamique au sein de Microsoft 365 et des versions récentes d’Excel, il est désormais envisageable de s’affranchir des manipulations manuelles de colonnes auxiliaires, de collages spéciaux et de tris de fenêtres grâce à une formule imbriquée unifiée. Cette approche moderne repose sur l’articulation coordonnée de trois fonctions d’avant-garde : CHOISIRLIGNES (CHOOSEROWS), TRIERPAR (SORTBY), et TABLEAU.ALEAT (RANDARRAY).
Considérons une base de données brute logée dans la plage A2:E1001, représentant N = 1000 participants sur 5 variables, et un objectif d’échantillonnage de n = 50 sujets. L’opérateur peut inscrire dans la cellule supérieure gauche de sa feuille de destination la syntaxe matricielle suivante :
=CHOISIRLIGNES(TRIERPAR(A2:E1001; TABLEAU.ALEAT(LIGNES(A2:E1001); 1)); SEQUENCE(50))
Cette expression matricielle se décompose logiquement comme suit : la fonction LIGNES(A2:E1001) évalue dynamiquement la cardinalité de la population N. La fonction TABLEAU.ALEAT(1000; 1) génère un vecteur d’indices aléatoires continus de dimension correspondante. La fonction TRIERPAR procède à la permutation virtuelle intégrale des lignes de la plage de données d’origine selon ce vecteur stochastique, sans modifier l’affichage physique de la table source. Enfin, la fonction CHOISIRLIGNES couplée à SEQUENCE(50) extrait strictement les cinquante premières lignes issues de cette permutation ordonnée.
7.2 Formule d’indexation dynamique sans colonne auxiliaire
L’atout méthodologique majeur de cette formulation matricielle réside dans la non-altération structurelle de la base de sondage parente. La matrice d’origine A2:E1001 conserve rigoureusement sa disposition native, son tri historique, son indexation chronologique et sa pureté relationnelle, sans qu’aucune colonne temporaire ne vienne polluer son schéma de données.
Le tableau résultant « se déverse » (selon la terminologie propre au mécanisme de débordement dynamique ou spill) automatiquement sur 50 lignes et 5 colonnes depuis la cellule d’ancrage. Ce pipeline algorithmique condensé supprime toutes les interventions intermédiaires manuelles à la souris, sources potentielles d’erreurs de sélection de plage ou de fausses manipulations.
De plus, cette technique permet une mise à jour paramétrique immédiate. Si le plan expérimental nécessite soudainement d’élever la taille de l’échantillon de 50 à 75 participants pour compenser une modification de devis, il suffit de substituer l’argument SEQUENCE(50) par SEQUENCE(75) pour que l’extraction s’étende instantanément au volume révisé, sous réserve des contrôles d’immuabilité décrits ci-après.
7.3 Avantages et limites des approches matricielles dynamiques
Si la concision de cette formule matricielle moderne représente indéniablement un bond qualitatif en matière d’élégance informatique, elle présente des inconvénients substantiels que le chercheur doit scrupuleusement évaluer. Le défaut structurel le plus critique réside dans la persistance de la volatilité : la fonction TABLEAU.ALEAT() imbriquée au cœur de la syntaxe est volatile au même titre qu’ALEA(). En conséquence, à chaque recalcul général du classeur, la formule réévalue l’ensemble des tirages et projette un échantillon de 50 participants totalement distinct de celui de la minute précédente.
Pour neutraliser ce péril et stabiliser l’échantillon, le chercheur doit impérativement, dès la génération jugée satisfaisante, sélectionner la zone de débordement matriciel, copier le bloc dans le presse-papier, et appliquer un Collage spécial en valeurs sur lui-même ou sur un onglet dédié. Cette opération fige le résultat et détruit la dynamique sous-jacente, sécurisant l’échantillon dans un état fixe et auditable.
Enfin, une limite technique rédhibitoire concerne la compatibilité descendante. Les formules CHOISIRLIGNES et TRIERPAR ne sont pas reconnues par les versions perpétuelles antérieures d’Excel (Excel 2019, 2016, 2013 ou versions académiques anciennes). L’ouverture d’un tel classeur sur l’ordinateur d’un collaborateur non équipé de la version Microsoft 365 provoquera l’erreur critique d’évaluation #NOM?, ruinant la portabilité du fichier d’échantillonnage.
8. Stratification de l’échantillon aléatoire sous Excel
8.1 Nécessité méthodologique de l’échantillonnage stratifié en psychologie
Bien que l’échantillonnage aléatoire simple soit mathématiquement neutre, il est vulnérable aux fluctuations d’échantillonnage, particulièrement lorsque la taille n est restreinte. Dans les études comportementales et sociologiques, certaines variables catégorielles fondamentales (telles que le sexe biologique, les classes d’âge, le niveau socio-éducatif ou la sévérité clinique) exercent une influence déterminante sur les mesures d’intérêt. Un tirage purement aléatoire non contrôlé peut malencontreusement aboutir à une sous-représentation critique d’un sous-groupe clé (par exemple, obtenir 15 % d’hommes et 85 % de femmes dans un échantillon censé refléter une parité équilibrée).
L’échantillonnage aléatoire stratifié contourne cet écueil en partitionnant préalablement la population de taille N en sous-groupes mutuellement exclusifs et collectivement exhaustifs, nommés strates (N1, N2, …, Nk). Au sein de chacune de ces strates, un échantillonnage aléatoire simple indépendant est exécuté pour extraire des sous-échantillons de taille déterminée (n1, n2, …, nk). Cette démarche garantit une représentativité catégorielle exacte et améliore significativement la précision statistique des estimateurs globaux en réduisant la variance intra-groupe.
L’allocation peut être proportionnelle (les fractions d’échantillonnage ni / Ni sont identiques à travers toutes les strates, reproduisant fidèlement la structure sociodémographique de la population) ou équiprobable/optimale (extraction de volumes égaux dans chaque strate pour maximiser la puissance comparative de sous-groupes minoritaires). Pour une analyse mathématique formelle de l’efficacité relative de la stratification comparée au tirage simple, nous renvoyons aux travaux classiques de Cochran (1977).
8.2 Procédure opérationnelle par segmentation de cohortes
La mise en œuvre d’un tirage stratifié manuel sous Excel requiert une hiérarchisation structurée du processus de tri. La première phase consiste à organiser la base de sondage globale en sous-tables ordonnées selon la variable de stratification. L’opérateur applique un tri primaire multicritère dont la clé de premier niveau correspond à la variable catégorielle (par exemple, la colonne Groupe_Age structurée en trois modalités : Jeune, Adulte, Senior).
La seconde phase consiste à générer les coefficients aléatoires de façon conventionnelle via la fonction =ALEA(), puis à figer impérativement ces nombres par un Collage spécial en valeurs pour prévenir toute oscillation. Une fois les valeurs stabilisées, l’opérateur configure un tri imbriqué à deux niveaux via la fenêtre contextuelle de tri : le niveau supérieur trie sur la variable de stratification (ex. Groupe_Age de A à Z), et le sous-niveau immédiat trie sur la colonne Valeur_Aleatoire (du plus petit au plus grand).
L’effet visuel et mathématique de cette disposition est puissant : la matrice se structure en blocs étanches de strates démographiques au sein desquelles les individus sont classés dans un désordre aléatoire complet. Il ne reste plus à l’analyste qu’à procéder à l’extraction séquentielle manuelle des ni premières observations assignées au sein de chaque bloc (par exemple, les 40 premiers Jeunes, les 40 premiers Adultes et les 40 premiers Seniors), réalisant ainsi un échantillon stratifié parfait.
8.3 Automatisation du tirage stratifié avec FILTRE et ALEA
Pour les gestionnaires de données exploitant des flux de participants continus sous Microsoft 365, la segmentation manuelle peut être avantageusement remplacée par une chaîne de fonctions de filtrage dynamique. La fonction FILTRE (FILTER) permet d’isoler virtuellement une strate spécifique sans requérir de tri spatial destructif de la table mère.
En combinant cette instruction avec les matrices dynamiques, l’opérateur peut extraire de manière entièrement autonome l’échantillon d’une strate donnée directement dans un tableau dédié. La syntaxe prend la forme générale suivante, ici illustrée pour extraire aléatoirement 25 participants de la modalité « Féminin » logée dans la colonne C de la table Table_Participants :
=CHOISIRLIGNES(TRIERPAR(FILTRE(Table_Participants; Table_Participants[Sexe]= »F »); TABLEAU.ALEAT(LIGNES(FILTRE(Table_Participants; Table_Participants[Sexe]= »F »)); 1)); SEQUENCE(25))
L’exécution de cette formule génère de façon indépendante et stochastique le contingent féminin requis. L’analyste duplique cette formule dans des cellules distinctes pour chaque modalité (ex. strate masculine, strate non-binaire), en ajustant la condition logique et la taille de tirage ciblée. La consolidation finale des résultats dans un registre unique compose un échantillon aléatoire rigoureusement stratifié, alliant traçabilité formelle, équilibre paramétrique et automatisation procédurale avancée.
9. Mise en œuvre d’un échantillonnage avec remise via RECHERCHEV
9.1 Architecture logique du tirage avec remplacement sous Excel
Bien que moins prévalent dans les expérimentations biomédicales directes, l’échantillonnage aléatoire simple avec remise (EASR) est conceptuellement indispensable dans plusieurs démarches avancées de la modélisation statistique. C’est notamment le fondement computationnel des simulations stochastiques de Monte-Carlo et des techniques non paramétriques de rééchantillonnage de type bootstrap de Bradley Efron (1979), conçues pour estimer empiriquement les intervalles de confiance ou l’erreur-type d’un paramètre sans formuler d’hypothèse forte sur la loi de distribution sous-jacente.
Sous Excel, modéliser un tirage avec remise nécessite de rompre le lien d’unicité stricte imposé par le tri spatial sans remise. Dans ce modèle, une observation de la base de sondage parente peut être tirée au sort une fois, plusieurs fois, ou pas du tout au cours d’une même session d’extraction. L’architecture logique consiste à indexer la population source de 1 à N au moyen d’un numéro d’ordre incrémental rigoureux et ininterrompu.
L’échantillonnage ne consiste plus à permuter spatialement les enregistrements, mais à simuler une succession de n tirages indépendants au sein de l’espace discret des nombres entiers [1, N], puis à interroger dynamiquement la base source pour rapatrier l’ensemble des données attributaires associées à chaque numéro stochastique désigné.
9.2 Construction de la table de pointage avec ALEA.ENTRE.BORNES
Pour concrétiser ce protocole opérationnel, l’opérateur crée une nouvelle feuille de calcul intitulée Simulation_Bootstrap. Dans une première colonne d’identification de pointage (colonne A, lignes 2 à n + 1), il insère la fonction de génération aléatoire discrète paramétrée sur la cardinalité de la population cible :
=ALEA.ENTRE.BORNES(1; N)
En étendant cette formule sur les n lignes d’échantillonnage, le tableur génère instantanément n valeurs d’index entières. La nature discrète de cette loi uniforme assure que chaque entier entre 1 et N possède une probabilité mathématique constante de survenue égale à 1 / N à chaque tirage. Des doublons d’index apparaîtront naturellement dans la séquence, modélisant avec exactitude le comportement d’un tirage bernoullien avec remise.
Pour reconstituer les données qualitatives et quantitatives complètes des unités sélectionnées, l’analyste déploie dans la colonne contiguë la classique fonction de recherche matricielle :
=RECHERCHEV(A2; Base_Donnees_Brute!$A$2:$F$1001; 2; FAUX)
(Ou, de manière encore plus robuste et performante sous les versions modernes d’Excel, la combinaison INDEX / EQUIV ou la fonction RECHERCHEX). Les formules rapatrient instantanément les métadonnées de l’observation correspondante. Dès la finalisation de l’extraction, un Collage spécial en valeurs doit être appliqué sur l’ensemble de la table de pointage afin de figer la simulation et prévenir toute réévaluation stochastique lors des calculs d’agrégation subséquents.
9.3 Traitement des occurrences multiples dans l’analyse de données
L’incorporation délibérée d’observations redondantes au sein d’un échantillon avec remise impose une vigilance analytique majeure lors de la phase de calcul des statistiques descriptives et inférentielles. L’analyste doit contrôler la structure des fréquences d’apparition individuelles à l’aide de la fonction NB.SI, en comptabilisant le nombre d’occurrences attribuées à chaque identifiant unique de la base source.
Dans un contexte d’inférence probabiliste conventionnelle sur participants réels, la présence accidentelle d’occurrences multiples biaiserait catastrophiquement les degrés de liberté des tests statistiques (tels que le test t de Student ou l’ANOVA). Cela entraînerait une sous-estimation artificielle de l’erreur-type de mesure et une inflation substantielle du risque d’erreur de type I (faux positifs), car le logiciel traiterait comme indépendantes des mesures issues en réalité du même sujet biologique.
Toutefois, dans le cadre légitime d’une procédure d’auto-amorçage (bootstrapping) ou d’une modélisation de sensibilité, ces occurrences multiples reflètent fidèlement la masse de probabilité empirique. L’analyste doit documenter explicitement dans son rapport méthodologique que la matrice d’échantillonnage résultante présente une structure d’observations non indépendantes générées dans le cadre formalisé d’une procédure de simulation stochastique.
10. Détermination préalable de la taille d’échantillon et puissance statistique
10.1 Paramètres clés du calcul de taille d’échantillon
L’exécution technique d’un échantillonnage sous Excel ne saurait constituer un acte méthodologique isolé ; elle doit être précédée par la détermination rigoureuse de la taille d’échantillon minimale n requise. Sélectionner un contingent trop restreint expose l’étude à un manque d’adéquation statistique, rendant l’expérimentateur incapable de détecter un effet expérimental réel (erreur de type II). Inversement, extraire une cohorte démesurée engendre des coûts logistiques et humains superflus, tout en soulevant des questionnements éthiques quant à l’exposition inutile de participants à des contraintes expérimentales.
Cette calibration prospective exige la formalisation préalable de quatre paramètres métrologiques fondamentaux :
- Le seuil de signification alpha (α) : Généralement fixé à 0,05 dans les sciences du comportement, il quantifie le risque maximal toléré de rejeter à tort une hypothèse nulle qui est en réalité vraie. Il détermine la valeur critique standardisée Z dérivée de la loi normale (soit Z = 1,96 pour un test bilatéral à 95 %).
- La marge d’erreur absolue tolérée (e) : Exprime la précision souhaitée autour de l’estimateur (par exemple, ±3 % ou ±5 points sur une échelle d’évaluation psychométrique).
- La variance attendue ou la proportion a priori (p) : Dans le cas d’une proportion binaire, la valeur la plus conservatrice est fixée à p = 0,5, maximisant le produit p(1 – p) et assurant la taille d’échantillon la plus protectrice.
- La taille totale de la population accessible (N) : Paramètre déterminant si la population cible présente une dimension finie nécessitant un ajustement mathématique.
10.2 Modélisation de la formule de Cochran dans une feuille de calcul
Il est aisé de structurer un module de dimensionnement autonome dans Microsoft Excel en implémentant l’équation fondamentale formulée par William G. Cochran. Pour une population théorique infinie, la taille de base n0 est gouvernée par la relation mathématique : n0 = (Z^2 * p * (1 – p)) / e^2.
Dans une feuille Excel dédiée nommée Calcul_Puissance, l’opérateur configure une table de saisie des paramètres élémentaires :
- Cellule
B1: Niveau de confiance (ex.0,95) - Cellule
B2: Marge d’erreur tolérée e (ex.0,05) - Cellule
B3: Proportion attendue p (ex.0,50) - Cellule
B4: Taille de la population de référence N (ex.1200)
Dans la cellule B5, la valeur critique Z est calculée dynamiquement au moyen de la fonction de répartition inverse de la loi normale centrée réduite :
=LOI.NORMALE.STANDARD.INVERSE(1 – (1 – B1)/2)
La taille préliminaire n0 est déduite en cellule B6 par la formule :
=(B5^2 * B3 * (1 – B3)) / (B2^2)
Enfin, lorsque la population parente est finie, l’analyste applique en cellule B7 le facteur correctif de population finie via l’expression :
=ARRONDI.SUP((B6) / (1 + ((B6 – 1) / B4)); 0)
L’usage impératif de la fonction ARRONDI.SUP garantit une majoration entière conservatrice, produisant le volume exact n d’individus à sélectionner lors de l’étape de tri probabiliste.
10.3 Considérations relatives à l’attrition et au taux de non-réponse
Dans tout protocole empirique longitudinal ou interventionnel, le chercheur se heurte inéluctablement au phénomène d’attrition expérimentale (abandons de participants en cours d’étude, données manquantes post-recrutement, perdus de vue cliniques). Si l’on extrait strictement la taille théorique minimale n calculée par la formule de Cochran, le volume effectif de données finales exploitables risque d’être inférieur au seuil de puissance prescrit, invalidant les tests de significativité ultérieurs.
Pour prémunir le protocole contre cette érosion, une marge de sécurité stochastique doit être intégrée sous Excel en amont de l’extraction. Si l’expérience de terrain ou la littérature suggère un taux de non-réponse ou d’attrition attendu noté R (par exemple, R = 20 % ou 0,20), la taille d’échantillon corrigée finale n_ajuste à extraire physiquement sous Excel se calcule selon l’équation :
n_ajuste = ARRONDI.SUP(n / (1 – R); 0)
Ce suréchantillonnage planifié garantit que, même après la survenue inévitable des défections de participants au cours de la collecte des données, le volume terminal d’enregistrements conformes demeurera strictement supérieur ou égal au minimum mathématique requis par l’analyse de puissance a priori. Cette approche préserve la viabilité statistique de l’étude tout en assurant une parfaite transparence vis-à-vis des comités d’éthique institutionnels.
11. Biais d’échantillonnage fréquents et pièges techniques à éviter
11.1 Pièges liés à l’omission du collage spécial en valeurs
L’omission de figer les valeurs pseudo-aléatoires représente l’écueil le plus répandu et le plus dommageable lors de l’utilisation d’Excel pour l’échantillonnage scientifique. De nombreux praticiens novices procèdent à l’insertion de la formule =ALEA(), appliquent immédiatement un tri croissant sur leur tableau, sélectionnent les n premières lignes, puis enregistrent et ferment leur classeur en considérant la manipulation achevée.
Ce comportement trahit une incompréhension de la volatilité computationnelle du logiciel. Lors de la réouverture ultérieure du classeur par un examinateur, un co-auteur ou un évaluateur externe, le tableur recalcule automatiquement l’intégralité des formules =ALEA(). Si une quelconque commande de tri est à nouveau activée, ou si les formules sont encore liées aux cellules mères, la hiérarchie spatiale originelle est irrémédiablement perdue.
Cette instabilité dynamique place le laboratoire dans l’incapacité d’authentifier la composition exacte du groupe de participants ayant pris part à l’évaluation. Dans le pire des scénarios, les assignations de cohortes d’un essai randomisé en double aveugle se trouvent modifiées par inadvertance, conduisant à une crise de reproductibilité interne critique et au rejet méthodologique pur et simple des manuscrits soumis aux revues à comité de lecture.
11.2 Erreurs de tri partiel corrompant l’intégrité de la matrice
Un piège technique d’une gravité exceptionnelle réside dans l’exécution d’un tri partiel décorrélé. Lorsque l’opérateur active une commande de tri rapide (via les icônes de tri du ruban) sans avoir au préalable étendu la sélection à toutes les colonnes adjacentes de données, Excel affiche parfois un avertissement invitant à Étendre la sélection. Si l’opérateur ignore cet avertissement et choisit par mégarde l’option Continuer avec la sélection en cours, le logiciel ne permutera que la colonne active.
Les conséquences d’une telle manœuvre sont silencieuses mais désastreuses : les scores aléatoires sont réordonnés, mais les identifiants, les noms, les âges, les scores psychométriques et les antécédents médicaux des participants restent immobiles dans leurs cellules d’origine. Pire encore : si le tri est appliqué à la colonne de noms sans englober les résultats cliniques, les identités des patients sont interverties avec les données médicales d’autrui, corrompant définitivement l’intégrité de la base expérimentale.
Pour parer à ce danger systémique, l’analyste doit instaurer une clé de contrôle d’intégrité matricielle. La méthode recommandée consiste à générer, avant tout tri, une colonne témoin hébergeant la concaténation de l’identifiant et d’une variable stable (ex. =A2&"_"&C2), puis à vérifier après réorganisation, sur un échantillon d’épreuves, que cette concordance logique interne n’a souffert d’aucune déconnexion spatiale.
11.3 Limites algorithmiques d’Excel pour les études de haute précision
Bien que Microsoft Excel soit amplement satisfaisant pour la majorité des échantillonnages cliniques et comportementaux de dimensions conventionnelles (cohortes de quelques dizaines à quelques dizaines de milliers d’individus), le logiciel n’a pas été initialement conçu comme un générateur stochastique certifié pour la cryptographie ou la recherche physique de haute précision. La suite algorithmique sous-jacente d’Excel présente des limites documentées en matière d’équiprobabilité multidimensionnelle et de comportement asymptotique à très grande échelle.
Les générateurs d’Excel ne passent pas l’intégralité des batteries de tests de non-corrélation stochastique les plus exigeantes de la métrologie moderne (telles que la suite Dieharder ou les tests du NIST). Pour des banques de données massives (Big Data épidémiologique comprenant plusieurs centaines de milliers ou millions de lignes), des biais mineurs mais statistiquement décelables d’autocorrélation spectrale peuvent émerger, altérant subtilement la parfaite neutralité du tirage au sort.
Par conséquent, pour les essais cliniques multivariés de phase III, les protocoles psychopharmacologiques d’envergure internationale ou les études génomiques majeures, il est scientifiquement préférable de déléguer l’acte de randomisation à des progiciels académiques spécialisés tels que le logiciel R (via la fonction native sample() basée sur un Mersenne Twister irréprochable) ou des bibliothèques certifiées sous Python (telles que secrets ou random.SystemRandom qui exploitent l’entropie matérielle du système d’exploitation).
12. Validation, reproductibilité et traçabilité scientifique de la sélection
12.1 Documentation du journal de bord de l’extraction de données
L’intégrité scientifique d’une sélection probabiliste requiert que chaque étape opérationnelle fasse l’objet d’une consigne documentaire rigoureuse, permettant à tout auditeur indépendant de rejouer mentalement ou techniquement le protocole et d’en attester la parfaite conformité. L’équipe de recherche doit annexer au classeur de travail une feuille de métadonnées dédiée, fonctionnant comme un véritable journal de bord numérique.
Ce journal de bord doit obligatoirement formaliser les éléments contextuels suivants :
- L’horodatage exact (date, heure) auquel la génération et le figeage des valeurs aléatoires ont été matérialisés.
- La désignation précise de la version commerciale d’Excel mobilisée (ex. Microsoft 365 Version 2402 build 16.0…) et l’architecture du système hôte.
- L’identité de l’opérateur technique ayant exécuté la commande de tri.
- Le relevé exhaustif des filtres préalables appliqués (taille initiale de la base brute N_brut, volume des exclusions pour inéligibilité ou valeurs manquantes, taille finale stabilisée de la base de sondage N).
- La formule exacte employée (ex.
=ALEA()ouCHOISIRLIGNES(...)) et la clé de tri adoptée (ordre croissant sur l’indice aléatoire).
Cette rigueur documentaire répond pleinement aux directives internationales des principes FAIR (Facile à trouver, Accessible, Interopérable, Réutilisable), désormais imposées par les agences publiques de financement de la recherche (comme l’ANR en France ou les National Institutes of Health aux États-Unis).
12.2 Vérification statistique de l’équiprobabilité de l’échantillon
Après extraction physique du sous-ensemble de taille n, il est méthodologiquement recommandé d’effectuer un contrôle qualité statistique direct au sein d’Excel afin de s’assurer de l’absence d’aberration majeure d’échantillonnage sur les covariables d’intérêt. Bien que le hasard pur puisse légitimement produire des fluctuations marginales, l’échantillon extrait ne doit pas s’écarter de manière invraisemblable de la population parente.
Pour les variables quantitatives continues (ex. l’âge moyen des participants), l’opérateur calcule la moyenne et l’écart-type de l’échantillon extrait et les confronte aux métriques de la population globale N. Il est tout à fait possible d’implémenter sous Excel un test de conformité de moyenne (test t de Student à un échantillon) en utilisant la fonction :
=TEST.T(Echantillon_Extrait; Population_Parente; 2; 3)
Pour les variables catégoriques (ex. la répartition par genre ou par classe socioprofessionnelle), l’analyste construit une table de contingence croisée confrontant les effectifs observés aux effectifs théoriques déduits de la population source, puis évalue l’adéquation distributionnelle via la fonction du Chi-deux :
=TEST.KHIDUX(Plage_Effectifs_Observes; Plage_Effectifs_Theoriques)
L’obtention d’une p-value nettement supérieure au seuil usuel de 0,05 atteste que l’échantillon sélectionné ne présente aucune anomalie de représentativité sur ces dimensions fondamentales, confortant ainsi la validité interne du protocole d’extraction probabiliste.
12.3 Préparation de l’exportation vers les logiciels d’analyse statistique
L’extraction de l’échantillon achevée et sa représentativité vérifiée, la base de travail finale doit être préparée pour son intégration harmonieuse au sein des progiciels dédiés à l’analyse inférentielle et à la modélisation avancée, tels que SPSS Statistics, Jamovi, JASP ou les scripts de calcul R. Une base conservée au format binaire propriétaire (.xlsx) enrichie de multiples feuilles intermédiaires et de colonnes de calculs volatils peut susciter des conflits d’importation.
La première mesure préparatoire consiste à expurger la feuille Echantillon_Final_Extrait de toute colonne auxiliaire devenue superflue pour la modélisation des hypothèses, en supprimant notamment la colonne d’index aléatoire Valeur_Aleatoire qui n’a plus de pertinence une fois le classement opéré. L’opérateur veille ensuite à ce que les en-têtes de colonnes n’incorporent aucun caractère spécial, espace typographique ou symbole diacritique susceptible de corrompre les parseurs de données syntaxiques (préférer Temps_Reaction_ms à Temps de Réaction (en ms)).
Enfin, la feuille épurée doit être exportée individuellement sous un standard d’encodage texte universel non propriétaire, typiquement le format CSV (délimité par des virgules) (*.csv) ou Texte Unicode UTF-8 (délimité par des tabulations) (*.txt). L’adoption de l’encodage UTF-8 prévient toute dégradation des chaînes textuelles ou des caractères accentués lors du chargement dans les environnements Linux ou les consoles d’analyse statistique multilingues, garantissant un flux de travail transparent de la collecte bureautique initiale jusqu’à la publication académique finale des résultats.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Sampling+Techniques%2C+3rd+Edition-p-9780471162407
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1-26. https://doi.org/10.1214/aos/1176344552
- Institut National de la Statistique et des Études Économiques. (2022). Méthodes et principes de sondage. Insee Méthodes. https://www.insee.fr/fr/information/2408337
- Microsoft Corporation. (2024). Précision arithmétique à virgule flottante dans Excel. Support Technique Microsoft. https://learn.microsoft.com/fr-fr/office/troubleshoot/excel/floating-point-arithmetic-inaccurate-result
- National Institute of Standards and Technology. (2010). A statistical test suite for random and pseudorandom number generators for cryptographic applications (Special Publication 800-22, Rev. 1a). U.S. Department of Commerce. https://csrc.nist.gov/publications/detail/sp/800-22/rev-1a/final
- Wichmann, B. A., & Hill, I. D. (1982). Algorithm AS 183: An efficient and portable pseudo-random number generator. Journal of the Royal Statistical Society. Series C (Applied Statistics), 31(2), 188-190. https://doi.org/10.2307/2347988