
Dans le champ du traitement des données quantitatives et de l’analyse biostatistique, la rigueur méthodologique repose non seulement sur le choix des modèles stochastiques, mais également sur l’intégrité de l’architecture logicielle sous-jacente. L’environnement SAS (Statistical Analysis System), reconnu pour sa robustesse industrielle dans la recherche médicale, épidémiologique et économétrique, impose un typage strict et statique de ses structures tabulaires. Au sein de cet écosystème, la mauvaise manipulation des types de données représente une source majeure d’artefacts analytiques, d’inefficacités algorithmiques et d’erreurs de compilation silencieuses.
La transmutation d’une variable numérique en une chaîne de caractères constitue l’une des opérations de prétraitement les plus fréquentes, mais aussi l’une des plus délicates lorsqu’elle est exécutée sans une compréhension intime des mécanismes internes du compilateur SAS. Qu’il s’agisse d’harmoniser des identifiants d’échantillons longitudinaux, de préserver des zéros initiaux au sein de nomenclatures officielles, ou d’extraire des descripteurs nominaux à partir d’échelles psychométriques discrètes, cette opération requiert une précision chirurgicale. Une variable déclarée sous une forme numérique continue ne possède ni la même sémantique relationnelle, ni le même comportement en mémoire qu’un vecteur de symboles textuels.
Ce guide exhaustif a pour vocation de déconstruire pas à pas l’ensemble des fondements théoriques, des processus machine et des stratégies programmatiques régissant la conversion numérique-vers-caractère sous SAS. En explorant la fonction canonique PUT(), la manipulation du vecteur de données de programme (Program Data Vector), les interactions complexes entre gabarits de formatage et allocations d’octets, ainsi que les risques inhérents aux conversions implicites, ce document offre aux biostatisticiens, data managers et chercheurs quantitatifs les clés indispensables à une manipulation irréprochable de leurs cohortes informationnelles.
1. Introduction à la conversion de types de données dans l’environnement SAS
1.1 Importance de la typologie des données dans le traitement statistique
Dans tout environnement computationnel dédié à la statistique inférentielle, la typologie des variables conditionne la validité des opérations arithmétiques et la cohérence de la modélisation. Au sein de SAS, cette différentiation ne se résume pas à une simple commodité syntaxique : elle trace une frontière infranchissable entre les variables quantitatives continues et les identifiants alphanumériques. Une variable quantitative représente une grandeur mesurable soumise aux lois de l’algèbre réelle, permettant le calcul d’espérances, de variances ou de dérivées fonctionnelles. À l’inverse, une variable alphanumérique est une séquence discrète de glyphes, conçue pour catégoriser, stratifier ou désigner des entités observationnelles.
L’impact du typage strict s’exprime avec une acuité particulière lors de l’allocation de la mémoire vive et de la gestion de l’espace sur les disques de stockage. Lorsqu’une variable est définie sous une forme inadéquate, le moteur d’exécution de SAS alloue des ressources disproportionnées ou déclenche des mécanismes de conversion à la volée qui dégradent considérablement les temps de calcul. Dans les protocoles de recherche quantitative à haut débit, tels que les études génomiques ou les cohortes épidémiologiques massives, la mauvaise affectation d’un type textuel à une mesure continue, ou inversement, compromet la reproductibilité du pipeline de traitement et surcharge inutilement les bandes passantes des architectures serveur.
Par ailleurs, la sélection rigoureuse des types conditionne directement le bon déroulement des procédures analytiques. Des commandes statistiques telles que PROC GLM, PROC MIXED ou PROC REG exigent impérativement des variables dépendantes et indépendantes continues conformes aux règles du calcul matriciel. Tenter d’injecter une variable textuelle dans un modèle de régression logistique sans passer par une instruction de classe engendre un arrêt immédiat de la compilation. De même, les méthodes de classification non supervisée et les analyses factorielles reposent sur des matrices de variance-covariance qui ne tolèrent aucune ambiguïté de typage.
1.2 Problématique du stockage numérique d’identifiants discrets
L’une des dérives les plus pernicieuses observées dans la gestion de bases de données SAS consiste à enregistrer des identifiants discrets sous un format numérique conventionnel. Ce phénomène survient fréquemment lors de l’importation brute de fichiers délimités ou de feuilles de calcul issues d’autres logiciels, où des colonnes telles que le numéro de sécurité sociale, le code postal ou le matricule d’un participant sont interprétées par défaut comme des grandeurs arithmétiques. Cette erreur structurelle expose le chercheur à des opérations de sommation ou de moyennage totalement dénuées de sens épistémologique, faussant les étapes d’audit descriptif des cohortes.
Le risque le plus immédiat concerne la troncature systématique des zéros initiaux. Dans un système de codification numérique, les valeurs 0142, 00142 et 142 sont rigoureusement identiques et ramenées à l’entier scalaire 142. Pourtant, dans une nomenclature nosologique ou un système d’identification géographique, le zéro de tête véhicule une information hiérarchique critique. La conversion numérique automatique entraîne l’évaporation de cette information contextuelle, rendant caduque toute tentative ultérieure de croisement avec des registres externes qui respectent scrupuleusement la longueur nominale du code.
Cette problématique s’accentue dramatiquement lors des fusions de tables de données longitudinales via l’instruction MERGE ou des jointures relationnelles sous PROC SQL. Pour qu’une opération de jointure réussisse, les clés de liaison doivent impérativement partager un type et une sémantique identiques. La tentative de joindre une table clinique où l’identifiant patient est codé en numérique avec un registre de suivi biologique où ce même identifiant est stocké sous forme de chaîne textuelle déclenche une erreur fatale dans le journal SAS. Enfin, la transmission de ces données vers des systèmes de gestion de bases de données relationnelles conformes aux normes SQL impose une stricte adéquation entre la définition des colonnes et les contraintes d’intégrité référentielle.
1.3 Objectifs pédagogiques et périmètre de ce guide méthodologique
Ce guide méthodologique a été conçu pour doter les analystes et programmeurs SAS d’une autonomie absolue face aux opérations de transformation de types. L’objectif premier est de démystifier le fonctionnement interne de la fonction canonique PUT(), souvent confondue avec sa contrepartie réciproque INPUT(). Nous analyserons en profondeur l’anatomie de cette fonction, ses arguments obligatoires, son comportement face aux structures de mémoire tampon, et les règles régissant la transmission du gabarit formel vers la nouvelle chaîne alphanumérique créée.
Au-delà de la simple récitation syntaxique, ce travail explore les subtilités inhérentes à l’interaction entre les formats d’écriture et les longueurs effectives des chaînes de caractères. Une compréhension superficielle de ces notions conduit inévitablement à des troncatures invisibles ou à la prolifération d’espaces blancs indésirables, susceptibles de vicier les tests d’égalité conditionnelle et les tris lexicographiques. Ce manuel détaille également les protocoles d’assainissement de code permettant de purger intégralement le journal SAS de tout message d’avertissement relatif aux conversions implicites.
Enfin, le périmètre de notre analyse s’ancre délibérément dans le cadre de la recherche quantitative rigoureuse. Qu’il s’agisse de standardiser des banques d’items psychométriques, de reformater des vecteurs d’observations médicales pour les soumissions réglementaires, ou d’optimiser l’occupation mémoire d’entrepôts de données colossaux, les préconisations formulées ici reposent sur les standards industriels et académiques les plus exigeants, garantissant une pérennité maximale à vos scripts d’analyse.
2. Fondements théoriques : Distinction entre variables numériques et caractères dans SAS
2.1 Architecture interne des types de variables du système SAS
Contrairement aux langages modernes de programmation orientée objet ou aux systèmes de bases de données modernes qui proposent une pléthore de types primitifs (entiers signés ou non signés, booléens, dates natives, chaînes à longueur variable), SAS repose fondamentalement sur une dichotomie stricte et invariable. Une variable SAS n’appartient qu’à deux mondes exclusifs : elle est soit de type numérique, soit de type caractère. Cette dualité simplificatrice découle de choix d’architecture logicielle opérés dès les origines du système, privilégiant la vélocité du traitement par lots sur des architectures distribuées.
Toute variable numérique sous SAS est stockée en interne sous la forme d’un nombre en virgule flottante double précision, respectant la norme standard IEEE 754 sur 8 octets (soit 64 bits), indépendamment du fait que la variable représente un entier discret (comme l’âge ou le sexe codé 0/1) ou une mesure continue hautement précise. Cette architecture alloue 53 bits à la mantisse, 11 bits à l’exposant et 1 bit pour le signe, garantissant une précision d’environ 15 à 17 chiffres décimaux significatifs. À l’opposé, les variables de type caractère sont enregistrées sous forme de vecteurs d’octets de longueur fixe, déclarée lors de leur initialisation, chaque octet codant un caractère selon la table d’encodage active (ASCII, UTF-8 ou EBCDIC).
Cette divergence structurelle dicte la gestion des valeurs manquantes. Pour une variable numérique, une donnée absente est représentée en mémoire par une configuration binaire spécifique de l’exposant flottant, affichée visuellement sous la forme d’un point standard (.) ou d’une valeur manquante spéciale (.A à .Z, ou ._). Pour une variable de type caractère, une valeur manquante n’est rien d’autre qu’une succession continue d’espaces blancs d’une longueur strictement égale à la dimension allouée à la colonne. Enfin, le principe directeur du système SAS stipule l’immuabilité absolue du type d’une variable au sein d’une même étape DATA : une fois compilée sous un type déterminé, une variable ne peut en aucun cas changer de nature en cours d’exécution.
2.2 Mécanismes de typage lors de l’étape de compilation et d’exécution
Pour appréhender l’impossibilité de modifier le type d’une variable sans créer une nouvelle entité, il est indispensable de disséquer le fonctionnement du vecteur de données de programme, désigné sous l’acronyme PDV (Program Data Vector). Le PDV constitue la zone de mémoire vive tampon structurée que SAS configure lors de la phase de compilation d’une étape DATA. Durant cette phase préparatoire, le compilateur lit l’ensemble des instructions séquentielles du bloc de code afin d’inventorier toutes les variables évoquées, de leur assigner un décalage d’adresse mémoire fixe et de figer leurs attributs fondamentaux : nom, type, longueur et étiquette.
Dès lors qu’une variable apparaît pour la première fois dans le code source — que ce soit au détour d’une instruction INPUT, d’une instruction d’affectation arithmétique ou d’une lecture de table via l’instruction SET — son type est irrémédiablement inscrit dans le dictionnaire du PDV. Si une variable est introduite sans instruction explicite de longueur textuelle, elle se voit attribuer par défaut le statut de nombre flottant de 8 octets. Aucun mécanisme au sein de la boucle d’exécution séquentielle ne permet de réécrire la table des symboles du PDV une fois la phase de compilation achevée.
Lors de la phase d’exécution, le moteur traite le jeu de données observation par observation, en copiant les valeurs du flux d’entrée vers les cellules allouées du PDV, puis en exécutant les transformations algorithmiques avant d’écrire l’état final du vecteur dans la table de destination. Si un programmeur tente d’affecter directement une chaîne de caractères à une variable préexistante de type numérique, le compilateur détecte une incompatibilité structurelle directe entre la valeur transmise et le récepteur binaire dans le PDV. Cette tentative déclenche l’émission immédiate d’un message d’erreur ou force une conversion implicite erratique, déstabilisant l’ensemble de l’étape d’exécution.
2.3 Impact du formatage sur l’intégrité des analyses psychométriques
Dans les disciplines empiriques relatives à la psychométrie, aux sciences du comportement et à la santé publique, la confusion entre le type technique d’une variable et son niveau d’échelle de mesure engendre des erreurs d’inférence substantielles. Une distinction épistémologique majeure doit être opérée entre la valeur brute sous-jacente stockée dans les registres binaires de la machine et la représentation symbolique visualisée à l’écran par l’analyste. Un chiffre présent dans une cellule de données ne constitue pas ipso facto une entité arithmétique légitime.
Considérons le cas emblématique des échelles de Likert et des batteries de réponses à des questionnaires standardisés, où les modalités varient généralement de 1 (« Pas du tout d’accord ») à 5 (« Tout à fait d’accord »). Lorsque ces scores sont préservés sous une forme purement numérique non convertie, les utilisateurs non avertis sont fréquemment incités à estimer des moyennes ou des écarts-types paramétriques sur des données ordinales pures, violant ainsi les postulats métrologiques fondamentaux décrits par Stevens. La conversion de ces scores numériques en étiquettes ou en chaînes de caractères codées permet d’ériger une barrière technique contre ces pratiques d’agrégation fallacieuses.
De surcroît, les items d’évaluation standardisés nécessitent souvent d’être concaténés pour composer des signatures de réponses ou des profils de symptômes individuels (par exemple, fusionner les scores d’items pour former une chaîne descriptive globale telle que « 1-2-1-4-5 »). Réaliser cette concaténation à partir de variables numériques brutes expose l’analyste à des pertes de structures, des décalages d’indices ou des calculs de sommes involontaires. La transmutation explicite de ces indicateurs en variables caractères normalisées garantit une traçabilité parfaite des réponses individuelles et sécurise l’application ultérieure des modèles de la théorie de réponse aux items (TRI).
3. La fonction fondamentale PUT() : Syntaxe, mécanisme et paramètres
3.1 Syntaxe formelle et paramètres requis de la fonction PUT()
L’instrument canonique universellement déployé dans l’écosystème SAS pour transmuter une valeur numérique en chaîne de caractères textuelle est la fonction intégrée PUT(). La formulation syntaxique de base de cette fonction répond à un schéma rigide et immuable : variable_caractere = put(source_numerique, format_sas.). Cette instruction requiert systématiquement deux arguments obligatoires, séparés par une virgule, et ne peut être exécutée de manière isolée ; elle doit nécessairement s’insérer au sein d’une expression d’assignation ou d’évaluation conditionnelle dans une étape DATA ou une requête SQL.
Le premier argument, source_numerique, désigne l’entité quantitative à convertir, qu’il s’agisse d’un identificateur de variable existant dans le jeu de données d’entrée, d’une constante numérique littérale, ou du résultat d’une expression arithmétique complexe. Le second argument, format_sas., constitue le patron de mise en forme ou le gabarit d’écriture qui dicte à SAS comment transcrire la configuration binaire flottante en symboles textuels intelligibles. Il est impératif de souligner que le gabarit spécifié doit obligatoirement comporter un point terminal (.) afin d’être formellement reconnu par l’interpréteur syntaxique comme un format et non comme le nom d’une autre variable ou fonction.
L’omission de ce point terminal figure parmi les erreurs de syntaxe les plus courantes chez les praticiens juniors, provoquant un arrêt immédiat de la compilation avec la mention explicite que l’argument n’a pu être résolu. Face à une variable source dont l’état est déclaré manquant, la fonction PUT() adopte un comportement déterministe prévisible : elle applique les règles intrinsèques du format de conversion pour générer une chaîne de caractères contenant la représentation textuelle de l’absence de donnée, qui correspond classiquement à un point isolé suivi d’espaces blancs, à moins d’un traitement conditionnel spécifique.
3.2 Principe de fonctionnement interne de PUT()
Pour maîtriser l’usage de la fonction PUT(), il convient d’en disséquer la mécanique cybernétique interne. Lors de son invocation, la fonction n’effectue pas une simple mutation d’attributs de bas niveau ; elle prend la valeur numérique brute, l’introduit dans le sous-système de formatage de SAS, applique la table de correspondance morphologique stipulée par le format, et retourne en sortie un flux textuel strictement conforme à la largeur définie par ce dernier. La variable source n’est aucunement modifiée au cours de ce processus ; elle demeure intacte au sein du PDV sous sa configuration originelle.
Cette opération réalise une transcription morphologique complète. Par exemple, si l’on applique le format monétaire DOLLAR8.2 à la valeur numérique scalaire 1234.56, la fonction PUT() n’émet pas une série d’octets purement arithmétiques, mais construit la chaîne de caractères littérale « $1,234.56 ». La nouvelle variable résultante contient textuellement le symbole du dollar et la virgule de séparation des milliers. Cette métamorphose illustre parfaitement le changement de paradigme fondamental : on quitte le domaine des entités calculables pour entrer dans le domaine de l’imagerie typographique.
Il est fondamental d’établir ici une distinction sans équivoque entre la fonction PUT() et la fonction réciproque INPUT(), source intarissable de confusions dans les scripts d’analyse. Une règle mnémotechnique reconnue permet de stabiliser cette distinction : la fonction INPUT() prend en entrée (« IN ») une chaîne de caractères et la convertit en une valeur numérique selon un informat de lecture, tandis que la fonction PUT() extrait (« OUT / PUT ») une valeur interne pour l’écrire et la matérialiser sous une forme textuelle externe. Ainsi, pour passer du numérique au caractère, seule la fonction PUT() est syntaxiquement et conceptuellement valide.
3.3 Attribution automatique de la longueur de la variable cible
L’un des comportements les plus déterminants de la fonction PUT() concerne la fixation de la longueur physique allouée à la variable alphanumérique de destination dans la table SAS finale. Par défaut, en l’absence de déclaration antérieure explicite, le compilateur SAS détermine la longueur de la chaîne de sortie en se calquant de manière stricte et invariable sur la largeur spécifiée dans le format d’écriture retenu. Si le programmeur utilise l’instruction d’assignation texte = put(score, 8.);, la variable texte sera automatiquement dimensionnée à une longueur fixe de 8 octets.
Cette règle d’inférence automatique impose une rigueur d’ingénierie logicielle absolue. Si la largeur choisie pour le gabarit de formatage est excessive par rapport au volume réel d’information à encoder — par exemple en utilisant un format BEST12. pour stocker des entiers à deux chiffres — SAS comblera le vide en allouant 12 octets fixes pour chaque observation de la table. Multipliée par plusieurs dizaines de millions d’enregistrements, cette sur-allocation engendre une dilatation massive et injustifiée du volume des fichiers de données sur disque, entraînant une dégradation notable des performances d’entrée/sortie.
Inversement, si une instruction LENGTH a été déclarée en amont dans l’étape DATA pour spécifier explicitement la dimension de la variable cible, une règle de préséance hiérarchique s’applique. Si la longueur préalablement décrétée via l’instruction LENGTH est plus courte que la largeur du gabarit mentionné dans la fonction PUT(), SAS tronquera silencieusement ou émettra un avertissement selon la nature du dépassement, amputant la partie droite ou gauche de la chaîne textuelle générée. Il est donc indispensable d’aligner de manière cohérente la largeur du format de conversion avec l’espace de stockage alloué dans le dictionnaire des variables.
4. Analyse pas à pas de l’exemple canonique de conversion
4.1 Création du jeu de données initial (original_data)
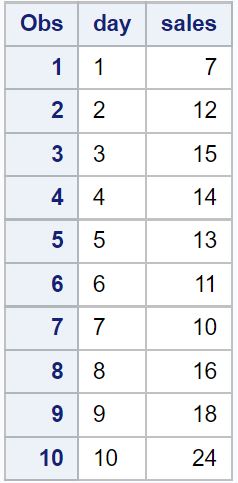
Afin d’illustrer de manière pragmatique et reproductible la séquence intégrale de conversion, nous concevons un jeu de données minimaliste représentatif des situations de gestion courante. Cette table, baptisée conventionnellement original_data, simule le recueil chronologique de métriques de vente ou d’admissions cliniques sur une séquence temporelle journalière. La mise en place de cette table repose sur l’exploitation standardisée de l’étape DATA couplée à l’instruction DATALINES, permettant d’intégrer directement les observations au sein du code source.
Le bloc d’instructions se structure de la manière suivante : nous initions l’étape par la commande DATA original_data;, suivie de l’instruction INPUT day sales;, puis de la déclaration DATALINES; sous laquelle sont alignées les lignes d’observations numériques, avant de clore l’instruction par un point-virgule et la commande exécutoire RUN;. Dans cet agencement élémentaire, l’instruction INPUT ne comporte aucun modificateur de format textuel (tel que le symbole dollar $) ; par voie de conséquence, le compilateur SAS attribue par inférence le type numérique standard aux variables day et sales.
Chacune de ces deux variables se voit instantanément allouer une empreinte mémoire de 8 octets en virgule flottante double précision au sein du PDV. L’instruction RUN; déclenche la compilation définitive, l’itération à travers les lignes de données brutes et l’écriture sur le disque de la table SAS compilée. À ce stade, la variable day, bien que conceptuellement destinée à représenter un jour calendaire ou un numéro séquentiel discret, est reconnue par le système comme une grandeur arithmétique continue, capable de subir des opérations d’intégration ou de multiplication, ce qui constitue une hérésie relationnelle.
4.2 Vérification diagnostique des métadonnées avec PROC CONTENTS
Avant d’opérer la moindre manipulation structurelle sur une base de données, la démarche de bonne pratique en data management impose la réalisation d’un diagnostic objectif de ses métadonnées. L’utilitaire dédié à cet audit technique au sein de l’environnement SAS est la procédure PROC CONTENTS. Cette procédure n’affiche pas les données observationnelles en elles-mêmes, mais extrait l’en-tête de la table de données, révélant la cartographie complète des attributs physiques et logiques assignés lors de la phase de création.
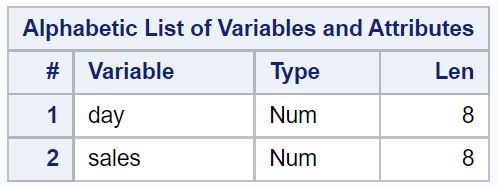
L’exécution de la commande PROC CONTENTS DATA=original_data; RUN; produit un rapport exhaustif articulé en plusieurs sections fondamentales. L’analyste doit porter une attention chirurgicale au tableau intitulé « Alphabetic List of Variables and Attributes ». Au sein de cette section, chaque variable est détaillée à travers son nom, son type (reflété par la mention explicite « Num » ou « Char »), sa longueur en octets (« Len »), ainsi que ses éventuels formats et informats d’affichage ou d’acquisition associés.
Dans notre cas de référence, la ligne consacrée à la variable day atteste sans équivoque de son statut initial : la colonne « Type » affiche le descripteur « Num », et la colonne « Len » indique la valeur 8. Cette confirmation empirique valide le constat que la variable est régie par les règles du calcul flottant IEEE 754. Documenter ainsi l’état des métadonnées avant toute altération programmatique constitue un standard d’assurance qualité indispensable, particulièrement dans les environnements soumis aux réglementations strictes de la Food and Drug Administration (FDA) ou des Bonnes Pratiques Cliniques (BPC).
4.3 Implémentation de la transformation via une nouvelle étape DATA
Fort de cet état des lieux, la mise en œuvre de la transformation structurelle s’opère par le déploiement d’une nouvelle étape DATA, conçue pour ingérer la table originale, opérer la conversion morphologique et générer une table de sortie enrichie. Nous définissons cette table dérivée sous le nom de converted_data. La lecture séquentielle de la table primaire est orchestrée par l’instruction SET original_data;, qui charge les variables du jeu de données source directement dans le PDV à chaque itération de la boucle d’exécution.
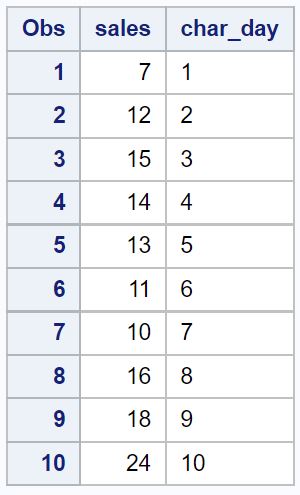
La transmutation proprement dite est formalisée par la ligne d’affectation : char_day = put(day, 8.);. Lors de l’évaluation de cette expression, le moteur SAS lit la valeur numérique contenue dans la case mémoire associée à day, applique le gabarit standard 8., convertit la grandeur en une séquence textuelle justifiée à droite sur 8 octets, et alloue cette valeur à la nouvelle variable char_day. L’exécution de cette étape est scellée par l’instruction RUN;. L’intégrité visuelle des observations peut ensuite être contrôlée par l’invocation de l’utilitaire PROC PRINT DATA=converted_data; RUN;.
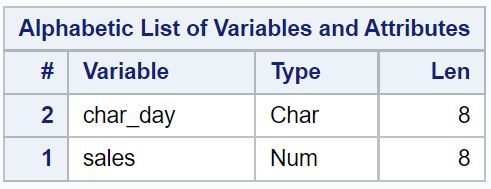
L’étape de validation finale consiste à réitérer l’audit des métadonnées sur la nouvelle entité via PROC CONTENTS DATA=converted_data; RUN;. L’inspection méticuleuse de la sortie révèle désormais la présence conjointe de la variable source day (toujours classifiée en type « Num », 8 octets) et de la variable dérivée char_day, catégorisée explicitement sous le type « Char », assortie d’une longueur physique de 8 octets. La conversion est techniquement accomplie avec un succès total, garantissant l’adéquation formelle de la variable à des traitements purement textuels.
5. Gestion des métadonnées et inspection approfondie avec PROC CONTENTS
5.1 Interprétation exhaustive de la sortie PROC CONTENTS
L’analyse des rapports générés par la procédure PROC CONTENTS requiert un niveau d’expertise technique approfondi pour déceler les anomalies silencieuses de modélisation. Au-delà de la vérification élémentaire du libellé « Char » dans la colonne du type, l’ingénieur de données doit scruter les divergences potentielles entre les formats de présentation résiduels et la longueur physique brute de stockage. Dans un environnement SAS, une variable peut posséder une longueur de 8 octets mais être greffée d’un format d’affichage qui masque une partie substantielle de son contenu, ou réciproquement.
Il convient de distinguer impérativement la longueur déclarée sous la forme $w. de celle déclarée sous la forme w.. Pour une variable numérique, un format tel que 8. signifie que la valeur sera projetée sur un écran ou un état d’impression avec une largeur de 8 colonnes d’affichage, bien que son empreinte mémoire demeure immuablement fixée à 8 octets flottants. Pour une variable de type caractère, la spécification d’un format comme $8. ou l’absence totale de format explicite indique que la chaîne physique stockée en mémoire vive occupe exactement 8 octets scalaires, chaque caractère ASCII standard réclamant un octet individuel.
Une vigilance redoublée s’impose également quant à l’encodage de la session SAS active (par exemple UTF-8 versus LATIN1/wlatin1). Dans une session configurée en UTF-8, fréquente sur les serveurs SAS Viya ou SAS Linux modernes, les caractères accentués ou les glyphes non-latins requièrent de 2 à 4 octets par caractère pour leur encodage binaire. Si une conversion de variable numérique vers caractère fait appel à un format qui génère des caractères spéciaux (par exemple des symboles monétaires régionaux ou des abréviations linguistiques), la longueur physique en octets déclarée dans PROC CONTENTS doit obligatoirement être dimensionnée pour absorber cette inflation d’octets sans troncature de fin de chaîne.
5.2 Automatisation du contrôle qualité via l’Output Delivery System (ODS)
Dans les environnements industriels et pharmaceutiques régis par des contraintes réglementaires sévères, la revue visuelle manuelle des impressions issues de PROC CONTENTS est proscrite au profit de protocoles automatisés de contrôle d’intégrité logicielle. SAS offre un levier puissant d’interfaçage programmatique grâce à son système de diffusion des sorties, l’Output Delivery System (ODS). L’instruction ODS OUTPUT permet de capturer directement la table structurelle des variables générée par PROC CONTENTS sous la forme d’un véritable jeu de données SAS exploitable algorithmiquement.
La syntaxe canonique implique l’instruction ODS OUTPUT Variables = meta_table; PROC CONTENTS DATA=converted_data; RUN; ODS OUTPUT CLOSE;. Le jeu de données meta_table ainsi matérialisé contient des colonnes système standardisées, parmi lesquelles Variable (nom de la colonne analysée) et Type (valeur numérique valant 1 pour les variables quantitatives et 2 pour les variables textuelles). À partir de cette table, le statisticien peut implémenter des tests d’assertion stricts au sein d’une étape DATA d’audit ou d’un macro-programme de conformité.
Un mécanisme typique de validation consistera à filtrer la ligne relative à la variable cible et à vérifier conditionnellement que sa valeur d’attribut correspond bien au code 2. Dans l’éventualité où l’assertion est infirmée — par exemple si la conversion n’a pas été exécutée ou si la mauvaise colonne a été traitée — le programme est paramétré pour générer un message d’erreur critique dans le journal via l’instruction %PUT ERROR: Typage non conforme détecté; et interrompre immédiatement le pipeline d’intégration continue via la commande ABORT CANCEL;, empêchant la dissémination de données corrompues vers les procédures d’analyse inférentielle.
5.3 Comparaison avant/après : Étude de l’impact structural
L’évaluation méticuleuse de l’impact structurel consécutif à la mutation de type implique une quantification rigoureuse des différentiels volumétriques et relationnels. D’un point de vue de l’empreinte disque, une variable numérique standard allouée sur 8 octets consomme rigoureusement 800 mégaoctets pour une table de 100 millions d’enregistrements. Si cette même variable est convertie en une chaîne alphanumérique via un format $8., la consommation brute reste stationnaire à 800 mégaoctets, mais la structure informationnelle est drastiquement altérée.
Cette altération se manifeste immédiatement dans les sorties de restitution visuelle et les fichiers d’exportation délimités (tels que les formats CSV ou TSV). Les variables numériques sont alignées à droite par défaut dans les rapports tabulaires et visualisées sans délimiteurs d’échappement. Les variables de type caractère, en revanche, adoptent généralement une justification à gauche dans les flux de sortie éditoriaux et se voient automatiquement encapsulées par des guillemets d’encadrement lors de l’exportation vers des bases de données SQL via PROC EXPORT, signalant aux moteurs distants la nature textuelle des valeurs.
De surcroît, la modification du typage altère la nature même des opérations de tri et d’indexation. Un tri exécuté via PROC SORT sur une variable numérique obéit à l’ordre mathématique universel des réels, où -5 est strictement inférieur à 2, et 2 inférieur à 10. Dès lors que la variable est transmutée en chaîne textuelle, le tri devient strictement lexicographique (ou basé sur la séquence binaire de l’encodage) : la valeur textuelle « 10 » se positionnera avant la valeur « 2 », introduisant une distorsion temporelle ou catégorielle si l’analyste n’a pas anticipé l’ajout préalable de zéros de cadrage.
6. Remplacement vs Renommage : Stratégies de réassignation de variables
6.1 La contrainte de non-mutation de type dans SAS
L’un des écueils majeurs auxquels se heurtent immanquablement les programmeurs habitués à des langages à typage dynamique (comme Python ou R) réside dans l’incapacité absolue de SAS à modifier le type d’une variable au sein d’un jeu de données de manière directe et unitaire. En Python, une opération telle que df['x'] = df['x'].astype(str) réaffecte le pointeur de type de la colonne sans exiger la modification de son label. Sous SAS, l’instruction syntaxique naïve day = put(day, 8.); conduit à un échec de compilation catégorique.
Cette contrainte découle directement du fonctionnement du PDV explicité antérieurement. Lors de la phase de compilation de l’étape DATA, la lecture de la table source via l’instruction SET intègre immédiatement le nom de la variable d’origine dans la table des symboles en lui assignant de manière irrévocable le type numérique et un espace d’adressage de 8 octets flottants. Lorsque le compilateur évalue ensuite l’instruction d’assignation où la même variable apparaît à gauche de l’opérateur d’égalité, il constate une contradiction irrésoluble : la fonction PUT() renvoie un flux textuel qui ne peut physiquement être injecté dans une case mémoire typée pour recevoir un nombre flottant.
En conséquence, le journal SAS émet le message d’erreur fatale bien connu des analystes : « ERROR: Variable day has been defined as both character and numeric ». L’étape de traitement est purement et simplement avortée avant même le début de l’exécution de la première boucle d’observations. Il est donc techniquement impossible de contourner la création transitoire d’une variable tierce ; le développeur doit concevoir une stratégie de transition élégante pour conserver la nomenclature originelle de ses colonnes.
6.2 Technique DROP et réassignation sélective
Pour éliminer la présence de la variable numérique obsolète tout en intégrant la version textuelle convertie, la méthode la plus élémentaire consiste à déployer l’instruction DROP. Cette instruction ordonne au compilateur d’exclure expressément une ou plusieurs variables spécifiques lors de l’écriture physique finale des données du PDV vers la table enregistrée sur le système de fichiers. L’entité existe en mémoire vive durant toute l’exécution de l’étape DATA, mais elle est occultée du dictionnaire de données final.
La formulation typique prend la forme d’un script articulé ainsi : DATA converted; SET original_data; char_day = put(day, 8.); DROP day; RUN;. Dans ce schéma opérationnel, la variable quantitative day est exploitée pour alimenter la fonction de conversion, puis elle est évincée de la structure de sortie. La table de destination converted ne présente désormais plus que la variable char_day, éliminant ainsi toute ambiguïté quant à la présence d’une colonne arithmétique devenue superflue.
Néanmoins, cette approche présente une limite méthodologique sévère : elle impose l’adoption d’un nom de colonne distinct (char_day au lieu de day). Si le pipeline analytique en aval — constitué de macro-programmes standardisés, de requêtes SQL complexes ou de procédures d’édition de tables — est intégralement codé pour cibler le descripteur original day, la modification du nom brise la compatibilité ascendante de la chaîne de traitement, contraignant le développeur à réécrire l’ensemble des modules d’analyse subséquents.
6.3 Combinaison des options DROP et RENAME pour conserver le nom d’origine
Pour préserver rigoureusement l’architecture nominale d’un jeu de données tout en modifiant le type d’une variable, la technique la plus sophistiquée et universellement recommandée par les architectes logiciels SAS repose sur l’exploitation synchronisée de la variable temporaire, combinée aux options ou instructions DROP et RENAME. Cette stratégie permet de substituer la nouvelle variable textuelle à l’ancienne variable numérique, en conservant de manière parfaitement transparente l’appellation d’origine.
L’implémentation la plus robuste s’articule directement au sein des options du jeu de données en entrée de l’instruction SET. Le paradigme s’articule comme suit :
DATA destination_table;
SET source_table(RENAME=(day = temp_day));
day = put(temp_day, 8.);
DROP temp_day;
RUN;
Dans cette séquence remarquable, la commande RENAME appliquée à la table d’entrée métamorphose la variable numérique originelle day en une variable temporaire temp_day dès son importation dans le PDV. Le nom canonique day devient alors immédiatement disponible dans la table des symboles pour être alloué, en toute légalité compilatoire, à une nouvelle variable déclarée nativement sous le type caractère par la fonction PUT().
Il importe toutefois de souligner une conséquence collatérale de cette méthode : dans la table résultante, la nouvelle variable day est ajoutée à la suite des colonnes préexistantes, perdant son positionnement spatial d’origine dans la cartographie des variables. Pour les organisations dont les spécifications de livraison imposent un ordonnancement strict des colonnes, le rétablissement de la séquence originale des variables peut être orchestré sans surcharge mémoire au moyen d’une instruction RETAIN positionnée tout au début du bloc de code, déclarant l’ensemble des noms de colonnes dans l’ordre spatial requis avant l’appel de l’instruction SET.
7. Le rôle crucial des formats SAS dans la fonction PUT()
7.1 Sélection des formats numériques standards (w. et w.d)
Le comportement et l’utilité pratique de la fonction PUT() dépendent intrinsèquement du format de restitution qui lui est associé. Les formats numériques de base, généralement désignés par la nomenclature structurelle w. et w.d, gouvernent la manière dont les valeurs entières et les nombres à virgule fixe sont projetés dans le domaine textuel. Dans cette syntaxe, le descripteur w régit la largeur totale en octets de la chaîne de sortie, tandis que la composante facultative d détermine le nombre de positions allouées à la fraction décimale après le séparateur.
Une caractéristique primordiale des formats numériques de la famille w. réside dans leur propension structurelle à justifier systématiquement la valeur textuelle générée à droite du récepteur, en injectant des espaces de remplissage à gauche pour combler la largeur spécifiée. Si l’on applique l’instruction put(5, 4.), le moteur ne produit pas un caractère unique « 5 », mais génère une chaîne textuelle de quatre octets composée de trois espaces blancs préliminaires suivis du chiffre : « 5 ». Cette mécanique répond aux exigences historiques d’alignement des colonnes sur les imprimantes matricielles, mais introduit des défis majeurs lors des manipulations de chaînes.
Par ailleurs, l’utilisation du gabarit w.d impose des règles d’arrondi implicite qui doivent être rigoureusement anticipées. Si la valeur numérique 12.3456 est convertie au moyen du format 6.2, SAS effectue un arrondi arithmétique standard pour produire la chaîne littérale « 12.35 ». Si la largeur totale w est sous-dimensionnée par inadvertance par rapport à la magnitude du nombre — par exemple en tentant de projeter la valeur 123456 à travers un format 4. — SAS se trouve dans l’incapacité d’écrire l’entité et sature la chaîne de caractères résultante avec une série d’astérisques (« **** »), dégradant irrémédiablement l’information stockée.
7.2 Formats d’affichage spécialisés : Z. et notation scientifique
Dans de nombreuses applications de recherche épidémiologique et clinique, la préservation des zéros de tête au sein des identifiants d’échantillons ou des codes géographiques représente un prérequis impératif. Pour répondre à cette exigence sans recourir à des algorithmes complexes d’adjonction de caractères, SAS propose la famille de formats spécialisés Zw. (pour Zero-fill). Ce format fonctionne de manière strictement analogue au format standard w., à l’exception cruciale qu’au lieu de combler les positions vacantes à gauche avec des espaces blancs, il insère automatiquement des zéros numériques.
L’exploitation du format Z. s’avère particulièrement puissante lors de la normalisation d’identifiants de sujets d’étude. Si une base de données source consigne les numéros d’inclusion sous forme scalaire (1, 2, …, 150), l’instruction code_patient = put(id_scalaire, z5.); générera une série d’identificateurs standardisés de longueur 5 : « 00001 », « 00002 », …, « 00150 ». Cette uniformisation garantit une parité visuelle et textuelle parfaite, prévient les erreurs de désalignement lors des exports vers des plateformes d’investigation clinique électronique (EDC), et assure un comportement irréprochable des index de recherche lexicographique.
Pour le traitement des grandeurs physiques extrêmes, telles que les concentrations enzymatiques nanolytiques ou les charges virales colossales, SAS fournit les formats de notation scientifique de la famille Ew.. L’application d’un format comme E12. convertit une valeur flottante double précision en sa représentation normalisée avec mantisse et exposant de base 10 (par exemple « 1.234567E+08 »). Ce mécanisme garantit qu’aucune valeur infinitésimale ou gigantesque ne soit altérée par un débordement de capacité lors de sa transformation textuelle.
7.3 Utilisation de formats personnalisés définis par PROC FORMAT
La puissance d’abstraction de la fonction PUT() atteint son paroxysme lorsqu’elle est combinée avec des dictionnaires de correspondances sémantiques personnalisés, élaborés en amont au moyen de la procédure PROC FORMAT. Cette procédure permet à l’ingénieur de données de concevoir des règles de translation discrètes sur mesure, reliant des entiers ou des intervalles continus de réels à des libellés textuels hautement descriptifs. La fonction PUT() devient alors un opérateur de recodage qualitatif d’une redoutable élégance.
Considérons l’exemple emblématique d’un essai thérapeutique randomisé évaluant la toxicité clinique selon les critères de l’Organisation Mondiale de la Santé. Via PROC FORMAT, l’analyste crée un gabarit nommé toxgrade. associant les codes scalaires 0 à 4 aux mentions « Aucune », « Légère », « Modérée », « Sévère », et « Menace vitale ». Dès lors, l’application de la fonction au sein de l’étape DATA prend la forme : libelle_toxicite = put(score_brut, toxgrade.);. En une instruction unique, la donnée numérique est non seulement convertie en variable caractère, mais elle subit simultanément une interprétation sémiotique contrôlée.
Cette approche conjointe offre des garanties d’homogénéité exceptionnelles dans les rapports d’analyse psychométrique et médicale. Toute modification subséquente de la taxonomie ou de l’orthographe d’un libellé n’exige aucune altération du code de manipulation au sein des étapes DATA ; il suffit d’ajuster le dictionnaire dans l’appel initial de PROC FORMAT pour que l’ensemble du pipeline de transformation hérite automatiquement de la nouvelle terminologie. Cette séparation stricte entre les données brutes et la logique de présentation constitue l’un des piliers de l’architecture logicielle SAS.
8. Conversion avec justification et gestion des espaces blancs
8.1 Le problème de l’alignement par défaut à droite de PUT()
Bien que la fonction PUT() convertisse impeccablement le type de données sous-jacent, le statisticien est immédiatement confronté à une contrainte morphologique intrinsèque : la justification à droite. Comme nous l’avons souligné, l’application d’un gabarit numérique standard (tel que 8. ou BEST12.) engendre la création d’espaces blancs de tête (leading blanks) servant de remplissage pour satisfaire la largeur totale assignée au gabarit. Cette anomalie apparente constitue un vestige de la mise en page des cartes perforées et des terminaux passifs des années 1970.
Dans un contexte moderne de data science, ces espaces initiaux se révèlent particulièrement problématiques. Lorsqu’une chaîne comportant des espaces de tête est soumise à une opération de concaténation simple avec une autre chaîne (par exemple pour forger un identifiant composite à l’aide de l’opérateur de concaténation double barre ||), les espaces blancs résiduels sont intégralement incorporés à l’intérieur de la nouvelle clé. Ainsi, la concaténation de « SUBJ_ » avec le résultat textuel de put(42, 6.) produira la séquence corrompue « SUBJ_ 42 », totalement impropre à une indexation rigoureuse.
De surcroît, ces espaces invisibles faussent radicalement les opérations de comparaison logique et les filtres conditionnels. Une expression booléenne telle que if char_id = ’42’ renverra systématiquement la valeur booléenne fausse si la variable char_id héberge des espaces de tête (« 42 »), car sous SAS, la comparaison textuelle prend en compte l’alignement strict de la séquence des octets depuis la gauche. Il est donc impératif de coupler la conversion de type avec des routines d’élagage morphologique adaptées.
8.2 Nettoyage sélectif : Fonctions LEFT(), TRIM() et STRIP()
Pour neutraliser ces marges résiduelles indésirables, l’arsenal fonctionnel de SAS propose une triade de fonctions de manipulation de chaînes : LEFT(), TRIM() et STRIP(). Historiquement, la démarche standard consistait à invoquer la fonction LEFT() pour basculer la chaîne vers la gauche du vecteur de stockage, migrant ainsi les espaces blancs de tête vers la queue de la variable. Pour expurger ensuite les espaces de fin, les programmeurs imbriquaient cette opération avec la fonction TRIM(), produisant l’instruction classique char_var = trim(left(put(num_var, 8.)));.
Bien que fonctionnelle, cette construction imbriquée a été avantageusement supplantée depuis l’avènement de SAS 9 par l’introduction de la fonction native STRIP(). Cette dernière condense en une passe algorithmique unique l’élimination exhaustive de la totalité des espaces blancs positionnés à la fois au début et à la fin de la séquence textuelle, sans affecter les espaces intermédiaires qui pourraient séparer des mots. L’instruction s’en trouve grandement purifiée et optimisée : char_var = strip(put(num_var, 8.));.
Cette formulation combinée STRIP(PUT(…)) est aujourd’hui reconnue par les autorités du développement SAS comme le standard absolu d’excellence pour la transmutation d’entiers ou de grandeurs réelles vers des chaînes de caractères pures. Elle garantit que la variable alphanumérique résultante commence impérativement par le premier chiffre significatif ou le signe algébrique de la valeur, tout en libérant l’espace restant pour satisfaire la longueur totale allouée, évitant ainsi toute mauvaise surprise lors des fusions et des contrôles conditionnels.
8.3 Fonction CATS() et ses variantes comme alternative intégrée
Dans les scénarios où la conversion d’une variable numérique a pour unique finalité son intégration au sein d’une concaténation multi-champs, la fonction PUT() peut être avantageusement remplacée par la famille des fonctions de concaténation modernes, au premier rang desquelles trône la fonction CATS(). Cette fonction prend en arguments une liste hétérogène de variables — qu’elles soient numériques ou de caractères — applique automatiquement un processus de conversion sur les arguments arithmétiques, et concatène l’ensemble en purgeant immédiatement tous les espaces résiduels de tête et de queue.
L’utilisation de CATS() simplifie considérablement la syntaxe. Une opération qui réclamait antérieurement l’instruction verbeuse nom_complet = trim(left(put(centre, 4.))) || ‘_’ || strip(put(patient, z4.)); peut être réécrite avec une concision et une lisibilité parfaites sous la forme : nom_complet = cats(centre, ‘_’, put(patient, z4.));. Il est à noter que l’on peut mixer au sein des arguments de CATS() des variables numériques brutes et des expressions d’affectation explicites basées sur PUT() pour les composants nécessitant un formatage particulier comme le remplissage de zéros.
Toutefois, une précaution méthodologique majeure doit être observée lors de l’abandon de la fonction PUT() au profit exclusif de CATS() sur une variable numérique isolée. Lorsqu’elle traite une valeur numérique brute sans gabarit stipulé, la fonction CATS() applique par défaut le format interne BEST12. avant d’opérer l’élagage textuel. Si ce comportement par défaut convient parfaitement aux entiers, il peut générer des approximations ou des basculements imprévus en notation scientifique pour les nombres réels comportant de nombreuses décimales, justifiant le maintien de l’approche explicite STRIP(PUT(…, format.)) pour un contrôle métrologique total.
9. Traitement des cas complexes : Valeurs manquantes, décimales et notation scientifique
9.1 Conversion et comportement des valeurs manquantes
La gestion des valeurs manquantes représente l’une des pierres d’achoppement les plus critiques lors de la transition d’un schéma numérique vers un schéma textuel. Au niveau des structures internes de SAS, un blanc statistique numérique standard est encodé par une configuration flottante réservée, matérialisée dans les sorties par un point typographique unique (.). Lorsque l’analyste applique sans précaution l’instruction char_var = put(num_var, 8.); à un enregistrement dont la valeur est absente, la fonction PUT() traduit littéralement cette valeur en écrivant une chaîne de caractères contenant ce fameux point (« . »), justifié à droite.
Cette transcription littérale pose un risque méthodologique majeur : pour un système d’analyse textuelle, le caractère « . » n’est aucunement interprété comme une absence de donnée, mais comme une chaîne de caractères pleine d’un octet contenant un glyphe de ponctuation valide. Des instructions de filtrage telles que if char_var = ‘ ‘ évalueront cette modalité comme fausse, faussant radicalement le dénombrement des données manquantes dans les rapports de synthèse épidémiologique et les modèles de survie.
Pour préserver l’intégrité de la base de données et convertir un vide numérique en un vide textuel véritable (une chaîne de purs espaces blancs), le déploiement d’un filtre logique conditionnel ou de la fonction MISSING() est formellement requis. Le paradigme programmatique irréprochable s’écrit ainsi :
if missing(num_var) then char_var = ‘ ‘;
else char_var = strip(put(num_var, 8.));
Dans le cadre de l’exploitation de valeurs manquantes spéciales (codées de .A à .Z pour catégoriser par exemple les refus de réponse ou les pertes de suivi en recherche clinique), cette routine peut être raffinée afin de transcrire explicitement le code de la valeur manquante sous forme d’une étiquette textuelle informative normalisée.
9.2 Préservation de la précision décimale et erreurs d’arrondi
La conversion de mesures quantitatives continues issues d’instruments de métrologie de haute précision (telles que des concentrations plasmatiques, des coordonnées géodésiques ou des temps de réaction milliseconde) requiert un dimensionnement mathématique scrupuleux du format de conversion w.d. L’erreur la plus pernicieuse consiste à omettre la comptabilisation physique du séparateur décimal dans le calcul de la largeur totale w.
Dans l’architecture SAS, le point marquant la frontière décimale consomme obligatoirement un octet plein au sein de la largeur w. Par exemple, pour projeter sans perte d’information un indice psychométrique dont la partie entière culmine à trois chiffres et qui exige quatre décimales de précision (ex: 785.4321), la largeur totale doit absorber 3 chiffres entiers + 1 point décimal + 4 chiffres fractionnaires = 8 caractères. Le gabarit adéquat est donc 8.4. L’application erronée d’un format 7.4 forcerait SAS à tronquer ou dégrader l’affichage pour respecter la largeur allouée, altérant irréversiblement la fidélité de la donnée transcrite.
En outre, il convient d’anticiper les variations régionales d’encodage des séparateurs décimaux lors de l’exportation internationale des bases de données. Dans l’écosystème anglo-saxon, le séparateur standard est le point, géré nativement par les formats w.d. Si la table de sortie est destinée à alimenter des systèmes institutionnels francophones ou européens utilisant la virgule, le statisticien évitera des scripts artisanaux de remplacement de caractères en exploitant directement le format international intégré COMMAw.d ou le format européen NUMXw.d au sein de la fonction PUT(), garantissant une conformité métrologique immédiate.
9.3 Conversion de valeurs extrêmes et gestion des débordements
Le traitement des bases de données hétérogènes, où une même colonne quantitative peut accueillir simultanément des mesures infinitésimales issues de calibrages fins et des montants scalaires colossaux issus d’agrégations, expose le programmeur au phénomène de débordement de capacité de format (format width overflow). Comme évoqué précédemment, si la valeur absolue d’un nombre excède la capacité d’accueil fixée par la largeur w d’un format conventionnel, SAS remplace la donnée par une suite d’astérisques (« ** »), détruisant définitivement l’information sous-jacente.
Pour parer à ce risque de saturation lors du traitement de distributions asymétriques ou à queue lourde, l’emploi de formats adaptatifs de la famille BESTw. s’impose avec force au sein de la fonction PUT(). Le format BESTw. délègue au compilateur algorithmique de SAS le soin d’arbitrer en temps réel la représentation textuelle la plus compacte et la plus fidèle possible pour chaque observation individuelle, en fonction de la largeur w mise à disposition.
Si la grandeur est un entier modeste, BESTw. l’affiche sous forme entière ; si la grandeur comporte des décimales, il maximise le nombre de chiffres fractionnaires visibles ; et si la grandeur dépasse l’espace alloué, il bascule dynamiquement et sans perte d’information en notation scientifique exponentielle. Une bonne pratique d’ingénierie préliminaire consiste toutefois à interroger au préalable la distribution empirique via PROC MEANS (en extrayant les métriques MIN et MAX) afin de dimensionner l’argument w avec une marge de sécurité absolue de deux à trois octets supplémentaires.
10. Conversion implicite versus conversion explicite : Risques méthodologiques
10.1 Le mécanisme de conversion implicite de SAS et ses dangers
L’un des traits les plus distinctifs du moteur d’exécution de SAS réside dans sa permissivité apparente face aux erreurs de typage, incarnée par le mécanisme de la conversion implicite (ou coercition automatique de type). Lorsqu’un programmeur commet l’erreur d’utiliser une variable numérique au sein d’une opération textuelle — par exemple en exécutant une affectation telle que long_id = ‘ID_’ || num_id; ou en passant un nombre à une fonction purement dédiée aux chaînes comme SUBSTR() — le système ne bloque pas immédiatement l’exécution.
Au lieu d’interrompre l’étape DATA, le compilateur SAS tente de réparer silencieusement l’incohérence syntaxique en exécutant en arrière-plan une conversion automatique. Pour ce faire, il applique de sa propre initiative le format universel BEST12. à la variable numérique défaillante, convertit le résultat en chaîne de 12 octets justifiée à droite, et poursuit l’exécution de la boucle séquentielle. En apparence, le programme termine son cycle sans crash machine, ce qui procure au développeur non averti une fausse impression de réussite opérationnelle.
Cette bienveillance logicielle masque en réalité une source dévastatrice d’artefacts d’analyse. Le format BEST12. imposant une largeur rigide de 12 positions, la conversion implicite d’une modeste valeur scalaire comme 15 génère une séquence de 10 espaces de tête suivis des deux chiffres. La concaténation subséquente produira l’aberration « ID_ 15 ». Dans un protocole de criblage pharmacologique ou de suivi de cohorte, ce décalage invisible brise instantanément toutes les jointures relationnelles ultérieures et vicie intégralement les calculs d’occurrences.
10.2 Pourquoi la conversion explicite avec PUT() est impérative
Face aux aléas destructeurs des mécanismes automatiques, l’usage délibéré et exclusif de la conversion explicite par la fonction PUT() constitue un impératif méthodologique non négociable dans l’ingénierie de données professionnelle. La conversion explicite formalise avec une transparence absolue les intentions du statisticien au sein du code source, garantissant que chaque paramètre de transformation (largeur, cadrage, gestion des décimales, traitement des anomalies) est déterministe et souverainement orchestré par le concepteur de l’analyse.
Ce déterminisme est indispensable pour satisfaire aux critères d’auditabilité et de reproductibilité computationnelle édictés par les revues scientifiques internationales et les agences sanitaires mondiales telles que l’Agence Européenne des Médicaments (EMA). Un code source qui s’appuie sur des conversions implicites est instable : son comportement peut varier si le script est migré vers une version ultérieure du système SAS, ou si la configuration des options régionales du serveur d’hébergement est modifiée par les administrateurs système.
En outre, la conversion explicite assainit intégralement la lisibilité du code pour la relecture par les pairs (peer code review). Tout collègue ou auditeur externe inspectant une instruction strip(put(code, z6.)) comprend sans la moindre ambiguïté la trajectoire structurelle empruntée par la donnée. Cet investissement dans la clarté syntaxique réduit drastiquement la dette technique des équipes de biométrie et accélère considérablement la validation des plans de gestion des données (Data Management Plans).
10.3 Audit du journal (SAS Log) pour traquer les conversions parasites
Le journal d’exécution (la SAS Log) constitue le baromètre suprême de l’intégrité logicielle d’un traitement de données. Lorsqu’une étape DATA opère une conversion implicite, le moteur SAS y consigne systématiquement un message d’avertissement caractéristique libellé en ces termes : « NOTE: Numeric values have been converted to character values at the places given by: (Line):(Column) ». Dans une équipe d’analystes assermentés, la présence d’une telle note dans le journal est formellement prohibée et motive un rejet immédiat du livrable de programmation.
L’assainissement systématique du journal exige le déploiement d’une stratégie de traque systématique. Les développeurs chevronnés utilisent des utilitaires d’analyse lexicale automatisée ou configurent les environnements d’intégration continue pour scanner les journaux à la recherche des chaînes de caractères « converted to character » ou « converted to numeric ». Tout fichier journal contenant ces occurrences doit être requalifié en état d’anomalie jusqu’à ce que la ligne incriminée soit pourvue d’une instruction explicite PUT() ou INPUT() appropriée.
Il est également possible de durcir le comportement de l’interpréteur SAS via la commande globale d’options. Bien qu’il n’existe pas d’option universelle pour bloquer spécifiquement la conversion implicite sous forme d’erreur bloquante pure, l’utilisation de l’option OPTIONS MSGLEVEL=I; permet d’amplifier la granularité des messages diagnostiques émis dans la LOG, révélant les indexations d’arrière-plan, les tris masqués et l’ensemble des coercitions de format opérées à l’insu de l’utilisateur, conférant ainsi un contrôle total sur l’écologie computationnelle du pipeline.
11. Applications empiriques : Codage d’items, identifiants et scores d’échelles
11.1 Harmonisation des identifiants de participants d’enquêtes
L’une des concrétisations les plus manifestes de la conversion numérique-vers-caractère s’incarne dans les chaînes de normalisation des identifiants de sujets au sein des protocoles d’enquêtes longitudinales à multiples cohortes. Fréquemment, les données brutes proviennent de centres investigateurs décentralisés attribuant de simples identifiants séquentiels entiers (sujets 1 à 120 pour le centre A, sujets 1 à 85 pour le centre B), tandis que les règles de gestion du promoteur exigent un matricule unique international strict de 10 caractères sous la forme « SITE_XXXXX ».
L’orchestration programmatique de cette normalisation s’accomplit avec une robustesse totale en mariant la fonction CATS() et la fonction PUT() paramétrée avec un gabarit de zéro-remplissage :
DATA cohort_harmonized;
SET cohort_raw;
attrib USUBJID length=$12 label= »Universal Subject ID »;
USUBJID = cats(« SITE_ », put(site_num, z3.), « _ », put(patient_seq, z5.));
RUN;
Dans cette structure, un participant du site hospitalier numéro 4 ayant reçu le numéro d’ordre séquentiel 89 se voit assigner de manière déterministe le matricule universel « SITE_004_00089 ».
Cette normalisation rigoureuse scelle l’intégrité référentielle de la base de données. Elle élimine tout risque de collision d’identifiants lors de l’empilement longitudinal des visites de suivi sous PROC APPEND, garantit une anonymisation conforme aux exigences du Règlement Général sur la Protection des Données (RGPD) par suppression des identifiants bruts sources, et prépare le jeu de données pour une fusion sans faille avec les profils d’analyse pharmacocinétique externe.
11.2 Recodage de variables d’échelles psychométriques
Dans les sciences comportementales et la modélisation des résultats rapportés par les patients (Patient-Reported Outcomes – PRO), la manipulation des batteries d’items psychométriques (comme les inventaires de personnalité ou les échelles de dépression de Beck) impose fréquemment des opérations de recomposition structurelle. Pour étudier les patterns de réponses atypiques, les psychométriciens doivent souvent fusionner les réponses discrètes d’une vingtaine d’items numériques pour former un mot de profil unique (response string).
Tenter de fusionner des variables d’items numériques brutes sans conversion formelle aboutirait à une suite dégradée par des espaces ou à des calculs de sommes algébriques involontaires. Le protocole d’ingénierie adéquat fait intervenir un tableau de variables (ARRAY) itéré dans une boucle séquentielle :
DATA psych_profiles;
SET questionnaire_data;
array items{10} item1-item10;
length response_profile $10;
response_profile = ‘ ‘;
do i = 1 to 10;
if items{i} ne . then substr(response_profile, i, 1) = put(items{i}, 1.);
else substr(response_profile, i, 1) = ‘X’;
end;
DROP i;
RUN;
Dans cet algorithme, chaque item individuel est transmuté de manière déterministe en un caractère unique par put(items{i}, 1.) et positionné précisément dans la chaîne globale, les valeurs manquantes étant rigoureusement identifiées par le caractère sentinelle « X ».
La chaîne response_profile ainsi forgée permet d’exécuter des analyses de typologie comportementale d’une grande finesse, des recherches de régularités d’omissions (item non-response analysis), ou d’alimenter directement des logiciels spécialisés dans les modèles de Rasch ou les équations structurelles latentes, tout en préservant intacte la traçabilité des mesures individuelles au sein du référentiel SAS.
11.3 Préparation de tables synthétiques pour la restitution et l’exportation
L’étape terminale du cycle de traitement des données scientifiques consiste à transformer les estimations numériques issues des procédures analytiques en matrices tabulaires d’édition, conformes aux exigences typographiques des revues biomédicales et aux standards de l’American Psychological Association (APA). La convention d’édition impose classiquement de présenter les distributions quantitatives sous la forme consolidée d’une cellule unique combinant l’espérance et la dispersion : « Moyenne (Écart-Type) ».
Pour matérialiser cette présentation à partir des tables d’agrégation produites par PROC SUMMARY ou PROC MEANS, la transmutation des grandeurs flottantes continues vers une formulation textuelle élégante est orchestrée au moyen de conversions multiples soigneusement calibrées :
DATA table_publication;
SET descriptive_stats;
length display_mean_sd $25;
display_mean_sd = strip(put(mean_val, 8.2)) || » ( » || strip(put(sd_val, 8.2)) || « ) »;
RUN;
Cette instruction produit une colonne directement exploitable par la procédure d’édition PROC REPORT ou exportable vers Microsoft Word via le système ODS RTF, dispensant l’équipe éditoriale de fastidieuses opérations manuelles de mise en forme sous traitement de texte.
En outre, la conversion textuelle explicite et contrôlée permet de préserver rigoureusement l’homogénéité des décimales visibles. Là où une variable numérique standard masque fréquemment les zéros finaux (affichant « 12.3 » pour la valeur 12.30), l’application du format 8.2 au sein de la fonction PUT() force textuellement le maintien des deux chiffres après la virgule (« 12.30 »), respectant ainsi scrupuleusement les canons métrologiques stipulant que le nombre de décimales reflète fidèlement la précision de l’instrumentation de mesure.
12. Bonnes pratiques, optimisation computationnelle et erreurs fréquentes à éviter
12.1 Inventaire des erreurs de programmation les plus récurrentes
L’analyse des pratiques de développement sous SAS met en lumière un répertoire d’erreurs classiques dont l’élimination systématique élève immédiatement le niveau de fiabilité des scripts d’analyse. La faute originelle, déjà esquissée mais qui mérite une mise en garde réitérée, consiste en la confusion tragique entre la fonction d’extraction PUT() et la fonction d’ingestion INPUT(). L’utilisation d’une instruction telle que char_var = input(num_var, 8.); engendre instantanément une notification d’erreur de compilation fatale, la fonction INPUT() réclamant impérativement un premier argument de type textuel.
La seconde anomalie, d’une fréquence redoutable, réside dans l’omission du point terminal dans la désignation du gabarit de format. Rédiger put(age, 8) au lieu de put(age, 8.) induit en erreur l’interpréteur syntaxique de SAS, qui tente de résoudre le token « 8 » comme une variable ou un paramètre absent, interrompant le processus avec le message « ERROR: Open code statement recursion detected » ou un blocage de validation syntaxique équivalent. L’analyste doit cultiver le réflexe absolu d’associer immédiatement le nom du format à son point régulateur.
Un troisième piège réside dans le phénomène de troncature silencieuse. Si le développeur déclare en amont une instruction LENGTH identifiant $4; puis exécute l’assignation identifiant = put(numero_compte, 10.);, le compilateur appliquera docilement la conversion sur 10 caractères mais n’en retiendra que les 4 premiers pour les consigner dans la table, amputant irrémédiablement 6 chiffres essentiels. Enfin, l’absence d’élagage des espaces de tête via la fonction STRIP() avant une opération d’appariement représente la cause racine d’innombrables fusions avortées lors de l’exécution d’instructions MERGE ou de jointures relationnelles sous PROC SQL.
12.2 Optimisation des performances sur des volumétries massives
À l’ère des mégadonnées de santé (Big Data) regroupant des dizaines de millions d’enregistrements transactionnels, l’efficience algorithmique des étapes de conversion devient un enjeu de performance primordial. La première règle d’optimisation consiste en un dimensionnement hyper-strict de l’empreinte mémoire au moyen de l’instruction LENGTH. Allouer aveuglément une largeur par défaut de 12 ou 20 octets à une chaîne textuelle qui n’en requiert structurellement que 3 (par exemple un code de spécialité médicale) entraîne une consommation excessive d’espace disque et un engorgement drastique du bus d’échange mémoire de la station de travail.
Sur le plan de la vélocité d’exécution processeur, des benchmarks rigoureux mettent en évidence des disparités notables entre les différentes approches d’élagage de chaînes. L’utilisation de la fonction native moderne STRIP(PUT(…)) surpasse de manière significative l’ancienne séquence combinée TRIM(LEFT(PUT(…))), cette dernière imposant deux passages de lecture mémoire distincts dans le flux d’octets. De même, la fonction CATS() démontre une efficacité computationnelle optimale lorsqu’il s’agit de concaténer simultanément de multiples colonnes arithmétiques.
Pour le traitement vectorisé de volumes colossaux comportant des dizaines de colonnes quantitatives à convertir en parallèle (comme le nettoyage d’un panel de 500 indicateurs financiers ou cliniques), il est impératif d’éviter la prolifération de dizaines d’instructions PUT() écrites manuellement. Le recours aux structures matricielles temporaires (ARRAY) combiné à une boucle itérative DO OVER permet au compilateur de maintenir les adresses de blocs mémoire en cache de niveau 1 (L1), réduisant considérablement les cycles d’horloge de l’unité centrale. Enfin, toute transformation doit s’inscrire dans une étape DATA unique et préexistante, en proscrivant formellement la multiplication d’étapes DATA transitoires intermédiaires qui saturent les disques par des opérations d’écriture/lecture superflues.
12.3 Check-list méthodologique pour une conversion de type irréprochable
Afin de prémunir vos protocoles de recherche contre toute régression algorithmique ou contamination d’artefacts structurels, il est hautement recommandé de soumettre systématiquement chaque opération de conversion à une liste de contrôle méthodologique standardisée en quatre phases successives :
- Phase d’Audit Préalable : Déployer systématiquement une procédure PROC CONTENTS sur la table d’origine pour documenter de manière formelle le statut numérique des colonnes sources, leur distribution scalaire, ainsi que la présence éventuelle de formats d’affichage résiduels susceptibles de fausser les largeurs anticipées.
- Phase de Dimensionnement Rigoureux : Calculer manuellement la largeur textuelle maximale requise (en englobant impérativement les zéros de tête potentiels, le signe négatif éventuel, le point séparateur de décimales et le nombre maximal de fractions requises). Déclarer cette largeur de manière explicite et anticipée via une instruction LENGTH placée en amont absolu dans l’étape DATA.
- Phase d’Implémentation Standardisée : Déployer impérativement l’expression canonique explicite variable_cible = strip(put(variable_source, format_adequat.));. En cas de traitement de variables comportant des enregistrements absents, insérer la vérification conditionnelle préalable via la fonction MISSING() afin de garantir la génération de véritables blancs textuels.
- Phase de Validation et d’Audit Post-Exécution : Vérifier l’intégralité du journal SAS pour s’assurer de l’absence totale de la note « Numeric values have been converted to character values ». Exécuter une procédure PROC CONTENTS de contrôle pour valider l’acquisition du type « Char » par la variable finale. Enfin, procéder à une inspection d’intégrité visuelle via PROC PRINT (OBS=20) pour vérifier l’exactitude des alignements typographiques et la persistance des structures numériques critiques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cody, R. (2018). Cody’s data cleaning techniques using SAS (3rd ed.). SAS Institute Inc.
- Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute Inc.
- European Medicines Agency. (2014). Guideline on the content, management and archiving of the clinical trial master file (including common technical document). European Medicines Agency. https://www.ema.europa.eu
- Food and Drug Administration. (2021). Data standards for drug and biological product submissions containing real-world data: Guidance for industry. U.S. Department of Health and Human Services. https://www.fda.gov/regulatory-information/search-fda-guidance-documents
- IEEE Computer Society. (2019). IEEE standard for floating-point arithmetic (IEEE Std 754-2019). Institute of Electrical and Electronics Engineers. https://doi.org/10.1109/IEEESTD.2019.8766229
- SAS Institute Inc. (2020). SAS® 9.4 Functions and CALL routines: Reference (5th ed.). SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2021). SAS® 9.4 Statements: Reference (3rd ed.). SAS Institute Inc. https://documentation.sas.com
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677