
Dans le champ du traitement des données quantitatives et de l’analyse biostatistique, le système d’analyse statistique SAS (Statistical Analysis System) occupe une place prépondérante, reconnue pour sa rigueur algorithmique et sa conformité aux exigences réglementaires internationales. Toutefois, la robustesse de cet environnement repose sur une discipline méthodologique stricte quant à la typologie des variables manipulées. Lors de l’acquisition de données issues d’environnements hétérogènes, tels que les dossiers patients informatisés, les entrepôts de données cliniques ou les formulaires de collecte électronique (eCRF), les vecteurs temporels se trouvent fréquemment dégradés en chaînes alphanumériques. Cette altération de forme prive l’analyste de toute capacité de calcul arithmétique direct, tout en exposant les protocoles d’analyse à des erreurs d’ordonnancement lexicographique pernicieuses.
La transformation adéquate d’une variable temporelle textuelle en un scalaire numérique conforme à l’architecture interne de SAS ne relève pas d’une simple commodité syntaxique ; elle constitue une étape essentielle du prétraitement garantissant l’intégrité métrologique des séries chronologiques et des modèles d’analyse de survie. Dès lors que l’on cherche à évaluer des intervalles d’exposition, des durées d’incubation ou des délais de récidive, la conversion en entiers relatifs indexés sur l’époque de référence SAS conditionne l’exactitude des estimateurs de Kaplan-Meier et des modèles de risques proportionnels de Cox. Une mécompréhension des mécanismes internes d’évaluation séquentielle et des règles d’interprétation lexicale peut conduire à des biais de mesure massifs ou à la génération involontaire de données manquantes non documentées.
Le présent traité expose de manière exhaustive et systématique les fondements théoriques, les mécanismes computationnels sous-jacents et les protocoles empiriques permettant de convertir avec exactitude des variables de caractères en variables temporelles au sein du DATA Step de SAS. En articulant la théorie sous-jacente des jours juliens modifiés, le fonctionnement du vecteur de données du programme, l’usage heuristique des informats universels et les stratégies de vectorisation par tableaux et macro-processus, cette contribution offre un guide méthodologique de référence destiné aux biostatisticiens, ingénieurs de données et chercheurs confrontés aux exigences de la recherche quantitative appliquée.
1. Fondements théoriques de la représentation temporelle et textuelle dans SAS
1.1 La dichotomie fondamentale entre variables alphanumériques et numériques
L’architecture interne du compilateur SAS repose sur un principe d’économie structurelle strict hérité de sa conception matricielle originelle : tout champ de données appartient invariablement à l’une des deux seules catégories primitives reconnues, à savoir le type caractère (alphanumérique) et le type numérique (représenté en mémoire sous la forme d’un nombre à virgule flottante en double précision, codé selon la norme standard IEEE 754 sur 8 octets). Il n’existe pas, sur le plan matériel au niveau de l’allocation binaire, de type « Date » autonome ou isolé. Cette absence de troisième type primitif impose que toute notion de temporalité soit modélisée soit par le biais d’un codage textuel externe, soit par le truchement d’un scalaire numérique interne.
Lorsque des données d’horodatage ou des dates calendaires sont importées et maintenues sous la forme de chaînes de caractères, les conséquences analytiques s’avèrent délétères pour l’ensemble de la chaîne de traitement. D’une part, l’exécution d’opérations arithmétiques directes, telles que le calcul d’une différence de jours pour évaluer la durée de séjour hospitalier d’un patient ou la détermination d’un âge biologique précis, devient techniquement impossible sans déclencher des conversions implicites aléatoires ou des blocages du processeur de traitement. L’opérateur de soustraction appliqué à deux chaînes de texte constitue une aberration syntaxique qui force le compilateur SAS à tenter une coercition de type imprévisible, aboutissant régulièrement à l’émission d’avertissements critiques dans le journal d’exécution (SAS Log) et à l’affectation systématique de valeurs manquantes (missing values).
D’autre part, la conservation des dates sous forme textuelle corrompt irrémédiablement les opérations relationnelles élémentaires de comparaison et de tri. Dans l’espace des caractères, l’ordonnancement s’effectue selon la table de collation ASCII ou EBCDIC, imposant un classement strictement lexicographique de gauche à droite. Sous ce paradigme, une date enregistrée sous la forme « 01/12/2023 » sera systématiquement évaluée comme chronologiquement antérieure à « 02/01/2010 », car le premier octet signifiant « 01 » précède « 02 », occultant totalement la hiérarchie logique des millésimes et des mois. Cette distorsion introduit des failles majeures dans le séquençage longitudinal des cohortes et fausse les filtres de sélection conditionnelle (instructions WHERE et IF). La conversion rigoureuse vers une représentation numérique est donc un impératif épistémologique préalable à toute inférence statistique valide.
1.2 Le système d’époque SAS et le calcul en jours juliens modifiés
Pour résoudre l’incompatibilité entre le flux continu du calendrier grégorien et la rigidité du calcul numérique binaire, le système SAS s’appuie sur une convention chronologique désignée sous le terme d’époque SAS. Ce système définit un point zéro temporel fixe, arbitrairement ancré au 1er janvier 1960 (noté 01JAN1960:00:00:00). Dès lors, toute date SAS valide correspond strictement à un nombre entier relatif représentant le décalage arithmétique direct, quantifié en nombre exact de jours civils, séparant ladite date de ce point d’origine séculaire. Le 1er janvier 1960 est associé à la valeur entière 0 ; le 2 janvier 1960 se traduit par l’entier 1 ; tandis que le 31 décembre 1959 reçoit la valeur scalaire -1.
Cette approche métrologique s’inspire du principe astronomique des jours juliens et des jours juliens modifiés (MJD), consistant à linéariser la complexité multiséculaire du calendrier civil en une droite numérique continue et sans discontinuité. Les singularités calendaires telles que l’alternance des mois de 30 et 31 jours, les anomalies structurelles du mois de février et l’intercalation quadriennale des années bissextiles — incluant les exceptions séculaires non bissextiles prévues par la réforme grégorienne (comme les années 1700, 1800 et 1900) — sont intégralement résolues au moment de la projection sur l’axe des entiers relatifs.
Les avantages computationnels découlant de cette représentation unifiée sont déterminants pour la performance des algorithmes d’analyse. La détermination de la durée exacte écoulée entre deux événements biographiques distincts ne nécessite aucune boucle algorithmique complexe ni appel récurrent à des tables de concordance : elle se réduit à une opération élémentaire de soustraction algébrique entre deux scalaires entiers. En outre, la continuité de cet espace numérique constitue le socle indispensable sur lequel s’adossent les modèles mathématiques de séries temporelles (ARIMA, modèles d’espace d’états) et les algorithmes d’estimation de survie paramétriques et non paramétriques, où la variable temps doit impérativement posséder les propriétés métrologiques d’une échelle d’intervalle ou de rapport continue.
1.3 Problématique du typage des données dans les corpus empiriques
Dans la pratique scientifique et clinique contemporaine, les bases de données brutes soumises aux biostatisticiens proviennent rarement d’une saisie directe et contrôlée au sein de l’écosystème SAS. Elles résultent le plus souvent d’extractions massives depuis des systèmes transactionnels distants, de tables relationnelles SQL hétéroclites ou de classeurs électroniques de type délimité (formats CSV ou TSV). Au cours de ces transferts d’information inter-plateformes, la sémantique originelle des champs temporels est fréquemment détruite lors des étapes de sérialisation textuelle.
Lors de l’utilisation de procédures automatisées de détection, telles que la commande PROC IMPORT, le moteur d’acquisition de SAS est contraint d’appliquer des heuristiques fondées sur l’échantillonnage des premières rangées d’observations (via l’instruction GUESSINGROWS). Si les premiers enregistrements comportent des anomalies syntaxiques, des séparateurs incohérents (comme l’alternance désordonnée de barres obliques, de tirets ou de points) ou des libellés textuels sporadiques (tels que « Inconnu », « N/A », ou des annotations cliniques manuscrites répertoriées dans le même champ), le moteur procède par précaution au typage global de la colonne sous la forme d’un vecteur de caractères alphanumériques de longueur arbitraire.
Cette rétrogradation structurelle affecte l’intégrité de bases de données volumineuses consacrées aux études épidémiologiques et aux évaluations psychométriques. L’hétérogénéité des syntaxes de recueil engendre des biais silencieux d’une extrême gravité : l’analyste suppose fréquemment que le logiciel traitera les données selon leur sémantique présumée, alors que la machine exécute des tris et des jointures sur la base d’une disposition textuelle désordonnée. Ce décalage épistémologique entre la signification conceptuelle du phénomène mesuré (le moment d’apparition d’un événement clinique) et son implémentation physique (une suite d’octets sans intelligence temporelle intrinsèque) justifie l’application systématique d’un protocole délibéré et contrôlé de conversion explicite de type.
2. L’architecture de la fonction INPUT() dans le DATA Step
2.1 Syntaxe fondamentale et mode opératoire du compilateur
Le pivot algorithmique assurant la transmutation d’une grandeur alphanumérique en un scalaire temporel au sein de l’environnement SAS réside dans l’appel à la fonction interne INPUT(). La signature canonique de cette fonction fondamentale s’énonce selon la syntaxe suivante :
variable_cible = INPUT(source_caractere, informat.);
Il importe de disséquer le comportement séquentiel du compilateur SAS lorsque cette instruction est évaluée lors de la phase d’exécution pas-à-pas du DATA Step. Le système alloue un espace mémoire temporaire désigné sous l’appellation de vecteur de données du programme (Program Data Vector ou PDV). Le PDV constitue la structure tampon où chaque observation individuelle est assemblée et modifiée en mémoire vive avant d’être écrite définitivement sur le support de stockage physique. Lorsque le pointeur d’exécution atteint l’instruction INPUT(), la chaîne contenue dans la variable source est analysée à travers le prisme de la règle de décodage prescrite par l’informat fourni en second argument.
Une distinction structurelle absolue doit être opérée entre la fonction INPUT() et son antithèse fonctionnelle, la fonction PUT(). Alors que INPUT() réalise la lecture d’une chaîne de caractères pour en extraire une entité numérique ou restructurée selon un schéma d’entrée (conversion du texte vers le nombre), la fonction PUT() effectue l’opération inverse, consistant à projeter une valeur numérique sous-jacente vers une chaîne textuelle formatée pour l’affichage (conversion du nombre vers le texte). Confondre ces deux mécanismes relève d’une erreur d’aiguillage compilatoire fréquente qui bloque l’exécution du programme.
Par ailleurs, en vertu des règles immuables de gestion du PDV, une variable enregistrée dans la table source avec un type caractère ne peut en aucun cas voir son type modifié dynamiquement au cours du même DATA Step. Tenter d’assigner le résultat de l’instruction INPUT() à la variable source originale elle-même (par exemple : date_recueil = INPUT(date_recueil, DDMMYY10.);) constitue une infraction syntaxique rédhibitoire : le compilateur rejette la tentative de redéfinition de type ou génère une erreur d’incompatibilité fatale, forçant l’ingénieur de données à assigner impérativement la valeur résultante à un identifiant lexical distinct.
2.2 Mécanique de lecture de la chaîne textuelle
L’évaluation interne opérée par la fonction INPUT() procède par décomposition analytique du flux d’octets constituant la chaîne source. Contrairement aux fonctions classiques de manipulation de texte qui traitent les symboles comme des entités purement sémantiques, l’association de INPUT() à un informat temporel active une routine d’analyse lexicale spécialisée au sein du moteur d’exécution de SAS.
Dans un premier temps, l’algorithme procède au balayage des octets pour identifier la présence d’espaces typographiques superflus situés en tête ou en queue de chaîne. Les informats temporels standards manifestent une tolérance intrinsèque en ignorant les blancs marginaux, concentrant leur analyse sur le noyau informationnel signifiant de la chaîne. La séquence d’octets est ensuite segmentée en composantes temporelles élémentaires en fonction des paramètres géométriques définis par l’informat : identification des positions relatives réservées au quantième du jour, au rang ordinal du mois civil et au millésime séculaire de l’année.
Une fois les composantes isolées et validées vis-à-vis des règles du calendrier grégorien (vérification que le quantième ne dépasse pas 28, 29, 30 ou 31 selon le mois et l’année considérée), l’algorithme exécute une fonction de transformation mathématique projetant ces coordonnées calendaires sur la droite des jours juliens modifiés centrée sur le 1er janvier 1960. Si la structure syntaxique de la chaîne s’écarte du gabarit stipulé par l’informat — par exemple si une chaîne présente une structure « 2023-12-05 » alors que l’informat spécifié est DDMMYY10. —, l’analyseur lexical entre en collision logique. Incapable de faire correspondre le flux de caractères avec le masque attendu, le compilateur interrompt l’affectation, affecte la valeur numérique manquante générique (représentée par un point « . ») à la variable cible, et consigne un avertissement d’invalidité structurelle dans le journal système.
2.3 Le statut de la variable d’origine et la gestion de la mémoire
L’impossibilité technique de modifier in-situ le typage d’une colonne au sein d’une table SAS découle directement du modèle architectural de stockage orienté enregistrement. Lorsqu’une table SAS est instanciée, son en-tête descriptif (le dictionnaire de métadonnées) fige irréversiblement la longueur binaire et le type de chaque colonne composant l’espace relationnel. Pour convertir une variable textuelle tout en maintenant la conformité nominale du schéma de données original, l’ingénieur doit orchestrer une substitution architecturale en trois étapes successives au sein de son DATA Step.
La première phase réside dans la lecture et l’affectation du scalaire calculé vers une variable cible transitoire dotée d’un nom distinct. La deuxième étape requiert l’expulsion méthodique de la variable caractère d’origine hors du tampon d’écriture final à l’aide de l’instruction DROP. En excluant le champ textuel devenu obsolète, l’analyste prévient toute duplication redondante de l’information et évite la surcharge inutile des fichiers de tables physiques (extensions .sas7bdat).
La troisième phase mobilise l’instruction déclarative RENAME, configurée pour modifier les métadonnées de nommage de la variable cible nouvellement générée au moment exact où les enregistrements sont déversés du PDV vers la table de sortie finale. Cette gymnastique syntaxique permet d’éliminer la variable de chaîne brute tout en réassignant son nom d’origine à la colonne numérique convertie. Dans les contextes de méga-données (Big Data) ou d’études épidémiologiques transversales regroupant des dizaines de millions d’observations, cette rationalisation du cycle de vie des variables au sein du DATA Step conditionne directement la taille de l’empreinte mémoire, le débit des entrées-sorties sur disque (I/O) et l’efficacité globale du partitionnement des tables.
3. Typologie des informats de lecture temporelle dans SAS
3.1 Les informats conventionnels fondés sur l’ordre grégorien
Le système SAS propose une bibliothèque étendue d’informats dédiés à la reconnaissance des représentations calendaires numériques pures. Ces gabarits de lecture se distinguent par l’ordre hiérarchique selon lequel ils décryptent les trois segments fondamentaux de la date que sont le jour, le mois et l’année. Le choix de l’informat doit s’opérer avec une précision absolue en fonction de l’ancrage culturel et géographique régissant la collecte des données empiriques.
L’informat MMDDYYw. est spécifiquement paramétré pour décoder la convention nord-américaine standard, laquelle postule que la première valeur numérique rencontrée code le mois civil, la seconde le quantième du jour, et la dernière le millésime. À l’inverse, l’informat DDMMYYw. répond à la logique calendaire européenne, sud-américaine et internationale dominante, subordonnant la lecture dans l’ordre rigoureusement croissant des grandeurs : jour, mois, puis année. Enfin, l’informat YYMMDDw. structure son décodage selon l’ordre décroissant préconisé par la norme internationale ISO 8601, garantissant une cohérence hiérarchique directe de l’année vers le jour.
Dans ces désignations, la lettre générique w indique la largeur totale (width), quantifiée en nombre strict de colonnes d’octets, allouée à la fenêtre de lecture du pointeur d’entrée. Ainsi, l’informat DDMMYY8. est dimensionné pour capturer des chaînes textuelles compactes de 8 caractères dépourvues de séparateurs explicites (telles que « 31122023 ») ou des dates courtes incorporant des délimiteurs mais dotées d’une année tronquée à deux chiffres (« 31/12/23 »). En revanche, l’informat DDMMYY10. étend son champ d’investigation sur 10 caractères, offrant l’espace géométrique requis pour absorber harmonieusement les dates complètes articulées autour d’un millésime à quatre chiffres séparé par des caractères de ponctuation (« 31/12/2023 »). Une inadéquation entre la largeur w spécifiée et la morphologie réelle de la chaîne textuelle entraîne une troncature mécanique du flux de lecture ou l’interruption prématurée de l’analyse lexicale.
3.2 Les informats textuels avec abréviations alphabétiques du mois
De nombreux systèmes de gestion de bases de données biomédicales s’affranchissent des ambiguïtés numériques inhérentes à l’ordre grégorien en enregistrant le mois civil non point sous la forme d’un entier ordinal, mais sous celle d’une chaîne alphabétique de trois lettres abréviatives. Pour décoder de telles séquences, SAS dispose de la famille d’informats DATEw., dont la déclinaison canonique la plus répandue est DATE9. (dévolue à la lecture de motifs tels que « 01JAN2023 » ou « 15OCT1984 »).
La mécanique interne de l’informat DATEw. se caractérise par une insensibilité native à la casse typographique : que la mention textuelle du mois soit formalisée en lettres majuscules (« JAN »), en minuscules (« jan ») ou en casse mixte (« Jan »), le décodeur lexical assure une transcription numérique rigoureusement identique. Cette robustesse structurelle en fait l’outil privilégié de l’intégration de données hospitalières hétéroclites issues de saisies cliniques manuelles.
Il convient néanmoins de souligner une limitation méthodologique fondamentale relative à la dépendance linguistique de la session SAS exécutée. Par défaut, l’informat DATEw. requiert l’emploi d’abréviations anglophones standard (JAN, FEB, MAR, APR, MAY, JUN, JUL, AUG, SEP, OCT, NOV, DEC). Si un corpus de données empiriques francophones enregistre les mois sous les abréviations « FÉV », « MAI », « AOÛ » ou « DÉC », l’informat DATEw. conventionnel échouera systématiquement, générant des valeurs manquantes. L’analyste doit alors soit recourir aux informats multilingues spécifiques internationalisés, soit procéder à une harmonisation lexicale préalable des chaînes pour rétablir la nomenclature attendue par le moteur de parsing.
3.3 Les informats julien et formats séquentiels spécialisés
Certains protocoles industriels, militaires ou épidémiologiques anciens ont recours à des modes de repérage séquentiels continus excluant le découpage mensuel traditionnel. L’informat JULIANw. répond à cet impératif de traitement en décodant la notation calendaire julienne standardisée, laquelle fusionne au sein d’un bloc numérique compact le millésime de l’année et le numéro séquentiel continu du jour de l’année (de 1 à 365, ou 366 pour les années bissextiles).
L’utilisation de l’informat JULIAN7. permet d’interpréter sans ambiguïté une notation telle que « 2023001 » comme désignant formellement le 1er janvier 2023, et « 2023032 » comme correspondant au 1er février de la même année. Ce formatage garantit une linéarité parfaite sans nécessiter la gestion complexe des décalages mensuels lors des phases d’acquisition de données télémétriques brutes ou de traçabilité logistique de santé publique.
Dans d’autres configurations empiriques de recueils longitudinaux, la granularité temporelle se trouve délibérément dégradée au niveau du mois d’inclusion, sans indication précise du jour civil d’intervention. L’informat MONYYw. (par exemple MONYY7. pour la chaîne « JAN2023 ») intervient dans ce contexte pour transcrire cette information partielle. Néanmoins, en raison de l’exigence structurelle de SAS d’ancrer chaque point temporel sur un scalaire représentant un jour exact par rapport à 1960, l’utilisation de l’informat MONYYw. impose systématiquement une règle d’imputation unilatérale automatique : il affecte par défaut la valeur résultante au premier jour du mois considéré (soit le 1er janvier 2023 dans notre exemple). L’ingénieur doit être pleinement conscient de cette interpolation implicite afin de ne point biaiser les métriques calculées en aval.
4. Distinction épistémologique entre informats d’entrée et formats de restitution
4.1 La double réalité de la variable temporelle sous SAS
Pour maîtriser le traitement des données chronologiques dans SAS, il est nécessaire d’adopter une dissociation conceptuelle stricte entre l’état binaire sous-jacent de la donnée et sa modalité d’extériorisation graphique. Une variable temporelle dans SAS possède une double réalité ontologique qu’il convient de distinguer avec une rigueur absolue : l’essence scalaire interne d’une part, et l’apparence morphologique externe d’autre part.
Au niveau le plus profond de l’architecture de la table de données, la date est une quantité scalaire invariante, purement numérique, correspondant à l’entier représentant le décompte de jours écoulés depuis le 1er janvier 1960. Cette valeur mathématique est la seule entité manipulée par l’unité de calcul arithmétique et logique lors de l’exécution des filtres, des régressions ou des tests statistiques. L’utilisateur final n’a, par défaut, aucune raison d’interagir directement avec cet entier abstrait.
Le format d’affichage (instruction FORMAT) constitue, quant à lui, une simple couche cosmétique de surimpression, un filtre optique appliqué dynamiquement lors de la restitution des résultats. L’omission délibérée ou accidentelle d’une instruction de formatage après une conversion réussie par INPUT() engendre une incompréhension récurrente chez les praticiens novices : la variable convertie s’affiche sous la forme d’un nombre entier opaque (par exemple, 23375 pour le 31 décembre 2023). Cet affichage brut ne traduit aucunement une anomalie logicielle ou un échec de la conversion, mais matérialise l’état physique authentique de la variable, dépouillée de son masque d’interprétation visuelle.
4.2 Cohérence et divergence entre informats et formats
Une liberté architecturale majeure offerte par SAS réside dans l’indépendance structurelle complète existant entre l’informat d’acquisition (la règle de lecture) et le format d’extériorisation (la règle d’affichage). L’analyste n’est en aucune manière contraint de calquer son format de sortie sur l’informat ayant présidé à l’ingestion des données textuelles initiales.
Il est parfaitement légitime et courant, dans le cadre de chaînes d’intégration de données internationales, d’ingérer une date codée selon la syntaxe américaine à l’aide de l’informat d’entrée MMDDYY10., tout en instruisant immédiatement le système de restituer cette même information temporelle sous le formalisme européen standardisé à l’aide de l’instruction FORMAT ma_variable DDMMYY10.; ou sous une convention internationale verbeuse via DATE9.. Cette dichotomie opératoire permet de réaliser l’harmonisation visuelle et sémantique d’un ensemble de tables disparates sans devoir reprogrammer les routines de capture.
Dans les procédures d’édition et de diffusion de rapports statistiques (telles que PROC PRINT ou PROC REPORT), la présence du descripteur de format attaché aux métadonnées de la colonne garantit que le moteur de rendu interceptera la valeur scalaire entière sous-jacente pour reconstituer à la volée une chaîne de caractères intelligible pour le lecteur humain. L’indépendance arithmétique de la variable est intégralement préservée : le tri s’opère toujours sur le scalaire sous-jacent, éliminant tout risque d’incohérence lexicographique lors de la production de tables récapitulatives longitudinales.
4.3 Vérification métrologique de la donnée convertie
Tout protocole rigoureux de traitement de données empiriques impose une phase d’audit métrologique visant à valider l’effectivité et la conformité du changement de typage au terme de l’exécution du DATA Step. La procédure descriptive PROC CONTENTS constitue l’outil diagnostique de référence pour inspecter le dictionnaire interne de la table SAS résultante.
L’examen des sorties générées par PROC CONTENTS doit porter sur deux éléments discriminants fondamentaux : d’une part, la confirmation que l’attribut Type de la variable incriminée est formellement passé de Char à Num, matérialisant le succès du basculement structurel au sein du PDV ; d’autre part, la vérification de la présence effective de la métadonnée Format associée, assurant que le masque visuel adéquat a été durablement greffé à la définition de la colonne.
Complémentairement à cette inspection structurelle, le déploiement d’une procédure PROC MEANS appliquée à la variable nouvellement convertie permet d’auditer instantanément la cohérence statistique de la distribution temporelle créée. L’observation des métriques scalaires extrêmes (valeurs minimales et maximales) offre un moyen immédiat de déceler d’éventuelles aberrations de conversion : la présence de valeurs négatives excessives ou d’entiers disproportionnés trahit instantanément l’usage d’un informat inadapté ayant confondu les segments du jour et de l’année, ou une mauvaise interprétation des siècles lors de l’application des fenêtres chronologiques.
5. Protocole pratique de base : Implémentation empirique pas-à-pas
5.1 Création et inspection du jeu de données brut
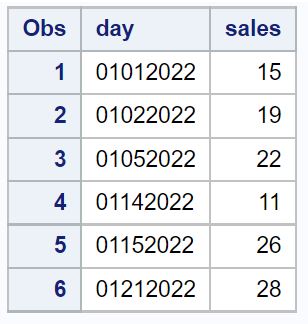
Afin de matérialiser de façon concrète et reproductible le processus de conversion, considérons un scénario empirique représentatif dans lequel une cohorte de sujets présente des données temporelles collectées sous la forme de chaînes de caractères hétérogènes. La première étape consiste à instancier un environnement d’expérimentation contrôlé à travers un DATA Step d’initialisation exploitant les instructions DATALINES ou CARDS.
Dans ce bloc déclaratif, l’ingénieur spécifie l’instruction INPUT id $ raw_date $;, au sein de laquelle la présence explicite du symbole dollar ($) contraint expressément le compilateur à allouer deux colonnes de type caractère au sein du PDV. Ce typage artificiel force le système à traiter la variable d’horodatage comme une suite de symboles typographiques inertes, reproduisant fidèlement l’état dégradé d’une importation brute non contrôlée.
Une visualisation préliminaire du jeu de données via la procédure PROC PRINT permet de poser un diagnostic structurel immédiat. L’observation attentive de la disposition graphique des valeurs au sein des cellules de la table met en évidence un marqueur fondamental du comportement interne de SAS : par convention typographique inviolable, toute variable reconnue comme alphanumérique est alignée de manière systématique sur le bord gauche de la colonne, tandis que les valeurs purement numériques font l’objet d’un alignement sur le bord droit. Ce simple décalage optique constitue le premier révélateur visuel de la nature textuelle et inopérante de la variable temporelle brute.
5.2 Écriture de la transformation et instanciation du nouveau champ
Une fois le diagnostic structurel établi, l’ingénieur de données procède à l’écriture de l’étape de transformation proprement dite. Cette phase exige l’ouverture d’un nouveau DATA Step lisant la table brute précédente et opérant la dérivation mathématique requise. L’opération centrale s’articule autour de l’instruction d’affectation instanciant la nouvelle entité scalaire :
date_propre = INPUT(raw_date, MMDDYY10.);
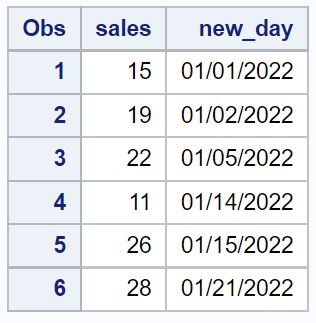
Cette ligne de programmation active la routine d’analyse lexicale décrite précédemment, convertissant chaque occurrence textuelle valide en son équivalent scalaire relatif à 1960. Immédiatement en dessous de cette assignation, l’instruction déclarative FORMAT date_propre DDMMYY10.; est adjointe pour conférer à la variable cible son masque d’interprétation visuelle normalisé, garantissant que les représentations futures de la table restitueront une date intelligible ordonnée selon la convention grégorienne européenne.
Dans le même temps, pour des impératifs d’assainissement de la mémoire et de conformité aux standards de sécurité méthodologique des données, la commande DROP raw_date; est injectée dans le corps de l’étape. Lors de la compilation, cette directive ordonne au gestionnaire de persistance d’omettre la colonne textuelle native lors de l’écriture des blocs de données sur le disque dur. L’analyste veille ensuite à soumettre le code à l’interpréteur et procède à l’inspection minutieuse du journal d’exécution (SAS Log) afin de certifier l’absence absolue de messages d’avertissement de type « Numeric values have been converted to character » ou « NOTE: Invalid data », confirmant la pureté de la transformation.
5.3 Préservation de l’architecture nominale par la clause RENAME
Bien que le protocole décrit à la sous-section précédente accomplisse avec succès la métamorphose de typage, il présente l’inconvénient technique d’altérer la nomenclature du dictionnaire de données du projet : le champ chronologique est désormais étiqueté sous le nom date_propre, alors que les programmes d’analyse statistiques situés en aval, ainsi que les macros d’automatisation préexistantes, s’attendent à trouver la variable sous son appellation historique originale raw_date.
Pour résoudre cette rupture d’interopérabilité sans violer la règle interdisant la modification directe du typage in-situ au sein du PDV, l’ingénieur combine de façon synchrone l’instruction DROP et l’option de jeu de données RENAME= au sein de la même étape DATA. La formulation syntaxique s’articule comme suit :
DATA table_finale(DROP=raw_date RENAME=(date_propre=raw_date));
SET table_brute;
date_propre = INPUT(raw_date, MMDDYY10.);
FORMAT date_propre DDMMYY10.;
RUN;
L’intelligence de ce mécanisme réside dans la chronologie différentielle des opérations compilatoires. Durant la phase d’exécution interne du DATA Step, le PDV manipule distinctement la variable source raw_date (qui est lue et analysée) et la variable réceptrice date_propre (qui reçoit le scalaire entier calculé). Ce n’est qu’au moment exact du déversement physique des observations vers la table de sortie table_finale que les options de filtrage et de substitution interviennent : la colonne initiale est écartée du schéma persistant, tandis que la nouvelle variable numérique hérite du libellé original. Une vérification finale sous PROC PRINT certifie la parfaite restitution de la structure nominale initiale, désormais adossée à une variable numérique typée et formatée selon l’état de l’art.
6. Traitement des variations syntaxiques et des délimiteurs irréguliers
6.1 Robustesse des informats standards face aux délimiteurs variés
L’un des atouts architecturaux les plus remarquables des informats temporels natifs de SAS réside dans leur capacité intrinsèque de résilience face à la variabilité des caractères de séparation typographique. Les concepteurs du compilateur ont doté les informats conventionnels (tels que MMDDYYw., DDMMYYw. ou YYMMDDw.) d’un mécanisme d’analyse syntaxique permissif capable de neutraliser les variations de délimiteurs sans exiger de reconfiguration préalable du code.
Ainsi, lorsqu’un informat comme DDMMYY10. est sollicité, il est en mesure de décoder avec une égale précision des chaînes aussi structurellement divergentes que « 15/08/2023 », « 15-08-2023 », « 15.08.2023 » ou même « 15 08 2023 ». L’analyseur lexical ne recherche point un symbole textuel fixe ; il détecte la rupture de continuité numérique induite par l’apparition d’un caractère non alphanumérique quelconque, et utilise cette scansion pour délimiter le quantième, le mois et l’année.
Cette tolérance trouve néanmoins sa stricte limite logique dans l’hypothèse de l’absence totale de séparateurs. Si la chaîne textuelle se présente sous une structure agrégée dense de type « 15082023 », l’informat doit être impérativement calibré avec une largeur géométrique exacte correspondant à la somme des octets significatifs (dans ce cas précis, DDMMYY8.). Si l’analyste applique par mégarde DDMMYY10. à une suite compacte de 8 chiffres sans séparateurs, le pointeur de lecture tentera de consommer deux octets supplémentaires au-delà de la chaîne signifiante, risquant d’absorber des résidus de mémoire adjacents ou d’échouer en générant un scalaire manquant en raison d’un dépassement de bloc inattendu.
6.2 Problématique de l’ambiguïté séculaire et gestion de l’option YEARCUTOFF
Une source critique de distorsion chronologique réside dans le traitement des représentations temporelles tronquées n’exprimant le millésime que sur deux chiffres (par exemple « 12/05/23 » ou « 08/11/98 »). Cette contraction morphologique réintroduit le spectre de l’ambiguïté séculaire, soulevant la question fondamentale : l’année « 23 » renvoie-t-elle à l’an 1923 ou à l’an 2023 ?
Pour arbitrer mathématiquement cette indétermination, l’architecture globale de SAS implémente une option système centrale désignée sous le nom de YEARCUTOFF. Cette option administrative définit une fenêtre glissante continue d’une amplitude fixe de 100 années consécutives, déterminant le siècle d’attribution de toute année encodée sur deux chiffres. La syntaxe canonique d’ajustement de ce paramètre s’exécute hors du DATA Step sous la forme :
OPTIONS YEARCUTOFF = 1920;
Dans cette configuration, la fenêtre d’interprétation centenaire couvre rigoureusement la période s’étendant du 1er janvier 1920 au 31 décembre 2019. Par voie de conséquence, une date présentant le millésime « 23 » sera automatiquement attribuée à l’année 1923, tandis qu’une valeur « 15 » sera projetée sur l’année 2015. Dans les versions modernes de SAS, la valeur par défaut de YEARCUTOFF est généralement fixée à 1926. Toutefois, lors du traitement de cohortes de médecine gériatrique ou de registres généalogiques historiques où figurent des individus centenaires nés au début du XXe siècle, un mauvais calibrage de cette option système induit des décalages massifs d’un siècle entier dans l’estimation de l’âge des sujets, faussant irréversiblement les régressions biostatistiques.
6.3 Harmonisation préalable des chaînes hautement hétérogènes
Il survient fréquemment des situations où l’hétérogénéité des données brutes excède les capacités d’absorption natives des informats standards, notamment lorsque des espaces irréguliers multiples, des délimiteurs composites contradictoires ou des résidus typographiques parasitent le signal textuel. L’ingénieur doit alors déployer une phase d’assainissement mécanique préalable par le biais des fonctions de manipulation de chaînes intégrées à SAS.
La fonction COMPBL() permet de comprimer les suites de blancs contigus en un espace unique standardisé, tandis que la fonction COMPRESS() neutralise sélectivement les symboles dérangeants (tels que la présence simultanée de points-virgules, de tildes ou de guillemets d’échappement accidentellement collés à la date lors de l’exportation CSV). L’application conjointe des fonctions STRIP() et TRIM() garantit l’éradication absolue de tout espace résiduel périphérique avant la soumission de la chaîne à l’informat.
Dans les cas extrêmes où la structure calendaire se trouve éclatée ou hybride, l’analyste peut recourir à un découpage chirurgical du flux d’octets par la fonction SUBSTR(). Cette technique d’extraction positionnelle permet de capturer isolément la sous-chaîne du jour, celle du mois et celle de l’année, pour ensuite les réagencer dans un ordre parfaitement orthodoxe via la fonction de concaténation CATX(). Le produit textuel unifié ainsi reconstitué peut alors être soumis à l’évaluation finale de la fonction INPUT() avec une certitude absolue de conformité structurelle.
7. Utilisation heuristique de l’informat universel ANYDTDTEw.
7.1 Principes algorithmiques et souplesse heuristique d’ANYDTDTEw.
Conscient de la complexité croissante des données non structurées issues de multiples capteurs ou de plateformes décentralisées, SAS a développé un moteur d’inférence sémantique sophistiqué matérialisé par la famille d’informats universels ANYDTDTEw.. Contrairement aux informats conventionnels qui appliquent une règle de grammaire rigide et unidimensionnelle, ANYDTDTEw. met en œuvre une démarche de décodage heuristique dynamique.
Lorsqu’une chaîne de caractères lui est transmise, l’algorithme d’ANYDTDTEw. évalue de façon itérative une multiplicité d’arbres de décision syntaxiques afin de diagnostiquer la disposition des données. Ce moteur est capable d’absorber au sein d’une seule et même colonne de table des enregistrements hétéroclites mêlant des dates textuelles anglo-saxonnes (« 12OCT2022 »), des notations ISO 8601 (« 2022-10-12 »), des conventions françaises avec séparateurs (« 12/10/2022 ») ou des blocs julien continus.
Cette flexibilité algorithmique dispense l’analyste de rédiger de longues cascades de conditions logiques (IF-THEN-ELSE) articulées autour de tests d’expressions régulières fastidieux. Néanmoins, cette puissance d’absorption heuristique a un coût computationnel tangible : l’exécution des boucles d’inférence successives pour chaque ligne de données requiert une charge processeur significativement plus élevée que l’application directe d’un informat déterministe simple, ce qui impose de réserver son usage aux corpus véritablement hétérogènes.
7.2 Risques épistémologiques et gestion de l’ambiguïté jour/mois
En dépit de sa remarquable plasticité opérationnelle, l’emploi de l’informat ANYDTDTEw. introduit un péril méthodologique majeur désigné sous le terme de dilemme de la date symétrique. Lorsqu’une chaîne textuelle présente une configuration numérique comprise dans l’intervalle des douze premiers jours du mois — par exemple « 04/05/2023 » —, il est formellement impossible, pour un être humain comme pour un automate, de déterminer sur la seule base de la syntaxe si cette mention renvoie au 4 mai 2023 ou au 5 avril 2023.
Face à cette indétermination fondamentale, le moteur heuristique de SAS s’en remet à une règle d’arbitrage par défaut pilotée par l’option système globale DATESTYLE. La syntaxe régissant ce paramètre d’arbitrage s’exprime sous la forme :
OPTIONS DATESTYLE = 'DMY';
Si la directive DATESTYLE est configurée sur DMY (Day-Month-Year), l’informat tranchera systématiquement en faveur de la lecture européenne, affectant le chiffre 4 au jour et le chiffre 5 au mois de mai. Si cette option est laissée sur sa configuration américaine native MDY, le compilateur inversera silencieusement les composantes, transmutant la date en 5 avril 2023.
Ce phénomène d’inversion non signalée représente un risque d’introduction de biais de mesure silencieux aux conséquences dramatiques dans les essais cliniques longitudinaux. Les courbes d’incidence et les estimations de survie peuvent se trouver totalement faussées par des décalages chronologiques sporadiques de plusieurs semaines introduits à l’insu de l’expérimentateur. Pour ces motifs, la plupart des unités de recherche clinique et des agences de régulation pharmaceutique (telles que la FDA) restreignent drastiquement l’usage de l’informat ANYDTDTEw. au profit d’informats déterministes contrôlés et validés.
7.3 Diagnostic des erreurs d’interprétation avec ANYDTDTEw.
Dans l’éventualité où l’exploitation d’ANYDTDTEw. s’avère incontournable en raison d’une dégradation extrême du corpus d’entrée, il devient impératif de mettre en place un protocole d’audit et de diagnostic statistique post-conversion destiné à identifier les éventuelles bifurcations conventionnelles illégitimes au sein de la série.
Une méthodologie rigoureuse consiste à construire un jeu de variables de contrôle logique confrontant les valeurs dérivées par l’heuristique à des hypothèses biologiques ou organisationnelles plausibles. Par exemple, au sein d’une série d’inclusions étalée sur une année civile continue, la détection d’une concentration anormale d’événements datés exclusivement entre le 1er et le 12 de chaque mois trahit formellement une bascule erronée de l’informat qui a interverti les jours et les mois pour les valeurs numériques éligibles.
De surcroît, lorsque la chaîne d’entrée présente un motif textuel corrompu dépourvu de tout signal chronologique identifiable, l’algorithme d’ANYDTDTEw. peut, dans certaines versions, produire des interprétations aberrantes en tentant d’agréger des séquences d’octets isolées. L’adjonction de filtres logiques conditionnels vérifiant que les scalaires obtenus s’inscrivent impérativement dans un intervalle de vraisemblance défini (par exemple, entre 01JAN2000 et 31DEC2030) constitue une précaution indispensable pour neutraliser les faux positifs chronologiques générés par le moteur heuristique.
8. Prétraitement et nettoyage des données textuelles corrompues avant conversion
8.1 Épuration des caractères parasites et harmonisation syntaxique
La robustesse d’un pipeline de transformation de données réside dans sa capacité à traiter les scories typographiques en amont de la compilation arithmétique. Les flux d’extraction de bases de données transactionnelles véhiculent fréquemment des caractères invisibles ou non imprimables (tels que des tabulations horizontales, des retours chariot de type CR-LF ou des espaces insécables) qui paralysent la fonction INPUT().
L’utilisation avancée de la fonction COMPRESS() combinée à des modificateurs de paramètres offre une réponse ciblée à cette pollution. L’instruction chaine_epuree = COMPRESS(chaine_brute, , 'kw'); permet d’extraire sélectivement et de ne conserver que les caractères alphanumériques et les symboles d’espacement conventionnels, purgeant instantanément les octets non imprimables et les caractères de contrôle matériel.
Une autre complication récurrente découle de la collision entre encodages de caractères distincts (notamment les disparités entre les pages de code UTF-8 et Windows Latin-1 / ISO-8859-1). La présence de mois abrégés comportant des voyelles accentuées (comme le mois d’août ou de février dans les nomenclatures latines) peut provoquer des ruptures de lecture si la session SAS active n’est pas instanciée sous la variante SAS Unicode (UTF-8). L’application de la fonction TRANWRD() pour substituer chirurgicalement les motifs accentués corrompus (« AOÛ » ou « FÉV ») par leurs équivalents anglophones standards non accentués permet de rétablir un flux d’octets immédiatement digestible par les informats de la famille DATEw..
8.2 Utilisation des expressions régulières (PRXPARSE et PRXCHANGE)
Lorsque la variabilité des données textuelles échappe aux fonctions de nettoyage linéaire, l’intégration des expressions régulières conformes au standard Perl (mécanisme PRX de SAS) confère à l’ingénieur une puissance de filtrage et de réagencement inégalée. L’instruction PRXPARSE initialise la compilation d’un motif structurel d’expression régulière, tandis que la fonction PRXCHANGE exécute des substitutions dynamiques de haute précision.
Cette approche se révèle indispensable lorsque l’information temporelle est enfouie au cœur d’une chaîne de commentaires cliniques libres (telle que « Inclusion réalisée le 14-06-2021 au centre hospitalier »). Grâce à une expression régulière de capture ciblant le motif chronologique spécifique (par exemple : /(d{1,2})[-/](d{1,2})[-/](d{4})/), l’analyste peut extraire sélectivement les groupes de chiffres représentatifs du jour, du mois et de l’année.
Une fois les fragments capturés au moyen de la syntaxe de rétro-référence ($1, $2, $3), PRXCHANGE permet de restructurer le motif extrait sous un agencement textuel parfaitement normalisé (tel que « 2021-06-14 »), immédiatement compatible avec l’informat YYMMDD10.. Cette méthodologie garantit l’éradication des chaînes narratives périphériques et prévient toute transmission de segments textuels parasites à l’instruction INPUT(), éliminant ainsi les causes structurelles d’émission d’erreurs d’invalidation dans le journal de traitement.
8.3 Stratégies face aux dates tronquées et informations manquantes
Une problématique récurrente dans les études épidémiologiques rétrospectives réside dans le recueil d’informations chronologiques incomplètes : il arrive fréquemment que l’année et le mois d’un événement pathologique soient documentés avec certitude, mais que le quantième exact du jour demeure inconnu du patient ou non consigné dans le dossier médical.
La soumission directe d’une chaîne tronquée (telle que « 05/2021 » ou « MAY2021 ») à un informat exigeant une granularité journalière (comme DDMMYY10.) provoque un échec systématique d’interprétation et aboutit à l’assignation indésirable d’une valeur manquante globale. Face à cette situation, l’analyste doit formaliser une règle de gestion empirique validée par le protocole scientifique.
Une convention académique fréquemment adoptée consiste à procéder à une imputation déterministe au premier jour du mois civil identifié (en concaténant arbitrairement le préfixe « 01/ » en amont de la chaîne), ou à imputer la valeur médiane fixée au quinzième jour du mois civil pour minimiser l’erreur absolue moyenne de décalage temporel. Quelle que soit la stratégie d’imputation retenue, il est déontologiquement requis d’instancier une variable indicatrice d’imputation (variable booléenne de flag) au sein de la table SAS. Ce marqueur métrologique permet d’isoler en toute transparence les observations ayant fait l’objet d’une reconstruction artificielle lors des phases ultérieures d’analyse de sensibilité statistique.
9. Gestion des anomalies de conversion et contrôle des erreurs dans le journal
9.1 Mécanique du modificateur d’invalidation (?) et de suppression totale (??)
Le comportement algorithmique par défaut du moteur d’exécution de SAS face à une anomalie de lecture de données textuelles se caractérise par une verbosité explicite : dès que la fonction INPUT() se heurte à une chaîne dont la morphologie viole la syntaxe de l’informat prescrit, le compilateur écrit un avertissement formel dans la log (NOTE: Invalid data for variable...), imprime un extrait brut de la ligne de mémoire corrompue et incrémente la variable automatique du système _ERROR_ en lui affectant la valeur 1.
Si ce dispositif d’alerte s’avère précieux durant la phase de débogage préliminaire sur un échantillon restreint, il devient particulièrement pénalisant lors du traitement de corpus massifs comprenant des millions de lignes intégrant des valeurs textuelles légitimement manquantes ou aberrantes. Le journal d’exécution se trouve alors saturé par des gigaoctets de messages de diagnostic répétés, dégradant les performances d’entrées-sorties et masquant les erreurs critiques d’une autre nature.
Pour réguler finement ce comportement sans interrompre la transformation, SAS met à disposition les modificateurs de formatage d’entrée interrogatifs. L’apposition d’un point d’interrogation unique immédiatement en amont de l’informat (date_num = INPUT(raw_date, ? MMDDYY10.);) neutralise l’impression des extraits de mémoire et supprime les messages d’avertissement répétitifs dans le journal, tout en maintenant la levée du drapeau système _ERROR_=1. L’utilisation du double modificateur interrogatif (date_num = INPUT(raw_date, ?? MMDDYY10.);) accomplit une suppression totale : elle inhibe tout affichage d’erreur dans la log et empêche formellement l’incrémentation de la variable _ERROR_, permettant de maintenir un journal d’exécution immaculé conforme aux exigences d’audit des environnements de production industrielle.
9.2 Traitement différentiel des valeurs manquantes résultantes
Lorsqu’une chaîne de caractères ne peut être résolue par la fonction INPUT(), la valeur affectée à la variable numérique résultante est par défaut la valeur manquante numérique standard de SAS, matérialisée par le point périodique (« . »). Toutefois, l’architecture du système SAS autorise une granularité épistémologique bien supérieure grâce à l’implémentation des valeurs manquantes spéciales (special missing values), représentées par les vingt-six lettres majuscules précédées d’un point (de .A à .Z) ainsi que par le caractère de soulignement (._).
L’exploitation de cette fonctionnalité avancée permet à l’ingénieur de documenter précisément la cause structurelle de la défaillance de conversion plutôt que de l’engloutir dans une valeur manquante indifférenciée. À l’aide de conditions logiques préalables, l’analyste peut assigner la valeur .N lorsque la donnée d’origine était explicitement libellée « Non collectée », .I pour une mention d’origine « Inconnue », ou .E pour caractériser une chaîne syntaxiquement aberrante ou corrompue.
Cette différenciation sémantique s’avère déterminante lors des phases de modélisation biométrique et d’évaluation des biais d’attrition : elle permet d’effectuer un audit rétrospectif transparent sur la nature des données lacunaires et de choisir, pour chaque typologie de données manquantes, les stratégies d’imputation multiple ou de modélisation marginale les plus adaptées sur le plan statistique.
9.3 Surveillance automatisée du journal d’exécution (SAS Log Audit)
Dans tout environnement de recherche certifié ou de biostatistique réglementée (soumis par exemple aux normes de la FDA ou aux recommandations CDISC), l’absence totale de mentions d’erreurs non documentées dans le journal d’exécution constitue une exigence d’audit non négociable. L’automatisation du contrôle de conformité du DATA Step de conversion s’effectue via l’interception programmatique de la variable système automatique _ERROR_.
Puisque la variable _ERROR_ est réinitialisée à 0 au début de chaque itération du DATA Step et bascule à 1 dès qu’une anomalie compilatoire ou une incohérence de données survient, l’analyste peut implémenter une logique de surveillance conditionnelle à la fin de son bloc de traitement :
IF _ERROR_ = 1 THEN DO;
PUTLOG "ALERTE METROLOGIQUE: Rupture de conversion sur l'observation " _N_ " avec la chaîne: " raw_date;
_ERROR_ = 0;
END;
Ce protocole intercepte l’anomalie de manière délibérée, extrait l’information diagnostique précise au moyen de l’instruction PUTLOG pour l’inscrire dans le journal d’audit institutionnel, puis neutralise l’indicateur de faute en le forçant à 0 avant le passage à l’itération suivante. Cette maîtrise algorithmique garantit une traçabilité totale des défaillances de données tout en prévenant l’apparition de messages de panne génériques non contrôlés dans les rapports finaux de validation.
10. Automatisation et passage à l’échelle : Traitements vectorisés et macro-processus
10.1 Traitement simultané de colonnes multiples via les tableaux SAS (ARRAYS)
Les bases de données épidémiologiques contemporaines et les cohortes de recherche en sciences sociales comportent rarement une variable temporelle isolée. Elles intègrent fréquemment des dizaines, voire des centaines d’horodatages longitudinaux relatifs aux dates de visites successives, aux prises de traitements thérapeutiques ou aux jalons d’évaluation psychométrique. La réplication unitaire d’instructions INPUT() individuelles devient alors une source majeure d’inefficacité de programmation et d’erreurs matérielles.
Pour automatiser ce traitement à l’échelle, SAS offre la structure vectorielle des tableaux (ARRAY). L’ingénieur déclare deux tableaux parallèles de dimension équivalente : le premier regroupe l’ensemble des vecteurs de caractères sources à convertir, tandis que le second dimensionne le groupe de variables numériques réceptrices destinées à héberger les scalaires calculés.
L’itération s’effectue au moyen d’une boucle compacte (DO i = 1 TO DIM(tableau_sources);), appliquant l’instruction INPUT() à chaque élément indicé au cours d’un cycle unique de parcours du PDV. L’attribution uniforme du format visuel de sortie peut ensuite s’effectuer en une ligne déclarative unique ciblant l’ensemble des éléments du tableau numérique récepteur. Cette vectorisation logicielle rationalise la syntaxe du programme, élimine les redondances de code et garantit une parfaite homogénéité de typage sur l’ensemble de la matrice multidimensionnelle des données temporelles.
10.2 Industrialisation de la conversion par le langage macro de SAS
Au sein d’un laboratoire de recherche ou d’un centre de gestion de données cliniques, la réutilisation standardisée des algorithmes validés passe par l’implémentation de composants d’automatisation réutilisables développés à l’aide du langage de programmation SAS Macro. Une macro-commande robuste et paramétrée permet d’encapsuler l’intégralité du processus de validation, de conversion, de suppression et de renommage au sein d’une abstraction logicielle unifiée.
Une macro industrielle de conversion reçoit en paramètres d’entrée le nom de la bibliothèque active, le libellé de la table à restructurer, le nom du champ de caractères source et l’informat cible préconisé. À l’intérieur du corps de la macro, le programmeur soumet une interrogation préalable aux métadonnées système via la table de dictionnaire DICTIONARY.COLUMNS (ou sa vue associée SASHELP.VCOLUMN). Cette requête garantit que la variable soumise existe bel et bien et qu’elle présente formellement un typage Char avant d’autoriser le déclenchement du DATA Step de mutation.
Si la condition de validation des métadonnées est remplie, la macro génère dynamiquement le DATA Step de production incorporant les clauses sécurisées d’interception d’erreurs, de masquage des descripteurs de format et d’échange nominal via RENAME. Ce déploiement algorithmique garantit que l’ensemble des analystes de l’institution applique rigoureusement le même niveau d’excellence technique, éliminant les variations de programmation arbitraires d’un projet de recherche à l’autre.
10.3 Considérations de performance sur les très grandes volumétries de données
Lorsque le volume de données à traiter atteint des dimensions massives — dépassant des centaines de millions d’enregistrements représentatifs de données de facturation d’assurance maladie ou de flux de surveillance épidémiologique nationale —, l’efficacité computationnelle de la conversion devient un critère opérationnel prépondérant. Deux architectures de traitement peuvent alors être mobilisées : le DATA Step conventionnel et le moteur relationnel PROC SQL.
Bien que PROC SQL autorise l’usage direct de la fonction INPUT() dans les clauses de sélection (par exemple : SELECT INPUT(raw_date, MMDDYY10.) AS date_num FORMAT=DDMMYY10. FROM source;), cette approche génère une charge processeur souvent plus importante en raison de l’absence d’optimisation bas niveau du cycle d’évaluation du PDV et des contraintes d’ordonnancement relationnel propres au moteur SQL. Le DATA Step demeure nettement plus efficient en termes de débit brut d’entrées-sorties et de consommation de cycles processeur (CPU).
En outre, l’optimisation des performances lors de la conversion de méga-données requiert l’application systématique des options de filtrage DROP= et KEEP= directement au niveau des déclarations de jeux de données d’entrée (sur l’instruction SET) plutôt que dans le corps du DATA Step. Cette restriction géométrique en amont limite drastiquement le volume d’octets transférés depuis le sous-système de disques vers le tampon de mémoire vive, réduisant ainsi la saturation du bus de mémoire du système et accélérant le traitement global des cohortes volumineuses.
11. Applications spécifiques aux plans de recherche empiriques et longitudinaux
11.1 Calcul précis d’intervalles temporels post-conversion
L’aboutissement méthodologique de toute opération de conversion de variables textuelles vers le standard numérique SAS réside dans l’exploitation analytique de la variable temporelle au moyen des fonctions de calcul d’intervalles hautement spécialisées de SAS, au premier rang desquelles figurent INTCK() et INTNX().
La fonction INTCK() permet de quantifier avec une exactitude métrologique absolue le nombre d’intervalles de temps (exprimés en jours, semaines, mois, trimestres ou années) séparant deux dates calendaires converties. Dans le cadre de l’évaluation de la survie globale d’une cohorte ou du calcul de la durée d’exposition cumulée à un agent pharmacologique, l’utilisation de l’option continue 'CONTINUOUS' au sein de INTCK() garantit que le calcul arithmétique mesure le temps exact écoulé sur l’échelle continue, s’affranchissant des effets de bord liés au simple franchissement de frontières calendaires discrètes.
Réciproquement, la fonction INTNX() permet d’incrémenter une date convertie d’un pas temporel discret déterminé, facilitant la modélisation de protocoles expérimentaux longitudinaux où des visites de suivi doivent être planifiées à intervalles rigides de 30, 60 ou 90 jours post-inclusion. L’ancrage rigoureux de ces fonctions sur des scalaires entiers préalablement validés élimine toute instabilité de calcul et garantit la conformité des indicateurs de temps d’exposition indispensables aux modèles à risques proportionnels de Cox et aux courbes actuarielles de Kaplan-Meier.
11.2 Reconstitution du parcours chronologique des participants
Dans les protocoles de recherche longitudinaux répétés, un défi récurrent réside dans la reconstitution de la trajectoire biographique ou clinique exacte des participants suivis au cours du temps. Des données importées depuis des fichiers textuels désordonnés ne reflètent presque jamais la séquence chronologique authentique de survenue des événements pathologiques.
La conversion préalable des horodatages textuels en entiers scalaires continus permet de mobiliser en toute sécurité la procédure de tri relationnel PROC SORT, configurée avec des clauses d’ordonnancement imbriquées : BY patient_id date_visite;. Dès lors que la variable de date est devenue un champ numérique, l’algorithme d’ordonnancement applique un tri mathématique parfait, garantissant que chaque ligne d’observation est physiquement disposée dans l’ordre strict de son occurrence temporelle.
Cette linéarisation chronologique est le prérequis technique absolu pour orchestrer l’identification des événements initiaux et terminaux au sein du DATA Step à l’aide des variables automatiques FIRST.variable et LAST.variable. L’analyste peut ainsi isoler avec une certitude absolue la première consultation d’un sujet, dépister les ruptures ou décrochages de suivi thérapeutique et décompter les délais précis menant à la défection d’un patient au sein de la cohorte.
11.3 Synchronisation de bases disparates dans les études multi-sources
La recherche épidémiologique contemporaine mobilise couramment des architectures de données multi-sources croisant, par exemple, des données d’enquêtes psychométriques déclaratives avec des registres médico-administratifs hospitaliers ou des bases nationales d’allocations de santé. Ces différents écosystèmes transactionnels enregistrent quasi systématiquement leurs composantes temporelles selon des gabarits et des conventions syntaxiques antagonistes.
La synchronisation relationnelle de ces référentiels distincts au moyen d’instructions de fusion (MERGE dans un DATA Step ou jointures relationnelles JOIN sous PROC SQL) est strictement impossible tant que les critères d’appariement chronologique sont maintenus sous des formalismes textuels hétérogènes. Deux enregistrements décrivant un même événement survenu le 1er mai 2023 ne pourront jamais fusionner si l’un porte la chaîne « 01/05/2023 » et l’autre la chaîne « 2023-05-01 ».
L’application méthodique de protocoles de conversion normalisés transforme ces représentations textuelles disparates en un identifiant scalaire temporel universel et univoque : l’entier SAS. Cet alignement métrologique fait disparaître les singularités de saisie des différents centres de collecte, permettant d’exécuter des jointures relationnelles strictes et d’assurer une traçabilité totale des flux d’information au sein des plateformes de recherche translationnelle et des entrepôts de données cliniques centralisés.
12. Bonnes pratiques de programmation, pièges récurrents et guide de dépannage
12.1 Pièges classiques et erreurs conceptuelles fréquentes
L’observation empirique des pratiques de programmation chez les analystes en cours de perfectionnement révèle la persistance de plusieurs erreurs conceptuelles et syntaxiques récurrentes lors de la manipulation des données temporelles sous SAS. La plus dévastatrice réside dans la confusion cognitive entre les fonctions INPUT() et PUT().
Un utilisateur cherchant à convertir une chaîne textuelle en date et soumettant l’instruction erronée nouvelle_date = PUT(chaine_date, DDMMYY10.); contraint le compilateur SAS à tenter une coercition de type implicite désastreuse. Le logiciel cherchera d’abord à convertir la chaîne textuelle en un nombre intermédiaire selon des règles aveugles avant de lui appliquer la fonction PUT(), résultant dans la quasi-totalité des cas en l’émission d’un avertissement explicite dans la log et la génération d’une variable textuelle vide ou corrompue.
Un second piège syntaxique classique réside dans l’omission du point final marquant la fin de l’informat dans la signature de la fonction (par exemple : INPUT(raw_date, MMDDYY10) sans le point terminal). En l’absence de ce délimiteur grammatical obligatoire, le compilateur ne reconnaît point le jeton lexical comme étant un informat SAS certifié : il l’interprète à tort comme l’identifiant d’une variable numérique non initialisée, ce qui entraîne l’échec immédiat de la compilation du bloc de code.
Enfin, la méconnaissance du statut ontologique de la variable entraîne fréquemment des diagnostics d’erreur illégitimes : l’analyste, observant l’entier relatif brut d’une date convertie pour laquelle l’instruction FORMAT a été omise, conclut à tort à une corruption logicielle et déploie des routines de correction inutiles, alors qu’il suffisait d’appliquer le masque visuel adapté pour restituer la morphologie calendaire souhaitée.
12.2 Liste de contrôle méthodologique pour l’ingénieur de données SAS
Pour garantir la conformité scientifique et réglementaire des processus de prétraitement de données, tout ingénieur de données et biostatisticien opérant sous SAS devrait soumettre sa production à une liste de contrôle méthodologique formalisée préalablement au versement des tables converties dans l’environnement d’analyse finale :
- Audit d’intégrité du journal d’exécution : Vérifier scrupuleusement l’absence totale de messages
ERROR:,WARNING:etNOTE: Invalid datasur l’ensemble de la log globale du projet. - Vérification métrologique de typage : Confirmer via
PROC CONTENTSque l’attribut Type de la variable transformée est formellement enregistré commeNum, et qu’un descripteur de format d’affichage explicite lui est attaché. - Conservation des effectifs et audit des données manquantes : Effectuer un comptage comparatif strict du nombre total d’observations ainsi que du volume de valeurs manquantes avant et après l’opération de conversion, afin de s’assurer qu’aucun enregistrement valide n’a été corrompu en donnée manquante non planifiée.
- Validation de l’alignement géopolitique et régional : Certifier que le choix de l’informat (notamment la distinction
DDMMYYw.versusMMDDYYw.) concorde rigoureusement avec les normes administratives du pays ou des centres cliniques ayant procédé au recueil initial des données. - Audit de cohérence de distribution temporelle : Exécuter une procédure
PROC MEANSouPROC UNIVARIATEpour inspecter les bornes chronologiques minimales et maximales obtenues, validant la vraisemblance biologique et historique des observations. - Documentation et traçabilité : Consigner explicitement dans le cahier d’observation électronique de programmation les règles de gestion appliquées aux valeurs textuelles manquantes ou corrompues (notamment le détail des imputations partielles ou des expressions régulières mobilisées).
12.3 Modèle d’implémentation standardisé (Code de référence prêt pour la production)
Afin de clore ce corpus méthodologique par un composant directement opérationnel, la section suivante présente l’architecture logicielle standardisée d’un DATA Step complet de production intégrant les meilleures pratiques d’ingénierie logicielle SAS : validation de conformité, suppression du bruit typographique, lecture protégée par modificateurs d’erreurs, assignation de format, sécurisation de la mémoire et réassignation nominale par substitution.
Le bloc déclaratif de référence se structure comme suit :
DATA etude_clinique_validee (DROP=_char_date _clean_date);
SET source_hospitaliere (RENAME=(date_recueil=_char_date));
LENGTH _clean_date $10;
/* Épuration préalable des caractères de contrôle et blancs parasites */
_clean_date = STRIP(COMPRESS(_char_date, , 'kw'));
/* Conversion sécurisée avec modificateurs interrogatifs doubles */
IF _clean_date NE '' THEN DO;
date_recueil = INPUT(_clean_date, ?? DDMMYY10.);
IF date_recueil = . THEN DO;
/* Attribution d'une valeur manquante spéciale pour rupture d'intégrité */
date_recueil = .I;
PUTLOG "AVERTISSEMENT: Valeur textuelle non convertible ligne " _N_ " : " _char_date;
END;
END;
ELSE DO;
date_recueil = .;
END;
/* Assignation pérenne du format d'extériorisation */
FORMAT date_recueil DDMMYY10.;
LABEL date_recueil = "Date standardisée de recueil clinique (Entier SAS)";
RUN;
Ce script de référence réunit l’intégralité des préceptes théoriques et méthodologiques énoncés tout au long du présent article. Il garantit la préservation de la traçabilité des enregistrements, élimine tout risque de corruption silencieuse de la table de données, maintient une propreté absolue du journal d’exécution et délivre une variable temporelle possédant toutes les qualités métrologiques requises pour soutenir les analyses biostatistiques les plus rigoureuses de la recherche contemporaine.
Références
Cody, R. (2018). Cody’s Data Cleaning Techniques Using SAS (3rd ed.). SAS Institute Inc. https://support.sas.com/pub/pubsearch.jsp
Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc. https://www.sas.com/store/books/categories/usage-and-reference/the-little-sas-book-sixth-edition/prodBK_69046_en.html
International Organization for Standardization. (2019). Date and time — Representations for information interchange — Part 1: Basic rules (ISO Standard No. 8601-1:2019). https://www.iso.org/standard/70907.html
SAS Institute Inc. (2021). SAS® 9.4 Formats and Informats: Reference. SAS Institute Inc. https://go.documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/leforinforref/titlepage.htm
SAS Institute Inc. (2023). SAS® 9.4 Language Reference: Concepts (6th ed.). SAS Institute Inc. https://go.documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lrcon/titlepage.htm
U.S. Food and Drug Administration. (2021). Data Standards Manual: Monograph on Date and Time Formats. U.S. Department of Health and Human Services. https://www.fda.gov/industry/fda-data-standards-advisory-board/fda-data-standards-manual-monographs