
Dans le paysage contemporain du traitement et de l’analyse exploratoire de données, les tableurs infonuagiques occupent une place prépondérante, à la croisée de l’accessibilité ergonomique et de la puissance calculatoire. Au sein de cet écosystème, l’application Google Sheets se distingue par l’intégration d’un moteur d’interrogation particulièrement sophistiqué, matérialisé par la fonction QUERY. Cette fonction transcende les paradigmes traditionnels d’évaluation cellulaire itérative en introduisant un modèle déclaratif inspiré du langage de requête structuré (SQL). L’utilisateur ne spécifie plus une succession d’opérations algorithmiques locales, mais formule une intention analytique globale que le moteur sous-jacent optimise et exécute sur des matrices de données arbitrairement complexes.
Au cœur de ce dispositif computationnel, l’opérateur d’agrégation COUNT constitue l’un des piliers méthodologiques fondamentaux de l’inférence quantitative et de la statistique descriptive. Le dénombrement, acte élémentaire en apparence, sous-tend en réalité l’ensemble des métriques d’effectifs, de fréquences relatives, de taux de prévalence et d’estimations probabilistes au sein des corpus observationnels ou expérimentaux. Déployé à travers la clause déclarative de Google Sheets, l’opérateur COUNT permet d’agréger, de filtrer, de partitionner et de pivoter des volumétries massives avec une concision syntaxique et une frugalité de mémoire vive que les fonctions matricielles conventionnelles ne sauraient égaler sans dégradation notable des performances logicielles.
Le présent traité constitue un exposé exhaustif et rigoureux de l’architecture, de la syntaxe et des applications empiriques de l’opérateur COUNT au sein de la fonction QUERY. À travers une progression didactique articulée autour de fondements théoriques, de considérations typologiques strictes et de cas d’usage contextualisés, ce document vise à doter les analystes, chercheurs quantitatifs et ingénieurs de données des compétences requises pour exploiter pleinement la puissance de calcul de Google Sheets, tout en prévenant les biais silencieux inhérents aux disparités de typage ou aux anomalies structurelles de données tabulaires.
1. Fondements théoriques de la fonction QUERY et du mécanisme d’agrégation COUNT
1.1 Architecture du langage de requête de l’API de visualisation Google
L’architecture interne de la fonction QUERY repose directement sur le langage de requête de l’API Google Visualization (Google Visualization API Query Language). Ce dialecte pseudo-SQL a été conçu pour standardiser et externaliser la manipulation analytique de structures de données tabulaires avant leur projection graphique ou leur restitution matricielle. Contrairement au standard ANSI SQL, ce langage opère dans un environnement client-serveur hybride où la source de données est constituée non pas de tables relationnelles indexées sur disque physique, mais d’une plage matricielle de cellules hébergée en mémoire vive au sein du navigateur ou des serveurs distribués de Google.
La sémantique de l’évaluation déclarative qui caractérise QUERY s’oppose fondamentalement à l’évaluation impérative ou fonctionnelle des formules de tableur classiques. Alors qu’un enchaînement matriciel conventionnel évalue chaque cellule de manière itérative ou via des tableaux dynamiques expansifs, QUERY compile la chaîne d’instructions textuelles en un arbre syntaxique abstrait (Abstract Syntax Tree, AST). Le flux d’exécution logique s’amorce par l’ingestion de la plage matricielle source, se poursuit par l’inférence typologique des colonnes, applique séquentiellement les prédicats de filtrage et d’agrégation, puis restitue une nouvelle matrice dimensionnée exactement selon les spécifications de sortie.
Cette délégation computationnelle confère des avantages majeurs. Le moteur d’évaluation optimise le graphe de dépendance et minimise les allocations de mémoire tampon. L’agrégation est ainsi opérée en amont de la génération des cellules individuelles de sortie, ce qui évite la saturation du moteur de calcul JavaScript du navigateur web lors de la manipulation de jeux de données massifs comprenant des dizaines de milliers d’enregistrements.
1.2 Typologie et spécificités de l’opérateur COUNT
D’un point de vue formel, le dénombrement au sein d’un ensemble de données structuré consiste en l’application d’un morphisme mesurant le cardinal d’un sous-ensemble d’observations satisfaisant un prédicat d’appartenance déterminé. Au sein de la fonction QUERY, l’opérateur COUNT n’opère pas comme une simple fonction scalaire qui renverrait une valeur élémentaire pour une référence donnée, mais comme un opérateur d’agrégation relationnelle opérant sur une colonne vectorielle pour en réduire la dimensionnalité à un scalaire unique ou à un vecteur partitionné.
Il convient d’établir une distinction opératoire rigoureuse entre le comptage scalaire, le comptage matriciel itératif et l’agrégation relationnelle propre à COUNT. Le comptage scalaire traite chaque unité d’information de manière isolée. Le comptage matriciel procède par évaluation booléenne d’un tableau d’éléments binaires. En revanche, l’agrégation relationnelle COUNT de l’API Visualization scanne la colonne spécifiée en tant qu’attribut formel, ignore les entités sémantiquement nulles, et préserve l’intégrité de l’alignement dimensionnel en présence de clauses de partitionnement.
En outre, l’opérateur COUNT applique un traitement différencié selon les types primitifs soumis à son analyse. Contrairement à certaines représentations erronées, COUNT dans QUERY est polymorphe : il est capable de recenser des chaînes de caractères (string), des nombres réels ou entiers (number), des valeurs temporelles (date, datetime, timeofday) ainsi que des booléens (boolean). Toutefois, la condition absolue de son incrémentation repose sur la présence d’une valeur reconnue et conforme au type dominant de la colonne observée, rejetant les cellules vides ou corrompues.
1.3 Analyse comparative : COUNT() dans QUERY versus fonctions natives NB et NBVAL
Les utilisateurs avancés de tableurs hésitent fréquemment entre l’usage des primitives natives telles que NB, NBVAL, NB.SI ou NB.SI.ENS et le recours systématique à QUERY avec COUNT. Les fonctions natives souffrent de limites computationnelles structurelles lorsqu’elles sont déployées sur de très grands volumes de données ou au sein de modèles prévisionnels comportant des centaines d’évaluations conditionnelles croisées. Les formules imbriquées génèrent une dette technique et une charge cognitive considérables, exigeant la duplication constante des plages d’analyse pour chaque critère additionnel.
À l’inverse, l’unification d’une requête analytique au sein d’une unique chaîne textuelle paramétrée apporte une lisibilité conceptuelle supérieure. Une seule formule QUERY peut encapsuler simultanément le filtrage multidimensionnel, l’agrégation de plusieurs métriques, le regroupement catégoriel, le tri et le formatage, réduisant ainsi la complexité du graphe de dépendance du classeur. Cette compacité garantit une auditabilité accrue du modèle analytique lors des revues de code ou des contrôles de qualité des données.
Cependant, une disparité comportementale cruciale réside dans la gestion de l’hétérogénéité des types de données. Les fonctions natives telles que NBVAL dénombrent indifféremment toute cellule contenant un contenu textuel, numérique, logique ou une formule renvoyant une chaîne vide. L’opérateur COUNT de QUERY obéit quant à lui à la règle stricte du type majoritaire imposée par l’API Google. Si une colonne contient une prépondérance de valeurs numériques mais intègre sporadiquement des annotations textuelles, QUERY considérera la colonne comme strictement numérique et ignorera silencieusement les cellules textuelles lors du dénombrement, un comportement fondamental qui nécessite un prétraitement scrupuleux de la source.
2. Structuration et prétraitement des données pour une agrégation rigoureuse
2.1 Normalisation de la matrice source
Pour qu’une requête d’agrégation matricielle produise des résultats déterministes et exempts d’artefacts, la matrice source doit se conformer aux principes de normalisation relationnelle élémentaire. L’exigence fondamentale réside dans la rectangularité stricte de la plage de données. Chaque ligne doit représenter une unité d’observation homogène, et chaque colonne doit correspondre à une variable ou un attribut invariant. La présence de plages asymétriques, de cellules fusionnées ou de décalages dimensionnels dénature la lecture séquentielle effectuée par l’interpréteur de requête.
La distinction formelle entre métadonnées et données observationnelles constitue un impératif méthodologique. La ligne d’en-tête doit comporter exclusivement des identifiants sémantiques textuels univoques, dépourvus de retours à la ligne superflus ou de caractères d’échappement ambigus. Toute tentative d’introduire des sous-titres, des totaux intermédiaires ou des notes méthodologiques au sein même du corps de la matrice corrompt la distribution statistique des types de données et fausse le dénombrement.
De surcroît, l’impact des lignes intercalaires vierges ne doit pas être sous-estimé. Si une ligne entièrement vide est insérée par inadvertance au sein du corpus de données, le moteur de Google Sheets peut, selon la configuration des arguments de la fonction, interpréter cette rupture comme une frontière structurelle ou inclure ces enregistrements vides dans les ensembles de regroupement partitionné, générant ainsi des catégories fantômes affublées d’un dénombrement non nul.
2.2 Gestion de la pureté typologique des colonnes
Le moteur d’inférence de l’API Google Visualization attribue de façon déterministe un type de données unique à chaque colonne d’une table de données. Ce processus d’assignation scanne les premières lignes de la plage et détermine si la colonne doit être traitée comme une série numérique, textuelle, temporelle ou booléenne. Dès lors qu’une typologie dominante est établie (généralement à un seuil majoritaire empirique), tout enregistrement déviant au sein de la même colonne est considéré comme une discordance de type irréconciliable.
Cette particularité architecturale entraîne un effet destructeur majeur : la disparition silencieuse de données lors de l’agrégation. Par exemple, si une colonne recensant des identifiants d’inventaire contient majoritairement des chaînes de chiffres (interprétées comme des entiers) et occasionnellement des identifiants alphanumériques contenant des lettres, ces derniers seront convertis en valeurs nulles internes lors de l’exécution de la requête. Par conséquent, l’opérateur COUNT ne les comptabilisera pas, induisant une sous-estimation systématique de l’effectif réel sans qu’aucun message d’erreur d’exécution ne soit levé par le logiciel.
Pour pallier cette vulnérabilité analytique, il est nécessaire de mettre en œuvre des stratégies de conversion explicite préalable. L’utilisation en amont de fonctions de coercition typologique telles que TO_TEXT ou l’adjonction d’un préfixe apostrophe unifié garantit que l’intégralité du vecteur matriciel est convertie au format chaîne. De même, pour les données quantitatives polluées par des mentions textuelles (telles que « N/A » ou « En attente »), une opération de nettoyage matriciel préalable via ARRAYFORMULA et REGEXREPLACE s’avère indispensable avant d’alimenter la fonction QUERY.
2.3 Traitement méthodologique des valeurs manquantes et nulles
L’analyse rigoureuse des données impose une différenciation conceptuelle nette entre trois états fondamentaux d’une cellule : l’absence d’information (cellule vide ou valeur NULL au sens relationnel), la chaîne de caractères de longueur nulle (« ») issue d’une formule conditionnelle, et la valeur scalaire zéro (0). Chacun de ces états induit des conséquences radicalement divergentes sur le comportement de l’opérateur COUNT au sein du dialecte de requête de Google Sheets.
L’opérateur COUNT ignore systématiquement les cellules authentiquement vides (NULL). Si une colonne spécifique est ciblée par l’instruction count(ColX), le résultat reflétera exclusivement le nombre de lignes où ColX contient une valeur typologiquement valide non nulle. En revanche, si la cellule contient un zéro numérique (0) ou une valeur booléenne FALSE, l’opérateur la considère comme une observation effective et l’incrémente dans son dénombrement. La chaîne vide (« ») peut quant à elle être interprétée comme une valeur textuelle valide si la colonne est typée en texte, ou comme une valeur nulle si la colonne est typée en numérique.
Cette mécanique a un impact direct sur l’établissement des dénominateurs statistiques. Dans les protocoles de recherche quantitative, omettre de distinguer les non-réponses des réponses nulles conduit à biaiser le calcul des fréquences relatives et des indices de complétude. Le choix judicieux de la colonne passée en paramètre à l’opérateur COUNT conditionne donc la validité interne de l’ensemble des proportions dérivées ultérieurement.
3. Méthode 1 : Dénombrement exhaustif sans contrainte (Total des occurrences)
3.1 Syntaxe canonique de base : SELECT COUNT(colonne)
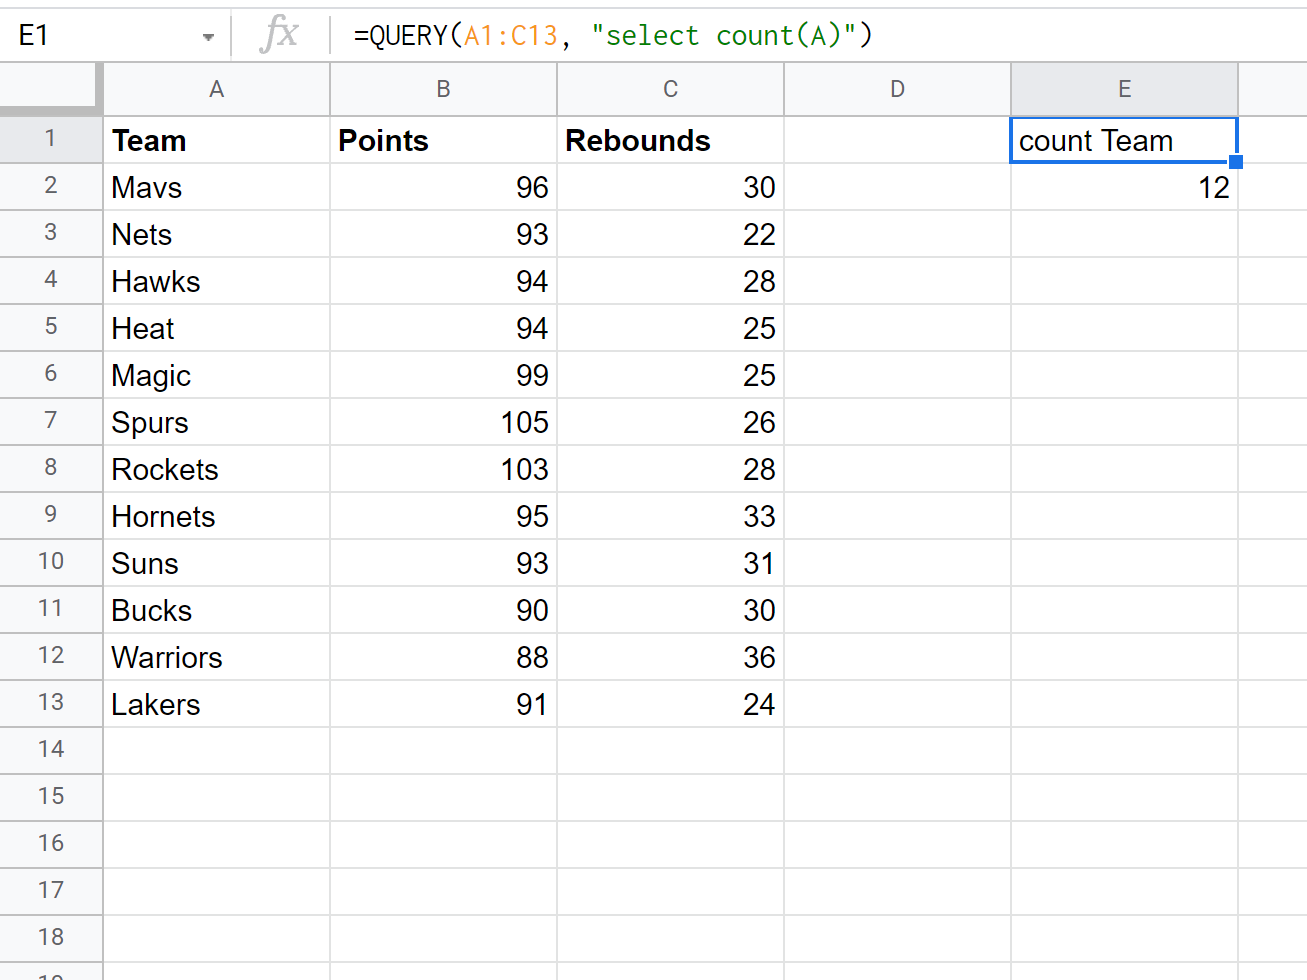
La formulation la plus dépouillée de l’agrégation univariée repose sur une syntaxe élémentaire qui condense l’ensemble de la logique déclarative. La structure minimale prend la forme canonique suivante dans la barre de formule de Google Sheets :
=QUERY(A1:C13; « select count(A) »)
Dans cette expression, le premier argument spécifie la matrice bidimensionnelle d’investigation, tandis que le second argument transmet la commande textuelle au compilateur interne. Le verbe d’action select ordonne la projection du résultat, et l’opérateur count(A) stipule l’exécution de la réduction cardinale sur les éléments vectoriels situés dans la colonne A de la plage spécifiée.
Le choix de la colonne passée comme argument opératoire au sein de la fonction COUNT revêt une importance stratégique majeure. Si la colonne A comporte des cellules non renseignées mais que l’analyste cherche à quantifier le volume global de lignes d’enregistrement dans la table, cibler la colonne A produira une sous-estimation du nombre total d’observations. Dans un tel contexte, il convient de cibler systématiquement une colonne d’indexation primaire, c’est-à-dire un champ dont la présence est garantie pour chaque enregistrement (comme un identifiant unique ou une clé d’enregistrement invariante).
Par défaut, l’interpréteur de requête génère automatiquement une étiquette textuelle surplombant la valeur numérique calculée. Cette étiquette adopte invariablement la nomenclature standardisée constituée du nom de l’opérateur suivi de l’identifiant de la colonne traitée (par exemple, « count A » ou « count Code »). Cette caractéristique nécessite un ajustement technique rigoureux dès lors que le résultat doit être réinjecté dans une chaîne de traitement automatisée sans être altéré par cette ligne d’en-tête imprévue.
3.2 Paramétrage précis de l’argument d’en-tête
La fonction QUERY accepte un troisième argument, fréquemment négligé ou mal compris des utilisateurs : l’argument headers. Cet entier naturel facultatif indique formellement au moteur le nombre de lignes initiales de la plage de données qui doivent être interprétées exclusivement comme des métadonnées descriptives (en-têtes de colonnes) et exclues du corpus observationnel à traiter analytiquement.
Lorsque cet argument est omis, Google Sheets engage un algorithme d’inférence heuristique pour deviner la présence et le volume d’en-têtes en analysant les écarts typologiques entre la première ligne et les lignes subséquentes. Si la première ligne contient des chaînes textuelles alors que le reste de la colonne est majoritairement composé de nombres, l’algorithme déduit correctement la présence d’un en-tête unique. Toutefois, si la matrice est uniformément textuelle ou si les données observationnelles comportent des libellés qualitatifs similaires aux titres de colonnes, l’heuristique échoue fréquemment.
L’omission de ce paramètre peut conduire à deux dérives majeures : l’inclusion accidentelle du titre de la colonne dans le dénombrement (générant un faux positif unitaire artificiel), ou au contraire l’absorption de données empiriques légitimes dans la zone de métadonnées. La rigueur scientifique impose de fixer explicitement cet argument à 1 (ou au nombre exact de lignes d’en-tête effectives) lors de chaque instanciation de QUERY, garantissant la reproductibilité computationnelle du dénombrement.
3.3 Optimisation des performances sur les jeux de données massifs
L’évaluation des temps de calcul et de la consommation des ressources matérielles démontre une supériorité substantielle de l’opérateur COUNT intégré à QUERY par rapport aux constructions itératives matricielles. Lors du traitement de bases de données dépassant plusieurs dizaines de milliers de lignes au sein de Google Sheets, l’emploi de formules de type SUMPRODUCT (SOMMEPROD) ou de formules imbriquées ARRAYFORMULA(COUNTIF(…)) provoque une saturation progressive de la pile d’exécution du navigateur et un gel temporaire de l’interface utilisateur.
QUERY minimise cette latence computationnelle grâce à sa compilation interne vectorisée. Cependant, pour préserver cette efficience, une bonne pratique absolue consiste à proscrire l’usage inconsidéré de plages ouvertes non bornées lorsque la base de données est volatile. Déclarer une plage sous la forme A:C force le moteur à allouer un espace mémoire virtuel couvrant l’intégralité de la capacité maximale de la feuille de calcul (souvent plusieurs dizaines de milliers de lignes vides résiduelles), ce qui ralentit considérablement la vitesse de balayage de la fonction.
Il est préconisé de borner rigoureusement les coordonnées de la matrice (par exemple A1:C15000) ou d’encapsuler la plage au sein d’une fonction de réduction dynamique préalable qui élimine les lignes vides en amont, garantissant ainsi que l’opérateur COUNT focalise son allocation de mémoire vive exclusivement sur les enregistrements physiquement porteurs de données.
4. Méthode 2 : Dénombrement conditionnel à critère univarié via la clause WHERE
4.1 Filtrage sur variables quantitatives continues et discrètes
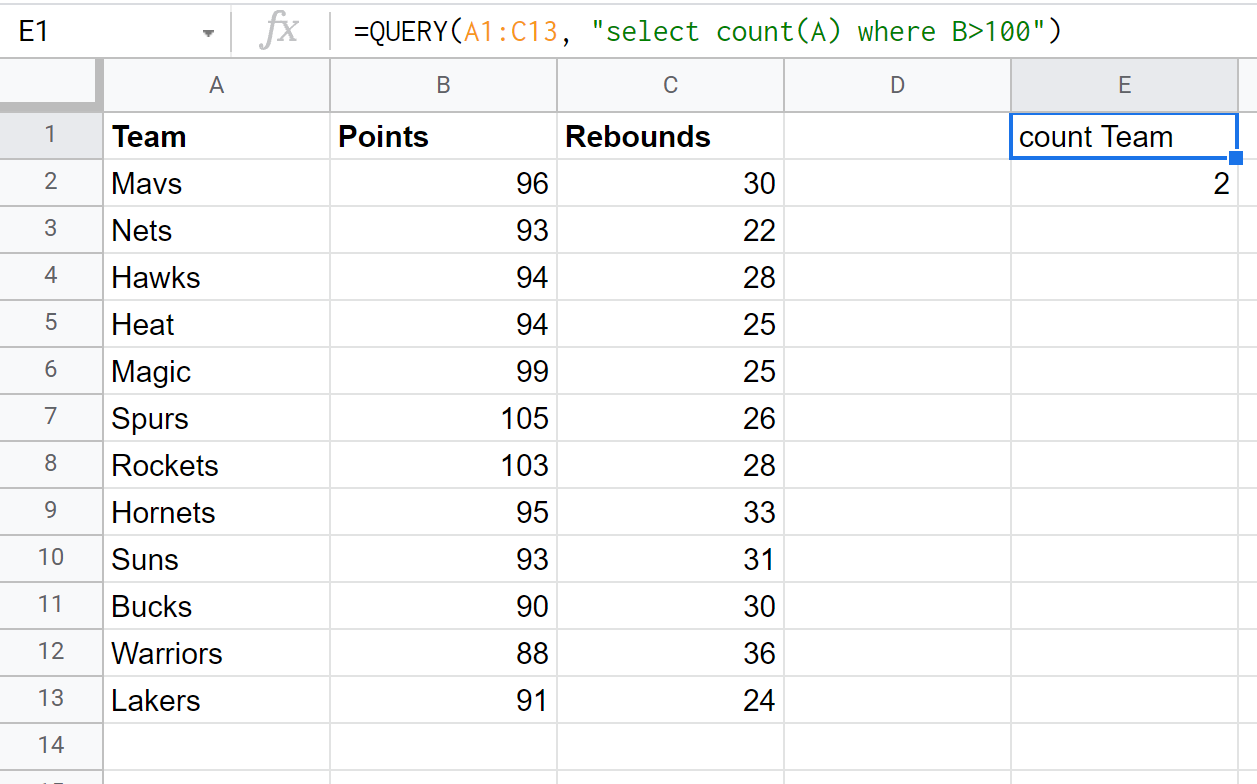
Le dénombrement prend toute sa valeur analytique lorsqu’il est subordonné à des contraintes logiques discriminantes. L’adjonction de la clause WHERE permet d’introduire un filtrage conditionnel univarié opérant une restriction sélective sur l’ensemble des observations avant l’exécution du dénombrement par l’opérateur COUNT. La syntaxe canonique s’articule ainsi :
=QUERY(A1:C13; « select count(A) where B > 100 »; 1)
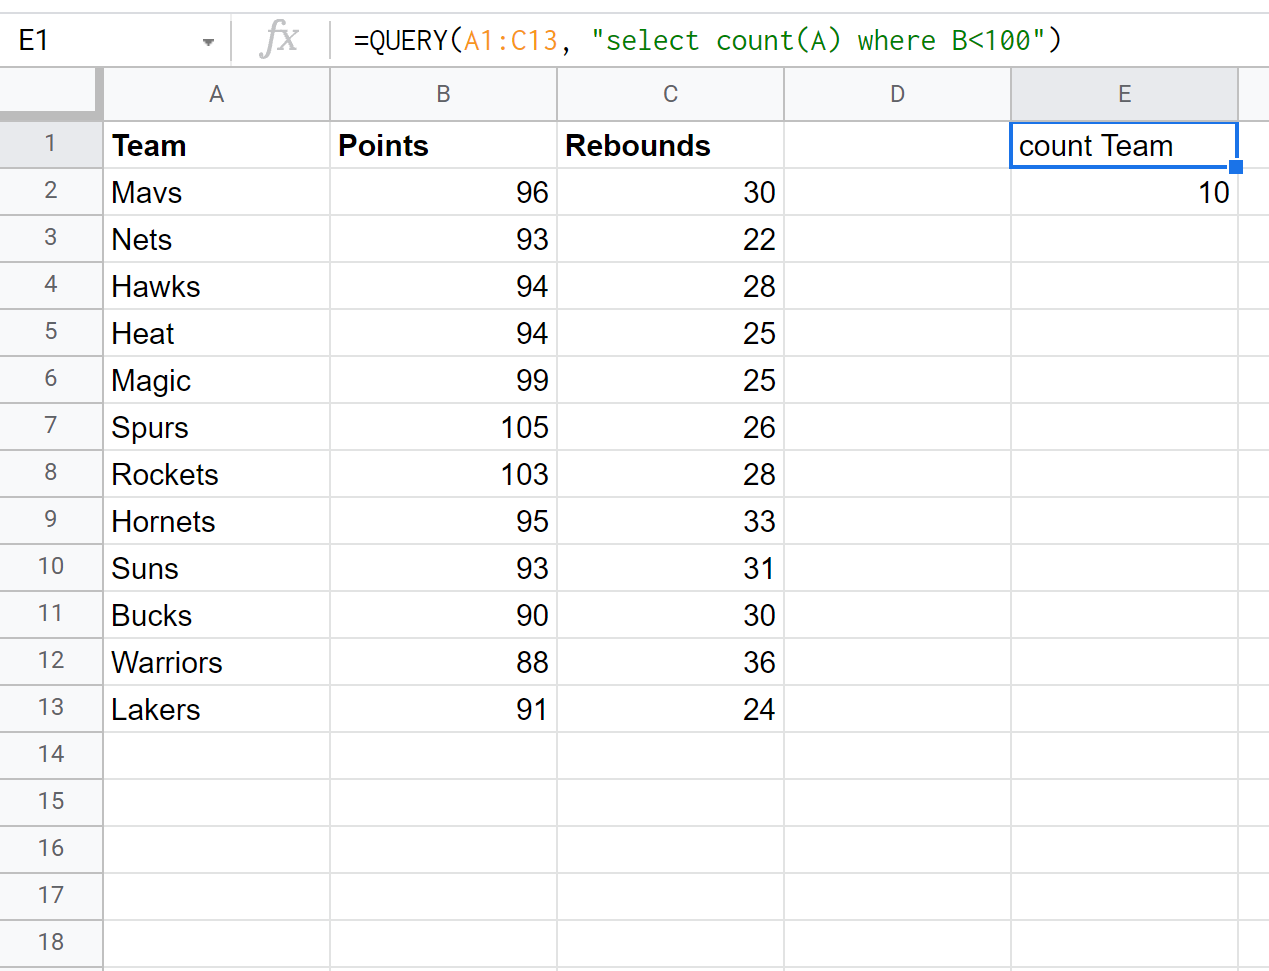
Dans cette modélisation, le moteur évalue le prédicat arithmétique appliqué à la colonne B pour chaque ligne de la matrice. Seuls les tuples pour lesquels la condition s’évalue formellement à TRUE sont conservés dans le sous-ensemble matriciel temporaire transmis à l’opérateur d’agrégation. Les opérateurs relationnels standardisés sont intégralement pris en charge par l’interpréteur : l’égalité stricte (=), l’inégalité ou différence (!= ou <>), ainsi que les inégalités strictes ou larges (<, <=, >, >=).
Cette approche permet d’isoler instantanément des métriques d’intérêt épidémiologique ou financier, telles que le nombre de participants présentant une mesure biométrique supérieure à un seuil pathologique standardisé, ou le nombre de transactions financières dépassant un plafond d’alerte. L’évaluation s’effectue sans aucune instanciation de colonnes intermédiaires, préservant la pureté conceptuelle de la feuille de calcul.
4.2 Filtrage sur variables qualitatives nominales
Le filtrage de variables catégorielles ou nominales exige le respect scrupuleux d’un formalisme syntaxique rigide imposé par l’analyseur lexical de la visualisation Google. Contrairement aux valeurs numériques qui s’expriment sous forme de littéraux nus, toute chaîne de caractères introduite au sein de la clause WHERE doit être obligatoirement délimitée par des apostrophes simples (guillemets simples : ‘valeur’). L’absence de ces délimiteurs provoque une erreur immédiate d’analyse syntaxique (parse error).
De plus, l’opérateur de comparaison textuelle se caractérise par une stricte sensibilité à la casse (majuscules et minuscules). L’instruction conditionnelle where A = ‘PARIS’ ignorera irrémédiablement les enregistrements contenant « Paris » ou « paris ». Pour garantir la robustesse du dénombrement face aux aléas de la saisie utilisateur, il est méthodologiquement recommandé de normaliser la comparaison en utilisant les fonctions scalaires de conversion de casse intégrées au langage de requête, telles que lower() ou upper(), par exemple : where lower(A) = ‘paris’.
Une complexité technique additionnelle survient lorsque la valeur textuelle recherchée renferme intrinsèquement une apostrophe (par exemple, « l’oréal » ou « d’Alembert »). Dans cette configuration, l’apostrophe interne entre en conflit direct avec le délimiteur syntaxique de la chaîne. Il devient impératif d’échapper ce caractère ou d’utiliser des stratégies d’assemblage spécifiques, faute de quoi le compilateur interprète l’apostrophe textuelle comme la terminaison prématurée du littéral, générant une rupture syntaxique irrécupérable.
4.3 Filtrage temporel : manipulation des dates et horodatages
L’application de critères de dénombrement sur des dimensions chronologiques représente l’une des sources d’erreurs les plus courantes au sein de la fonction QUERY. Les variables de date hébergées dans Google Sheets sont stockées sous-jacemment sous forme de numéros de série séquentiels (le nombre de jours écoulés depuis le 30 décembre 1899), mais le compilateur de requêtes n’interprète pas les chaînes temporelles usuelles au format local (tel que « JJ/MM/AAAA »).
Pour être reconnue par la clause WHERE, une date littérale doit être explicitement déclarée en précédant la chaîne du mot-clé réservé date, suivi impérativement de la valeur chronologique au format international standardisé ISO 8601, à savoir strictement ‘YYYY-MM-DD’. La syntaxe canonique de dénombrement temporel prend ainsi la forme :
=QUERY(A1:C13; « select count(A) where C >= date ‘2023-01-01′ »; 1)
Le langage met également à disposition des analystes des fonctions d’extraction scalaires permettant de segmenter les composants temporels sans nécessiter la construction d’une chaîne complète de date. Les fonctions year(), month(), et day() peuvent être appelées directement au sein du prédicat conditionnel. Il importe toutefois de souligner une idiosyncrasie fondamentale de l’API Google Visualization : la fonction month() opère selon une indexation base zéro (où le mois de janvier correspond à la valeur 0 et le mois de décembre à la valeur 11), ce qui exige un décalage computationnel systématique de la part de l’analyste sous peine d’induire un déphasage temporel d’un mois dans les résultats statistiques.
5. Méthode 3 : Dénombrement multi-critères et articulation logique avancée
5.1 Conjonction stricte : L’opérateur AND
L’investigation empirique nécessite fréquemment l’intersection simultanée de plusieurs dimensions analytiques. La conjonction stricte est formalisée au sein de la clause WHERE par l’opérateur logique AND. Sur le plan de la théorie des ensembles, cet opérateur modélise l’intersection de deux ou plusieurs sous-ensembles d’observations, retenant exclusivement les enregistrements qui satisfont concomitamment l’ensemble des prédicats formulés :
=QUERY(A1:D20; « select count(A) where B = ‘Mavs’ and C > 100 »; 1)
Le flux d’exécution évalue séquentiellement les conditions. Dès lors qu’une ligne de données invalide le premier prédicat, le moteur court-circuite l’évaluation des prédicats subséquents pour cette ligne spécifique, optimisant ainsi le traitement de matrices volumineuses. L’opérateur COUNT agrège l’ensemble résiduel final correspondant à l’intersection logique parfaite.
Une attention méthodologique particulière doit être portée à la gestion des intersections nulles. Lorsqu’aucun enregistrement de la matrice ne satisfait l’ensemble combiné des conditions conjonctives, la requête ne renvoie pas un scalaire zéro (0), mais déclenche un état de retour vide. En l’absence de précaution, cet état peut propager une erreur #N/A dans les cellules adjacentes, nécessitant l’adjonction protectrice de la fonction native IFNA ou SI.NON.DISP pour contraindre formellement l’affichage d’un zéro explicite indispensable aux bilans comptables ou statistiques.
5.2 Disjonction inclusive : L’opérateur OR
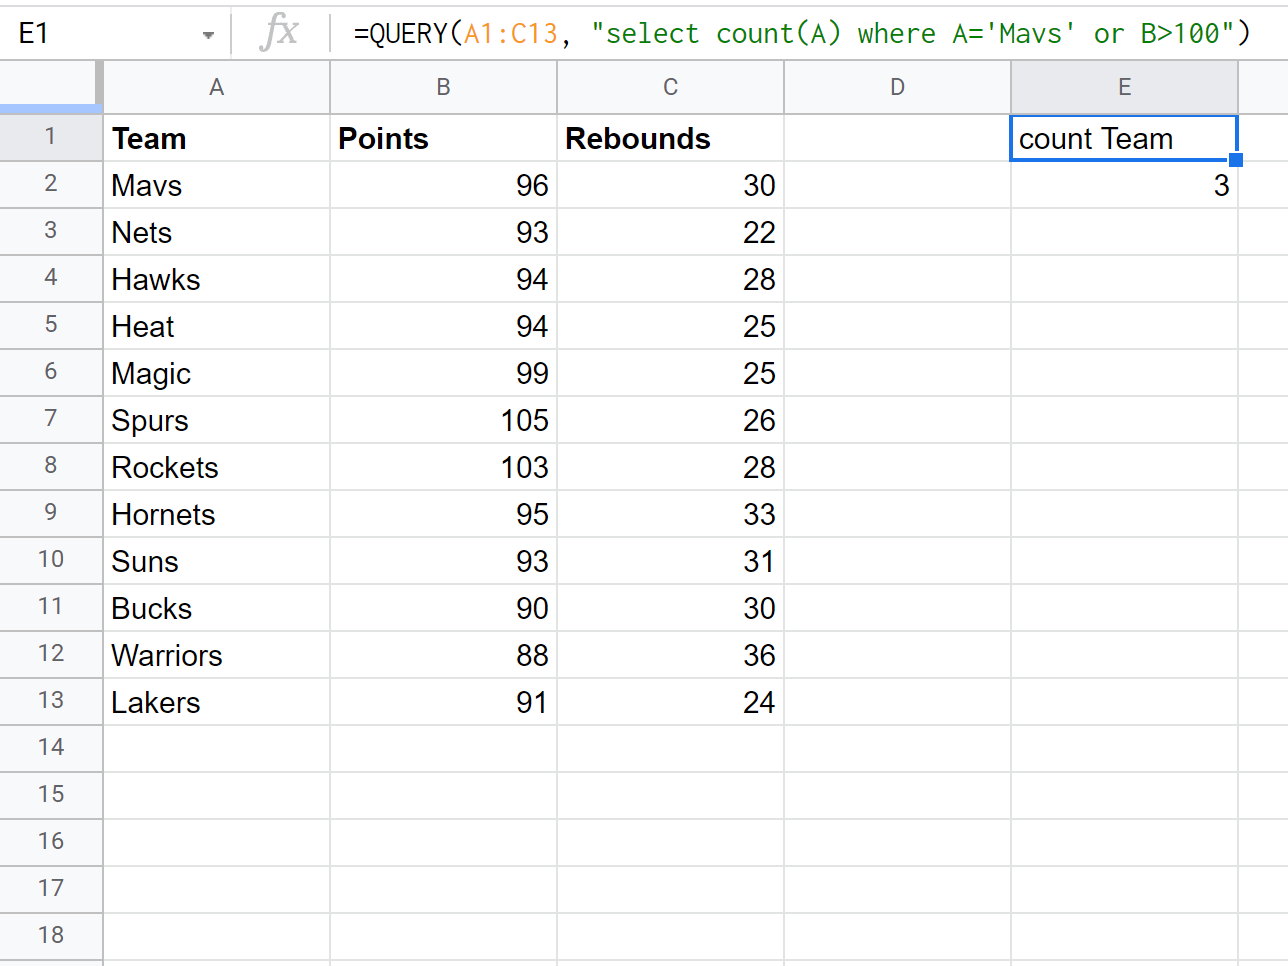
À l’opposé de la conjonction, la disjonction modélise l’union logique de sous-ensembles de données et s’exprime par l’opérateur booléen OR. L’application de cet opérateur ordonne à la fonction de recenser toute ligne validant au moins l’un des critères formulés, indépendamment de la validité des autres conditions :
=QUERY(A1:D20; « select count(A) where B = ‘Mavs’ or C > 100 »; 1)
La disjonction opérée par le compilateur est strictement inclusive : un enregistrement satisfaisant à la fois la condition B = ‘Mavs’ et la condition C > 100 n’est comptabilisé qu’une seule et unique fois. L’algèbre relationnelle sous-jacente prévient tout risque de redondance ou de double comptage, garantissant que le cardinal de l’union respecte rigoureusement le principe d’inclusion-exclusion.
Il importe de ne pas confondre cette disjonction inclusive avec la disjonction exclusive (XOR), qui n’existe pas sous forme de mot-clé primitif dans le langage de requête de l’API. Si une problématique exige le dénombrement des observations validant l’un ou l’autre critère à l’exclusion formelle de leur intersection conjointe, l’analyste doit formuler explicitement cette restriction par une combinaison combinatoire d’opérateurs AND, OR et de négations logiques (NOT).
5.3 Précédence logique et parenthésage complexe
Dès lors qu’une requête agrège simultanément des conjonctions (AND) et des disjonctions (OR), la question de la précédence des opérateurs devient critique pour l’exactitude des résultats statistiques. Conformément aux axiomes de l’algèbre booléenne classique, l’opérateur AND possède une priorité opératoire naturelle supérieure à l’opérateur OR. En l’absence de délimiteurs explicites, le moteur compilera les conditions conjonctives de manière prioritaire, ce qui peut altérer substantiellement la sémantique voulue par l’analyste.
Considérons la formule non parenthésée : where A = ‘Nord’ or A = ‘Sud’ and B > 500. L’interpréteur compile cette instruction comme signifiant : « recenser tous les enregistrements de la région Nord indépendamment de B, ainsi que les enregistrements de la région Sud dont la valeur B excède 500 ». Si l’intention méthodologique originelle visait à analyser l’ensemble des deux régions soumises uniformément au seuil critique de 500, la formule s’avère conceptuellement erronée et produit un biais de surévaluation majeur.
L’utilisation délibérée des parenthèses neutralise cette précédence implicite et force l’arborescence d’évaluation souhaitée :
=QUERY(A1:D20; « select count(A) where (A = ‘Nord’ or A = ‘Sud’) and B > 500 »; 1)
Le parenthésage rigoureux garantit l’intégrité de la logique ensembliste, particulièrement lors de la stratification de cohortes complexes croisant des caractéristiques sociodémographiques et des seuils d’inclusion biomédicaux.
6. Agrégation partitionnée : L’implémentation de la clause GROUP BY
6.1 Principes du partitionnement catégoriel des données
L’une des fonctionnalités les plus puissantes de l’opérateur COUNT réside dans son aptitude à s’exécuter non plus sur l’intégralité d’un vecteur isolé, mais de façon partitionnée à travers les strates d’une variable factorielle via la clause GROUP BY. Cette opération correspond formellement à la décomposition de la matrice de données initiale en sous-groupes disjoints, suivie de l’application de l’opérateur COUNT sur chacun de ces sous-ensembles, avant la réagrégation des résultats dans une table de fréquences univariée.
La règle d’or syntaxique du partitionnement impose une contrainte stricte : toute colonne non agrégée qui apparaît dans la clause select doit impérativement figurer dans la clause group by. Toute violation de ce principe relationnel déclenche immédiatement une erreur d’incompatibilité de dimensions. La formule d’une table de fréquences élémentaire s’établit selon la syntaxe suivante :
=QUERY(A1:C20; « select B, count(A) group by B »; 1)
Le comportement de l’agrégation partitionnée face aux cellules de regroupement vides (NULL) mérite une attention méticuleuse. Si la variable factorielle (colonne B) comporte des cellules non renseignées, le moteur de requête ne rejette pas ces lignes d’office. Il instancie une modalité spécifique, représentée par une ligne blanche dans la colonne de regroupement de sortie, et lui attribue le dénombrement exact des observations dépourvues d’affectation catégorielle, offrant ainsi un outil diagnostique précieux pour l’évaluation de la complétude des bases de données.
6.2 Groupement multidimensionnel (Tabulations croisées unilatérales)
L’extension du partitionnement à plusieurs variables qualitatives permet de construire des analyses dimensionnelles stratifiées à haute résolution. En juxtaposant plusieurs identifiants de colonnes au sein de la clause GROUP BY, l’analyste ordonne la segmentation des effectifs selon une hiérarchie factorielle combinatoire :
=QUERY(A1:D50; « select B, C, count(A) group by B, C »; 1)
Dans cette configuration, l’algorithme génère un tuple unique pour chaque croisement distinct des modalités observées entre la colonne B et la colonne C, associant à chaque couple la fréquence absolue correspondante calculée par count(A). Ce mécanisme préserve l’intégrité de la structure relationnelle tabulaire en projetant les résultats dans un format vertical « long » (tidy data), hautement propice aux traitements statistiques subséquents, tels que les tests du Chi-deux d’indépendance ou les modèles d’analyse de variance factorielle.
La lecture et l’interprétation de ces matrices hiérarchiques requièrent néanmoins de s’assurer qu’aucun niveau factoriel n’a été masqué par des erreurs de saisie (espaces insécables, variations typographiques). Une précaution analytique consiste à associer systématiquement ce partitionnement multidimensionnel à un tri hiérarchique afin de faciliter l’exploration cognitive des effectifs de sous-groupes.
6.3 Interaction entre filtres de sélection et partitionnement
L’articulation entre le filtrage préliminaire et l’agrégation partitionnée obéit à un ordre d’évaluation rigoureusement invariant défini par l’algèbre relationnelle. La clause WHERE est systématiquement exécutée en amont du partitionnement opéré par la clause GROUP BY. Cette séquentialité logique possède des implications méthodologiques fondamentales pour l’analyste.
Lors de l’exécution d’une commande telle que :
=QUERY(A1:D100; « select B, count(A) where D > 50 group by B »; 1)
Le processeur élimine en premier lieu l’intégralité des observations qui ne satisfont pas le critère d’exclusion univarié D > 50. Ce n’est que sur le sous-ensemble résiduel que le moteur structure les classes de la colonne B et opère le comptage par strate. Par conséquent, si une modalité particulière de la variable B ne possède aucun enregistrement dont la valeur D excède 50, cette modalité disparaîtra purement et simplement de la table de fréquences résultante, sans même afficher un effectif égal à zéro.
Cette élimination sélective peut introduire un biais méthodologique insidieux dans les analyses comparatives transversales : la disparition d’une modalité expérimentale complète au sein de la table de sortie peut échapper à l’attention de l’observateur non averti, faussant l’évaluation de la représentativité des sous-cohortes ou masquant des phénomènes d’attrition différentielle.
7. Transposition matricielle et tables de contingence via la clause PIVOT
7.1 Mécanisme de pivotement appliqué aux résultats de dénombrement
Tandis que la clause GROUP BY organise le partitionnement catégoriel de façon strictement verticale le long de l’axe des ordonnées (lignes), la clause PIVOT introduit une transformation géométrique bidimensionnelle de la matrice de sortie. Elle projette dynamiquement les modalités d’une variable catégorielle le long de l’axe des abscisses, convertissant les valeurs textuelles discrètes d’une colonne en en-têtes de colonnes de synthèse.
La combinaison conjointe de GROUP BY, COUNT et PIVOT permet de générer de manière totalement automatisée un tableau croisé dynamique à double entrée, sans requérir l’instanciation des outils d’interface graphique manuels de Google Sheets :
=QUERY(A1:D100; « select count(A) group by B pivot C »; 1)
Dans ce modèle d’exécution, chaque modalité unique de la colonne B constitue une ligne horizontale de la matrice résultante, tandis que chaque modalité unique de la colonne C engendre une nouvelle colonne dédiée. L’opérateur COUNT quantifie les fréquences d’occurrence situées précisément à la convergence de ces deux attributs, établissant ainsi une synthèse d’une densité informationnelle exceptionnelle au sein d’une seule formule compacte.
7.2 Construction d’une matrice de contingence bidirectionnelle
La matrice de contingence représente la pierre angulaire de l’analyse exploratoire bivariée pour variables qualitatives. L’application du pivotement d’effectifs via QUERY matérialise instantanément le tableau des effectifs observés ($n_{ij}$) indispensable à la modélisation statistique de tableaux de contingence croisés.
L’attribution des étiquettes par le moteur de rendu lors d’une opération PIVOT génère une ligne supérieure hiérarchique mentionnant la valeur pivotée combinée à l’opérateur (par exemple « count-Homme », « count-Femme »). Pour exploiter ces résultats au sein de calculs d’association (tels que le V de Cramér ou le calcul des résidus ajustés), l’analyste doit veiller à la structure dimensionnelle des en-têtes.
Un phénomène critique réside dans la gestion des intersections catégorielles vides. Si aucune observation ne correspond à l’intersection d’une modalité $i$ de la ligne et d’une modalité $j$ de la colonne, le moteur de visualisation injecte une cellule vide (NULL) à l’intersection correspondante plutôt qu’un zéro arithmétique. Cette absence de valeur discrète perturbe les calculs matriciels subséquents (sommes marginales, produits croisés). Il est par conséquent fréquent d’encapsuler la formule de pivotement au sein d’une fonction de conversion matricielle, ou d’exploiter les fonctions de substitution conditionnelle pour garantir la complétude numérique de la table de contingence.
7.3 Limites computationnelles et alternatives de pivotement
Bien que la clause PIVOT offre une élégance formelle indéniable, son déploiement sur des matrices massives est assujetti à des restrictions techniques strictes propres à la conception des tableurs électroniques. Une feuille Google Sheets impose une limite absolue quant au nombre total de colonnes autorisées au sein d’un onglet (actuellement fixée à un plafond global). Si l’attribut soumis à la clause PIVOT présente une cardinalité excessive (par exemple, une variable contenant des centaines d’identifiants uniques ou de codes postaux), le compilateur génère une erreur d’expansion matricielle ou sature l’affichage.
De plus, la lisibilité cognitive d’une table de contingence pivotée décroît de manière exponentielle lorsque le nombre de colonnes s’accroît outre mesure. Dans les contextes où l’effectif catégoriel pivoté est élevé, la structure « large » devient inadaptée à l’interprétation humaine directe.
Dans ces scénarios de forte dispersion catégorielle, il est méthodologiquement préférable d’abandonner l’instruction PIVOT au profit d’un groupement bidimensionnel strictement vertical (group by B, C). Cette structure tabulaire unilatérale, bien que moins visuelle d’emblée, garantit une portabilité logicielle intégrale et permet une exportation standardisée vers des logiciels de biostatistique et d’économétrie avancés tels que le logiciel R ou les bibliothèques d’analyse de données en Python (Pandas), sans restructuration préalable.
8. Ordonnancement et hiérarchisation des effectifs agrégés avec ORDER BY
8.1 Tri directionnel basé sur la métrique agrégée
L’exploration des données nécessite fréquemment d’ordonnancer les entités observées selon leur représentativité volumétrique. La clause ORDER BY permet de subordonner la disposition structurelle des résultats à la grandeur même de l’indicateur calculé par l’opérateur de dénombrement. La syntaxe standard requiert la répétition formelle de l’expression d’agrégation au sein de l’instruction de tri :
=QUERY(A1:C20; « select B, count(A) group by B order by count(A) desc »; 1)
Le modificateur directionnel desc prescrit un tri décroissant, propulsant au sommet de la table les modalités catégorielles possédant les effectifs les plus massifs. À l’inverse, le modificateur asc (appliqué par défaut en l’absence de précision) ordonne un tri croissant, exposant d’emblée les classes marginales ou faiblement représentées.
Il est crucial de dissocier conceptuellement le tri opéré sur le libellé catégoriel (order by B) du tri exécuté sur la valeur agrégée (order by count(A)). Le premier répond à un impératif d’indexation alphabétique pour faciliter la recherche ponctuelle d’une modalité au sein d’un rapport, tandis que le second répond à une finalité d’analyse distributionnelle, facilitant l’identification immédiate du mode statistique et la classification de type Pareto (règle des 80/20).
8.2 Résolution des ex æquo par critères de tri hiérarchiques
Dans les jeux de données comportant un nombre élevé de catégories pour une volumétrie globale restreinte, il est courant que plusieurs modalités affichent un effectif agrégé rigoureusement identique. Dans cette situation d’équivalence statistique, l’algorithme de tri applique un ordonnancement indéterminé si aucune clé de tri secondaire n’a été spécifiée.
Pour éliminer cet arbitraire et garantir le strict déterminisme des résultats lors des rafraîchissements dynamiques de la base de données, l’analyste doit formuler une séquence hiérarchique de critères de tri au sein de la clause ORDER BY :
=QUERY(A1:C20; « select B, count(A) group by B order by count(A) desc, B asc »; 1)
Dans cette expression hautement standardisée, le moteur classe prioritairement les groupes selon la décroissance de leur effectif d’observations. Dès lors qu’une égalité arithmétique survient entre deux ou plusieurs catégories, la seconde clé prend immédiatement le relais et ordonne les ex æquo par ordre alphabétique croissant de leur dénomination textuelle. Cette double contrainte assure la stabilité visuelle des synthèses managériales ou académiques lors des mises à jour incrémentales du classeur.
8.3 Écrêtage des résultats via la clause LIMIT
L’association de l’ordonnancement directionnel avec la clause LIMIT constitue un outil analytique performant pour circonscrire l’extraction aux $N$ entités dominantes d’un système d’information (analyse dite du « Top-N »). Cette stratégie de filtrage par le rang évite la pollution cognitive des tableaux de bord par de multiples micro-catégories anecdotiques :
=QUERY(A1:C50; « select B, count(A) group by B order by count(A) desc limit 5 »; 1)
Cette instruction extrait avec une exactitude mathématique les cinq modalités les plus fréquentes de la distribution empirique. Par inversion de la direction du tri (asc), la même construction permet d’isoler instantanément les anomalies de complétude, les erreurs de frappe sporadiques ou les signaux faibles se manifestant par des fréquences unitaires marginales.
De surcroît, le dialecte autorise l’adjonction de la clause OFFSET conjointement à LIMIT. Ce paramètre permet de décaler le point de départ de l’extraction d’un nombre déterminé d’enregistrements. Cette combinaison offre une mécanique d’ingénierie logicielle pour implémenter un système de pagination native des synthèses statistiques massives au sein d’une interface de tableur, sans alourdir le rendu graphique initial.
9. Formatage typographique et lisibilité cognitive : Les clauses LABEL et FORMAT
9.1 Personnalisation sémantique des en-têtes avec LABEL
L’utilisation brute de l’opérateur COUNT engendre par défaut l’insertion d’en-têtes génériques standardisés par le moteur de rendu, à l’instar de « count A » ou « count Identifiant ». Ces libellés bruts sont totalement inadaptés à une publication scientifique, un rapport d’audit institutionnel ou un tableau de bord exécutif. La clause LABEL fournit le mécanisme déclaratif indispensable pour redéfinir formellement et avec élégance les métadonnées de colonnes :
=QUERY(A1:C20; « select B, count(A) group by B label count(A) ‘Effectif Observé' »; 1)
La syntaxe impose d’isoler l’expression d’agrégation ciblée, suivie du nouveau libellé délimité par des apostrophes simples. Il est possible de redéfinir simultanément plusieurs en-têtes au sein de la même clause en séparant simplement les assignations par des virgules (ex. label B ‘Département’, count(A) ‘Nombre d »Employés’).
Une astuce ergonomique essentielle consiste à supprimer purement et simplement la ligne d’en-tête générée par la fonction QUERY. En assignant explicitement une chaîne de caractères vide à l’opérateur (label count(A) »), le compilateur neutralise la génération du titre sans altérer le flux de calcul des données numériques sous-jacentes. Cette technique s’avère particulièrement précieuse lorsque la formule QUERY est imbriquée au sein de structures matricielles composites ou d’en-têtes personnalisés préexistants sur la feuille de calcul.
9.2 Formatage numérique des indicateurs avec FORMAT
Le contrôle typographique des métriques quantitatives s’étend au-delà de la dénomination des colonnes grâce à l’intervention de la clause FORMAT. Cette instruction permet d’appliquer des masques de formattage stricts directement aux scalaires dénombrés, garantissant une homogénéité visuelle absolue indépendamment des paramètres régionaux de la feuille de calcul :
=QUERY(A1:C20; « select B, count(A) group by B format count(A) ‘0000’ »; 1)
Dans cet exemple précis, le masque force l’affichage de chaque dénombrement sur quatre positions numériques fixes en injectant des zéros de remplissage initiaux (padding). Il est également envisageable d’appliquer des séparateurs de milliers stricts (ex. format count(A) ‘#,##0’) pour stabiliser la lisibilité des volumes démographiques ou transactionnels considérables.
Il importe toutefois d’émettre une mise en garde méthodologique quant à l’usage de FORMAT. L’application d’un masque textuel élaboré via cette clause transforme parfois la nature interne de la restitution en chaîne textuelle visualisée. Si ces données agrégées doivent faire l’objet de calculs ultérieurs (sommations, moyennes pondérées, tests paramétriques) par d’autres formules de la feuille de calcul, un formatage textuel excessif peut induire des erreurs d’incompatibilité de type au sein des fonctions mathématiques en aval.
9.3 Considérations ergonomiques et réduction de la charge cognitive
La conception d’interfaces analytiques et de rapports quantitatifs doit se conformer aux standards de l’ergonomie cognitive pour maximiser la vitesse d’assimilation des décideurs et des pairs évaluateurs. Les normes académiques et professionnelles internationales, telles que les préconisations stylistiques de l’American Psychological Association (APA), prescrivent une clarté typographique rigoureuse, la standardisation univoque des abréviations statistiques (ex. l’usage conventionnel de N majuscule pour l’échantillon global et de n minuscule pour les sous-cohortes), et le bannissement total des jargons logiciels bruts.
Le déploiement harmonieux des clauses LABEL et FORMAT permet d’aligner directement la restitution des requêtes QUERY sur ces exigences méthodologiques. Un tableau descriptif ne doit nécessiter aucun retraitement manuel ultérieur avant son insertion dans un document formel. La réduction du bruit visuel (élimination des bordures agressives, alignement décimal rigoureux, épuration des titres de colonnes) contribue directement à minimiser la charge cognitive de l’observateur et prévient les erreurs de diagnostic issues d’une mauvaise interprétation des unités d’agrégation.
10. Techniques avancées : Filtrage par motifs réguliers et dénombrement d’unicité
10.1 Dénombrement textuel complexe via CONTAINS, STARTS WITH et MATCHES
L’évaluation des variables textuelles requiert fréquemment d’outrepasser les strictes comparaisons d’égalité scalaire pour inspecter des fragments morphologiques de chaînes de caractères. Le langage de l’API Visualization intègre des opérateurs d’évaluation de chaînes particulièrement performants : contains, starts with, et l’opérateur d’expressions régulières matches.
L’opérateur contains recense les occurrences d’une sous-chaîne sans égard pour sa position relative dans la cellule :
=QUERY(A1:C50; « select count(A) where B contains ‘Clinique' »; 1)
L’opérateur starts with vérifie quant à lui la concordance stricte des caractères initiaux, ce qui est idéal pour dénombrer des codifications normalisées (comme les codes de la Classification Internationale des Maladies ou les nomenclatures douanières). Toutefois, le degré de raffinement ultime est atteint avec le prédicat matches, qui permet de confronter le contenu cellulaire à la puissance d’une expression régulière complète (Regex) :
=QUERY(A1:C50; « select count(A) where B matches ‘.*(Alpha|Bêta)-[0-9]{3}' »; 1)
Cette approche permet de quantifier avec une extrême précision des corpus qualitatifs hétérogènes, des schémas de codage séquentiels ou des protocoles expérimentaux imbriqués, sans jamais nécessiter l’éclatement préalable des données en colonnes accessoires.
10.2 La problématique de l’unicité : Simulation de COUNT DISTINCT
L’une des limites les plus déconcertantes du dialecte QUERY de Google Sheets réside dans l’absence native de l’instruction standard SQL COUNT(DISTINCT …). Tenter d’injecter ce syntagme dans la chaîne de commande déclenche inévitablement une erreur d’analyse lexicale. Or, la quantification du nombre d’entités uniques (par exemple, le nombre de patients distincts au sein d’une base de consultations répétées) est une nécessité absolue dans toute recherche quantitative.
Pour contourner élégamment cette lacune architecturale, l’analyste doit concevoir des architectures modulaires hybrides. La méthode la plus élégante et computationnellement sobre consiste à coupler la fonction native UNIQUE en amont de l’évaluation QUERY, ou à imbriquer l’agrégation partitionnée. Dans cette optique, l’utilisation de QUERY pour générer une liste dédupliquée via GROUP BY, suivie d’un dénombrement externe constitue un schéma classique :
=COUNTA(QUERY(A1:C100; « select A group by A »; 1)) – 1
Une alternative puissante consiste à restructurer la plage matricielle source directement au sein du premier argument de QUERY via la formule native :
=QUERY(UNIQUE(A2:B100); « select count(Col1) »; 0)
En nettoyant la matrice source de ses redondances par l’opération matricielle UNIQUE avant son ingestion par le processeur QUERY, l’opérateur COUNT exécute alors un dénombrement exhaustif qui équivaut rigoureusement à un dénombrement d’unicité, garantissant une parfaite exactitude des dénombrements d’individus ou d’entités uniques sans duplication.
10.3 Gestion dynamique des paramètres de requête via concaténation
L’industrialisation d’une feuille de calcul requiert que les requêtes statistiques s’adaptent de manière réactive aux sélections formulées par l’utilisateur au sein de menus déroulants ou de cellules de commande, sans forcer la réécriture manuelle de la chaîne textuelle QUERY. Cette modularité dynamique s’opère par la concaténation méticuleuse des références cellulaires au sein de l’instruction déclarative.
La règle d’assemblage dépend fondamentalement de la typologie de la variable injectée. Pour un critère numérique hébergé en cellule E1, la chaîne s’assemble par de simples guillemets doubles et l’opérateur d’union ampersand (&) :
=QUERY(A1:C20; « select count(A) where B > » & E1; 1)
En revanche, dès lors que la cellule de commande (ex. E2) héberge un critère textuel, l’analyste doit impérativement veiller à ce que l’assemblage final réinjecte les apostrophes simples nécessaires à la conformité syntaxique du compilateur :
=QUERY(A1:C20; « select count(A) where B = ‘ » & E2 & « ‘ »; 1)
Une défaillance mineure dans l’alignement des guillemets doubles et des apostrophes simples entraîne la rupture immédiate de la chaîne de requête. Pour les critères temporels dynamiques, la formule doit en outre contraindre le formatage de la référence de date via la fonction native TEXTE (ex. « where C >= date ‘ » & TEXT(E3; « yyyy-mm-dd ») & « ‘ ») pour éviter que le numéro de série sous-jacent de la cellule ne corrompe l’évaluation chronologique.
11. Audit, diagnostic des anomalies et résolution des dysfonctionnements
11.1 Typologie des erreurs syntaxiques et sémantiques récurrentes
L’exécution de requêtes complexes confronte fréquemment l’analyste à des dysfonctionnements dont l’origine peut s’avérer ardue à diagnostiquer. L’anomalie la plus explicite se matérialise sous la forme de l’erreur générique #VALUE!, accompagnée de la mention détaillée « Invalid query: Unable to parse query string ». Cette notification signale invariablement une infraction lexicale ou syntaxique : clause mal orthographiée, omission d’une apostrophe de fermeture autour d’un littéral textuel, virgule superflue ou parenthèse non appariée.
Une anomalie plus insidieuse concerne les erreurs de type PARSE ERROR induites par l’introduction d’apostrophes non échappées au sein des données textuelles dynamiques. Si une cellule référencée transmet la valeur « Aujourd’hui », l’apostrophe centrale de ce mot entre en collision avec les balises syntaxiques de délimitation, induisant l’effondrement immédiat de l’arbre syntaxique.
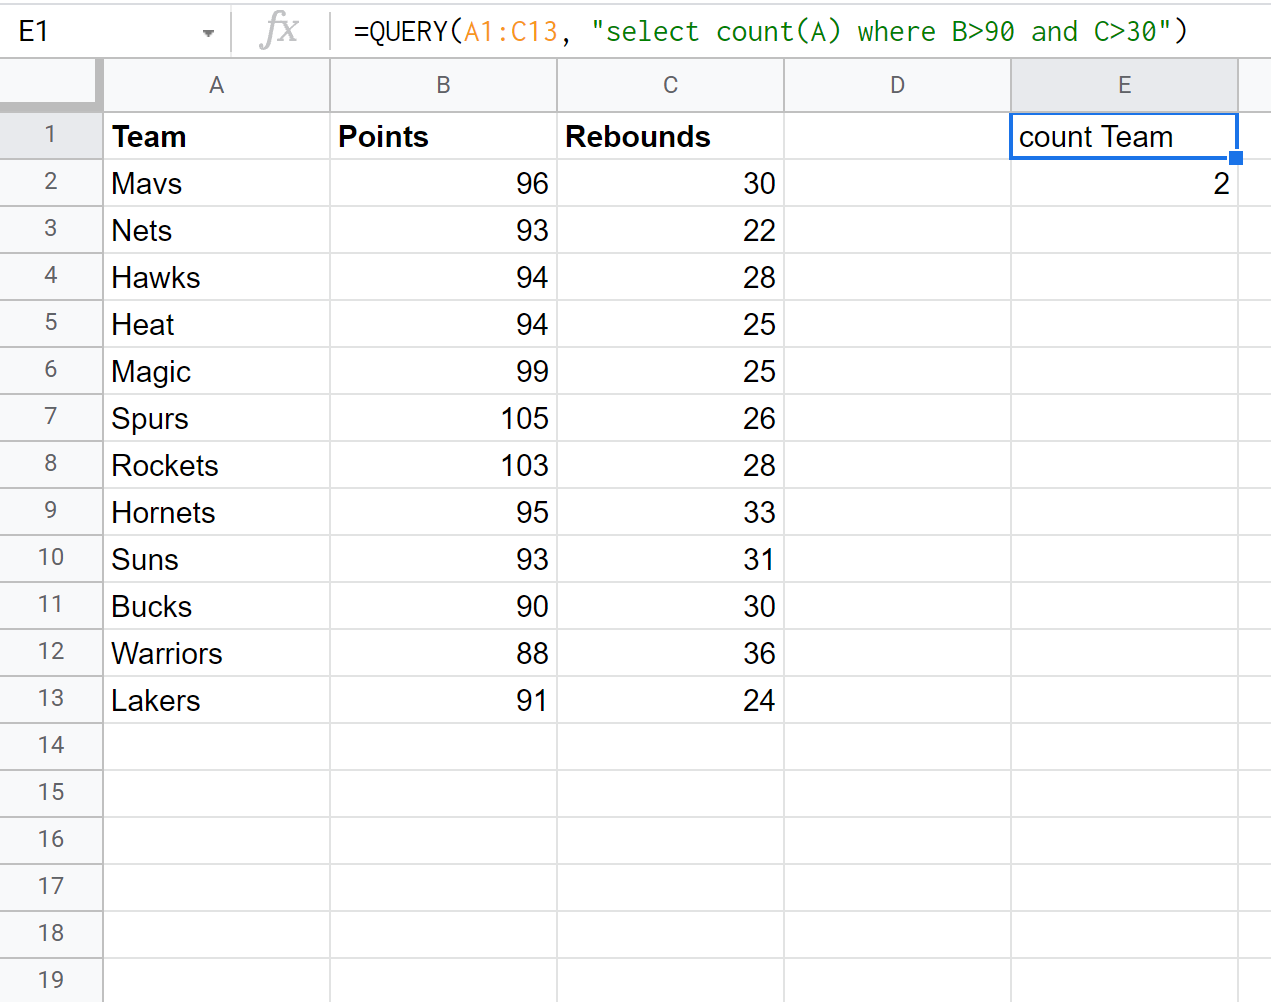
Le dysfonctionnement le plus critique demeure toutefois l’anomalie sémantique silencieuse. Si l’opérateur COUNT renvoie une valeur numérique manifestement inférieure à la réalité empirique sans lever le moindre avertissement logiciel, le diagnostic doit immédiatement s’orienter vers la pureté typologique de la colonne analysée. L’existence d’une pollution de type (cellules textuelles au sein d’une colonne numérique majoritaire) conduit le processeur à convertir purement et simplement les cellules dissidentes en entités nulles invisibles, faussant l’agrégation de manière totalement imperceptible pour l’utilisateur non averti.
11.2 Problématiques relatives aux délimiteurs régionaux et paramètres linguistiques
L’interopérabilité des modèles construits sous Google Sheets est intimement liée aux configurations régionales et linguistiques paramétrées dans les propriétés du classeur. Une source majeure de blocage analytique réside dans la confusion entre les délimiteurs syntaxiques anglophones et francophones.
Dans un environnement francophone standard (France, Belgique, Canada francophone), le séparateur d’arguments officiel d’une fonction de tableur est obligatoirement le point-virgule (;), car la virgule (,) est statutairement réservée à la notation du séparateur décimal. À l’inverse, dans les paramètres linguistiques anglophones, les arguments sont traditionnellement séparés par des virgules (,). Toutefois, il importe de souligner avec acuité que l’intérieur de la chaîne de texte de la requête QUERY obéit scrupuleusement aux conventions syntaxiques du langage de visualisation Google, qui sont invariablement d’inspiration anglo-saxonne :
=QUERY(A1:C20; « select B, count(A) group by B »; 1)
Dans cette formule valide en configuration francophone, les arguments de la fonction QUERY externe sont rigoureusement articulés par des points-virgules, mais les clauses internes de la chaîne de requête (séparation des colonnes dans select ou group by) continuent d’exiger des virgules. De surcroît, les seuils numériques inscrits en dur dans la clause WHERE doivent impérativement adopter le point (.) comme délimiteur décimal (ex. where B > 10.5 et non 10,5), faute de quoi l’analyseur lexical interprète la virgule décimale comme une séparation de clause, provoquant un arrêt d’exécution instantané.
11.3 Bonnes pratiques méthodologiques pour la maintenance et la pérennité
Pour assurer la pérennité et la transférabilité des modèles statistiques au sein des équipes de recherche ou des organisations professionnelles, il est impératif d’adopter une méthodologie de développement rigoureuse. La première recommandation structurelle repose sur la modularisation des requêtes complexes. Plutôt que de concentrer l’ensemble des transformations dans une formule indéchiffrable s’étalant sur plusieurs lignes d’écran, il est vivement conseillé de séquencer les étapes de nettoyage typologique et de pré-filtrage dans des onglets dédiés.
La documentation interne des formules représente un gage d’auditabilité indispensable. L’analyste gagne à utiliser des cellules adjacentes de métadonnées pour consigner formellement la rationalité mathématique des prédicats appliqués dans la clause WHERE. L’emploi de plages nommées standardisées (Named Ranges) via l’interface de Google Sheets permet également de substituer des coordonnées matricielles opaques (ex. A1:D5000) par des dénominations sémantiques explicites (ex. CohorteClinique2023), améliorant drastiquement la lisibilité du code déclaratif.
Enfin, l’instauration systématique de protocoles de tests de non-régression s’avère indispensable lors de l’accroissement continu des bases de données observationnelles. L’analyste doit vérifier périodiquement que l’expansion volumétrique de la matrice source n’altère pas la typologie dominante des colonnes stratégiques et que les totaux agrégés par l’opérateur COUNT demeurent parfaitement étanches face aux importations de nouveaux jeux de données périphériques.
12. Applications empiriques : Protocoles d’analyse pour la recherche quantitative
12.1 Traitement et validation d’instruments de mesure psychométriques
L’administration de questionnaires psychométriques ou d’enquêtes d’opinion s’appuie massivement sur des échelles ordinales de type Likert (par exemple de 1 pour « Pas du tout d’accord » à 5 pour « Tout à fait d’accord »). Le traitement quantitatif de ces données exige un dépouillement minutieux de la distribution des réponses afin d’évaluer la variabilité des items et de détecter d’éventuels effets de plancher ou de plafond.
L’opérateur COUNT au sein de la fonction QUERY offre un mécanisme d’une grande efficacité pour automatiser ce dépouillement psychométrique. Considérons une matrice de données brutes où la colonne A répertorie l’identifiant du participant et les colonnes B à F enregistrent les scores attribués à cinq items spécifiques. Pour quantifier instantanément la distribution des fréquences de réponse associées au premier item (colonne B), la formule suivante est déployée :
=QUERY(B2:B; « select B, count(B) where B is not null group by B order by B asc label count(B) ‘Effectif' »; 0)
Cette requête structure immédiatement une table de distribution ordonnée présentant la fréquence absolue de chaque point de l’échelle. Par ailleurs, la détection des questionnaires invalides en raison d’un taux de non-réponse excessif s’opère par le dénombrement sélectif des cellules nulles. En exploitant l’opérateur relationnel is null, le chercheur isole et quantifie le volume de données manquantes par sujet ou par variable :
=QUERY(A2:B; « select count(A) where B is null »; 0)
Cette automatisation permet d’appliquer objectivement les règles d’exclusion de sujets définies dans les protocoles de recherche quantitative avant d’engager des réductions dimensionnelles par analyse factorielle ou calcul des indices de consistance interne (Alpha de Cronbach).
12.2 Suivi longitudinal des participants et contrôle de l’attrition
Les protocoles de recherche expérimentale ou épidémiologique à visée longitudinale requièrent le suivi temporel d’une même cohorte d’individus à travers plusieurs vagues successives d’investigation (Time 1, Time 2, Time 3). L’un des écueils majeurs de ces dispositifs réside dans le phénomène d’attrition (perte de participants au fil du temps), susceptible d’introduire des biais d’échantillonnage substantiels si les désistements sont corrélés aux variables de l’étude.
La fonction QUERY avec l’opérateur COUNT permet de concevoir des matrices de monitoring du flux des participants avec une transparence méthodologique totale. Supposons une base de données consolidée répertoriant les participants (colonne A), leur strate d’assignation expérimentale (Groupe Contrôle vs Groupe Traitement, colonne B) et leur présence effective validée lors des jalons temporels subséquents (colonnes C et D, codées par des indicateurs booléens ou textuels) :
=QUERY(A2:D; « select B, count(A) where C = ‘Présent’ and D = ‘Présent’ group by B label count(A) ‘Effectif Complet' »; 0)
Ce partitionnement instantané permet à l’équipe de recherche de comparer en temps réel le ratio des effectifs finaux par rapport à la taille d’échantillon nominale initiale. Le croisement de ces dénombrements avec des prédicats sociodémographiques via la clause WHERE permet d’identifier immédiatement si les abandons surviennent de manière aléatoire (Missing Completely at Random, MCAR) ou si une sous-population spécifique présente un taux d’abandon disproportionné, préservant ainsi la validité écologique et la robustesse inférentielle des conclusions expérimentales.
12.3 Établissement des tables descriptives finales de l’échantillon d’étude
L’aboutissement formel de tout protocole de recherche quantitative réside dans la publication du tableau synthétique initial, universellement désigné sous l’appellation de « Tableau 1 » dans la littérature biomédicale et comportementale standardisée. Ce tableau a pour mission de résumer exhaustivement la composition démographique, clinique ou méthodologique de l’échantillon global et de ses subdivisions expérimentales.
La combinaison méthodique de plusieurs formules QUERY exploitant l’opérateur COUNT permet d’automatiser intégralement la génération de ce tableau sans recourir à des scripts externes complexes ni à des copier-coller manuels générateurs d’erreurs typographiques. En articulant des requêtes stratifiées pour chaque variable catégorielle (genre, tranches d’âge, statut marital, sévérité clinique) associées aux clauses LABEL et FORMAT, l’analyste produit des sous-ensembles matriciels directement empilables :
=QUERY(A2:E1000; « select B, count(A) group by B pivot C label count(A) » »; 0)
Cette approche garantit une reproductibilité analytique absolue (computational reproducibility). Si le jeu de données observationnelles sous-jacent est corrigé suite à une vérification des données sources ou augmenté de nouvelles observations, l’ensemble des dénombrements, ventilations et pourcentages constitutifs du Tableau 1 s’ajuste instantanément et dynamiquement, éliminant tout risque de discordance numérique entre les données primaires et les statistiques finales rapportées dans les manuscrits scientifiques.
Références
- Google. (s. d.). Google Visualization API Query Language. Google Developers. https://developers.google.com/chart/interactive/docs/querylanguage
- Google. (s. d.). Fonction QUERY : Aide Google Sheets. Centre d’aide Google Docs Editors. https://support.google.com/docs/answer/3093343
- International Organization for Standardization. (2019). Date and time — Representations for information interchange (ISO Standard No. 8601-1:2019). https://www.iso.org/iso-8601-date-and-time-format.html
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1–55. https://www.jstor.org/stable/2136402
- Monk, R. (2018). Boolean Algebra. Stanford Encyclopedia of Philosophy. https://plato.stanford.edu/entries/boolalg-math/
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org/
- The R Foundation. (s. d.). The R Project for Statistical Computing. R Project. https://www.r-project.org/
- Goyvaerts, J., & Levithan, S. (2012). Regular Expressions Cookbook (2nd ed.). O’Reilly Media. https://www.regular-expressions.info/