
L’avènement des architectures infonuagiques et la démocratisation des outils de productivité collaborative ont profondément transformé la praxéologie du traitement des données au sein des organisations académiques, industrielles et de recherche. Parmi ces instruments modernes, Google Sheets s’est distingué non plus seulement comme un simple tableur matriciel conventionnel, mais comme un environnement d’exécution hybride capable d’implémenter des opérations ensemblistes complexes directement héritées de la théorie des bases de données relationnelles. Au cœur de cette puissance calculatoire réside la fonction QUERY, une passerelle programmatique intégrant une déclinaison déclarative du langage SQL standardisée selon les protocoles de l’API Google Visualization.
Dans le paradigme classique de l’analyse exploratoire des données quantitatives, la transformation d’enregistrements linéaires continus en synthèses multidimensionnelles intelligibles requiert invariablement la mise en œuvre de tables de contingence ou de tableaux croisés dynamiques. Si l’interface graphique propose des assistants visuels natifs pour bâtir ces agrégations par glisser-déposer, ces approches souffrent d’une rigidité architecturale intrinsèque, d’une opacité procédurale et d’une vulnérabilité prononcée lors des processus d’automatisation des flux analytiques. À l’inverse, l’invocation de la clause PIVOT au sein d’une expression QUERY permet de conjuguer la rigueur de l’algèbre booléenne à l’élasticité dynamique du modèle matriciel des feuilles de calcul, autorisant une restructuration orthogonale des données d’une élégance algorithmique absolue.
Le présent traité méthodologique explore de manière exhaustive les fondements conceptuels, la mécanique syntaxique et les applications appliquées de l’opérateur PIVOT de la fonction QUERY. De l’algèbre relationnelle formelle jusqu’aux protocoles rigoureux de recherche en psychométrie et sciences sociales, nous détaillerons comment cette instruction transcende la simple cosmétique tabulaire pour s’ériger en instrument d’inférence, de contrôle qualité et de modélisation statistique avancée, garantissant une reproductibilité sans faille des chaînes d’analyse documentaire et numérique.
1. Introduction théorique à la clause PIVOT dans l’écosystème Google Sheets
1.1 Fondements de l’algèbre relationnelle appliquée aux feuilles de calcul
L’intégration de la fonction QUERY dans l’écosystème Google Sheets repose sur l’adoption délibérée d’un paradigme de programmation déclaratif, issu directement des travaux fondateurs d’Edgar F. Codd sur l’algèbre relationnelle. Contrairement aux approches impératives traditionnelles où l’analyste prescrit une succession séquentielle d’itérations, de conditions et de décalages matriciels au travers de boucles algorithmiques ou d’imbrications de formules fonctionnelles, le langage de requête de l’API Google Visualization permet d’énoncer formellement la morphologie du résultat attendu sans se préoccuper des mécanismes sous-jacents de bas niveau relatifs à l’allocation mémoire ou à l’indexation matricielle. Cette abstraction libère le chercheur des contingences mécaniques de l’infrastructure logicielle en l’invitant à penser la donnée comme une relation mathématique stricte, définie par un ensemble de tuples assujettis à des prédicats prédéterminés.
Le passage d’un modèle tabulaire plat à un modèle multidimensionnel constitue une étape épistémologique cruciale dans l’analyse quantitative. Dans une structure tabulaire normalisée en première forme normale, chaque ligne représente une observation atomique unique, et chaque colonne incarne un attribut invariant du phénomène observé. Si cette architecture s’avère optimale pour le stockage relationnel et la minimisation de la redondance des informations, elle se révèle impropre à la lecture herméneutique immédiate et à la mise en exergue des interactions de second ordre. Le pivotement intervient alors comme une projection orthogonale, réalisant une rotation dimensionnelle où les modalités discrètes d’un vecteur catégoriel vertical sont transposées horizontalement pour constituer le nouvel en-tête d’un système de coordonnées cartésiennes. D’un point de vue géométrique et matriciel, il s’agit d’une transformation tensorielle qui transforme un vecteur d’attributs unidimensionnel en un hyperplan bidimensionnel synthétique.
Cette formalisation mathématique confère une reproductibilité algorithmique intégrale aux processus de manipulation de données. Dans le contexte de la recherche académique, où la crise de la reproductibilité scientifique impose une traçabilité irréprochable des traitements préliminaires appliqués aux données brutes, l’abandon des manipulations manuelles au profit de requêtes déclaratives déterministes constitue un impératif méthodologique. Toute altération, exclusion ou réorganisation spatiale des données opérée manuellement via l’interface graphique introduit une entropie stochastique, augmentant le risque d’erreur humaine non documentée. À l’opposé, l’inscription d’une transformation dimensionnelle dans une clause PIVOT explicite fige le protocole analytique dans une formule scripturale auditable, immuable et immédiatement déployable sur de nouveaux jeux de données sans dérive opératoire.
1.2 Définition et rôle fonctionnel du tableau croisé dynamique par formule
D’un point de vue structural, il convient de distinguer avec netteté trois opérations logiques distinctes souvent confondues dans le langage vernaculaire de l’analyse bureautique : la projection, l’agrégation et le pivotement. La projection correspond à l’isolation sélective d’un sous-ensemble d’attributs au sein du jeu relationnel, opérée syntaxiquement par la clause SELECT. L’agrégation, quant à elle, opère une réduction dimensionnelle verticale en condensant une multiplicité d’observations le long d’un axe catégoriel unique via des estimateurs scalaires tels que la somme arithmétique ou la moyenne, orchestrée par la clause GROUP BY. Le pivotement représente une opération structurelle d’un ordre supérieur : il ne se contente pas de réduire la volumétrie des données, il opère une redistribution morphologique croisée en créant dynamiquement autant de colonnes distinctes qu’il existe de valeurs discrètes uniques dans l’attribut désigné en paramètre de pivot.
La puissance cardinale de l’implémentation de cette opération par voie de formule réside dans son dynamisme réactif en temps réel. Les classeurs hébergés dans le nuage fonctionnent selon un modèle de graphe de dépendance acyclique direct, dans lequel chaque modification élémentaire appliquée à une cellule source propage immédiatement une vague de recalcul à l’ensemble des nœuds dépendants. Alors que les tableaux croisés dynamiques traditionnels basés sur des interfaces utilisateur requièrent fréquemment une actualisation manuelle explicite ou l’activation de déclencheurs asynchrones lourds, le moteur de calcul de la fonction QUERY réévalue la projection et la distribution croisée à chaque cycle d’invalidation du tampon mémoire. Cette réactivité confère aux tableaux de bord et aux environnements de calcul scientifique une vivacité analytique absolue, éliminant tout déphasage temporel entre la collecte primaire et son rendu synthétique.
Enfin, l’automatisation de la synthèse d’indicateurs de recherche sans intervention humaine ouvre des perspectives remarquables pour la conception de protocoles expérimentaux automatisés. Lorsqu’un formulaire de saisie en ligne ou un capteur télémétrique alimente en continu une feuille de calcul primaire, l’expression QUERY associée à l’opérateur PIVOT métabolise les flux entrants instantanément. Les indicateurs statistiques de synthèse se déploient, s’ajustent et s’étendent latéralement au fur et à mesure que de nouveaux groupes ou de nouvelles cohortes de sujets émergent au sein du corpus d’observation. Cette autonomie procédurale constitue une rupture majeure avec les méthodes conventionnelles de traitement des données, érigeant la fonction de requête en véritable moteur d’ingénierie statistique autonome au cœur du tableur.
2. Anatomie syntaxique de la fonction QUERY et de l’opérateur PIVOT
2.1 Décomposition formelle des arguments de la fonction QUERY
L’évaluation fonctionnelle de l’instruction QUERY dans l’écosystème Google Sheets obéit à une signature formelle standardisée comprenant trois arguments distincts, dont l’agencement détermine la validité sémantique de l’évaluation : la plage de données source (souvent désignée par le terme data ou range), la chaîne textuelle de commande (désignée par query), et le paramètre optionnel de configuration des en-têtes (désigné par headers). La plage source délimite le domaine d’extraction cartésien et impose des contraintes de dimensionnalité strictes. L’absence d’ambiguïté dans cette délimitation implique de désigner des plages continues, qu’elles soient statiques ou ouvertes (par exemple d’une cellule d’origine jusqu’à la limite inférieure indéterminée de la feuille), afin d’autoriser l’intégration continue de nouveaux enregistrements sans altérer l’arborescence structurelle de la référence.
La chaîne textuelle de commande constitue le noyau d’instruction déclarative transmis à l’interpréteur de l’API Google Visualization. Rédigée obligatoirement sous forme de chaîne de caractères délimitée par des guillemets doubles, cette expression obéit aux lois formelles d’une grammaire non contextuelle spécifique. Une attention rigoureuse doit être portée à l’échappement des caractères, à la casse des mots-clés et à l’usage scrupuleux des identifiants de colonnes. Dans une plage native directe, les colonnes sont identifiées par des lettres capitales correspondant aux coordonnées physiques de la feuille de calcul (A, B, C), tandis que dans un environnement matriciel virtuel généré par des accolades d’assemblage, les colonnes perdent leur référent spatial au profit d’identifiants abstraits numérotés sous la forme normalisée Col1, Col2, Col3.
Le troisième argument, trop souvent omis par les praticiens novices, régit la hauteur verticale de la strate d’en-tête présente au sommet de la plage source. Cet entier naturel indique explicitement au compilateur combien de lignes initiales doivent être traitées comme des métadonnées lexicales et non comme des données scalaires candidates aux calculs arithmétiques. Si ce paramètre est laissé indéfini (-1 par défaut), l’algorithme sous-jacent applique une heuristique probabiliste pour déduire la présence d’en-têtes, ce qui engendre régulièrement des défaillances typologiques critiques lorsque les premières lignes contiennent des données hétérogènes. En matière de typologie de données, le moteur de requête applique une règle d’or d’homogénéité stricte : chaque colonne est dominée par un type de données unique (numérique, textuel, booléen, ou horodaté), déterminé par la majorité des valeurs présentes. Toute cellule déviant de cette typologie majoritaire est purement et simplement annihilée et évaluée comme une valeur nulle (null), ce qui souligne l’exigence d’un nettoyage préliminaire irréprochable de la matrice brute.
2.2 Ordre d’exécution logique des clauses au sein de la requête
L’interprétation d’une chaîne de commande au sein du compilateur de l’API Visualization ne s’effectue pas selon l’ordre séquentiel de lecture occidentale, mais obéit à une hiérarchie stricte d’évaluation logique. Cette hiérarchie prédétermine la validité de chaque instruction et conditionne l’optimisation des performances de calcul. L’architecture ordonnée des clauses s’établit selon la séquence formelle immuable suivante :
- SELECT : Identification des projections d’attributs et des fonctions d’agrégation scalaires nécessaires au schéma final.
- WHERE : Application des prédicats de filtrage booléens préliminaires sur les tuples individuels avant toute consolidation spatiale.
- GROUP BY : Découpage partitionnel de la relation le long des axes de regroupement dimensionnels verticaux.
- PIVOT : Déploiement transversal et transposition orthogonale d’une dimension catégorielle pour instancier de nouveaux axes d’attributs.
- ORDER BY : Tri déterministe, ascendant ou descendant, des résultats agrégés sur les dimensions primaires ou secondaires.
- LIMIT : Troncation quantitative du cardinal de sortie pour borner l’extraction aux premiers rangs d’observations.
- LABEL : Réécriture cosmétique et redéfinition sémantique des désignations d’en-têtes générées par le compilateur.
- FORMAT : Imposition d’un masque de formatage typologique sur les valeurs scalaires résultantes.
Une interdépendance théorique absolue lie de manière indissoluble la clause GROUP BY à la clause PIVOT. Dès lors qu’une opération de pivotement est appelée, elle impose par nature mathématique une opération de réduction matricielle. Le compilateur ne peut répartir horizontalement les valeurs agrégées d’une variable quantitative sans ancrer préalablement la structure verticale sur au moins une variable de segmentation. Par conséquent, il est conceptuellement et syntaxiquement impossible de déclarer une clause PIVOT sur une fonction d’agrégation sans définir conjointement la projection d’une coordonnée de ligne via GROUP BY, à moins d’agréger la totalité du jeu de données en une cellule matricielle unique étalée horizontalement.
Le mécanisme sous-jacent de génération dynamique des nouvelles colonnes à partir des valeurs uniques mérite une explicitation approfondie. Lorsque l’interpréteur rencontre l’instruction PIVOT associée à une colonne catégorielle, il opère un balayage linéaire complet du vecteur désigné afin d’en extraire la liste mathématique fermée de ses éléments distincts. Chaque valeur unique ainsi recensée est promue au rang d’identifiant de nouvelle colonne dans le tableau de sortie. Si la fonction d’agrégation appelée dans le SELECT porte sur un attribut continu, le moteur subdivise le calcul d’agrégation à l’intersection exacte de chaque modalité de ligne définie par le GROUP BY et de chaque modalité de colonne nouvellement instanciée par le PIVOT, opérant de facto une cartographie matricielle bidimensionnelle entièrement automatisée.
3. Évaluation comparative : QUERY PIVOT versus tableau croisé dynamique natif
3.1 Avantages computationnels et flexibilité de l’approche formulée
L’arbitrage méthodologique entre l’emploi de l’outil graphique conventionnel de tableau croisé dynamique et la formulation programmatique via QUERY(... PIVOT ...) engage des considérations structurelles profondes relatives à l’intégrité logicielle du classeur. Le principal avantage computationnel de l’approche par formule réside dans l’absence totale de surcharge d’objets graphiques dans l’arborescence interne du document. Les tableaux croisés natifs constituent des objets d’interface complexes, dotés de leurs propres métadonnées d’affichage, de caches sérialisés et de panneaux de configuration latéraux. La multiplication de ces composants visuels dans un classeur analytique volumineux induit invariablement une dégradation progressive de la réactivité de l’application, un accroissement substantiel du poids du fichier en mémoire vive et des risques accrus de corruption de schéma lors des exports synchronisés.
Par contraste, l’utilisation d’une simple formule n’occupe qu’un nœud computationnel standard dans le moteur de calcul du tableur. Cette légèreté structurelle permet une intégration sans couture de la matrice pivotée au sein de pipelines de formules imbriquées. Le résultat généré par une clause PIVOT peut être immédiatement encapsulé comme argument d’entrée pour d’autres fonctions matricielles telles que INDEX, MATCH, FILTER, TRANSPOSE ou MMULT, sans nécessiter d’étapes intermédiaires de référencement spatial manuel ou de zones tampons de transfert. Cette continuité algorithmique autorise l’élaboration de chaînes de traitement statistique hautement sophistiquées, opérant de façon entièrement fluide depuis la saisie des observations brutes jusqu’aux calculs finaux d’estimateurs paramétriques.
En outre, la portabilité du code source analytique s’avère infiniment supérieure avec la fonction QUERY. Dans un environnement de recherche collaborative ou d’ingénierie de production, dupliquer une matrice analytique complexe ne requiert rien d’autre que la copie textuelle d’une chaîne de commande d’une cellule à une autre, voire son injection programmée par le biais d’un script d’automatisation d’Google Apps Script. Cette portabilité garantit une résilience structurelle face aux mutations des données sources : si des colonnes d’enregistrements s’étendent en profondeur, la formule absorbe la nouvelle variance sans nécessiter d’ajustement manuel du périmètre des plages sources dans des boîtes de dialogue graphiques, offrant une robustesse pérenne aux systèmes de veille et d’analyse longitudinale.
3.2 Limites inhérentes et considérations d’ergonomie
Nonobstant sa supériorité algorithmique sur de multiples fronts, l’utilisation de l’opérateur PIVOT de la fonction QUERY comporte des limites d’architecture que tout analyste rigoureux se doit d’anticiper avec lucidité. La restriction fonctionnelle la plus pénalisante concerne l’impossibilité intrinsèque d’effectuer des regroupements hiérarchiques multi-colonnes au sein d’une clause de pivotement unique. Alors que le générateur natif de tableaux croisés dynamiques autorise sans difficulté l’imbrication élégante de plusieurs dimensions de colonnes superposées (par exemple, segmenter horizontalement par année, puis à l’intérieur de chaque année par catégorie socioprofessionnelle), la clause PIVOT du langage de visualisation n’accepte qu’un seul et unique attribut en paramètre opérationnel. Tout contournement de cette contrainte impose la concaténation préalable artificielle des dimensions dans les données brutes, au détriment de l’élégance relationnelle du schéma.
Une seconde complexité majeure réside dans l’application de formats conditionnels et de styles visuels sur des ensembles de données dont l’expansion latérale demeure par nature indéterminée. Étant donné que le nombre et l’intitulé des colonnes créées par la clause PIVOT dépendent exclusivement de la cardinalité instantanée des valeurs uniques de l’attribut pivoté, l’amplitude horizontale de la matrice résultante varie dynamiquement. Dès lors, configurer des règles de mise en forme conditionnelle ou appliquer des bordures typographiques harmonisées sur des colonnes dont les positions physiques changent en fonction de l’actualisation des données sources s’avère particulièrement ardu et requiert l’élaboration de règles de formatage appliquées à des plages matricielles larges préemptives.
Enfin, la dimension ergonomique et la courbe d’apprentissage représentent une barrière non négligeable pour les collaborateurs ou les analystes non initiés au paradigme SQL. L’absence d’interface visuelle d’assistance signifie que toute anomalie typographique, toute discordance d’identifiant de colonne ou toute omission de clause intermédiaire sanctionne la cellule d’une erreur d’exécution catégorique (généralement matérialisée par l’infâme code d’erreur #VALUE!). La résolution de ces incidents exige une capacité d’abstraction logique et une compréhension intime de la hiérarchie des opérateurs relationnels, compétences que l’usage usuel des tableurs traditionnels ne développe pas nécessairement chez les utilisateurs généralistes.
4. Implémentation pratique fondamentale : L’agrégation via la fonction SUM()
4.1 Construction pas à pas de la requête d’addition matricielle
Pour appréhender concrètement la cinématique opératoire de la clause PIVOT, il est impératif d’examiner la construction méthodique de la requête d’addition matricielle la plus fondamentale. Considérons un jeu de données de recherche quantitative consignant des transactions financières ou des mesures de performance réparties sur plusieurs régions géographiques et plusieurs départements opérationnels. La structure tabulaire brute se déploie de la colonne A à la colonne C, où la colonne A répertorie la région (variable qualitative nominale), la colonne B spécifie le département (variable catégorielle secondaire), et la colonne C consigne la valeur numérique continue d’un indicateur métrique déterminé.
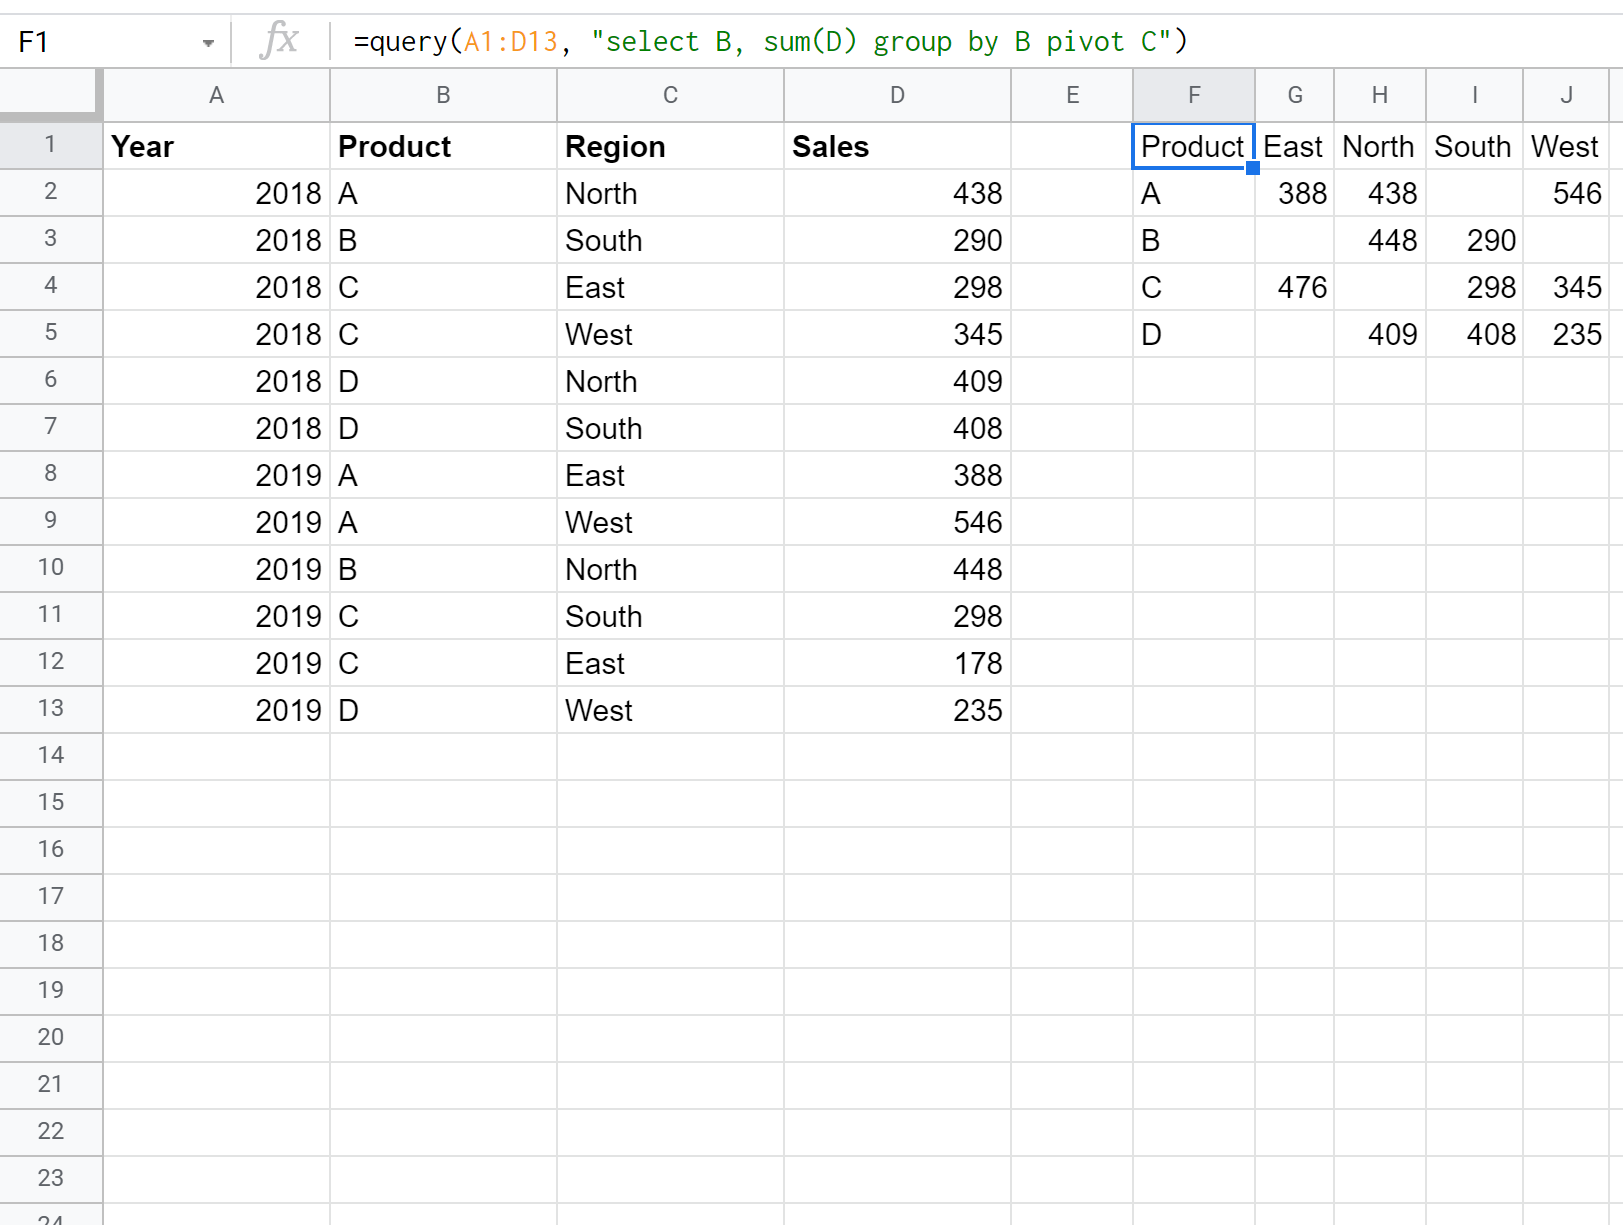
L’objectif analytique consiste à structurer une matrice bidimensionnelle où chaque ligne représentera de manière unique une région géographique, chaque colonne représentera un département opérationnel distinct, et l’intersection spatiale de chaque ligne et de chaque colonne affichera la somme arithmétique rigoureuse des valeurs métriques collectées pour ce croisement factoriel précis. La construction algorithmique de cette synthèse s’énonce dans l’environnement de calcul via la formulation suivante :
=QUERY(A1:C1000; "SELECT A, SUM(C) GROUP BY A PIVOT B"; 1)
L’analyse textuelle détaillée de ce modèle syntaxique universel révèle une orchestration parfaitement symétrique des forces de transformation relationnelle. L’expression SELECT A, SUM(C) notifie formellement au moteur que l’attribut A doit être retenu comme descripteur principal et que l’attribut C doit être traité par l’opérateur d’agrégation arithmétique additive. Cependant, l’apparition conjointe de GROUP BY A et de PIVOT B infléchit radicalement la trajectoire de rendu. La clause GROUP BY A contraint le moteur à condenser les tuples de telle sorte que chaque région géographique ne figure qu’une seule et unique fois le long de l’axe vertical des ordonnées. Simultanément, la clause PIVOT B intercepte la projection de la somme de C : au lieu de l’agréger dans une colonne descendante unique, elle diffracte l’opérateur SUM(C) le long d’un axe d’abscisses horizontales généré dynamiquement à partir des modalités observées au sein de la colonne B. La matrice résultante constitue une décomposition croisée irréprochable de la distribution des masses métriques.
4.2 Interprétation quantitative et lecture de la matrice de résultats
La lecture herméneutique de la grille spatiale générée par l’instruction précédente obéit à des règles d’interprétation statistique précises. Chaque intersection de coordonnée matricielle $(L_i, C_j)$ exprime la valeur de l’estimateur empirique d’agrégation conditionné par l’intersection des deux événements catégoriels correspondants : l’appartenance à la strate de ligne $i$ et à la classe de colonne $j$. D’un point de vue quantitatif, cette architecture résout instantanément la question de la répartition factorielle sans nécessiter de calculs manuels itératifs d’intersections booléennes complexes reposant sur de multiples critères de conditionnalité.
Une attention épistémologique aiguë doit être consacrée au traitement implicite appliqué par le moteur de l’API Google Visualization en cas d’absence d’observation empirique pour un croisement factoriel donné. Lorsqu’une région géographique donnée ne comporte aucun enregistrement associé à un département spécifique au sein de la base d’observation primaire, l’algorithme ne génère pas une valeur numérique zéro par défaut. Au lieu de cela, il préserve la vacuité ontologique de la cellule en y injectant une valeur vide (évaluation interne null). Cette distinction entre le vide formel (l’absence totale d’observation dans l’échantillonnage) et le zéro arithmétique (une observation enregistrée dont la somme des grandeurs est strictement nulle) est d’une importance capitale pour la validité des inférences scientifiques ultérieures, prévenant ainsi les biais de confusion dans le calcul des variances ou des coefficients d’ajustement structurel.
Enfin, la vérification de la cohérence globale du système impose le contrôle méticuleux des totaux marginaux par rapport à la base source non agrégée. Dans la mesure où la clause PIVOT standard ne génère pas nativement de lignes ou de colonnes marginales de somme totale (les fameux « Totaux Généraux » des interfaces graphiques), le chercheur doit être conscient que la somme de l’ensemble des cellules de la matrice pivotée doit demeurer strictement congruente à la somme totale directe de la colonne source d’origine, abstraction faite des potentielles valeurs négatives ou des anomalies d’arrondi numérique. Cette conservation scalaire totale confirme l’isomorphisme de la transformation matricielle opérée par l’expression déclarative.
5. Mesures de tendance centrale : Structuration croisée avec AVG()
5.1 Formulation de la moyenne arithmétique bidimensionnelle
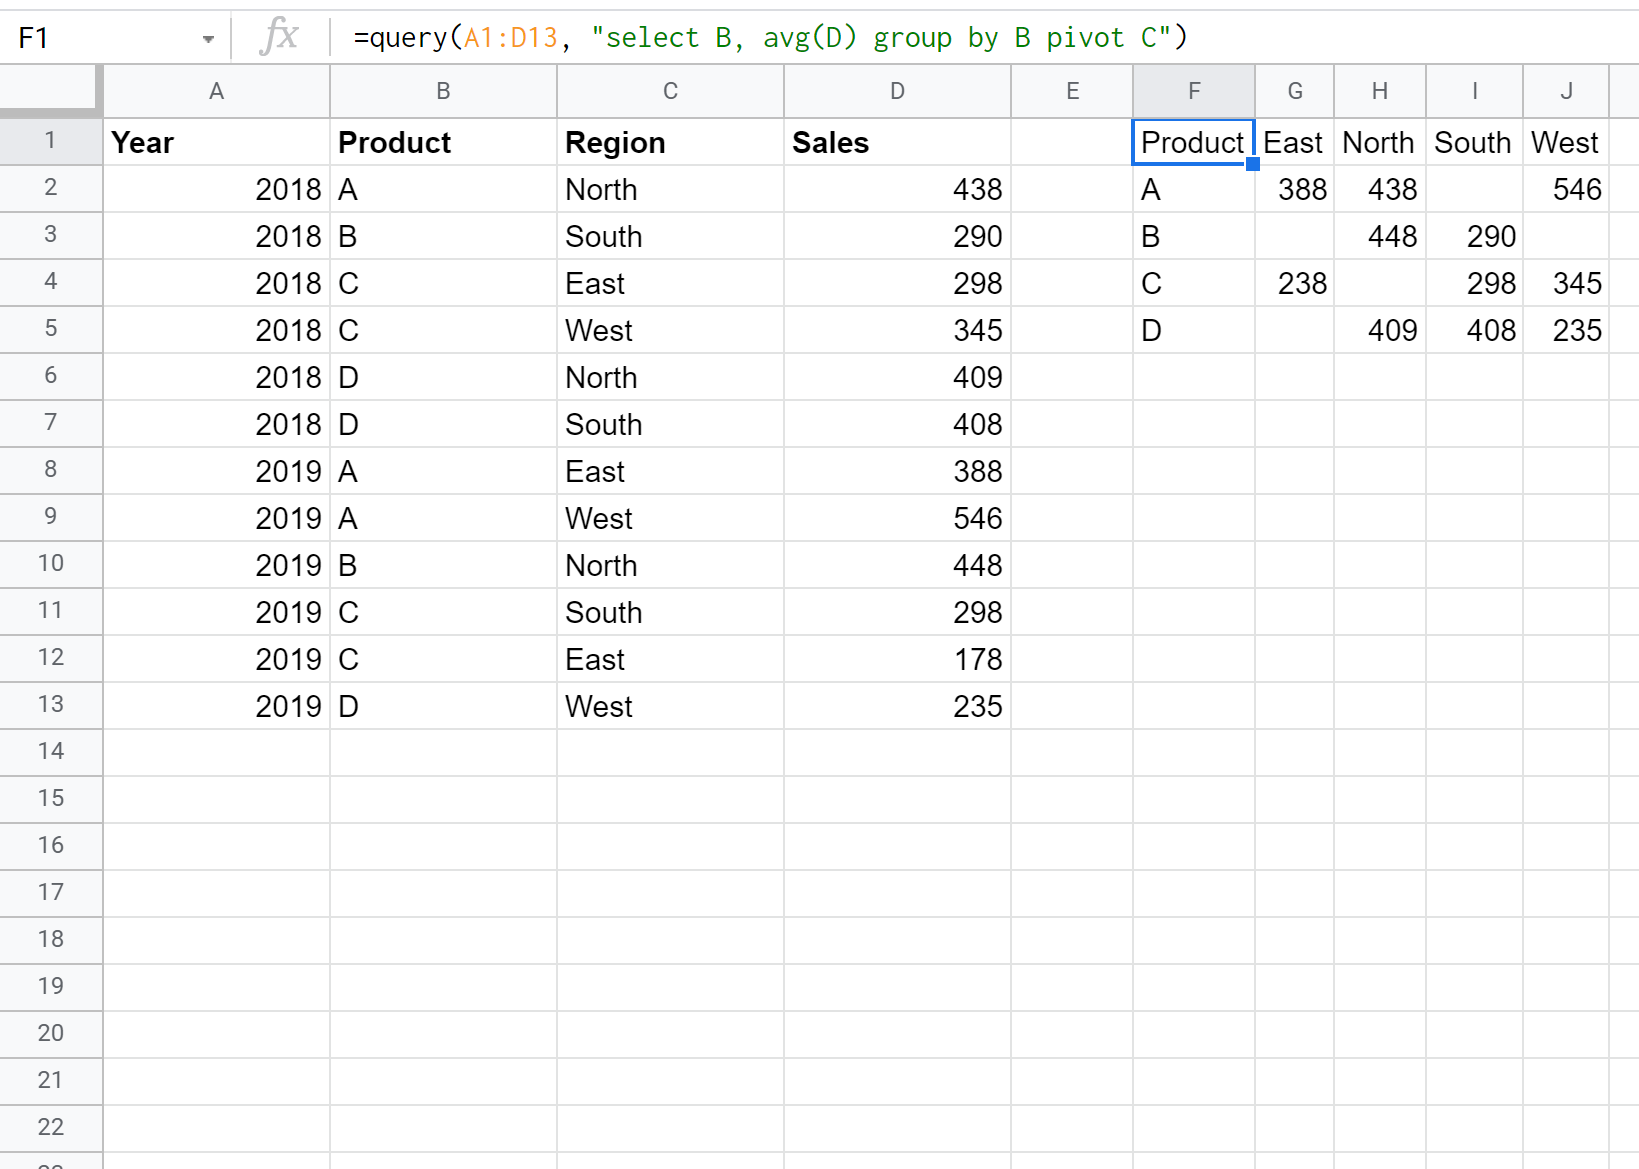
L’exploration des distributions quantitatives ne saurait se cantonner aux agrégations d’addition, qui demeurent par essence sensibles aux disparités volumétriques d’échantillonnage entre les différentes strates étudiées. L’investigation des structures phénoménologiques requiert préférentiellement l’usage de mesures de tendance centrale, au premier rang desquelles trône la moyenne arithmétique. L’implémentation d’une moyenne croisée bidimensionnelle au travers de la fonction QUERY fait appel à l’opérateur scalaire AVG(), dont la syntaxe structurelle s’articule rigoureusement de la façon suivante :
=QUERY(Donnees!A1:D5000; "SELECT A, AVG(D) GROUP BY A PIVOT C"; 1)
D’un point de vue conceptuel et statistique, une mise en garde s’impose quant à l’interprétation mathématique des grandeurs résultantes. La fonction AVG() intégrée à la clause de requête procède à une agrégation directe non pondérée sur les tuples individuels sous-jacents assignés à chaque cellule de croisement. Cela signifie que la moyenne affichée à l’intersection d’une modalité de la colonne A et d’une classe de la colonne C représente la somme arithmétique exacte des valeurs de la colonne D de cette strate subdivisée par l’effectif strict d’observations valides au sein de cette même strate. Cette démarche ne doit en aucun cas être confondue avec une moyenne de moyennes, démarche mathématiquement fallacieuse qui méconnaîtrait les effectifs marginaux de sous-groupes.
La robustesse algorithmique de AVG() face aux cellules nulles et aux valeurs manquantes constitue un atout analytique majeur mais exige une vigilance extrême. Les cellules dépourvues d’information quantitative (contenant des chaînes vides ou des valeurs nulles au sens relationnel) sont automatiquement exclues du dénominateur lors de la division arithmétique calculée par l’API. En d’autres termes, le dénominateur de la fraction moyenne représente exclusivement l’effectif des cellules contenant des valeurs numériques authentiques. Toutefois, si un opérateur a encodé par erreur une absence de réponse sous la forme explicite d’un chiffre zéro, ce dernier sera immanquablement inclus dans le calcul de la masse scalaire, tirant artificiellement la moyenne arithmétique de la strate vers le bas et distordant gravement l’estimation du paramètre de centralité de la population étudiée.
5.2 Applications empiriques aux scores d’échelles psychométriques
L’intérêt opératoire de cette architecture bidimensionnelle se révèle particulièrement manifeste dans le champ de la psychométrie appliquée et de la modélisation des comportements. Considérons un protocole expérimental évaluant le niveau d’anxiété situationnelle ou de charge cognitive perçue, mesuré au moyen d’un instrument psychométrique standardisé (tel que l’échelle de Likert ou l’inventaire de Spielberger), administré à une cohorte stratifiée d’individus. Le jeu de données répertorie en colonne A l’identifiant du profil de personnalité du sujet (introversion, extraversion, névrosisme), en colonne B la condition expérimentale imposée (condition de stress aigu, condition de relaxation, condition témoin neutre), et en colonne C le score psychométrique global obtenu.
En formulant la requête articulant GROUP BY A et PIVOT B sur l’opérateur AVG(C), l’analyste obtient instantanément une cartographie matricielle croisant les profils psychologiques individuels avec les conditions environnementales imposées. La disposition tabulaire obtenue permet une inspection visuelle directe des variations moyennes inter-groupes, autorisant une comparaison préliminaire immédiate des effets principaux des deux variables indépendantes ainsi qu’une première appréciation qualitative de potentielles interactions factorielles d’ordre deux. Si l’amplitude de la moyenne d’un groupe de personnalité s’envole sous condition de stress tandis qu’elle demeure stable pour un autre groupe sous la même condition, l’interaction apparaît avec une clarté optique saisissante au sein de la matrice.
De surcroît, cette mise en page matricielle constitue un puissant dispositif de détection diagnostique des biais de réponse et des distorsions d’échantillonnage. En observant l’alignement horizontal et vertical des moyennes calculées, l’œil exercé du statisticien identifie sans délai d’éventuelles asymétries de complétion, des tendances lourdes à l’acquiescement ou des effets de polarisation systématique des scores au sein de sous-cohortes marginales. Cette phase d’exploration matricielle préliminaire conditionne directement la validité des analyses confirmatoires subséquentes, telles que l’analyse de variance factorielle univariée ou multivariée (ANOVA/MANOVA), en fournissant une vérification empirique rapide de la plausibilité descriptive des données recueillies.
6. Analyses fréquentielles et dénombrement : Fonctions COUNT() et COUNTA()
6.1 Distinction technique entre COUNT() et COUNTA() en mode croisé
L’exploration des propriétés quantitatives d’un corpus de recherche implique fréquemment le dénombrement discret des unités expérimentales plutôt que l’évaluation de grandeurs continues. Dans le cadre de la formalisation syntaxique du compilateur de l’API Google Visualization, l’analyste dispose de deux opérateurs d’énumération dont la dissemblance sémantique s’avère critique : COUNT() et COUNTA(). La maîtrise de leur différenciation technique conditionne directement l’exactitude des calculs de densité et de fréquence relative au sein d’une distribution matricielle croisée.
L’opérateur COUNT() est ontologiquement lié aux données quantitatives et numériques. Son mécanisme d’évaluation parcourt les enregistrements de la colonne assignée et n’incrémente le compteur d’effectif que si et seulement si le contenu de la cellule observée est reconnu par l’analyseur typologique comme un scalaire numérique valide, une date sérielle formelle ou un horodatage explicite. Tout contenu textuel, booléen ou nul est rigoureusement ignoré par COUNT(). En conséquence, l’application de cet opérateur à une colonne de descripteurs catégoriels nominaux (comme des identifiants alphanumériques de participants ou des désignations verbales de traitements) produit inexorablement un résultat vide ou une matrice peuplée de zéros conceptuels, générant une incompréhension récurrente chez les chercheurs non familiarisés avec cette rigidité typologique.
À l’opposé, l’opérateur COUNTA() possède un spectre d’évaluation universellement étendu aux représentations alphanumériques. Cet opérateur dénombre toute cellule non vide, quelle que soit la nature symbolique ou scalaire de son contenu (chaînes textuelles, caractères spéciaux, entiers, réels ou expressions booléennes). Toutefois, l’utilisation de COUNTA() recèle un piège méthodologique pernicieux : la contamination par les espaces invisibles et les chaînes de longueur nulle générées par des formules préalables ou des importations défectueuses de fichiers CSV. Une cellule visuellement vide mais contenant un espace insécable ou le résultat d’une condition d’affichage vide "" sera catégoriquement décomptée par COUNTA() comme une observation empirique valide. Il incombe donc à l’analyste de procéder à une purge préalable méthodique de la base source au moyen de fonctions de nettoyage textuel (comme TRIM ou CLEAN) afin d’immuniser les dénombrements croisés contre ces artefacts insidieux.
6.2 Modélisation de tableaux de contingence pour tests statistiques
L’un des accomplissements analytiques les plus précieux de la clause PIVOT réside dans sa capacité à modéliser de façon entièrement automatisée des tableaux de contingence d’une rigueur absolue, préparant ainsi le terrain pour la conduite d’inférences non paramétriques, singulièrement le célèbre test d’indépendance du Chi-deux de Pearson ($\chi^2$). En croisant deux variables catégorielles nominales ou ordinales au moyen de l’expression suivante :
=QUERY(Observations!A1:B2000; "SELECT A, COUNTA(B) GROUP BY A PIVOT B"; 1)
le chercheur matérialise instantanément le tableau des effectifs observés ($O_{ij}$). Chaque cellule à l’intersection de la ligne $i$ et de la colonne $j$ décline précisément le nombre d’occurrences empiriques simultanées des deux attributs d’intérêt au sein de l’échantillon collecté.
Cette automatisation matricielle permet de vérifier immédiatement et sans artifice de calcul l’exhaustivité des effectifs par cellule d’échantillonnage, condition préalable impérative à la validité mathématique du test d’indépendance de Pearson. Comme le stipule la règle méthodologique canonique de Cochran, un test de Chi-deux ne conserve sa pertinence asymptotique que si aucune cellule de la matrice de contingence ne présente un effectif théorique nul et si au moins 80 % des cellules affichent un effectif attendu strictement supérieur à cinq unités. La visualisation directe de la matrice d’effectifs observés via la requête pivotée permet d’isoler en un regard les strates sous-représentées, les déséquilibres flagrants d’assignation ou les croisements catégoriels anémiques qui mettraient en péril la robustesse de l’inférence statistique.
Par ailleurs, l’identification rapide des distributions asymétriques ou des cellules vides oriente sans délai la stratégie de modélisation du chercheur. Face à un tableau de contingence révélant des clairières d’effectifs marginaux trop ténus, l’analyste averti sait qu’il doit renoncer aux approximations asymptotiques standard pour s’orienter vers des procédures de rééchantillonnage exactes, à l’instar du test exact de Fisher étendu aux matrices $R \times C$ ou de simulations computationnelles par bootstrap de Monte-Carlo. La requête de pivotement s’affirme ainsi non comme une simple étape de mise en page documentaire, mais comme un véritable filtre d’orientation épistémologique dictant le choix des procédures mathématiques adaptées à la réalité empirique du terrain.
7. Analyse des valeurs extrêmes : Utilisation de MIN() et MAX()
7.1 Configuration des requêtes pour l’évaluation des bornes
L’auscultation métrique d’un corpus de données ne peut se satisfaire d’une appréhension unilatérale de ses paramètres de tendance centrale ou de masse volumique globale. La compréhension exhaustive d’un phénomène quantitatif exige la caractérisation rigoureuse de ses frontières dimensionnelles et de ses comportements aux limites. Au sein de la boîte à outils algorithmique de l’API Google Visualization, les fonctions d’agrégation d’extrêmes MIN() et MAX() occupent une fonction déterminante pour cartographier les bornes inférieures et supérieures d’une distribution conditionnellement aux facteurs de segmentation spatiale.
La formalisation d’une requête orientée vers l’extraction des amplitudes extrêmes par croisement factoriel s’articule selon une logique tout à fait analogue à celle des opérateurs additifs ou barycentriques. Considérons un système d’acquisition de données expérimentales consignant en colonne A la référence d’un protocole d’essai, en colonne B la classe environnementale de température d’exposition, et en colonne C une mesure de résistance mécanique des matériaux. L’extraction matricielle croisée du point d’affaissement mécanique minimal s’énoncera sous la forme structurée :
=QUERY(Essais!A1:C10000; "SELECT A, MIN(C) GROUP BY A PIVOT B"; 1)
L’intérêt statistique de cette formulation prend une dimension supérieure lorsque l’analyste déploie de manière coordonnée et séquentielle deux requêtes distinctes mais géométriquement alignées, l’une ciblant MIN(C) et l’autre ciblant MAX(C). La juxtaposition matricielle de ces deux résultats d’extraction permet de déduire sans calcul intermédiaire l’amplitude totale d’étalement empirique (le range scalaire) propre à chaque croisement factoriel, calculée par la différence absolue entre le terme maximal et le terme minimal de chaque coordonnée correspondante. Cette décomposition révèle immédiatement la stabilité ou la dispersion marginale des réponses quantitatives observées sous la contrainte croisée des différentes strates expérimentales.
7.2 Applications diagnostiques et contrôle qualité des données
Dans le domaine du contrôle de la qualité des données et de l’ingénierie de vérification métrologique, l’utilisation croisée de MIN() et MAX() via la clause PIVOT s’avère un instrument de veille diagnostique d’une redoutable efficacité. Lors des processus d’ingestion de flux de mesures massifs en provenance de passerelles d’acquisition automatisées, de capteurs connectés ou de questionnaires auto-administrés sur le web, la pollution de la base par des valeurs aberrantes (outliers) dues à des défaillances de transducteurs ou à des erreurs de saisie manuelle représente une menace permanente pour l’intégrité de l’analyse scientifique.
Une requête pivotée projetant simultanément ou alternativement les bornes extrêmes par groupe de collecte permet d’isoler instantanément toute déviation typographique manifeste. Par exemple, si l’évaluation des bornes d’un score d’âge ou d’une échelle psychométrique bornée de 1 à 7 révèle subitement une valeur maximale égale à 77 ou un minimum négatif au sein d’une strate démographique précise, l’analyste sait immédiatement que la strate en question a subi une erreur d’encodage systématique ou une frappe double accidentelle. Cette détection précoce évite la propagation de ces artéfacts dévastateurs au sein des estimateurs de régression ou des matrices de variance-covariance ultérieures.
En outre, cette disposition matricielle des bornes extrêmes permet de surveiller de façon extrêmement visuelle et systématique l’apparition des effets de plafond (ceiling effects) et des effets de plancher (floor effects) au sein des instruments de mesure standardisés. Si, sous certaines conditions factorielles identifiées en colonnes de pivot, la valeur de MAX() ou de MIN() coïncide de manière généralisée avec la limite théorique absolue de l’instrument de mesure pour l’ensemble des strates de lignes, le chercheur recueille un indice probant attestant de l’inadéquation de la sensibilité métrique de son échelle pour cette sous-population spécifique. Cet avertissement quantitatif invite à repenser la calibration instrumentale ou à appliquer des modèles de censure statistique appropriés (tels que la modélisation de régression Tobit) pour tenir compte de cette saturation structurelle de la mesure.
8. Filtrage contextuel en amont : Intégration de la clause WHERE
8.1 Logique booléenne et restriction du jeu de données source
La puissance d’une transformation matricielle multidimensionnelle ne réside pas uniquement dans sa capacité à synthétiser des masses volumineuses de données indifférenciées, mais tout autant dans son aptitude à circonscrire son champ d’action à des sous-ensembles d’observations répondant à des critères d’admissibilité logiques extrêmement exigeants. L’implémentation de ces contraintes de qualification préliminaire s’effectue par l’adjonction de la clause de filtrage conditionnel WHERE, dont le positionnement architectural obéit à une rigueur syntaxique inflexible : elle doit impérativement s’insérer en aval de la projection SELECT et en amont de toute instruction de consolidation GROUP BY ou de redistribution PIVOT.
Le compilateur de l’API Google Visualization articule le traitement de la clause WHERE en conformité stricte avec les principes de l’algèbre booléenne classique. Les prédicats de restriction peuvent faire appel aux opérateurs relationnels standards d’égalité (=), de disjonction (!= ou <>), de comparaison de grandeurs (>, >=, <, <=), ainsi qu’à des opérateurs textuels spécialisés d’une grande puissance descriptive à l’instar de contains, starts with, ends with, ou de la conformité à des modèles réguliers via matches. Ces clauses de conditionnalité élémentaires peuvent s’assembler en propositions logiques d’une complexité arbitraire au moyen des opérateurs de coordination booléenne AND, OR et de la négation unaire NOT, avec une gestion rigoureuse des priorités de calcul permise par la parenthésation algébrique :
=QUERY(Enquetes!A1:F5000; "SELECT A, AVG(E) WHERE D > 18 AND (F = 'Valide' OR F = 'Certifie') AND C IS NOT NULL GROUP BY A PIVOT B"; 1)
Le déploiement de ce filtrage contextuel en amont transforme fondamentalement la dynamique d’exécution de la requête. Au lieu de surcharger les couches de partitionnement horizontal et vertical en calculant des agrégations sur l’ensemble de la volumétrie brute pour n’en masquer ensuite qu’une fraction à la lecture visuelle, le moteur de calcul procède à une élagage précoce drastique des tuples non conformes dès la phase d’ingestion. Cette réduction pré-agrégative préserve considérablement les cycles d’évaluation du processeur, optimise l’allocation de la mémoire tampon et immunise les agrégateurs de pivot contre toute contamination par des enregistrements non qualifiés ou des métadonnées orphelines.
8.2 Isolation de sous-populations spécifiques
L’intérêt méthodologique du couplage harmonieux entre le filtrage en amont WHERE et la redistribution matricielle PIVOT s’avère particulièrement fécond lorsqu’il s’agit de segmenter des cohortes d’études selon des exigences éthiques ou des critères d’inclusion sociodémographiques prédéfinis. Dans toute démarche empirique rigoureuse impliquant des sujets humains, l’analyse ne saurait agréger indistinctement les réponses de participants n’ayant pas explicitement accordé leur consentement éclairé ou présentant des profils d’invalidation caractérisés (par exemple, un temps de passation aberrant ou l’échec avéré à des items de contrôle d’attention).
Grâce à la flexibilité de la clause WHERE, le chercheur instaure un verrou d’exclusion sans altérer physiquement le fichier d’archives primaires des données brutes. Les données non conformes demeurent consignées dans le registre historique pour des impératifs d’auditabilité scientifique, mais elles se trouvent hermétiquement écartées du périmètre computationnel de la table de contingence ou de la matrice de moyennes générée par la formule. Cette isolation transparente des sous-populations garantit que les interactions observées au sein des cellules de croisement factoriel ne reflètent que la variance légitime d’individus répondant scrupuleusement aux spécifications définies par le protocole de recherche préliminaire.
De surcroît, cette stratégie d’exclusion conditionnelle préserve la pérennité architecturale du tableau de bord global. Contrairement aux approches artisanales consistant à tronquer manuellement des lignes de données ou à scinder une feuille de calcul en une multitude de sous-fichiers fragmentés et déconnectés, l’ajustement dynamique des critères au sein de la clause WHERE recalcule instantanément la matrice pivotée sans déstabiliser la mise en page générale ni compromettre l’alignement dimensionnel des graphiques ou des modèles analytiques situés en aval du flux de données.
9. Harmonisation typographique et sémantique : La clause LABEL
9.1 Neutralisation et personnalisation des en-têtes auto-générés
L’une des particularités les plus déroutantes du moteur d’exécution de la fonction QUERY réside dans sa propension systématique à prefixer les étiquettes de colonnes agrégées et pivotées par l’intitulé de la fonction mathématique mobilisée. Par exemple, si l’on applique l’instruction SUM(C) combinée à un PIVOT B, le compilateur génère spontanément des en-têtes composites combinant le nom de la modalité de la colonne B avec l’intitulé scalaire d’agrégation, produisant des libellés particulièrement verbeux et inélégants de la forme « somme Montant [Modalité_X] » ou « avg Score [Modalité_Y] ». Cette prolifération syntaxique automatique dégrade significativement la lisibilité esthétique de la matrice et complique considérablement son exploitation directe au sein de publications de recherche ou de présentations destinées à des décideurs.
Pour neutraliser cette expansion lexicale indésirable et réinstaurer une rigueur typographique totale, l’analyste chevronné mobilise la clause LABEL. Cette clause de clôture sémantique permet de redéfinir contractuellement l’affichage textuel de n’importe quel attribut ou fonction présent dans le champ de la requête. Son usage le plus subtil réside dans la neutralisation absolue des en-têtes automatiques : en assignant explicitement une chaîne de caractères vide (matérialisée par deux guillemets simples consécutifs '') à l’expression d’agrégation, le moteur se trouve expressément contraint de supprimer le préfixe de la fonction lors de la projection horizontale des valeurs de pivot :
=QUERY(Donnees!A1:C1000; "SELECT A, SUM(C) GROUP BY A PIVOT B LABEL SUM(C) ''"; 1)
L’application de ce mécanisme supprime instantanément la pollution textuelle générée par l’API. Les en-têtes de colonnes déployés transversalement par la clause PIVOT sont alors épurés de tout scorie calculatoire pour n’afficher plus que l’intitulé authentique, brut et immaculé des modalités de la variable catégorielle pivotée. Si une redéfinition formelle est souhaitée pour l’attribut de ligne primaire, il suffit d’adjoindre un label personnalisé à l’identifiant de la colonne A (par exemple LABEL A 'Cohorte d'étude', SUM(C) ''), conférant à l’ensemble de la structure matricielle une noblesse de présentation conforme aux standards graphiques et éditoriaux les plus pointilleux.
9.2 Maintien de la cohérence de présentation dans les rapports académiques
Dans la sphère de la communication académique et de la rédaction scientifique, la mise en forme des représentations tabulaires ne relève nullement d’une préoccupation esthétique accessoire, mais obéit à des normes codifiées avec un formalisme impitoyable, telles que les règles éditoriales édictées par l’American Psychological Association (normes APA de 7e édition). Selon ces principes, les tableaux doivent proscrire tout jargon informatique, toute référence aux mécanismes d’indexation logicielle et toute abréviation non standardisée, au profit de descripteurs sémantiques universels, intelligibles et exempts d’ambiguïté pour la communauté internationale des pairs.
L’utilisation concertée de la clause LABEL au sein d’une expression QUERY PIVOT garantit une standardisation immédiate des matrices de résultats, facilitant leur exportation directe vers des environnements de composition typographique scientifiques de haute précision tels que LaTeX ou des traitements de texte académiques standard. En supprimant les artefacts de génération de requêtes et en calibrant rigoureusement le nom de chaque facteur de segmentation, la matrice générée peut être convertie en code de tableau formel sans exiger une fastidieuse phase de réécriture manuelle des cellules d’en-tête, réduisant à néant les risques de divergences terminologiques entre le corps du manuscrit et ses annexes descriptives quantitatives.
Par ailleurs, cette maîtrise sémantique s’avère providentielle dans le cadre de consortiums de recherche internationaux impliquant des équipes pluridisciplinaires et polyglottes. En paramétrant les chaînes textuelles de la clause LABEL au moyen de références de cellules dynamiques ou de structures conditionnelles selon la localisation de l’utilisateur, l’infrastructure matricielle peut adapter instantanément ses intitulés descriptifs (par exemple en alternant entre l’anglais, le français ou l’espagnol) tout en conservant une mécanique computationnelle sous-jacente strictement invariant. Cette plasticité linguistique décuple l’interopérabilité des outils de restitution et assure un alignement herméneutique total entre les chercheurs partenaires d’un même programme scientifique mondial.
10. Traitement des valeurs nulles et modélisation avancée avec IF/ARRAYFORMULA
10.1 Substitution des cellules vides par des valeurs explicites
L’un des défis mathématiques et informatiques les plus prégnants inhérents à l’exécution de l’instruction PIVOT réside dans l’apparition récurrente de cellules désespérément vides au sein de la matrice finale de résultats. Comme établi précédemment dans ce traité, lorsqu’aucun enregistrement empirique ne concorde avec l’intersection spécifique d’une modalité de ligne et d’une coordonnée de colonne, le compilateur de l’API Visualization retourne une valeur nulle formelle. Si cette vacuité respecte scrupuleusement la vérité ontologique de l’absence d’observation, elle constitue une entrave computationnelle redoutable pour les fonctions de calcul matriciel standard positionnées en aval (telles que MMULT, SUMPRODUCT ou les calculs de distances euclidiennes), qui achoppent invariablement sur les cellules non peuplées ou les interprètent de façon asymétrique selon les contextes.
Pour palier cette limite structurelle sans dénaturer la logique déclarative du tableur, l’analyste doit encapsuler la fonction QUERY au sein d’une enveloppe matricielle récursive mobilisant la puissance de l’instruction vectorielle ARRAYFORMULA combinée à des prédicats conditionnels d’évaluation de vacuité logique. Considérons une requête pivotée générant une matrice où les absences d’occurrences doivent être rigoureusement converties en la valeur arithmétique 0 pour permettre une sommation ultérieure sans faille. L’architecture de la formule hybride s’articule ainsi :
=ARRAYFORMULA(IF(QUERY(Donnees!A1:C1000; "SELECT A, SUM(C) GROUP BY A PIVOT B"; 1) = ""; 0; QUERY(Donnees!A1:C1000; "SELECT A, SUM(C) GROUP BY A PIVOT B"; 1)))
Cette construction algorithmique opère une transformation vectorielle intégrale : l’instruction ARRAYFORMULA instancie une évaluation itérative élément par élément sur la totalité de la grille dimensionnelle générée par la fonction QUERY interne. Chaque cellule est examinée : si son évaluation textuelle renvoie une chaîne vide ou une référence nulle, l’aiguillage booléen de la fonction IF substitue instantanément la valeur par le chiffre scalaire 0 ; dans le cas contraire, la grandeur numérique originale issue du pivotement est scrupuleusement préservée.
Dans un contexte de méthodologie de recherche qualitative ou mixte, cette stratégie de substitution dynamique peut être orientée vers l’attribution de marqueurs sémantiques explicites. Au lieu d’injecter un chiffre arithmétique susceptible de créer une ambiguïté interprétative avec un résultat nul réel, l’analyste peut décréter l’affichage d’un sigle épistémologique conventionnel tel que « N/A » (Non Applicable) ou « ND » (Non Détecté). Cette explicitation formelle distingue sans équivoque la carence observationnelle de la mesure zéro, consolidant l’intelligibilité des rapports d’audit scientifique et prémunissant les lecteurs tiers contre des conclusions analytiques hâtives ou fallacieuses.
10.2 Gestion des formats de données complexes en pivot
L’élasticité de l’opérateur PIVOT se heurte fréquemment à des difficultés méthodologiques subtiles lorsque la dimension transversale projetée horizontalement implique des types de données complexes, au premier rang desquels figurent les données chronologiques, les dates sérielles et les horodatages continus. Par nature, une feuille de calcul consigne les dates sous la forme d’un nombre réel sériel dont la partie entière exprime le décompte des jours écoulés depuis une époque origine conventionnelle (généralement le 30 décembre 1899) et la fraction décimale matérialise la fraction horaire de la journée. Si l’on applique brutalement une clause PIVOT sur une colonne de dates non standardisées, le moteur crée autant de colonnes distinctes qu’il existe de fractions de secondes ou de jours différents, provoquant une pulvérisation dimensionnelle ingérable de la matrice.
Pour maîtriser ce risque d’explosion combinatoire horizontale, le compilateur offre la clause spécialisée FORMAT, qui permet de contraindre la sérialisation typologique des valeurs manipulées. Cependant, l’usage le plus rigoureux consiste à coupler cette normalisation avec des fonctions scalaires de temporalité intégrées directement dans le corps de l’instruction QUERY, telles que year(), month(), ou quarter(). Par exemple, pour structurer un tableau croisé agrégeant des indicateurs par secteur d’activité le long d’un axe horizontal ventilé par année civile homogène, la syntaxe déclarative prendra la forme épurée :
=QUERY(Transactions!A1:D; "SELECT A, SUM(D) GROUP BY A PIVOT year(B) FORMAT SUM(D) '#,##0.00 €'"; 1)
Dans cette expression avancée, la fonction interne year(B) opère une extraction unificatrice sur la date brute, réduisant la cardinalité temporelle à l’ensemble discret des années observées, tandis que la clause terminale FORMAT SUM(D) '#,##0.00 €' applique uniformément un masque de présentation monétaire normalisé sur l’ensemble des cellules projetées sous les différentes colonnes annuelles générées.
Une vigilance capitale doit impérativement être accordée aux paramètres linguistiques et régionaux régissant le classeur Google Sheets hôte. Selon que le document est configuré sous un paramétrage régional francophone ou anglo-saxon, les conventions de délimitation syntaxique subissent une mutation structurelle qui met en échec de nombreux analystes : les virgules séparatrices d’arguments dans les fonctions doivent être transmutées en points-virgules, et le point décimal anglo-saxon cède la place à la virgule décimale latine. Une méconnaissance de ces disparités de localisation environnementale constitue la source la plus fréquente de non-compilation des requêtes complexes au sein d’équipes de recherche multinationales, exigeant une documentation scrupuleuse des configurations régionales au sein des protocoles de calcul partagés.
11. Optimisation des performances et scalabilité des calculs
11.1 Gestion de la mémoire et limites de l’API Google Visualization
L’adoption de la fonction QUERY couplée à la clause PIVOT comme épine dorsale d’un système d’analyse de données impose une conscience aiguë des contraintes architecturales et des limites computationnelles inhérentes aux environnements infonuagiques partagés. L’API Google Visualization, bien qu’exécutée sur une infrastructure de serveurs distribués d’une puissance colossale, alloue à chaque instance de calcul un quota borné de cycles processeur et de mémoire vive dynamique afin de préserver l’intégrité globale du système multi-tenant. La manipulation de bases d’enregistrements volumineuses, excédant plusieurs centaines de milliers de lignes, expose l’analyste à des dégradations sensibles de performance si certaines règles élémentaires d’hygiène logicielle sont ignorées.
Le facteur de risque critique le plus destructeur pour les performances réside dans l’effet d’emballement induit par une cardinalité de pivot excessive. La projection d’un attribut catégoriel en ordonnée horizontale via PIVOT est mathématiquement viable tant que l’ensemble des valeurs uniques demeure modeste (de quelques unités à quelques dizaines de colonnes). En revanche, si un analyste étourdi applique par inadvertance une clause PIVOT sur un identifiant quasi-unique, comme un numéro de transaction aléatoire, une adresse de messagerie électronique ou un horodatage précis à la milliseconde, la requête va tenter d’instancier plusieurs dizaines de milliers de colonnes simultanées. Cet accroissement dimensionnel exponentiel heurte immédiatement la limite physique absolue de Google Sheets (qui plafonne la capacité d’une feuille à 18 278 colonnes et 10 millions de cellules) et provoque un effondrement immédiat du processus de recalcul avec génération d’une erreur d’allocation mémoire irrécupérable.
Pour prévenir ces goulots d’étranglement dévastateurs, la première bonne pratique d’optimisation consiste à proscrire formellement les références de plages matricielles ouvertes infinies et non maîtrisées au sein de calculs intensifs. Bien que l’expression A:C paraisse séduisante par sa capacité à englober d’office les extensions futures, elle contraint l’interpréteur à balayer des centaines de milliers de lignes résiduelles entièrement vides au bas de la feuille active, saturant inutilement les canaux de communication inter-processus. Il convient d’appliquer des plages judicieusement bornées ou de contraindre le périmètre d’investigation en amont par des filtres structurels stricts, garantissant que l’effort de calcul du moteur se concentre exclusivement sur les zones peuplées d’informations empiriques tangibles.
11.2 Stratégies d’imbrication et architecture de données propre
Dès lors que la complexité des modèles statistiques croisés s’intensifie, l’ingénierie logicielle au sein du tableur prescrit d’abandonner les requêtes monolithiques hypertrophiées au profit d’architectures de données modulaires organisées en couches d’abstraction successives. La mise en œuvre de prétraitements de données via des requêtes secondaires étagées constitue la stratégie d’optimisation la plus élégante pour soulager la charge de calcul de l’opérateur de pivotement final.
Dans ce modèle d’architecture étagée, une première couche de requêtes ou de formules vectorielles opère un nettoyage atomique de premier niveau : élimination des doublons bruts, normalisation des casses typographiques, imputation des données manquantes évidentes et agrégation temporelle intermédiaire (par exemple, passage du grain de la seconde au grain journalier). Les données ainsi assainies et condensées sont déversées dans une table d’étape intermédiaire (souvent qualifiée de zone Staging dans le lexique de l’ingénierie des entrepôts de données). Ce n’est qu’en aval de ce palier de stabilisation que l’expression QUERY(... PIVOT ...) intervient, opérant sur une matière déjà purifiée, hautement structurée et d’une cardinalité maîtrisée, ce qui garantit une vitesse d’exécution quasi-instantanée et élimine tout risque de divergence calculatoire.
Par ailleurs, l’emploi systématique des plages nommées confère une robustesse de maintenance inestimable aux infrastructures de recherche complexes. En substituant aux coordonnées physiques arbitraires (comme Feuille1!A1:G10000) un identifiant nominal sémantiquement porteur (tel que Matrice_Observations_Brutes), l’analyste prémunit son code déclaratif contre les ruptures de références consécutives aux déplacements ou réorganisations manuelles des onglets sources. Enfin, un audit impératif des dépendances de formules doit être conduit périodiquement : il s’agit de s’assurer scrupuleusement que la cellule hébergeant l’instruction QUERY PIVOT ne figure pas, directement ou indirectement, dans le faisceau d’alimentation des plages qu’elle examine, afin de prévenir l’apparition de boucles de dépendances récursives ou de calculs itératifs circulaires qui paralyseraient irrémédiablement le moteur d’exécution du tableur.
12. Cas d’usage méthodologiques appliqués à la recherche quantitative
12.1 Cartographie bidimensionnelle de protocoles expérimentaux
Pour illustrer la quintessence opératoire de la clause PIVOT dans le domaine de la méthodologie expérimentale de pointe, considérons un protocole de recherche biomédicale ou psychopharmacologique à mesures répétées mené en double aveugle. Dans cette configuration empirique standard, un échantillon d’individus est assigné aléatoirement à deux ou plusieurs groupes thérapeutiques (groupe témoin sous placebo versus groupe expérimental recevant un principe actif novateur), et diverses mesures physiologiques ou comportementales continues sont prélevées longitudinalement à des intervalles temporels standardisés (pré-test à $T_0$, post-test immédiat à $T_1$, et suivi longitudinal à $T_2$).
La structure d’enregistrement brute consigne au fil de l’eau, dans une organisation linéaire normalisée : en colonne A l’identifiant individuel anonymisé du participant, en colonne B le bras thérapeutique d’assignation (Témoin vs Expérimental), en colonne C le jalon temporel de la session d’évaluation ($T_0, T_1, T_2$), et en colonne D la concentration plasmatique d’un biomarqueur d’intérêt. L’application d’une requête combinant GROUP BY B et PIVOT C sur la fonction scalaire AVG(D) produit en une fraction de seconde la matrice synoptique fondamentale suivante :
=QUERY(EssaiClinique!A1:D; "SELECT B, AVG(D) WHERE B IS NOT NULL GROUP BY B PIVOT C"; 1)
Le résultat matriciel déploie horizontalement les trois jalons temporels ordonnés, tandis que l’axe vertical isole les deux cohortes de sujets. Cette spatialisation offre au biostatisticien une lisibilité immédiate de la cinétique du biomarqueur : l’effet thérapeutique principal et l’interaction temporelle factorielle sautent aux yeux avant même le recours aux modélisations confirmatoires lourdes de modèles mixtes linéaires ou d’analyses de variance à mesures répétées. La clarté descriptive de cet aperçu multidimensionnel accélère considérablement la phase d’exploration préliminaire, guidant le choix des ajustements paramétriques subséquents avec un niveau de confiance méthodologique optimal.
12.2 Synthèse et validation des instruments de mesure
Un second domaine d’application électif concerne l’évaluation des propriétés psychométriques et la validation structurelle des questionnaires d’évaluation standardisés dans les sciences du comportement et de l’éducation. Lors de la phase de validation transculturelle ou de calibration factorielle d’un inventaire d’évaluation psychologique, les chercheurs doivent examiner avec une minutie obsessionnelle le taux de complétion effectif de chaque item constitutif ainsi que la cohérence interne des sous-dimensions théoriques postulées par le modèle de mesure.
Supposons un jeu de données consignant les réponses individuelles recueillies lors d’une vaste campagne d’administration psychométrique : la colonne A répertorie la dimension théorique évaluée par l’item (par exemple la résilience émotionnelle, l’auto-efficacité, ou la régulation cognitive), la colonne B identifie le numéro spécifique de la sous-cohorte d’échantillonnage territorial, et la colonne C consigne le statut booléen ou quantitatif de validation de la réponse soumise par le participant. En formulant une requête croisant les dimensions d’échelles en lignes avec les cohortes régionales en pivot horizontal sous l’égide de l’opérateur d’effectif ou de moyenne d’achèvement, le chercheur structure un tableau de bord analytique irremplaçable :
=QUERY(Psychometrie!A1:C10000; "SELECT A, COUNT(C) GROUP BY A PIVOT B LABEL A 'Dimension Théorique', COUNT(C) ''"; 1)
Cette matrice dynamique fait immédiatement office de tour de contrôle psychométrique : elle permet de surveiller en temps réel le taux de complétion par participant et par dimension factorielle, d’identifier d’éventuelles désaffections localisées face à certains blocs de questions réputés trop intrusifs ou cognitivement éprouvants, et de valider l’équilibre échantillonnal indispensable aux analyses factorielles confirmatoires (CFA). Les recommandations internationales pour la science ouverte et la publication transparente des jeux de données d’analyse (Open Science Framework, principes FAIR) imposent désormais de documenter avec une limpidité totale l’exhaustivité des réponses recueillies. La génération de ces tableaux de synthèse par le biais d’instructions QUERY pérennes et reproductibles s’impose ainsi comme le standard d’excellence méthodologique pour toute équipe de recherche soucieuse de satisfaire aux critères de transparence et d’intégrité de la science moderne.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
Google Developers. (2023). Google Visualization API Query Language Reference. Google Developers Documentation. https://developers.google.com/chart/interactive/docs/querylanguage
Google Workspace Support. (2023). Fonction QUERY dans Google Sheets. Centre d’aide Google. https://support.google.com/docs/answer/3093343
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0