
Dans le domaine de l’ingénierie des données et de l’analyse biostatistique, le traitement analytique des grands ensembles d’informations repose sur des opérations fondamentales de réduction dimensionnelle. Parmi ces opérations, l’agrégation conditionnelle et le calcul de métriques cumulatives par sous-groupes constituent le socle de toute démarche décisionnelle rigoureuse. L’environnement logiciel de SAS (Statistical Analysis System), reconnu mondialement pour sa robustesse algorithmique et sa conformité aux exigences réglementaires strictes telles que celles de la Food and Drug Administration (FDA), fournit aux data scientists et aux statisticiens une multitude d’architectures computationnelles pour exécuter ces agrégations avec une précision arithmétique optimale.
Le calcul de la somme par groupe représente bien plus qu’une banale sommation arithmétique. Il s’agit d’un processus structurel au cours duquel des flux d’enregistrements hétérogènes sont partitionnés selon des critères catégoriels précis, traités séquentiellement ou ensemblistement, puis synthétisés dans des structures tabulaires prêtes pour la modélisation statistique ou le rapportage institutionnel. Les praticiens sont constamment confrontés à un arbitrage méthodologique : convient-il d’adopter l’approche déclarative du langage d’interrogation structuré (SQL), la puissance de contrôle séquentiel offerte par le vecteur de données du programme (Program Data Vector ou PDV) au sein de l’étape DATA, ou bien l’efficience précompilée des procédures analytiques spécialisées telles que PROC MEANS et PROC SUMMARY ?
Ce guide exhaustif a pour vocation d’analyser en profondeur les mécanismes internes, la syntaxe, l’optimisation des ressources et la validation numérique du calcul de la somme par groupe dans l’écosystème SAS. En décortiquant les paradigmes procéduraux, les comportements sous-jacents face aux valeurs manquantes, la gestion des entrées-sorties sur disque ainsi que les structures avancées en mémoire vive, cette étude propose un cadre de référence théorique et pratique pour transformer des volumes massifs d’observations en synthèses quantitatives fiables et reproductibles.
1. Introduction méthodologique à l’agrégation de données groupées dans SAS
1.1 Importance de la sommation par sous-groupes en analyse quantitative
La sommation par sous-groupes constitue une opération fondamentale de transformation des données qui permet de passer d’un niveau micro-analytique, caractérisé par des observations atomiques individuelles, à un niveau macro-analytique structuré autour de catégories d’intérêt. Dans des disciplines rigoureuses telles que l’épidémiologie clinique, l’économétrie ou la recherche comportementale, les chercheurs recueillent des milliers, voire des millions de points de contact individuels. La nécessité de réduire ces dimensions matricielles est primordiale pour rendre l’information intelligible et interprétable, sans pour autant sacrifier la structure sous-jacente des covariables.
Il existe une distinction méthodologique fondamentale entre l’obtention d’agrégats globaux et la décomposition factorielle par strates. Si la moyenne ou la somme totale d’une variable métrique fournit une mesure de tendance centrale ou de volume à l’échelle d’une population entière, elle masque inévitablement les disparités internes et les effets de composition. En décomposant ces sommes selon des variables de stratification nominales ou ordinales, l’analyste met en lumière la variabilité inter-strates et prépare le terrain pour l’analyse de variance, la régression hiérarchique ou les modèles à effets mixtes.
Enfin, au sein du pipeline d’ingénierie statistique, la sommation par groupe intervient comme une phase cruciale de prétraitement et de nettoyage. Elle permet d’établir des pondérations, de dériver des variables de niveau supérieur (par exemple, calculer le budget total consommé par un département pour le réinjecter au niveau de chaque projet) et de créer des indicateurs composites de synthèse. La maîtrise de cette étape garantit l’intégrité analytique des modèles prédictifs déployés en aval.
1.2 Panorama des paradigmes de traitement disponibles sous SAS
L’une des grandes forces de l’environnement SAS réside dans sa dualité paradigmatique, offrant aux ingénieurs le choix entre des logiques de programmation déclaratives, impératives et analytiques dédiées. Le paradigme déclaratif s’incarne principalement à travers la procédure PROC SQL, qui implémente le standard ANSI du Structured Query Language avec des extensions propriétaires hautement optimisées. Dans ce cadre, le développeur spécifie le résultat attendu sans dicter l’algorithme sous-jacent, laissant l’optimiseur de requêtes déterminer le plan d’accès aux tables et les algorithmes de jointure ou de hachage les plus appropriés.
À l’inverse, l’étape DATA incarne un paradigme impératif, séquentiel et procédural gouverné par le vecteur de données du programme (Program Data Vector – PDV). Ce modèle repose sur une boucle implicite qui lit chaque observation ligne par ligne, permettant un contrôle granulaire absolu sur chaque cycle d’exécution grâce aux instructions de traitement par groupe (BY-Group processing). L’ingénieur dicte explicitement quand les compteurs doivent être réinitialisés, comment les valeurs doivent être retenues en mémoire et à quel moment précis l’enregistrement consolidé doit être écrit sur le disque.
Entre ces deux approches se trouvent les procédures analytiques préprogrammées, au premier rang desquelles figurent PROC MEANS et PROC SUMMARY. Conçues spécifiquement pour le calcul haute performance de statistiques descriptives univariées et multivariées, ces procédures utilisent des algorithmes C/C++ internes compilés, capables de paralléliser les calculs statistiques et de générer automatiquement des tables multidimensionnelles complexes sans exiger une écriture fastidieuse de code algorithmique.
1.3 Objectifs pédagogiques et cadre d’évaluation des performances
L’objectif de cette étude est de doter les programmeurs SAS, qu’ils soient analystes juniors ou architectes de données confirmés, d’une grille de lecture critique pour sélectionner la méthode d’agrégation la plus adaptée à leurs contraintes opérationnelles. Le choix d’une méthode ne doit jamais être le fruit du hasard ou d’une simple préférence stylistique ; il doit découler d’une analyse rigoureuse de la volumétrie des données, de l’état de pré-ordonnancement des tables et de la complexité des regroupements factoriels requis.
Le cadre d’évaluation des performances s’articule autour de trois indicateurs système majeurs : l’empreinte en mémoire vive (RAM), le temps processeur (CPU time) et la bande passante d’entrées-sorties (I/O). Alors qu’une solution déclarative sous PROC SQL peut s’avérer extrêmement concise à écrire, elle peut engendrer un coût machine prohibitif si l’optimiseur déclenche des tris implicites sur des tables de plusieurs centaines de gigaoctets. Inversement, l’étape DATA séquentielle exige un tri préalable explicite (via PROC SORT), déplaçant la charge de traitement en amont de la chaîne analytique.
Enfin, la rigueur métrologique impose d’évaluer la précision numérique et la conservation des métadonnées lors de chaque phase de réduction. La gestion de l’arithmétique en virgule flottante double précision, la préservation des formats d’affichage monétaires ou temporels et la documentation formelle des attributs de table représentent des critères d’évaluation tout aussi déterminants que la simple vitesse d’exécution.
2. Fondements syntaxiques et structure du jeu de données de référence
2.1 Création du jeu de données d’expérimentation via l’étape DATA
Pour assurer la reproductibilité expérimentale des concepts théoriques développés dans cet article, nous établissons un jeu de données de référence standardisé simulant les performances sportives d’athlètes au sein de différentes franchises. Ce corpus, nommé arbitrairement my_data, encapsule à la fois des variables qualitatives nominales et des mesures métriques continues, reproduisant ainsi les défis classiques d’imbrication factorielle observés en entreprise.
L’étape DATA suivante procède à l’allocation des types, des longueurs et au chargement des enregistrements à partir d’un flux textuel brut délimité par l’instruction datalines :
data my_data;
input team $ position $ points;
datalines;
A Guard 12
A Guard 20
A Guard 22
A Forward 14
A Forward 16
A Forward 10
B Guard 20
B Guard 22
B Forward 25
B Forward 17
B Forward 25
;
run;
Dans cette structure, la variable nominale team code l’appartenance à l’entité collective (équipes A et B), la variable position qualifie le rôle tactique sur le terrain (Guard ou Forward), et la variable quantitative points enregistre les réalisations métriques individuelles. La syntaxe input team $ position $ points; indique au compilateur SAS d’allouer par défaut huit octets pour les chaînes de caractères et huit octets en format flottant double précision pour la variable numérique.
2.2 Inspection structurelle et validation des données
Toute manipulation analytique rigoureuse doit débuter par une validation immédiate de l’intégrité de la table ainsi matérialisée. La procédure PROC PRINT permet d’afficher l’ensemble des enregistrements dans le journal d’exécution ou au sein de la destination de livraison ODS (Output Delivery System), confirmant l’alignement séquentiel des colonnes et l’absence de décalage dans la lecture des flux de données :
proc print data=my_data noobs;
run;
L’inspection des descripteurs de table via la procédure PROC CONTENTS constitue l’étape subséquente incontournable pour auditer les métadonnées. L’instruction proc contents data=my_data; run; révèle non seulement la structure physique du fichier (pages de données, encodage des caractères, date de création), mais vérifie également que les types de variables correspondent aux attentes computationnelles. Une erreur classique consisterait à importer la variable points sous forme de chaîne de caractères, ce qui bloquerait toute tentative de sommation ultérieure.
L’examen empirique de la distribution des scores révèle onze observations réparties de manière asymétrique : six athlètes appartiennent à l’équipe A (trois arrières et trois ailiers) et cinq athlètes à l’équipe B (deux arrières et trois ailiers). Cette configuration déséquilibrée constitue un banc d’essai idéal pour vérifier le comportement des algorithmes face à des tailles d’échantillons non uniformes.
2.3 Propriétés distributionnelles et classification des variables d’agrégation
D’un point de vue de la modélisation statistique, les variables de regroupement catégorielles peuvent être classées selon leur niveau d’échelle et leur structure d’indépendance. Dans notre jeu de données, nous distinguons une agrégation univariée (portant uniquement sur la variable team) et une agrégation multivariée ou croisée (combinant team et position). La variable team présente deux modalités exhaustives et mutuellement exclusives, ce qui en fait un facteur fixe binaire.
La relation entre team et position présente une structure hiérarchique imbriquée ou factorielle croisée complète, dans la mesure où chaque modalité de la position tactique est observée au sein de chaque franchise sportive. L’orthogonalité des variables de classification garantit que la décomposition de la variance et la sommation des sous-totaux ne souffrent pas de colinéarité structurelle ou de cellules vides dans la matrice de contingence sous-jacente.
Comprendre la distribution empirique de la variable métrique points est également capital : elle ne présente aucune valeur négative ni valeur aberrante extrême, mais illustre une variabilité intra-groupe sensible. L’équipe A affiche des scores variant de 10 à 22 points, tandis que l’équipe B présente des valeurs s’échelonnant de 17 à 25 points. Ces caractéristiques serviront de bornes de contrôle pour valider l’exactitude de nos calculs d’agrégation dans les sections suivantes.
3. Calcul de la somme par un groupe unique avec PROC SQL
3.1 Structure syntaxique fondamentale de l’instruction GROUP BY
La procédure PROC SQL implémente une approche ensembliste élégante pour agréger des données numériques. Contrairement à l’étape DATA, l’utilisateur n’a pas à se préoccuper de l’ordre séquentiel dans lequel les enregistrements sont physiquement stockés sur le sous-système de disques. La syntaxe repose sur l’intégration harmonieuse de la clause SELECT, de la fonction d’agrégation vectorielle SUM() et de la clause d’ordonnancement logique GROUP BY.
Considérons l’implémentation minimale suivante pour agréger les scores selon l’unique dimension de l’équipe :
proc sql;
select team, sum(points) as sum_points
from my_data
group by team;
quit;
Dans ce bloc d’instructions, la fonction sum(points) ordonne au moteur SQL de condenser toutes les lignes partageant la même valeur pour le champ team en une observation synthétique unique. L’opérateur as sum_points attribue explicitement un alias représentatif à la colonne calculée résultante, évitant ainsi la génération automatique de noms de variables opaques ou tronqués par le système.
3.2 Exécution et analyse du traitement univarié
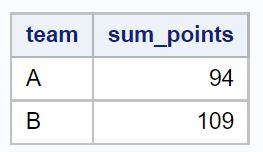
Lors de l’exécution de cette requête, le moteur de traitement SQL de SAS analyse la table source et procède à une analyse discriminante des clés de regroupement. Pour l’équipe A, les scores individuels (12, 20, 22, 14, 16, 10) sont sommés pour produire un total arithmétique rigoureux de 94 points. Pour l’équipe B, le cumul des observations (20, 22, 25, 17, 25) génère un montant consolidé de 109 points.
Sur le plan mécanique interne, l’optimiseur de requêtes SQL (SQL Query Optimizer) évalue si la table est préalablement triée ou indexée par la variable team. En l’absence d’index spécifique, SAS instancie dynamiquement une structure d’arbre binaire ou recourt à un algorithme de tri interne en mémoire temporaire (Hash Grouping ou Sort-Merge Grouping). Ce tri implicite est totalement transparent pour l’analyste, mais constitue un facteur de consommation de cycles processeur dont il faut impérativement tenir compte lors du passage à l’échelle industrielle.
Le résultat généré par ce traitement univarié met immédiatement en évidence l’avantage comparatif de l’équipe B en termes de volume offensif global (109 points contre 94 pour l’équipe A), démontrant la capacité immédiate de la sommation par groupe à transformer un tableau de données brutes en un format décisionnel exploitable.
3.3 Stockage permanent ou temporaire de la table agrégée
Par défaut, l’exécution d’une instruction SELECT au sein de PROC SQL dirige l’affichage des résultats exclusivement vers la fenêtre d’affichage ODS sans créer de table de données réutilisable dans l’espace de travail. En programmation d’entreprise, il est presque toujours nécessaire de matérialiser ce résultat dans une table SAS temporaire (logée dans la bibliothèque WORK) ou permanente.
Pour pérenniser ces agrégats, la syntaxe doit être enrichie de la directive CREATE TABLE comme suit :
proc sql;
create table aggregated_team as
select team, sum(points) as sum_points format=comma8.0 label=’Score Total’
from my_data
group by team;
quit;
Cette approche confère un contrôle total sur les attributs de la table cible. L’analyste peut associer directement des formats de présentation (par exemple, format=comma8.0) et des libellés documentaires (label='Score Total') dès la phase de création. La table aggregated_team devient ainsi un composant structuré prêt à être consommé par d’autres modules de modélisation ou exporté vers des systèmes de bases de données relationnelles distants.
4. Calcul de la somme par groupes multiples avec PROC SQL
4.1 Extension de la clause GROUP BY à plusieurs dimensions factorielles
L’analyse descriptive univariée atteint rapidement ses limites lorsqu’il s’agit de comprendre des phénomènes multidimensionnels complexes. Dans de nombreuses situations réelles, les données doivent être découpées selon une taxonomie hiérarchique ou un croisement de plusieurs facteurs d’exposition. Sous PROC SQL, l’extension du calcul de la somme à des groupes multiples s’effectue avec une fluidité syntaxique remarquable par l’ajout successif de variables dans la clause GROUP BY.
Le code suivant illustre l’évaluation simultanée de l’équipe et de la position tactique sur le terrain :
proc sql;
create table aggregated_team_position as
select team, position, sum(points) as sum_points
from my_data
group by team, position;
quit;
L’ordre de déclaration des colonnes au sein de la clause GROUP BY définit la granularité du partitionnement logique. Bien que l’ordre n’affecte pas la valeur arithmétique de la somme pour chaque cellule factorielle, il dicte l’ordre d’imbrication des enregistrements dans la table générée, facilitant la lecture humaine ou les jointures ultérieures fondées sur des clés composites hiérarchisées.
4.2 Décomposition granulaire des sous-totaux
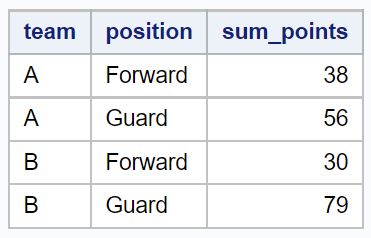
L’exécution de cette requête croisée scinde nos onze observations originales en quatre cellules distinctes correspondant aux intersections cartésiennes réelles présentes dans l’échantillon. L’analyse des résultats révèle les distributions sous-jacentes suivantes :
- Équipe A, Forward : la somme des scores (14 + 16 + 10) équivaut à 40 points.
- Équipe A, Guard : la somme des scores (12 + 20 + 22) s’élève à 54 points.
- Équipe B, Forward : la somme des scores (25 + 17 + 25) atteint 67 points.
- Équipe B, Guard : la somme des scores (20 + 22) totalise 42 points.
Ce niveau de granularité apporte des éclairages fondamentaux qui demeuraient invisibles au niveau macroscopique univarié. Si l’équipe B domine globalement au score général (109 contre 94), cette supériorité est exclusivement imputable à ses joueurs en position « Forward » (67 points contre 40 pour l’équipe A). À l’inverse, sur le segment tactique « Guard », l’équipe A surpasse l’équipe B (54 points contre 42). Ce phénomène illustre l’importance capitale du partitionnement factoriel multiple pour éviter les biais d’agrégation et le paradoxe de Simpson.
4.3 Filtrage post-agrégation à l’aide de la clause HAVING
Dans de nombreux cas d’usage, il est indispensable de restreindre la table de sortie aux seuls groupes dont la somme cumulée excède un seuil opérationnel spécifique. Les développeurs non avertis commettent fréquemment l’erreur conceptuelle de tenter d’insérer des fonctions d’agrégation au sein de la clause WHERE, ce qui déclenche immédiatement une erreur d’analyse syntaxique dans le compilateur SAS.
La règle fondamentale du modèle relationnel impose que la clause WHERE opère comme un filtre pré-agrégation, agissant ligne par ligne avant le calcul des totaux, tandis que la clause HAVING agit strictement en post-agrégation, filtrant les résultats une fois les groupes constitués :
proc sql;
select team, position, sum(points) as sum_points
from my_data
group by team, position
having sum_points > 50;
quit;
Dans cet exemple, seules les strates satisfaisant la condition stricte d’avoir accumulé strictement plus de 50 points seront émises dans la table résultante. En l’occurrence, le sous-groupe des arrières de l’équipe A (54 points) et celui des ailiers de l’équipe B (67 points) seront conservés, tandis que les autres catégories seront élaguées de l’ensemble final. Cette ségrégation précoce optimise considérablement la taille des jeux de données destinés au stockage à long terme.
5. Approche procédurale via l’étape DATA et les variables FIRST. et LAST.
5.1 Prérequis de tri préalable avec PROC SORT
L’approche séquentielle au sein de l’étape DATA repose sur une mécanique radicalement différente de la logique relationnelle de SQL. Pour que SAS puisse exécuter un traitement de groupe via l’instruction BY, les données sources doivent impérativement être ordonnées selon les variables de regroupement, sous peine d’interruption immédiate du programme par une erreur critique du superviseur SAS.
L’ordonnancement rigoureux des données s’effectue par l’appel à la procédure de tri PROC SORT :
proc sort data=my_data out=my_data_sorted;
by team position;
run;
Le moteur d’exécution de PROC SORT analyse les clés de classification simples ou composites et réorganise physiquement les pages d’enregistrements sur le disque. Cet ordonnancement garantit que tous les enregistrements partageant les mêmes valeurs de team et position deviennent strictement contigus en mémoire. Cet agencement linéaire permet au pointeur de lecture du Program Data Vector de balayer les données de manière unidirectionnelle, sans jamais nécessiter de coûteux retours en arrière dans le flux d’entrées-sorties.
5.2 Mécanisme d’accumulation séquentielle avec RETAIN et opérateur somme
Une fois les données rigoureusement ordonnées, l’étape DATA déploie toute sa puissance algorithmique grâce à la combinaison de deux mécanismes internes : l’instruction RETAIN (ou son équivalent implicite) et les variables temporaires automatiques générées par l’instruction BY, à savoir FIRST.variable et LAST.variable.
Par défaut, à chaque itération de la boucle de l’étape DATA, le superviseur réinitialise toutes les variables numériques à la valeur manquante (représentée par un point). L’opérateur de sommation implicite (syntaxe d’addition variable + increment;) modifie ce comportement par défaut : il applique automatiquement une clause de rétention en mémoire à la variable d’accumulation et convertit silencieusement les éventuelles valeurs manquantes en zéros arithmétiques :
data team_summary (drop=points);
set my_data_sorted;
by team position;
if first.position then sum_points = 0;
sum_points + points;
if last.position then output;
run;
Dans ce segment de code, lorsque le moteur rencontre la première observation d’une nouvelle position au sein d’une équipe (first.position = 1), le compteur sum_points est réinitialisé à zéro. À chaque ligne lue pour ce même groupe, l’expression sum_points + points; incrémente le cumulatif. L’instruction RETAIN implicite empêche SAS de vider la valeur du compteur entre les cycles de lecture.
5.3 Sélection et émission des enregistrements agrégés finaux
Le contrôle de l’écriture sur le disque s’exécute à l’aide de la conditionnelle if last.position then output;. Dans un traitement par étapes séquentiel, chaque ligne d’origine traverse le vecteur de données du programme. Si l’instruction OUTPUT n’était pas soumise à cette condition, la table de sortie contiendrait l’ensemble des observations initiales avec une colonne supplémentaire affichant la progression cumulative de la somme (somme glissante ou running total).
L’utilisation judicieuse de last.position force l’écriture d’une ligne sur le disque uniquement lorsque le pointeur de lecture atteint l’ultime observation du sous-groupe factoriel actif. La variable atomique points est exclue de la structure finale via l’option drop=points pour garantir que la table résultante présente une dimensionnalité strictement identique à celle obtenue par la procédure SQL.
Cette approche procédurale offre une flexibilité incomparable : elle permet d’effectuer des calculs conditionnels hautement personnalisés au cours du cycle de sommation, de générer des indicateurs d’alertes complexes ou de ventiler simultanément les flux vers plusieurs tables de sortie distinctes à l’aide de blocs logiques SELECT-WHEN ou IF-THEN-ELSE impossibles à formuler sous une syntaxe SQL standard.
6. Agrégation statistique avancée avec PROC MEANS et PROC SUMMARY
6.1 Configuration élémentaire et choix des instructions de classification
Les procédures analytiques PROC MEANS et PROC SUMMARY sont spécifiquement conçues pour l’ingénierie statistique et l’agrégation de masse. Bien qu’elles partagent des fondations algorithmiques rigoureusement identiques, leur syntaxe offre deux méthodes distinctes pour segmenter les observations : l’instruction CLASS et l’instruction BY.
L’implémentation classique avec l’instruction CLASS s’articule comme suit :
proc means data=my_data noprint nway;
class team position;
var points;
output out=summary_output (drop=_type_ _freq_) sum=sum_points;
run;
Contrairement à l’instruction BY qui exige un ordonnancement préalable strict par PROC SORT, l’instruction CLASS traite les données sans tri physique obligatoire en construisant une table de hachage interne ou un arbre de combinaison des niveaux factoriels directement en mémoire vive. L’instruction quantitative VAR isole les métriques numériques à soumettre au calcul, interdisant le traitement inutile d’autres colonnes numériques présentes dans la table source.
6.2 Extraction vers une table de sortie avec l’instruction OUTPUT
Le cœur de l’automatisation analytique repose sur la clause OUTPUT OUT=, qui matérialise les calculs statistiques dans un nouveau jeu de données. La spécification explicite sum=sum_points restreint l’opération de calcul à la seule sommation numérique et renomme le vecteur résultant de manière intelligible.
Par défaut, toute procédure de classification SAS génère deux variables système fondamentales :
_TYPE_: un identifiant binaire ou décimal qui code le niveau d’agrégation représenté par l’enregistrement (par exemple, total général, sous-total par équipe, ou total croisé équipe-position)._FREQ_: une variable de comptage entier indiquant le nombre exact d’observations brutes ayant contribué au calcul de la statistique dans cette cellule.
L’ajout de l’option NWAY dans l’en-tête de la procédure est une bonne pratique indispensable lorsque l’analyste ne désire extraire que le niveau de stratification le plus fin (le croisement complet de toutes les variables CLASS), en éliminant automatiquement tous les sous-totaux marginaux et le grand total général. L’utilisation conjointe de l’option de jeu de données drop=_type_ _freq_ finalise le nettoyage de la table pour lui conférer une pureté structurelle optimale.
6.3 Différenciation opérationnelle entre PROC MEANS et PROC SUMMARY
Sur le plan historique et architectural, la distinction entre PROC MEANS et PROC SUMMARY est devenue subtile mais demeure essentielle dans les environnements de production industrielle. Par défaut, la procédure PROC MEANS est configurée pour diriger l’impression de ses résultats vers la destination de rapportage ODS active (génération de tableaux HTML, PDF ou texte brut dans le visualiseur de résultats SAS).
À l’inverse, PROC SUMMARY a été historiquement conçue pour le travail par lots (batch processing) et n’active aucun mécanisme d’affichage par défaut. Elle se focalise exclusivement sur la génération silencieuse et ultra-rapide de tables de données via l’instruction OUTPUT. Bien que l’option NOPRINT neutralise l’affichage de PROC MEANS, PROC SUMMARY demeure le standard de facto au sein des scripts d’ingénierie de données en raison de sa sémantique orientée production.
De surcroît, ces deux procédures supportent l’option CHARTYPE, qui force SAS à représenter la variable _TYPE_ sous forme d’une chaîne de caractères binaires (ex. « 11 » pour deux facteurs croisés), facilitant ainsi le décodage programmatique des niveaux hiérarchiques lors de l’analyse d’enquêtes ou de données censurées complexes.
7. Gestion des données manquantes et valeurs nulles dans la sommation
7.1 Comportement différentiel face aux valeurs manquantes selon la méthode
L’intégrité d’un calcul de sommation dépend directement de la façon dont le système traite les valeurs manquantes (missing values), représentées par un point d’interrogation ou un point décimal simple (.) en environnement SAS numérique. Une disparité fondamentale sépare l’arithmétique directe de l’étape DATA des fonctions préprogrammées.
Si un analyste utilise l’opérateur arithmétique d’addition classique (+) au sein d’une étape DATA séquentielle, SAS applique le principe de propagation stricte des valeurs nulles : toute addition impliquant une valeur manquante renvoie inexorablement une valeur manquante (par exemple, 5 + . = .). Cette caractéristique peut altérer de manière silencieuse des calculs d’agrégation entiers si un seul individu d’un sous-groupe n’a pas renseigné son score.
À l’opposé, tant la fonction SQL sum() que la fonction SAS SUM() et les procédures MEANS/SUMMARY ignorent les valeurs manquantes lors de l’accumulation arithmétique. Si un sous-groupe contient les valeurs 10, 20 et une valeur manquante, la sommation retournera 30, et non une valeur nulle. Ce n’est que si l’intégralité des observations d’un sous-groupe est manquante que le résultat final sera évalué à une valeur manquante numérique.
7.2 Option MISSING et conservation des catégories incomplètes
Un écueil statistique classique concerne les valeurs manquantes situées non pas dans les variables quantitatives d’analyse, mais dans les variables qualitatives de regroupement elles-mêmes. Par défaut, PROC MEANS, PROC SUMMARY et l’étape DATA avec instruction CLASS excluent systématiquement de l’analyse toute observation présentant une valeur manquante dans l’une des variables de classification.
Cette exclusion arbitraire peut introduire un biais de sélection sévère et fausser le rapprochement des effectifs totaux avec la population source. Pour contraindre SAS à considérer les valeurs manquantes de regroupement comme des strates analytiques valides à part entière, il est impératif d’intégrer l’option MISSING dans la déclaration de la procédure :
proc summary data=my_data missing nway;
class team position;
var points;
output out=summary_with_missing sum=sum_points;
run;
Sous PROC SQL, la norme relationnelle impose déjà ce comportement par défaut : les valeurs NULL au sein d’une colonne de partitionnement sont regroupées au sein d’une catégorie unique. L’harmonisation de ces comportements entre les différentes procédures représente une étape cruciale pour garantir la cohérence des indicateurs agrégés à l’échelle d’une entreprise.
7.3 Audit des agrégats pour détecter les biais induits par les valeurs absentes
Tout rapport analytique professionnel doit intégrer un protocole d’audit permettant d’évaluer la complétude des données ayant généré les sommes de groupe. Se contenter d’afficher la somme arithmétique sans documenter le taux de couverture des observations expose l’analyste à de graves erreurs d’interprétation managériale ou clinique.
L’instruction OUTPUT de PROC SUMMARY permet d’extraire simultanément la somme, le nombre d’observations valides (N) et le nombre exact d’observations manquantes (NMISS) pour chaque cellule de calcul :
proc summary data=my_data nway;
class team;
var points;
output out=audit_aggregation
sum=sum_points
n=valid_count
nmiss=missing_count;
run;
L’évaluation du ratio missing_count / (valid_count + missing_count) permet d’établir des règles de décision automatisées. Si le taux d’attrition au sein d’un groupe dépasse un seuil d’alerte prédéfini (par exemple, 15 % de données non renseignées), la somme calculée peut être signalée comme sujette à caution ou réorientée vers un algorithme d’imputation multiple avant validation définitive.
8. Optimisation des performances sur des volumétries massives
8.1 Empreinte mémoire et allocation des ressources d’exécution
Lors du traitement de tables massives renfermant des centaines de millions d’enregistrements (telles que des logs de télécommunications ou des flux de transactions financières), l’architecture sous-jacente du calcul de somme par groupe détermine la viabilité technique du traitement. Le premier paramètre de régulation réside dans l’allocation de la mémoire vive via l’option système MEMSIZE et le dimensionnement de la bibliothèque temporaire WORK.
L’étape DATA séquentielle associée à un jeu de données préalablement trié présente l’empreinte mémoire la plus faible et la plus prévisible. Dans la mesure où le vecteur de données du programme ne conserve qu’une seule ligne à la fois en mémoire vive (à l’exception de quelques compteurs d’accumulation), l’algorithme s’exécute selon une complexité spatiale théorique en (O(1)). Elle est totalement immunisée contre les saturations de mémoire vive, quelle que soit la taille de la table sur disque.
À l’inverse, PROC SQL et PROC SUMMARY avec instruction CLASS allouent des structures dynamiques en RAM pour cartographier l’ensemble des combinaisons factorielles. Si la cardinalité des variables de groupement est très élevée (plusieurs millions de modalités uniques), la mémoire allouée peut saturer, contraignant SAS à basculer vers des fichiers d’échange temporaires sur disque (spilling). Ce phénomène de pagination induit une chute spectaculaire des débits d’entrées-sorties et un allongement massif des temps d’exécution processeur.
8.2 Utilisation stratégique des index pour accélérer le partitionnement
L’indexation de la table source constitue un puissant levier d’accélération pour les requêtes d’agrégation, mais son utilisation requiert une compréhension fine de l’optimiseur SAS. Un index simple ou composite (créé via l’instruction CREATE INDEX sous PROC DATASETS ou PROC SQL) maintient un arbre B (B-Tree) ordonné des valeurs de clés pointant directement vers les numéros d’enregistrement physiques correspondants.
Lorsqu’une procédure SQL soumet une clause GROUP BY sur des colonnes indexées, l’optimiseur peut exploiter cet index pour lire les données dans un ordre déjà stratifié, évitant ainsi l’exécution d’un algorithme de tri lourd et consommateur d’I/O. Toutefois, si la table est fortement fragmentée sur le disque, la lecture séquentielle via un index peut générer des accès disques aléatoires (random I/O) qui s’avèrent paradoxalement plus lents qu’un balayage séquentiel complet (full table scan).
Il est donc préconisé d’utiliser des index uniquement lorsque la table est volumineuse, que les variables de regroupement présentent une sélectivité optimale, et que les données physiques sur le disque présentent un taux de corrélation de clustering élevé avec l’index.
8.3 Techniques de traitement en mémoire avec les tables de hachage
Pour les environnements SAS disposant d’une large allocation de mémoire vive, l’utilisation des objets de hachage (hash objects) intégrés à l’étape DATA représente la méthode la plus rapide et la plus sophistiquée pour calculer des sommes par groupe sans aucun tri physique préalable. Cette structure algorithmique implémente une table de dispersion associative en mémoire dont la complexité de recherche et de mise à jour approche le temps constant théorique (O(1)).
L’extrait de code suivant démontre l’implémentation industrielle d’un hash object d’agrégation :
data _null_;
if 0 then set my_data(keep=team points);
if _N_ = 1 then do;
declare hash h(hashexp: 8, ordered: ‘ascending’);
h.defineKey(‘team’);
h.defineData(‘team’, ‘sum_points’);
h.defineDone();
end;
set my_data end=eof;
if h.find() = 0 then do;
sum_points = sum_points + points;
h.replace();
end;
else do;
sum_points = points;
h.add();
end;
if eof then h.output(dataset: ‘hash_aggregated_team’);
run;
Cette technique lit la table brute en une seule et unique passe séquentielle. Pour chaque enregistrement, SAS interroge la table de hachage en mémoire. Si l’équipe existe déjà, le score est cumulé et la nouvelle somme est stockée via la méthode replace(). Si la clé est rencontrée pour la première fois, l’enregistrement est initialisé avec la méthode add(). À la lecture de la dernière observation (eof), la méthode output() matérialise l’intégralité de la synthèse sur disque. Cette approche surpasse systématiquement PROC SQL et PROC SORT sur les très grands volumes de données.
9. Restructuration et mise en forme des résultats agrégés
9.1 Pivotage des données agrégées avec PROC TRANSPOSE
Les tables issues des processus de sommation sont systématiquement générées dans une disposition dite « longue » (normalized or tall form), où chaque combinaison factorielle est matérialisée par une ligne d’enregistrement distincte. Dans de multiples scénarios de présentation exécutive ou de calcul matriciel, il est indispensable de faire pivoter cette structure vers une disposition dite « large » (wide form), où une dimension factorielle est transposée en une série de colonnes d’agrégats.
La procédure PROC TRANSPOSE permet de réaliser cette métamorphose topologique de manière totalement paramétrée :
proc transpose data=aggregated_team_position out=pivoted_summary(drop=_name_);
by team;
id position;
var sum_points;
run;
Dans cette architecture de transformation, l’instruction BY team; établit les lignes invariantes du nouveau tableau. L’instruction ID position; ordonne au transpositeur d’utiliser les modalités textuelles de la variable position (en l’occurrence, « Forward » et « Guard ») comme intitulés normés des nouvelles colonnes numériques calculées. L’instruction VAR sum_points; désigne la métrique quantitative sommée à réaffecter dans les cellules matricielles ainsi créées.
9.2 Formatage et habillage visuel via PROC FORMAT et ODS
Une somme numérique brute dépourvue de sémantique de mise en forme altère la lisibilité des livrables analytiques. L’association de dictionnaires de formats via PROC FORMAT et l’exploitation des destinations ODS permettent de transformer des tables SAS dépouillées en tableaux de bord institutionnels à forte valeur ajoutée.
L’ingénieur peut encapsuler les règles d’habillage numérique et de codage des modalités à l’aide de directives déclaratives :
proc format;
value $team_desc ‘A’ = ‘Franchise Atlantique’ ‘B’ = ‘Franchise Pacifique’;
picture pt_format low-high = ‘000 pts’ (prefix=’Score: ‘);
run;
ods excel file= »Rapport_Aggregations.xlsx » style=statistical;
proc print data=aggregated_team noobs label;
format team $team_desc. sum_points pt_format.;
label team = ‘Division Sportive’ sum_points = ‘Performance Consolidée’;
run;
ods excel close;
Cette séquence assigne des libellés exhaustifs, applique un masque de formattage dynamique personnalisé (picture format) et exporte directement la synthèse financière ou opérationnelle vers une feuille de calcul Excel nativement stylisée selon les chartes graphiques statistiques du système. Cette séparation rigoureuse entre la couche de stockage des calculs et la couche de présentation constitue l’un des piliers des architectures de données professionnelles sous SAS.
9.3 Normalisation des métadonnées des tables de sortie
Au sein d’un entrepôt de données d’entreprise ou d’un lac de données clinique, les tables de synthèse agrégées ne sont jamais isolées ; elles alimentent des pipelines de production automatisés (batch ETL). La présence de noms de colonnes anarchiques générés automatiquement par des procédures analytiques (tels que _TYPE_, _FREQ_ ou des alias tronqués) constitue un facteur majeur d’instabilité logicielle.
La procédure PROC DATASETS offre un cadre unifié et hautement performant pour renommer, réétiqueter et documenter les tables de sommes sans nécessiter de réécriture physique des fichiers de données :
proc datasets library=work nolist;
modify aggregated_team;
rename sum_points = total_score_val;
label total_score_val = « Somme arithmétique validée des points 2024 »;
quit;
Cette standardisation garantit que les métadonnées techniques respectent scrupuleusement le dictionnaire de données institutionnel. La traçabilité des transformations et la stabilité des interfaces de programmation applicative (API) internes de SAS s’en trouvent ainsi pérennisées.
10. Validation empirique et contrôle d’intégrité des calculs de sommes
10.1 Rapprochement arithmétique entre total général et totaux groupés
Le contrôle de qualité des données (Data Quality Assurance) impose de vérifier l’exactitude des calculs de sommation par des mécanismes de contrôle de bouclage comptable. L’un des principes cardinaux réside dans la démonstration mathématique de l’égalité stricte entre le total général non groupé de la population cible et la somme intégrale des sous-totaux factoriels générés par groupe.
Toute divergence entre ces deux agrégats révèle systématiquement une anomalie sous-jacente : présence de doublons cachés introduits par de mauvaises jointures cartésiennes, élimination silencieuse d’enregistrements présentant des valeurs manquantes dans les clés de classification, ou corruption de pointeurs de lecture. Ce rapprochement peut être totalement automatisé à l’aide d’un bloc macro conditionnel SAS :
%macro audit_sommes(table_source=, var_analyse=, table_agregee=, var_agregee=);
proc sql noprint;
select sum(&var_analyse) into :grand_total from &table_source;
select sum(&var_agregee) into :somme_groupes from &table_agregee;
quit;
%if %sysevalf(&grand_total ne &somme_groupes) %then %do;
%put ERROR: Incohérence arithmétique détectée ! Total brut: &grand_total. vs Somme groupes: &somme_groupes.;
%abort cancel;
%end;
%else %do;
%put NOTE: Validation arithmétique réussie. Bouclage parfait (&grand_total.).;
%end;
%mend audit_sommes;
L’intégration systématique de telles balises de validation défensive au sein des chaînes d’intégration continue protège l’écosystème analytique contre la propagation d’indicateurs erronés dans les rapports réglementaires.
10.2 Techniques de double programmation pour la certification des résultats
Dans les industries hautement régulées, telles que le développement clinique de médicaments sous la supervision de l’Agence Européenne des Médicaments (EMA) ou de la FDA, la norme méthodologique exige la pratique de la double programmation indépendante. Cette discipline stipule que deux programmeurs statisticiens doivent produire indépendamment la même table agrégée en utilisant deux méthodologies de programmation distinctes (par exemple, PROC SQL versus étape DATA ou PROC MEANS).
La confrontation rigoureuse des deux jeux de données de sortie s’opère via la procédure de validation d’élite PROC COMPARE :
proc compare base=aggregated_team compare=summary_output criterion=0.00000001 novalues;
id team;
var sum_points;
run;
La procédure PROC COMPARE audite chaque cellule de données ligne par ligne et variable par variable. Le journal d’exécution compile un rapport exhaustif attestant de la conformité intégrale des deux sources ou consignant les moindres divergences détectées, qu’il s’agisse de légers décalages d’arrondi ou de discordances structurelles dans les clés de classification. Le code de retour système SYSINFO permet d’automatiser la signature électronique de conformité du script.
10.3 Gestion des arrondis et précision des types de données numériques
L’environnement SAS architecture ses variables numériques selon le standard international IEEE 754 pour la virgule flottante en double précision sur huit octets (64 bits). Bien que ce système procure environ 15 à 17 chiffres significatifs de précision, l’accumulation séquentielle de nombres décimaux peut induire des erreurs d’arrondi infinitésimales (floating-point roundoff errors).
Ces anomalies de précision s’expliquent par le fait que certaines fractions décimales (comme 0.1 ou 0.7) ne possèdent pas de représentation binaire exacte finie, se transformant en fractions périodiques infinies en base deux. Lors de sommations répétées sur des millions de lignes, ces micro-résidus s’accumulent et peuvent générer des discordances apparentes lorsqu’un opérateur logique vérifie une condition de stricte égalité (par exemple, if sum_points = 100.3 then ...).
Pour neutraliser totalement ce comportement machine, il est fortement recommandé d’encapsuler les métriques dans la fonction de troncation arithmétique ROUND() :
sum_points = round(sum_points + points, 0.0001);
Cette précaution mathématique élimine le bruit résiduel en virgule flottante et préserve l’isomorphisme parfait des calculs quel que soit le compilateur ou le système d’exploitation hôte (Linux, Windows Server ou z/OS mainframe).
11. Cas d’usage avancés et variations fonctionnelles de sommation
11.1 Calcul de sous-totaux et totaux généraux avec GROUPING SETS et ROLLUP
Les rapports décisionnels exigent fréquemment la présentation conjointe de plusieurs niveaux hiérarchiques au sein d’une seule et même structure tabulaire : les détails croisés les plus fins, les sous-totaux intermédiaires par catégorie majeure, et le total général consolidé. Historiquement, l’obtention d’un tel résultat imposait l’écriture de multiples requêtes unies par des clauses UNION ALL.
La procédure PROC SQL enrichie des extensions analytiques permet de générer ces hiérarchies en une seule passe logique grâce aux opérateurs ROLLUP et GROUPING SETS :
proc sql;
select team, position, sum(points) as sum_points
from my_data
group by rollup(team, position);
quit;
L’opérateur ROLLUP(team, position) génère automatiquement trois strates d’agrégation décroissantes :
- Le niveau fin : sommes croisées pour chaque combinaison unique de
teametposition. - Le niveau intermédiaire : sous-total de chaque
team, où la variablepositionest assignée à une valeur nulle. - Le niveau racine : grand total général de l’ensemble du jeu de données (203 points), où les deux variables de classification sont nulles.
Cette compacité syntaxique réduit considérablement le coût machine en évitant des relectures multiples des tables de données et simplifie l’architecture globale des flux de travail décisionnels.
11.2 Sommation conditionnelle au sein des groupes via l’expression CASE WHEN
Un défi classique d’ingénierie de données consiste à agréger des données en appliquant des règles d’exclusion ou de pondération différenciées selon la valeur d’autres attributs, sans scinder la table originale. L’imbrication de la fonction d’agrégation SUM() avec l’expression conditionnelle CASE WHEN sous PROC SQL constitue l’un des idiomes de programmation les plus puissants du langage SAS.
Supposons que nous souhaitions segmenter, pour chaque franchise sportive, les points marqués exclusivement lors d’actions à haute performance (définies arbitrairement comme un score individuel supérieur ou égal à 20 points) par rapport aux points réguliers :
proc sql;
create table conditional_aggregation as
select team,
sum(points) as total_global,
sum(case when points >= 20 then points else 0 end) as points_elite,
sum(case when points < 20 then points else 0 end) as points_standard
from my_data
group by team;
quit;
Cette construction permet de vectoriser le traitement logique. En une seule lecture de la table my_data, SAS calcule simultanément le volume global et ventile les contributions selon des partitions opérationnelles étanches. Cette méthode élimine le recours à des étapes DATA intermédiaires de filtrage et accélère considérablement le temps de calcul global des entrepôts de données.
11.3 Calculs de pourcentages et poids relatifs intra-groupe
La sommation par groupe constitue souvent le dénominateur fondamental nécessaire au calcul de ratios de contribution relative, comme la proportion de points inscrits par chaque joueur au sein de son équipe respective. Réaliser cette opération nécessite d’associer la somme globale du groupe à chaque observation individuelle.
Sous PROC SQL, cette opération s’exécute de façon spectaculaire grâce au mécanisme de ré-agrégation automatique (Remerging Summary Statistics) :
proc sql;
create table team_share as
select team, position, points,
sum(points) as team_total,
(points / sum(points)) * 100 as pct_of_team format=6.2
from my_data
group by team;
quit;
Lorsque le moteur SQL constate qu’une variable individuelle (points) coexiste dans la clause SELECT avec une statistique agrégée (sum(points)) partitionnée par une variable de groupe (team), il effectue automatiquement une auto-jointure interne (remerging). SAS calcule d’abord la somme de l’équipe, puis la diffuse sur chaque ligne individuelle appartenant à cette équipe, permettant ainsi le calcul immédiat du pourcentage de contribution relative de chaque joueur. Cette fonctionnalité propriétaire de SAS SQL épargne au développeur la complexité d’une auto-jointure explicite.
12. Synthèse comparative des méthodes et arbre décisionnel
12.1 Matrice d’évaluation technique et opérationnelle
Pour structurer le choix de l’ingénieur SAS face aux différentes technologies d’agrégation étudiées tout au long de cet article, il convient de dresser un bilan analytique multicritère évaluant la compacité syntaxique, la vitesse de traitement, l’impact sur les entrées-sorties et les contraintes de pré-tri.
- PROC SQL : Brille par sa concision syntaxique, sa portabilité relationnelle universelle et sa capacité native d’auto-jointure (remerging). En revanche, elle présente une consommation de mémoire vive difficilement contrôlable sur des données massives et peut masquer des opérations de tri implicites très coûteuses.
- Étape DATA avec BY-Group : Offre un contrôle algorithmique absolu sur le flux d’exécution et une consommation mémoire quasi-nulle ((O(1))). Toutefois, elle impose un prérequis inviolable d’ordonnancement physique via PROC SORT et exige un volume de code plus important pour sécuriser les compteurs avec
RETAINetFIRST./LAST.. - PROC MEANS / PROC SUMMARY : Constituent les moteurs de calcul statistique les plus optimisés, exploitant le multithreading matériel et offrant une extraction multidimensionnelle native avec l’option
NWAY. Leurs limites tiennent à une syntaxe parfois austère pour les non-statisticiens et à la production de variables système (_TYPE_,_FREQ_) devant être élaguées. - Tables de Hachage en mémoire (Hash Objects) : Fournissent les performances d’exécution les plus fulgurantes en s’affranchissant totalement du tri préalable. Leur complexité de mise en œuvre réserve cependant leur usage à des développeurs seniors disposant de serveurs dotés d’une volumétrie de RAM généreuse.
12.2 Arbre décisionnel pour le choix de la procédure optimale
L’orientation méthodologique au sein d’un projet analytique SAS peut être résumée sous forme d’une série de règles de décision logiques rigoureuses :
Si l’analyste recherche avant tout la simplicité d’écriture au sein d’un flux de données principalement articulé autour de requêtes relationnelles ou doit calculer simultanément des pourcentages de contribution intra-groupe (remerging), PROC SQL représente la solution par défaut.
Si la table de données source est déjà ordonnée physiquement par les variables de regroupement ou si le traitement nécessite l’application de logiques de dérivation procédurales hautement personnalisées au fil de l’eau (ventilation multi-tables, règles de gestion métier complexes), l’Étape DATA avec variables FIRST. et LAST. s’impose incontestablement.
Si l’objectif consiste à générer de multiples indicateurs de dispersion (somme, moyenne, écart-type, quantiles) ou à analyser les combinaisons de facteurs hiérarchiques sans se soucier du tri préalable tout en exploitant la parallélisation matérielle, PROC SUMMARY avec l’instruction CLASS et l’option NWAY constitue le standard de l’industrie.
Enfin, face à des volumétries de données massives non triées nécessitant une exécution en temps réel ou un débit batch contraint, le recours à un Hash Object en étape DATA s’avère le choix d’excellence technique absolue.
12.3 Recommandations et bonnes pratiques de programmation SAS
Pour assurer la maintenabilité et la robustesse des applications statistiques au fil des cycles de vie logiciels, plusieurs normes de développement doivent être systématiquement appliquées :
Premièrement, bannissez formellement les noms de variables de sortie non documentés. Tout agrégat doit recevoir un alias explicite reflétant sa nature arithmétique et la variable sous-jacente (par exemple, points_sum ou total_points au lieu de l’intitulé générique par défaut). Deuxièmement, documentez systématiquement la gestion des valeurs manquantes dans les métadonnées de production, en utilisant expressément l’option MISSING si les catégories nulles portent une signification analytique.
Troisièmement, encapsulez vos séquences d’agrégation récurrentes dans des macros paramétrées compilées, afin d’interdire la duplication de code et de propager de manière transparente les optimisations d’options système (telles que BUFSIZE ou THREADS). Enfin, appliquez systématiquement des protocoles de double validation arithmétique avec PROC COMPARE avant tout déploiement en production, garantissant que vos calculs de sommes par groupe demeurent universellement reproductibles, précis et irréprochables.
Références
- Cody, R. (2018). Learning SAS by Example: A Programmer’s Guide (2nd ed.). SAS Institute Inc. https://support.sas.com/en/books.html
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc. https://support.sas.com/en/books.html
- IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://standards.ieee.org/ieee/754/6027/
- SAS Institute Inc. (2020). SAS 9.4 SQL Procedure User’s Guide (4th ed.). SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2021). Base SAS 9.4 Procedures Guide: Statistical Procedures (5th ed.). SAS Institute Inc. https://documentation.sas.com
- Secor, P. (2014). Hash Object Programming in Base SAS. SAS Institute Inc. https://support.sas.com/resources/papers/proceedings14/1480-2014.pdf