
L’analyse des comportements humains et des processus cognitifs confronte régulièrement le chercheur à des dynamiques non linéaires où l’ampleur du changement s’atténue à mesure que l’exposition, la pratique ou l’intensité de la stimulation augmentent. Dans le champ de la psychologie quantitative, des neurosciences comportementales et des sciences sociales, la tentation de recourir de manière systématique au modèle linéaire généralisé classique conduit souvent à des biais d’estimation substantiels et à une mécompréhension fondamentale des lois psychophysiques sous-jacentes. La régression logarithmique s’impose alors comme l’un des outils analytiques les plus élégants et les plus robustes pour capturer ces phénomènes caractérisés par des rendements marginaux décroissants et des effets de saturation progressive sans rupture de continuité.
Le recours à l’environnement statistique R offre une flexibilité sans équivalent pour formaliser, estimer, diagnostiquer et représenter ces modèles semi-logarithmiques. Grâce à son écosystème combinant des fonctions de base éprouvées comme la commande standard d’estimation linéaire et des extensions modernes dédiées à l’exploration visuelle et à l’inférence robuste, R permet de décomposer chaque étape du flux analytique avec une transparence totale. Ce guide exhaustif propose une traversée méthodique, théorique et opérationnelle de la modélisation logarithmique dans R, conçue pour guider les chercheurs et analystes de données depuis les fondations mathématiques et historiques jusqu’aux diagnostics avancés des résidus et aux applications concrètes sur des données empiriques.
Au-delà de la simple manipulation syntaxique, cet article aborde les implications épistémologiques et psychométriques liées à la transformation des variables prédictives continues. Nous examinerons en détail pourquoi la compression logarithmique de l’échelle explicative permet de préserver l’interprétabilité métrique de la variable dépendante tout en reflétant fidèlement l’organisation psychologique des facultés mnésiques, motrices ou perceptuelles. À travers une démarche reproductible, articulée autour de simulations numériques contrôlées et d’études de cas réalistes, ce document constitue une référence complète pour quiconque souhaite intégrer la régression logarithmique au sein de ses pratiques d’analyse quantitative.
1. Fondements théoriques de la régression logarithmique en psychologie quantitative
1.1 Principes des dynamiques non linéaires à décélération progressive
L’observation du comportement humain révèle presque invariablement que les variations initiales d’un état interne ou d’une performance externe sont les plus spectaculaires, avant de fléchir sous l’effet d’une résistance structurelle, physiologique ou cognitive. Ces dynamiques se caractérisent mathématiquement par une dérivée première positive lorsque la trajectoire est ascendante ou négative lorsqu’elle est descendante, associée systématiquement à une dérivée seconde de signe opposé, traduisant une décélération continue de la vitesse de changement. Contrairement à une idée reçue, cette décélération n’implique pas nécessairement l’existence d’une frontière absolue ou d’une borne supérieure infranchissable, mais plutôt une difficulté croissante à progresser le long de l’axe de la variable dépendante.
Il convient d’établir une démarcation épistémologique stricte entre les modèles exponentiels et les modèles logarithmiques. Alors que les transformations exponentielles décrivent des phénomènes où le taux de variation est proportionnel au niveau déjà atteint, engendrant des croissances explosives ou des effondrements vertigineux, les lois logarithmiques modélisent un étirement de l’échelle des stimuli. Dans un cadre logarithmique, chaque pas unitaire sur l’échelle des abscisses produit un effet de plus en plus marginal sur l’ordonnée. Cette propriété est essentielle face aux effets de plafonnement observés en psychométrie, où les gains de score aux tests d’aptitude deviennent infinitésimaux à mesure que le sujet approche de ses capacités maximales de traitement de l’information.
Les manifestations empiriques de cette décélération foisonnent dans la littérature expérimentale contemporaine. Les protocoles d’habituation chez le nourrisson ou l’animal démontrent que la diminution de la réponse d’orientation vers un stimulus récurrent suit une pente abrupte lors des premières expositions, avant de se stabiliser sur un plateau asymptotique. De manière analogue, les lois de rétention mnésique et les dynamiques de saturation sensorielle traduisent l’incapacité des systèmes physiologiques à maintenir une réactivité linéaire face à des sollicitations physiques répétées ou continues, confirmant la pertinence universelle de l’opérateur logarithmique pour décrire ces régularités.
1.2 Historique et applications empiriques : de la loi de Weber-Fechner à l’apprentissage
La genèse de la modélisation logarithmique en sciences humaines remonte aux travaux pionniers de Gustav Theodor Fechner, qui s’est appuyé sur les observations empiriques d’Ernst Heinrich Weber pour formaliser la première loi quantitative de la psychophysique. Weber avait découvert que le seuil différentiel de discrimination sensorielle est proportionnel à l’intensité du stimulus de référence. En intégrant cette relation différentielle, Fechner a démontré que la sensation perçue varie comme le logarithme de l’intensité physique du stimulus. Cette découverte a constitué la première tentative mathématique réussie pour relier le monde matériel objectif aux états de conscience subjectifs, posant les bases de la mesure en psychologie expérimentale.
Quelques décennies plus tard, Hermann Ebbinghaus a transposé cette rigueur mathématique à l’étude des processus mentaux supérieurs en explorant systématiquement la dynamique temporelle de la mémoire humaine. En mesurant le temps nécessaire pour réapprendre des listes de syllabes sans signification après des intervalles de rétention variables, Ebbinghaus a formalisé sa célèbre courbe de l’oubli. Cette dernière illustre une chute vertigineuse de l’information retenue dans les premières minutes et heures suivant l’apprentissage, relayée ensuite par une érosion extrêmement lente et stabilisée sur des semaines, une cinétique fidèlement capturée par des fonctions semi-logarithmiques liant le pourcentage d’économie mnésique au logarithme du temps écoulé.
Dans le domaine de l’acquisition des compétences motrices et cognitives, les recherches sur la loi de la pratique ont mis en évidence que les temps de réaction diminuent drastiquement au cours des premiers essais avant d’atteindre une phase de consolidation où les gains d’efficacité nécessitent un nombre exponentiellement accru de répétitions. Aujourd’hui, la transposition de ces postulats historiques vers l’analyse statistique informatisée sous des logiciels comme R permet non seulement d’ajuster ces courbes avec une précision métrique inégalée, mais également de tester formellement les paramètres d’échelle et les constantes d’interception au regard des théories neurophysiologiques modernes.
1.3 Objectifs pédagogiques et cadre méthodologique de l’implémentation sous R
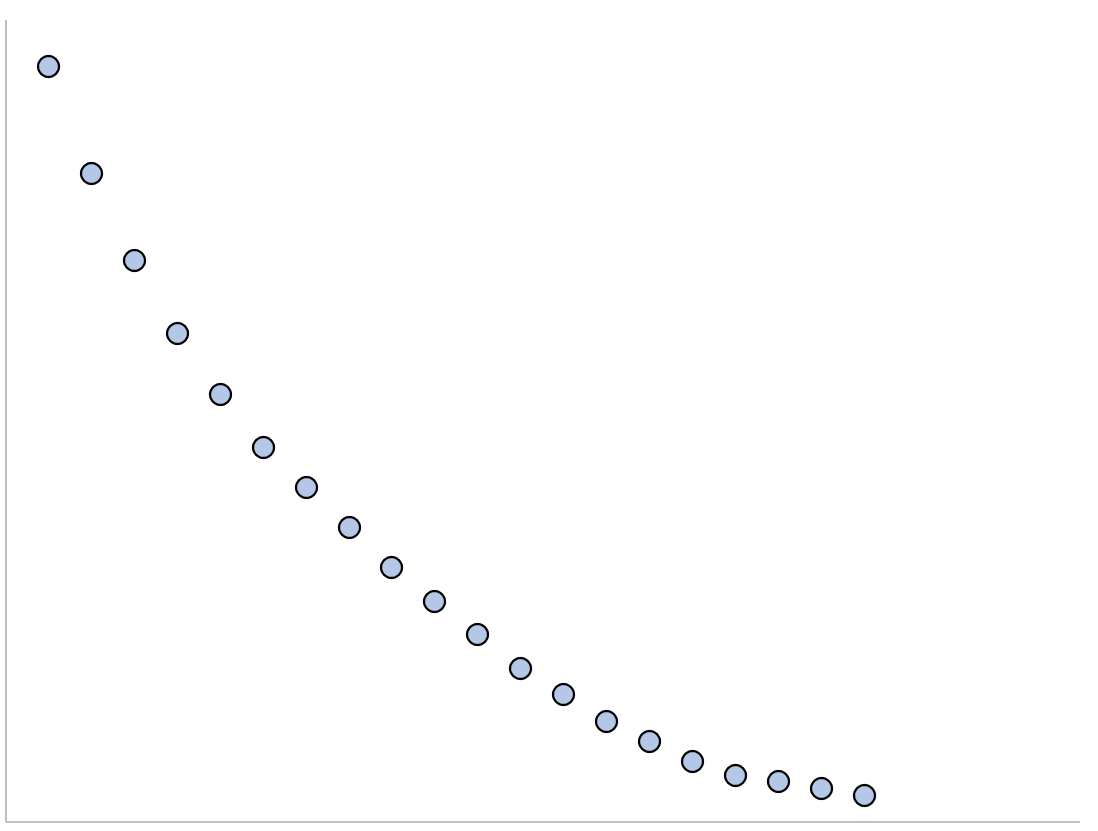
L’objectif central de ce guide est de fournir une architecture méthodologique complète et reproductible pour l’analyse de données non linéaires par le biais de la régression logarithmique. Le flux de travail s’articule autour d’une séquence linéaire de huit étapes standardisées, garantissant que l’analyste ne se contente pas d’exécuter aveuglément un algorithme d’optimisation, mais comprenne la répercussion de chaque choix computationnel sur l’inférence finale. Ce parcours englobe la préparation initiale des données, la formalisation syntaxique au sein de l’environnement R, l’interprétation fine des sorties console, la validation des postulats gaussiens et la communication graphique rigoureuse des trajectoires prédites.
La sélection des métriques d’ajustement constitue un jalon fondamental de ce cadre pédagogique. Trop souvent, les analystes s’en remettent exclusivement au coefficient de détermination classique sans considérer sa sensibilité à la distribution des prédicteurs ou sa vulnérabilité en présence de déformations d’échelle. Nous aborderons en détail l’utilisation conjointe de critères d’information pénalisés, tels que le critère d’Akaike et le critère bayésien de Schwarz, ainsi que l’examen scrupuleux des résidus studentisés pour arbitrer entre des représentations concurrentes d’un même phénomène psychologique.
Enfin, ce document accorde une importance primordiale aux exigences de reproductibilité scientifique, conformément aux standards internationaux promus par l’American Psychological Association et l’écosystème open-source R. La modularité du code présenté, l’exclusion délibérée des opérations manuelles non tracées dans des tableurs externes et la fixation explicite des germes de simulation garantissent que chaque résultat exposé peut être vérifié, répliqué et adapté en toute confiance à de nouveaux corpus empiriques dans le cadre de recherches académiques ou appliquées.
2. Formulation mathématique et spécification analytique du modèle
2.1 Dérivation de l’équation générale du modèle logarithmique
La régression logarithmique simple, souvent désignée dans la littérature économétrique et statistique sous le terme de modèle semi-logarithmique de niveau-log, relie une variable dépendante continue observée sur son échelle naturelle à une variable indépendante continue soumise à une transformation par le logarithme népérien. L’expression algébrique fondamentale s’énonce selon la relation canonique :
y = a + b * ln(x) + ε
Dans cette formalisation, le terme y représente le vecteur des scores observés sur la variable de réponse, tandis que x incarne le vecteur des mesures sur la variable explicative, restreint impérativement à des valeurs strictement positives. Le paramètre a désigne l’ordonnée à l’origine, correspondant analytiquement à la valeur attendue de y lorsque l’argument du logarithme népérien est égal à l’unité, puisque ln(1) = 0. Cette propriété algébrique confère à la constante une signification empirique directe, pourvu que la valeur unitaire sur l’axe x possède une pertinence théorique au sein du protocole d’observation.
Le paramètre b, qualifié de pente d’échelle ou de coefficient de déformation logarithmique, gouverne à la fois la direction et la courbure de la trajectoire moyenne. Sur le plan géométrique, la dérivée première de la fonction par rapport à x s’écrit dy/dx = b / x. Cette formulation démontre avec netteté que le taux instantané de changement de la variable dépendante est inversement proportionnel à la magnitude absolue de la variable prédictive : plus la valeur de x est élevée, plus l’impact d’une incrémentation unitaire infinitésimale de ce prédicteur sur y devient négligeable. Le signe de b dicte quant à lui la concavité de la courbe, engendrant une dynamique de saturation ascendante si b est positif, ou une cinétique d’extinction décélérée si b est négatif.
2.2 Hypothèses sous-jacentes du modèle linéaire généralisé par transformation
L’estimation d’un modèle logarithmique par la méthode des moindres carrés ordinaires repose sur la satisfaction d’un ensemble de conditions stochastiques indispensables pour garantir que les estimateurs des coefficients bénéficient des propriétés d’optimalité établies par le théorème de Gauss-Markov. La première exigence stipule que l’espérance conditionnelle des perturbations stochastiques ε sachant x doit être rigoureusement nulle. De surcroît, la variance de ces résidus doit demeurer constante sur l’ensemble du continuum de la variable transformée, une propriété connue sous le terme d’homoscédasticité conditionnelle :
Var(ε | x) = σ²
Une contrainte mathématique absolue réside dans la stricte positivité du domaine de définition du prédicteur. La fonction logarithme népérien n’admettant aucune valeur réelle pour les arguments inférieurs ou égaux à zéro, toute observation nulle ou négative sur l’axe x invalide l’opération de calcul matriciel et nécessite un traitement algébrique préalable documenté. En outre, l’inférence statistique valide requiert l’indépendance mutuelle des observations, condition particulièrement critique lors du recueil de données longitudinales ou répétées chez les mêmes sujets, où la corrélation intra-individuelle des résidus peut biaiser à la baisse les erreurs-types estimées.
Lorsque ces postulats sont violés, les conséquences sur la qualité de l’estimation peuvent être dévastatrices. La présence d’hétéroscédasticité n’altère pas le caractère non biaisé des coefficients ponctuels a et b, mais elle détruit l’efficacité statistique des estimateurs, rendant caduques les valeurs de p issues des distributions de Student conventionnelles. De même, la non-normalité sévère des termes d’erreur dans des échantillons restreints compromet la couverture probabiliste réelle des intervalles de confiance calculés pour la trajectoire moyenne.
2.3 Distinction formelle entre régression logarithmique et modèles log-linéaires
Une confusion terminologique récurrente dans les sciences quantitatives concerne la distinction entre le modèle logarithmique, le modèle log-linéaire et le modèle log-log. Le tableau analytique suivant synthétise les différences structurelles fondamentales régissant ces trois familles de spécifications non linéaires, en mettant en lumière la nature des transformations appliquées aux variables et la formule d’interprétation marginale qui en découle :
- Modèle semi-logarithmique (niveau-log) : y = a + b * ln(x). Seul le prédicteur est transformé. L’interprétation indique qu’une variation relative de 1 % de la variable x induit une variation absolue de b / 100 unités sur l’échelle originale de la réponse y. Ce modèle est parfaitement adapté à l’analyse de mesures psychologiques quantifiées sur des échelles d’intervalles standardisées où la réponse conserve son unité naturelle.
- Modèle log-linéaire (log-niveau) : ln(y) = a + b * x. Seule la variable dépendante est transformée. Dans cette configuration, une augmentation d’une unité entière sur l’échelle originale de x entraîne une variation relative d’environ (e^b – 1) * 100 % sur la variable y. Cette structure modélise des processus de croissance ou de décroissance exponentielle continue.
- Modèle bi-logarithmique (log-log) : ln(y) = a + b * ln(x). Les deux variables subissent une compression par le logarithme népérien. Le paramètre b exprime directement l’élasticité constante entre les deux dimensions, signifiant qu’une variation de 1 % de x s’accompagne d’une variation de b % de la variable de réponse y.
En psychologie cognitive et en psychométrie, le maintien de la variable de réponse sur son échelle métrique originelle via le modèle semi-logarithmique offre l’avantage inestimable de préserver l’intégrité clinique et pratique des résultats. Les temps de réaction restent exprimés en millisecondes, les scores de rappel en nombre d’items mémorisés, et les grandeurs physiologiques en unités physiques directes, évitant ainsi les pièges cognitifs liés à la ré-inversion des prédictions issues d’échelles transformées non linéaires.
3. Configuration de l’environnement de recherche sous R
3.1 Initialisation de la session et gestion des paquets statistiques
L’exécution rigoureuse d’un protocole d’analyse de régression exige un paramétrage méthodique de la session de calcul R afin de garantir une reproductibilité computationnelle intégrale. Il est impératif d’ajuster les options globales du système, notamment pour limiter l’affichage prématuré des notations scientifiques compactes et pour calibrer le seuil d’arrondi numérique. L’utilisation d’une instruction telle que options(scipen = 7, digits = 5) assure une lisibilité optimale des sorties numériques au sein du terminal sans dégrader la précision arithmétique sous-jacente des calculs en virgule flottante.
Bien que les fonctions natives de l’environnement R de base permettent de mener à bien l’intégralité de l’estimation par les moindres carrés ordinaires via la bibliothèque de base stats, l’intégration raisonnée de paquets spécialisés enrichit considérablement le diagnostic et la visualisation. L’écosystème tidyverse, articulé autour de dplyr et ggplot2, rationalise la manipulation des tableaux de données et la génération de graphiques vectoriels publiables conformes aux normes académiques. Par ailleurs, le paquet car (Companion to Applied Regression) fournit des outils incontournables pour l’évaluation de l’hétéroscédasticité et la détection d’observations à fort effet de levier.
Pour documenter rigoureusement la session et permettre la réplication fidèle des analyses par des tiers, il est fortement conseillé de consigner la version exacte de l’interpréteur R ainsi que l’ensemble des bibliothèques mobilisées au terme de l’exécution grâce à la fonction standard sessionInfo(). Cette pratique, adoptée par les revues de psychologie computationnelle, prévient les divergences algorithmiques découlant des évolutions fonctionnelles des paquets tiers au fil des années.
3.2 Gestion des prérequis d’échantillonnage et de puissance statistique
La validité statistique de l’estimation de deux paramètres continus (l’interception a et la pente logarithmique b) repose sur un équilibre subtil entre la variance résiduelle du phénomène et la dispersion géométrique des observations le long de l’axe transformé. En règle générale, la puissance statistique requise pour rejeter l’hypothèse nulle d’absence de courbure logarithmique dépend moins de la taille absolue de l’échantillon que de la présence de mesures adéquatement espacées le long du continuum de la variable prédictive.
L’analyste doit porter une attention scrupuleuse à la distribution de la variable x. Si les observations sont massées exclusivement dans des plages de valeurs élevées de x, la variance de ln(x) sera très faible en raison de la compression inhérente au logarithme, ce qui provoquera une inflation dramatique de l’erreur-type associée au coefficient de pente. Pour obtenir une estimation de haute précision, le chercheur doit idéalement adopter un échantillonnage distribué de façon géométrique ou logarithmique lors du recueil des données empiriques, garantissant une répartition équilibrée des points de mesure sur l’échelle transformée.
En termes de sensibilité, les points d’observation situés aux deux extrémités du spectre expérimental exercent un contrôle déterminant sur le calcul de la pente. Les mesures recueillies immédiatement après le point d’origine fournissent l’information cruciale sur l’amplitude de l’accélération ou de la chute initiale, tandis que les mesures tardives stabilisent l’estimation du plateau. La perte de données dans l’une de ces fenêtres critiques dégrade exponentiellement la fiabilité de l’inférence paramétrique et majore les risques d’erreurs de type II.
4. Étape 1 : Structuration et simulation des données empiriques
4.1 Génération de jeux de données contrôlés à décroissance logarithmique
Pour illustrer de manière pédagogique le processus analytique, la construction d’un jeu de données synthétique contrôlé offre un terrain d’expérimentation idéal. Considérons un protocole expérimental en psychologie de l’apprentissage moteur et cognitif où l’on mesure l’évolution du temps nécessaire pour accomplir une tâche de résolution de problème complexe à travers 50 sessions d’entraînement successives. Le modèle théorique sous-jacent postule une réduction rapide du temps de complétion au fil des premiers essais, suivie d’une phase de consolidation asymptotique.
Dans l’environnement R, la création de ce scénario débute par l’initialisation du vecteur des sessions au moyen de la fonction de séquence 1:50. Nous définissons ensuite une valeur théorique pour l’ordonnée à l’origine, par exemple a = 120 secondes (temps moyen prédit lors de la session initiale), et un coefficient de décélération négatif, disons b = -22.5. L’application directe de la fonction mathématique log() sur le vecteur des sessions génère la trajectoire déterministe sous-jacente.
Afin de reproduire fidèlement l’aléa inhérent à toute mesure psychométrique, une composante d’erreur stochastique issue d’une loi normale centrée est injectée au modèle au moyen de l’instruction rnorm(n = 50, mean = 0, sd = 4.5). Les données sont ensuite fusionnées au sein d’une structure rectangulaire standardisée de type data.frame, comprenant la variable explicative Session et la variable dépendante TempsReponse. Cette configuration permet de disposer d’un banc d’essai transparent dont les véritables paramètres générateurs sont connus à l’avance, autorisant une confrontation critique des estimations produites ultérieurement par les algorithmes de régression.
4.2 Gestion des valeurs nulles et négatives sur le prédicteur
Un écueil méthodologique classique survient lorsque les protocoles d’investigation comportent une condition de contrôle étiquetée par l’indice zéro, comme un pré-test, une mesure de base avant traitement ou un temps d’exposition nul. Sur le plan de l’analyse réelle, la fonction logarithme népérien tend vers moins l’infini lorsque son argument s’approche de zéro par valeurs positives, et n’est tout simplement pas définie pour zéro ou les valeurs négatives. L’exécution d’un modèle sous R impliquant de telles valeurs renvoie inéluctablement des valeurs infinies ou non définies (notées -Inf ou NaN), interrompant le flux de calcul.
La solution algébrique conventionnelle consiste à appliquer une translation linéaire positive au vecteur explicatif par l’addition d’une constante scalaire de décalage, telle que x_trans = x + c. Dans la littérature expérimentale, le choix de la constante c fait l’objet de vifs débats méthodologiques. Si l’ajout arbitraire d’une valeur unitaire standardisée (c = 1) est fréquemment rencontré car elle préserve la propriété commode que le logarithme du point zéro devienne nul (ln(0 + 1) = 0), cette opération altère artificiellement la structure de courbure du modèle lorsque les valeurs de x sont initialement très petites.
Le chercheur doit être pleinement conscient que le choix de cette constante modifie substantiellement l’estimation de l’ordonnée à l’origine et l’interprétation théorique du seuil de base. Dans le cas de variables physiques continues, telles que le temps de réaction ou des intensités lumineuses, l’addition d’une constante arbitraire peut déformer les relations de proportionnalité relative et introduire un biais de spécification non négligeable. Il est recommandé de privilégier un rééchelonnement théoriquement justifié, ou, lorsque la nature du phénomène le permet, d’enregistrer le temps d’observation depuis un instant initial strictement non nul.
4.3 Inspection dimensionnelle et vérification préliminaire des types de données
Avant d’engager toute procédure de modélisation mathématique formelle, l’inspection de l’architecture structurelle du jeu de données constitue une mesure de prudence indispensable. L’analyste doit interroger la classe des objets au sein du tableau de données en exploitant la commande str(donnees), laquelle certifie que la variable dépendante et le régresseur sont effectivement encodés sous la forme de vecteurs numériques à virgule flottante de type numeric, et non sous forme de chaînes de caractères ou de facteurs qualitatifs à la suite d’une mauvaise importation.
L’appel à la fonction summary(donnees) offre un aperçu immédiat des propriétés de dispersion des variables, notamment les extremums, les quartiles et la moyenne empirique. Cette synthèse permet de repérer instantanément d’éventuelles valeurs aberrantes issues d’erreurs de saisie cléricale, d’identifier des scores négatifs prohibés sur le prédicteur destiné à subir la transformation logarithmique, et de quantifier précisément le nombre d’enregistrements manquants (notés NA) qui nécessiteraient une imputation ou une exclusion raisonnée.
Enfin, la vérification de la monotonicité et de l’intégrité séquentielle des identifiants temporels s’impose. S’assurer que les observations se succèdent dans un ordre temporel cohérent sans duplication inopinée garantit que les décalages sériels ultérieurs et les diagnostics d’autocorrélation résiduelle reposeront sur une chronologie rigoureusement exacte, condition sine qua non de la modélisation des processus dynamiques en psychologie.
5. Étape 2 : Exploration visuelle préliminaire de la trajectoire non linéaire
5.1 Construction du nuage de points initial avec les fonctions de base
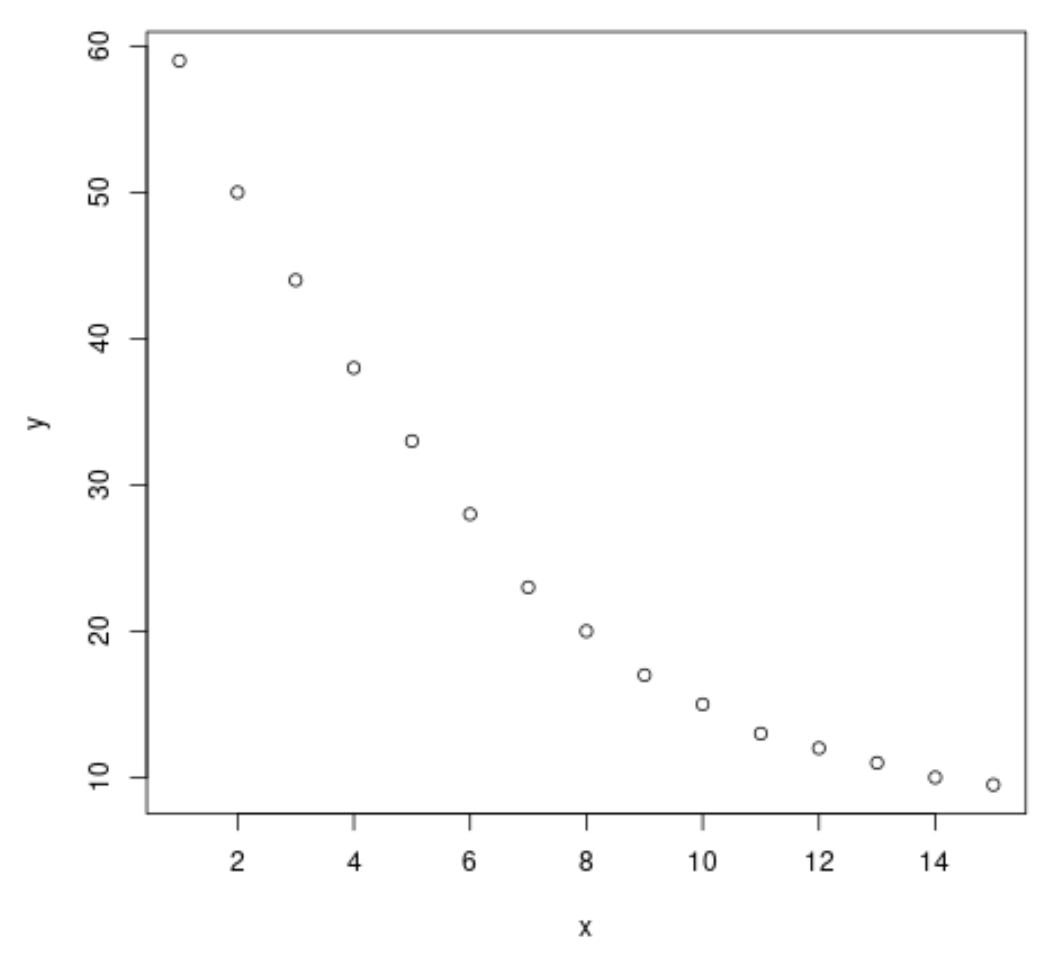
L’exploration visuelle constitue la première étape empirique d’un diagnostic d’adéquation fonctionnelle. Il est primordial d’observer la configuration brute des points de dispersion dans leur espace métrique d’origine avant toute manipulation analytique. À l’aide de la fonction graphique native plot(), l’analyste peut générer un tracé préliminaire en stipulant explicitement la formule de relation entre les variables, tout en enrichissant le graphique d’options graphiques soignées telles qu’un identifiant de symbole solide (pch = 19), une teinte contrastée et des libellés d’axes clairs et explicites.
Ce graphique initial permet de procéder à un diagnostic visuel qualitatif de la forme fonctionnelle globale. Dans notre exemple d’apprentissage, la présence d’une descente abrupte sur les premières unités temporelles, relayée graduellement par un amortissement progressif de la pente vers une trajectoire quasi horizontale, fournit l’indice visuel cardinal d’une dynamique logarithmique. L’absence de points d’inflexion ou de renversements de tendance permet d’écarter précocement les fonctions oscillatoires ou les polynômes de degré élevé.
L’observation du nuage permet également de déceler de visu d’éventuelles ruptures d’homogénéité de la variance des résidus. Si l’écartement vertical des points autour de la trajectoire générale tend à s’élargir ou à se comprimer de manière disproportionnée le long de l’axe horizontal, ce signal alertera l’analyste sur la présence probable d’une hétéroscédasticité qui devra être formellement confirmée et corrigée lors des étapes inférentielles subséquentes.
5.2 Visualisation de l’espace transformé par échelle semi-logarithmique
L’étape de confirmation visuelle la plus décisive réside dans le passage à une représentation en coordonnées semi-logarithmiques. Si la relation sous-jacente obéit fidèlement à la loi mathématique y = a + b * ln(x), alors la représentation graphique de la variable dépendante en fonction directe du logarithme du prédicteur doit opérer une rectification géométrique complète du nuage de points, transformant la trajectoire curviligne en un alignement rigoureusement rectiligne.
Dans l’interpréteur R, cette projection peut être réalisée selon deux modalités distinctes : soit en appliquant l’opérateur logarithmique au sein de l’instruction graphique en écrivant plot(log(Session), TempsReponse), soit en conservant les valeurs brutes de la variable explicative mais en ordonnant au moteur graphique d’ajuster l’axe des abscisses selon une métrique logarithmique au moyen de l’argument formel log = « x ». Cette seconde option présente l’avantage pédagogique majeur de maintenir l’affichage des valeurs concrètes des sessions tout en dilatant l’intervalle visuel entre les premiers essais et en comprimant l’espace entre les essais tardifs.
L’évaluation visuelle d’un alignement rectiligne post-transformation confirme la pertinence de la classe de modèle choisie. Si, après application de l’échelle logarithmique sur l’axe horizontal, les points continuent de manifester une courbure résiduelle prononcée (par exemple une forme de cuvette ou une persistance d’accélération), l’analyste devra conclure que le phénomène sous observation s’écarte du cadre logarithmique simple et relève plus vraisemblablement d’une dynamique exponentielle, d’une loi de puissance ou d’une fonction sigmoïde à seuils critiques.
5.3 Modélisation exploratoire non paramétrique locale (LOESS)
Pour immuniser le chercheur contre les biais de confirmation inhérents à une inspection visuelle purement subjective, le recours à un lissage non paramétrique local de type LOESS (Locally Estimated Scatterplot Smoothing) constitue une approche exploratoire particulièrement robuste. Cette méthode estime la tendance centrale des données sans imposer d’a priori rigide sur la forme algébrique globale de la fonction mathématique, en ajustant des régressions polynomiales locales pondérées sur des voisinages restreints d’observations.
Sous R, l’intégration de ce lissage est facilitée par la commande lines(lowess(Session, TempsReponse)) sur un graphique de base, ou via les couches d’esthétique de ggplot2. L’analyste doit veiller à calibrer avec discernement le paramètre d’étendue locale (désigné sous le vocable de span). Une valeur de lissage trop étroite conduit au surapprentissage du bruit expérimental et engendre des ondulations artefactuelles erratiques, tandis qu’une valeur trop large étouffe les accélérations brutales authentiques survenues lors des premiers intervalles d’observation.
La confrontation directe de la trajectoire dégagée par le lissage LOESS avec le profil mathématique théorique du logarithme népérien permet de juger si la décélération observée se poursuit de manière continue et monotone sur l’ensemble de la plage d’étude. Si la courbe non paramétrique épouse fidèlement la forme concave attendue sans s’infléchir vers un plateau absolu prématuré, le chercheur peut aborder l’étape suivante d’estimation paramétrique avec un niveau de confiance théorique élevé.
6. Étape 3 : Estimation paramétrique du modèle avec la fonction lm()
6.1 Syntaxe de modélisation directe sans modification préalable des colonnes
L’estimation des coefficients d’un modèle logarithmique sous l’environnement R ne nécessite aucun algorithme complexe d’optimisation non linéaire. En vertu des principes de linéarité dans les paramètres, il suffit de projeter le prédicteur dans l’espace logarithmique pour que le modèle demeure rigoureusement linéaire au sens de l’algèbre matricielle. L’estimation peut donc être menée au moyen de la célèbre fonction des moindres carrés ordinaires lm() en intégrant l’opérateur de transformation directement au sein de la formule de régression :
modele_log <- lm(TempsReponse ~ log(Session), data = donnees)
Cette syntaxe directe offre des bénéfices computationnels et méthodologiques majeurs par rapport à la méthode rudimentaire consistant à insérer au préalable une colonne intermédiaire transformée au sein du tableau de données. D’une part, elle garantit l’intégrité du tableau d’origine en évitant la duplication redondante de vecteurs. D’autre part et surtout, elle encapsule l’instruction de transformation au sein de l’objet de régression lui-même. Ainsi, lors des opérations futures d’extrapolation ou de prédiction à l’aide de la fonction predict(), le moteur de R appliquera automatiquement le logarithme népérien aux nouvelles données d’entrée brutes, éliminant tout risque d’erreur humaine liée à des transformations manuelles discordantes.
Sur le plan mécanique, la fonction lm() résout l’équation normale classique b_hat = (X’X)⁻¹ X’Y, où la matrice d’expérience X est composée d’une première colonne unitaire dédiée à l’ordonnée à l’origine et d’une seconde colonne constituée des valeurs transformées ln(Session). Le calcul procède par décomposition QR de la matrice d’expérience, garantissant une stabilité numérique optimale même en présence d’un conditionnement mathématique sous-optimal.
6.2 Variantes logarithmiques : choix de la base décimale (log10) ou binaire (log2)
Bien que le logarithme népérien (en base mathématique e ≈ 2.71828) constitue le choix par défaut imposé par la fonction log() sous R, certaines sous-disciplines des sciences quantitatives privilégient des bases logarithmiques alternatives en fonction de la structure théorique des phénomènes étudiés. L’analyste peut ainsi spécifier log10(Session) ou log2(Session) au sein de la formule du modèle :
- Logarithme décimal (base 10) : Fréquemment mobilisé en psychophysique auditive ou visuelle pour exprimer des ordres de grandeur physiques standards (décibels, échelles de magnitude lumineuse). L’équation s’écrit alors y = a + b_10 * log10(x).
- Logarithme binaire (base 2) : Particulièrement célèbre en psychologie cognitive expérimentale, où il constitue le cœur de la formalisation de la loi de Hick-Hyman relative au temps de décision face à des choix multiples. Le paramètre estimé quantifie la variation de la réponse consécutive à chaque doublement du nombre d’alternatives ou du temps d’apprentissage.
Il est crucial de comprendre que le choix de la base n’exerce aucune influence sur la qualité fondamentale de l’ajustement statistique. Les résidus, les valeurs prédites, la somme des carrés des erreurs, la statistique F globale et le coefficient de détermination R² demeurent rigoureusement identiques, quelle que soit la base logarithmique sélectionnée. Seule la valeur numérique du coefficient de pente se trouve rééchelonnée selon une relation analytique exacte dérivée du changement de base : b_naturel = b_10 * ln(10) = b_2 * ln(2). L’adoption d’une base particulière relève donc exclusivement d’un arbitrage de clarté communicative vis-à-vis de la communauté scientifique ciblée.
6.3 Extraction programmatique des objets de sortie du modèle
L’exécution de la fonction lm() instancie un objet complexe appartenant à la classe S3 de type lm, contenant l’ensemble des données d’estimation sous la forme d’une liste hiérarchique structurée. La programmation statistique moderne prescrit de ne jamais recopier manuellement les valeurs affichées à l’écran, mais de procéder à leur extraction programmatique au moyen de fonctions d’accès spécialisées conçues pour préserver la traçabilité des pipelines de traitement.
Pour récupérer le vecteur des coefficients estimés, le recours à la fonction standard coef(modele_log) extrait l’ordonnée à l’origine (accessible par coef(modele_log)[1]) et la pente d’échelle (coef(modele_log)[2]). L’incertitude d’estimation conjointe de ces paramètres s’obtient via la matrice de variance-covariance des coefficients au moyen de l’instruction vcov(modele_log), dont les éléments diagonaux fournissent les variances asymptotiques d’échantillonnage indispensables au calcul manuel d’intervalles de confiance ou de contrastes statistiques personnalisés.
De surcroît, le vecteur des prédictions conditionnelles s’obtient instantanément grâce à l’accesseur fitted(modele_log), tandis que les écarts empiriques entre les scores réels et ces valeurs théoriques se collectent via residuals(modele_log). Ces vecteurs constituent la matière première indispensable sur laquelle reposeront les vérifications diagnostiques et les représentations visuelles détaillées ci-après.
7. Étape 4 : Interprétation rigoureuse des coefficients et signification statistique
7.1 Décomposition de la sortie de la commande summary()
L’évaluation des propriétés inférentielles de l’ajustement est traditionnellement initiée par l’appel de l’instruction summary(modele_log) au sein de la console R. Cette commande déclenche la mise en forme synthétique des propriétés d’échantillonnage du modèle. Le tableau des coefficients structure les informations cruciales selon quatre colonnes canoniques : l’estimation ponctuelle (Estimate), l’erreur-type conventionnelle (Std. Error), la valeur de la statistique de test t de Student et la probabilité critique d’erreur de première espèce (Pr(>|t|)).
L’erreur-type reflète l’incertitude théorique associée à l’estimation des coefficients si l’on répétait l’expérience un nombre infini de fois sous les mêmes conditions d’échantillonnage. Le ratio entre le coefficient ponctuel et son erreur-type produit la statistique de Student t, testant formellement l’hypothèse nulle d’égalité du paramètre à zéro (H0 : b = 0). Si la valeur de p associée s’établit en deçà du seuil de significativité conventionnel fixé à alpha = 0.05, l’analyste conclut à l’existence d’une contribution explicative statistiquement significative du logarithme de la variable prédictive.
En bas de la sortie console figurent les degrés de liberté résiduels, calculés selon la différence n – k – 1 (où n représente la taille globale de l’échantillon et k le nombre de prédicteurs, soit 50 – 1 – 1 = 48 dans notre cas d’école). Ces degrés de liberté régissent la forme de la loi de Student mobilisée pour évaluer la significativité et rappellent que l’inférence repose sur un arbitrage mathématique entre la richesse de l’information empirique disponible et le nombre de paramètres libres estimés.
7.2 Règle de calcul pour l’interprétation substantielle de la pente
L’interprétation sémantique du coefficient de pente dans un modèle semi-logarithmique présente une spécificité analytique majeure qu’il convient de maîtriser parfaitement pour éviter les erreurs d’énoncé trop fréquentes dans les mémoires de recherche. Dans la mesure où la variable dépendante y demeure sur son échelle brute tandis que la variable explicative x a subi une compression par le logarithme népérien, le coefficient b ne traduit pas l’effet d’une hausse unitaire de x, mais l’effet d’une variation proportionnelle ou relative de x.
Sur le plan des approximations mathématiques, lorsque la variation relative de la variable explicative est de l’ordre de 1 %, l’impact sur la variable dépendante correspond à un centième de la pente estimée :
Δy ≈ (b / 100) pour une augmentation de 1 % de x
Pour illustrer ce principe avec notre modèle d’apprentissage moteur où la pente estimée s’établit à b = -22.5, une incrémentation relative de 1 % du numéro de session d’entraînement entraîne une diminution moyenne prédite du temps de réponse d’environ -22.5 / 100 = -0.225 seconde. Lorsque l’on s’intéresse à des variations relatives plus amples, telles qu’un doublement intégral de la valeur du prédicteur (une augmentation de 100 % de x), la formule exacte impose de multiplier le coefficient par le logarithme népérien de deux :
Δy = b * ln(2) ≈ b * 0.69315
Dans notre contexte, chaque fois que l’exposition expérimentale double (par exemple en passant de la session 2 à la session 4, ou de la session 20 à la session 40), le sujet gagne en moyenne -22.5 * 0.69315 ≈ -15.6 secondes sur le temps de résolution de la tâche. Cette règle de calcul éclaire magistralement la réalité psychologique de l’apprentissage : alors qu’il suffit de progresser de deux petites sessions pour gagner 15.6 secondes au début du processus (de la session 2 à la session 4), il faudra accumuler vingt sessions supplémentaires pour obtenir exactement le même gain d’efficacité une fois parvenu à la vingtième session.
7.3 Interprétation contextuelle de l’ordonnée à l’origine
L’ordonnée à l’origine a dans un modèle logarithmique correspond à la prédiction d’espérance mathématique de la réponse conditionnellement à ln(x) = 0, ce qui équivaut mathématiquement à évaluer le comportement du système lorsque le prédicteur original se positionne exactement à la valeur x = 1. Si, dans l’architecture expérimentale, la valeur x = 1 désigne l’état initial du système (par exemple le premier essai d’apprentissage ou une dose unitaire d’exposition), le paramètre a possède une interprétation substantielle transparente : il capture le niveau de base ou la performance brute du participant avant toute répétition cumulative.
Toutefois, la cohérence psychologique de cette constante peut être mise en péril si l’échelle de mesure originale ne comporte aucune valeur naturelle égale à l’unité. Par exemple, si l’on modélise l’acuité auditive en fonction de la fréquence en Hertz, la valeur x = 1 Hz se situe bien en deçà du seuil de perception humaine audible, rendant la constante dénuée de sens physique direct bien qu’indispensable au calibrage géométrique du modèle.
De surcroît, tout changement de l’unité de mesure opérée sur la variable indépendante provoque une translation systématique de la valeur de l’ordonnée à l’origine sans modifier la pente. Si le chercheur choisit d’exprimer le temps d’entraînement en minutes plutôt qu’en sessions discrètes, la nouvelle constante intégrera le décalage -b * ln(facteur_conversion). Cette propriété algébrique impose une rigueur absolue dans la communication des unités de mesure afin d’assurer l’interprétabilité croisée des résultats au sein de la littérature spécialisée.
8. Étape 5 : Évaluation de l’ajustement et comparaison avec des modèles concurrents
8.1 Analyse du coefficient de détermination (R²) et de son ajustement
L’évaluation de la capacité du modèle logarithmique à rendre compte de la dispersion empirique repose classiquement sur le coefficient de détermination R². Dans le cadre de la méthode des moindres carrés ordinaires, cette grandeur quantifie la proportion de la variance totale de la variable dépendante expliquée par la covariation avec le prédicteur transformé. Si le R² s’élève par exemple à 0.88, cela signifie que 88 % de la variabilité observée dans les temps de réponse individuels est directement imputable à la progression logarithmique des sessions.
Toutefois, la dépendance exclusive envers le R² brut présente des écueils méthodologiques bien documentés. Ce dernier tend mécaniquement à croître ou à demeurer artificiellement élevé dès lors que l’on introduit des paramètres supplémentaires, sans égard pour leur utilité théorique. L’analyste doit donc systématiquement examiner le R² ajusté, qui pénalise l’indice global en fonction du ratio entre le nombre de paramètres libres et la taille de l’échantillon, garantissant une mesure d’ajustement épurée de toute inflation artificielle.
Il est en outre essentiel de rappeler une contrainte statistique fondamentale : le coefficient de détermination ne peut en aucun cas être utilisé pour comparer des modèles dont la variable de réponse a subi des transformations différentes. Si l’on compare un modèle logarithmique (où y est sur son échelle native) à un modèle exponentiel où la réponse a été convertie en ln(y), les sommes des carrés totales ne portent plus sur les mêmes grandeurs physiques, rendant toute comparaison directe de leurs R² respectifs formellement invalide sur le plan mathématique.
8.2 Comparaison formelle avec le modèle linéaire standard
L’affirmation de la supériorité empirique de l’hypothèse logarithmique sur une trajectoire linéaire classique requiert une confrontation statistique rigoureuse entre deux modèles estimés sur le même jeu de données. Pour ce faire, nous ajustons conjointement un modèle linéaire simple standard :
modele_lin <- lm(TempsReponse ~ Session, data = donnees)
Puisque le modèle linéaire classique et le modèle logarithmique partagent strictement la même variable dépendante et le même nombre de paramètres libres (une constante et une pente), la confrontation ne peut pas s’opérer par un test de rapport de vraisemblance pour modèles emboîtés. La méthode d’arbitrage standardisée repose sur l’examen des critères d’information pénalisés, au premier rang desquels figurent le critère d’Akaike (AIC) et le critère bayésien de Schwarz (BIC), calculables via les instructions AIC(modele_lin, modele_log) et BIC(modele_lin, modele_log).
Ces critères évaluent la log-vraisemblance globale du modèle tout en infligeant une pénalité liée au nombre de coefficients estimés. Le modèle présentant la valeur d’AIC la plus faible est considéré comme le plus parcimonieux et le plus fidèle à la dynamique génératrice des données. Selon les règles de décision conventionnelles en modélisation quantitative, une différence d’AIC (désignée par ΔAIC) supérieure à 10 unités fournit une preuve empirique décisive en faveur du modèle privilégié, reléguant le modèle concurrent au rang d’hypothèse statistiquement invraisemblable.
8.3 Comparaison avec les modèles polynomiaux et exponentiels
Face à des trajectoires courbées, certains chercheurs recourent hâtivement à des régressions polynomiales d’ordre deux ou trois (incluant des termes en x² ou x³). Si un polynôme quadratique peut offrir un ajustement numérique localement satisfaisant, il présente des faiblesses théoriques rédhibitoires pour modéliser des processus d’apprentissage ou de mémoire : la parabole finit inévitablement par s’inverser au-delà d’un extremum critique, prédisant de manière absurde qu’un entraînement prolongé finirait par ralentir le sujet ou dégrader systématiquement sa performance motrice.
La compétition avec le modèle exponentiel à décroissance constante (souvent estimé sous la forme ln(y) ~ x) pose quant à elle une question théorique profonde quant à la nature de la décélération. Alors que le modèle exponentiel suppose que le pourcentage de gain demeure constant pour chaque pas unitaire d’exposition, le modèle logarithmique postule un ralentissement encore plus prononcé des gains marginaux le long du continuum temporel. Le tableau suivant récapitule les arbitrages méthodologiques majeurs régissant le choix entre ces différentes formulations :
- Modèle logarithmique : Monotone sans inversion ; décroissance continue de l’impact marginal ; idéal pour les lois psychophysiques et la pratique cognitive prolongée.
- Modèle polynomial d’ordre 2 : Présence artificielle d’un point d’inflexion et d’un renversement de trajectoire non plausible au-delà de la plage observée ; risque élevé de surapprentissage du bruit expérimental.
- Modèle exponentiel : Décroissance proportionnelle géométrique stricte ; tend vers une asymptote horizontale théorique de zéro si aucune constante additive n’est adjointe.
En vertu du principe épistémologique du rasoir d’Ockham, la préférence accordée au modèle logarithmique repose sur sa capacité à décrire des processus de consolidation cognitive durables tout en évitant les bifurcations irréalistes engendrées par des formulations polynomiales mathématiquement instables aux limites.
9. Étape 6 : Diagnostic approfondi des résidus et vérification des postulats
9.1 Inspection graphique standardisée via les graphiques de diagnostic R
La validation formelle d’un modèle de régression linéaire sous transformation logarithmique ne saurait s’achever sur l’examen des seuls indices de performance globale ; elle exige une auscultation minutieuse des perturbations résiduelles. L’interpréteur R offre un dispositif d’évaluation clinique standardisé en exécutant la commande plot(modele_log), précédée d’un partitionnement de la fenêtre graphique au moyen de l’instruction par(mfrow = c(2, 2)) afin d’afficher simultanément les quatre graphiques d’autopsie analytique.
Le premier quadrant présente le graphique des résidus bruts en fonction des valeurs ajustées (Residuals vs Fitted). Dans un modèle bien spécifié, les résidus doivent se répartir de manière purement stochastique autour de la ligne horizontale centrale d’espérance zéro, formant une bande d’amplitude homogène sur toute la largeur de l’affichage. L’apparition d’un motif sinusoïdal ou d’une courbure résiduelle prononcée indique que la transformation logarithmique n’a pas entièrement capturé la non-linéarité fondamentale du processus sous-jacent.
Le second quadrant affiche le diagramme quantile-quantile normal (Normal Q-Q). Ce graphique confronte la distribution empirique des résidus studentisés aux quantiles théoriques d’une loi normale idéale. Un alignement régulier des points le long de la bissectrice en pointillé certifie le respect du postulat de normalité des erreurs, condition indispensable à l’exactitude des calculs de p-valeurs dans des échantillons de taille modeste. Tout écart en crochet ou en forme de « S » aux extrémités alertera l’analyste sur la présence de queues de distribution épaisses ou d’une asymétrie marquée.
9.2 Tests inférentiels de normalité et d’homoscédasticité
Bien que le diagnostic visuel soit indispensable pour apprécier la nature des déviations, la validation d’une recherche quantitative exige souvent des critères formels d’objectivation inférentielle. Pour sonder la normalité des résidus, l’application du test de Shapiro-Wilk s’opère directement par l’instruction shapiro.test(residuals(modele_log)). L’acceptation de l’hypothèse nulle (caractérisée par une p-valeur supérieure au seuil usuel de 0.05) confirme que les perturbations ne divergent pas substantiellement d’une distribution gaussienne théorique.
L’hypothèse d’homoscédasticité (égalité de la variance des résidus tout au long de l’axe prédictif) peut être formellement éprouvée à l’aide du test de Breusch-Pagan, disponible dans l’extension lmtest via l’appel bptest(modele_log). Le rejet de l’hypothèse nulle d’homoscédasticité traduit la présence d’une variance résiduelle hétérogène le long de la trajectoire d’apprentissage.
Dans l’éventualité où une hétéroscédasticité significative est diagnostiquée, l’analyste n’est pas contraint d’abandonner son modèle logarithmique. La stratégie contemporaine recommandée par les méthodologistes consiste à recalculer la matrice de variance-covariance des coefficients en appliquant les corrections pour erreurs-types robustes développées par White et étendues par MacKinnon et White (généralement désignées sous les acronymes HC1, HC2 ou HC3), implémentées dans le paquet sandwich au travers de la commande coeftest(modele_log, vcov = vcovHC(modele_log, type = « HC3 »)).
9.3 Mesures de levier et identification des observations influentes
L’estimation par la méthode des moindres carrés ordinaires étant notoirement vulnérable à l’influence disproportionnée de valeurs singulières, l’examen des mesures de levier constitue une étape critique. Les valeurs de levier (calculables au moyen de la fonction hatvalues(modele_log)) mesurent l’éloignement d’une observation par rapport au centre de gravité des valeurs de ln(x). En raison de la compression logarithmique, les points initiaux (très proches de zéro) et les points finaux très isolés peuvent exercer un effet de levier considérable sur la rotation de la droite ajustée.
Pour mesurer l’impact conjoint d’un résidu élevé et d’un levier structurel, le calcul de la distance de Cook via cooks.distance(modele_log) quantifie le déplacement global du vecteur des coefficients prédits lorsque l’observation sous examen est omise de l’estimation. Par convention analytique, toute observation présentant une distance de Cook supérieure au seuil critique de 4 / (n – k – 1) ou approchant la valeur unitaire doit être inspectée avec la plus grande vigilance méthodologique.
L’identification d’une observation influente ne justifie pas son rejet arbitraire du jeu de données. Le chercheur doit conduire un arbre de décision rigoureux : vérifier en premier lieu s’il s’agit d’une erreur d’enregistrement ou d’un artefact matériel, évaluer ensuite si le participant a manifesté une incompréhension documentée des consignes durant la session, et, dans l’hypothèse d’un comportement authentique mais atypique, rapporter les estimations avec et sans le point litigieux au sein d’une analyse de sensibilité transparente.
10. Étape 7 : Visualisation avancée de la courbe ajustée avec ggplot2
10.1 Superposition directe de la fonction logarithmique via stat_smooth()
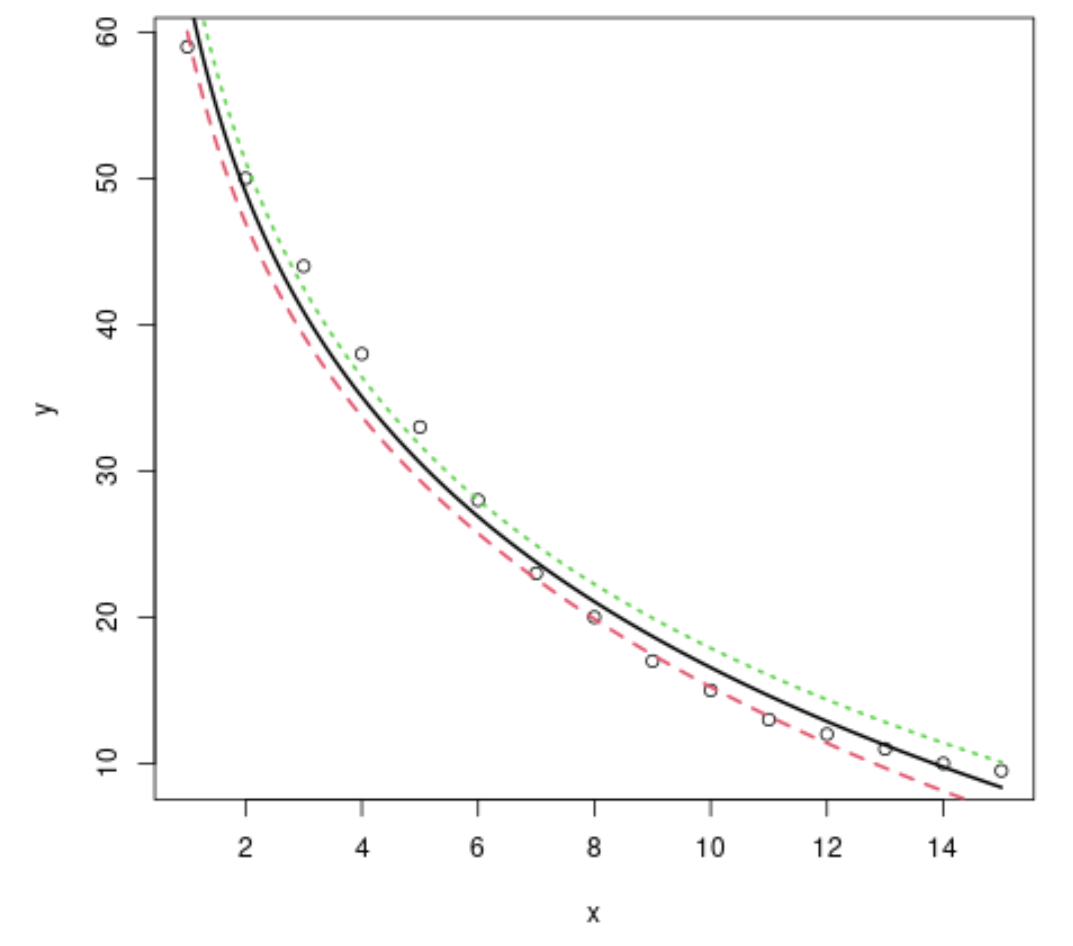
La production de figures de haute qualité pour la diffusion scientifique bénéficie largement de la puissance déclarative du paquet ggplot2. L’approche la plus directe pour superposer la trajectoire de régression logarithmique sur un nuage de points consiste à exploiter la couche de lissage paramétrique stat_smooth() ou geom_smooth() en paramétrant minutieusement ses arguments mathématiques :
ggplot(donnees, aes(x = Session, y = TempsReponse)) + geom_point(alpha = 0.7, color = « navy ») + geom_smooth(method = « lm », formula = y ~ log(x), color = « firebrick », fill = « pink », se = TRUE)
Dans cette formulation, l’argument formula = y ~ log(x) instruit le moteur graphique d’appliquer une régression linéaire sur la transformation logarithmique de l’axe des abscisses local, tout en restituant l’affichage sur les coordonnées cartésiennes originelles des données brutes. L’argument se = TRUE commande la génération automatique d’un ruban d’incertitude représentant l’intervalle de confiance à 95 % de la moyenne prédite.
La vectorisation fluide générée par cette instruction produit une courbe parfaitement continue et esthétiquement irréprochable, éliminant tout aspect polygoné ou haché. La clarté visuelle ainsi obtenue permet au lecteur d’appréhender d’un seul regard la qualité du calage du modèle théorique sur la variabilité interindividuelle observée.
10.2 Visualisation manuelle par génération d’une grille prédictive continue
Bien que l’usage direct de geom_smooth() soit extrêmement pratique, la maîtrise totale des représentations visuelles complexes exige de savoir générer une grille prédictive autonome. Cette méthode est indispensable dès lors que l’on souhaite intégrer des intervalles de prédiction individuelle, comparer simultanément plusieurs sous-groupes expérimentaux ou modéliser des interactions non linéaires.
La démarche débute par la construction d’un nouveau tableau de données synthétique couvrant l’amplitude de la variable x avec une densité très fine, par exemple 500 points équidistants générés par la fonction seq(min(x), max(x), length.out = 500). Ce tableau est ensuite injecté dans la fonction predict() en requérant le calcul explicite des erreurs-types d’ajustement :
grille <- data.frame(Session = seq(1, 50, length.out = 500))
preds <- predict(modele_log, newdata = grille, interval = « confidence », level = 0.95)
grille_graphique <- cbind(grille, preds)
L’analyste dispose dès lors d’un objet de données entièrement transparent qu’il peut coupler au tracé principal via une couche geom_line() pour la trajectoire théorique et une couche geom_ribbon() pour les bornes supérieure et inférieure. Cette modularité offre un contrôle ergonomique absolu sur l’épaisseur du trait, la transparence des zones ombrées et la stratification des données par strate expérimentale.
10.3 Formatage typographique et conformité aux normes APA
La valorisation des résultats empiriques dans des revues savantes à comité de lecture nécessite l’application de standards graphiques rigoureux, proscrivant les fioritures visuelles inutiles qui encombrent l’interprétation. Les normes édictées par l’American Psychological Association imposent une sobriété esthétique absolue : suppression des arrière-plans grisâtres, élimination des quadrillages internes superflus et mise en exergue des axes principaux d’observation.
Sous ggplot2, cette mise en conformité est initiée par l’application du thème épuré theme_classic(). Il convient ensuite de formater précisément le libellé des axes en stipulant les grandeurs étudiées ainsi que leurs unités de mesure standardisées (par exemple : « Session d’apprentissage (ordre chronologique) » et « Temps de réponse moyen (en secondes) »).
L’enrichissement du graphique par des annotations textuelles intégrées directement dans l’espace de données à l’aide de annotate() rehausse considérablement la valeur informative de la figure. L’affichage des paramètres cardinaux de l’ajustement, tels que l’équation analytique finale (y = 120.4 – 22.3 * ln(x)) et le coefficient R² ajusté, permet au lecteur de quantifier l’ajustement sans avoir à naviguer sans cesse entre le texte et le panneau illustratif. L’exportation finale sera idéalement exécutée via l’utilitaire ggsave() en format vectoriel non dégradable (PDF, SVG) ou en format matriciel haute définition calibré à une résolution minimale de 300 DPI (TIFF).
11. Étape 8 : Prédiction de trajectoires et calcul des intervalles statistiques
11.1 Génération de prédictions ponctuelles pour de nouvelles observations
L’utilité pragmatique d’un modèle de régression logarithmique réside fréquemment dans sa capacité à produire des estimations fiables sur des situations prospectives ou des configurations non directement échantillonnées durant l’expérience. L’évaluation de nouvelles valeurs explicatives s’articule autour de la fonction générique predict(), laquelle reçoit impérativement en argument le modèle estimé ainsi qu’un nouveau tableau structuré sous forme de data.frame, dont les intitulés de colonnes doivent être rigoureusement identiques à ceux stipulés lors de l’ajustement initial.
Considérons l’anticipation de la performance d’un sujet parvenu à sa 60ème ou 75ème session d’entraînement continu. Nous déclarons la structure nouvelles_sessions <- data.frame(Session = c(60, 75)). L’exécution de predict(modele_log, newdata = nouvelles_sessions) renvoie instantanément l’espérance mathématique conditionnelle du temps de réaction associée à ces nouveaux seuils chronologiques.
Il est impératif d’exercer une vigilance critique quant au domaine d’évaluation des entrées. Si le tableau de prédiction comporte une valeur inférieure ou égale à zéro, le moteur de R échouera à calculer le logarithme et renverra des valeurs manquantes ou des erreurs d’exécution. Par ailleurs, l’analyste doit garder à l’esprit la démarcation conceptuelle fondamentale entre l’espérance de la moyenne théorique d’un groupe de participants soumis à ces sessions et la réalisation singulière d’un individu spécifique isolé, distinction qui gouverne le calcul des intervalles d’incertitude décrits ci-après.
11.2 Calcul des intervalles de confiance vs intervalles de prédiction
L’expression de l’incertitude statistique entourant les estimations d’un modèle logarithmique exige une différenciation méthodologique scrupuleuse entre l’intervalle de confiance et l’intervalle de prédiction. Ces deux notions répondent à des interrogations scientifiques et pratiques fondamentalement divergentes :
- Intervalle de confiance de la trajectoire moyenne : Spécifié via l’argument interval = « confidence » dans la fonction predict(). Il quantifie l’erreur d’échantillonnage attachée à la position de la courbe moyenne idéale de la population. Cet intervalle se rétrécit à mesure que la taille de l’échantillon global n s’accroît, reflétant la convergence asymptotique de l’estimation de la moyenne.
- Intervalle de prédiction pour une observation future : Spécifié au moyen de l’argument interval = « prediction ». Il incorpore à la fois l’incertitude sur l’estimation de la trajectoire moyenne de la population et la variance de l’erreur stochastique individuelle inhérente à chaque mesure singulière (sigma²). Même si la taille de l’échantillon tendait vers l’infini, la largeur de cet intervalle resterait au minimum égale à environ +/- 1.96 * sigma.
Sur le plan géométrique, l’intervalle de prédiction s’avère considérablement plus large que l’intervalle de confiance. La représentation conjointe de ces deux rubans d’incertitude sur un même graphique permet aux praticiens de la psychologie appliquée de communiquer honnêtement auprès des décideurs ou des patients : l’intervalle de confiance délimite les certitudes théoriques du chercheur, tandis que l’intervalle de prédiction circonscrit la variabilité concrète à laquelle on doit s’attendre pour un individu particulier soumis au protocole.
11.3 Risques méthodologiques liés à l’extrapolation au-delà de la plage observée
L’extrapolation prospective constitue le piège le plus insidieux guettant l’utilisateur de modèles logarithmiques. Bien que la fonction logarithme népérien manifeste une croissance ou une décroissance extrêmement amortie pour des valeurs élevées de x, elle ne possède aucune asymptote horizontale formelle : sa limite mathématique lorsque x tend vers l’infini positif demeure l’infini (positif ou négatif selon le signe de la pente b).
Cette propriété mathématique intrinsèque engendre des non-sens théoriques dramatiques en psychométrie si l’on extrapole inconsidérément le modèle bien au-delà de la plage d’observation empirique. Dans notre modélisation du temps d’apprentissage, la projection du modèle vers des sessions hypothétiquement très élevées (par exemple la session 500 ou 1000) conduira inéluctablement le modèle à prédire des temps de réponse négatifs, une absurdité biologique et physique flagrante.
Les recommandations méthodologiques sont sans équivoque : un modèle semi-logarithmique ne doit jamais être utilisé pour extrapoler le comportement d’un système à des horizons temporels ou des amplitudes d’exposition radicalement distincts de l’intervalle expérimental validé empiriquement. Dès lors que l’objectif scientifique consiste à déterminer la borne inférieure incompressible d’un processus neurophysiologique, le chercheur doit abandonner le modèle semi-logarithmique simple au profit d’un modèle non linéaire à véritable asymptote fixe, tel qu’une fonction exponentielle à trois paramètres estimée par les moindres carrés non linéaires.
12. Applications pratiques en psychologie, extensions complexes et pièges à éviter
12.1 Étude de cas 1 : Modélisation de la courbe d’apprentissage moteur
Pour mettre en pratique ces concepts au sein d’une expérience authentique de psychologie expérimentale, analysons une recherche consacrée à l’acquisition d’une tâche de motricité fine sur simulateur chirurgical ou de pointage digital chez de jeunes adultes. Les participants accomplissent 20 blocs d’essais standardisés consécutifs, la variable dépendante étant le temps de mouvement net mesuré en millisecondes. Les données empiriques révèlent un temps initial moyen approchant 850 ms lors du premier bloc, chutant de manière abrupte aux alentours de 550 ms dès le cinquième bloc, pour finir par osciller autour de 420 ms lors des derniers blocs.
L’ajustement du modèle logarithmique sous R par la syntaxe modele_moteur <- lm(TempsMouvement ~ log(Bloc), data = donnees_motrices) fournit une ordonnée à l’origine estimée à a = 848.2 ms et une pente de b = -142.6 ms. L’interprétation substantielle indique que chaque doublement du nombre de blocs d’essais accomplis engendre un gain d’efficacité neuromotrice de -142.6 * ln(2) ≈ -98.8 ms. Ce paramètre de pente offre un indice métrique direct de la plasticité motrice du sujet, autorisant la comparaison rigoureuse de la vitesse d’apprentissage entre des populations cliniques (par exemple des patients cérébrolésés en réhabilitation) et des groupes contrôles sains.
Toutefois, la confrontation de ce modèle aux limites physiologiques du système nerveux met en lumière la nature transitoire de la loi logarithmique. Le temps de conduction axonale, le délai synaptique et la contraction musculaire établissent un seuil temporel incompressible en deçà duquel le mouvement humain ne peut physiquement descendre (environ 150 à 200 ms pour ce type de geste). La régression logarithmique décrit avec une précision remarquable la phase d’apprentissage dynamique et de consolidation, mais elle devra être complétée par des modèles asymptotiques si l’entraînement est poursuivi sur des centaines d’essais supplémentaires jusqu’à épuisement complet de la marge d’amélioration.
12.2 Étude de cas 2 : Décroissance de la rétention d’information en mémoire
Une seconde application canonique s’intéresse à la cinétique d’oubli d’un corpus de matériel sémantique ou lexical. Dans ce protocole, des groupes équivalents de participants apprennent une liste de paires de mots jusqu’à un critère de maîtrise parfait, puis sont testés en rappel libre après des délais de rétention échelonnés de manière exponentielle : 1 heure, 4 heures, 24 heures, 72 heures, 168 heures (une semaine) et 720 heures (un mois). La variable de réponse est le pourcentage d’items fidèlement restitués.
La relation entre le temps écoulé (Delai) et le pourcentage de rappel s’ajuste élégamment via modele_oubli <- lm(PourcentageRappel ~ log(Delai), data = donnees_memoire). Les paramètres estimés permettent de quantifier la vitesse d’érosion mnésique. La pente négative b formalise le déclin cognitif : une augmentation de 1 % du délai de rétention se traduit par une baisse d’environ b / 100 points de pourcentage de rappel. Cette formulation réhabilite l’intuition d’Ebbinghaus en montrant que l’oubli n’est pas un processus linéaire constant : la quantité brute d’informations perdues entre la première et la dixième heure d’intervalle est infiniment plus massive que celle perdue entre la centième et la deux-centième heure.
À partir des coefficients estimés a et b, le chercheur peut dériver analytiquement le temps de demi-vie mnésique, c’est-à-dire l’intervalle temporel T_demi nécessaire pour que le taux de rappel chute à 50 %. Il suffit pour cela de résoudre l’équation 50 = a + b * ln(T_demi), ce qui donne immédiatement par inversion algébrique sous R : T_demi = exp((50 – a) / b). Cette capacité à dériver des indicateurs temporels concrets à partir des sorties paramétriques illustre la remarquable puissance applicative de la régression logarithmique en recherche translationnelle.
12.3 Extensions vers les modèles linéaires mixtes et non linéaires généralisés
Dans la recherche contemporaine en psychologie, le recueil des données s’opère rarement sur un plan inter-sujets pur ; il repose le plus souvent sur des mesures répétées chez les mêmes individus. L’application d’une régression logarithmique standard par moindres carrés ordinaires sans considération pour la structure groupée des données violerait frontalement le postulat d’indépendance des observations et sous-estimerait lourdement les erreurs-types des coefficients. La solution statistique d’excellence consiste à transposer la logique logarithmique au sein des modèles linéaires à effets mixtes (LMM) via le paquet lme4.
La formulation syntaxique s’écrit alors : lmer(TempsReponse ~ log(Session) + (1 + log(Session) | Sujet), data = donnees_longitudinales). Ce modèle sophistiqué autorise chaque participant à posséder sa propre ordonnée à l’origine (sa performance initiale individuelle au bloc 1) ainsi que sa propre pente logarithmique de progression. L’analyste peut ainsi estimer la variance de la dynamique d’apprentissage au sein de la population et tester si des covariables interindividuelles (telles que l’âge, l’intelligence fluide ou le niveau de stress) modulent l’intensité de la décélération.
Enfin, lorsque les données imposent une véritable asymptote horizontale non nulle (par exemple un plancher physiologique ou un plafond de saturation absolu à 100 %), la transition vers la régression non linéaire généralisée s’impose au moyen de la fonction native nls() (Nonlinear Least Squares). L’arbre décisionnel suivant résume les choix méthodologiques qui s’offrent au chercheur face à des données psychologiques non linéaires :
- Régression logarithmique simple (lm) : Observations indépendantes ; décélération continue sans asymptote fixe théorique stricte dans la fenêtre d’étude ; interprétabilité immédiate des coefficients d’échelle.
- Régression logarithmique à effets mixtes (lmer) : Mesures répétées longitudinales ; variabilité interindividuelle sur le point de départ et sur la vitesse d’apprentissage ; prise en compte des corrélations intra-sujets.
- Régression non linéaire paramétrique (nls) : Nécessité d’estimer formellement une asymptote physiologique c via une formulation de type y = c + a * exp(-b * x) ou des équations logistiques.
En respectant scrupuleusement ces démarcations conceptuelles et computationnelles, les chercheurs en psychologie quantitative et en sciences du comportement disposent d’un arsenal méthodologique complet pour modéliser avec fidélité, élégance et robustesse les phénomènes dynamiques non linéaires qui constituent l’essence même du fonctionnement cognitif et moteur de l’être humain.
Références
Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
Ebbinghaus, H. (1885). Über das Gedächtnis: Untersuchungen zur experimentellen Psychologie. Duncker & Humblot.
Fechner, G. T. (1860). Elemente der Psychophysik. Breitkopf und Härtel.
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
Newell, A., & Rosenbloom, P. S. (1981). Mechanisms of skill acquisition and the law of practice. In J. R. Anderson (Ed.), Cognitive skills and their acquisition (pp. 1–55). Lawrence Erlbaum Associates.
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Zeileis, A. (2004). Econometric computing with HC and HAC covariance matrix estimators. Journal of Statistical Software, 11(10), 1–17. https://doi.org/10.18637/jss.v011.i10