
Dans le domaine des sciences comportementales, de la psychologie clinique, de la psychiatrie quantitative et de la recherche biomédicale, les chercheurs sont constamment confrontés à des variables qui mesurent le nombre de fois où un événement spécifique se manifeste au cours d’une période temporelle ou dans un espace délimité. Qu’il s’agisse de comptabiliser les épisodes d’automutilation chez des adolescents souffrant de troubles de la personnalité limite, les récidives d’abus de substances chez des patients en cours de sevrage, les crises de panique hebdomadaires ou le nombre d’erreurs d’inattention dans une tâche de neuropsychologie informatisée, ces mesures partagent une structure mathématique commune : elles se composent exclusivement d’entiers naturels positifs ou nuls. Malgré cette caractéristique fondamentale, une proportion alarmante d’études publiées continue de recourir à des modèles de régression linéaire par les moindres carrés ordinaires (MCO), au prix d’artifices méthodologiques tels que la transformation logarithmique arbitraire des scores.
L’application inappropriée de modèles linéaires continus et gaussiens à des distributions discrètes et asymétriques engendre des biais méthodologiques majeurs. Ces failles analytiques se traduisent par des estimations d’intervalles de confiance invalides, des prédictions absurdes de valeurs négatives pour des phénomènes pourtant non négatifs, et une distorsion systématique des erreurs-types. Afin de préserver l’intégrité de la modélisation statistique, l’adoption des modèles linéaires généralisés (GLM) s’impose comme une nécessité méthodologique incontournable. Au cœur de ce paradigme, deux cadres de modélisation paramétrique se disputent la primauté : la régression de Poisson et la régression binomiale négative. Bien que la première soit souvent perçue comme le point de départ canonique pour les données de comptage, la seconde constitue fréquemment l’ajustement empirique le plus réaliste face à l’hétérogénéité des comportements humains.
L’arbitrage formel entre ces deux approches ne relève pas d’une simple préférence computationnelle, mais engage la validité même des conclusions scientifiques tirées d’une étude. Choisir à tort le modèle de Poisson en présence de surdispersion expose l’analyste à un effondrement dramatique de ses erreurs-types, multipliant artificiellement les déclarations de significativité statistique et alimentant directement la crise de reproductibilité qui frappe les sciences empiriques. À l’inverse, l’emploi systématique et non justifié de modèles plus complexes peut engendrer une instabilité paramétrique inutile lorsque la parcimonie est de mise. Ce guide exhaustif a pour vocation d’analyser en profondeur les fondements mathématiques, les hypothèses stochastiques, les méthodes diagnostiques et les stratégies de sélection régissant la confrontation entre régression de Poisson et régression binomiale négative, offrant ainsi aux chercheurs un cadre rigoureux pour étayer leurs choix analytiques.
1. 1. Introduction aux données de comptage en sciences comportementales et psychologiques
1.1 Définition et propriétés mathématiques des données de comptage
Les données de comptage correspondent à des variables aléatoires quantitatives discrètes dont le support mathématique est restreint à l’ensemble des entiers naturels, noté ℕ = {0, 1, 2, 3, …}. Contrairement aux variables continues, une variable de comptage ne peut adopter de valeurs fractionnaires ou décimales : elle dénombre des unités d’occurrence distinctes et indivisibles d’un phénomène défini. De plus, ces données possèdent une frontière structurelle stricte en zéro, ce qui interdit rigoureusement l’existence de valeurs négatives. Dans la quasi-totalité des contextes comportementaux et psychologiques, les distributions empiriques de ces variables présentent une forte asymétrie positive (dextrogire), caractérisée par une masse probabiliste imposante concentrée sur les petites valeurs entières — et particulièrement sur le zéro — ainsi qu’une longue traîne s’étendant vers des valeurs élevées plus rares.
Cette structure distributionnelle viole intrinsèquement les deux postulats fondamentaux sur lesquels repose la régression linéaire classique par les moindres carrés ordinaires (OLS) : la normalité des résidus et l’homoscédasticité, c’est-à-dire la constance de la variance de l’erreur conditionnellement aux prédicteurs. Dans les processus de comptage réels, la variance empirique est intrinsèquement dépendante de la moyenne conditionnelle : plus le nombre moyen d’événements prédits est grand, plus l’incertitude et l’étalement des observations augmentent. Ignorer cette liaison moyenne-variance conduit inévitablement l’estimateur OLS à produire des erreurs-types hétéroscédastiques et non fiables, ruinant toute tentative d’inférence valide basée sur les statistiques de Student ou de Fisher.
Sur le plan prédictif, l’application aveugle d’un modèle linéaire standard à une variable de comptage aboutit fréquemment à des aberrations manifestes, telles que la génération de valeurs prédites négatives pour des sous-groupes d’individus présentant de faibles scores sur les covariables explicatives. En recherche clinique, il est impensable d’estimer qu’un patient ayant suivi une thérapie comportementale réalisera, en moyenne, « -1,4 crise d’angoisse » par mois. Par ailleurs, des variables critiques comme le nombre de tentatives de suicide, la fréquence des récidives chez les usagers d’opiacés, ou le dénombrement des lapsus attentionnels lors d’un protocole cognitif sous privation de sommeil, exhibent une nature discrète indéniable qui interdit l’assimilation à un continuum gaussien sans introduire de biais substantiels dans l’estimation de la pente des effets.
1.2 Le rôle fondamental des modèles linéaires généralisés (GLM)
Introduits dans les travaux fondateurs de Nelder et Wedderburn (1972), les modèles linéaires généralisés ont profondément révolutionné l’analyse des variables dépendantes non gaussiennes en proposant une architecture paramétrique unifiée. Un GLM repose formellement sur une structure tripartite : une composante aléatoire, un prédicteur linéaire et une fonction de lien. La composante aléatoire spécifie que la variable dépendante Y, conditionnellement aux prédicteurs, suit une distribution appartenant à la famille exponentielle de dispersions (englobant les lois gaussienne, de Poisson, binomiale, gamma, et sous certaines formulations, binomiale négative). Le prédicteur linéaire, noté ηi, agrège linéairement l’ensemble des covariables associées à leurs coefficients respectifs selon la formulation vectorielle standard :
ηi = β0 + β1X1i + β2X2i + … + βkXki
La composante pivotale qui articule ce prédicteur linéaire avec l’espérance conditionnelle μi = E(Yi|Xi) de la variable de comptage est la fonction de lien, notée g(·), telle que ηi = g(μi). Pour les modèles de comptage, la fonction de lien canonique est la fonction logarithmique naturelle, g(μ) = ln(μ). Dès lors, le modèle s’exprime sous la forme ln(μi) = Xiβ, ce qui équivaut, par inversion de la fonction de lien, à une relation multiplicative non linéaire pour la moyenne conditionnelle :
μi = exp(Xiβ) = exp(β0) × exp(β1X1i) × … × exp(βkXki)
Cette formulation garantit rigoureusement que l’espérance mathématique μi demeure strictement positive pour toute combinaison de covariables, éliminant ainsi toute possibilité de prédiction négative absurde. De surcroît, le recours à un GLM log-linéaire surpasse catégoriquement la pratique artisanale et dépassée consistant à appliquer une transformation empirique directe de type log(Y + 1) sur la variable brute avant d’ajuster un modèle gaussien. Les travaux méthodologiques de O’Hara et Kotze (2010) ont démontré de manière indiscutable que la transformation log(Y + 1) induit des biais d’estimation massifs, distord les relations fonctionnelles sous-jacentes, et engendre une perte sévère de puissance statistique, en particulier lorsque la moyenne conditionnelle est faible ou que la proportion de zéros est prépondérante. Le GLM préserve quant à lui l’intégrité de l’espace d’échantillonnage discret tout en modélisant adéquatement la structure hétéroscédastique des résidus.
1.3 Problématique centrale du choix de modélisation
L’accès aux modèles linéaires généralisés ouvre une interrogation décisive pour le statisticien et le chercheur en sciences humaines : quel modèle paramétrique spécifique convient-il de privilégier pour décrire la composante aléatoire ? L’arbitrage s’articule principalement entre la régression de Poisson, modèle de référence par excellence pour les dénombrements, et la régression binomiale négative, sa généralisation flexible conçue pour relâcher les contraintes stochastiques strictes. La régression de Poisson se distingue par son élégante parcimonie : elle postule que la variance conditionnelle est rigoureusement identique à la moyenne conditionnelle, un phénomène mathématique désigné sous le terme d’équidispersion.
Cependant, dans la réalité complexe des données observationnelles et expérimentales en psychologie, cette équivalence théorique se vérifie presque jamais. L’hétérogénéité biologique, cognitive et sociologique non capturée par les variables explicatives génère une dispersion empirique bien plus large que celle tolérée par le cadre de Poisson, un phénomène omniprésent qualifié de surdispersion. Lorsque l’analyste persiste à employer un modèle de Poisson face à des données surdispersées, les estimateurs des coefficients de régression demeurent convergents, mais leurs erreurs-types associées sont sévèrement sous-estimées. Cette contraction artificielle de l’incertitude entraîne une explosion des erreurs de première espèce (taux de faux positifs), conduisant les chercheurs à conclure abusivement à l’efficacité d’une thérapie ou à la significativité de corrélations psychopathologiques.
À l’inverse, l’utilisation automatique et non contextualisée de la régression binomiale négative soulève des questions de robustesse et de sur-paramétrisation dans les échantillons de taille restreinte. Estimer conjointement les pentes de régression et un paramètre de surdispersion requiert des algorithmes d’optimisation numérique itératifs qui peuvent peiner à converger si la taille d’échantillon est faible ou si les données ne contiennent pas une variance excédentaire suffisante. Le choix raisonné entre ces deux approches ne peut être réduit à une simple habitude logicielle : il conditionne la validité inférentielle, la réplicabilité des résultats empiriques et la portée clinique des inférences formulées.
2. 2. Fondements théoriques du modèle de régression de Poisson
2.1 Distribution de Poisson et formulation stochastique
La distribution univariée de Poisson constitue le socle probabiliste de la modélisation des événements discrets se déroulant dans un continuum spatio-temporel fixe. Soit Y une variable aléatoire désignant le nombre d’occurrences d’un événement au cours d’une fenêtre d’observation standardisée. On dit que Y suit une loi de Poisson de paramètre λ > 0, notée Y ~ P(λ), si sa fonction de masse de probabilité discrète s’exprime, pour toute valeur entière y ∈ ℕ, par l’équation suivante :
P(Y = y | λ) = [e-λ × λy] / y!
où e représente la constante népérienne et y! désigne la factorielle de l’entier y. L’émergence d’un processus de Poisson pur repose sur trois postulats fondamentaux : l’homogénéité temporelle (le taux d’occurrence instantané λ est constant durant toute la durée d’observation), la non-simultanéité des événements (la probabilité que deux événements distincts se produisent dans un intervalle de temps infinitésimal est négligeable), et l’indépendance stochastique (le nombre d’événements observés dans un intervalle donné est totalement indépendant du nombre d’événements survenus dans tout intervalle disjoint antérieur).
Dans le cadre de la régression de Poisson, l’intensité moyenne d’occurrence n’est plus considérée comme constante pour l’ensemble des individus, mais varie en fonction d’un vecteur de prédicteurs Xi selon la spécification log-linéaire λi = exp(Xiβ). Pour un échantillon de n observations indépendantes, la fonction de vraisemblance conjointe L(β) s’obtient par le produit des probabilités individuelles :
L(β) = ∏i=1n [exp(-exp(Xiβ)) × (exp(Xiβ))yi] / yi!
En prenant le logarithme naturel de cette fonction, nous obtenons la log-vraisemblance standard :
ln L(β) = ∑i=1n [yi (Xiβ) – exp(Xiβ) – ln(yi!)]
L’estimation des coefficients vectoriels β s’effectue par la méthode du maximum de vraisemblance (MLE). En dérivant la log-vraisemblance par rapport au vecteur β, on obtient le vecteur gradient, ou équations de score :
∂(ln L) / ∂β = ∑i=1n [yi – exp(Xiβ)] Xi = 0
Ce système d’équations transcendantes ne possède pas de solution analytique fermée dans le cas général. Sa résolution requiert l’emploi d’algorithmes d’optimisation numérique tels que l’algorithme des moindres carrés itérativement repondérés (IRLS) ou la méthode de Newton-Raphson. Sous les conditions standards de régularité asymptotique, l’estimateur résultant β̂ est convergent, asymptotiquement normal et asymptotiquement efficace, avec une matrice de variance-covariance asymptotique donnée par l’inverse de la matrice d’information de Fisher observée.
2.2 Interprétation des coefficients et ratios de taux d’incidence (IRR)
L’interprétation des coefficients estimés β̂ dans un modèle log-linéaire diffère radicalement de celle des modèles linéaires gaussiens en raison de la nature multiplicative imposée par la fonction de lien. Soit un modèle univarié comportant une seule covariable continue X : ln(E(Y|X)) = β0 + β1X. Si nous augmentons la valeur de la variable explicative d’une unité, la nouvelle espérance conditionnelle devient E(Y|X + 1) = exp(β0 + β1(X + 1)). En examinant le rapport de ces deux espérances mathématiques, nous constatons :
E(Y|X + 1) / E(Y|X) = exp(β0 + β1X + β1) / exp(β0 + β1X) = exp(β1)
Cette quantité exponentiée, notée exp(β), est universellement appelée le Ratio de Taux d’Incidence (Incidence Rate Ratio, ou IRR). L’IRR exprime la modification proportionnelle et multiplicative du taux attendu d’occurrence de l’événement induite par une augmentation d’une unité de la variable prédictive correspondante, toutes les autres covariables du modèle étant maintenues rigoureusement constantes.
Dans la pratique clinique, la conversion des coefficients logarithmiques bruts en IRR simplifie considérablement la restitution des conclusions empiriques :
- Si exp(βj) = 1 (ou βj = 0), la covariable Xj n’exerce aucune influence sur le taux moyen de survenue des événements.
- Si exp(βj) > 1 (ou βj > 0), chaque accroissement d’une unité de Xj multiplie le taux moyen d’incidents par un facteur exp(βj). Par exemple, un IRR de 1,35 se traduit cliniquement par une augmentation de 35 % du nombre attendu d’événements : [exp(β) – 1] × 100 %.
- Si exp(βj) < 1 (ou βj < 0), la covariable est associée à une réduction du taux moyen d’incidents. Un IRR de 0,72 indique ainsi une diminution relative de 28 % du taux attendu de l’événement clinique considéré.
L’estimation des intervalles de confiance à 95 % entourant ces ratios de taux d’incidence s’effectue usuellement en appliquant la transformation exponentielle directement aux bornes de l’intervalle de confiance de Wald calculé sur le coefficient additif brut : [exp(β̂j – 1.96 × SE(β̂j)) ; exp(β̂j + 1.96 × SE(β̂j))]. Alternativement, pour les paramètres transformés, l’usage de la méthode delta permet d’approximer la variance asymptotique de exp(β̂), garantissant une précision inférentielle adéquate même sous de légères asymétries de l’échantillonnage fini.
2.3 Inclusion des termes d’exposition statistique (Offsets)
L’une des contraintes analytiques fréquentes en psychologie expérimentale et épidémiologique réside dans le fait que les unités observationnelles ne sont pas toujours examinées durant des intervalles de temps identiques, ou ne sont pas exposées à un volume égal d’opportunités de générer l’événement étudié. Par exemple, mesurer le nombre d’actes d’agressivité chez des patients hospitalisés en psychiatrie n’a de sens que si l’on prend en considération le nombre exact de jours d’hospitalisation de chaque patient. Un patient hospitalisé 180 jours présentant 10 actes agressifs présente une intensité comportementale nettement inférieure à celle d’un patient cumulant 8 actes au cours d’un séjour de seulement 14 jours.
Pour intégrer rigoureusement cette variabilité de l’exposition, le modèle doit modéliser un taux par unité de temps ou d’effort, soit μi / ti, où ti désigne la mesure d’exposition quantitative propre à l’individu i. En formalisant cette relation par le lien logarithmique, nous obtenons :
ln(μi / ti) = Xiβ ⇒ ln(μi) – ln(ti) = Xiβ ⇒ ln(μi) = ln(ti) + Xiβ
Le terme ln(ti) est désigné sous le terme technique d’offset statistique. Dans l’architecture du GLM, l’offset correspond à une covariable quantitative dont le coefficient de régression est structurellement fixé à la valeur 1, et n’est donc pas estimé par l’algorithme d’optimisation. L’omission d’un offset requis altère substantiellement la signification théorique des estimateurs : elle confond la variation réelle du taux comportemental intrinsèque avec la simple variabilité des durées de mesure ou du nombre d’items administrés aux participants, produisant des artefacts statistiques majeurs.
3. 3. L’hypothèse fondamentale d’équidispersion et ses limites pratiques
3.1 Le principe formel de l’équidispersion
La distribution de Poisson possède une singularité mathématique remarquable qui constitue à la fois sa force conceptuelle et sa plus grande vulnérabilité empirique : elle est entièrement caractérisée par un paramètre unique, λ. De cette architecture à paramètre unique découle directement la propriété fondamentale d’équidispersion, stipulant l’égalité absolue entre l’espérance mathématique du processus et sa variance :
E(Y) = Var(Y) = λ
Transposée au contexte de la régression de Poisson, l’équidispersion impose que pour n’importe quelle configuration donnée de covariables explicatives X, la variance conditionnelle des réponses individuelles soit strictement égale à la moyenne conditionnelle prédite par le modèle :
Var(Yi | Xi) = E(Yi | Xi) = μi = exp(Xiβ)
Cette hypothèse implique une rigidité structurelle extrême. Elle postule que le mécanisme stochastique régissant la fréquence moyenne des événements gouverne également, de façon déterministe et invariable, la dispersion de ces événements autour de cette moyenne. Si cette propriété offre une élégance mathématique indéniable et simplifie le calcul de la vraisemblance, elle s’accorde très mal avec la dynamique des comportements humains. En sciences sociales et comportementales, il est exceptionnel que la variabilité résiduelle observée se conforme à cette contrainte théorique étroite.
3.2 Facteurs induisant la rupture de l’équidispersion
L’effondrement systématique de l’équidispersion dans les plans de recherche expérimentaux et observationnels découle de plusieurs mécanismes sous-jacents bien documentés en méthodologie quantitative. Le premier réside dans l’existence d’une hétérogénéité individuelle non observée. Dans toute étude psychologique, des facteurs latents majeurs — variations génétiques, susceptibilités neurobiologiques, traits de personnalité ou contextes familiaux non mesurés — introduisent des disparités substantielles de propension de base entre les individus. Dès lors que cette variabilité latente n’est pas explicitement modélisée par des prédicteurs dans la matrice X, elle se diffuse dans le terme d’erreur résiduel, augmentant la variabilité bien au-delà de la valeur prédite par le modèle conditionnel de Poisson.
Le second mécanisme relève de la violation du postulat d’indépendance des événements, fréquemment désignée sous l’appellation de contagion temporelle ou de renforcement comportemental. Le modèle de Poisson exige que la survenue d’un événement n’altère en rien la probabilité d’occurrence des événements futurs. Or, dans les comportements addictifs, les conduites suicidaires ou les compulsions associées au trouble obsessionnel-compulsif, la réalisation d’un premier acte modifie profondément la dynamique psychique du sujet : elle brise des barrières inhibitrices ou active des circuits de renforcement neurochimique qui rendent les événements ultérieurs bien plus probables (contagion positive). À l’inverse, l’apparition d’un événement peut induire une période réfractaire au cours de laquelle toute nouvelle occurrence est impossible (contagion négative, induisant alors une sous-dispersion).
Enfin, le regroupement des observations au sein de clusters écologiques — tels que des patients traités au sein de différentes cliniques, des élèves nichés dans des classes scolaires ou des familles soumises à un même environnement — introduit des corrélations intra-groupes qui gonflent artificiellement la variance empirique globale. Associée aux inévitables erreurs de mesure inhérentes aux inventaires auto-rapportés (qui augmentent le bruit résiduel), cette structure complexe d’agrégation d’événements rompt définitivement l’équidispersion théorique.
3.3 Conséquences statistiques de l’ignorance du postulat
Lorsque la condition d’équidispersion est violée par la présence d’une surdispersion non traitée, le recours naïf au modèle de régression de Poisson standard produit des conséquences statistiques désastreuses sur la validité de l’inférence. En vertu des propriétés théoriques de l’estimation quasi-vraisemblance démontrées par Gouriéroux, Monfort et Trognon (1984), les estimateurs ponctuels des coefficients de régression β̂ conservent leur propriété de convergence et demeurent asymptotiquement sans biais, à condition expresse que la fonction de lien logarithmique soit correctement spécifiée : E(Y|X) = exp(Xβ).
Cependant, l’ensemble de l’inférence statistique s’effondre au niveau de l’estimation de l’incertitude. La matrice de variance-covariance asymptotique standard, calculée sous l’hypothèse stricte Var(Y|X) = μ, sous-estime drastiquement les véritables erreurs-types des estimateurs :
SEPoisson(β̂j) ≪ SERéelle(β̂j)
Cette contraction artificielle des erreurs-types a pour conséquence directe une surestimation massive des statistiques de test de Wald :
z = β̂j / SE(β̂j)
Les p-valeurs calculées deviennent fallacieusement minuscules, provoquant une inflation incontrôlée du taux d’erreur de première espèce (α). L’analyste conclut alors à l’existence d’effets thérapeutiques hautement significatifs ou valide de prétendus corrélats étiologiques qui ne constituent en réalité que des artefacts statistiques dus à la surdispersion non contrôlée. De surcroît, les intervalles de confiance construits sous ces erreurs-types sous-évaluées affichent un taux de recouvrement empirique bien inférieur au seuil nominal de 95 %, sapant directement la reproductibilité scientifique des travaux publiés.
4. La surdispersion statistique : mécanismes, formes et implications
4.1 Phénoménologie de la surdispersion (Overdispersion)
La surdispersion (overdispersion en anglais) désigne l’état statistique dans lequel la variance observée au sein des données dépasse de façon statistiquement et substantiellement significative la variance postulée par le modèle théorique sous-jacent. Dans le contexte d’une distribution de Poisson, cela se traduit par la constatation empirique suivante :
Var(Y | X) > E(Y | X)
Il est fondamental d’établir une distinction analytique rigoureuse entre la surdispersion marginale et la surdispersion conditionnelle. La surdispersion marginale se rapporte aux données brutes non ajustées : lorsque l’on calcule la moyenne et la variance univariées de la variable dépendante Y, il est fréquent d’observer une variance très largement supérieure à la moyenne. Toutefois, cette surdispersion brute peut simplement refléter le fait que des covariables puissantes n’ont pas encore été prises en compte. Une fois ces prédicteurs introduits dans le prédicteur linéaire, la variance conditionnelle peut, en théorie, s’aligner sur la moyenne conditionnelle μi. On parle alors de surdispersion apparente, causée par l’omission de variables explicatives ou par une spécification erronée de la forme fonctionnelle (comme l’omission de termes polynomiaux ou d’interactions non linéaires).
En revanche, la surdispersion réelle (ou intrinsèque) persiste même après avoir spécifié un modèle complet et adéquatement paramétré. Elle traduit la présence d’une hétérogénéité stochastique inhérente au processus générateur de données lui-même. À l’opposé, la sous-dispersion (underdispersion), situation où Var(Y|X) < E(Y|X), demeure un phénomène excessivement rare dans les études comportementales humaines. Elle ne s’observe typiquement que dans des protocoles de laboratoire ultra-contrôlés impliquant des processus d’exclusion mutuelle ou des temps de latence physiologiquement contraignants limitant artificiellement la variabilité des dénombrements.
4.2 Modélisation de l’hétérogénéité par un mélange continu
La méthode la plus rigoureuse et élégante pour formaliser la surdispersion réelle consiste à conceptualiser le processus de comptage individuel comme un modèle de mélange continu hiérarchique, plus spécifiquement un mélange continu de Poisson. Supposons que, conditionnellement à la moyenne observée μi et à un facteur d’hétérogénéité latente inobservé νi propre à chaque individu, la variable dépendante Yi suive rigoureusement une loi de Poisson :
Yi | μi, νi ~ P(μi × νi)
où νi > 0 représente un effet aléatoire multiplicatif non observé, résumant l’ensemble des prédispositions génétiques, cognitives ou environnementales spécifiques à l’individu i qui n’ont pu être capturées par les covariables mesurées. Pour préserver l’identifiabilité du modèle sans distordre la moyenne globale, nous imposons que ce facteur latent possède une espérance mathématique égale à l’unité : E(νi) = 1. Sa variance, en revanche, est un paramètre libre inconnu noté α, tel que Var(νi) = α, reflétant l’ampleur de l’hétérogénéité interindividuelle inobservée au sein de la population.
Sur le plan mathématique, le choix de la distribution probabiliste pour ce terme latent νi est guidé par les principes de la théorie bayésienne et des distributions conjuguées. La distribution continue la plus adéquate pour modéliser une variable aléatoire strictement positive de moyenne unitaire est la loi Gamma, paramétrée par une forme k = 1/α et un taux θ = 1/α :
νi ~ Gamma(k = 1/α, θ = 1/α)
En intégrant le paramètre latent νi sur l’ensemble de son domaine de définition stochastique [0, +∞[, la distribution marginale de Yi (inconditionnelle par rapport à l’hétérogénéité inobservée) s’obtient analytiquement par convolution :
P(Yi = yi | μi, α) = ∫0∞ P(Yi = yi | μi, νi) × f(νi; α) dνi
Cette intégrale de mélange Poisson-Gamma possède une solution fermée exacte : elle génère précisément la distribution de probabilité de la régression binomiale négative. Ce cadre mathématique confère une légitimité théorique solide au modèle binomial négatif, en l’interprétant directement comme un modèle de Poisson enrichi pour intégrer formellement la variabilité résiduelle interindividuelle.
4.3 Impacts sur la puissance statistique et la prédiction
Les conséquences d’une surdispersion non modélisée ne se limitent pas à l’inflation des erreurs de type I : elles dégradent profondément l’exactitude des projections prédictives individuelles. Lorsqu’un modèle de Poisson est erronément ajusté à des données surdispersées, sa variance sous-estimée produit des intervalles de prédiction beaucoup trop étroits. Les cas cliniques extrêmes (par exemple, les patients à très haut risque de récidive ou à très forte charge symptomatique) sont alors considérés comme des anomalies probabilistes impossibles par le modèle, alors qu’ils relèvent simplement de la distribution réelle à queues lourdes.
De plus, cette mauvaise spécification affaiblit la puissance statistique réelle des tests d’hypothèses conduits dans le cadre d’essais cliniques randomisés. En sous-estimant la variabilité résiduelle authentique du phénomène sous étude, les calculs de taille d’échantillon a priori fondés sur l’hypothèse de Poisson sous-dimensionnent systématiquement les cohortes requises pour mettre en évidence un effet thérapeutique réel avec une puissance adéquate de 80 % ou 90 %. La prise en compte explicite de la surdispersion via un modèle binomial négatif s’avère donc indispensable dès la conception méthodologique du protocole de recherche.
5. 5. Le modèle de régression binomiale négative : cadre mathématique et paramétrage
5.1 Formulation probabiliste et fonctions de variance
Issue de la dérivation du mélange continu Poisson-Gamma, la régression binomiale négative réintroduit la flexibilité nécessaire dans l’ajustement des dénombrements. Soit Y une variable de comptage dont l’espérance conditionnelle est notée μ = E(Y|X) = exp(Xβ). La fonction de masse de probabilité univariée de la distribution binomiale négative, exprimée sous sa paramétrisation moyenne-dispersion, prend la forme suivante :
P(Y = y | μ, α) = [ Γ(y + α-1) / ( y! × Γ(α-1) ) ] × [ α-1 / (μ + α-1) ]α-1 × [ μ / (μ + α-1) ]y
où Γ(·) désigne la fonction gamma d’Euler, qui généralise la factorielle aux nombres réels telle que Γ(n) = (n – 1)!. L’élément structural déterminant de ce modèle réside dans sa fonction de variance quadratique, caractéristique du modèle canonique qualifié dans la littérature économétrique et statistique de modèle NB2 (Cameron et Trivedi, 2013) :
Var(Y | X) = μ + α × μ2
Dans cette équation, la variance conditionnelle est décomposée en deux termes distincts : le premier terme (μ) correspond à la composante de variance de Poisson pure (variabilité intrinsèque du dénombrement), tandis que le second terme (αμ2) représente la variabilité excédentaire générée par l’hétérogénéité inobservée. Il existe également une formulation alternative, désignée sous le nom de modèle NB1, dans laquelle la fonction de variance est linéaire : Var(Y|X) = μ + αμ = (1 + α)μ. Toutefois, dans les sciences du comportement, le modèle quadratique NB2 s’impose de façon prédominante en raison de son adéquation remarquable avec l’amplification non linéaire de la variance observée aux valeurs moyennes élevées.
Il est capital d’observer le comportement analytique limite de la fonction de variance lorsque le paramètre de dispersion α tend vers zéro :
limα → 0 [Var(Y | X)] = limα → 0 (μ + αμ2) = μ
De façon rigoureusement identique, la fonction de masse de probabilité binomiale négative converge ponctuellement vers la distribution de Poisson lorsque α → 0. Le modèle de régression de Poisson apparaît donc formellement comme un cas particulier niché (nested) au sein de la famille plus générale de la régression binomiale négative.
5.2 Le paramètre de dispersion alpha
Le paramètre α (souvent documenté comme le coefficient de surdispersion) quantifie l’intensité de la variabilité non modélisée. Une confusion terminologique et logicielle récurrente mérite d’être soulignée pour éviter toute erreur d’interprétation lors de la manipulation des packages statistiques contemporains. Alors que la littérature théorique privilégie le paramètre de surdispersion directe α (où α = 0 désigne l’absence totale de surdispersion), des environnements majeurs tels que la fonction glm.nb() du package MASS sous le logiciel R paramètrent le modèle selon le terme θ = 1/α, désigné comme le paramètre d’échelle ou de taille (shape/size parameter).
Dans ce cadre paramétrique alternatif, la relation limite s’inverse : une absence de surdispersion (modèle de Poisson pur) correspond à θ → +∞. Inversement, une valeur empirique de θ faible (θ < 1 ou θ proche de zéro) signale une surdispersion particulièrement sévère. L’estimation de ce paramètre conjointement aux coefficients vectoriels β s’effectue usuellement par un algorithme d’estimation par maximum de vraisemblance alterné ou par profilage de vraisemblance : le système optimise alternativement les coefficients de régression conditionnellement à α, puis réestime α conditionnellement aux coefficients jusqu’à convergence numérique stable de la hessienne.
Dans les cohortes cliniques de psychiatrie quantitative, des valeurs estimées de α oscillant entre 0,20 et 1,50 sont extrêmement courantes. Elles témoignent de l’impossibilité pratique de capter l’intégralité de la variabilité humaine à l’aide de simples prédicteurs linéaires auto-rapportés, légitimant l’estimation empirique de ce paramètre d’échelle additionnel.
5.3 Interprétation des estimateurs en régression binomiale négative
L’un des avantages conceptuels majeurs du modèle binomial négatif réside dans la préservation intégrale de la fonction de lien logarithmique. Dès lors que l’on modélise ln(μ) = Xβ, l’interprétation sémantique et clinique des coefficients de régression β̂ est rigoureusement identique à celle exposée précédemment pour la régression de Poisson. L’exponentiation des coefficients, exp(β̂), produit exactement les Ratios de Taux d’Incidence (IRR), autorisant une comparabilité directe des amplitudes d’effet entre études.
La divergence analytique fondamentale s’exprime exclusivement dans l’évaluation de la précision de ces estimations : les erreurs-types estimées sous le modèle binomial négatif intègrent la composante de variance excédentaire αμ2. En conséquence, les erreurs-types sont plus larges et réalistes que celles issues d’un modèle de Poisson mal ajusté. Les intervalles de confiance à 95 % s’élargissent pour refléter la véritable incertitude expérimentale, et les p-valeurs augmentent jusqu’à des seuils scientifiquement défendables. Néanmoins, il importe de rappeler que la régression binomiale négative ne constitue pas une panacée universelle : si la surdispersion est exclusivement engendrée par une abondance massive de scores nuls résultant d’un processus binaire distinct, le modèle NB2 peut demeurer sous-optimal face aux modèles dédiés à l’inflation de zéros.
6. 6. Comparaison empirique et méthodologique : Poisson versus Binomiale négative
6.1 Tableau comparatif des propriétés structurelles
Afin de synthétiser les divergences structurelles majeures distinguant les deux modèles fondamentaux de données de comptage, le tableau suivant récapitule leurs propriétés mathématiques, computationnelles et inférentielles fondamentales :
- Hypothèse distributionnelle sous-jacente : Le modèle de Poisson repose sur une loi univariée à un seul paramètre P(λ). Le modèle binomial négatif (NB2) postule une distribution de mélange continu bivariée Poisson-Gamma.
- Formulation de la fonction de variance : Poisson contraint la variance à l’égalité formelle avec la moyenne, Var(Y|X) = μ. La binomiale négative incorpore une relation quadratique extensible, Var(Y|X) = μ + αμ2.
- Paramètres estimés : Poisson n’estime que le vecteur des coefficients de régression β (dimension p). La binomiale négative estime le vecteur β ainsi que le paramètre de dispersion d’échelle α (dimension p + 1).
- Comportement asymptotique : Lorsque la taille d’échantillon N croît et que α → 0, le modèle binomial négatif converge asymptotiquement vers l’estimateur de Poisson. En petits échantillons homogènes sans surdispersion, l’ajustement de la binomiale négative peut induire une instabilité numérique mineure liée à l’estimation de α sur la frontière paramétrique.
- Sensibilité aux valeurs extrêmes : Le modèle de Poisson est excessivement sensible aux valeurs isolées de comptage élevé, lesquelles tirent anormalement la moyenne conditionnelle et génèrent des résidus disproportionnés. Le modèle binomial négatif absorbe ces observations éloignées avec une robustesse substantiellement accrue grâce à sa fonction de variance tolérante.
6.2 Biais d’estimation et robustesse comparative
Sur le plan des propriétés statistiques formelles des estimateurs, un paradoxe méthodologique apparent émerge des comparaisons théoriques. D’un côté, le modèle de Poisson jouit d’une robustesse structurelle reconnue par le théorème de Gouriéroux et collègues : si la relation moyenne est correctement modélisée sous la forme exp(Xβ), l’estimateur β̂Poisson demeure rigoureusement sans biais et convergent, même si la distribution réelle s’avère binomiale négative, gamma ou log-normale. Son talon d’Achille réside exclusivement dans sa matrice de variance empirique.
D’un autre côté, bien que le modèle binomial négatif résolve magistralement le problème de l’estimation de la variance résiduelle en ajustant formellement le terme α, il repose théoriquement sur l’exactitude de la distribution de mélange Gamma. Si le véritable processus générateur d’hétérogénéité latente dévie drastiquement d’une loi Gamma (en suivant par exemple une distribution bimodale ou log-normale discontinue), les estimations conjointes de β et α peuvent theoretically être affectées dans des conditions extrêmes d’échantillonnage fini. Cependant, dans la quasi-totalité des simulations montées en psychométrie, le coût statistique lié à l’estimation du paramètre additionnel α dans le modèle NB2 est infinitésimal en regard du gain spectaculaire réalisé en matière de validité de l’inférence par rapport au modèle de Poisson non corrigé.
6.3 Scénarios typiques orientant vers l’un ou l’autre modèle
Dans la pratique de la recherche académique, le choix entre ces deux paradigmes s’aligne étroitement sur le design d’investigation et la nature des construits psychologiques investigués. Le modèle de Poisson standard conserve toute sa pertinence et sa supériorité parcimonieuse dans les contextes hautement contrôlés :
- Protocoles expérimentaux rigoureux en laboratoire où chaque sujet subit un protocole de stimulation parfaitement standardisé et temporalisé (ex. tâches de temps de réaction avec décompte d’omissions rares).
- Études d’épidémiologie clinique sur des cohortes d’une extrême homogénéité portant sur des événements rares survenant au sein de fenêtres temporelles courtes.
- Situations où la variance empirique calculée au sein des cellules factorielles du plan expérimental se révèle sensiblement équivalente à leurs moyennes arithmétiques respectives.
À l’opposé, la régression binomiale négative s’avère impérative et méthodologiquement obligatoire dans les contextes suivants :
- Études en psychopathologie développementale mesurant des épisodes comportementaux au sein de la population générale (ex. nombre de crises de colère, comportements délinquants, fugues), caractérisés par une immense variabilité interindividuelle et une prédominance de faibles scores accompagnée d’une fraction d’individus cumulant des centaines d’occurrences.
- Enquêtes longitudinales ou transversales fondées sur des questionnaires auto-administrés évaluant la fréquence de consommation de substances licites ou illicites (alcool, nicotine, cannabis).
- Données d’observation en milieu naturel (écoles, services d’urgence, prisons) où des phénomènes d’agrégation institutionnelle et d’influence mutuelle gonflent irrémédiablement la dispersion résiduelle.
7. 7. Techniques diagnostiques 1 : Analyse des résidus et graphiques de résidus standardisés
7.1 Typologie des résidus pour modèles linéaires généralisés
Dans le cadre des modèles de régression linéaire classique par OLS, l’analyse des résidus est conceptuellement directe : le résidu brut ei = yi – ŷi possède, sous l’hypothèse de validité du modèle, une variance constante σ2. Dans le périmètre des GLM, cette définition brute est totalement obsolète, car la variance théorique dépend intrinsèquement de la valeur prédite μi. Pour évaluer la qualité d’ajustement d’un modèle de comptage, les statisticiens emploient deux grandes catégories de résidus transformés : les résidus de Pearson et les résidus de déviance.
Le résidu de Pearson ajuste la déviation brute en la divisant par l’écart-type conditionnel prédit par la fonction de variance V(μ) du modèle examiné. Pour le modèle de Poisson, où V(μi) = μi, et pour le modèle binomial négatif (NB2), où V(μi) = μi + αμi2, le résidu de Pearson individuel s’écrit respectivement :
rP, iPoisson = (yi – μ̂i) / √(μ̂i) et rP, iNB = (yi – μ̂i) / √(μ̂i + α̂ μ̂i2)
Le résidu de déviance, noté di, quantifie quant à lui la contribution algébrique individuelle de chaque observation à la statistique de déviance résiduelle globale du modèle (la déviance étant le double de la différence de log-vraisemblance entre le modèle saturé parfait et le modèle ajusté). Il s’exprime sous la forme di = sign(yi – μ̂i) × √(di2), offrant une distribution souvent plus proche de la normalité asymptotique que les résidus de Pearson.
Pour affiner ces diagnostics, il est nécessaire de calculer les résidus standardisés (souvent appelés résidus studentisés en OLS). Cette opération pondère le résidu par la racine de (1 – hii), où hii désigne le leverage (l’élément diagonal correspondant de la matrice chapeau H) reflétant l’effet de levier exercé par l’individu dans l’espace multidimensionnel des covariables :
rP, istd = rP, i / √(1 – hii)
7.2 Construction et interprétation du graphique des résidus standardisés
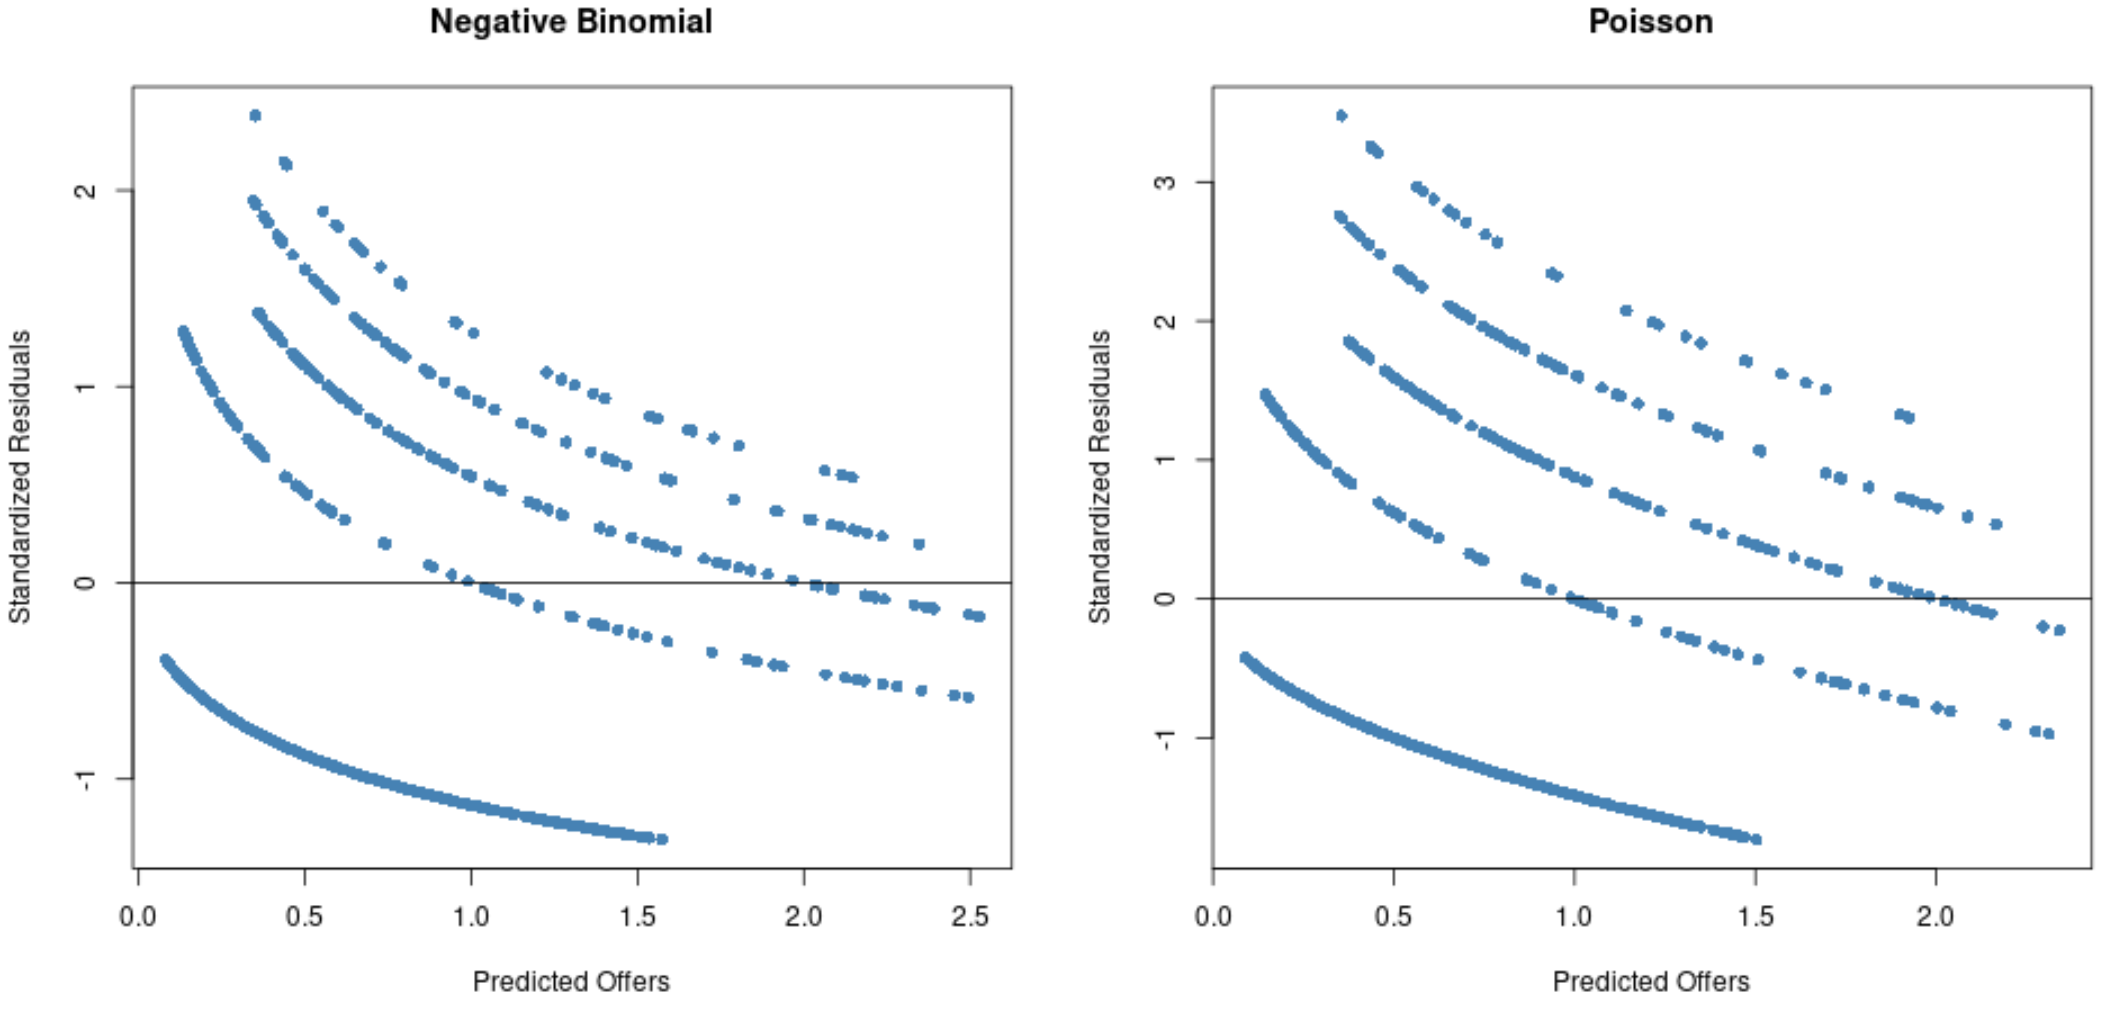
L’inspection visuelle du graphique mettant en relation les résidus de Pearson standardisés (en ordonnée) avec les valeurs prédites μ̂ (ou leur transformation logarithmique, en abscisse) constitue la procédure diagnostique empirique la plus révélatrice de la surdispersion. Si le modèle de régression de Poisson sous-jacent est parfaitement spécifié et que l’hypothèse d’équidispersion est rigoureusement satisfaite, les résidus standardisés doivent se disperser aléatoirement autour de la ligne horizontale de référence zéro, sans structure apparente, et leur variance empirique doit être approximativement égale à 1.
Deux règles heuristiques formelles régissent la lecture critique de ce tracé diagnostique :
- La règle de l’intervalle canonique [-2, +2] : Dans un modèle adéquatement équidispensé, approximativement 95 % des résidus standardisés doivent impérativement s’inscrire à l’intérieur de la bande délimitée par les seuils ordonnés [-2, +2], conformément aux propriétés d’une loi normale centrée réduite de référence.
- Le seuil critique d’alerte [-3, +3] : La présence récurrente de multiples observations excédant la plage normative [-3, +3] constitue un signal diagnostique indiscutable de surdispersion sévère. Si les résidus s’étalent sur des amplitudes atteignant des valeurs de +5, +8 ou +15, l’équidispersion de Poisson est catégoriquement invalidée.
De plus, l’analyste doit traquer l’apparition de profils morphologiques caractéristiques tels que les motifs en entonnoir (évasement progressif de l’étalement vertical des résidus à mesure que les valeurs prédites augmentent). Ce motif en entonnoir trahit l’incapacité de la fonction de variance linéaire de Poisson à contenir l’amplification d’amplitude des résidus, signalant qu’une fonction de variance quadratique de type NB2 est structurellement requise.
7.3 Diagnostics graphiques complémentaires
Au-delà du traditionnel tracé des résidus de Pearson, la boîte à outils diagnostique moderne met à disposition des représentations graphiques plus sophistiquées. Les résidus quantiles aléatoires, démocratisés par le package de référence DHARMa dans l’environnement R, résolvent le problème de la discrétisation des résidus dans les modèles GLM. En transformant les résidus discrets en quantiles continus uniformément distribués via des simulations probabilistes du modèle sous hypothèse nulle, ils permettent la génération de diagrammes quantile-quantile (Q-Q plots) d’une clarté remarquable. Tout écart systématique de la trajectoire des points par rapport à la bissectrice théorique fournit un test visuel infaillible de surdispersion ou d’inflation de zéros.
Une autre technique visuelle remarquable est le rootogramme suspendu (hanging rootogram), conceptualisé à l’origine par John Tukey et adapté aux GLM de comptage par Kleiber et Zeileis (2016). En traçant la racine carrée des fréquences observées et attendues de telle sorte que les barres pendent littéralement depuis la courbe des valeurs attendues jusqu’à l’axe horizontal, le rootogramme met immédiatement en relief les dénombrements pour lesquels le modèle s’avère déficitaire ou excédentaire. Il visualise instantanément si le modèle sous-estime systématiquement la fréquence des zéros ou échoue à modéliser la traîne lourde des observations massives.
8. 8. Techniques diagnostiques 2 : Tests statistiques formels de surdispersion et comparaison de modèles
8.1 Le test du rapport de vraisemblance (LRT) appliqué à la dispersion
Si l’inspection visuelle des résidus fournit des indices précieux, la rigueur méthodologique impose la conduite de tests d’hypothèses formels. Le test le plus largement déployé pour discriminer le modèle de Poisson du modèle binomial négatif est le Test du Rapport de Vraisemblance (Likelihood Ratio Test, ou LRT). Ce test évalue formellement l’hypothèse nulle d’équidispersion de Poisson contre l’hypothèse alternative de surdispersion binomiale négative :
H0 : α = 0 versus H1 : α > 0
La statistique de test standard repose sur la différence des log-vraisemblances maximales obtenues respectivement pour le modèle binomial négatif restreint (ln LNB) et le modèle de Poisson emboîté (ln LPoisson) :
LRT = 2 × [ ln LNB(β̂NB, α̂) – ln LPoisson(β̂Poisson) ]
Cependant, ce test soulève une difficulté statistique majeure trop souvent ignorée : l’hypothèse nulle α = 0 se situe exactement sur la frontière de l’espace paramétrique admissible, puisque le paramètre de dispersion α ne peut mathématiquement pas adopter de valeurs strictement négatives dans la formulation standard NB2. En vertu des démonstrations de Chernoff (1954) et Self et Liang (1987), la distribution asymptotique sous l’hypothèse nulle d’un test sur la frontière n’est pas une loi classique du χ2 à 1 degré de liberté, mais un mélange probabiliste 50:50 d’une masse ponctuelle en zéro (Dirac δ0) et d’un χ2 à 1 degré de liberté, noté formellement :
LRT ~ 0.5 × χ02 + 0.5 × χ12
Pour corriger cette contrainte de frontière et ne pas employer un test excessivement conservateur, la véritable p-valeur du LRT corrigé pour tester l’adjonction du paramètre de dispersion s’obtient simplement en divisant par deux la p-valeur dérivée de la distribution usuelle du χ2(1) :
p-valeurcorrigée = 0.5 × P(χ12 > LRTobservé)
Si cette p-valeur corrigée est inférieure au seuil critique nominal (typiquement 0,05), l’hypothèse nulle α = 0 est rejetée avec confiance, attestant formellement de la supériorité statistique du modèle binomial négatif.
8.2 Tests de score et statistiques de Wald pour la dispersion
L’exécution du test de rapport de vraisemblance exige d’ajuster consécutivement les deux modèles, ce qui peut se révéler computationnellement coûteux face à de gigantesques bases de données. Pour pallier cette contrainte, Cameron et Trivedi ont dérivé un test de score élégant qui ne nécessite que l’ajustement préalable du modèle de régression de Poisson standard. Le test de Cameron-Trivedi évalue la relation entre les résidus de Poisson et les valeurs prédites en ajustant une régression linéaire auxiliaire sans constante :
[ (yi – μ̂i)2 – yi ] / μ̂i = α × g(μ̂i) + εi
Pour tester spécifiquement l’architecture de variance quadratique NB2, la fonction choisie est g(μ̂i) = μ̂i. La significativité de la pente estimée α̂ au moyen d’un simple test t de Student unilatéral permet de conclure instantanément à la présence de surdispersion, sans avoir à faire converger l’algorithme d’optimisation de la binomiale négative.
Par ailleurs, les chercheurs inspectent couramment l’indice heuristique de dispersion basé sur la déviance résiduelle ou le χ2 de Pearson divisé par les degrés de liberté résiduels (df) :
Φ̂ = χPearson2 / (n – k) = [ ∑i=1n (yi – μ̂i)2 / μ̂i ] / (n – k)
Sous l’hypothèse d’équidispersion stricte, ce ratio Φ̂ doit être sensiblement égal à 1. Une valeur de Φ̂ excédant substantiellement 1,20 ou 1,50 fournit une indication diagnostique empirique forte d’une violation de l’hypothèse de Poisson. Toutefois, il convient d’être vigilant : ce ratio est sensible aux erreurs de spécification de la fonction de lien et à la taille d’échantillon, et ne doit jamais se substituer aux tests formels de score ou de rapport de vraisemblance.
8.3 Critères d’information et validation croisée
Lorsque l’on compare des architectures de modélisation concurrentes qui ne sont pas nécessairement parfaitement emboîtées, les critères d’information pénalisés constituent des repères décisionnels indispensables. Le critère d’information d’Akaike (AIC) et le critère d’information bayésien (BIC) opèrent un arbitrage quantitatif rigoureux entre la qualité de l’ajustement aux données (capturée par la log-vraisemblance maximale ln L) et la complexité du modèle (pénalisée par le nombre de paramètres estimés K) :
AIC = -2 × ln L + 2K et BIC = -2 × ln L + K × ln(n)
Dans la compétition entre Poisson (K paramètres) et Binomiale Négative (K + 1 paramètres), la binomiale négative n’est pénalisée que par l’adjonction d’une seule unité paramétrique (ΔK = 1). Dès lors que la surdispersion est présente, le gain en log-vraisemblance procuré par l’intégration de la fonction de variance quadratique dépasse presque systématiquement la faible pénalité de complexité de 2 points d’AIC. Selon les directives classiques de Burnham et Anderson (2002), un différentiel ΔAIC = AICPoisson – AICNB supérieur à 10 démontre un support empirique écrasant en faveur du modèle binomial négatif, reléguant le modèle de Poisson au rang de spécification erronée.
Pour les chercheurs privilégiant l’exactitude prédictive hors-échantillon plutôt que la seule théorie de l’information, la validation croisée par k-blocs (k-fold cross-validation) apporte une validation empirique supplémentaire. En scindant les données en sous-ensembles d’entraînement et de validation, elle permet de comparer la racine de l’erreur quadratique moyenne de prédiction (RMSEP) ou le score de probabilité logarithmique (log-score probabiliste). Cette démarche confirme systématiquement que face à des données surdispersées, le modèle binomial négatif génère des prédictions de densité de probabilité bien mieux étalonnées sur les données de test non observées.
9. 9. Gestion des cas particuliers : Inflation de zéros, troncature et alternatives semi-paramétriques
9.1 Le phénomène d’excès de zéros (Zero-Inflation)
L’un des défis analytiques les plus répandus en psychopathologie quantitative réside dans la prolifération massive de scores nuls au sein de la variable dépendante. Par exemple, lors de l’évaluation du nombre d’arrestations policières au cours des six derniers mois dans un échantillon de la population générale, une écrasante majorité des participants présentera un score rigoureusement égal à zéro. Si une proportion importante de zéros peut naturellement être absorbée par le modèle binomial négatif grâce à sa grande flexibilité d’échelle, il survient des configurations où la masse en zéro transcende ce que n’importe quelle distribution univariée standard peut modéliser.
Il est fondamental de distinguer deux sources étiologiques de zéros :
- Les zéros structurels : Ils correspondent à des individus qui ne sont conceptuellement pas à risque de produire l’événement étudié (par exemple, des participants totalement abstinents de toute consommation d’alcool dans une étude sur les épisodes de frénésie éthylique).
- Les zéros d’échantillonnage (ou accidentels) : Ils concernent des individus qui appartiennent bel et bien à la population susceptible de manifester le comportement, mais qui se trouve n’avoir commis aucun acte durant la fenêtre temporelle restreinte de l’étude par simple fluctuation stochastique.
Pour modéliser formellement cette double dynamique génératrice, Lambert (1992) a introduit les modèles gonflés en zéros : le modèle ZIP (Zero-Inflated Poisson) et le modèle ZINB (Zero-Inflated Negative Binomial). Ces modèles superposent deux processus : une composante logistique binaire qui prédit l’appartenance à la classe des zéros structurels, et une composante de comptage (Poisson ou Binomiale Négative) régissant la fréquence de survenue chez les individus éligibles. Alternativement, les modèles barrière (Hurdle Models), théorisés par Mullahy (1986), découplent totalement le franchissement du premier événement (modèle binaire 0 vs > 0) de la dynamique de récurrence conditionnelle aux valeurs strictement positives.
La discrimination formelle entre un modèle standard (Poisson ou NB2) et son homologue gonflé en zéros (ZIP ou ZINB) ne peut s’opérer par un simple LRT classique, car les modèles ne sont pas rigoureusement nichés. On recourt alors traditionnellement au test non emboîté de Vuong (1989), complété par les ajustements méthodologiques contemporains de Desmarais et Harden (2013). Une statistique de Vuong significativement positive valide la supériorité de l’architecture avec inflation de zéros.
9.2 Données tronquées et censurées
Un autre défi d’échantillonnage concerne les données de dénombrement tronquées à zéro (Zero-Truncated Counts). Ce scénario émerge dès lors que le processus de recrutement d’une étude clinique conditionne l’inclusion des patients à la condition formelle d’avoir manifesté le comportement au moins une fois. Par exemple, une étude examinant la durée de séjour hospitalier (en nombre de jours entiers) chez des patients psychiatriques admis en unité fermée, ou le dénombrement des consultations médicales chez des patients recrutés en salle d’attente, exclut structurellement la possibilité d’observer la valeur zéro.
Ajuster un modèle de Poisson ou binomial négatif standard à de telles données biaise lourdement l’estimation de l’espérance conditionnelle, car l’espace d’échantillonnage réel débute à Y = 1. Il est alors requis d’employer des formulations distributionnelles tronquées : la Poisson tronquée à zéro (ZTP) ou la Binomiale négative tronquée à zéro (ZTNB). La fonction de masse probabiliste est alors re-normalisée en divisant la probabilité standard par la probabilité complémentaire de ne pas observer zéro :
P(Y = y | Y > 0, μ) = P(Y = y | μ) / [1 – P(Y = 0 | μ)]
De façon symétrique, lorsque la fenêtre temporelle d’observation est interrompue arbitrairement avant que certains participants n’aient terminé leur séquence comportementale (censure à droite des comptages), le recours à des extensions de modèles de survie discrets ou à des régressions de Poisson censurées devient impératif pour éviter des estimations artificiellement tirées vers le bas.
9.3 Approches alternatives : Quasi-Poisson et erreurs-types robustes
Face à la surdispersion, l’analyste n’est pas strictement restreint au modèle binomial négatif paramétrique standard. Deux alternatives méthodologiques majeures méritent d’être considérées dans l’arsenal du statisticien : le modèle Quasi-Poisson et l’estimation de variance sandwich robuste.
L’approche du Quasi-Poisson, formulée par Wedderburn (1974) dans le cadre de la théorie des quasi-vraisemblances, refuse de postuler une distribution probabiliste entièrement spécifiée pour la composante aléatoire. Elle retient uniquement la fonction de lien logarithmique ln(μ) = Xβ, mais modélise la variance empirique comme une fonction linéaire de la moyenne proportionnelle à un paramètre d’échelle libre Φ :
Var(Y | X) = Φ × μ
Dans ce cadre, les coefficients estimés β̂ sont strictement identiques à ceux obtenus par la régression de Poisson standard, mais leurs erreurs-types associées sont systématiquement corrigées en étant multipliées par le facteur multiplicatif √Φ̂. Le quasi-Poisson offre une flexibilité intéressante lorsqu’on hésite sur la nature exacte de la distribution de probabilité, mais il possède une limite conceptuelle majeure : n’étant pas fondé sur une véritable fonction de vraisemblance complète, il interdit le calcul de l’AIC et du BIC, compliquant grandement les procédures de sélection formelle de modèles.
La seconde alternative repose sur le conservatisme du modèle de Poisson couplé à une estimation de variance sandwich robuste de Huber-White (parfois désignée sous le nom d’estimateur sandwich ou de quasi-maximum de vraisemblance, QMLE). Comme l’ont formalisé Wooldridge (1999) et Cameron et Trivedi (2013), l’estimateur sandwich calcule la variance asymptotique selon la formule matricielle :
Vsandwich = (X’ M X)-1 [ ∑i=1n (yi – μ̂i)2 Xi Xi‘ ] (X’ M X)-1
où M est la matrice diagonale des variances prédites. Cette correction procure des erreurs-types asymptotiquement valides même en présence d’une surdispersion arbitraire ou de certaines formes d’hétéroscédasticité non modélisées. Néanmoins, pour des échantillons cliniques de taille modérée (N < 200), la modélisation paramétrique explicite via la régression binomiale négative demeure systématiquement plus efficace et offre une puissance statistique supérieure à l’approche sandwich de Poisson.
10. 10. Guide décisionnel séquentiel pour la sélection du modèle
10.1 Étape 1 : Analyse exploratoire approfondie des données brutes
Toute démarche de modélisation de dénombrements doit impérativement débuter par une analyse exploratoire minutieuse de la distribution univariée de la variable dépendante Y, ainsi que de ses relations bivariées avec les prédicteurs clés. La première opération quantitative fondamentale consiste à calculer l’indice de dispersion brut non ajusté, défini comme le ratio de la variance échantillonnale sur la moyenne empirique :
ID = sY2 / Y̅
Si la variable dépendait rigoureusement d’un processus de Poisson univarié, cet indice oscillerait étroitement autour de la valeur 1,0. Dans les cohortes de psychopathologie ou de neurosciences comportementales, il n’est pas rare de constater un ratio brut excédant 5, 10 ou 20, fournissant un premier signal préliminaire massif de surdispersion, bien que cette dispersion puisse être en partie résorbée par l’adjonction future de covariables pertinentes.
Parallèlement, l’analyste doit dresser l’histogramme des comptages bruts pour scruter la forme distributionnelle globale. Trois éléments visuels critiques doivent être inventoriés :
- La proportion exacte d’observations nulles (P(Y = 0)). Si cette fraction excède 50 % ou 60 % de l’échantillon global, l’éventualité d’un modèle avec inflation de zéros devra être gardée en mémoire pour les étapes ultérieures.
- La présence de valeurs extrêmes isolées dans la queue supérieure droite de la distribution. Ces points doivent être audités afin de s’assurer qu’il ne s’agit pas d’erreurs d’encodage de données ou d’artefacts expérimentaux nécessitant une exclusion ou une analyse de sensibilité.
- L’identification formelle de toute variable d’hétérogénéité d’exposition (temps passé en consultation, durée du suivi, nombre de questions présentées), imposant la construction immédiate du terme d’offset logarithmique ln(ti).
10.2 Étape 2 : Ajustement comparatif initial et diagnostic des résidus
La seconde phase consiste à ajuster en parallèle le modèle de régression de Poisson canonique de référence et le modèle de régression binomiale négative (NB2) intégrant l’ensemble théorique des covariables X sélectionnées pour répondre à la question scientifique de recherche. Dès la fin de l’estimation de Poisson, le premier réflexe méthodologique ne doit pas être d’examiner la significativité des p-valeurs des coefficients, mais d’extraire la matrice des résidus de Pearson standardisés.
L’expérimentateur construit immédiatement le nuage de points mettant en relation ces résidus de Pearson standardisés avec les valeurs prédites par le modèle de Poisson. Si le graphique révèle une dissémination homogène et symétrique à l’intérieur de la bande normative [-2, +2], sans forme géométrique d’entonnoir et sans valeur s’écartant au-delà du corridor critique [-3, +3], l’hypothèse de travail de Poisson peut être provisoirement retenue.
En revanche, si l’on constate qu’une proportion substantielle de résidus (par exemple 8 %, 15 % ou plus) déborde hors de l’intervalle [-2, +2], ou que des résidus extrêmes atteignent des valeurs de +4 ou +8, la présence d’une surdispersion conditionnelle est graphiquement confirmée. À ce stade, la comparaison visuelle avec le tracé des résidus issu du modèle binomial négatif NB2 démontre généralement une normalisation spectaculaire de la dispersion résiduelle, attestant que la fonction de variance quadratique absorbe l’hétérogénéité excédentaire.
10.3 Étape 3 : Tests formels, arbitrage et sélection finale
La phase conclusive valide la sélection du modèle optimal par le croisement convergent des tests inférentiels formels et des critères de pénalisation théorique de l’information :
- Exécution du test LRT sur la frontière : L’analyste réalise le test du rapport de vraisemblance entre le modèle de Poisson et le modèle binomial négatif. En appliquant la correction de Self-Liang (p-valeur divisée par 2), si la statistique de test se révèle hautement significative (p < 0,001), l’hypothèse nulle α = 0 est définitivement abandonnée au profit du modèle binomial négatif NB2.
- Confrontation des métriques AIC et BIC : L’examen des critères d’information doit corroborer ce choix. Une réduction de l’AIC supérieure à 10 points sous le modèle binomial négatif entérine formellement sa supériorité parcimonieuse.
- Arbitrage final sur l’excès de zéros : Si la proportion de zéros au sein des données était particulièrement massive lors de la phase exploratoire, l’expérimentateur compare le modèle NB2 retenu à sa formulation avec inflation de zéros (ZINB) au moyen du test non emboîté de Vuong. Si le test de Vuong n’atteint pas le seuil de significativité statistique et que l’AIC ne s’améliore pas de façon notable, le modèle binomial négatif standard NB2 est proclamé modèle définitif.
Cet arbre décisionnel unifié garantit une démarche rigoureuse, reproductible et méthodologiquement étayée, immunisant le chercheur contre les biais inférentiels consécutifs à un choix arbitraire de modélisation.
11. 11. Implémentation pratique et interprétation logicielle (R et Python)
11.1 Mise en œuvre complète sous l’environnement R
L’écosystème statistique du logiciel libre R offre l’environnement computationnel le plus mature et le plus complet pour l’ajustement et le diagnostic comparatif des modèles de données de comptage. Le modèle de régression de Poisson s’ajuste nativement via la fonction standard glm() en spécifiant l’argument distributionnel family = poisson(link = "log"). L’ajustement du modèle binomial négatif quadratique (NB2) avec estimation conjointe par maximum de vraisemblance du paramètre de taille θ requiert quant à lui l’emploi de la fonction optimisée glm.nb() fournie par l’incontournable package MASS.
Le flux analytique de référence se déploie selon la syntaxe suivante :
Pour le modèle de base : modele_poi <- glm(crises ~ therapie + score_anxiete + offset(log(semaines_suivi)), data = donnees_cliniques, family = poisson(link = "log"))
Pour le modèle binomial négatif : library(MASS)
modele_nb <- glm.nb(crises ~ therapie + score_anxiete + offset(log(semaines_suivi)), data = donnees_cliniques)
La comparaison formelle des ajustements par le test de rapport de vraisemblance corrigé sur la frontière est exécutée via la fonction lrtest() du package lmtest, ou par l’appel générique anova(modele_poi, modele_nb). Afin d’extraire les diagnostics résiduels basés sur les quantiles simulés d’une fiabilité absolue, l’analyste sollicitera le package DHARMa :
library(DHARMa)
simulation_res <- simulateResiduals(fittedModel = modele_nb, n = 1000)
plot(simulation_res)
testDispersion(simulation_res)
La fonction testDispersion() calcule une simulation non paramétrique de l’indice de dispersion résiduel et délivre une p-valeur empirique exacte attestant de l’éradication complète de la surdispersion sous la paramétrisation binomiale négative choisie.
11.2 Mise en œuvre complète sous Python
Dans l’écosystème Python orienté vers la science des données, la bibliothèque de référence pour la modélisation statistique inférentielle est statsmodels. Contrairement à Scikit-learn, qui priorise la minimisation de fonctions de perte pour la prédiction sans délivrance d’erreurs-types ou de p-valeurs, Statsmodels offre des tables statistiques exhaustives conformes aux standards académiques.
L’implémentation repose sur le module statsmodels.formula.api, qui autorise la déclaration de formules de régression inspirées de la syntaxe de Wilkinson-Rogers :
import statsmodels.formula.api as smf
import statsmodels.api as sm
# Ajustement du modèle de régression de Poisson
mod_poisson = smf.poisson('crises ~ C(therapie) + score_anxiete', data=df, offset=np.log(df['semaines_suivi'])).fit()
print(mod_poisson.summary())
Pour ajuster le modèle binomial négatif NB2 sous Python, Statsmodels propose deux approches distinctes. La première recourt à la classe générique smf.negativebinomial(formula, data), en spécifiant l’argument loglike_method='nb2'. La seconde utilise le module GLM généralisé :
# Régression binomiale négative via Statsmodels GLM
mod_nb2 = smf.glm('crises ~ C(therapie) + score_anxiete', data=df, offset=np.log(df['semaines_suivi']), family=sm.families.NegativeBinomial(alpha=sm.families.links.nbinom2())).fit()
print(mod_nb2.summary())
Pour évaluer formellement le test de surdispersion de Cameron et Trivedi sous Python, un script automatisé extrait les valeurs prédites μ̂ et calcule la régression linéaire des résidus transformés :
y_hat = mod_poisson.predict()
y_val = df['crises']
res_aux = ((y_val - y_hat)**2 - y_val) / y_hat
reg_aux = sm.OLS(res_aux, y_hat).fit()
print('P-valeur du test auxiliaire de surdispersion :', reg_aux.pvalues[0])
L’obtention d’une p-valeur unilatérale hautement significative confirme l’impératif computationnel de basculer vers le modèle NegativeBinomial.
11.3 Lecture critique des sorties console et tableaux statistiques
L’analyse d’une sortie console produite par R ou Statsmodels requiert une grille de lecture méthodique. Prenons l’exemple d’un tableau d’estimation issu d’un modèle binomial négatif modélisant le nombre d’incidents comportementaux :
- Déviance résiduelle et Degrés de liberté : Une lecture rapide compare la Residual Deviance au nombre de Degrees of Freedom. Si le ratio s’établit à proximité de 1,00 à 1,15, cela signale un étalonnage harmonieux de la variance conditionnelle.
- Log-Likelihood : La log-vraisemblance maximale atteinte par le modèle binomial négatif doit afficher une valeur algébrique substantiellement moins négative que celle du modèle de Poisson (par exemple, -412,5 contre -580,2), traduisant un gain d’ajustement considérable.
- Le paramètre d’échelle (Theta ou Alpha) : Dans la sortie de
glm.nb()sous R, la dernière ligne affiche :Theta: 2.145 (Std. Err.: 0.284). La valeur de surdispersion équivalente est α̂ = 1 / 2,145 = 0,466. L’erreur-type associée démontre que ce paramètre est borné très loin de l’infini, attestant d’une surdispersion structurelle robuste. - Lecture des pentes β et conversion en IRR : Si le coefficient brut associé à la covariable
therapie_TCCafficheEstimate = -0.446, Std. Error = 0.112, z = -3.98, p = 6.8e-05, l’analyste procède immédiatement à l’exponentiation : IRR = exp(-0,446) = 0,640. L’intervalle de confiance à 95 % s’établit à [exp(-0,446 – 1,96 × 0,112) ; exp(-0,446 + 1,96 × 0,112)] = [0,514 ; 0,797]. La conclusion clinique s’énonce ainsi : « Toutes choses égales par ailleurs, les patients ayant bénéficié de la thérapie cognitivo-comportementale manifestent une réduction relative statistiquement significative de 36 % du taux attendu d’incidents par rapport au groupe témoin (IRR = 0,64, IC 95 % [0,51, 0,80], p < 0,001) ».
12. 12. Bonnes pratiques de reporting académique et considérations avancées
12.1 Normes de publication scientifique (APA 7e édition et équivalents)
La publication de modèles de régression pour données de comptage dans les revues internationales de premier rang (telles que celles affiliées à l’American Psychological Association, APA) impose un niveau élevé de transparence méthodologique. Trop d’articles omettent encore de justifier le choix de leur fonction de variance, se contentant d’évoquer l’emploi vague d’un « modèle de Poisson ». Les recommandations actuelles (normes APA 7e édition et lignes directrices STROBE/CONSORT) exigent une rigueur formalisée dès la section Méthode :
- Justification théorique et empirique préalable : L’auteur doit expliciter pourquoi la régression linéaire standard OLS a été écartée (nature discrète, borne en zéro, asymétrie marquée) et décrire la procédure statistique précise employée pour arbitrer entre la distribution de Poisson et la distribution binomiale négative.
- Restitution des métriques diagnostiques de dispersion : La section des Résultats doit rapporter textuellement le test de surdispersion réalisé, la valeur estimée du paramètre d’échelle α (ou θ) avec son intervalle de confiance à 95 %, ainsi que la comparaison des critères d’information (ΔAIC). Une formulation canonique recommandée est la suivante : « L’analyse préliminaire a mis en évidence une surdispersion conditionnelle substantielle (χ2/df = 3,42 ; test du rapport de vraisemblance corrigé sur la frontière : χ20:1 = 148,6, p < 0,001), justifiant le rejet du modèle de Poisson au profit d’une régression binomiale négative quadratique (NB2 ; paramètre d’échelle θ = 2,15, IC 95 % [1,64, 2,79] ; ΔAIC = 146,6) ».
- Présentation tabulaire normalisée : Les tableaux de régression doivent comporter de façon systématique : les coefficients de régression bruts non standardisés (B), les erreurs-types associées (SE), les Ratios de Taux d’Incidence (IRR), leurs intervalles de confiance à 95 % exacts, et les p-valeurs précises (sans recourir à la simple notation binaire p < 0,05). La taille de l’échantillon N, la log-vraisemblance maximale et la déviance résiduelle doivent impérativement figurer en note de bas de tableau.
12.2 Extension aux modèles mixtes et hiérarchiques (Multilevel Count Models)
Dans la recherche contemporaine en psychologie cognitive, expérimentale ou sociale, les protocoles empiriques impliquent presque constamment des mesures répétées dans le temps (études longitudinales, méthodes d’échantillonnage des expériences de vie ou Ecological Momentary Assessment) ou des structures d’échantillonnage en grappes (élèves imbriqués dans des classes, patients nichés au sein de thérapeutes). Dans de telles configurations, les observations individuelles violent l’hypothèse d’indépendance stochastique résiduelle.
Le cadre théorique développé dans cet article s’étend alors naturellement aux Modèles Linéaires Généralisés Mixtes (GLMM). La question de l’arbitrage entre Poisson et Binomiale Négative se complexifie, car il convient désormais de distinguer conceptuellement deux sources distinctes de variabilité excédentaire :
- La surdispersion induite par la structure de regroupement (cluster-level variance), qui peut être élégamment capturée par l’introduction d’un effet aléatoire gaussien sur l’intercept au niveau du groupe : ln(μij) = Xijβ + u0j, avec u0j ~ N(0, σu2).
- La surdispersion observationnelle pure (observation-level overdispersion), persistant au niveau individuel le plus fin même après conditionnement sur les effets aléatoires de grappe.
Sous l’environnement R, le package spécialisé glmmTMB (Brooks et al., 2017) s’est imposé comme la référence absolue pour estimer ces modèles complexes, surpassant largement les limites computationnelles de la fonction glmer() du package lme4. glmmTMB autorise l’ajustement sans faille de modèles hiérarchiques longitudinaux de Poisson, de quasi-Poisson, de binomiale négative (NB1 et NB2), ainsi que leurs extensions avec inflation de zéros, tout en modélisant des structures de corrélation temporelle résiduelle de type autorégressif d’ordre 1 (AR1).
12.3 Synthèse épistémologique pour la recherche clinique
Le choix d’une architecture de modélisation statistique ne constitue en aucun cas un détail technique subalterne ou un simple choix de commodité calculatoire. Il engage directement la responsabilité éthique et sociétale du chercheur. Dans le champ de la santé mentale et des neurosciences comportementales, valider à tort l’efficacité clinique d’une molécule pharmacologique ou d’une intervention psychothérapeutique sur la foi de faux positifs engendrés par un modèle de Poisson surdispersé peut orienter inutilement des années de recherche translationnelle et exposer des patients réels à des thérapeutiques inefficaces.
Il est donc temps d’abandonner définitivement les pratiques méthodologiques obsolètes que constituent la régression linéaire ordinaire sur comptages bruts et les transformations artificielles par le logarithme de Y + 1. La maîtrise rigoureuse des modèles linéaires généralisés, articulée autour de la distinction fondamentale entre équidispersion de Poisson et flexibilité quadratique binomiale négative, constitue un pilier méthodologique indispensable à tout chercheur soucieux de rigueur inférentielle, de robustesse empirique et de reproductibilité scientifique.
Références
- Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- Burnham, K. P., & Anderson, D. R. (2002). Model selection and multimodel inference: A practical information-theoretic approach (2e éd.). Springer-Verlag. https://doi.org/10.1007/b97636
- Cameron, A. C., & Trivedi, P. K. (2013). Regression analysis of count data (2e éd.). Cambridge University Press. https://doi.org/10.1017/CBO9781139016650
- Chernoff, H. (1954). On the distribution of the likelihood ratio test of one-sided hypotheses associated with a normally distributed variable. The Annals of Mathematical Statistics, 25(3), 573–578. https://doi.org/10.1214/aoms/1177728723
- Desmarais, B. A., & Harden, J. J. (2013). Testing for zero inflation in count models: Bias correction for the Vuong test. The Stata Journal, 13(4), 810–835. https://doi.org/10.1177/1536867X1301300408
- Gouriéroux, C., Monfort, A., & Trognon, A. (1984). Pseudo maximum likelihood methods: Applications to Poisson models. Econometrica, 52(3), 701–720. https://doi.org/10.2307/1913472
- Kleiber, C., & Zeileis, A. (2016). Visualizing count data regressions using rootograms. The American Statistician, 70(3), 296–303. https://doi.org/10.1080/00031305.2016.1173590
- Lambert, D. (1992). Zero-inflated Poisson regression, with an application to defects in manufacturing. Technometrics, 34(1), 1–14. https://doi.org/10.2307/1269547
- Mullahy, J. (1986). Specification and testing of some modified count data models. Journal of Econometrics, 33(3), 341–365. https://doi.org/10.1016/0304-4076(86)90002-3
- Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370–384. https://doi.org/10.2307/2344614
- O’Hara, R. B., & Kotze, D. J. (2010). Do not log-transform count data. Methods in Ecology and Evolution, 1(2), 118–122. https://doi.org/10.1111/j.2041-210X.2010.00021.x
- Self, S. G., & Liang, K.-Y. (1987). Asymptotic properties of maximum likelihood estimators and likelihood ratio tests under nonstandard conditions. Journal of the American Statistical Association, 82(398), 605–610. https://doi.org/10.1080/01621459.1987.10478472
- Vuong, Q. H. (1989). Likelihood ratio tests for model selection and non-nested hypotheses. Econometrica, 57(2), 307–333. https://doi.org/10.2307/1912557
- Wedderburn, R. W. M. (1974). Quasi-likelihood functions, generalized linear models, and the Gauss-Newton method. Biometrika, 61(3), 439–447. https://doi.org/10.1093/biomet/61.3.439
- Wooldridge, J. M. (1999). Distribution-free estimation of some nonlinear panel data models. Journal of Econometrics, 90(1), 77–97. https://doi.org/10.1016/S0304-4076(98)00033-5
- Zeileis, A., Kleiber, C., & Jackman, S. (2008). Regression models for count data in R. Journal of Statistical Software, 27(8), 1–25. https://doi.org/10.18637/jss.v027.i08