
Dans le paysage contemporain de la recherche biomédicale, de l’épidémiologie clinique et des sciences comportementales, l’évaluation rigoureuse des relations d’association entre des facteurs d’exposition et des événements d’intérêt constitue un pilier méthodologique fondamental. Lorsqu’il s’agit d’analyser des variables dépendantes dichotomiques — telles que la survenue ou l’absence d’une pathologie, la rémission clinique ou l’échec thérapeutique —, le rapport de cotes, communément désigné sous son appellation anglophone Odds Ratio (OR), s’impose comme l’une des métriques statistiques les plus largement mobilisées. Toutefois, l’observation d’une corrélation brute entre deux entités dissimule fréquemment une réalité sous-jacente bien plus intriquée, dans laquelle de multiples facteurs confondants viennent biaiser, amplifier ou masquer l’effet réel de la variable explicative principale.
C’est précisément au cœur de cette complexité causale qu’intervient le rapport de cotes ajusté (adjusted Odds Ratio ou aOR). Fruit de l’avènement des modèles linéaires généralisés et plus particulièrement de la régression logistique multivariée, le rapport de cotes ajusté permet d’isoler l’effet spécifique d’un déterminant en neutralisant statistiquement l’influence perturbatrice exercée par des covariables concomitantes. Contrairement au rapport de cotes brut qui se contente d’une sommation marginale potentiellement trompeuse, l’aOR répond au postulat méthodologique fondamental du raisonnement « toutes choses étant égales par ailleurs » (ceteris paribus), offrant ainsi aux chercheurs et aux praticiens une estimation épurée des liens étiologiques ou pronostiques.
Le présent traité propose une exploration exhaustive, théorique et appliquée du rapport de cotes ajusté. De sa différenciation probabiliste d’avec le risque relatif jusqu’à ses subtilités d’interprétation dans le cadre de devis observationnels complexes, ce document s’attache à déconstruire les mécanismes mathématiques régissant son calcul, à décrypter les phénomènes d’illusion statistique tels que le paradoxe de Simpson, et à guider le lecteur à travers des exemples concrets issus de la périnatalité, de la psychiatrie et de la psychologie du travail. En conjuguant rigueur formelle, illustrations empiriques pas-à-pas et recommandations pour l’implémentation logicielle, ce guide constitue une référence incontournable pour quiconque souhaite maîtriser l’inférence causale moderne.
1. Introduction et fondements conceptuels du rapport de cotes
1.1 Distinction probabiliste entre cote (odds) et probabilité
La compréhension rigoureuse du rapport de cotes exige en premier lieu d’établir une frontière épistémologique et mathématique stricte entre deux concepts continuellement confondus dans le discours profane et parfois même dans la littérature scientifique : la probabilité et la cote. D’un point de vue axiomatique, la probabilité d’un événement, traditionnellement notée p ou P(E), quantifie la vraisemblance que cet événement se réalise au sein d’un univers d’éventualités possibles. Elle s’exprime sous la forme du ratio unitaire entre le nombre d’occurrences favorables et le nombre total d’événements observables. Par construction, la probabilité est strictement bornée sur le continuum fermé [0 ; 1], ou sous forme de pourcentage allant de 0 % à 100 %. Si une cohorte de 100 individus comprend 20 personnes développant un trouble anxieux généralisé, la probabilité d’observer ce trouble est de 20 / 100, soit 0,20 ou 20 %.
À l’opposé, la cote, traduite de l’anglais odds, ne rapporte pas l’événement au tout, mais met en balance la probabilité de survenue de l’événement avec la probabilité complémentaire de sa non-survenue. Mathématiquement, pour une probabilité p donnée, la cote se définit par la relation fonctionnelle suivante : Cote = p / (1 – p). Reprenant l’exemple précédent, la cote d’apparition du trouble anxieux s’établit à 0,20 / (1 – 0,20) = 0,20 / 0,80 = 0,25 (que l’on formule couramment comme une cote de 1 contre 4). Alors que la probabilité est confinée à l’intervalle [0, 1], la cote s’étend quant à elle sur la demi-droite réelle positive [0 ; +infini[. Lorsque l’événement est hautement improbable, sa probabilité et sa cote convergent asymptotiquement vers une valeur quasi identique ; en revanche, dès lors que la probabilité dépasse 0,10 (soit 10 %), la divergence s’accentue exponentiellement. Par exemple, une probabilité de 0,80 correspond à une cote phénoménale de 0,80 / 0,20 = 4,00, ce qui illustre l’erreur conceptuelle majeure consistant à assimiler une cote quadruplée à une probabilité quadruplée.
Dans l’analyse comportementale et psychiatrique, la méconnaissance de cette distorsion asymptotique engendre des erreurs d’appréciation du risque absolu. En confondant la cote avec la probabilité, les investigateurs s’exposent à dramatiser l’impact d’un facteur pronostique. Considérer qu’une cote multipliée par deux équivaut à un doublement du risque brut d’une pathologie constitue un contresens logique formel lorsque l’issue clinique étudiée présente une prévalence modérée à élevée dans la population cible.
1.2 Le rapport de cotes brut (Unadjusted Odds Ratio)
Le rapport de cotes non ajusté, ou brut (fréquemment abrégé en cOR pour crude Odds Ratio), découle directement de l’algèbre des tables de contingence d’ordre 2×2. Considérons une matrice croisant un facteur d’exposition binaire (Exposé E+ versus Non-exposé E-) et une issue clinique binaire (Cas M+ versus Témoins M-). Dans cette table classique, désignons par a le nombre de sujets exposés malades, par b le nombre de sujets exposés sains, par c le nombre de sujets non-exposés malades, et par d le nombre de sujets non-exposés sains. La cote d’exposition chez les malades est représentée par le quotient a / c, tandis que la cote d’exposition chez les témoins non malades correspond à b / d.
Le rapport de ces deux entités, nommé rapport des produits croisés, s’exprime par l’équation canonique :
OR = (a / c) / (b / d) = (a * d) / (b * c)
Dans une recherche transversale ou dans un protocole de type cas-témoins, cette métrique quantifie la force du lien d’association bivarié entre l’exposition et l’affection. Un OR égal à 1,00 traduit l’absence totale d’association (l’hypothèse nulle), un OR supérieur à 1,00 indique que l’exposition accroît la cote de survenue de l’issue, tandis qu’un OR inférieur à 1,00 dépeint un potentiel facteur de protection. Cependant, l’analyse bivariée brute souffre d’une tare épistémique congénitale : elle postule implicitement que la population est parfaitement homogène en dehors de l’exposition considérée.
Cette cécité méthodologique face aux variables tierces limite drastiquement la validité interne du rapport de cotes non ajusté. En psychologie et en épidémiologie sociale, négliger l’impact de déterminants transversaux — tels que le niveau socio-économique, les prédispositions génétiques ou les comorbidités sous-jacentes — conduit inévitablement à un biais d’estimation. L’effet attribué à l’exposition peut s’avérer n’être que le reflet spectral d’une autre variable occultée, imposant dès lors le recours impératif à des techniques de stratification ou d’ajustement multivarié pour rétablir la vérité empirique.
1.3 Pertinence du rapport de cotes dans la recherche psychologique
L’utilisation prépondérante du rapport de cotes au sein des sciences psychologiques, de la pédopsychiatrie et de la psychopathologie expérimentale découle en grande partie de la structure intrinsèque des variables d’intérêt propres à ces disciplines. Les critères diagnostiques, tels qu’établis par les nomenclatures internationales (DSM-5-TR ou CIM-11), catégorisent quasi systématiquement les états cliniques sous un format dichotomique : présence ou absence d’un épisode dépressif majeur, déclenchement ou non d’un état de stress post-traumatique, franchissement ou non du seuil d’addiction comportementale.
Sur le plan de la conception méthodologique, la recherche en santé mentale s’appuie massivement sur des devis observationnels rétrospectifs ou des études cas-témoins, les impératifs éthiques interdisant formellement l’assignation aléatoire d’individus à des expositions délétères telles que des traumatismes de l’enfance, des situations de précarité extrême ou des violences conjugales. Or, dans une étude cas-témoins où l’échantillonnage s’effectue sur la base de la variable dépendante (le statut de malade ou de témoin), le calcul direct de l’incidence et, par dérivation, du risque relatif (RR) s’avère mathématiquement impossible, puisque la taille globale de la population à risque n’est pas connue. L’Odds Ratio demeure alors la seule métrique valide capable d’estimer la force du lien statistique.
En outre, le rapport de cotes s’insère idéalement au cœur des modèles probabilistes de l’inférence causale moderne. En psychopathologie cognitive et comportementale, où la causalité linéaire stricte s’efface devant des réseaux de causalité multifactorielle, l’estimation des cotes relatives permet de pondérer l’impact spécifique de facteurs environnementaux ou neurobiologiques dans des contextes hautement polymorphes, posant ainsi les jalons nécessaires à l’élaboration de modèles prédictifs solides.
2. Définition formelle et caractéristiques du rapport de cotes ajusté (aOR)
2.1 Définition mathématique et conceptuelle de l’aOR
Le rapport de cotes ajusté, désigné formellement par le sigle aOR (pour adjusted Odds Ratio), constitue une mesure d’association conditionnelle calculée entre une variable indépendante principale (l’exposition) et une variable dépendante binaire (l’événement clinique), tout en maintenant statistiquement invariantes un ensemble fini de covariables potentielles. Contrairement à la mesure brute qui observe la relation dans une dimension marginale globale, l’aOR déploie une projection mathématique dans un espace multidimensionnel où l’influence des variables de confusion identifiées est neutralisée.
Le principe théorique sous-jacent repose sur la célèbre maxime épistémologique ceteris paribus (« toutes choses étant égales par ailleurs »). L’aOR quantifie la modification relative de la cote de survenue de l’issue clinique pour deux groupes de sujets différant exclusivement par leur niveau d’exposition au prédicteur central, mais partageant rigoureusement les mêmes caractéristiques pour l’ensemble des autres paramètres introduits dans le modèle statistique. Si l’on étudie l’impact de l’exposition à un stress chronique sur le déclenchement d’une pathologie cardiovasculaire, l’aOR représentera l’effet propre de ce stress chez des individus possédant rigoureusement le même âge, le même indice de masse corporelle, le même statut tabagique et le même profil lipidique.
Sur le plan opérationnel, cette prouesse de contrôle statistique n’exige pas de recourir à un appariement physique exhaustif de chaque participant — procédé qui deviendrait rapidement impraticable dès que le nombre de covariables excède deux ou trois. L’ajustement est orchestré mathématiquement à travers la modélisation multivariée, au premier rang de laquelle figure la régression logistique binaire, capable d’isoler l’effet net d’une variable au sein d’une équation paramétrique continue.
2.2 Différence fondamentale entre Odds Ratio brut (cOR) et ajusté (aOR)
La distinction opérée entre le rapport de cotes brut (cOR) et le rapport de cotes ajusté (aOR) reflète l’abîme conceptuel qui sépare les associations statistiques marginales des associations conditionnelles. Le cOR évalue l’association globale, indifférenciée et brute entre deux variables, telle qu’elle transparaît au niveau de l’échantillon non décomposé. En revanche, l’aOR fournit une série d’estimations pondérées à travers les différents strates formées par les covariables, combinant ces informations en un estimateur synthétique unique sous l’hypothèse de l’homogénéité des effets.
Dans la pratique scientifique, la confrontation entre le cOR et l’aOR donne lieu à plusieurs configurations révélatrices de la structure des données :
- L’atténuation de l’effet : Le cOR se révèle substantiellement élevé, mais l’aOR régresse vers la valeur nulle de 1,00 après ajustement. Ce cas de figure démontre que l’association apparente était majoritairement factice, générée par la présence d’une variable de confusion liée à la fois à l’exposition et à la maladie.
- L’amplification de l’effet : L’aOR affiche une amplitude significativement supérieure à celle du cOR. Ce phénomène intervient lorsqu’une variable de confusion agissait comme un facteur d’inhibition ou de masquage (suppressor variable) dans l’analyse bivariée.
- L’inversion de l’effet : L’aOR traverse la ligne d’équivalence unitaire par rapport au cOR, transformant une apparente augmentation du risque en un effet protecteur avéré, ou inversement. Il s’agit de la manifestation la plus frappante des distorsions d’agrégation.
En règle générale, la communauté épidémiologique considère qu’un écart relatif supérieur à 10 % ou 15 % entre la valeur du rapport de cotes brut et celle du rapport de cotes ajusté — calculé par la formule |(cOR – aOR) / aOR| — atteste de la présence d’une distorsion de confusion substantielle, justifiant pleinement l’adoption préférentielle du modèle ajusté comme base d’inférence scientifique.
2.3 Objectifs scientifiques de l’ajustement statistique
L’ajustement statistique poursuit un ensemble cohérent d’objectifs scientifiques orientés vers l’optimisation de la validité interne des recherches observationnelles. Le premier de ces objectifs réside indubitablement dans la neutralisation active du biais de confusion. En annulant mathématiquement les disparités de distribution des facteurs pronostiques entre les sujets exposés et non exposés, l’ajustement recrée artificiellement les conditions d’équilibre structural qui caractérisent les essais cliniques randomisés contrôlés, considérés comme la référence de la démarche probante.
Parallèlement, l’introduction judicieuse de covariables fortement associées à la variable dépendante permet de réduire la variance non expliquée du modèle, ce qui affine la précision de l’estimateur de l’effet principal et resserre son intervalle de confiance. En clarifiant la distinction entre les déterminants directs d’une affection et les corrélats indirects qui gravitent autour de la chaîne étiologique, la modélisation ajustée protège la communauté scientifique contre l’attribution erronée d’un statut causal à des épiphénomènes.
Enfin, l’ajustement statistique offre un cadre robuste pour compenser les déséquilibres structurels inhérents aux échantillons de convenance ou aux cohortes longitudinales sujettes à des attritions sélectives. En intégrant des indicateurs de pondération ou des variables socio-démographiques d’ajustement, les chercheurs restaurent l’impartialité de leurs conclusions et garantissent que les inférences tirées de leurs données ne constituent pas de simples artefacts d’échantillonnage.
3. Le cadre méthodologique de la régression logistique multivariée
3.1 Formulation de l’équation logit et transformation logarithmique
Pour saisir l’émergence mathématique du rapport de cotes ajusté, il convient d’examiner les fondements de la régression logistique, développée sous l’égide de la théorie des modèles linéaires généralisés (GLM). Lorsqu’une variable d’issue Y est de nature dichotomique (codée 1 pour le succès ou l’apparition de la maladie, et 0 pour l’échec ou la santé), la modélisation classique par régression linéaire ordinaire se heurte à des obstacles infranchissables : les probabilités prédites peuvent déborder de l’intervalle [0, 1], et l’hypothèse de normalité et d’homoscédasticité des termes d’erreur est fondamentalement violée puisque la distribution sous-jacente relève d’une loi de Bernoulli.
Pour surmonter cette aporie, la régression logistique applique une transformation mathématique spécifique à la probabilité conditionnelle p = P(Y = 1 | X). Cette transformation, nommée fonction logit, s’énonce comme le logarithme naturel (ou népérien) de la cote de l’événement :
logit(p) = ln(p / (1 – p))
Le logit possède l’inestimable propriété algébrique de cartographier le segment probabiliste restreint [0 ; 1] sur l’ensemble continu infini des nombres réels ]-infini ; +infini[. Dès lors, il devient possible d’exprimer la relation entre les variables prédictives et l’issue selon une équation linéaire multivariée classique :
logit(p) = ln(p / (1 – p)) = beta_0 + beta_1 * X_1 + beta_2 * X_2 + … + beta_k * X_k
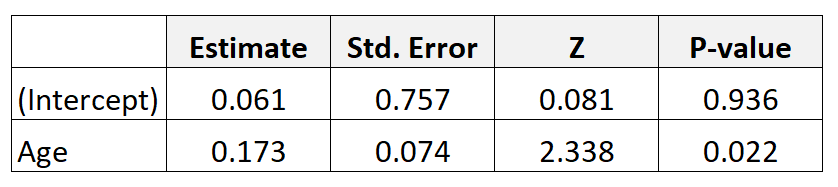
Dans cette formulation, beta_0 représente l’ordonnée à l’origine (le logit de base lorsque tous les prédicteurs sont nuls), tandis que chaque coefficient beta_i traduit le changement incrémental du log-odds (le logarithme de la cote) pour une variation unitaire du prédicteur X_i, toutes les autres variables du modèle étant maintenues rigoureusement constantes.
3.2 Dérivation de l’aOR à partir des coefficients de régression
La dérivation formelle du rapport de cotes ajusté à partir des paramètres estimés par l’équation de régression logistique constitue l’une des élégances mathématiques de la statistique appliquée. Supposons que nous souhaitions comparer la cote de l’événement entre deux individus : l’un exposé à un facteur binaire (noté X_1 = 1) et l’autre non exposé (noté X_1 = 0), sachant que tous deux possèdent des valeurs strictement identiques pour l’ensemble des k – 1 autres covariables (vecteur Z).
Exprimons les équations de logit respectives pour ces deux profils :
logit(p_exposé) = beta_0 + beta_1 * 1 + sum(beta_j * Z_j)
logit(p_non_exposé) = beta_0 + beta_1 * 0 + sum(beta_j * Z_j)
Soustrayons à présent l’équation des non-exposés de celle des exposés. Par les propriétés algébriques des logarithmes, la soustraction de deux logarithmes équivaut au logarithme de leur quotient :
logit(p_exposé) – logit(p_non_exposé) = ln(Cote_exposé / Cote_non_exposé) = ln(aOR)
Dans le membre de droite, l’ordonnée à l’origine beta_0 ainsi que la totalité de la somme linéaire relative aux covariables constantes sum(beta_j * Z_j) s’annulent parfaitement par soustraction :
ln(aOR) = beta_1
En appliquant la fonction exponentielle des deux côtés de l’égalité afin de revenir à l’échelle arithmétique d’origine, nous obtenons la loi fondamentale de la régression logistique :
aOR = exp(beta_1)
Pour les variables catégorielles comportant plus de deux modalités (par exemple le niveau d’instruction découpé en primaire, secondaire et supérieur), le modèle recourt au codage disjonctif complet ou codage d’indicatrices (dummy variables). Une catégorie est arbitrairement assignée comme référence de base, et chaque coefficient exponentié exp(beta) associé aux autres modalités représente l’aOR spécifique de cette modalité comparativement à la référence choisie.
3.3 Estimation par le maximum de vraisemblance et hypothèses du modèle
L’estimation des coefficients de régression logistique beta ne s’effectue pas au moyen de la méthode des moindres carrés ordinaires, inapplicable en présence d’une variable dépendante binaire, mais repose sur la méthode du maximum de vraisemblance (Maximum Likelihood Estimation, MLE). Le principe computationnel consiste à définir une fonction mathématique de vraisemblance L qui exprime la probabilité conjointe d’observer l’échantillon empirique recueilli sous un ensemble déterminé de paramètres. Par commodité algorithmique, les logiciels maximisent le logarithme de cette fonction (la log-vraisemblance) via des algorithmes itératifs d’optimisation numérique tels que la méthode de Newton-Raphson.
La validité statistique de l’aOR dérivé repose sur le respect impératif de plusieurs postulats méthodologiques :
- La linéarité du logit : Pour toute variable prédictive continue introduite dans le modèle, la relation entre cette variable et le logarithme de la cote doit être strictement linéaire. Si cette condition est violée, l’aOR global calculé est faux, imposant alors des transformations polynomiales ou le recours à des fonctions splines.
- L’indépendance des observations : Les résidus et les réponses individuelles doivent être mutuellement indépendants, excluant les structures de données appariées ou longitudinales sans recours préalable à des modèles hiérarchiques ou à des équations d’estimation généralisées (GEE).
- L’absence de multicollinéarité : Les covariables ne doivent pas présenter de corrélations linéaires excessives entre elles, sous peine de gonfler artificiellement les erreurs-types des estimateurs.
- La règle des événements par variable (EPV) : Pour garantir la convergence stable de l’algorithme du maximum de vraisemblance et éviter les biais asymptotiques d’échantillonnage, la littérature biostatistique prescrit d’observer au minimum 10 à 15 événements (pour la modalité la moins fréquente de l’issue) par paramètre libre estimé dans le modèle.
4. Pourquoi et quand ajuster : Phénomène de confusion et biais statistiques
4.1 Le concept épidémiologique de variable de confusion (confounder)
L’ajustement statistique ne saurait résulter d’une démarche purement opportuniste ou mécanique consistant à introduire l’intégralité des variables collectées dans un logiciel ; il exige une justification causale rigoureuse. En épidémiologie théorique, une variable tierce Z est formellement qualifiée de facteur de confusion si et seulement si elle satisfait simultanément à trois critères axiomatiques indissociables :
- Elle doit être statistiquement associée à la variable d’exposition principale dans la population source.
- Elle doit constituer un déterminant ou un facteur de risque autonome de la survenue de l’événement clinique, indépendamment de son lien éventuel avec l’exposition.
- Elle ne doit pas se situer sur la trajectoire causale directe reliant l’exposition à la maladie (elle ne doit pas être une variable médiatrice intermédiaire).
Cette distinction entre facteur de confusion et médiateur s’avère absolument déterminante pour l’intégrité de la recherche. Si un investigateur ajuste par erreur sur une variable médiatrice — qui constitue le véhicule biologique ou psychologique par lequel l’exposition produit son impact —, il annihile artificiellement l’effet réel de cette exposition, aboutissant à une conclusion faussement négative. Par exemple, si l’on étudie l’impact de l’exposition à des traumatismes infantiles sur la dépression adulte, et que l’on ajuste sur le niveau d’estime de soi à l’adolescence (qui constitue un mécanisme de médiation intermédiaire), on risque d’occulter le rôle fondamental du trauma originel.
Pour prévenir ces aberrations analytiques, la méthodologie contemporaine préconise l’utilisation systématique des graphes acycliques dirigés (Directed Acyclic Graphs ou DAGs). Ces représentations schématiques de la topologie causale permettent d’identifier visuellement les chemins secondaires non causaux (dits « chemins de porte dérobée » ou backdoor paths) nécessitant un ajustement pour bloquer la transmission du biais, tout en sanctuarisant les variables médiatrices.
4.2 Le paradoxe de Simpson et ses implications en psychologie
L’illustration la plus spectaculaire et la plus troublante de la nécessité impérieuse d’ajuster réside dans le célèbre paradoxe de Simpson. Ce paradoxe mathématique décrit une situation où une association statistique observée au niveau d’une population globale agrégée s’inverse radicalement ou disparaît complètement lorsque la population est scindée et analysée au sein de ses sous-groupes constitutifs homogènes.
Considérons un scénario clinique évaluant l’efficacité d’une nouvelle psychothérapie comportementale versus un traitement standard sur le taux de rémission d’un état de stress post-traumatique au sein d’un échantillon de 400 patients. L’analyse bivariée globale (non ajustée) révèle un taux de rémission de 40 % (80/200) dans le groupe traité par la nouvelle thérapie contre 50 % (100/200) dans le groupe standard, suggérant un OR brut de 0,67 : la nouvelle thérapie semble nettement inférieure au traitement classique.
Cependant, en stratifiant les patients selon la sévérité initiale du traumatisme (traumatisme aigu simple versus traumatisme complexe sévère), la vérité se dévoile. Chez les patients présentant un traumatisme simple, le taux de rémission sous nouvelle thérapie est de 80 % (40/50) contre 70 % (70/100) sous traitement standard (OR = 1,71). Chez les patients atteints de traumatismes complexes, le taux de rémission s’élève à 26,7 % (40/150) sous thérapie nouvelle contre 30,0 % (30/100) sous traitement standard (OR = 1,18 après réévaluation fine des effectifs réels). Dans chaque sous-groupe pris individuellement, la thérapie nouvelle surpasse l’ancienne ! L’illusion globale provenait du fait que les psychiatres, conscients du potentiel du traitement innovant, y avaient assigné de manière disproportionnée les cas les plus dévastés et les plus réfractaires. Seul le calcul du rapport de cotes ajusté permet de dissoudre ce mirage et de révéler l’efficacité intrinsèque du protocole expérimental.
4.3 Biais de sélection et distorsions d’échantillonnage
L’ajustement multivarié ne constitue pas une panacée universelle et peut, lorsqu’il est appliqué en dépit du bon sens structuraliste, introduire des biais encore plus pernicieux que ceux qu’il prétendait corriger. Le péril méthodologique majeur réside ici dans le conditionnement erroné sur un collisionneur (collider stratification bias ou biais de Berkson).
Un collisionneur est une variable qui reçoit l’impact causal convergent de deux autres variables distinctes (représenté dans un DAG par la configuration Exposition -> Collisionneur <- Maladie). Si un investigateur incorpore malencontreusement un tel facteur comme covariable d’ajustement dans son modèle de régression logistique, il crée de manière purement artificielle une corrélation statistique fallacieuse entre l’exposition et la maladie là où aucune relation causale n’existait préalablement dans la nature.
En recherche hospitalière et psychologique, ce phénomène se matérialise fréquemment lors de l’ajustement sur le statut d’hospitalisation ou sur le recours volontaire aux soins d’urgence. Sélectionner des individus sur la base d’une variable qui dépend à la fois de la condition psychopathologique et de la vulnérabilité sociologique distord intrinsèquement les cotes relatives. Une sélection rigoureuse des covariables ne doit donc jamais se fonder sur de purs critères d’association statistique aveugle, mais doit impérativement s’ancrer dans une connaissance ontologique et mécanistique approfondie du champ théorique étudié.
5. Exemple d’application 1 : Âge maternel et faible poids de naissance
5.1 Modélisation univariée initiale et calcul de l’OR brut
Afin d’ancrer ces développements théoriques dans la réalité tangible de la biostatistique appliquée, étudions une première recherche observationnelle en épidémiologie périnatale. Une équipe médicale cherche à évaluer l’association entre l’âge maternel avancé au moment de l’accouchement (opérationnalisé par une variable binaire : 35 ans ou plus [Age = 1] versus moins de 35 ans [Age = 0]) et l’avènement d’un faible poids de naissance chez le nouveau-né (défini selon l’OMS comme un poids strictement inférieur à 2 500 grammes, codé FPN = 1 versus poids normal FPN = 0).
L’étude transversale porte sur un échantillon représentatif de 1 000 accouchements consécutifs au sein d’une maternité hospitalière universitaire. Le dépouillement initial des données permet de dresser la table de contingence bivariée suivante :
- Mères âgées de 35 ans et plus (n = 300) : 60 nouveau-nés présentent un faible poids de naissance (a = 60) et 240 ont un poids normal (b = 240).
- Mères de moins de 35 ans (n = 700) : 70 nouveau-nés présentent un faible poids de naissance (c = 70) et 630 ont un poids normal (d = 630).
Procédons au calcul du rapport de cotes non ajusté (cOR) par la méthode des produits croisés :
Cote chez les mères âgées = a / b = 60 / 240 = 0,250
Cote chez les mères jeunes = c / d = 70 / 630 = 0,111
cOR = 0,250 / 0,111 = (60 * 630) / (240 * 70) = 37 800 / 16 800 = 2,25
L’ajustement d’un modèle de régression logistique simple produit un coefficient beta_brut = ln(2,25) = 0,811 (erreur-type = 0,195, p < 0,001). Sur la base exclusive de cette analyse univariée naïve, les cliniciens concluraient précipitamment que le fait d’accoucher à 35 ans ou plus multiplie par 2,25 la cote de donner naissance à un enfant de faible poids, semblant désigner l’âge biologique maternel comme un déterminant pathogène majeur.
5.2 Intégration des covariables cliniques et comportementales
Cependant, l’équipe épidémiologique suspecte à juste titre que cette relation brute est lourdement contaminée par des déterminants comportementaux et socio-économiques concomitants. L’interrogatoire approfondi des dossiers médicaux permet de recueillir des informations exhaustives sur deux covariables cruciales : le statut tabagique maternel actif durant le troisième trimestre de la gestation (Tabac = 1 pour fumeuse, 0 pour non-fumeuse) et le suivi prénatal tardif ou incomplet (Suivi_inadéquat = 1 versus 0).
L’analyse bivariée exploratoire croisant l’âge et le tabagisme révèle une hétérogénéité sociologique majeure : dans cette cohorte spécifique issue d’un bassin minier en reconversion industrielle, les femmes âgées de 35 ans et plus affichent un taux de prévalence tabagique actif de 40 % (120/300), comparativement à seulement 15 % (105/700) chez les mères plus jeunes. Parallèlement, le tabagisme maternel constitue un facteur de risque fœtotoxique documenté de longue date, induisant une hypoxie chronique et un retard de croissance intra-utérin majeur.
L’omission de cette variable comportementale constitue un cas d’école de biais de confusion positif : le tabagisme est massivement corrélé à l’exposition (l’âge maternel avancé) tout en constituant une cause indépendante et directe de l’issue (le retard pondéral). L’âge maternel supportait ainsi injustement la responsabilité étiologique du tabagisme actif.
5.3 Calcul pas-à-pas et interprétation comparative de l’aOR
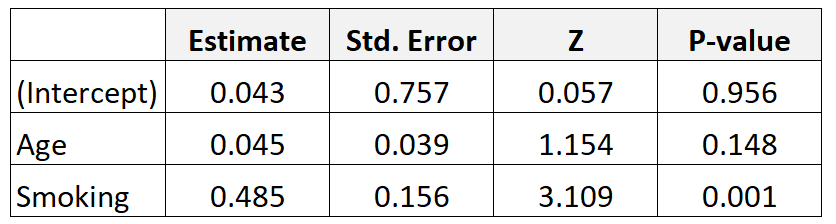
Pour restaurer la réalité étiologique, l’équipe implémente un modèle de régression logistique multivarié intégrant simultanément l’âge maternel, le statut tabagique et la qualité du suivi prénatal. L’algorithme du maximum de vraisemblance fait converger l’équation vers les paramètres suivants :
logit(P[FPN = 1]) = -2,845 + 0,223 * Age + 1,386 * Tabac + 0,854 * Suivi_inadéquat
Isolons le paramètre associé à l’âge maternel avancé : son coefficient bêta ajusté s’établit désormais à beta_ajusté = 0,223 (erreur-type = 0,212). Procédons à l’exponentiation formelle de cette estimation pour obtenir le rapport de cotes ajusté :
aOR_age = exp(0,223) = 1,25 (IC 95 % : [0,82 ; 1,89], p = 0,293)
À l’inverse, l’exponentiation du coefficient assigné au tabagisme révèle la force dévastatrice de cette exposition comportementale :
aOR_tabac = exp(1,386) = 4,00 (IC 95 % : [2,65 ; 6,04], p < 0,001)
La comparaison systématique entre le cOR de 2,25 et l’aOR de 1,25 démontre une réduction drastique de l’amplitude de l’association de l’ordre de 44 %. De surcroît, la borne inférieure de l’intervalle de confiance de l’aOR englobe désormais très largement la valeur nulle d’équivalence de 1,00, attestant de l’absence totale de significativité statistique de l’effet propre de l’âge une fois le tabac contrôlé. Pour les praticiens en obstétrique et en santé publique, la conclusion clinique change radicalement : l’âge maternel chronologique isolé ne constitue pas en soi un danger physiologique prééminent pour la biométrie fœtale ; les efforts prioritaires de prévention doivent impérativement se focaliser sur le sevrage tabagique et l’accompagnement médicosocial précoce.
6. Exemple d’application 2 : Dépression majeure et adhésion thérapeutique
6.1 Problématique clinique de l’observance en psychiatrie
L’inobservance médicamenteuse constitue un fléau thérapeutique endémique dans la prise en charge des affections psychiatriques chroniques et des pathologies somatiques au long cours. Dans les pathologies telles que le diabète de type 2 ou les troubles cardiovasculaires, l’irruption comorbide d’un épisode dépressif caractérisé (EDC) est universellement redoutée par les cliniciens, qui lui imputent une rupture majeure du suivi thérapeutique. Pour évaluer rigoureusement cette hypothèse, un protocole d’observation suit 500 patients atteints d’hypertension artérielle sévère durant douze mois.
L’inobservance thérapeutique est mesurée de façon standardisée via un dispositif de pilulier électronique connecté, opérationnalisée sous la forme d’une variable binaire (Non_observant = 1 si le pourcentage de prises effectives est inférieur à 80 %, 0 si l’adhésion est optimale). L’exposition principale est la présence d’une dépression majeure caractérisée documentée à l’inclusion (Depression = 1, n = 150 ; versus absence de dépression Depression = 0, n = 350).
L’analyse bivariée simple sans aucun ajustement délivre les résultats bruts suivants :
- Chez les patients dépressifs : 75 manifestent une inobservance critique (50,0 %) et 75 restent observants (cote = 75 / 75 = 1,00).
- Chez les patients non dépressifs : 70 manifestent une inobservance (20,0 %) et 280 maintiennent leur traitement (cote = 70 / 280 = 0,25).
Le calcul immédiat de l’Odds Ratio non ajusté indique :
cOR = 1,00 / 0,25 = 4,00 (IC 95 % : [2,64 ; 6,06], p < 0,001)
Cette estimation préliminaire suggère que le diagnostic de dépression majeure quadruple la cote de rupture de traitement, orientant exclusivement les politiques de remédiation vers l’administration intensive d’antidépresseurs.
6.2 Ajustement pour l’anxiété comorbide et le soutien social
Néanmoins, la réalité clinique en psychiatrie de liaison est éminemment plus complexe. Deux variables tierces de nature psychosociale interfèrent puissamment dans cette relation. D’une part, l’anxiété psychique comorbide (mesurée sur l’échelle continue de Hamilton-Anxiété, HAMA), qui amplifie la peur viscérale des complications médicales et pousse paradoxalement certains patients à une observance scrupuleuse, ou au contraire favorise des comportements d’évitement en cas d’effets secondaires. D’autre part, la perception du soutien social instrumental (quantifiée par le score psychométrique du MSPSS allant de 12 à 84 points), un réseau d’aidants solide suppléant fréquemment aux défaillances de l’initiative personnelle du patient dépressif.
Enfin, la pharmacovigilance clinique impose d’intégrer le nombre d’effets indésirables subjectifs déclarés par le patient (vertiges, dysfonction érectile, asthénie), codé de manière ordinale ou transformé en prédicteur quantitatif. La littérature montre que les individus souffrant de dépression tendent à rapporter une sensibilité et une intolérance majorées aux effets secondaires médicamenteux, introduisant une confusion patente.
La formulation théorique d’un modèle multivarié devient alors indispensable pour dissocier ce qui relève de l’aboulie et de l’anhédonie dépressive intrinsèques, de ce qui appartient au déficit structurel d’entourage social ou à la charge iatrogène des molécules prescrites.
6.3 Analyse des résultats chiffrés et implications thérapeutiques
L’ajustement du modèle de régression logistique multivarié global incorpore la dépression (variable binaire), le score de soutien social (continu, centré sur la moyenne), le score d’anxiété (continu) et la survenue d’effets indésirables notables (binaire). Le tableau d’estimation paramétrique livre les valeurs suivantes :
- Dépression majeure : beta = 0,642, erreur-type = 0,245
- Soutien social (par point supplémentaire) : beta = -0,045, erreur-type = 0,011
- Effets indésirables (présence vs absence) : beta = 0,916, erreur-type = 0,230
- Anxiété (par incrément d’un point) : beta = 0,012, erreur-type = 0,015 (non significatif)
Procédons au calcul du rapport de cotes ajusté pour la dépression :
aOR_depression = exp(0,642) = 1,90 (IC 95 % : [1,18 ; 3,07], p = 0,009)
Analysons parallèlement l’effet propre du soutien social perçu :
aOR_soutien = exp(-0,045) = 0,956 (IC 95 % : [0,935 ; 0,977], p < 0,001)
Ces constatations modifient profondément la lecture clinique des données. Si la dépression demeure bel et bien un prédicteur péjoratif indépendant de l’observance thérapeutique, son impact réel est considérablement amoindri par rapport à l’illusion brute initiale (l’aOR s’établit à 1,90 contre 4,00 pour le cOR). Plus de la moitié de l’association univariée apparente était en réalité captée par l’isolement social des patients et par l’impact des effets secondaires non gérés.
D’un point de vue praxéologique, ces résultats démontrent aux équipes psychiatriques qu’un traitement pharmacologique de l’humeur ne suffira pas à rétablir l’adhésion aux soins. L’intervention thérapeutique la plus efficace devra conjuguer une éducation thérapeutique sur les effets iatrogènes et une consolidation active des réseaux de soutien de proximité, chaque incrément de dix points sur l’échelle de soutien social réduisant la cote d’inobservance de plus de 36 % (exp(-0,045 * 10) = 0,637).
7. Exemple d’application 3 : Épuisement professionnel (Burnout) et stress au travail
7.1 Modélisation du risque d’épuisement professionnel sévère
Le troisième domaine d’application s’inscrit au sein de la psychologie des organisations et de l’ergonomie cognitive. Dans les environnements corporatifs sous haute tension, la recrudescence du syndrome d’épuisement professionnel ou burnout soulève de vives controverses quant à la part respective des contraintes professionnelles objectives et de la vulnérabilité psychologique individuelle. Une étude multicentrique examine un panel de 1 200 cadres supérieurs du secteur bancaire.
L’issue clinique binaire est l’épuisement professionnel sévère (Burnout = 1 versus 0), calibré à partir du score de la sous-échelle d’épuisement émotionnel du Maslach Burnout Inventory (MBI) au-delà du seuil standardisé de 30 points. La variable explicative centrale retenue est l’exposition récurrente à une surcharge horaire extrême, définie par l’accomplissement documenté de plus de 55 heures de travail hebdomadaires (Surcharge = 1 [n = 400] versus moins de 55 heures [n = 800]).
Les données empiriques brutes révèlent que 160 cadres parmi les 400 surexposés développent un épuisement sévère (40,0 %, cote = 160 / 240 = 0,667), contre 120 parmi les 800 cadres travaillant moins de 55 heures (15,0 %, cote = 120 / 680 = 0,176). Le rapport de cotes brut est sans équivoque :
cOR = 0,667 / 0,176 = 3,78 (IC 95 % : [2,88 ; 4,96], p < 0,001)
Ce résultat univarié semble justifier l’imputation exclusive de la pathologie à la charge horaire imposée par les structures managériales.
7.2 Ajustement pour les traits de personnalité et le climat organisationnel
Cependant, les psychologues du travail soulignent l’impérieuse nécessité d’ajuster sur la dimension dispositionnelle individuelle, en particulier le trait de personnalité Névrosisme (instabilité émotionnelle), évalué via le modèle des Big Five (inventaire NEO-PI-R). Les individus à fort névrosisme éprouvent une réactivité émotionnelle disproportionnée face aux stresseurs quotidiens et s’investissent fréquemment dans des comportements de sur-engagement compulsif ou de perfectionnisme dysfonctionnel les conduisant précisément à accumuler des horaires démesurés.
Parallèlement, les théories organisationnelles modernes (modèle de Karasek et Siegrist) soulignent le rôle déterminant du soutien managérial et de la justice organisationnelle perçue. Une charge de travail écrasante peut être remarquablement tolérée si elle s’accompagne d’une autonomie décisionnelle substantielle et d’un climat d’équité procédurale irréprochable. L’équation multivariée incorpore par conséquent le névrosisme (score standardisé T), la latitude décisionnelle (continue) et l’ancienneté dans l’entreprise (en années).
7.3 Synthèse des résultats et dissociation des effets individuels et contextuels
L’estimation du modèle logistique multivarié complet produit des coefficients particulièrement instructifs :
- Surcharge horaire (> 55 h/sem) : beta = 0,833, erreur-type = 0,165
- Score de Névrosisme (par écart-type) : beta = 0,693, erreur-type = 0,098
- Latitude décisionnelle (par niveau) : beta = -0,405, erreur-type = 0,082
Dérivons le rapport de cotes ajusté pour la surcharge de travail :
aOR_surcharge = exp(0,833) = 2,30 (IC 95 % : [1,66 ; 3,18], p < 0,001)
Et pour le trait de personnalité de névrosisme :
aOR_nevrosisme = exp(0,693) = 2,00 (IC 95 % : [1,65 ; 2,42], p < 0,001)
Ce calcul comparatif met en lumière deux vérités scientifiques fondamentales. D’une part, l’atténuation du rapport de cotes de la surcharge horaire (passant de 3,78 à 2,30) prouve qu’une proportion substantielle de l’association brute était alimentée par la disposition névrotique des individus qui s’auto-sélectionnaient dans ces amplitudes horaires extrêmes. D’autre part, même après avoir rigoureusement contrôlé l’impact de la vulnérabilité psychologique intrinsèque des salariés, l’aOR associé à la charge de travail reste hautement significatif à 2,30. La surcharge horaire ne relève donc en aucun cas d’un simple fantasme projectif d’employés fragilisés : elle constitue un facteur de risque environnemental autonome destructeur.
En termes de politique préventive, ces données permettent de dépasser le clivage stérile opposant partisans de la responsabilité individuelle et tenants de la culpabilité managériale. Les plans de prévention des risques psychosociaux en entreprise doivent conjuguer une limitation stricte des durées excessives de travail avec des programmes de développement de la flexibilité cognitive et de régulation émotionnelle.
8. Interprétation rigoureuse de la magnitude et de la direction de l’aOR
8.1 Signification des seuils de référence : Égal, supérieur ou inférieur à 1
L’interprétation sémantique et clinique du rapport de cotes ajusté obéit à un décodage géométrique rigoureux fixé par la position de l’estimateur par rapport à la valeur unitaire 1,00, qui matérialise l’hypothèse nulle d’indépendance conditionnelle. La métrique de l’aOR étant strictement multiplicative et asymétrique (les effets protecteurs sont confinés dans l’espace étroit compris entre 0 et 1, tandis que les effets délétères s’étendent de 1 à l’infini), la conversion mentale de ces valeurs requiert une méthodologie standardisée.
Lorsque l’aOR est strictement supérieur à 1,00, il désigne une élévation de la cote de survenue de l’événement dans le groupe exposé comparativement au groupe de référence, à profil de covariables rigoureusement identique. L’augmentation relative de la cote s’obtient par la formule arithmétique :
Pourcentage d’augmentation = (aOR – 1) * 100
Ainsi, un aOR calculé à 1,45 se traduit textuellement par : « Les sujets exposés présentent, toutes choses étant égales par ailleurs, une cote de survenue de la pathologie majorée de 45 % par rapport aux sujets non exposés ».
Inversement, lorsqu’un aOR s’inscrit entre 0 et 1,00, il identifie un facteur associé à une réduction de la cote, communément baptisé facteur protecteur. L’erreur la plus fréquente consiste à affirmer qu’un aOR de 0,70 représente une diminution de risque de 70 %. La formulation exacte repose sur la soustraction complémentaire à l’unité :
Pourcentage de réduction = (1 – aOR) * 100
Un aOR de 0,70 signifie qu’à covariables égales, l’exposition réduit la cote de survenue de l’issue clinique de (1 – 0,70) * 100 = 30 %. Si l’on désire exprimer cet effet protecteur sous la forme d’un coefficient multiplicateur inverse plus intuitif pour les cliniciens, il suffit de calculer l’inverse mathématique 1 / aOR (soit 1 / 0,70 = 1,43), permettant d’énoncer que les sujets non exposés ont une cote 1,43 fois plus élevée de tomber malades que les sujets exposés.
8.2 Confusion récurrente : Odds Ratio versus Risque Relatif (RR)
Dans l’arsenal épidémiologique, l’amalgame discursif entre le rapport de cotes ajusté (aOR) et le risque relatif ajusté (aRR) demeure l’une des sources les plus prolifiques de mauvaise interprétation médicale. Le risque relatif correspond au rapport direct des probabilités cumulées d’un événement entre deux cohortes d’exposition : RR = P(M+ | E+) / P(M+ | E-). Alors que le risque relatif quantifie directement la probabilité de survenue, le rapport de cotes compare des structures de cotes non linéaires.
L’assimilation de l’aOR à une mesure directe du Risque Relatif n’est biologiquement et mathématiquement tolérable que sous la stricte hypothèse de rareté de l’événement (rare disease assumption). Selon cette condition formalisée initialement par Jerome Cornfield, lorsque la prévalence ou l’incidence cumulée de l’issue clinique étudiée est strictement inférieure à 10 % (idéalement inférieure à 5 %) dans l’ensemble de la population cible, le terme (1 – p) tend asymptotiquement vers 1, de sorte que la cote p / (1 – p) converge vers la probabilité brute p. Dans ce contexte épidémiologique restreint, l’aOR constitue une excellente approximation numérique du risque relatif.
En revanche, dès lors que l’événement clinique est fréquent — ce qui est le cas de la majorité des syndromes anxio-dépressifs, des addictions communes ou des troubles musculo-squelettiques dont les taux dépassent souvent 20 % ou 30 % —, l’aOR s’écarte violemment du RR. L’Odds Ratio a pour propriété structurelle de surestimer systématiquement la force de l’association réelle comparativement au Risque Relatif :
- Si l’effet est de nature délétère (aOR > 1), l’aOR sera substantiellement plus grand que le véritable aRR.
- Si l’effet est protecteur (aOR < 1), l’aOR sera systématiquement plus bas (plus protecteur en apparence) que l’aRR.
Pour illustrer ce décrochage, imaginons une maladie affichant une incidence de 40 % chez les exposés et de 20 % chez les non-exposés. Le véritable Risque Relatif s’établit à 0,40 / 0,20 = 2,00. Calculons à présent l’Odds Ratio correspondant : Cote_exposé = 0,40 / 0,60 = 0,667 ; Cote_non_exposé = 0,20 / 0,80 = 0,250 ; OR = 0,667 / 0,250 = 2,67. Si le clinicien conclut que l’exposition double le risque absolu (ce que décrit fidèlement le RR de 2,00), il est exact ; s’il s’appuie sur l’OR pour déclarer que l’exposition multiplie le risque par 2,67, il commet une surestimation conceptuelle caractérisée de 33,5 %. Lorsque l’issue est fréquente et que l’on dispose de données longitudinales, il est donc vivement recommandé d’abandonner le modèle logistique au profit d’alternatives telles que la régression log-binomiale ou la régression de Poisson modifiée avec variance robuste, qui estiment directement des risques relatifs ajustés non distordus.
8.3 Interprétation pour les prédicteurs continus versus catégoriels
L’herméneutique de l’aOR dépend étroitement de l’échelle de mesure sur laquelle repose la variable explicative dans l’équation paramétrique. Lorsque le prédicteur est purement dichotomique (par exemple, exposition à un toxique versus non-exposition), l’aOR capture le saut discret opéré entre ces deux statuts mutuellement exclusifs.
En revanche, lorsque la variable prédictive est de nature métrique continue — telle que l’âge chronologique en années, le score d’une échelle psychométrique d’anxiété allant de 0 à 60 points, ou le taux sanguin d’une cytokine inflammatoire —, l’aOR calculé par la régression logistique standard exp(beta) quantifie la modification de la cote pour une progression marginale d’une seule unité de mesure. Or, une incrémentation d’une unité unique est fréquemment dénuée de sens clinique perceptible : que représente une augmentation d’un point isolé sur l’échelle de dépression de Beck qui en compte soixante-trois ? Un aOR de 1,03 par unité semblera trompeusement anecdotique au clinicien.
Pour restaurer l’intelligibilité des résultats, il est méthodologiquement recommandé d’exprimer l’aOR pour un saut clinique pertinent de plusieurs unités (noté delta, par exemple 5 points, 10 points ou un écart-type complet). En vertu des règles de linéarité du logit, le coefficient global pour un saut de magnitude delta s’obtient en multipliant le coefficient bêta par delta, dont on extrait l’exponentielle :
aOR_(delta) = exp(delta * beta) = (aOR_unitaire)^delta
Si l’aOR unitaire d’un biomarqueur s’établit à 1,05 par ng/ml, l’aOR ajusté pour une augmentation standardisée de 10 ng/ml sera de : (1,05)^10 = 1,63, révélant une élévation de 63 % de la cote pathologique qui était restée imperceptible dans l’affichage par défaut des logiciels.
Concernant les variables qualitatives polytomiques (comportant M catégories distinctes), le choix méthodologique de la catégorie de référence (reference group) s’avère stratégique. La modalité de référence doit impérativement constituer un groupe conceptuellement stable, bien défini et surtout pourvu d’un effectif suffisant. L’assignation d’une catégorie numérique résiduelle ou excessivement restreinte comme point de base introduit une instabilité majeure dans le calcul de l’erreur-type, provoquant un élargissement aberrant des intervalles de confiance de l’ensemble des aOR comparatifs calculés pour les autres modalités.
9. Inférence statistique : Intervalles de confiance et tests d’hypothèses
9.1 Calcul et lecture des intervalles de confiance à 95 %
L’estimation ponctuelle d’un rapport de cotes ajusté issue d’un échantillon ne saurait refléter avec certitude la valeur paramétrique réelle gouvernant la population mère globale. Toute inférence rigoureuse impose dès lors d’encadrer cette estimation par un intervalle de confiance à 95 % (IC 95 %), lequel définit la plage de valeurs au sein de laquelle se situerait le véritable paramètre inconnu de la population dans 95 % des réplications théoriques du même protocole expérimental.
Le calcul mathématique de l’intervalle de confiance ne peut s’effectuer directement sur l’échelle asymétrique des cotes relatives. Il est impératif d’opérer d’abord le calcul sur l’échelle symétrique des logarithmes de cotes (l’échelle des coefficients beta), où le théorème central limite garantit une distribution asymptotiquement gaussienne. Les bornes inférieure et supérieure sur l’échelle logit se construisent classiquement au moyen de l’erreur-type estimée (SE(beta)) et de la valeur critique de la loi normale centrée réduite correspondant au seuil alpha de 5 % (soit Z = 1,96) :
Borne_inf_logit = beta – 1,96 * SE(beta)
Borne_sup_logit = beta + 1,96 * SE(beta)
L’obtention des bornes de l’intervalle de confiance sur l’échelle naturelle de l’aOR s’effectue ensuite en prenant l’exponentielle de ces deux limites logarithmiques :
IC 95 % aOR = [exp(beta – 1,96 * SE(beta)) ; exp(beta + 1,96 * SE(beta))]
Cette transformation non linéaire confère à l’intervalle de confiance de l’aOR une asymétrie caractéristique : la distance séparant l’estimation ponctuelle de la borne supérieure est systématiquement plus étendue que celle la séparant de la borne inférieure.
La règle d’or de l’interprétation inférentielle stipule que si l’intervalle de confiance à 95 % englobe la valeur nulle d’indépendance de 1,00 (par exemple IC 95 % : [0,85 ; 1,42]), l’investigateur ne peut en aucun cas rejeter l’hypothèse nulle au seuil de significativité de 5 % ; l’association observée peut résulter des seules fluctuations d’échantillonnage. En revanche, si l’intervalle est intégralement disjoint de 1,00 (ses deux bornes étant soit strictement supérieures, soit strictement inférieures à l’unité), l’association est déclarée statistiquement significative.
9.2 Tests de significativité : Test de Wald et Rapport de Vraisemblance
Pour statuer formellement sur la validité d’une hypothèse nulle d’absence d’effet d’une covariable (H0: beta_i = 0, ce qui équivaut rigoureusement à H0: aOR_i = 1), deux méthodologies asymptotiques principales coexistent au sein des logiciels statistiques :
Le test de Wald s’impose comme la méthode la plus largement disséminée dans les sorties logicielles standards (telles que celles de SPSS). La statistique de test de Wald s’obtient en divisant le coefficient estimé par son erreur-type, valeur qui est ensuite élevée au carré pour suivre asymptotiquement une distribution du Chi-deux à 1 degré de liberté :
Wald = (beta / SE(beta))^2
Bien que d’une remarquable simplicité de calcul, le test de Wald présente une tare structurelle documentée sous le nom d’aberration de Hauck-Donner : lorsque la véritable magnitude de l’effet est extrêmement puissante ou que les effectifs par case sont ténus, l’erreur-type tend à être massivement surévaluée par l’algorithme, conduisant paradoxalement la statistique de Wald à s’effondrer vers zéro et générant un résultat faussement non significatif.
Pour contourner cet écueil, la théorie statistique moderne accorde une suprématie méthodologique indiscutable au test du rapport de vraisemblance (Likelihood Ratio Test, LRT). Ce test compare directement la qualité d’ajustement global de deux modèles emboîtés : le modèle complet incluant la variable cible et un modèle restreint expurgé de celle-ci. La statistique du rapport de vraisemblance s’énonce par la différence de leur déviance (-2 log-vraisemblance) :
Statistique LRT = 2 * (ln L_complet – ln L_restreint)
Cette métrique suit rigoureusement une loi de distribution du Chi-deux avec un nombre de degrés de liberté égal au différentiel de paramètres libres entre les deux modèles. Le LRT ne souffre d’aucune distorsion face aux grands coefficients et doit impérativement être privilégié lors de l’évaluation formelle de prédicteurs polytomiques ou d’interactions multivariées.
9.3 Significativité statistique versus pertinence clinique
L’évaluation épistémologique d’un rapport de cotes ajusté ne saurait être confinée à la lecture mécanique de la valeur p. L’impératif éthique et scientifique impose de distinguer radicalement la significativité statistique de la pertinence clinique (ou magnitude de l’effet). La valeur p est une fonction conjointe de la magnitude réelle de la relation et de la puissance de l’échantillon analysé.
Dans les méga-bases de données épidémiologiques ou les registres nationaux de santé regroupant plusieurs centaines de milliers d’individus, une puissance statistique démesurée conduira quasi invariablement à des valeurs p infinitésimales (p < 0,0001) pour des associations totalement dérisoires sur le plan clinique, telles qu’un aOR de 1,02 (IC 95 % : [1,01 ; 1,03]). Présenter un accroissement de la cote de 2 % comme une avancée diagnostique majeure pour orienter une pratique médicale relève d’une illusion méthodologique dangereuse.
À l’opposé, au sein d’études pilotes portant sur des pathologies rares ou des cohortes restreintes, un aOR très impressionnant de 3,50 peut afficher un intervalle de confiance large s’étendant de [0,92 à 13,30], assorti d’une valeur p de 0,065. Conclure platement à « l’absence totale d’effet » sous le prétexte bureaucratique que le seuil arbitraire de 0,05 n’a pas été formellement franchi constitue un manquement flagrant à la logique de découverte empirique. Ce résultat suggère une probabilité clinique très forte d’effet protecteur ou délétère substantiel, plaidant de toute urgence pour une réplication du protocole sur un échantillon calibré avec une puissance adéquate.
10. Validation du modèle statistique et gestion des pièges méthodologiques
10.1 Évaluation de la qualité d’ajustement globale (Goodness-of-Fit)
L’interprétation de l’aOR n’a de validité que si le modèle de régression logistique multivarié global qui le génère décrit fidèlement la structure empirique des données observées. L’investigateur doit impérativement déployer une batterie d’outils diagnostiques d’ajustement global (Goodness-of-fit).
Le test de calibration le plus réputé est sans conteste le test de Hosmer-Lemeshow. Son principe opérationnel consiste à partitionner l’échantillon des sujets en déciles homogènes de risque calculé sur la base des probabilités individuelles prédites par le modèle, puis à confronter le nombre d’événements effectivement observés au nombre d’événements théoriquement attendus dans chaque décile via une statistique du Chi-deux. Contrairement aux tests statistiques usuels, l’objectif méthodologique recherché ici est la non-significativité (p > 0,05). Une valeur p supérieure au seuil critique atteste qu’il n’existe pas d’écart statistiquement divergent entre les prédictions du modèle et la réalité observée, validant ainsi la calibration interne de l’équation.
Parallèlement, la quantification du pouvoir explicatif s’effectue au moyen des indicateurs de pseudo-R² (notamment le R² de Cox & Snell et sa correction par le R² de Nagelkerke). Alors qu’en régression linéaire ordinaire le coefficient de détermination R² quantifie le pourcentage précis de variance expliqué, les pseudo-R² en régression logistique ne constituent que des indices de substitution approximatifs de nature descriptive, reposant sur le ratio des log-vraisemblances. Ils ne doivent en aucun cas être interprétés comme une part stricte de variance biologique expliquée.
Enfin, la capacité de discrimination du modèle est systématiquement éprouvée par la construction de la courbe ROC (Receiver Operating Characteristic) et le calcul de l’aire sous la courbe (Area Under the Curve, AUC ou statistique C). Une AUC comprise entre 0,70 et 0,80 traduit un pouvoir de discrimination acceptable, au-delà de 0,80 elle atteste d’une excellente performance prédictive, tandis qu’une valeur avoisinant 0,50 révèle une totale inefficacité prédictive équivalente au hasard.
10.2 Diagnostic de la multicollinéarité parmi les covariables
L’un des pièges statistiques les plus dévastateurs menaçant la validité des modèles multivariés est la multicollinéarité, situation dans laquelle deux ou plusieurs variables explicatives introduites simultanément présentent de très fortes intercorrélations linéaires. La présence d’une multicollinéarité sévère ne fausse pas nécessairement le pouvoir prédictif global du modèle, mais elle déstabilise dramatiquement le calcul mathématique de l’inversion matricielle, provoquant une explosion artificielle des erreurs-types des coefficients beta associés aux prédicteurs incriminés.
Sur le plan pratique, l’investigateur observe alors des intervalles de confiance de l’aOR devenus gigantesques et incohérents, ainsi qu’une instabilité volatile où l’adjonction ou la suppression d’une poignée d’individus dans l’échantillon suffit à inverser totalement le signe des paramètres estimés.
Le diagnostic préventif de ce phénomène repose sur le calcul formel du Facteur d’Inflation de la Variance (Variance Inflation Factor ou VIF) pour chaque prédicteur. Un seuil de tolérance standardisé fixe la ligne de démarcation :
- Un VIF inférieur à 2,5 indique une collinéarité minimale et parfaitement acceptable.
- Un VIF compris entre 5 et 10 atteste d’une collinéarité modérée à sévère exigeant une vigilance critique.
- Un VIF strictement supérieur à 10 dénote une multicollinéarité catastrophique imposant une restructuration immédiate de l’architecture du modèle.
Face à une multicollinéarité excessive entre deux prédicteurs cliniquement cruciaux, les stratégies de remédiation consistent soit à éliminer la covariable théoriquement la moins pertinente, soit à fusionner les deux entités via des techniques de réduction dimensionnelle (analyse en composantes principales), soit à privilégier des algorithmes de pénalisation paramétrique de type régression Ridge ou Lasso.
10.3 Modification d’effet (interaction) versus confusion statistique
Il est impératif d’opérer une distinction ontologique absolue entre deux réalités statistiques fondamentalement dissemblables : le facteur de confusion et le modificateur d’effet (ou interaction statistique). Le facteur de confusion constitue une nuisance méthodologique parasitaire qu’il convient de neutraliser statistiquement pour accéder à l’effet causal net moyen. À l’inverse, la modification d’effet représente un phénomène biologique ou psychologique d’un intérêt scientifique capital : elle signifie que l’amplitude, voire la direction, de l’association entre l’exposition et la maladie varie intrinsèquement en fonction du niveau d’une tierce variable.
Confondre ces deux notions conduit à des conclusions erronées. Si l’effet protecteur d’un médicament sur la rémission d’une dépression est massif chez les femmes (aOR = 0,30), mais totalement nul chez les hommes (aOR = 1,00), la variable « sexe » ne constitue pas un facteur de confusion qu’il faudrait bêtement ajuster pour obtenir un aOR global synthétique moyenné à 0,65. Cet aOR ajusté unique constituerait une fiction mathématique abstraite ne correspondant à la réalité clinique d’aucun des deux groupes. Il s’agit d’une modification d’effet majeure imposant de maintenir les données scindées.
Méthodologiquement, la vérification de l’existence d’une modification d’effet impose d’introduire formellement des termes d’interaction multiplicatifs dans l’équation de régression logistique (notés X_1 * X_2). Si le terme d’interaction s’avère statistiquement significatif au seuil préalablement défini, l’investigateur doit impérativement renoncer à présenter un aOR global ajusté monolithique, et se doit de publier des aOR stratifiés décrivant fidèlement l’effet de l’exposition au sein de chaque strate spécifique de la variable modératrice.
11. Implémentation computationnelle : Tutoriels pratiques sous R, SPSS et Python
11.1 Estimation de l’aOR sous le logiciel R
Le langage de programmation et environnement d’analyse statistique R constitue l’instrument privilégié de l’épidémiologie moderne pour la modélisation paramétrique. L’ajustement d’un modèle logistique binaire s’opère canoniquement par l’intermédiaire de la fonction native glm() (Generalized Linear Models), en spécifiant l’argument fondamental family = binomial(link = "logit").
Dans la console R, la spécification d’un modèle multivarié intégrant une issue binaire (remission), un prédicteur d’exposition principal (traitement) et deux covariables d’ajustement (age et sexe) s’articule comme suit :
modele_multivarie <- glm(remission ~ traitement + age + sexe, data = dataset_clinique, family = binomial(link = "logit"))
La commande summary(modele_multivarie) restitue les coefficients beta ainsi que les erreurs-types associées et les valeurs p calculées par le test de Wald. Pour dériver automatiquement les rapports de cotes ajustés (aOR) et leurs intervalles de confiance à 95 %, l’analyste fait appel à l’exponentiation vectorisée des coefficients et des bornes de la matrice de covariance :
aOR_resultats <- exp(cbind(aOR = coef(modele_multivarie), confint(modele_multivarie)))
Pour une mise en forme académique immédiate conforme aux standards des revues internationales de premier rang, le recours au package spécialisé gtsummary s’impose. La ligne de commande gtsummary::tbl_regression(modele_multivarie, exponentiate = TRUE) génère instantanément un tableau d’édition complet comprenant les estimations de l’aOR, les intervalles de confiance rigoureux et les valeurs p. Par ailleurs, la restitution visuelle de ces résultats s’effectue traditionnellement sous la forme d’un forest plot épuré généré via la bibliothèque forestmodel ou la syntaxe déclarative de ggplot2.
11.2 Procédure pas-à-pas sous IBM SPSS Statistics
Au sein des facultés de psychologie et des départements de recherche clinique hospitalière, le logiciel IBM SPSS Statistics conserve une implantation historique majeure en raison de son interface graphique ergonomique et de ses menus déroulants intuitifs. L’estimation d’un rapport de cotes ajusté s’y opère selon un cheminement rigoureux et standardisé :
- Ouvrez votre matrice de données dans SPSS, puis naviguez à travers le menu principal : Analyser -> Régression -> Logistique binaire…
- Dans la fenêtre de dialogue principale, faites glisser votre variable d’issue dichotomique dans le champ intitulé Dépendante.
- Sélectionnez votre prédicteur principal ainsi que l’ensemble des variables tierces de confusion, puis transférez-les conjointement dans le champ Covariables.
- Si votre jeu de données comprend des variables qualitatives nominales (comme le groupe d’intervention ou la catégorie socio-professionnelle), cliquez impérativement sur le bouton Catégorielle… situé sur la droite. Basculez ces variables dans la zone des covariables catégorielles et définissez précisément le contraste de référence souhaité (sélectionnez la modalité « Première » ou « Dernière » selon vos hypothèses de travail, puis validez par le bouton Changer).
- Cliquez sur le sous-menu Options…, cochez rigoureusement les cases Test d’adéquation de Hosmer-Lemeshow et Intervalle de confiance pour Exp(B) à 95 %, puis cliquez sur Poursuivre et enfin sur OK pour lancer l’exécution du calcul.
Dans le classeur de résultats SPSS (Viewer), la lecture critique doit immédiatement se focaliser sur le tableau final intitulé Variables dans l’équation au sein du « Bloc 1 ». Dans cette grille, la colonne intitulée B consigne les coefficients de régression logistique, la colonne E.S. rapporte les erreurs-types, et la colonne primordiale Exp(B) correspond mot pour mot au rapport de cotes ajusté (aOR). Encadrant cette estimation ponctuelle, les colonnes 95 % I.C. pour EXP(B) affichent les bornes inférieure et supérieure nécessaires à la transcription académique de vos résultats.
11.3 Modélisation logistique en Python avec Statsmodels
L’écosystème open-source de Python s’affirme comme une plateforme d’excellence pour l’analyse épidémiologique avancée, grâce à la synergie d’outils tels que Pandas, NumPy et Statsmodels. Si la célèbre bibliothèque Scikit-Learn propose une implémentation massivement mobilisée de la régression logistique via son module LogisticRegression, celle-ci est structurellement conditionnée pour l’optimisation prédictive en apprentissage automatique (machine learning) et applique par défaut une pénalisation de régularisation L2, distordant de fait l’estimation non biaisée des erreurs-types et rendant difficile l’extraction des intervalles de confiance inférentiels.
Pour un objectif d’inférence statistique causale académique rigoureuse, l’utilisation de la bibliothèque Statsmodels s’avère indispensable. La mise en œuvre computationnelle s’articule selon le script suivant :
import statsmodels.api as sm

import statsmodels.formula.api as smf

import numpy as np
# Définition et ajustement du modèle via la syntaxe de formule R
modele = smf.logit(formula='statut_pathologie ~ exposition_toxique + age + C(categorie_sociale)', data=df_patients)
resultats = modele.fit()
# Affichage exhaustif du diagnostic inférentiel
print(resultats.summary())
# Calcul vectorisé des aOR et des intervalles de confiance à 95 %
parametres = resultats.params
confiance = resultats.conf_int()
tableau_aOR = np.exp(np.column_stack([parametres, confiance]))
tableau_aOR = pd.DataFrame(tableau_aOR, columns=['aOR', 'IC 95% Inf', 'IC 95% Sup'], index=parametres.index)
print(tableau_aOR)
Cette implémentation native garantit une précision asymptotique optimale et permet d’exporter directement des tableaux d’aOR épurés et exploitables dans des pipelines d’intégration continue de science des données reproductible.
12. Normes de reporting scientifique et recommandations académiques
12.1 Conformité aux directives internationales de publication (STROBE et APA)
La transcription des résultats issus de modélisations multivariées dans les manuscrits scientifiques doit satisfaire aux critères d’intégrité et de reproductibilité édictés par les grands consortiums méthodologiques internationaux. Pour les études épidémiologiques observationnelles (cohortes, cas-témoins, transversales), la déclaration STROBE (Strengthening the Reporting of Observational Studies in Epidemiology) impose une transparence méthodologique absolue.
Selon l’article 16 des lignes directrices STROBE, les investigateurs ont l’obligation méthodologique formelle de rapporter conjointement les estimations non ajustées (cOR) et les estimations ajustées (aOR), accompagnées systématiquement de leurs intervalles de confiance à 95 % respectifs. Cette double divulgation permet à la communauté des pairs d’apprécier visuellement l’ampleur exacte de la distorsion de confusion introduite par les covariables. De surcroît, le manuscrit doit consigner avec une clarté irréprochable la liste exhaustive de l’ensemble des covariables d’ajustement intégrées dans l’équation paramétrique finale, ainsi que la justification rationnelle ayant présidé à leur sélection.
Sur le plan typographique et stylistique, les normes éditoriales de l’American Psychological Association (normes APA, 7e édition) prescrivent une mise en forme standardisée des paramètres statistiques dans le corps du texte. Les symboles désignant des statistiques d’échantillon ou des fonctions mathématiques s’écrivent obligatoirement en italique, à l’exception des lettres grecques : p, z, t, mais OR ou aOR (en capitales d’imprimerie). Une restitution académique canonique se structure selon le modèle suivant :
« Après ajustement pour l’âge chronologique, le niveau d’éducation et la présence d’une comorbidité dépressive, l’insomnie chronique demeure significativement associée à la survenue d’un déclin cognitif léger (aOR = 1,78, IC 95 % [1,24 ; 2,56], p = 0,002). »
12.2 Les écueils méthodologiques avancés : Surajustement et sélection pas-à-pas
La confection d’un modèle statistique ajusté requiert d’éviter deux écueils méthodologiques majeurs : le surajustement (overfitting) et les algorithmes de sélection automatique aveugle. Le phénomène de surajustement intervient lorsqu’un investigateur introduit un nombre excessif de covariables dans son équation de régression comparativement au volume effectif d’événements observés dans son jeu de données, en violation flagrante de la règle minimale des 10 à 15 événements par variable (EPV). Le modèle commence alors à ajuster le « bruit » idiosyncratique de l’échantillon plutôt que la loi sous-jacente du signal biologique. Il en résulte des estimations de coefficients délirantes, des erreurs-types hypertrophiées et une incapacité totale de généralisation du modèle à des cohortes externes.
Le second écueil, tout aussi pernicieux, réside dans l’utilisation paresseuse des méthodes de sélection pas-à-pas (stepwise regression, sélection descendante ou ascendante automatisée). Ces algorithmes d’optimisation numérique mécanique, reposant aveuglément sur les seuils d’exclusion statistique arbitraires (p < 0,05 ou p > 0,10), sont formellement réprouvés par les plus éminents biostatisticiens contemporains :
- Ils ignorent totalement les structures causales réelles sous-jacentes et peuvent accidentellement retenir des collisionneurs ou éliminer des facteurs de confusion capitaux dotés d’un effet modeste.
- Ils génèrent un biais algorithmique massif connu sous le nom de biais d’optimisme, rétrécissant artificiellement les erreurs-types des coefficients restants.
- Ils faussent radicalement la distribution des valeurs p résultantes en multipliant les comparaisons masquées sans correction formelle.
La sélection des covariables d’ajustement doit impérativement être une démarche réflexive, théorisée à l’avance et guidée par la littérature empirique et la construction rigoureuse de graphes acycliques dirigés (DAGs). Enfin, la présence fréquente de données manquantes (missing data) parmi les covariables sélectionnées ne doit jamais être traitée par l’exclusion pure et simple des sujets (analyse par cas complets, génératrice d’un biais d’attrition majeur) ; elle exige le recours à des méthodologies d’imputation multiple par équations chaînées (MICE) pour garantir la robustesse sans faille des aOR publiés.
12.3 Guide récapitulatif pour la lecture critique d’articles scientifiques
Afin d’armer les cliniciens, les chercheurs et les évaluateurs face au flot ininterrompu de publications biomédicales, voici une grille heuristique de lecture critique articulée en cinq étapes fondamentales pour disséquer méthodologiquement la validité d’un rapport de cotes ajusté :
- Vérification de la rareté de l’événement et de la sémantique de l’interprétation : Identifiez immédiatement la prévalence de l’issue clinique dans l’étude. Si l’événement survient chez plus de 10 % des participants, vérifiez scrupuleusement que les auteurs n’ont pas abusivement interprété leur aOR comme s’il s’agissait d’un Risque Relatif, gonflant artificiellement l’impact clinique réel du traitement ou du facteur d’exposition.
- Rationnel théorique et légitimité de l’ensemble d’ajustement : Examinez la liste exhaustive des covariables introduites dans l’équation multivariée. L’ajustement est-il théoriquement étayé ? Les auteurs ont-ils évité d’ajuster sur des variables médiatrices situées sur la trajectoire causale directe, et n’ont-ils pas conditionné le modèle sur de probables collisionneurs ?
- Respect des contraintes dimensionnelles de l’échantillon (EPV) : Confrontez le nombre total de prédicteurs libres estimés dans l’équation au nombre absolu d’événements observés pour la modalité la plus rare de l’issue dichotomique. La règle des 10 événements par variable a-t-elle été respectée afin d’immuniser le modèle contre le surajustement paramétrique ?
- Examen combiné de la magnitude, de l’intervalle de confiance et de la valeur p : Ne vous laissez pas éblouir par la mention stérile « p < 0,05 ». Scrutez avec discernement l’amplitude ponctuelle de l’aOR et la largeur de son intervalle de confiance à 95 %. L’estimation est-elle cliniquement substantielle ou purement anecdotique au regard de la santé des patients ? L’intervalle est-il resserré ou révèle-t-il une imprécision d’échantillonnage majeure ?
- Sanctuarisation de la non-causalité de l’observationnel : Détectez avec intransigeance toute glissade lexicale dans la section « Discussion » de l’article tendant à conférer à l’aOR le statut d’une preuve de causalité mécanique directe. Même magnifiquement ajusté, un rapport de cotes issu d’un devis d’observation ne capture jamais qu’une association conditionnelle épurée, et ne saurait en aucun cas s’affranchir du spectre de la confusion résiduelle liée aux variables non mesurées.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cornfield, J. (1951). A method of estimating comparative rates from clinical data; applications to cancer of the lung, breast, and cervix. Journal of the National Cancer Institute, 12(6), 1269–1275. https://doi.org/10.1093/jnci/12.6.1269
- Greenland, S., Pearl, J., & Robins, J. M. (1999). Causal diagrams for epidemiologic research. Epidemiology, 10(1), 37–48. https://doi.org/10.1097/00001648-199901000-00008
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118548387
- Maslach, C., Jackson, S. E., & Leiter, M. P. (1996). Maslach Burnout Inventory manual (3rd ed.). Consulting Psychologists Press.
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373–1379. https://doi.org/10.1016/s0895-4356(96)00236-3
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Vandenbroucke, J. P., von Elm, E., Altman, D. G., Gøtzsche, P. C., Mulrow, C. D., Pocock, S. J., Poole, C., Schlesselman, J. J., Egger, M., & STROBE Group. (2007). Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration. PLOS Medicine, 4(10), e297. https://doi.org/10.1371/journal.pmed.0040297
- World Health Organization. (2019). The ICD-11 classification of mental and behavioural disorders: Clinical descriptions and diagnostic guidelines. World Health Organization. https://icd.who.int
- Zou, G. (2004). A modified poisson regression approach to prospective studies with binary data. American Journal of Epidemiology, 159(7), 702–706. https://doi.org/10.1093/aje/kwh090